

华硕 ExpertCenter Pro ET900N G3 是我们测试的第二款 GB300 DGX 工作站,也是我们第一款在实验室进行实际操作的同类产品;我们之前对 MSI XpertStation WS300 的测试是远程进行的。它采用了与我们在 MSI XpertStation WS300 中测试的相同的 NVIDIA 芯片:Grace Blackwell Ultra Desktop Superchip,拥有 72 个 Grace 核心、B300 GPU、252GB HBM3e 显存、496GB LPDDR5X 内存以及配备两个 400GbE 端口的 ConnectX-8 SuperNIC 网卡。华硕将这款核心平台封装在一个简洁的塔式机箱中,专为桌面 AI 而设计,并添加了一些 WS300 所没有的亮点:顶部两个提手、一个专门用于 ConnectX-8 光驱笼的风扇,以及一个 1,600W 的 80 PLUS 钛金认证电源。
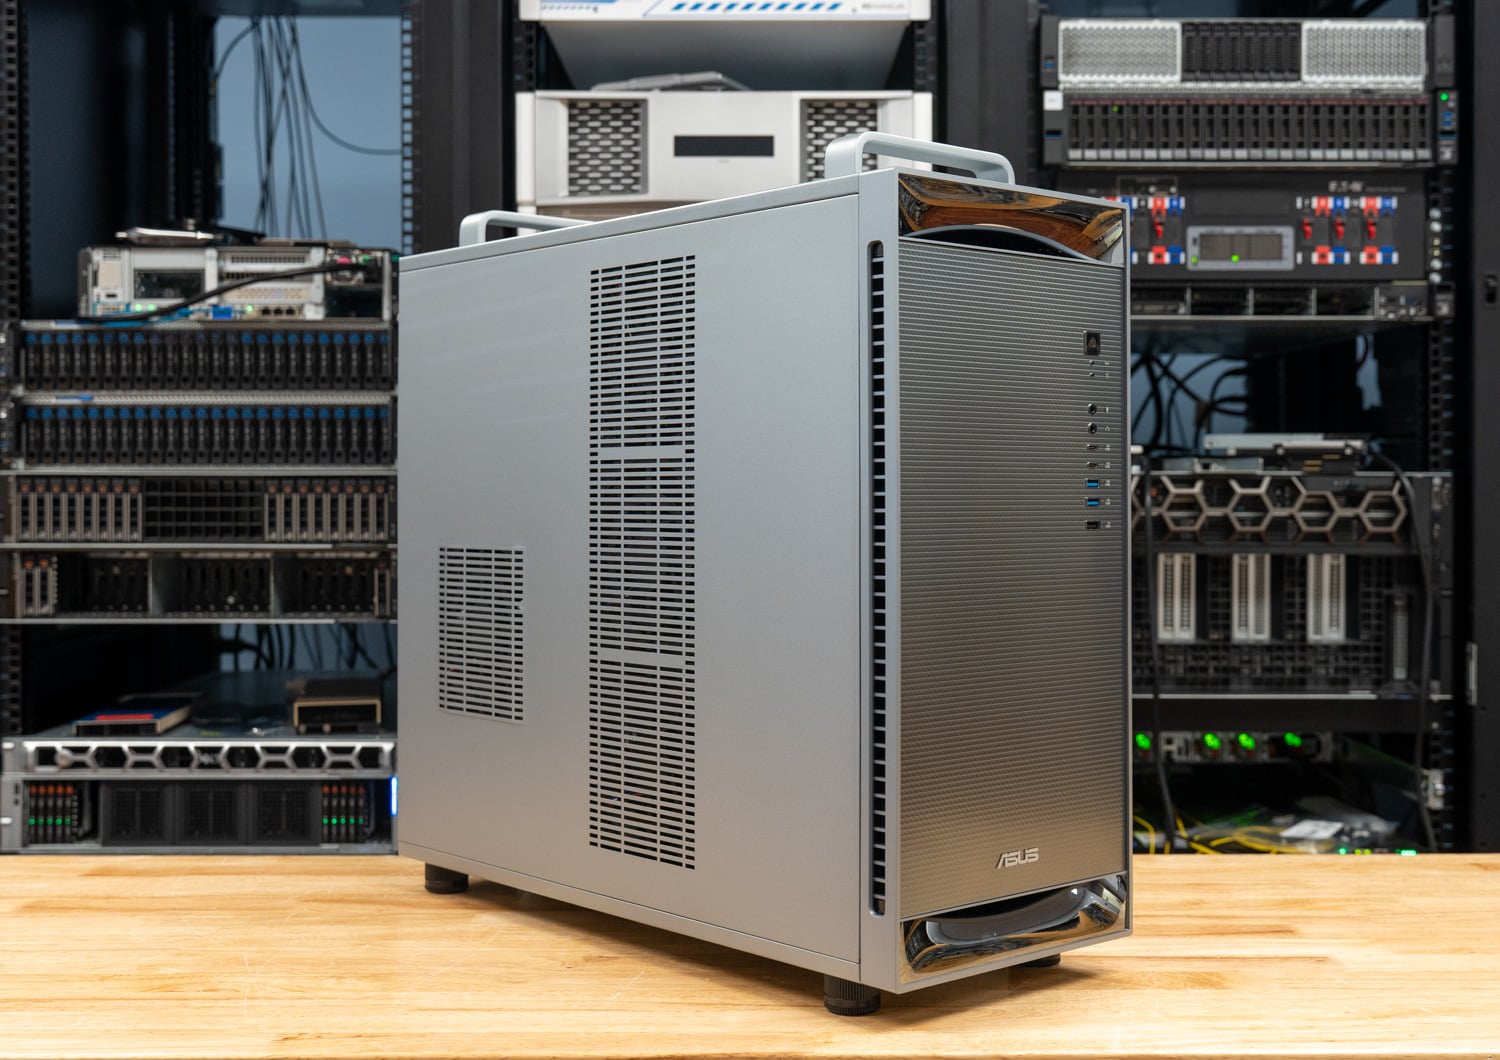
华硕将一台搭载 RTX PRO 2000 显卡的 ET900N G3 机箱寄到实验室,进行了一周左右的基准测试、拍照和外观检查。关于该平台本身、B300 芯片、Grace 芯片、NVLink-C2C 芯片、MIG 焊盘以及 DGX Station 工作站的用途,WS300 评测已经涵盖了这些内容。本次评测的重点在于华硕围绕 Superchip 芯片打造的产品,以及其性能是否能与我们之前测试过的第一款 GB300 塔式机箱相媲美。
华硕 ExpertCenter Pro ET900N G3 规格
| 规格 | 华硕 ExpertCenter Pro ET900N G3 |
|---|---|
| 平台概述 | |
| 超级芯片 | NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip |
| 中央处理器 | NVIDIA Grace,72 个 Arm Neoverse V2 内核 |
| GPU | NVIDIA Blackwell Ultra (B300),最高可达 20 PFLOPS NVFP4 稀疏性 |
| CPU-GPU互连 | NVLink-C2C,900GB/s 双向 |
| 内存 | |
| 连贯记忆 | 748GB |
| GPU内存 | 252GB HBM3e,7.1TB/s |
| CPU内存 | 496GB LPDDR5X,396GB/s,4x SOCAMM |
| 存放 | |
| 引导驱动器 | 2 个 M.2 2280 PCIe 5.0 x4 (M Key) 插槽,分别安装了 2 块 2TB NVMe 固态硬盘,组成 RAID 1 阵列。 |
| 扩张驱动 | 2 个 M.2 2280 (M Key) 插槽,华硕官方标称 PCIe 6.0 x4,出厂时已打开。 |
| 社交 | |
| SuperNIC | NVIDIA ConnectX-8,2 个 QSFP112 400GbE 端口 |
| 以太网(EtherNet) | 1 个 Marvell 10GbE 端口 1 个 Realtek 1GbE (BMC) |
| 扩展 | |
| PCIe插槽 | 1x PCIe 5.0 x16 2 个 PCIe 5.0 x16 插槽(x8 信号) |
| 外接显卡 | 最多可配备一张 NVIDIA RTX PRO Blackwell 显卡;评测样机配备的是 RTX PRO 2000 Blackwell 显卡。 |
| I / O | |
| 面前 | 2 个 USB 10Gbps Type-C 接口 2 个 USB 10Gbps Type-A 接口 1x的USB 2.0 耳机和麦克风插孔 |
| 后 | 4 个 USB 10Gbps Type-A 接口 1 个 Micro-USB COM(BMC 串行控制台) 1 个 Mini DisplayPort (BMC) 3个音频插孔 |
| 管理与安全 | |
| BMC | ASPEED AST2600,配备 AMI MegaRAC 固件、IPMI 和 Redfish |
| 安保防护 | 车载TPM 2.0 |
| 电源和冷却 | |
| 电源 | 1 个 1,600W ATX 电源,80 PLUS 钛金认证 |
| 散热器 | 采用一体式水冷散热系统(据华硕称),GB300、SOCAMM 和 ConnectX-8 均配备冷板;前置和顶部散热器,后置机箱风扇,QSFP112 插槽上方设有专用风扇。 |
| 工作温度 | 10C到35C |
| 软件和外形尺寸 | |
| 运行系统 | Ubuntu 将支持 NVIDIA AI 开发工具;华硕表示计划推出基于 Windows 的 AI 开发支持。 |
| 尺寸 | 根据华硕官方数据,尺寸为 584 x 232 x 565 毫米(23.0 x 9.1 x 22.3 英寸)。 |
| 重量 | 净重27公斤,毛重32公斤 |
设计与建造
华硕将ET900N G3包装成一款商务工作站,采用拉丝银色机箱、深色网状前面板、镀铬顶盖和底座,以及位于前面板下方的华硕徽标。其尺寸符合平台要求:根据华硕官方数据,ET900N G3的尺寸为584 x 232 x 565毫米,比WS300(高529毫米、深570毫米、宽246毫米)略高略窄。27公斤的重量意味着它并非一款可以随意搬运的系统,而这正是华硕第一个独特设计的意义所在。机箱顶部边缘前后各有一个金属把手,方便两人无需触碰面板即可将主机抬到桌面或推车上。在办公设备上,这些把手看起来或许有些格格不入,但如果你曾经在实验室里搬运过GB300主机,就会明白它们的重要性了。
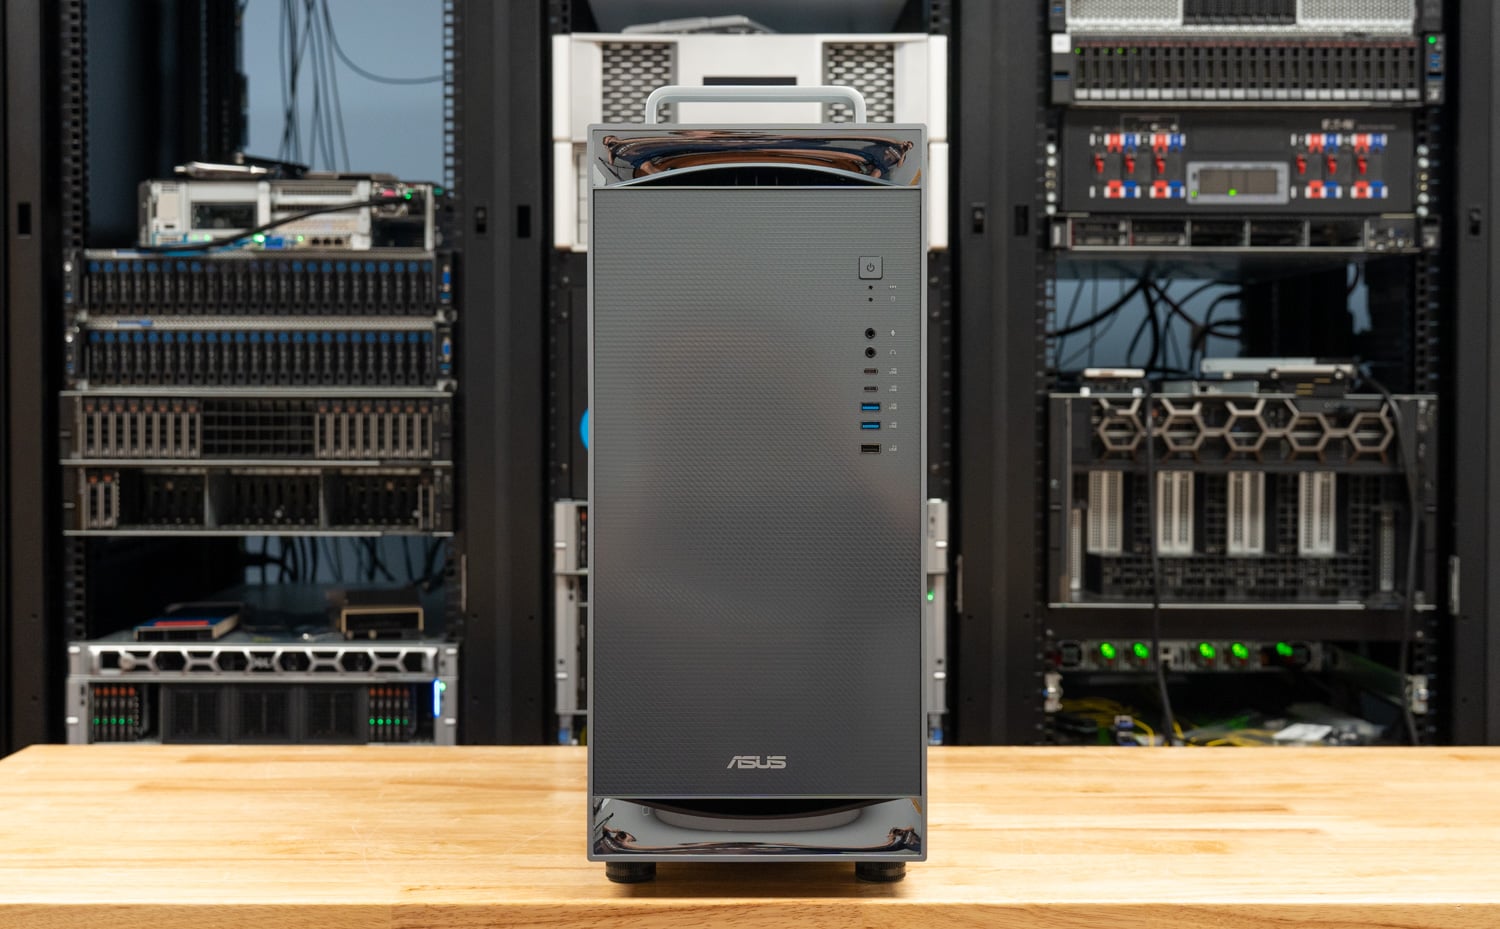
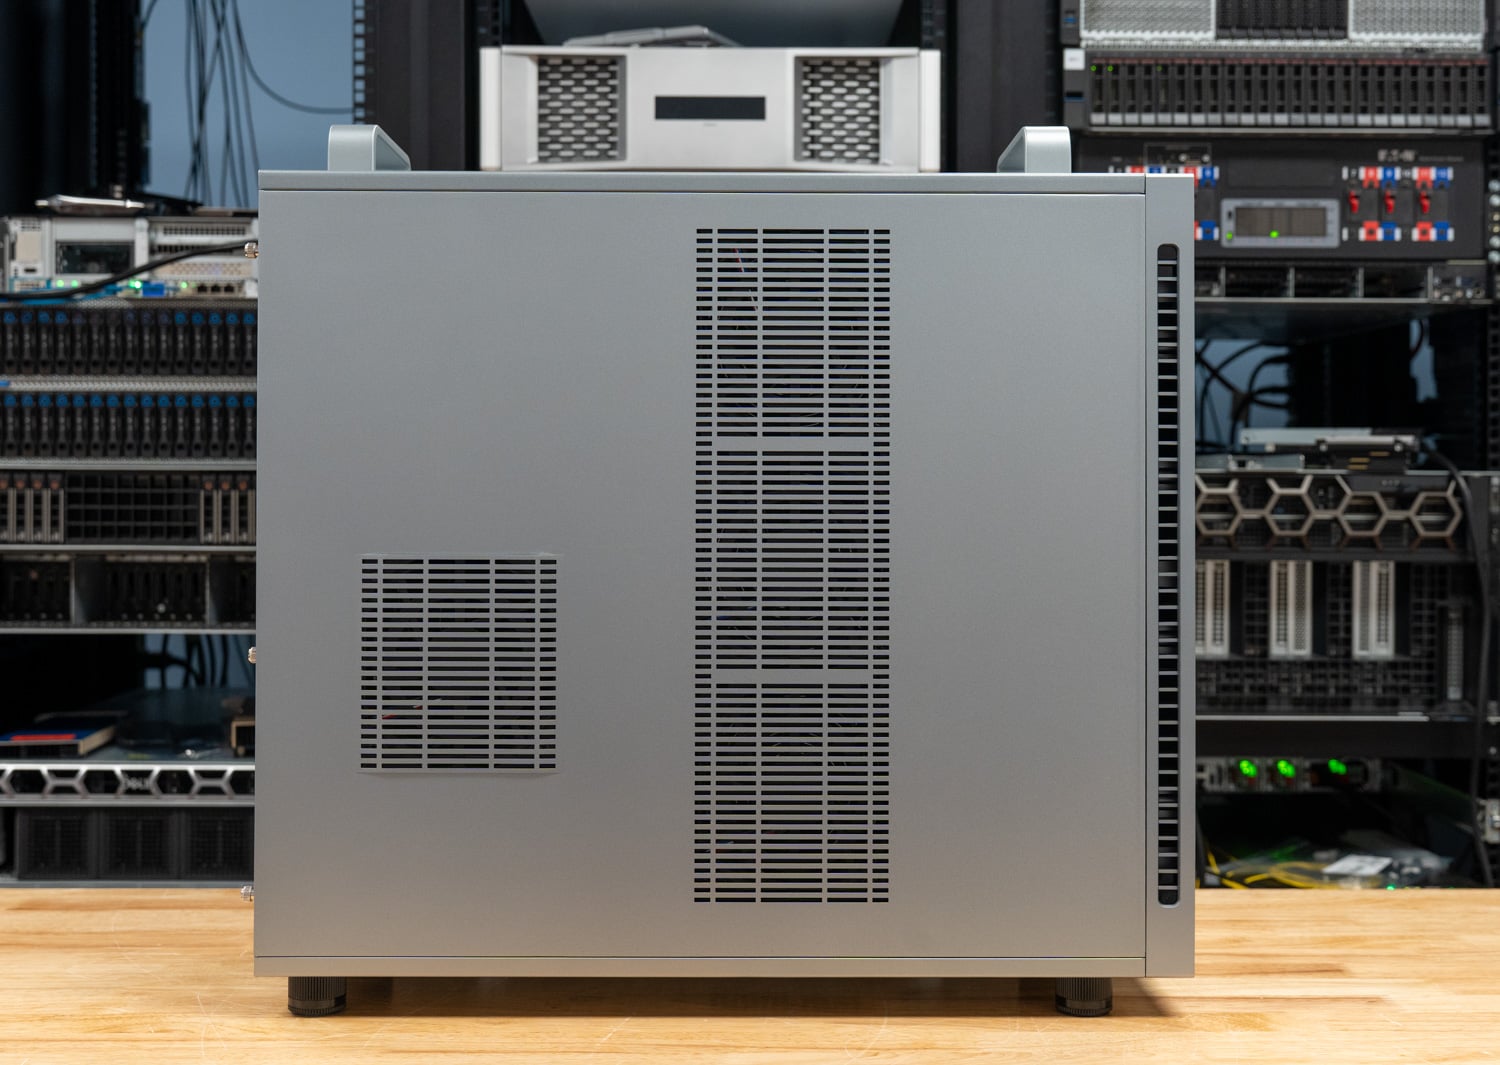
前面板配备电源按钮、两个 10Gbps USB Type-A 接口、两个 10Gbps USB Type-C 接口、一个 USB 2.0 接口以及独立的耳机和麦克风接口,所有接口均呈垂直排列在网状面板的右上角。侧面板是一块大面积的通风面板,前端有一条长长的穿孔柱用于散热器进气,后端则是一个较小的方形格栅,与系统风扇对齐。机箱没有侧透面板,也没有灯光,这符合目标用户的喜好。
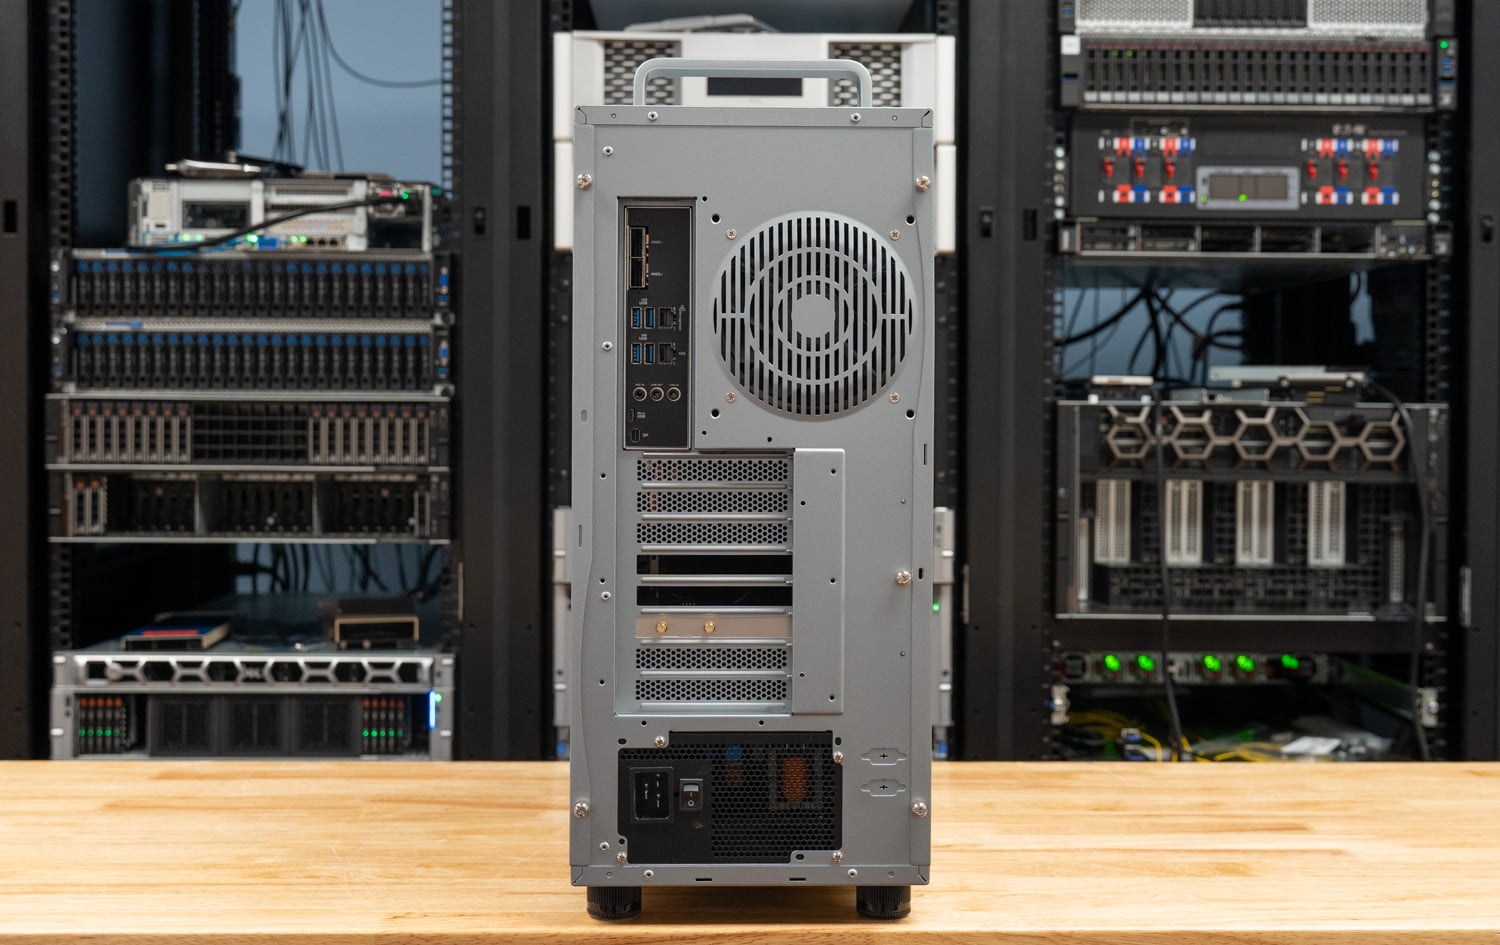
在背面,布局将工作站 I/O 与下方的服务器硬件分隔开来。上方的接口组包含四个 10Gbps USB Type-A 端口、10GbE 和 1GbE RJ45 网线接口、三个音频接口、BMC 的 Micro-USB 控制台端口以及 BMC 用于设置的 Mini DisplayPort 接口。两个用于 ConnectX-8 的 QSFP112 光驱笼位于 I/O 挡板的顶部;旁边是一个排气风扇;三个扩展槽挡板位于中间;电源及其 C19 电源接口位于底部。与 WS300 一样,Mini DisplayPort 接口是 BMC 用于初始设置和故障排除的输出接口;任何想要在这台机器上使用桌面功能的用户都需要 RTX PRO 显卡。
ET900N G3 内部结构
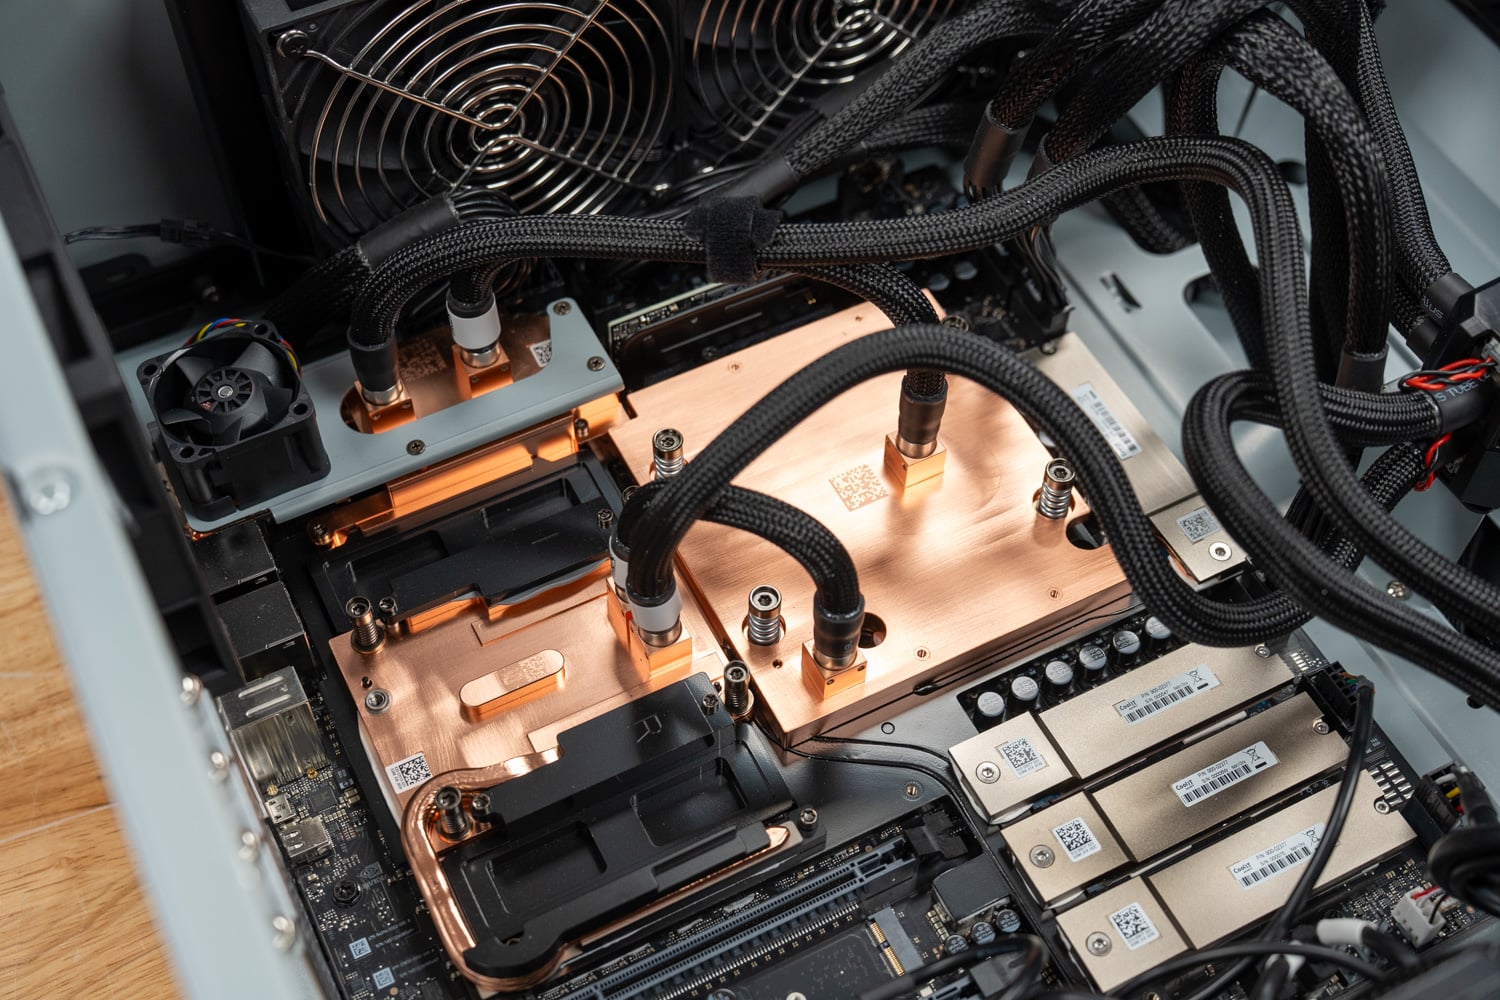
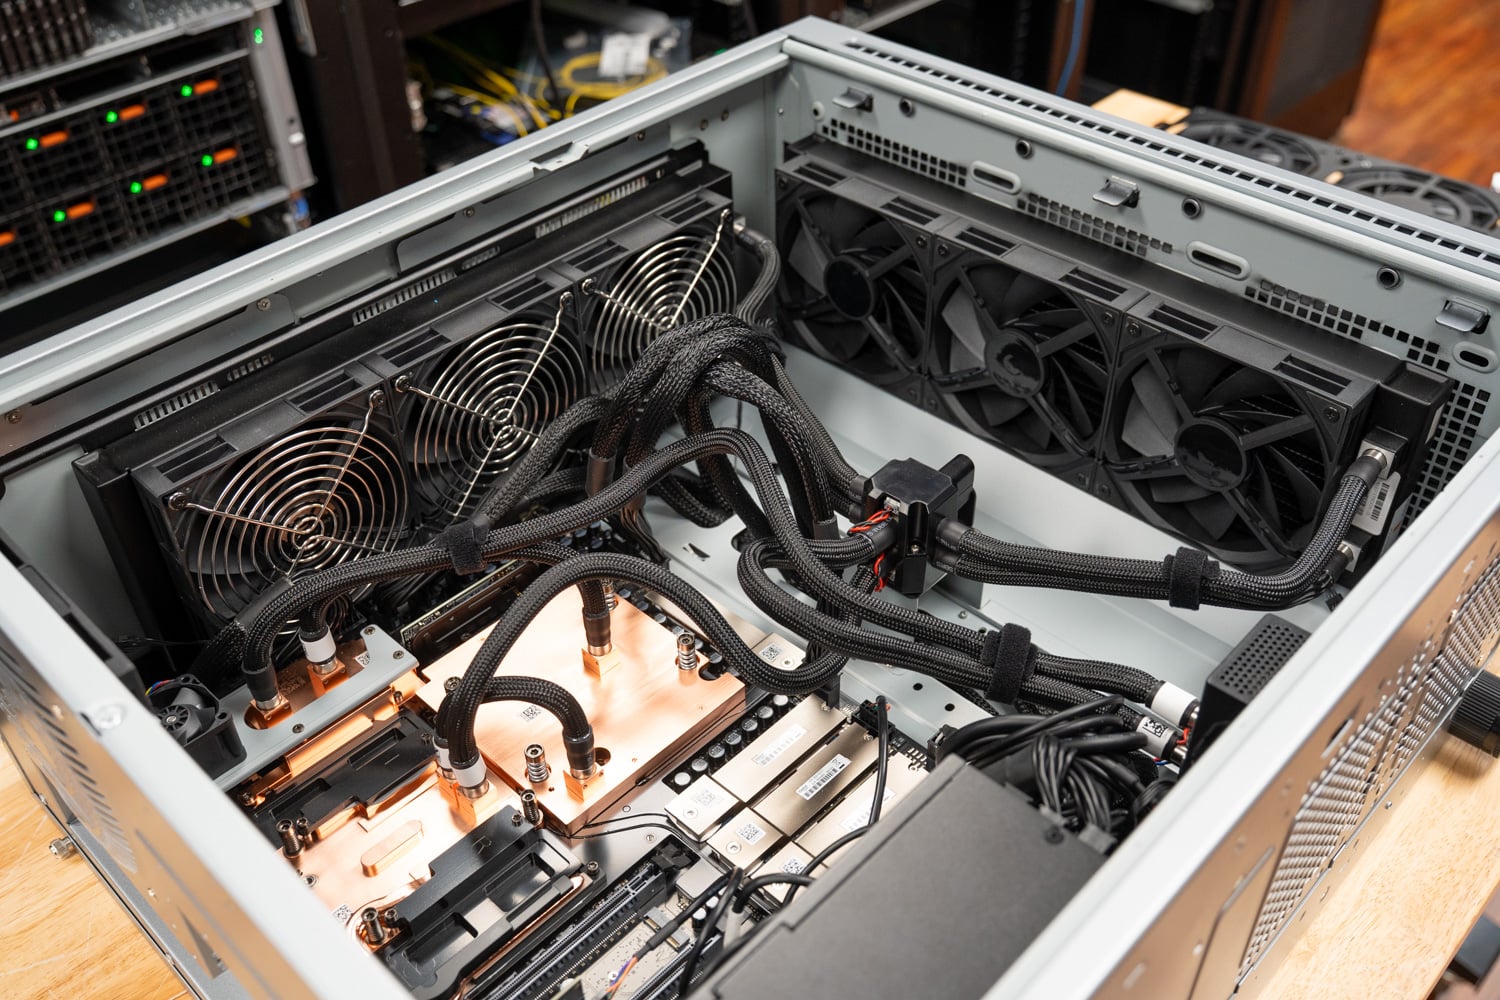
拆下侧面板后,ET900N G3 看起来与 WS300 非常相似,这并不令人意外,因为它们都采用了相同的 NVIDIA 主板。GB300 Superchip 显卡位于机箱左侧的铜质冷板组件下方,SOCAMM 内存模块则位于其旁边的铜质冷板下方,而 ConnectX-8 内存模块则位于靠近后部 I/O 接口的第三个冷板下方。编织软管从这些冷板连接到安装在机箱横梁上的分配歧管,然后再连接到散热器。三个全尺寸 PCIe 插槽位于 Superchip 显卡下方,电源位于机箱前下方角落,底部的线缆通道则由金属罩遮盖。
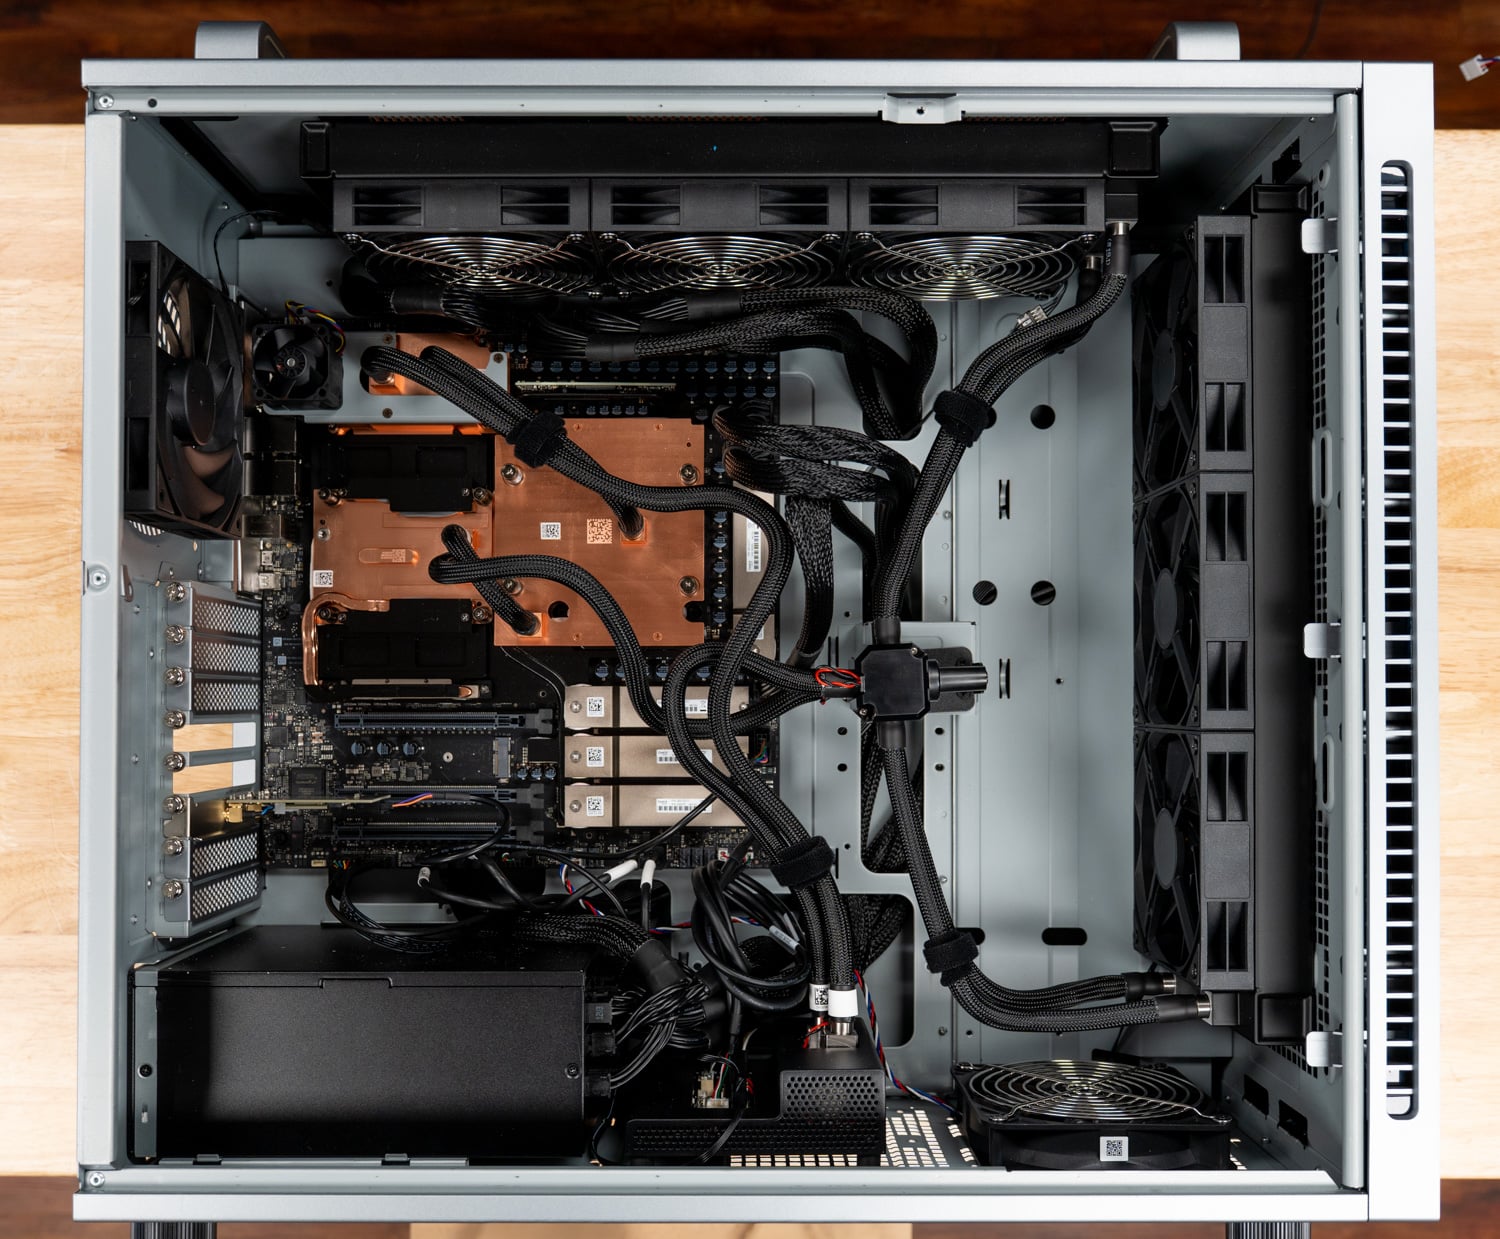
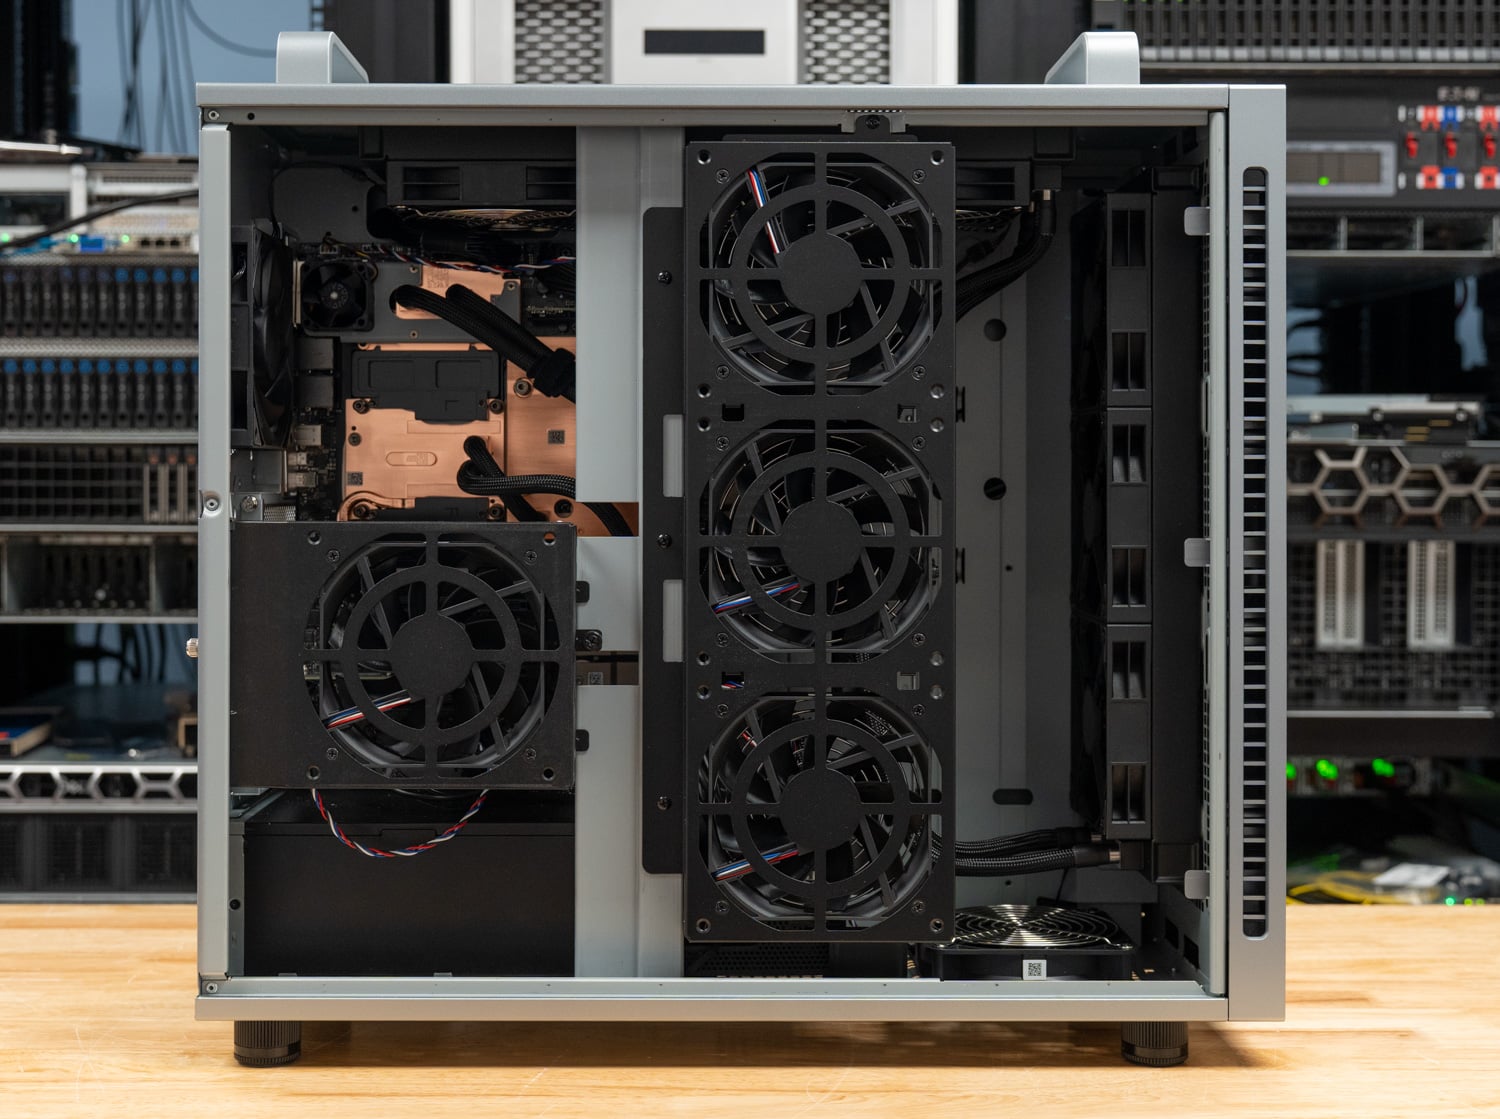
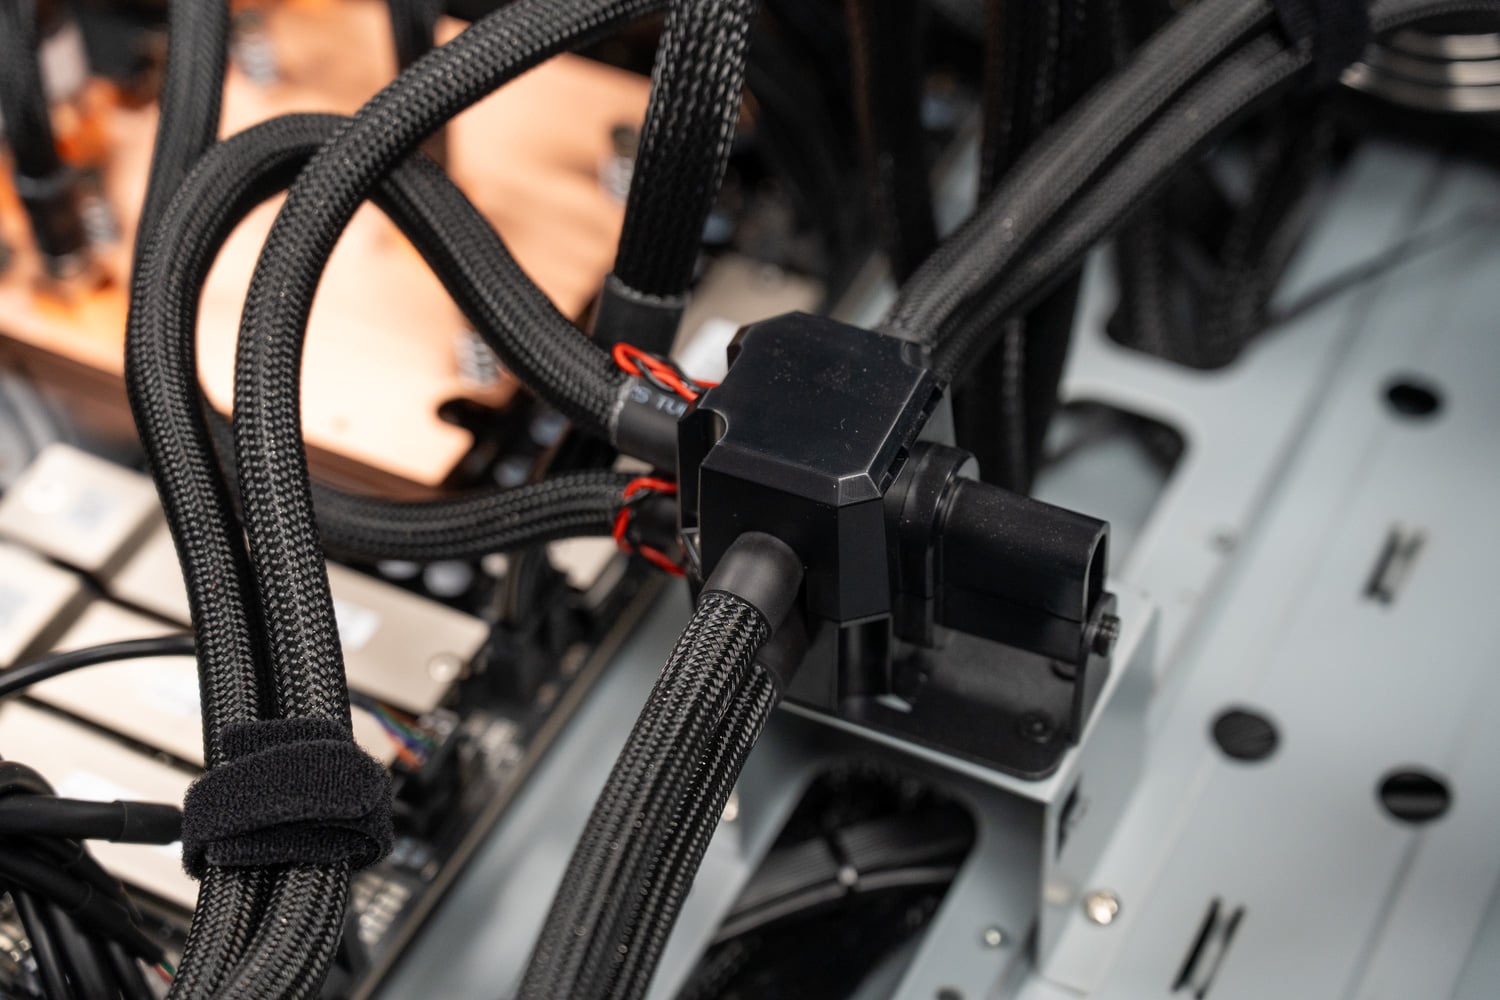
内部布局与WS300相同:一个散热器垂直安装在前格栅后方,另一个散热器位于顶部,每个散热器都配有一排风扇,后部还有一个底盘风扇。冷却液管路采用套管包裹,并用魔术贴固定在横梁上。歧管将来自四个冷板的冷却液管路集中起来,使得每个散热器只需两根管路即可连接。
光学爱好者
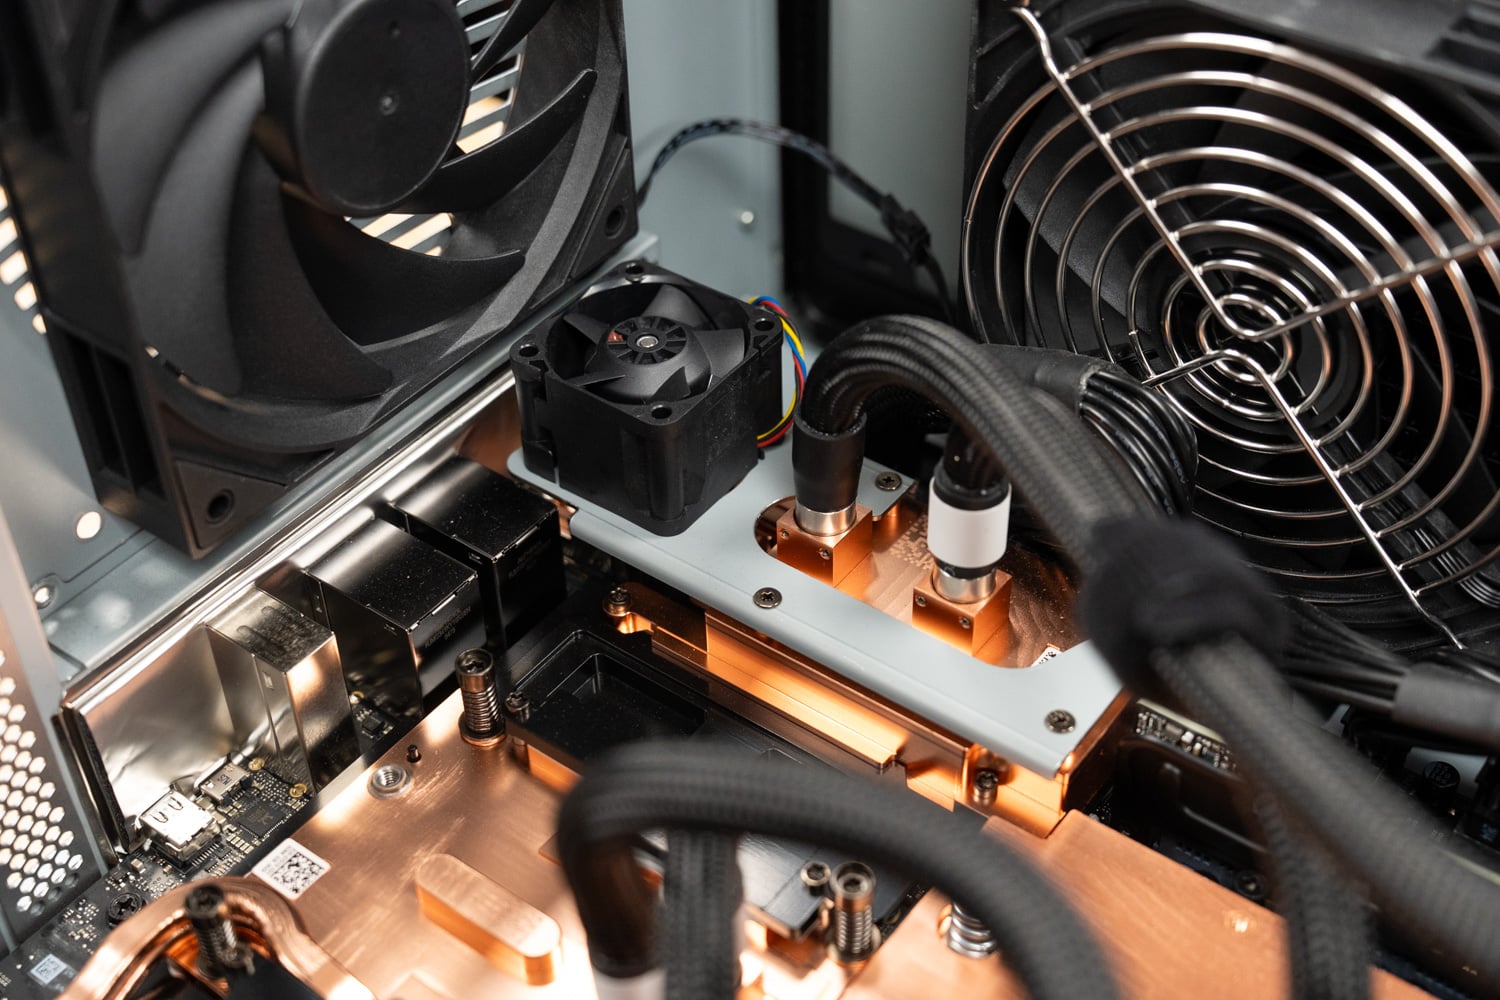
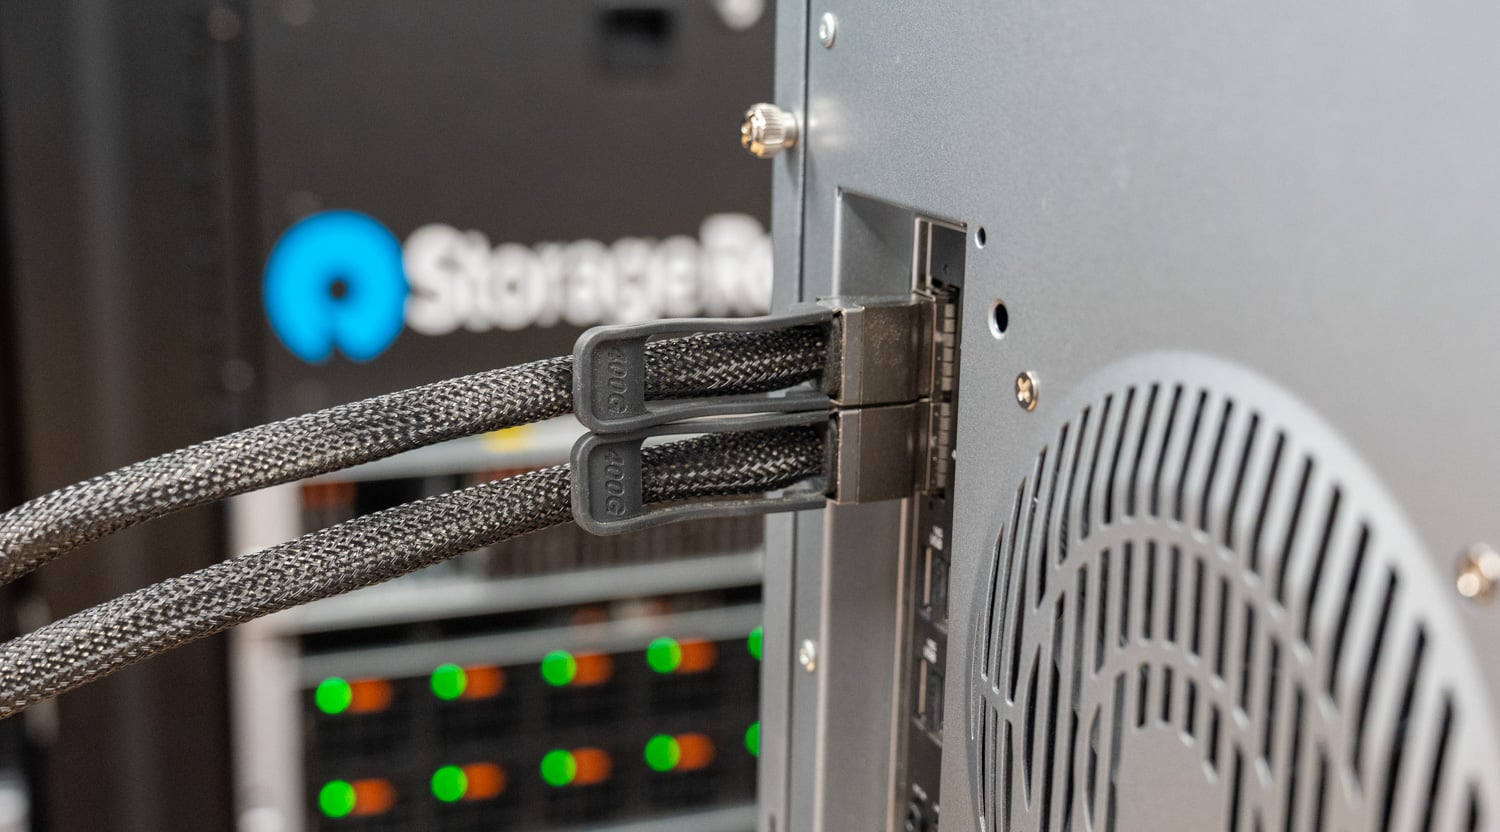
WS300 上没有的散热元件是安装在 ConnectX-8 冷板上方支架上的小型风扇,它指向 QSFP112 光模块笼。液冷回路负责 SuperNIC 芯片本身的散热,但 400G 光收发器会产生自身热量,并且位于金属笼内,冷板只能通过传导散热。在其他测试中,我们注意到 ConnectX-8 在持续负载下会发热,光模块本身也会过热,因此,对于计划长时间在光纤上运行 ET900N G3 的用户来说,在光模块笼上设置专用气流通道是一个非常实用的设计。而对于 DAC(我们正是通过这种方式将其连接到第二个 GB300 工作站,以进行仍在进行的集群推理深度测试),风扇的散热需求则相对较低。
存储、扩展和电源
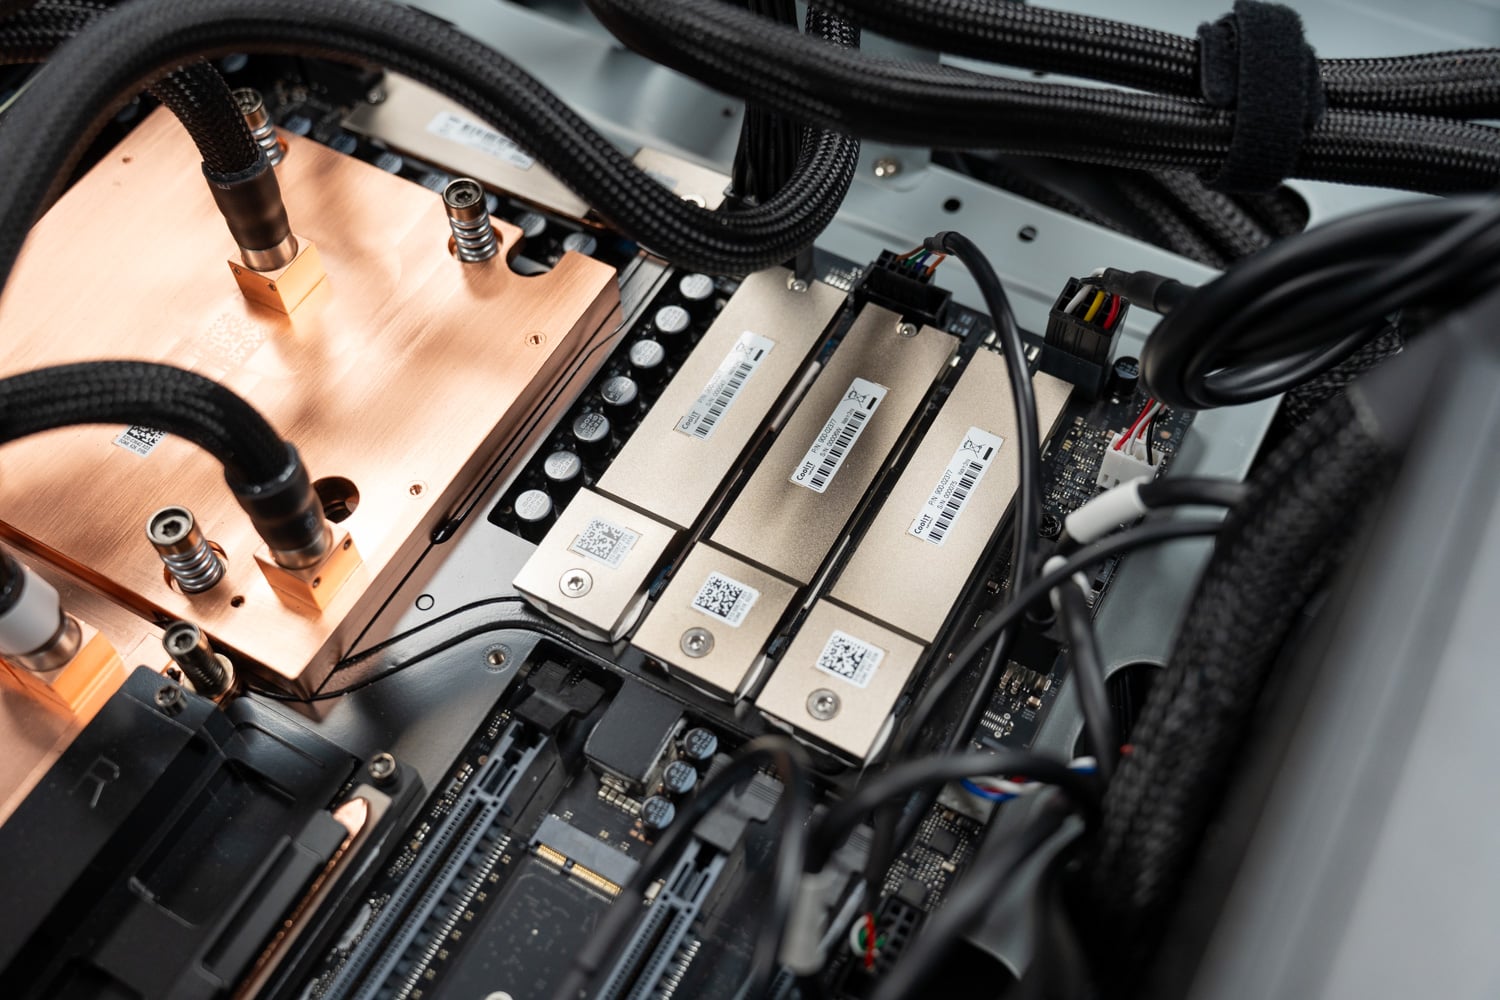
华硕 ET900N G3 出厂时配备了一块 2TB NVMe 固态硬盘,用于安装操作系统和 NVIDIA 软件栈,该硬盘安装在通过 PCIe 5.0 x4 连接到 Grace 的两个 M.2 2280 插槽中。另外两个插槽则悬挂在 ConnectX-8 的集成 PCIe 交换机上,出厂时为空。
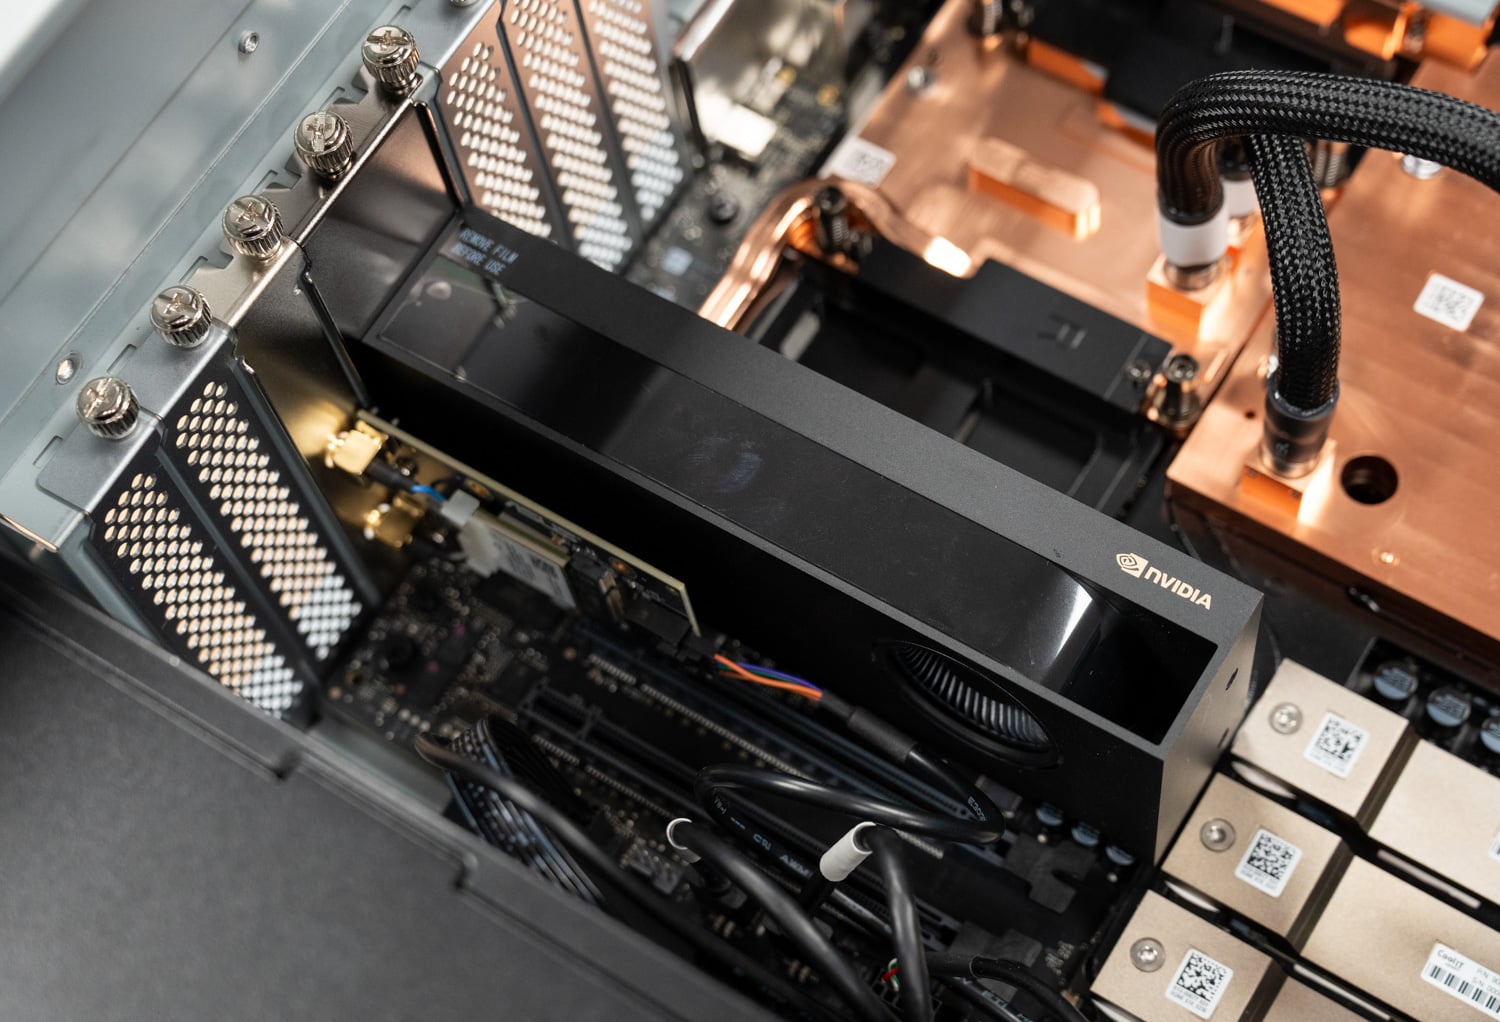
我们评测的样机配备了一块插在 PCIe 5.0 x16 插槽中的 NVIDIA RTX PRO 2000 Blackwell 显卡,这是华硕官方列出的配置之一。该显卡提供显示输出,且不会显著消耗 GB300 的功耗预算。华硕表示,该机箱最多可容纳一块 RTX PRO Blackwell 显卡。为了确保 Superchip 芯片拥有完整的加速预算,我们在进行基准测试前将其拔出,这与我们之前评测 WS300 时的情况相同。我们并未在该机箱中测试高功耗的 RTX PRO 显卡;关于高功耗 RTX PRO 显卡及其对共享功耗预算的影响,我们将在即将发布的 GB300 Station 评测中进行详细介绍。
这款电源是华硕80 PLUS钛金级认证的1,600W ATX电源,比WS300的白金级电源更高一级。钛金级电源在115V输入电压下,50%负载时效率需达到94%,而白金级电源的效率为92%。钛金级电源是唯一一个在10%负载下设定效率下限的电源级别,因此在GB300满载运行时,ET900N G3电源的功耗应该比白金级电源低几十瓦。电源预算仍然是共享的:Grace处理器、B300主板、水泵、风扇、存储设备以及任何RTX PRO显卡都使用这1,600W电源。NVIDIA的vsloshd服务会根据Superchip处理器和独立显卡的功耗变化来分配电源,两者的功耗都没有固定上限。WS300的评测文章详细介绍了这一机制,而这款电源也采用了相同的机制。北美地区的安装仍然需要使用独立的20A电路。
连接方式
ConnectX-8 的两个 QSFP112 端口是 ET900N G3 连接其他所有设备的接口,例如存储设备、第二个 DGX Station 或集群架构。这些端口已经在实验室中使用,ET900N G3 通过 400G DAC 连接到第二个 GB300 Station,用于我们稍后将单独发布的集群推理深度分析。10GbE Marvell 端口用于处理普通主机流量,而 Realtek 1GbE 端口则专用于 BMC。
测试笔记
本次评测中的所有结果均来自华硕寄送至我们实验室的样机,该样机采用出厂标配的内存配置:252GB HBM3e 和 496GB LPDDR5X。系统未安装 RTX PRO 显卡,因此 GB300 Superchip 显卡拥有完整的加速器功率预算,与我们 WS300 的测试条件相同。软件栈、vLLM 配置、工作负载配置文件和并发扫描均与 WS300 的测试相同,因此两款主机可以直接进行比较。本次评测仅关注性能,我们并未对该样机进行功耗或温度测试。
工作负载与我们在每个本地 AI 系统上运行的两个 vLLM 实时推理配置文件相同:一个是输入和输出均为 512 个标记的等效工作负载,另一个是预填充密集型工作负载,输入和输出均为 8,192 个标记,并发流数量从 1 个到 128 个不等。对于前沿规模的模型,我们将其与配备两张或四张RTX PRO 6000显卡的戴尔 PowerEdge XE7740 GPU 服务器进行比较,这是这些检查点最接近的单机替代方案。对于较小的模型,我们将其与同一台 XE7740 服务器上的单张 RTX PRO 6000 显卡、戴尔 PowerEdge R770服务器上的单张 H200 NVL 显卡以及由宏碁 Veriton GN100代表的GB10 DGX Spark进行比较,后者与我们在 WS300 评测中使用的 Spark 相同。以下 ET900N G3 的数据是运行日志中的确切值;对比系统数据取自我们的结果图表。
推理性能
连贯记忆池的前沿模型
GB300 的存在意义在于服务于 B300 252GB HBM3e 内存容量边界两侧的显卡型号,因此我们首先考察跨越该边界的四个关键点:DeepSeek V4 闪存和 MiniMax M2.7 内存都能轻松装入 HBM 显存,MiniMax M3 内存勉强够用,并将一部分性能负载转移到 Grace 显存;GLM-5.2 内存则承担了大约一半的性能负载。在每张图表的另一端,我们可以看到最接近的单机解决方案:PowerEdge XE7740 服务器,其中集成了多张 RTX PRO 6000 系列显卡,并在需要时将性能负载转移到主机内存。
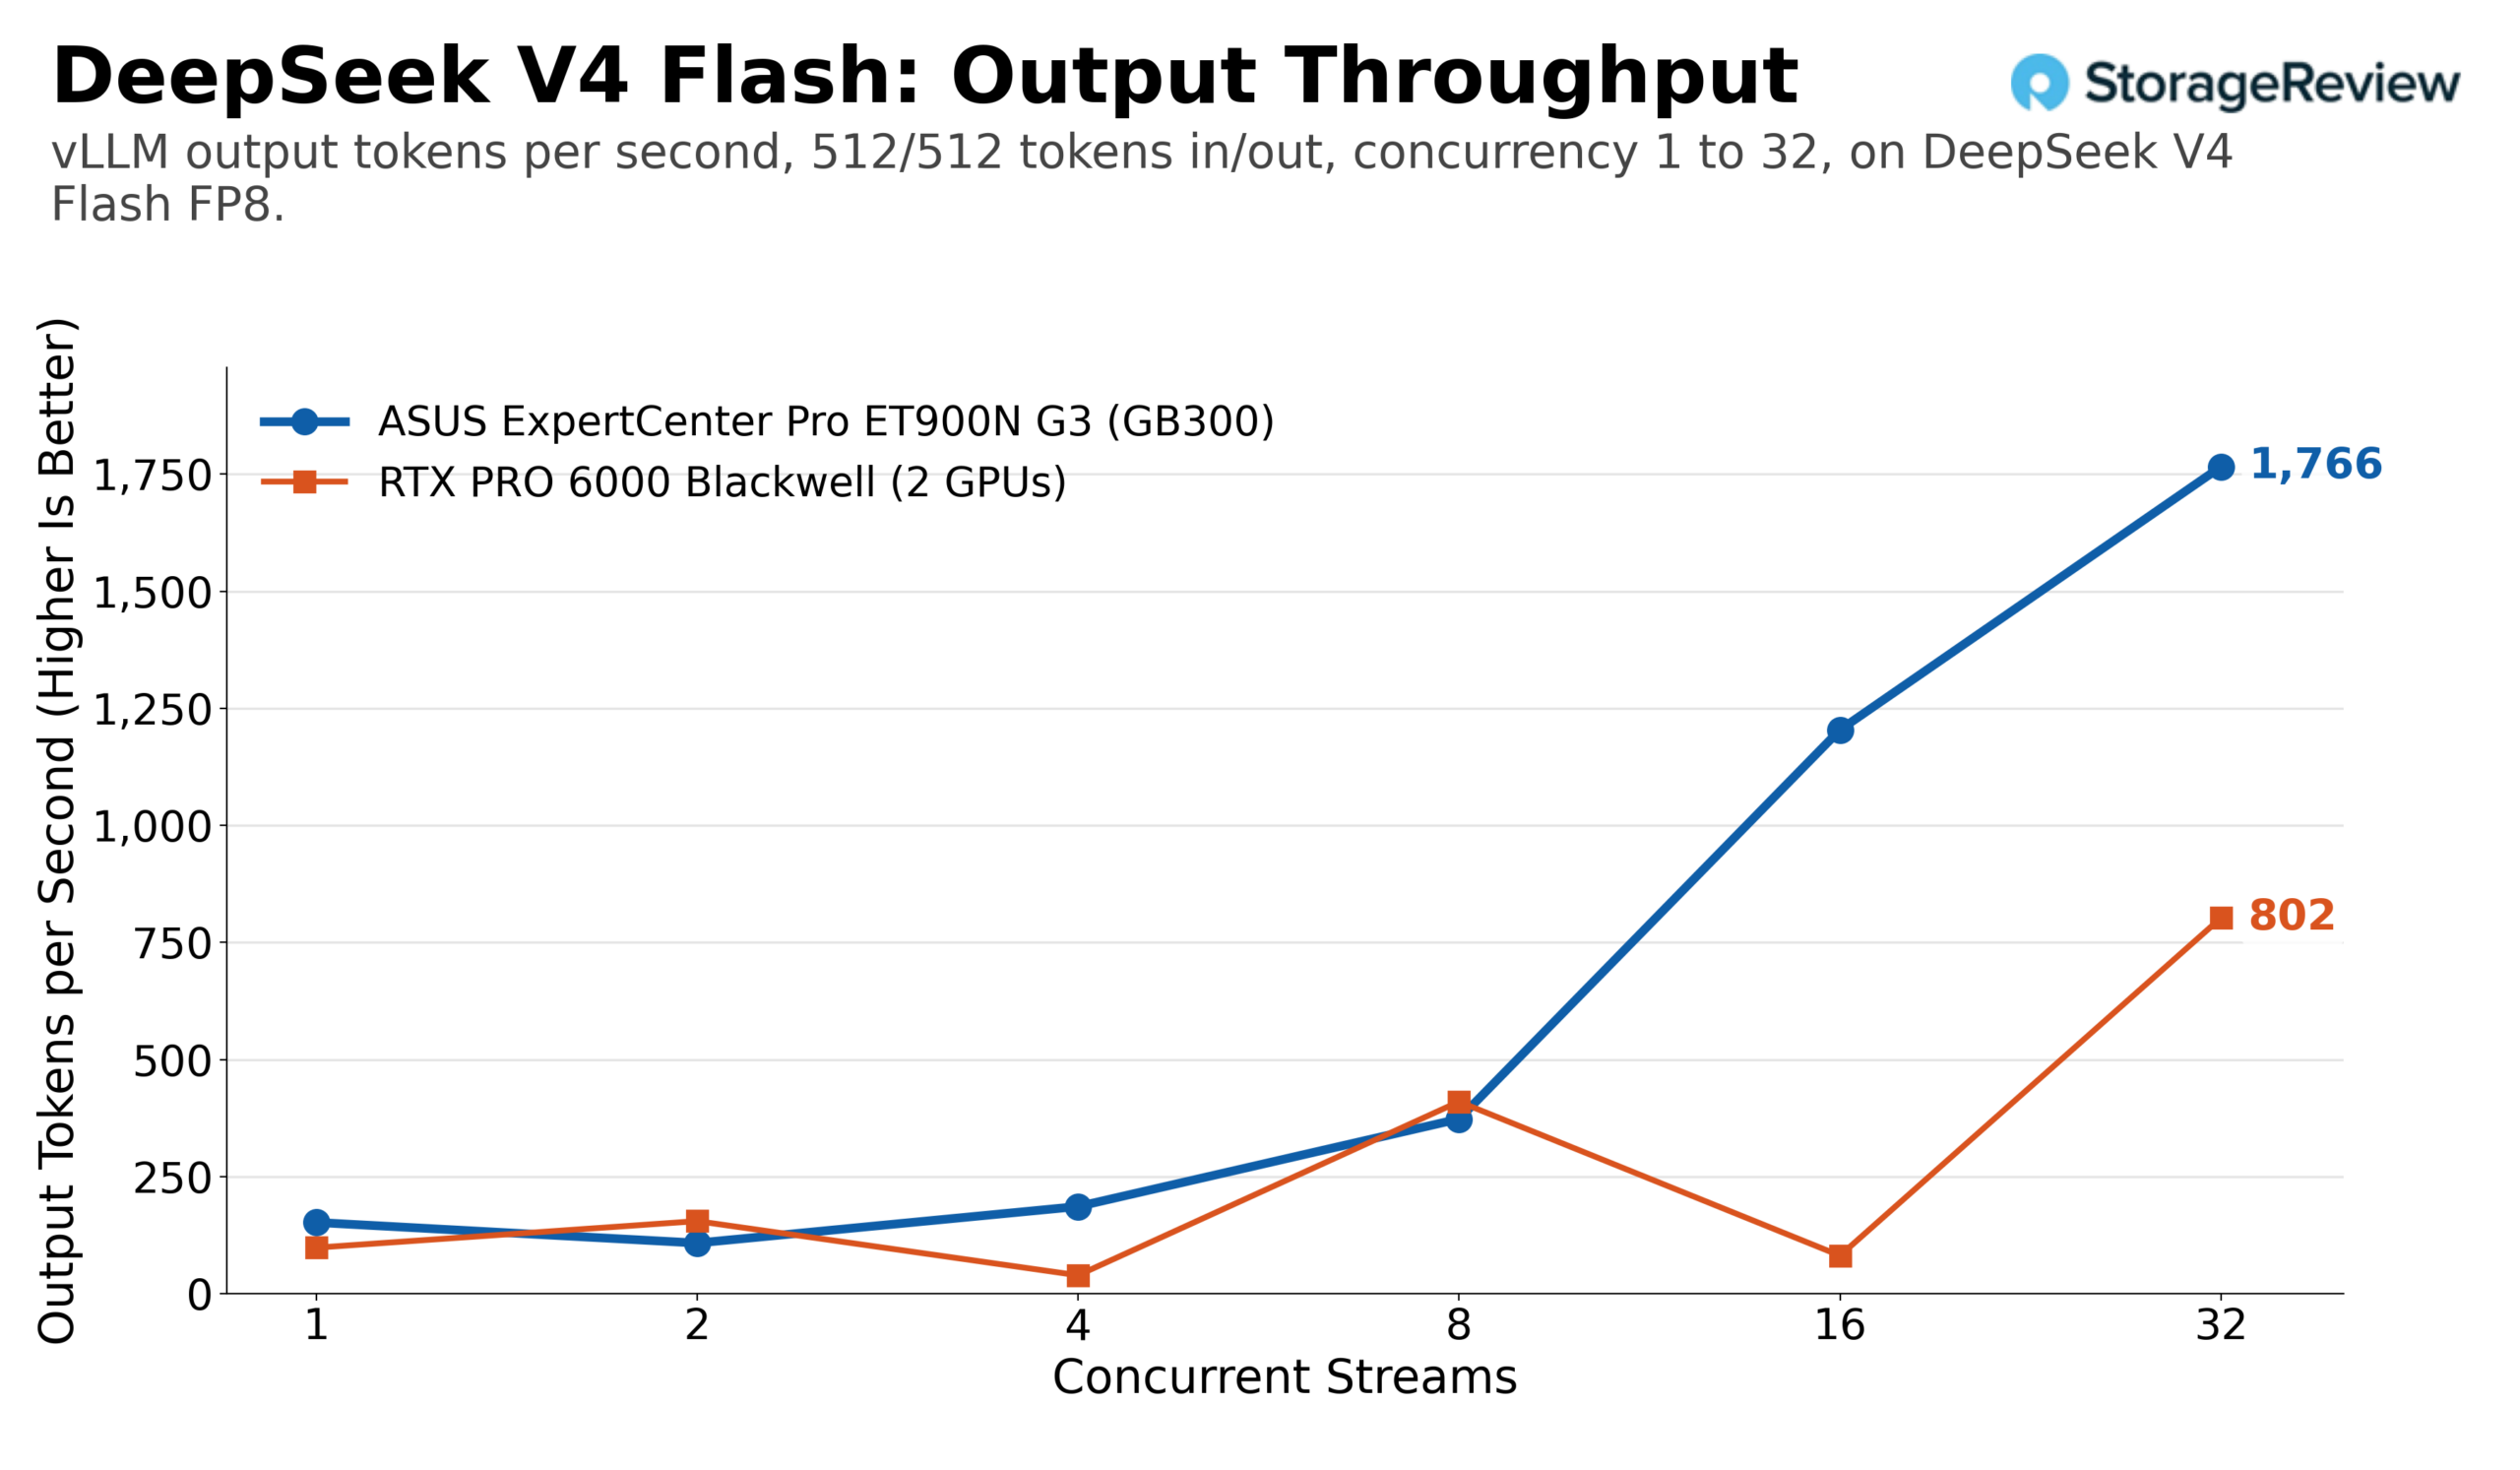
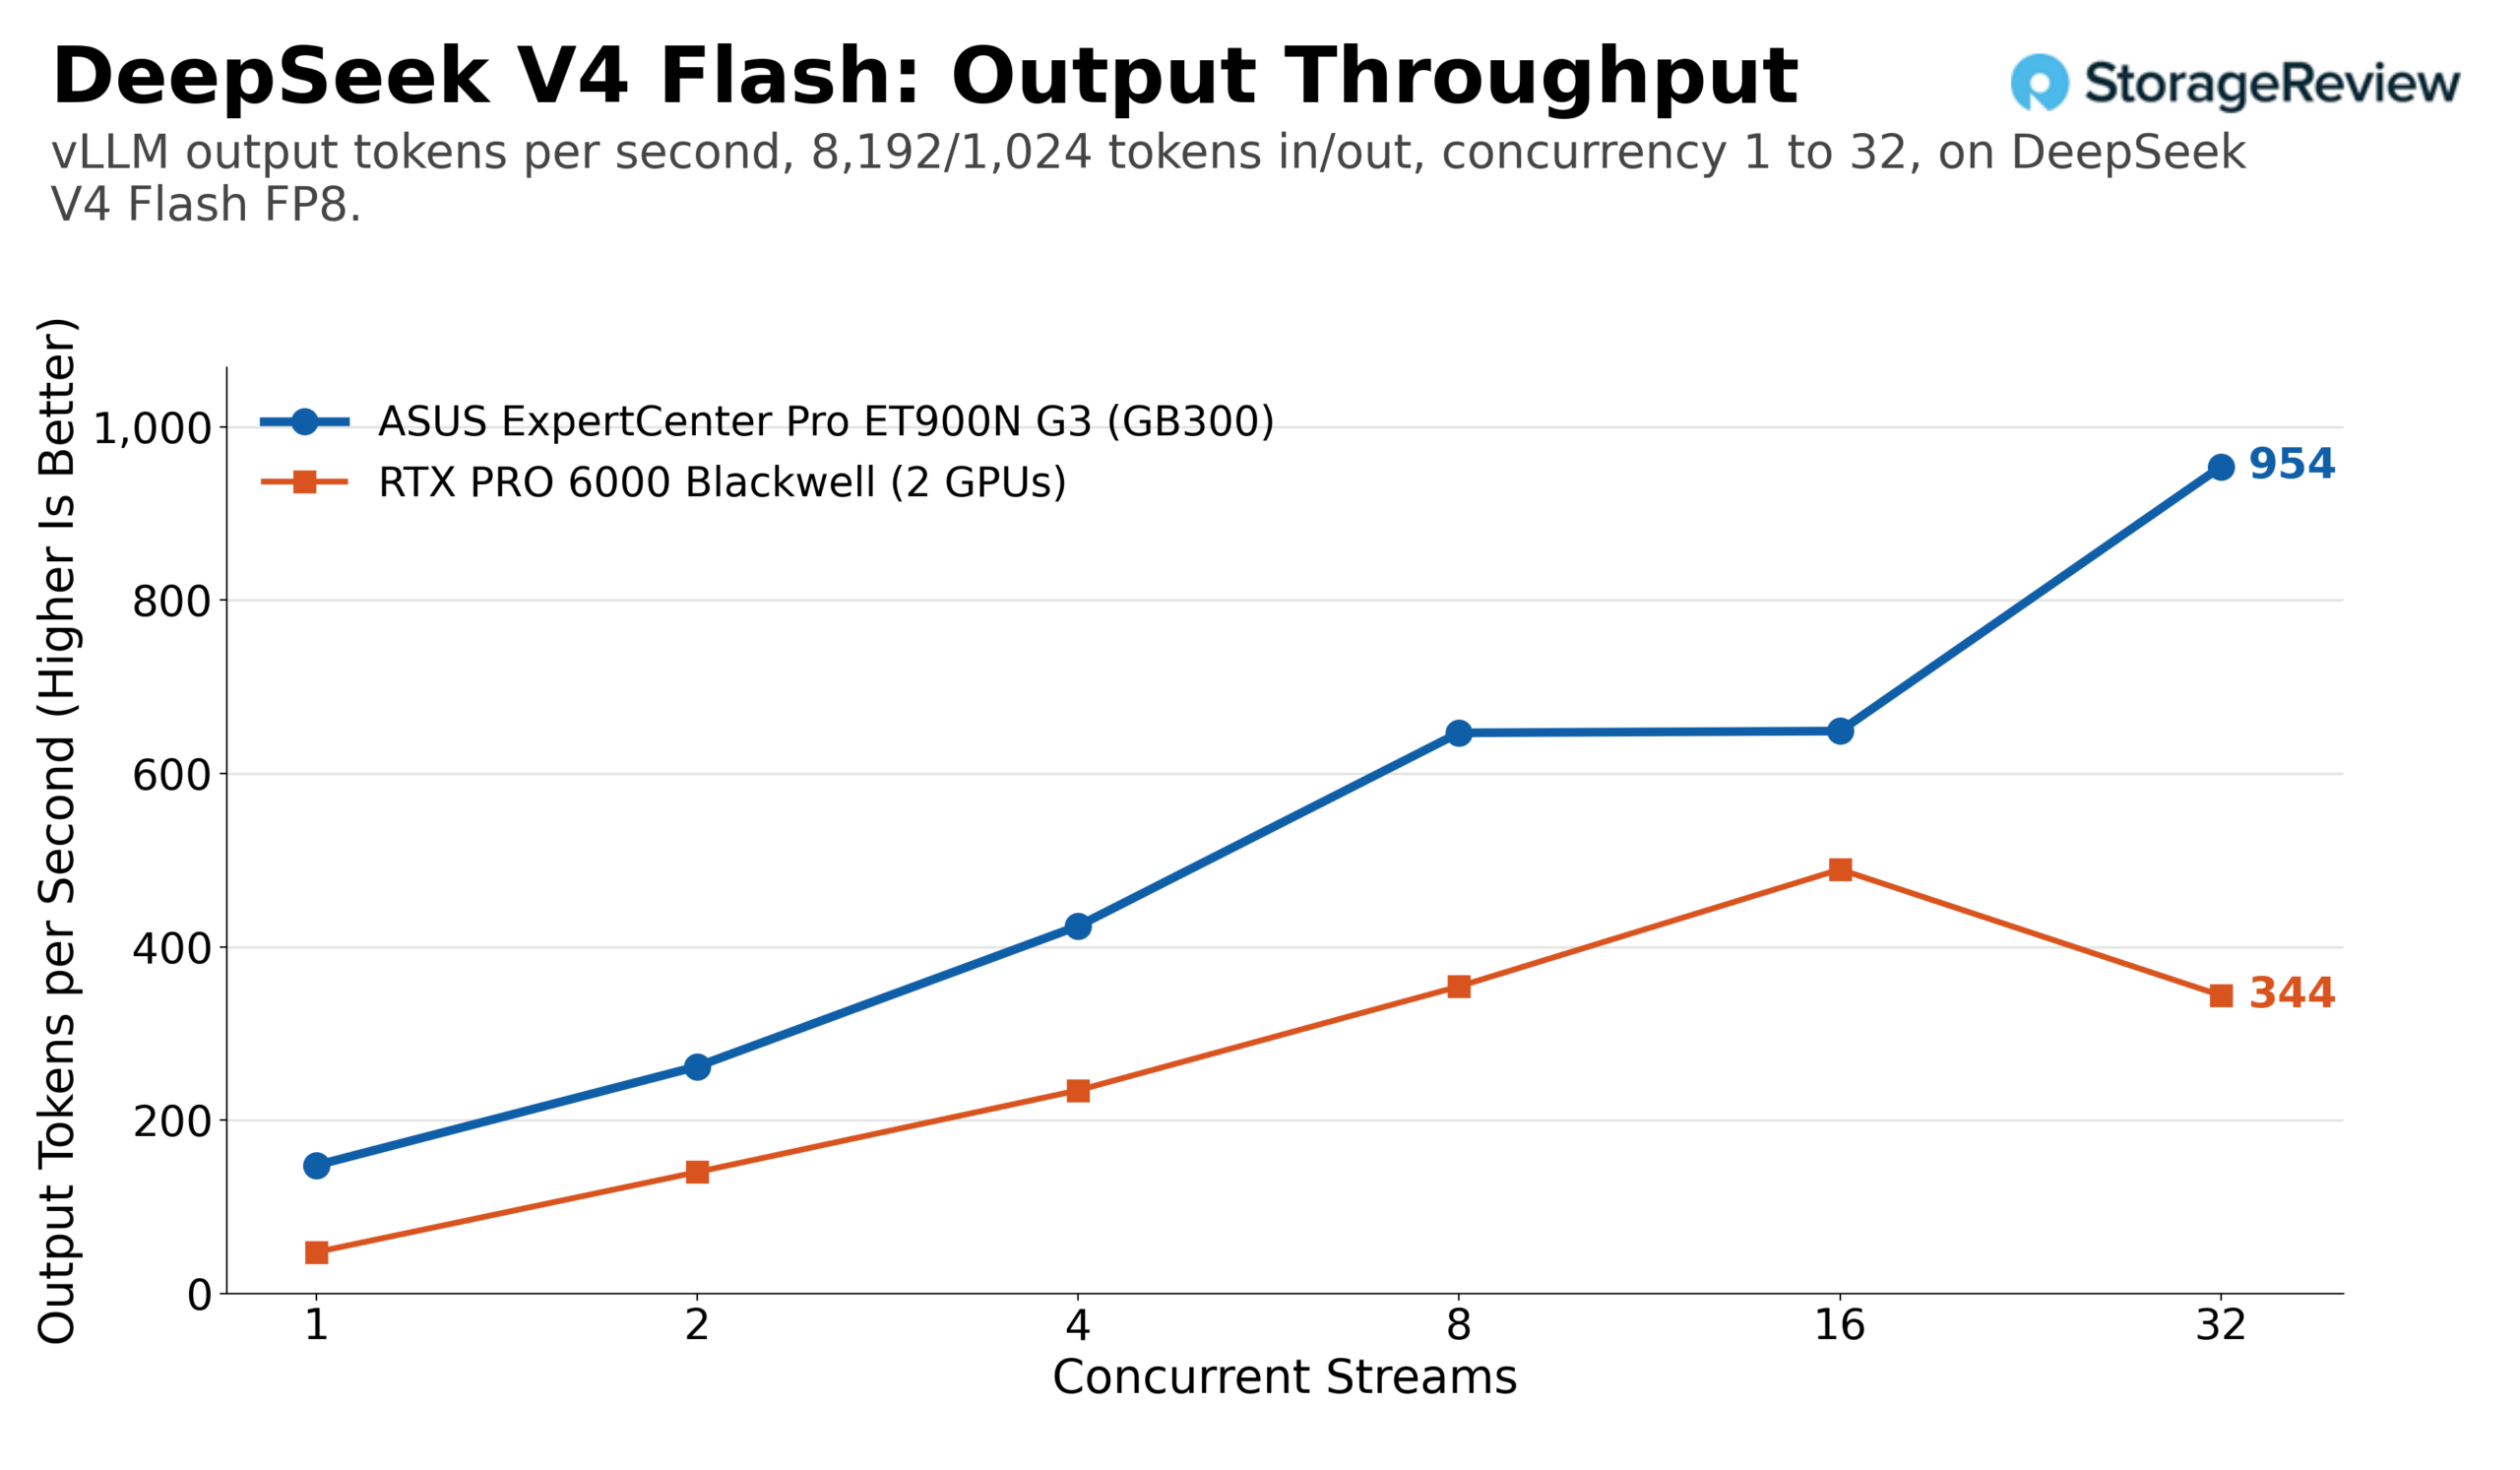
DeepSeek V4 Flash 的测试非常简单:一个约 20GB 的原生 FP8 检查点,B300 可以轻松处理。在相同的工作负载下,输出吞吐量从单流时的每秒 152 个令牌提升至 32 流时的每秒 1,766 个令牌,总令牌吞吐量达到每秒 3,532 个令牌。在预填充较多的场景下,ET900N G3 的输出令牌数从每秒 148 个提升至每秒 954 个,总令牌数达到每秒 8,587 个。两张 RTX PRO 6000 显卡在相同工作负载下峰值输出令牌数接近每秒 800 个,在长提示符场景下约为每秒 490 个令牌,低并发情况下性能曲线波动较大。
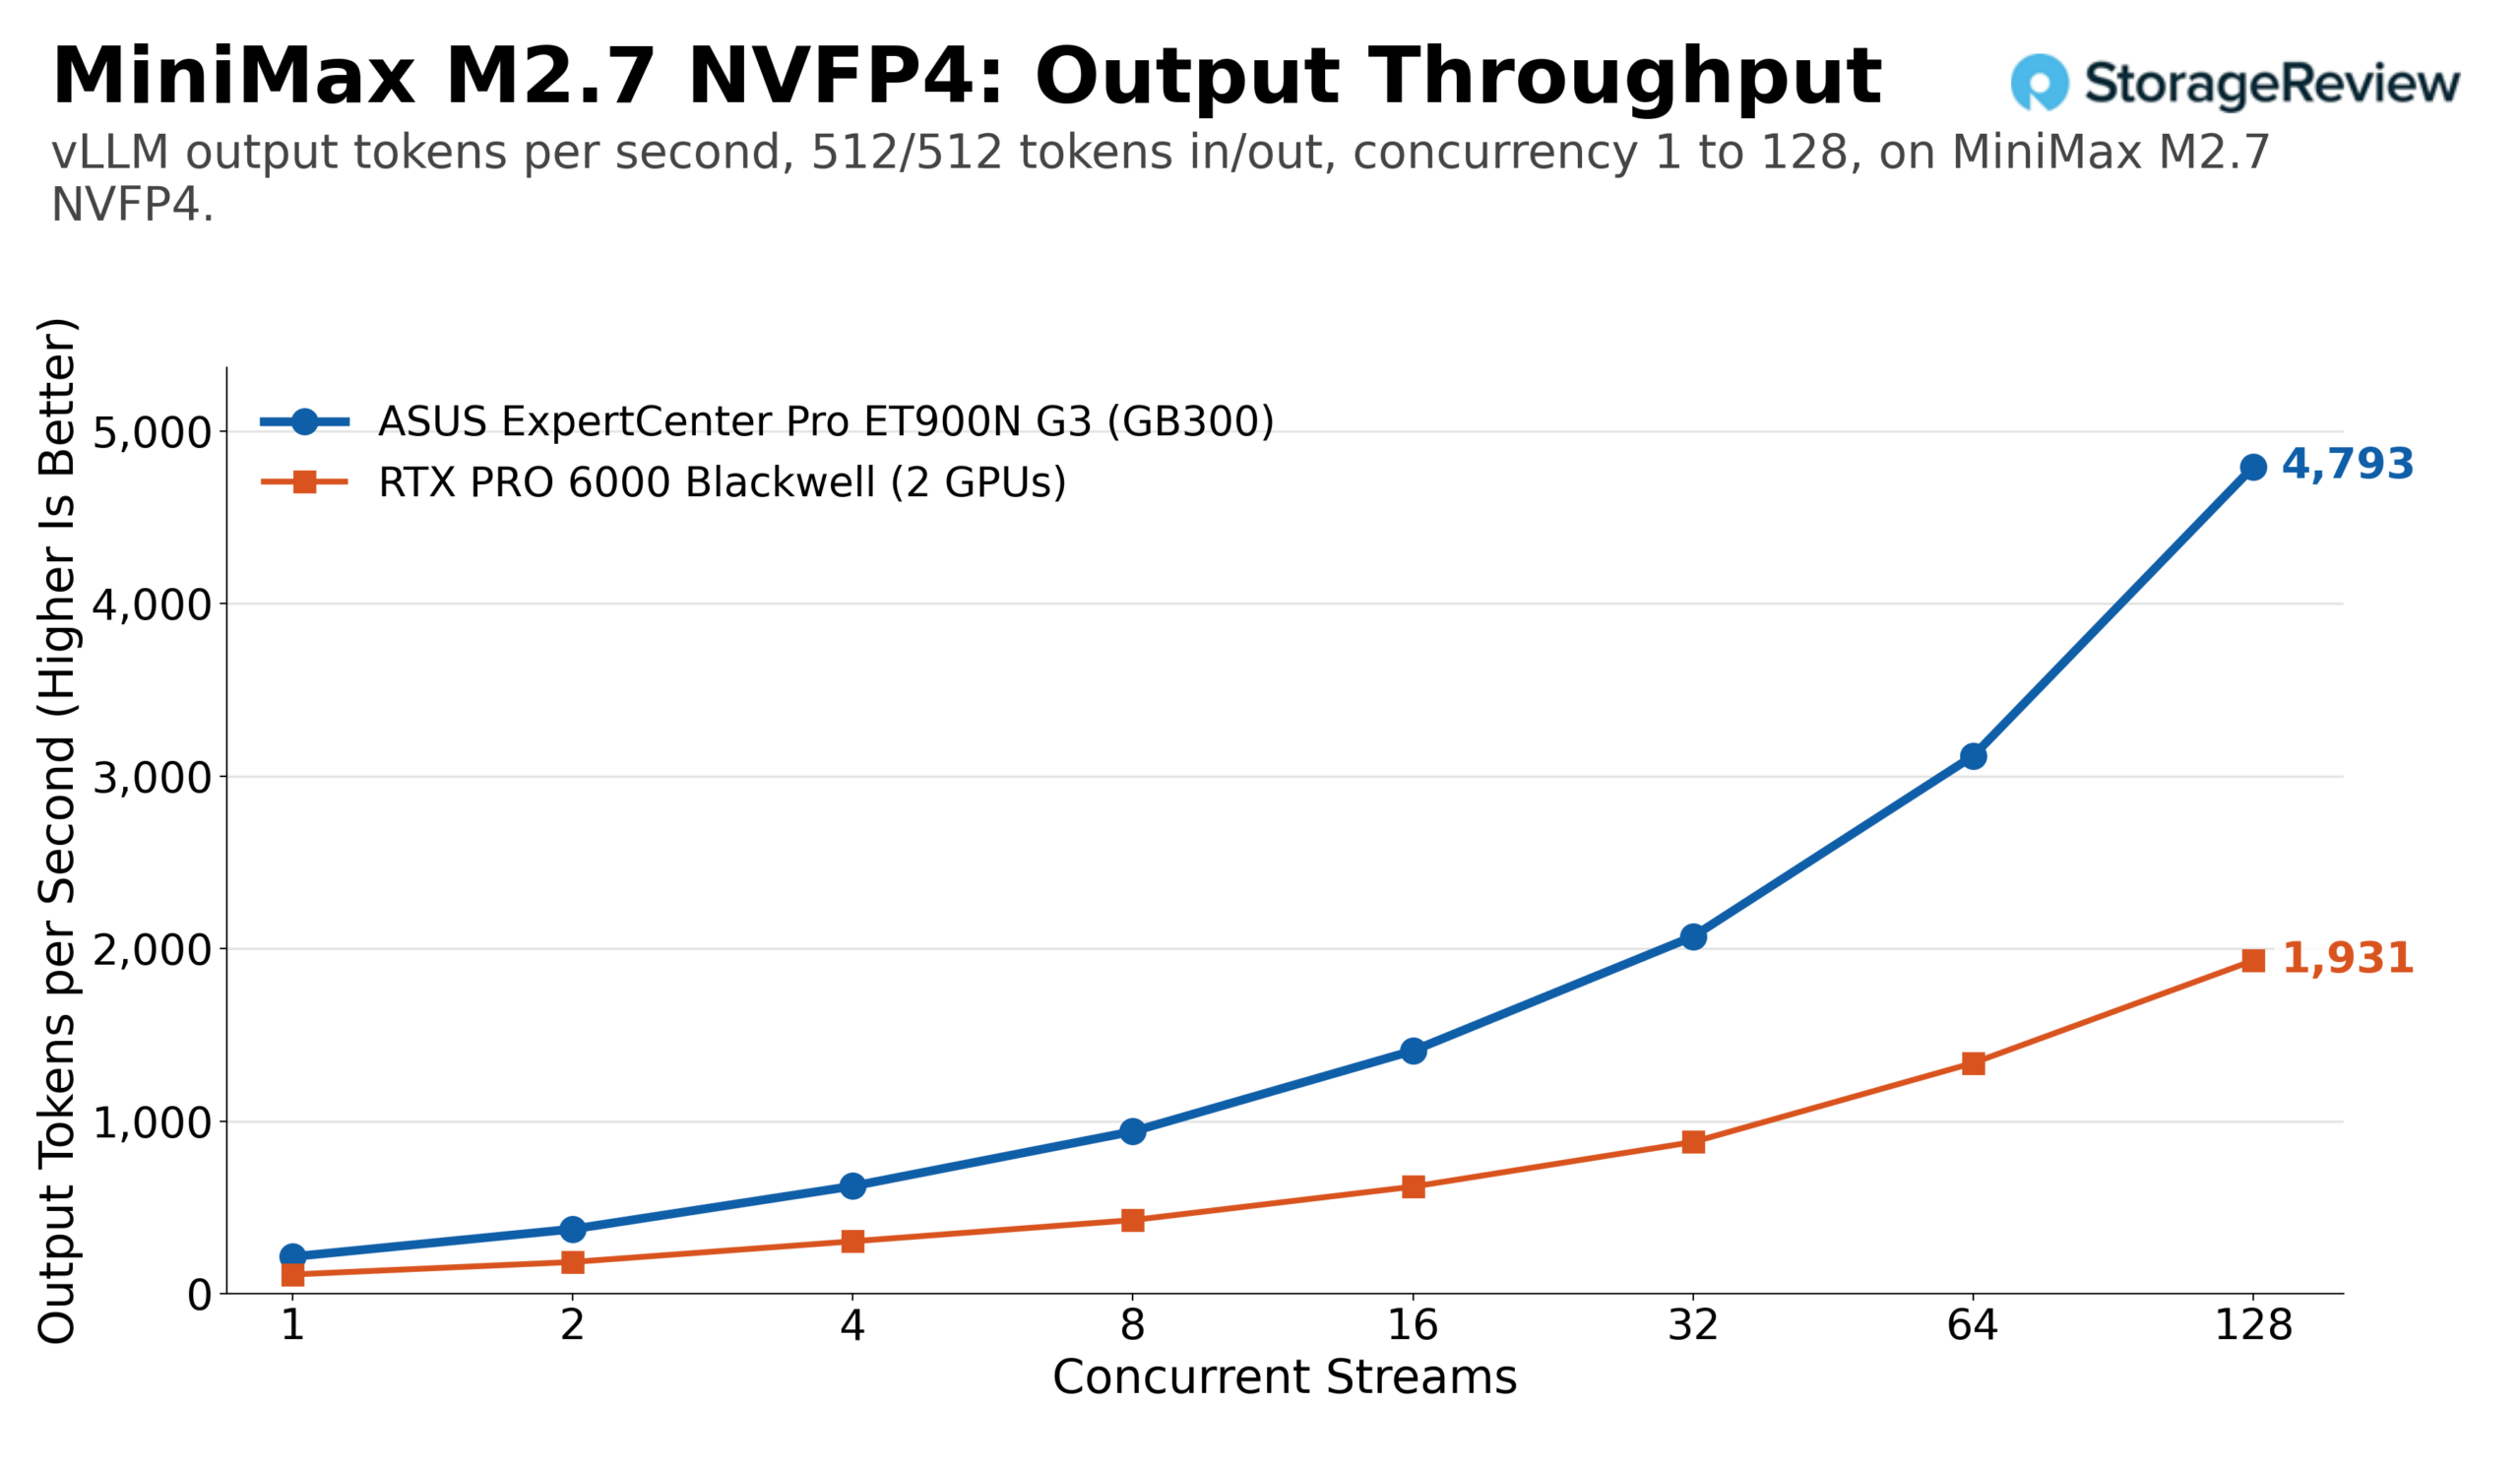
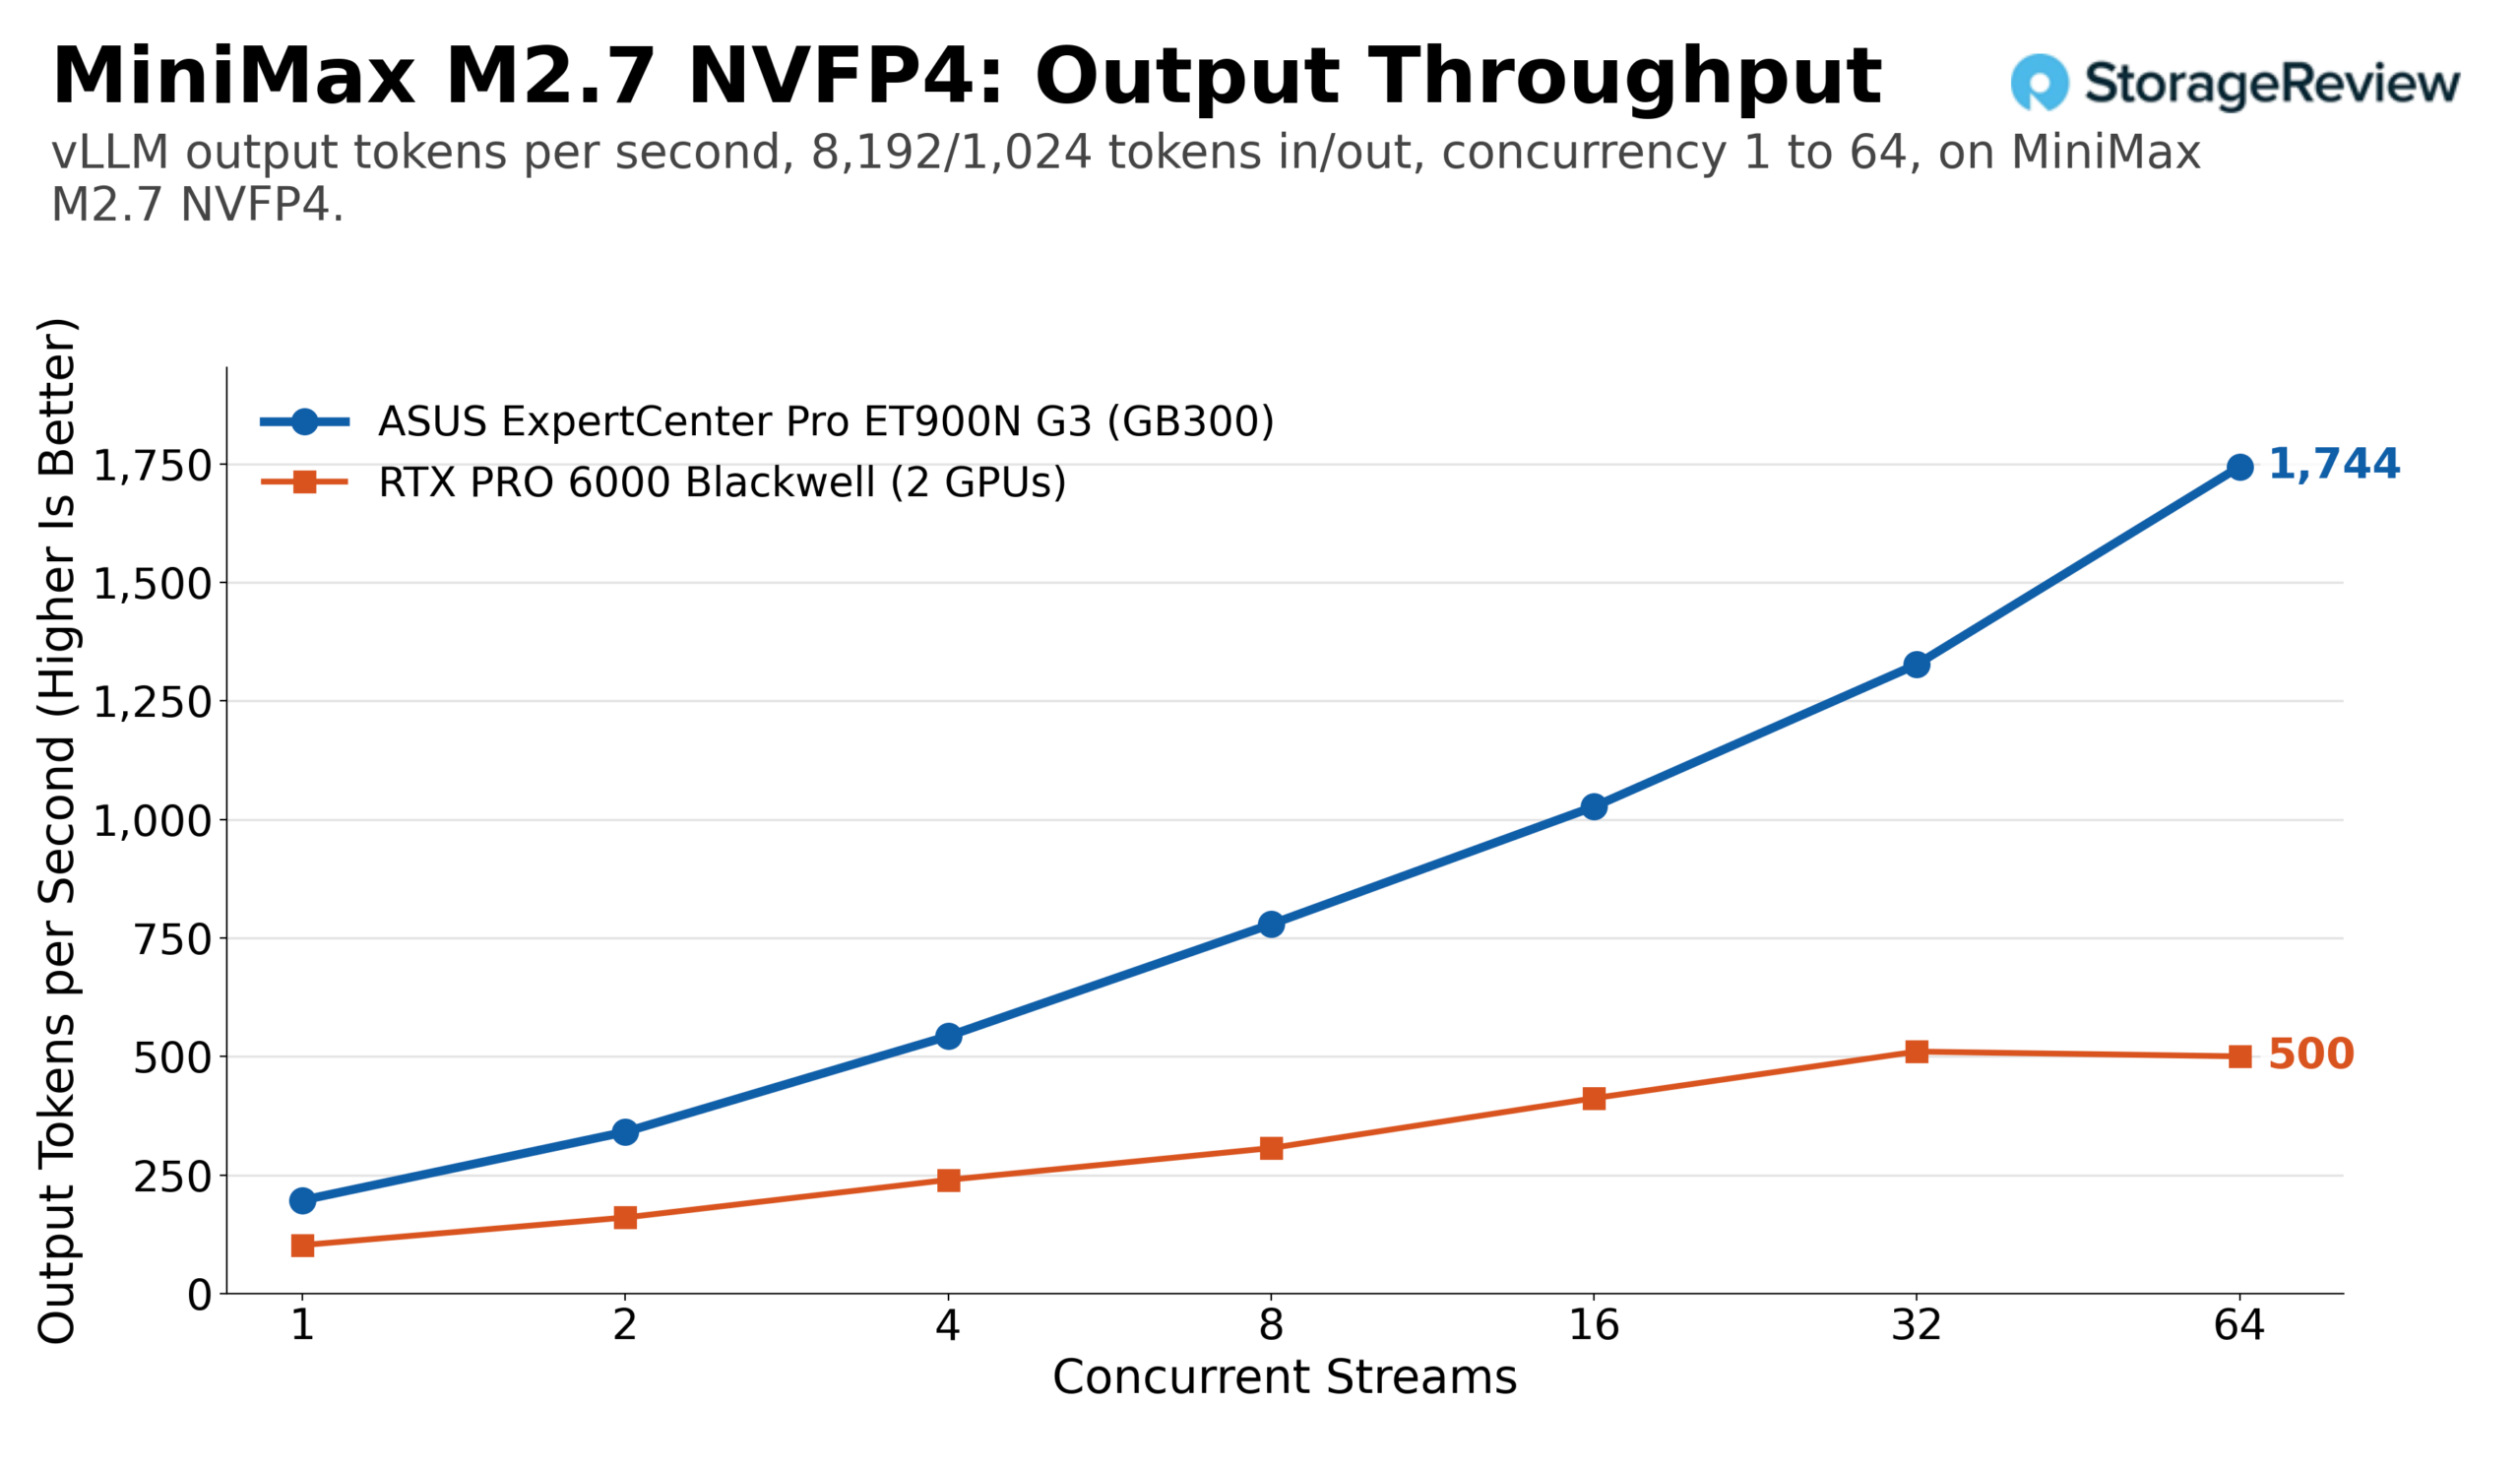
采用 NVIDIA NVFP4 量化技术的 MiniMax M2.7 占用约 125GB HBM 显存,是四款显卡中性能扩展性最强的。在相同工作负载下,其输出令牌数从单流每秒 214 个提升至 128 流每秒 4,793 个,总吞吐量达到 9,586 个。在预填充密集型运行中,其输出令牌数扩展至每秒 1,744 个,总令牌数扩展至每秒 15,700 个(64 流)。两张 RTX PRO 6000 系列显卡的性能曲线与 MiniMax M2.7 类似,但扩展性不到 MiniMax M2.7 的一半,在相同工作负载下最高输出令牌数接近每秒 1,930 个,在长提示符下约为每秒 510 个。
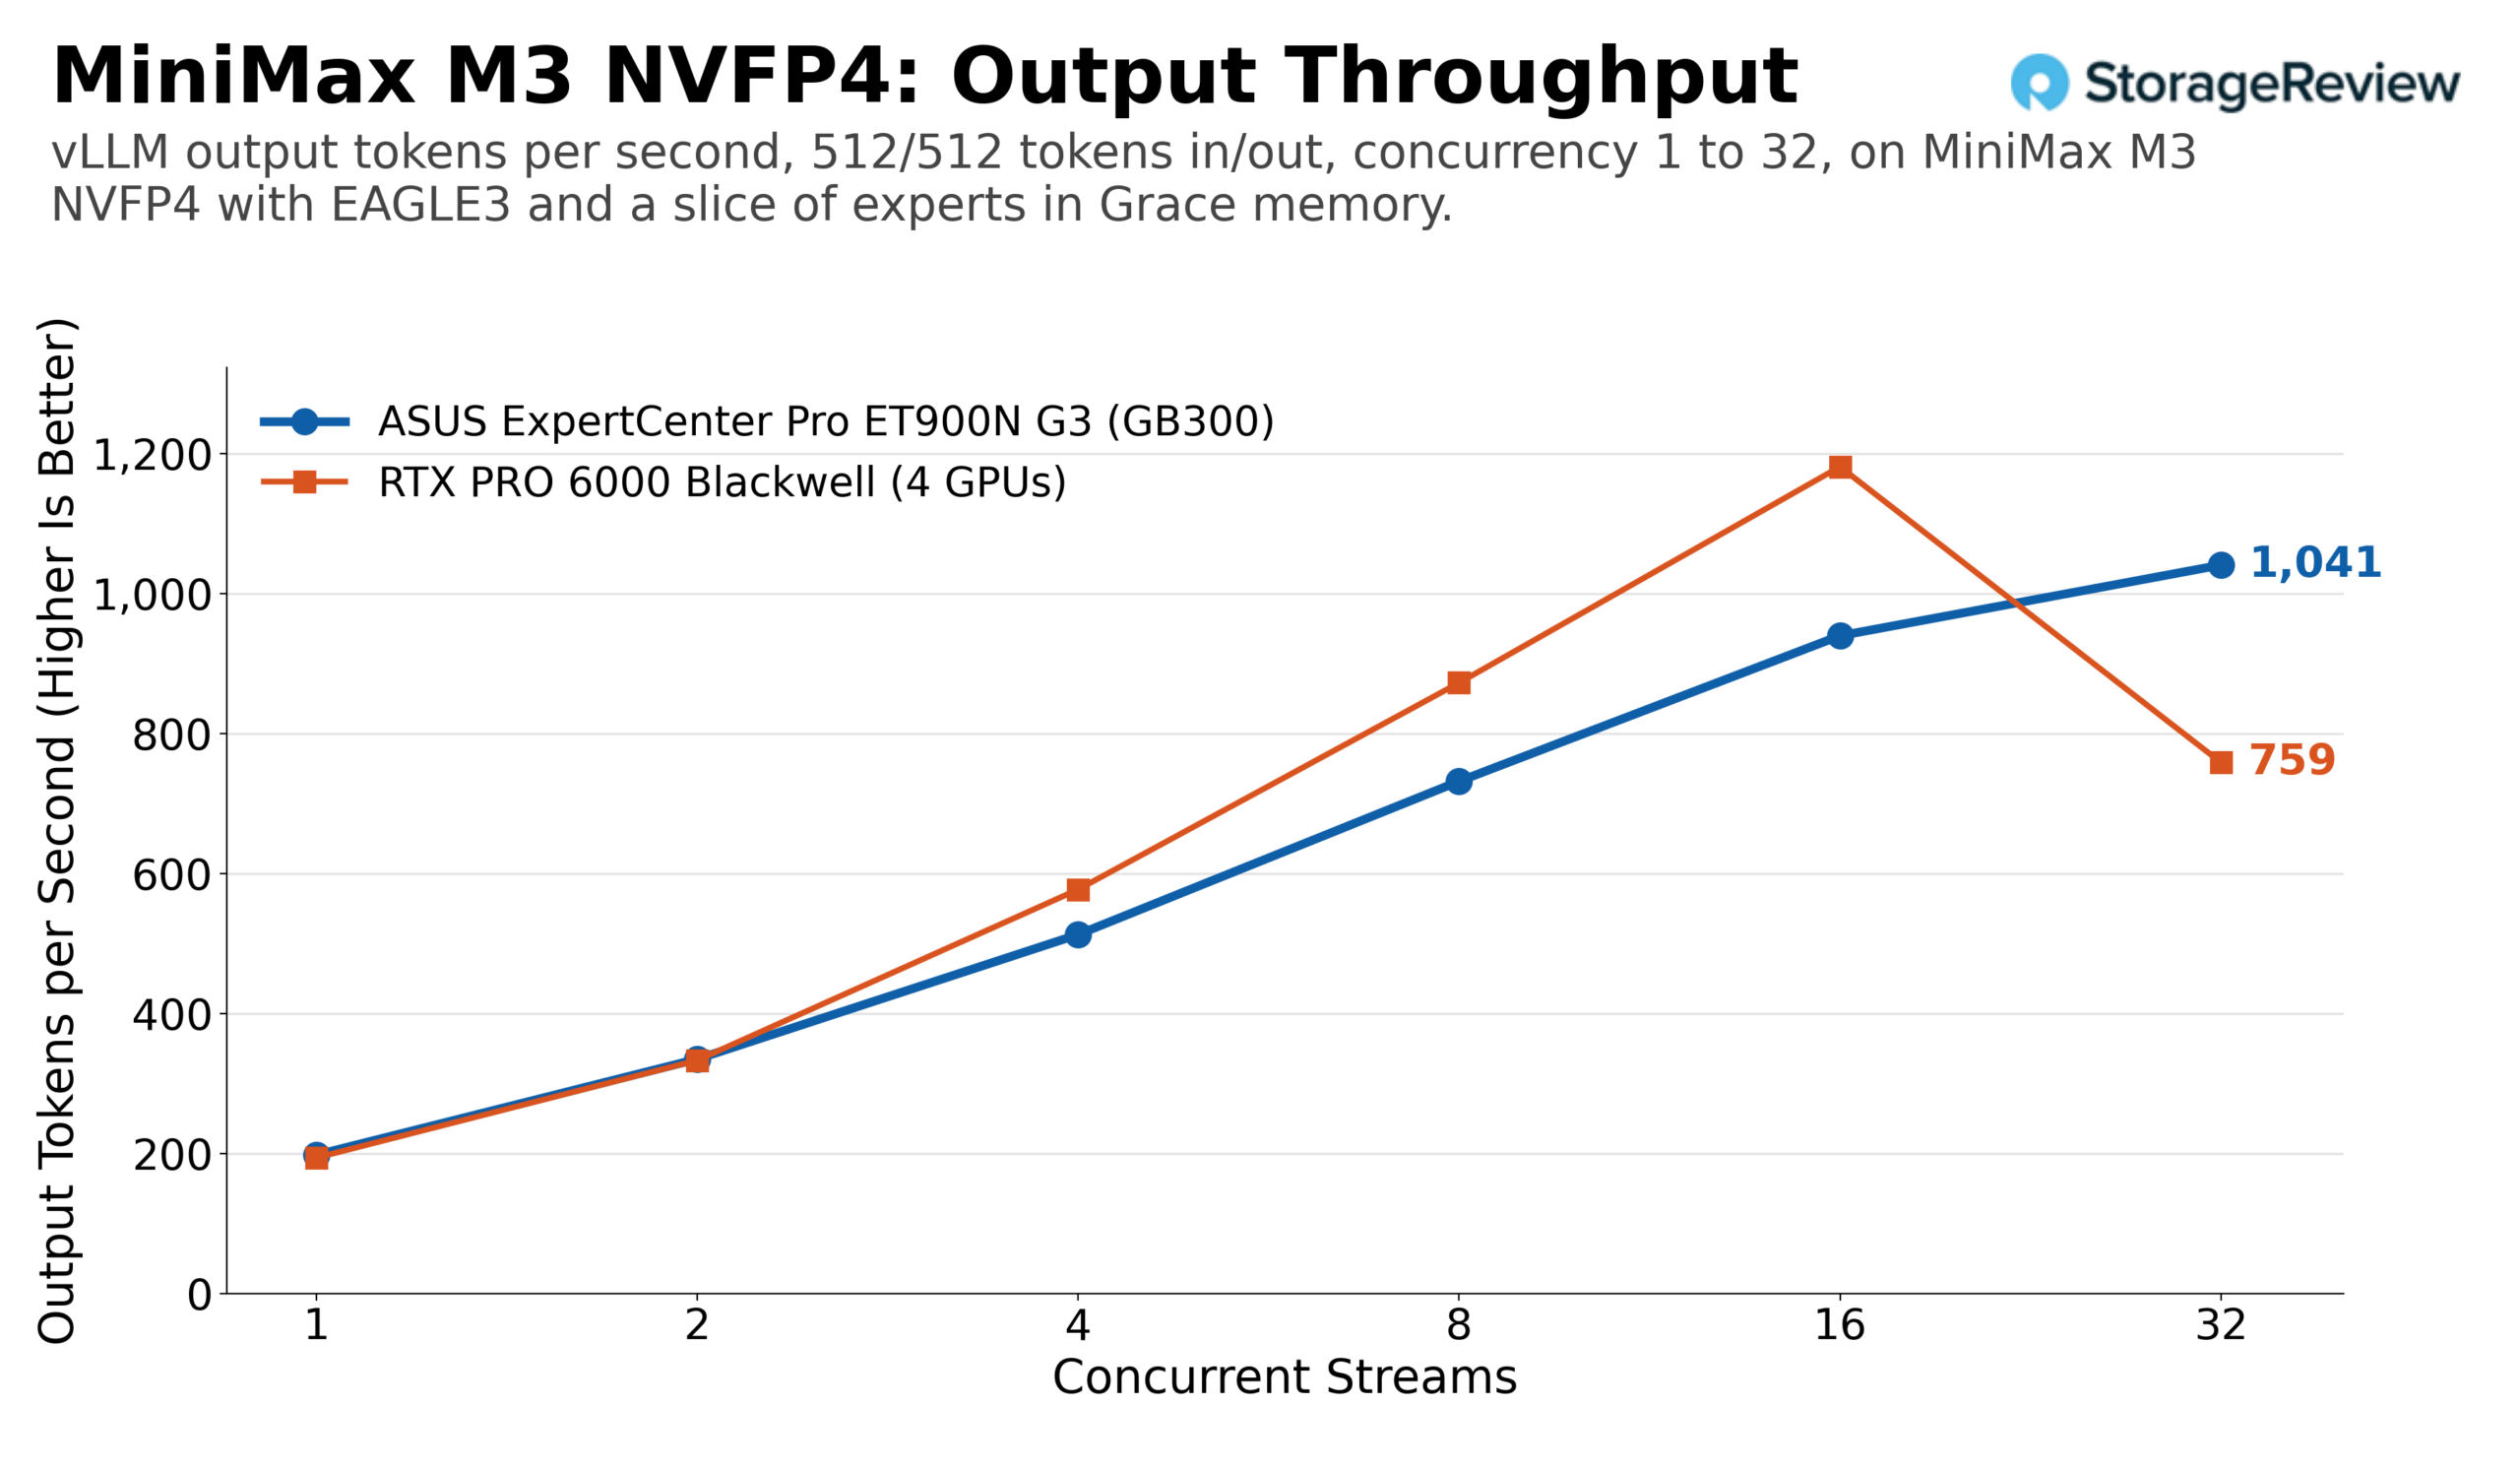
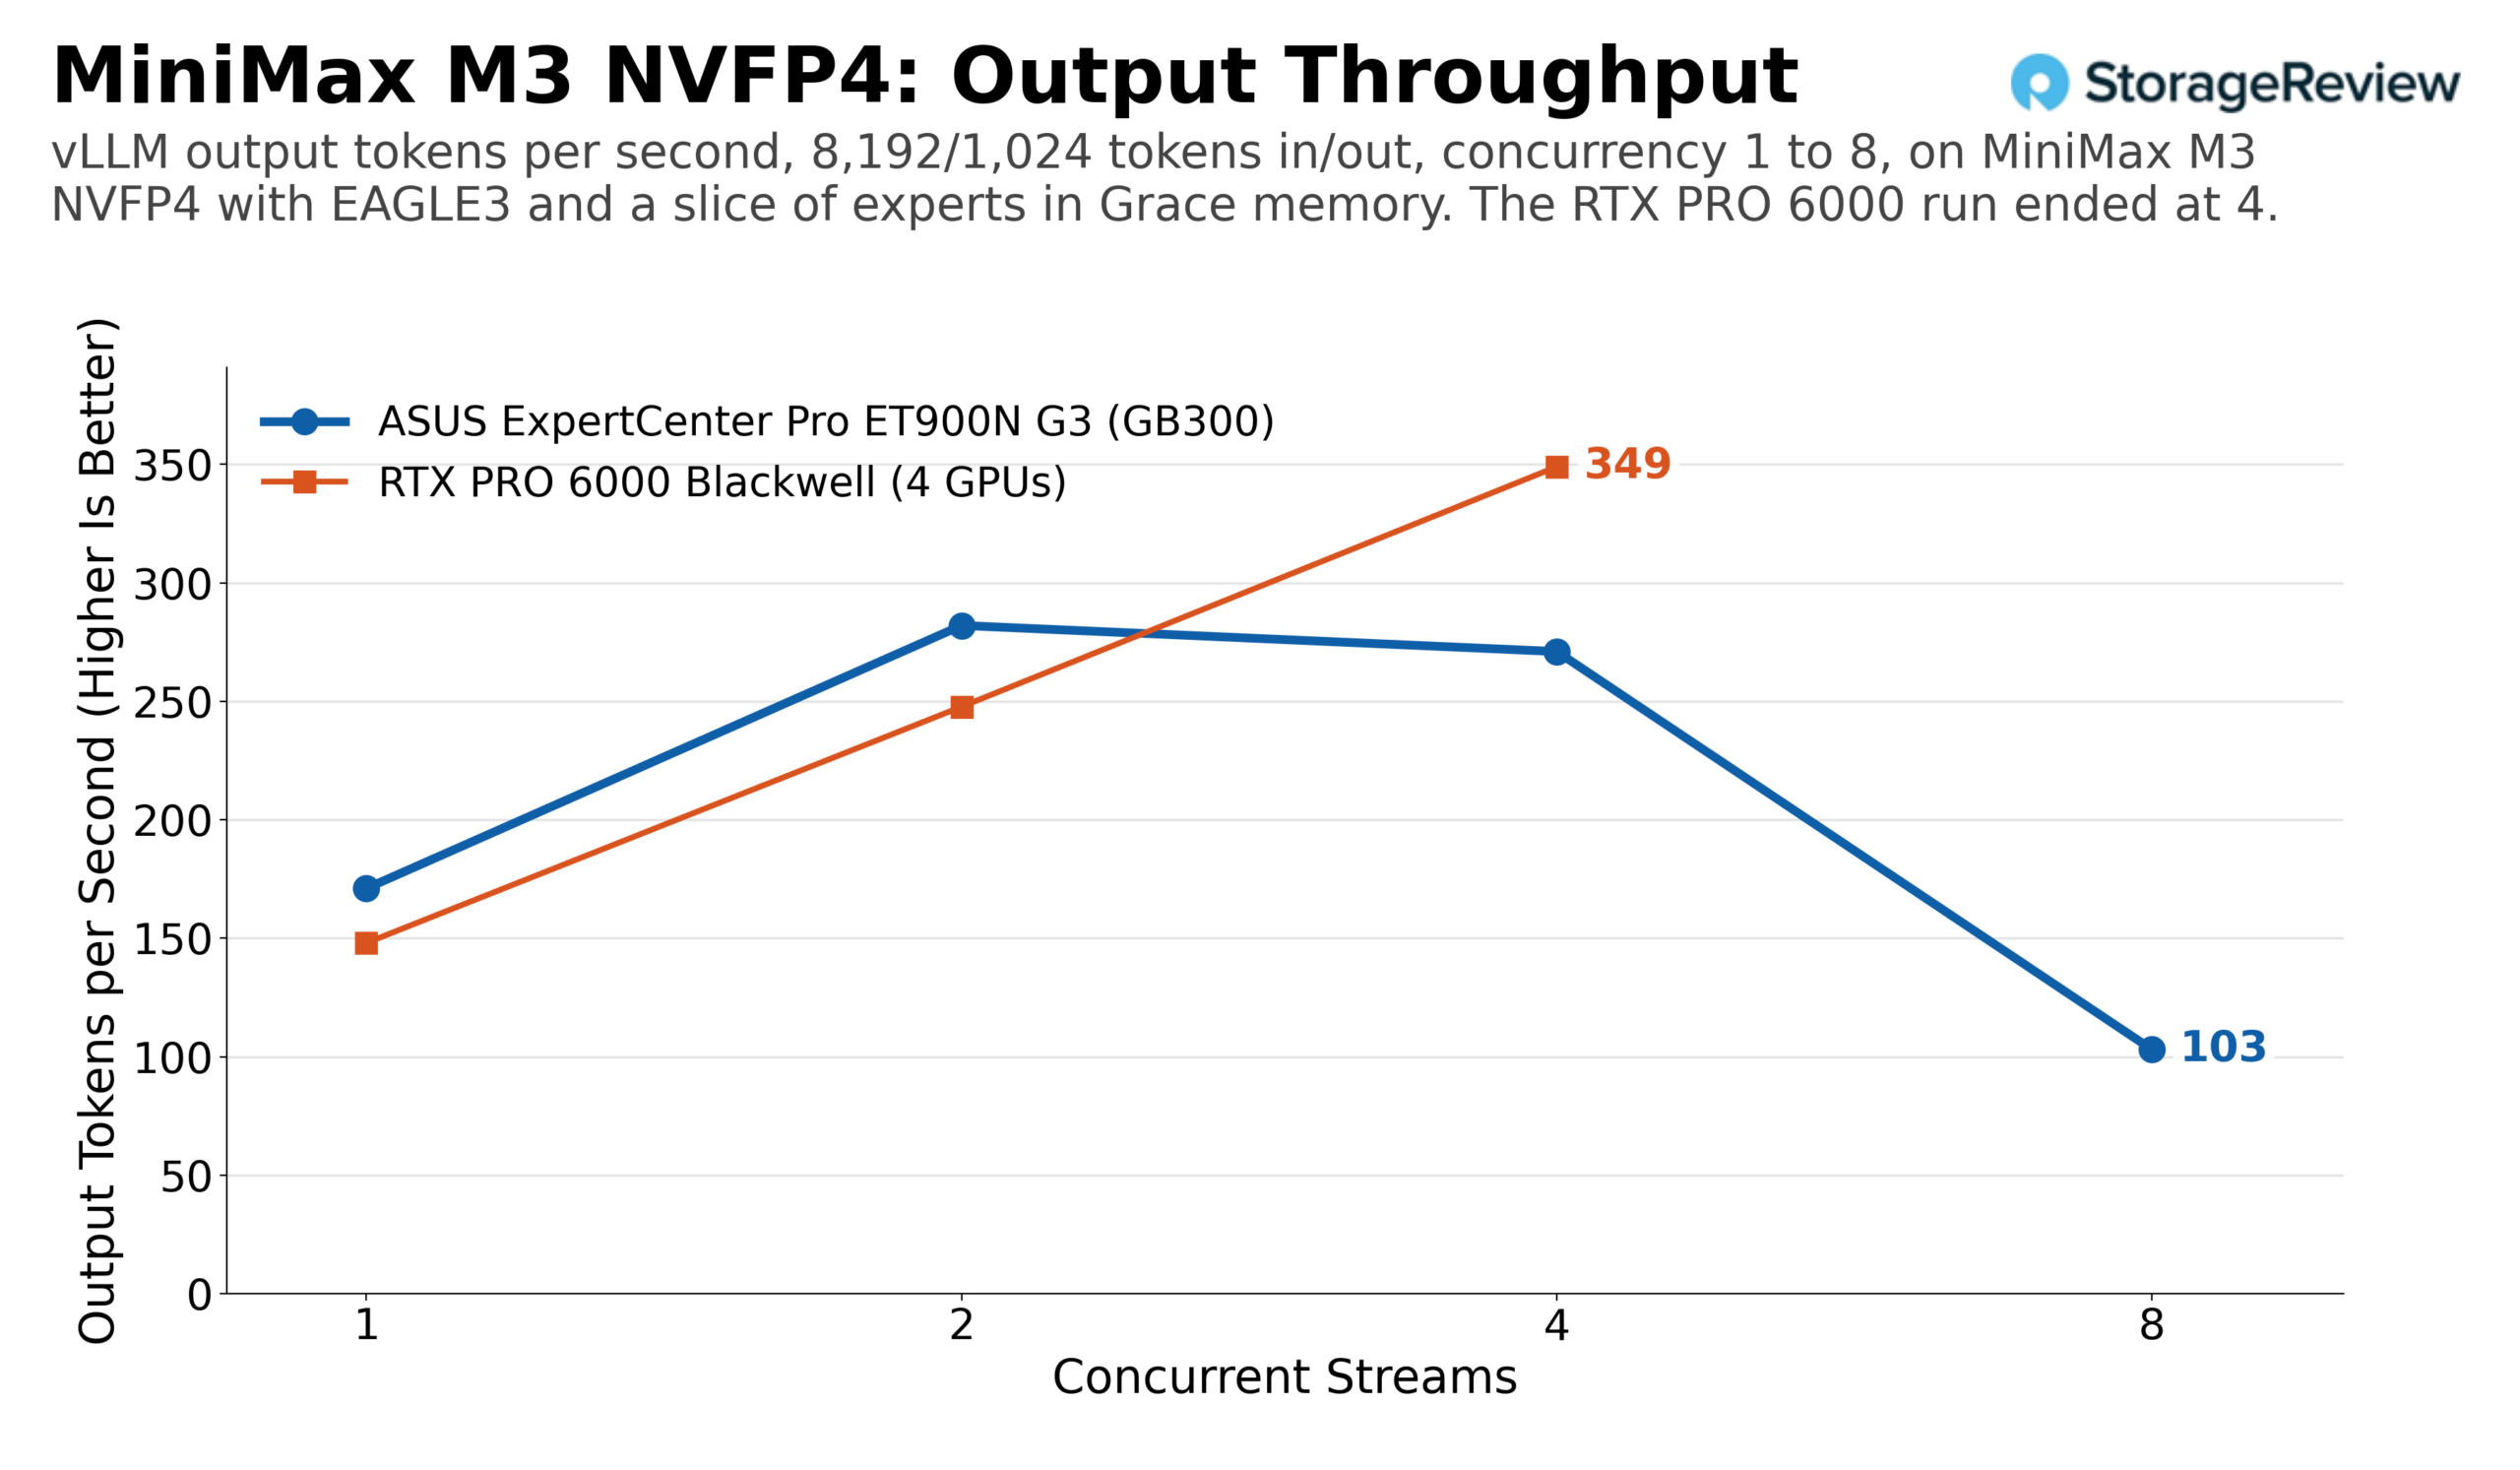
MiniMax M3 展示了内存容量捉襟见肘的现状。NVFP4 检查点小于 252GB,但运行时和键值缓存也需要空间,因此部分专家信息驻留在 Grace 内存中,并且每个涉及这些专家信息的解码步骤都会经过 NVLink-C2C。在相同的负载下,使用 EAGLE3 推测解码时,ET900N G3 在 32 个流下达到了每秒 1,041 个输出标记;而预填充密集型配置在两个流下达到了每秒 282 个输出标记的峰值,四个流下保持在每秒 271 个,而八个流下则由于长提示消耗了剩余缓存而降至每秒 103 个。四张配备相同推测解码器的 RTX PRO 6000 显卡在八个流下保持了相同的速度,并在 16 个流下以每秒约 1,180 个输出标记的速度领先,然后在 32 个流下回落至约每秒 760 个输出标记。在预填充较多的配置下,四卡盒每秒可处理约 349 个输出令牌(四个流),而 Station 则为 271 个。该型号正好位于 HBM 边界,是该系列中唯一一个四卡 384GB VRAM 与 252GB HBM 加上卸载功能相竞争的型号。
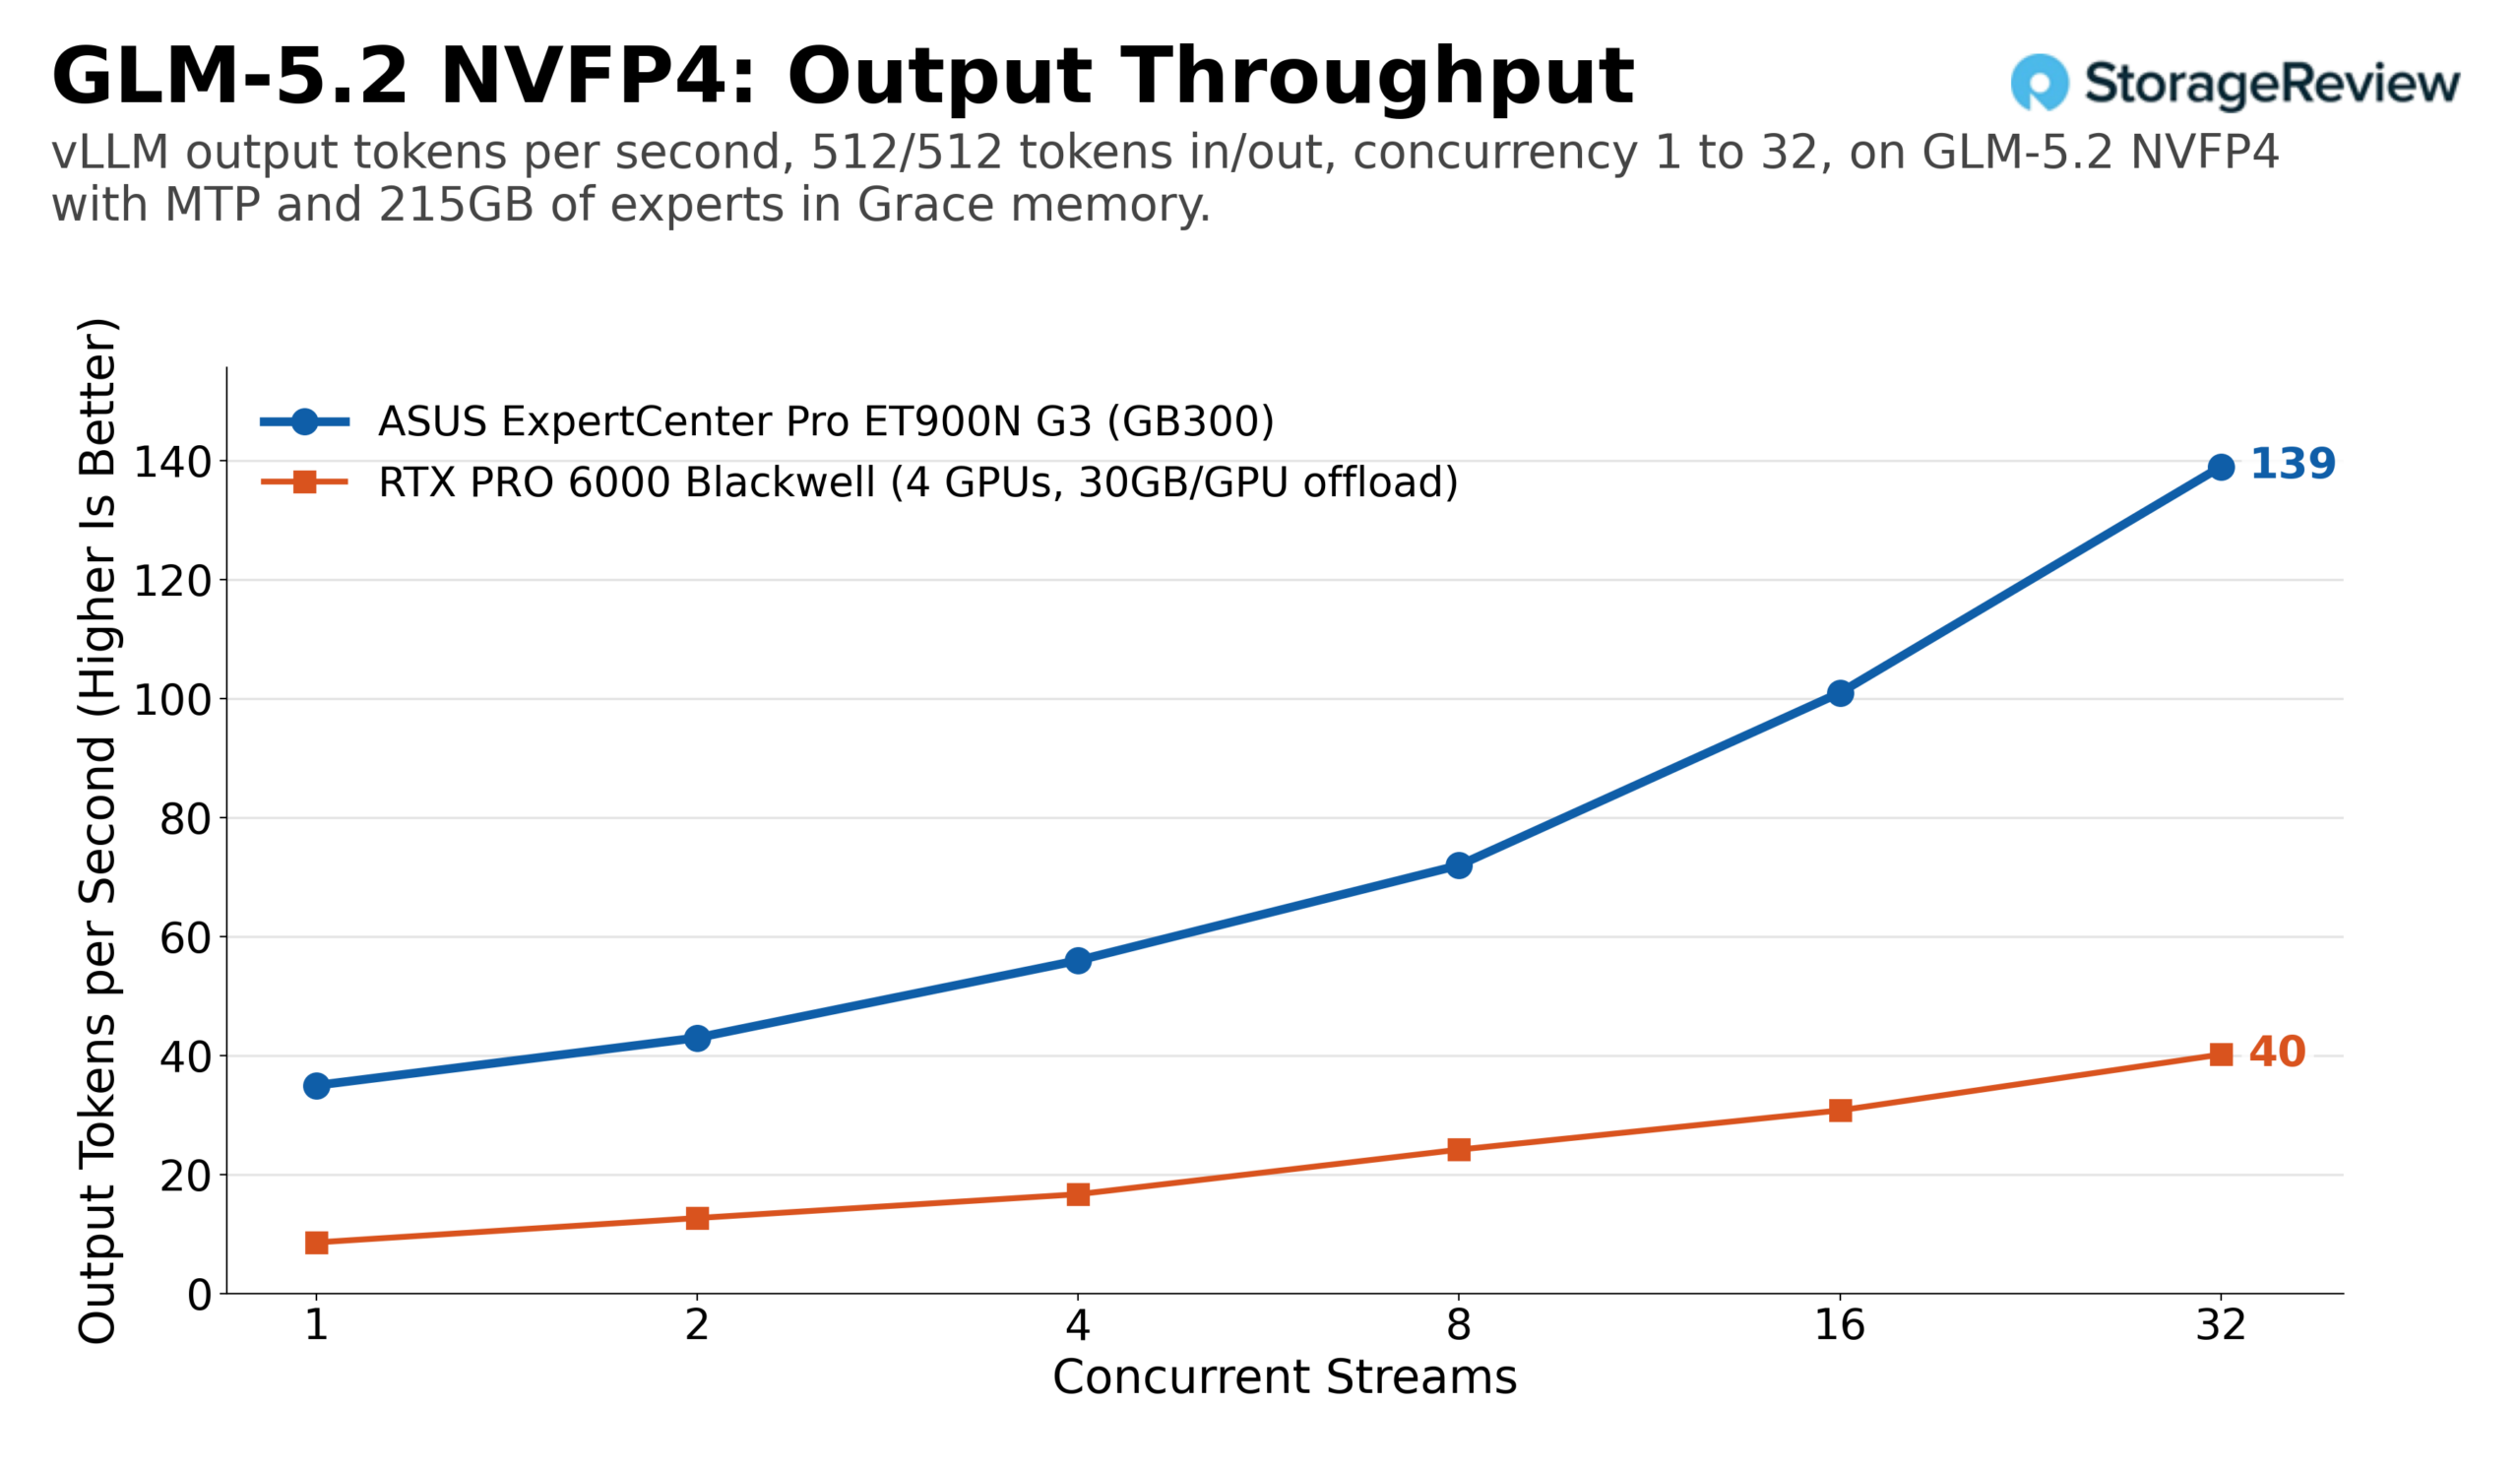
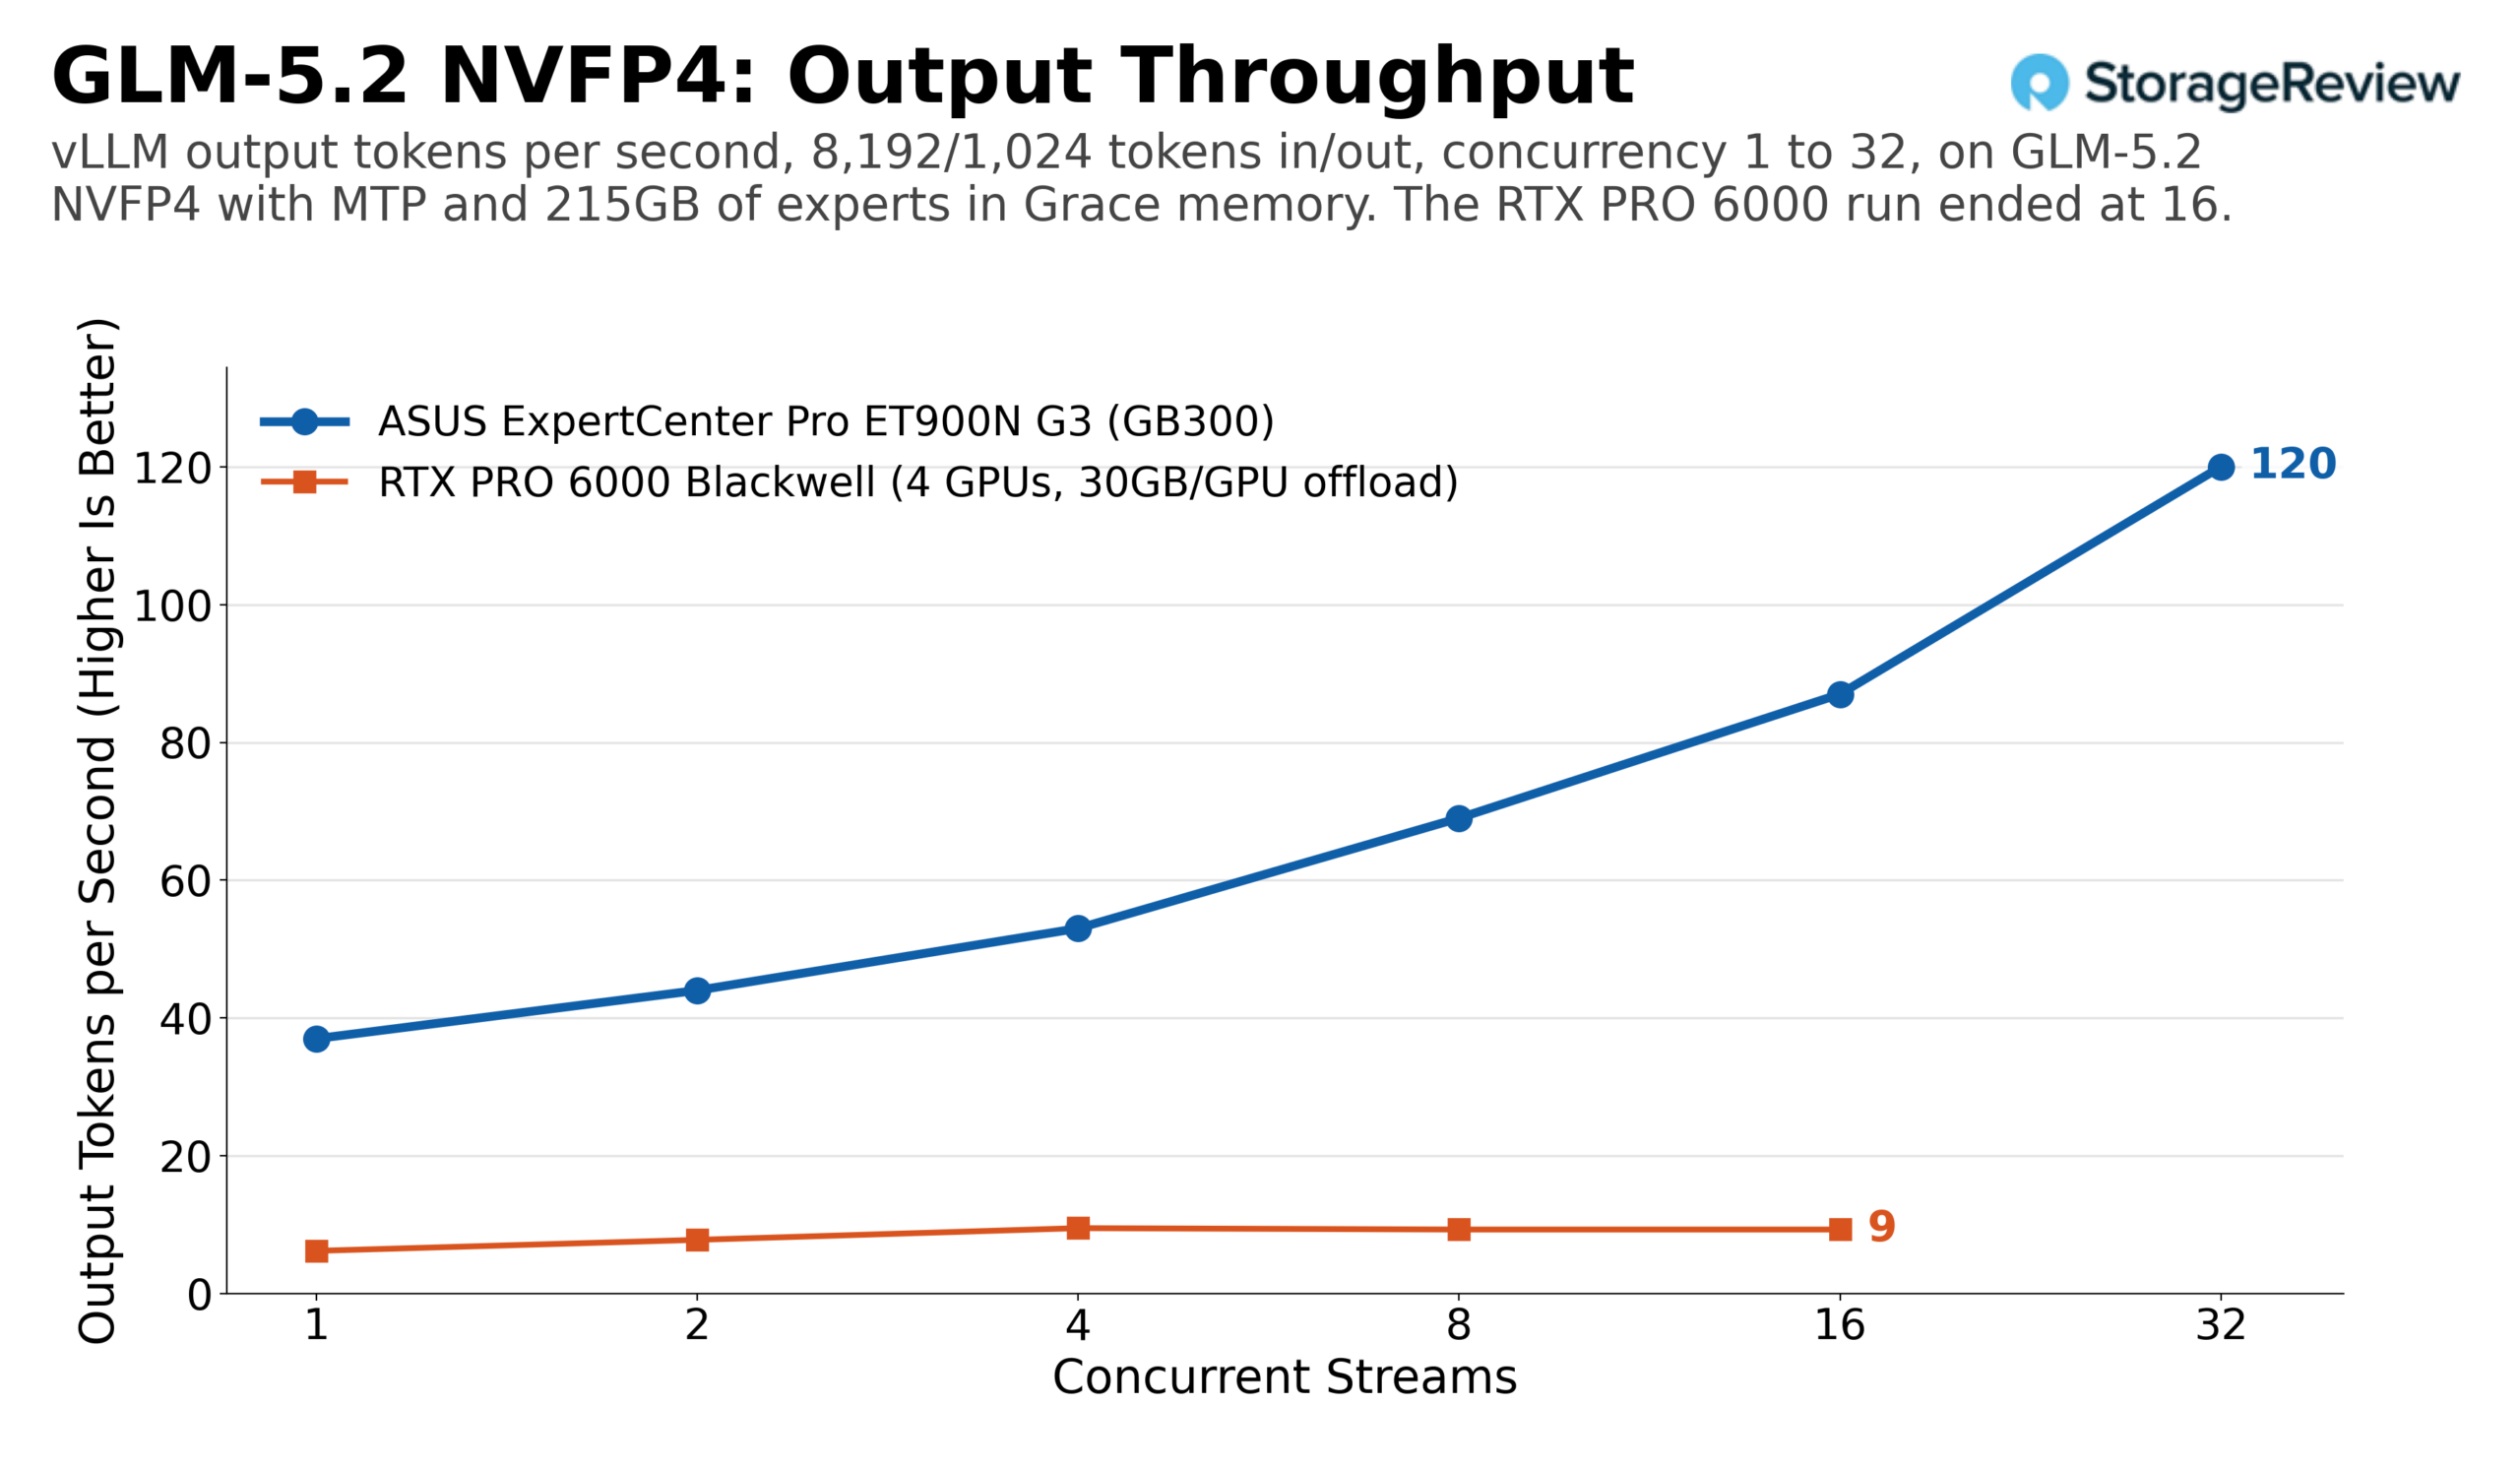
GLM-5.2 是只有相干池才能实现的用例。NVFP4 检查点在 Grace 内存中保存了约 215GB 的专家权重,并采用 MTP 推测解码。在相同的工作负载下,ET900N G3 处理单流数据时每秒输出 35 个标记,处理 32 流数据时每秒输出 139 个标记,总吞吐量达到 277。在预填充较多的场景下,扫描运行到 32 流,每秒输出 120 个标记,总标记数达到 1,079 个。四张 RTX PRO 6000 显卡,每张显卡将约 30GB 的内存卸载到主机内存,在处理 32 流数据时每秒输出约 40 个标记,而从四个流开始,在长提示符下每秒输出约 9 到 10 个标记。这两个系统都无法让 433GB 型号感觉很快,但 GB300 的 396GB/s LPDDR5X 和 900GB/s NVLink-C2C 路径,对于卸载专家来说,其扩展能力在 PCIe 连接的主机内存通过四张卡达到极限时仍然能够继续提升。
与 MSI WS300 相比,ET900N G3 的前沿模型结果在我们能够比较的每个点上都相差不到 1%:在 DeepSeek V4 Flash 上,两个塔式机在 32 流下每秒输出 1,766 个令牌;在 MiniMax M2.7 上,128 流下每秒输出 4,793 个令牌,而 MSI WS300 为 4,801 个令牌;在 MiniMax M3 上,两个塔式机在 32 流下每秒输出 1,041 个令牌;在 GLM-5.2 上,两个塔式机在 32 流下每秒输出 139 个令牌。
与 RTX PRO 6000、H200 NVL 和 DGX Spark 共享型号
基准测试的后半部分使用了足够小的模型,以便所有系统都能运行:原生 MXFP4 模式下的 GPT-OSS-20B 和 120B;BF16 和 FP8 模式下的 Llama 3.1 8B;BF16 和 FP8 模式下的 Mistral Small 24B;以及 BF16 和 FP8 模式下的 Qwen3 Coder 30B。自 WS300 评测以来,新增了一块 H200 NVL,即 NVIDIA 的 141GB Hopper 显卡,这使得对比测试中出现了上一代数据中心加速器。
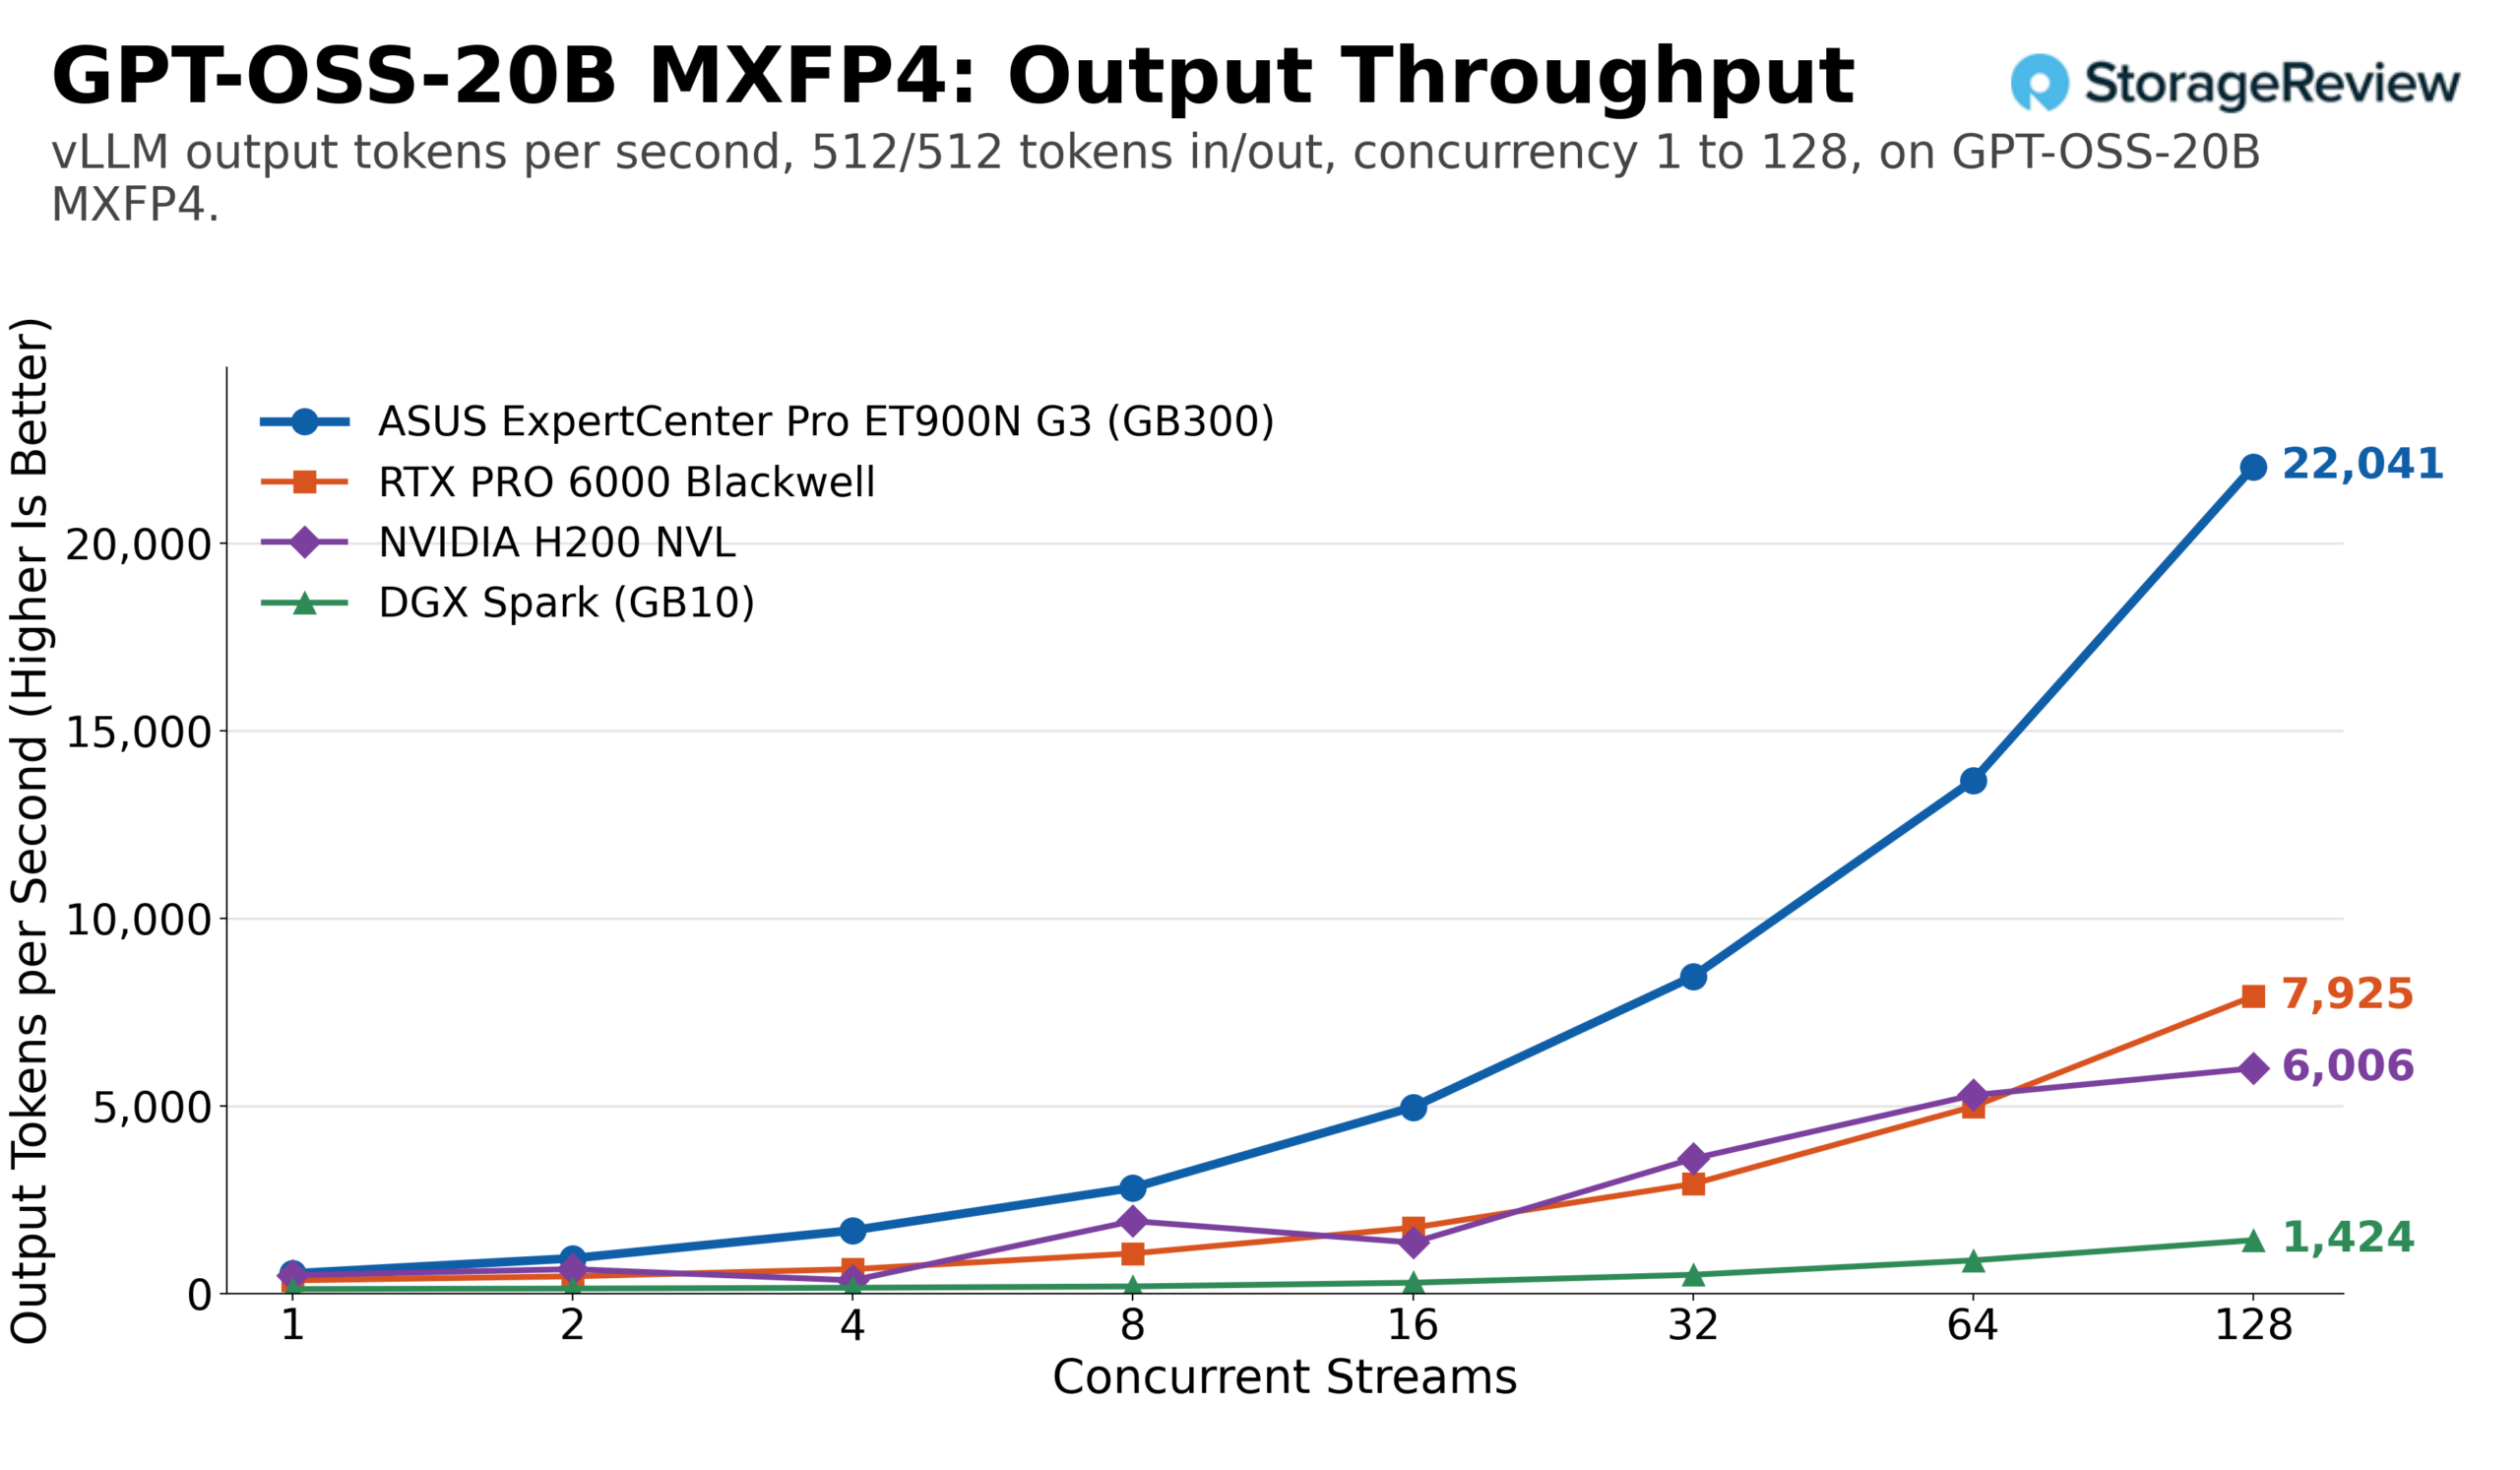
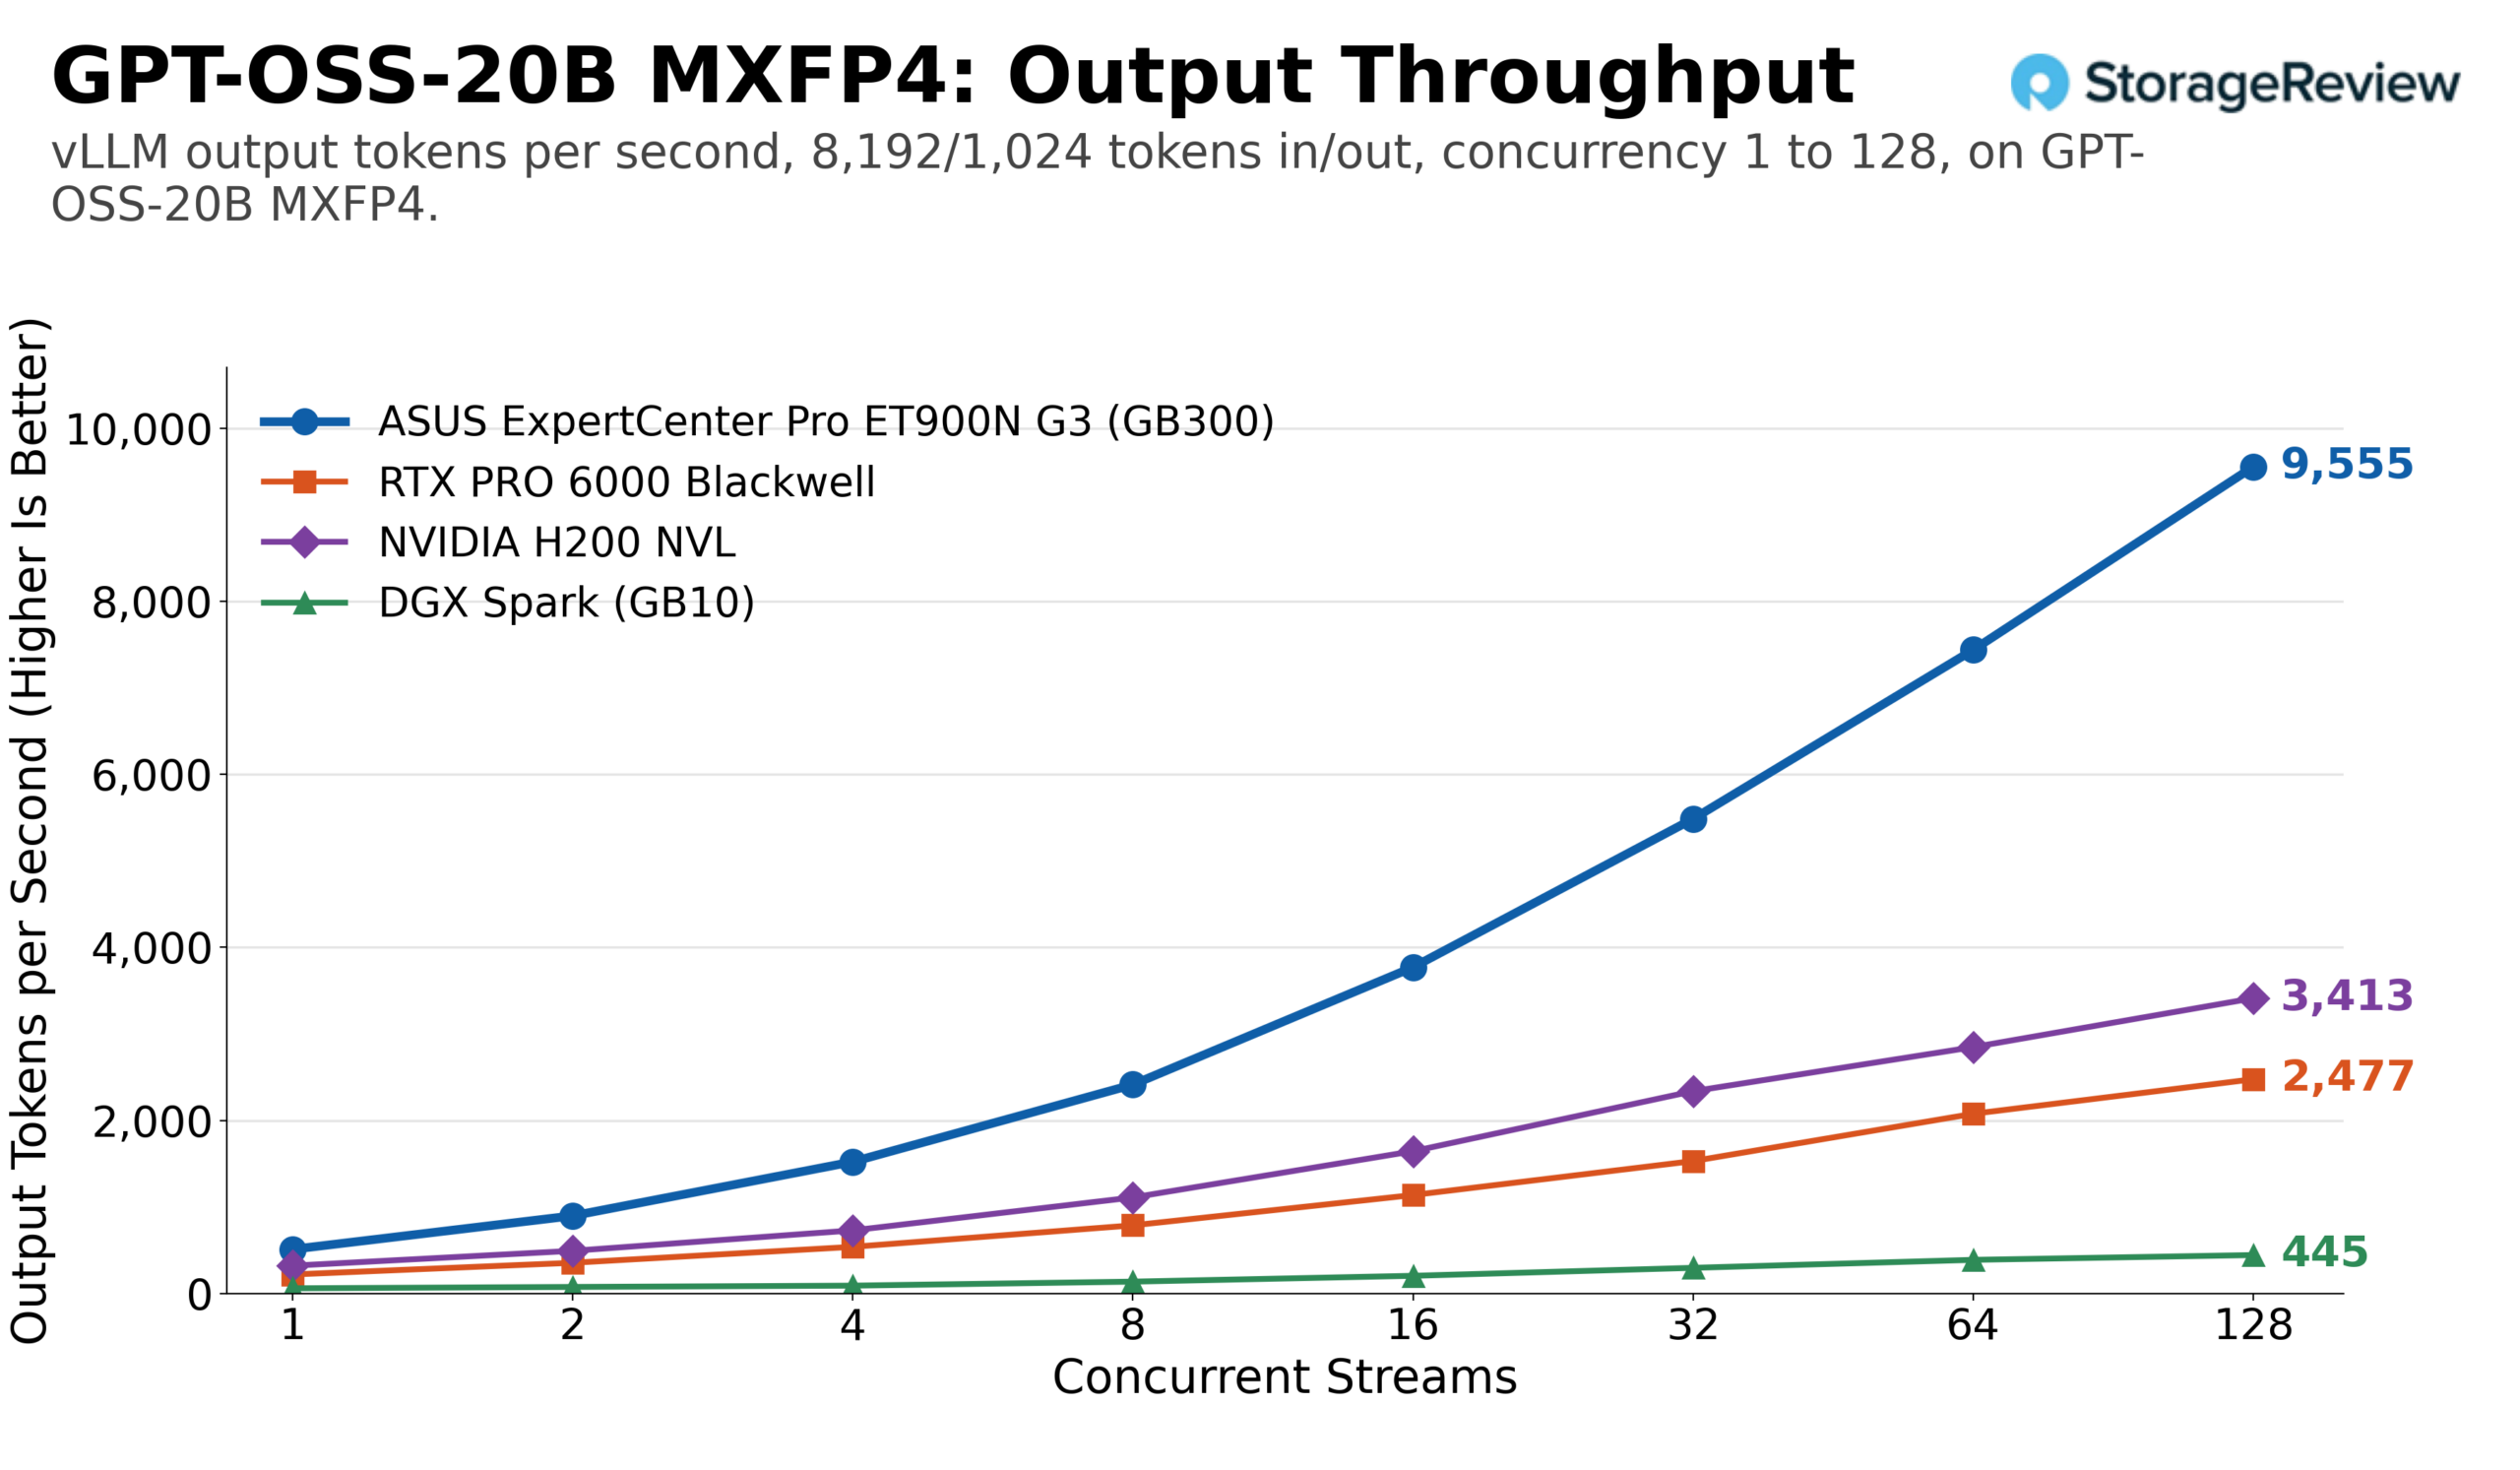
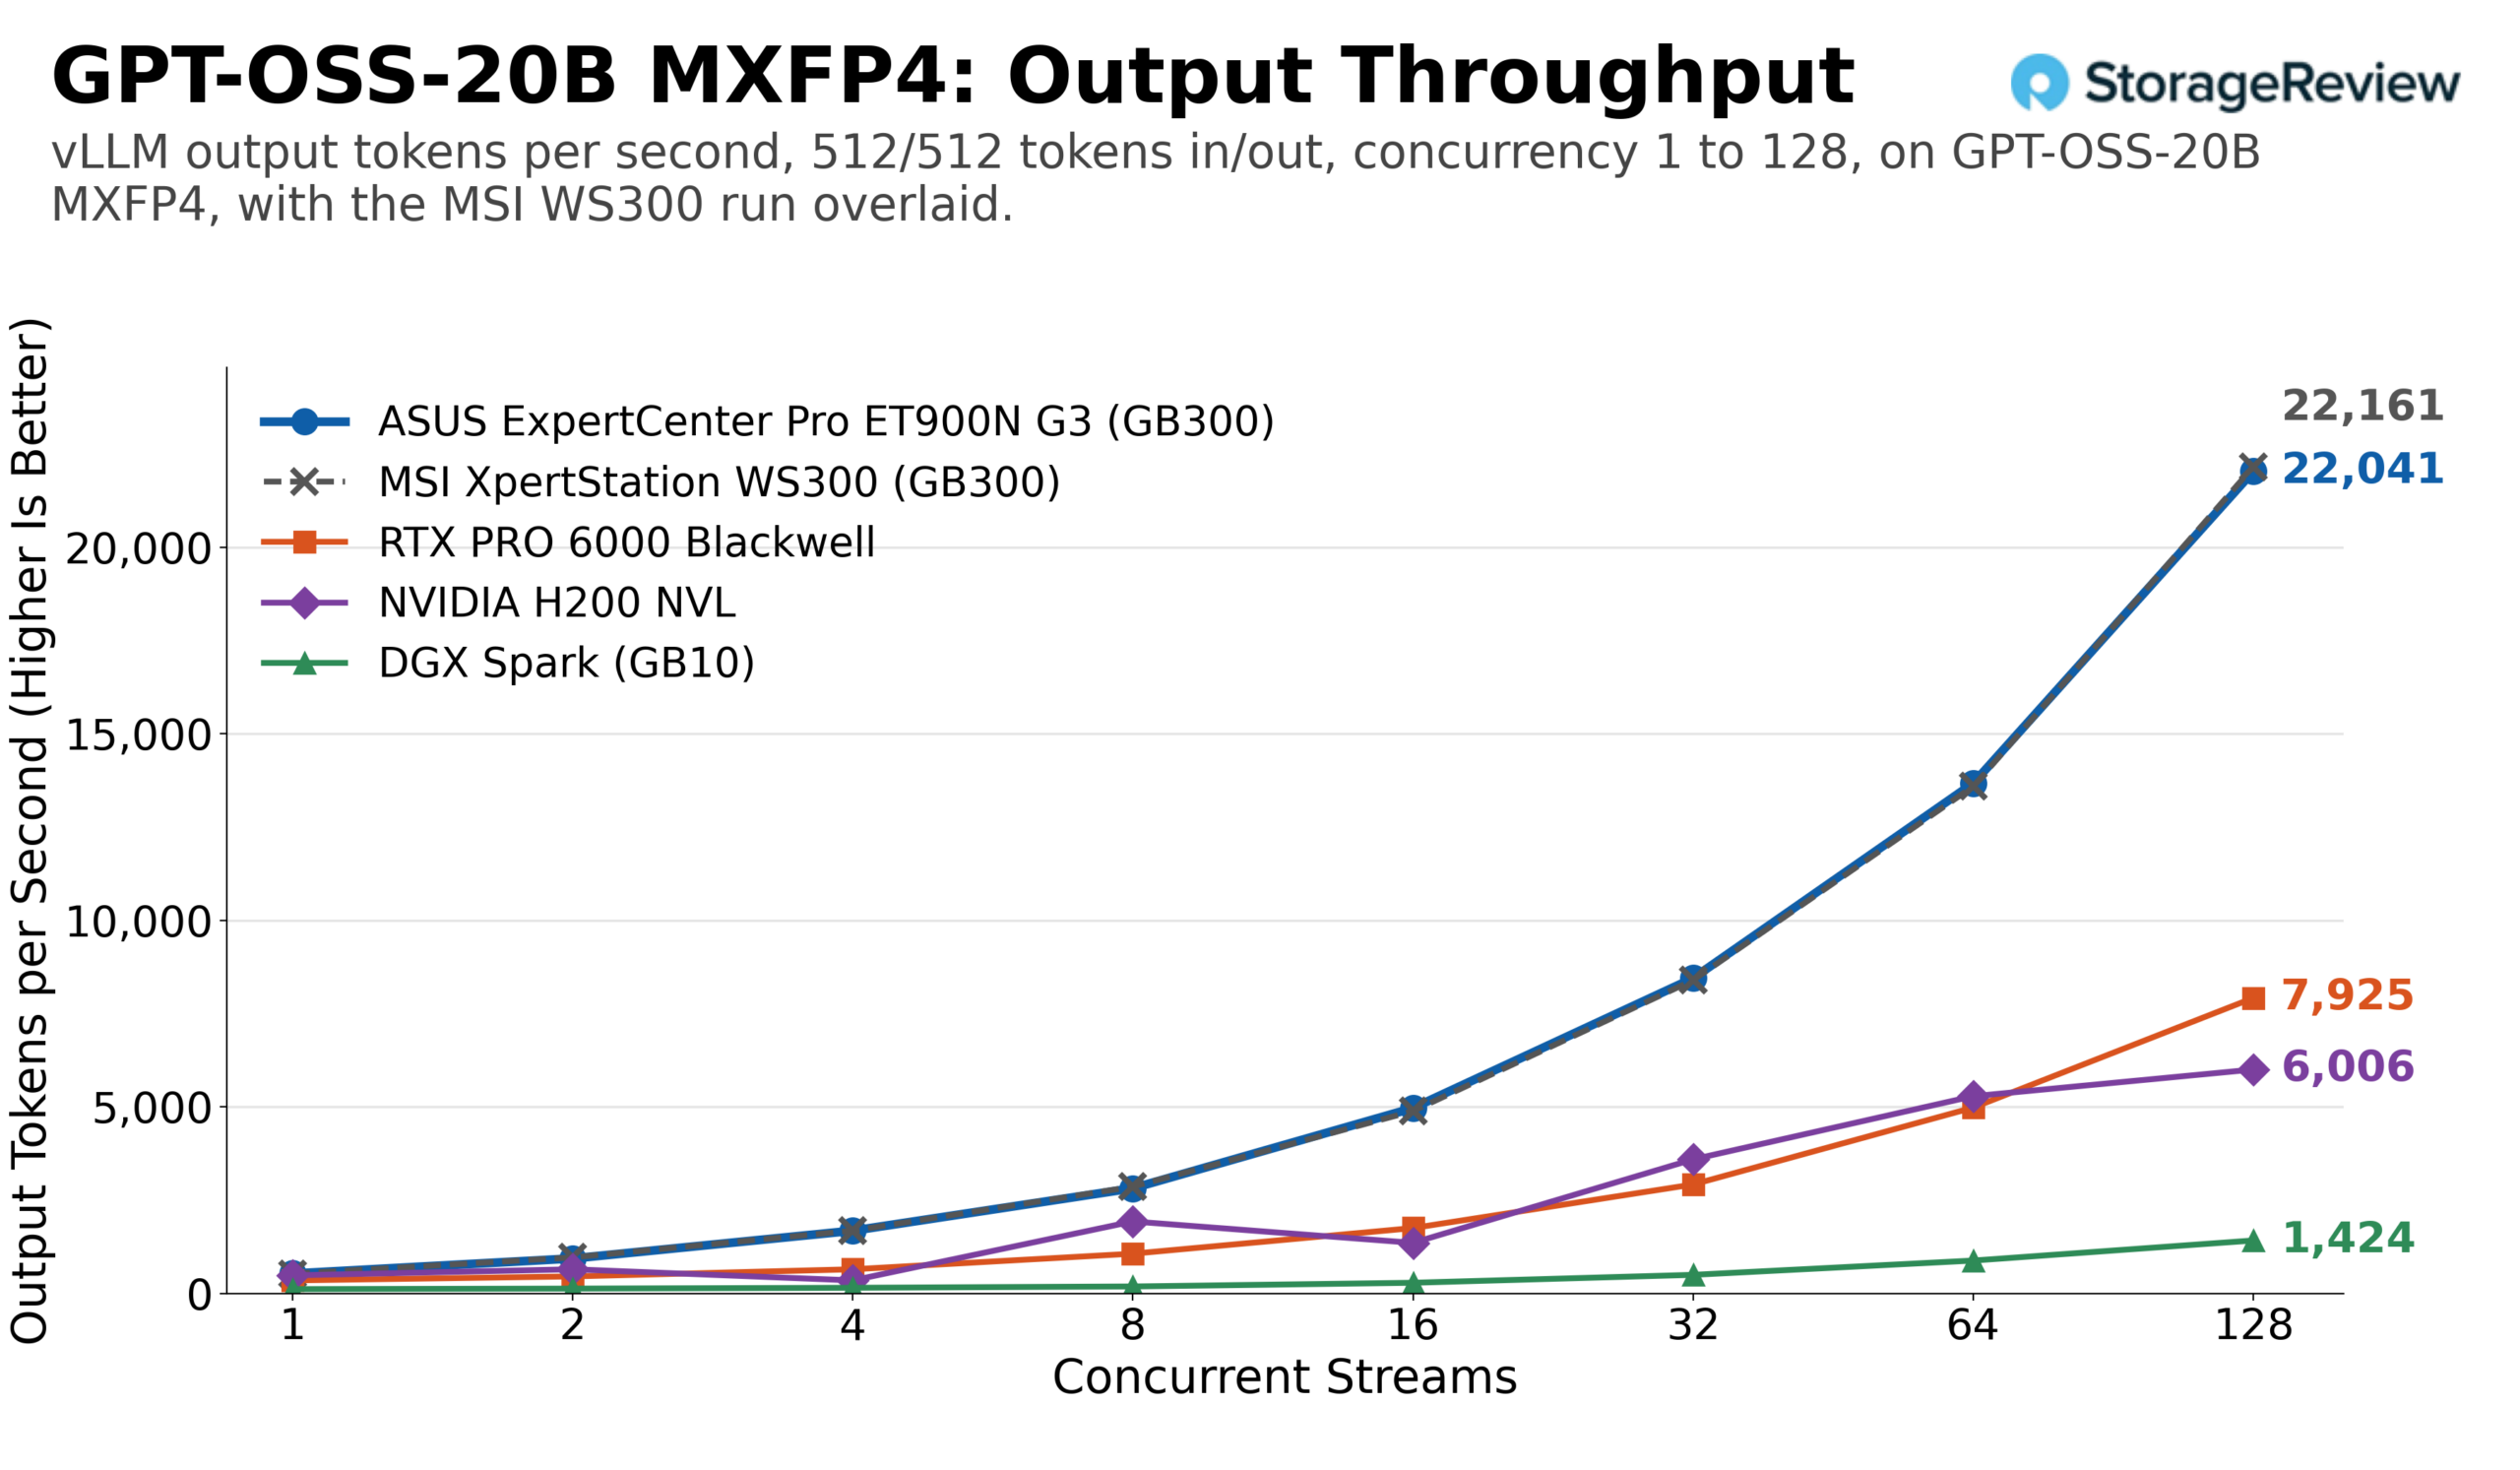
GPT-OSS-20B 是这组测试中最友好的,每个系统都能轻松通过。在相同的工作负载下,ET900N G3 在 128 个流下每秒输出 22,041 个令牌,总共 44,082 个令牌,而 RTX PRO 6000 约为 7,920 个令牌,H200 NVL 约为 6,010 个令牌,DGX Spark 约为 1,420 个令牌。在单流模式下,Station 每秒可产生 536 个输出令牌,而显卡为 354 个,H200 为 489 个,Spark 为 120 个。预填充密集型配置文件进一步拉大了差距:Station 在 128 个流下每秒可产生 9,555 个输出令牌,总共 85,994 个,而 RTX PRO 6000 约为 2,480 个,H200 NVL 为 3,410 个,Spark 为 445 个。
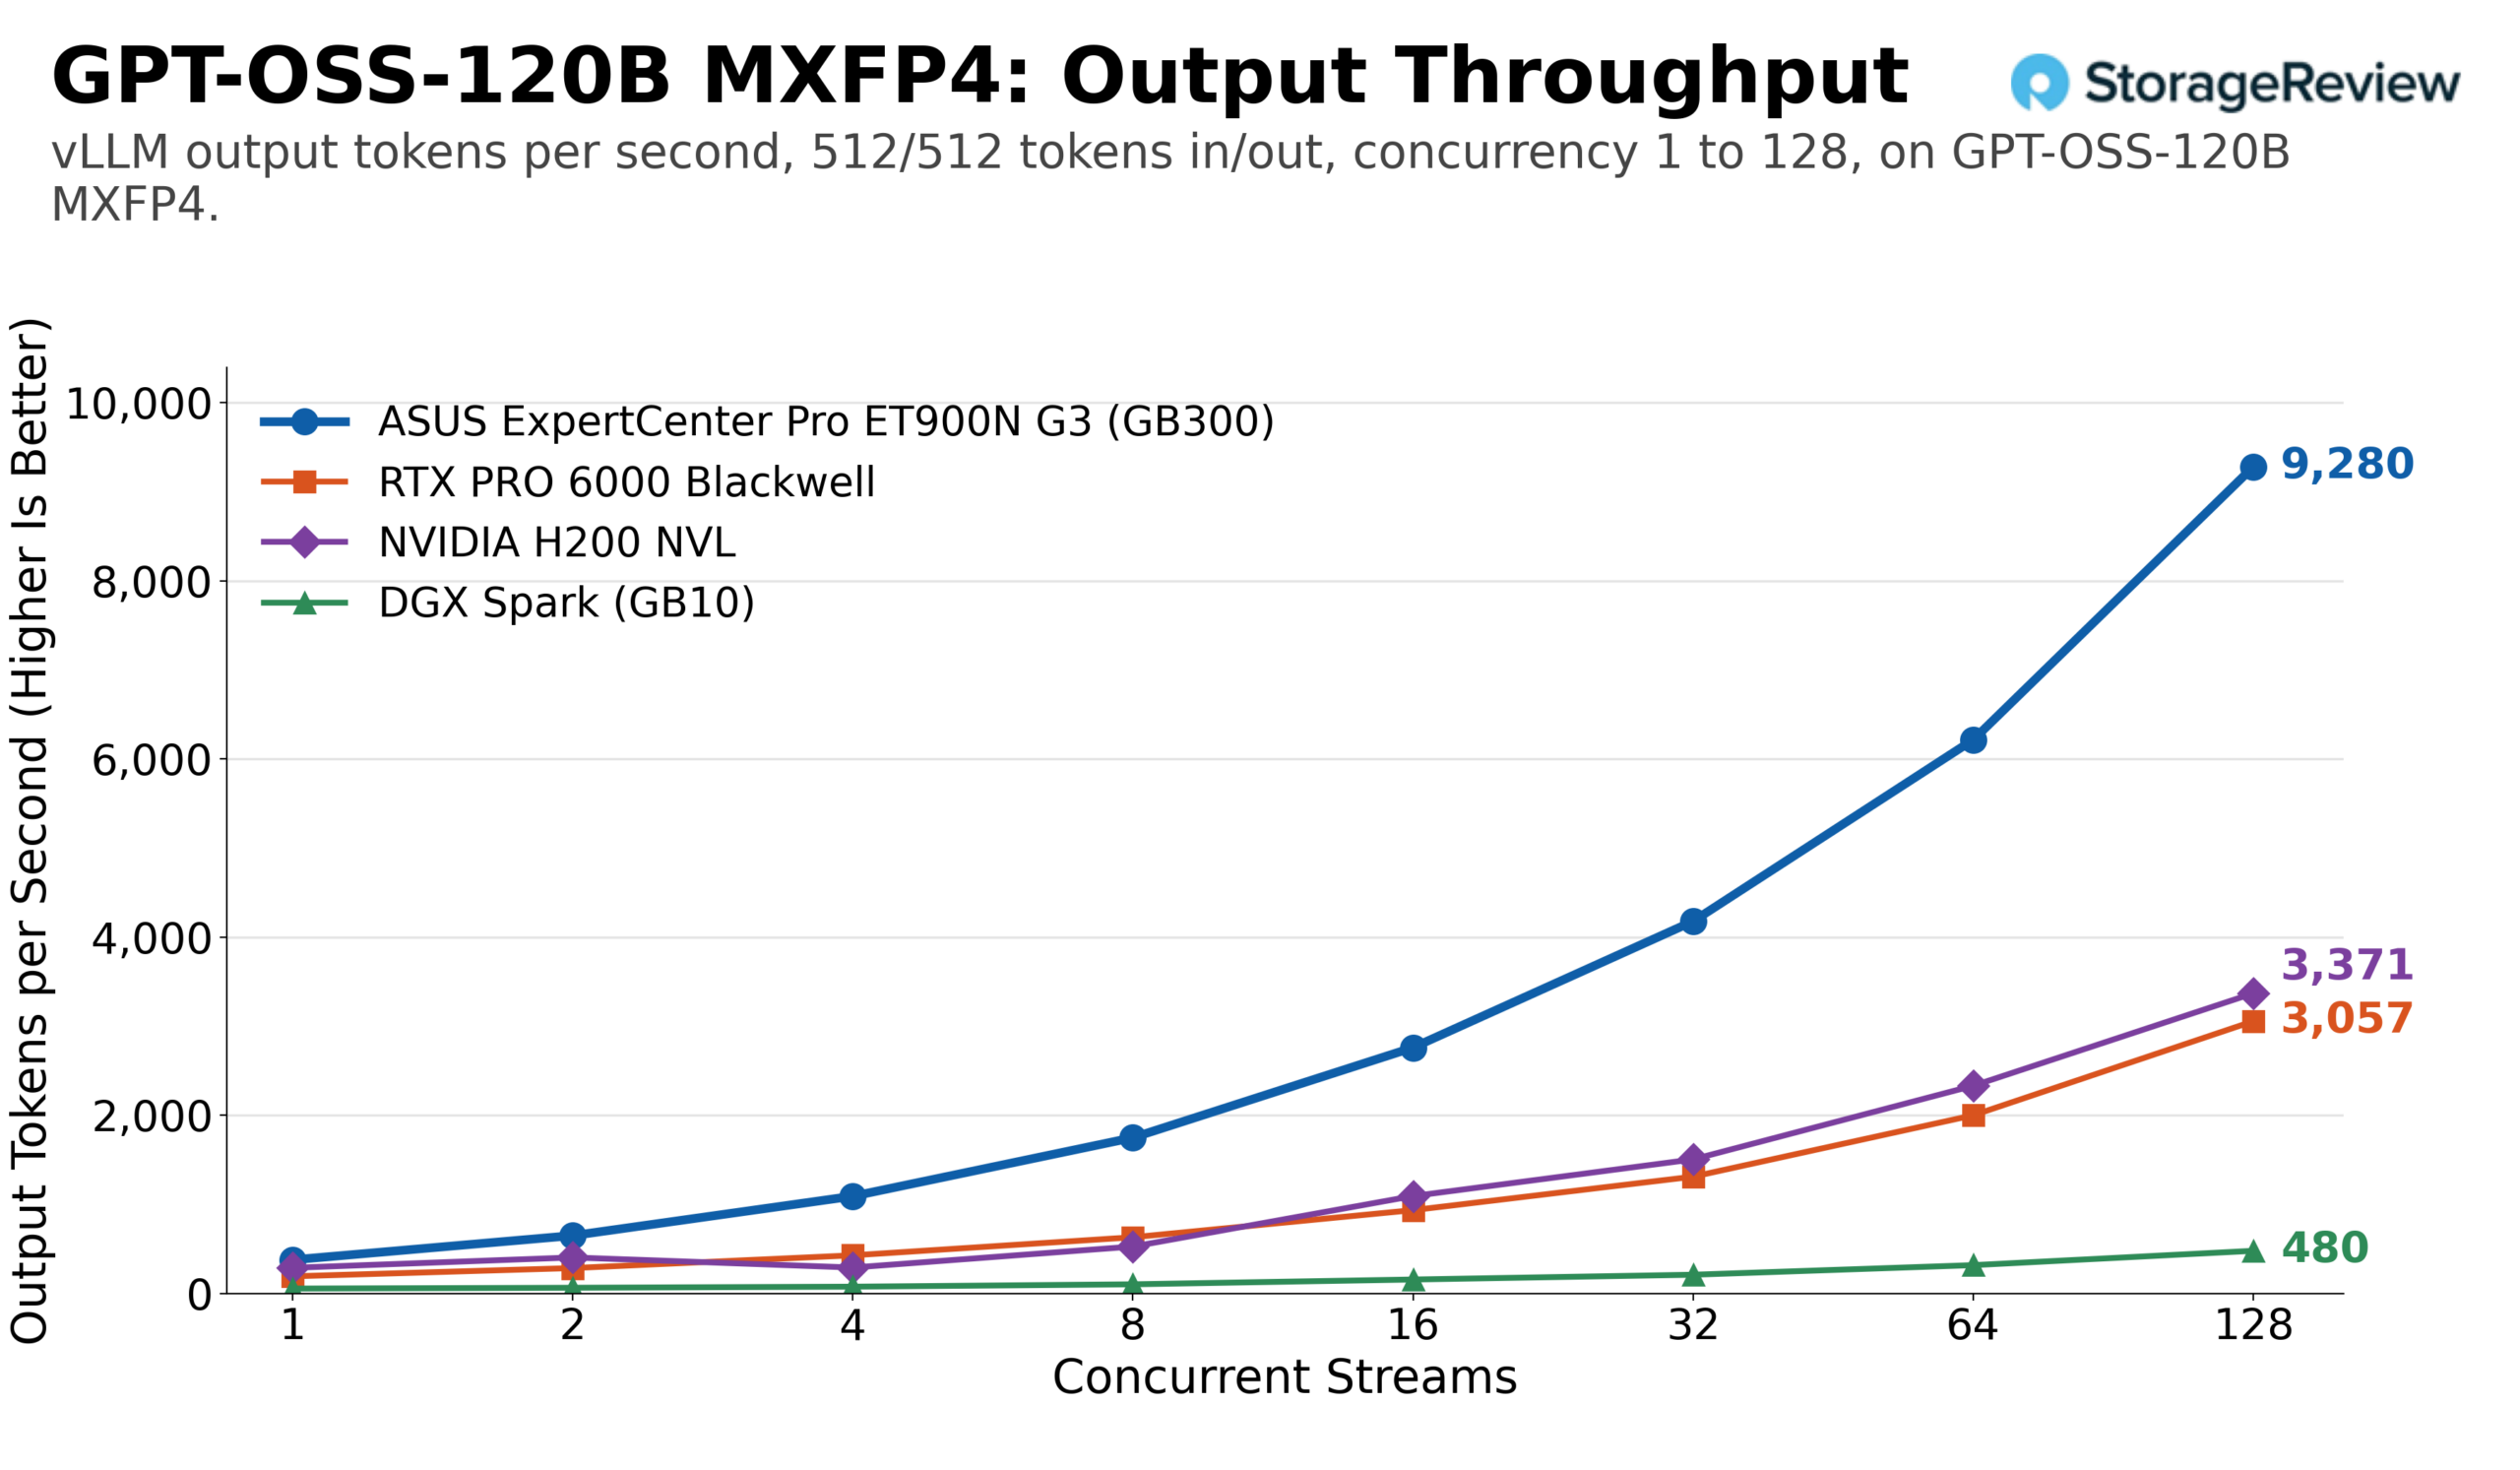
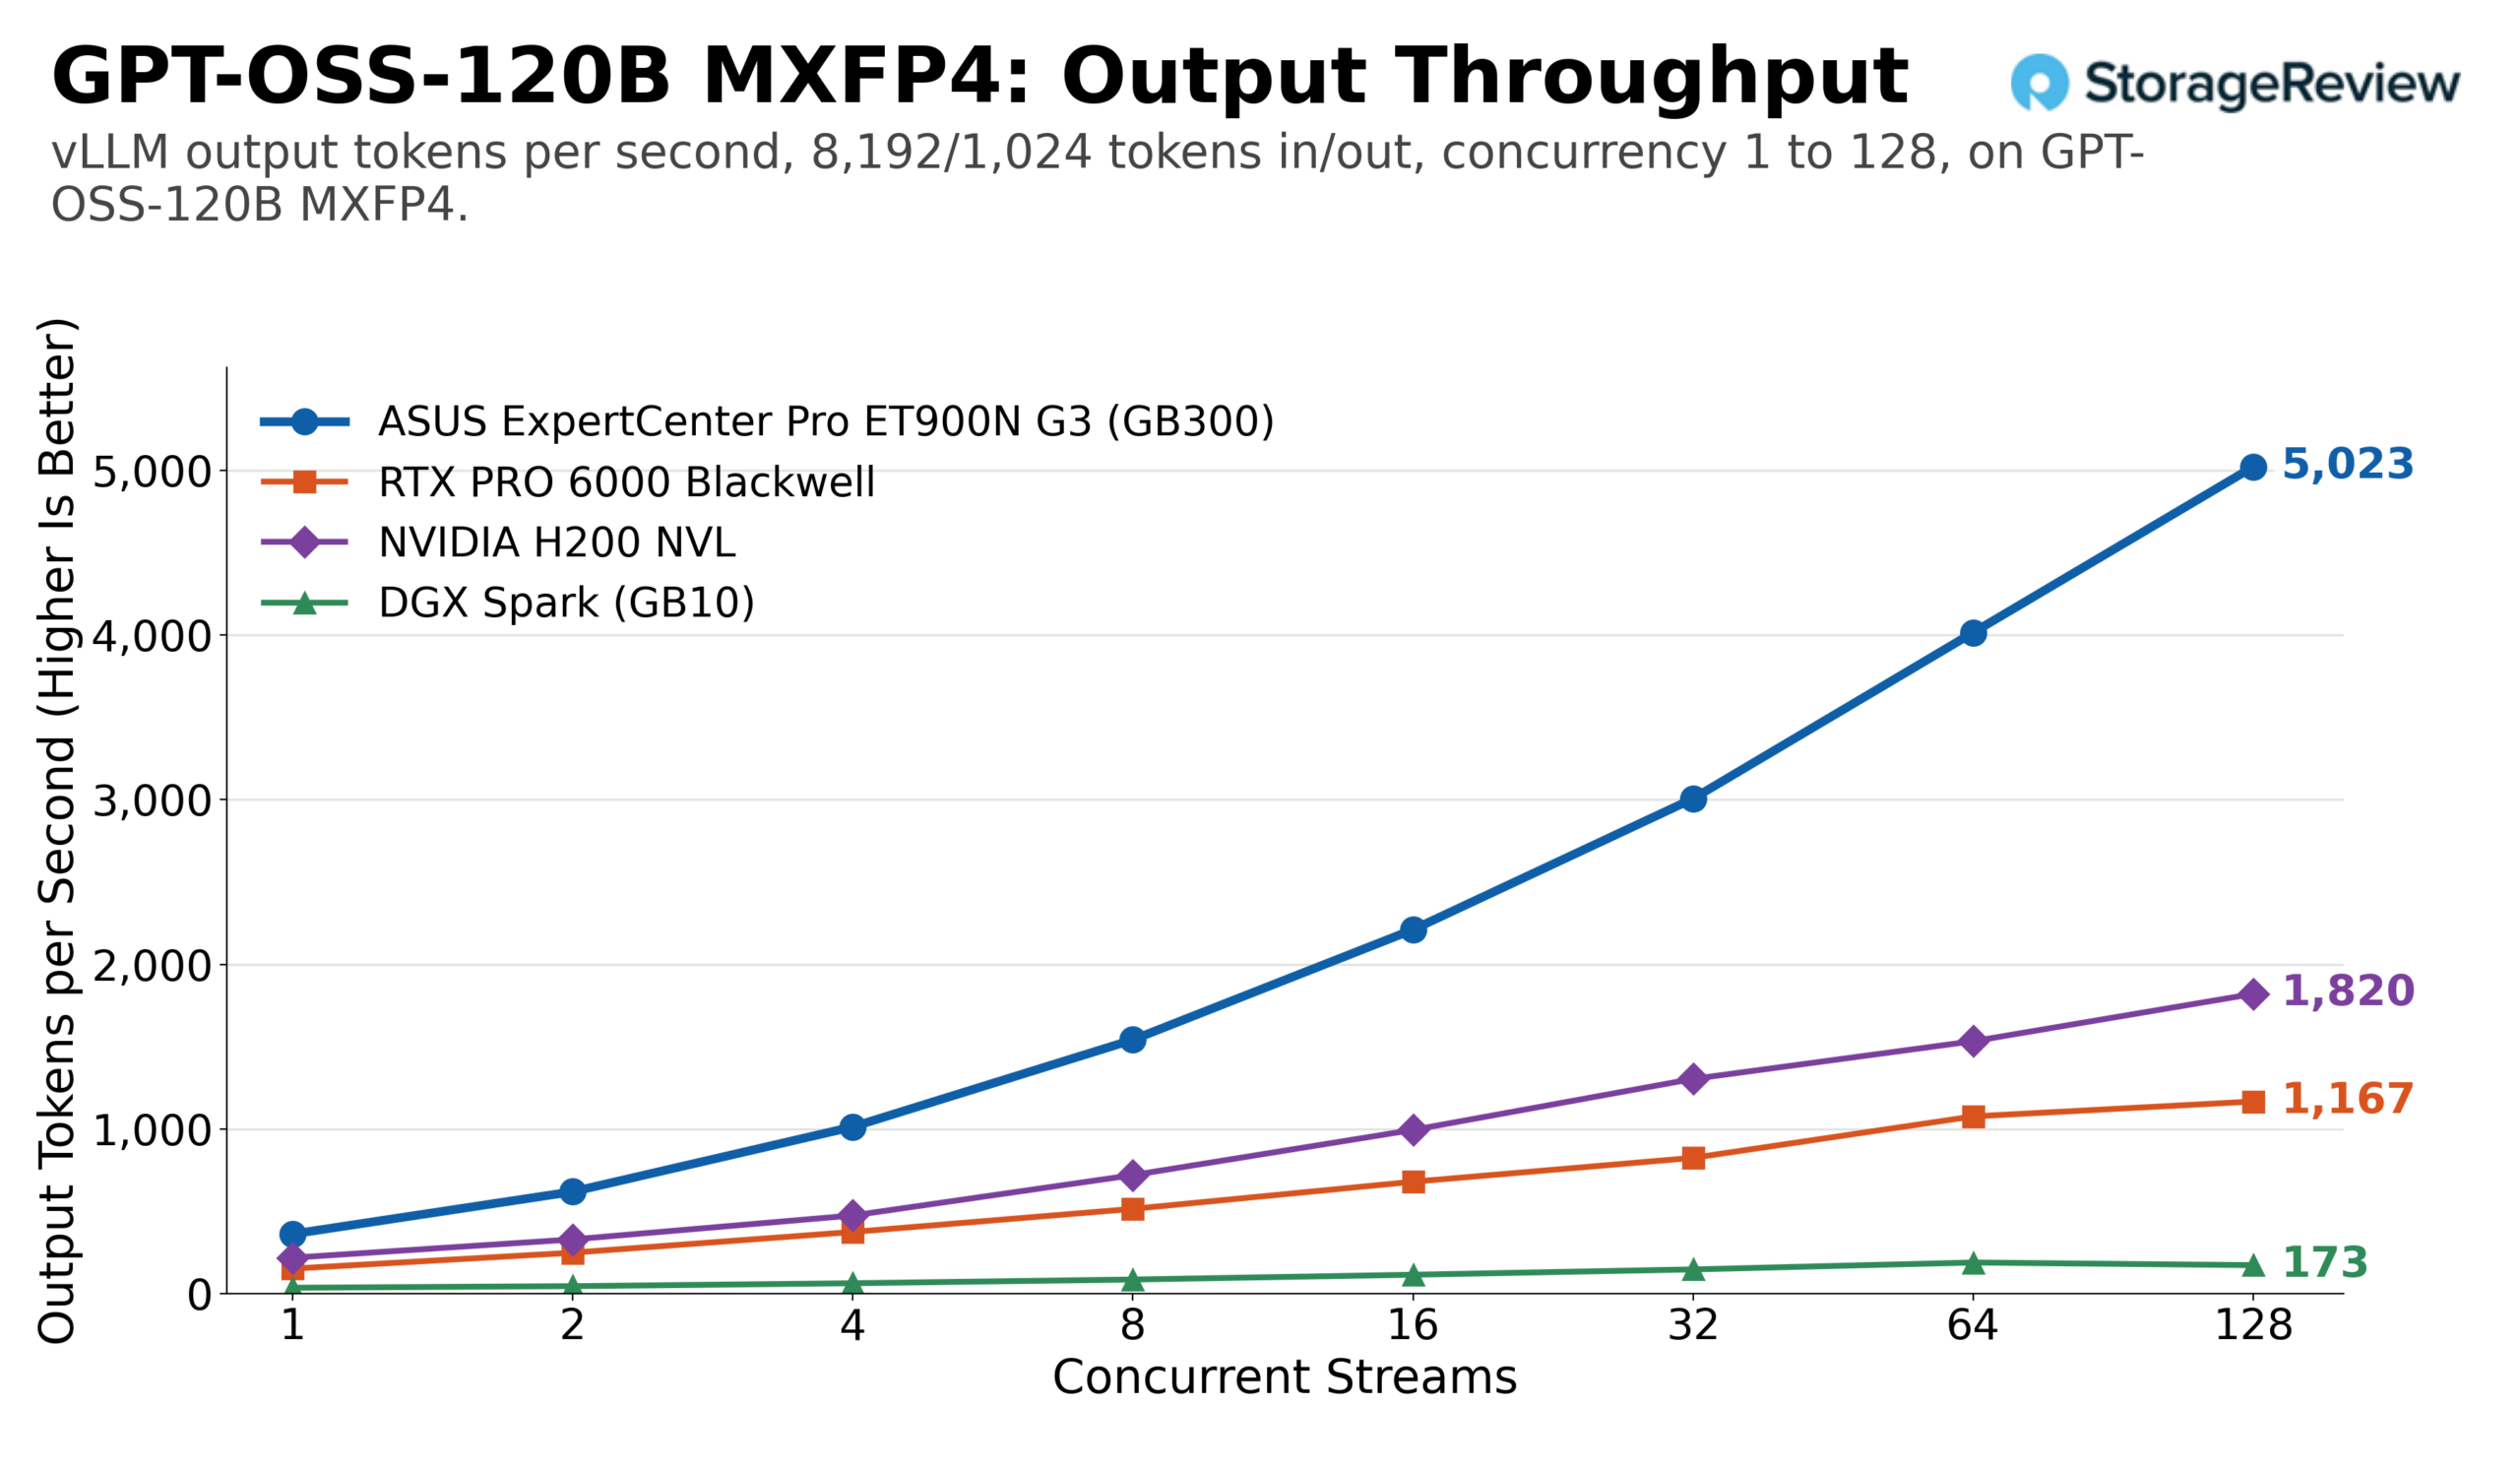
GPT-OSS-120B 是内存性能开始展现优势的起点。在相同的工作负载下,ET900N G3 在 128 个流的负载下达到了每秒 9,280 个输出令牌,大约是 RTX PRO 6000(3,060 个)的三倍,H200 NVL(3,370 个)的 2.8 倍,以及 Spark(480 个)的 19 倍以上。在长时间提示的情况下,较小的系统很快就耗尽了键值缓存空间:RTX PRO 6000 的输出令牌最高约为每秒 1,170 个,H200 NVL 接近每秒 1,820 个,而 Station 在 128 个流的负载下仍在持续提升,最终达到了每秒 5,023 个,总吞吐量为每秒 45,205 个令牌。
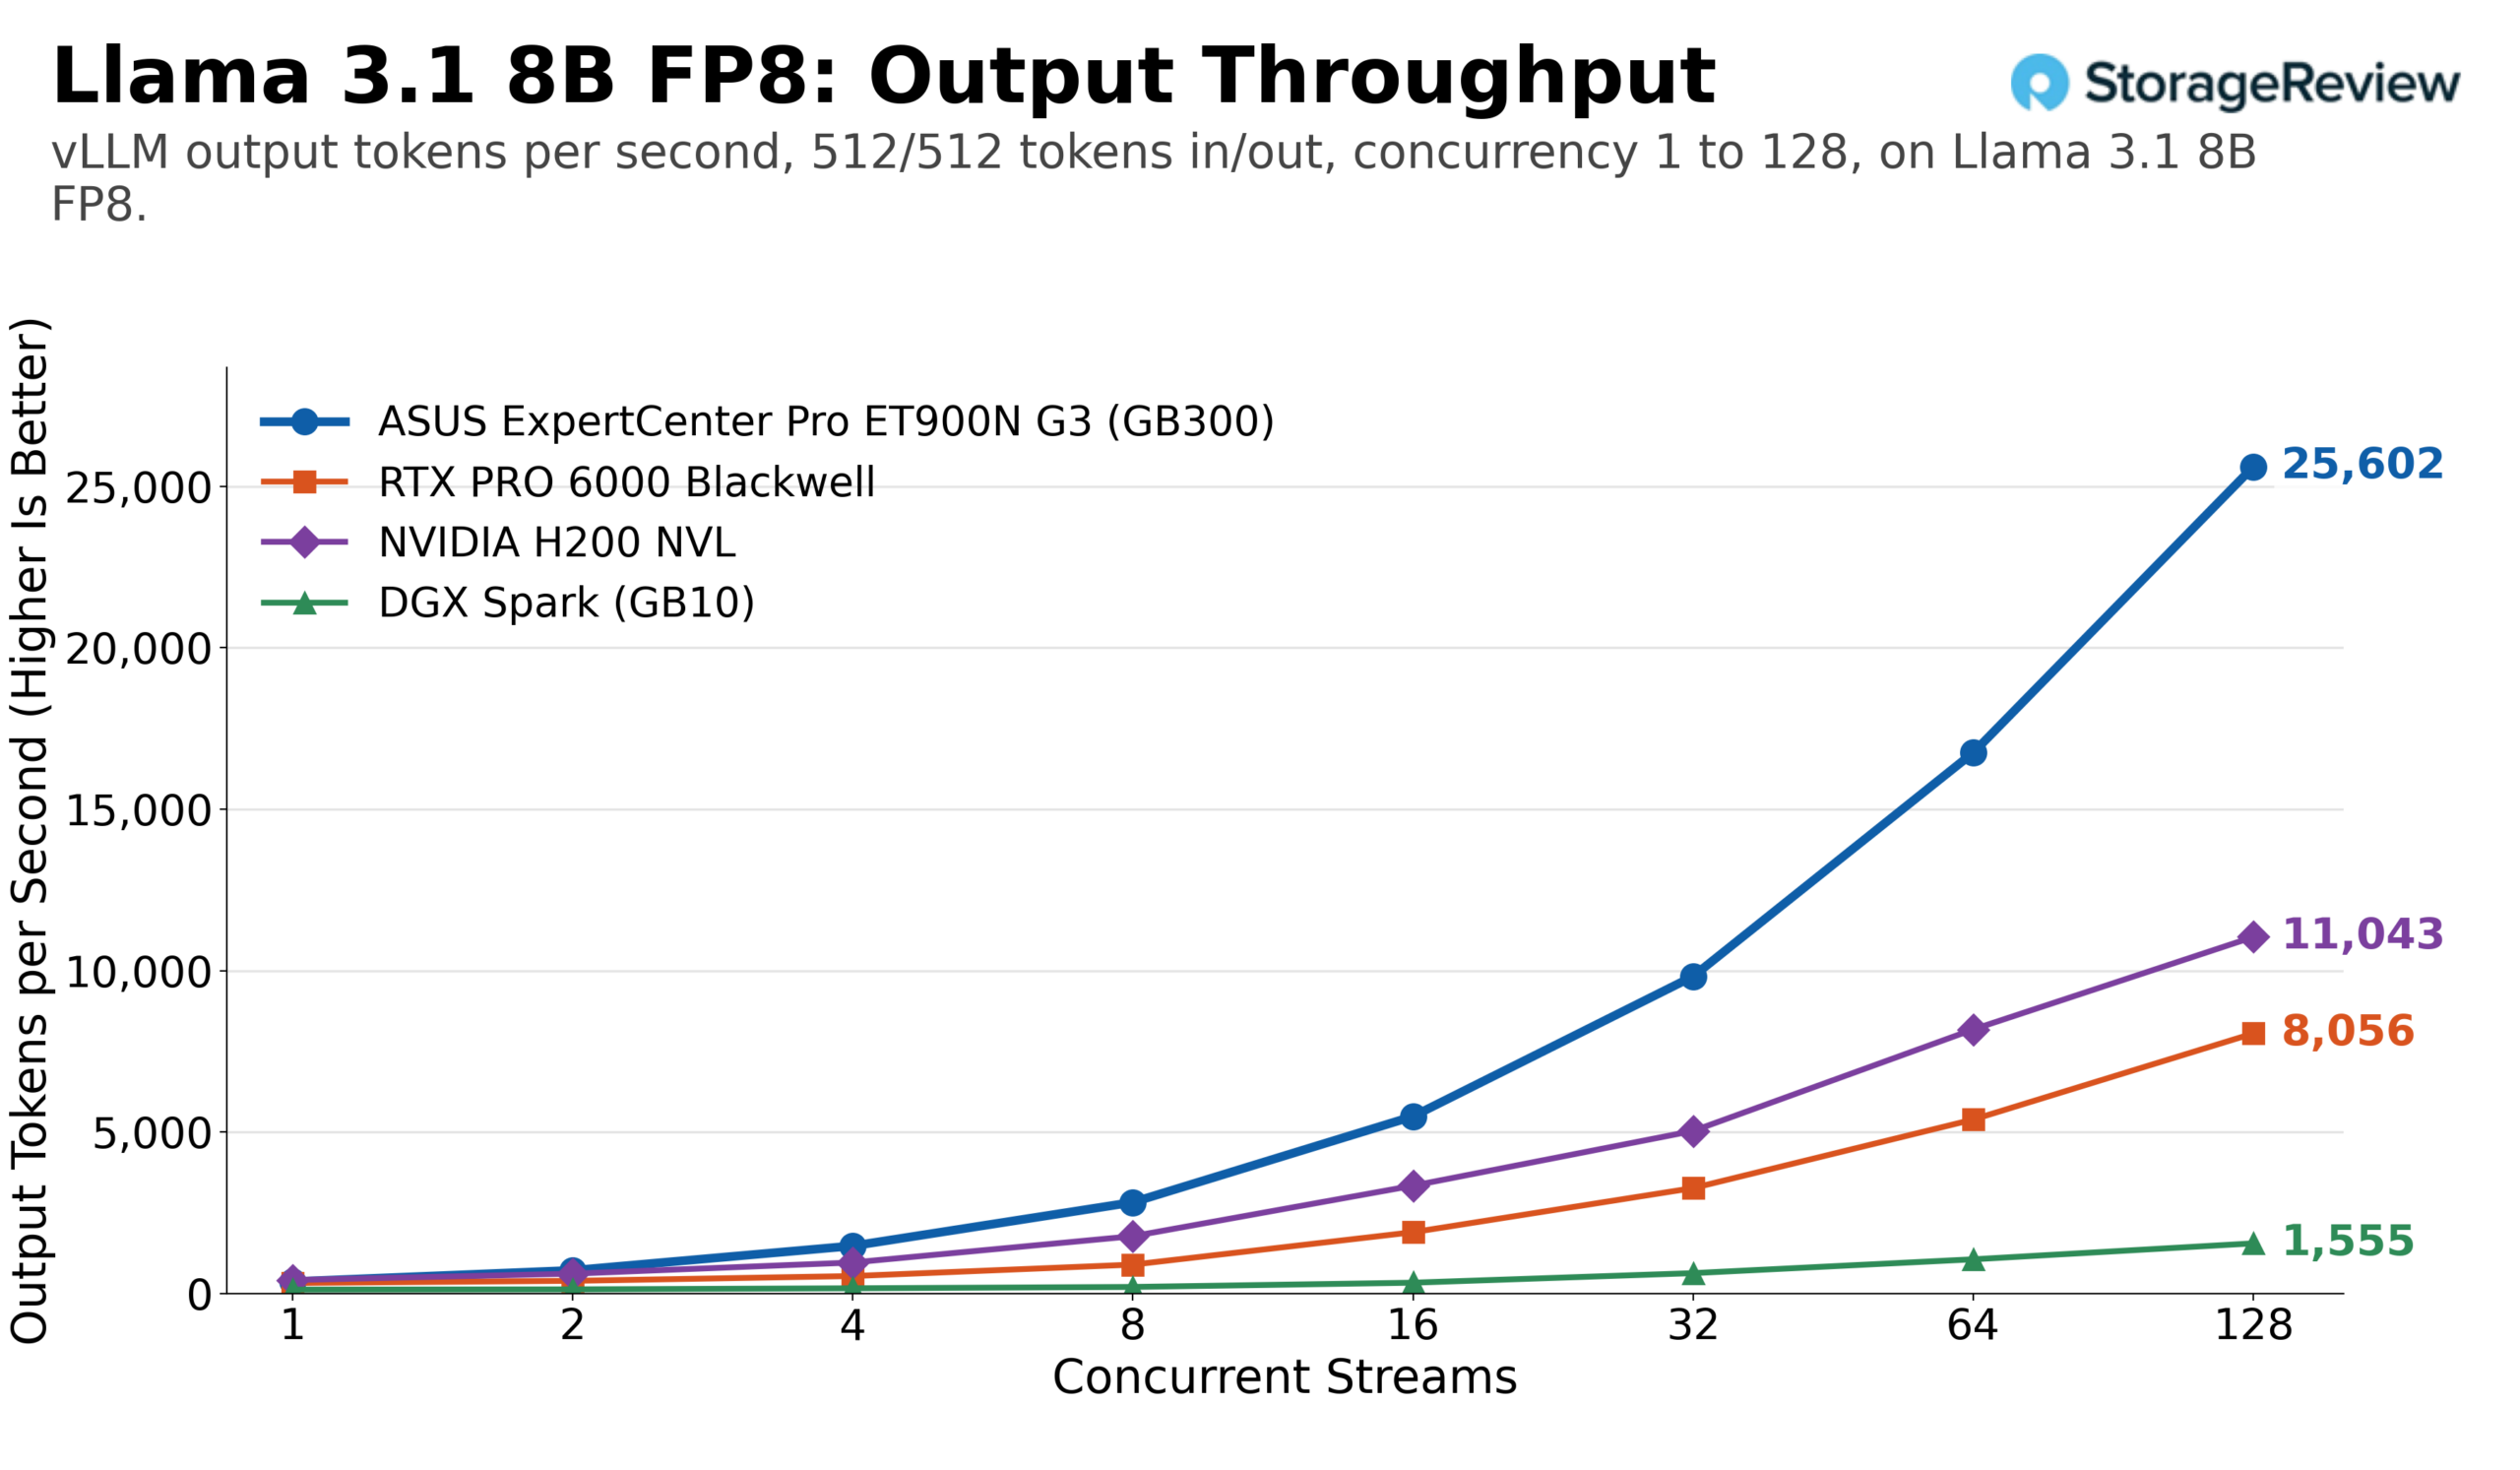
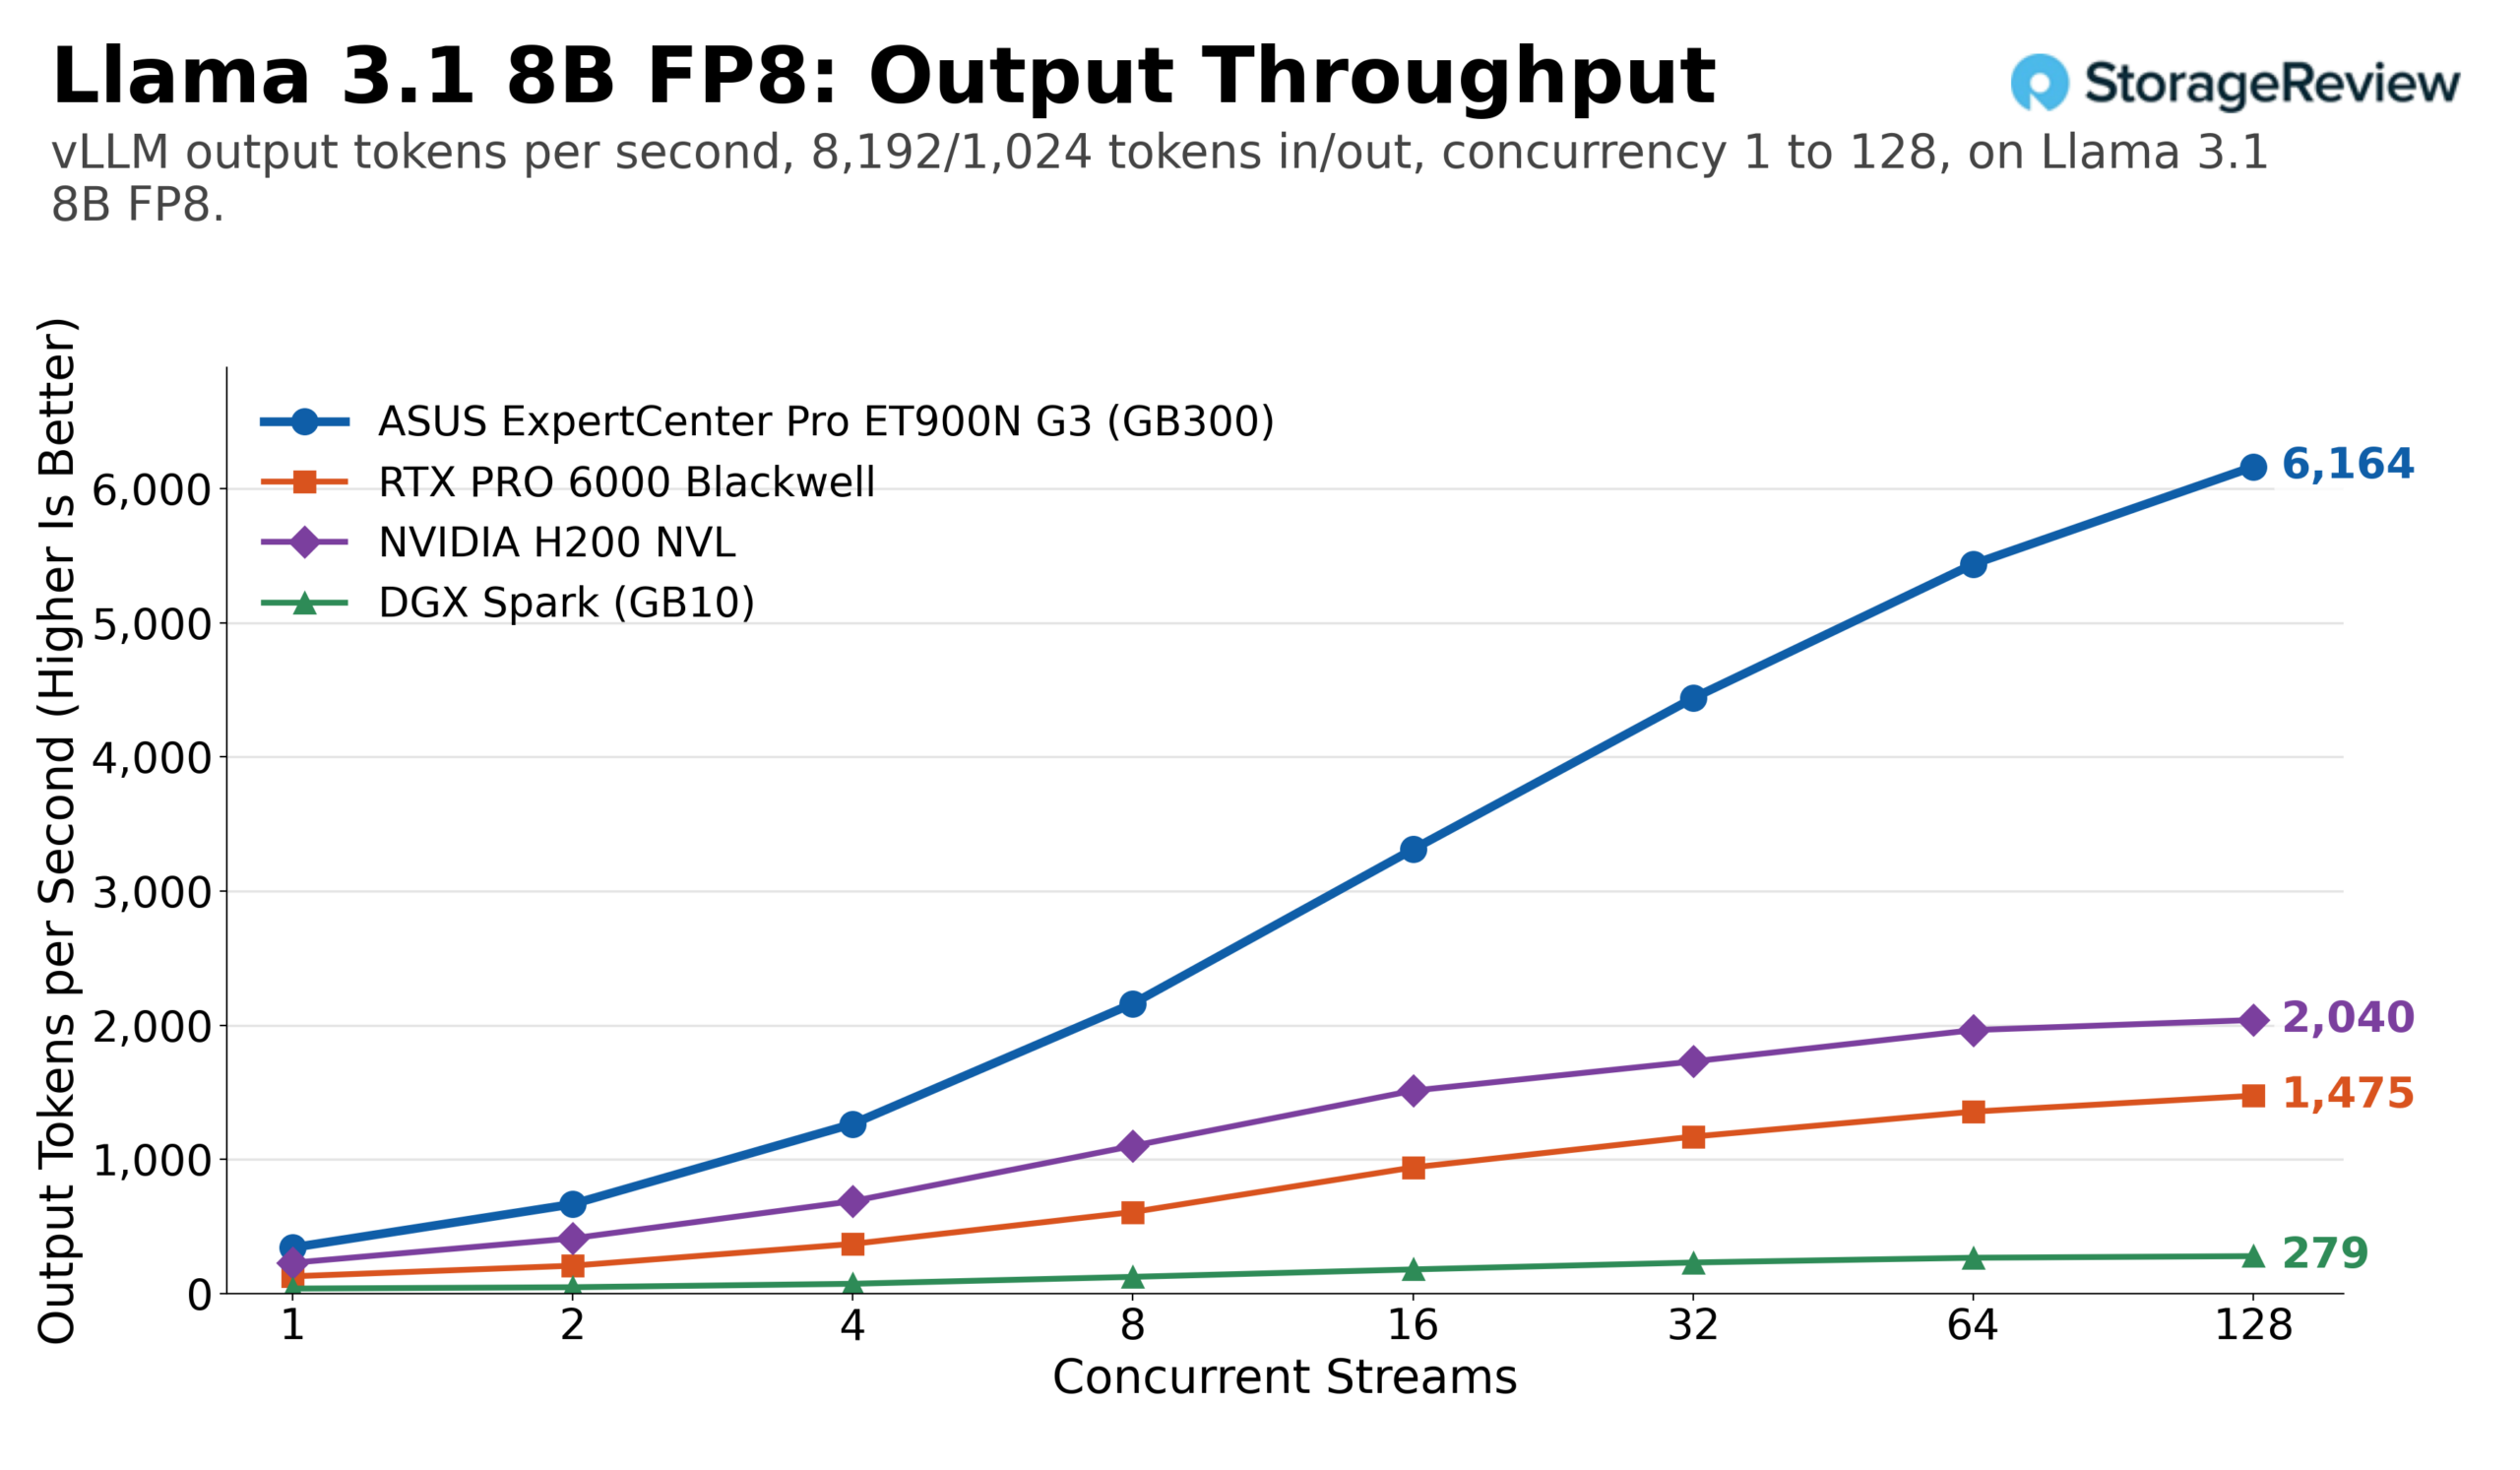
Llama 3.1 8B 在 FP8 模式下是该组测试中单项数值最高的。在相同工作负载下,ET900N G3 在 128 个流上每秒输出 25,602 个令牌,总计 51,205 个令牌,而 RTX PRO 6000 和 H200 NVL 的输出令牌数分别为约 8,060 个和 11,040 个。从 BF16 模式降至 FP8 模式后,Station 的性能提升了约 50%(从 17,074 个令牌提升至 25,602 个令牌),RTX PRO 6000 的性能提升了约 70%,H200 NVL 的性能提升了约 37%。预填充密集型配置文件压缩了所有数据,Station 的输出令牌数为每秒 6,164 个令牌,显卡为每秒 1,480 个令牌,H200 为每秒 2,040 个令牌。
Mistral Small 24B 在 FP8 模式下表现出最宽的性能比。在相同工作负载下,ET900N G3 的峰值输出令牌数达到每秒 11,075 个,是 RTX PRO 6000(3,240 个)的 3.4 倍,是 H200 NVL(4,610 个)的 2.4 倍,几乎是 Spark(559 个)的 20 倍。在长时间的提示符处理下,RTX PRO 6000 的峰值输出令牌数达到 32 个流,约为每秒 480 个;H200 NVL 的峰值输出令牌数约为每秒 854 个;Station 的峰值输出令牌数为每秒 2,302 个,流数为 128 个。


Qwen3 Coder 30B 是一款混合专家模型,其活动参数数量较少,在该模型中,单流性能差距缩小。在相同工作负载下,单流模式下,RTX PRO 6000 的输出速度约为每秒 232 个输出令牌,而 Station 为 319 个,H200 NVL 为 308 个。批量处理后,性能排名恢复正常:在 128 个流的情况下,ET900N G3 在 FP8 模式下达到了每秒 12,439 个输出令牌,是 Station(3,990 个)的 3.1 倍,是 H200 NVL(7,450 个)的 1.7 倍。在预填充较多的场景下,Station 达到了每秒 3,837 个输出令牌,而 RTX PRO 6000 在 64 个流下峰值约为每秒 880 个,H200 NVL 约为每秒 1,820 个。


在所有共享型号中,ET900N G3 的性能是单张 RTX PRO 6000 的 2.8 到 3.4 倍,是 H200 NVL 的 1.7 到 3.7 倍(满并发运行),并且在长时间提示下,由于键值缓存空间耗尽,其性能优势会进一步扩大。与 WS300 相比,这四款显卡的性能差距同样在 1% 以内:在 GPT-OSS-20B 上分别为 22,041 和 22,161,在 GPT-OSS-120B 上分别为 9,280 和 9,294,在 Mistral Small FP8 上分别为 11,075 和 11,157,在 Qwen3 Coder FP8 上分别为 12,439 和 12,425。包含性能差距较大的三款显卡在内的完整 14 款显卡对比将在下一节中呈现。
双塔机箱,同一底板:华硕 ET900N G3 对比 微星 WS300
ET900N G3 和 MSI XpertStation WS300 均采用相同的 NVIDIA GB300 DGX Station 主板,只是机箱不同。两款产品均在相同的 vLLM 版本上进行了相同的 14 种模型、相同的两种工作负载以及相同的并发测试。下图对比了 ET900N G3 在所有模型下的峰值输出吞吐量与 WS300 的峰值输出吞吐量。
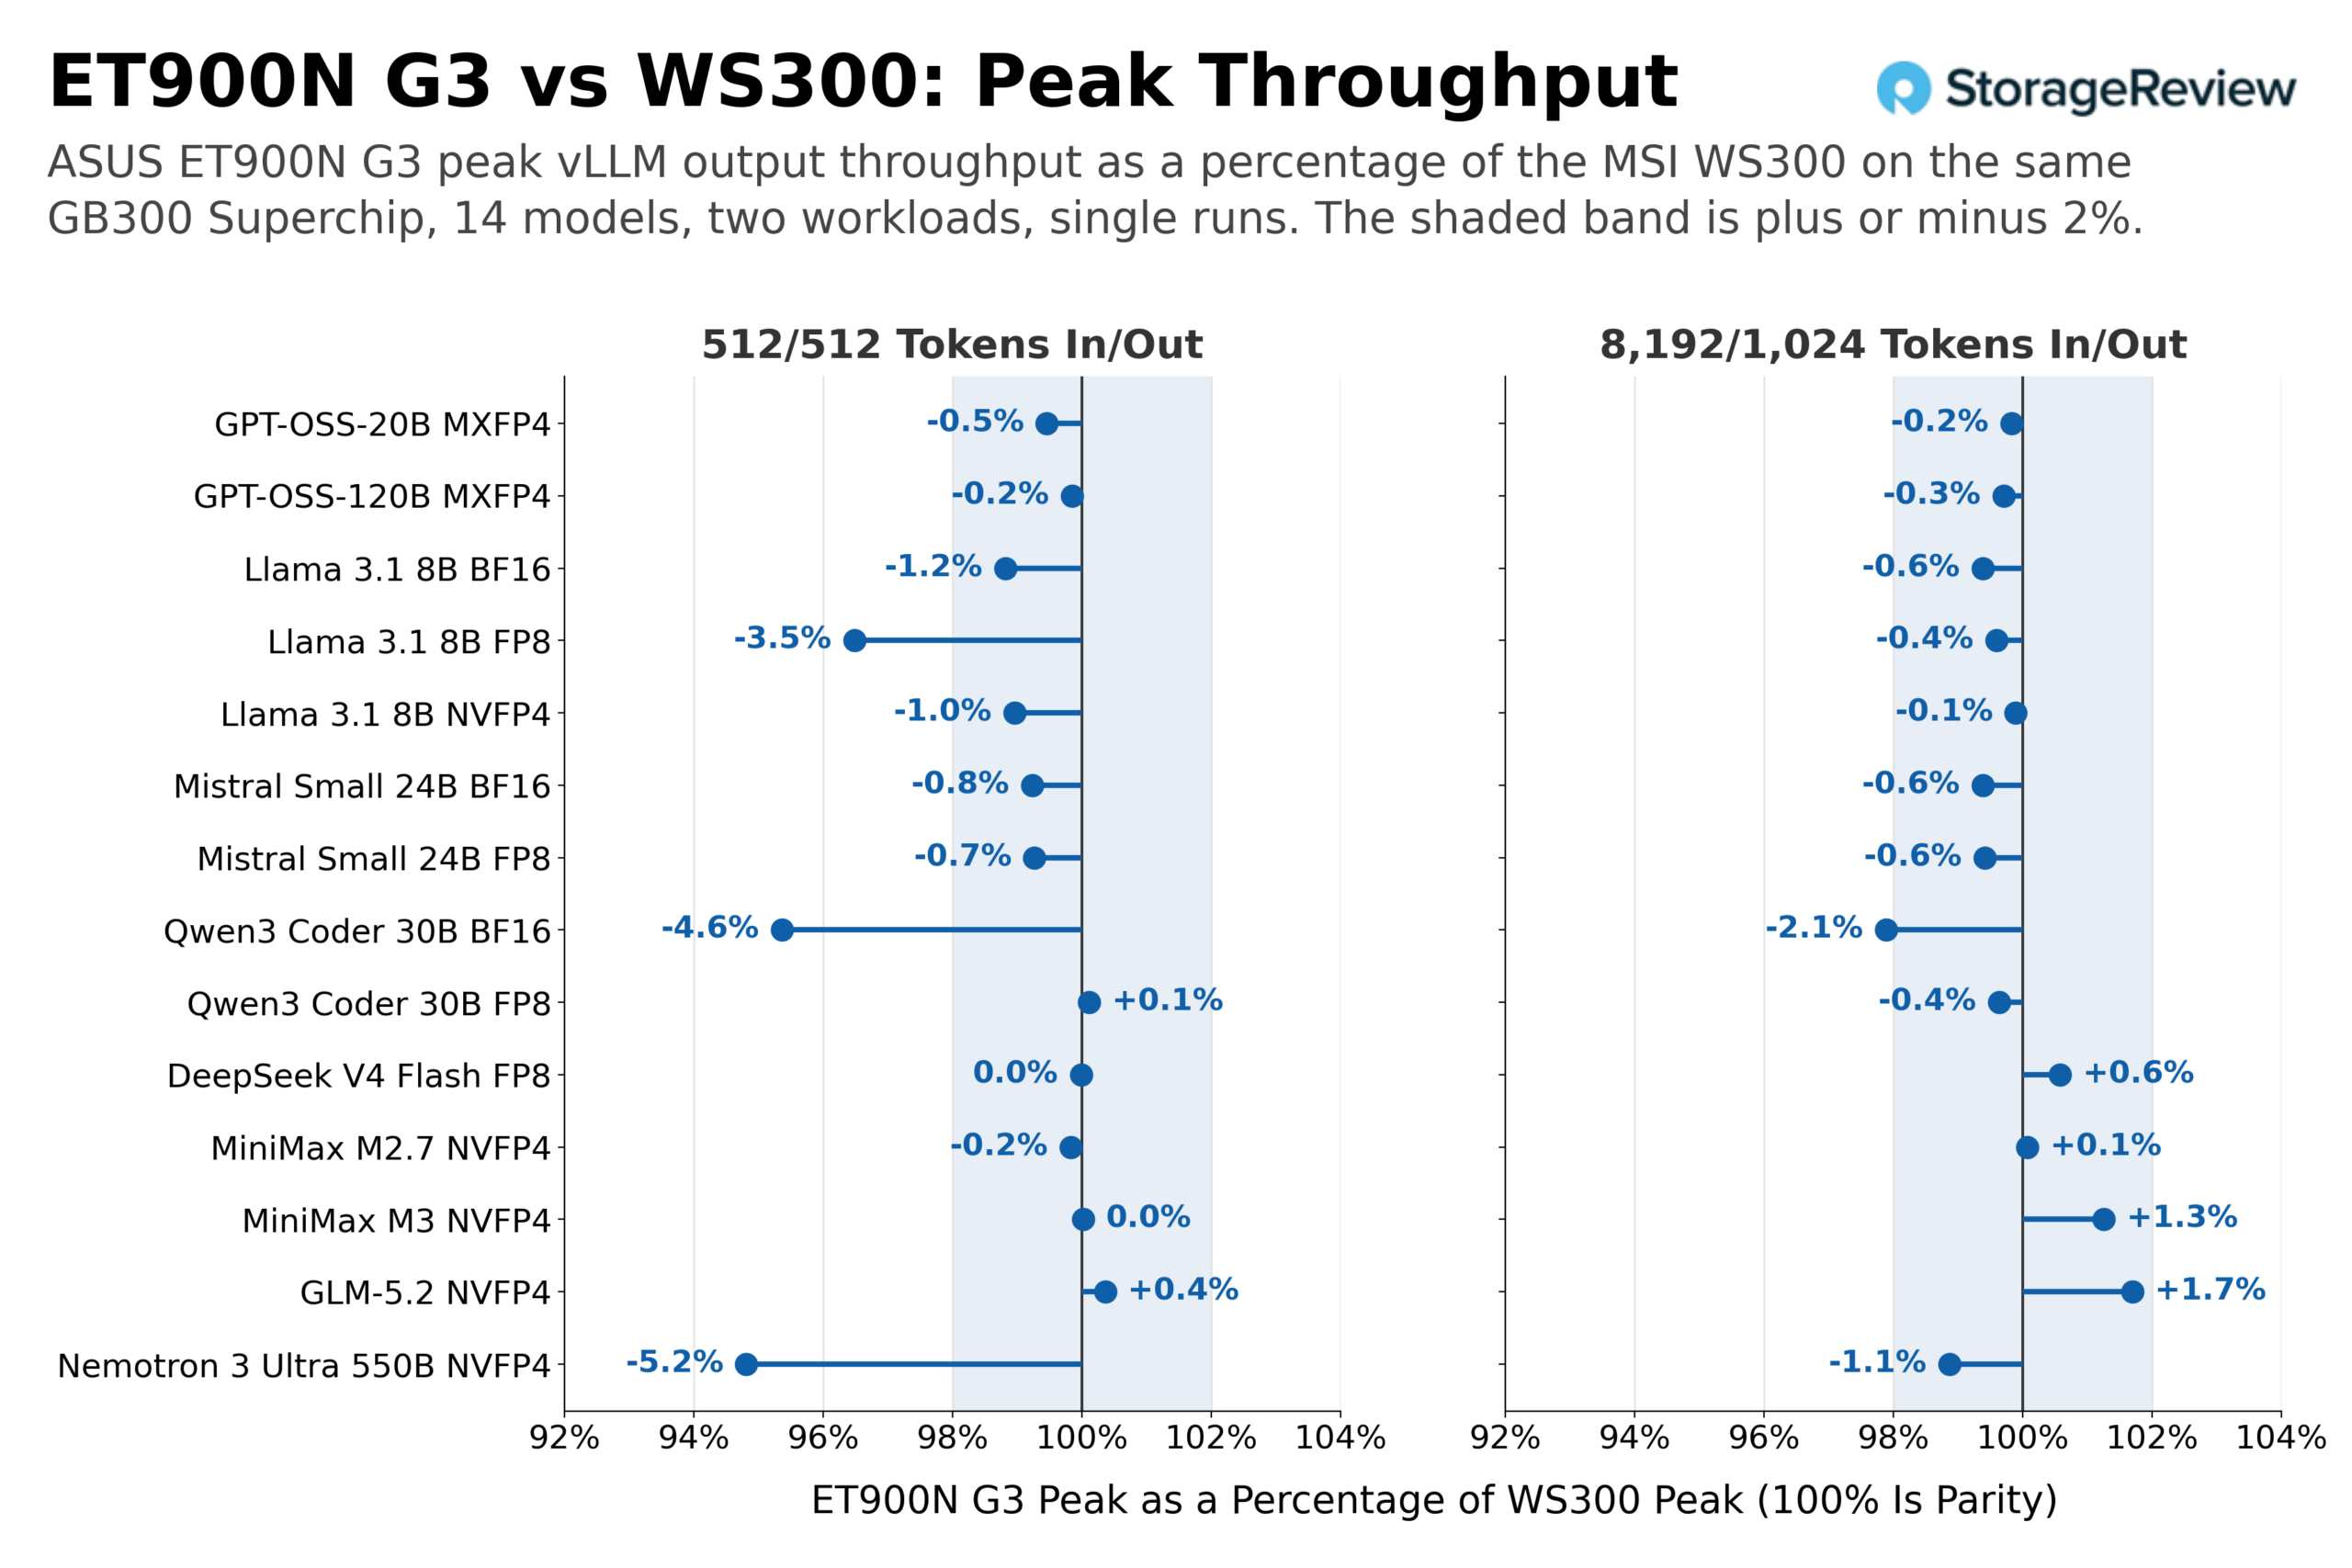
在28组模型-工作负载组合中,24组的性能差距在2%以内,其中大多数WS300的优势仅为百分之几。有4组的性能差距超出这个范围,其中3组是在相同工作负载下进行的测试:Llama 3.1 8B FP8的性能比WS300低3.5%(每秒输出令牌数分别为25,602和26,536),Qwen3 Coder 30B BF16的性能比WS300低4.6%(每秒输出令牌数分别为10,000和10,486),Nemotron 3 Ultra 550B的性能比WS300低5.2%(每秒输出令牌数分别为159和168),此外,Qwen3 Coder 30B BF16在长提示符模式下的性能也比WS300低2.1%。这里的所有数据都是在每台塔式机上单次运行的结果,因此14个模型中有3个模型之间存在2%到5%的差距,我们不能将其归咎于机箱本身。我们只是记录数据以及两者之间的差异。依赖于一致性内存池的型号,例如 MiniMax M3 和 GLM-5.2,在两种工作负载下都达到了相同或更高的性能;我们认为这对于平台而言是最重要的结果:Grace 卸载路径在华硕机箱和微星机箱中的表现相同。
| 型号 | WS300 512/512 | ET900N G3 512/512 | Delta | WS300 8,192/1,024 | ET900N G3 8,192/1,024 | Delta |
|---|---|---|---|---|---|---|
| GPT-OSS-20B MXFP4 | 22,161 | 22,041 | -0.5% | 9,572 | 9,555 | -0.2% |
| GPT-OSS-120B MXFP4 | 9,294 | 9,280 | -0.2% | 5,038 | 5,023 | -0.3% |
| 羊驼 3.1 8B BF16 | 17,278 | 17,074 | -1.2% | 3,520 | 3,498 | -0.6% |
| Llama 3.1 8B FP8 | 26,536 | 25,602 | -3.5% | 6,189 | 6,164 | -0.4% |
| Llama 3.1 8B NVFP4 | 28,698 | 28,400 | -1.0% | 6,744 | 6,737 | -0.1% |
| 密斯特拉尔小型 24B BF16 | 7,922 | 7,861 | -0.8% | 1,643 | 1,633 | -0.6% |
| 密斯特拉尔小型 24B FP8 | 11,157 | 11,075 | -0.7% | 2,316 | 2,302 | -0.6% |
| Qwen3 程序员 30B BF16 | 10,486 | 10,000 | -4.6% | 3,830 | 3,749 | -2.1% |
| Qwen3 Coder 30B FP8 | 12,425 | 12,439 | +0.1% | 3,851 | 3,837 | -0.4% |
| DeepSeek V4 闪存 FP8 | 1,766 | 1,766 | 0.0% | 948 | 954 | +0.6% |
| MiniMax M2.7 NVFP4 | 4,801 | 4,793 | -0.2% | 1,743 | 1,744 | +0.1% |
| MiniMax M3 NVFP4 | 1,041 | 1,041 | 0.0% | 278 | 282 | +1.3% |
| GLM-5.2 NVFP4 | 138 | 139 | +0.4% | 118 | 120 | +1.7% |
| Nemotron 3 Ultra 550B NVFP4 | 168 | 159 | -5.2% | 142 | 140 | -1.1% |
GPT-OSS-20B 是该数据集中吞吐量最高的密集型案例,而 GLM-5.2 是卸载型案例,两者在没有比率的情况下显示出重叠:在这两个案例中,WS300 的运行结果与 ET900N G3 的运行结果完全一致。
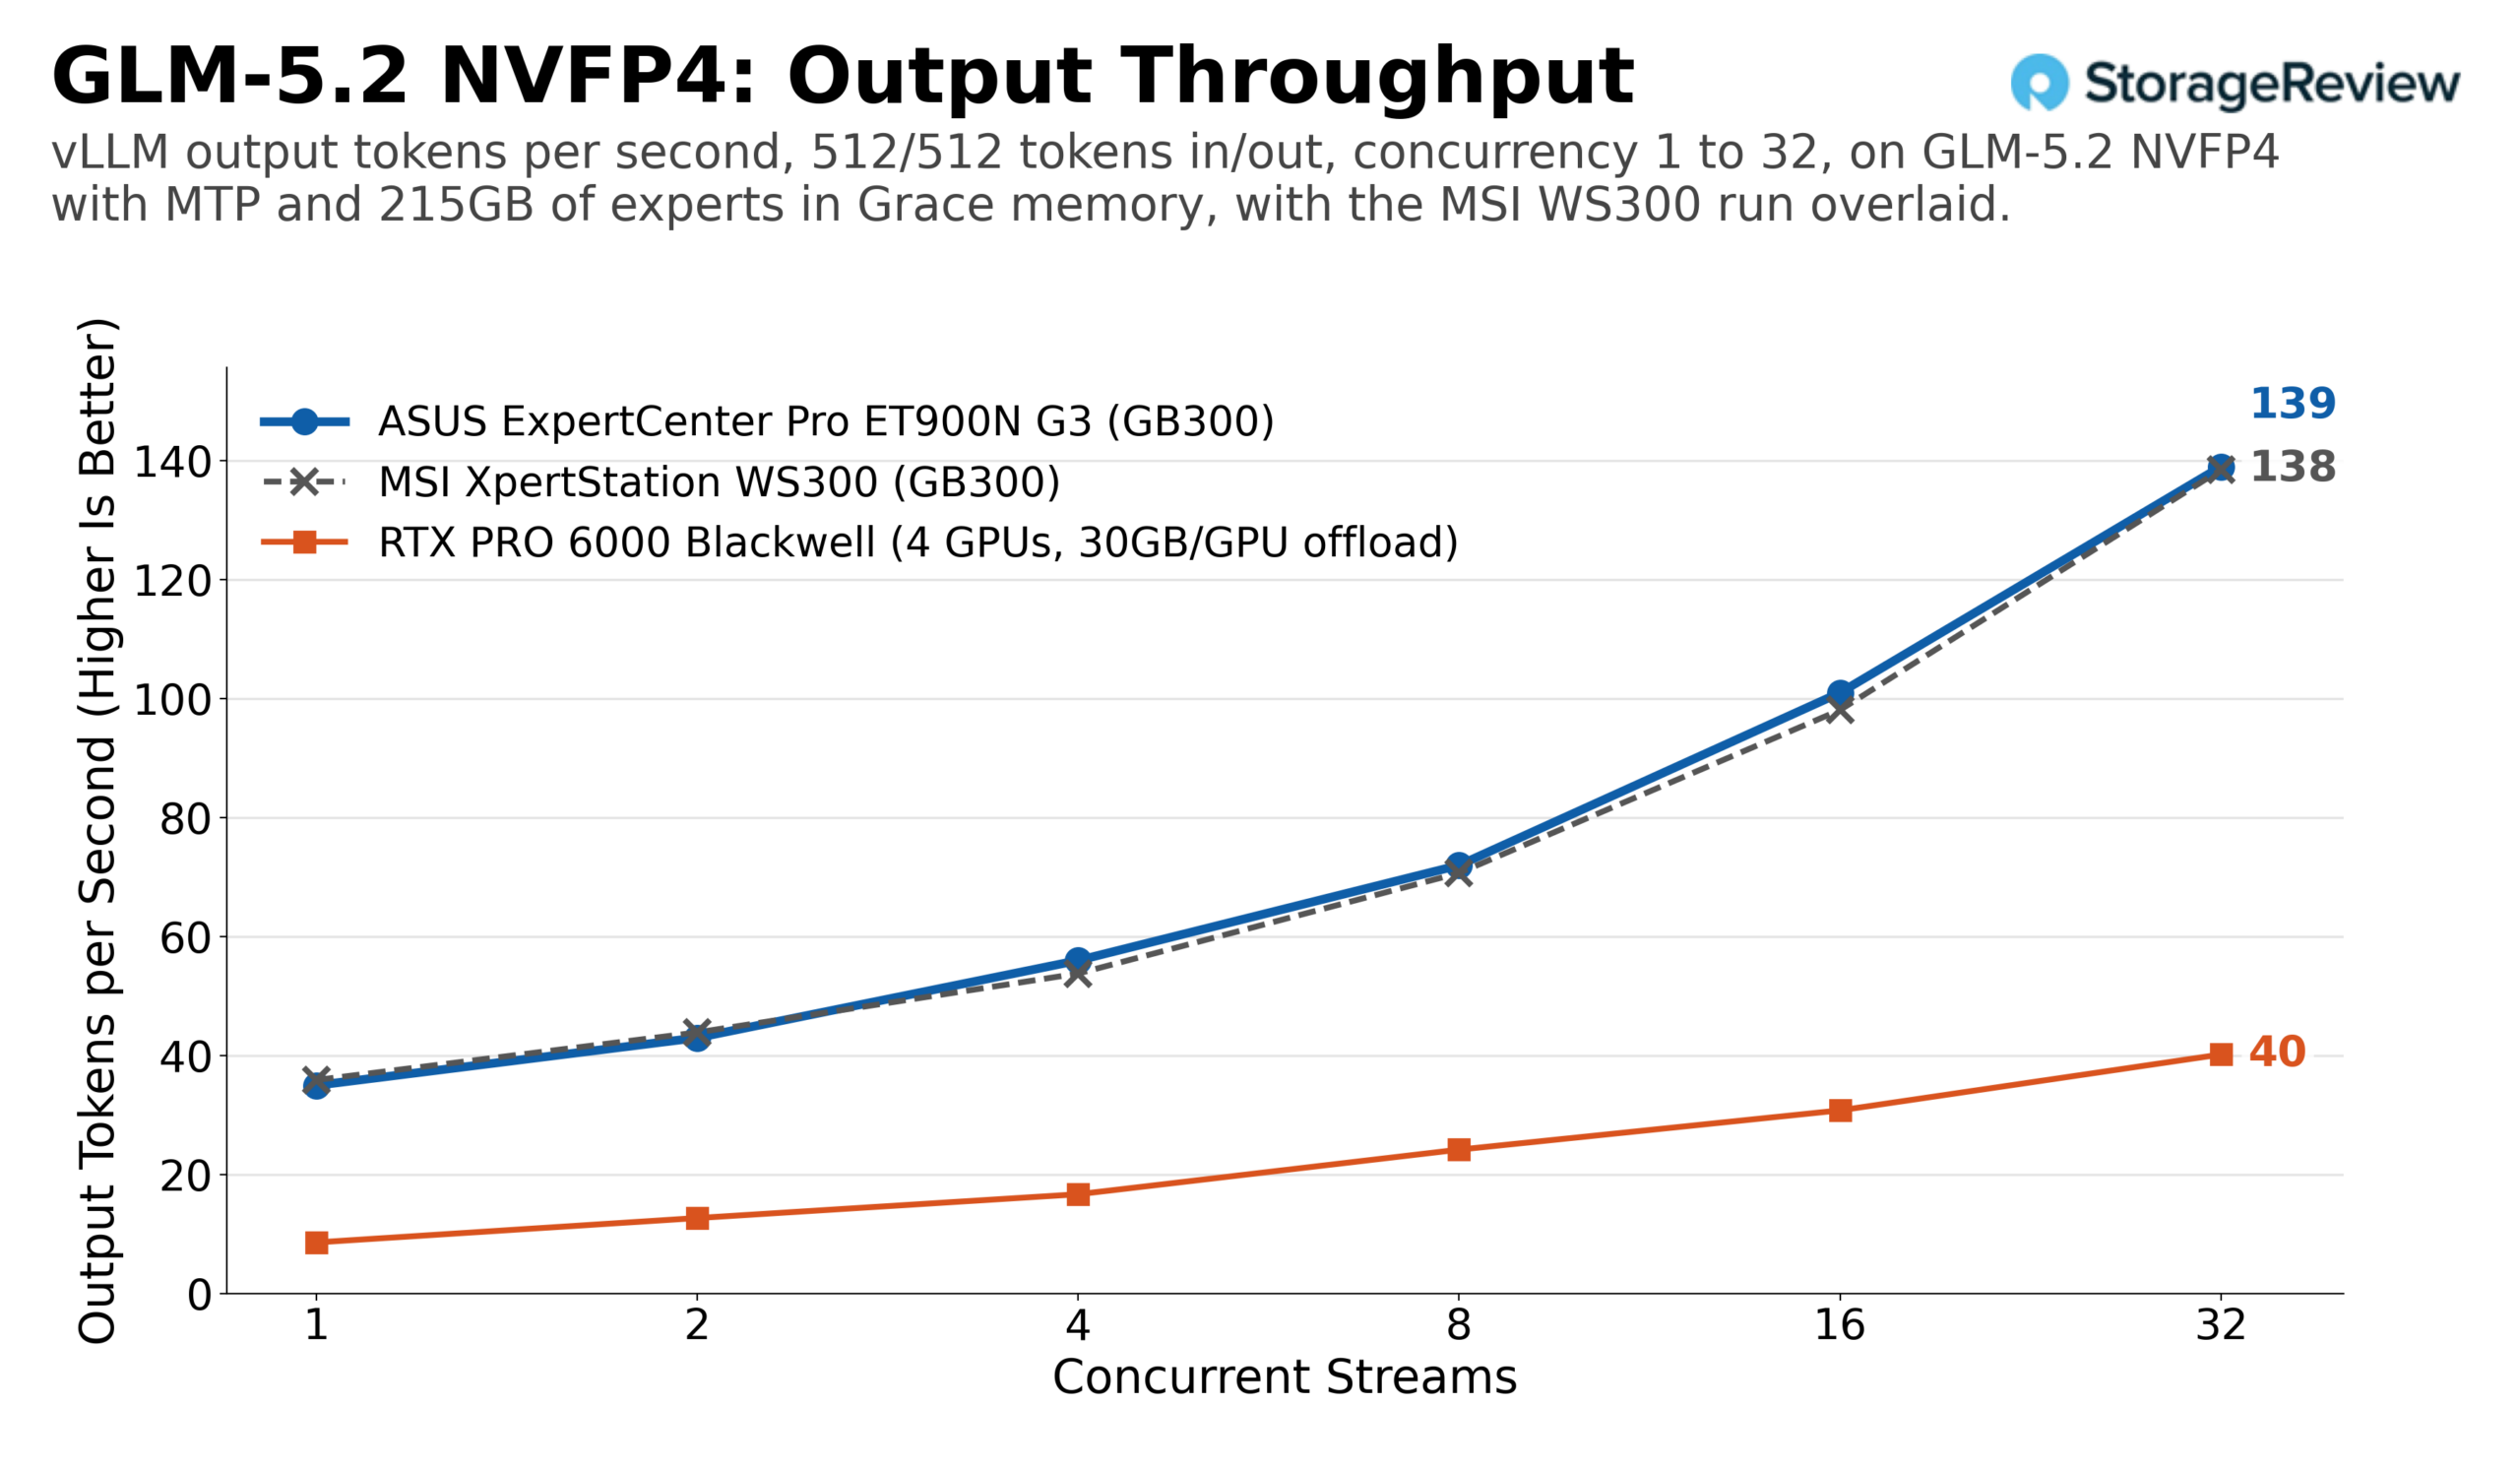
随着更多GB300塔式机送至实验室进行测试,我们将在此基础上进行更深入的比较。接下来是惠普的ZGX,之后还会有更多机型。每台机器都运行相同的测试程序,因此不同OEM厂商实现方案之间的任何差异都会在此图表中体现出来,每台塔式机对应一张图表,而模型图表则包含原始曲线。
结语
华硕 ExpertCenter Pro ET900N G3 作为参考平台的第二代产品,其表现与第一代产品相符。在 14 种模型和两种工作负载下,其 vLLM 峰值吞吐量在 28 项对比测试中的 24 项中与 MSI XpertStation WS300 的差距在 2% 以内,从 DeepSeek V4 Flash 的每秒 1,766 个输出令牌到 GPT-OSS-20B 的每秒 22,041 个输出令牌,仅有 4 项单次运行结果略低,差距在 2% 到 5% 之间。此外,它还支持 GLM-5.2,并配备 215GB 的 Grace 内存,其处理速度甚至超过了四张 RTX PRO 6000 系列显卡。GB300 Superchip 芯片设定了性能上限,而华硕在执行方面表现出色。
华硕的改进非常实用:把手让27公斤重的机箱可以轻松搬运,无需握住面板;QSFP112接口上方的风扇解决了长时间运行400G光模块可能遇到的问题;钛金电源则能降低墙插功耗。Arm架构主机、20A电路、仅支持BMC的显示输出以及安装大型显卡时共享的1,600W功率预算,这些都是平台本身的特性,两款机箱都适用。
GB300 DGX Station 仍然是我们放在桌面上功能最强大的设备,而华硕的版本也让购买变得非常划算。
在我们的 最适合本地人工智能的桌面电脑 leaderboard, the ET900N G3 now stands alongside the WS300 as a tested alternative in the Best GB300 System slot.



 Amazon