

边缘服务器通过在数据中心和云端之外提供计算资源,助力实时决策。本文中,我们在 SuperMicro IoT SuperServer SYS-210SE-31A(一款功能强大的多节点边缘服务器)上运行了多项边缘基准测试。显然,工程师在设计这款服务器时就考虑到了边缘推理,因为它正是为推理而生的。
SuperMicro IoT SuperServer SYS-210SE-31A 概述
我们对 SuperMicro IoT SuperServer SYS-210SE-31A 的全面评测表明,它不仅在 5G 和物联网领域具有应用前景,而且如果搭配 PCIe 存储卡和高速网卡,在零售甚至存储领域也具有应用前景。
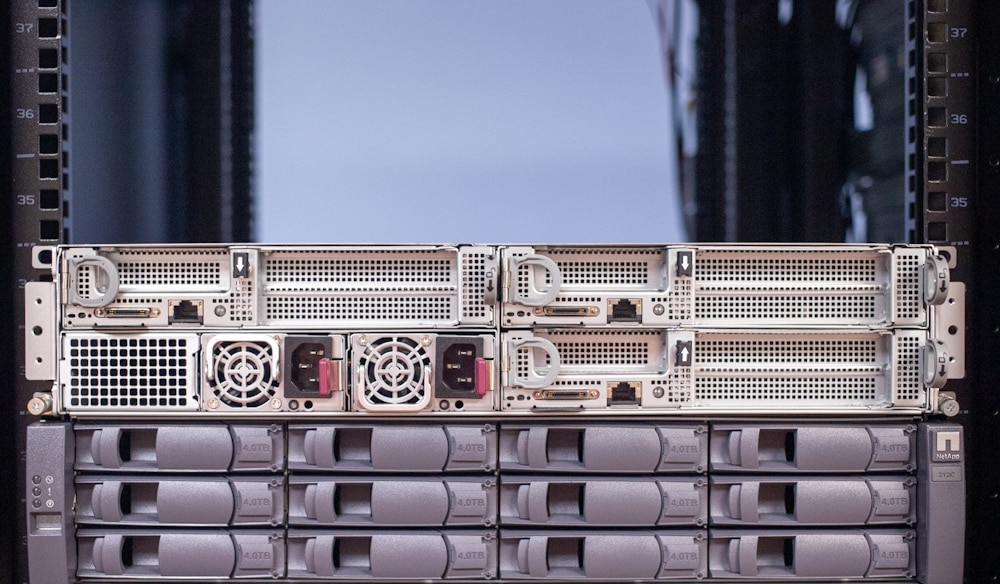
该服务器的多节点特性使其用途广泛。 它适合三个 CPU 节点,每个节点具有以下内容:
- 一个第三代英特尔至强可扩展处理器(“Ice Lake”),最高 32C/64T 和 205W,可选配特殊配置的 270W 芯片。
- 四个风扇模块。
- 八个 DIMM 插槽; 内存上限为 2TB,使用 256GB 3DS DIMM。
- 两个 M.2 2280/22110 PCIe Gen4 插槽。
- 4个PCIe Gen16 x4全高/半长和16个PCIe GenXNUMX xXNUMX半高/半长。
- 一个用于 IMPI 2.0 的 GbE 和一个 KVM 软件狗。
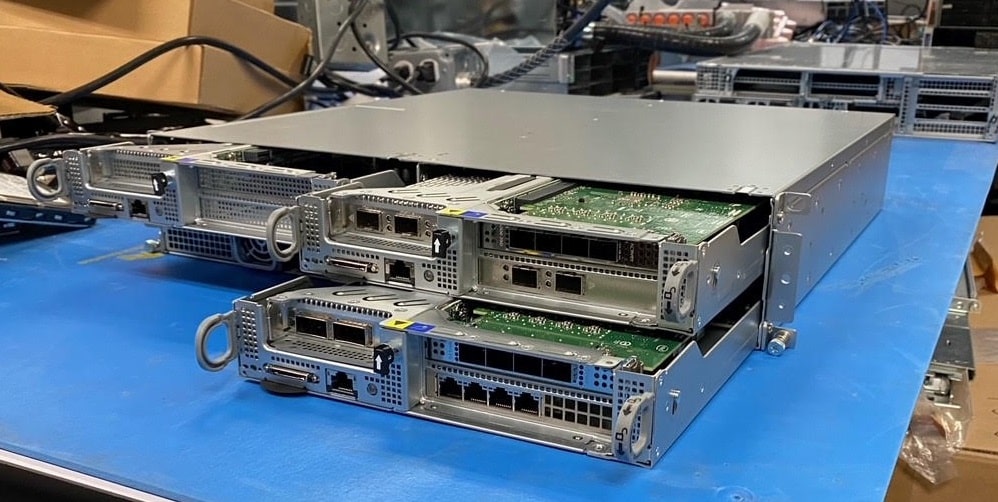
在这里您可以看到拉出的节点,就像它们自己的迷你机架式服务器一样。
这是一个节点的内部。 请注意一切都紧密地结合在一起。
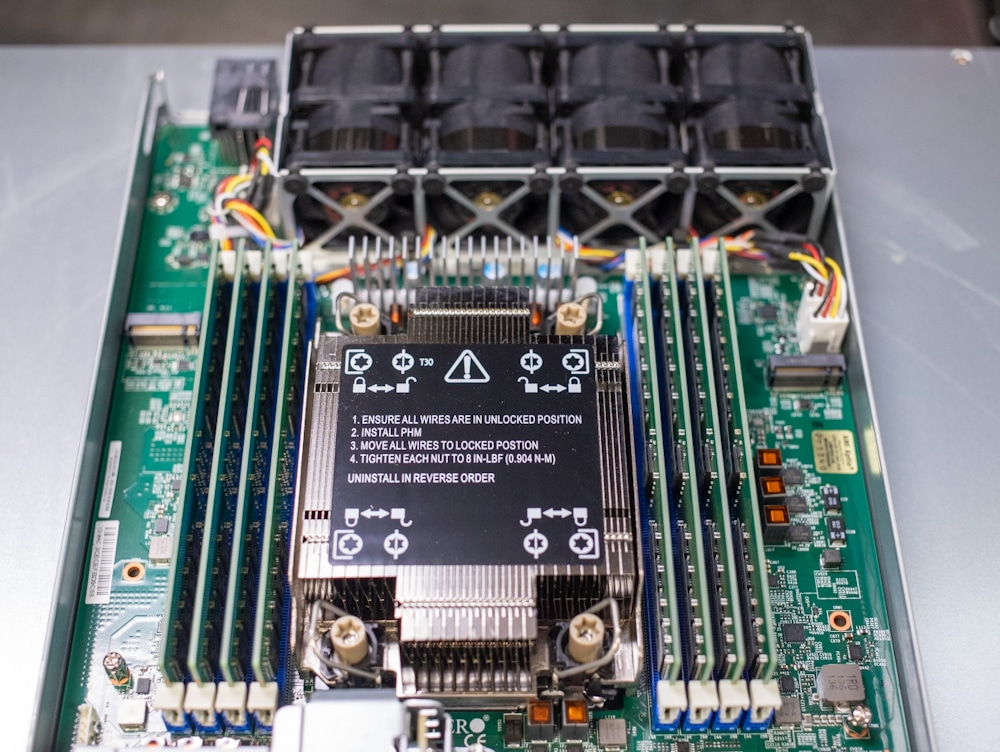
该服务器的主要弱点是存储,节点内存储仅限于两个 M.2 引导驱动器插槽,没有原生 2.5 英寸或 3.5 英寸托架。 如前所述,您可以相当轻松地添加 PCIe 存储。 网络存储也是一种选择; 其超过 1GbE 的连接性取决于扩展卡。
突出此服务器的边缘焦点是它能够在高达 45 摄氏度的环境中运行,并在 55 摄氏度的环境中短暂停留,以及其可用的灰尘过滤器。
边缘推理:边缘服务器案例
我们的专题文章《边缘推理借助新硬件走向成熟》阐述了边缘计算的现状。如今向边缘的迁移在传统时代似乎是倒退之举,因为当时采用的是层级式的“中心辐射”架构,目的是将数据传回中央位置。实时决策是推动边缘计算发展的动力,它能够提供更快的洞察和响应速度,并降低对网络连接的依赖。
边缘推理可以在云端完成,但通常只适用于非时间敏感、非关键的应用程序。 当然,缺乏网络连接意味着云是行不通的。
在 SuperMicro IoT SuperServer SYS-210SE-31A 上测试边缘
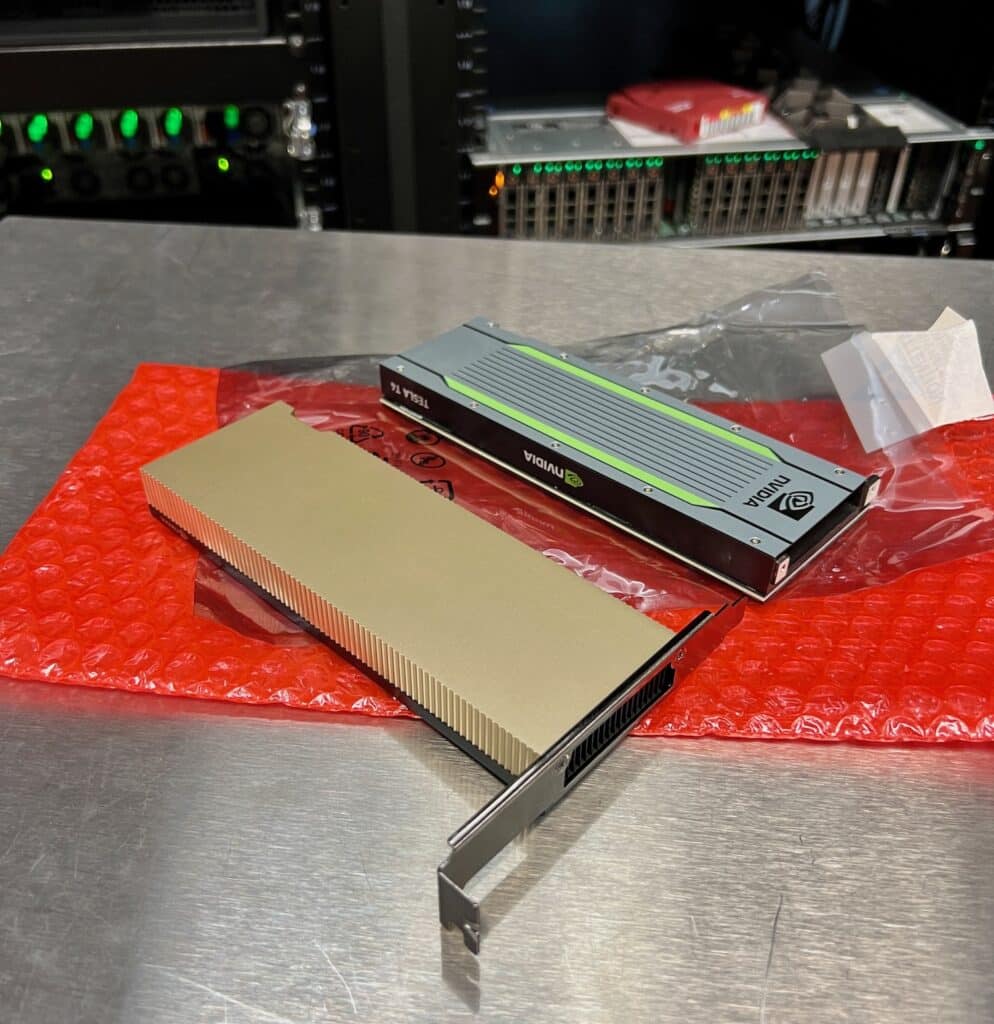
现在,进入我们的测试。 GPU 处理数据的能力推动了边缘推理,而边缘服务器通常坚持使用单槽、低配置的卡,如 NVIDIA A2 和较旧但流行的 T4。 我们正在评估的 SuperMicro IoT SuperServer SYS-210SE-31A 具有 T4。 下面是两张牌,右边是T4,左边是A2。 每个节点的硬件配置包括 Intel Xeon Gold 6330 CPU 和 128GB DDR4 RAM。
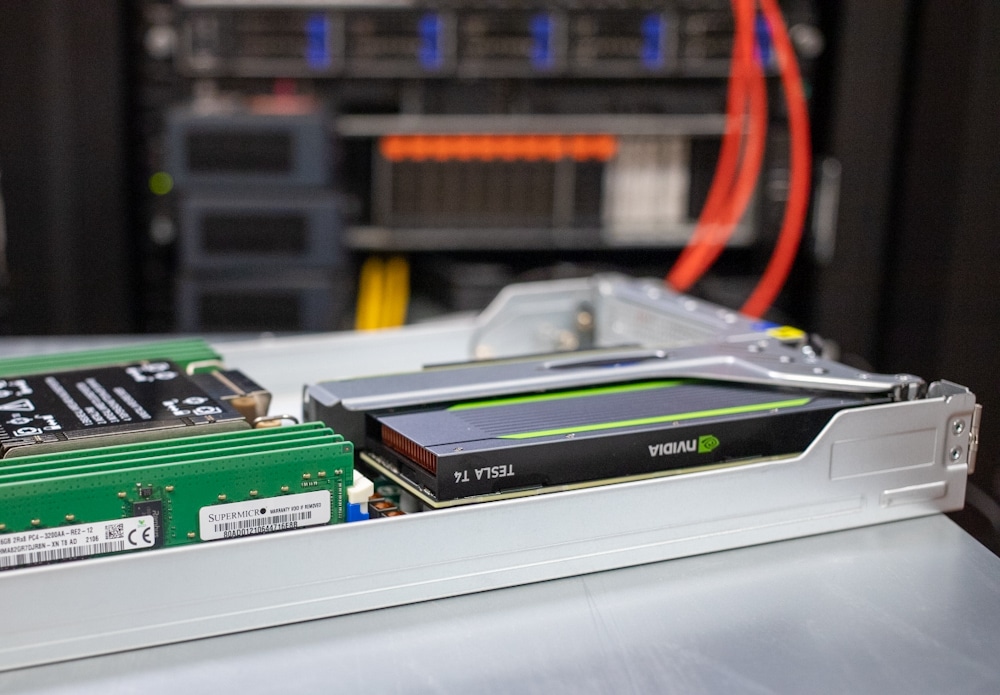
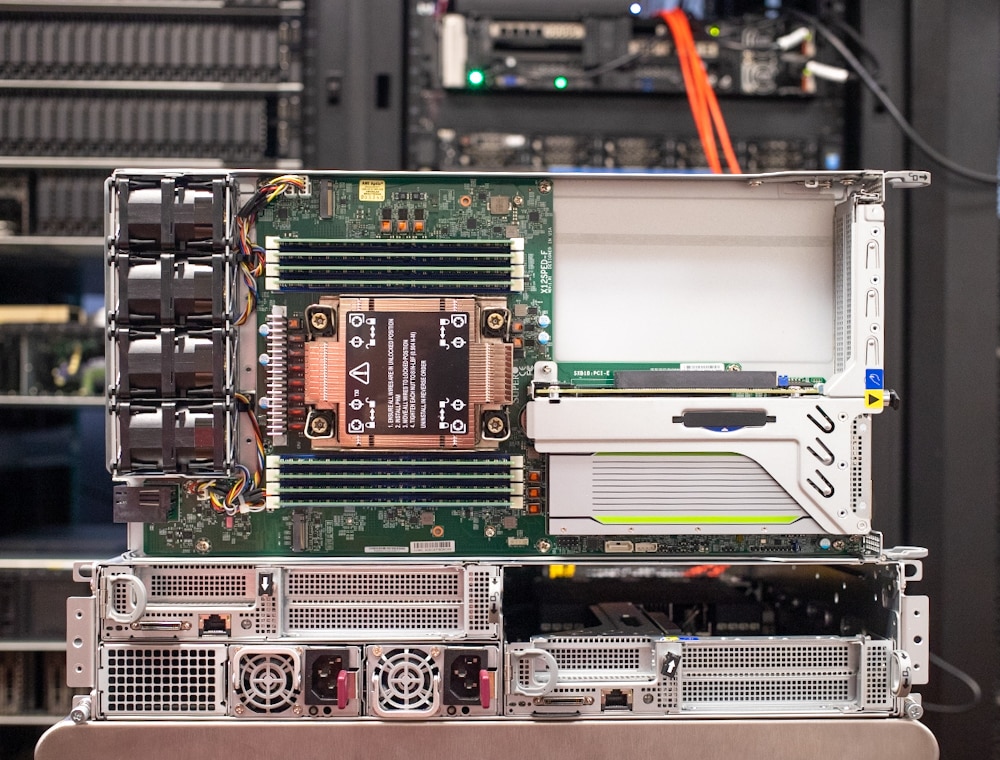
这是安装在其中一个 SuperMicro 节点中的 T4。
T4显卡的功耗为70瓦,这意味着它的所有电力都来自PCIe插槽。其图灵架构配备了张量核心,在FP32、FP16、INT8和INT4精度方面远胜于CPU。NVIDIA A2显卡的功耗略低,为40瓦至60瓦,但采用了更新、更高效的架构。请参阅我们关于边缘推理的文章,其中对这两款显卡进行了比较,我们在联想ThinkEdge SE450服务器上对它们进行了测试。
我们正在使用 MLPerf Inference: Edge 基准测试套件,它比较了各种现实世界边缘场景中流行的 DL 模型的推理性能。 在我们的测试中,我们有 ResNet50 图像分类模型和用于问答任务的 BERT-Large NLP 模型的数字。 两者都在 Offline 和 SingleStream 配置中运行。
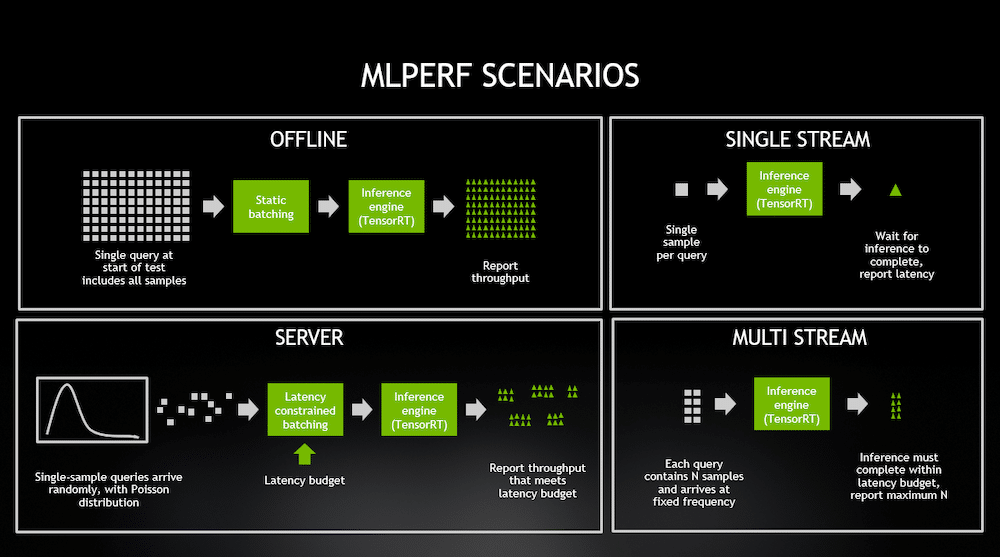
离线场景以“批处理模式”评估推理性能,此时所有测试数据都立即可用,并且不考虑延迟。 在这个任务中,推理脚本可以按任意顺序处理测试数据,目标是最大化每秒的查询数(QPS=吞吐量)。 QPS 数越高越好。
相比之下,单流配置一次处理一个测试样本。 一旦对单个输入执行了推理(在 ResNet50 的情况下,输入是单个图像),就会测量延迟,并使下一个样本可供推理工具使用。 目标是最小化处理每个查询的延迟; 延迟越低越好。 为简洁起见,查询流的第 90 个百分位延迟被捕获为目标指标。
下图来自NVIDIA 一篇关于 MLPerf 推理 0.5 的博客文章,它很好地可视化了各种场景。您可以在这里阅读 MLPerf 推理的原始论文,了解更多关于各种场景的信息。
我们测试了在 SuperMicro IoT SuperServer SYS-210SE-31A 内部的两个节点上运行的工作负载。 第三个节点被设置为备用节点。
| 基准 | 节点 1 (NVIDIA T4) | 节点 3 (NVIDIA T4) |
| RestNet50 当前离线 | 5,587 个样本/秒 | 5,492 个样本/秒 |
| BERT 单流 | 6.8 毫秒(90th 百分比) | 7.0 毫秒(90th 百分比) |
| BERT 当前离线 | 397 个样本/秒 | 396 个样本/秒 |
NVIDIA T4 整体印象深刻。 节点 1 表现出略微更好的性能。 也就是说,T4 是一款较旧的卡,具有比较新的 A2 更高的功率配置文件。 我们看到在 ThinkEdge SE2 中测试 A450,它在某些地方的延迟也比 T4 低,同时使用更少的功率。 应用和功率考虑因素应决定两者之间的选择。 不过就目前而言,我们对 Supermicro 机箱可以为这些类型的工作负载提供的密度感到满意。
总结
边缘竞赛带来了边缘计算的快速进步。 没有比 GPU 更明显的了,特别是像 NVIDIA T4 和更新的 A2 这样的低配置、低功耗选项。 我们在 SuperMicro IoT SuperServer SYS-4SE-210A(一种高度通用的三节点边缘服务器)中测试了 T31。
T4 表现出卓越的性能,考虑到它的年龄,这更令人印象深刻。 不过,它确实比 A2 消耗更多的功率,因此请根据您的边缘推理需求明智地选择。 我们预计,随着边缘驱动型公司继续优化 GPU 利用率,备受推崇的 GPU 仍有很长的路要走。
此外,Supermicro 物联网服务器配备精良,可以处理这些卡,在边缘提供非常密集的推理性能。


 Amazon