

英特尔 Arc Pro B70 是英特尔迄今为止推出的功能最强大、最有前途的桌面级 AI 显卡,但有时它也最令人失望。今年三月发布时,英特尔将 32GB GDDR6 显存版本的定价为 949 美元。然而,内存短缺的困境已经将整个市场的售价推高至 1,100 美元以上(截至本文撰写之时)。即便如此,B70 的价格仍然低于英伟达的 RTX Pro 4000 系列显卡,后者定价更高,尽管仅配备 24GB 显存(比 B70 少三分之一),但售价已超过 2,000 美元。一台工作站或服务器可以容纳四块 B70 显卡,共享 128GB 显存,足以运行 1200 亿参数的混合专家模型,其并发能力以往需要投入更多资金才能实现。硬件性能令人印象深刻,而价格更是令人咋舌。阻碍它前进的,正是我们去年 12 月预览的 B60 所面临的同样问题:软件还不完善,我们不禁要问:英特尔最终能否做到这一点?
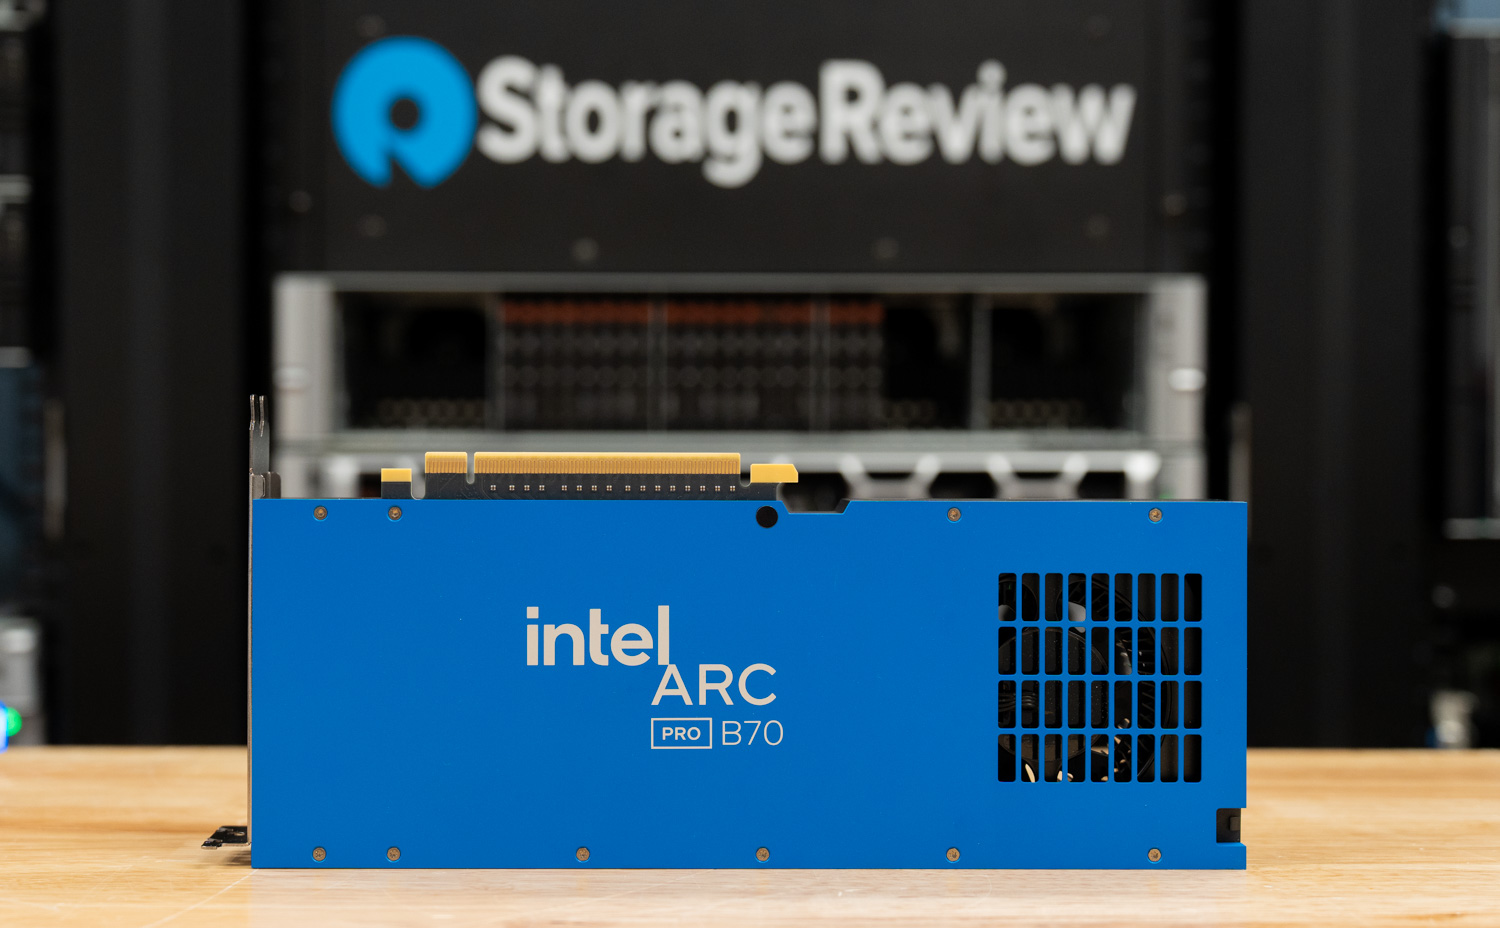
我们之前不止一次遇到过英特尔的类似情况。当年我们评测Arc Pro B60 Battlematrix时,它搭载了性能卓越的芯片,但尚未正式发布,而B70则继承了这两点。这款显卡采用更大的BMG-G31芯片,拥有32个Xe2核心、256个XMX引擎,以及367 TOPS的INT8算力。它采用256位总线,带宽为608 GB/s,功耗可在160W至290W之间配置。英特尔表示,与B60相比,B70在工作站工作负载下的平均性能提升为44%,在专业应用场景下最高可达69%。需要注意的是,B60采用双GPU设计,占用一个x8/x8插槽,而B70则为单GPU设计,需要占用一条完整的PCIe 5.0 x16通道,这会影响四卡机箱的配置方式。
英特尔的营销策略完全依赖于本地化推断,并选择了英伟达的 RTX Pro 4000 24GB 作为对比对象。根据英特尔在 Linux 系统下的数据,B70 的 32GB 内存可以容纳大约 93K 个 KV 缓存令牌,而 RTX Pro 4000 只能容纳 42K 个,在内存耗尽之前,B70 的 32GB 内存可以达到更高的令牌吞吐量,随着并发用户数的增加,其令牌吞吐量最高可提升 85%,在高负载下,其首次令牌响应速度最高可提升 6.2 倍,并且每美元可获得的令牌数量最高可达 RTX Pro 4000 的两倍。以上数据是英特尔在 BF16 环境下,使用 Llama 3.1 8B 小型服务器进行单卡测试得出的;我们将对 B70 进行更严苛的测试。此处提及的每美元可获得的令牌数量是基于发布时的标价;以当前价格计算,英特尔的优势依然存在甚至更大。
在进行基准测试之前,这种权衡至关重要,因为它决定了哪些用户应该购买这张显卡。我们认为,英特尔的LLM Scaler(支持Battlemage的vLLM开发分支)充其量仍处于测试阶段。其模型覆盖范围有限;一些本应有效的量化路径目前无法正常工作,而且堆栈也限制了硬件的性能。我们在戴尔PowerEdge XE7740服务器上的英特尔Gaudi 3处理器上也遇到了同样的问题,其FP8软测试结果并非源于芯片本身,而是英特尔vLLM分支中不成熟的代码路径所致。B70显卡也面临着同样的问题。英特尔必须在此做出决定,并比目前更加积极地坚持下去。
NVIDIA 的护城河并非仅仅在于 CUDA。部署模型时真正重要的,是那些看似枯燥乏味却至关重要的东西:文档、示例、可运行的容器、论坛解答,以及足以解决大多数问题的社区历史。AMD 显然也在朝着同样的方向推进 ROCm。Intel 需要对 Arc Pro 投入同样的精力,否则 B70 可能会沦为一款发烧友喜欢但团队难以采用的显卡。
为了进行清晰的对比,本次评测平台与B60评测平台完全相同:一台搭载AMD EPYC 9374F处理器和512GB DDR5内存的Supermicro AS-4125GS-TNRT服务器,分别运行四块B70(128GB)和四块B60(96GB)显卡,均采用vLLM内存管理。与B60评测一样,本次评测并非基于英特尔的全英特尔Battlematrix参考平台(该参考平台搭配的是Xeon 6处理器)。基于英特尔芯片的量产系统性能可能有所不同。请将以下评测视为基于相同平台、同代产品性能和性价比的对比,所有结果均受软件成熟度的影响。
英特尔 Arc Pro B70 技术规格
| 规格 | 英特尔 Arc Pro B70 |
|---|---|
| General (将军) | |
| 产品系列 | 英特尔 Arc Pro B 系列显卡 |
| 型号 | 英特尔 Arc Pro B70 |
| 代号名称 | 战斗法师 |
| 微体系架构 | Xe2 |
| 工艺技术 | 台积电N5 |
| 发布日期 | 第1季度 2026 年 |
| 保修政策 | 3年 |
| 显卡规格 | |
| Xe核心 | 32 |
| 渲染切片 | 8 |
| 光线追踪单元 | 32 |
| 英特尔 XMX 引擎 | 256 |
| Xe矢量引擎 | 256 |
| 图形时钟 | 2280 MHz |
| 最大动态时钟 | 2800 MHz |
| FP32 性能 | 22.94 TFLOPS |
| INT8 AI 性能 | 367 TOPS |
| 主板总功耗 (TBP) | 230瓦(可配置:160-290瓦) |
| PCI Express接口 | PCIe 5.0 x16 |
| 内存 | |
| 内存容量 | 32GB GDDR6 |
| Magistrala pamięci | 256 bit |
| 内存带宽 | 608 GB /秒 |
| ECC内存 | 支持 |
| 显示和 I/O | |
| 显示输出 | DisplayPort 2.1 |
| 最大显示数量 | 4 |
| 最大分辨率 | 7680 × 4320 @ 120Hz (HDMI / DisplayPort) |
| 可变刷新率 | HDMI VRR,VESA 自适应同步 |
| 功能与软件 | |
| 视频编码/解码 | H.264、H.265 (HEVC)、AV1 |
| 光线追踪 | 支持 |
| 人工智能框架 | oneAPI、OpenVINO、Intel PyTorch 扩展 (IPEX) |
| 图形 API | DirectX 12 Ultimate、Vulkan 1.3、OpenGL 4.6、OpenCL 3.0 |
| 英特尔 XeSS | 支持 |
| HDR支持 | HDR10、HDR10+ 游戏、杜比视界 |
| 多格式编解码器引擎 | 2 |
| 物理规格 | |
| 尺寸 | 10.5×3.9英寸 |
| 槽宽 | 双插槽 |
| 重量 | 1020克 |
| 电源连接器 | 1 × 8 针 (ATX 2×4) |
英特尔 Arc Pro B70 的构造和设计
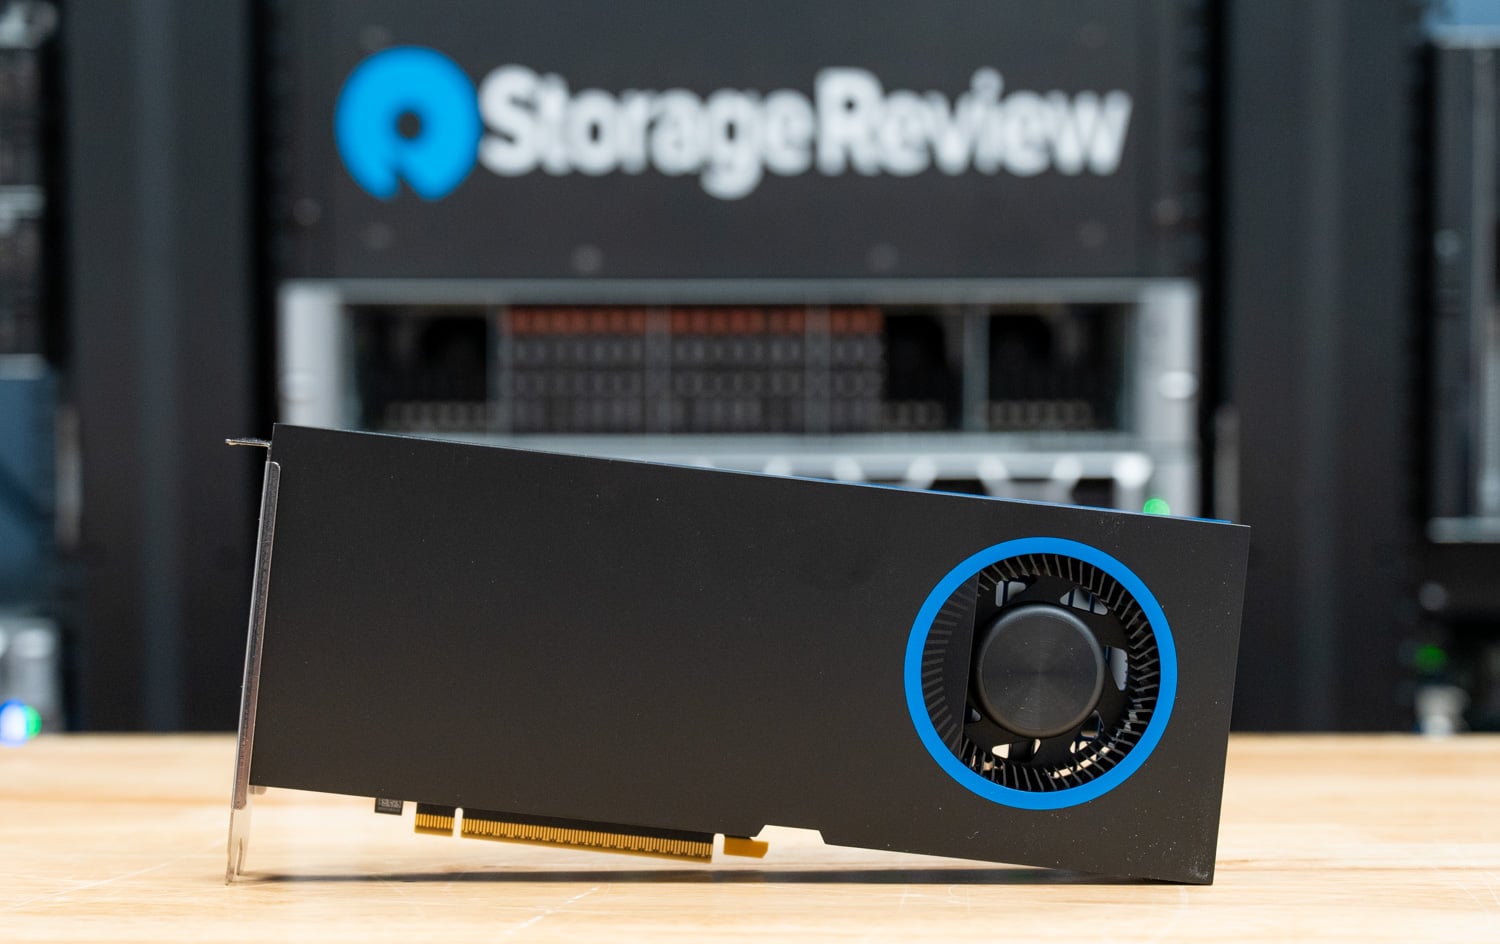
英特尔 Arc Pro B70 显卡尺寸为 10.5 × 3.9 英寸(267 × 99 毫米),重量为 2.25 磅,采用紧凑的双槽设计,外观简洁低调。该显卡采用哑光黑色涂装,并饰以英特尔标志性的蓝色点缀。它配备全长阳极氧化铝背板,增强了显卡的刚性,并与英特尔的品牌标识相呼应。
它采用单鼓式风扇设计,将空气吸入散热器,然后直接从后部 I/O 挡板排出。这种封闭式散热设计使显卡体积小巧,并保持系统内部气流顺畅。
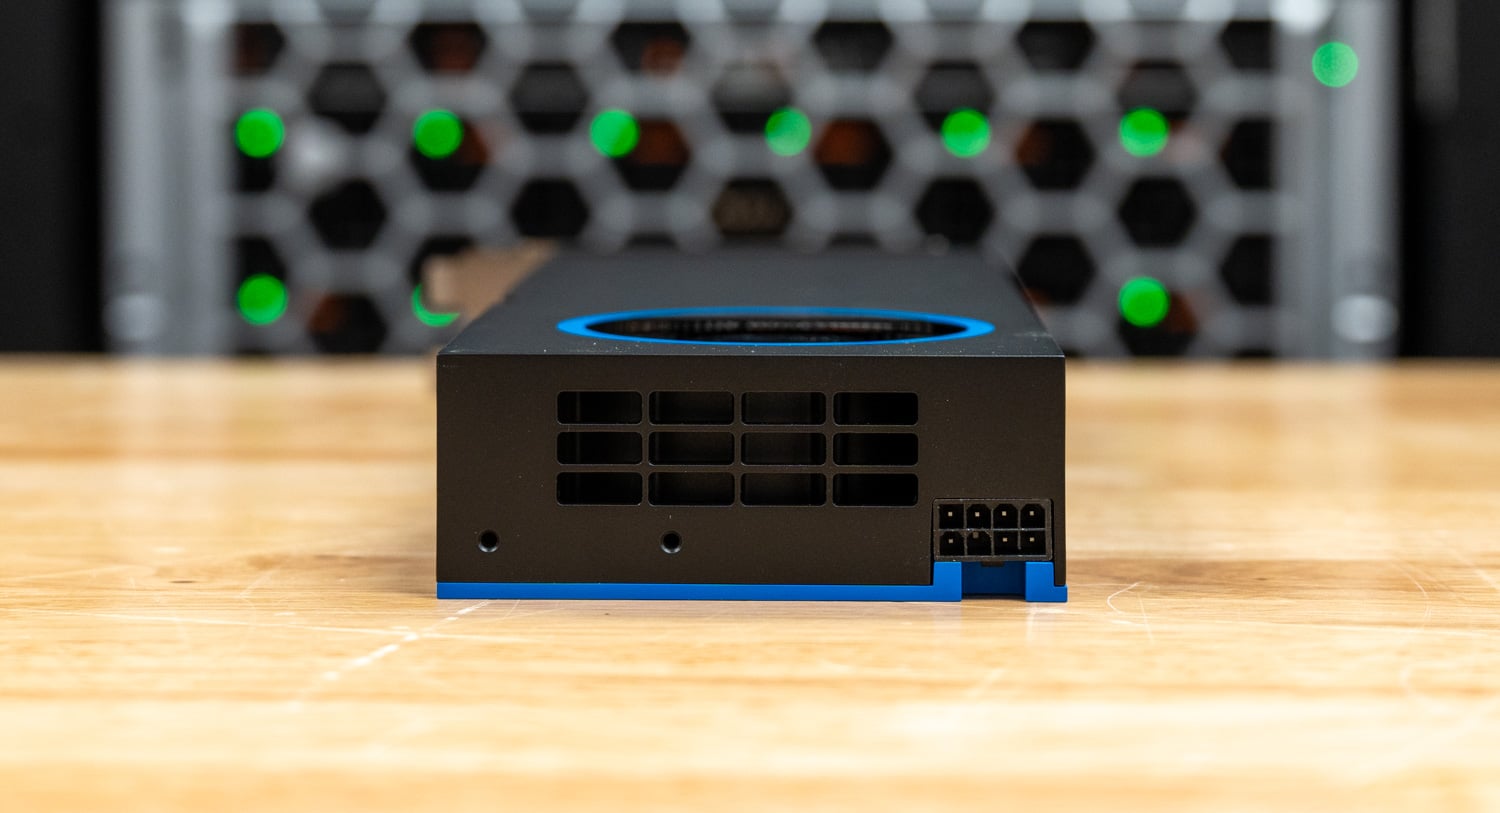
在显卡背面,与 PCIe 挡板相对的位置,英特尔提供了一个 8 针 (2×4) PCIe 电源接口,用于提供外部电源。显卡外壳的这一端还设有额外的进气口,为鼓风机提供新鲜空气,以及用于安装可选 GPU 支撑支架的螺纹安装点,以提高工作站部署中的稳定性。
Arc Pro B70 的底部边缘采用标准的 PCIe 5.0 x16 接口,用于连接主机。这个角度也突显了该卡的双槽设计。它为内置的涡轮散热解决方案提供了足够的空间,同时又保持了足够的紧凑性,适用于高密度工作站和服务器安装。
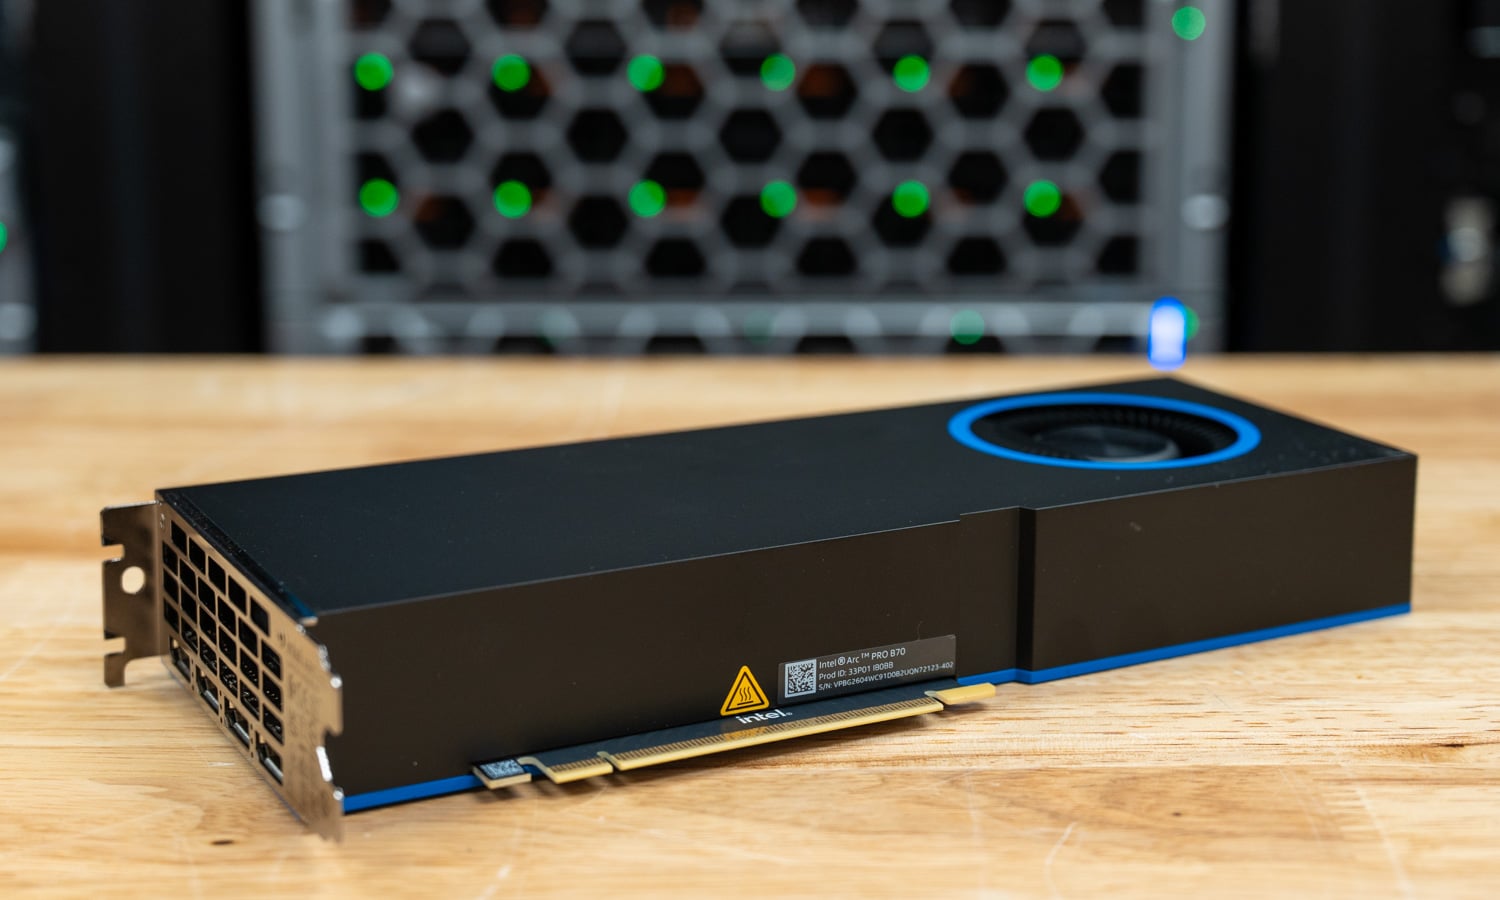
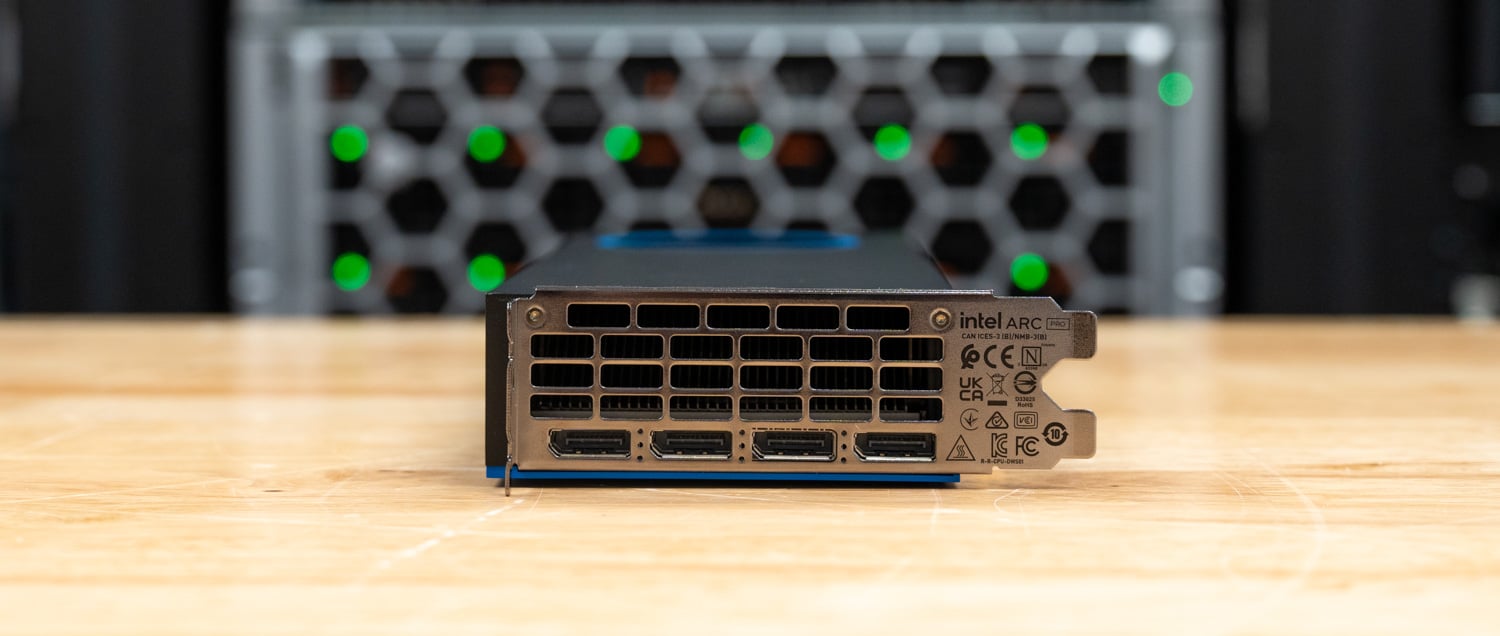
I/O挡板配备一个大型通风排气口,使鼓风机能够将热空气直接排出机箱。排气口下方是四个DisplayPort 2.1输出接口,每个接口均可驱动分辨率高达7680 × 4320 (8K) 且刷新率高达120Hz的显示器,为高分辨率多显示器工作站环境提供充足的带宽。
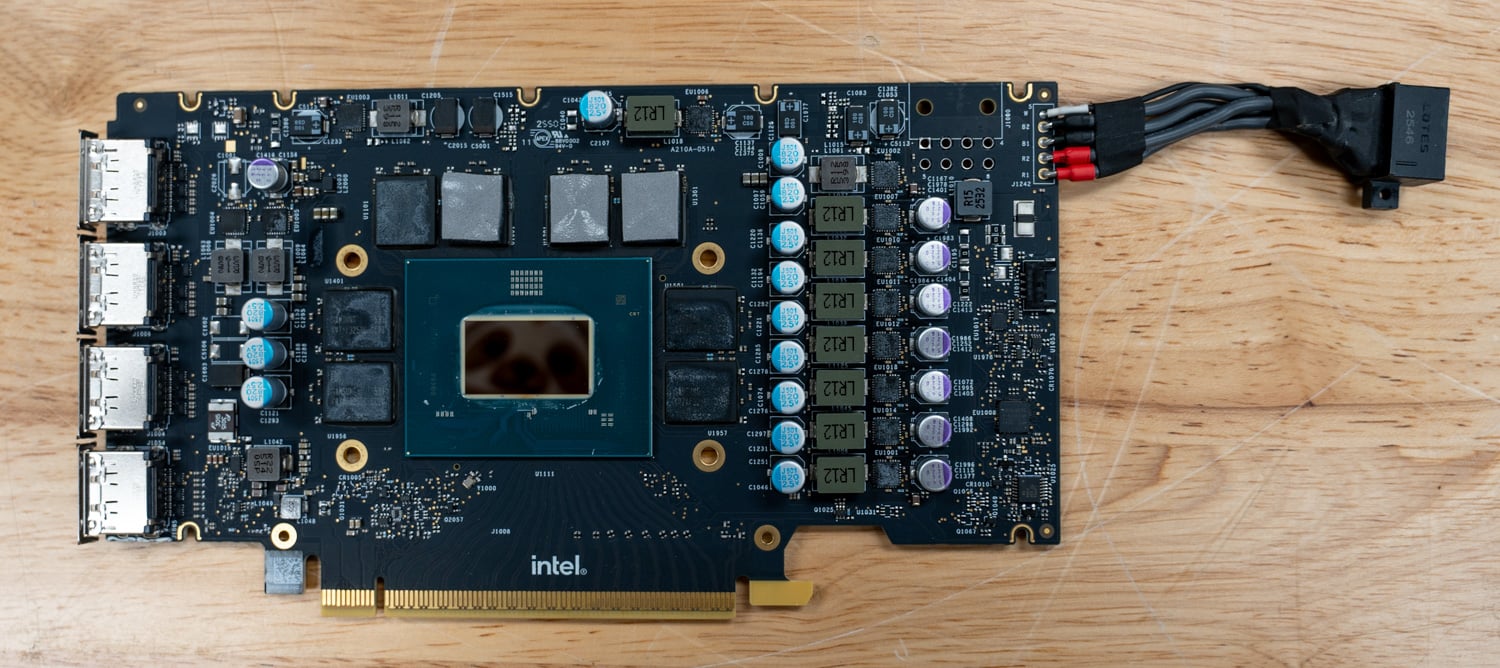
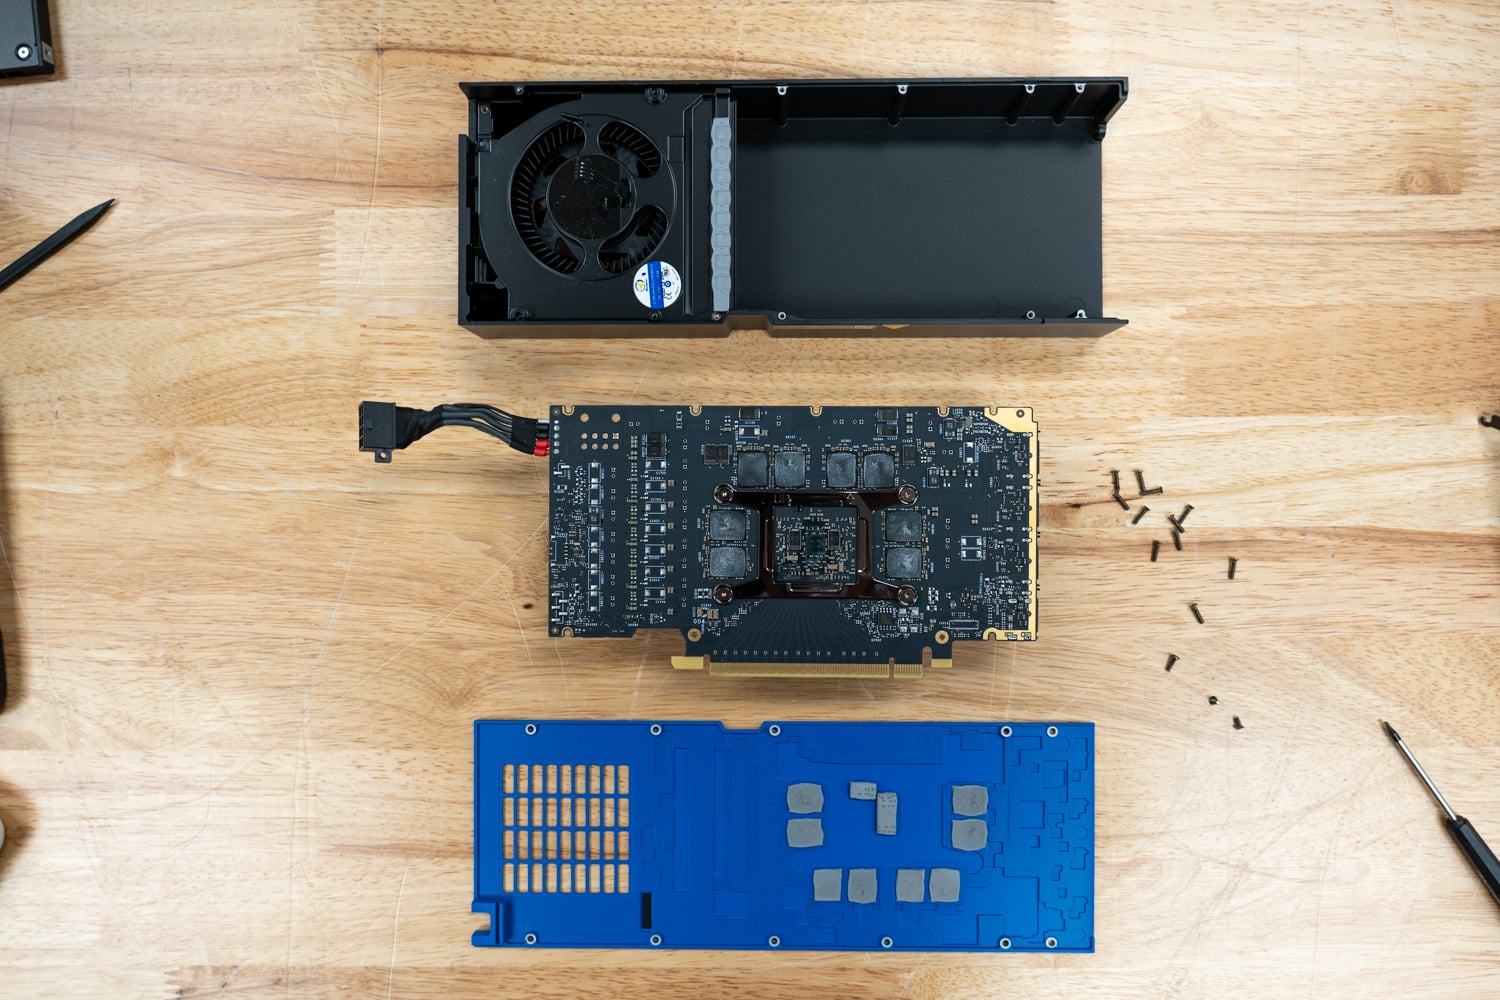
拆下散热器后,Arc Pro B70 的 PCB 板便展现出驱动显卡的主要组件。其核心是英特尔 32 核 Xe2-HPG GPU,周围环绕着 32GB 专用 GDDR6 显存,通过 256 位显存位宽连接,提供高达 608 GB/s 的显存带宽。该 GPU 还集成了 256 个 XMX AI 引擎,可提供高达 367 INT8 TOPS 的 AI 计算性能,以及 32 个专用光线追踪单元,用于硬件加速光线追踪工作负载。GPU 周围是供电电路、显存电路和显示输出组件,共同支撑着显卡的整体设计。
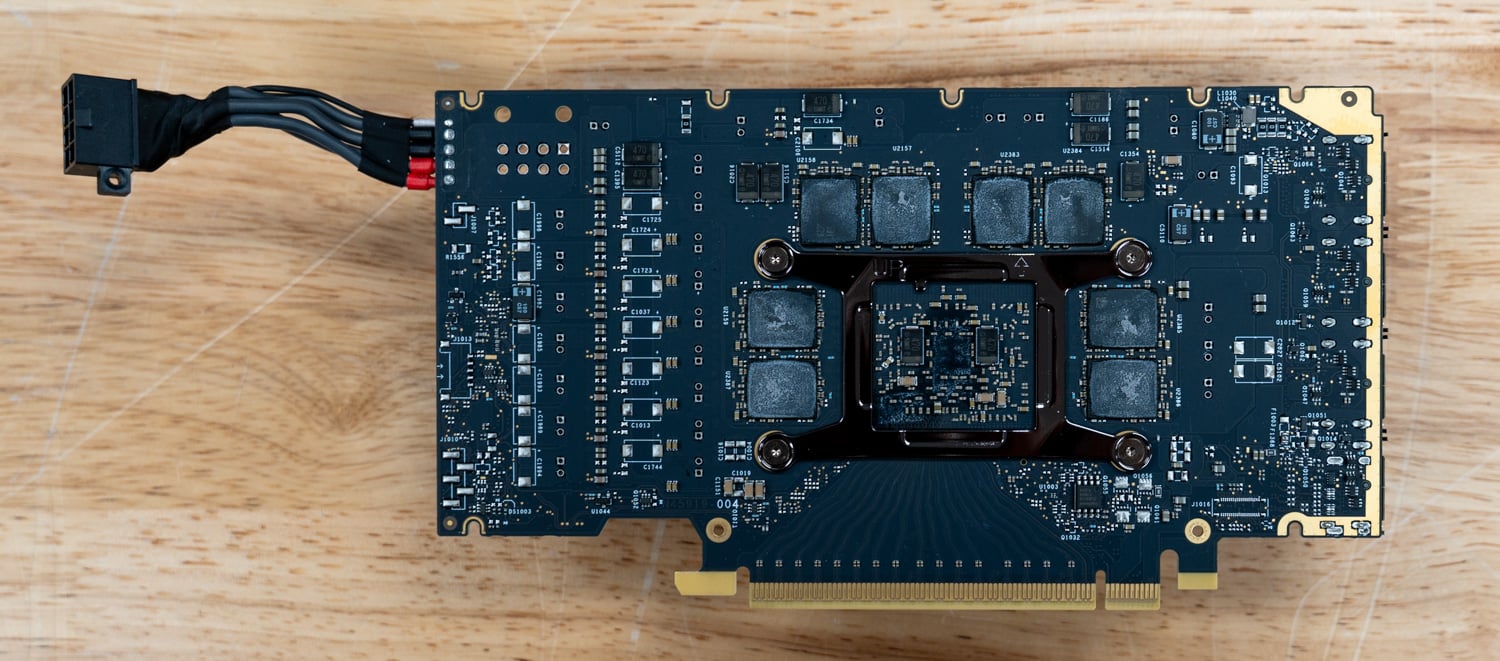
PCB背面露出更多GDDR6显存封装以及部分显卡供电电路。环绕GPU封装的大型固定支架有助于均匀分散散热器的安装压力。8针PCIe电源接口为显卡提供外部电源。通过PCIe插槽供电,Arc Pro B70的总板载功耗最高可达230W。
英特尔 Arc Pro B70 性能测试
Windows 测试 – StorageReview AMD Threadripper 测试平台
以下是我们将用于单颗 Intel Arc Pro B70 测试的测试平台:
- 主板: 华硕 Pro WS TRX50-SAGE WIFI
- CPU: AMD Ryzen Threadripper 7980X 64 核
- RAM: 128GB DDR5 4800MT/s
- 存储: 2TB 三星 980 Pro
- OS: Windows 11 Pro for Workstations
测试的同类GPU
- 英特尔 Arc Pro B50
- 英特尔 Arc Pro B70
- AMD Radeon RX 9060 XT
- 的AMD Radeon RX 9070
- AMD Radeon RX 9070 XT
- NVIDIA GeForce RTX 5060 Ti
- NVIDIA GeForce RTX 5070FE
UL Procyon:AI 文本生成
Procyon AI 文本生成基准测试采用简洁一致的评估方法,简化了 AI LLM 性能测试。它允许对多个 LLM 模型进行重复测试,同时最大限度地降低大型模型的复杂性以及各种可变因素的影响。该基准测试由 Procyon 与 AI 硬件领域的领先企业合作开发,优化了本地 AI 加速器的使用,从而提供更可靠、更高效的性能评估。以下结果是使用 NVIDIA 模型上的 TensorRT 和 AMD 模型上的 ONNX 测得的。
在本次对比测试中,Arc Pro B70 的代际提升幅度最大,在 Phi、Mistral 和 Llama 3 平台上,其整体得分较 B50 提升了 60%,同时首令牌获取时间缩短了 40-45%。与 AMD 的显卡相比,B70 在 Phi 平台上的得分比 Radeon RX 9060 XT 高出 224%(4,152 分 vs. 1,281 分),在 Mistral 平台上高出 220%(4,082 分 vs. 1,274 分),在 Llama 3 平台上高出 250%(4,029 分 vs. 1,150 分)。与 Radeon RX 9070 XT 相比,Intel 仍然保持着 100%、83% 和 95% 的优势。 NVIDIA缩小了与B70的差距,RTX 5060 Ti在Phi和Mistral测试中均落后B70 45%,而RTX 5070在相同测试中仍落后15-20%。最突出的结果是Llama 2测试,B45以5,769分的成绩在所有对比测试中名列前茅,比RTX 5070高出85%,比RX 9070 XT高出151%。
| UL Procyon:AI 文本生成 | 英特尔 Arc Pro B50 | 英特尔 Arc Pro B70 | AMD Radeon RX 9060 XT | 的AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070FE |
|---|---|---|---|---|---|---|---|
| 菲总分 | 2,593 | 4,152 | 1,281 | 1,933 | 2,080 | 2,870 | 3,453 |
| Phi 输出时间到第一个标记 | 0.275小号 | 0.155小号 | 1.473小号 | 0.954小号 | 0.855小号 | 0.375小号 | 0.323小号 |
| 每秒输出 Phi 令牌数 | 72.128 个代币/秒 | 104.121 个代币/秒 | 94.453 个代币/秒 | 139.187 个代币/秒 | 144.471 个代币/秒 | 120.773 个代币/秒 | 150.435 个代币/秒 |
| Phi 总时长 | 39.179小号 | 37.924小号 | 39.365小号 | 26.989小号 | 25.587小号 | 25.216小号 | 20.302小号 |
| 米斯特拉尔总成绩 | 2,483 | 4,082 | 1,274 | 2,040 | 2,231 | 2,807 | 3,562 |
| Mistral 输出第一个令牌的时间 | 0.346小号 | 0.180小号 | 1.827小号 | 1.109小号 | 0.946小号 | 0.526小号 | 0.433小号 |
| 每秒 Mistral 输出代币数 | 46.799 个代币/秒 | 65.834 个代币/秒 | 65.115 个代币/秒 | 101.300 个代币/秒 | 103.348 个代币/秒 | 91.057 个代币/秒 | 120.507 个代币/秒 |
| 米斯特拉尔总持续时间 | 59.907小号 | 58.976小号 | 54.516小号 | 34.960小号 | 33.350小号 | 33.377小号 | 25.496小号 |
| Llama3 总体评分 | 2,427 | 4,029 | 1,150 | 1,904 | 2,070 | 2,599 | 3,125 |
| Llama3 输出第一个标记的时间 | 0.311小号 | 0.166小号 | 1.632小号 | 0.981小号 | 0.845小号 | 0.449小号 | 0.379小号 |
| Llama3 每秒输出令牌数 | 45.031 个代币/秒 | 66.340 个代币/秒 | 53.167 个代币/秒 | 87.594 个代币/秒 | 89.102 个代币/秒 | 74.709 个代币/秒 | 100.388 个代币/秒 |
| Llama3 总时长 | 61.926小号 | 53.687小号 | 62.563小号 | 38.273小号 | 36.742小号 | 39.489小号 | 29.720小号 |
| Llama2 总体评分 | – | 5,769 | 1,252 | 2,047 | 2,298 | 2,576 | 3,125 |
| Llama2 输出第一个标记的时间 | – | 0.259小号 | 2.992小号 | 1.926小号 | 1.565小号 | 0.844小号 | 0.785小号 |
| Llama2 每秒输出令牌数 | – | 63.666 个代币/秒 | 34.654 个代币/秒 | 59.673 个代币/秒 | 61.127 个代币/秒 | 41.386 个代币/秒 | 56.647 个代币/秒 |
| Llama2 总时长 | – | 44.131小号 | 99.027小号 | 59.100小号 | 55.520小号 | 71.302小号 | 53.234小号 |
UL Procyon: 人工智能图像生成
Procyon AI 图像生成基准测试能够持续、准确地衡量各种硬件(从低功耗 NPU 到高端 GPU)的 AI 推理性能。它包含三项测试:针对高端 GPU 的 Stable Diffusion XL (FP16) 测试、针对中等性能 GPU 的 Stable Diffusion 1.5 (FP16) 测试以及针对低功耗设备的 Stable Diffusion 1.5 (INT8) 测试。该基准测试会针对每个系统使用最佳推理引擎,从而确保结果的公平性和可比性。
图像生成是Arc Pro B70相较于其小兄弟的另一大亮点,其稳定扩散1.5 FP16得分提升了179%(2,101分对比754分),同时生成时间也从132.6秒缩短至47.6秒,降幅达64%。B70的性能基本与RTX 5060 Ti持平(2,101分对比2,110分,差距不到1%),但分别落后于RX 9070 XT 19%和RTX 5070 29%。在稳定扩散XL FP16测试中,英特尔再次将B50的性能提升了近三倍(提升181%),仅比RTX 5060 Ti高出8%,落后于RTX 5070 FE约18%。 INT8 工作负载有利于 NVIDIA 的 TensorRT 实现,尽管 B70 仍然比 B50 提高了 265%,并将图像生成时间缩短了 72% 以上。
| UL Procyon:人工智能图像生成 (总分:越高越好) |
英特尔 Arc Pro B50 | 英特尔 Arc Pro B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | 的AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5070FE |
|---|---|---|---|---|---|---|---|
| 稳定扩散 1.5 (FP16) — 总体得分 | 754 | 2,101 | 1,436 | 2,110 | 2,280 | 2,598 | 2,937 |
| 稳定扩散 1.5 (FP16) — 总时间 | 132.585小号 | 47.585小号 | 69.633小号 | 47.590小号 | 43.858小号 | 38.481小号 | 34.038小号 |
| 稳定扩散 1.5 (FP16) — 图像生成速度 | 8.287 秒/图像 | 2.974 秒/图像 | 4.352 秒/图像 | 2.974 秒/图像 | 2.741 秒/图像 | 2.405 秒/图像 | 2.127 秒/图像 |
| 稳定扩散 1.5 (INT8) — 总体得分 | 5,020 | 18,344 | 无 | 27,705 | 无 | 无 | 36,320 |
| 稳定扩散 1.5 (INT8) — 总时间 | 49.795小号 | 13.628小号 | 无 | 9.024小号 | 无 | 无 | 6.883小号 |
| 稳定扩散 1.5 (INT8) — 图像生成速度 | 6.224 秒/图像 | 1.703 秒/图像 | 无 | 1.128 秒/图像 | 无 | 无 | 0.860 秒/图像 |
| 稳定扩散 XL (FP16) — 总体得分 | 748 | 2,102 | 1,124 | 1,940 | 1,805 | 2,010 | 2,473 |
| 稳定扩散 XL (FP16) — 总时间 | 790.774小号 | 285.344小号 | 533.736小号 | 326.550小号 | 332.400小号 | 298.499小号 | 242.606小号 |
| 稳定扩散 XL (FP16) — 图像生成速度 | 49.423 秒/图像 | 17.834 秒/图像 | 33.359 秒/图像 | 20.409 秒/图像 | 20.775 秒/图像 | 18.656 秒/图像 | 15.163 秒/图像 |
乐士马克
Luxmark 是一款 GPU 基准测试软件,它使用开源光线追踪渲染器 LuxRender 来评估系统在处理高精度 3D 场景时的性能。该基准测试软件尤其适用于评估服务器和工作站的图形渲染能力,尤其是在视觉特效和建筑可视化应用中,因为在这些应用中,精确的光照模拟至关重要。
LuxMark 测试表明,Arc Pro B70 在 Battlemage 任务中展现出卓越的性能扩展性。在 Food 场景下,其性能较 B50 提升了 128%,在 Hall 场景下提升了 137%。此外,它在 Food 场景下的性能也比 Radeon RX 9060 XT 高出 33%,在 Hall 场景下高出 53%。主打游戏性能的 RX 9070 XT 在 Food 场景下保持着约 54% 的优势,在 Hall 场景下则保持着约 37% 的优势,而 NVIDIA 的 RTX 5070 FE 则分别领先 62% 和 81%。总而言之,B70 已稳固确立了其作为工作站工作负载强大 OpenCL 渲染加速器的地位。
| 乐士马克 (越高越好) |
英特尔 Arc Pro B50 | 英特尔 Arc Pro B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | 的AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5070FE |
|---|---|---|---|---|---|---|---|
| 食物评分 | 2,456 | 5,609 | 4,220 | 6,590 | 8,233 | 8,610 | 9,061 |
| 霍尔斯 | 5,158 | 12,220 | 8,007 | 15,348 | 16,566 | 16,758 | 22,062 |
Geekbench 6
Geekbench 6是一款跨平台基准测试软件,用于衡量系统整体性能。Geekbench 浏览器允许您将任何系统与 Geekbench 6 进行比较。
Arc Pro B70 的得分为 140,165 分,比 Arc Pro B50 提升了整整 100%。它比 Radeon RX 9070 高出约 1%,比 RX 9060 XT 高出 36%,仅比 RTX 5060 Ti 低 7%。NVIDIA 的 RTX 5070 FE 将其领先优势扩大到约 24%,而 AMD 的 RX 9070 XT 则领先约 35%,这使得 B70 稳居主流高端计算显卡的中游水平。
| Geekbench 6 OpenCL (越高越好) |
英特尔 Arc Pro B50 | 英特尔 Arc Pro B70 | AMD Radeon RX 9060 XT | 的AMD Radeon RX 9070 | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070FE | AMD Radeon RX 9070 XT |
|---|---|---|---|---|---|---|---|
| GPU OpenCL 分数 | 70,038 | 140,165 | 102,750 | 138,463 | 150,743 | 173,255 | 188,892 |
3DMark
3DMark Port Royal、Speed Way 和 Steel Nomad 是三款 GPU 基准测试软件,用于测试 GPU 在不同场景下的性能。Port Royal 侧重于光线追踪,Speed Way 评估 GPU 在赛车模拟中的性能,而 Steel Nomad 则以高强度、逼真的图形挑战 GPU 的性能。它们评估 GPU 在渲染、光照和动态场景方面的能力。
新架构显著提升了图形性能。在 Port Royal 测试中,Arc Pro B70 的得分比 B50 高出 154%;在 Speed Way 测试中高出 136%;在 Steel Nomad 测试中高出 149%。与 RX 9060 XT 相比,B70 在 Port Royal 测试中领先 9%;在 Speed Way 测试中领先 7%;在 Steel Nomad 测试中领先 9%。与 RTX 5060 Ti 相比,B70 在 Port Royal 测试中性能差距在 2% 以内;在 Speed Way 测试中落后 23%;在 Steel Nomad 测试中领先 13%。高端的 RTX 5070 FE 和 RX 9070 XT 的性能优势依然保持在 31% 到 83% 之间,具体优势取决于工作负载,这体现了它们作为高性能游戏 GPU 的定位。
| 3DMark (越高越好) |
英特尔 Arc Pro B50 | 英特尔 Arc Pro B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070FE | 的AMD Radeon RX 9070 | AMD Radeon RX 9070 XT |
|---|---|---|---|---|---|---|---|
| 皇家港口 | 4,197 | 10,668 | 9,751 | 10,432 | 14,026 | 15,760 | 17,989 |
| 速度方式 | 1,355 | 3,202 | 3,004 | 4,184 | 5,869 | 5,791 | 6,237 |
| 钢铁游牧者(DX12) | 1,644 | 4,089 | 3,767 | 3,611 | 5,019 | 5,992 | 6,977 |
黄玉视频 AI
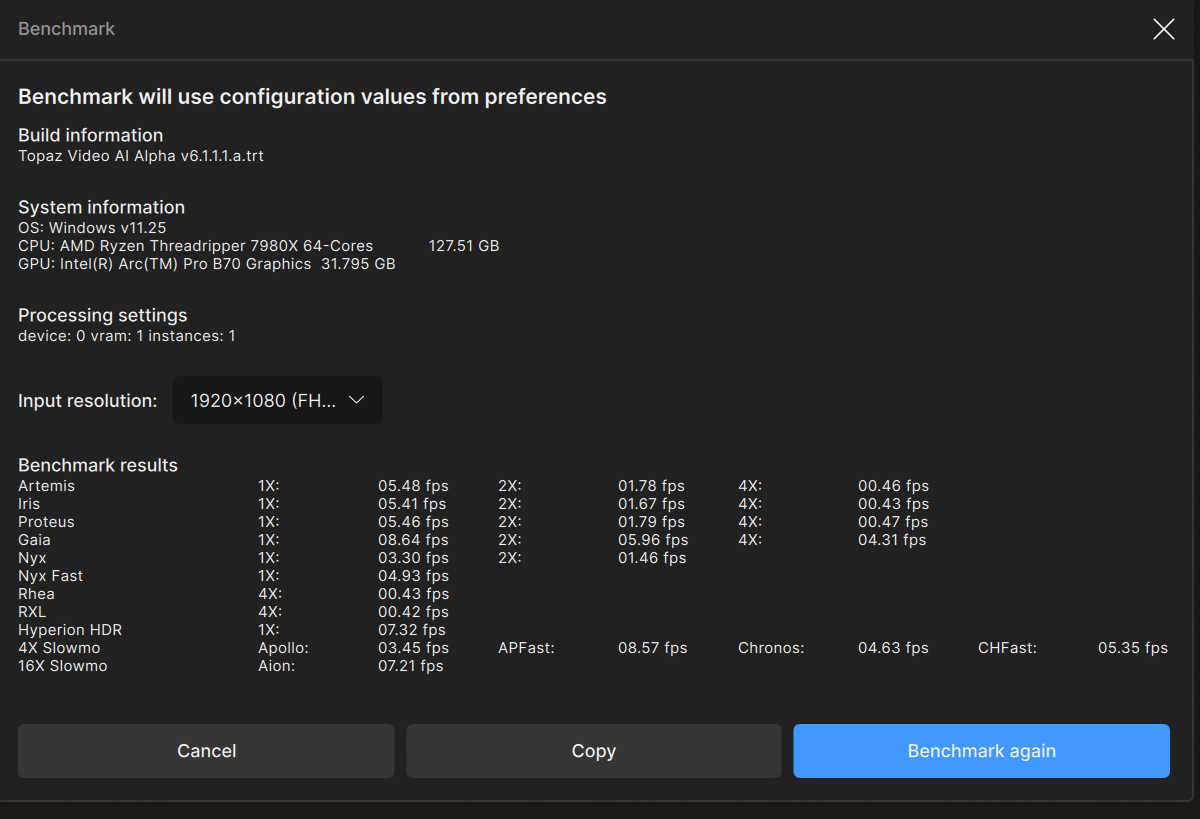
Topaz Video AI 是一款专业的视频增强和修复应用程序,它利用先进的 AI 模型实现视频的增强和修复。该软件支持多种任务,包括将视频提升至 4K 或 8K 分辨率、锐化模糊内容、降低噪点、增强面部细节、为黑白视频着色以及插帧以获得更流畅的运动效果。该套件内置基准测试工具,可测量系统在各种视频增强算法下的性能,从而清晰展现硬件平台处理高要求 AI 视频处理工作负载的能力。
Arc Pro B70 相较于英特尔上一代专业级产品有了显著提升,尤其是在 AI 超采样工作负载方面。该显卡在 Artemis、Iris 和 Proteus 三种 1 倍增强模式下分别达到 5.48 FPS、5.41 FPS 和 5.46 FPS,而 Gaia 则高达 8.64 FPS,是标准增强模型中最快的。计算量更大的修复模型运行速度自然会稍慢一些,Nyx 为 3.30 FPS,Nyx Fast 为 4.93 FPS,Hyperion HDR 则为 7.32 FPS。慢动作生成性能同样出色,Apollo 为 3.45 FPS,APFast 为 8.57 FPS,Chronos 为 4.63 FPS,CHFast 为 5.35 FPS,Aion 为 7.21 FPS。总的来说,这些结果表明 Arc Pro B70 可以处理 Topaz AI 的全部工作流程,从视频增强和降噪到 HDR 转换和帧插值,使其成为希望利用英特尔 XMX AI 加速的创作者的可靠选择。
搅拌机4.5
Blender 是一款开源的 3D 建模应用程序。本次基准测试使用 Blender Benchmark 工具在 GPU 上运行。得分以每分钟采样数衡量,数值越高表示性能越好。
Arc Pro B70 在 Monster 测试中每分钟可生成 1,524.6 个样本,在 Junkshop 测试中每分钟可生成 846.9 个样本,在 Classroom 测试中每分钟可生成 912.2 个样本。虽然这些数据无法与 RX 9070 XT 或 RTX 5070 等高端发烧级 GPU 相媲美,但它们表明 Battlemage 拥有足够的渲染性能,足以满足专业可视化和内容创作工作负载的需求。凭借其 32GB 的显存和经过认证的工作站驱动程序,B70 在渲染能力、AI 加速和专业可靠性之间实现了理想的平衡。
| Blender 4.5.0(每分钟采样次数越多越好) | 英特尔 Arc Pro B70 |
|---|---|
| 怪物 | 1,524.60 |
| 旧货店 | 846.87 |
| 课堂 | 912.24 |
功耗:英特尔 B70
功耗是任何计算平台的重要组成部分。每一代新的GPU在负载下都会消耗更多电量,因此需要更大的电源和充足的散热气流。然而,速度更快的GPU虽然可以达到更高的峰值功耗,但每次工作负载的持续时间却会缩短。我们在测试实验室中使用Quarch Mains Analyzer测量了Procyon AI图像生成器稳定扩散XL FP16测试期间的系统总功耗。该工作负载使每块GPU都接近其功耗极限,每张生成图像的起始点和终止点都清晰可见。
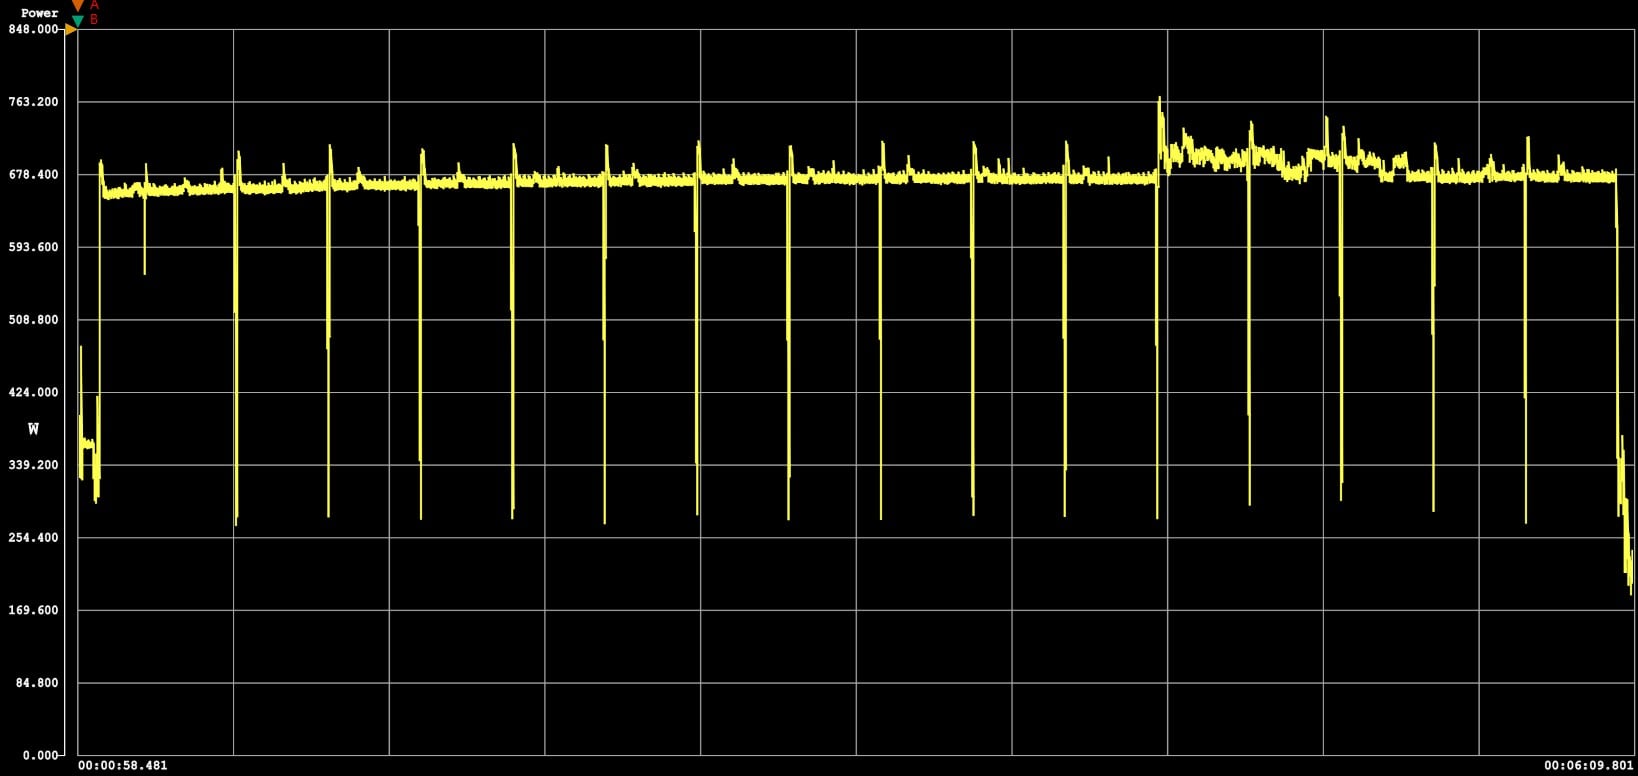
在对 Intel Arc Pro B70 进行测试时,我们测得系统空闲功耗为 207W,工作负载期间峰值功耗为 705.6W,工作负载平均功耗为 638.6W。
| 稳定扩散 XL FP16 功率效率 (越低越好) |
英特尔 Arc Pro B50 | 英特尔 Arc Pro B70 | 的AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | PNY NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070FE |
|---|---|---|---|---|---|---|
| 耗电量 | 5.32瓦 | 3.45瓦 | 4.00瓦 | 3.41瓦 | 2.13瓦 | 2.46瓦 |
| 测试时间 | 49.9小号 | 18.46小号 | 33.0小号 | 17.4小号 | 20.2小号 | 19.2小号 |
vLLM 在线服务基准性能
vLLM 是目前最流行的 LLM 高吞吐量推理和服务引擎。vLLM 在线服务基准测试是一个性能评估工具,用于衡量并发请求下的实际服务性能。它通过向运行中的 vLLM 服务器发送请求来模拟生产环境中的工作负载,并可配置请求速率、输入/输出长度和并发客户端数量等参数。该基准测试测量关键指标,包括吞吐量(每秒令牌数)、首令牌到达时间 (TTFT) 和每个输出令牌的到达时间 (TPOT),帮助用户了解 vLLM 在不同负载条件下的性能。
测试平台:
- 服务器: Supermicro AS-4125GS-TNRT
- 处理器: AMD 霄龙 9374F
- 内存:512GB 三星 4800 MT/s DDR5
- ISL 2k/ OSL 256
可比GPU测试
- 英特尔 Arc Pro B60
- 英特尔 Arc Pro B70
- NVIDIA RTX Pro 6000
- NVIDIA DGX Spark
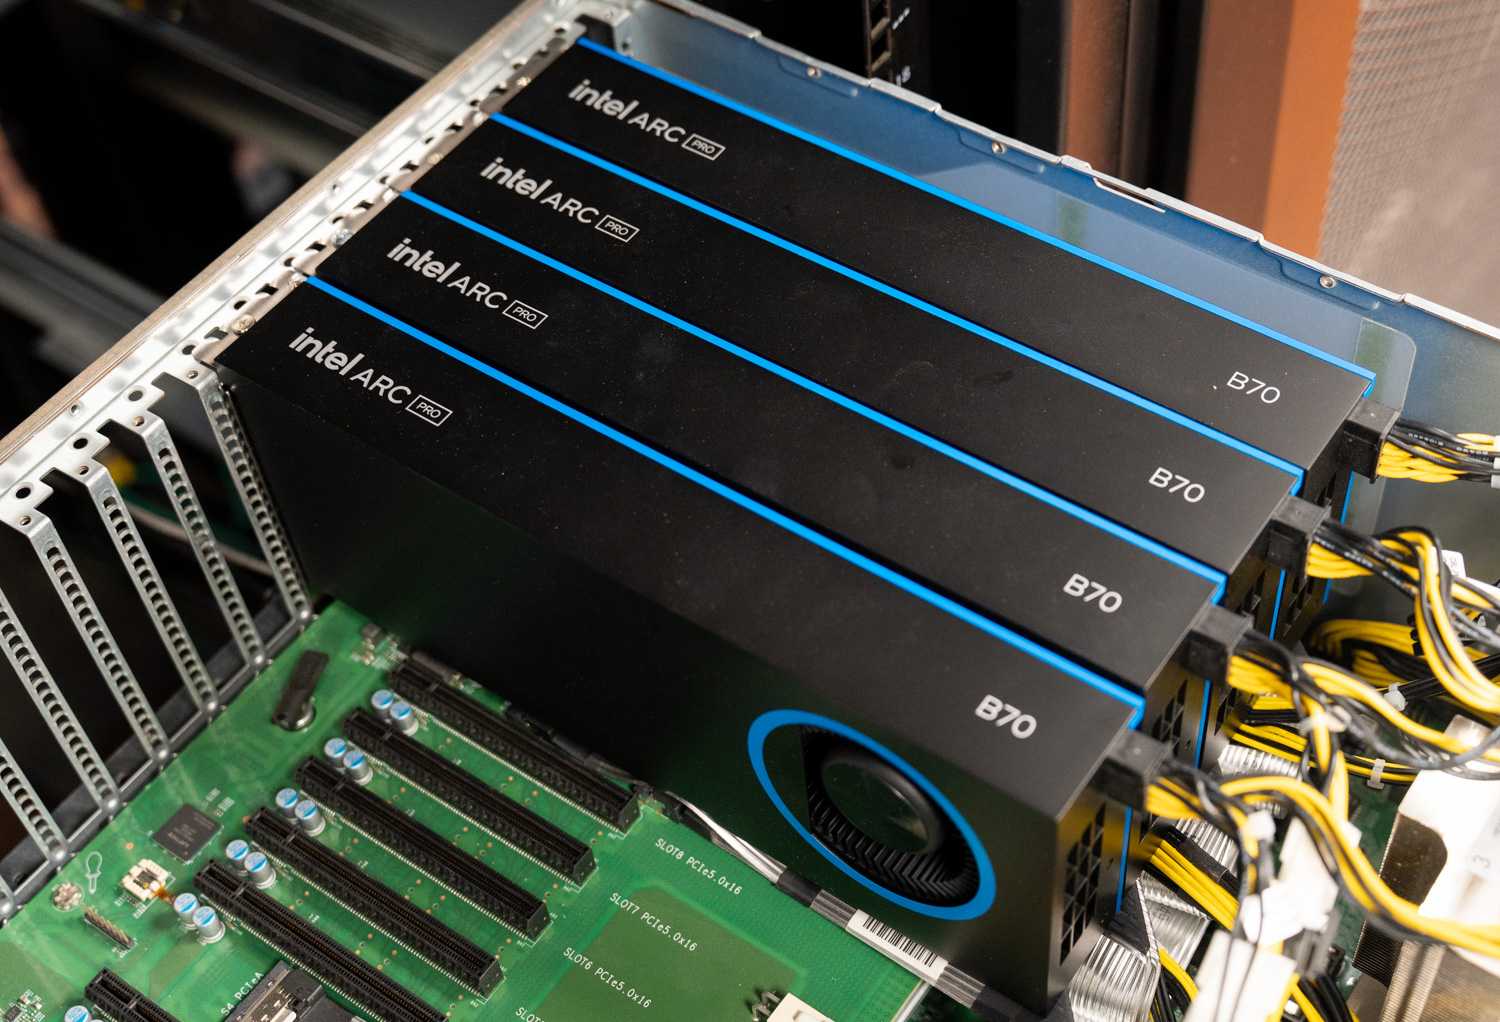
我们在Supermicro主机上测试了四块B70(128GB)和四块B60(96GB)主板,并将其与一块RTX Pro 6000显卡和一块DGX Spark显卡进行了对比。显卡数量不均是特意设计的:一套四块B70主板的标价为949美元,价格接近一块Spark显卡,远低于一块RTX Pro 6000显卡,因此本次对比是基于大致的预算,而非显卡数量。
米斯特拉尔小型 24B
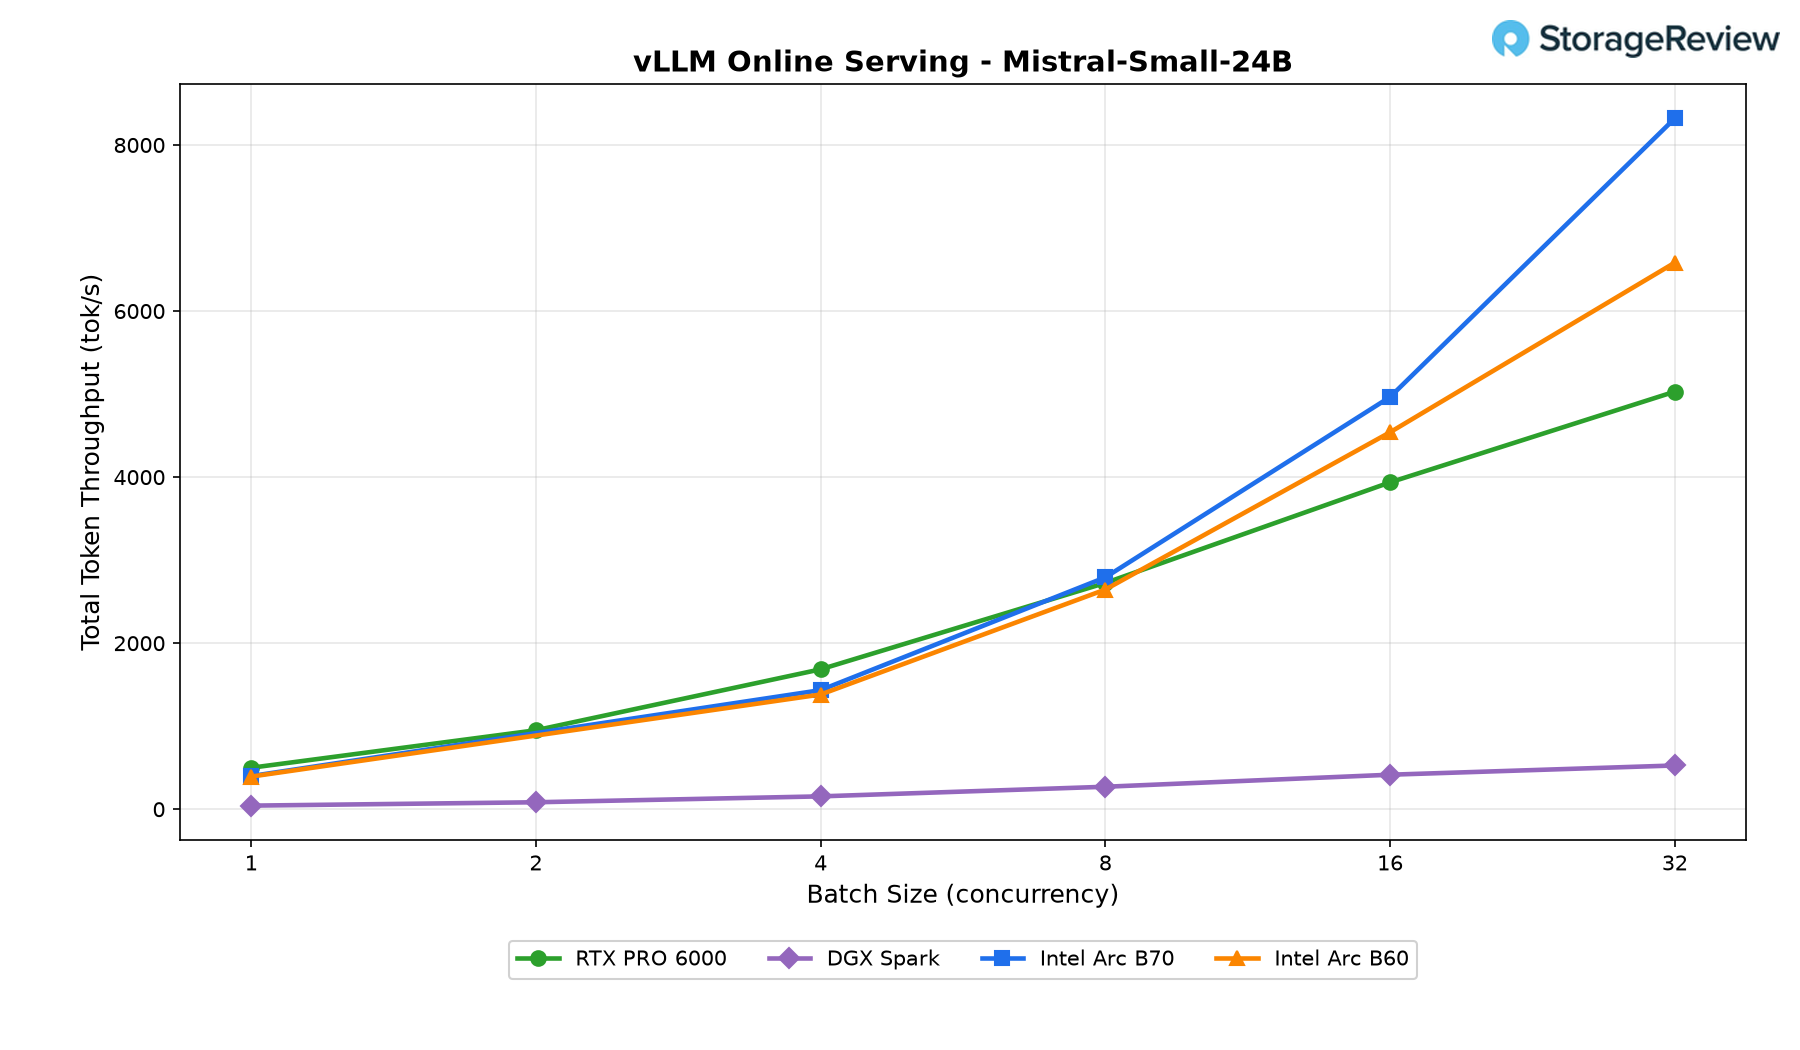
在 Mistral-Small-24B 工作负载测试中,Intel Arc Pro B70 表现最为出色,其运算速度从批处理大小为 1 时的 450 tok/s 提升至批处理大小为 32 时的 8,321 tok/s。虽然 RTX PRO 6000 在批处理大小为 4 时略占优势,但 B70 在批处理大小为 8 时超越了它,并稳步扩大差距,最终在最高并发量下领先约 65%。与尺寸更小的同系列显卡 Arc Pro B60 相比,B70 在测试初期保持着一定的领先优势,并在批处理大小为 32 时将优势扩大到约 26%。DGX Spark 在整个测试过程中始终落后,最高运算速度仅为 527 tok/s,这意味着在满载情况下,B70 的速度几乎是 B60 的 16 倍。
Qwen3编码器30B
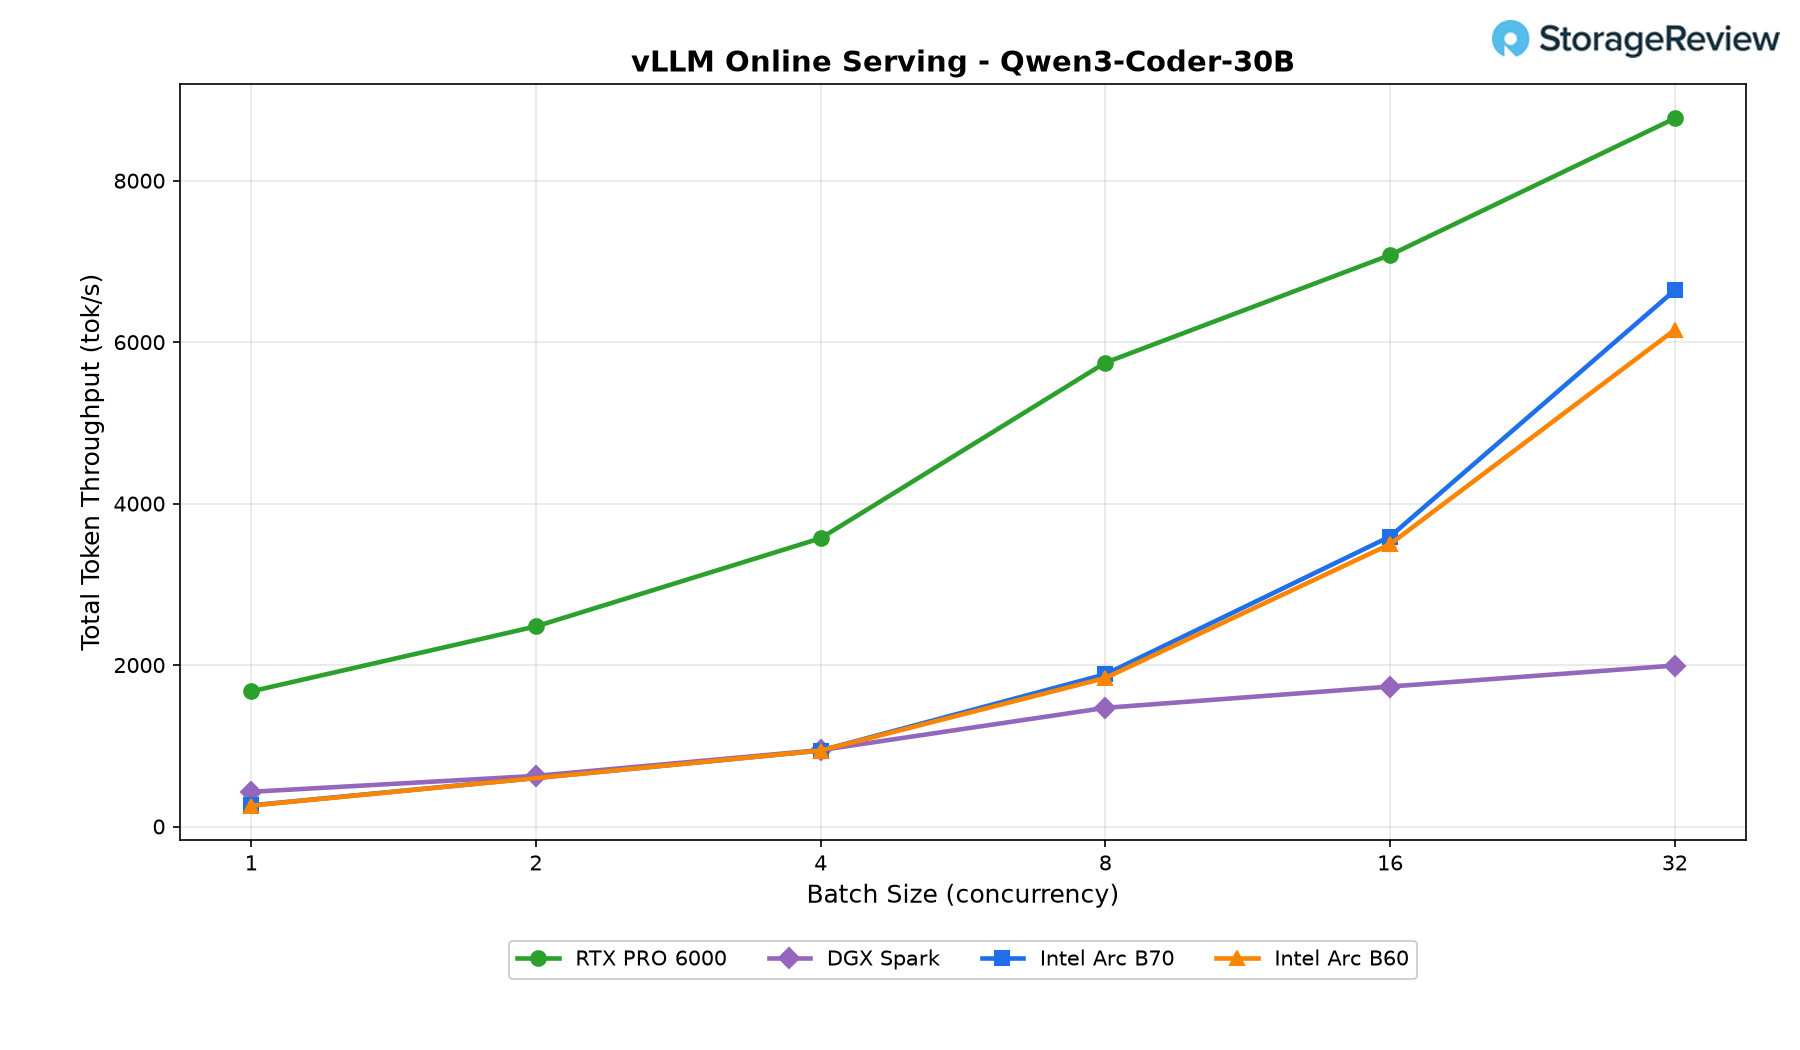
Qwen3-Coder-30B 测试结果显示,RTX PRO 6000 表现最佳,在所有并发级别下均保持了最高的吞吐量,最终达到 8,772 tok/s。Intel Arc Pro B70 的扩展性同样出色,在批处理大小为 32 时达到了 6,643 tok/s,并且始终保持着对 Arc Pro B60 的小幅但稳定的优势,速度提升约 8%。尽管在面向开发者的工作负载下,B70 的性能不及 RTX PRO 6000,但在最大并发级别下,其吞吐量仍然是 DGX Spark 的三倍以上,这凸显了其高效处理大量并发推理请求的能力。
羊驼 3.1 8B
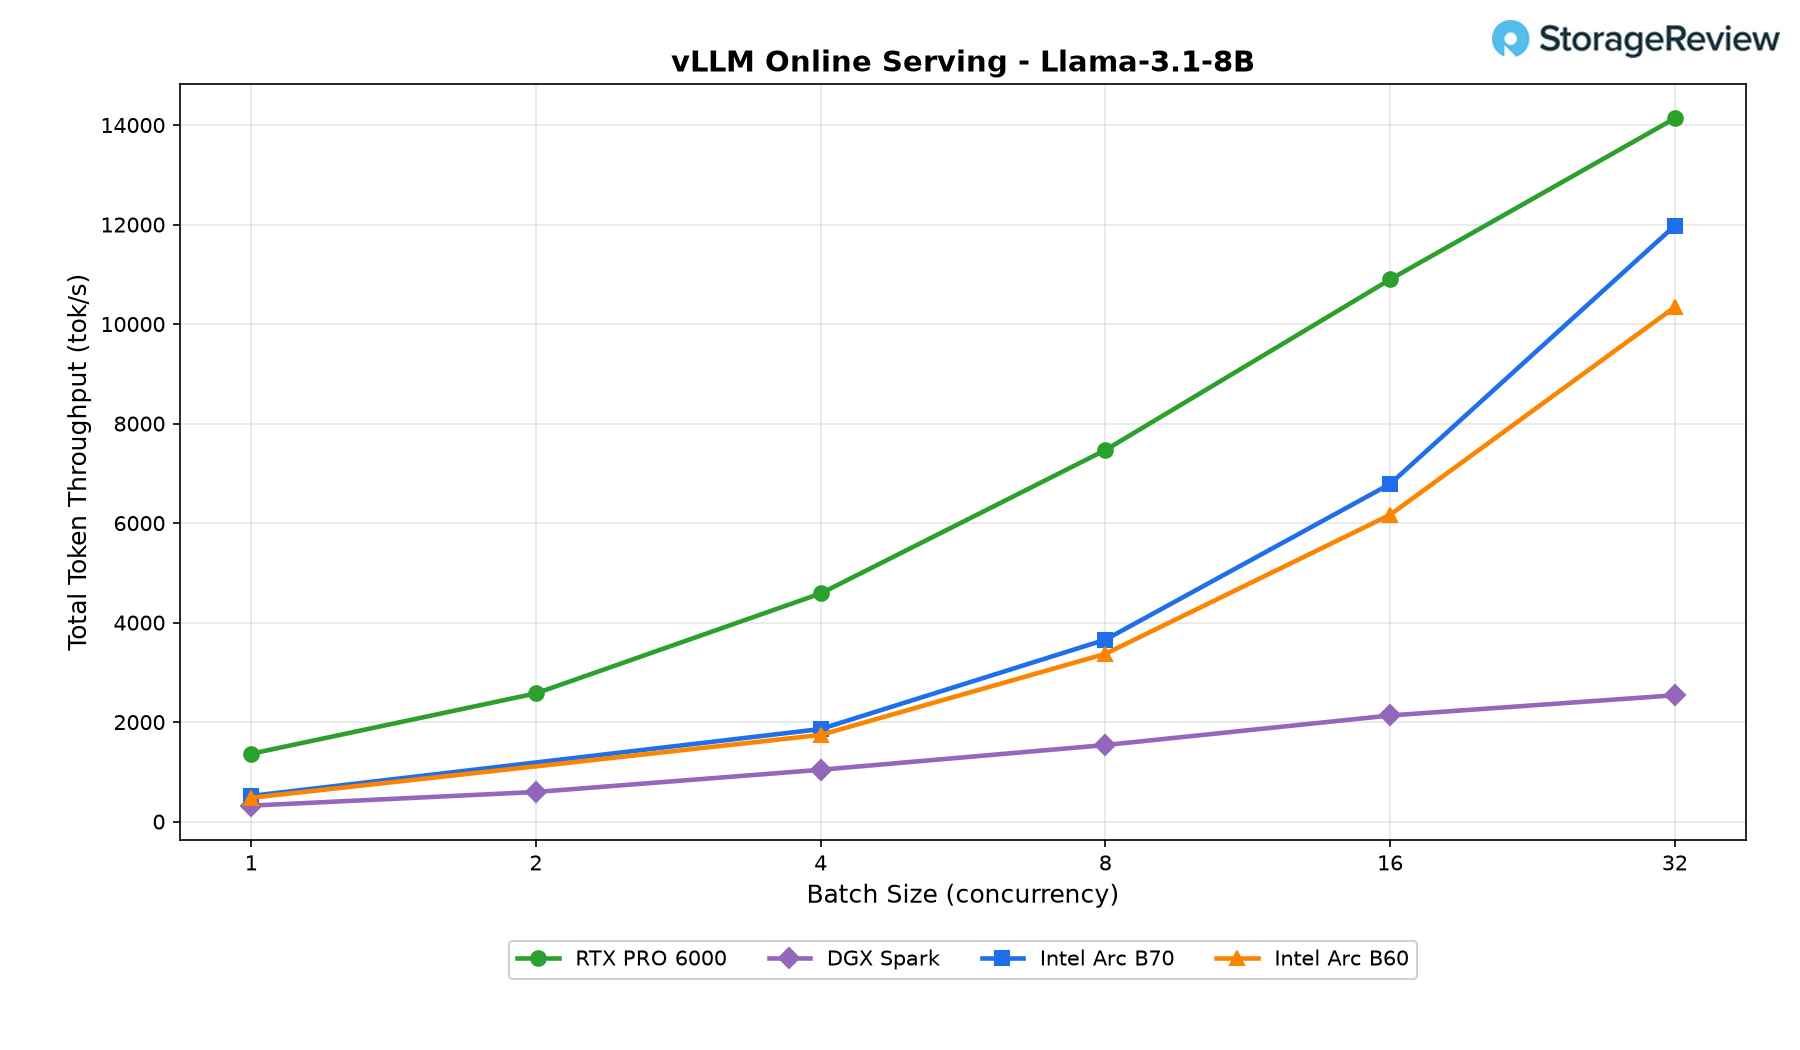
在较小的 Llama-3.1-8B 模型中,所有独立 GPU 的性能都随着并发量的增加而显著提升,但 RTX PRO 6000 仍然是性能的绝对领先者。Intel Arc Pro B70 在批处理大小为 32 时达到了近 12,000 tok/s 的吞吐量,比 Arc Pro B60 领先约 16%,同时达到了 RTX PRO 6000 吞吐量的约 85%。随着并发量的增加,B70 与 DGX Spark 的差距继续扩大,在最高批处理大小下,B70 的吞吐量约为 DGX Spark 的 4.7 倍。结果还表明,B70 能从更大的请求队列中获益匪浅,从而充分利用可用的 GPU 资源。
GPT OSS 20B
在 GPT-OSS-20B 基准测试中,RTX PRO 6000 再次位居榜首,最终速度接近 16,900 tok/s。Intel Arc Pro B70 的速度略高于 10,000 tok/s,在整个性能曲线上始终保持着对 Arc Pro B60 的微弱但可测量的领先优势,在批处理大小为 32 时速度提升约 7%。虽然它比 NVIDIA 的旗舰工作站 GPU 落后约 40%,但其吞吐量仍然是 DGX Spark 的近三倍。批处理大小超过 8 后近乎线性的扩展也表明,随着并发请求的增加,B70 的性能依然得到了充分利用。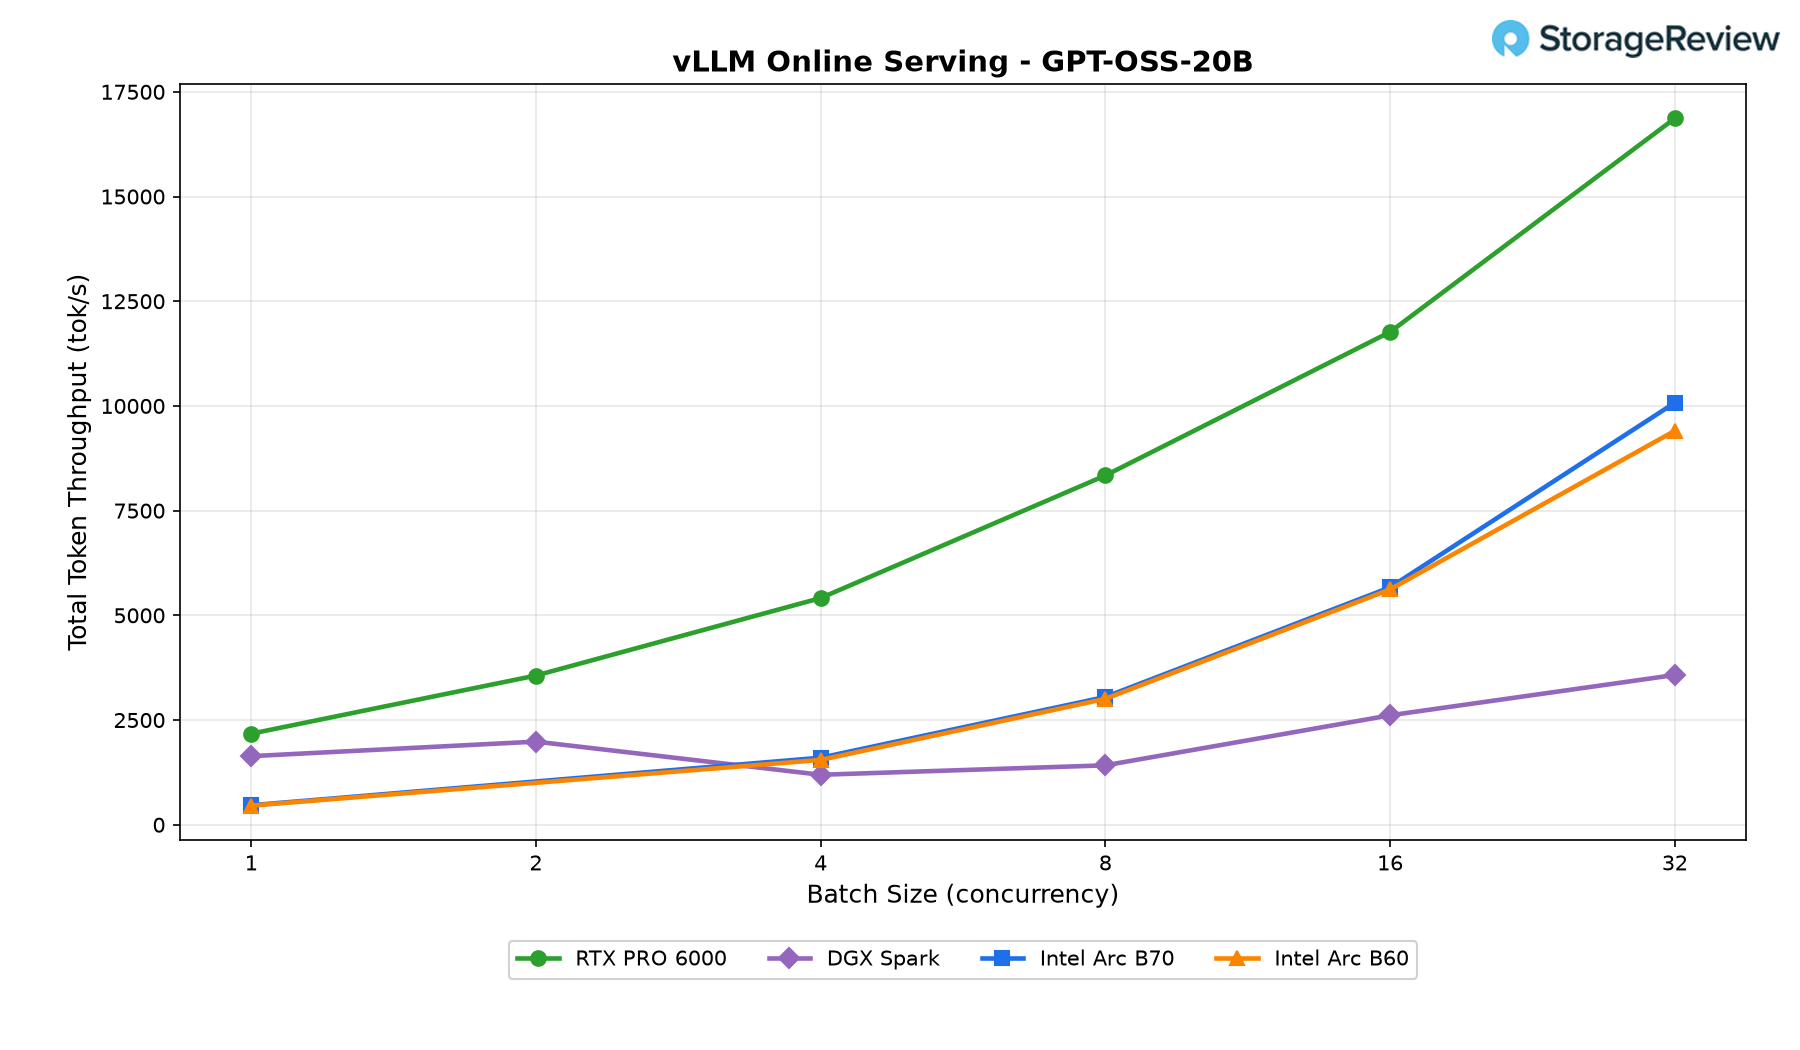
GPT OSS 120B
在所有平台上,该组中最大的模型都表现出更高的性能要求,但英特尔 Arc Pro B70 依然保持了高效的扩展性。它的吞吐量达到了 6,870 tok/s,比 Arc Pro B60 高出约 7%,同时达到了 RTX PRO 6000 吞吐量的四分之三左右。在相同的并发水平下,DGX Spark 的吞吐量为 2,175 tok/s,这意味着 B70 的性能大约是其 3.2 倍。虽然 RTX PRO 6000 保持了整体领先地位,但 B70 也证明了它在处理大型语言模型方面仍然具有很强的竞争力,尤其是在高并发导致硬件满负荷运行时。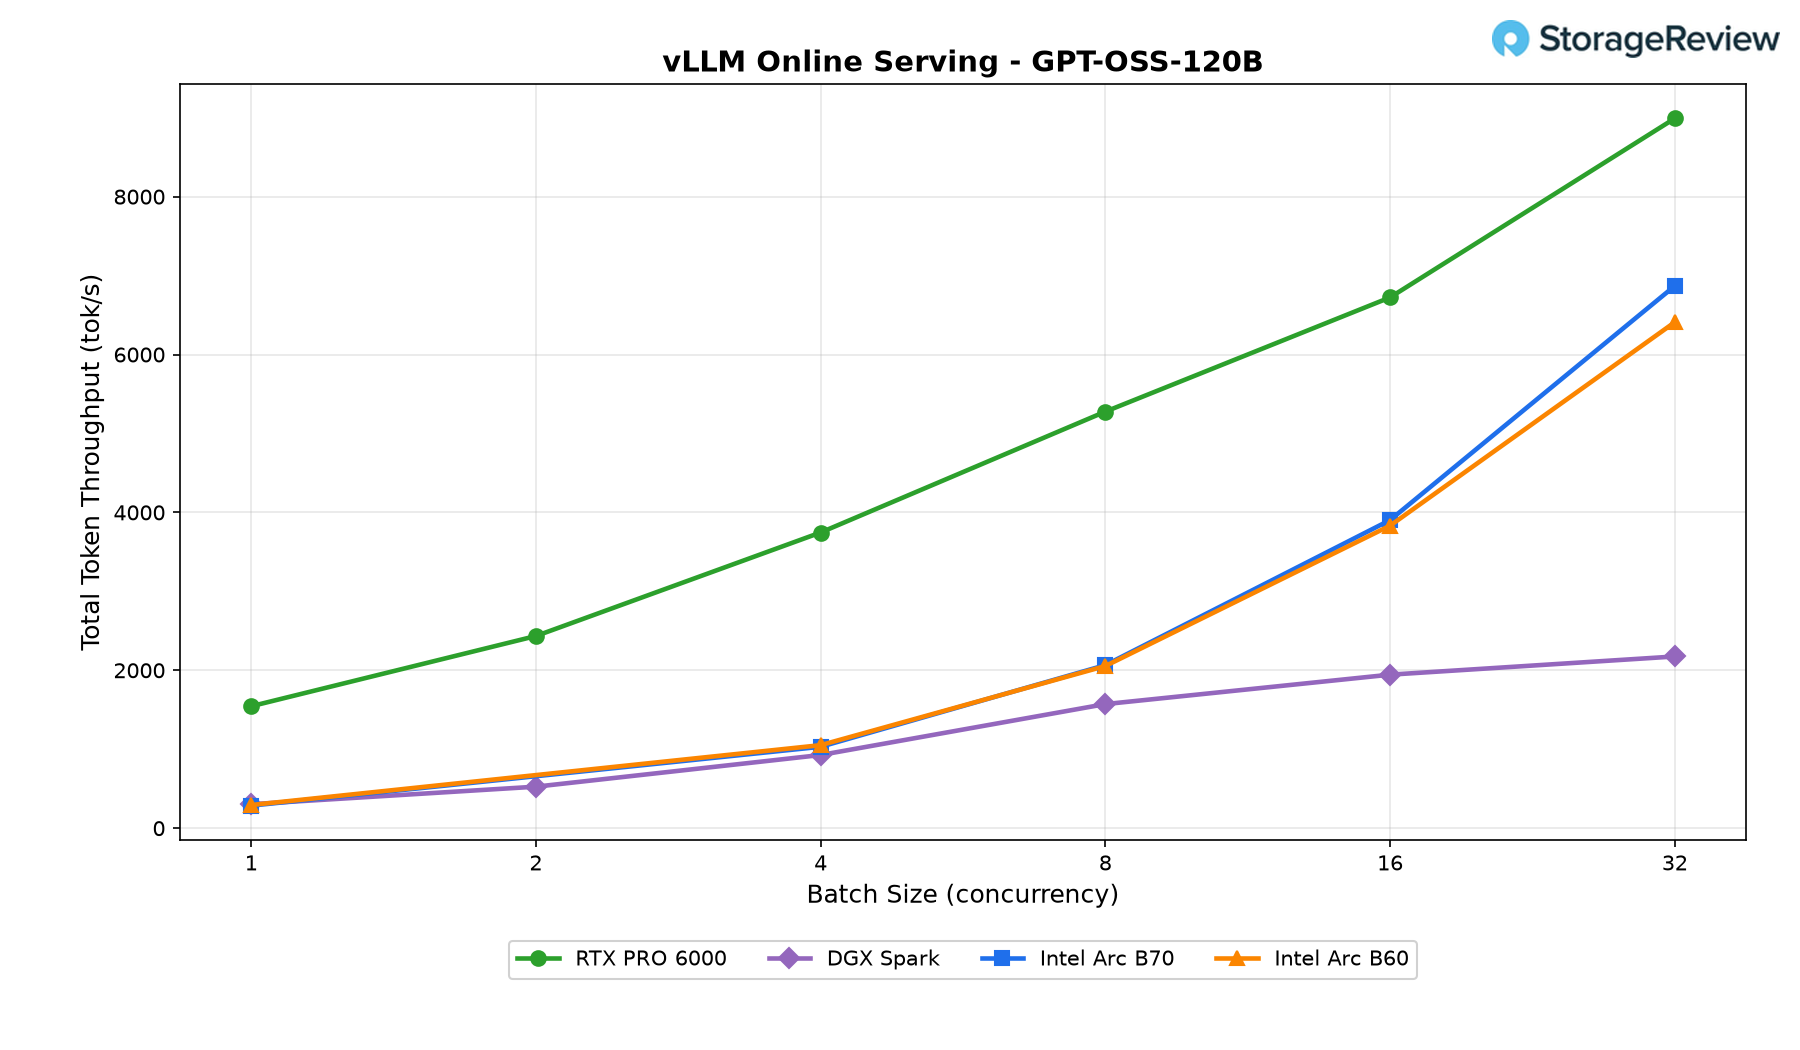
结语
英特尔 Arc Pro B70 是英特尔迄今为止发布的最具吸引力的工作站 AI GPU 之一。其上市建议零售价为 949 美元,凭借 32GB ECC GDDR6 显存和卓越的性能,在许多 AI 和专业工作负载中超越了同价位的消费级 GPU,同时又远低于 NVIDIA 的工作站级同类产品,从而占据了独特的市场地位。即使目前市场价格已超过 1,100 美元,但与 RTX Pro 4000 等产品相比,其性价比仍然极具吸引力,尤其对于那些需要大型本地模型或多 GPU 部署的用户而言,因为在这些情况下,内存容量而非原始计算能力才是瓶颈。
从硬件角度来看,Intel Arc Pro B70 表现出色:在稳定扩散 1.5 图像生成测试中,其性能与 RTX 5060 Ti 基本持平;渲染效果令人满意;运行现代语言模型的速度也足以使其成为本地 AI 基础设施的理想选择,在 Llama 3.1 8B 测试中达到了近 12,000 tok/s 的处理速度;四张 B70 显卡在 Mistral Small 24B 测试中,满并发性能比我们测试的单张 RTX Pro 6000 参考显卡高出 65%。一台工作站配备四张 B70 显卡,可提供 128GB 显存,标价约为 3,800 美元,远低于单张高端工作站 GPU 的价格。
Arc Pro B70 面临的最大挑战并非芯片本身,而是围绕它的软件生态系统。驱动程序的质量和框架支持仍然落后于 NVIDIA 的 CUDA 生态系统和 AMD 日益成熟的 ROCm 堆栈。尽管 Intel 在 oneAPI、OpenVINO 以及支持 Battlemage 的 vLLM 开发方面取得了显著进展,但用户仍然需要做好应对偶尔出现的兼容性问题、有限的模型支持以及比竞争对手平台更繁琐的故障排除工作的准备。对于那些寻求几乎适用于所有 AI 框架和应用程序的“开箱即用”GPU 的用户来说,NVIDIA 和 AMD 仍然是更稳妥的选择。
总而言之,对于那些重视显存容量、工作站功能以及性价比的AI性能的买家来说,Arc Pro B70显卡值得推荐,前提是他们了解自己购买的产品。它是一款性能卓越的硬件,定价也极具竞争力,但其长期成功几乎完全取决于英特尔对持续软件开发和扩展生态系统支持的投入。如果英特尔能够维持这项投入,B70将拥有成为消费级和专业级AI加速领域最具性价比产品的硬件基础。否则,它可能会沦为一款潜力巨大却始终无法达到NVIDIA和AMD竞争对手那样易用性的显卡。


 Amazon