

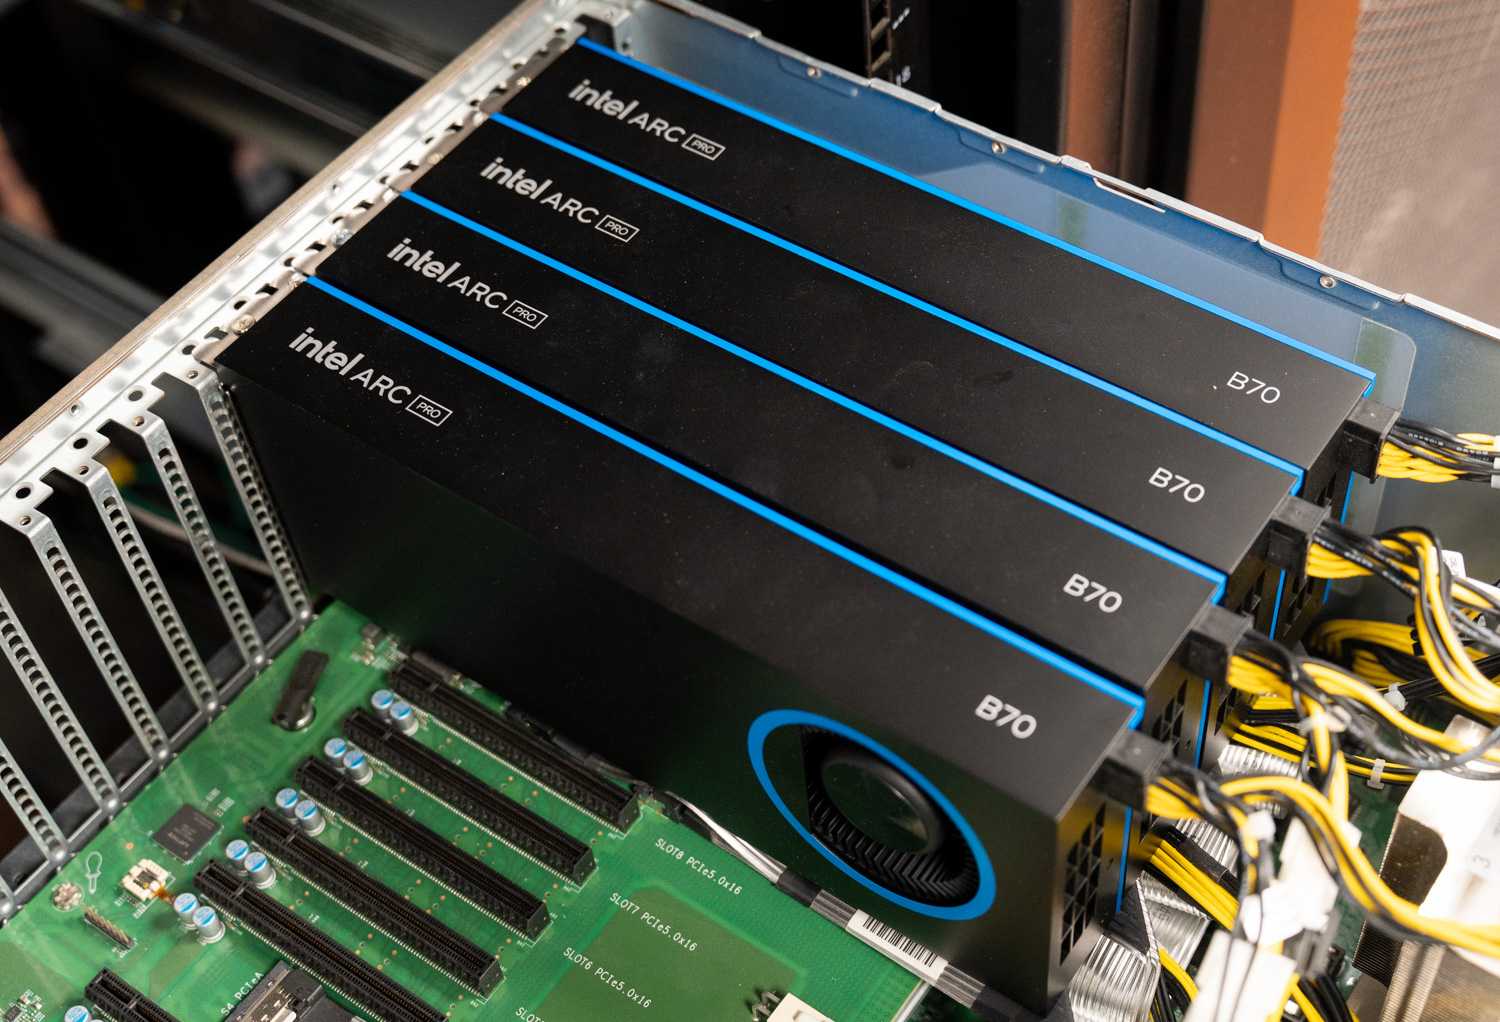
英特爾 Arc Pro B70 是英特爾迄今推出的功能最強大、最有前途的桌面級 AI 顯示卡,但有時它也最令人失望。今年三月發佈時,英特爾將 32GB GDDR6 記憶體版本的定價為 949 美元。然而,記憶體短缺的困境已經將整個市場的售價推高至 1,100 美元以上(截至本文撰寫之時)。即便如此,B70 的價格仍低於英偉達的 RTX Pro 4000 系列顯示卡,後者定價更高,儘管僅配備 24GB 顯存(比 B70 少三分之一),但售價已超過 2,000 美元。一台工作站或伺服器可容納四塊 B70 顯示卡,共享 128GB 顯存,足以運行 1200 億參數的混合專家模型,其並發能力以往需要投入更多資金才能實現。硬體性能令人印象深刻,而價格更是令人咋舌。阻礙它前進的,正是我們去年 12 月預覽的 B60 所面臨的同樣問題:軟體還不完善,我們不禁要問:英特爾最終能否做到這一點?
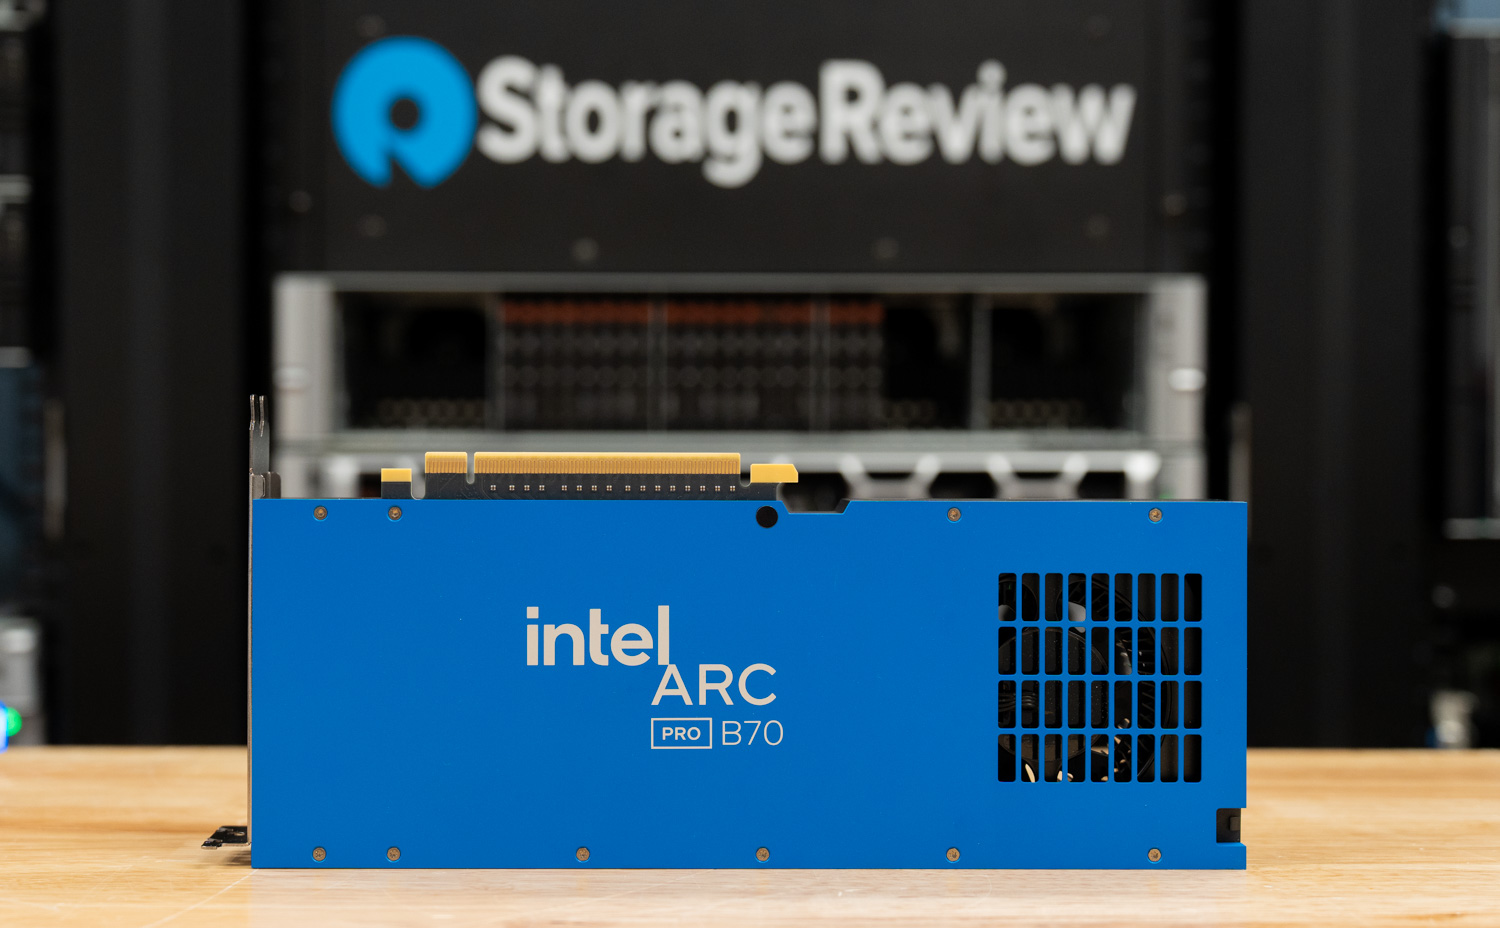
我們之前不只一次遇到英特爾的類似情況。當年我們評測Arc Pro B60 Battlematrix時,它搭載了性能卓越的晶片,但尚未正式發布,而B70則繼承了這兩點。這款顯示卡採用更大的BMG-G31晶片,擁有32個Xe2核心、256個XMX引擎,以及367 TOPS的INT8算力。它採用256位元匯流排,頻寬為608 GB/s,功耗可在160W至290W之間配置。英特爾表示,與B60相比,B70在工作站工作負載下的平均效能提升為44%,在專業應用情境下最高可達69%。要注意的是,B60採用雙GPU設計,佔用一個x8/x8插槽,而B70則為單GPU設計,需要佔用一條完整的PCIe 5.0 x16通道,這會影響四卡機箱的配置方式。
英特爾的行銷策略完全依賴在地化推斷,並選擇了英偉達的 RTX Pro 4000 24GB 作為對比對象。根據英特爾在 Linux 系統下的數據,B70 的 32GB 內存可以容納大約 93K 個 KV 緩存令牌,而 RTX Pro 4000 只能容納 42K 個,在內存耗盡之前,B70 的 85GB 內存可以達到更高的令牌負載,隨著並發用戶數的增加,其在最高速度下可提升令牌速度功率為最高的功率加碼倍,且每美元可獲得的代幣數量最高可達 RTX Pro 6.2 的兩倍。以上數據是英特爾在 BF16 環境下,使用 Llama 3.1 8B 小型伺服器進行單卡測試得出的;我們將對 B2 進行更嚴苛的測試。此處提及的每美元可獲得的令牌數量是基於發佈時的標價;以當前價格計算,英特爾的優勢依然存在甚至更大。
在進行基準測試之前,這種權衡至關重要,因為它決定了哪些用戶應該購買這張顯示卡。我們認為,英特爾的LLM Scaler(支援Battlemage的vLLM開發分支)充其量仍處於測試階段。其模型覆蓋範圍有限;一些本應有效的量化路徑目前無法正常工作,而且堆疊也限制了硬體的性能。我們在戴爾PowerEdge XE7740伺服器上的英特爾Gaudi 3處理器上也遇到了同樣的問題,其FP8軟體測試結果並非源自於晶片本身,而是由英特爾vLLM分支中不成熟的程式碼路徑所致。 B70顯示卡也面臨同樣的問題。英特爾必須在此做出決定,並比目前更積極地堅持下去。
NVIDIA 的護城河並非僅在於 CUDA。部署模型時真正重要的,是那些看似枯燥乏味卻至關重要的東西:文件、範例、可運行的容器、論壇解答,以及足以解決大多數問題的社群歷史。 AMD 顯然也朝著同樣的方向推進 ROCm。 Intel 需要對 Arc Pro 投入相同的精力,否則 B70 可能會淪為發燒友喜歡但團隊難以採用的顯示卡。
為了進行清晰的對比,本次評測平台與B60評測平台完全相同:一台搭載AMD EPYC 9374F處理器和512GB DDR5內存的Supermicro AS-4125GS-TNRTRTD分別運行四塊B70(128GB)和四塊B60(96GB)顯伺服器,分別採用四塊B70(128GB)和四塊B60(96GB)顯伺服器,分別採用vLLM記憶體管理。與B60評測一樣,本次評測並非基於英特爾的全英特爾Battlematrix參考平台(此參考平台搭配的是Xeon 6處理器)。基於英特爾晶片的量產系統性能可能有所不同。請將以下評測視為基於相同平台、同代產品效能和性價比的對比,軟體成熟度會影響最終結果。
英特爾 Arc Pro B70 技術規格
| 規格 | 英特爾 Arc Pro B70 |
|---|---|
| 一般規格 | |
| 產品系列 | 英特爾 Arc Pro B 系列顯示卡 |
| 型號 | 英特爾 Arc Pro B70 |
| 代碼名稱 | 戰鬥法師 |
| 微體系架構 | Xe2 |
| 工藝技術 | 台積電N5 |
| 發射日期 | Q1 2026 |
| 保固 | 3年 |
| 顯卡規格 | |
| Xe核心 | 32 |
| 渲染切片 | 8 |
| 光線追踪單元 | 32 |
| 英特爾 XMX 引擎 | 256 |
| Xe向量引擎 | 256 |
| 圖形時鐘 | 2280 MHz |
| 最大動態時鐘 | 2800 MHz |
| FP32 性能 | 22.94 TFLOPS |
| INT8 AI 效能 | 367 TOPS |
| 主板總功耗 (TBP) | 230瓦(可設定:160-290瓦) |
| PCI Express接口 | PCIe 5.0 x16 |
| 記憶體應用 | |
| 內存容量 | 32GB GDDR6 |
| 內存總線 | 256-位 |
| 內存帶寬 | 608 GB / s |
| ECC內存 | 支持 |
| 顯示和 I/O | |
| 顯示輸出 | DisplayPort 2.1 |
| 最大顯示數量 | 4 |
| 最大分辨率 | 7680 × 4320 @ 120Hz (HDMI / DisplayPort) |
| 可變刷新率 | HDMI VRR,VESA 自適應同步 |
| 功能與軟體 | |
| 視訊編碼/解碼 | H.264、H.265 (HEVC)、AV1 |
| 光線追踪 | 支持 |
| 人工智能框架 | oneAPI、OpenVINO、Intel PyTorch 擴充 (IPEX) |
| 圖形 API | DirectX 12 Ultimate、Vulkan 1.3、OpenGL 4.6、OpenCL 3.0 |
| 英特爾 XeSS | 支持 |
| HDR支持 | HDR10、HDR10+ 遊戲、杜比視界 |
| 多格式編解碼器引擎 | 2 |
| 物理規格 | |
| 尺寸 | 10.5×3.9英寸 |
| 槽寬 | 雙槽 |
| 重量 | 1020g |
| 電源連接器 | 1 × 8 針 (ATX 2×4) |
英特爾 Arc Pro B70 的構造與設計
英特爾 Arc Pro B70 顯示卡尺寸為 10.5 × 3.9 吋(267 × 99 mm),重量為 2.25 磅,採用緊湊的雙槽設計,外觀簡潔低調。此顯示卡採用霧面黑色塗裝,並以英特爾標誌性的藍色點綴。它配備全長陽極氧化鋁背板,增強了顯示卡的剛性,並與英特爾的品牌標誌相呼應。
它採用單鼓式風扇設計,將空氣吸入散熱器,然後直接從後部 I/O 擋板排出。這種封閉式散熱設計使顯示卡體積小巧,並保持系統內部氣流順暢。
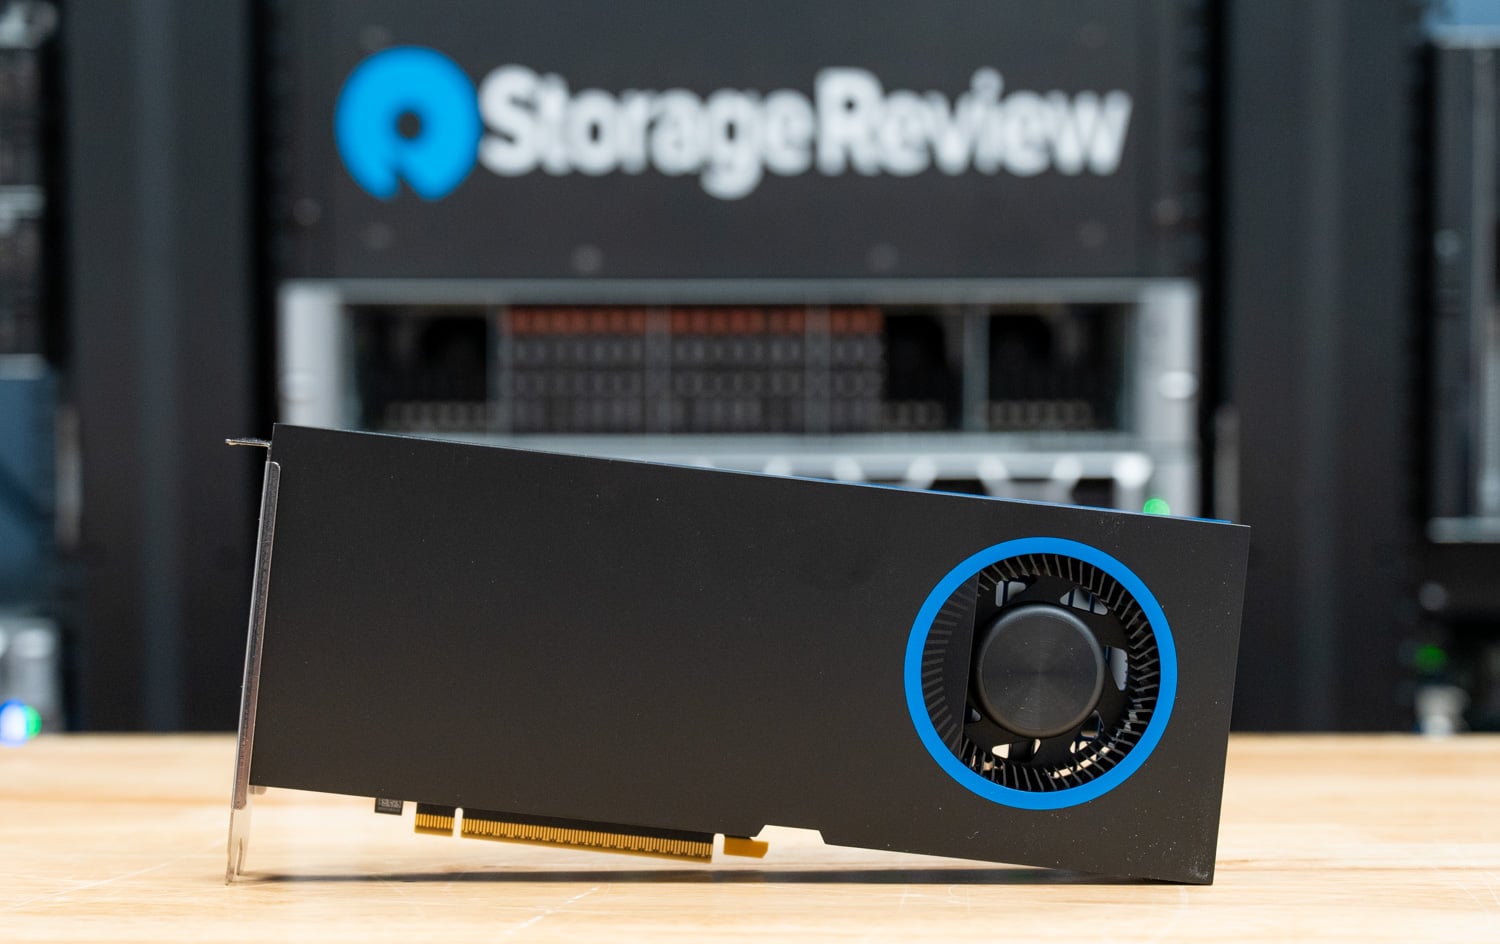
在顯示卡背面,與 PCIe 擋板相對的位置,英特爾提供了一個 8 針 (2×4) PCIe 電源接口,用於提供外部電源。顯示卡外殼的這一端還設有額外的進氣口,為鼓風機提供新鮮空氣,以及用於安裝選用 GPU 支撐支架的螺紋安裝點,以提高工作站部署中的穩定性。
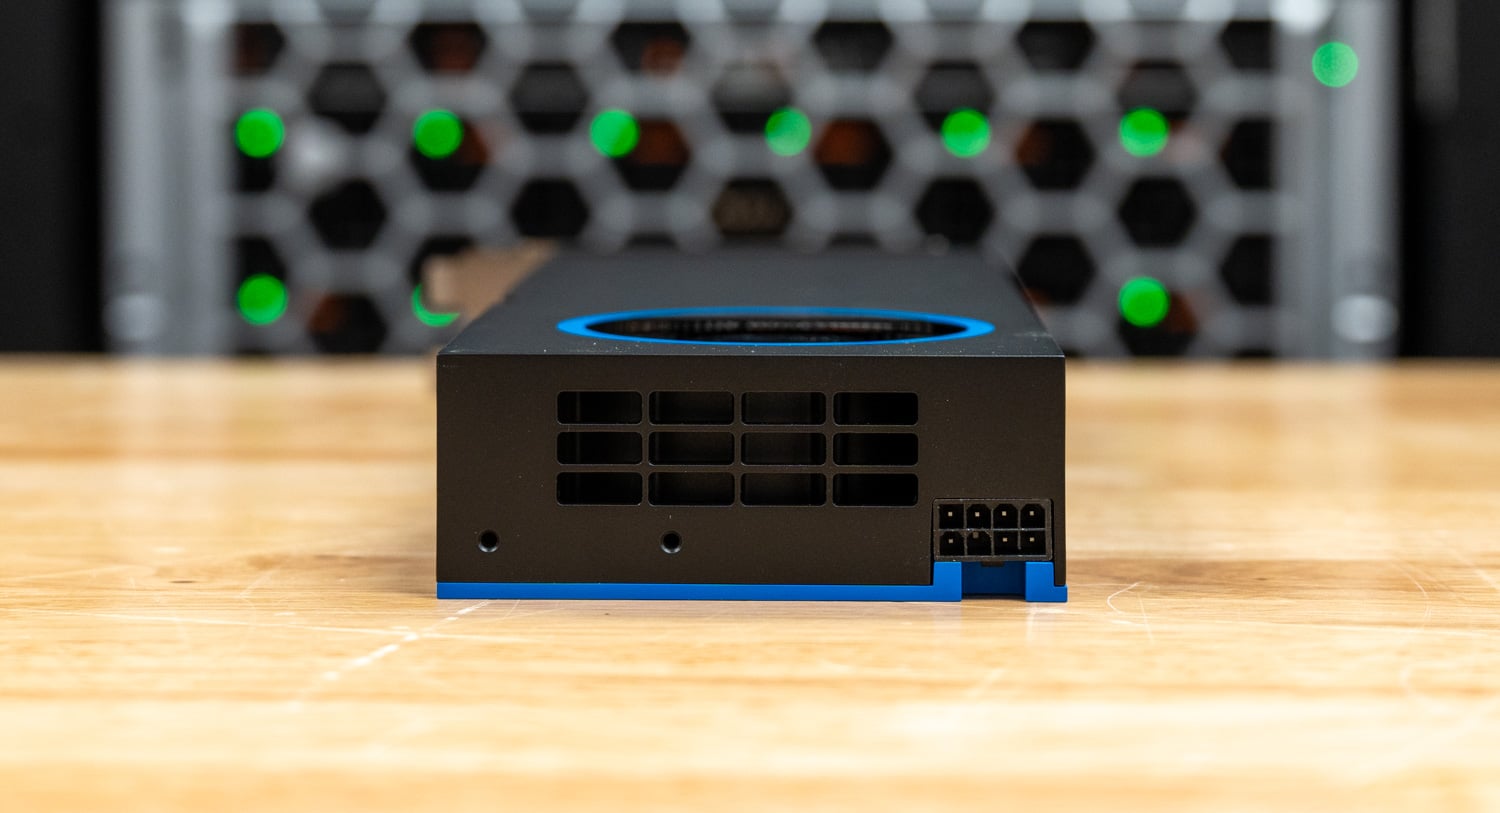
Arc Pro B70 的底部邊緣採用標準的 PCIe 5.0 x16 接口,用於連接主機。這個角度也突顯了該卡的雙槽設計。它為內建的渦輪散熱解決方案提供了足夠的空間,同時又保持了足夠的緊湊性,適用於高密度工作站和伺服器安裝。
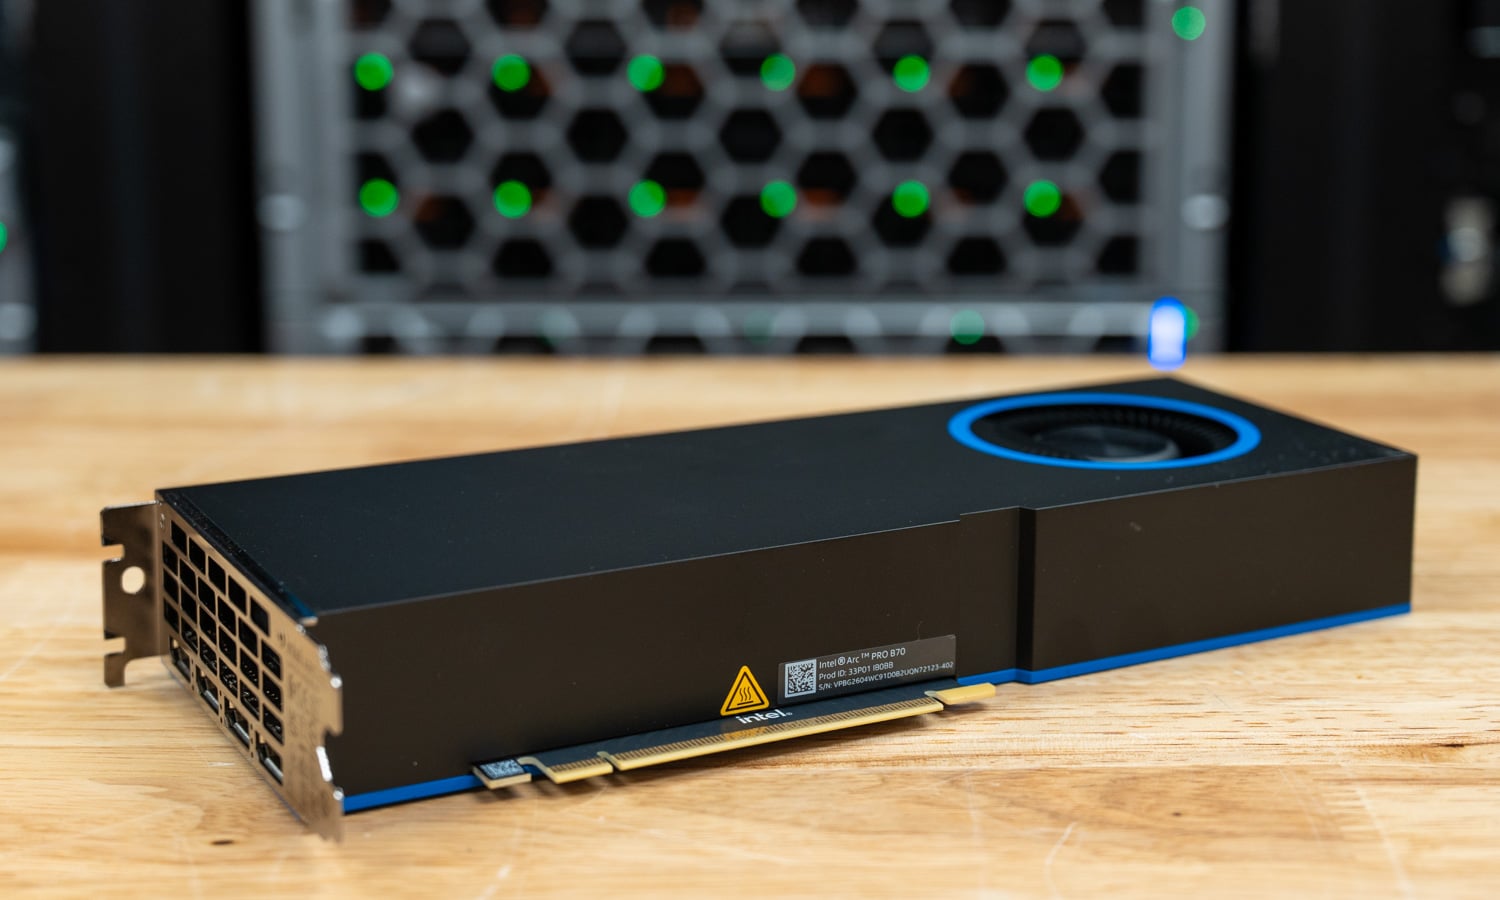
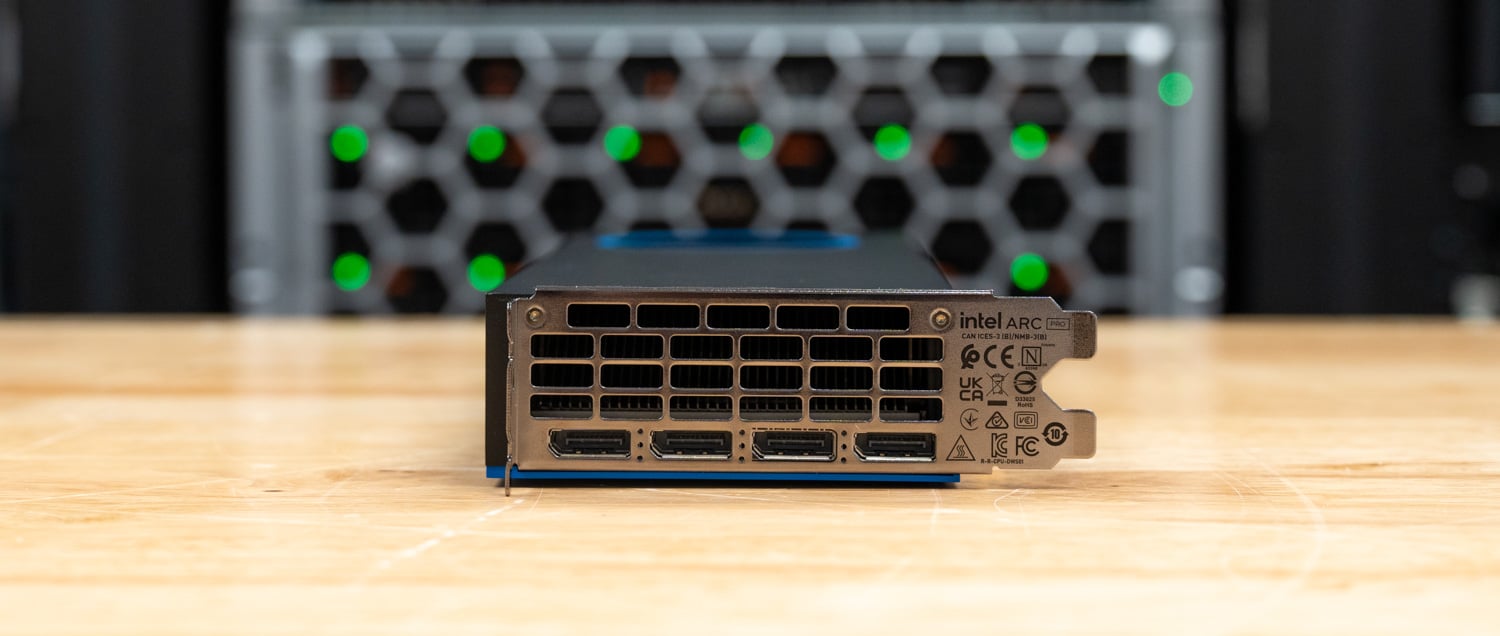
I/O擋板配備一個大型通風排氣口,使鼓風機能夠將熱空氣直接排出機殼。排氣口下方是四個DisplayPort 2.1輸出接口,每個接口均可驅動分辨率高達7680 × 4320 (8K) 且刷新率高達120Hz的顯示器,為高分辨率多顯示器工作站環境提供充足的頻寬。
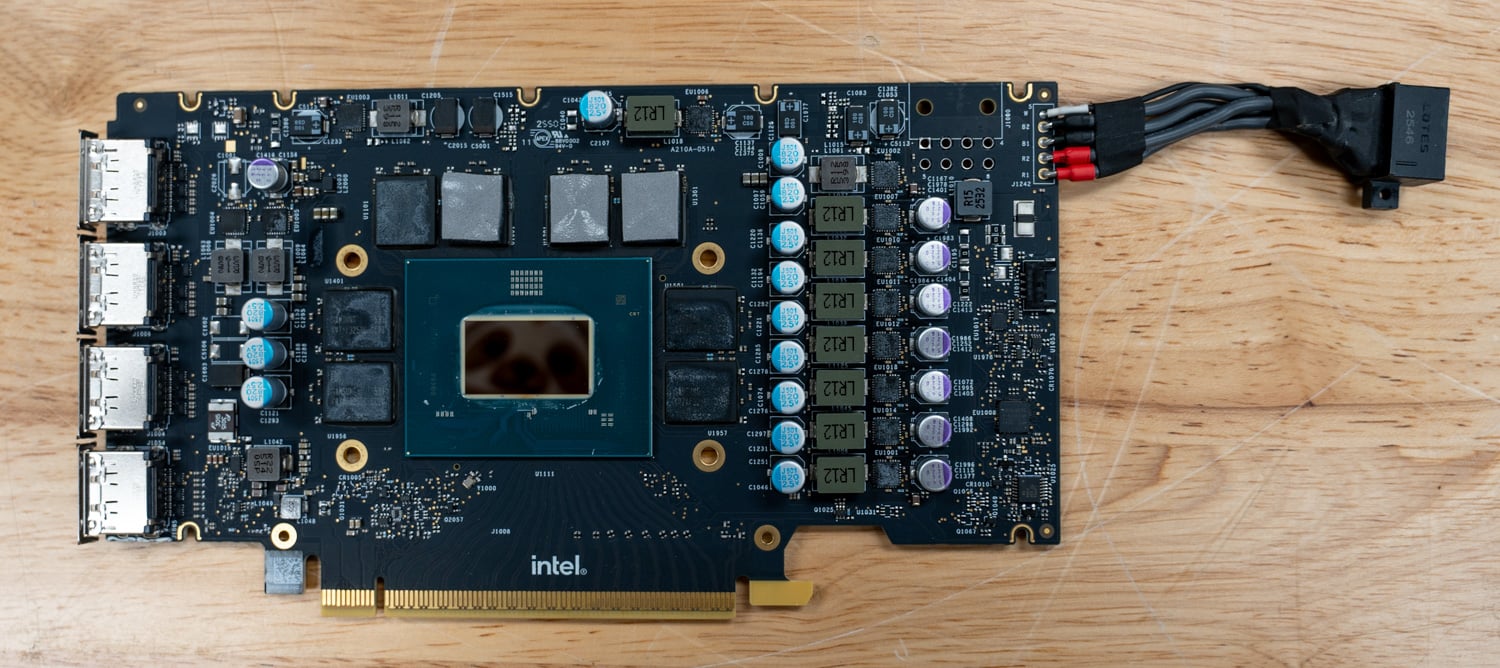
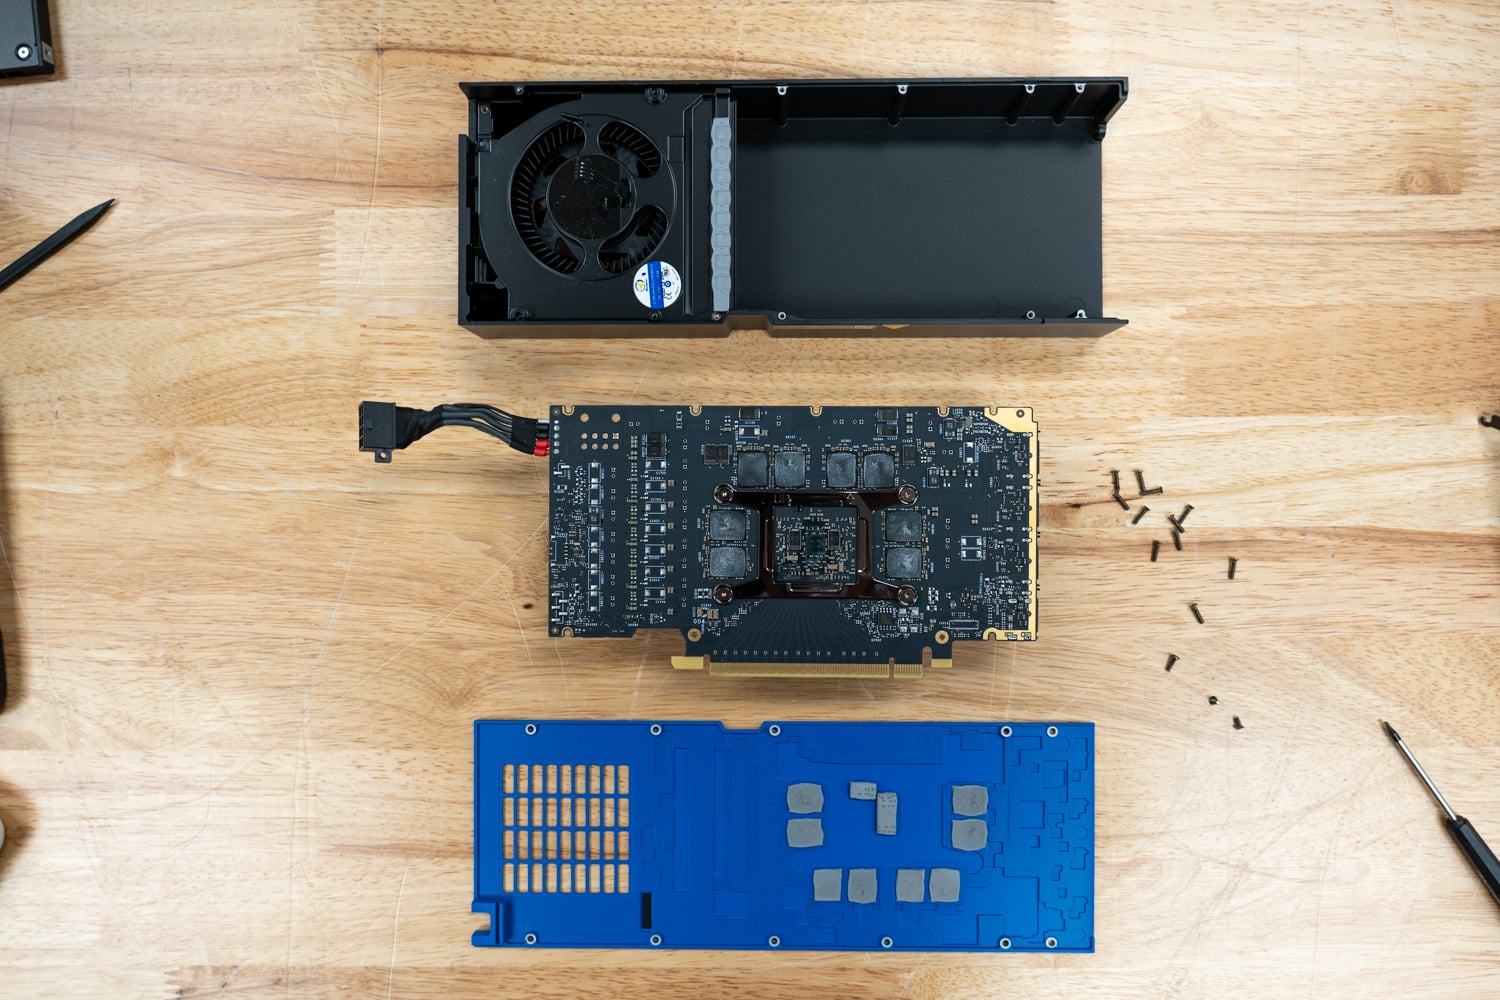
拆下散熱器後,Arc Pro B70 的 PCB 板便展現出驅動顯示卡的主要組件。其核心是英特爾 32 核心 Xe2-HPG GPU,周圍環繞著 32GB 專用 GDDR6 顯存,透過 256 位元顯存位寬連接,提供高達 608 GB/s 的顯存頻寬。該 GPU 還整合了 256 個 XMX AI 引擎,可提供高達 367 INT8 TOPS 的 AI 運算效能,以及 32 個專用光線追蹤單元,用於硬體加速光線追蹤工作負載。 GPU 周圍是供電電路、顯存電路和顯示輸出組件,共同支撐著顯示卡的整體設計。
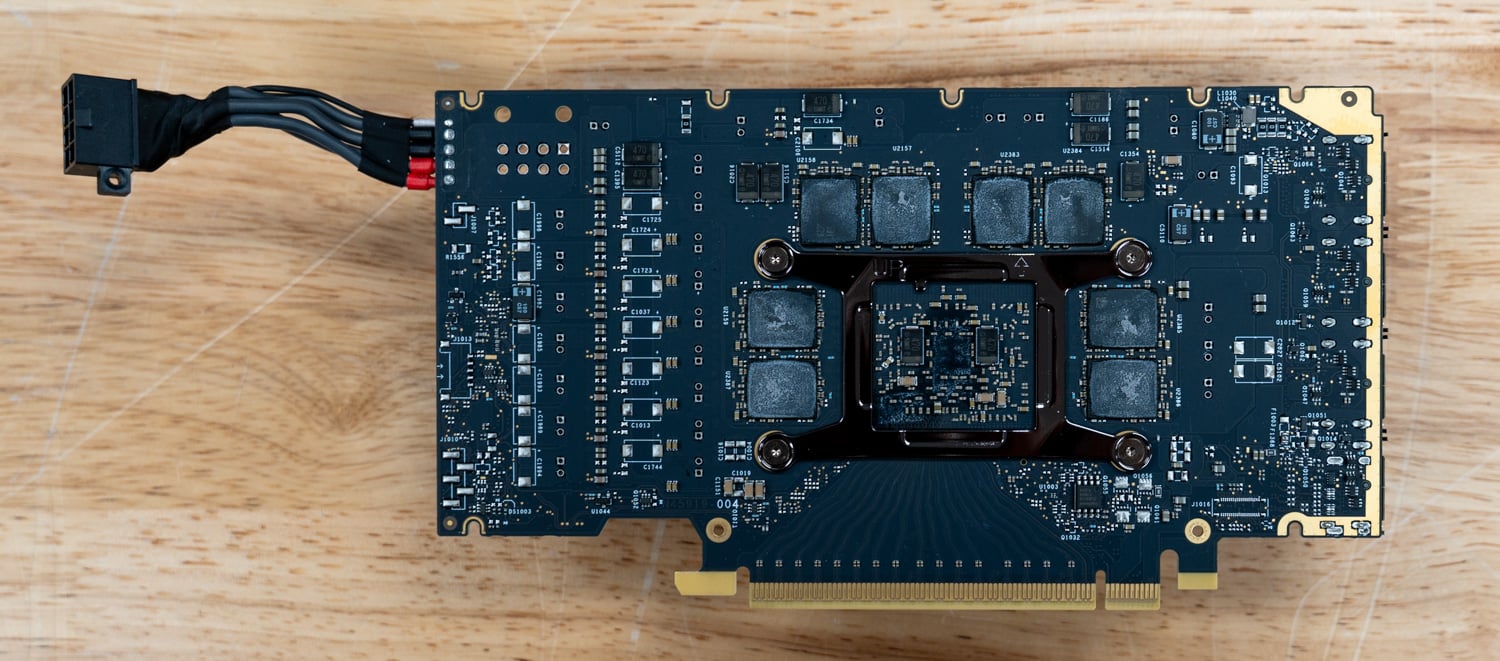
PCB背面露出更多GDDR6顯存封裝以及部分顯示卡供電電路。環繞GPU封裝的大型固定支架有助於均勻分散散熱器的安裝壓力。 8針PCIe電源介面為顯示卡提供外部電源。透過PCIe插槽供電,Arc Pro B70的總板載功耗最高可達230W。
英特爾 Arc Pro B70 效能測試
Windows 測試 – StorageReview AMD Threadripper 測試平台
以下是我們將用於單顆 Intel Arc Pro B70 測試的測試平台:
- 主板: 華碩 Pro WS TRX50-SAGE WIFI
- 中央處理器: AMD 銳龍 Threadripper 7980X 64 核心
- 隨機存取存儲器: 128GB DDR5 4800MT/秒
- 貯存: 2TB 三星 980 Pro
- 操作系統: Windows 11 Pro for Workstations
測試的同類GPU
- 英特爾 Arc Pro B50
- 英特爾 Arc Pro B70
- AMD Radeon RX 9060 XT
- 的AMD Radeon RX 9070
- AMD Radeon RX 9070 XT
- NVIDIA GeForce RTX 5060 Ti
- NVIDIA GeForce RTX 5070 FE
UL Procyon:人工智慧文字生成
Procyon AI 文字產生基準測試採用簡潔一致的評估方法,簡化了 AI LLM 效能測試。它允許對多個 LLM 模型進行重複測試,同時最大限度地降低大型模型的複雜性以及各種可變因素的影響。此基準測試由 Procyon 與 AI 硬體領域的領導企業合作開發,優化了本地 AI 加速器的使用,從而提供更可靠、更有效率的效能評估。以下結果是使用 NVIDIA 模型上的 TensorRT 和 AMD 模型上的 ONNX 測得的。
在本次比較測試中,Arc Pro B70 的世代提升幅度最大,在 Phi、Mistral 和 Llama 3 平台上,其整體得分較 B50 提升了 60%,同時首令牌獲取時間縮短了 40-45%。與 AMD 的顯示卡相比,B70 在 Phi 平台上的得分比 Radeon RX 9060 XT 高出 224%(4,152 分 vs. 1,281 分),在 Mistral 平台上高出 220%(4,082 分 vs. 1,274 分),在 Llama 3 平台上高出 250 分)。與 Radeon RX 9070 XT 相比,Intel 仍然保持著 100%、83% 和 95% 的優勢。 NVIDIA縮小了與B70的差距,RTX 5060 Ti在Phi和Mistral測試中均落後B70 45%,而RTX 5070在相同測試中仍落後15-20%。最突出的結果是Llama 2測試,B70以5,769分的成績在所有對比測試中名列前茅,比RTX 5070高出85%,比RX 9070 XT高出151%。
| UL Procyon:人工智慧文字生成 | 英特爾 Arc Pro B50 | 英特爾 Arc Pro B70 | AMD Radeon RX 9060 XT | 的AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070 FE |
|---|---|---|---|---|---|---|---|
| Phi 總分 | 2,593 | 4,152 | 1,281 | 1,933 | 2,080 | 2,870 | 3,453 |
| Phi 輸出到第一個代幣的時間 | 0.275小號 | 0.155小號 | 1.473小號 | 0.954小號 | 0.855小號 | 0.375小號 | 0.323小號 |
| Phi 每秒輸出令牌 | 72.128 令牌/秒 | 104.121 令牌/秒 | 94.453 令牌/秒 | 139.187 令牌/秒 | 144.471 令牌/秒 | 120.773 令牌/秒 | 150.435 令牌/秒 |
| Phi 總持續時間 | 39.179小號 | 37.924小號 | 39.365小號 | 26.989小號 | 25.587小號 | 25.216小號 | 20.302小號 |
| 米斯特拉爾總分 | 2,483 | 4,082 | 1,274 | 2,040 | 2,231 | 2,807 | 3,562 |
| 米斯特拉爾輸出第一個令牌的時間 | 0.346小號 | 0.180小號 | 1.827小號 | 1.109小號 | 0.946小號 | 0.526小號 | 0.433小號 |
| 米斯特拉爾每秒輸出令牌 | 46.799 令牌/秒 | 65.834 令牌/秒 | 65.115 令牌/秒 | 101.300 令牌/秒 | 103.348 令牌/秒 | 91.057 令牌/秒 | 120.507 令牌/秒 |
| 米斯特拉爾總持續時間 | 59.907小號 | 58.976小號 | 54.516小號 | 34.960小號 | 33.350小號 | 33.377小號 | 25.496小號 |
| Llama3 總分 | 2,427 | 4,029 | 1,150 | 1,904 | 2,070 | 2,599 | 3,125 |
| Llama3 輸出第一個令牌的時間 | 0.311小號 | 0.166小號 | 1.632小號 | 0.981小號 | 0.845小號 | 0.449小號 | 0.379小號 |
| Llama3 每秒輸出令牌 | 45.031 令牌/秒 | 66.340 令牌/秒 | 53.167 令牌/秒 | 87.594 令牌/秒 | 89.102 令牌/秒 | 74.709 令牌/秒 | 100.388 令牌/秒 |
| Llama3 整體持續時間 | 61.926小號 | 53.687小號 | 62.563小號 | 38.273小號 | 36.742小號 | 39.489小號 | 29.720小號 |
| Llama2 總分 | - | 5,769 | 1,252 | 2,047 | 2,298 | 2,576 | 3,125 |
| Llama2 輸出第一個令牌的時間 | - | 0.259小號 | 2.992小號 | 1.926小號 | 1.565小號 | 0.844小號 | 0.785小號 |
| Llama2 每秒輸出令牌 | - | 63.666 令牌/秒 | 34.654 令牌/秒 | 59.673 令牌/秒 | 61.127 令牌/秒 | 41.386 令牌/秒 | 56.647 令牌/秒 |
| Llama2 整體持續時間 | - | 44.131小號 | 99.027小號 | 59.100小號 | 55.520小號 | 71.302小號 | 53.234小號 |
UL Procyon: 人工智能圖像生成
Procyon AI 影像產生基準測試能夠持續且準確地衡量各種硬體(從低功耗 NPU 到高階 GPU)的 AI 推理效能。它包含三個測試:針對高階 GPU 的 Stable Diffusion XL (FP16) 測試、針對中型效能 GPU 的 Stable Diffusion 1.5 (FP16) 測試以及針對低功耗裝置的 Stable Diffusion 1.5 (INT8) 測試。此基準測試會針對每個系統使用最佳推理引擎,確保結果的公平性和可比較性。
影像生成是Arc Pro B70相較於其小兄弟的另一大亮點,其穩定擴散1.5 FP16得分提升了179%(2,101分對比754分),同時生成時間也從132.6秒縮短至47.6秒,降幅達64%。 B70的性能基本上與RTX 5060 Ti持平(2,101分比對2,110分,差距不到1%),但分別落後RX 9070 XT 19%和RTX 5070 29%。在穩定擴散XL FP16測試中,英特爾再次將B50的性能提升了近三倍(提升181%),僅比RTX 5060 Ti高出8%,落後於RTX 5070 FE約18%。 INT8 工作負載有利於 NVIDIA 的 TensorRT 實現,儘管 B70 仍然比 B50 提高了 265%,並將影像產生時間縮短了 72% 以上。
| UL Procyon:人工智慧影像生成 (總分:越高越好) |
英特爾 Arc Pro B50 | 英特爾 Arc Pro B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | 的AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5070 FE |
|---|---|---|---|---|---|---|---|
| 穩定擴散 1.5 (FP16) — 總體得分 | 754 | 2,101 | 1,436 | 2,110 | 2,280 | 2,598 | 2,937 |
| 穩定擴散 1.5 (FP16) — 總時間 | 132.585小號 | 47.585小號 | 69.633小號 | 47.590小號 | 43.858小號 | 38.481小號 | 34.038小號 |
| 穩定擴散 1.5 (FP16) — 影像產生速度 | 8.287 秒/影像 | 2.974 秒/影像 | 4.352 秒/影像 | 2.974 秒/影像 | 2.741 秒/影像 | 2.405 秒/影像 | 2.127 秒/影像 |
| 穩定擴散 1.5 (INT8) — 總體得分 | 5,020 | 18,344 | 不適用 | 27,705 | 不適用 | 不適用 | 36,320 |
| 穩定擴散 1.5 (INT8) — 總時間 | 49.795小號 | 13.628小號 | 不適用 | 9.024小號 | 不適用 | 不適用 | 6.883小號 |
| 穩定擴散 1.5 (INT8) — 影像生成速度 | 6.224 秒/影像 | 1.703 秒/影像 | 不適用 | 1.128 秒/影像 | 不適用 | 不適用 | 0.860 秒/影像 |
| 穩定擴散 XL (FP16) — 總體得分 | 748 | 2,102 | 1,124 | 1,940 | 1,805 | 2,010 | 2,473 |
| 穩定擴散 XL (FP16) — 總時間 | 790.774小號 | 285.344小號 | 533.736小號 | 326.550小號 | 332.400小號 | 298.499小號 | 242.606小號 |
| 穩定擴散 XL (FP16) — 影像產生速度 | 49.423 秒/影像 | 17.834 秒/影像 | 33.359 秒/影像 | 20.409 秒/影像 | 20.775 秒/影像 | 18.656 秒/影像 | 15.163 秒/影像 |
樂士馬克
Luxmark 是一款 GPU 基準測試軟體,它使用開源光線追蹤渲染器 LuxRender 來評估系統在處理高精度 3D 場景時的效能。此基準測試軟體尤其適用於評估伺服器和工作站的圖形渲染能力,尤其是在視覺特效和建築視覺化應用中,因為在這些應用中,精確的光照模擬至關重要。
LuxMark 測試表明,Arc Pro B70 在 Battlemage 任務中展現出卓越的效能擴展性。在 Food 場景下,其效能較 B50 提升了 128%,在 Hall 場景下提升了 137%。此外,它在 Food 場景下的效能也比 Radeon RX 9060 XT 高出 33%,在 Hall 場景下高出 53%。主打遊戲效能的 RX 9070 XT 在 Food 場景下保持約 54% 的優勢,在 Hall 場景下則保持約 37% 的優勢,而 NVIDIA 的 RTX 5070 FE 則分別領先 62% 和 81%。總而言之,B70 已穩固確立了其作為工作站工作負載強大 OpenCL 渲染加速器的地位。
| 樂士馬克 (越高越好) |
英特爾 Arc Pro B50 | 英特爾 Arc Pro B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | 的AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5070 FE |
|---|---|---|---|---|---|---|---|
| 食物評分 | 2,456 | 5,609 | 4,220 | 6,590 | 8,233 | 8,610 | 9,061 |
| 霍爾分數 | 5,158 | 12,220 | 8,007 | 15,348 | 16,566 | 16,758 | 22,062 |
Geekbench 6
Geekbench 6是一款跨平台基準測試軟體,用於衡量系統整體效能。 Geekbench 瀏覽器可讓您將任何系統與 Geekbench 6 進行比較。
Arc Pro B70 的得分為 140,165 分,比 Arc Pro B50 增加了整整 100%。它比 Radeon RX 9070 略勝一籌(約 1%),比 RX 9060 XT 高出 36%,僅比 RTX 5060 Ti 落後 7%。 NVIDIA 的 RTX 5070 FE 將其領先優勢擴大到約 24%,而 AMD 的 RX 9070 XT 則領先約 35%,這使得 B70 穩居主流高階運算顯示卡的中游水準。
| Geekbench 6 OpenCL (越高越好) |
英特爾 Arc Pro B50 | 英特爾 Arc Pro B70 | AMD Radeon RX 9060 XT | 的AMD Radeon RX 9070 | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070 FE | AMD Radeon RX 9070 XT |
|---|---|---|---|---|---|---|---|
| GPU OpenCL 分數 | 70,038 | 140,165 | 102,750 | 138,463 | 150,743 | 173,255 | 188,892 |
3DMark
3DMark Port Royal、Speed Way 和 Steel Nomad 是三款 GPU 基準測試軟體,用於測試 GPU 在不同場景下的效能。 Port Royal 專注於光線追踪,Speed Way 評估 GPU 在賽車模擬中的性能,而 Steel Nomad 則以高強度、逼真的圖形挑戰 GPU 的性能。它們評估 GPU 在渲染、光照和動態場景方面的能力。
新架構顯著提升了圖形效能。在 Port Royal 測試中,Arc Pro B70 的得分比 B50 高出 154%;在 Speed Way 測試中高出 136%;在 Steel Nomad 測試中高出 149%。與 RX 9060 XT 相比,B70 在 Port Royal 測試中領先 9%;在 Speed Way 測試中領先 7%;在 Steel Nomad 測試中領先 9%。與 RTX 5060 Ti 相比,B70 在 Port Royal 測試中表現差距在 2% 以內;在 Speed Way 測試中落後 23%;在 Steel Nomad 測試中領先 13%。高階的 RTX 5070 FE 和 RX 9070 XT 的效能優勢仍保持在 31% 至 83% 之間,具體優勢取決於工作負載,這體現了它們作為高效能遊戲 GPU 的定位。
| 3DMark (越高越好) |
英特爾 Arc Pro B50 | 英特爾 Arc Pro B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070 FE | 的AMD Radeon RX 9070 | AMD Radeon RX 9070 XT |
|---|---|---|---|---|---|---|---|
| 皇家港口 | 4,197 | 10,668 | 9,751 | 10,432 | 14,026 | 15,760 | 17,989 |
| 速度之路 | 1,355 | 3,202 | 3,004 | 4,184 | 5,869 | 5,791 | 6,237 |
| 鋼鐵游牧者(DX12) | 1,644 | 4,089 | 3,767 | 3,611 | 5,019 | 5,992 | 6,977 |
黃玉視頻 AI
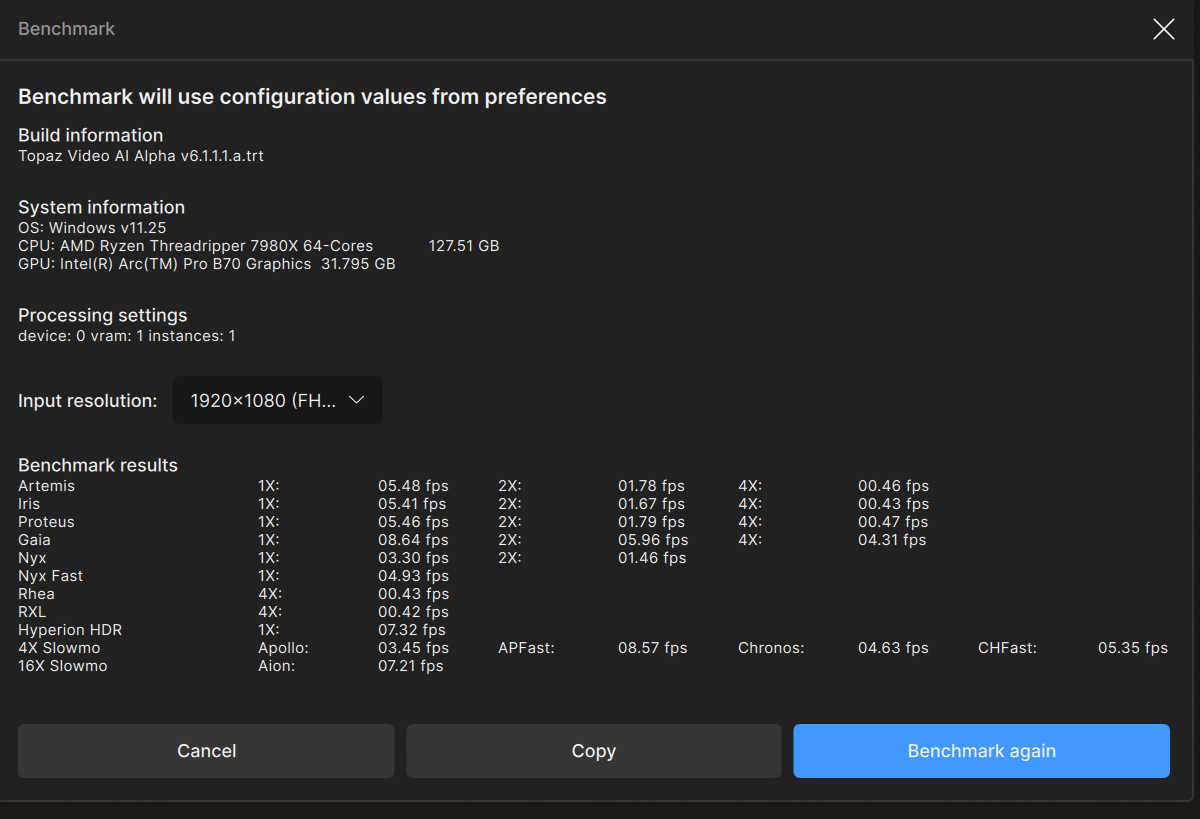
Topaz Video AI 是一款專業的視訊增強和修復應用程序,它利用先進的 AI 模型實現視訊的增強和修復。該軟體支援多種任務,包括將影片提升至 4K 或 8K 解析度、銳利化模糊內容、降低雜訊、增強臉部細節、為黑白影片著色以及插幀以獲得更流暢的運動效果。該套件內建基準測試工具,可測量系統在各種視訊增強演算法下的效能,從而清晰展現硬體平台處理高要求 AI 視訊處理工作負載的能力。
Arc Pro B70 相較於英特爾上一代專業級產品有了顯著提升,尤其是在 AI 超採樣工作負載方面。這張顯示卡在 Artemis、Iris 和 Proteus 三種 1 倍增強模式下分別達到 5.48 FPS、5.41 FPS 和 5.46 FPS,而 Gaia 則高達 8.64 FPS,是標準增強機型中最快的。計算量較大的修復模型運行速度自然會稍慢一些,Nyx 為 3.30 FPS,Nyx Fast 為 4.93 FPS,Hyperion HDR 則為 7.32 FPS。慢動作產生效能同樣出色,Apollo 為 3.45 FPS,APFast 為 8.57 FPS,Chronos 為 4.63 FPS,CHFast 為 5.35 FPS,Aion 為 7.21 FPS。總的來說,這些結果表明 Arc Pro B70 可以處理 Topaz AI 的全部工作流程,從影片增強和降噪到 HDR 轉換和幀插值,使其成為希望利用英特爾 XMX AI 加速的創作者的可靠選擇。
攪拌機4.5
Blender 是一款開源的 3D 建模應用程式。本次基準測試使用 Blender Benchmark 工具在 GPU 上運作。得分以每分鐘採樣數衡量,數值越高表示表現越好。
Arc Pro B70 在 Monster 測試中每分鐘可產生 1,524.6 個樣本,在 Junkshop 測試中每分鐘可產生 846.9 個樣本,在 Classroom 測試中每分鐘可產生 912.2 個樣本。雖然這些資料無法與 RX 9070 XT 或 RTX 5070 等高階發燒 GPU 相媲美,但它們表明 Battlemage 擁有足夠的渲染效能,足以滿足專業視覺化和內容創作工作負載的需求。憑藉其 32GB 的顯存和經過認證的工作站驅動程序,B70 在渲染能力、AI 加速和專業可靠性之間實現了理想的平衡。
| Blender 4.5.0(每分鐘採樣次數越多越好) | 英特爾 Arc Pro B70 |
|---|---|
| Monster | 1,524.60 |
| 舊貨店 | 846.87 |
| 課堂 | 912.24 |
耗電量:Intel B70
功耗是任何運算平台的重要組成部分。每一代新的GPU在負載下都會消耗更多電量,因此需要更大的電源和足夠的散熱氣流。然而,速度更快的GPU雖然可以達到更高的峰值功耗,但每次工作負載的持續時間會縮短。我們在測試實驗室中使用Quarch Mains Analyzer測量了Procyon AI影像產生器穩定擴散XL FP16測試期間的系統總功耗。此工作負載使每塊GPU都接近其功耗極限,每張生成影像的起始點和終止點都清晰可見。
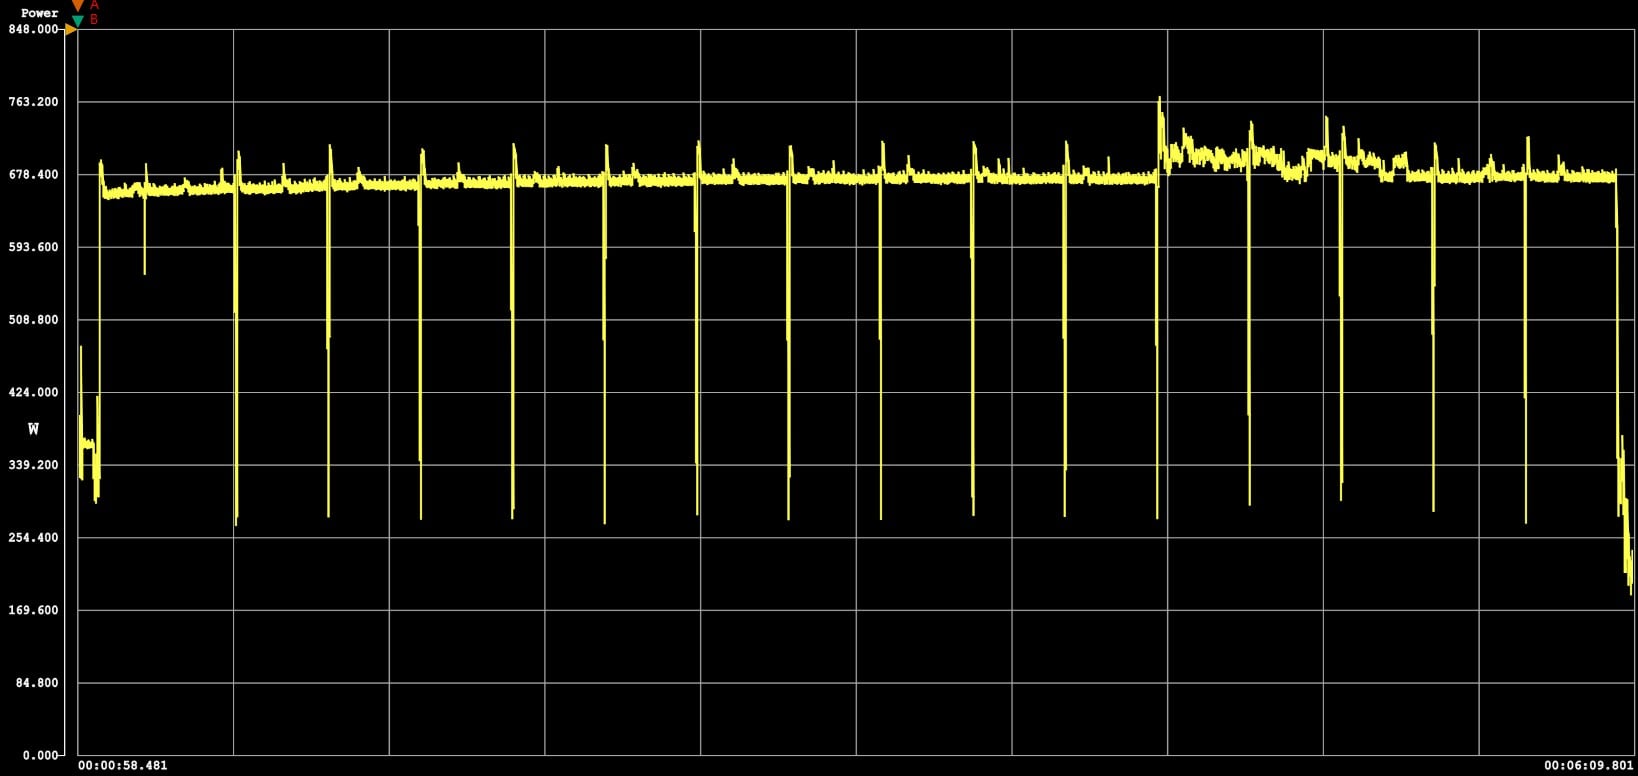
在對 Intel Arc Pro B70 進行測試時,我們測得係統空閒功耗為 207W,工作負載期間峰值功耗為 705.6W,工作負載平均功耗為 638.6W。
| 穩定擴散 XL FP16 功率效率 (越低越好) |
英特爾 Arc Pro B50 | 英特爾 Arc Pro B70 | 的AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | PNY NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070 FE |
|---|---|---|---|---|---|---|
| 耗電量 | 5.32瓦 | 3.45瓦 | 4.00瓦 | 3.41瓦 | 2.13瓦 | 2.46瓦 |
| 測試時間 | 49.9小號 | 18.46小號 | 33.0小號 | 17.4小號 | 20.2小號 | 19.2小號 |
vLLM 線上服務基準效能
vLLM 是目前最受歡迎的 LLM 高吞吐量推理和服務引擎。 vLLM 線上服務基準測試是一種效能評估工具,用於衡量並發請求下的實際服務效能。它透過向運行中的 vLLM 伺服器發送請求來模擬生產環境中的工作負載,並可配置請求速率、輸入/輸出長度和並發客戶端數量等參數。此基準測試可測量關鍵指標,包括吞吐量(每秒令牌數)、首令牌到達時間 (TTFT) 和每個輸出令牌的到達時間 (TPOT),可協助使用者了解 vLLM 在不同負載條件下的效能。
測試平台:
- 服務器: Supermicro AS-4125GS-TNRT
- 處理器: AMD 霄龍 9374F
- 記憶體:512B 三星 4800 MT/s DDR5
- ISL 2k/ OSL 256
可比較GPU測試
- 英特爾 Arc Pro B60
- 英特爾 Arc Pro B70
- NVIDIA RTX Pro 6000
- NVIDIA DGX Spark
我們在Supermicro主機上測試了四塊B70(128GB)和四塊B60(96GB)主機板,並將其與一塊RTX Pro 6000顯示卡和一塊DGX Spark顯示卡進行了比較。顯示卡數量不均是刻意設計的:一套四塊B70主機板的標價為949美元,價格接近一塊Spark顯示卡,遠低於一塊RTX Pro 6000顯示卡,因此本次對比是基於大致的預算,而非顯示卡數量。
米斯特拉爾小型 24B
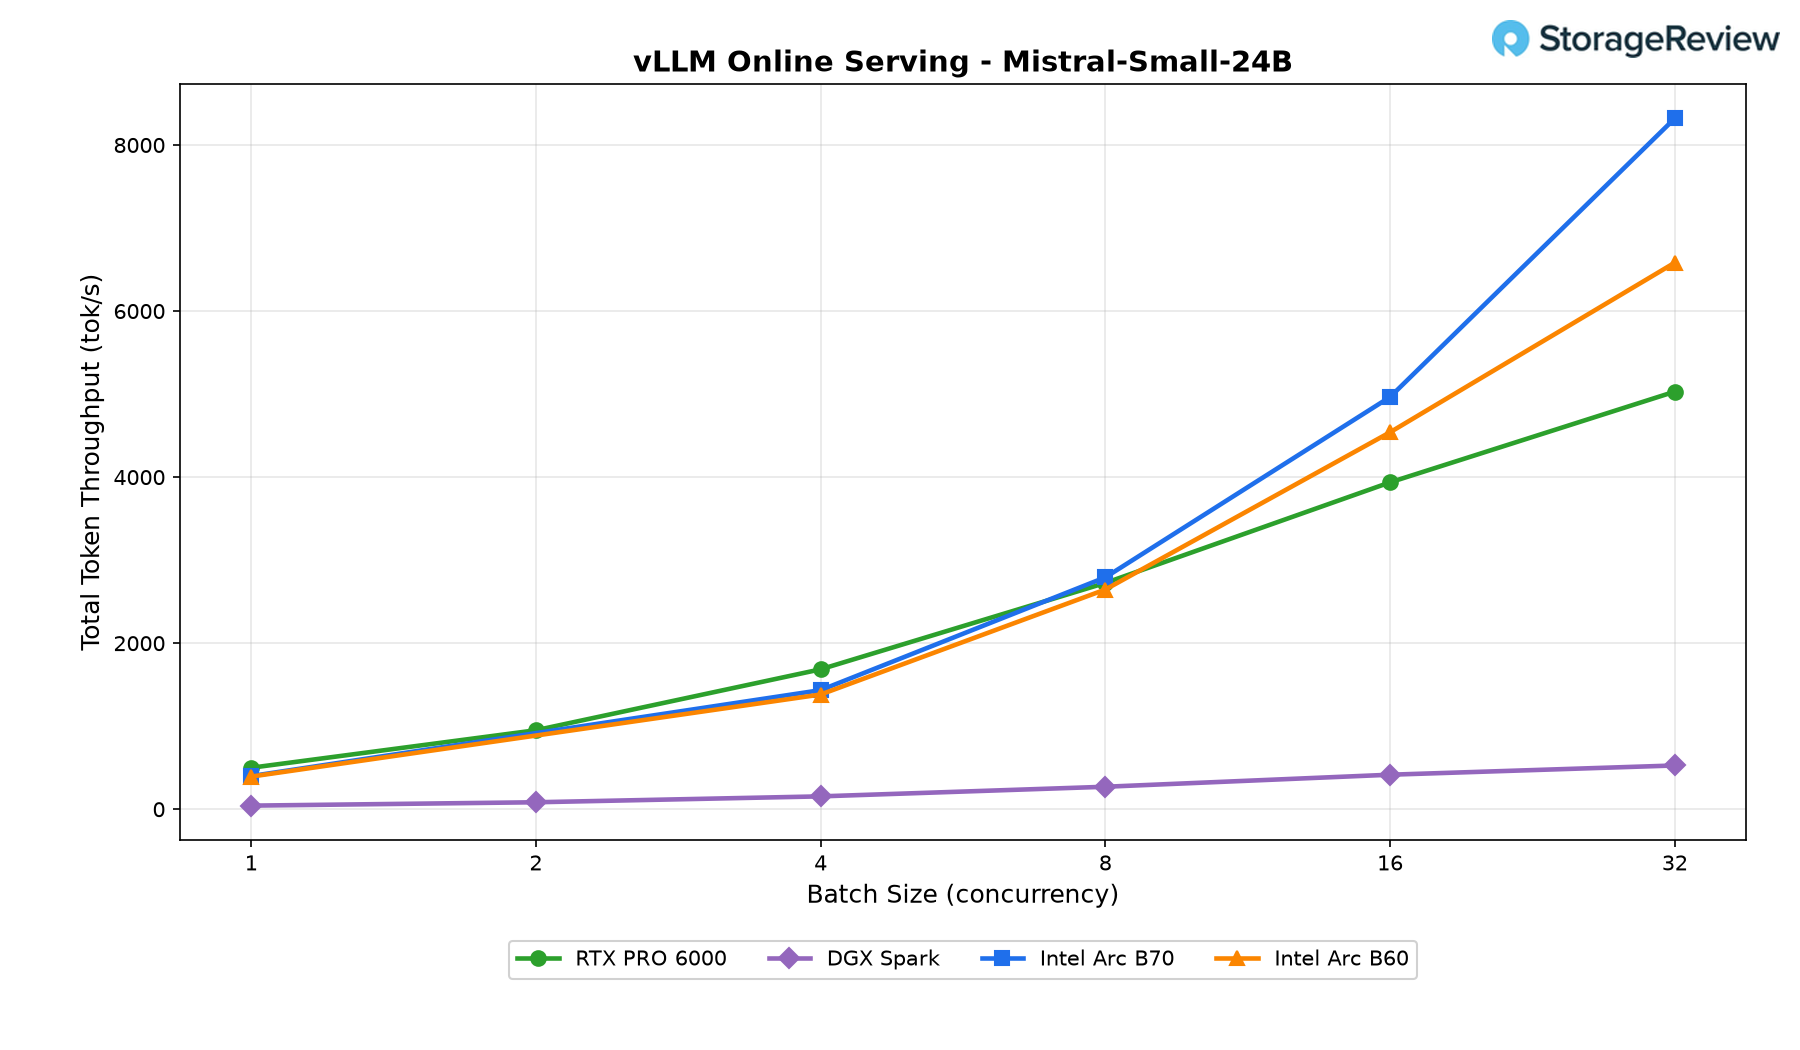
在 Mistral-Small-24B 工作負載測試中,Intel Arc Pro B70 表現最為出色,其運算速度從批次大小為 1 時的 450 tok/s 提升至批次大小為 32 時的 8,321 tok/s。雖然 RTX PRO 6000 在批次大小為 4 時略佔優勢,但 B70 在批次大小為 8 時超越了它,並穩步擴大差距,最終在最高並發數下領先約 65%。與尺寸較小的同系列顯示卡 Arc Pro B60 相比,B70 在測試初期保持著一定的領先優勢,並在批次大小為 32 時將優勢擴大到約 26%。 DGX Spark 在整個測試過程中始終落後,最高運算速度僅為 527 tok/s,這意味著在滿載情況下,B70 的速度幾乎是 B60 的 16 倍。
Qwen3編碼器30B
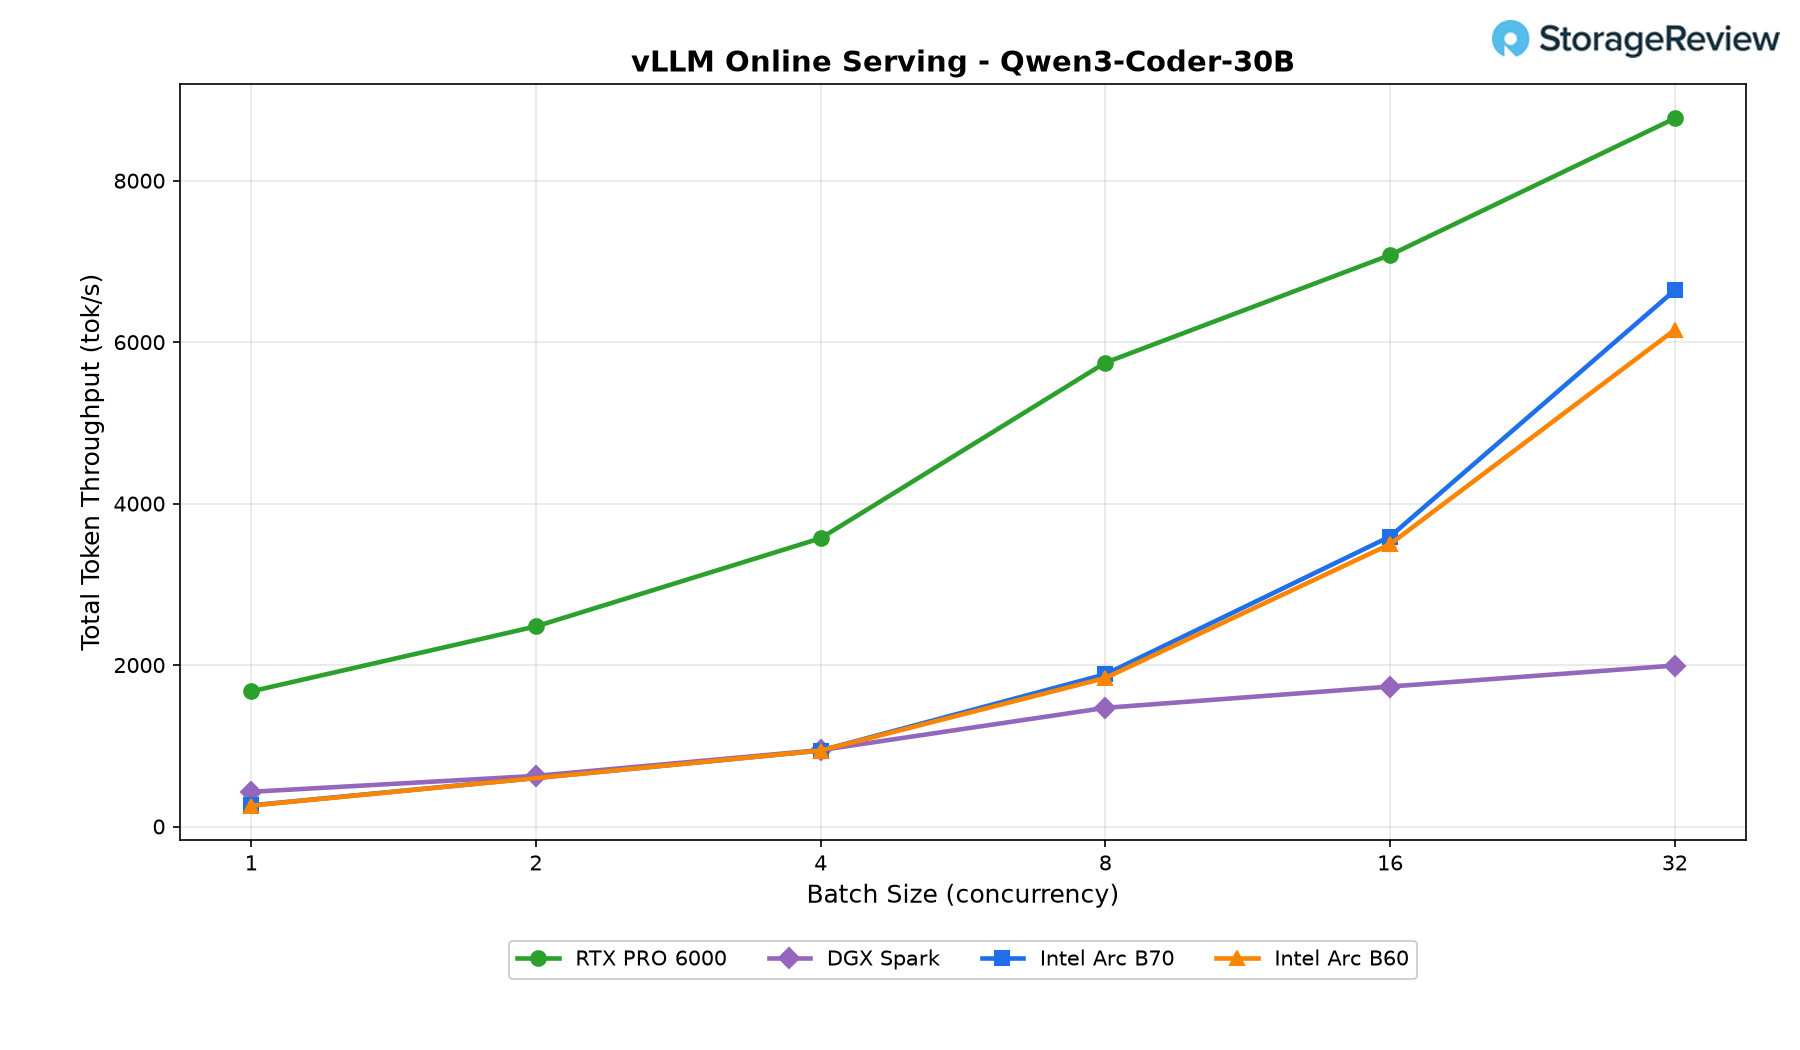
Qwen3-Coder-30B 測試結果顯示,RTX PRO 6000 表現最佳,在所有同時等級下均保持了最高的吞吐量,最終達到 8,772 tok/s。 Intel Arc Pro B70 的擴展性同樣出色,在批次大小為 32 時達到了 6,643 tok/s,並且始終保持著對 Arc Pro B60 的小幅但穩定的優勢,速度提升約 8%。儘管在面向開發者的工作負載下,B70 的效能不如 RTX PRO 6000,但在最大並發等級下,其吞吐量仍然是 DGX Spark 的三倍以上,這凸顯了其高效處理大量並發推理請求的能力。
羊駝 3.1 8B
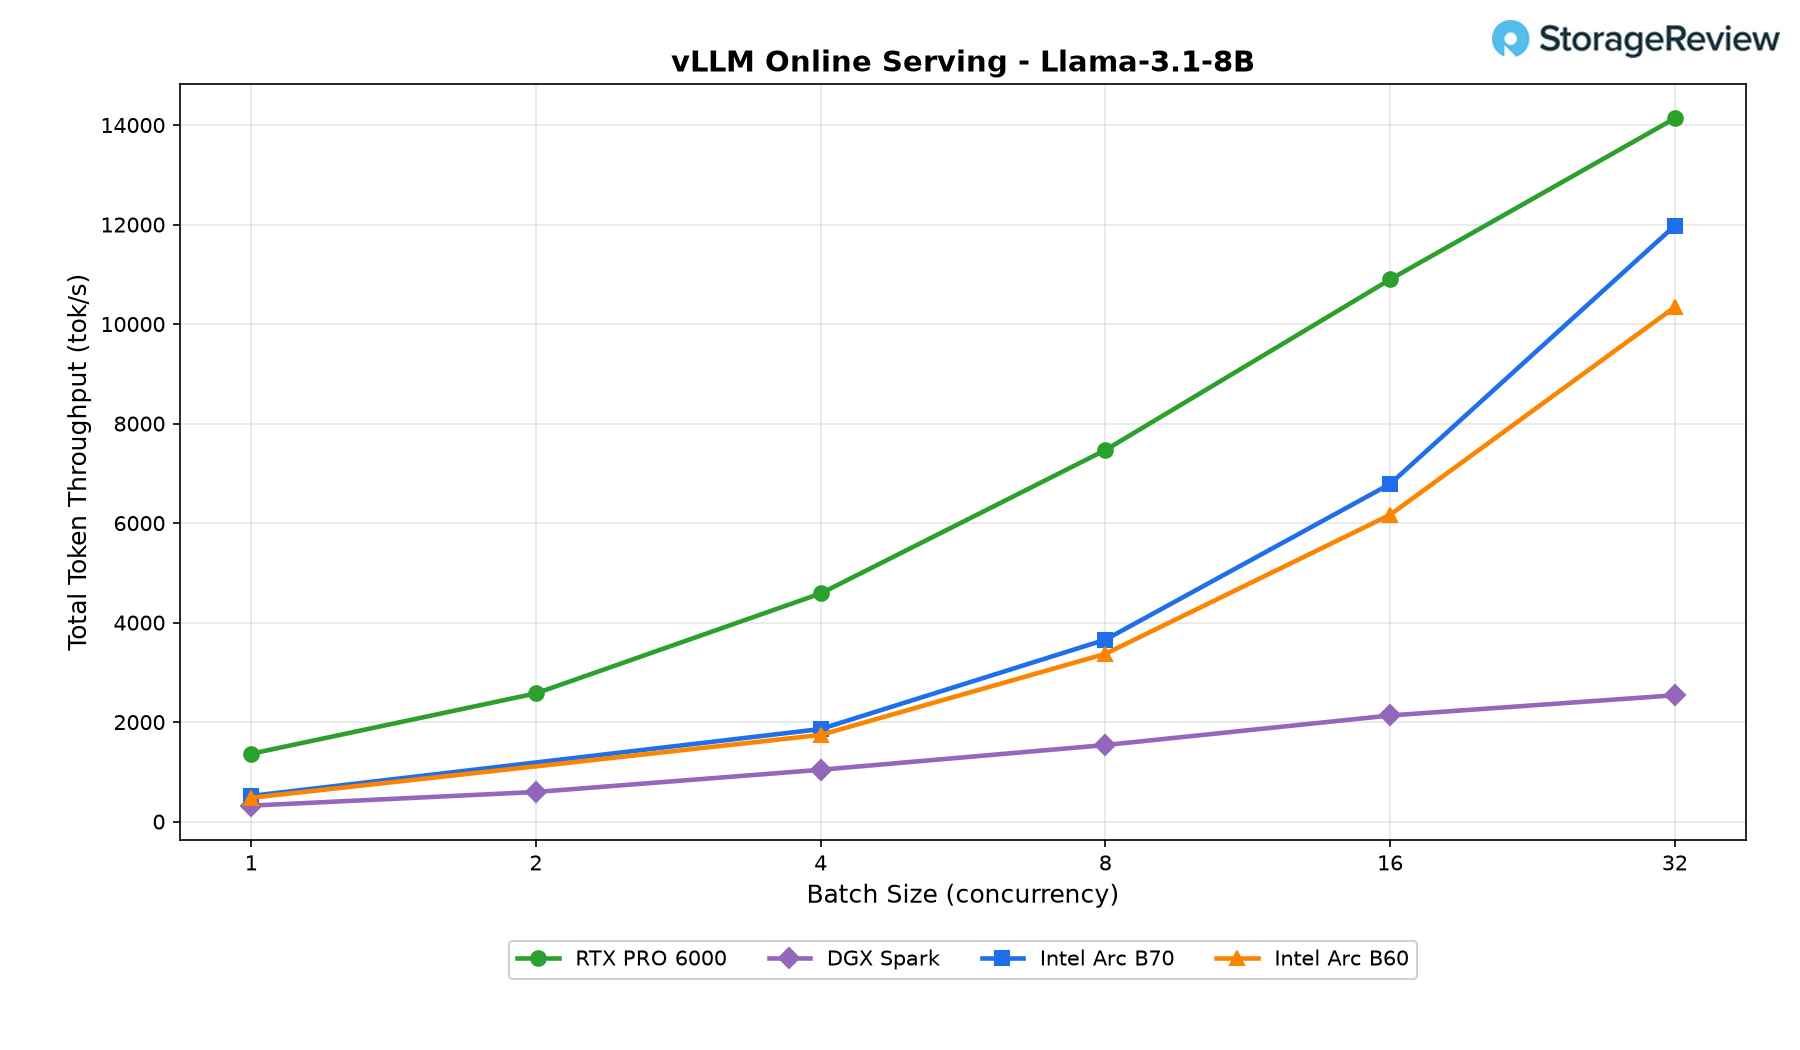
在較小的 Llama-3.1-8B 車型中,所有獨立 GPU 的效能都隨著同時數量的增加而顯著提升,但 RTX PRO 6000 仍然是效能的絕對領先者。 Intel Arc Pro B70 在批次大小為 32 時達到了近 12,000 tok/s 的吞吐量,比 Arc Pro B60 領先約 16%,同時達到了 RTX PRO 6000 吞吐量的約 85%。隨著併發量的增加,B70 與 DGX Spark 的差距持續擴大,在最高批次大小下,B70 的吞吐量約為 DGX Spark 的 4.7 倍。結果還表明,B70 能從更大的請求佇列中獲益匪淺,從而充分利用可用的 GPU 資源。
GPT OSS 20B
在 GPT-OSS-20B 基準測試中,RTX PRO 6000 再次位居榜首,最終速度接近 16,900 tok/s。 Intel Arc Pro B70 的速度略高於 10,000 tok/s,在整個效能曲線上始終保持著對 Arc Pro B60 的微弱但可測量的領先優勢,在批次大小為 32 時速度提升約 7%。雖然它比 NVIDIA 的旗艦工作站 GPU 落後約 40%,但其吞吐量仍然是 DGX Spark 的近三倍。批次大小超過 8 後近乎線性的擴展也表明,隨著並發請求的增加,B70 的效能依然得到了充分利用。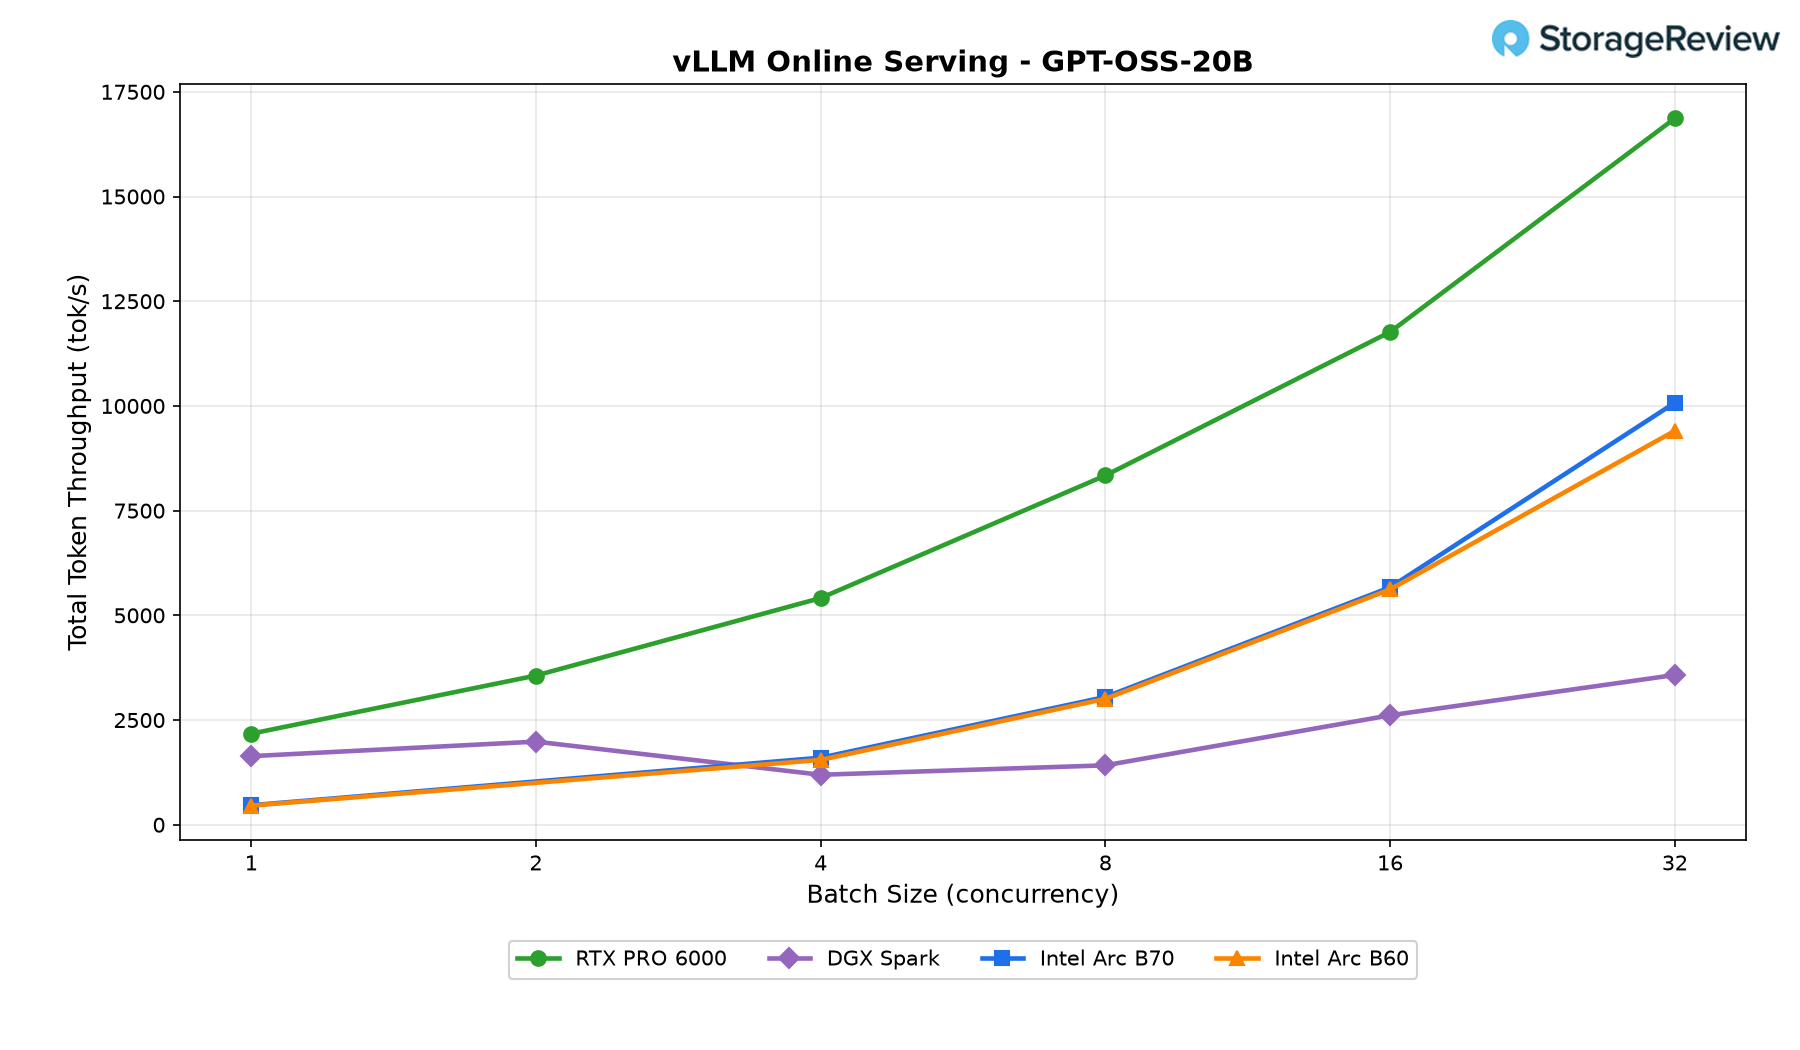
GPT OSS 120B
在所有平台上,該組中最大的型號都表現出更高的性能要求,但英特爾 Arc Pro B70 仍然保持了高效的擴展性。它的吞吐量達到了 6,870 tok/s,比 Arc Pro B60 高出約 7%,同時達到了 RTX PRO 6000 吞吐量的四分之三左右。在相同的並發水準下,DGX Spark 的吞吐量為 2,175 tok/s,這意味著 B70 的性能大約是其 3.2 倍。雖然 RTX PRO 6000 保持了整體領先地位,但 B70 也證明了它在處理大型語言模型方面仍然具有很強的競爭力,尤其是在高並發導致硬體滿載運行時。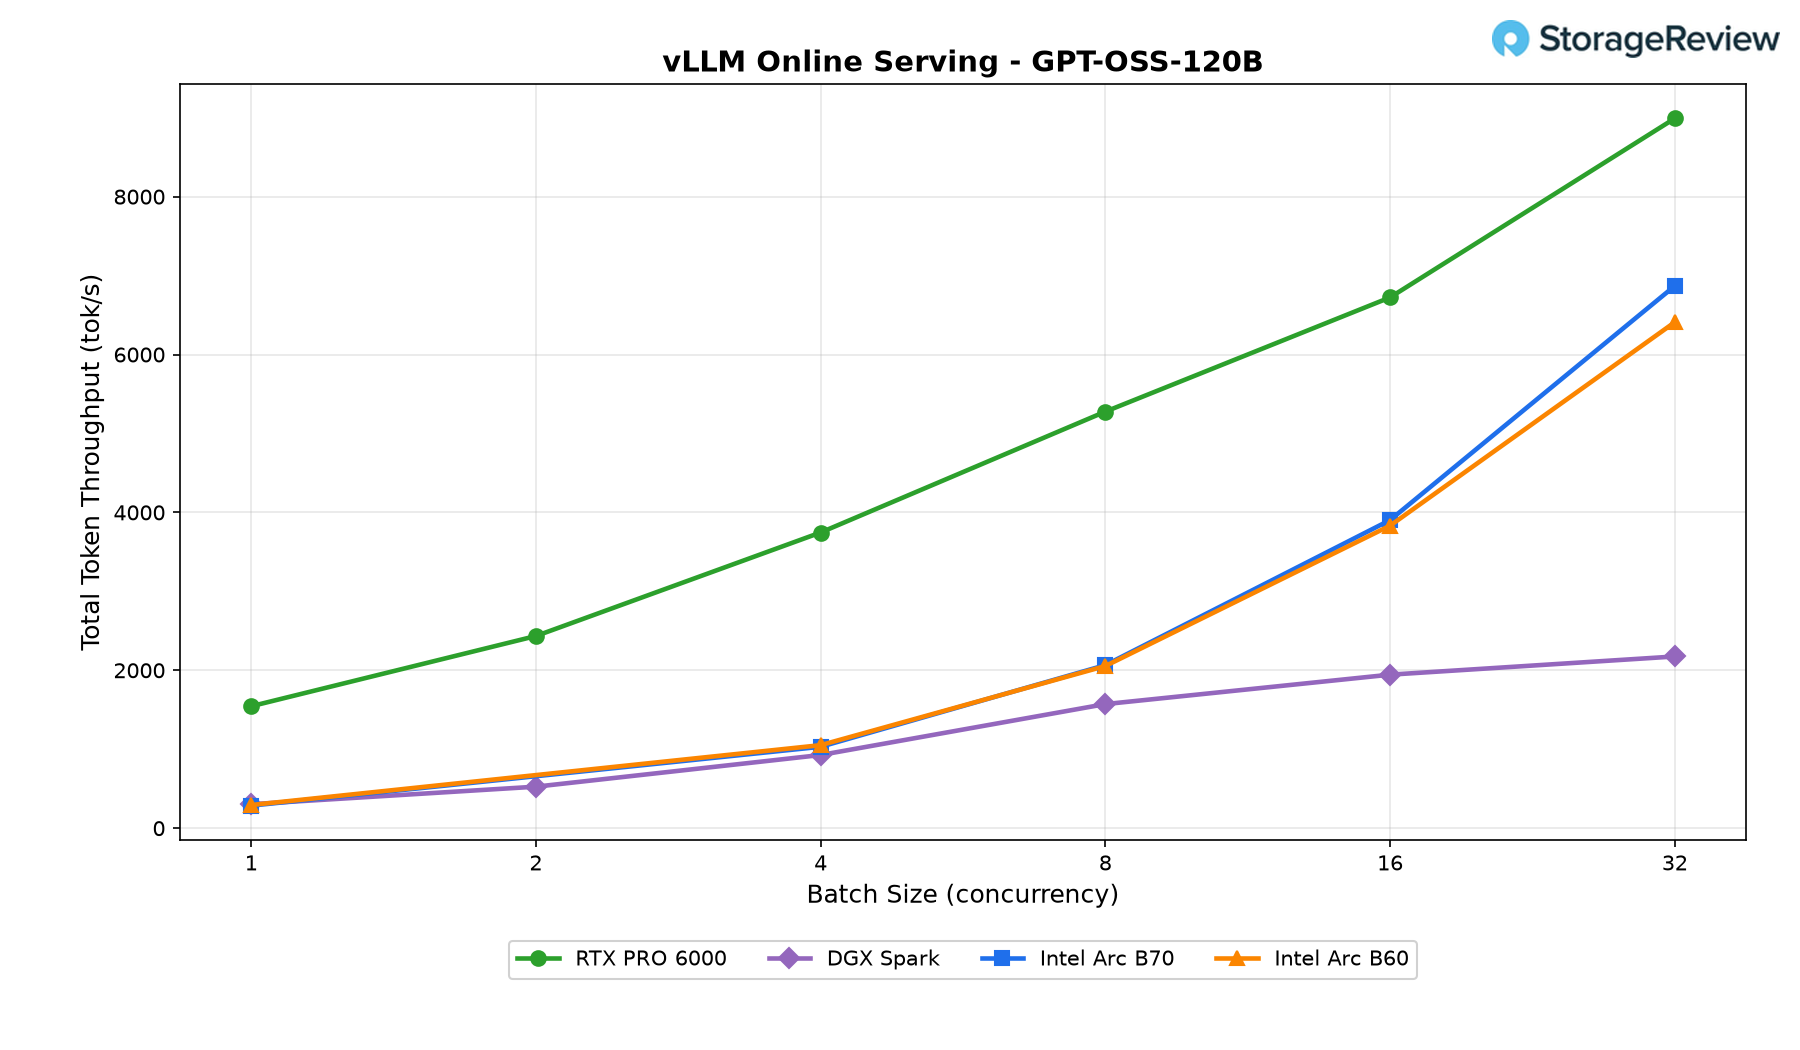
結語
英特爾 Arc Pro B70 是英特爾迄今發布的最具吸引力的工作站 AI GPU 之一。其上市建議零售價為 949 美元,憑藉 32GB ECC GDDR6 顯存和卓越的性能,在許多 AI 和專業工作負載中超越了同價位的消費級 GPU,同時又遠低於 NVIDIA 的工作站級同類產品,從而佔據了獨特的市場地位。即使目前市場價格已超過 1,100 美元,但與 RTX Pro 4000 等產品相比,其性價比仍然極具吸引力,尤其對於那些需要大型本地模型或多 GPU 部署的用戶而言,因為在這些情況下,內存容量而非原始計算能力才是瓶頸。
從硬體角度來看,Intel Arc Pro B70 表現出色:在穩定擴散 1.5 影像產生測試中,其性能與 RTX 5060 Ti 基本持平;渲染效果令人滿意;運行現代語言模型的速度也足以使其成為本地 AI 基礎設施的理想選擇,在 Llama 3.1 8B 測試中達到了近 12,000077777777777777000 年 Mist to Smalls;測試中,滿並發效能比我們測試的單張 RTX Pro 6000 參考顯示卡高出 65%。一台工作站配備四張 B70 顯示卡,可提供 128GB 記憶體,售價約 3,800 美元,遠低於單張高階工作站 GPU 的價格。
Arc Pro B70 面臨的最大挑戰並非晶片本身,而是圍繞它的軟體生態系統。驅動程式的品質和框架支援仍然落後於 NVIDIA 的 CUDA 生態系統和 AMD 日益成熟的 ROCm 堆疊。儘管 Intel 在 oneAPI、OpenVINO 以及支援 Battlemage 的 vLLM 開發方面取得了顯著進展,但用戶仍然需要做好應對偶爾出現的兼容性問題、有限的模型支援以及比競爭對手平台更繁瑣的故障排除工作的準備。對於那些尋求幾乎可以在所有 AI 框架和應用程式中「開箱即用」的 GPU 的用戶來說,NVIDIA 和 AMD 仍然是更穩健的選擇。
總而言之,對於那些重視顯存容量、工作站功能以及性價比的AI性能的買家來說,Arc Pro B70顯示卡值得推薦,前提是他們了解自己購買的產品。它是一款性能卓越的硬件,定價也極具競爭力,但其長期成功幾乎完全取決於英特爾對持續軟體開發和擴展生態系統支援的投入。如果英特爾能夠維持這項投入,B70將擁有成為消費級和專業級AI加速領域最具性價比產品的硬體基礎。否則,它可能會淪為一款潛力巨大卻始終無法達到NVIDIA和AMD競爭對手那樣易用性的顯示卡。


 Amazon