

Bisher durchlief jeder von einer GPU gelesene Speicherzugriff die Host-CPU, die das Dateisystem verwaltete, Befehle ausführte und die Daten zurückgab. Dieser Mehraufwand ist bei großen sequenziellen Übertragungen vernachlässigbar, wird aber zum limitierenden Faktor bei Millionen von 512-Byte-Operationen pro Sekunde. Auf der FMS 2026 in Santa Clara kündigte NVIDIA neue Software und eine Brancheninitiative zur Beseitigung dieses Flaschenhalses an.
Die zentrale Ankündigung betrifft cuFile, eine API, die es GPUs ermöglicht, direkt auf Speicher zuzugreifen. NVIDIA stellt cuFile und den zugehörigen Software-Stack als Open Source zur Verfügung. Der Code wird in der neuen XIO-SIG-Organisation auf GitHub gehostet. Zu den Gründungsmitgliedern und Betreuern gehören Google, Intel, Meta und NVIDIA. Darüber hinaus hat NVIDIA Storage-Next offiziell ins Leben gerufen, eine Initiative, die seit mindestens der GTC 2025 öffentlich diskutiert wurde. Storage-Next umfasst mittlerweile über 40 Speicher- und Flash-Anbieter wie DDN, KIOXIA und Micron sowie Controller-Hersteller, Kühlungsspezialisten und Normungsorganisationen. Diese Teilnehmer definieren gemeinsam, wie sich Speichergeräte verhalten sollen, wenn eine GPU anstelle einer CPU als Client fungiert.
Das Problem: Hostvermittelte E/A
GPU-Systeme arbeiteten traditionell mit einem hostzentrierten I/O-Modell. Die CPU plant GPU-Aufgaben, stellt Daten bereit und initiiert alle Übertragungen zwischen GPU und Netzwerk oder Speicher. Jeder Vorgang folgt einer festgelegten Sequenz: Der GPU-Kernel wird ausgeführt, die Kontrolle kehrt zur CPU zurück, die CPU richtet die Übertragung ein, und der nächste Kernel wird gestartet. Die Kosten pro Vorgang, hauptsächlich der Overhead für den Kernelstart und die CPU-GPU-Synchronisierung, werden in Mikrosekunden gemessen. Während dieser Overhead bei großen Datenmengen vernachlässigbar ist, wird er bei feingranularen Operationen signifikant.
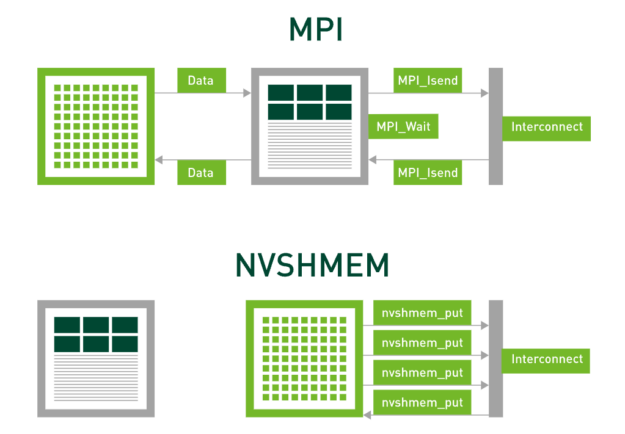
Für die GPU-zu-GPU-Kommunikation eliminierte NVIDIA die Host-Beteiligung durch NVSHMEM. Dadurch kann Gerätecode Übertragungen direkt initiieren und diese mit der Berechnung überlappen. Die Auswirkungen sind erheblich: Als GROMACS seine Halo-Austausch-Kommunikation von MPI auf NVSHMEM umstellte, wurde die Kommunikation aus dem kritischen Pfad entfernt und vollständig mit der Berechnung überlappt.
Der Speicher hielt das hostbasierte Modell aufrecht. Ein Lesevorgang von einem NVMe-Laufwerk gibt die Kontrolle weiterhin an die CPU zurück, führt das Dateisystem aus und wartet auf dessen Abschluss. Das Training toleriert dies, da die Lesevorgänge umfangreich und selten sind. Die Inferenz hingegen nicht. Das Bereitstellen von KV-Cache-Einträgen, Einbettungen und Vektorsuchergebnissen erzeugt Millionen kleiner, zufälliger Lesevorgänge pro Sekunde, wobei die CPU bei jedem einzelnen Lesevorgang beteiligt ist.
GPU-initiierte E/A und SCADA
SCADA (Scaled Accelerated Data Access) wendet das NVSHMEM-Modell auf Speichersysteme an und ermöglicht es der GPU, ihre eigene Speicher-E/A zu initiieren und zu verwalten.
Die zugrundeliegende Forschung ist BaM (Big Accelerator Memory), das von NVIDIA, IBM, der University of Illinois und der University at Buffalo auf der ASPLOS 2023 veröffentlicht wurde. BaM demonstrierte eine GPU, die NVMe-Laufwerke direkt verwaltet, indem sie die über ihre Threads generierten kleinen Anfragen zusammenfasst und zwischenspeichert, um die Laufwerksauslastung durch lange Warteschlangen ohne Eingriff des Hostsystems zu gewährleisten. Auf identischer Hardware führte BaM Datenanalyse-Workloads 5.3-mal schneller aus als CPU-initiierte Zugriffe und führte Graph-Workloads aus Flash-Speicher mit bis zu 21.7-mal geringeren Hardwarekosten aus als die Speicherung derselben Daten im Host-Speicher.
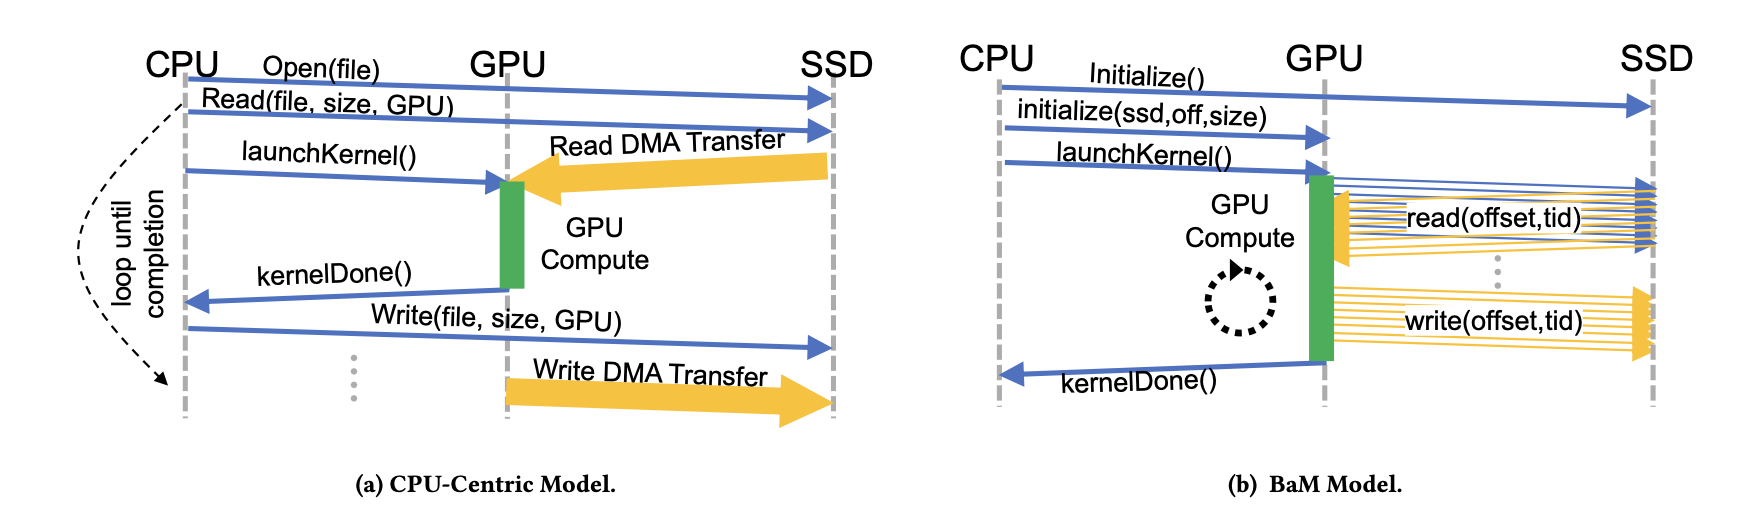
SCADA ist die marktreife Form. Eine Laufzeitumgebung auf der GPU befindet sich zwischen den Kernel-Threads und dem Speicher. Sie bündelt verstreute kleine Anfragen zu Lesevorgängen, die entweder aus einem GPU-Cache bedient oder an Laufwerke gesendet werden, die lokale NVMe-SSDs oder ein entfernter Speicherserver sein können.
Der direkte Gerätezugriff muss eingeschränkt werden, da der ungeschützte Zugriff auf ein gemeinsam genutztes Laufwerk es einer Anwendung ermöglichen könnte, die Daten einer anderen Anwendung zu lesen oder zu beschädigen. NVIDIAs Design trennt daher die Berechtigungsstufen. Leistungskritische Teile einer Anwendung laufen unprivilegiert außerhalb der Trusted Computing Base. Eine privilegierte Komponente konfiguriert den geschützten Zugriff zwischen jeder Anwendung und ausschließlich ihrem autorisierten Speicher bei der Einrichtung mithilfe standardmäßiger Linux-Sicherheitsmechanismen. NVIDIA nennt diese Trennung und die Linux-basierte Interoperabilität als Grund dafür, dass der Stack als Open Source und nicht als geschlossene CUDA-Komponente veröffentlicht wird.
Wie sich SCADA von GPUDirect Storage unterscheidet
Jeder Speichervorgang besteht aus einem Datenpfad (die übertragenen Bytes) und einem Steuerungspfad (Anforderungserstellung, -übermittlung und -abwicklung). GPUDirect Storage (GDS), eingeführt 2019 und seit 2021 verfügbar, entkoppelt die CPU vom Datenpfad: Über cuFile werden Daten per DMA zwischen Laufwerk und GPU-Speicher ohne Zwischenspeicher im Host-RAM übertragen. Laut NVIDIAs Einführungsunterlagen liegt die maximale Übertragungsrate des CPU-Pfads einer DGX-2 bei 50 GB/s. GDS kann Pfade kombinieren und so eine maximale Übertragungsrate von nahezu 200 GB/s erreichen. DDN, VAST, WEKA, Pure Storage und andere führende Anbieter von KI-Speicherlösungen haben dies zertifiziert. Der Steuerungspfad verbleibt auf der CPU: Die Host-Software entscheidet weiterhin, welche Daten abgerufen werden sollen und sendet jede Anfrage. Die GPU ist das DMA-Ziel und nicht der Initiator.
Bei großen Übertragungsgrößen ist diese Aufteilung unproblematisch. Ein Lesevorgang von 1 MB amortisiert die Kosten des Steuerungspfads auf null. Bei 512 Byte kehrt sich das Verhältnis um. Die fixen Kosten pro Anfrage dominieren, und die CPU stößt an ihre Kapazitätsgrenzen, lange bevor die Festplatten ausgelastet sind. SCADA verlagert den Steuerungspfad auf die GPU, die die Latenz pro Operation auf dieselbe Weise wie die Speicherlatenz absorbiert, indem sie Hunderttausende von Operationen gleichzeitig ausführt.
Die beiden existieren nebeneinander: cuFile für Massenübertragungen, SCADA für große Mengen kleiner, zufälliger Lesevorgänge.
Storage-Next und das 512-Byte-Problem
SCADA deckt die GPU-Seite ab. Storage-Next befasst sich mit der Laufwerksseite, die derzeit für eine andere Arbeitslast optimiert ist.
Enterprise-SSDs sind seit einem Jahrzehnt für zufällige Lesezugriffe von 4 KB optimiert und entsprechen damit den Zugriffsmustern von Datenbanken und Virtualisierung. Die meisten Controller leisten bei einem 512-Byte-Lesezugriff annähernd denselben Aufwand wie bei einem 4-KB-Lesezugriff, sodass Anfragen unter 4 KB den gleichen Aufwand wie 4-KB-Anfragen verursachen. Die Zugriffsmuster für Inferenz sind kleiner: Einbettungen umfassen einige hundert Bytes, und KV-Cache-Blöcke sind deutlich kleiner als ein Kilobyte. Die Bedienung dieser Daten von für 4 KB optimierten Laufwerken führt zu einer achtfachen Leseverstärkung, wodurch Bandbreite und Controller-Cache verschwendet werden. Bei Datenmengen im Terabyte-Bereich mit kleinen Objekten entscheidet diese Verstärkung darüber, ob Flash-Speicher als Speicherebene überhaupt geeignet ist.
Storage-Next ist ein Projekt zur Neuausrichtung von Laufwerken, Controllern und Systemen für kleinere Speichereinheiten. Es wurde auf der bereits laufenden GTC 2025 öffentlich vorgestellt und verfolgt das Ziel, die IOPS von 512 Byte pro GPU unter Berücksichtigung von Leistungsaufnahme und Latenz zu maximieren. Auf der FMS-Konferenz präsentierte NVIDIA eine Mitgliederzahl von über 40 Speicher- und Flash-Anbietern und legte SCADA als Grundlage für die weitere Entwicklung fest.
Als Referenzwert dient Microns SC25-Demonstration mit 230 Millionen IOPS (512-Byte-Random-Read) von einem einzelnen Server im SCADA-Programmiermodell: 44 Micron 9650 PCIe Gen6 SSDs hinter drei Broadcom PEX90000 Gen6 Switches, angesteuert von drei H100-Controllern in einem H3 Platform Falcon 6048-Gehäuse. Dieser Wert entspricht etwa 95 % der kombinierten IOPS-Leistung der 44 Laufwerke von 5.5 Millionen.
Die Zusammensetzung dieser Zahl ist entscheidend. 230 Millionen Lesevorgänge à 512 Byte entsprechen etwa 118 GB/s Nutzdaten, die vier oder fünf dieser Laufwerke sequenziell liefern könnten. Die Leistung liegt in der Anzahl der Operationen. Würde diese Leistung durch Host-Software aufrechterhalten, wären allein für die Verarbeitung von Übermittlung und Abschluss Dutzende von CPU-Kernen ausgelastet, doch die einzelne CPU der Demo war praktisch im Leerlauf. Verteilt auf die über hunderttausend Threads einer GPU ergibt sich eine Last von einigen tausend Operationen pro Thread und Sekunde.
Die SSD-Leistung ist heute der entscheidende Faktor. Microns 9650, die erste PCIe-Gen6-SSD, erreicht sequentielle 28 GB/s und rekordverdächtige 5.5 Millionen IOPS beim zufälligen Lesen. Micron berichtet in der Demo von einer linearen Skalierung von 1 bis 44 Laufwerken. Kioxias GP-Serie, eine XL-Flash-SSD für 512-Byte-Zugriffe , wird im Rahmen von Storage-Next entwickelt. NVIDIAs Storage-Next-Roadmap sieht PCIe-Gen7-SSDs mit jeweils 100 Millionen IOPS vor – ein Ziel, auf das Controller-Hersteller wie Marvell bereits hinarbeiten. Um diese Werte zu erreichen, sind eine Neuentwicklung der Controller, eine für kleine Datenmengen dimensionierte Fehlerkorrektur und Standards für das GPU-native Laufwerksverhalten erforderlich.
Zuordnung zu Training und Inferenz
Die beiden Pfade entsprechen zwei Zugriffsmustern. Das Training ist bandbreitenbegrenzt. Es streamt große, sequentielle Datenfragmente und schreibt periodisch mehrere Terabyte große Checkpoints, währenddessen die GPUs im Leerlauf sind. Der CPU-Overhead ist bei diesen Übertragungsgrößen vernachlässigbar, daher bleiben GDS und der neu als Open Source veröffentlichte cuFile-Stack die korrekte Schnittstelle, gemessen in GB/s pro GPU und Checkpoint-Dauer.
Die Inferenz ist IOPS-gebunden. Der KV-Cache, der den Aufmerksamkeitsstatus für jedes bereits in einer Konversation verarbeitete Token speichert, wächst mit der Kontextlänge. Agentenbasierte Systeme führen Tausende von Konversationen gleichzeitig aus. Der GPU-Speicher wird schnell überlastet, und das erneute Berechnen verdrängter Einträge benötigt mehr GPU-Zeit als deren erneutes Lesen. Das Standarddesign sieht einen mehrstufigen Cache vor, der vom GPU-Speicher über den Systemspeicher bis zum Flash-Speicher reicht und durch eine große Anzahl kleiner, zufälliger Lesezugriffe aufgefüllt wird. Vektorsuche und Einbettungszugriffe erzeugen dasselbe Muster. Dies ist die Zugriffsstruktur, die SCADA anstrebt, und der Grund dafür, dass NVIDIA 512-Byte-IOPS anstelle von Bandbreite angibt. Die Bereitstellung des KV-Cache aus dem Flash-Speicher anstatt aus dem Arbeitsspeicher erhöht die Anzahl der von jeder GPU unterstützten Kontexte und gleichzeitigen Benutzer, was die Bereitstellungskosten pro Benutzer bestimmt.
Die Hardware: Vera BlueField-4 STX und CMX
Die Plattformschicht ist NVIDIA Vera BlueField-4 STX , die auf der GTC 2026 vorgestellte und diese Woche erweiterte Rack-Speicherarchitektur. STX kombiniert die Vera-Rubin-Plattform mit BlueField-4-Speicherprozessoren, die jeweils Vera-Arm-Kerne mit 800 Gbit/s integrierter Netzwerkgeschwindigkeit und etwa der sechsfachen Rechenleistung von BlueField-3 kombinieren.
Auf der FMS veröffentlichte NVIDIA einen Benchmark für diese Kerne. Eine zweistufige Komprimierungs- und Verschlüsselungspipeline, die repräsentativ für die Inline-Datenspeichersysteme ist, die für den gesamten Datenverkehr gelten, erreichte auf Vera eine bis zu 3.21-fache Durchsatzleistung einer x86-CPU. Daraus lässt sich schließen, dass Verschlüsselung, Komprimierung und Verifizierung, die derzeit x86-Kerne in Speicherkontrollern beanspruchen, mit geringerem Stromverbrauch auf Vera-Silizium verlagert werden können. DOCA, NVIDIAs Software-Framework für BlueField, setzt Sicherheitsrichtlinien im Datenpfad durch. CMX Context Memory Storage , basierend auf STX, bündelt Flash-Speicher hinter BlueField-4 als gemeinsam genutzte KV-Cache-Ebene für Inferenz über lange Kontexte. Partnersysteme von DDN, Dell, HPE, IBM, VAST Data, WEKA und anderen werden in der zweiten Jahreshälfte 2026 erwartet.
Abschließende Gedanken
Die strategische Ausrichtung ist klar: NVIDIA veröffentlicht die Schnittstelle, über die GPUs auf Speicher zugreifen, stellt die Implementierung als Open Source zur Verfügung und organisiert über 40 Hersteller, um das zugrundeliegende Hardwareverhalten zu standardisieren. Die Öffnung von cuFile weicht von NVIDIAs bisheriger Praxis ab, diese Schicht in CUDA zu integrieren. Eine GPU-basierte Speicherschnittstelle ist jedoch nur dann sinnvoll, wenn Hersteller von Laufwerken, Controllern und Arrays darauf aufbauen. Intels Beteiligung als Maintainer ist ein wichtiges Signal. Ein führender Anbieter von x86-Chips in aktuellen Speichersystemen unterstützt Software, die diese Chips aus dem I/O-Pfad entfernt.
Microns Demonstration beweist die Machbarkeit. Drei GPUs trieben 44 Gen6-Laufwerke mit rund 95 % ihrer kombinierten Nennleistung an – bei einer Blockgröße, die in der Branche bisher vernachlässigt wurde. Nun fehlt nur noch die Umsetzung: Der Code muss auf GitHub veröffentlicht werden, SCADA muss sich vom Framework zur unterstützten CUDA-Komponente weiterentwickeln, und Hersteller müssen SSDs mit optimierten Lesegeschwindigkeiten in großen Stückzahlen auf den Markt bringen. Die oben genannten Zahlen stammen von NVIDIA und seinen Partnern und sind keine unabhängigen Messungen. Wir werden sie testen, sobald die STX-Systeme in der zweiten Jahreshälfte im Labor eintreffen.


 Amazon