

Wir haben uns nun einige GB300 DGX Stations angesehen und hatten kürzlich zwei davon gleichzeitig in unserem Labor: die ASUS ExpertCenter Pro ET900N G3 und die HP ZGX Fury AI Station . Da die beiden Tower nebeneinander standen, wollten wir sie verbinden und herausfinden, welchen Leistungszuwachs eine zweite GB300 für ein einzelnes System bei besser koordinierten KI-Workloads am Arbeitsplatz bringen kann.
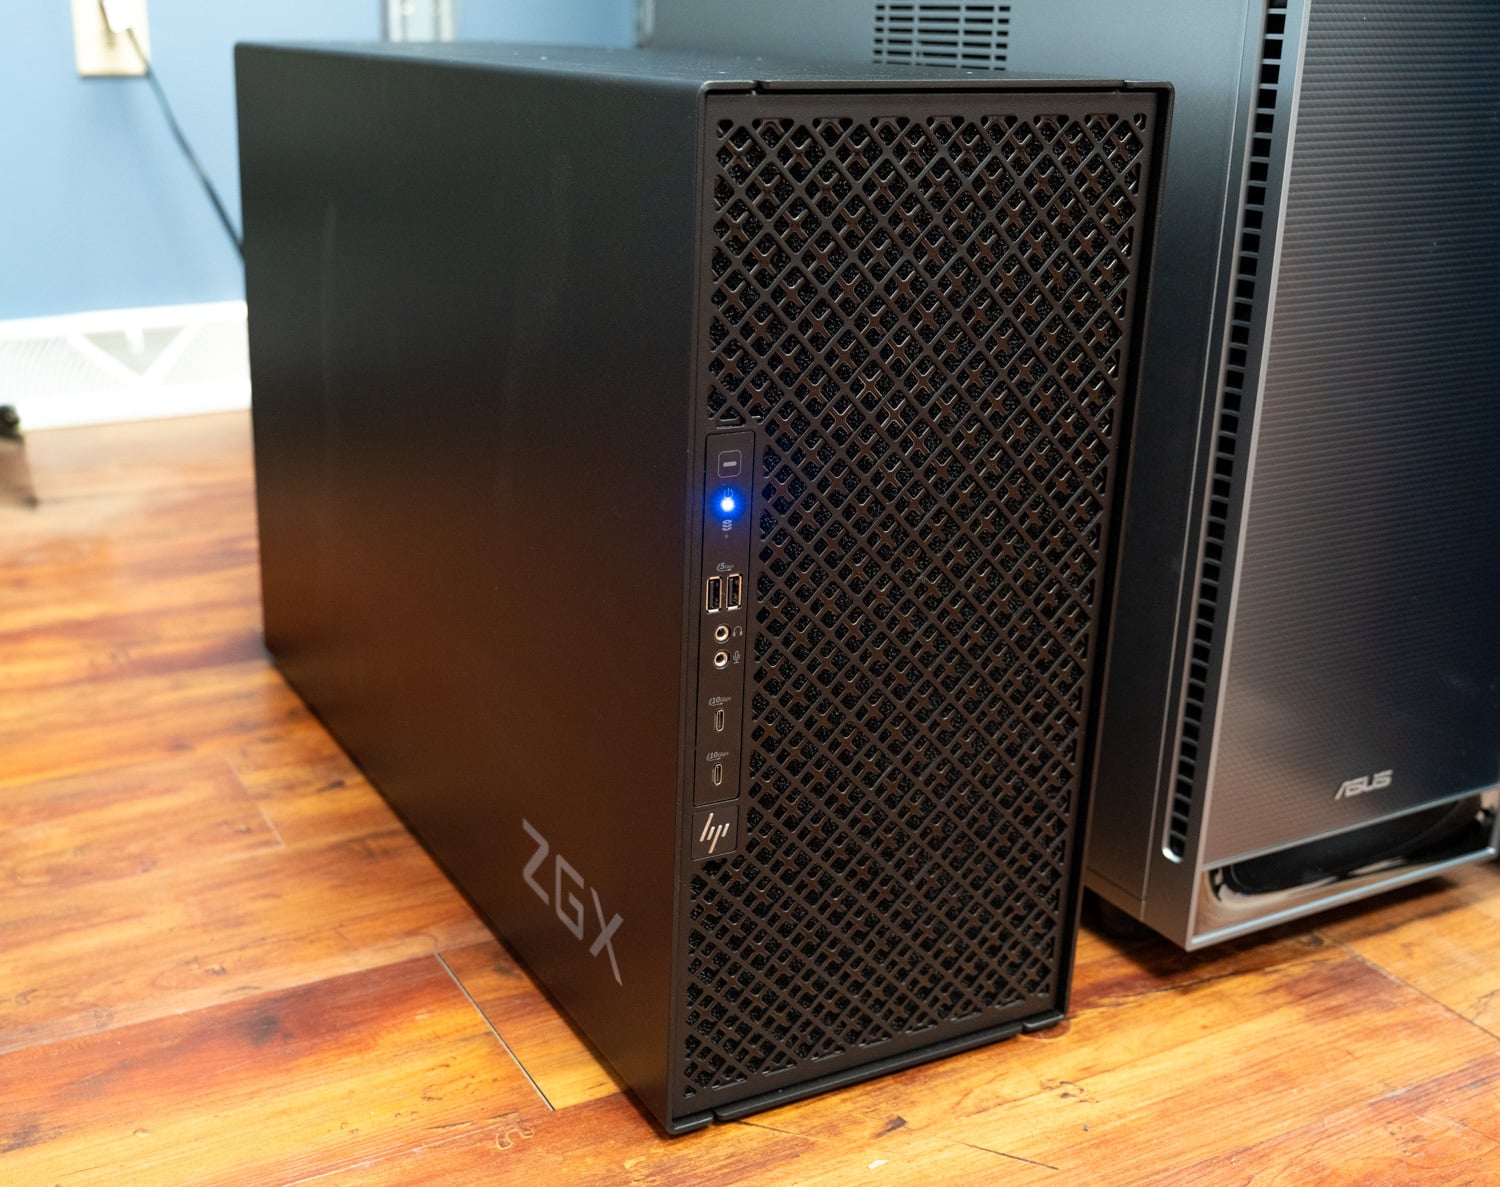
Die schrittweise Erweiterung eines Desktop-Systems ist keine neue Idee; NVIDIA hat dies mit der GB10-Plattform explizit propagiert. Eines der besonderen Merkmale der DGX Spark war die Möglichkeit, mit einem System zu beginnen und bei steigender Arbeitslast weitere anzuschließen. Die GB300 bietet deutlich mehr Leistung, doch der Betrieb größerer Modelle oder die Unterstützung mehrerer Benutzer kann selbst einen der schnellsten von uns getesteten Desktop-Rechner an seine Grenzen bringen. Genau darauf wollten wir in unserem ursprünglichen Test von MSI hinaus : Wenn Ihre Arbeitslast eine dieser Stationen rechtfertigt, ist es leicht nachzuvollziehen, warum sich später mehrere lohnen könnten.
Für viele Käufer entscheiden die Kosten darüber, wann eine Erweiterung wirtschaftlich sinnvoll wird. Wer jetzt versteht, wie gut zwei Stationen zusammenarbeiten, bekommt eine klarere Vorstellung davon, welchen Nutzen eine spätere Erweiterung bringen könnte.
Wichtige Erkenntnisse
- Zwei Kabel, 98 % der Leitungsgeschwindigkeit: Zwei 400G-DACs zwischen den ConnectX-8-Ports des ASUS ET900N G3 und des HP ZGX Fury erreichten im NCCL-Modus 98 GB/s bei Broadcast, Reduce und Senden/Empfangen, verglichen mit den maximal möglichen 100 GB/s des Paares. GPUDirect RDMA erzielte 392 GB/s pro Schiene, und ein 8-Byte-RDMA-Schreibvorgang dauerte durchschnittlich 1.46 µs. Die Einrichtung erfolgte über NVIDIAs Playbook.
- GLM-5.2 erzielt bei gleicher Parallelität einen 11-fachen Gewinn: Der 433 GB große NVFP4-Checkpoint überträgt etwa 215 GB an Expertengewichten in den Grace-Speicher einer Station, die 139 Ausgabetoken pro Sekunde bei 32 Streams verarbeitete; aufgeteilt auf zwei B300s im Tensor-Parallelmodus erreichte sie 1,525 bei 32 Streams und 3,141 bei 256 Streams.
- GLM-5.3 steigert die Token-Rate von 188 auf 5,018 pro Sekunde: Den größten Zuwachs im Set, nämlich das 27-fache, erzielte das andere Modell, das über 252 GB HBM3e verfügt. Das Paar erreichte bei gleicher Arbeitslast immer noch 256 Streams und hielt bei 8,192-Token-Aufforderungen fast 600 Ausgabetoken pro Sekunde, etwa das Fünffache des einzelnen Turms.
- MiniMax-M3 lange Eingabeaufforderungen enden bei acht Streams an einer Station: Der einzelne Turm fiel auf 103 Ausgabetoken pro Sekunde bei acht Streams, als der KV-Cache leer war; das Paar bediente zum gleichen Zeitpunkt 736 Token, 7.1x, und steigerte die Leistung auf 1,801 Token bei 256 Streams.
- Passende Modelle erhalten eine zweite Kopie und eine Vorabfüllungs-/Dekodierungsaufteilung: Mit einer Station im Prefill-Modus und der anderen im Decode-Modus verdreifachte GLM-5.3 Flash den Durchsatz bei kurzen Eingabeaufforderungen auf 32 Streams (828 auf 2,721) und verdoppelte den Durchsatz bei langen Eingabeaufforderungen (1,219 auf 2,448). DeepSeek V4.1 Flash erzielte den höchsten Ausgabedurchsatz aller getesteten Modelle mit 5,248 Token pro Sekunde bei 256 Streams.
Netzwerk auf der DGX-Station
Bevor wir uns dem Cluster zuwenden, fassen wir die Netzwerkfunktionen zusammen, die wir in unserem MSI-Testbericht behandelt haben. Die ConnectX-8 SuperNIC bietet mehr als nur die Netzwerkverbindung. Ihr integrierter PCIe-Switch übernimmt auch einen Teil der internen Ein-/Ausgabe der Station und verbindet sie mit dem Grace-Chip sowie den beiden PCIe Gen 6 x4-Speichersteckplätzen.
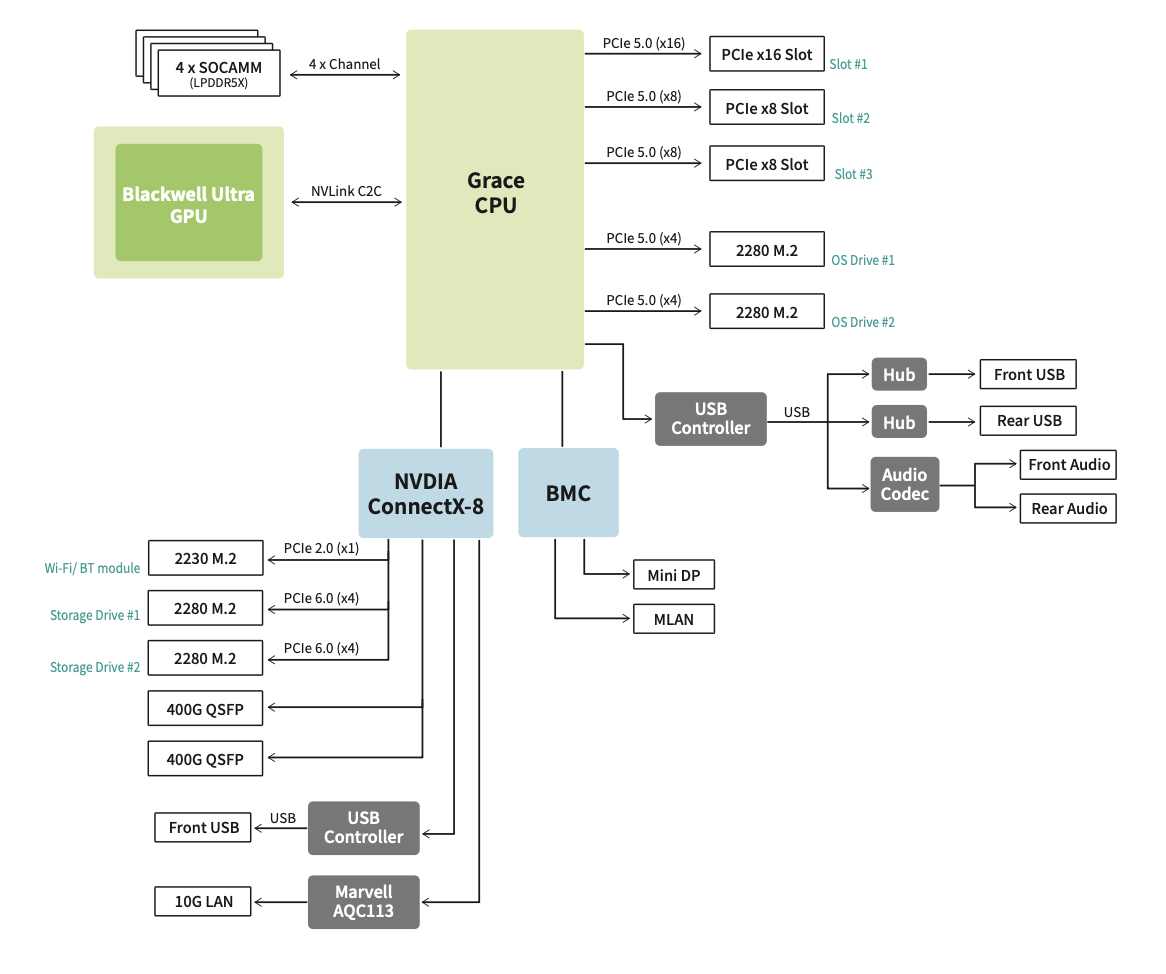
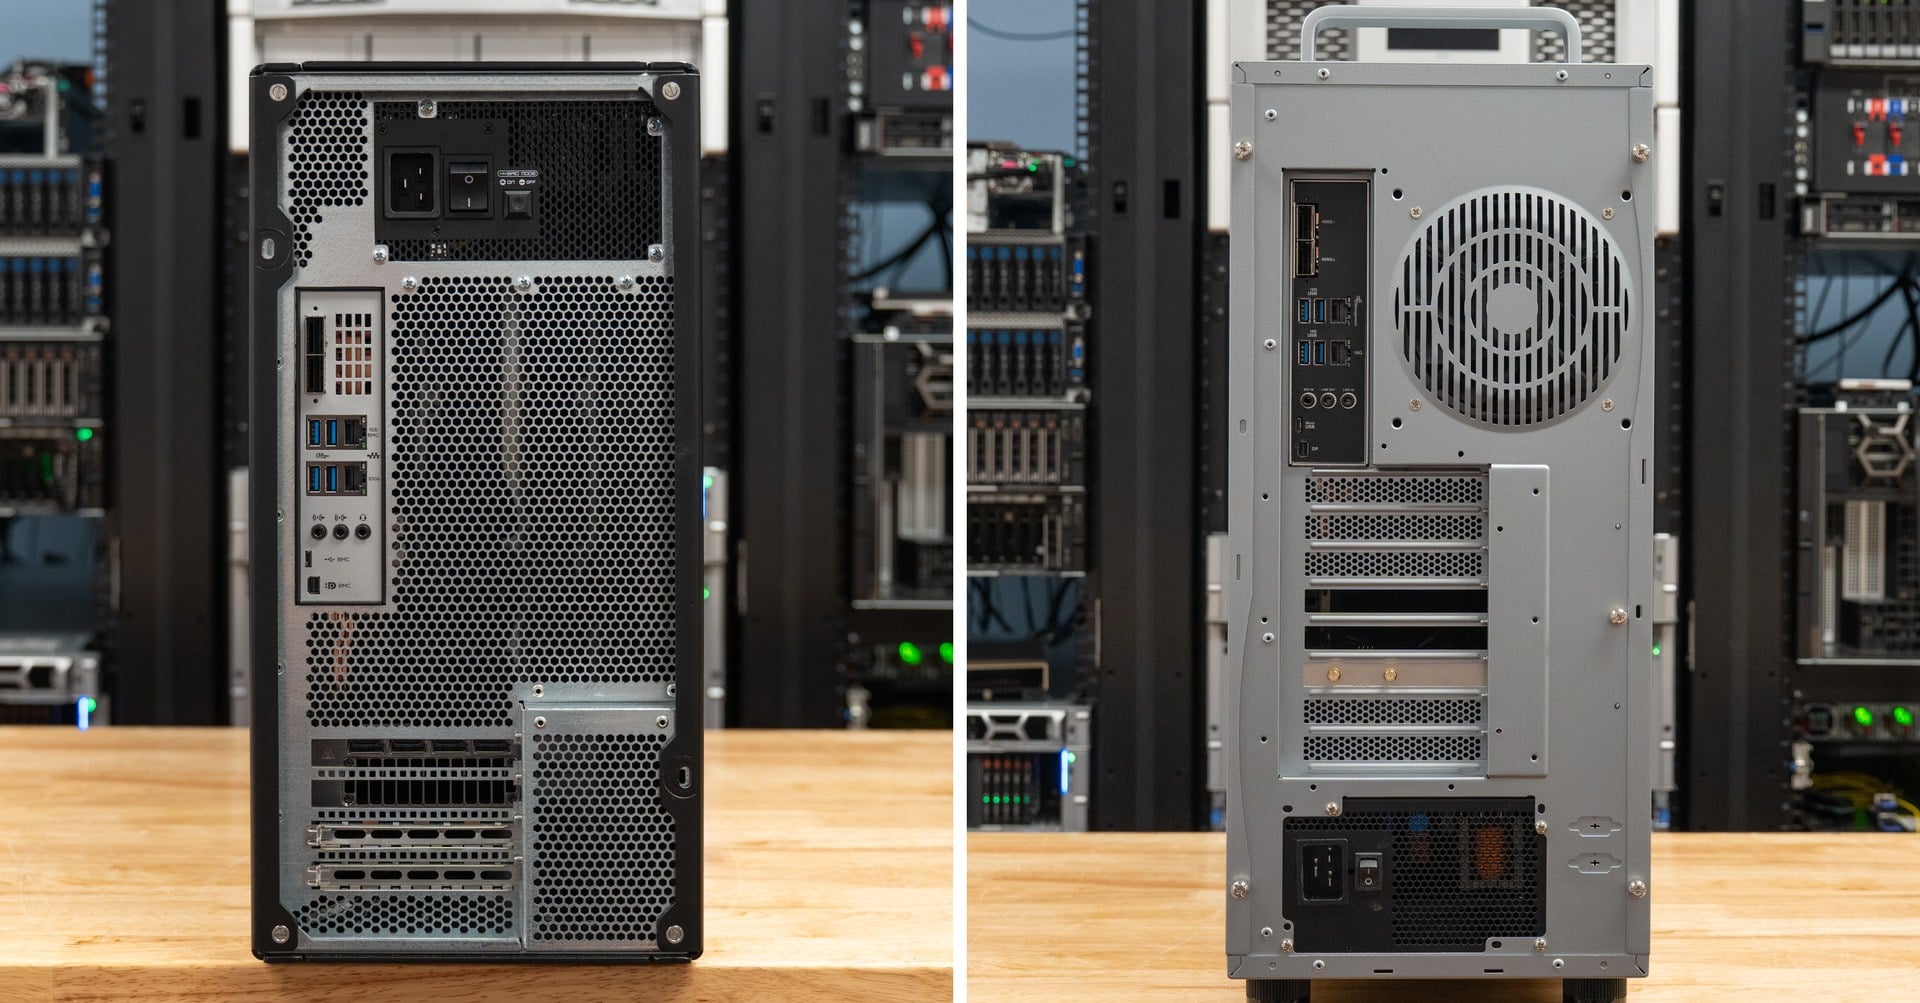
Für die eigentliche Netzwerkverbindung stellt das System zwei QSFP112-Ports mit einer Nennleistung von jeweils 400 Gbit/s zur Verfügung, wodurch eine Gesamtbandbreite von 800 Gbit/s zur Verfügung steht, um Stationen miteinander zu verbinden oder sie an ein größeres Netzwerk anzuschließen.
Im Vergleich zur Implementierung des DGX Spark, die wir in unserem ursprünglichen DGX Spark-Testbericht behandelt haben , war der ConnectX-7 der 400-Gbit/s-Klasse des Spark leistungsfähiger, als die PCIe-Konnektivität des GB10 voll ausnutzen konnte. Der Controller befand sich hinter zwei separaten PCIe 5.0 x4-Verbindungen, was den nutzbaren Netzwerkdurchsatz auf etwa 200 Gbit/s beschränkte. Seine zwei physischen Ports erschienen unter Linux als vier logische Ethernet-Schnittstellen. Um die volle Bandbreite zu erreichen, mussten diese Schnittstellen dem angeschlossenen Gehäuse zugeordnet, beide dahinterliegenden logischen Schnittstellen konfiguriert und sichergestellt werden, dass der RDMA-Datenverkehr beide PCIe-Pfade nutzen konnte.
The Station bietet uns eine einfachere Lösung mit zwei 400-Gb/s-Anschlüssen, die jeweils als unabhängige Netzwerkschiene dienen können.
Die Übertragung der vierfachen nutzbaren Bandbreite des Spark über zwei QSFP-Steckplätze erhöht zwar den Kühlbedarf, doch in unseren Tests bewältigte jedes Gerät diese Aufgabe problemlos. Der ConnectX-8 selbst ist flüssigkeitsgekühlt, und einige Hersteller wie MSI erweitern diese Kühlung auf die QSFP-Steckplätze, während andere Systeme, wie in unserem ASUS-Test, Kühlkörper und separate Lüfter über den Steckplätzen verwenden. Diese Kühlung ist besonders für optische Module von Vorteil, da diese mehr Wärme erzeugen als passive DACs. Beide Ansätze funktionierten in unseren Tests einwandfrei, und wir hatten keine Probleme mit der Kühlung des Netzwerks.
Verbindung zweier Bahnhöfe
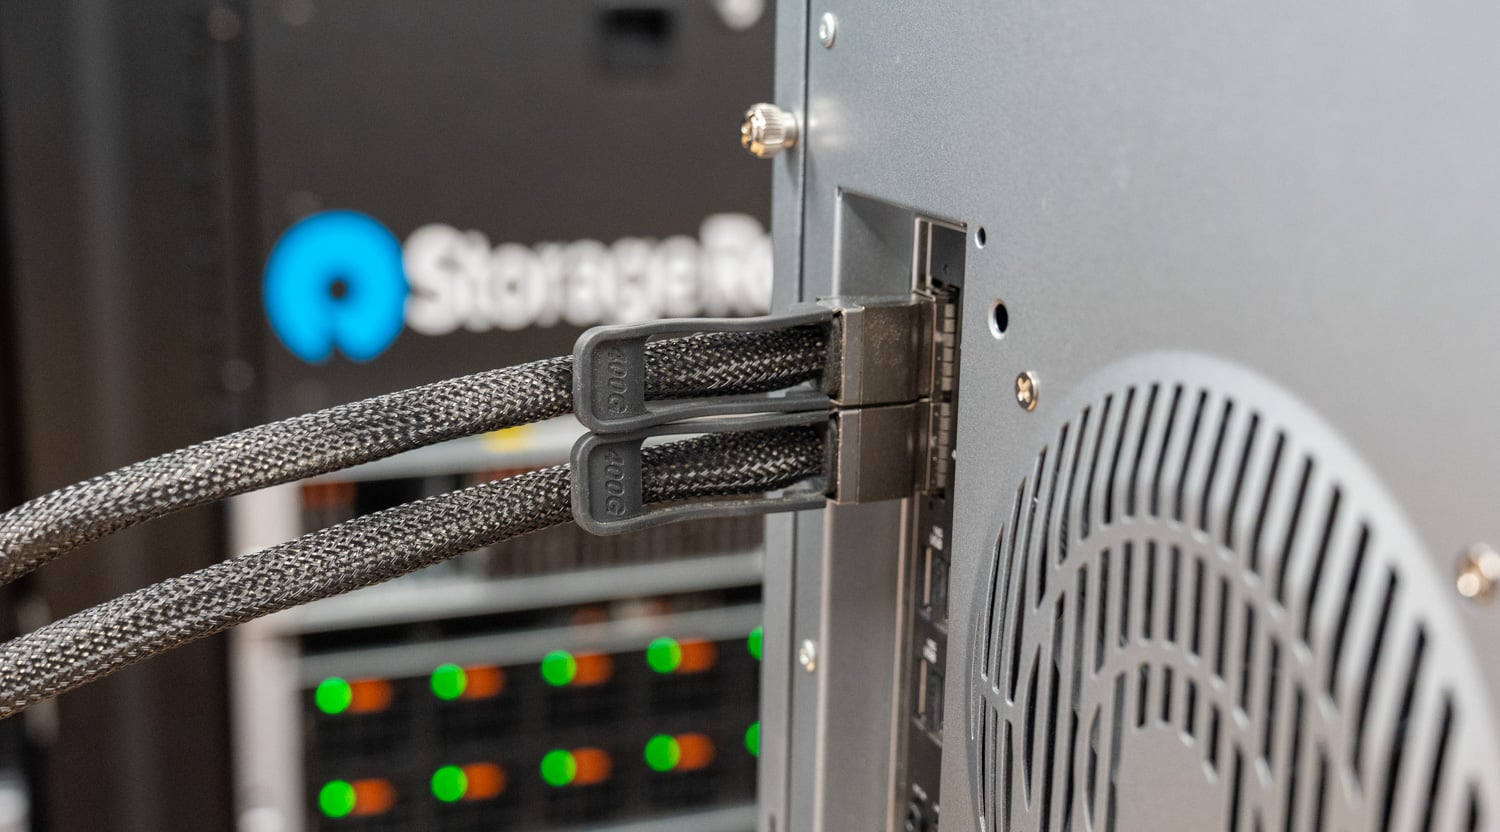
Das Clustern zweier DGX-Stationen war einfach: Wir haben die ASUS- und die HP-Station direkt über zwei 400G Direct Attach Copper (DAC)-Kabel zwischen ihren entsprechenden QSFP112-Ports verbunden, wodurch wir zwei unabhängige 400Gb/s-Verbindungen erhielten.
Auf Softwareseite bietet NVIDIA eine Schritt-für-Schritt- Anleitung für die Clusterung der Systeme. Die Anweisungen waren so verständlich, dass wir Claude Code einfach den Link zur Verfügung stellten und die Einrichtung dem Programm überließen. Es konfigurierte das Netzwerk zwischen den beiden Stationen, führte NCCL-Bandbreitentests durch und erstellte einen Ergebnisbericht.
Die Anleitung ist ein nummeriertes Playbook, das von einem dritten Rechner aus ausgeführt wird und beide Stationen über SSH erreicht. Die Ports sind als passende Verbindungen (QSFP0 zu QSFP0 und QSFP1 zu QSFP1) verkabelt, wobei jede Verbindung eine eigene Punkt-zu-Punkt-RoCEv2-Verbindung bildet: Die Skripte aktivieren die beiden ConnectX-8-Schnittstellen mit einer MTU von 9,000 Byte, weisen jeder Verbindung ein eigenes privates /24-Netz zu und wenden die Laufzeiteinstellungen für RoCE und GPUDirect an.
Ein Validierungsdurchlauf bestätigt anschließend, dass beide Verbindungen mit 400 Gbit/s trainiert wurden, dass Jumbo-Pings über beide Schienen laufen und dass die beiden RDMA-Geräte mlx5_0 und mlx5_1 als aktiv gemeldet werden. Ein ib_write_bw-Lauf auf jeder Schiene beweist, dass das Fabric RDMA-Datenverkehr und nicht nur Pings verarbeitet. Danach wird NCCL mit NCCL_IB_HCA=mlx5_0,mlx5_1 auf beide Schienen konfiguriert, und der Job wird wie jeder andere Zwei-Knoten-Lauf gestartet. Die folgenden Ergebnisse stammen aus dieser Sequenz.
Die erste Tabelle stammt aus den NCCL-Tests. Dabei handelt es sich um Kollektive, die verteilte Inferenz- oder Trainingsaufgaben auf den beiden B300-Systemen mit beiden belegten Schienen ausführen. Mit einer GPU pro Station tauschen die beiden GPUs in jedem Kollektiv Daten über die beiden 400G-Verbindungen aus. Die Spalte „Busbandbreite“ entspricht daher direkt den 100 GB/s (800 Gbit/s), die die beiden Kabel bereitstellen. Der Wert „Peak“ stellt das beste Ergebnis über alle Nachrichtengrößen hinweg dar; die Spalte „16 GiB“ zeigt die größte getestete Nachricht an, bei der sich die Bandbreite stabilisiert hat.
| Produktion | Spitzengröße | Maximale Busbandbreite | Busbandbreite bei 16 GiB |
|---|---|---|---|
| All-reduzieren | 1 GiB | 92.242 GB / s | 91.346 GB / s |
| Alle versammeln | 16 GiB | 87.893 GB / s | 87.893 GB / s |
| Streuung reduzieren | 2 GiB | 93.930 GB / s | 92.905 GB / s |
| Broadcast | 16 GiB | 97.975 GB / s | 97.975 GB / s |
| Reduziert | 16 GiB | 97.978 GB / s | 97.978 GB / s |
| Alle für alle | 8 GiB | 80.522 GB / s | 80.512 GB / s |
| Senden/Empfangen, unidirektional | 16 GiB | 97.953 GB / s | 97.953 GB / s |
| Senden/Empfangen, bidirektional | 16 GiB | 83.748 GB/s pro Richtung | 167.496 GB/s Gesamt |
Broadcast, Reduce und unidirektionales Senden/Empfangen erreichten jeweils 98 GB/s, was 98 % der maximalen Übertragungskapazität der beiden Kabel entspricht. Die Übertragungsmuster mit bidirektionaler Datenübertragung lagen niedriger: 92 GB/s für All-Reduce und 80 GB/s für All-to-All. Das Ergebnis für bidirektionales Senden/Empfangen dient als Referenzwert: Bei gleichzeitiger Übertragung beider GPUs lag die Übertragungsrate in jeder Richtung bei 84 GB/s, insgesamt also bei 167 GB/s über die gesamte Verbindung.
Die zweite Tabelle geht unterhalb von NCCL auf den rohen RDMA-Pfad über und verwendet ib_write_bw für jeweils eine Schiene. Die GPUDirect-Zeilen beschreiben 1-MiB-Übertragungen vom HBM eines B300 in den des anderen, wobei die Netzwerkkarte direkt auf den GPU-Speicher zugreift und ihn beschreibt. Beide Schienen erreichen 392 Gbit/s, was 98 % der Leitungsgeschwindigkeit entspricht. Die Host-Memory-Zeilen stellen den grundlegenden Funktionstest des Leitfadens dar: ein einzelnes Warteschlangenpaar, das Daten aus dem Grace-Speicher bezieht. Laut NVIDIAs Playbook liegt die Übertragungsrate bei 220 bis 230 Gbit/s auf einer 400-Gbit/s-Schiene; wir haben 228 Gbit/s gemessen. Die Latenzzeile beschreibt einen 8-Byte-Schreibvorgang mit durchschnittlich 1.46 µs.
| Test | Bandbreite | Linknutzung |
|---|---|---|
| GPUDirect RDMA, GPU-Speicher, ib_write_bw, 1 MiB-Übertragungen | ||
| Schiene 0 | 392.15 Gb / s | 98.04% |
| Schiene 1 | 392.15 Gb / s | 98.04% |
| Host-Memory-RDMA, beide Schienen | ||
| RDMA-Schreiben, Einweg | 228.15 Gb / s | |
| RDMA-Lesen, Einweg | 228.23 Gb / s | |
| RDMA-Senden, Einweg | 228.16 Gb / s | |
| RDMA-Schreiben, bidirektional | 447.10 Gbit/s Gesamt | |
| RDMA-Schreiblatenz, 8 Byte | Durchschnittlich 1.46 µs; 99. Perzentil 1.63 und 1.66 µs (nach Schiene). | |
Wie wir den Cluster getestet haben
Da die Zeit mit dem System begrenzt war, konzentrierten wir uns auf Inferenz, die aktuell beliebteste KI-Anwendung. Wir planen, diese Arbeit auf größere Cluster auszuweiten. In diesem Artikel konzentrierten wir uns auf größere Modelle und verglichen eine einzelne Station mit zwei Stationen unter Verwendung von Tensorparallelität (TP) und Prefill/Decode-Disaggregation (PD).
Tensorparallelität verteilt die Gewichtstensoren und Berechnungen innerhalb des Modells auf mehrere GPUs. In unserer Zwei-Stationen-Konfiguration (TP2) verwaltet jede B300 einen Teil des Modells, und beide bearbeiten jede Anfrage. Dadurch steht uns mehr High-Bandwidth Memory (HBM) für die Gewichte sowie mehr Rechenleistung für deren Ausführung zur Verfügung. Da die GPUs während der Inferenz Zwischenergebnisse austauschen und sich über NCCL synchronisieren müssen, wird der Kommunikationsaufwand zu einem Teil der Modellausführungskosten.
Die disaggregierte Inferenz ordnet die Prefill- und Decode-Phasen einer Anfrage separaten Workern zu. Prefill verarbeitet die Eingabeaufforderung und erstellt den Key-Value-Cache (KV-Cache), den Aufmerksamkeitszustand, den das Modell während der Generierung wiederverwendet. Decode nutzt diesen Zustand anschließend, um Ausgabetoken nacheinander zu generieren. Die beiden Phasen haben unterschiedliche Verarbeitungsanforderungen: Prefill ist rechenintensiv, während Decode speicherintensive Bandbreite benötigt. In größeren Umgebungen ermöglicht diese Disaggregation der Inferenz dem Betreiber, die Worker je nach Bedarf unabhängig zu skalieren, wie unsere Arbeit zum KV-Cache-Offload gezeigt hat.
In einer Einzelknotenkonfiguration, in der beide Phasen einen Worker gemeinsam nutzen, kann vLLM die Vorverarbeitung eingehender Prompts mit der Dekodierung bereits laufender Anfragen verschachteln. Diese Promptverarbeitung kann die Zeit zwischen den Ausgabetokens verlängern. In unserer PD-Konfiguration übernimmt eine Station die Vorverarbeitung und überträgt den KV-Cache der Anfrage an die andere Station, die die Dekodierung durchführt. Jeder Worker hat Zugriff auf seine eigene Kopie des Modells, einschließlich aller im Grace-Speicher abgelegten Daten. Der Dekodierungs-Worker muss die Verarbeitung neuer Prompts nicht mehr parallel zur Tokengenerierung einplanen, wodurch der Inferenzdurchsatz beschleunigt wird.
Für unsere Tests bestimmte der Speicherbedarf des Modells die Wahl des Ansatzes. Bei den größten Checkpoints, bei denen eine einzelne Station einen erheblichen Teil der Modellgewichte in den Grace-Speicher auslagern musste, lieferte TP die beste Leistung. Durch die Verteilung der Gewichte auf zwei GPUs konnte ein größerer Teil des Modells im HBM verbleiben, wodurch der Auslagerungsverlust reduziert wurde. Für Modelle, die gut auf einer Station Platz fanden – entweder vollständig im HBM oder mit geringer Auslagerung in den Grace-Speicher –, verwendeten wir die PD-Disaggregation. Dies umfasste DeepSeek V4.1 Flash, dessen Engramm-Lookup-Tabellen im Grace-DRAM platziert wurden.
Um die Vergleichbarkeit mit unserer bisherigen Abdeckung zu gewährleisten, haben wir unsere bewährte Methodik mit festen Eingabesequenzlängen (ISL) und Ausgabesequenzlängen (OSL) beibehalten. Bei gleichmäßiger Arbeitslast werden 512 Eingabe- und 512 Ausgabetoken verwendet, während bei Arbeitslast mit hohem Prefill-Anteil 8,192 Eingabe- und 1,024 Ausgabetoken zum Einsatz kommen. Die Anzahl der gleichzeitigen Anfragen wird variiert, während die Sequenzlängen konstant bleiben.
Die Einzelstations-Baseline in jedem Diagramm ist die ASUS ET900N G3 aus unserem Test, die auf 32 Streams gesweept wurde; die Zweistationsläufe gehen bis zu 256. Jeder Punkt repräsentiert einen einzelnen Durchlauf, sodass ein Einbruch bei einer Parallelitätsstufe als erfasst gemeldet wird.
Inferenzkonfiguration
| Modell | Clustermodus | Software | Spekulative Dekodierung | Erinnerung an Gnade |
|---|---|---|---|---|
| DeepSeek V4.1 Flash (FP8) | Vorbefüllung/Dekodierungsaufteilung, vollständige Kopie pro Station | vllm/vllm-openai:deepseekv41-flash-0909 | Eigener Zeichner des Modells, 5 Tokens festgelegt | Zwei FP8-Engrammtabellen (188.84 GiB) sind im Grace-Speicher fixiert, zusätzlich wurden 131.97 GB an Expertengewichten ausgelagert, auf jeder Station. |
| GLM-5.3 NVFP4 | Tensorparallel (TP2) | NVIDIA vLLM 26.08 NGC-Container (vLLM 0.27.1) | MTP, fester 5-Token-Draft | Keine im Cluster; 215 GB an Expertengewichten auf einer einzelnen Station ausgelagert. |
| GLM-5.3 Flash NVFP4 | Vorbefüllung/Dekodierungs-Disaggregation, ASUS-Vorbefüllung, HP-Dekodierung | vLLM 0.28.1 RC1 | MTP, fester 5-Token-Draft | Keine Präsentation |
| GLM-5.2 NVFP4 | Tensorparallel (TP2) | NVIDIA vLLM 26.08 NGC-Container (vLLM 0.27.1) | MTP, fester 3-Token-Draft | Keine im Cluster; etwa 215 GB an Expertengewichten wurden auf eine einzelne Station ausgelagert. |
| MiniMax-M3 NVFP4 | Tensorparallel (TP2) | NVIDIA vLLM 26.08 NGC-Container (vLLM 0.27.1) | EAGLE3, fester 3-Token-Draft | Keine im Cluster; ein Teil der Experten ist auf eine einzelne Station verteilt. |
Inferenzleistung
DeepSeek V4.1 Flash
DeepSeek V4.1 Flash lief disaggregiert, wobei eine Station das Prefill und die andere die Dekodierung übernahm. Jede Station enthielt eine vollständige Kopie des Modells: die beiden FP8-Engrammtabellen mit insgesamt 188.84 GiB, die im Grace-Speicher abgelegt waren, und weitere 131.97 GB an Expert Weights, die ebenfalls in den Grace-Speicher ausgelagert wurden. Damit ist es die einzige Konfiguration im Testfeld, bei der auf beiden Geräten Grace-Speicher zum Einsatz kommt. Es ist auch das einzige Modell ohne Single-Station-Test, da der ASUS-Test den älteren V4-Flash-Checkpoint verwendete und die beiden nicht direkt vergleichbar sind.
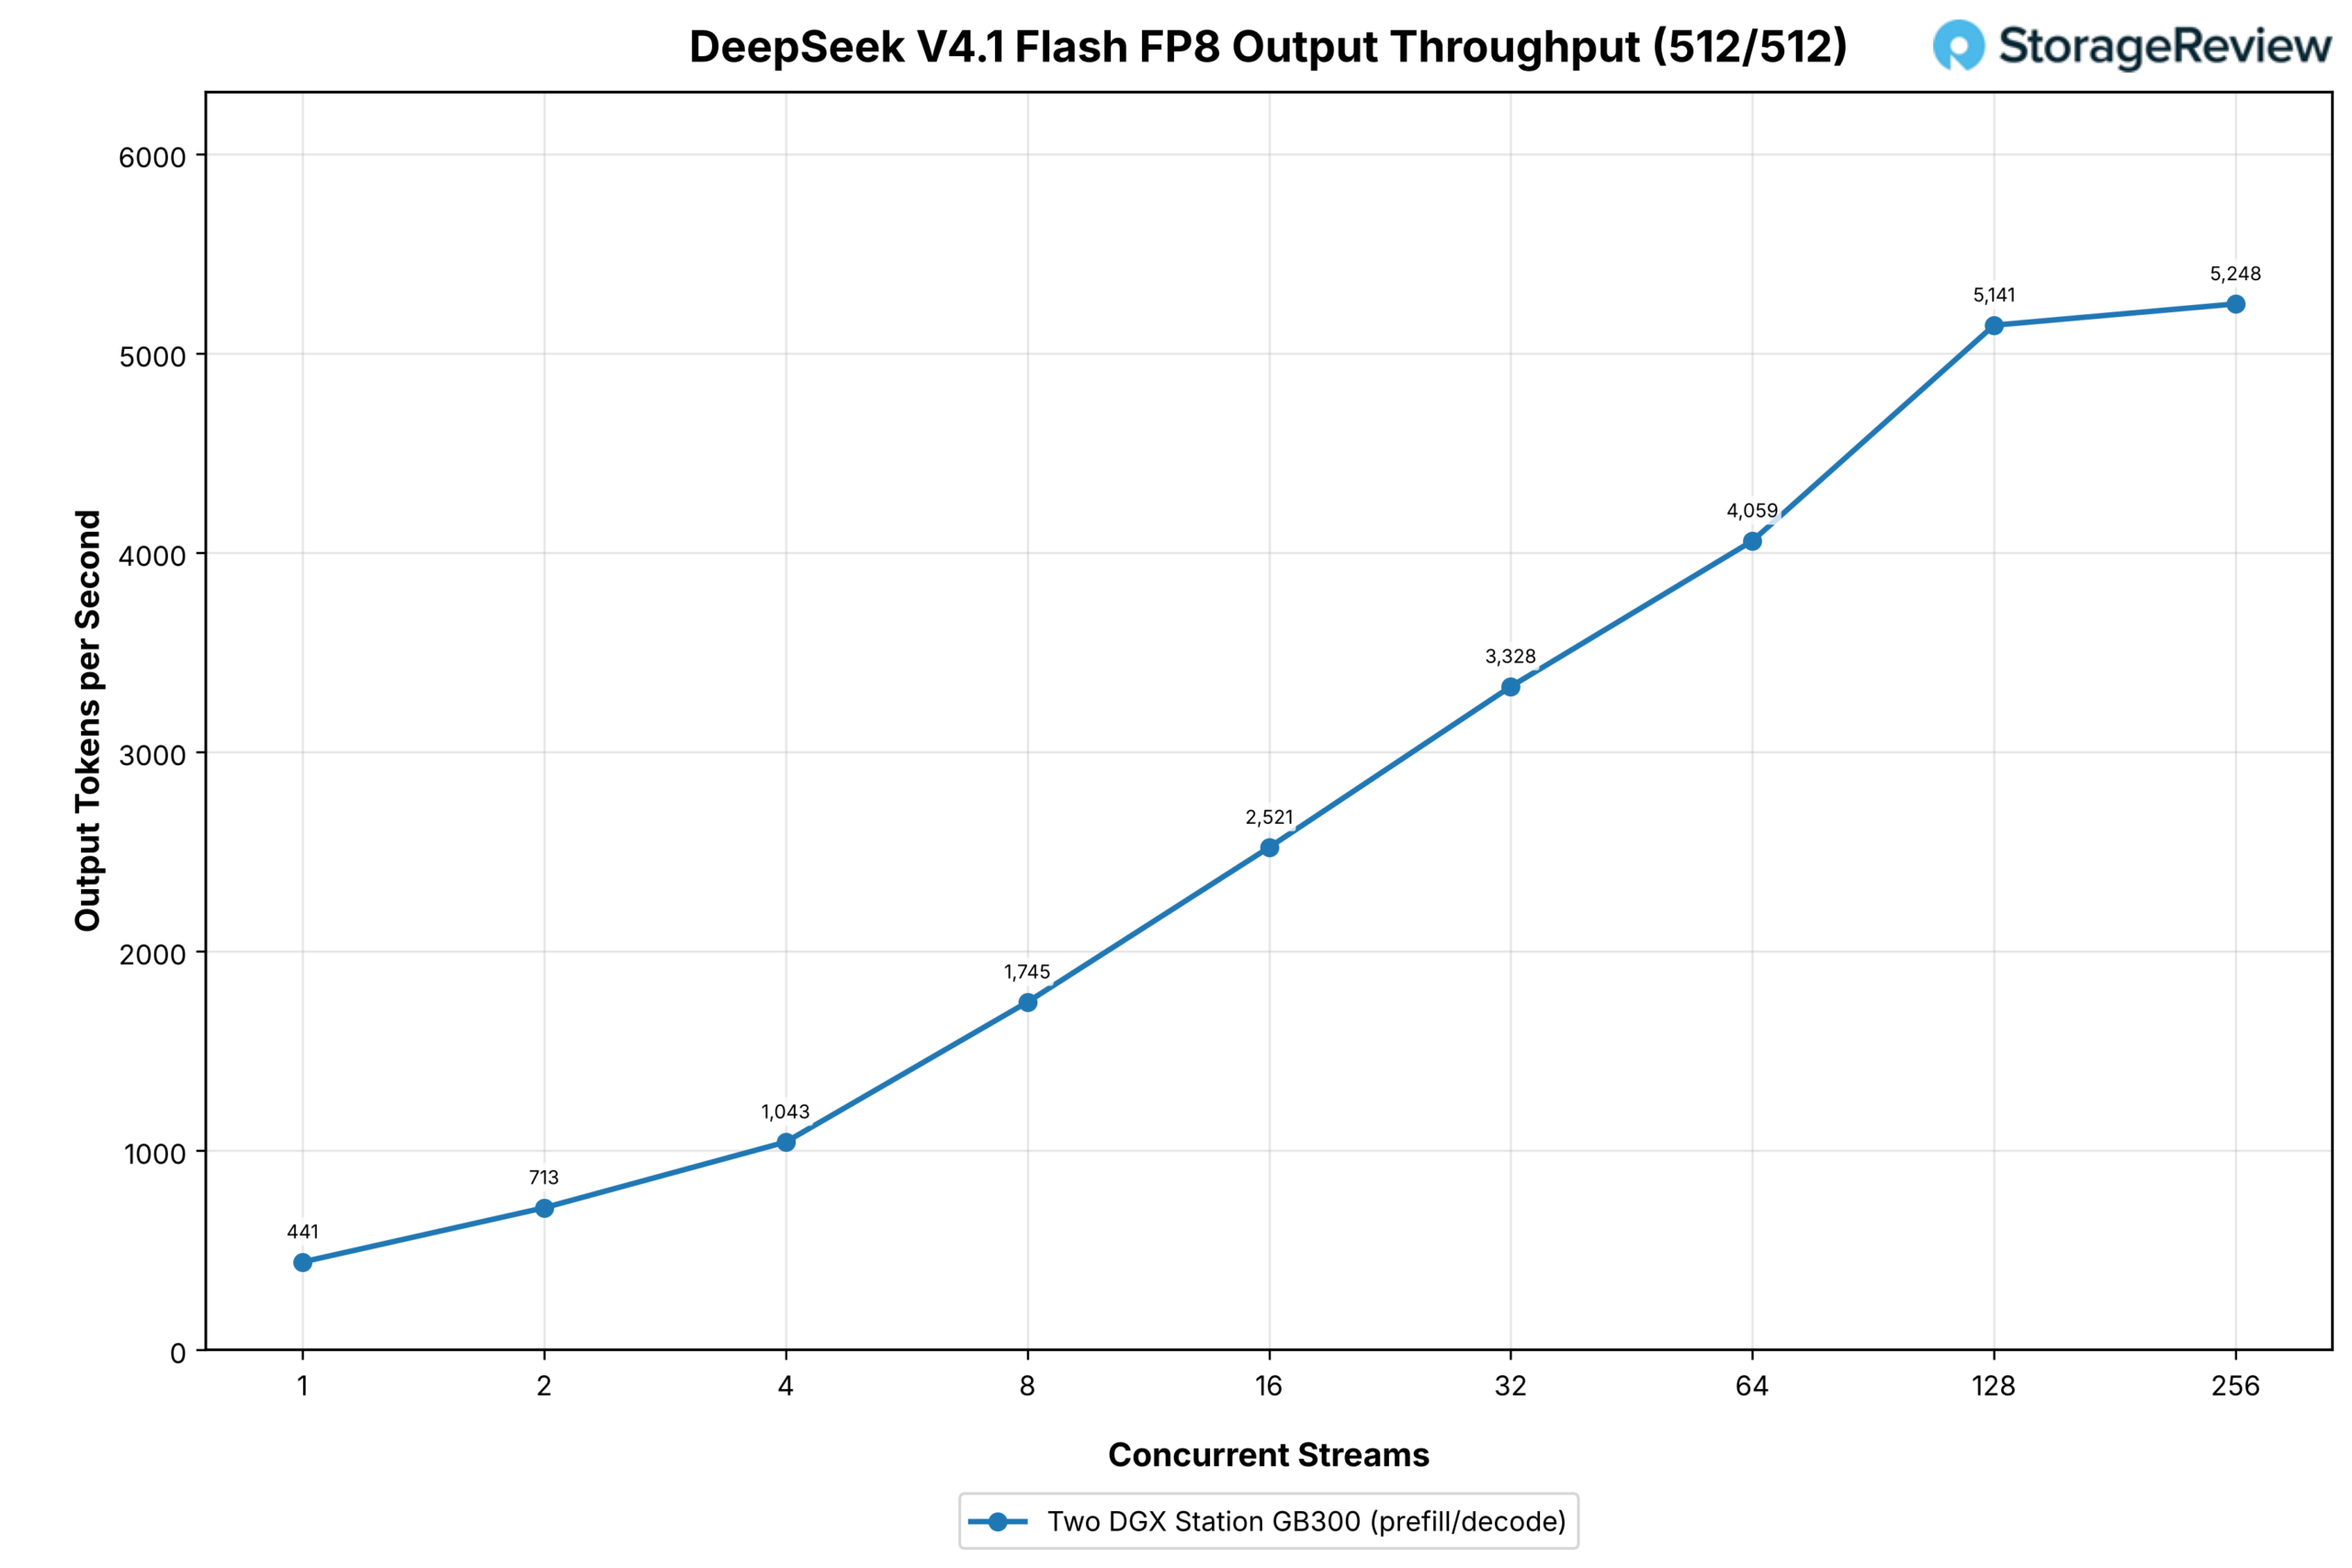
Im Zwei-Stationen-Cluster erreichte das native FP8-Modell eine Ausgabeleistung von 441 Token pro Sekunde bei einem Datenstrom bis zu 3,328 bei 32, 5,141 bei 128 und 5,248 bei 256 Datenströmen. Dies war der höchste Durchsatz aller Modelle in diesem Testfeld, wobei die Kurve nur im oberen Bereich abflachte. Zum Vergleich: Die einzelne ASUS Station erreichte in unserem Test mit V4-Flash eine Ausgabeleistung von 1,766 Token pro Sekunde bei 32 Datenströmen.
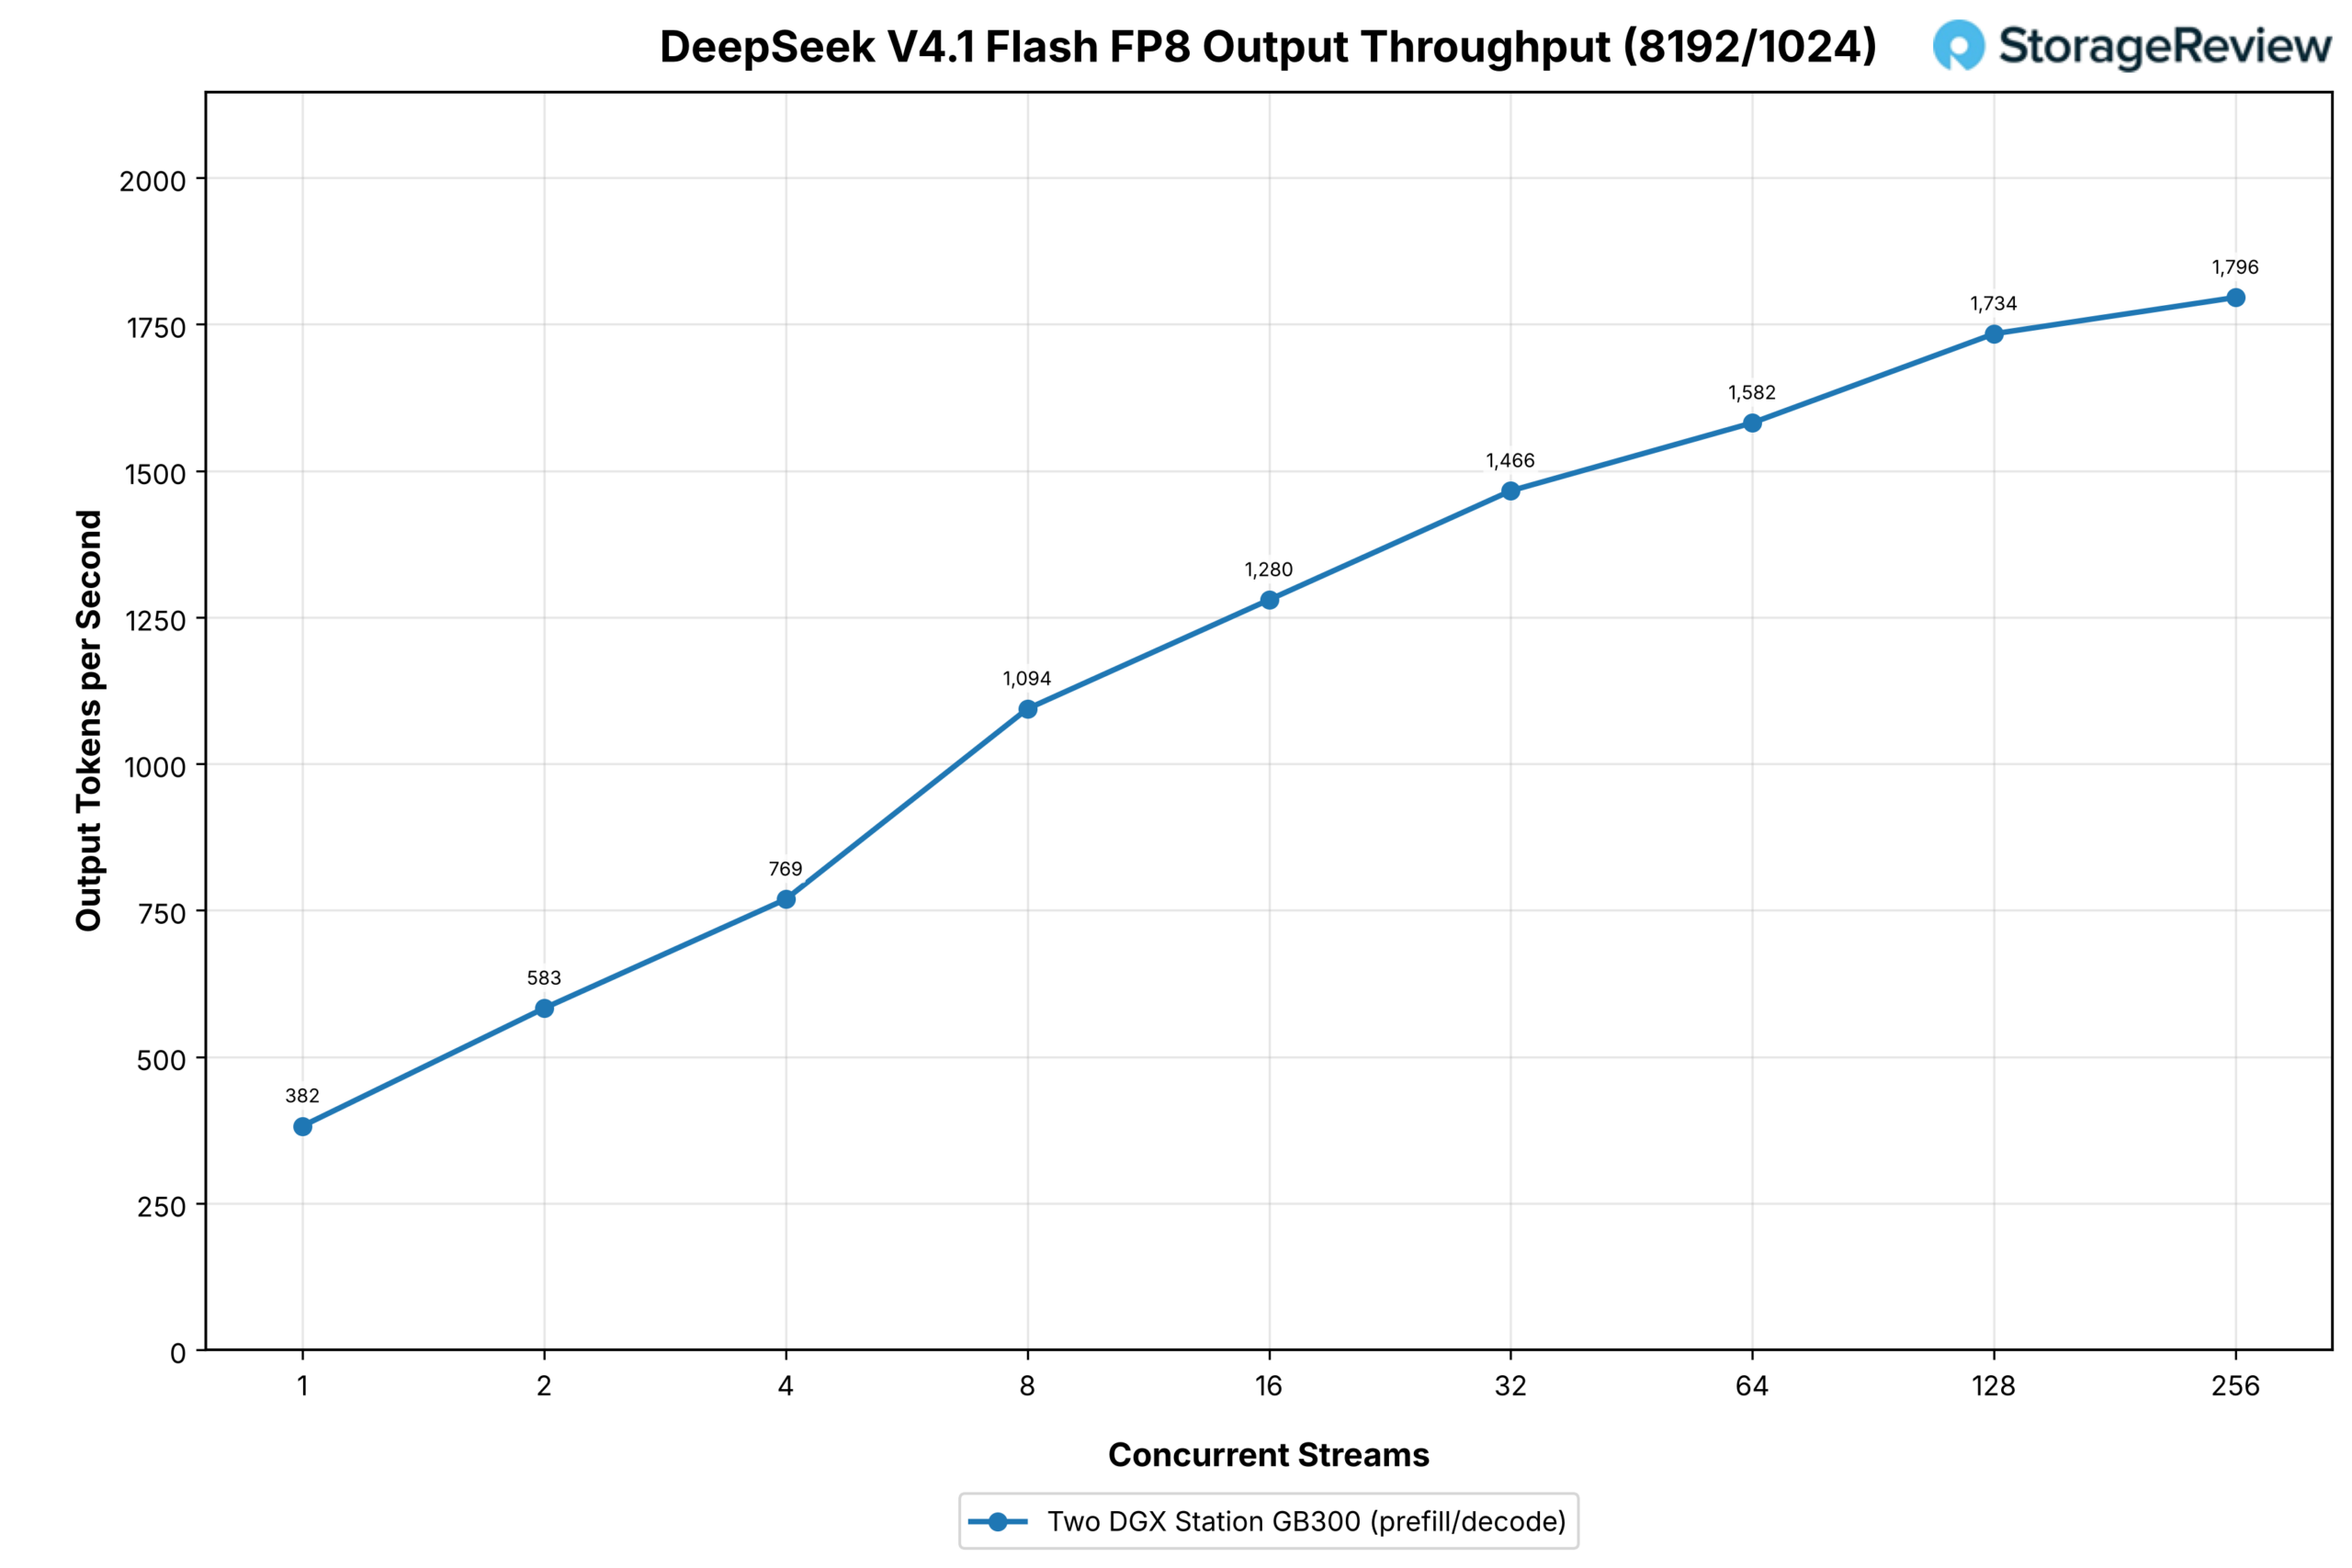
Bei hohem Prefill-Anteil erreichte der Cluster eine Ausgabeleistung von 382 Token pro Sekunde bei einem Datenstrom, 1,466 bei 32 und 1,796 bei 256. Da jede Anfrage 8,192 Eingabe-Token enthält, lag der Gesamtdurchsatz im Spitzenbereich bei 16,163 Token pro Sekunde. Dank der Engrammtabellen und 131.97 GB an Expertengewichten im Grace-Speicher jeder Station verlaufen die Kurven über den gesamten Messbereich hinweg gleichmäßig.
GLM-5.3
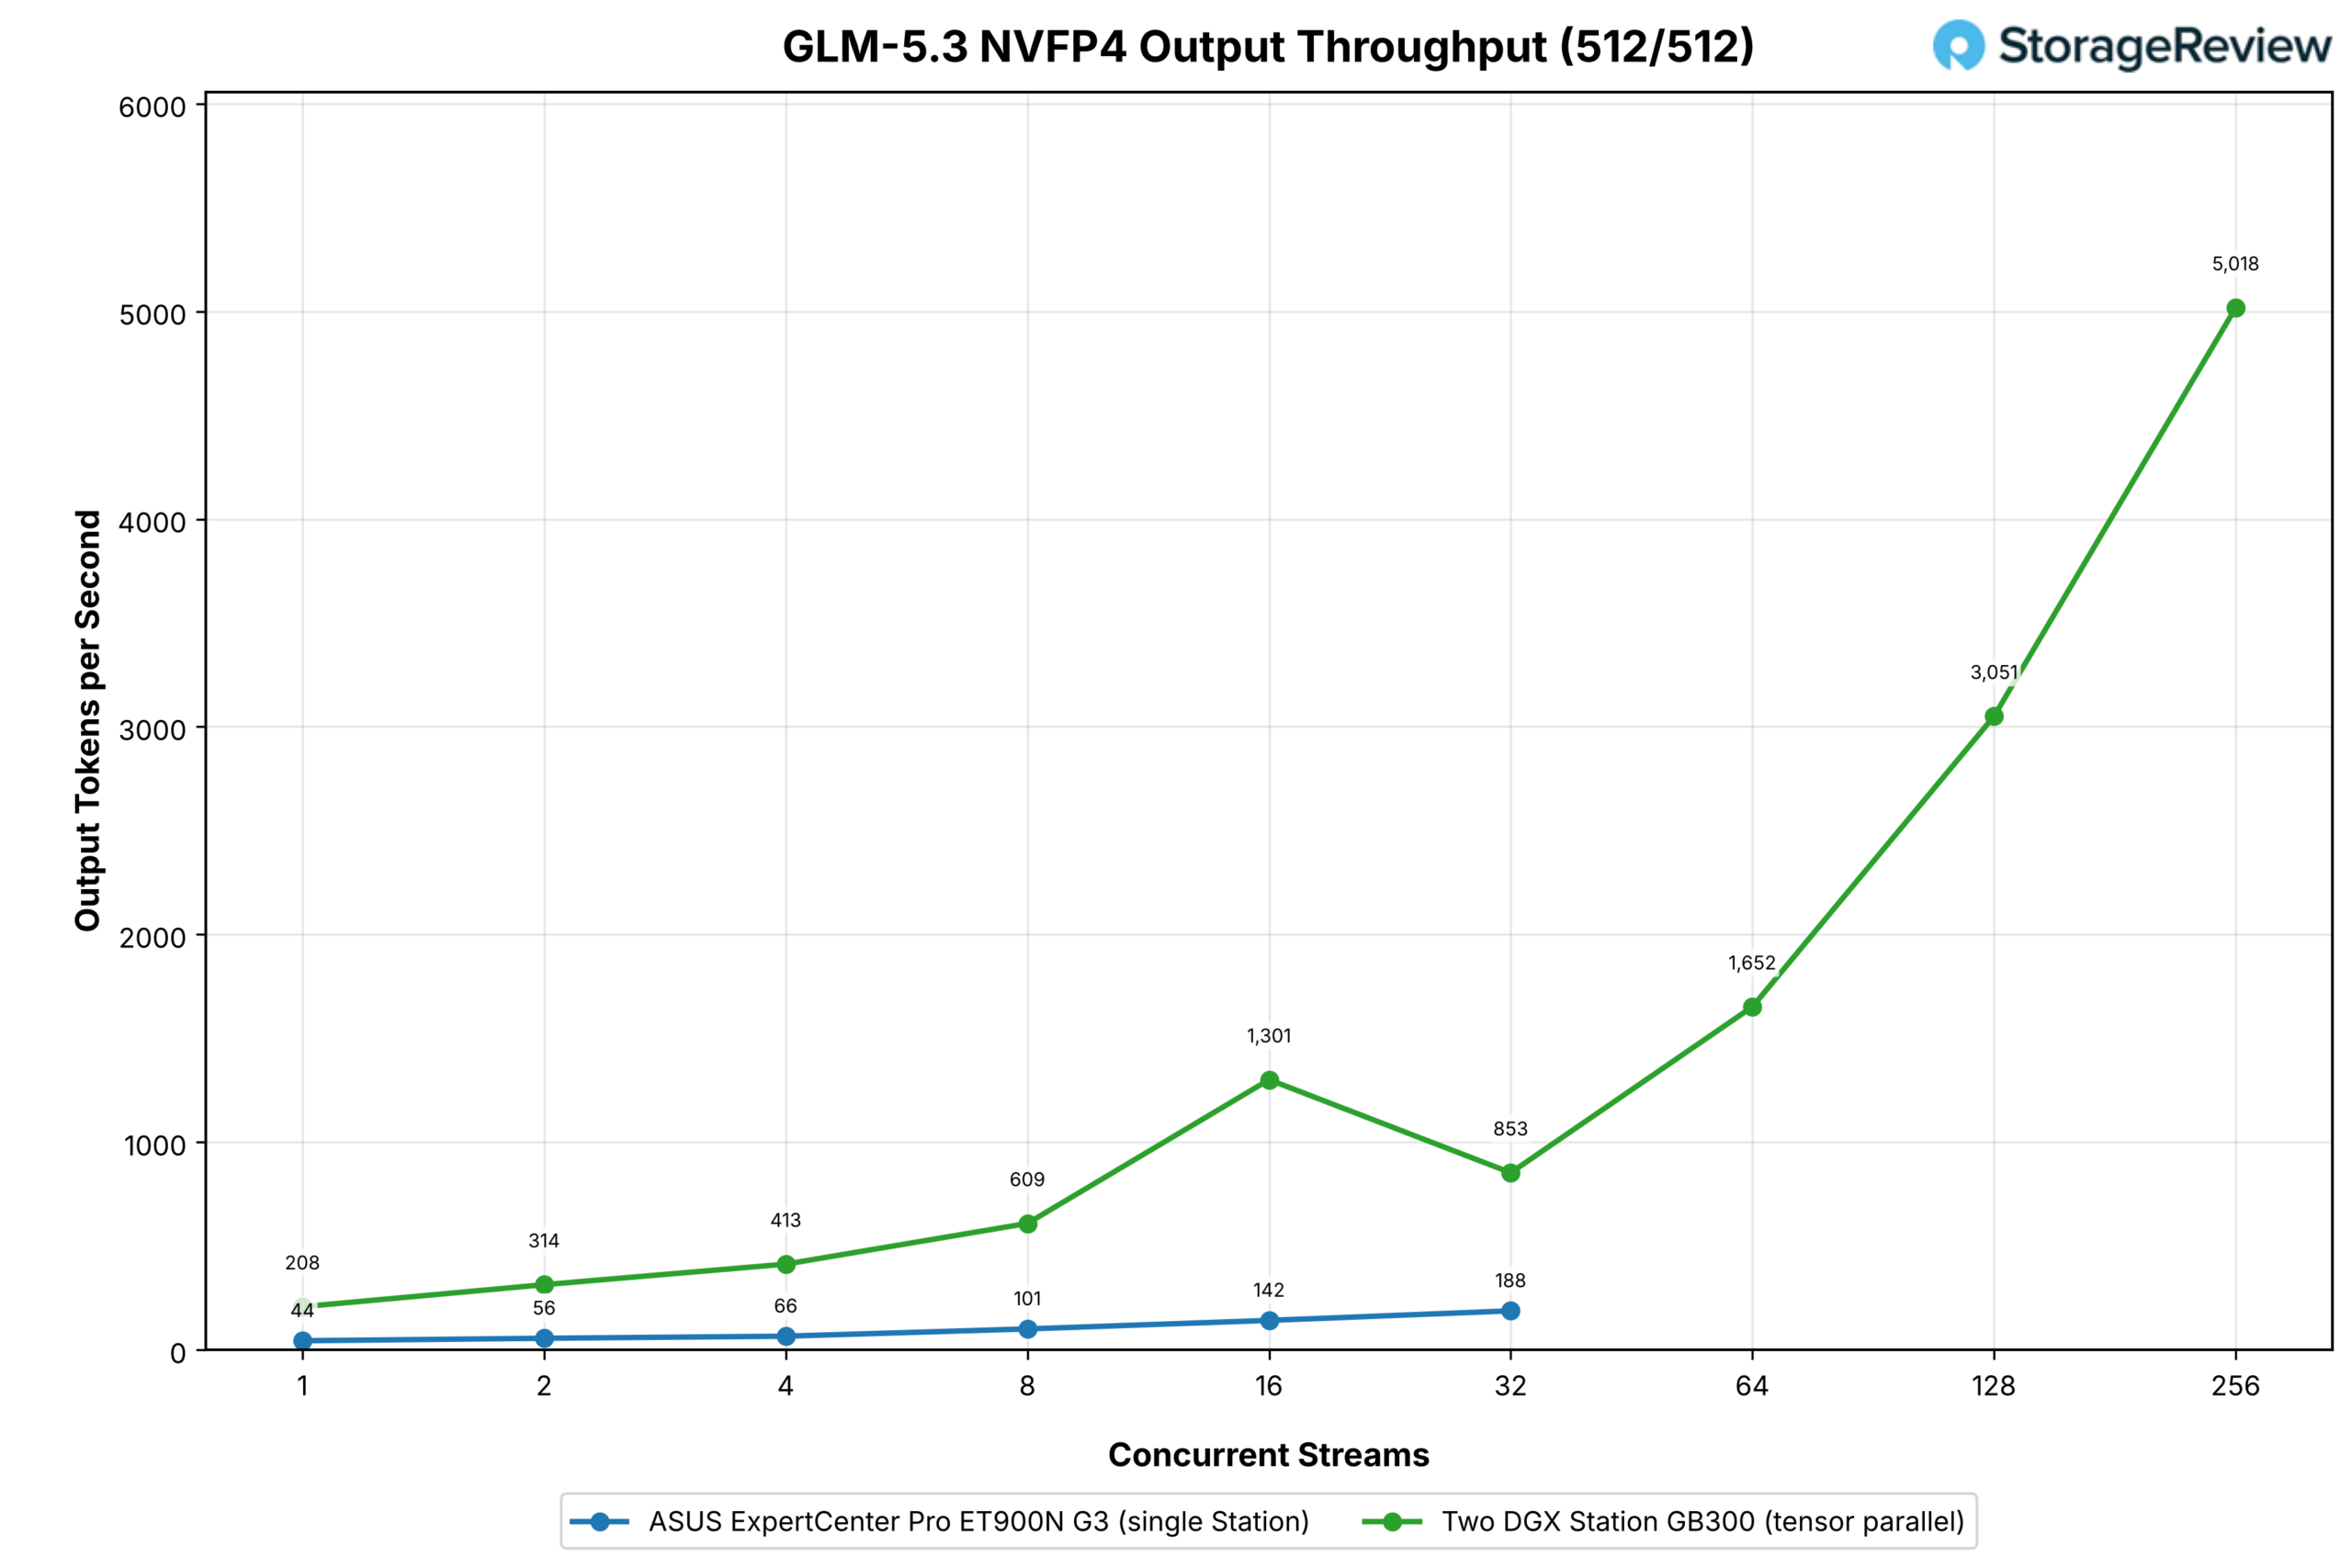
GLM-5.3 lief in TP2 ohne Grace-Offload. Auf einer einzelnen Station wurden 215 GB an Expertengewichten in den Grace-Speicher ausgelagert, und das Cluster-Ergebnis folgte GLM-5.2 über weite Strecken des Sweeps, bevor es ungleichmäßig wurde. Eine Station steigerte die Ausgabeleistung von 44 Token pro Sekunde bei einem Datenstrom auf 188 Token pro Sekunde bei 32 Datenströmen und gleicher Arbeitslast.
Der Cluster aus zwei Stationen erreichte eine Anzahl von 208 Streams bei einem Datenstrom und 1,301 bei 16 Streams – das 4.7- bis 9.2-Fache der Anzahl der Streams eines einzelnen Turms. Anschließend fiel die Anzahl auf 853 bei 32 Streams und stieg dann wieder auf 1,652 bei 64 Streams, 3,051 bei 128 Streams und 5,018 bei 256 Streams. Der Wert von 32 Streams entspricht den erfassten Daten. Sowohl die Batch-Entscheidungen als auch die Kernel-Auswahl ändern sich mit zunehmender Parallelität. Zudem fügt eine Tensor-parallele Bereitstellung auf jeder Schicht eine Kollektivoperation hinzu, die vor dem nächsten Schritt abgeschlossen sein muss. Daher verläuft die Kurve nicht linear, aber der Maximalwert von 256 Streams entspricht dem 27-Fachen dessen, was eine Station bei 32 Streams erreichte.
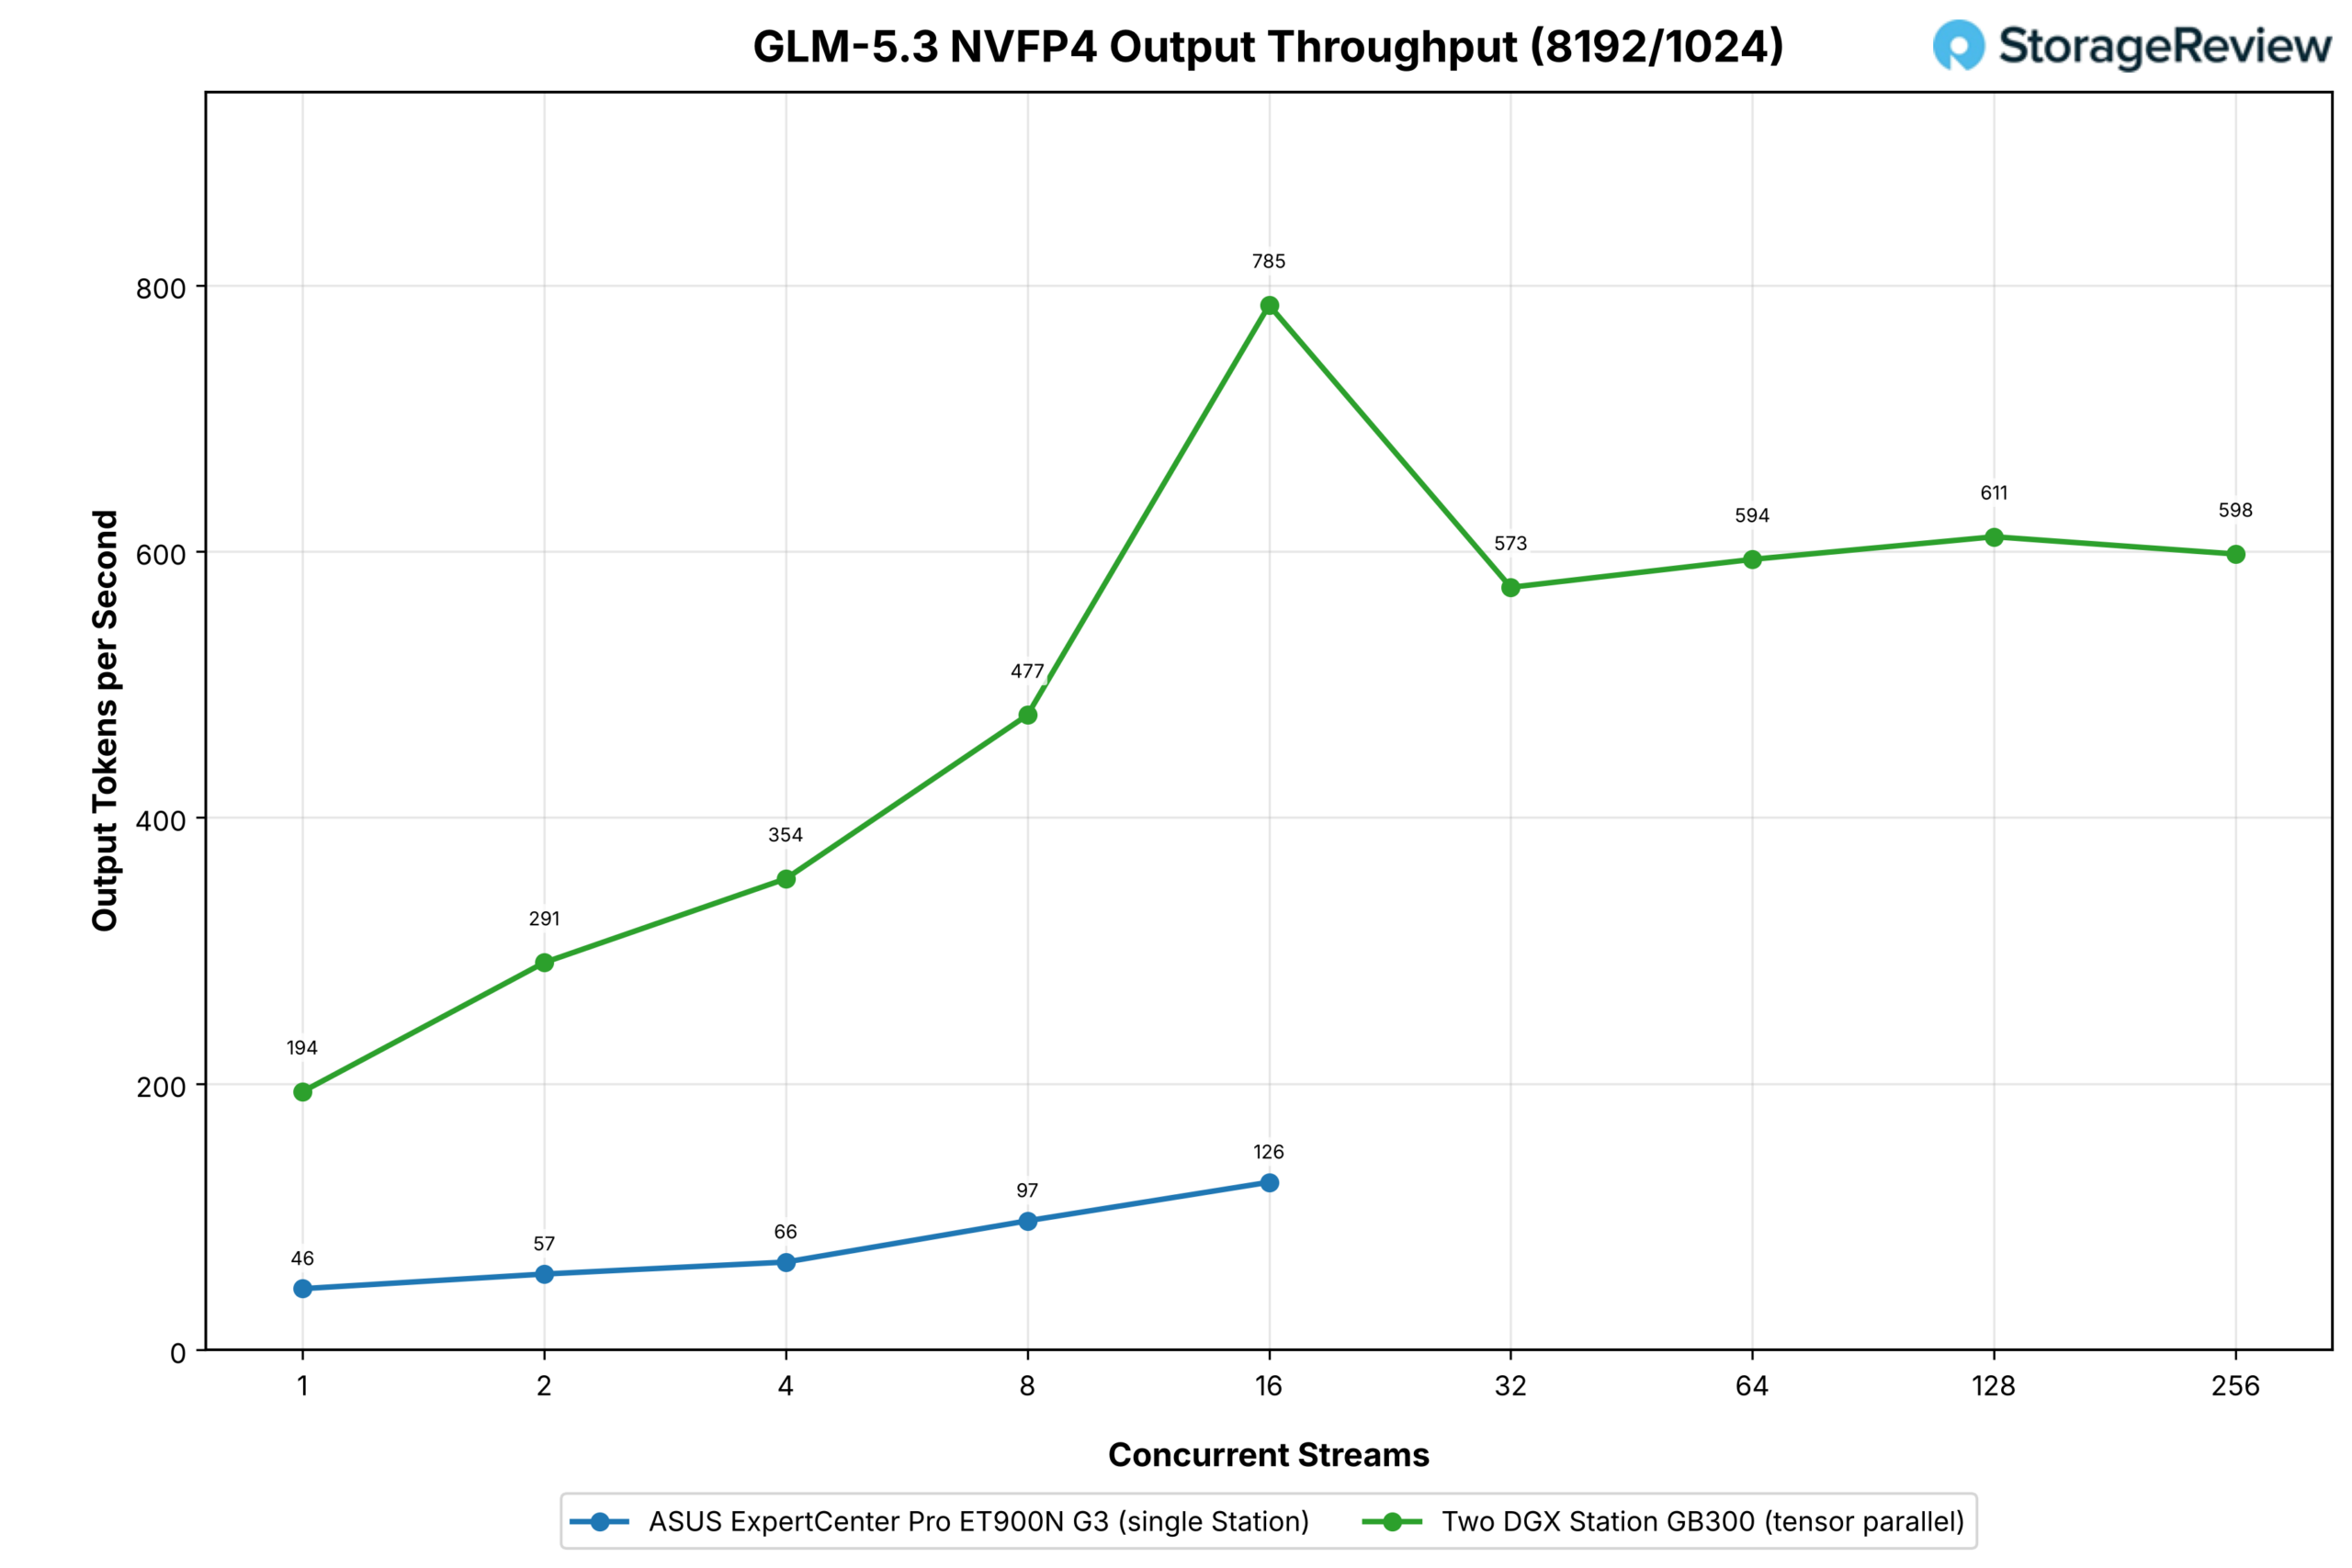
Bei hohem Prefill-Anteil erreichte die einzelne Station planmäßig maximal 16 Streams: Ein ausgelagertes Modell flacht frühzeitig ab, und eine weitere Erhöhung der Parallelität bringt kaum neue Erkenntnisse. Die Ausgaberate stieg von 46 Token pro Sekunde bei einem Stream auf 126 bei 16 Streams. Der Cluster erreichte im gleichen Bereich eine Steigerung von 194 auf 785 Token pro Sekunde (maximal das 6.2-Fache) und pendelte sich dann zwischen 573 und 611 Token pro Sekunde (32 bis 256 Streams) ein. Die maximale Ausgaberate bei langen Eingabeaufforderungen liegt bei etwa 600 Token pro Sekunde und ist damit immer noch etwa fünfmal so hoch wie die der einzelnen Station.
GLM-5.3 Blitzgerät
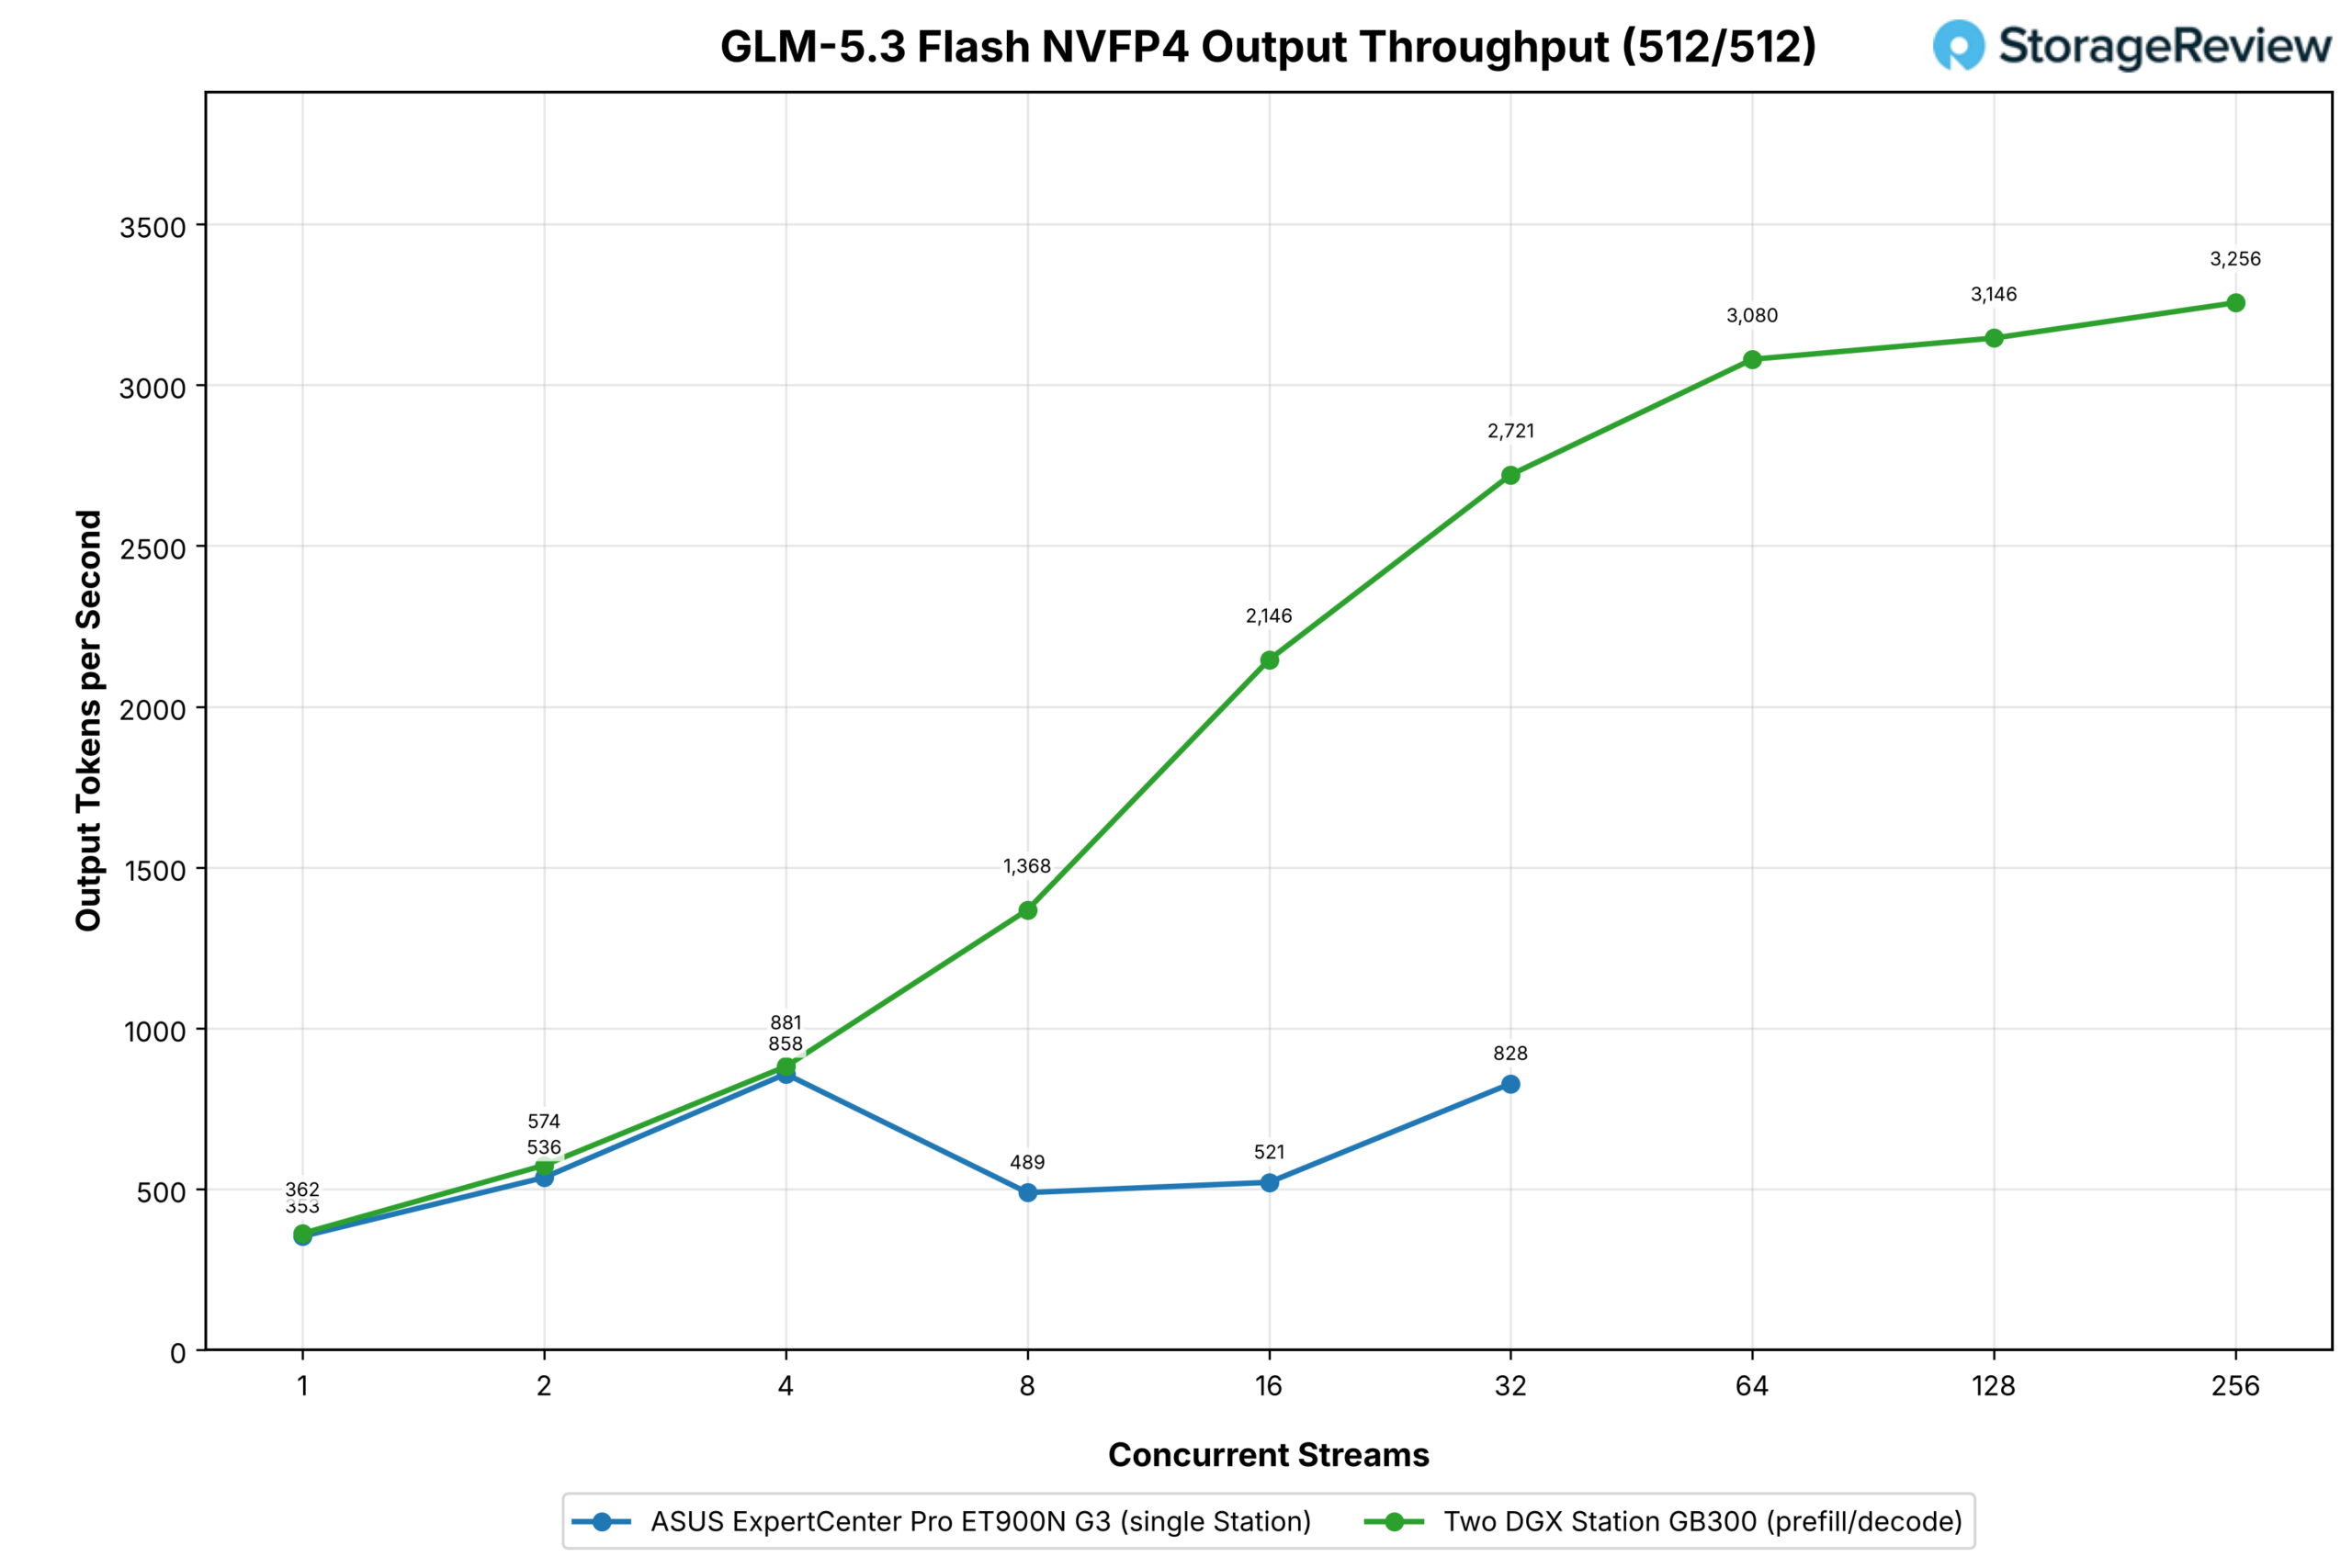
Der GLM-5.3-Flashspeicher ist so klein, dass jede Station eine vollständige Kopie speichern kann. Daher lief er disaggregiert, wobei das ASUS-System das Vorbefüllen und das HP-System die Dekodierung übernahm. Da der Flashspeicher nur wenige aktive Parameter benötigt, läuft er auf einer einzelnen Station bereits schnell: 353 Ausgabetoken pro Sekunde bei einem Datenstrom und 828 bei 32 Datenströmen unter gleicher Arbeitslast. Die mittlere Auslastung (858 bei vier Datenströmen, 489 bei acht Datenströmen) wird als erfasst gemeldet.
Bei dem disaggregierten Paar stieg die gleiche Arbeitslast von 362 Ausgabetoken pro Sekunde bei einem Stream auf 2,721 bei 32, das 3.3-fache des einzelnen Turms, und weiter auf 3,256 bei 256 Streams.
Bei einem und zwei Datenströmen entspricht das Paar fast genau einer einzelnen Station, was zu erwarten ist, wenn die Dekodierungsstation die gleiche Arbeit allein erledigt; der Gewinn ergibt sich erst, wenn genügend Anfragen in Bearbeitung sind, damit die Vorfüllstation ausgelastet bleibt und die Dekodierungsstation davon profitiert, dass sie nie pausieren muss, um vorzufüllen.
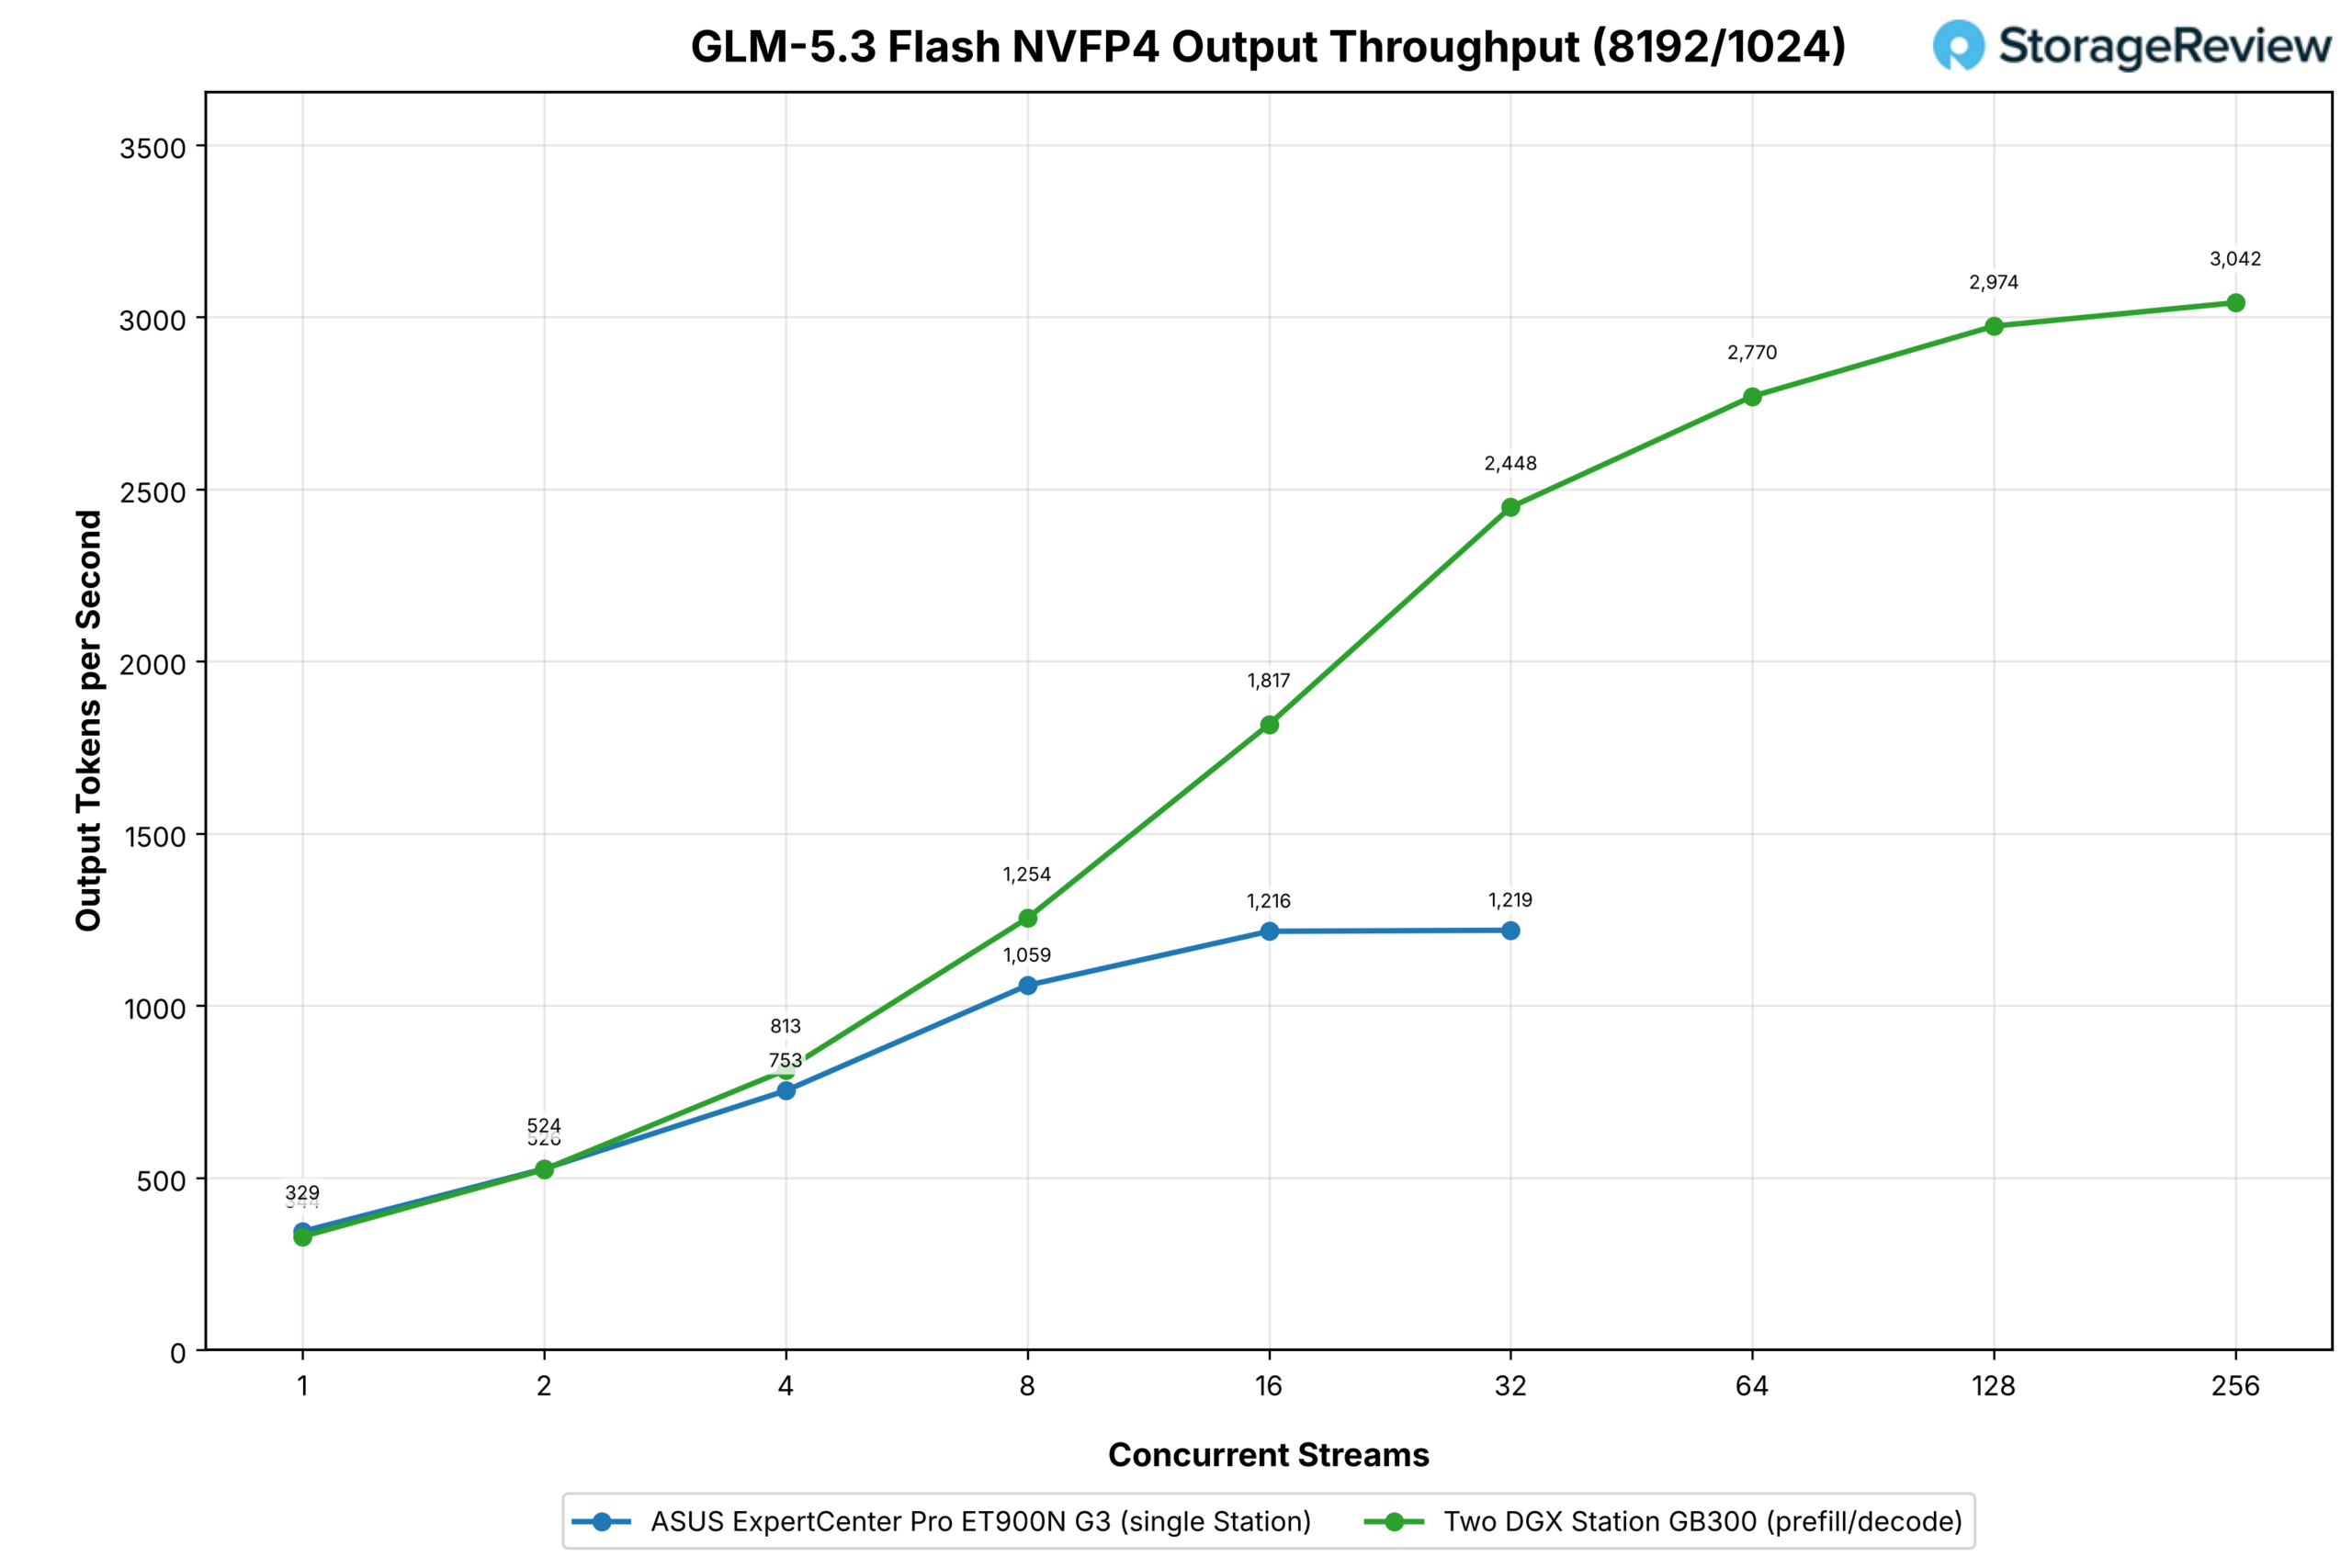
Bei hohem Prefill-Anteil stieg die Ausgabeleistung der einzelnen Station von 344 Token pro Sekunde bei einem Datenstrom auf 1,216 bei 16 Datenströmen und blieb bei 1,219 bei 32 Datenströmen konstant. Das Prefill/Decode-Paar steigerte seine Ausgabeleistung kontinuierlich von 329 bei einem Datenstrom auf 2,448 bei 32 Datenströmen – das Doppelte der Leistung der einzelnen Station, bei der sie sich stabilisiert hatte – und erreichte schließlich 3,042 bei 256 Datenströmen. Diese Aufteilung ist für lange Eingabeaufforderungen optimiert, da die Prefill-Station die 8,192 Token umfassenden Eingabeaufforderungen verarbeitet, während der KV-Cache und die Rechenleistung der Decode-Station auf Generierung laufen.
GLM-5.2
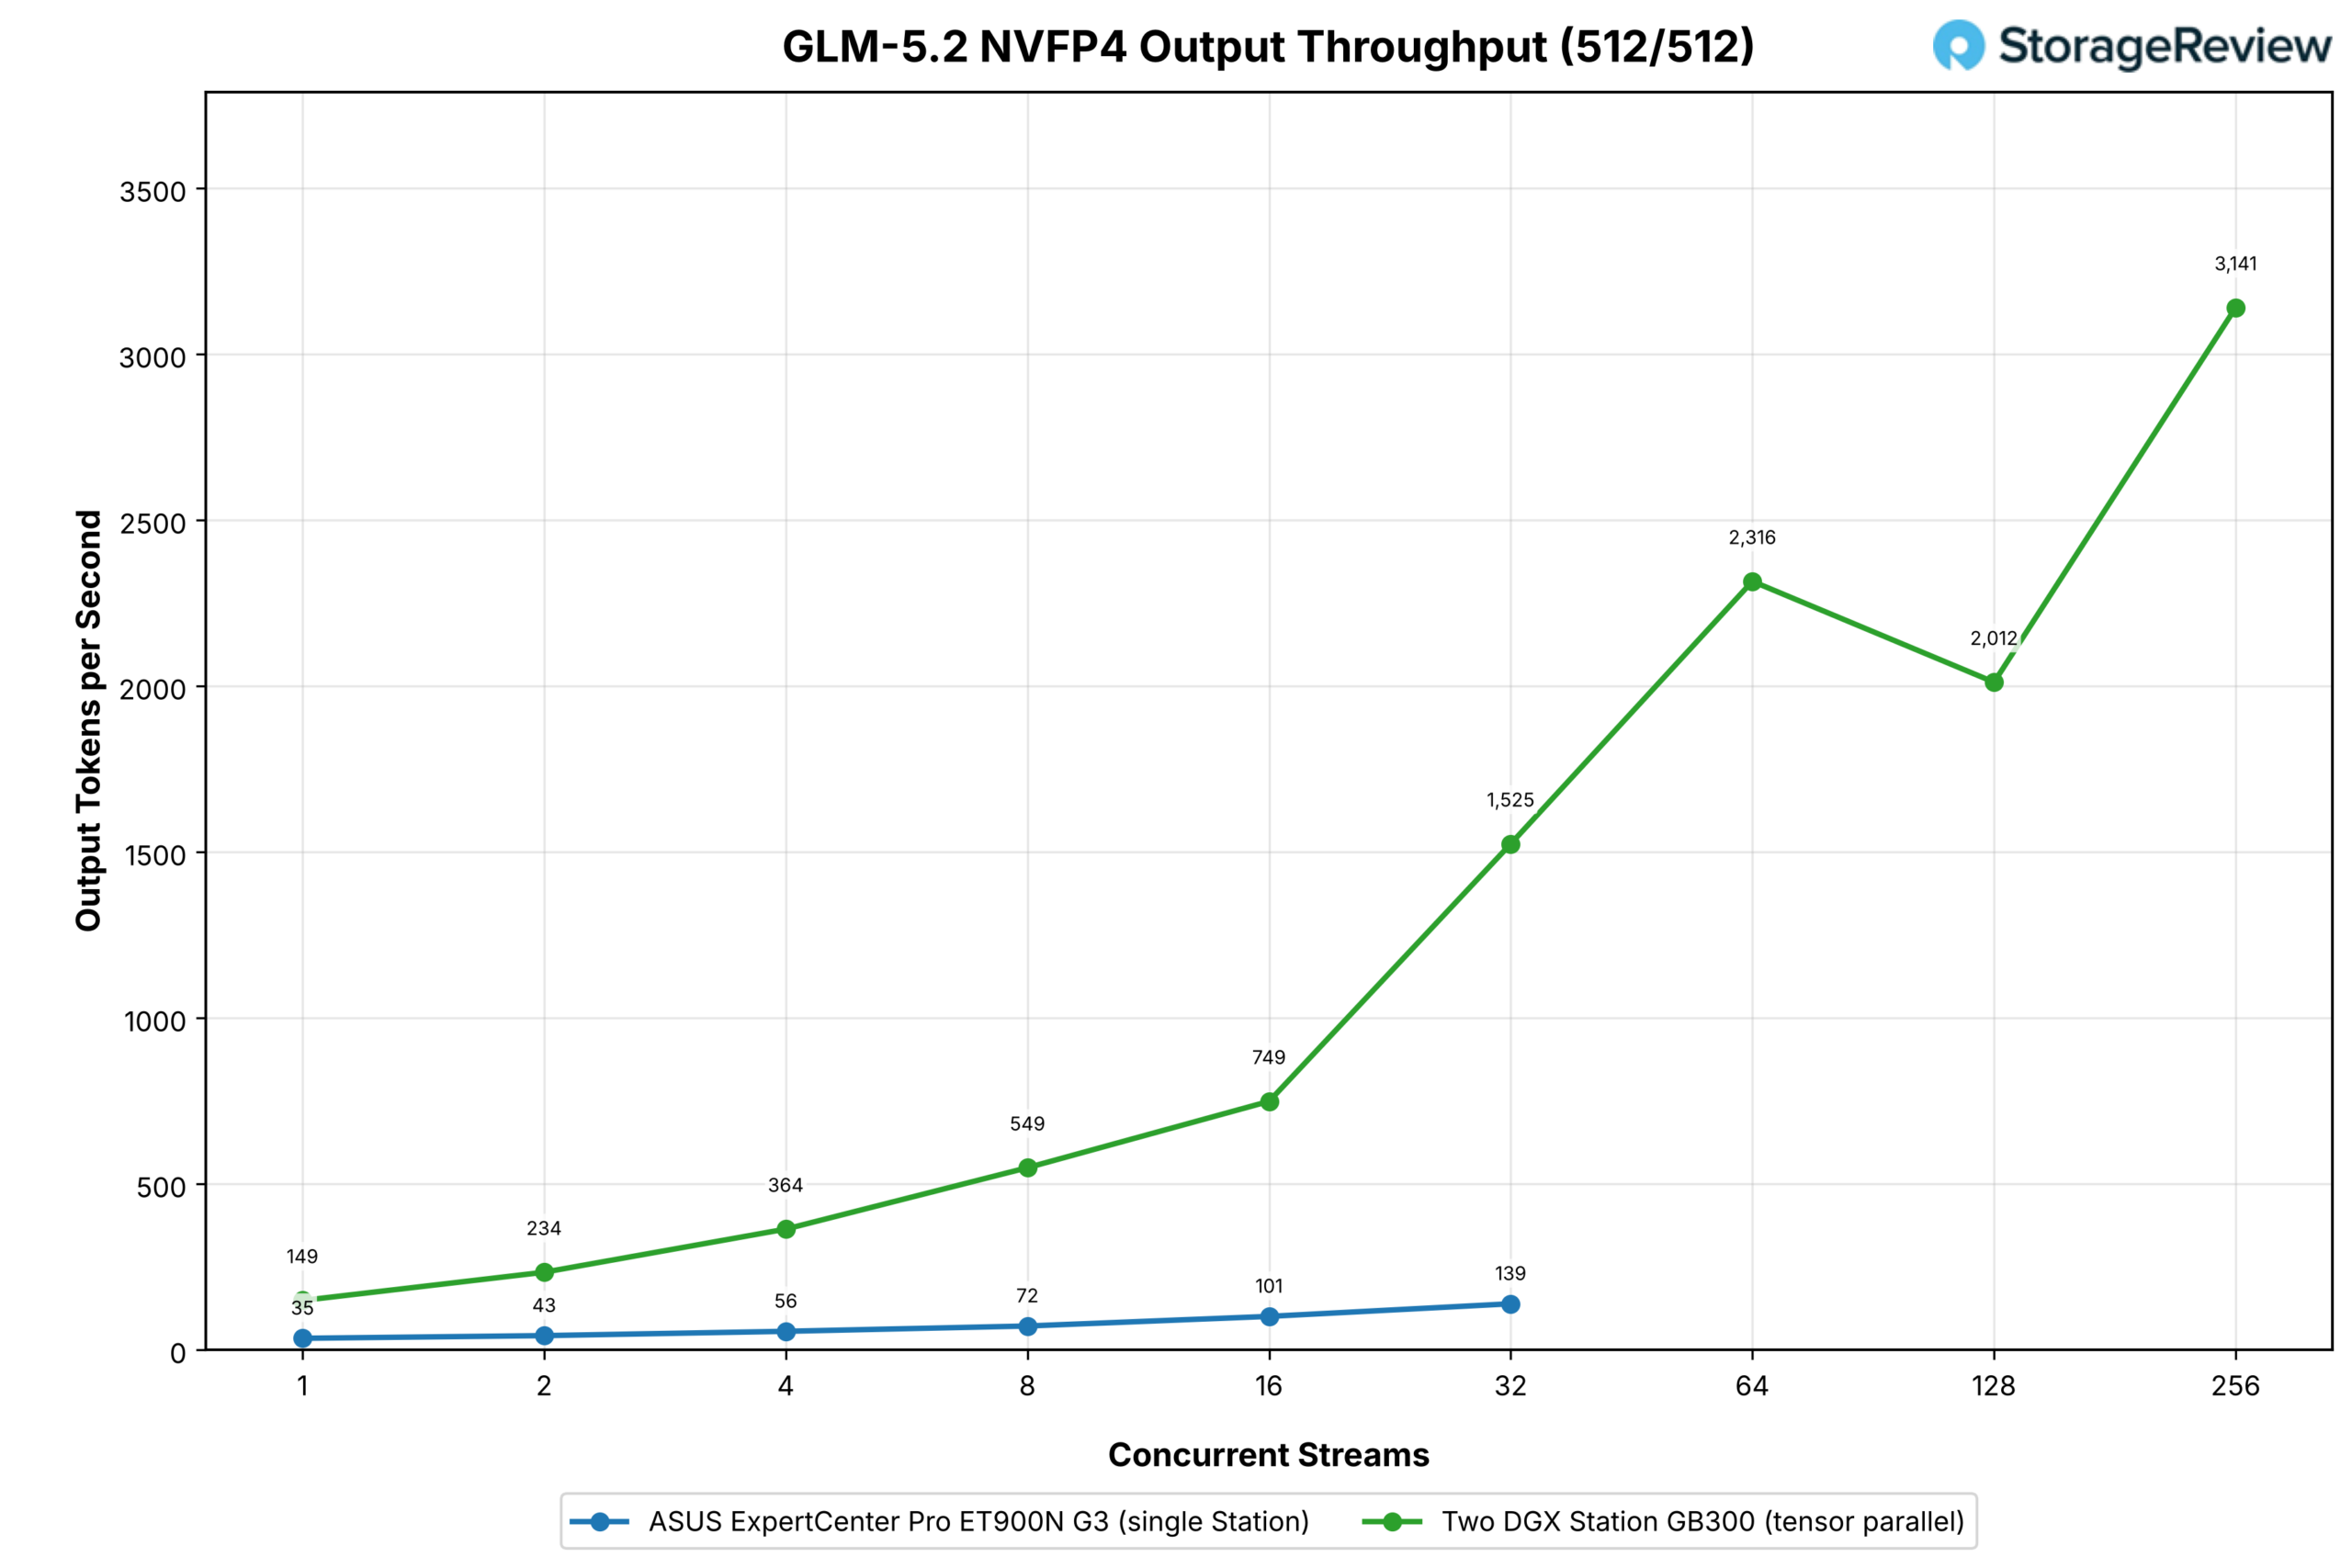
GLM-5.2 lief in TP2 ohne Grace-Offload auf dem Cluster und ist das Modell, das am ehesten für eine zweite Station spricht. Der NVFP4-Checkpoint ist etwa 433 GB groß, sodass auf einer GB300 ungefähr 215 GB an Expert Weights im Grace-Speicher liegen. Jeder Dekodierungsschritt, der diese betrifft, durchläuft NVLink-C2C und LPDDR5X mit 396 GB/s. Auf zwei Stationen verteilt, speichert jede GB300 etwa die Hälfte des Modells in HBM3e.
Bei gleicher Arbeitslast lieferte die einzelne ET900N G3 35 Ausgabetoken pro Sekunde bei einem Datenstrom und 139 bei 32. Der Zwei-Stationen-Cluster startete mit 149 Token pro Sekunde bei einem Datenstrom (4.3-mal so viel wie die einzelne Station), erreichte 1,525 bei 32 Datenströmen (11-mal so viel) und übertraf die Leistung der einzelnen Station kontinuierlich auf 2,316 bei 64 und 3,141 bei 256, mit einem kurzen Rückgang auf 2,012 bei 128. Ein Modell, das eine Station für wenige Benutzer in Konversationsgeschwindigkeit bedient, kann mit zwei Stationen eine ganze Abteilung bedienen.
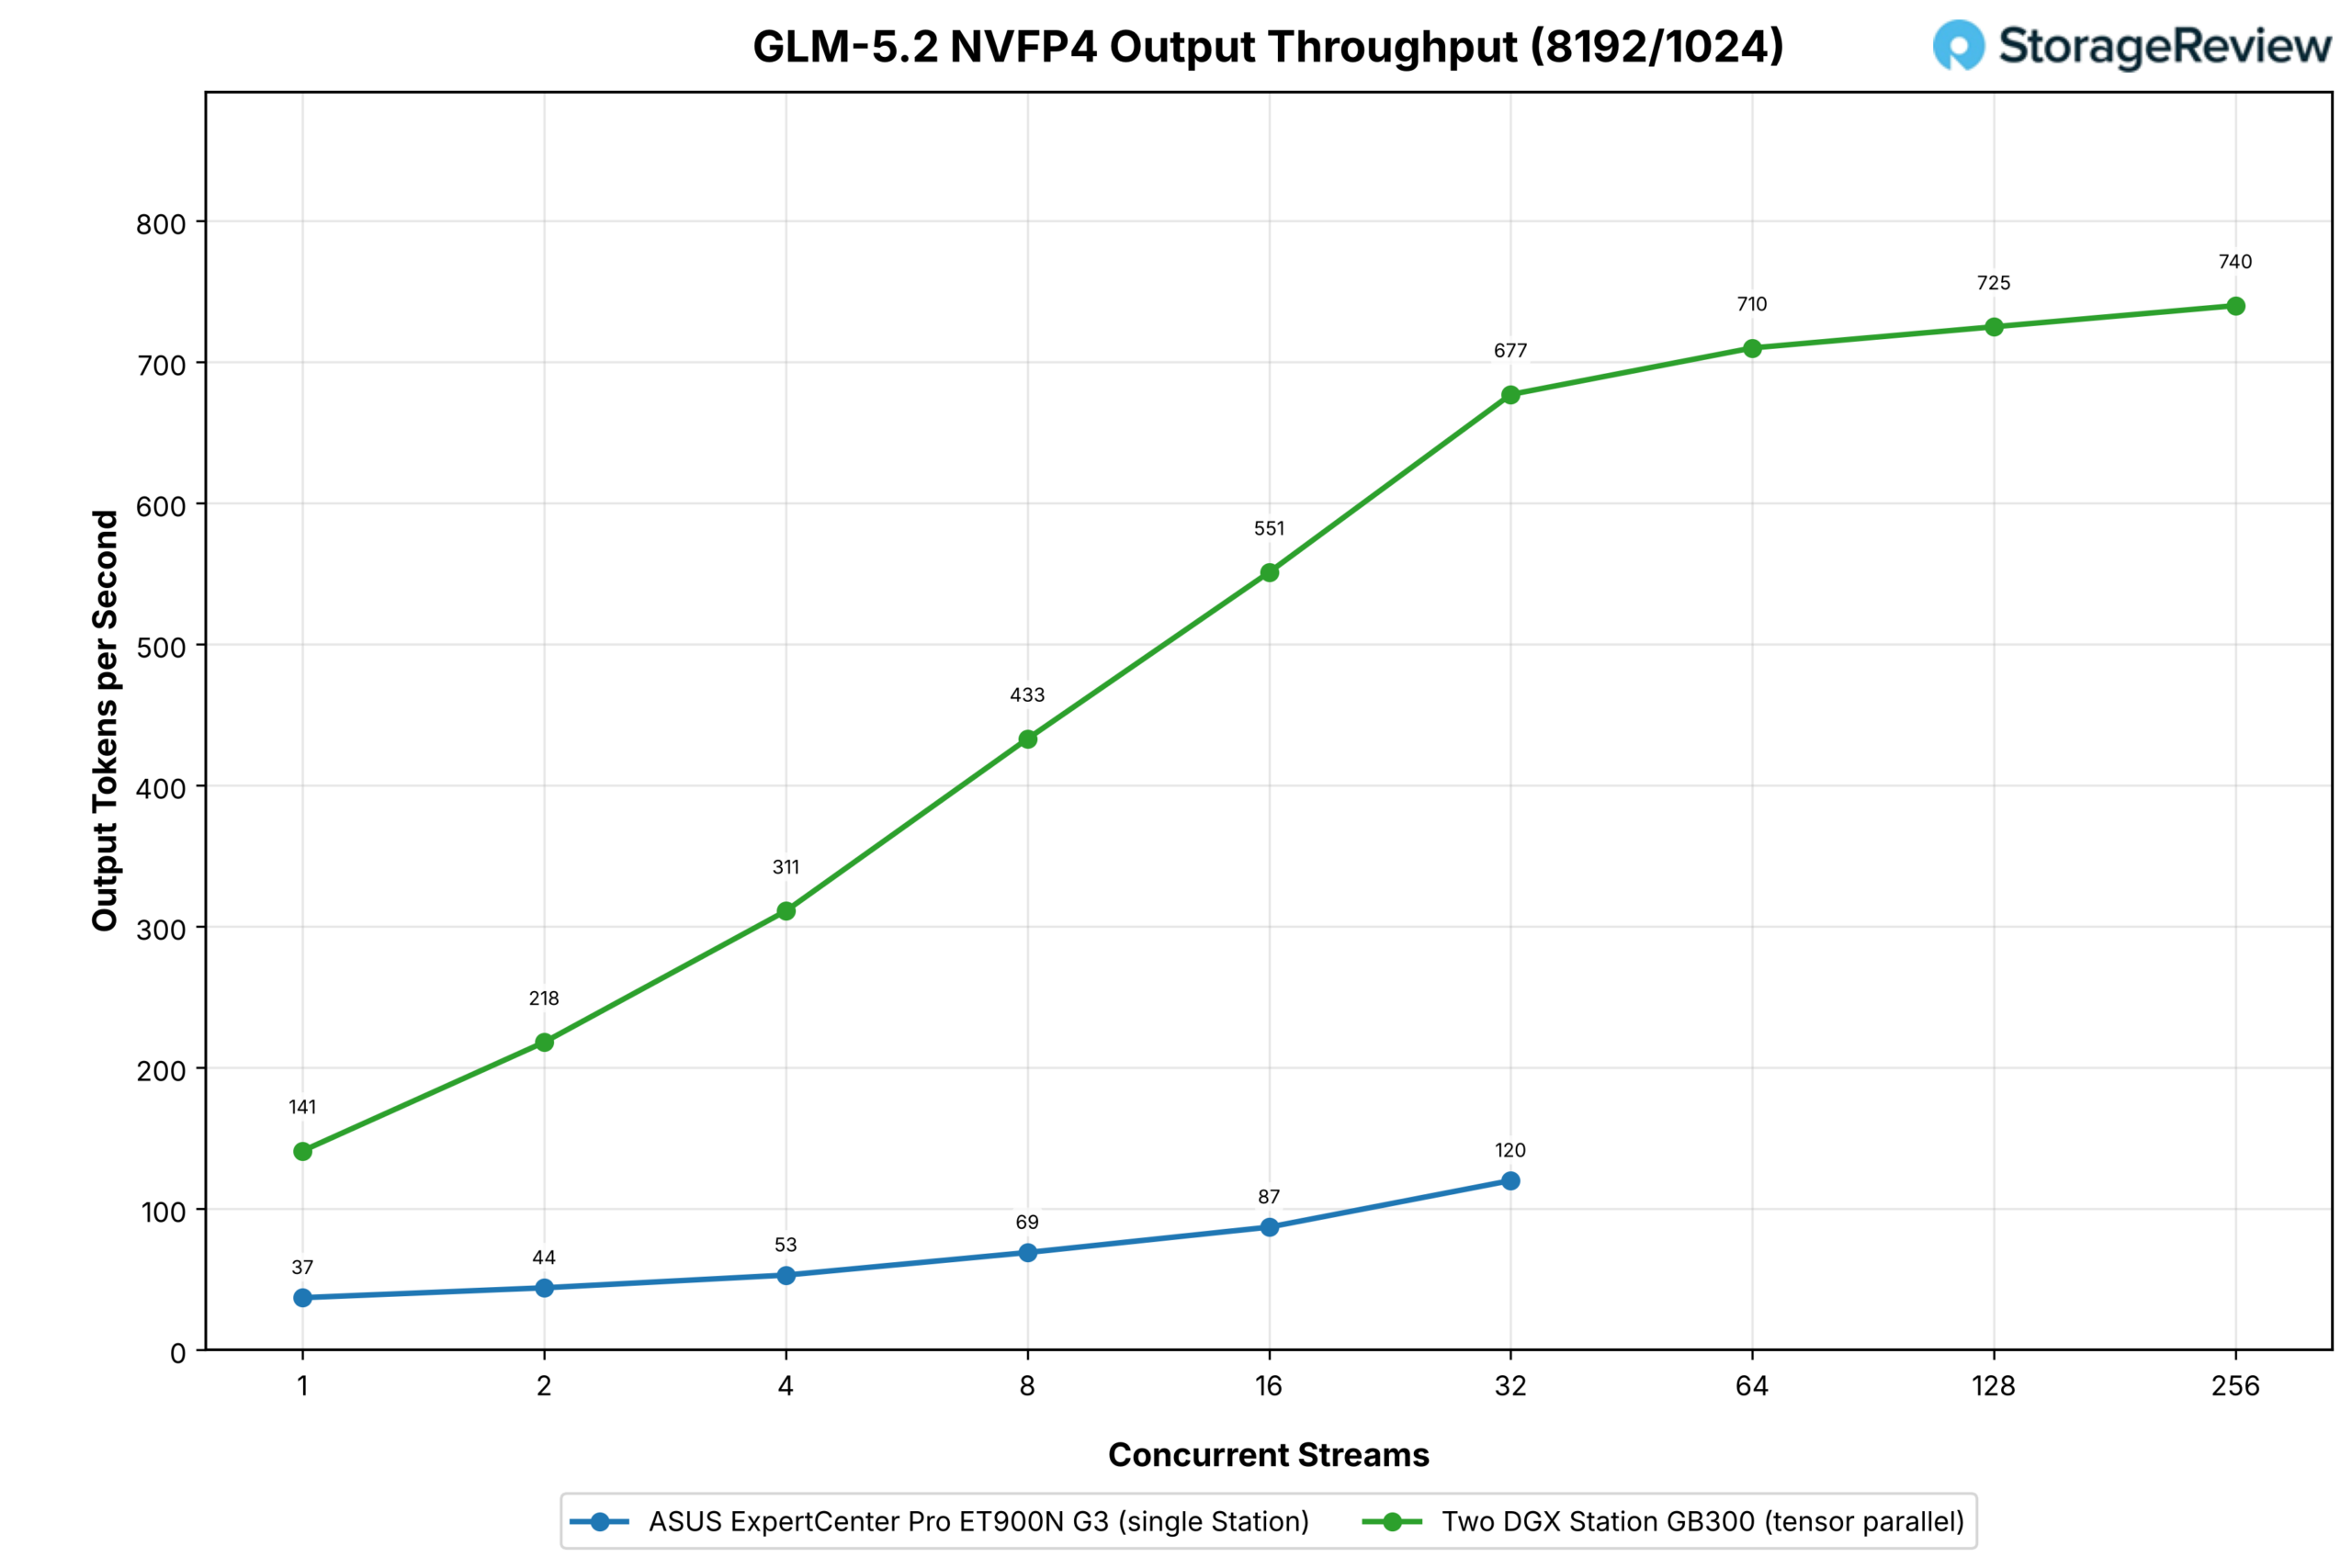
Das Profil mit hohem Prefill-Anteil zeigt das gleiche Bild bei niedrigerer Höhe: Eine Station steigt von 37 Ausgabetoken pro Sekunde bei einem Stream auf 120 bei 32 Streams, und der Cluster steigt im gleichen Bereich von 141 auf 677, also um das 3.8-Fache am unteren Ende des Sweeps und um das 5.6-Fache am oberen Ende, bevor er sich bei 710, 725 und 740 über 256 Streams hinweg abflacht.
Bei längeren Eingabeaufforderungen wird mehr Arbeit in die Vorbelegung investiert, da beide Konfigurationen rechenintensiv sind. Daher ist der durch die zweite Station erzielte Entlastungsverlust im Vergleich zu kurzen Eingabeaufforderungen geringer. Der Gewinn liegt bei beiden Profilen deutlich über dem Doppelten, da die zweite Station ein 433-GB-Modell aus dem LPDDR5X-Speicher auslagert und den gesamten Speicher in HBM speichert. Dies ist hier wichtiger als die Rechenleistung der zweiten B300.
MiniMax-M3
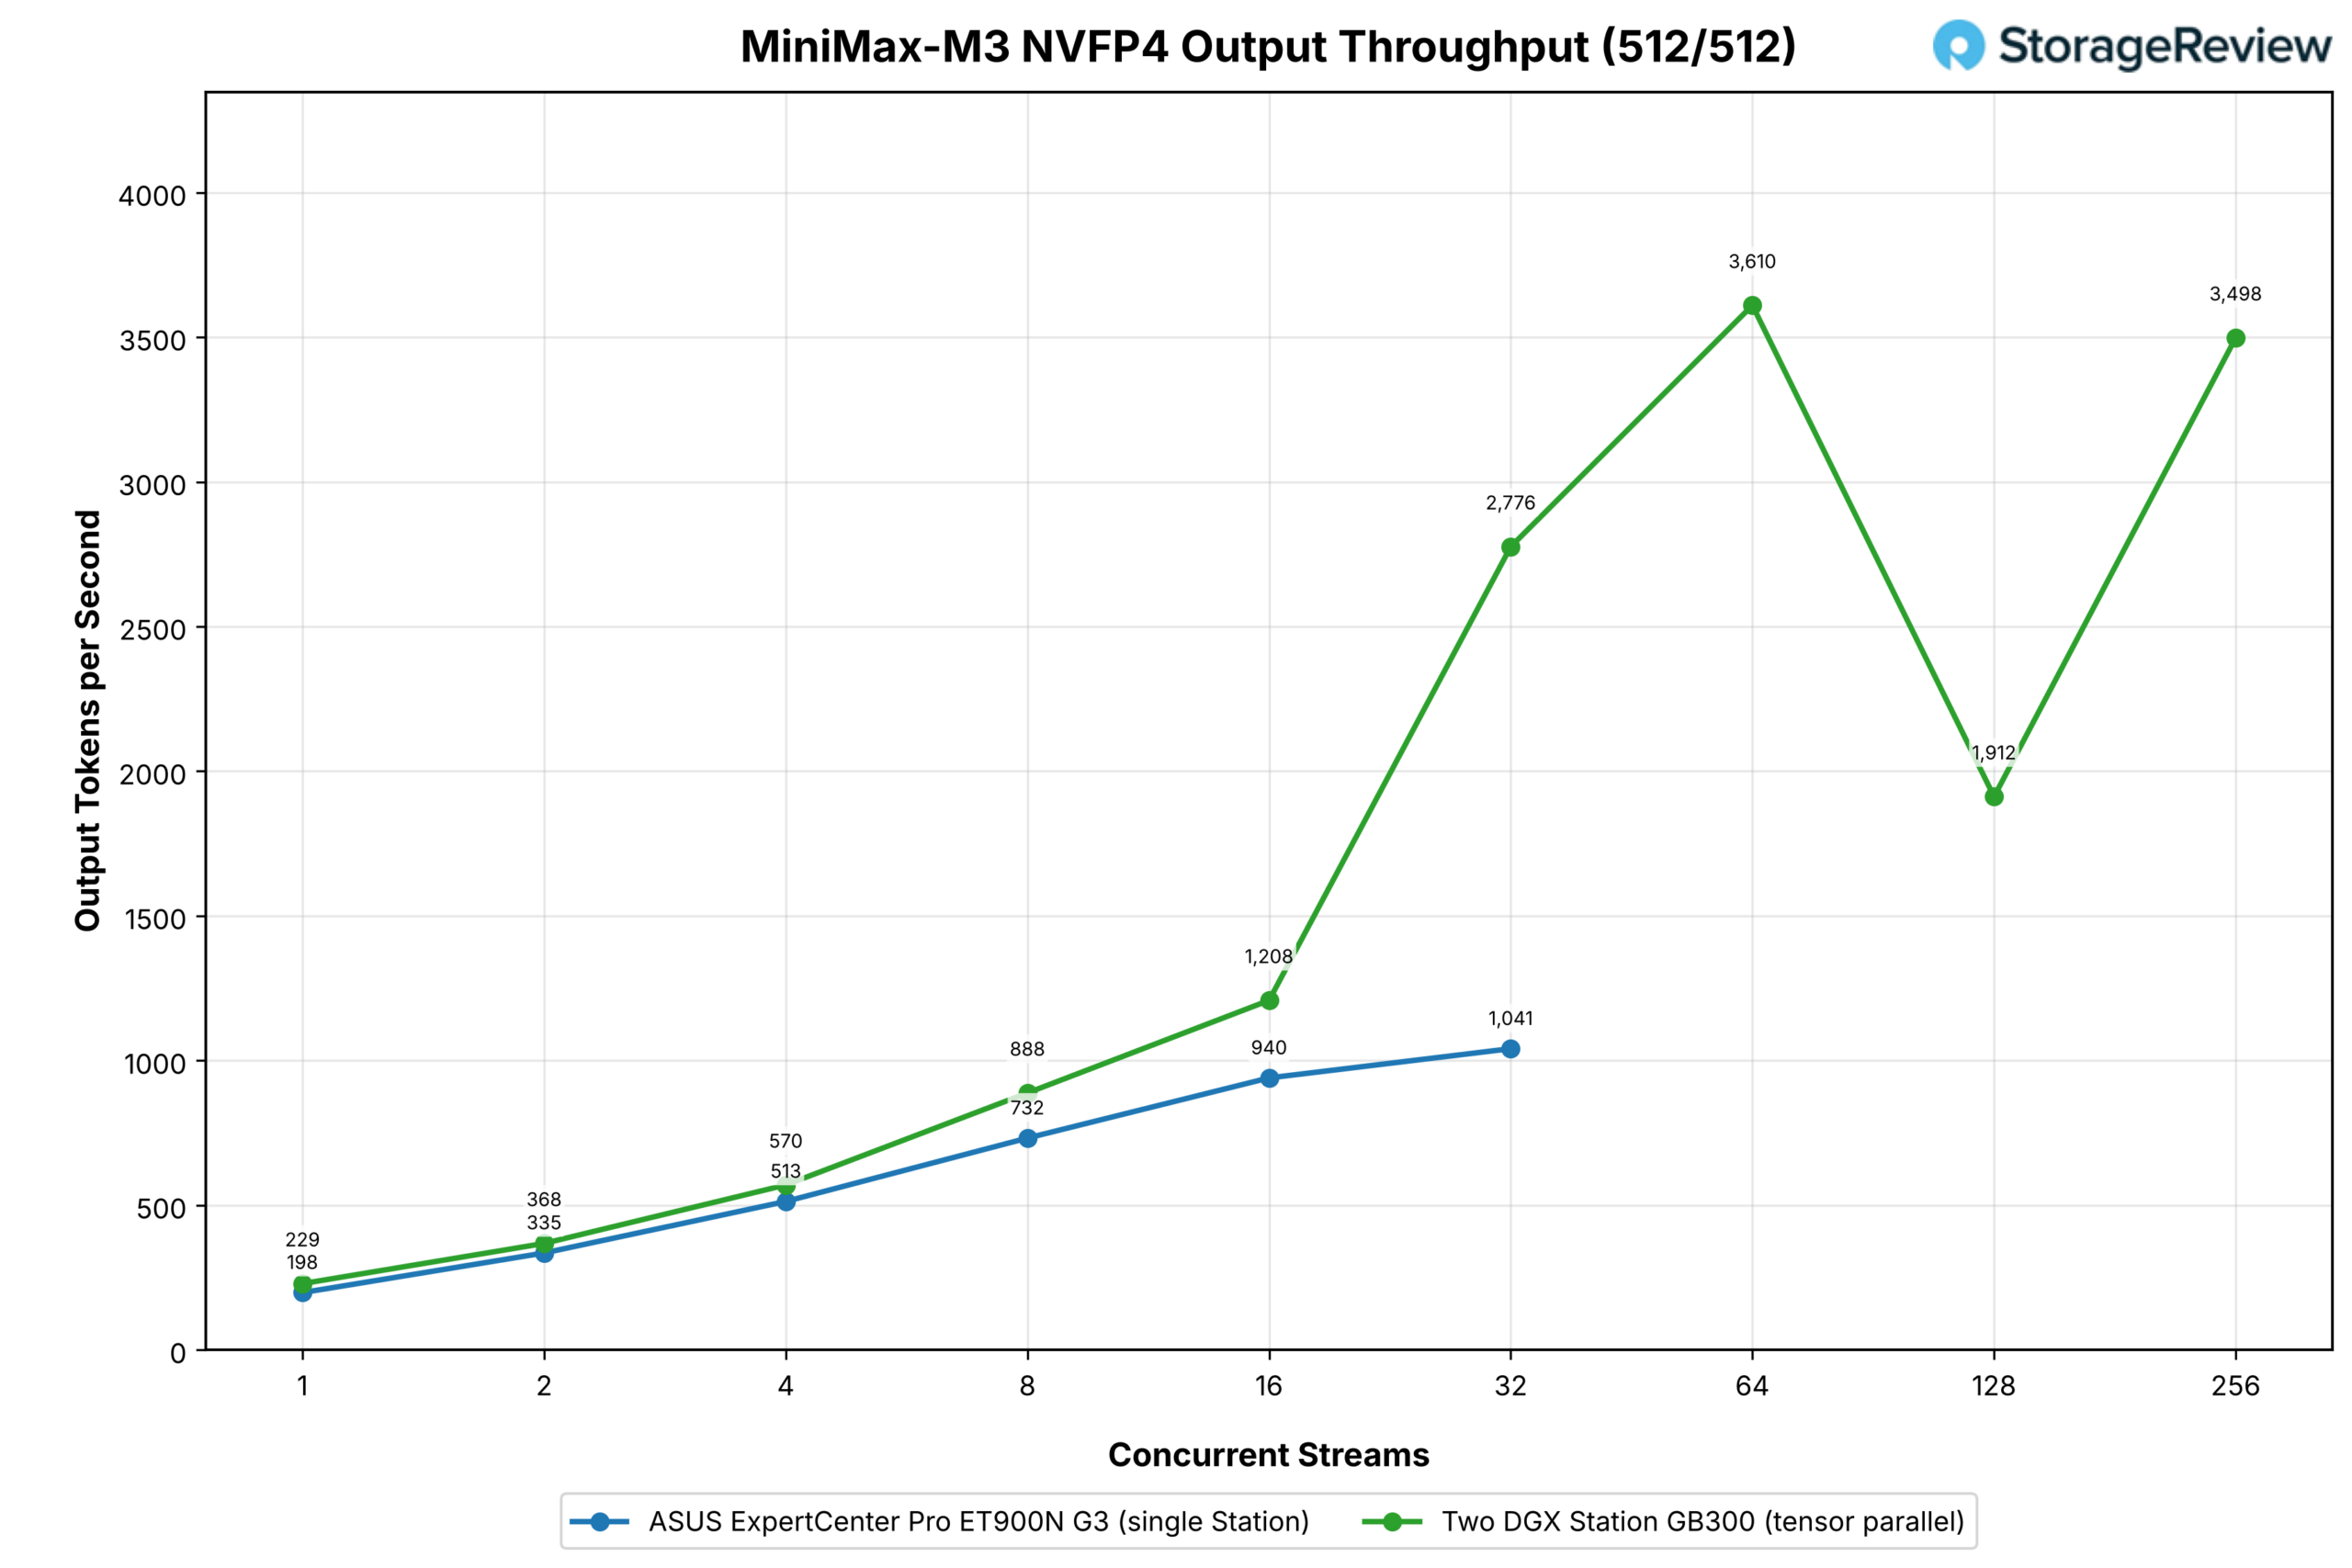
MiniMax-M3 lief in TP2 ohne Grace-Offload. Auf einer Station erreichte es die HBM-Grenze, wobei ein Teil seiner Leistung im Grace-Speicher lag. Im ASUS-Test erzielte es unter der gleichen Arbeitslast wie EAGLE3 1,041 Ausgabetoken pro Sekunde bei 32 Streams.
Der Cluster folgt der einzelnen Station über 16 Streams hinweg (1,208 gegenüber 940) dicht auf den Fersen und setzt sich dann ab: 2,776 bei 32, das 2.7-Fache der einzelnen Station, 3,610 bei 64, ein Rückgang auf 1,912 bei 128 und 3,498 bei 256. Zwei Stationen bringen hier weniger zusätzlichen Nutzen als bei GLM-5.2, da eine Station bereits den Großteil dieses Modells im HBM speichert. Der Beitrag der zweiten GPU entspricht daher eher einer reinen Rechenleistungssteigerung mit zusätzlichem KV-Cache-Spielraum.
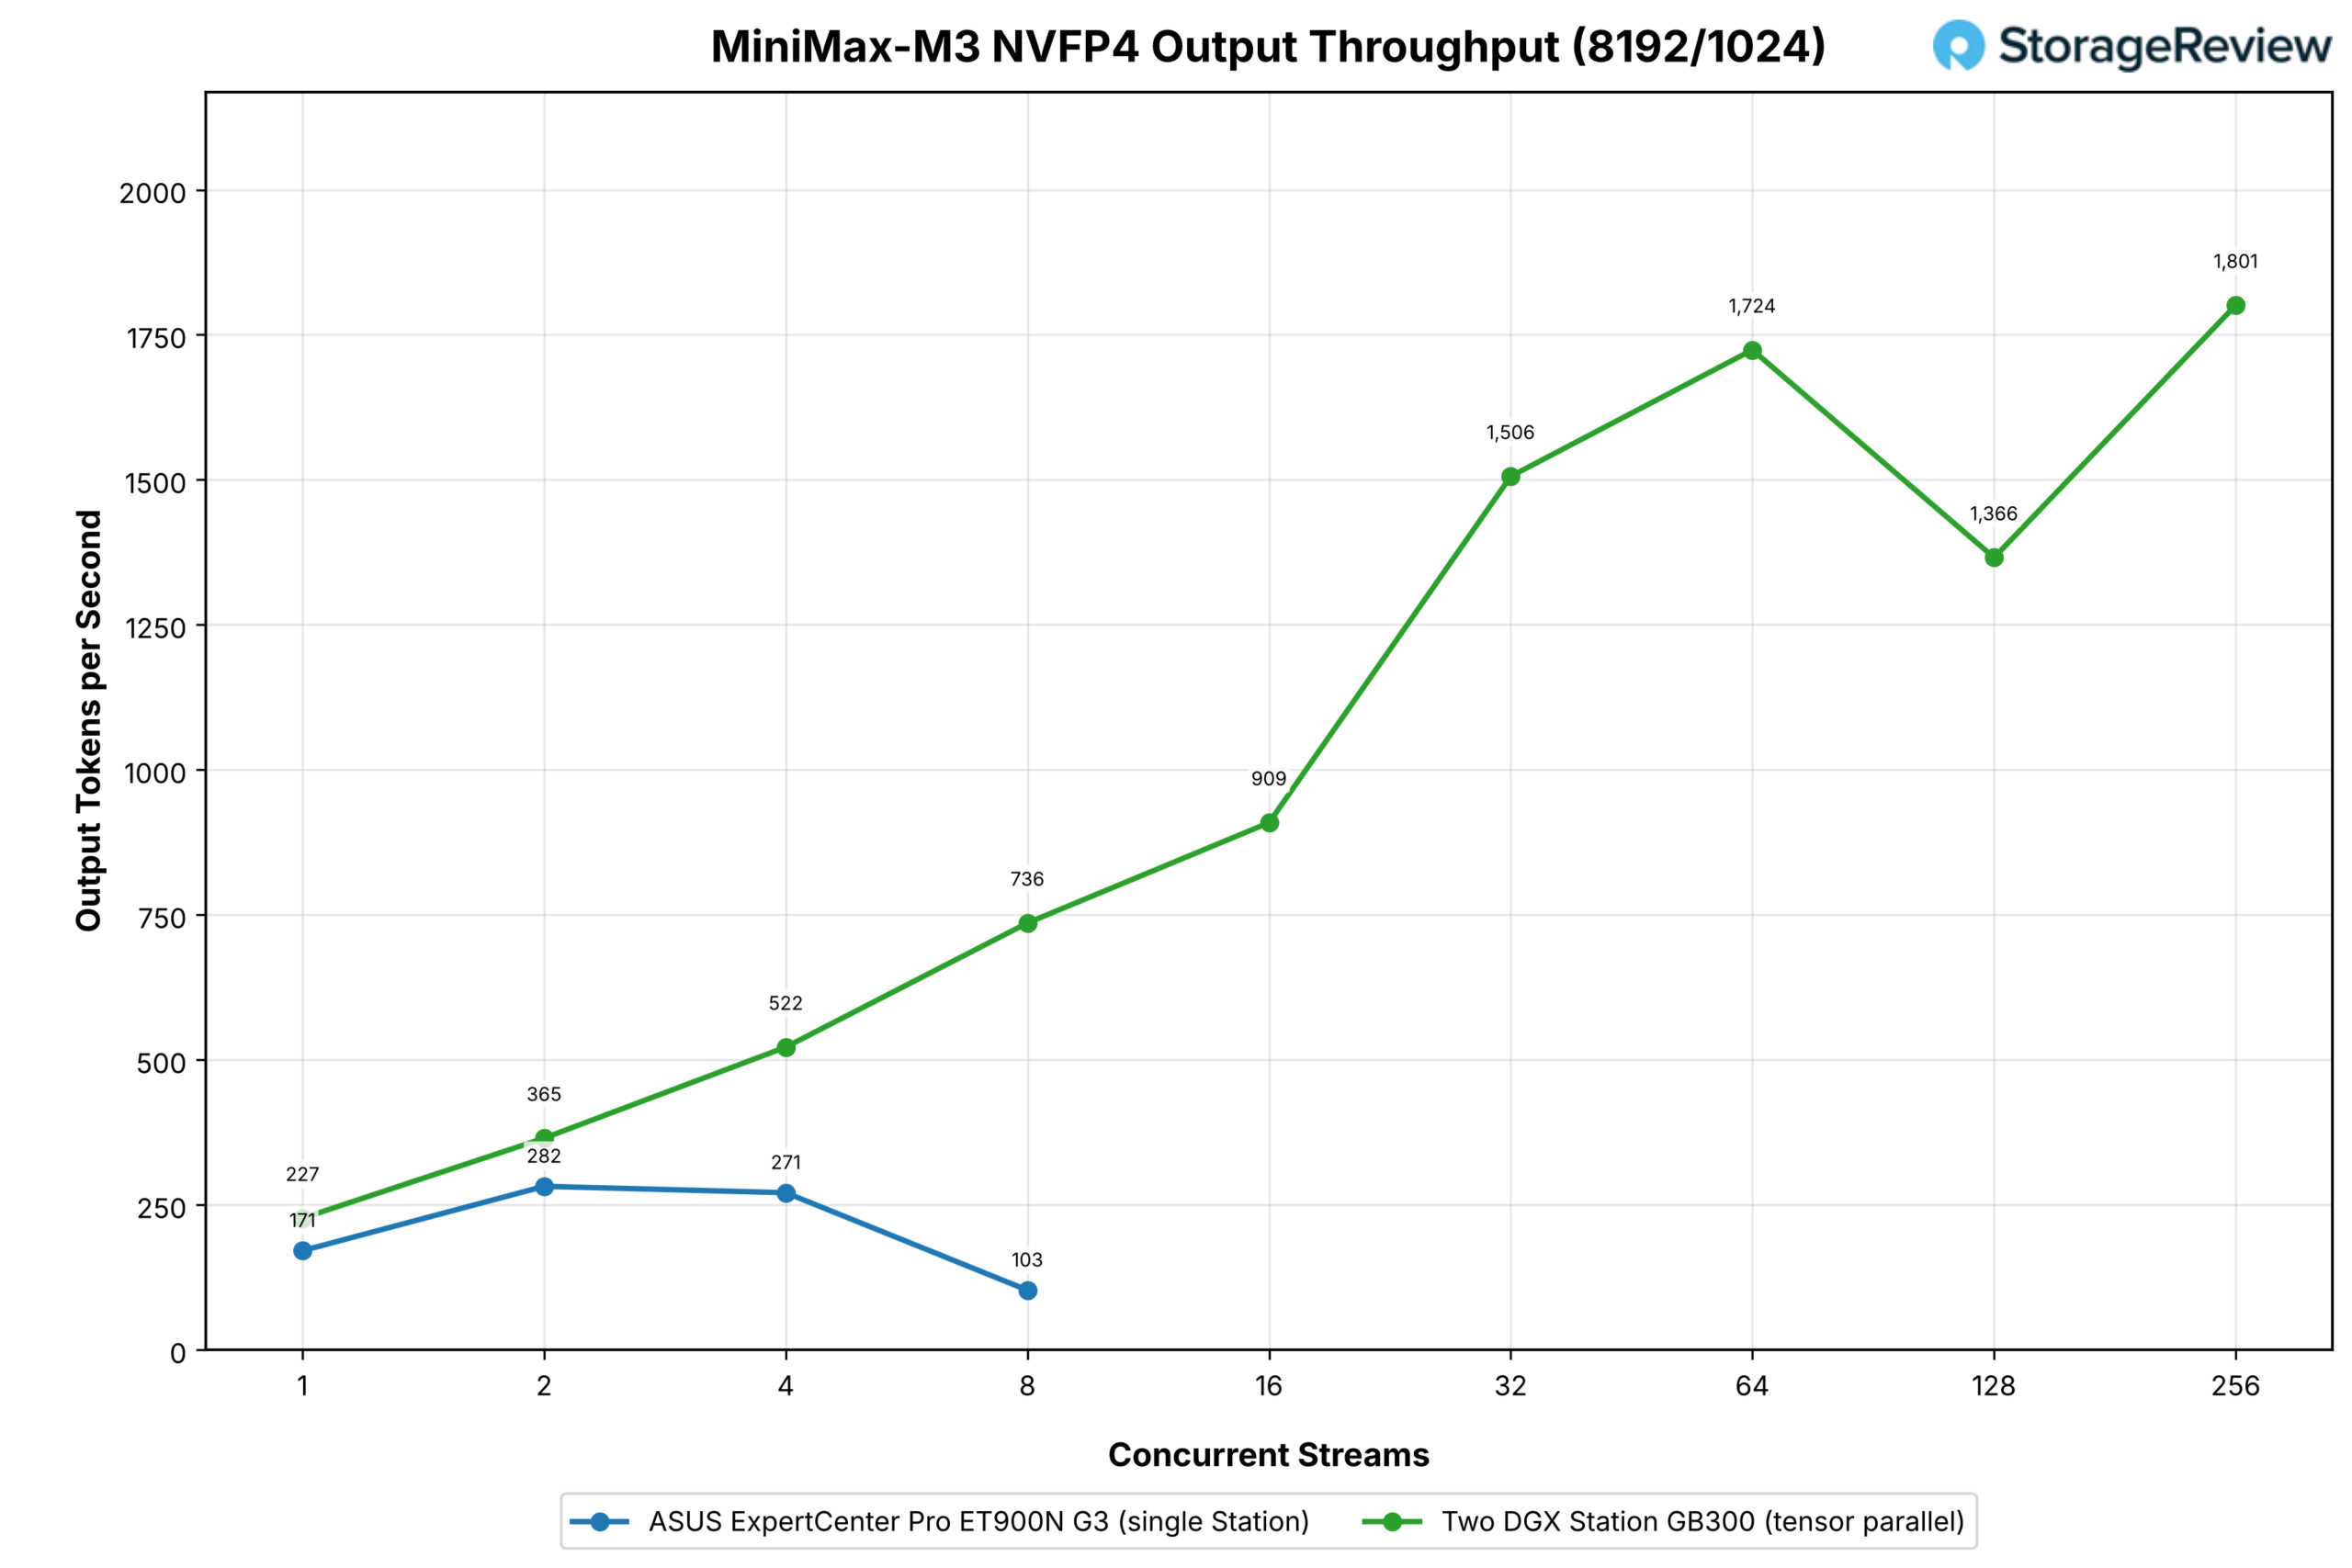
Bei dem Profil mit hohem Vorfüllbedarf stieß MiniMax-M3 an die Grenzen des Speicherplatzes auf einer Station: 8,192-Token-Aufforderungen verbrauchen den verbleibenden KV-Cache schnell, sodass der einzelne Turm bei zwei Streams einen Spitzenwert von 282 Ausgabetoken pro Sekunde erreichte, bei vier Streams 271 hielt und bei acht Streams auf 103 fiel, wo der Sweep endete, weil nichts mehr zu messen war.
Bei der Aufteilung des Modells auf zwei Stationen ergaben sich für dieselben Punkte die Werte 365, 522 und 736, was einem Zuwachs von 30 % bei zwei Datenströmen entspricht, bei denen beide Konfigurationen über ausreichend Cache verfügen, und einem 7.1-fachen Zuwachs bei acht Datenströmen, bei denen einer der Cache erschöpft ist. Der Cluster erreichte anschließend Werte von 909 bei 16, 1,506 bei 32, 1,724 bei 64, 1,366 bei 128 und 1,801 bei 256 – ein Bereich, den die einzelne Station mit diesem Profil nicht erreichen kann.
Fazit
Zwei GB300 DGX Stations, die über ihre eigenen ConnectX-8-Anschlüsse miteinander verkabelt sind, tun genau das, was die NVIDIA-Dokumentation von ihnen verspricht; die Einrichtung verlief problemlos, und dies sind die ersten Durchsatzdaten, die wir für die Dual-System-Konfiguration gesehen haben.
Die zweite Station macht sich bei den Modellen bemerkbar, die über 252 GB HBM3e hinausgehen: GLM-5.2 erreicht bei einer Station 139 Ausgabetoken pro Sekunde bei 32 Streams, bei zwei Stationen 1,525 und bei 256 Streams 3,141, da die Aufteilung ein 433-GB-Modell aus LPDDR5X herausholt; GLM-5.3 erreicht bei 256 Streams 5,018 Token pro Sekunde, ausgehend von einem Maximum von 188 Token pro Sekunde bei einer einzelnen Station; MiniMax-M3 steigert sich bei langen Eingabeaufforderungen von einem System, das bei acht Streams langsamer wird, zu einem System, dessen Leistung bei 256 Streams immer noch steigt.
Bei den beiden Modellen, die in eine Station passen, GLM-5.3 Flash und DeepSeek V4.1 Flash, ist die beste Methode zur Verwendung der zweiten Box, jeder Station eine vollständige Kopie zuzuweisen, das Vorbefüllen vom Dekodieren zu trennen und den Dekodierungs-Worker ohne Pause generieren zu lassen; bei GLM-5.3 Flash verdoppelte dies den Durchsatz bei langen Eingabeaufforderungen auf 32 Streams und verdreifachte den Durchsatz bei kurzen Eingabeaufforderungen, und DeepSeek V4.1 Flash erzielte mit 5,248 Token pro Sekunde den höchsten Ausgabedurchsatz im Set.
Unsere Meinung zu dem Produkt hat sich seit dem Test der MSI XpertStation WS300 nicht geändert : Es handelt sich um ein interessantes Gerät für einen bestimmten Markt, und wenn Sie Bedarf an einem solchen Gerät haben, könnten Sie möglicherweise auch Bedarf an einem weiteren finden.
Am besten lassen sie sich als flexible Infrastruktur betreiben: ein Pool, auf dem ein Team seine Arbeit plant und der sich bei Projektänderungen anpasst. NVIDIA besitzt die nötigen Komponenten dafür. Das Unternehmen hat Run:ai für die Arbeitsplanung, Brev für Entwicklungsumgebungen und Lepton für einen Marktplatz für Rechenleistung erworben. Jede dieser drei Lösungen, kombiniert mit einem Rack von NVIDIA Stations, würde das Produkt deutlich attraktiver machen, sofern man Zugriff darauf hat.
Die Zwei-Box-Konfiguration skalierte gut; den größten Leistungszuwachs erzielten wir mit GLM-5.3, von 188 Ausgabetoken pro Sekunde auf einer einzelnen Station auf 5,018 im Zwei-Box-System (eine Steigerung um das 27-Fache). Bei gleicher Parallelität erreichte GLM-5.2 eine 11-fache Steigerung bei 32 Streams, beides Modelle, die eine einzelne Station nur durch Auslagern von Gewichten in den Grace-Speicher bedienen kann. Das entspricht einem Ergebnis von 300 GB gegenüber 2 x 400 GB und macht uns neugierig, wie eine Vera-Rubin-Station aussehen wird, wenn NVIDIA sie mit der nächsten Generation von HBM und NVLink-C2C auf den Markt bringt.
Der Einsatzbereich hat sich nicht verändert: Zwei Stationen auf einem Schreibtisch, ohne Rack oder Rechenzentrum im Hintergrund, ermöglichen nun die gleichen Modelle, für die früher ein GPU-Server und die dazugehörige Infrastruktur notwendig waren. So hat ein Team, das keinen Platz im Rechenzentrum bekommt oder nicht darauf warten möchte, die Möglichkeit, direkt nebenan modernste Inferenz zu nutzen. NVIDIA hat in dieser Kategorie – unabhängig vom Preis – neue Maßstäbe gesetzt. Die GB300-Klasse ist in unserer Rangliste der besten Desktop-PCs für lokale KI vertreten, und die Clusterdaten bestätigen diese Empfehlung.



 Amazon