

NVIDIA ha anunciado una nueva GPU para computación científica en SC26. Rubin HPC forma parte de la plataforma Vera Rubin, que integra más de 50 000 núcleos CUDA en una sola GPU, y NVIDIA prevé que esté disponible en 2028. El resto de las novedades de la compañía en SC26 incluyen un rack Vera de 192 CPU para trabajos de simulación, que estará disponible a principios de 2027, el paquete de modelos abiertos Nemotron for Science, nuevas bibliotecas CUDA-X, una plataforma de codiseño cuántico con IBM y Fermilab, y el despliegue de conmutadores ópticos integrados de Lambda.
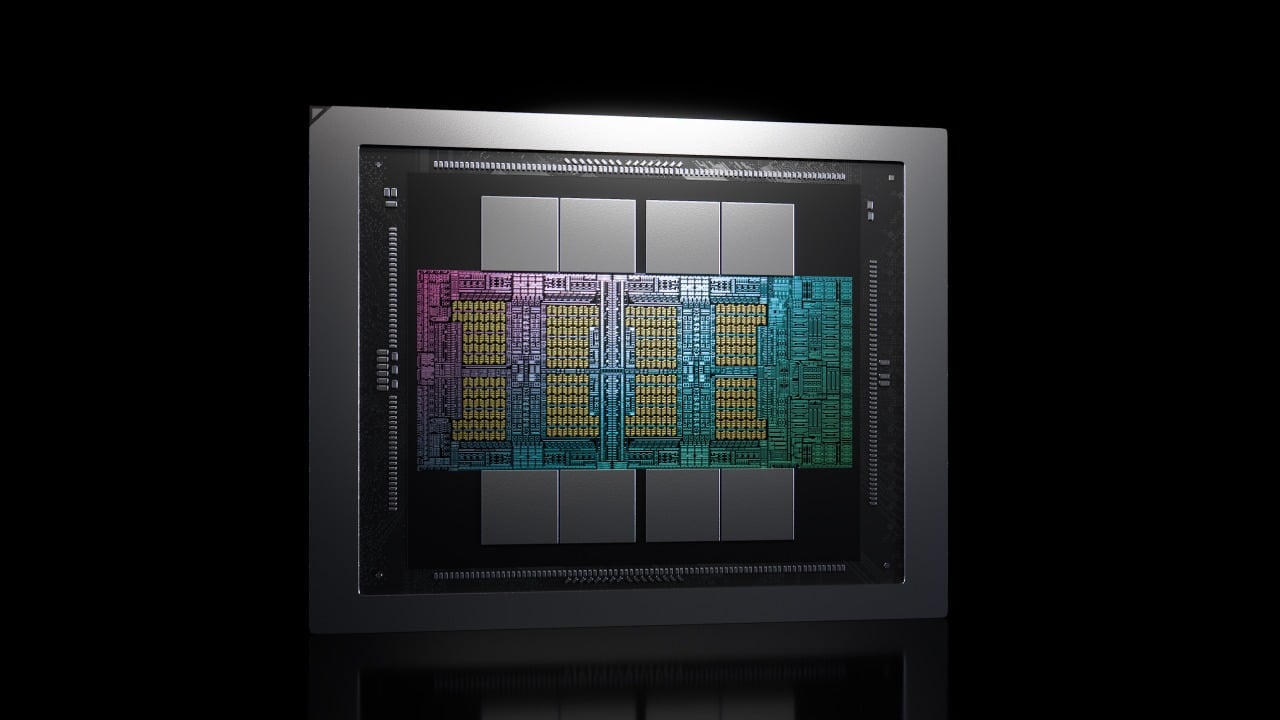
GPU Rubin HPC
NVIDIA describe Rubin HPC como una GPU para simulación y procesamiento de datos en ciencia, ingeniería y análisis, diseñada para escalar el flujo de datos junto con la capacidad de procesamiento. Además de su número récord de núcleos, la compañía destaca su capacidad de aceleración de datos dispersos, que mantiene estos núcleos alimentados con datos y enlaces GPU a GPU a través de NVLink de séptima generación. Las cargas de trabajo objetivo incluyen operaciones con matrices dispersas, cálculos de plantillas, ordenación y reducciones, patrones fundamentales en modelos climáticos, simulación de ingeniería, análisis genómico y análisis de riesgo financiero.

En el escenario de SC26, NVIDIA anunció que Rubin HPC triplica el rendimiento de simulación y análisis, y admite todos los niveles de precisión, desde FP64 hasta FP4. La compañía no especificó la base para esta cifra de 3x, ni publicó datos sobre la capacidad de memoria, el rendimiento FP64, el consumo de energía o las configuraciones del sistema. Ian Buck, vicepresidente de computación de alto rendimiento y a hiperescala de NVIDIA, relacionó esta característica con la investigación de agentes, afirmando que "una simulación más rápida implica un descubrimiento más rápido" para los agentes que trabajan en problemas de ciencia e ingeniería. Intel también presentó su GPU D270 , compatible con FP64, para las mismas cargas de trabajo de simulación en la feria.
Bastidores para CPU Vera para computación de alto rendimiento (HPC)
La plataforma de CPU Vera para computación de alto rendimiento (HPC) es un rack NVIDIA MGX con refrigeración líquida que alberga 192 CPU Vera conectadas mediante InfiniBand Quantum-X800, con aproximadamente 300 TB de memoria, 1 PB de almacenamiento y un ancho de banda de memoria máximo agregado de más de 200 TB/s. Cada bandeja de 1U aloja ocho CPU junto con almacenamiento y gestión NVMe, y el rack reutiliza el chasis, la distribución de energía y la refrigeración de los sistemas NVL72. Cada CPU cuenta con 88 núcleos Olympus, 176 subprocesos y memoria SOCAMM2 LPDDR5X con una velocidad nominal de hasta 1.2 TB/s.

Se trata de una configuración distinta a la de los racks Vera de 256 CPU que Dell y Supermicro anunciaron para entornos de pruebas de agentes en la GTC de Berlín, con la incorporación de InfiniBand y computación en red SHARP para una simulación estrechamente acoplada. NVIDIA afirma que Dell Technologies, HPE, Lenovo y Supermicro ofrecerán los racks HPC a partir de principios de 2027. DKRZ, el Centro Alemán de Computación Climática, ha seleccionado las CPU Vera para su supercomputadora HLRE-5, construida por Bull, que también incluye sistemas GB200 e InfiniBand Quantum-2 y cuya puesta en marcha está prevista para principios de 2028.
NVIDIA afirma que Vera ofrece el doble de eficiencia energética que las CPU x86. En sus pruebas, Vera ofreció un rendimiento 1.9 veces superior y un rendimiento por vatio 2.4 veces mayor que los sistemas x86 en el caso OpenFOAM motorBike Large, y proyecta un rendimiento 1.6 veces superior y una eficiencia 2 veces mayor en el modelo de investigación y pronóstico meteorológico. Estos son resultados del fabricante que no hemos ejecutado ni auditado, y NVIDIA no ha especificado los procesadores x86. En nuestro análisis de la CPU Vera , un sistema Vera de dos sockets completó una malla OpenFOAM grande 1.44 veces más rápido que un sistema EPYC 9965 de 384 núcleos y 1.20 veces más rápido que un sistema Xeon 6978P de 240 núcleos.
En cuanto al software, el SDK 26.11 de NVIDIA HPC ya está disponible con compiladores y bibliotecas optimizadas para Vera, y un compilador Fortran de última generación, desarrollado en colaboración con centros de computación de alto rendimiento y laboratorios nacionales, se encuentra en fase beta pública. NVIDIA afirma que el compilador ejecuta los programas Fortran existentes con mayor rapidez en sus plataformas sin necesidad de reescribir el código.
Bibliotecas Nemotron para la Ciencia y CUDA-X
Nemotron for Science incluye el modelo abierto Nemotron 3.5 Super VL con evaluaciones científicas, recetas posteriores al entrenamiento y LitmusBench v0.2, un conjunto de datos abierto con casi 50 000 preguntas de razonamiento químico. El modelo y el conjunto de datos ya están disponibles en Hugging Face, y NVIDIA afirma que el modelo se ha optimizado para ejecutarse localmente en un DGX Spark de 128 GB. El Laboratorio Nacional Argonne lo está integrando en su sistema multiagente StructBioReasoner para terapias basadas en proteínas, y RIKEN lo ha puesto a disposición en su plataforma de supercomputación RIKYU AI.
Entre los clientes que entrenaron el modelo posteriormente, Lila Sciences casi duplicó la precisión de la síntesis de puntos cuánticos hasta el 61 %, lo que, según NVIDIA, supera el 54 % de GPT-6 Astra con un coste de inferencia entre 10 y 20 veces menor. Terray Therapeutics recuperó aproximadamente el 76 % de las reacciones anotadas en la prueba RxnScribe para la lectura de diagramas de reacciones químicas. Un agente del Instituto Real de Tecnología KTH reparó el 81 % de las configuraciones de dinámica molecular de GROMACS dañadas en una sola ejecución nocturna en un único DGX Spark.
Entre las novedades de CUDA-X, el conjunto de herramientas cuPhoton correlaciona las observaciones del Telescopio del Horizonte de Sucesos en ocho minutos, cuando antes el análisis tardaba más de un mes. cuPotential acelera el software de simulación molecular existente hasta tres veces, y Daviator, un conjunto de kernels de GPU por lotes para el Paquete de Simulación Ab initio de Viena, ejecuta cálculos cuántico-mecánicos hasta 22 veces más rápido y con un coste hasta un 75 % menor. NVIDIA no especificó los valores de referencia para las cifras de cuPotential y Daviator.
cuSpa y una biblioteca HMMER acelerada por GPU ya son de código abierto. En el Memorial Sloan Kettering Cancer Center, cuSpa logró una aceleración de 900 veces en comparación con las CPU en los cálculos de polígonos celulares, y la biblioteca HMMER ejecutó búsquedas de referencia hasta 84 veces más rápido que la versión estándar de HMMER en Basecamp Research. La biblioteca rapids-singlecell, desarrollada en colaboración con scverse, ahora se distribuye en un único contenedor diseñado para agentes, y 10x Genomics la ha integrado en su plataforma Sentira.
Codiseño cuántico con IBM y Fermilab
En el ámbito cuántico, NVIDIA e IBM están ubicando sistemas NVIDIA DGX B200 junto con computadoras cuánticas de IBM, incluyendo sistemas que utilizan el procesador IBM Quantum Nighthawk, para respaldar una plataforma modular de codiseño cuántico desarrollada con Fermilab. Los investigadores la utilizarán para evaluar códigos de corrección de errores, algoritmos de decodificación y aplicaciones cuántico-clásicas para física nuclear y de altas energías. IBM estableció un acuerdo similar con AMD y el Laboratorio Nacional de Oak Ridge , combinando Nighthawk con un clúster Instinct MI355X. NVIDIA no proporcionó información sobre el número de sistemas, su ubicación ni el cronograma.
Por otra parte, NVIDIA lanzó TCBP-JOBS, un algoritmo de decodificación en la biblioteca CUDA-Q QEC 0.9.0 que, según afirma, decodifica hasta 13 000 veces más rápido que los principales algoritmos existentes y reduce el tiempo de cálculo para los nuevos diseños de computadoras cuánticas de 12 semanas a 45 minutos. La plataforma CUDA-Q también incorpora un servidor de decodificación, un conjunto ampliado de primitivas tolerantes a fallos, una biblioteca de algoritmos CUDA-Q con componentes de aplicación reutilizables y CUDA-Q Pulse para dar forma a los pulsos de control que impulsan los cúbits.
NVIDIA afirma que el despliegue de procesadores cuánticos en centros de supercomputación se ha multiplicado casi por siete en cinco años, con cerca de 30 centros que actualmente utilizan más de 50 procesadores. Slurm 26.11, que se lanzará a finales de noviembre, incorpora una interfaz cuántica que permite a los fabricantes de QPU describir su hardware una sola vez, en un único archivo, y reutilizar esa integración en todos los centros. Es compatible con las interfaces de computación de alto rendimiento cuántico QRMI y QDMI, con la contribución de IBM a través de su Interfaz de Gestión de Recursos Cuánticos (QRUI), lo que permite a los centros programar procesadores cuánticos junto con CPU y GPU. Alice & Bob, IBM, IQM, Pasqal, Quantinuum y MQSC lo están adoptando, y NVIDIA adquirió al desarrollador de Slurm, SchedMD, a finales de 2025.
NVIDIA también destacó el trabajo de química cuántico-clásica realizado por IBM y RIKEN, finalista del Premio Gordon Bell de la ACM 2026, que calculó las energías de enlace para complejos proteína-ligando de hasta 12 635 átomos. Esto representa más de 40 veces el valor de referencia cuántico-clásico anterior de 303 átomos. La parte clásica se ejecutó en la supercomputadora ROQUO de RIKEN, que se basa en sistemas NVIDIA GB200 y Quantum-X800 InfiniBand.
Entre los proyectos del ecosistema en la plataforma, Altera y Oxford Quantum Circuits construyeron un controlador cuántico basado en FPGA que conecta el control y la lectura de cúbits a las GPU a través de NVQLink, y Quantum Motion integró su marco de química QUICHE con CUDA-Q. QunaSys usó cuQuantum y 1,024 GPU NVIDIA de la generación Hopper en ABCI-Q para simular más de 300 millones de operaciones cuánticas, alcanzando precisión química para un modelo de cuatro átomos de hidrógeno. Los investigadores de NVIDIA usaron la supercomputadora JUPITER para simular 104 cúbits bajo ruido realista.
Lambda implementa ópticas empaquetadas conjuntamente
Lambda utiliza conmutadores de óptica integrada (CPO) de NVIDIA Photonics para conectar racks GB300 NVL72 en una implementación de más de 10 000 GPU. Cada conmutador cuenta con 144 puertos a 800 Gb/s y 18 fuentes de luz externas que los técnicos pueden reemplazar in situ, mientras que en una óptica enchufable, un láser defectuoso implica el reemplazo del módulo completo. Las pruebas citadas por NVIDIA mostraron una latencia de red aproximadamente un 4 % menor a escala de rack y hasta un 10 % menor a escala de pod, con el mismo rendimiento que la óptica enchufable.

La temperatura media de los componentes ópticos en la implementación fue de 36 °C, frente a los 51 °C de los componentes ópticos enchufables convencionales. NVIDIA afirma que sus conmutadores fotónicos ofrecen una eficiencia energética hasta 5 veces superior, una fiabilidad hasta 15 veces mayor y un número de láseres 4 veces menor que los diseños enchufables. NVIDIA también aprovechó la feria para celebrar los 20 años de CUDA, que, según la compañía, cuenta ahora con más de 11 millones de desarrolladores y más de 1,000 bibliotecas CUDA-X.


 Amazon