

Etched a levé 300 millions de dollars lors d'un tour de table de série C, pour une valorisation de 10.3 milliards de dollars. Cette annonce a été faite fin juillet, moins d'un mois après la sortie de la société de sa phase de développement confidentielle. Sequoia a mené ce tour de table, auquel ont également participé a16z, Jane Street, Diffusion et SK Hynix. La société a présenté cette levée de fonds comme la plus haute valorisation jamais atteinte lors d'un tour de table de série C mené par Sequoia.
Etched prévoit d'utiliser ces fonds pour accroître sa production et accélérer le déploiement chez ses clients. Outre son usine taïwanaise déjà construite, l'entreprise a ouvert un site de 7 400 mètres carrés à environ 15 minutes de son siège social. Ce site de Milpitas, d'une capacité de 10 MW, accueillera un laboratoire de lancement de nouveaux produits, une ligne de production interne de composants montés en surface, des activités de prototypage et des opérations de déploiement à plus grande échelle.
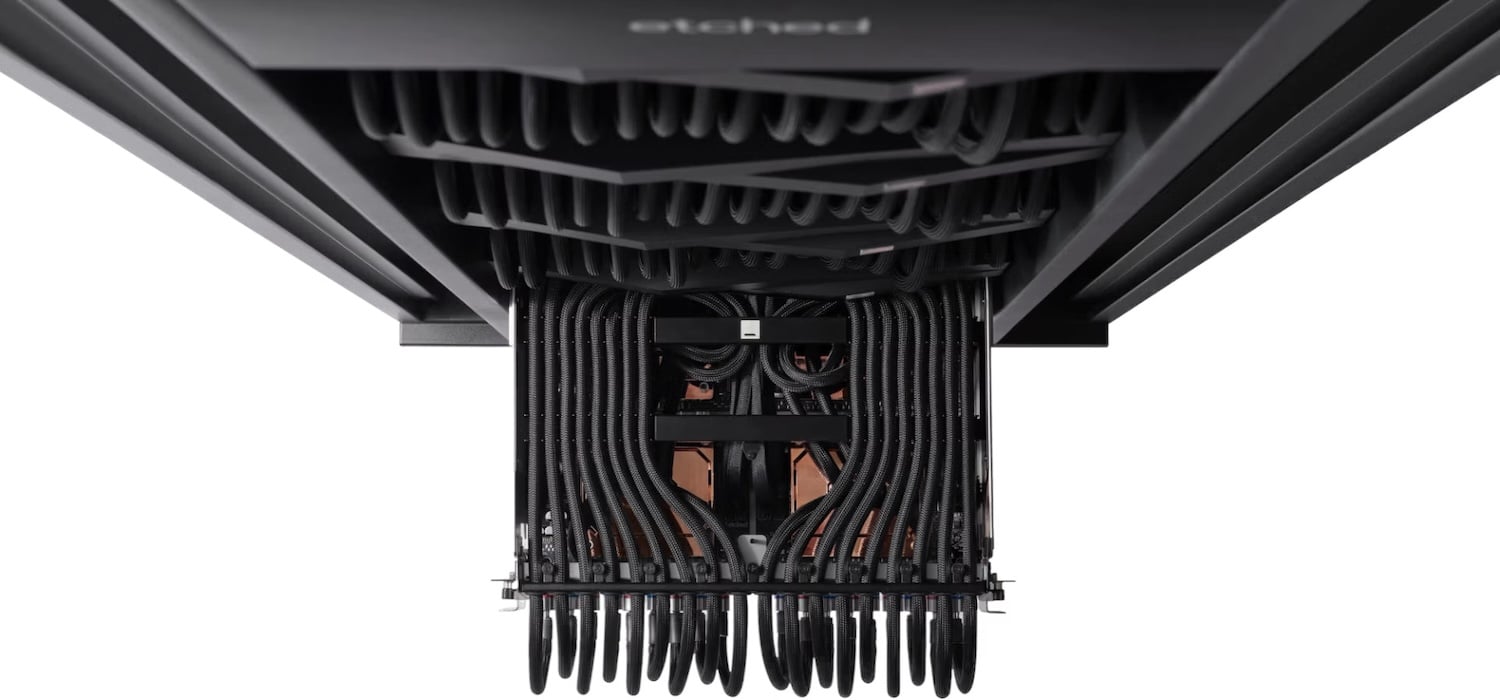
L'entreprise se concentre sur des systèmes dédiés à l'inférence IA, qu'elle considère comme un élément central et en pleine expansion des charges de travail d'IA. Etched vise un débit d'inférence plus élevé, des coûts d'exploitation réduits et une meilleure efficacité énergétique afin de prendre en charge des déploiements à plus grande échelle que ce que l'infrastructure actuelle des centres de données peut offrir de manière économique.
Prise en charge de plusieurs modèles
Etched affirme que son matériel prend en charge plusieurs architectures de modèles et n'est pas limité à un seul type. Ses clusters d'inférence exécutent actuellement de grands modèles de type « mix of experts », tels que DeepSeek et Qwen, ainsi que Mamba, un modèle d'espace d'états dont l'architecture diffère de celle des systèmes basés sur les transformateurs. Cette approche vise à permettre aux clients d'utiliser la même infrastructure malgré l'évolution des architectures de modèles.
L'entreprise développe deux technologies pour ses systèmes à l'échelle du rack. L'interférence basse tension (LVI) vise à augmenter la densité d'opérations en virgule flottante (FLOP) tout en conservant une consommation énergétique donnée. Les systèmes conventionnels sont souvent limités par des contraintes thermiques qui restreignent la fréquence d'horloge avant qu'elle n'atteigne leur performance de calcul théorique maximale. Etched utilise une conception conjointe du matériel et du système pour optimiser le débit tout en réduisant la consommation et les coûts.
Combinaison de SRAM et de HBM
La mémoire à l'échelle du cluster (CSM) combine SRAM et HBM au sein d'un système de mémoire conçu pour un cluster entier plutôt que pour un processeur individuel. L'architecture crée un pool de SRAM partagé sur l'ensemble du cluster et le connecte via une interconnexion propriétaire à large bande passante et faible latence. Selon Etched, cette conception vise à améliorer la latence d'accès à la mémoire tout en évitant les compromis en termes de coût, de rendement, de fiabilité, de dissipation thermique et de puissance de calcul associés aux systèmes basés uniquement sur la SRAM et aux approches utilisant la DRAM 3D.

Etched a indiqué que la demande pour ses systèmes d'inférence dépasse l'offre, les clients passant de la phase d'évaluation au déploiement en production. L'entreprise a rapidement étoffé ses effectifs, qui compte désormais 400 personnes, grâce au recrutement d'ingénieurs issus de NVIDIA, Broadcom, Google TPU, SK Hynix et de sociétés de trading haute fréquence.
L'entreprise opère depuis un bureau de San Jose qui comprend un laboratoire de prototypage NPI et un centre de données de 2 MW faisant fonctionner en continu le matériel Etched. Sonya Huang, associée chez Sequoia, a déclaré qu'Etched avait réalisé des progrès exceptionnels pour une entreprise de semi-conducteurs en moins de trois ans. Elle a ajouté que les solutions de calcul dédiées à l'inférence pourraient devenir prédominantes à mesure que l'inférence se développe.
Gavin Uberti, cofondateur et PDG d'Etched, a déclaré que l'entreprise estime que les infrastructures d'IA de pointe nécessitent bien plus que de simples améliorations matérielles. Il a décrit l'approche de l'entreprise comme une refonte complète de l'architecture technologique, axée sur l'amélioration de la vitesse d'inférence, la rentabilité et l'évolutivité.
Le cofondateur et président Rob Wachen a déclaré que l'entreprise a encore beaucoup de travail à accomplir pour atteindre une échelle de gigawatt et qu'elle collabore avec des investisseurs en infrastructures d'IA pour accélérer le processus. Il a ajouté que l'équipe travaille sans relâche avec les premiers clients pour concrétiser son premier produit.


 Amazon