

CTERA a publié le rapport « Cold Data Storage », une analyse de 16 pétaoctets de données de production en temps réel, issue de 856 analyses de partage de fichiers dans des environnements NAS d'entreprise, y compris dans des secteurs réglementés. Le chiffre principal est alarmant : seulement 4.4 % de la capacité de stockage est activement utilisée, c'est-à-dire modifiée au cours des 90 derniers jours. Le reste est considéré comme « froid » : 83.1 % de la capacité totale se trouve dans des fichiers non modifiés depuis plus d'un an, 97.5 % des fichiers individuels n'ont pas été modifiés pendant cette période, 88 % n'ont pas été consultés depuis plus d'un an et seulement 9.9 % des données stockées ont été consultées au cours d'une période de 90 jours donnée. CTERA conclut que les entreprises utilisent leur niveau de stockage le plus coûteux comme une archive de facto, et que cela a des conséquences à trois niveaux : le coût, les risques de sécurité et la qualité des données récupérées par les systèmes d'IA.
Le stockage primaire comme archive accidentelle
Rien de tout cela n'est nouveau ; le secteur informatique utilise l'acronyme ROT (redondant, obsolète ou trivial) depuis des années. Ce que le rapport quantifie, c'est l'effet multiplicateur. Les fichiers inactifs sur une baie principale consomment de la capacité flash ou hybride et sont ensuite inclus dans chaque sauvegarde, instantané et tâche de réplication qui protège ce niveau de stockage. Par conséquent, les ressources nécessaires à la maintenance de l'infrastructure augmentent avec des données que personne ne consulte. « Lorsque seulement 4.4 % de la capacité est activement utilisée, les entreprises utilisent leur niveau de stockage le plus coûteux comme une archive froide. Cela crée un effet multiplicateur sur les coûts de stockage et de protection des données, l'exposition aux risques de sécurité et, désormais, la qualité des informations disponibles pour les systèmes d'IA », explique Aron Brand, directeur technique de CTERA. Sa solution : un meilleur placement. « La réponse n'est pas simplement de supprimer les anciennes données ; il s'agit de mieux décider où ces données doivent être stockées. Les informations peuvent être conservées et protégées sans être stockées sur un stockage principal coûteux. » C'est le même signal de demande qui explique la croissance des livraisons de stockage LTO observée cette année.
Exposition aux risques et qualité de la récupération par IA
Les données inactives restent généralement sur les mêmes partages réseau accessibles, avec les mêmes droits d'accès, que les données utilisées quotidiennement. Ainsi, les utilisateurs et les applications peuvent accéder à bien plus d'informations que nécessaire pour leurs opérations quotidiennes. Déplacer ces données hors du système de fichiers actif réduit la quantité d'informations sensibles exposées, sans modifier les données conservées.
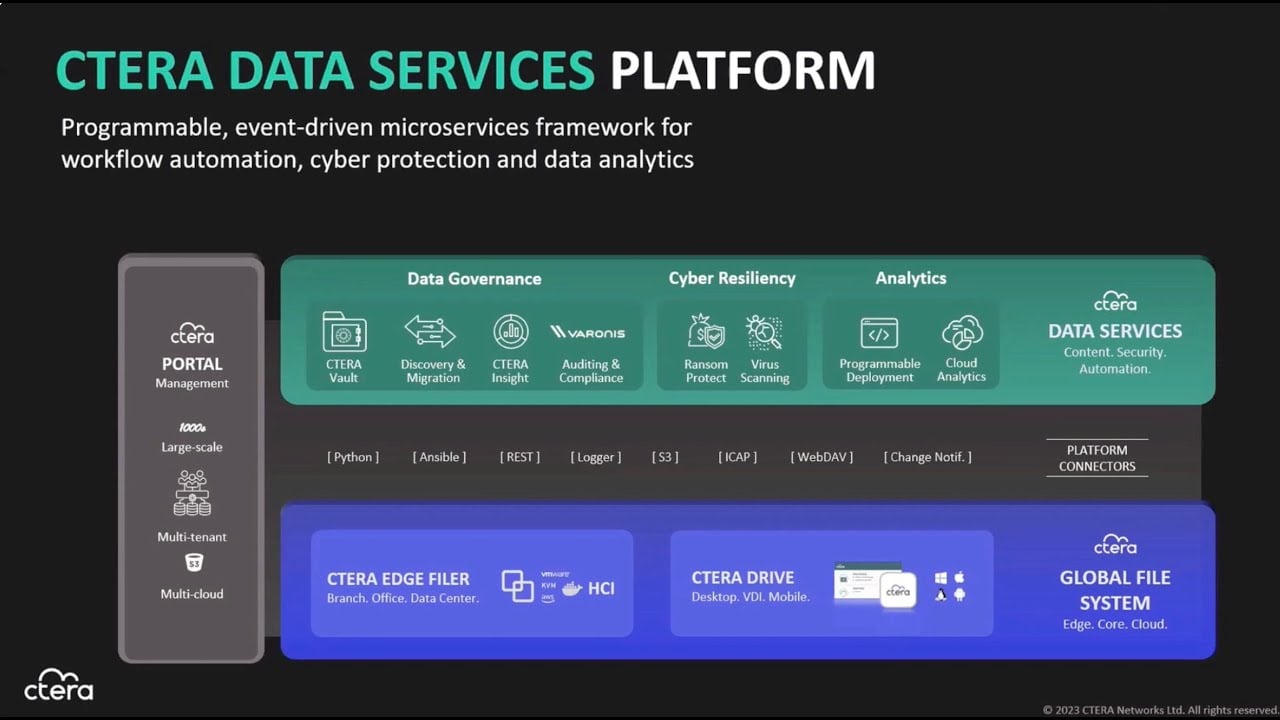
Le concept de préparation à l'IA est relativement récent. À mesure que les organisations déploient des outils de recherche et d'extraction de données dans leurs archives, d'importants volumes de documents anciens ou obsolètes entrent en concurrence avec les documents actuels en termes de pertinence. La fiabilité d'un modèle dépend alors de la qualité des données extraites. CTERA travaille sur ce sujet depuis un certain temps : son intégration n8n permet d'accéder aux données des fichiers pour les flux de travail d'IA, et sa solution Fusion Direct cible les fichiers et les objets pour les pipelines d'IA. Le rapport plaide en faveur d'un nettoyage du corpus avant son indexation par ces pipelines. Le rapport complet est disponible auprès de CTERA après inscription.


 Amazon