

MLCommons a publié aujourd'hui les résultats de MLPerf Storage v3.0, et cette édition change non seulement la nature du benchmark, mais aussi son classement. Pour la première fois, le seul benchmark de stockage IA audité couvre l'intégralité du pipeline : débit d'entraînement, sauvegarde des points de contrôle et deux nouvelles charges de travail d'inférence, un test de base de données vectorielle et un test de cache clé-valeur. Dix-neuf organisations ont soumis 143 résultats, dont onze participent pour la première fois, parmi lesquelles Microsoft Azure, NVIDIA, Everpure et une vague de startups spécialisées dans le stockage IA, probablement inconnues du grand public. Il est également à noter que DDN, Huawei, Hammerspace et Lightbits, qui dominaient le classement de la version 2.0, n'ont pas participé à cette édition.
Une précision importante concernant la comparabilité : la version 3.0 utilise désormais des accélérateurs B200 au lieu de H100, ce qui augmente la bande passante par accélérateur. Par conséquent, les résultats de la version 3.0 ne sont pas comparables à ceux de la version 2.0. Ces données proviennent de soumissions de fournisseurs auditées par MLCommons ; StorageReview n’a ni réalisé ni vérifié ces tests de manière indépendante.
Le point de contrôle est l'événement principal
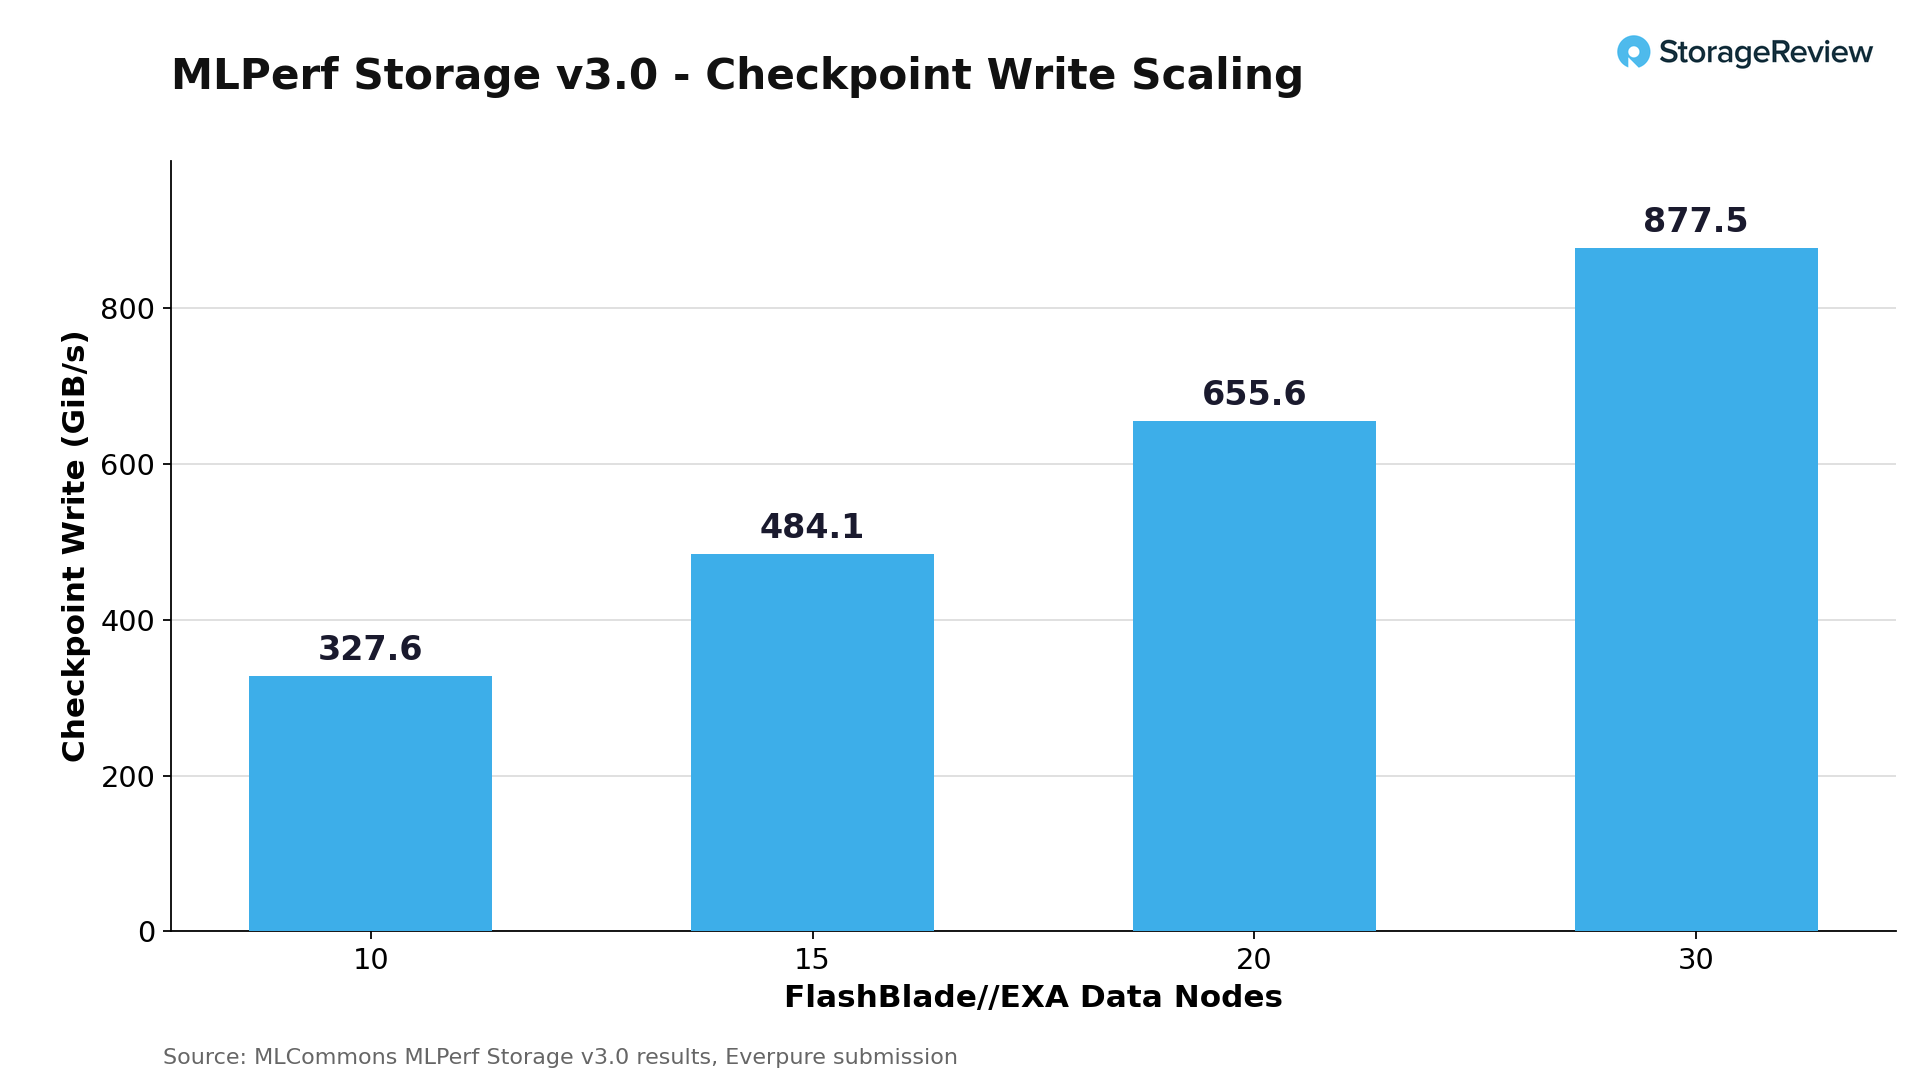
MLCommons a ajouté la création de points de contrôle comme charge de travail prioritaire, car elle constitue un goulot d'étranglement avéré : les tâches d'entraînement à grande échelle écrivent d'énormes quantités d'état à intervalles réguliers, et chaque seconde passée à vider un point de contrôle représente une seconde d'inactivité de l'accélérateur. C'est ici que figure le résultat le plus élevé de cette session. Everpure (anciennement Pure Storage), pour sa première participation à MLPerf Storage, a soumis des résultats FlashBlade//EXA qui évoluent de manière quasi linéaire avec le nombre de nœuds de données : 327.6 Gio/s d'écriture de points de contrôle avec 10 nœuds de données, 484.1 Gio/s avec 15, 655.6 Gio/s avec 20 et 877.5 Gio/s d'écriture avec 833.0 Gio/s de lecture avec 30 nœuds de données. Everpure a passé l'année dernière à affirmer des débits importants pour //EXA ; c'est la première fois qu'un résultat audité confirme ces affirmations.
Le deuxième meilleur score en matière de points de contrôle est sans doute l'événement le plus marquant du secteur. Azure Managed Lustre, le premier service de stockage cloud hyperscale jamais soumis à ce test de performance, a atteint 642.2 Gio/s en écriture de points de contrôle sur un déploiement de 4 096 Tio avec 128 clients. Il y a deux tours, il aurait été difficile d'imaginer un service de fichiers cloud managé rivaliser avec des baies de stockage dédiées à l'IA.
| Points de contrôle (Meilleures soumissions) | Système | Écrire en noir et blanc (Gio/s) |
|---|---|---|
| Everpure | FlashBlade//EXA, 30 nœuds de données | 877.5 |
| Azure | Lustre géré, 4 096 Tio, 128 clients | 642.2 |
| YanRongTech | F9000X, 8 clients | 313.7 |
| Suzhou Zishan Longlin | Configurations multiples | 313.7 |
| Données de Turing | F9200, 8 clients | 307.1 |
| UBIX | UbiPower18000, 3 nœuds de stockage | 293.8 |
Formation : Des noms que vous ne connaissez probablement pas
Le classement de l'entraînement 3D U-Net est dominé par les nouveaux venus. Le F9000X de YanRongTech a maintenu une bande passante de lecture de 543.9 Gio/s, alimentant 99 accélérateurs B200 simulés, soit le débit d'entraînement le plus élevé de cette session. TuringData, une entreprise singapourienne d'infrastructure d'IA qui participait pour la première fois, a terminé à 4 Gio/s derrière, avec 541.5 Gio/s, alimentant 96 B200 simulés à partir de seulement trois nœuds de stockage. Ce même cluster F9200 à trois nœuds a également soumis Checkpoint-70B à 539.9 Gio/s en lecture et 307.1 Gio/s en écriture. L'UbiPower18000 d'UBIX, composé de trois nœuds de stockage avec 16 disques NVMe de 15.36 To et un réseau quadruple NDR400, a atteint 454.1 Gio/s. HPE était le seul fournisseur de baies d'entreprise établi à soumettre des résultats de formation, avec le K3000 à 345.8 Gio/s.
| Formation 3D U-Net (Meilleures soumissions) | Lire N/B (GiB/s) | Accélérateurs B200 simulés |
|---|---|---|
| YanRongTech F9000X | 543.9 | 99 |
| TuringData F9200 | 541.5 | 96 |
| UBIX UbiPower18000 | 454.1 | 80 |
| Suzhou Zishan Longlin | 433.4 | 80 |
| FarmGPU | 406.7 | 75 |
| Azure Managed Lustre | 379.1 | 70 |
L'inférence rejoint le benchmark
Les deux nouvelles charges de travail tiennent compte de la croissance réelle de la demande de stockage. Le test de cache KV mesure la rapidité avec laquelle un système de stockage peut gérer la pagination de l'état d'attention pour le service LLM à contexte long, un modèle que nous avons analysé en détail dans notre étude sur le déchargement du cache KV chez Dell et Solidigm . Everpure a de nouveau enregistré le meilleur résultat de cette session, avec 1 623,4 Gio/s de lecture du cache KV sur une configuration FlashBlade//EXA à 51 hôtes. UBIX (443.7 Gio/s) et FarmGPU (443.6 Gio/s) dominent les performances à l'échelle standard. Côté bases de données vectorielles, le système Seahorse de TTA a affiché le meilleur débit de requêtes, avec 57 620 requêtes par seconde.
L'autre changement structurel concerne le protocole. La version 3.0 a introduit la prise en charge du stockage objet S3, et environ un sixième des soumissions l'ont utilisée. NVIDIA a représenté la majeure partie de ces soumissions avec 20 tests AIStore, déployés sur des configurations bare metal sur OCI, AWS et GCP, atteignant un débit maximal de 133.3 Gio/s en écriture de points de contrôle. Bien que ces chiffres absolus restent inférieurs à ceux des systèmes de fichiers parallèles, l'utilisation du stockage objet pour les charges de travail d'entraînement et de points de contrôle au sein de ce benchmark ouvre un territoire auparavant réservé aux systèmes de fichiers POSIX.
MLCommons a également commencé à suivre la consommation d'énergie et l'efficacité de l'espace rack comme des indicateurs de premier ordre lors de cette session.
Lame Flash Everpure//EXA
Le système Everpure FlashBlade//EXA a conservé la tête dans les catégories de point de contrôle de modèle de paramètres 405B et 1.25T ainsi que dans les benchmarks de récupération de cache clé-valeur (KV), soulignant la capacité de la plateforme à maintenir un débit élevé lors des charges de travail d'entraînement et d'inférence d'intelligence artificielle à forte intensité de données.
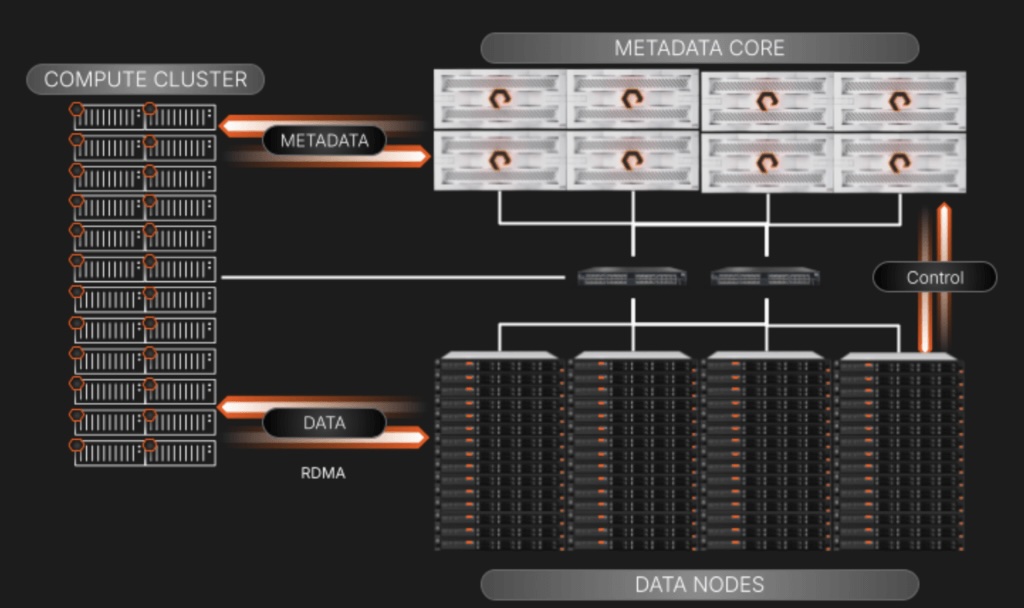
La configuration soumise par Everpure associait 30 lames FlashBlade//EXA (120 modules DirectFlash gérant les métadonnées) à 30 nœuds de données Linux/NVMe, offrant ainsi une capacité utilisable d'environ 866 To dans un système de fichiers unique. Les métadonnées étaient réparties sur pNFS/TCP et les données brutes sur NFSv3 via RDMA. Lors d'une simulation de point de contrôle avec 1.25 T de paramètres et 1 024 accélérateurs clients, la configuration à 30 nœuds a maintenu une bande passante d'écriture de 877.52 Gio/s pendant 17.74 secondes, et une bande passante de lecture de 588.28 Gio/s en 28.99 secondes. Lors du test d'inférence du cache KV, il a rapporté 85 736 jetons/sec sur une exécution Llama 3.1 8B uniquement en stockage, 67 642 jetons/sec sur une exécution 8B combinant stockage et mémoire système, et 33 403 jetons/sec sur une exécution 70B uniquement en stockage.
Que signifient les absences non justifiées ?
Une session de benchmark témoigne de deux choses : les capacités des participants et les performances des absents. VAST Data, WEKA et DDN, fournisseurs ayant remporté les plus importants déploiements de néocloud et d'usines d'IA, n'ont pas participé à la v3.0, tout comme Huawei, Hammerspace et Lightbits, participants à la v2.0. Les fournisseurs peuvent manquer des sessions pour diverses raisons : cycles d'ingénierie, calendrier de publication, enjeux politiques liés aux benchmarks. L'absence à une session n'indique pas nécessairement la lenteur d'un système. Toutefois, cela signifie que les données auditées et les données de déploiement concernent désormais des listes de fournisseurs différentes, que les acheteurs doivent prendre en compte. Notre page « Meilleures baies de stockage » suit précisément cette distinction, en indiquant les données auditées et les données de déploiement, et a été mise à jour avec les résultats complets de la v3.0.
Les résultats de la version 3.0 sont publiés aujourd'hui sur la page de référence du stockage MLCommons.



 Amazon