

L'architecture NVIDIA Hopper a occupé le devant de la scène lors de NVIDIA GTC avec l'objectif d'alimenter la prochaine vague de centres de données IA. Nommée en l'honneur de Grace Hopper, une pionnière de l'informatique américaine, la plate-forme de calcul accéléré de nouvelle génération offre des performances d'un ordre de grandeur par rapport à son prédécesseur, NVIDIA Ampere.
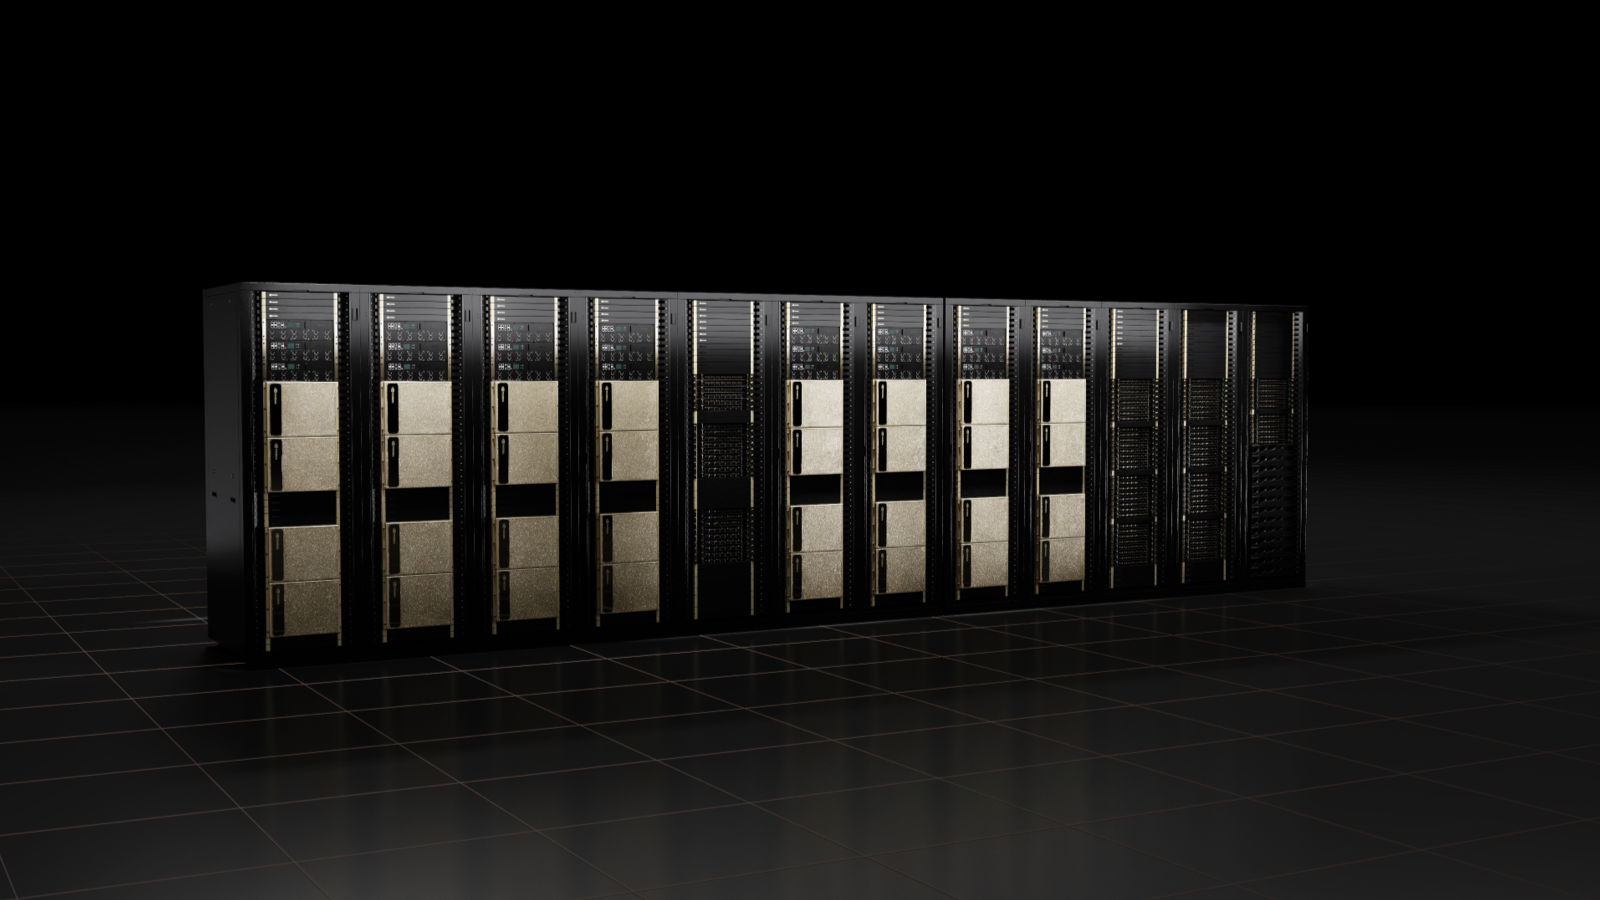
NVIDIA a également annoncé son premier GPU basé sur Hopper, le NVIDIA H100, doté de 80 milliards de transistors. Considéré comme l'accélérateur le plus grand et le plus puissant au monde, le H100 est doté d'un moteur Transformer et d'une interconnexion NVIDIA NVLink hautement évolutive pour faire progresser de gigantesques modèles de langage d'IA, des systèmes de recommandation profonds, la génomique et des jumeaux numériques complexes.
"Les centres de données deviennent des usines d'IA - traitant et affinant des montagnes de données pour produire de l'intelligence", a déclaré Jensen Huang, fondateur et PDG de NVIDIA. "NVIDIA H100 est le moteur de l'infrastructure d'IA mondiale que les entreprises utilisent pour accélérer leurs activités axées sur l'IA."
Technologie H100
Construit à l'aide d'un processus TSMC 4N de pointe conçu pour les besoins de calcul accélérés de NVIDIA, le H100 présente des avancées significatives pour accélérer l'IA, le HPC, la bande passante mémoire, l'interconnexion et la communication, y compris une connectivité externe de près de 5 To/s. Le Hopper H100 est le premier GPU à prendre en charge PCIe Gen5 et à utiliser HBM3, (High Bandwidth Memory 3) permettant 3 To/s de bande passante mémoire. Vingt GPU H100 peuvent supporter l'équivalent du trafic Internet mondial, ce qui permet aux clients de fournir des systèmes de recommandation avancés et de grands modèles de langage exécutant l'inférence sur les données en temps réel.
Le choix pour le traitement du langage naturel, le Transformer Engine est l'un des modèles d'apprentissage en profondeur les plus importants jamais inventés. Le Transformer Engine de l'accélérateur H100 est conçu pour accélérer ces réseaux jusqu'à 6x par rapport à la génération précédente sans perte de précision.
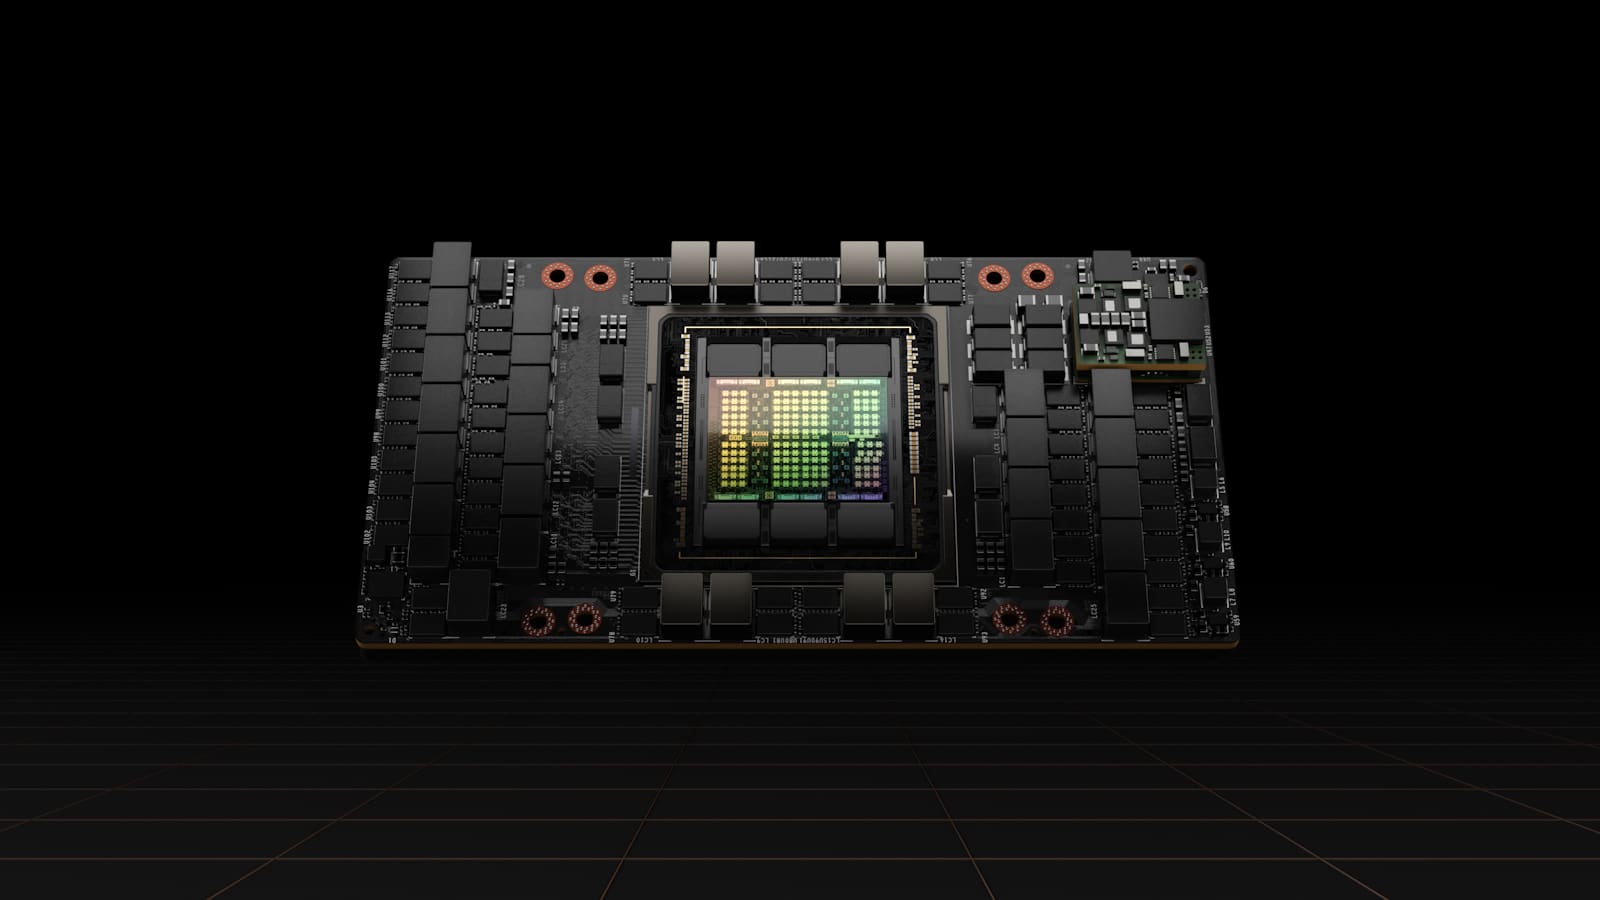
Avec la technologie Multi-Instance GPU (MIG), l'architecture Hopper permet à un seul GPU d'être partitionné en sept instances plus petites et entièrement isolées pour gérer différents types de travaux. En étendant jusqu'à 7 fois les capacités MIG par rapport à la génération précédente, l'architecture Hopper offre des configurations multi-locataires sécurisées dans des environnements cloud sur chaque instance GPU.
Le H100 est le premier accélérateur au monde doté de capacités informatiques confidentielles pour protéger les modèles d'IA et les données des clients pendant le traitement. Les clients peuvent également appliquer l'informatique confidentielle à l'apprentissage fédéré pour les secteurs sensibles à la confidentialité tels que la santé, les services financiers et les infrastructures cloud partagées.
Le NVIDIA NVLink de 4e génération se combine avec un nouveau commutateur NVLink externe qui l'étend en tant que réseau évolutif au-delà du serveur, connectant jusqu'à 256 GPU H100 à une bande passante 9 fois plus élevée que la génération précédente en utilisant NVIDIA HDR Quantum InfiniBand.
NVIDIA H100 peut être déployé dans pratiquement tous les centres de données, y compris sur site, dans le cloud, dans le cloud hybride et en périphérie, et devrait être disponible plus tard cette année.
Système DGX H100
NVIDIA a annoncé le système DGX de quatrième génération, DGX H100, comprenant huit GPU H100 offrant 32 pétaflops de performances d'IA à la nouvelle précision FP8, offrant l'échelle nécessaire pour répondre aux exigences de calcul massives des grands modèles de langage, des systèmes de recommandation, de la recherche médicale et de la science du climat .
Chaque système DGX H100 contient huit GPU H100, connectés comme un par NVLink de quatrième génération, offrant une connectivité de 900 Go/s, soit 1.5 fois plus que la génération précédente. NVLink de NVIDIA est une interconnexion GPU à GPU à faible latence et sans perte qui inclut des fonctionnalités de résilience, telles que la détection d'erreurs au niveau de la liaison et des mécanismes de relecture de paquets pour garantir une livraison réussie des données.
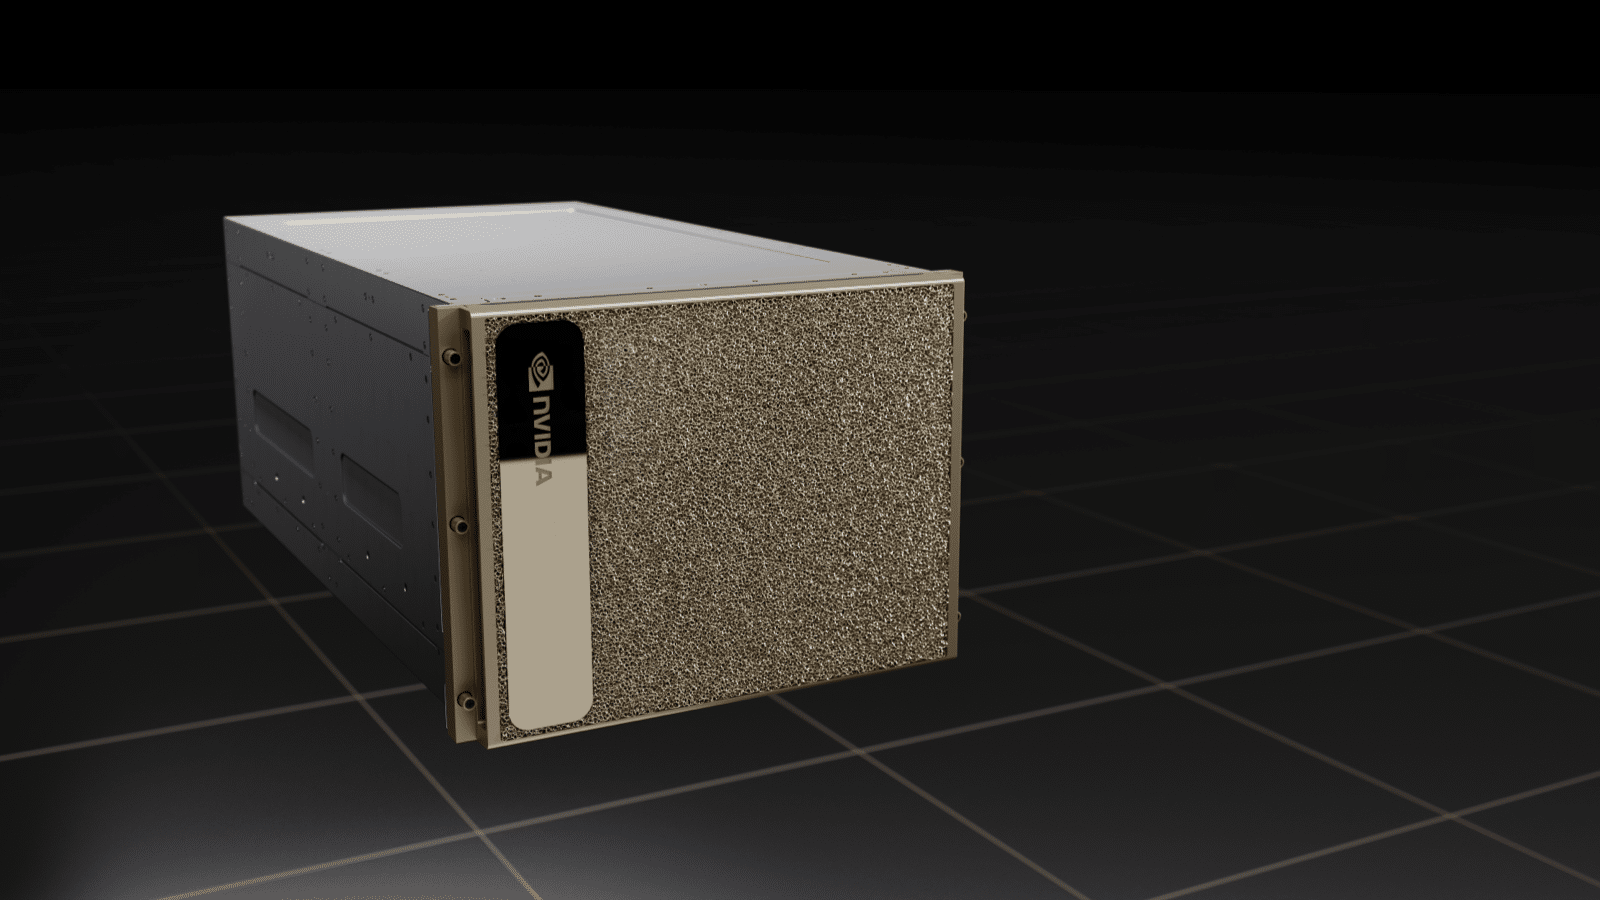
En plus du NVLink de quatrième génération, le H100 présente également la nouvelle interconnexion réseau NVLink. Cette version évolutive de NVLink permet la communication GPU à GPU jusqu'à 256 GPU sur plusieurs nœuds de calcul. NVIDIA a également introduit la technologie NVSwitch de troisième génération qui comprend des commutateurs à la fois à l'intérieur et à l'extérieur des nœuds pour connecter plusieurs GPU dans des environnements de serveurs, de clusters et de centres de données. Un nœud avec le nouveau NVSwitch fournit 64 ports de NVLinks pour accélérer la connectivité multi-GPU, doublant presque le débit total du commutateur de 7.2 Tbits/s à 13.6 Tbits/s. NVSwitch permet aux huit GPU H100 de se connecter via NVLink. Un commutateur NVLink externe peut mettre en réseau jusqu'à 32 nœuds DGX H100 dans les supercalculateurs NVIDIA DGX SuperPOD de nouvelle génération.
Grâce CPU Superpuce
NVIDIA a annoncé Grace CPU Superchip, contenant 144 cœurs Arm dans un seul socket. Il s'agit du premier processeur de centre de données discret basé sur Arm Neoverse conçu pour l'infrastructure d'IA et le calcul haute performance, offrant deux fois plus de bande passante mémoire et d'efficacité énergétique.
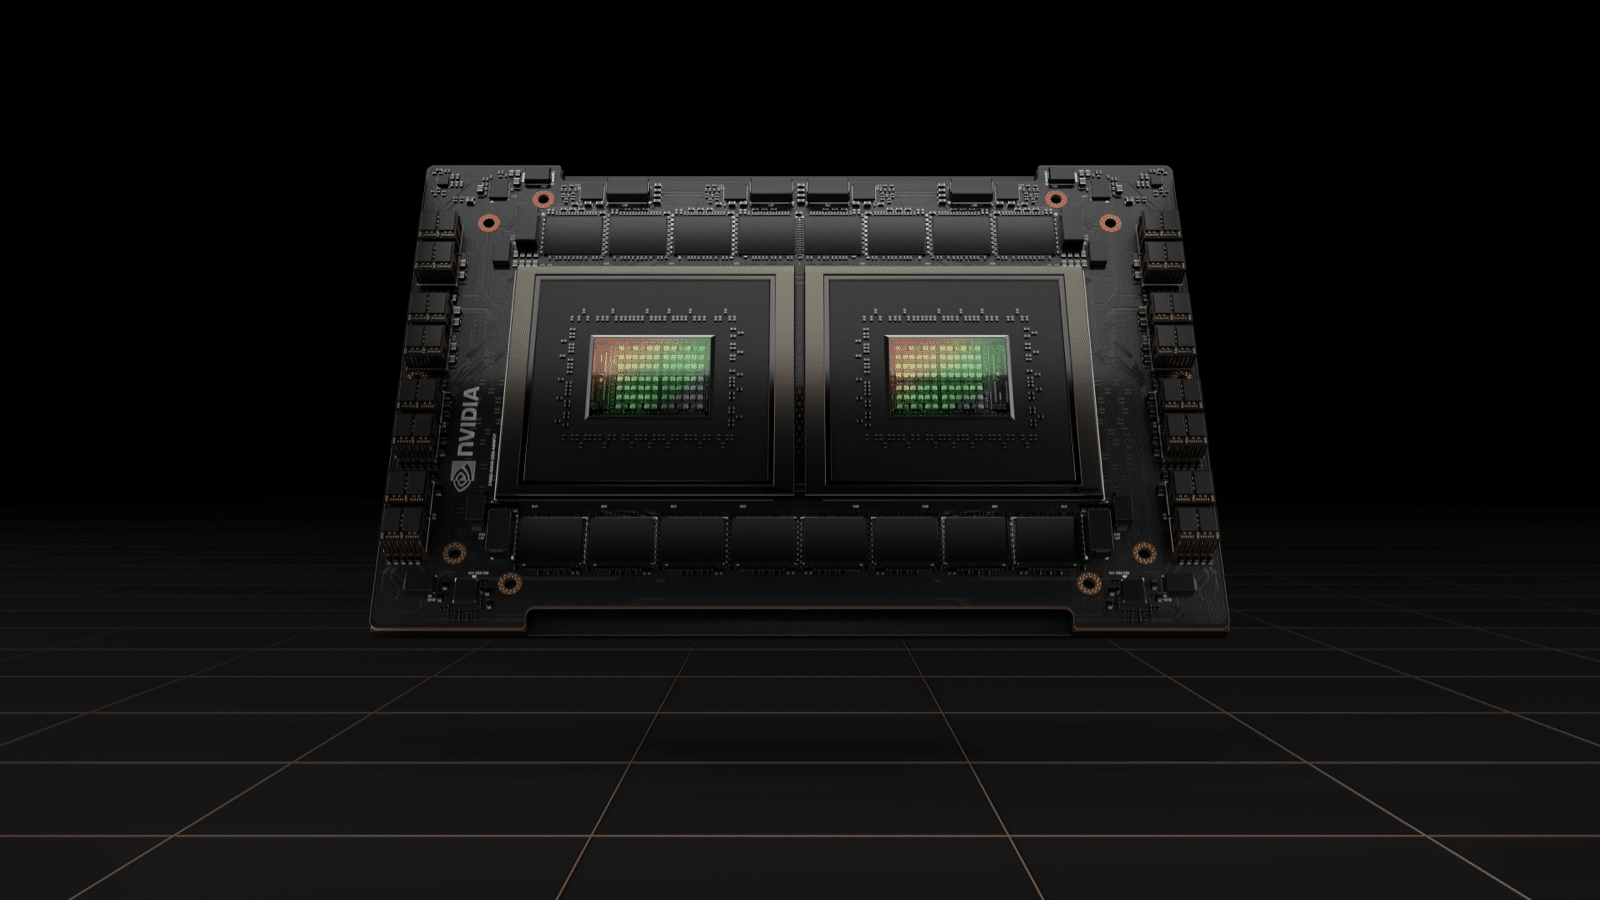
Le sous-système de mémoire se compose d'une mémoire LPDDR5x avec code de correction d'erreur pour un équilibre entre vitesse et consommation d'énergie. Le sous-système de mémoire LPDDR5x double la bande passante des conceptions DDR5 traditionnelles à 1 To/s tout en consommant considérablement moins d'énergie.
Le Grace CPU Superchip exécutera toutes les piles de logiciels informatiques de NVIDIA, y compris NVIDIA RTX, NVIDIA HPC, NVIDIA AI et Omniverse. La puce Grace CPU ainsi que les cartes réseau NVIDIA ConnectX-7 offrent la flexibilité d'être configurées dans des serveurs en tant que systèmes autonomes uniquement CPU ou en tant que serveurs accélérés par GPU avec un, deux, quatre ou huit GPU basés sur Hopper, permettant aux clients d'optimiser les performances. pour leurs charges de travail spécifiques tout en conservant une pile logicielle unique.
Système informatique omnivers
En gardant l'accent sur le centre de données, NVIDIA a annoncé NVIDIA OVX, un système informatique conçu pour alimenter des jumeaux numériques à grande échelle. Un jumeau numérique est un monde virtuel connecté au monde physique. NVIDIA OVX est conçu pour exploiter une simulation de jumeau numérique complexe qui s'exécutera au sein de NVIDIA Omniverse, une plateforme de simulation mondiale physiquement précise en temps réel et de collaboration de conception 3D.
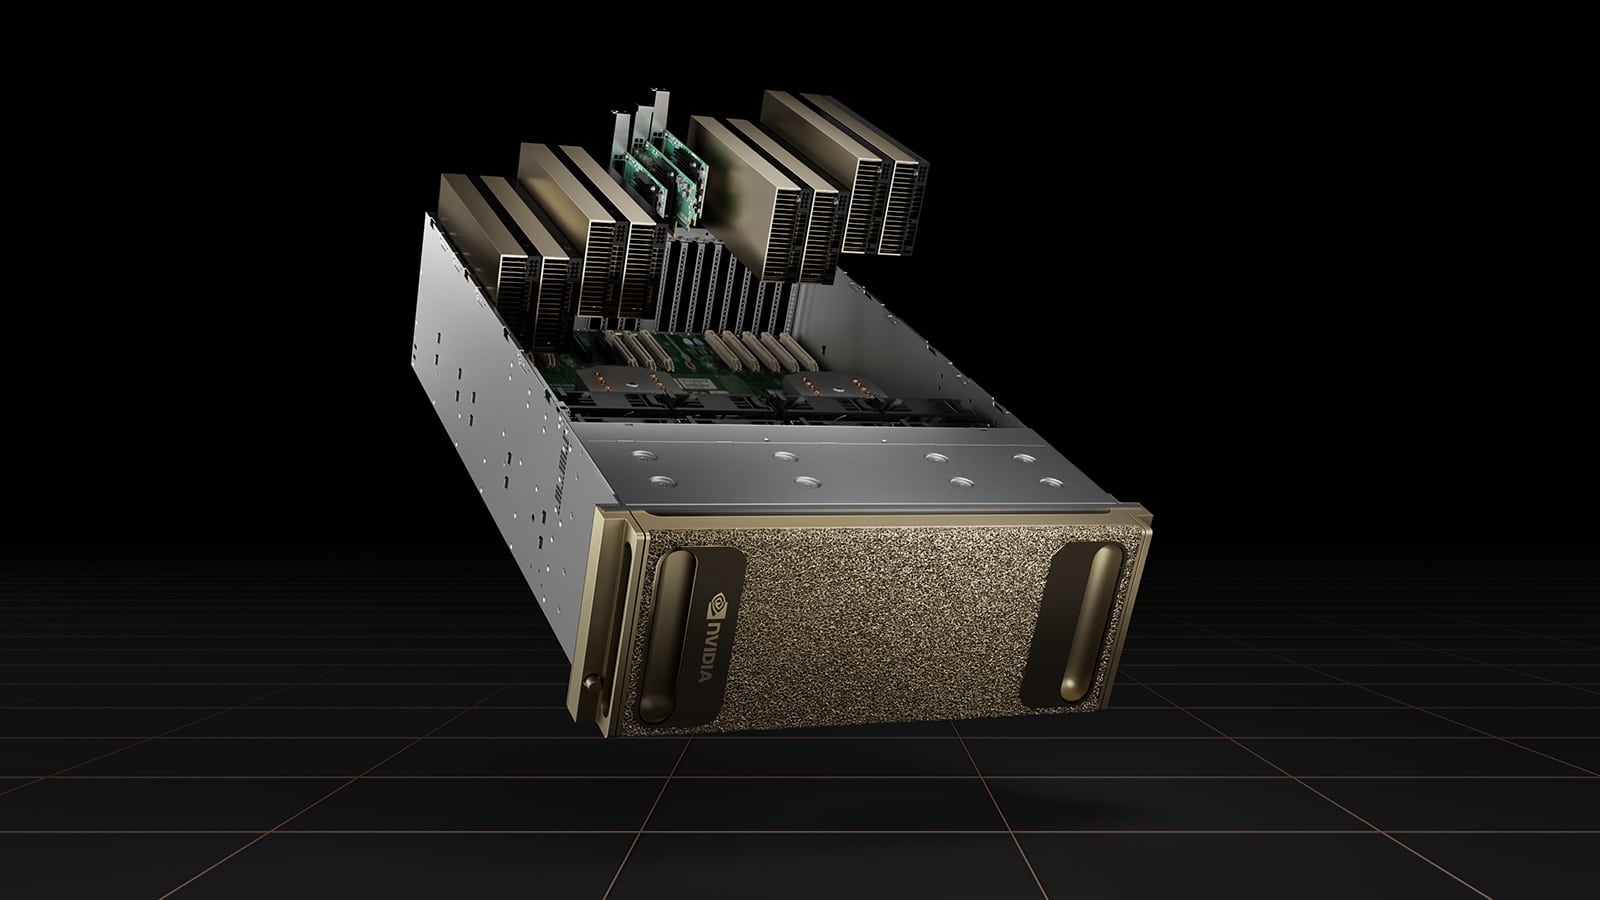
Combinant un calcul, des graphiques et une intelligence artificielle accélérés par GPU hautes performances avec un accès au stockage à faible latence et haute vitesse, le système OVX fournira les performances requises pour créer des jumeaux numériques avec une précision réelle. OVX peut simuler des jumeaux numériques complexes pour modéliser des bâtiments, des usines, des villes et le monde.
Le serveur OVX comprend huit GPU NVIDIA A40, trois cartes réseau ConnectX-6 DX 200 Gbps, 1 To de mémoire et 16 To de stockage NVMe. Le système OVX évolue d'un seul module de huit serveurs OVX à un SuperPOD OVX avec 32 serveurs connectés via un commutateur NVIDIA Spectrum-3 ou plusieurs SuperPOD OVX.
Kit de développement Jetson AGX Orin
NVIDIA a également annoncé la disponibilité du kit de développement Jetson AGX Orin, un supercalculateur IA compact et économe en énergie pour la robotique avancée, les machines autonomes et l'informatique embarquée et de pointe de nouvelle génération. Les spécifications du Jetson AGX Orin sont impressionnantes, offrant 275 billions d'opérations par seconde, soit plus de 8 fois la puissance de traitement du modèle précédent, tout en conservant un facteur de forme de la taille d'une paume. Doté de l'architecture GPU NVIDIA Ampere, de processeurs Arm Cortex-A78AE, d'accélérateurs d'apprentissage en profondeur et de vision de nouvelle génération, d'une bande passante mémoire plus rapide, d'interfaces à haut débit et d'un capteur multimodal, le Jetson AGX Orin peut alimenter plusieurs pipelines d'applications d'IA simultanées.
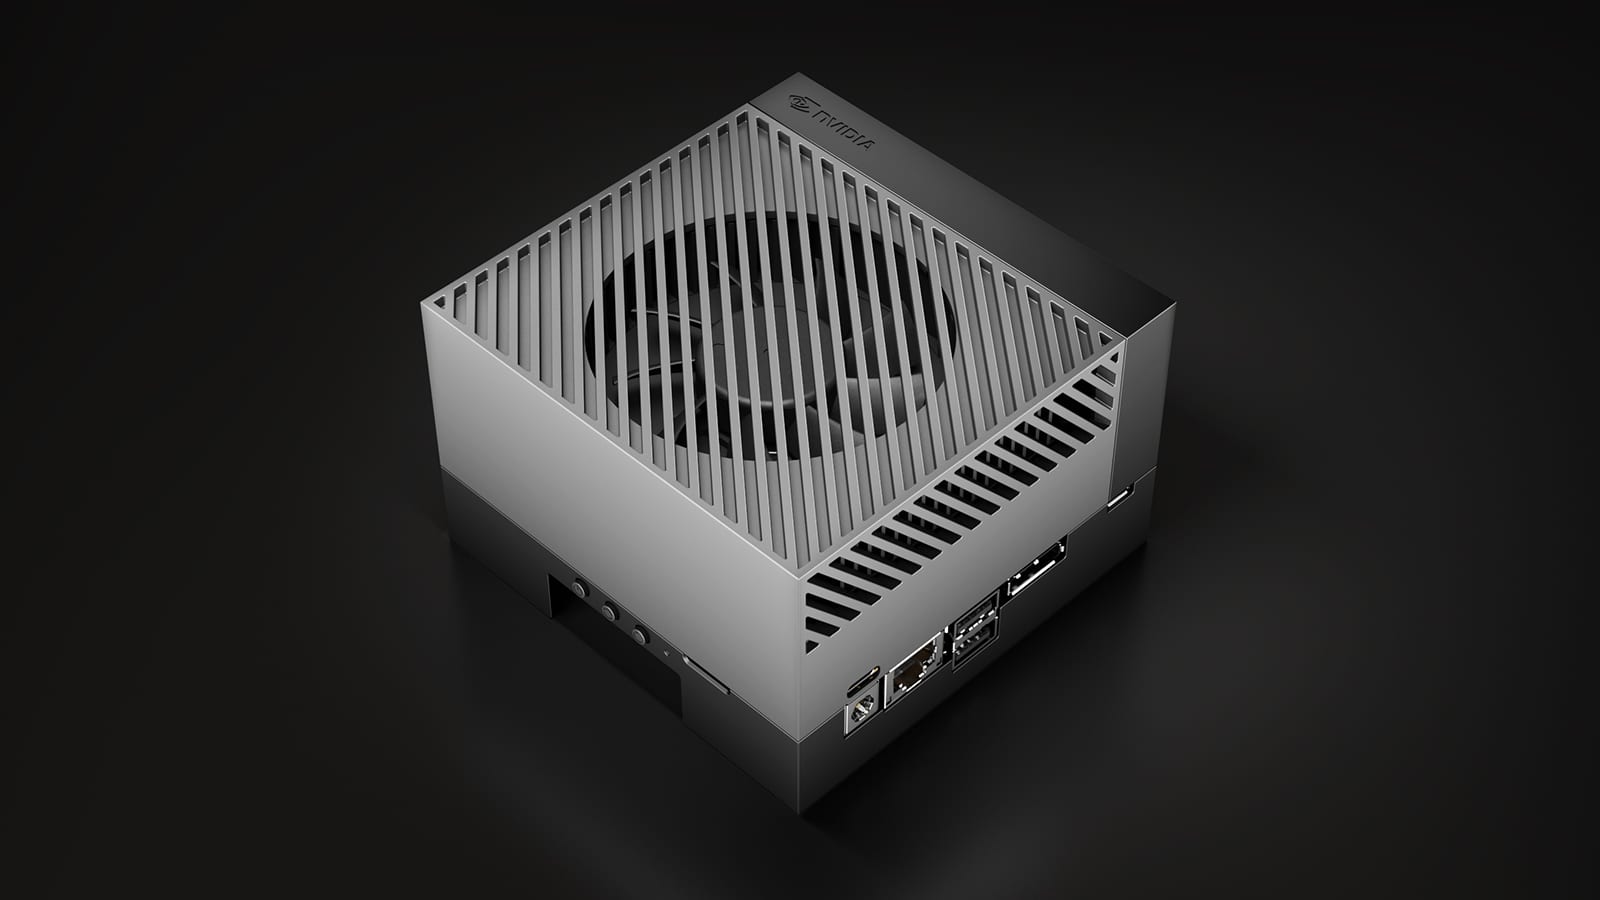
Les clients utilisant Jetson AGX Orin peuvent tirer parti de la pile informatique accélérée NVIDIA CUDA-X complète, avec 60 mises à jour de sa collection de bibliothèques, d'outils et de technologies. Ils auront également un accès complet au SDK NVIDIA JetPack, aux modèles pré-formés du catalogue NVIDIA NGC et aux derniers frameworks et outils de développement et d'optimisation d'applications, tels que NVIDIA Isaac sur Omniverse, NVIDIA Metropolis et NVIDIA TAO Toolkit.
NVIDIA Spectre-4
Restant concentré sur le centre de données, NVIDIA a annoncé sa plate-forme Ethernet NVIDIA Spectrum-4. Le commutateur de nouvelle génération offre 400 Gbit/s de bout en bout avec un débit de commutation 4 fois plus élevé que les générations précédentes. Le Spectrum-4 comprend ConnectX-7 SmartNIC, BlueField-3 DPLU et le logiciel d'infrastructure de centre de données DOCA.
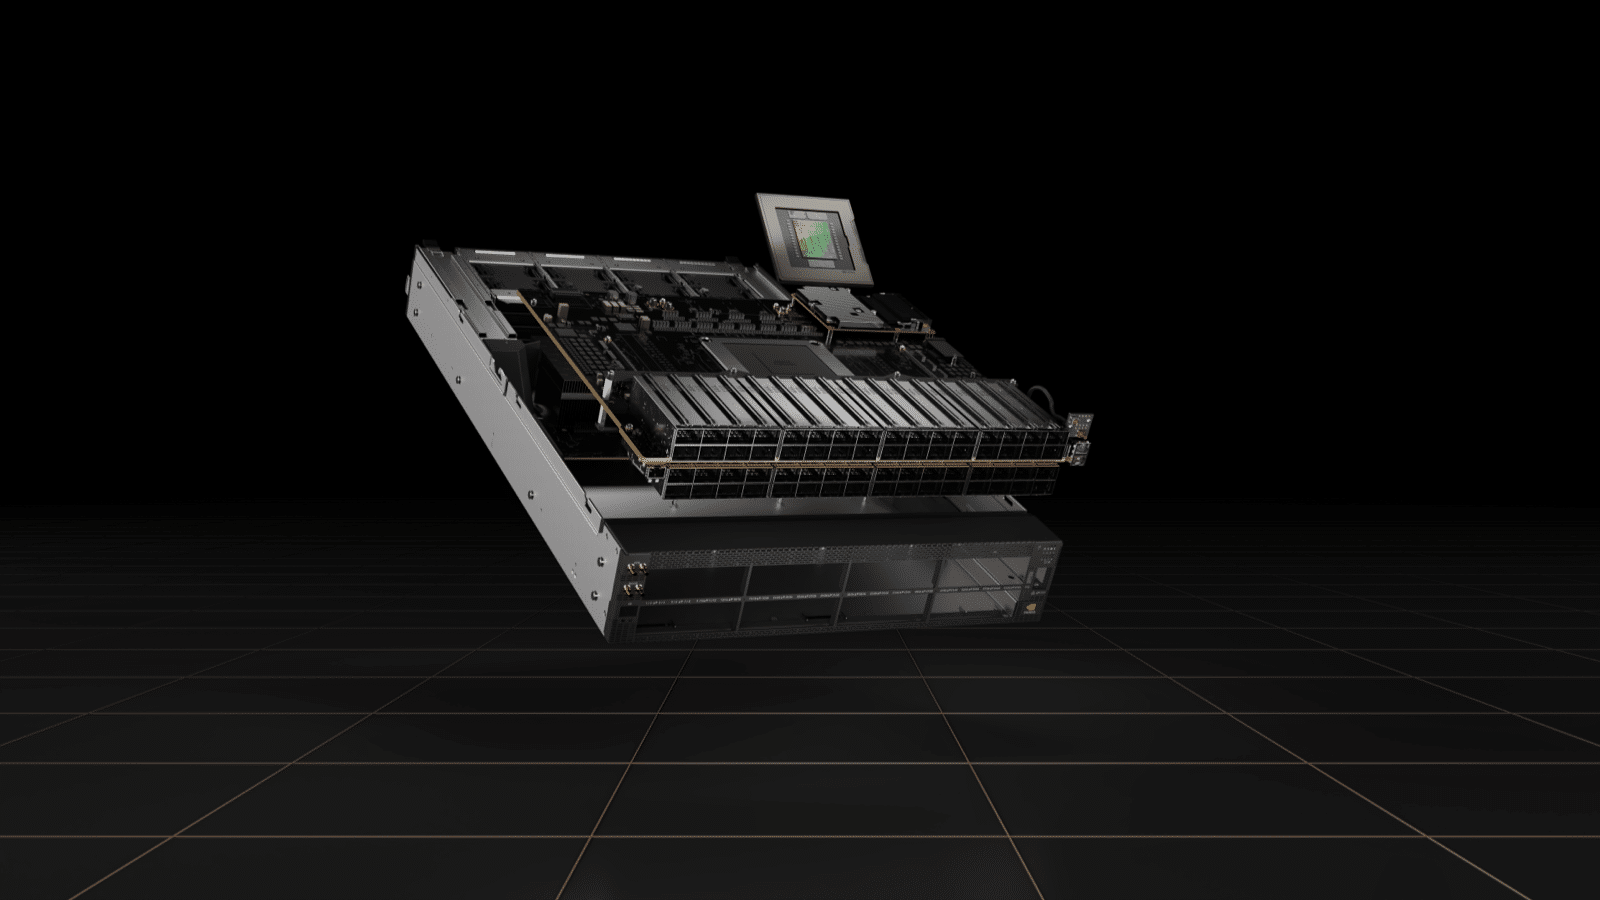
Conçus pour l'IA, les commutateurs Spectrum-4 permettent une précision à la nanoseconde, accélèrent, simplifient et sécurisent la structure réseau avec une bande passante par port 2 fois plus rapide, 4 fois moins de commutateurs et une consommation d'énergie 40 % inférieure à celle des générations précédentes. Avec une bande passante ASIC agrégée de 51.2 Tbit/s prenant en charge 128 ports de 400 GBE, un routage adaptatif et des mécanismes de contrôle de congestion améliorés, Spectrum-4 optimise le RDMA sur les tissus Ethernet convergents, accélérant considérablement les centres de données.
Conclure
L'événement GTC de NVIDIA a été riche en nouveautés, avec des mises à jour logicielles, des performances et une vitesse accrues. L'accent a été mis sur les centres de données, mais aussi sur les robots mobiles autonomes (AMR) et, bien sûr, l'edge computing. Le GPU Hopper H100 était la star du salon, mais ce produit a été au cœur de nombreuses autres annonces. NVIDIA a rassemblé tous les communiqués de presse et les articles de blog importants ici ; n'hésitez pas à y jeter un œil.


 Amazon