

NVIDIA GTC 2023 a démarré en introduisant de nouveaux produits, partenaires, innovations et logiciels. Pour vous donner une idée de l'ampleur des annonces, le keynote a duré 78 minutes. Quatre nouvelles plates-formes ont été annoncées, chacune optimisée pour une charge de travail d'inférence générative spécifique et un logiciel spécialisé.
Les plates-formes combinent la pile complète de logiciels d'inférence de NVIDIA avec les derniers processeurs NVIDIA Ada, Hopper et Grace Hopper. Deux nouveaux GPU, le GPU NVIDIA L4 Tensor Core et le GPU H100 NVL, ont été lancés aujourd'hui.
Le processeur graphique NVIDIA L4 pour la vidéo IA offre des performances vidéo 120 fois supérieures à celles des processeurs, tout en réduisant de 99 % la consommation d'énergie. Le L4 fait office de GPU universel pour quasiment toutes les charges de travail, offrant des capacités améliorées de décodage et de transcodage vidéo, de streaming vidéo, de réalité augmentée, de vidéo générative IA, et bien plus encore.
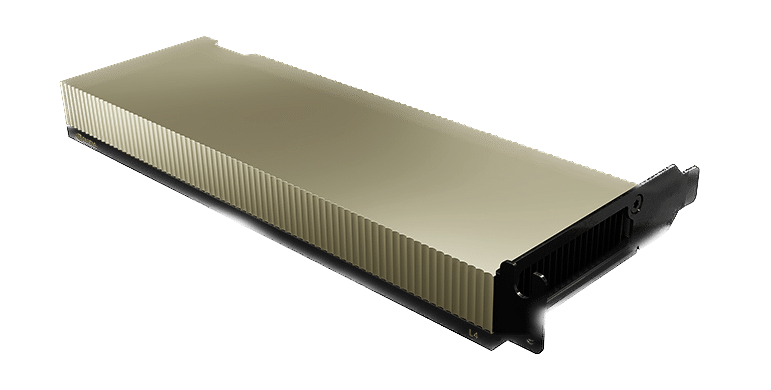
Le GPU NVIDIA Ada Lovelace L4 Tensor Core offre une accélération universelle et une efficacité énergétique pour les applications vidéo, IA, de bureau virtualisées et graphiques dans l'entreprise, dans le cloud et à la périphérie. Avec la plate-forme d'intelligence artificielle de NVIDIA et la pile complète
approche, L4 est optimisé pour l'inférence à grande échelle pour un large éventail d'applications d'IA, y compris les recommandations, les assistants d'avatar IA basés sur la voix, l'IA générative, la recherche visuelle et l'automatisation des centres de contact.
Le L4 est l'accélérateur NVIDIA le plus efficace pour une utilisation grand public, et les serveurs équipés de la puissance L4 offrent des performances vidéo AI jusqu'à 120 fois supérieures et des performances AI génératives 2.7 fois plus élevées que les solutions CPU, ainsi que des performances graphiques 4 fois supérieures à celles de la génération GPU précédente. NVIDIA L4 est un facteur de forme polyvalent, économe en énergie, à un seul emplacement et à profil bas, ce qui le rend idéal pour les grands déploiements et les emplacements périphériques.
Le processeur graphique NVIDIA L40 pour la génération d'images est optimisé pour le rendu graphique et la génération d'images 2D, vidéo et 3D assistée par l'IA. La plateforme L40 constitue le moteur de NVIDIA Omniverse, une plateforme permettant de créer et d'exploiter des applications de métavers dans les centres de données. Elle offre des performances d'inférence 7 fois supérieures pour la diffusion stable et 12 fois supérieures pour Omniverse par rapport à la génération précédente.
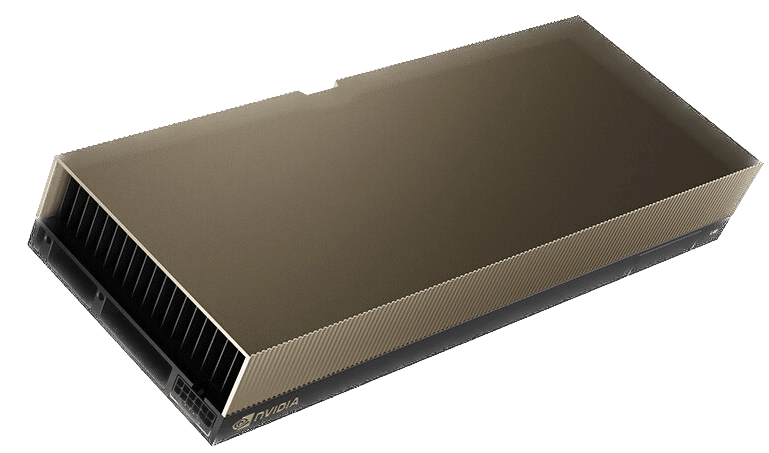
Le GPU NVIDIA L40 offre une informatique visuelle hautes performances pour le centre de données, avec des capacités graphiques, de calcul et d'IA de nouvelle génération. Construit sur l'architecture NVIDIA Ada Lovelace, le L40 exploite la puissance des cœurs RT, Tensor et CUDA de dernière génération pour offrir des performances de visualisation et de calcul pour les charges de travail exigeantes des centres de données.
Le L40 offre un débit amélioré et des capacités simultanées de lancer de rayons et d'ombrage qui améliorent les performances de lancer de rayons et accélèrent les rendus pour les flux de travail de conception et d'architecture de produits, d'ingénierie et de construction. Le GPU L40 offre une prise en charge matérielle pour la parcimonie structurelle et un format TF32 optimisé pour des gains de performances prêts à l'emploi pour une formation plus rapide des modèles d'IA et de science des données. Les capacités graphiques accélérées améliorées par l'IA, y compris DLSS, offrent une résolution améliorée avec de meilleures performances dans certaines applications.
La grande mémoire GPU du L40 s'attaque aux applications et aux charges de travail gourmandes en mémoire telles que la science des données, la simulation, la modélisation 3D et le rendu avec 48 Go de mémoire GDDR6 ultra-rapide. La mémoire est allouée à plusieurs utilisateurs avec le logiciel vGPU pour répartir les charges de travail importantes entre les équipes de création, de science des données et de conception.
Conçu pour les opérations de centre de données d'entreprise 24 heures sur 7 et 40 jours sur 40 avec du matériel et des composants économes en énergie, le NVIDIA L3 est optimisé pour se déployer à grande échelle et offrir des performances maximales pour diverses charges de travail de centre de données. Le LXNUMX comprend un démarrage sécurisé avec la technologie racine de confiance, offrant une couche de sécurité supplémentaire, et est conforme NEBS niveau XNUMX pour répondre aux normes des centres de données.
La carte NVIDIA H100 NVL est idéale pour le déploiement à grande échelle de modèles de langage complexes tels que ChatGPT. Dotée de 94 Go de mémoire et de l'accélération Transformer Engine, la nouvelle H100 NVL offre des performances d'inférence jusqu'à 12 fois supérieures à celles de la génération précédente A100 pour GPT-3, à l'échelle d'un centre de données.
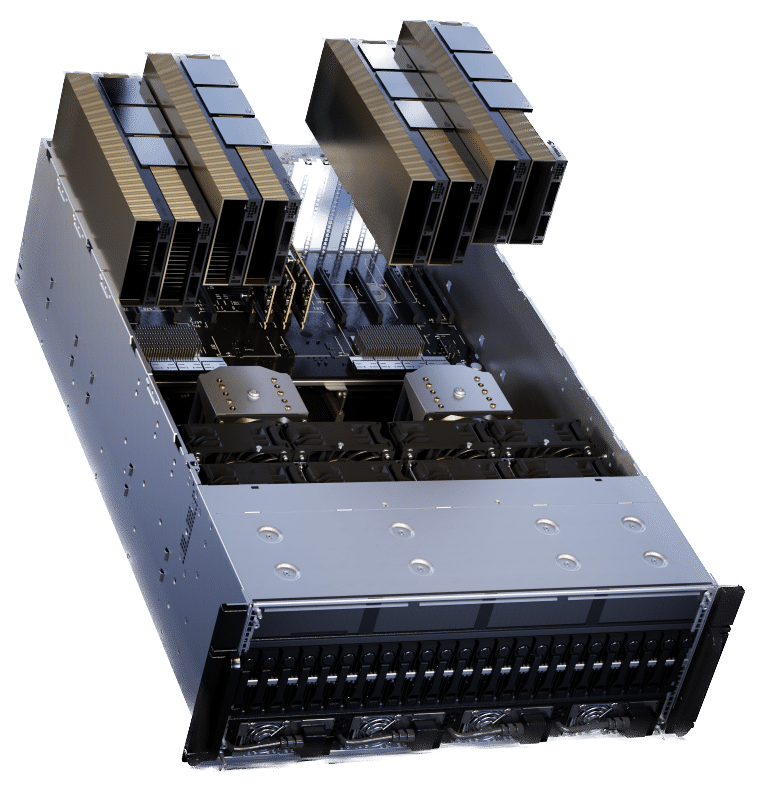
Le NVL H100 basé sur PCIe avec pont NVLink utilise Transformer Engine, NVLink et 188 Go de mémoire HBM3 pour offrir des performances et une évolutivité optimales dans les centres de données. Le H100 NVL prend en charge les grands modèles de langage jusqu'à 175 milliards de paramètres. Les serveurs équipés de GPU H100 NVL augmentent les performances du modèle GPT-175B jusqu'à 12 fois par rapport aux systèmes NVIDIA DGX A100 tout en maintenant une faible latence dans les environnements de centre de données à puissance limitée.
NVIDIA Grace Hopper pour les modèles de recommandation est idéal pour les modèles de recommandation graphiques, les bases de données vectorielles et les réseaux neuronaux graphiques. Grâce à sa connexion NVLink-C2C à 900 Go/s entre le processeur et le GPU, Grace Hopper offre des transferts de données et des requêtes sept fois plus rapides que PCIe Gen 5.
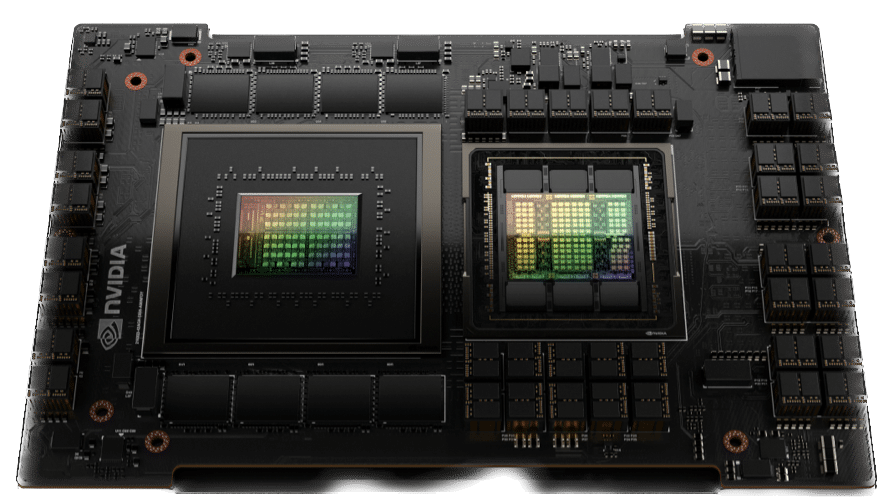
Le NVIDIA Grace Hopper Superchip est un processeur accéléré révolutionnaire conçu dès le départ pour les applications d'IA et de calcul haute performance (HPC) à grande échelle. La superpuce offrira des performances jusqu'à 10 fois plus élevées pour les applications exécutant des téraoctets de données, permettant aux scientifiques et aux chercheurs de trouver des solutions sans précédent aux problèmes les plus complexes du monde.
La puce NVIDIA Grace Hopper Superchip combine les architectures Grace et Hopper à l'aide de NVIDIA NVLink-C2C pour fournir un modèle de mémoire cohérent CPU + GPU pour les applications accélérées d'IA et de HPC. Grace Hopper comprend une interface cohérente de 900 gigaoctets par seconde (Go/s), est 7 fois plus rapide que PCIe Gen5 et offre une bande passante de mémoire système globale 30 fois supérieure au GPU par rapport à NVIDIA DGX A100. En plus de tout cela, il exécute toutes les piles et plates-formes logicielles NVIDIA, y compris le SDK NVIDIA HPC, NVIDIA AI et NVIDIA Omniverse.
Les modèles de système de recommandation modernes nécessitent des quantités importantes de mémoire pour stocker les tables d'intégration. Les tables d'intégration contiennent des représentations sémantiques pour les éléments et les fonctionnalités des utilisateurs, ce qui permet de fournir de meilleures recommandations aux consommateurs.
Généralement, ces intégrations suivent une distribution de loi de puissance pour la fréquence d'utilisation puisque certains vecteurs d'intégration sont consultés plus fréquemment que d'autres. NVIDIA Grace Hopper permet des pipelines de système de recommandation à haut débit qui
stocker les vecteurs d'intégration les plus fréquemment utilisés dans la mémoire HBM3 et les vecteurs d'intégration restants dans la mémoire LPDDR5X de plus grande capacité. L'interconnexion NVLink C2C fournit aux GPU Hopper un accès haut débit à leur mémoire LPDDR5X locale. Dans le même temps, le système de commutation NVLink étend cela pour fournir aux GPU Hopper un accès à large bande passante à toute la mémoire LPDDR5X de toutes les superpuces Grace Hopper du réseau NVLink.


 Amazon