

NVIDIA a présenté Helix Parallelism, une nouvelle méthode développée pour son architecture GPU Blackwell, visant à améliorer les performances de l'IA en temps réel sur de très grands ensembles de données. Cette technique répond au besoin croissant des LLM de traiter des contextes de plusieurs millions de jetons. NVIDIA démontre que cette approche peut multiplier les vitesses de traitement par 32 par rapport aux méthodes conventionnelles, permettant ainsi des applications d'IA plus complexes et plus réactives.
Le défi du million de jetons : pourquoi l'IA avait besoin d'une nouvelle approche
Les frontières de l'IA ont dépassé les simples requêtes pour s'étendre au raisonnement complexe et à long terme. Les applications avancées requièrent un contexte extrêmement vaste pour être efficaces. Qu'il s'agisse d'un assistant IA mémorisant des mois de conversations, d'un outil juridique analysant des gigaoctets de jurisprudence d'un coup, ou d'un partenaire de codage maîtrisant l'intégralité d'un référentiel, ces tâches nécessitent le traitement de millions de jetons.
Cependant, atteindre ce niveau expose deux goulots d’étranglement fondamentaux.
- Goulot d'étranglement du cache KV : lors de la génération de jetons autorégressifs, les modèles calculent l'attention portée aux jetons précédemment générés afin d'éviter un facteur d'échelle quadratique. Pour ce faire, les jetons précédemment générés sont mis en cache, un processus appelé cache KV. Dans des contextes de plusieurs millions de jetons, ce cache devient énorme, sature la bande passante mémoire du GPU et ralentit considérablement les temps de réponse.
- Le goulot d'étranglement des pondérations FFN : pour chaque nouveau jeton généré par un modèle, celui-ci doit charger d'importantes pondérations FFN (Feed-Forward Network) depuis la mémoire. Dans les applications interactives à faible latence, ce processus de chargement constant devient une source majeure de retard.
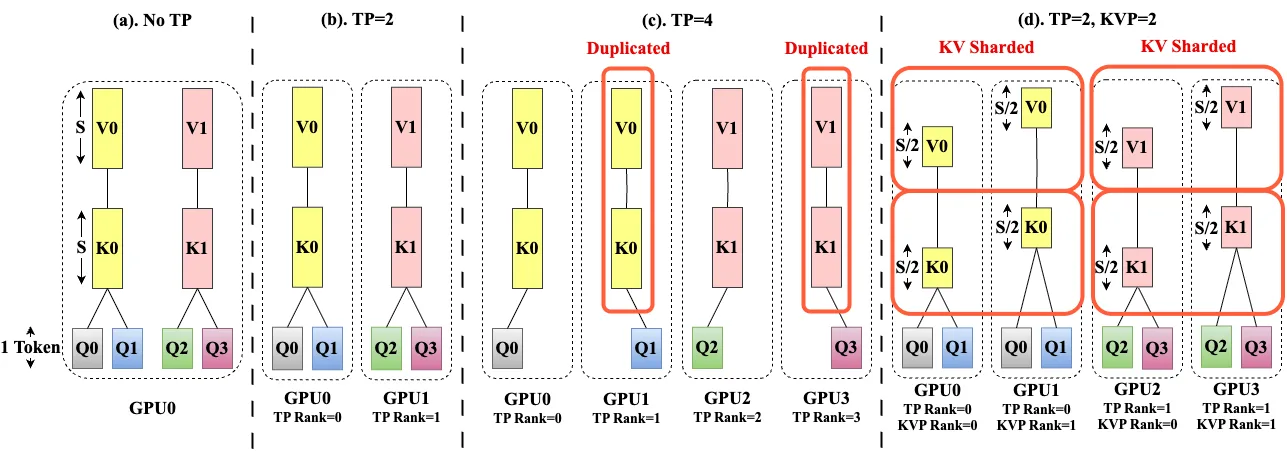
Actuellement, nous utilisons des méthodes comme le parallélisme tensoriel, qui répartit les tenseurs d'un modèle, et donc la mémoire requise et le travail de calcul, entre plusieurs GPU. Bien qu'efficace pour certaines tâches, ses avantages diminuent avec les nouveaux mécanismes d'attention. Dans les mécanismes d'attention comme GQA (Grouped Query Attention) ou MLA (Multi-Latent Attention), afin de réduire l'utilisation de la mémoire, plusieurs têtes de requête partagent un ensemble plus restreint de têtes KV. Cependant, lorsque la taille du parallélisme tensoriel dépasse le nombre de têtes KV, une duplication des têtes KV est nécessaire en raison de la latence importante introduite par la communication entre GPU à chaque étape. Cette duplication annule certains avantages du parallélisme tensoriel.
Parallélisme des hélices
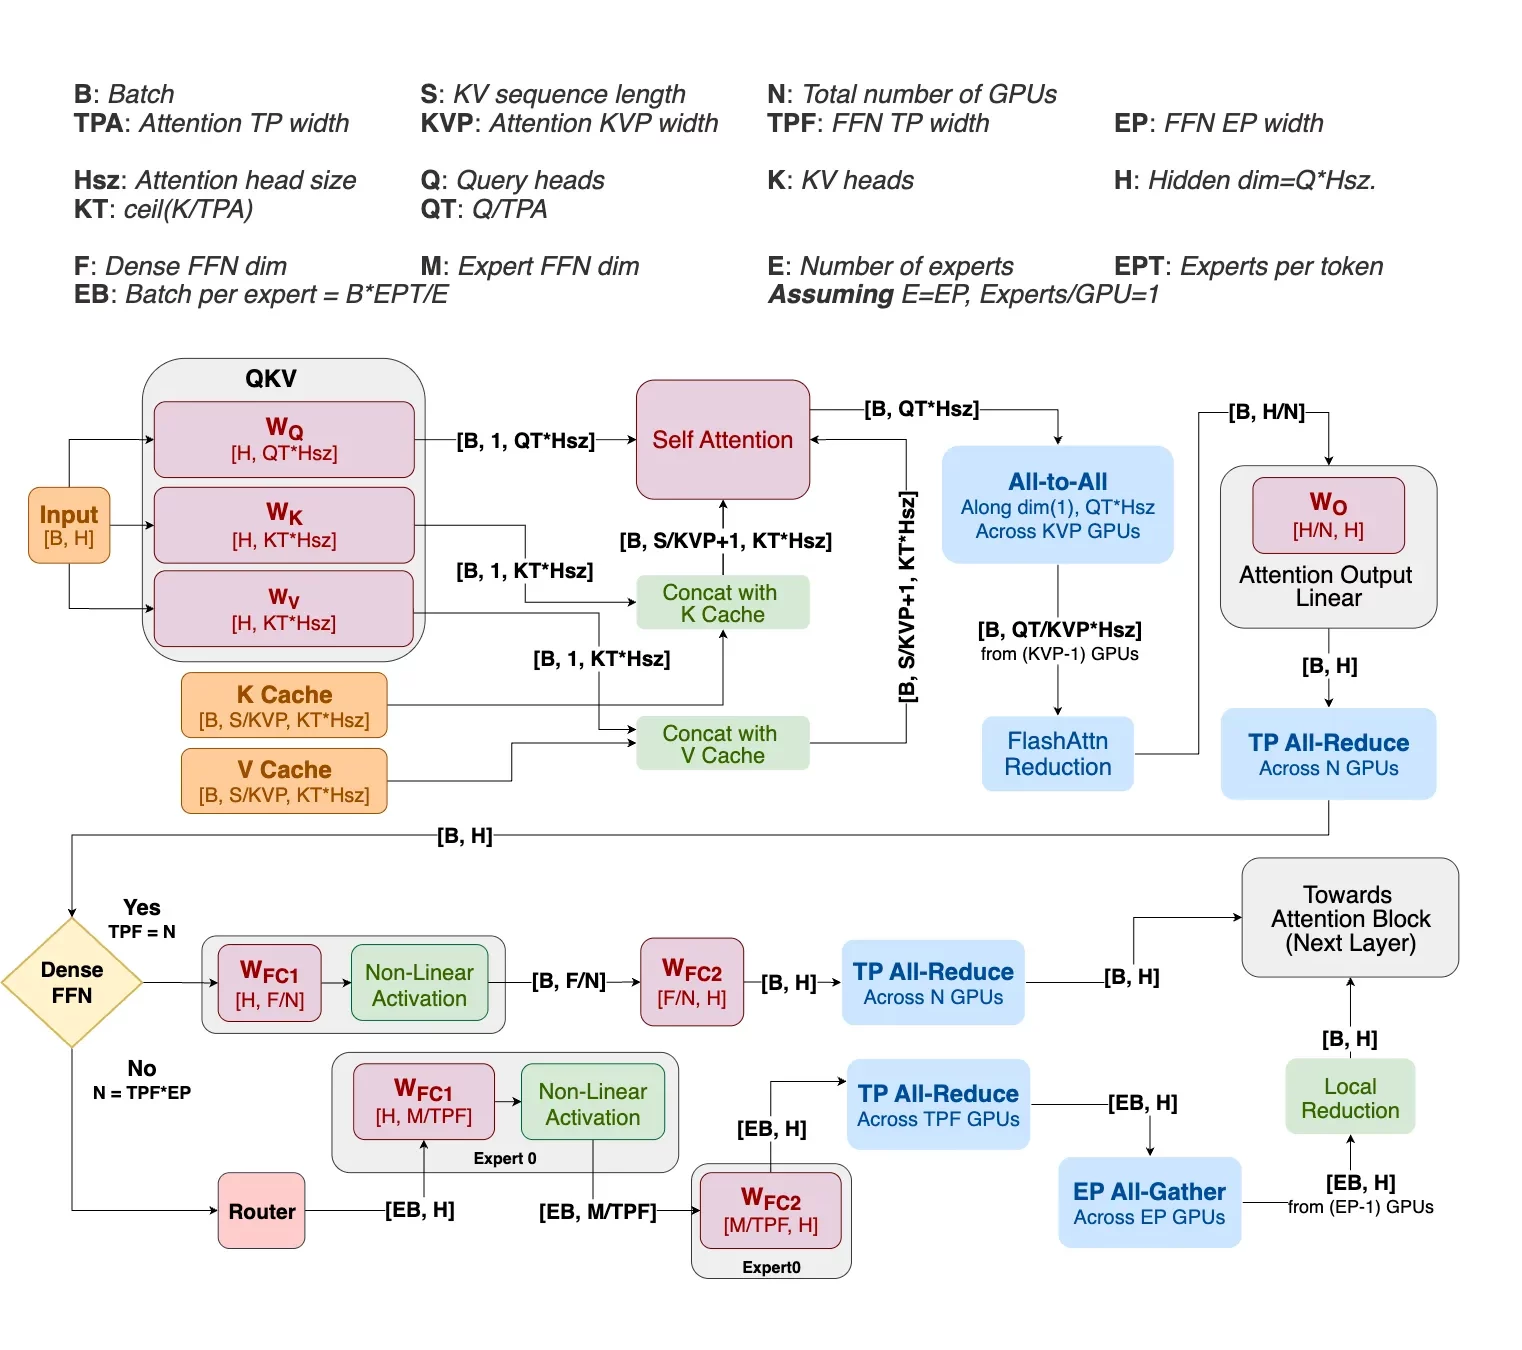
Pour résoudre ce problème, Helix Parallelism de NVIDIA introduit une stratégie hybride qui traite les deux goulots d'étranglement comme des problèmes distincts à résoudre dans un pipeline temporel fluide. Au lieu d'utiliser une méthode de parallélisme unique pour l'ensemble du processus, Helix reconfigure dynamiquement le même pool de GPU afin d'utiliser la stratégie optimale à chaque étape du calcul.
Le processus peut être décomposé en deux phases principales pour chaque couche du modèle.
Phase 1 : La phase d'attention (s'attaquer au cache KV)
Helix corrige directement le goulot d'étranglement du cache KV en combinant deux formes de parallélisme. Premièrement, il applique le parallélisme KV, qui fragmente le cache KV sur plusieurs GPU le long de la dimension séquentielle. Ainsi, chaque GPU ne conserve qu'une partie du contexte total, réduisant ainsi la charge mémoire.
Simultanément, le parallélisme tensoriel est utilisé pour diviser les têtes d'attention, garantissant ainsi que le nombre de divisions ne dépasse pas le nombre de têtes KV. Cette combinaison évite la duplication du cache, fléau du parallélisme tensoriel traditionnel. Le résultat est une grille 2D de GPU capable de calculer efficacement l'attention sur un contexte massif sans qu'aucun GPU ne soit surchargé. La communication entre ces GPU est gérée par un échange unique et efficace, de type « tout-à-tout », dont le coût est indépendant de la longueur du contexte, ce qui le rend hautement évolutif.
Phase 2 : La phase FFN (Aborder les poids FFN)
La communication globale à la fin de la phase d'attention répartit également les données de sortie entre les GPU. Ainsi, les données sont parfaitement organisées pour que le calcul FFN puisse commencer immédiatement.
Le même pool de GPU est réapprovisionné dans un grand groupe de parallélisme tensoriel. Les données étant pré-partitionnées, chaque GPU peut effectuer une multiplication matricielle locale à l'aide de son fragment de poids FFN massifs. Ce calcul initial s'effectue en parallèle, sans communication entre GPU, optimisant ainsi la vitesse. Ce n'est qu'après cette étape de calcul local que les GPU participent à une communication tout-en-un efficace pour combiner leurs résultats partiels dans le résultat final.
La dernière pièce du puzzle réside dans la gestion par Helix du cache KV à mesure qu'il croît. À mesure que le modèle génère de nouveaux jetons, ceux-ci doivent être ajoutés au cache. Une approche naïve pourrait créer un point chaud mémoire en écrivant tous les nouveaux jetons sur un seul GPU. Helix évite cela grâce à un système de mise à jour circulaire astucieux. Par exemple, le premier bloc de nouveaux jetons peut être envoyé au GPU 0, le bloc suivant au GPU 1, et ainsi de suite. Cette approche échelonnée garantit une croissance uniforme de l'utilisation de la mémoire sur tous les GPU du groupe de parallélisme KV, maintenant ainsi des performances équilibrées et un débit constant, quelle que soit la taille du contexte.
Une nouvelle frontière de performance sur Blackwell
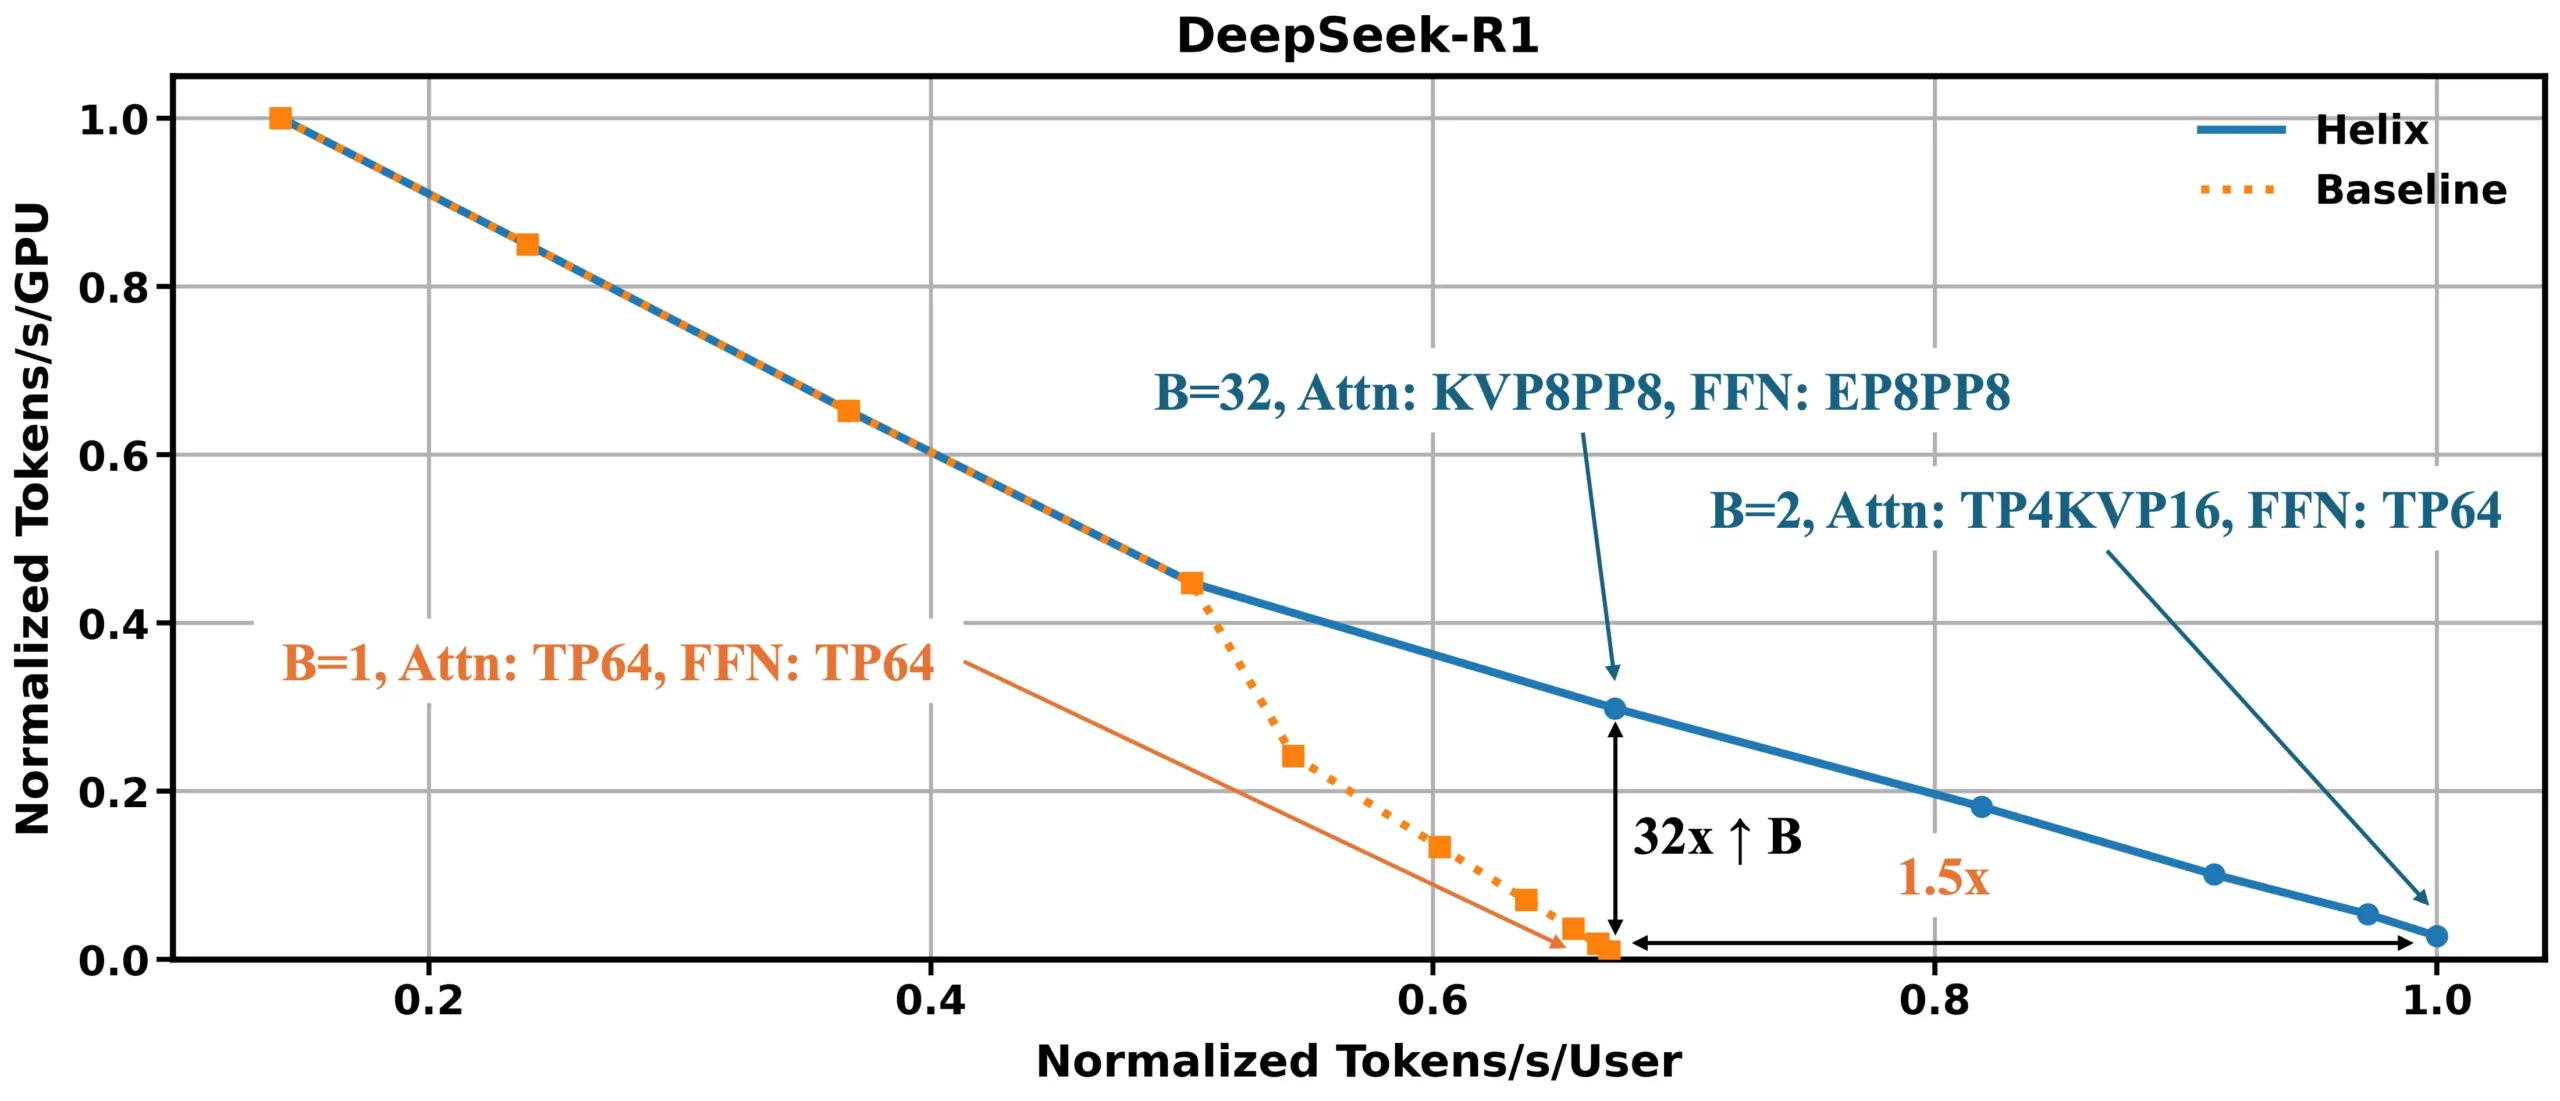
Helix établit une nouvelle référence de performance pour le décodage LLM à contexte long. Les résultats sont basés sur une simulation exhaustive sur le Blackwell NVL72 utilisant le modèle paramétrique DeepSeek R1 671B (FP4) avec un contexte hypothétique d'un million de jetons, en faisant varier systématiquement les stratégies de partitionnement et les tailles de lots afin de trouver le meilleur compromis débit-latence. Pour les applications nécessitant une évolutivité importante, comme la gestion simultanée de nombreux utilisateurs, Helix peut multiplier le nombre d'utilisateurs simultanés jusqu'à 32 fois pour un budget de latence donné. Pour les configurations à faible concurrence où la réactivité d'un utilisateur unique est essentielle, cette technique peut améliorer l'interactivité utilisateur jusqu'à 1.5 fois en réduisant la latence minimale possible entre les jetons. Ces gains sont rendus possibles par la fragmentation du cache KV et des pondérations FFN sur tous les périphériques disponibles, ce qui réduit considérablement la pression sur la DRAM et améliore l'efficacité de calcul.
Pour une analyse technique plus approfondie de la méthodologie et des résultats de la simulation, voici le lien vers le rapport complet.


 Amazon