

Au fil des générations de matériel, les fournisseurs de mémoire et de réseaux ont identifié différents points de blocage dans les clusters de calcul haute performance. Les fabricants de mémoire se sont concentrés sur la bande passante de la mémoire intégrée, tandis que les fournisseurs d'infrastructure réseau se sont intéressés au débit inter-châssis et inter-racks. Aujourd'hui, ces deux perspectives convergent vers un même goulot d'étranglement : la limitation de la bande passante qui restreint la circulation des données entre les nœuds de calcul distribués et les pools de mémoire.
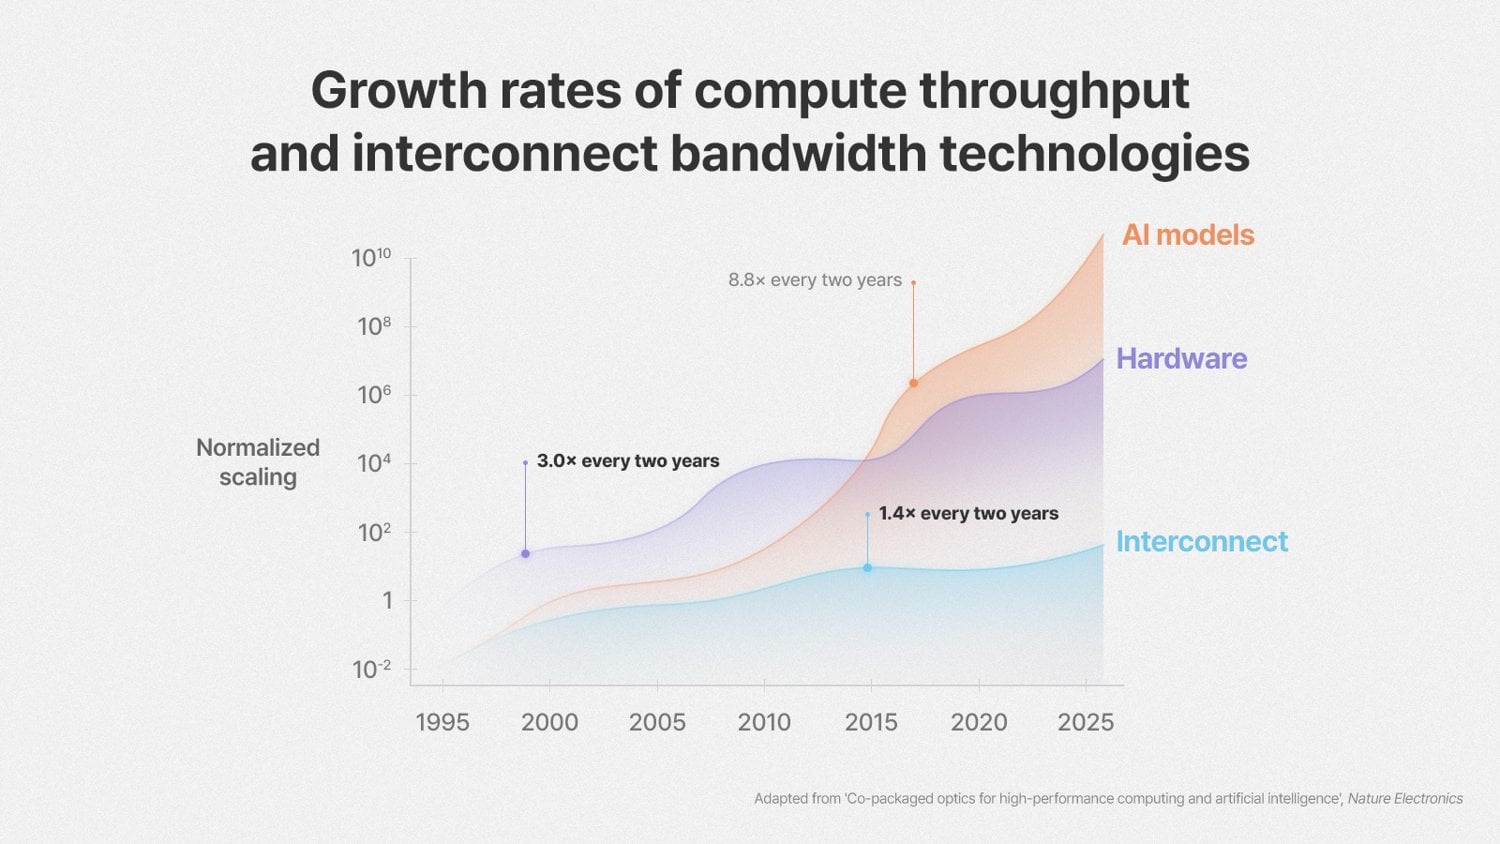
Si la mémoire à large bande passante (HBM) a permis de résoudre efficacement les limitations de bande passante au niveau des accélérateurs d'IA individuels, les charges de travail modernes d'entraînement et d'inférence à très grande échelle s'étendent désormais sur des dizaines de milliers de processeurs répartis dans des racks et des modules. Dans ces topologies distribuées, le débit de calcul a historiquement triplé environ tous les deux ans, tandis que la bande passante d'interconnexion a augmenté d'environ 1.4 fois sur la même période. Ce déséquilibre place le principal goulot d'étranglement de la mise à l'échelle au niveau de la couche d'interconnexion physique.
Cette évaluation est tirée d'un article de synthèse publié le 20 août dans Nature Electronics , intitulé « Optique intégrée pour le calcul haute performance et l'intelligence artificielle », co-écrit par SK hynix et des chercheurs de l'Université de Virginie, de l'Université de l'Illinois à Urbana-Champaign, du MIT, de l'Université technologique de Nanyang et de l'Université Yonsei. Seunghoon Hong, responsable de l'équipe Infrastructure IA chez SK hynix, et Kyusang Lee, professeur à l'Université de Virginie, en sont les auteurs correspondants.
| Stage | Résultat |
|---|---|
| Changement de goulot d'étranglement dans la mise à l'échelle des clusters d'IA | |
| HBM intégré | Résolution du goulot d'étranglement de la mémoire intégrée/du boîtier |
| Traces de cuivre | Atteint l'atténuation physique / le mur de puissance hors puce |
| Intégration CPO | Converge le tissu optique directement sur le substrat |
Pour pallier cette contrainte, SK hynix, en collaboration avec des chercheurs des universités de Virginie, d'UIUC, de NTU, du MIT et de Yonsei, a publié une étude dans Nature Electronics intitulée « Optique intégrée pour le calcul haute performance et l'intelligence artificielle ». Cet article détaille comment l'optique intégrée (CPO) et les interconnexions optiques de calcul (OCI) doivent évoluer de concert avec les architectures de mémoire et d'encapsulation pour permettre la mise à l'échelle future des clusters.
Les limites physiques des interconnexions en cuivre
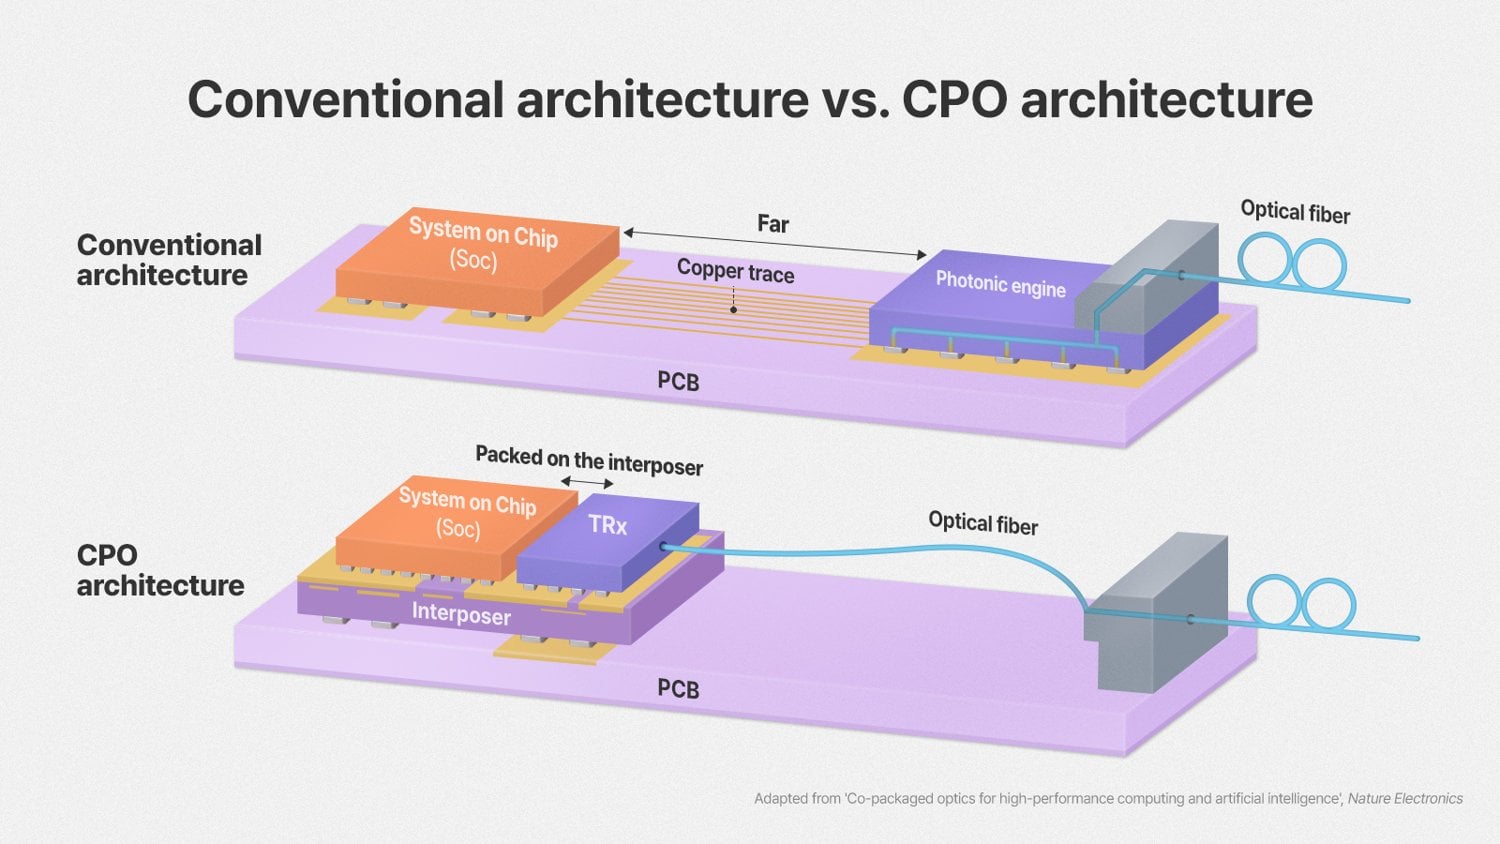
Les interconnexions électriques standard, utilisant des pistes en cuivre et des câbles en cuivre à connexion directe, restent pratiques sur de courtes distances. Cependant, avec l'augmentation des débits de données, la signalisation électrique souffre d'une forte atténuation du signal, de pertes d'insertion et d'une consommation d'énergie accrue. La gestion des signaux à haut débit sur de longues pistes et fonds de panier nécessite des circuits d'égalisation et de resynchronisation complexes, ce qui introduit une latence supplémentaire et consomme une quantité d'énergie considérable.
Comment les solutions optiques co-emballées changent la donne
La technologie CPO pallie ces limitations physiques en intégrant les émetteurs-récepteurs optiques directement sur le même substrat que les processeurs ou accélérateurs hôtes. La conversion des signaux électriques à haute vitesse en canaux photoniques, directement adjacents au silicium de calcul, minimise la longueur des pistes électriques, réduisant ainsi la capacité parasite et la dégradation du signal. Cette architecture permet une transmission optique à faible perte et à large bande passante entre cartes, racks et modules, tout en maintenant une densité de bande passante élevée et une meilleure immunité aux interférences électromagnétiques.
| Métrique | Spécifications cibles |
|---|---|
| Spécifications cibles pour les nœuds CPO | |
| Densité de bande passante des nœuds | > 100 Tb/s par nœud |
| L'efficacité énergétique | < 1 pJ/bit |
| Latence d'interconnexion puce à puce | <10 ns |
| Parcours d'intégration | Interposeur 2.5D vers hétérogène 3D |
La feuille de route prévoit une évolution architecturale allant des modules multipuces 2D standard et de l'intégration d'interposeurs en silicium 2.5D vers un empilement hétérogène 3D. L'étape architecturale ultime consiste à étendre les liaisons optiques directement au sein du sous-système de mémoire.
L'utilisation d'un interposeur photonique pour interfacer directement les piles de mémoire avec les moteurs de calcul permet de s'affranchir des limitations de routage classiques au niveau de la carte. Cette approche crée des pools de mémoire partagée désagrégés à faible latence, où plusieurs moteurs de calcul peuvent accéder à une capacité partagée via un fond de panier optique, sans les pénalités de sérialisation et de désérialisation typiques des architectures réseau traditionnelles.
Défis d'ingénierie liés au déploiement commercial
Le passage des dispositifs photoniques sur silicium à faible consommation, utilisés lors de démonstrations d'encapsulation avancée, à l'intégration dans les centres de données de production présente plusieurs défis d'ingénierie non résolus. L'intégration de ces dispositifs aux côtés de circuits logiques hôtes à haute puissance exige une isolation thermique sophistiquée et des conceptions avancées de refroidissement microfluidique ou direct sur le boîtier.
De plus, l'industrie doit développer des protocoles de cohérence standardisés à faible latence, capables d'orchestrer les transactions de mémoire à couplage optique sans nécessiter de logiciel propriétaire. Une commercialisation fiable exigera une co-conception matérielle de bout en bout, couvrant les topologies de puces DRAM, les contrôleurs de mémoire personnalisés, les moteurs photoniques et le conditionnement sur substrat hétérogène. Pour SK hynix, la feuille de route optique se déroule en parallèle de sa feuille de route conventionnelle ; l'entreprise a présenté en détail, lors du salon FMS 2026 , la mémoire HBM4 à 16 couches et la mémoire NAND à 375 couches collées sur plaquette .


 Amazon