

WhiteFiber a dévoilé les premiers résultats de recherche et développement du projet Redwood, une architecture de supercluster GPU distribuée conçue pour fonctionner sur des centres de données géographiquement dispersés. Annoncé la semaine dernière, le test a permis d'atteindre un débit de 111.2 Tbit/s sur 83 km de fibre noire, avec une latence aller-retour garantie de 0.9 ms.
WhiteFiber a indiqué que la latence est inférieure à 8 % de la limite physique de propagation de la lumière dans la fibre optique sur cette distance. L'entreprise n'a utilisé qu'une partie du spectre de fibres disponible lors du test, un résultat qui, selon elle, représente déjà environ le double de la capacité des essais sur le terrain publiés et réalisés sur l'ensemble du spectre. Elle prévoit d'exploiter l'intégralité du spectre avant un lancement commercial prévu au troisième trimestre 2026.
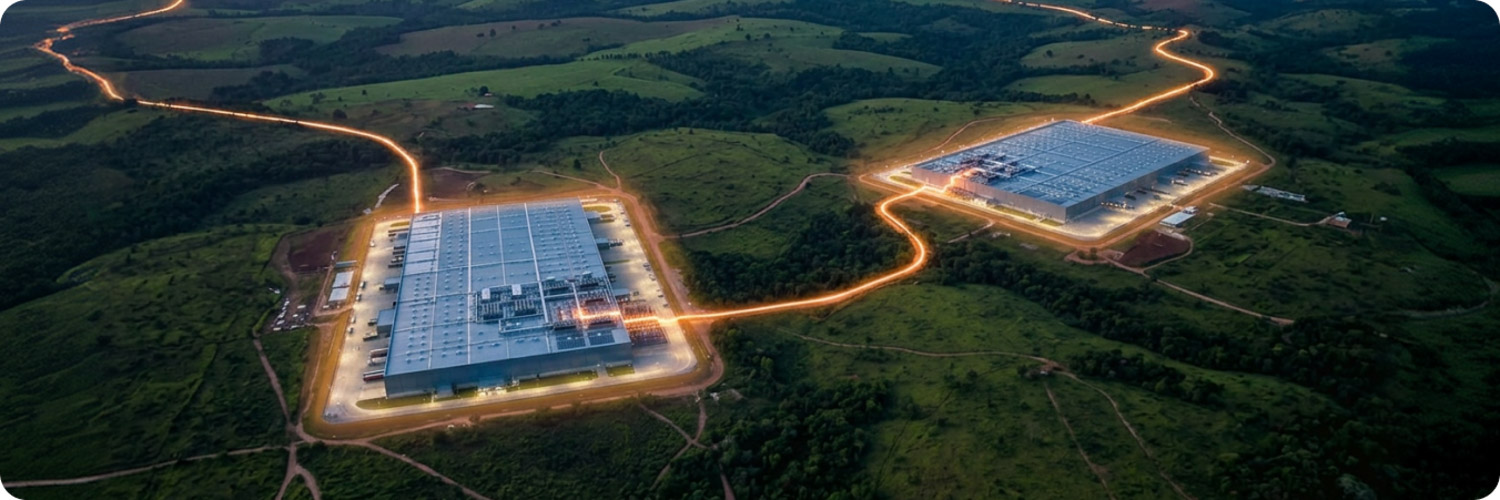
Ce projet a été réalisé en collaboration avec DriveNets et WEKA. DriveNets fournit l'infrastructure d'IA basée sur Ethernet entre les installations, tandis que WEKA NeuralMesh assure le stockage et la gestion de la mémoire à l'échelle du cluster. WhiteFiber a déposé des demandes de brevet relatives à cette mise en œuvre.
Traitement de plusieurs sites comme un seul cluster GPU
L'architecture vise à faire fonctionner deux centres de données comme un seul supercluster GPU logique, plutôt que comme deux clusters indépendants reliés par une liaison DCI classique. Cette distinction est cruciale pour les charges de travail d'entraînement et d'inférence en IA, où la synchronisation GPU-à-GPU, les opérations collectives et l'accès à une infrastructure de données partagée peuvent déterminer la taille utile du cluster.
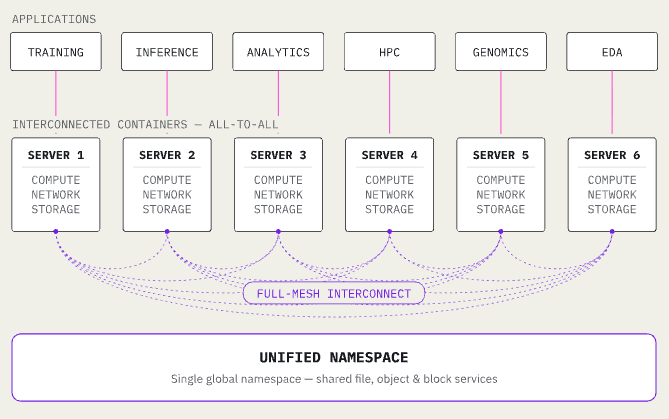
WhiteFiber positionne sa plateforme pour les charges de travail dont l'ampleur dépasse les capacités d'un site unique en matière de puissance, de refroidissement, d'espace, de résilience ou de souveraineté des données. L'entreprise entrevoit également des applications dans l'informatique de périphérie, les télécommunications et les déploiements d'IA souveraine.
L'annonce conjointe de DriveNets précise le matériel : l'infrastructure relie deux clusters de GPU NVIDIA H200 de WhiteFiber distants de 52 kilomètres. DriveNets décrit ce déploiement comme le premier supercluster d'IA commercial à grande échelle et à longue portée du secteur, validé en production et non en laboratoire. Dans le cadre de cette validation, les entreprises ont comparé les performances de chaque rack au sein d'un même site avec celles des racks répartis sur les deux sites. La méthodologie est détaillée dans le livre blanc de DriveNets.
Conception de réseau DriveNets
L'environnement inter-sites utilise la fibre noire redondante et l'infrastructure IA DriveNets pour acheminer le trafic GPU et de stockage. DriveNets décrit cette architecture comme une infrastructure Ethernet planifiée, conçue pour des communications IA distribuées et prévisibles, plutôt que comme une extension Ethernet longue distance traditionnelle.
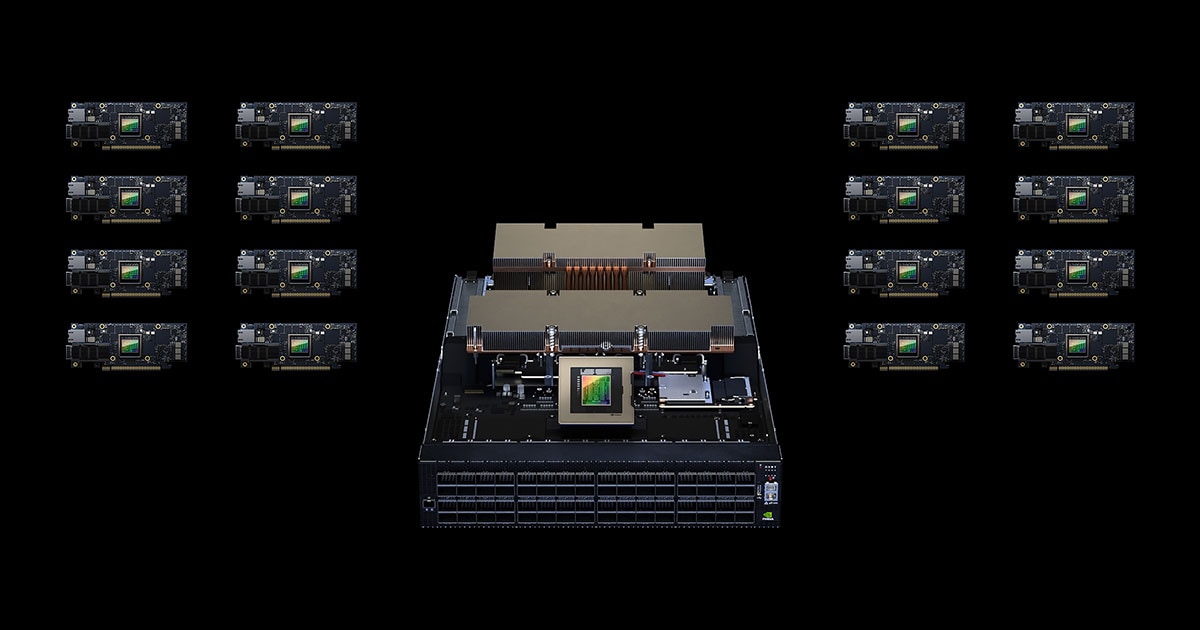
Cette architecture étend l'infrastructure d'IA entre différents sites grâce à la technologie Fabric Scheduled Ethernet de DriveNets, déployée sur ses commutateurs 9300F, 5300R et 5301R. Elle combine l'équilibrage de charge au niveau des cellules, la mise en file d'attente virtuelle de bout en bout et des interconnexions à mémoire tampon importante qui absorbent les pics de trafic IA synchronisés avant qu'ils ne provoquent une congestion sur les liaisons intersites. DriveNets affirme qu'il en résulte une connectivité prévisible et sans perte entre les sites, maintenant une utilisation élevée des GPU, comme si l'ensemble du cluster était hébergé sur un seul site.
Ensemble, ces mécanismes visent à préserver un comportement prévisible pour les communications collectives à distance, tout en prenant en charge une infrastructure de calcul et de stockage unifiée. L'isolation multi-locataires fait partie intégrante de l'objectif de conception.
Il en résulte une architecture qui considère le réseau de fibres optiques comme faisant partie intégrante d'une infrastructure d'IA, et non comme une simple connexion de transport entre sites. L'objectif est de réduire l'importance opérationnelle des limites physiques du centre de données pour les charges de travail exécutées sur l'ensemble du cluster.
Une approche différente de celle de NVIDIA Spectrum-XGS
La plateforme de test de WhiteFiber est différente de l'Ethernet NVIDIA Spectrum-XGS. Cependant, ces travaux s'inscrivent dans la tendance plus large du secteur à déployer une infrastructure d'IA à grande échelle.
Lors de la conférence Hot Chips 2025, Jensen Huang, PDG de NVIDIA, a souligné la nécessité de connecter les centres de données à travers les villes, les pays et les continents afin de créer des usines d'IA à grande échelle. L'approche Spectrum-XGS de NVIDIA utilise un contrôle de congestion prenant en compte la distance, une gestion précise de la latence et la télémétrie pour améliorer la prévisibilité des communications GPU distribuées. CoreWeave figure parmi les premiers utilisateurs cités par NVIDIA.
WhiteFiber a fourni des mesures préliminaires sur le terrain plus précises que celles divulguées publiquement par NVIDIA pour les déploiements Spectrum-XGS. Son test sur 83 km a atteint un débit de 111.2 Tbit/s et une latence aller-retour de 0.9 ms, bien que les systèmes utilisent des architectures différentes et que leurs résultats ne soient pas directement comparables.
La formation à distance s'étend au-delà d'un seul établissement.
L'annonce de WhiteFiber intervient alors que d'autres fournisseurs de cloud et d'infrastructure étudient des architectures d'entraînement et d'inférence IA multisites.
Oracle Cloud Infrastructure et NVIDIA ont publié des travaux utilisant le framework NeMo et Megatron-Core pour exécuter un entraînement LLM sur des centres de données distants d'environ 1 000 km. NVIDIA a annoncé une scalabilité de l'entraînement supérieure à 96 % grâce à une approche hiérarchique de réduction globale et à des communications inter-centres de données segmentées. Ces travaux constituent principalement une démonstration logicielle et système, et non un test de performance de transport à l'échelle métropolitaine.
Google a également développé TPU Multislice, permettant à plusieurs tranches de TPU de fonctionner comme un environnement d'entraînement distribué à plus grande échelle, réparti sur son réseau de centres de données et ses interconnexions optiques. Google a indiqué que l'entraînement Gemini utilisait plusieurs centres de données, la plateforme étant conçue pour gérer le partitionnement de la charge de travail et la résilience à grande échelle.
WhiteFiber ambitionne d'appliquer une architecture intersites similaire à l'infrastructure cloud GPU, en privilégiant la connectivité métropolitaine à haut débit et faible latence. L'entreprise prévoit de communiquer davantage de détails sur l'architecture et la disponibilité de sa solution à l'approche de son déploiement commercial au troisième trimestre 2026.


 Amazon