

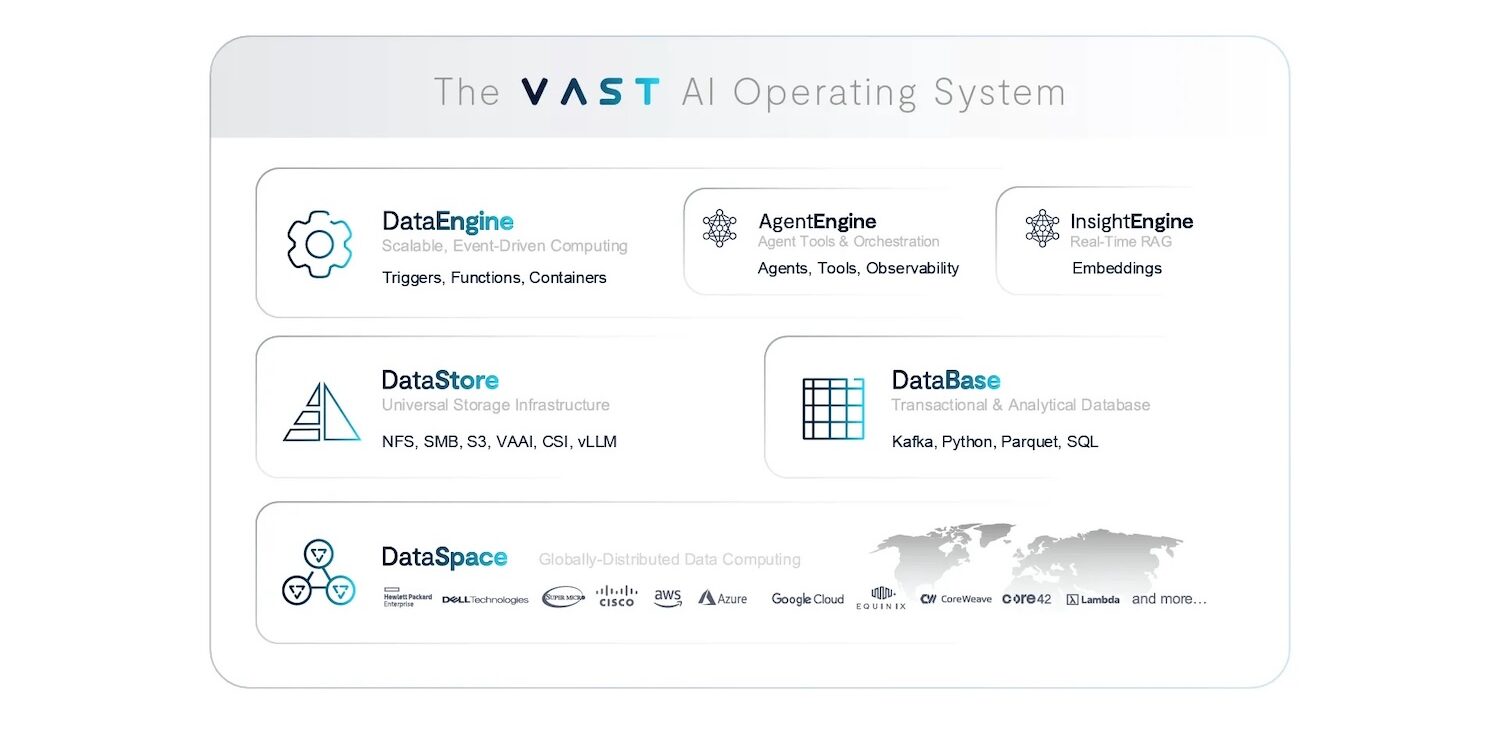
VAST Data a lancé une nouvelle architecture d'inférence prenant en charge la plateforme de stockage de contexte d'inférence NVIDIA. Ce système est conçu pour les applications d'IA impliquant des sessions multi-tours continues pilotées par des agents. VAST présente cette plateforme comme une classe de stockage dédiée à l'IA, optimisant l'accès au cache clé-valeur (KV), permettant un partage rapide du contexte d'inférence entre les nœuds et améliorant l'efficacité énergétique. L'architecture repose sur des DPU NVIDIA BlueField-4 et un réseau Ethernet Spectrum-X, tandis que le système d'exploitation d'IA de VAST (AI OS) fournit les logiciels nécessaires à la gestion efficace de cette infrastructure partagée.
Pour en savoir plus sur l'importance du cache KV, consultez cette analyse approfondie que nous avons réalisée avec Pliops.
Cette annonce marque un tournant dans les facteurs limitant les performances d'inférence dans les applications concrètes. L'inférence passant de simples requêtes à un raisonnement continu impliquant plusieurs agents et utilisateurs, l'idée que le contexte reste confiné à un seul serveur GPU devient obsolète. Dans ce contexte, les performances globales dépendent de plus en plus de la qualité du stockage, de la restauration, de la réutilisation, de l'extension et du partage de l'historique d'inférence pendant les opérations en cours. Le cache KV évolue d'une optimisation interne à un chemin de données principal, influençant le temps d'obtention du premier jeton (TTFT), l'utilisation du GPU et l'efficacité du cluster.
Reconstruction du chemin de données d'inférence autour des DPU
La stratégie de VAST consiste à exécuter le logiciel VAST AI OS directement sur les DPU NVIDIA BlueField-4. Plutôt que de considérer le stockage et les services de contexte comme des composants externes accessibles via un modèle client-serveur classique, l'architecture intègre ces services de données directement au sein du serveur GPU, où l'inférence a lieu, tout en prenant en charge les configurations de nœuds de données dédiés. Cette approche vise à minimiser les goulots d'étranglement et à éliminer les copies et les délais inutiles qui ralentissent les performances lorsque la concurrence augmente.
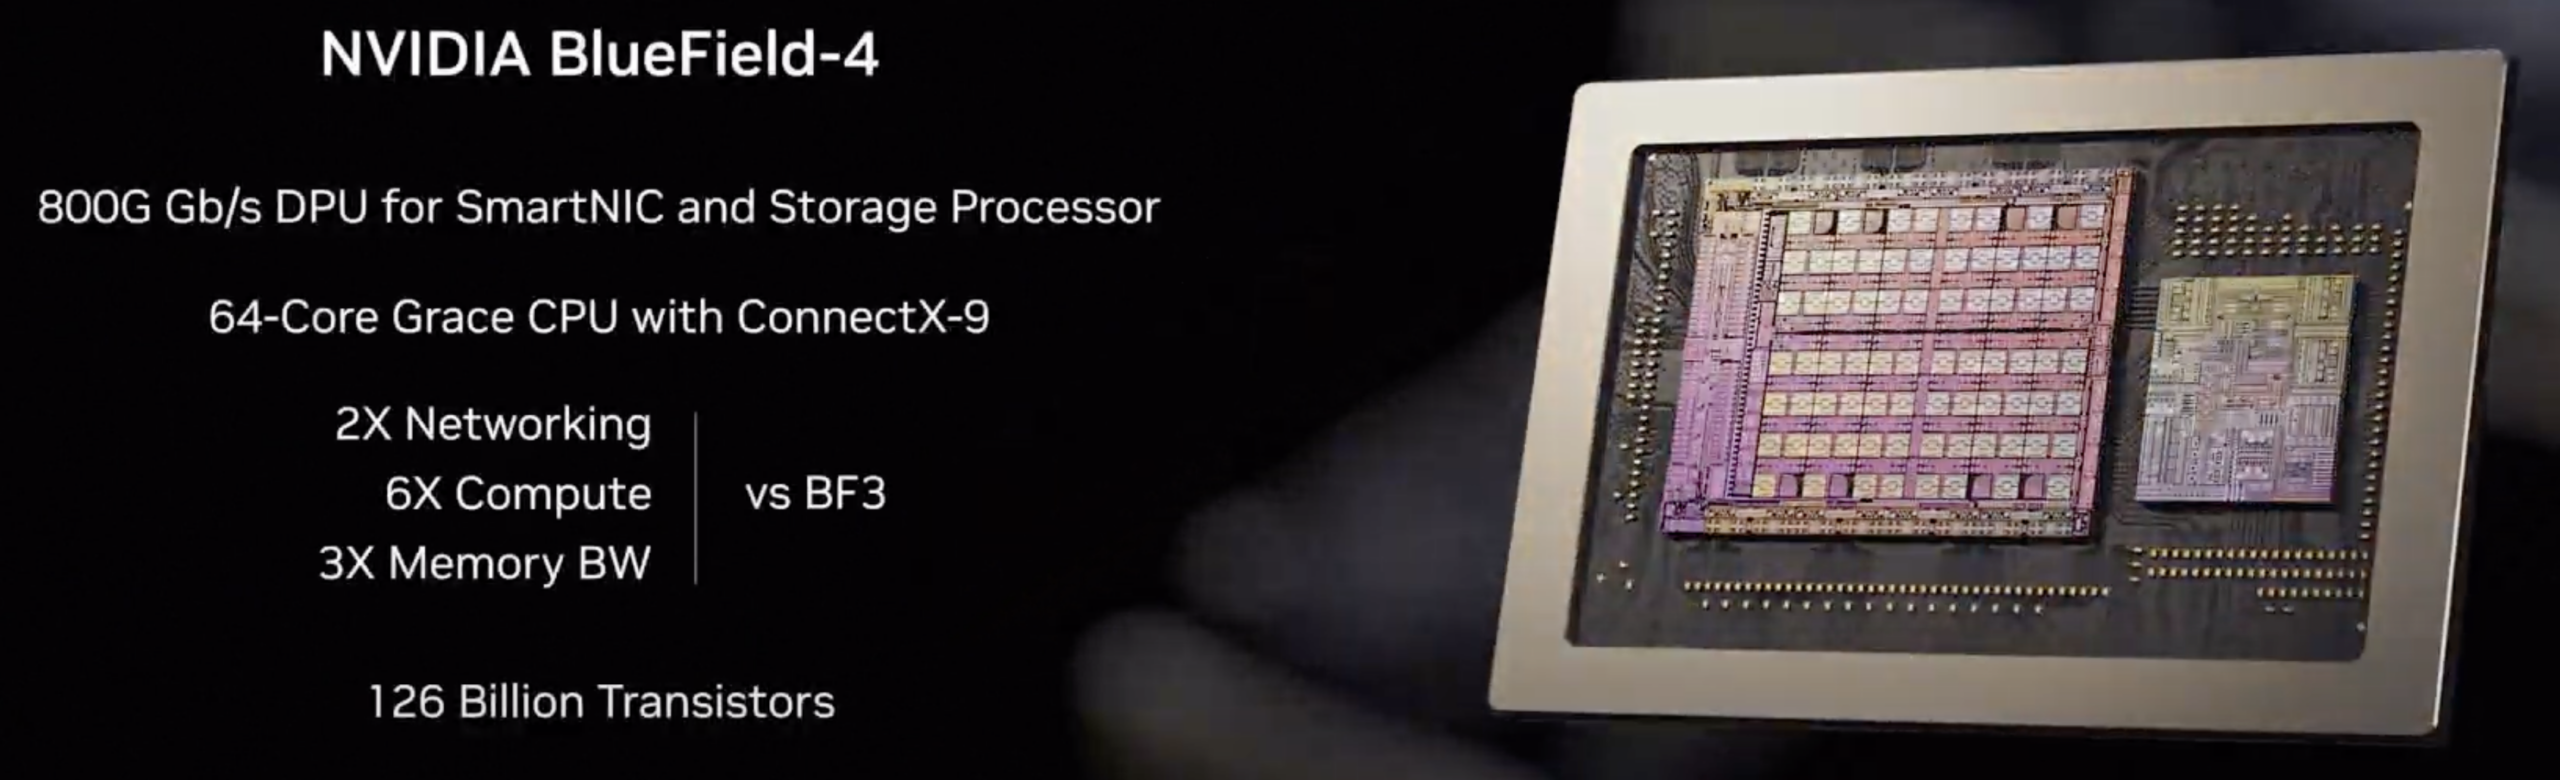
Cette conception native DPU répond explicitement aux besoins pratiques des grands systèmes d'inférence. Lorsque des centaines, voire des milliers de sessions s'exécutent simultanément, la gestion du cache KV se transforme en une activité d'entrée/sortie (E/S) continue. Le système doit lire rapidement le contexte pour assurer la continuité des sessions, le stocker pour une utilisation à long terme et le partager entre les nœuds de calcul afin d'éviter les traitements redondants lorsque l'infrastructure achemine les opérations via des chemins plus lents ou requiert une coordination importante. Le TTFT augmente, ce qui contraint les GPU à attendre au lieu de traiter les données. VAST affirme que le déplacement du plan de données vers le serveur via BlueField-4 permet une gestion plus efficace du trafic de contexte, un débit plus élevé et une latence plus fiable, au plus près de la boucle de traitement du GPU.
VAST privilégie également un routage efficace de la mémoire GPU vers le stockage NVMe persistant via l'architecture RDMA. Ceci permet un transfert de contexte fluide entre les serveurs GPU et le stockage, réduisant ainsi les opérations de traitement de données répétitives courantes dans les systèmes traditionnels. L'objectif est de garantir que le déplacement du contexte reste synchronisé avec le réseau haute performance, tout en minimisant la charge du processeur et la surcharge côté client.
Contexte partagé et cohérent à grande échelle
La nouvelle architecture s'appuie sur la conception parallèle DASE (Disaggregated Shared Everything) de VAST. VAST explique que cela permet à chaque hôte d'accéder à un espace de noms de contexte partagé et globalement cohérent, sans les coûts de coordination généralement associés à la montée en charge. Dans le cadre d'une inférence de longue durée pilotée par des agents, ce détail devient crucial. Le contexte est non seulement volumineux, mais aussi de plus en plus partagé.
Les systèmes multi-agents nécessitent souvent l'utilisation simultanée d'outils, des transferts entre plusieurs agents et un comportement similaire à la mémoire lors des interactions. Cela implique de réutiliser le contexte plutôt que de le recréer et de le partager entre les nœuds d'inférence plutôt que de le lier à un seul. Si les systèmes ne peuvent maintenir la localité du contexte en raison de la planification, de l'éviction ou de la récupération après une panne, ils doivent rapidement restaurer et poursuivre les sessions sans retraiter de longs historiques d'invites. Ainsi, le cache clé-valeur devient une ressource essentielle du cluster, et le défi consiste à le rendre largement accessible sans créer de goulot d'étranglement pour la synchronisation.
Selon VAST, l'association de services de données basés sur DPU et d'une architecture de stockage partagée crée une couche de contexte accessible globalement, dont l'efficacité reste optimale malgré l'augmentation du nombre de sessions simultanées. Au lieu de procéder à une mise à l'échelle par ajout de sections de contexte isolées, la plateforme permet aux clusters de s'étendre tout en bénéficiant de la réutilisation et du partage.
Le contexte comme nouvelle enveloppe de performance
John Mao, cadre chez VAST, a souligné que l'avantage concurrentiel des grands systèmes d'inférence évolue de la simple puissance de calcul vers les systèmes de mémoire et de contexte. Il a résumé que les clusters les plus performants ne seront pas seulement ceux affichant le pic de FLOPS le plus élevé, mais aussi ceux capables de partager et de gérer le contexte en temps réel. Il a également insisté sur l'importance d'un accès instantané et à la demande au contexte comme facteur clé de performance, prévenant que sans récupération et réutilisation rapides du contexte, les GPU restent inactifs et l'efficacité s'en trouve affectée.
Ce constat rejoint l'expérience de nombreux opérateurs face à l'augmentation de la taille des modèles et de la durée des sessions. Les parcs d'inférence sont souvent configurés pour une production maximale de jetons, mais les performances sont fortement impactées par la latence de fin de requête et le TTFT en situation de forte charge. À mesure que les requêtes s'allongent et que les sessions persistent, le temps consacré à la gestion du contexte augmente. Si le contexte ne peut être rapidement restauré ou réutilisé, des cycles GPU sont gaspillés à rétablir l'état ou à attendre le déplacement des données. L'architecture de VAST considère le cache KV comme une infrastructure partagée, réduisant ainsi ces problèmes et améliorant l'efficacité globale du cluster.
Passer de l'expérimentation à l'inférence de production gouvernée
VAST présente également sa plateforme comme une solution de transition entre les déploiements expérimentaux et les services d'inférence prêts pour la production, y compris dans des environnements réglementés. L'inférence devenant un service générateur de revenus avec des exigences spécifiques en matière de sécurité et de conformité, la gestion du cache clé-valeur requiert plus que de la simple rapidité : elle exige une supervision rigoureuse.
Lors de sessions longues, le contexte peut inclure des invites sensibles, des étapes de raisonnement, des résultats d'outils et des informations fournies par l'utilisateur. Les entreprises exigent de plus en plus de contrôles de politiques, de mesures d'isolation, de pistes d'audit et de gestion du cycle de vie pour ce contexte. VAST affirme que ces services de données natifs de l'IA sont intégrés au système d'exploitation de l'IA, permettant ainsi aux organisations de considérer le cache clé-valeur comme une ressource gérable plutôt que comme un état temporaire.
D'un point de vue opérationnel, VAST vise à résoudre les problèmes courants rencontrés dans les environnements d'inférence de grande envergure : les crises de reconstruction de contexte qui surviennent lorsque les caches sont perdus ou non partageables, et le gaspillage de temps GPU lorsque le contexte devient le facteur limitant, au détriment du calcul. L'entreprise estime qu'améliorer la persistance et la réutilisation du contexte permettra de réduire les recalculs et d'accroître son utilisation, améliorant ainsi le rendement énergétique et le rapport coût-efficacité à mesure que la taille des contextes et la concurrence des sessions augmentent.
NVIDIA : La gestion du contexte optimise les coûts de mise à l’échelle
Kevin Deierling, vice-président senior du réseau chez NVIDIA, a souligné l'importance du contexte en IA, le comparant à la mémoire humaine. Il a affirmé qu'une gestion efficace du contexte est essentielle pour la mise à l'échelle de l'inférence multi-tours et multi-utilisateurs, ce qui modifie la façon dont la mémoire contextuelle est gérée à grande échelle. Il a noté que VAST Data AI OS, associé à NVIDIA BlueField-4, prend en charge cette problématique en fournissant un chemin de données stable et à haut débit, même lorsque les charges de travail augmentent. Ce partenariat est important car il intègre les DPU et l'infrastructure Ethernet au cœur du contexte d'inférence, et pas seulement pour l'accès au stockage principal ou la mise en réseau. Le point crucial est que le contexte représente désormais un défi pour la mise en réseau et le stockage, en plus d'être un problème lié aux GPU. Les configurations d'inférence modernes nécessiteront une accélération ciblée et un transfert de données fiable pour garantir le fonctionnement optimal des GPU.
Si l'architecture de VAST tient ses promesses, son impact réel se traduira moins par des scores de référence maximaux que par une performance de service constante : un TTFT réduit en cas de nombreuses sessions actives, une diminution des baisses de performance avec l'augmentation du contexte, une meilleure utilisation des ressources grâce à la réduction des reconstructions de contexte, et une transition plus directe vers l'inférence multi-nœuds où le partage de contexte constitue un atout plutôt qu'un inconvénient. Elle oriente également l'infrastructure d'inférence vers un modèle plus « natif de l'IA », en traitant le cache KV comme une couche de mémoire gérée, supportée par NVMe persistant et partagée entre les nœuds avec des limites de latence strictes.
Conférence VAST Forward
VAST Data présentera sa stratégie lors de la première conférence utilisateurs VAST Forward, qui se tiendra du 24 au 26 février 2026 à Salt Lake City, dans l'Utah. L'entreprise prévoit d'y inclure des sessions techniques détaillées, des ateliers pratiques et des programmes de certification, avec la participation de ses dirigeants , clients et partenaires.


 Amazon