

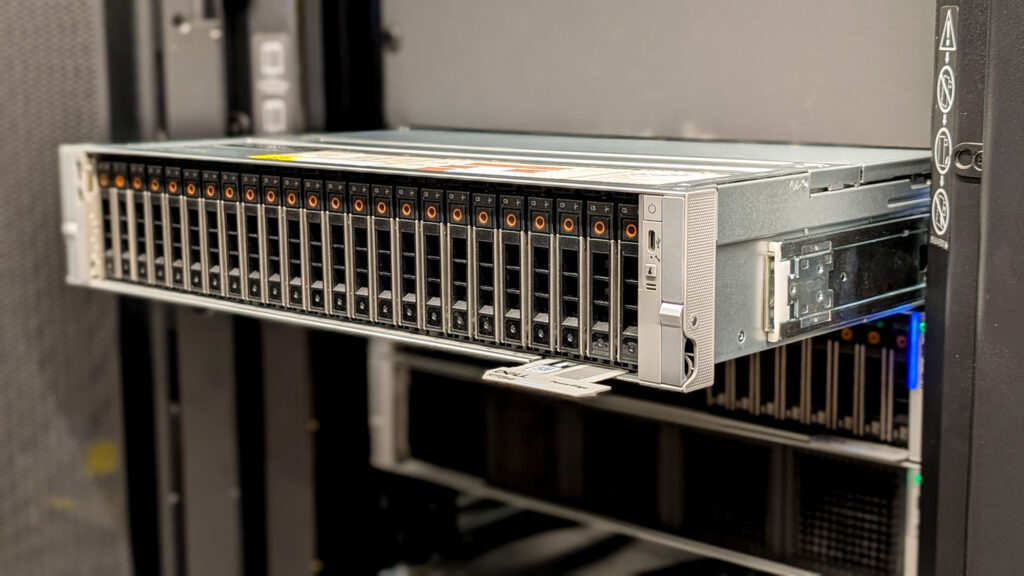
Certains serveurs étendent les fonctionnalités existantes, tandis que d'autres redéfinissent les attentes. Le Dell PowerEdge R7725xd appartient à cette seconde catégorie. Lors de nos tests récents, configuré avec 24 SSD NVMe PCIe Gen5 Micron 9550 PRO et quatre cartes réseau 2x 200 GbE, ce serveur 2U a atteint un débit de stockage brut supérieur à celui de tous les systèmes que nous avons mesurés jusqu'à présent. En interne, la plateforme a maintenu un débit supérieur à 300 Go/s sur l'ensemble du pool NVMe. Sur le réseau, elle a fourni 160 Go/s via RDMA standard, sans aucune complexité supplémentaire.
Il ne s'agit pas simplement d'un serveur de stockage plus rapide. C'est un système qui révolutionne l'architecture du calcul intensif en données. Les pipelines modernes d'entraînement et d'inférence en IA sont souvent limités non pas par la puissance des GPU, mais par la vitesse à laquelle les données peuvent être préparées, diffusées, mélangées et sauvegardées. Les nœuds GPU de grande capacité resteront inactifs si le stockage ne suit pas. Pour pallier ces limitations, les équipes utilisent des caches, le surdimensionnement et une hiérarchisation complexe afin de garantir que les accélérateurs reçoivent les données suffisamment rapidement pour justifier leur coût.
Le serveur Dell PowerEdge R7725xd élimine le goulot d'étranglement à la source. Il est construit autour d'un fond de panier U.2 à 24 baies, chaque disque bénéficiant d'une liaison PCIe Gen5 x4 dédiée directement au processeur AMD EPYC. L'absence de répartition de bande passante et d'extension de fond de panier permet de réduire la concurrence. Les performances évoluent de manière fluide grâce à une architecture matérielle qui agrège le débit sans contention. Dans une configuration classique à deux sockets, les processeurs sont connectés par quatre liaisons XGMI pour la communication inter-sockets. Dans le R7725xd, l'une de ces liaisons est réaffectée pour offrir 16 lignes PCIe Gen5 supplémentaires par processeur, portant le total du serveur à 160 lignes PCIe Gen5 (96 pour les SSD en façade et 64 pour les quatre emplacements PCIe à l'arrière). Associé aux SSD Micron 9550 PRO, conçus pour des charges de travail d'écriture soutenues et une endurance élevée, le système devient un moteur de données à haut débit capable de prendre en charge des charges de travail intensives en points de contrôle et en flux continu.
Nous avons superposé PEAK:AIO à cette architecture afin d'exploiter les chemins de soumission parallèles et de maintenir l'efficacité malgré l'augmentation de la concurrence. Le résultat : des performances optimales et constantes, même en cas de forte charge. La plateforme peut fonctionner comme un nœud d'exécution local pour le prétraitement, l'entraînement ou la transformation, ou encore comme un espace de stockage à large bande passante réparti sur plusieurs systèmes GPU via le réseau. Pour les plus audacieux, il est même possible de combiner les deux.
Points clés à retenir
- Débit sans précédent sur un seul nœud : Le R7725xd a maintenu une bande passante interne de plus de 300 Go/s et de 160 Go/s via NVMe-oF RDMA, rivalisant avec les clusters de stockage multi-nœuds à l'intérieur d'un châssis 2U.
- Véritable architecture Gen5, sans commutateurs, sans distribution par faisceaux : Tous les SSD Micron 9550 PRO 24 reçoivent des lignes PCIe Gen5 x4 dédiées directement depuis le processeur, permettant une mise à l'échelle à débit maximal sans contention.
- Propulsé par un processeur AMD EPYC série 9005 : Les deux processeurs AMD EPYC 9575F fournissent le nombre de voies, la bande passante mémoire et la topologie NUMA nécessaires pour des E/S à haute concurrence soutenues.
- Conçu pour les charges de travail intensives en IA, en analytique et en points de contrôle : Ce système élimine les goulots d'étranglement d'E/S qui ralentissent les pipelines GPU modernes, permettant une transmission de données continue et à large bande passante.
- PEAK:AIO débloque le parallélisme complet : La pile logicielle PEAK:AIO maintient les structures de file d'attente saturées sous charge, offrant des performances d'entreprise à un rapport dollar par Go très avantageux.
Conçu spécifiquement pour optimiser le débit NVMe
Dans sa dernière génération de serveurs, Dell a abandonné l'utilisation de commutateurs PCIe dans les configurations à haute densité de stockage. Des modèles comme le PowerEdge R770 ou le R7725 proposent des baies PCIe Gen5 x4, prenant en charge jusqu'à 16 SSD, et passent à des baies x2 pour les configurations avec un fond de panier de stockage plus important. Les serveurs de génération précédente, tels que le PowerEdge R760, intégraient un commutateur PCIe dans les configurations NVMe à 24 baies. Afin de simplifier l'assemblage et d'éliminer la complexité liée à un commutateur PCIe, les nouveaux serveurs ont adopté une stratégie de réduction du nombre de lignes PCIe dans les configurations à haute densité de stockage. Du moins, jusqu'au R7725xd.
La différence entre le R7725 standard et le R7725xd réside dans la manière dont les plateformes allouent les ressources du complexe racine PCIe. Le R7725 de base répartit les lignes PCIe entre le stockage, l'extension GPU et les E/S générales. La variante « xd » réalloue ces ressources afin que le sous-système NVMe devienne le principal consommateur de bande passante PCIe. Les 24 baies U.2 sont câblées directement aux racines PCIe Gen5 du processeur, chaque SSD bénéficiant de son propre point de terminaison x4, et non d'une liaison montante partagée accessible via un commutateur PCIe ou un arbre de réordonnancement. Ceci confère à chaque disque des structures de file d'attente indépendantes et des chemins DMA indépendants vers le contrôleur mémoire.
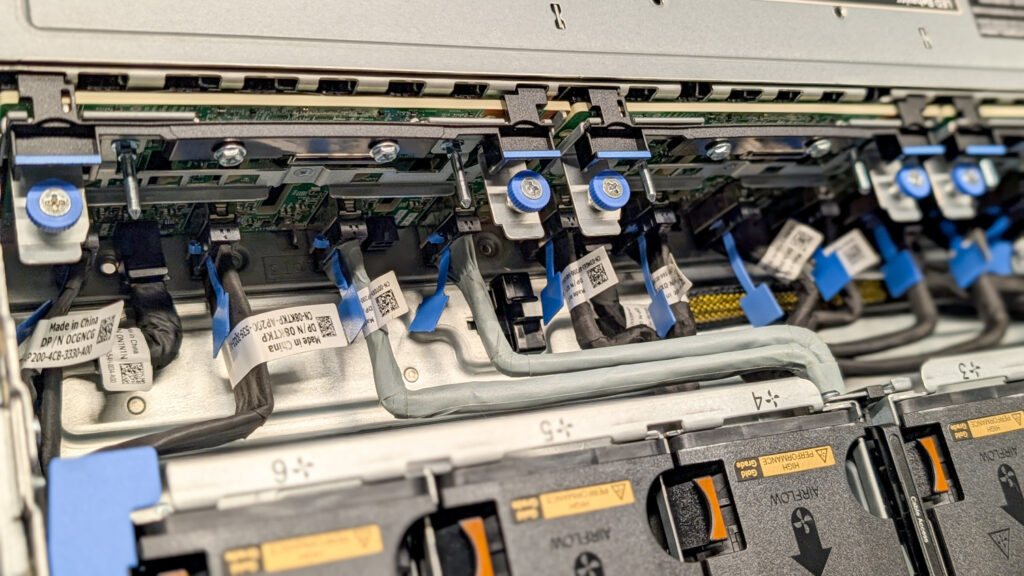
La topologie du fond de panier et des cartes d'extension reflète cet engagement. Dell regroupe les connecteurs NVMe et les emplacements PCIe sur les deux sockets AMD EPYC, de sorte que chaque processeur gère directement une partie du disque. En pratique, cela crée deux domaines NVMe symétriques, chacun avec ses propres caractéristiques de latence et une pleine concurrence en lecture/écriture. Lors de l'installation de quatre cartes réseau Broadcom double port 200 GbE en tant que cartes d'extension, le positionnement des emplacements a permis à chaque carte d'être intégrée à un domaine PCIe aligné sur le groupe NVMe correspondant. En NVMe sur RDMA, le trafic réseau est ainsi resté localisé au socket gérant les E/S du disque associé, évitant le saut Infinity Fabric inter-socket qui ajoute généralement de la latence et consomme de la bande passante en charge.
Le comportement thermique assure également un débit soutenu. L'interface U.2 reste avantageuse dans les configurations Gen5 denses car elle offre un canal de flux d'air défini et une surface de dissipation thermique prévisible pour chaque périphérique. Les modules de ventilation haute pression statique et le système de conduits du châssis du R7725xd garantissent un flux d'air constant dans les 24 baies, permettant ainsi des charges de travail d'écriture complètes et continues sans limitation de débit. La conception mécanique complète la conception électrique : chaque disque peut maintenir ses performances maximales car la plateforme est conçue pour refroidir 24 périphériques Gen5 fonctionnant simultanément en pleine charge.
Cette combinaison d'alignement du complexe racine, d'une disposition cohérente des voies NUMA (accès mémoire non uniforme), d'un placement des cartes réseau adapté aux sockets et d'un boîtier U.2 à stabilité thermique permet au système d'atteindre des E/S à débit maximal à grande échelle. L'architecture évite les goulots d'étranglement et optimise les performances.
Présentation du Dell PowerEdge R7725xd iDRAC 10
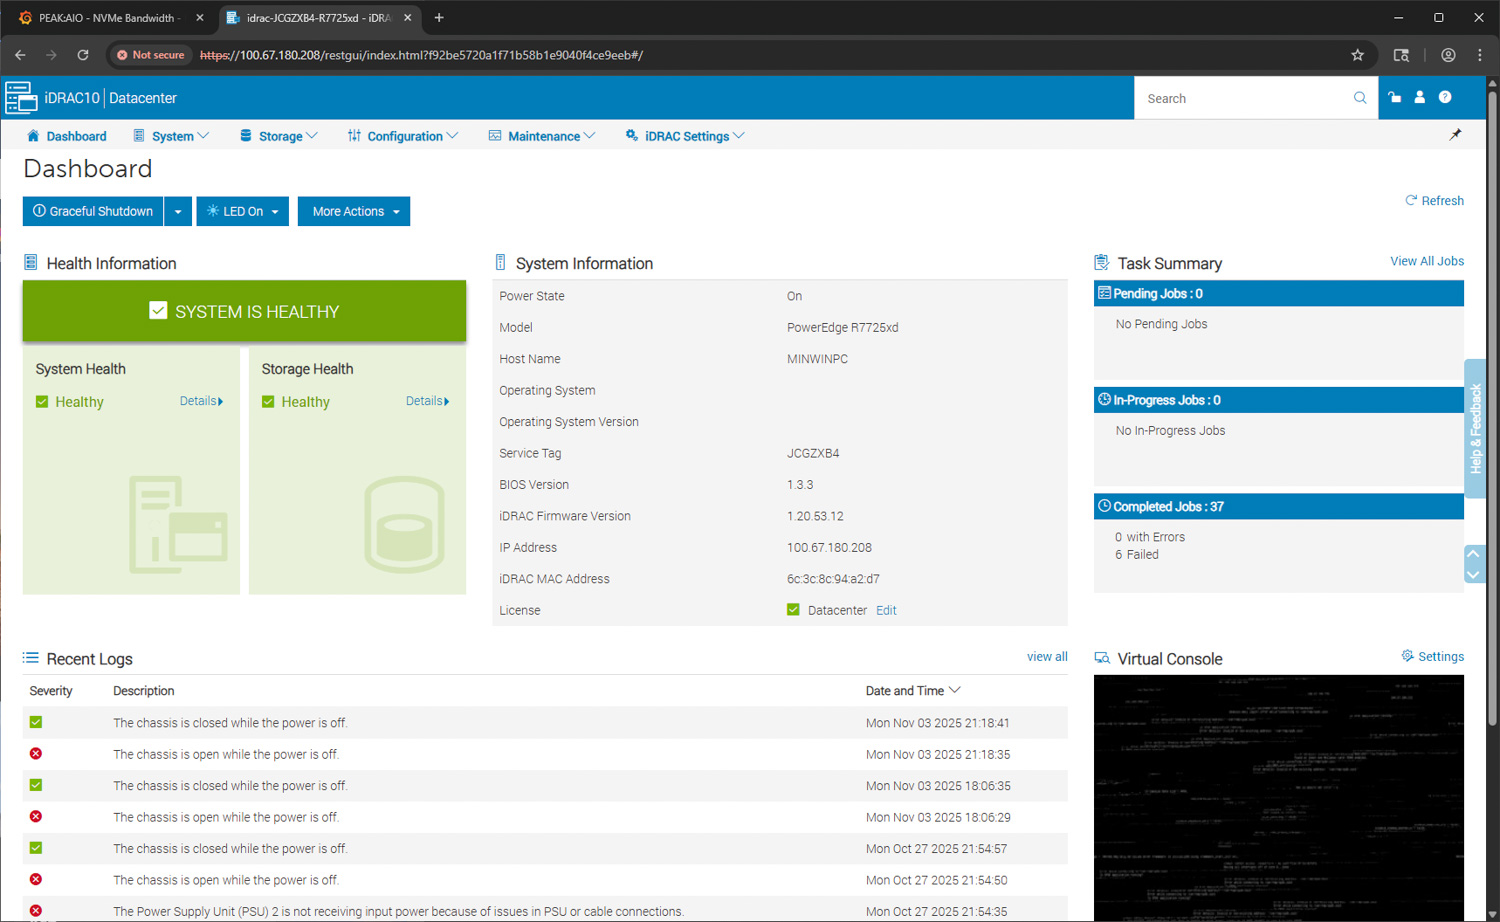
Cette génération du R7725xd, comme de nombreuses autres plateformes de 17e génération que nous avons testées, intègre la nouvelle plateforme iDRAC 10 de Dell, qui centralise la gestion à distance, la surveillance de l'état du système et le contrôle hors bande. Le tableau de bord offre un aperçu immédiat de l'état général du système, de l'état du stockage et de l'activité récente. Sur notre unité de test, le rapport d'état du système et du stockage est au vert, confirmant le fonctionnement normal du serveur. Les informations système essentielles, telles que le modèle, le nom d'hôte, la version du BIOS, le niveau du firmware iDRAC, l'adresse IP et les informations de licence, sont affichées à droite de l'interface.
Le tableau de bord comprend également un panneau récapitulatif des tâches affichant les opérations terminées, en attente et en cours. En dessous, une liste des journaux récents recense les événements d'intrusion dans le châssis et les messages relatifs à l'alimentation, offrant ainsi un aperçu rapide des changements d'état du matériel sans nécessiter de navigation dans les menus. Le panneau de la console virtuelle est accessible dans le coin inférieur droit pour un contrôle KVM à distance complet.
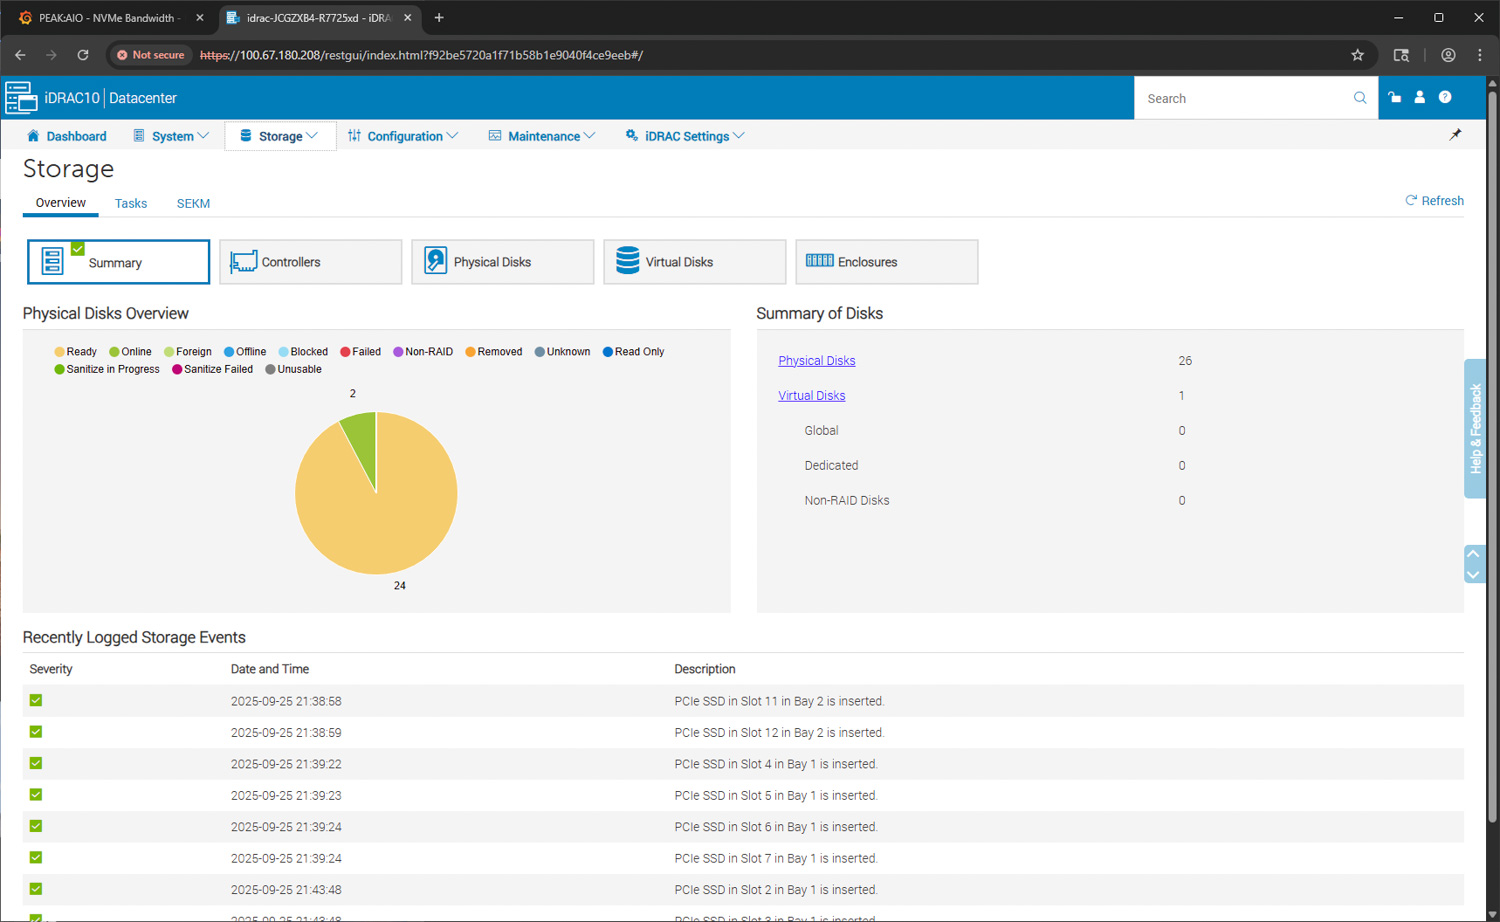
La section stockage d'iDRAC 10 offre une vue d'ensemble complète de tous les disques physiques installés sur le R7725xd. Le panneau récapitulatif affiche le nombre total de disques connectés, accompagné d'un graphique circulaire illustrant leur état. Dans cette configuration, 24 SSD NVMe sont actifs et prêts à l'emploi, et deux périphériques de démarrage supplémentaires sont présents dans le système, distincts du banc NVMe principal en façade.
À droite, le panneau « Résumé des disques » détaille les disques physiques et les disques virtuels associés. Le R7725xd utilisant une architecture NVMe directe sans contrôleur RAID traditionnel, tous les disques sont identifiés comme non-RAID et adressables individuellement, conformément à la conception du système pour les grands pools NVMe et les plateformes SDS.
Sous le résumé d'état, la section « Événements de stockage récemment enregistrés » répertorie les journaux d'insertion de chaque SSD PCIe, classés par baie et emplacement. Cet enregistrement confirme la bonne détection des disques dans toutes les baies et permet d'identifier tout problème d'insertion, de câblage ou d'échange à chaud. Pour les déploiements de grande envergure, ces journaux sont utiles pour suivre le provisionnement des disques ou vérifier que la capacité a été correctement allouée.
La dernière capture d'écran présente la vue détaillée des périphériques NVMe dans iDRAC10. Chaque disque NVMe installé dans le système est listé avec son état, sa capacité et son emplacement. La sélection d'un disque permet d'afficher le détail complet de ses caractéristiques.
Dans cet exemple, le panneau d'informations du disque affiche la chaîne de modèle complète, le protocole du périphérique, le format et les paramètres PCIe négociés. Les périphériques NVMe fonctionnent à une vitesse de liaison de 32 GT/s avec une connexion x4 négociée, confirmant ainsi que les disques exploitent toute la bande passante du fond de panier PCIe Gen5 du système. La section d'informations indique également le pourcentage d'endurance, l'état des disques disponibles et le type de protocole, permettant ainsi aux administrateurs de surveiller l'état et la durée de vie prévue des disques.
Ce rapport détaillé sur les disques est précieux dans les configurations NVMe haute densité où la largeur de la liaison, la vitesse négociée et l'état du support influencent directement le comportement de la charge de travail et les performances de stockage.
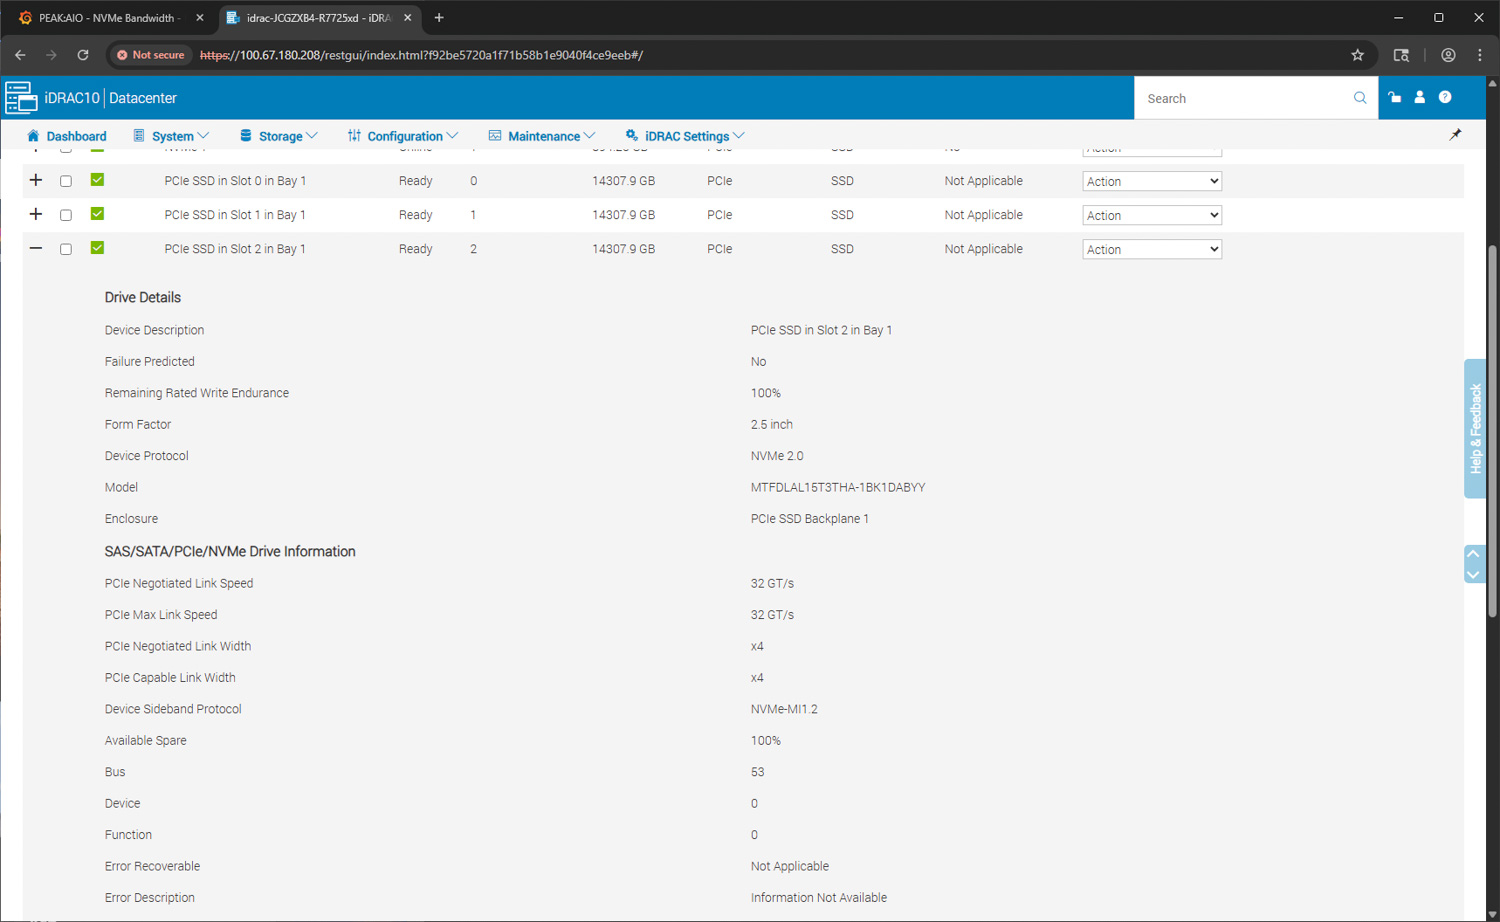
Globalement, l'interface iDRAC 10 offre une vue claire et axée sur le matériel de l'architecture de stockage NVMe du R7725xd, permettant une validation facile de l'état de la liaison, de l'état du disque et de l'intégrité du système en un coup d'œil.
Performances du Dell PowerEdge R7725xd
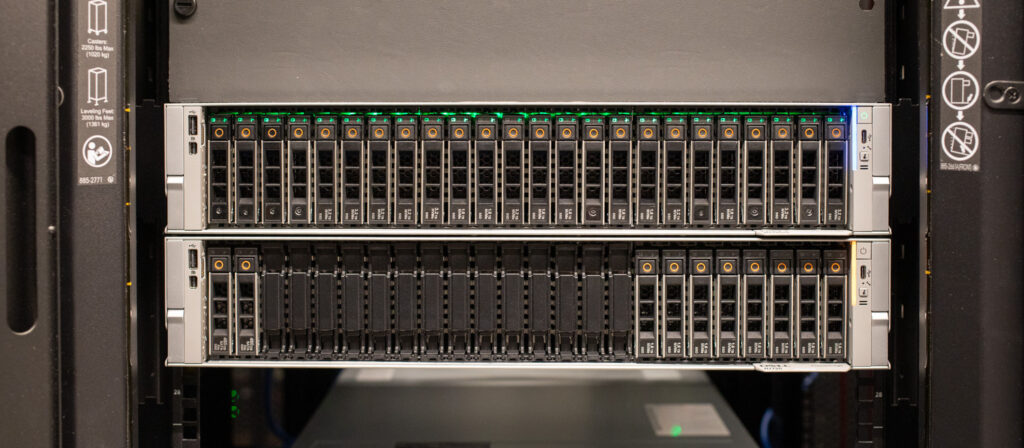
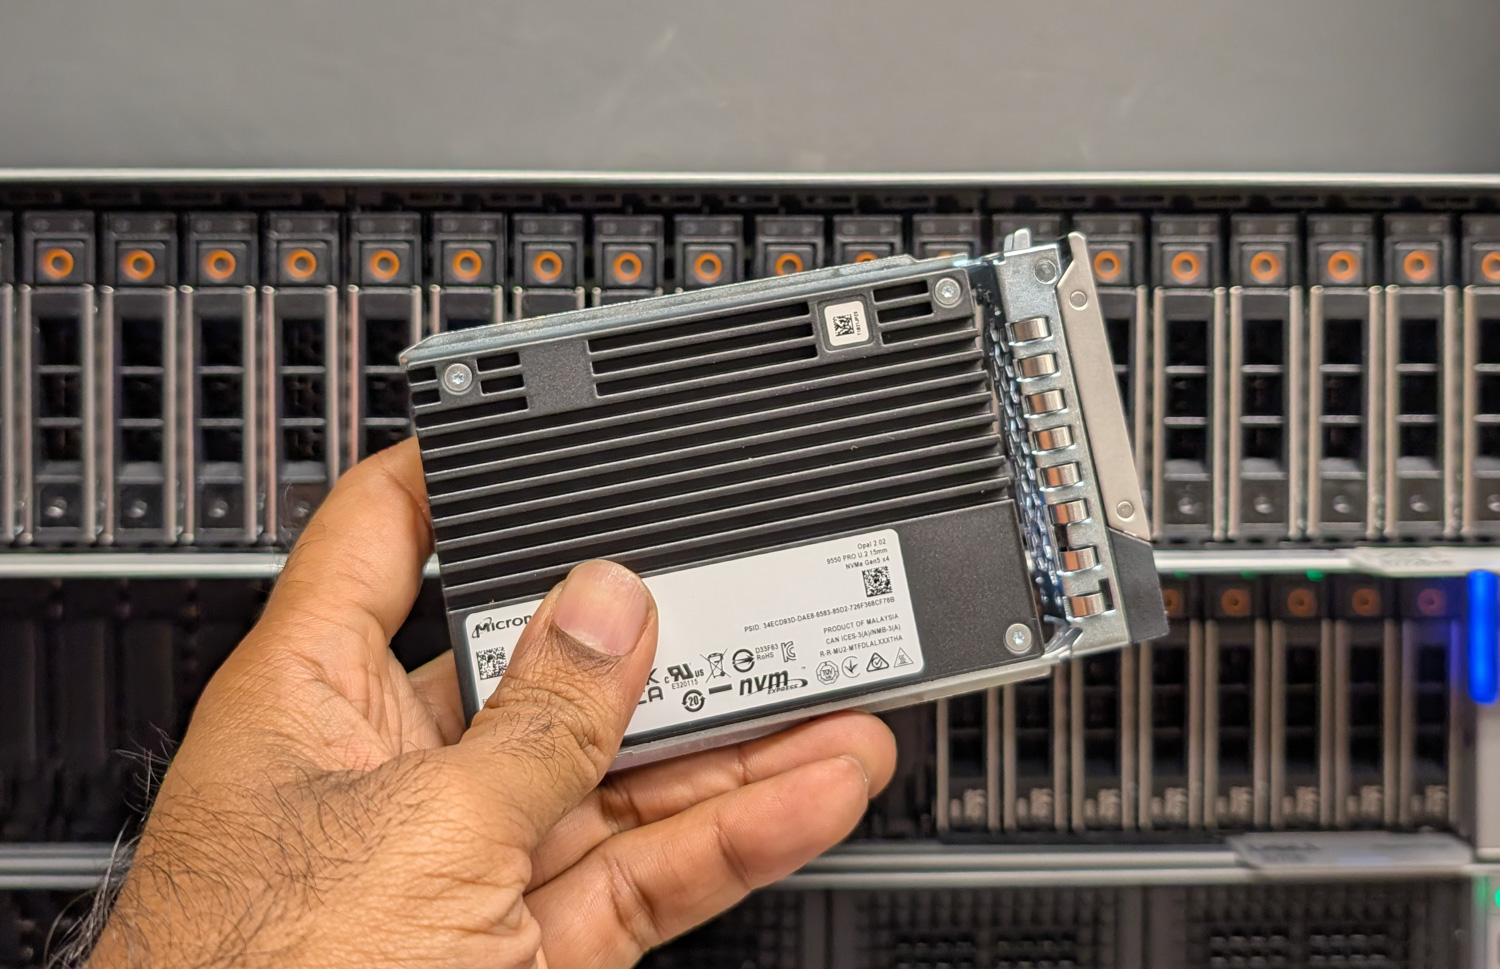
Avant les tests, notre système a été configuré avec une configuration à la fois équilibrée et performante. Il est équipé de deux processeurs AMD EPYC 9575F, chacun doté de 64 cœurs haute fréquence, et de 24 modules DIMM DDR5 de 32 Go fonctionnant à 6 400 MT/s. Pour le stockage, le châssis est entièrement équipé de 24 SSD NVMe Micron 9550 PRO U.2 de 15.36 To, chacun connecté via une interface PCIe Gen5 x4 dédiée. Ceci offre une capacité brute totale de 368.64 To, et les disques Micron 9550 PRO atteignent des vitesses de lecture séquentielles allant jusqu'à 14 000 Mo/s et des vitesses d'écriture séquentielles allant jusqu'à 10 000 Mo/s. La mise en réseau est assurée par quatre adaptateurs Broadcom BCM57608 qui fournissent un total de huit ports 200 Gb, ainsi que par une carte réseau OCP BCM57412 offrant deux ports 10 gigabits supplémentaires.
Spécifications du système de test
- CPU: 2 processeurs AMD EPYC 9575F à 64 cœurs haute fréquence
- Mémoire: 24 x 32 Go DDR5 à 6400 MT/s
- Stockage: 24 disques Micron 9550 PRO U.2 de 15.36 To (connectés chacun sur 4 lignes PCIe Gen5) ; compatible avec des disques jusqu’à 128 To actuellement, et des capacités supérieures à venir.
- Réseau: 4 cartes réseau Broadcom BCM57608 2x200G, 1 carte réseau OCP BCM57412 2x10Gb
- Commutateur: Dell PowerSwitch Z9664
Benchmark de performance FIO
Pour mesurer les performances de stockage du PowerEdge R7725xd, nous avons utilisé des indicateurs standard du secteur et l'outil FIO. Dans cette section, nous nous concentrons sur les benchmarks FIO suivants :
- Aléatoire 4K – 1M
- Séquentiel 4K – 1M
FIO – Local – Bande passante
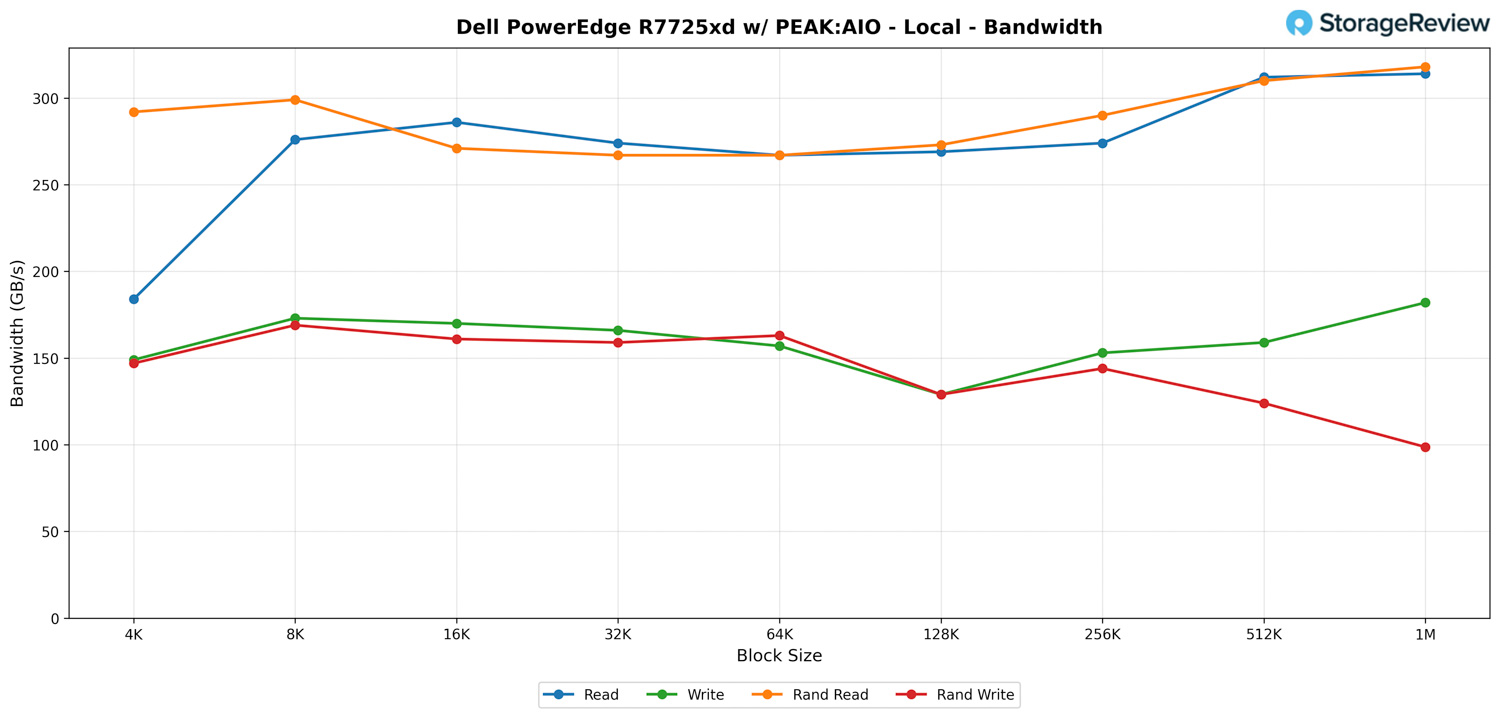
Lors des tests d'accès local aux 24 disques NVMe PCIe Gen5 du Dell PowerEdge R7725xd, le système affiche les performances attendues d'une plateforme où chaque disque est connecté aux processeurs via une liaison PCIe Gen5 x4 complète. Sans couche réseau, il s'agit du débit interne pur de l'architecture de stockage Gen5 de Dell et de la bande passante PCIe de la plateforme AMD EPYC exploitée sans restriction.
Les lectures séquentielles débutent à 184 Go/s avec des blocs de 4 Ko et augmentent rapidement avec la taille des blocs. De 512 Ko à 1 Mo, le serveur maintient un débit constant de 312 à 314 Go/s, ce qui témoigne de l'excellente capacité du système à agréger les 24 × 4 voies Gen5 pour obtenir une bande passante de lecture soutenue, sans aucun goulot d'étranglement au niveau du contrôleur.
Les écritures séquentielles suivent une courbe différente, mais restent dans la plage attendue. Commençant à 149 Go/s, les résultats augmentent jusqu'à une centaine de Go/s et atteignent 182 Go/s à 1 million d'écritures. Ceci correspond au comportement en écriture des SSD Micron 9550 PRO et à la surcharge inhérente aux écritures NVMe hautement parallèles sur un si grand nombre de périphériques indépendants.
Les performances en lecture aléatoire constituent un autre point fort. Le système atteint des vitesses proches de 300 Go/s avec les plus petites tailles de blocs, diminue légèrement en moyenne, puis remonte entre 200 et 300 Go/s avec les plus grandes tailles de blocs. À 1 Mo, les lectures aléatoires atteignent un maximum de 318 Go/s, démontrant ainsi la capacité de la plateforme à répartir uniformément les opérations mixtes sur l'ensemble des 24 disques.
Les écritures aléatoires sont effectuées à un débit inférieur, ce qui est typique des tâches de métadonnées dispersées et d'allocation d'écriture sur un large ensemble NVMe. Les résultats se maintiennent entre 140 et 160 Go/s pendant la majeure partie du test et diminuent légèrement pour atteindre un peu moins de 100 Go/s à 1 Mbit/s.
FIO – Local – IOPS
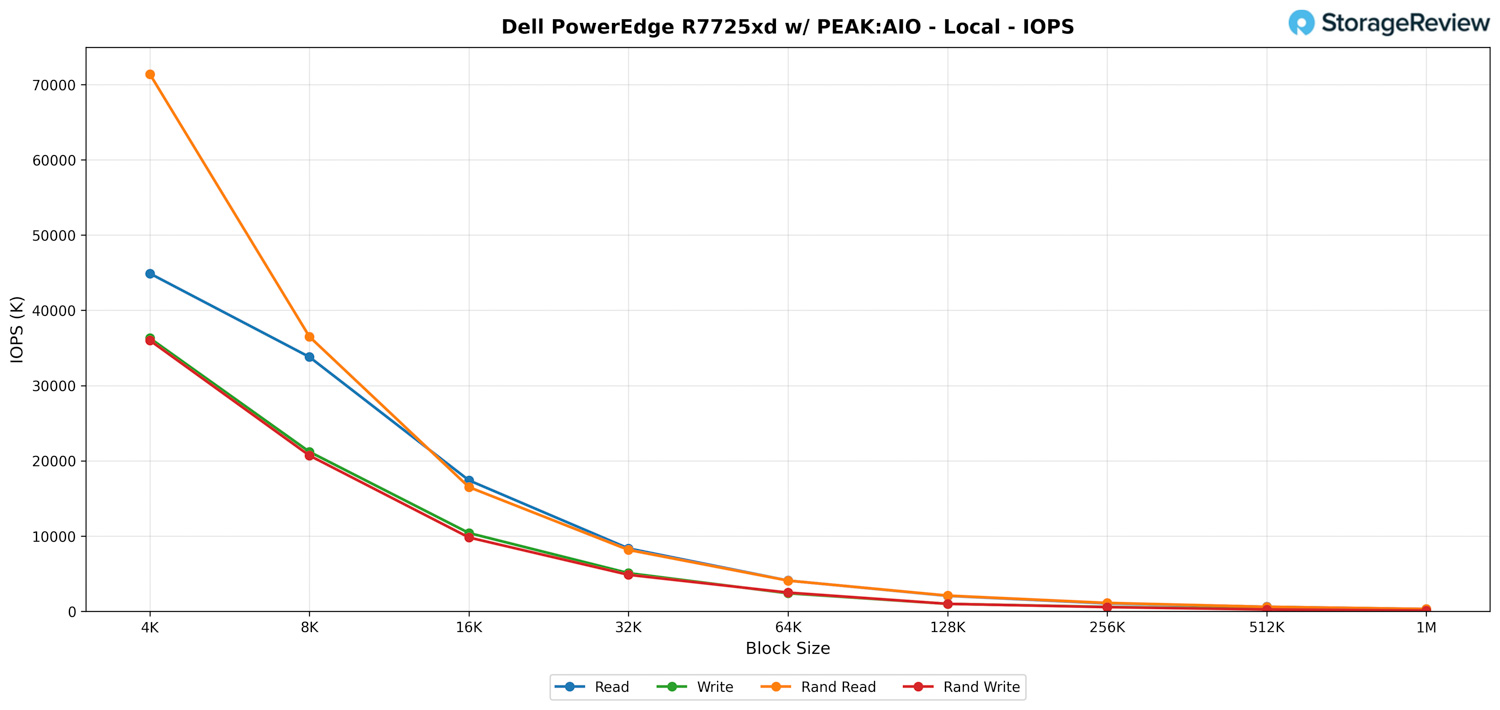
Du point de vue des IOPS, le R7725xd démontre des performances robustes pour les petits blocs, avec des taux de requêtes atteignant plusieurs dizaines de millions avant que les tailles de blocs plus importantes ne fassent basculer la charge de travail vers un profil axé sur la bande passante.
À 4K, les lectures atteignent 44.9 millions d'IOPS et les écritures 36.3 millions. Les lectures aléatoires culminent à 71.4 millions d'IOPS, démontrant ainsi la capacité du système à répartir efficacement les charges de travail à forte attente sur l'ensemble des disques. Ces valeurs diminuent naturellement avec l'augmentation de la taille des blocs, mais la progression reste constante pour les tailles de 8K, 16K et 32K.
Pour des blocs de 16 Ko et 32 Ko, les lectures se stabilisent à 17.4 millions et 8.35 millions d'IOPS, les lectures aléatoires affichant des valeurs similaires, à 16.5 millions et 8.15 millions. Les écritures suivent la tendance attendue, avec une légère baisse mais une stabilité relative, que ce soit pour les accès séquentiels ou aléatoires.
À partir de 64 Ko, le test passe d'un simple calcul d'IOPS à un scénario davantage limité par la bande passante. Les IOPS chutent à quelques millions, puis atteignent plusieurs centaines de milliers. Pour une taille de bloc de 1 Mo, les IOPS en lecture avoisinent les 300 000, celles en écriture les 174 000, et les opérations aléatoires se situent dans la même gamme de valeurs.
Globalement, les résultats IOPS locaux démontrent clairement la capacité du système à supporter des charges de travail à très haute profondeur de file d'attente sur de petits blocs, avec une mise à l'échelle prévisible à mesure que les transferts augmentent et que la bande passante devient le facteur dominant.
PEAK:AIO : Pourquoi le Dell PowerEdge R7725xd est adapté à cette charge de travail
PEAK:AIO est conçu pour les environnements exigeant un accès extrêmement rapide et à faible latence à de grands ensembles de données, notamment pour l'entraînement de l'IA, les pipelines d'inférence, la modélisation financière et l'analyse en temps réel. La plateforme tire pleinement parti du stockage NVMe haute densité, d'une bande passante PCIe équilibrée et d'une latence prévisible à grande échelle. Pour répondre à ces exigences, le matériel sous-jacent doit fournir un débit soutenu tout en maintenant des performances constantes et reproductibles sous des charges importantes simultanées.
C’est là que le Dell PowerEdge R7725xd s’intègre naturellement à PEAK:AIO. Son architecture est conçue pour optimiser les ressources PCIe Gen5, en exposant la pleine bande passante de ses 24 baies NVMe U.2 en façade directement aux processeurs, sans recourir aux contrôleurs RAID traditionnels. Cette configuration offre à PEAK:AIO le parallélisme et la latence attendus des pipelines de données NVMe modernes. Les SSD NVMe sont répartis en deux groupes RAID 0.
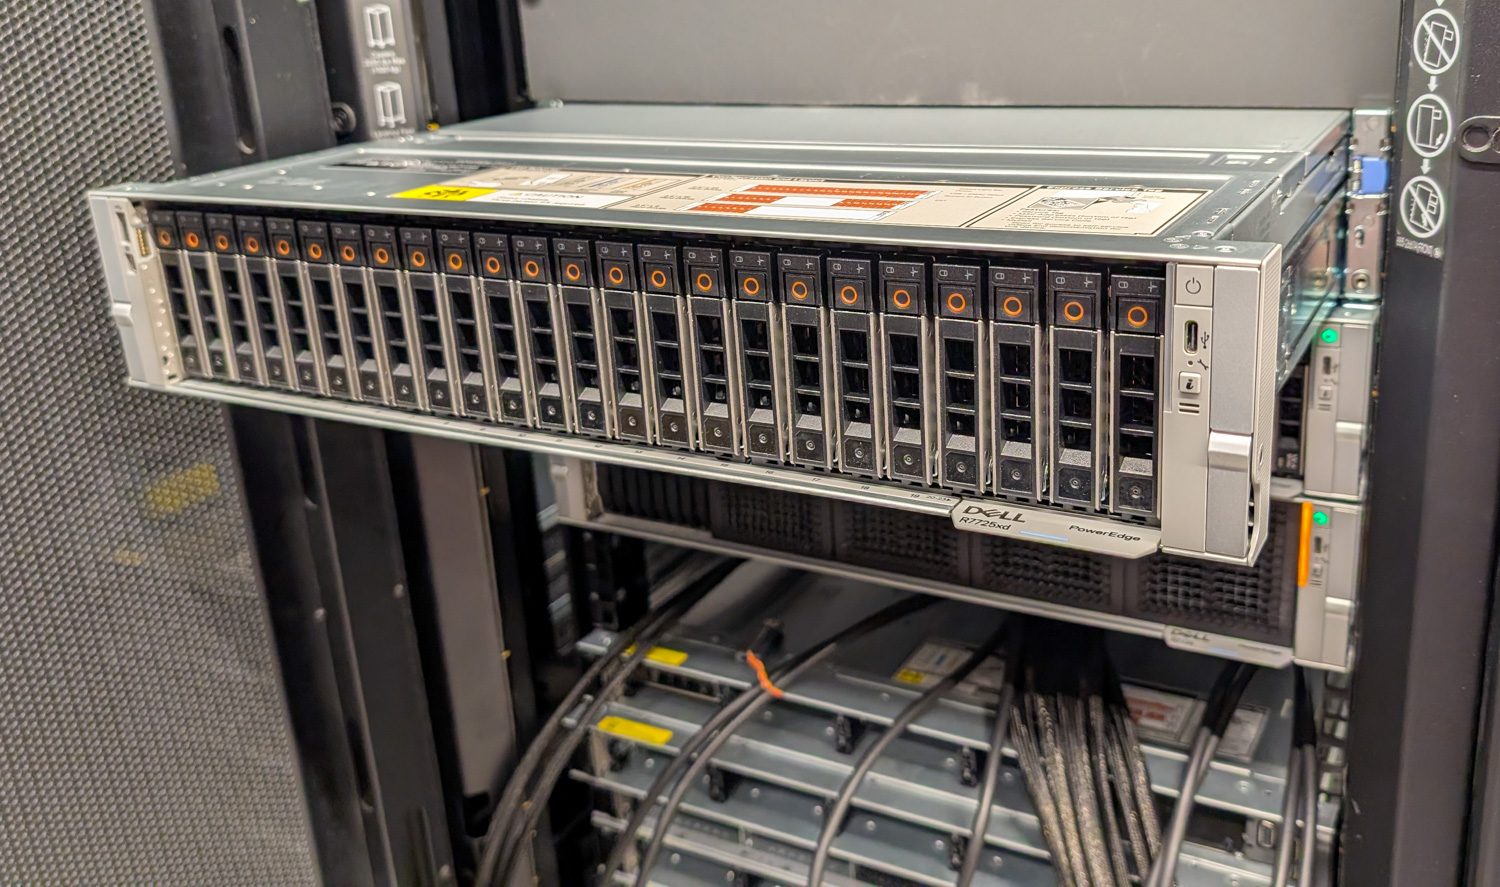
Dans le scénario de test, nous avons utilisé deux systèmes clients connectés au R7725xd, chacun équipé de deux cartes réseau Broadcom BCM57608 2x 200G. Cela a créé un total de quatre liaisons montantes 200G alimentant chaque client, poussant le R7725xd dans une configuration haute performance réaliste, similaire à celle des déploiements PEAK:AIO en production. Ce niveau de bande passante réseau nous a permis de solliciter pleinement le sous-système NVMe, la topologie PCIe et les interconnexions du processeur sans goulot d'étranglement au niveau de la couche carte réseau.
Il en résulte une plateforme parfaitement adaptée aux charges de travail PEAK:AIO. Le R7725xd offre une capacité NVMe haute densité, un débit PCIe Gen5, deux processeurs AMD EPYC 9005 pour le parallélisme et une capacité réseau permettant l'ingestion de données multi-clients à plusieurs centaines de gigabits par client. Toutes ces caractéristiques sont essentielles pour atteindre les performances attendues de PEAK:AIO.
PEAK:AIO – NVMe-oF RDMA – Bande passante
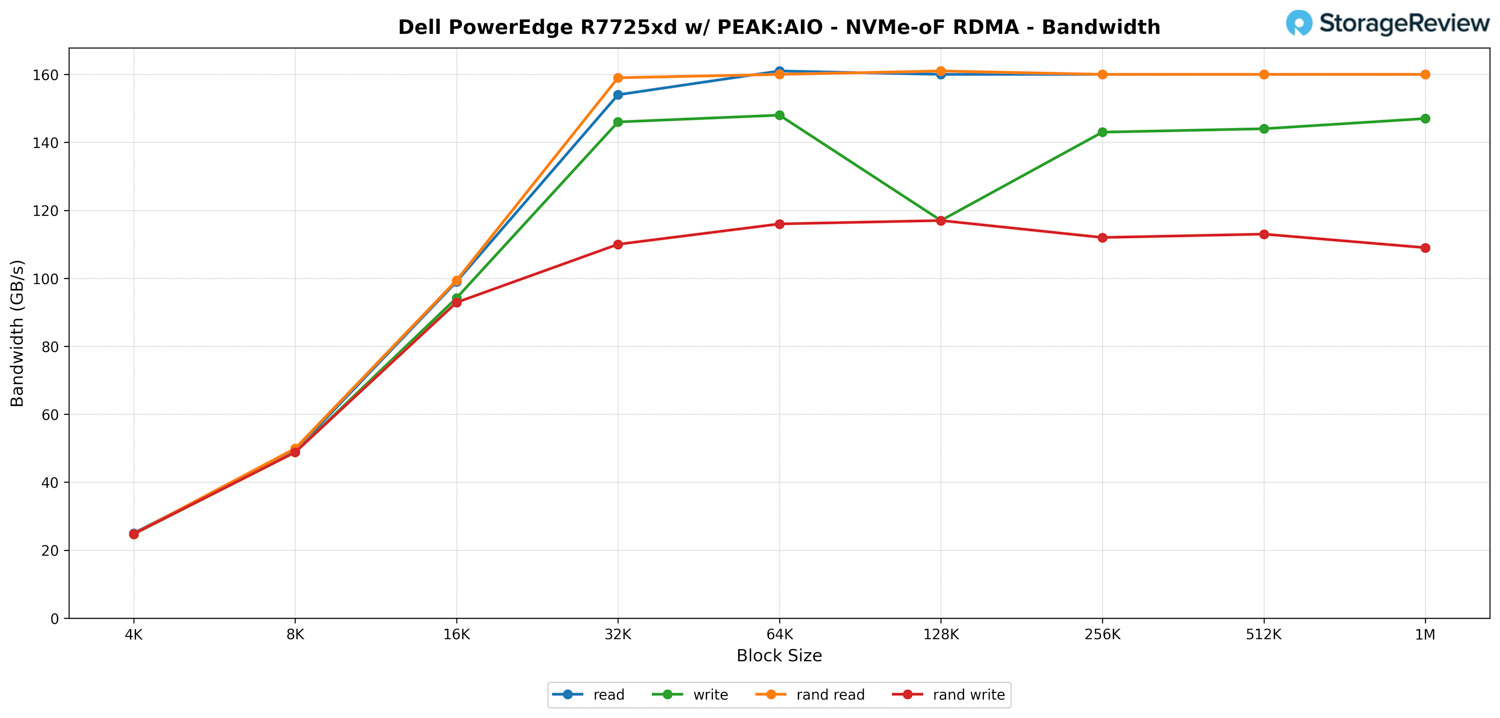
L'analyse des résultats de bande passante NVMe-oF RDMA sur le PowerEdge R7725xd avec PEAK:AIO confirme les attentes pour un système disposant d'une telle bande passante PCIe et réseau. Le débit augmente rapidement avec la taille des blocs jusqu'à se stabiliser près de la limite pratique de la plateforme.
Avec des blocs de petite taille, les performances débutent autour de 20 Go/s en lecture comme en écriture, ce qui est normal car les transferts de 4 et 8 Ko sollicitent davantage le chemin des IOPS que celui du débit. Dès que l'on atteint des blocs de 16 et 32 Ko, le débit s'améliore considérablement. Les lectures grimpent à environ 154 Go/s à 32 Ko et continuent de progresser jusqu'à environ 160 Go/s, ce qui correspond aux performances attendues d'une configuration à deux clients sur quatre liaisons de 200 Gb/s.
Les performances en lecture aléatoire sont quasiment identiques à celles en lecture séquentielle. PEAK:AIO gère efficacement l'alimentation des files d'attente de commandes, de sorte que la bande passante en lecture aléatoire suit sensiblement celle en lecture séquentielle, se stabilisant entre 159 et 161 Go/s environ de 32 000 à 1 million d'accès. Cela indique que la pile de stockage ne présente aucun goulot d'étranglement en cas d'accès mixte, et que la topologie PCIe du R7725xd répartit la charge uniformément entre les 24 disques NVMe Gen5.
Les performances en écriture suivent une courbe similaire, bien qu'elles plafonnent légèrement en dessous de celles en lecture. Les écritures séquentielles se maintiennent entre 140 et 148 Go/s pour les blocs de taille moyenne, chutant à environ 117 Go/s pour les blocs de 128 Ko, avant de remonter lorsque la taille des blocs augmente. Les écritures aléatoires se comportent différemment et se stabilisent autour de 110-117 Go/s, ce qui est normal pour les charges de travail à files d'attente mixtes qui introduisent une surcharge supplémentaire.
Le principal enseignement de cette section est que le R7725xd maintient sans difficulté une bande passante extrêmement élevée via NVMe-oF, même avec plusieurs clients sollicitant fortement le système. Dès que la taille des blocs atteint 32 Ko ou plus, le serveur sature systématiquement sa bande passante réseau et de stockage disponible. C'est précisément le type de performance que PEAK:AIO est conçu pour obtenir, ce qui confirme la capacité de la plateforme à évoluer dans des conditions réelles.
PEAK AIO – NVMe-oF IOPS RDMA
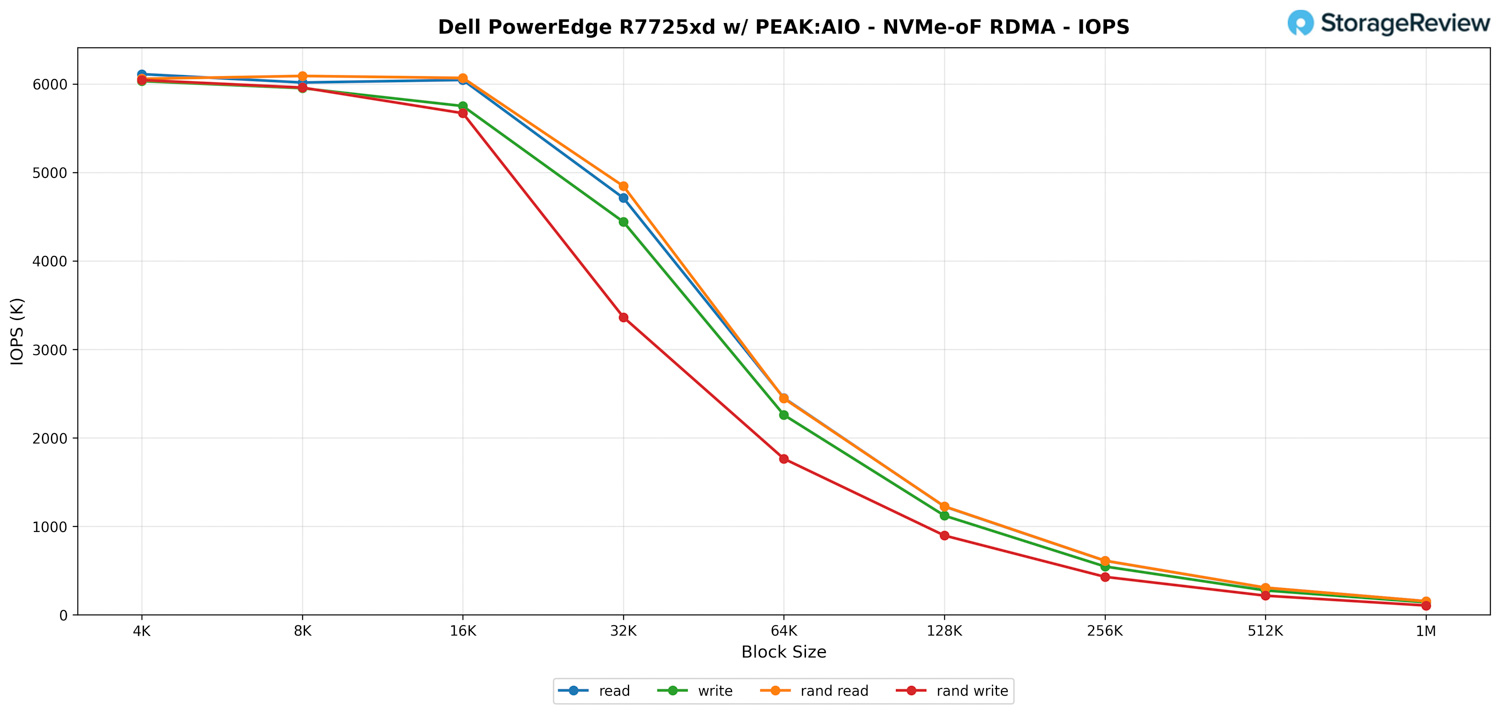
Du côté des IOPS, le PowerEdge R7725xd affiche d'excellentes performances pour les petits blocs, malgré des résultats initialement inférieurs aux attentes ; ce problème devrait être résolu grâce à une meilleure prise en charge des pilotes réseau. Malgré cela, la tendance générale de mise à l'échelle correspond exactement au comportement typique du NVMe-oF RDMA lorsque la taille des blocs augmente.
Avec la plus petite taille de bloc, le système peut fournir plus de 6 millions d'IOPS pour les charges de travail séquentielles et aléatoires. Les performances en lecture, écriture, lecture aléatoire et écriture aléatoire restent sensiblement les mêmes à 4K et 8K, ce qui indique que les clients frontaux, l'infrastructure PCIe et les disques NVMe eux-mêmes peuvent suivre sans difficulté le rythme des requêtes.
À mesure que la taille des blocs augmente, la baisse attendue des IOPS commence. À 32 Ko, les lectures atteignent environ 4.7 millions d'IOPS, tandis que les écritures suivent légèrement avec environ 4.4 millions. Les écritures aléatoires sont les plus touchées, chutant à environ 3.3 millions d'IOPS, ce qui correspond à la surcharge supplémentaire de la file d'attente et du processeur induite par les accès mixtes.
Avec des blocs de grande taille, les IOPS continuent de diminuer de façon linéaire et prévisible. À partir de 256 000 et 512 000 transferts, le débit devient le critère prédominant et les IOPS chutent naturellement à quelques centaines de milliers. Pour une taille de bloc de 1 Mo, toutes les charges de travail convergent vers 140 000 à 153 000 IOPS, ce qui correspond aux valeurs de bande passante observées dans la section précédente.
Performances de stockage GPUDirect
L'un des tests que nous avons effectués sur la R7725xd était le test Magnum IO GPUDirect Storage (GDS). GDS est une fonctionnalité développée par NVIDIA qui permet aux GPU de contourner le CPU lors de l'accès aux données stockées sur des disques NVMe ou d'autres périphériques de stockage haute vitesse. Au lieu de faire transiter les données par le CPU et la mémoire système, GDS permet une communication directe entre le GPU et le périphérique de stockage, réduisant ainsi considérablement la latence et améliorant le débit de données.
Comment fonctionne le stockage GPUDirect
Traditionnellement, lorsqu'un GPU traite des données stockées sur un disque NVMe, ces données doivent transiter par le CPU et la mémoire système avant d'atteindre le GPU. Ce processus engendre des goulots d'étranglement, le CPU jouant le rôle d'intermédiaire, ce qui augmente la latence et consomme des ressources système précieuses. GPUDirect Storage élimine cette inefficacité en permettant au GPU d'accéder directement aux données depuis le périphérique de stockage via le bus PCIe. Ce chemin direct réduit la surcharge liée aux transferts de données, permettant ainsi des transferts plus rapides et plus efficaces.
Les charges de travail d'IA, notamment celles impliquant l'apprentissage profond, sont très gourmandes en données. L'entraînement de grands réseaux neuronaux nécessite le traitement de téraoctets de données, et tout retard dans le transfert de données peut entraîner une sous-utilisation des GPU et des temps d'entraînement plus longs. GPUDirect Storage relève ce défi en garantissant que les données sont transmises au GPU le plus rapidement possible, minimisant ainsi les temps d'inactivité et maximisant l'efficacité de calcul.
En outre, GDS est particulièrement utile pour les charges de travail impliquant la diffusion de grands ensembles de données, comme le traitement vidéo, le traitement du langage naturel ou l'inférence en temps réel. En réduisant la dépendance au processeur, GDS accélère le déplacement des données et libère les ressources du processeur pour d'autres tâches, améliorant ainsi encore les performances globales du système.
Au-delà de la bande passante brute, GPUDirect avec NVMe-oF (TCP/RDMA) offre également des E/S à très faible latence. Ainsi, les GPU ne manquent jamais de données, ce qui en fait le système idéal pour l'inférence d'IA en temps réel, les pipelines d'analyse et la relecture vidéo.
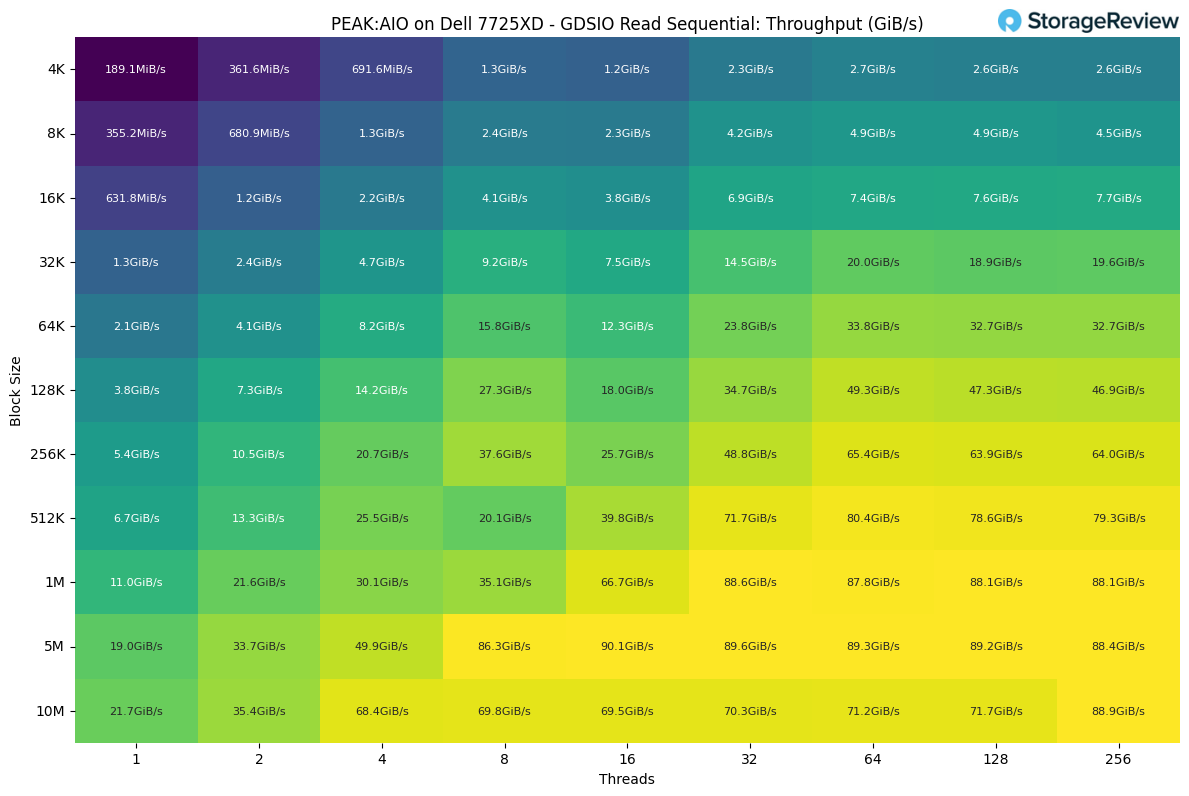
Lecture séquentielle GDSIO
Lors de l'analyse de PEAK:AIO avec un client utilisant GDSIO, le débit de lecture présente une nette corrélation avec l'augmentation de la taille des blocs et du nombre de threads. Ce client unique était connecté via deux liaisons 400G, limitant son potentiel total à 90 Go/s.
Avec des blocs de petite taille et un faible nombre de threads, les performances restent modestes : les lectures 4K atteignent environ 189 Mio/s avec un seul thread. Dès que le nombre de threads augmente, le système réagit instantanément, atteignant 691 Mio/s avec quatre threads et dépassant les Gio/s pour les blocs plus volumineux.
Les tailles de blocs intermédiaires présentent la plus grande sensibilité au nombre de threads. À 32 000 threads, le débit passe de 1.3 Gio/s avec un seul thread à près de 20 Gio/s avec 64 threads, avec une légère diminution au-delà. Un comportement similaire est observé à 64 000 et 128 000 threads : le système passe de quelques Gio/s à faible parallélisme à plus de 30 Gio/s lorsque la charge de travail augmente.
Dès que l'on atteint des tailles de blocs plus importantes, le débit se stabilise, le système approchant ses performances maximales pour un client unique. À 1 Mio, les performances passent de 11 Gio/s avec un seul thread à environ 88 Gio/s avec un nombre élevé de threads. Les transferts de 5 Mio et 10 Mio présentent le même plateau, plafonnant autour de 89-90 Gio/s, que le test soit exécuté avec 64, 128 ou 256 threads.
Écriture séquentielle GDSIO
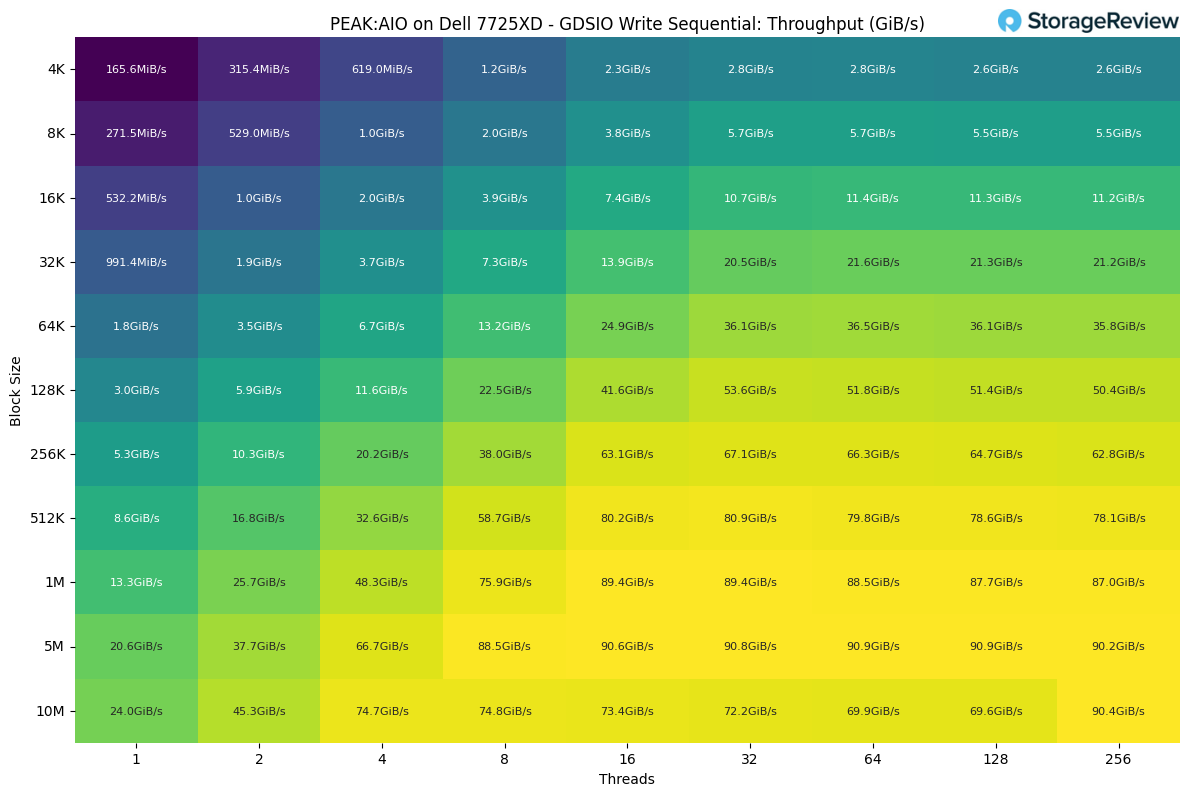
En écriture, le comportement en termes de mise à l'échelle suit une tendance similaire à celle des lectures, mais avec des performances légèrement inférieures pour la plupart des tailles de blocs, ce qui est normal pour des charges de travail d'écriture séquentielles. Pour les plus petites tailles de blocs, le débit initial est de 165 Mio/s pour un seul thread à 4 Ko et augmente régulièrement avec le parallélisme. À quatre threads, il atteint un peu plus de 619 Mio/s avant de dépasser 1 Gio/s à huit threads.
Les tailles de blocs intermédiaires affichent des gains plus marqués à mesure que le nombre de threads augmente. À 32 K, le débit initial est légèrement inférieur à 1 Gio/s et dépasse les 21 Gio/s pour des niveaux de threads plus élevés. Les plages de 64 K et 128 K confirment cette tendance, passant de quelques Gio/s à environ 30 Gio/s, voire 50 Gio/s, à mesure que la charge de travail se parallélise davantage.
C’est lors de transferts plus importants que le système atteint son débit d’écriture maximal. À 1 Mio, les performances passent de 13.3 Gio/s avec un seul thread à un peu moins de 90 Gio/s avec un nombre élevé de threads. Les tests à 5 Mio et 10 Mio présentent une tendance similaire, avec des résultats culminant autour de 90 Gio/s, que le système fonctionne avec 64, 128 ou 256 threads.
Redéfinir la performance à l'ère de la 5e génération
Le Dell PowerEdge R7725xd est bien plus qu'un simple serveur de stockage ; il révolutionne la distribution de la bande passante au sein d'une baie. En éliminant les commutateurs PCIe et en offrant à chaque disque NVMe un accès direct au processeur, Dell a créé un système où le débit évolue de manière fluide, la dissipation thermique reste prévisible et la gestion de la concurrence devient un atout plutôt qu'un inconvénient.
Associé aux SSD Micron 9550 PRO et au logiciel d'E/S parallèles PEAK:AIO, le R7725xd se transforme d'un châssis NVMe haute densité en un véritable moteur de données. Il peut exploiter au maximum son infrastructure PCIe locale, alimenter les GPU via RDMA à pleine vitesse, ou encore servir simultanément de serveur de calcul et de stockage, le tout dans un format 2U.
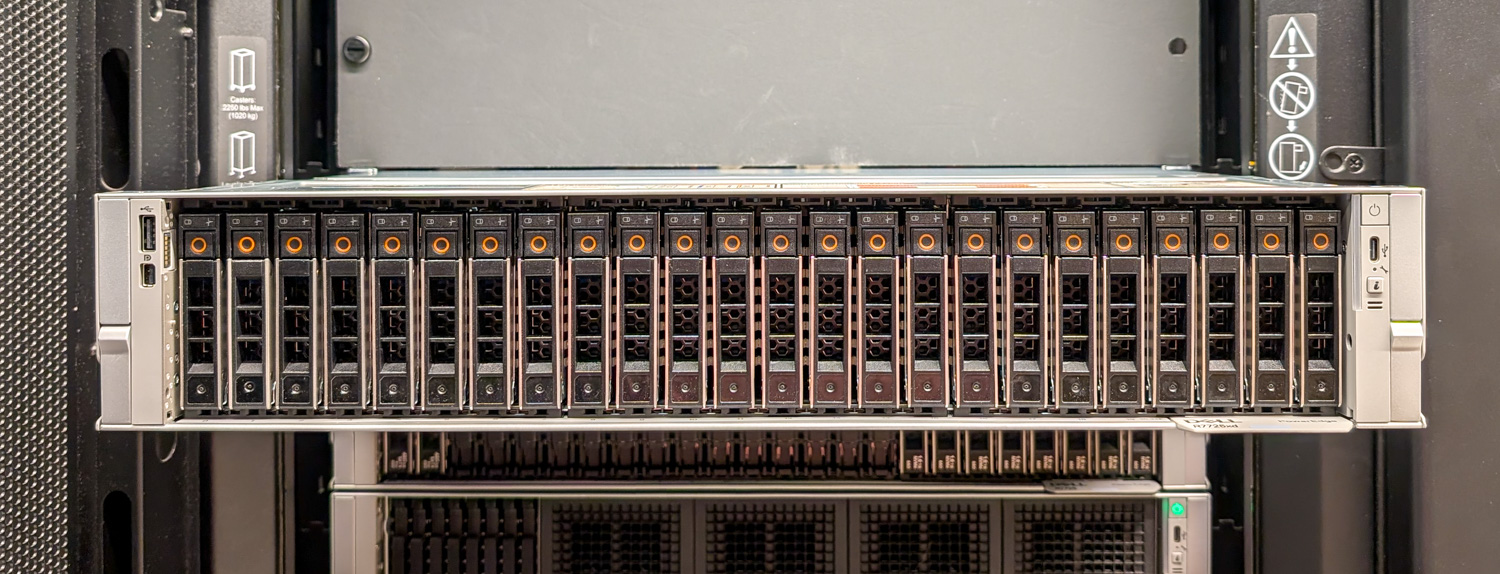
Dell PowerEdge R7225xd
Concrètement, cette configuration offre un débit local supérieur à 300 Go/s et un débit réseau de 160 Go/s, rivalisant avec les performances des clusters de stockage multi-nœuds pour une complexité et un coût bien moindres. Elle illustre parfaitement ce qui se produit lorsque chaque couche de l'architecture, du silicium au logiciel, est conçue pour optimiser l'efficacité et garantir une bande passante soutenue.
Le R7725xd établit une nouvelle référence en matière de performances de stockage mono-nœud à l'ère de la 5e génération. Pour les entreprises développant des pipelines d'IA de nouvelle génération, des solutions d'analyse à haute vitesse ou des environnements d'entraînement avec de nombreux points de contrôle, il offre un aperçu des possibilités offertes par une conception du système éliminant tout goulot d'étranglement.
Ce rapport est parrainé par Dell Technologies. Tous les points de vue et opinions exprimés dans ce rapport sont basés sur notre vision impartiale du ou des produits à l'étude.


 Amazon