

Ce n'est un secret pour personne que nous aimons la densité massive des SSD Solidigm 61.44 To U.2 NVMe. Nous avons effectué de nombreux tests d'endurance et de performance, fait des découvertes scientifiques et poussé les calculs de records du monde vers de nouveaux sommets extraordinaires. Ainsi, avec l’engouement pour l’IA qui se développe à un rythme effréné tout autour de nous, la prochaine étape logique était de voir comment les disques Solidigm NVMe se comparent dans le monde dynamique de l’IA 2024.
Comprendre les avantages d’une densité de stockage extrême
Les SSD QLC de 61.44 To de Solidigm se distinguent par leur capacité de stockage remarquable, permettant aux centres de données d'emballer plus de stockage sur moins de disques. Cette densité extrême est particulièrement avantageuse dans les serveurs IA, où les ensembles de données connaissent une croissance exponentielle et où des solutions de stockage efficaces sont primordiales. Grâce à ces disques SSD haute capacité, les centres de données peuvent réduire le nombre de disques physiques, diminuer l'encombrement, réduire la consommation d'énergie et simplifier la maintenance.
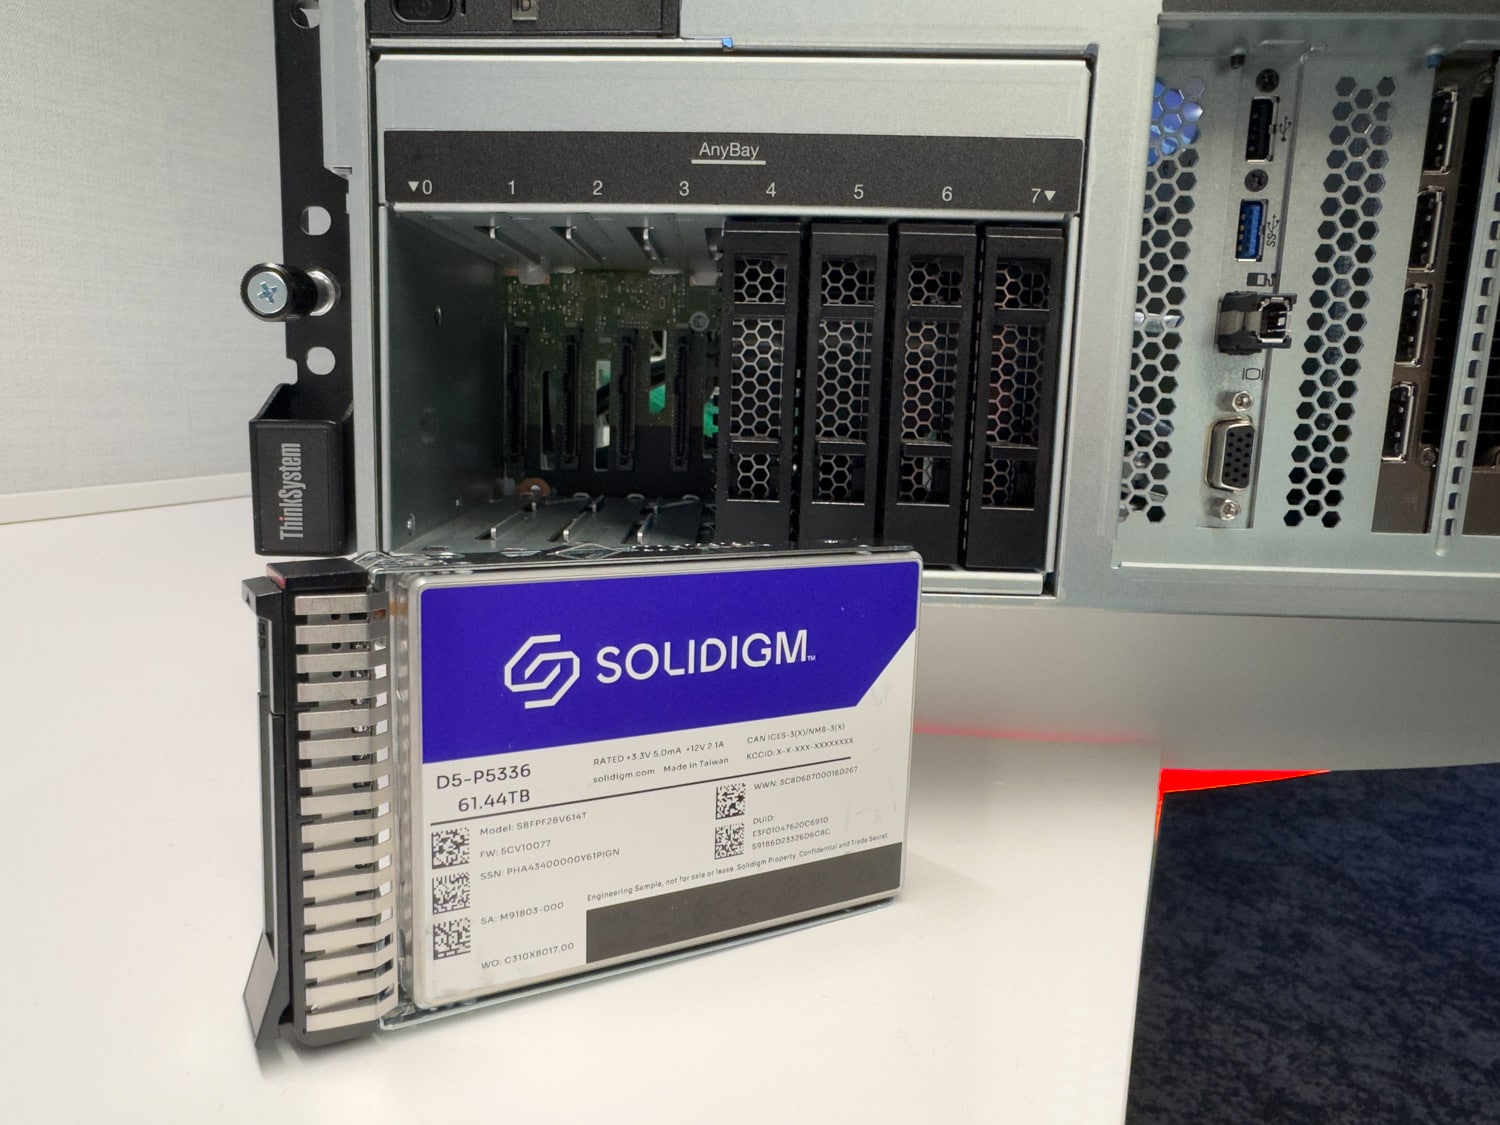
Vue de face du Lenovo ThinkSystem SR675 V3 montrant le SSD Solidigm
Voies PCIe limitées dans les serveurs GPU
L'un des principaux défis des serveurs GPU modernes est le nombre limité de voies PCIe disponibles une fois que les GPU ont obtenu leur part. Essentiels pour les charges de travail d'IA, les GPU nécessitent une bande passante PCIe importante, laissant souvent des voies limitées pour d'autres composants, notamment les périphériques de stockage et la mise en réseau. Cette contrainte rend indispensable l’optimisation de l’utilisation des voies PCIe disponibles. Les SSD QLC de 61.44 To de Solidigm offrent une solution en fournissant une capacité de stockage massive sur un seul disque, réduisant le besoin de plusieurs disques et conservant les voies PCIe pour les GPU et autres composants essentiels.
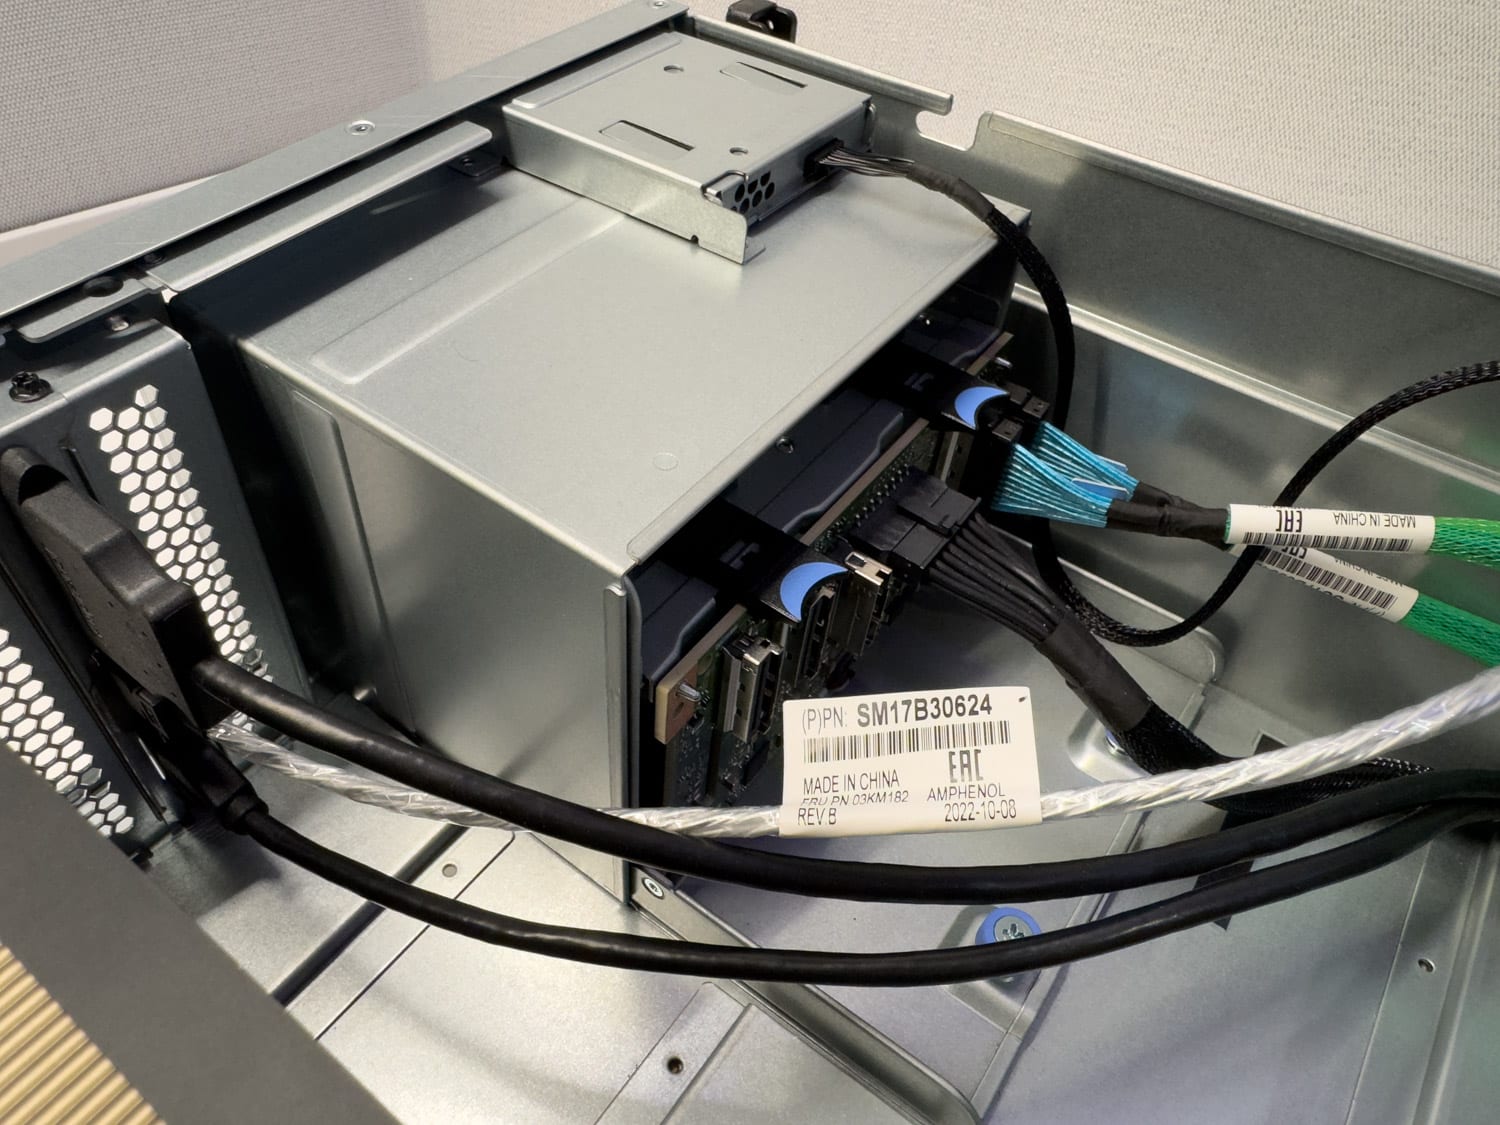
Vue interne supérieure du boîtier de disque Lenovo ThinkSystem SR675 V3
Charges de travail IA et exigences de stockage
Les charges de travail de l'IA peuvent être globalement classées en trois phases : la préparation des données, la formation et le réglage fin, et l'inférence. Chaque phase a des exigences de stockage uniques, et les SSD haute capacité de Solidigm peuvent améliorer considérablement les performances et l'efficacité au cours de ces phases. Le déploiement de disques QLC haute capacité, comme le Solidigm D5-P5336, profite à toutes les charges de travail d'IA. La plupart des avantages vont de la préparation des données à la formation et du réglage fin à l'inférence.
Préparation des données
La préparation des données est le fondement de tout projet d'IA et implique la collecte, le nettoyage, la transformation et l'augmentation des données. Cette phase nécessite un stockage étendu car les ensembles de données brutes peuvent être énormes. Les SSD QLC de 61.44 To de Solidigm peuvent stocker de grandes quantités de données brutes sans compromettre les performances. De plus, les vitesses de lecture et d'écriture séquentielles élevées de ces SSD garantissent un accès rapide aux données, accélérant ainsi le processus de préparation. Pour la préparation des données, les SSD QLC Soidigm 61.44 To répondent à toutes les exigences décrites ci-dessus avec des avantages tels que :
- Capacité de stockage massive : Gestion efficace de grands ensembles de données.
- Vitesses séquentielles élevées : Accès et traitement rapides des données.
- Latence réduite : Délais minimisés dans la récupération des données, améliorant ainsi l’efficacité du flux de travail.
Formation et mise au point
La formation de modèles d’IA est un processus intensif qui implique d’introduire de nombreux ensembles de données dans des réseaux neuronaux pour ajuster les pondérations et les biais. Cette phase est exigeante en termes de calcul et nécessite des IOPS (opérations d'entrée/sortie par seconde) élevées et un stockage à faible latence pour suivre les échanges rapides de données entre le stockage et les GPU. Les SSD de Solidigm excellent à cet égard, offrant des performances et une durabilité élevées. L'extrême densité de ces SSD permet d'utiliser des ensembles de données plus étendus dans la formation, conduisant potentiellement à des modèles plus précis. Pour répondre aux demandes de formation et de réglage fin, les SSD Solidigm offrent les éléments suivants :
- IOPS élevées : Prend en charge les échanges de données rapides essentiels à la formation.
- Durabilité: Technologie QLC optimisée pour les charges de travail lourdes en lecture/écriture, idéale pour les cycles de formation répétés.
- Évolutivité: Étendez le stockage sans ajouter de disques physiques, tout en conservant une utilisation efficace des voies PCIe.
Inférence
Une fois formés, les modèles d’IA sont déployés pour faire des prédictions ou des décisions basées sur de nouvelles données, ce que l’on appelle l’inférence. Cette phase nécessite souvent un accès rapide aux données prétraitées et une gestion efficace des demandes de lecture accrues. Les SSD QLC de 61.44 To de Solidigm offrent les performances de lecture nécessaires et une faible latence pour garantir que les opérations d'inférence sont effectuées de manière fluide et rapide. Les SSD Solidigm dépassent les performances et la faible latence en offrant les avantages suivants :
- Performances de lecture rapides : Garantit un accès rapide aux données pour une inférence en temps réel.
- Faible latence: Critique pour les applications nécessitant des réponses immédiates.
- Grande capacité: Stockez efficacement de nombreuses données d’inférence et des résultats historiques.
La technologie QLC offre des avantages significatifs pour les applications d'inférence, notamment une capacité de stockage élevée, une rentabilité, des vitesses de lecture rapides, une utilisation efficace du PCIe, une durabilité et une efficacité de flux de travail améliorée. Ces avantages améliorent collectivement les performances, l'évolutivité et la rentabilité des tâches d'inférence, faisant des disques QLC un choix idéal pour les déploiements modernes d'IA et d'apprentissage automatique.
Pourquoi est-il important de disposer d’un stockage volumineux aussi près que possible du GPU ?
Pour l’IA et l’apprentissage automatique, la proximité du stockage avec le GPU peut avoir un impact significatif sur les performances. La conception d'un centre de données IA nécessite un examen attentif de plusieurs facteurs pour garantir une fonctionnalité et une efficacité optimales. C’est pourquoi il est crucial de disposer d’un stockage étendu et aussi proche que possible du GPU. Comme nous l'avons exploré récemment, l'accès à une solution de stockage en réseau de grande taille commence à se transformer en un outil unique, mais s'en remettre uniquement à lui n'est peut-être pas toujours le choix optimal.
Latence et bande passante
L’une des principales raisons qui justifient de placer un espace de stockage important à proximité du GPU est de minimiser la latence et d’optimiser la bande passante. Les charges de travail de l’IA, notamment lors des entraînements, impliquent des transferts de données fréquents et massifs entre le stockage et le GPU. Une latence élevée peut bloquer l'ensemble du processus, ralentissant les temps de formation et réduisant l'efficacité.
Dans les charges de travail d'IA, où la disponibilité rapide des données est essentielle, une faible latence garantit que les GPU reçoivent les données rapidement, réduisant ainsi les temps d'inactivité et améliorant l'efficacité globale des calculs. Pendant la phase de formation, d’énormes volumes de données doivent être continuellement introduits dans le GPU pour être traités. En minimisant la latence, DAS garantit que les demandes de vitesse élevée des applications d'IA sont satisfaites, ce qui entraîne des temps de formation plus rapides et des flux de travail plus efficaces.
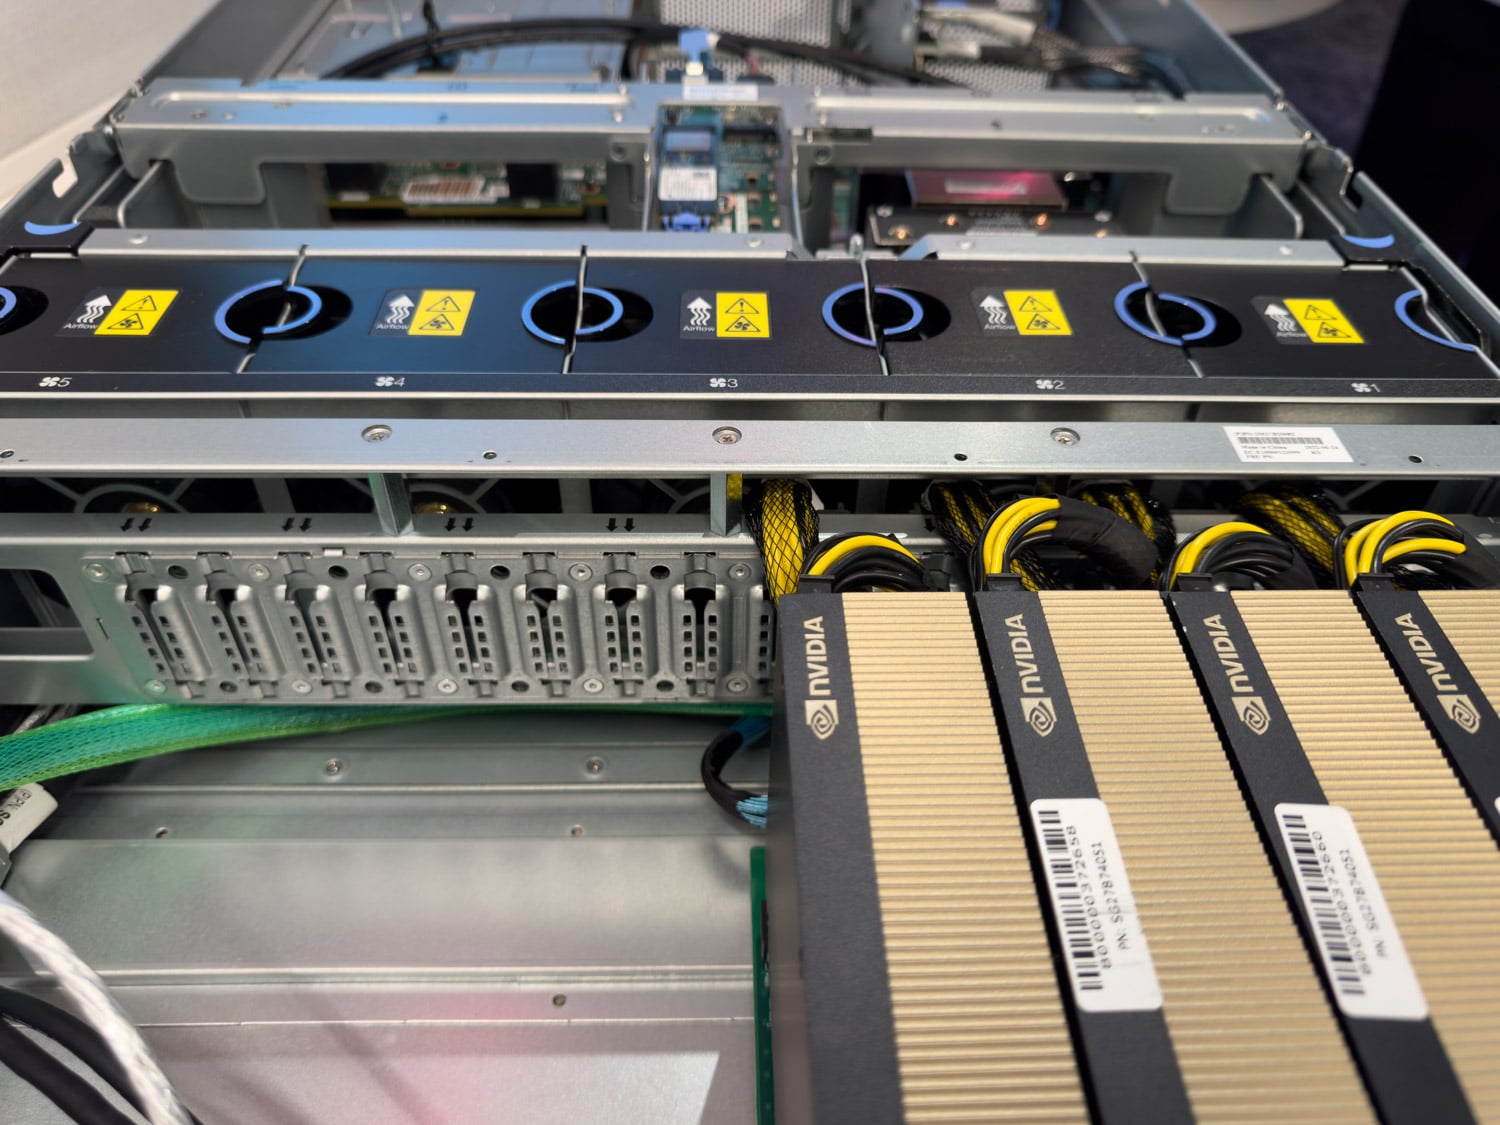
Vue interne des GPU Lenovo ThinkSystem SR675 V3
Débit de données et performances d'E/S
Les SSD NVMe locaux excellent dans la gestion d'un grand nombre d'opérations d'entrée/sortie par seconde (IOPS), ce qui est crucial pour la nature intensive en lecture/écriture des charges de travail d'IA. Pendant la phase de formation, les modèles d'IA nécessitent un accès rapide à de vastes référentiels de données, ce qui nécessite des solutions de stockage capables de répondre à la forte demande de transactions de données.
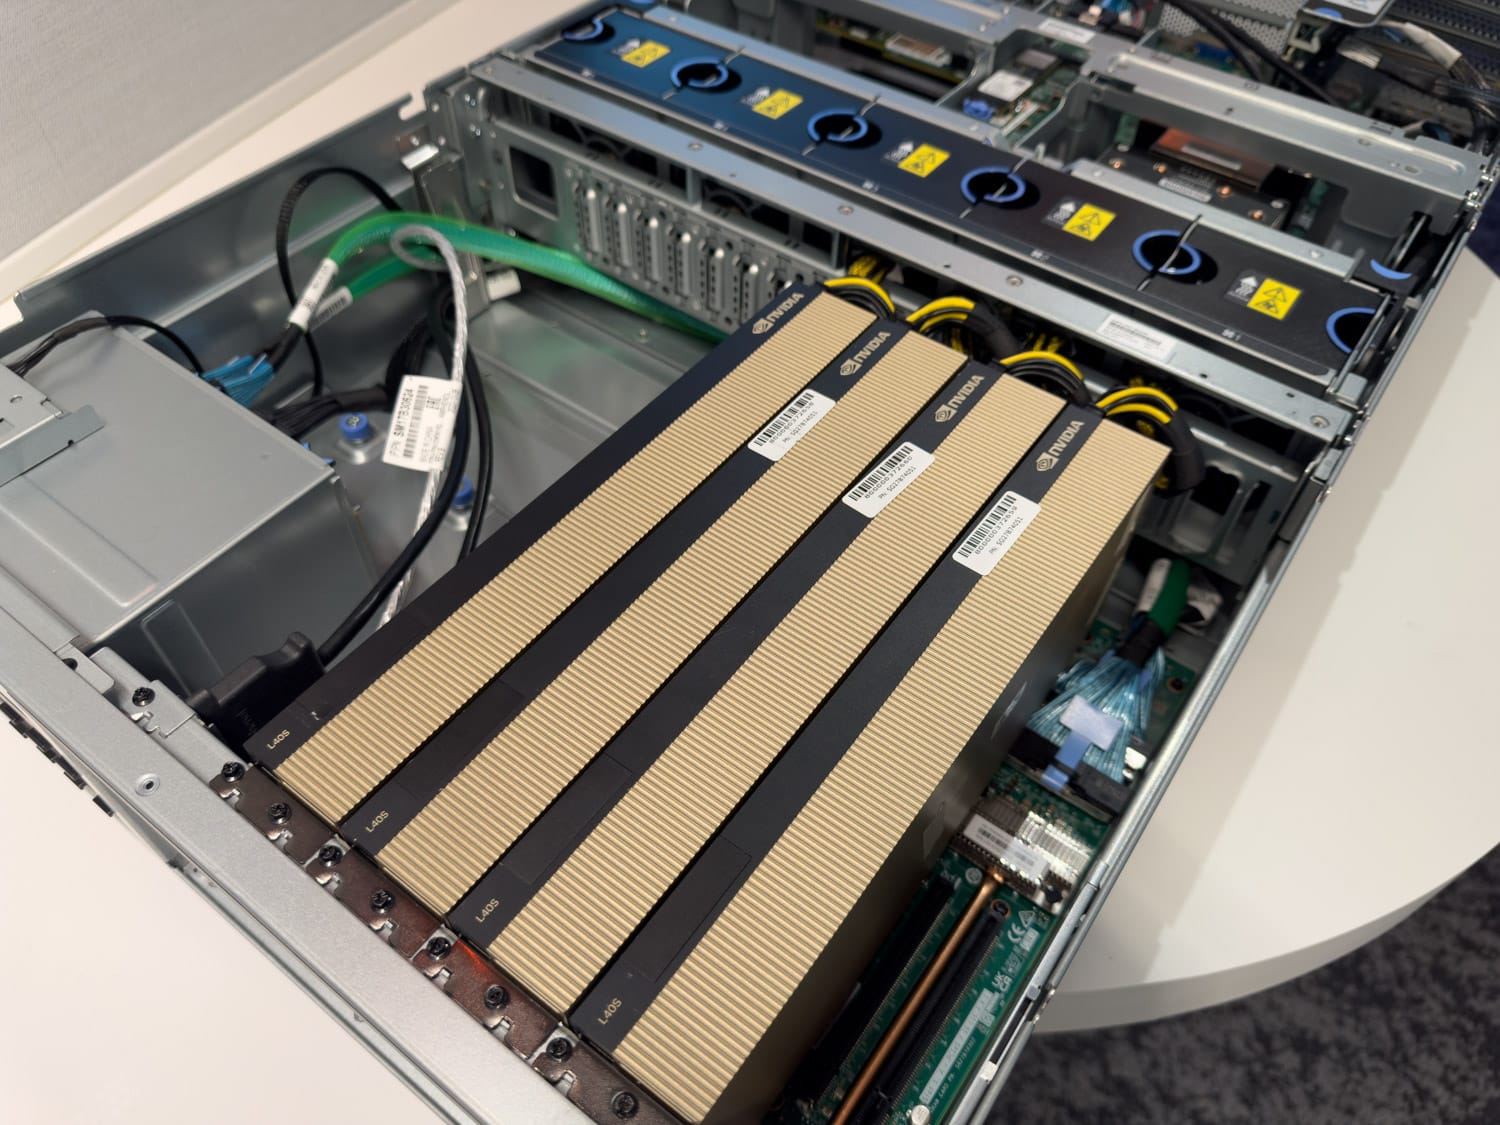
Vue en angle de dessus des GPU NVIDIA L40S
Le Solidigm D5-P5336, conçu pour les scénarios haute capacité et hautes performances, offre des IOPS exceptionnelles, permettant des processus de récupération et d'écriture de données plus rapides. Cette capacité garantit que les GPU restent occupés avec le calcul plutôt que d'attendre les données, maximisant ainsi l'efficacité et réduisant les temps de formation. Les performances IOPS élevées des SSD NVMe locaux les rendent idéaux pour les environnements exigeants des applications d'IA, où un accès et un traitement rapides des données sont essentiels pour des performances optimales.
Gestion des données
Bien que dans certains scénarios, disposer d'un espace de stockage suffisant directement connecté au GPU simplifie la gestion des données, cela ajoute une couche de gestion des données nécessaire pour stocker les données sur le serveur GPU. Dans un monde parfait, votre GPU est occupé à fonctionner et votre CPU se connecte au réseau pour enregistrer des points de contrôle ou extraire de nouvelles données. Les disques Solidigm de 61.44 To contribuent à réduire le nombre de transactions de données nécessaires. Vous pouvez également en tenir compte en utilisant une configuration réseau simplifiée et des systèmes de fichiers distribués. Cette approche simple peut rationaliser les flux de travail et réduire le risque d'erreurs ou de retards liés aux données.
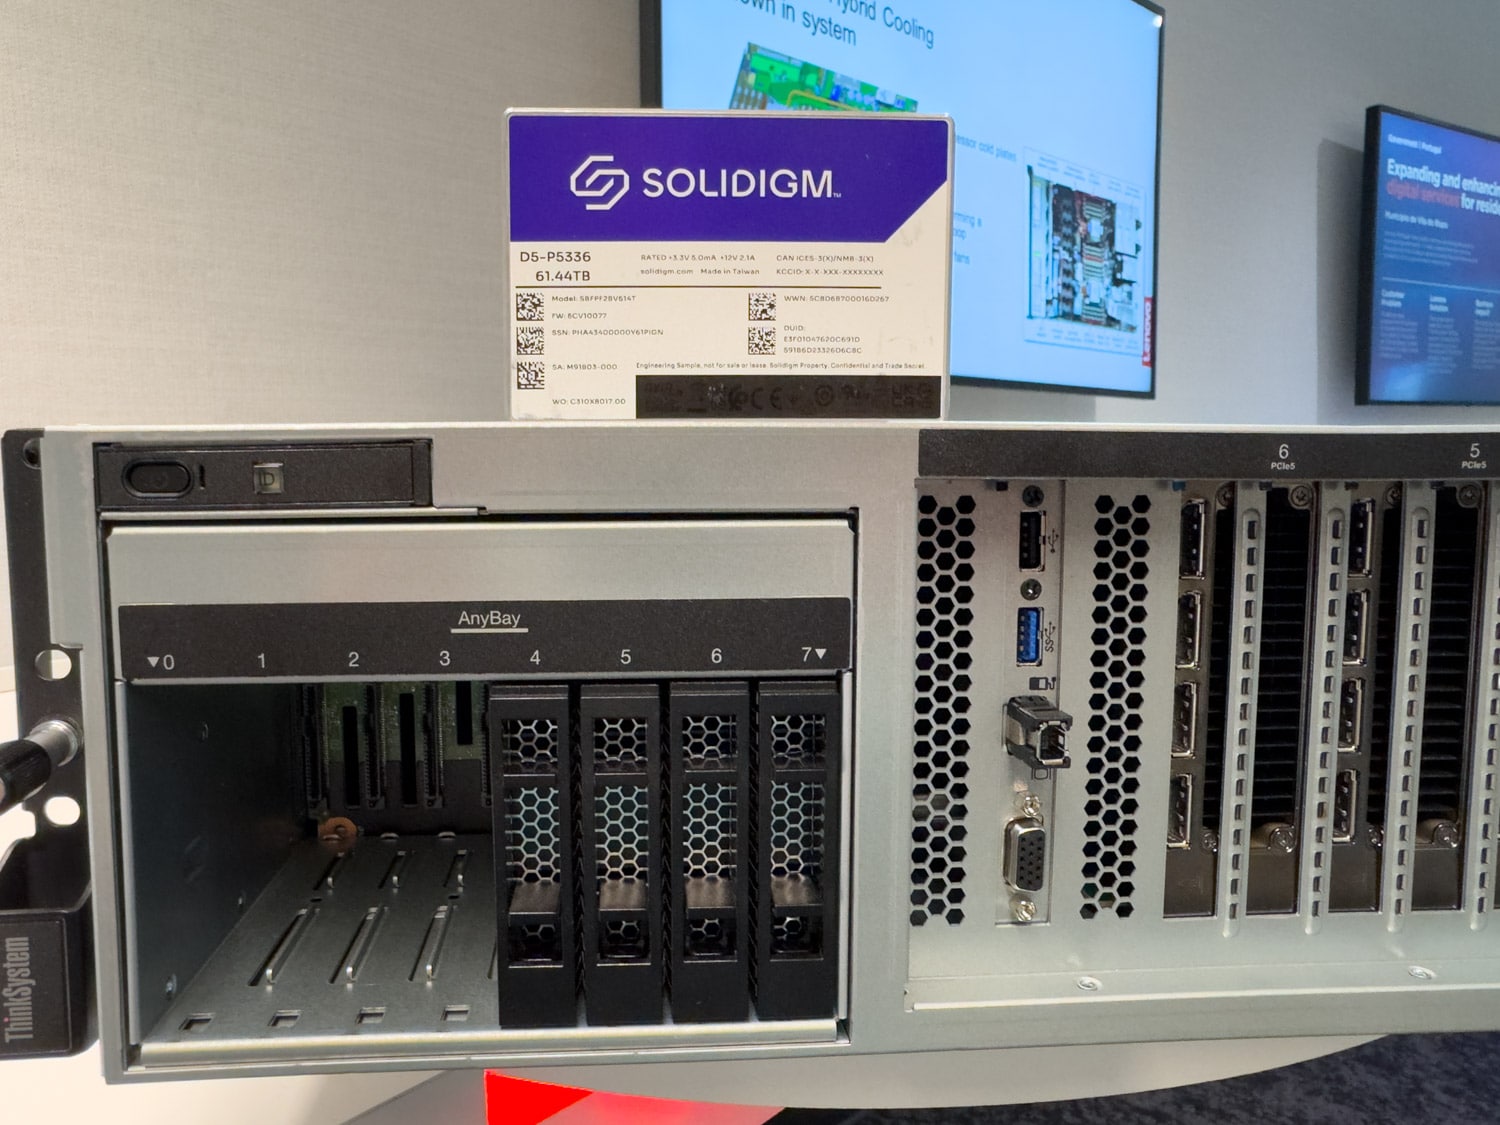
Vue de face du Lenovo ThinkSystem SR675 V3
Supposons que vous travailliez sur un seul serveur et peaufiniez des modèles adaptés à une poignée de GPU connectés localement. Dans ce cas, vous bénéficiez du stockage local, plus simple à configurer et à gérer que les solutions de stockage en réseau. La configuration, l'administration et la maintenance du stockage en réseau peuvent être complexes et chronophages, nécessitant souvent des connaissances spécialisées et une infrastructure supplémentaire. En revanche, les solutions de stockage local telles que les SSD NVMe sont plus simples à intégrer dans les configurations de serveurs existantes.
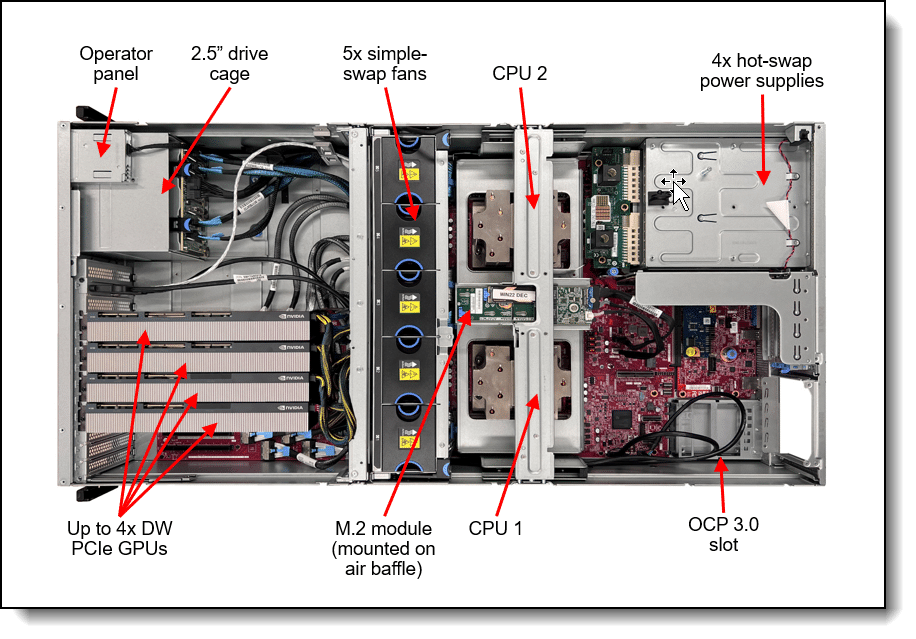
Schéma Lenovo ThinkSystem SR675 V3
Cette simplicité de configuration et de maintenance permet aux équipes informatiques de se concentrer davantage sur l'optimisation des charges de travail d'IA plutôt que sur les subtilités de la gestion du stockage réseau. En conséquence, le déploiement et la gestion du stockage pour les applications d'IA deviennent plus simples et efficaces avec les SSD NVMe locaux.
Coût et évolutivité
Même si les solutions NAS peuvent évoluer horizontalement en ajoutant davantage de périphériques de stockage, elles entraînent également des coûts liés à l'infrastructure réseau et des goulots d'étranglement potentiels en termes de performances. À l’inverse, investir dans un stockage local haute capacité peut offrir des avantages immédiats en termes de performances sans mises à niveau importantes du réseau.
Les solutions de stockage local sont souvent plus rentables que les systèmes de stockage en réseau (NAS), car elles éliminent le besoin de matériel réseau coûteux et de configurations complexes. La configuration et la maintenance d'un NAS impliquent des investissements importants dans les équipements réseau, tels que des commutateurs et des routeurs haut débit, ainsi que des coûts continus de gestion et de maintenance du réseau.
Des disques SSD locaux de grande capacité intégrés directement au serveur sont utilisés comme zone de transit, réduisant ainsi le besoin d'infrastructure supplémentaire. Cette intégration directe réduit les coûts matériels et simplifie le processus de configuration, ce qui la rend plus économique pour les organisations cherchant à optimiser leurs charges de travail d'IA sans engager de dépenses élevées.
Pour évaluer en profondeur les performances des SSD Solidigm 61.44 To QLC dans une configuration de serveur AI, nous comparerons une gamme de quatre SSD Solidigm P5336 61.44 To installés dans un Lenovo ThinkSystem SR675 V3. Cette configuration de serveur comprend également un ensemble de quatre GPU NVIDIA L40S. L'outil d'analyse comparative utilisé à cette fin est GDSIO, un utilitaire spécialisé conçu pour mesurer les performances de stockage dans les environnements de stockage direct GPU (GDS). Nous avons examiné deux configurations : un GPU pour les performances d'un seul disque et un GPU pour quatre disques configurés pour RAID0.
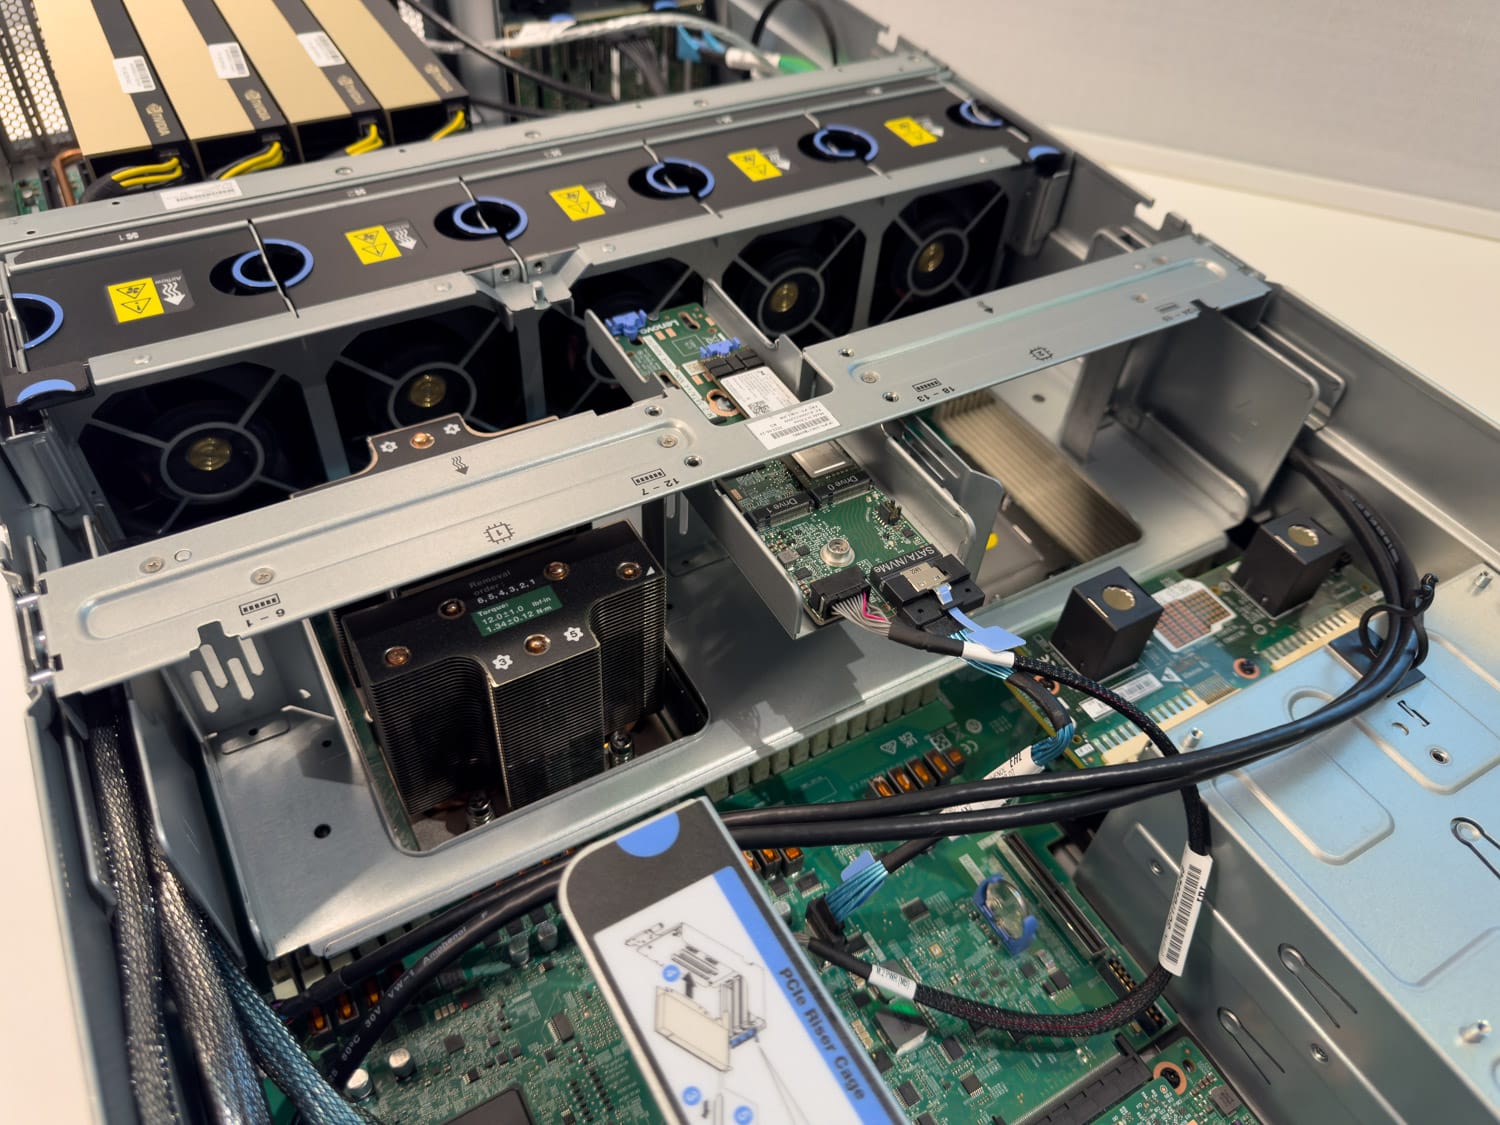
Vue de dessus du Lenovo ThinkSystem SR675 V3 avec quatre GPU L40S
Rester avec nous. Les sections suivantes couvrent les spécificités des tests et la manière dont ils imitent les différentes étapes du pipeline d'IA.
Paramètres de test
Le processus d'analyse comparative implique divers paramètres de test qui simulent différentes étapes du pipeline d'IA. Ces paramètres incluent io_sizes, threads et transfer_type, chacun étant choisi pour représenter des aspects spécifiques des charges de travail d'IA.
1. Tailles d'E/S :
- 4K, 128K, 256K, 512K, 1M, 4M, 16M, 64M, 128M : Ces différentes tailles d'E/S permettent de simuler différents modèles de transfert de données. Des tailles d'E/S plus petites (128 Ko, 256 Ko, 512 Ko) imitent des scénarios dans lesquels de petits morceaux de données sont fréquemment consultés, ce qui est typique lors des étapes de préparation des données. Les tailles d'E/S plus grandes (1 M, 4 M, 16 M, 64 M, 128 M) représentent des transferts de données en masse, souvent observés lors des étapes de formation et d'inférence, au cours desquelles des lots de données entiers sont déplacés.
2. Fils:
- 1, 4, 16, 32 : Le nombre de threads représente le niveau de concurrence d'accès aux données. Un seul thread teste les performances de base, tandis qu'un nombre de threads plus élevé (4, 16, 32) simule des activités de traitement de données parallèles plus intensives, semblables à ce qui se produit lors de sessions de formation à grande échelle où plusieurs flux de données sont gérés simultanément.
3. Types de transfert :
- Stockage->GPU (GDS) : Ce type de transfert exploite le GPU Direct Storage (GDS), permettant des transferts de données directs entre les SSD et les GPU, en contournant le CPU. Cette configuration est idéale pour tester l'efficacité des chemins de données directs et minimiser la latence, reflétant des scénarios d'inférence en temps réel.
- Stockage->CPU->GPU : Ce chemin de transfert de données traditionnel consiste à déplacer les données du stockage vers le CPU avant de les transférer vers le GPU. Cette méthode simule des scénarios dans lesquels un traitement intermédiaire ou une mise en cache peuvent se produire au niveau du processeur, ce qui est attendu lors de la phase de préparation des données. Nous pourrions affirmer que ce chemin de données représenterait les performances quel que soit le fournisseur de GPU.
- Stockage->PAGE_CACHE->CPU->GPU : Ce chemin utilise le cache de pages pour les transferts de données, où les données sont d'abord mises en cache en mémoire avant d'être traitées par le CPU puis transférées vers le GPU. Cette configuration est utile pour tester l'impact des mécanismes de mise en cache et de la bande passante mémoire sur les performances globales, ce qui est pertinent lors de la formation lorsque les données peuvent être prétraitées et mises en cache pour plus d'efficacité. Encore une fois, nous pourrions affirmer que ce chemin de données représenterait les performances quel que soit le fournisseur de GPU.
Imiter les étapes du pipeline IA
Les tests de référence sont conçus pour refléter les différentes étapes du pipeline d'IA, garantissant que les mesures de performance obtenues sont pertinentes et complètes.
Préparation des données:
- Tailles d'E/S : Plus petit (128K, 256K, 512K)
- Sujets: 1, 4
- Types de transfert : « Stockage->CPU->GPU », « Stockage->PAGE_CACHE->CPU->GPU »
- Objectif : Évaluez la manière dont les disques SSD gèrent les petits transferts de données fréquents et l'implication du processeur, essentiels lors des phases d'ingestion, de nettoyage et d'augmentation des données.
Formation et mise au point :
- Tailles d'E/S : Moyen à grand (1M, 4M, 16M)
- Sujets: 4, 16, 32
- Types de transfert : « Stockage->GPU (GDS) », « Stockage->CPU->GPU »
- Objectif : Évaluez les performances dans des conditions de débit de données élevé avec plusieurs flux de données simultanés, ce qui représente la gestion intensive des données requise lors de la formation et du réglage précis du modèle.
Inférence :
- Tailles d'E/S : Grand à très grand (16 M, 64 M, 128 M) et 4K
- Sujets: 1, 4, 16
- Types de transfert : Stockage->GPU (GDS)
- Objectif : Mesurez l'efficacité des transferts de données directs à grande échelle vers le GPU, essentiels pour les applications d'inférence en temps réel où un accès rapide aux données et une latence minimale sont primordiaux. 4K est conçu pour examiner les recherches effectuées dans la base de données RAG.
En faisant varier ces paramètres et en testant différentes configurations, nous pouvons obtenir un profil de performances détaillé des SSD Solidigm 61.44 To QLC dans un environnement de serveur d'IA hautes performances, fournissant ainsi un aperçu de leur adéquation et de leur optimisation pour diverses charges de travail d'IA. Nous avons examiné les données en effectuant plus de 1200 XNUMX tests sur quelques semaines.
Configuration du serveur
- Lenovo Think System SR675 V3
- Processeur AMD EPYC 9254 24 cœurs
- 6 X 64 Go DDR5, capacité totale de 384 Go
- 4X GPU NVIDIA L40S
- 4 disques SSD NVMe Solidigm P61.44 QLC de 5336 To
- Ubuntu Server 22.04
- Version du pilote NVIDIA : 535.171.04
- Version CUDA : 12.2
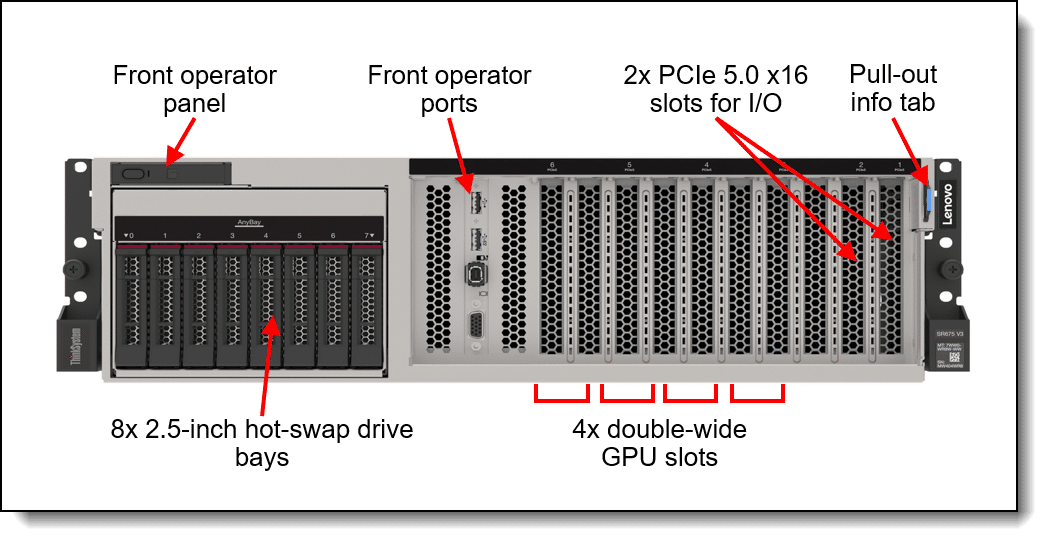
Vue de face du Lenovo ThinkSystem SR675 V3
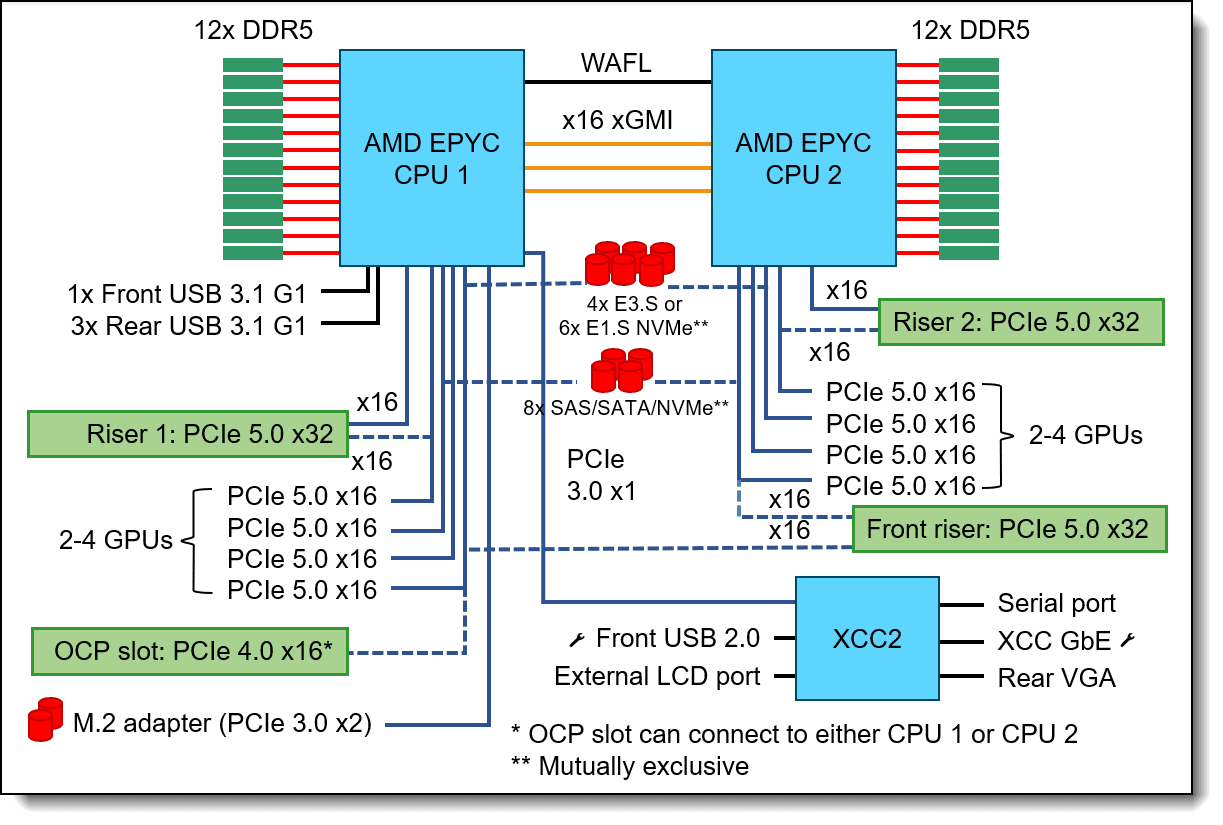
Architecture Lenovo ThinkSystem SR675 V3
Résultats de référence
Tout d’abord, examinons les charges de travail de type formation et inférence. La taille d'E/S GPU Direct 1024K représente le chargement du modèle, les données d'entraînement chargées sur le GPU et d'autres tâches d'inférence par lots volumineuses comme dans le travail d'image ou de vidéo.
| 4Conduire | Type d'E / S | Type de transfert | Threads | Taille de l'ensemble de données (Kio) | Taille des E/S (Ko) | Débit (Gio/sec) | Latence moyenne (usecs) |
|---|---|---|---|---|---|---|---|
| ÉCRIRE | GPUD | 8 | 777,375,744 | 1024 | 12.31 | 634.55 | |
| LIS | GPUD | 8 | 579,439,616 | 1024 | 9.30 | 840.37 | |
| RANDÉCRITURE | GPUD | 8 | 751,927,296 | 1024 | 12.04 | 648.67 | |
| RANDIRER | GPUD | 8 | 653,832,192 | 1024 | 10.50 | 743.89 |
Ensuite, examinez les tailles d'E/S plus petites, pour une charge de travail de type RAG, par exemple où un accès rapide et aléatoire aux données 4k à une base de données RAG stockée sur disque. Des E/S aléatoires efficaces sont nécessaires pour les scénarios dans lesquels les charges de travail d'inférence doivent accéder aux données de manière non séquentielle, comme avec des systèmes de recommandation ou des applications de recherche. La configuration RAID0 présente de bonnes performances pour les opérations séquentielles et aléatoires, ce qui est crucial pour les applications d'IA qui impliquent un mélange de modèles d'accès comme RAG. Les valeurs de latence de lecture sont particulièrement faibles, notamment dans les GPUD .
8 threads de travail ont été sélectionnés ici, qui ne saturent pas complètement le SSD, mais fournissent un instantané plus représentatif de ce que vous pouvez trouver dans une charge de travail de type RAG. Cela fournit un contexte d'application prête à l'emploi autour du point de vue du GPU avec un nombre limité de tâches travaillées et une profondeur de file d'attente plus élevée, ce qui mérite de noter que cela montre qu'il reste plus de performances sur la table qui peuvent être obtenues grâce à d'autres optimisations logicielles. .
| 4Conduire | Type d'E / S | Type de transfert | Threads | Taille de l'ensemble de données (Kio) | Taille des E/S (Ko) | Débit (Gio/sec) | Latence moyenne (usecs) |
|---|---|---|---|---|---|---|---|
| ÉCRIRE | GPUD | 8 | 69,929,336 | 4 | 1.12 | 27.32 | |
| LIS | GPUD | 8 | 37,096,856 | 4 | 0.59 | 51.52 | |
| RANDÉCRITURE | GPUD | 8 | 57,083,336 | 4 | 0.91 | 33.42 | |
| RANDIRER | GPUD | 8 | 27,226,364 | 4 | 0.44 | 70.07 |
Si vous n'utilisez pas GPU Direct en raison de bibliothèques ou de GPU non pris en charge, voici ces deux types si vous utilisez le CPU dans le transfert de données. Dans ce serveur spécifique, le Lenovo ThinkSystem SR675 V3, étant donné que tous les périphériques PCIe passent par le complexe racine du processeur, nous constatons une bande passante comparable mais prenons un coup sur notre latence. On peut s'attendre à une amélioration d'un système avec des commutateurs PCIe.
| 4Conduire | Type d'E / S | Type de transfert | Threads | Taille de l'ensemble de données (Kio) | Taille des E/S (Ko) | Débit (Gio/sec) | Latence moyenne (usecs) |
|---|---|---|---|---|---|---|---|
| ÉCRIRE | CPU_GPU | 8 | 767,126,528 | 1024 | 12.24 | 638.05 | |
| LIS | CPU_GPU | 8 | 660,889,600 | 1024 | 10.58 | 738.75 | |
| RANDÉCRITURE | CPU_GPU | 8 | 752,763,904 | 1024 | 12.02 | 649.76 | |
| RANDIRER | CPU_GPU | 8 | 656,329,728 | 1024 | 10.47 | 746.26 | |
| ÉCRIRE | CPU_GPU | 8 | 69,498,220 | 4 | 1.11 | 27.47 | |
| LIS | CPU_GPU | 8 | 36,634,680 | 4 | 0.58 | 52.31 |
Le tableau indique des débits élevés pour les opérations de lecture, en particulier avec le GPUD type de transfert. Par exemple, lisez les opérations dans GPUD Le mode atteint plus de 10.5 Gio/sec. Cela profite aux charges de travail d’IA, qui nécessitent souvent un accès rapide aux données pour entraîner de grands modèles.
Les performances équilibrées entre les opérations aléatoires et séquentielles rendent cette configuration adaptée aux tâches d'inférence, qui nécessitent souvent un mélange de ces modèles d'accès. Même si les valeurs de latence ne sont pas extrêmement faibles, elles restent dans des limites acceptables pour de nombreuses applications d'inférence.
De plus, nous constatons des débits impressionnants, avec des opérations d’écriture atteignant jusqu’à 12.31 Gio/s et des opérations de lecture jusqu’à 9.30 Gio/s. Ce débit élevé profite aux charges de travail d’IA qui nécessitent un accès rapide aux données pour la formation et l’inférence des modèles.
Lectures séquentielles et optimisation
En passant à une taille d'E/S de 128 M et en parcourant les threads de travail, nous pouvons voir le résultat de l'optimisation d'une charge de travail pour une solution de stockage.
| Type de transfert | Threads | Débit (Gio/s) | Latence (usec) |
|---|---|---|---|
| Stockage->CPU->GPU | 16 | 25.134916 | 79528.88255 |
| Stockage->CPU->GPU | 4 | 25.134903 | 19887.66948 |
| Stockage->CPU->GPU | 32 | 25.12613 | 159296.2804 |
| Stockage->GPU (GDS) | 4 | 25.057484 | 19946.07198 |
| Stockage->GPU (GDS) | 16 | 25.044871 | 79770.6007 |
| Stockage->GPU (GDS) | 32 | 25.031055 | 159478.8246 |
| Stockage->PAGE_CACHE->CPU->GPU | 16 | 24.493948 | 109958.4447 |
| Stockage->PAGE_CACHE->CPU->GPU | 32 | 24.126103 | 291792.8345 |
| Stockage->GPU (GDS) | 1 | 23.305366 | 5362.611458 |
| Stockage->PAGE_CACHE->CPU->GPU | 4 | 21.906704 | 22815.52797 |
| Stockage->CPU->GPU | 1 | 15.27233 | 8182.667969 |
| Stockage->PAGE_CACHE->CPU->GPU | 1 | 6.016992 | 20760.22778 |
Écrire correctement toute application pour interagir avec le stockage est primordial et doit être pris en compte car les entreprises souhaitent maximiser leur investissement GPU.
GPU direct
En isolant les performances du GPU Direct uniquement dans tous les tests, nous pouvons avoir une idée générale de la façon dont la technologie NVIDIA brille.
| Type d'E / S | Type de transfert | Threads | Taille de l'ensemble de données (Kio) | Taille des E/S (Ko) | Débit (Gio/sec) | Latence moyenne (usecs) |
|---|---|---|---|---|---|---|
| ÉCRIRE | GPUD | 8 | 777,375,744 | 1024 | 12.31 | 634.55 |
| LIS | GPUD | 8 | 579,439,616 | 1024 | 9.30 | 840.37 |
| RANDÉCRITURE | GPUD | 8 | 751,927,296 | 1024 | 12.04 | 648.67 |
| RANDIRER | GPUD | 8 | 653,832,192 | 1024 | 10.50 | 743.89 |
| ÉCRIRE | GPUD | 8 | 69,929,336 | 4 | 1.12 | 27.32 |
| LIS | GPUD | 8 | 37,096,856 | 4 | 0.59 | 51.52 |
| RANDÉCRITURE | GPUD | 8 | 8,522,752 | 4 | 0.14 | 224.05 |
| RANDIRER | GPUD | 8 | 21,161,116 | 4 | 0.34 | 89.99 |
| RANDÉCRITURE | GPUD | 8 | 57,083,336 | 4 | 0.91 | 33.42 |
| RANDIRER | GPUD | 8 | 27,226,364 | 4 | 0.44 | 70.07 |
Réflexions de clôture
Puisque cet article se concentre sur le Solidigm 61.44 To P5336, prenons du recul et abordons le débat TLC vs QLC autour des performances par rapport à la capacité. Lorsque l'on regarde d'autres produits du portefeuille Solidigm, comme la gamme D7, qui utilise TLC 3D NAND, la capacité est limitée en échange de performances. Lors de nos tests, en particulier avec les disques Solidigm de 61.44 To, nous avons constaté des performances de débit globales qui peuvent maintenir correctement les GPU alimentés en données à faibles latences. Nous entendons des retours d'ODM et d'OEM concernant la demande de stockage de plus en plus proche du GPU, et le disque Solidigm D5-P5336 semble faire l'affaire. Comme il existe généralement un nombre limité de baies NVMe disponibles sur les serveurs GPU, les disques denses Solidigm figurent en tête de liste pour le stockage sur serveur GPU local.
En définitive, la capacité de stockage massive offerte par ces disques, associée aux GPU, ne constitue qu'une partie de la solution ; leurs performances restent indispensables. En additionnant les performances d'un seul disque sur plusieurs, on constate qu'un débit suffisant est disponible, même pour les tâches les plus exigeantes. Dans le cas d'une configuration RAID 0 à quatre disques utilisant GDSIO, le débit total en écriture peut atteindre 12.31 Gio/s, et en lecture, 25.13 Gio/s.
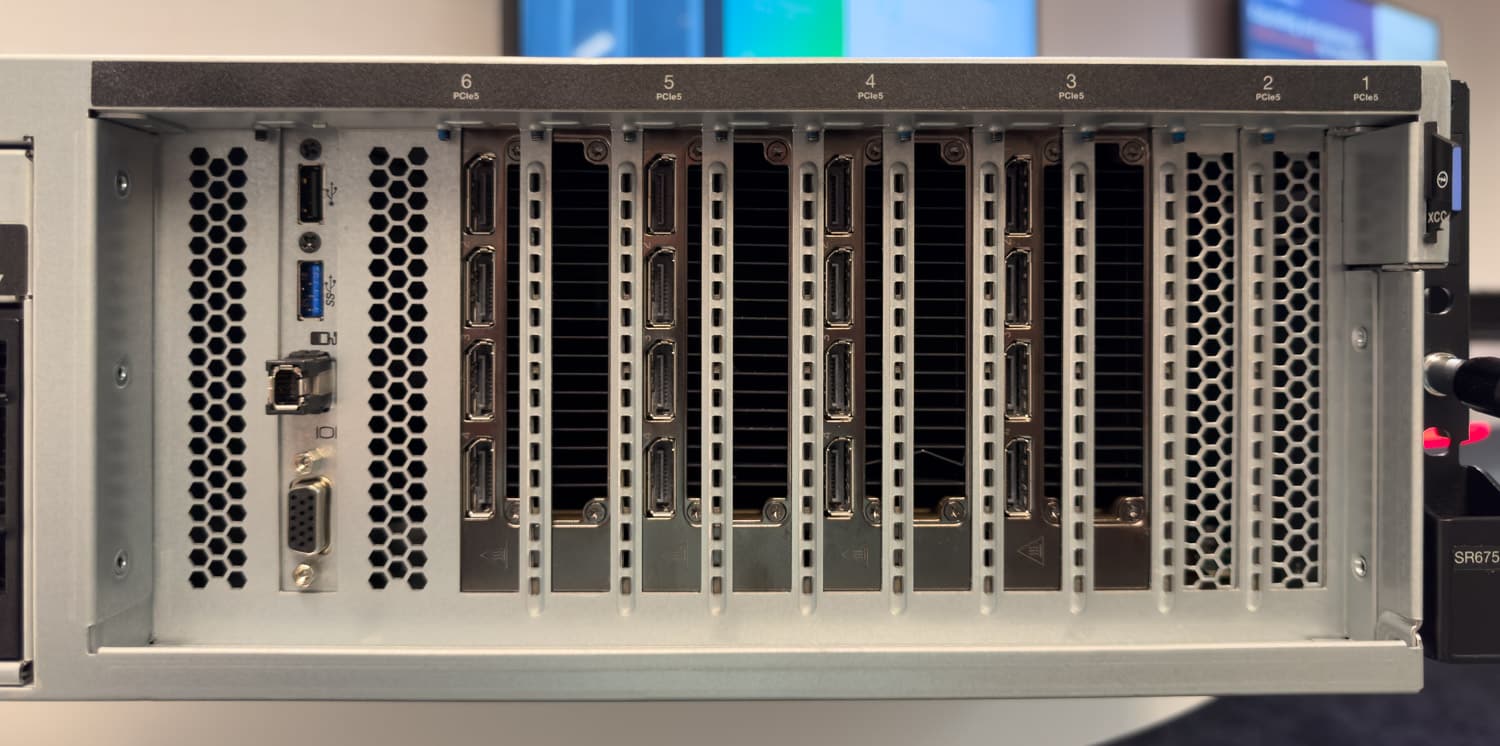
Vue arrière du Lenovo ThinkSystem SR675 V3 pour les GPU
Ce niveau de débit est plus que suffisant pour les tâches d'IA les plus exigeantes, telles que la formation de grands modèles d'apprentissage en profondeur sur des ensembles de données massifs ou l'exécution d'inférences en temps réel sur des flux vidéo haute résolution. La possibilité d'augmenter les performances en ajoutant davantage de disques à la matrice RAID0 en fait un choix incontournable pour les applications d'IA où un accès rapide et efficace aux données est crucial.
Cependant, il est important de noter que les configurations RAID0, bien qu'offrant des performances élevées, n'offrent aucune redondance des données. Il est donc essentiel de mettre en œuvre des stratégies de sauvegarde et de protection des données appropriées pour éviter toute perte de données en cas de panne de disque.
Une autre considération unique dans les centres de données aujourd'hui est la puissance. Alors que les serveurs d’IA consomment plus d’énergie que jamais et ne montrent aucun signe de ralentissement, la puissance totale disponible est l’un des plus gros goulots d’étranglement pour ceux qui cherchent à intégrer des GPU dans leurs centres de données. Cela signifie que l’accent est encore plus mis sur l’économie de chaque watt possible. Si vous pouvez obtenir plus de To par watt, nous abordons quelques processus de réflexion intéressants autour du coût total de possession et des coûts d'infrastructure. Même retirer ces disques du serveur GPU et les placer dans un serveur de stockage à l'échelle du rack peut fournir un débit massif avec des capacités extrêmes.
L'intégration de disques SSD QLC Solidigm D5-P5336 de 61.44 To avec des serveurs d'IA à emplacements limités NVMe représente une avancée significative pour relever les défis de stockage des charges de travail d'IA modernes. Leur densité extrême, leurs caractéristiques de performance et leur rapport To/watt les rendent idéaux pour les phases de préparation, de formation et de réglage des données, ainsi que d'inférence. En optimisant l'utilisation des voies PCIe et en fournissant des solutions de stockage haute capacité, ces SSD permettent à l'AI Factory moderne de se concentrer sur le développement et le déploiement de modèles plus sophistiqués et plus précis, stimulant ainsi l'innovation dans le domaine de l'IA.
Page Lenovo ThinkSystem SR675 V3
Ce rapport est sponsorisé par Solidigm. Tous les points de vue et opinions exprimés dans ce rapport sont basés sur notre vision impartiale du ou des produits à l'étude.


 Amazon