

Les systèmes d'IA de bureau basés sur le GPU GB10 de NVIDIA ont une mission bien précise : mettre à disposition 128 Go de mémoire unifiée et une puissance de calcul d'un pétaflops sur un bureau, à portée de main de l'utilisateur, pour une itération instantanée. Leur principal inconvénient ? L'absence de connexion au stockage existant de l'organisation. Chaque DGX Spark et ses variantes OEM sont livrés avec un unique emplacement M.2 court, limitant la capacité locale à environ 4 To et plaçant l'ensemble des données, modèles et points de contrôle de cette machine hors du système de gouvernance, de contrôle d'accès, de sauvegarde et d'audit du centre de données. Multipliez cela par un laboratoire, un département ou un campus, et vous obtenez des dizaines d'îlots isolés de 4 To, chacun contenant sa propre copie des mêmes modèles et données, et dont la sécurité dépend entièrement du bureau sur lequel il est installé.
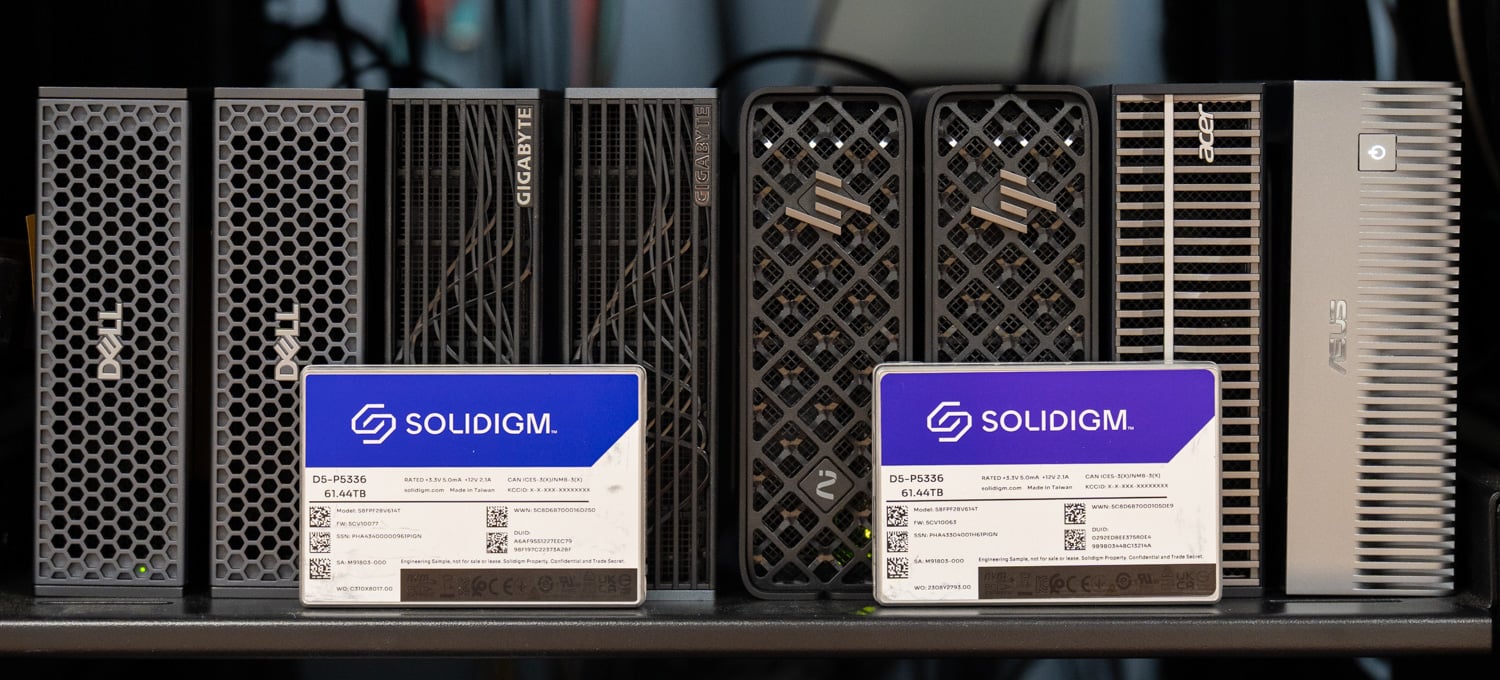
Ce projet ramène le problème de stockage au cœur du centre de données. Nous avons construit un hôte de stockage partagé DGX Spark à partir d'un serveur Dell PowerEdge R770AP, de huit SSD Solidigm D5-P5336 QLC en RAID 5 Graid SupremeRAID, d'une connectivité réseau Broadcom 400 GbE et d'un contrôleur Tuxera Fusion assurant le transfert NFS sur RDMA. Huit modules Spark ont ensuite été connectés à ses ports 100 GbE. Chaque module Spark du réseau utilise le même pool de stockage gouverné et protégé par parité via une seule ligne. Une seule copie de chaque modèle et ensemble de données est utilisée par tous, aucun poste de travail ne nécessite plus de stockage que celui fourni d'origine, et les modules Spark eux-mêmes peuvent être installés dans le rack adjacent à la baie de stockage, où leur sécurité, leur refroidissement et leur partage sont facilités. L'intérêt principal de cette architecture réside dans l'emplacement des données, et n'importe quel serveur NVMe doté de cartes réseau rapides peut convenir. L'université d'État de l'Oregon, qui explore un laboratoire Spark à grande échelle pour l'apprentissage de l'IA et souhaite donner aux étudiants accès à des ensembles de données de recherche mesurés en dizaines de téraoctets, a partagé sa réflexion avec nous lors de la conception du projet, et pour des données de cette échelle, le stockage partagé était l'approche qui convenait à cette évaluation.
Points clés à retenir
- Un seul réseau, huit Sparks, aucun logiciel client : Huit DGX Sparks de cinq OEM montent des partages NFS/RDMA à partir d'une seule baie Solidigm D5-P5336 QLC derrière Graid SupremeRAID et Tuxera Fusion, sur les ports 100GbE qu'ils possèdent déjà, avec un montage en une seule ligne sur Ubuntu standard.
- Les modèles hébergés se chargent comme les modèles locaux : Un modèle Qwen3.5-122B-A10B-NVFP4 de 78 Go chargé à partir de la baie partagée en 269.6 secondes sur un Spark, soit à 13 % des 239.6 secondes nécessaires au même Spark à partir de son NVMe interne, et huit Sparks chargeant la même copie unique à la fois ont terminé entre 232.8 et 326.5 secondes.
- Un exemplaire remplace un silo sur chaque bureau : Les modèles et les ensembles de données stockés sur un système de stockage de centre de données gouverné et protégé par parité remplacent les copies par poste de travail sur des disques M.2 de 4 To. L'utilisation est ainsi optimisée, les copies de données réduites et Spark n'a plus besoin d'être mis à niveau en termes de stockage ni installé sur un bureau. Pour un laboratoire d'apprentissage automatique à grande échelle comme celui que l'Université d'État de l'Oregon explore, où les ensembles de données de recherche atteignent plusieurs dizaines de téraoctets, cette approche correspond parfaitement au cas d'utilisation évalué.
- Les disques durs fixent la limite supérieure, et le réseau dispose d'une marge de manœuvre : Avec les huit Sparks fonctionnant simultanément, la grappe RAID 5 à huit disques a atteint un débit maximal proche de 25 Gio/s, soit environ 214 Gbit/s, utilisant 27 % des 800 Gbit/s offerts par les deux cartes réseau Broadcom BCM57608 de l'hôte. Un Spark effectuant une lecture de la grappe à 10.8 Gio/s égale la vitesse la plus élevée que nous ayons mesurée pour un SSD M.2 interne dans un système GB10.
- La gouvernance fait partie intégrante du protocole : NFS avec RDMA place les dossiers par utilisateur, les ensembles de données partagés et les modèles hébergés dans un seul espace de noms avec Active Directory, Kerberos et les hooks LDAP, ce qui permet aux données de rester sous le contrôle du centre de données pendant que les Sparks sont installés dans le rack.
Le problème d'une intelligence artificielle sur chaque bureau
Le DGX Spark et ses variantes OEM (Dell, GIGABYTE, HP, Acer et ASUS) partagent la plateforme GB10 et la même capacité de stockage maximale. Lors de notre test initial du DGX Spark , le stockage constituait la principale limitation de la plateforme. L'emplacement interne accepte les SSD M.2 courts ; les SSD clients de 8 To au format 2280 ne sont donc pas compatibles. Le Luisuantech GP Spark que nous avons testé en août dernier résout ce problème grâce à un boîtier M.2 à quatre baies connecté à un port 100 GbE. Cette solution est idéale pour une configuration individuelle et, à l'échelle d'un laboratoire, pour une configuration plus importante sur chaque bureau.
La capacité ne représente que la moitié du problème ; l’autre moitié concerne le devenir des données une fois installées sur un poste de travail. Un modèle de 78 Go téléchargé sur un Spark constitue une copie invisible pour le service informatique. Un jeu de données de recherche stocké sur une mémoire flash locale est une copie hors du calendrier de sauvegarde, hors de la politique d’accès et hors des audits institutionnels. Dix Sparks dans un laboratoire signifient dix copies identiques des mêmes données, consommant 780 Go de mémoire flash qui pourraient être utilisés à d’autres fins, et dix risques de transfert d’un jeu de données avec la machine. Le problème s’aggrave avec l’augmentation du nombre de machines, qu’il s’agisse de systèmes de 10 Go ou de toute infrastructure d’IA de bureau. Toutes les organisations ayant géré un parc d’ordinateurs portables connaissent ce schéma, et la solution était alors la même : conserver les données sur un stockage partagé dans le centre de données et laisser le poste de travail fonctionner comme un poste de travail.
Heureusement, NVIDIA a conçu le Spark avec des ports adaptés. Chaque unité embarque deux cages QSFP56 sur un ConnectX-7 intégré, offrant une bande passante utilisable maximale de 200 Gbit/s via deux liaisons PCIe Gen5 x4. Dans notre test du cluster DGX Spark , nous avons décrit la configuration à rôles partagés, où une cage est dédiée à un autre Spark et l'autre au stockage. Ce projet utilise une cage par Spark pour le stockage à 100 Gbit/s, laissant la seconde disponible pour le clustering ou une bande passante supplémentaire. À 100 Gbit/s, chaque Spark dispose d'une bande passante théorique d'environ 12.5 Go/s vers le serveur de stockage, ce qui dépasse la bande passante fournie par l'emplacement M.2 interne de la plupart de ces systèmes.
Une fois les données transférées à l'autre extrémité de la liaison, le rôle du Spark évolue. Il devient un point de terminaison de calcul doté d'un disque de démarrage et d'un disque cache local, et la capacité n'est plus facturée par poste de travail. Un modèle ou un ensemble de données est écrit une seule fois et lu par chaque client, ce qui augmente l'utilisation du stockage et diminue le nombre de copies. La protection des données est assurée par une baie de stockage avec parité dans un châssis serveur, et le contrôle d'accès, le chiffrement au repos, la sauvegarde et l'audit sont gérés de la même manière que pour les autres systèmes. Le Spark ne nécessitant plus que de l'alimentation et une liaison 100 GbE, il n'est plus nécessaire de le placer sur un bureau. Installé en rack à côté du serveur de stockage, il est plus frais, plus silencieux, physiquement sécurisé et disponible pour tous les utilisateurs.
L'hôte de stockage
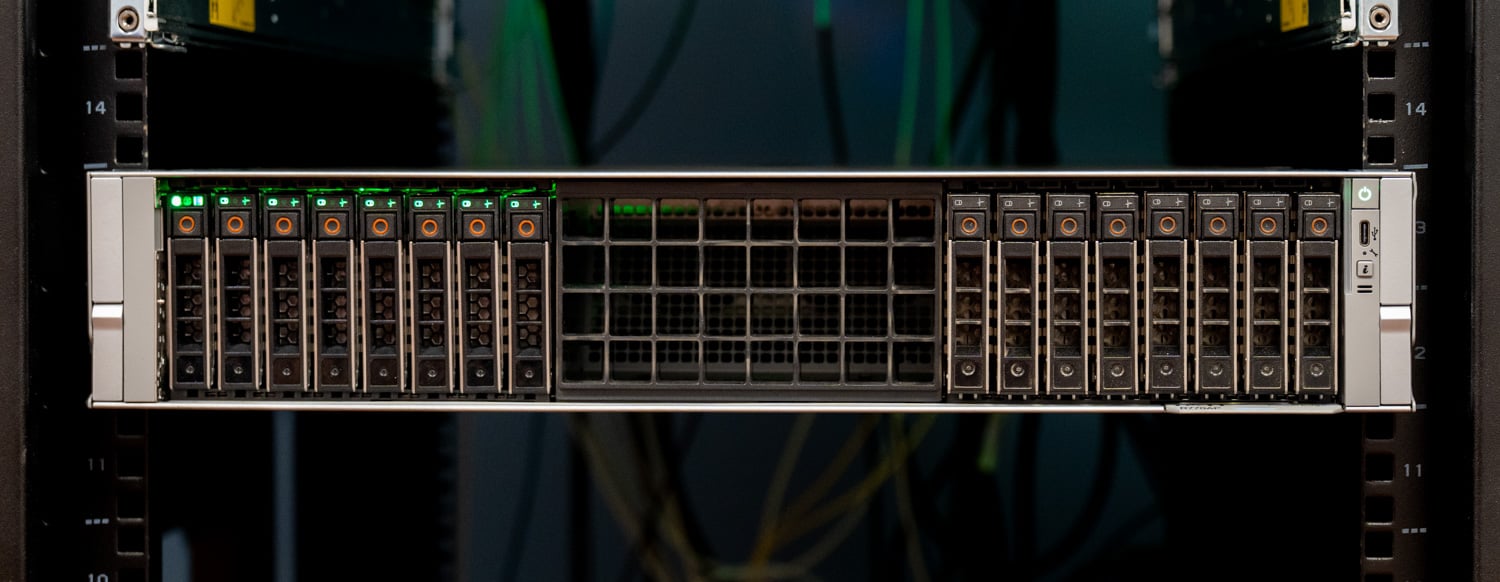
Le serveur de stockage est un Dell PowerEdge R770AP , la même plateforme 2U Xeon 6 que nous avons testée en début d'année. Nous l'avons utilisé car il était disponible gratuitement au laboratoire au début du projet. N'importe quel serveur NVMe capable d'accueillir des cartes réseau rapides et un petit GPU peut convenir, et le R770AP est une option, même s'il est légèrement surdimensionné. Notre configuration comprend deux processeurs Xeon 6 6978P, 1.5 To de mémoire DDR5 répartis sur 24 barrettes DIMM, utilise l'un de ses deux bancs de huit baies NVMe Gen5 et connecte les disques et le GPU Graid au CPU 0, tandis que les deux adaptateurs 400 GbE sont connectés au CPU 1. Le serveur fonctionne sous Ubuntu 24.04.
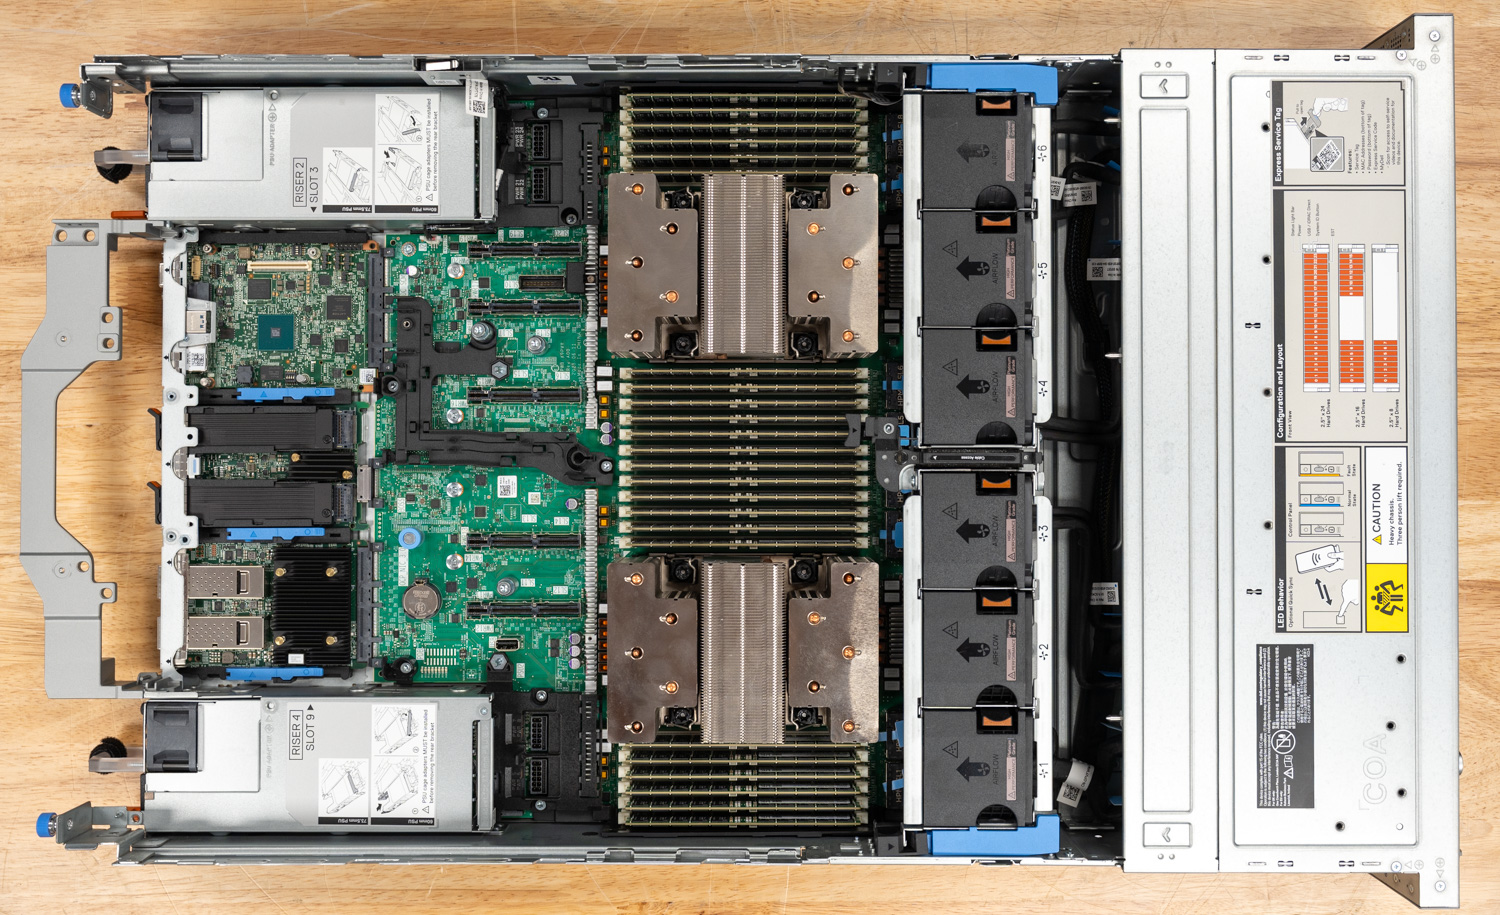
| Composant | Configuration de l'hôte de stockage |
|---|---|
| Server | Serveur Dell PowerEdge R770AP, 2U, 16 baies NVMe Gen5 de 2.5 pouces |
| Processeur | 2 processeurs Intel Xeon 6 6978P |
| Mémoire | 1.5 To DDR5 (24 x 64 Go) |
| Stockage | 8x Solidigm D5-P5336 61.44 To U.2 PCIe 4.0 QLC (491.52 To brut) |
| RAID | Graid SupremeRAID, RAID 5 sur les huit disques, GPU NVIDIA RTX A2000 sur le CPU 0 |
| Système de fichiers | XFS sur le disque virtuel SupremeRAID |
| Serveur de fichiers | Tuxera Fusion (Fusion NFS, version préliminaire privée), NFS 4.1 sur RDMA (RPC-RDMA sur le port 20049), mode utilisateur |
| Networking | 2x Broadcom BCM57608 (Thor 2) port unique 400GbE, PCIe Gen5 x16 sur le processeur 1, RoCEv2 |
| Basculer | Dell PowerSwitch Z9864F-ON, 64 ports OSFP112 800 GbE, SONiC d'entreprise |
| Liens clients | Liaison optique 800G décomposée en 8 liaisons 100GbE, une liaison par Spark, quatre Sparks par carte réseau de stockage sur des VLAN distincts. |
| ANNONCEURS | 2x Dell Pro Max avec GB10, 2x GIGABYTE AI TOP ATOM, 2x HP ZGX Nano G1n, Acer Veriton GN100, ASUS Ascent GX10 |
| OS | Ubuntu LTS 24.04 |
Pourquoi QLC, et pourquoi le D5-P5336
Lors de nos échanges avec l'Université d'État de l'Oregon concernant le concept du laboratoire Spark, la capacité s'est avérée être la première exigence, compte tenu de l'immensité des ensembles de données de recherche. Ce serveur a pour mission de stocker toutes les données nécessaires à une salle entière de machines Spark et de les mettre à disposition dans un format accessible simultanément par de nombreux clients. Il s'agit d'un profil d'utilisation exigeant en lecture, avec des blocs de grande taille et une capacité élevée, un profil pour lequel la technologie QLC a été conçue. La gamme D5-P5336 offre des capacités allant de 7.68 To à 122.88 To ; les disques U.2 de 61.44 To utilisés ici sont certifiés par Solidigm pour des vitesses de lecture séquentielle allant jusqu'à 7 000 Mo/s, des vitesses d'écriture séquentielle allant jusqu'à 3 000 Mo/s, 1.005 million d'IOPS en lecture aléatoire 4K et une endurance de 65.2 PoW, soit 0.58 écriture par jour sur cinq ans, sur une mémoire NAND QLC 192 couches avec une unité d'indirection de 16 Ko.
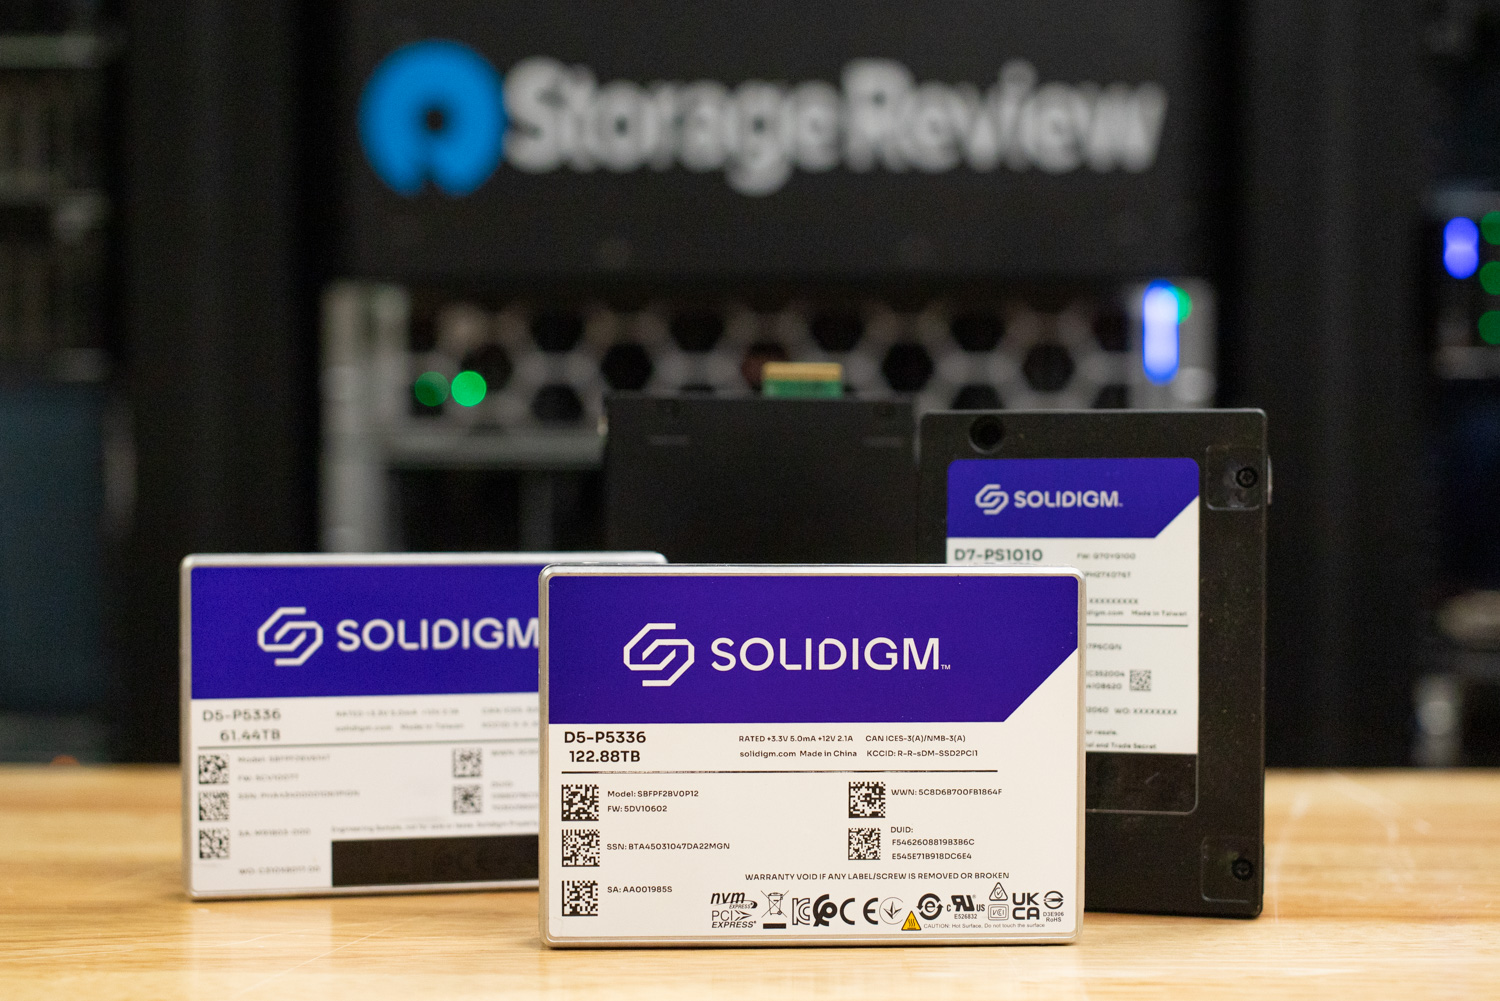
Les huit disques de 61.44 To occupent la moitié des baies avant du R770AP, et une configuration de production peut opter pour n'importe quelle capacité et n'importe quel nombre de baies. Malgré cela, huit disques en RAID 5 offrent environ 430 To d'espace utilisable avec une tolérance aux pannes de disque unique. C'est plus de 100 fois la capacité d'un emplacement M.2 de Spark et suffisant pour la bibliothèque de modèles d'un département, les jeux de données partagés utilisés par les étudiants et les répertoires personnels de chaque utilisateur. Remplir les huit autres baies double cette capacité sans modifier l'architecture réseau, et les dimensions détaillées plus loin dans cet article démontrent pourquoi les disques sont l'élément clé pour l'extension du système.
L'unité d'indirection de 16 Ko est cruciale pour cette charge de travail, car l'unité d'indirection plus grande de Solidigm privilégie la densité et le coût au détriment de l'efficacité des petites écritures aléatoires. Or, pour une unité dédiée aux modèles et aux jeux de données, les petites écritures aléatoires sont minoritaires. Le chargement des modèles et le flux de données impliquent de grandes lectures séquentielles. Les points de contrôle et les fichiers étudiants sont écrits une seule fois, puis lus fréquemment. Cette répartition des tâches est idéale pour un environnement de test Spark : la baie QLC partagée stocke toutes les données lues par plusieurs utilisateurs, tandis que le périphérique M.2 dédié à Spark gère le trafic de travail (scratch et swap) écrit par un seul utilisateur.
RAID sur GPU : Graid SupremeRAID
Un RAID NVMe sur huit disques Gen4, chacun capable de lire à 7 000 Mo/s, représente le point où une carte RAID matérielle classique devient le facteur limitant, car chaque octet doit transiter par son port PCIe. Le RAID logiciel, quant à lui, est confronté à des défis de ressources différents. Graid SupremeRAID décharge les calculs de parité sur un GPU et conserve le chemin de données sur les lignes PCIe de l'hôte, ce qui explique pourquoi nous avons constaté des débits supérieurs à 180 Go/s lors de nos tests SupremeRAID AE avec 16 disques. Pour cet hôte, nous avons exécuté SupremeRAID sur une NVIDIA RTX A2000, un petit GPU pour station de travail.
Les huit disques D5-P5336 ont été effacés de manière sécurisée et remplis séquentiellement avant d'être confiés à Graid, puis configurés en une seule grappe RAID 5. Le lecteur virtuel ainsi créé a été formaté en XFS et géré par Tuxera. Le RAID 5 est le niveau idéal pour un partage de ce type : une panne de disque maintient la grappe en ligne, les reconstructions s'effectuent sans interruption de service et la perte de capacité est d'un disque sur huit. Le RAID 6 ou le RAID 10 seraient des choix judicieux pour un déploiement en production privilégiant la protection contre les interruptions de service à la capacité, et SupremeRAID prend en charge les deux.
Le réseau : Broadcom 400 GbE et un cœur de réseau 800 Gb.
La partie stockage du réseau est assurée par deux adaptateurs Broadcom BCM57608 Thor 2 intégrés au R770AP. Chaque adaptateur est une carte réseau 400 GbE à port unique sur une interface PCIe Gen5 x16. Broadcom présente le BCM57608 comme la carte réseau 400G la plus économe en énergie du marché, et ses fonctionnalités en font un choix judicieux : RoCEv2 avec contrôle de congestion DCQCN amélioré, routage adaptatif, démarrage sécurisé avec racine de confiance matérielle et déchargement du chiffrement kTLS intégré. Dans cette architecture, RoCEv2 prend en charge NFS sur RDMA, et le contrôle de congestion empêche les interférences entre plusieurs clients lorsqu'ils sollicitent simultanément la bande passante. Lors de la compilation, le pilote bnxt_en a signalé que les modules optiques des ports 400G atteignaient leur seuil d'alerte de 70 °C sous charge soutenue. Nous avons résolu ce problème en ajustant légèrement le profil de ventilation du R770AP, et les cartes réseau ont ensuite fonctionné sans incident.
Les deux cartes réseau sont connectées à un commutateur Dell PowerSwitch Z9864F-ON , le commutateur central 800G de notre laboratoire, exécutant Enterprise SONiC. Le Z9864F-ON dispose de 64 ports OSFP112 800 GbE et peut être configuré en 2 x 400 Gb, 4 x 200 Gb ou 8 x 100 Gb. Une interface optique 800 Gb, configurée en 8 x 100 Gb, connecte les huit Sparks (une liaison par Spark) au même commutateur qui termine les deux liaisons de stockage 400 Gb. Chaque carte réseau 400 Gb est sur son propre VLAN et dessert quatre Sparks. Ainsi, l'hôte de stockage présente deux cibles RDMA et la charge est répartie équitablement entre elles. En pratique, il s'agit d'une topologie à débit maximal : 8 x 100 Gbit/s de bande passante client d'un côté, 2 x 400 Gbit/s de bande passante de stockage de l'autre et un commutateur d'une capacité de 102.4 Tbit/s au milieu.
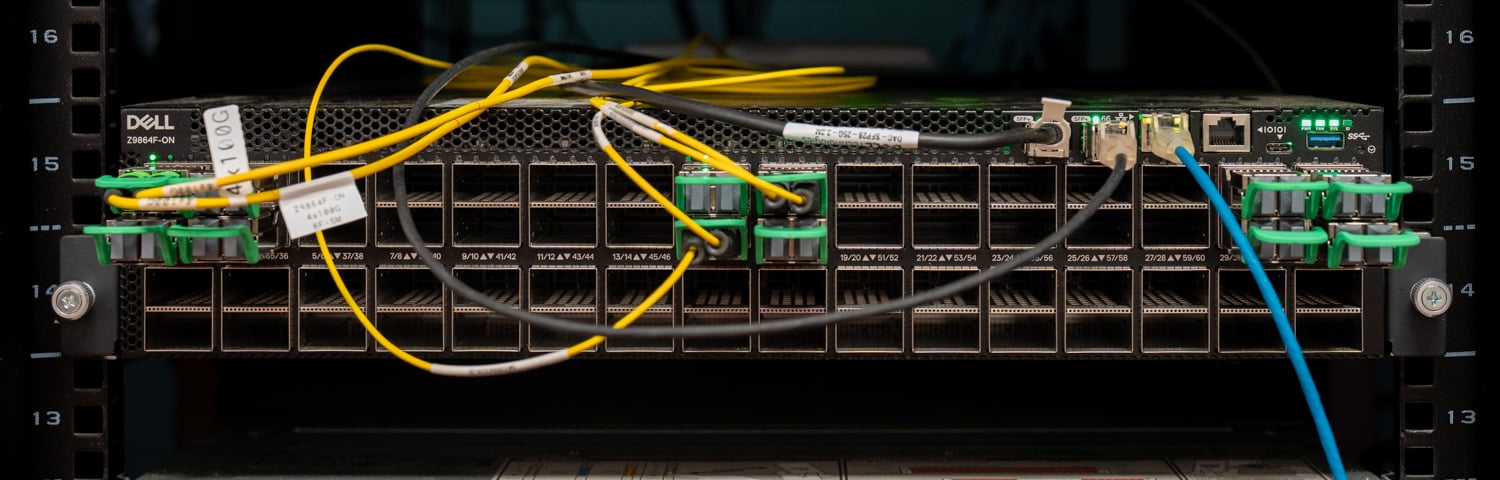
Nous avons validé l'infrastructure avant même l'installation du moindre logiciel de stockage. Les tests serveur à serveur entre le R770AP et un second hôte via les liaisons 400G ont fonctionné à pleine vitesse dans les deux sens, et le trafic RDMA provenant des Sparks a confirmé le bon fonctionnement des ports d'extension 100G. Une fois les partages NFS opérationnels par les ingénieurs de Tuxera, les tests iperf3 effectués entre les Sparks et leurs cartes réseau respectives ont affiché un débit stable de 99 Gbit/s avec quatre flux parallèles et aucune retransmission.
Pourquoi NFS, et pourquoi Tuxera
Avec Graid proposant un périphérique de stockage par blocs rapide, l'hôte de stockage peut servir les instances Spark comme cibles de blocs NVMe-oF ou comme partages de fichiers. Nous avons testé le chemin d'accès par blocs lors de l'évaluation de GP Spark, et il fonctionne bien pour un seul client. Pour un laboratoire composé de plusieurs instances Spark, nous recherchions une autre solution. Les volumes par blocs étant de type un-à-un, chaque utilisateur aurait besoin d'un LUN, et dès que deux utilisateurs souhaitent accéder au même jeu de données, il faut le copier, ce que cette conception vise précisément à éviter. NFS se situe au centre de ce schéma : un espace de noms unique contient les jeux de données partagés, les modèles hébergés et les dossiers par utilisateur. Chaque montage Spark utilise le client NFS déjà présent dans Ubuntu, et les outils Kubernetes et Slurm qu'une université déploierait sur un laboratoire Spark sont tous compatibles NFS.
Fusion NFS est la composante NFS de Tuxera Fusion, le serveur de fichiers multiprotocole qui prend en charge SMB et NFS sur un seul cœur multithread en mode utilisateur. Nous avons découvert Fusion SMB dans le cadre d'un projet de workflow multimédia Solidigm et Tuxera en 2024. Tuxera annonce un débit allant jusqu'à 22.7 Go/s sur une connexion 200 GbE unique avec RDMA, surpassant ainsi les performances de NFSD et Ganesha (d'après ses propres tests). Le produit prend en charge NFS 4.1, le clustering actif-actif à montée en charge horizontale, le basculement transparent et l'intégration avec Active Directory, Kerberos et LDAP. Ce dernier point constitue le point d'ancrage de la gouvernance : le même annuaire qui contrôle les accès à Spark contrôle également les ressources accessibles sur le partage. Attention : la version utilisée dans cet article est une préversion privée de Fusion NFS qui, selon Tuxera, n'est pas encore totalement optimisée en termes de performances, et le logiciel n'est pas encore disponible à la vente. Sa disponibilité générale est prévue pour novembre, après SC'26.
Tuxera a installé Fusion sur le R770AP, formaté le volume Graid avec XFS et configuré le serveur avec NFS sur le port standard et RPC-RDMA sur le port 20049, en omettant les écouteurs SMB puisque ce projet utilise exclusivement NFS. La configuration initiale des threads comprenait quatre threads de protocole, chacun avec huit threads pour la transmission et la réception du transport, les données VFS et les métadonnées VFS. Tuxera décrit cette configuration comme un point de départ pour l'optimisation. Les services d'annuaire ont été volontairement exclus de la configuration de laboratoire ; un déploiement universitaire ajouterait ses propres services d'identité. Côté Spark, le montage du partage se fait en une seule commande :
sudo mount -t nfs -o proto=rdma,port=20049 :/mnt/shares/smbnfs1/ /localnfs
Cette unique ligne de commande représente l'intégralité de l'intégration client, sans pilote, sans configuration d'initiateur et sans logiciel fournisseur sur le Spark. Un utilisateur se connectant à un autre Spark demain exécutera la même ligne et verra les mêmes fichiers.
Preuve de configuration : huit Sparks sur un seul ensemble de données
Avant toute modélisation, nous avons effectué un test de bon fonctionnement sur chaque Spark individuellement : une lecture séquentielle de 1 million de requêtes (fio) avec 16 tâches et une profondeur de file d'attente de 16, sur son propre dossier du système. Les huit unités ont renvoyé un débit compris entre 10.0 et 11.2 Gio/s, saturant la liaison 100 GbE de chacune. Nous avons ensuite réalisé un test de charge pour vérifier que les huit unités pouvaient supporter leur part de charge. Chaque test maintient 16 threads avec une profondeur de file d'attente cumulée de 16 et les répartit sur une, deux, quatre et huit Sparks, sur des charges de travail séquentielles de 1 million de requêtes, aléatoires de 64 000 et 16 000, séquentielles et aléatoires de 4 000, avec des opérations de lecture et d'écriture, des E/S directes et une durée de 60 secondes par test. Chaque Spark écrit dans son propre dossier sur le système, quatre par carte réseau de stockage, et aucune QoS n'est implémentée. Avec les huit unités chargées simultanément, les performances en lecture séquentielle (1M) par unité variaient de 3.09 à 3.13 Gio/s, les performances en lecture aléatoire (64K) de 6 648 à 6 779 IOPS et les performances en écriture aléatoire (4K) de 2 136 à 2 155 IOPS, sur cinq OEM répartis sur deux VLAN sans application de répartition équitable. Chaque unité Spark a atteint la baie, chaque unité a reçu une part égale de la charge et la configuration était prête pour la charge de travail critique.
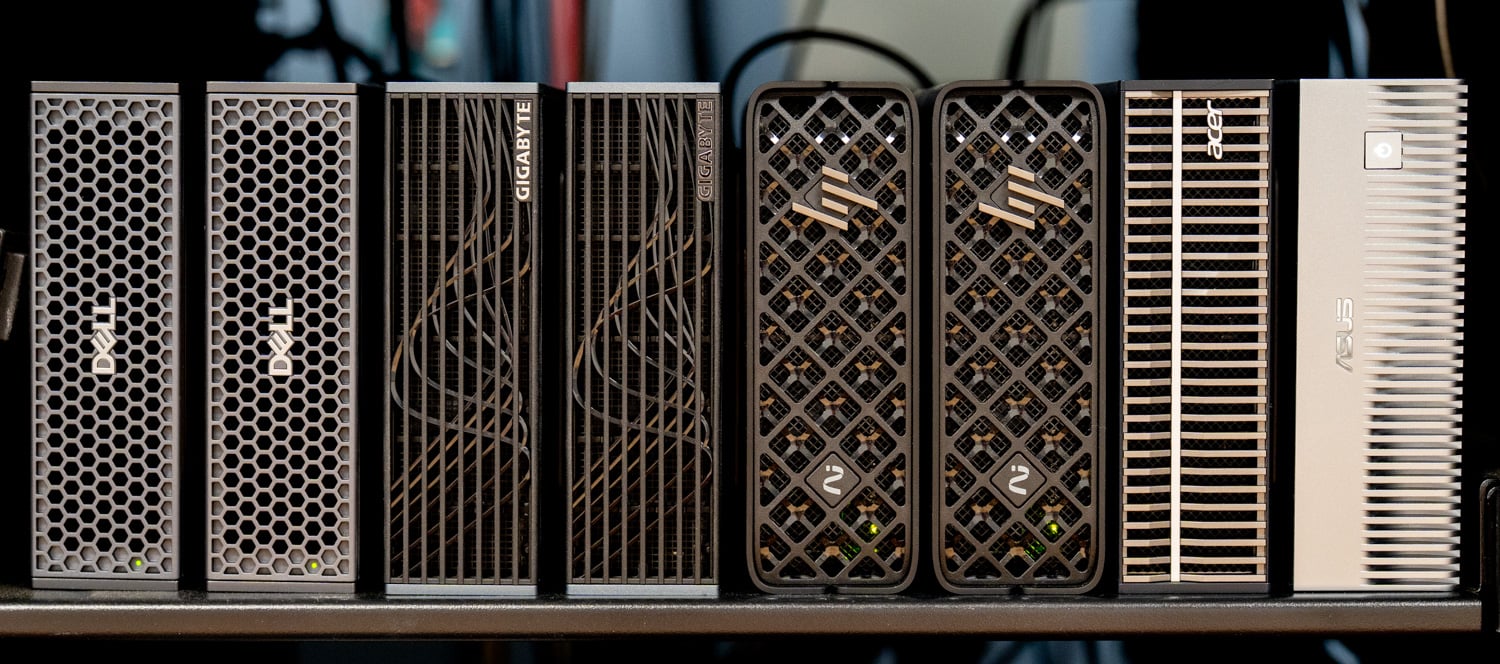
| Spark (huit clients, 2 threads x QD16 chacun) | Carte réseau de stockage | Lecture séquentielle 1M | IOPS en lecture aléatoire 64K | IOPS en lecture aléatoire 4K | IOPS en écriture aléatoire 4K |
|---|---|---|---|---|---|
| Dell Pro Max avec GB10 (1) | 1 | 3,176 Mio/s | 6,648 | 10,000 | 2,150 |
| GIGABYTE AI TOP ATOM (1) | 1 | 3,195 Mio/s | 6,779 | 10,300 | 2,142 |
| HP ZGX Nano G1n (1) | 1 | 3,201 Mio/s | 6,696 | 10,100 | 2,136 |
| Acer Veriton GN100 | 1 | 3,194 Mio/s | 6,670 | 10,100 | 2,149 |
| Dell Pro Max avec GB10 (2) | 2 | 3,184 Mio/s | 6,694 | 10,200 | 2,155 |
| GIGABYTE AI TOP ATOM (2) | 2 | 3,187 Mio/s | 6,667 | 10,100 | 2,141 |
| HP ZGX Nano G1n (2) | 2 | 3,189 Mio/s | 6,678 | 10,100 | 2,151 |
| ASUS Ascent GX10 | 2 | 3,163 Mio/s | 6,734 | 10,300 | 2,145 |
Dimensionnement du serveur : Deux cartes réseau et une marge de manœuvre confortable
Cette même analyse permet de répondre à la question que tout laboratoire ou entreprise doit se poser avant d'acheter : quelles sont les limites de performance, et quel composant du système hôte les détermine ? Les quatre graphiques ci-dessous illustrent le débit de lecture pour les quatre charges de travail, la charge fixe passant d'un à huit Spark ; le débit d'écriture est traité dans le texte et le tableau ci-dessous.
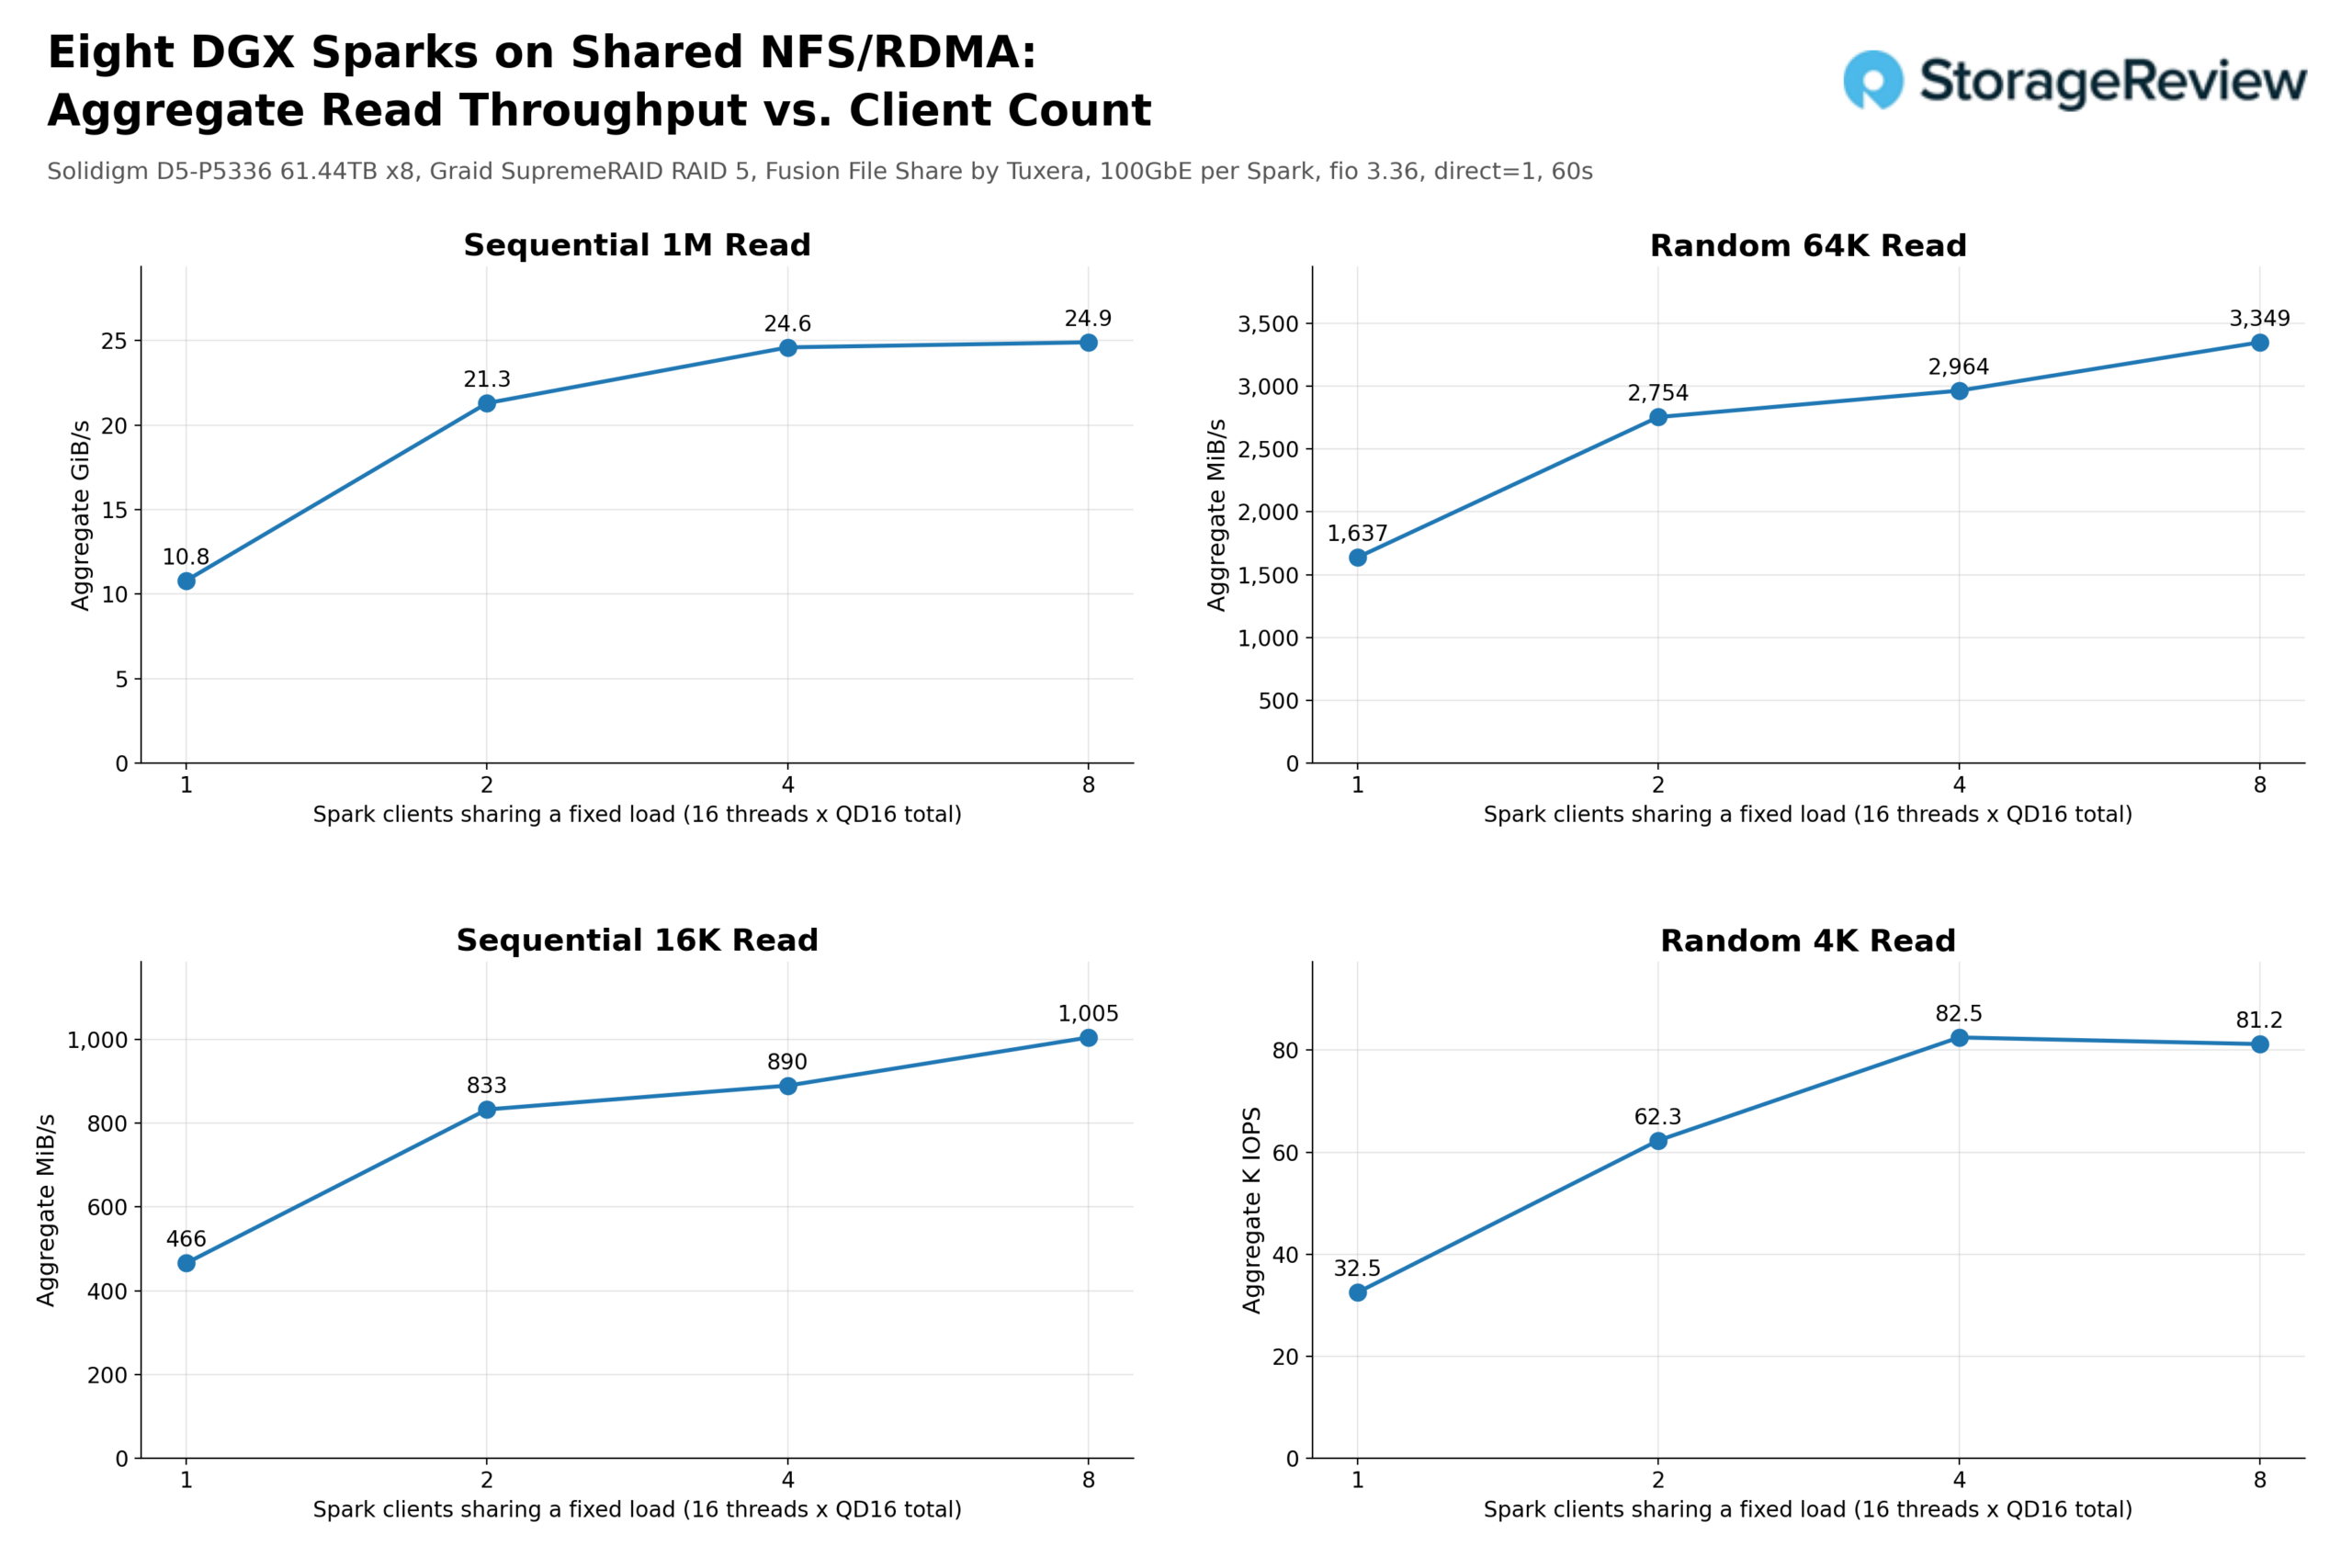
Le débit de lecture séquentielle agrégé (1 Mo) est passé de 10.8 Gio/s sur un Spark à 21.3 Gio/s sur deux, 24.6 Gio/s sur quatre et 24.9 Gio/s sur huit. En termes de réseau, cela correspond à 93 Gbit/s, 183 Gbit/s, 212 Gbit/s et 214 Gbit/s, contre 800 Gbit/s pour les deux cartes réseau Broadcom 400GbE. Ainsi, à pleine charge (huit clients), la baie utilisait 27 % de la capacité réseau de l'hôte. Le plateau observé aux alentours de 25 Gio/s est dû à la baie RAID 5 QLC à huit disques ; les cartes réseau, le commutateur et les liaisons 100 GbE propres aux Sparks n'ont jamais constitué la limite.
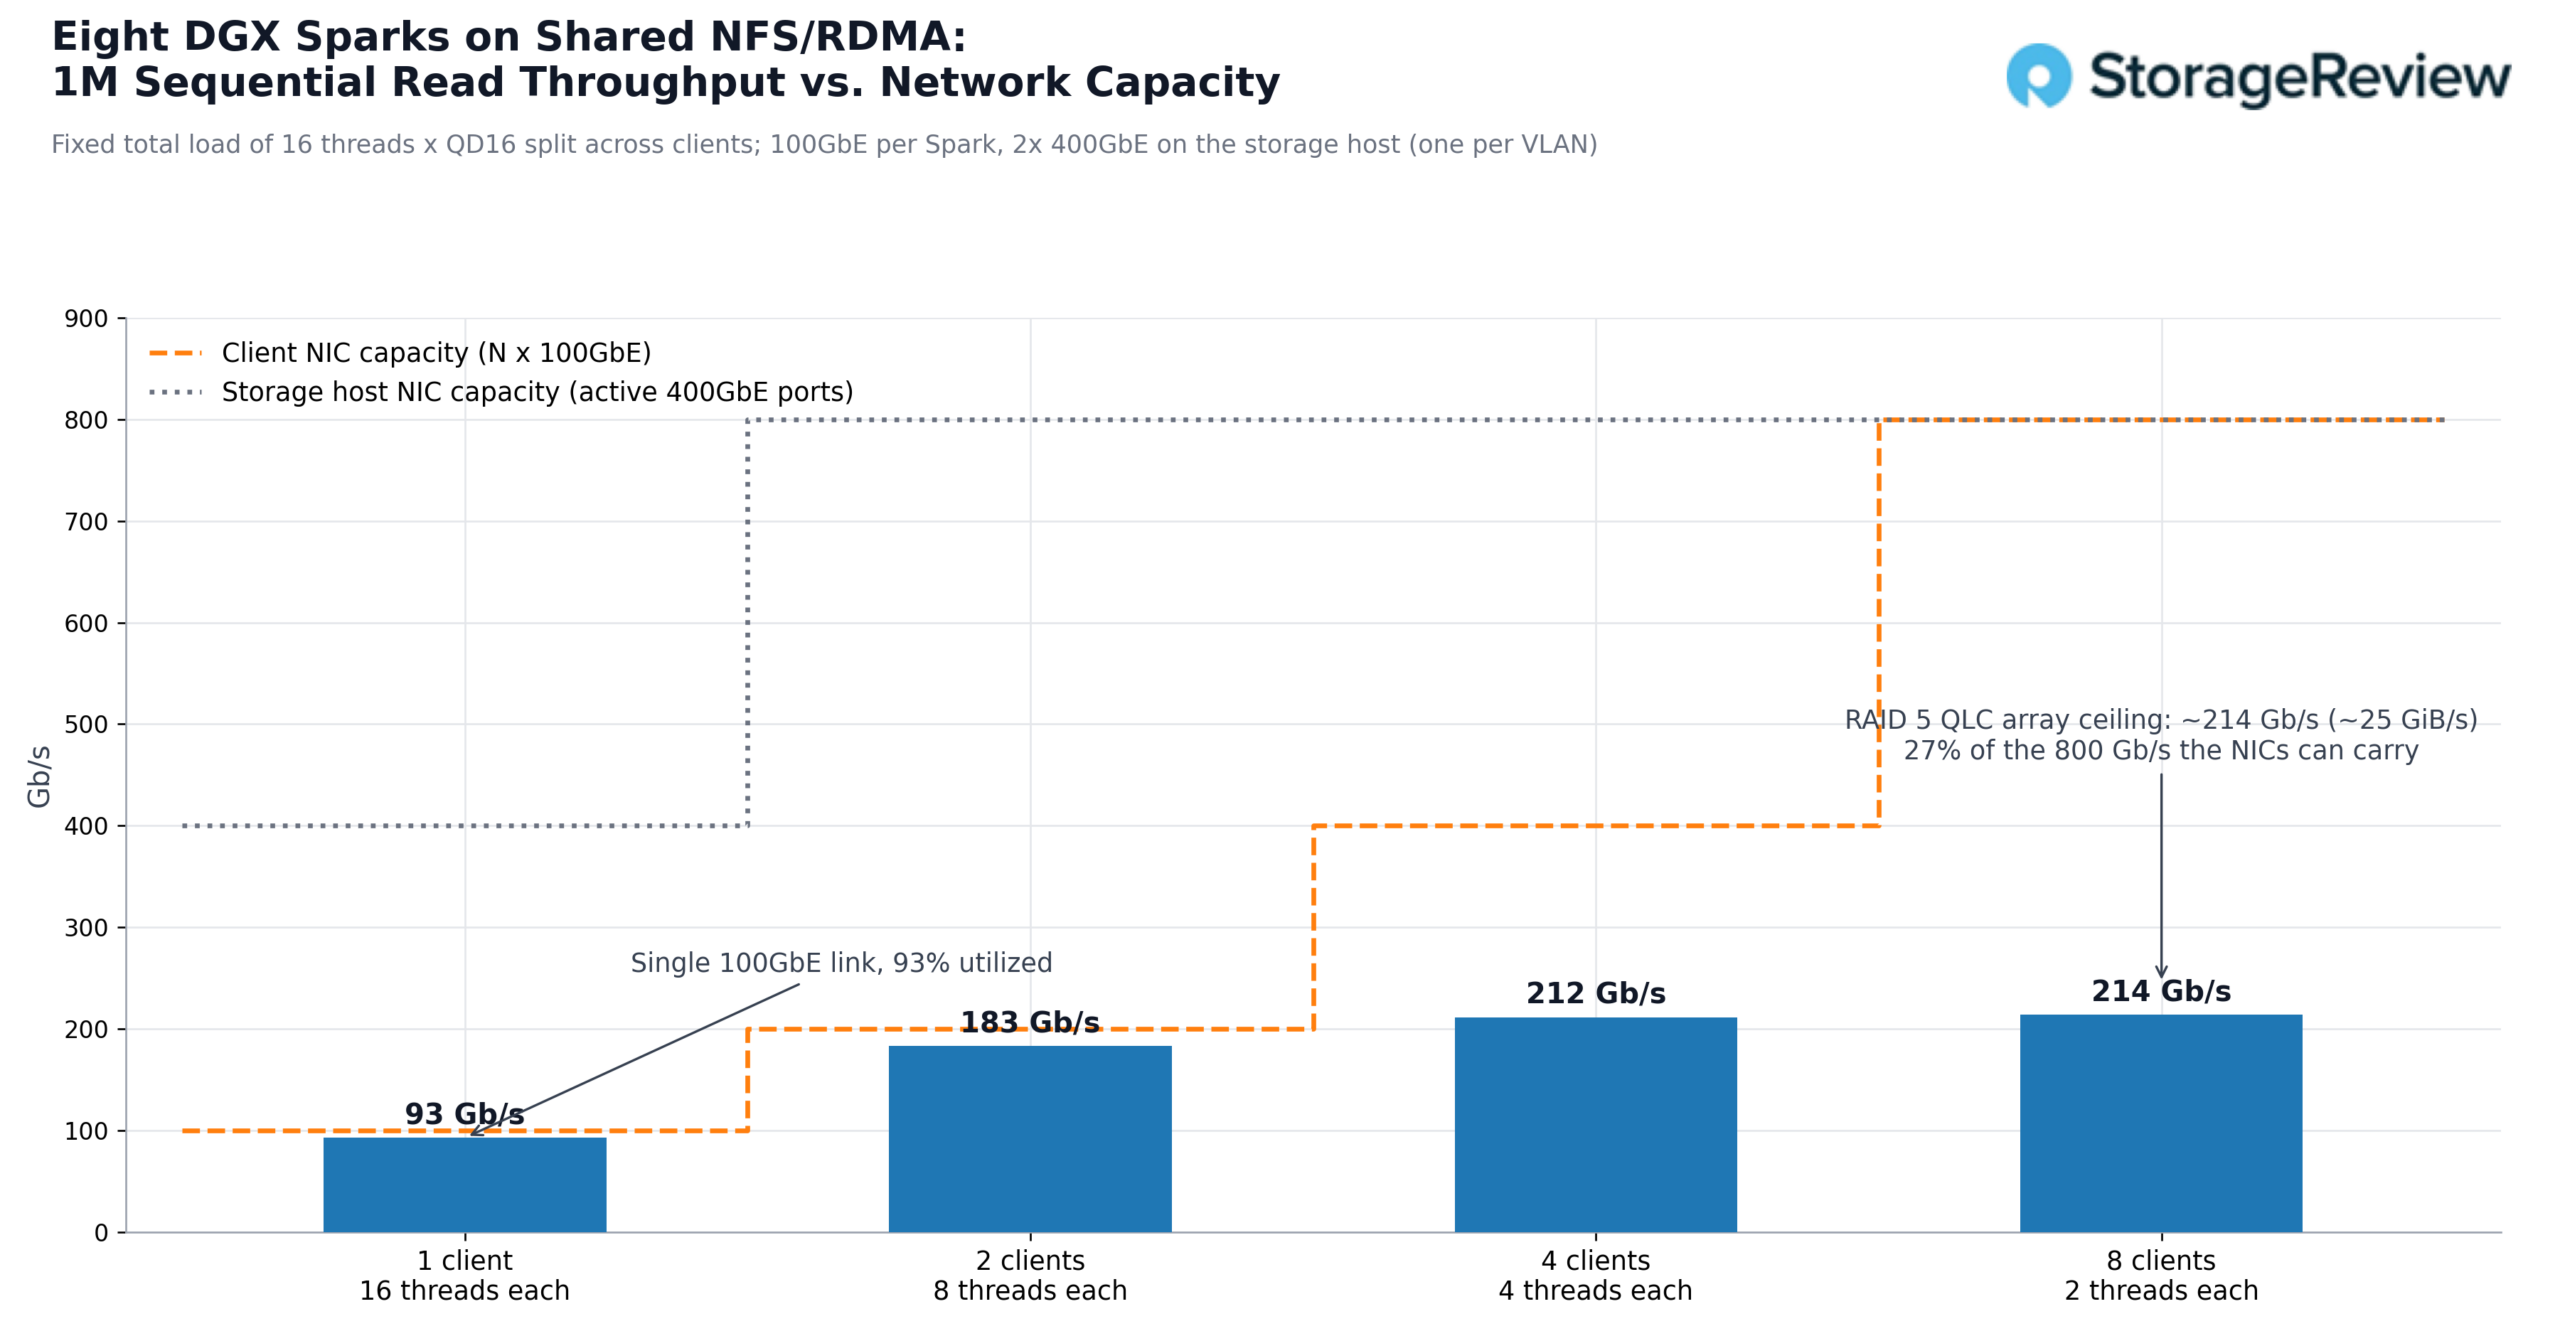
Deux cartes réseau côté serveur gèrent déjà huit disques Spark à pleine capacité, et elles couvriraient également les huit autres baies du R770AP : doubler le nombre de disques, que ce soit avec une deuxième baie ou un RAID plus étendu, augmente la bande passante en lecture sur les deux mêmes ports, avec une marge confortable. Il en va de même pour les E/S. Les lectures aléatoires 4K passent de 32 500 IOPS sur un client à un plateau d'environ 81 000 IOPS avec quatre clients et plus, la latence par E/S diminuant de 7.9 ms à 3.1 ms à mesure que la file d'attente de chaque client diminue. Quant aux lectures aléatoires 64K, elles passent de 1 637 à 3 349 Mio/s, le réseau restant largement en deçà de sa limite dans les deux cas.
L'autre point de comparaison important concerne le stockage déjà installé sur le Spark. Lors de nos tests individuels du GB10, les lectures GDSIO 1M depuis le M.2 interne ont atteint près de 11.2 Gio/s sur les Acer Veriton GN100 et GIGABYTE AI TOP ATOM. Le Dell Pro Max avec GB10 et le HP ZGX Nano G1n ont atteint environ 5.5 Gio/s, tandis que l'ASUS Ascent GX10 s'est approché des 5 Gio/s. À titre de comparaison, le boîtier NVMe-oF externe du Luisuantech GP Spark a fourni 9.5 Go/s via le même port 100 GbE. Une seule Spark lisant depuis la baie QLC partagée à 10.8 Gio/s égale les performances des disques internes les plus rapides de ce groupe et double environ les performances du plus lent, via un seul câble, d'après les données accessibles à tous les autres Spark. Les outils diffèrent : GDSIO sur les disques internes et fio via NFS ici ; il s'agit donc d'une comparaison de plages de performances.
Le tableau complet est présenté ci-dessous, avec les chiffres agrégés pour les quatre charges de travail et chaque nombre de clients. Le nombre de lignes de lecture augmente avec le nombre de clients jusqu'à saturation du RAID, tandis que le nombre de lignes d'écriture reste constant, d'un à huit Spark, car le chemin de parité RAID 5 limite le nombre d'écritures du RAID à un plafond fixe, quel que soit le nombre de clients qui le partagent. Pour un partage conçu pour être lu par plusieurs utilisateurs et écrit une seule fois lors de l'ingestion, c'est le profil pour lequel l'architecture a été optimisée.
| Agrégat (16 threads au total) | 1 Spark | 2 Étincelles | 4 Étincelles | 8 Étincelles |
|---|---|---|---|---|
| Lecture séquentielle 1M | 10.8 Gio/s | 21.3 Gio/s | 24.6 Gio/s | 24.9 Gio/s |
| 1 M d'écriture séquentielle | 2.4 Gio/s | 2.4 Gio/s | 2.4 Gio/s | 2.4 Gio/s |
| Lecture aléatoire 64K | 1,637 Mio/s | 2,754 Mio/s | 2,964 Mio/s | 3,349 Mio/s |
| Écriture aléatoire 64K | 722 Mio/s | 719 Mio/s | 723 Mio/s | 703 Mio/s |
| Lecture séquentielle 16K | 466 Mio/s | 833 Mio/s | 890 Mio/s | 1,005 Mio/s |
| Écriture séquentielle 16K | 57 Mio/s | 60 Mio/s | 62 Mio/s | 28 Mio/s |
| Lecture aléatoire 4K | 32.5K IOPS | 62.3K IOPS | 82.5K IOPS | 81.2K IOPS |
| Écriture aléatoire 4K | 17.8K IOPS | 17.7K IOPS | 17.5K IOPS | 17.2K IOPS |
Modèles d'hébergement sur stockage partagé
Le test fio confirme que la baie et le réseau sont parfaitement adaptés. Le prochain test crucial pour ce cas d'utilisation consiste à déterminer si un modèle hébergé sur la baie partagée se charge aussi bien qu'un modèle hébergé sur le NVMe dédié du Spark, car c'est sur ce flux de travail que repose toute la conception : une seule copie, hébergée de manière centralisée et accessible à tous. Nous avons choisi Qwen3.5-122B-A10B en NVFP4, un modèle de mélange d'experts à 122 milliards de paramètres occupant 78 Go sur disque et tenant dans les 128 Go de mémoire unifiée d'un seul Spark. Nous avons mesuré le temps écoulé entre le lancement du serveur d'inférence et l'obtention d'un signal de bon fonctionnement, ainsi que la bande passante de stockage moyenne pendant cette période, dans trois scénarios : un Spark chargeant depuis son NVMe interne, le même Spark chargeant via NFS/RDMA depuis la baie partagée, et les huit Spark chargeant simultanément la même copie unique depuis la baie.
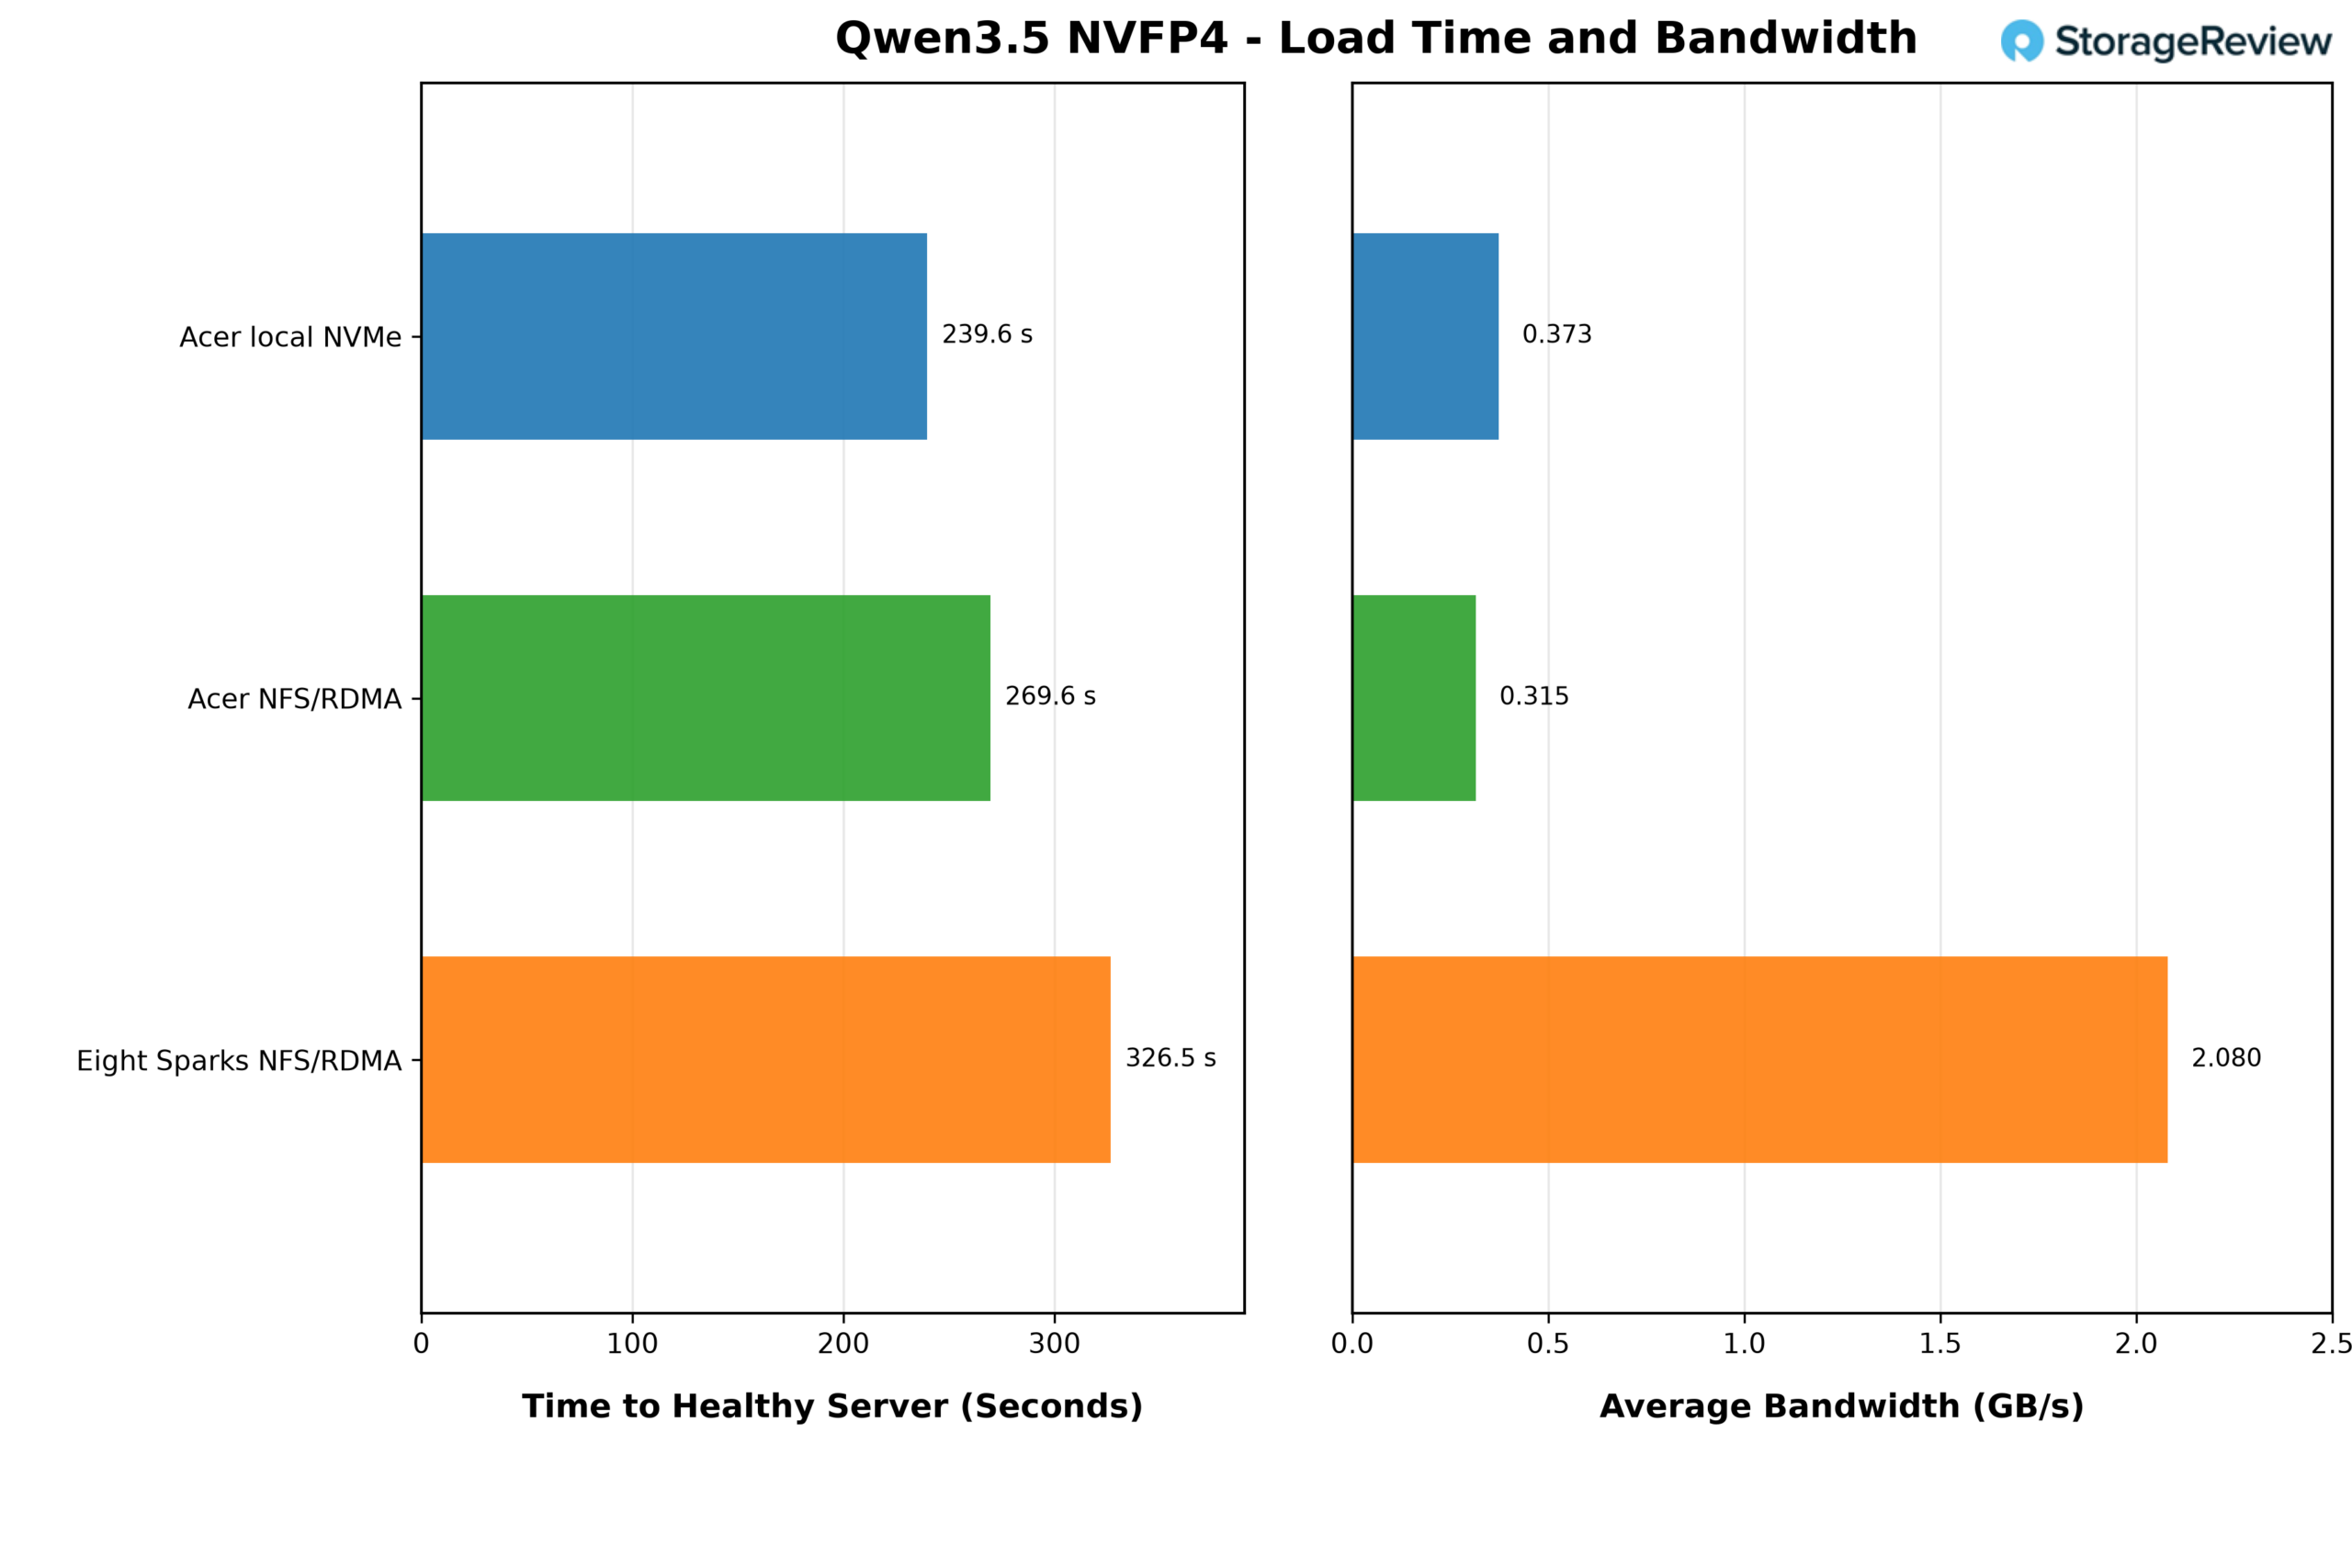
Depuis le SSD NVMe interne, l'Acer Veriton GN100 a atteint un serveur opérationnel en 239.6 secondes, avec une vitesse moyenne de 0.373 Go/s. Depuis la baie partagée via NFS/RDMA, le même Spark a mis 269.6 secondes à 0.315 Go/s, soit environ 30 secondes (13 %) de plus. Ces moyennes montrent qu'avec un chargement de 78 Go en quatre minutes, le chargement d'un modèle Spark n'est pas limité par le stockage dans les deux cas. Le traitement des poids par le GB10 détermine la vitesse, et le stockage passe la majeure partie du temps à attendre.
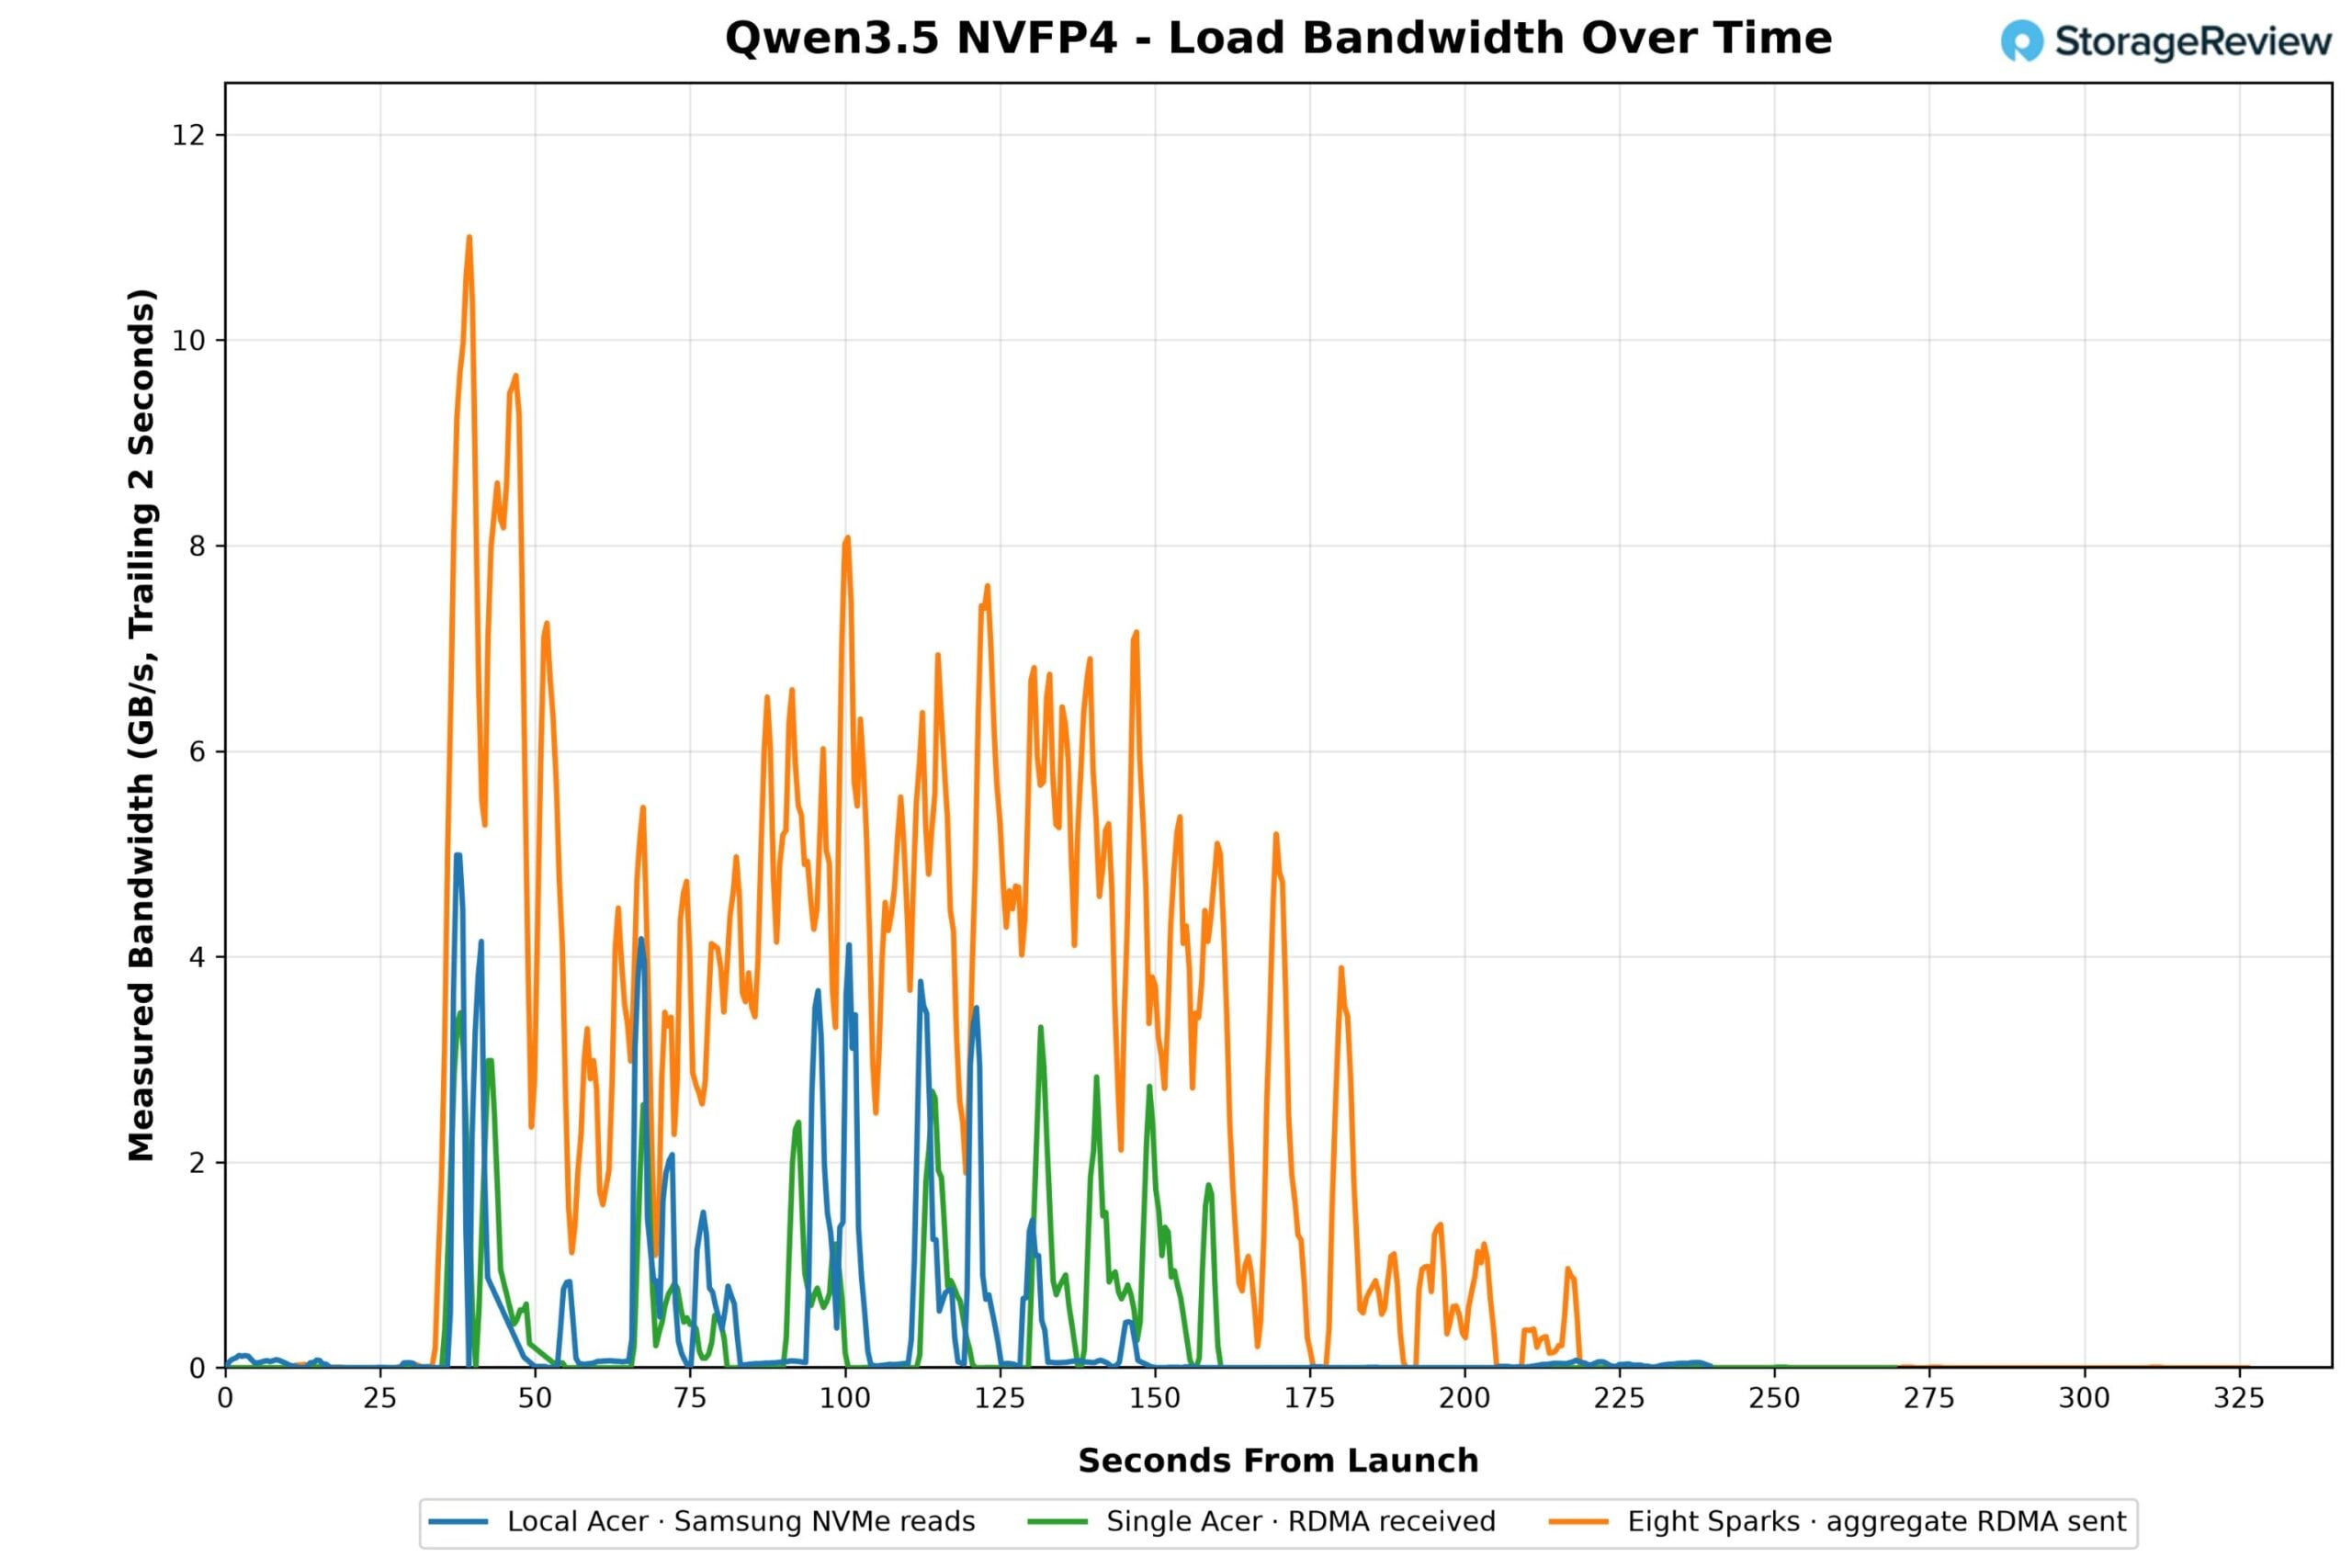
Le tracé de bande passante révèle ce schéma : les lectures NVMe locales arrivent par rafales atteignant un pic proche de 5 Go/s, séparées par de longs intervalles ; le client NFS unique présente la même forme de rafales, avec des pics légèrement inférieurs. La courbe agrégée des huit Sparks illustre la capacité du système sous forte demande simultanée. Avec les huit Sparks accédant simultanément à la même quantité de mémoire (78 Go), le système a atteint un pic agrégé de 11 Go/s durant la première minute, puis s'est stabilisé entre 4 et 8 Go/s environ pendant les deux minutes suivantes, le temps que les Sparks traitent leurs données. La moyenne sur l'ensemble de la période s'est établie à 2.08 Go/s. Comparé aux 25 Gio/s que le balayage fio a démontrés comme étant la capacité maximale du système, le chargement simultané d'un modèle par huit Sparks n'a utilisé qu'une fraction de la capacité disponible.
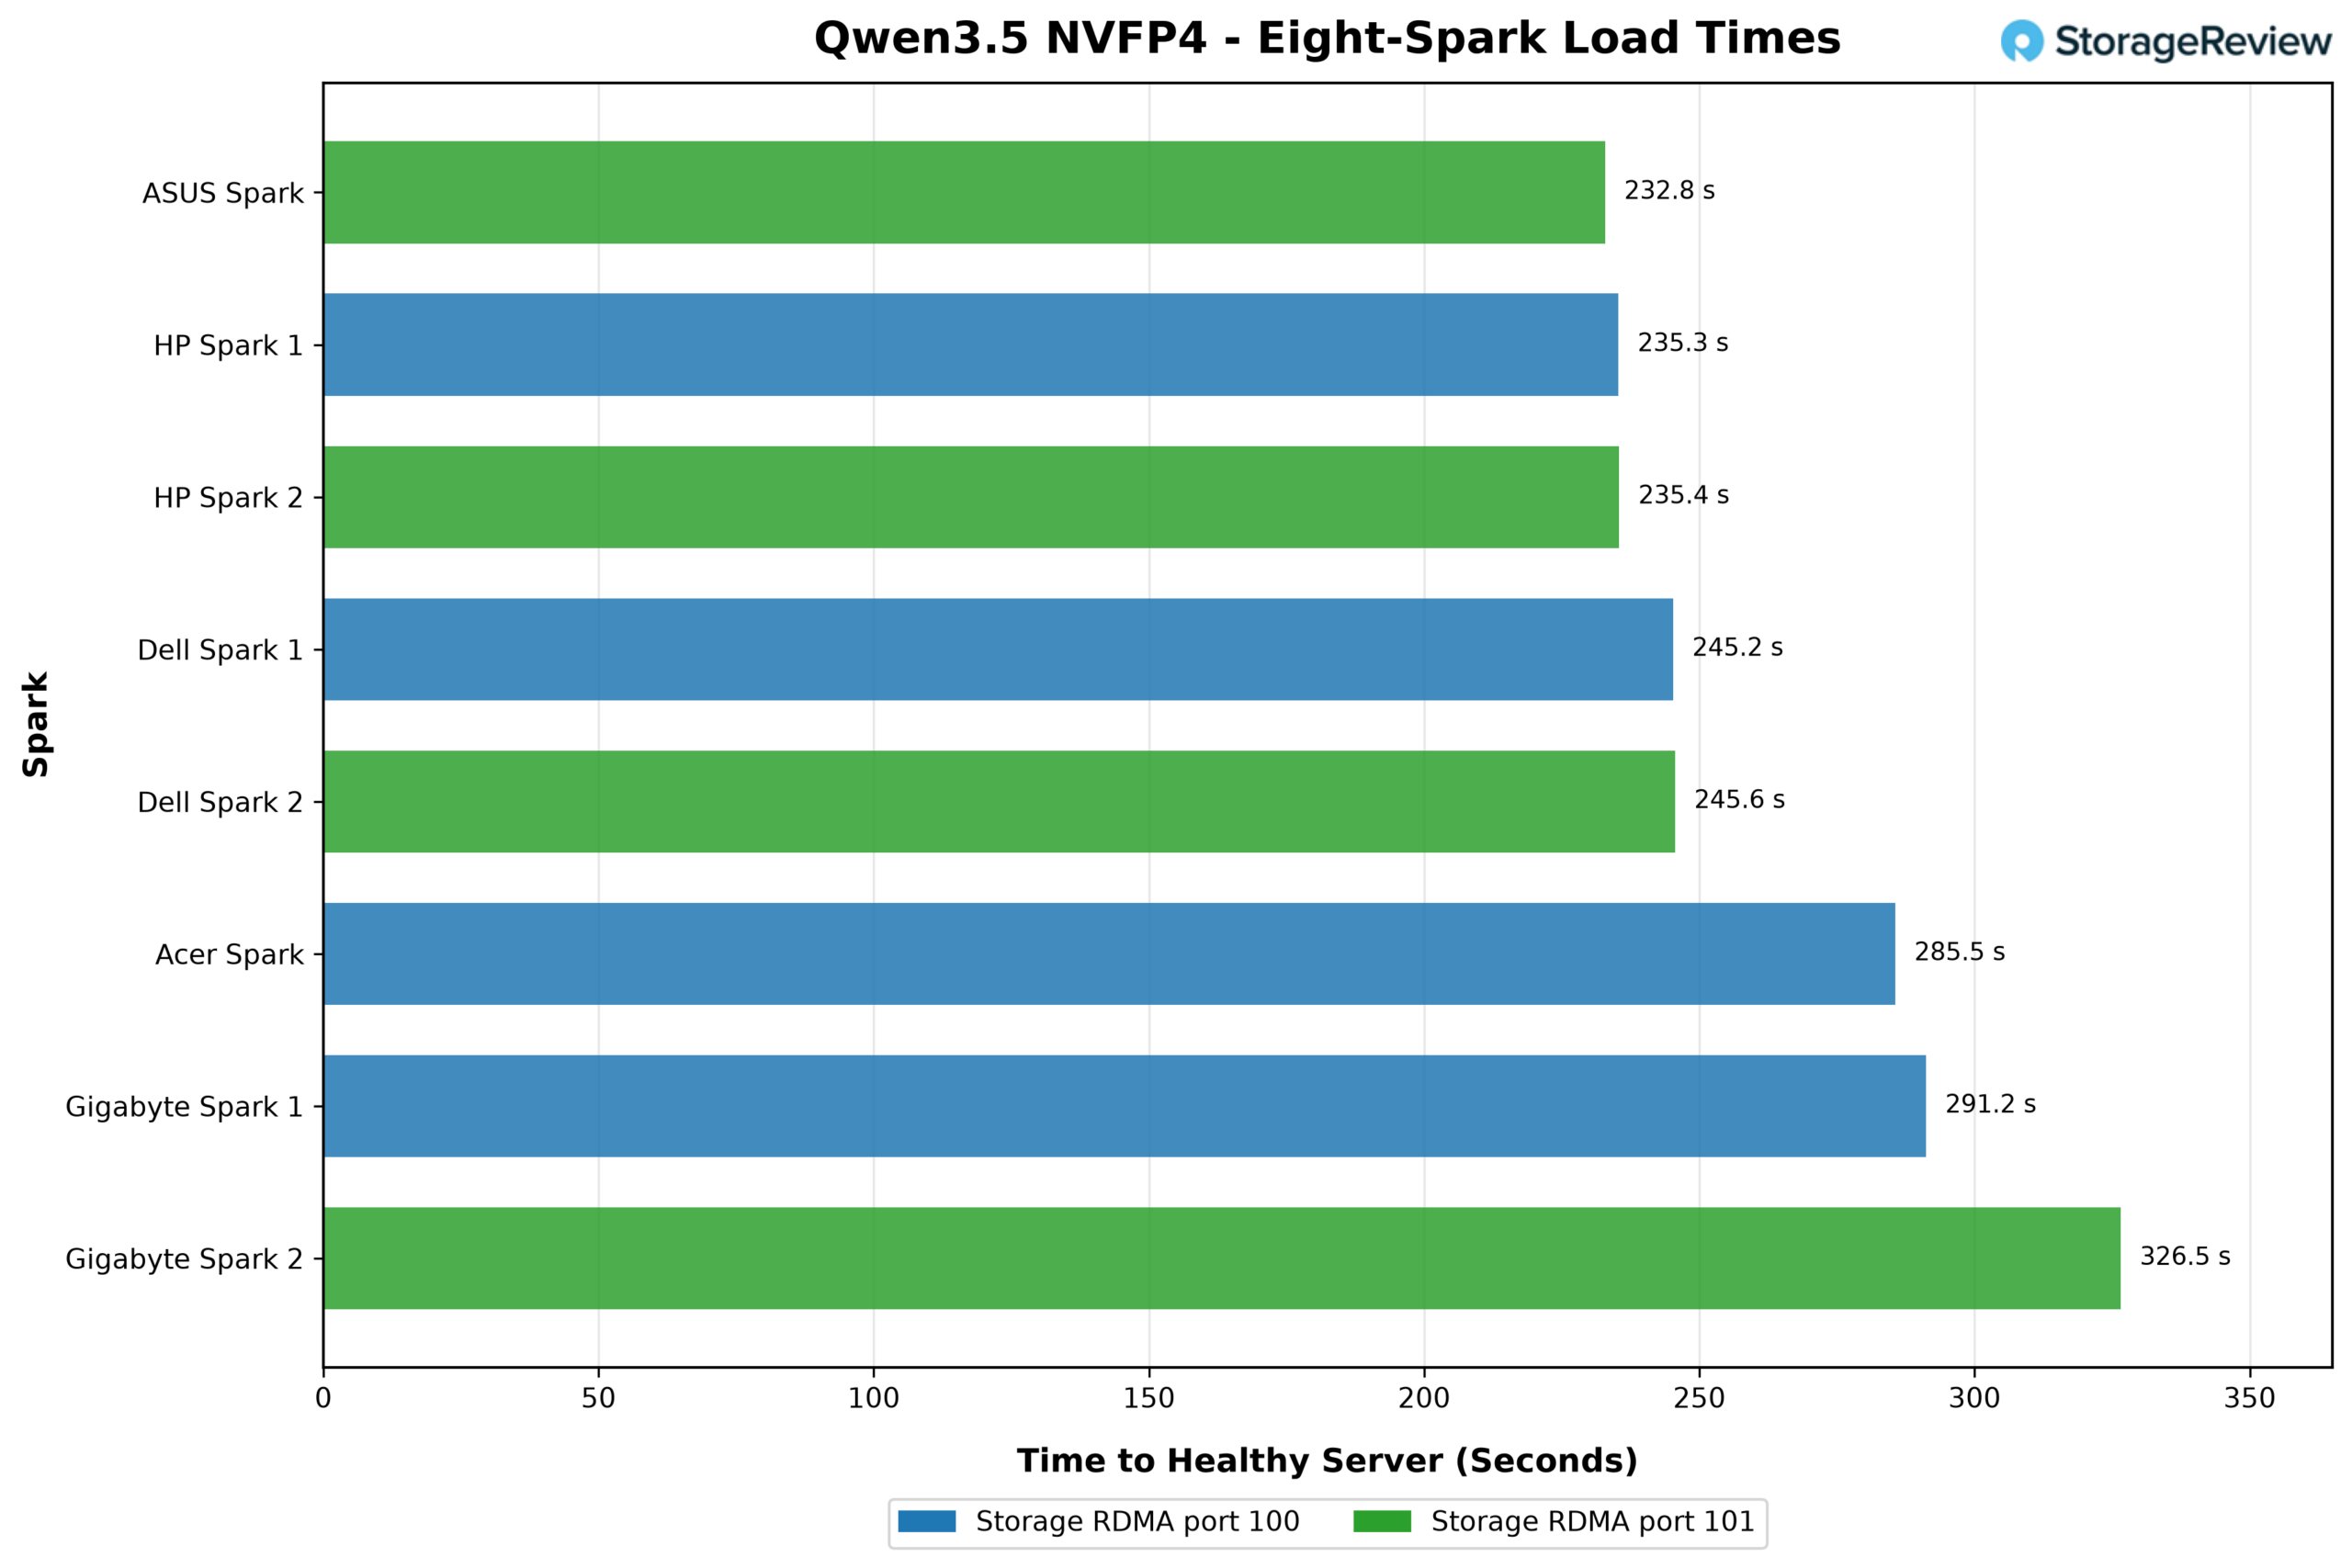
Les temps de chargement par unité lors du test à huit systèmes ont varié de 232.8 secondes sur l'ASUS Ascent GX10 à 326.5 secondes sur l'une des unités GIGABYTE AI TOP ATOM. Les deux systèmes HP ZGX Nano G1n ont affiché des temps de 235.3 et 235.4 secondes, tandis que les deux Dell Pro Max équipés d'unités GB10 ont atteint 245.2 et 245.6 secondes. Cinq des huit Sparks, chargés simultanément depuis la baie partagée, ont surpassé le chargement d'un seul Spark via NFS/RDMA, et trois d'entre eux ont même fait mieux que le test NVMe local. Cet écart n'est pas lié au fournisseur : en l'absence de QoS, l'unité qui attend la baie à chaque instant varie d'un test à l'autre, et les deux unités connectées à chaque carte réseau de stockage se répartissent équitablement entre les performances les plus rapides et les plus lentes.
Pour un laboratoire, le résultat est qu'il peut conserver une copie de chaque modèle sur le réseau, et n'importe quel Spark, ou n'importe quel Spark, la charge en à peu près le même temps qu'il faudrait pour charger une copie locale, sans étape de téléchargement, sans consommation de capacité locale et sans copie des poids sur un bureau.
Le cas d'utilisation de l'État de l'Oregon
Le Collège des sciences de la Terre, de l'océan et de l'atmosphère de l'Université d'État de l'Oregon (OSU) collabore régulièrement à nos travaux sur l'infrastructure d'IA, depuis la recherche océanographique en temps réel à bord d'un navire de recherche jusqu'à l'évaluation académique assistée par l'IA avec Metrum AI . Chris Sullivan, directeur de la recherche et du calcul académique à l'OSU, et son architecte, Thomas Olson, étudient la possibilité de créer un laboratoire Spark à grande échelle pour l'apprentissage de l'IA, pouvant accueillir jusqu'à 100 unités. Leurs réflexions sur le stockage ont influencé notre conception de deux manières spécifiques.
Premièrement, le stockage doit être indépendant des Sparks. L'OSU a envisagé un système de fichiers réparti entre les Sparks eux-mêmes, mais l'a rejeté pour une salle de classe, car l'ajout ou la suppression d'un seul nœud perturberait le service de stockage pour tous. Un système centralisé, accessible depuis n'importe quel Spark, permet d'ajouter, de supprimer, de réinstaller ou de confier un Spark à un autre étudiant sans impacter les données des autres. Deuxièmement, le stockage doit suivre l'utilisateur. Nous décrivons l'exigence de l'OSU comme une version renforcée des partages de fichiers dédiés à l'IA, où les étudiants stockent des informations persistantes lorsqu'ils passent d'un système à l'autre. Avec NFS, cela correspond à un dossier par étudiant : il suffit de se connecter à n'importe quel Spark, de monter le partage, et votre travail est disponible.
Ce sont les jeux de données qui expliquent pourquoi cette solution est plus importante pour l'OSU que pour un serveur personnel. La Faculté des sciences de la Terre, de l'océan et de l'atmosphère souhaite mettre ses données de recherche, des collections océanographiques et atmosphériques se chiffrant en dizaines de téraoctets, à la disposition des étudiants pour leurs propres recherches. Une telle solution n'existe pas sur un disque dur classique : un emplacement M.2 de 4 To ne peut contenir une seule de ces collections, et même un laboratoire rempli de boîtiers externes impliquerait d'acheter et de remplir une copie pour chaque bureau, puis de maintenir chaque copie à jour, ce qu'aucun département ne pourrait se permettre. Héberger les données une seule fois sur la baie de stockage et les monter via 100 GbE est l'approche qui répondait à cette exigence lors de notre évaluation. La même baie héberge la bibliothèque de modèles, ce qui permet aux étudiants de passer leur session à exécuter Qwen, Llama ou tout autre modèle, sans aucune étape de téléchargement. Le même principe s'applique aux entreprises déployant des systèmes d'IA de bureau comme postes de travail de développement : il suffit de monter l'ensemble de données de production sur un réseau rapide et de laisser le système le traiter directement. Cela évite de créer un second lac de données pour que les machines aient des données à lire. Les données restent dans le centre de données, soumises aux contrôles d'accès, au chiffrement et aux sauvegardes déjà en place, et Spark ne contient aucune donnée sensible lorsqu'il quitte le centre.
Conclusion
Le matériel d'IA de bureau excelle dans de nombreux domaines, mais son intégration au parc de données d'une organisation laisse à désirer. L'unique emplacement M.2 de chaque système GB10 y contribue : les données nécessaires à un utilisateur sont copiées sur une mémoire flash locale, invisibles pour le service informatique, non protégées et dupliquées sur chaque poste de travail ayant le même besoin. Pour un seul Spark, un boîtier de stockage local externe constitue une solution acceptable. En revanche, pour un laboratoire, un département ou une entreprise déployant ces systèmes par dizaines, chaque poste de travail avec ses propres données crée un silo. La solution est alors celle adoptée depuis des années par les centres de données : déployer la capacité sur un réseau haut débit, la gérer une seule fois et la partager. Les Sparks bénéficient déjà d'une connectivité réseau à haut débit ; ce projet illustre les avantages d'une infrastructure dédiée et démontre que les Sparks ont toute leur place dans le rack adjacent.
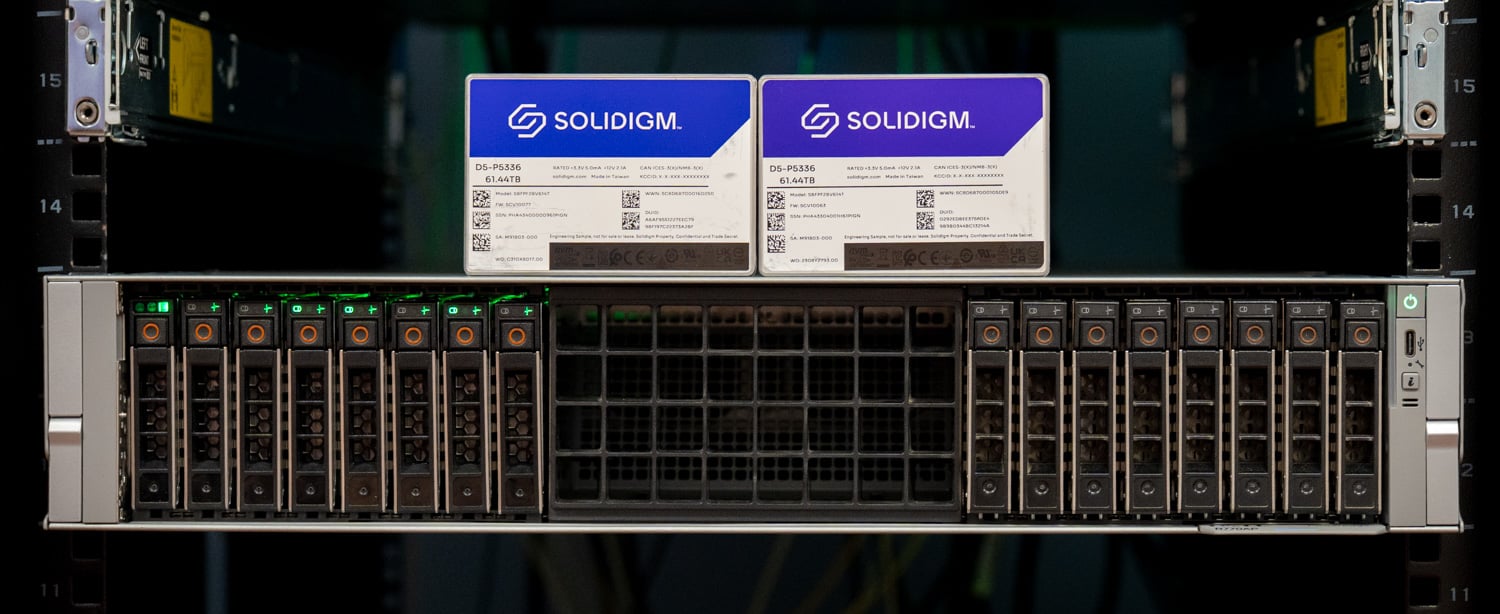
Huit disques Solidigm D5-P5336 QLC en RAID 5 Graid, installés dans un serveur Dell, ont fourni à huit Spark un seul jeu de données protégé par parité. Deux cartes réseau Broadcom 400 GbE et une carte mère Dell Z9864F-ON avec un module d'extension 800 Gb ont fourni à chaque Spark une bande passante de 100 GbE. Le logiciel Fusion NFS over RDMA de Tuxera a permis de monter cette capacité en une seule ligne sur une installation Ubuntu standard, avec des points d'entrée pour le service d'annuaire afin de gérer les accès. Sous une charge fixe répartie sur les huit Spark, la baie a atteint un débit de lecture séquentielle agrégé de 24.9 Gio/s, réparti équitablement sans QoS. Un seul Spark a saturé sa liaison à 10.8 Gio/s, soit la vitesse du meilleur disque interne de tous les systèmes GB10 que nous avons testés. Ce débit maximal utilisait 27 % de la capacité des deux cartes réseau côté serveur ; le réseau est donc dimensionné pour un serveur plus puissant. Le test du modèle a confirmé le flux de travail : un modèle de 78 Go hébergé une seule fois sur la baie partagée se charge sur un Spark à moins de 13 % du NVMe local, et sur huit Sparks simultanément, cinq des huit terminant plus rapidement que l’exécution NFS seule.
Le stockage flash QLC rend ce modèle économique viable car la charge de travail est intensive en capacité et en lecture, les points forts du D5-P5336. Un seul serveur peut stocker ce que cent Sparks ne pourraient jamais gérer localement, avec une copie unique de chaque donnée, toutes contrôlées par le centre de données. L'Université d'État de l'Oregon dispose d'un stockage de production pour la recherche, adapté aux travaux urgents. Le concept exploré par Chris Sullivan et Thomas Olson représente un niveau éducatif actuellement inexistant pour l'université : un pool partagé et géré, dimensionné pour une baie de Sparks ou plus, composé d'un serveur et de quelques disques haute capacité. Ce pool pourrait mettre à disposition d'un laboratoire d'apprentissage IA à grande échelle des dizaines de téraoctets de données océanographiques et atmosphériques réelles, sur la même infrastructure que celle utilisée par les Sparks.
Ce rapport est sponsorisé par Solidigm. Tous les points de vue et opinions exprimés dans ce rapport sont basés sur notre vision impartiale du ou des produits à l'étude.
Les références à des produits commerciaux dans cet article sont données à titre informatif et ne constituent pas une approbation de la part de l'Université d'État de l'Oregon.



 Amazon