

NVIDIA e Cisco hanno annunciato oggi i piani per Ultra-Dense Small Form Factor Pluggable (USFP), un formato di modulo ottico progettato per Ethernet a 400 Gb/s per corsia nelle reti AI. I primi transceiver previsti integrano 16 corsie full-duplex in un ingombro simile a quello di un modulo OSFP, il che si traduce in 6.4 Tb/s per modulo, e il connettore è progettato per espandersi fino a 32 corsie e 12.8 Tb/s. NVIDIA e Cisco affermano che USFP offre una larghezza di banda e una densità sul pannello frontale quadruplicate rispetto ai moduli pluggable a 200 Gb/s per corsia, con un'efficienza energetica circa 1.3 volte superiore.
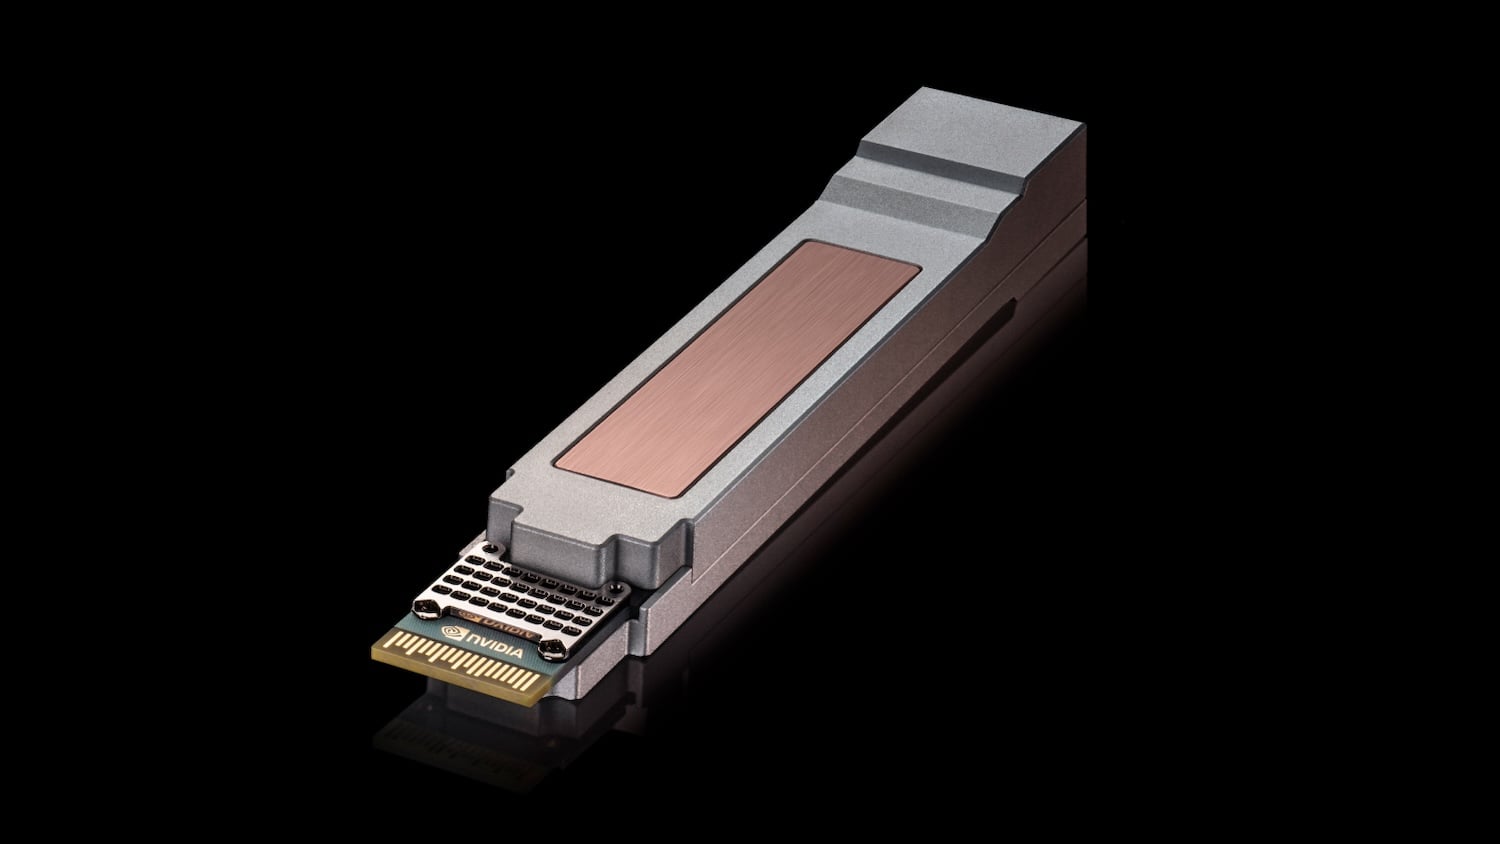
USFP è un piano senza un programma di campionamento o una data di disponibilità, e NVIDIA e Cisco intendono trasformare il progetto in una specifica industriale aperta attraverso un accordo multi-sorgente guidato dalla comunità. Si tratta di un elemento di un insieme più ampio di contributi di NVIDIA all'OCP Global Summit che comprende anche i progetti di rack Vera Rubin, il software di fabbrica DSX AI, le specifiche per impianti e reti, l'alimentazione a 800 V CC e la collaborazione con Meta e Google in ambito Ethernet.
USFP aumenta il numero di corsie e la densità di banda del pannello frontale
USFP raddoppia sia il numero di corsie che la velocità per corsia dei moduli attuali, consentendo, secondo NVIDIA e Cisco, a uno switch di connettere più endpoint da 1.6 Tb/s senza aggiungere un livello di rete. I moduli sono progettati sia per switch che per SuperNIC. Le aziende considerano la densità del pannello frontale come il fattore limitante per la crescita delle infrastrutture AI: una volta esaurite le porte di uno switch, il passo successivo è un ulteriore livello di switch con più componenti ottici, il che aumenta la latenza, il consumo energetico e i costi. USFP mantiene il modello plug-in, in modo che i moduli rimangano sostituibili e riparabili sul campo.
"Costruire le più grandi fabbriche di intelligenza artificiale del mondo inizia con il ripensare anche le connessioni più piccole", ha affermato Gilad Shainer, vicepresidente senior di NVIDIA. Bill Gartner, vicepresidente senior e direttore generale dei sistemi ottici e dell'ottica di Cisco, ha dichiarato che per spingere le ottiche plug-in a 400 Gb/s per corsia è necessario ben più di un semplice ampliamento dei design dei moduli attuali.
Un nuovo connettore supporta la segnalazione a 400 Gb/s
Il connettore è una matrice di contatti bidimensionale con una sequenza di inserimento in due fasi, in cui i contatti ad alta velocità si attivano solo dopo che il modulo è stato posizionato. NVIDIA e Cisco affermano che ciò riduce l'usura dei contatti, migliora l'integrità del segnale e rende la forza di inserimento più prevedibile. Il connettore è progettato per 400 Gb/s per corsia e, secondo le aziende, migliora le prestazioni anche a 200 Gb/s per corsia.
Un modulo USFP può dissipare fino a 100 W senza un circuito di raffreddamento dedicato all'interno del ricetrasmettitore, il che, secondo le aziende, semplifica la progettazione degli switch e ne migliora l'affidabilità. Ogni configurazione USFP supporta progetti ottici che semplificano l'elaborazione del segnale per ridurre la latenza e il consumo energetico, e il formato è compatibile con una vasta gamma di tecnologie ottiche e classi di portata. NVIDIA e Cisco stanno collaborando con TE Connectivity e Amphenol su alloggiamenti, connettori e moduli, e si prevede l'ingresso di altri partner, basandosi sul lavoro di interoperabilità già in corso tra le reti Ethernet basate su NVIDIA Spectrum-X e Cisco Silicon One.
MGX 1.2 estende l'infrastruttura rack di Vera Rubin
NVIDIA ha contribuito a OCP con i suoi progetti di rack e vassoi di calcolo Vera Rubin attraverso l'architettura aperta MGX, come parte del design di riferimento MGX di terza generazione nell'ambito dell'iniziativa Open DC di OCP, insieme ai design di raffreddamento a liquido aperti MQD e MQDB. La specifica MGX 1.2 aggiunge il raffreddamento a liquido a innesto cieco su scala rack, un'infrastruttura di interconnessione interoperabile su scala rack e una busbar da 5,000 A raffreddata a liquido, con supporto nativo per apparecchiature da 19 pollici e implementazioni rack fino a 250 kW.
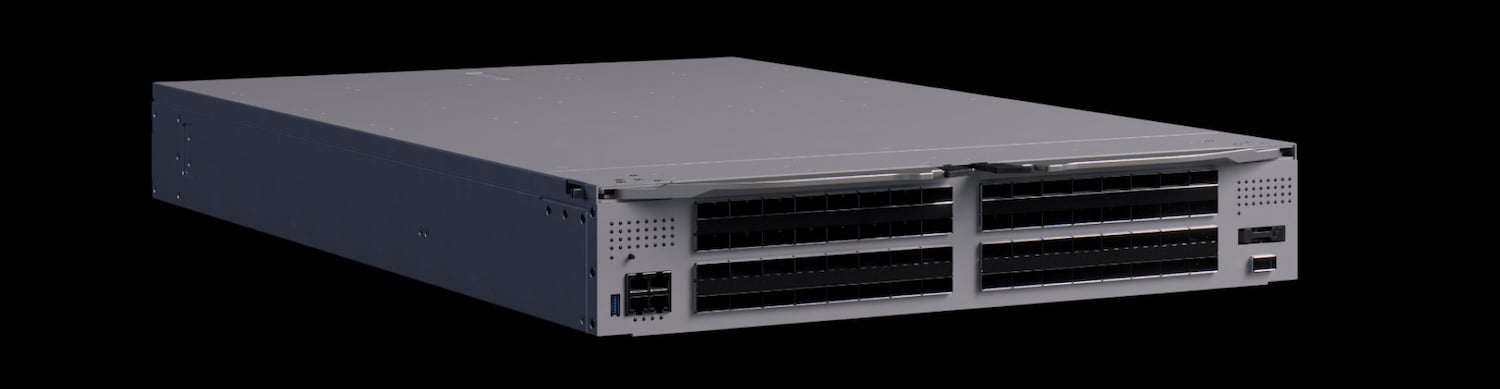
Le specifiche includono alloggiamenti I/O configurabili, vassoi di calcolo a liquido senza ventole e interfacce di alimentazione e raffreddamento standardizzate. NVIDIA afferma che le interfacce comuni riducono i tempi di assemblaggio, test e assistenza per i partner. Una specifica di progettazione separata per il rack della CPU Vera estende MGX oltre il calcolo accelerato. NVIDIA posiziona Vera Rubin NVL72 come piattaforma per l'addestramento e l'inferenza su larga scala e il rack della CPU Vera per la chiamata di strumenti, l'orchestrazione e l'esecuzione in ambiente sandbox che i carichi di lavoro agentici aggiungono.
DSX OS aggiunge componenti per la gestione di rete, rack e cluster
NVIDIA ha ampliato DSX OS, il sistema operativo open source della sua piattaforma DSX AI factory, con quattro componenti open source. NVIDIA Config Manager automatizza la configurazione, la convalida e la manutenzione degli switch nelle infrastrutture AI. NVIDIA Cluster Readiness Engine sottopone i cluster GPU a stress test con simulazioni di carico di lavoro prima dell'inizio dell'addestramento, consentendo, secondo NVIDIA, di individuare problemi hardware che altrimenti causerebbero il fallimento dei processi.

NVIDIA Rack Management Service considera il rack come unità operativa, con astrazione hardware e gestione del firmware a tale livello. Cluster API Provider per NVIDIA Infrastructure Controller gestisce l'implementazione bare-metal e l'onboarding dei tenant, e NVIDIA afferma di trasformare l'hardware grezzo in cluster pronti per la produzione in poche ore. I componenti derivano dall'esperienza di NVIDIA con DGX Cloud e sono progettati per consentire ai fornitori di servizi cloud e ai partner software di integrare le operazioni di AI factory in piattaforme multi-tenant.
Le specifiche aperte riguardano la progettazione degli impianti e il ripristino della rete.
NVIDIA, AMD, Google e Meta hanno pubblicato la Open Data Center Specification v0.7, un progetto condiviso per le infrastrutture che copre l'architettura di alimentazione, il raffreddamento e la configurazione fisica, a cui produttori di apparecchiature, fornitori di servizi di colocation e operatori possono fare riferimento per la progettazione. Google, Meta, Microsoft e NVIDIA hanno anche pubblicato la OCP Grid Resilience Specification, che definisce come le grandi infrastrutture per l'intelligenza artificiale dovrebbero gestire le interruzioni di corrente: rimanere connesse, rispondere automaticamente e tornare a un carico quasi pieno in meno di due secondi. NVIDIA afferma che entrambe le specifiche sono in linea con il suo progetto di riferimento DSX.
Visionbay ha presentato i piani per K-1, una piattaforma per fabbriche di intelligenza artificiale che combina l'architettura di riferimento a 800 V CC di NVIDIA con le apparecchiature di alimentazione e termiche di Vertiv per le future implementazioni di Vera Rubin. K-1 sposta la conversione da CA a CC nei centri di alimentazione a livello di cluster e distribuisce la corrente a 800 V CC più vicino ai processori, con un'adozione graduale di 800 V CC, raffreddamento a liquido ed espansione modulare. Visionbay non ha ancora comunicato una data di implementazione.
Meta adotta Spectrum-6 e le reti multiplane
Meta adotterà Ethernet NVIDIA Spectrum-6 a 102.4 Tb/s per le sue fabbriche di intelligenza artificiale Vera Rubin. NVIDIA afferma che Spectrum-6 raddoppia la capacità di switching e la larghezza di banda per corsia rispetto a Spectrum-4, operando a 200G per corsia con isolamento delle prestazioni tra i job. Lo switch N-IceCube di Meta, basato su Spectrum-6, è installato nel rack IcePack 100T con raffreddamento a liquido ed esegue FBOSS, il software di switching open source di Meta, che utilizza l'interfaccia OCP Switch Abstraction Interface per il controllo dell'hardware indipendente dal fornitore.
Spectrum-X Multiplane combina gli switch Spectrum-6 con le SuperNIC ConnectX-9 e distribuisce il traffico GPU in hardware su un massimo di otto piani di rete indipendenti. NVIDIA afferma che il design è scalabile oltre le 100,000 GPU con un numero inferiore di livelli di switch e, in caso di guasto di un componente, il traffico viene spostato sui piani rimanenti in modo che i processi continuino a funzionare con una larghezza di banda ridotta. Meta e NVIDIA affermano di aver convalidato i vantaggi in termini di resilienza sia on-premise che nel cloud, senza tuttavia pubblicare dati specifici.
Google Falcon Transport punta al futuro hardware di rete NVIDIA.
NVIDIA e Google hanno annunciato il supporto per Falcon Transport nelle future schede di rete SuperNIC NVIDIA ConnectX-10 e nelle DPU BlueField. Falcon offre dati affidabili su Ethernet tramite bilanciamento del carico multipath, controllo della congestione programmabile, ripristino della perdita di pacchetti basato su hardware e sicurezza per connessione. NVIDIA lo implementa con accelerazione hardware e software DOCA, in modo che le schede di rete NVIDIA e Google possano comunicare su un protocollo di trasporto comune, mentre le applicazioni mantengono le interfacce RDMA standard. Le aziende affermano che ciò migliora l'utilizzo della larghezza di banda e la prevedibilità delle prestazioni per il traffico di intelligenza artificiale e storage man mano che le reti Ethernet si espandono.
Cisco distribuisce i sistemi Silicon One G300 e aggiunge un componente Top-of-Rack da 51.2T
Cisco ha sfruttato lo stesso annuncio OCP per aggiornare la propria gamma di chip. Il Silicon One G300 da 102.4 Tb/s è ora disponibile in versione di campionamento e i primi sistemi basati su G300 sono in fase di spedizione ai clienti. Cisco ha inoltre aggiunto il G302, un ASIC switch da 51.2 Tb/s con SerDes da 200G, progettato per sistemi top-of-rack con ottiche da 1.6T e raffreddamento a liquido diretto al chip, la cui commercializzazione è prevista entro la fine del 2026. Cisco ha anche annunciato che il suo chip di routing deep-buffer P200 da 51.2 Tb/s è ora in produzione presso i principali fornitori di servizi cloud: Microsoft ha avviato la produzione di sistemi P200 e Alibaba Cloud ha implementato il suo router proprietario Quantum Cat su P200 nella sua backbone eCORE, con SONiC.
Il resto dei prodotti Cisco è operativo. Il Cisco 8001 è uno switch di gestione basato su Silicon One A100, disponibile nelle versioni a 10G e 1G, che porta SONiC sulla rete out-of-band, consentendo agli operatori di utilizzare un unico set di API e automazione dalla struttura fino al rack. SONiC, validato da Cisco, è incluso nell'architettura Nexus One e un'opzione Live Protect, che applica patch alle vulnerabilità note in fase di esecuzione prima della correzione definitiva, è prevista per la metà del 2027. Cisco è membro di ESUN e dichiara di essere al lavoro sulla specifica 1.0 per le reti scale-up.


 Amazon