

CoreWeave ha sfruttato la conferenza Fully Connected 2026 di San Francisco per mettere in produzione NVIDIA Vera Rubin NVL72, con Cognition come primo cliente a eseguire carichi di lavoro reali. Gli ingegneri di Cognition riportano un throughput totale di token per GPU fino a 4.8 volte superiore rispetto a un modello di riferimento GB200 NVL72 per l'inferenza SWE-2 con interattività corrispondente, e 3.8 volte superiore per l'apprendimento per rinforzo. Entrambi i benchmark sono stati eseguiti da Cognition stessa su CoreWeave Cloud, con carichi di lavoro agentici in stile produzione, senza divulgare le dimensioni del modello, la lunghezza del contesto o le impostazioni del batch.
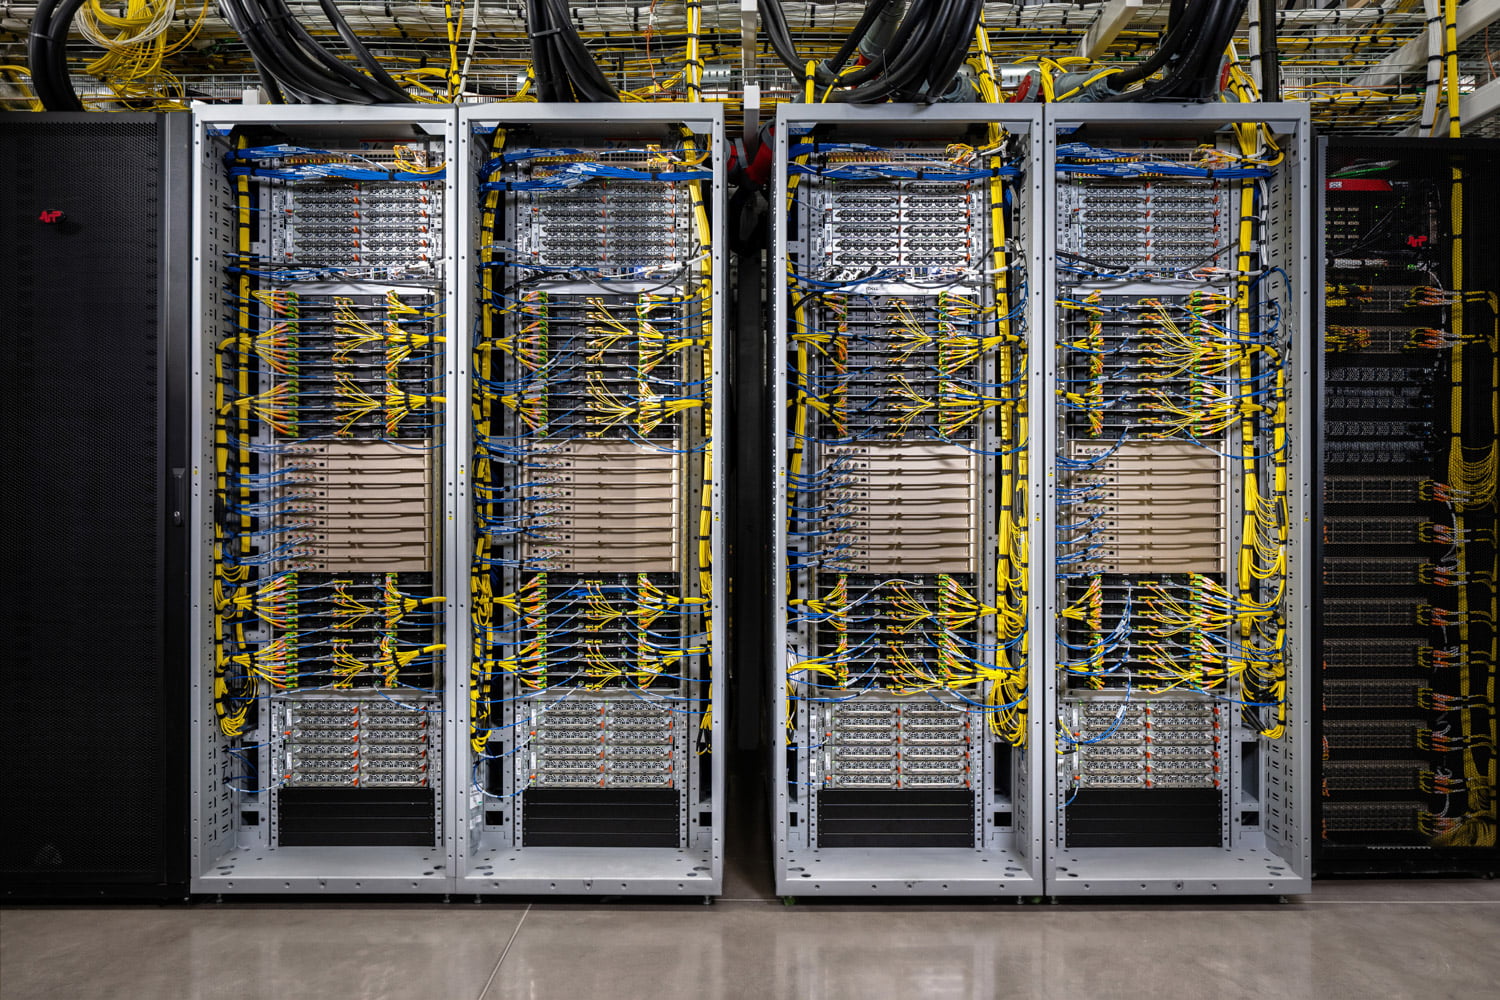
Vera Rubin NVL72 entra in produzione con tecnologia CoreWeave
Cognition esegue l'addestramento, l'apprendimento per rinforzo e l'inferenza di produzione per Devin su CoreWeave. CoreWeave afferma di aver installato il cluster Vera Rubin NVL72 all'inizio di settembre e di aver reso operativi i carichi di lavoro di Cognition entro pochi giorni dalla consegna del rack, definendo l'esecuzione di Cognition il primo benchmark di inferenza Vera Rubin eseguito da un cliente. Secondo Cognition, il risultato di SWE-2 si traduce in un maggior numero di sessioni Devin simultanee per GPU e in tempi di ricerca più rapidi.
Il comunicato stampa di CoreWeave afferma che Vera Rubin NVL72 è ora disponibile; il suo post sul blog relativo all'implementazione di Cognition parla di disponibilità limitata, quindi è prevedibile che l'assegnazione sia per ora soggetta a restrizioni. I clienti lo utilizzano con lo stesso software e modello operativo delle flotte GB200 NVL72 e GB300 NVL72 di CoreWeave: CoreWeave Kubernetes Service, SUNK, Mission Control, Sandbox e inferenza serverless.
I rack stessi, i modelli NVL72 prodotti da Dell con due SuperNIC ConnectX-9 per GPU, e le fasi di validazione eseguite da CoreWeave prima che un rack entri in produzione, sono ciò di cui abbiamo parlato nel nostro articolo di settembre sulla presentazione dei sistemi multi-rack . La novità è che ora hanno un cliente pagante che li utilizza.
Densità della sandbox dell'agente target della CPU NVIDIA Vera
CoreWeave aggiungerà inoltre la CPU NVIDIA Vera al suo portfolio come livello di calcolo autonomo per le attività agentive: esecuzione in ambienti sandbox, ambienti di apprendimento per rinforzo, chiamate a strumenti, esecuzione di codice e l'elaborazione dei dati relativa all'addestramento e al ragionamento su GPU. Non è stata fornita alcuna data precisa, se non un generico "presto disponibile".
Un nodo Vera su CoreWeave combina due CPU Vera a 88 core con 1.5 TB di RAM, 15.36 TB di NVMe locale e una DPU BlueField-4 a 800 Gbps. Un rack completo ospita 128 CPU e 11,264 core con DPU BlueField-4 e switching Ethernet Spectrum-X, che secondo CoreWeave supporta oltre 11,000 ambienti isolati simultanei. Nei propri test, CoreWeave riporta un avvio della sandbox dell'agente oltre 3 volte più veloce su Vera rispetto a una CPU x86 non specificata. Vera verrà eseguita bare metal sulla stessa piattaforma e con gli stessi modelli di consumo della flotta di GPU, inclusa la capacità spot.
CoreWeave Forge collega sviluppo e produzione
CoreWeave Forge, lanciato durante la fiera, integra Weights & Biases Models, il lavoro di OpenPipe sulla post-elaborazione e il progetto open-source marimo notebook in un unico livello di sviluppo per modelli e agenti. Copre il tracciamento degli esperimenti, le valutazioni, le tracce degli agenti, i checkpoint, l'esecuzione in ambiente sandbox, la post-elaborazione e la distribuzione dell'inferenza, e CoreWeave afferma che è aperto a modelli, framework e altre piattaforme cloud. MasterClass e Canva lo stanno già utilizzando.
Forge è disponibile nelle edizioni Free, Pro ed Enterprise, con la versione Pro a partire da 60 dollari al mese e una prova gratuita di 30 giorni. Sono già disponibili le seguenti funzionalità: ARIA, Sandbox, Modelli Weights & Biases, Serverless SFT, Serverless RL, Registry, Notebooks e inferenza sia Serverless che Dedicated. In anteprima: Agent Lens, Model Distillation e RL Rollouts, che consentono di caricare un checkpoint in un'implementazione live mentre il ciclo di training continua a essere eseguito.
Secondo quanto dichiarato da CoreWeave, Agent Lens rileva il 20% in più di guasti critici e risolve i problemi a un decimo del costo, rispetto a un modello LLM generico di frontiera non specificato; il post sul blog dell'azienda indica un costo pari alla metà, quindi è bene prendere questo dato con le pinze. Si afferma inoltre che Serverless RL si addestra 1.4 volte più velocemente e con un costo inferiore del 40% rispetto a una configurazione autogestita. Non sono stati forniti dati relativi a carico di lavoro, modello, hardware e metodologia.
Implementazione della rete di partner e dell'inferenza clinica
Il CoreWeave Partner Network, disponibile da oggi, raggruppa le integrazioni che CoreWeave dichiara di aver testato in condizioni di produzione e qualificato in base alle richieste dei clienti, in ambiti quali infrastruttura, servizi dati, ISV, sicurezza, modelli e inferenza. Tra i partner figurano CrowdStrike, VAST Data, Reflection, ClickHouse, LanceDB, Inferact, RadixArk, IBM e Red Hat. Exa, Parallel Web Systems e You.com si uniscono tramite un'integrazione di ricerca condivisa per gli agenti ospitati su CoreWeave, che verrà implementata nelle settimane successive all'annuncio. L'obiettivo è consentire ai clienti di mantenere i propri livelli di servizio, osservabilità, runbook e strumenti di sicurezza esistenti, anche durante la migrazione dei carichi di lavoro sul cloud.
Ennoble Care, che fornisce assistenza domiciliare primaria, palliativa e di fine vita a circa 50,000 pazienti all'anno in 15 stati, ha scelto CoreWeave Cloud per l'inferenza clinica basata sull'intelligenza artificiale. L'implementazione viene eseguita su nodi NVIDIA RTX PRO 6000 Blackwell Server Edition riservati tramite CoreWeave Kubernetes Service, con isolamento hardware e controlli zero-trust per i dati clinici e supporto tecnico diretto incluso. CoreWeave afferma che CKS avvia i container da 8 a 10 volte più velocemente rispetto a un'alternativa cloud generica, senza specificare la piattaforma, il carico di lavoro o la configurazione di test.


 Amazon