

NVIDIA ha aggiunto una configurazione con memoria unificata da 64 GB della DGX Spark , a partire da 4,999 dollari e venduta in esclusiva tramite Acer, ASUS, Dell, Gigabyte, HP e MSI dal 23 ottobre. La nuova SKU integra lo stesso chip GB10 Grace Blackwell Superchip, la stessa connettività di rete ConnectX-7, il sistema operativo DGX OS e lo stesso stack software NVIDIA AI del modello da 128 GB. Secondo NVIDIA, l'unità da 64 GB è in grado di eseguire modelli con fino a 100 miliardi di parametri per inferenza locale, fine-tuning e flussi di lavoro basati su agenti, senza inviare dati al cloud.
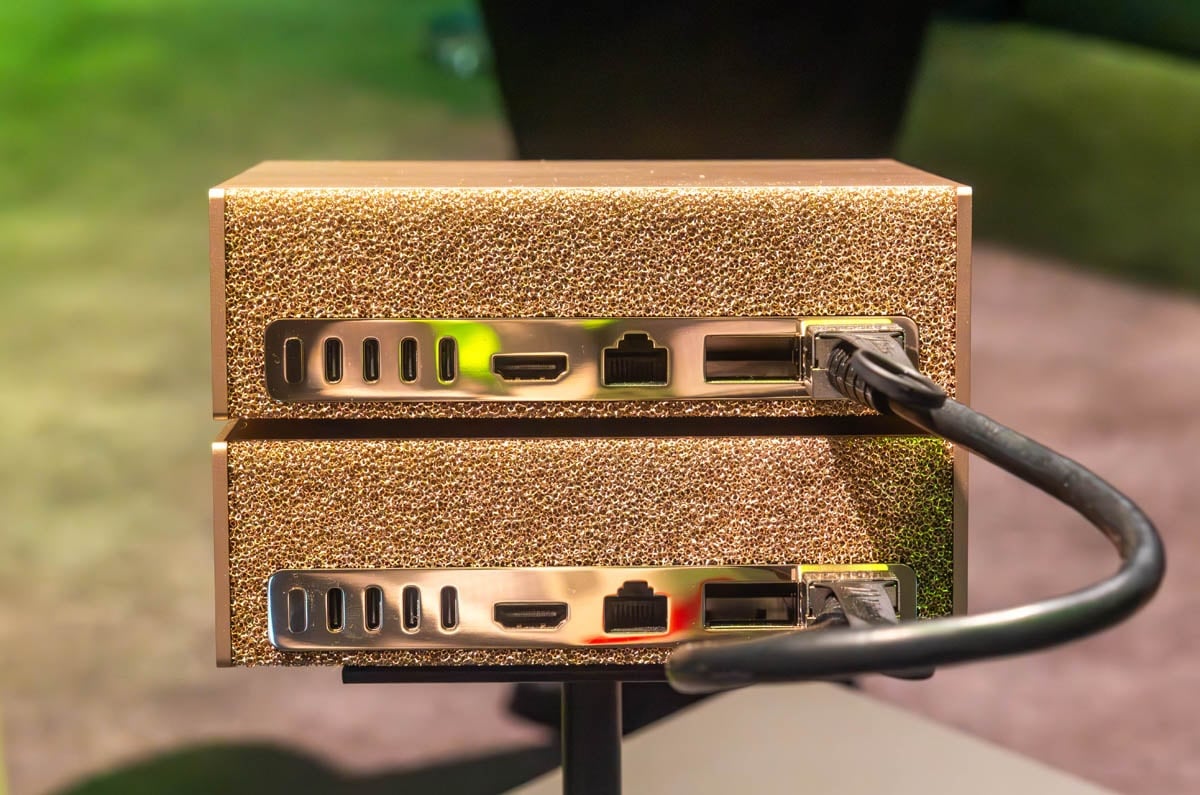
Due Spark da 64 GB per un cluster da 128 GB
Il vantaggio principale del modello più economico (rispetto ai prezzi di mercato del modello più grande) è che due unità in cluster offrono prestazioni più che soddisfacenti. Ogni DGX Spark è dotato di una scheda di rete ConnectX-7 integrata, quindi una coppia si connette direttamente tramite un cavo QSFP su un collegamento 200GbE, senza bisogno di uno switch intermedio. NVIDIA Sync Cluster Assistant gestisce il rilevamento, convalida la configurazione del dispositivo e configura la rete ConnectX-7. Due unità da 64 GB si uniscono per formare una memoria unificata di 128 GB, che secondo NVIDIA è sufficiente per eseguire modelli fino a 200 miliardi di parametri.
Secondo i dati interni di NVIDIA, l'accoppiamento si basa su Qwen3.8 27B: due sistemi clusterizzati da 64 GB offrono prestazioni fino a 1.7 volte superiori rispetto a un singolo sistema da 128 GB. Poiché ogni nodo esegue le stesse librerie CUDA, gli stessi motori di inferenza e la stessa immagine del sistema operativo DGX, un carico di lavoro si estende su entrambe le unità senza dover ricostruire l'ambiente software. I framework di inferenza supportati includono llama.cpp, Ollama, vLLM e LM Studio. NVIDIA ha pubblicato un breve video sulla connessione di due Spark con NVIDIA Sync.
Abbiamo eseguito un cluster di inferenza distribuito su unità Dell, Gigabyte e HP DGX Spark e, più recentemente, abbiamo implementato uno storage condiviso dietro un cluster Spark su una rete 100GbE . La versione da 64 GB riduce il prezzo di ingresso per questo tipo di configurazione, a scapito del fatto che una singola unità ora dispone della metà della memoria rispetto al modello precedente.
Il launcher NVIDIA Sync Model arriverà a fine ottobre.
La seconda parte dell'annuncio riguarda il software. NVIDIA Sync Model Launcher, previsto per la fine di ottobre, scarica ed esegue un modello su un singolo Spark o su una coppia di Spark in cluster, prendendo come esempio Qwen3.8 27B, ed espone l'endpoint risultante ai computer degli sviluppatori sulla rete. Può anche configurare OpenCode per quel modello, consentendo agli sviluppatori di programmare da un browser mentre il cluster Spark si occupa dell'inferenza.
I sistemi da 64 GB vengono forniti con lo stesso software del modello da 128 GB: DGX OS, librerie AI CUDA-X, NVIDIA Agent Toolkit, modelli aperti Nemotron e runtime tra cui Ollama, vLLM e PyTorch con CUDA. NVIDIA presenta il dispositivo come una piattaforma locale per agenti, inferenza, fine-tuning, data science e sviluppo edge, e la porta ConnectX-7 consente di aggiungere una seconda unità in un secondo momento. Per gli sviluppatori di agenti, NVIDIA indica i suoi playbook per NemoClaw, OpenClaw, Hermes Agent e OpenShell su build.nvidia.com come punti di partenza.


 Amazon