

La MSI XpertStation WS300 è basata sulla più recente architettura DGX Station di NVIDIA, la generazione più performante finora, che integra un nodo Grace Blackwell Ultra GB300 completo accanto alla scrivania. Il dato più rilevante è di 20 petaFLOPS di calcolo FP4, erogati da una singola GPU Blackwell Ultra collegata a una CPU Grace a 72 core tramite un collegamento NVLink-C2C da 900 GB/s. Entrambi i processori attingono da un pool di memoria coerente da 748 GB: 252 GB di HBM3e abbinati a 496 GB di LPDDR5X, sufficienti per ospitare un modello con un trilione di parametri nella memoria locale.
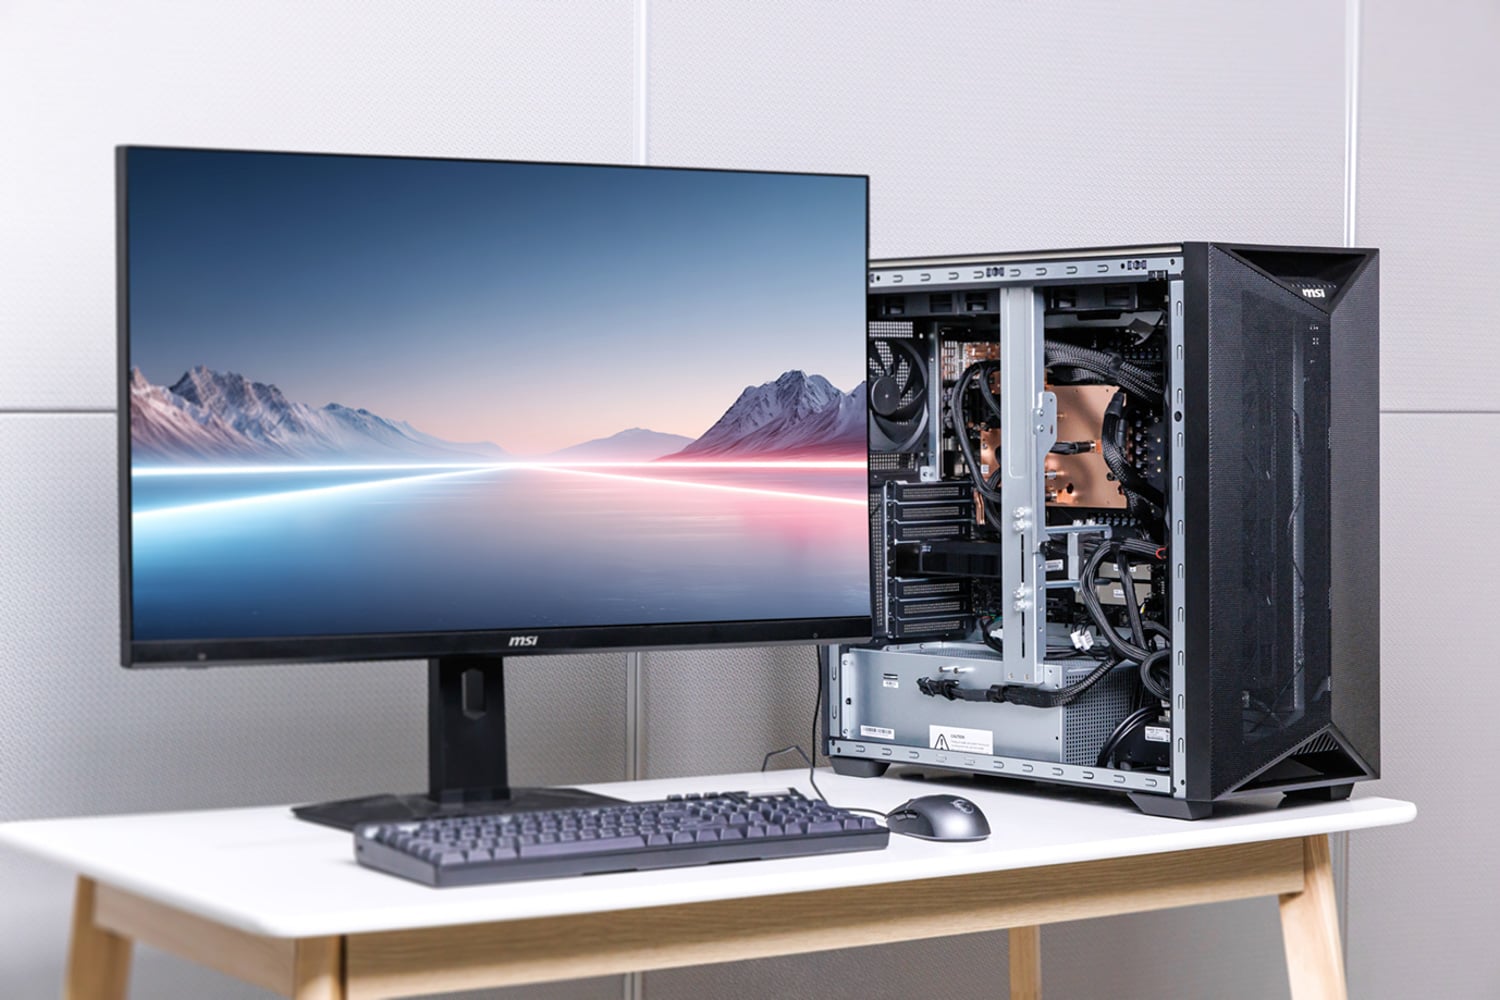
La DGX Station supporta anche il clustering di più unità tramite la sua ConnectX-8 SuperNIC, che offre due porte 400GbE per una larghezza di banda di 800Gb/s. Il risultato è una macchina di livello data center che può essere utilizzata in casa o in ufficio anziché in una sala server.
Specifiche tecniche della stazione NVIDIA DGX
XpertStation WS300 è l'implementazione MSI della piattaforma GB300 DGX Station di NVIDIA. NVIDIA fornisce la scheda madre Grace Blackwell Ultra e l'ambiente software, mentre MSI fornisce lo chassis, il sistema di raffreddamento a liquido, l'alimentazione, la configurazione dello storage, le interfacce I/O esterne e il modello di assistenza che trasformano la piattaforma in un sistema desktop completo. Poiché la CPU Grace, la GPU Blackwell Ultra, l'interconnessione NVLink-C2C e la rete ConnectX-8 sono fisse, la vera differenziazione OEM risiede nell'efficacia con cui il sistema circostante supporta, gestisce e sfrutta tale hardware. MSI ha configurato questo sistema con quattro SSD Micron 4600 Gen5 M.2 da 2 TB per i test. Due SSD sono stati configurati in RAID1 per lo storage di avvio, mentre gli altri due erano SSD dedicati per spazio di lavoro temporaneo o altri utilizzi.
| Specificazione | Dettagli |
|---|---|
| Architettura | |
| CPU | NVIDIA Grace, Arm Neoverse V2 a 72 core |
| GPU | NVIDIA Blackwell Ultra (B300) |
| Tensor Core | 5th Generation |
| Interconnessione CPU-GPU | NVLink-C2C, 900 GB/s bidirezionale |
| Memorie | |
| Memoria coerente | Fino a 748 GB |
| Memoria GPU | Fino a 252 GB HBM3e |
| Larghezza di banda della memoria della GPU | 7.1 TB / s |
| Memoria della CPU | Fino a 496 GB LPDDR5X (4 x SOCAMM) |
| Larghezza di banda della memoria della CPU | 396 GB / s |
| Archiviazione | |
| Unità di avvio | 2 x M.2 2280 PCIe 5.0 x4 NVMe (collegati alla CPU), con 2 SSD Micron 4600 Gen5 da 2 TB in RAID 1 |
| Unità di espansione | 2 x M.2 2280 PCIe 5.0 x4 NVMe (ConnectX-8 collegato), popolati per i test con 2 x 2TB Micron 4600 Gen5 |
| Networking | |
| NIC | NVIDIA ConnectX-8 SuperNIC, 2 x 400G QSFP112 (800 Gb/s complessivi) |
| Ethernet | 1 x RJ45 10GBase-T (Marvell AQC113) |
| Porta di gestione | 1 x RJ45 1000Base-T (dedicato fuori banda) |
| Wireless | Slot M.2 2230 Key-E, PCIe 2.0 x1 (Wi-Fi 6E/Wi-Fi 7, Bluetooth) |
| Espansione | |
| Slot PCIe | 1 slot PCIe 5.0 x16 FHFL a doppio slot; 2 slot PCIe 5.0 x16 FHFL a singolo slot (8 segnali) |
| GPU aggiuntive supportate | NVIDIA RTX PRO 2000 Blackwell, RTX PRO 4000 Blackwell SFF, RTX PRO 6000 Blackwell Workstation / Max-Q |
| I/O frontale/superiore | |
| USB | 2 porte USB 3.2 Gen 2 di tipo A; 2 porte USB 3.2 Gen 2 di tipo C (5V/3A) |
| audio | 2 prese jack (uscita linea / microfono) |
| I / O posteriori | |
| USB | 4 porte USB 10 Gbps di tipo A; 1 porta Micro-USB COM (console seriale) |
| Display | 1 x Mini DisplayPort (video BMC, max 1024 x 768, senza DP++) |
| audio | 3 prese jack (ingresso linea / uscita linea / microfono) |
| Gestione e sicurezza | |
| BMC | ASPEED AST2600 con firmware AMI MegaRAC, IPMI 2.0 e Redfish, memoria locale eMMC. |
| Sicurezza | TPM 2.0, rilevamento di intrusione nello chassis, radice di fiducia hardware Microchip CEC1736 (ERoT) |
| Raffreddamento | |
| Raffreddamento a liquido | Modulo di raffreddamento a liquido con potenza nominale di 1400 W per CPU + GPU, con blocchi per GPU, CPU, memoria e ConnectX-8. |
| Radiatori / Ventilatori | 2 radiatori da 360 mm; 1 ventola di sistema 12025 |
| Potenza | |
| Alimentazione di laboratorio | 1 alimentatore ATX da 1600 W, certificazione 80 PLUS Platinum (150 x 86 x 210 mm) |
| AC Input | 100-114 V CA, 15 A, 47-63 Hz (potenza massima 1300 W); 115-240 V CA, 15-8 A, 47-63 Hz (potenza massima 1600 W) |
| Fattore di forma | |
| Dimensioni | 245.7 x 529.0 x 570.4 mm (9.67 x 20.83 x 22.46 pollici), L x A x P |
Progetta e costruisci
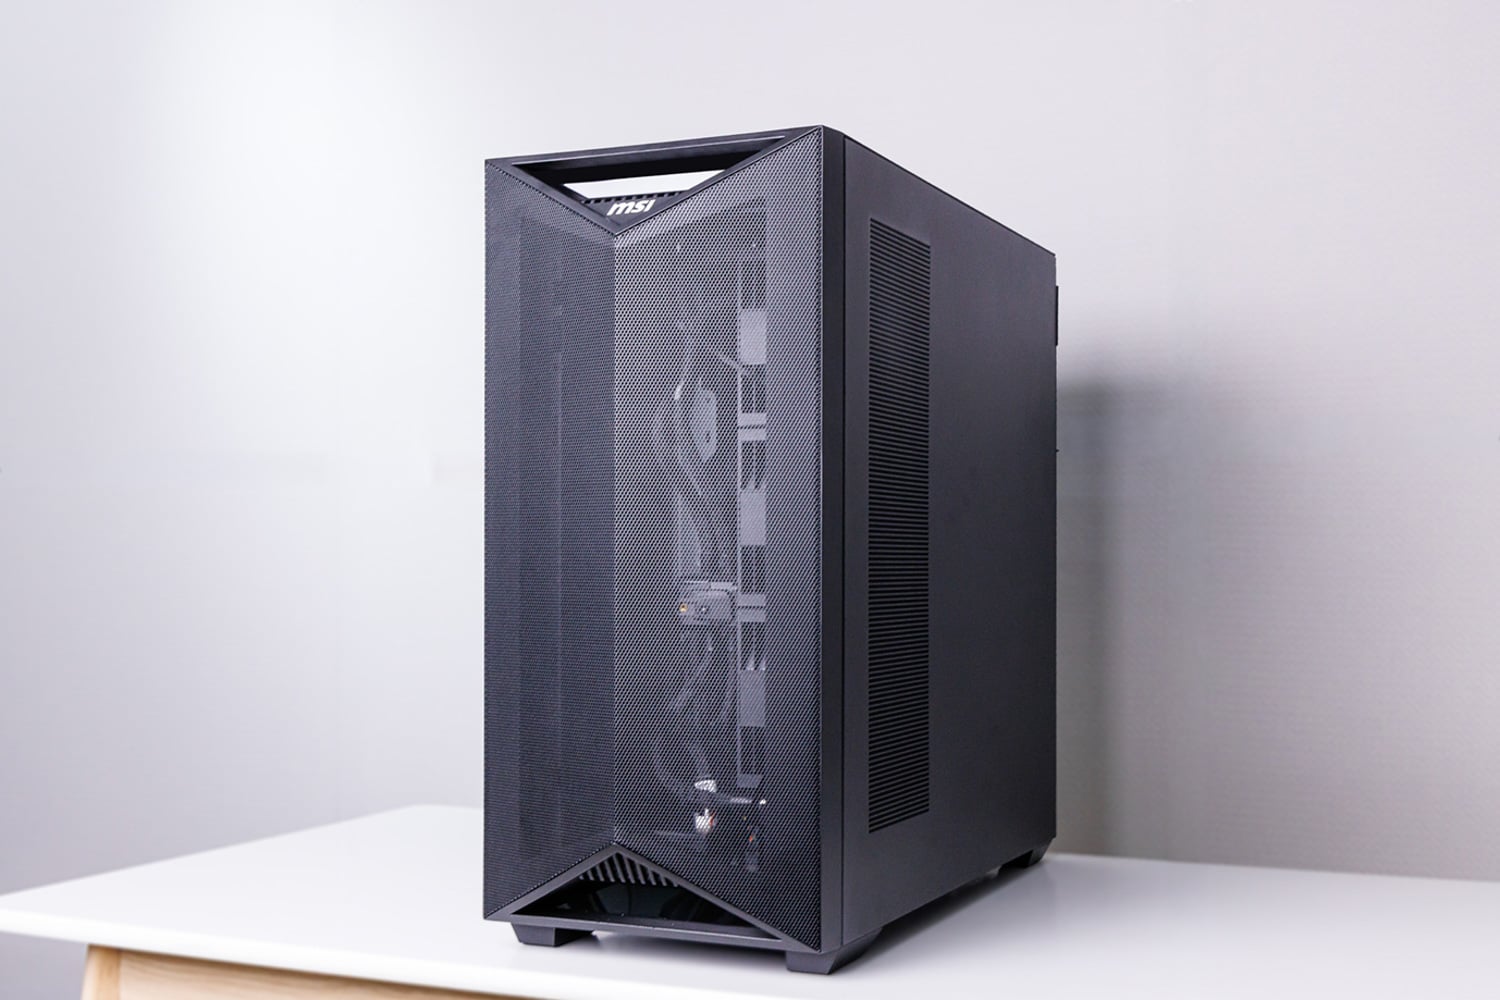
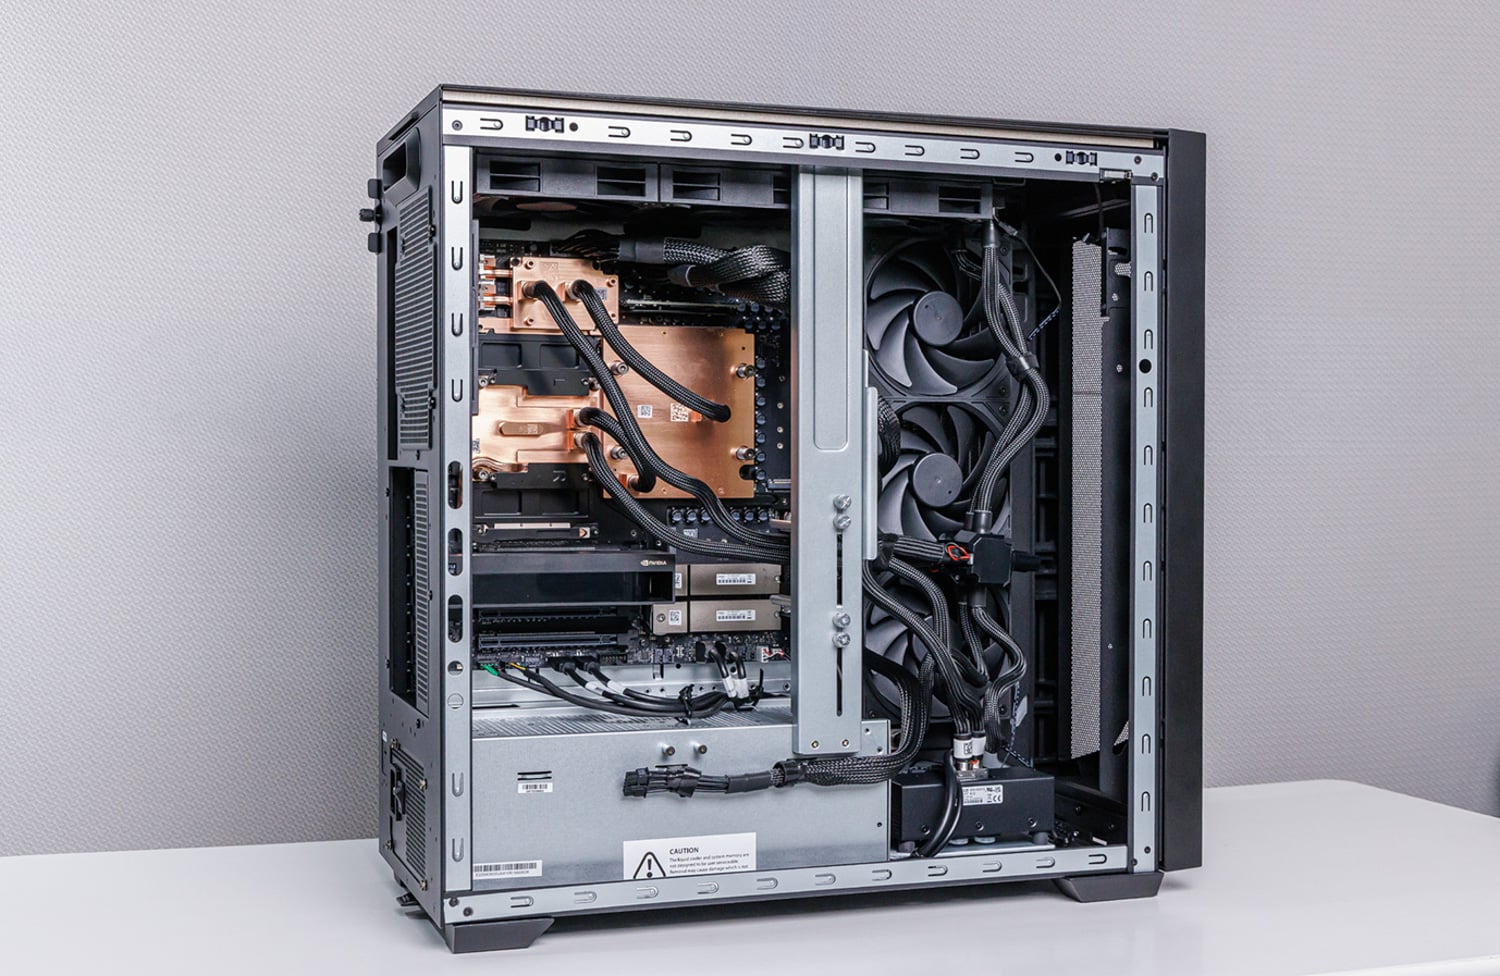
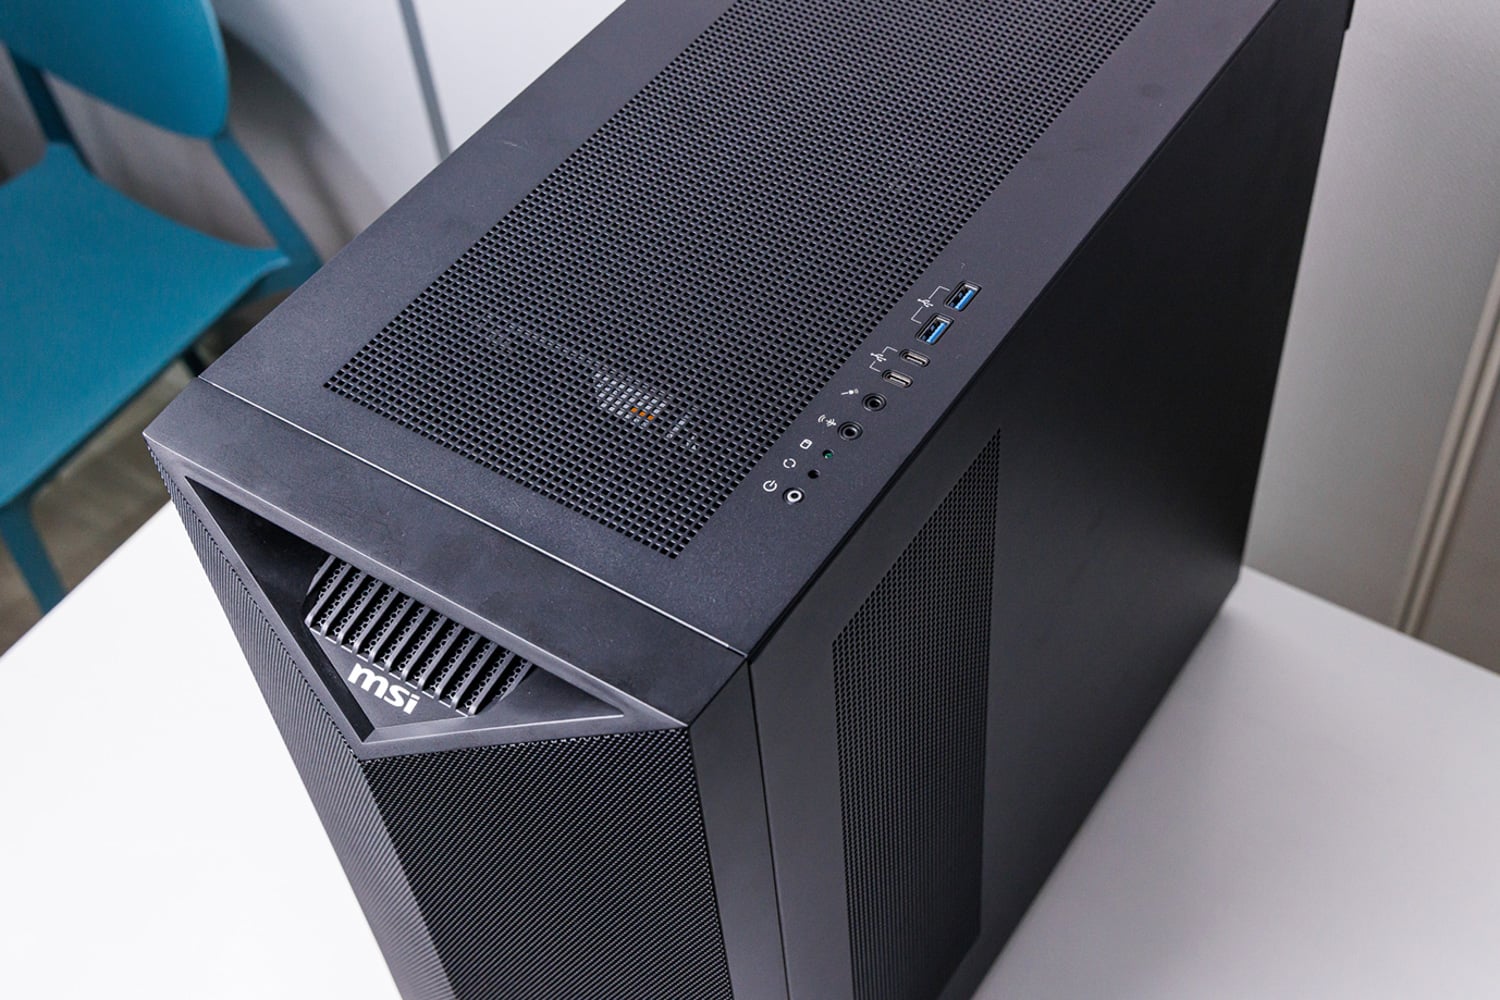
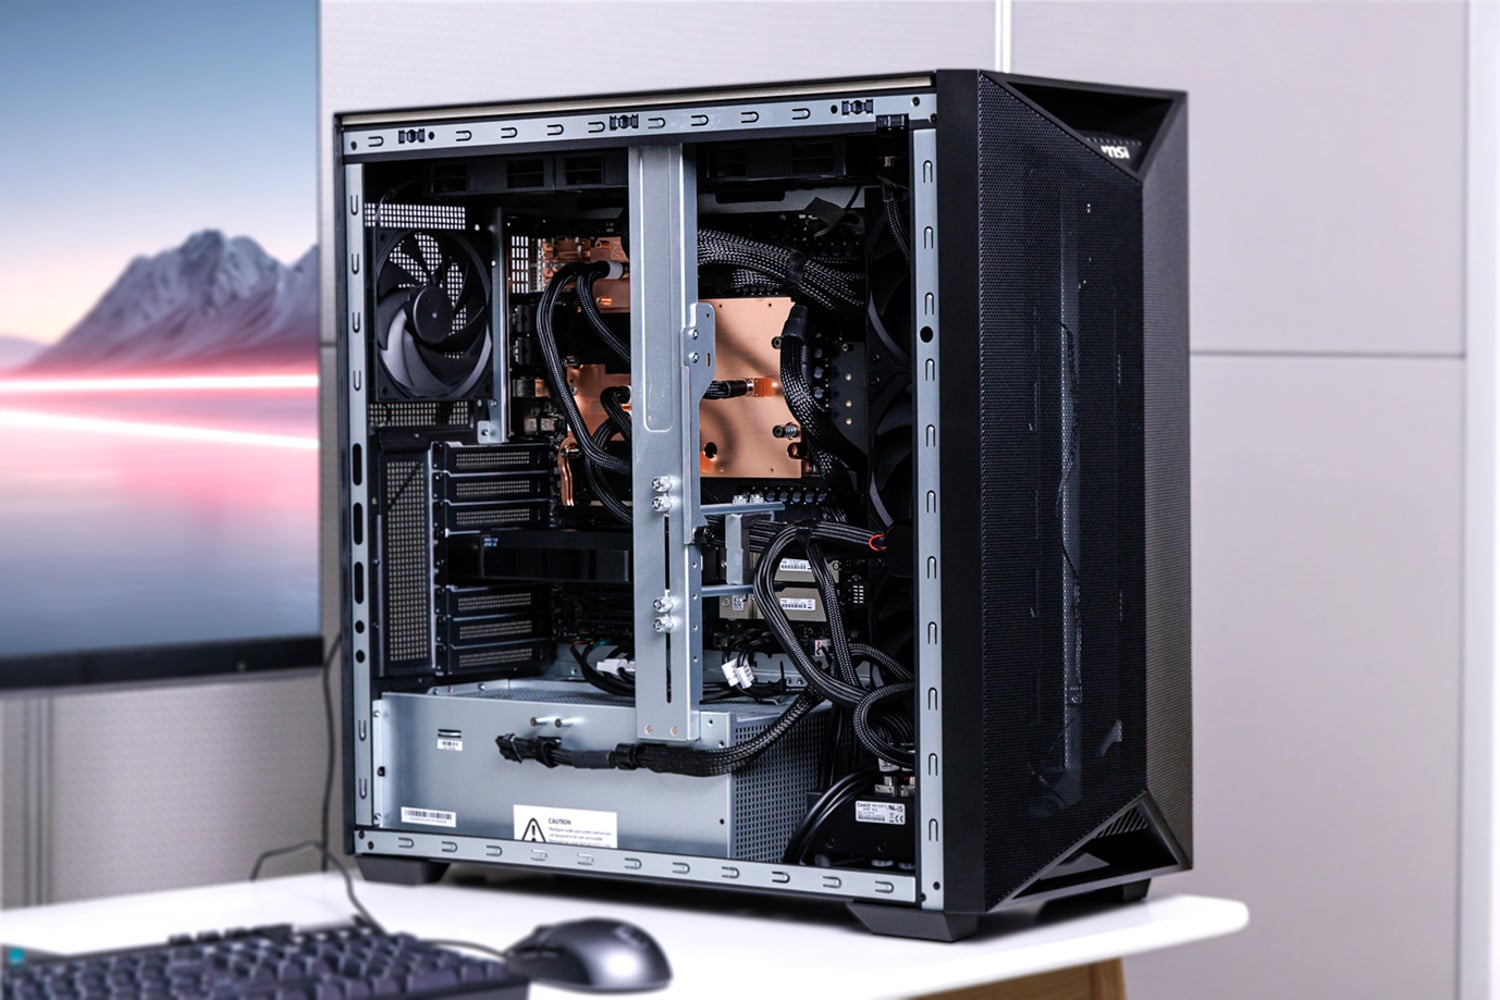
A prima vista, XpertStation sembra una normale workstation moderna dal design elegante e professionale. Ma se si rimuove il pannello laterale, la somiglianza finisce qui.
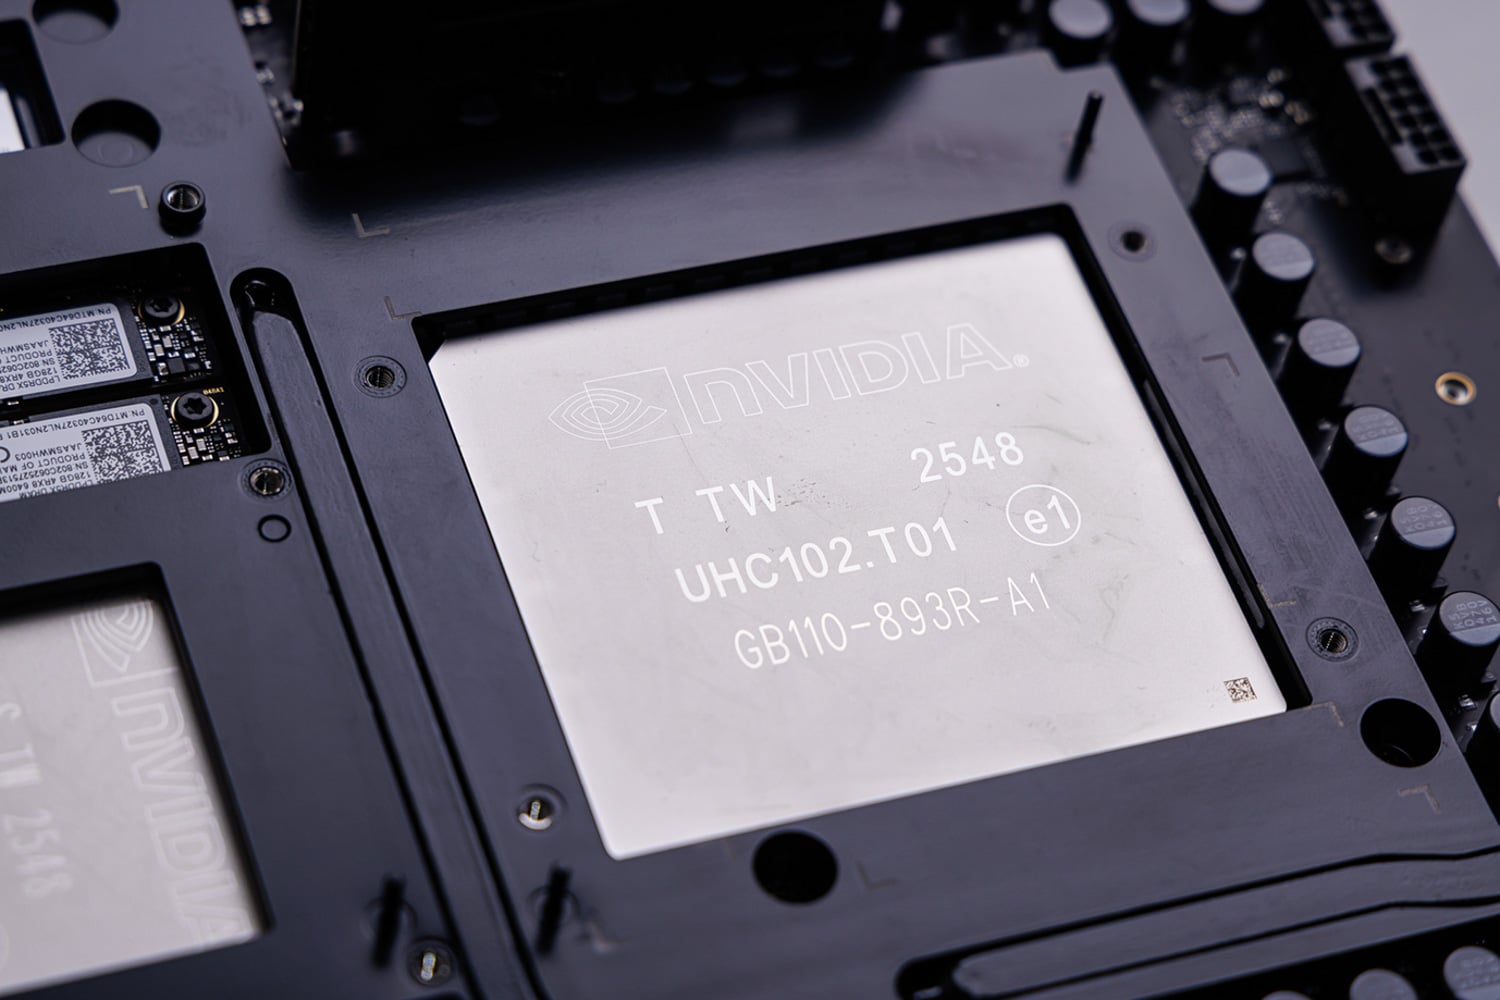
GB300 Grace Blackwell Ultra Desktop Superchip
Al centro della WS300 si trova la nostra stella: la GPU NVIDIA B300, basata sull'architettura Blackwell Ultra.
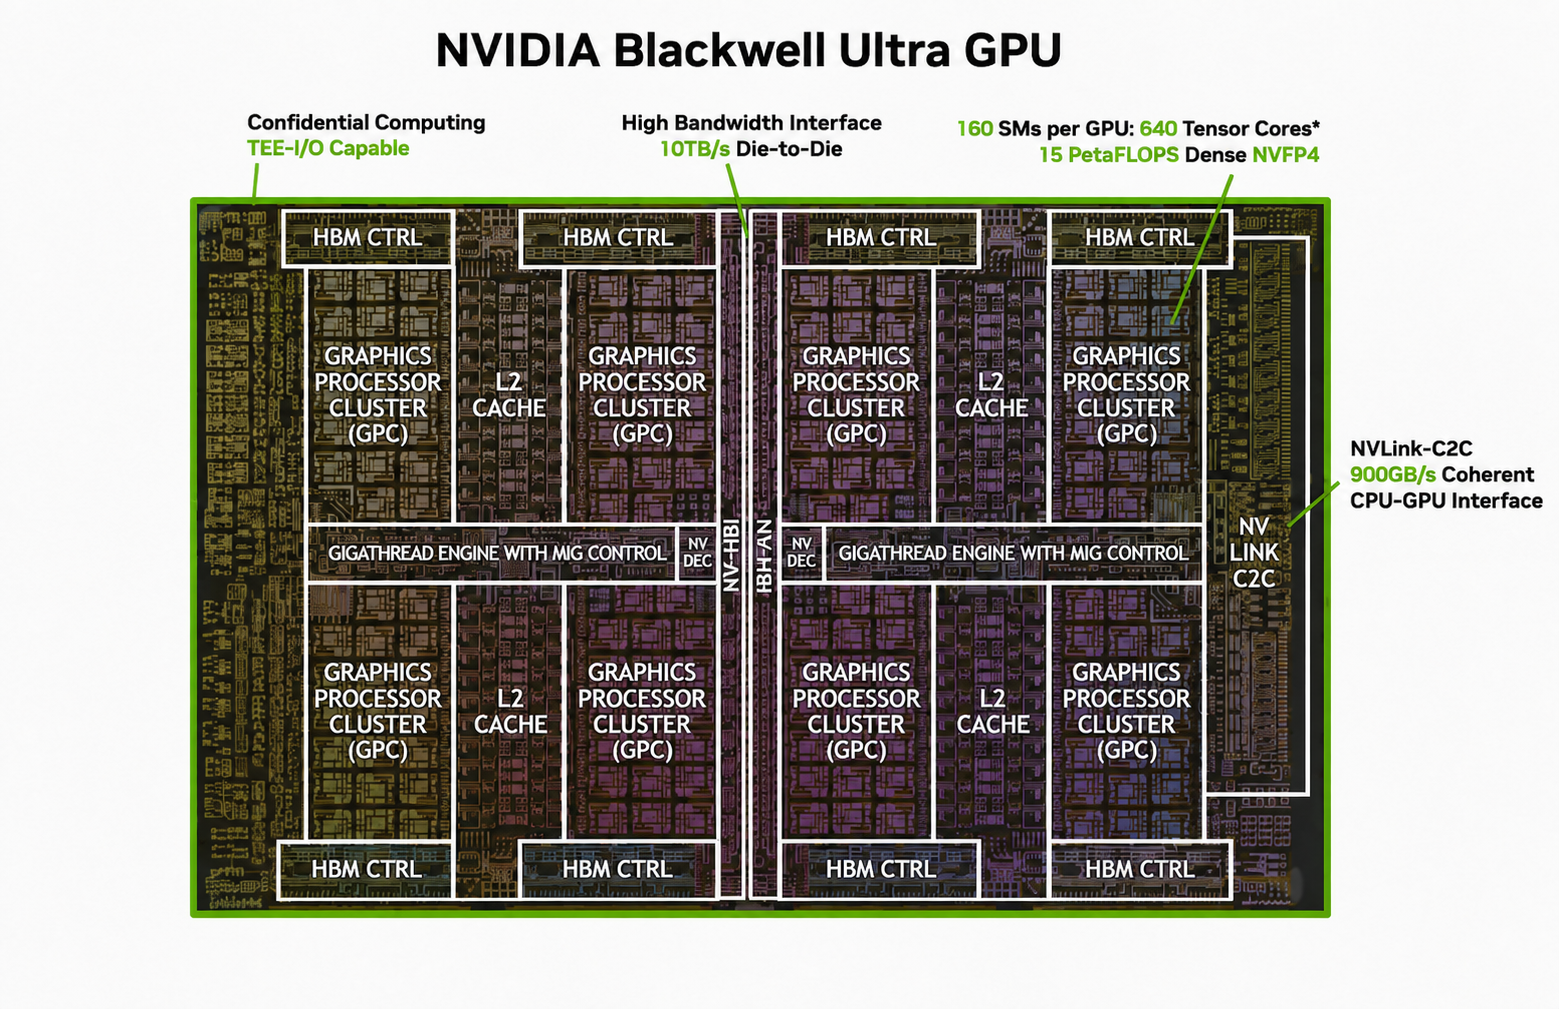
Fonte: NVIDIA, annotato da StorageReview
La B300 è una delle GPU più avanzate attualmente disponibili, caratterizzata da un design a doppio reticolo basato sul processo 4NP di TSMC. I due die sono collegati dall'interfaccia die-to-die NV-HBI di NVIDIA a 10 TB/s, che consente alla GPU di funzionare come un singolo acceleratore CUDA. La B300 utilizzata in DGX Station si basa sul design Blackwell Ultra a 208 miliardi di transistor, con fino a 160 SM e 640 Tensor Core di quinta generazione. Dispone inoltre di 252 GB di HBM3e con una larghezza di banda di memoria di 7.1 TB/s. Essendo destinata ai data center, la B300 non dispone di uscita video standard né di encoder hardware NVENC. Include, tuttavia, sette motori NVDEC e sette decoder nvJPEG. La GPU supporta anche MIG, consentendo di partizionarla in un massimo di sette istanze isolate. Per quanto riguarda la potenza di calcolo, la B300 offre:
| Precisione | Peak Performance |
|---|---|
| Prestazioni di calcolo B300 | |
| NVFP4 Tensor Core | 20 PFLOPS sparsi / 15 PFLOPS densi |
| FP8 / FP6 Tensor Core | 10 PFLOP |
| Nucleo Tensoriale INT8 | 330 TOP |
| Core tensoriale FP16 / BF16 | 5 PFLOP |
| Nucleo Tensoriale TF32 | 2.5 PFLOP |
| FP32 | 80 TFLOPS |
| FP64 / FP64 Tensor Core | 1.3 TFLOPS |
| I valori di picco si basano sulla frequenza di boost della GPU. Le specifiche di Tensor Core utilizzano la sparsità, salvo diversa indicazione. | |
Abbinata alla B300 troviamo Grace, la prima CPU per data center di NVIDIA. Utilizza 72 core Arm Neoverse V2, ma il processore circostante è progettato internamente da NVIDIA, inclusi la gerarchia della cache, i controller di memoria, l'I/O di sistema, la Scalable Coherency Fabric e l'interfaccia NVLink-C2C. Grace offre 72 core e 72 thread hardware, con ogni core che implementa Armv9 con estensioni crittografiche e quattro unità vettoriali SVE2 a 128 bit. Il core dispone di un decodificatore di istruzioni a sei vie in grado di gestire fino a otto istruzioni per ciclo di clock, sei ALU scalari, 64 KB ciascuno di cache L1 per istruzioni e dati e 1 MB di cache L2 privata. A livello di die, la CPU condivide 114 MB di cache L3.
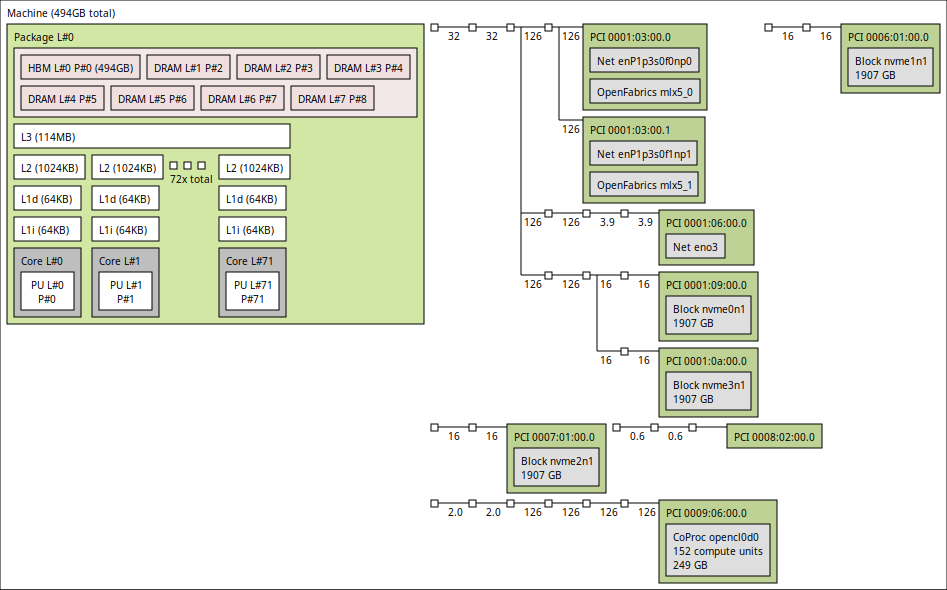
I core e le slice della cache L3 sono collegati tramite la Scalable Coherency Fabric di NVIDIA, un'interconnessione a maglia con una larghezza di banda di bisezione di 3.2 TB/s. La fabric collega inoltre i core della CPU alla memoria, all'I/O di sistema e all'interfaccia NVLink-C2C, fornendo a Grace la larghezza di banda per il trasferimento dati necessaria ad alimentare il B300. Nel WS300, Grace gestisce le attività lato CPU relative all'acceleratore: avvio del kernel GPU, caricamento dei dati, preelaborazione, tokenizzazione e orchestrazione del modello. La vista topologica sottostante offre una chiara panoramica del design a singolo socket, con una CPU Grace a 72 core e i dispositivi della piattaforma collegati attorno ad essa.
Grace è dotata di 496 GB di memoria LPDDR5X, che offre una larghezza di banda di 396 GB/s. Anziché saldare la memoria direttamente sulla scheda madre, DGX Station utilizza quattro moduli SOCAMM. SOCAMM, acronimo di System-on-Chip Advanced Memory Module, integra la memoria LPDDR5X in un formato compatto e rimovibile. Ciò consente alla piattaforma di mantenere i vantaggi in termini di larghezza di banda ed efficienza energetica della LPDDR5X, rendendo al contempo la memoria facilmente sostituibile. Un modulo guasto può essere sostituito senza dover sostituire l'intera scheda madre.
A collegare Grace e la B300 c'è l'interfaccia NVLink-C2C di NVIDIA, un'interconnessione a livello di package che offre una larghezza di banda bidirezionale di 900 GB/s, circa sette volte superiore a quella di una connessione PCIe Gen5 x16. La differenza più importante risiede nella coerenza della memoria. In una workstation convenzionale, la CPU e la GPU dedicata mantengono spazi di memoria separati, con i dati copiati tra di esse tramite PCIe. Con NVLink-C2C, Grace e la B300 condividono uno spazio di indirizzamento coerente, consentendo a ciascun processore di accedere direttamente alla memoria collegata all'altro.
Il risultato è uno spazio di indirizzamento coerente di 748 GB, non un blocco di HBM da 748 GB. La B300 dispone di 252 GB di HBM3e con una velocità di 7.1 TB/s, mentre Grace contribuisce con 496 GB di LPDDR5X a 396 GB/s. I dati memorizzati nella memoria Grace devono comunque attraversare il collegamento C2C, quindi l'HBM rimane la posizione migliore per i pesi dei modelli, i tensori e i buffer a cui si accede frequentemente. La memoria Grace funge invece da livello di grande capacità, consentendo ai carichi di lavoro che superano i 252 GB di memoria locale della B300 di rimanere su un unico sistema anziché essere suddivisi su più GPU. Misureremo l'impatto sulle prestazioni del passaggio a questo secondo livello di memoria più avanti nella sezione dei test.
Topologia del sistema
Partendo dal package GB300, il diagramma a blocchi di MSI mostra come il resto del sistema si connette attorno a Grace. La CPU si trova al centro della topologia I/O, con due slot M.2 PCIe 5.0 x4 collegati direttamente ad essa. MSI li popola con una coppia di SSD Micron 4600 da 2 TB configurati in RAID 1 per il sistema operativo e lo stack software NVIDIA. Anche i tre slot di espansione a lunghezza intera sono collegati direttamente a Grace, con un collegamento PCIe 5.0 x16 e due collegamenti PCIe 5.0 x8.
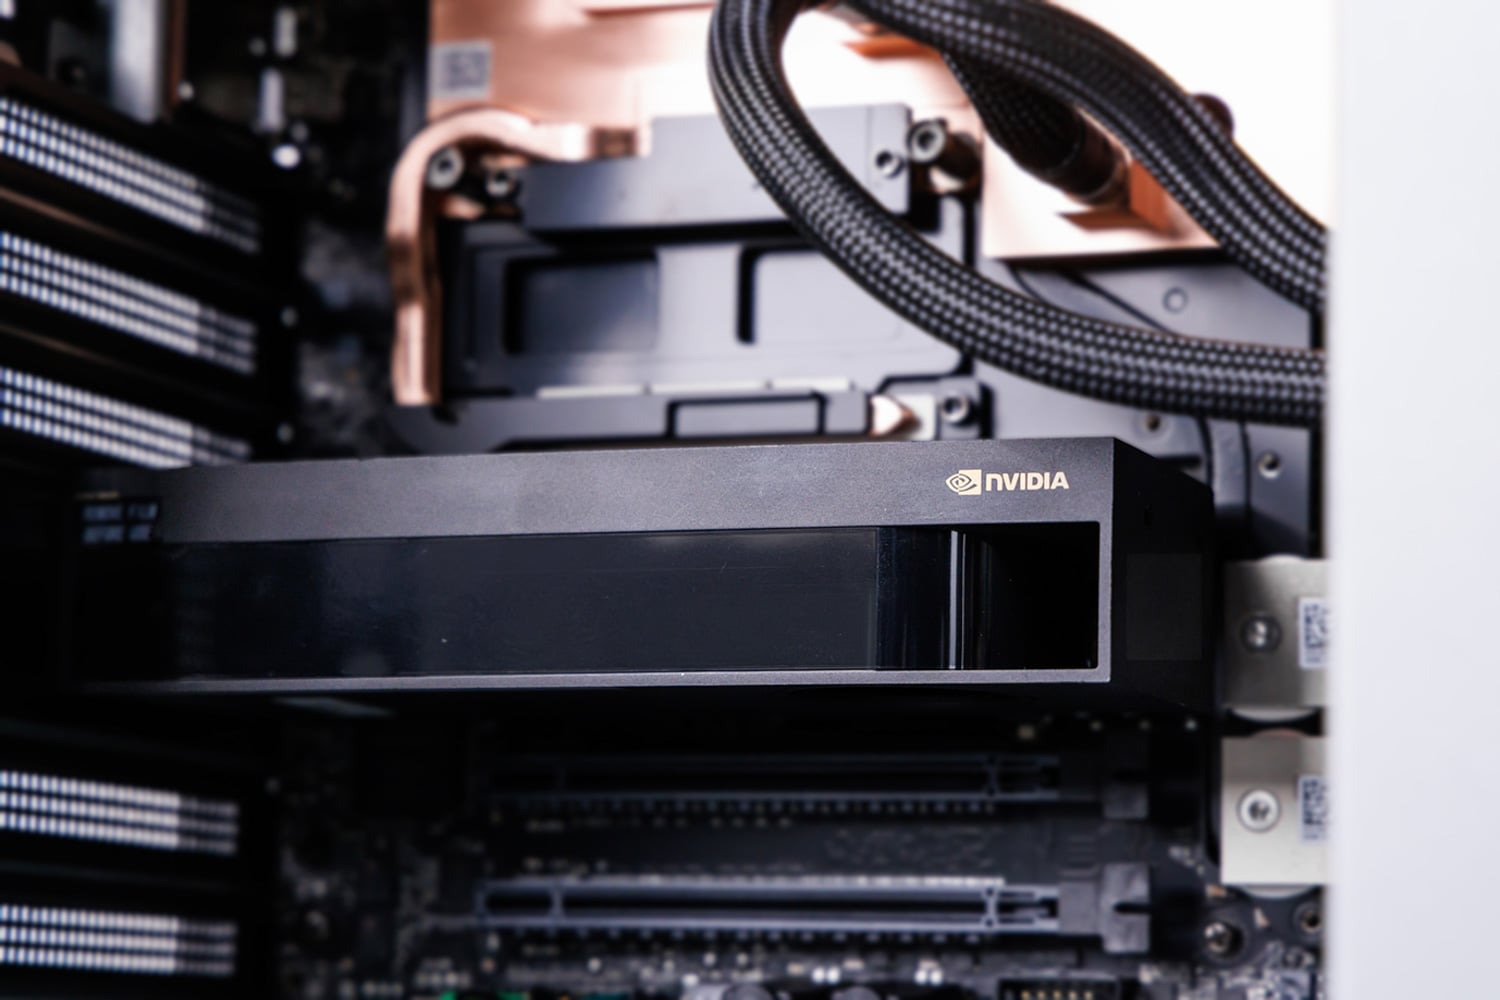
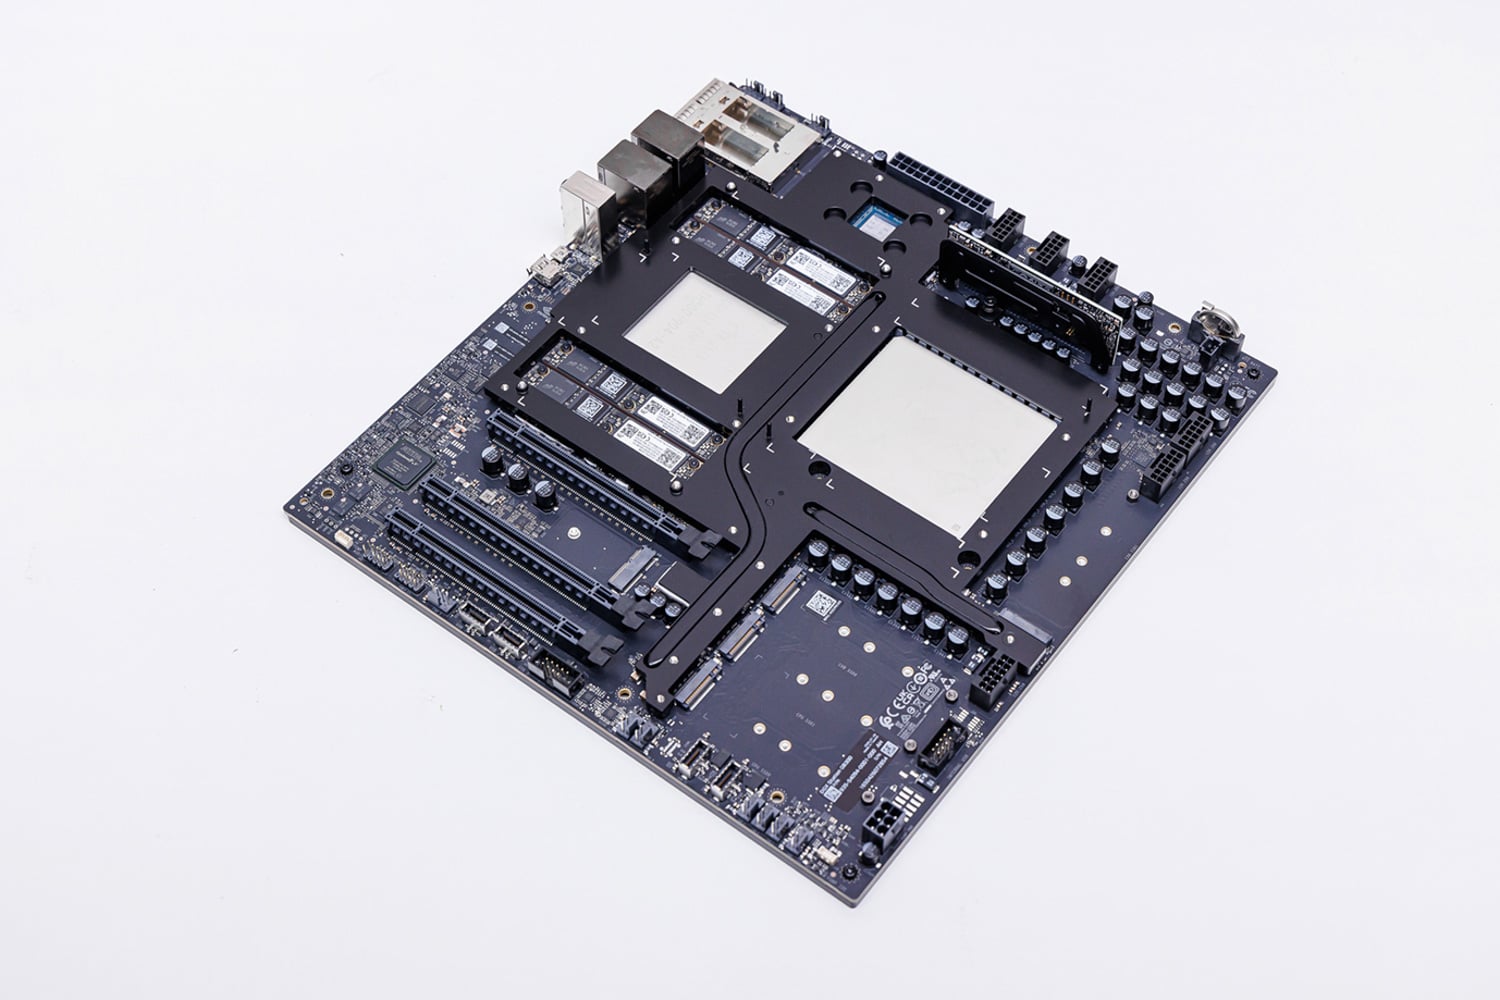
MSI ha inoltre predisposto il case per l'installazione di una GPU di grandi dimensioni. Un cavo di alimentazione precablato da 12VHPWR è facilmente accessibile nella parte anteriore del case, evitando la necessità di far passare un altro cavo all'interno del sistema. Il rinforzo metallico verticale che irrigidisce il case incorpora anche una staffa anti-flessione per supportare schede RTX PRO lunghe e pesanti.
Un controller USB sul lato Grace gestisce le principali porte USB anteriori e posteriori del sistema, insieme al codec audio. Grace si collega anche all'ASPEED AST2600 BMC, che fornisce una porta di gestione dedicata da 1 GbE, un'uscita Mini DisplayPort limitata a 1024 x 768 e una console seriale Micro-USB. La Mini DisplayPort è pensata per la configurazione iniziale e la risoluzione dei problemi, non come uscita video principale del sistema. Chiunque intenda utilizzare il WS300 come un normale computer desktop avrà comunque bisogno di una delle schede aggiuntive RTX PRO opzionali.
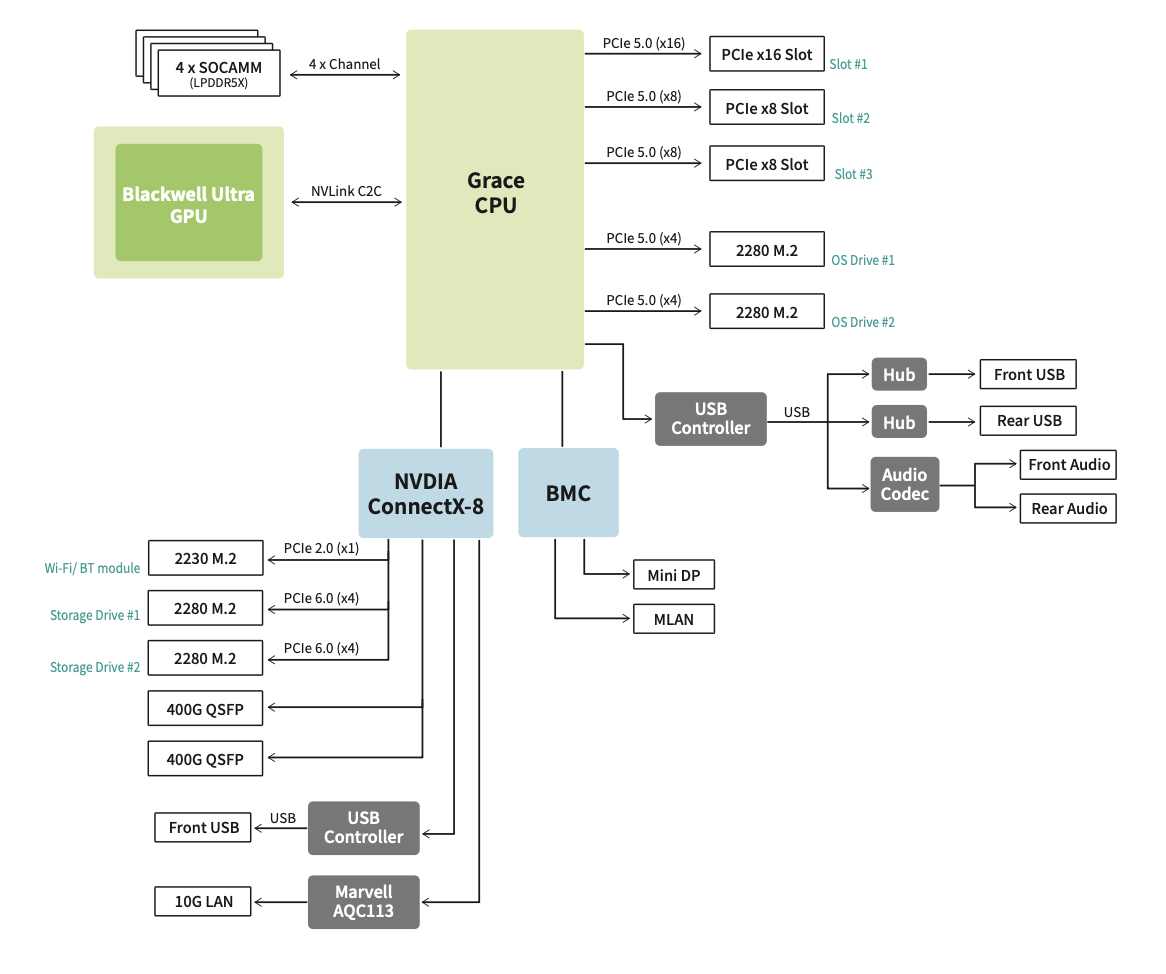
L'altra soluzione principale è la ConnectX-8 SuperNIC di NVIDIA. La sua caratteristica più evidente è la coppia di porte 400GbE QSFP112 sul pannello posteriore, che offrono una larghezza di banda di rete aggregata fino a 800 Gb/s. ConnectX-8 include anche uno switch PCIe integrato con 48 linee; il suo collegamento upstream è compatibile con PCIe Gen6, ma le porte downstream che espone ai dispositivi funzionano a PCIe 5.0, consentendo a MSI di utilizzarla come hub I/O secondario anziché come semplice scheda di rete.
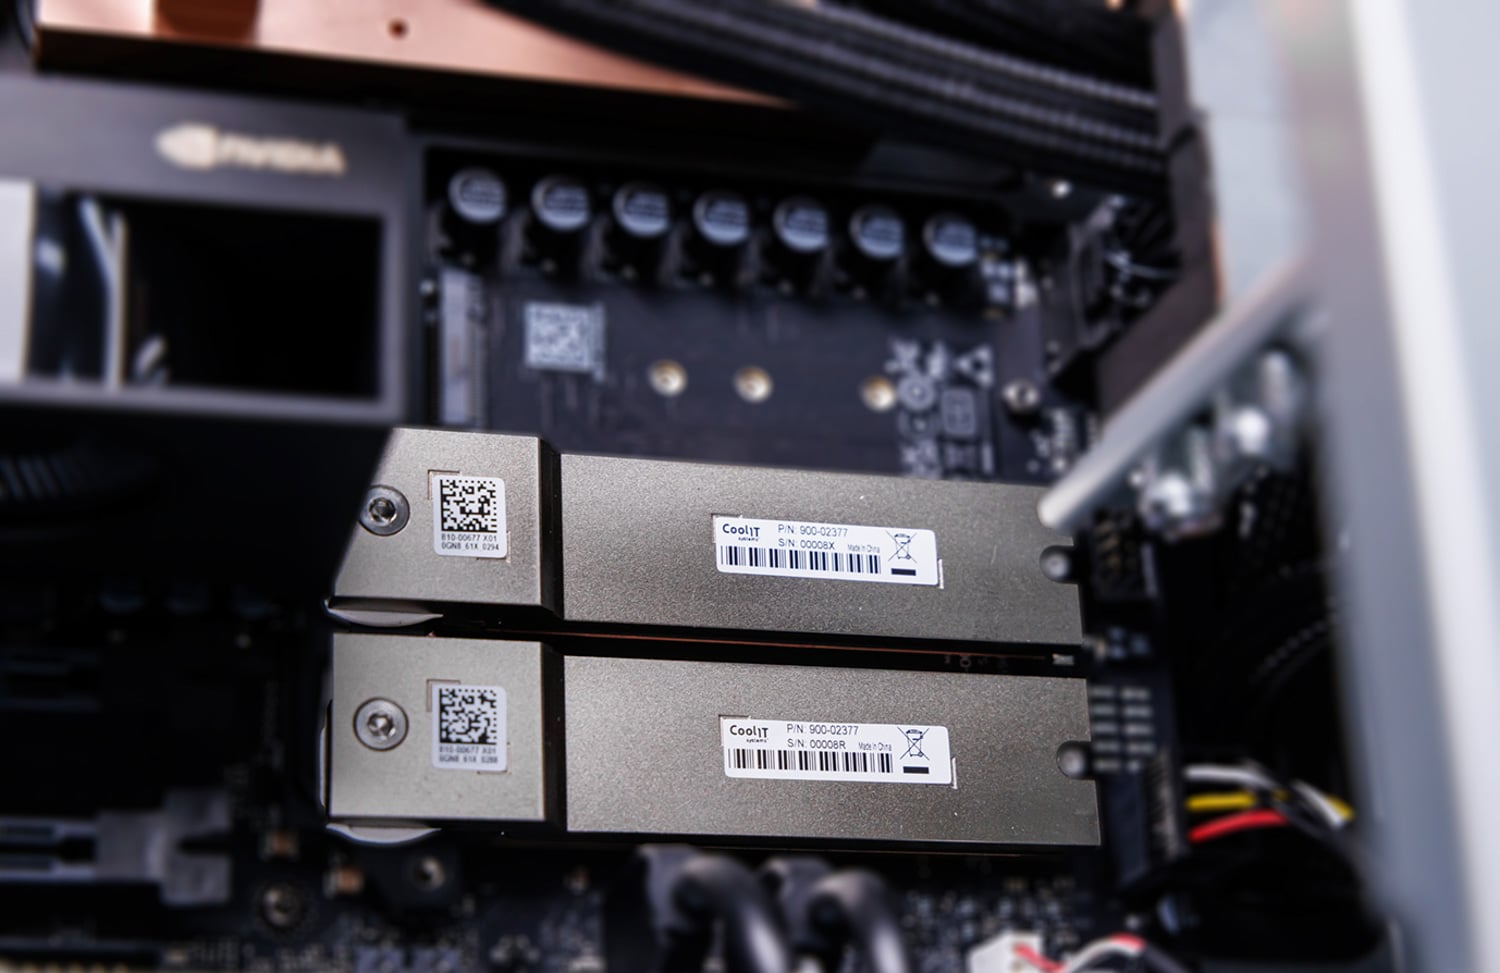
Due collegamenti PCIe 5.0 x4 provenienti dalla ConnectX-8 alimentano i restanti slot M.2 2280, che MSI lascia liberi per future espansioni. Lo stesso ramo collega anche lo slot M.2 2230 per Wi-Fi e Bluetooth tramite PCIe 2.0 x1, il controller Marvell AQC113 per la porta 10GBase-T e un secondo controller USB che fornisce un ulteriore percorso USB per il pannello frontale.
Potenza e raffreddamento
Il WS300 è alimentato da un singolo alimentatore ATX da 1,600 W con certificazione 80 PLUS Platinum e connettore C19. Per le installazioni in Nord America, la DGX Station richiede un circuito dedicato da 20 A per fornire al sistema la potenza massima erogabile.
La potenza nominale di 1,600 W rappresenta il limite massimo per l'intero sistema. Grace, la B300, l'unità di archiviazione, le pompe, le ventole e qualsiasi scheda RTX PRO opzionale attingono tutti alla stessa fonte di alimentazione. L'aggiunta di una scheda grafica ad alta potenza espande le capacità del WS300, ma non attinge a un pool di energia separato. Quando sia la B300 che la scheda RTX sono sotto carico, devono condividere l'energia già disponibile, il che può ridurre le prestazioni della GPU della B300.
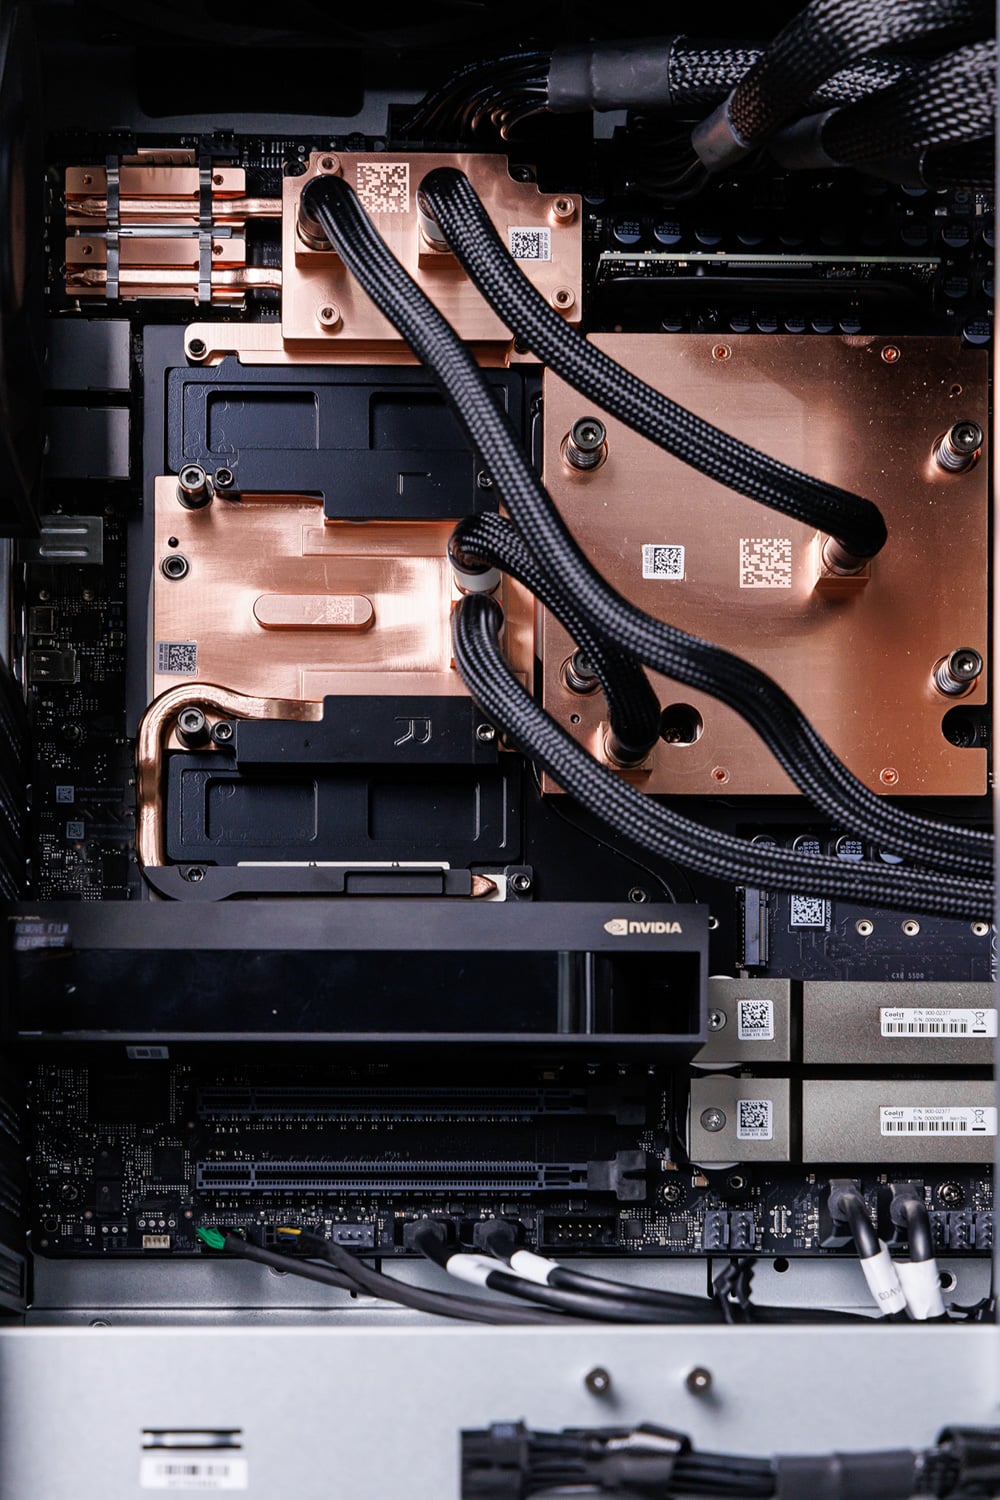
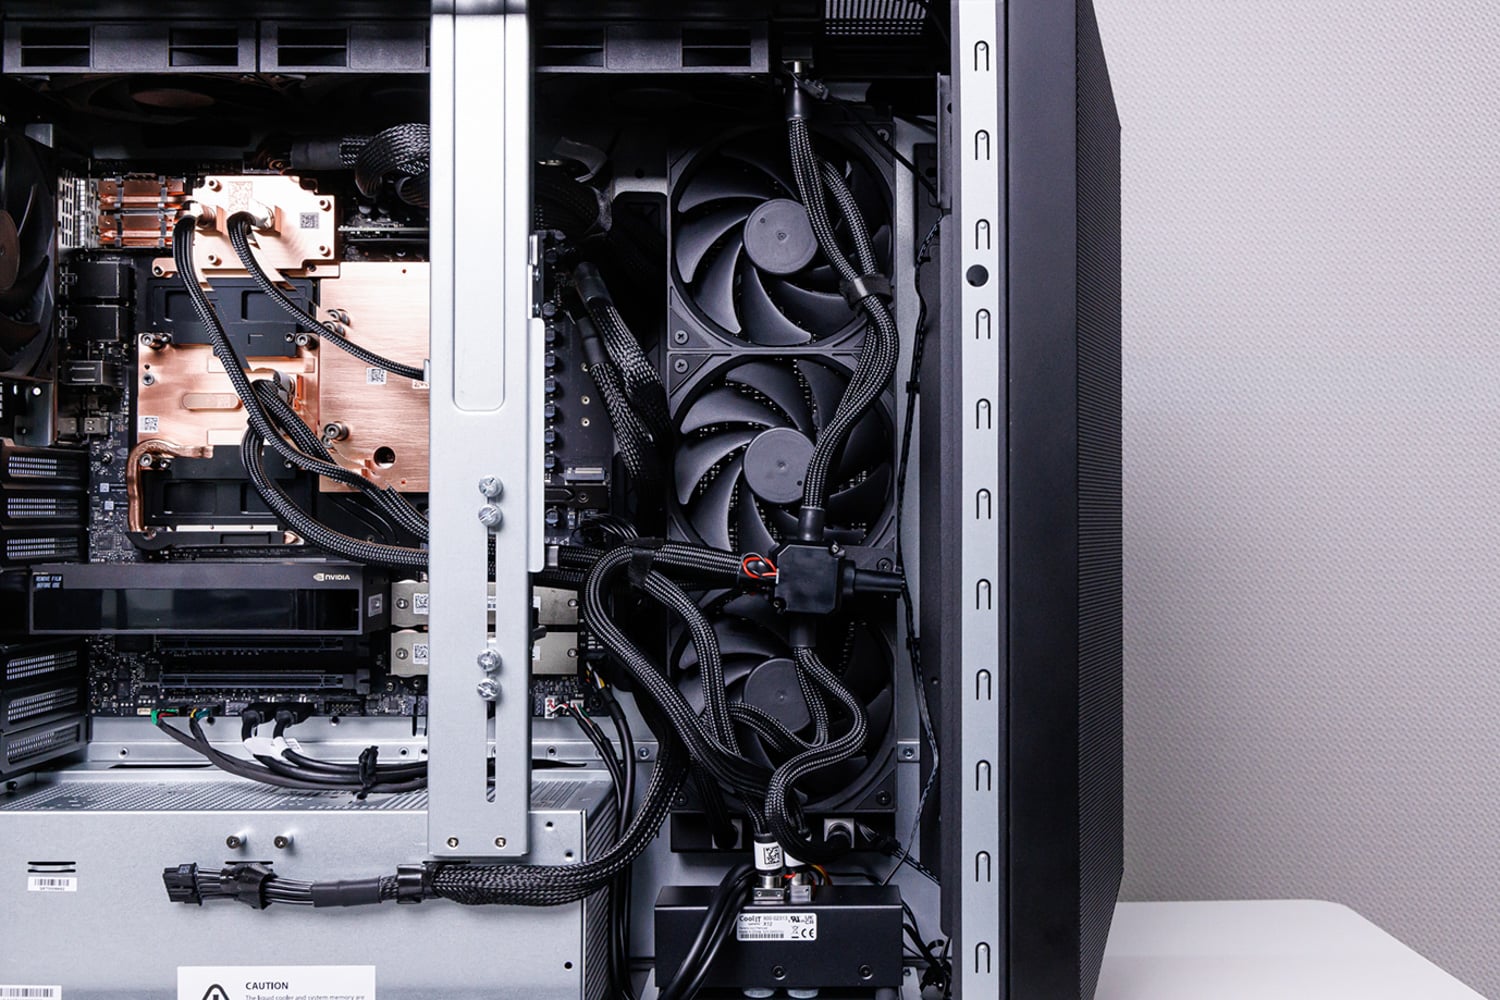
MSI gestisce il carico termico risultante con un circuito di raffreddamento a liquido personalizzato che copre il B300, la CPU Grace, la memoria SOCAMM e il ConnectX-8, inclusi gli alloggiamenti per le unità ottiche. Il calore viene dissipato attraverso due radiatori da 360 mm, mentre una ventola separata da 120 mm muove l'aria attraverso il resto dello chassis. MSI dichiara una potenza nominale del sistema di raffreddamento fino a 1,400 W per CPU e GPU. Durante i nostri test, la temperatura del B300 ha raggiunto un picco di 71 °C, mentre la CPU non ha mai superato i 65 °C con un consumo di 1292 W da parte della GPU.
Schizzi di potenza
NVIDIA gestisce questo budget condiviso tramite il servizio vsloshd. Nella sua modalità dinamica predefinita, il servizio monitora il consumo energetico in tempo reale del modulo GB300 e di una scheda RTX PRO opzionale, ridistribuendo il margine di potenza disponibile tra di essi anziché vincolare ciascun dispositivo a un limite fisso. Con la policy attuale, la scheda RTX ha la priorità, quindi quando necessita di maggiore potenza, il sistema riduce prima il limite di potenza del GB300 prima di aumentare quello della RTX. Senza una scheda RTX installata, l'intero budget di potenza rimane disponibile per il modulo GB300.
Ciò significa che la RTX PRO 6000 opzionale non offre semplicemente prestazioni aggiuntive rispetto alla B300. Quando entrambe le GPU sono in funzione, la potenza assegnata alla scheda RTX viene prelevata direttamente dal budget della GB300 e può ridurre la frequenza di clock e le prestazioni della B300.
La piattaforma include anche un freno di potenza hardware per i casi in cui il sistema rileva un'erogazione di energia degradata. Abbiamo riscontrato questo problema durante i nostri test pratici, quando dei connettori di alimentazione allentati hanno causato la riduzione del limite di potenza del WS300 anziché lo spegnimento o il continuo assorbimento di potenza a piena potenza tramite una connessione compromessa. La macchina è rimasta online in modalità a potenza ridotta fino alla risoluzione del problema di connessione.
Connettività
Prima di passare oltre lo chassis, vale la pena dare una rapida occhiata alle porte I/O anteriori e posteriori. Le porte I/O anteriori includono due porte USB 3.2 Gen 2 Type-A, due porte USB 3.2 Gen 2 Type-C, jack separati per uscita audio e microfono, e i pulsanti di accensione e reset.
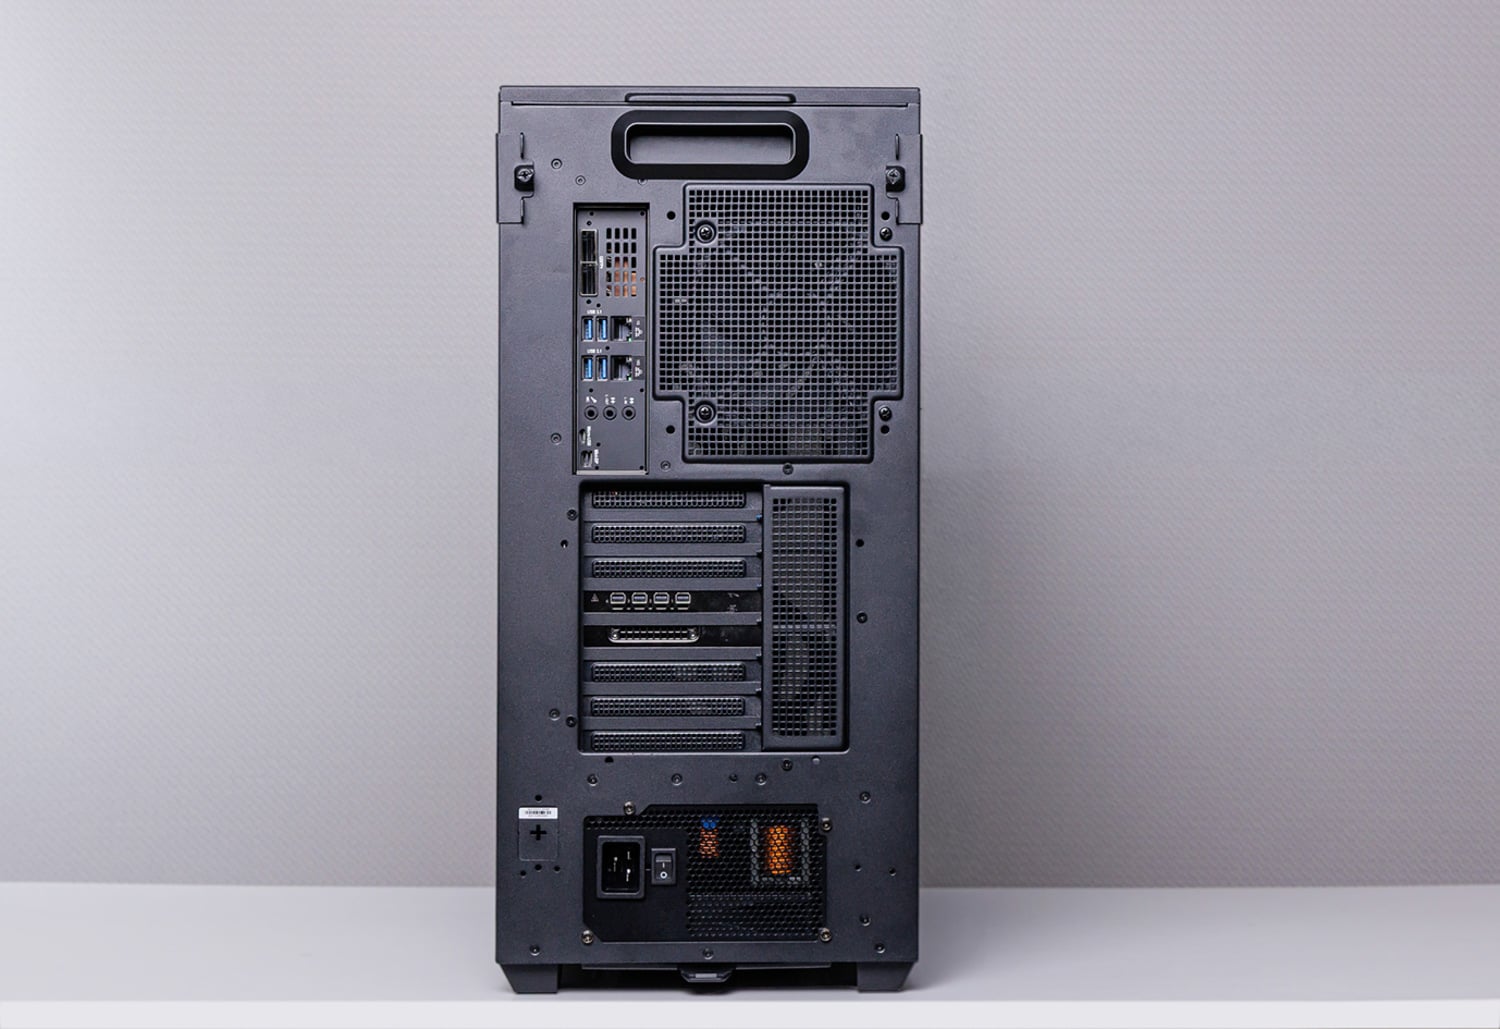
Il pannello posteriore è suddiviso tra la connettività della workstation e l'hardware del server sottostante. ConnectX-8 offre due porte 400GbE QSFP112, mentre una porta 10GBase-T separata gestisce la normale rete host e una porta 1GbE dedicata si collega al BMC. Quattro porte USB Type-A da 10 Gbps e tre jack audio gestiscono le periferiche locali. Il BMC espone anche una console seriale Micro-USB e una Mini DisplayPort. L'ingresso di alimentazione C19 si trova nella parte inferiore dello chassis e il Wi-Fi 6E o il Wi-Fi 7 con Bluetooth possono essere aggiunti tramite lo slot interno M.2 2230 Key-E.
Carichi di lavoro del data center sulla scrivania
Finora abbiamo descritto cos'è DGX Station; la domanda più utile per gli acquirenti è cosa XpertStation permette di fare a un team. Il valore di WS300 diventa più chiaro se lo si considera come una piattaforma di sviluppo piuttosto che semplicemente come un sistema di inferenza ad alta capacità. La sua GPU B300, la CPU Grace, il supporto MIG, la grafica RTX PRO opzionale e lo stack software per data center consentono di eseguire su un singolo nodo locale diversi flussi di lavoro che normalmente dipenderebbero da hardware cluster condiviso.
MIG come strumento di sviluppo
Immaginate di eseguire contemporaneamente diversi processi completamente separati su una singola GPU, ognuno isolato dagli altri. Questo è ciò che fa Multi-Instance GPU (MIG): segmenta spazialmente l'hardware del B300 in un massimo di sette slice, o istanze, di dimensioni uguali. Ogni istanza ottiene la propria quota fissa di SM, HBM, cache e larghezza di banda della memoria, ha una propria identità di dispositivo e appare a CUDA come una GPU separata.
Ciò consente di sviluppare, testare e convalidare carichi di lavoro multi-GPU; addestrare script; e sviluppare per strumenti come Dynamo, LLM-D, ecc.
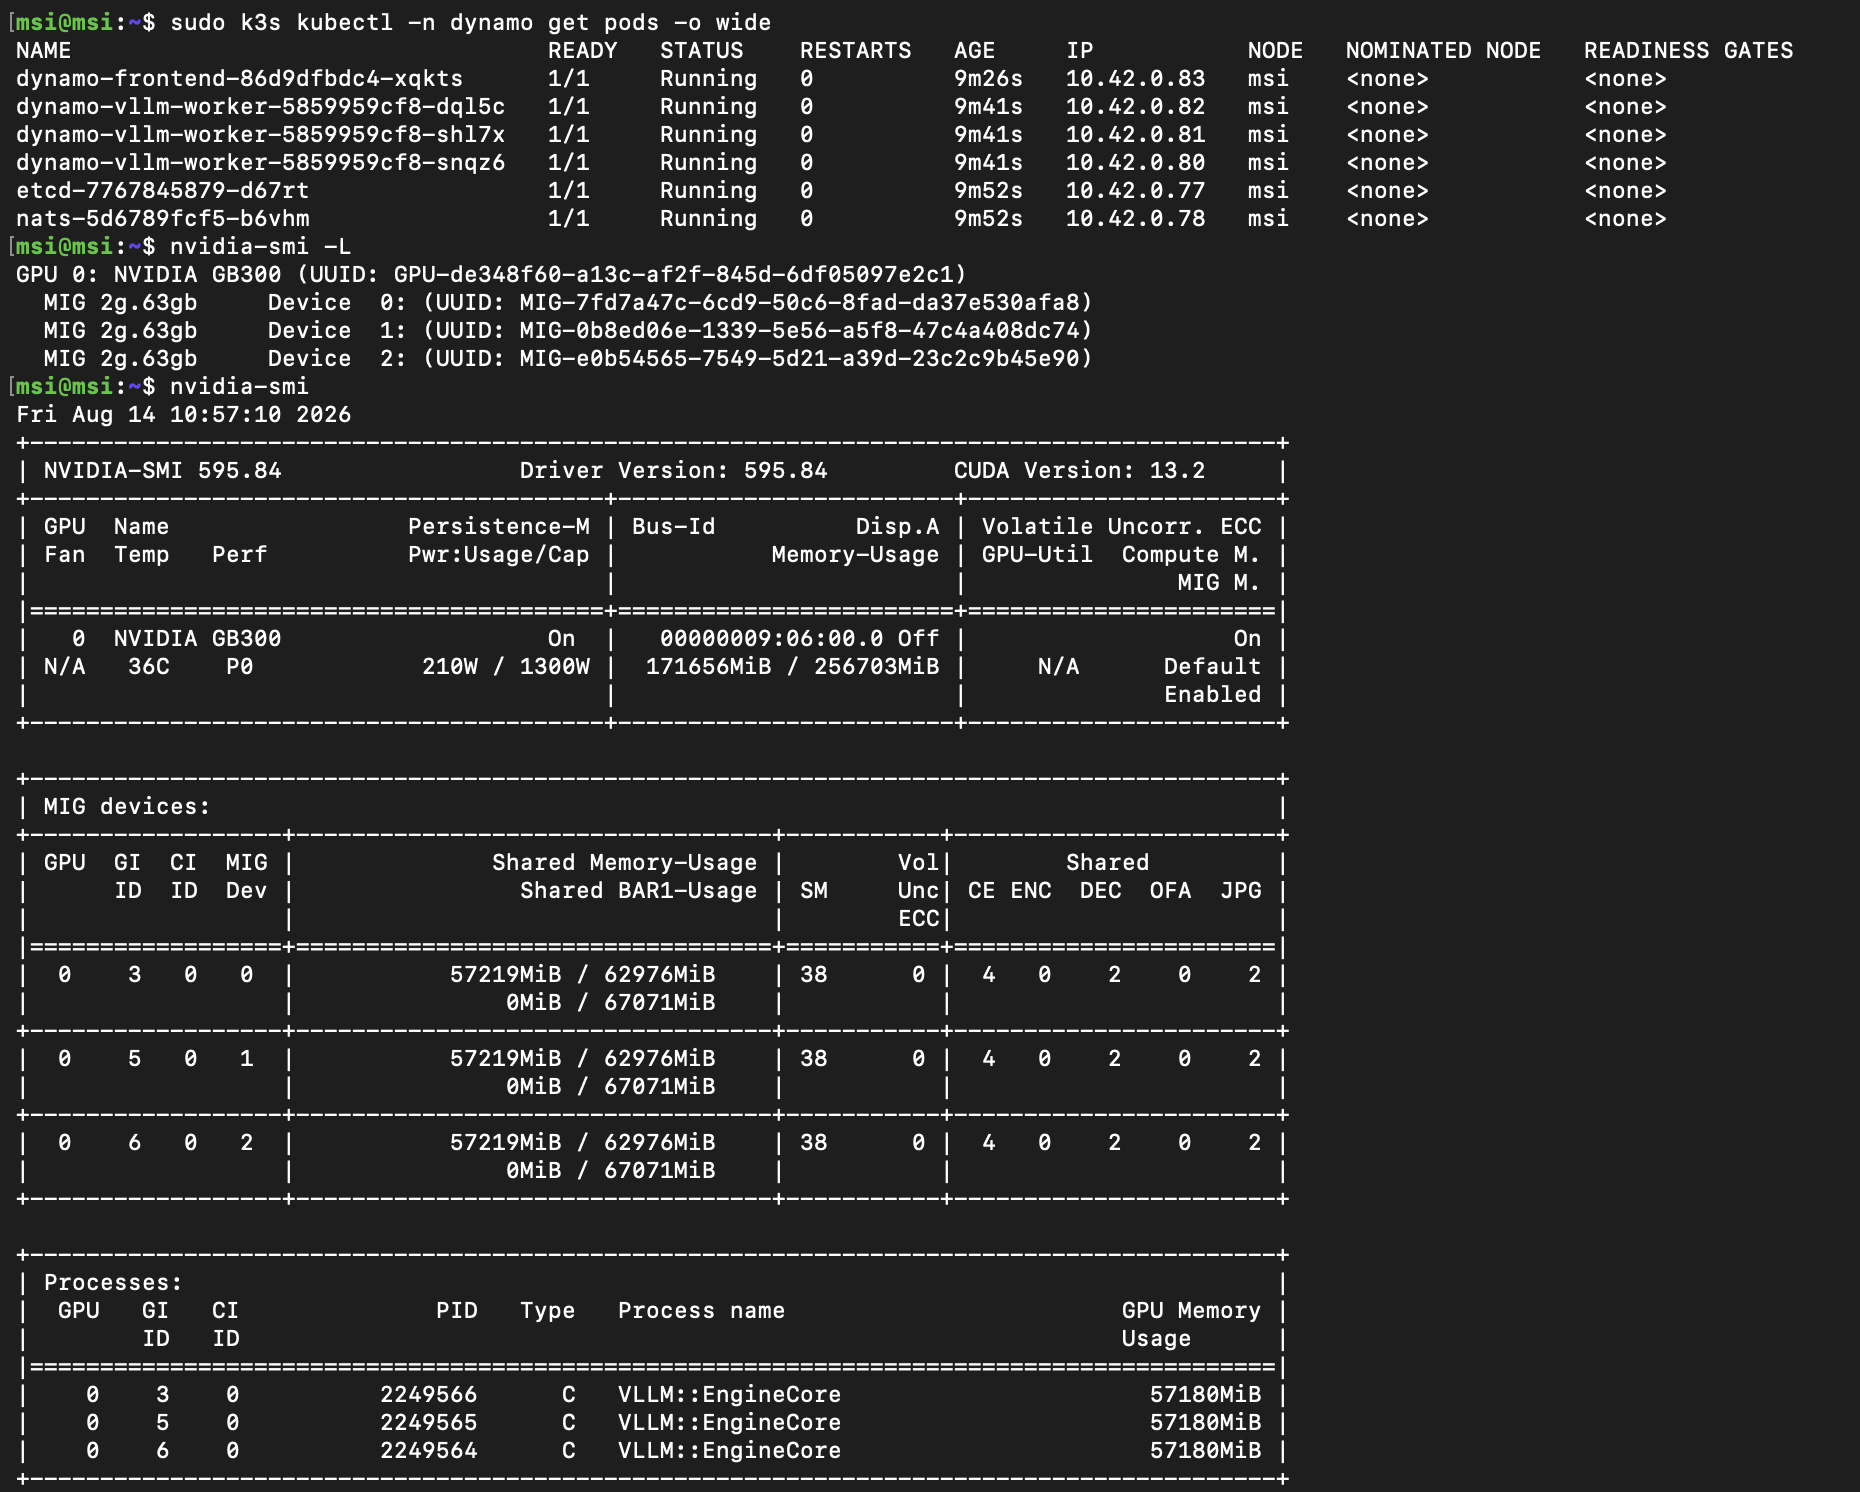
Per i nostri test, abbiamo configurato il B300 con 3 istanze MIG e le abbiamo utilizzate per avviare i componenti NVIDIA Dynamo su dispositivi CUDA separati. Questo rispecchia il modo in cui sviluppiamo gran parte dei nostri strumenti di benchmark: verificare che si comportino esattamente come previsto significa iterare ripetutamente su hardware reale. Avere un B300 locale che possiamo suddividere e riconfigurare, senza dover programmare l'utilizzo di un server condiviso e senza il consumo energetico, il calore e il rumore di un rack in una stanza, elimina una quantità sorprendente di overhead da questo tipo di lavoro iterativo.
Isaac GR00T e il ciclo fisico dell'IA
Un altro flusso di lavoro che si adatta particolarmente bene alla DGX Station è l'intelligenza artificiale fisica.
Abbiamo già testato questo tipo di flusso di lavoro in passato , ma richiedeva diversi sistemi dotati di GPU di classi differenti. La DGX Station riunisce queste fasi, prima separate, in un'unica macchina da scrivania.
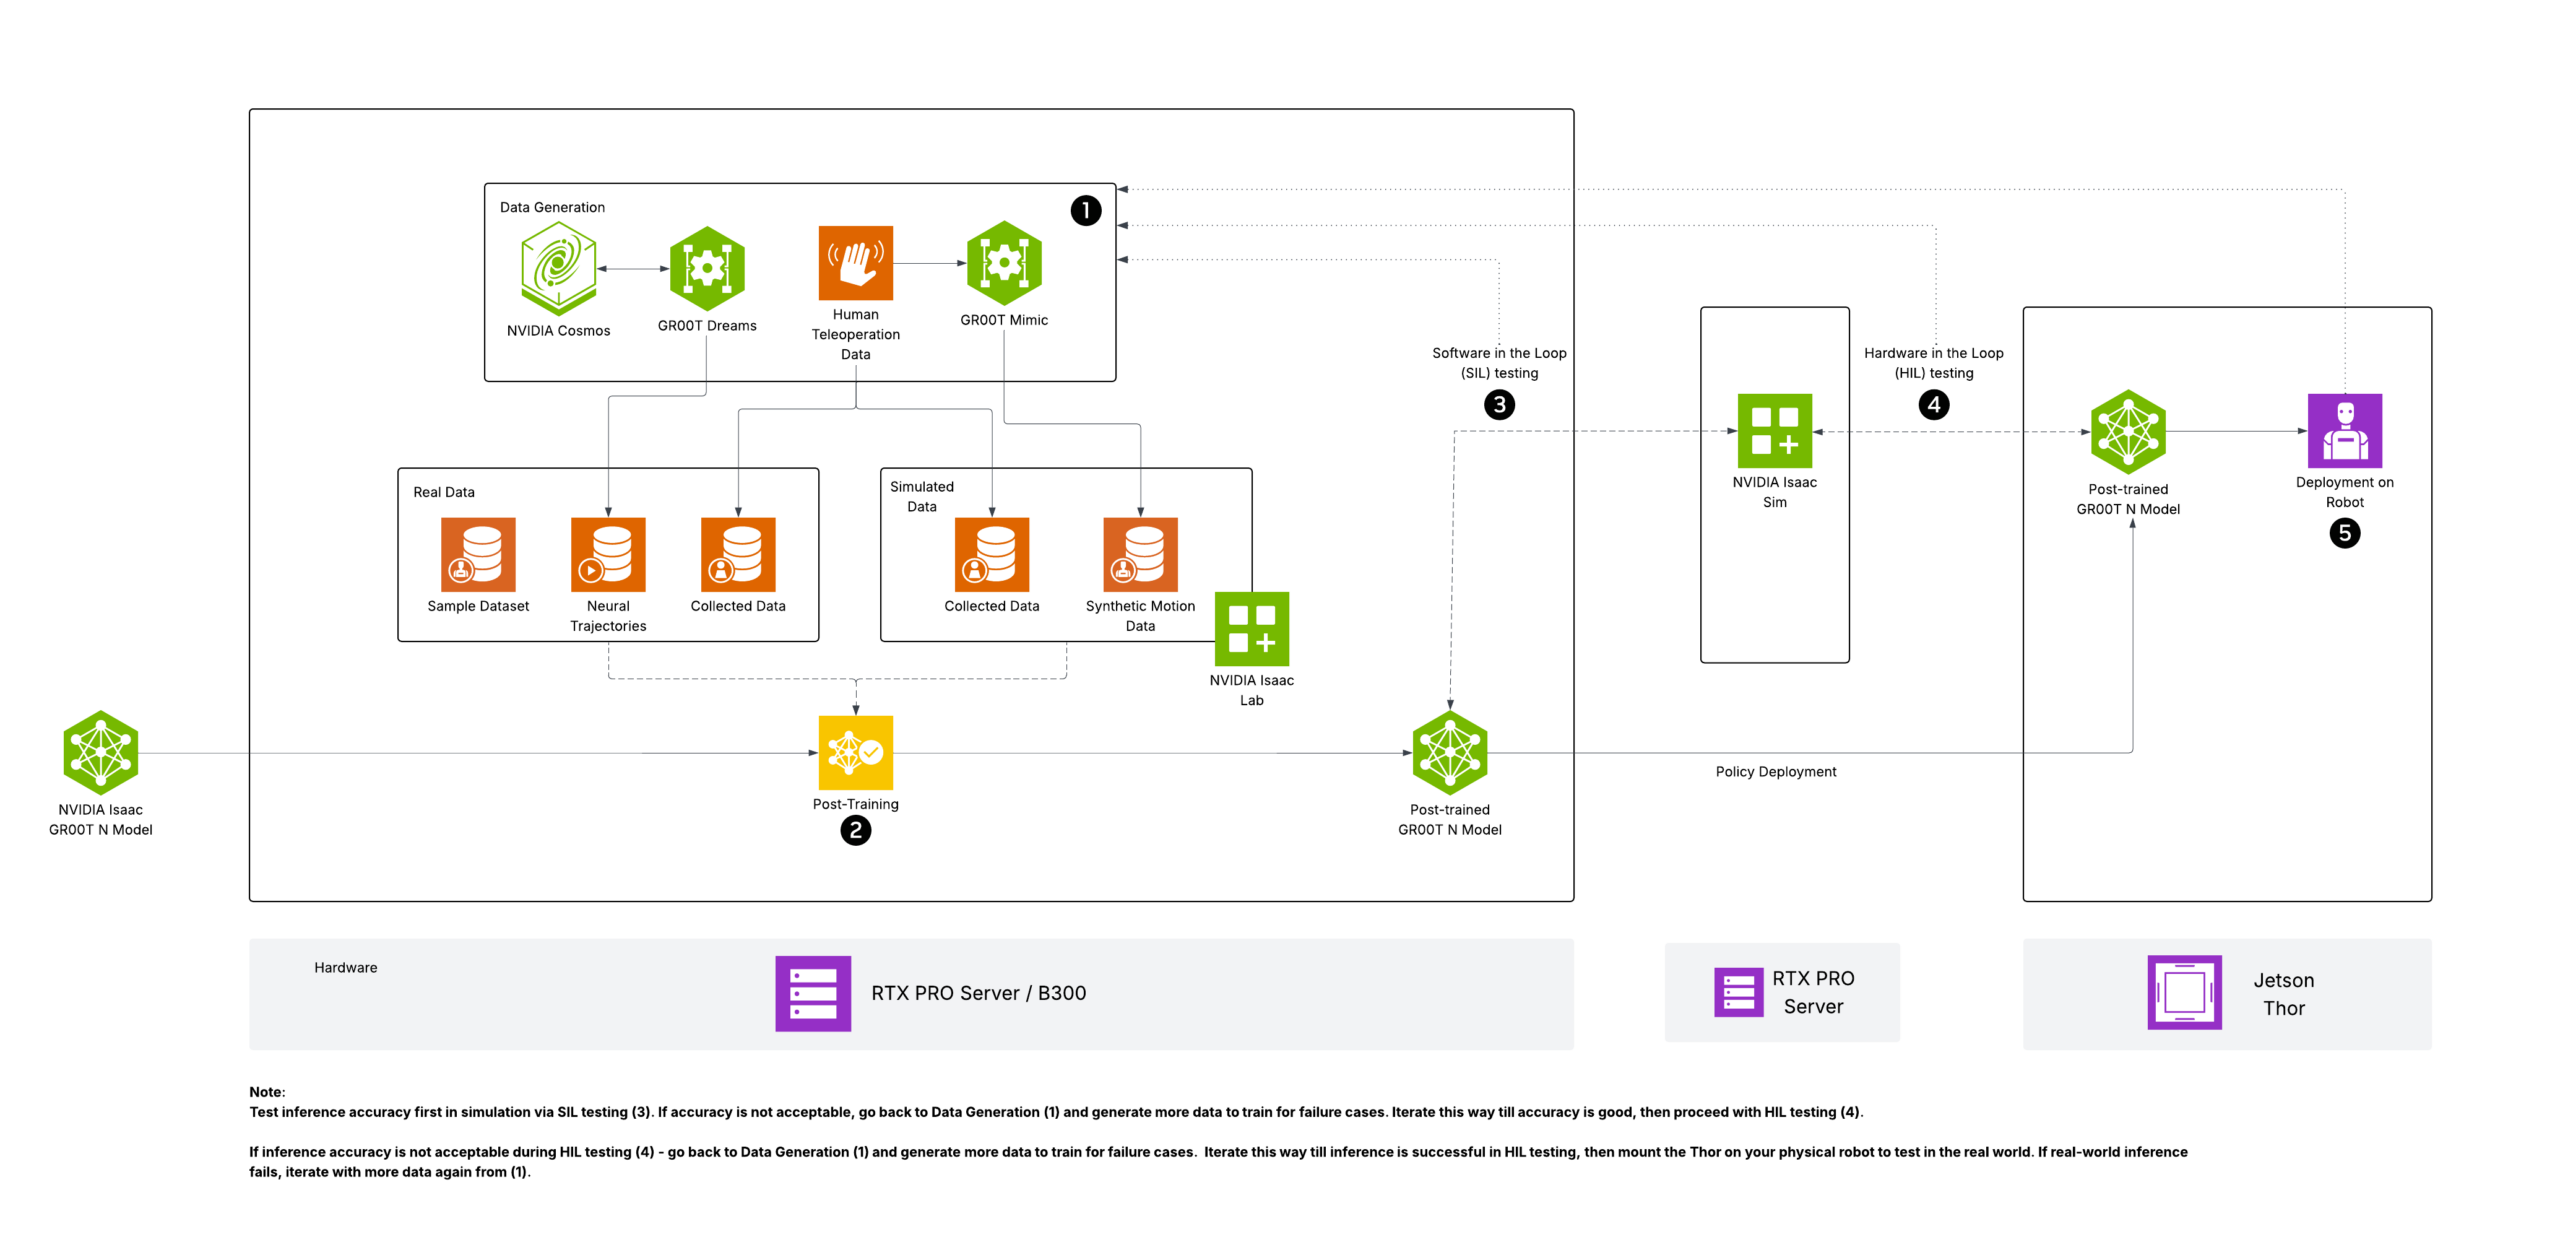
Il processo inizia con la teleoperazione: un operatore guida il robot attraverso un'attività per acquisire una piccola serie di dimostrazioni reali. Questi esempi entrano quindi nel flusso di lavoro di Isaac GR00T. La GPU RTX PRO opzionale gestisce le esigenze grafiche e di ray-tracing di Isaac Sim, mentre Isaac Lab e GR00T-Mimic espandono le dimostrazioni originali in una raccolta molto più ampia di traiettorie sintetiche fisicamente plausibili. Infine, il B300 perfeziona il modello GR00T utilizzando il set di dati combinato reale e sintetico.
Fonte: NVIDIA
Dopo un'accurata messa a punto, la policy risultante può essere validata in simulazione prima di essere implementata sul robot per la valutazione nel mondo reale. Questo crea un ciclo di sviluppo serrato: si acquisisce una dimostrazione reale, la si riproduce e la si varia in simulazione, si riaddestra il modello e si testa la policy aggiornata sull'hardware. Per i team con accesso limitato a robot, operatori o finestre di raccolta dati, consolidare simulazione, generazione di dati sintetici e addestramento del modello in un unico sistema desktop può ridurre significativamente le difficoltà di ogni iterazione.
Sviluppo del kernel Blackwell Ultra
Probabilmente, però, il caso d'uso migliore per la DGX Station è l'ottimizzazione del kernel. Quando un team scrive kernel CUDA o Triton per Blackwell Ultra, non c'è niente di meglio che eseguirli sull'architettura di destinazione. La WS300 mette a disposizione dello sviluppatore un B300 e 252 GB di HBM3e, consentendo di profilare carichi di lavoro reali, ispezionare il comportamento della memoria, ottimizzare i percorsi dei Tensor Core, unire le operazioni e iterare senza dover prenotare tempo su un server a otto GPU o un sistema rack.
I sistemi più grandi sono ancora importanti, ma possono essere riservati per attività che li richiedono: scalabilità NVLink, collettivi NCCL, kernel di comunicazione, inferenza multi-GPU e validazione finale del throughput. Il WS300 gestisce localmente il lavoro del kernel a singola GPU, mantenendo disponibili i costosi sistemi condivisi per i test su larga scala. Per un team focalizzato sull'ottimizzazione di Blackwell Ultra, questa è una delle macchine di sviluppo più semplici e dirette che il mercato possa offrire.
Se la DGX Station fosse stata commercializzata insieme ai primi sistemi Blackwell Ultra, sospettiamo che la fornitura iniziale sarebbe andata esaurita quasi immediatamente, finendo nelle mani di laboratori di intelligenza artificiale, team di sviluppo di compilatori, sviluppatori di motori di inferenza e altri gruppi impegnati nella messa a punto del software per B300. Ancora oggi, l'accesso diretto alla GPU di destinazione potrebbe essere il motivo più valido per cui un'organizzazione dovrebbe acquistarne una.
Cookie di prestazione
Nota sui test: i test sono stati condotti da remoto su un sistema ospitato da MSI, con StorageReview che ha controllato l'intero ambiente software per tutta la durata della valutazione. Il sistema è stato testato senza una GPU RTX PRO o altre schede aggiuntive PCIe installate. Ciò ha consentito al GB300 Superchip di sfruttare appieno la potenza di accelerazione disponibile del sistema durante i test.
Numero massimo di FLOPS Matmul raggiungibili (MAMF)
Innanzitutto, per contestualizzare le prestazioni di calcolo del B300, abbiamo eseguito il test MAMF su tre sistemi di generazione Blackwell. MAMF (Maximum Achievable Matmul FLOPS) è una metrica di prestazione pratica progettata per misurare il picco realistico di operazioni in virgola mobile al secondo che possono essere raggiunte sugli acceleratori di machine learning durante le operazioni di moltiplicazione di matrici, offrendo un benchmark più accurato rispetto al picco teorico di FLOPS spesso pubblicizzato nelle specifiche hardware.
Per questo test, analizziamo ciascuno dei 3 sistemi in BF16, FP8 e NVFP4 e riportiamo il miglior risultato sostenuto (denso) per precisione.
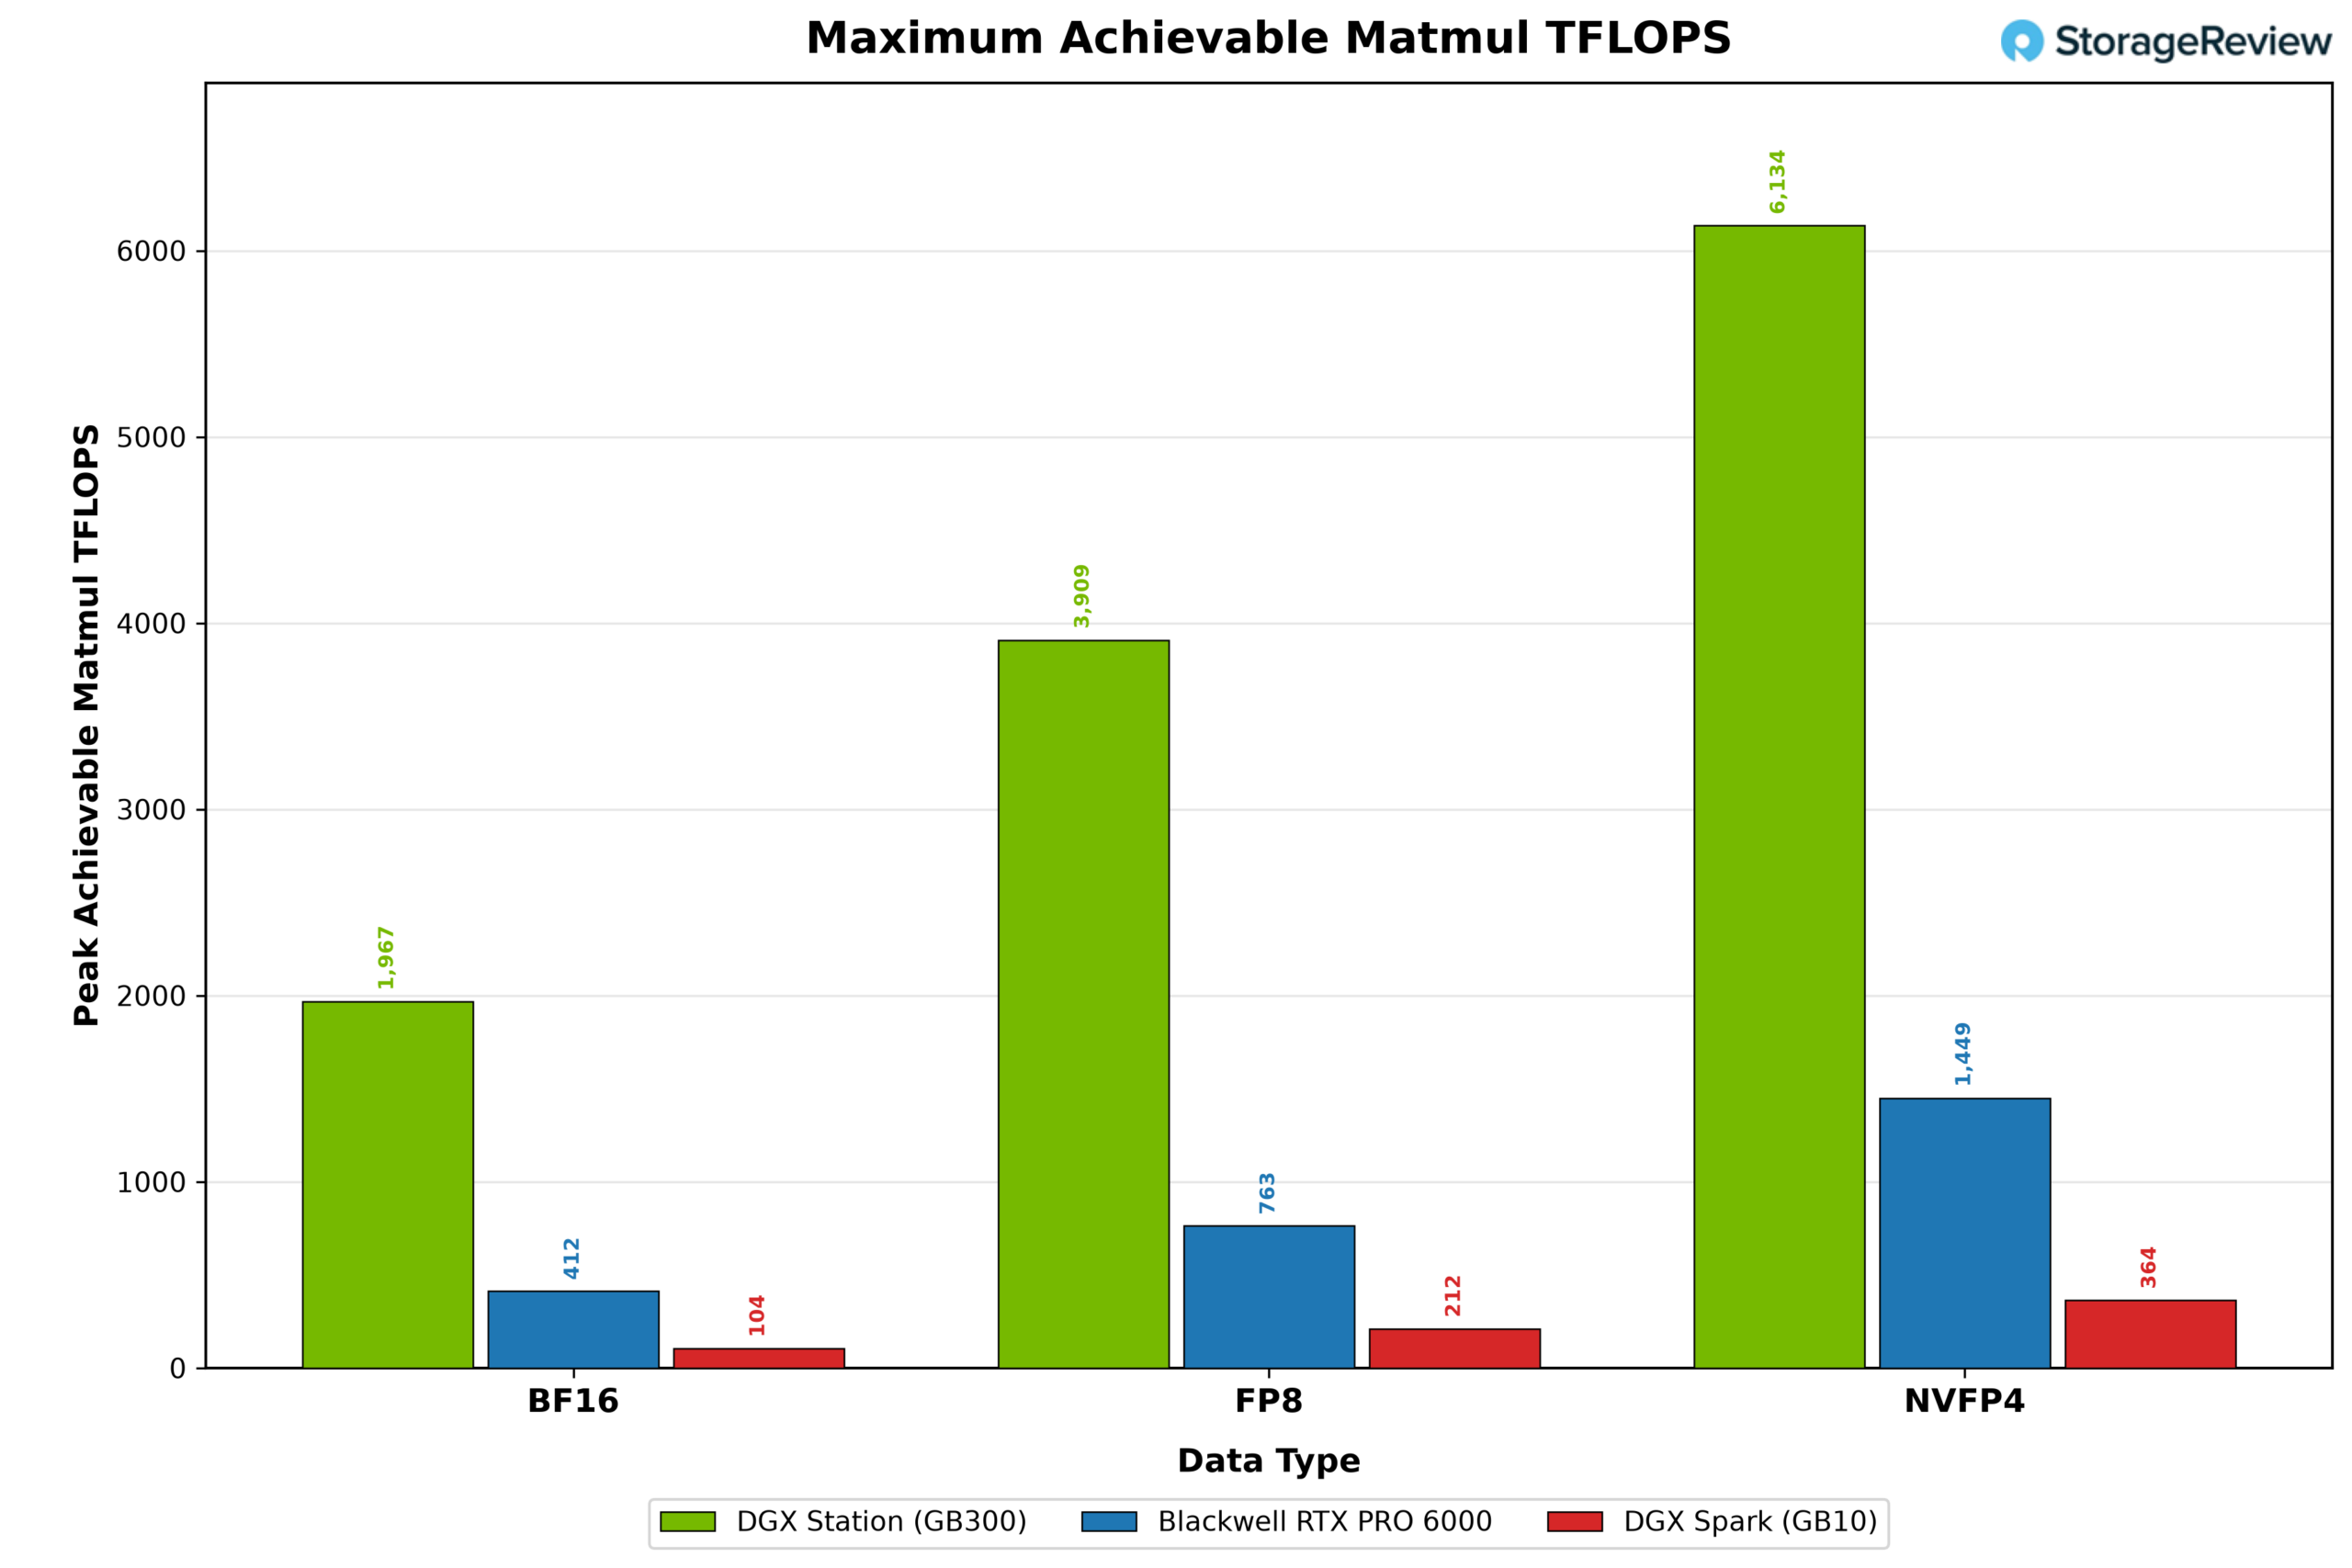
La GB300 primeggia in ogni precisione. In BF16 raggiunge 1,967 TFLOPS contro i 412 della RTX PRO 6000 e i 104 della DGX Spark . FP8 segue lo stesso andamento: 3,909, 763 e 211. NVFP4 porta la GB300 a 6,134 TFLOPS, con la RTX PRO 6000 a 1,449 e la Spark a 364. I rapporti sono notevolmente stabili in tutte e tre le precisioni: la GB300 ha un vantaggio da 4 a 5 volte sulla RTX PRO 6000 e da 17 a 19 volte sulla Spark, mentre la RTX PRO 6000 mantiene un vantaggio di circa 4 volte sulla Spark.
Larghezza di banda NVB
La potenza di calcolo grezza è utile solo se l'acceleratore è in grado di fornire dati alle sue unità di esecuzione. Ciò è particolarmente importante per l'inferenza AI, dove la generazione di token durante la fase di decodifica è spesso limitata più dalla larghezza di banda della memoria che dal numero di FLOPS disponibili.
Sul chip GB300 Superchip, tale gerarchia si estende dalla memoria HBM3e locale del B300, alla memoria LPDDR5X di Grace e all'interconnessione NVLink-C2C che le collega. L'utility NVBandwidth di NVIDIA analizza i diversi percorsi di copia attraverso questi componenti, mostrando sia la larghezza di banda disponibile all'interno della GPU sia il costo del trasferimento dei dati tra i domini di memoria della GPU e della CPU.
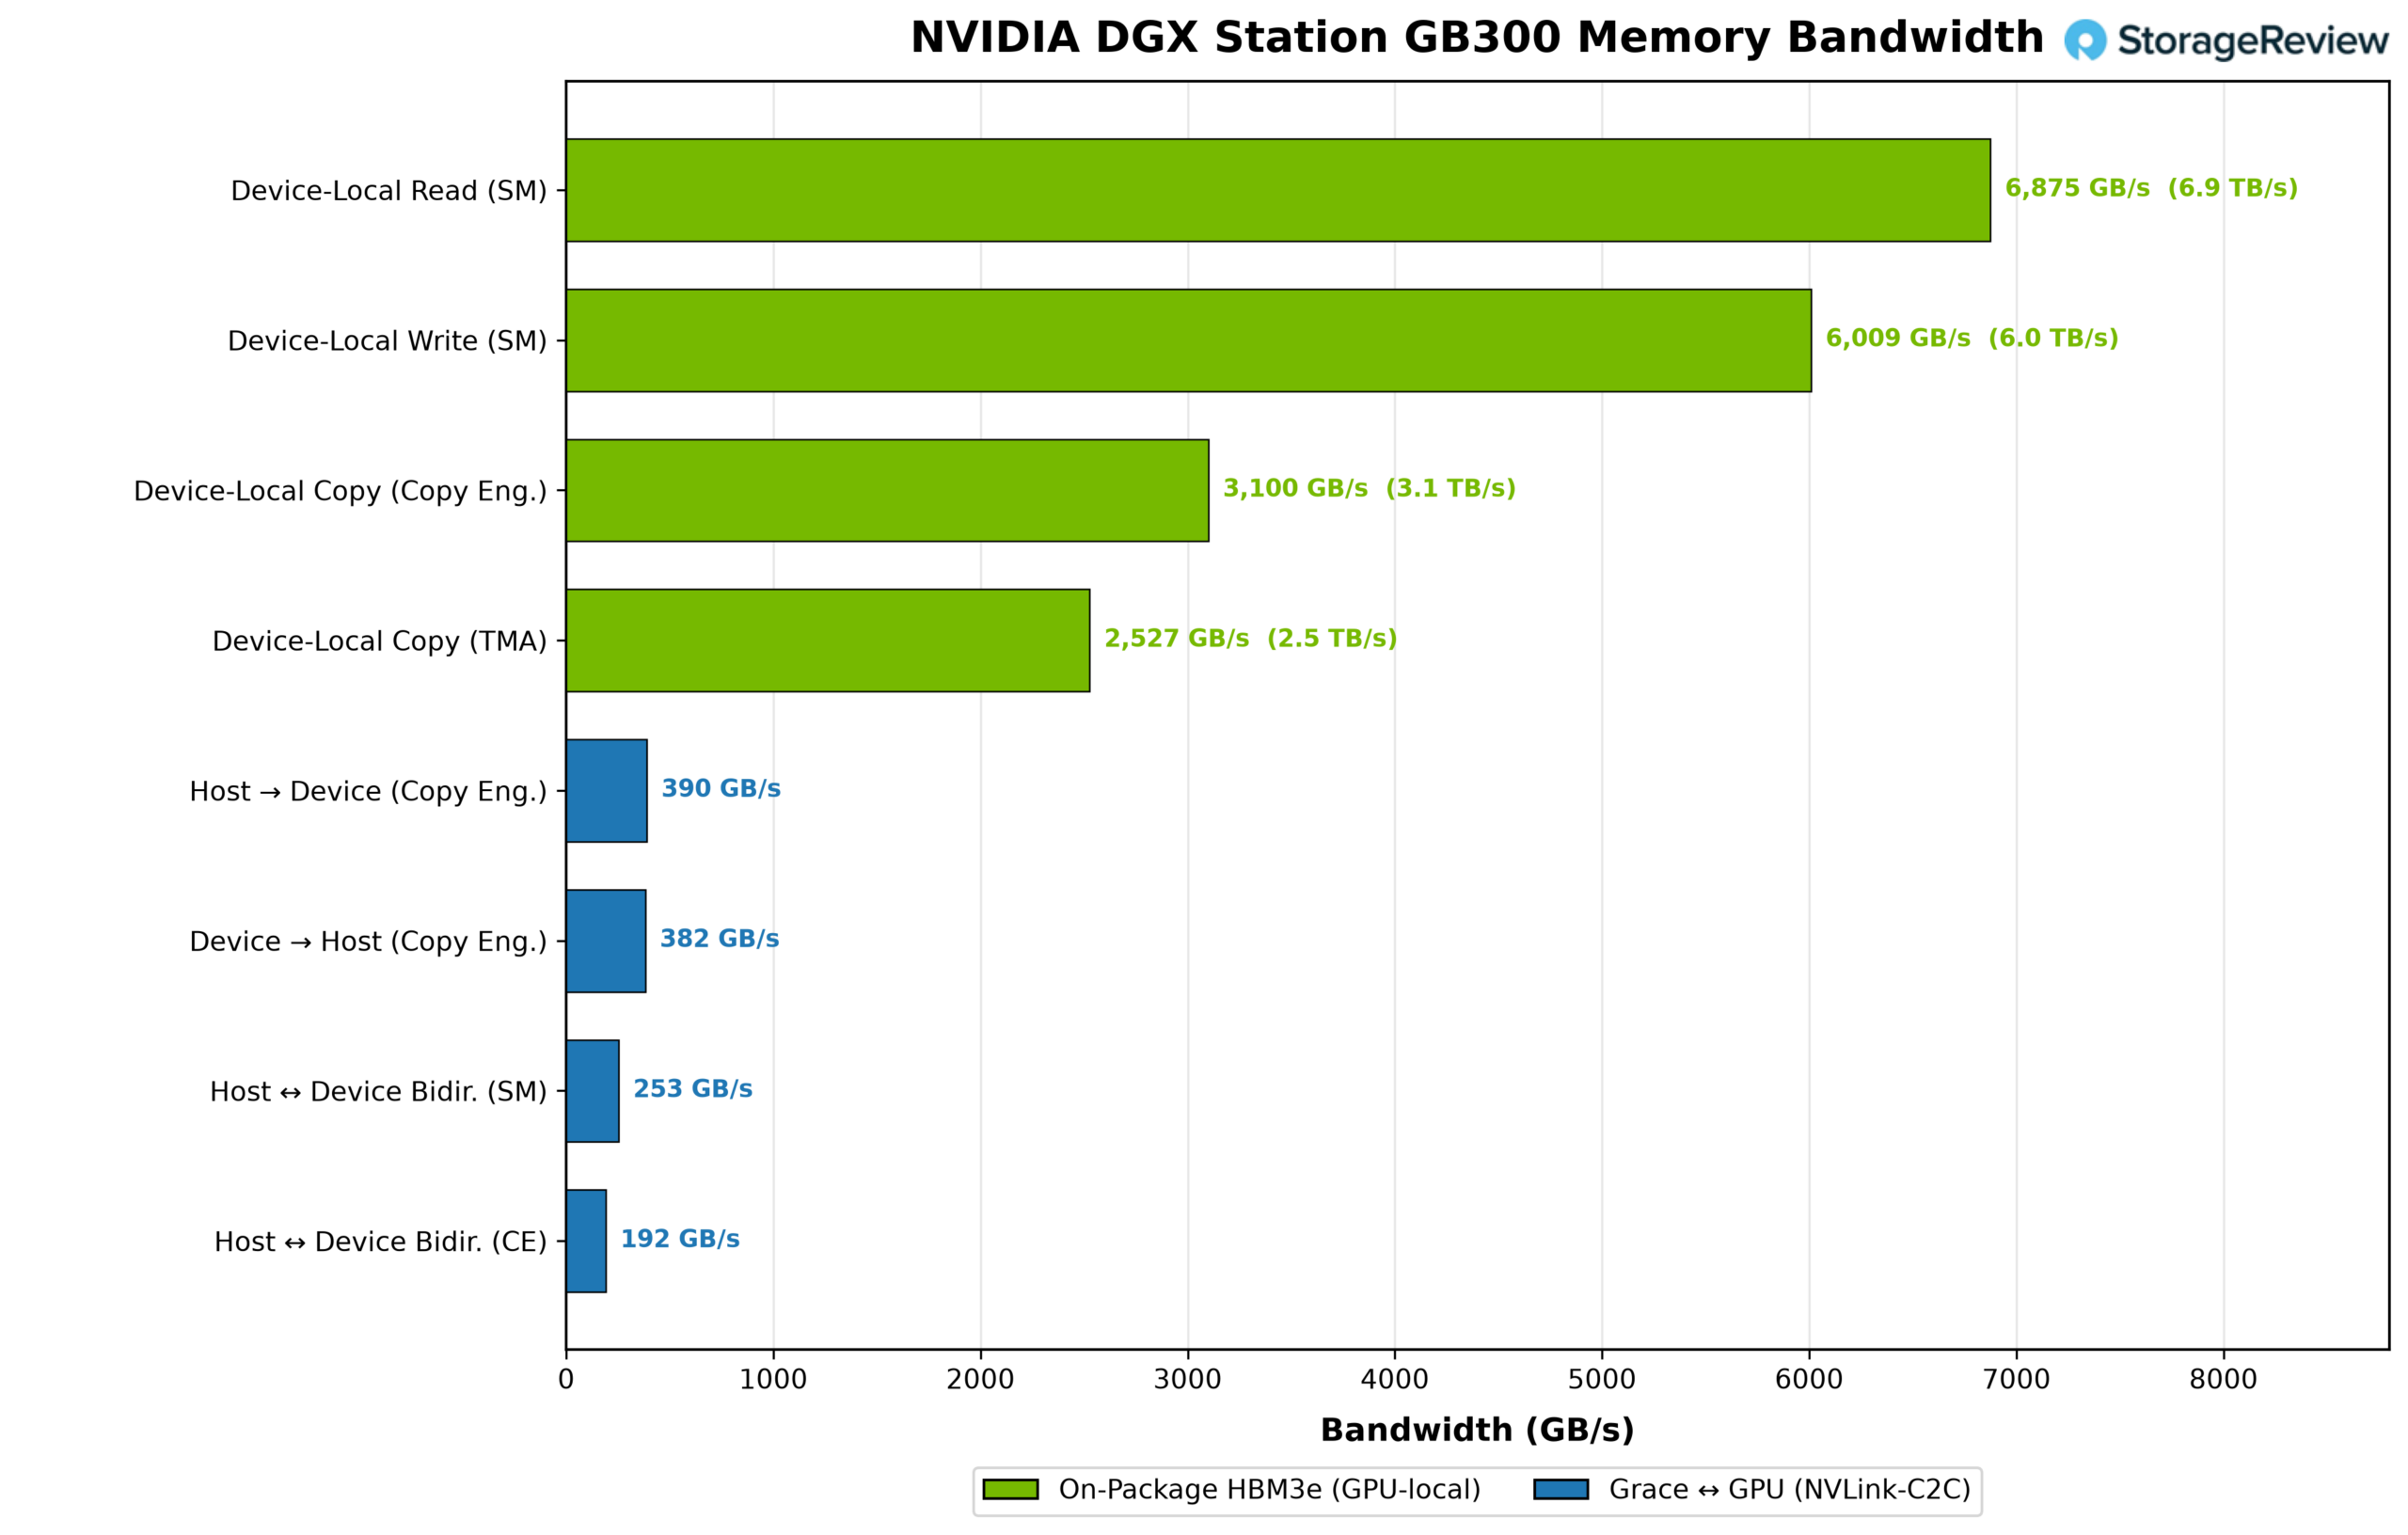
I primi quattro test misurano il trasferimento dei dati all'interno dei 252 GB di memoria HBM3e della B300. Le velocità di lettura locali raggiungono i 6,875 GB/s, ovvero circa 6.9 TB/s, un valore che si avvicina di pochi punti percentuali alla larghezza di banda di memoria nominale della GPU di 7.1 TB/s. Le velocità di scrittura locali raggiungono i 6,009 GB/s.
Le operazioni di copia da HBM a HBM sono più lente perché ogni copia consuma larghezza di banda due volte: una volta per leggere la sorgente e una seconda volta per scrivere la destinazione. I motori di copia dedicati raggiungono i 3,100 GB/s, mentre il Tensor Memory Accelerator registra 2,527 GB/s.
I test rimanenti attraversano NVLink-C2C e accedono ai 496 GB di memoria LPDDR5X di Grace. I trasferimenti dalla memoria Grace alla HBM B300 raggiungono i 390 GB/s, mentre i trasferimenti nella direzione opposta raggiungono i 382 GB/s. Sebbene NVLink-C2C fornisca fino a 900 GB/s di larghezza di banda coerente tra CPU e GPU, i trasferimenti misurati sono limitati dalla larghezza di banda di 396 GB/s della memoria LPDDR5X di Grace. I trasferimenti bidirezionali evidenziano ulteriormente tale limitazione. Il traffico simultaneo raggiunge i 253 GB/s utilizzando copie basate su SM e 192 GB/s tramite i motori di copia.
Inferenza
Dopo aver completato i test di basso livello, passiamo all'inferenza LLM. Qui, l'attenzione si sposta dai picchi numerici ai token al secondo, al tempo di risposta al primo token e alla latenza sotto carico, offrendoci una visione più chiara del comportamento del WS300 come sistema di erogazione del servizio.
Cominciamo con la capacità distintiva del Superchip GB300: la capacità di gestire modelli che si trovano ai limiti della memoria HBM3e da 252 GB del B300. È qui che il suo pool di memoria coerente da 748 GB diventa fondamentale. I cinque checkpoint passano da due modelli che si adattano comodamente alla HBM, a uno che nominalmente ci sta ma lascia troppo poco margine per il runtime e la cache KV, e infine a due modelli che devono trasferire una parte sostanziale dei loro pesi alla memoria Grace.
Nota: laddove menzionato, i modelli sono stati eseguiti con decodifica speculativa per una maggiore velocità di decodifica, con la quantità di token di accettazione forzata impostata sulla quantità di token di decodifica speculativa. I risultati mostrano quindi le prestazioni nel caso migliore; nell'erogazione di servizi reali, la velocità di elaborazione è dinamica e dipende dalla qualità dei token di decodifica speculativa.
Modelli che si adattano perfettamente all'HBM
DeepSeek v4 Flash (0731)
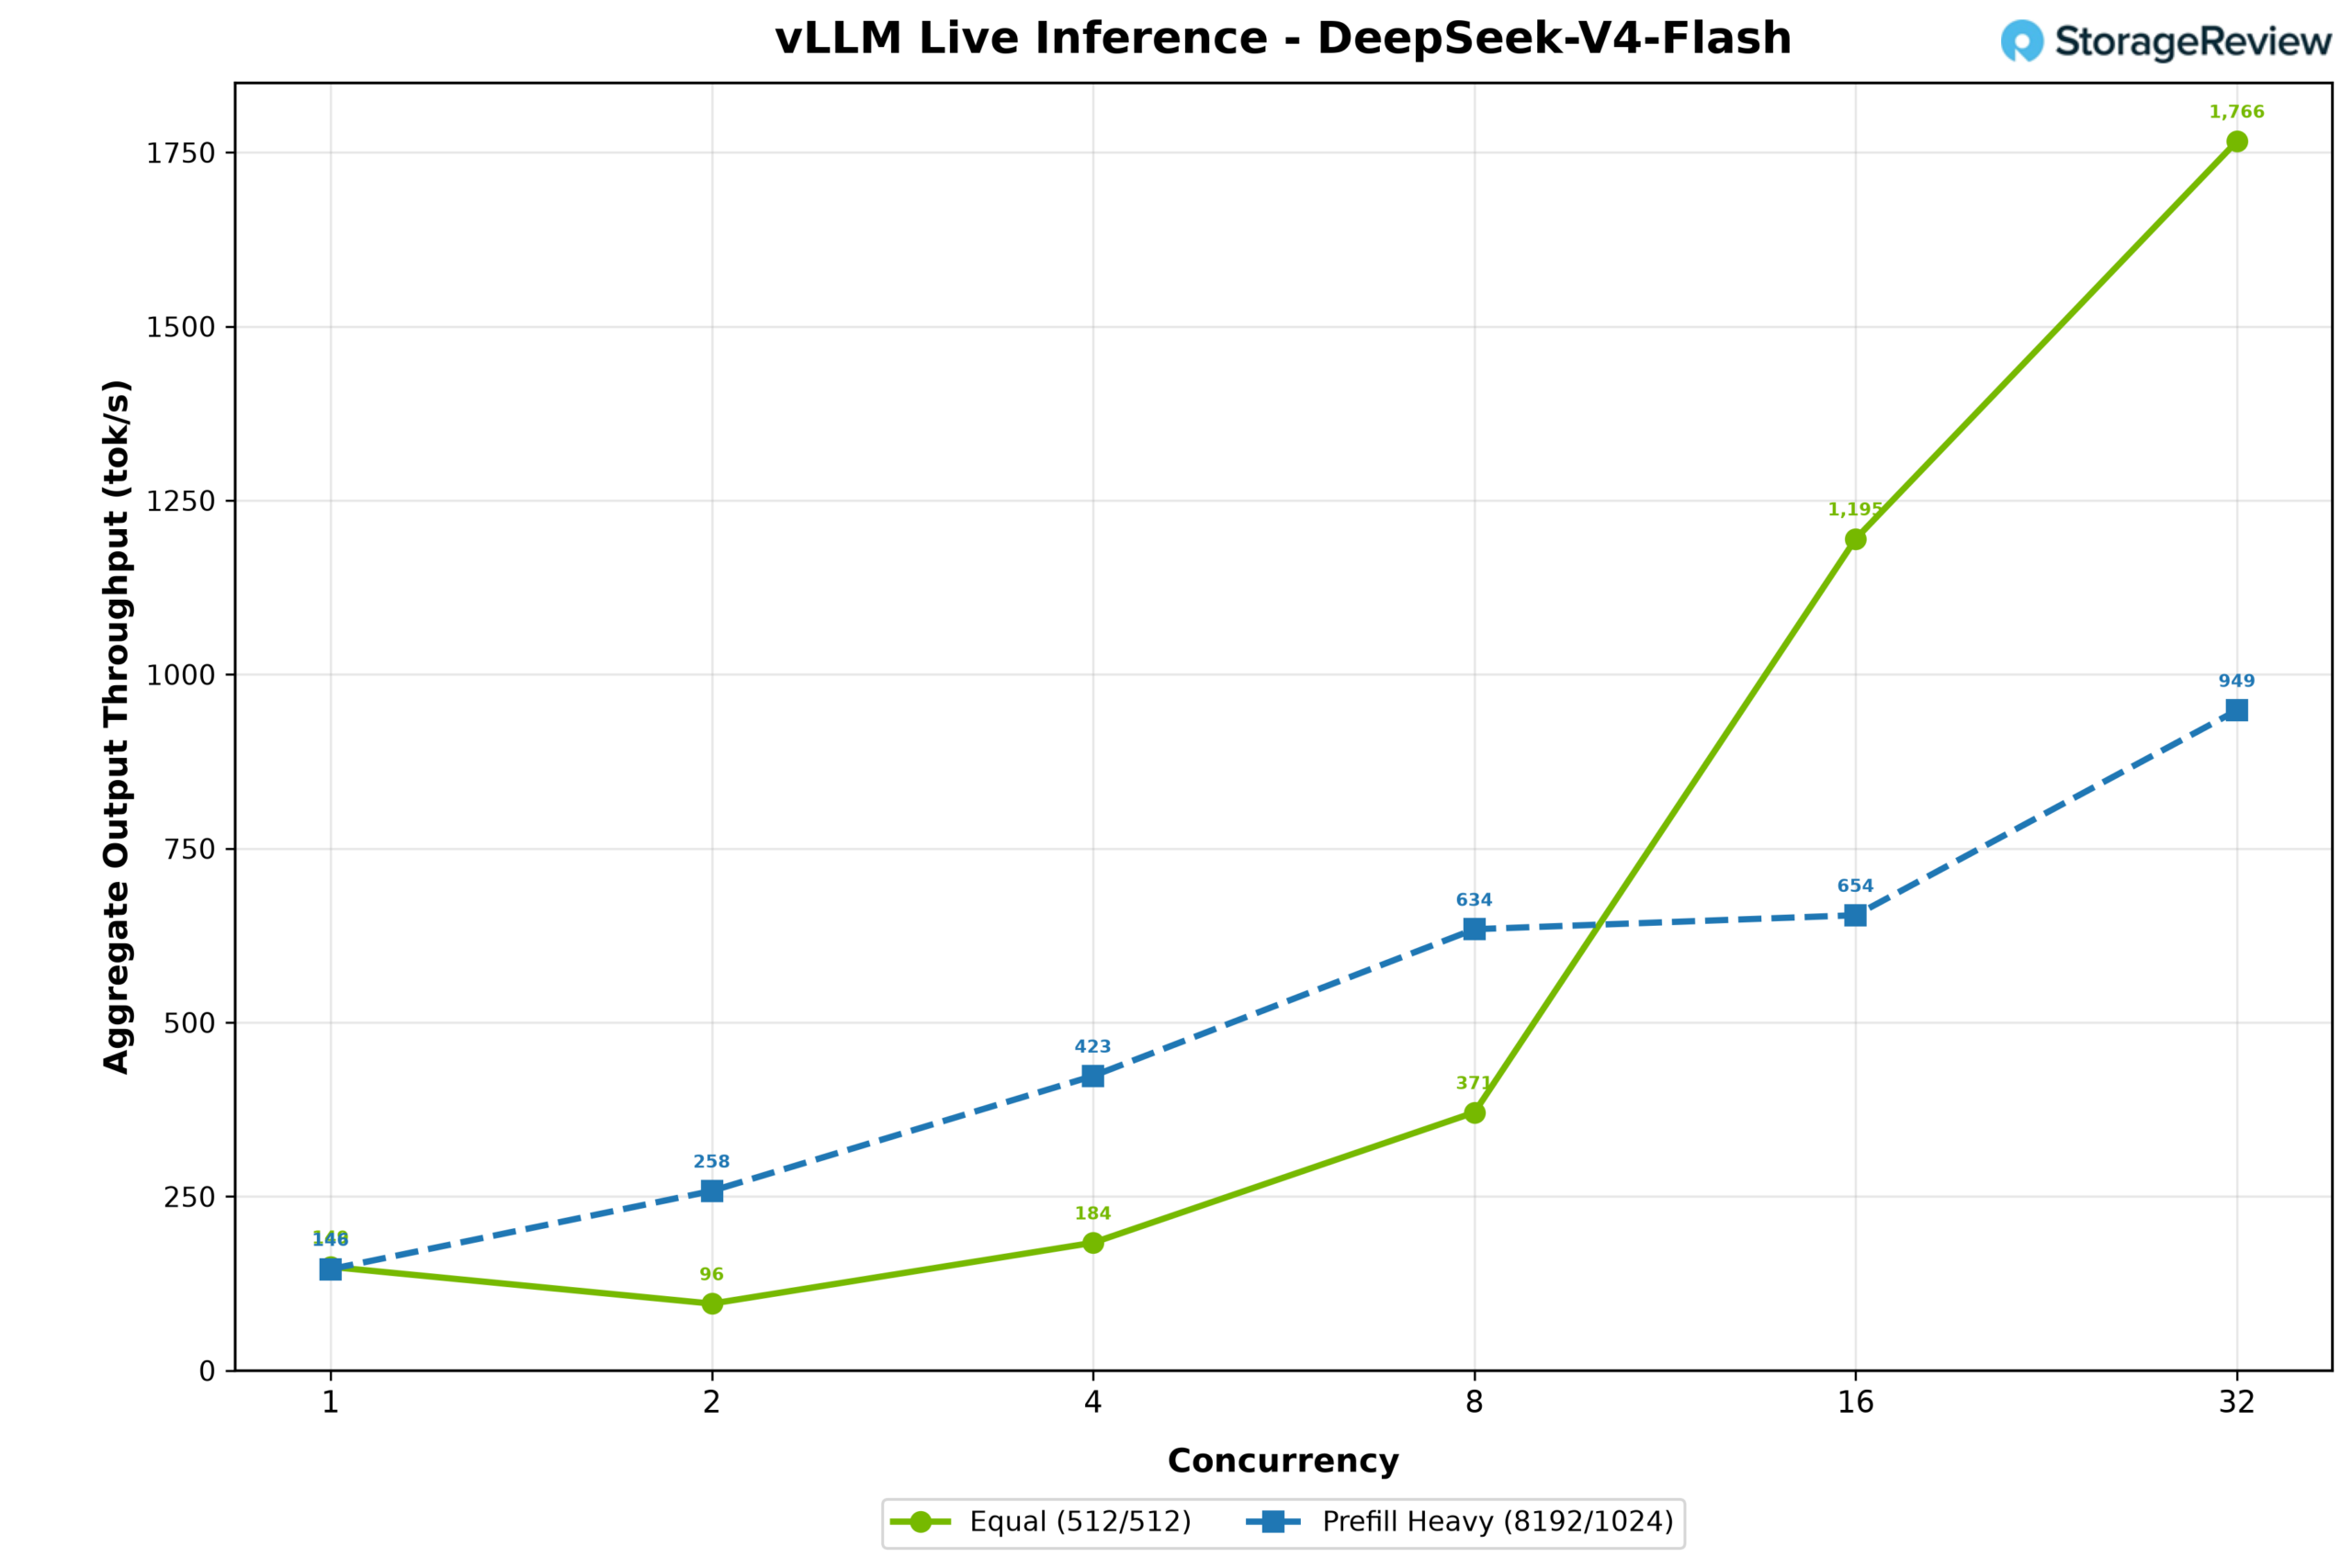
Il primo modello testato è stato il popolarissimo DeepSeek v4 Flash (0731), che consuma 14+6 GB di memoria come checkpoint nativo FP8. Questo modello è noto per essere molto efficiente e facile da usare, come abbiamo potuto constatare sulla DGX Station. Nel carico di lavoro 512/512, la velocità di elaborazione iniziale era di 149 token al secondo con una concorrenza pari a 1, per poi salire rapidamente a 1,766 con una concorrenza pari a 32. Il carico di lavoro con pre-riempimento intensivo ha visto una velocità di elaborazione scalare da 146 a 949 token al secondo.
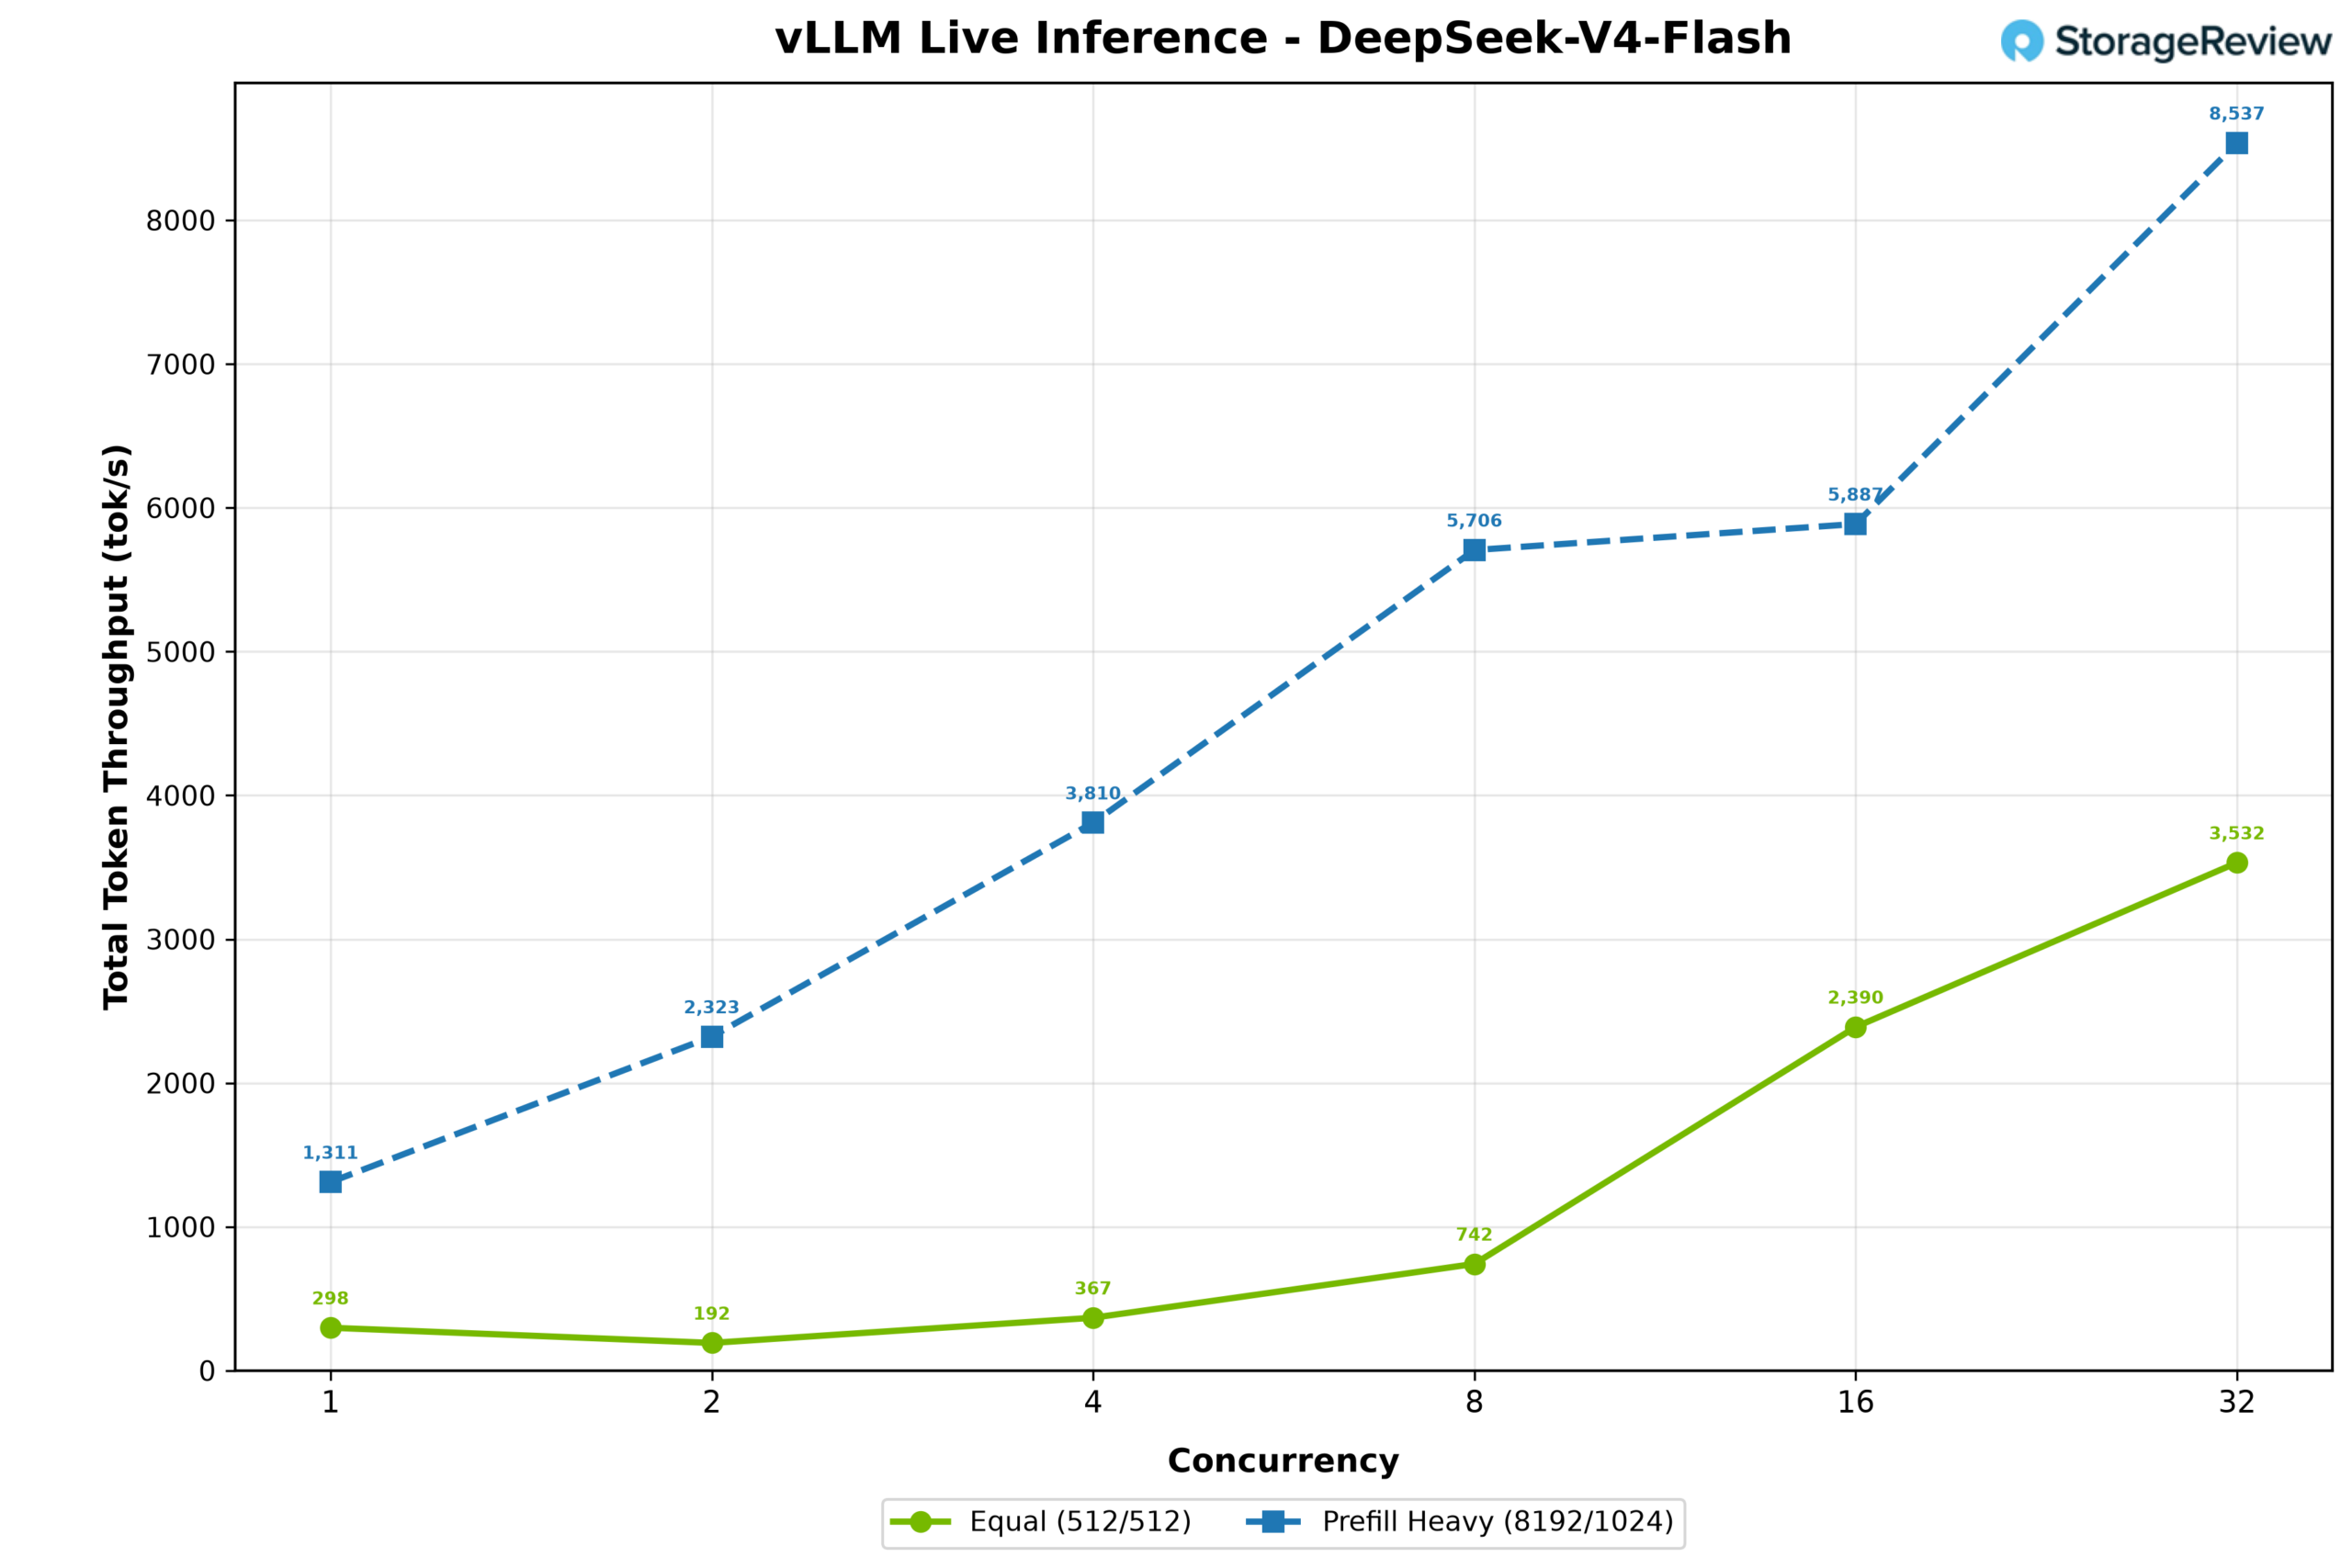
La velocità di elaborazione totale dei token è aumentata di pari passo, con il carico di lavoro 512/512 che è passato da 298 a 3,532 token al secondo e il carico di lavoro con pre-riempimento che è aumentato da 1,311 a 8,537.
MiniMax M2.7 (NVFP4)
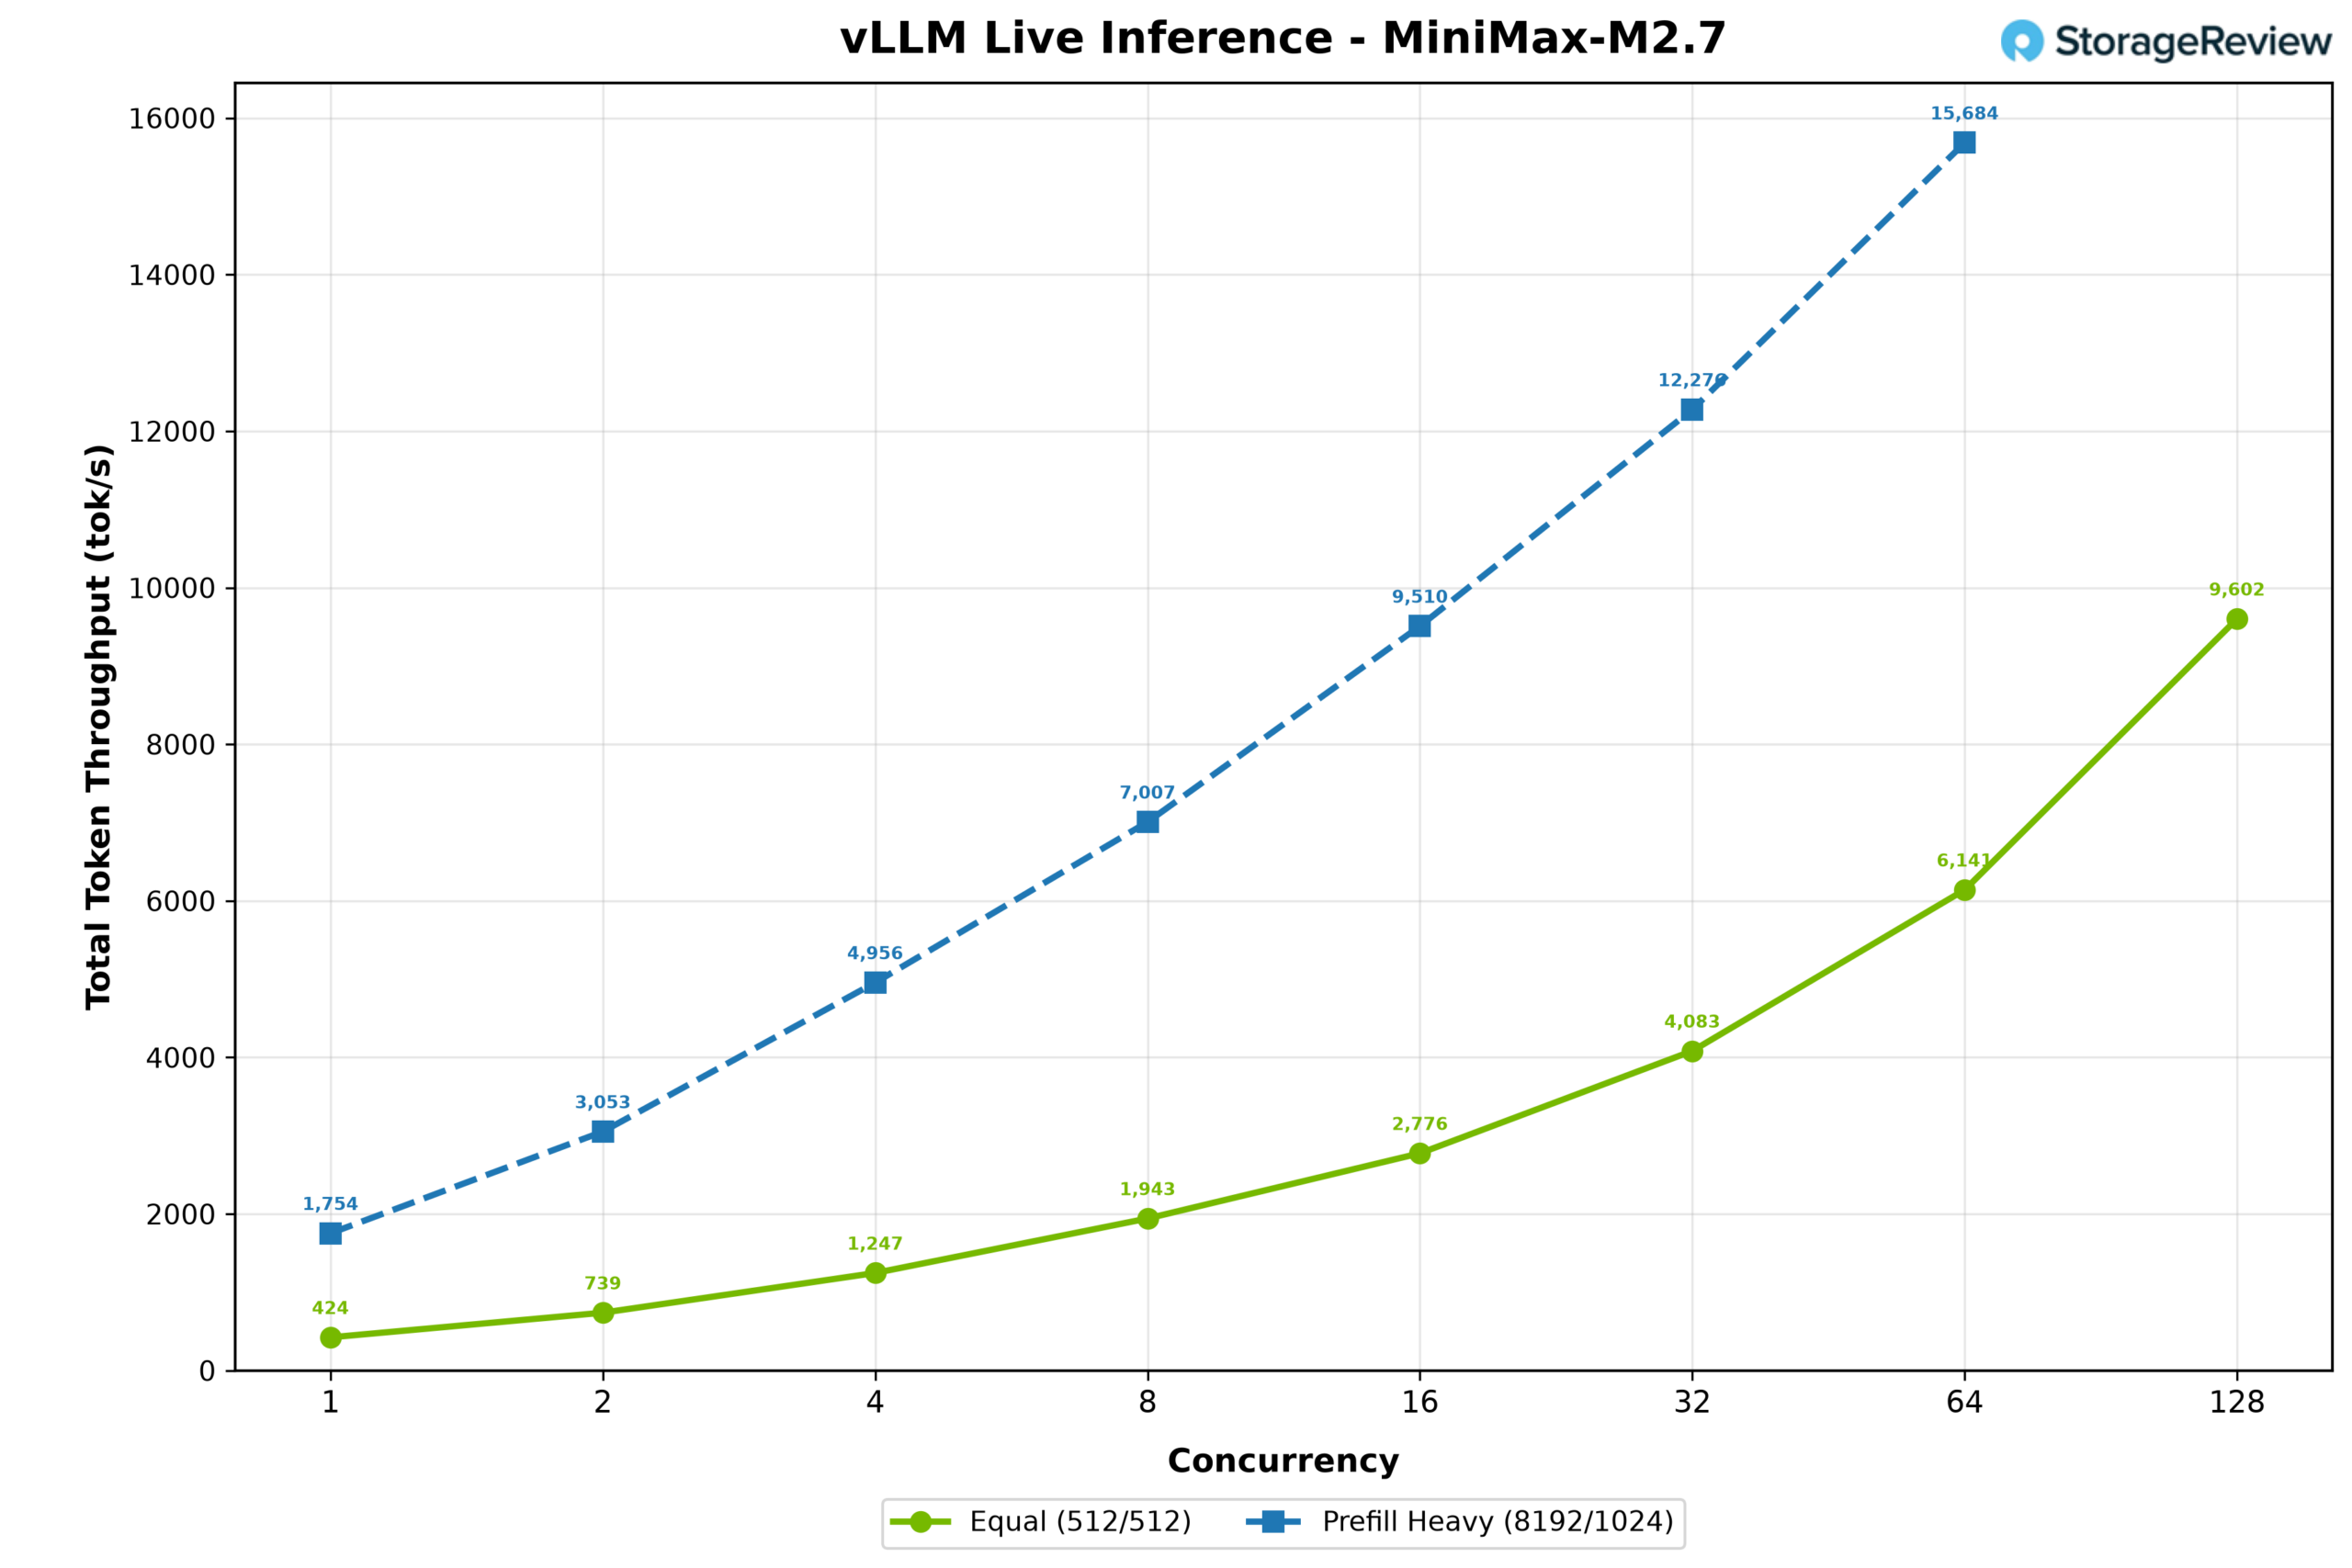
Il prossimo modello testato è il MiniMax M2.7, uno dei nostri preferiti, con 125 GB di VRAM. Nel carico di lavoro 512/512, il throughput iniziale era di 193 token al secondo con una concorrenza di 1 e ha raggiunto rapidamente i 4,801 token al secondo con una concorrenza di 128. Il carico di lavoro con pre-riempimento intensivo è passato da 195 token al secondo con una concorrenza di 1 a 1,743 token al secondo con una concorrenza di 64. Il throughput totale dei token ha mostrato la tendenza opposta: il carico di lavoro con pre-riempimento intensivo è passato da 1,754 a 15,684 token al secondo con una concorrenza di 64, mentre il carico di lavoro 512/512 è passato da 424 a 9,602 token al secondo con una concorrenza di 128.
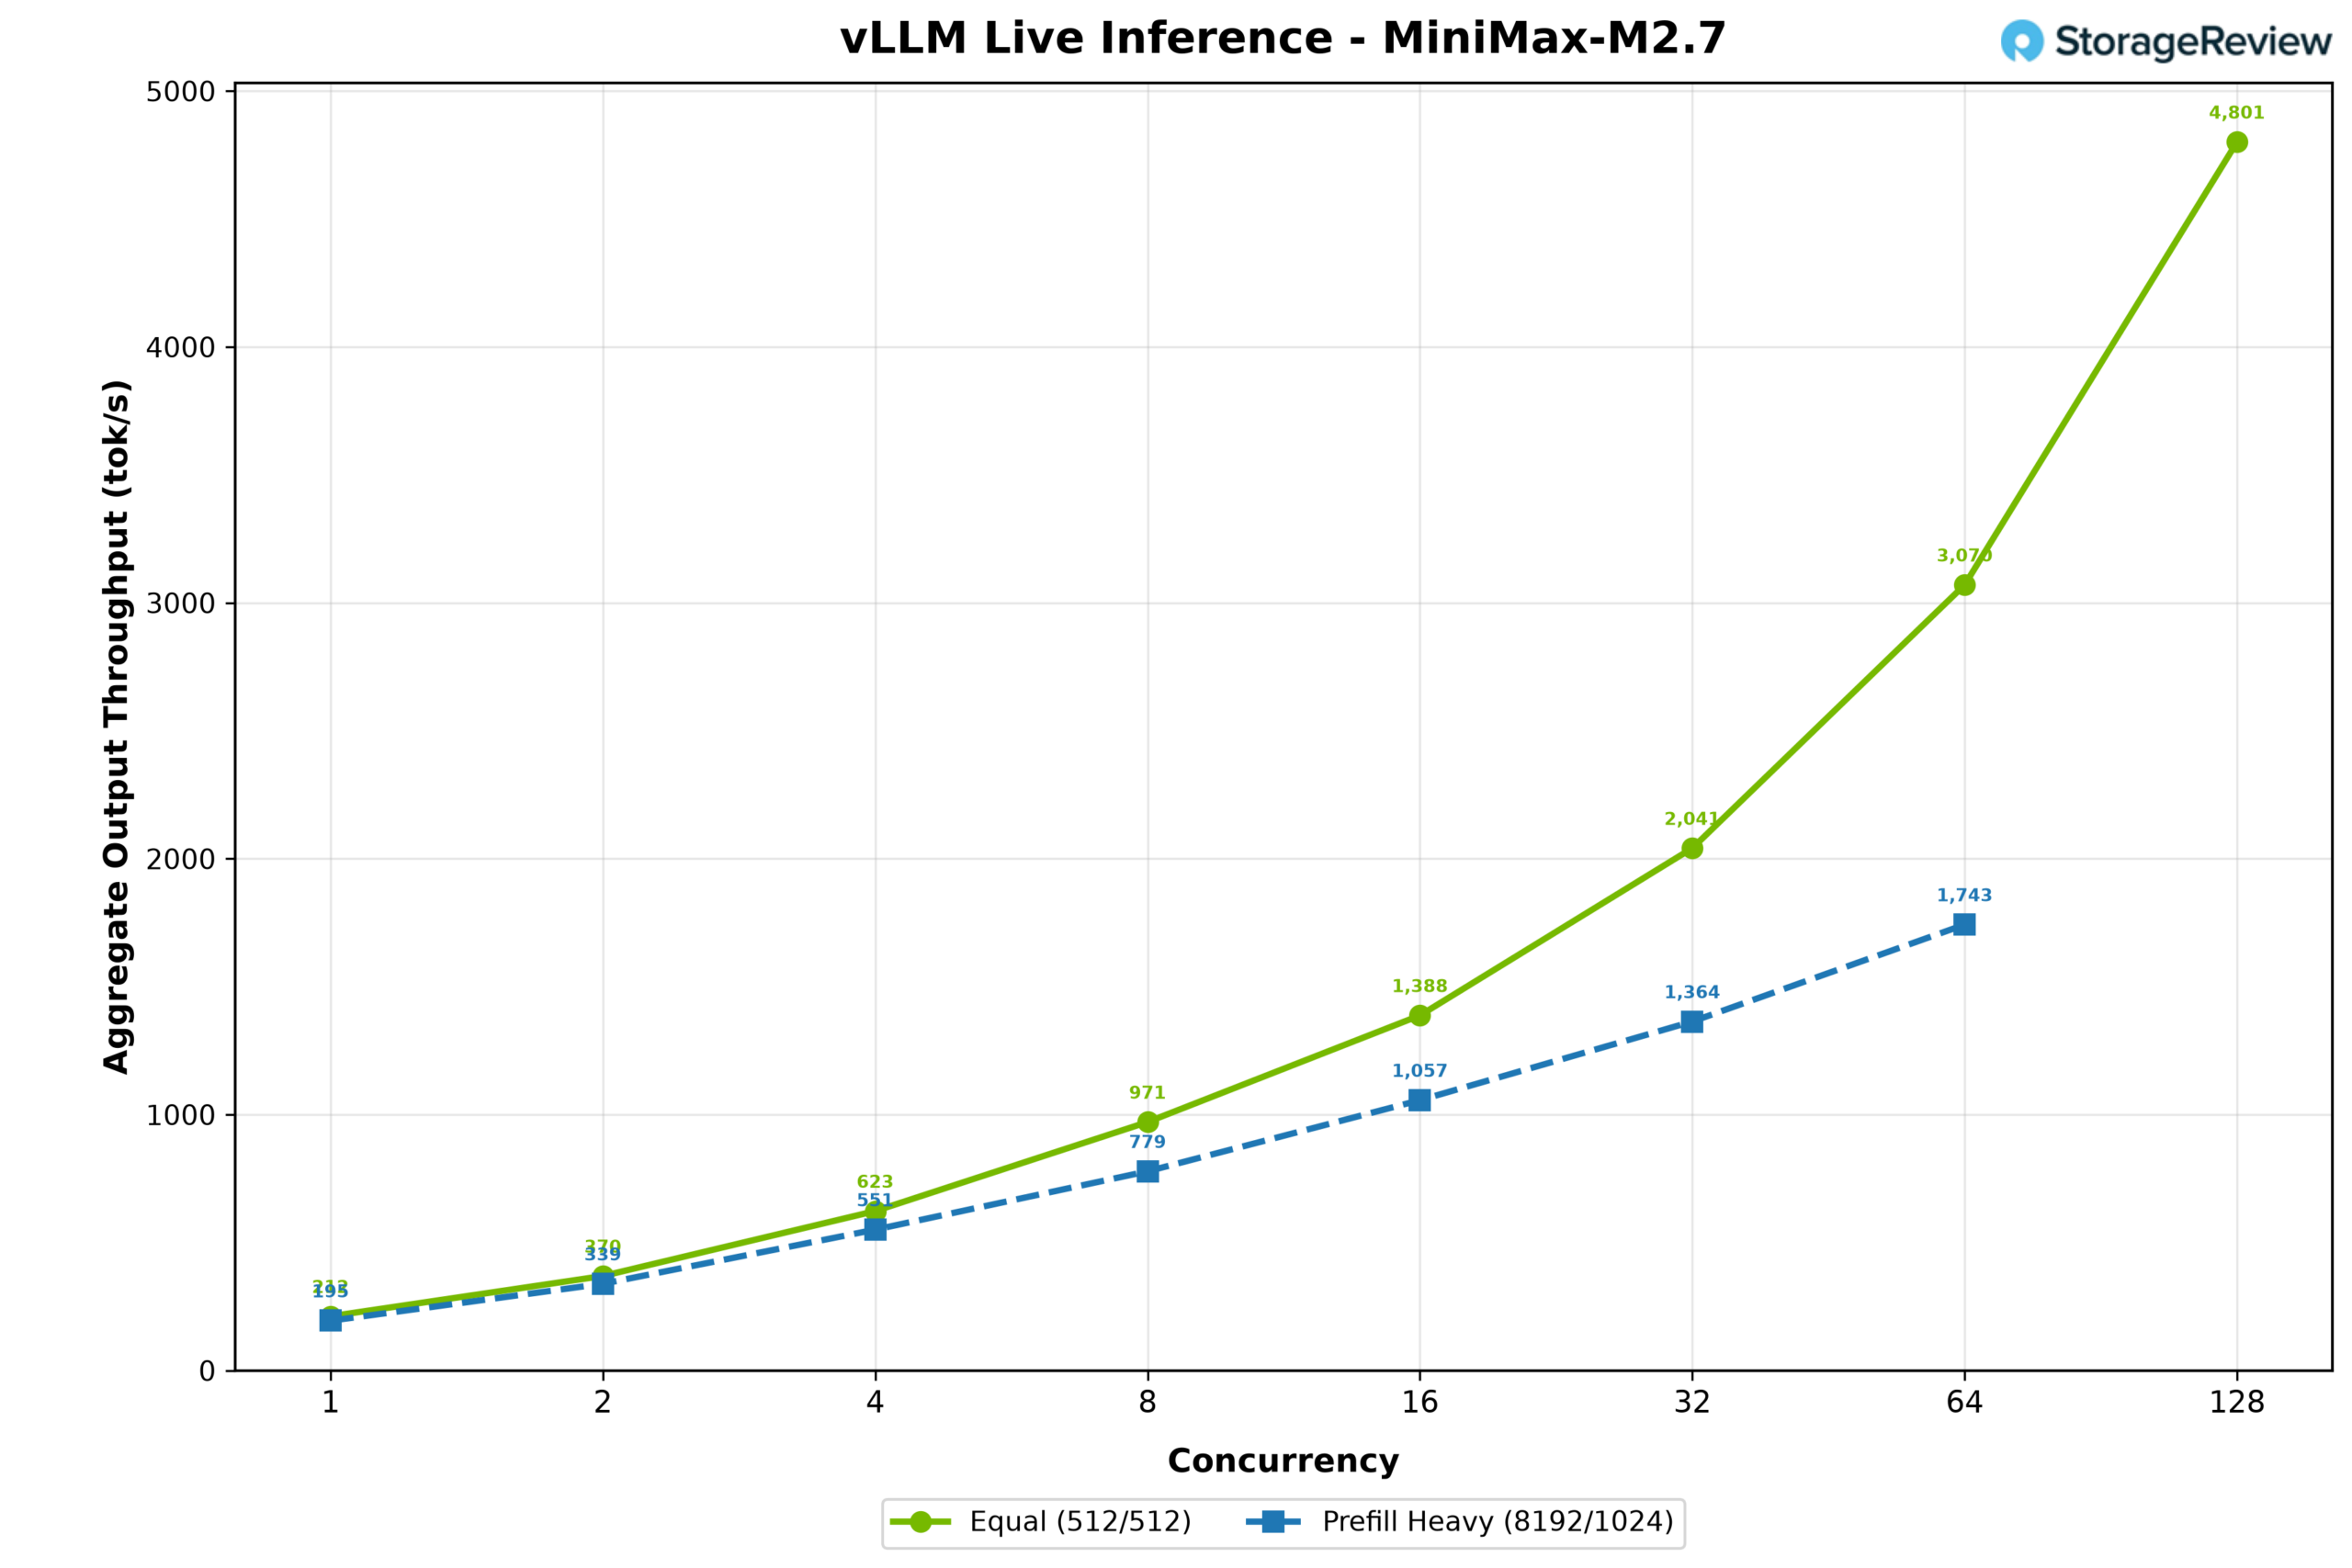
Il throughput totale dei token ha mostrato la tendenza opposta, con il carico di lavoro prevalentemente di pre-riempimento che è passato da 1,754 a 15,684 token al secondo fino a una concorrenza di 64, mentre il carico di lavoro 512/512 è aumentato da 424 a 9,602 token al secondo a una concorrenza di 128.
Modelli che a malapena si adattano all'HBM
MiniMax M3 (NVFP4)
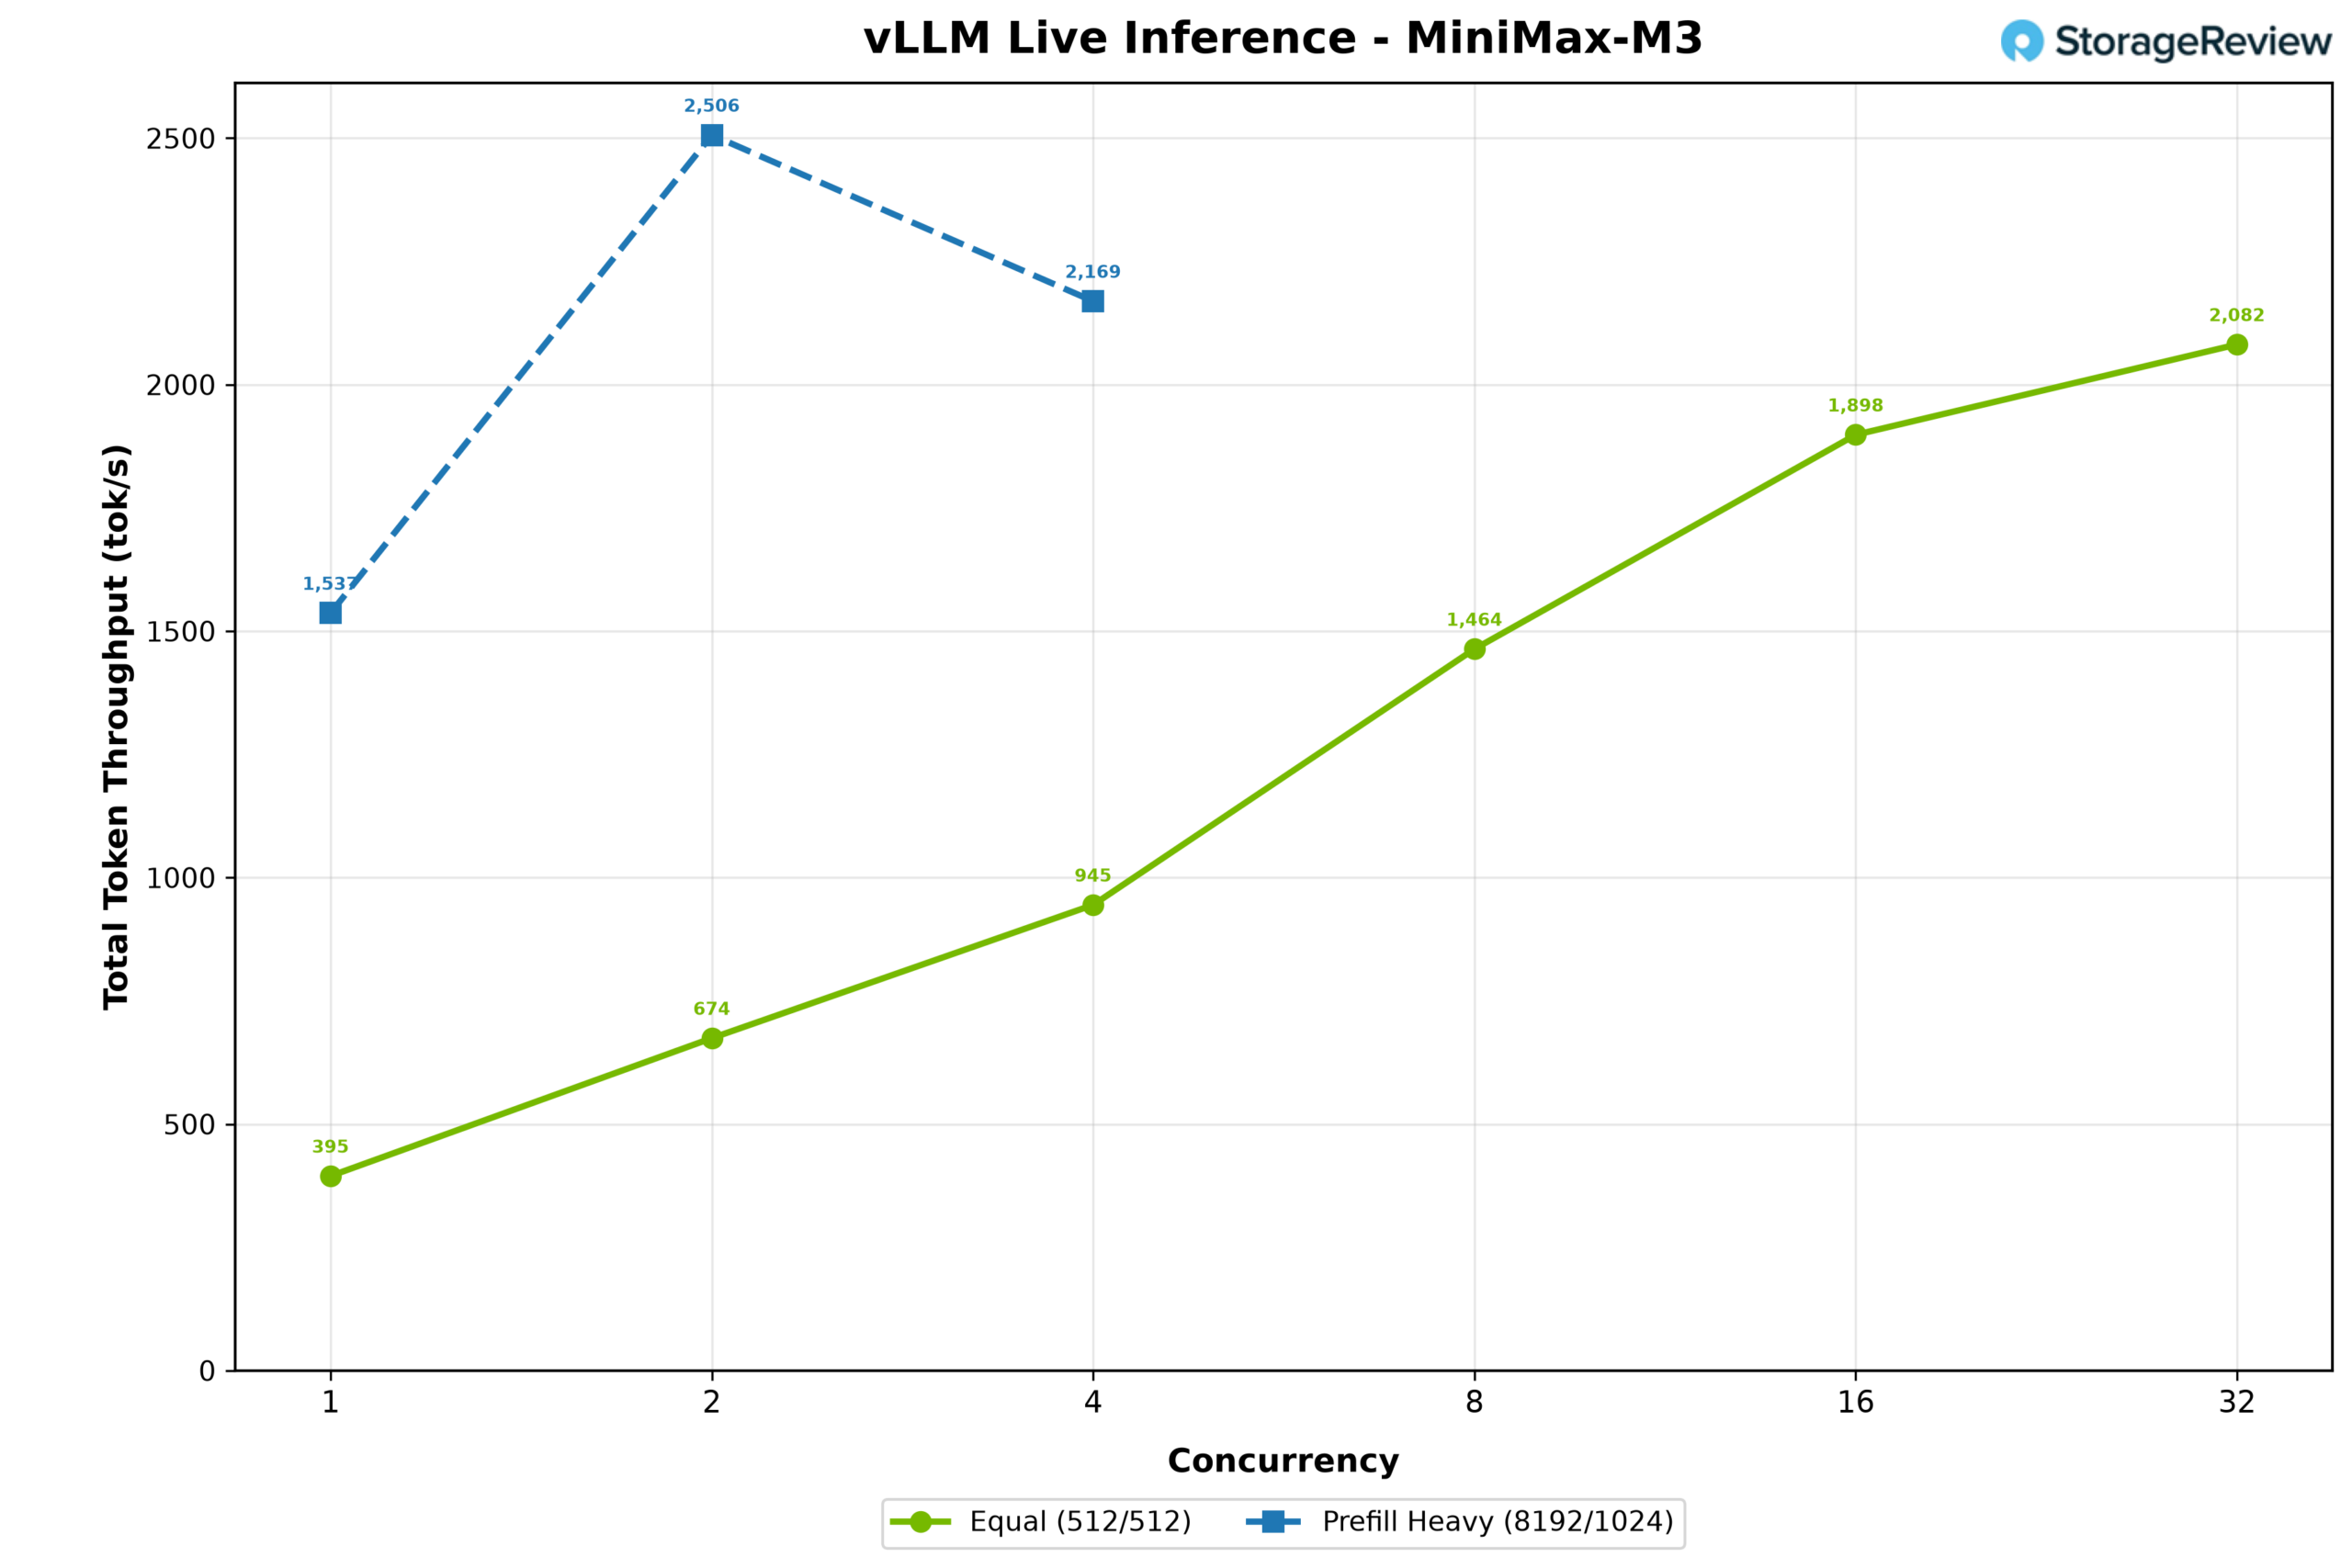
MiniMax M3 mostra cosa significa "a malapena entrare" nella pratica. Il suo checkpoint NVFP4 da 233 GB è più piccolo dei 252 GB di HBM del B300, ma il modello necessita comunque di spazio per il runtime e la cache KV. Alla fine ha occupato 223 GB di HBM, con 21 GB di expert delegati a Grace. È stata utilizzata la decodifica speculativa EAGLE3-GQA con una lunghezza di accettazione sintetica di 3 token. Nel carico di lavoro 512/512, la velocità di elaborazione iniziale era di 197 token al secondo con concorrenza 1 ed è aumentata costantemente fino a 1,041 token al secondo con concorrenza 32. Il carico di lavoro con pre-riempimento intensivo è aumentato da 171 token al secondo con concorrenza 1 a un picco di 278 con concorrenza 2, prima di diminuire a 241 con concorrenza 4.
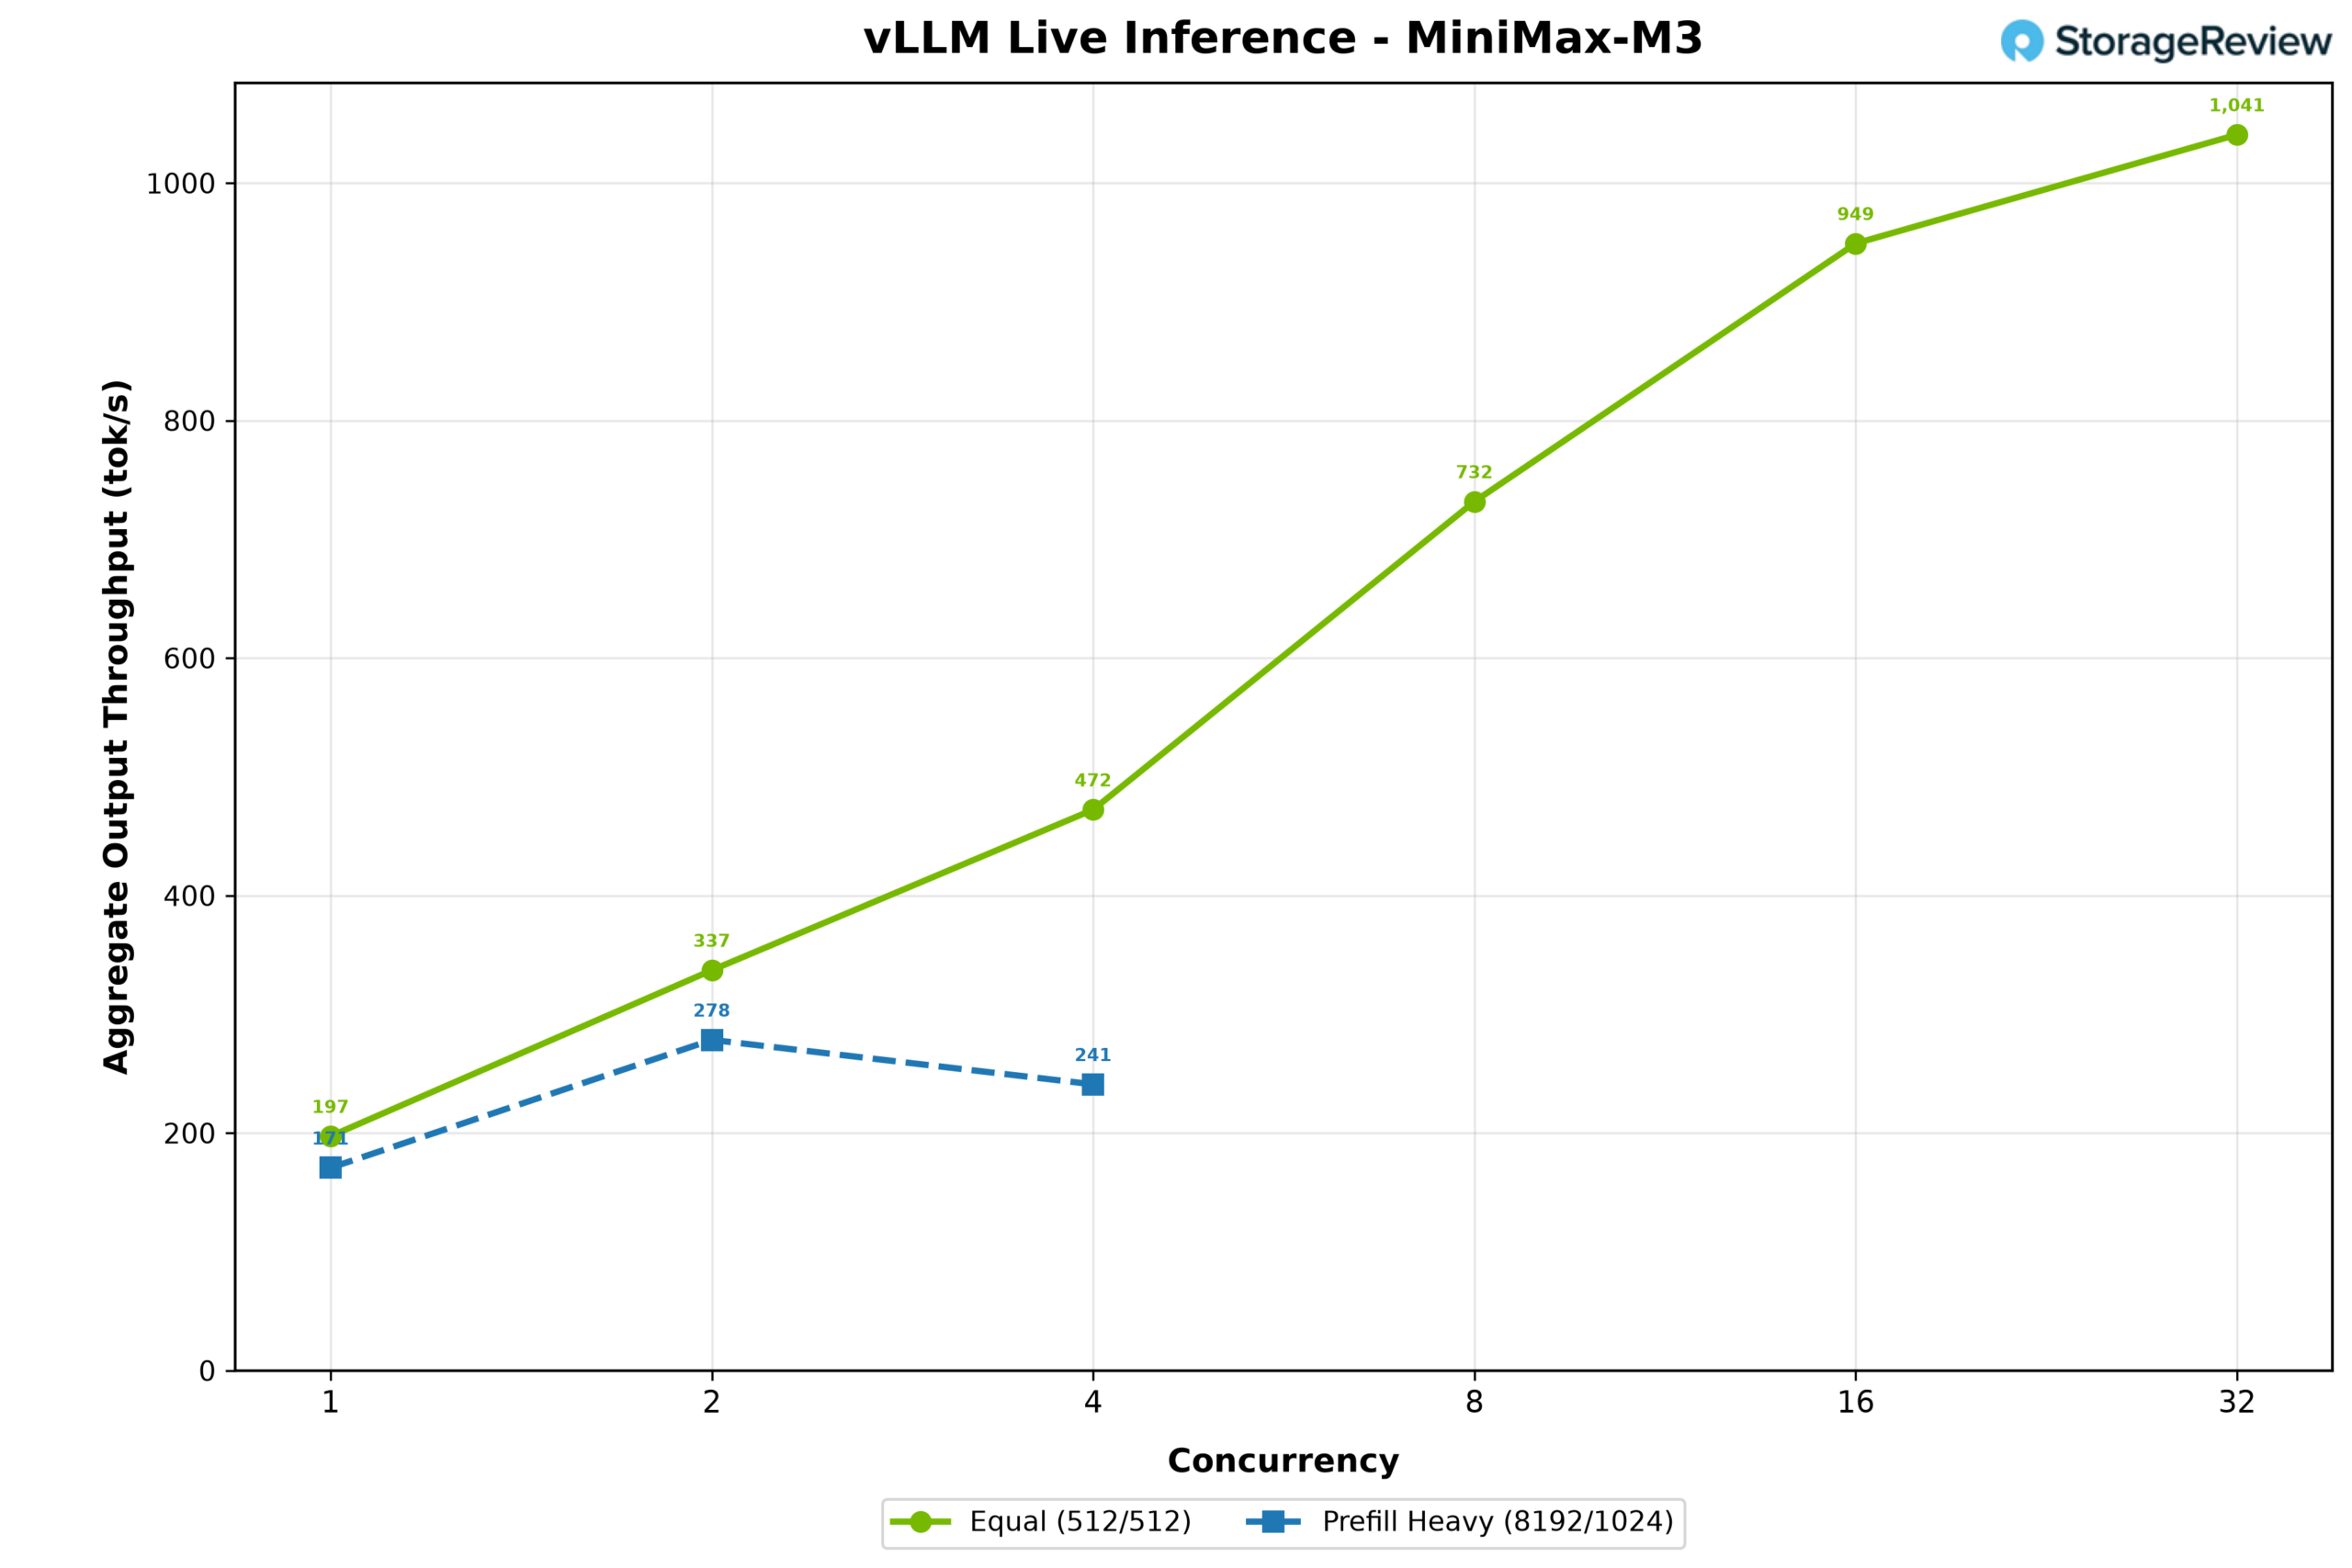
Il throughput totale dei token ha seguito un andamento simile, con il carico di lavoro 512/512 che è passato da 395 a 2,082 token al secondo, mentre il carico di lavoro con pre-riempimento intensivo ha raggiunto un picco di 2,506 token al secondo con concorrenza 2, prima di scendere a 2,169 con concorrenza 4.
Modelli che non rientrano nell'HBM
GLM-5.2 (NVFP4)
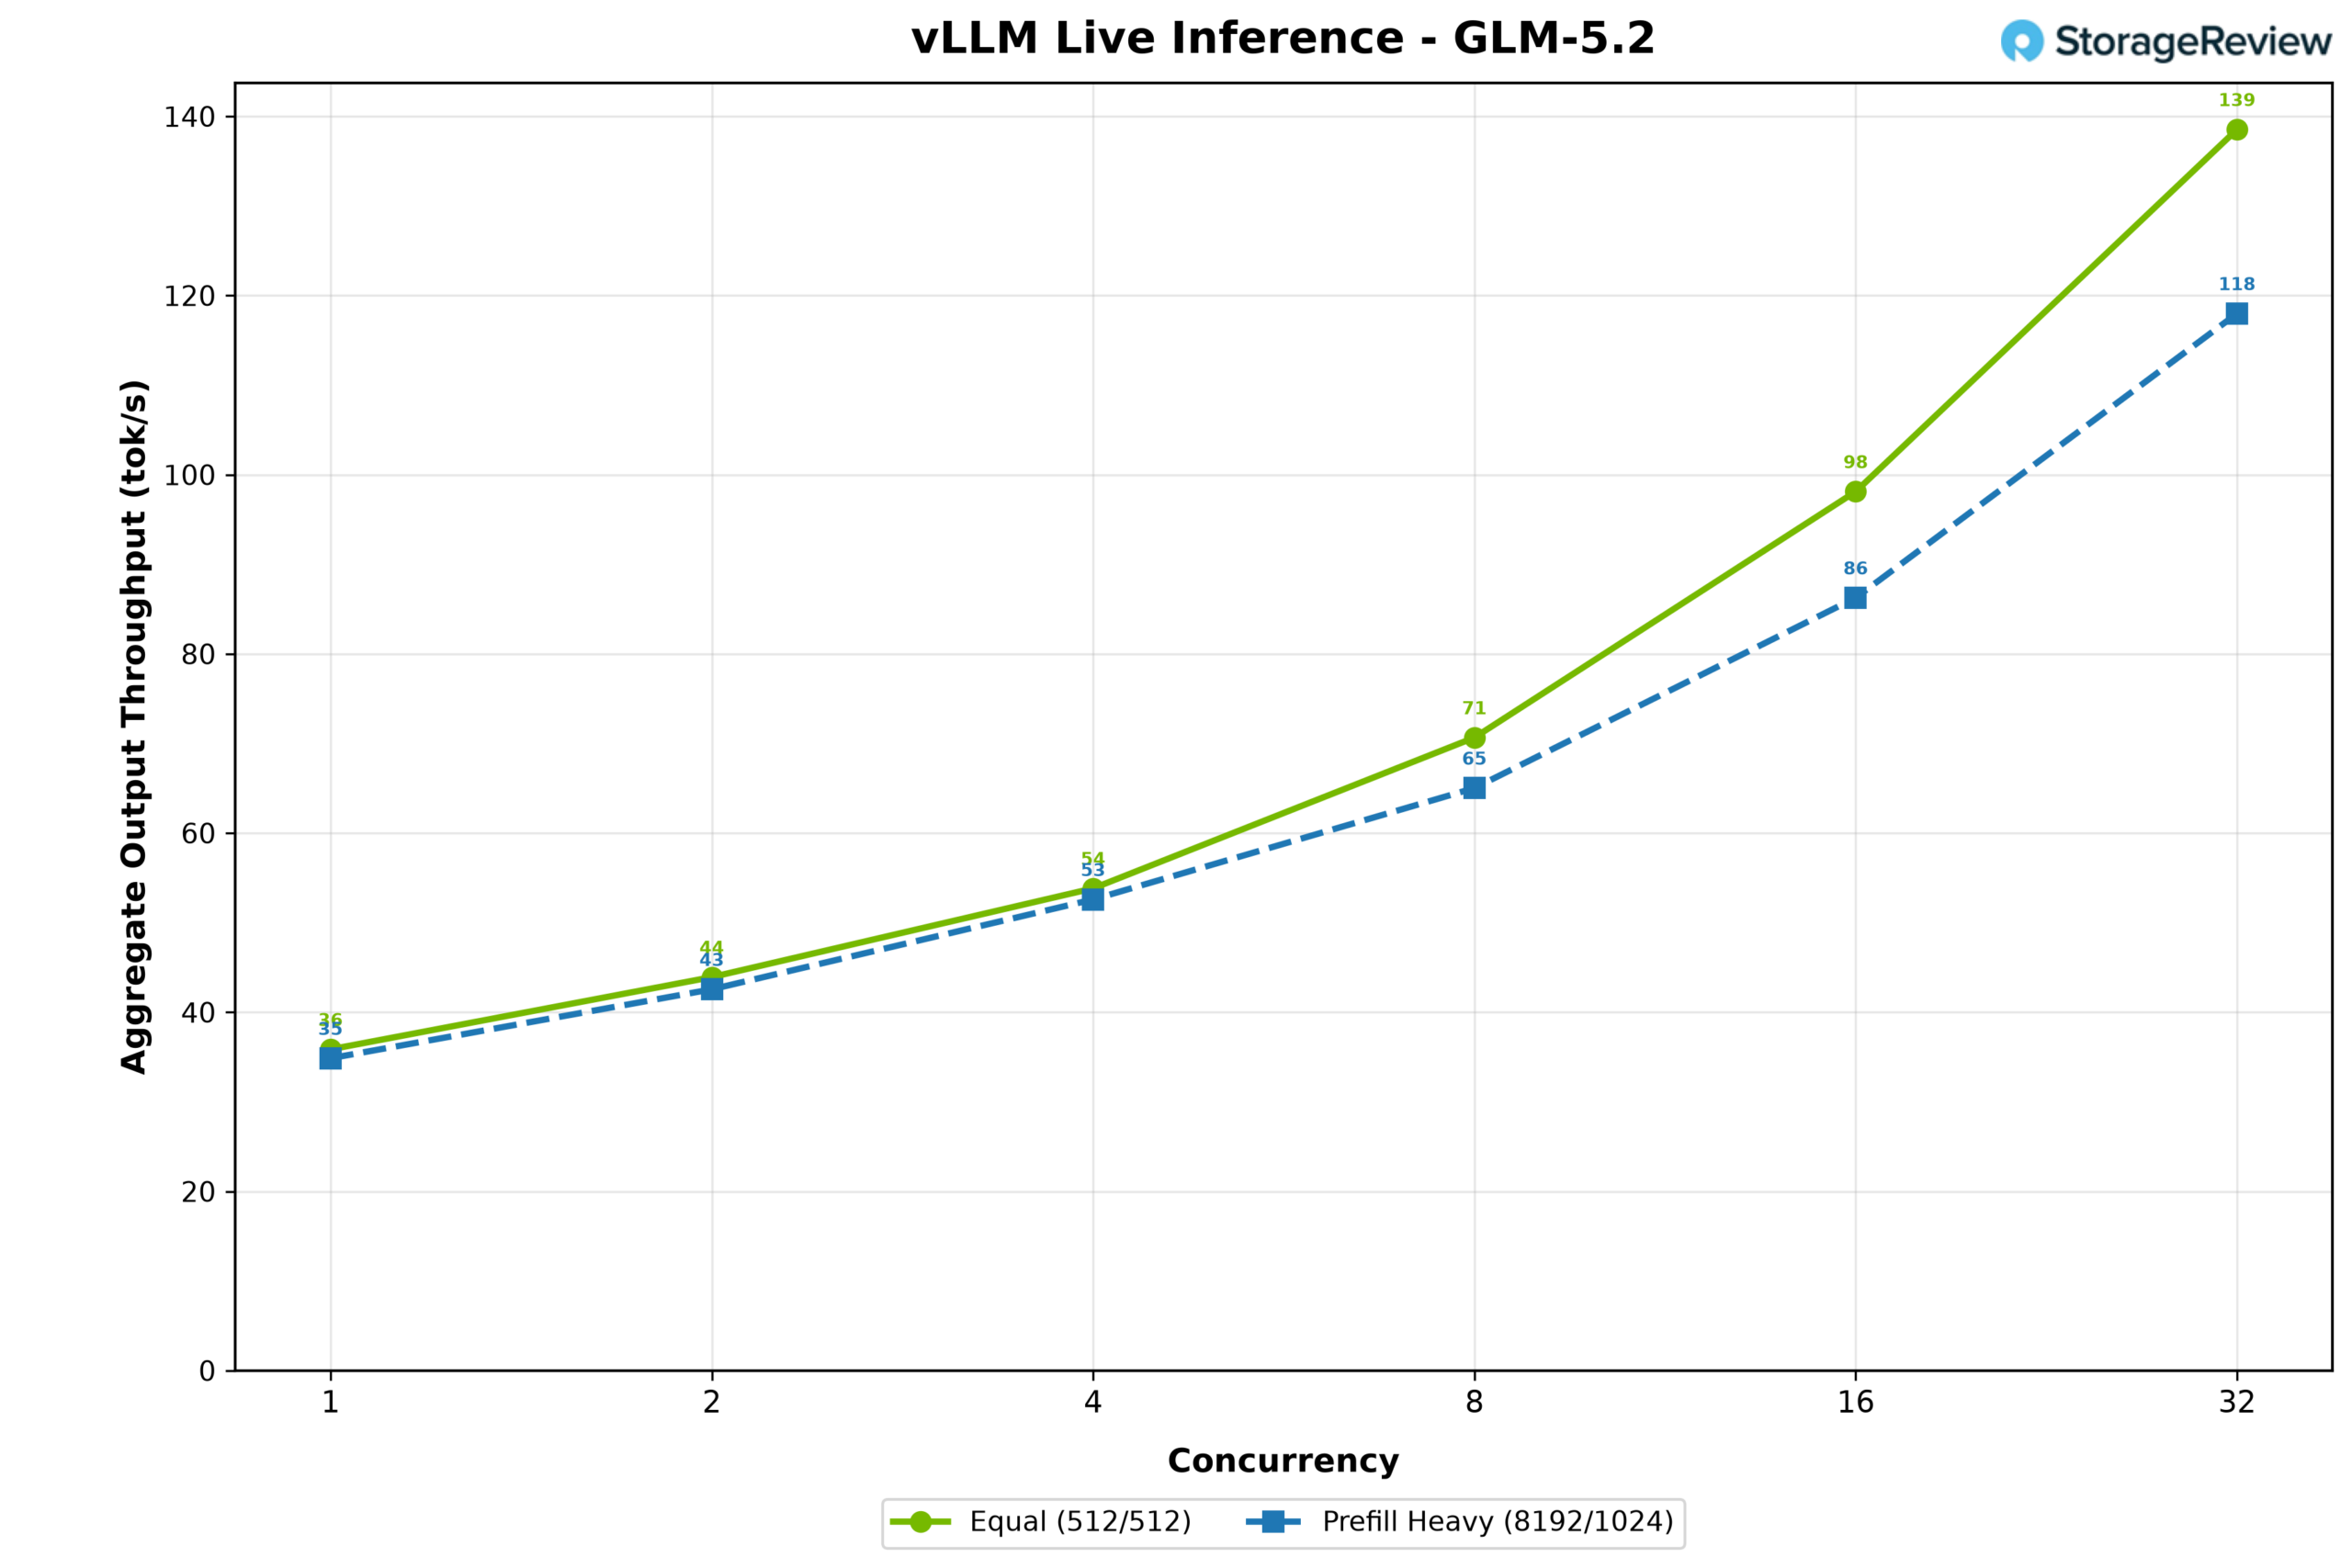
GLM-5.2 è stato testato utilizzando il quant NVFP4 di NVIDIA. Il suo checkpoint da 433 GB ha utilizzato 218 GB di HBM, con 216 GB di pesi degli esperti trasferiti nella memoria Grace. È stata utilizzata la decodifica speculativa MTP con una lunghezza di accettazione sintetica di 3 token. Il throughput di output nel carico di lavoro 512/512 è aumentato da 36 token al secondo con concorrenza 1 a 139 con concorrenza 32. Il carico di lavoro 8,192/1,024 ha seguito da vicino, passando da 35 a 118 token al secondo. I risultati simili tra i due profili mostrano che la generazione è rimasta limitata principalmente dallo spostamento degli esperti trasferiti tra la memoria Grace e la GPU. La scansione si è conclusa con concorrenza 32 perché non c'era più abbastanza HBM disponibile per ulteriore contesto.
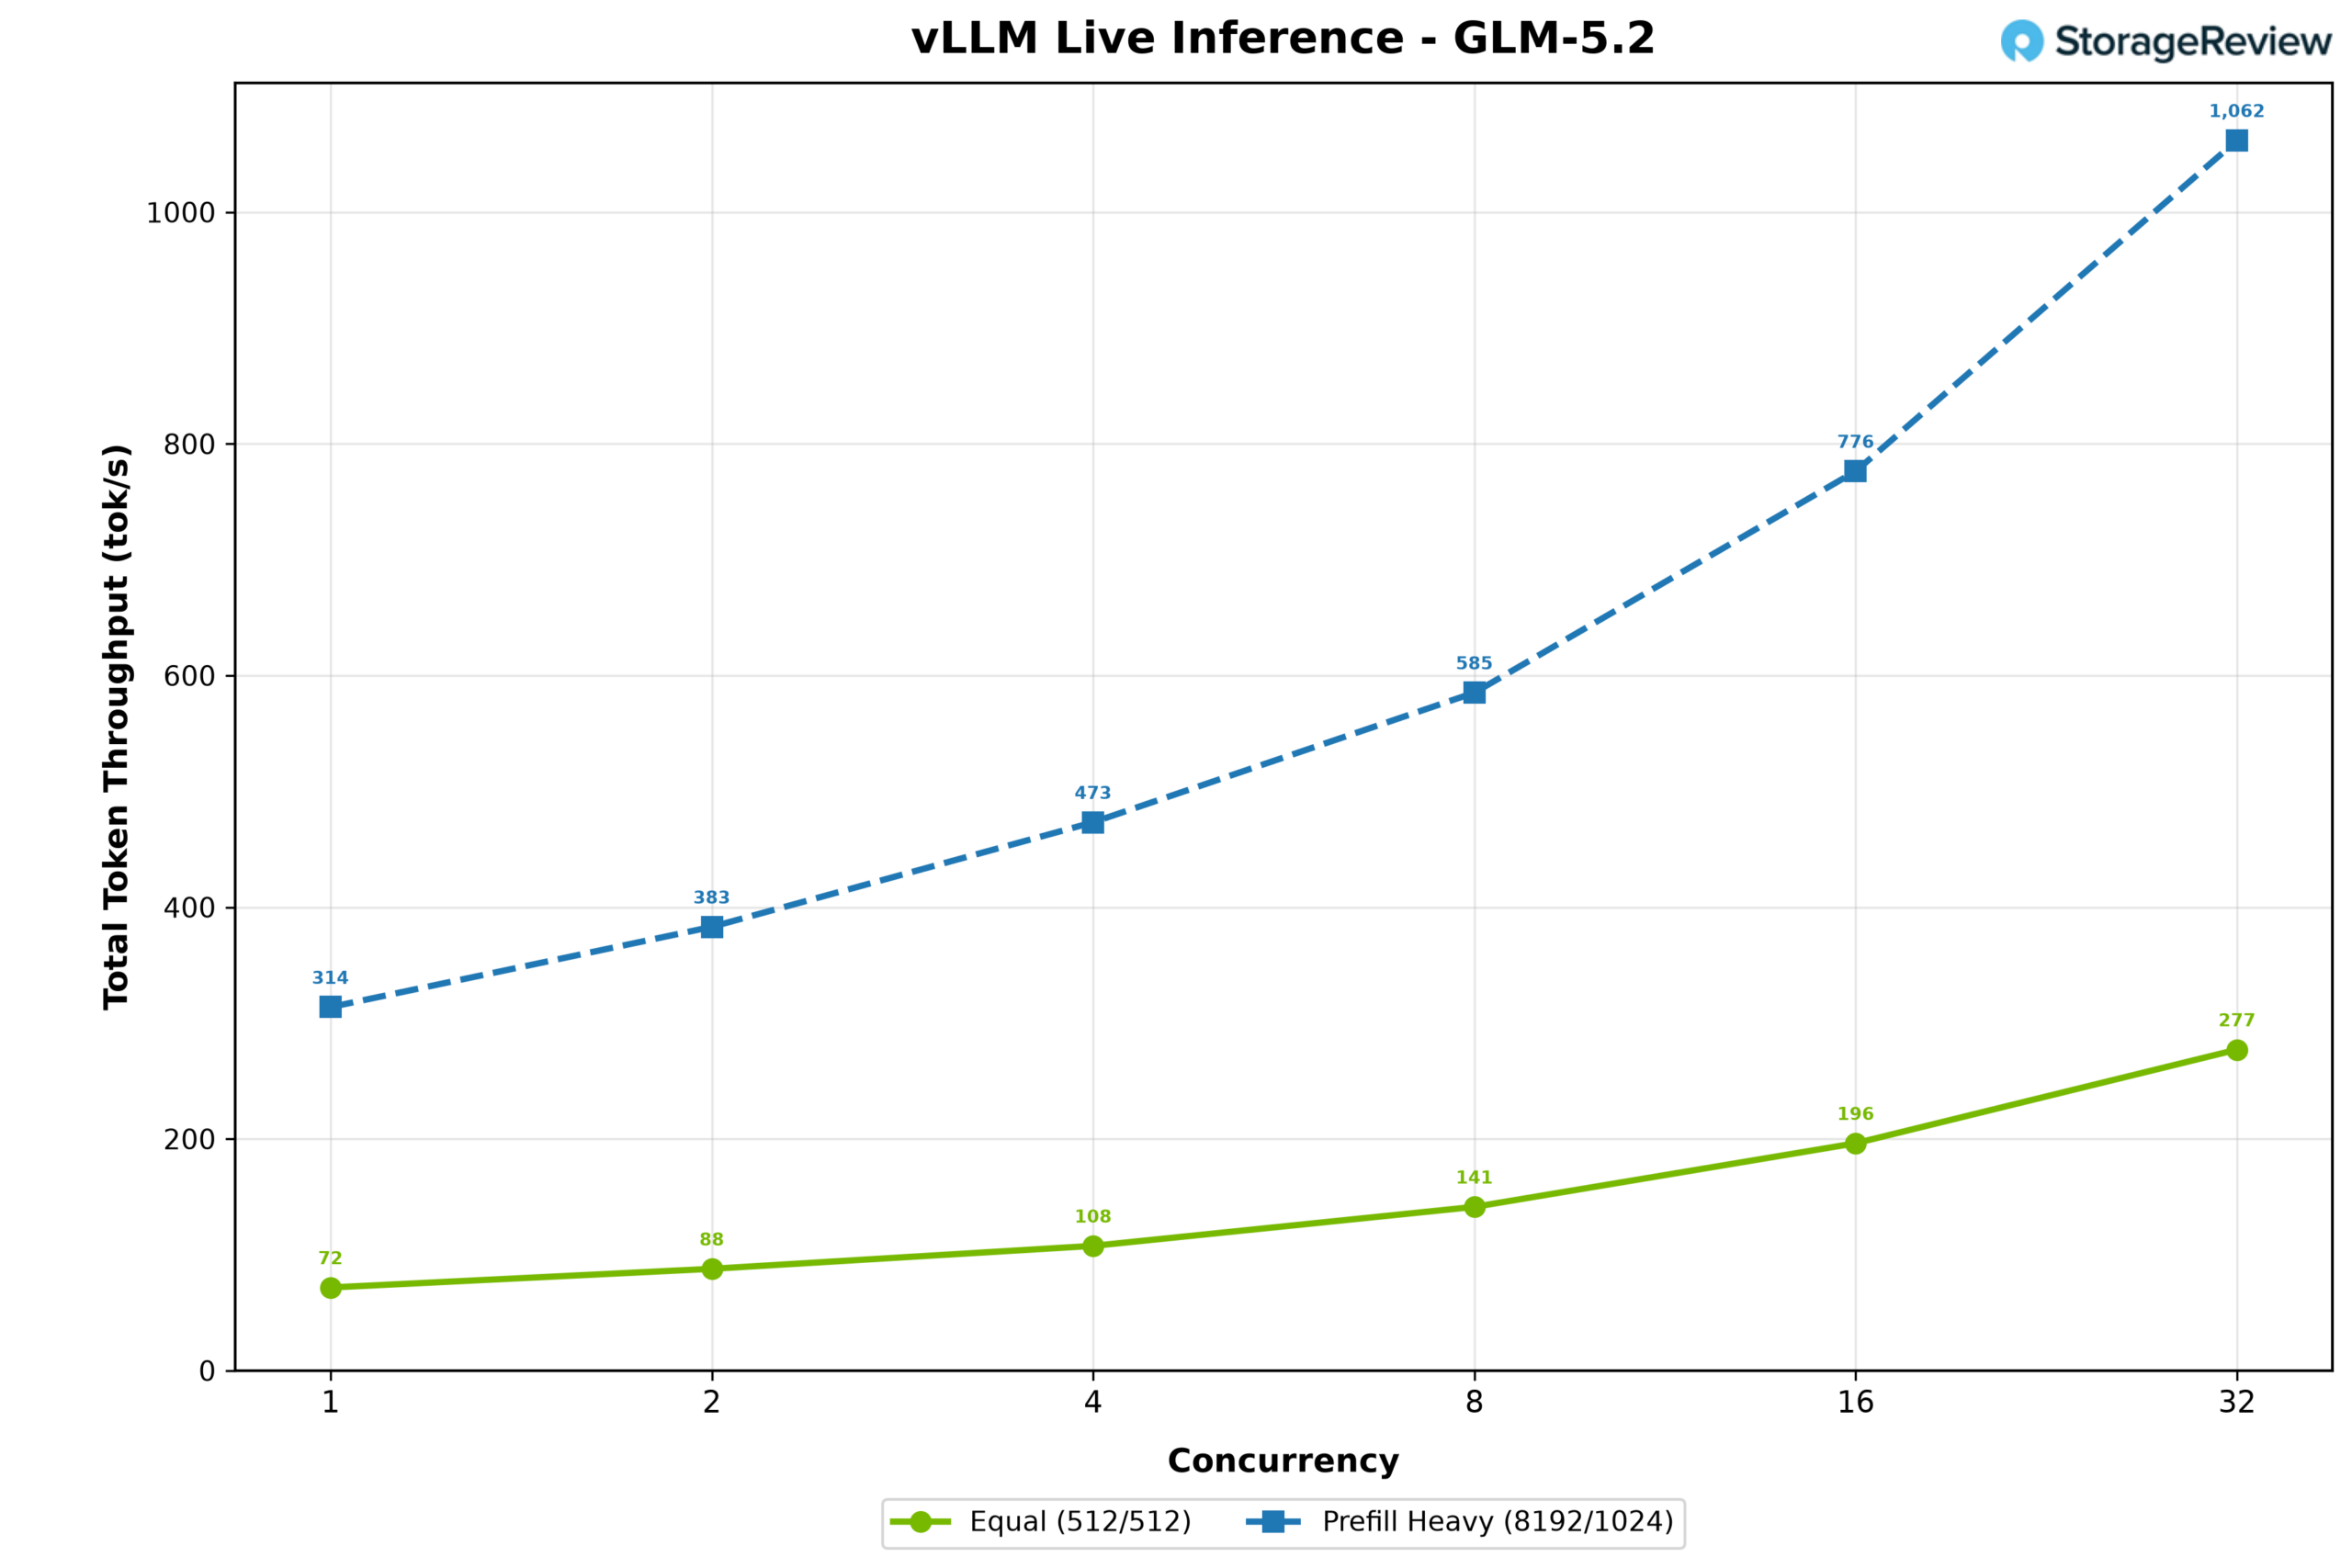
Il throughput totale dei token ha seguito lo stesso andamento, con il carico di lavoro 512/512 che è passato da 72 a 277 token al secondo e il carico di lavoro con pre-riempimento intenso che è salito da 314 a 1,062; in questo caso, i prompt più lunghi separano finalmente i due profili, poiché i token di pre-riempimento stessi contribuiscono al totale.
Nemotron-3-Ultra 550B (NVFP4)
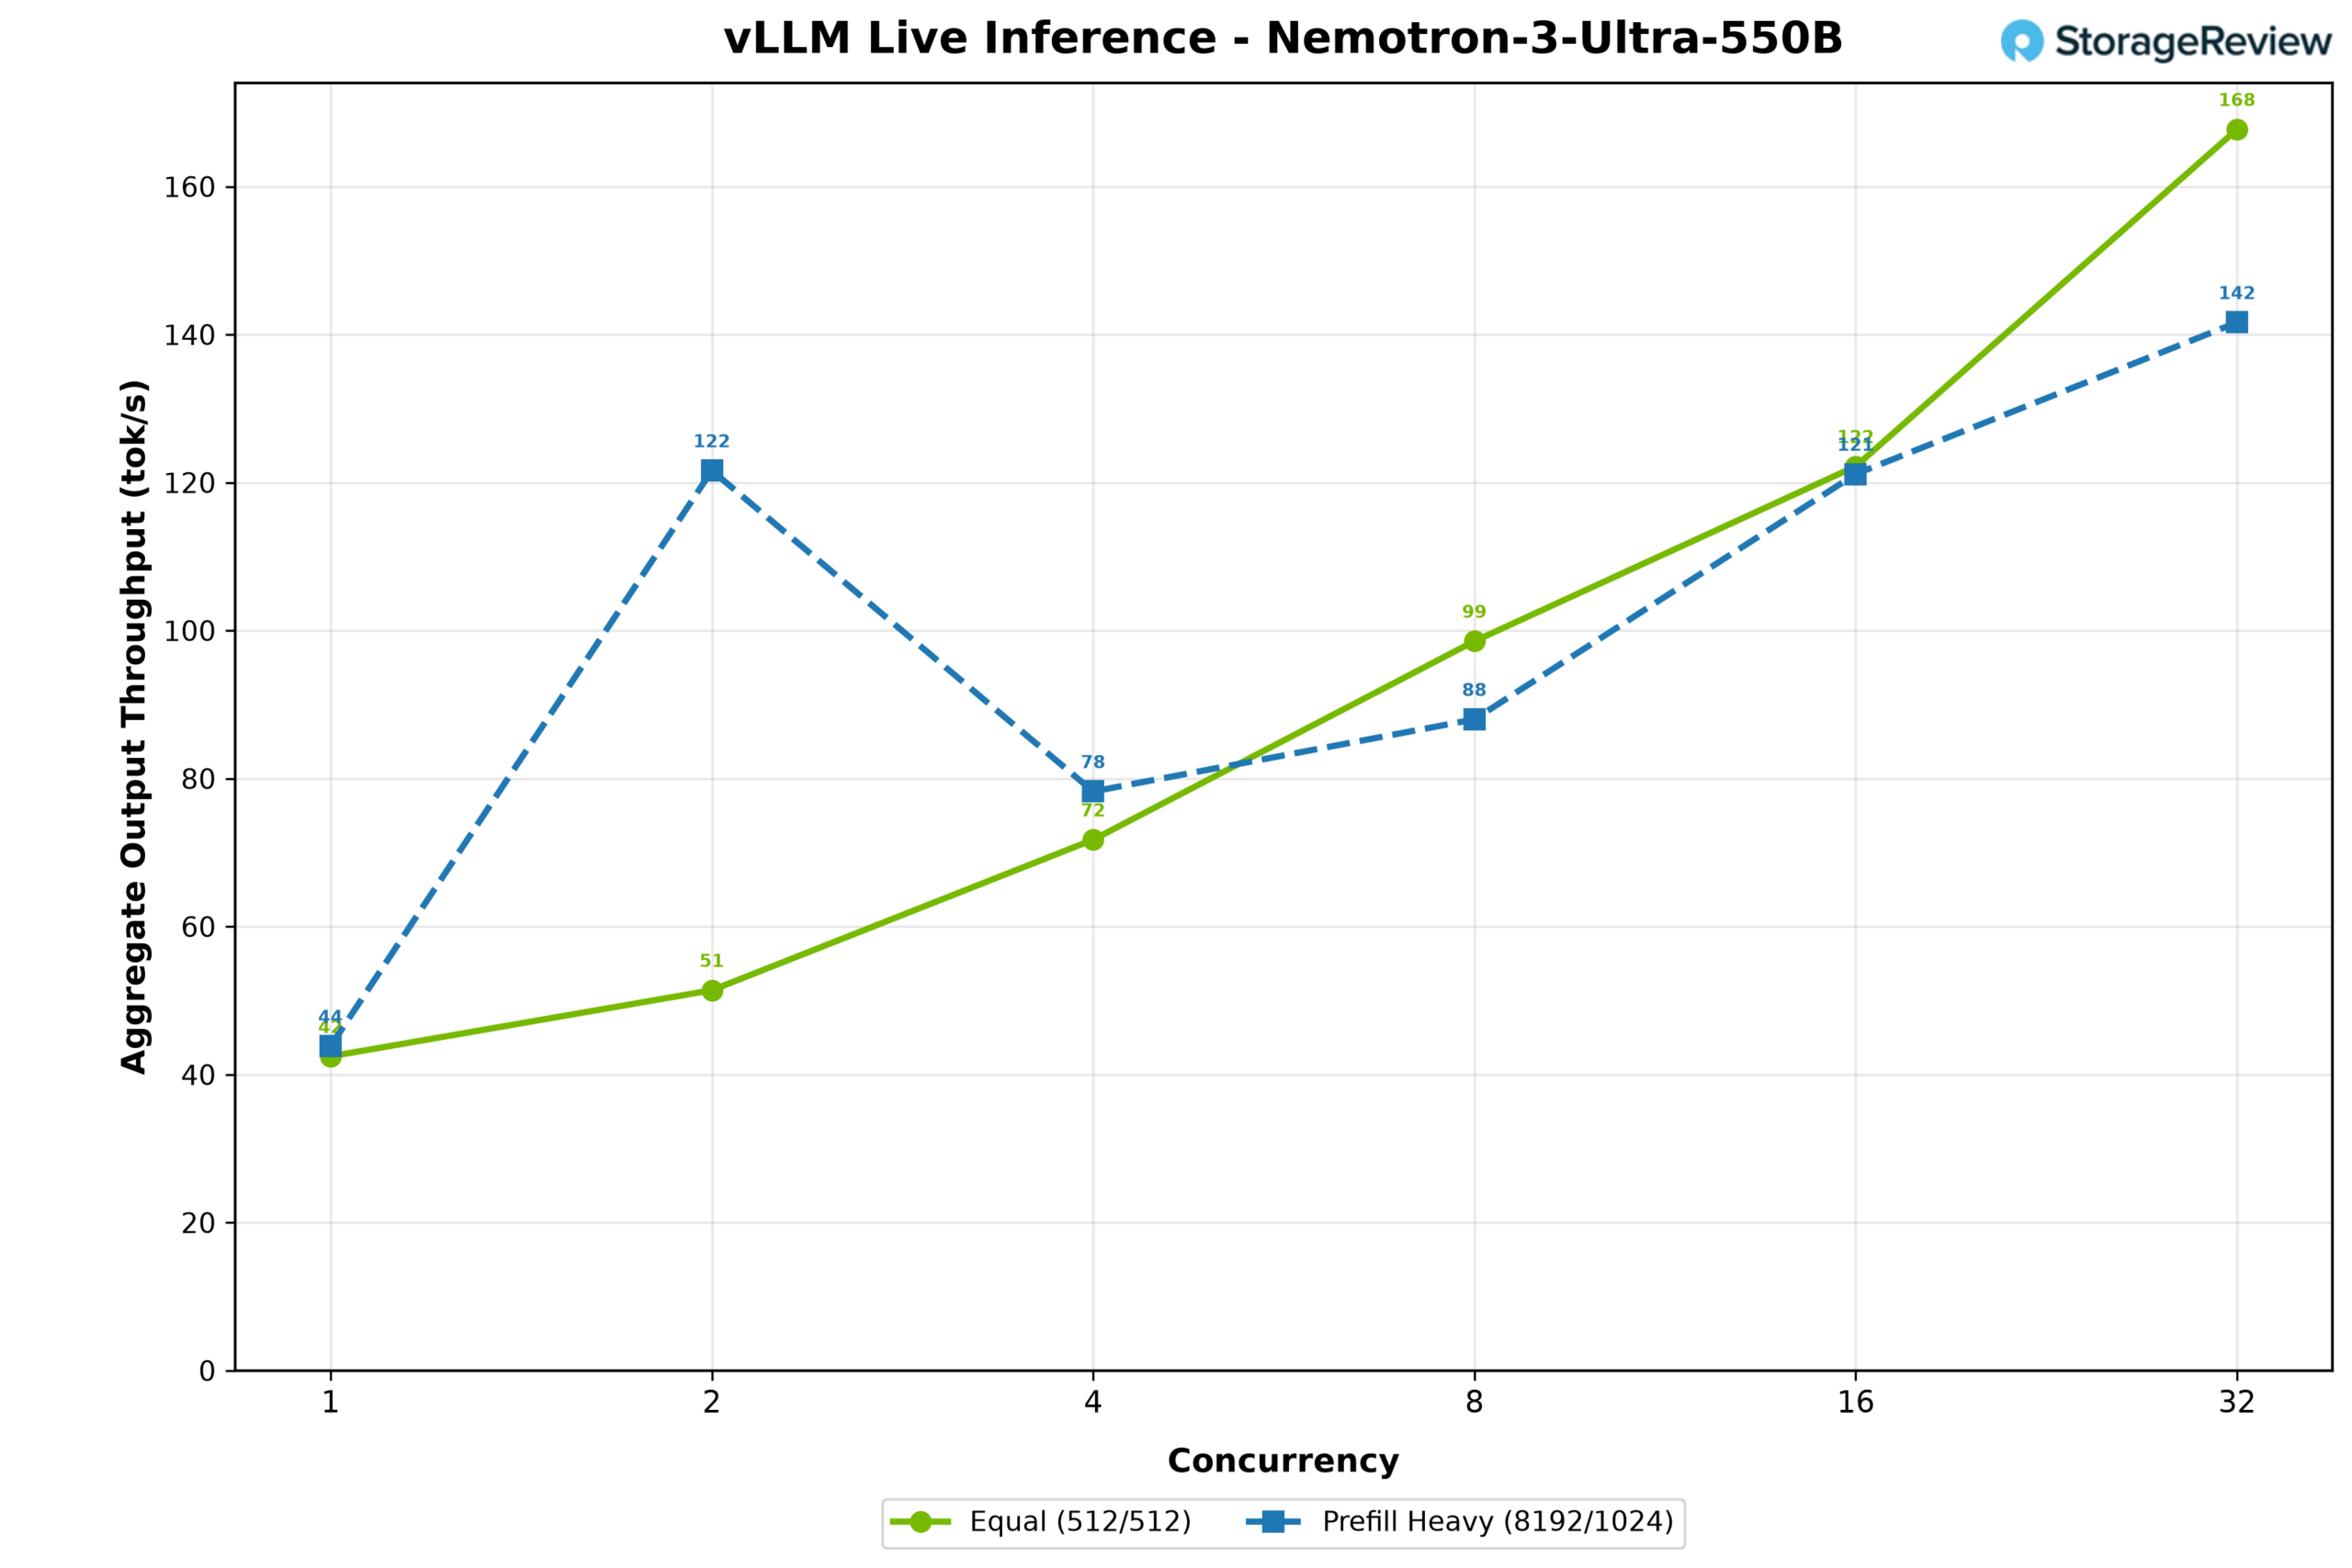
Nemotron-3-Ultra 550B è il modello più grande che abbiamo eseguito, ed è quello che sfrutta più direttamente l'intero pool coerente. Si tratta di un modello ibrido Transformer-Mamba NVFP4 da 307 GB, decisamente troppo grande per la sola HBM, con 114 GB dei suoi pesi trasferiti nella memoria Grace. È stata utilizzata la decodifica speculativa MTP con una lunghezza di accettazione sintetica di 5 token. Il throughput di output nel carico di lavoro 512/512 è partito da 43 token al secondo con concorrenza 1 ed è salito a 168 con concorrenza 32. Il carico di lavoro con pre-riempimento ha mostrato un andamento più interessante: il throughput è aumentato da 44 token al secondo con concorrenza 1 a un picco di 122 con concorrenza 2, per poi scendere a 78 con concorrenza 4, poiché i prompt lunghi hanno riempito la cache KV limitata. Come nel caso di GLM-5.2, i due profili si sovrappongono strettamente, indicando ancora una volta che la migrazione degli esperti tra Grace e la GPU è il fattore limitante, piuttosto che la potenza di calcolo. La scansione si è conclusa a 32 concorrenti per lo stesso motivo: non c'era più abbastanza HBM disponibile per un contesto aggiuntivo.
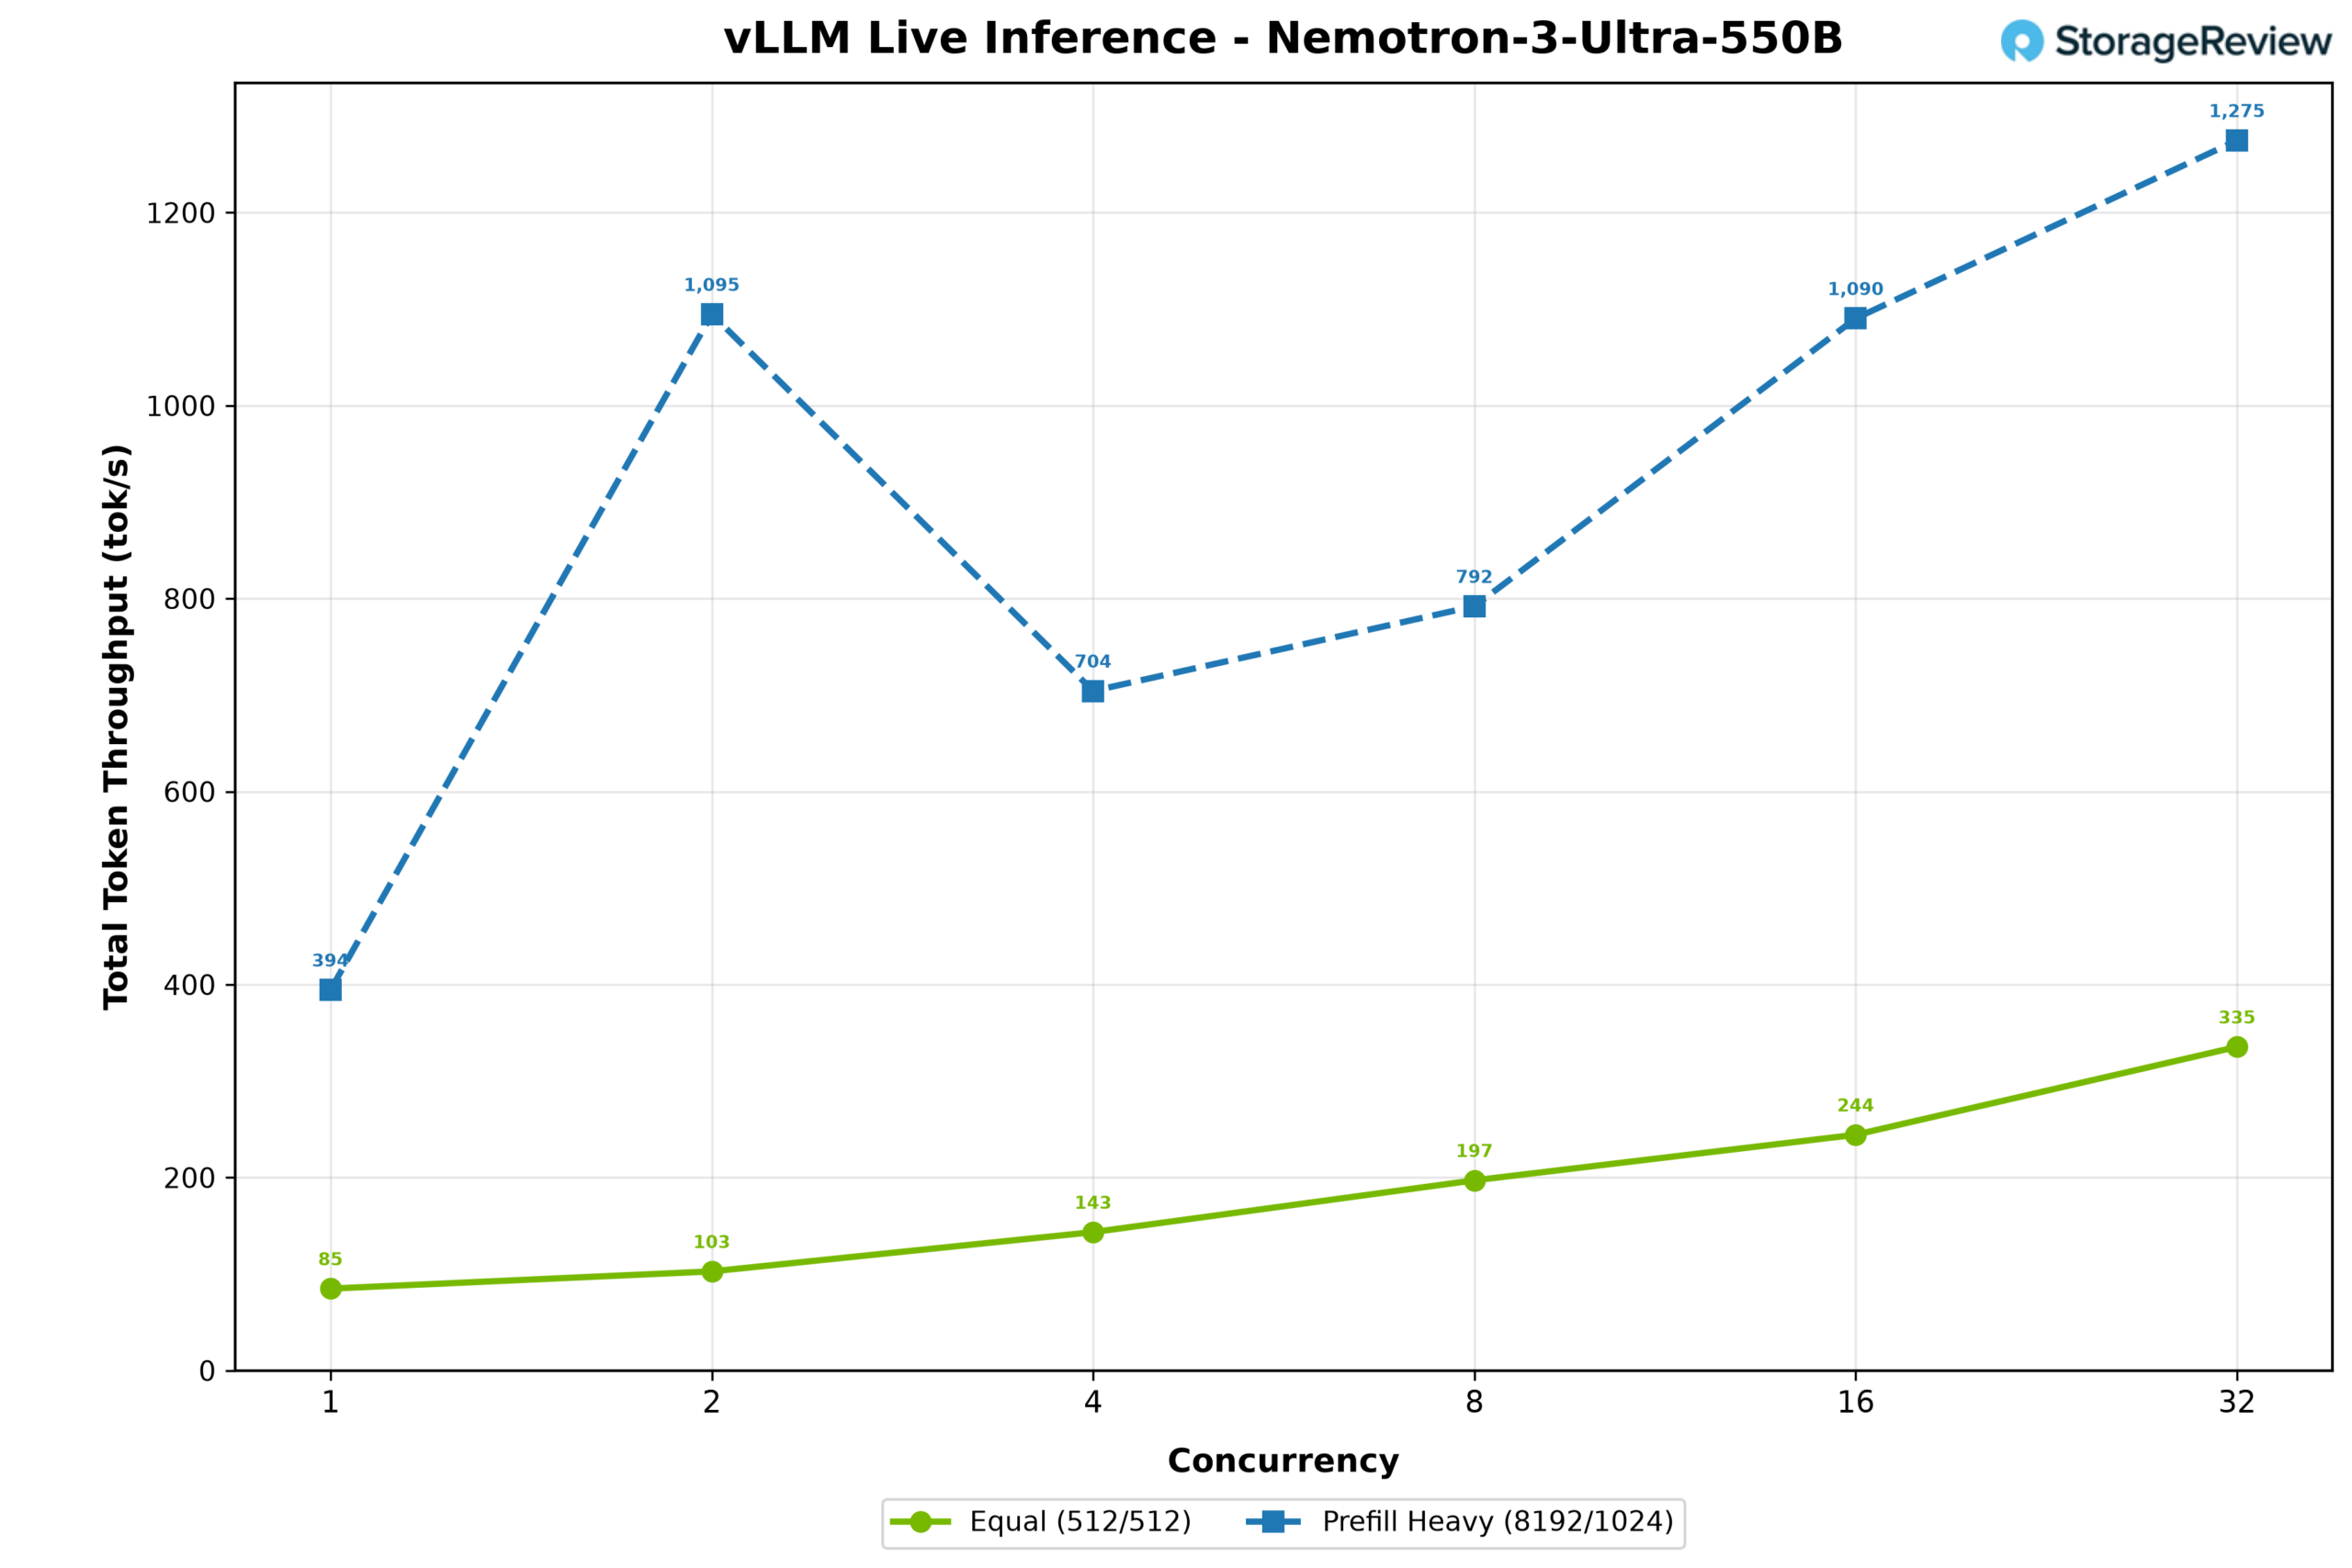
Il throughput totale dei token è seguito da un andamento più marcato, con il carico di lavoro prevalentemente di pre-riempimento che ha raggiunto un picco di 2,506 token al secondo con una concorrenza pari a 2, per poi diminuire a 2,169 con una concorrenza pari a 4, mentre il carico di lavoro 512/512 è passato da 85 a 336 token al secondo.
WS300 contro Blackwell RTX PRO 6000 contro DGX Spark
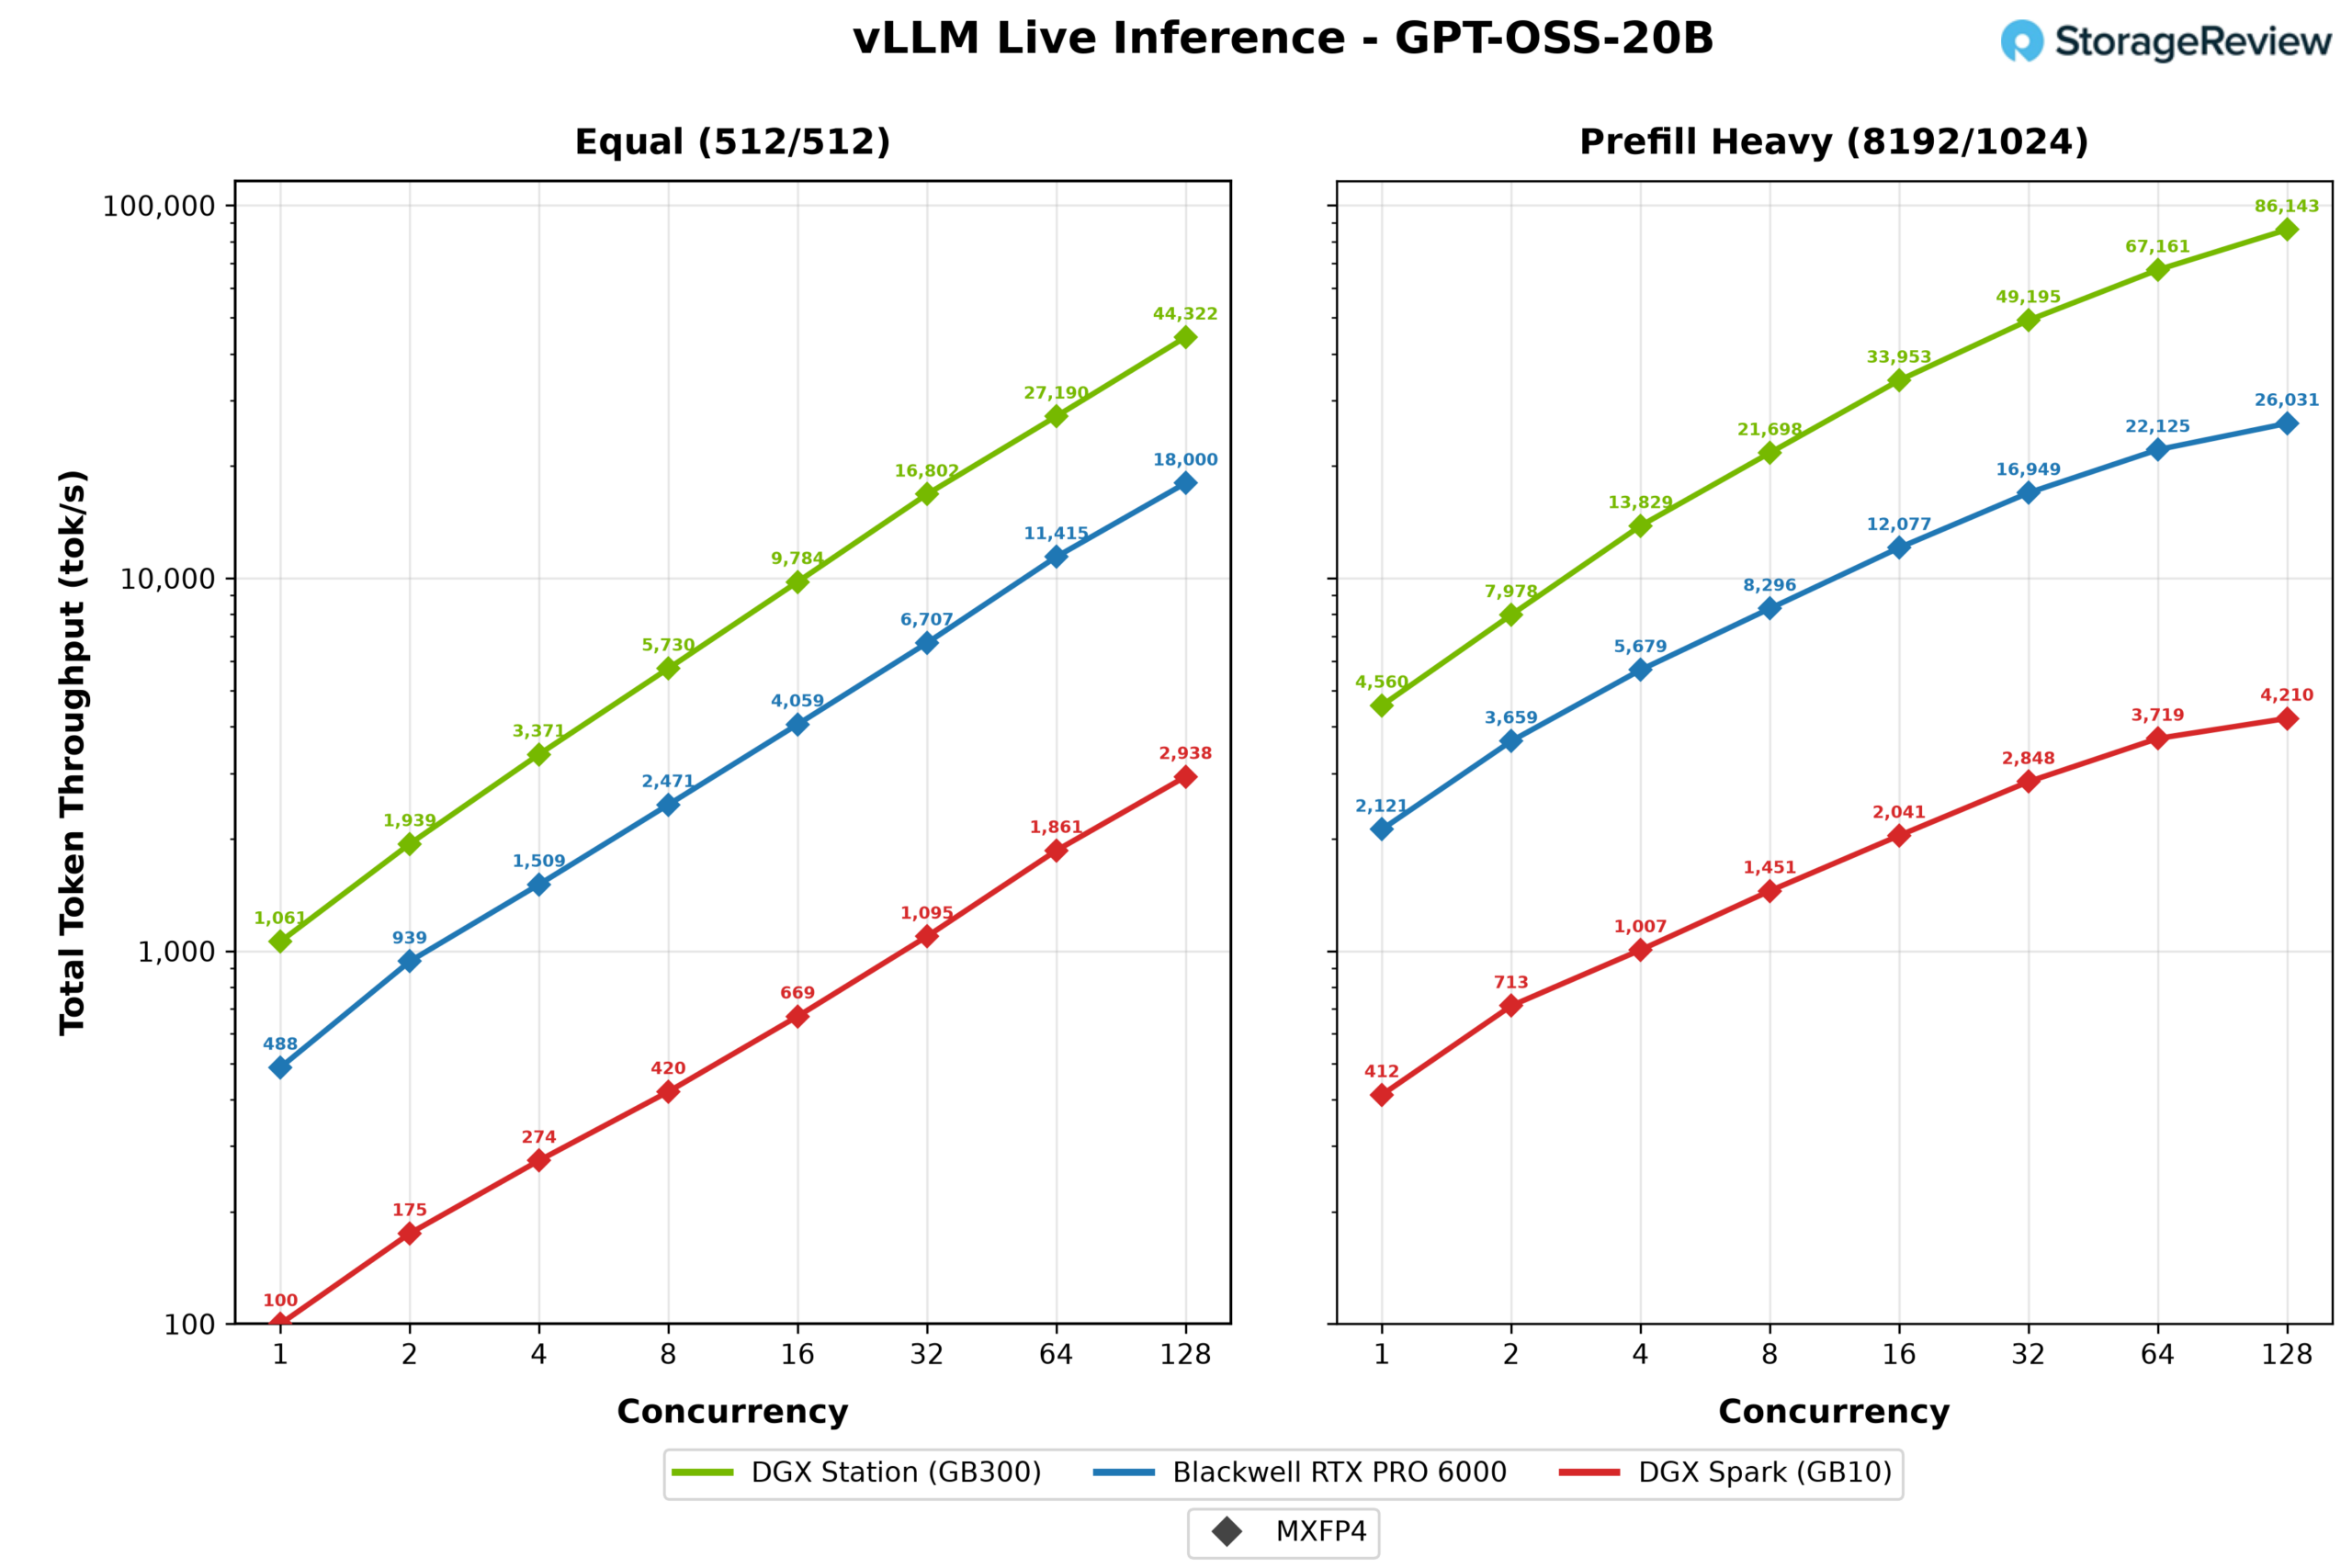
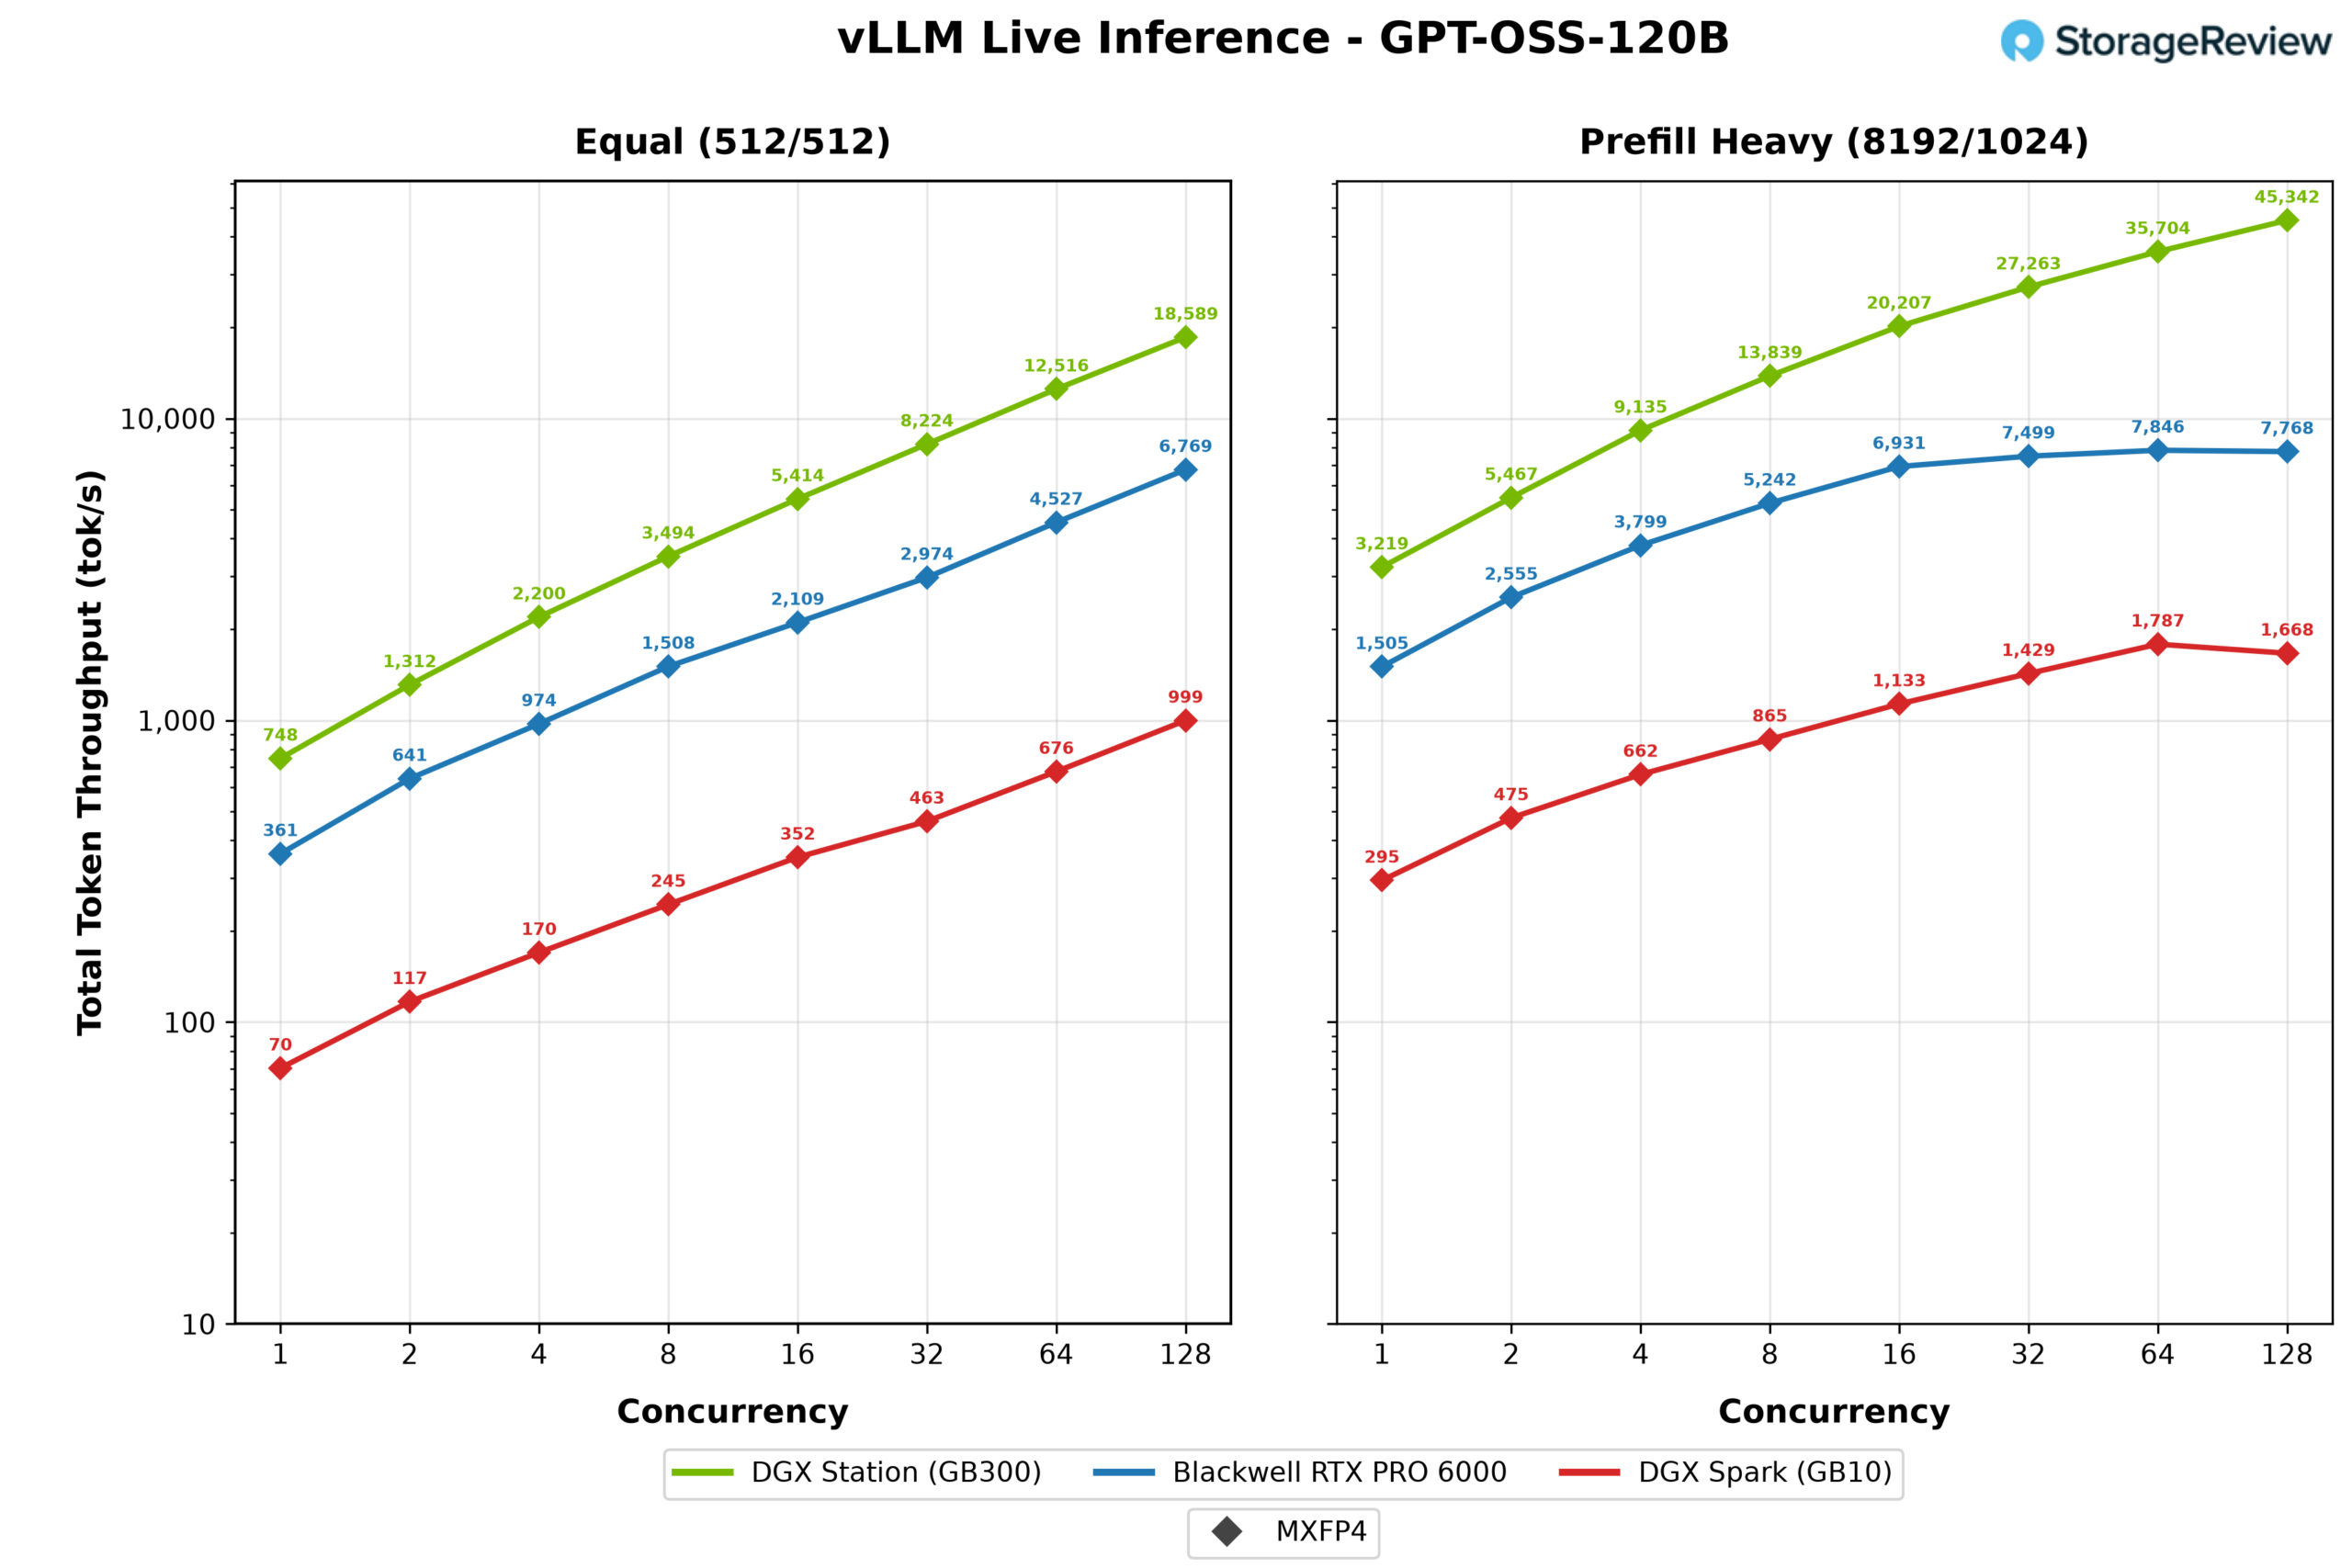
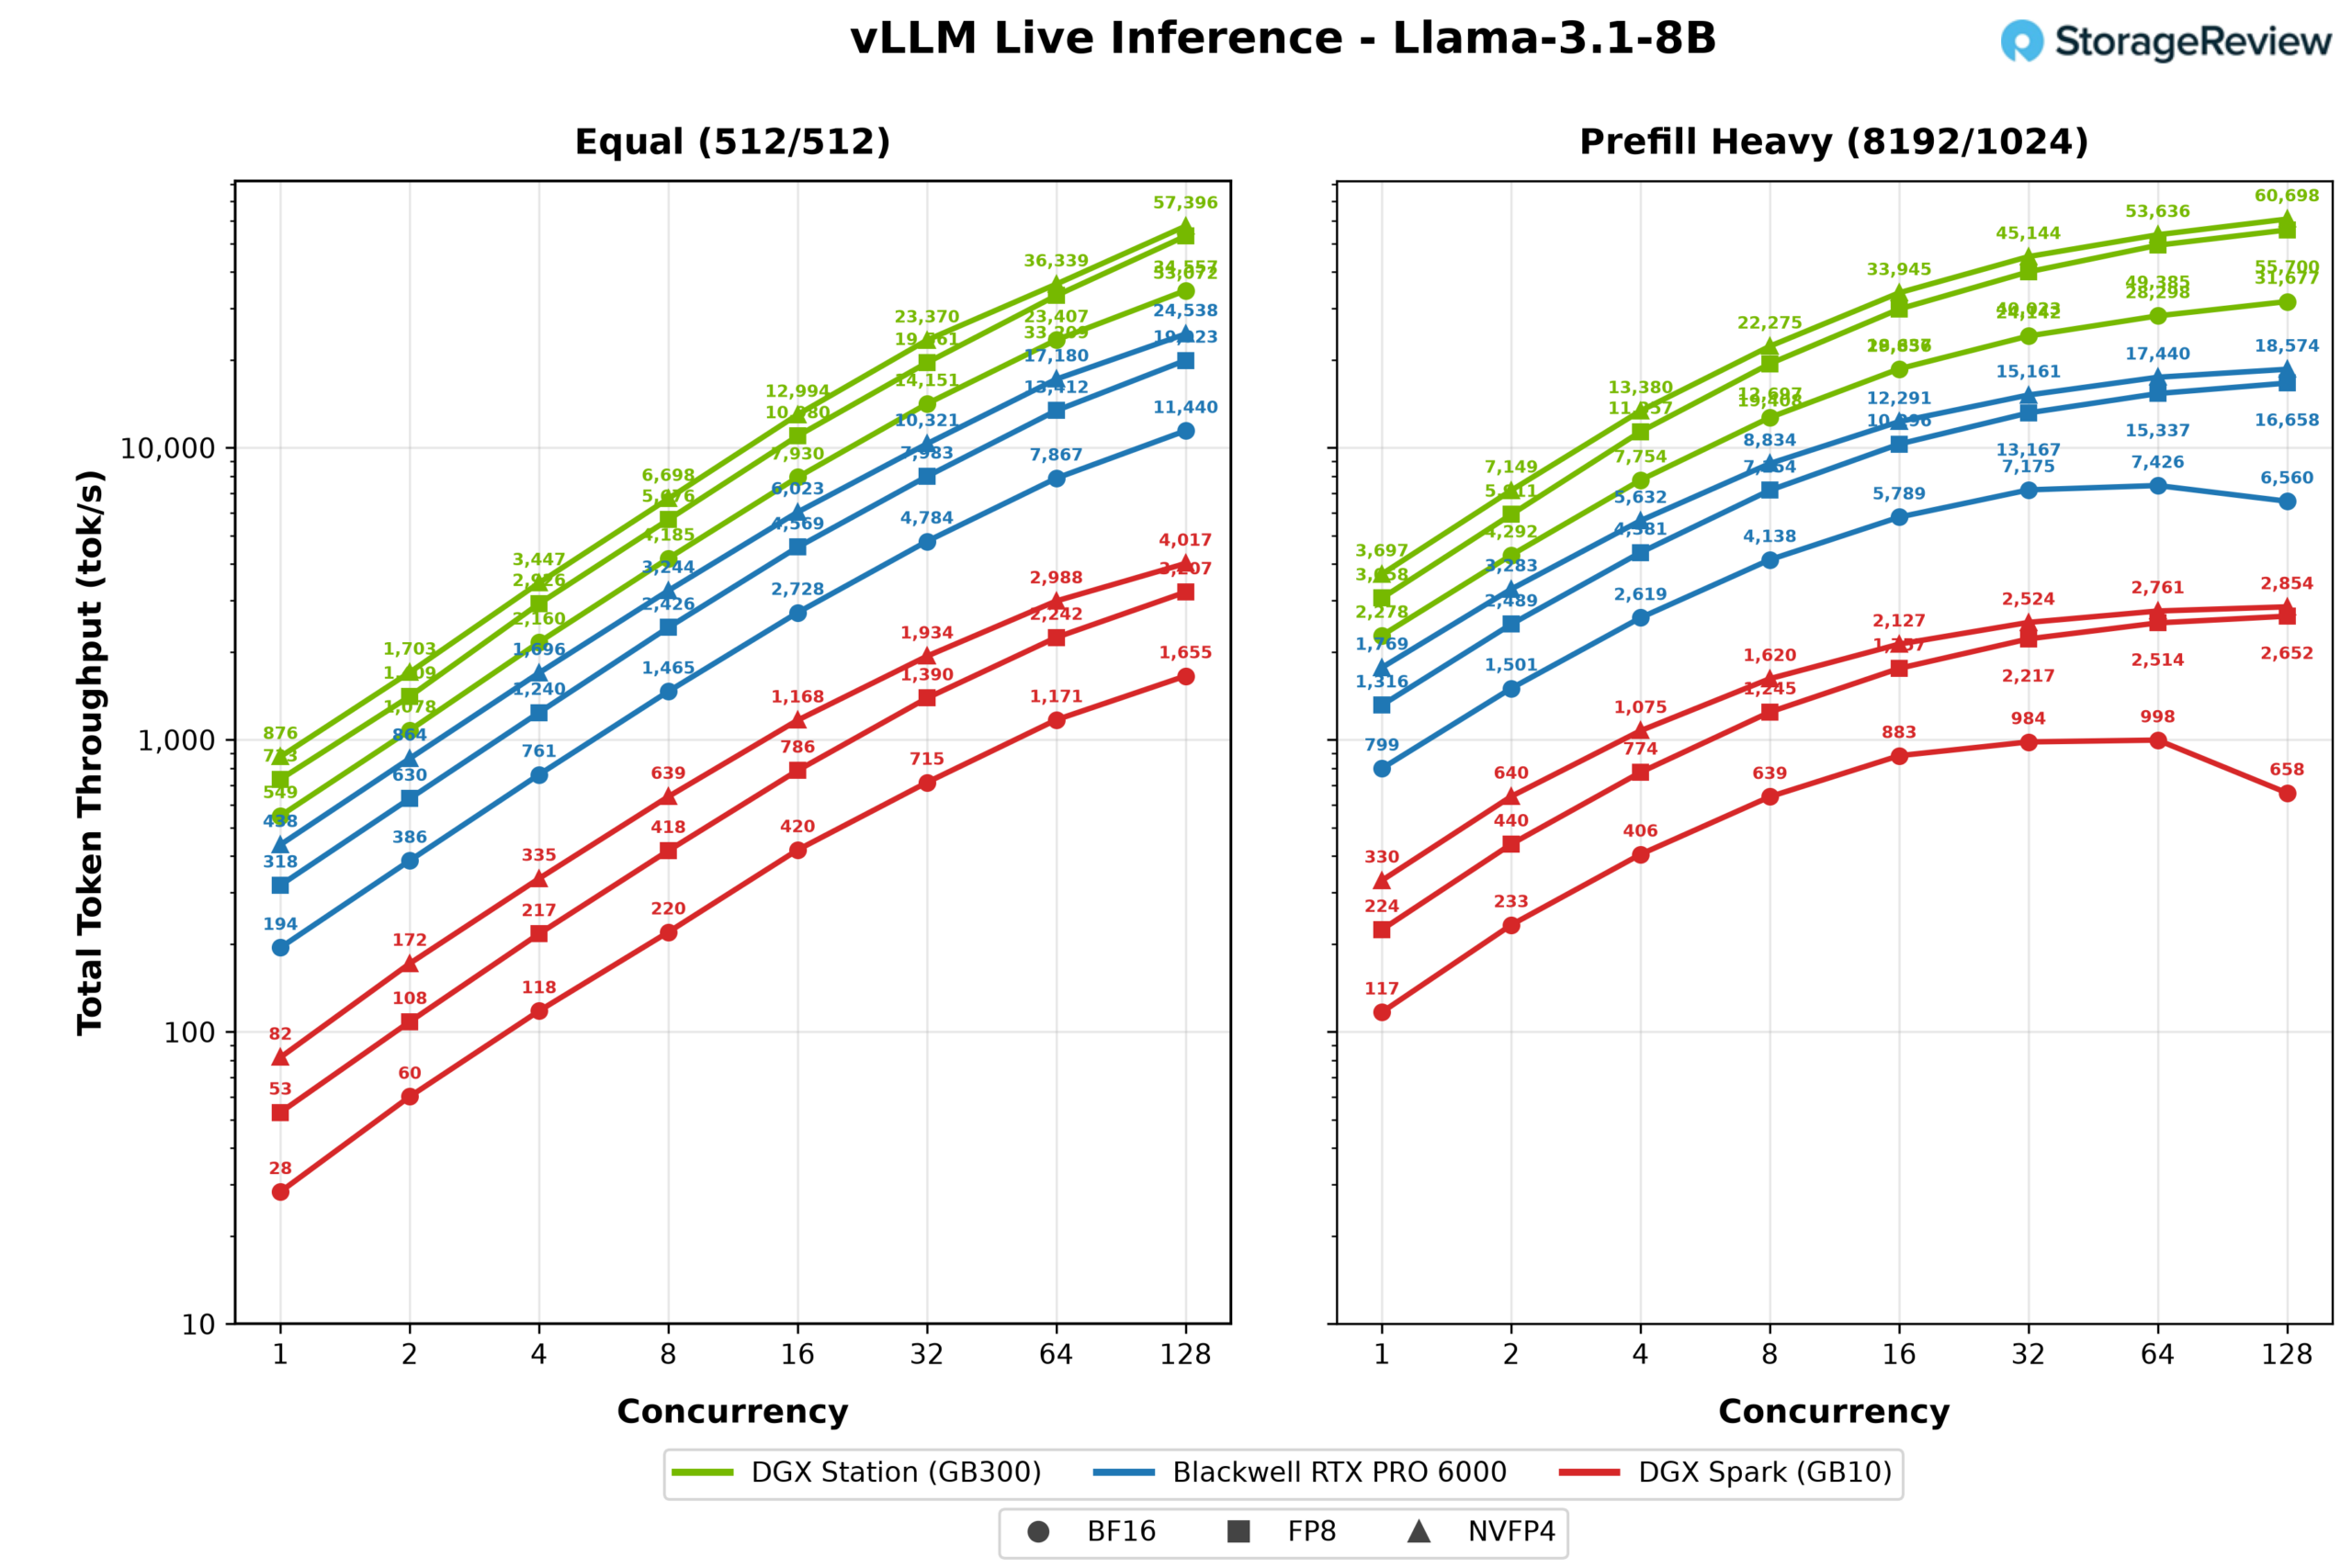
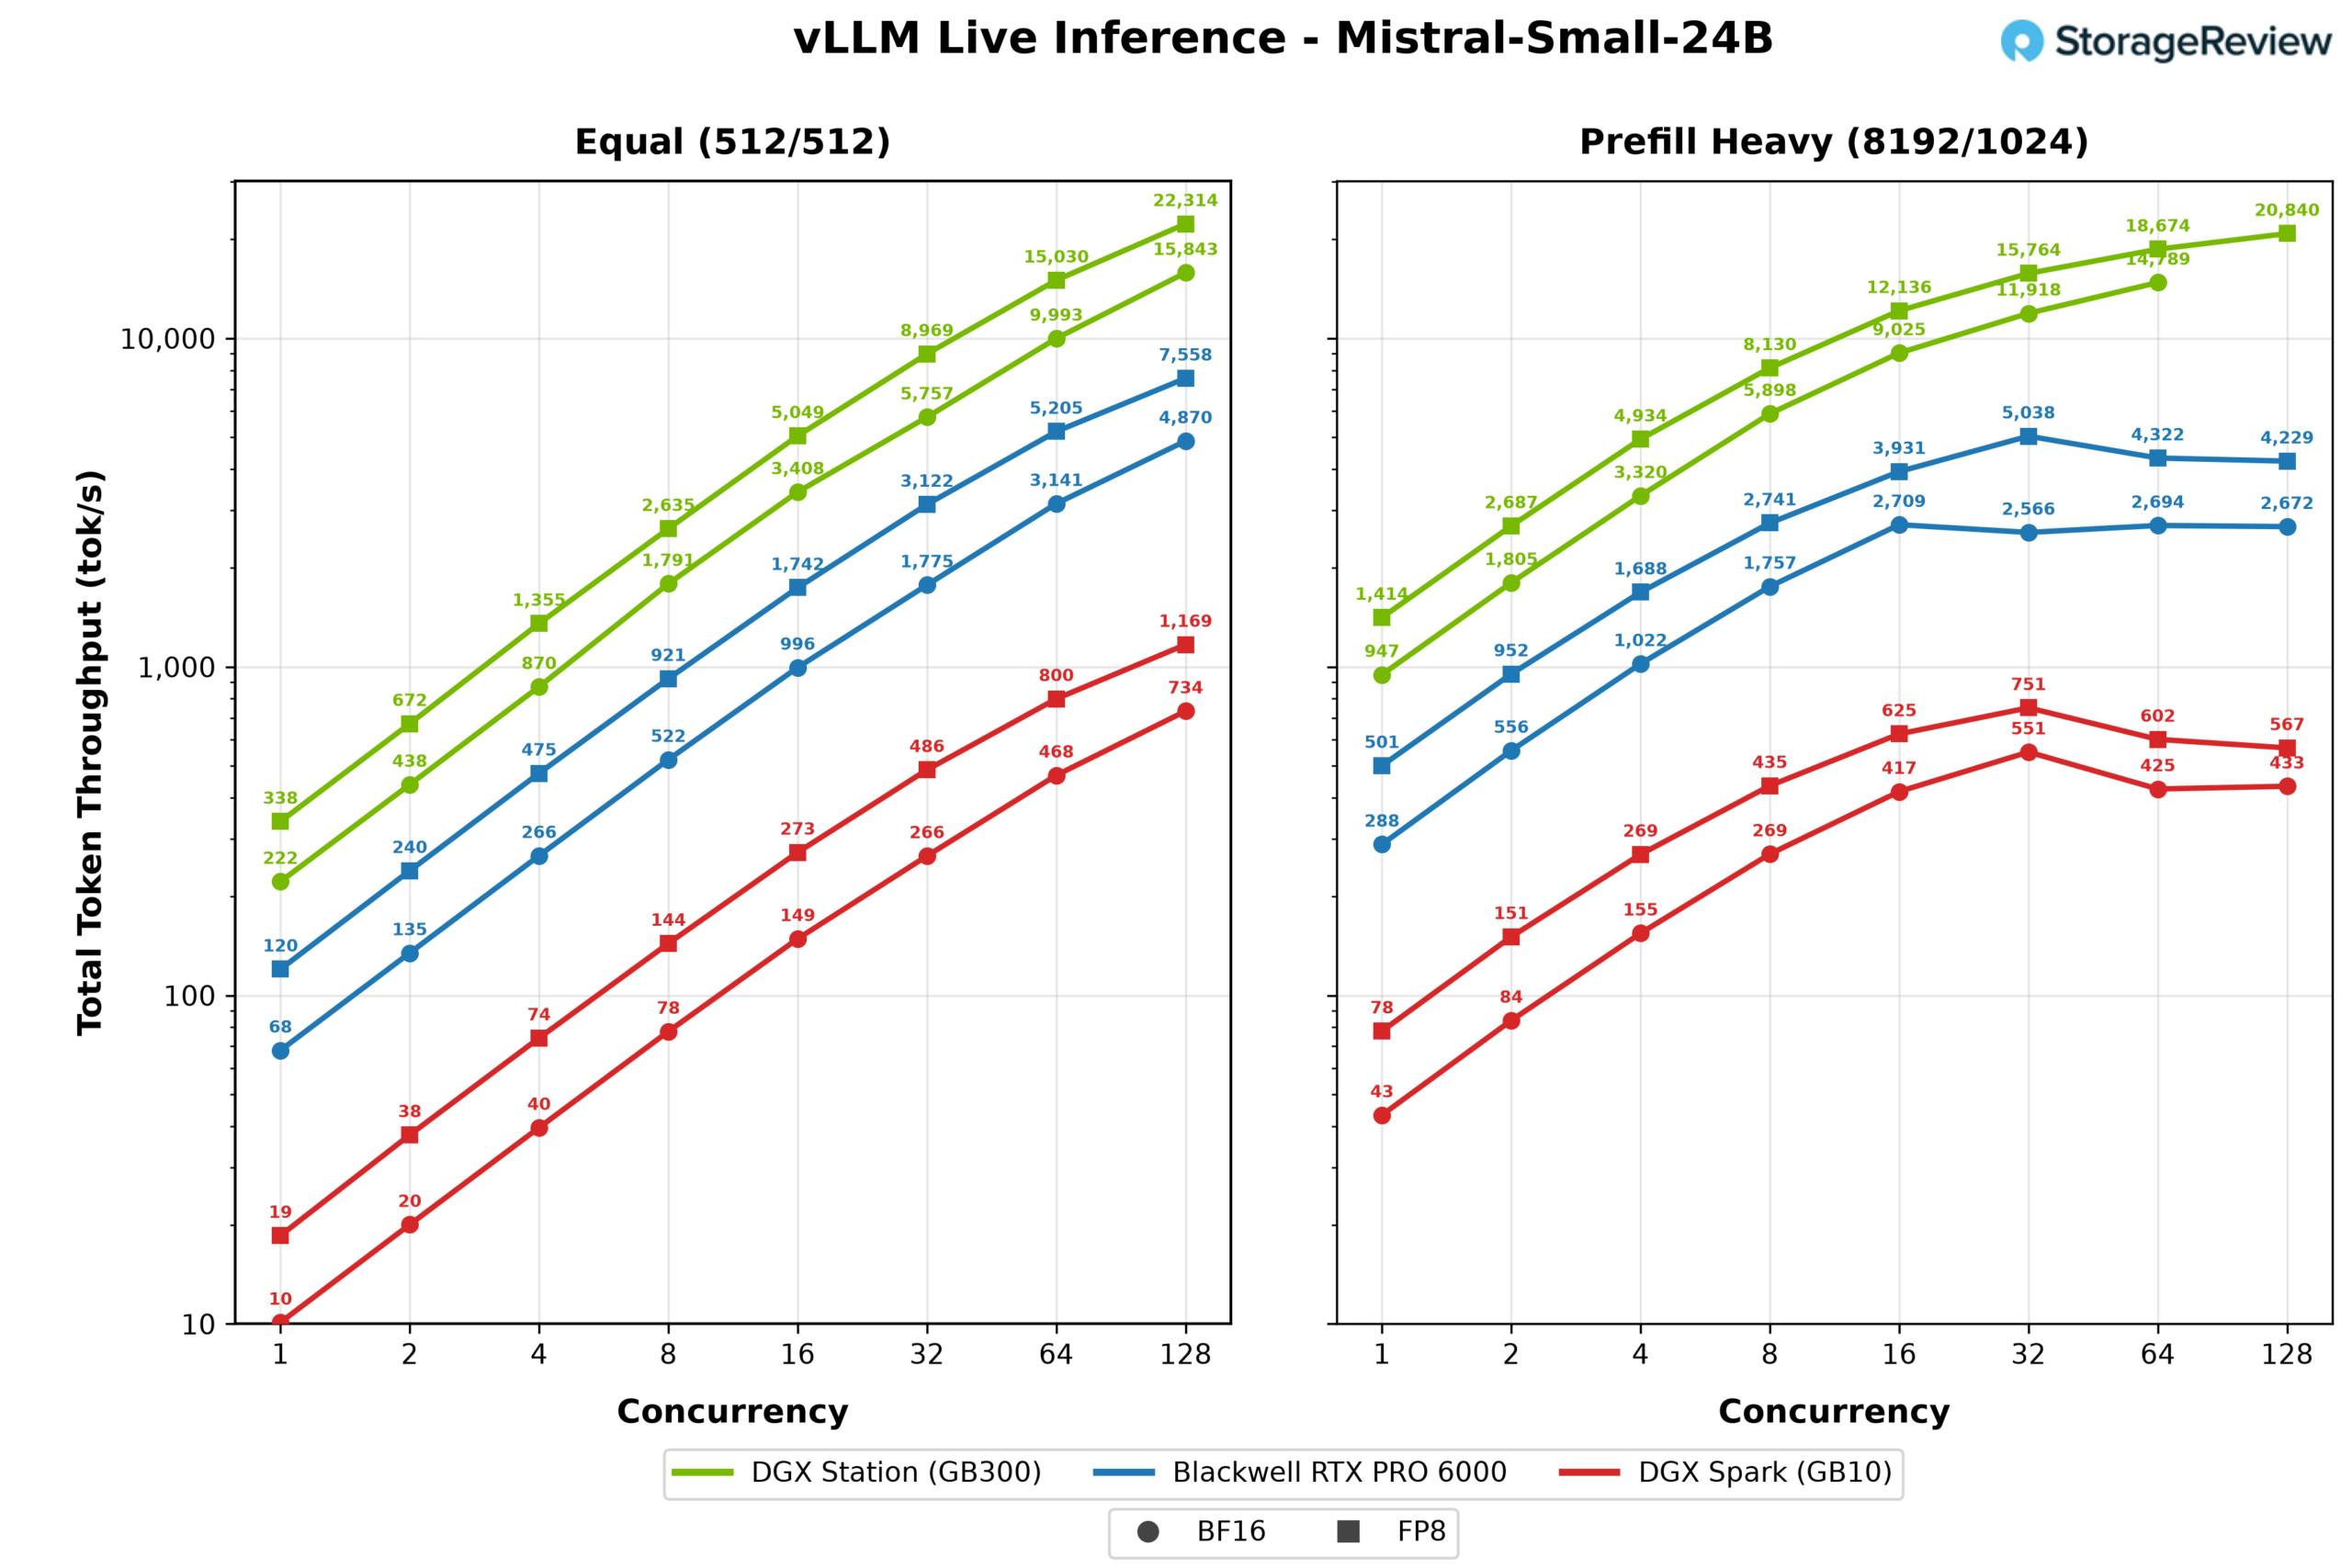
Questa seconda parte dei nostri test di inferenza mette a confronto il WS300 con le altre due soluzioni per avere Blackwell su una scrivania o nelle sue vicinanze: la Blackwell RTX PRO 6000, la scheda workstation da 600 W di NVIDIA, installata nel Dell Pro Max Tower T2 che abbiamo recensito in precedenza, e la DGX Spark basata su GB10, qui rappresentata dall'Acer Veriton GN100 . Ciascun sistema ha eseguito gli stessi carichi di lavoro di inferenza live vLLM in due scenari: un carico di lavoro uguale con 512 token di input e 512 di output e un carico di lavoro con pre-riempimento intensivo con 8,192 token di input e 1,024 di output, a livelli di concorrenza da 1 a 128. Abbiamo rappresentato graficamente l'output aggregato e il throughput totale per ogni modello che tutti e tre i sistemi possono gestire in comune: GPT-OSS-20B e GPT-OSS-120B nel loro formato nativo MXFP4, Llama 3.1 8B a BF16, FP8 e NVFP4, e Mistral Small 24B e Qwen3 Coder 30B a BF16 e FP8.
GPT-OSS-20B
GPT-OSS-20B è il test più accessibile del set, un checkpoint che si adatta facilmente a tutti e tre i sistemi. Con lo stesso carico di lavoro, la WS300 ha scalato senza problemi fino a 22,161 token di output al secondo con 128 stream simultanei, circa 2.5 volte la RTX PRO 6000 con 9,000 e 15 volte la DGX Spark con 1,469. I risultati a singolo stream raccontano la stessa storia in miniatura: 530 token al secondo sulla Station, 244 sulla scheda e 50 sulla Spark.
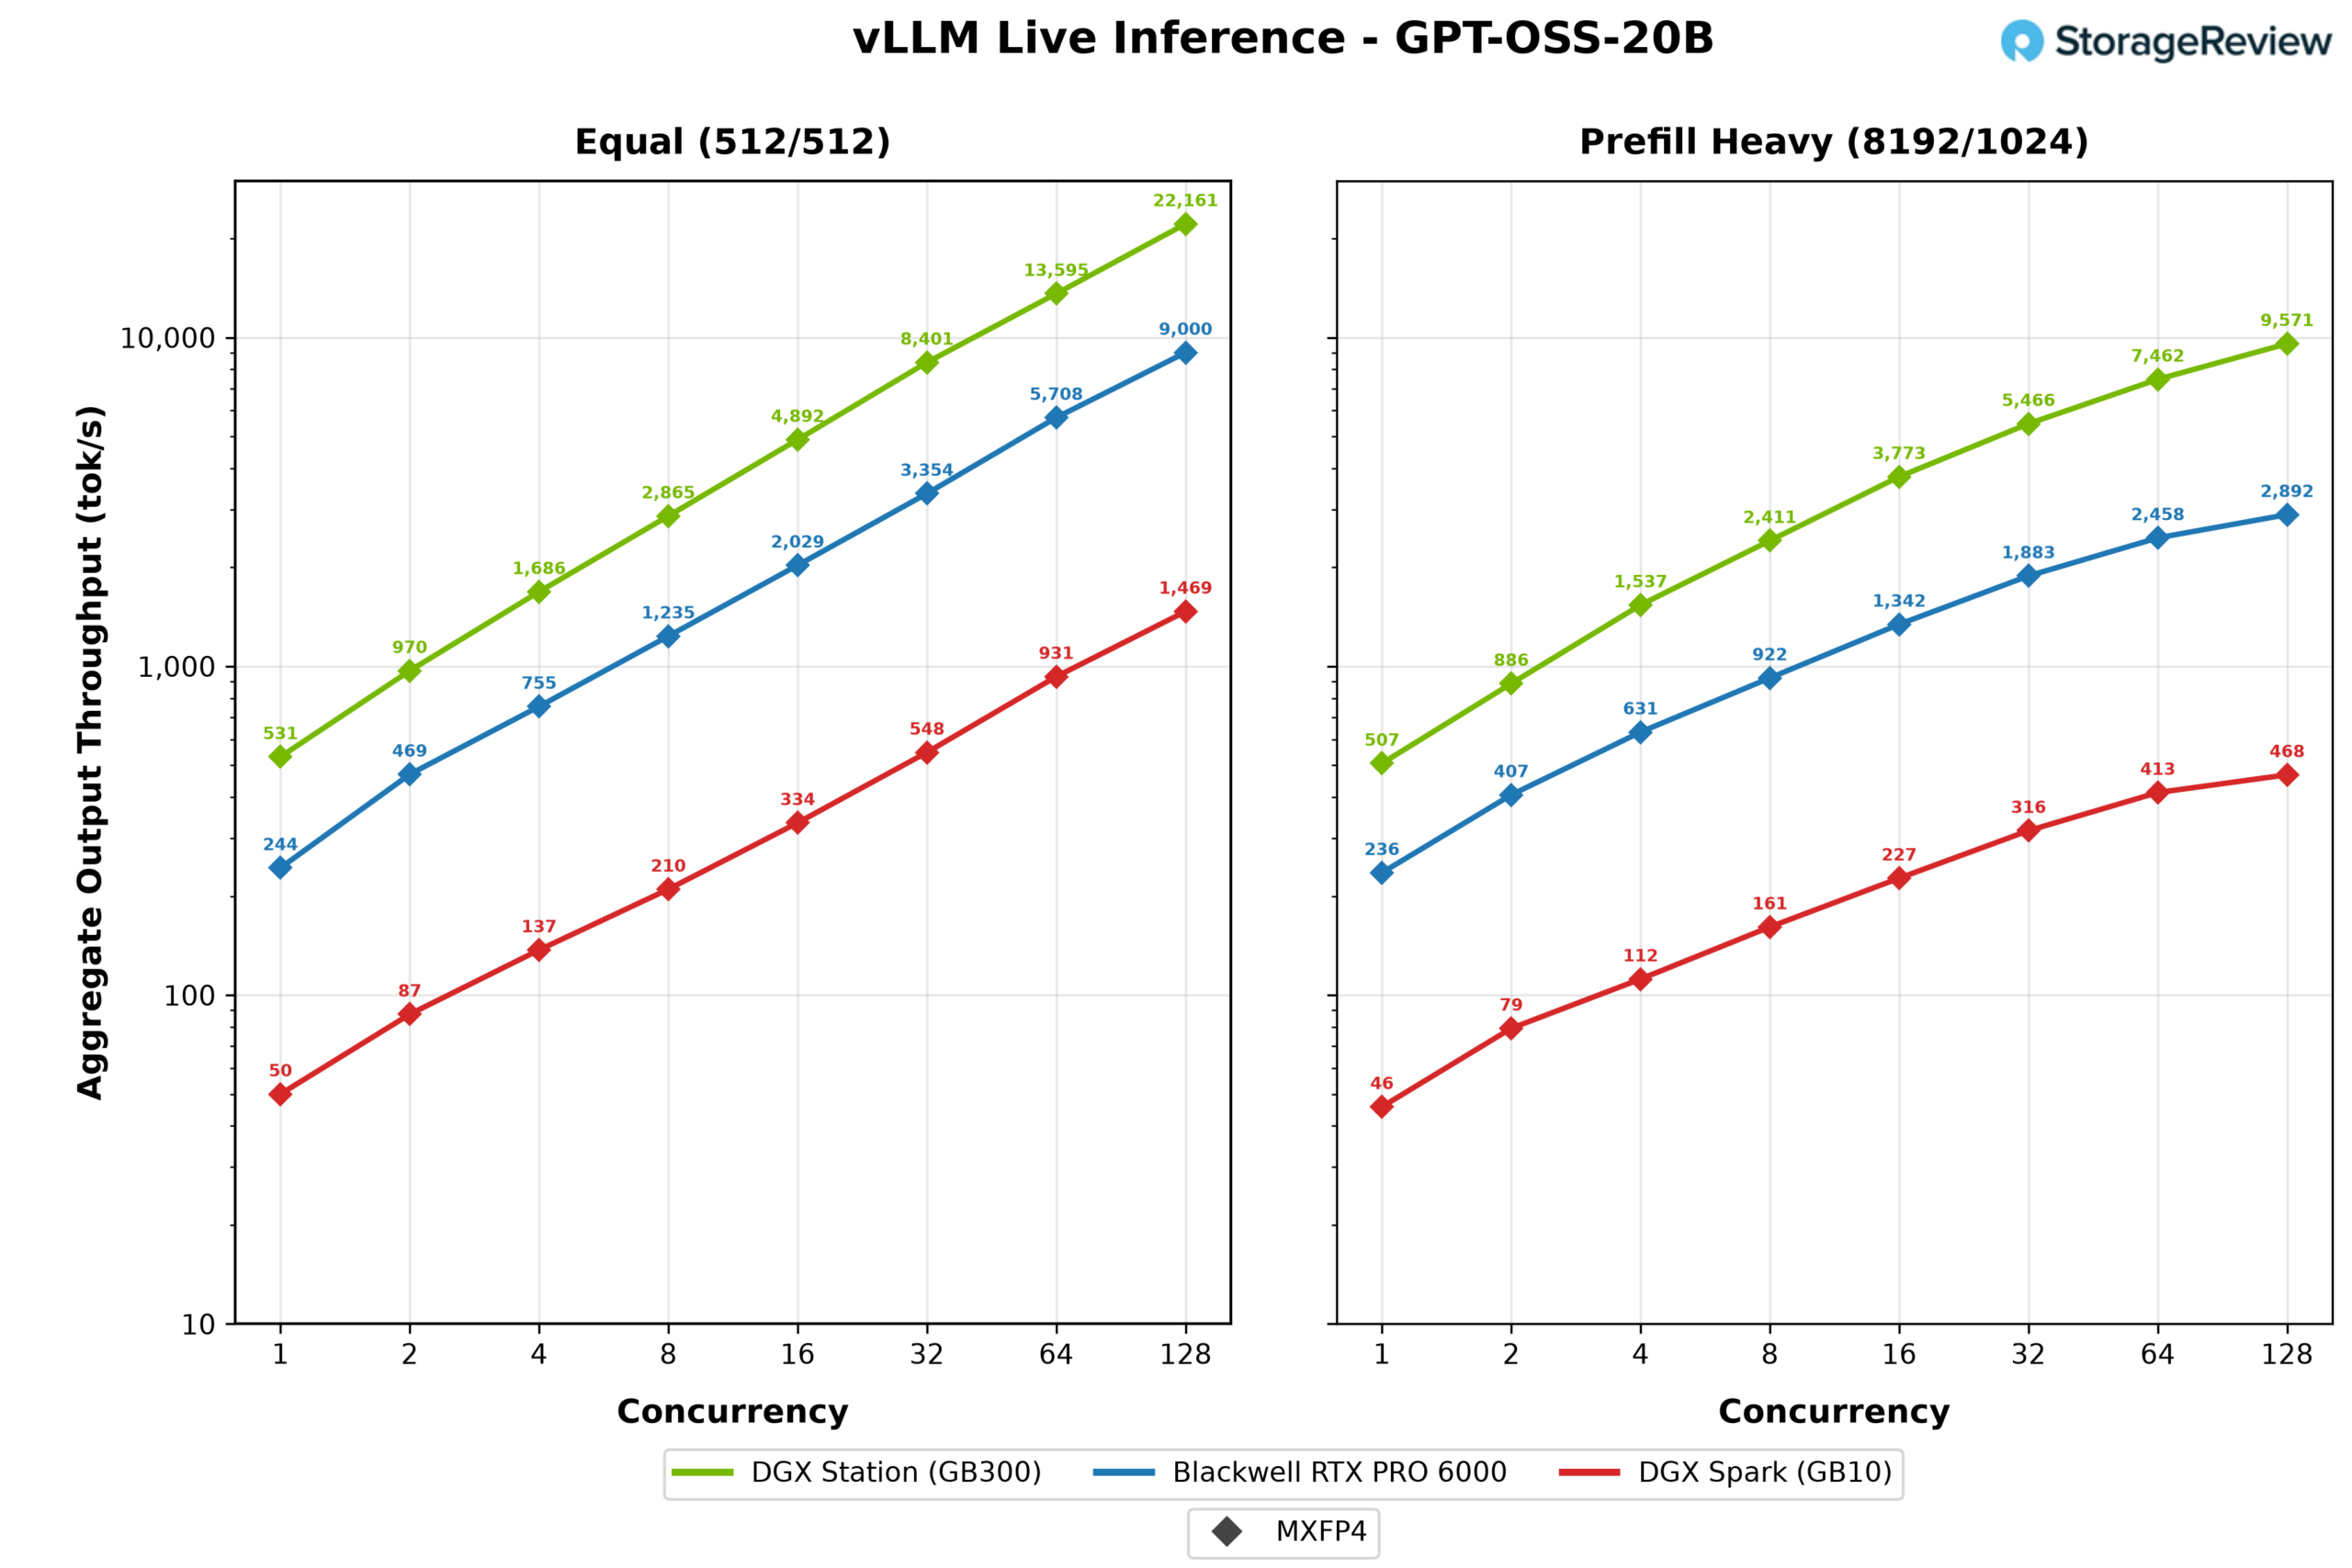
Lo scenario con precaricamento intensivo differenzia ulteriormente i dispositivi. Con 8,192 richieste di token, il WS300 ha comunque erogato 9,572 token di output al secondo al picco, che si traducono in oltre 86,000 token totali al secondo una volta conteggiato il precaricamento, mentre l'RTX PRO 6000 ha raggiunto un massimo di 2,892 e lo Spark di 468.
GPT-OSS-120B
Passando a GPT-OSS-120B, tutti e tre i sistemi sono ancora in grado di caricare il modello, ma la gerarchia della memoria inizia a diventare rilevante. Il WS300 ha raggiunto un picco di 9,294 token di output al secondo con lo stesso carico di lavoro, 2.7 volte superiore a quello dell'RTX PRO 6000 (3,384) e quasi 19 volte superiore a quello del DGX Spark (500).
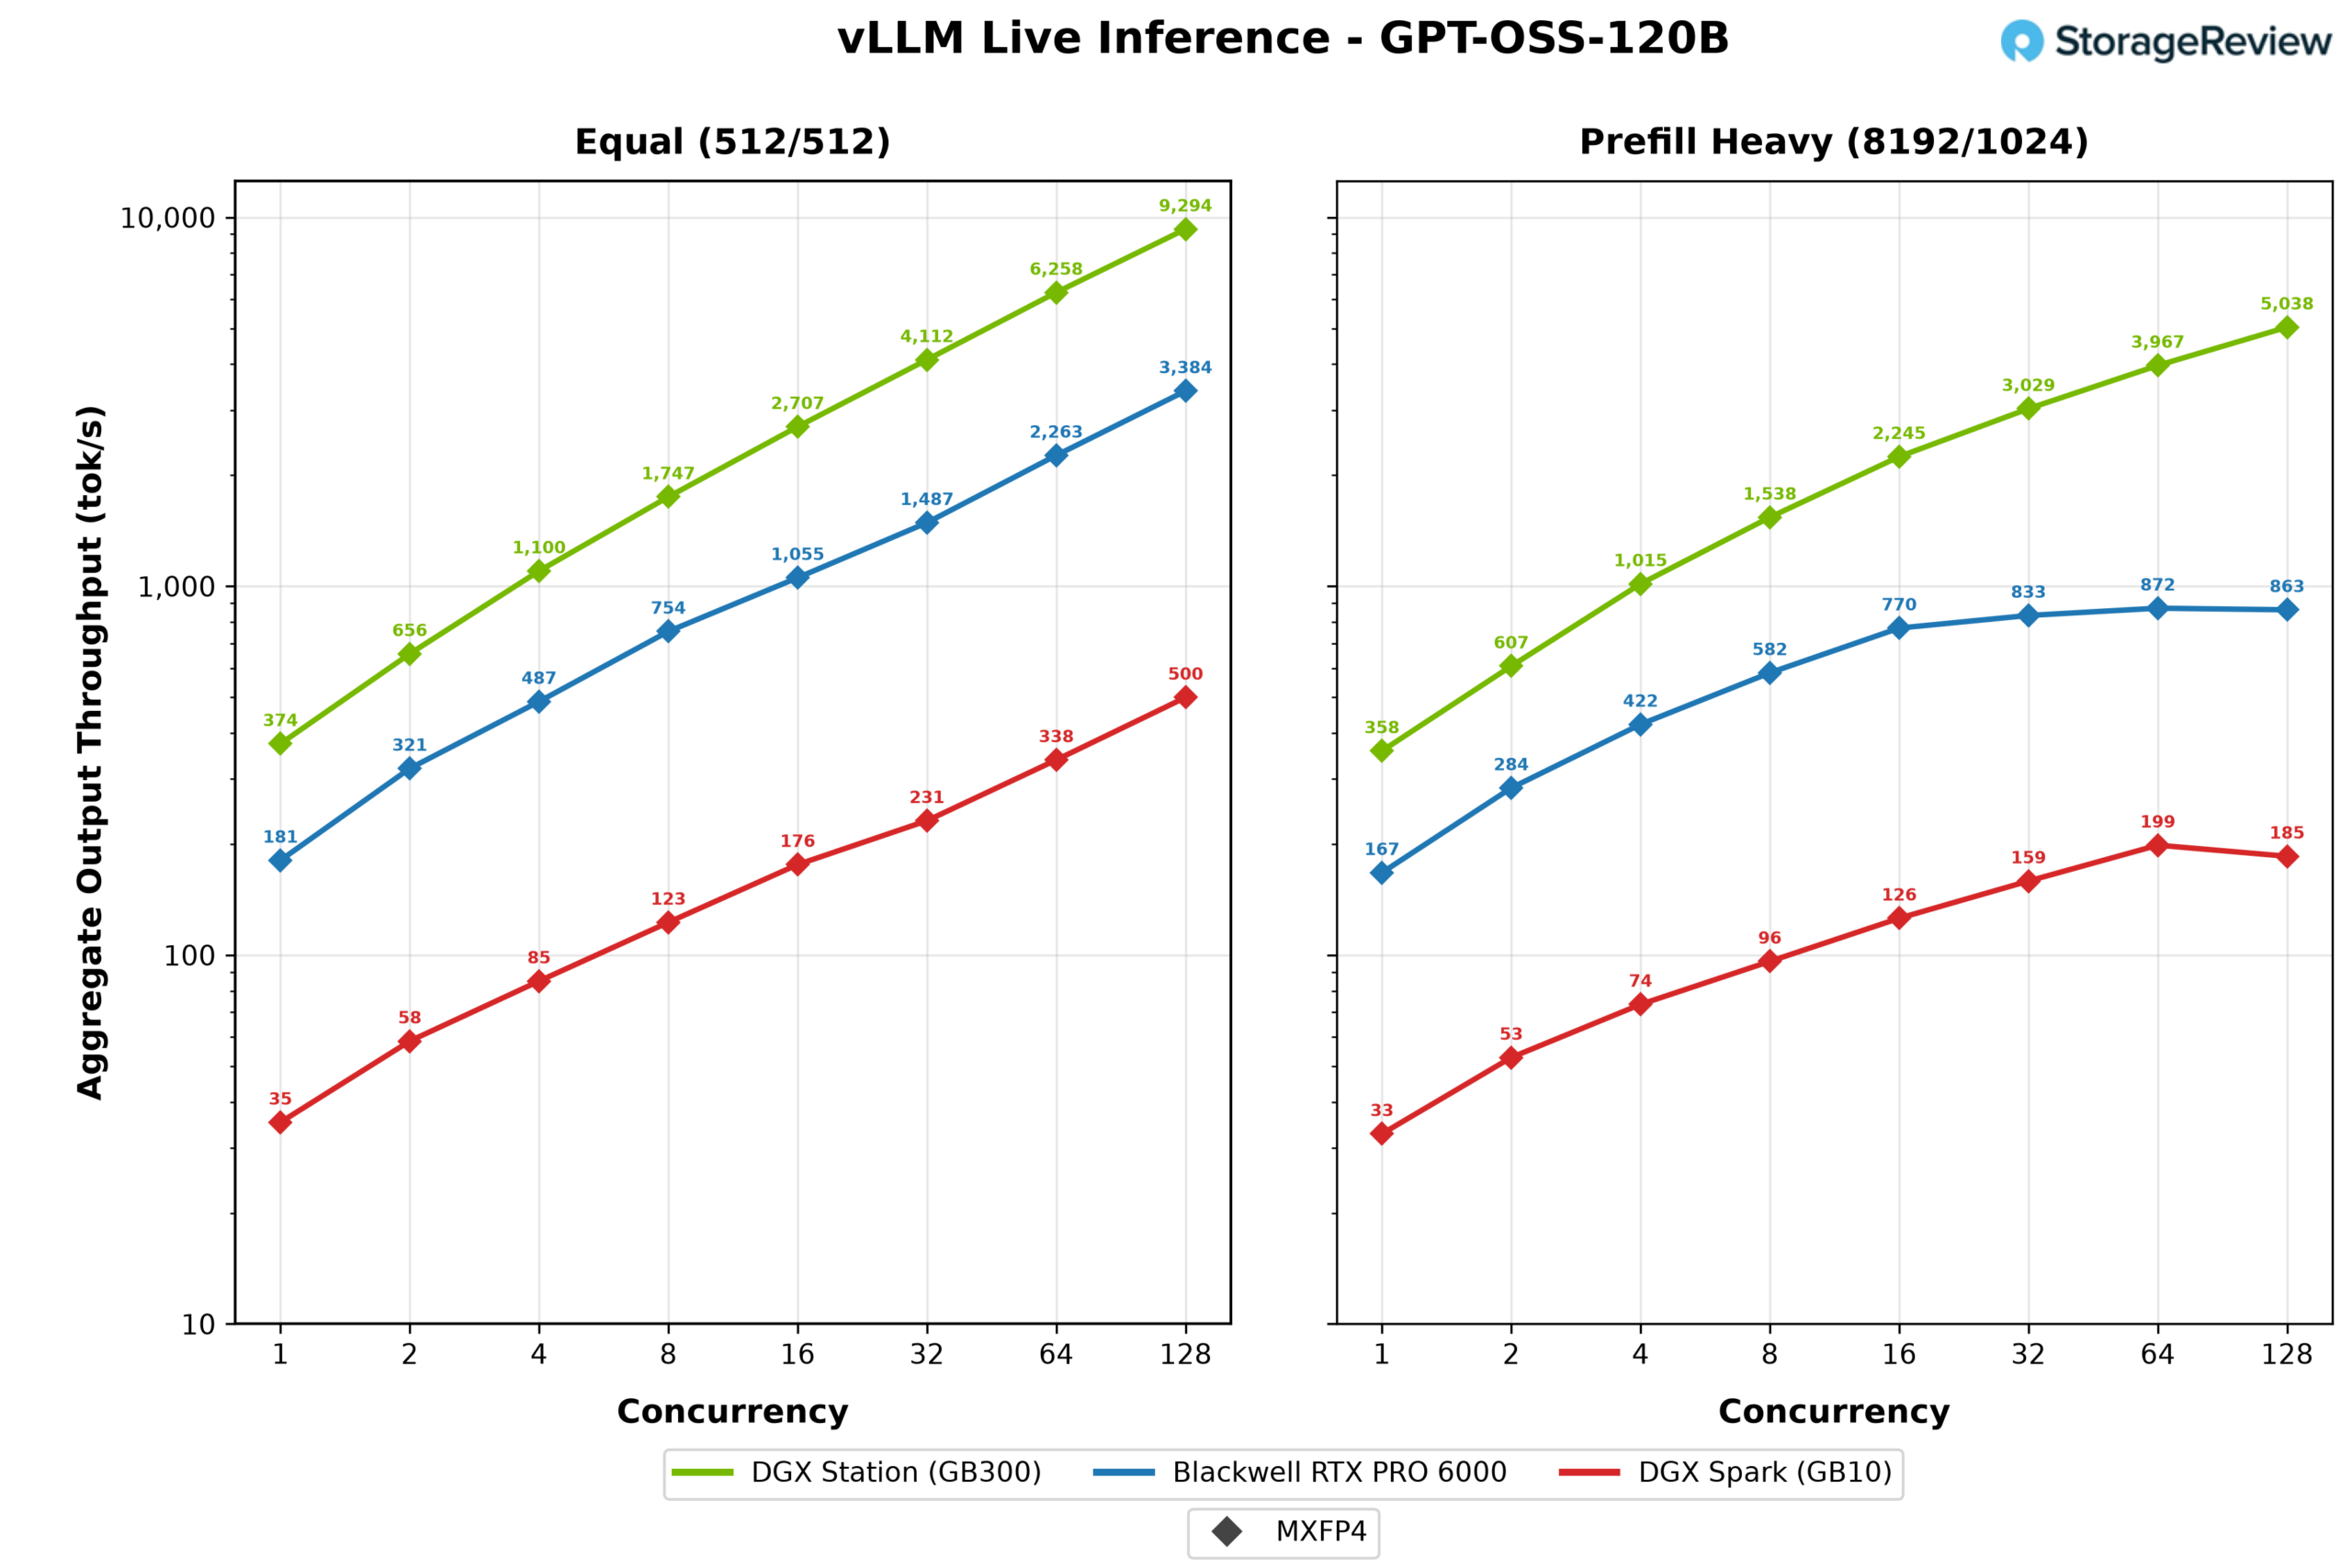
È durante le sessioni di precaricamento più intense che i sistemi più piccoli raggiungono i loro limiti. La RTX PRO 6000 si è stabilizzata a 872 token di output al secondo con 64 stream simultanei, mentre la Spark a 199, mentre la WS300 continuava a crescere con 128 stream e ha terminato con 5,038, un divario di quasi 6 volte rispetto alla scheda. I prompt lunghi riempiono la cache KV e i sistemi con meno memoria disponibile esauriscono lo spazio per il batching molto prima della Station.
Lama 3.1 8B
Llama 3.1 8B è abbastanza piccolo da poterlo eseguire a BF16, FP8 e NVFP4 su ogni sistema, il che lo rende il test più chiaro per valutare i vantaggi della quantizzazione su ciascuna macchina. Con 128 stream simultanei e lo stesso carico di lavoro, la WS300 è passata da 17,278 token di output al secondo a BF16 a 28,698 a NVFP4, con un incremento del 66%. La RTX PRO 6000 ha guadagnato il 114% dallo stesso passaggio, da 5,720 a 12,269, e la DGX Spark ha guadagnato il 143%, da 828 a 2,009. Vale la pena ricordare questo schema: più piccola è la macchina, maggiori sono i vantaggi della quantizzazione.
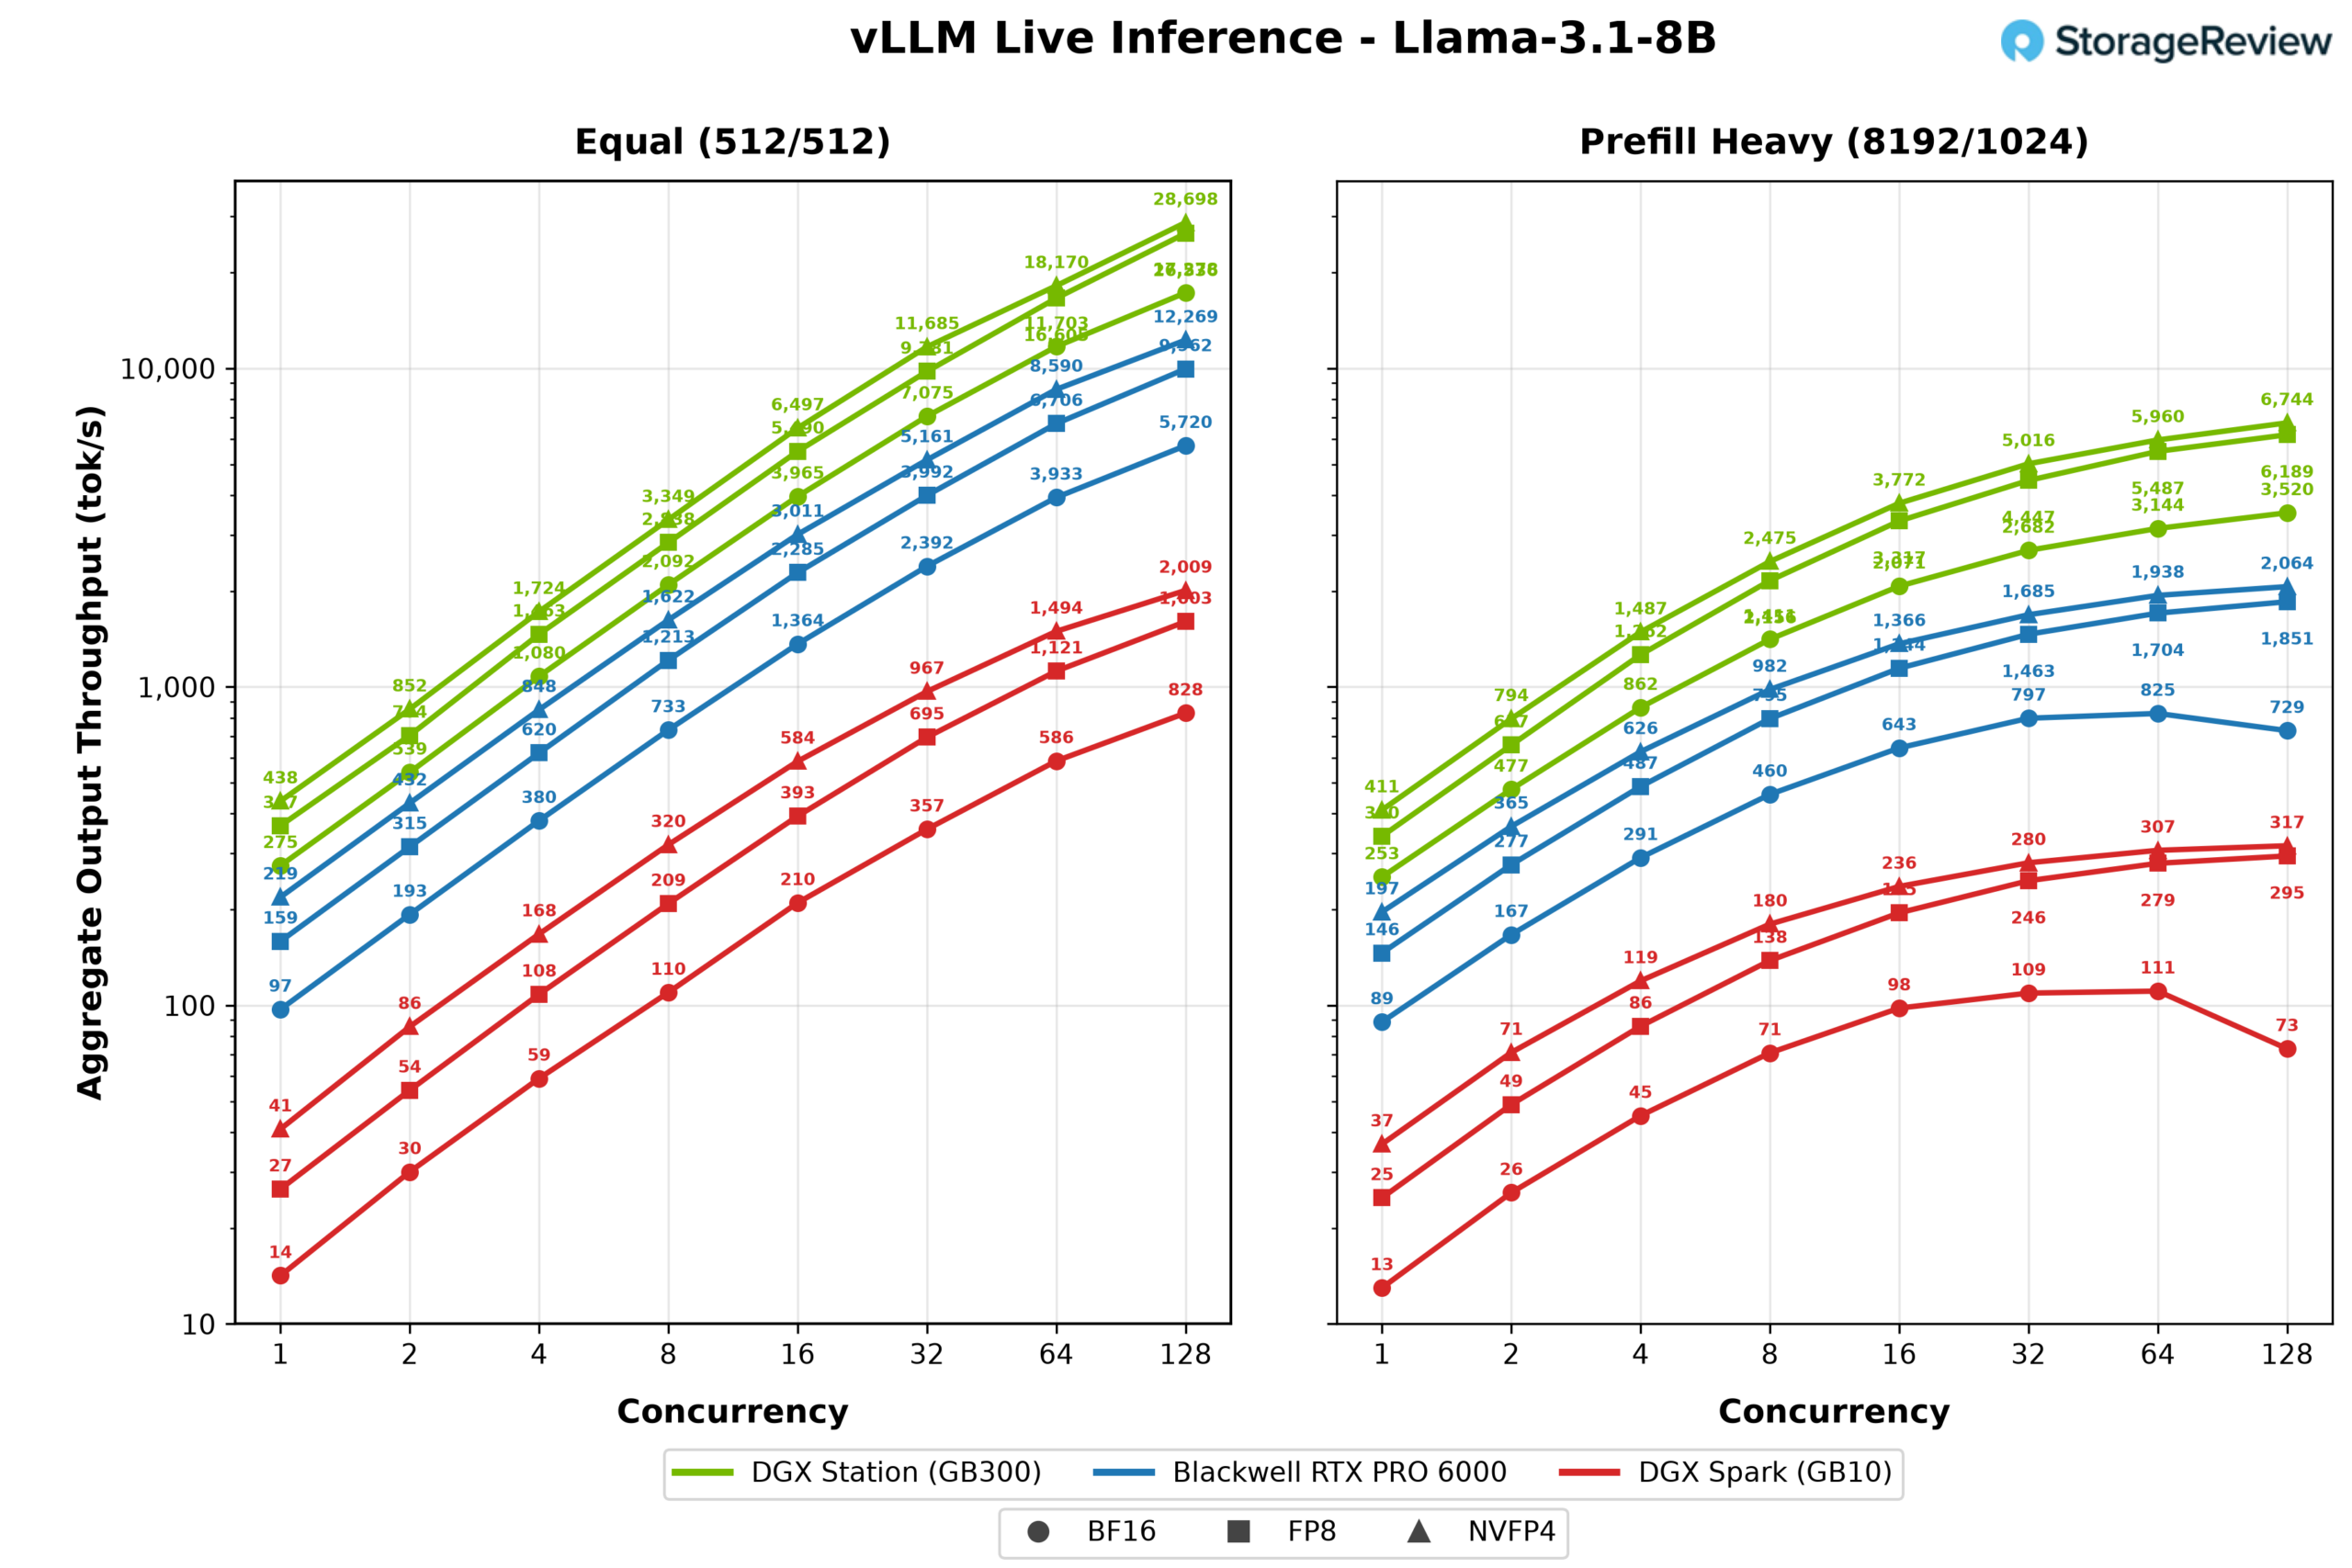
I risultati con precaricamento intensivo comprimono l'intero campo, con la corsa NVFP4 della WS300 che raggiunge un picco di 6,744 token di output al secondo contro i 2,064 della scheda e i 317 della Spark.
Mistral Piccolo 24B
Mistral Small 24B ha prodotto gli intervalli più ampi del set. A FP8 con lo stesso carico di lavoro, la WS300 ha raggiunto un picco di 11,157 token di output al secondo, tre volte la RTX PRO 6000 a 3,779 e 19 volte la DGX Spark a 585. In modalità single stream, i 169 token al secondo della Station sono molto più vicini al comfort interattivo rispetto ai 9 della Spark.
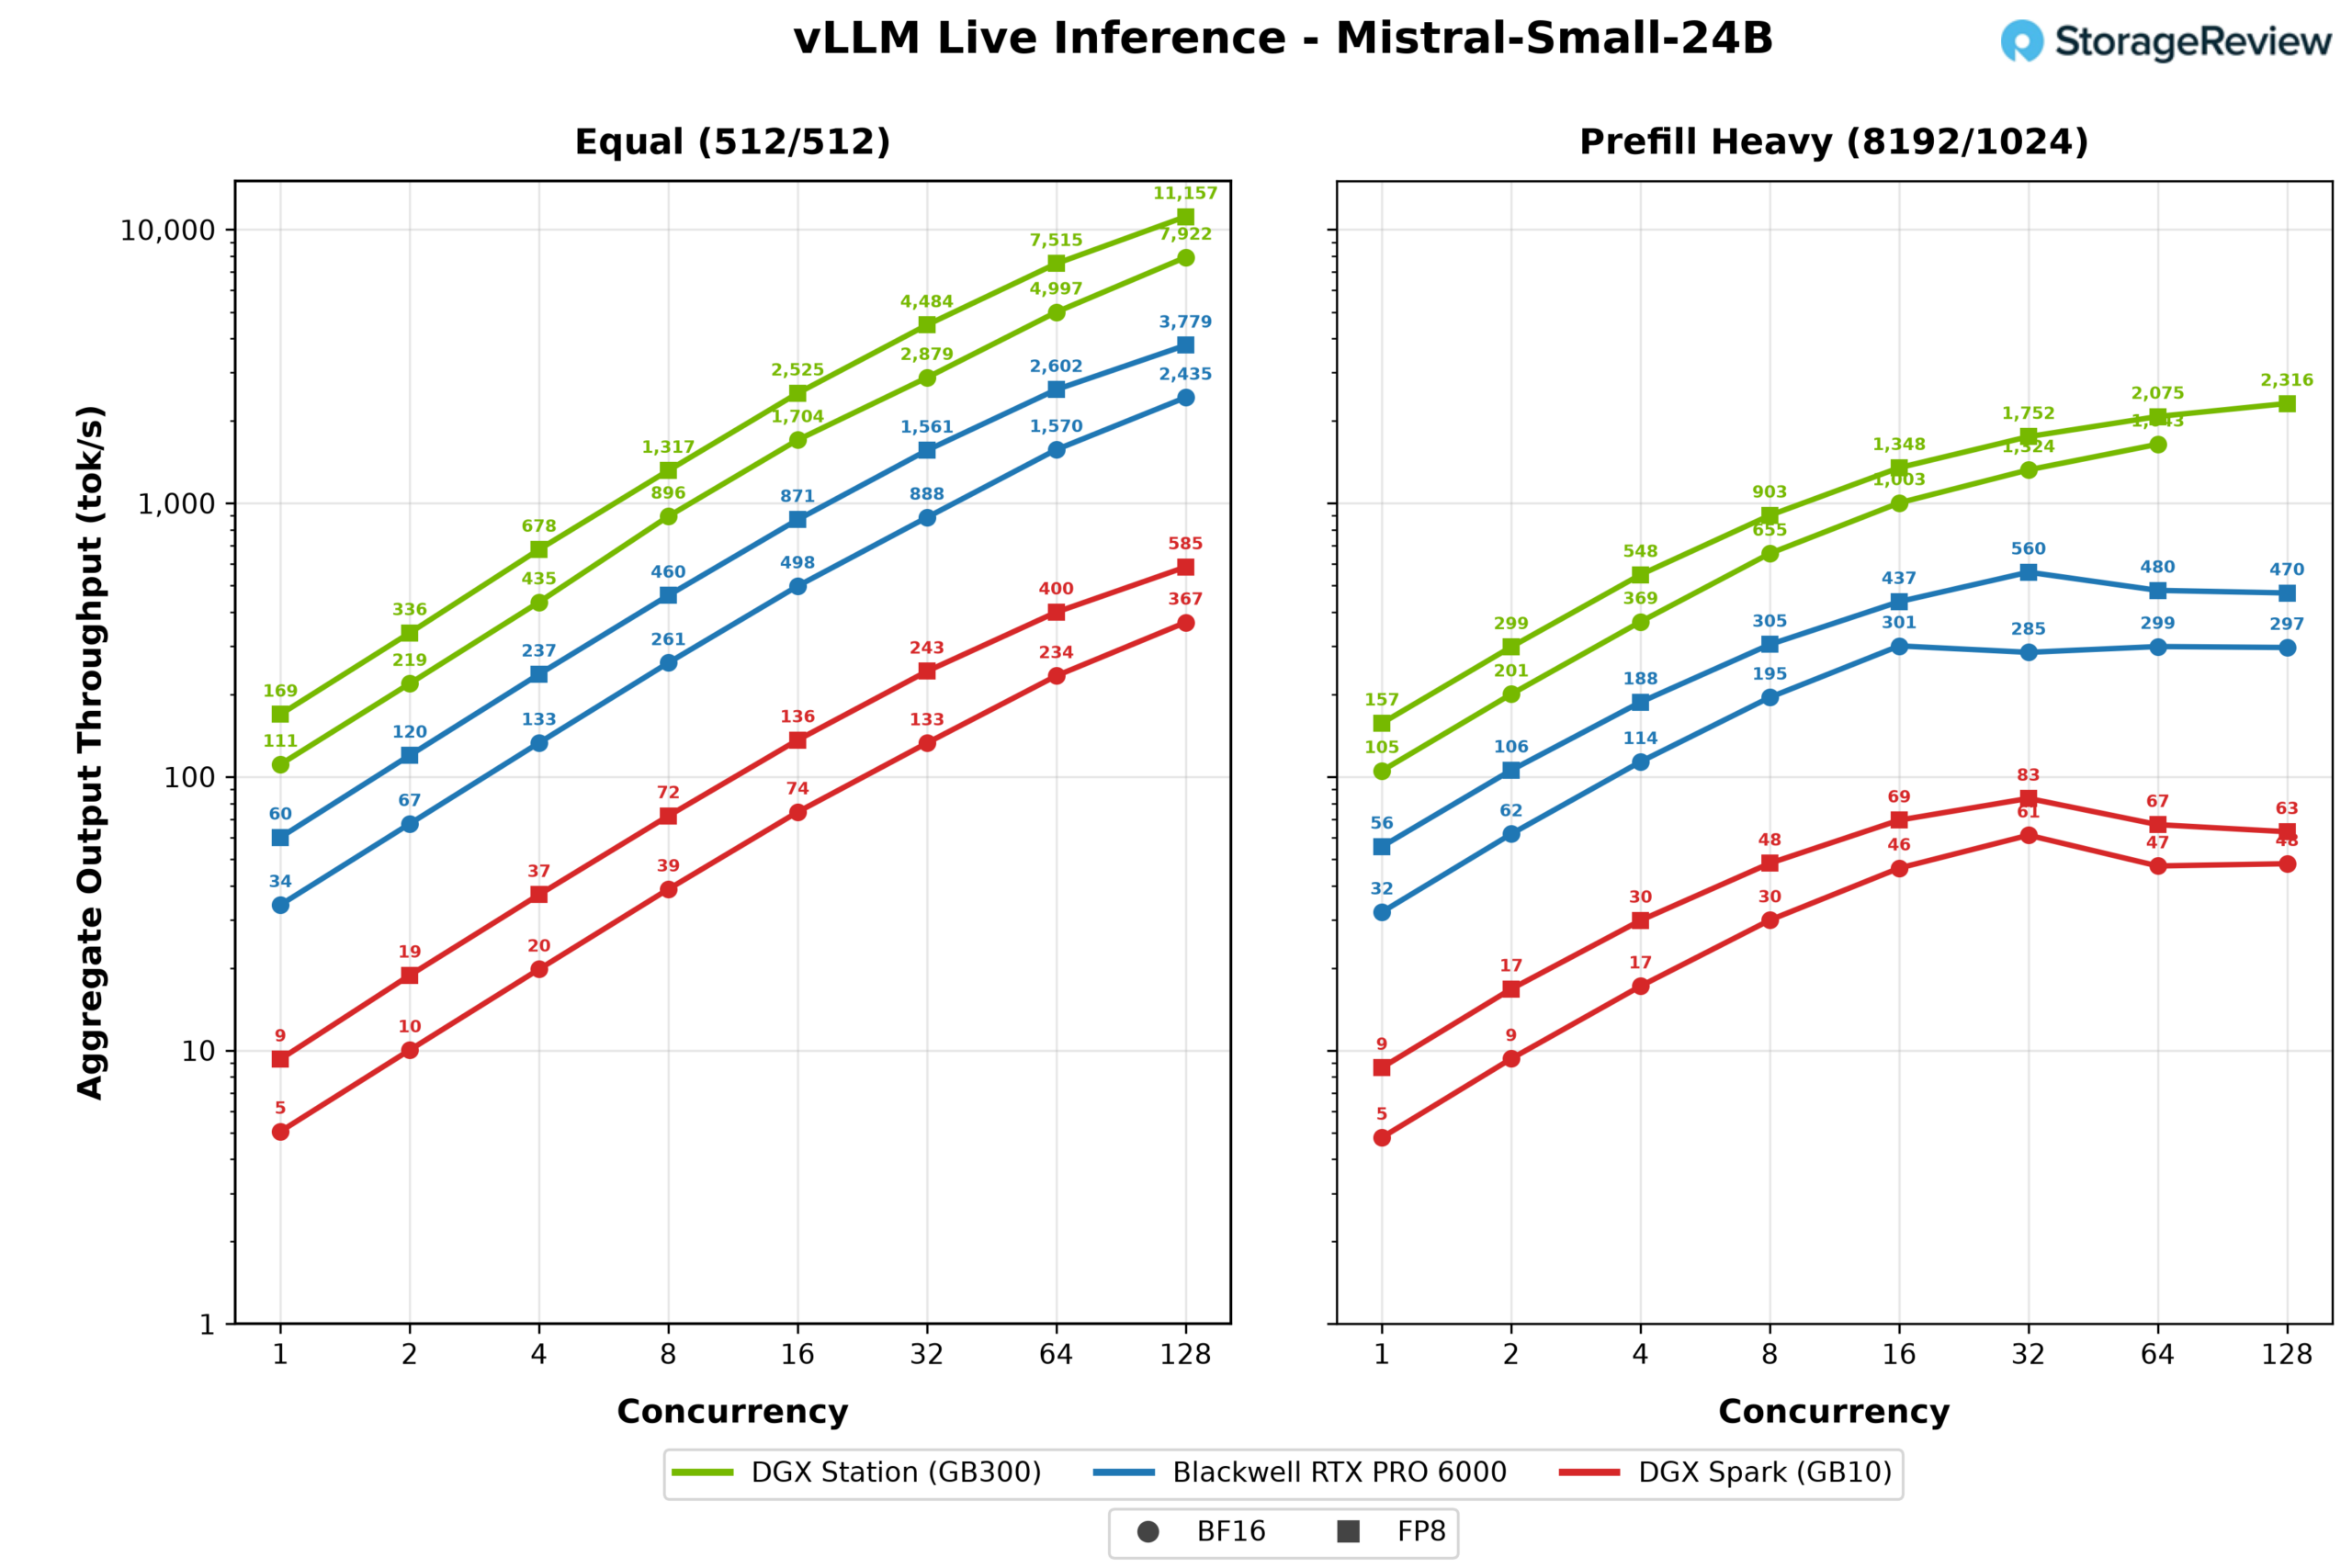
Sotto un carico di precaricamento elevato, la RTX PRO 6000 ha raggiunto un picco di soli 32 stream simultanei e 560 token di output al secondo prima di calare, mentre la WS300 ha continuato a raggiungere 2,316 con 128 stream.
Qwen3 Coder 30B
Qwen3 Coder 30B, un modello misto di esperti con un numero ridotto di parametri attivi, è l'unico test in cui i sistemi più piccoli colmano il divario nel singolo flusso. Con una singola richiesta simultanea e lo stesso carico di lavoro, la RTX PRO 6000 ha fornito 208 token di output al secondo contro i 310 della WS300, il risultato più vicino in questo confronto a quello della Station, e persino la Spark è riuscita a ottenere un valore utilizzabile di 55. L'elaborazione in batch ripristina l'ordine usuale: con 128 flussi, i 12,425 token di output al secondo della Station a FP8 sono 2.4 volte superiori a quelli della scheda e quasi 16 volte superiori a quelli della Spark.
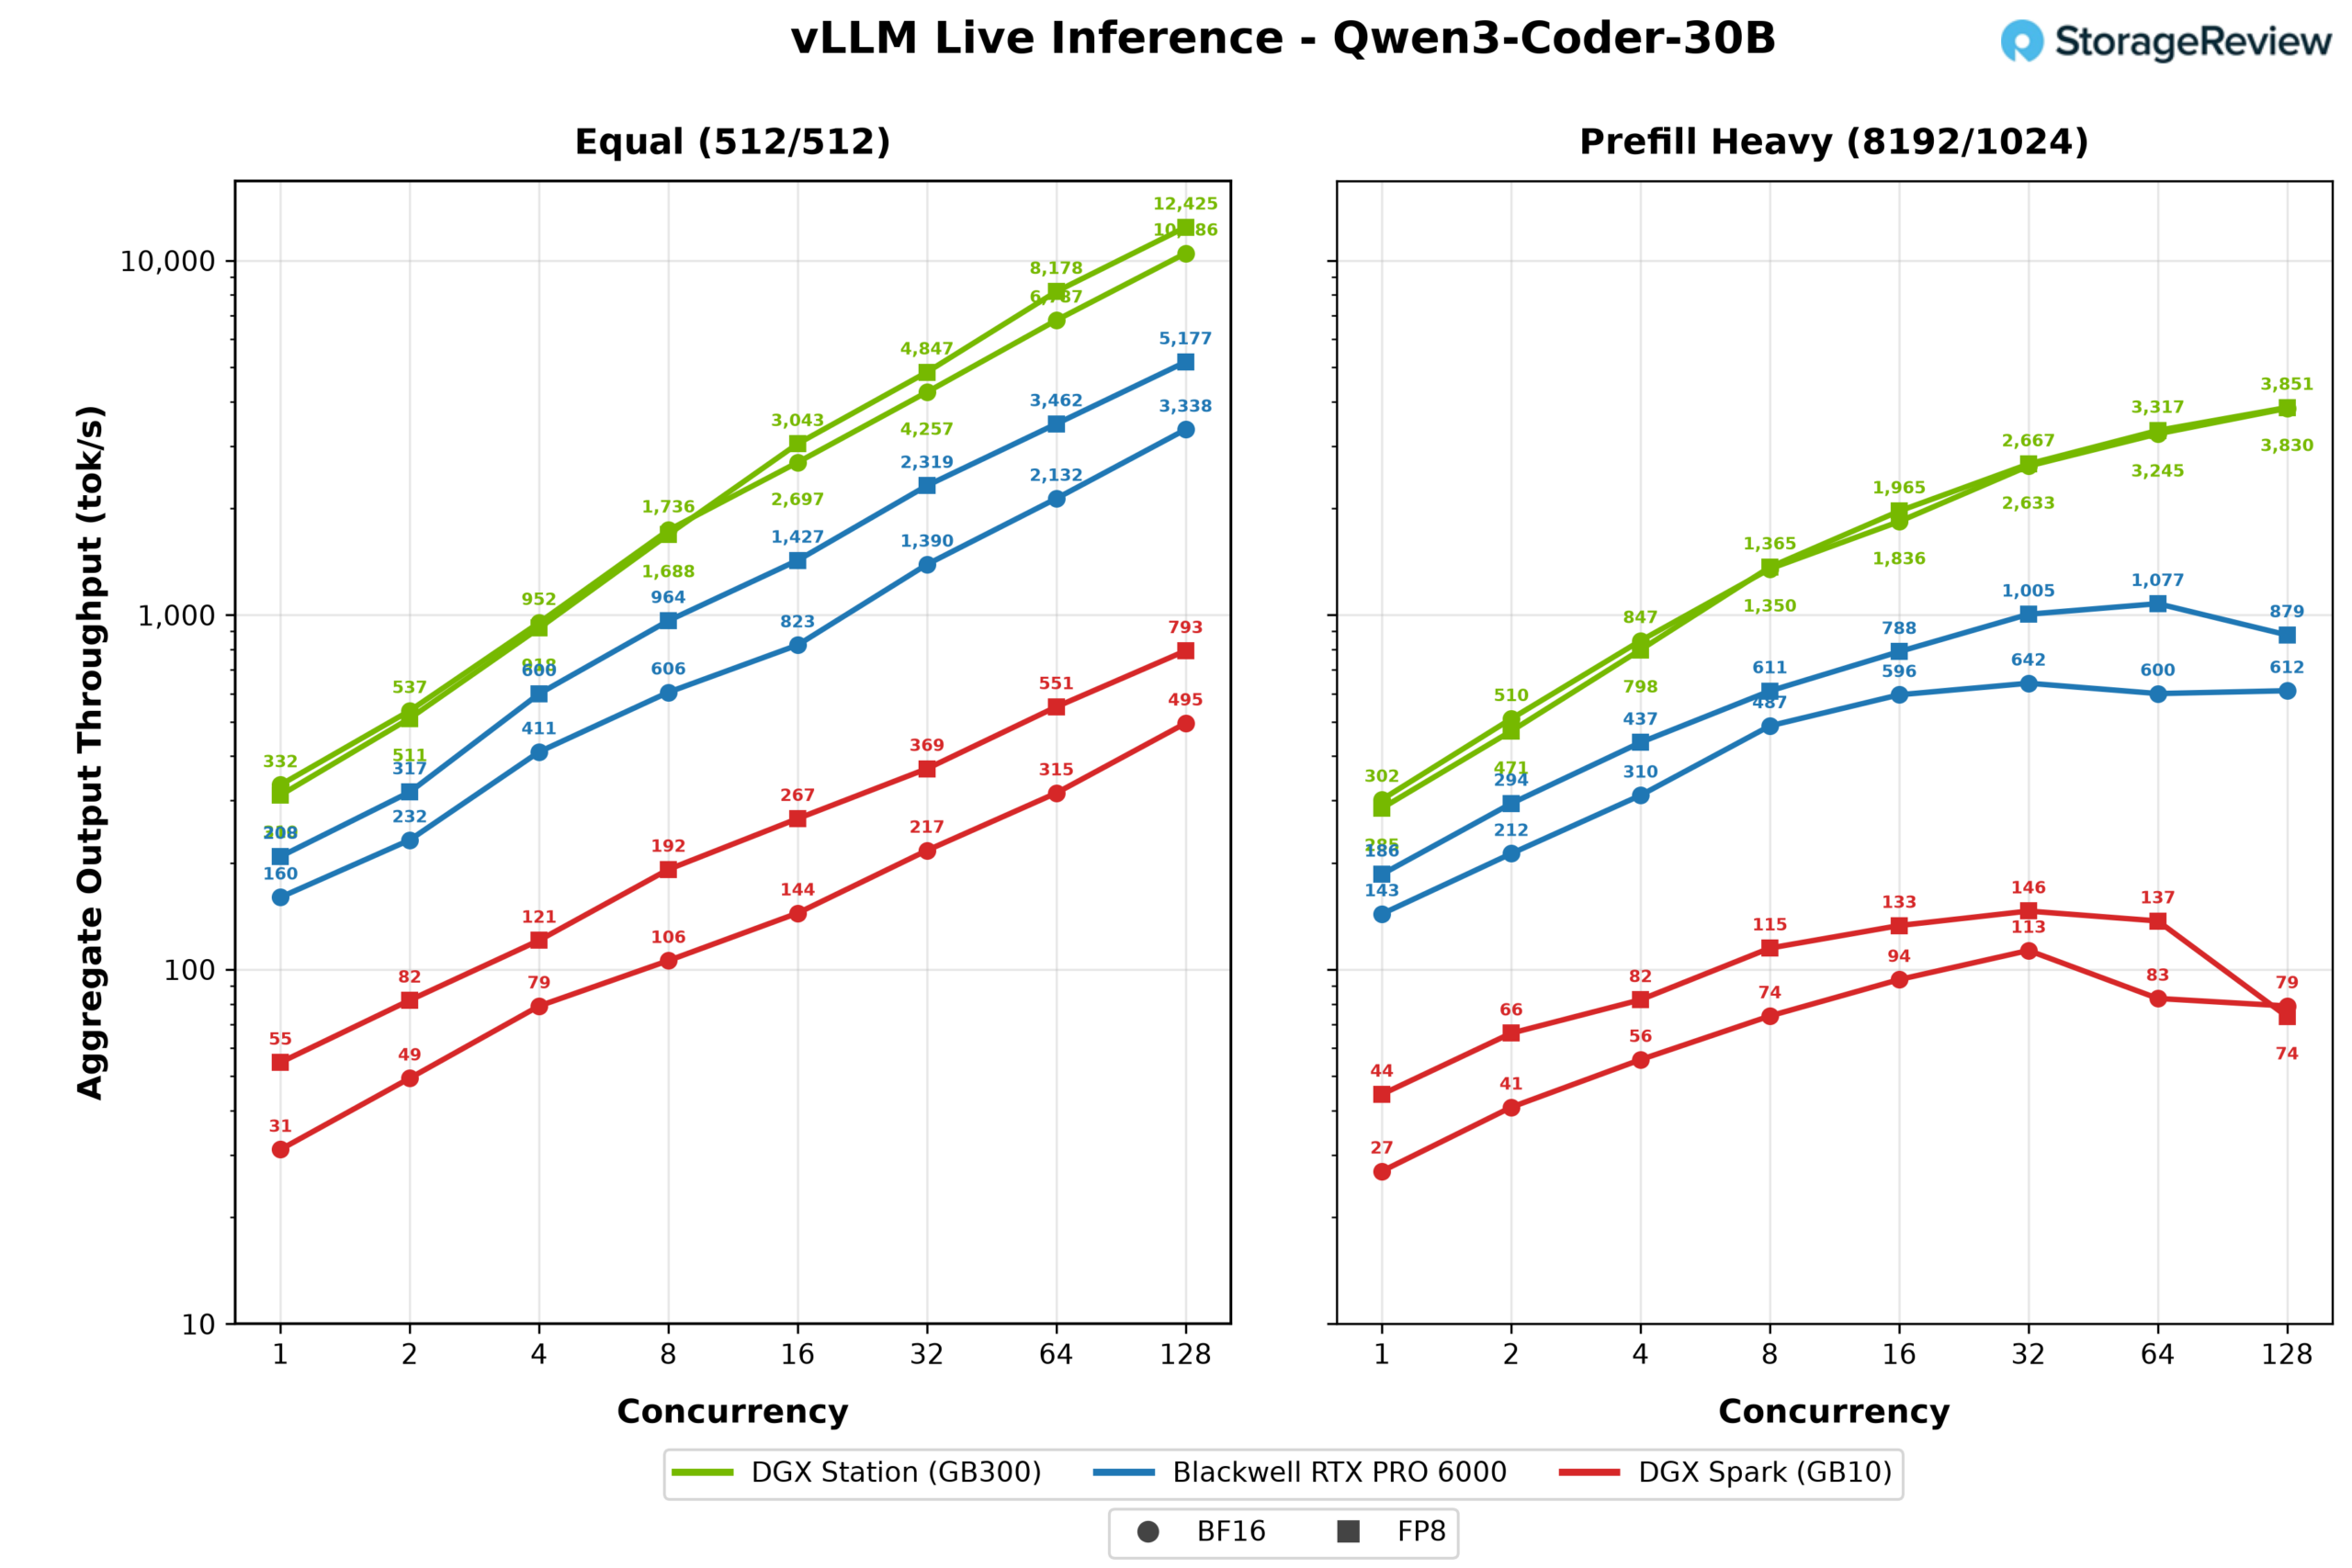
Il precaricamento intensivo ha seguito lo schema consolidato, con la WS300 che ha raggiunto 3,851 token di output al secondo, mentre la scheda ha toccato un picco di 1,077 e la Spark di 146.
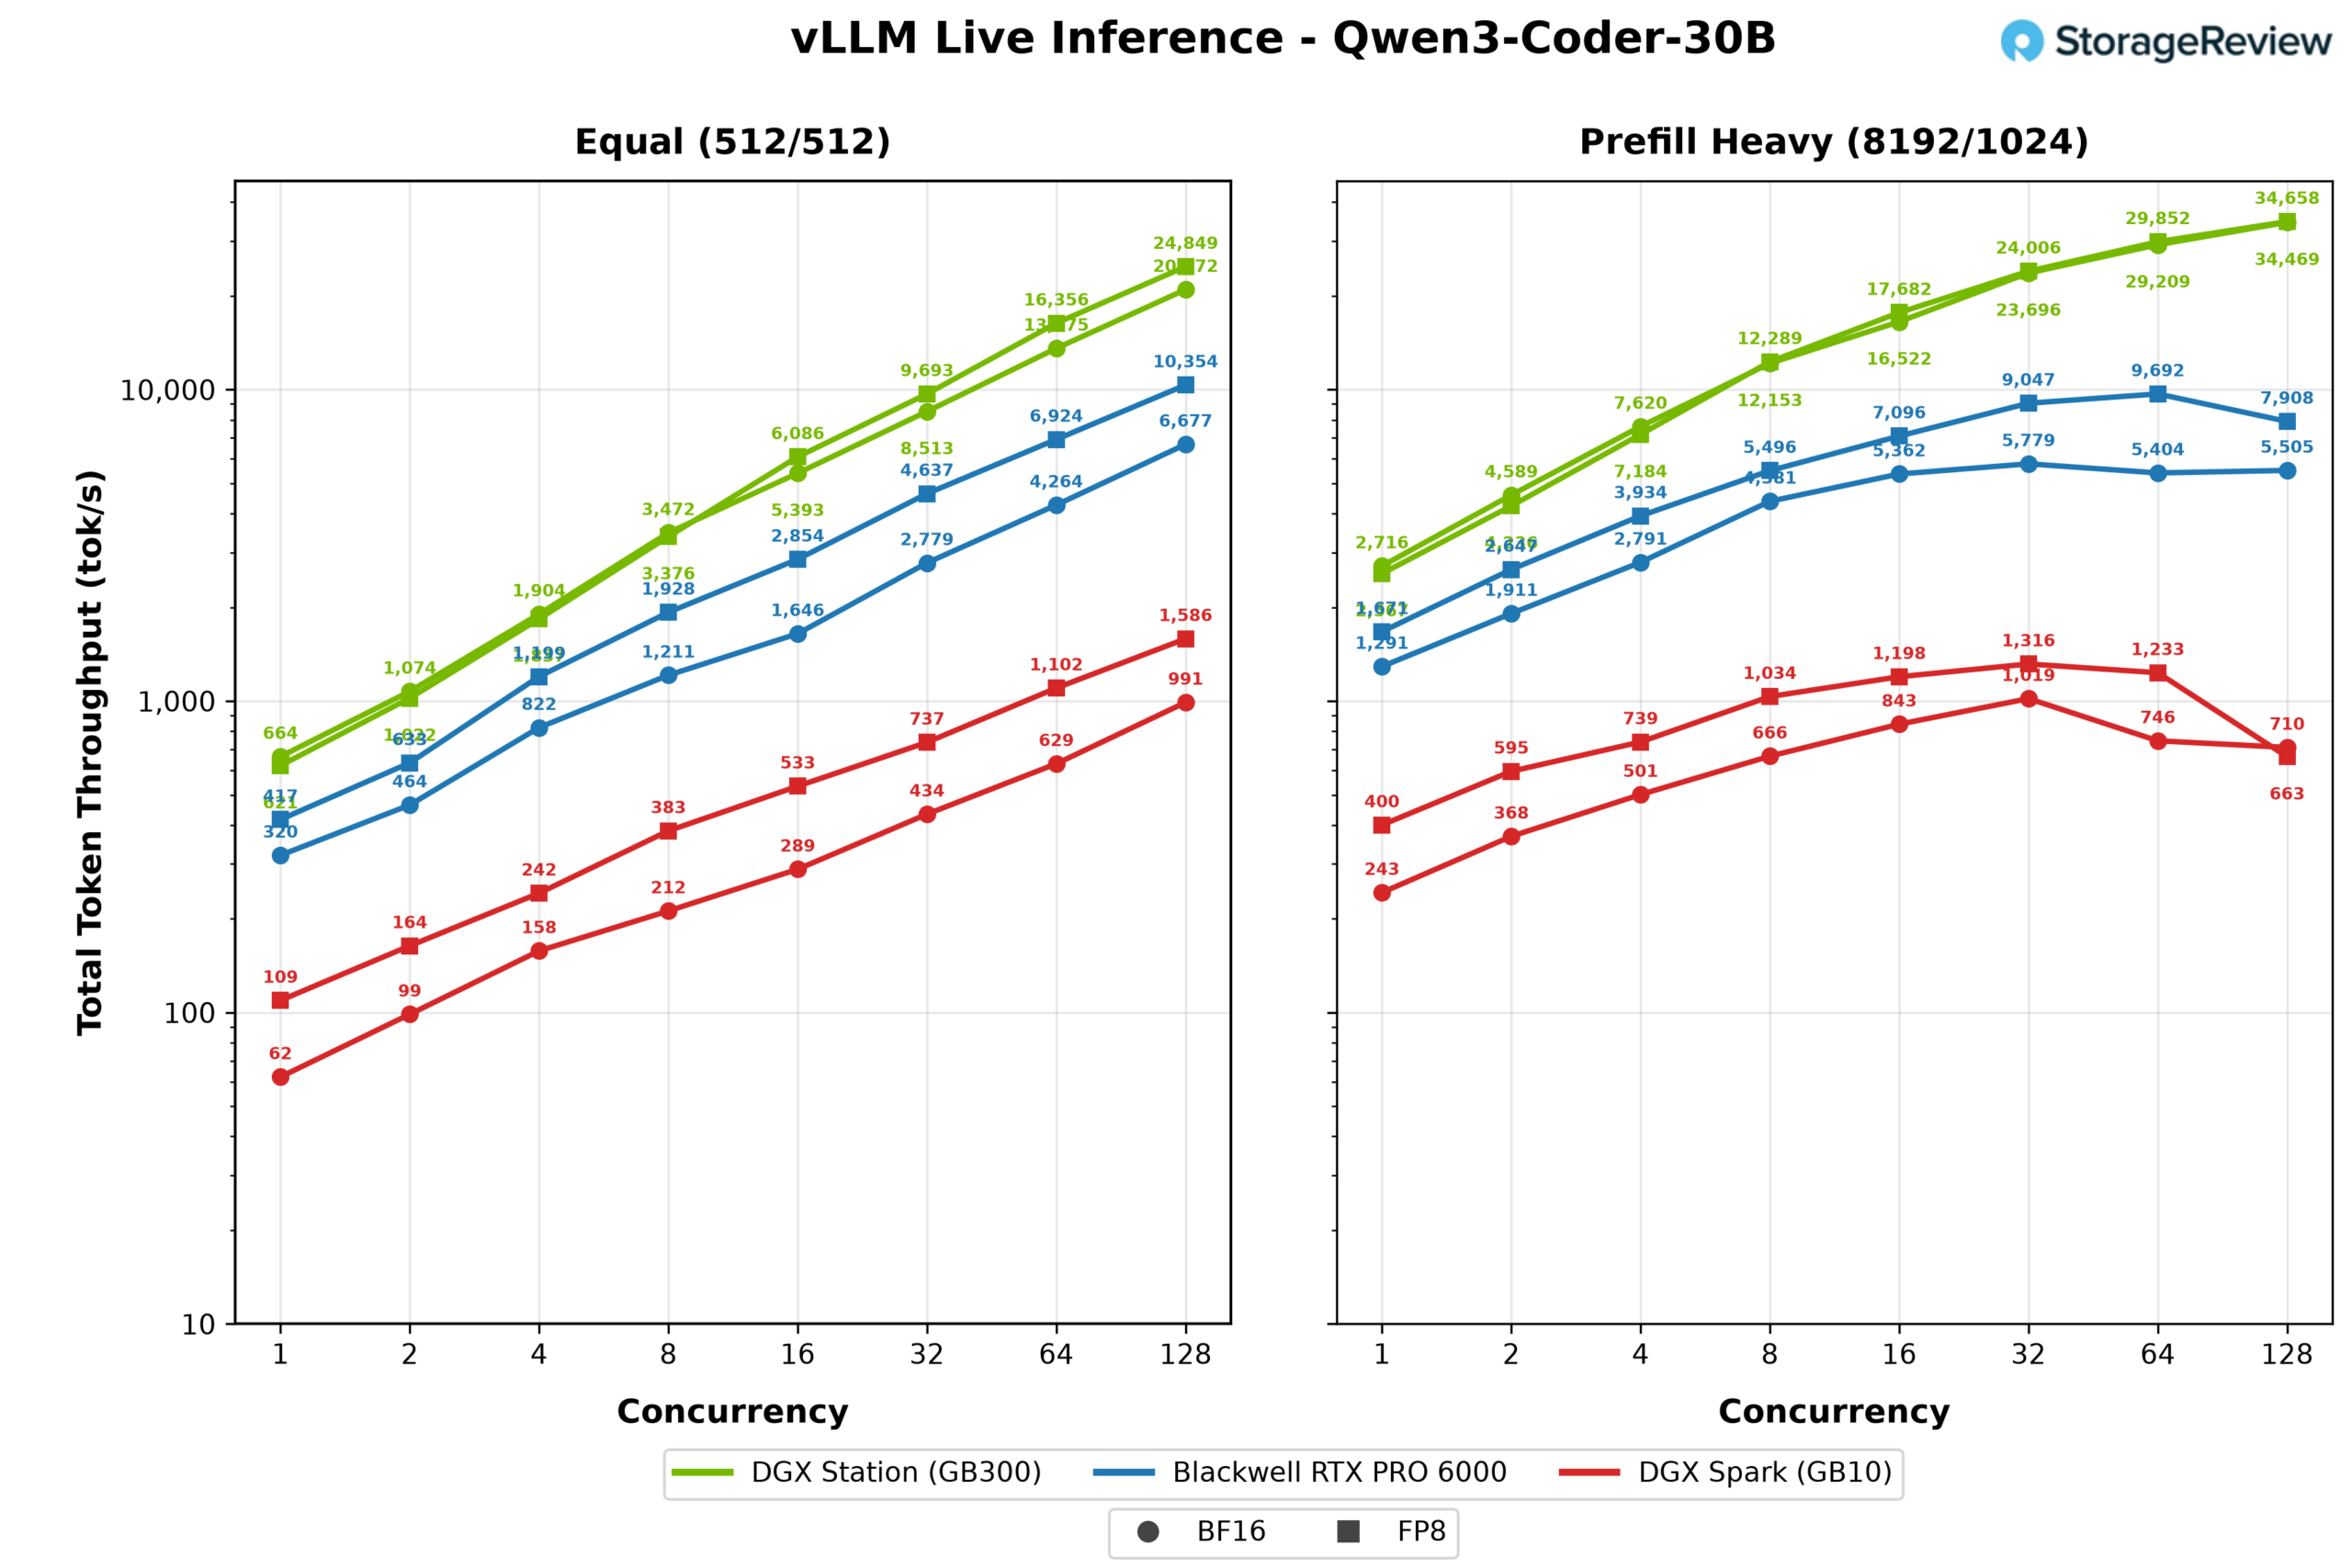
Nei cinque modelli condivisi, la WS300 ha ottenuto un throughput da 2.3 a 3 volte superiore a quello della Blackwell RTX PRO 6000 e da 14 a 19 volte superiore a quello della DGX Spark a piena concorrenza, con un margine che si allarga fino a 6 volte rispetto alla scheda quando i prompt lunghi mettono sotto stress la cache KV. Tutte e tre le macchine utilizzano lo stesso stack CUDA e gli stessi percorsi di quantizzazione; ciò che la Station acquista è la capacità di memoria e la larghezza di banda, che si traducono qui in margine di concorrenza e tolleranza al contesto lungo. Altrettanto importante è ciò che questi grafici non possono mostrare: nessuno dei modelli di frontiera su scala reale nelle sezioni precedenti si carica nemmeno sugli altri due sistemi.
GDSIO
I moderni carichi di lavoro di intelligenza artificiale dipendono dal trasferimento di batch di dati, pesi dei modelli e checkpoint dalla memoria di archiviazione alla memoria GPU con una velocità sufficiente a mantenere l'acceleratore occupato. NVIDIA GPUDirect Storage elimina il tradizionale percorso a doppia copia, in cui i dati vengono prima letti da un'unità SSD nella memoria di sistema e poi copiati nella memoria della GPU.
La GB300 DGX Station implementa questa funzionalità in modo diverso rispetto a un server GPU PCIe convenzionale. L'SSD Micron 4600 utilizzato per il nostro test è collegato allo switch PCIe integrato in ConnectX-8. ConnectX-8 si connette a monte alla CPU Grace, mentre la GPU B300 si connette a Grace tramite NVLink-C2C. L'SSD e la GPU non si trovano sotto lo stesso switch PCIe. Il traffico di storage passa invece attraverso lo switch ConnectX-8, entra nel root complex PCIe di Grace, attraversa la struttura di coerenza di Grace e passa attraverso NVLink-C2C per raggiungere la memoria HBM3e della B300.
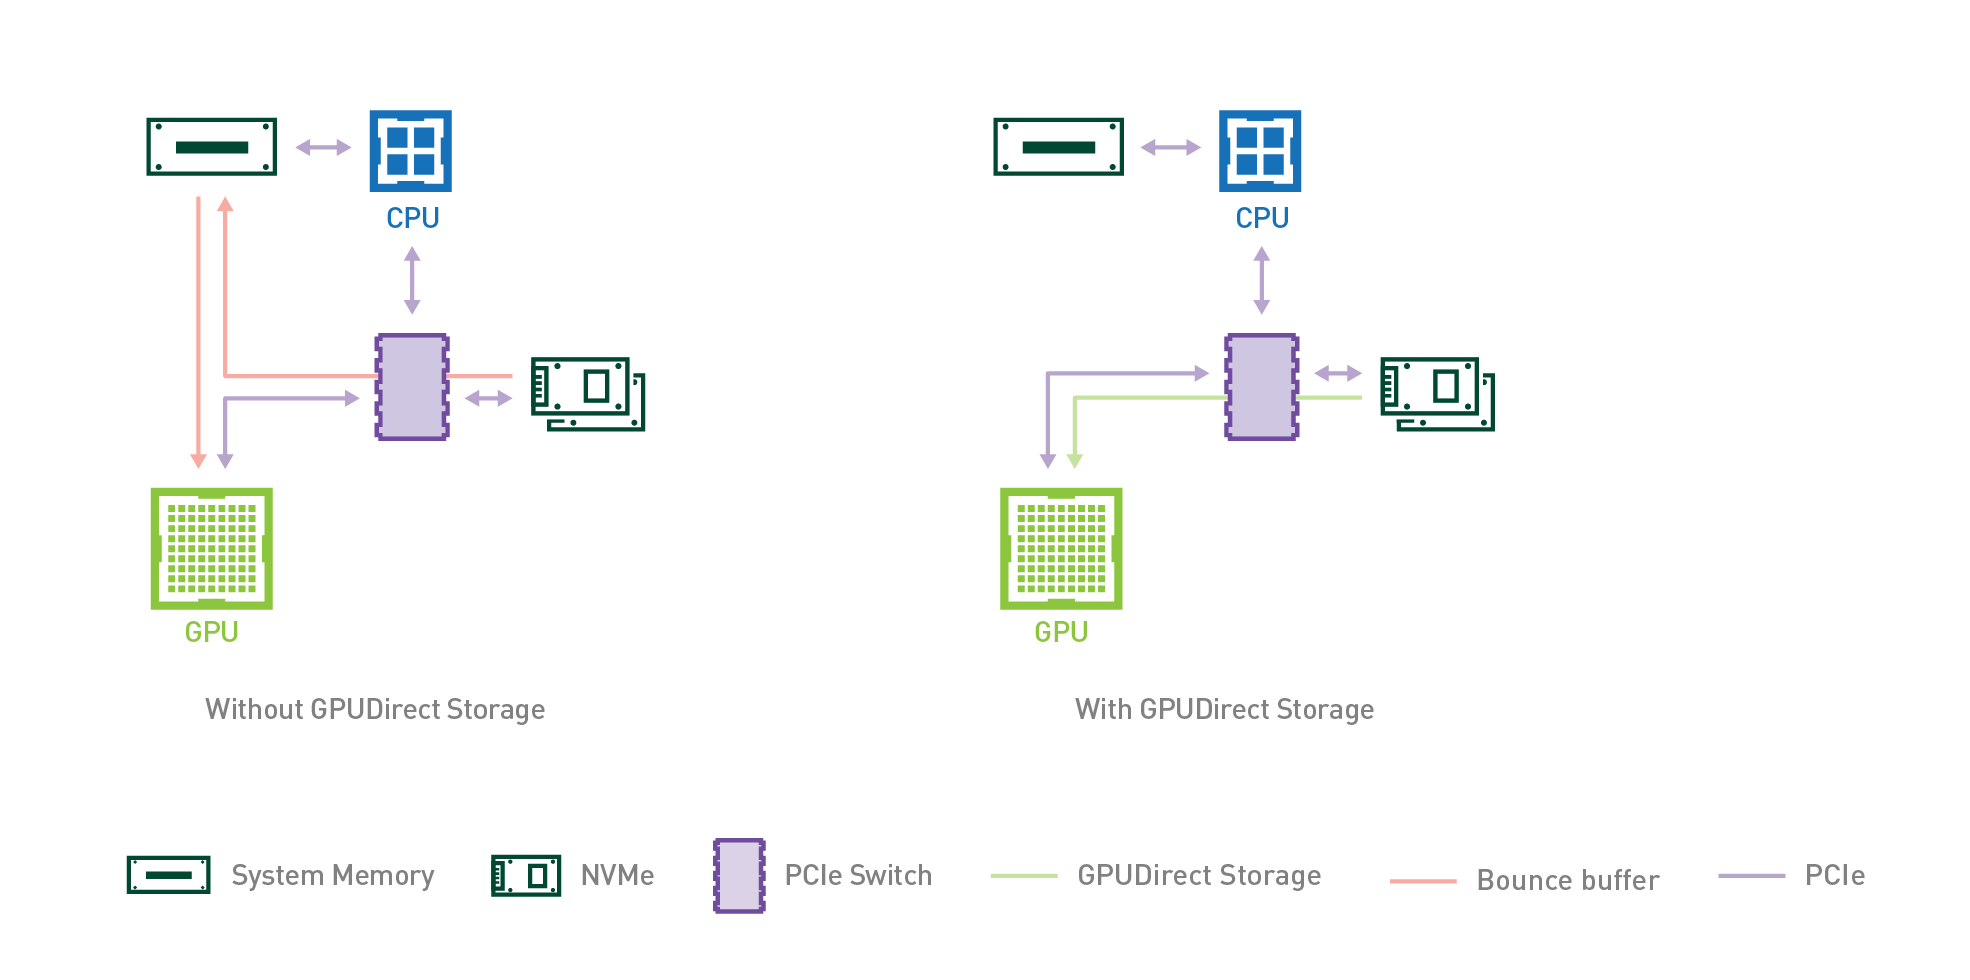
Con GPUDirect Storage, cuFile registra un buffer allocato in HBM3e B300 come origine o destinazione per l'I/O di archiviazione. In lettura, il controller del Micron 4600 utilizza il DMA per posizionare i dati in HBM3e; in scrittura, recupera i dati da HBM3e. Entrambe le operazioni seguono il percorso Grace e NVLink-C2C descritto in precedenza, senza memorizzare temporaneamente il payload nella memoria LPDDR5X di Grace. Grace gestisce comunque il filesystem e il piano di controllo NVMe, inclusi l'invio dei comandi e la traduzione degli indirizzi, ma non copia i dati. GPUDirect Storage elimina quindi la fase di memorizzazione temporanea nella memoria di sistema, anche se il traffico passa comunque attraverso Grace nel suo percorso tra l'SSD e la memoria B300. Per i carichi di lavoro di intelligenza artificiale, le letture sequenziali corrispondono allo streaming del dataset, al caricamento del modello e al ripristino dei checkpoint, mentre le scritture sequenziali corrispondono al salvataggio dei checkpoint e ad altri trasferimenti verso l'archiviazione. Per testare le prestazioni di GDSIO, abbiamo misurato le prestazioni di archiviazione utilizzando un SSD secondario autonomo.
Configurazione di test GDSIO
- Spazio di avvio: 2 x Micron 4600 da 2 TB in RAID1
- Memoria secondaria: 2 x Micron 4600 2TB
Analizzando le prestazioni di lettura sequenziale GDSIO, l'unità scala in modo coerente sia con il numero di thread che con la dimensione del blocco. A 16 KB, il throughput aumenta da 16 MiB/s con 1 thread a 250 MiB/s con 16 thread, raggiungendo 2.0 GiB/s con 128 thread. Dimensioni di blocco maggiori aumentano molto più rapidamente, con 256 KB che raggiungono 11.8 GiB/s con 64 thread e un picco di 12.9 GiB/s con 128 thread. I risultati migliori si ottengono con 512 KB e 1 MB, dove il throughput raggiunge un massimo di 13.1 GiB/s, con il carico di lavoro da 1 MB che raggiunge tale livello con soli 32 thread e lo mantiene fino a 128 thread.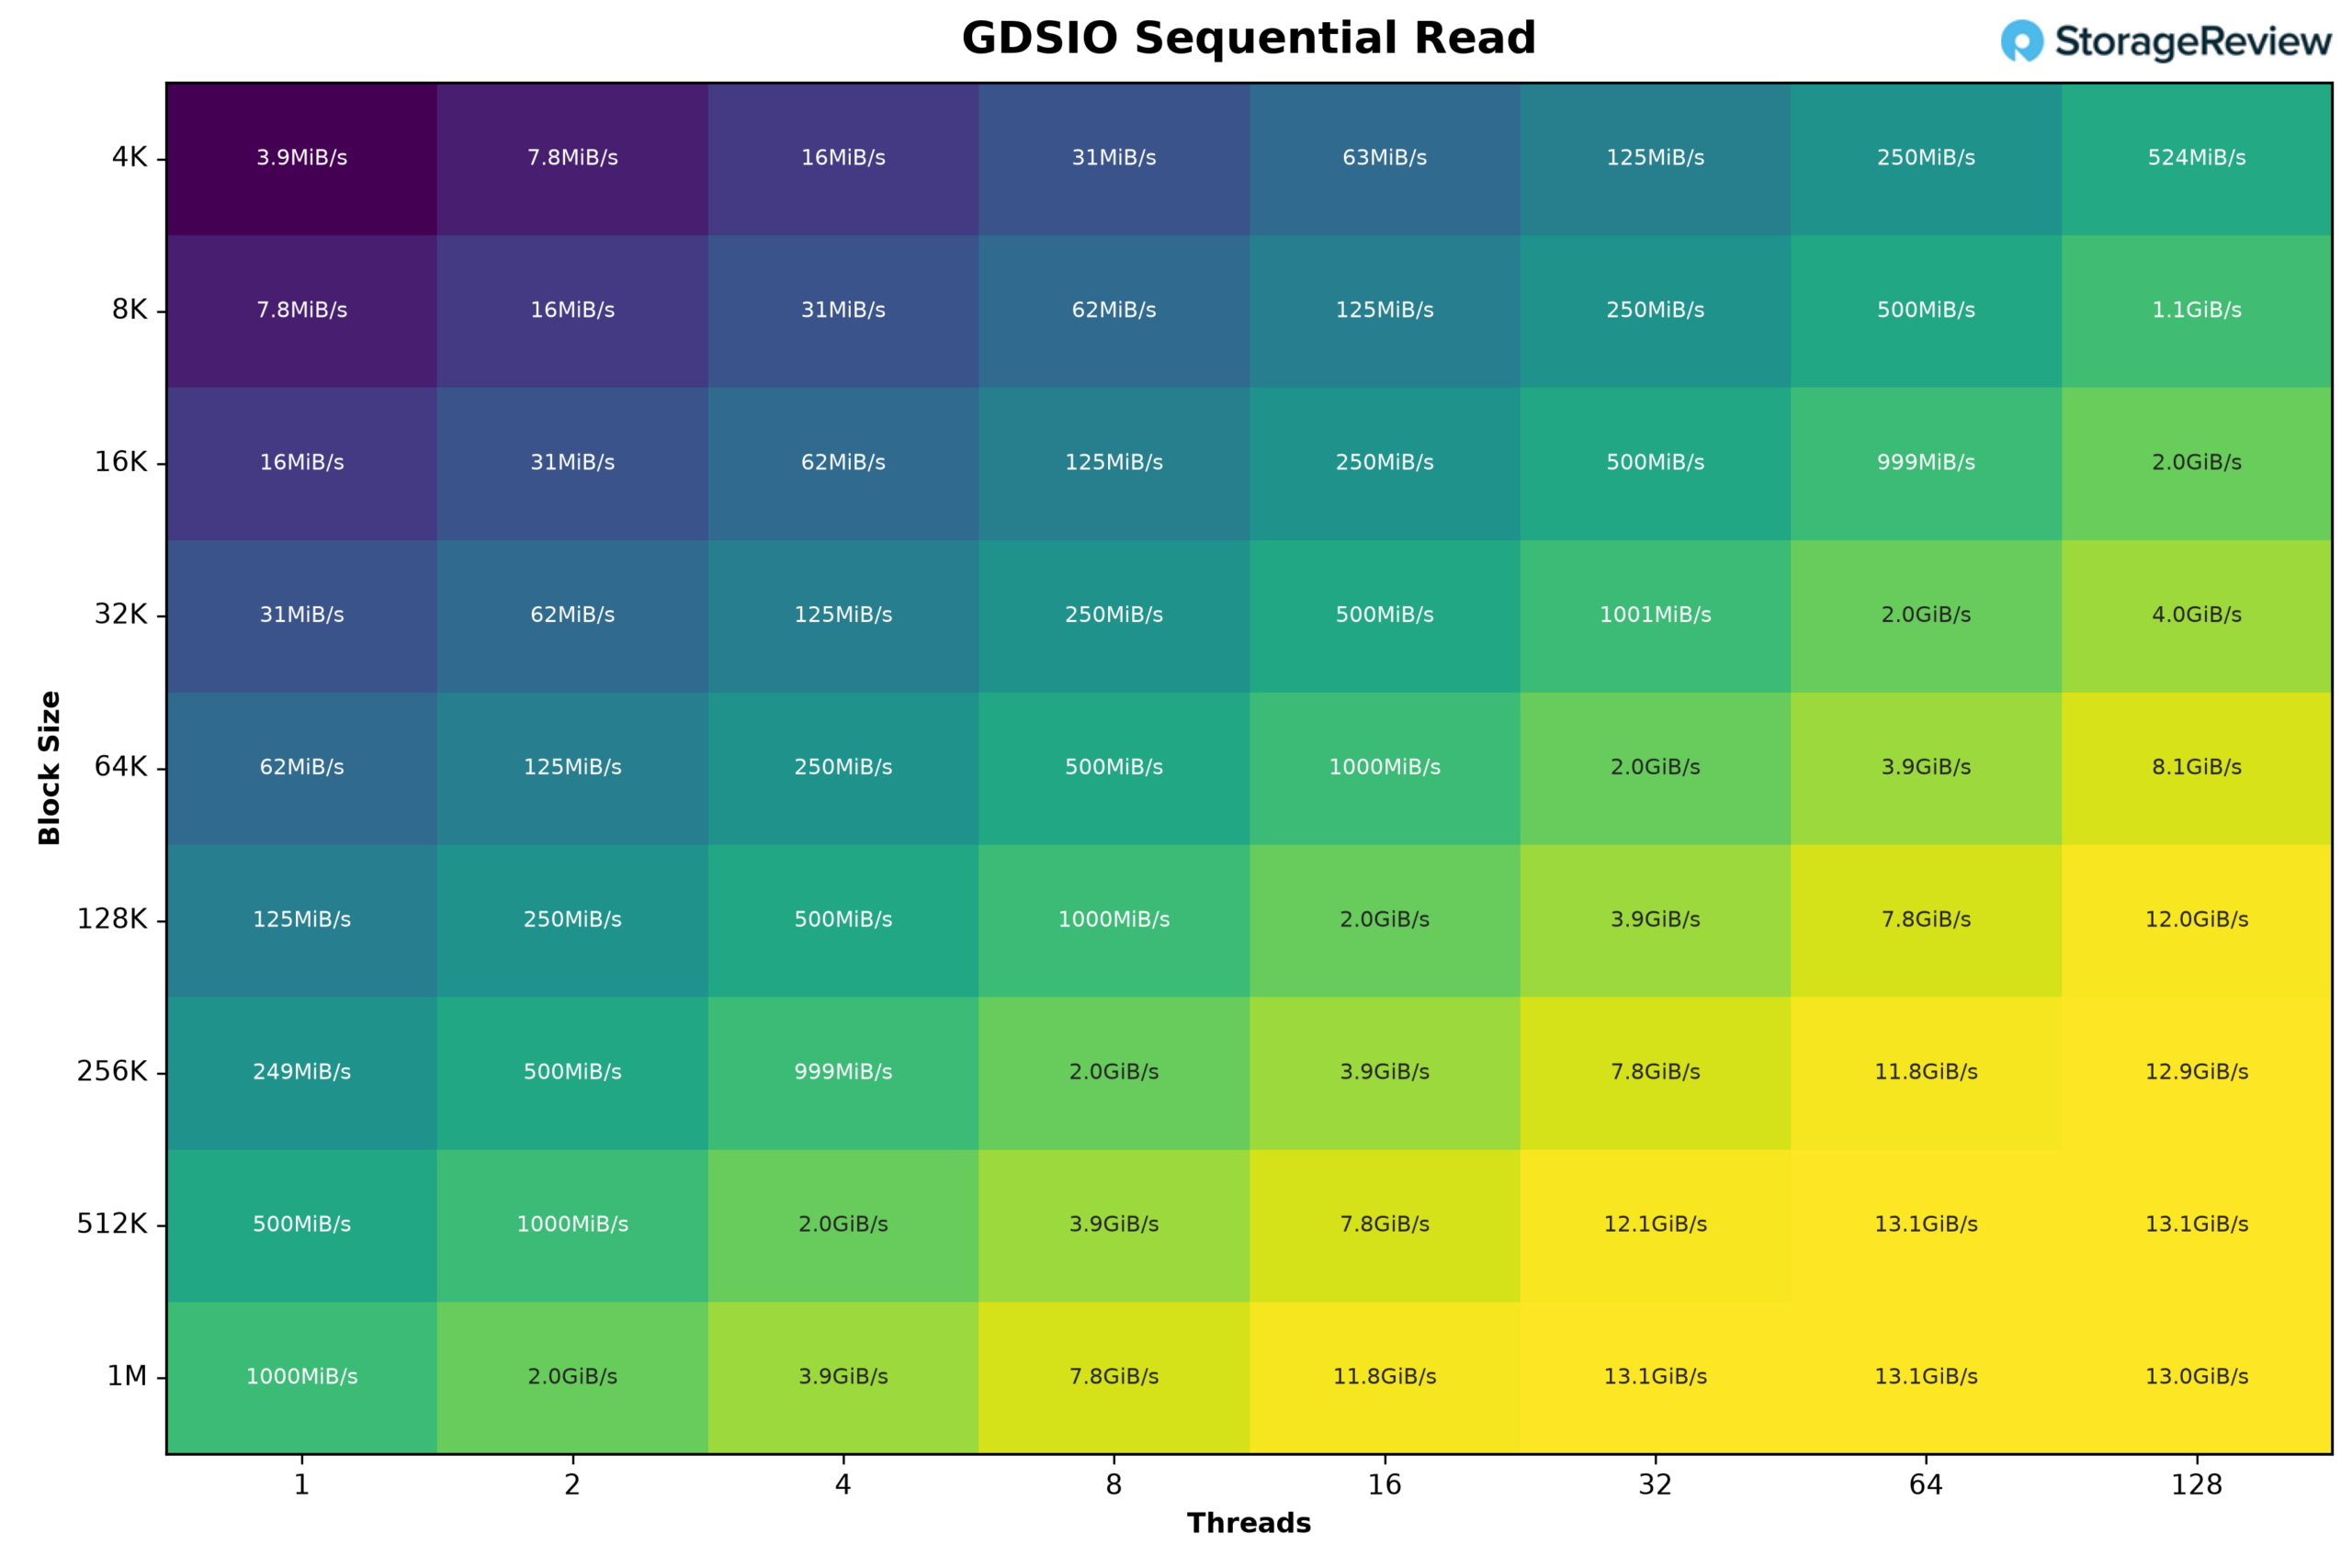
Passando alle prestazioni di scrittura sequenziale GDSIO, l'unità scala in modo coerente sia con il numero di thread che con la dimensione del blocco. A 16 KB, la velocità di trasmissione aumenta da 16 MiB/s con 1 thread a 250 MiB/s con 16 thread, raggiungendo 2.0 GiB/s con 128 thread. Dimensioni di blocco maggiori aumentano molto più rapidamente, con 256 KB che raggiungono 7.5 GiB/s con 32 thread e 12.0 GiB/s con 64 thread. Il risultato migliore si ottiene con il carico di lavoro da 1 MB, che raggiunge il limite massimo di 12.0 GiB/s con soli 16 thread e mantiene tale prestazione fino a 128 thread. 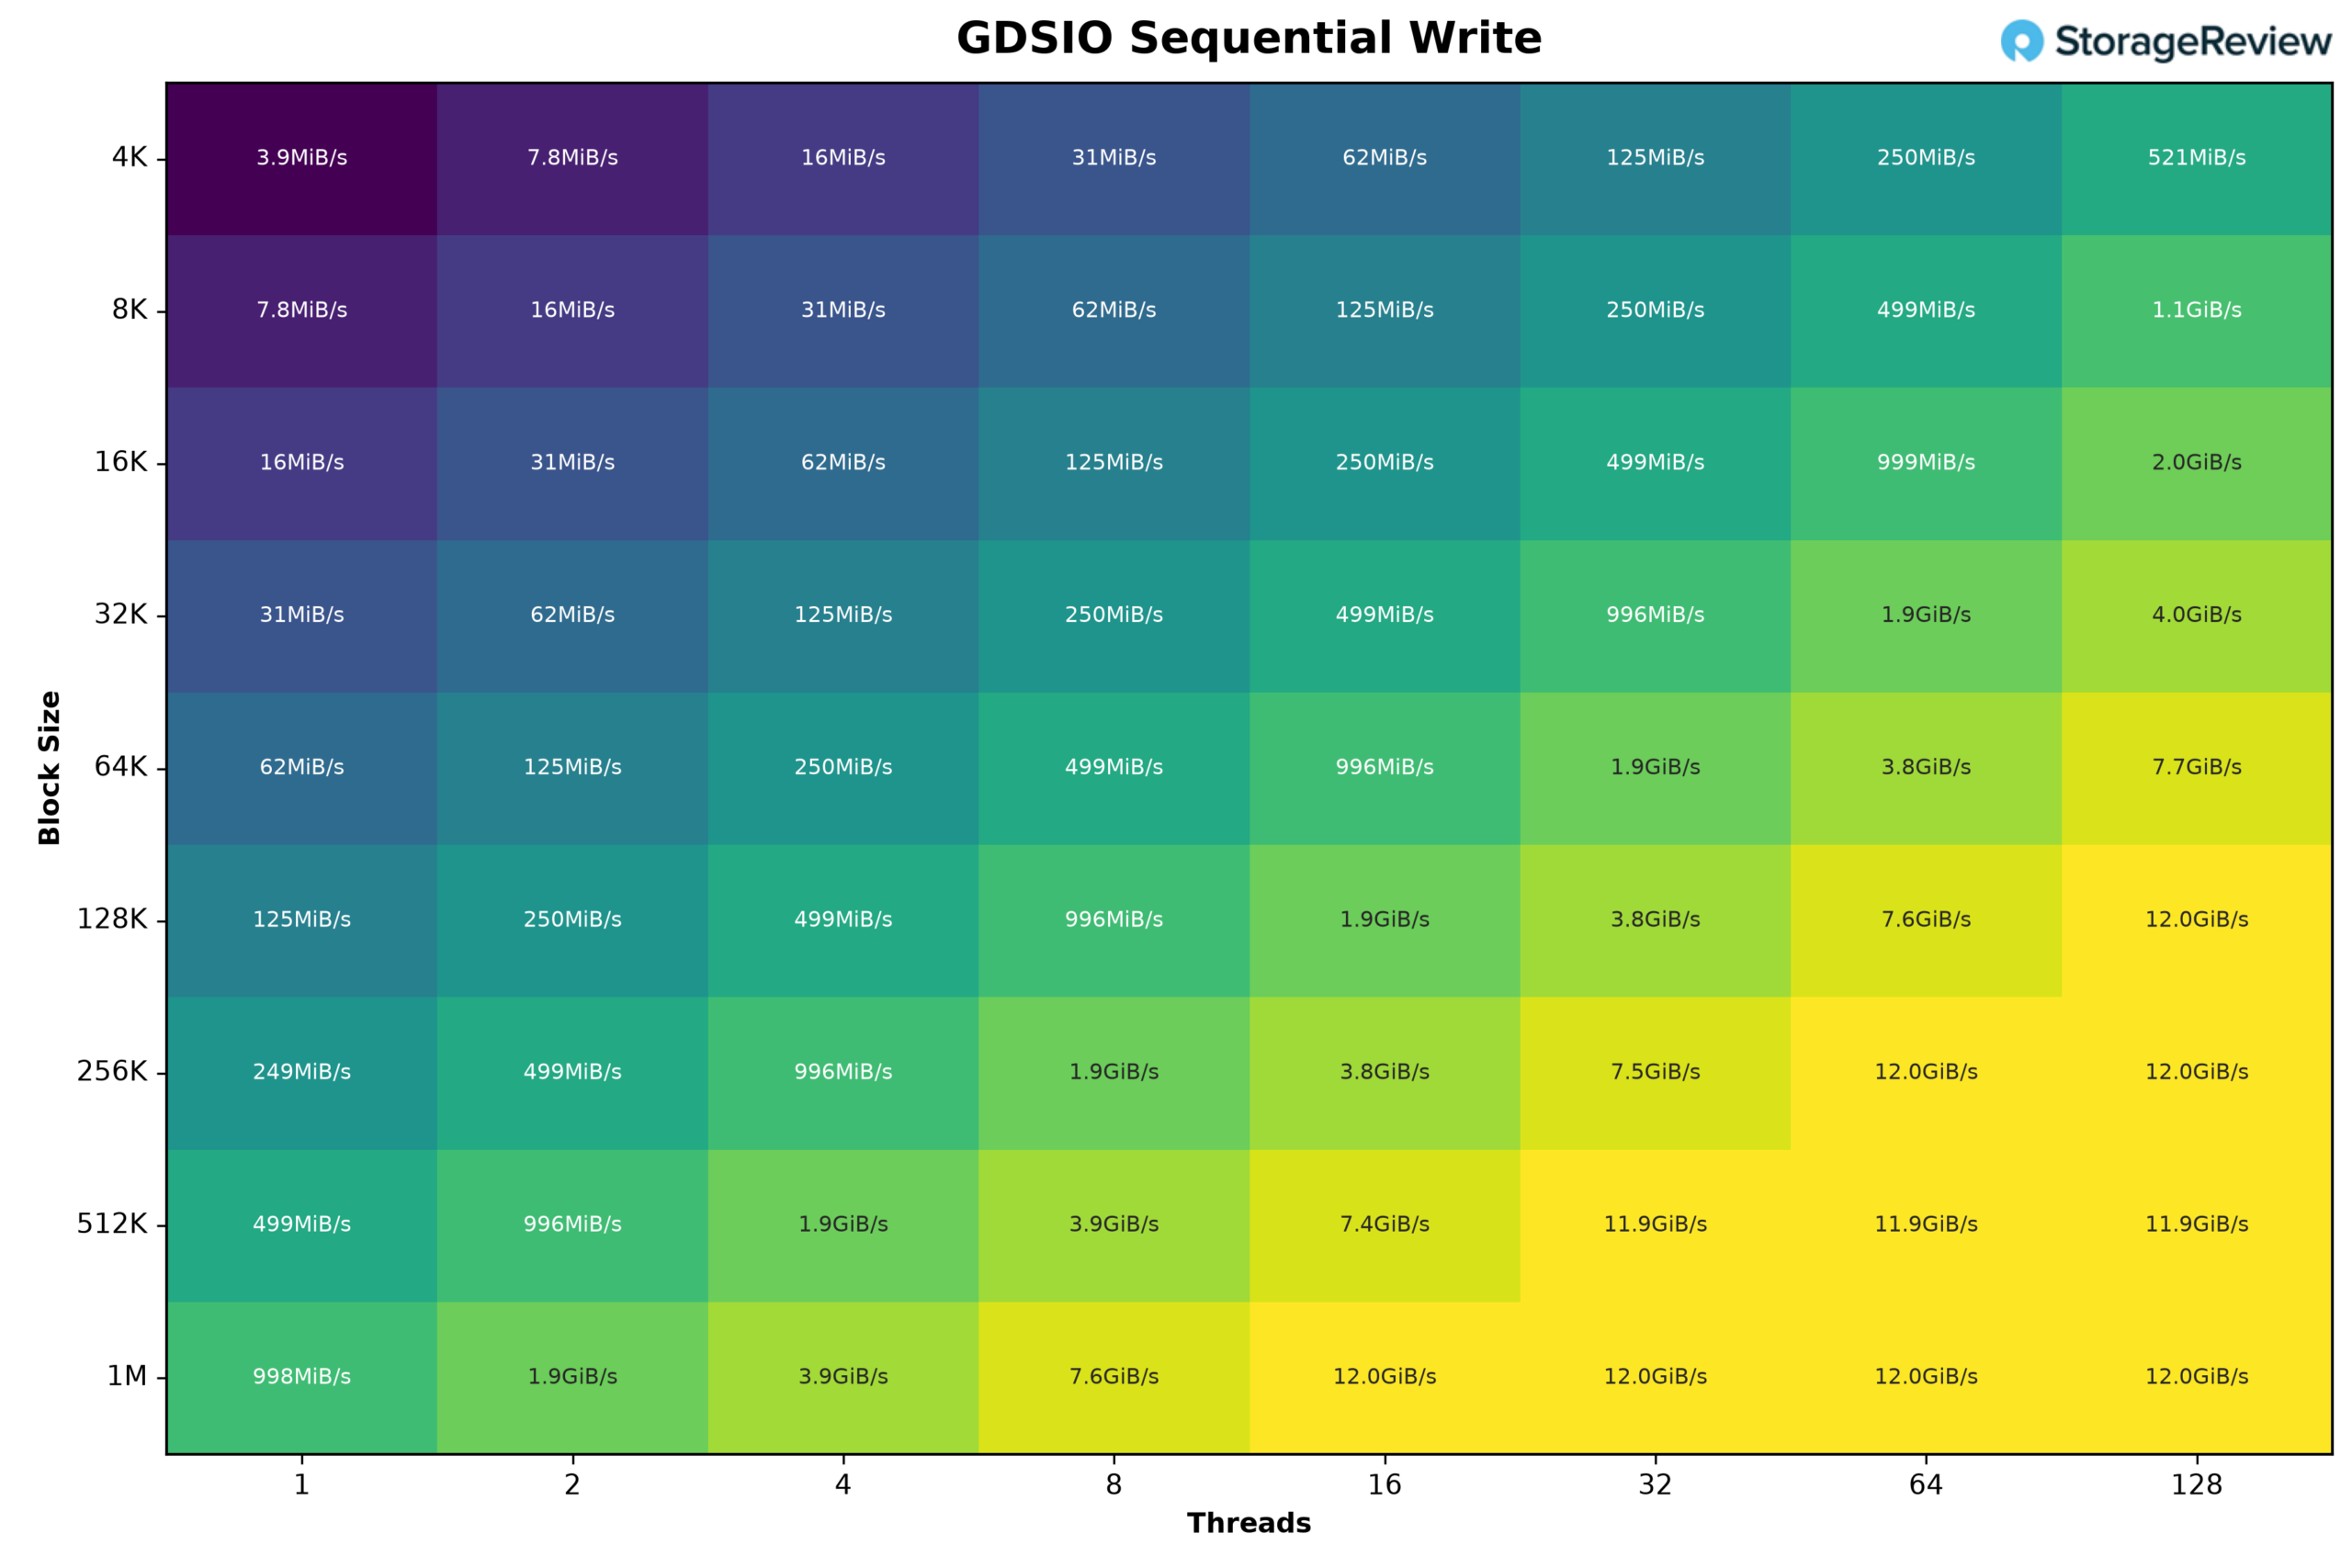
A chi è destinata la MSI XpertStation WS300?
Il WS300 è pensato per le organizzazioni che necessitano di accesso diretto a Blackwell Ultra ma non vogliono che ogni esperimento inizi con una prenotazione del cluster o una richiesta al cloud. Laboratori di intelligenza artificiale, sviluppatori di motori di inferenza, team di framework e compilatori, gruppi di robotica e team di intelligenza artificiale aziendali possono utilizzarlo come nodo di sviluppo locale per i flussi di lavoro sopra descritti. MIG consente agli sviluppatori di testare e sviluppare per una configurazione multi-GPU, mentre BMC rende il sistema gestibile da remoto.
È una soluzione ideale anche per sviluppatori di IA esperti che necessitano di un sistema pronto all'uso. Il valore aggiunto non risiede solo nel B300, ma nell'intera piattaforma che lo circonda: 252 GB di HBM3e, Grace e 496 GB di LPDDR5X, ConnectX-8, storage di avvio in mirroring, raffreddamento a liquido, gestione remota e supporto MSI, il tutto in un unico case. I limiti pratici sono rappresentati dall'architettura ARM, dalla necessità di un circuito dedicato da 20 A e dal budget condiviso di 1,600 W quando è installata una scheda RTX PRO di grandi dimensioni.
Per sfruttare al meglio la WS300, è fondamentale anche il software che la accompagna. NVIDIA offre un'ampia gamma di playbook e guide all'implementazione, pensati per aiutare i team a mettere online il sistema e a sfruttarne rapidamente le risorse. Approfondiremo diversi di questi strumenti in futuri articoli, tra cui Brev, che semplifica l'accesso condiviso alla workstation e ne migliora l'utilizzo, evitando che una risorsa così costosa rimanga inutilizzata.
Per quanto riguarda il prezzo, MSI non lo ha pubblicato e le macchine di questa categoria raramente hanno un prezzo di listino; si tratta di una questione che va discussa con il team di vendita, non di un semplice pulsante "aggiungi al carrello". Il confronto onesto non va fatto con altre workstation, ma con ciò che un team di intelligenza artificiale sta già pagando: tempo riservato sul cluster, impegni per GPU nel cloud e costi di pianificazione dovuti all'attesa di hardware condiviso.
Conclusione
La MSI XpertStation WS300 è la workstation più performante che abbiamo mai recensito, e uno dei rari prodotti in grado di rivoluzionare le possibilità di un singolo professionista. Checkpoint di livello avanzato, normalmente accessibili solo tramite una prenotazione di cluster, come GLM-5.2 con 433 GB di memoria e Nemotron-3-Ultra con 550 miliardi di parametri, vengono caricati e resi disponibili su un dispositivo posizionato accanto alla scrivania, in modo privato e sempre accessibile. È questa la ragione del nostro entusiasmo per questo sistema.
La DGX Station è pensata per gli sviluppatori: sviluppatori di kernel per Blackwell Ultra, team di motori di inferenza e framework, gruppi di robotica che utilizzano l'intero ciclo Isaac e, in generale, utenti frustrati dalla pianificazione di esperimenti su hardware condiviso. Al di fuori di questa nicchia, i motivi per acquistare questi sistemi sono piuttosto limitati. L'host Arm esclude alcune toolchain; il circuito da 20 A è un requisito di installazione su circuiti a 120 V; non è presente un'uscita video senza una scheda aggiuntiva; e una workstation RTX PRO 6000 costa molto meno, coprendo il lavoro di un singolo utente con modelli che rientrano nei suoi 96 GB.
Anche gli aspetti economici determinano la dimensione ottimale dell'implementazione. Un singolo WS300 è facilmente giustificabile in base al tempo di cluster riservato, e lo stesso vale per una coppia per team. Aumentare ulteriormente il numero di server smette di essere conveniente a un certo punto: quando un'organizzazione arriva ad acquistare quattro tower GB300, ad esempio, con la stessa cifra può acquistare un server B300 a otto vie con più memoria per GPU, partizionamento MIG più denso e NVLink tra ogni GPU. La soluzione ideale è un server sulla scrivania, magari due in laboratorio, a complemento dell'investimento nel data center.
NVIDIA fornisce la scheda madre, quindi la differenza tra gli OEM si riduce all'implementazione, e l'esecuzione di MSI in questo caso è solida. Un circuito di raffreddamento a liquido da 1,400 W raffredda la B300, Grace, SOCAMM e ConnectX-8, e la piattaforma è rimasta stabile durante i test. Un'analisi più approfondita è ora disponibile: la nostra analisi termica dettagliata della WS300 combina i dati della piastra di raffreddamento e del radiatore di MSI con un test strumentato di 2.8 ore che mostra il die mantenuto a 60 °C e una frequenza di clock stabile di 2.07 GHz a pieno carico. Il budget di potenza di 1,600 W viene distribuito automaticamente tra i componenti e, quando abbiamo testato il power brake hardware con una connessione compromessa, ha limitato le prestazioni anziché spegnersi. Un cavo 12VHPWR precablato e una staffa anti-flessione supportano il percorso di espansione RTX PRO. Avendo testato la prima GB300 DGX Station che ci è pervenuta, possiamo affermare che la XpertStation WS300 stabilisce uno standard elevato per la piattaforma.
XpertStation WS300 si è aggiudicata il primo posto nella classifica dei migliori sistemi GB300 per IA locale ed è il punto di riferimento per la discussione sulla memoria nella nostra guida su RAM, GPU e storage per IA agentica.


 Amazon