

TCP မှတစ်ဆင့် NVMe ကို တီထွင်ခဲ့သော Lightbits Labs ကုမ္ပဏီသည် မနက်ဖြန် စက်တင်ဘာ ၁၅ ရက်၊ Santa Clara တွင်ကျင်းပမည့် AI Infra Summit တွင် အများပြည်သူရှေ့မှောက် ပွဲဦးထွက်ပြသမည့် KV cache orchestration engine တစ်ခုဖြစ်သည့် Inferra ဖြင့် inference software ထဲသို့ ဝင်ရောက်နေပါသည်။ ၎င်း software သည် DRAM နှင့် NVMe storage tiers များတစ်လျှောက် GPU memory ကို virtualize လုပ်ကာ KV cache ကို persistent data layer အဖြစ်သို့ ပြောင်းလဲပေးသောကြောင့် long-context နှင့် multi-session workloads များအတွက် attention state များသည် HBM တွင် တပ်ဆင်ရန် သို့မဟုတ် ပျက်ကွက်သွားသည့်အခါ ပြန်လည်တွက်ချက်ရန် မလိုအပ်ပါ။ Lightbits သည် ရှိပြီးသား GPU များတွင် concurrent inference session ၁၆ ဆအထိ ပိုမိုများပြားလာပြီး၊ ၎င်းတို့ကို ပြန်လည်တွက်ချက်မည့်အစား prefetching attention state များမှ latency ၁၀၀ ဆကျော် တိုးတက်မှုနှင့် context window ၁၀ သန်းအထိ ရှိကြောင်း ပြောကြားထားပြီး engine သည် OVH ပါဝင်သော တစ်ခုအပါအဝင် customer beta program များတွင် လည်ပတ်နေပြီဟု ပြောကြားခဲ့သည်။
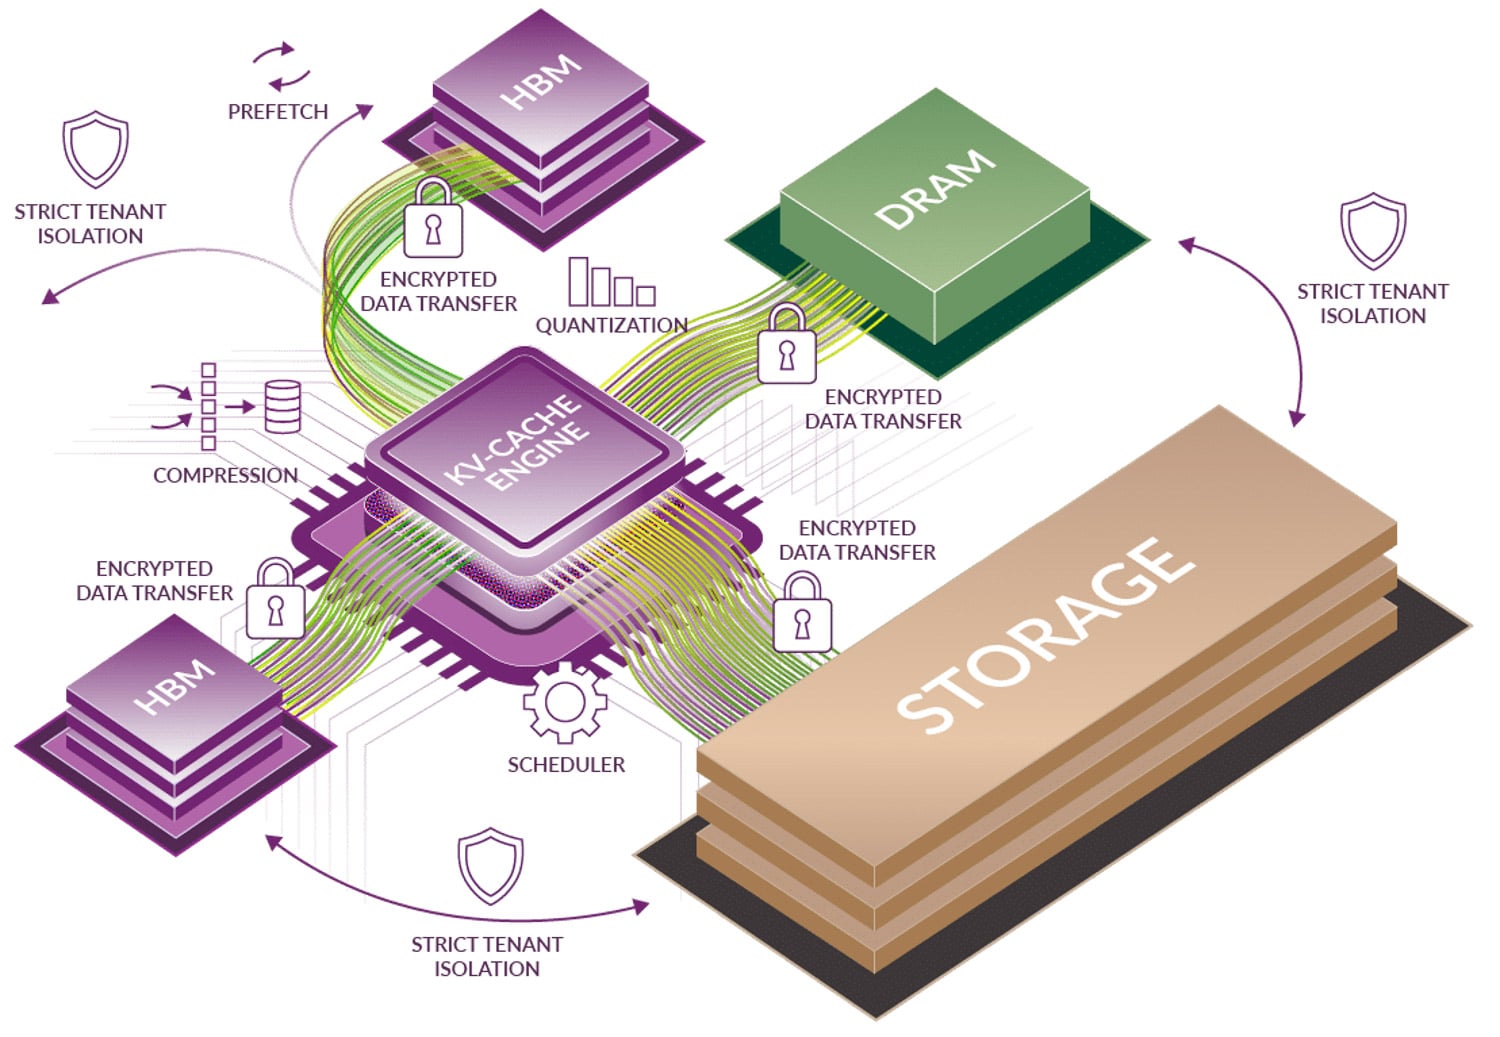
ပြန်လည်တွက်ချက်မည့်အစား ကြိုတင်ရယူပါ
Inferra ရဲ့ bottleneck targets ကတော့ KV cache offload ကို flash piece ထဲ ဖြတ်သွားတဲ့ targets ပါ ။ context lengths တွေ များလာပြီး sessions တွေ များလာတာနဲ့အမျှ KV cache က GPU memory ကို ကျော်လွန်သွားပြီး serving stack က deploy လုပ်ပြီး prefill ကို နောက်မှ ပြန်တွက်တာ ဒါမှမဟုတ် GPU တစ်ခု ထိန်းထားနိုင်တဲ့ sessions အရေအတွက်ကို ကန့်သတ်ပါတယ်။ paths နှစ်ခုစလုံးက GPU cycles တွေကို လုပ်ပြီးသား work တွေပေါ်မှာ burn လုပ်ပါတယ်။ Inferra က memory နဲ့ storage tiers တွေမှာ cache ကို live ဖြစ်နေစေပြီး predictive prefetcher က model က လိုအပ်တဲ့အချိန်မှာ attention states တွေကို GPU ဆီ ပြန်ဆွဲပေးပါတယ်။ Lightbits က ဒီ approach က Time-to-First-Token (TTFT) နဲ့ Time Per Output Token (TPOT) နှစ်ခုလုံးကို လျှော့ချပေးတယ်လို့ ပြောပြီး 100x figure က အဲဒီ states တွေကို scratch ကနေ ပြန်တွက်တာထက် latency တိုးတက်လာတာလို့ ဆိုပါတယ်။
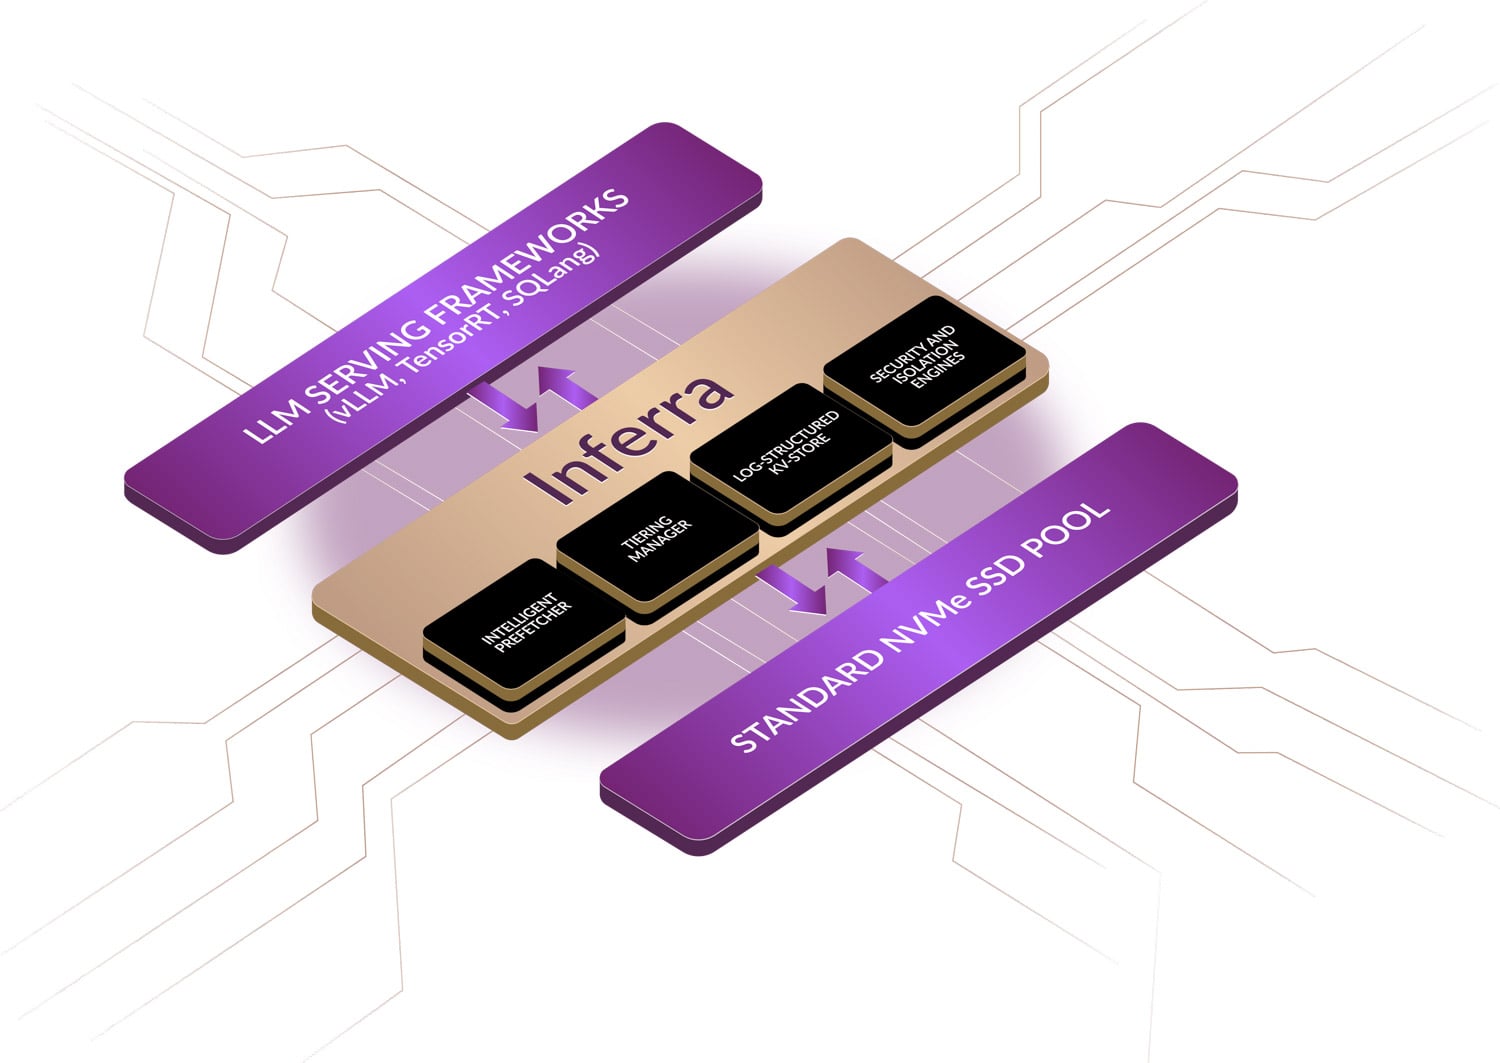
Lightbits ရဲ့ block diagram က အပိုင်းလေးပိုင်းကို ဖော်ပြထားပါတယ်- intelligent prefetcher၊ tiering manager၊ log-structured KV store နဲ့ security and isolation engines တို့ဖြစ်ပြီး အပေါ်က serving framework နဲ့ အောက်က standard NVMe SSD pool ကြားမှာ ရှိပါတယ်။ ကုမ္ပဏီက vLLM၊ TensorRT နဲ့ SGLang တို့ကို supported serving frameworks အဖြစ် စာရင်းပြုစုထားပြီး engine က GPU နဲ့ SSD-agnostic ဖြစ်တယ်လို့ ဆိုပါတယ်။ log-structured store က flash tier ကို အဆက်မပြတ်ပြောင်းလဲနေတဲ့ cache အတွက် လက်တွေ့ကျစေတာဖြစ်ပြီး၊ update တွေကို အစဉ်လိုက်ထည့်သွင်းပြီး drives တွေကို random write သေးသေးလေးတွေ သိမ်းဆည်းထားတာကြောင့်ပါ။ 3 DWPD drive က အဲဒီအခန်းကဏ္ဍမှာ ဘယ်လိုရပ်တည်နေလဲဆိုတာကို Solidigm D7-PS1030 review မှာ ကျွန်တော်တို့ လေ့လာကြည့်ခဲ့ပါတယ် ။ multi-tenant ဘက်မှာ Lightbits က secure tenant isolation နဲ့ shared inference infrastructure တစ်လျှောက် intelligent cache management အကြောင်း၊ tiers တွေကြား encrypted transfer နဲ့ ဖော်ပြထားပြီး neocloud က KV pool တစ်ခုကို consistent SLA တွေနဲ့ customer အများအပြားဆီ လွှဲပြောင်းပေးနိုင်ပါတယ်။
Lightbits Labs ၏ ပူးတွဲတည်ထောင်သူနှင့် ဥက္ကဋ္ဌ Avigdor Willenz က training pipeline များအတွက် တည်ဆောက်ထားသော storage မှ ခွဲထွက်မှုတစ်ခုအဖြစ် မိတ်ဆက်ခဲ့သည်။ Inference သည် “လုံးဝကွဲပြားသော ပုံစံတစ်ခု” ဟု ၎င်းက ပြောကြားခဲ့ပြီး “KV cache bottleneck ကို ဖြေရှင်းရန် legacy training နှင့် storage system များကို ပြန်လည်ပြင်ဆင်ခြင်းသည် အလုပ်မဖြစ်ပါ။ ၎င်းကို ကွဲပြားသောခေတ်အတွက် တည်ဆောက်ခဲ့ခြင်းဖြစ်သည်။ GPU စွမ်းဆောင်ရည်ပြဿနာကို ဖြေရှင်းရန် Inferra ကို အခြေခံမှစတင်၍ ကျွန်ုပ်တို့ အင်ဂျင်နီယာပြုလုပ်ခဲ့ပြီး ၎င်းသည် customer beta program များတွင် အောင်မြင်ကြောင်း သက်သေပြခဲ့ပြီးဖြစ်သည်။”
OVH၊ Solidigm နှင့် Booth 219 သရုပ်ပြမှုများ
OVH သည် အမည်ပေးထားသော beta ဖောက်သည်ဖြစ်သည်။ “Inferra ၏ ဉာဏ်ရည်ထက်မြက်သော KV cache tiering ဖြင့် ကျွန်ုပ်တို့သည် GPU အသုံးပြုမှု တိုးတက်မှုများစွာကို ပြသနိုင်ခဲ့ပြီး ကျွန်ုပ်တို့၏ဖောက်သည်များအား ၎င်းတို့၏ AI agent နှင့် RAG workloads အတွက် ပိုမိုတိုးချဲ့နိုင်ပြီး ကုန်ကျစရိတ်သက်သာသော အခြေခံအုတ်မြစ်ကို ပေးအပ်ရန် လမ်းခင်းပေးနိုင်ခဲ့သည်” ဟု OVH ၏ chief product and technology officer ဖြစ်သူ Yaniv Fdida က ပြောကြားခဲ့သည်။ Solidigm သည် ၎င်း၏ AI Central Lab တွင် D7-PS1010 drives များပေါ်တွင် engine ကို လည်ပတ်ခဲ့ပြီး ကုမ္ပဏီ၏ ecosystem၊ solutions နှင့် market enablement ၏ VP ဖြစ်သူ Avi Shetty က ရလဒ်များသည် “intelligent software layer virtualization ပါရှိသော network-attached storage သည် large context, agentic AI အတွက် memory wall ကို မည်သို့ဖောက်ထွင်းနိုင်ကြောင်း ပြသခဲ့သည်” ဟု ပြောကြားခဲ့သည်။ network-attached NVMe pool နှင့် software tier တွဲဖက်မှုသည် Lightbits ၏ မူလနေရာဖြစ်သည်။ ၎င်း၏ LightOS block storage ကို ၂၀၁၉ ခုနှစ်မှစ၍ NVMe/TCP တွင် တည်ဆောက်ထားသည်။
Lightbits မှ AI ထုတ်ကုန်နှင့် စီးပွားရေးဆိုင်ရာ အကြီးတန်းဒုတိယဥက္ကဋ္ဌ Ramesh Chettuvetty က Inferra ကို “Idle GPU များကို ဖယ်ရှားပေးပြီး commodity hardware ပေါ်တွင် 10M tokens အထိ context windows များကို power ပေးသည့် ကမ္ဘာ့ပထမဆုံး KV cache acceleration engine” ဟု ခေါ်ဆိုခဲ့ပြီး “ချက်ချင်းပြန်အမ်းငွေပေးပြီး ပထမနေ့မှစ၍ အသားတင်အပြုသဘောဆောင်သော ငွေစုများကို ထုတ်ပေးသည်” ဟု ပြောကြားခဲ့သည်။ ၎င်းတို့သည် မည်သည့်လွတ်လပ်သောစမ်းသပ်မှုမတိုင်မီ ရောင်းချသူများ၏ တောင်းဆိုချက်များဖြစ်ပြီး ထုတ်ပြန်ချက်တွင် ဈေးနှုန်း၊ packaging သို့မဟုတ် ယေဘုယျရရှိနိုင်မည့်ရက်စွဲကို မဖော်ပြထားပါ။ အင်ဂျင်သည် ယနေ့တွင် customer beta အဆင့်တွင် ရှိနေသည်။ Lightbits သည် session-density နှင့် latency ရလဒ်များ၏ live demo များကို session 219 တွင် ပြသနေပြီး booking မလုပ်မီ ၎င်းတို့၏ကိုယ်ပိုင် cluster နှင့် GPU ငွေစုများကို model လုပ်လိုသော အဖွဲ့များအတွက် Pod Efficiency Analyzer ကို တင်ထားသည်။


 အမေဇုံ