

Enterprise AI အခြေခံအဆောက်အအုံသည် လေ့ကျင့်ရေးပုံစံများကို အကောင်းဆုံးဖြစ်အောင်လုပ်ဆောင်ခြင်းမှ ၎င်းတို့ကို ဝန်ဆောင်မှုပေးခြင်းသို့ ပြောင်းလဲခဲ့ပြီး ၎င်းသည် စီးပွားရေးကို ပြောင်းလဲစေခဲ့သည်။ လေ့ကျင့်ရေးသည် endpoint ပါရှိသော အရင်းအနှီးစီမံကိန်းတစ်ခုဖြစ်သည်။ Inference သည် ဝန်ဆောင်မှုကို အသက်ဝင်နေသရွေ့ လည်ပတ်နေသော ထုတ်လုပ်မှု workload တစ်ခုဖြစ်ပြီး output ကို token များဖြင့် တိုင်းတာသည်။ ဤသည်မှာ AI အော်ပရေတာများ ရင်ဆိုင်နေရသော tokenomics ပြဿနာဖြစ်သည်- GPU များကို rack လုပ်ပြီး ပါဝါဘတ်ဂျက်ကို သတ်မှတ်ပြီးသည်နှင့် စီးပွားရေးလုပ်ငန်းသည် hardware မှ ထုတ်လုပ်သော token မည်မျှပေါ်တွင် မူတည်သည်။
ရှည်လျားပြီး ဘက်ပေါင်းစုံ workloads များတွင်၊ စကားပြောဆိုမှုများ ကြီးထွားလာသည်နှင့်အမျှ တူညီသော context ကို model မှတစ်ဆင့် အထပ်ထပ်အခါခါ ပေးပို့ပါသည်။ GPU သည် ထို token များကို တစ်ကြိမ် process လုပ်ရန် ငွေပေးချေပြီးဖြစ်သော်လည်း KV cache ကို ဖယ်ရှားလိုက်သောအခါ system သည် ထို context ကို ထပ်မံ prefill လုပ်ရပါသည်။ ၎င်းသည် ရန်သူအား ပြန်လည်တွက်ချက်စေသည်။ မည်သည့်အတိုင်းအတာတွင်မဆို၊ ၎င်းသည် rounding error မဟုတ်ပါ။ ၎င်းသည် power၊ GPU အချိန်၊ queue တိုးတက်မှု သို့မဟုတ် အပို hardware အဖြစ် ပြန်လည်ပေးအပ်သော ကုန်ကျစရိတ်ဖြစ်သည်။
reflexive fix ကတော့ rack ထဲက ဈေးအကြီးဆုံး resource တွေကို ပိုဝယ်ဖို့ပါပဲ- GPU တွေပိုများများ၊ DRAM တွေပိုများလာခြင်း။ ဒါပေမယ့် recompute က ပြန်သုံးလို့ရတဲ့ တစ်ခုခုကို ထုတ်လုပ်ပေးပြီးသားပါ။ KV cache က data သက်သက်ပါ။ reload cost နည်းနည်းနဲ့ ဈေးသက်သာစွာ သိမ်းဆည်းပြီး ပြန်ယူလို့ရပါတယ်။ ဈေးကြီးတဲ့ prefill computation ကို ရှောင်ရှားနိုင်ပါတယ်။ မေးခွန်းက cache ကို သိမ်းထားသင့်မသိမ်းထားသင့်ဆိုတာထက် ဘယ်မှာသိမ်းထားရမလဲဆိုတာက ပိုအရေးကြီးပါတယ်။ performance မှာလည်း ကုန်ကျစရိတ်များပါတယ်။ VRAM က အမြန်ဆုံး tier ဖြစ်ပြီး အရှားပါးဆုံးပါ။ တစ်ခါ saturated ဖြစ်သွားရင် inference server က cache တွေကို ဖယ်ထုတ်ပါတယ်။ DRAM က headroom ကို မြင့်မားပြီး မြန်မြန်ဆန်ဆန် မြင့်တက်လာတဲ့ ဈေးနှုန်းနဲ့ ဝယ်ယူပါတယ်။ Flash က သင်္ချာပြောင်းလဲနိုင်တဲ့နေရာပါ။ DRAM ထက် နှေးကွေးပေမယ့် terabyte တစ်ခုချင်းစီအတွက် ဈေးသက်သာပြီး context ကို ထိန်းထားနိုင်တဲ့ capacity လုံလောက်ပါတယ်။ ပိုမြန်တဲ့ tier တွေက discard လုပ်ရတဲ့ context ပါ။ ဒါက conversation တစ်ခုလုံးကို reprocessing လုပ်တာနဲ့ ရိုးရိုးရှင်းရှင်း ပြန်ဖတ်တာရဲ့ ကွာခြားချက်ပါ။
သက်ရောက်မှုကို တိုင်းတာဖို့အတွက် Dell PowerEdge XE7740 မှာ multi-turn agentic test workload တစ်ခုကို တည်ဆောက်ခဲ့ပြီး model, GPU နဲ့ serving stack constant ကို ထိန်းထားခဲ့ပါတယ်။ system တစ်ခုကို အရွယ်အစားသတ်မှတ်တဲ့သူတိုင်းအတွက် အရေးကြီးတဲ့ အရေအတွက်က memory tiers ပြည့်သွားပြီးနောက် ဘာတွေဖြစ်လာမလဲဆိုတာပါပဲ။ အဲဒီအချိန်ကို ကျော်လွန်သွားတဲ့အခါ flash ဟာ တစ်စက္ကန့်ကို token စုစုပေါင်း ၃၀,၀၀၀ ခန့် ထိန်းသိမ်းထားနိုင်ပြီး DRAM ရဲ့ ၁၇,၀၀၀ နဲ့ နှိုင်းယှဉ်ရင် သူ့ရဲ့ကိုယ်ပိုင် peak ရဲ့ ၉၄% ကို ထိန်းထားနိုင်ခဲ့ပြီး DRAM tier က ၄၂% အထိ ကျဆင်းသွားခဲ့ပါတယ်။ offload tier နှစ်ခုစလုံးဟာ peak မှာ VRAM-only baseline ကို ကြီးမားတဲ့ margin နဲ့ ကျော်လွန်ခဲ့ပါတယ် (DRAM မှာ ၂.၉X နဲ့ flash မှာ ၂.၂X)၊ ဒါပေမယ့် peak ကတော့ DRAM tier ကုန်တော့မယ့်နေရာပါပဲ။ ဈေးအကြီးဆုံး memory က peak ကို ဝယ်ယူပြီး context တွေ တိုးလာတာနဲ့အမျှ flash က ထိန်းထားပေးပါတယ်။
ရလဒ်များထဲသို့ မဝင်မီ KV cache ဆိုတာ ဘာလဲ၊ ဘာကြောင့် ပြည့်သွားတာလဲ၊ စနစ်မှာ ဈေးသက်သာတဲ့ နေရာမရှိတဲ့အခါ inference စွမ်းဆောင်ရည် ဘာကြောင့် ပြိုလဲလာရတာလဲဆိုတာကို တိတိကျကျ သိထားသင့်ပါတယ်။
Key ကို Takeaways
- DRAM မလုပ်ဆောင်နိုင်သည့်အရာကို Flash က ထောက်ပံ့ပေးသည်- မှတ်ဉာဏ်ဖိအားကြောင့် ဖယ်ရှားခံရသည်အထိ ပုံစံသုံးခုစလုံးသည် အတူတူပင်လုပ်ဆောင်ကြသည်။ VRAM သည် ဦးစွာပြည့်သွားပြီး 512GB DRAM အဆင့်သည် လည်ပတ်မှုထဲသို့ မိနစ် ၄၅ ခန့်ပြည့်ကာ ဖယ်ရှားခြင်းစတင်သည်။ ထိုအချိန်ကိုကျော်လွန်၍ flash သည် တစ်စက္ကန့်လျှင် စုစုပေါင်းတိုကင် ၃၀,၀၀၀ ခန့်ကို ထိန်းသိမ်းထားနိုင်ပြီး DRAM ၏ ၁၇,၀၀၀ နှင့် နှိုင်းယှဉ်ပါက ၎င်း၏ကိုယ်ပိုင်အမြင့်ဆုံး၏ ၉၄% ကို ထိန်းသိမ်းထားစဉ် DRAM သည် ၄၂% သို့ ကျဆင်းသွားသည်။
- Offload သည် ပြန်လည်တွက်ချက်ရန် ဆုံးရှုံးသွားသော throughput ကို ပြန်လည်ရယူသည်- အမြင့်ဆုံးအချိန်၌ KV cache offload သည် DRAM tier ပေါ်ရှိ VRAM-only baseline ထက် total serving throughput ကို 2.9X အထိနှင့် flash တွင် 2.2X အထိ မြှင့်တင်ပေးခဲ့သည်။ အမြတ်အစွန်းမှာ GPU တွက်ချက်ပြီးသား context ကို ပြန်လည်တည်ဆောက်မည့်အစား offload tier မှ ပြန်လည်ဖတ်ရှုသောကြောင့်ဖြစ်သည်။
- ပြန်လည်အသုံးပြုသူများသည် ကွာခြားချက်ကို အများဆုံးခံစားရသည်- ပြန်လည်စတင်ထားသော session တွင် အဆိုးဆုံးအခြေအနေတွင် first-token latency မှာ VRAM-only baseline တွင် ၁၃.၉ စက္ကန့်ဖြစ်ပြီး flash တွင် ၃.၂ စက္ကန့်ဖြစ်သည်။ Offload သည် interactive user ဖြတ်သန်းသွားမည့် bound ထဲတွင် ထိုအမြီးကို ထိန်းထားပေးသည်။
- အကျိုးဆောင်ယာဉ်ကြောပိတ်ဆို့မှုကြောင့် နှင်ထုတ်ခြင်းသည် ကုန်ကျစရိတ်များစေသည်- instrumentated Claude Code traffic တစ်ပတ်တာရဲ့ cache reads က 98.16% ရှိပြီး အမှန်တကယ် cold input က 0.02% သာရှိပါတယ်။
- KV offload သည် မြင့်မားသော ခံနိုင်ရည်ရှိသော drive များ လိုအပ်သည့် write-heavy workload တစ်ခုဖြစ်သည်- မော်ဒယ်ထုတ်လုပ်တဲ့ token တိုင်းက KV entry တစ်ခုကို ရေးသားပေးပြီး TTL churn က ၂၄ နာရီပတ်လုံး tier ကို ပြန်လည်ရေးသားပေးပါတယ်။ ကျွန်ုပ်တို့ရဲ့ ရေရှည်ရေးသားမှုနှုန်းမှာ ကျွန်ုပ်တို့စမ်းသပ်ခဲ့တဲ့ mirrored RAID10 array ဟာ drive တစ်ခုကို တစ်နေ့ကို drive ရေးသားမှု ၃.၂ ကြိမ်ခန့်ရှိပြီး RAID0 အနေနဲ့ DWPD striped ၁.၆ ကြိမ်ခန့်အထိ ကျဆင်းသွားကာ D7-PS1030 ရဲ့ DWPD အဆင့်သတ်မှတ်ချက် ၃ နဲ့ ညီမျှပါတယ်။ flash tier ရဲ့ အဓိကကန့်သတ်ချက်က capacity ဒါမှမဟုတ် speed မဟုတ်ဘဲ endurance ဖြစ်ပြီး cache က တစ်ခါသုံးဖြစ်တဲ့အတွက် write-focused drive ကို ဒီလောက်ခက်ခဲစွာလုပ်ဆောင်တာက လက်ခံနိုင်တဲ့ အရောင်းအဝယ်တစ်ခုပါ။
ကောက်ချက်ချခြင်း မည်သို့အလုပ်လုပ်သည်
ဘာသာစကားမော်ဒယ်ကြီးများသည် အလိုအလျောက်ပြန်လည်ချိန်ညှိပေးသည်- အထွက်တိုကင်တစ်ခုစီကို ၎င်းမတိုင်မီက ထွက်ပေါ်လာသော တိုကင်တိုင်းပေါ်တွင် အခြေအနေပေးထားသည်။ အာရုံစူးစိုက်မှုယန္တရားသည် (အစီအစဥ်ရှိ တိုကင်တစ်ခုစီအတွက်) ယခင်တိုကင်တိုင်း၏ key (K) နှင့် value (V) vector များနှင့် တိုက်ဆိုင်စစ်ဆေးသည့် query (Q) vector တစ်ခုကို တွက်ချက်ခြင်းဖြင့် ထိုအခြေအနေပေးမှုကို အကောင်အထည်ဖော်သည်။ အာရုံစူးစိုက်မှုအထွက်သည် တန်ဖိုးများ၏ အလေးချိန်ပေါင်းစပ်မှုတစ်ခုဖြစ်ပြီး အလေးချိန်များသည် QK dot products မှ လာခြင်းဖြစ်သည်။
တောင်းဆိုမှုတစ်ခုရောက်ရှိလာသောအခါ၊ ၎င်းတွင်ပါရှိသော token တိုင်းအတွက် K နှင့် V tensors များမရှိမချင်း prompt ကိုဖြေကြားနိုင်မည်မဟုတ်ပါ။ ထိုပထမခြေလှမ်းမှာ prefill ဖြစ်သည်- engine သည် prompt ကို model မှတစ်ဆင့် parallel pass တစ်ခုတည်းဖြင့် run ပြီးရလဒ် K နှင့် V tensors များကို memory သို့ရေးသားသည်။ ထို့ကြောင့် Prefill သည် compute-bound ဖြစ်ပြီး ၎င်း၏ latency သည် prompt အရှည်နှင့်အတူ ချိန်ညှိသည်။
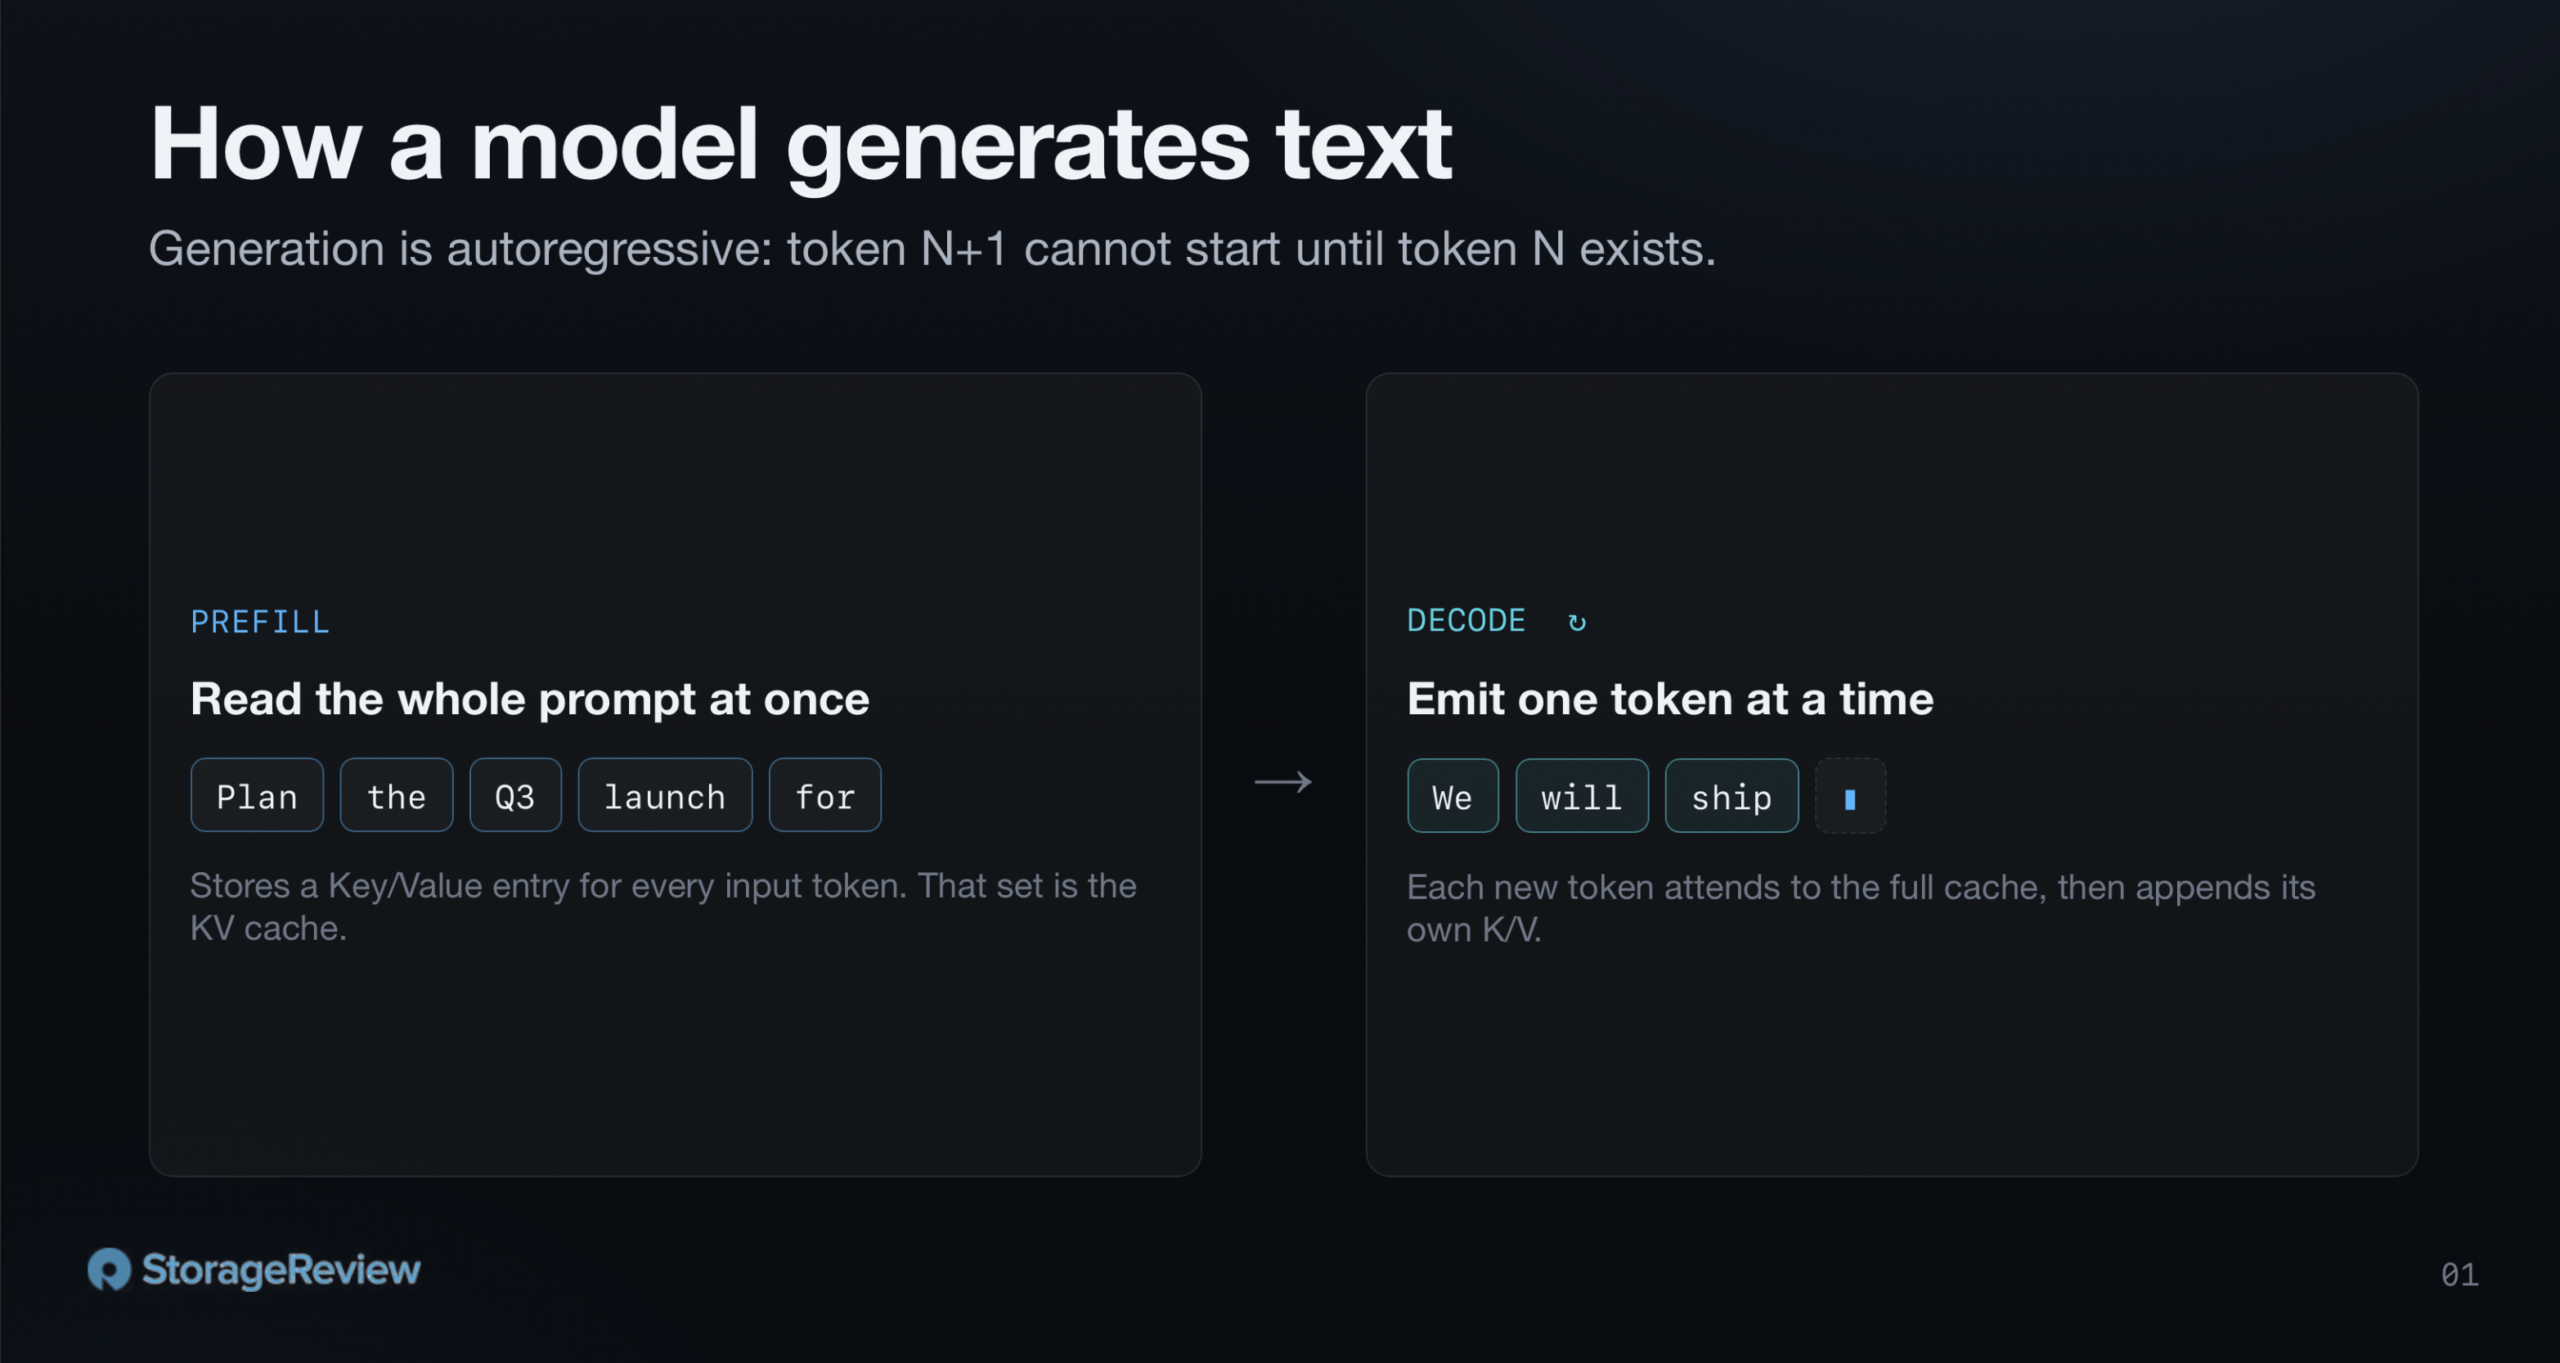
ကြိုတင်ဖြည့်သွင်းမှုပြီးဆုံးသည်နှင့် အင်ဂျင်သည် တစ်ကြိမ်လျှင် တိုကင်တစ်ခုစီဖြင့် တုံ့ပြန်မှုကို ထုတ်လွှတ်သည်။ တိုကင်အသစ်တစ်ခုစီသည် ယခင်တိုကင်တိုင်း၏ K နှင့် V ကို ပြန်လည်ဖတ်ရှုပြီး ၎င်း၏ attention output ကို တွက်ချက်ကာ နောက်တစ်ဆင့်အတွက် ၎င်း၏ကိုယ်ပိုင် K နှင့် V ကို မှတ်ဉာဏ်ထဲသို့ ရေးသားသည်။ ထိုဒုတိယအဆင့်သည် decode ဖြစ်သည်။ ၎င်းသည် sequential ဖြစ်ပြီး မှတ်ဉာဏ်-bandwidth-bound ဖြစ်သည်။ အဘယ်ကြောင့်ဆိုသော် တိုကင်တစ်ခုစီကို ထုတ်လုပ်ရန် မှတ်ဉာဏ်မှ ယခင်တိုကင်အားလုံးအတွက် cached K နှင့် V tensors များကို load လုပ်ရန်နှင့် အနာဂတ်အဆင့်များအတွက် တိုကင်အသစ်၏ K နှင့် V tensors များကို မရေးသားမီ ၎င်းတို့ပေါ်တွင် attention ကို တွက်ချက်ရန် လိုအပ်သောကြောင့်ဖြစ်သည်။
အဆင့်နှစ်ခုလုံးမှ K နှင့် V tensors များသည် KV cache ဖြစ်သည်။ ၎င်းတို့မပါဘဲ n+1th token ကိုထုတ်လုပ်ခြင်းသည် အဆင့်တိုင်းတွင် ယခင် n token အားလုံးအတွက် key များနှင့်တန်ဖိုးများကို ပြန်လည်တွက်ချက်မည်ဖြစ်ပြီး ၎င်းသည် compute complexity တွင် quadratic ဖြစ်သည်။ cache ရှိနေချိန်တွင်၊ token အသစ်တစ်ခုစီသည် ၎င်း၏ကိုယ်ပိုင် K နှင့် V ကိုသာ တွက်ချက်ပြီး ကျန်တာကို memory မှဖတ်သောကြောင့် per-token ကုန်ကျစရိတ်သည် linear ဖြစ်နေသည်။
အေးဂျင့်အသွားအလာက ဘယ်လိုပုံစံရှိလဲ
လူတွေက inference ကို memory-bandwidth-bound လို့ ဖော်ပြလေ့ရှိပါတယ်၊ အကြောင်းကတော့ decode က response ရဲ့ user-visible အပိုင်းကို လွှမ်းမိုးထားလို့ပါ။ phase နှစ်ခုကြားက တကယ့် balance က workload-dependent ဖြစ်ပါတယ်။ essay ရှည်တစ်ခုကို တောင်းဆိုတဲ့ short prompt က decode-heavy ဖြစ်ပြီး၊ JSON အသေးစား edit တစ်ခုကို တောင်းဆိုတဲ့ agent prompt က prefill-heavy ဖြစ်ပါတယ်။ cache ကို မှားယွင်းစွာ စီမံခန့်ခွဲမိတဲ့အခါ ဘယ်ဘက်က လွှမ်းမိုးထားလဲဆိုတာက ဆုံးဖြတ်ပေးပါတယ်။
ပြန်လည်တွက်ချက်မှုပြဿနာ၏ပုံသဏ္ဍာန်သည် ထိုချိန်ခွင်လျှာမှ ဆင်းသက်လာပြီး “agentic” သည် အသုံးပြုမှုပုံစံအမျိုးမျိုးကို လွှမ်းခြုံထားသည်။ Agentic coding သည် ယခုအချိန်တွင် ထိုပုံစံများထဲမှ အလွန်ရေပန်းစားပြီး OpenRouter leaderboards တွင် ၎င်းသည် အသုံးပြုသော token များ၏ များစွာသောအပိုင်းကို ပါဝင်သည်။ ကိုယ်စားပြု case တစ်ခုကို ပမာဏသတ်မှတ်ရန်အတွက်၊ ကျွန်ုပ်တို့သည် OpenTelemetry (OTEL) logging ဖြင့် Claude Code ကို instrument လုပ်ခဲ့ပြီး တစ်ပတ်စာ traces များကို Grafana သို့ export လုပ်ခဲ့သည်။ အမျိုးအစားအလိုက် ထို token traffic ကို ခွဲခြမ်းစိတ်ဖြာခြင်းကို အောက်တွင်ပြထားသည်။ မှတ်ချက်- ဤ Claude Code အသုံးပြုမှုသည် 1M context length ရှိသော Claude Opus 4.8 မော်ဒယ်တွင်ဖြစ်ပြီး coding project များစွာတွင် တစ်ပြိုင်နက်တည်း လုပ်ဆောင်နေသည်။
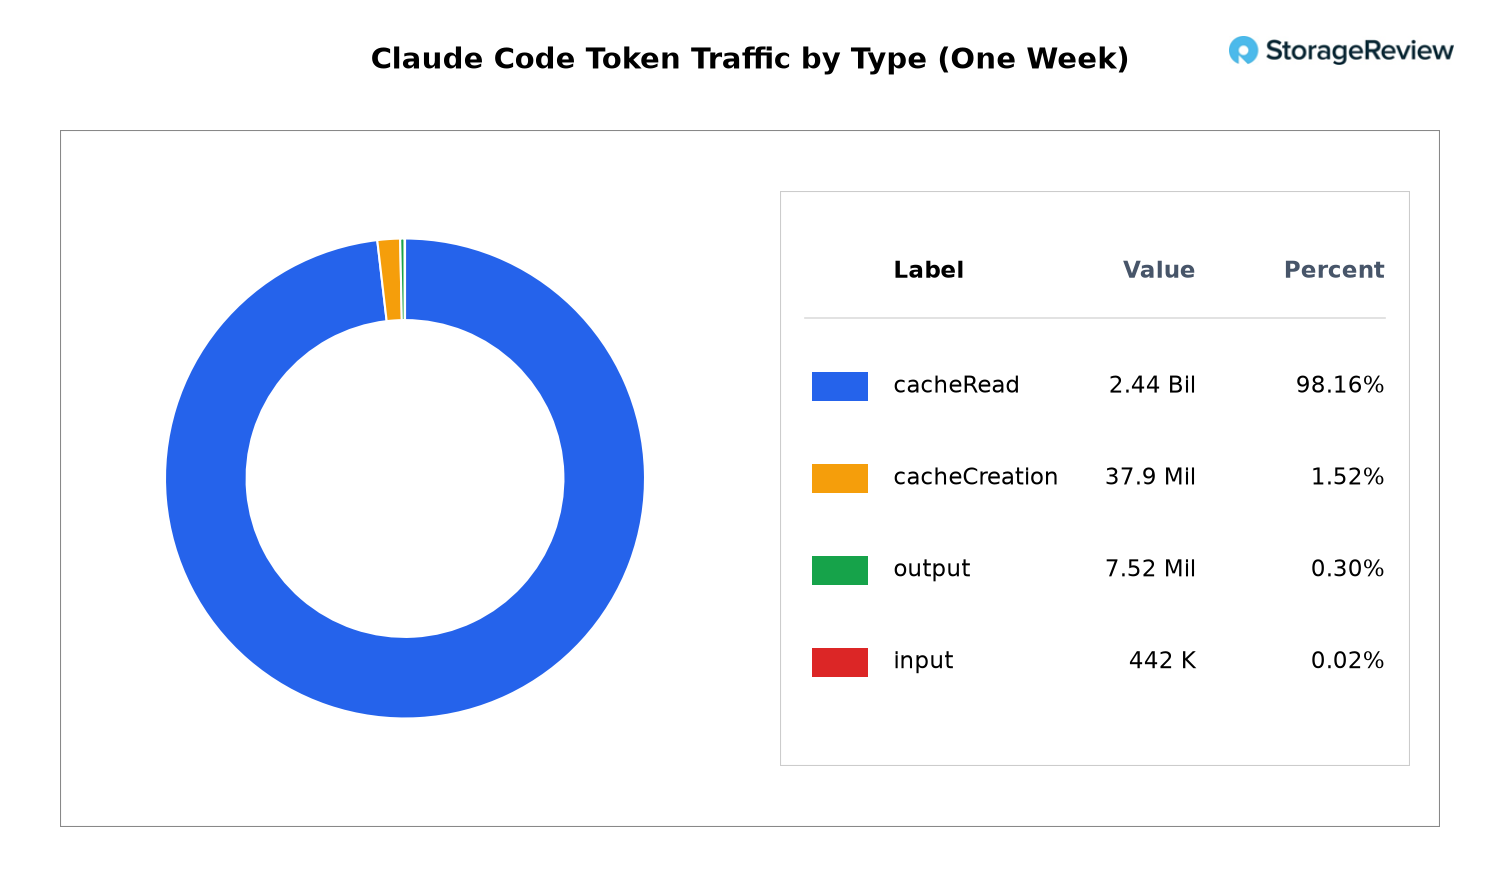
ကက်ရှ်ဖတ်ရှုမှုများသည် တိုကင်အသွားအလာအားလုံး၏ 98.16% ရှိသည်။ ကက်ရှ်ဖန်တီးမှု (ယခင်ကတွေ့မြင်ခဲ့ရသော prefix တစ်ခုသည် ၎င်း၏ entry သက်တမ်းကုန်ဆုံးသွားသောကြောင့် ပြန်လည်ဖြည့်သွင်းခြင်း) သည် 1.52% ရှိသည်။ အထွက်တိုကင်များသည် 0.30% ရှိသည်။ အမှန်တကယ်အေးခဲထားသော input တိုကင်များသည် 0.02% ရှိသည်။
ယာဉ်ကြောပိတ်ဆို့မှု၏ ၉၈% သည် cache read များဖြစ်သည့် workload တစ်ခုတွင်၊ offload မပါဘဲ ဖယ်ရှားခြင်းဆိုသည်မှာ စနစ်လုပ်ဆောင်တော့မည့် အလုပ်အများစုကို ပြန်လည်ကြိုတင်ဖြည့်သွင်းခြင်းဟု ဆိုလိုသည်။ bottleneck သည် ပုံမှန်အားဖြင့် optimize လုပ်ထားသော အဆင့်ဖြစ်သည့် decode bandwidth မှ GPU သည် အစောပိုင်းအလှည့်များတွင် လုပ်ဆောင်ပြီးဖြစ်သော prefill compute သို့ ပြောင်းလဲသွားပါသည်။ အမှန်စင်စစ်၊ တူညီသောအကြောင်းပြချက်ကြောင့် အတိုင်းအတာတစ်ခုအထိ decode workers များထက် prefill workers များကို လည်ပတ်နေသော disaggregated serving architectures များကို မြင်တွေ့ရခြင်းမှာ အတော်လေးအဖြစ်များပါသည်- prefill သည် gating phase ဖြစ်သည်။
၉၈% ကိန်းဂဏန်းသည် အသုံးပြုသူတစ်ဦး၏ traffic ရောနှောမှုဖြစ်သည်။ တိုတောင်းသော chat workload သည် cold traffic ပိုများကို ပြသလိမ့်မည်။ တစ်ကြိမ်လျှင် မတူညီသောစာရွက်စာတမ်းများကို ပြန်လည်ထည့်သွင်းသည့် retrieval-augmented system သည်လည်း ပြသလိမ့်မည်။ စကားပြောဆိုမှုများ ရှည်လျားနေပါစေ၊ prefix များ တည်ငြိမ်နေပါစေ၊ အသုံးပြုသူများသည် တူညီသော context သို့ ပြန်လာနေပါစေ ယေဘုယျပုံသဏ္ဍာန်သည် ရှိနေသည်။
ကက်ရှ်ဘယ်မှာရှိပြီး ပြည့်သွားတဲ့အခါ ဘာဖြစ်သွားလဲ
ဒီ cache က တကယ်တမ်းဘယ်မှာရှိလဲ၊ နေရာလွတ်ကုန်သွားရင် ဘာဖြစ်မလဲ။ model weights load လုပ်ပြီးနောက်၊ ကျန်ရှိနေတဲ့ VRAM က KV cache space ဖြစ်လာပြီး fixed-size blocks တွေအဖြစ် ပိုင်းခြားပါတယ်၊ ပြီးတော့ startup မှာ engine က သူဘယ်နှစ်ခု tokens ကိုင်ထားနိုင်လဲဆိုတာ ပြောပြပါတယ်။ အဲဒီ pool က KV Offloading မပါဘဲ standard setup မှာ cache ရှင်သန်နိုင်တဲ့ တစ်ခုတည်းသောနေရာပါ။
GPU server တွေက ဈေးကြီးပြီး token တွေက product ဖြစ်တာကြောင့် ရည်မှန်းချက်က ၂၄ နာရီပတ်လုံး ထောက်ပံ့ပေးဖို့ပါ။ ဆိုလိုတာက compute ကို idle မဖြစ်အောင် process လုပ်ဖို့ စောင့်ဆိုင်းနေတဲ့ request queue ငယ်လေးတွေနဲ့ GPU ကို load လုပ်ထားခြင်းဖြစ်ပြီး response latency ကို service-level-objective (SLO) အတွင်း ထိန်းထားဖို့ queue ကို ဟန်ချက်ညီအောင်ထိန်းထားပေးပါတယ်။ request တိုင်းက သူ့ရဲ့ full context window ကို အသုံးမပြုနိုင်တာကြောင့် ပြီးစီးသွားတဲ့ KV အများစုဟာ VRAM မှာ cache လုပ်ထားလေ့ရှိပါတယ်။ ဒါပေမယ့် sustained load အောက်မှာ cache က ပြည့်သွားပြီး တစ်ခါပြည့်သွားရင် entry အဟောင်းတွေကို နေရာလွတ်ပေးဖို့ delete လုပ်ပါတယ်။
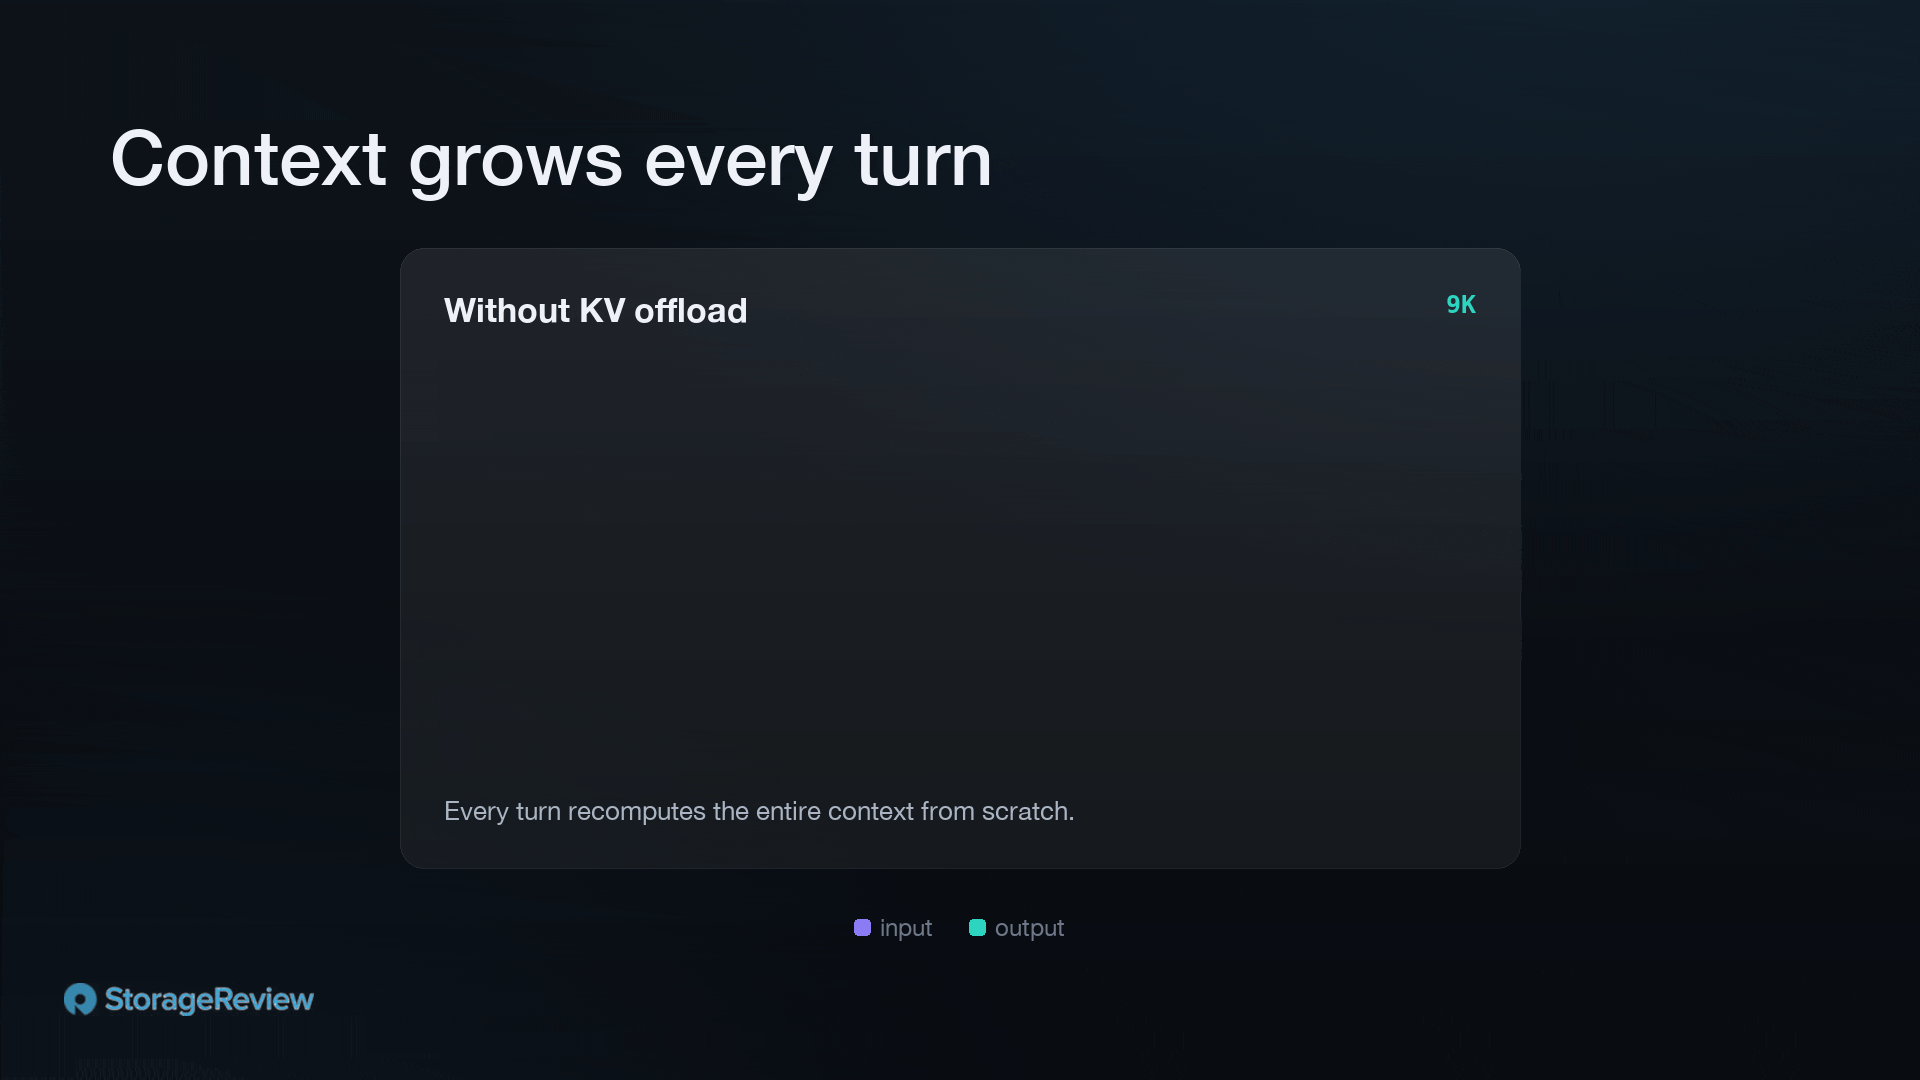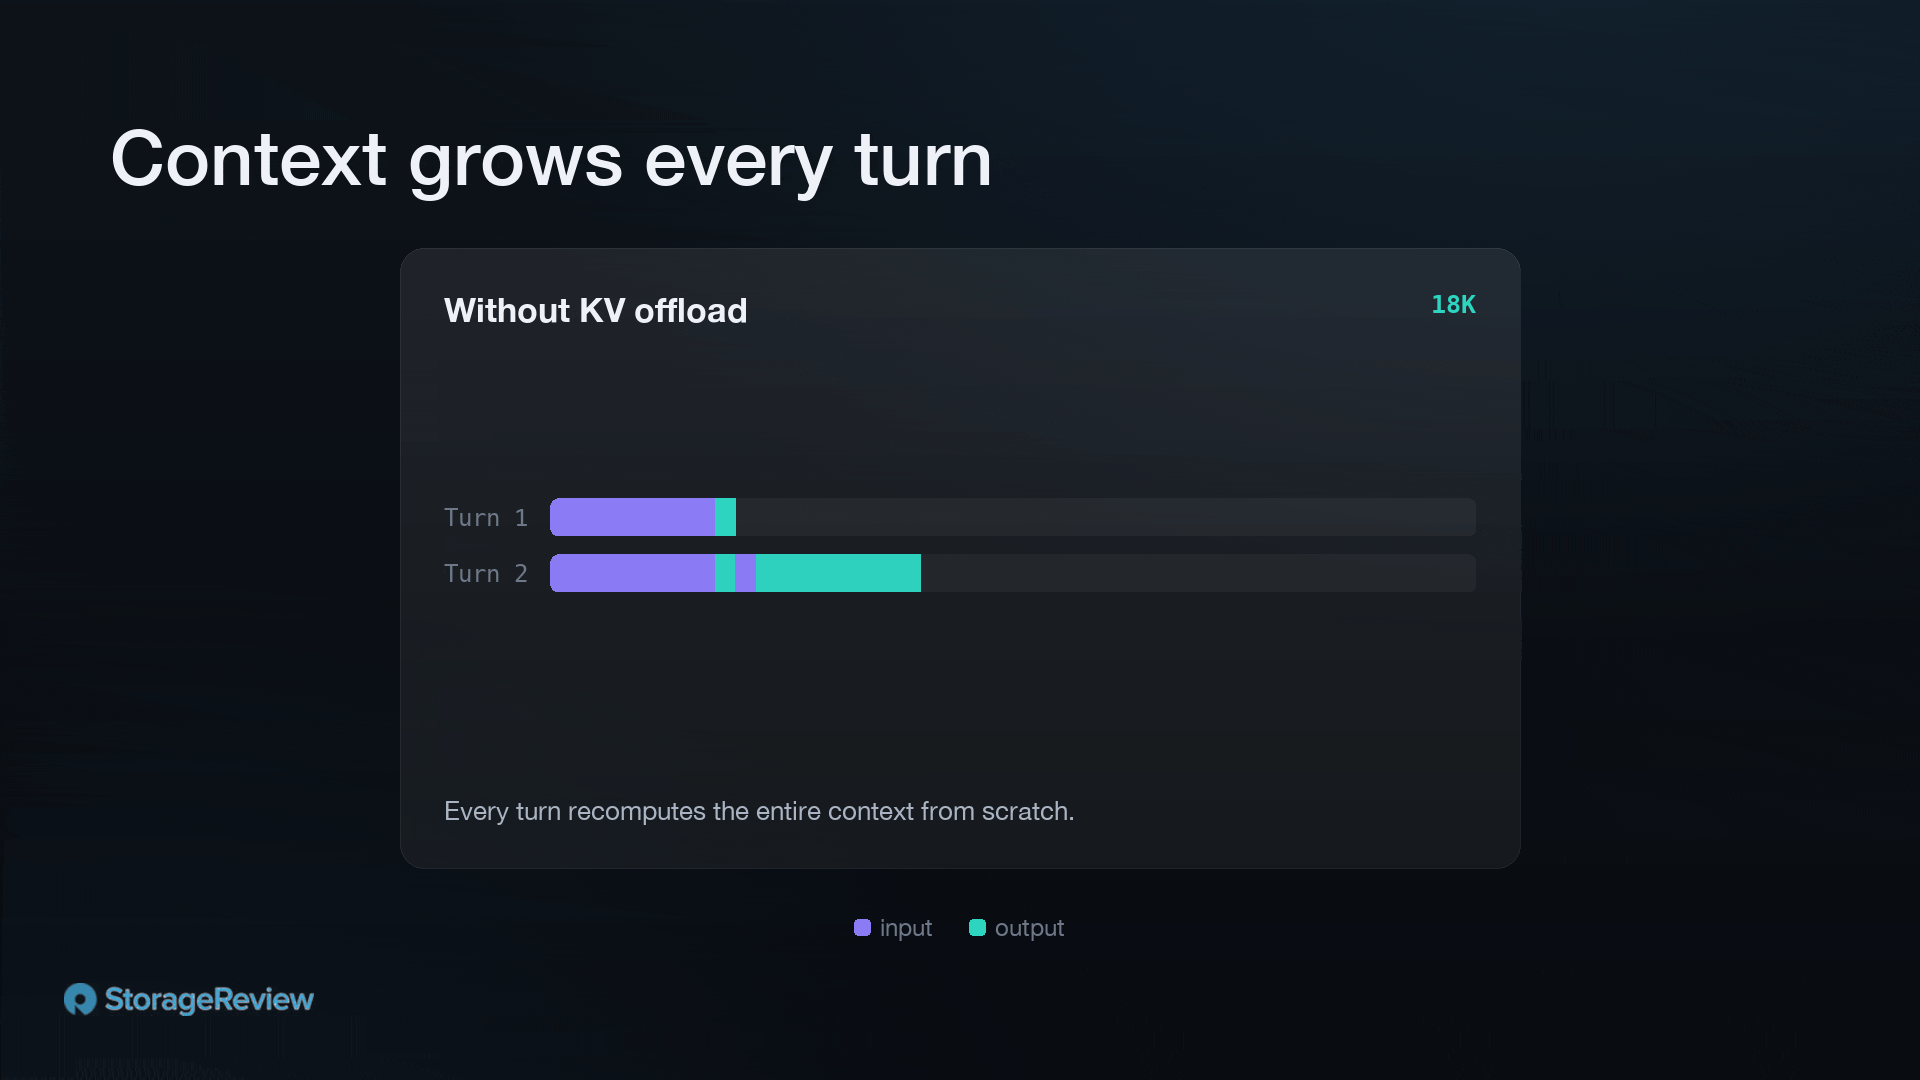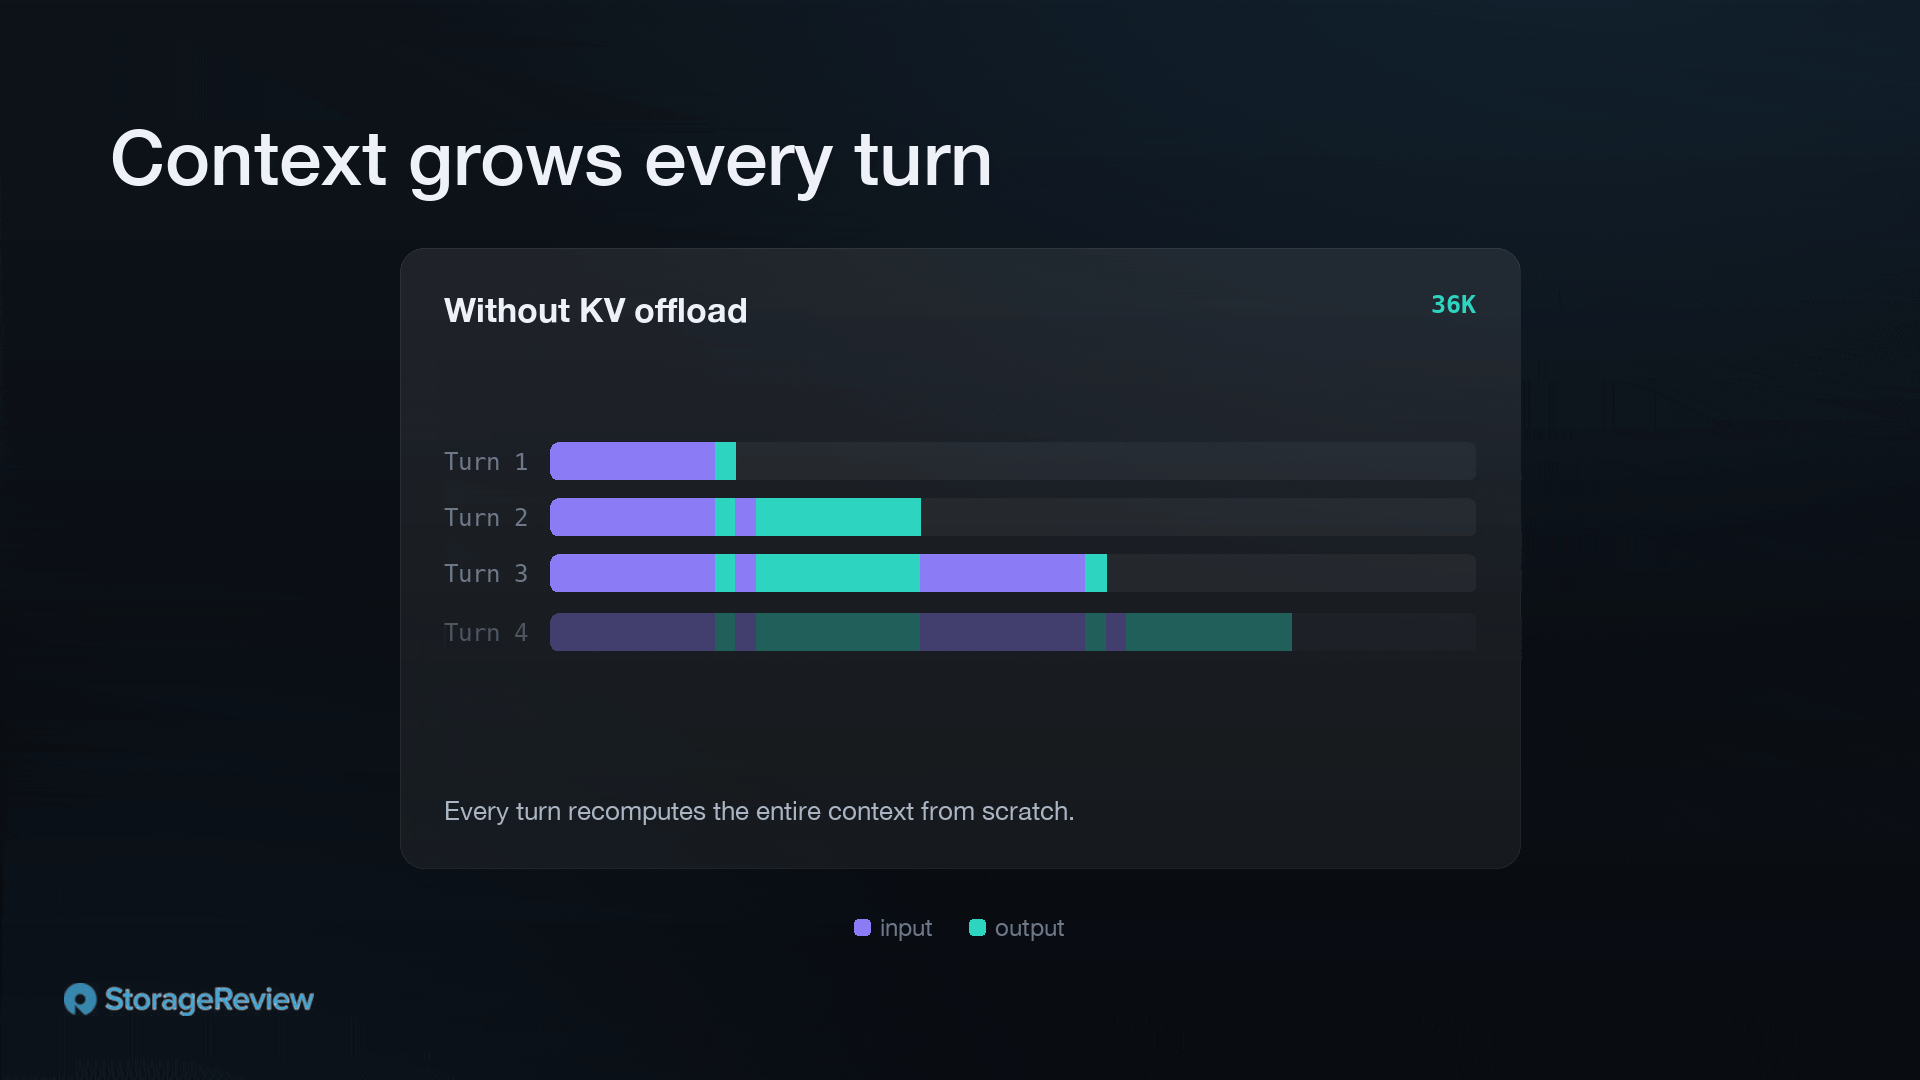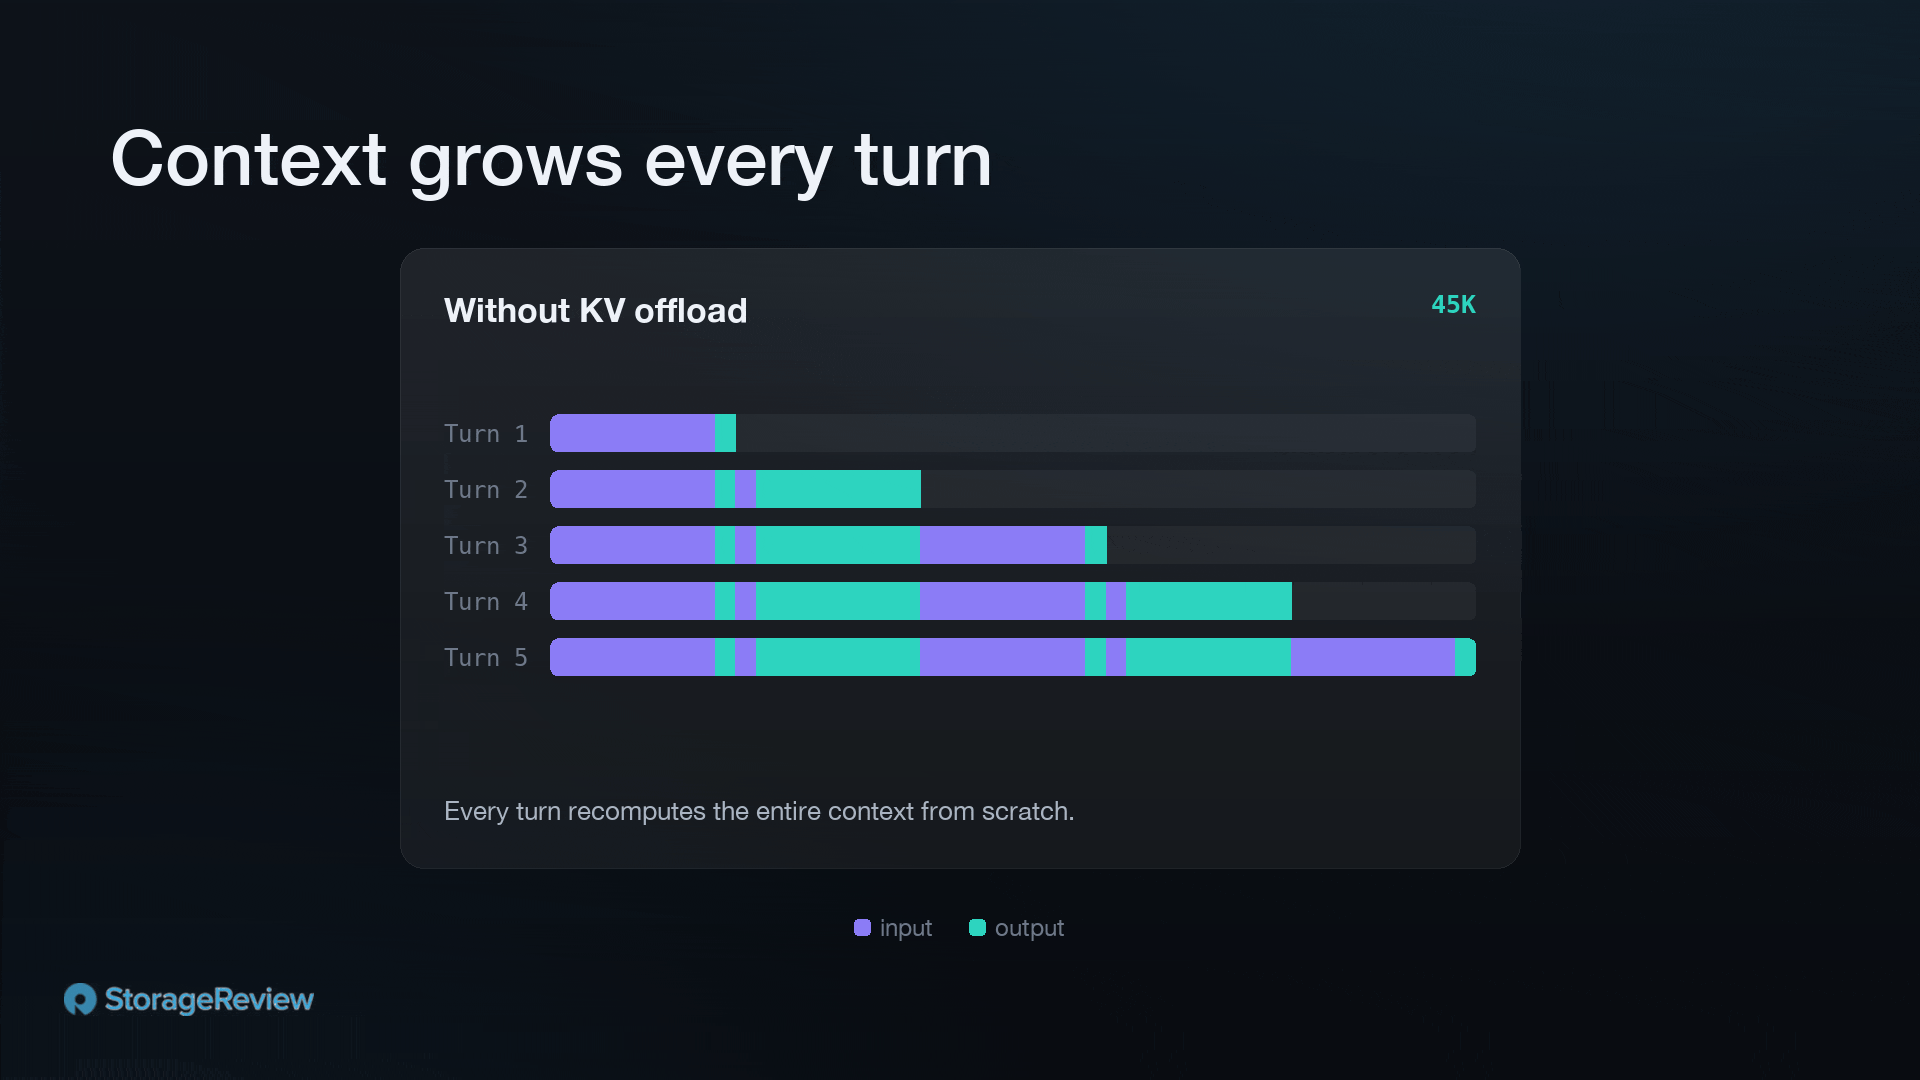
စံပြကမ္ဘာမှာဆိုရင် အဖြေတိုင်းကို တစ်ချက်တည်းနဲ့ ပြီးသွားပါလိမ့်မယ်။ ဒါပေမယ့် မော်ဒယ်တွေက သိပ်မကောင်းဘူး၊ ဒါကြောင့် user တစ်ယောက်နဲ့ ဒါမှမဟုတ် အေးဂျင့်တွေကြားမှာ agent loop တွေကို လည်ပတ်ပါတယ်။ နောက်အလှည့်ရောက်ရင်၊ သူ့ရဲ့ KV ကို cache မလုပ်ရသေးရင် engine က အခုထိ စကားပြောဆိုမှုတစ်ခုလုံးအပြင် token အသစ်တွေကိုပါ ပြန်လည်လုပ်ဆောင်ပါတယ်။ အရင်အလှည့်တိုင်းရဲ့ context ကို မော်ဒယ်ကနေတစ်ဆင့် ပြန်လုပ်ဆောင်ပြီး GPU က အဲဒီ token တွေမှာ လုပ်ပြီးသား တွက်ချက်မှုကို နောက်အလှည့်တိုင်းအတွက် ဒုတိယ၊ တတိယနဲ့ နောက်ဆက်တွဲအကြိမ်တွေအတွက် ပေးချေပါတယ်။ ဒီလေ့ကျင့်ခန်းရဲ့ ဒီအပိုင်းက အလဟဿပါပဲ။
KV Cache Offload ပြောင်းလဲမှုများ
VRAM ပြည့်သွားတဲ့အချိန်မှာ ဖယ်ထုတ်မယ့်အစား၊ offload က cache တွေကို အဆင့်ဆင့်အောက်ကို တဖြည်းဖြည်း လျှံကျစေပါတယ်- VRAM ကနေ system memory ကို SSD ကို။ hot working set က VRAM မှာရှိနေမှာဖြစ်ပြီး fit မဖြစ်တော့တဲ့ entry တွေကို system memory ကို push လုပ်မှာဖြစ်ပြီး system memory ပြည့်သွားရင် SSD ဒါမှမဟုတ် networked storage tier ကို ပြန် push လုပ်မှာပါ။ memory pressure ကြောင့်မဟုတ်ဘဲ user-set time-to-live (TTL) ကြောင့် တကယ့်ဖယ်ထုတ်မှုကတော့ ရှားပါးလာပါတယ်။
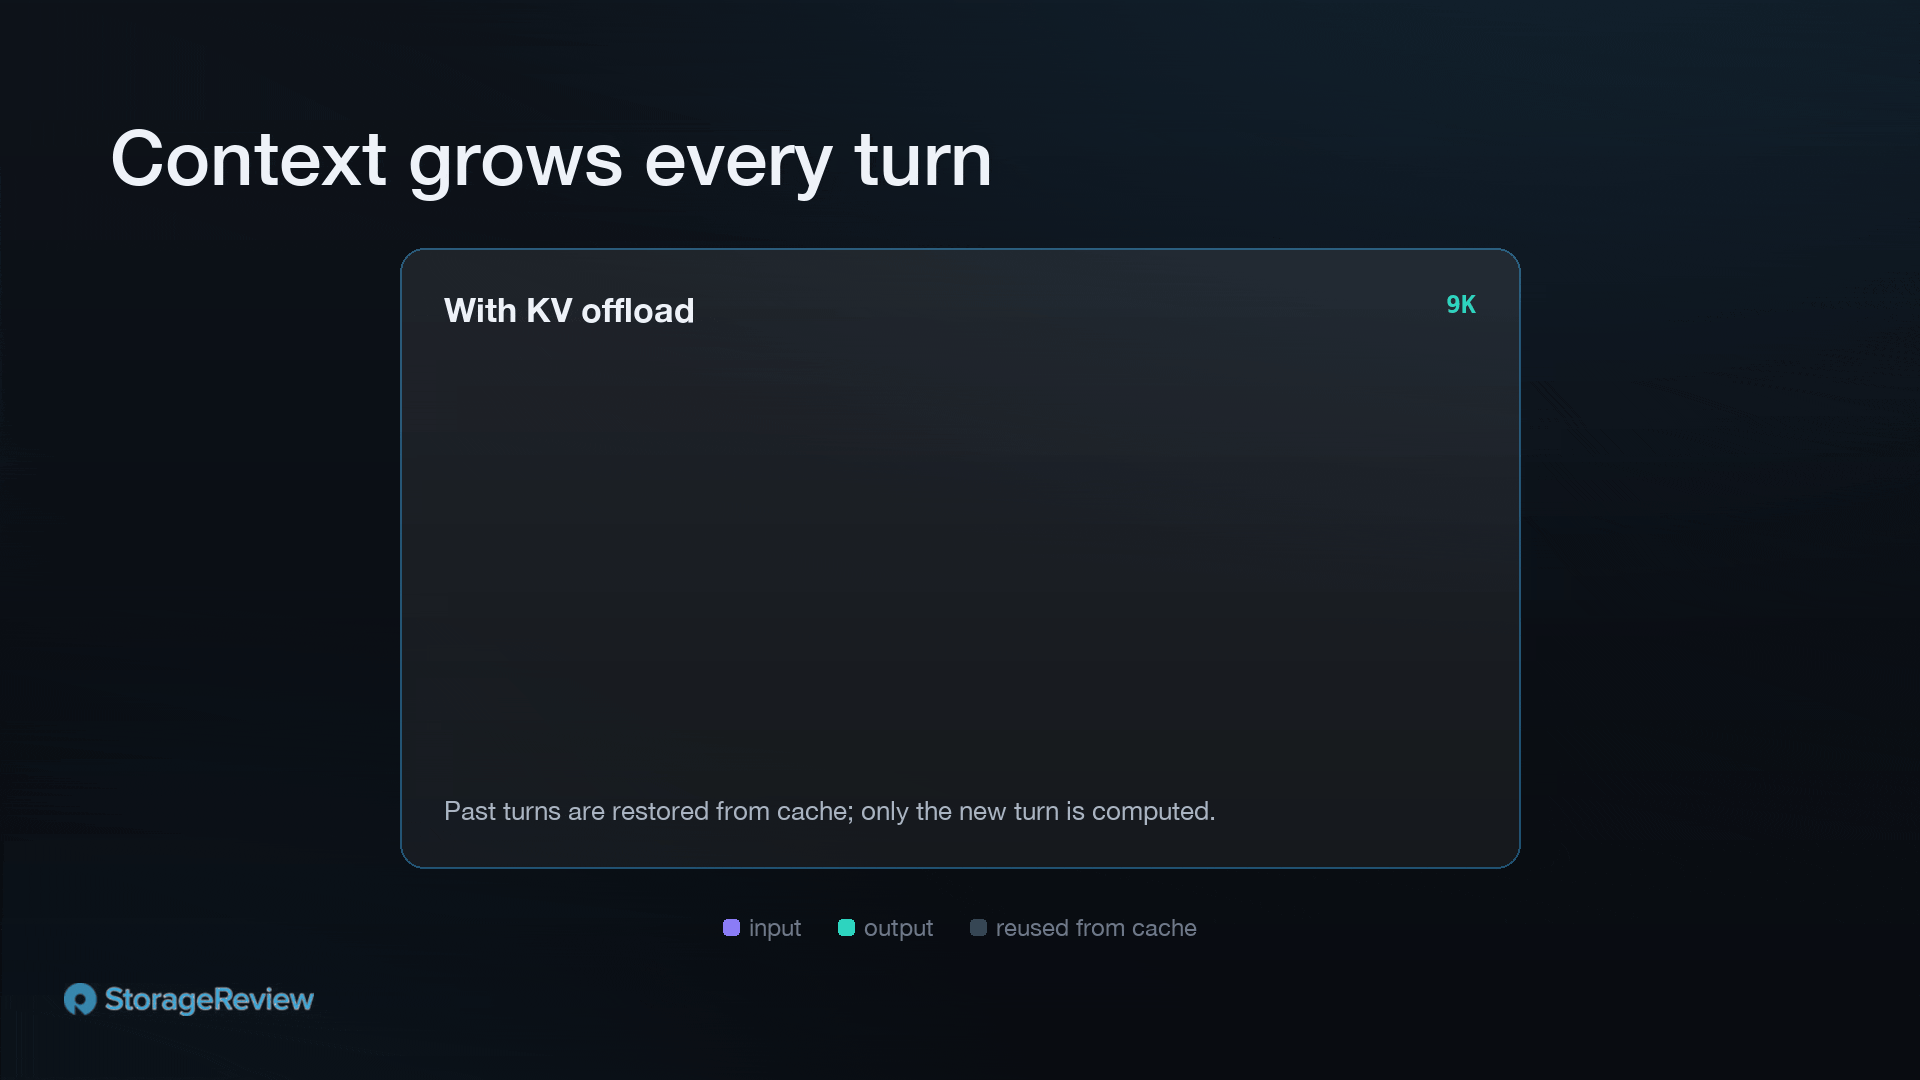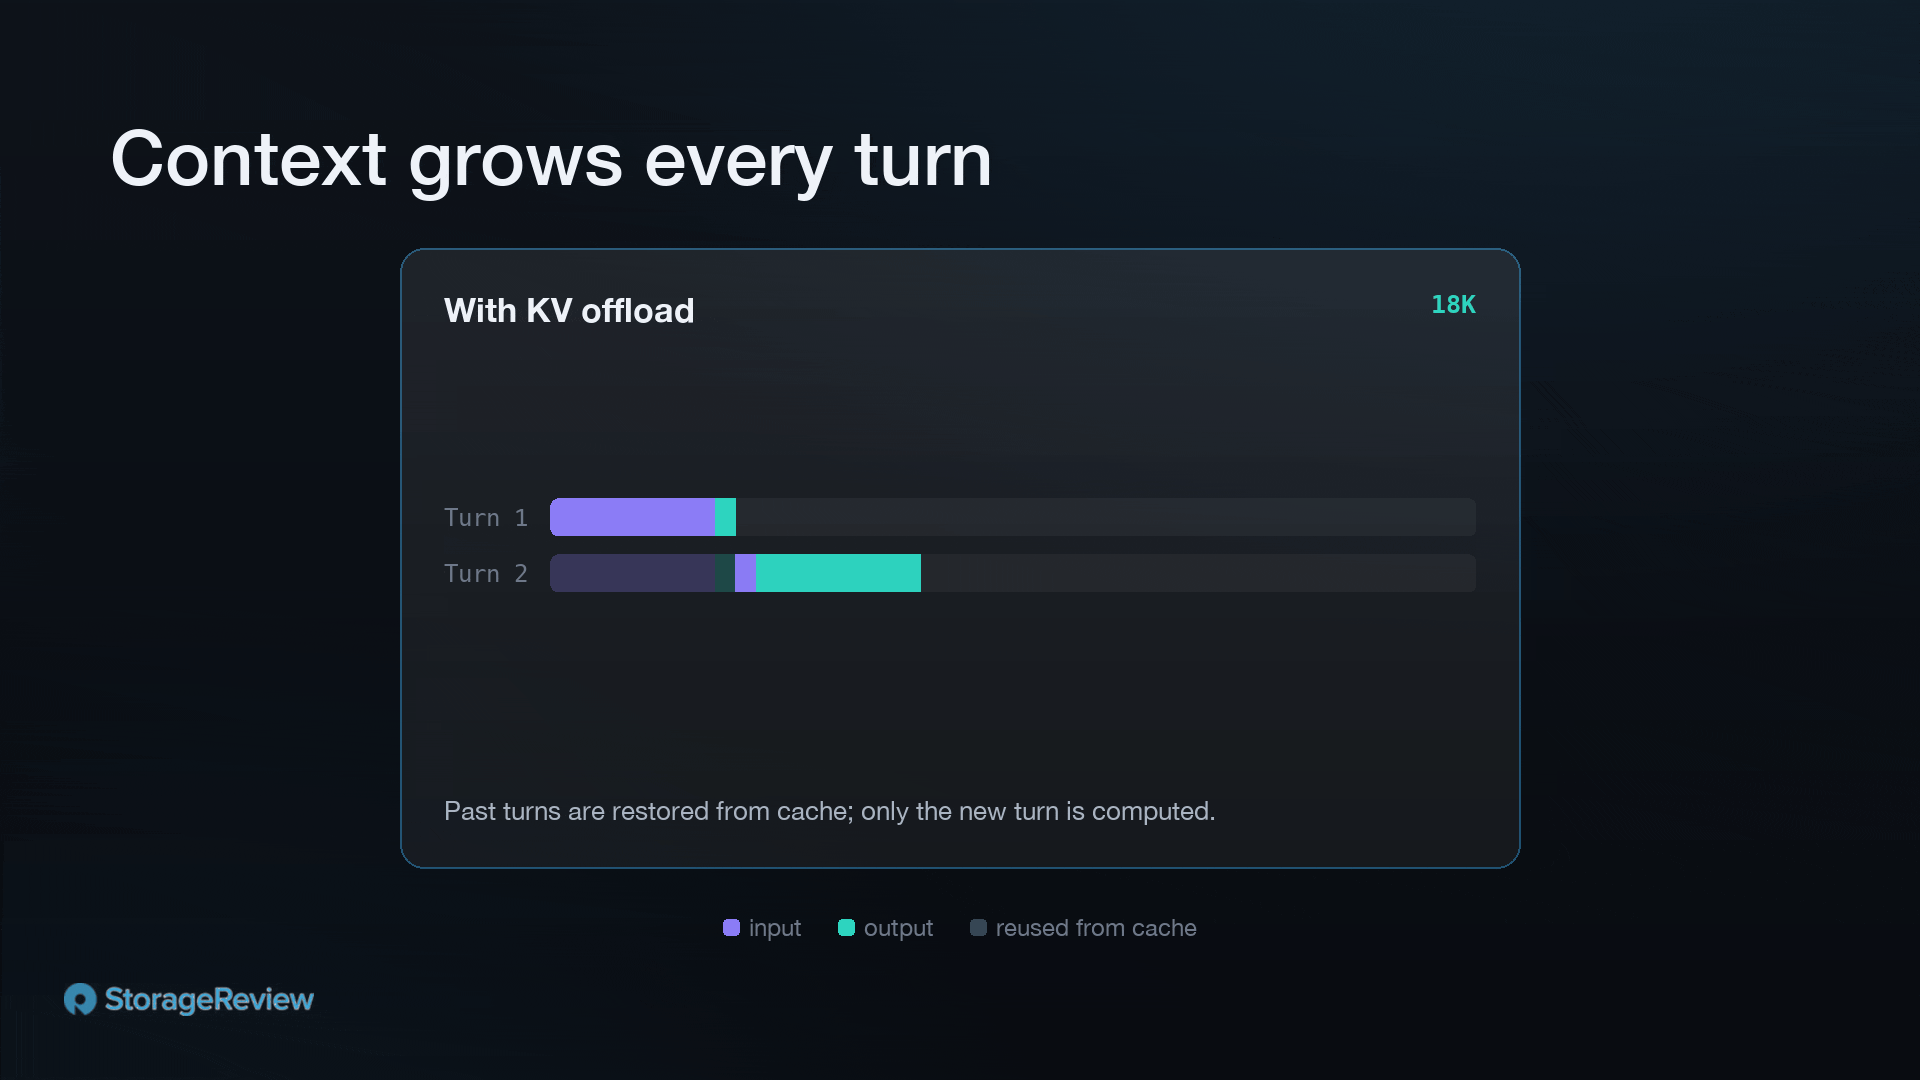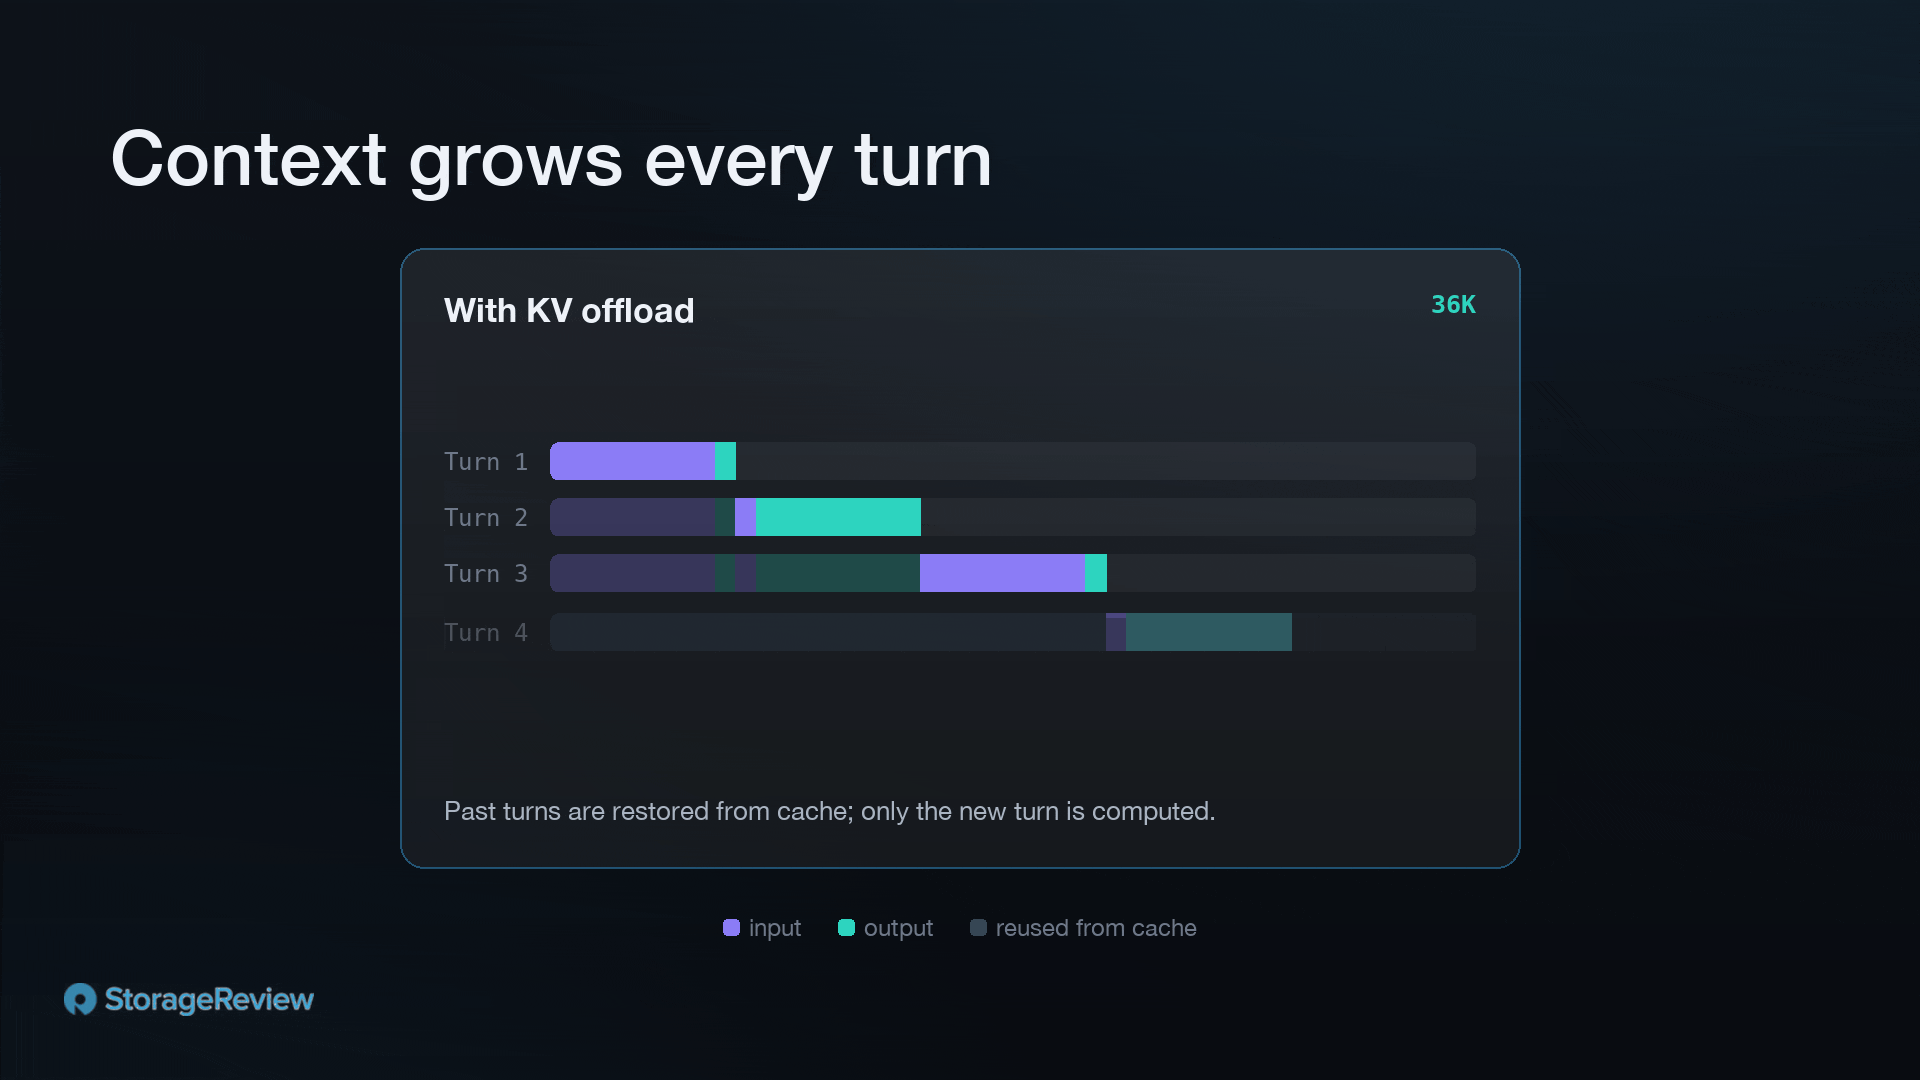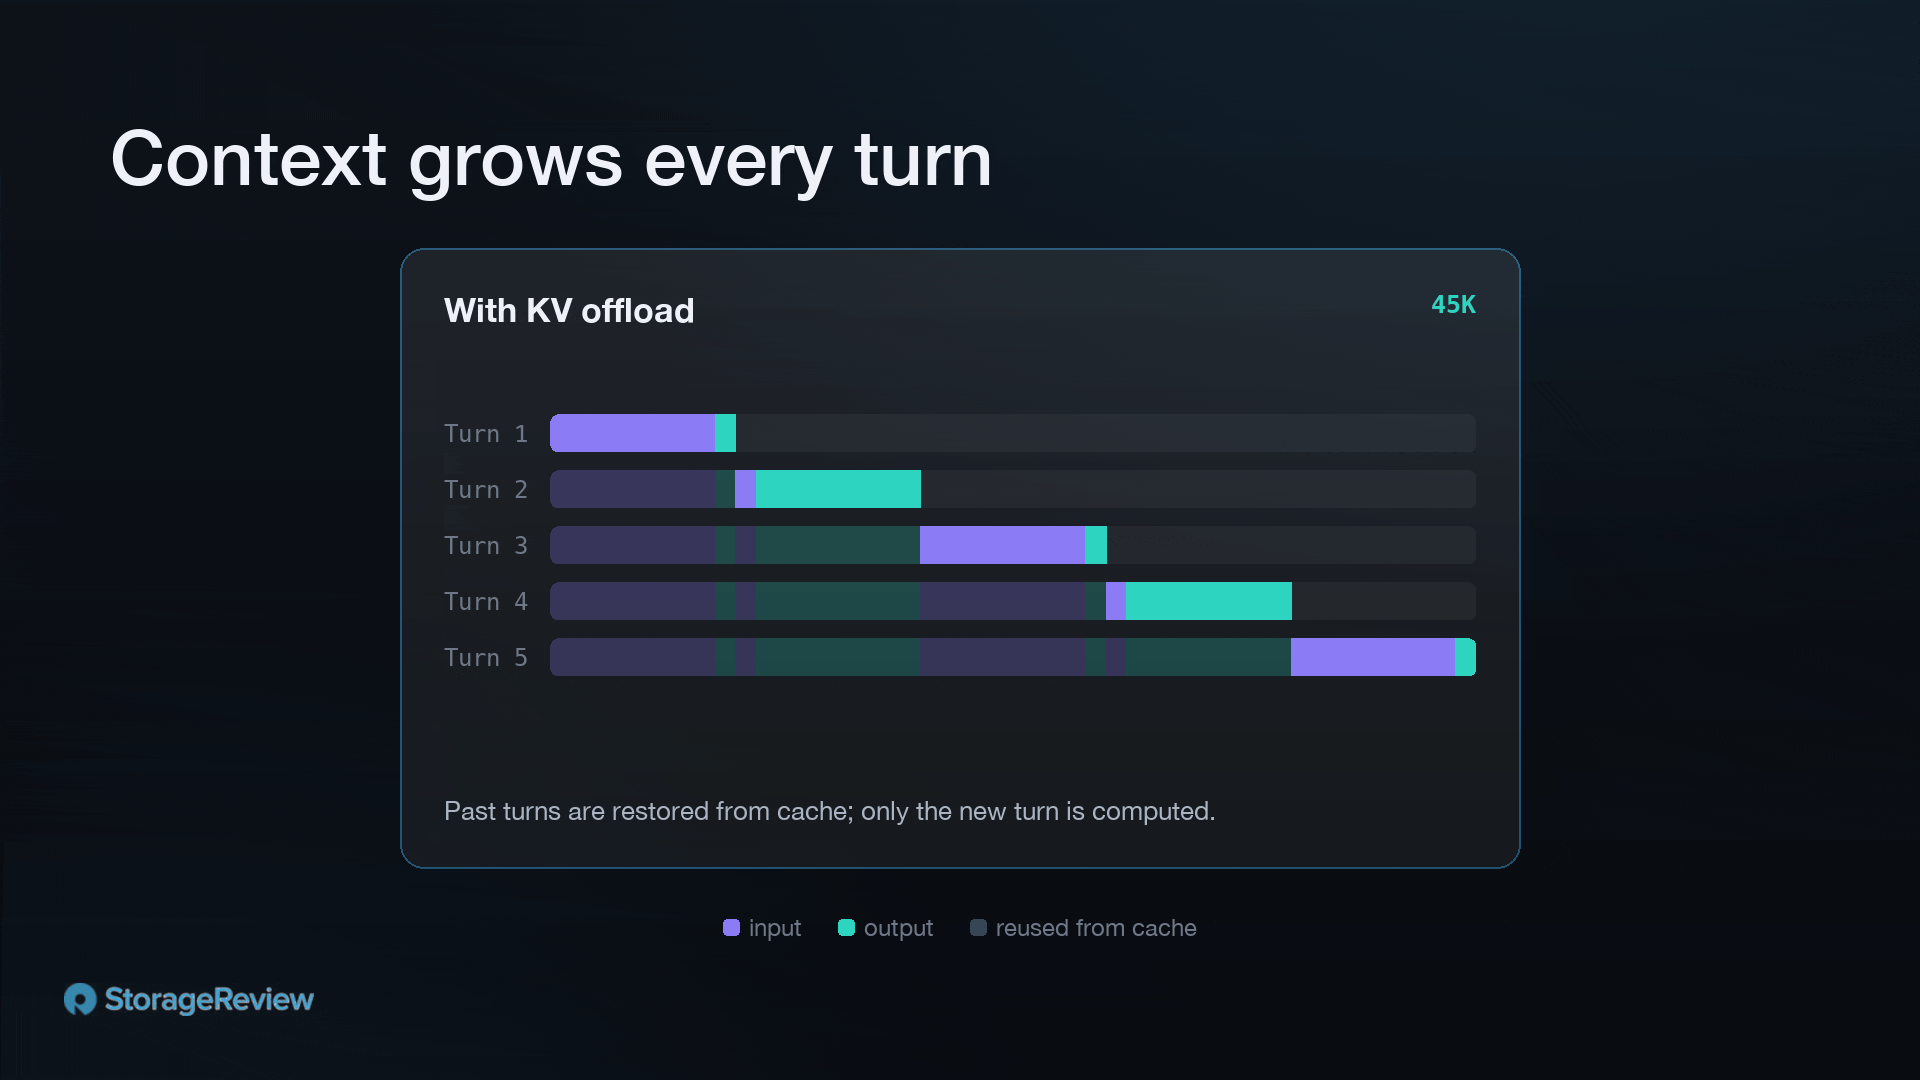
နောက်တစ်ကြိမ် အလှည့်ရောက်တဲ့အခါ context token ထောင်ပေါင်းများစွာကို ပြန်လည်တွက်ချက်မယ့်အစား RAM ဒါမှမဟုတ် flash storage ကနေ KV ကို ပြန်ဆွဲယူပါတယ်။ system memory ကနေ ပြန်လည် load လုပ်တာက latency အနည်းငယ်သာရှိပေမယ့် prefill ကို ပြန်လည်လုပ်ဆောင်တာထက် အများကြီးစျေးသက်သာပြီး ပိုမြန်ပါတယ်။ NVMe ကနေ ပြန်လည် load လုပ်တာက DRAM fetch ထက် အနည်းငယ်နှေးပေမယ့် အစားထိုးတဲ့ recompute ထက် အများကြီးပိုမြန်ပါတယ်။ Storage capacity က စျေးသက်သာပါတယ်။ GPU compute ကတော့ မသက်သာပါဘူး။ ဒါကြောင့် multi-second recompute ကိုကျော်ဖို့ အလှည့်အစမှာ reload latency အနည်းငယ်လဲလှယ်တာက အပေါင်းလက္ခဏာပါပဲ။
ကျွန်ုပ်တို့ မည်သို့စမ်းသပ်ခဲ့သနည်း။
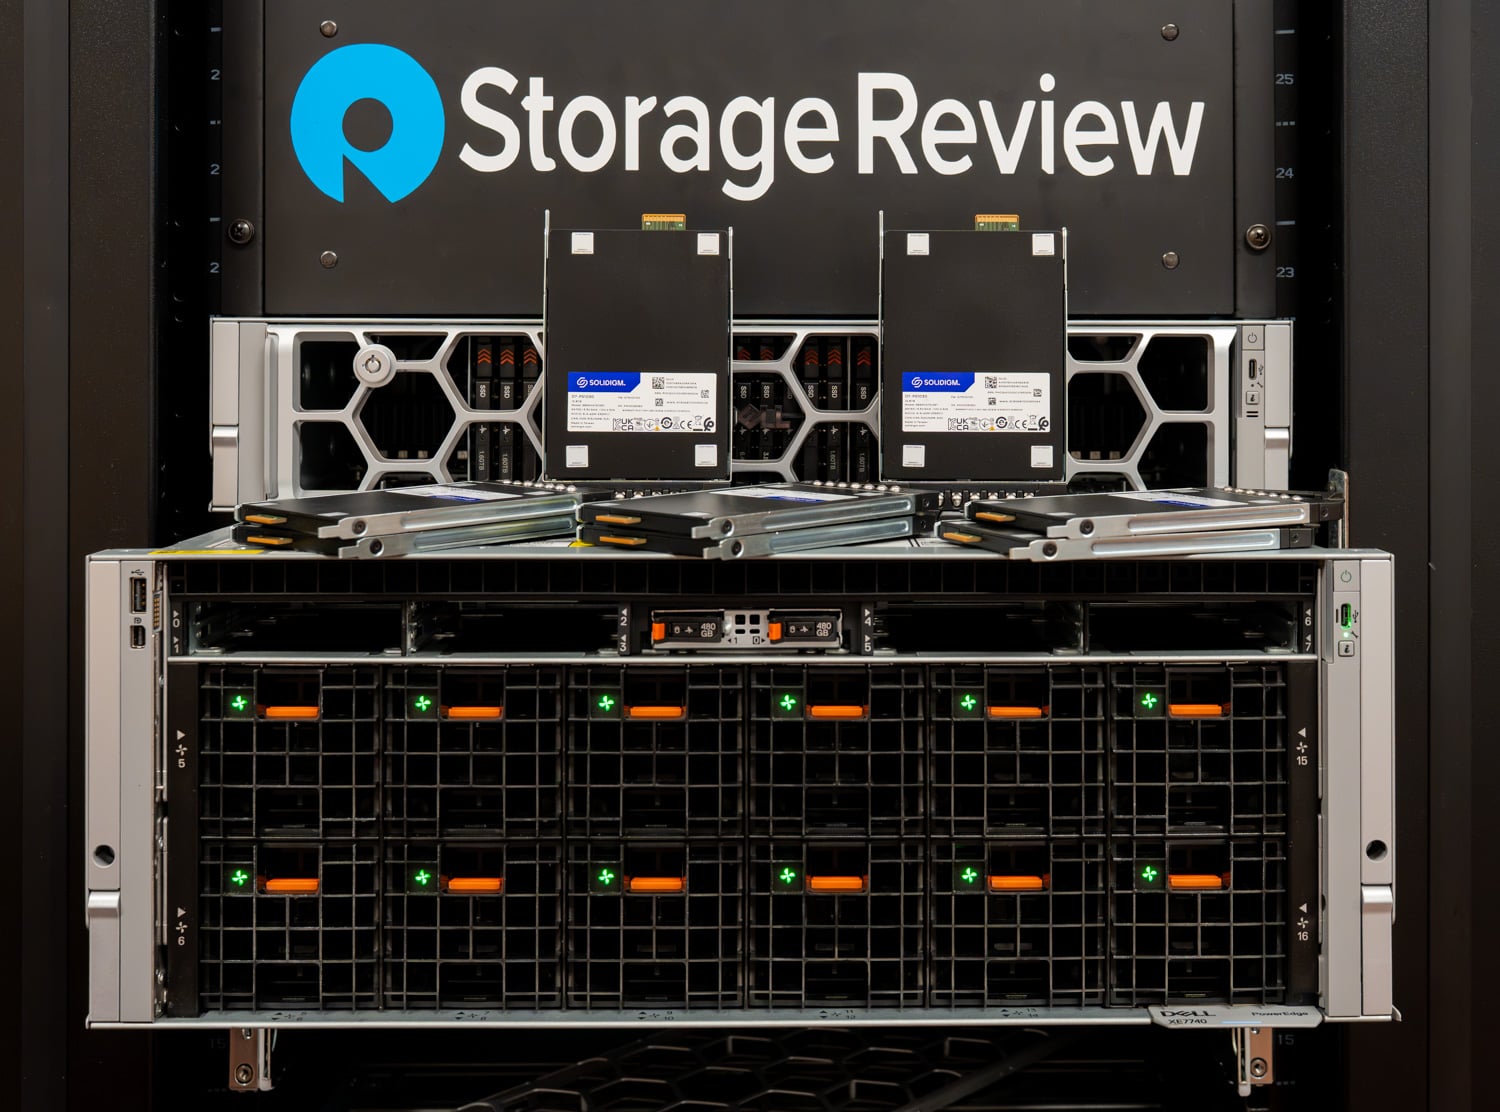
ကျွန်ုပ်တို့သည် ၎င်းကို ကျွန်ုပ်တို့၏ ဓာတ်ခွဲခန်းတွင် စမ်းသပ်ခဲ့သည်။ စနစ်ဖွဲ့စည်းပုံမှာ အောက်ပါအတိုင်းဖြစ်သည်။
- ဆာဗာ: Dell PowerEdge XE7740
- GPU များ: NVIDIA RTX PRO 6000 Blackwell Server Edition (96GB) ၄ ခု
- စနစ်မှတ်ဉာဏ်: 1TB DDR5 (16 x 64GB 5200MT/s DDR5)
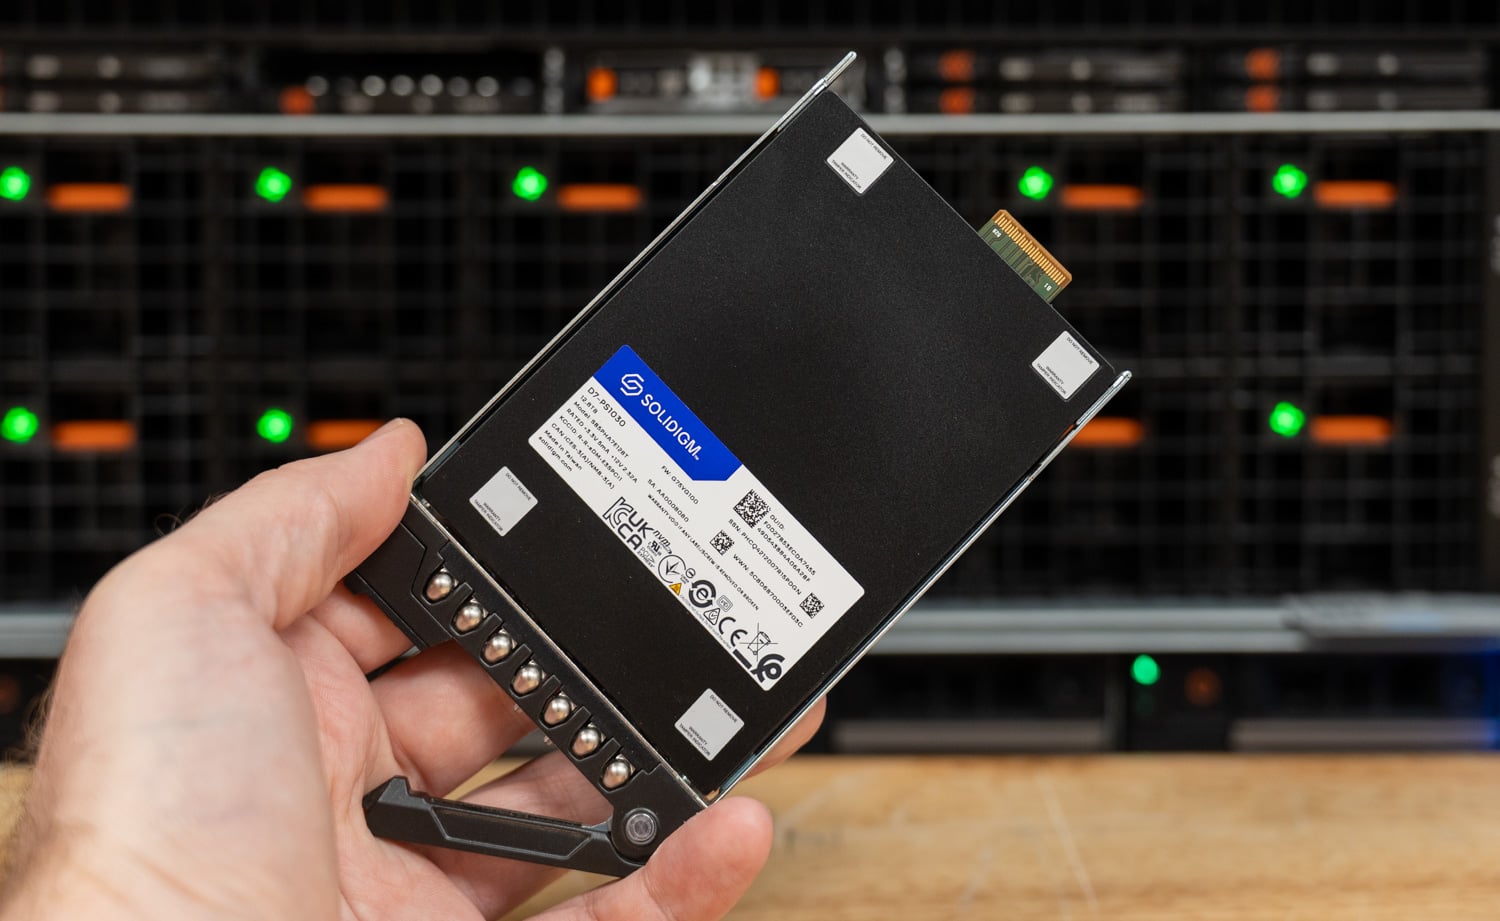
- သိုလှောင်မှု: Solidigm PS1030 12.8TB E3.S Drives (RAID10) ၈ ခု
- ကျွေးမွေးသည့် stack: LMCache 0.5.0 ပါရှိသော vLLM 0.22.0
- မော်ဒယ်: MiniMax-M2.7
စမ်းသပ်ပလက်ဖောင်းသည် ဤအလုပ်ပမာဏအတွက် ပြီးပြည့်စုံသော ကိုက်ညီမှုတစ်ခုဖြစ်သည်။ Dell ၏ PowerEdge XE7740 ကို enterprise AI inference အတွက် ရည်ရွယ်ချက်ရှိရှိ တည်ဆောက်ထားပြီး PCIe Gen5 chassis တစ်ခုဖြစ်ပြီး double-wide GPU ၈ ခုအထိ ပံ့ပိုးပေးသည်။ ကျွန်ုပ်တို့လုပ်ဆောင်ခဲ့သော four-GPU configuration သည် ရောင်းချခဲ့သော အရောင်းရဆုံး configuration များထဲမှ တစ်ခုဖြစ်သည်။ ၎င်းသည် inference ဖြန့်ကျက်မှုအမျိုးမျိုးအတွက် လုံလောက်သော accelerator စွမ်းရည်ကို ပေးစွမ်းပြီး ၀ယ်လိုအားတိုးလာသည်နှင့်အမျှ ရှစ်ခုအထိ တိုးချဲ့ရန် တူညီသော box တွင် နေရာချန်ထားသည်။ NVIDIA RTX PRO 6000 Blackwell Server Edition တစ်ခုစီတွင် GDDR7 memory 96GB ပါဝင်သောကြောင့် ကတ်လေးခုသည် cache များ GPU မှ ထွက်ခွာရန်မလိုအပ်မီ VRAM များစွာကို ထောက်ပံ့ပေးသည်။ အောက်တွင် offload tier သည် RAID10 ရှိ 12.8TB Solidigm D7-PS1030 drives ရှစ်ခုကို အသုံးပြုထားပြီး KV cache tier မှထုတ်ပေးသော ရေရှည်ရေးသားမှုများနှင့် ကိုက်ညီသော Gen5 high-endurance flash ဖြစ်သည်။ နောက်ဆုံးအနေဖြင့် မော်ဒယ်ရွေးချယ်မှုဖြစ်သော MiniMax-M2.7 သည် စမ်းသပ်ချိန်တွင် ကျွန်ုပ်တို့၏ four-GPU configuration နှင့် ကိုက်ညီသော ထိပ်တန်း open coding မော်ဒယ်များထဲမှ တစ်ခုဖြစ်သည်။
ကျွန်ုပ်တို့သည် configuration သုံးခုကို စမ်းသပ်ခဲ့သည်-
- VRAM အခြေခံ၊ offload မရှိသော stock vLLM တစ်ခု၊ VRAM တွင် ကိုက်ညီသည့်အရာကို cache လုပ်ထားပြီး ကျန်အရာအားလုံးကို ဖယ်ရှားသည်။
- LMCache ကို စနစ်မှတ်ဉာဏ်သို့ offload လုပ်နေပြီး offload အတွက် 512GB ခွဲဝေပေးထားသည်။
- LMCache ကို flash သို့ offload လုပ်ပြီး၊ local RAID10 NVMe array ကို offload tier အဖြစ်အသုံးပြုကာ၊ 64GB RAM staging buffer ဖြင့် ရှေ့တွင်ထားရှိသည်။
ကျွန်ုပ်တို့သည် workload ကို fixed synthetic prefix sweep အစား real agent coding traffic ပေါ်တွင် model လုပ်ခဲ့ပါသည်။ ထို traffic သည် prefill-heavy ဖြစ်ပြီး decode-light ဖြစ်ပြီး prefix reuse အများအပြားပါဝင်ပါသည်။ session များသည် တစ်မိနစ်လျှင် λ = 2.5 sessions နှုန်းဖြင့် Poisson process အနေဖြင့် ရောက်ရှိလာပါသည်။ session တစ်ခုစီသည် turn များစွာဖြင့် လည်ပတ်ပါသည်။ turn တစ်ခုစီတွင် model သည် tool သို့မဟုတ် command result တစ်ခုဖြစ်သည့် short append တစ်ခုကို ယူဆောင်သွားပြီး tool calls ၂၅၀ မှ ၆၀၀ အထိနှင့် တစ်ခါတစ်ရံတွင် token file read ၁,၅၀၀ မှ ၃,၅၀၀ အထိ ယူဆောင်ပါသည်။ ၎င်းသည် tool calls သို့မဟုတ် brief reasoning ၄၀ မှ ၂၀၀ အထိတိုတောင်းသော tokens ဖြင့် response လုပ်ကာ တစ်ခါတစ်ရံတွင် token code block ၄၀၀ မှ ၉၀၀ အထိတိုတောင်းသော response ဖြင့် reply လုပ်ပါသည်။ Turn lengths များကို ±၁၀၀ tokens များဖြင့် jitter လုပ်ပါသည်။ session များသည် 64k-token context ceiling သို့ monotonously ကြီးထွားလာပြီး ၎င်းတို့အား deep-context regime တွင်ထားရှိပြီး working set သည် VRAM ထက်ကျော်လွန်ပါသည်။ seeded load တူညီခြင်းသည် tier သုံးခုလုံးကိုမောင်းနှင်ပြီး tier တစ်ခုချင်းစီတွင် ၃ မိနစ် cache warm-up ရှိသည်။
မန်မိုရီ config အကြောင်း အမြန်မှတ်ချက်- တင်ပို့လိုက်တဲ့ XE7740 မှာ ပရောဂျက်အမျိုးမျိုးကို လွှမ်းခြုံဖို့ ရည်ရွယ်ထားတဲ့ ထိပ်တန်း build တစ်ခုဖြစ်တဲ့ 2TB DDR5 ပါဝင်ပြီး၊ ၂၀၂၆ မန်မိုရီ မထုတ်လုပ်ခင်က ဈေးနှုန်းကြောင့် DRAM ဟာ အတော်လေး ကွာခြားသွားပါတယ်။ မူလ configuration ဟာ အဖွဲ့အစည်းတစ်ခုအနေနဲ့ ဒီနေ့ GPU လေးခုနဲ့ မှာယူမယ့်ပမာဏနဲ့ နှိုင်းယှဉ်ရင် အလွန်အကျွံ သတ်မှတ်ချက်ရှိခဲ့တာကြောင့် ပိုပြီး လက်တွေ့ကျအောင် မန်မိုရီ 1TB ကို ဖယ်ရှားလိုက်ပြီး မန်မိုရီ throughput အများဆုံးကို ထိန်းသိမ်းဖို့ channel တစ်ခုစီကို DIMM တစ်ခုစီ ချန်ထားခဲ့ပါတယ်။
flash tier အကြောင်း methodology note တစ်ခုကတော့ run တွေမှာ LMCache ရဲ့ local disk backend ကို array ရှေ့မှာ လိုအပ်တဲ့ 64GB RAM staging buffer နဲ့ အသုံးပြုခဲ့ပါတယ်။ flash မှာ ထိန်းထားတဲ့ KV footprint ဟာ run တစ်လျှောက်လုံး host ရဲ့ total DRAM ထက် အများကြီး ကျော်လွန်သွားတာကြောင့် ရလဒ်တွေက host memory ထက် drive service ကို ထင်ဟပ်စေပါတယ်။
performance
ဝန်အားအောက်ရှိ စီးဆင်းမှု
KV လုပ်ငန်းအစုံသည် အလွှာတစ်ခုစီ၏ သိုလှောင်နိုင်မှုထက် ကျော်လွန်လာသည်နှင့်အမျှ လည်ပတ်မှုတစ်လျှောက် စုစုပေါင်း ဝန်ဆောင်မှုပေးသည့် ပမာဏ-
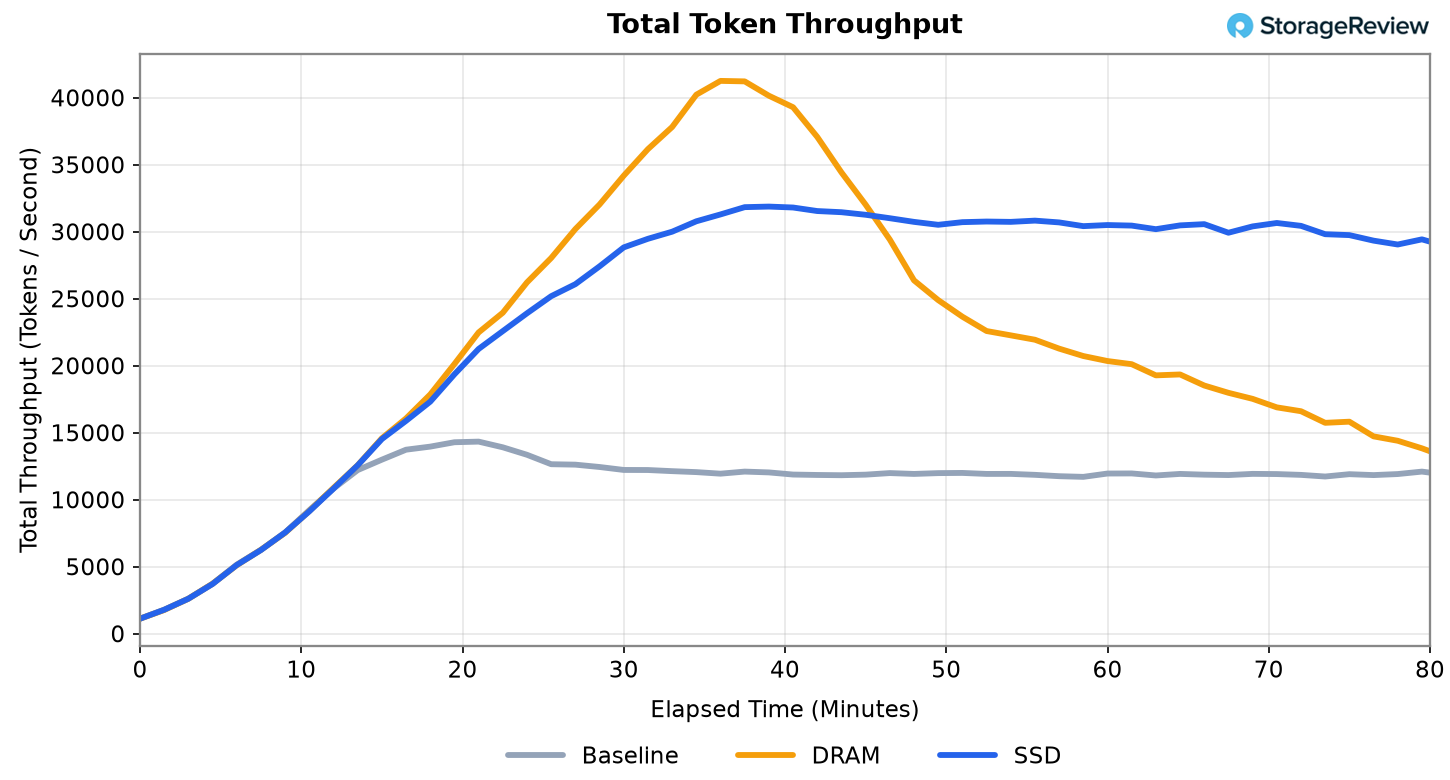
cache တွေ ပြည့်နေချိန်မှာ ပထမ ၁၀ မိနစ်အတွင်း tier တိုင်းဟာ အတူတကွ မြင့်တက်လာပြီး စွမ်းဆောင်ရည်မှာ အခြေခံအားဖြင့် ကွာခြားမှု မရှိပါဘူး။ ပြီးရင် memory tier တွေ ပြည့်သွားတဲ့အခါ ကွဲသွားပါတယ်။ VRAM တစ်ခုတည်းသာရှိတဲ့ baseline ဟာ အရင်ဆုံး ရပ်တန့်သွားပါတယ်။ VRAM ပြည့်သွားတဲ့အခါ တစ်စက္ကန့်ကို token စုစုပေါင်း ၁၂၀၀၀ လောက် ရပ်တန့်သွားပါတယ်။ session အသစ်တစ်ခုစီဟာ အဟောင်းတစ်ခုကို ဖယ်ရှားပစ်ပြီး အဲဒီ session ပြန်လာတဲ့အခါ အစားထိုးလိုက်တဲ့ cache ကို အစကနေ ပြန်လည်တည်ဆောက်ရမှာဖြစ်လို့ စက္ကန့်တိုင်းရဲ့ ပမာဏကို ပြန်လည်ဖြည့်သွင်းဖို့နဲ့ decode လုပ်ဖို့ ပမာဏ နည်းသွားပါတယ်။
DRAM နှင့် SSD အဆင့်များသည် ထိုအဆင့်ကို ကျော်လွန်နေဆဲဖြစ်သည်၊ အဘယ်ကြောင့်ဆိုသော် ၎င်းတို့၏ cache များပြည့်သွားသည်အထိ ၎င်းတို့သည် မန်မိုရီ သို့မဟုတ် disk မှ prefix တိုင်းနီးပါးကို ပြန်လည်တွက်ချက်မည့်အစား ဝန်ဆောင်မှုပေးသောကြောင့်ဖြစ်သည်။ re-prefill တွင် baseline လောင်ကျွမ်းသွားသောအချိန်သည် တိုကင်အသစ်များထုတ်လုပ်ရာတွင် အသုံးပြုသည်။
အမြင့်ဆုံးအချိန်မှာ offload ဟာ DRAM tier မှာ baseline ရဲ့ စုစုပေါင်း serving throughput ရဲ့ 2.9X (+188%) နဲ့ flash tier မှာ 2.2X (+122%) အထိ ပေးပို့ပါတယ်။ working set က VRAM ထက် ကျော်လွန်မသွားခင်မှာ configuration သုံးခုစလုံးဟာ တစ်ခုနဲ့တစ်ခု ရာခိုင်နှုန်းတစ်ခုအတွင်းမှာပဲ ရောက်သွားပါလိမ့်မယ်။ ဘာမှ evict မလုပ်တဲ့အတွက် offload ပြန်ကောင်းလာဖို့ ဘာမှမရှိပါဘူး။ memory pressure က evict လုပ်တဲ့အခါမှသာ အကျိုးကျေးဇူးပေါ်လာပြီး server ကို push လုပ်တဲ့အတိုင်းအတာနဲ့အမျှ တိုးလာပါတယ်။
DRAM ပြည့်သွားတဲ့အခါ tier ပိုကြီးတဲ့အခြေအနေပေါ်လာပါတယ်။ ဒီ load မှာ 512 GB RAM cache ဟာ run ပြီး ၄၅ မိနစ်လောက်မှာ saturated ဖြစ်ပြီး အဲဒီကနေစပြီး exit လုပ်ရပါတယ်။ returning prefix တွေ လွဲချော်ပြီး re-prefilled ဖြစ်တတ်တာကြောင့် cache ကို ရှောင်ရှားဖို့ ရည်ရွယ်ထားတဲ့ တိကျတဲ့ recommendation ပါ။ terabytes headroom ရှိတဲ့ SSD tier ဟာ အဲဒီအတားအဆီးကို ဘယ်တော့မှ မထိပါဘူး။ crossover ကျော်လွန်ပြီး flash ဟာ တစ်စက္ကန့်ကို token စုစုပေါင်း ၃၀,၀၀၀ လောက် ထိန်းသိမ်းထားနိုင်ပြီး DRAM ရဲ့ ၁၇,၀၀၀ လောက်နဲ့ နှိုင်းယှဉ်ရင် တိုကင်တွေ ပိုများပြီး RAM ကုန်သွားတဲ့အခါ SSD အတွက် ၇၅% throughput အားသာချက်ရှိပါတယ်။ တစ်နည်းအားဖြင့် saturating လုပ်ပြီးနောက် DRAM tier ဟာ သူ့ရဲ့ peak throughput ရဲ့ ၄၂% သာ ပေးပို့နိုင်ပြီး SSD tier ကတော့ သူ့ရဲ့ကိုယ်ပိုင် throughput ရဲ့ ၉၄% ပေးပို့ပါတယ်။ ဒါက လေ့ကျင့်ခန်းတစ်ခုလုံးကို ဖွင့်ပေးတဲ့ စွမ်းရည်လှေကားပါ- VRAM က အရင်ကုန်သွားပြီး 512 GB DRAM tier က နောက်မှကုန်သွားပြီး gigabytes အစား terabytes နဲ့တိုင်းတာတဲ့ storage tier က ဘယ်တော့မှ မကုန်သွားပါဘူး၊ ဒါကြောင့် ပိုမြန်တဲ့ tier တွေက စွန့်ပစ်လိုက်ရတဲ့အထိ ကြာရှည်စွာ အခြေအနေကို ဝန်ဆောင်မှုပေးနေပါတယ်။
စုစုပေါင်း throughput နံပါတ်ကို ဖတ်ရှုရာတွင် သတိပြုရမည့်အချက်တစ်ခုမှာ ၎င်းအစီရင်ခံသည့် တစ်စက္ကန့်လျှင် သောင်းနှင့်ချီသော token များသည် GPU များက token များကို တွက်ချက်သည့်နှုန်းမဟုတ်ပါ။ အများအားဖြင့် ၎င်းတို့သည် offload tier ၏ serving rate ဖြစ်သည်။ စုစုပေါင်း throughput တွင် input prefill token တိုင်းနှင့် request တစ်ခုစီတွင် ပါရှိသော output decode token တိုင်းကို ရေတွက်သည်။ သို့သော် cache ရှိနေချိန်တွင် hit သည် GPU တွင် ပြန်လည် prefill လုပ်မည့်အစား prefix ၏ KV ကို DRAM သို့မဟုတ် flash မှ ပြန်လည် load လုပ်သည်။
အထွက်တိုကင်များအထိ ရေတွက်မှုကို ကန့်သတ်ခြင်းဖြင့် အသုံးပြုသူ အမှန်တကယ်စောင့်ဆိုင်းနေသော throughput ၏ အစိတ်အပိုင်းသည် ပိုမိုရှင်းလင်းသော ရုပ်ပုံကို ပေးစွမ်းသည်။
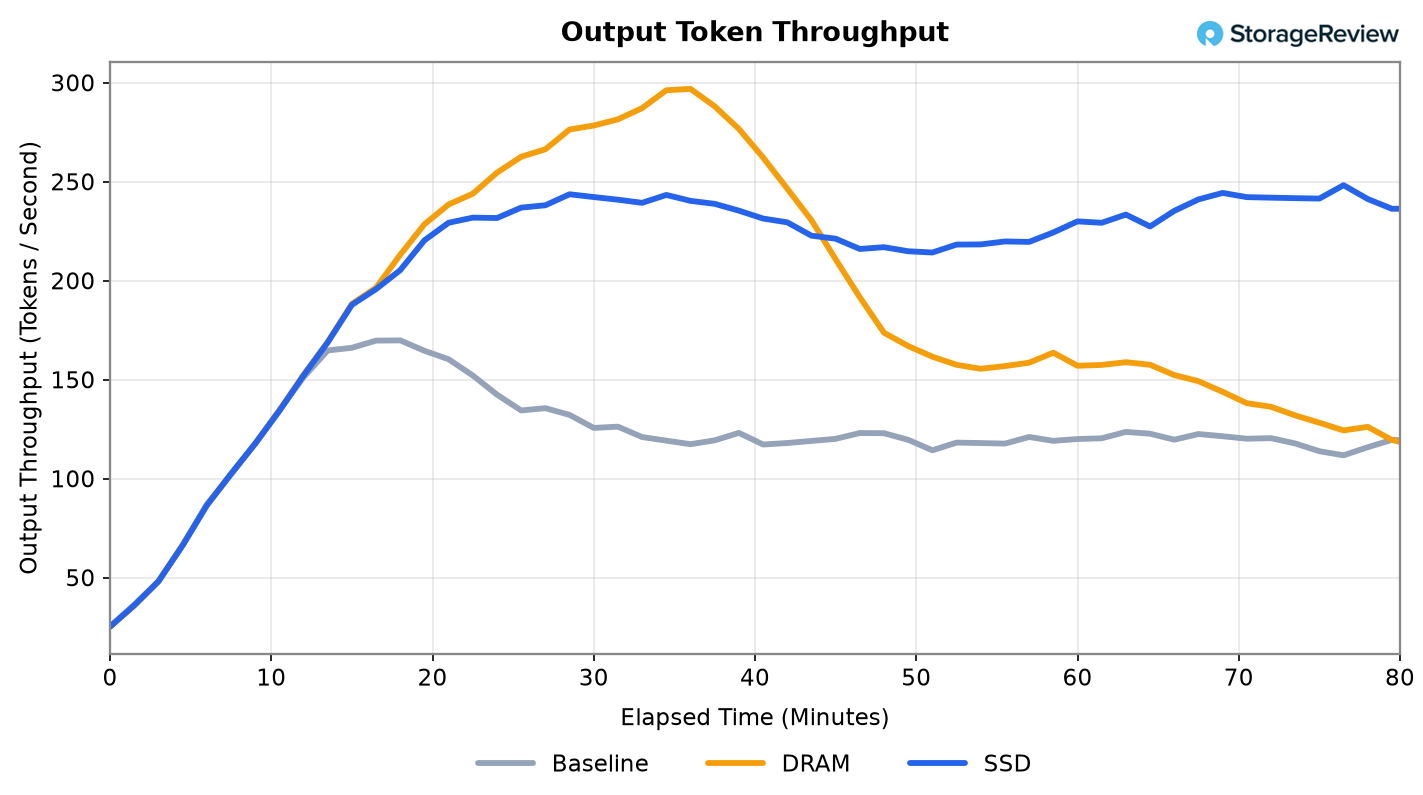
အထွက်တိုကင်များတွင်၊ cache များပြည့်နေချိန်တွင် အလွှာသုံးလွှာသည် ထပ်မံ၍ အတူတကွ ခြေရာခံပြီးနောက် crossover တွင် ပိုင်းခြားသွားသည်။ DRAM အလွှာသည် တစ်စက္ကန့်လျှင် တိုကင် ၃၀၀ နီးပါး အမြင့်ဆုံးရောက်ရှိပြီး အခြေခံထက် ၇၅% တိုးလာကာ ဖယ်ရှားပစ်သည်နှင့်အမျှ ပြန်လည်ကျဆင်းသွားသည်။ flash သည် ကျန်အချိန်တစ်လျှောက်လုံး ၂၅၀ နီးပါး ရှိနေပြီး အခြေခံထက် ၄၆% တိုးလာသည်။ RAM နှင့် SSD လိုင်းများသည် DRAM ပြည့်သွားသည်အထိ တစ်ခုနှင့်တစ်ခု ၁၀% ခန့်အတွင်းတွင် ရှိနေကြသည်။ ထို့နောက် ကွာဟချက်သည် ကျယ်လာသည်။
ပထမဆုံးတိုကင်နှောင့်နှေးမှု- အသုံးပြုသူစောင့်ဆိုင်းနေသည့်အရာ
Throughput သည် စုစုပေါင်း token ထုတ်လုပ်မှုကို တိုင်းတာသည်။ ပထမဆုံး token သို့ရောက်ရန် အချိန်က တစ်ဦးချင်းအသုံးပြုသူတစ်ဦး မြင်တွေ့ရသည့်အရာကို တိုင်းတာသည်- send ကို နှိပ်လိုက်သည့်အချိန်မှ ပထမဆုံး token ပြန်လာသည်အထိ စောင့်ဆိုင်းချိန်။ ကျွန်ုပ်တို့သည် ၎င်းကို run တစ်လျှောက်တွင် median တွင် plot လုပ်သည်၊ ၎င်းသည် working set ကြီးထွားလာပြီး tier တစ်ခုစီ ပြည့်လာသည်နှင့်အမျှ ဖြစ်သည်။
cache တွေရှိနေတဲ့အချိန်မှာ tier သုံးခုစလုံးက first token ကို စက္ကန့်ဝက်လောက်အတွင်း ပြန်ပေးပါတယ်။ ပြီးရင် သူတို့ရဲ့ throughput အစီအစဉ်အတိုင်း ကွဲပြားသွားပါတယ်။ baseline က အရင်ဆုံး ပျက်သွားပါတယ်။ run အစောပိုင်းမှာ ၁၀ စက္ကန့်ကျော်သွားပြီး DRAM tier က ၄၅ မိနစ်အမှတ်အသားလောက်ပြည့်တဲ့အထိ ၁ စက္ကန့် TTFT အောက်မှာ ပိုကြာကြာနေတတ်ပါတယ်။ ပြီးရင် 512 GB ပြည့်သွားတဲ့အထိ ပြန်တွက်ချက်တဲ့အခါ latency က မြင့်တက်လာပါတယ်။ SSD tier က အညင်သာဆုံး ကျဆင်းသွားပြီး run ရဲ့နောက်တစ်ဝက်မှာ သုံးခုထဲက အနိမ့်ဆုံးကို ထိန်းထားပါတယ်။
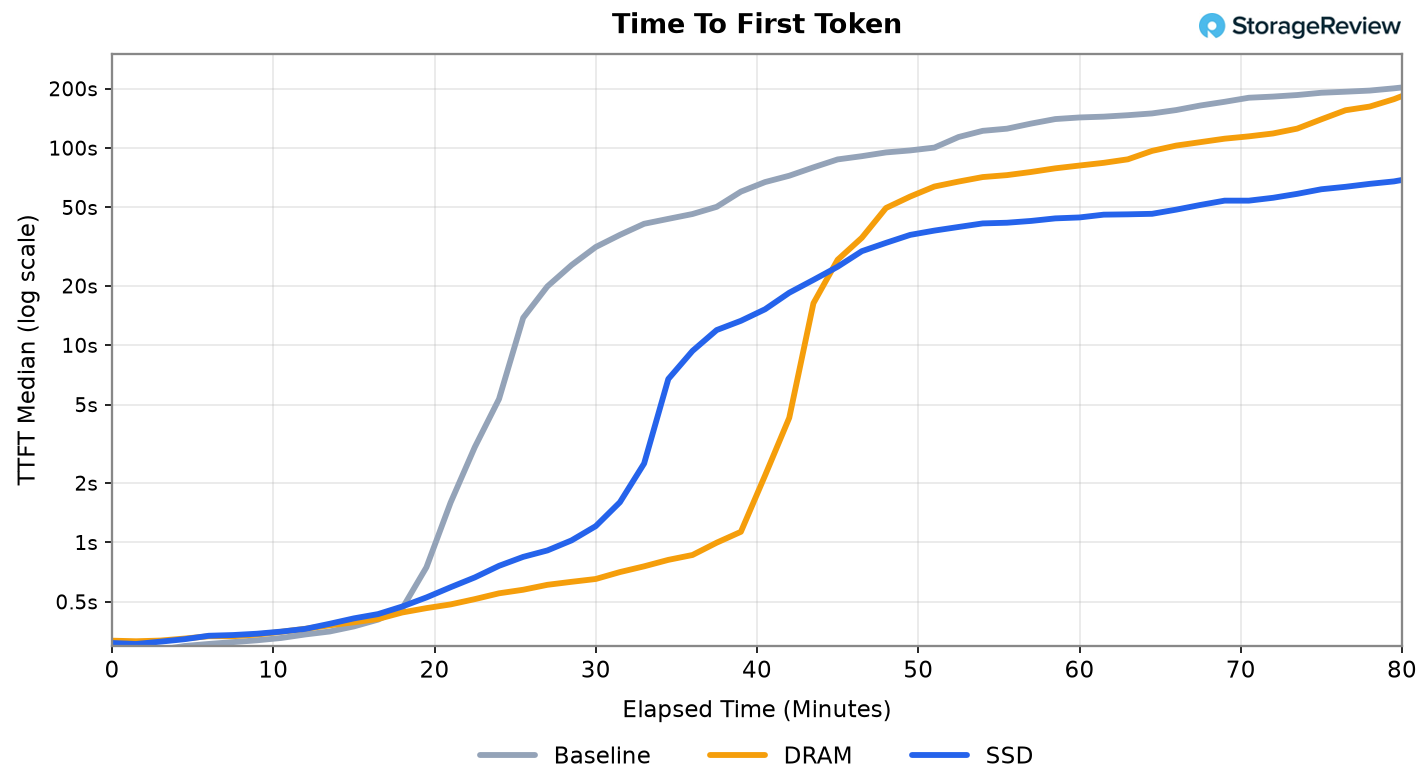
အဲဒီလှန်လိုက်တာက tiering argument အသေးစားလေးပါ။ DRAM က latency winner ဖြစ်ပြီး working set က အဲဒီ tier မှာ အံဝင်ခွင်ကျဖြစ်ပြီး flash က latency winner မဟုတ်တဲ့အခါ flash က latency winner ပါ၊ ဘာလို့လဲဆိုတော့ DRAM tier က ပစ်ပယ်ထားတဲ့ context ကို ထိန်းသိမ်းထားနိုင်လို့ပါ။
ပြန်လည်အသုံးပြုသူပြဿနာ
အထက်ဖော်ပြပါ latency နံပါတ်များသည် စဉ်ဆက်မပြတ် session တစ်ခုအတွင်း turn များကို လွှမ်းခြုံထားသည်။ ပြန်လည်အသုံးပြုသူ case သည် ကွဲပြားသည်- session တစ်ခုသည် စကားပြောဆိုမှုအလယ်တွင် ခေတ္တရပ်ပြီး မိနစ် ၁၅ ခန့် idle ထားပြီးနောက် ၎င်းရပ်တန့်သွားသည့်နေရာမှ ပြန်လည်စတင်သည်။ ကျွန်ုပ်တို့သည် turn ၂၀ ခန့်အကြာတွင် ငြိမ်သက်သွားပြီး မိနစ် ၁၅ အကြာတွင် ပြန်လည်ရှင်သန်လာသော cohort တစ်ခုဖြင့် ၎င်းကို model လုပ်ခဲ့ပြီး အလုပ်များသော server သည် ၎င်း၏ cache များမှတစ်ဆင့် အခြား traffic များကို လည်ပတ်ရန် လုံလောက်သောအချိန်ဖြစ်သည်။ ထိုကဲ့သို့သော ပြန်လည်ရှင်သန်မှု ၁၁ ခုသည် tier တစ်ခုစီ၏ measurement window တွင် ကျရောက်ခဲ့ပြီး workload ကို tier များတစ်လျှောက်တွင် တူညီစွာ seed လုပ်ထားသောကြောင့် တူညီသော session ၁၁ ခုကို run တိုင်းတွင် ပြန်လည်ရှင်သန်စေပြီး resume turn နှင့် ဆင်တူသော နှိုင်းယှဉ်မှုကို ပေးစွမ်းသည်။ အောက်ပါဇယားတွင် tier တစ်ခုစီ၏ normal turn တွင် resume turn နှင့် နှိုင်းယှဉ်ထားသော median first-token အချိန်ကို ပုံဖော်ထားပြီး whisker သည် sample တွင် အဆိုးဆုံး resume ကို အမှတ်အသားပြုသည်။
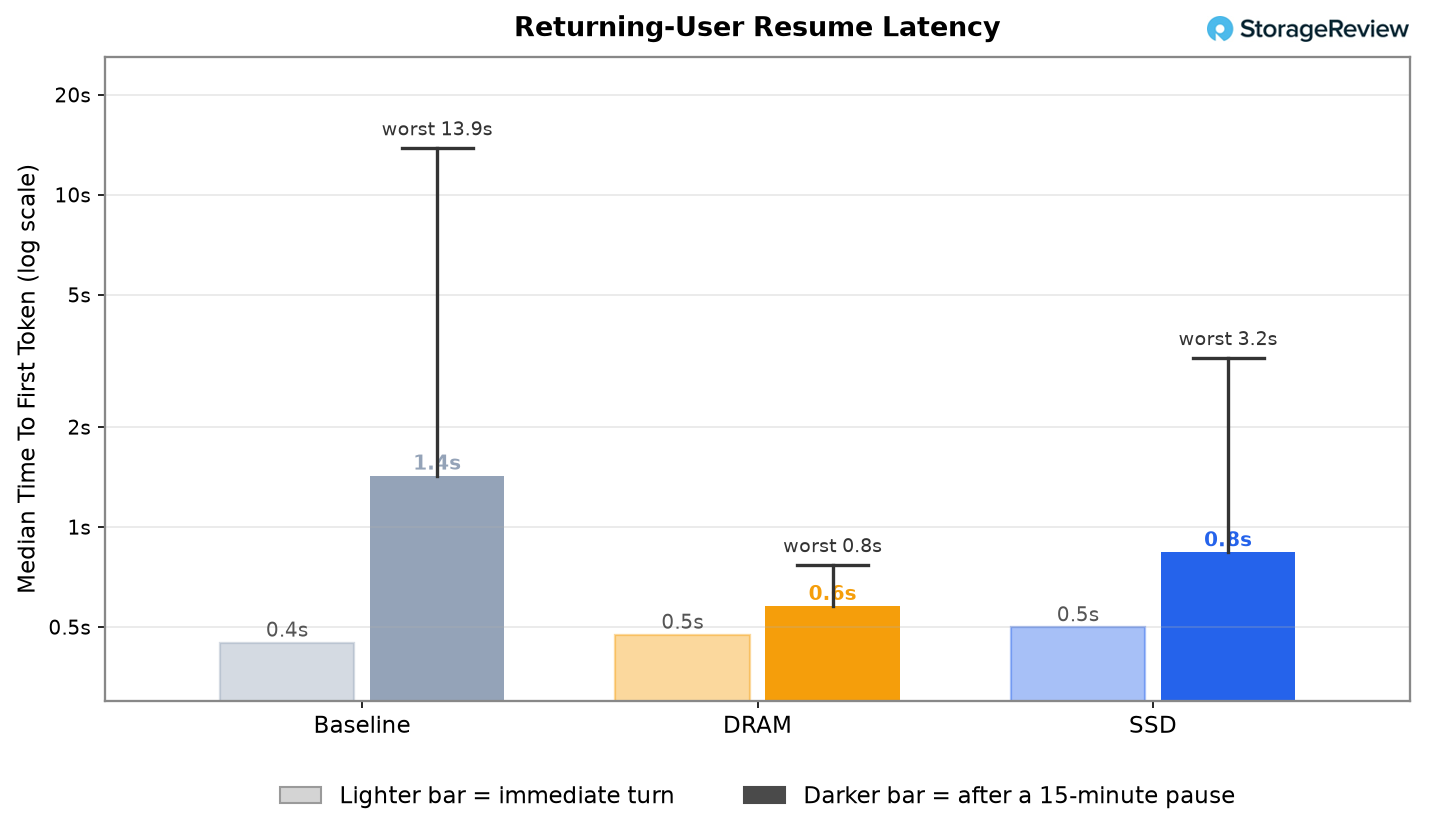
အလယ်အလတ်အဆင့်မှာ ကိန်းဂဏန်းတွေက mechanics ခန့်မှန်းထားတာကိုပဲ အတည်ပြုပေးပြီး tiers တွေက မျှော်မှန်းထားတဲ့ အစီအစဉ်အတိုင်း ပြန်ရောက်သွားပါတယ်။ DRAM leads: dormant session တစ်ခုဟာ 0.6 စက္ကန့်အတွင်း ပြန်စပြီး ပုံမှန် turn တစ်ခုရဲ့ 0.5 စက္ကန့်ထက် အနည်းငယ်သာ ပိုများပါတယ်။ SSD က 0.8 စက္ကန့်နဲ့ ဒုတိယနေရာမှာ ရှိနေပါတယ်။ NVMe fetch ဟာ DRAM fetch ထက် နှေးကွေးတယ်ဆိုတာ ကျွန်တော်တို့ သိပါတယ်၊ ဒါက ဒီမှာ ချောင်းကြည့်နေတဲ့ အရာရဲ့ အစိတ်အပိုင်းတစ်ခုပါ။ VRAM-only baseline က 1.4 စက္ကန့်နဲ့ အနှေးဆုံးဖြစ်ပါတယ်။ offload လုပ်စရာ ဘာမှမရှိတဲ့အတွက် idle session ရဲ့ prefix ကို live traffic အတွက် GPU memory ကနေ ဖယ်ရှားလိုက်ပြီး ပထမဆုံး turn ပြန်တာက ပြန်လည်တွက်ချက်ရပါတယ်။ အကောင်းဆုံးအခြေအနေမှာဆိုရင် spread တစ်ခုလုံးက တစ်စက္ကန့်လောက်ပဲ ရှိပါတယ်။
အကောင်းဆုံးအခြေအနေက ရွေးချယ်မှုပြုလုပ်တဲ့ အခြေအနေမဟုတ်ပါဘူး။ အလွှာတစ်ခုစီမှာ ပြန်လည်ရှင်သန်မှု ၁၁ ခုထဲက အဆိုးဆုံးအခြေအနေကတော့ DRAM မှာ ၀.၈ စက္ကန့်၊ SSD မှာ ၃.၂ စက္ကန့်နဲ့ baseline မှာ ၁၃.၉ စက္ကန့်ပါ။ ပထမဆုံး token အတွက် ၁၄ စက္ကန့်စောင့်ဆိုင်းရတာ ခံနိုင်ရည်ရှိလား၊ ဒါမှမဟုတ် SLO ချိုးဖောက်မှုပြင်းထန်တာ ခံနိုင်ရည်ရှိမရှိ service ပေါ်မှာ မူတည်ပေမယ့် interactive တစ်ခုခုအတွက်ကတော့ နောက်ဆုံးအခြေအနေပါ။ offload tiers တွေကသာ အဲဒီ tail ကို user ဖြတ်သန်းရမယ့် bound ထဲမှာ ထားပေးပါတယ်။ ပြန်လည်တွက်ချက်တဲ့ cost ဟာ returning user တည်ဆောက်ထားတဲ့ history ပမာဏနဲ့ ချိန်ညှိထားတာကြောင့် context မှာလည်း ကျယ်ပြန့်လာပါတယ်။ throughput test ရဲ့ ပိုနက်ရှိုင်းတဲ့ context တွေမှာ baseline tail က ၁၄ စက္ကန့်ကျော် ကြာမြင့်ပြီး DRAM နဲ့ SSD ကတော့ bounded reload ပဲ ခံရပါတယ်။
KV Cache ရွေးချယ်ခြင်းနှင့် အရွယ်အစားသတ်မှတ်ခြင်း
Offload tier နှစ်ခုစလုံးဟာ VRAM-only baseline ကို အတိုင်းအတာတစ်ခုအထိ ကျော်လွန်ပြီး အဲဒီကိုရောက်တဲ့အခါ တစ်ခုနဲ့တစ်ခု နီးကပ်စွာ ရောက်ရှိသွားကြပါတယ်။ throughput win က VRAM ကို free လုပ်လိုက်တာပဲဖြစ်ပြီး၊ deprived လုပ်ထားတဲ့ cache က DRAM မှာရောက်သည်ဖြစ်စေ SSD မှာရောက်သည်ဖြစ်စေ throughput win က အတူတူပဲဖြစ်လို့ ကွာဟချက်က နည်းပါတယ်။ cache ဘယ် tier ကနေ ပြန်လာတာလဲဆိုတာက ဂရုမစိုက်ပါဘူး။ DRAM fetch က NVMe fetch ထက် ပိုမြန်တာကြောင့် latency က ပိုမြန်ပါတယ်၊ ဒါပေမယ့် နှစ်ခုစလုံးက KV တစ်ခုတည်းကို scratch ကနေ ပြန်တွက်ချက်ဖို့ထက် ပိုသက်သာပါတယ်။
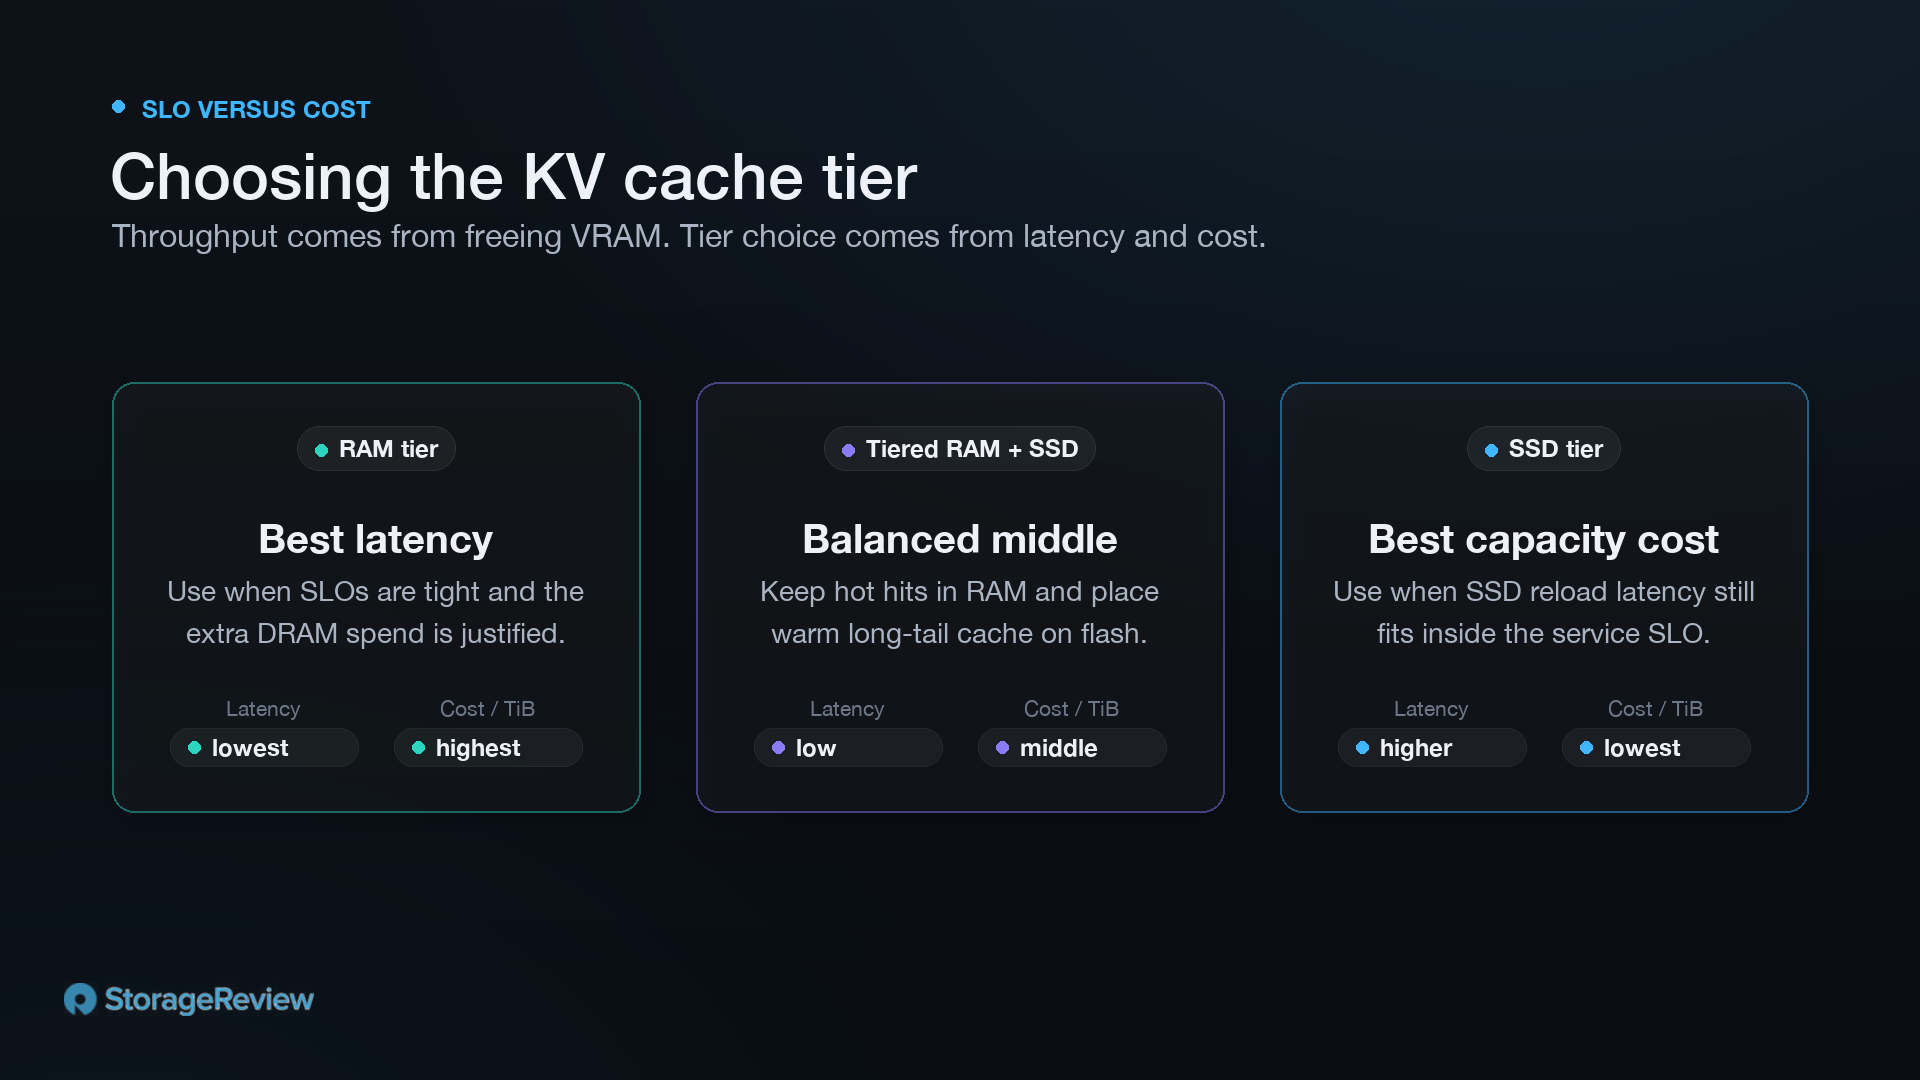
နှစ်ခုကြား ရွေးချယ်မှုကတော့ operator က ဘာအတွက် optimize လုပ်နေလဲဆိုတဲ့အပေါ် မူတည်ပြီး SLO-versus-cost trade-off ပါ။ offloaded cache တစ်ခုလုံးကို RAM မှာ သိမ်းဆည်းထားခြင်းအားဖြင့် အကောင်းဆုံး latency ကို ရရှိစေပေမယ့် flash မှာ latency uplift အနည်းငယ်အတွက် CAPEX အများကြီး လိုအပ်ပါတယ်။ Tiering က အလယ်အလတ်အဆင့်ပါ - latency-critical hits တွေကို အရေးကြီးတဲ့နေရာမှာ စုပ်ယူပေးတဲ့ RAM tier ပိုသေးပြီး နောက်ကွယ်မှာ storage tier တစ်ခုပါရှိပြီး မီလီစက္ကန့် ရာဂဏန်းအတွင်း ပြန်မလာဘဲ ပိုနွေးတဲ့ long-tail cache တွေကို သိမ်းဆည်းထားပါတယ်။
KV cache များအကြောင်း စဉ်းစားရန် နောက်ထပ်နည်းလမ်းတစ်ခုမှာ ၎င်းတို့၏ အရွယ်အစားဖြစ်သည်။ storage tier ၏ အရွယ်အစားကို setup မှ ထိန်းသိမ်းထားနိုင်သည့် အများဆုံး token throughput ပမာဏအပေါ် မူတည်သည်။ စနစ်တစ်ခု ထိန်းသိမ်းရမည့် KV footprint မှာ cache entries များ၏ TTL ၏ throughput အကြိမ်ဖြစ်သည်။ ထုတ်လုပ်ထားသော token တိုင်းသည် KV entry တစ်ခုကို ရေးသားသောကြောင့် သင်္ချာသည် token များ ရောက်ရှိလာသည့်နှုန်းနှင့် ၎င်းတို့ကို မည်မျှကြာအောင် သိမ်းဆည်းထားသည်ကို တွက်ချက်ခြင်းဖြစ်သည်။ ထုတ်လုပ်မှုတွင် TTL default နှစ်ခုမှာ ငါးမိနစ်နှင့် တစ်နာရီဖြစ်သည်။
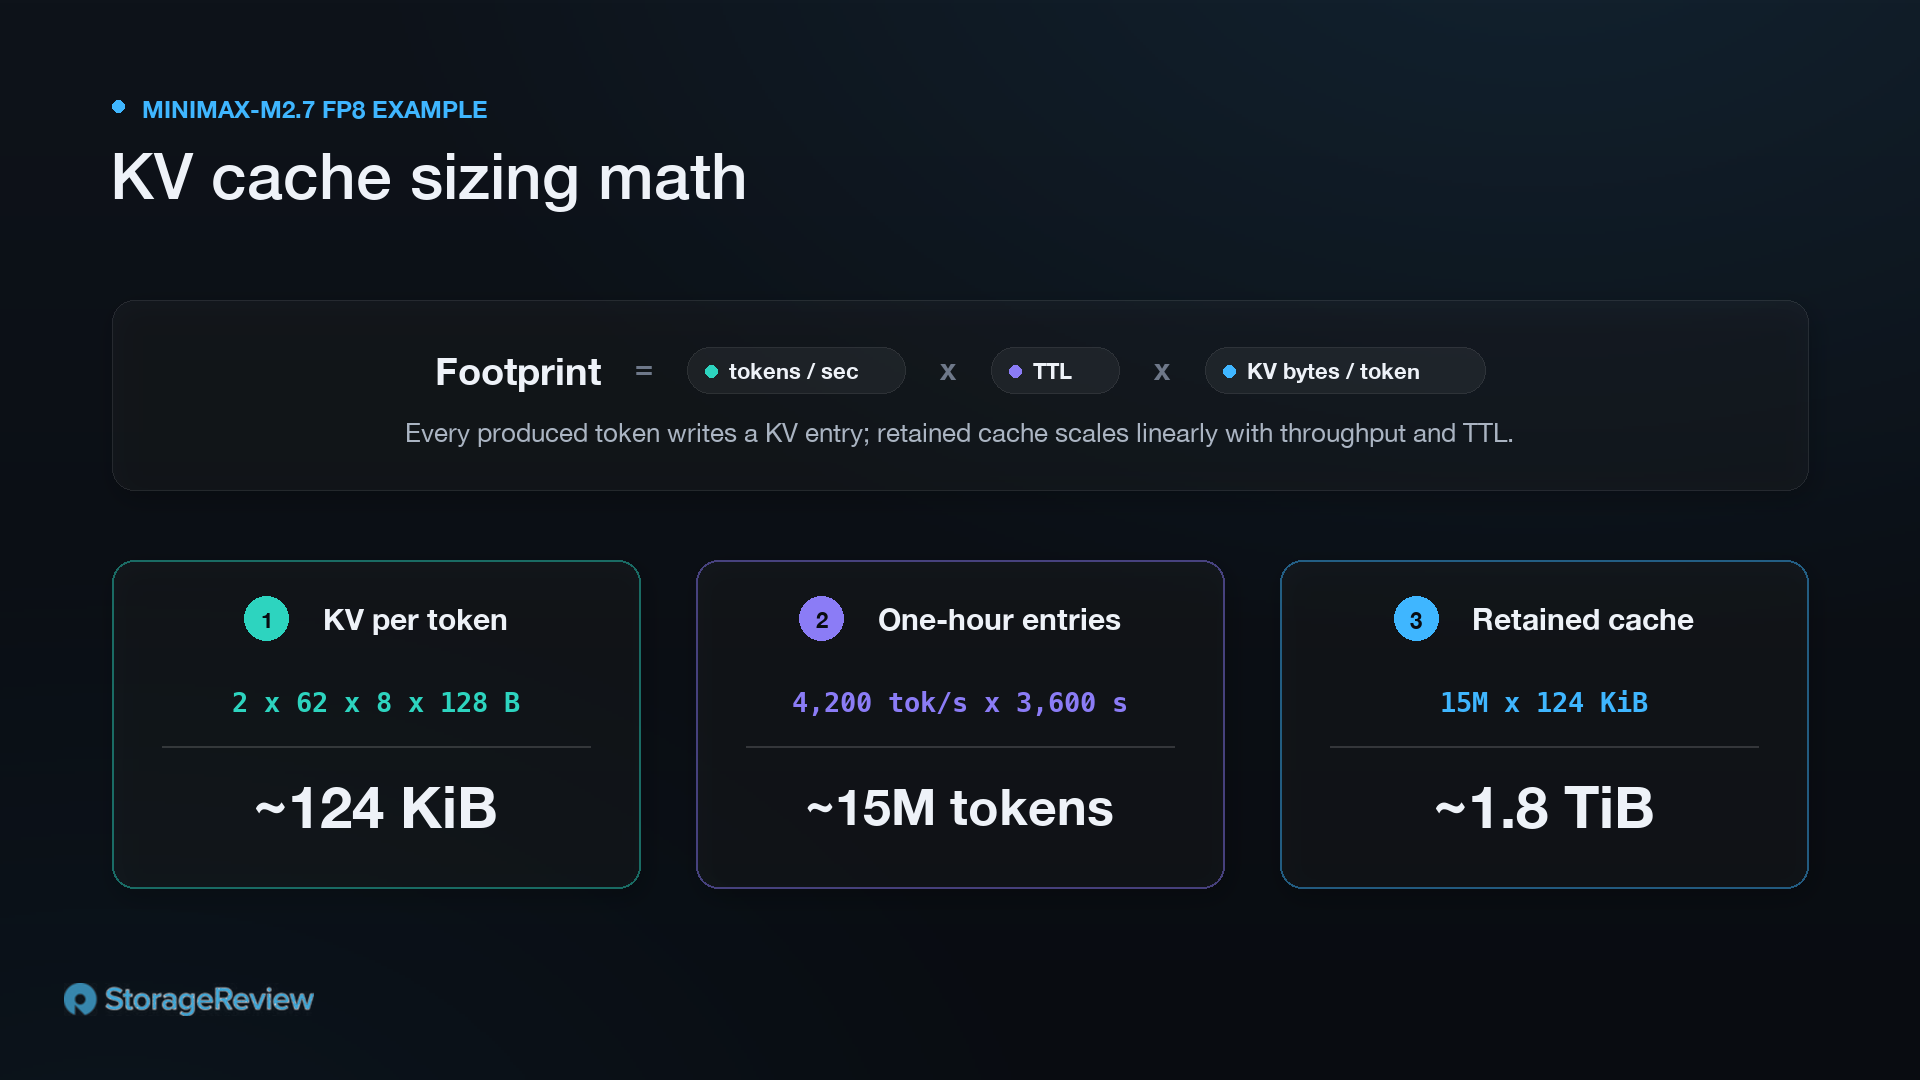
FP8 မှာ MiniMax-M2.7 အတွက် KV cache အရွယ်အစားကို ဒီမှာစမ်းသပ်ထားတဲ့အတိုင်း တွက်ချက်ကြည့်ရအောင်။ KV element တစ်ခုကို တစ် byte မှာ per-token entry က 2 × 62 × 8 × 128 bytes ဒါမှမဟုတ် ခန့်မှန်းခြေအားဖြင့် 124 KiB ဖြစ်ပါတယ်။ ဒါက grouped-query-attention transformer တိုင်းအတွက် ယေဘုယျအားဖြင့် သက်ရောက်ပါတယ်- per-token KV ဆိုတာ layers × KV-heads × head-dim × 2 (K နဲ့ V အတွက်) × dtype-bytes ဖြစ်တာကြောင့် layers ဒါမှမဟုတ် KV heads ပိုများတဲ့ model က token တစ်ခုကို အချိုးကျပိုရေးပါတယ်။ ဒီမှာ အလယ်အလတ် operating point (RAM tier မှာ တစ်စက္ကန့်ကို tokens ၄,၂၀၀ ခန့်) မှာ တစ်နာရီ retention လုပ်ရင် cache tokens ၁၅ သန်းလောက် ထုတ်လုပ်ပေးပြီး token တစ်ခုကို 124 KiB ဆိုရင် 1.8 TB လောက်ရှိပါတယ်။ အဲဒါက DRAM အများကြီးဖြစ်ပြီး build cost ကို မြင့်တက်စေပါတယ်။
အဲဒါကို ထည့်သွင်းစဉ်းစားပြီး SLO လိုအပ်ချက်တွေနဲ့ ဘတ်ဂျက်က tier ရွေးချယ်မှုကို လမ်းညွှန်ပေးပါတယ်။ SSD-tier reload latency က ၎င်းထဲမှာ ကျရောက်လောက်အောင် လျော့ရဲနေရင် KV cache ရဲ့ ဒုတိယ tier ဟာ storage တစ်ခုတည်းမှာပဲ ရှိနေနိုင်ပြီး connector တွေက လိုအပ်တဲ့ RAM staging buffer ပါးလွှာတာကိုသာ ရှေ့က ထားရပါမယ်။ storage ကုန်ကျစရိတ်က အသင့်အတင့်ပါပဲ- ကျွန်ုပ်တို့ရဲ့ စမ်းသပ်မှုအားလုံးအတွင်း peak KV traffic ဟာ အလယ်အလတ် operating point မှာ 4.1 GB/s write နဲ့ 1.1 GB/s read ရှိပြီး fio-measured ceiling 114 GB/s ခန့်ရှိပါတယ်။ ကျွန်ုပ်တို့အသုံးပြုခဲ့တဲ့ RAID10 array မှာ bandwidth ၂၈ ဆခန့် အပိုရှိတာကြောင့် XE7740 ဟာ သူ့ရဲ့ GPU ရှစ်လုံးအပြည့်နဲ့ concurrent load ပိုယူနေတဲ့အချိန်မှာတောင် flash ဟာ bottleneck မဖြစ်ဖို့ အတော်လေး ရှောင်ရှားနိုင်ပါတယ်။ အဲဒီ headroom က operator ကို speed ထက် capacity အတွက် tier ကို provide လုပ်ခွင့်ပေးပါတယ်။ D7-PS1030 ရဲ့ terabyte တစ်ခုထပ်တိုးလာတိုင်း TTL နဲ့ system က resident ထားရှိတဲ့ working set ကို တိုးချဲ့ပေးပြီး resident cache ပိုကြီးတာက recompute ကို ပိုရှောင်ရှားနိုင်ပြီး token တွေကို ပို serve လုပ်နိုင်တယ်လို့ ဆိုလိုပါတယ်။
ဒီ tier ကို အဆုံးအဖြတ်ပေးတဲ့ ကန့်သတ်ချက်က ခံနိုင်ရည်ရှိမှုပါ။ KV offload cache ဟာ write-intensive ဖြစ်ပါတယ်- မော်ဒယ်က ထုတ်လုပ်တဲ့ token တိုင်းဟာ KV entry တစ်ခုကို ရေးသားပေးပြီး TTL churn က tier ကို ၂၄ နာရီလုံးလုံး ပြန်လည်ရေးသားနေတာကြောင့် drive တွေက write တွေကို ရပ်တန့်မသွားပါဘူး။ ကျွန်ုပ်တို့ရဲ့ eight-drive array မှာ sustained writes က 1.9GB/s ရှိပြီး ကျွန်ုပ်တို့ စမ်းသပ်ထားတဲ့ RAID10 layout အောက်မှာ mirroring က media စုပ်ယူတာကို နှစ်ဆတိုးစေပြီး 12.8TB drive တစ်ခုစီမှာ တစ်နေ့ကို drive write ၃.၂ ခုလောက်ရှိပြီး D7-PS1030 ရဲ့ 3 DWPD sustained rating ထက် အနည်းငယ်ပိုများပါတယ်။ primary storage အတွက်ကတော့ အရည်အချင်းမပြည့်မီပေမယ့် ဒီကိစ္စမှာတော့ လက်ခံနိုင်ပါတယ်။ cache ကို ဒီဇိုင်းအရ စွန့်ပစ်နိုင်ပြီး ဟောင်းနွမ်းနေတဲ့ drive ရဲ့ failure mode ကို data loss မဟုတ်ဘဲ ပြန်လည်တွက်ချက်ပါတယ်။ RAID0 က ဒီ tier အတွက် တချို့လူတွေအတွက် ပိုသင့်တော်တယ်လို့ ငြင်းခုံနိုင်ပါတယ်၊ drive ရှစ်ခုလုံးမှာ striping လုပ်ထားတာကြောင့် ဘာမှ နှစ်ခါမရေးဘဲ media rate ကို 1.6 DWPD လောက်အထိ လျှော့ချပေးပါတယ်၊ rating အတွင်းမှာ အဆင်ပြေပါတယ်။ ဘယ်လိုပဲဖြစ်ဖြစ် နိဂုံးချုပ်ကတော့ ဒီလိုပါပဲ- ဒီ workload က box ထဲက တခြားဘာထက်မဆို ခံနိုင်ရည်ကို ပိုမြန်မြန်ကုန်ဆုံးစေပါတယ်၊ သီးသန့် high-end drive တွေက tier လိုအပ်တဲ့ capacity ရဲ့ အစိတ်အပိုင်းလေးတစ်ခုပဲ သယ်ဆောင်ပါတယ်၊ အဲဒီပေါင်းစပ်မှုက PS1030 လိုမျိုး write-focused high capacity drive ကို မှန်ကန်တဲ့ရွေးချယ်မှုဖြစ်စေပါတယ်။
တစ်ဒေါ်လာလျှင် တိုကင်များ
စွမ်းဆောင်ရည်အပိုင်းမှာ flash ဟာ throughput အများစုကို ထိန်းသိမ်းထားပြီး အလုပ်လုပ်တဲ့ set က memory ထက် ကျော်လွန်သွားတဲ့အခါ DRAM မလုပ်နိုင်တဲ့ first-token latency ကို ထိန်းသိမ်းထားကြောင်း ပြသခဲ့ပါတယ်။ စီးပွားရေးအရ ဒါကို အရေးကြီးစေတာက holding လုပ်တဲ့ tier ရဲ့ ကုန်ကျစရိတ်ပါ။ ပြန်လည်တွက်ချက်ဖို့ အလွယ်ဆုံးဖြေရှင်းနည်းကတော့ system ထဲမှာ အဲဒီစျေးကြီးတဲ့ DRAM ကို ပိုဝယ်ဖို့ပါပဲ။ storage tier ဟာ capacity တစ်ယူနစ်ကို သိသိသာသာ စျေးသက်သာရင်သာ offload argument က အလုပ်လုပ်ပါတယ်။
ကွာဟချက်ရဲ့ အရှင်းလင်းဆုံးဗားရှင်းကတော့ ဈေးနှုန်းမဟုတ်ဘဲ စွမ်းရည်ပါ။ 512GB DRAM offload tier က ပြည့်သွားပြီး ဖယ်ရှားပစ်ခဲ့တဲ့ tier ဖြစ်ပြီး terabytes နဲ့ တိုင်းတာတဲ့ flash tier ကတော့ မပြည့်သွားတဲ့ tier ဖြစ်ပါတယ်။ လက်တွေ့ကျတဲ့ DRAM ဘတ်ဂျက်တိုင်းဟာ GPU တွေဘေးမှာ KV cache terabytes ဆယ်ဂဏန်းကို မထားနိုင်တာကြောင့် context length အတိုင်းအတာတစ်ခုကျော်လွန်သွားတဲ့အခါ fast DRAM နဲ့ flash ရွေးချယ်မှုက မတူညီပါဘူး။ flash နဲ့ context ကို စွန့်ပစ်လိုက်တာက အဓိကကျပြီး throughput နဲ့ latency ကို ကုန်ကျစရိတ်ဖြစ်စေပါတယ်။
ဈေးနှုန်းအရ၊ enterprise flash သည် DRAM ၏ terabyte တစ်ခုလျှင် ကုန်ကျစရိတ်၏ အစိတ်အပိုင်းအနည်းငယ်ဖြင့် ကြာမြင့်စွာ ရောင်းချခဲ့ပြီး၊ ၎င်းသည် NAND ၏ multilevel, 3D-stacked cell များနှင့် DRAM ၏ one-transistor-one-capacitor ဒီဇိုင်းတို့မှ ဆင်းသက်လာသော ဖွဲ့စည်းပုံဆိုင်ရာ ကွာဟချက်တစ်ခုဖြစ်သည်။ ၂၀၂၆ ခုနှစ် မှတ်ဉာဏ်အကျပ်အတည်းသည် နှစ်မျိုးလုံးကို သိသိသာသာ မြင့်တက်စေခဲ့ပြီး NAND စာချုပ်ဈေးနှုန်းများသည် အနည်းဆုံး တစ်နှစ်ပတ်လုံး DRAM ကဲ့သို့ပင် မြန်ဆန်စွာ မြင့်တက်နေသောကြောင့် DRAM မြင့်တက်လာစဉ် flash သည် စျေးသက်သာလာခြင်း မဟုတ်ပါ။ သို့သော် ယနေ့ခေတ် မြင့်တက်လာသော အဆင့်များတွင်ပင် per-terabyte ကွာဟချက်သည် ဆက်လက်တည်ရှိနေပြီး flash သည် serving budget နှင့် ကိုက်ညီသော ကုန်ကျစရိတ်ဖြင့် terabyte-scale cache capacity ကို ရရှိနိုင်သည့် တစ်ခုတည်းသော အဆင့်အဖြစ် ရှိနေဆဲဖြစ်သည်။
Throughput နဲ့ cost point လည်း အတူတူပါပဲ။ Flash က ရှေ့ကို တွန်းပို့ပေးတဲ့ crossover မှာ DRAM tier ထက် တစ်စက္ကန့်ကို token ပိုရနေတာ၊ နည်းတာမဟုတ်ဘူး၊ ဒါကြောင့် capacity အတွက် throughput ကို လဲလှယ်တာမဟုတ်ဘဲ terabyte တစ်ခုအတွက် ကုန်ကျစရိတ်နည်းတဲ့ media မှာ ပိုပေးနေတာပါ။ token-per-second-per-dollar အရဆိုရင် flash အတွက် ကွာခြားချက်ကြီးတစ်ခုဖြစ်ပြီး DRAM ကုန်ဆုံးတဲ့နေရာဖြစ်ပြီး flash မရှိတော့တဲ့နေရာဖြစ်လို့ ထိန်းသိမ်းရမယ့် context ကို ပိုရှည်စေပါတယ်။
DRAM ဟာ သင့်တော်တဲ့ tier အဖြစ် ဆက်ရှိနေပြီး၊ connector တွေ လိုအပ်တဲ့ ပါးလွှာတဲ့ RAM staging buffer ကလည်း flash ရှေ့မှာ ရှိနေပါသေးတယ်။ ဒါပေမယ့် GPU တွေ ထပ်ထည့်တာ ဒါမှမဟုတ် DRAM တွေ ထပ်ထည့်တာက cache ပြည့်သွားတဲ့အထိ workload အတွက်ပဲ လိုအပ်တဲ့ အမြင့်ဆုံးစွမ်းဆောင်ရည်ကို ဝယ်ယူဖို့ terabyte တစ်ခုအတွက် အများဆုံး ကုန်ကျပါတယ်။ flash ကို offload လုပ်ခြင်း သို့မဟုတ် tiering လုပ်ခြင်းက terabyte တစ်ခုအတွက် ကုန်ကျစရိတ်ကို အကန့်အသတ်မရှိ ထိန်းသိမ်းထားနိုင်ပြီး တတ်နိုင်တဲ့ terabyte တစ်ခုအတွက် ကုန်ကျစရိတ်လည်း ရှိပါတယ်။ ဒါပေမယ့် နောက်ဆုံးဆုံးဖြတ်ချက်ကတော့ operator က optimize လုပ်နေတဲ့ workload အတွက် SLO လိုအပ်ချက်တွေအပေါ်မှာပဲ မူတည်ပါတယ်။
ကောက်ချက်
inference workloads အတွက် tokenomics က အဓိကပါပဲ။ token က product ဖြစ်ပြီး recompute က အလဟဿပါ။ GPU က အဲဒီ context ကို တစ်ခါတည်း ထုတ်လုပ်ပြီးဖြစ်ပြီး ပြန်တည်ဆောက်ဖို့ လုပ်နေပါတယ်။ ကျွန်တော်တို့ရဲ့ instrumented Claude Code traffic တစ်ပတ်မှာ tokens ရဲ့ 98.16% ဟာ cache reads တွေဖြစ်ပြီး GPU က တွက်ချက်ပြီးသား context ဖြစ်ပြီး တခြားနည်းနဲ့ eviction လုပ်တိုင်း ပြန်တည်ဆောက်မှာဖြစ်လို့ Agentic serving က အမြင့်ဆုံးနေရာပါ။ KV cache offload က အဲဒီ history ကို ပြန်တည်ဆောက်မယ့် prefill compute ကို tokens အသစ်တွေအဖြစ် ပြောင်းလဲပေးပါတယ်။ XE7740 မှာဆိုရင် heavy load အောက်မှာ VRAM-only baseline ရဲ့ total serving throughput ရဲ့ 2.9X အထိ ပြသခဲ့ပြီး model, GPUs နဲ့ engine တွေက တည်ငြိမ်နေခဲ့ပါတယ်။ DRAM tier က filled ဖြစ်ပြီး ပြန်ကျသွားတဲ့အခါ flash က capacity နဲ့ DRAM က throughput ကို မယှဉ်နိုင်ဘူးလို့ hold လုပ်ခဲ့ပါတယ်။
ဒါတွေအားလုံးက DRAM လိုအပ်ချက်ကို အဆုံးသတ်စေတာ မဟုတ်ပါဘူး။ အတိုချုပ်ပြောရရင် session တစ်ခု ပွင့်ပြီး ခဏလောက် လည်ပတ်ပြီး cache က memory ထက် မကျော်လွန်ခင် ပိတ်သွားတဲ့ bursty workloads တွေအတွက် DRAM က မှန်ကန်တဲ့ tier ဖြစ်ပြီး KV cache offload ကလည်း ဘာမှ ထပ်မတိုးပါဘူး။ working set က သင့်တော်ပြီး latency က အကောင်းဆုံးဖြစ်ပြီး ဘာမှ ထုတ်ပစ်စရာ မရှိပါဘူး။
ဒါပေမယ့် DRAM tier တစ်ခုတည်းနဲ့ လုံလောက်တဲ့ ပရိုဖိုင်ကို ခြွင်းချက်အဖြစ် ကျွန်တော်တို့ မြင်ပါတယ်။ production inference အများစုဟာ အခုဆိုရင် ရှည်လျားပြီး အဆက်မပြတ် အလုပ်လုပ်ပါတယ်- multi-turn agent တွေ၊ large context တွေ၊ တည်ငြိမ်တဲ့ concurrency တွေ၊ တူညီတဲ့ session ကို ပြန်လာတဲ့ user တွေ။ အဲဒီမှာ working set ဟာ operator တစ်ယောက်က provision လုပ်နိုင်သမျှ memory tier တွေထက် ကျော်လွန်သွားပြီး cache ကို ဖယ်ရှားပစ်လိုက်ပြီး GPU ကို ၎င်းထုတ်လုပ်ပြီးသား context ကို ပြန်လည်တည်ဆောက်ပြီး အလုပ်လုပ်ခိုင်းပါတယ်။ အဲဒါက စျေးကြီးတဲ့ failure mode ဖြစ်ပြီး ဒါဟာ အဖြစ်များပါတယ်။
ထို workloads များအတွက် KV cache ကို flash သို့ offload လုပ်ခြင်းသည် မျက်နှာစာနှစ်ခုတွင် အကျိုးရှိစေသည်။ ၎င်းသည် GPU များအား အဟောင်းများကို ပြန်လည်တွက်ချက်မည့်အစား token အသစ်များကို ထုတ်လုပ်နေစေပြီး၊ ၎င်းသည် ဤလေ့ကျင့်ခန်းတစ်ခုလုံး၏ tokenomics ထိရောက်မှုကို တိုင်းတာပြီး ၎င်းကိုဖြစ်နိုင်စေသော capacity ကို system တွင် ကုန်ကျစရိတ်အသက်သာဆုံး တာရှည်ခံ tier တွင် ထားရှိပေးသည်။ build sheet တွင် အရေးကြီးဆုံးအကျိုးဆက်မှာ ၎င်းဖယ်ရှားလိုက်သည့်အရာဖြစ်သည်- cache အတွက် flash ကို အားကိုးသော server တစ်ခုကို DRAM နည်းပါးစွာဖြင့် သတ်မှတ်နိုင်ပြီး ၂၀၂၆ ခုနှစ်တွင် ရှိခဲ့သည့် memory ဈေးနှုန်းဖြင့် ၎င်းသည် quote တွင် ရရှိနိုင်သော အကြီးမားဆုံး ငွေစုမှုတစ်ခုဖြစ်သည်။ token သည် product ဖြစ်ပြီး ယခုအခါ serving ကို လွှမ်းမိုးထားသော long-context workloads များအတွက် token-efficient path သည် token တစ်ခုတည်းကို နှစ်ကြိမ်ထုတ်လုပ်ရန် ငွေပေးချေမှုကို ရပ်တန့်ပြီး ထိုလမ်းကြောင်းသည် flash မှတစ်ဆင့် လည်ပတ်သည်။
AI အတွက် Solidigm SSD သိုလှောင်မှု
ဤအစီရင်ခံစာကို Solidigm မှ ကမကထပြုပါသည်။ ဤအစီရင်ခံစာတွင် ဖော်ပြထားသော အမြင်များနှင့် ထင်မြင်ယူဆချက်အားလုံးသည် ထည့်သွင်းစဉ်းစားနေသော ထုတ်ကုန်(များ)အပေါ် ကျွန်ုပ်တို့၏ ဘက်မလိုက်သော အမြင်ပေါ်တွင် အခြေခံထားပါသည်။


 အမေဇုံ