

Solidigm D7-PS1030 သည် ကုမ္ပဏီ၏ ပထမဆုံး PCIe 5.0 ဒေတာစင်တာမိသားစု၏ အလယ်အလတ်ခံနိုင်ရည်ရှိသော အစိတ်အပိုင်းဖြစ်ပြီး D7-PS1010 နှင့် မျှဝေထားသော ပလက်ဖောင်းကို 3 DWPD အဆင့်သတ်မှတ်ချက်နှင့် 800K IOPS အထိ ကျပန်းရေးသားနိုင်မှု အမြင့်ဆုံးဖြစ်ပြီး ၎င်း၏ စံခံနိုင်ရည်ရှိသော ညီအစ်ကိုမောင်နှမ၏ 400K ထက် နှစ်ဆဖြစ်သည်။ မိသားစုသည် E3.S နှင့် U.2 တွင် 1.6TB မှ 12.8TB အထိ ရှိပြီး 176-layer TLC NAND ကိုအသုံးပြုထားပြီး အဆင့်သတ်မှတ်ချက်စွမ်းဆောင်ရည်မှာ 14,500 MB/s sequential read နှင့် 10,000 MB/s sequential write အထိရှိသည်။ Solidigm သည် write-centric နှင့် ရောနှောထားသော workloads များကို ပစ်မှတ်ထားသည်- OLTP၊ metadata logging၊ HPC နှင့် write pressure ဘယ်တော့မှ လျော့ကျမသွားသည့် AI/ML pipelines။ ကျွန်ုပ်တို့၏ review unit မှာ 12.8TB E3.S မော်ဒယ်ဖြစ်သည်။
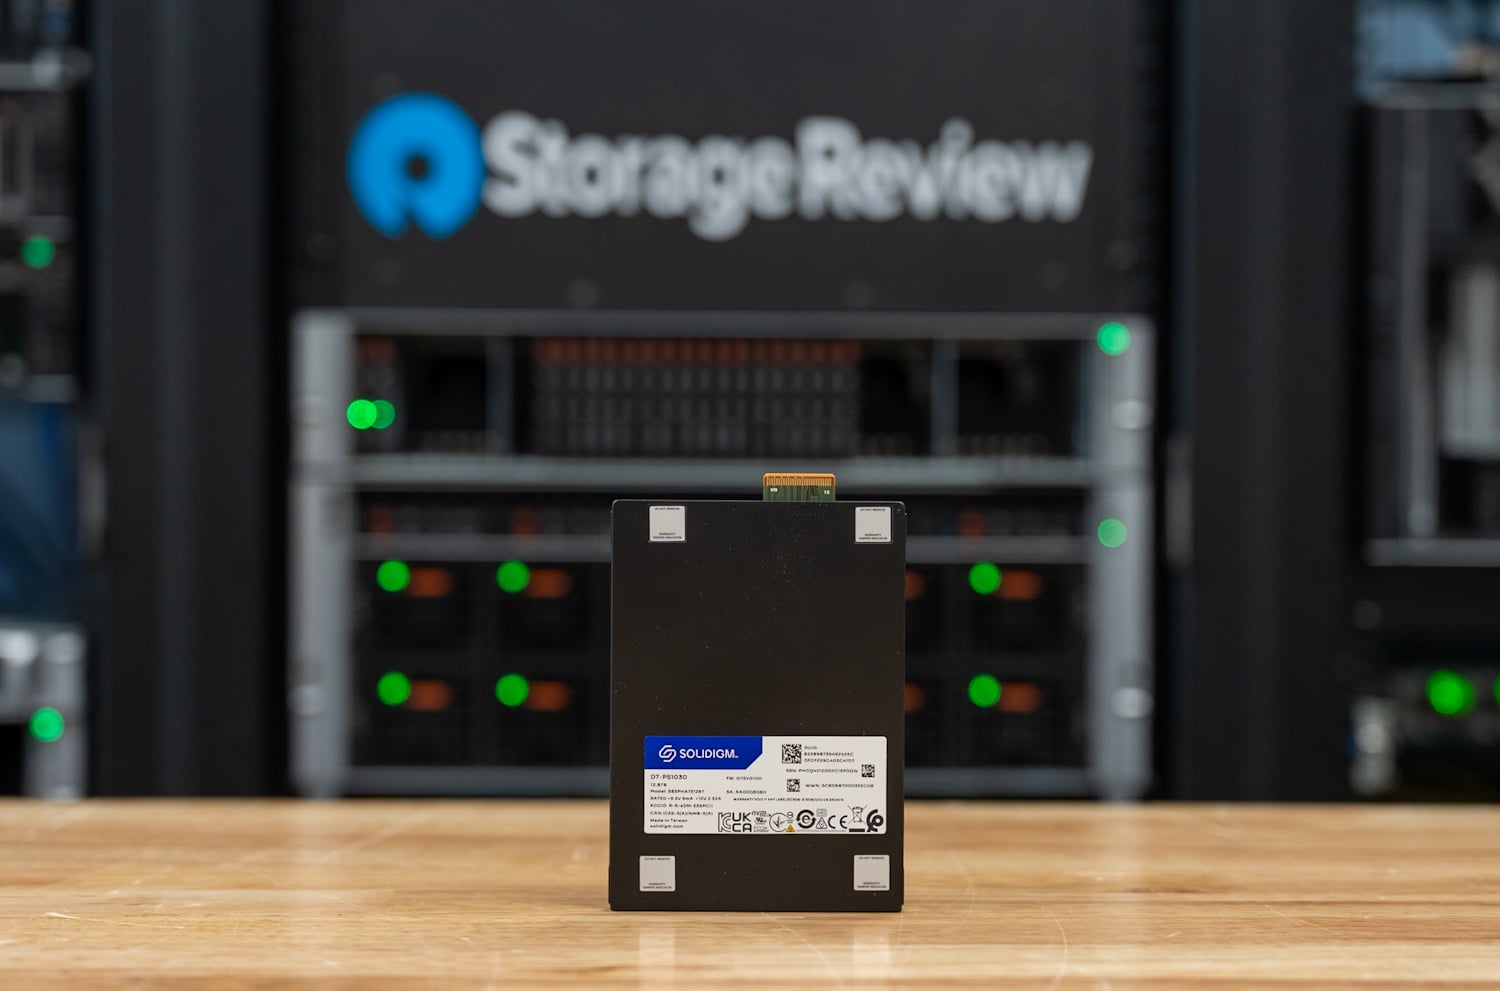
E3.S 7.5mm ကိုယ်ထည်ရှိ Solidigm D7-PS1030 12.8TB။
ဒီ drive နဲ့ ကျွန်တော်တို့ ပထမဆုံးအကြိမ် လုပ်တာ မဟုတ်ပါဘူး။ ဒါပေမယ့် drive တစ်ခုတည်းကို benchmark လုပ်တာ ပထမဆုံးအကြိမ်ပါ။ ဒီ 12.8TB unit တွေထဲက ရှစ်ခုဟာ Dell PowerEdge XE7740 မှာ ကျွန်တော်တို့ရဲ့ KV cache offload work မှာ flash tier ကို သယ်ဆောင်ထားပြီး array ဟာ နာရီပတ်လုံး 1.9GB/s ဆက်တိုက် KV write လုပ်နိုင်ပြီး၊ mirroring အောက်မှာ drive တစ်ခုချင်းစီကို တစ်နေ့ကို drive write ၃.၂ ခုလောက် ဒါမှမဟုတ် RAID0 အနေနဲ့ striped DWPD ၁.၆ ခုလောက် ရှိတဲ့ duty cycle ပါ။ PS1030 ရဲ့ 3 DWPD rating ကို တည်ဆောက်ထားတဲ့ bracket အတိအကျပါပဲ။ KV offload ဆိုတာ capacity ဒါမှမဟုတ် peak speed မဟုတ်ဘဲ endurance က tier ရဲ့ defining constraint ဖြစ်တဲ့ workload တစ်ခုပါ။ Gen5 headlines တွေမှာ လွှမ်းမိုးထားတဲ့ read-intensive class ဟာ သူ့ရဲ့ 1 DWPD budget ကို အဲဒီ duty နဲ့ မြန်မြန်ကုန်သွားပါလိမ့်မယ်။
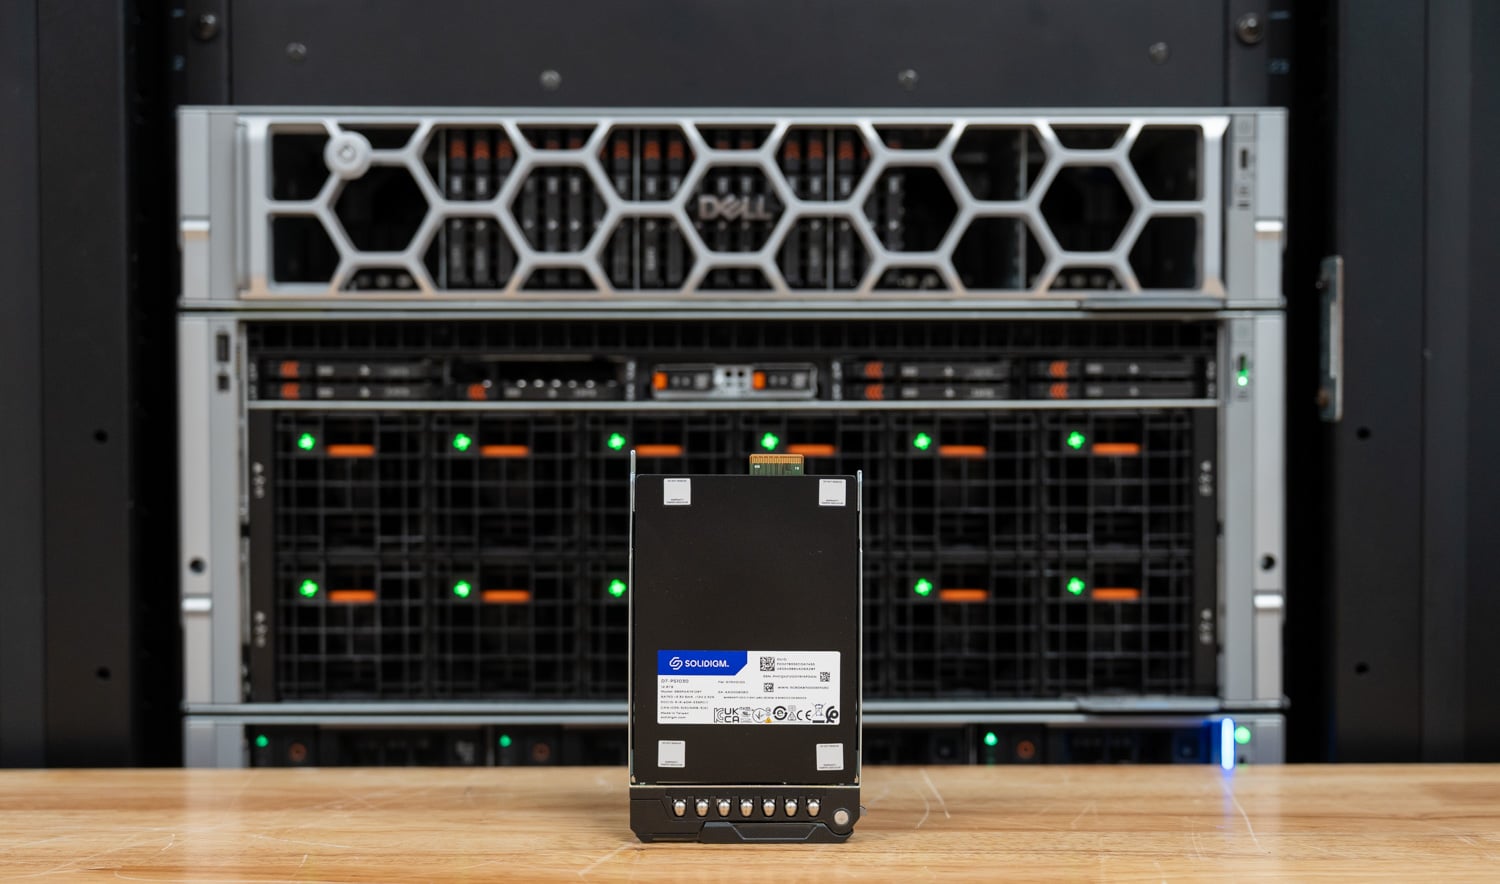
ကျွန်ုပ်တို့၏ KV cache offload စမ်းသပ်မှုကို လက်ခံကျင်းပသည့် Dell PowerEdge XE7740 ရှေ့ရှိ PS1030။
12.8TB မှာ Solidigm က drive ကို 2.75 million 4K random read IOPS နဲ့ full 800K random write IOPS ရှိတယ်လို့ အဆင့်သတ်မှတ်ထားပြီး မိသားစုရဲ့ 3.1M random read peak က capacity stack မှာ နိမ့်ကျနေပါတယ်။ Gen5 field နဲ့အညီ active power က 23W normal နဲ့ 5W idle ဖြစ်ပြီး fixed rack budget နဲ့ အလုပ်လုပ်တဲ့ operator တွေအတွက် 5W မှ 25W အထိ configure လုပ်နိုင်တဲ့ power state ငါးခုပါရှိပါတယ်။ Solidigm က မှတ်သားထိုက်တဲ့ နောက်ထပ်အချက်နှစ်ချက်ကိုလည်း ပြောကြားခဲ့ပါတယ်။ အဲဒါကတော့ နှိုင်းယှဉ်လို့ရတဲ့ drive တွေထက် 70% အထိ စွမ်းအင်ထိရောက်မှု ပိုကောင်းပြီး drive ရဲ့ သက်တမ်းတစ်လျှောက် 90% IOPS အထိ တသမတ်တည်းရှိပါတယ်။ ခံနိုင်ရည်ကို တိုတောင်းတဲ့ horizons တွေမှာ ပိုမြန်မြန်ကုန်ဆုံးစေနိုင်ပါတယ်။ တူညီတဲ့ media က သုံးနှစ်တာကာလအတွင်း 4.98 DWPD ကို support လုပ်ပါတယ်၊ 12.8TB model က ဘယ်နည်းနဲ့မဆို write 70PB အတွက် အဆင့်သတ်မှတ်ထားပါတယ်။ ယုံကြည်စိတ်ချရမှုဆိုင်ရာ သတ်မှတ်ချက်များသည် အတန်းအစားနှင့် ကိုက်ညီပါသည်- ၂.၅ သန်းနာရီ MTBF၊ ငါးနှစ်အာမခံနှင့် 1E-18 အတွက် UBER Solidigm စမ်းသပ်မှု။ လုံခြုံရေးရွေးချယ်မှုများတွင် TCG Opal 2.02 SED ချိန်ညှိမှု၊ FIPS 140-3 Level 2-certifiable hardware၊ OCP-standard secure boot နှင့် firmware signing၊ ထို့အပြင် device attestation နှင့် key revocation တို့ ပါဝင်သည်။
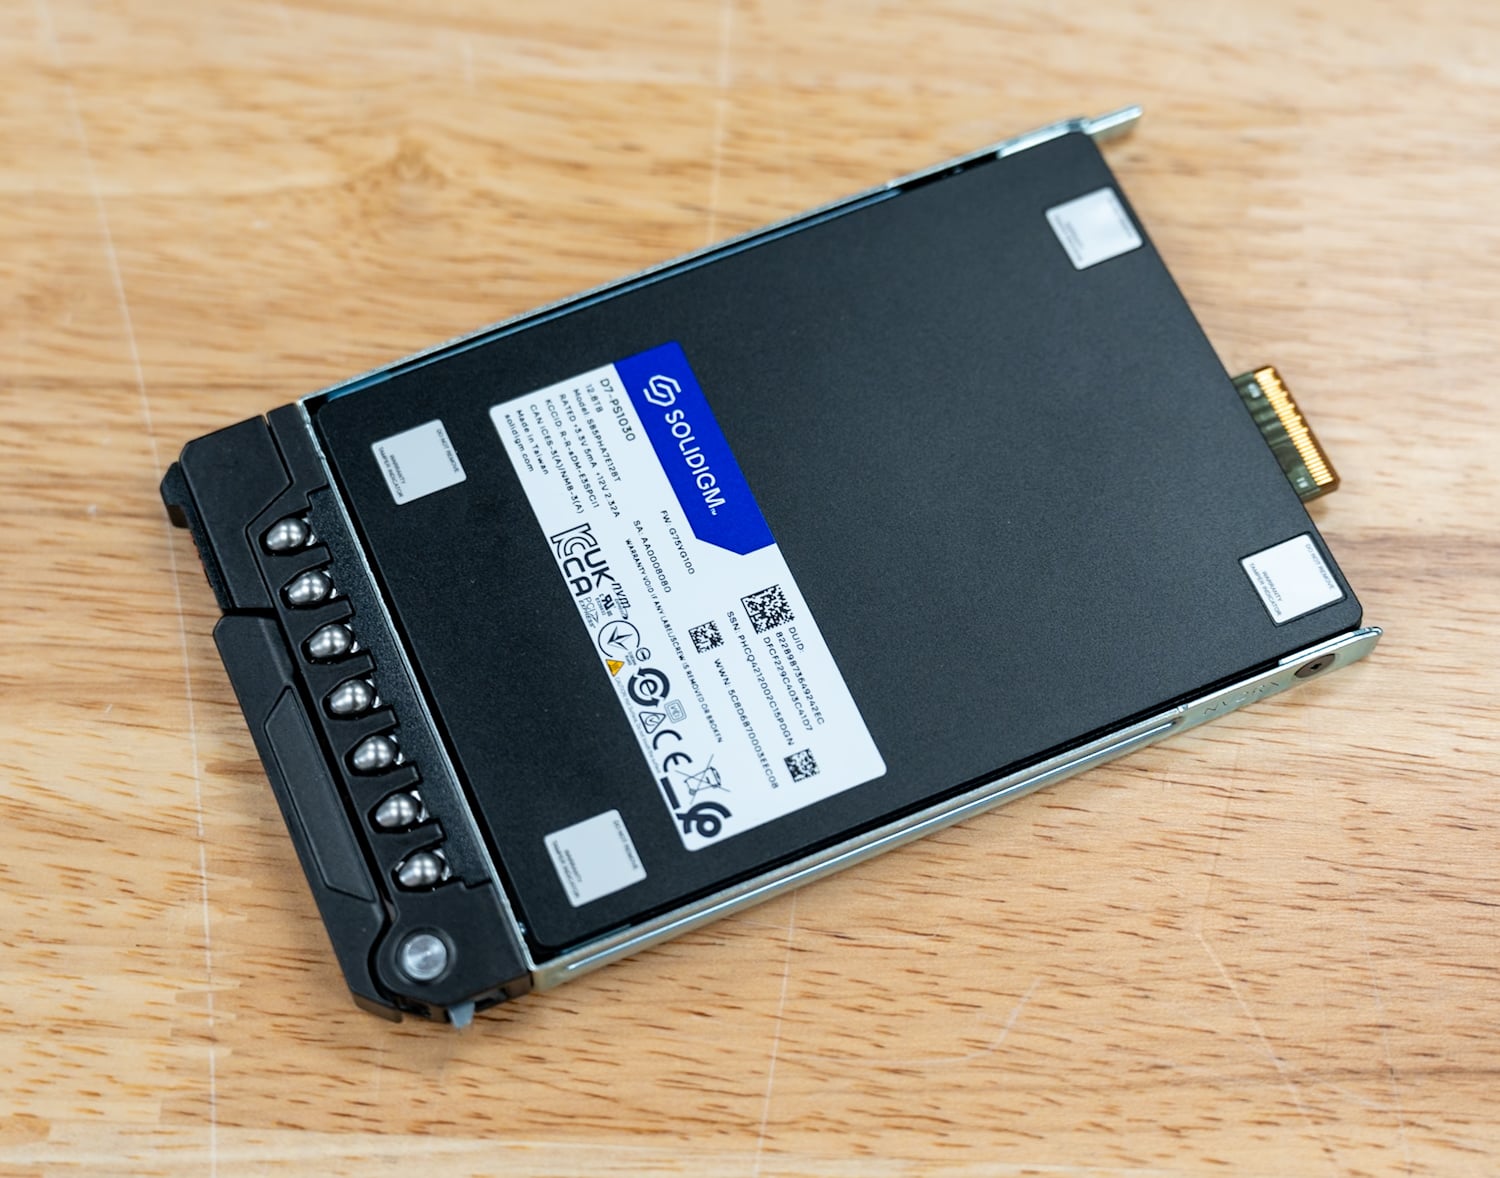
E3.S Dell caddy ထဲမှာ။
Solidigm D7-PS1030 သတ်မှတ်ချက်များ
| specification | Solidigm D7-PS1030 (12.8TB E3.S၊ မိသားစုအဆင့် မှတ်တမ်းတင်ထားသည်) |
|---|---|
| ပလက်ဖောင်းခြုံငုံသုံးသပ်ချက် | |
| စွမ်းရည် | 1.6TB 3.2TB 6.4TB 12.8TB (စမ်းသပ်ပြီး) |
| အချက်များ | E3.S 7.5mm (စမ်းသပ်ပြီး) U.2 15mm |
| အင်တာဖေ့စ်/ပရိုတိုကော | PCIe 5.0 x4၊ NVMe |
| Nande | Solidigm ၁၇၆-အလွှာ TLC 3D NAND |
| စွမ်းဆောင်ရည် (ရောင်းချသူ အဆင့်သတ်မှတ်ချက်အထိ) | |
| အစဉ်လိုက်ဖတ်ရှုခြင်း (128K) | တစ်စက္ကန့်လျှင် ၁၀,၀၀၀ MB (မိသားစု) |
| အစဉ်လိုက်ရေးသားခြင်း (128K) | တစ်စက္ကန့်လျှင် ၁၀,၀၀၀ MB (မိသားစု) |
| ကျပန်းဖတ်ရှုခြင်း (4K) | ၁,၅၀၀,၀၀၀ IOPS (၁ TB) 3,100K IOPS အထိ (မိသားစု အမြင့်ဆုံး) |
| ကျပန်းရေးသားခြင်း (4K) | 800K IOPS |
| စွမ်းအားနှင့် ခံနိုင်ရည် | |
| ပါဝါ (တက်ကြွ / အားလပ်ချိန်) | ၂၃ ဝပ် အမျိုးအစား / ၅ ဝပ် အမျိုးအစား ပါဝါအခြေအနေ ငါးခု၊ 5W မှ 25W အထိ ပြင်ဆင်နိုင်သည် |
| တည်မြဲခြင်း | ၄.၉၈ DWPD (၃ နှစ်အခြေခံ) ၄.၉၈ DWPD (၃ နှစ်အခြေခံ) 12.8TB မှာ 70 PBW |
| ယုံကြည်စိတ်ချရမှုနှင့်လုံခြုံရေး | |
| MTBF / UBER | 2,500,000 နာရီ 1E-18 အထိ စမ်းသပ်ပြီး |
| လုံခွုံရေး | TCG Opal 2.02 (SED မျိုးကွဲ) FIPS 140-3 အဆင့် 2 အသိအမှတ်ပြုလက်မှတ်ရနိုင်သည် OCP-စံနှုန်း Secure Boot နှင့် firmware signing စက်ပစ္စည်း အသိအမှတ်ပြုခြင်း၊ သော့ ရုပ်သိမ်းခြင်း |
| အာမခံချက် | 5 နှစ်များ |
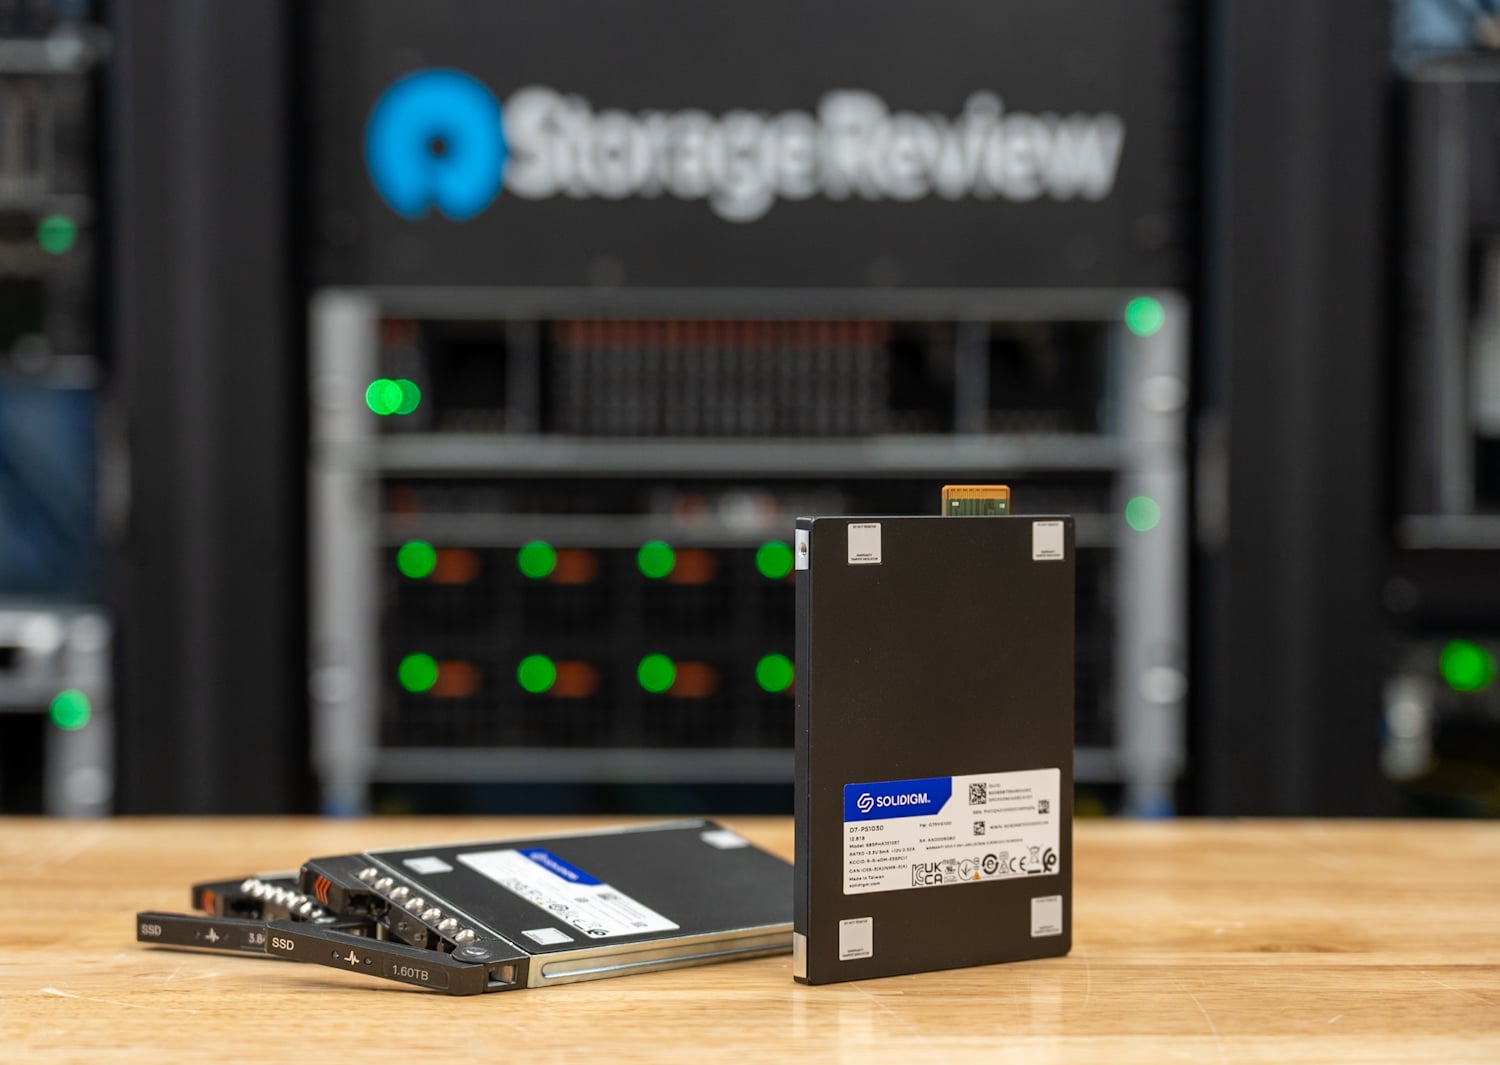
PS1030 ယူနစ်များကို E3.S တွင် တင်ပို့သည်။ မိသားစုကို U.2 တွင်လည်း တင်ပို့သည်။
Solidigm D7-PS1030 စွမ်းဆောင်ရည်
အောက်ပါဇယားများအတွက် အကြောင်းအရာမှာ PS1030 သည် ကျွန်ုပ်တို့၏ နှိုင်းယှဉ်မှုနယ်ပယ်တွင် မကြာသေးမီက Gen5 လွှမ်းခြုံမှုကို မောင်းနှင်ခဲ့သော read-intensive drives များနှင့် ရောနှောအသုံးပြုမှု တန်ပြန်အလေးချိန်အဖြစ် ရောက်ရှိလာပါသည်။ ဇွန်လတွင် ကျွန်ုပ်တို့ သုံးသပ်ခဲ့သော KIOXIA CD9P-R နှင့် နှိုင်းယှဉ်ပါက PS1030 သည် rated sequential read (14,500 vs 14,800 MB/s) ကို ပေးစွမ်းသော်လည်း rated random write (800K vs 450K IOPS) ထက် နှစ်ဆနီးပါးနှင့် write budget (3 vs 1 DWPD) ထက် သုံးဆတိုးလာပါသည်။ အုပ်စုတွင် ၎င်း၏ အနီးကပ်ဆုံး ဒဿနိကဗေဒပြိုင်ဘက်မှာ Micron 7600 MAX ဖြစ်ပြီး၊ နယ်ပယ်ရှိ အခြား DWPD drive ၃ ခုဖြစ်ပြီး Micron 9550 MAX သည် ကျွန်ုပ်တို့၏ ယူနစ်နှင့် တူညီသော 12.8TB စွမ်းရည်ဖြင့် စွမ်းဆောင်ရည်အဆင့် ရောနှောအသုံးပြုမှုတိုက်ပွဲကို ယူဆောင်လာပါသည်။
မောင်းနှင်မှုစမ်းသပ်ခြင်းပလက်ဖောင်း
ဤသုံးသပ်ချက်တွင် workload အားလုံးအတွက် ကျွန်ုပ်တို့၏ test platform အဖြစ် Ubuntu 22.04.2 LTS ကို အသုံးပြုထားသော Dell PowerEdge R760 ကို အသုံးပြုထားပါသည်။ Serial Cables Gen5 JBOF တပ်ဆင်ထားသောကြောင့် U.2၊ E1.S၊ E3.S နှင့် M.2 SSD များနှင့် ကျယ်ကျယ်ပြန့်ပြန့် တွဲဖက်အသုံးပြုနိုင်ပါသည်။ ကျွန်ုပ်တို့၏ system configuration ကို အောက်တွင်ဖော်ပြထားပါသည်။
- Intel Xeon Gold 6430 (32-Core, 2.1GHz) ၂ ခု
- 16 x 64GB DDR5-4400 မှတ်ဉာဏ်
- 480GB Dell BOSS SSD
- စီးရီးကြိုးများ Gen5 JBOF
- NVIDIA L4
နှိုင်းယှဉ်ထားသော ဒရိုက်များ
- KIOXIA CD9P-R 7.68TB (၃ DWPD)
- KIOXIA CM9-R 15.36TB (၃ DWPD)
- SanDisk DC SN861 7.68TB (၃ DWPD)
- Solidigm PS1010 7.68TB (၃ DWPD)
- မိုက်ခရွန် ၉၅၅၀ မက်စ် ၁၂.၈ တီဘီ (၃ DWPD)
- မိုက်ခရွန် ၉၅၅၀ မက်စ် ၁၂.၈ တီဘီ (၃ DWPD)
- Micron 9550 Pro 7.68TB (1 DWPD)
DLIO စစ်ဆေးရေးစံနှုန်း
AI လေ့ကျင့်ရေးပတ်ဝန်းကျင်များတွင် SSD လက်တွေ့ကမ္ဘာစွမ်းဆောင်ရည်ကို အကဲဖြတ်ရန်အတွက်၊ ကျွန်ုပ်တို့သည် Data and Learning Input/Output (DLIO) benchmark tool ကို အသုံးပြုခဲ့ပါသည်။ Argonne National Laboratory မှ တီထွင်ထားသော DLIO ကို deep learning workloads များတွင် I/O ပုံစံများကို စမ်းသပ်ရန် အထူးဒီဇိုင်းထုတ်ထားပါသည်။ ၎င်းသည် checkpointing၊ data ingestion နှင့် model training ကဲ့သို့သော စိန်ခေါ်မှုများကို storage system များက မည်သို့ကိုင်တွယ်ဖြေရှင်းသည်ဆိုသည့်အပေါ် ထိုးထွင်းသိမြင်မှုများကို ပေးစွမ်းသည်။
အောက်ဖော်ပြပါဇယားတွင် drive တစ်ခုစီ၏ ပျမ်းမျှ checkpoint ပြီးစီးချိန်ကို pass သုံးကြိမ်အတွင်း ပြသထားသည်။ နည်းလေ ပိုကောင်းလေဖြစ်သည်။ ဤဒေတာနှင့်ပတ်သက်၍ မှတ်ချက်တစ်ခုရှိသည်- run တစ်ခုရှိ checkpoint အရေအတွက်သည် drive တစ်ခုစီ၏ စွမ်းရည်နှင့် ချိန်ညှိထားသောကြောင့် drive ကြီးများသည် checkpoint များ ပိုမိုမှတ်တမ်းတင်ပြီး checkpoint တစ်ခုစီ၏ ရလဒ်များသည် အရွယ်အစားအမျိုးမျိုးရှိသော drive များတစ်လျှောက် point တစ်ခုစီအလိုက် ချိန်ညှိထားခြင်းမရှိပါ။ ထို့ကြောင့် drive တစ်ခုစီ၏ run ကို တိုက်ရိုက်နှိုင်းယှဉ်နိုင်သော ကိန်းဂဏန်းတစ်ခုအဖြစ် ပုံမှန်ဖြစ်စေသည့် pass ပျမ်းမျှများကို ကျွန်ုပ်တို့ထုတ်ဝေခြင်းဖြစ်သည်။ machine learning model များကို လေ့ကျင့်ပေးသည့်အခါ၊ မော်ဒယ်၏အခြေအနေကို ပုံမှန်သိမ်းဆည်းရန်နှင့် အနှောင့်အယှက်များ သို့မဟုတ် ပါဝါပြတ်တောက်မှုများအတွင်း တိုးတက်မှုဆုံးရှုံးမှုကို ကာကွယ်ရန်အတွက် checkpoint များသည် မရှိမဖြစ်လိုအပ်ပါသည်။ ဤသိုလှောင်မှုဝယ်လိုအားသည် အထူးသဖြင့် ရေရှည် သို့မဟုတ် ပြင်းထန်သော workload များအောက်တွင် ခိုင်မာသောစွမ်းဆောင်ရည် လိုအပ်ပါသည်။ ကျွန်ုပ်တို့သည် ၂၀၂၄ ခုနှစ်၊ ဩဂုတ်လ ၁၃ ရက်နေ့တွင် ထုတ်ပြန်ခဲ့သော DLIO benchmark version 2.0 ကို အသုံးပြုခဲ့ပါသည်။
ကျွန်ုပ်တို့၏ benchmarking သည် လက်တွေ့ကမ္ဘာအခြေအနေများကို ထင်ဟပ်စေရန်အတွက်၊ ကျွန်ုပ်တို့၏ စမ်းသပ်မှုသည် LLAMA 3.1 405B model architecture ပေါ်တွင် အခြေခံခဲ့သည်။ model parameters၊ optimizer states နှင့် layer states များကို ဖမ်းယူရန် torch.save() ကို အသုံးပြု၍ checkpointing ကို အကောင်အထည်ဖော်ခဲ့သည်။ ကျွန်ုပ်တို့၏ setup သည် ရှစ် GPU များတစ်လျှောက် ဖြန့်ဝေထားသော 4-way tensor parallelism နှင့် 2-way pipeline parallel processing ပါ၀င်သည့် hybrid parallelism strategy ကို အကောင်အထည်ဖော်ကာ ရှစ် GPU စနစ်ကို simulate လုပ်ခဲ့သည်။ ဤ configuration သည် ခေတ်မီ large language models များကို လေ့ကျင့်ရန် လိုအပ်ချက်များကို ထင်ဟပ်စေသည့် 1,636GB checkpoint size ကို ရရှိခဲ့သည်။
| မောင်း | Pass 1 ပျမ်းမျှ (စက္ကန့်) | Pass 2 ပျမ်းမျှ (စက္ကန့်) | Pass 3 ပျမ်းမျှ (စက္ကန့်) |
|---|---|---|---|
| SanDisk DC SN861 7.68TB | 461.3 | 558.6 | 553.3 |
| မိုက်ခရွန် ၉၅၅၀ မက်စ် ၁၂.၈ တီဘီ | 462.8 | 558.9 | 555.3 |
| မိုက်ခရွန် ၉၅၅၀ ပရို ၇.၆၈ တီဘီ | 461.4 | 577.9 | 559.7 |
| Solidigm PS1010 7.68TB | 458.8 | 561.1 | 564.6 |
| မိုက်ခရွန် ၉၅၅၀ မက်စ် ၁၂.၈ တီဘီ | 464.2 | 581.5 | 567.3 |
| KIOXIA CD9P-R 7.68TB | 464.7 | 575.6 | 570.6 |
| KIOXIA CM9-R 15.36TB | 462.8 | 571.9 | 580.9 |
| Solidigm PS1030 12.8TB | 462.3 | 578.0 | 599.2 |
pass ပျမ်းမျှတွေကို ကြည့်မယ်ဆိုရင် Solidigm PS1030 ဟာ Pass 1 မှာ ၄၆၂.၃ စက္ကန့်နဲ့ စတင်ခဲ့ပြီး နှိုင်းယှဉ်အဖွဲ့တစ်ခုလုံးဟာ ၄၅၉ စက္ကန့်ကနေ ၄၆၅ စက္ကန့်လောက်အထိ ခုနစ်စက္ကန့်အတွင်း ရောက်ရှိခဲ့ပါတယ်။ ခွဲထွက်မှုက နောက်ပိုင်းမှာ ဖြစ်ပေါ်လာခဲ့ပါတယ်။ Pass 2 မှာ PS1030 ဟာ SanDisk SN861 ရဲ့ ၅၅၈.၆ စက္ကန့်ကနေ Micron 7600 MAX ရဲ့ ၅၈၁.၅ စက္ကန့်အထိ ရှိတဲ့ field ရဲ့ အပေါ်ပိုင်းမှာ ၅၇၈.၀ စက္ကန့်အထိ မြင့်တက်လာခဲ့ပြီး Pass 3 မှာတော့ နှိုင်းယှဉ်အဖွဲ့မှာ အမြင့်ဆုံးပျမ်းမျှဖြစ်တဲ့ ၅၉၉.၂ စက္ကန့်အထိ ကျဆင်းသွားခဲ့ပြီး ကျန်တဲ့ field တွေကတော့ SN861 ရဲ့ ၅၅၃.၃ စက္ကန့်နဲ့ KIOXIA CM9-R ရဲ့ ၅၈၀.၉ စက္ကန့်ကြားမှာ ရှိနေပါတယ်။
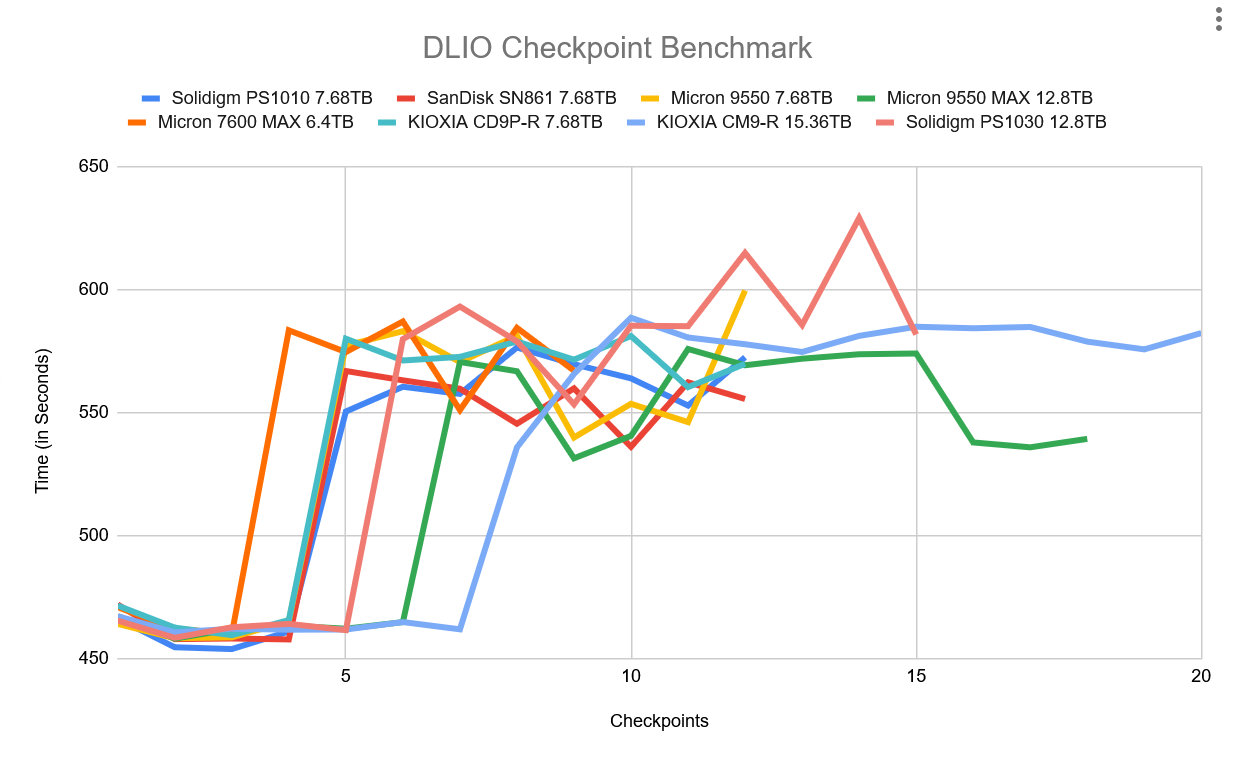
PS1030 ရဲ့ ကိုယ်ပိုင် checkpoint log က အဲဒီ drift ရဲ့ပုံသဏ္ဍာန်ကို ပြသထားပါတယ်။ PS1030 ဟာ ၄၆၅.၃ စက္ကန့်မှာ ဖွင့်ပြီး checkpoint 5 မှာ ၄၆၁ စက္ကန့်နီးပါး ထိန်းထားနိုင်ခဲ့ပါတယ်။ ကူးပြောင်းပြီးတာနဲ့ ၅၅၃ စက္ကန့်ကနေ ၅၉၃ စက္ကန့်အထိ ကြာမြင့်ခဲ့ပြီး checkpoint 12 ကို ၆၁၄.၇ စက္ကန့်မှာ ပိတ်ခဲ့ပြီး နောက်ဆုံး checkpoint တွေဟာ ၆၂၉.၀ စက္ကန့်အထိ အမြင့်ဆုံးရောက်ရှိခဲ့ပါတယ်။ ရလဒ်ကတော့ drive ရဲ့ အားနည်းချက်အသစ်တစ်ခုထက် အားနည်းချက်တစ်ခုနဲ့ ကိုက်ညီပါတယ်- DLIO checkpointing ဟာ 128K single-worker FIO စမ်းသပ်မှုက ညွှန်ပြခဲ့တဲ့ sequential write burst ကြီးတစ်ခုနဲ့ တစ်ထပ်တည်းကျပါတယ်။ ကွာဟချက်က အမှန်တကယ်ဖြစ်ပေမယ့် ကန့်သတ်ထားပြီး Pass 3 ပျမ်းမျှတွေမှာ KIOXIA CD9P-R နဲ့ နှိုင်းယှဉ်ရင် ၅% လောက်ရှိပြီး PS1030 ဟာ swinging မဟုတ်ဘဲ pass တွေမှာ ခန့်မှန်းခြေအားဖြင့် scale လုပ်နိုင်ခဲ့ပါတယ်။
FIO စွမ်းဆောင်ရည် စံနှုန်း
အသုံးများသော စက်မှုလုပ်ငန်း မက်ထရစ်များတွင် SSD တစ်ခုစီ၏ သိုလှောင်မှုစွမ်းဆောင်ရည်ကို တိုင်းတာရန်အတွက်၊ ကျွန်ုပ်တို့သည် FIO ကို အသုံးပြုပါသည်။ drive တစ်ခုစီသည် တူညီသော စမ်းသပ်မှုလုပ်ငန်းစဉ်ကို ဖြတ်သန်းရပြီး ၎င်းတွင် drive အပြည့်ဖြည့်ခြင်း နှစ်ကြိမ်၏ ကြိုတင်ပြင်ဆင်ခြင်းအဆင့်၊ ထို့နောက် steady-state စွမ်းဆောင်ရည်တိုင်းတာခြင်း ပါဝင်သည်။ တိုင်းတာနေသော workload အမျိုးအစားတစ်ခုစီ ပြောင်းလဲလာသည်နှင့်အမျှ၊ ကျွန်ုပ်တို့သည် ထို transfer size အသစ်၏ နောက်ထပ်ကြိုတင်ပြင်ဆင်ခြင်း ဖြည့်ခြင်းကို လုပ်ဆောင်ပါသည်။
ဤအပိုင်းတွင်၊ ကျွန်ုပ်တို့သည် အောက်ပါ FIO စံနှုန်းများကို အာရုံစိုက်ပါသည်။
- ၁၂၈K အစီအစဉ်အတိုင်း
- 64K ကျပန်း
- ၁၂၈K အစီအစဉ်အတိုင်း
- 4K ကျပန်း
128K အစဉ်လိုက်ရေးသားမှု (IODepth 16 / NumJobs 1)
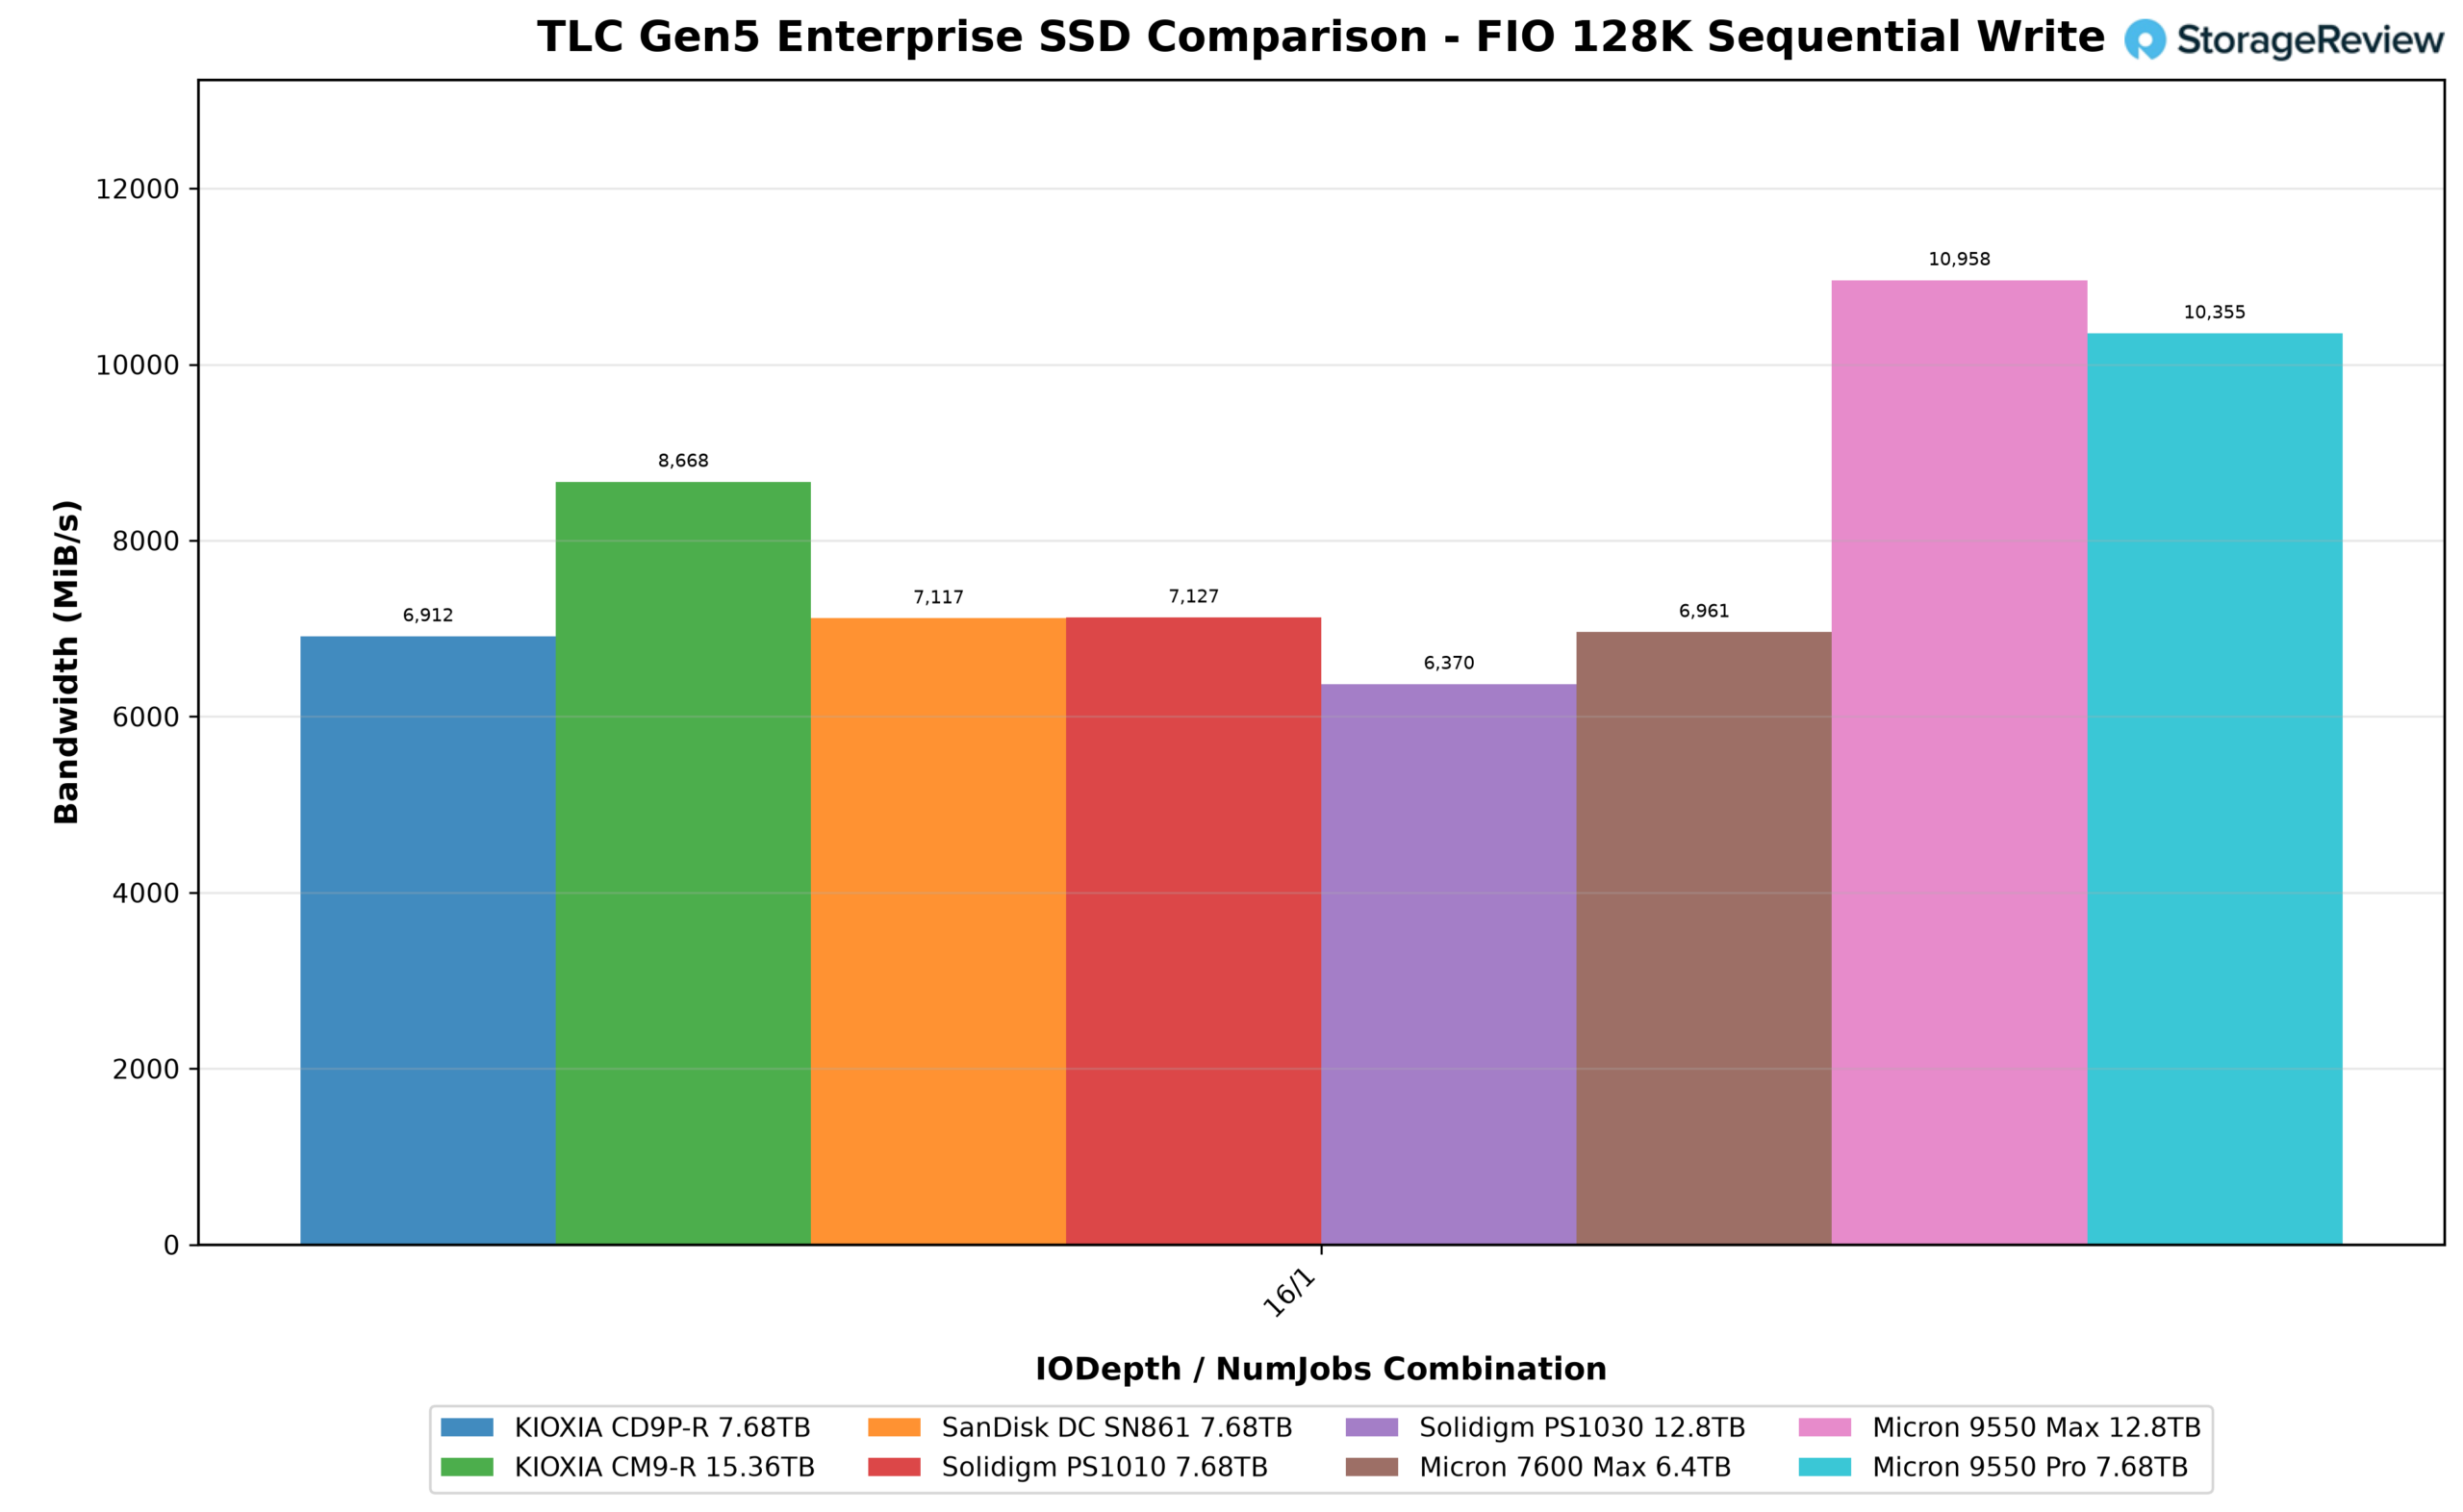
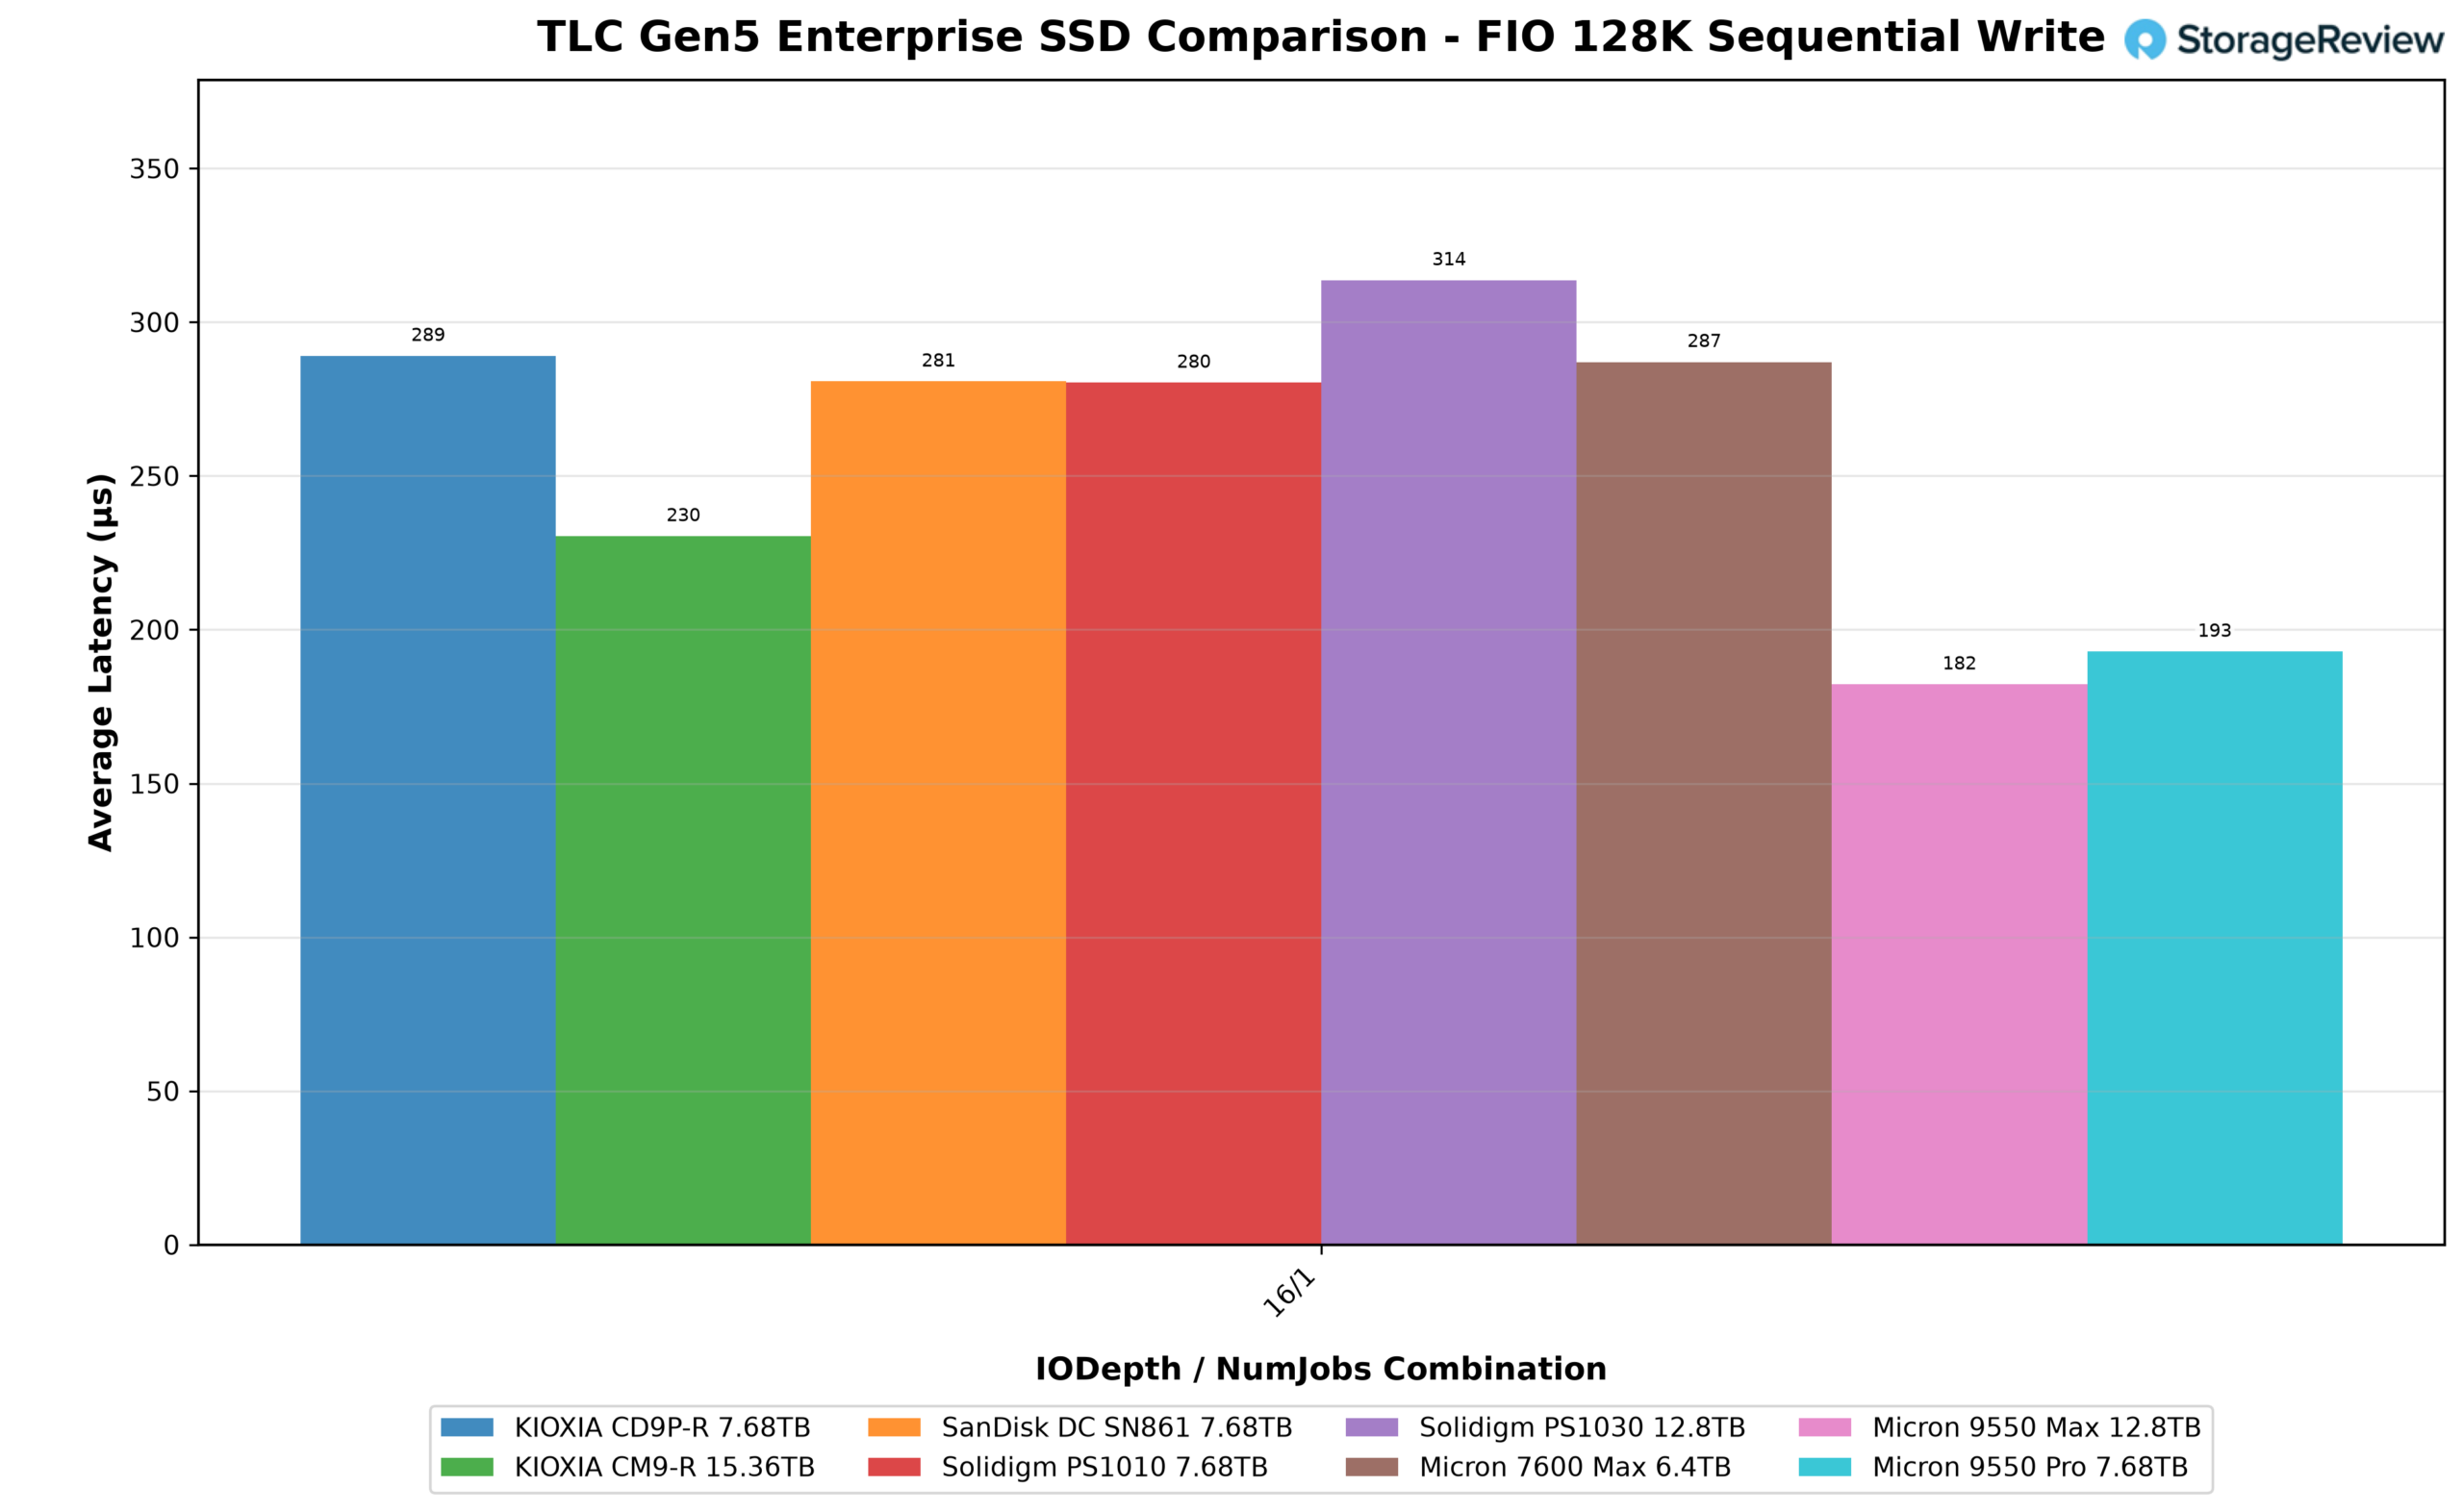
steady-state 128K sequential write test မှာ အခြား SSD တွေနဲ့ ယှဉ်ရင် PS1030 က အားနည်းချက်တချို့ ပြသနေတဲ့ နေရာတစ်ခုပါ။ drive ဟာ 313.7 µs မှာ 6,370.3 MB/s ရရှိခဲ့ပြီး အုပ်စုထဲမှာ bandwidth အနိမ့်ဆုံးနဲ့ latency အမြင့်ဆုံးဖြစ်ပြီး read-intensive KIOXIA CD9P-R မှာတောင် 6,912.4 MB/s နောက်ကျကျန်နေခဲ့ပါတယ်။ Micron 9550 MAX က 10,957.9 MB/s နဲ့ ဦးဆောင်နေပြီး 9550 Pro က 10,354.6 MB/s နဲ့ KIOXIA CM9-R က 8,668.1 MB/s နဲ့ တတိယနေရာမှာ ရပ်တည်ခဲ့ပါတယ်။ PS1030 ရဲ့ ညီအစ်မဖြစ်တဲ့ PS1010 (7,126.5 MB/s) နဲ့ SanDisk DC SN861 (7,116.5 MB/s) တို့က အလယ်အလတ်အဆင့်မှာ ရှိနေပြီး Micron 7600 MAX က 6,960.6 MB/s ရှိပါတယ်။
ဘောင်အတွင်း ထားရှိသင့်သည်- ၎င်းသည် အလုပ်တစ်ခုတည်းအတွက် လုပ်ဆောင်ရသည့် workload တစ်ခုဖြစ်ပြီး PS1030 ၏ write architecture ကို stream တစ်ခုတည်းရရှိရန်မဟုတ်ဘဲ အလုပ်များကို ဖြန့်ဝေရန် တည်ဆောက်ထားသည်။ အောက်ဖော်ပြပါ random write အပိုင်းများတွင် parallelism ကို မိတ်ဆက်ပြီးသည်နှင့် data များစွာကို ရွှေ့နေသော drive တစ်ခုတည်းကို ပြသထားပြီး ၎င်းသည် ၎င်း၏ target workloads မှ ထုတ်ပေးသော access pattern နှင့် ကိုက်ညီပါသည်။
128K အစဉ်လိုက်ဖတ်ရှုမှု (IODepth 64 / NumJobs 1)
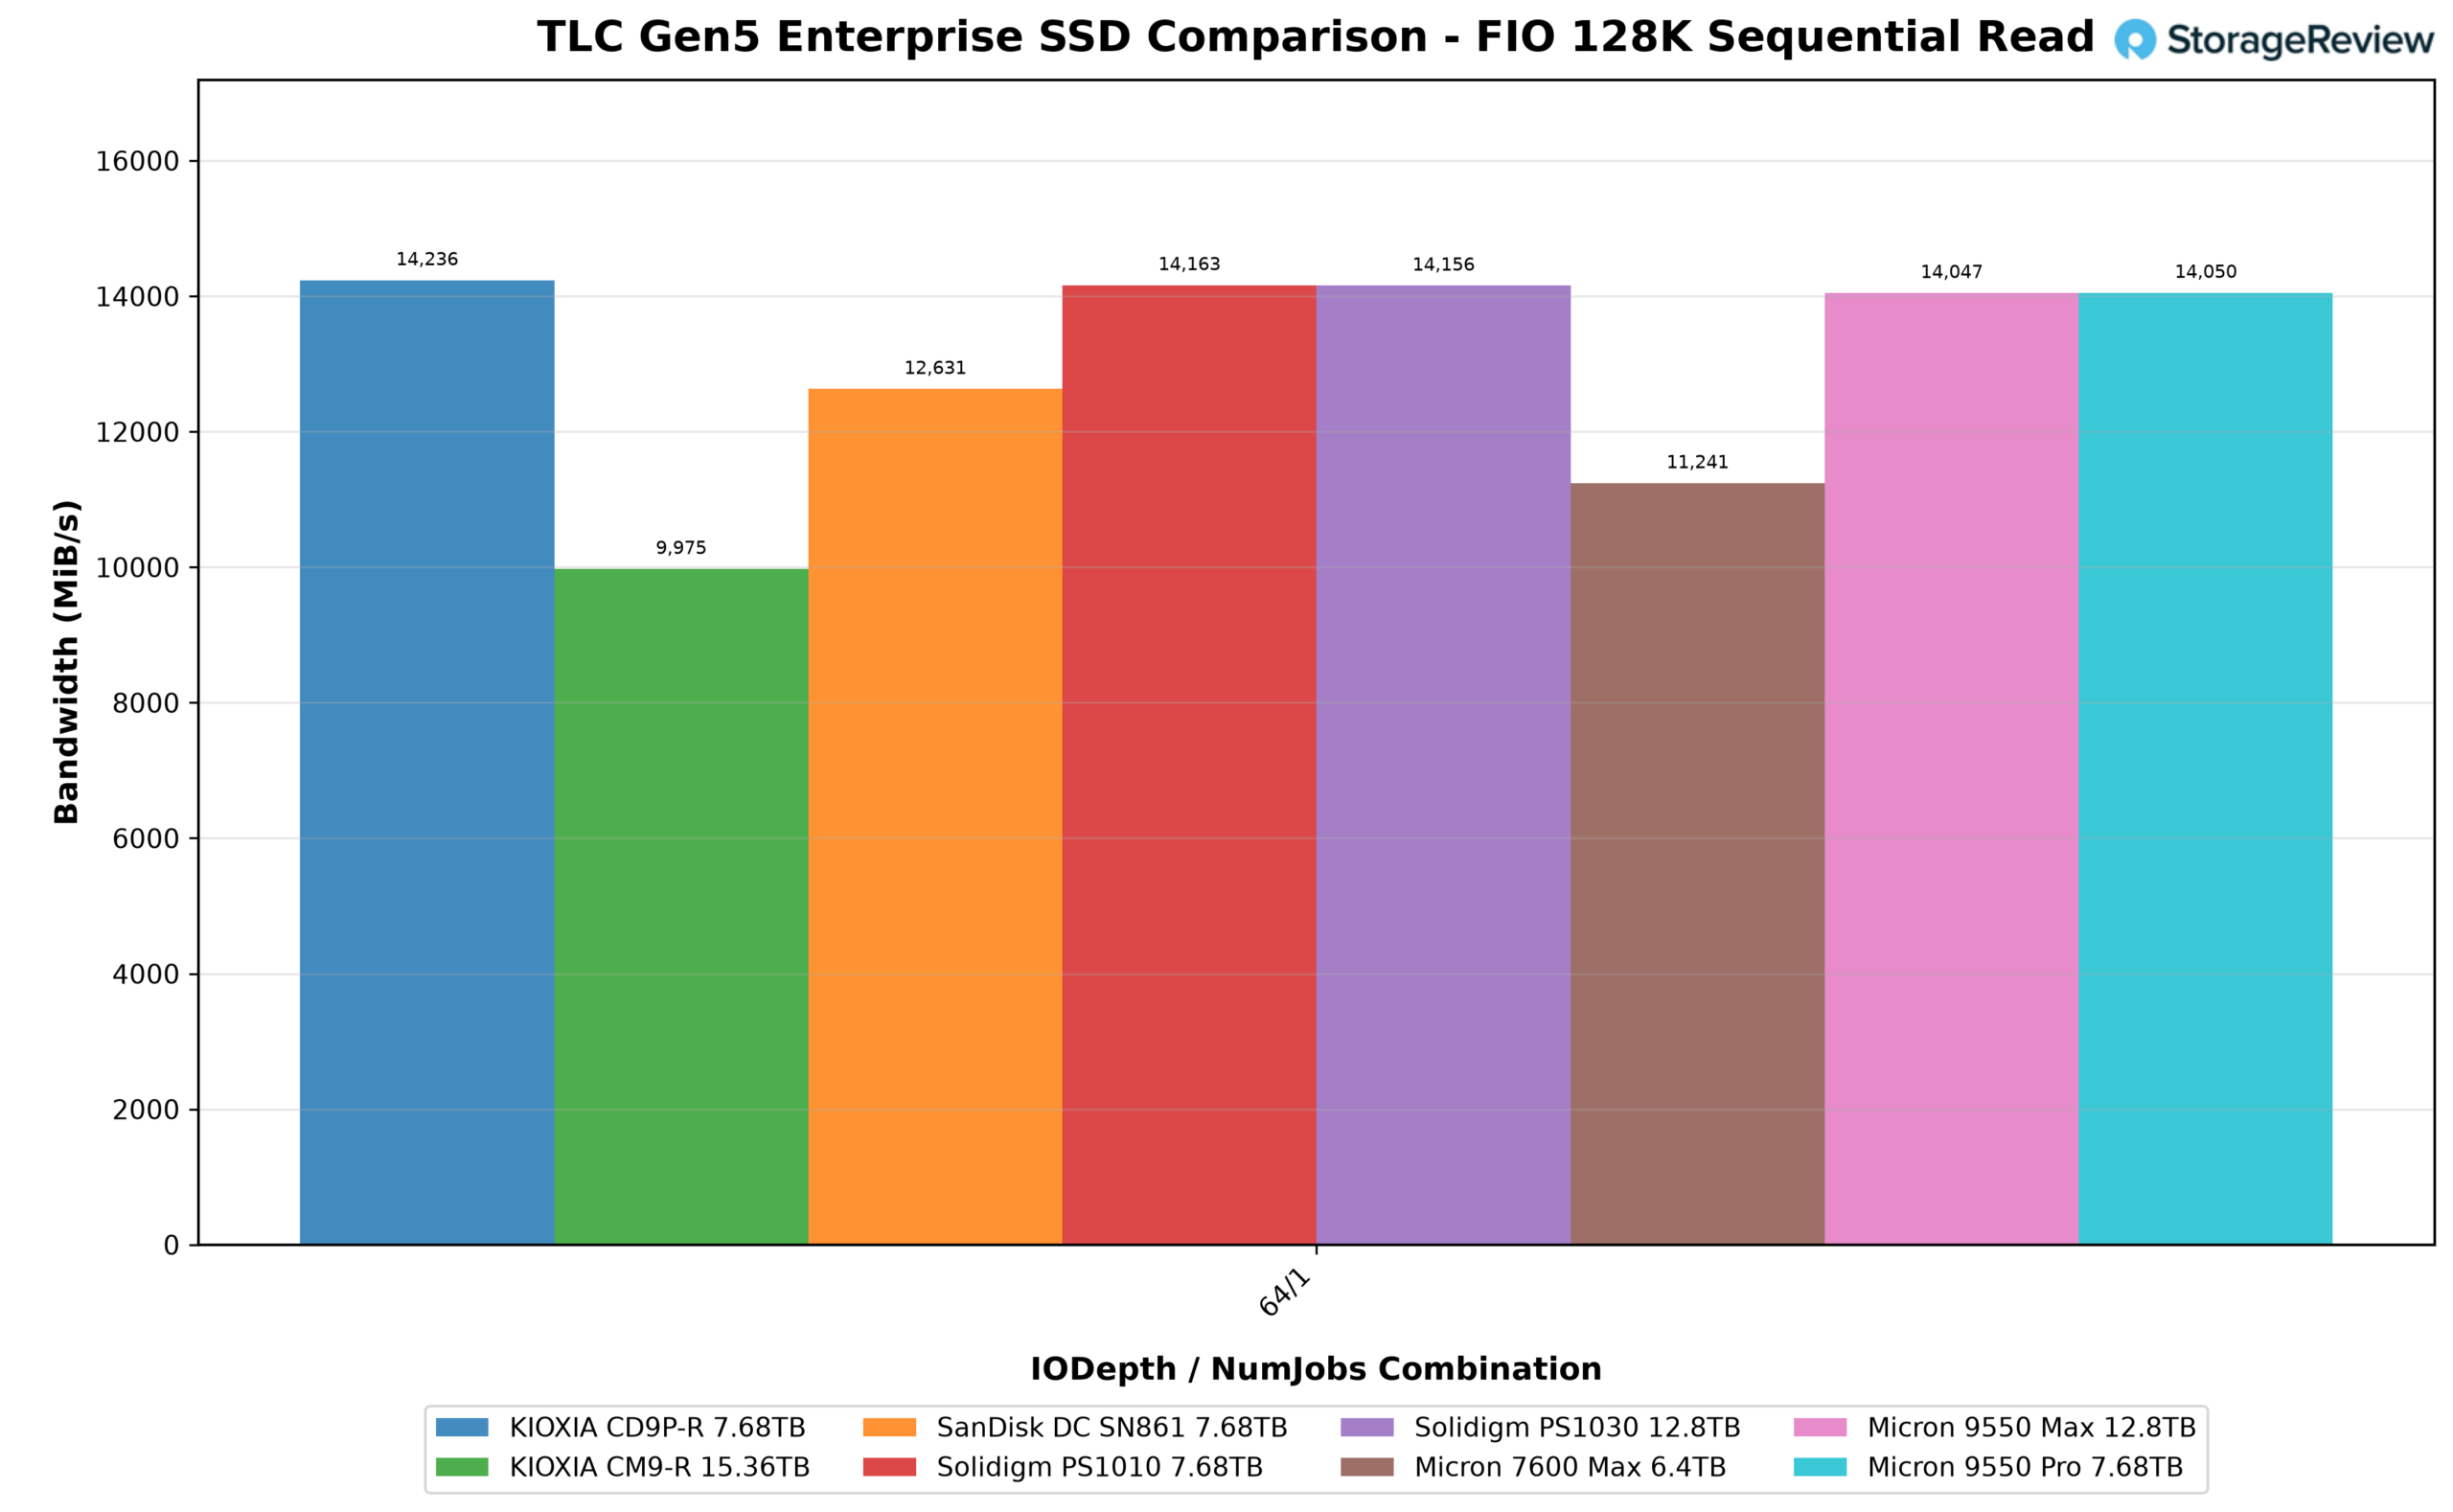
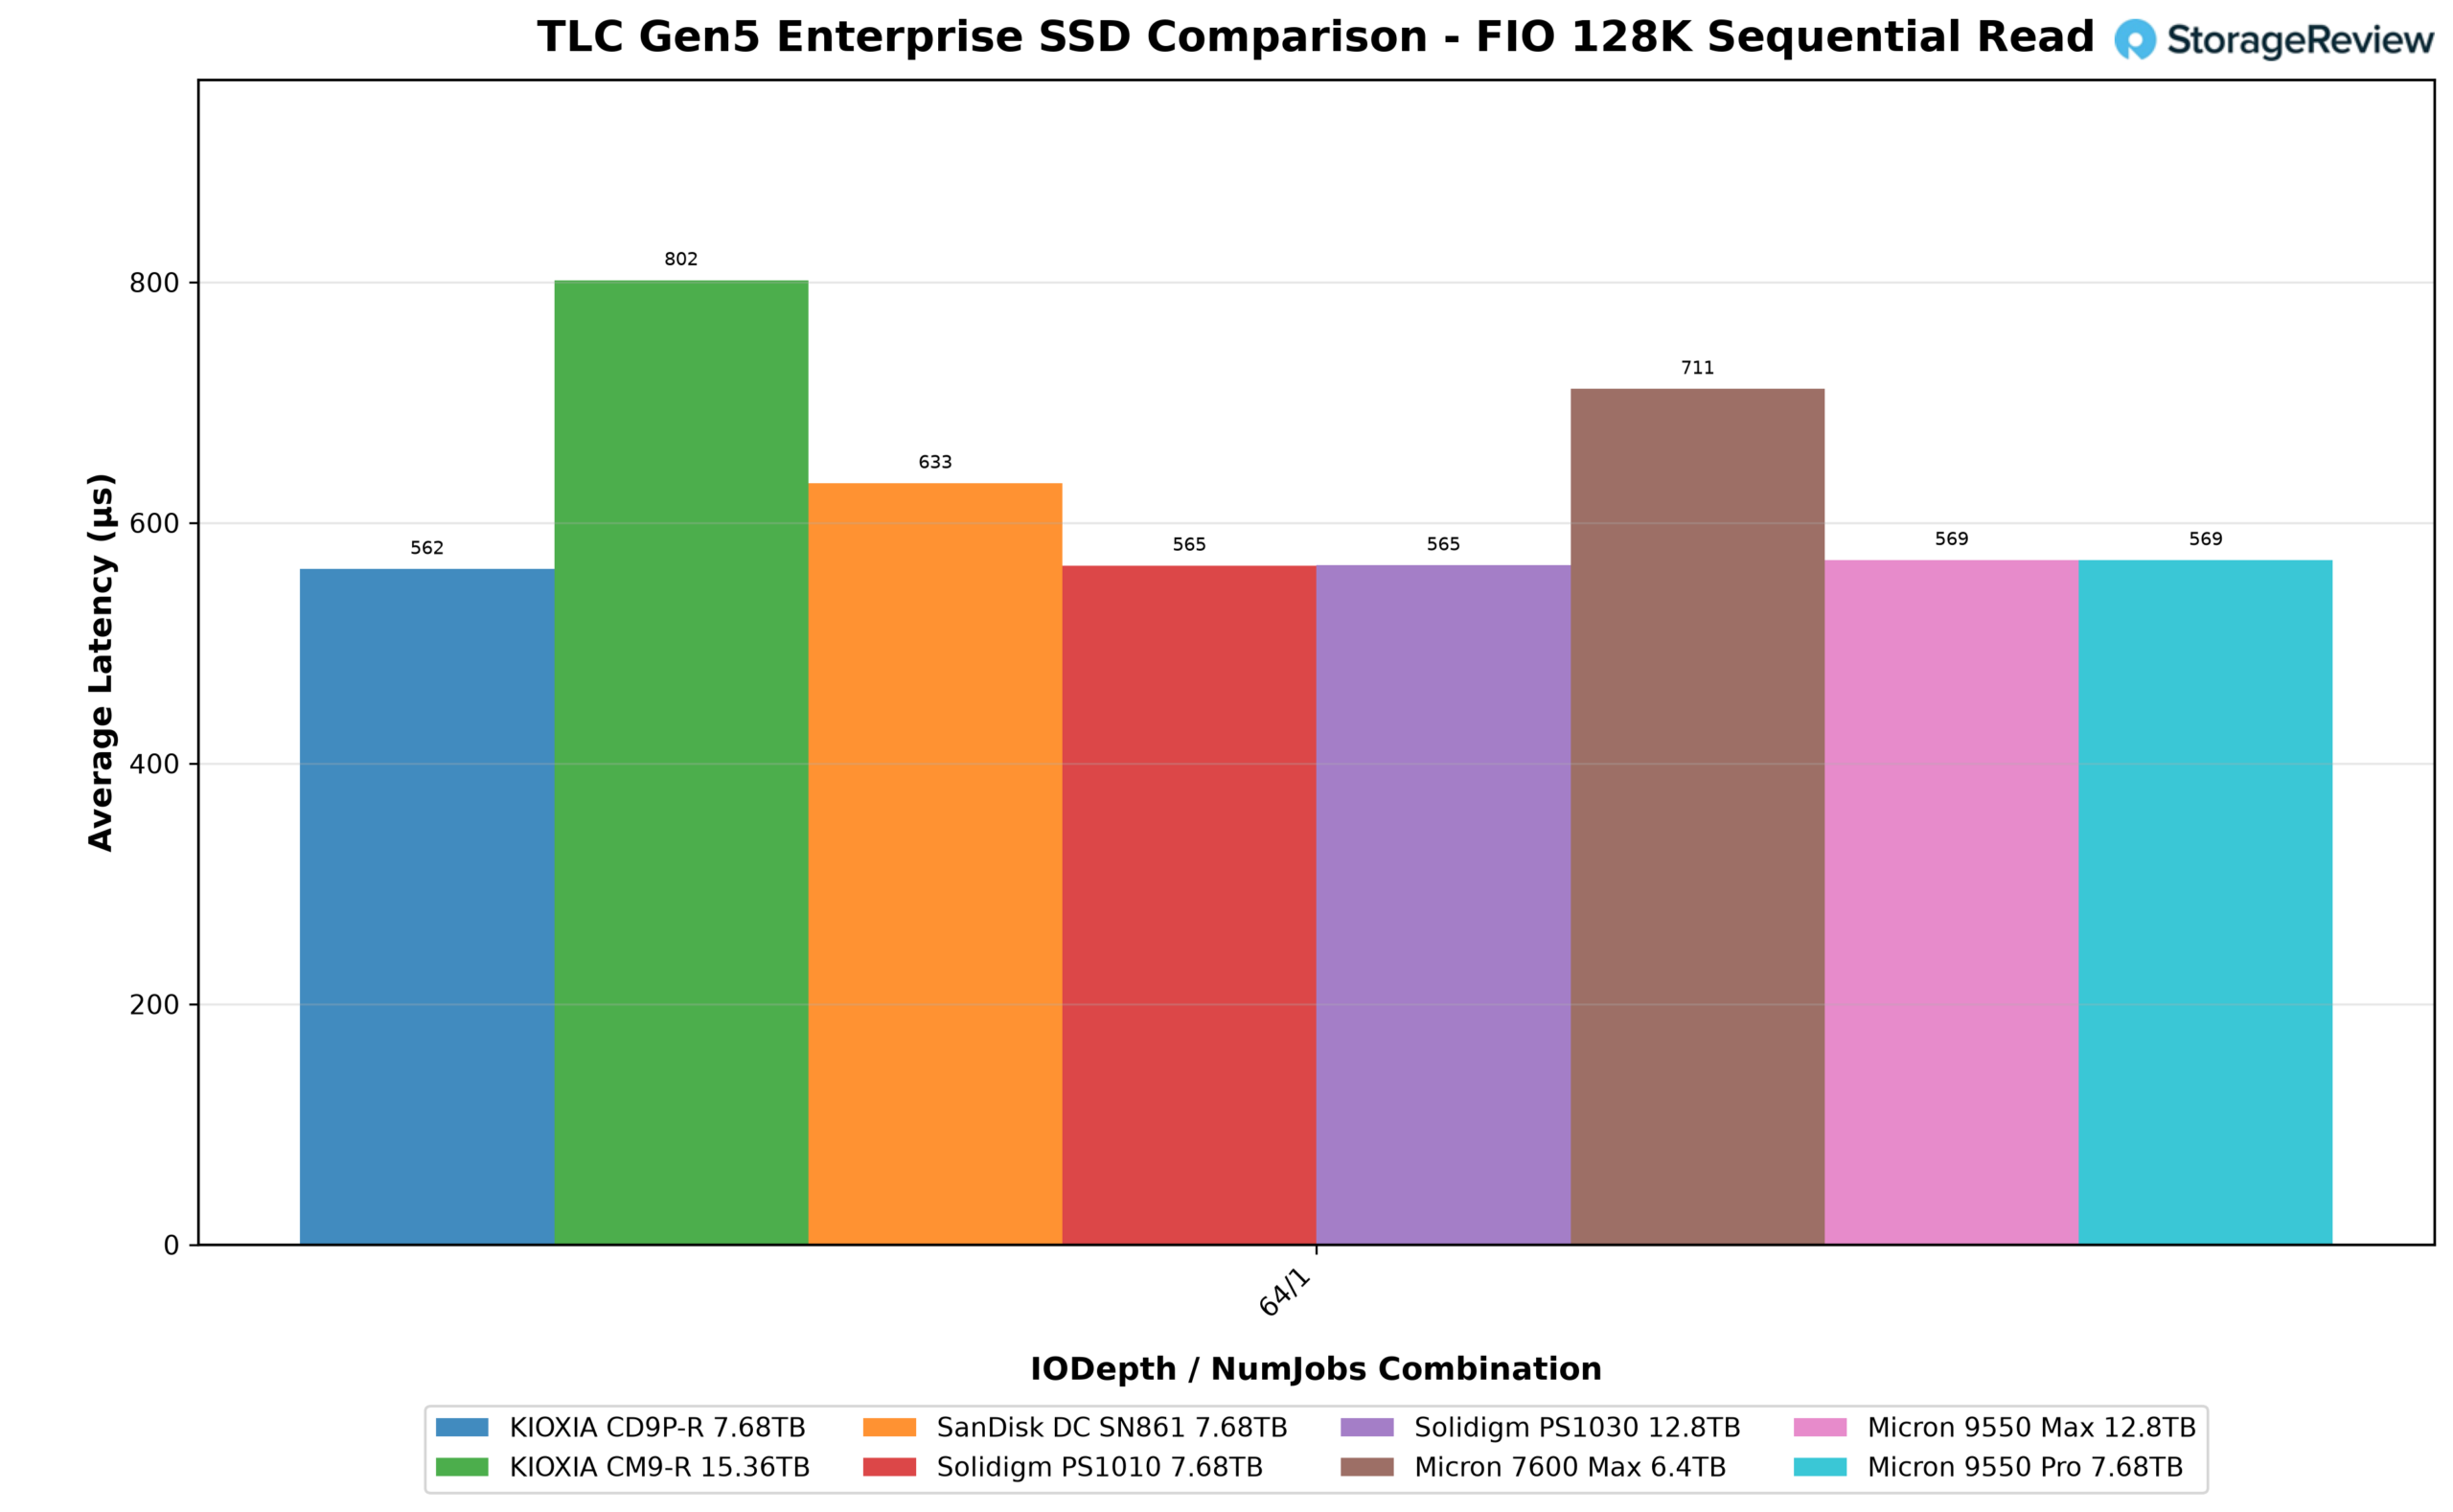
read ဘက်ခြမ်းက script ကို ပြောင်းပြန်လှန်လိုက်ပါတယ်။ PS1030 ဟာ 564.8 µs မှာ 14,156.4 MB/s ပေးပို့နိုင်ခဲ့ပြီး သူ့ရဲ့ညီအစ်မ PS1010 (14,163.3 MB/s) နဲ့ ထိရောက်စွာ တူညီပြီး အုပ်စုဦးဆောင် CD9P-R (14,235.9 MB/s) ရဲ့ 0.6% အတွင်းမှာ ရှိနေပါတယ်။ Micron 9550 Pro (14,050.1 MB/s) နဲ့ 9550 MAX (14,047.5 MB/s) တို့ဟာ drive ငါးခုပါဝင်တဲ့ package ကို ပြီးမြောက်စေခဲ့ပြီး Gen5 interface ကို 200 MB/s band အတွင်း ပြည့်နှက်စေခဲ့ပါတယ်။ SN861 ကတော့ 12,631.2 MB/s၊ 7600 MAX က 11,240.5 MB/s နဲ့ write test မှာ အလွန်အားကောင်းတဲ့ CM9-R ကတော့ single-job configuration မှာ 9,974.6 MB/s နဲ့ နောက်ဆုံးနေရာမှာ ရှိနေပါတယ်။ ၎င်း၏ရေးသားဘတ်ဂျက်ဖြင့်ရောင်းချသော drive တစ်ခုအတွက်၊ big-block read များတွင် ဘာမှမစွန့်လွှတ်ခြင်းသည် ဤဇယားတွင် တိတ်ဆိတ်စွာအနိုင်ရရှိခြင်းဖြစ်သည်။
64K ကျပန်းရေးပါ။
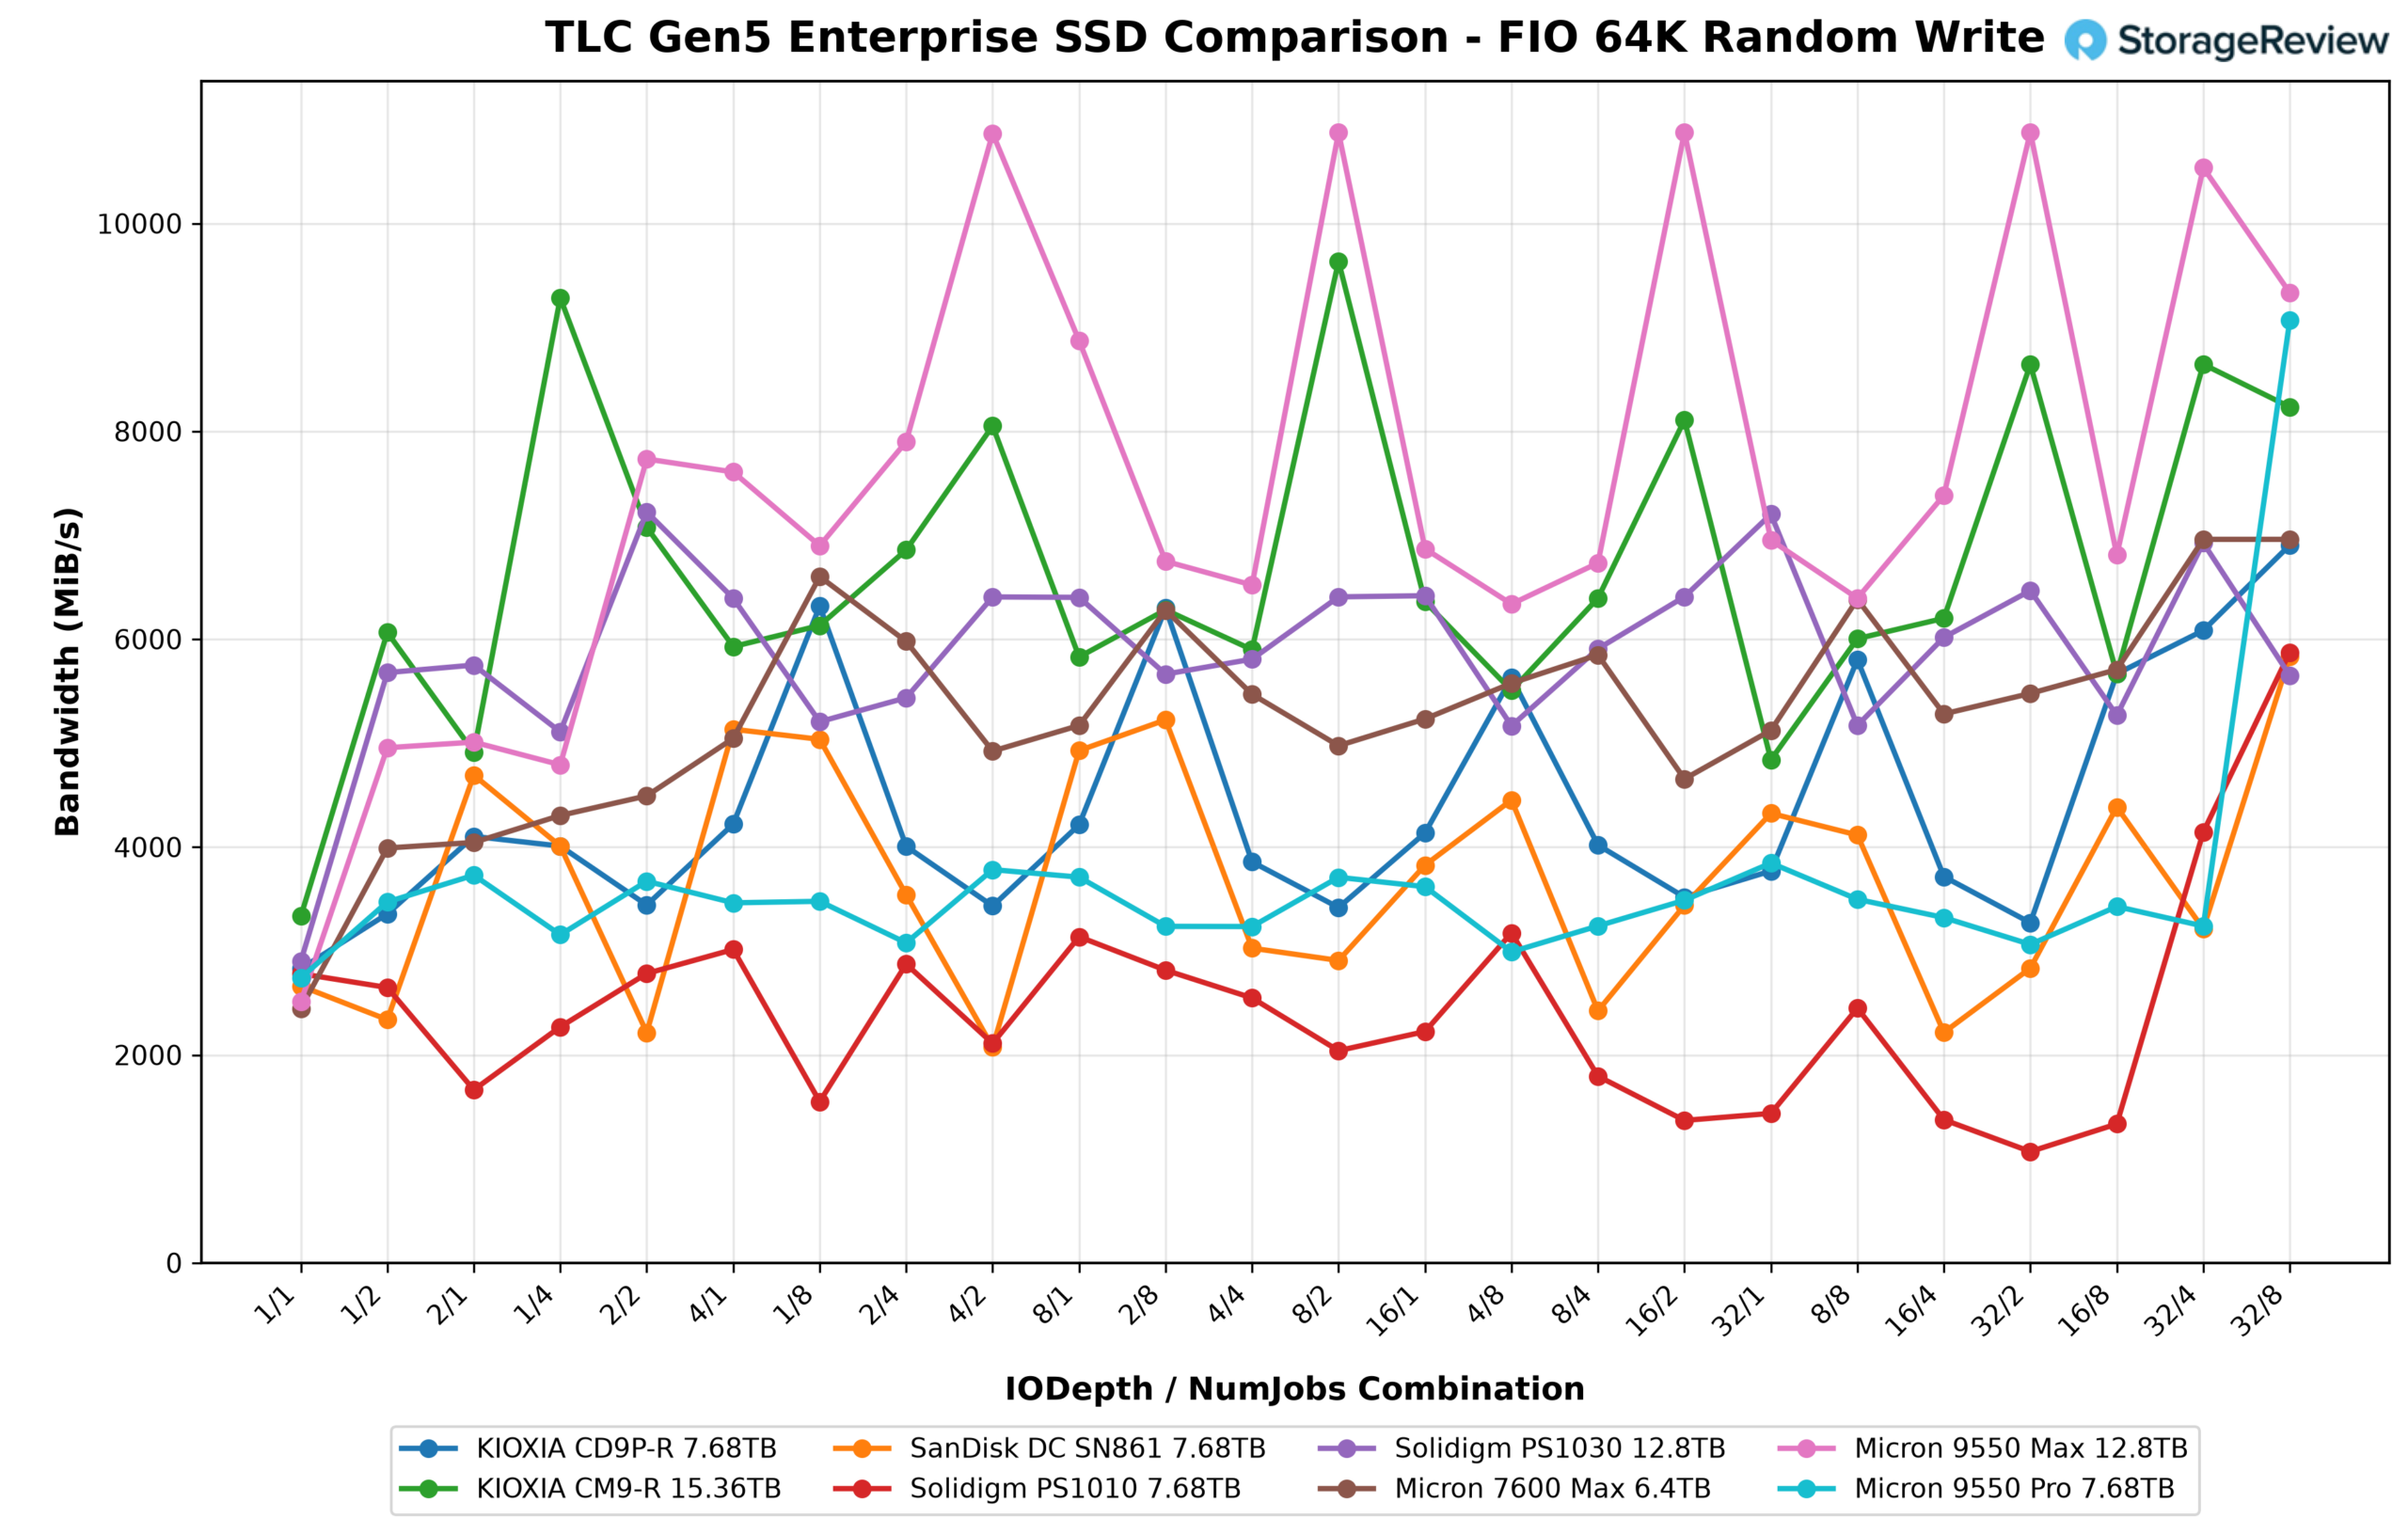
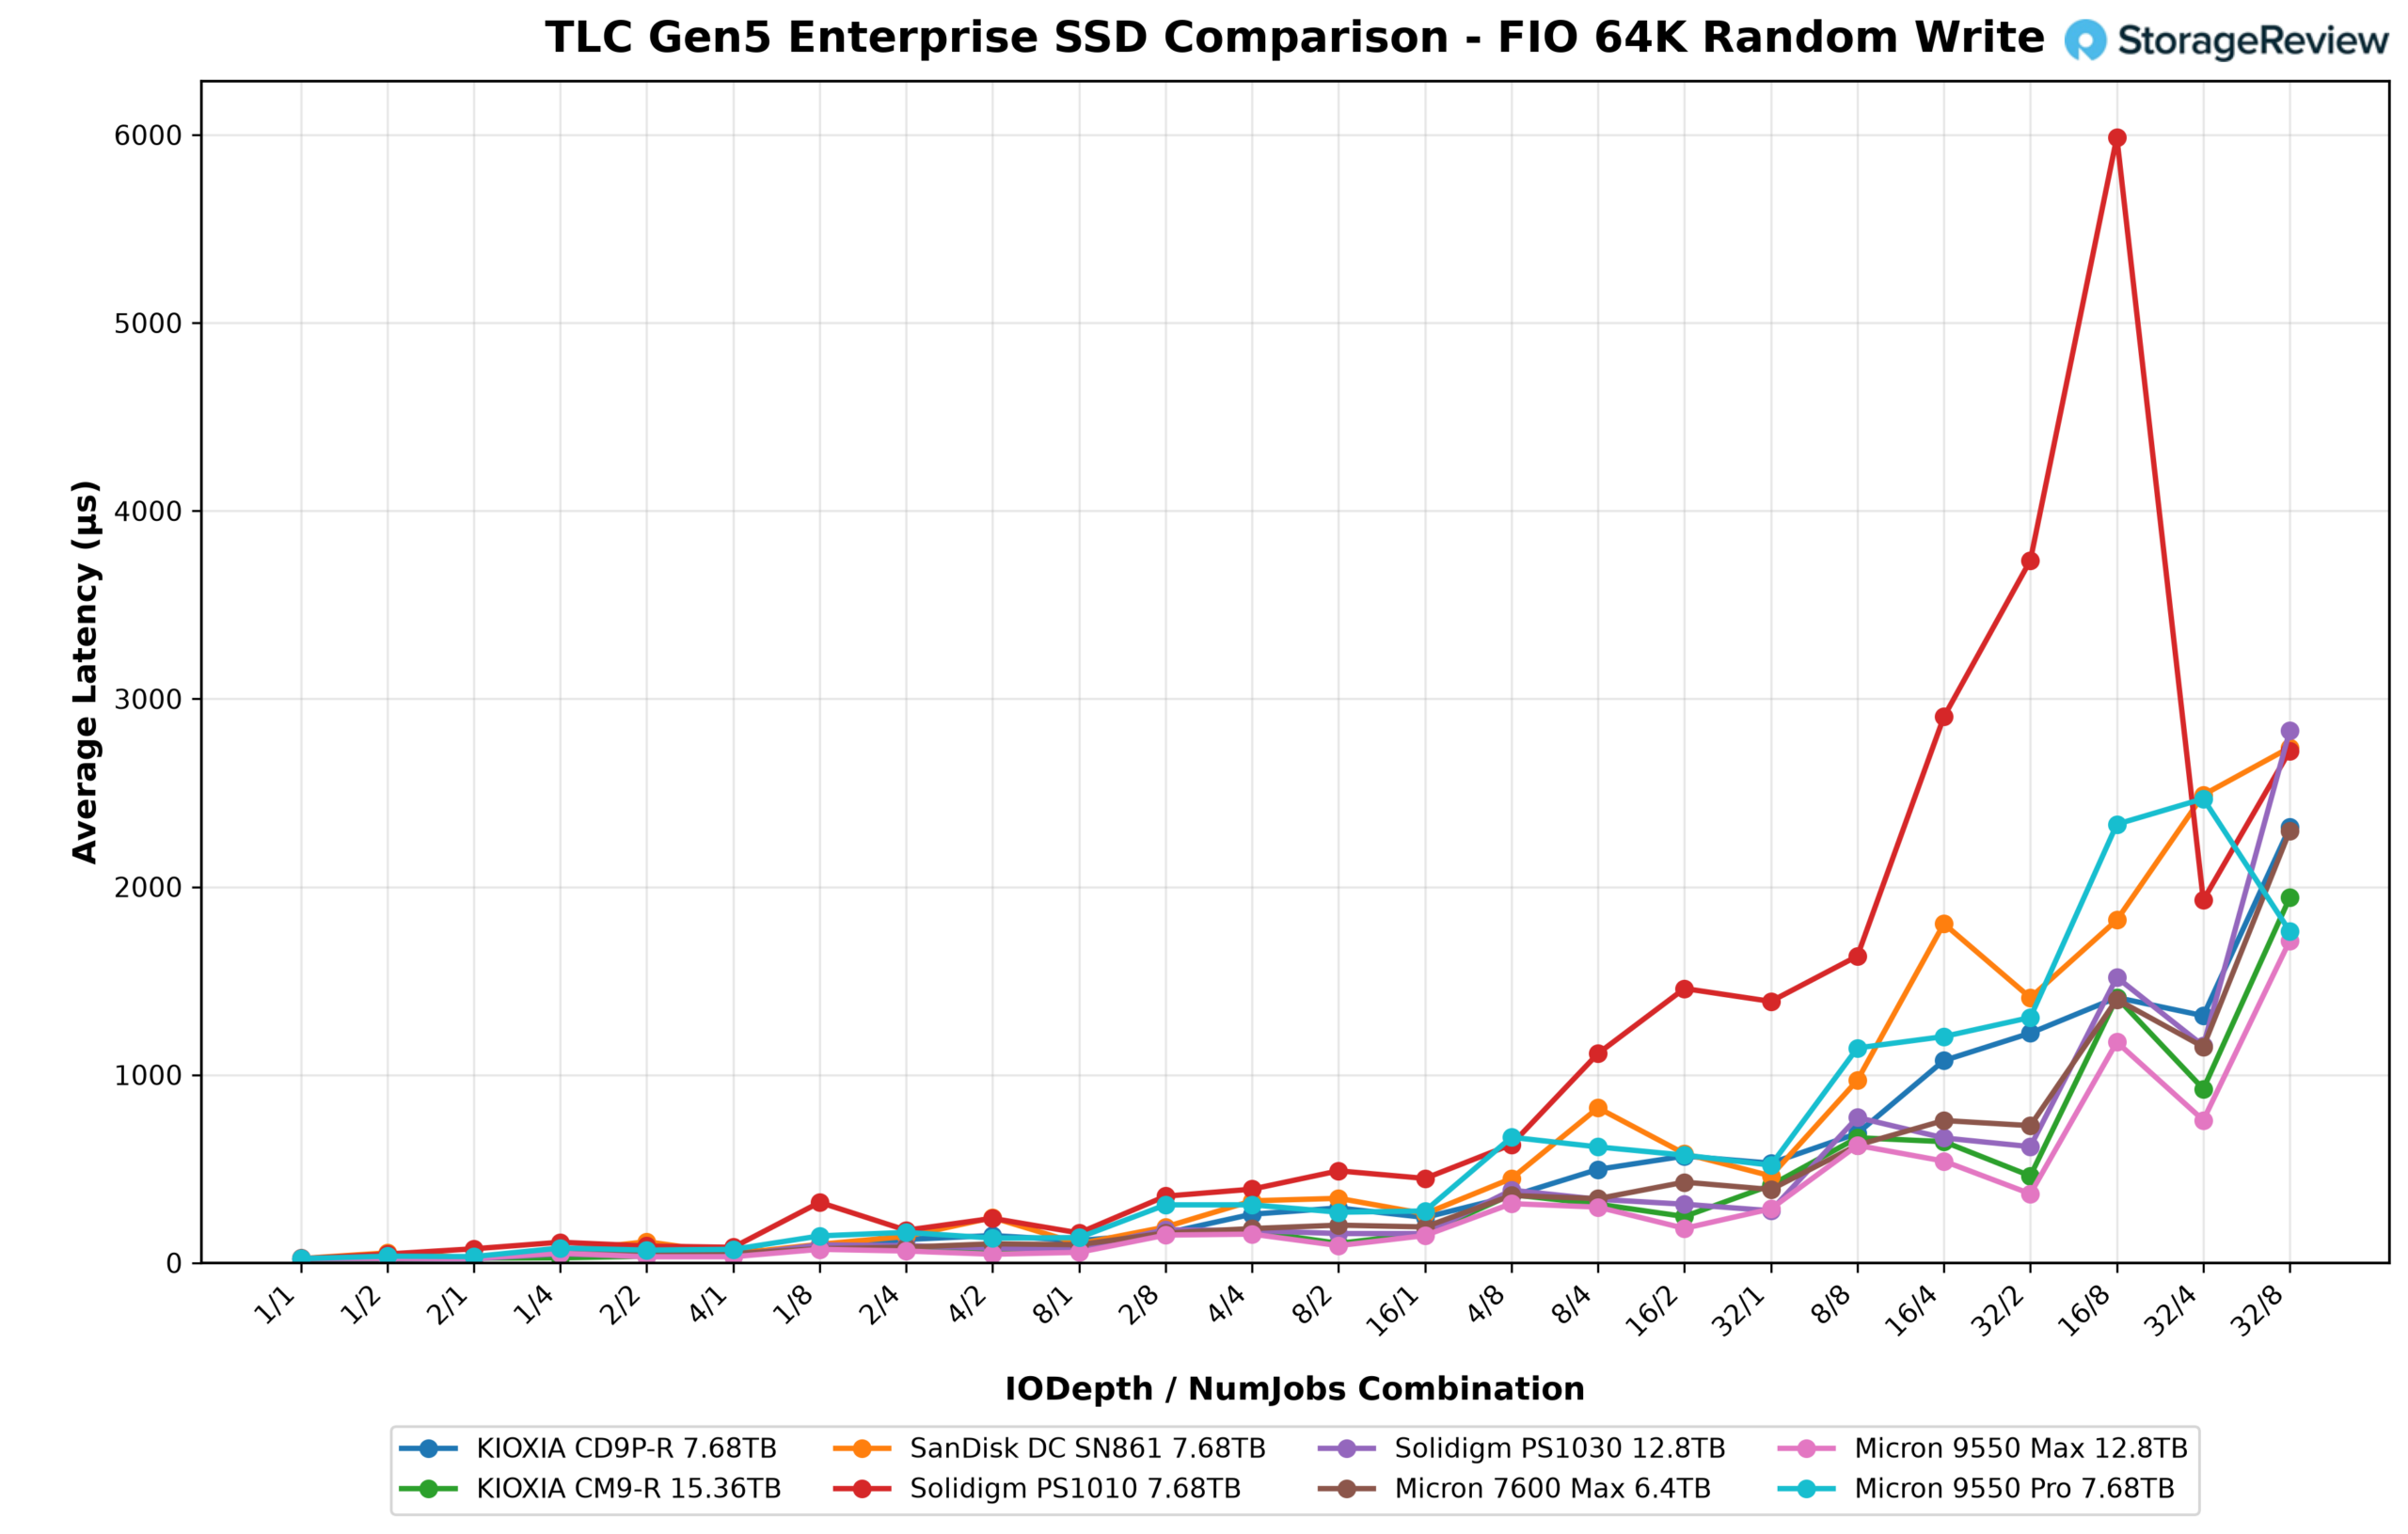
PS1030 ရဲ့ စရိုက်လက္ခဏာကို ပြသနေတဲ့ 64K random write sweep ပါ။ drive ဟာ 7,224.0 MB/s အထိ အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး Micron 9550 MAX (10,878.1 MB/s), KIOXIA CM9-R (9,635.3 MB/s) နဲ့ Micron 9550 Pro (9,069.4 MB/s) တို့ပြီးရင် အုပ်စုထဲမှာ စတုတ္ထနေရာ ရရှိခဲ့ပြီး Micron 7600 MAX (6,960.5 MB/s) နဲ့ ကျန်တဲ့ field တွေထက် သာလွန်ပါတယ်။ PS1030 ကို ထူးခြားစေတာက အဲဒီအမြင့်ဆုံးရောက်ရှိခဲ့တဲ့နေရာပါပဲ။ IODepth 2 / NumJobs 2 မှာ latency 34.3 µs သာရှိခဲ့ပြီး field အများစုဟာ အကောင်းဆုံးနံပါတ်တွေကို ရောက်ရှိဖို့ deep queues တွေ လိုအပ်ခဲ့ပါတယ်။ drive ဟာ ချက်ချင်းဆိုသလို ပြည့်သွားပြီး sweep ကျန်တဲ့အချိန်တွေမှာ ပြားချပ်နေမှာဖြစ်ပြီး ဒါက ၂၄ နာရီပတ်လုံး အသင့်အတင့် တပြိုင်နက်တည်း လည်ပတ်နေတဲ့ steady-state write tier အတွက် သင်လိုချင်တဲ့ profile အတိအကျပါပဲ။ ၎င်း၏ညီအစ်မနှင့် ကွာခြားချက်မှာ စွမ်းဆောင်ရည်စံနှုန်းများကို ထိန်းသိမ်းထားသည့် ခံနိုင်ရည်အဆင့်လည်းဖြစ်သည်- PS1010 သည် 5,873.9 MB/s ဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး PS1030 ထက် ၂၃% လျော့နည်းသည်။
latency အရ PS1030 သည် IODepth 1 / NumJobs 1 တွင် 21.1 µs ဖြင့် ဖွင့်လှစ်ခဲ့ပြီး CM9-R ၏ 18.4 µs ပြီးနောက် ဒုတိယနေရာတွင် ရပ်တည်ခဲ့ပြီး တစ်ခုလုံးတွင် အဆိုးဆုံးအချိန်သည် 2,831 µs ရှိပြီး PS1010 ၏ 5,987 µs မြင့်တက်မှု၏ ထက်ဝက်အောက် လျော့နည်းသည်။ 9550 MAX သည် မြင့်မားသော တစ်ပြိုင်နက်တည်းလုပ်ဆောင်မှုများတွင် အထိန်းချုပ်ဆုံးအဖြစ် ဆက်လက်တည်ရှိနေပြီး 1,714 µs ဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့သည်။
64K ကျပန်းဖတ်ပါ။
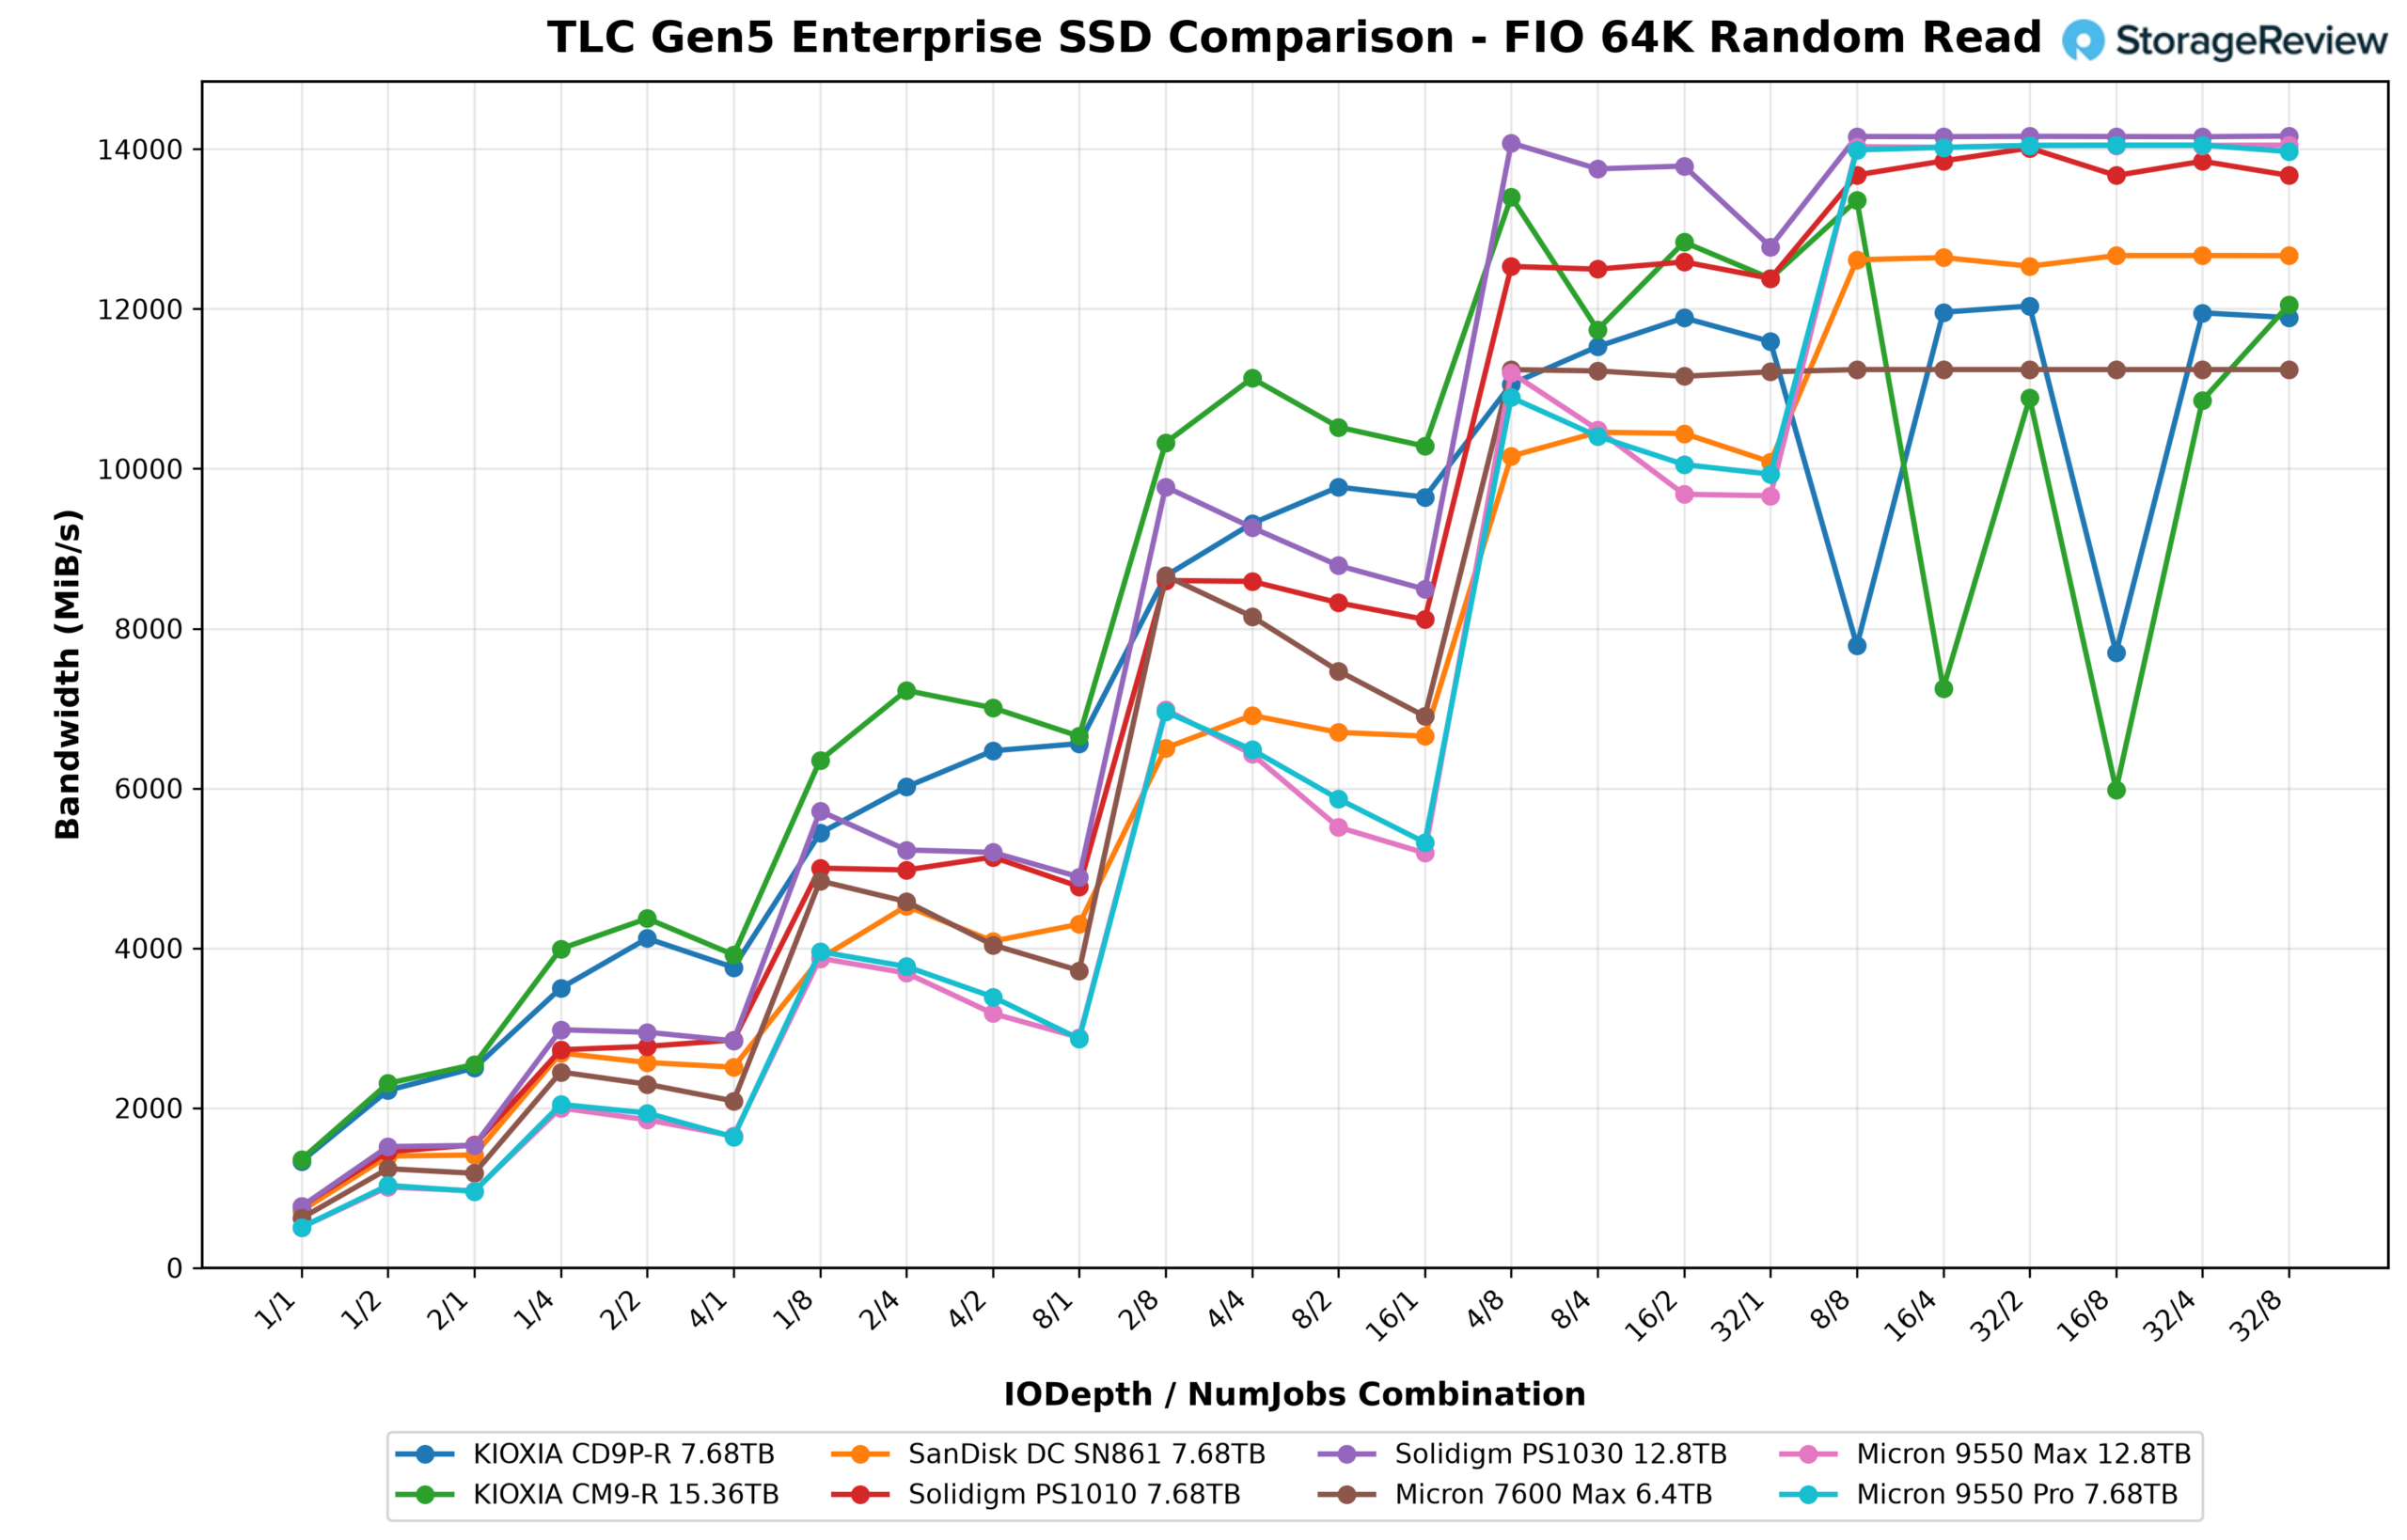
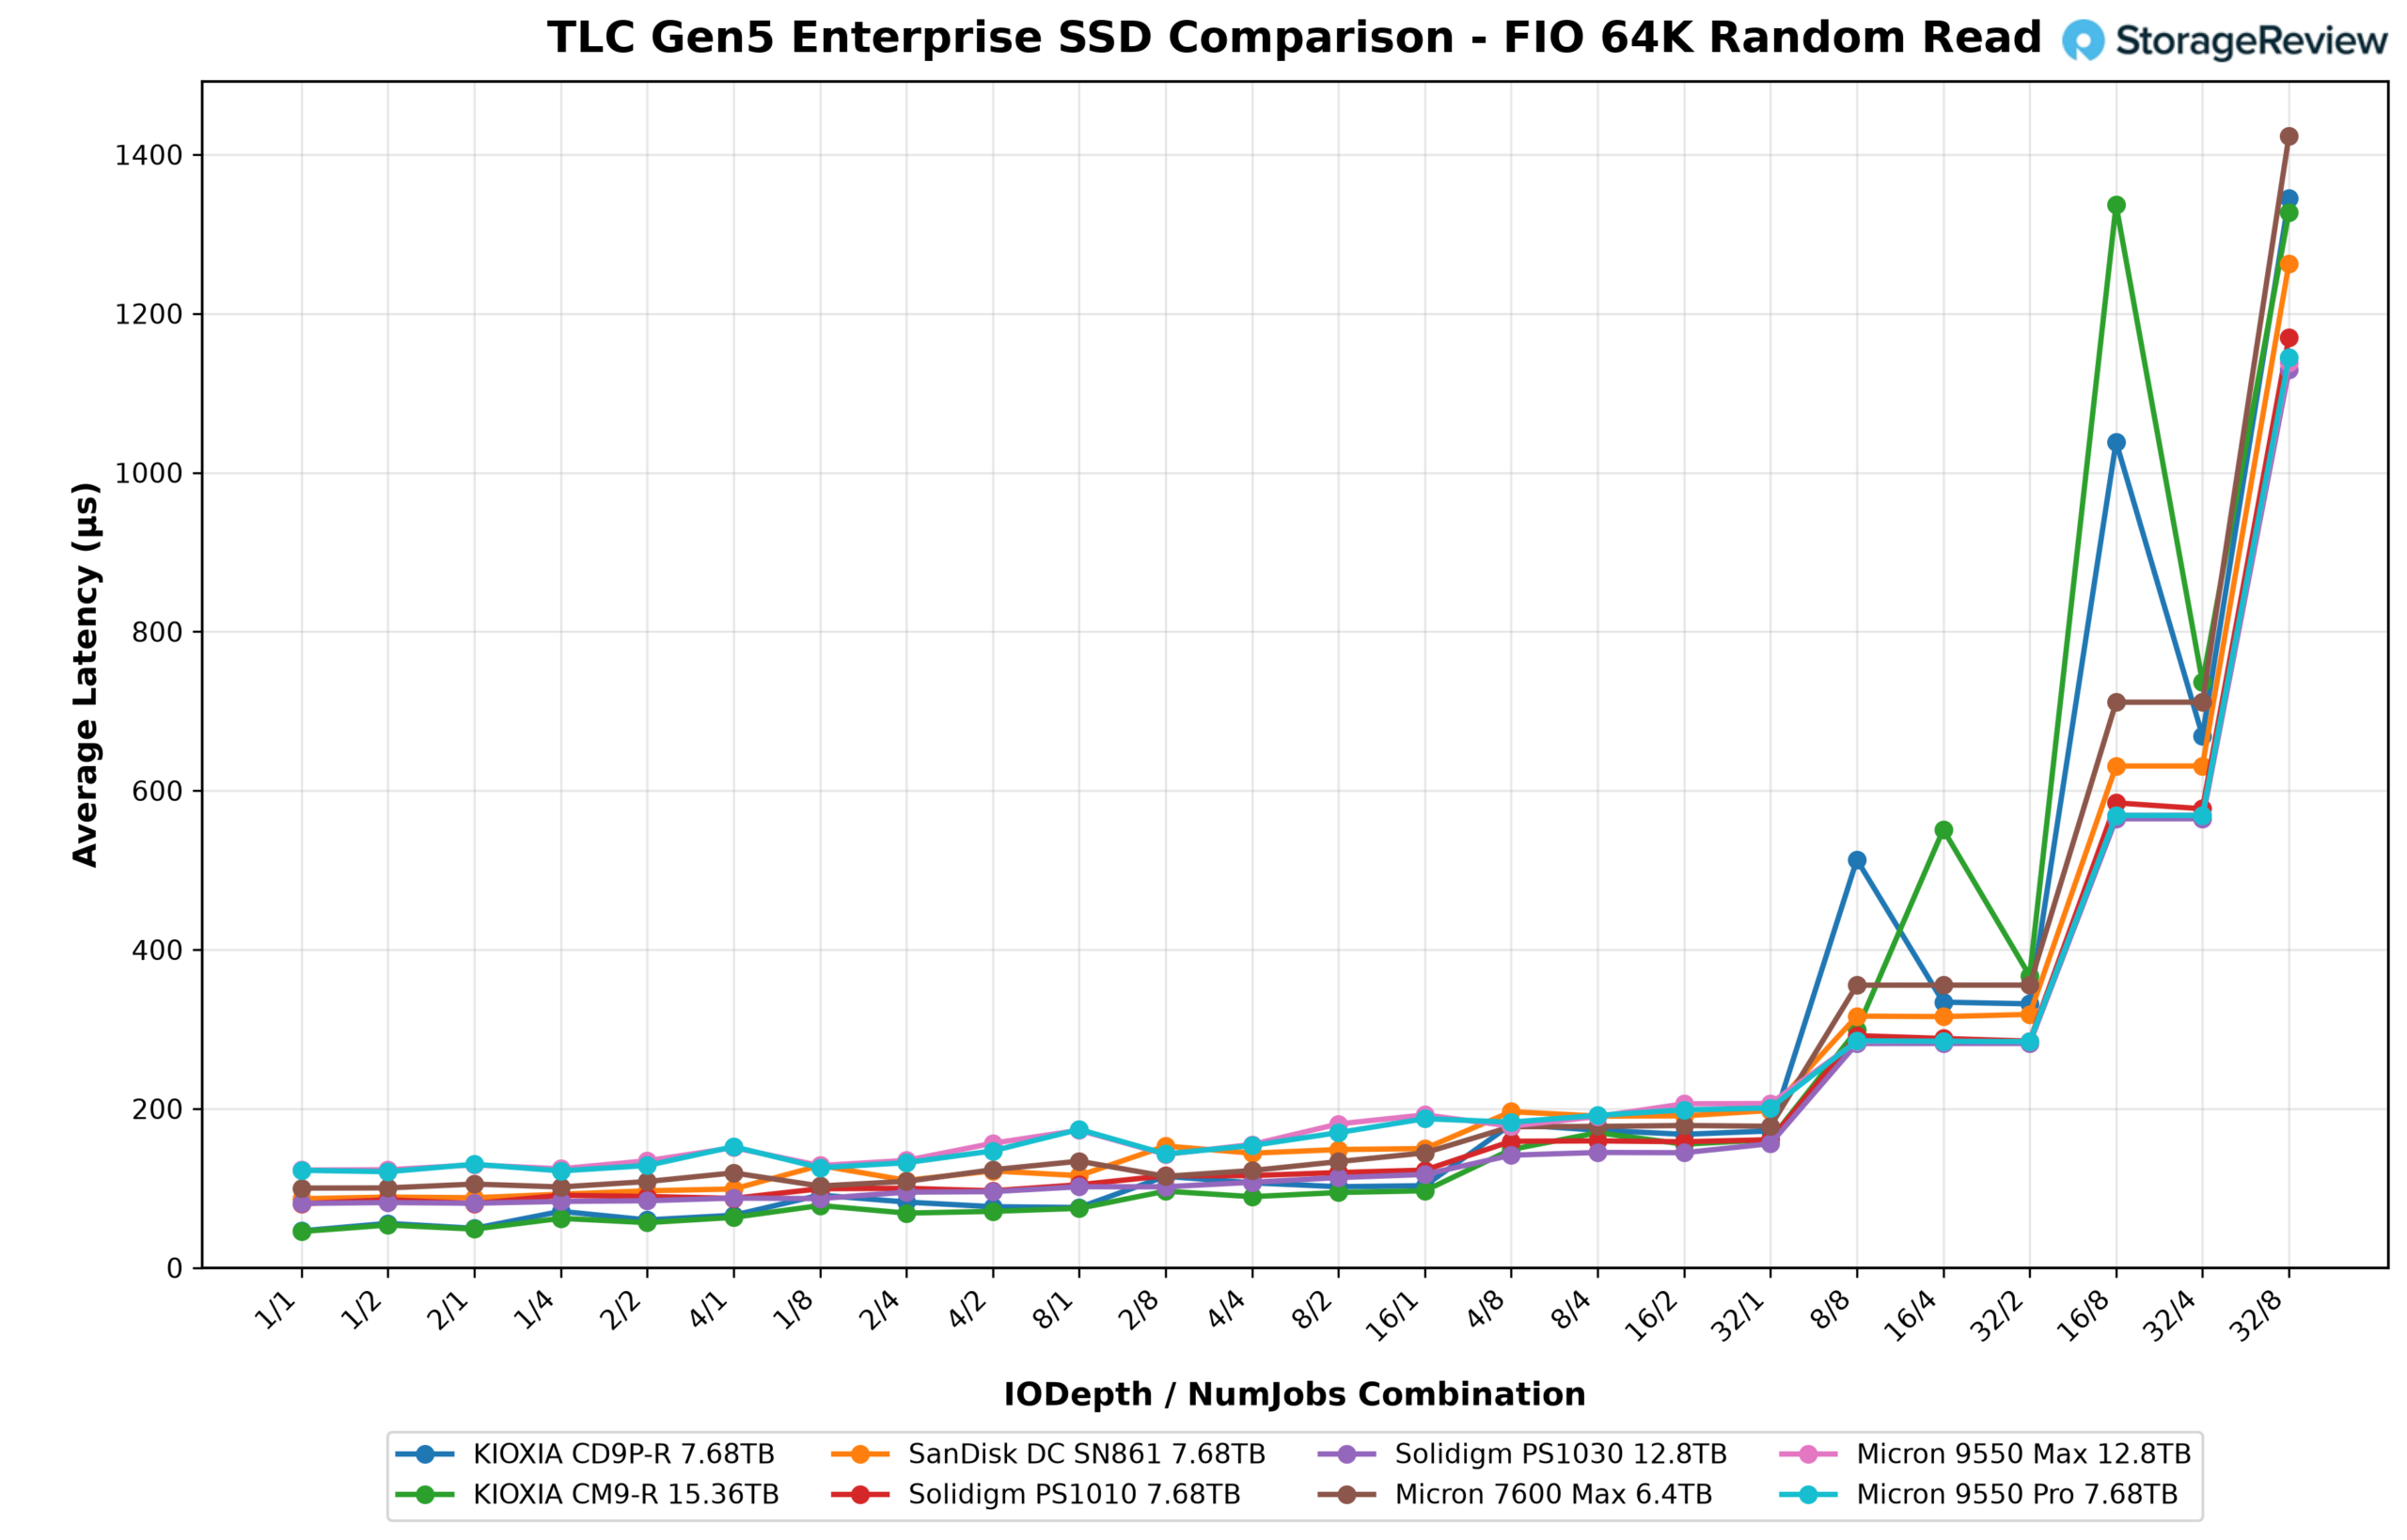
PS1030 သည် အုပ်စု၏ အကောင်းဆုံး 64K ကျပန်းဖတ်ရှုမှု အမြင့်ဆုံးကို 14,162.9 MB/s (IODepth 32 / NumJobs 8) ဖြင့် ရရှိခဲ့ပြီး Micron 9550 Pro (14,049.9 MB/s)၊ 9550 MAX (14,049.7 MB/s) နှင့် PS1010 (14,013.6 MB/s) တို့ထက် အနည်းငယ် သာလွန်ခဲ့ပြီး CM9-R သည် 13,402.4 MB/s နှင့် CD9P-R သည် 12,036.0 MB/s ဖြင့် နောက်ကျကျန်နေခဲ့သည်။ queue-depth နည်းတဲ့ဇာတ်လမ်းက KIOXIA drives တွေနဲ့ သက်ဆိုင်ပါတယ်၊ ကျွန်ုပ်တို့ရဲ့ CD9P-R review မှာလိုပဲ- CM9-R က 1,359.0 MB/s နဲ့ CD9P-R က 1,334.0 MB/s နဲ့ IODepth 1 / NumJobs 1 မှာ latency territory 45 µs ခန့်ရှိပြီး PS1030 က 768.4 MB/s နဲ့ 81.0 µs မှာ စတင်ခဲ့ပါတယ်။ PS1030 က single-stream response အတွက်မဟုတ်ဘဲ scaling အတွက် ဒီဇယားရဲ့ ထိပ်ဆုံးမှာ ရှိပါတယ်။
16K အစဉ်လိုက်ရေးသားခြင်း
စမ်းသပ်မှုကိုယ်တိုင်နှင့်ပတ်သက်သည့် မှတ်ချက်- ဤနှိုင်းယှဉ်အုပ်စုမှစတင်၍ ကျွန်ုပ်တို့၏ 16K လွှမ်းခြုံမှုသည် ကျပန်းမဟုတ်ဘဲ အစဉ်လိုက်ဖြစ်ပြီး ကျွန်ုပ်တို့၏ Micron 9550 MAX သုံးသပ်ချက် တွင် ကျွန်ုပ်တို့ ပထမဆုံးဖော်ထုတ်ခဲ့သော workload ဖြစ်သည်။ အလတ်စား sequential streams များသည် ဤ drives များ ထုတ်လုပ်မှုတွင် လုပ်ဆောင်သည့်အရာများကို ပိုမိုကောင်းမွန်စွာ ကိုယ်စားပြုပြီး အထူးသဖြင့် AI pipelines များတွင်ဖြစ်ပြီး၊ ၎င်းတို့သည် drive တစ်လျှောက် ကျပန်း hits များကို ပြန့်ကျဲစေမည့်အစား အစီအစဉ်တကျ လေ့ကျင့်ရေးဒေတာများကို stream လုပ်ခြင်း၊ အလယ်အလတ်ရလဒ်များကို အဆင့်လိုက်ထုတ်ပေးခြင်းနှင့် runs များတွင် inference tiers များကို feed လုပ်ခြင်းတို့ကို ပြုလုပ်သည်။
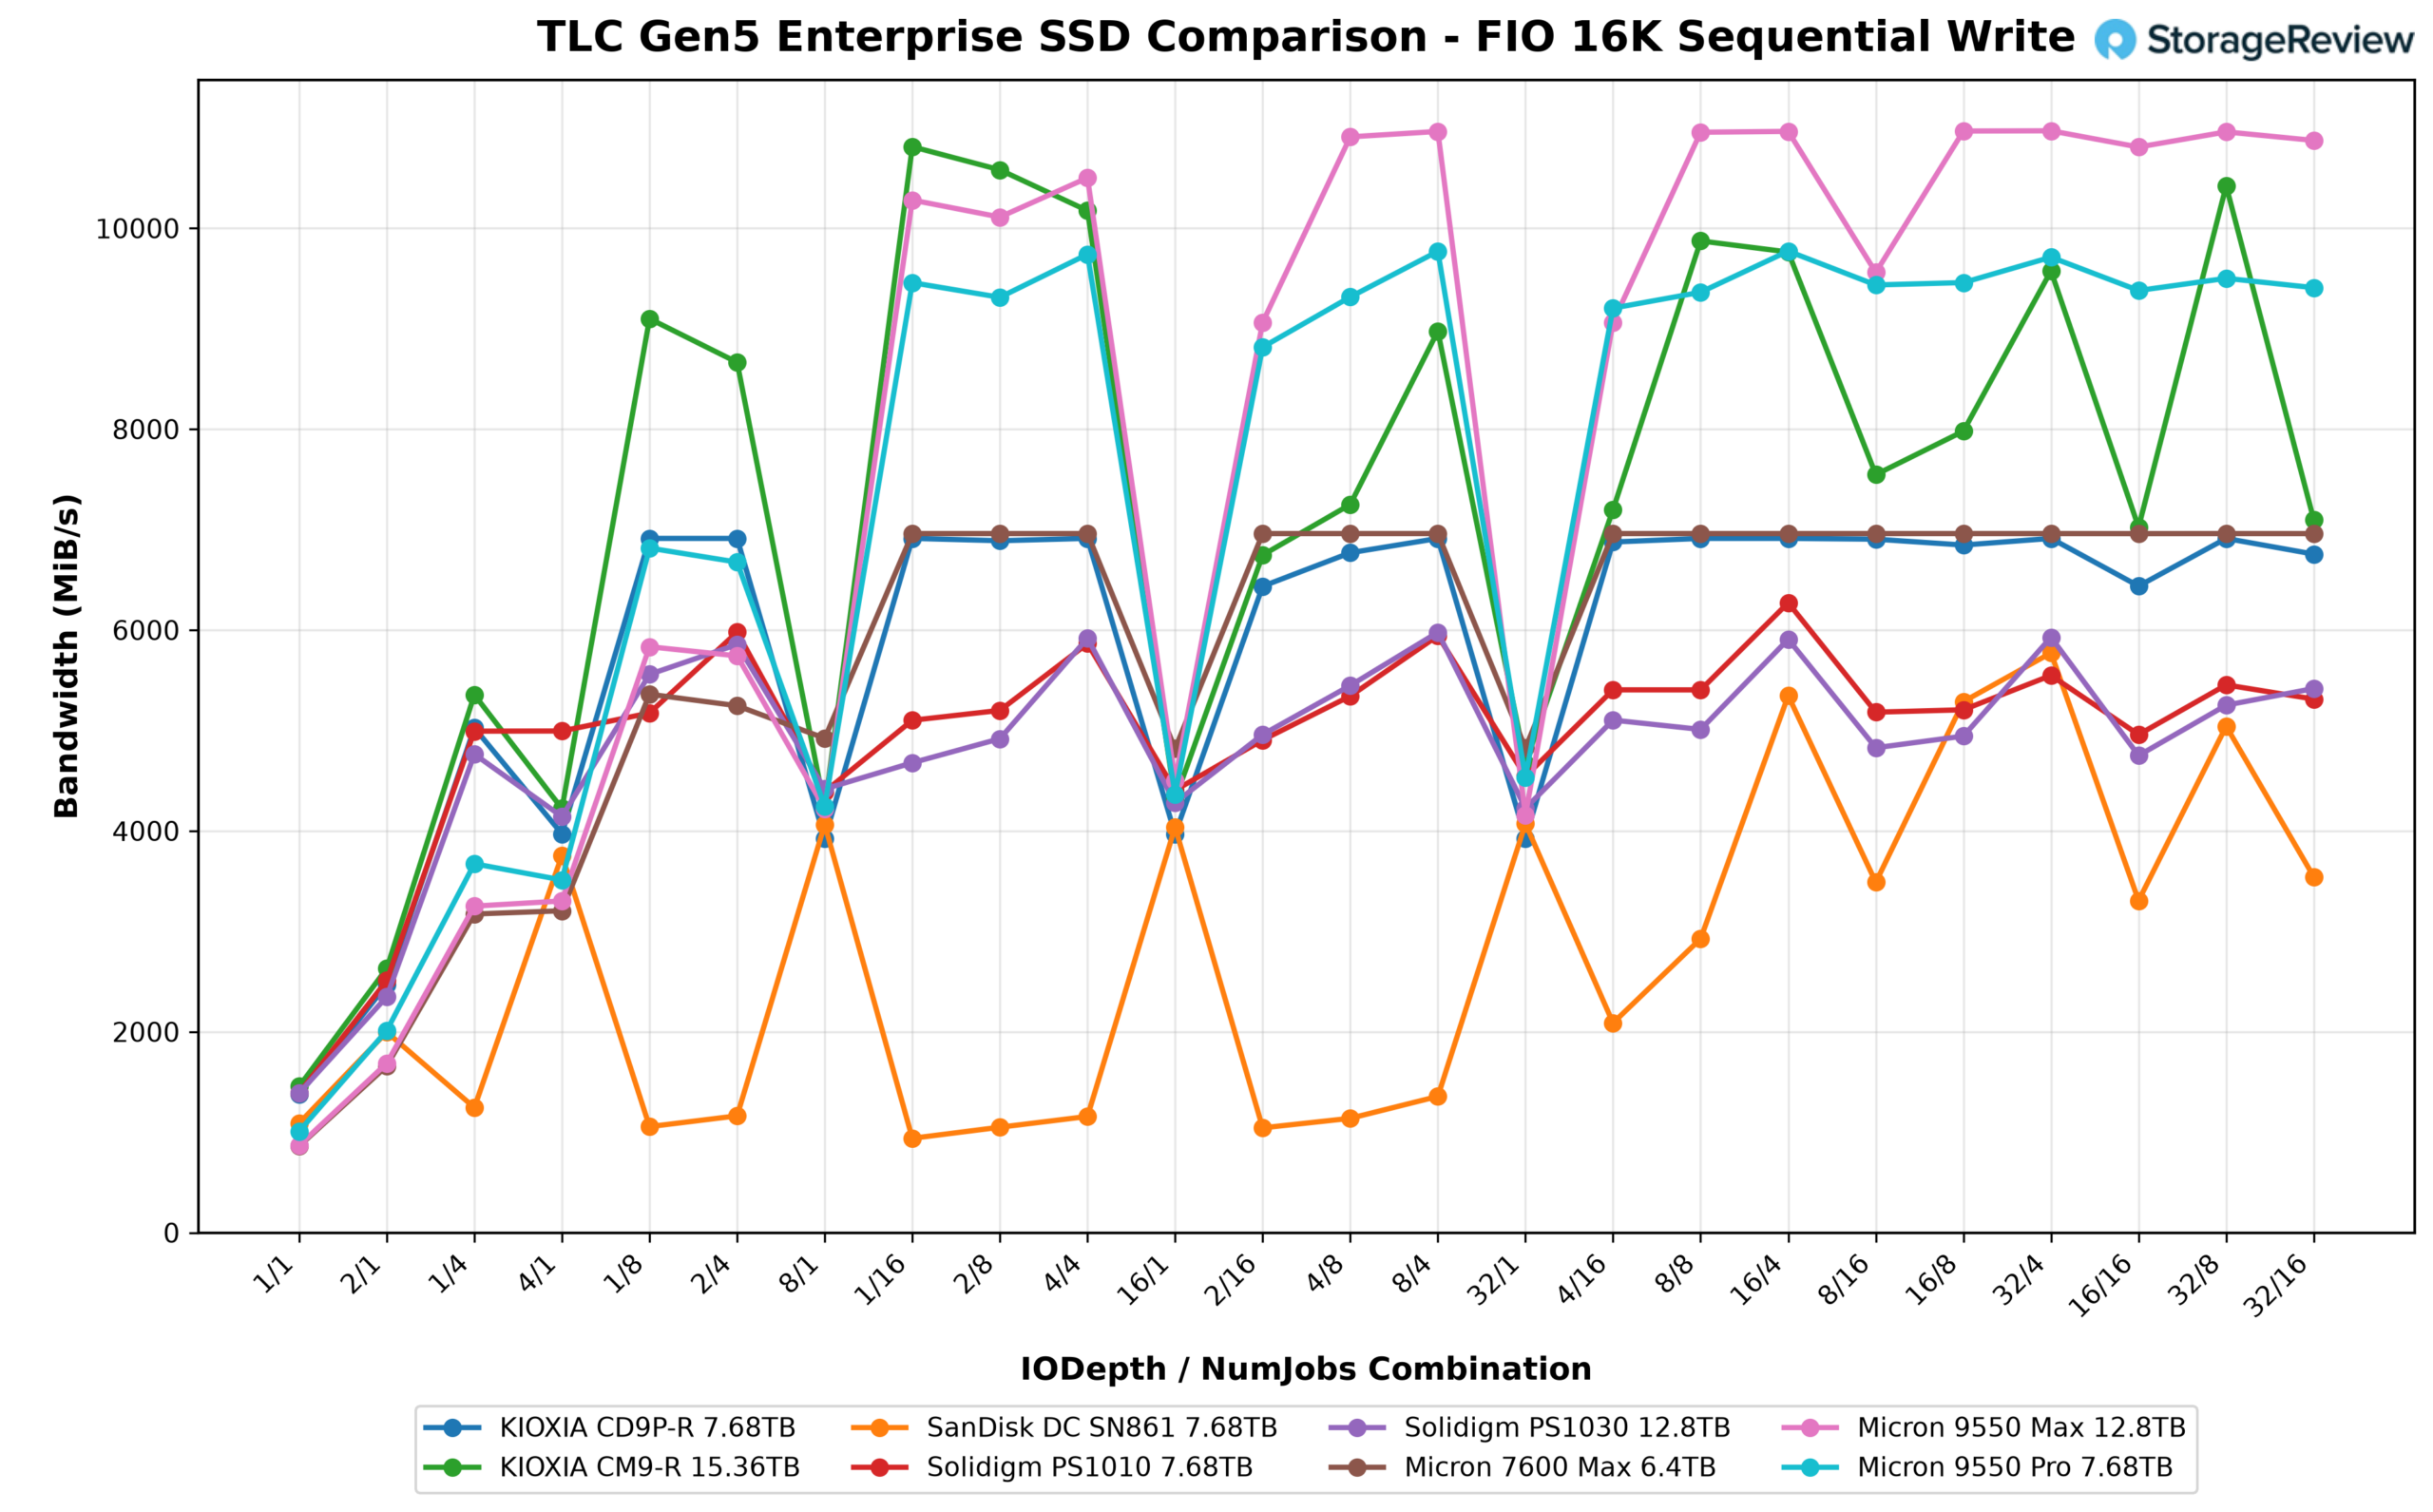
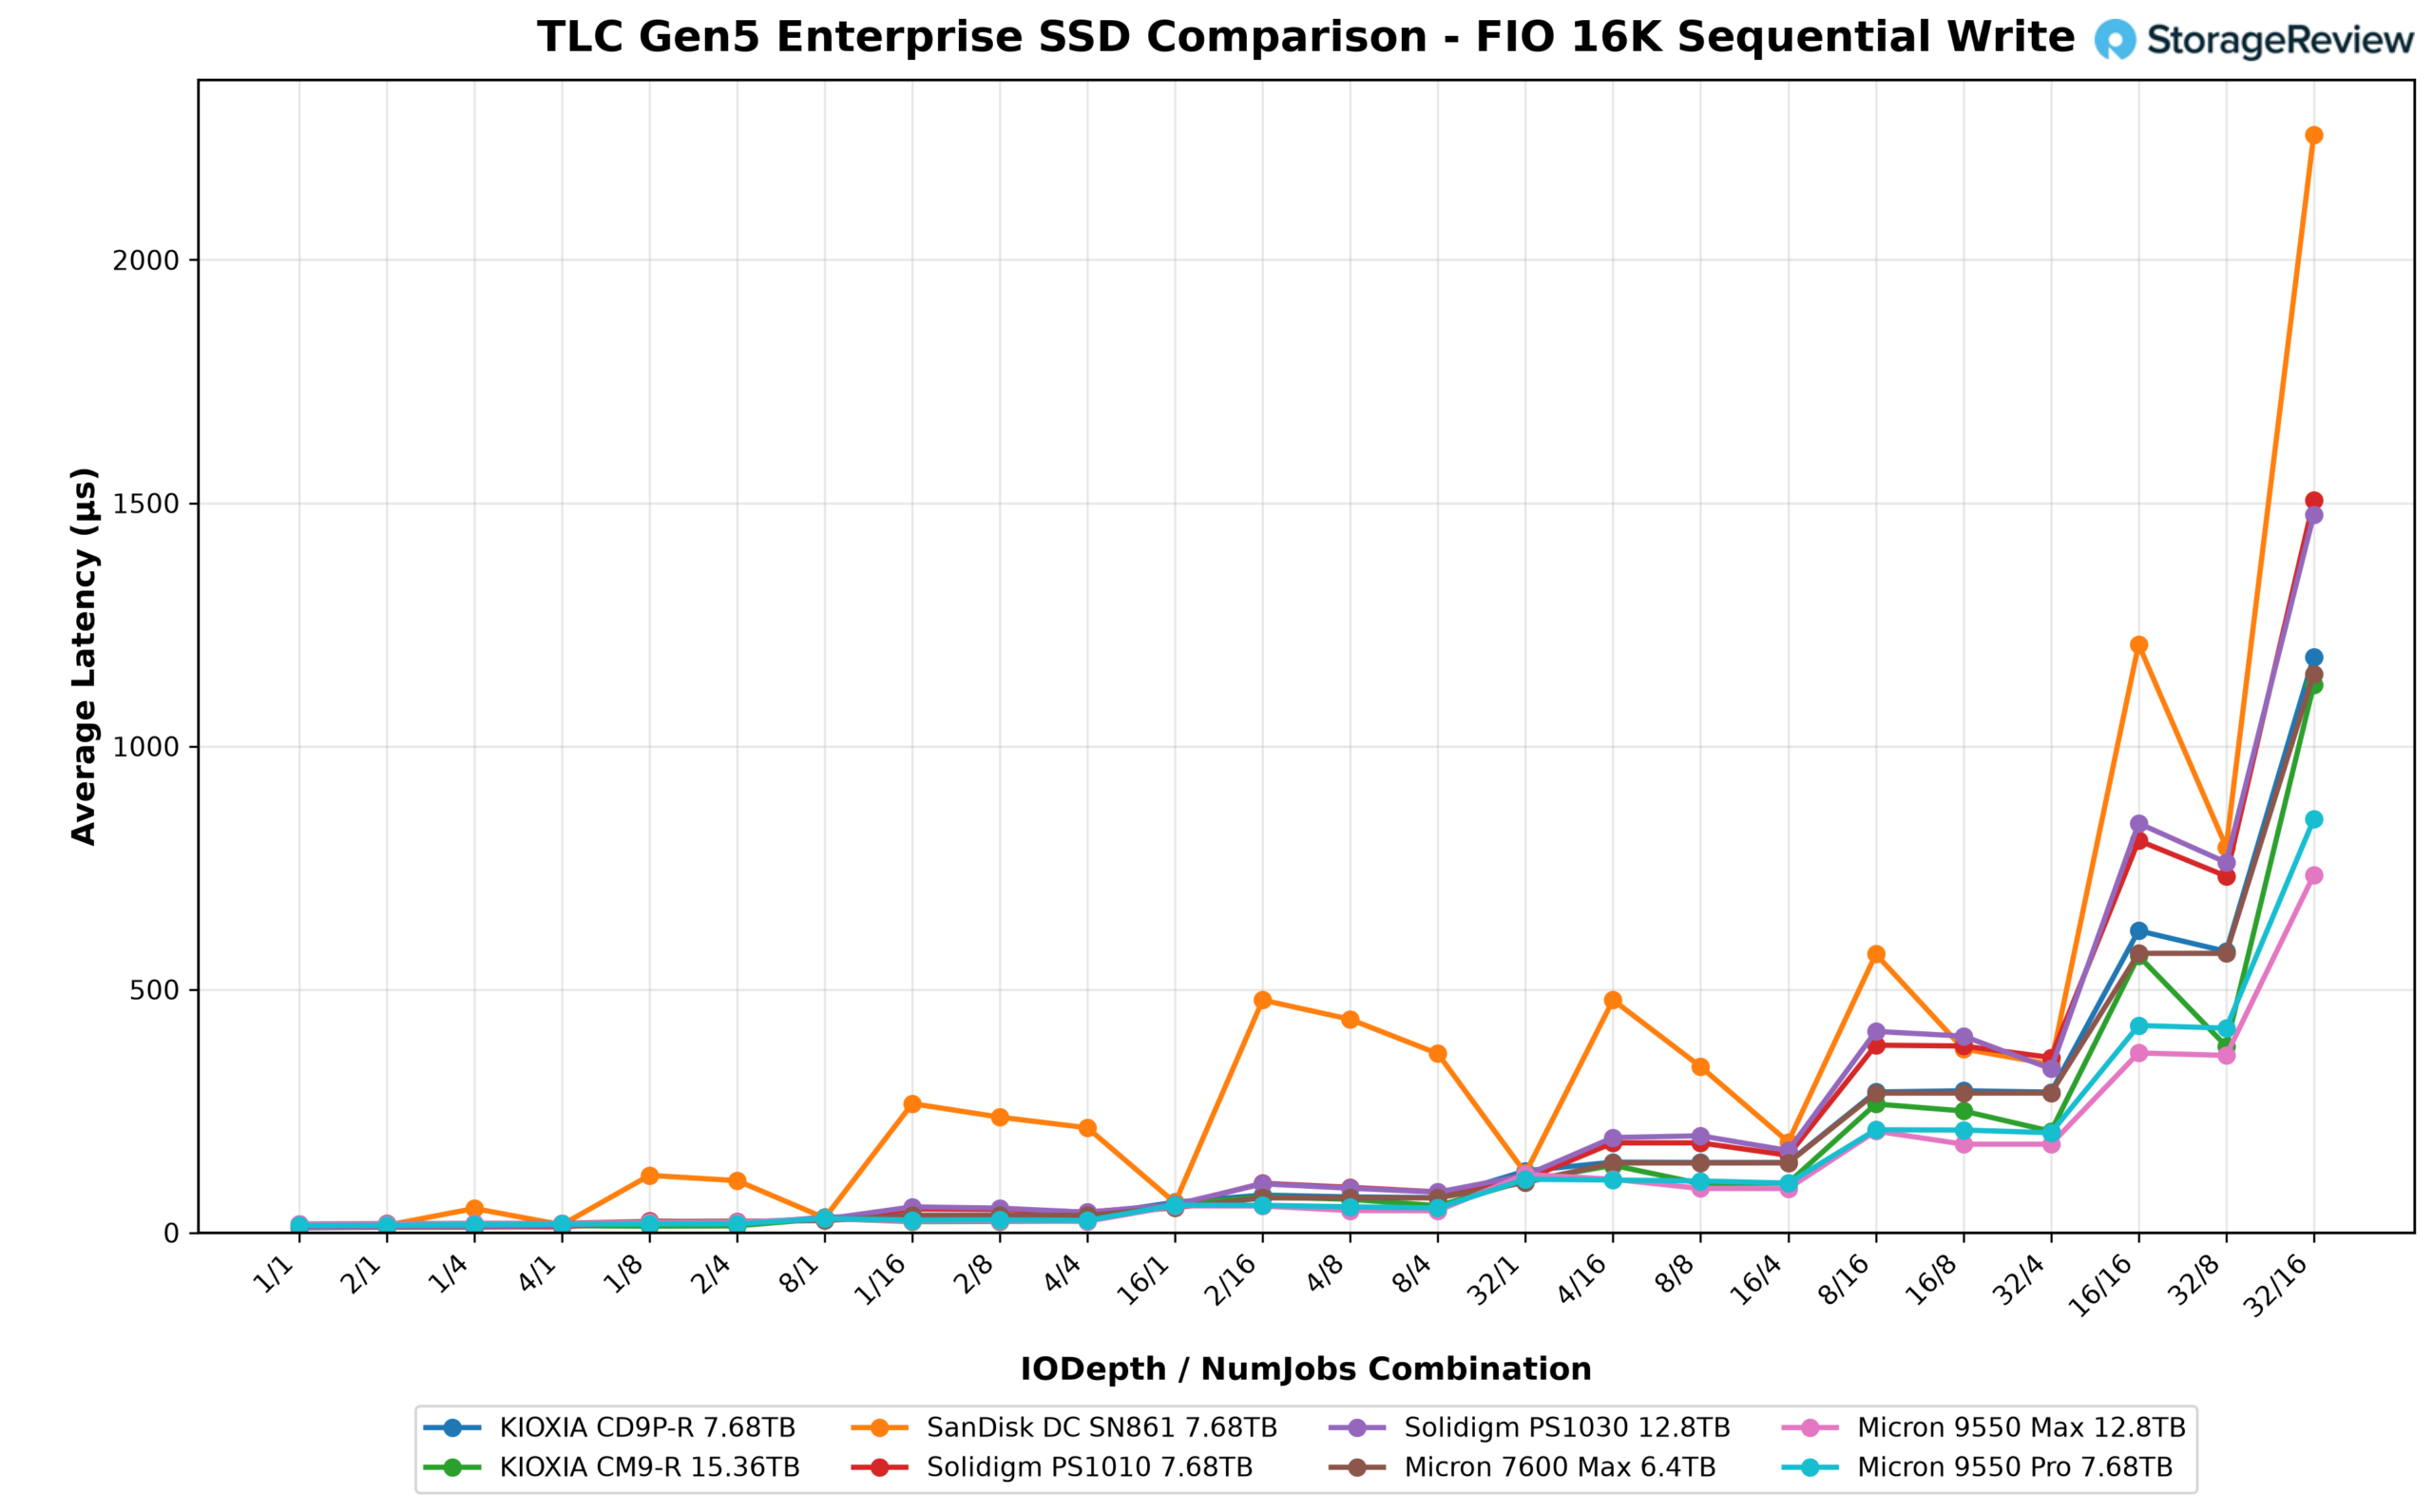
ရလဒ်များသည် ကျပန်းရွေးချယ်မှုများနှင့် နှိုင်းယှဉ်ပါက နယ်ပယ်ကို ပြန်လည်ပြင်ဆင်လိုက်ပါသည်။ Micron 9550 MAX သည် 10,970.8 MB/s (IODepth 32 / NumJobs 4) ဖြင့် ဦးဆောင်နေပြီး KIOXIA CM9-R သည် 10,812.2 MB/s နှင့် 9550 Pro သည် 9,772.8 MB/s ဖြင့် တူညီလုနီးပါးဖြစ်သည်။ PS1030 သည် 5,977.7 MB/s (IODepth 8 / NumJobs 4) ဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး အုပ်စုတွင် သတ္တမနေရာတွင် ရပ်တည်ခဲ့ပြီး SanDisk DC SN861 သည် 5,772.5 MB/s ဖြင့် ရှေ့တွင် ရပ်တည်ခဲ့ပြီး ၎င်း၏ညီအစ်မ PS1010 ထက် အနည်းငယ်နိမ့်ကျသော 6,271.7 MB/s ဖြင့် အနည်းငယ်နိမ့်ကျခဲ့သည်။ သို့သော် sweep ၏ပုံသဏ္ဍာန်မှာ random စမ်းသပ်မှုများတွင် ပြသခဲ့သည့် signature တူညီပါသည်- PS1030 သည် IODepth 2 / NumJobs 4 အရ latency 21.1 µs ဖြင့် 5,856.7 MB/s ရှိပြီးဖြစ်ပြီး matrix ၏ကျန်အပိုင်းတွင် 4,700 မှ 6,000 MB/s အကြား flat band ကိုထိန်းသိမ်းထားသည်။ ၎င်း၏ single-worker latency 10.9 µs သည် CM9-R (10.4 µs) နှင့် CD9P-R (11.0 µs) နှင့်အတူ ဦးဆောင် cluster တွင်ရှိနေပြီး Microns ထက် 15.1 မှ 17.8 µs အောက်တွင်ရှိသည်။ write-focused brief ပါသော drive အတွက် ceiling သည် အသင့်အတင့်ဖြစ်သော်လည်း queue depth နှင့် microsecond-class latency အနည်းဆုံး၊ ရေရှည် cache သို့မဟုတ် staging tier ရှိသည့် operating point နှင့် ကျွန်ုပ်တို့၏ KV cache deployment တွင် ရက်သတ္တပတ်များစွာ စဉ်ဆက်မပြတ် write stream များကိုဖြတ်သန်းရန် ဤ drive ကိုသယ်ဆောင်ခဲ့သည့် profile တူညီသည်။
၁၆K အစဉ်လိုက်ဖတ်ရှုခြင်း
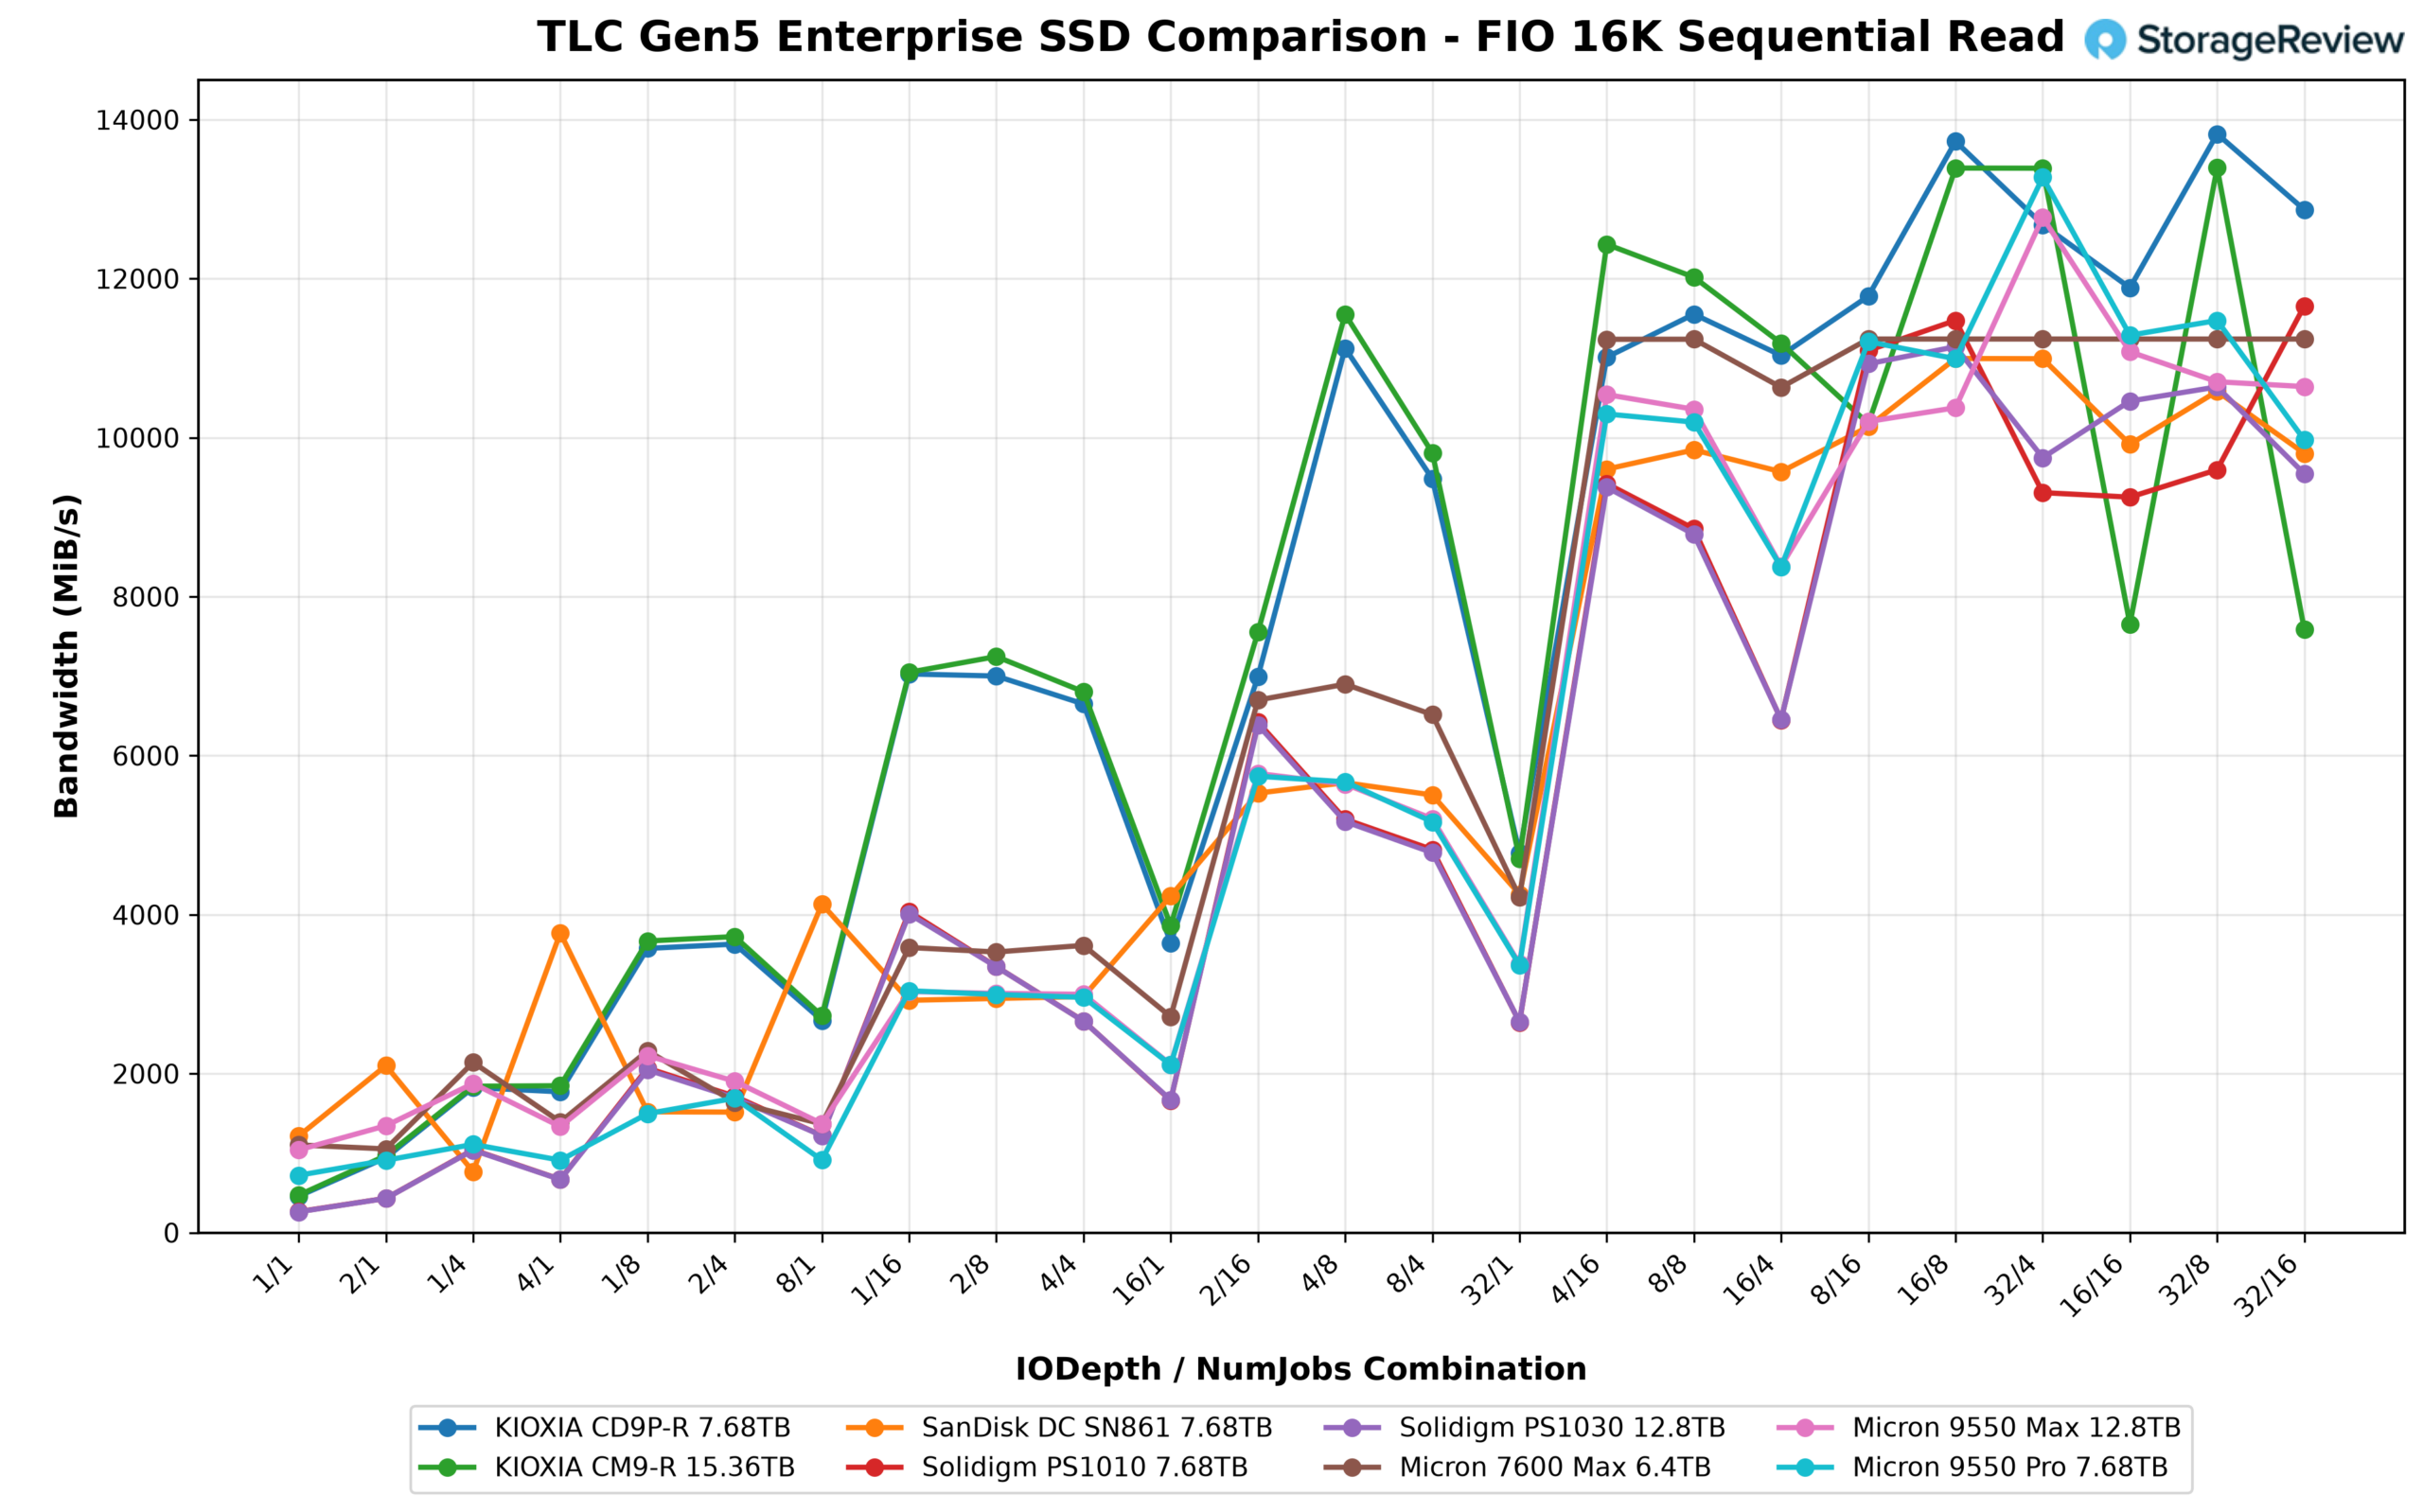
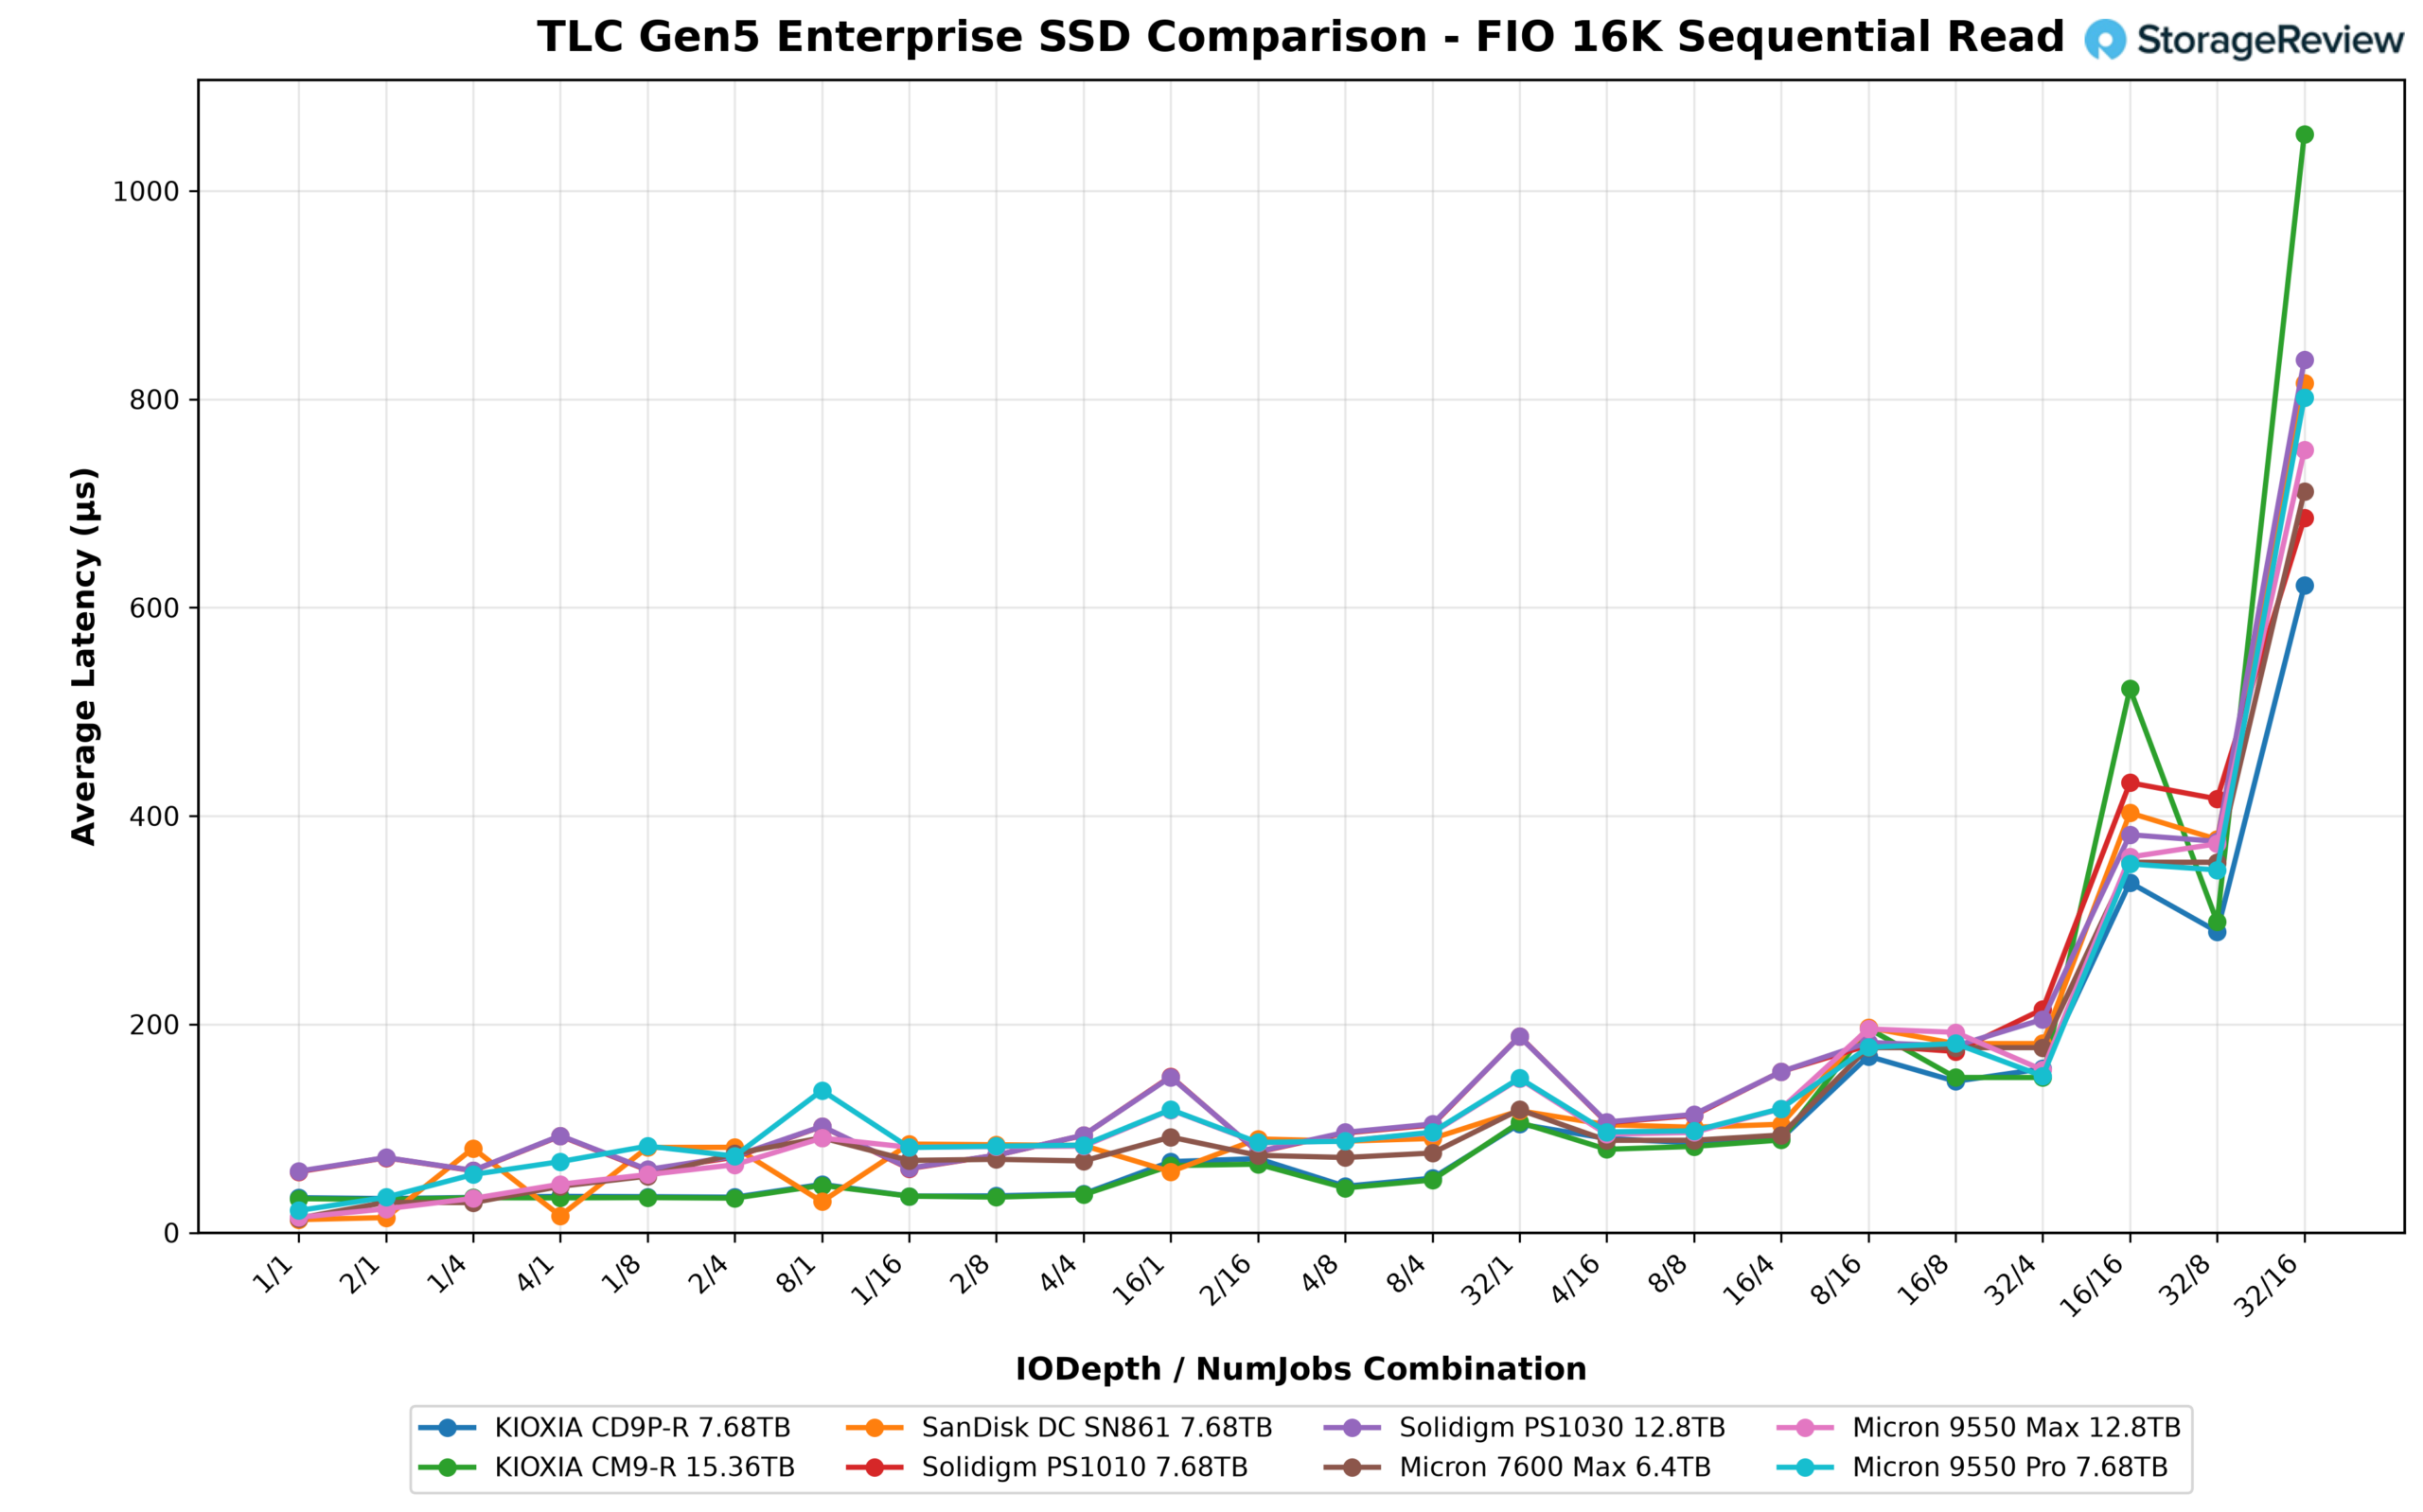
ဖတ်ရှုမှုအပိုင်းတွင် KIOXIA CD9P-R သည် 13,819.7 MB/s ဖြင့် ဦးဆောင်နေပြီး CM9-R သည် 13,393.2 MB/s နှင့် Micron 9550 Pro သည် 13,273.5 MB/s ဖြင့် နီးကပ်စွာ ရပ်တည်လျက်ရှိသည်။ PS1030 သည် 11,142.8 MB/s (IODepth 16 / NumJobs 8) ဖြင့် 179.1 µs ဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး အုပ်စုတွင် သတ္တမနေရာတွင် ရပ်တည်ခဲ့ပြီး SN861 သည် 10,995.0 MB/s ဖြင့် ရှေ့တွင် ရပ်တည်ခဲ့ပြီး ၎င်း၏ညီအစ်မ 11,656.3 MB/s ဖြင့် နောက်တွင် ရပ်တည်ခဲ့ပြီး အုပ်စုဦးဆောင်မှု၏ ငါးပုံတစ်ပုံခန့် နောက်ကျကျန်ခဲ့သည်။ single-stream ပုံက random-read ဇာတ်လမ်းကိုလည်း ပြောင်းပြန်လှန်ပစ်လိုက်ပါတယ်- 16K reads တွေကို order လုပ်တဲ့အခါ SN861 က 12.5 µs မှာဖွင့်ပြီး Microns က 13.9 နဲ့ 21.3 µs ကြားမှာဖွင့်ပါတယ်၊ Solidigm platform က 59 µs အနီးမှာစတင်ပါတယ်၊ PS-series drives နှစ်ခုလုံးက 64K မှာပြသခဲ့တဲ့ low-concurrency read လက္ခဏာပါပဲ။ အလတ်စား reads တွေက ဒီ platform က အများဆုံးပေးစွမ်းနိုင်တဲ့ matrix ရဲ့ထောင့်မှာရှိနေဆဲပါ။ AI pipeline ရဲ့ streaming-read ဘက်ကို read-intensive class က ပိုကောင်းအောင်ဝန်ဆောင်မှုပေးပါတယ်၊ ဒါက ဒီ drive ကိုအနိုင်ရဖို့တည်ဆောက်ထားတဲ့ငြင်းခုံချက်မဟုတ်ပါဘူး။
4K ကျပန်းရေးပါ။
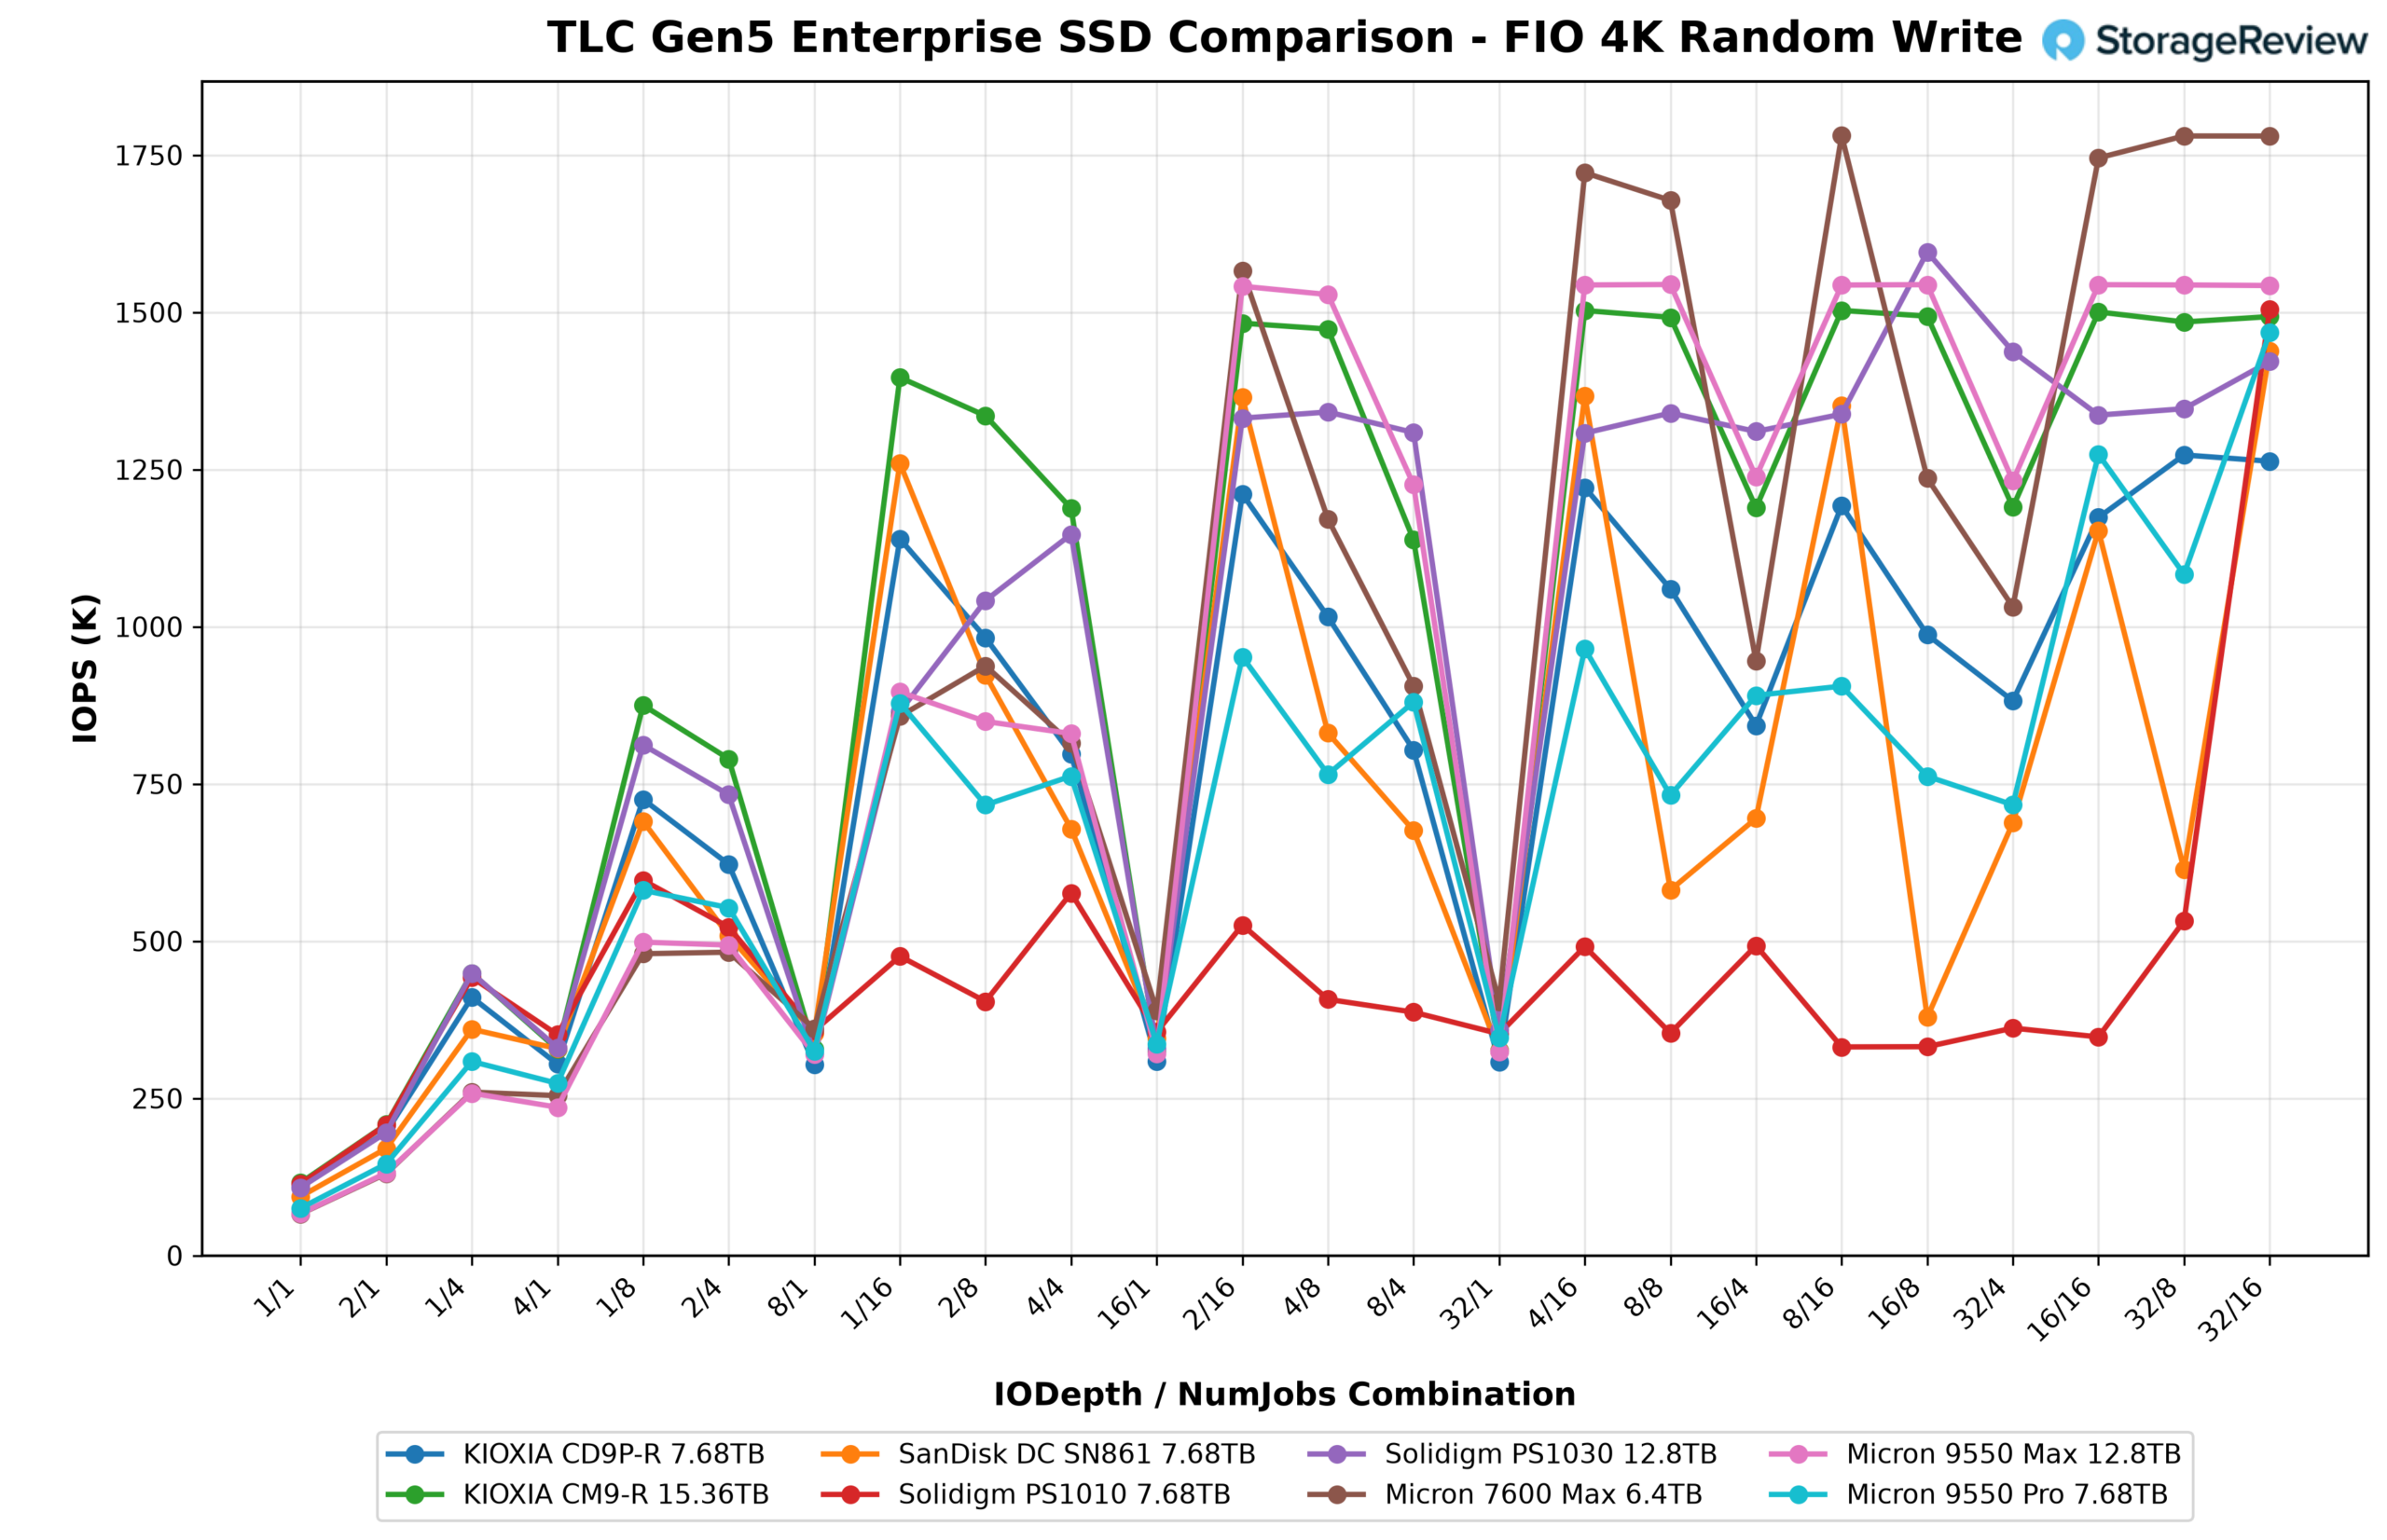
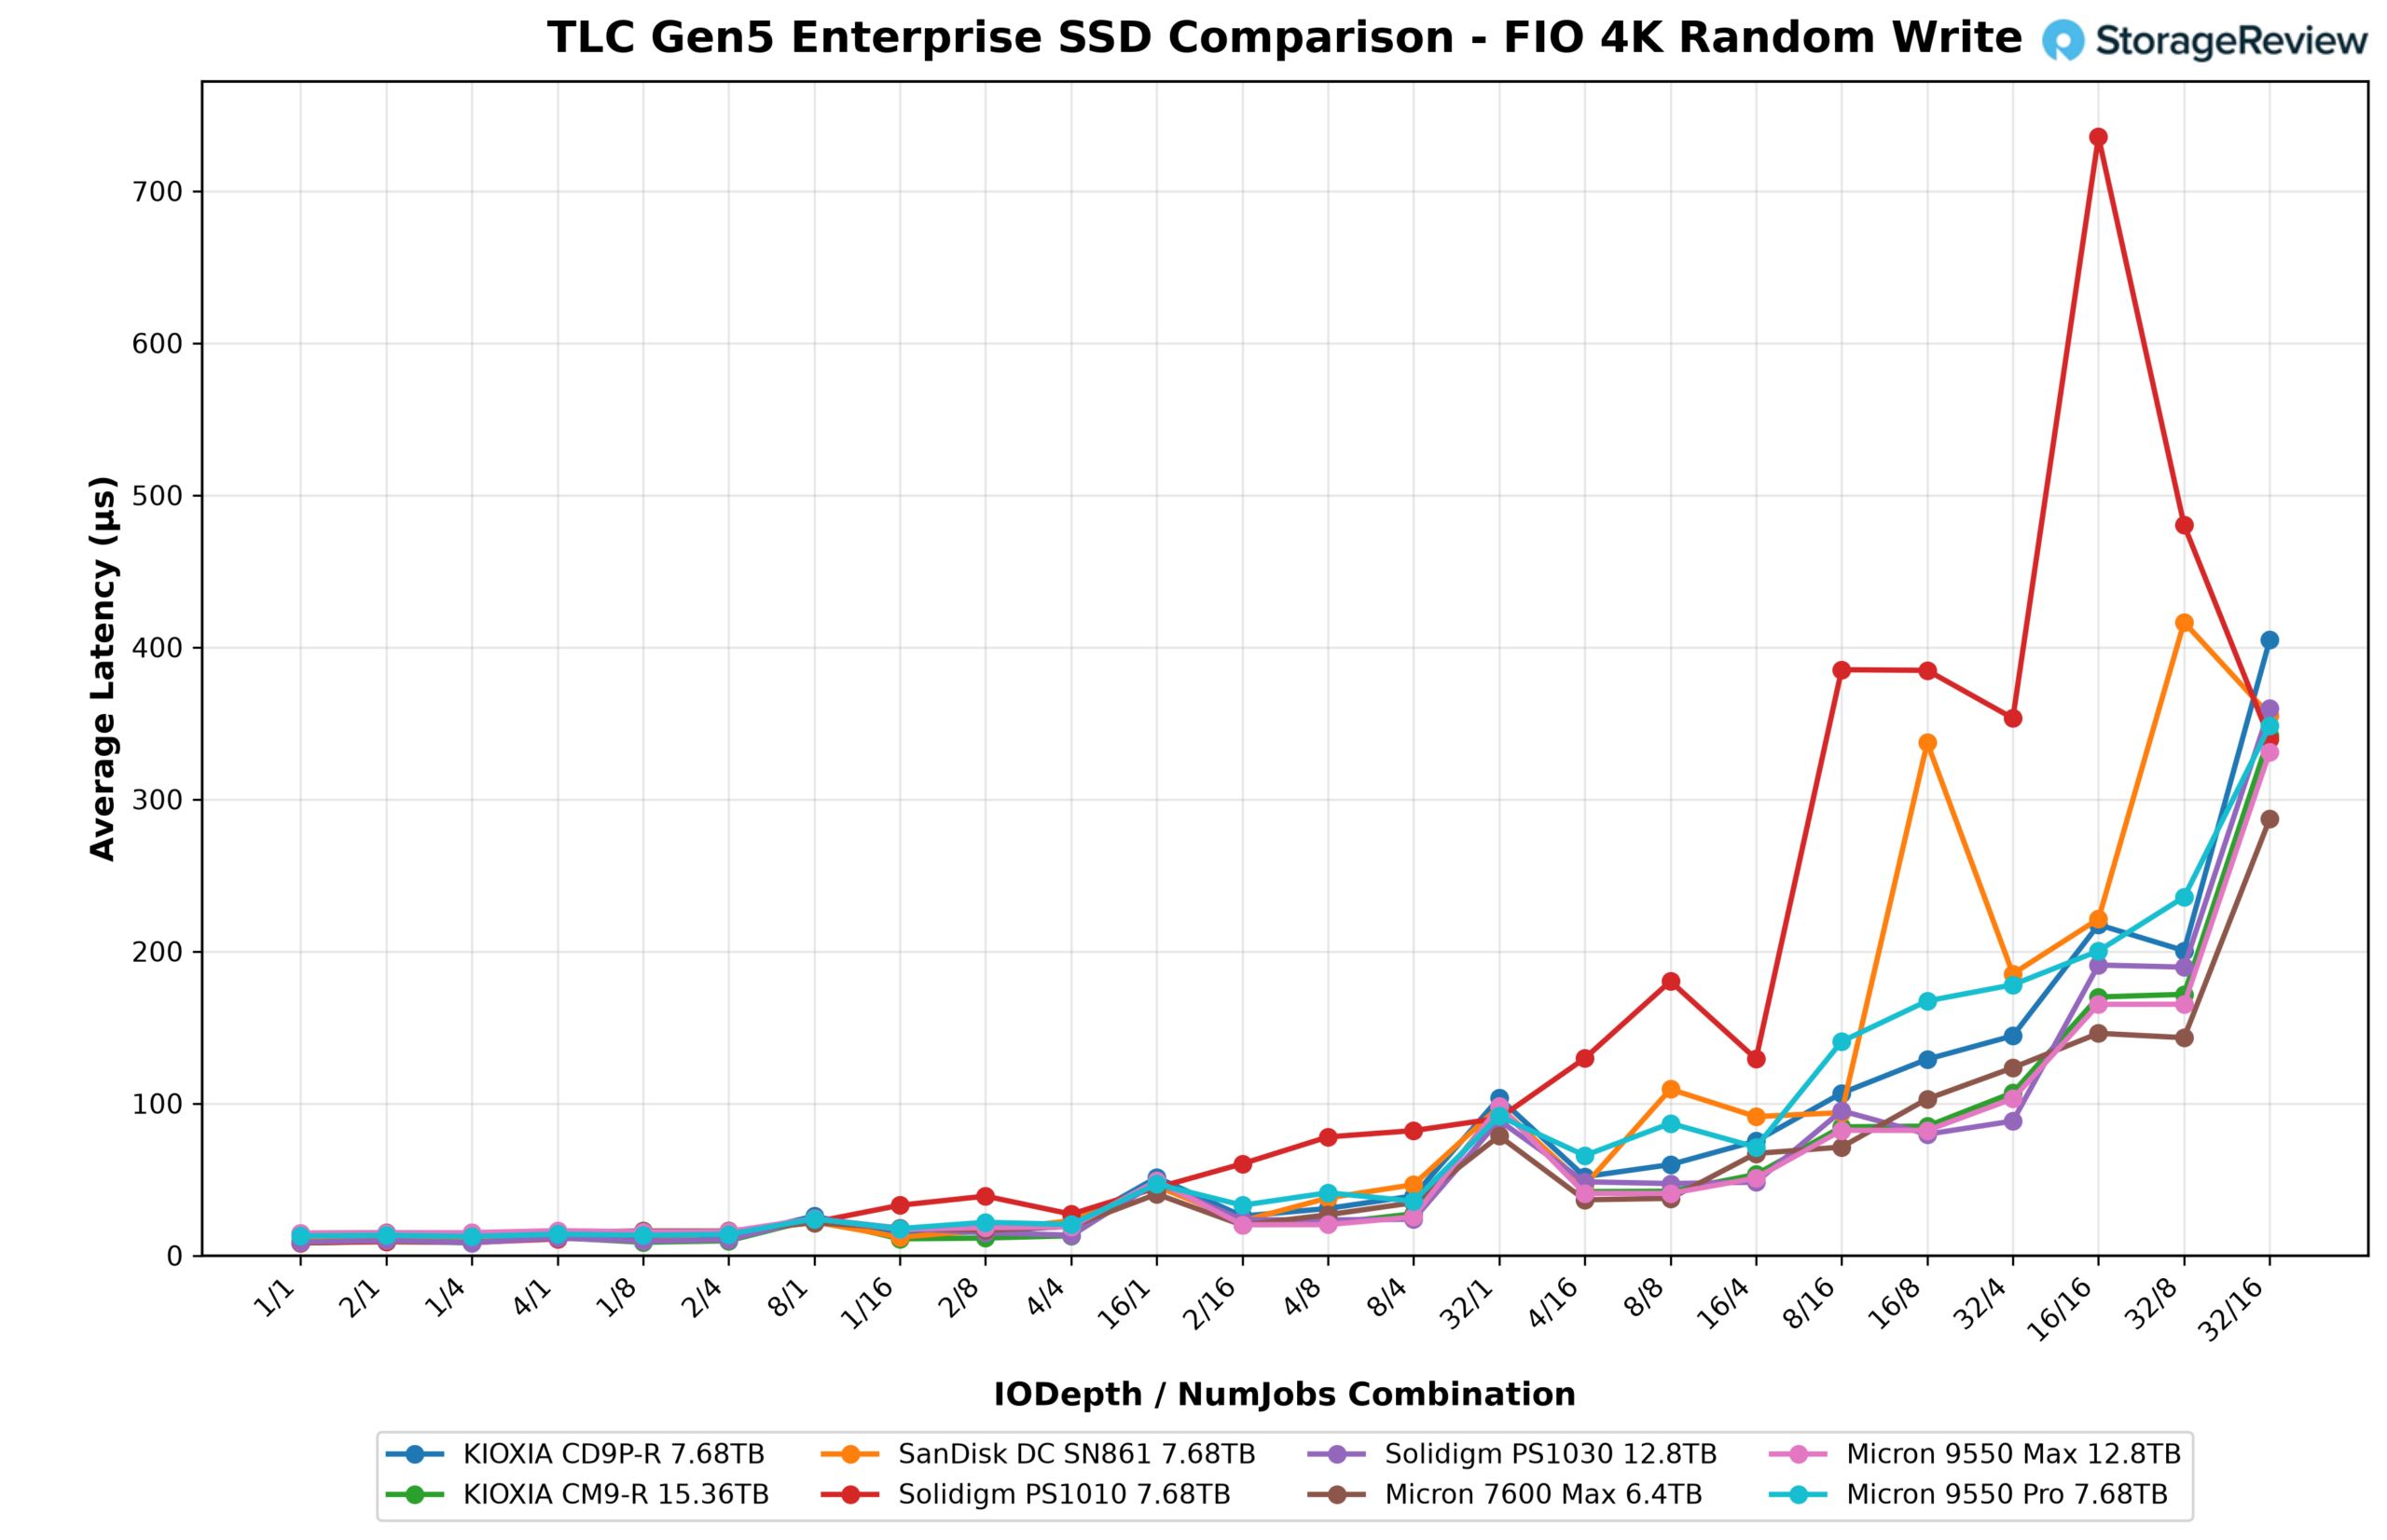
3 DWPD drive နှင့် PS1030 အတွက် ခေါင်းစဉ်ဇယားသည် ပြီးမြောက်အောင်မြင်ခဲ့သည်။ IODepth 16 / NumJobs 8 တွင် ၎င်း၏ အမြင့်ဆုံး 1,595.8K IOPS သည် အုပ်စုတွင် ဒုတိယနေရာရရှိခဲ့ပြီး 3 DWPD Micron 7600 MAX ၏ 1,781.2K ပြီးနောက် ဒုတိယနေရာရရှိခဲ့ပြီး 9550 MAX (1,544.2K), PS1010 (1,504.7K), CM9-R (1,502.9K), 9550 Pro (1,467.6K), SN861 (1,438.3K) နှင့် CD9P-R (1,273.1K) တို့၏ ရှေ့တွင် ရှိနေသည်။ ထိုတိုင်းတာထားသော အမြင့်ဆုံးသည် Solidigm သည် fixed queue depth တွင် သတ်မှတ်ထားသော drive ၏ 800K အဆင့်သတ်မှတ်ချက်ထက် နှစ်ဆဖြစ်သည်။ steady-state sweeps များက ပိုမိုတွေ့ရှိခဲ့သည်။
နှောင့်နှေးမှုအပြုအမူသည် အငြင်းအခုံကို အဆုံးသတ်စေသည်။ PS1030 သည် CM9-R (8.2 µs) နှင့် PS1010 (8.3 µs) တို့ပါဝင်သော ဦးဆောင် cluster တွင် IODepth 1 တွင် 8.8 µs ဖြင့် ဖွင့်လှစ်ခဲ့ပြီး ၎င်း၏ အမြင့်ဆုံး throughput ကို 79.8 µs ဖြင့်သာ ရောက်ရှိခဲ့ပြီး sweep တွင် မည်သည့်နေရာတွင်မျှ 359.6 µs မကျော်လွန်ခဲ့ပါ။ ဆန့်ကျင်ဘက်အားဖြင့် PS1010 သည် အမြင့်ဆုံး 339.7 µs သို့ ရောက်ရှိရန် IODepth 32 / NumJobs 16 လိုအပ်သည်။ ၎င်းသည် အဆိုးဆုံးအခြေအနေတွင် 735.6 µs သို့ ဦးတည်နေသည်။ OLTP logs များနှင့် KV-cache-style traffic အတွက် ဤ drive သည် ရည်ရွယ်ထားသည့်အတိုင်း single-digit microseconds များတွင် ရေးသားမှုအနည်းငယ်နှင့် 400 µs အောက် ceiling သည် အရေးကြီးသော profile ဖြစ်သည်။
4K ကျပန်းဖတ်ပါ။
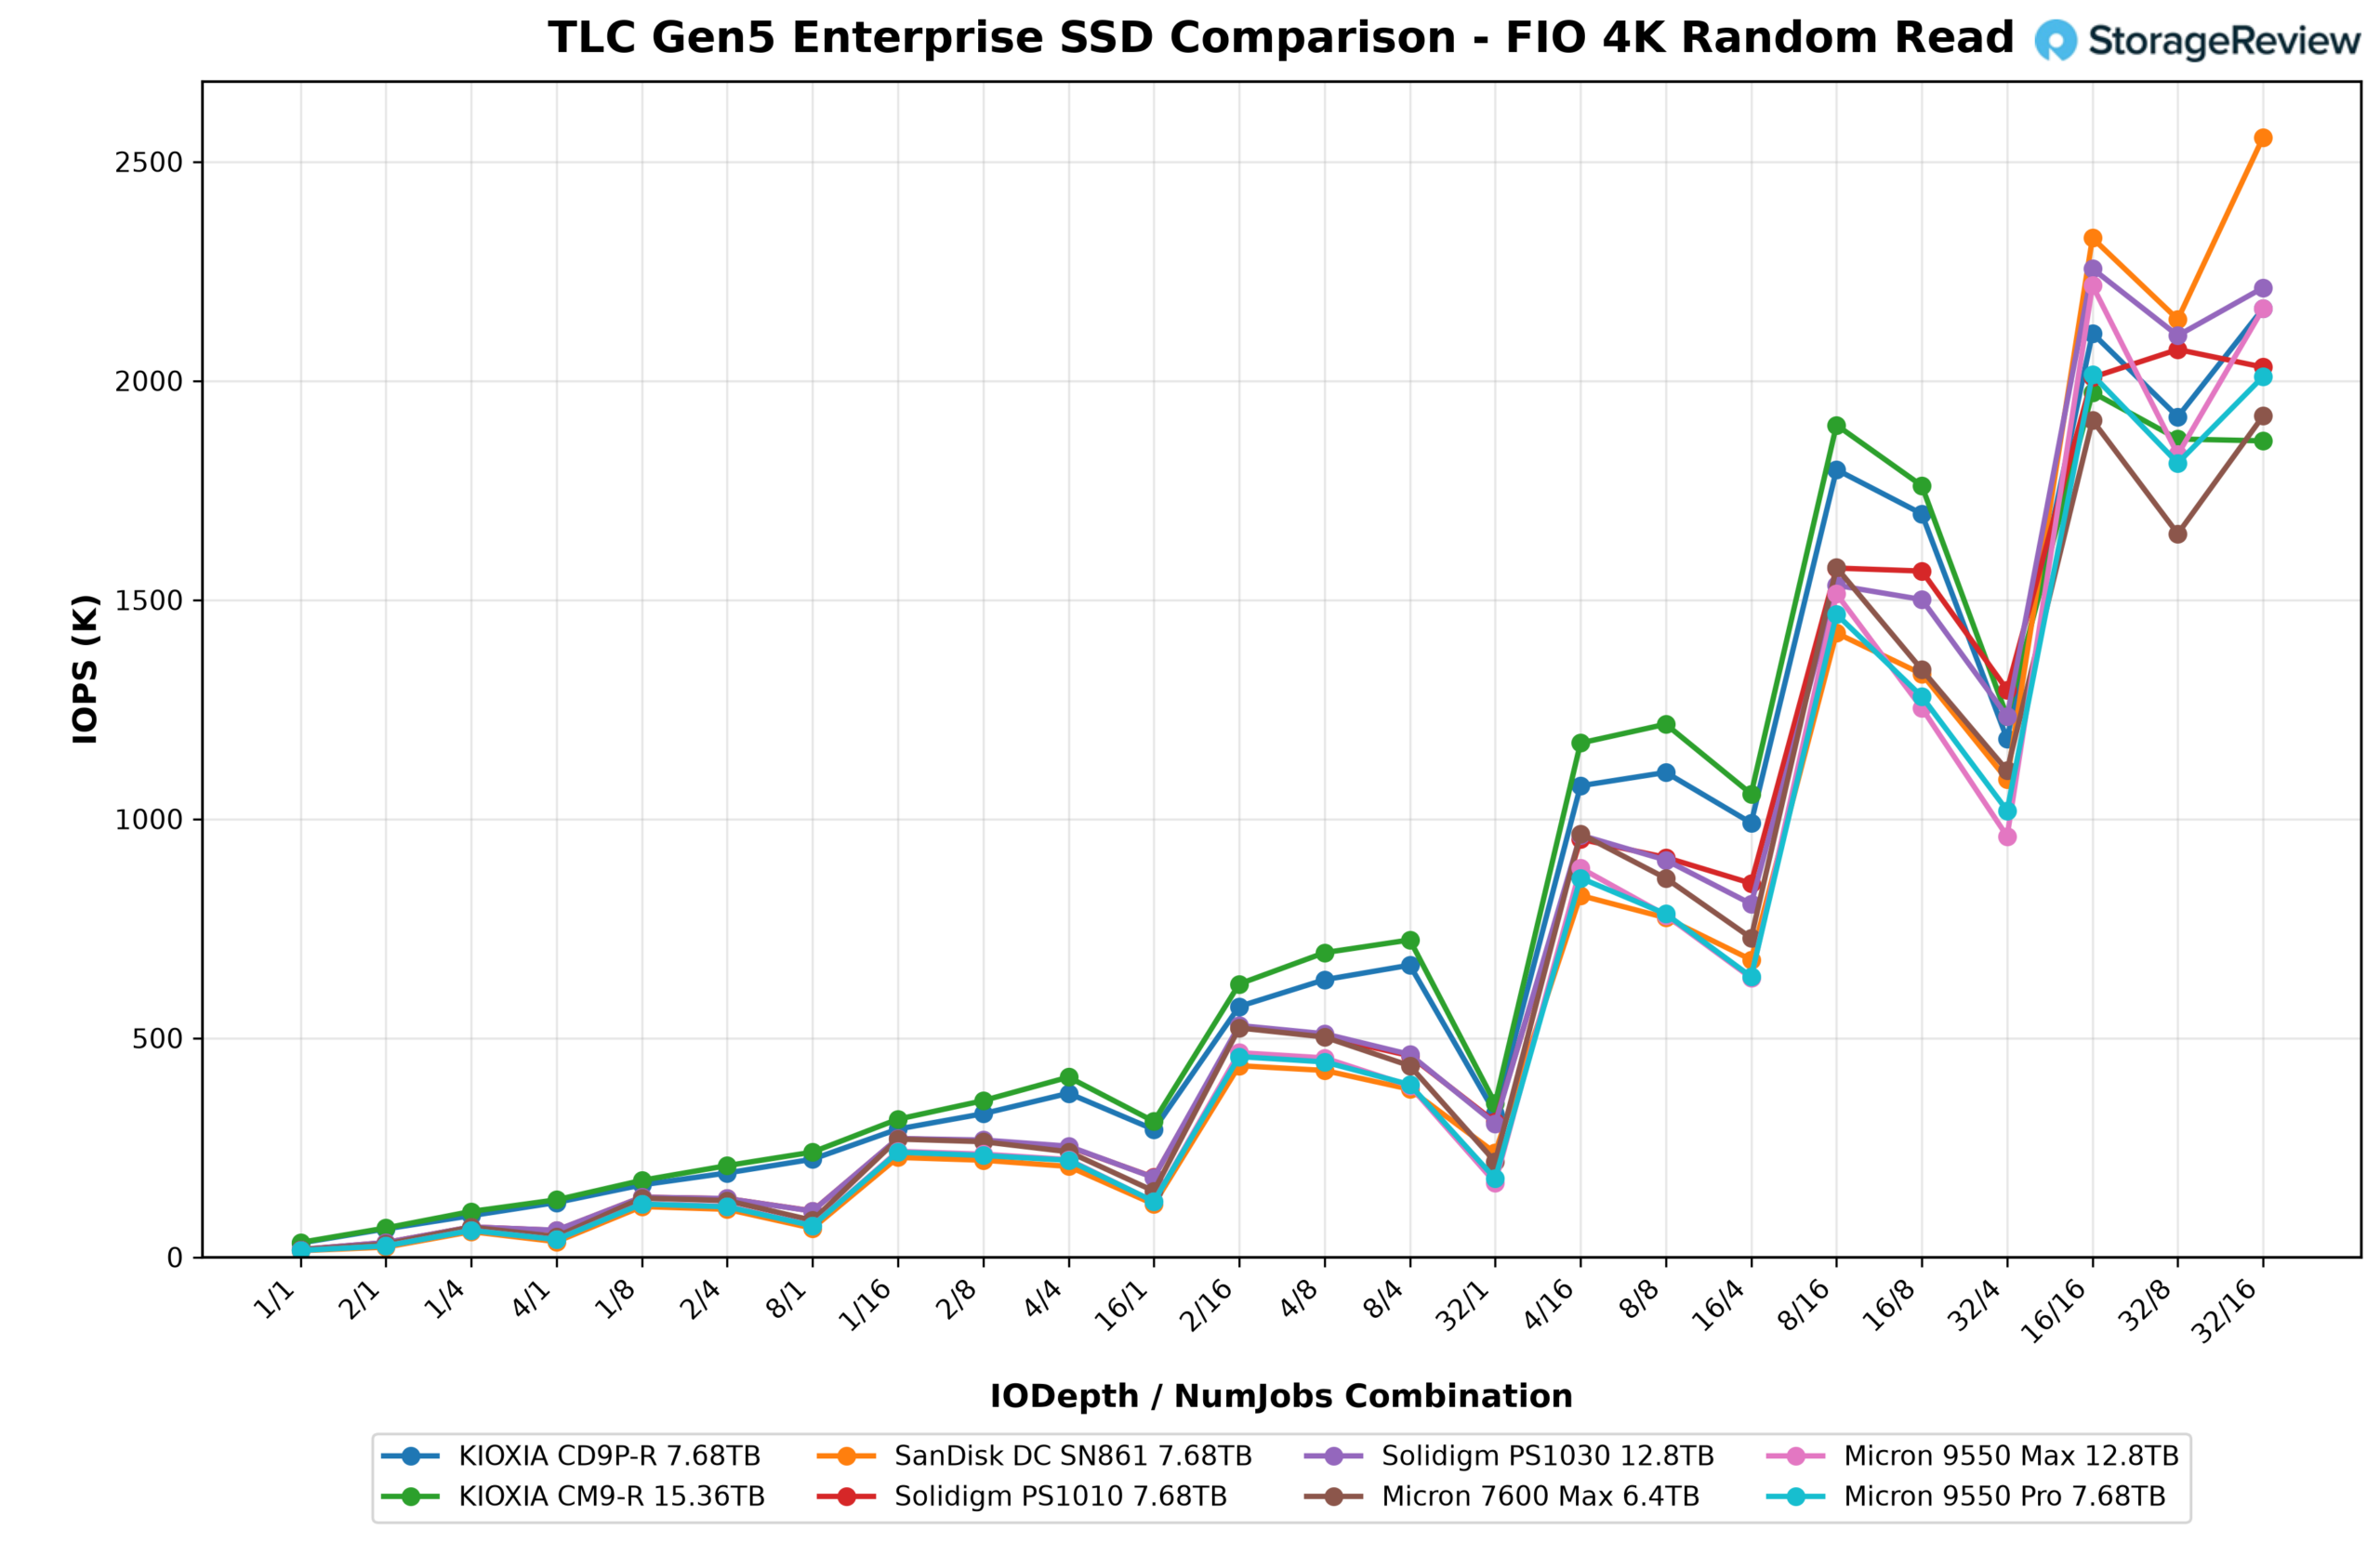
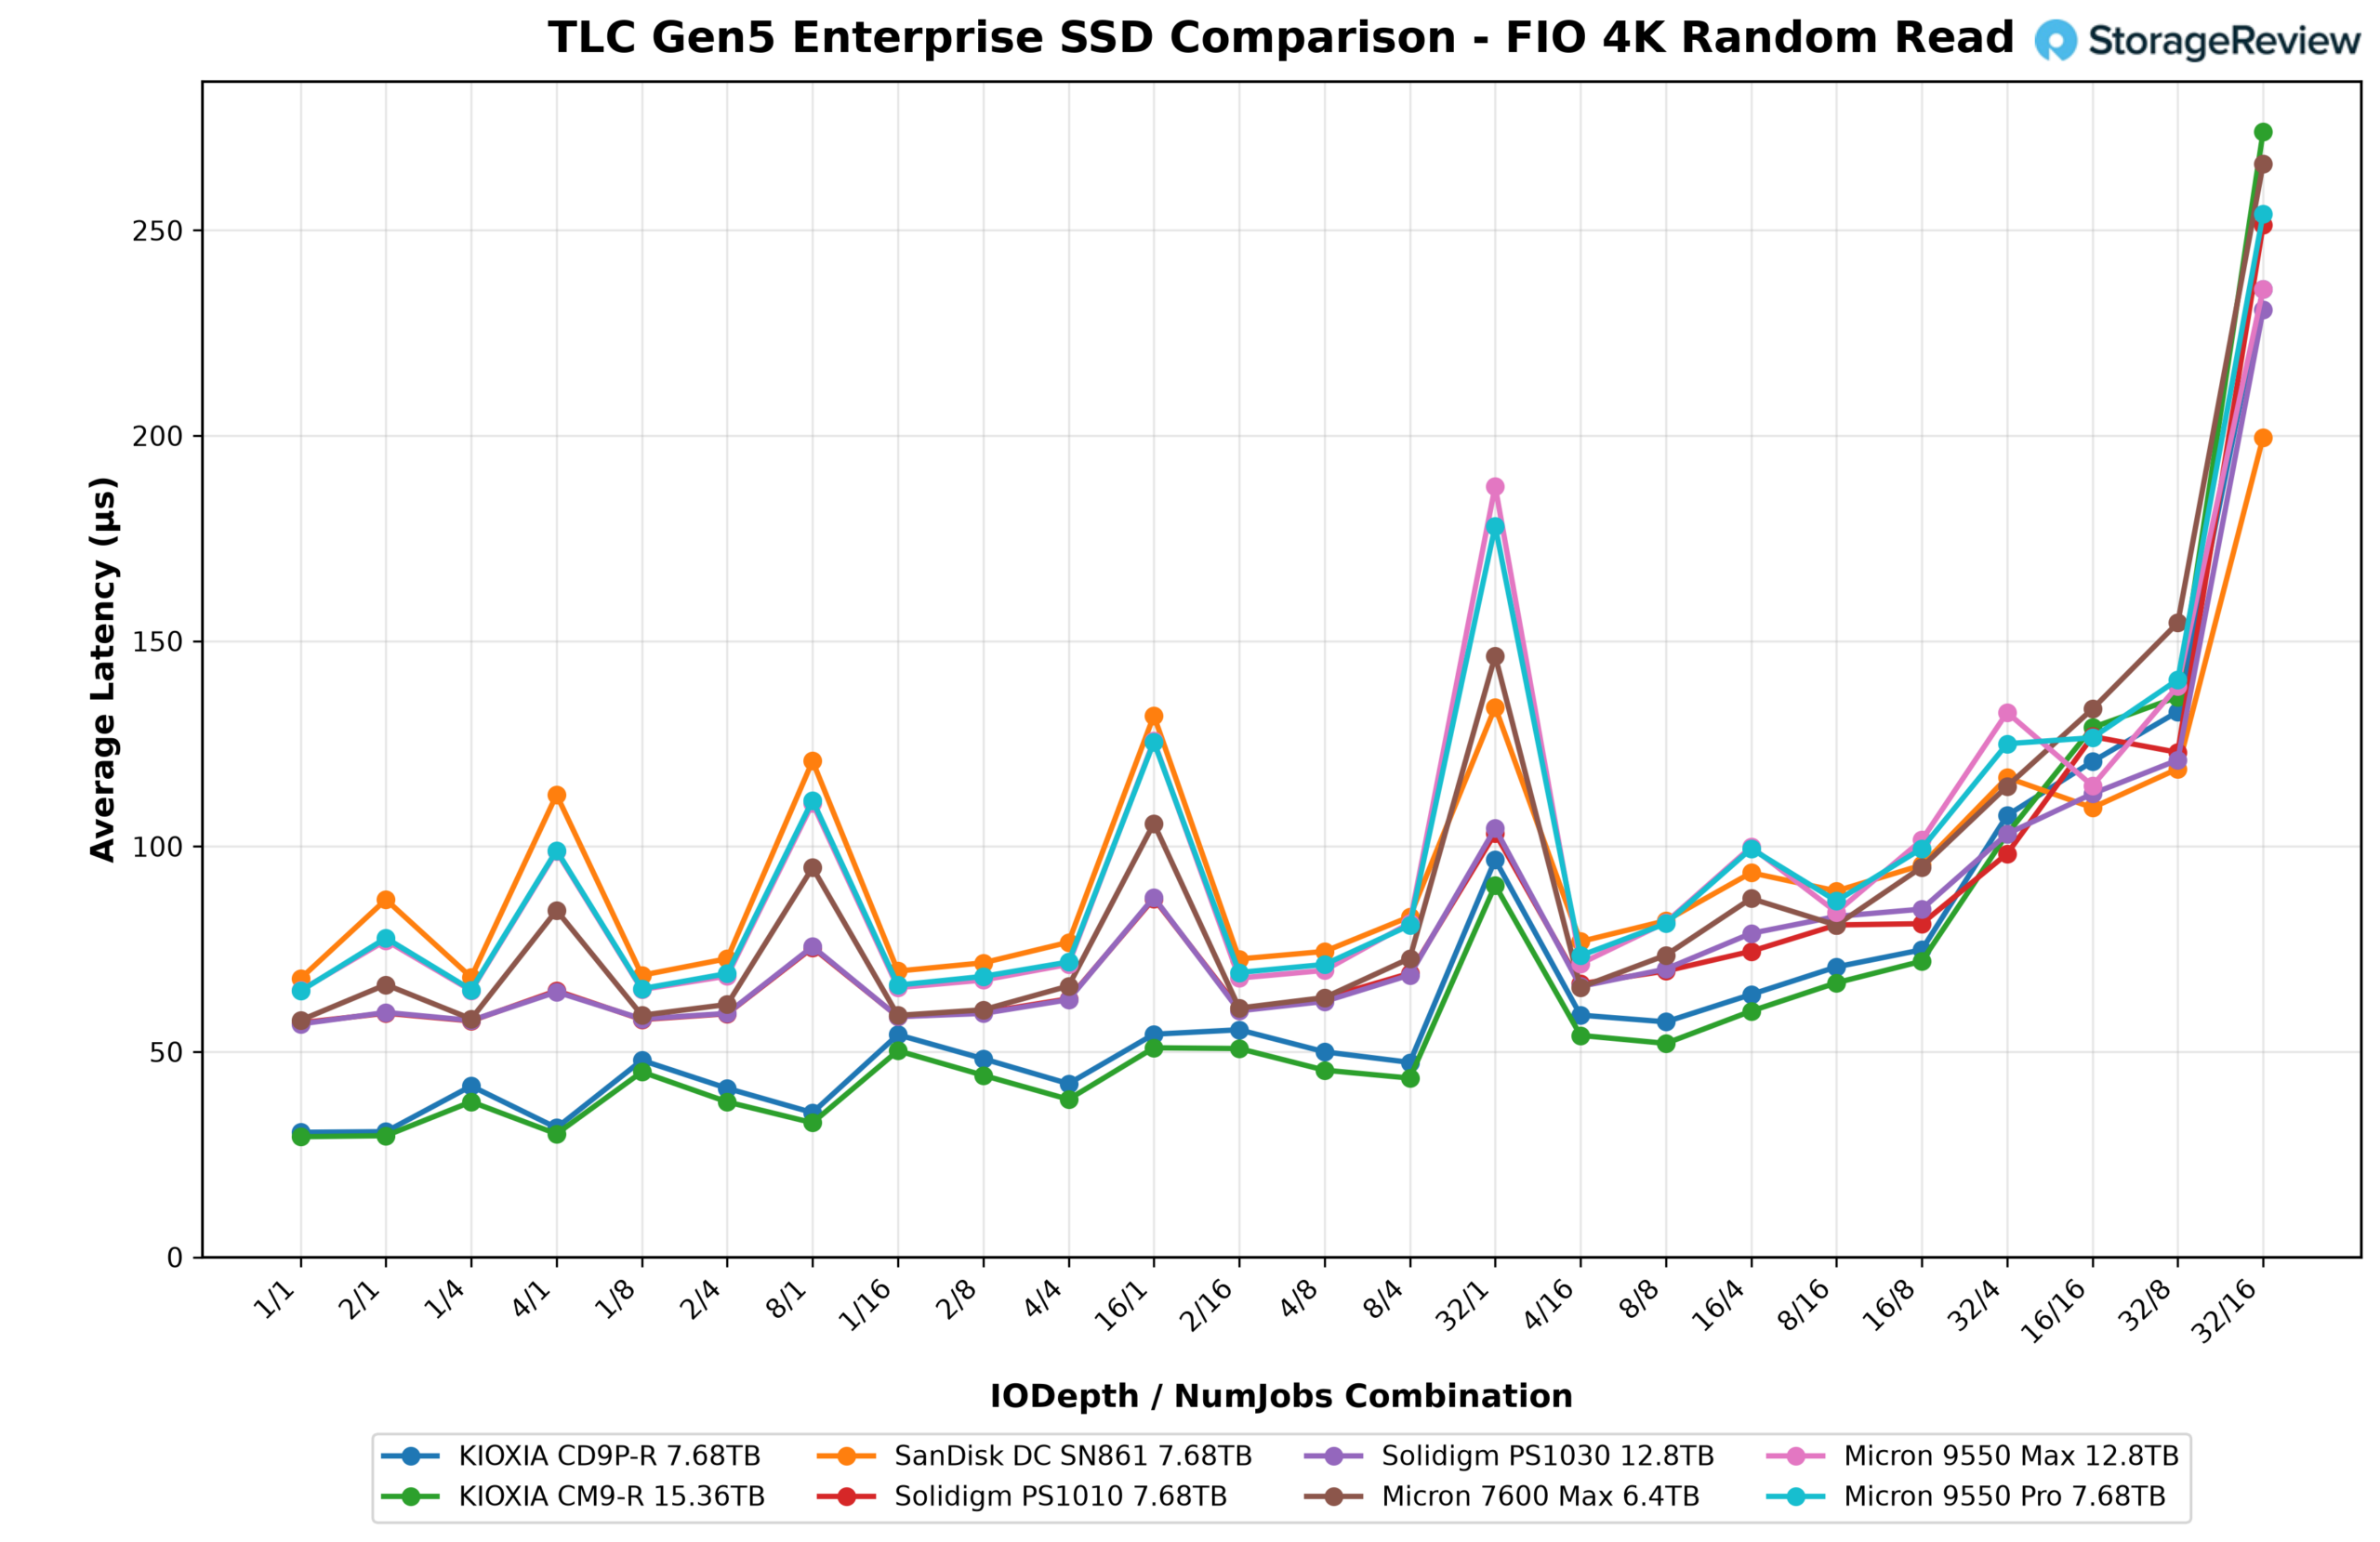
PS1030 သည် ၎င်း၏ရေးသားမှုကို အုပ်စု၏ ဒုတိယအကောင်းဆုံး 4K ကျပန်းဖတ်ရှုမှုအမြင့်ဆုံးဖြစ်သည့် IODepth 16 / NumJobs 16 နှင့် 112.8 µs တွင် 2,255.8K IOPS ဖြင့် ကျောထောက်နောက်ခံပြုထားပြီး SanDisk SN861 ၏ 2,555.6K IOPS ထက် နောက်ကျပြီး Micron 9550 MAX (2,217.6K IOPS) နှင့် CD9P-R (2,165.0K IOPS) တို့ထက် သာလွန်သည်။ IODepth 1 / NumJobs 1 မှာ KIOXIA low-latency signature က ထပ်မံဦးဆောင်ခဲ့ပါတယ်- CM9-R က 29.3 µs နဲ့ CD9P-R က 30.4 µs မှာ ဦးဆောင်နေခဲ့ပေမယ့် PS1030 ရဲ့ 56.8 µs က ကျန်တာတွေထဲမှာ အကောင်းဆုံးဖြစ်ပြီး သူ့ရဲ့ ညီအစ်ကိုမောင်နှမတွေနဲ့ 9550s နှစ်ခုလုံး (ခန့်မှန်းခြေအားဖြင့် 65 µs) နဲ့ SN861 (67.8 µs) တွေထက် သာလွန်နေပါတယ်။ 4K read နဲ့ 4K write နှစ်ခုလုံးမှာ ဒုတိယနေရာရတဲ့ ရောနှောအသုံးပြု drive တစ်ခုဟာ read များတဲ့ ဒီနယ်ပယ်မှာ သူ့ရဲ့ job description ရဲ့ တစ်ဝက်စီကို လွှမ်းခြုံထားပါတယ်။
GPU တိုက်ရိုက်သိုလှောင်မှု
ဤ testbench တွင် ကျွန်ုပ်တို့ပြုလုပ်ခဲ့သော စမ်းသပ်မှုများထဲမှတစ်ခုမှာ Magnum IO GPU Direct Storage (GDS) စမ်းသပ်မှုဖြစ်သည်။ GDS သည် NVIDIA မှ တီထွင်ထားသော အင်္ဂါရပ်တစ်ခုဖြစ်ပြီး NVMe drives များ သို့မဟုတ် အခြားမြန်နှုန်းမြင့် storage devices များတွင် သိမ်းဆည်းထားသော အချက်အလက်များကို ဝင်ရောက်ကြည့်ရှုသည့်အခါ GPU များသည် CPU ကိုကျော်ဖြတ်နိုင်စေပါသည်။ CPU နှင့် system memory မှတစ်ဆင့် data များကို routing လုပ်မည့်အစား GDS သည် GPU နှင့် storage device အကြား တိုက်ရိုက်ဆက်သွယ်မှုကို ဖွင့်ပေးပြီး latency ကို သိသိသာသာလျှော့ချပေးပြီး data throughput ကို တိုးတက်ကောင်းမွန်စေပါသည်။
GPU Direct Storage ဘယ်လိုအလုပ်လုပ်လဲ
ရိုးရာအစဉ်အလာအရ GPU တစ်ခုက NVMe drive မှာသိမ်းဆည်းထားတဲ့ဒေတာတွေကို စီမံဆောင်ရွက်တဲ့အခါ ဒေတာဟာ GPU ဆီကိုမရောက်ခင် CPU နဲ့ system memory ကနေတစ်ဆင့် ဦးစွာဖြတ်သန်းသွားရပါမယ်။ ဒီလုပ်ငန်းစဉ်က CPU က ကြားခံအဖြစ်လုပ်ဆောင်ပြီး latency ကိုတိုးစေပြီး အဖိုးတန် system resource တွေကို သုံးစွဲတာကြောင့် ပိတ်ဆို့မှုတွေကို ဖြစ်ပေါ်စေပါတယ်။ GPU Direct Storage က GPU ကို PCIe bus မှတစ်ဆင့် storage device ကနေ ဒေတာကို တိုက်ရိုက်ဝင်ရောက်ခွင့်ပြုခြင်းဖြင့် ဒီထိရောက်မှုမရှိခြင်းကို ဖယ်ရှားပေးပါတယ်။ ဒီ direct path က ဒေတာရွေ့လျားမှု overhead ကို လျော့ကျစေပြီး ပိုမိုမြန်ဆန်ထိရောက်တဲ့ ဒေတာလွှဲပြောင်းမှုတွေကို ဖြစ်စေပါတယ်။
AI workloads များ၊ အထူးသဖြင့် deep learning ပါဝင်သည့် workloads များသည် data များစွာအသုံးပြုရပါသည်။ ကြီးမားသော neural network များကို လေ့ကျင့်ပေးရန်အတွက် data terabytes များကို processing လုပ်ရန် လိုအပ်ပြီး data transfer နှောင့်နှေးမှုတစ်စုံတစ်ရာသည် GPU များကို အသုံးမချနိုင်ခြင်းနှင့် လေ့ကျင့်ချိန်ပိုကြာခြင်းတို့ ဖြစ်စေနိုင်ပါသည်။ GPU Direct Storage သည် data ကို GPU သို့ အမြန်ဆုံးပေးပို့ခြင်း၊ အားလပ်ချိန်ကို အနည်းဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းနှင့် တွက်ချက်မှုစွမ်းဆောင်ရည်ကို အမြင့်ဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းဖြင့် ဤစိန်ခေါ်မှုကို ဖြေရှင်းပေးပါသည်။
ထို့အပြင်၊ GDS သည် ဗီဒီယိုလုပ်ဆောင်ခြင်း၊ သဘာဝဘာသာစကားလုပ်ဆောင်ခြင်း သို့မဟုတ် အချိန်နှင့်တပြေးညီ ကောက်ချက်ချခြင်းကဲ့သို့သော ဒေတာအစုအဝေးကြီးများကို streaming လုပ်ခြင်းပါဝင်သည့် workloads များအတွက် အထူးအကျိုးရှိပါသည်။ CPU အပေါ် မှီခိုမှုကို လျှော့ချခြင်းဖြင့် GDS သည် ဒေတာရွှေ့ပြောင်းမှုကို အရှိန်မြှင့်ပေးပြီး အခြားအလုပ်များအတွက် CPU အရင်းအမြစ်များကို လွတ်လပ်စေပြီး စနစ်စွမ်းဆောင်ရည်ကို ပိုမိုမြှင့်တင်ပေးပါသည်။
GDSIO အစဉ်လိုက် ဖတ်ရှုမှု ပမာဏ
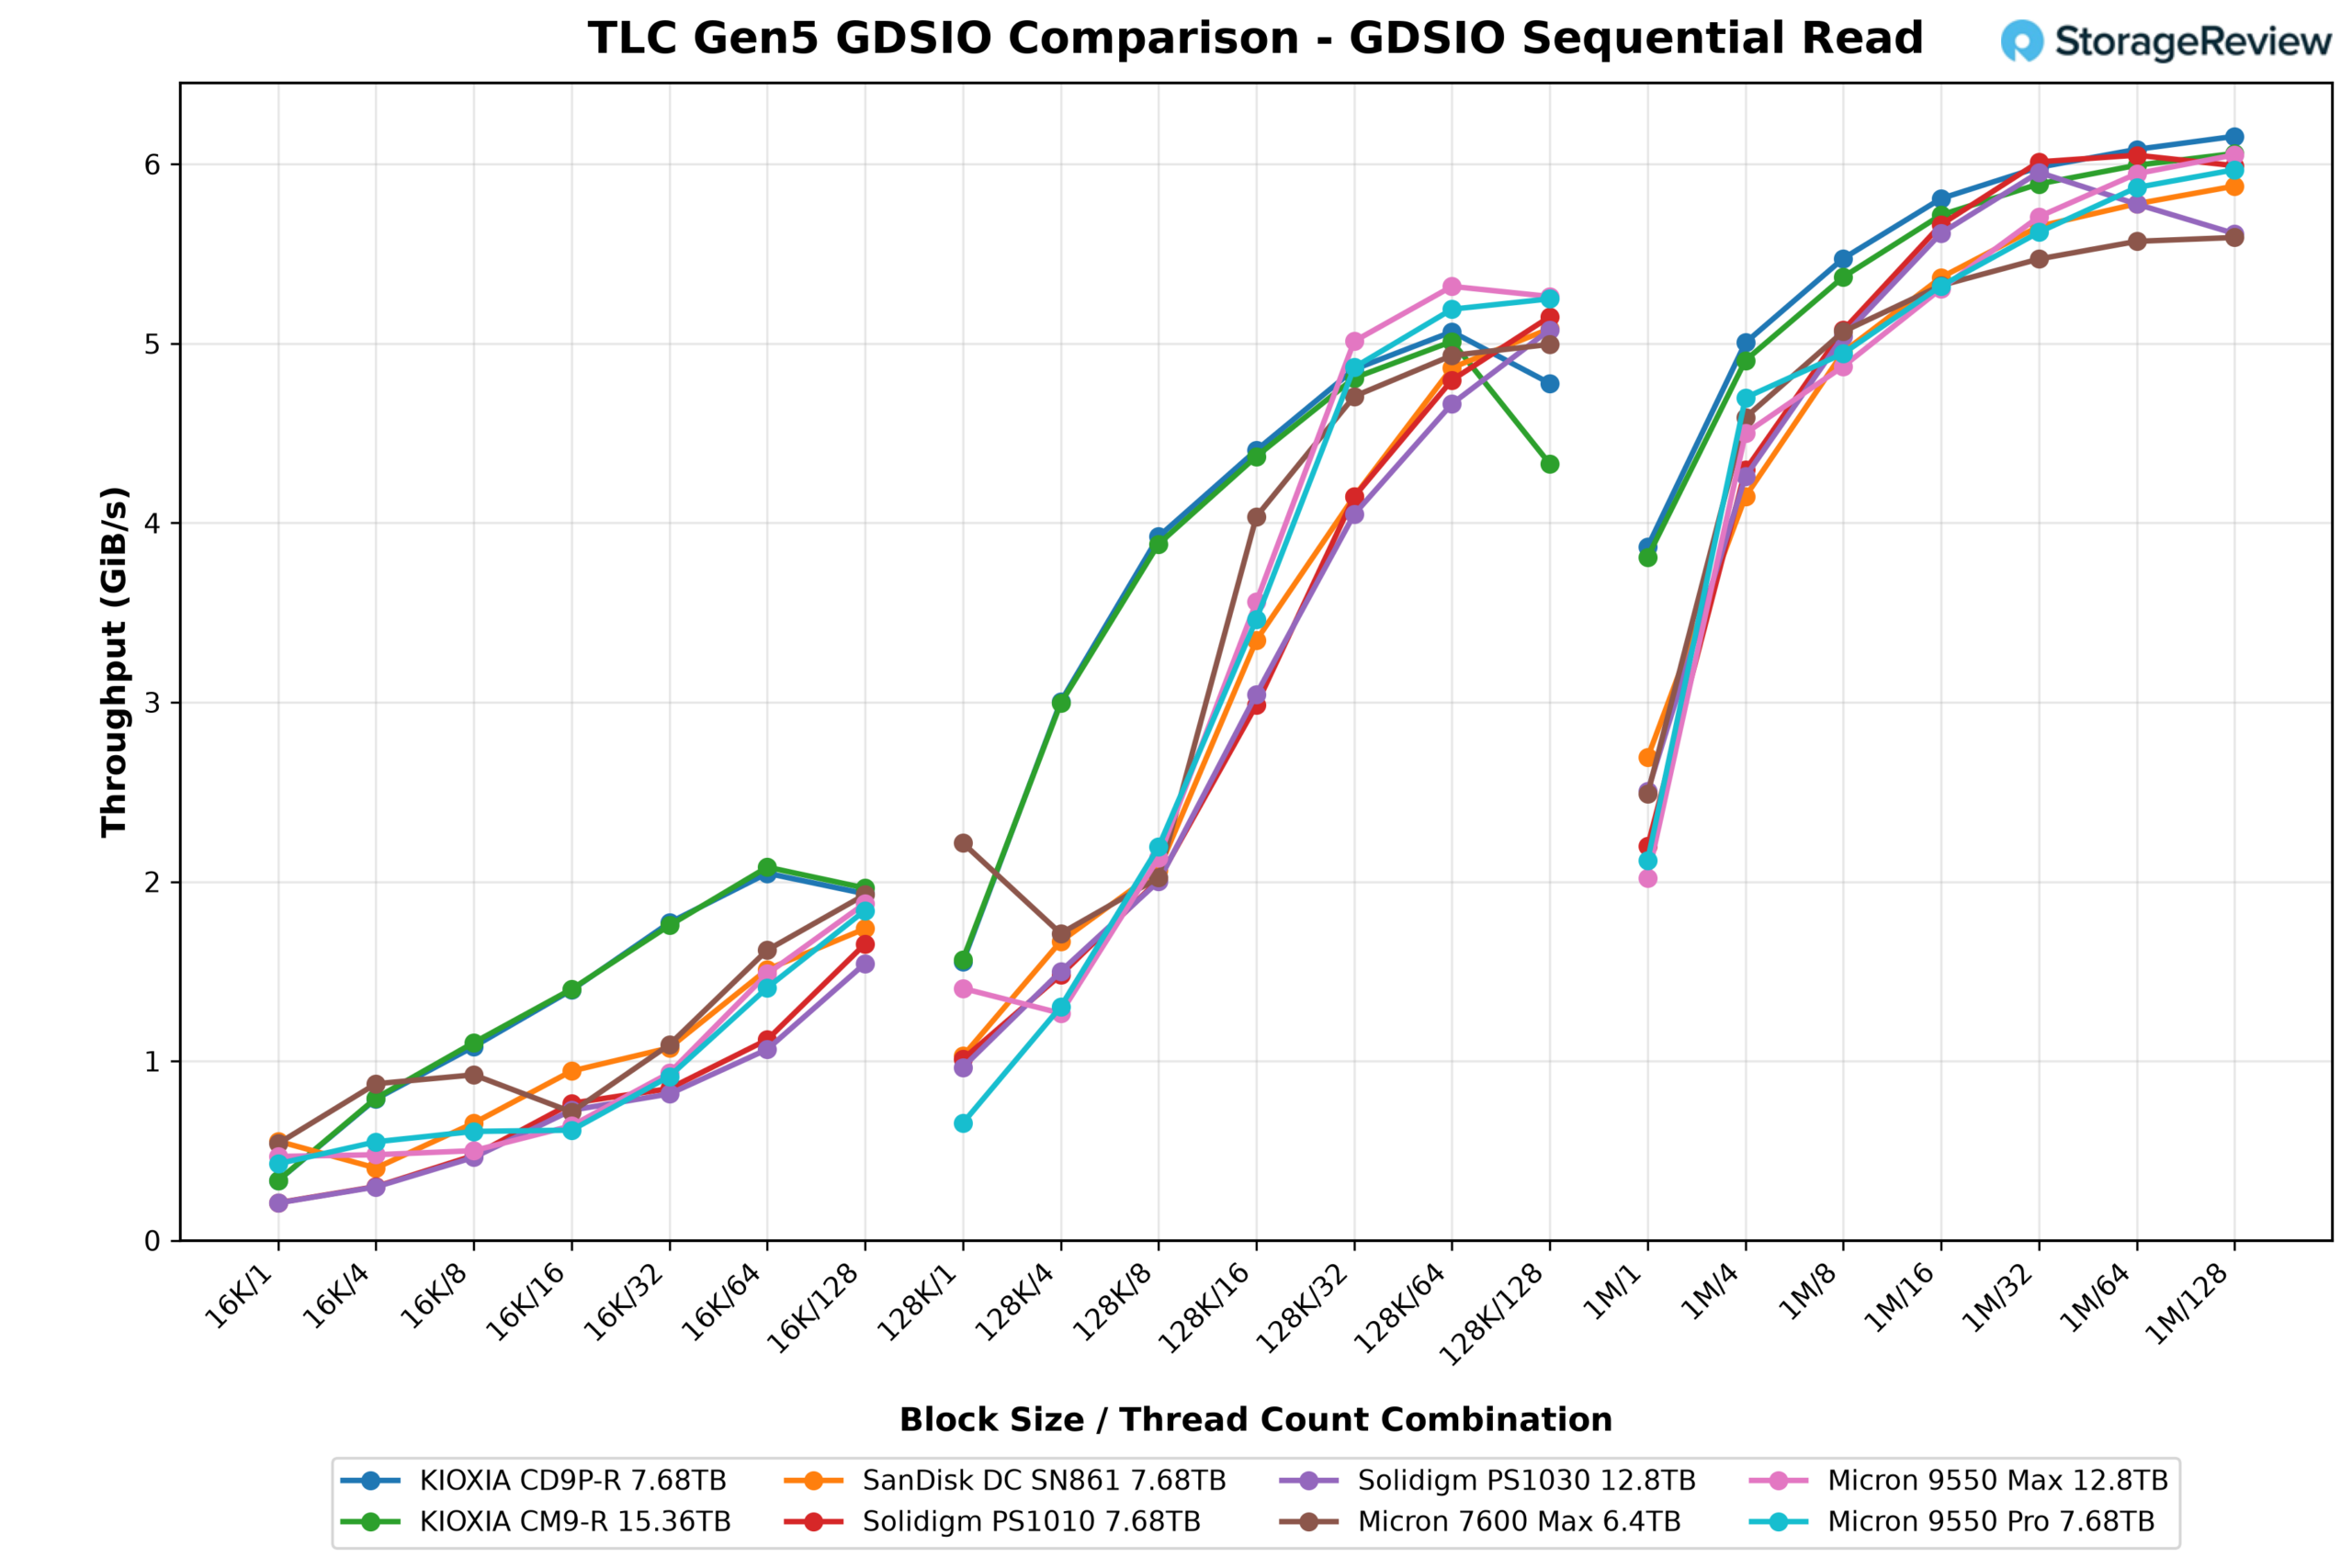
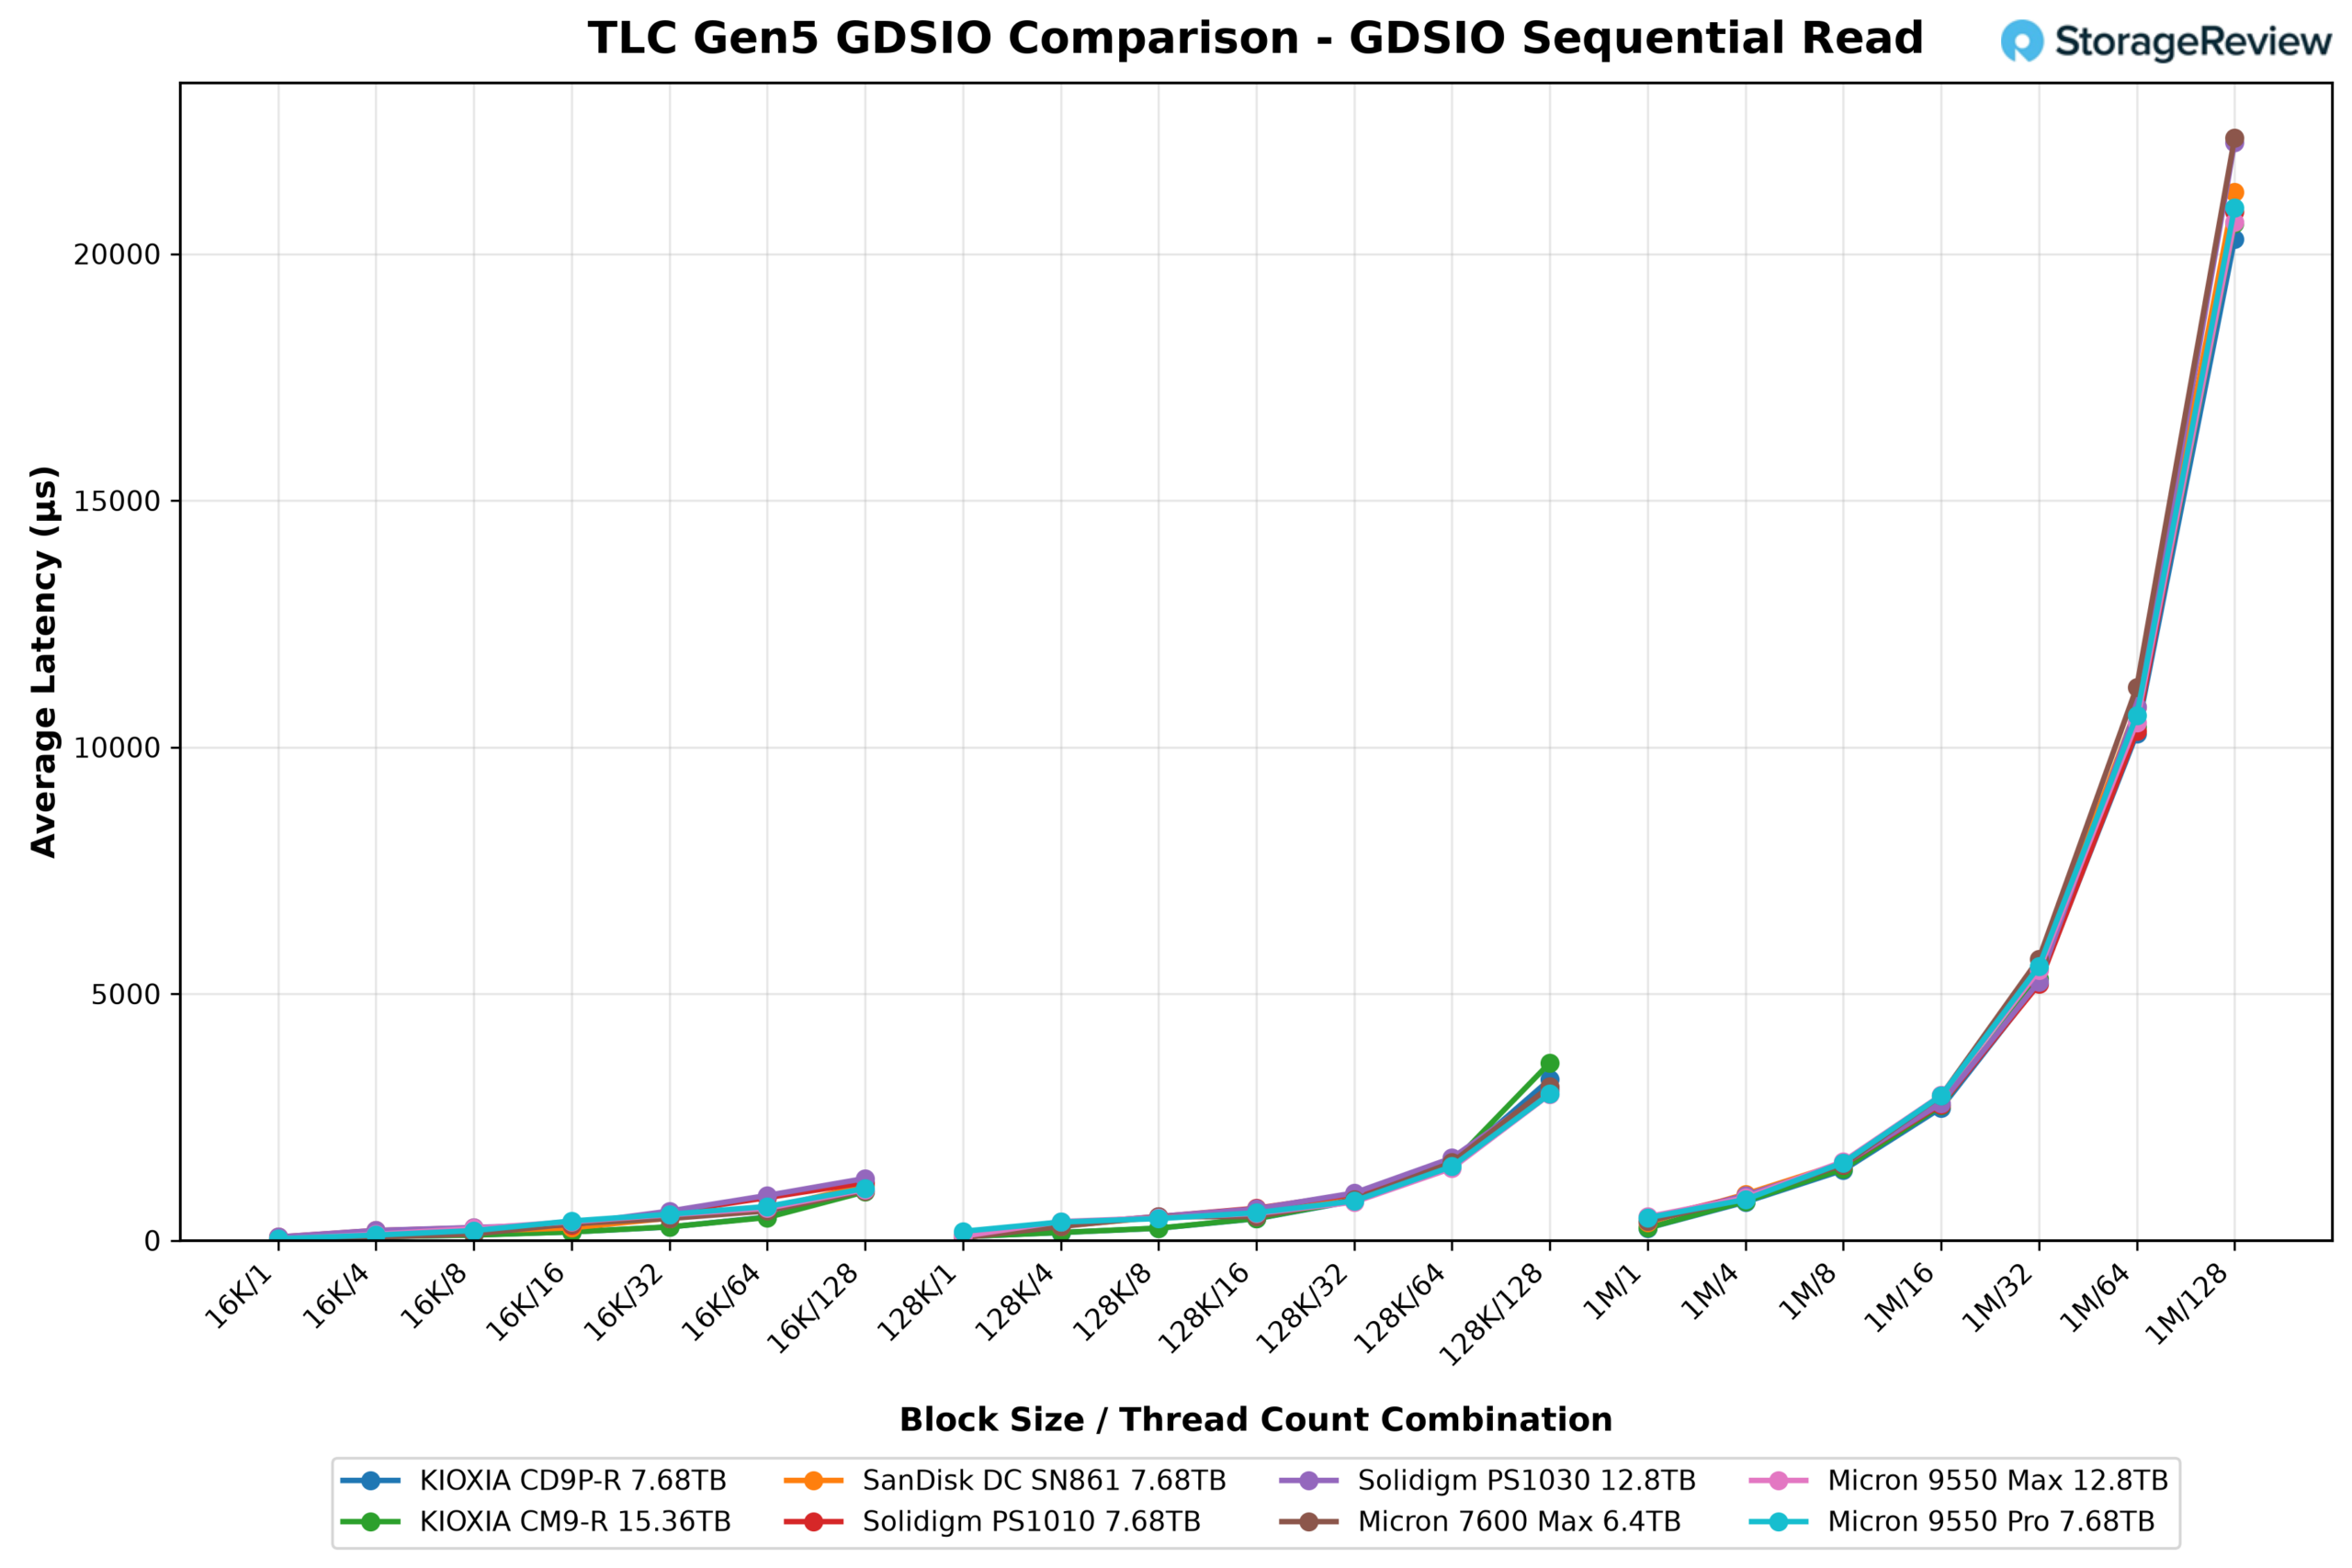
16K block-size segment မှာ PS1030 ဟာ single thread မှာ 0.2 GiB/s ခန့်နဲ့ opens လုပ်ခဲ့ပြီး၊ အုပ်စုထဲမှာ အနိမ့်ဆုံး entry point ဖြစ်ပြီး၊ 71.6 µs single-thread GDS read latency နဲ့ ကိုက်ညီပါတယ် (သူ့ရဲ့ sibling က 71.1 µs ရှိပြီး၊ CD9P-R review မှာ ကျွန်တော်တို့ flag လုပ်ထားတဲ့ platform trait နဲ့ တူညီပါတယ်)။ mid-range မှာ တဖြည်းဖြည်း scale လုပ်လာခဲ့ပြီး 1.6K/128 မှာ 16 GiB/s ဝန်းကျင်နဲ့ segment ကို အပြီးသတ်ခဲ့ပြီး KIOXIA pair က 2.0 GiB/s နီးပါး segment ကို ဦးဆောင်ခဲ့ပါတယ်။ KIOXIA drives ရဲ့ thread-scaling အားသာချက်ဟာ 128K segment မှာလည်း ပါရှိခဲ့ပြီး CD9P-R နဲ့ CM9-R တို့က 128K/16 မှတစ်ဆင့် ထွက်ခွာသွားခဲ့ပြီး PS1030 က main group ကို ခြေရာခံခဲ့ပြီး 128K/64 မှာ 4.7 GiB/s ခန့်နဲ့ 128K/128 မှာ 5.0 GiB/s ခန့် ရောက်ရှိခဲ့ပါတယ်။
1M အပိုင်းမှာ နယ်ပယ်က ပေါင်းစည်းသွားခဲ့ပါတယ်။ PS1030 ဟာ အမြင့်ဆုံး 5.95 GiB/s (1M/32) အထိ မြင့်တက်ခဲ့ပြီး၊ CD9P-R ထက် အုပ်စုအကောင်းဆုံး 6.16 GiB/s ရဲ့ 3.5% အတွင်းမှာပဲ ရှိပြီး CM9-R က 6.06၊ PS1010 နဲ့ 9550 MAX က 6.05 နဲ့ 9550 Pro က 5.97 GiB/s ရှိခဲ့ပါတယ်။ 7600 MAX က 5.59 GiB/s နဲ့ နောက်ဆုံးနေရာမှာ ရှိနေပါတယ်။ အမြင့်ဆုံး 16K IOPS မှာ KIOXIA အတွဲက ဦးဆောင်နေခဲ့ပါတယ် (CM9-R အတွက် 136.4K၊ CD9P-R အတွက် 134.2K)၊ PS1030 ရဲ့ 101.2K က အုပ်စုထဲမှာ အနိမ့်ဆုံးပါ။ small-block GPU-direct reads တွေက ဒီ platform ရဲ့ အားသာချက် မဟုတ်ပါဘူး။
GDSIO အစဉ်လိုက်ရေးသားမှု ပမာဏ
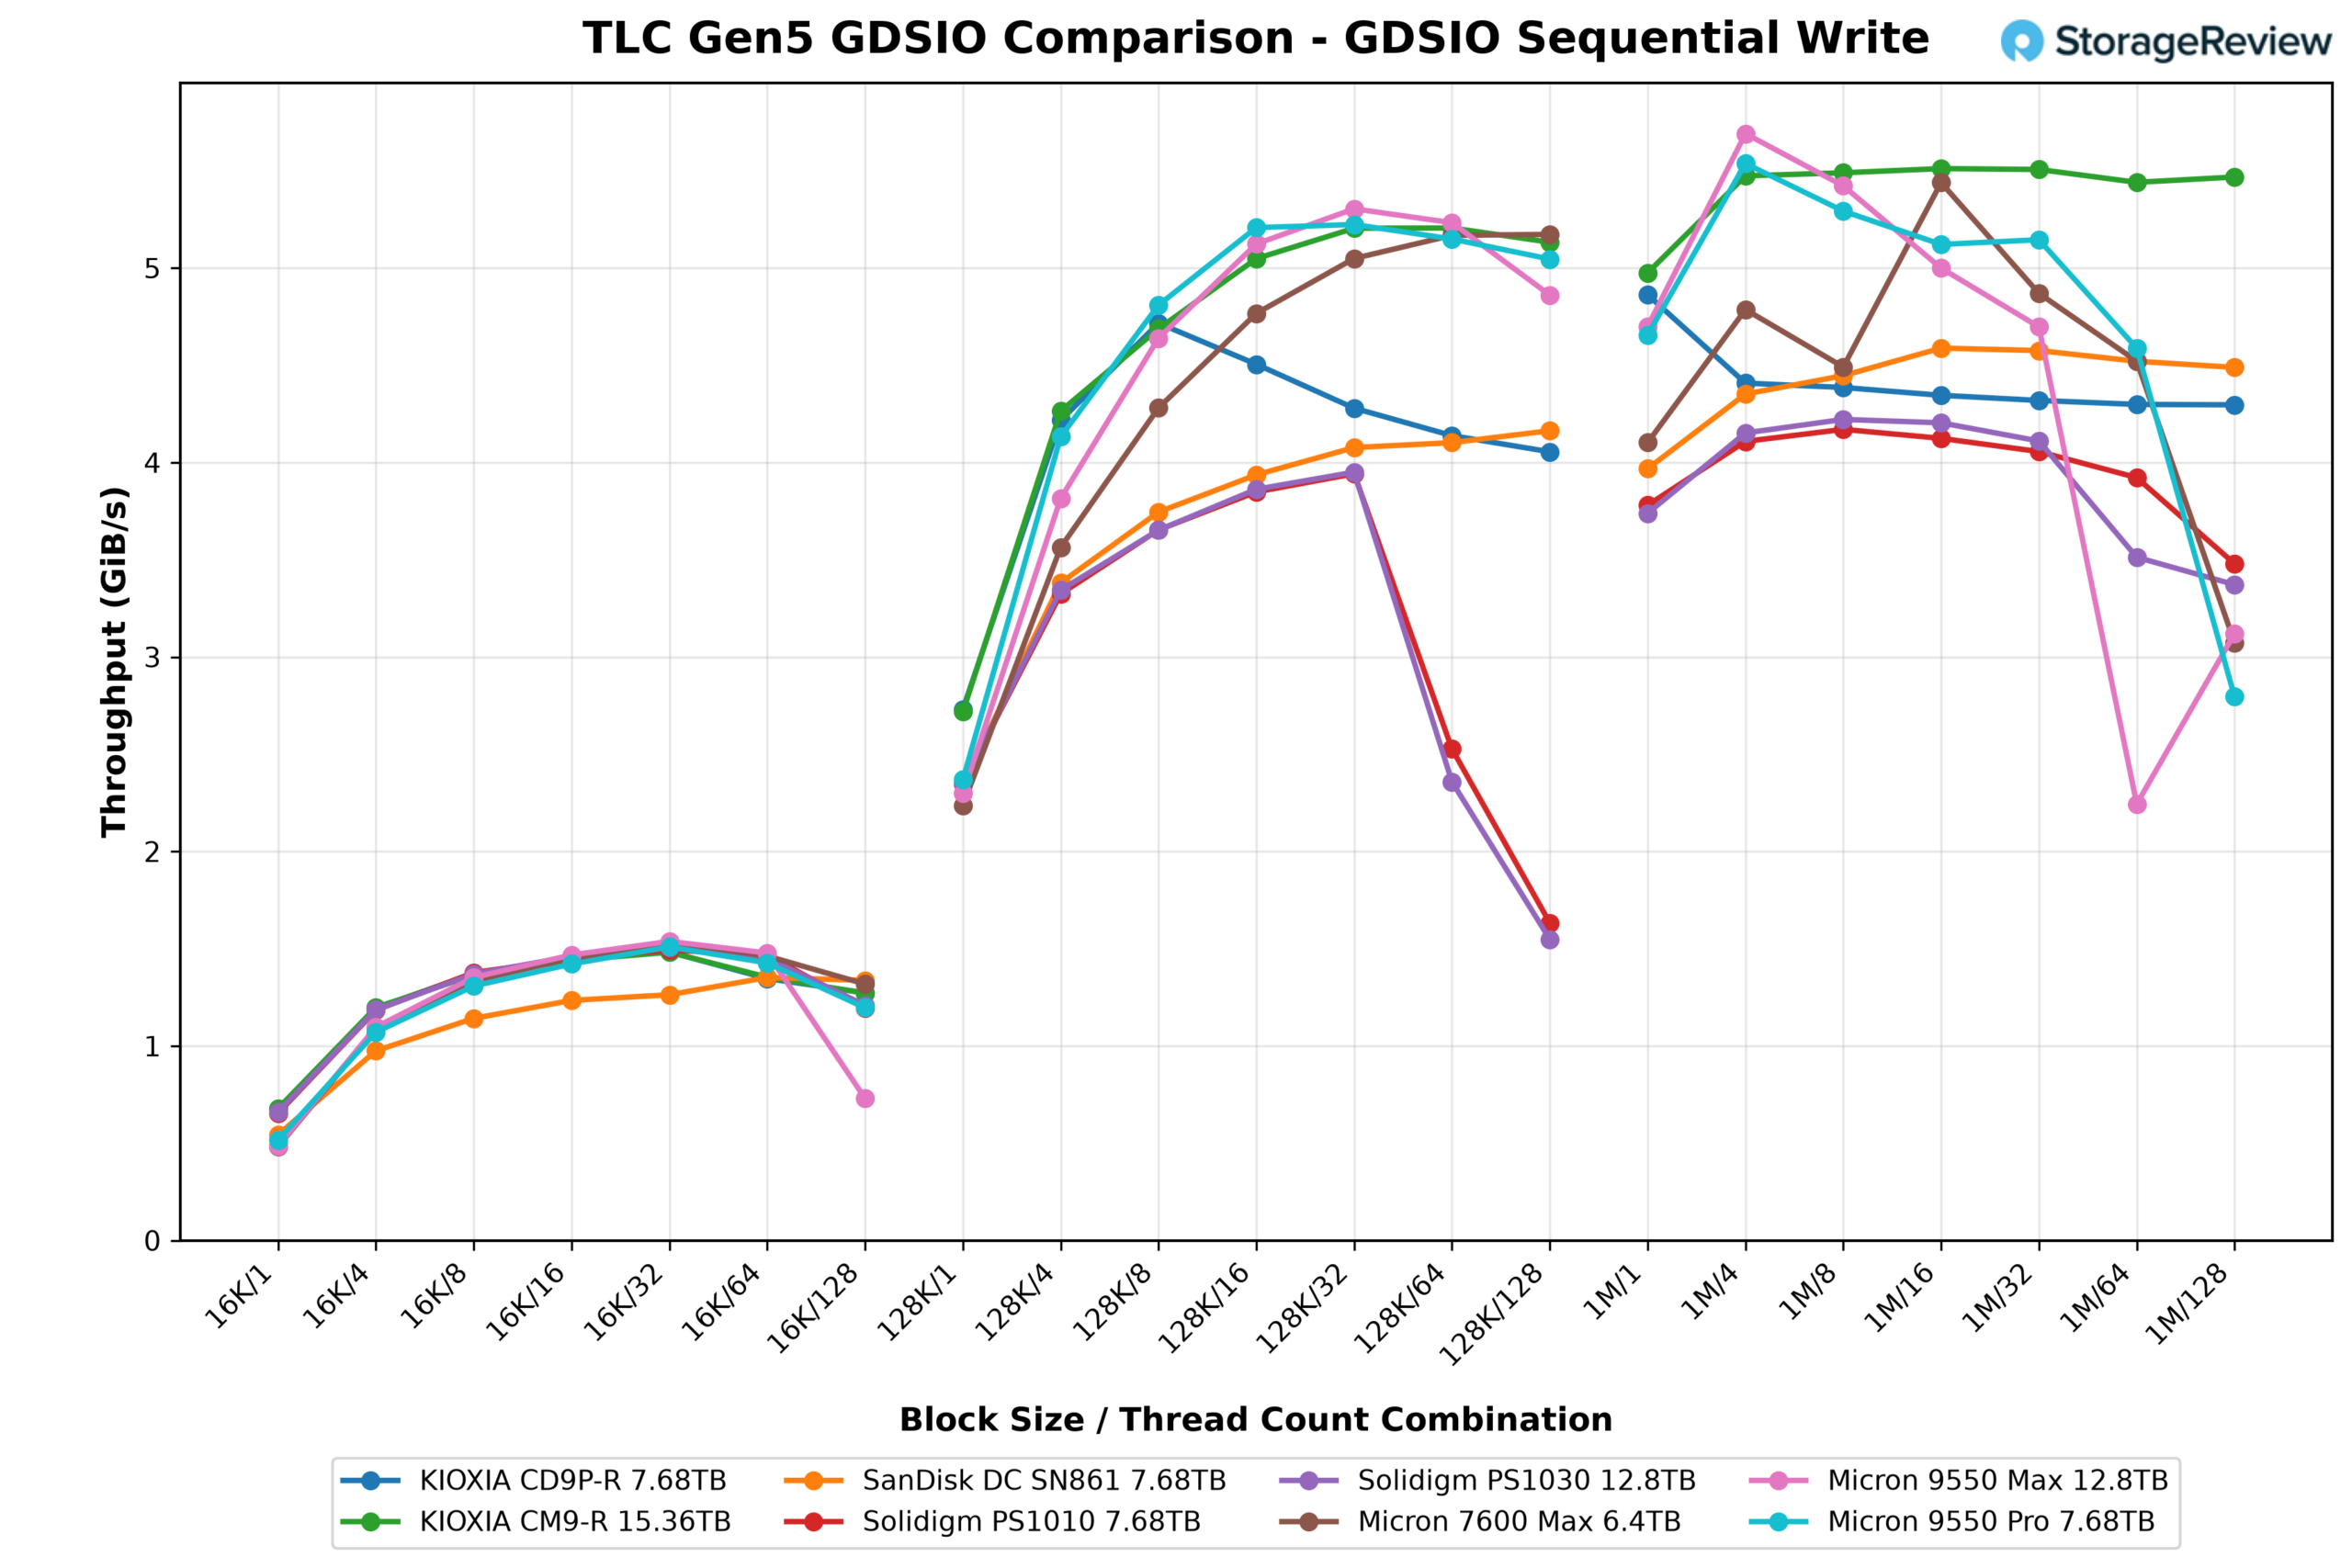
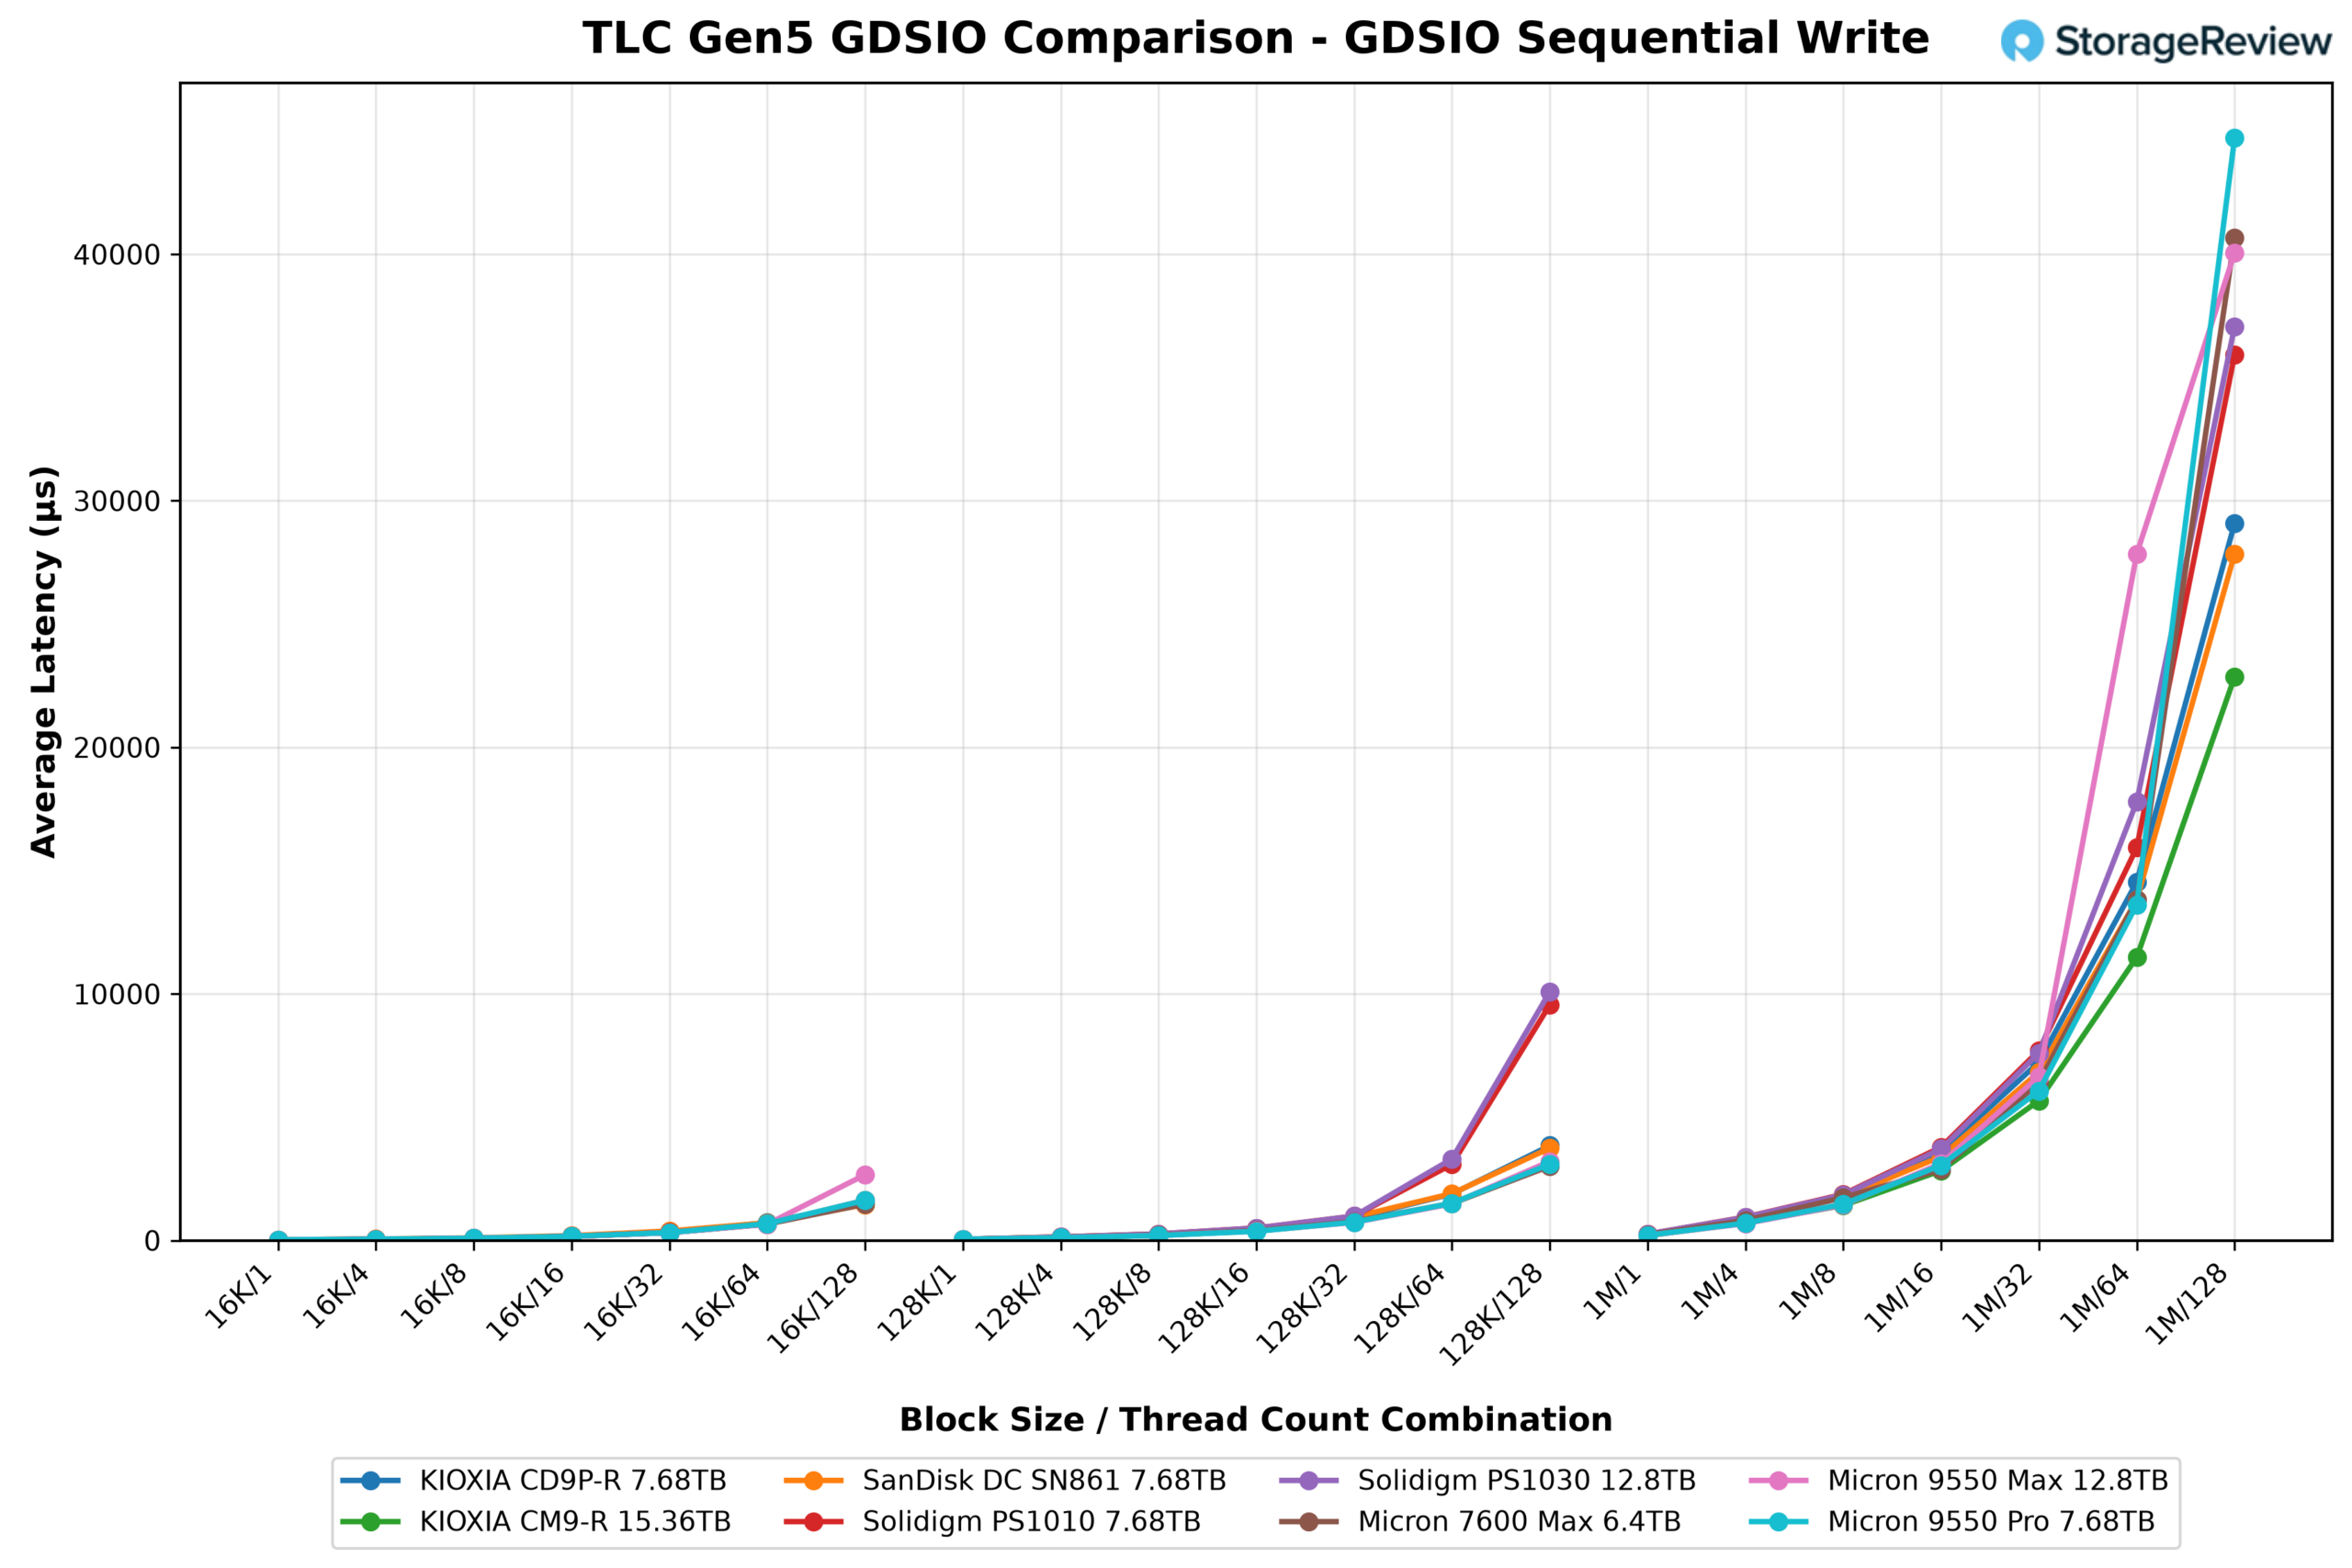
write sweep သည် PS1030 ဝယ်ယူသူများ လေ့လာသင့်သောဇယားဖြစ်ပြီး၊ drive ၏ အကောင်းဆုံးပုံစံများနှင့် ၎င်း၏ထူးခြားချက်တစ်ခုတည်း နှစ်မျိုးလုံးပါဝင်သောကြောင့်ဖြစ်သည်။ 16K အပိုင်းတွင်၊ drive ရှစ်ခုစလုံးသည် 0.5 မှ 1.5 GiB/s band တွင်အတူတကွ track လုပ်ခဲ့ပြီး PS1030 ၏ 22.3 µs ၏ single-thread write latency သည် KIOXIA drive နှစ်ခု (တစ်ခုလျှင် 21.4 µs) နှင့် ၎င်း၏ညီအစ်မ (21.9 µs) တို့နှင့်အတူ ဦးဆောင် cluster တွင် ရှိနေခဲ့သည်။ 128K အပိုင်းတွင်၊ PS1030 သည် 128K/32 တွင် 3.95 GiB/s ခန့်အထိ ရှင်းလင်းစွာ scale လုပ်ပြီးနောက် ချောက်ကမ်းပါးမှ ကျဆင်းသွားသည်- 128K/64 တွင် 2.35 GiB/s ခန့်နှင့် 128K/128 တွင် 1.55 GiB/s ခန့်ရှိပြီး၊ အပိုင်းဦးဆောင်သူများ၏ စွမ်းဆောင်ရည်၏ သုံးပုံတစ်ပုံထက်နည်းသည်။ ဒါက CD9P-R သုံးသပ်ချက်မှာ PS1010 မှာ ကျွန်တော်တို့ မှတ်တမ်းတင်ထားတဲ့ high-thread-count write collapse ပါပဲ၊ PS1030 မှာ point-for-point နီးပါး ပြန်လည်ထုတ်လုပ်ထားတာပါ (PS1010 က 2.5 ကို ကျဆင်းသွားပြီး တူညီတဲ့အမှတ်တွေမှာ 1.65 GiB/s ရှိပါတယ်)။ ၎င်းနောက်မှာ ဘာပဲရှိနေပါစေ endurance tier မှာမဟုတ်ဘဲ platform မှာ ရှိနေပါတယ်၊ ပြီးတော့ dataset မှာ အရေးအကြီးဆုံး အပြစ်အနာအဆာအဖြစ် ရှိနေဆဲပါ။
1M အပိုင်းက ပျော့ပျောင်းသွားပေမယ့် ပုံစံကို မဖျက်ပစ်ခဲ့ပါဘူး။ PS1030 ဟာ 4.22 GiB/s (1M/8) မှာ အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး ၎င်းရဲ့ ညီအစ်မရဲ့ 4.17 GiB/s ထက်သာ သာလွန်ကာ 1M/128 မှာ 3.35 GiB/s ခန့်အထိ ကျဆင်းသွားခဲ့ပြီး CM9-R ကတော့ အုပ်စုထဲမှာ အတည်ငြိမ်ဆုံးမျဉ်းကို 5.51 GiB/s အမြင့်ဆုံးဆီသို့ ဦးတည်နေခဲ့ပြီး 9550 MAX ကတော့ မှတ်တမ်းတင်ထားတဲ့ မတည်ငြိမ်မှုနဲ့အတူ 5.69 GiB/s မှာ အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး 1M/64 မှာ 2.2 GiB/s နီးပါး ကျဆင်းသွားခဲ့ပါတယ်။ 9550 Pro (5.54), 7600 MAX (5.44), CD9P-R (4.86), နဲ့ SN861 (4.59 GiB/s) တို့ဟာ အော်ဒါကို ဖြည့်စွက်ပေးခဲ့ပါတယ်။ PS1030 ရဲ့ ပစ်မှတ်ဝယ်ယူသူအတွက် သက်သာတဲ့ကျေးဇူးတော်- KV cache နဲ့ log-style tiers တွေဟာ drive တစ်ခုစီမှာ thread အရေအတွက် အသင့်အတင့်နဲ့ ရေးသားကြပြီး PS1030 ကတော့ collapse ဖြစ်နေတဲ့ 64-plus GPU-direct write threads တွေမှာ မဟုတ်ဘဲ အပြစ်အနာအဆာကင်းစွာ လုပ်ဆောင်ပါတယ်။ ကျွန်ုပ်တို့ရဲ့ KV cache deployment ဟာ array ဟာ bottleneck ကို ဘယ်တော့မှ မချဉ်းကပ်ဘဲ ဒီ drives ရှစ်ခုကို ရက်သတ္တပတ်များစွာ လည်ပတ်ခဲ့ပါတယ်။ ဒါပေမယ့် ဒီ platform ပေါ်မှာ heavy multi-threaded GDS write streaming ကို စီစဉ်သူတိုင်းဟာ သူတို့ရဲ့ တိကျတဲ့ pattern ကို ဦးစွာ benchmark လုပ်သင့်ပါတယ်။
ကောက်ချက်
Solidigm D7-PS1030 ဟာ အလယ်အလတ်အဆင့် Gen5 drive တစ်ခုရဲ့ လုပ်ဆောင်နိုင်စွမ်းကို လုပ်ဆောင်ပေးပြီး အချက်အလက်တွေအရ ထူးခြားတဲ့ ကျွမ်းကျင်မှုရှိတဲ့ drive တစ်ခုကို ပြသထားပါတယ်။ ၎င်းရဲ့ ထူးခြားချက်ကတော့ parallel small-block work ပါ။ 4K random write (1,595.8K IOPS၊ တတိယမြောက် DWPD Micron 7600 MAX ထက်သာ နောက်ကျပါတယ်) နဲ့ 4K random read (2,255.8K IOPS) နှစ်ခုစလုံးမှာ အုပ်စုထဲမှာ ဒုတိယနေရာရထားပြီး အုပ်စုရဲ့ အကောင်းဆုံး 64K random read 14,162.9 MB/s နဲ့ 128K sequential read မှာ full Gen5 line rate 14,156.4 MB/s ရှိပါတယ်။ စိတ်ဝင်စားစရာကောင်းတာက ဘယ်လိုရောက်သွားလဲဆိုတော့ IODepth 2 ဒါမှမဟုတ် NumJobs 8 မှာ ဆယ်ဂဏန်း microseconds အတွင်း latency နဲ့ အမြင့်ဆုံးရောက်ပြီး ပြိုင်ဘက်တွေက deep queue တွေလိုအပ်ပြီး latency နဲ့ ငွေပေးချေရပါတယ်။ drive ဟာ အစောပိုင်းမှာ saturated ဖြစ်ပြီး တည်ငြိမ်ပြီး အဆိုးဆုံးအခြေအနေမှာ write latency ကို PS1010 ရဲ့ ထက်ဝက်လောက်မှာ ထိန်းထားပါတယ်။
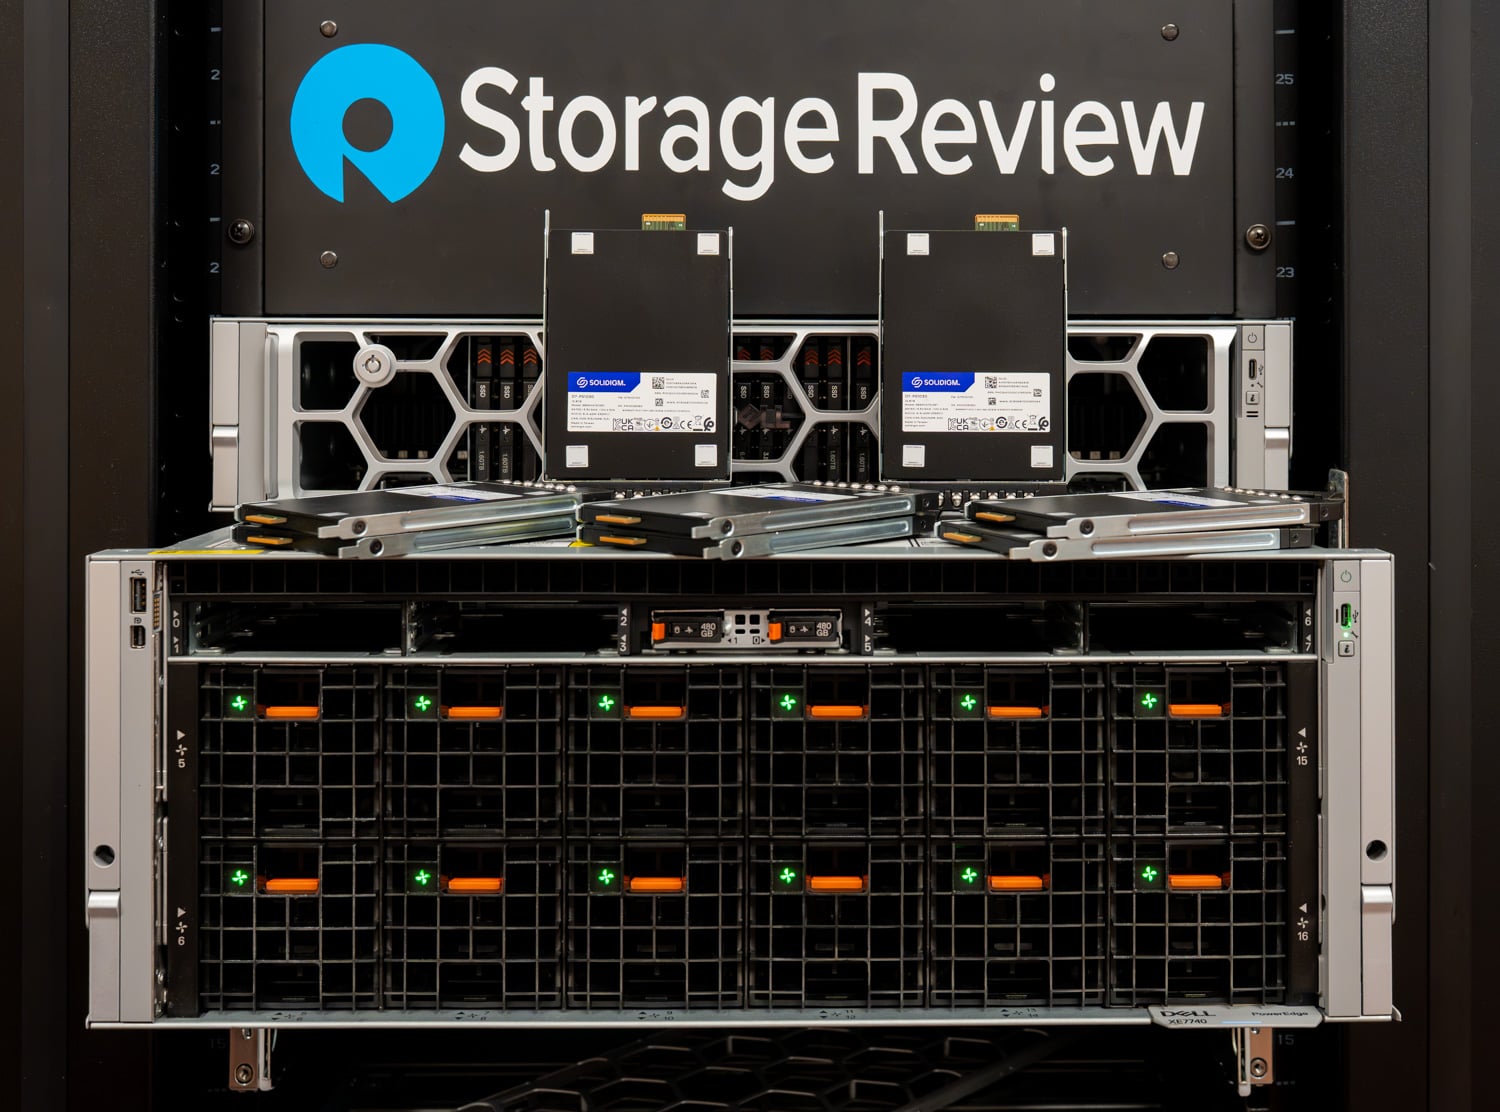
ကျွန်ုပ်တို့၏ KV cache offload အလုပ်တွင် eight-drive PS1030 tier ကို host လုပ်ခဲ့သော XE7740 bay။
သို့သော် အပေးအယူများရှိပါသည်။ Single-worker 128K sequential writes သည် အုပ်စုတွင် နောက်ဆုံးတွင် 6,370.3 MB/s ဖြင့် ရောက်ရှိလာခဲ့ပြီး ထိုပုံစံကို အလေးပေးဖော်ပြထားသည့် DLIO checkpointing သည် အုပ်စု၏ အမြင့်ဆုံး Pass 3 ပျမ်းမျှ 599.2 စက္ကန့်ဖြင့် ရောက်ရှိခဲ့သည်။ 16K sequential စမ်းသပ်မှုများသည်လည်း နှစ်ဖက်စလုံးတွင် နောက်ကျကျန်ခဲ့ပြီး write peak 5,977.7 MB/s နှင့် read peak 11,142.8 MB/s တို့သည် ရှစ်ခုအနက် ခုနစ်ခုမြောက်သို့ ရောက်ရှိခဲ့သည်။ GDSIO write sweep သည် PS1010 ၏ high-thread 128K ကျဆင်းမှုကို point-for-point နီးပါး ပြန်လည်ထုတ်လုပ်ခဲ့ပြီး ၎င်းသည် တစ်ကြိမ်တည်းမဟုတ်ဘဲ platform အပြုအမူတစ်ခုအဖြစ် အတည်ပြုခဲ့ပြီး small-block GPU-direct reads များသည် KIOXIA drives များကို ကျယ်ပြန့်သော margin ဖြင့် အကျိုးပြုသည်။ ဤအရာများထဲမှ မည်သည့်အရာကမျှ drive ၏ brief ကို ထိခိုက်စေခြင်းမရှိသော်လည်း ၎င်းကို မီးမောင်းထိုးပြသည်- PS1030 သည် single-stream ingest အတွက် drive မဟုတ်ပါ။
၎င်းကိုတည်ဆောက်ထားခြင်းကြောင့် မည်သည့် bench run ထက်မဆို ပိုမိုရှည်လျားသောပုံစံဖြင့် သက်သေပြခဲ့ပြီးဖြစ်သည်။ ဤ drive ရှစ်ခုသည် ကျွန်ုပ်တို့၏ XE7740 inference work တွင် KV cache offload tier အဖြစ် ရက်သတ္တပတ်များစွာကြာအောင် ကုန်ဆုံးခဲ့ပြီး ၎င်းတို့၏ 3 DWPD rating ကိုကျော်လွန်သွားသော duty cycle တွင် 1.9 GB/s စဉ်ဆက်မပြတ်၊ ၂၄ နာရီ write များကို စုပ်ယူခဲ့ပြီး tier သည် bottleneck မဖြစ်ခဲ့ပေ။ bench data သည် ၎င်းအလုပ်လုပ်ရသည့်အကြောင်းရင်းကို ရှင်းပြသည်- early-saturating write behavior၊ low queue depths တွင် single-digit-microsecond 4K write latency နှင့် controlled latency ceiling တို့သည် continuously written cache သို့မဟုတ် log tier မှ ဆုချီးမြှင့်သော လက္ခဏာများဖြစ်သည်။ Endurance-bound၊ latency-sensitive၊ moderately concurrent write workloads၊ KV cache offload၊ OLTP logging နှင့် metadata tiers များသည် PS1030 နှင့်သက်ဆိုင်ပြီး ၎င်း၏ 3 DWPD budget နှင့် 4.98 DWPD သုံးနှစ် option သည် read-intensive class ကို ဖယ်ထုတ်မည့် duty cycles များကို လုပ်ဆောင်နိုင်စေပါသည်။



 အမေဇုံ