

Marvell သည် FMS 2026 ကို အသုံးပြု၍ hyperscaler များနှင့် cloud provider များအား compute မှ သီးခြားစီ memory ကို တိုးချဲ့ရန် ကူညီပေးရန် ရည်ရွယ်သည့် memory infrastructure နည်းပညာအသစ်များကို မိတ်ဆက်ခဲ့သည်။ ၎င်း portfolio တွင် server-level AI storage၊ rack-scale CXL memory expansion and pooling နှင့် pod-level optical shared memory တို့ ပါဝင်သည်။
ထုတ်ဝေမှုများသည် agentic AI inference မှ တိုးပွားလာသော memory demand များကို ပစ်မှတ်ထားသည်။ မော်ဒယ်ကြီးများ၊ context window များ ပိုရှည်လာခြင်းနှင့် key-value cache များ တိုးချဲ့လာခြင်းတို့သည် memory capacity၊ bandwidth နှင့် connectivity အတွက် လိုအပ်ချက်များကို တိုးပွားစေပါသည်။ ရိုးရာ server-attached architectures များတွင် ဤလိုအပ်ချက်များသည် processor ရပ်တန့်ခြင်းနှင့် data movement မထိရောက်ခြင်းတို့ကို ဖြစ်ပေါ်စေနိုင်သည်။

မှတ်ဉာဏ်ခွဲထုတ်ခြင်းက မှတ်ဉာဏ်ကို ကွန်ပျူတာအရင်းအမြစ်များနှင့် သီးခြားစီ တိုးချဲ့ခြင်း၊ စုစည်းခြင်းနှင့် မျှဝေခြင်းတို့ကို ခွင့်ပြုသည်။ Marvell က ၎င်း၏ချဉ်းကပ်မှုသည် မှတ်ဉာဏ်အသုံးပြုနိုင်စွမ်းကို မြှင့်တင်ရန်၊ နှောင့်နှေးမှုနှင့် ဒေတာရွေ့လျားမှုကို လျှော့ချရန်နှင့် ပရိုဆက်ဆာအသုံးပြုမှုကို တိုးမြှင့်ရန် ဒီဇိုင်းထုတ်ထားကြောင်း ပြောကြားခဲ့သည်။ ရည်မှန်းချက်မှာ ရှိပြီးသားဒေတာစင်တာ ပါဝါနှင့် နေရာကန့်သတ်ချက်များအတွင်း တိုကင်များ ပိုမိုထုတ်လုပ်ရန်ဖြစ်သည်။
Marvell မှ Custom Cloud Solutions ၏ အမှုဆောင်ဒုတိယဥက္ကဋ္ဌနှင့် အထွေထွေမန်နေဂျာ Will Chu က AI အခြေခံအဆောက်အအုံသည် သီးခြားဆာဗာများမှ compute၊ memory နှင့် ချိတ်ဆက်မှုတို့ကို ပေါင်းစပ်ထားသော integrated system များဆီသို့ ရွေ့လျားနေကြောင်း ပြောကြားခဲ့သည်။ အရင်းအမြစ်အသုံးပြုမှုကို မြှင့်တင်ရန်နှင့် AI ဖြန့်ကျက်မှုများ၏ ကုန်ကျစရိတ်နှင့် ပါဝါလိုအပ်ချက်များကို စီမံခန့်ခွဲရန်အတွက် ပိုမိုလွတ်လပ်သော memory scaling လိုအပ်ကြောင်း ၎င်းက ထပ်လောင်းပြောကြားခဲ့သည်။
ဆာဗာအဆင့် AI သိုလှောင်မှု
Marvell Bravera SC6 PCIe 6.0 SSD controller ကို high-bandwidth memory နှင့် SSD storage အကြား KV-cache data မကြာခဏရွှေ့ပြောင်းရန် လိုအပ်သည့် AI inference workloads များကို ပံ့ပိုးပေးရန် ဒီဇိုင်းထုတ်ထားသည် ။ Marvell က ယင်း controller သည် ၎င်း၏ Bravera SC5 PCIe 5.0 ရှေ့ပြေးမော်ဒယ်ထက် နှစ်ဆပိုမိုမြန်ဆန်ကြောင်း ပြောကြားခဲ့သည်။
cache transfer စွမ်းဆောင်ရည်ကို မြှင့်တင်ခြင်းဖြင့် SC6 သည် AI၊ cloud နှင့် enterprise workloads များအတွက် storage efficiency တိုးမြှင့်ရန် ရည်ရွယ်ပါသည်။ controller သည် write amplification နည်းပါးစေရန်နှင့် NAND ဝန်ဆောင်မှုသက်တမ်း ပိုမိုရှည်ကြာစေရန်လည်း ရည်ရွယ်ပါသည်။ ပေးသွင်းသူများစွာထံမှ NAND အတွက် ပံ့ပိုးမှုသည် hyperscaler များကို SSD များ ရယူခြင်းနှင့် ဖြန့်ကျက်ခြင်းတွင် ပိုမိုပြောင်းလွယ်ပြင်လွယ်ရှိစေပါသည်။
Bravera SC6 ကို ၂၀၂၆ ခုနှစ် စတုတ္ထသုံးလပတ်တွင် နမူနာယူမှုစတင်ရန် မျှော်လင့်ရသည်။
Rack-Scale မှတ်ဉာဏ် ချဲ့ထွင်ခြင်းနှင့် စုပေါင်းခြင်း
Marvell ရဲ့ Structera X မှတ်ဉာဏ်တိုးချဲ့မှု ဖြေရှင်းချက်တွေဟာ ကုမ္ပဏီရဲ့ ရှိပြီးသား Structera CXL ပလက်ဖောင်းပေါ် မှာ တည်ဆောက်ထားပြီး ပိုကြီးပြီး ပိုပြောင်းလွယ်ပြင်လွယ်ရှိတဲ့ မှတ်ဉာဏ်စုပုံမှုတွေကတစ်ဆင့် မှတ်ဉာဏ်အများကြီးသုံးတဲ့ AI ဝန်ထုပ်ဝန်ပိုးတွေကို ကိုင်တွယ်ဖြေရှင်းဖို့ hyperscaler တွေကို ကူညီပေးဖို့ ဒီဇိုင်းထုတ်ထားပါတယ်။ hyperscaler မိတ်ဖက်တွေနဲ့ တီထွင်ထားတဲ့ ပလက်ဖောင်းဟာ ဆာဗာတွေတစ်လျှောက် မှတ်ဉာဏ်တိုးချဲ့မှုနဲ့ အရင်းအမြစ်မျှဝေမှုကို ပံ့ပိုးပေးပါတယ်။
Structera X သည် မော်ဒယ်ကြီးများ၊ context window ရှည်များနှင့် KV-cache လိုအပ်ချက်များ တိုးမြှင့်လာခြင်းတို့ကို လိုက်လျောညီထွေဖြစ်စေရန် လက်ရှိမှတ်ဉာဏ်ရင်းနှီးမြှုပ်နှံမှုများ၏ အသုံးချမှုကို မြှင့်တင်ရန် ရည်ရွယ်ပါသည်။ မှတ်ဉာဏ်စွမ်းရည်ကို တစ်ဦးချင်း server configuration များမှ ခွဲထုတ်ခြင်းဖြင့် platform သည် ပိုမိုလိုက်လျောညီထွေဖြစ်အောင် ပြုလုပ်နိုင်သော CXL-based expansion နှင့် pooling architectures များကို ပံ့ပိုးပေးနိုင်ပါသည်။
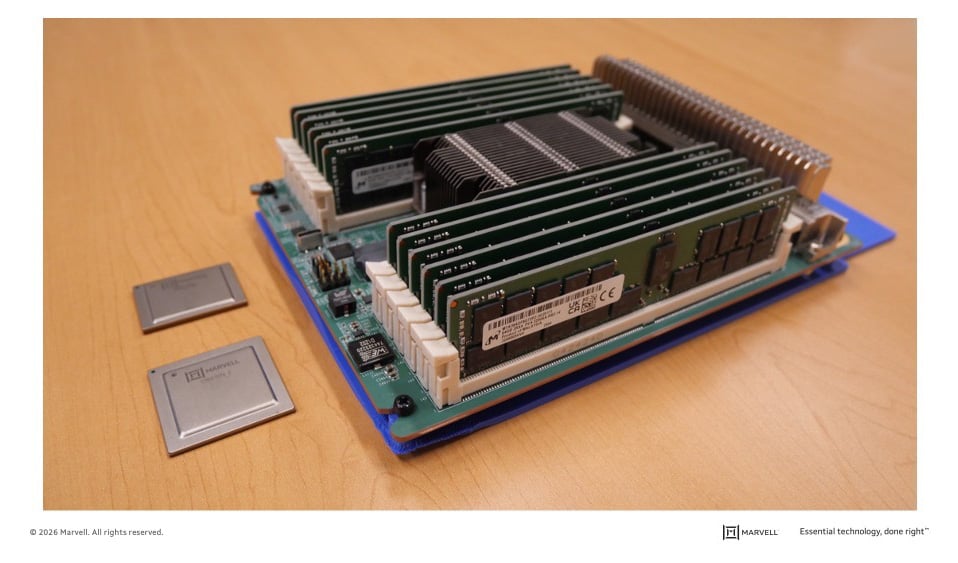
Marvell က ဒီချဉ်းကပ်မှုဟာ အခြေခံအဆောက်အအုံအသုံးပြုမှုနဲ့ လုပ်ငန်းလည်ပတ်မှုထိရောက်မှုကို တိုးတက်ကောင်းမွန်အောင် ဒီဇိုင်းထုတ်ထားသလို စုစုပေါင်းပိုင်ဆိုင်မှုကုန်ကျစရိတ်တွေကိုလည်း လျှော့ချပေးနိုင်တယ်လို့ ပြောပါတယ်။ ဒါ့အပြင် အနာဂတ် CXL မှတ်ဉာဏ်စုစည်းမှုနဲ့ မျှဝေမှုစနစ်တွေအတွက် အခြေခံအုတ်မြစ်တစ်ခုကိုလည်း ချမှတ်ပေးတယ်လို့ ဆိုပါတယ်။
Pod-Level Optical Shared Memory
Marvell ရဲ့ Photonic Fabric အစိတ်အပိုင်းတွေမှာ optical memory module တွေ၊ network interface controller တွေနဲ့ multiple rack တွေကို spanning လုပ်ထားတဲ့ shared-memory architecture အတွက် chiplets တွေ ပါဝင်ပါတယ်။ ဒီစနစ်ကို XPU တွေနဲ့ rack တွေကို မီတာ ၅၀ အထိ အကွာအဝေးတွေမှာ ချိတ်ဆက်ဖို့ ဒီဇိုင်းထုတ်ထားပါတယ်။
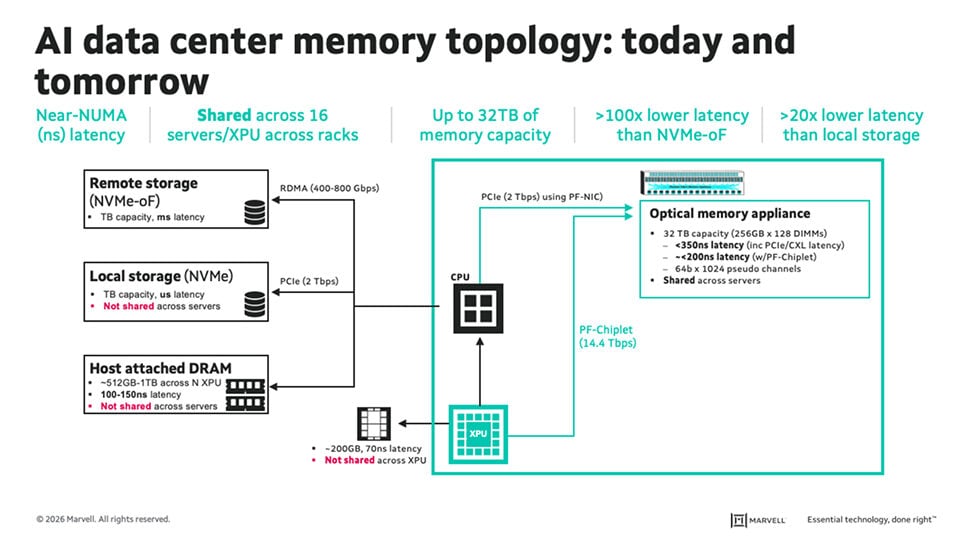
ဒီဗိသုကာလက်ရာက bandwidth မြင့်မားပြီး latency နည်းပါးတဲ့ warm KV-cache offload ကို 32TB အထိ ပံ့ပိုးပေးပါတယ်။ storage ကနေ KV-cache data ကို ပြန်လည်ရယူမယ့်အစား AI စနစ်တွေက shared optical memory tier ကနေ ဝင်ရောက်ကြည့်ရှုနိုင်ပါတယ်။ Marvell က ဒါက inference throughput ကို တိုးတက်ကောင်းမွန်စေပြီး၊ ပိုကြီးတဲ့ model တွေနဲ့ ပိုရှည်တဲ့ context window တွေကို ပံ့ပိုးပေးပြီး token efficiency ကို မြှင့်တင်ပေးနိုင်တယ်လို့ ပြောပါတယ်။
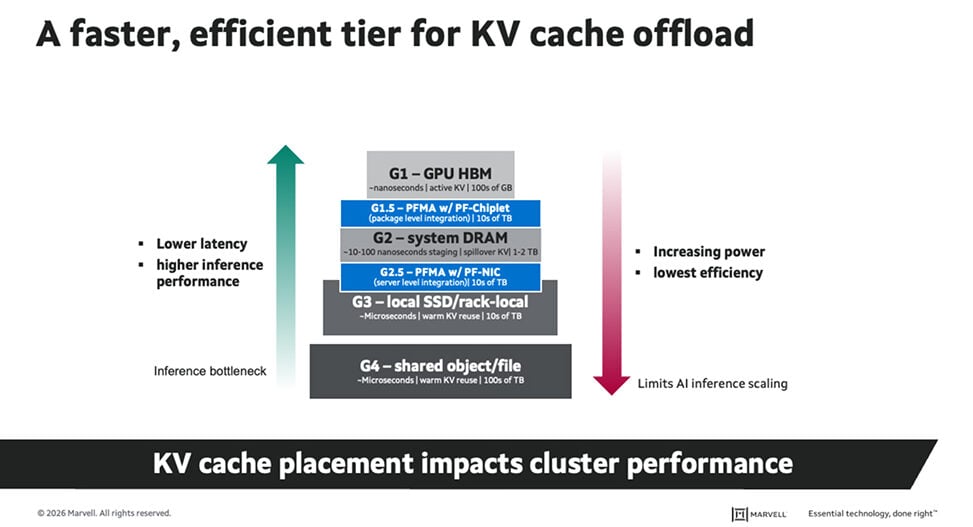
ကုမ္ပဏီသည် လက်ရှိဒေတာစင်တာနေရာနှင့် ပါဝါကန့်သတ်ချက်များအတွင်း တိုကင်ပမာဏ နှစ်ဆမှ သုံးဆအထိ မြင့်မားသော ပမာဏကို ခန့်မှန်းထားသည်။ အမှန်တကယ်စွမ်းဆောင်ရည်သည် စနစ်ဖွဲ့စည်းမှု၊ အလုပ်ပမာဏဝိသေသလက္ခဏာများနှင့် ပတ်ဝန်းကျင် AI အခြေခံအဆောက်အအုံ အကောင်အထည်ဖော်မှုပေါ်တွင် မူတည်လိမ့်မည်။
Marvell သည် FMS 2026၊ ပြခန်း #805 တွင် ၎င်းတို့၏ portfolio ကို ပြသနေသည်။ အဆိုပါကြေငြာချက်သည် inference-memory သတင်းများက လွှမ်းမိုးထားသော တစ်ပတ်အတွင်း ထွက်ပေါ်လာပြီး NVIDIA ၏ Storage-Next နှင့် SCADA တွန်းအားပေးမှုများ နှင့် ကိုက်ညီသည် - Marvell က PCIe Gen7 SSD များသည် IOPS သန်း ၁၀၀ ကို ထောက်ပံ့ပေးရန် လိုအပ်ကြောင်း ထောက်ပြခဲ့ပြီး Bravera SC6 ကဲ့သို့သော controller များသည် GPU-driven small-block access အတွက် တည်ဆောက်ထားသော drive များဆီသို့ ဦးတည်သော ခြေလှမ်းများဖြစ်သည်။


 အမေဇုံ