

MinIO သည် ကြီးမားသော AI inference ပတ်ဝန်းကျင်များတွင် တိုးပွားလာနေသော အတားအဆီးများကို ဖြေရှင်းရန် ဒီဇိုင်းထုတ်ထားသော context memory store တစ်ခုဖြစ်သည့် MemKV ကို ကြေညာခဲ့သည် ။ AIStor နှင့်အတူ ကုမ္ပဏီ၏ portfolio ၏ ဒုတိယအဓိက အစိတ်အပိုင်းအဖြစ် ရပ်တည်ထားသော MemKV သည် MinIO ၏ data infrastructure ကို memory tier အတွင်းသို့ တိုးချဲ့ပြီး GPU cluster များတစ်လျှောက် လည်ပတ်နေသော agentic AI workloads များအတွက် persistent, shared context ကို ပစ်မှတ်ထားသည်။
AI စနစ်များသည် single-response interaction မှ multi-step reasoning နှင့် task execution သို့ တိုးတက်ပြောင်းလဲလာသည်နှင့်အမျှ inference cycle များတစ်လျှောက် context ကို ထိန်းသိမ်းခြင်းသည် အလွန်အရေးကြီးလာပါသည်။ လက်ရှိ architecture များတွင် HBM နှင့် DRAM ကဲ့သို့သော GPU နှင့်ကပ်လျက် memory tiers များတွင် capacity အကန့်အသတ်ရှိသောကြောင့် context များ မကြာခဏ ပျောက်ဆုံးလေ့ရှိသည်။ ၎င်းသည် GPU များအား ယခင်ထုတ်လုပ်ထားသော context ကို ပြန်လည်တွက်ချက်ရန် ဖိအားပေးသောကြောင့် latency၊ compute utilization နှင့် energy consumption များ တိုးလာစေသည်။ MinIO သည် ၎င်းကို အထူးသဖြင့် hyperscale နှင့် cloud environments များတွင် scale အလိုက် ပေါင်းစုသည့် recompute tax အဖြစ် သတ်မှတ်သည်။
MemKV ကို petabyte scale မှာ microsecond retrieval လုပ်နိုင်တဲ့ shared, persistent memory layer တစ်ခု ပံ့ပိုးပေးခြင်းအားဖြင့် ဒီပြဿနာကို လျော့ပါးစေဖို့ ဒီဇိုင်းထုတ်ထားပါတယ်။ inference operations တွေမှာ context ကို ထိန်းသိမ်းခြင်းအားဖြင့် platform ဟာ redundant computation ကို လျှော့ချပေးပြီး overall system efficiency ကို တိုးတက်စေပါတယ်။ internal benchmarks တွေမှာ MinIO က production concurrency level တွေမှာ time-to-first-token တိုးတက်မှုတွေကို တင်ပြပါတယ်။ GPU ၁၂၈ ခုနဲ့ 128K-token context window တွေပါဝင်တဲ့ representative deployment မှာ GPU utilization ဟာ ၅၀ ရာခိုင်နှုန်းကနေ ၉၀ ရာခိုင်နှုန်းကျော်အထိ မြင့်တက်လာခဲ့ပြီး နှစ်စဉ် compute cost သိသိသာသာ သက်သာစေခဲ့ပါတယ်။
MinIO ၏ ခေါင်းဆောင်ပိုင်းက ပြန်လည်တွက်ချက်မှု အထွေထွေကုန်ကျစရိတ်ကို သေးငယ်သော ဖြန့်ကျက်မှုများတွင် သမိုင်းကြောင်းအရ ဖုံးကွယ်ထားလေ့ရှိသော်လည်း စကေးအရ ဖွဲ့စည်းပုံဆိုင်ရာ ထိရောက်မှုမရှိခြင်း ဖြစ်လာကြောင်း ထောက်ပြခဲ့သည်။ GPU cluster များ ကြီးထွားလာသည်နှင့်အမျှ context ကို အထပ်ထပ်အခါခါ ပြန်လည်ထုတ်လုပ်ခြင်း၏ ကုန်ကျစရိတ်သည် ပါဝါသုံးစွဲမှုနှင့် အခြေခံအဆောက်အအုံ လိုအပ်ချက်များ နှစ်မျိုးလုံးတွင် မြင့်တက်လာပြီး ရည်ရွယ်ချက်ရှိရှိ တည်ဆောက်ထားသော မှတ်ဉာဏ်စနစ်များကို ရေရှည်တည်တံ့သော AI လုပ်ငန်းဆောင်တာများအတွက် လိုအပ်စေသည်။
မှတ်ဉာဏ်စကေး အပေးအယူကို ကိုင်တွယ်ဖြေရှင်းခြင်း
ရိုးရာ AI အခြေခံအဆောက်အအုံများသည် မြန်နှုန်းနှင့် စကေးအကြား အပေးအယူလုပ်ရန် တွန်းအားပေးသည်။ HBM နှင့် DRAM ကဲ့သို့သော မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော မှတ်ဉာဏ်အဆင့်များသည် မိုက်ခရိုစက္ကန့် latency ကို ပေးစွမ်းသော်လည်း စွမ်းရည်ကန့်သတ်ချက်ရှိပြီး စျေးကြီးသည်။ ဆန့်ကျင်ဘက်အားဖြင့် သိုလှောင်မှုစနစ်များသည် စကေးကို ပေးစွမ်းသော်လည်း မီလီစက္ကန့် latency ကို ဖြစ်ပေါ်စေပြီး ၎င်းသည် အချိန်နှင့်တပြေးညီ ကောက်ချက်ချခြင်းနှင့် ရေရှည်ဆက်စပ်သော ကျိုးကြောင်းဆင်ခြင်ခြင်းအတွက် မသင့်တော်ပါ။
MemKV ကို latency နည်းပါးသော ဝင်ရောက်ခွင့်နှင့် ကြီးမားသော စွမ်းရည်ကို ပေါင်းစပ်ထားသော shared memory tier တစ်ခုကို မိတ်ဆက်ပေးခြင်းဖြင့် ဤကွာဟချက်ကို ဖြည့်ဆည်းရန် ဒီဇိုင်းထုတ်ထားသည်။ NVIDIA BlueField-4 STX တွင် လည်ပတ်ရန် တည်ဆောက်ထားပြီး NVIDIA Dynamo နှင့် NIXL တို့နှင့် ပေါင်းစပ်ထားသော ဤပလက်ဖောင်းသည် GPU cluster တစ်ခုလုံးကို inference လိုအပ်ချက်များနှင့် ကိုက်ညီသော အမြန်နှုန်းများဖြင့် context data များ၏ ဘုံ pool တစ်ခုကို ဝင်ရောက်ကြည့်ရှုနိုင်စေပါသည်။ ဤချဉ်းကပ်မှုသည် မတူညီသော memory နှင့် storage layer များအကြား context ကို သယ်ယူပို့ဆောင်ရန် မလိုအပ်တော့ဘဲ latency ကို လျှော့ချပေးပြီး throughput ကို တိုးတက်ကောင်းမွန်စေပါသည်။
ကောက်ချက်ချမှု လုပ်ငန်းဝန်များအတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသော ဗိသုကာ
MemKV ကို inference data path အတွက် ရည်ရွယ်ချက်ရှိရှိ တည်ဆောက်ထားပြီး GPU memory hierarchy ရှိ G3.5 layer ၏ MinIO ၏ ဖော်ပြချက်နှင့် ကိုက်ညီပါသည်။ ၎င်းသည် microsecond-level access လက္ခဏာများကို ထိန်းသိမ်းထားစဉ် NVMe-based infrastructure တွင် petabyte-scale capacity ကို ပေးစွမ်းပြီး GPU compute resources များမှ memory scale ကို ထိရောက်စွာ ခွဲထုတ်ပါသည်။
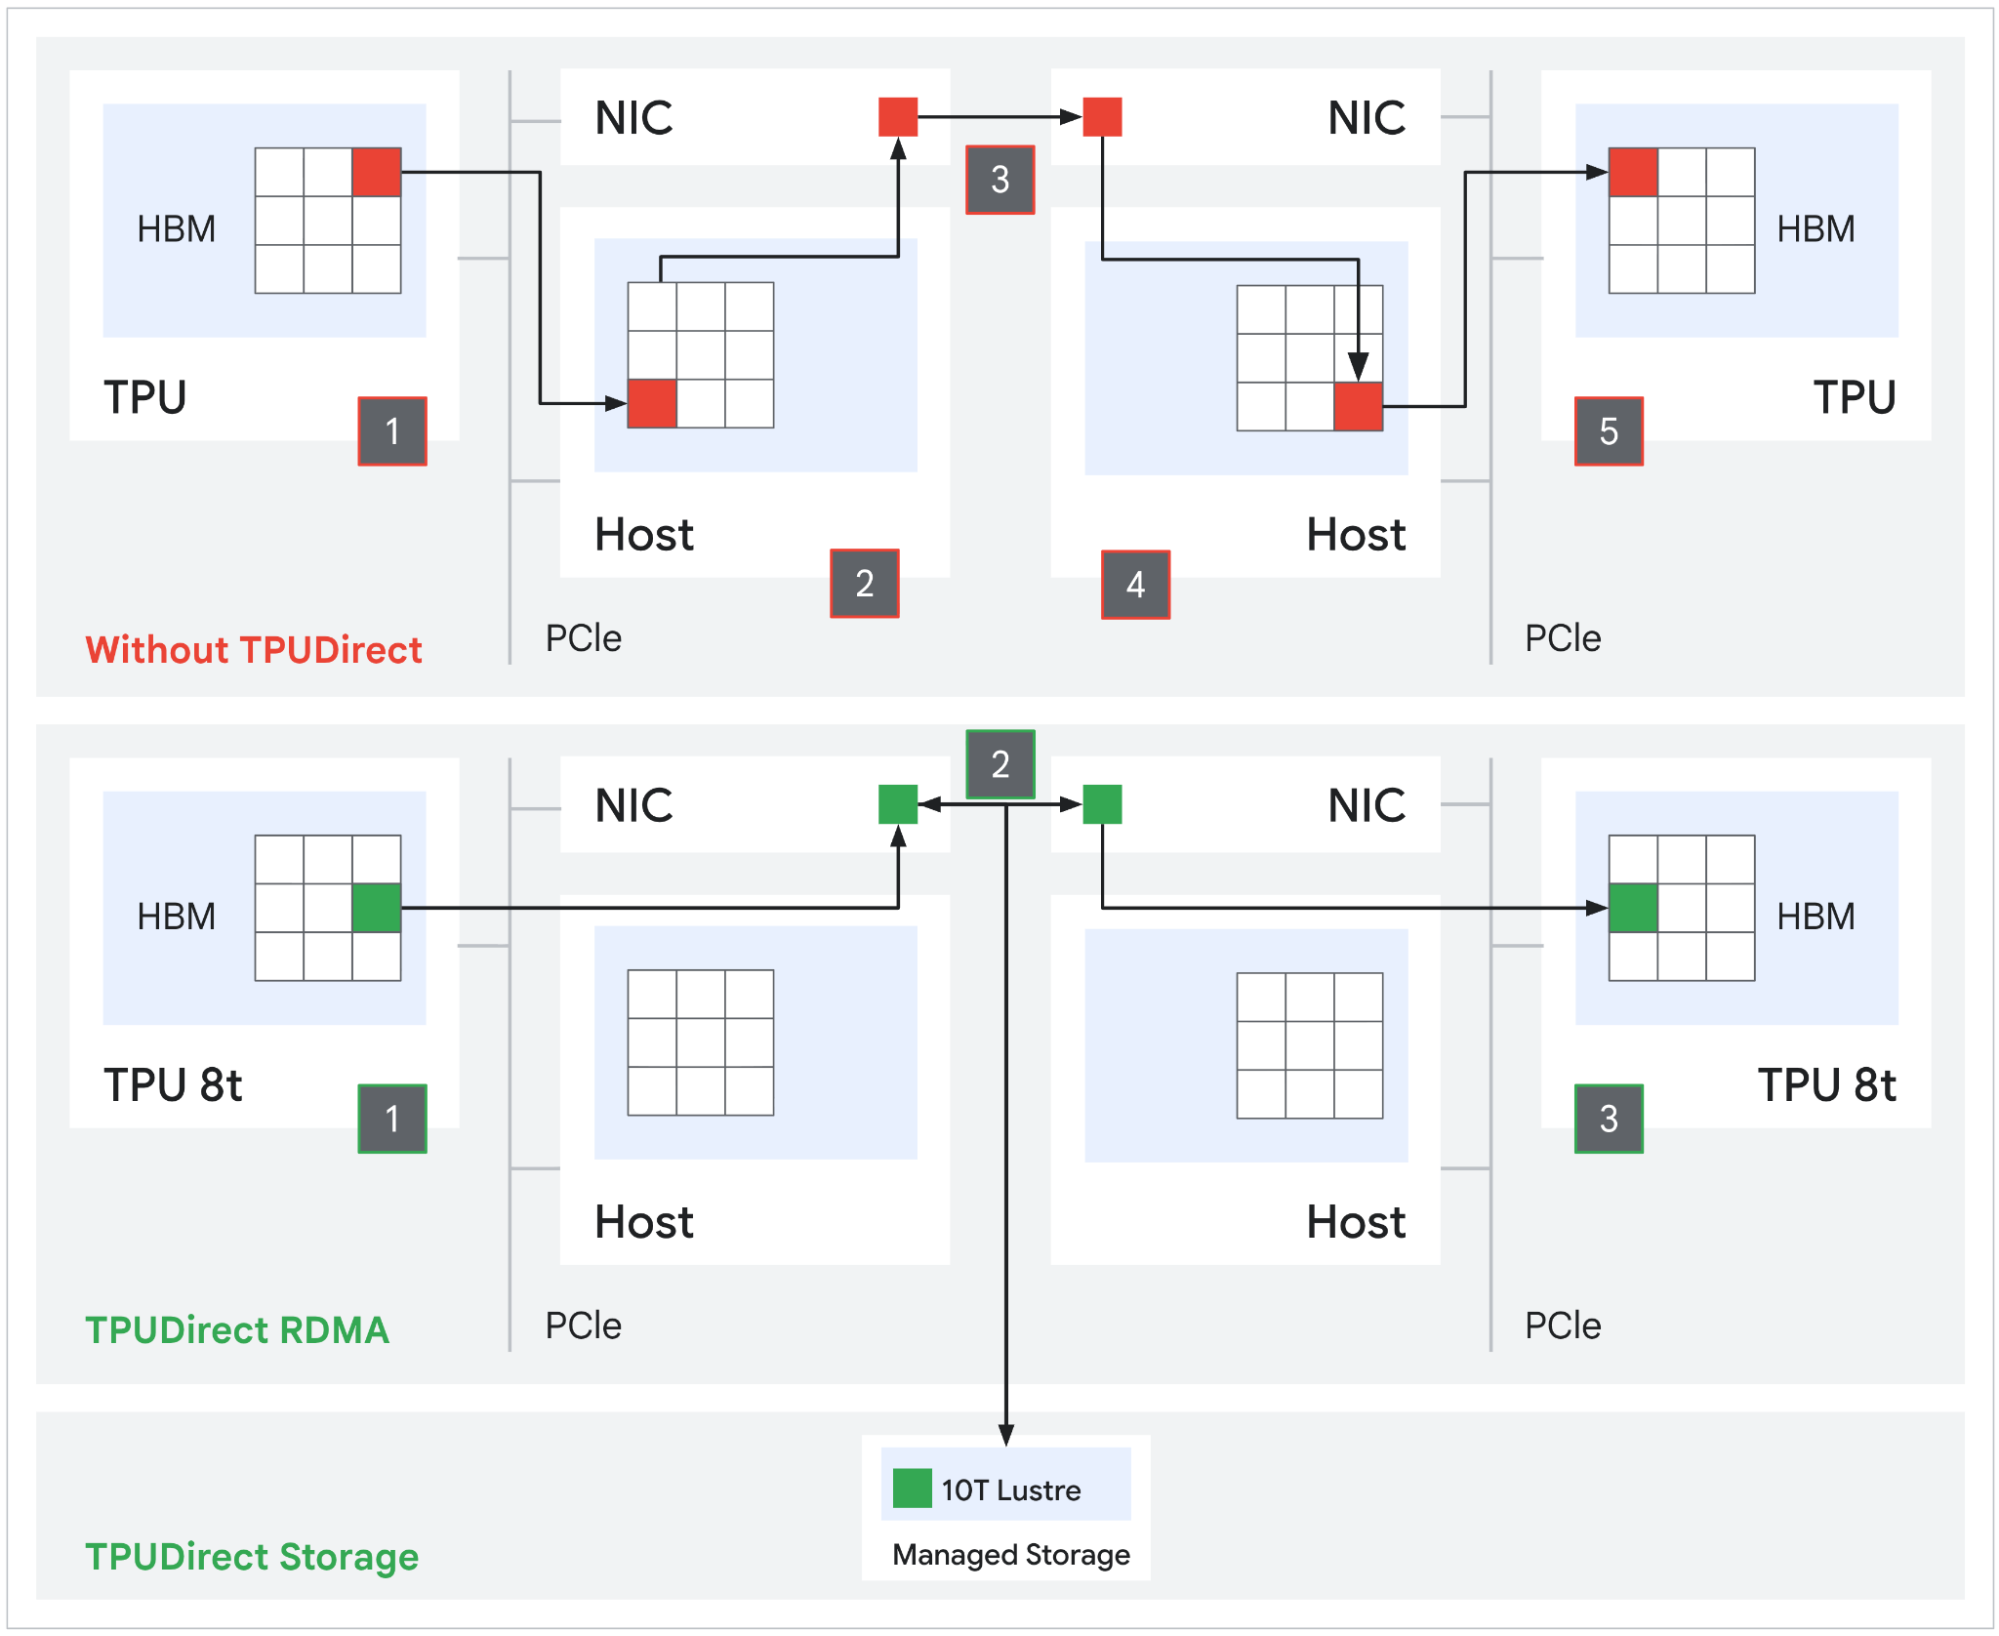
စနစ်သည် end-to-end RDMA transport မှတစ်ဆင့် NVMe မှ AI data path သို့ data ကို တိုက်ရိုက်ရွှေ့ပြောင်းခြင်းဖြင့် ရိုးရာ storage abstractions များကို ရှောင်ရှားသည် ။ ၎င်းသည် object-and file-based architectures များတွင် အဖြစ်များသော HTTP protocols၊ file-system translation နှင့် intermediary storage server များမှ overhead ကို ဖယ်ရှားပေးသည်။
ရင်းမြစ်: Google က
အဓိကဗိသုကာဒြပ်စင်များတွင် NVIDIA BlueField-4 STX ပေါ်တွင် storage layer တွင် embed လုပ်ထားသော ARM64 binary အဖြစ် native execution ပါဝင်ပြီး external x86 storage node များအပေါ် မှီခိုမှုကို လျှော့ချပေးပါသည်။ ဒေတာလွှဲပြောင်းမှုများသည် ရိုးရာ storage stack များကို ကျော်လွှားကာ RDMA မှတစ်ဆင့် GPU memory မှ NVMe သို့ ဖြစ်ပေါ်ပါသည်။ MemKV သည် 2 MB မှ 16 MB အထိရှိသော block အရွယ်အစားကြီးများကိုလည်း အသုံးပြုပြီး legacy 4 KB storage block များအစား GPU throughput pattern များအတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသည်။ ကွန်ရက်စွမ်းဆောင်ရည်ကို NVIDIA Spectrum-X Ethernet နှင့် PCIe Gen6 အပါအဝင် ခေတ်မီမြန်နှုန်းမြင့် fabric များနှင့် ကိုက်ညီစေပြီး cluster တစ်လျှောက် wire-speed နီးပါး data ရွှေ့ပြောင်းနိုင်စေပါသည်။
အသုံးပြုနိုင်မှု
MinIO MemKV ကို ချက်ချင်းရရှိနိုင်ပါသည်။


 အမေဇုံ