

MLCommons သည် ယနေ့ MLPerf Storage v3.0 ရလဒ်များကို ထုတ်ပြန်ခဲ့ပြီး ယင်းအဆင့်တွင် benchmark ဆိုသည်မှာ အဘယ်အရာဖြစ်သည်သာမက မည်သူဦးဆောင်နေသည်ကိုပါ ပြောင်းလဲစေခဲ့သည်။ ပထမဆုံးအကြိမ်အဖြစ် တစ်ခုတည်းသော audited AI storage benchmark သည် training throughput၊ checkpointing နှင့် inference workloads အသစ်နှစ်ခု၊ vector database test နှင့် KV cache test အပါအဝင် pipeline တစ်ခုလုံးကို လွှမ်းခြုံထားသည်။ အဖွဲ့အစည်း ၁၉ ခုသည် ရလဒ် ၁၄၃ ခု တင်သွင်းခဲ့ပြီး ၎င်းတို့အနက် ၁၁ ခုမှာ Microsoft Azure၊ NVIDIA၊ Everpure နှင့် စာဖတ်သူအများစု မသိသော AI storage startup လှိုင်းတစ်ခု အပါအဝင် ပထမဆုံးအကြိမ် တင်သွင်းသူများဖြစ်သည်။ v2.0 leaderboard ကို သတ်မှတ်ပေးခဲ့သော အမည်များဖြစ်သည့် DDN၊ Huawei၊ Hammerspace နှင့် Lightbits တို့သည် ဤအဆင့်တွင် တင်သွင်းခြင်း မရှိခဲ့ပါ။
နှိုင်းယှဉ်နိုင်သော မှတ်စုတစ်ခုကို ရှေ့တွင်ဖော်ပြထားသည်။ v3.0 သည် ၎င်း၏ သရုပ်ဖော်ထားသော accelerator များကို H100 မှ B200 သို့ ရွှေ့ခဲ့ပြီး၊ ၎င်းသည် per-accelerator bandwidth bar ကို မြင့်တက်စေသောကြောင့် v3.0 နံပါတ်များကို v2.0 ရလဒ်များနှင့် နှိုင်းယှဉ်၍မရပါ။ ၎င်းတို့သည် MLCommons မှ စစ်ဆေးထားသော ရောင်းချသူ တင်သွင်းချက်များဖြစ်သည်။ StorageReview သည် ဤစမ်းသပ်မှုကို ပြုလုပ်ခဲ့ခြင်း သို့မဟုတ် လွတ်လပ်စွာ အတည်ပြုခြင်း မရှိပါ။
စစ်ဆေးရေးဂိတ်သည် အဓိကဖြစ်ရပ်ဖြစ်သည်
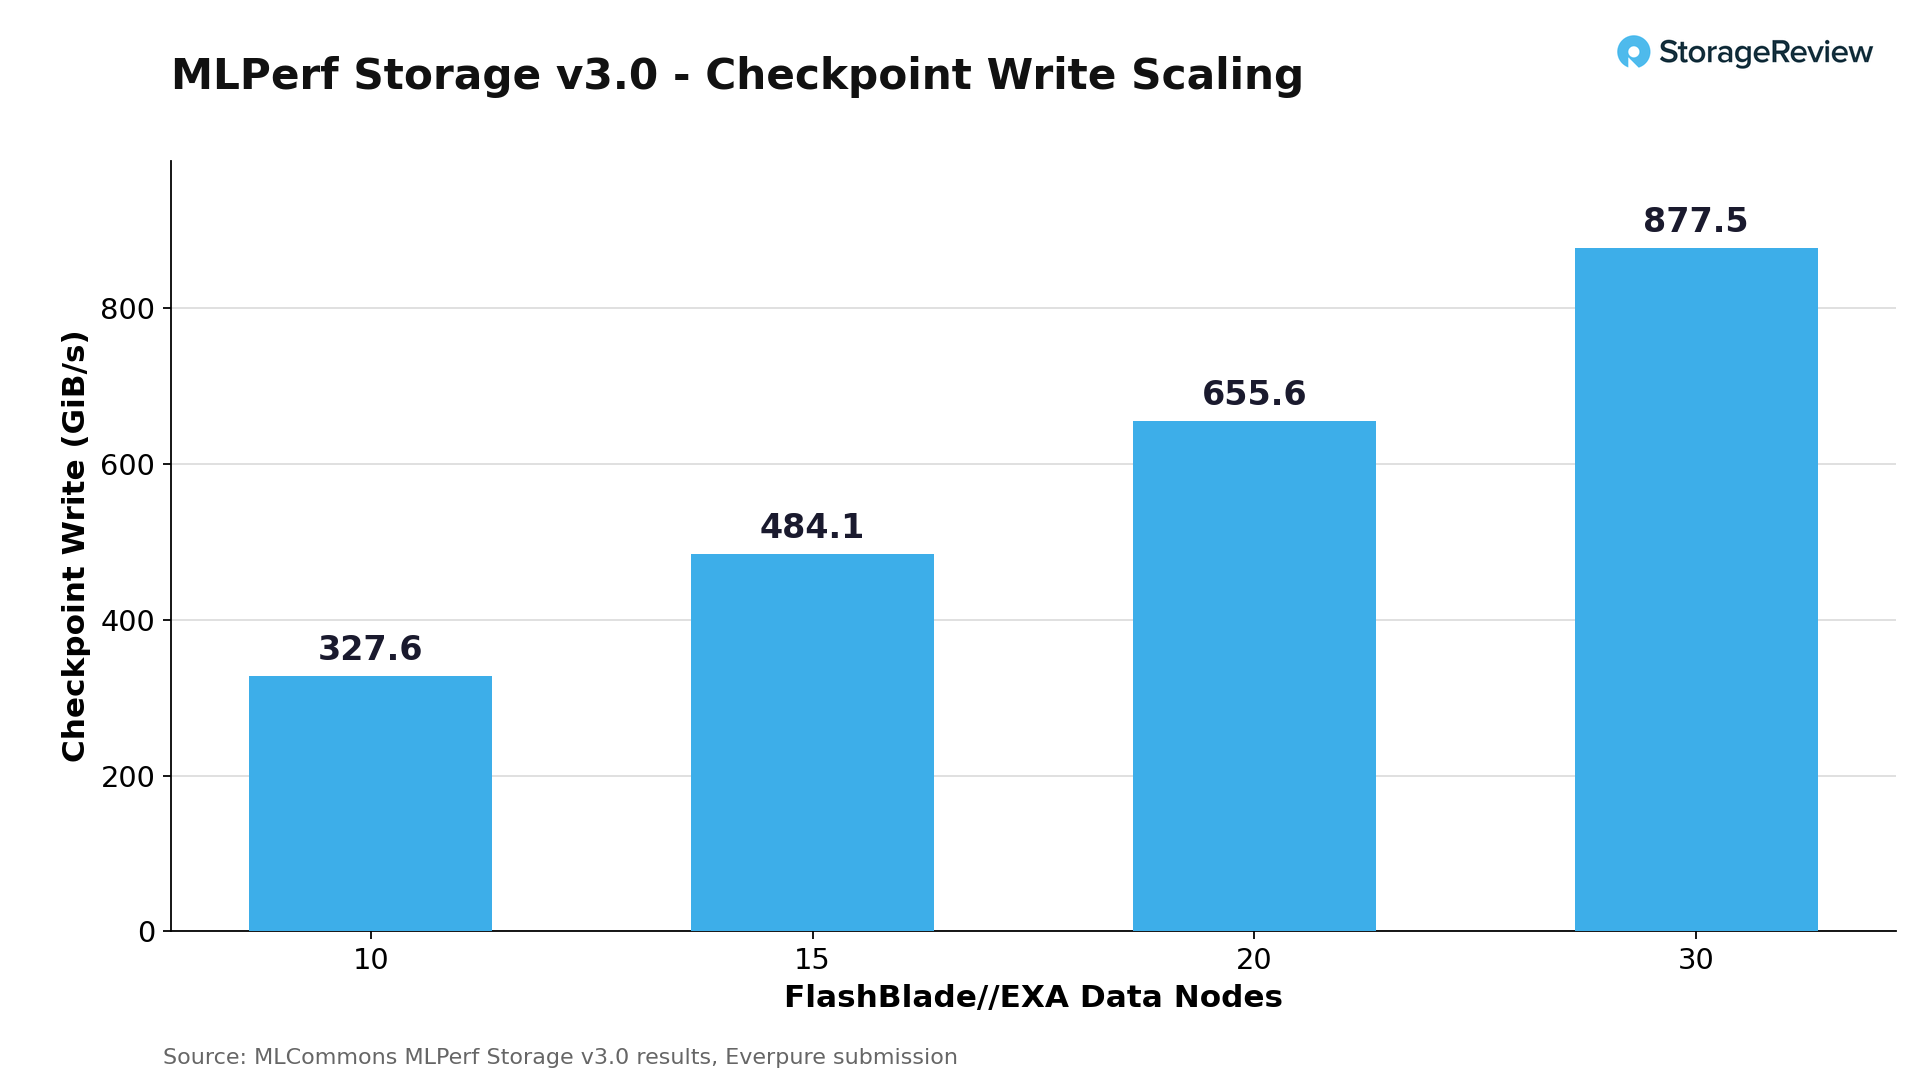
MLCommons သည် checkpointing ကို ပထမတန်းစား workload အဖြစ် ထည့်သွင်းခဲ့သည်၊ အဘယ်ကြောင့်ဆိုသော် ၎င်းသည် အတည်ပြုထားသော bottleneck ဖြစ်လာသောကြောင့်ဖြစ်သည်- frontier-scale training jobs များသည် ပုံမှန်ကြားကာလများတွင် state အမြောက်အမြားကို ရေးသားကြပြီး checkpoint တစ်ခုကို flush လုပ်ရန် အသုံးပြုသည့် စက္ကန့်တိုင်းသည် idle accelerator အချိန်၏ တစ်စက္ကန့်ဖြစ်သည်။ round တွင် အများဆုံးဂဏန်းသည် ဤနေရာတွင် ရှိသည်။ Everpure (ယခင် Pure Storage) သည် ၎င်း၏ ပထမဆုံး MLPerf Storage တွင် data node အရေအတွက်နှင့် linearly scale လုပ်ထားသော FlashBlade//EXA ရလဒ်များကို တင်သွင်းခဲ့သည်- data node ၁၀ ခုတွင် checkpoint write 327.6 GiB/s၊ 15 ခုတွင် 484.1 GiB/s၊ 20 ခုတွင် 655.6 GiB/s နှင့် data node ၃၀ ခုတွင် 833.0 GiB/s read ဖြင့် 877.5 GiB/s write ရရှိခဲ့သည်။ Everpure သည် ပြီးခဲ့သည့်နှစ်က //EXA အတွက် throughput claim ကြီးကြီးမားမားများ ပြုလုပ်ခဲ့သည်။ ၎င်းသည် audited result တစ်ခုသည် ထို claim များ၏ ဦးတည်ချက်ကို ထောက်ခံသည့် ပထမဆုံးအကြိမ်ဖြစ်သည်။
ဒုတိယအကြီးဆုံး checkpoint နံပါတ်သည် ပိုမိုကြီးမားသော စက်မှုလုပ်ငန်းဇာတ်လမ်းဖြစ်သည်ဟု ငြင်းခုံနိုင်ပါသည်။ benchmark သို့ တင်သွင်းခဲ့သော ပထမဆုံး hyperscale cloud storage ဝန်ဆောင်မှုဖြစ်သော Azure Managed Lustre သည် client ၁၂၈ ဦးဖြင့် 4,096 TiB ဖြန့်ကျက်မှုမှ checkpoint write 642.2 GiB/s ရရှိခဲ့ပါသည်။ ရည်ရွယ်ချက်ရှိရှိတည်ဆောက်ထားသော AI storage arrays များကဲ့သို့ တူညီသောစကားဝိုင်းတွင် နံပါတ်များကို ထည့်သွင်းထားသည့် managed cloud file service တစ်ခုသည် လွန်ခဲ့သော နှစ်ချီက စိတ်ကူးရန်ခက်ခဲခဲ့ပါသည်။
| စစ်ဆေးရေးဂိတ် (ထိပ်တန်းတင်သွင်းမှုများ) | စံနစ် | အဖြူအမည်း ရေးပါ (GiB/s) |
|---|---|---|
| Everpure | FlashBlade//EXA၊ ဒေတာနုတ် ၃၀ | 877.5 |
| Azure | စီမံခန့်ခွဲထားသော Lustre၊ 4,096TiB၊ client ၁၂၈ ဦး | 642.2 |
| ယန်ရွန်တက်ခ် | F9000X၊ client ၈ ခု | 313.7 |
| Suzhou Zishan Longlin | ပုံစံအမျိုးမျိုး | 313.7 |
| TuringData | F9200၊ client ၈ ယောက် | 307.1 |
| UBIX | UbiPower18000၊ သိုလှောင်မှု node ၃ ခု | 293.8 |
လေ့ကျင့်ရေး- သင်မသိနိုင်သော အမည်များ
3D U-Net လေ့ကျင့်ရေး ဦးဆောင်သူစာရင်းမှာ အသစ်ဝင်ရောက်လာသူများ၏ အစိတ်အပိုင်းဖြစ်သည်။ YanRongTech ၏ F9000X သည် read bandwidth 543.9 GiB/s ရရှိခဲ့ပြီး simulated B200 accelerators ၉၉ ခုကို feeding ပေးခဲ့ပြီး ယင်းသည် ယင်းအချီတွင် အမြင့်ဆုံး လေ့ကျင့်မှု throughput ဖြစ်သည်။ စင်ကာပူ AI အခြေခံအဆောက်အအုံကုမ္ပဏီ TuringData သည် ၎င်း၏ ပထမဆုံးတင်သွင်းမှုတွင် storage node သုံးခုမှ simulated B200s ၉၆ ခုကို feeding ပေးခဲ့ပြီး 541.5 GiB/s ဖြင့် ၄ GiB/s နောက်ကျကျန်ခဲ့ပြီး တူညီသော three-node F9200 cluster သည်လည်း Checkpoint-70B ကို 539.9 GiB/s read နှင့် 307.1 GiB/s write ဖြင့် တင်ပြခဲ့သည်။ UBIX ၏ UbiPower18000 သည် 16 x 15.36TB NVMe drives များနှင့် quad NDR400 networking ပါရှိသော storage node သုံးခုကို 454.1 GiB/s ဖြင့် တင်ပြခဲ့သည်။ HPE သည် လေ့ကျင့်မှုရလဒ်များကို တင်သွင်းသည့် တစ်ခုတည်းသော တည်ထောင်ပြီးသား enterprise array ရောင်းချသူဖြစ်ပြီး K3000 သည် 345.8 GiB/s ရှိသည်။
| 3D U-Net လေ့ကျင့်ရေး (ထိပ်တန်းတင်သွင်းမှုများ) | အဖြူအမည်းဖတ်ရန် (GiB/s) | တုပထားသော B200 အရှိန်မြှင့်စက်များ |
|---|---|---|
| YanRongTech F9000X | 543.9 | 99 |
| TuringData F9200 | 541.5 | 96 |
| UBIX UbiPower18000 | 454.1 | 80 |
| Suzhou Zishan Longlin | 433.4 | 80 |
| FarmGPU | 406.7 | 75 |
| Azure စီမံခန့်ခွဲထားသော Lustre | 379.1 | 70 |
ကောက်ချက်ချခြင်းသည် စံနှုန်းနှင့် ဆက်စပ်နေသည်
သိုလှောင်မှုဝယ်လိုအား အမှန်တကယ်တိုးပွားလာနေသည့် workload အသစ်နှစ်ခုက အသိအမှတ်ပြုသည်။ KV cache စမ်းသပ်မှုသည် သိုလှောင်မှုစနစ်တစ်ခုသည် long-context LLM serving အတွက် attention state ကို မည်မျှမြန်မြန် page လုပ်နိုင်သည်ကို တိုင်းတာပြီး ကျွန်ုပ်တို့၏ Dell နှင့် Solidigm KV cache offload အလုပ် တွင် နက်နက်နဲနဲ စစ်ဆေးခဲ့သော ပုံစံ ဖြစ်သည်။ Everpure သည် 51-host FlashBlade//EXA configuration တွင် KV cache read ၏ အများဆုံးနံပါတ် 1,623.4 GiB/s ကို ထပ်မံတင်ခဲ့ပြီး UBIX (443.7 GiB/s) နှင့် FarmGPU (443.6 GiB/s) တို့သည် standard-scale submissions များတွင် ဦးဆောင်နေသည်။ vector database ဘက်တွင် TTA ၏ Seahorse စနစ်သည် query throughput chart တွင် တစ်စက္ကန့်လျှင် query ၅၇,၆၂၀ ဖြင့် ထိပ်ဆုံးမှ ရပ်တည်ခဲ့သည်။
နောက်ထပ်ဖွဲ့စည်းပုံပြောင်းလဲမှုကတော့ protocol ပါ။ v3.0 မှာ S3 object storage support ကိုထည့်သွင်းထားပြီး submission ခြောက်ပုံတစ်ပုံခန့်က အသုံးပြုထားပါတယ်။ NVIDIA က OCI၊ AWS နဲ့ GCP မှာ bare-metal configuration တွေကို လွှမ်းခြုံထားတဲ့ AIStore submission ၂၀ နဲ့ အဲဒီ submission အများစုကို တာဝန်ယူထားပြီး checkpoint write 133.3 GiB/s အထိ အမြင့်ဆုံးရရှိထားပါတယ်။ absolute numbers တွေက parallel file systems တွေကို လိုက်ရှာနေပေမယ့် benchmark အတွင်းမှာ object storage running training နဲ့ checkpoint workloads တွေက POSIX file systems တွေ အရင်က သူတို့ဘာသာသူတို့ ထားခဲ့တဲ့ နယ်မြေကို အမှတ်အသားပြုထားပါတယ်။
MLCommons သည် ယခုအချီတွင် ပါဝါနှင့် rack-space ထိရောက်မှုကို ပထမတန်းစား တိုင်းတာမှုများအဖြစ် စတင်ခြေရာခံခဲ့သည်။
Everpure FlashBlade//EXA
Everpure FlashBlade//EXA စနစ်သည် 405B နှင့် 1.25T parameter model checkpointing အမျိုးအစားများအပြင် Key-Value (KV) cache retrieval benchmarks များတွင် ဦးဆောင်နေခဲ့ပြီး data-intensive artificial intelligence လေ့ကျင့်မှုနှင့် inference workloads များအတွင်း platform ၏ မြင့်မားသော throughput ကို ထိန်းသိမ်းနိုင်စွမ်းကို မီးမောင်းထိုးပြခဲ့သည်။
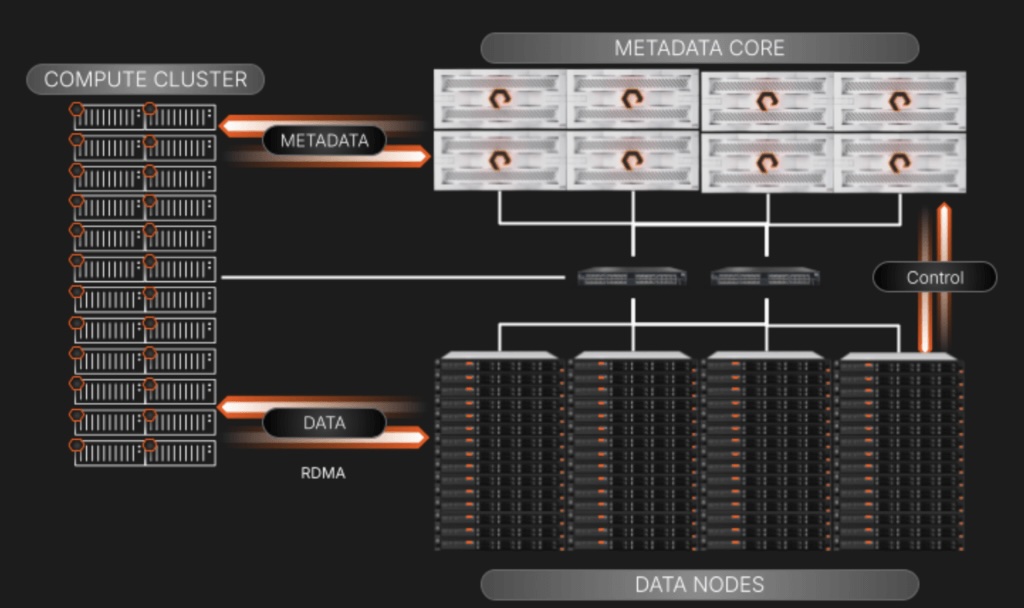
Everpure ၏ တင်ပြထားသော configuration သည် FlashBlade//EXA blades ၃၀ (metaddata ကိုင်တွယ်သည့် DirectFlash Modules ၁၂၀) နှင့် Linux/NVMe data node ၃၀ ကို single file system တွင် အသုံးပြုနိုင်သော capacity ၈၆၆ TB ခန့်အတွက် တွဲဖက်ထားပြီး၊ pNFS/TCP မှတစ်ဆင့် metadata နှင့် RDMA ပေါ်ရှိ NFSv3 မှတစ်ဆင့် bulk data များကို ပိုင်းခြားထားသည်။ client accelerators ၁,၀၂၄ ခုနှင့် 1.25T parameter checkpointing simulation တွင်၊ 30-node configuration သည် ၁၇.၇၄ စက္ကန့်အတွင်း write bandwidth ၈၇၇.၅၂ GiB/s နှင့် ၂၈.၉၉ စက္ကန့်အတွင်း read bandwidth ၅၈၈.၂၈ GiB/s တို့ကို ထိန်းသိမ်းထားနိုင်ခဲ့သည်။ KV cache inference test တွင် storage-only Llama 3.1 8B run တွင် tokens/sec ၈၅,၇၃၆၊ storage နှင့် system memory ပေါင်းစပ်ထားသော 8B run တွင် tokens/sec ၆၇,၆၄၂ နှင့် storage-only run တွင် tokens/sec ၃၃,၄၀၃ ရရှိကြောင်း အစီရင်ခံခဲ့သည်။
မလာရောက်ခြင်းဆိုသည်မှာ အဘယ်အရာကို ဆိုလိုသနည်း။
Benchmark round သည် အချက်နှစ်ချက်ကို သက်သေပြသည်- တင်သွင်းသူများ ဘာလုပ်နိုင်သည်နှင့် ပျက်ကွက်သူများ မပြသရန် ရွေးချယ်ခဲ့သည်တို့ဖြစ်သည်။ အကြီးမားဆုံး neocloud နှင့် AI factory deployments များကို အနိုင်ရရှိသော ရောင်းချသူများဖြစ်သည့် VAST Data၊ WEKA နှင့် DDN တို့သည် v3.0 မှ ထွက်ခဲ့ရပြီး v2.0 တင်သွင်းသူများဖြစ်သည့် Huawei၊ Hammerspace နှင့် Lightbits တို့လည်း ထွက်ခွာခဲ့ကြသည်။ ရောင်းချသူများသည် သာမန်အကြောင်းပြချက်များ၊ အင်ဂျင်နီယာစက်ဝန်းများ၊ ထုတ်ဝေချိန်နှင့် benchmark နိုင်ငံရေးများကြောင့် round များကို ကျော်သွားကြသည်။ ကျော်သွားခြင်းသည် စနစ်တစ်ခု နှေးကွေးနေကြောင်း သက်သေပြခြင်း မဟုတ်ပါ။ သို့သော် ၎င်းသည် စစ်ဆေးထားသော မှတ်တမ်းနှင့် ဖြန့်ကျက်မှုမှတ်တမ်းသည် ယခုအခါ ရောင်းချသူစာရင်း ကွဲပြားမှုကို ညွှန်ပြနေပြီး ဝယ်ယူသူများသည် နှစ်မျိုးလုံးကို ချိန်ဆရမည်ဟု ဆိုလိုသည်။ ကျွန်ုပ်တို့၏ အကောင်းဆုံးသိုလှောင်မှု Arrays စာမျက်နှာသည် ထို split ကို တိတိကျကျ ခြေရာခံပြီး စစ်ဆေးထားသော မှတ်တမ်းနှင့် ဖြန့်ကျက်မှု အထောက်အထားများကို အညွှန်းတပ်ထားပြီး v3.0 ရလဒ်အပြည့်အစုံဖြင့် အပ်ဒိတ်လုပ်ထားသည်။
v3.0 ရလဒ်များကို MLCommons သိုလှောင်မှု benchmark စာမျက်နှာတွင် ယနေ့ အများပြည်သူသိရှိနိုင်ပါသည် ။



 အမေဇုံ