

အချို့ဆာဗာများသည် ရှိပြီးသားအရာကို တိုးချဲ့ပြီး အချို့မှာမူ မျှော်လင့်ချက်များကို ပြန်လည်သတ်မှတ်သည်။ Dell PowerEdge R7725xd သည် ဒုတိယအမျိုးအစားတွင် ပါဝင်သည်။ ကျွန်ုပ်တို့၏ မကြာသေးမီက စမ်းသပ်မှုတွင် 24 Micron 9550 PRO PCIe Gen5 NVMe SSD များနှင့် 2x 200GbE NIC လေးခုဖြင့် configure လုပ်ထားသော ဤ 2U ဆာဗာသည် ကျွန်ုပ်တို့ ယခင်က တိုင်းတာခဲ့သော မည်သည့်စနစ်ထက်မဆို ပိုမိုမြင့်မားသော raw storage throughput ကို ရရှိခဲ့သည်။ အတွင်းပိုင်းတွင်၊ ပလက်ဖောင်းသည် NVMe pool တစ်လျှောက်တွင် 300 GB/s ကျော်ကို ထိန်းသိမ်းထားနိုင်သည်။ ကွန်ရက်ပေါ်တွင်၊ ၎င်းသည် စံ RDMA ကို အသုံးပြု၍ ရှုပ်ထွေးမှု ထပ်မံမပြုလုပ်ဘဲ 160 GB/s ကို ပေးပို့ခဲ့သည်။
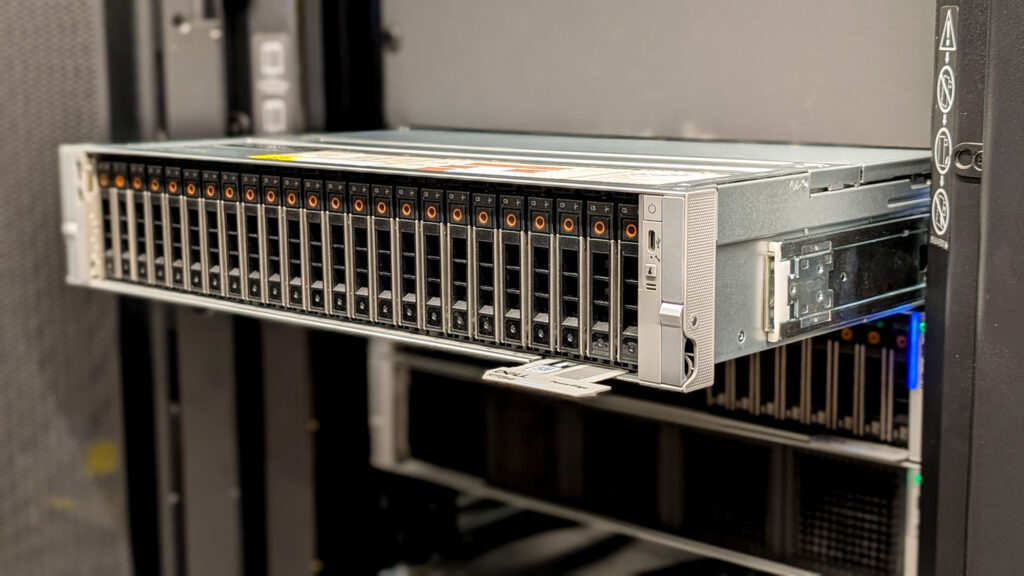
ဒါက ပိုမြန်တဲ့ storage server တစ်ခုတင် မဟုတ်ပါဘူး။ data-intensive computing ကို ဘယ်လိုတည်ဆောက်ထားလဲဆိုတာကို ပြောင်းလဲပေးတဲ့ စနစ်တစ်ခုပါ။ ခေတ်မီ AI လေ့ကျင့်ရေးနှင့် inference pipelines များသည် GPU horsepower ကြောင့်မဟုတ်ဘဲ data တွေကို ဘယ်လောက်မြန်မြန် staged လုပ်နိုင်မလဲ၊ stream လုပ်နိုင်မလဲ၊ shuffle လုပ်နိုင်မလဲနဲ့ checkpoint လုပ်နိုင်မလဲဆိုတဲ့အပေါ်မှာ ကန့်သတ်ခံရလေ့ရှိပါတယ်။ storage ကို မလိုက်နိုင်ရင် GPU node ကြီးတွေက အလုပ်မလုပ်ဘဲ ရပ်တန့်နေပါလိမ့်မယ်။ accelerator များသည် ၎င်းတို့၏ကုန်ကျစရိတ်များကို တရားမျှတစေရန်အတွက် data များကို မြန်မြန်ရရှိစေရန် cache များ၊ oversizing နှင့် complex tiering များကို အသုံးပြုခြင်းဖြင့် အဖွဲ့များသည် ဤကန့်သတ်ချက်များကို ဖြေရှင်းကြသည်။
Dell PowerEdge R7725xd သည် အရင်းအမြစ်တွင် ပိတ်ဆို့မှုကို ဖြေရှင်းပေးသည်။ ဆာဗာကို 24-bay U.2 backplane ဖြင့် တည်ဆောက်ထားပြီး drive တစ်ခုစီသည် AMD EPYC CPU complex သို့ တိုက်ရိုက် PCIe Gen5 x4 link ကို ရရှိသည်။ bandwidth fan-out မပါရှိဘဲ၊ concurrency ကို လျှော့ချရန် midplane expander ကို အသုံးမပြုပါ။ ယှဉ်ပြိုင်မှုမရှိဘဲ throughput ကို စုစည်းရန် hardware ကို တည်ဆောက်ထားသောကြောင့် စွမ်းဆောင်ရည်ကို သန့်ရှင်းစွာ ချိန်ညှိနိုင်သည်။ ရိုးရာ 2-socket configuration တွင် CPU များကို socket အချင်းချင်း ဆက်သွယ်ရန်အတွက် XGMI link 4 ခုဖြင့် ချိတ်ဆက်ထားသည်။ R7725xd မှာ ဒီလင့်ခ်တွေထဲက တစ်ခုကို CPU တစ်ခုချင်းစီအတွက် PCIe Gen5 လမ်းကြောင်း ၁၆ ခု ထပ်မံထည့်သွင်းထားတာကြောင့် server မှာ PCIe Gen5 လမ်းကြောင်း စုစုပေါင်း ၁၆၀ (ရှေ့ SSD အတွက် ၉၆ ခုနဲ့ နောက် PCIe slot လေးခုအတွက် ၆၄ ခု) ရရှိစေပါတယ်။ ရေရှည်ရေးသားမှု workloads နဲ့ မြင့်မားတဲ့ခံနိုင်ရည်အတွက် ဒီဇိုင်းထုတ်ထားတဲ့ Micron ရဲ့ 9550 PRO SSD တွေနဲ့ တွဲဖက်အသုံးပြုတဲ့အခါ system ဟာ checkpoint-intensive နဲ့ continuous streaming workloads တွေကို ပံ့ပိုးပေးနိုင်တဲ့ high-throughput data engine တစ်ခု ဖြစ်လာပါတယ်။
ကျွန်ုပ်တို့သည် parallel submission paths များကို အသုံးချရန်နှင့် တစ်ပြိုင်နက်တည်းလုပ်ဆောင်မှုများ တိုးလာသည်နှင့်အမျှ ထိရောက်မှုကို ထိန်းသိမ်းရန်အတွက် PEAK:AIO ကို ဤဗိသုကာ၏အပေါ်တွင် အလွှာလိုက် ထည့်သွင်းထားပါသည်။ ရလဒ်အနေဖြင့် အမြင့်ဆုံးစွမ်းဆောင်ရည်သာမက load အောက်တွင်လည်း စွမ်းဆောင်ရည်ကို ထိန်းသိမ်းထားနိုင်ခဲ့ပါသည်။ platform သည် preprocessing၊ training သို့မဟုတ် transformation အတွက် local execution node အဖြစ် လုပ်ဆောင်နိုင်သည်၊ သို့မဟုတ် network မှတစ်ဆင့် GPU systems များစွာတွင် high-bandwidth storage ကို ဝန်ဆောင်မှုပေးနိုင်ပါသည်။ စွန့်စားခန်းတစ်ခုကို သင်ခံစားနေပါက နှစ်ခုလုံးကို တစ်ပြိုင်နက်တည်း လုပ်ဆောင်နိုင်ပါသည်။
Key ကို Takeaways
- တစ်ခုတည်းသော Node တွင် မကြုံစဖူး throughput: R7725xd သည် internal bandwidth 300 GB/s ကျော်နှင့် NVMe-oF RDMA တွင် 160 GB/s ရရှိထားသောကြောင့် 2U chassis အတွင်းရှိ multi-node storage cluster များနှင့် ယှဉ်ပြိုင်နိုင်သည်။
- စစ်မှန်သော Gen5 ဗိသုကာ၊ Switch များ မပါဝင်ပါ၊ Fan-Out မလိုအပ်ပါ- 24 Micron 9550 PRO SSD အားလုံးသည် CPU complex မှ တိုက်ရိုက် dedicated x4 PCIe Gen5 lanes များကို ရရှိသောကြောင့် line-rate scaling ကို အငြင်းပွားမှုမရှိဘဲ ပြုလုပ်နိုင်စေပါသည်။
- AMD EPYC 9005 စီးရီးမှ စွမ်းအားပေးသည်- Dual AMD EPYC 9575F ပရိုဆက်ဆာများသည် စဉ်ဆက်မပြတ် မြင့်မားသော တစ်ပြိုင်နက်တည်း I/O အတွက် လိုအပ်သော lane count၊ memory bandwidth နှင့် NUMA topology တို့ကို ပံ့ပိုးပေးပါသည်။
- AI၊ Analytics နှင့် Checkpoint-Heavy Workloads များအတွက် ဒီဇိုင်းထုတ်ထားသည်- ဤစနစ်သည် ခေတ်မီ GPU ပိုက်လိုင်းများကို ရပ်တန့်စေသော I/O ပိတ်ဆို့မှုများကို ဖယ်ရှားပေးပြီး၊ bandwidth မြင့်မားသော data များကို စဉ်ဆက်မပြတ် ပေးပို့နိုင်စေပါသည်။
- PEAK:AIO သည် အပြည့်အဝ Parallelism ကို ဖွင့်လှစ်ပေးသည်- PEAK: AIO ရဲ့ software stack က queue structure တွေကို load အောက်မှာ ပြည့်နေအောင် ထိန်းထားပေးပြီး enterprise per GB အချိုးနဲ့ enterprise performance ကို ပေးစွမ်းပါတယ်။
NVMe စွမ်းဆောင်ရည်အတွက် ရည်ရွယ်ချက်ရှိရှိ တည်ဆောက်ထားသည်
နောက်ဆုံးပေါ် server များတွင် Dell သည် storage-dense server configuration များတွင် PCIe switch များကို အသုံးပြုခြင်းမှ ရွှေ့ပြောင်းခဲ့သည်။ PowerEdge R770 သို့မဟုတ် R7725 ကဲ့သို့သော မော်ဒယ်များသည် PCIe Gen5 x4 bays များကို ပေးဆောင်ပြီး SSD configuration ၁၆ ခုအထိ ပံ့ပိုးပေးပြီး storage backplane configuration များတွင် x2 bays သို့ ပြောင်းလဲနိုင်သည်။ PowerEdge R760 ကဲ့သို့သော ယခင်မျိုးဆက် server များတွင် 24-bay NVMe configuration များတွင် PCIe switch တစ်ခု ပါဝင်မည်ဖြစ်သည်။ build များကို ရိုးရှင်းစေရန်နှင့် PCIe switch မှ မိတ်ဆက်ပေးသော ရှုပ်ထွေးမှုကို ဖယ်ရှားရန်အတွက် server အသစ်များသည် storage-dense build များတွင် PCIe lanes အရေအတွက်ကို လျှော့ချရန် ဗျူဟာတစ်ခုကို လက်ခံကျင့်သုံးခဲ့ကြသည်။ ဆိုလိုသည်မှာ R7725xd အထိဖြစ်သည်။
စံ R7725 နှင့် R7725xd အကြား ကွာခြားချက်မှာ ပလက်ဖောင်းများက PCIe root-complex အရင်းအမြစ်များကို မည်သို့ခွဲဝေပေးသည်ဆိုသည့်အပေါ် မူတည်ပါသည်။ အခြေခံ R7725 သည် storage၊ GPU expansion နှင့် general-purpose I/O တို့တွင် PCIe လမ်းကြောင်းများကို ဖြန့်ဝေပေးသည်။ 'xd' ဗားရှင်းသည် ထိုဘတ်ဂျက်ကို ပြန်လည်ခွဲဝေပေးသောကြောင့် NVMe subsystem သည် PCIe bandwidth ၏ အဓိကသုံးစွဲသူဖြစ်လာသည်။ U.2 bay ၂၄ ခုကို CPU ၏ PCIe Gen5 roots ထဲသို့ တိုက်ရိုက်ချိတ်ဆက်ထားပြီး SSD တစ်ခုစီသည် ၎င်း၏ကိုယ်ပိုင် x4 endpoint ကို ရရှိပြီး PCIe switch သို့မဟုတ် re-timer tree မှတစ်ဆင့် ဖော်ထုတ်ထားသော shared uplink မဟုတ်ပါ။ ၎င်းသည် drive တိုင်းအား လွတ်လပ်သော queue structure များနှင့် လွတ်လပ်သော DMA path များကို memory controller သို့ ပြန်လည်ပေးသည်။
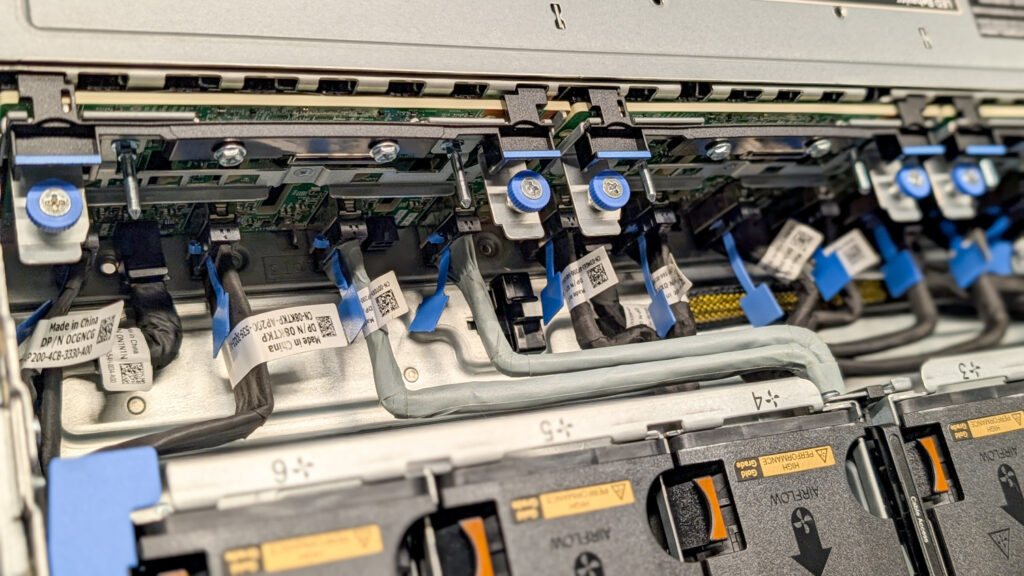
backplane နှင့် riser topology သည် ဤကတိကဝတ်ကို ထင်ဟပ်စေသည်။ Dell သည် NVMe connectors နှင့် PCIe slot များကို AMD EPYC sockets နှစ်ခုလုံးတွင် အုပ်စုဖွဲ့ထားသောကြောင့် processor တစ်ခုစီသည် drive set ၏ အစိတ်အပိုင်းတစ်ခုကို တိုက်ရိုက်ပိုင်ဆိုင်သည်။ လက်တွေ့တွင်၊ ၎င်းသည် local latency ဝိသေသလက္ခဏာများနှင့် full read/write concurrency ရှိသော symmetric NVMe domain နှစ်ခုကို ဖန်တီးပေးသည်။ Broadcom dual-port 200GbE NICs လေးခုကို add-in ကတ်များအဖြစ် ထည့်သွင်းသောအခါ၊ slot နေရာချထားမှုသည် NIC တစ်ခုစီကို သက်ဆိုင်ရာ NVMe အုပ်စုနှင့် ချိန်ညှိထားသော PCIe domain တွင် ဆင်းသက်နိုင်စေခဲ့သည်။ NVMe-over-RDMA အောက်တွင်၊ ၎င်းသည် network traffic သည် socket နှင့် ဆက်စပ်နေသော drive I/O ကို ကိုင်တွယ်သည့် socket တွင် local အဖြစ် ရှိနေစေပြီး၊ ပုံမှန်အားဖြင့် latency ကို ထည့်သွင်းပြီး load အောက်တွင် bandwidth ကို စားသုံးသည့် inter-socket Infinity Fabric hop ကို ရှောင်ရှားသည်။
အပူအပြုအမူသည် ရေရှည်တည်တံ့သော throughput ကိုလည်း ပံ့ပိုးပေးပါသည်။ U.2 သည် စက်ပစ္စည်းတစ်ခုစီအတွက် သတ်မှတ်ထားသော လေစီးဆင်းမှုလမ်းကြောင်းနှင့် ခန့်မှန်းနိုင်သော အပူစုပ်စက်မျက်နှာပြင်ဧရိယာကို ပံ့ပိုးပေးသောကြောင့် သိပ်သည်းသော Gen5 ဖွဲ့စည်းမှုတွင် အားသာချက်ရှိနေဆဲဖြစ်သည်။ R7725xd ၏ မြင့်မားသော static-pressure ပန်ကာမော်ဂျူးများနှင့် ကိုယ်ထည်ပြွန်များသည် bay ၂၄ ခုလုံးတွင် တသမတ်တည်း လေစီးဆင်းမှုကို ထိန်းသိမ်းပေးသောကြောင့် full-drive write workloads များကို throttling မရှိဘဲ စဉ်ဆက်မပြတ်လည်ပတ်နိုင်စေပါသည်။ စက်ပိုင်းဆိုင်ရာဒီဇိုင်းသည် လျှပ်စစ်ဒီဇိုင်းကို ဖြည့်စွက်ပေးသည်- platform ကို load လုပ်နေစဉ်တွင် တစ်ပြိုင်နက်တည်း Gen5 စက်ပစ္စည်း ၂၄ ခုကို အအေးပေးရန် တည်ဆောက်ထားသောကြောင့် drive တစ်ခုစီသည် full-rate စွမ်းဆောင်ရည်ကို ထိန်းသိမ်းနိုင်သည်။
root-complex alignment၊ တသမတ်တည်း non-uniform memory access (NUMA) lane layout၊ socket-aware NIC နေရာချထားမှုနှင့် အပူချိန်တည်ငြိမ်သော U.2 packaging တို့၏ ပေါင်းစပ်မှုကြောင့် စနစ်သည် line-rate I/O ကို အတိုင်းအတာတစ်ခုအထိ ရရှိနိုင်သည်။ ဗိသုကာလက်ရာသည် ပိတ်ဆို့မှုများကို ရှောင်ရှားပြီး စွမ်းဆောင်ရည်ကို အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ပေးသည်။
Dell PowerEdge R7725xd iDRAC 10 ခြုံငုံသုံးသပ်ချက်
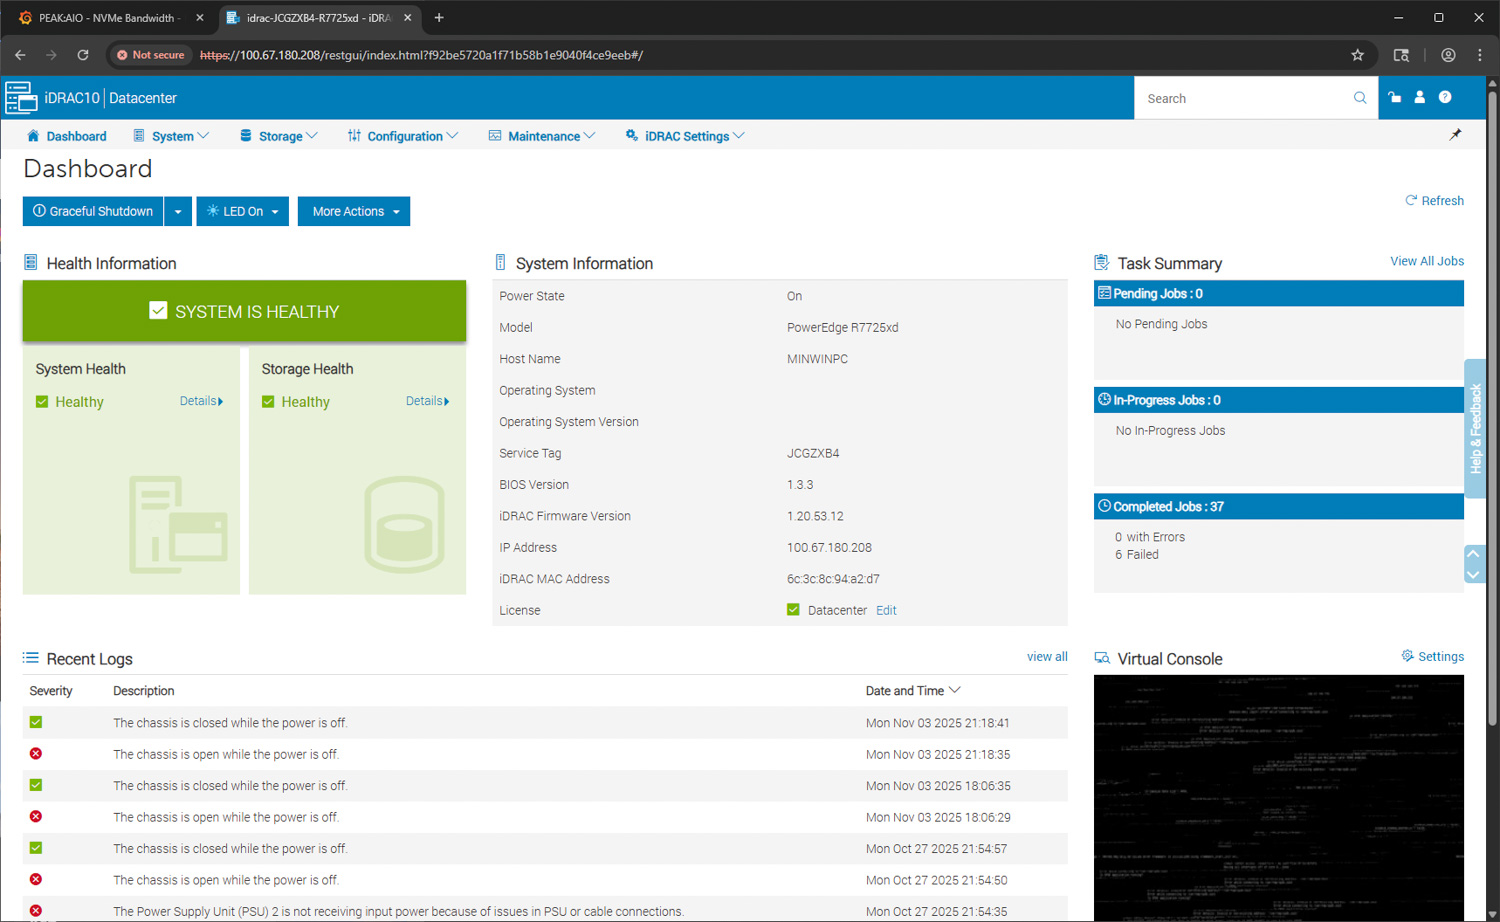
ကျွန်ုပ်တို့ အကဲဖြတ်ခဲ့သော အခြား 17th Gen platform အများစုကဲ့သို့ပင် R7725xd ၏ ယခုမျိုးဆက်တွင် Dell ၏ iDRAC 10 platform အသစ် ပါဝင်ပြီး ၎င်းသည် အဝေးထိန်းစီမံခန့်ခွဲမှု၊ ကျန်းမာရေးစောင့်ကြည့်ခြင်းနှင့် out-of-band ထိန်းချုပ်မှုတို့အတွက် အဓိကအချက်အဖြစ် ဆောင်ရွက်ပါသည်။ dashboard မြင်ကွင်းသည် စနစ်ကျန်းမာရေး၊ သိုလှောင်မှုအခြေအနေနှင့် မကြာသေးမီက လုပ်ဆောင်ချက်များ၏ အကျဉ်းချုပ်ကို ချက်ချင်းဖော်ပြသည်။ ကျွန်ုပ်တို့၏ စမ်းသပ်ယူနစ်အတွက် စနစ်နှင့် သိုလှောင်မှုကျန်းမာရေးအစီရင်ခံစာသည် အစိမ်းရောင်ဖြစ်ပြီး server သည် ပုံမှန်လည်ပတ်နေကြောင်း အတည်ပြုသည်။ မော်ဒယ်၊ hostname၊ BIOS version၊ iDRAC firmware level၊ IP address နှင့် လိုင်စင်အချက်အလက်များကဲ့သို့သော အဓိကစနစ်အသေးစိတ်အချက်အလက်များကို interface ၏ ညာဘက်ခြမ်းတွင် ပြသထားသည်။
ဒက်ရှ်ဘုတ်တွင် ပြီးစီးသွားသော၊ ဆိုင်းငံ့ထားသော နှင့် လုပ်ဆောင်ဆဲ လုပ်ငန်းဆောင်တာများကို ပြသသည့် task summary panel တစ်ခုလည်း ပါဝင်သည်။ ၎င်းအောက်တွင် မကြာသေးမီက မှတ်တမ်းများစာရင်းသည် chassis intrusion events များနှင့် power supply message များကို ဖမ်းယူထားပြီး၊ ပိုမိုနက်ရှိုင်းသော မီနူးများသို့ လမ်းညွှန်ရန် မလိုအပ်ဘဲ hardware state ပြောင်းလဲမှုများကို လျင်မြန်စွာ ထိုးထွင်းသိမြင်စေပါသည်။ virtual console panel ကို remote KVM control အပြည့်အစုံအတွက် အောက်ညာဘက်ထောင့်တွင် ရရှိနိုင်ပါသည်။
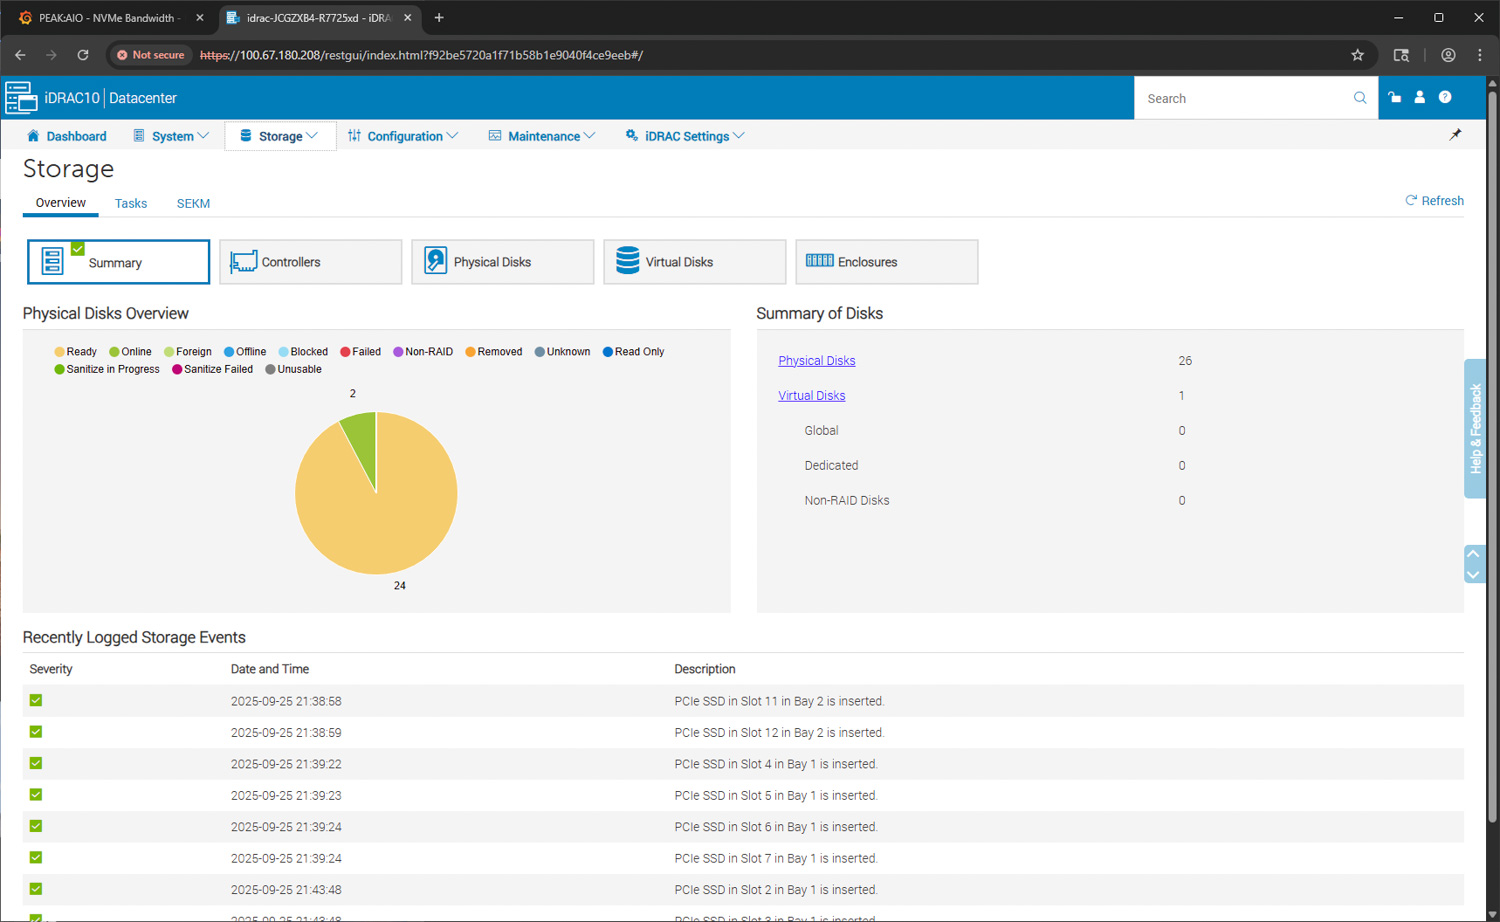
iDRAC 10 ရဲ့ storage section မှာ R7725xd မှာ install လုပ်ထားတဲ့ physical disk အားလုံးရဲ့ အပြည့်အစုံ overview ကို ပြသထားပါတယ်။ summary panel မှာ ချိတ်ဆက်ထားတဲ့ drive အားလုံးရဲ့ high-level count ကို ပြသထားပြီး drive ရဲ့ state တွေကို ပြသထားတဲ့ visual pie chart လည်း ပါဝင်ပါတယ်။ ဒီ configuration မှာ NVMe SSD ၂၄ ခုက active ဖြစ်ပြီး ready အဖြစ် report လုပ်ထားပါတယ်။ primary front NVMe bank ကနေ သီးခြားစီ system မှာ boot device နှစ်ခု ထပ်ထည့်ထားပါသေးတယ်။
ညာဘက်တွင်၊ Summary of Disks panel သည် ၎င်းတို့ကို physical disk များနှင့် ဆက်စပ်နေသော virtual disk များအဖြစ် ပိုင်းခြားထားသည်။ R7725xd သည် ရိုးရာ RAID controller များမပါဘဲ တိုက်ရိုက် NVMe architecture ကို အသုံးပြုထားသောကြောင့် drive အားလုံးကို Non-RAID အဖြစ် ဖော်ပြထားပြီး တစ်ဦးချင်းစီ addressable ဖြစ်ပြီး NVMe pool ကြီးများနှင့် SDS platform များအတွက် system ၏ ဒီဇိုင်းနှင့် ကိုက်ညီပါသည်။
အခြေအနေအကျဉ်းချုပ်အောက်တွင်၊ မကြာသေးမီက မှတ်တမ်းတင်ထားသော သိုလှောင်မှုဖြစ်ရပ်များဧရိယာသည် bay နှင့် slot အလိုက်စီစဉ်ထားသော PCIe SSD တစ်ခုစီအတွက် ထည့်သွင်းမှုမှတ်တမ်းများကို စာရင်းပြုစုထားသည်။ ဤမှတ်တမ်းသည် drive bay အားလုံးတွင် သင့်လျော်သော ထောက်လှမ်းမှုကို အတည်ပြုပြီး ထိုင်ခုံ၊ ကြိုး သို့မဟုတ် hot-swap လုပ်ဆောင်ချက်နှင့်ပတ်သက်သည့် ပြဿနာများကို ဖော်ထုတ်ရန် ကူညီပေးသည်။ ကြီးမားသော ဖြန့်ကျက်မှုများအတွက်၊ ဤမှတ်တမ်းများသည် drive provisioning ကို ခြေရာခံသည့်အခါ သို့မဟုတ် စွမ်းရည်ကို မျှော်လင့်ထားသည့်အတိုင်း ဖြည့်သွင်းထားကြောင်း အတည်ပြုသည့်အခါ အသုံးဝင်ပါသည်။
နောက်ဆုံး ဖန်သားပြင်ဓာတ်ပုံတွင် iDRAC10 အတွင်းရှိ အသေးစိတ် NVMe device မြင်ကွင်းကို ပြသထားသည်။ စနစ်တွင် ထည့်သွင်းထားသော NVMe drive တစ်ခုစီကို ၎င်း၏ အခြေအနေ၊ စွမ်းရည်နှင့် bay တည်နေရာတို့ဖြင့် စာရင်းပြုစုထားသည်။ သီးခြား drive တစ်ခုကို ရွေးချယ်ခြင်းဖြင့် ၎င်း၏ ဝိသေသလက္ခဏာများကို အပြည့်အစုံ ခွဲခြမ်းစိတ်ဖြာနိုင်သည်။
ဤဥပမာတွင်၊ drive အချက်အလက် panel သည် မော်ဒယ်စာကြောင်းအပြည့်အစုံ၊ device protocol၊ form factor နှင့် ညှိနှိုင်းထားသော PCIe setting များကို ပြသထားသည်။ NVMe device များသည် ညှိနှိုင်းထားသော x4 connection ဖြင့် 32 GT/s link speed ဖြင့် လည်ပတ်နေပြီး၊ drive များသည် system's PCIe Gen5 backplane တွင် bandwidth အပြည့်ဖြင့် လည်ပတ်နေကြောင်း အတည်ပြုပေးသည်။ အချက်အလက်ကဏ္ဍသည် endurance percentage၊ available spare status နှင့် protocol type တို့ကိုလည်း အစီရင်ခံပြီး administrator များအား drive ကျန်းမာရေးနှင့် lifecycle expectations များကို စောင့်ကြည့်ရန် ကူညီပေးသည်။
ဤအသေးစိတ် drive အစီရင်ခံခြင်းသည် link width၊ negotiated speed နှင့် media health တို့သည် workload behavior နှင့် storage performance ကို တိုက်ရိုက်လွှမ်းမိုးသည့် high-density NVMe configuration များတွင် အဖိုးတန်ပါသည်။
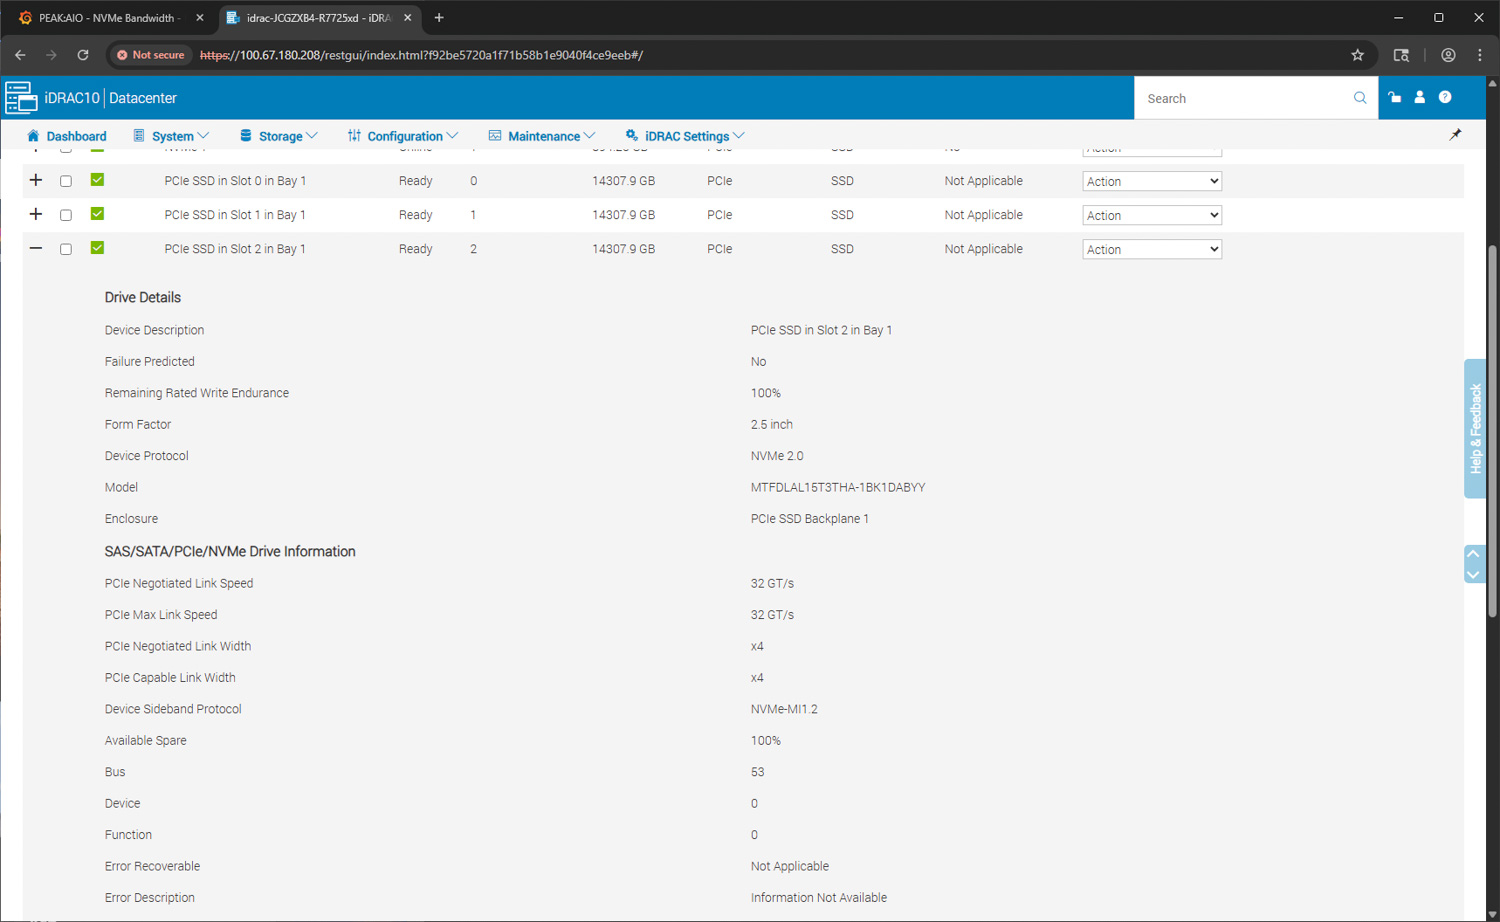
အလုံးစုံသော် iDRAC 10 interface သည် R7725xd ၏ NVMe storage architecture ကို ရှင်းလင်းပြတ်သားစွာ hardware-centric မြင်ကွင်းဖြင့် မြင်တွေ့နိုင်စေပြီး link health၊ drive status နှင့် system integrity တို့ကို တစ်ချက်ကြည့်လိုက်ရုံဖြင့် အလွယ်တကူ အတည်ပြုနိုင်စေပါသည်။
Dell PowerEdge R7725xd စွမ်းဆောင်ရည်
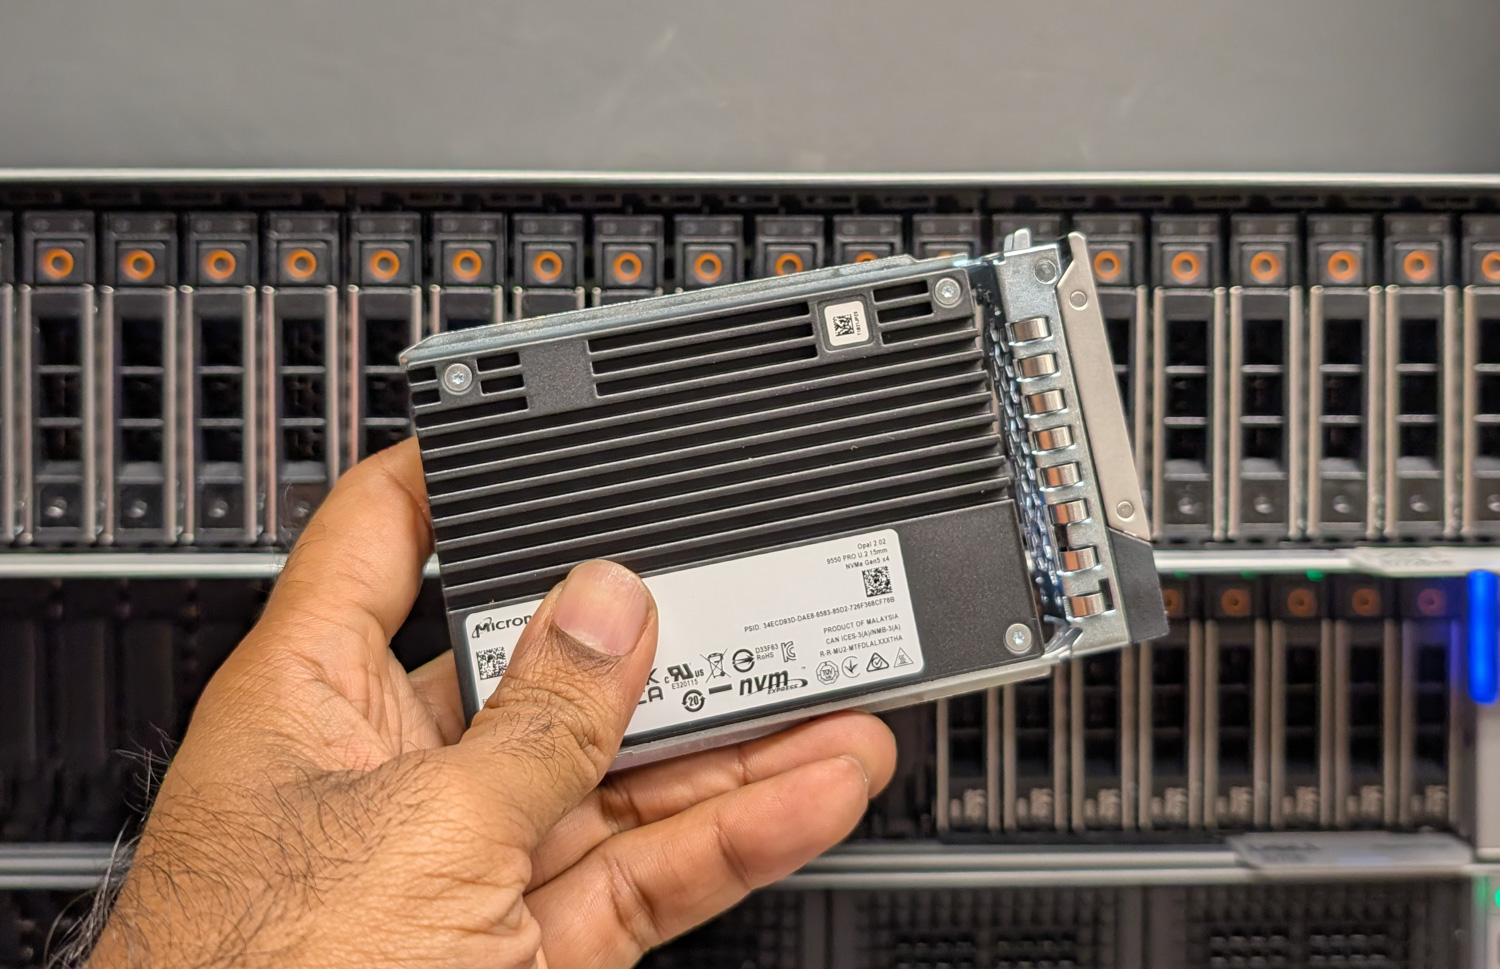
စမ်းသပ်ခြင်းမပြုမီ၊ ကျွန်ုပ်တို့၏စနစ်ကို ဟန်ချက်ညီသော်လည်း မြင့်မားသောစွမ်းဆောင်ရည်ဖြင့် ပြင်ဆင်ထားပါသည်။ စနစ်တွင် AMD EPYC 9575F ပရိုဆက်ဆာနှစ်ခု တပ်ဆင်ထားပြီး တစ်ခုစီတွင် 64 high-frequency core များပါဝင်ပြီး 6400 MT/s ဖြင့် လည်ပတ်နေသော 32GB DDR5 DIMM ၂၄ ခုနှင့် တွဲဖက်ထားသည်။ သိုလှောင်မှုအတွက်၊ ကိုယ်ထည်တွင် 15.36TB Micron 9550 PRO U.2 NVMe SSD ၂၄ ခုဖြင့် အပြည့်အဝဖြည့်ထားပြီး တစ်ခုစီကို dedicated PCIe Gen5 x4 link မှတစ်ဆင့် ချိတ်ဆက်ထားသည်။ ၎င်းသည် စုစုပေါင်း raw capacity 368.64 TB ကို ပေးစွမ်းနိုင်ပြီး Micron 9550 PRO drive များသည် 14,000 MB/s အထိ sequential read speeds နှင့် 10,000 MB/s အထိ sequential write speeds များကို ပေးစွမ်းနိုင်သည်။ ကွန်ရက်ချိတ်ဆက်မှုကို Broadcom BCM57608 adapter လေးခုဖြင့် ကိုင်တွယ်ပြီး 200Gb port ရှစ်ခုပေါင်းစပ်ပေးစွမ်းသည့်အပြင် 10-gigabit port နှစ်ခုထပ်ဆောင်းပေးစွမ်းနိုင်သော BCM57412 OCP NIC တစ်ခုဖြင့် ကိုင်တွယ်သည်။
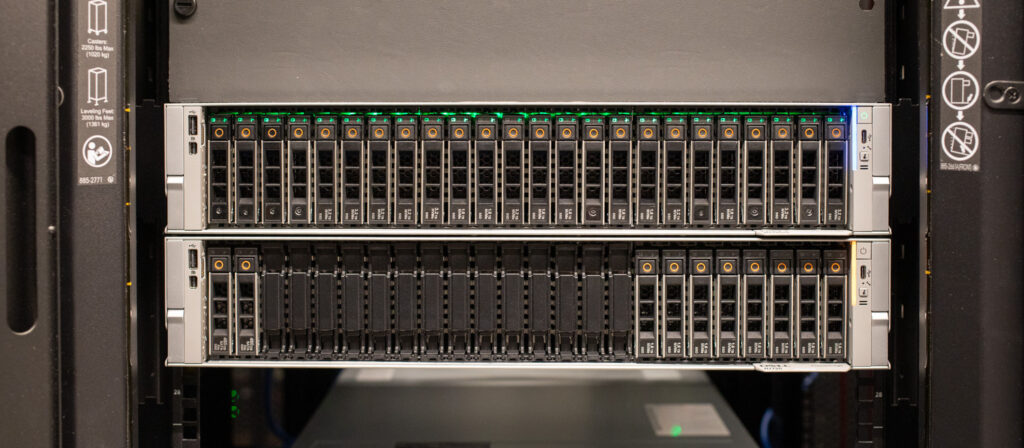
စမ်းသပ်စနစ် သတ်မှတ်ချက်များ
- CPU ကို: AMD EPYC 9575F 64-Core မြင့်မားသော ကြိမ်နှုန်းပရိုဆက်ဆာ ၂ ခု
- မှတ်ဉာဏ်: 24x 32GB DDR5 @ 6400MT/s
- သိုလှောင်မှု: 24x 15.36TB Micron 9550 PRO U.2 drives (PCIe Gen5 ၏ 4x lane တစ်ခုစီတွင် ချိတ်ဆက်ထားသည်)၊ ယနေ့ခေတ်တွင် 128TB drives အထိ ပံ့ပိုးပေးပြီး ပိုမိုမြင့်မားသော စွမ်းရည်များ ရှိလာမည်ဖြစ်သည်
- Network မှ: Broadcom BCM57608 2x200G NIC ၄ ခု၊ BCM57412 2x10Gb OCP NIC ၁ ခု
- switch: Dell PowerSwitch Z9664
FIO စွမ်းဆောင်ရည် စံနှုန်း
PowerEdge R7725xd ရဲ့ သိုလှောင်မှုစွမ်းဆောင်ရည်ကို တိုင်းတာဖို့အတွက်၊ ကျွန်တော်တို့ဟာ စက်မှုလုပ်ငန်းစံနှုန်း မက်ထရစ်တွေနဲ့ FIO ကိရိယာကို အသုံးပြုခဲ့ပါတယ်။ ဒီအပိုင်းမှာ၊ အောက်ပါ FIO စံနှုန်းတွေကို အာရုံစိုက်ပါတယ်။
- ကျပန်း 4K – 1M
- အဆက်မပြတ် 4K – 1M
FIO – ဒေသတွင်း – လှိုင်းအလျား
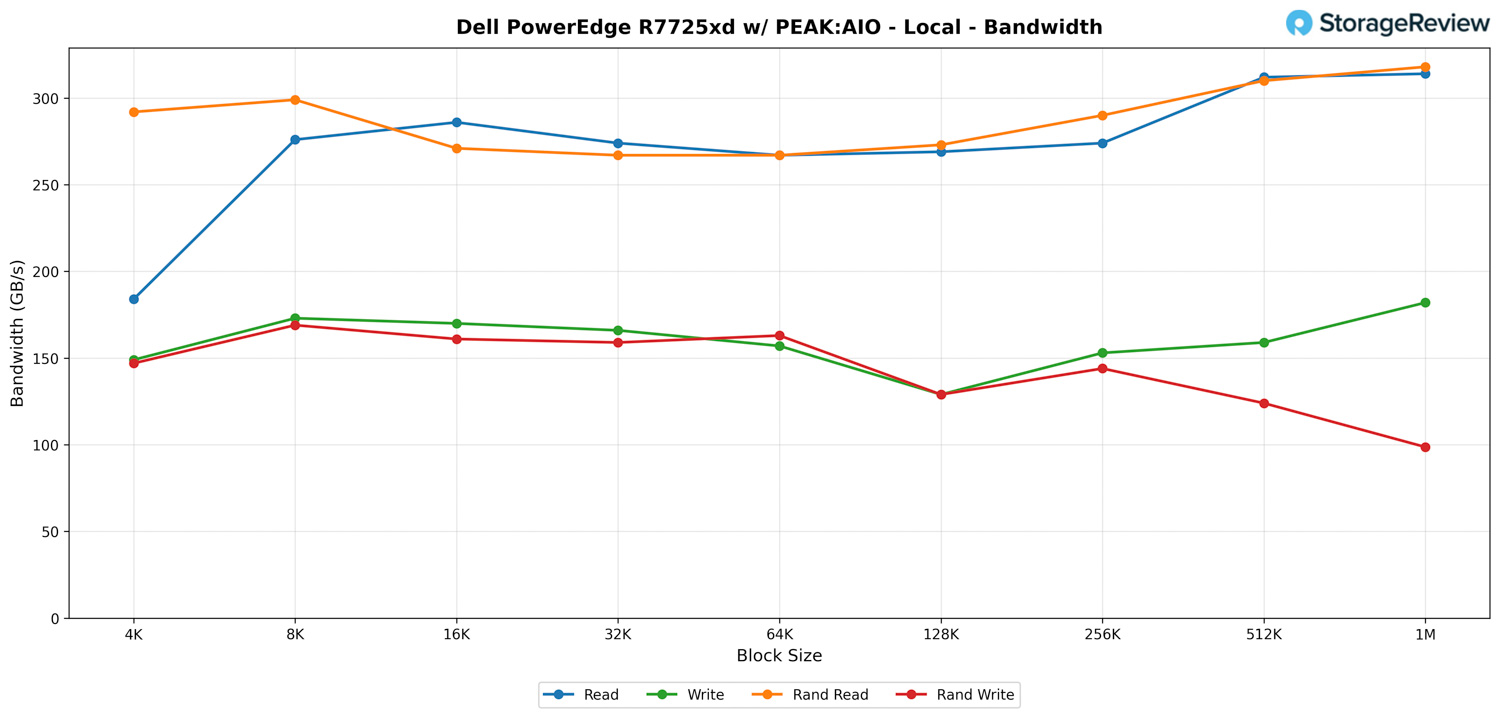
Dell PowerEdge R7725xd အတွင်းရှိ PCIe Gen5 NVMe drive ၂၄ ခု၏ local access ကို စမ်းသပ်သည့်အခါ system သည် full x4 lane PCIe Gen5 link ကို အသုံးပြု၍ CPU များနှင့် drive တိုင်းကို ချိတ်ဆက်ထားသည့် platform တစ်ခုမှ သင်မျှော်လင့်ထားသည့်အတိုင်း အတိအကျပြသသည်။ network layer မပါဝင်ဘဲ၊ ဤသည်မှာ Dell ၏ Gen5 storage layout ၏ pure, internal throughput နှင့် AMD EPYC platform ၏ PCIe bandwidth သည် ကန့်သတ်ချက်မရှိဘဲ အလုပ်လုပ်သည်။
4K blocks များဖြင့် အစဉ်လိုက်ဖတ်ရှုမှုများသည် 184 GB/s မှစတင်ပြီး block အရွယ်အစားတိုးလာသည်နှင့်အမျှ မြန်ဆန်စွာ တိုးချဲ့ပါသည်။ 512K မှ 1M အထိ၊ server သည် 312 မှ 314 GB/s အထိ တသမတ်တည်းထိန်းသိမ်းထားပြီး ၎င်းသည် controller-stage bottlenecks မရှိဘဲ စနစ်သည် 24 × 4 Gen5 လမ်းကြောင်းအားလုံးကို ရေရှည်ဖတ်ရှုမှု bandwidth အဖြစ် မည်မျှကောင်းမွန်စွာ စုစည်းနိုင်သည်ကို ခိုင်မာသောညွှန်ပြချက်တစ်ခုဖြစ်သည်။
အစဉ်လိုက်ရေးသားမှုများသည် မတူညီသောမျဉ်းကွေးတစ်ခုကို လိုက်နာသော်လည်း မျှော်မှန်းထားသည့်အတိုင်းအတာအတွင်းတွင် ခိုင်မာစွာရှိနေသည်။ 149 GB/s မှစတင်၍ ရလဒ်များသည် 100 ၏အလယ်အလတ်ကာလများတစ်လျှောက် မြင့်တက်လာပြီး 1 သန်းတွင် 182 GB/s အထိ ရောက်ရှိခဲ့သည်။ ၎င်းသည် Micron 9550 PRO SSD များ၏ ရေးသားမှုအပြုအမူနှင့် များစွာသော သီးခြားစက်ပစ္စည်းများတွင် မြင့်မားသော parallel NVMe ရေးသားမှုများ၏ overhead နှင့် ကိုက်ညီပါသည်။
ကျပန်းဖတ်ရှုမှုစွမ်းဆောင်ရည်သည် နောက်ထပ်ထူးခြားချက်တစ်ခုဖြစ်သည်။ စနစ်သည် အသေးငယ်ဆုံး block အရွယ်အစားများတွင် 300 GB/s နီးပါးအမြန်နှုန်းကို ရရှိပြီး အလယ်အလတ်အဆင့်တွင် အနည်းငယ်ကျဆင်းသွားပြီးနောက် block အရွယ်အစားကြီးများတွင် အပေါ်ပိုင်း 200s နှင့် အနိမ့်ဆုံး 300s သို့ ပြန်လည်ရောက်ရှိသည်။ 1M တွင် ကျပန်းဖတ်ရှုမှုများသည် အများဆုံး 318 GB/s အထိရောက်ရှိပြီး drive ၂၄ ခုလုံးတွင် ရောနှောထားသောလုပ်ဆောင်ချက်များကို ညီတူညီမျှဖြန့်ဝေနိုင်သည့် ပလက်ဖောင်း၏စွမ်းရည်ကို ပြသနေသည်။
ကျပန်းရေးသားမှုများသည် နိမ့်သောနှုန်းဖြင့် ထွက်ပေါ်လာပြီး ၎င်းသည် ကျယ်ပြန့်သော NVMe အစုံတစ်လျှောက် ပျံ့နှံ့နေသော metadata နှင့် write-allocation task များအတွက် ပုံမှန်ဖြစ်သည်။ ရလဒ်များသည် စမ်းသပ်မှုအများစုအတွက် 140 မှ 160 GB/s အတိုင်းအတာအတွင်း ရှိနေကာ 1 M တွင် 100 GB/s အောက်တွင်သာ လျော့နည်းသွားသည်။
FIO – ဒေသတွင်း – IOPS
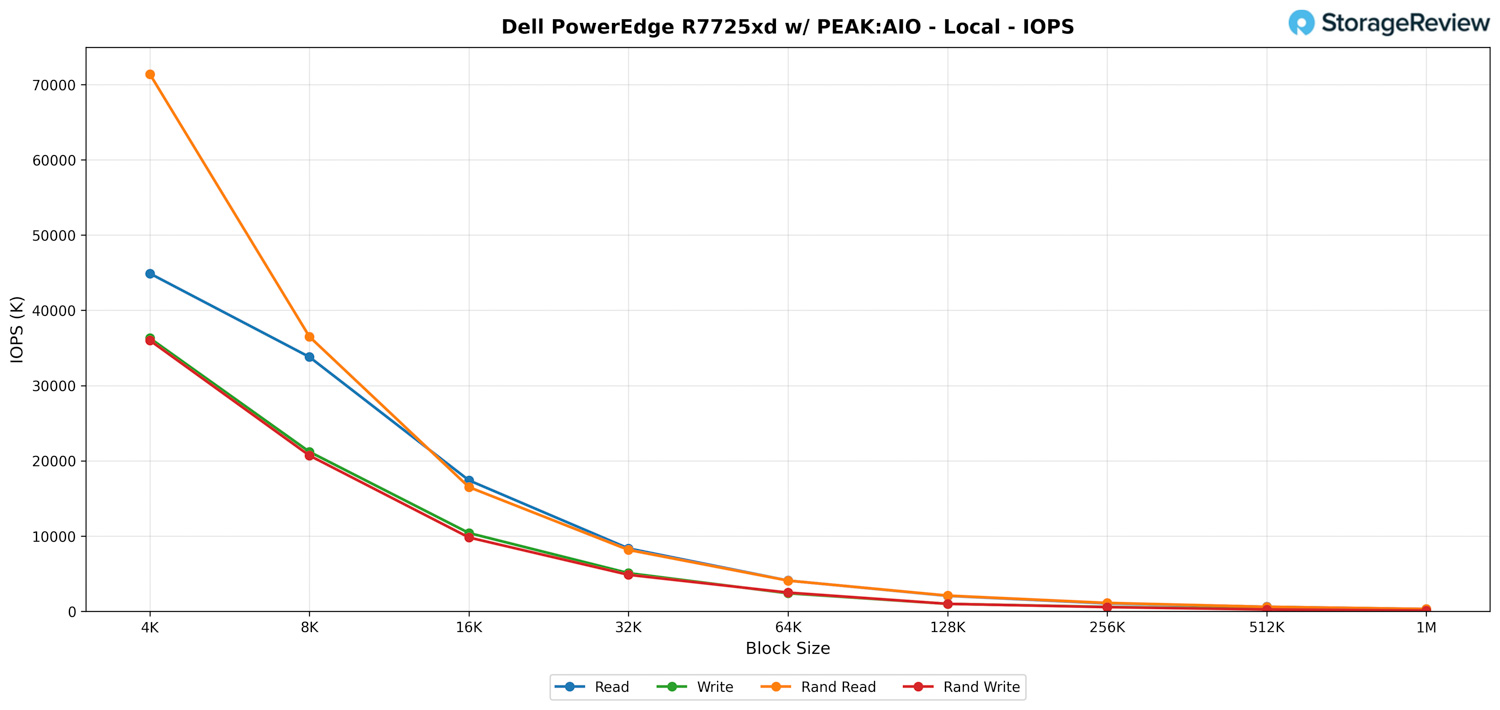
IOPS ဘက်ခြမ်းကို စစ်ဆေးသောအခါ၊ R7725xd သည် ခိုင်မာသော small-block စွမ်းဆောင်ရည်ကို ပြသထားပြီး၊ block အရွယ်အစားကြီးများသည် bandwidth-driven profile ဆီသို့ workload မပြောင်းလဲမီ request rate များသည် သန်းပေါင်းများစွာအထိ ရောက်ရှိပါသည်။
4K မှာ reads ၄၄.၉ သန်း IOPS ရှိပြီး writes ၃၆.၃ သန်း ရှိပါတယ်။ random reads တွေက IOPS ၇၁.၄ သန်းအထိ မြင့်မားတဲ့အဆင့်ကို ရောက်ရှိပြီး drives အားလုံးမှာ high-queue workloads တွေကို ထိထိရောက်ရောက် ဖြန့်ဝေပေးနိုင်တဲ့ စနစ်ရဲ့စွမ်းရည်ကို ပြသနေပါတယ်။ ဒီတန်ဖိုးတွေဟာ block size တွေ တိုးလာတာနဲ့အမျှ သဘာဝအတိုင်း လျော့ကျသွားပေမယ့် 8K၊ 16K နဲ့ 32K အပိုင်းအခြားတွေမှာ တိုးတက်မှုက တသမတ်တည်း ရှိနေပါသေးတယ်။
16K နှင့် 32K blocks များအရ reads များသည် 17.4 million နှင့် 8.35 million IOPS တွင် တည်ရှိပြီး random reads များသည် 16.5 million နှင့် 8.15 million တွင် အနီးကပ်တူညီနေပါသည်။ writes များသည် မျှော်မှန်းထားသောပုံစံကို လိုက်နာပြီး နိမ့်ကျစွာ ခြေရာခံသော်လည်း sequential နှင့် random access patterns နှစ်မျိုးလုံးတွင် တည်ငြိမ်နေပါသည်။
ကျွန်ုပ်တို့သည် 64K နှင့်အထက်သို့ ရွေ့လျားလာသည်နှင့်အမျှ စမ်းသပ်မှုသည် သန့်စင်သော IOPS မှ ပိုမိုသော bandwidth-bound scenario သို့ ကူးပြောင်းသွားသည်။ IOPS များသည် သန်းအနည်းငယ်အတွင်းသို့ ကျဆင်းသွားပြီး နောက်ဆုံးတွင် သိန်းနှင့်ချီသော အရေအတွက်သို့ ရောက်ရှိသွားသည်။ 1M block size တွင် read IOPS သည် 300K ဝန်းကျင်တွင် ရောက်ရှိပြီး 174K ခန့်တွင် write လုပ်ကာ random operations များသည် တူညီသော neighborhood တွင် ပြီးဆုံးသည်။
အလုံးစုံသော်၊ ဒေသတွင်း IOPS ရလဒ်များက စနစ်သည် သေးငယ်သော block များတွင် အလွန်မြင့်မားသော queue-depth workloads များကို ထိန်းသိမ်းနိုင်စွမ်းကို ရှင်းရှင်းလင်းလင်းပြသနေပြီး၊ transfers များ ကြီးထွားလာပြီး bandwidth သည် အဓိကအချက်ဖြစ်လာသည်နှင့်အမျှ ခန့်မှန်းနိုင်သော scaling ဖြင့် ပြသနေပါသည်။
PEAK:AIO: Dell PowerEdge R7725xd က ဘာကြောင့် ဒီ Workload နဲ့ ကိုက်ညီတာလဲ
PEAK: AIO ကို AI လေ့ကျင့်မှု၊ inference pipelines၊ financial modeling နှင့် real-time analytics များအတွက် dataset ကြီးများကို အလွန်မြန်ဆန်စွာ၊ low-latency access လိုအပ်သောပတ်ဝန်းကျင်များအတွက် ဒီဇိုင်းထုတ်ထားသည်။ ဤ platform သည် dense NVMe storage၊ balanced PCIe bandwidth နှင့် ခန့်မှန်းနိုင်သော latency တို့တွင် ဖွံ့ဖြိုးတိုးတက်သည်။ ဤလိုအပ်ချက်များကို ဖြည့်ဆည်းရန်အတွက်၊ underlying hardware သည် တစ်ပြိုင်နက်တည်း heavy load များအောက်တွင် တသမတ်တည်းနှင့် ထပ်ခါတလဲလဲလုပ်ဆောင်နိုင်သော စွမ်းဆောင်ရည်ကို ထိန်းသိမ်းထားစဉ်တွင် ရေရှည်တည်တံ့သော throughput ကို ပေးဆောင်ရမည်။
Dell PowerEdge R7725xd သည် PEAK:AIO နှင့် သဘာဝအတိုင်း ကိုက်ညီမှုရှိပါသည်။ စနစ်၏ ဗိသုကာပုံစံကို PCIe Gen5 အရင်းအမြစ်များကို အမြင့်ဆုံးဖြစ်အောင် ဒီဇိုင်းထုတ်ထားပြီး၊ ရိုးရာ RAID controllers များကို မှီခိုစရာမလိုဘဲ ၎င်း၏ ရှေ့တွင်တပ်ဆင်ထားသော U.2 NVMe bays ၂၄ ခု၏ bandwidth အပြည့်အဝကို CPU များသို့ တိုက်ရိုက်ဖော်ပြပေးပါသည်။ ဤအပြင်အဆင်သည် PEAK:AIO အား ခေတ်မီ NVMe-based data pipelines မှ မျှော်လင့်ထားသည့် parallelism နှင့် latency profile ကို ပေးစွမ်းသည်။ စနစ်ဖွဲ့စည်းပုံသည် NVMe SSD များကို RAID0 အုပ်စုနှစ်စုအဖြစ် ပိုင်းခြားထားသည်။
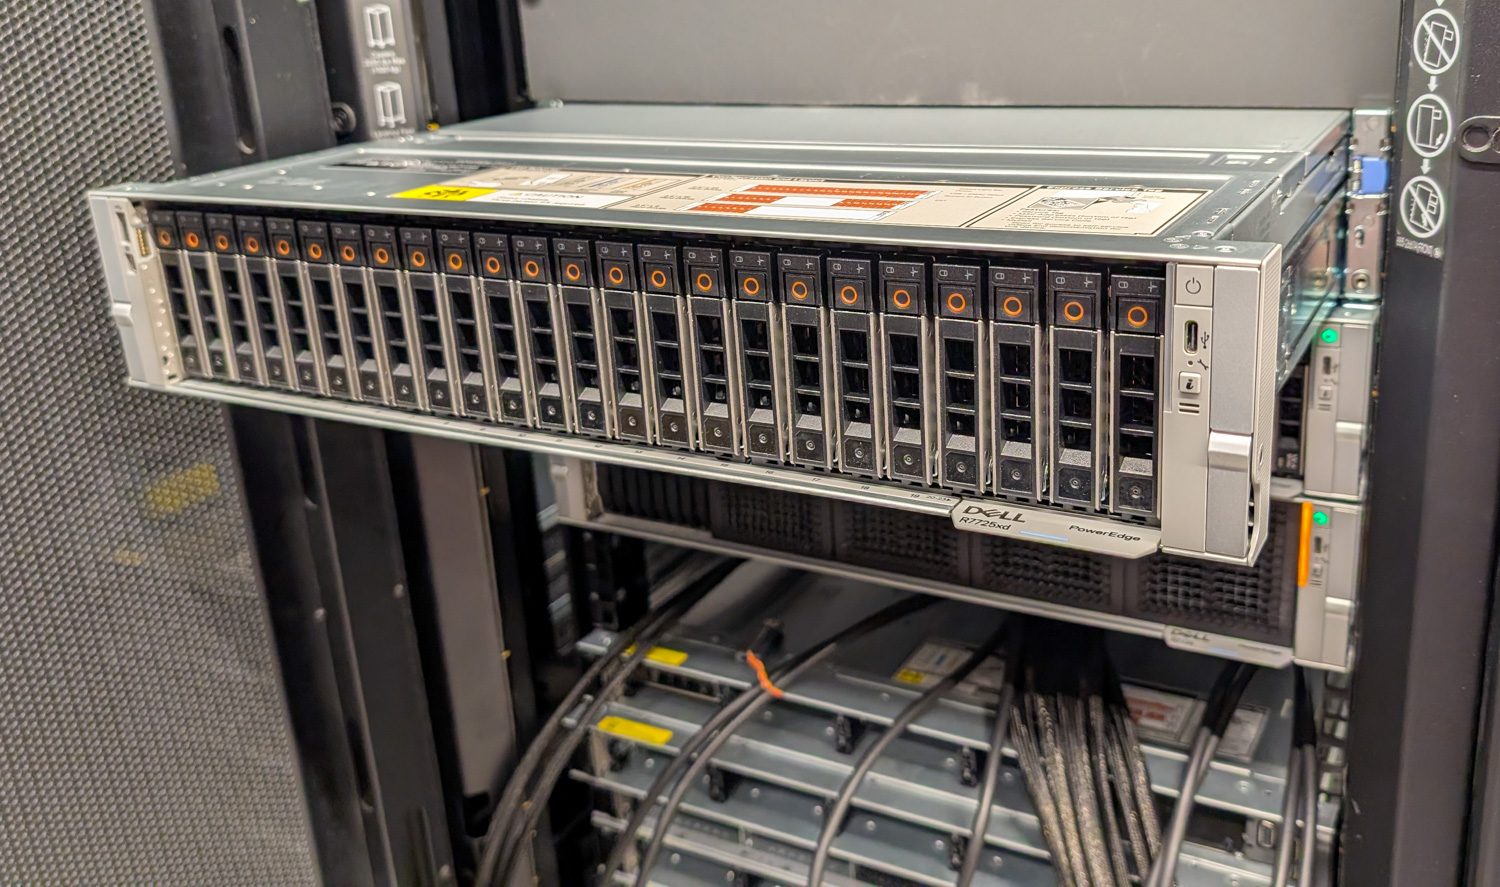
စမ်းသပ်ထားတဲ့ အခြေအနေမှာ၊ R7725xd နဲ့ ချိတ်ဆက်ထားတဲ့ client system နှစ်ခုကို အသုံးပြုခဲ့ပြီး၊ တစ်ခုချင်းစီမှာ Broadcom BCM57608 2x 200G NIC တွေ တပ်ဆင်ထားပါတယ်။ အဲဒါက client တစ်ခုချင်းစီထဲကို 200G uplink လေးခု ပေးပို့ပြီး R7725xd ကို ထုတ်လုပ်မှုမှာ PEAK:AIO deployments တွေ မြင်တွေ့ရတဲ့အတိုင်း လက်တွေ့ကျတဲ့ high-performance configuration တစ်ခုအဖြစ် တွန်းပို့ခဲ့ပါတယ်။ ဒီ network bandwidth အဆင့်က NIC layer မှာ bottleneck မဖြစ်စေဘဲ NVMe subsystem၊ PCIe topology နဲ့ CPU interconnects တွေကို အပြည့်အဝ stress ပေးနိုင်တဲ့ အခွင့်အရေးကို ပေးခဲ့ပါတယ်။
ရလဒ်အနေနဲ့ PEAK:AIO workloads တွေနဲ့ ထိရောက်စွာ ကိုက်ညီတဲ့ platform တစ်ခု ဖြစ်ပါတယ်။ R7725xd ဟာ သိပ်သည်းတဲ့ NVMe စွမ်းရည်၊ PCIe Gen5 throughput၊ parallelism အတွက် dual AMD EPYC 9005 processors နဲ့ client တစ်ခုချင်းစီအတွက် gigabits ရာပေါင်းများစွာနဲ့ multi-client data ingestion ကို ထိန်းသိမ်းပေးနိုင်တဲ့ networking စွမ်းရည်တွေကို ပေးစွမ်းပါတယ်။ ဒီဝိသေသလက္ခဏာအားလုံးဟာ PEAK:AIO ရဲ့ စွမ်းဆောင်ရည် မျှော်လင့်ချက်တွေကို အောင်မြင်စေဖို့ အခြေခံအုတ်မြစ်တွေ ဖြစ်ပါတယ်။
PEAK:AIO – NVMe-oF RDMA – Bandwidth
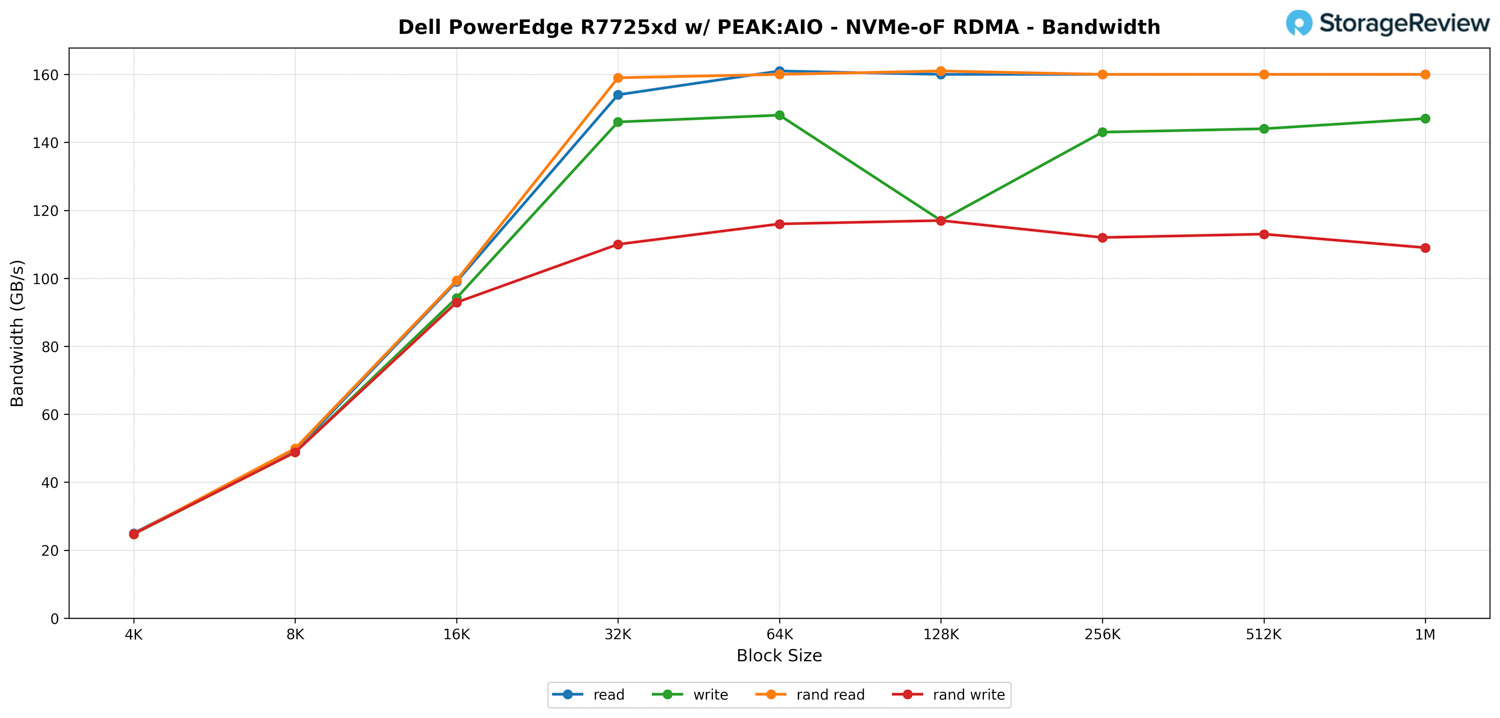
PEAK:AIO ပါဝင်တဲ့ PowerEdge R7725xd မှာ NVMe-oF RDMA bandwidth ရလဒ်တွေကို စစ်ဆေးကြည့်မယ်ဆိုရင် PCIe နဲ့ network bandwidth ဒီလောက်များတဲ့ စနစ်ကနေ ကျွန်တော်တို့ မျှော်လင့်ထားတဲ့ ယေဘုယျလမ်းကြောင်းအတိုင်းပါပဲ။ block size တိုးလာတာနဲ့အမျှ throughput ဟာ platform ရဲ့ လက်တွေ့ကန့်သတ်ချက်နားကို ရောက်တဲ့အထိ မြန်မြန်ဆန်ဆန် မြင့်တက်လာပါတယ်။
block အရွယ်အစားသေးငယ်တဲ့အခါ read နဲ့ write နှစ်မျိုးလုံးအတွက် performance က အလယ်အလတ် 20GB/s အတိုင်းအတာမှာ စတင်ပါတယ်။ ဒါဟာ ပုံမှန်ပါပဲ။ ဘာလို့လဲဆိုတော့ 4K နဲ့ 8K transfer တွေက IOPS path ကို throughput path ထက် အများကြီးပိုခက်အောင် တွန်းအားပေးလို့ပါ။ 16K နဲ့ 32K block တွေထဲကို ရောက်တာနဲ့ pipeline ပွင့်လာပါတယ်။ 32K မှာ read speed က 154 GB/s လောက်ကို ခုန်တက်သွားပြီး 160 GB/s အတိုင်းအတာအထိ ဆက်လက်မြင့်တက်သွားပါတယ်။ ဒါက 200 Gb/s link လေးခုကျော် dual-client setup တစ်ခု ဆင်းသက်လာမယ်လို့ မျှော်လင့်ရတဲ့ အနေအထားမှာ ရှိပါတယ်။
ကျပန်းဖတ်ရှုမှုစွမ်းဆောင်ရည်သည် အစီအစဉ်အတိုင်းနီးပါး ကိုက်ညီပါသည်။ PEAK:AIO သည် command queues များကို ကောင်းစွာထောက်ပံ့ပေးသောကြောင့် ကျပန်းဖတ်ရှုမှု bandwidth သည် အစီအစဉ်အတိုင်းဖတ်ရှုမှု bandwidth ကို အခြေခံအားဖြင့် အဆုံးစွန်ထိ ခြေရာခံပြီး 32K မှ 1M အထိ 159 မှ 161 GB/s ခန့်တွင် တည်ရှိပါသည်။ ၎င်းသည် storage stack သည် ရောနှောဝင်ရောက်မှုပုံစံများအောက်တွင် ပိတ်ဆို့မှုမရှိကြောင်းနှင့် R7725xd ၏ PCIe topology သည် Gen5 NVMe drives ၂၄ ခုတွင် load ကို ညီတူညီမျှဖြန့်ဝေနေကြောင်း ညွှန်ပြသည်။
ရေးသားစွမ်းဆောင်ရည်သည် အလားတူမျဉ်းကွေးတစ်ခုအတိုင်း လိုက်နာသော်လည်း ဖတ်ရှုမှုထက် အနည်းငယ်နိမ့်သည်။ အလတ်စားဘလောက်များတွင် အစဉ်လိုက်ရေးသားမှုများသည် 140 မှ 148 GB/s အတိုင်းအတာအတွင်း ရှိနေကာ 128K တွင် 117 GB/s ခန့်သို့ ကျဆင်းသွားသော်လည်း ဘလောက်အရွယ်အစား တိုးလာသည်နှင့်အမျှ ပြန်လည်ကောင်းမွန်လာသည်။ ကျပန်းရေးသားမှုများသည် ကွဲပြားစွာပြုမူပြီး 110-117 GB/s အနီးတွင် ပြားချပ်သွားပြီး ၎င်းသည် အပိုဆောင်း overhead ကို မိတ်ဆက်ပေးသည့် ရောနှောထားသော queue workloads များအတွက် ပုံမှန်ဖြစ်သည်။
ဒီအပိုင်းကနေ အဓိကယူဆောင်လာရမယ့်အချက်ကတော့ R7725xd ဟာ client အများအပြားက စနစ်ကို အကန့်အသတ်အထိ မောင်းနှင်နေရင်တောင် NVMe-oF မှာ bandwidth အလွန်မြင့်မားတာကို ထိန်းထားဖို့ အခက်အခဲမရှိပါဘူး။ block size တွေက 32K ဒါမှမဟုတ် ပိုမြင့်တဲ့အဆင့်ကို ရောက်တာနဲ့ server က ရရှိနိုင်တဲ့ network နဲ့ storage bandwidth ကို အဆက်မပြတ် ပြည့်နှက်စေပါတယ်။ ဒါက PEAK:AIO က ထုတ်ယူဖို့ ဒီဇိုင်းထုတ်ထားတဲ့ စွမ်းဆောင်ရည်အမျိုးအစားဖြစ်ပြီး ဒီရလဒ်တွေက တကယ့်လက်တွေ့အခြေအနေတွေမှာ platform ရဲ့ တိုးချဲ့နိုင်စွမ်းကို ခိုင်မာတဲ့ အတည်ပြုချက်တစ်ခု ဖြစ်စေပါတယ်။
PEAK AIO – NVMe-oF RDMA IOPS
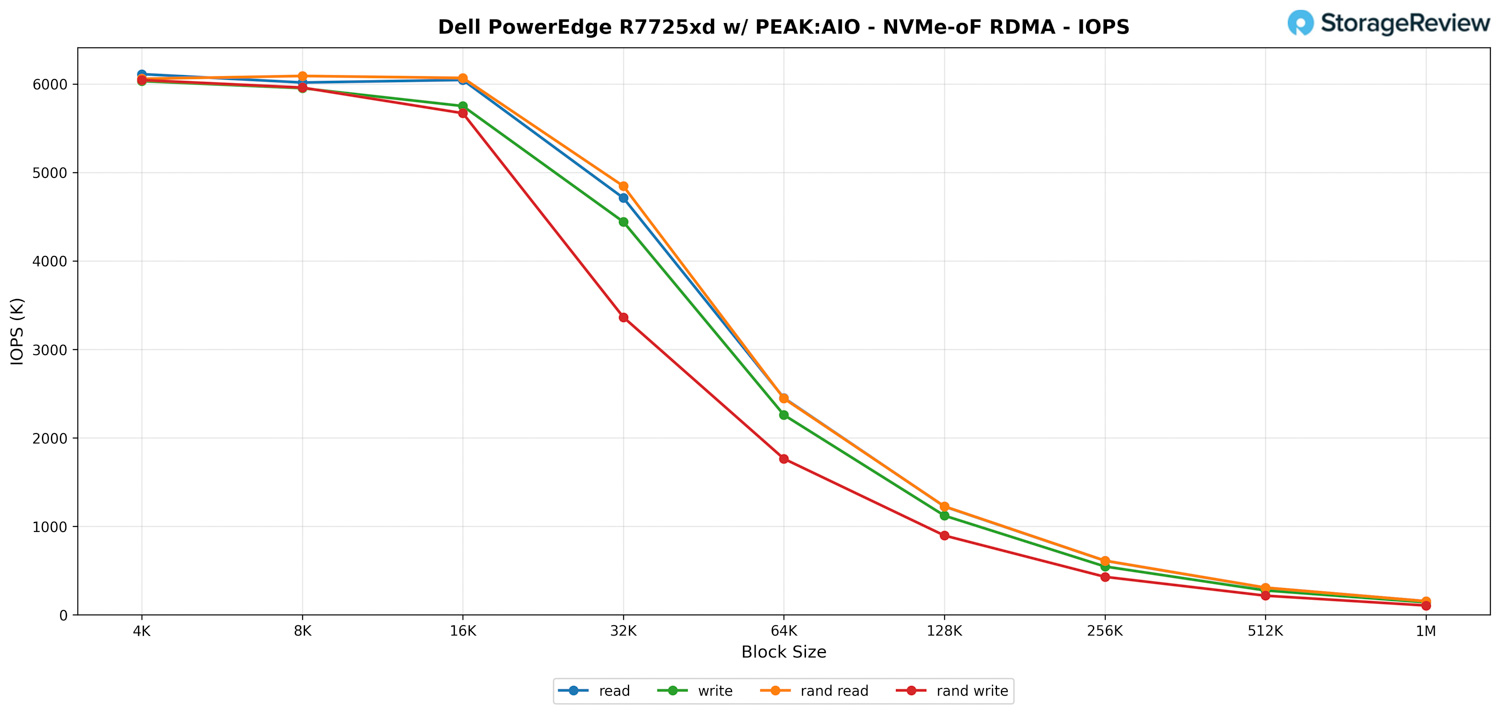
IOPS ဘက်တွင်၊ PowerEdge R7725xd သည် ကောင်းမွန်သော small-block စွမ်းဆောင်ရည်ကို ပြသထားသော်လည်း၊ ကျွန်ုပ်တို့သည် ကနဦးတွင် မျှော်မှန်းထားသည်ထက် နိမ့်ကျသော ကိန်းဂဏန်းများကို တွေ့ရှိခဲ့ရသည်။ အနာဂတ်တွင် ဤပြဿနာကို တိုးတက်ကောင်းမွန်သော network driver support ဖြင့် ဖြေရှင်းနိုင်လိမ့်မည်ဟု မျှော်လင့်ရသည်။ ထိုသို့ရှိနေသော်လည်း၊ အလုံးစုံ scaling trend သည် block size တိုးလာသောအခါ NVMe-oF RDMA ကဲ့သို့ပင် ပေါ်လာသည်။
အသေးငယ်ဆုံး block size မှာတင် system ဟာ sequential နဲ့ random workloads နှစ်မျိုးလုံးမှာ IOPS ၆ သန်းကျော်ကို ပေးပို့နိုင်ပါတယ်။ Read, write, random read နဲ့ random write အားလုံးဟာ 4K နဲ့ 8K မှာ တူညီတဲ့ range မှာ ရှိနေတာကြောင့် front-end clients, PCIe infrastructure နဲ့ NVMe drives တွေဟာ request rate နဲ့ ကိုက်ညီအောင် လုပ်ဆောင်ရာမှာ အခက်အခဲ မရှိဘူးလို့ ညွှန်ပြနေပါတယ်။
block size တွေ ကြီးလာတာနဲ့အမျှ IOPS ကျဆင်းမှု စတင်လာပါတယ်။ 32K မှာ read land IOPS ၄.၇ သန်းလောက်ရှိပြီး write ကတော့ ၄.၄ သန်းလောက်နဲ့ အနည်းငယ်နောက်ကျနေပါတယ်။ random write ကတော့ ဒီမှာ အကြီးမားဆုံးထိခိုက်ပြီး IOPS ၃.၃ သန်းလောက်အထိ ကျဆင်းသွားပါတယ်၊ ဒါက mixed-access patterns တွေကနေ မိတ်ဆက်ပေးတဲ့ additional queue နဲ့ CPU overhead နဲ့ ကိုက်ညီပါတယ်။
ကြီးမားသော block များထဲသို့ ရွေ့လျားသွားသောအခါ IOPS သည် ခန့်မှန်းနိုင်သော linear ပုံစံဖြင့် ဆက်လက်လျော့ကျသွားသည်။ 256K နှင့် 512K transfers များရောက်ရှိသောအခါ throughput သည် အဓိက metric ဖြစ်လာပြီး IOPS သည် ရာနှင့်ချီသော အလယ်အလတ်အဆင့်သို့ ကျဆင်းသွားသည်။ 1M block အရွယ်အစားတွင် workloads အားလုံးသည် 140K-153K IOPS အထိ ပေါင်းစည်းသွားပြီး ယခင်အပိုင်းတွင် ကျွန်ုပ်တို့တွေ့မြင်ခဲ့ရသော bandwidth နံပါတ်များနှင့် ကိုက်ညီပါသည်။
GPUDirect သိုလှောင်မှုစွမ်းဆောင်ရည်
R7725xd မှာ ကျွန်တော်တို့ ပြုလုပ်ခဲ့တဲ့ စမ်းသပ်မှုတွေထဲက တစ်ခုကတော့ Magnum IO GPUDirect Storage (GDS) စမ်းသပ်မှုပါ။ GDS ဆိုတာ NVIDIA မှ တီထွင်ထားတဲ့ လုပ်ဆောင်ချက်တစ်ခုဖြစ်ပြီး NVMe drives တွေ ဒါမှမဟုတ် တခြားမြန်နှုန်းမြင့် storage devices တွေမှာ သိမ်းဆည်းထားတဲ့ data တွေကို access လုပ်တဲ့အခါ GPU တွေကို CPU ကိုကျော်ပြီး လုပ်ဆောင်နိုင်စေပါတယ်။ CPU နဲ့ system memory ကနေတစ်ဆင့် data တွေကို routing လုပ်မယ့်အစား GDS က GPU နဲ့ storage device အကြား တိုက်ရိုက်ဆက်သွယ်မှုကို ဖြစ်စေပြီး latency ကို သိသိသာသာ လျှော့ချပေးပြီး data throughput ကို တိုးတက်စေပါတယ်။
GPUDirect သိုလှောင်မှု ဘယ်လိုအလုပ်လုပ်လဲ
ရိုးရာအစဉ်အလာအရ GPU တစ်ခုက NVMe drive မှာသိမ်းဆည်းထားတဲ့ဒေတာတွေကို စီမံဆောင်ရွက်တဲ့အခါ၊ ဒေတာဟာ GPU ဆီကိုမရောက်ခင် CPU နဲ့ system memory ကနေတစ်ဆင့် ဦးစွာဖြတ်သန်းသွားရပါမယ်။ ဒီလုပ်ငန်းစဉ်က CPU ဟာ ကြားခံတစ်ခုဖြစ်လာတာကြောင့် နှောင့်နှေးမှုကို ပေါင်းထည့်သလို အဖိုးတန် system resource တွေကို သုံးစွဲတာကြောင့် ပိတ်ဆို့မှုတွေကို ဖြစ်ပေါ်စေပါလိမ့်မယ်။ GPUDirect Storage က GPU ကို PCIe bus မှတစ်ဆင့် storage device ကနေ တိုက်ရိုက်ဒေတာတွေကို ရယူနိုင်အောင် လုပ်ပေးခြင်းအားဖြင့် ဒီထိရောက်မှုမရှိခြင်းကို ဖယ်ရှားပေးပါတယ်။ ဒီတိုက်ရိုက်လမ်းကြောင်းက ဒေတာရွေ့လျားမှု overhead ကို လျော့ကျစေပြီး ဒေတာလွှဲပြောင်းမှုတွေကို ပိုမိုမြန်ဆန်ထိရောက်စေပါတယ်။
AI workloads များ၊ အထူးသဖြင့် deep learning ပါဝင်သည့် workloads များသည် data များစွာအသုံးပြုရပါသည်။ ကြီးမားသော neural network များကို လေ့ကျင့်ပေးရန်အတွက် data terabytes များကို processing လုပ်ရန် လိုအပ်ပြီး data transfer နှောင့်နှေးမှုတစ်စုံတစ်ရာသည် GPU များကို အသုံးမချနိုင်ခြင်းနှင့် လေ့ကျင့်ချိန်ပိုကြာခြင်းတို့ ဖြစ်စေနိုင်ပါသည်။ GPUDirect Storage သည် data ကို GPU သို့ အမြန်ဆုံးပေးပို့ခြင်း၊ အားလပ်ချိန်ကို အနည်းဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းနှင့် တွက်ချက်မှုစွမ်းဆောင်ရည်ကို အမြင့်ဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းဖြင့် ဤစိန်ခေါ်မှုကို ဖြေရှင်းပေးပါသည်။
ထို့အပြင်၊ GDS သည် ဗီဒီယိုလုပ်ဆောင်ခြင်း၊ သဘာဝဘာသာစကားလုပ်ဆောင်ခြင်း သို့မဟုတ် အချိန်နှင့်တပြေးညီ ကောက်ချက်ချခြင်းကဲ့သို့သော ဒေတာအစုအဝေးကြီးများကို streaming လုပ်ခြင်းပါဝင်သည့် workloads များအတွက် အထူးအကျိုးရှိပါသည်။ CPU အပေါ် မှီခိုမှုကို လျှော့ချခြင်းဖြင့် GDS သည် ဒေတာရွှေ့ပြောင်းမှုကို အရှိန်မြှင့်ပေးပြီး အခြားအလုပ်များအတွက် CPU အရင်းအမြစ်များကို လွတ်လပ်စေပြီး စနစ်စွမ်းဆောင်ရည်ကို ပိုမိုမြှင့်တင်ပေးပါသည်။
raw bandwidth ထက်ကျော်လွန်၍ NVMe-oF (TCP/RDMA) ပါရှိသော GPUDirect သည် ultra-low-latency I/O ကိုလည်း ပေးဆောင်ပါသည်။ ၎င်းသည် GPU များကို data အတွက် ဘယ်တော့မှ ငတ်မွတ်ခေါင်းပါးမှုမရှိကြောင်း သေချာစေပြီး system ကို real-time AI inferencing၊ analytics pipelines နှင့် video replay အတွက် အသင့်တော်ဆုံးဖြစ်စေပါသည်။
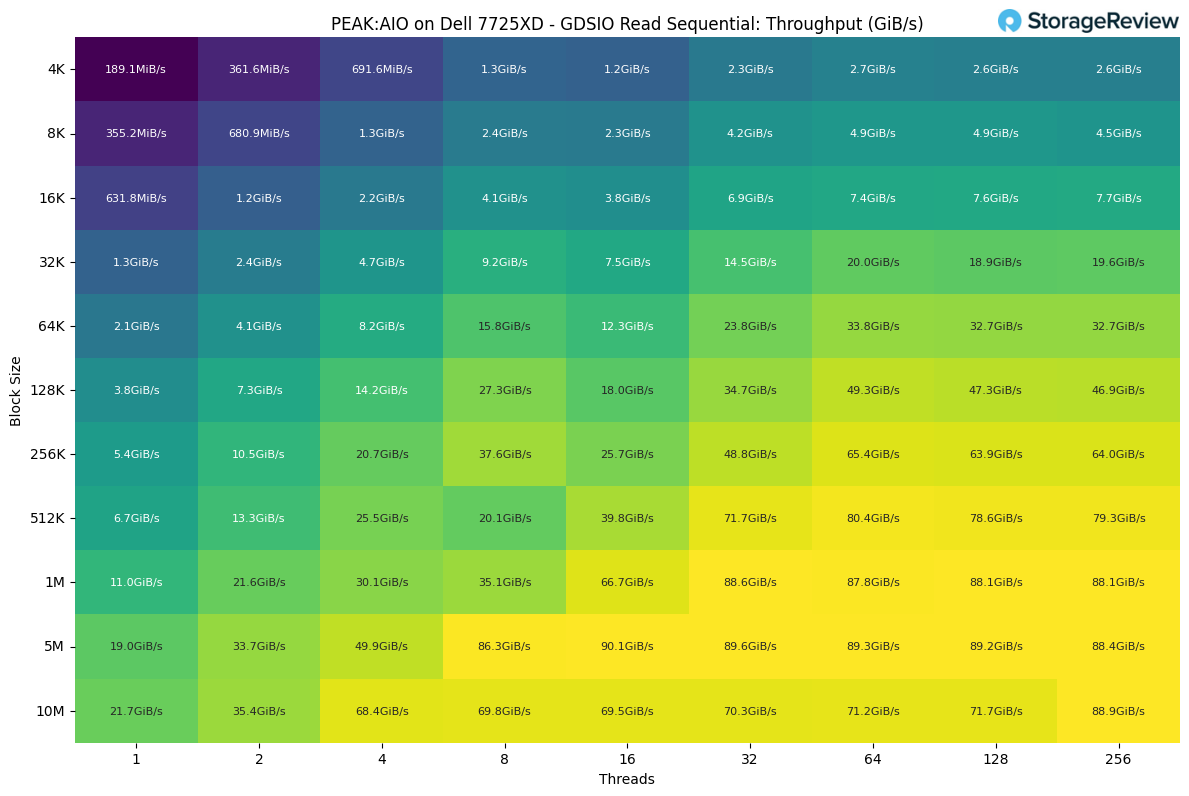
GDSIO ဖတ်ရှုခြင်း အစီအစဉ်
GDSIO ကိုအသုံးပြု၍ client တစ်ခုဖြင့် PEAK:AIO ကိုစစ်ဆေးသောအခါ၊ block size နှင့် thread count နှစ်ခုလုံးတိုးလာသည်နှင့်အမျှ read throughput သည်ရှင်းလင်းသော scaling pattern ကိုပြသသည်။ ဤ single client ကို 400G link နှစ်ခုမှတစ်ဆင့်ချိတ်ဆက်ထားပြီး ၎င်း၏စုစုပေါင်းအလားအလာကို 90 GB/s အထိကန့်သတ်ထားသည်။
အသေးငယ်ဆုံး block အရွယ်အစားနှင့် thread အရေအတွက်နည်းသောအခြေအနေတွင် 4K read များသည် single thread တွင် 189 MiB/s ခန့်စတင်ခြင်းဖြင့် စွမ်းဆောင်ရည်မှာ အသင့်အတင့်သာရှိပါသည်။ thread parallelism ကို တိုးမြှင့်လိုက်သည်နှင့် system သည် ချက်ချင်းတုံ့ပြန်ပြီး thread လေးခုတွင် 691MiB/s ကို တွန်းပို့ပြီး block ကြီးများထဲသို့ ဝင်ရောက်လာသည်နှင့် multi-GiB/s အကွာအဝေးသို့ ရောက်ရှိသွားပါသည်။
အလယ်အလတ်အဆင့် block အရွယ်အစားများသည် thread အရေအတွက်အပေါ် အပြင်းထန်ဆုံး sensitivity ကိုပြသသည်။ 32K တွင်၊ thread တစ်ခုတည်းတွင် 1.3 GiB/s မှ 64 thread ဖြင့် 20 GiB/s နီးပါးအထိ တိုးလာပြီး ၎င်းထက် အနည်းငယ်သာ လျော့နည်းသွားသည်။ အလားတူပုံစံသည် 64K နှင့် 128K တွင် ပေါ်လာပြီး workload တိုးလာသည်နှင့်အမျှ စနစ်သည် parallelism နည်းသော single-digit GiB/s မှ 30 GiB/s ကျော်သို့ ကူးပြောင်းသည်။
block size ကြီးတွေရောက်တာနဲ့ system က single client အတွက် performance ceiling ကိုရောက်လာတာနဲ့ thread put က level ကျသွားပါလိမ့်မယ်။ 1 MiB မှာ thread တစ်ခုမှာ 11GiB/s ကနေ thread count များရင် 88GiB/s လောက်အထိ performance တက်သွားပါတယ်။ 5 MiB နဲ့ 10 MiB transfer တွေက စမ်းသပ်မှုက thread 64, 128, ဒါမှမဟုတ် 256 မှာ run နေပါစေ thread တစ်ခုတည်းမှာ 89–90GiB/s လောက်နဲ့ အမြင့်ဆုံးရောက်ပါတယ်။
GDSIO ရေးရန် အစီအစဉ်တကျ
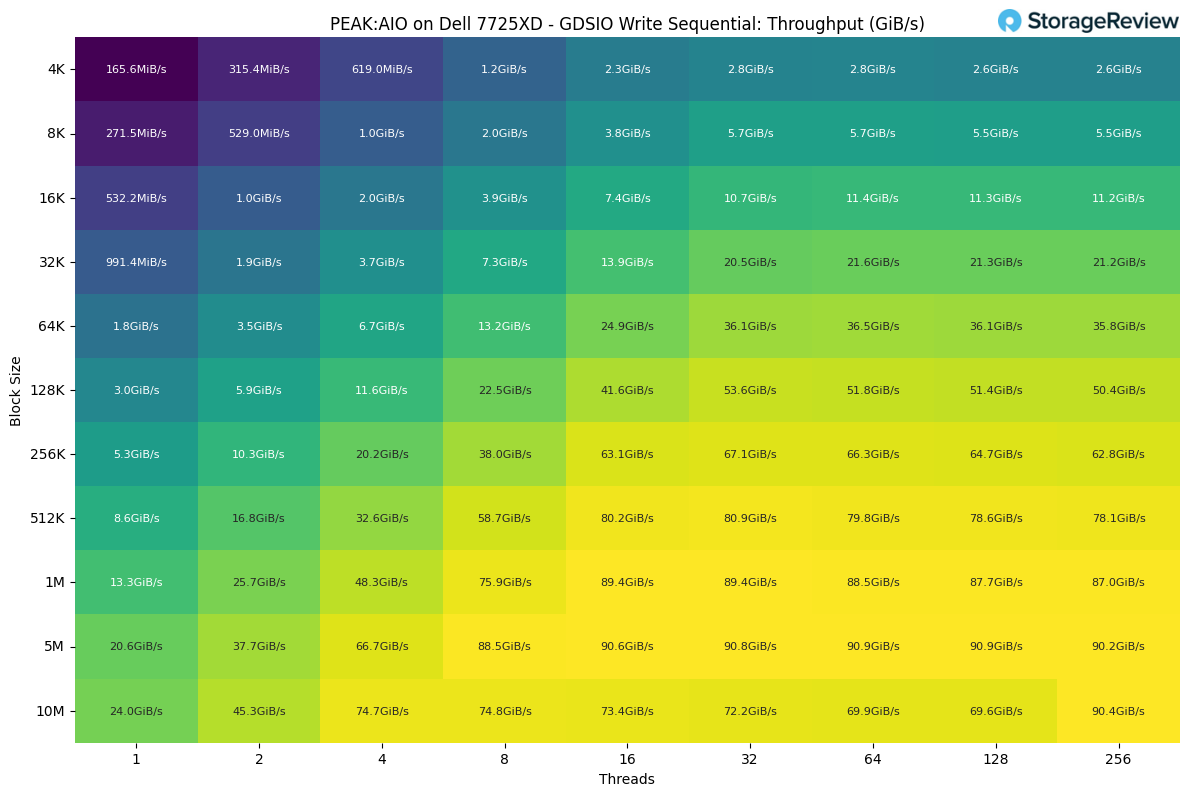
ရေးသားမှုဘက်တွင်၊ scaling အပြုအမူသည် ဖတ်ရှုမှုများနှင့် အလားတူပုံစံကို လိုက်နာသော်လည်း block အရွယ်အစားအများစုတွင် စွမ်းဆောင်ရည်အနည်းငယ်နိမ့်ပြီး sequential write workloads များအတွက် မျှော်လင့်ထားသည်။ အသေးဆုံး block အရွယ်အစားများတွင်၊ throughput သည် 4K တွင် single thread အတွက် 165 MiB/s မှစတင်ပြီး parallelism တိုးလာသည်နှင့်အမျှ တဖြည်းဖြည်းမြင့်တက်လာသည်။ thread လေးခုတွင်၊ ၎င်းသည် thread ရှစ်ခုတွင် 1GiB/s ကိုကျော်လွန်ခြင်းမပြုမီ 619MiB/s ကျော်အထိတိုးလာသည်။
thread အရေအတွက် မြင့်တက်လာသည်နှင့်အမျှ အလယ်အလတ်အဆင့် block အရွယ်အစားများသည် ပိုမိုအားကောင်းသော အကျိုးကျေးဇူးများကို ပြသသည်။ 32K တွင် throughput သည် 1 GiB/s အောက်မှ စတင်ပြီး thread အဆင့်မြင့်များတွင် 21 GiB/s ကျော်အထိ တိုးလာသည်။ 64K နှင့် 128K အဆင့်များသည် workload ပိုမို parallel ဖြစ်လာသည်နှင့်အမျှ single-digit နည်းသော GiB/s မှ အလယ်အလတ်အဆင့် 30 GiB/s နှင့် 50 GiB/s သို့ ရွေ့လျားနေသော trend ကို ဆက်လက်ထိန်းသိမ်းထားသည်။
စနစ်သည် ၎င်း၏ သဘာဝရေးသားမှုပမာဏ အမြင့်ဆုံးအဆင့်သို့ ရောက်ရှိသွားသောအခါတွင် ပိုမိုကြီးမားသော လွှဲပြောင်းမှုများ ဖြစ်ပေါ်လေ့ရှိသည်။ 1 MiB တွင် thread တစ်ခုတည်းတွင် စွမ်းဆောင်ရည်သည် 13.3GiB/s မှ thread အရေအတွက်များသောအခါ 90GiB/s အောက်တွင် မြင့်တက်လာသည်။ 5 MiB နှင့် 10 MiB စမ်းသပ်မှုများသည် အလားတူပုံစံကို လိုက်နာပြီး စနစ်သည် thread 64၊ 128 သို့မဟုတ် 256 တွင် လည်ပတ်နေသည်ဖြစ်စေ မသက်ဆိုင်ဘဲ ရလဒ်များသည် 90 GiB/s ဝန်းကျင်တွင် အမြင့်ဆုံးရောက်ရှိခဲ့သည်။
Gen5 ခေတ်တွင် စွမ်းဆောင်ရည်ကို ပြန်လည်သတ်မှတ်ခြင်း
Dell PowerEdge R7725xd သည် သိုလှောင်မှုဆာဗာတစ်ခုထက်ပိုပါသည်။ ၎င်းသည် rack အတွင်းရှိ bandwidth ကို မည်သို့ပေးပို့ပုံတွင် ပြောင်းလဲမှုတစ်ခုကို ကိုယ်စားပြုသည်။ PCIe switch များကို ဖယ်ရှားပြီး NVMe drive တိုင်းကို CPU သို့ တိုက်ရိုက်လမ်းကြောင်းပေးခြင်းဖြင့် Dell သည် throughput ကို သန့်ရှင်းစွာ ချိန်ညှိနိုင်ပြီး thermal များကို ခန့်မှန်းနိုင်ပြီး တစ်ပြိုင်နက်တည်းလုပ်ဆောင်ခြင်းသည် စိန်ခေါ်မှုတစ်ခုထက် ပိုင်ဆိုင်မှုတစ်ခုဖြစ်လာသည့် စနစ်တစ်ခုကို ဖန်တီးခဲ့သည်။
Micron ရဲ့ 9550 PRO SSD တွေနဲ့ PEAK:AIO ရဲ့ parallel I/O software တွေနဲ့ တွဲဖက်အသုံးပြုတဲ့အခါ R7725xd ဟာ သိပ်သည်းတဲ့ NVMe chassis ကနေ တကယ့် data engine အဖြစ် ပြောင်းလဲသွားပါတယ်။ ဒါဟာ သူ့ရဲ့ local PCIe fabric ကို ပြည့်စေနိုင်သလို line rate မှာ RDMA ပေါ်မှာ GPU တွေကို feed လုပ်နိုင်သလို၊ 2U envelope အတွင်းမှာ compute နဲ့ storage နှစ်မျိုးလုံးကို တစ်ပြိုင်နက်တည်း လုပ်ဆောင်နိုင်ပါတယ်။
Dell PowerEdge R7225xd
လက်တွေ့အားဖြင့် ဤဖွဲ့စည်းပုံသည် ဒေသတွင်း throughput 300 GB/s ကျော်နှင့် ကွန်ရက်မှတစ်ဆင့် 160 GB/s ပေးစွမ်းနိုင်ပြီး ရှုပ်ထွေးမှုနှင့် ကုန်ကျစရိတ်၏ အစိတ်အပိုင်းတစ်ခုတွင် multi-node storage cluster များ၏ စွမ်းဆောင်ရည်နှင့် ယှဉ်ပြိုင်နိုင်သည်။ ဆီလီကွန်မှ ဆော့ဖ်ဝဲအထိ stack ၏ အလွှာတိုင်းကို ထိရောက်မှုနှင့် ရေရှည်တည်တံ့သော bandwidth ကို အခြေခံ၍ ချိန်ညှိသောအခါ ဖြစ်ပျက်သည်များကို သရုပ်ပြခြင်းဖြစ်သည်။
R7725xd သည် Gen5 ခေတ်တွင် single-node storage စွမ်းဆောင်ရည်အတွက် စံနှုန်းအသစ်တစ်ခုကို ချမှတ်ပေးပါသည်။ နောက်မျိုးဆက် AI ပိုက်လိုင်းများ၊ မြန်နှုန်းမြင့် ခွဲခြမ်းစိတ်ဖြာမှုများ သို့မဟုတ် checkpoint-heavy လေ့ကျင့်ရေးပတ်ဝန်းကျင်များကို တည်ဆောက်နေသော အဖွဲ့အစည်းများအတွက်၊ bottleneck များကို စနစ်မှ လုံးဝဒီဇိုင်းထုတ်ထားသည့်အခါ မည်သို့ဖြစ်နိုင်သည်ကို အရိပ်အမြွက်ပြခြင်းပင်ဖြစ်သည်။

ဦးဆောင်သူစာရင်း- Dell PowerEdge R7725xd သည် ကျွန်ုပ်တို့၏ အကောင်းဆုံးဆာဗာများ ဦးဆောင်သူစာရင်းတွင် အကောင်းဆုံး 2U Storage Server ဆုကို ရရှိထားသည်။
ဤအစီရင်ခံစာကို Dell Technologies မှ ကမကထပြုပါသည်။ ဤအစီရင်ခံစာတွင် ဖော်ပြထားသော အမြင်များနှင့် ထင်မြင်ယူဆချက်အားလုံးသည် ထည့်သွင်းစဉ်းစားနေသော ထုတ်ကုန်(များ)အပေါ် ကျွန်ုပ်တို့၏ ဘက်မလိုက်သော အမြင်ပေါ်တွင် အခြေခံထားပါသည်။


 အမေဇုံ