

AMD Radeon RX 9070 series edition ကတ်များကို ယနေ့တွင် မိတ်ဆက်လိုက်ပါပြီ။ AMD သည် ASUS Prime RX 9070 နှင့် RX 9070 XT ကတ်များ၏ မျိုးကွဲများကို စမ်းသပ်ရန်အတွက် ဓာတ်ခွဲခန်းသို့ ပေးပို့ခဲ့သည်။ ကုမ္ပဏီ၏ ခေတ်မီ RDNA 4 ဗိသုကာနှင့် TSMC ၏ အဆင့်မြင့် 4nm လုပ်ငန်းစဉ်နည်းပညာပေါ်တွင် တည်ဆောက်ထားသော ဤ GPU များသည် မြင့်မားသော refresh 1440p ဂိမ်းကစားခြင်းနှင့် အခြေခံအဆင့် 4K အတွေ့အကြုံများကို ရှာဖွေနေသော ဂိမ်းကစားသူများအတွက် ဈေးနှုန်းနှင့် စွမ်းဆောင်ရည်ကြား အကောင်းဆုံးနေရာကို ရည်ရွယ်ပါသည်။ 9070 စီးရီးသည် ၎င်းတို့၏ စွမ်းဆောင်ရည်အတန်းအစားနှင့် နှိုင်းယှဉ်ပါက သင့်တင့်သော ပါဝါသုံးစွဲမှုကိန်းဂဏန်းများကို ထိန်းသိမ်းထားစဉ် အထင်ကြီးလောက်သော နည်းပညာတိုးတက်မှုများကို မိတ်ဆက်ပေးထားသည်။
အထက် အလယ်အလတ်တန်းစား အဆင့်တွင် တည်ရှိသော ဤ GPU များသည် ဂိမ်းစွမ်းဆောင်ရည်နှင့် AI အရှိန်မြှင့်တင်မှုကို ပေါင်းစပ်ထားပြီး ဂိမ်းကစားသူများနှင့် ဖန်တီးသူများအတွက် ဝန်ဆောင်မှုပေးပါသည်။ 16GB VRAM၊ မြှင့်တင်ထားသော ray tracing စွမ်းရည်များနှင့် FidelityFX Super Resolution 4 နှင့် HYPR-RX ကဲ့သို့သော AMD ၏ နောက်ဆုံးပေါ် AI-powered နည်းပညာများဖြင့် RX 9070 စီးရီးသည် ပါဝါထိရောက်မှုကို ထိန်းသိမ်းထားစဉ် မြင့်မားသောစွမ်းဆောင်ရည်ကို ပေးဆောင်ရန် ရည်ရွယ်ပါသည်။
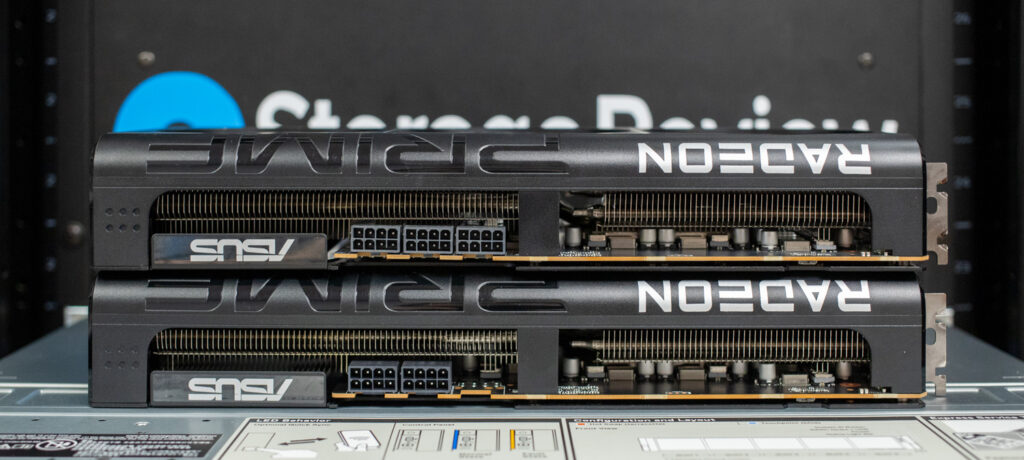
RX 9070 XT သည် အဆင့်မြင့်မော်ဒယ်ဖြစ်ပြီး၊ မြင့်မားသော clock speed များနှင့် မြင့်မားသော gaming workloads များအတွက် graphics cores များ ပိုမိုပေးဆောင်ပါသည်။ ASUS ၏ PRIME ဒီဇိုင်းသည် ခိုင်မာသော အအေးပေးစနစ်နှင့် ပါဝါပေးပို့မှုကို ယူဆောင်လာသောကြောင့် လေးလံသော loads များအောက်တွင် တသမတ်တည်း စွမ်းဆောင်ရည်ကို သေချာစေသည်။ GPU နှစ်ခုစလုံးသည် အနာဂတ်အတွက် အသင့်ဖြစ်ပြီး PCIe gen 5၊ DisplayPort 2.1 ပံ့ပိုးမှုနှင့် နောက်မျိုးဆက် application များအတွက် AI accelerators များပါရှိသောကြောင့် ၎င်းတို့ကို စွဲမက်ဖွယ်ကောင်းသော ဂိမ်းအတွေ့အကြုံများအတွက် အကောင်းဆုံးရွေးချယ်မှုဖြစ်စေသည်။
AMD Radeon RX 9070 နှင့် RX 9070 XT သတ်မှတ်ချက်များ
| Radeon RX 9070 XT နှင့် Radeon RX 9070 သတ်မှတ်ချက်များ | ||
| Radeon RX 9070 XT | Radeon RX 9070 | |
| GPU ကိုအမည် | Navi 48 | Navi 48 |
| GPU မျိုးကွဲ | Navi 48XT | Navi 48XL |
| ဗိသုကာအတတ်ပညာ | RDNA ၂ | RDNA ၂ |
| စက်ရုံ | TSMC | TSMC |
| လုပ်ငန်းစဉ်အရွယ်အစား | 4 nm | 4 nm |
| transistors | 53,900 သန်း | 53,900 သန်း |
| သိပ်သည်းဆ | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း |
| Size ကို Die | 357 mm² | 357 mm² |
| base နာရီ | 2400 MHz | 2070 MHz |
| နာရီ Boost | 2970 MHz | 2520 MHz |
| memory အရွယ်အစား | 16 GB ကို | 16 GB ကို |
| memory အမျိုးအစား | GDDR6 | GDDR6 |
| အရိပ်ယူနစ်များ | 4096 | 3584 |
| AI အရှိန်မြှင့်စက်များ | 128 | 112 |
| TMU များ | 256 | 256 |
| ROPs | 128 | 128 |
| ယူနစ်တွက်ချက် | 64 | 56 |
| RT ကို core | 64 | 56 |
| AMD Infinity Cache | ၆၄ မီဂါဘိုက် (တတိယမျိုးဆက်) | ၆၄ မီဂါဘိုက် (တတိယမျိုးဆက်) |
| မှတ်ဉာဏ်ဘတ်စ်ကား | 256 bit နဲ့ | 256 bit နဲ့ |
| bandwidth | 640 GB ကို / s နဲ့ | 640 GB ကို / s နဲ့ |
| အမြင့်ဆုံး ပစ်ဇယ်ဖြည့်နှုန်း | ၄၆၂.၁ GPixel/s | ၄၆၂.၁ GPixel/s |
| အမြင့်ဆုံး Texture ဖြည့်နှုန်း | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s |
| အမြင့်ဆုံး တစ်ခုတည်းသော တိကျမှု ပမာဏ | 48.7 TFLOPS | 36.1 TFLOPS |
| အမြင့်ဆုံး တစ်ဝက်တိကျမှု ပမာဏ | 97.3 TFLOPS | 72.3 TFLOPS |
| အမြင့်ဆုံး INT8 AI TOPS Throughput | 779 ထိပ် | 578 ထိပ် |
| အမြင့်ဆုံး INT4 AI TOPS Throughput | 1557 ထိပ် | 1156 ထိပ် |
| TDP | 304 ဒဗလျူ | 220 ဒဗလျူ |
| အကြံပြုထားသော PSU | 750 ဒဗလျူ | 650 ဒဗလျူ |
| အကျိုးရလဒ်များ | HDMI 2.1b ၁ ခု၊ DisplayPort 2.1a ၃ ခု | HDMI 2.1b ၁ ခု၊ DisplayPort 2.1a ၃ ခု |
| PCIe မျက်နှာပြင် | PCIe 5.0 x 16 | PCIe 5.0 x 16 |
| Power က Connectors | 3x 8 pin | 2x 8 pin |
| launch စျေး | $ 599 အမေရိကန်ဒေါ်လာ | $ 549 အမေရိကန်ဒေါ်လာ |
RDNA 4 မှာ ဘာတွေအသစ်အဆန်းရှိလဲ
AMD ရဲ့ RDNA 4 ဗိသုကာလက်ရာဟာ ယခင်မျိုးဆက်တွေနဲ့ သိသိသာသာ တိုးတက်ပြောင်းလဲလာမှုကို ကိုယ်စားပြုပြီး နယ်ပယ်အများအပြားမှာ သိသာထင်ရှားတဲ့ တိုးတက်မှုတွေ ယူဆောင်လာပါတယ်။ ဒီ GPU အသစ်တွေရဲ့ အဓိကအချက်ကတော့ ပြန်လည်ဒီဇိုင်းထုတ်ထားတဲ့ RDNA4 Compute Units တွေဖြစ်ပြီး RDNA 3 ထက် compute unit တစ်ခုစီရဲ့ စွမ်းဆောင်ရည် ၄၀% ခန့် ပိုမိုမြင့်မားပါတယ်။ ဒီစွမ်းဆောင်ရည် တိုးတက်မှုဟာ မှတ်ဉာဏ်ခွဲစနစ်တွေ တိုးတက်ကောင်းမွန်လာခြင်းနဲ့ GPU တစ်လျှောက်မှာ ပိုမိုကောင်းမွန်တဲ့ data flow လမ်းကြောင်းတွေကနေ လာတာပါ။
AMD ရဲ့ တတိယမျိုးဆက် RT accelerator တွေနဲ့ Ray tracing စွမ်းဆောင်ရည်ဟာ သိသိသာသာ မြင့်တက်လာတာကို တွေ့ရပါတယ်။ ဒုတိယမြောက် ray intersection engine ကို ထည့်သွင်းလိုက်ခြင်းအားဖြင့် ray-box နဲ့ ray-triangle testing လုပ်ဆောင်ချက်တွေအတွက် throughput ကို နှစ်ဆတိုးစေပြီး၊ ယခင်မျိုးဆက်တွေမှာ ကြုံတွေ့ရတဲ့ အတားအဆီးတွေပါ။ အသစ် သီးသန့် ray transformation hardware က ဒီ workloads တွေကို ပိုမိုမြန်ဆန်စေပြီး Oriented Bounding Boxes တွေအတွက် support လုပ်ခြင်းက memory overhead နည်းပါးပြီး ray traversal ကို ပိုမိုထိရောက်စေပါတယ်။
အထင်ရှားဆုံးတိုးတက်မှုကတော့ AI အရှိန်မြှင့်စွမ်းရည်တွေပါ။ RX 9070 စီးရီးမှာ ဒုတိယမျိုးဆက် AI အရှိန်မြှင့်စနစ်တွေ ပါဝင်ပြီး 9070 အတွက် AI TOPS ၁,၁၀၀ ခန့်နဲ့ 9070 XT အတွက် AI TOPS ၁၅၀၀ ကျော်ကို ပံ့ပိုးပေးပါတယ်။ ဒီသီးသန့် AI ယူနစ်တွေမှာ ချဲ့ထွင်ထားတဲ့ သင်္ချာပိုက်လိုင်းတွေ ပါဝင်ပြီး AI ဒေတာပုံစံအသစ်တွေကို ပံ့ပိုးပေးပါတယ်။
FSR4 နည်းပညာအသစ်သည် NVIDIA ၏ DLSS upscaling အတွက် AMD ၏ အဖြေဖြစ်ပြီး AMD မှ မူရင်းပုံရိပ်အရည်အသွေးထက် ပိုမိုကောင်းမွန်သည်ဟု ဆိုထားသည့်အရာကို ပေးစွမ်းနိုင်ရန် မြှင့်တင်ထားသော AI accelerator များကို အသုံးပြုထားသည်။ RDNA 4 hardware အတွက် အထူးပြုလုပ်ထားသော machine learning-based upscaling algorithms များကို အသုံးပြုခြင်းဖြင့် FSR4 သည် ပုံရိပ်အရည်အသွေးကို ထိန်းသိမ်းထားစဉ် စွမ်းဆောင်ရည်ကို မြှင့်တင်နိုင်သည်။ AMD သည် FSR 3.1 API နှင့် backward compatible ဖြစ်အောင် ဒီဇိုင်းထုတ်ထားသောကြောင့် developer များအနေဖြင့် ရှိပြီးသားဂိမ်းများတွင် အလွယ်တကူ အကောင်အထည်ဖော်နိုင်မည်ဖြစ်သည်။
ASUS Prime RX 9070 နှင့် RX 9070 XT တို့ကို တည်ဆောက်ပြီး ဒီဇိုင်းထုတ်ပါ။
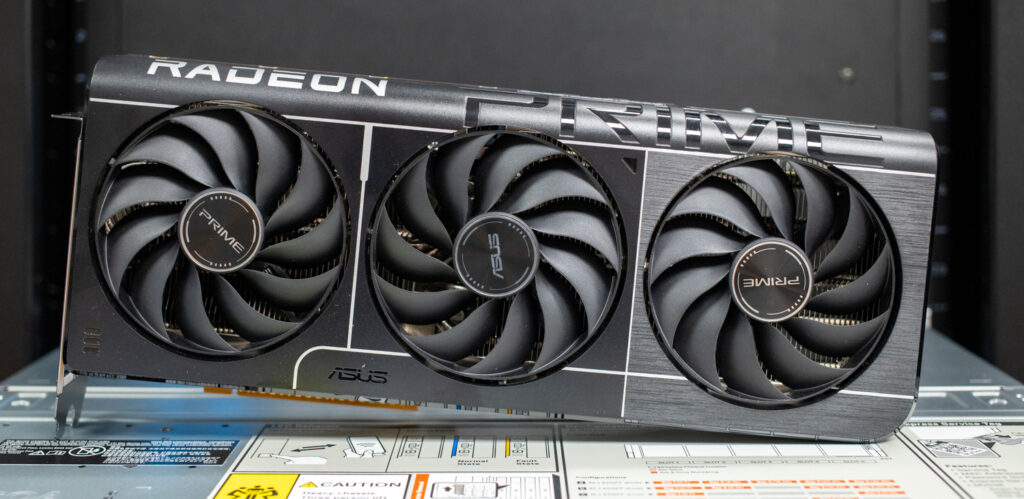
ASUS Prime Radeon 9070 နှင့် 9070 XT ကတ်အသစ်များ၏ တည်ဆောက်ပုံနှင့် ဒီဇိုင်းသည် ကျွန်ုပ်တို့ယခင်က သုံးသပ်ခဲ့သော ASUS Prime RTX 5070 Ti နှင့် အလွန်ဆင်တူပါသည် ။ ၎င်းတို့သည် ပါဝါပိုင်းတွင် ကွာခြားပါသည် - ကတ်နှစ်ခုလုံးတွင် အထူး 12-pin ပါဝါကြိုး မလိုအပ်ပါ၊ 9070 သည် စံ 8-pin ပါဝါပါ 2x 8-pin connectors များကို အသုံးပြုထားပြီး 9070 XT သည် 3x 8-pin connectors များကို အသုံးပြုထားသည်။ ကတ်နှစ်ခုလုံးတွင် 2.5 PCIe slot ဒီဇိုင်းအမြင့် လိုအပ်ချက် ပါရှိသည်။
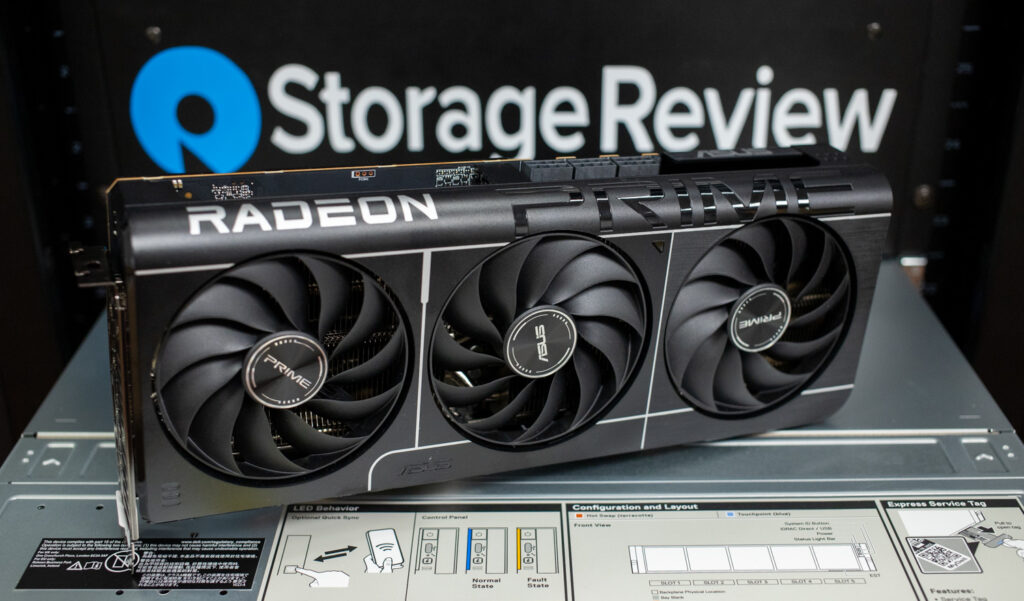
အအေးပေးစနစ်အတွက် ASUS သည် Radeon 9070 နှင့် 9070 XT တွင် တာရှည်ခံမှုနှင့် လေစီးဆင်းမှုကို တည်ငြိမ်စေရန်အတွက် dual ball bearings ပါရှိသော triple Axial-tech ပန်ကာဒီဇိုင်းကို အသုံးပြုထားသည်။ ပန်ကာများကို ကတ်တစ်ခုလုံးတွင် ကြီးမားသော heatsink နှင့် အပူပိုက်များဖြင့် တွဲဖက်ထားပြီး လေဝင်လေထွက်ကောင်းသော backplate နှင့် ဘေးဘက် cutout များက အပူပျံ့နှံ့မှုကို အများဆုံးဖြစ်စေသည်။ GPU အပူချိန် 50°C အောက်သို့ ကျဆင်းသွားသည့်အခါ ပန်ကာသုံးခုစလုံးသည် အလုပ်မလုပ်ဘဲ ရှိနေပြီး ပေါ့ပါးသော workload များ သို့မဟုတ် လိုအပ်ချက်နည်းသော ဂိမ်းကစားခြင်းများတွင် တိတ်ဆိတ်စွာ လည်ပတ်နိုင်စေပါသည်။ အပူချိန် 55°C ကျော်သွားသည်နှင့် ပန်ကာများသည် အလိုအလျောက် ပြန်လည်လည်ပတ်ပါသည်။
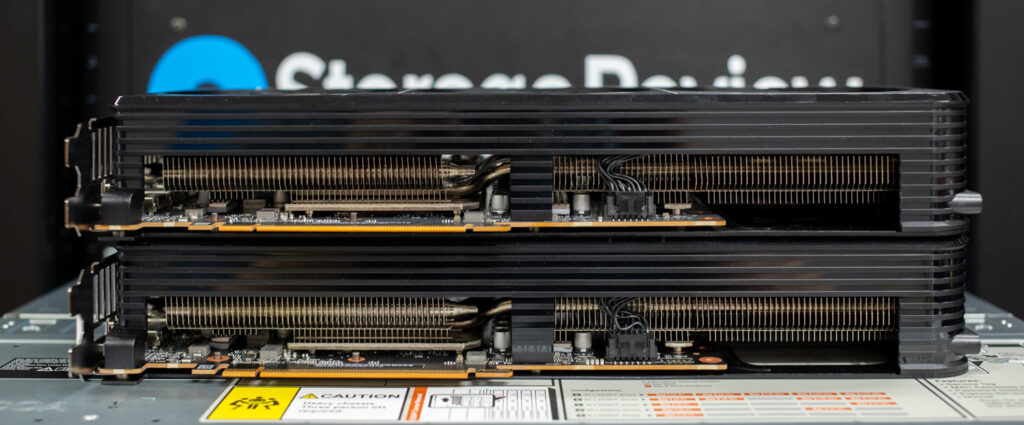
ကတ်တွေရဲ့ အောက်ခြေ slot ကိုကြည့်ရင် မော်ဒယ်နှစ်ခုစလုံးဟာ အအေးပေးစနစ်အတွက် တူညီတဲ့ဒီဇိုင်းကို မျှဝေထားပြီး heatsink၊ PCB layout နဲ့ လေဝင်လေထွက်ကောင်းအောင် လေဝင်လေထွက်ပေါက်တွေပါတဲ့ shroud တွေ ပါဝင်ပါတယ်။
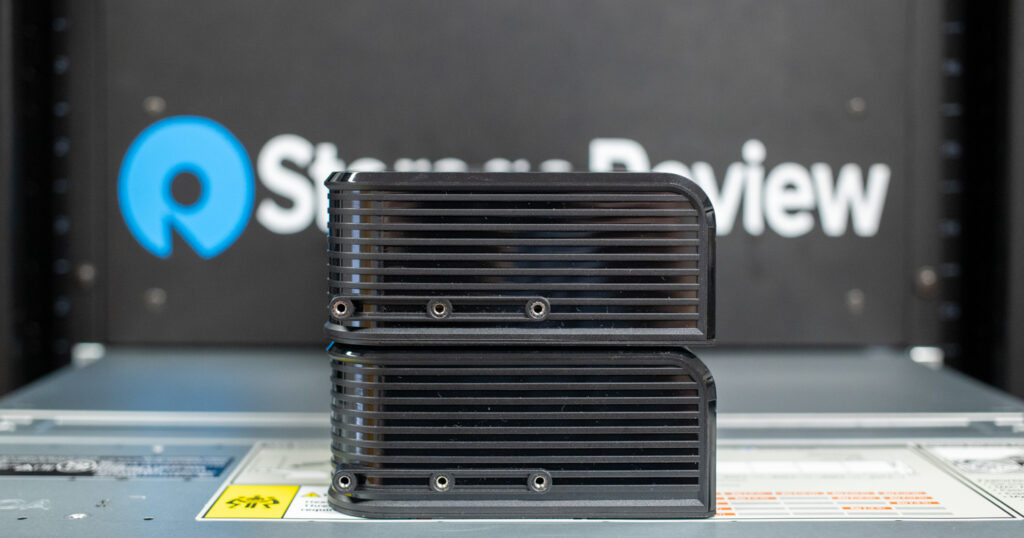
ကတ်နှစ်ခုလုံး၏ အဆုံးတွင် ကတ်ကို ဘူးထဲတွင် တပ်ဆင်စဉ် ကတ်ကျခြင်းကို ကာကွယ်ရန်နှင့် သယ်ယူပို့ဆောင်စဉ် တည်ငြိမ်မှုကို ပိုမိုကောင်းမွန်စေရန်အတွက် ရွေးချယ်နိုင်သော ကတ်တောင့်တင်းစေသည့်ကိရိယာအတွက် တူညီသောတပ်ဆင်သည့်နေရာတစ်ခု ပါရှိသည်။
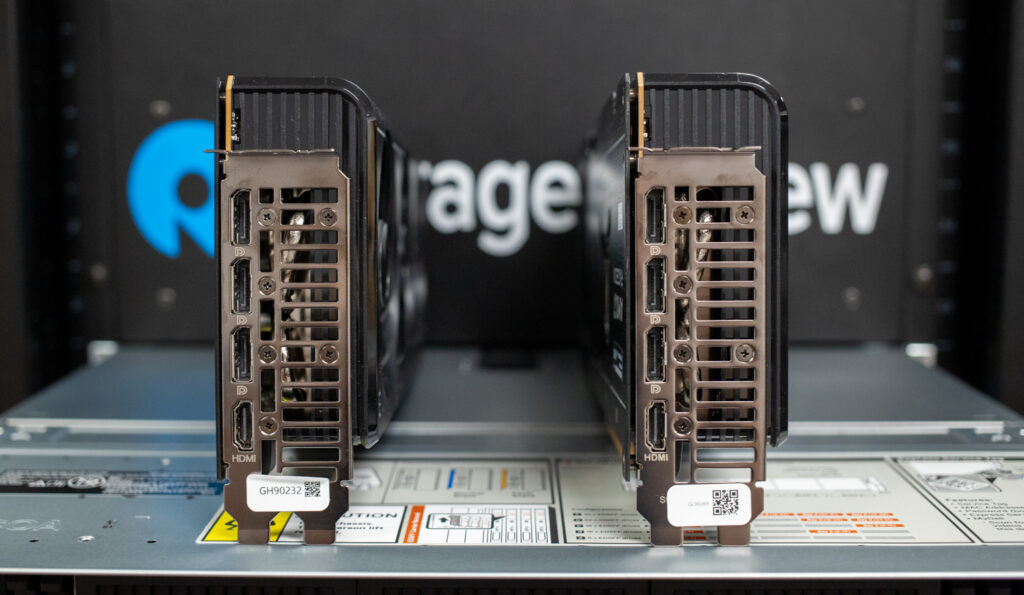
ကတ်နှစ်ခုလုံးရဲ့ စီးပွားရေးလုပ်ငန်းသုံးအနေနဲ့ display ချိတ်ဆက်မှုရွေးချယ်စရာတွေ ရှိပြီး တစ်ခုချင်းစီမှာ HDMI 2.1b ၁ ခုနဲ့ DisplayPort 2.1a ၃ ခု ပါဝင်ပါတယ်။ ASUS ဟာ ကြာရှည်ခံမှုနဲ့ တာရှည်ခံမှုကို သေချာစေဖို့ 304 stainless-steel PCIe bracket ဒီဇိုင်းကိုလည်း ထည့်သွင်းထားပါတယ်။
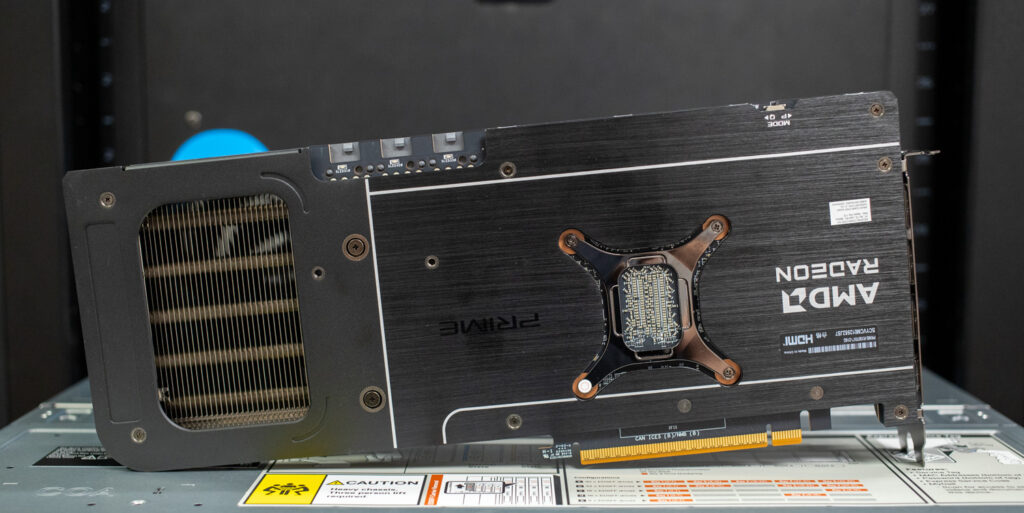
ကတ်နှစ်ခုလုံးရဲ့ အခြားထင်ရှားတဲ့အင်္ဂါရပ်တွေမှာ ကတ်ပေါ်က ခလုတ်တစ်ခုကနေတစ်ဆင့် ထိန်းချုပ်နိုင်တဲ့ BIOS ပါဝင်ပြီး၊ “P” (စွမ်းဆောင်ရည်) မုဒ်နဲ့ “Q” (တိတ်ဆိတ်) မုဒ်ကို ပြောင်းလဲပေးပါတယ်။ ယူနစ်နှစ်ခုစလုံးမှာ အအေးပေးစွမ်းဆောင်ရည်ကို မြှင့်တင်ပေးပြီး ချစ်ပ်နဲ့ထိတွေ့နေတဲ့ အပူပစ္စည်းရဲ့ ကြာရှည်ခံမှုကို မြှင့်တင်ပေးဖို့ ဒီဇိုင်းထုတ်ထားတဲ့ phase-change thermal pad တစ်ခုလည်း ပါဝင်ပါတယ်။ နောက်ဆုံးအနေနဲ့ ASUS က ကတ်ရဲ့ စွမ်းဆောင်ရည်ကို သီးခြားလိုအပ်ချက်တွေနဲ့ ကိုက်ညီအောင် ချိန်ညှိပေးနိုင်တဲ့ GPU Tweak III software ကို ပံ့ပိုးပေးပါတယ်။
စံနှုန်းသတ်မှတ်ခြင်း- ASUS Prime RX 9070 နှင့် RX 9070 XT
ASUS မှ Radeon ကတ်အသစ်များကို စမ်းသပ်ရန်အတွက်၊ 64-core CPU နှင့် custom water cooling loop ပါရှိသော ကျွန်ုပ်တို့၏ မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော AMD Threadripper platform ကို အသုံးပြုခဲ့ပါသည်။ ဤ setup သည် GPU သည် CPU bottleneck မရှိဘဲ အပြည့်အဝစွမ်းဆောင်ရည်ဖြင့် လည်ပတ်နိုင်ကြောင်း သေချာစေသည်။ နှိုင်းယှဉ်ကြည့်ရန်၊ ASUS Prime Radeon RX 9070 နှင့် RX 9070 XT တို့ကို NVIDIA Founders RTX 4070 နှင့် ASUS Prime NVIDIA RTX 5070 Ti တို့ နှင့်အတူ ဤ configuration တွင် စမ်းသပ်ခဲ့သည် ။
အောက်တွင် စနစ်ဖွဲ့စည်းပုံ အပြည့်အစုံကို ဖော်ပြထားသည်။
StorageReview AMD Threadripper စမ်းသပ်ပလက်ဖောင်း
- motherboard: ASUS Pro WS TRX50-SAGE WIFI
- CPU ကို: AMD Ryzen Threadripper 7980X 64-Core
- ရမ်: 128GB DDR5 4800MT/s
- သိုလှောင်မှု: 2TB Samsung 980 Pro
- OS ကို: Workstations အတွက် Windows 11 Pro
- ကားမောင်းသူ: AMD Adrenalin 25.3.1
UL Procyon: AI စာသားထုတ်လုပ်ခြင်း
Procyon AI Text Generation Benchmark သည် ကျစ်လစ်ပြီး တသမတ်တည်းရှိသော အကဲဖြတ်နည်းလမ်းကို ပေးဆောင်ခြင်းဖြင့် AI LLM စွမ်းဆောင်ရည်စမ်းသပ်မှုကို ရိုးရှင်းစေသည်။ ၎င်းသည် မော်ဒယ်အရွယ်အစားကြီးများနှင့် variable factor များ၏ ရှုပ်ထွေးမှုကို လျှော့ချနေစဉ်တွင် LLM မော်ဒယ်များစွာတွင် ထပ်ခါတလဲလဲ စမ်းသပ်နိုင်စေပါသည်။ AI hardware ဦးဆောင်သူများနှင့်အတူ တီထွင်ထားသောကြောင့် ပိုမိုယုံကြည်စိတ်ချရပြီး ထိရောက်သော စွမ်းဆောင်ရည်အကဲဖြတ်မှုများအတွက် ဒေသတွင်း AI accelerator များအသုံးပြုမှုကို အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ပေးပါသည်။ အောက်တွင်တိုင်းတာထားသော ရလဒ်များကို NVIDIA မော်ဒယ်များတွင် TensorRT နှင့် AMD မော်ဒယ်များအတွက် ONNX ကို အသုံးပြု၍ စမ်းသပ်ခဲ့သည်။
| UL Procyon: AI စာသားထုတ်လုပ်ခြင်း | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | Nvidia GeForce RTX 4070 | ASUS PRIME NVIDIA RTX 5070 Ti | NVIDIA RTX5070 |
| Phi ၏ စုစုပေါင်းရမှတ် | 1,933 | 2,080 | 3,191 | 4,179 | 3,453 |
| ပထမဆုံးတိုကင်သို့ Phi ထုတ်ပေးချိန် | 0.954 ့ | 0.855 ့ | 0.356 ့ | 0.290 ့ | 0.323 ့ |
| တစ်စက္ကန့်လျှင် Phi အထွက်တိုကင်များ | 139.187 တိုကင်/s | 144.471 တိုကင်/s | 141.575 တိုကင်/s | 192.487 တိုကင်/s | 150.435 တိုကင်/s |
| Phi ၏ စုစုပေါင်းကြာချိန် | 26.989 ့ | 25.587 ့ | 21.743 ့ | 15.771 ့ | 20.302 ့ |
| Mistral ၏ စုစုပေါင်းရမှတ် | 2,040 | 2.231 ့ | 2,987 | 4,412 | 3,562 |
| Mistral ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 1.109 ့ | 0.946 ့ | 0.508 ့ | 0.374 | 0.433 ့ |
| တစ်စက္ကန့်လျှင် Mistral Output Tokens များ | 101.300 တိုကင်/s | 103.348 တိုကင်/s | 99.590 တိုကင်/s | 160.167 တိုကင်/s | 120.507 တိုကင်/s |
| Mistral ၏ စုစုပေါင်းကြာချိန် | 34.960 ့ | 33.350 ့ | 30.651 ့ | 19.480 ့ | 25.496 ့ |
| Llama3 အလုံးစုံရမှတ် | 1,904 | 2,070 | 2,810 | 4,187 | 3,125 |
| Llama3 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.981 ့ | 0.845 ့ | 0.423 | 0.306 ့ | 0.379 ့ |
| တစ်စက္ကန့်လျှင် Llama3 အထွက်တိုကင်များ | 87.594 တိုကင်/s | 89.102 တိုကင်/s | 82.130 တိုကင်/s | 131.583 တိုကင်/s | 100.388 တိုကင်/s |
| Llama3 ၏ စုစုပေါင်းကြာချိန် | 38.273 ့ | 36.742 ့ | 36.147 ့ | 22.786 ့ | 29.720 ့ |
| Llama2 အလုံးစုံရမှတ် | 2,047 | 2,298 | 2,658 | 4,284 | 3,125 |
| Llama2 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 1.926 ့ | 1.565 ့ | 0.947 ့ | 0.560 ့ | 0.785 ့ |
| တစ်စက္ကန့်လျှင် Llama2 အထွက်တိုကင်များ | 59.673 တိုကင်/s | 61.127 တိုကင်/s | 49.487 တိုကင်/s | 75.905 တိုကင်/s | ၅၆.၆၄၇ တိုကင်/စက္ကန့် |
| Llama2 ၏ စုစုပေါင်းကြာချိန် | 59.100 ့ | 55.520 ့ | 61.300 ့ | 39.545 ့ | 53.234 ့ |
UL Procyon AI Text Generation စမ်းသပ်မှုတွင် ASUS Prime NVIDIA RTX 5070 Ti သည် မော်ဒယ်အားလုံးတွင် အမြင့်ဆုံးရမှတ်များဖြင့် ဦးဆောင်နေသည်။ ၎င်းသည် Phi တွင် ၄,၁၇၉ မှတ်၊ Mistral တွင် ၄,၄၁၂ မှတ်၊ Llama3 တွင် ၄,၁၈၇ မှတ် နှင့် Llama2 တွင် ၄,၂၈၄ မှတ် ရရှိထားသည်။ AMD Radeon RX 9070 XT သည် Phi တွင် ၂,၀၈၀ မှတ်၊ Mistral တွင် ၂,၂၃၁ မှတ်၊ Llama3 တွင် ၂,၀၇၀ မှတ် နှင့် Llama2 တွင် ၂,၂၉၈ မှတ် အသီးသီးဖြင့် နီးကပ်စွာ လိုက်လံလျက်ရှိသည်။ NVIDIA GeForce RTX 4070 သည် Phi တွင် ၃,၁၉၁ မှတ်၊ Mistral တွင် ၂,၉၈၇ မှတ်၊ Llama3 တွင် ၂,၈၁၀ မှတ် နှင့် Llama2 တွင် ၂,၆၅၈ မှတ် အသီးသီး ရရှိထားပြီး နောက်မှ လိုက်နေသည်။ AMD Radeon RX 9070 သည် Phi တွင် 1,933၊ Mistral တွင် 2,040၊ Llama3 တွင် 1,904 နှင့် Llama2 တွင် 2,047 ရရှိခဲ့ပြီး အမျိုးအစားအားလုံးတွင် အနိမ့်ဆုံးရမှတ်များဖြင့် နောက်ကျကျန်နေခဲ့သည်။
UL ပရိုဆိုင်ယွန်- AI ရုပ်ပုံမျိုးဆက်
Procyon AI Image Generation Benchmark သည် ပါဝါနည်း NPU များမှ အဆင့်မြင့် GPU များအထိ မတူညီသော ဟာ့ဒ်ဝဲများတွင် AI inference စွမ်းဆောင်ရည်ကို စဉ်ဆက်မပြတ်နှင့် တိကျစွာ တိုင်းတာပေးသည်။ ၎င်းတွင် စမ်းသပ်မှုသုံးခု ပါဝင်သည်- အဆင့်မြင့် GPU များအတွက် Stable Diffusion XL (FP16)၊ အလယ်အလတ် ပါဝါအားကောင်း GPU များအတွက် Stable Diffusion 1.5 (FP16) နှင့် ပါဝါနည်း စက်ပစ္စည်းများအတွက် Stable Diffusion 1.5 (INT8)။ benchmark သည် စနစ်တစ်ခုစီအတွက် အကောင်းဆုံး inference engine ကိုအသုံးပြုပြီး တရားမျှတပြီး နှိုင်းယှဉ်နိုင်သော ရလဒ်များကို သေချာစေသည်။
| UL Procyon: AI Image Generation (အလုံးစုံရမှတ်- မြင့်လေ ပိုကောင်းလေ) | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | Nvidia GeForce RTX 4070 | ASUS PRIME NVIDIA RTX 5070 Ti | NVIDIA RTX5070 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — အလုံးစုံရမှတ် | 2,280 | 2,598 | 2,400 | 3,755 | 2,937 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — ಒಟ್ಟಾರೆအချိန် | 43.858 ့ | 38.481 ့ | 41.661 | 26.625 ့ | 34.038 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) — အလုံးစုံရမှတ် | N / A | N / A | 31,048 | 46,744 | 36,320 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) — ಒಟ್ಟಾರೆအချိန် | N / A | N / A | 8.052 ့ | 5.348 ့ | 6.883 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT8) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | N / A | N / A | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — အလုံးစုံရမှတ် | 1,805 | 2,010 | 1,940 | 3,352 | 2,473 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — ಒಟ್ಟಾರೆအချိန် | 332.400 ့ | 298.499 ့ | 309.269 ့ | 178.946 ့ | 242.606 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
AI Image Generation စမ်းသပ်မှုတွင် Stable Diffusion 1.5 (FP16) နှင့် Stable Diffusion XL (FP16) ကို အဓိကထား၍ AMD Radeon RX 9070 စီးရီးသည် ကောင်းမွန်စွာ စွမ်းဆောင်ရည်ရှိသော်လည်း NVIDIA က သာလွန်ခဲ့သည်။ RX 9070 သည် 2,280 မှတ်၊ RX 9070 XT သည် 2,598 မှတ်၊ NVIDIA RTX 4070 သည် 2,400 မှတ်နှင့် ASUS Prime NVIDIA RTX 5070 Ti သည် 3,755 မှတ်ဖြင့် ထိပ်ဆုံးမှ ရပ်တည်ခဲ့သည်။ RX 9070 XT သည် Stable Diffusion XL (FP16) စမ်းသပ်မှုတွင် 4070 ထက် 2,010 မှတ်ဖြင့် အနည်းငယ် စွမ်းဆောင်ရည် မြင့်မားသော်လည်း 5070 Ti ၏ 3,352 မှတ်ထက် နောက်ကျနေဆဲဖြစ်သည်။ Radeon ကတ်များသည် 5070 Ti ထက် ပုံရိပ်ထုတ်လုပ်မှု အချိန်များ နှေးကွေးခဲ့သည်။
လပ်စ်မာ့ခ်
Luxmark သည် open-source ray tracing renderer ဖြစ်သော LuxRender ကို အသုံးပြု၍ အသေးစိတ်ကျသော 3D မြင်ကွင်းများကို ကိုင်တွယ်ရာတွင် စနစ်၏စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည့် GPU benchmark တစ်ခုဖြစ်သည်။ ဤ benchmark သည် server များနှင့် workstation များ၏ graphical rendering စွမ်းရည်ကို အကဲဖြတ်ရန်အတွက် အထူးသဖြင့် visual effect များနှင့် architectural visualization application များအတွက် တိကျသော အလင်း simulation သည် အရေးကြီးပါသည်။
| Luxmark (မြင့်လေ ပိုကောင်းလေ) | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | Nvidia GeForce RTX 4070 | ASUS PRIME NVIDIA RTX 5070 Ti | NVIDIA RTX5070 |
| အစားအသောက်ရမှတ် | 8,233 | 8,610 | 7,535 | 12,073 | 9,061 |
| ခန်းမရမှတ် | 16,566 | 16,758 | 20,003 | 28,635 | 22,062 |
Luxmark စမ်းသပ်မှုများတွင် ASUS Prime NVIDIA RTX 5070 Ti သည် အမျိုးအစားနှစ်ခုလုံးတွင် ဦးဆောင်နေသည်။ ၎င်းသည် Food စမ်းသပ်မှုတွင် 12,073 မှတ်နှင့် Hall စမ်းသပ်မှုတွင် 28,635 မှတ်ရရှိပြီး ဘုတ်အဖွဲ့တစ်ခုလုံးတွင် ကောင်းမွန်သောစွမ်းဆောင်ရည်ကို ပြသနေသည်။ AMD Radeon RX 9070 XT သည် Food စမ်းသပ်မှုတွင် 8,610 မှတ်နှင့် Hall စမ်းသပ်မှုတွင် 16,758 မှတ်ဖြင့် အနီးကပ်လိုက်နေပြီး စံ RX 9070 ထက် အနည်းငယ်သာလွန်သည်။ RX 9070 သည် Food စမ်းသပ်မှုတွင် 8,233 မှတ်နှင့် Hall စမ်းသပ်မှုတွင် 16,566 မှတ်ရရှိပြီး NVIDIA GeForce RTX 4070 သည် Food စမ်းသပ်မှုတွင် 7,535 မှတ်နှင့် Hall စမ်းသပ်မှုတွင် 20,003 မှတ်ဖြင့် နောက်ကျကျန်ခဲ့သည်။ အလုံးစုံပြောရလျှင် RTX 5070 Ti သည် စမ်းသပ်မှုနှစ်ခုလုံးတွင် 4070 နောက်ကျကျန်နေသောကြောင့် ထင်ရှားစွာ ဦးဆောင်နေသည်။
Geekbench 6
Geekbench 6 သည် အလုံးစုံစနစ်စွမ်းဆောင်ရည်ကို တိုင်းတာသည့် cross-platform benchmark တစ်ခုဖြစ်သည်။ Geekbench Browser သည် မည်သည့်စနစ်နှင့်မဆို နှိုင်းယှဉ်နိုင်စေပါသည်။
| Geekbench (မြင့်လေ ပိုကောင်းလေ) | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | Nvidia GeForce RTX 4070 | ASUS PRIME NVIDIA RTX 5070 Ti | NVIDIA RTX5070 |
| GPU OpenCL ရမှတ် | 138,463 | 173,255 | 174,725 | 246,875 | 188,892 |
Geekbench GPU OpenCL စမ်းသပ်မှုမှာ ASUS Prime NVIDIA RTX 5070 Ti က ရမှတ် ၂၄၆,၈၇၅ နဲ့ ဦးဆောင်နေပြီး ပြိုင်ဘက်တွေထက် သိသိသာသာ သာလွန်နေပါတယ်။ NVIDIA GeForce RTX 4070 က AMD Radeon ကတ်နှစ်ခုလုံးထက် ရမှတ် ၁၇၄,၇၂၅ နဲ့ ဒုတိယနေရာမှာ ရှိနေပါတယ်။ AMD Radeon RX 9070 XT က ရမှတ် ၁၇၃,၂၅၅ နဲ့ ဒုတိယနေရာမှာ ရှိနေပြီး RTX 4070 ထက် အနည်းငယ်သာ နောက်ကျနေပါတယ်။ စံ RX 9070 က ရမှတ် ၁၃၈,၄၆၃ နဲ့ နောက်ကျနေပြီး ဒီစမ်းသပ်မှုမှာ နောက်ဆုံးနေရာမှာ ရှိနေပါတယ်။
မာကု 3
3DMark Port Royal၊ Speed Way နှင့် Steel Nomad တို့သည် မတူညီသော အခြေအနေများတွင် GPU စွမ်းဆောင်ရည်ကို စမ်းသပ်သည့် benchmark များဖြစ်သည်။ Port Royal သည် ray tracing ကို အာရုံစိုက်ပြီး Speed Way သည် racing simulations များတွင် စွမ်းဆောင်ရည်ကို အကဲဖြတ်ပြီး Steel Nomad သည် မြင့်မားသော intensity၊ လက်တွေ့ကျသော ဂရပ်ဖစ်များဖြင့် GPU များကို စိန်ခေါ်သည်။ ၎င်းတို့သည် rendering၊ lighting နှင့် dynamic scenes များတွင် GPU စွမ်းရည်များကို အကဲဖြတ်သည်။
| 3DMark စမ်းသပ်မှု (မြင့်လေ ပိုကောင်းလေ) | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | Nvidia GeForce RTX 4070 | ASUS PRIME NVIDIA RTX 5070 Ti | NVIDIA RTX5070 |
| ဆိပ်ကမ်းတော်ဝင် | 15,760 | 17,989 | 11,074 | 19,290 | 14,026 |
| မြန်နှုန်းမြင့်လမ်း | 5,791 | 6,237 | 4,477 | 7,709 | 5,869 |
| သံမဏိ Nomad | 5,992 | 6,977 | 3,748 | 6,458 | 5,019 |
ဂိမ်းကစားခြင်းကို အဓိကထားသော 3DMark benchmarks များတွင် AMD Radeon RX 9070 နှင့် 9070 XT တို့သည် NVIDIA RTX 5070 ထက် စွမ်းဆောင်ရည်ပိုမိုကောင်းမွန်ပြီး AMD Radeon RX 9070 သည် ပျမ်းမျှ ၁၇% မြင့်မားပြီး RX 9070 XT သည် စမ်းသပ်မှုများတွင် ၂၈% မြင့်မားသည်။ RTX 5070 သည် ray tracing တွင် ၎င်း၏ကိုယ်ပိုင်အားသာချက်ရှိသော်လည်း AMD ၏ကတ်များသည် raw gaming စွမ်းဆောင်ရည်အတွက် ပိုမိုအားကောင်းသောရွေးချယ်မှုကို ပေးစွမ်းသည်။
ပါဝါသုံးစွဲမှု: ASUS Prime Radeon RX 9070 XT
ပါဝါသုံးစွဲမှုသည် မည်သည့် high သို့မဟုတ် low-end computing platform တွင်မဆို သိသာထင်ရှားသော အစိတ်အပိုင်းတစ်ခုဖြစ်သည်။ GPU မျိုးဆက်သစ်တစ်ခုစီသည် load အောက်တွင် ပါဝါပိုမိုသုံးစွဲပြီး ဆိုလိုသည်မှာ power supply များ ပိုမိုများပြားပြီး အအေးပေးရန်အတွက် လေစီးဆင်းမှု လုံလောက်ပါသည်။ သို့သော် ပါဝါစွမ်းဆောင်ရည်နှင့်ပတ်သက်သည့် အခြားရှုထောင့်တစ်ခုရှိသည်- ပိုမိုမြန်ဆန်သော GPU များသည် ပိုမိုမြင့်မားစွာ မြင့်တက်လာနိုင်သော်လည်း workload တစ်ခုချင်းစီ၏ ကြာချိန် လျော့ကျသွားသည်။
ASUS PRIME RX 9070 XT ရဲ့ ပါဝါသုံးစွဲမှုကို ကျွန်တော်တို့ စမ်းသပ်ခဲ့ပြီး၊ ၎င်းမှာ 304W TDP အဆင့်သတ်မှတ်ချက် ရှိပါတယ်။ Procyon AI image-generation စမ်းသပ်မှုအတွင်း၊ အားကုန်ချိန်မှာ ပါဝါသုံးစွဲမှုက 243W မှ load လုပ်နေချိန်မှာ 849W အထိ မြင့်တက်လာပြီး 606W တိုးလာပါတယ်။ load လုပ်နေချိန်မှာ ပျမ်းမျှပါဝါသုံးစွဲမှုက 676W ခန့်ရှိပါတယ်။ ဒါဟာ NVIDIA မော်ဒယ်တွေထက် တူညီတဲ့ကာလအတွင်းမှာ ပိုများပြီး စနစ်တစ်ခုလုံးမှာ ဝန်ပိုစေပါတယ်။
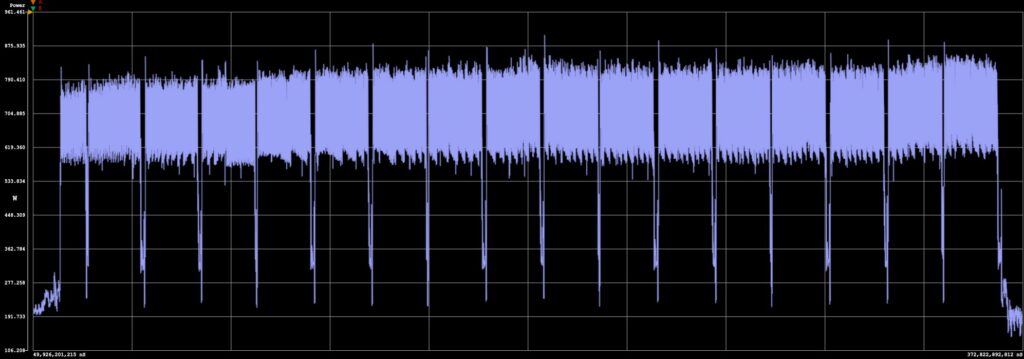 ဒုတိယမြောက် နောက်ဆုံးပုံရိပ်ကို ၁၁.၁ စက္ကန့်အတွင်း ထုတ်လုပ်ခဲ့ပြီး စနစ်သည် ထိုအချိန်ကာလအတွင်း 3.41Wh သုံးစွဲခဲ့သည်။
| ပါဝါစမ်းသပ်ခြင်း အကျဉ်းချုပ် |
AMD 9070 XT | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 | NVIDIA RTX5090 |
| ပါဝါသုံးစွဲမှု | 3.41Wh | 2.46Wh | 1.66Wh | 1.39Wh | 1.16Wh |
| စမ်းသပ်ကာလ | 17.4 ့ | 19.2 ့ | 11.1 ့ | 8.7 ့ | 5.1 ့ |
ကောက်ချက်
AMD မှထုတ်လုပ်သော ASUS Prime Radeon RX 9070 စီးရီးသည် မြင့်မားသောစွမ်းဆောင်ရည်၊ ထိရောက်မှုနှင့် ဈေးနှုန်းသင့်တင့်မှုတို့ကို ပေါင်းစပ်ထားသောကြောင့် ဂိမ်းကစားသူများနှင့် အကြောင်းအရာဖန်တီးသူများအတွက် အကောင်းဆုံးရွေးချယ်မှုတစ်ခုဖြစ်သည်။ RDNA 4 ဗိသုကာဖြင့်တည်ဆောက်ထားသော ဤ GPU များသည် 1440p နှင့် 4K ဂိမ်းကစားခြင်းတွင် ထူးချွန်ပြီး entry-level AI workloads များကို ကိုင်တွယ်နိုင်သည်။ 16GB GDDR6 မှတ်ဉာဏ်ဖြင့် RX 9070 သည် တောင်းဆိုမှုများသော အလုပ်များအတွက် bandwidth လုံလောက်စွာရရှိစေရန် သေချာစေသည်။
တတိယမျိုးဆက် Ray tracing (RT) Accelerators များသည် ဒုတိယ ray intersection engine နှင့် ယခင် RDNA 3 ထက် double ray traversal စွမ်းရည်ကို ပိုမိုကောင်းမွန်အောင်ပြုလုပ်ခြင်းအပါအဝင် သိသာထင်ရှားသောတိုးတက်မှုများကို ပေးစွမ်းသည်။ ထို့အပြင်၊ RX 9070 စီးရီးသည် ဒုတိယမျိုးဆက် AI Accelerators များကို ပံ့ပိုးပေးပြီး ဂိမ်းကစားခြင်းနှင့် အကြောင်းအရာဖန်တီးမှုတွင် ပိုမိုမြန်ဆန်သောလုပ်ဆောင်မှုအတွက် AI စွမ်းဆောင်ရည်ကို မြှင့်တင်ပေးသည့် data အမျိုးအစားအသစ်များနှင့် optimization များအတွက် ပံ့ပိုးမှုပေးပါသည်။
ASUS Prime Radeon RX 9070 စီးရီးသည် ဂိမ်းအလုပ်များတွင် ကောင်းမွန်စွာ စွမ်းဆောင်ရည်ရှိသော်လည်း AI အလုပ်များတွင်မူ နောက်ကျကျန်နေခဲ့သည်။ ရုပ်ပုံထုတ်လုပ်မှုကဲ့သို့သော နယ်ပယ်များတွင် 9070 XT သည် NVIDIA ၏ ပြိုင်ဘက်များထက် တူညီသောအလုပ်များကို ပြီးမြောက်ရန် ပါဝါပိုမိုသုံးစွဲသည်။ ဤပါဝါသုံးစွဲမှုမြင့်မားခြင်းသည် ရှည်လျားသောအလုပ်များတွင် စွမ်းဆောင်ရည်ကို ထိခိုက်စေပြီး NVIDIA သည် စွမ်းဆောင်ရည်နှင့် AI အလုပ်များတွင် အားသာချက်ရှိသည်။ သို့သော် RX 9070 စီးရီးသည် ပိုမိုတတ်နိုင်သောစျေးနှုန်းဖြင့် ခိုင်မာသောရလဒ်များကို ပေးဆောင်ပြီး AI အရှိန်မြှင့်တင်မှုနှင့် အထွေထွေရည်ရွယ်ချက်စွမ်းဆောင်ရည်ကို ရှာဖွေနေသော အသုံးပြုသူများအတွက် ဆွဲဆောင်မှုရှိသော ရွေးချယ်မှုတစ်ခုဖြစ်စေသည်။ drivers များသည် AI အလုပ်အချို့ကို ကန့်သတ်ထားသော်လည်း ကတ်များရင့်ကျက်လာသည်နှင့်အမျှ ဤနေရာတွင် တိုးတက်မှုကို မြင်တွေ့ရမည်ဟု မျှော်လင့်ပြီး ဤကဏ္ဍတွင် AMD ၏ ဆက်လက်ရင်းနှီးမြှုပ်နှံမှုသည် အကျိုးဖြစ်ထွန်းစေပြီး စားသုံးသူများအား ရွေးချယ်စရာများ ပိုမိုပေးစွမ်းလိမ့်မည်ဟု ကျွန်ုပ်တို့ မျှော်လင့်ပါသည်။


 အမေဇုံ