

Comino က မကြာသေးမီက ကျွန်ုပ်တို့ထံ ပြန်လည်သုံးသပ်ရန် Comino Grando ၏ နောက်ဆုံးထွက်ဗားရှင်းကို ပေးပို့ခဲ့ပြီး NVIDIA RTX PRO 6000 Blackwell ကတ်ရှစ်ကတ်ဖြင့် ပြင်ဆင်ထားပြီး ကတ်တစ်ခုစီတွင် 96GB VRAM ပါရှိပြီး GPU မှတ်ဉာဏ် စုစုပေါင်း 768GB ရှိသည်။ ကျွန်ုပ်တို့သည် ၂၀၂၄ ခုနှစ်တွင် 6x RTX 4090s ဖြင့် ပြင်ဆင်ထားပြီး GPU မှတ်ဉာဏ် စုစုပေါင်း 144GB ပါရှိသည့်အပြင် NVIDIA H100's ပါရှိသော ဗားရှင်းကိုလည်း ပြန်လည်သုံးသပ်ခဲ့သည် ။ ဤနောက်ဆုံးထွက် အပ်ဒိတ်သည် raw memory စွမ်းရည်နှင့် ပလက်ဖောင်းက ဖြေရှင်းနိုင်သည့် workloads အမျိုးမျိုးတွင် မျိုးဆက်တစ်ခု၏ ကြီးမားသော ခုန်ပျံကျော်လွှားမှုကို အမှတ်အသားပြုသည်။
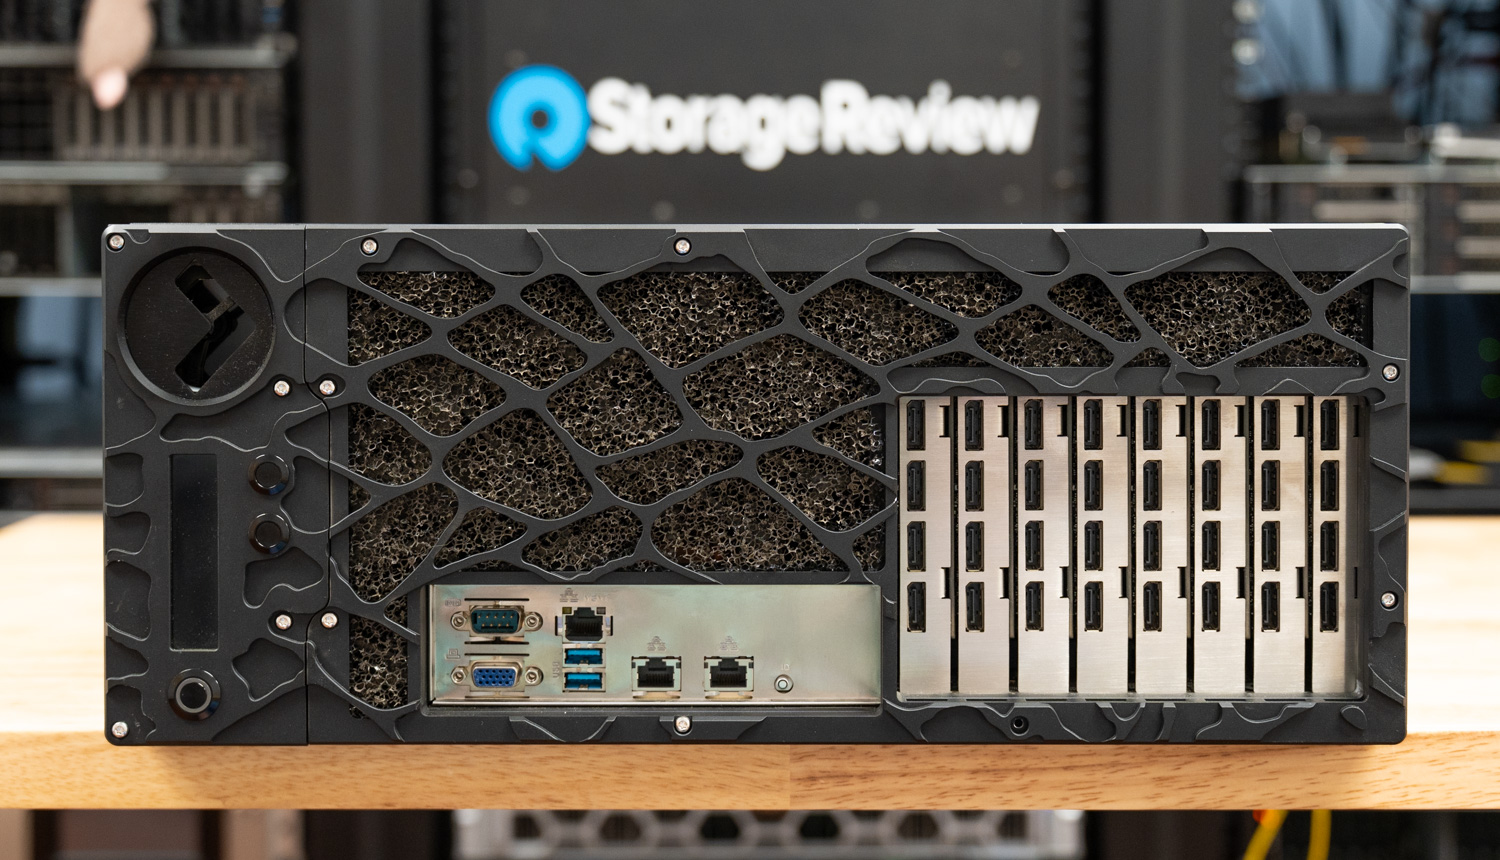
Grando သည် မြင့်မားသောသိပ်သည်းဆ GPU တွက်ချက်မှုနှင့် အပူချိန်စီမံခန့်ခွဲမှုကြားရှိ အရေးကြီးသောပဋိပက္ခကို ဖြေရှင်းရန် ဒီဇိုင်းထုတ်ထားသော ရည်ရွယ်ချက်ရှိရှိတည်ဆောက်ထားသော 4U ပလက်ဖောင်းတစ်ခုဖြစ်သည်။ စံလေအေးပေးသည့်ကိုယ်ထည်သည် ခေတ်မီပရော်ဖက်ရှင်နယ်ကတ်များ၏ စဉ်ဆက်မပြတ် 600W+ TDP လိုအပ်ချက်များအောက်တွင် ပြိုကွဲနေသော်လည်း Grando သည် အခြေခံအားဖြင့် ကွဲပြားသောချဉ်းကပ်မှုကို အသုံးပြုထားပြီး ကြီးမားသော 6.5kW အပူကို အဆက်မပြတ်စုပ်ယူနိုင်သော အရည်အေးပေးသည့်ဗိသုကာပုံစံကို အခြေခံမှတည်ဆောက်ထားသည်။ ၎င်းသည် ပြန်လည်ပြုပြင်မွမ်းမံခြင်း သို့မဟုတ် နောက်မှစဉ်းစားခြင်းမဟုတ်ပါ။ ၎င်း၏ပြောင်းပြန် motherboard အပြင်အဆင်မှ အရောင်ကုဒ်ဖြင့် အမြန်ဖြုတ်နိုင်သော manifold စနစ်အထိ ကိုယ်ထည်တစ်ခုလုံးကို အအေးပေးသည့်ကွင်းဆက်ပတ်လည်တွင် ဒီဇိုင်းထုတ်ထားသည်။
ရလဒ်အနေနဲ့ တစ်ခုတည်းသော 4U ကိုယ်ထည်တစ်ခုတည်းမှာ full-TDP professional GPU ရှစ်ခုကို ထောက်ပံ့ပေးနိုင်တဲ့ platform တစ်ခုဖြစ်ပြီး 3-38°C အပူချိန်ရှိတဲ့ ပတ်ဝန်းကျင်မှာ ၂၄/၇ လည်ပတ်နိုင်ခြင်း၊ thermal throttling မရှိဘဲ၊ high-RPM air cooling ရဲ့ acoustic assault မရှိဘဲ၊ ဝန်ဆောင်မှုပေးနိုင်မှုကို မထိခိုက်စေဘဲ လည်ပတ်နိုင်ပါတယ်။ AI inference၊ machine learning training ဒါမှမဟုတ် high-performance simulation workloads တွေကို ကျယ်ကျယ်ပြန့်ပြန့် ဖြန့်ကျက်နေတဲ့ အဖွဲ့အစည်းတွေအတွက် Grando က တကယ်ကို ရှားပါးတဲ့အရာတစ်ခုကို ပေးစွမ်းပါတယ်- density၊ thermal နဲ့ reliability အကြား ရွေးချယ်ဖို့ မတောင်းဆိုတဲ့ server တစ်ခုပါပဲ။
Comino Grando သတ်မှတ်ချက်များ
အောက်ဖော်ပြပါဇယားတွင် Comino Grando ပလပ်ဖောင်းအတွက် ရုပ်ပိုင်းဆိုင်ရာသတ်မှတ်ချက်များနှင့် ပံ့ပိုးပေးထားသော ဟာ့ဒ်ဝဲဖွဲ့စည်းပုံများကို ပြသထားသည်။
| Specification/ Feature တွေပါ။ | ကိုမီနို ဂရန်ဒို |
|---|---|
| Comino Grando Server နှင့် Rackable Workstation | |
| စွမ်းရည်အေး | ၆.၅kW (၂၀°C တွင် အများဆုံး ၆ ၅၀၀ W စုပ်ယူနိုင်သောလေ) |
| motherboards | EATX နှင့် EBB အထိ |
| GPU များ (ဆာဗာ) | ၂ အထိ; NVIDIA: RTX A6000၊ RTX 6000 ADA၊ RTX PRO 6000၊ A40၊ L40၊ L40S၊ A100၊ H100၊ H200 |
| GPU များ (Rackable Workstation) | ၂ အထိ; NVIDIA: 3090, 4090, 5080, 5090, RTX A6000, RTX 6000 ADA, RTX PRO 6000, A40, L40, L40S, A100, H100, H200; AMD: W7800၊ W7900 |
| CPU များ | ၂ အထိ; တစ်ခုတည်းသော Socket: Intel Xeon W-2400/2500 & 3400/3500, Intel Xeon Scalable 4th Gen, 5th Gen, XEON 6, AMD Threadripper PRO 5000WX, 7000WX, 9000WX, AMD EPYC 9004/9005 Dual Socket: Intel Xeon Scalable 4th Gen နှင့် 5th Gen၊ XEON 6၊ AMD EPYC 9004/9005 |
| ရမ် | 2TB အထိ |
| M2 ဒရိုက်များ | NVME ၈ ဆအထိ |
| သိုလှောင်ခြင်း | နောက်ဘက် panel hot swap cages: 4x hot swap SSDs (4x 7mm သို့မဟုတ် 2x 15mm) အထိနှင့် 4th PSU အစား နောက်ထပ် 4x (4x 7mm သို့မဟုတ် 2x 15mm) အထိ။ အတွင်းပိုင်း ၃.၅ လက်မ လှောင်အိမ်၊ ၄x ၃.၅ လက်မ သို့မဟုတ် ၄x ၂.၅ လက်မ ၁၅ မီလီမီတာ သို့မဟုတ် ၁၂x ၂.၅ လက်မ ၇ မီလီမီတာအထိ။ အတွင်းပိုင်း ၂.၅ လက်မ slot များ- ၂.၅ လက်မ SSD ၇ မီလီမီတာ ၄ ခုအထိ |
| ပါဝါထောက်ပံ့မှုနှင့် လည်ပတ်မှုဗို့အား | ၉၀-၁၄၀ ဗို့တွင် ၄ x 2000W Hot Swap CRPS အထိ ၉၀-၁၄၀ ဗို့တွင် ၄ x 1000W Hot Swap CRPS အထိ ထပ်ဆင့်မုဒ်များ- ၄+၀၊ ၃+၁၊ ၂+၂ |
| ဆူညံသံအဆင့်အထိ | ၁၁dB-၂၀dB |
| Lan | MoBo မှာ 2x 10 Gbit/s အထိနဲ့ PCIe မှာ 400Gbit/s အထိ ရရှိနိုင်ပါတယ်။ |
| OS | Ubuntu / Windows 11 (Pro/Home) / Windows Server |
| ရုပ်ပိုင်းဆိုင်ရာနှင့် အအေးပေးစနစ်ဆိုင်ရာ သတ်မှတ်ချက်များ | |
| အရည်အေး | VRM ပါသော CPU နှင့် GDDR နှင့် VRM ပါသော GPU |
| ရေလှောင်ကန် | Comino စိတ်ကြိုက် ၄၅၀ မီလီလီတာ ပါဝင်သော ပန့်များ |
| ပရိသတ်များ | ၃x Ultra High Flow 6200RPM (ဆူညံသံအဆင့်မြင့်မားခြင်း) သို့မဟုတ် ၃x High Flow 3000RPM (ဆူညံသံနည်း) |
| installation | ၁၉ လက်မ rack မှာ တပ်ဆင်အသုံးပြုနိုင်သလို၊ Workstation အနေနဲ့လည်း သီးခြားအသုံးပြုနိုင်ပါတယ်။ |
| လိုအပ်သော rack နေရာ | 4U |
| အရွယ် | ၄၃၉ x ၆၈၁ x ၁၇၇ မီလီမီတာ (လက်ကိုင်များနှင့် ထွက်နေသော အစိတ်အပိုင်းများ မပါ) |
| အလေးချိန် | GPU ၈ ခု: ၅၅ ကီလိုဂရမ် (အသားတင်)၊ ၇၂ ကီလိုဂရမ် (စုစုပေါင်း) GPU ၈ ခု: ၅၅ ကီလိုဂရမ် (အသားတင်)၊ ၇၂ ကီလိုဂရမ် (စုစုပေါင်း) GPU ၈ ခု: ၅၅ ကီလိုဂရမ် (အသားတင်)၊ ၇၂ ကီလိုဂရမ် (စုစုပေါင်း) |
| လည်ပတ်မှုနှင့် သိုလှောင်မှု အပူချိန်အပိုင်းအခြား | သိုလှောင်မှု: -၅..၅၀°C / ၂၃..၁၂၂°F လည်ပတ်မှု: ၃..၃၈°C / ၃၈..၁၀၀°F |
| Comino စောင့်ကြည့်ရေးစနစ် (CMS) | |
| ျခံဳငံုသံုးသပ္မႈ | အချိန်နှင့်တပြေးညီ စောင့်ကြည့်ရန်အတွက် အာရုံခံကိရိယာများနှင့် ဆော့ဖ်ဝဲပါရှိသော ထိန်းချုပ်ကိရိယာဘုတ် |
| အဓိကအားသာချက်များ | အအေးပေးစနစ်နှင့် CPU/GPU စောင့်ကြည့်ခြင်း၊ ဝက်ဘ်မျက်နှာပြင်၊ အအေးပေးစနစ်မှတ်တမ်း၊ အလုပ်အဖွဲ့များအတွက် ဗဟိုထိန်းချုပ်မှု စောင့်ကြည့်ခြင်း |
| အာရုံခံကိရိယာများနှင့် ချိတ်ဆက်ထားသော ကိရိယာများ | အပူချိန် (လေနှင့် အအေးခံရည်)၊ % စိုထိုင်းဆ၊ ဗို့အား၊ အအေးခံရည်စီးဆင်းမှု၊ ရေလှောင်ကန် အအေးခံရည်အဆင့်၊ ပန်ကာများ၊ ပန့်များ၊ မာစတာဘုတ်၊ မျက်နှာပြင်နှင့် ခလုတ်များ |
| ပေါင်းစည်းရေး ဖြစ်နိုင်ခြေများ | REST API မှတစ်ဆင့် စောင့်ကြည့်ခြင်းကို တည်ဆောက်ပြီး အာရုံခံကိရိယာဒေတာကို စောင့်ကြည့်ရေးဆော့ဖ်ဝဲ (ဥပမာ Zabbix၊ Grafana) သို့မဟုတ် ဒေတာဘေ့စ်များ (ဥပမာ InfluxDB) သို့ ပေးပို့ပါ။ |
| CMS နည်းပညာဆိုင်ရာ လိုအပ်ချက်များ | |
| OS | Windows ကို 11 / 10 Ubuntu 22.04/20.4 (Ubuntu အတွက် မှီခိုမှု- target system တွင် nvidia-smi နှင့် sensors utilities များ install လုပ်ထားရမည်) |
| Web Browser | Mozilla Firefox၊ Google Chrome၊ Chromium၊ Apple Safari၊ Microsoft Edge (သတိပြုရန်- Internet Explorer 11 ကို မပံ့ပိုးပါ) |
| Hard Disk ကို Drive ကို | 300MB |
| ထိန်းချုပ်ကိရိယာ ဖာမ်းဝဲဗားရှင်း | ၄.၁.၂၀ သို့မဟုတ် နောက်ပိုင်းဗားရှင်း |
| ထိန်းချုပ်ကိရိယာ PCB ဗားရှင်း | 2.xx.xx |
ဒီဇိုင်း၊ တည်ဆောက်မှုနှင့် GPU သိပ်သည်းဆ
ကိုယ်ထည် အပြင်အဆင်နှင့် ဖြန့်ကျက်မှု
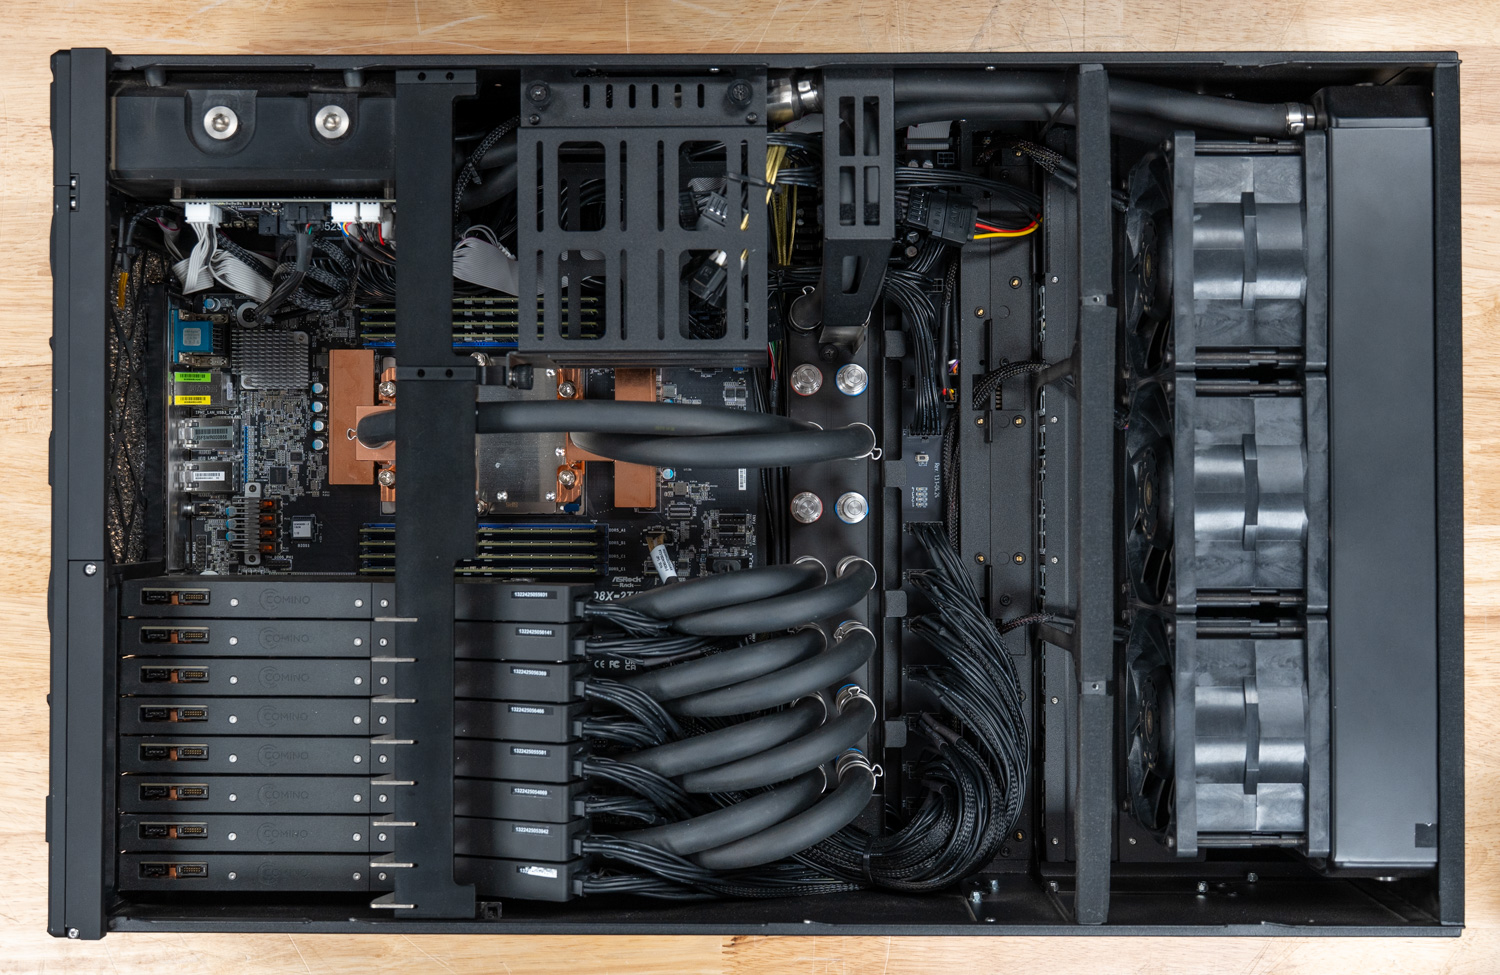
Grando Server သည် အရွယ်အစား ၁၇.၃ x ၂၆.၈ x ၆.၉၇ လက်မ (4U) ရှိပြီး နေရာချွေတာမှုတွင် masterclass တစ်ခုဖြစ်သည်။ ရိုးရာ server များနှင့်မတူဘဲ၊ motherboard ၏နောက်ကျောကို chassis ၏ရှေ့ဘက်တွင်ထားရှိပြီး ရိုးရာအတွင်းပိုင်းအပြင်အဆင်ကို ပြောင်းပြန်လှန်ထားသည်။ ၎င်းသည် RAM module များနှင့် VRM များကဲ့သို့သော လေအေးပေးသည့်အစိတ်အပိုင်းများသည် နောက်ဘက်ရှိ liquid-cooling radiator သို့မရောက်မီ အအေးဆုံး intake လေကိုလက်ခံရရှိကြောင်းသေချာစေသည်။
ကိုယ်ထည်ကိုယ်တိုင်က တူညီတဲ့ တိကျတဲ့စံနှုန်းနဲ့ တည်ဆောက်ထားပြီး အတွင်းအပြင်မှာ matte black powder-coat finish နဲ့ ခိုင်ခံ့တဲ့သံမဏိတည်ဆောက်ပုံ ပါဝင်ပါတယ်။ ဒီရည်ရွယ်ချက်ရှိရှိရွေးချယ်မှုက ပိုက်လိုင်းတွေ၊ ကြိုးတွေ၊ radiator နဲ့ PCB solder mask အထိ ကျယ်ပြန့်ပြီး သန့်ရှင်းပြီး ပရော်ဖက်ရှင်နယ်ဆန်တဲ့ အလှအပအတွက် ရှင်းလင်းတဲ့ရည်ရွယ်ချက်ကို ထင်ဟပ်စေပါတယ်။ ထို့အပြင်၊ စနစ်သည် ၁၉ လက်မ rack-mountable unit သို့မဟုတ် standalone desktop unit အဖြစ် ချောမွေ့စွာလုပ်ဆောင်နိုင်ပြီး စွယ်စုံသုံး ဖြန့်ကျက်မှုကို ပံ့ပိုးပေးပါတယ်။ ဖွဲ့စည်းမှုပုံစံပေါ်မူတည်ပြီး အလေးချိန် ၁၄၈ ပေါင်မှ ၁၅၉ ပေါင်ကြား ရှိပါတယ်။
GPU အအေးပြားများနှင့် ရေဘလောက်များ
သီးသန့်ကြေးနီရေဘလောက်များသည် Grando ၏သိပ်သည်းဆ၏အဓိကအစိတ်အပိုင်းဖြစ်ပြီး GPU die ကိုသာမက memory နှင့် voltage regulators ကဲ့သို့သော အခြားအစိတ်အပိုင်းများကိုပါ အအေးပေးသည်။ GPU တစ်ခုစီကို စင်ပေါ်တွင်ရရှိနိုင်သောကတ်တစ်ခုအဖြစ် တင်ပို့ပြီး Comino သည် custom cold-plate assembly ကိုတပ်ဆင်ထားသည်။ လက်တွေ့တွင် ဤပါးလွှာသောပရိုဖိုင်ဒီဇိုင်းသည် ကတ်တစ်ခုစီကို single-slot footprint အထိလျှော့ချပေးပြီး professional GPU ခြောက်ခု သို့မဟုတ် ရှစ်ခုကို 4U chassis တစ်ခုတည်းတွင် ဘေးချင်းယှဉ်ထိုင်နိုင်စေသည်။ ကျွန်ုပ်တို့၏သုံးသပ်ချက်ယူနစ်တွင် NVIDIA RTX PRO 6000 Blackwell ကတ်ရှစ်ကတ်ပါရှိပြီး တစ်ခုချင်းစီတွင် TDP 600W ရှိပြီး full load အောက်တွင် စုစုပေါင်းအအေးခံရန်လိုအပ်ချက် 4,800W ရှိသည်။
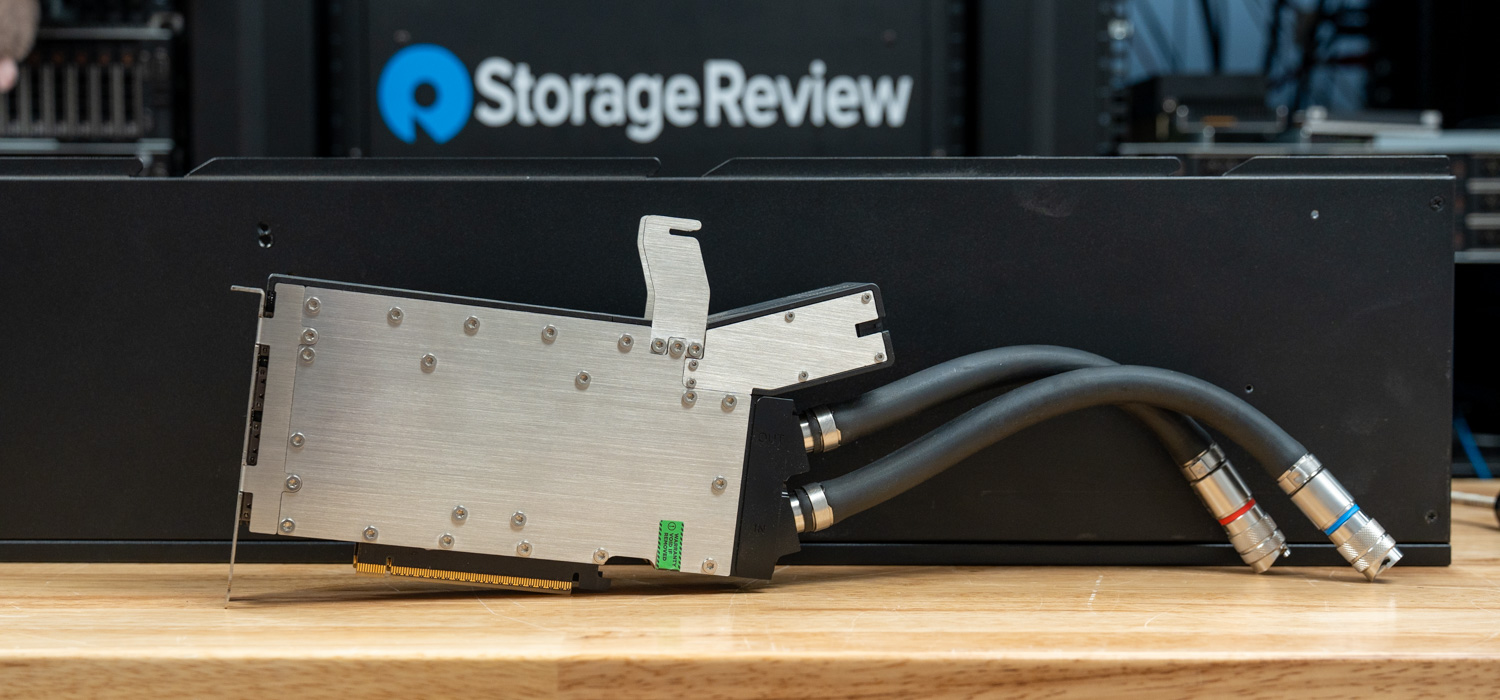
Comino ရဲ့ 8 single slot GPU density ကို air cooling နဲ့ ရရှိဖို့ဆိုတာ မဖြစ်နိုင်သလောက်ပါပဲ။ ဘာလို့လဲဆိုတော့ stock NVIDIA RTX PRO 6000 ကတ်တစ်ခုစီဟာ slot နှစ်ခုစာ နေရာယူထားပြီး လေစီးဆင်းမှု သိသိသာသာ လိုအပ်လို့ပါ။ ဆန့်ကျင်ဘက်အနေနဲ့ ဒီ custom-cooled ကတ်တွေက slot တစ်ခုစီမှာပဲ နေရာယူထားပါတယ်။ cold plate တွေကို ခိုင်ခိုင်မာမာ တည်ဆောက်ထားပြီး ကတ်တစ်ခုစီမှာ သိသာထင်ရှားတဲ့ အလေးချိန်ကို ထည့်သွင်းပေးထားပေမယ့် အဲဒီအလေးချိန်က ဒီအဆင့်မှာ လိုအပ်တဲ့ အရည်အသွေးနဲ့ အအေးပေးစွမ်းဆောင်ရည်ကို ထင်ဟပ်စေပါတယ်။
GPU အတွဲတစ်ခုစီကို ကတ်နှစ်ခုလုံးကို အဓိကအအေးပေးပိုက်နှင့် တစ်ခုတည်းသော အဝင်နှင့် အထွက်ချိတ်ဆက်မှုအဖြစ် ပေါင်းစည်းပေးသည့် သီးသန့် sub-manifold မှတစ်ဆင့် ချိတ်ဆက်ထားသည်။ ဤအတွဲလိုက်ချဉ်းကပ်မှုသည် အလုံးစုံ loop architecture ကို ရိုးရှင်းစေပြီး အဓိက manifold တွင် ချိတ်ဆက်မှုအရေအတွက်ကို လျှော့ချပေးကာ နည်းပညာရှင်တစ်ဦးအား ကတ်နှစ်ခုကို တစ်ပြိုင်နက်ဖယ်ရှားရန် quick-disconnect couplings တစ်စုံကို ဖြုတ်နိုင်စေပြီး ပြုပြင်ထိန်းသိမ်းမှုကို ပိုမိုချောမွေ့စေသည်။
ရေဖြန့်ဖြူးမှုနှင့် ရေလွှဲပိုက်
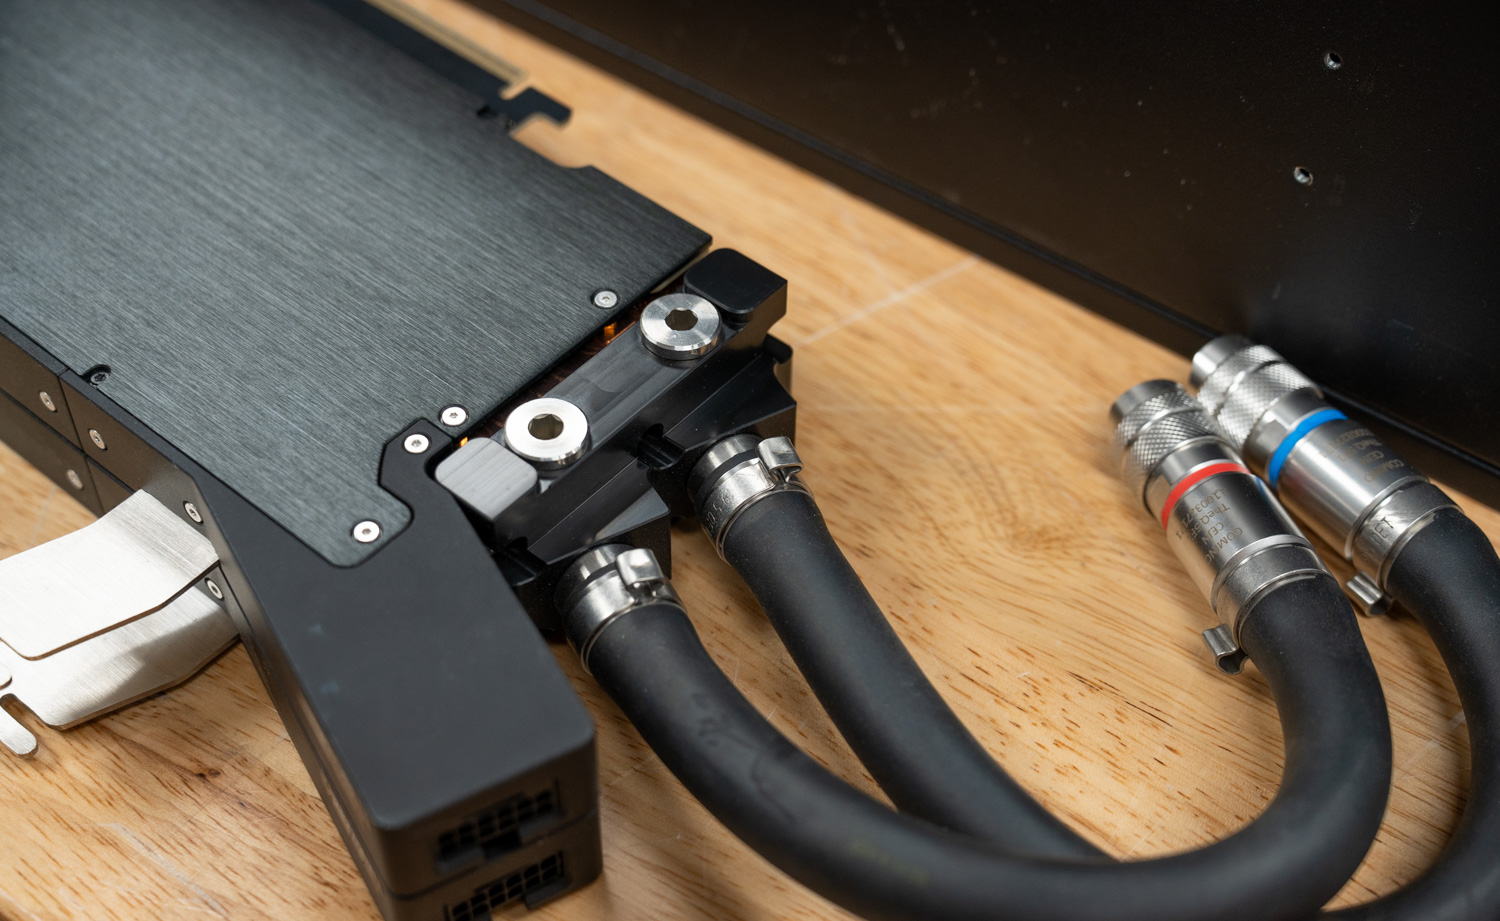
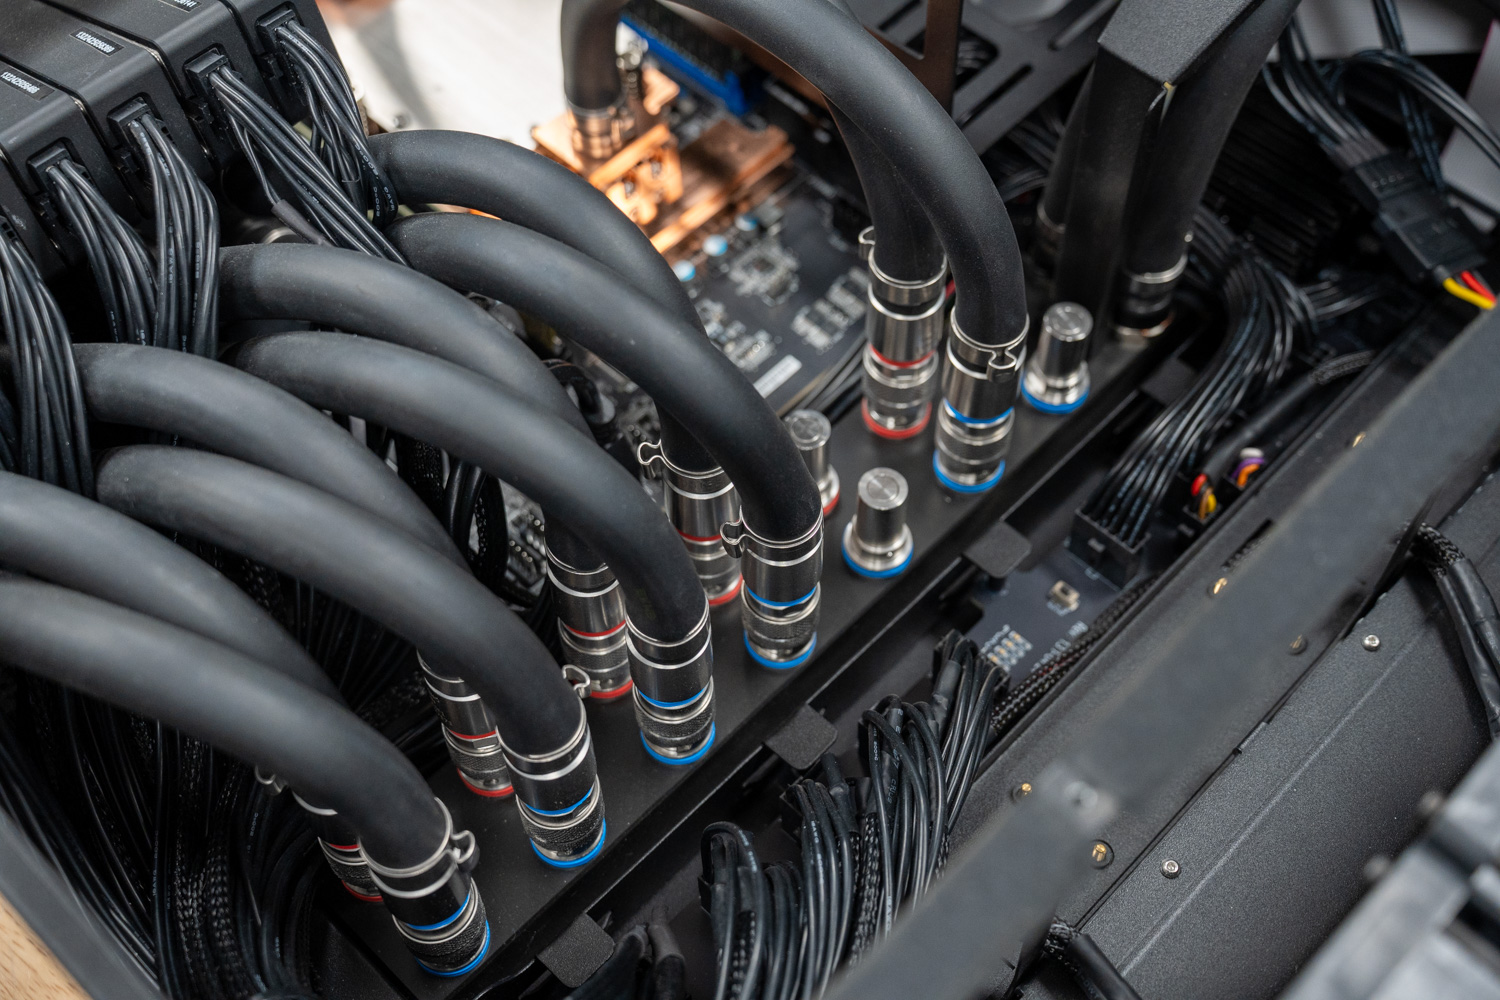
စနစ်၏အလယ်ဗဟိုတွင် GPU နှင့် CPU အအေးပြားတစ်ခုစီသို့ အအေးအရည်များ ထောက်ပံ့ပေးပြီး ရေတိုင်ကီသို့ ပြန်လည်ဝင်ရောက်သည့်လမ်းကြောင်းကို ပံ့ပိုးပေးသည့် ရေဖြန့်ဖြူးရေးပိုက်ကြီးတစ်ခုရှိသည်။ ပိုက်နှင့် GPU နှင့် CPU အကြား ချိတ်ဆက်မှုအားလုံးတွင် Comino ၏ “TheQ” Quick Disconnect Couplings များကို အသုံးပြုသည်။ ဤသံမဏိ dripless fittings များကို အနီနှင့် အပြာရောင်ကွင်းများဖြင့် အရောင်ကုဒ်လုပ်ထားပြီး တပ်ဆင်ခြင်း သို့မဟုတ် ပြုပြင်ထိန်းသိမ်းခြင်းအတွင်း မရေမရာမှုများကို ဖယ်ရှားပေးပါသည်။
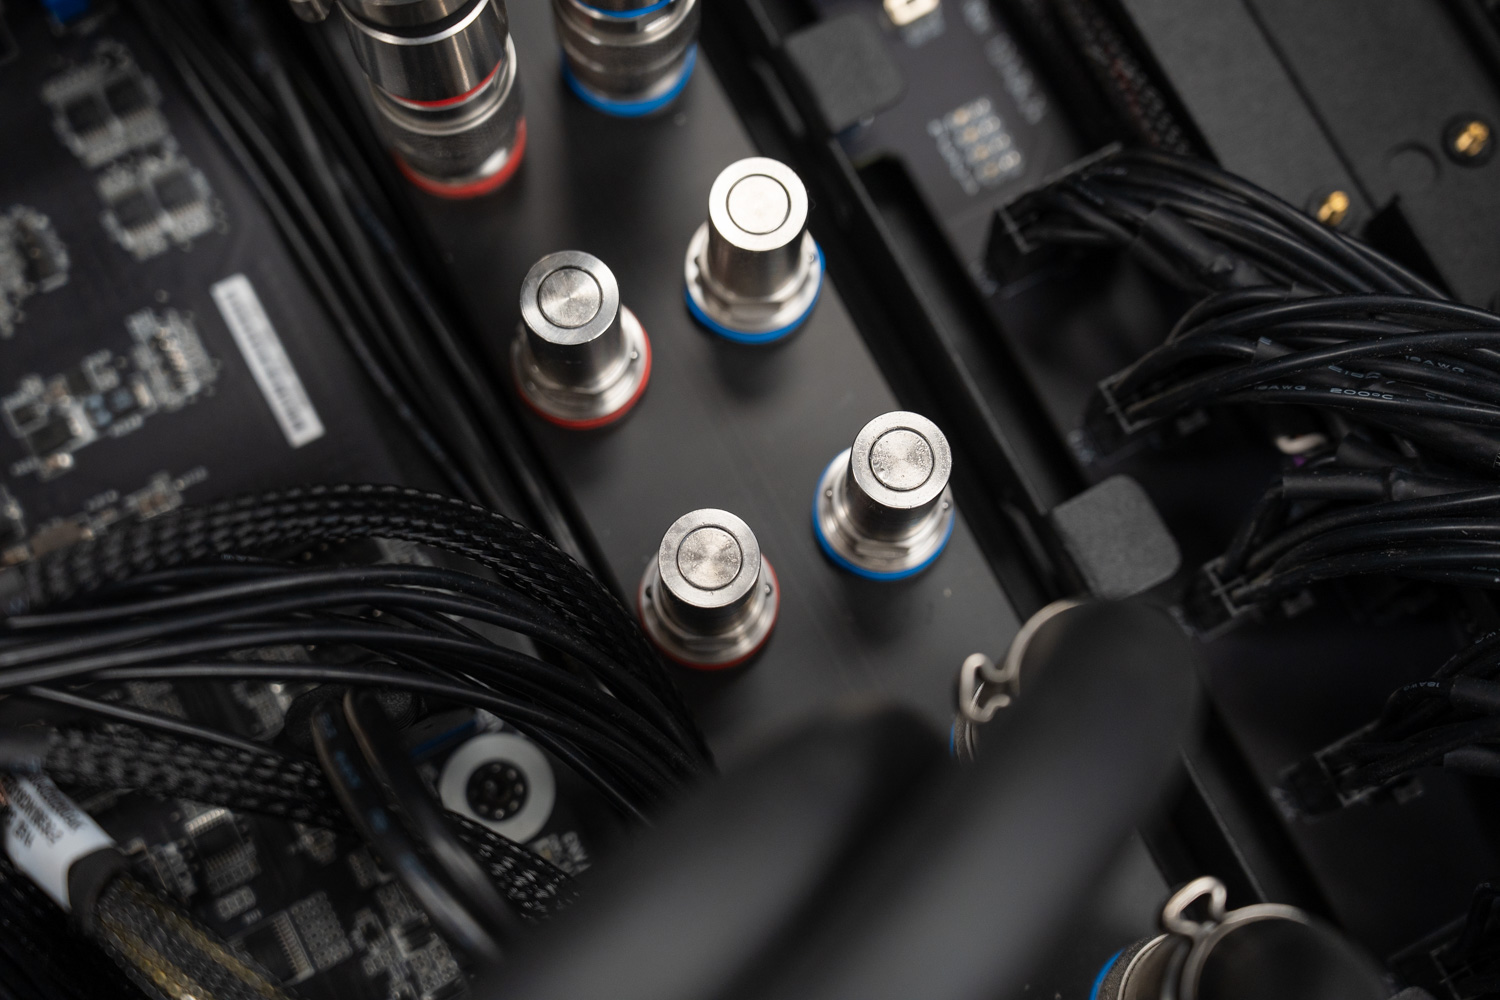
၎င်းတို့သည် ချိတ်ဆက်မှုဖြုတ်လိုက်သောအခါ ပေါင်းစပ်မျက်နှာပြင်တွင် အကြွင်းအကျန်အနည်းငယ်သာကျန်ရှိခဲ့ပြီး နည်းပညာရှင်များအနေဖြင့် 450ml ရေလှောင်ကန် သို့မဟုတ် ကျန်ရှိသော loop ကို မကုန်စေဘဲ တစ်ဦးချင်း GPU များ သို့မဟုတ် CPU ကို ဖယ်ရှားခြင်း သို့မဟုတ် အစားထိုးခြင်းတို့ကို ပြုလုပ်နိုင်စေပါသည်။ ဤနည်းအားဖြင့် Grando သည် လေအေးပေးစနစ်များ၏ ပြုပြင်ထိန်းသိမ်းမှုရိုးရှင်းမှုကို မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော အရည်အေးပေးပလက်ဖောင်းသို့ ယူဆောင်လာပါသည်။
CPU အအေးခံခြင်းနှင့် မှတ်ဉာဏ်
CPU နှင့် ၎င်း၏ ဗို့အားထိန်းညှိကိရိယာများသည် coolant loop နှင့် တိုက်ရိုက်ချိတ်ဆက်ထားသော သီးသန့် cold plate မှလည်း အကျိုးကျေးဇူးရရှိပြီး ပြင်းထန်သော multi-GPU workloads များအတွင်း processor သည် bottleneck မဖြစ်စေရန် ကာကွယ်ပေးပါသည်။ ကျွန်ုပ်တို့၏ review unit တွင် AMD EPYC 9474F 48-core processor တစ်ခုတည်းပါရှိသော AMD Turin/Genoa board ပါရှိသည်။ cold plate သည် ကတ် cold-plates များ၏ အရည်အသွေးကို ထင်ဟပ်စေပြီး ကြေးနီဖြင့် ပြုလုပ်ထားပြီး stainless-steel hardware ဖြင့် လုံခြုံအောင် ပြုလုပ်ထားသည်။
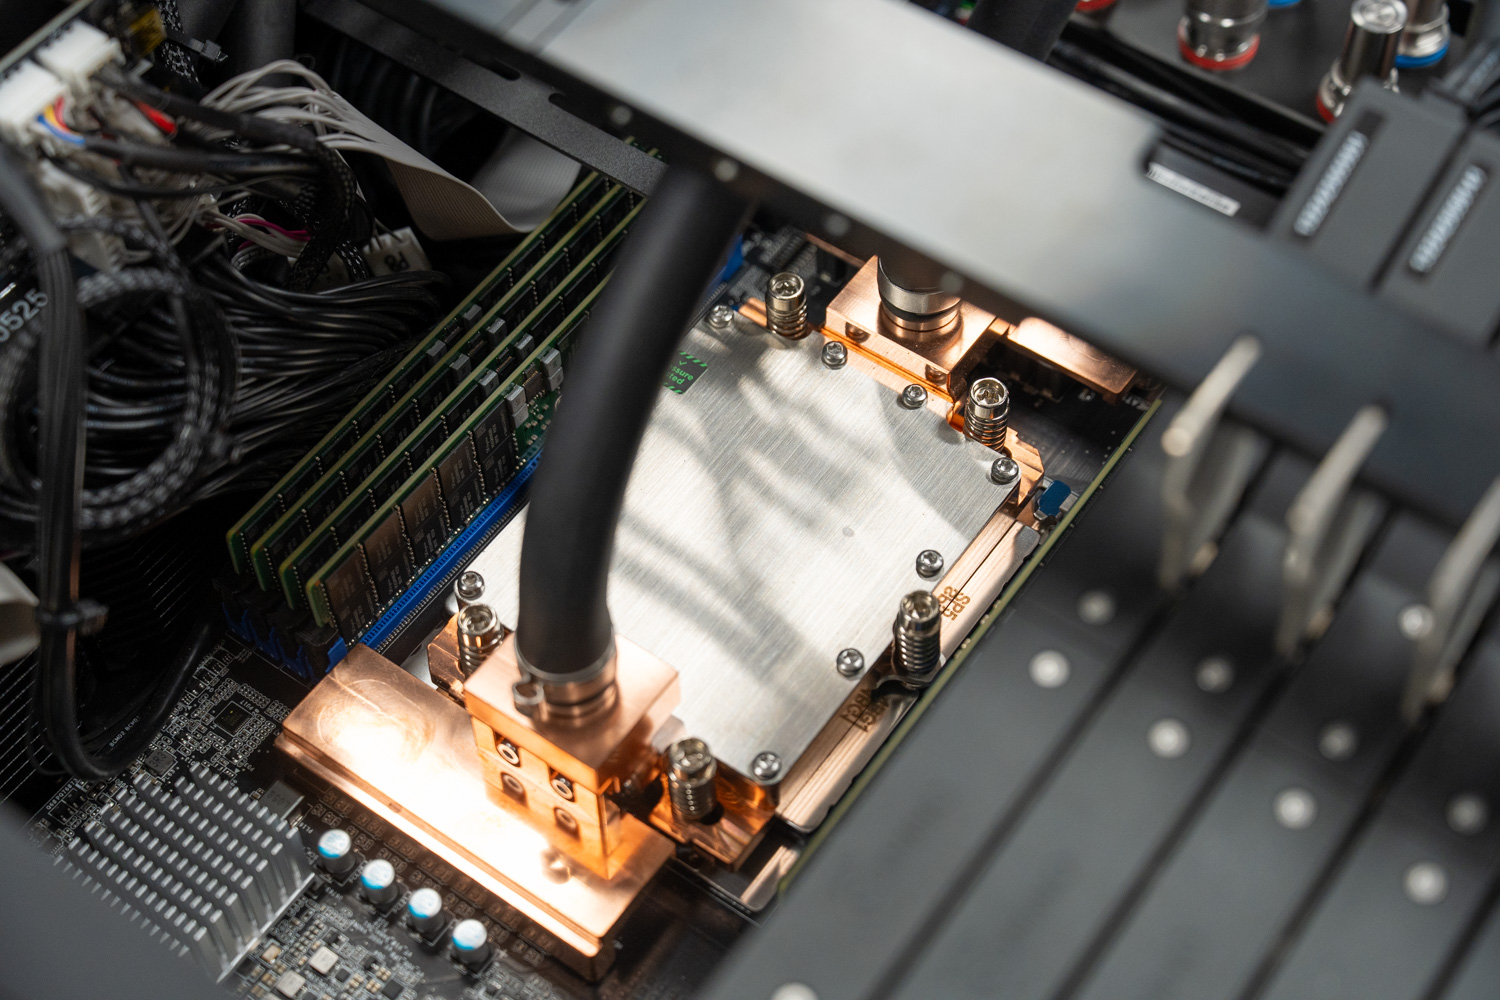
CPU ရဲ့ နှစ်ဖက်စလုံးမှာ 2TB RAM အထိ configuration တွေကို ပံ့ပိုးပေးတဲ့ DRAM slot ရှစ်ခု အပြည့်ထည့်ထားပြီး တပ်ဆင်ထားပါတယ်။ ကျွန်တော်တို့ရဲ့ review unit မှာ 512GB DDR5 RAM ပါရှိပါတယ်။ GPU နဲ့ CPU ဧရိယာရဲ့ အပေါ်ဘက်မှာ ထောင့်မှန်ကျတဲ့ support bar တစ်ခုရှိပြီး GPU လိုမျိုး sensitive components တွေကို လုံခြုံစေပြီး သယ်ယူပို့ဆောင်ရေးအတွင်းမှာလည်း chassis တောင့်တင်းမှုကို ထိန်းသိမ်းပေးပါတယ်။
ရေတိုင်ကီနှင့် ပန်ကာများ
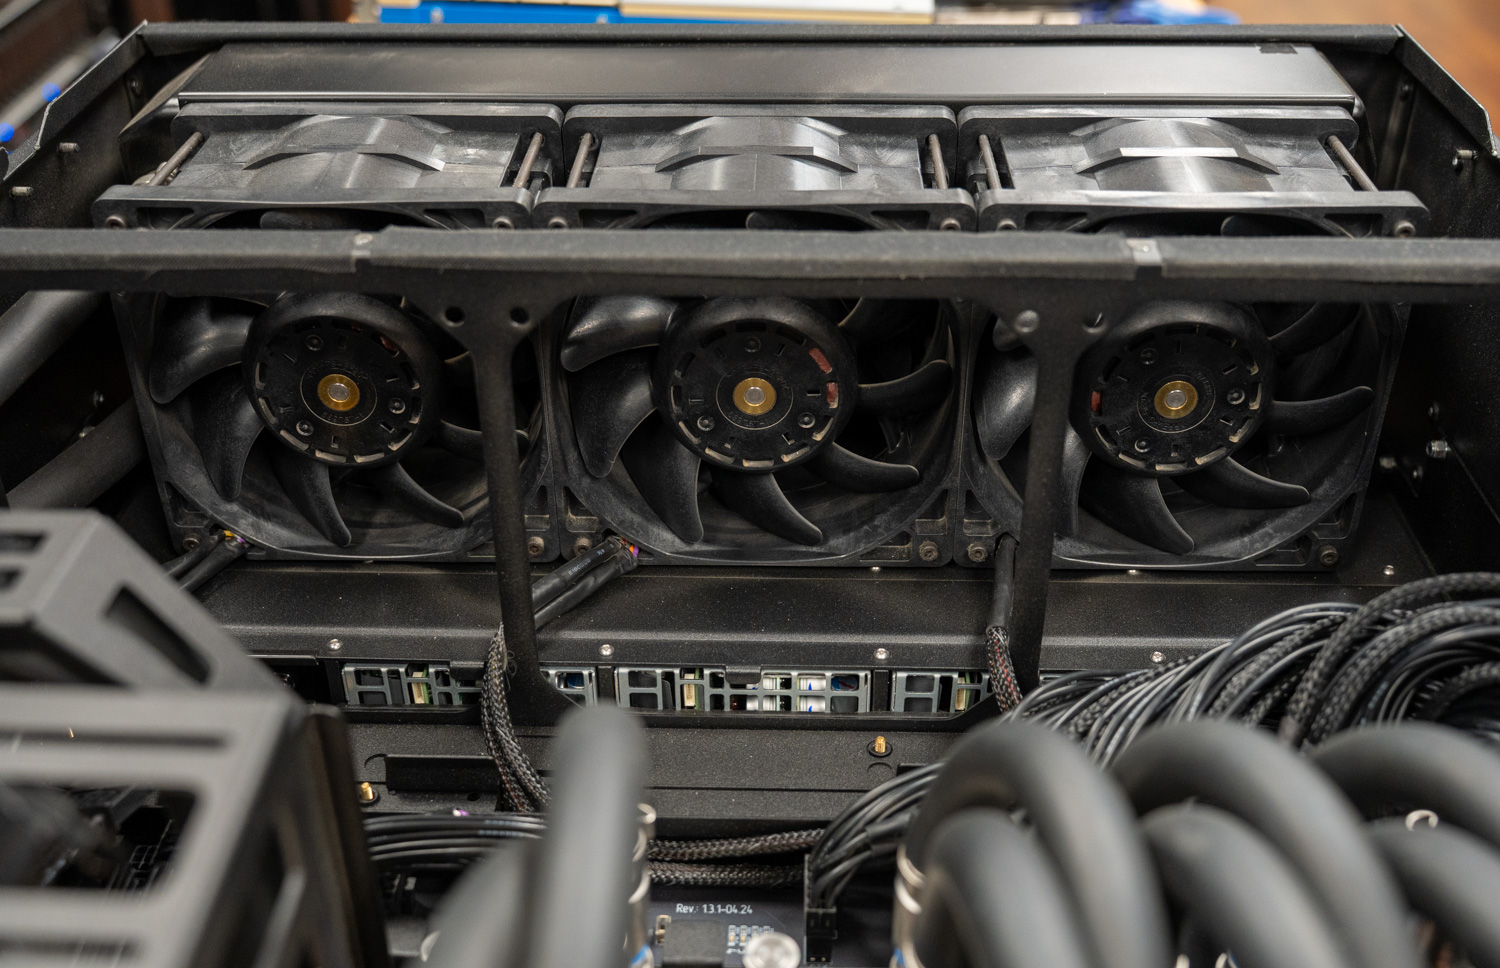
အအေးပေးစနစ်ကို ကိုယ်ထည်၏နောက်ဘက်တွင်တပ်ဆင်ထားသော 140mm သုံးထပ်ရေဒီယေတာကြီးဖြင့် ကိုင်တွယ်ထားပြီး 6,200 RPM အထိရောက်ရှိနိုင်ပြီး 1,000 m³/h အထိ လေစီးဆင်းမှုရှိသော မြန်နှုန်းမြင့် 140mm ပန်ကာသုံးခုနှင့် တွဲဖက်ထားသည်။ ထူထဲသောရေဒီယေတာမှ ပံ့ပိုးပေးသော သိပ်သည်းသော fin stack သည် ကျွန်ုပ်တို့၏ configuration တွင် အပူကို 6.5kW အထိ ပျံ့နှံ့စေရန် တည်ဆောက်ထားသော ပလက်ဖောင်းတွင် ဒီဇိုင်းထုတ်ထားသော အပူ headroom ကို ပေါ်လွင်စေသည်။
အံ့သြစရာအကောင်းဆုံးကတော့ အလုပ်ပမာဏနဲ့ ပန်ကာအမြန်နှုန်းတွေရှိနေပေမယ့် ဒီယူနစ်ဟာ ခံနိုင်ရည်ရှိတဲ့ ဆူညံသံဘောင်အတွင်းမှာပဲ ရှိနေနိုင်ပြီး အပြည့်အဝစောင်းထားရင် အသံအဆင့်က 70+ dB ရှိနေပါတယ်။ ဒါဟာ workstation စံနှုန်းတွေအရ ဆူညံပေမယ့် လျှပ်စစ်မီးဖိုငယ်လေးရဲ့ အပူထွက်ရှိမှုကို လျော့ကျစေတဲ့ စနစ်တစ်ခုအတွက်တော့ သိသိသာသာ အကန့်အသတ်ရှိပြီး Comino ရဲ့ အရည်ကွင်းဆက်က အစိတ်အပိုင်းတွေကနေ အပူကို ဘယ်လောက်ထိရောက်စွာ လွှဲပြောင်းပေးလဲဆိုတာကို ပြသနေပါတယ်။
ရှေ့မျက်နှာပြင်နှင့် တယ်လီမက်ထရီ မျက်နှာပြင်
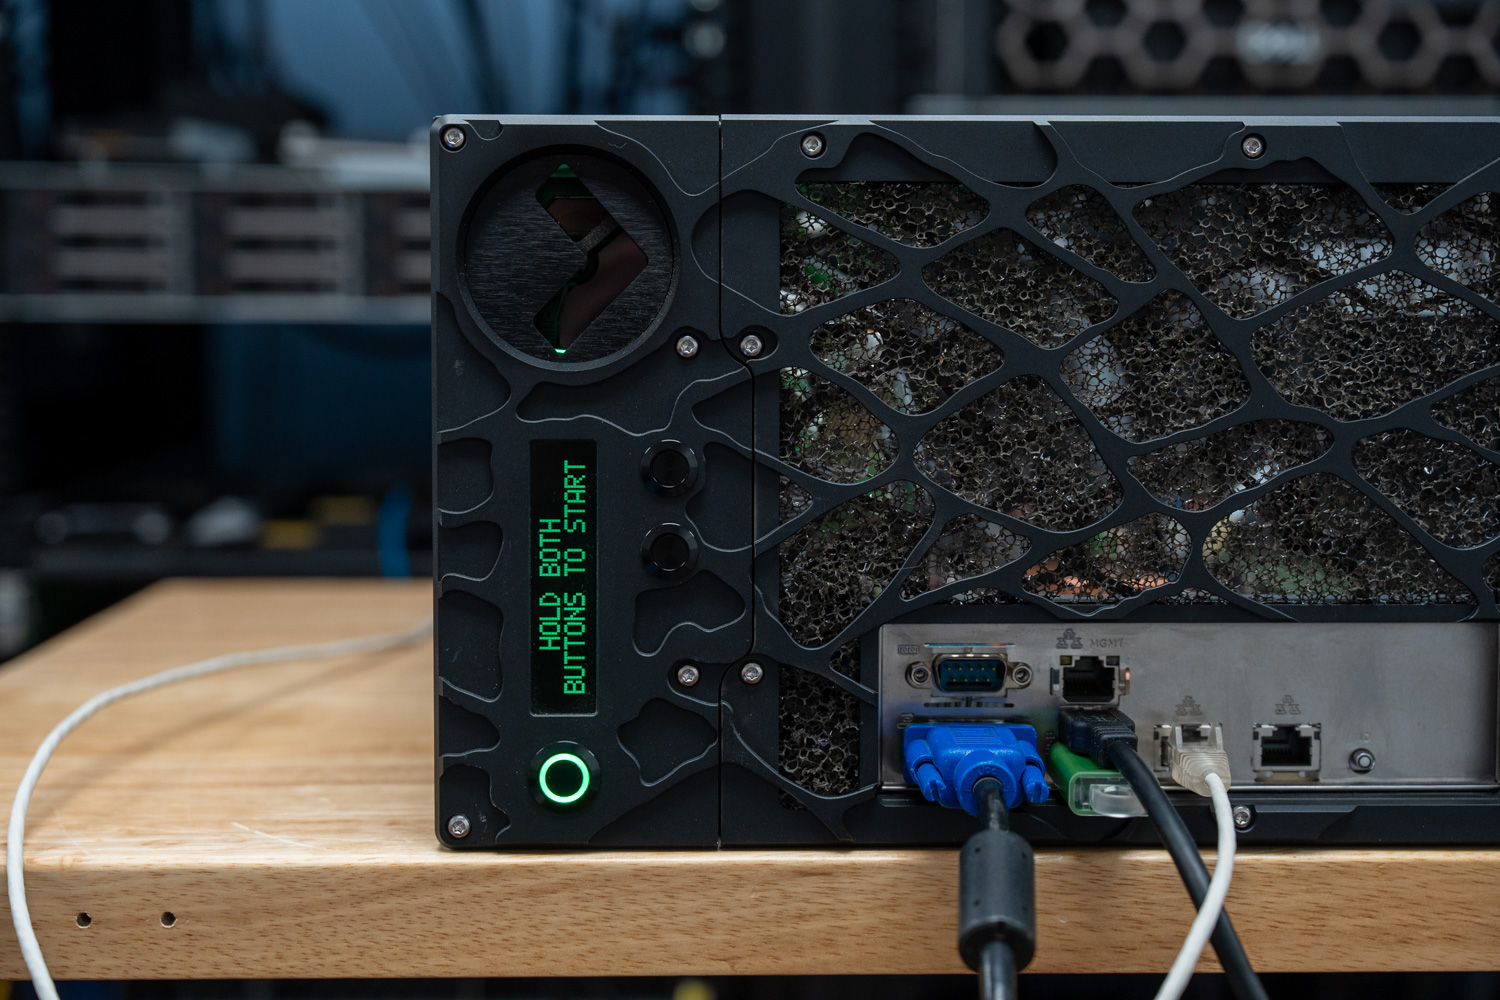
ရှေ့ panel မှာ LED display က pump status၊ ambient air temperature၊ coolant temperature နဲ့ fan speed အပါအဝင် အဓိက telemetry data တွေကို တိုက်ရိုက်ဖတ်ရှုနိုင်ပါတယ်။ အသုံးပြုသူတွေဟာ cooling module မှာရှိတဲ့ illuminated button တွေကို အသုံးပြုပြီး menu ကို navigate လုပ်နိုင်ပါတယ်။ ရရှိနိုင်တဲ့ data တွေကို scroll လုပ်ဖို့ short press တွေလုပ်နိုင်ပါတယ်။ PB2 button ကို ကြာကြာနှိပ်ထားရင် Commands၊ Service settings နဲ့ Event Log အပါအဝင် menu branch တွေကို ဖွင့်ပေးပါတယ်။ ထို့အပြင် ရှေ့ I/O panel မှာ display output အတွက် VGA port တစ်ခု၊ serial port တစ်ခု၊ USB port များစွာနဲ့ peripheral နဲ့ device ချိတ်ဆက်မှုအတွက် network connection တွေ ပါဝင်ပါတယ်။
ပါဝါနှင့် သိုလှောင်မှုဗိသုကာ
ပါဝါပေးပို့ခြင်းနှင့် ပိုလျှံခြင်း
ဤတွက်ချက်မှုအဆင့်ကို ပံ့ပိုးပေးရန်အတွက် တူညီသော ခိုင်မာသော ပါဝါပေးပို့မှု လိုအပ်ပါသည်။ Grando သည် 180–264V တွင် 8.0kW အထိ ထုတ်ပေးသည့် redundant configuration ဖြင့် hot-swap 1000W သို့မဟုတ် 2000W CRPS မော်ဂျူးလေးခုအထိ ပံ့ပိုးပေးပါသည်။ 4+0၊ 3+1 နှင့် 2+2 redundancy mode များအတွက် ပံ့ပိုးမှုဖြင့် စနစ်သည် 24/7 AI နှင့် HPC workloads များအတွက် စဉ်ဆက်မပြတ်လည်ပတ်မှုကို ထိန်းသိမ်းထားစဉ် PSU ပျက်ကွက်မှုများကို ခံနိုင်ရည်ရှိပါသည်။
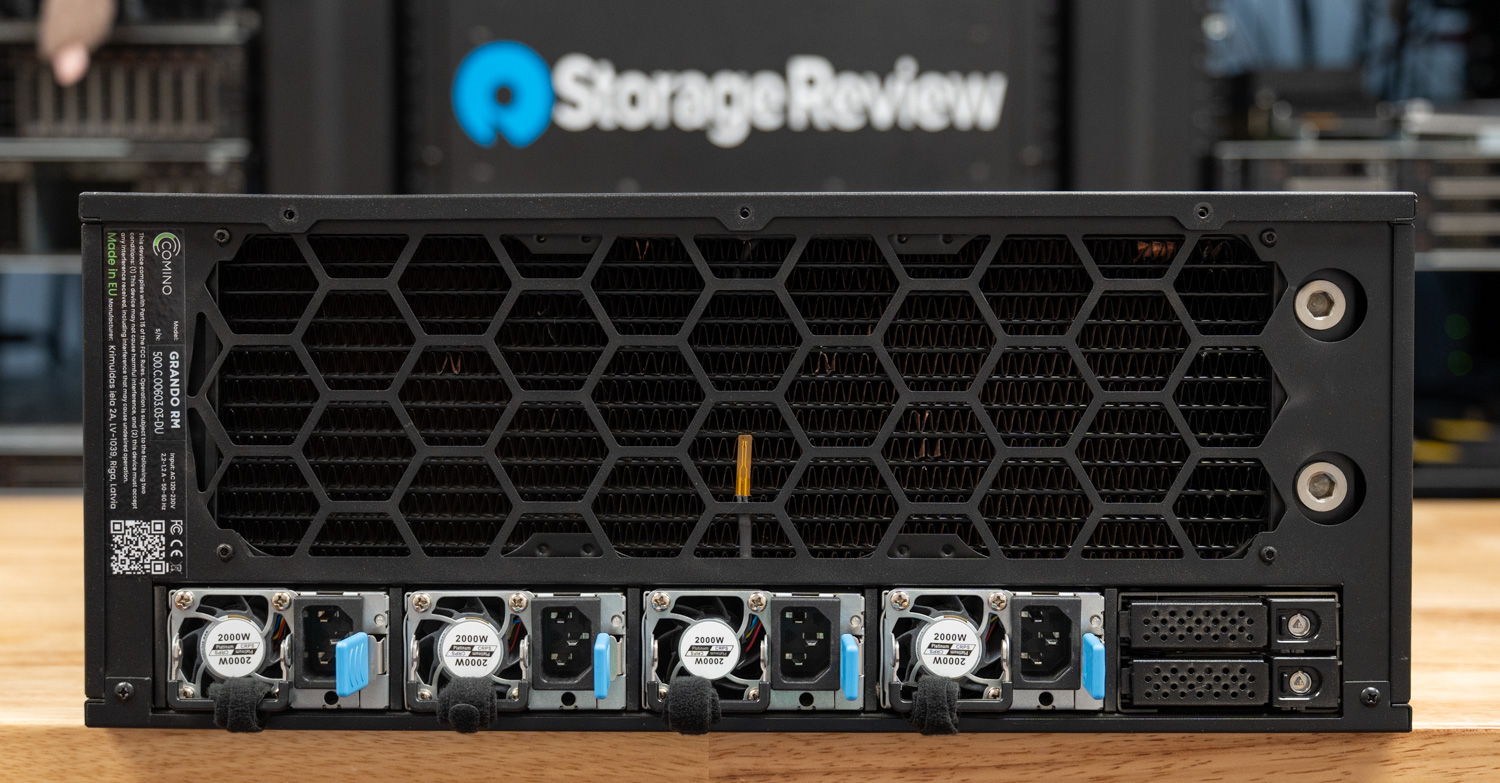
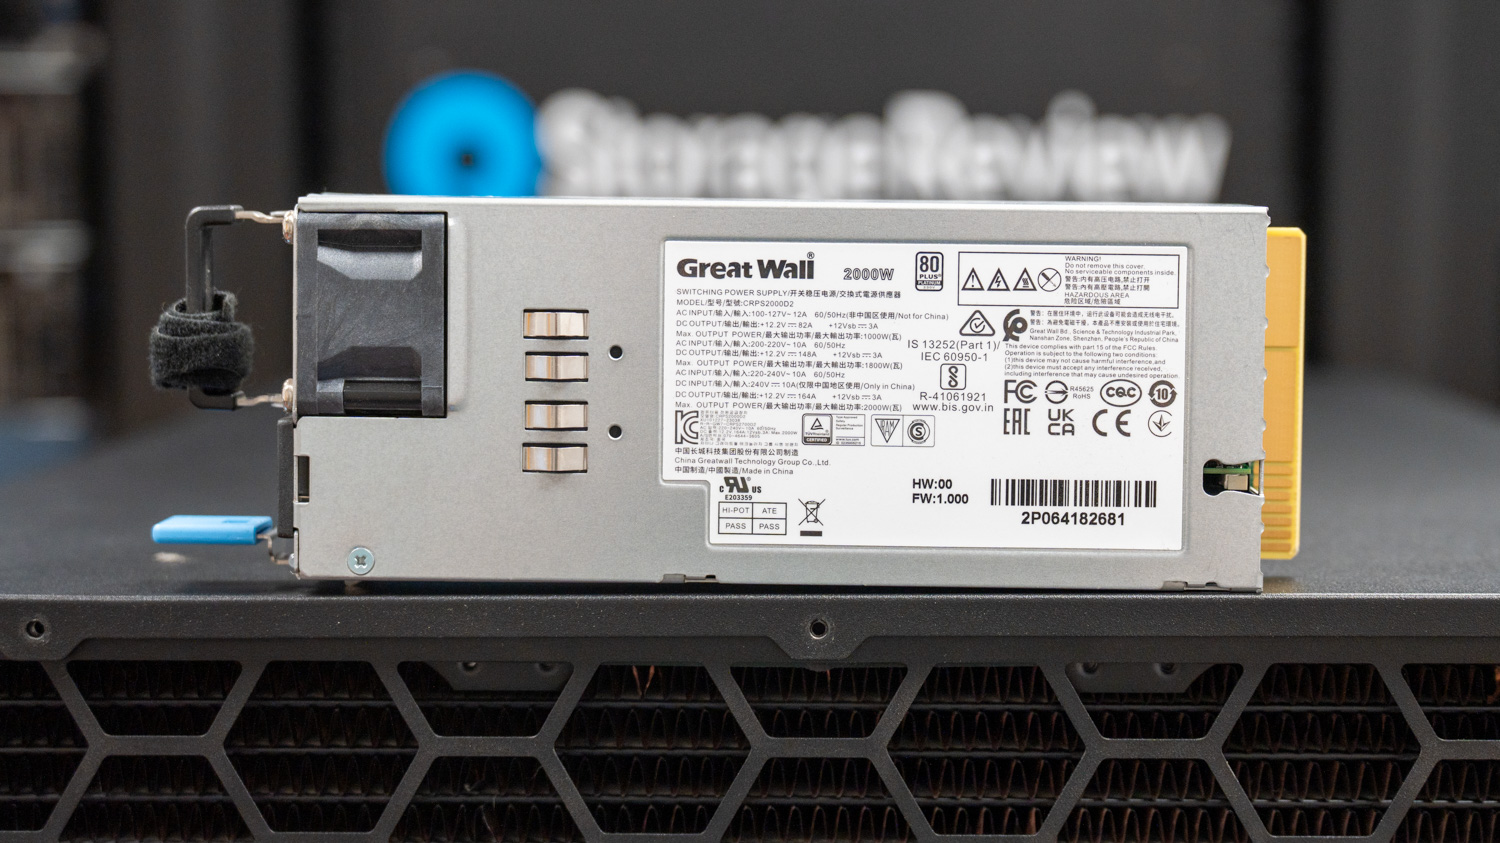
ကျွန်ုပ်တို့၏ သုံးသပ်ချက်ယူနစ်တွင် Great Wall 2000W 80 Plus Platinum hot-swap power supplies လေးခုပါရှိပြီး 8.0kW configuration အပြည့်အစုံကို ဖန်တီးပေးပါသည်။
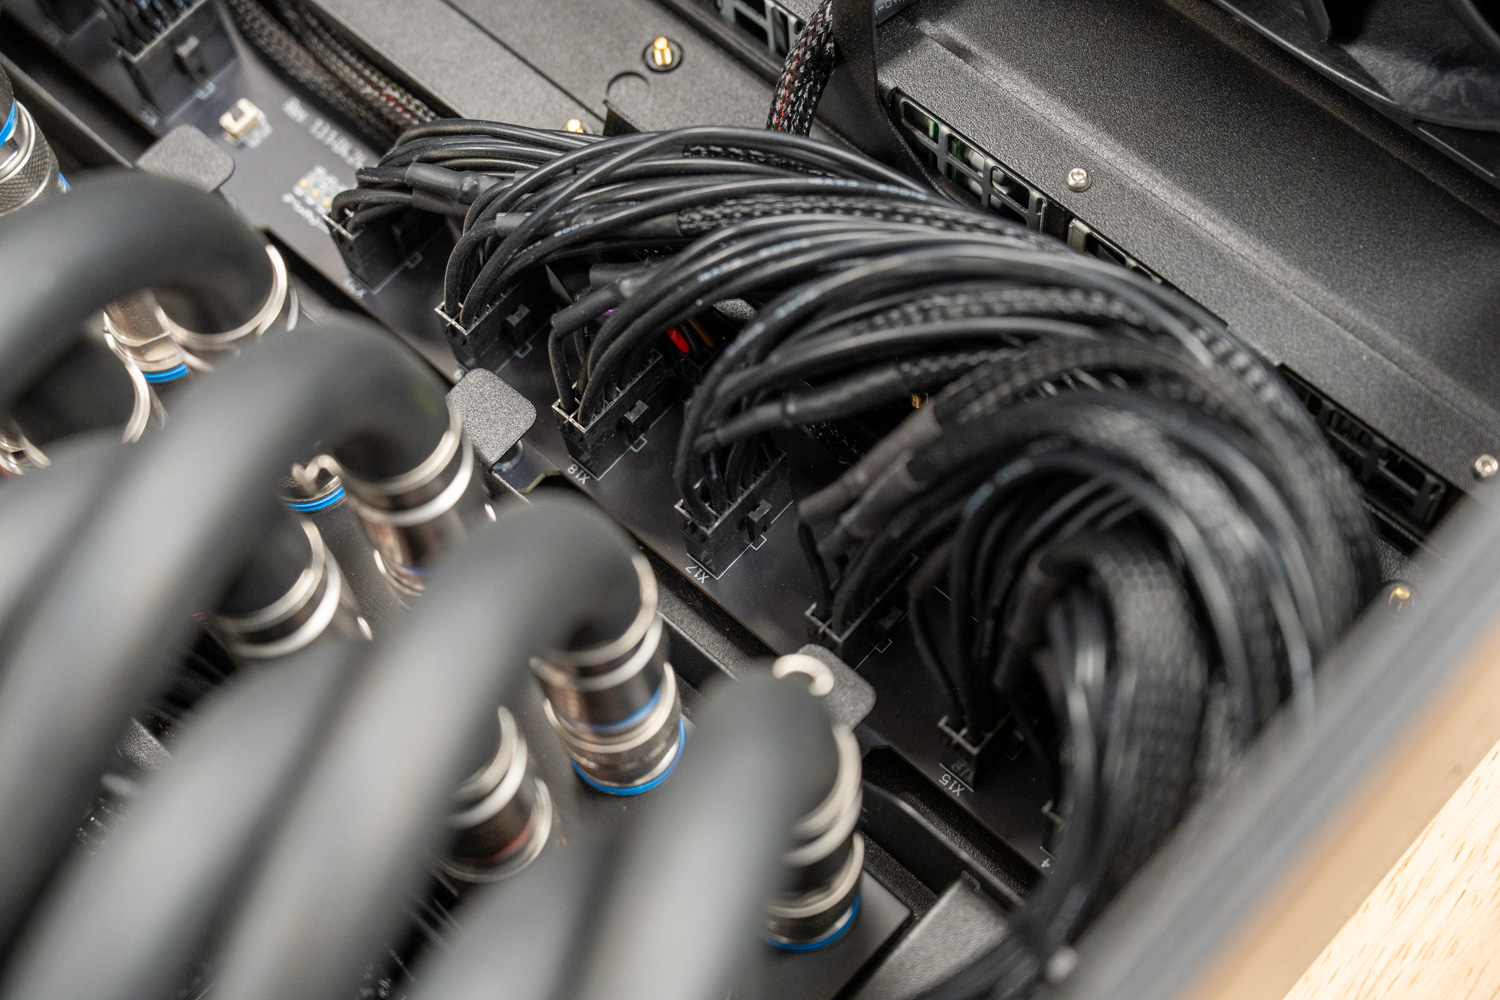
GPU တစ်ခုစီသို့ ပါဝါပေးပို့ခြင်းသည် GPU array နှင့် main cable run အကြားတွင်တပ်ဆင်ထားသော centralized 12-pin power distribution board မှတစ်ဆင့် လည်ပတ်သည်။ Grando သည် ဤ distribution board ကိုအသုံးပြု၍ incoming power feed များကို စုစည်းပြီးနောက် ၎င်းတို့ကို GPU တစ်ခုစီသို့ စနစ်တကျနှင့် နေရာချွေတာသောနည်းလမ်းဖြင့် ခွဲဝေပေးသည်။
PCIe၊ သိုလှောင်မှုနှင့် ကွန်ရက်ချိတ်ဆက်မှု
Grando သည် slot bandwidth ကို မထိခိုက်စေဘဲ GPU ခြောက်ခုကို အဆင်ပြေစွာ ပံ့ပိုးပေးပြီး chassis သည် အမြင့်ဆုံးသိပ်သည်းဆအတွက် ကတ်ရှစ်ခုပါ configuration အထိ ချိန်ညှိနိုင်သည်။ Comino ၏ ASRock Rack GENOAD8X-2T/BCM motherboard သည် x16 ခုနစ်ခုနှင့် x8 PCIe Gen 5 slot တစ်ခု ပံ့ပိုးပေးသောကြောင့် GPU ရှစ်ခုအနက် ခုနစ်ခုသည် x16 bandwidth အပြည့်ဖြင့် လည်ပတ်ပြီး ရှစ်ခုမြောက်ကတ်သည် x8 တွင် လည်ပတ်သည်။ ၎င်းသည် single-socket CPU တစ်ခုက ပံ့ပိုးပေးနိုင်သော PCIe lanes အရေအတွက်နှင့် PCIe switch plate ၏ အရွယ်အစား၊ ကုန်ကျစရိတ်နှင့် ရှုပ်ထွေးမှုကို ထည့်သွင်းရန် Comino ၏ တွန့်ဆုတ်မှုတို့အကြား အပေးအယူတစ်ခုဖြစ်သည်။ dual-socket motherboard သို့ ပြောင်းရွှေ့ခြင်းသည် PCIe lanes များ ပိုမိုပေးစွမ်းနိုင်သော်လည်း slot များ ပိုမိုနည်းပါးစေမည်ဖြစ်သည်၊ အဘယ်ကြောင့်ဆိုသော် ဒုတိယ socket သည် နေရာကန့်သတ်ချက်ရှိသော form factor တွင် PCIe slot များမှ အသုံးပြုသော နေရာယူမည်ဖြစ်သောကြောင့်ဖြစ်သည်။
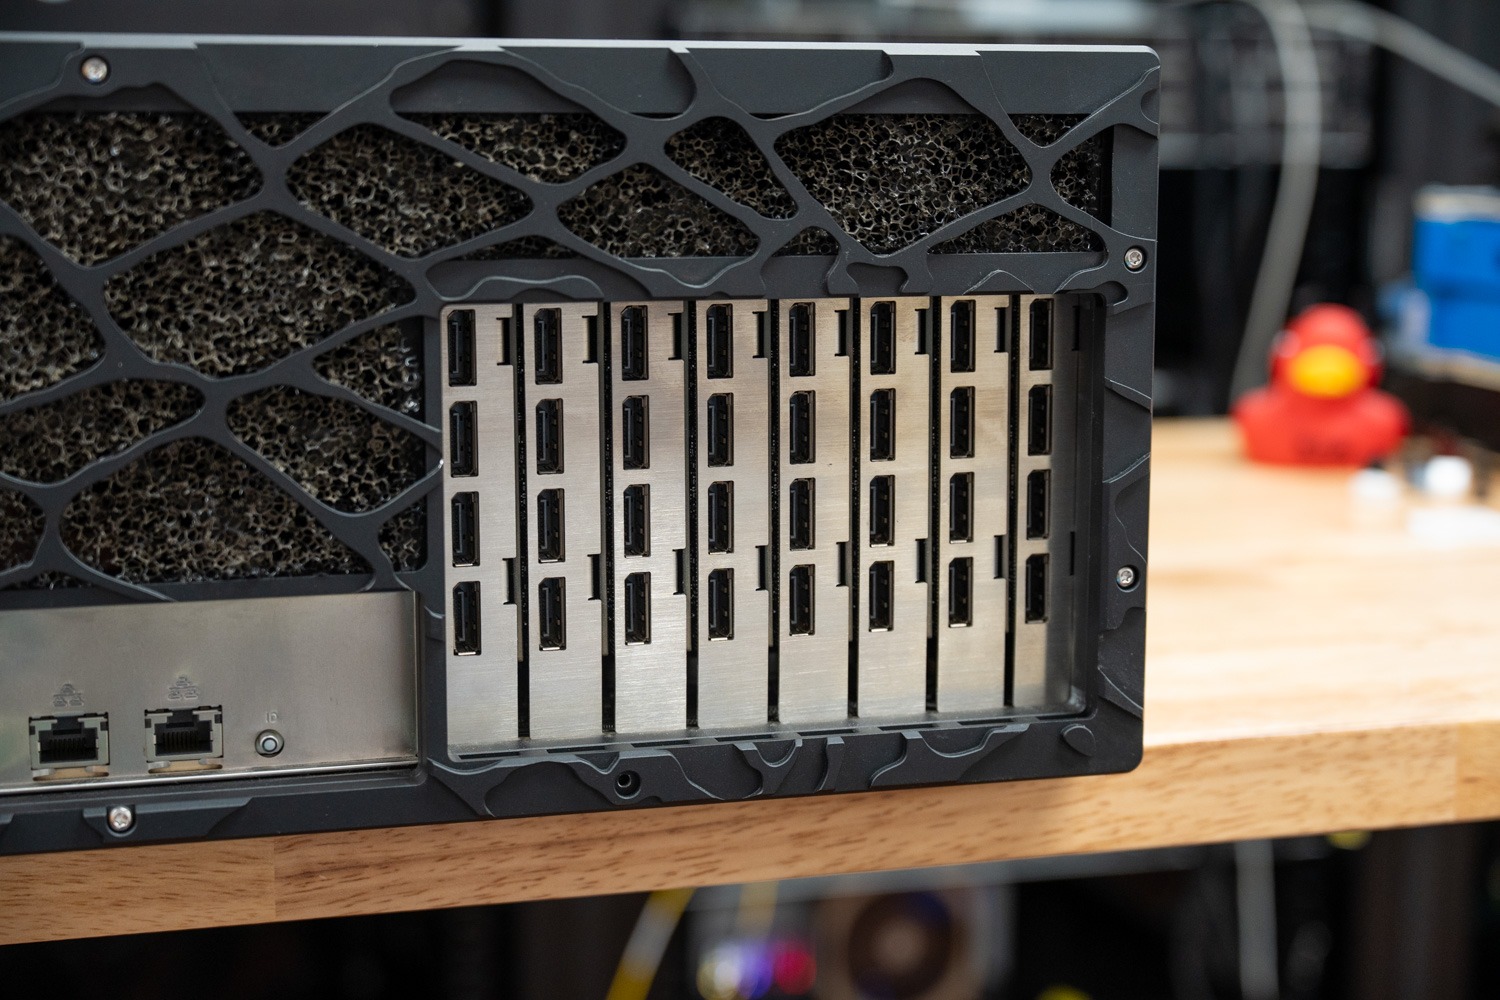
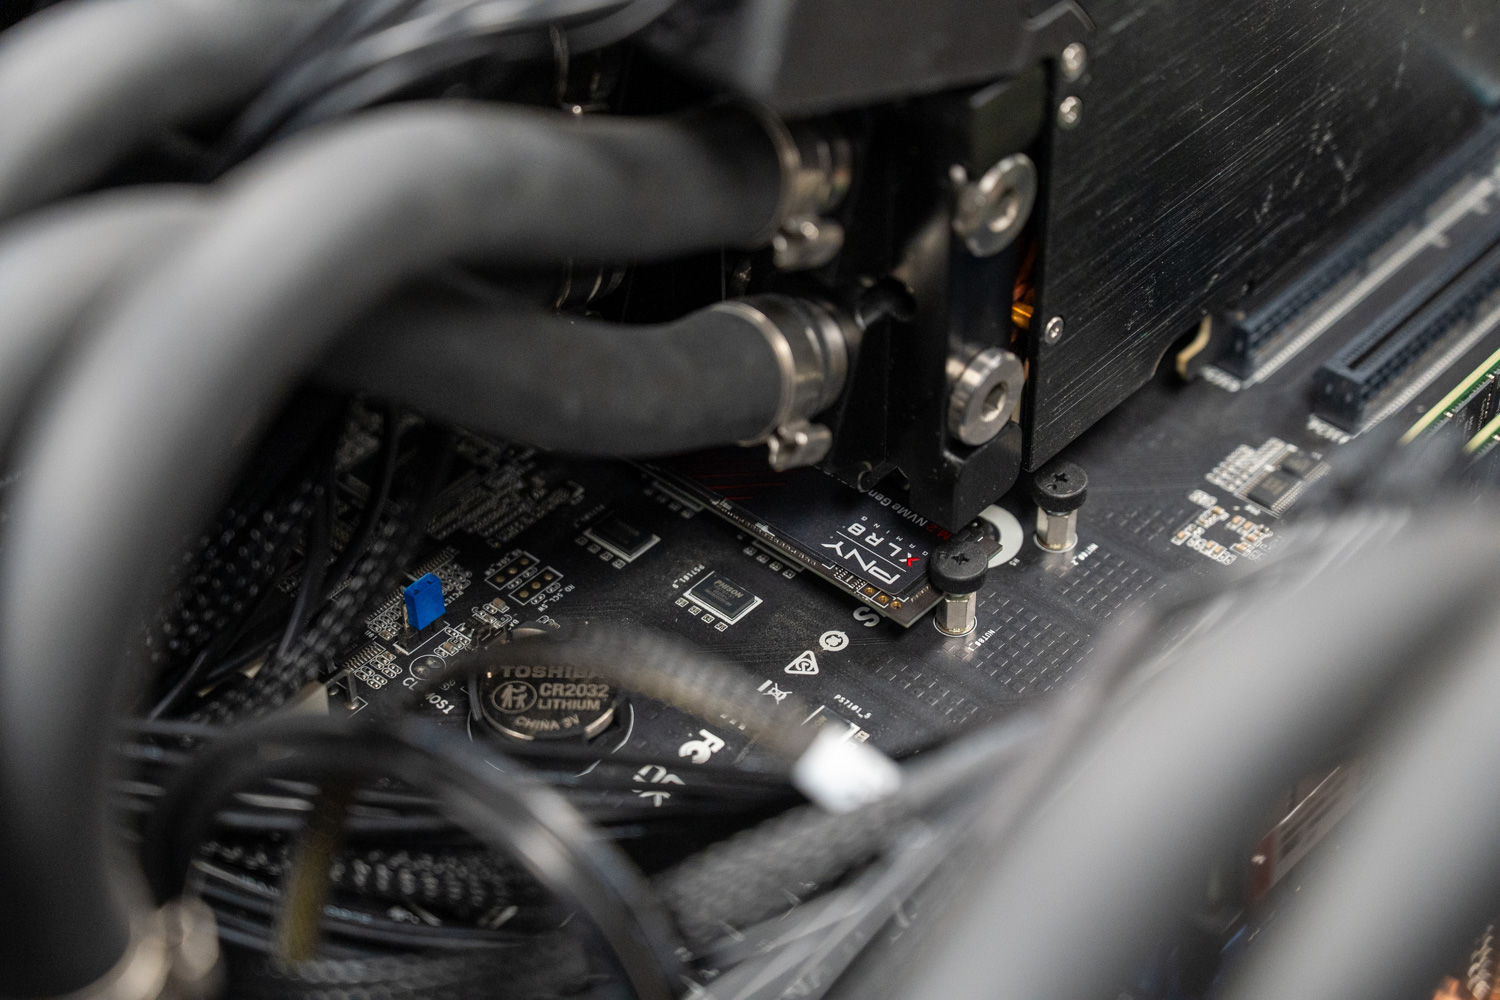
single-socket စနစ်တွင် GPU ရှစ်ခုကို အသုံးပြုခြင်းသည် ရရှိနိုင်သော PCIe လမ်းကြောင်းအများစုကို အသုံးပြုပြီး ၎င်းသည် အပေးအယူများလည်း ပါလာပါသည်။ AMD Genoa ကို အခြေခံထားသော ကျွန်ုပ်တို့၏ သုံးသပ်ချက်ယူနစ်တွင် စုစုပေါင်း PCIe Gen 5 လမ်းကြောင်း ၁၂၈ ခု ရှိပါသည်။ GPU ရှစ်ခုသည် ထိုလမ်းကြောင်း ၁၂၀ ကို အသုံးပြုသောကြောင့် ကျန်လမ်းကြောင်း ၈ ခုကို M.2 SSD slot တစ်ခုစီအတွက် x4 ခွဲထားသောကြောင့် MCIO connector နှစ်ခုမှတစ်ဆင့် ချိတ်ဆက်ထားသော chassis ၏နောက်ဘက်တွင် GPU ရှစ်ခုနှင့် NVMe drive အပြည့်အစုံကို တစ်ပြိုင်နက်တည်း လည်ပတ်ရန် မဖြစ်နိုင်ပါ။ ကျွန်ုပ်တို့၏ 8-GPU ဖွဲ့စည်းပုံအပြည့်တွင် သိုလှောင်မှုအတွက် M.2 slot ၂ ခုသာ ရရှိနိုင်ပါသည်။ အမြင့်ဆုံး GPU သိပ်သည်းဆနှင့်အတူ NVMe စွမ်းရည် ထပ်မံလိုအပ်သော administrator များသည် back-panel cages များမှတစ်ဆင့် နောက်ဘက် hot-swap NVMe storage ကို ထည့်သွင်းခြင်းသည် PCIe လမ်းကြောင်းများ ထပ်မံသုံးစွဲပြီး ၎င်းတို့၏စနစ်ရှိ GPU စွမ်းရည်အချို့ကို ပိတ်ပစ်မည်ကို သတိပြုသင့်သည်။
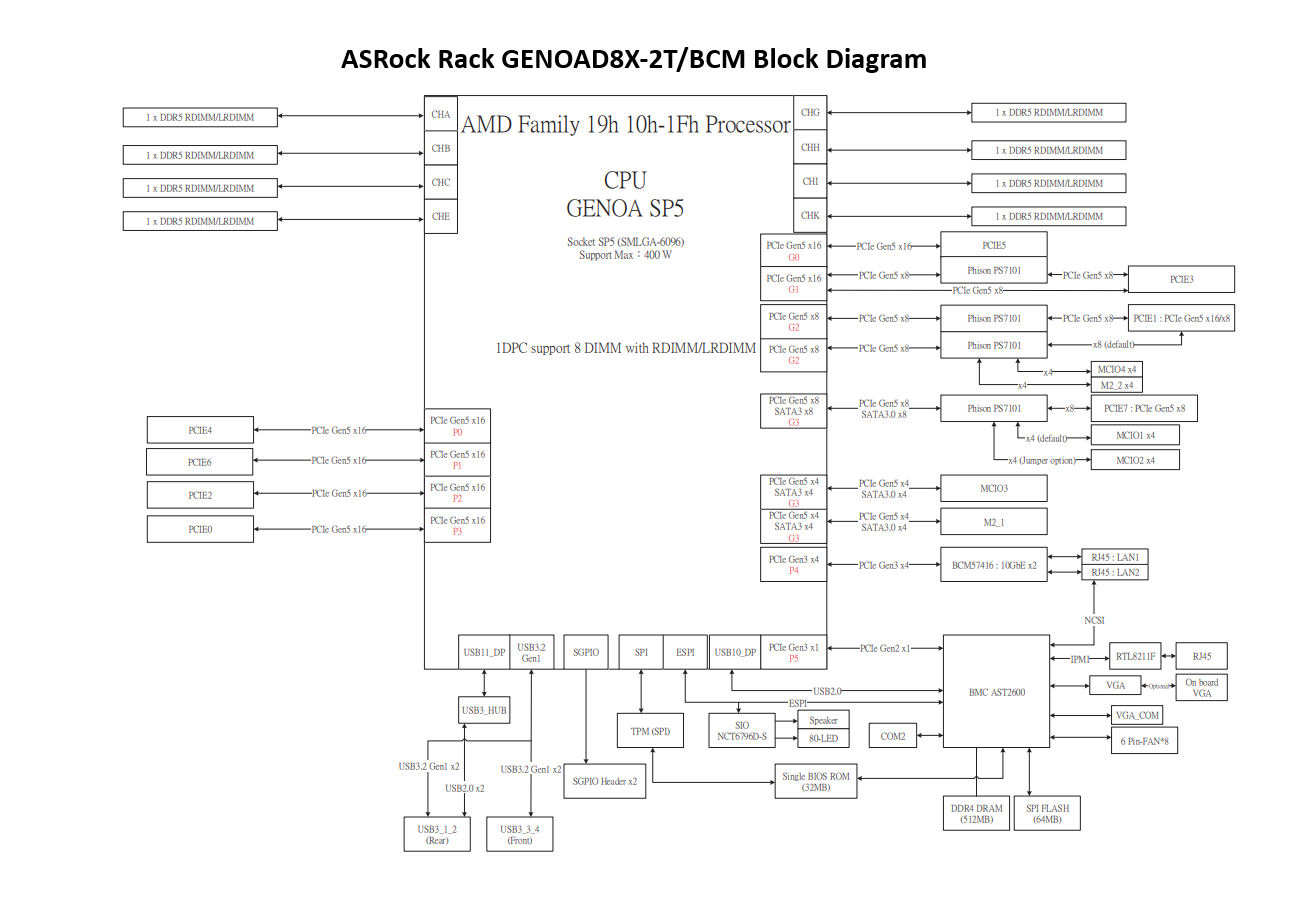
CPU၊ PCIe Gen 5 slots၊ DIMM channels၊ M.2 slots၊ BMC၊ USB၊ SATA နှင့် networking ချိတ်ဆက်မှုများကို ပြသသည့် ASRock Rack GENOAD8X-2T/BCM motherboard block diagram။
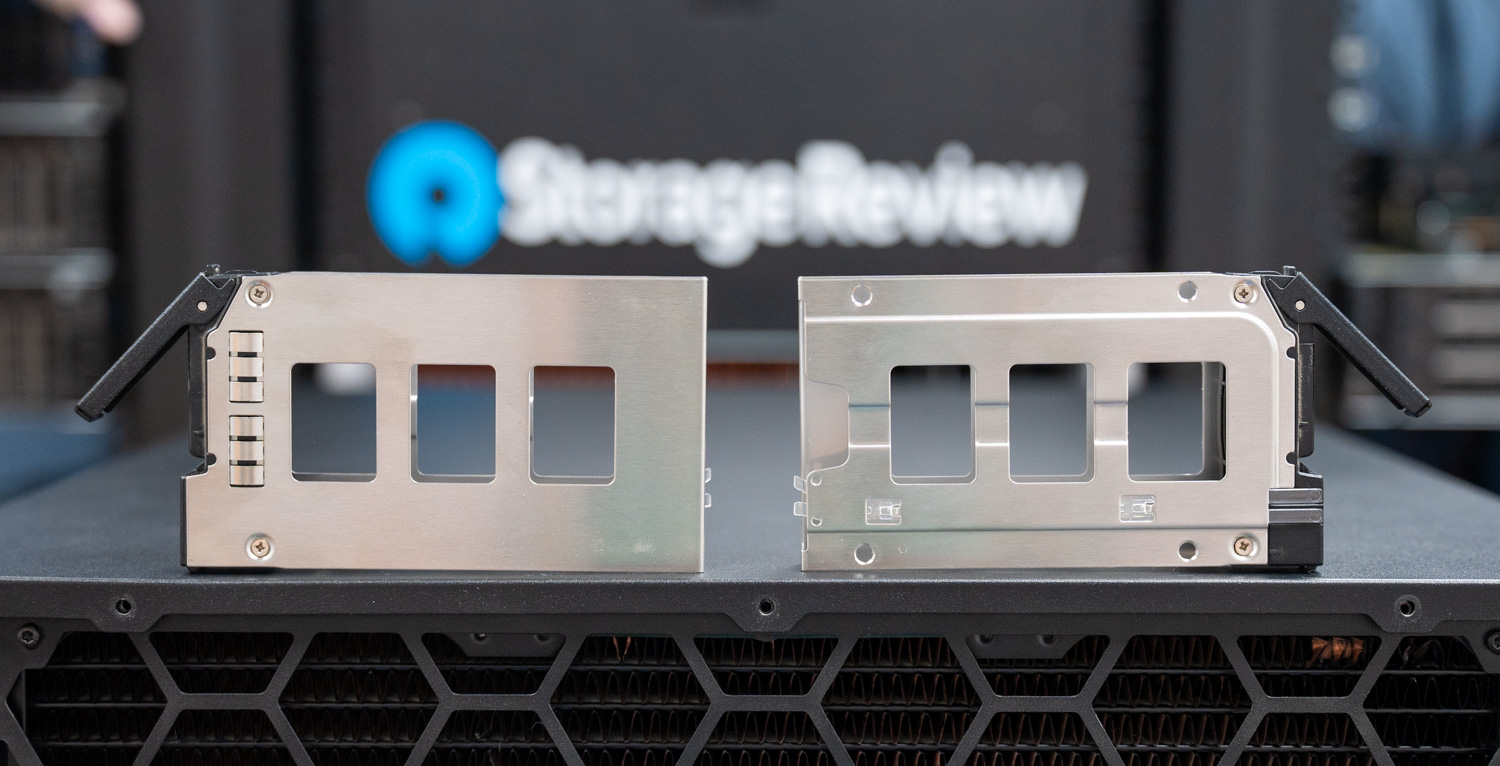
ဒါပေမယ့် သိုလှောင်မှုကတော့ မော်ဂျူလာနဲ့ ကျယ်ပြန့်ပါတယ်။ ဒါပေမယ့် configuration က GPU တွေအတွက် PCIe lane budget ကို သက်ရောက်မှုရှိပါတယ်။ ရည်ရွယ်ထားတဲ့ use case အတွက် စီစဉ်သင့်ပါတယ်။ ကျွန်ုပ်တို့ရဲ့ review unit ရဲ့ rear panel မှာ 4x 7mm ဒါမှမဟုတ် 2x 15mm configuration တွေမှာ 2.5-inch SSD လေးခုအထိ support လုပ်တဲ့ 2.5″ drive cage ပါရှိပြီး စတုတ္ထ PSU slot အစား optional second set လေးခုအထိ ရရှိနိုင်ပါတယ်။ ကျွန်ုပ်တို့ရဲ့ review unit ဟာ 8-GPU configuration အပြည့်အစုံကို support လုပ်ဖို့အတွက် power-supply bay လေးခုလုံး လိုအပ်တာကြောင့် hot-swap bay နှစ်ခုထဲက ပထမတစ်ခုကိုပဲ အသုံးပြုခွင့်ရှိခဲ့ပါတယ်။ အတွင်းပိုင်းမှာ chassis က 3.5-inch drive လေးခုအထိ၊ 2.5-inch 15mm drive လေးခုအထိ ဒါမှမဟုတ် 2.5-inch 7mm drive ဆယ့်နှစ်ခုအထိ၊ အပြင် configure လုပ်ရင် internal 2.5-inch 7mm SSD slot လေးခုအထိ ထည့်သွင်းနိုင်တဲ့ 3.5-inch cage ကို support လုပ်နိုင်ပါတယ်။
ကွန်ရက်ချိတ်ဆက်မှုအတွက် Broadcom BCM57416 မှ ပါဝါပေးသည့် onboard RJ45 10 Gb/s port နှစ်ခုသည် motherboard တွင် စံအဖြစ်ပါဝင်ပြီး dedicated Gigabit Ethernet IPMI management port လည်း ပါဝင်သည်။ administrator များသည် high-bandwidth fabric ချိတ်ဆက်မှုအတွက် 400 Gb/s အထိ ပံ့ပိုးပေးသည့် PCIe NIC များကို ထည့်သွင်းခြင်းဖြင့် bandwidth ကို ထပ်မံတိုးမြှင့်နိုင်သော်လည်း၊ နောက်ထပ် PCIe NIC များသည် GPU slot များကို နေရာယူထားပြီး စနစ်က လက်ခံနိုင်သော GPU အများဆုံးအရေအတွက်ကို လျှော့ချပေးသည်ကို သတိပြုပါ။
အဝေးထိန်းစီမံခန့်ခွဲမှုနှင့် စနစ်ထောက်လှမ်းရေး
ဟာ့ဒ်ဝဲကို ကာကွယ်ရန်နှင့် စွမ်းဆောင်ရည်ကို အကောင်းဆုံးဖြစ်စေရန်အတွက် စနစ်တွင် Comino Monitoring System (CMS) ပါဝင်သည်။ သီးခြား၊ ကိုယ်ပိုင်အုပ်ချုပ်ခွင့်ရှိသော controller board သည် CMS ကို မောင်းနှင်ပြီး အဓိက operating system နှင့် မသက်ဆိုင်သော server ၏ “ဦးနှောက်” အဖြစ် ဆောင်ရွက်သည်။ လက်တွေ့တွင်၊ ဤ controller သည် လေနှင့် အအေးပေးစက်၏ အပူချိန်၊ စိုထိုင်းဆအဆင့်၊ အအေးပေးစက်စီးဆင်းမှုနှုန်းနှင့် reservoir အဆင့်များကို အချိန်နှင့်တပြေးညီ ခြေရာခံသည့် အာရုံခံကိရိယာများစွာကို ဖတ်ရှုသည်။ အရေးကြီးသည်မှာ၊ ဤကိုယ်ပိုင်အုပ်ချုပ်ခွင့်ရှိသော ဒီဇိုင်းသည် CMS အား ယိုစိမ့်မှု သို့မဟုတ် pump ချို့ယွင်းမှုကို တွေ့ရှိပါက ကိုယ်တိုင်ရောဂါရှာဖွေခြင်းနှင့် အရေးပေါ်ပိတ်ခြင်းများကို စတင်နိုင်စေပြီး စျေးကြီးသော internal hardware ကို ပျက်စီးမှုမှ ကာကွယ်ပေးသည်။
ဝဘ်အခြေပြု GUI သည် နေ့စဉ်စီမံခန့်ခွဲမှုကို ကိုင်တွယ်ပေးပြီး CPU နှင့် GPU များအတွက် အအေးပေးစွမ်းဆောင်ရည်၊ ဖွင့်ချိန်နှင့် အချိန်နှင့်တပြေးညီ စွမ်းအင်သုံးစွဲမှုကို စီမံခန့်ခွဲသူများအား ရှင်းလင်းစွာမြင်သာစေပါသည်။ Enterprise-scale ဖြန့်ကျက်မှုများအတွက် CMS သည် Zabbix၊ Grafana နှင့် InfluxDB ကဲ့သို့သော REST API များမှတစ်ဆင့် ဗဟိုချုပ်ကိုင်မှုစောင့်ကြည့်ရေးကိရိယာများနှင့်လည်း ချိတ်ဆက်ပါသည်။ ဤစွမ်းရည်များပေါင်းစပ်ခြင်းဖြင့် စီမံခန့်ခွဲသူများအား ၃ နှစ်ကြာ ဝန်ဆောင်မှုကြားကာလကို ထိန်းသိမ်းရန်နှင့် မြင့်မားသောပတ်ဝန်းကျင်တွင်ပင် အပူချိန်ထိန်းချုပ်မှုမရှိဘဲ ဆာဗာကို အမြင့်ဆုံးစွမ်းဆောင်ရည်ဖြင့် လည်ပတ်နေစေရန် ကူညီပေးပါသည်။
AI ထက်ကျော်လွန်၍- ဖန်တီးမှုဆိုင်ရာနှင့် အင်ဂျင်နီယာဆိုင်ရာ အသုံးချမှုများ
ကျွန်ုပ်တို့၏ စမ်းသပ်မှုသည် AI inference workloads များကို အာရုံစိုက်ထားသော်လည်း Grando သည် ဒေသတွင်း GPU compute များစွာ လိုအပ်သော ဖန်တီးမှုဆိုင်ရာ ပရော်ဖက်ရှင်နယ်များနှင့် အင်ဂျင်နီယာများအတွက် တူညီသော လက်တွေ့ကျသော အခန်းကဏ္ဍမှ ဆောင်ရွက်ပေးပါသည်။ RTX PRO 6000 ကတ်ရှစ်ကတ်တွင် ပါဝင်သော 768GB VRAM သည် ရိုးရာ workstation configuration များနှင့် မယှဉ်နိုင်သော စွမ်းဆောင်ရည်များကို ဖွင့်လှစ်ပေးပါသည်။
FX အနုပညာရှင်များနှင့် ရွေ့လျားမှုဂရပ်ဖစ်ပညာရှင်များသည် VRAM တွင် ကြီးမားသော texture set များဖြင့် ရှုပ်ထွေးသောမြင်ကွင်းများကို အပြည့်အဝပုံဖော်နိုင်ပြီး 8K footage သို့မဟုတ် high-polygon ပတ်ဝန်းကျင်များကို အသုံးပြု၍ ထုတ်လုပ်မှုများကို ဒုက္ခပေးသော disk-swapping bottleneck များကို ဖယ်ရှားပေးပါသည်။ computational fluid dynamics သို့မဟုတ် structural simulation များကို လုပ်ဆောင်နေသော CAD အင်ဂျင်နီယာများသည် ၎င်းတို့၏မော်ဒယ်များကို multiple run များအဖြစ် ပိုင်းခြားခြင်းမရှိဘဲ မကြုံစဖူးရှုပ်ထွေးမှုရှိသော assembly များကို ကိုင်တွယ်ဖြေရှင်းနိုင်ပါသည်။ multi-stream 8K RAW timelines များဖြင့် အလုပ်လုပ်သော ဗီဒီယိုတည်းဖြတ်သူများ၊ ML-based noise reduction ကို full resolution ဖြင့် အသုံးပြုသော colorists များနှင့် cloud farm ရရှိနိုင်မှုကို စောင့်ဆိုင်းမည့်အစား path-traced finals များကို ဒေသတွင်းတွင် ပုံဖော်နေသော 3D အနုပညာရှင်များအားလုံးသည် GPU memory နှင့် compute ၏ ဤသိပ်သည်းဆမှ အကျိုးကျေးဇူးရရှိကြသည်။
Grando သည် ရှစ်-GPU အပြည့်အစုံ configuration မလိုအပ်ပါ။ Comino သည် ပလက်ဖောင်းကို လေး-GPU၊ ခြောက်-GPU နှင့် ရှစ်-GPU configuration များဖြင့် ပေးဆောင်ထားပြီး ဗားရှင်းအားလုံးကို ချက်ချင်းပို့ဆောင်ပေးနိုင်ပါသည်။ စတူဒီယိုငယ်များ၊ လွတ်လပ်သောဖန်တီးသူများနှင့် အင်ဂျင်နီယာအဖွဲ့များသည် workloads များ တိုးလာသည်နှင့်အမျှ ရှင်းလင်းသော upgrade လမ်းကြောင်းကို ထိန်းသိမ်းထားစဉ်တွင် ၎င်းတို့၏ရင်းနှီးမြှုပ်နှံမှုကို လက်ရှိလိုအပ်ချက်များနှင့် ကိုက်ညီအောင် ချိန်ညှိနိုင်ပါသည်။
ပလက်ဖောင်း အပေးအယူများ- သိပ်သည်းဆနှင့် ချဲ့ထွင်နိုင်မှု
Grando ရဲ့ ကျစ်လစ်တဲ့ ဒီဇိုင်းက စံ 4U footprint အတွင်း ထူးကဲတဲ့ GPU သိပ်သည်းဆနဲ့ အပူချိန်စီမံခန့်ခွဲမှုကို ပေးစွမ်းပေမယ့် အဲဒီသိပ်သည်းဆက ဖြန့်ကျက်မှုမလုပ်ခင်မှာ နားလည်သင့်တဲ့ ဗိသုကာပိုင်းဆိုင်ရာ အပေးအယူတွေ ပါဝင်ပါတယ်။
ကိုယ်ထည်တွင် EATX နှင့် EEB form factor များပါရှိသော motherboard များကို ထည့်သွင်းထားသော်လည်း ရိုးရာ dual-socket platform များတွင်တွေ့ရသော extended server board များကိုမူ ထည့်သွင်းထားခြင်းမရှိပါ။ ၎င်းသည် GPU array မှလွဲ၍ အခြား peripheral များအတွက် ရရှိနိုင်သော PCIe lanes စုစုပေါင်းအရေအတွက်ကို ကန့်သတ်ထားသည်။ ကျွန်ုပ်တို့၏ eight-GPU configuration တွင် AMD EPYC processor ၏ 128 PCIe Gen 5 lanes များကို GPU များမှ အပြည့်အဝနီးပါး အသုံးပြုထားပြီး onboard 10GbE port များထက်ကျော်လွန်၍ နောက်ထပ် NVMe storage သို့မဟုတ် မြန်နှုန်းမြင့် networking အတွက် bandwidth အနည်းငယ်သာကျန်ရှိတော့သည်။
ဒါက Dell၊ HPE နဲ့ Supermicro တို့ကနေ ကျွန်တော်တို့ သုံးသပ်ထားတဲ့ ရှစ် GPU ပလက်ဖောင်းတွေနဲ့ ဆန့်ကျင်ဘက်ပါပဲ။ အဲဒီစနစ်တွေက peripheral ချိတ်ဆက်မှုကို သိသိသာသာ ပံ့ပိုးပေးဖို့အတွက် ပိုကြီးတဲ့ chassis၊ dual-socket configuration နဲ့ PCIe switch topologies တွေကို အသုံးပြုပါတယ်။ ၎င်းတို့ဟာ full GPU complement နဲ့အတူ နောက်ထပ် NICs ဒါမှမဟုတ် DPU လေးခုကနေ ရှစ်ခုအထိ ထားရှိလေ့ရှိပြီး hot-swap NVMe bays ရှစ်ခု ဒါမှမဟုတ် ရှစ်ခုထက်ပိုတဲ့ hot-swap NVMe bays တွေကို ထည့်သွင်းလေ့ရှိတာကြောင့် high-bandwidth fabric interconnects လိုအပ်တဲ့ distributed inference workloads တွေအတွက် သင့်တော်ပါတယ်။
သို့သော် ထိုတိုးချဲ့ထားသောစွမ်းရည်သည် သိသိသာသာကုန်ကျစရိတ်ရှိသည်။ ပါဝါသုံးစွဲမှု 8kW ထက်ကျော်လွန်သည်။ အပူဝန်များသည် သီးသန့်ဒေတာစင်တာအအေးပေးစနစ်အခြေခံအဆောက်အအုံများလိုအပ်သည်။ ဆူညံသံကြမ်းပြင်များသည် ရည်ရွယ်ချက်ရှိရှိတည်ဆောက်ထားသောစက်ခန်းများပြင်ပတွင် ဖြန့်ကျက်ခြင်းကို တားဆီးသည်။ ထို့အပြင် လုပ်ငန်းသုံး GPU ပလက်ဖောင်းများတွင် စဉ်ဆက်မပြတ်ထောက်ပံ့မှုကန့်သတ်ချက်များကြောင့် ပို့ဆောင်ချိန်များသည် မကြာခဏ ခြောက်လမှ ၁၈ လအထိ ကြာမြင့်လေ့ရှိသည်။
Grando သည် ကွဲပြားသော ရာထူးတစ်ခုကို ရယူထားသည်။ ကြီးမားသော ဖြန့်ဝေထားသော လေ့ကျင့်မှုထက် မြန်ဆန်စွာ ဖြန့်ကျက်ခြင်း၊ စီမံခန့်ခွဲနိုင်သော လည်ပတ်မှုပတ်ဝန်းကျင်နှင့် ကောက်ချက်ချခြင်း သို့မဟုတ် ဖန်တီးမှုဆိုင်ရာ အလုပ်ပမာဏများကို ဦးစားပေးသော အဖွဲ့အစည်းများအတွက်၊ အပေးအယူများသည် မကြာခဏ အပြုသဘောဆောင်လေ့ရှိသည်။ ယခု ၎င်းတို့၏ ဟာ့ဒ်ဝဲကို လိုအပ်သော အဖွဲ့များသည် ၎င်းတို့ အမှန်တကယ် အလုပ်လုပ်နိုင်သည့် ပတ်ဝန်းကျင်တွင် Grando ၏ သိပ်သည်းဆအပေါ် ချဉ်းကပ်မှုသည် ရောက်ရှိပြီးသည်နှင့် လက်တွေ့ကျကျ ဖြန့်ကျက်၍မရသော ပလက်ဖောင်းအတွက် တန်းစီစောင့်ဆိုင်းခြင်းထက် ပိုမိုလက်တွေ့ကျသည်ဟု တွေ့ရှိနိုင်သည်။
Comino Grando စွမ်းဆောင်ရည်စမ်းသပ်မှုရလဒ်များ
System Configuration
- ကိုယ်ထည်: ကိုမီနို ဂရန်ဒို
- motherboard: ASRock Rack GENOAD8X-2T/BCM
- CPU ကို: AMD EPYC 9474F 48C
- မှတ်ဉာဏ်: 512GB DDR5
- GPU ကို: NVIDIA RTX PRO 6000 ၈ ကတ်
- သိုလှောင်မှု: M.2 SSD ကို
Claude ကုဒ်ဝန်ဆောင်မှု – MiniMax M2.5
ရိုးရာ raw LLM inference benchmarks များအပြင်၊ ဤ hardware သည် agent coding workflow တွင် မည်မျှကောင်းမွန်စွာ လုပ်ဆောင်နိုင်သည်ကို ကျွန်ုပ်တို့ အကဲဖြတ်လိုခဲ့ပြီး၊ အထူးသဖြင့် locally hosted model ကို အသုံးပြု၍ တစ်ပြိုင်နက်တည်း Claude Code sessions များစွာကို ဝန်ဆောင်မှုပေးခြင်းဖြင့်ဖြစ်သည်။ ဤအသုံးပြုမှုကိစ္စသည် development team productivity နှင့် တိုက်ရိုက်ဆက်စပ်နေသည်- အတွေ့အကြုံ ယိုယွင်းပျက်စီးသွားခြင်းမပြုမီ node တစ်ခုတည်းမှ ဝန်ဆောင်မှုပေးသော AI coding assistant ကို အင်ဂျင်နီယာမည်မျှ တစ်ပြိုင်နက်အသုံးပြုနိုင်သနည်း။
ဒါကိုစမ်းသပ်ဖို့အတွက်၊ ကျွန်တော်တို့ဟာ အသင့်အတင့်ခက်ခဲတဲ့ coding ပြဿနာတွေရဲ့ dataset တစ်ခုကို ထုတ်လုပ်ပေးတဲ့ benchmark harness တစ်ခုကို တည်ဆောက်ခဲ့ပါတယ် (ဥပမာ LRU cache ကို အကောင်အထည်ဖော်တာ၊ CLI todo application တစ်ခုတည်ဆောက်တာ၊ markdown converter တစ်ခုရေးသားတာနဲ့ REST API တစ်ခုတည်ဆောက်တာလိုမျိုး)။ ပြီးတော့ Claude Code session တစ်ခုစီကို သီးခြား Docker container တစ်ခုမှာ local vLLM server နဲ့ ယှဉ်ပြီး လုပ်ဆောင်ပါတယ်။ transparent proxy တစ်ခုဟာ session တွေနဲ့ inference endpoint ကြားမှာ ရှိနေပြီး Claude Code instance တစ်ခုစီအတွက် per-request metrics တွေကို ဖမ်းယူပါတယ်။ အသုံးပြုခဲ့တဲ့ model က MiniMax M2.5 ဖြစ်ပြီး system ရဲ့ NVIDIA RTX PRO 6000 GPU ရှစ်လုံးမှာ vLLM မှတစ်ဆင့် ဝန်ဆောင်မှုပေးပါတယ်။ public leaderboards တွေမှာ ထိပ်တန်း coding model မဟုတ်ပေမယ့် M2.5 ဟာ developer သူငယ်ချင်းတွေအပါအဝင် အသုံးပြုသူအများအပြား ဒေသတွင်းမှာ အသုံးပြုကြတဲ့ capable model တစ်ခုဖြစ်ပါတယ်။
အခြေခံကိုးကားချက်အတွက်၊ ကျွန်ုပ်တို့သည် production API ဝင်ရောက်ခွင့်အတွက် အလွန်ရေပန်းစားသော routing service များထဲမှ တစ်ခုဖြစ်သည့် OpenRouter.ai မှတစ်ဆင့် Anthropic ၏ Claude Opus 4.6 ပျမ်းမျှ output throughput ကို အသုံးပြုပါသည်။ ထိုအခြေခံသည် API request တစ်ခုလျှင် တစ်စက္ကန့်လျှင် တိုကင် ၃၇ ခုခန့် ရှိပါသည်။
ကျွန်ုပ်တို့သည် အဓိက မက်ထရစ်နှစ်ခုကို တိုင်းတာခဲ့သည်- Claude Code session တစ်ခုလျှင် တစ်စက္ကန့်လျှင် ပျမ်းမျှ output tokens (developer တစ်ဦးချင်းစီ ကြုံတွေ့ရသည်များ) နှင့် session အားလုံးတွင် တစ်စက္ကန့်လျှင် စုစုပေါင်း output tokens (server မှ ထုတ်လုပ်သော စုစုပေါင်းအလုပ်)။
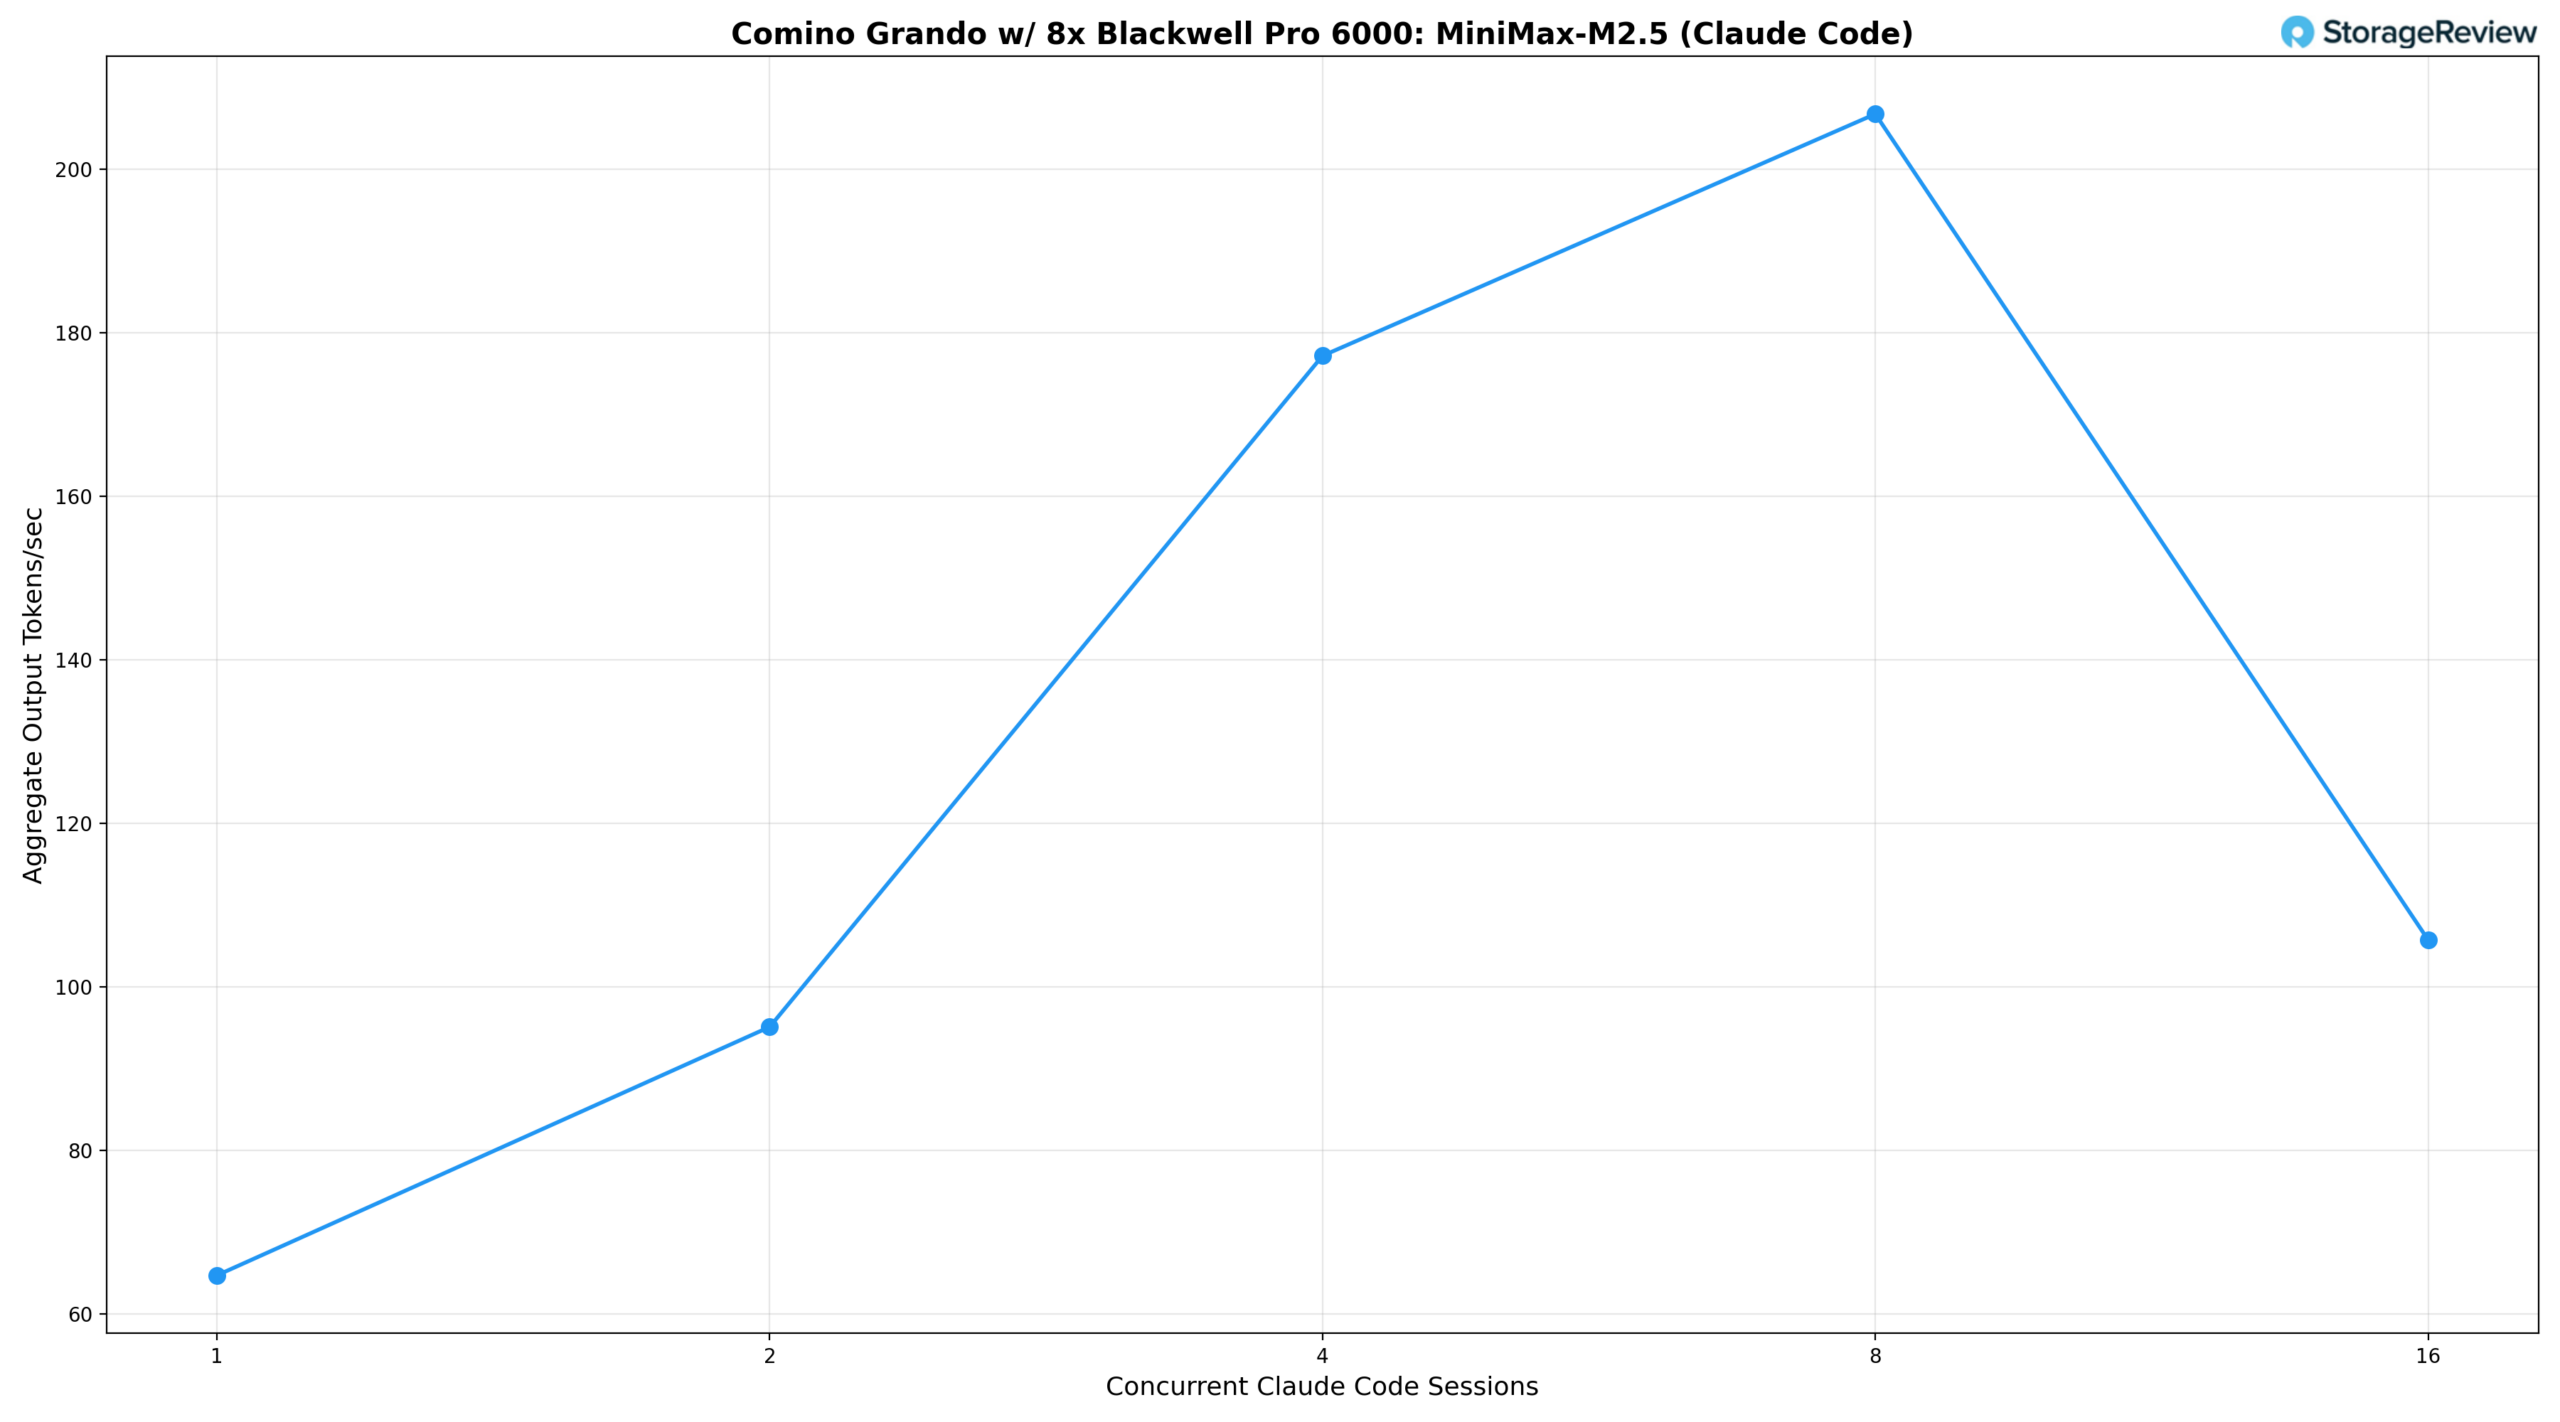
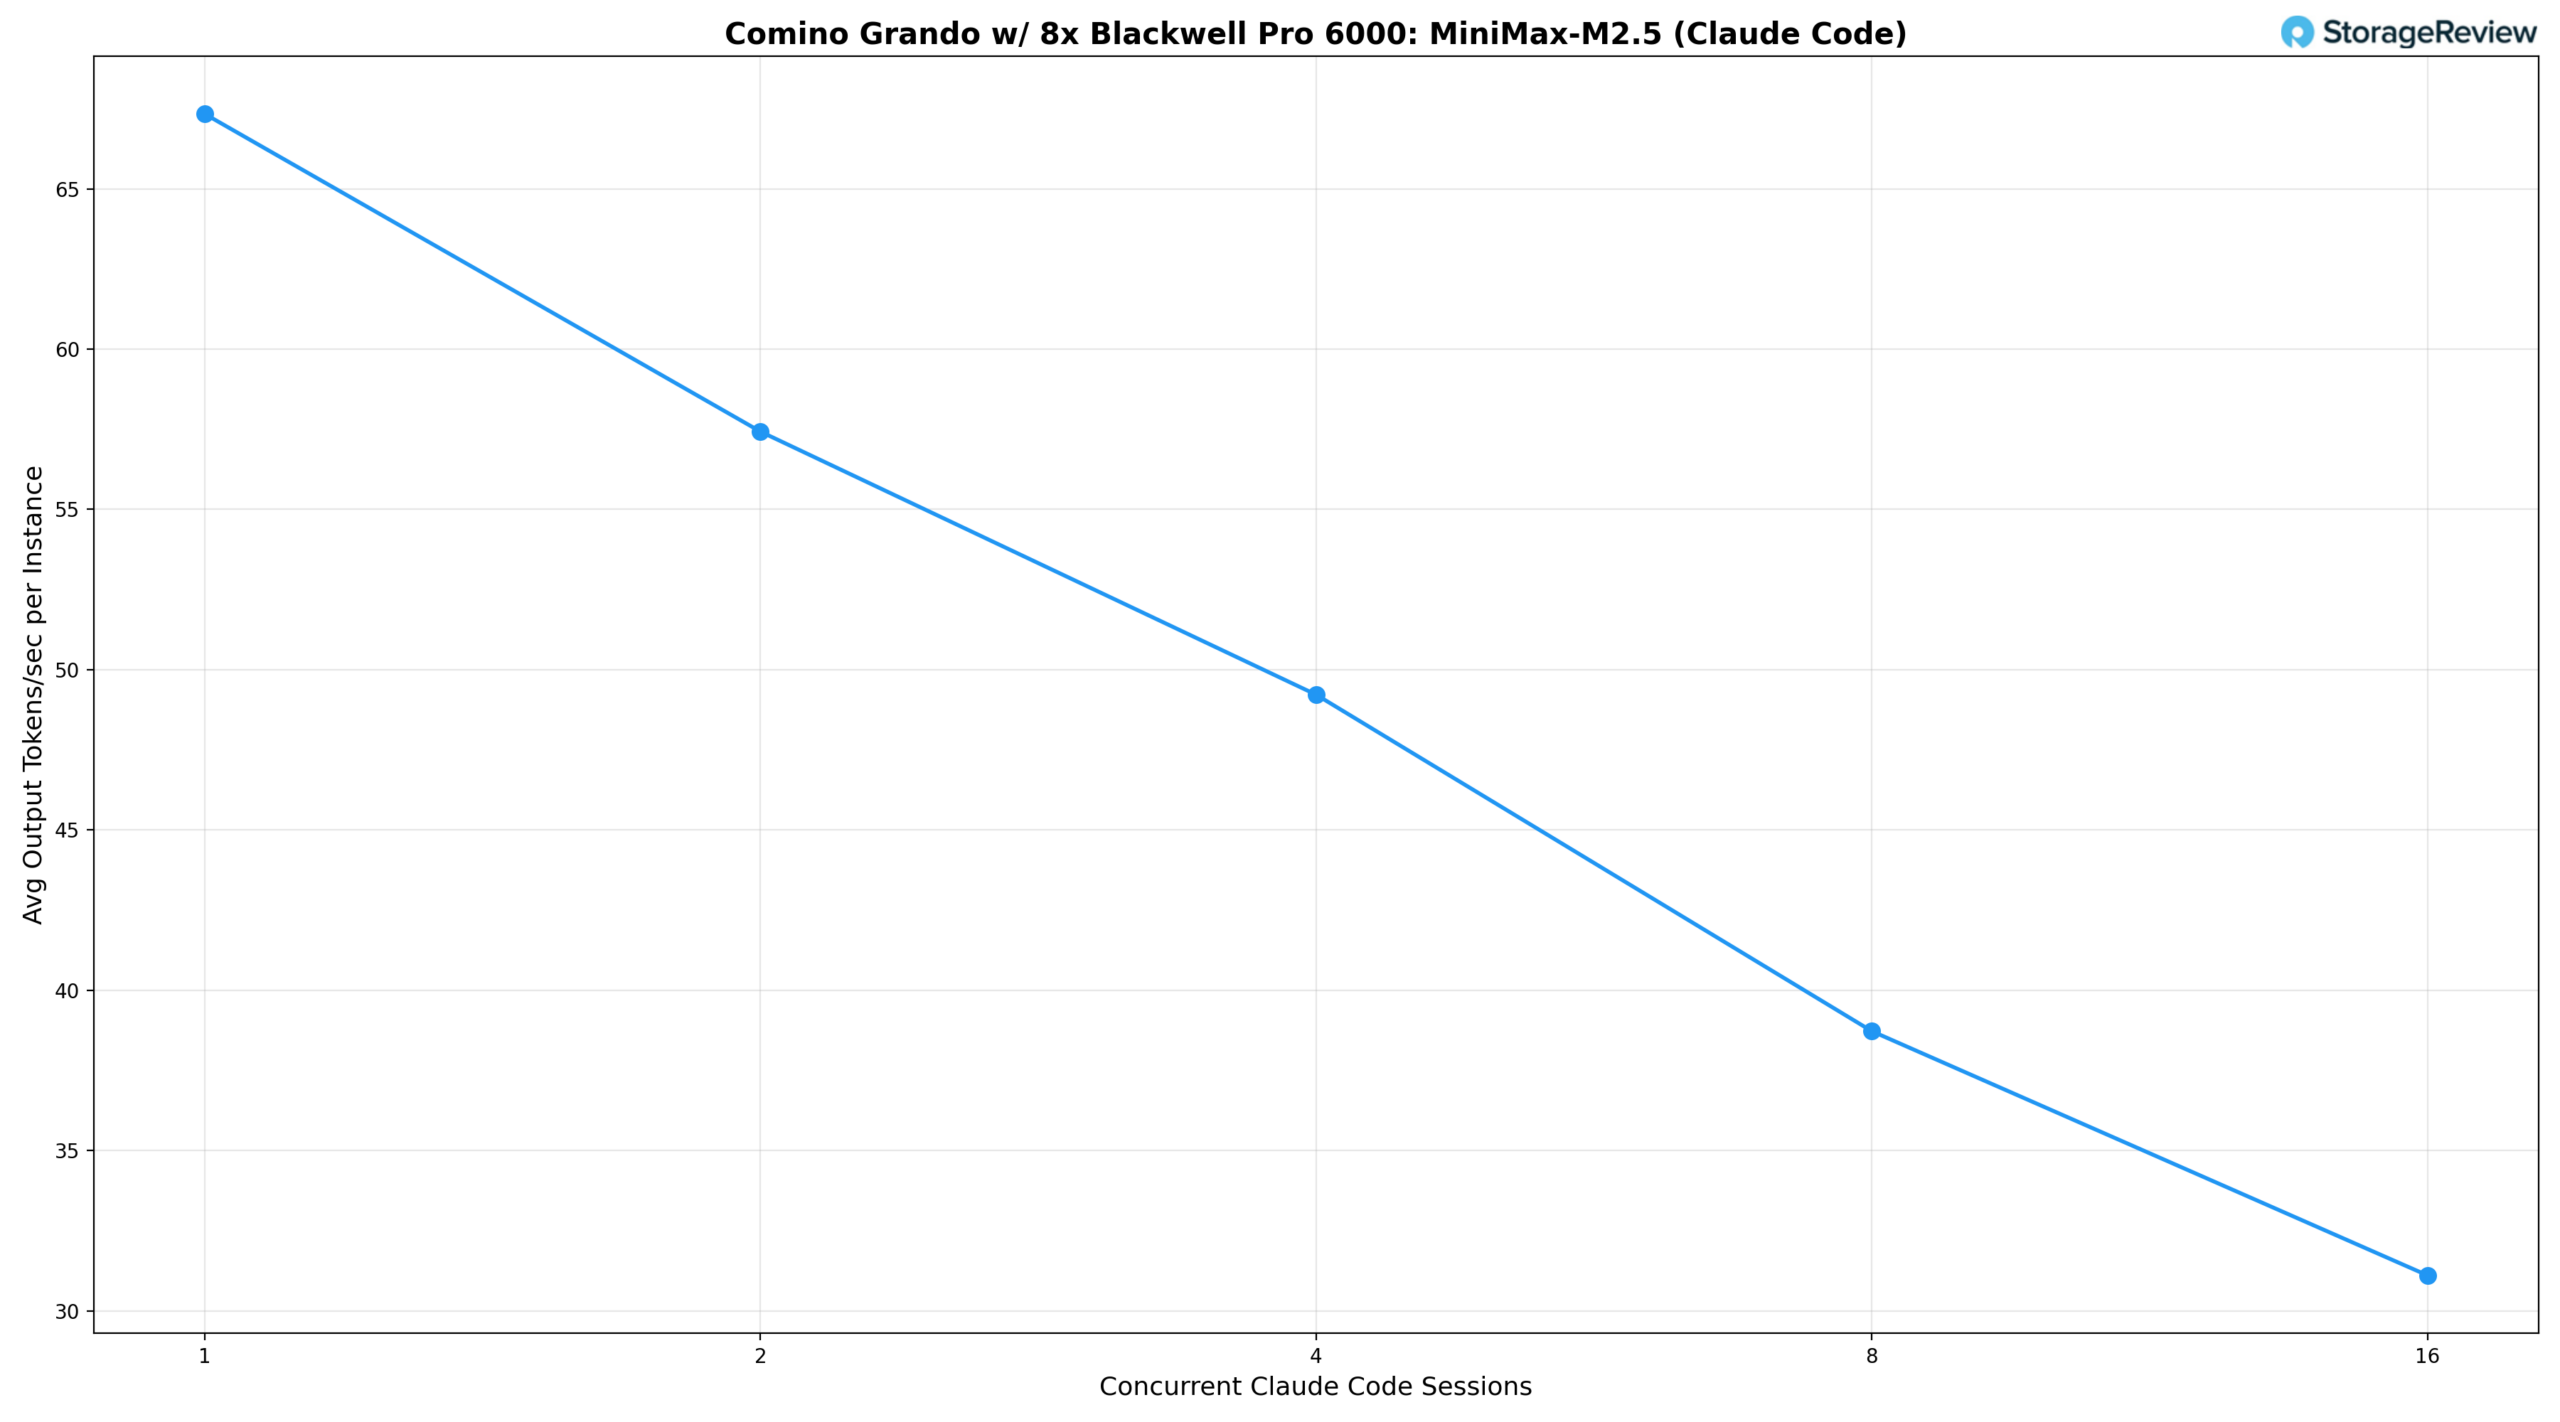
ရလဒ်များအရ Claude Code session တစ်ခုတည်းသည် အသုံးပြုသူတစ်ဦးလျှင် tok/s ၆၇.၃ ရရှိပြီး စုစုပေါင်း output ၆၄.၇ tok/s ရရှိသည်။ session နှစ်ခုတွင် instance တစ်ခုလျှင် throughput ၅၇.၄ tok/s အထိ ကျဆင်းသွားပြီး vLLM ၏ batching သည် overhead ကို amortize လုပ်လာသည်နှင့်အမျှ စုစုပေါင်း output သည် ၉၅.၁ tok/s အထိ မြင့်တက်သွားသည်။ concurrent session လေးခုသည် အသုံးပြုသူတစ်ဦးလျှင် tok/s ၄၉.၂ ရရှိထားပြီး interactive coding workflows အတွက် အလွန်တုံ့ပြန်မှုကောင်းသော အတွေ့အကြုံတစ်ခုဖြစ်ပြီး စုစုပေါင်း throughput သည် ၁၇၇.၂ tok/s သို့ ရောက်ရှိသည်။ session ရှစ်ခုသည် စုစုပေါင်း output အတွက် အကောင်းဆုံးနေရာဖြစ်ပြီး စုစုပေါင်း ၂၀၆.၇ tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိပြီး instance တစ်ခုလျှင် throughput ၃၈.၇ tok/s တွင် တည်ရှိပြီး real-time code generation နှင့် iteration အတွက် အဆင်ပြေသော အဆင့်တွင် ရှိနေသေးသည်။
တစ်ပြိုင်နက်တည်း session ၁၆ ခုတွင် စနစ်သည် ဂန္ထဝင် batching trade-off ကို ပြသသည်- instance တစ်ခုလျှင် throughput သည် 31.1 tok/s အထိ ကျဆင်းသွားပြီး စုစုပေါင်း output သည် 105.8 tok/s အထိ ကျဆင်းသွားသည်။ ဤ concurrency level တွင် 230B MiniMax M2.5 မော်ဒယ်သည် အသုံးပြုသူတစ်ဦးချင်းစီအတွက် အဓိပ္ပာယ်ရှိသော latency ကို မထည့်သွင်းဘဲ GPU ရှစ်ခု ခံနိုင်ရည်ရှိနိုင်သည့် ကန့်သတ်ချက်များကို တွန်းအားပေးနေကြောင်း ညွှန်ပြသည်။ session ၈ ခုမှ ၁၆ ခုအထိ စုစုပေါင်းကျဆင်းမှုသည် အချိန်ဇယားဆွဲရာတွင် ထိရောက်မှုမရှိခြင်းထက် တစ်ပြိုင်နက်တည်း decode load များခြင်းအောက်တွင် MoE ဗိသုကာကြီးတစ်ခု၏ memory-bandwidth လိုအပ်ချက်များကို ထင်ဟပ်စေသည်။
developer tooling အတွက် self-hosted AI infrastructure ကို အကဲဖြတ်နေသော အဖွဲ့အစည်းများအတွက် Grando သည် ခိုင်မာသော အကြောင်းပြချက်တစ်ခုဖြစ်သည်။ frontier-class 230B မော်ဒယ်ကို အသုံးပြုခြင်းဖြင့် ၎င်းသည် အမှန်တကယ် အပြန်အလှန်အကျိုးသက်ရောက်မှုရှိသော throughput အဆင့်များတွင် Claude Code session ရှစ်ခုအထိ တစ်ပြိုင်နက်တည်း သက်တောင့်သက်သာ ဝန်ဆောင်မှုပေးနိုင်ပြီး စုစုပေါင်း output အမြင့်ဆုံးတွင် per user speeds 38 tok/s ကျော်ရှိသည်။ အင်ဂျင်နီယာလေးဦးမှ ရှစ်ဦးအထိပါဝင်သော အဖွဲ့များသည် တုံ့ပြန်မှုတွင် သိသာထင်ရှားသော ယိုယွင်းမှုမရှိဘဲ အကောင်းဆုံး throughput ဖြင့် လုပ်ဆောင်နိုင်သည်။
အရည်အအေးပေးထားသော ဗိသုကာလက်ရာသည် ရိုးရာ GPU ဆာဗာများ မလည်ပတ်နိုင်သည့် ပတ်ဝန်းကျင်များတွင် ဤတွက်ချက်မှုအဆင့်ကို လက်တွေ့ကျစေသည်။ စနစ်သည် startup ရုံးခန်းတစ်ခု၊ စက်ခန်းငယ်တစ်ခု သို့မဟုတ် ပွင့်လင်းသော အလုပ်ခွင်၏ သီးသန့်ထောင့်တစ်ခုတွင် ထားရှိရန် လုံလောက်သော တိတ်ဆိတ်စွာ လည်ပတ်သည်။ အလားတူ GPU သိပ်သည်းဆရှိသော လေအေးပေးထားသော စနစ်များသည် ပုံမှန်အားဖြင့် 90 dB သို့မဟုတ် ထို့ထက်ပို၍ ရောက်ရှိလေ့ရှိပြီး သီးသန့်ဒေတာစင်တာနေရာ သို့မဟုတ် အနည်းဆုံး အသံပိုင်းဆိုင်ရာ ကုသမှုဖြင့် ပိတ်ထားသော ဆာဗာဗီရိုတစ်ခု လိုအပ်လောက်အောင် ဆူညံသည်။ Grando သည် ၎င်းကိုအသုံးပြုသော အဖွဲ့နှင့် အတူယှဉ်တွဲတည်ရှိနိုင်သည်။ ဒေတာတည်နေရာအပြည့်အစုံ၊ တိုကင်တစ်ခုလျှင် API ကုန်ကျစရိတ်မရှိခြင်းနှင့် မော်ဒယ်ရွေးချယ်မှုကို အပြည့်အဝထိန်းချုပ်ခြင်းတို့ဖြင့် ပေါင်းစပ်ထားသောကြောင့် ဒေတာစင်တာ အခြေခံအဆောက်အအုံ သို့မဟုတ် လော့ချ်စတက်ကုန်ကျစရိတ်မြင့်တက်မှုများ မလိုအပ်ဘဲ ကြီးထွားလာသော ဖွံ့ဖြိုးတိုးတက်ရေးအဖွဲ့နှင့်အတူ တိုးချဲ့နိုင်သော self-hosted လမ်းကြောင်းကို ပေးဆောင်သည်။
vLLM အွန်လိုင်းဝန်ဆောင်မှု – LLM ကောက်ချက်ချမှုစွမ်းဆောင်ရည်
vLLM သည် LLM များအတွက် အလွန်ရေပန်းစားသော high-throughput inference နှင့် serving engine များထဲမှ တစ်ခုဖြစ်သည်။ vLLM အွန်လိုင်း serving benchmark သည် concurrent request များအောက်တွင် ဤ inference engine ၏ လက်တွေ့ကမ္ဘာ serving စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည်။ ၎င်းသည် request rate၊ input နှင့် output length များနှင့် concurrent client အရေအတွက်ကဲ့သို့သော configure လုပ်နိုင်သော parameter များဖြင့် လည်ပတ်နေသော vLLM server သို့ request များပေးပို့ခြင်းဖြင့် production workload များကို simulate လုပ်သည်။ benchmark သည် throughput (တစ်စက္ကန့်လျှင် token များ)၊ ပထမဆုံး token မှအချိန်နှင့် output token တစ်ခုလျှင်အချိန် (TPOT) အပါအဝင် အဓိက metric များကို တိုင်းတာပြီး အသုံးပြုသူများ vLLM ၏ load condition အမျိုးမျိုးအောက်တွင် မည်သို့လုပ်ဆောင်သည်ကို နားလည်ရန် ကူညီပေးသည်။
ကျွန်ုပ်တို့သည် မတူညီသော concurrency profiles များအောက်တွင် throughput ကို အကဲဖြတ်ရန်အတွက် မတူညီသော architectures၊ parameter scales နှင့် quantization strategies များကို လွှမ်းခြုံထားသော မော်ဒယ်အစုံတစ်လျှောက် inference performance ကို စမ်းသပ်ခဲ့ပါသည်။
ရလဒ်များအကျဉ်းချုပ်
| ပုံစံ | စေ့စပ်သေချာခြင်း | ညီမျှသော (၂၅၆/၂၅၆) | ကြိုတင်ဖြည့်သွင်း-လေးလံသော (၈ ကီလိုမီတာ/၁ ကီလိုမီတာ) | ဒီကုဒ်-အကြီးစား (၁ ကီလိုမီတာ/၈ ကီလိုမီတာ) |
|---|---|---|---|---|
| Comino Grando w/ 8× RTX PRO 6000 Blackwell — vLLM ကောက်ချက်ရလဒ်များ (tok/s၊ BS=256 တွင် အမြင့်ဆုံး) | ||||
| GPT-OSS 20B | ep_dp1 | 17,280 | 32,061 | 11,187 |
| GPT-OSS 120B | ep_dp1 | 11,726 | 21,636 | 7,570 |
| Llama 3.1 8B ညွှန်ကြားချက် | FP8 | 12,109 | 20,137 | 7,353 |
| Llama 3.1 8B ညွှန်ကြားချက် | FP4 | 11,954 | 20,206 | 7,239 |
| Llama 3.1 8B ညွှန်ကြားချက် | BF16 | 11,752 | 17,346 | 6,155 |
| Qwen3 ကုဒ်ဒါ 30B A3B | FP8 | 10,985 | 16,659 | 4,907 |
| Qwen3 ကုဒ်ဒါ 30B A3B | BF16 | 10,588 | 16,680 | 4,829 |
| မစ်စထရယ် အသေးစား ၃.၁ ၂၄ဘီ | BF16 | 8,925 | 11,846 | 4,975 |
| မီနီမက်စ် M၂.၅ (၂၃၀ဘီ) | ep_dp1 | 5,753 | 7,357 * | 2,555 |
| tok/s ဖြင့် တန်ဖိုးအားလုံး၊ BS=၂၅၆ တွင် အမြင့်ဆုံး throughput ဖြစ်သည်။ *MiniMax M2.5 prefill-heavy သည် BS=၁၂၈ (၇,၃၅၇ tok/s) တွင် အမြင့်ဆုံးသို့ ရောက်ရှိခဲ့သည်။ BS=၂၅၆ သည် ၇,၁၄၁ tok/s ဖြစ်သည်။ | ||||
GPT-OSS 120B နှင့် 20B
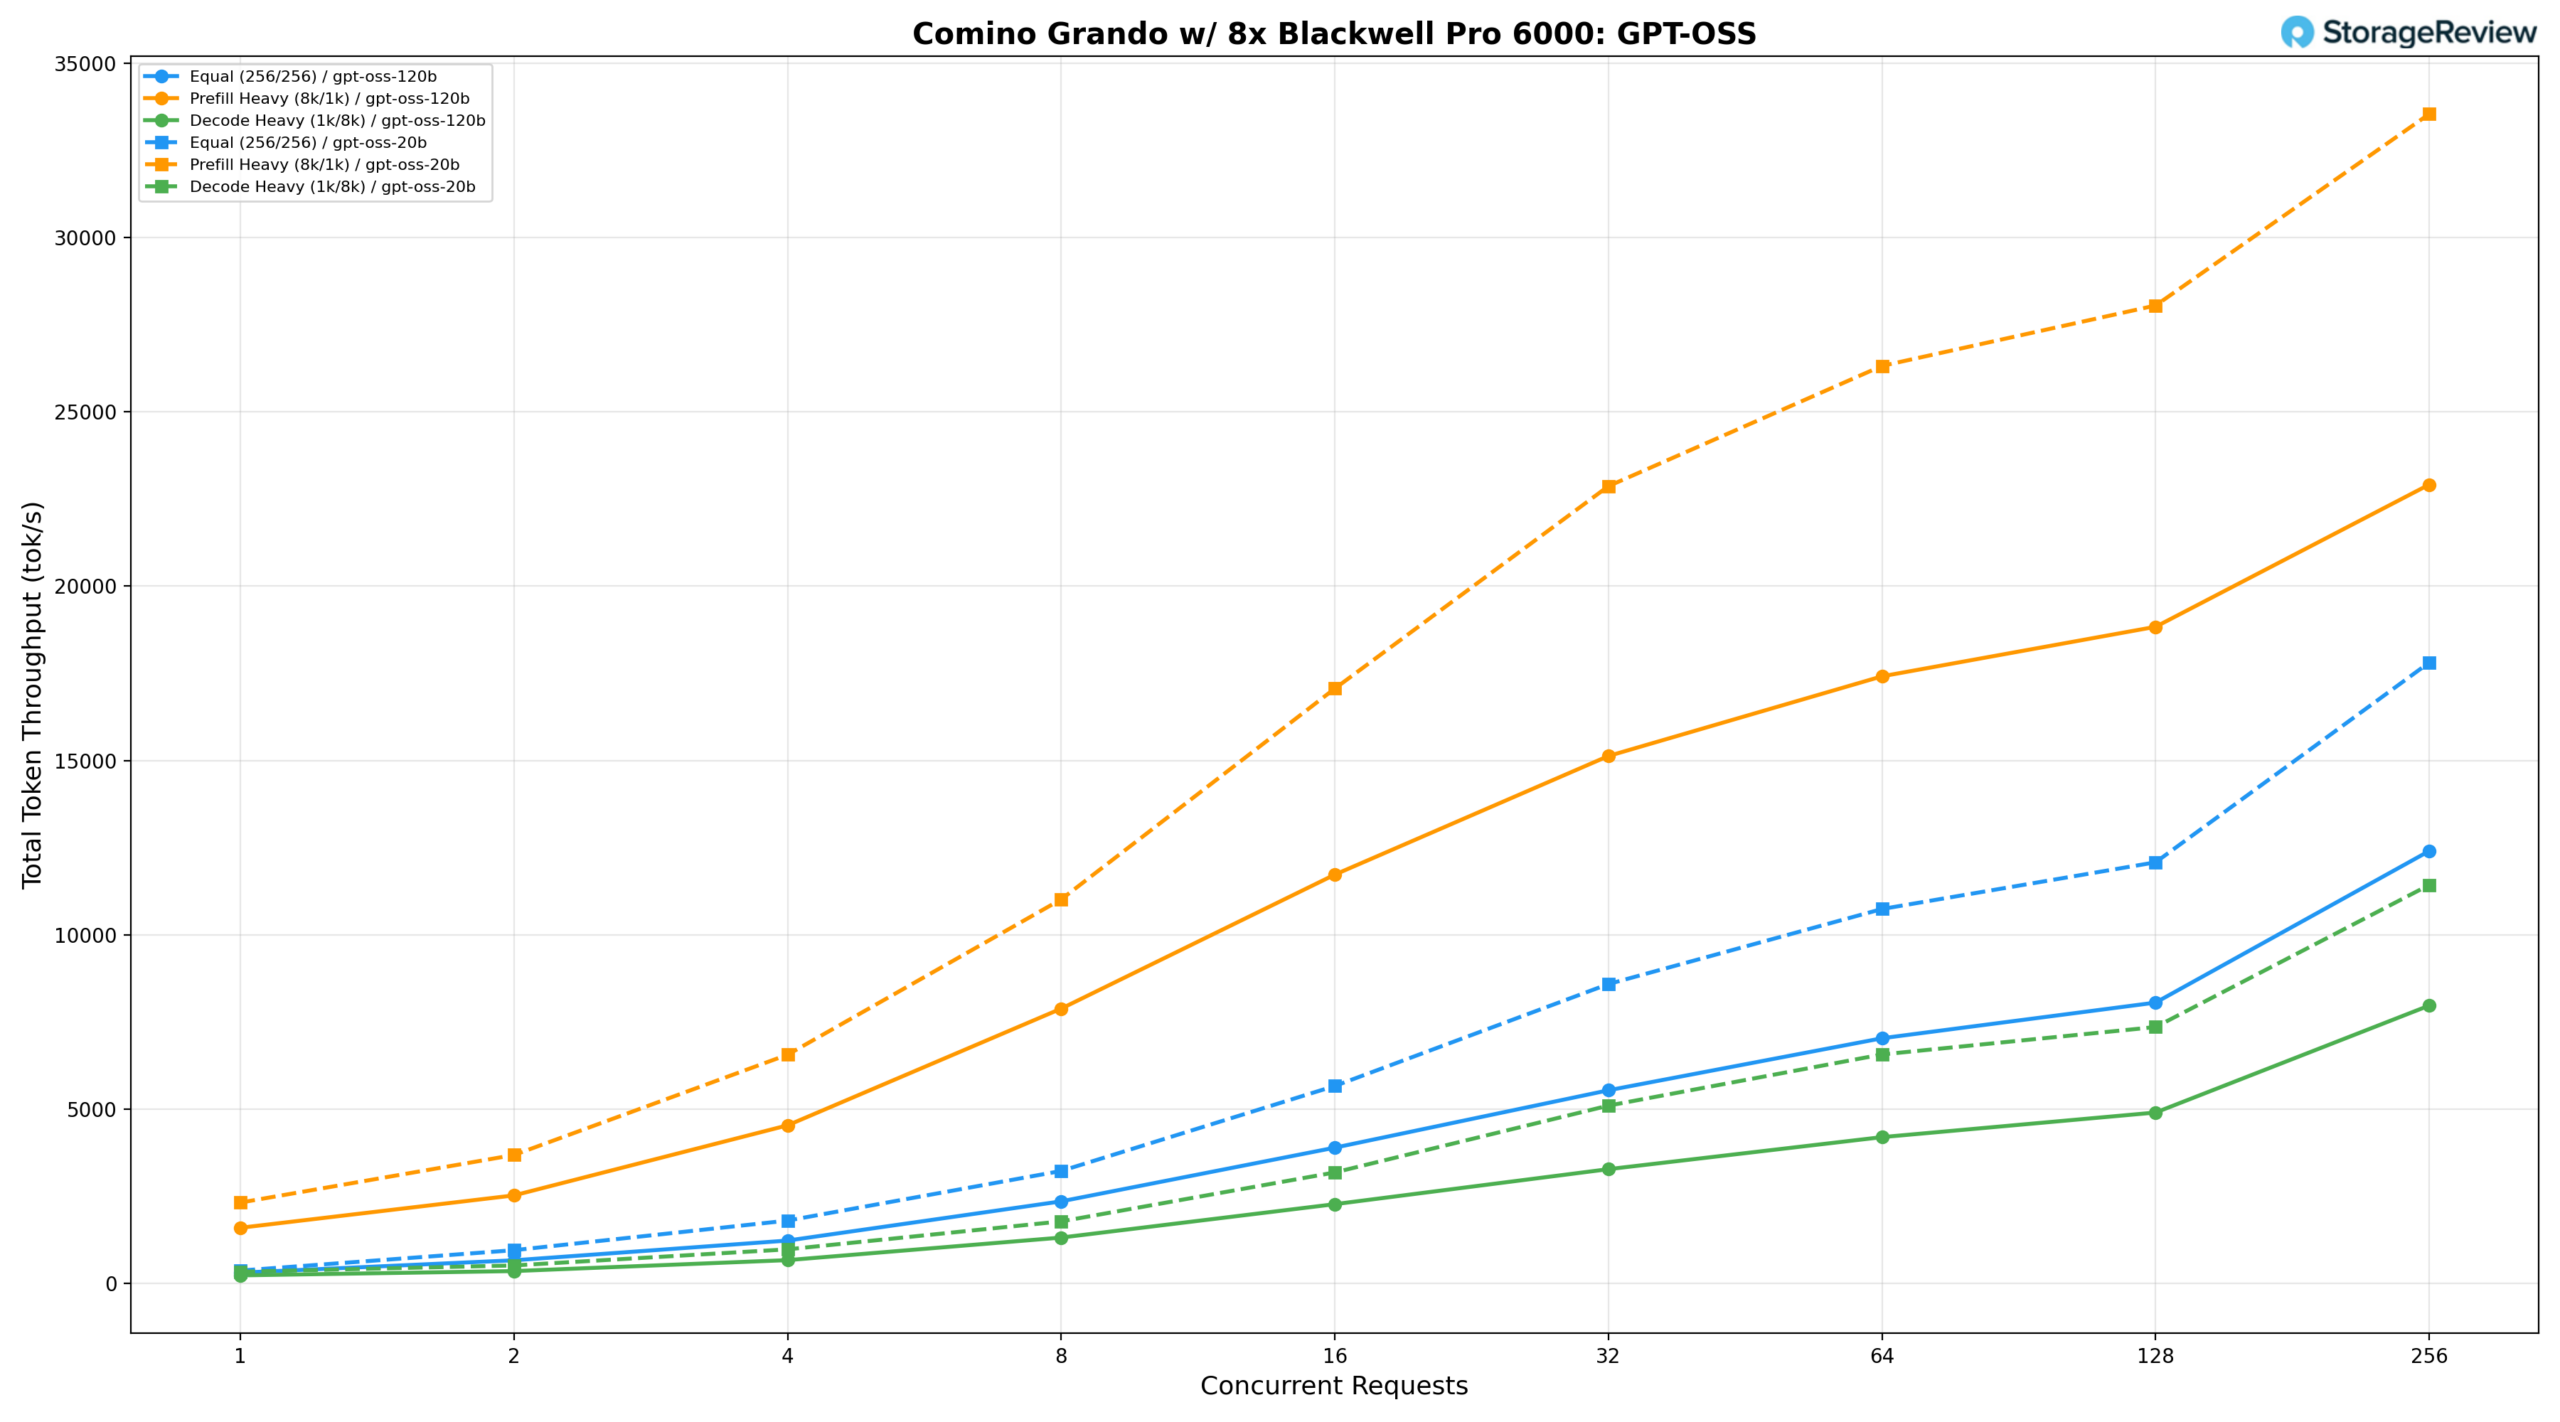
GPT-OSS မော်ဒယ်မိသားစုကို Comino Grando တွင် 120B နှင့် 20B ဖွဲ့စည်းမှုနှစ်ခုလုံးတွင် စမ်းသပ်ခဲ့သည်။
GPT-OSS 120B
တူညီသော workload (၂၅၆/၂၅၆) အောက်တွင်၊ 120B မော်ဒယ်သည် BS=1 တွင် 268.85 tok/s ပေးစွမ်းပြီး၊ BS=64 တွင် 6,666.23 tok/s ရောက်ရှိကာ BS=256 တွင် 11,726.04 tok/s တွင် အမြင့်ဆုံးရောက်ရှိပါသည်။ Prefill-heavy (8k/1k) သည် 1,375.69 tok/s မှစတင်၍ BS=64 တွင် 16,374.19 tok/s နှင့် BS=128 တွင် 17,944.55 tok/s အထိ မြင့်တက်ကာ BS=256 တွင် 21,636.41 tok/s တွင် အမြင့်ဆုံးရောက်ရှိပါသည်။ Decode-heavy (1k/8k) သည် BS=1 တွင် 196.28 tok/s မှ BS=256 တွင် 7,569.97 tok/s အထိ မြင့်တက်လာပြီး concurrency အဆင့်နိမ့်များတွင် latency ကို ကောင်းစွာထိန်းချုပ်ထားသည်။
GPT-OSS 20B
20B မော်ဒယ်သည် တူညီသော workload အောက်တွင် BS=1 တွင် 334.80 tok/s ပေးစွမ်းနိုင်ပြီး BS=64 တွင် 10,303.56 tok/s ရောက်ရှိကာ BS=256 တွင် 17,280.12 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိပါသည်။ Prefill-heavy သည် 2,007.90 tok/s မှစတင်၍ BS=64 တွင် 24,990.46 tok/s နှင့် BS=128 တွင် 26,866.25 tok/s အထိ မြင့်တက်ကာ BS=256 တွင် 32,060.72 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိပြီး မော်ဒယ်အရွယ်အစားနှစ်ခုလုံးတွင် မှတ်တမ်းတင်ထားသော အမြင့်ဆုံး absolute prefill throughput ဖြစ်သည်။ BS=1 တွင် Decode-heavy သည် 286.08 tok/s မှ BS=256 တွင် 11,187.36 tok/s အထိ တိုးလာပြီး အမြင့်ဆုံး တစ်ပြိုင်နက်တည်းတွင် 120B ၏ decode throughput ၏ 1.5 ဆခန့်ကို ပေးစွမ်းနိုင်သော်လည်း latency ပိုမိုတင်းကျပ်စွာ ထိန်းသိမ်းထားနိုင်သည်။
Qwen3 Coder 30B A3B ညွှန်ကြားချက်နှင့် FP8 ညွှန်ကြားချက်
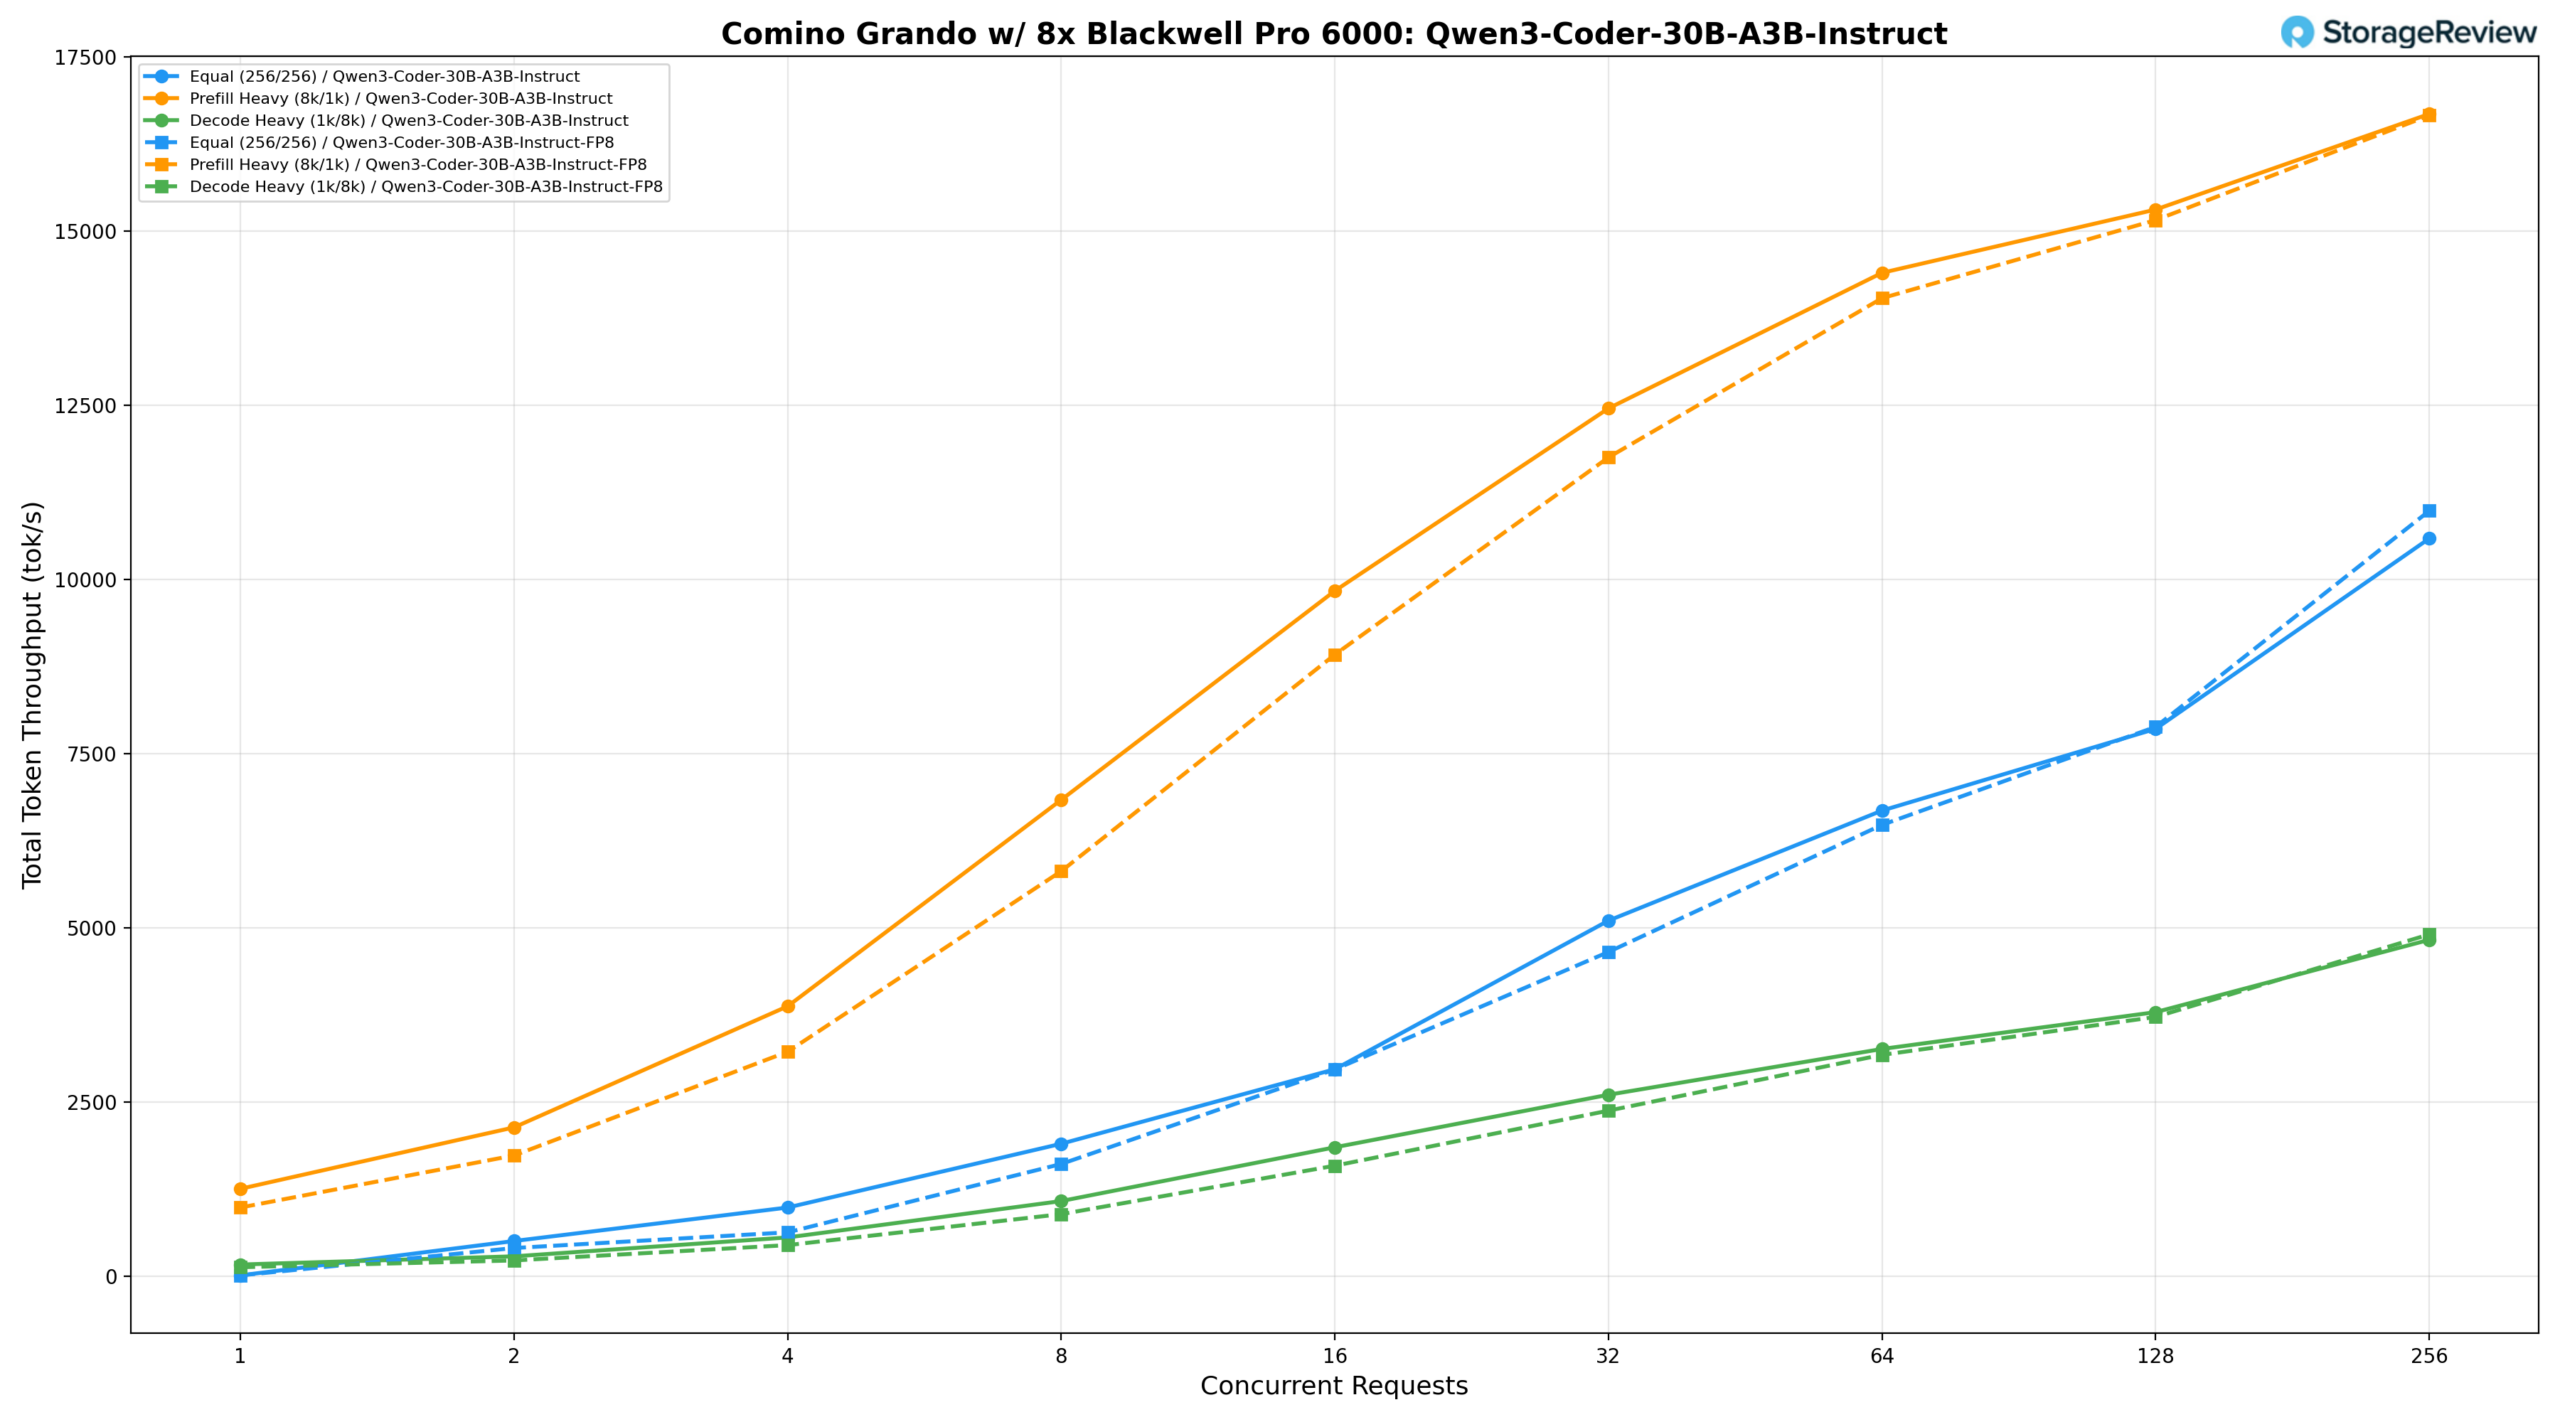
Qwen3-Coder-30B-A3B-Instruct မော်ဒယ်ကို BF16 နှင့် FP8 တိကျမှုနှစ်မျိုးလုံးဖြင့် စမ်းသပ်ခဲ့သည်။
Qwen3-Coder-30B-A3B-ညွှန်ကြားချက် (BF16)
ညီမျှသော workload (၂၅၆/၂၅၆) အောက်တွင်၊ BF16 မော်ဒယ်သည် BS=၈ တွင် ၁,၉၀၂.၃၂ tok/s ထုတ်ပေးပြီး BS=၆၄ တွင် ၆,၆၈၃.၅၈ tok/s ရောက်ရှိကာ BS=၂၅၆ တွင် ၁၀,၅၈၇.၅၆ tok/s တွင် အမြင့်ဆုံးရောက်ရှိသည်။ Prefill-heavy (၈k/၁k) သည် BS=၁ တွင် ၁,၂၅၆.၀၃ tok/s မှစတင်၍ BS=၆၄ တွင် ၁၄,၄၀၀.၅၇ tok/s နှင့် BS=၁၂၈ တွင် ၁၅,၃၀၈.၃၅ tok/s အထိ မြင့်တက်ကာ BS=၂၅၆ တွင် ၁၆,၆၇၉.၅၂ tok/s တွင် အမြင့်ဆုံးရောက်ရှိသည်။ Decode-heavy (1k/8k) သည် BS=1 တွင် 169.19 tok/s မှ BS=256 တွင် 4,828.82 tok/s အထိ တိုးလာပြီး တစ်ပြိုင်နက်တည်းအဆင့်နိမ့်များတွင် latency ကို ကောင်းစွာထိန်းချုပ်ထားသည်။
Qwen3-Coder-30B-A3B-ညွှန်ကြားချက် (FP8)
FP8 မော်ဒယ်သည် အခြေအနေအများစုတွင် BF16 နှင့် နှိုင်းယှဉ်နိုင်သော throughput ကို ပေးစွမ်းနိုင်ပြီး BS=64 တွင် တူညီသော workload 6,478.54 tok/s အထိ ရောက်ရှိပြီး BS=256 တွင် 10,984.61 tok/s တွင် အမြင့်ဆုံးရောက်ရှိကာ အမြင့်ဆုံးတစ်ပြိုင်နက်တည်းတွင် BF16 ထက် အနည်းငယ်တိုးတက်မှုရှိသည်။ Prefill-heavy သည် BS=1 တွင် 987.48 tok/s မှစတင်၍ BS=64 တွင် 14,036.46 tok/s နှင့် BS=128 တွင် 15,156.69 tok/s အထိ မြင့်တက်ကာ BS=256 တွင် 16,658.98 tok/s တွင် အမြင့်ဆုံးရောက်ရှိသည်။ Decode-heavy သည် BS=1 တွင် 130.70 tok/s မှ BS=256 တွင် 4,906.51 tok/s အထိ တိုးလာပြီး အမြင့်ဆုံး တစ်ပြိုင်နက်တည်းတွင် BF16 ထက် အနည်းငယ်သာ ကျော်လွန်နေသော်လည်း ကျန်ရှိသော တစ်ပြိုင်နက်တည်း အပိုင်းအခြားတစ်လျှောက်လုံးတွင် ပုံစံနှစ်ခုသည် အနီးကပ် ကိုက်ညီနေဆဲဖြစ်သည်။
Mistral Small 3.1 24B ညွှန်ကြားချက် ၂၅၀၃
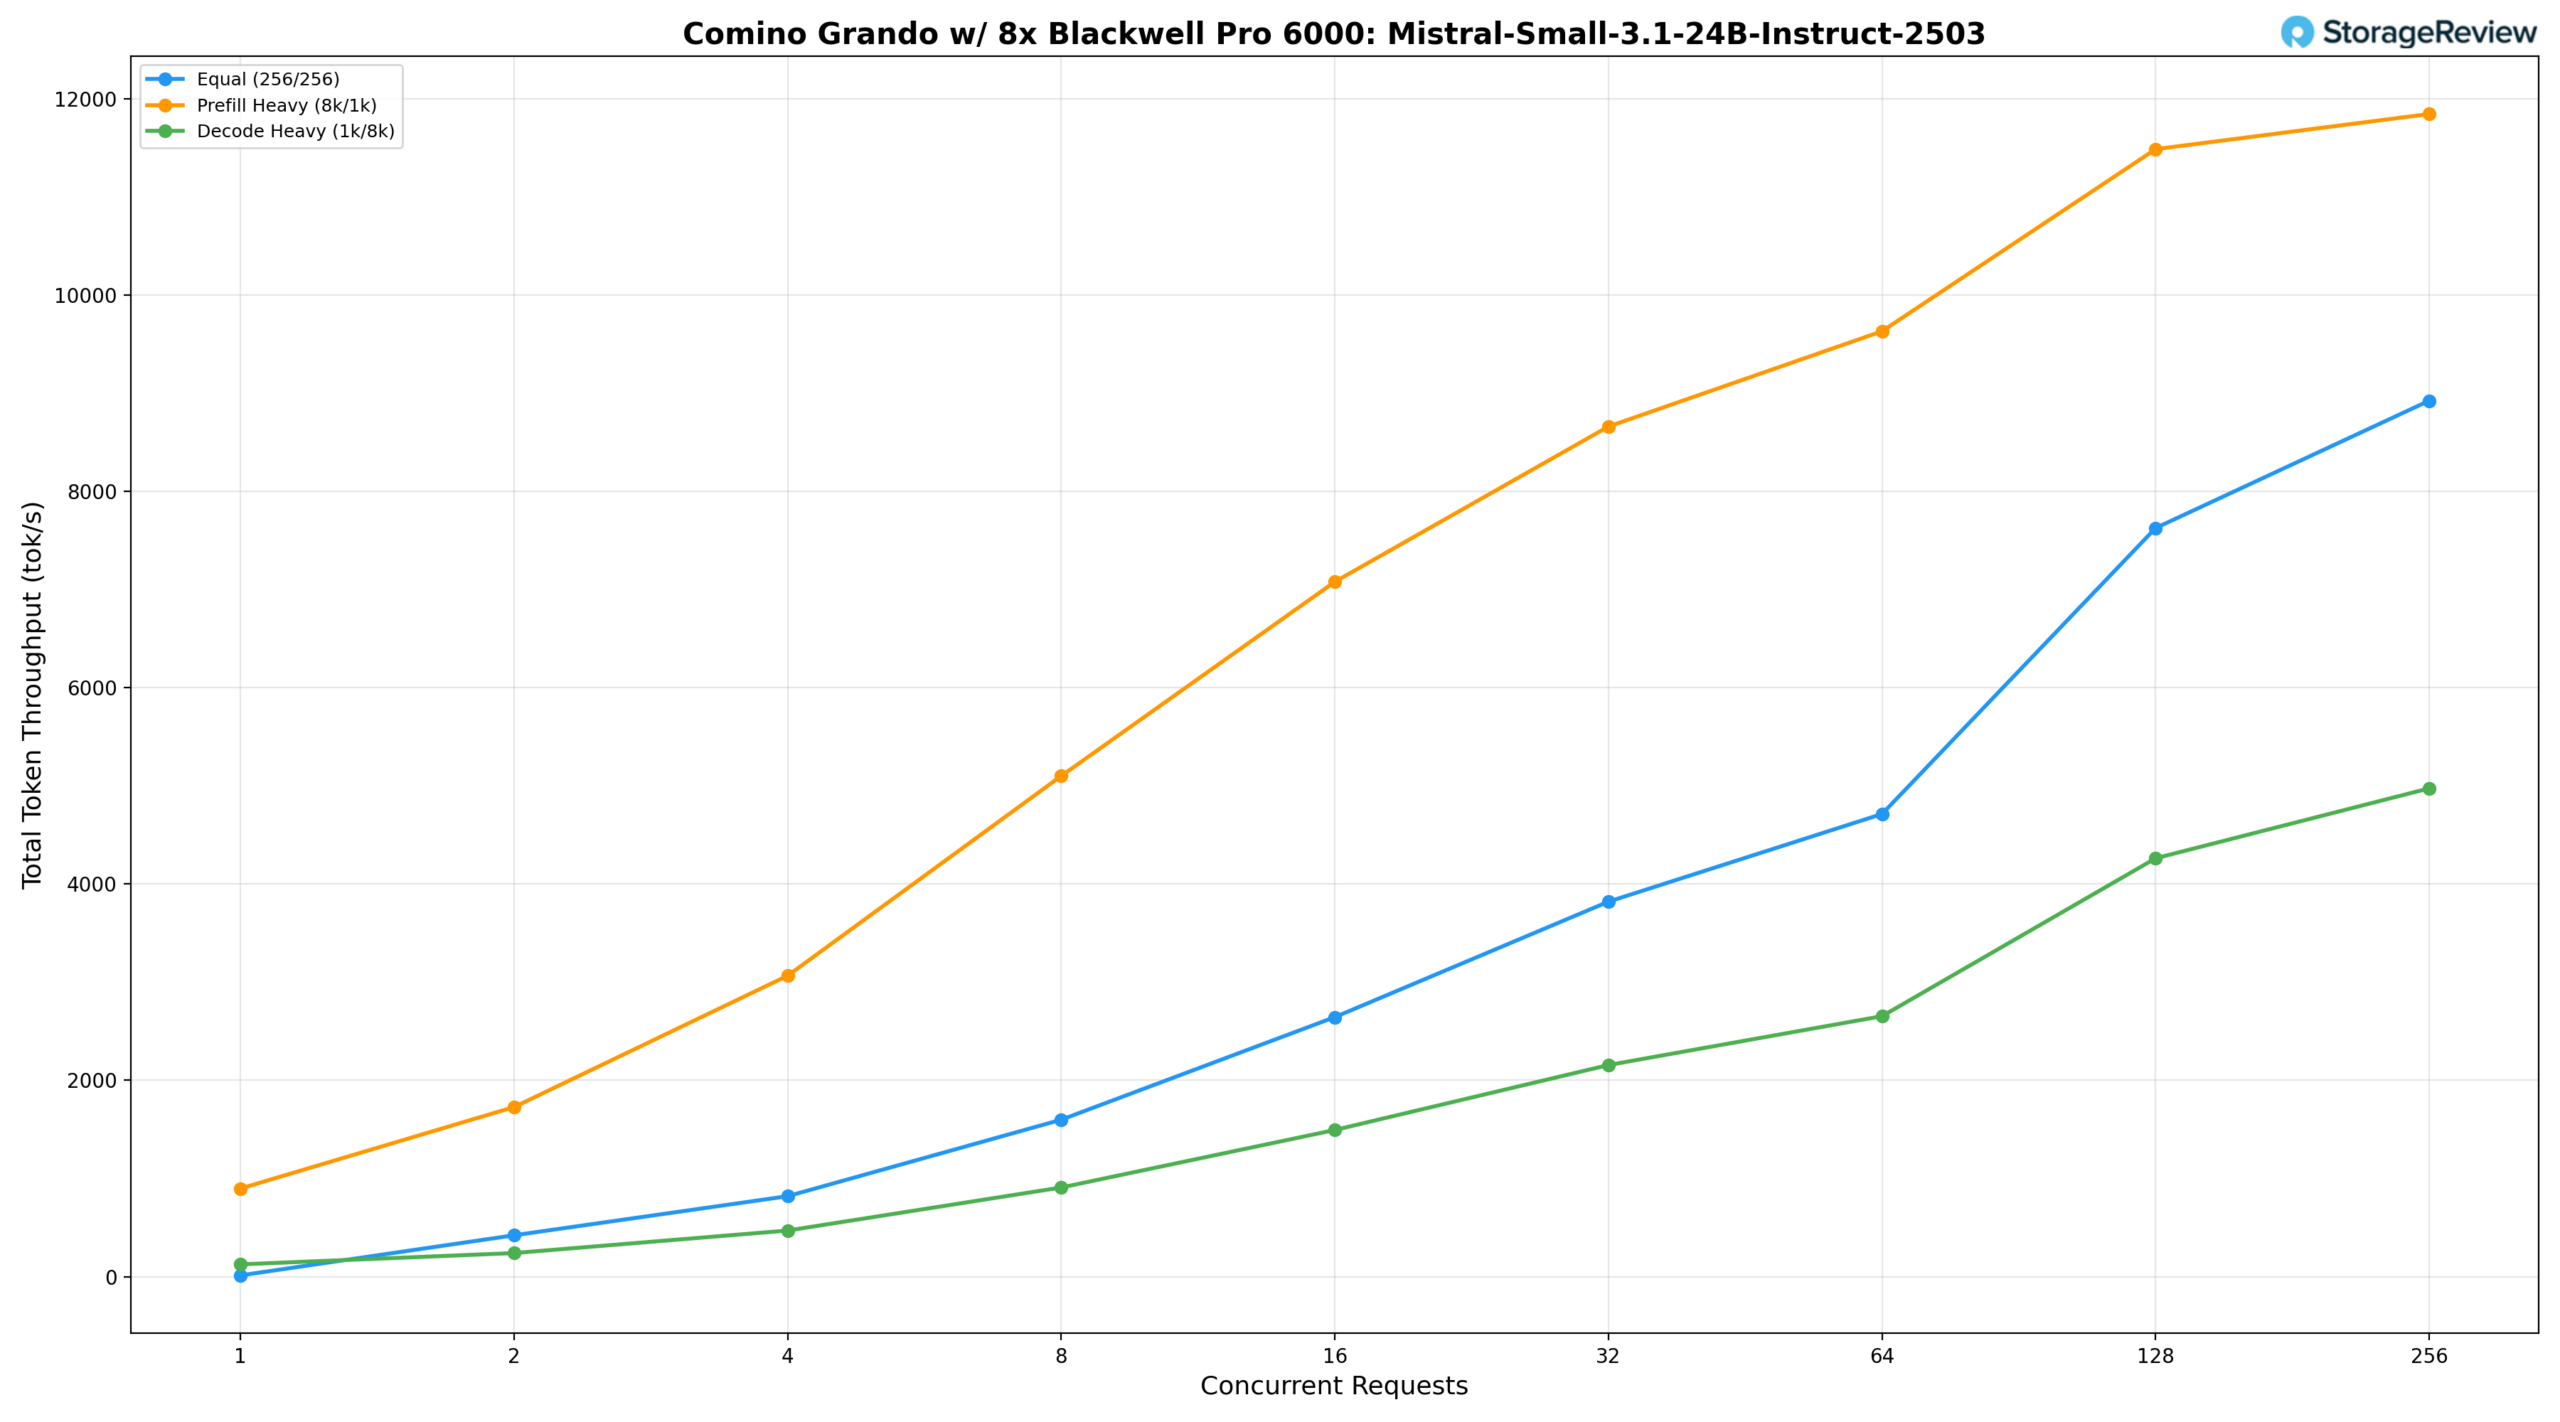
ညီမျှသော workload (၂၅၆/၂၅၆) အောက်တွင်၊ မော်ဒယ်သည် BS=၈ တွင် tok/s ၁,၅၉၈.၇၉ ထုတ်ပေးပြီး၊ BS=၆၄ တွင် tok/s ၄,၇၁၃.၈၄ ရောက်ရှိကာ BS=၂၅၆ တွင် tok/s ၈,၉၂၅.၁၂ အထိ အားကောင်းလာသည်။ Prefill-heavy (၈k/၁k) သည် BS=၁ တွင် tok/s ၈၉၇.၈၄ မှစတင်၍ BS=၆၄ တွင် tok/s ၉,၆၃၂.၅၈ နှင့် BS=၁၂၈ တွင် tok/s ၁၁,၄၈၈.၁၃ အထိ မြင့်တက်ကာ BS=၂၅၆ တွင် tok/s ၁၁,၈၄၆.၁၅ ဖြင့် အမြင့်ဆုံးရောက်ရှိသည်။ Decode-heavy (1k/8k) သည် BS=1 တွင် 124.98 tok/s မှ BS=64 တွင် 2,653.82 tok/s အထိ တိုးလာပြီးနောက်၊ ပိုမိုမြင့်မားသော concurrency အဆင့်များတွင် သိသိသာသာ အရှိန်မြှင့်လာပြီး BS=128 တွင် 4,262.53 tok/s အထိ ရောက်ရှိပြီး BS=256 တွင် 4,975.06 tok/s တွင် အမြင့်ဆုံးရောက်ရှိကာ၊ concurrency scales များအဖြစ် decode throughput ကို ခိုင်မာစွာ ထိန်းသိမ်းနိုင်သည့် မော်ဒယ်၏စွမ်းရည်ကို ထင်ဟပ်စေသည်။
Llama 3.1 8B ညွှန်ကြားချက်
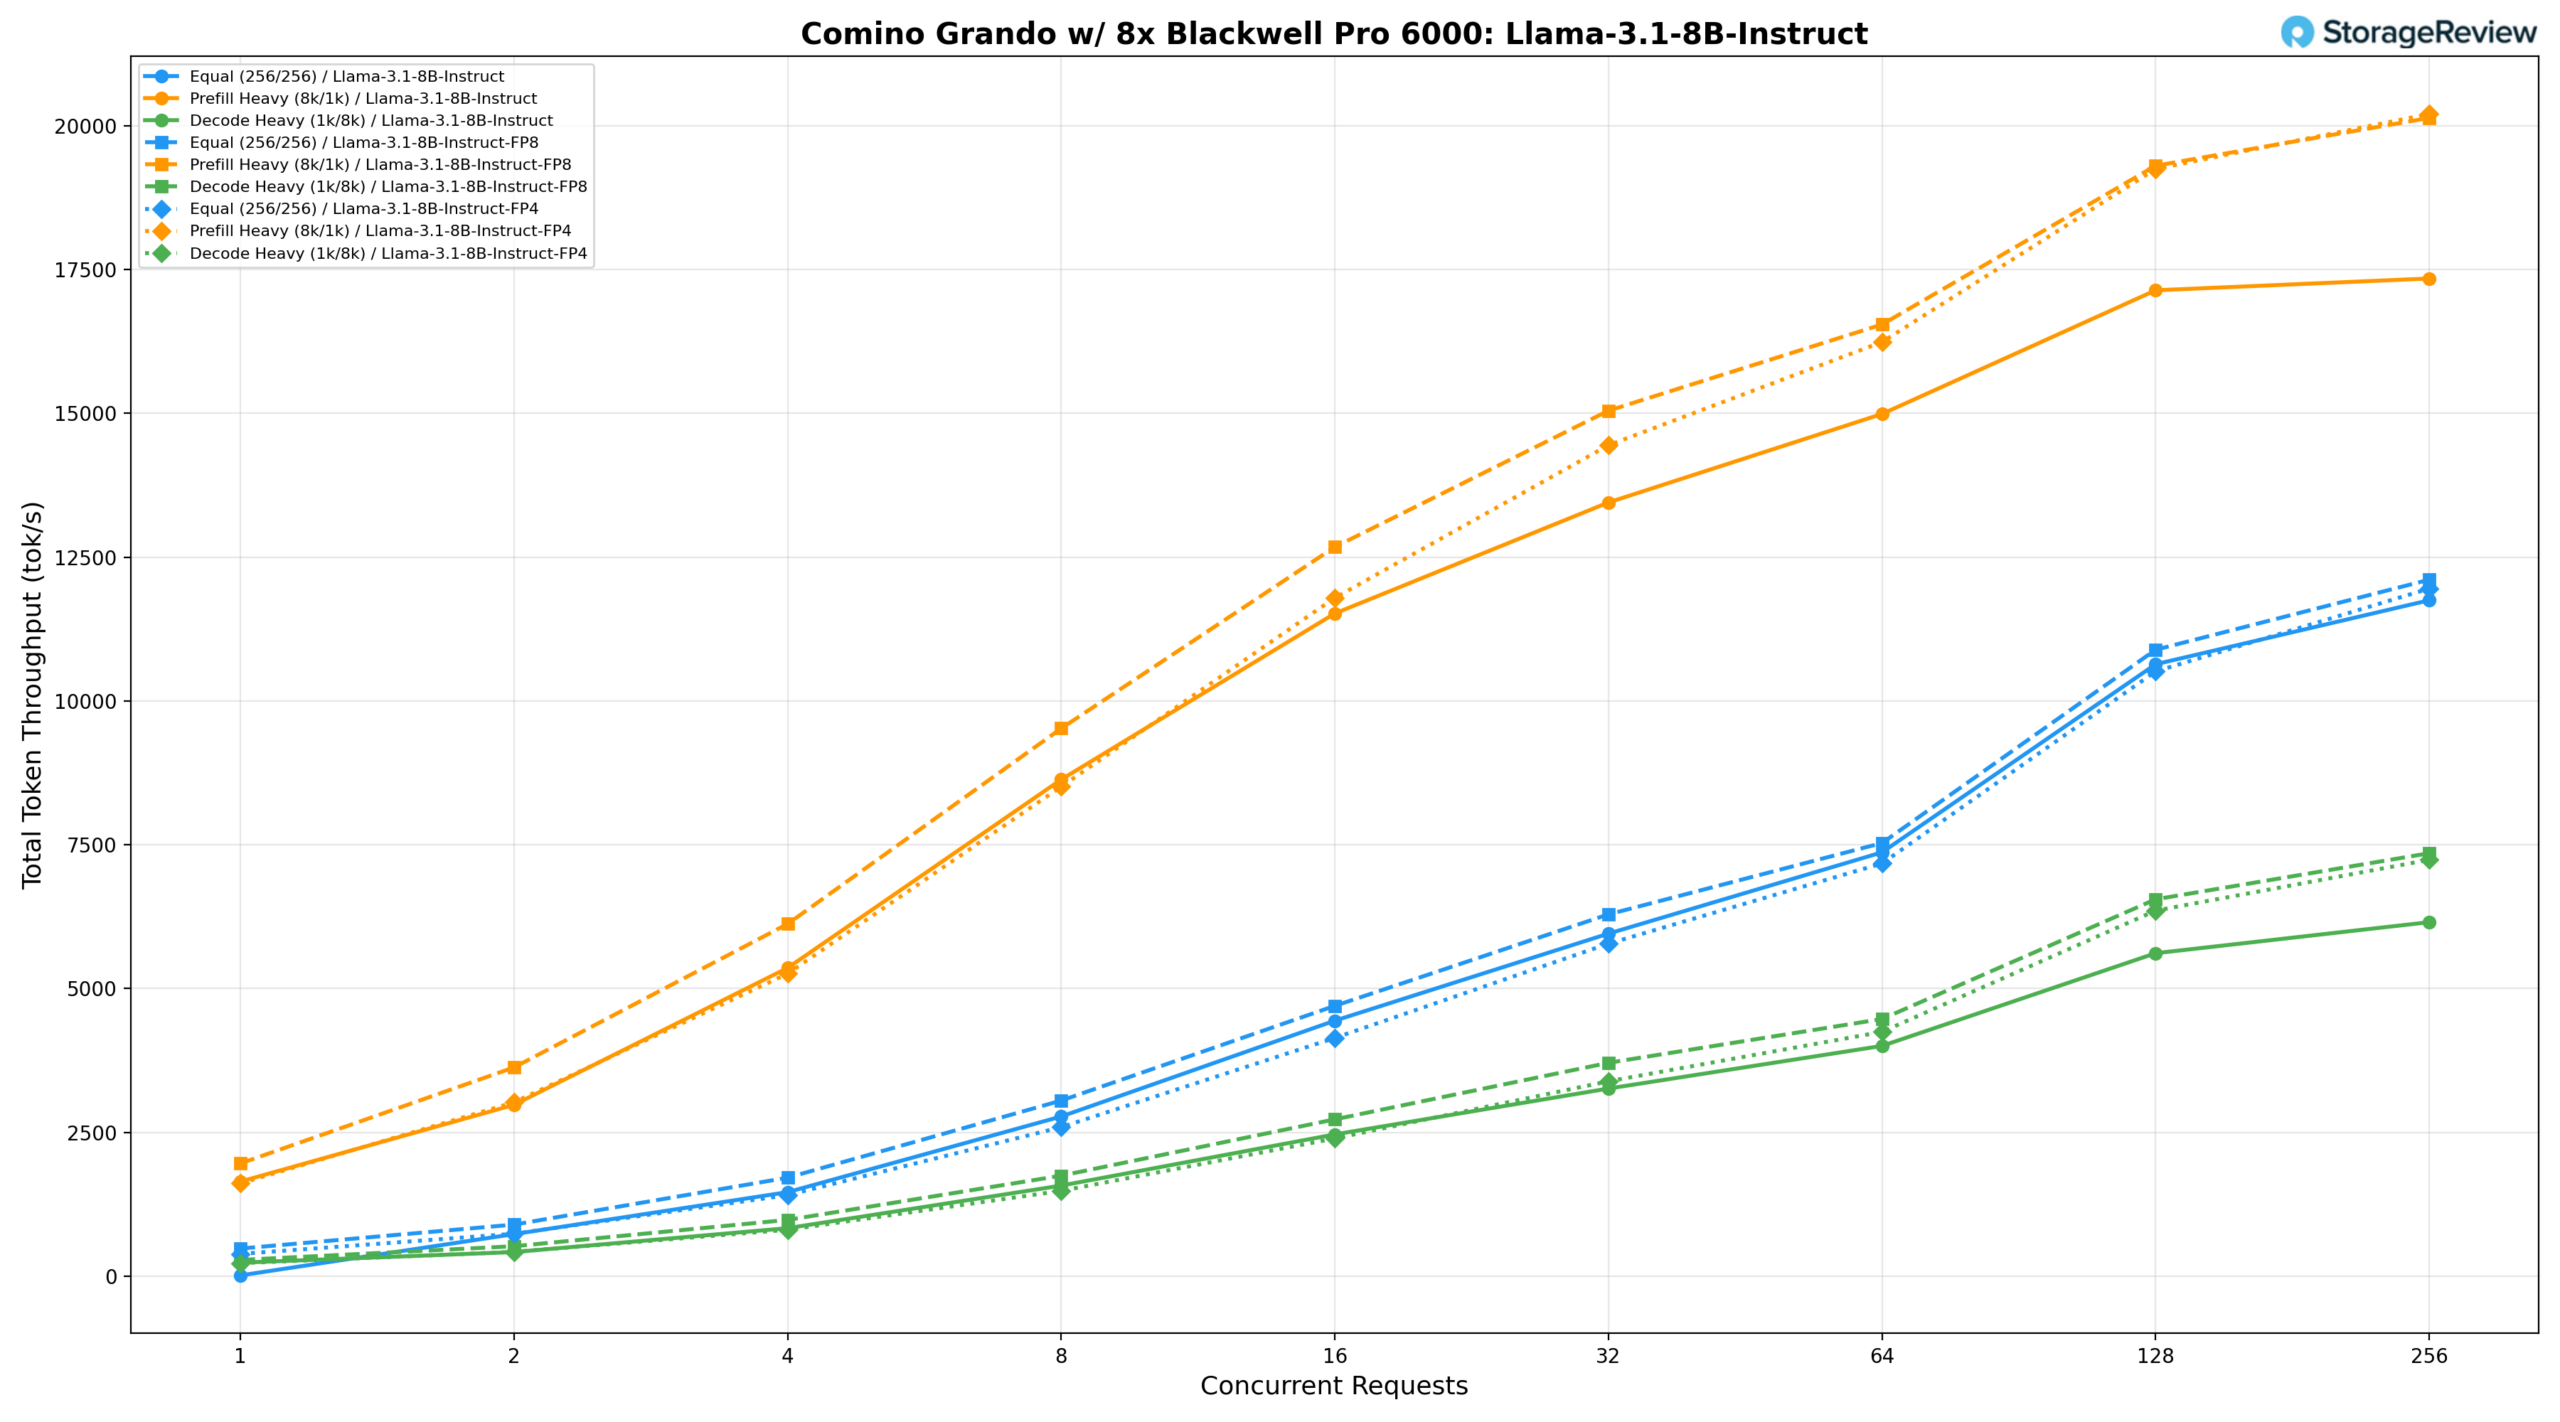
Llama-3.1-8B-Instruct မော်ဒယ်ကို Comino တွင် တိကျမှုပုံစံသုံးခုဖြင့် စမ်းသပ်ခဲ့ပြီး၊ quantization သည် ဤမော်ဒယ်အရွယ်အစားအတွက် throughput ကို မည်သို့အကျိုးသက်ရောက်သည်ကို ရှင်းလင်းစွာမြင်တွေ့နိုင်စေပါသည်။
လာမာ ၃.၁ ၈ဘီ ညွှန်ကြားချက် BF၁၆
ညီမျှသော workload (၂၅၆/၂၅၆) အောက်တွင်၊ BF16 မော်ဒယ်သည် BS=၈ တွင် ၂,၇၇၆.၄၂ tok/s ထုတ်ပေးပြီး၊ BS=၆၄ တွင် ၇,၃၆၉.၀၁ tok/s ရောက်ရှိကာ BS=၂၅၆ တွင် ၁၁,၇၅၁.၅၆ tok/s တွင် အမြင့်ဆုံးရောက်ရှိသည်။ Prefill-heavy (8k/1k) သည် BS=၁ တွင် ၁,၆၄၅.၂၉ tok/s မှစတင်၍ BS=၆၄ တွင် ၁၄,၉၉၀.၄၇ tok/s နှင့် BS=၁၂၈ တွင် ၁၇,၁၄၀.၇၁ tok/s အထိ မြင့်တက်ပြီး BS=၂၅၆ တွင် ၁၇,၃၄၅.၈၀ tok/s တွင် အမြင့်ဆုံးရောက်ရှိသည်။ Decode-heavy (1k/8k) သည် BS=၁ တွင် ၂၃၄.၇၈ tok/s မှ BS=၂၅၆ တွင် ၆,၁၅၄.၇၃ tok/s အထိ မြင့်တက်လာသည်။
လာမာ ၃.၁ ၈ဘီ ညွှန်ကြားချက် FP၄
FP8 ပမာဏသတ်မှတ်ခြင်းသည် အခြေအနေအားလုံးတွင် အဓိပ္ပာယ်ရှိသော မြှင့်တင်မှုကို ပေးစွမ်းသည်။ တူညီသော workload သည် BS=64 တွင် 7,530.39 tok/s သို့ရောက်ရှိပြီး BS=256 တွင် 12,108.98 tok/s တွင် အမြင့်ဆုံးသို့ ရောက်ရှိသည်။ BS=64 တွင် Prefill-heavy သည် 16,546.53 tok/s နှင့် BS=128 တွင် 19,306.49 tok/s သို့ မြင့်တက်ပြီး BS=256 တွင် 20,137.35 tok/s တွင် အမြင့်ဆုံးသို့ ရောက်ရှိပြီး အမြင့်ဆုံး တစ်ပြိုင်နက်တည်းတွင် BF16 ထက် 16% ခန့် တိုးလာသည်။ BS=256 တွင် Decode-heavy သည် 7,353.40 tok/s တွင် အမြင့်ဆုံးသို့ ရောက်ရှိပြီး BF16 ထက် 19% ခန့် စောသည်။
လာမာ ၃.၁ ၈ဘီ ညွှန်ကြားချက် FP၄
FP4 သည် မြင့်မားသော concurrency အဆင့်များတွင် FP8 နှင့် အနီးကပ်ယှဉ်ပြိုင်နိုင်သော throughput ကို ပေးစွမ်းသော်လည်း batch အရွယ်အစားနိမ့်သောအခါတွင် အနည်းငယ်နောက်ကျကျန်နေပါသည်။ BS=256 တွင် တူညီသော workload သည် 11,954.40 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိပြီး BS=256 တွင် prefill-heavy သည် 20,205.57 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိကာ အမြင့်ဆုံး concurrency အဆင့်တွင် FP8 ထက် အနည်းငယ်သာလွန်ပါသည်။ BS=256 တွင် Decode-heavy သည် 7,239.29 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိပြီး FP8 တစ်လျှောက်လုံး၏ ရာခိုင်နှုန်းအနည်းငယ်အတွင်းတွင် ရှိနေသောကြောင့် throughput တွင် အဓိပ္ပာယ်ရှိသော စွန့်လွှတ်မှုမရှိဘဲ memory efficiency ကို ဦးစားပေးသည့်အခါ FP4 ကို ဆွဲဆောင်မှုရှိသော ရွေးချယ်မှုတစ်ခုဖြစ်စေပါသည်။
MiniMax M2.5
Comino Grando မှာ စမ်းသပ်ထားတဲ့ MiniMax-M2.5 230B ဟာ ကျွန်တော်တို့အသုံးပြုခဲ့တဲ့ မော်ဒယ်တွေထဲမှာ အကြီးဆုံးနဲ့ အလိုအပ်ဆုံး မော်ဒယ်ဖြစ်ပါတယ်။
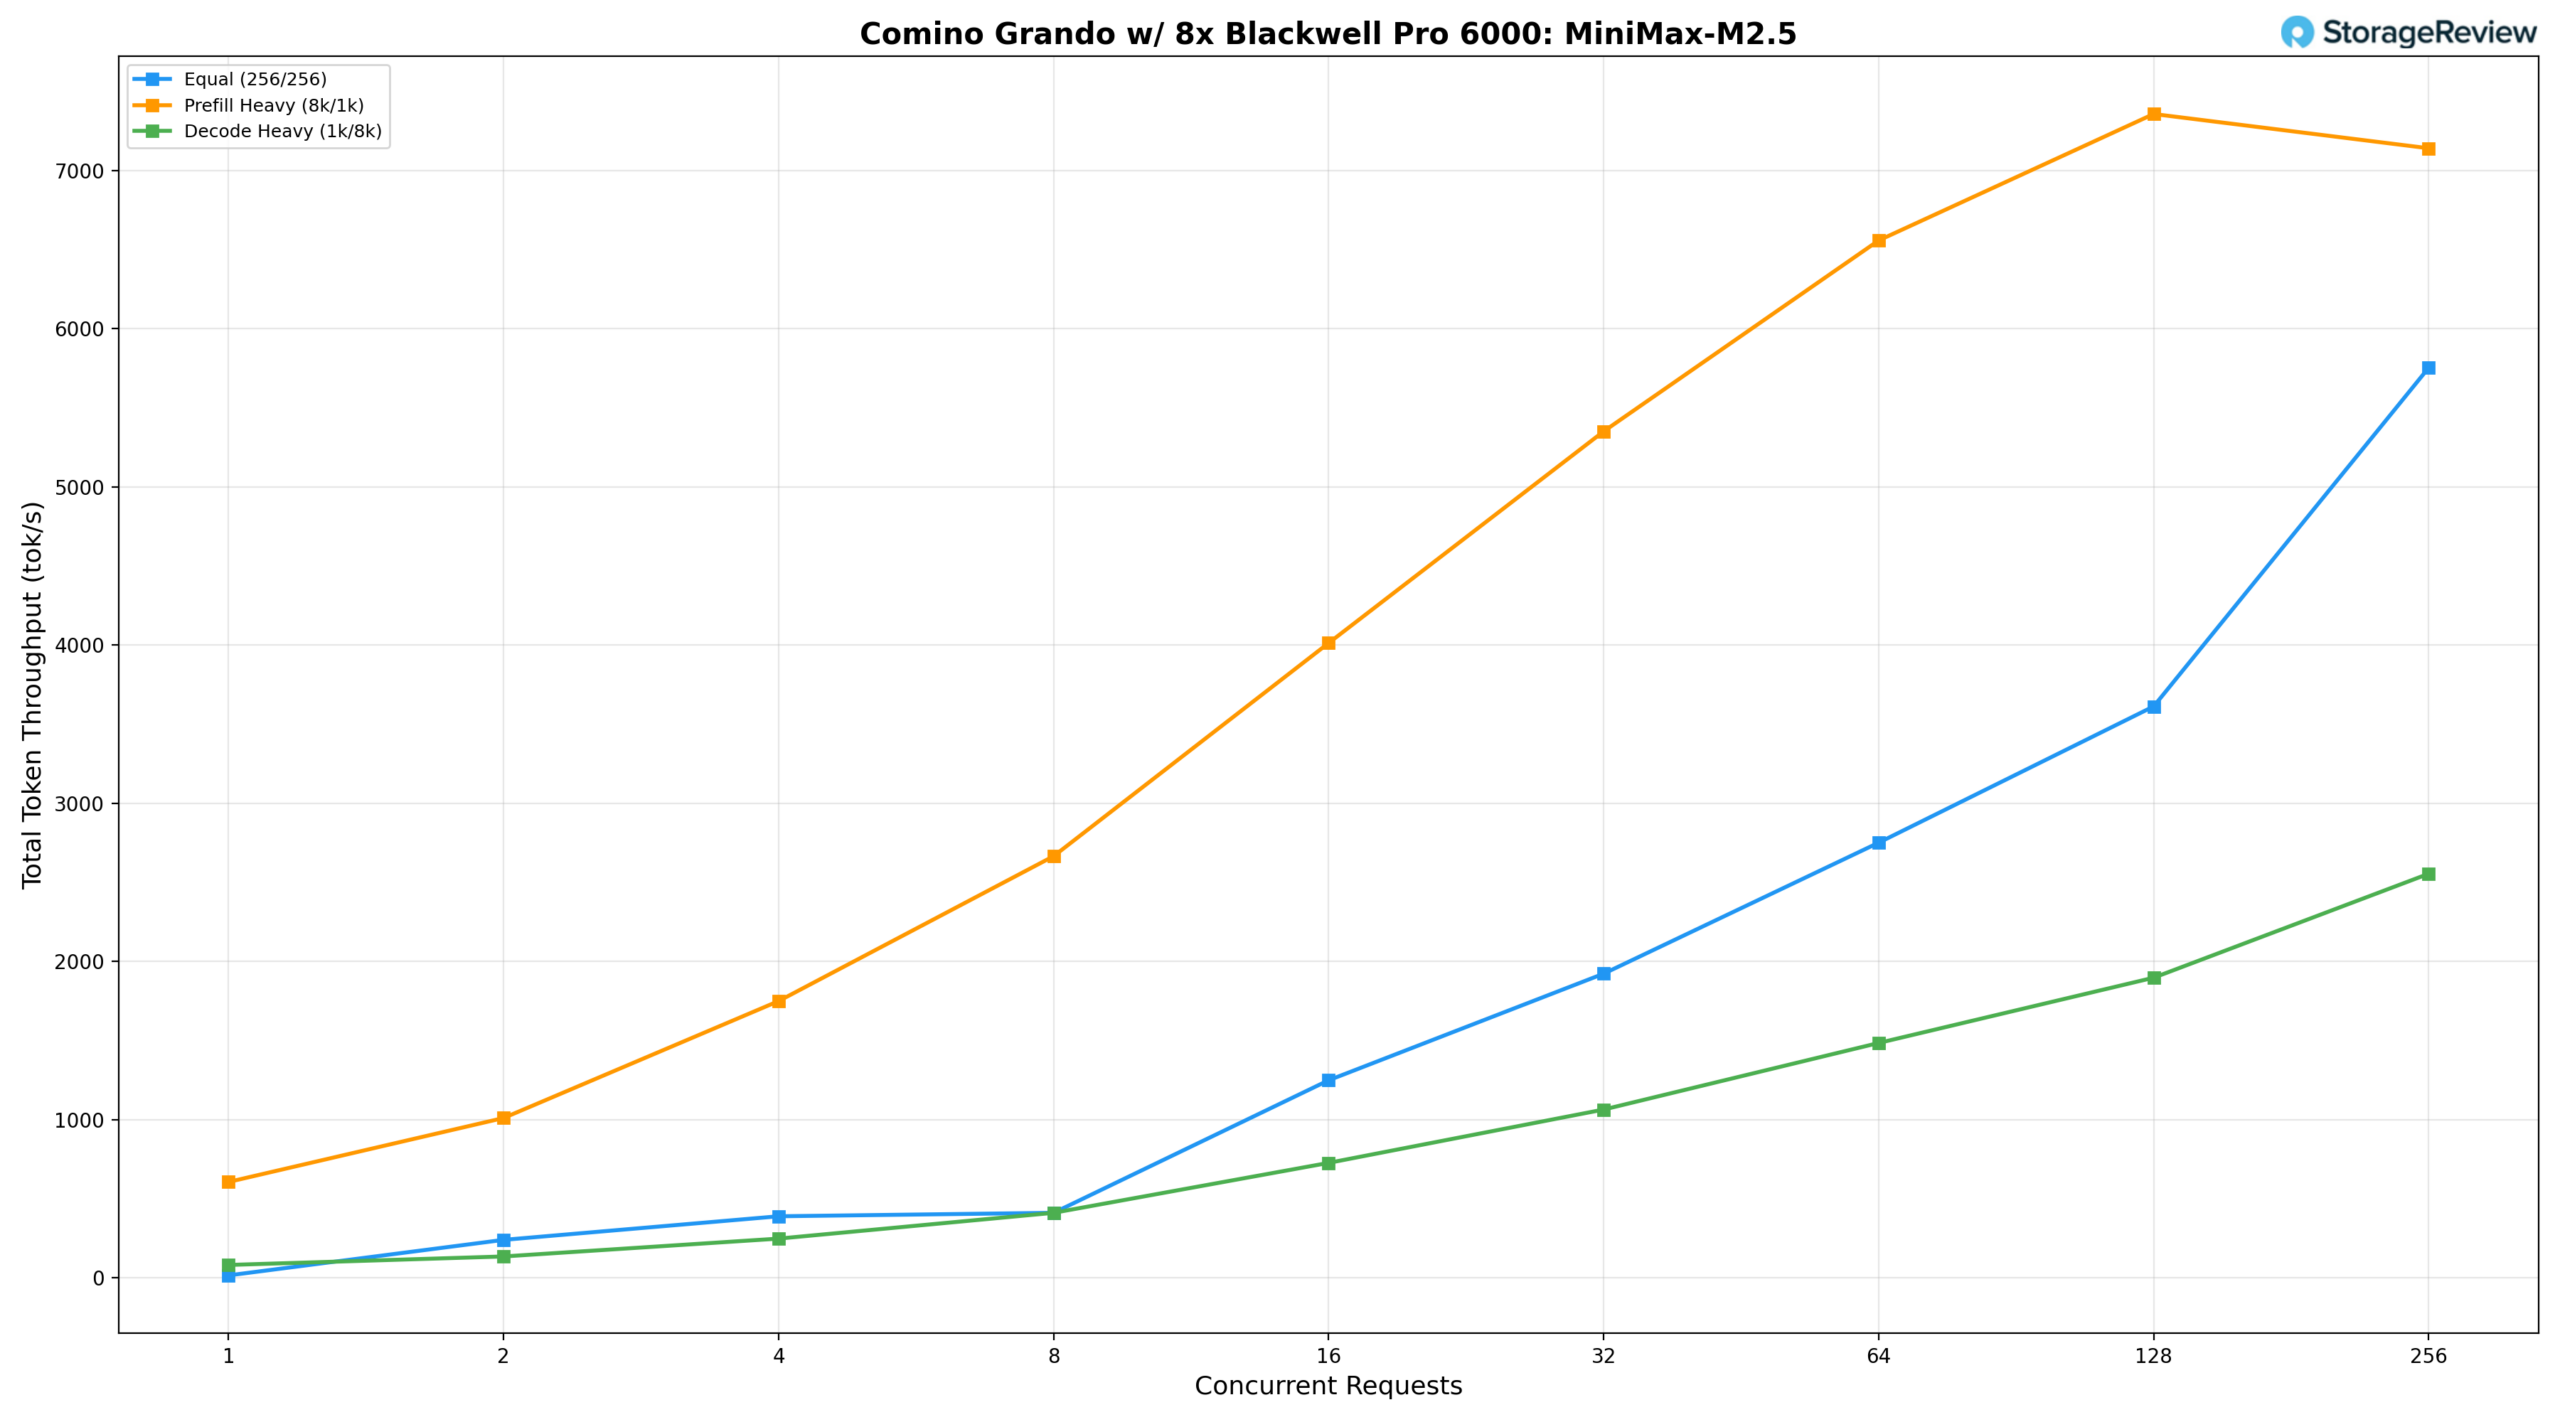
ညီမျှသော workload (၂၅၆/၂၅၆) အောက်တွင်၊ မော်ဒယ်သည် BS=၁ တွင် ၁၆.၃၅ tok/s မှစတင်ပြီး BS=၆၄ တွင် ၂,၇၅၁.၂၅ tok/s သို့ရောက်ရှိကာ၊ မြင့်မားသော concurrency တွင် အားကောင်းစွာ ချိန်ညှိပြီး BS=၂၅၆ တွင် ၅,၇၅၃.၂၄ tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိသည်။ Prefill-heavy (8k/1k) သည် BS=၁ တွင် ၆၀၆.၉၇ tok/s မှစတင်၍ BS=၃၂ တွင် ၅,၃၅၁.၀၂ tok/s နှင့် BS=၆၄ တွင် ၆,၅၅၇.၉၂ tok/s သို့ တဖြည်းဖြည်းတက်လာပြီး BS=၁၂၈ တွင် ၇,၃၅၇.၂၆ tok/s တွင် အမြင့်ဆုံးရောက်ရှိပြီးနောက် BS=၂၅၆ တွင် ၇,၁၄၀.၇၄ tok/s သို့ အနည်းငယ်လျော့ကျသွားကာ၊ မော်ဒယ်သည် BS=၁၂၈ ထက်ကျော်လွန်သော prefill throughput တွင် ပြည့်ဝမှုသို့ ချဉ်းကပ်လာကြောင်း ညွှန်ပြသည်။ Decode-heavy (1k/8k) သည် BS=1 တွင် 82.21 tok/s မှ BS=64 တွင် 1,485.28 tok/s အထိ အဆက်မပြတ်တိုးတက်လာပြီး BS=256 တွင် 2,554.87 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိကာ ရေရှည် decode workloads များအောက်ရှိ 230B MoE ဗိသုကာ၏ မျှော်လင့်ထားသည့် မှတ်ဉာဏ် bandwidth လိုအပ်ချက်များကို ထင်ဟပ်စေသည်။
ကောက်ချက်
Comino Grando ကို NVIDIA RTX PRO 6000 GPU ရှစ်ခု၏ အပြည့်အဝအလားအလာကို ဖွင့်လှစ်ရန် ရည်ရွယ်ချက်ဖြင့် တည်ဆောက်ထားသော စနစ်တစ်ခုအဖြစ် အကောင်းဆုံးနားလည်ပါသည်။ inverted motherboard layout မှသည် cooling loop နှင့် integrated monitoring stack အထိ အဓိကဒီဇိုင်းဆုံးဖြတ်ချက်တိုင်းသည် ထို GPU များသည် အပူချိန် သို့မဟုတ် ပါဝါကန့်သတ်ချက်များမရှိဘဲ 600W TDP အပြည့်ဖြင့် စဉ်ဆက်မပြတ်လည်ပတ်နိုင်စေရန် ရည်ရွယ်ပါသည်။
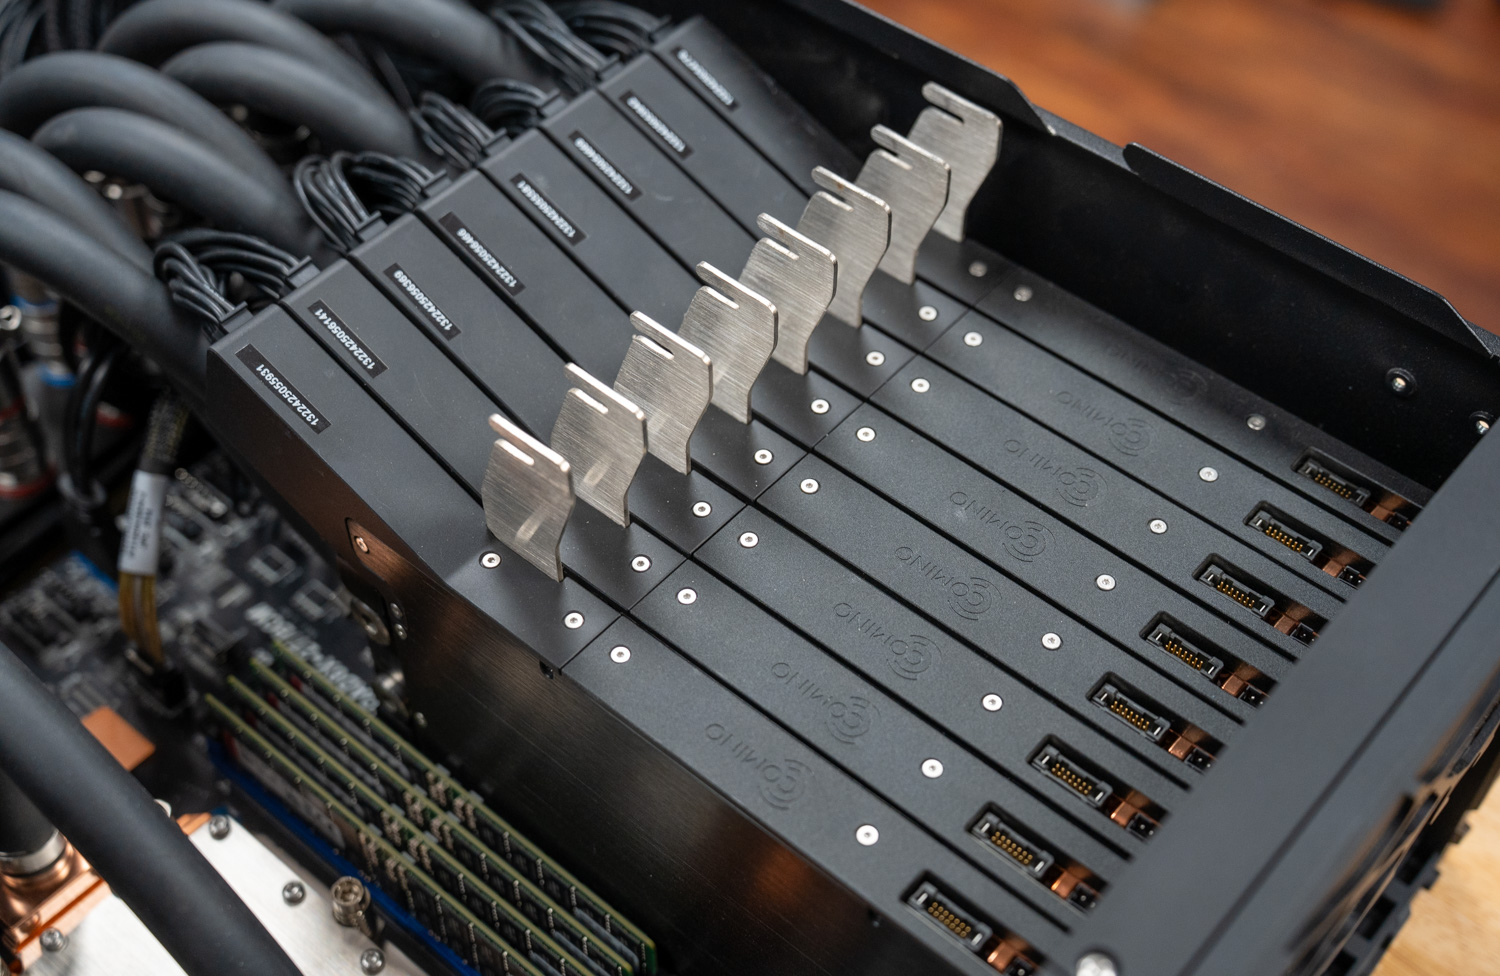
Grando ကို ဆွဲဆောင်မှုရှိစေတာက တစ်ခုတည်းသော အင်္ဂါရပ်မဟုတ်ဘဲ စနစ်တစ်ခုလုံး ပေါင်းစပ်ထားပုံပါ။ အရည်အအေးပေးစနစ်က bolt-on ထပ်ထည့်တာမဟုတ်ဘဲ ဗိသုကာပုံစံပါ။ ပါဝါပေးပို့မှုက မလိုအပ်ဘဲ hot-swappable ဖြစ်ပြီး 600W ကတ်ရှစ်ကတ်ရဲ့ 4,800W ဝန်အားအထိ တိုးချဲ့နိုင်ပြီး နေရာလွတ်လည်း အပိုရှိပါတယ်။ စောင့်ကြည့်စနစ်က အပူချိန်ကို အစီရင်ခံတာထက် ကျော်လွန်ပါတယ်။ တစ်ခုခု မှားယွင်းသွားတဲ့အခါ hardware ကို အလိုအလျောက် ကာကွယ်ပေးပါတယ်။ ဒီမှာ ဘာမှ နောက်မှစဉ်းစားမိသလို မခံစားရပါဘူး။
စွမ်းဆောင်ရည်ကိန်းဂဏန်းများက ထိုစည်းလုံးညီညွတ်မှုကို အားဖြည့်ပေးသည်။ Llama 3.1 8B မှ 230B MiniMax M2.5 အထိ မော်ဒယ်အမျိုးမျိုးတွင် Grando သည် self-hosted platform အတွက် ကောင်းစွာခံနိုင်ရည်ရှိသော throughput ကိန်းဂဏန်းများကို ပေးဆောင်ခဲ့သည်။ Claude Code concurrency testing သည် လက်တွေ့တန်ဖိုးကို ပိုမိုကောင်းမွန်စွာ မြှင့်တင်ပေးသည်- အင်ဂျင်နီယာရှစ်ဦးသည် ဒေသတွင်း hosted 230B မော်ဒယ်နှင့် တစ်ပြိုင်နက်တည်း agentic coding session များကို interactive speeds များဖြင့် လုပ်ဆောင်နိုင်ပြီး အမြင့်ဆုံး aggregate output တွင် per-user throughput 38 tok/s ကျော်ရှိသည်။ လေးဦးမှ ရှစ်ဦးအထိရှိသော အဖွဲ့များသည် သိသာထင်ရှားသော ယိုယွင်းပျက်စီးမှုမရှိဘဲ အကောင်းဆုံးနီးပါး throughput ဖြင့် လုပ်ဆောင်နိုင်သည်။
ဒီ configuration ရဲ့တန်ဖိုးဟာ AI inference ထက်ကျော်လွန်ပါတယ်။ GPU တစ်ခုလျှင် 96GB VRAM နှင့် dense multi-GPU scaling ပါဝင်တာကြောင့် ဒီ platform ဟာ VFX rendering၊ large-scale simulation နဲ့ complex CAD pipelines တွေအပါအဝင် high-end creative နဲ့ engineering workloads တွေအတွက်လည်း သင့်တော်ပါတယ်။ system ဟာ four-GPU နဲ့ two-GPU configuration တွေအထိ လျှော့ချပေးတာကြောင့် workstation-class density လိုအပ်သေးတဲ့ studio ငယ်တွေနဲ့ team တွေအတွက် ဒီ performance level ကို အသုံးပြုနိုင်ပါတယ်။
Grando ဟာ ကျွန်တော်တို့ သုံးသပ်ခဲ့တဲ့ enterprise eight-GPU platform တွေနဲ့ အကွာခြားဆုံးကတော့ deployment လက်တွေ့ကျမှုပါ။ အဲဒီ system တွေမှာ PCIe lane headroom ပိုများပြီး၊ NIC slots ပိုများပြီး၊ deep storage connectivity လည်း ပိုပေးစွမ်းနိုင်ပေမယ့် dedicated data center infrastructure လည်း လိုအပ်ပြီး၊ 8kW ကျော် ထုတ်ယူရမှာဖြစ်ပြီး၊ တစ်နှစ်ကျော်အထိ lead time တွေ ရှိပါတယ်။ Grando ဟာ peripheral expandability အချို့ကို user တွေနဲ့ အခန်းတစ်ခန်း မျှဝေအသုံးပြုနိုင်လောက်အောင် တိတ်ဆိတ်ငြိမ်သက်စွာ လည်ပတ်နိုင်တဲ့ system တစ်ခုနဲ့ လဲလှယ်ပြီး၊ ပတ်ဝန်းကျင်ကို အပူနည်းနည်းပဲ ဖြန့်ကျက်ပေးပြီး အခုပဲ တင်ပို့ပေးပါတယ်။ အမြင့်ဆုံး fabric connectivity ထက် မြန်ဆန်စွာ deployment နဲ့ manageable operating environments တွေကို ဦးစားပေးတဲ့ organization တွေအတွက်၊ trade-off က အဆင်ပြေပါတယ်။
ထုတ်ကုန်စာမျက်နှာ - Comino Grando
Comino ပြင်ဆင်သူ – စာမျက်နှာ
ဦးဆောင်သူစာရင်း- Comino Grando RTX PRO 6000 သည် ကျွန်ုပ်တို့၏ Best Desktops for Local AI ဦးဆောင်သူစာရင်းတွင် Extreme Pick နေရာကို ရရှိထားသည်။ ၎င်းအတွင်းရှိ RTX PRO 6000 သည် ကျွန်ုပ်တို့၏ Best Enterprise GPUs ဦးဆောင်သူစာရင်းတွင် Best Enterprise Inference GPU ကို ရရှိထားသည်။


 အမေဇုံ