

လွန်ခဲ့တဲ့ နှစ်အနည်းငယ်အတွင်း ဘာသာစကားပုံစံကြီးတွေကို ဒေသတွင်းမှာ run လုပ်ရတာ အများကြီး ပိုလွယ်ကူလာပေမယ့် မော်ဒယ်တစ်ခုကို ဒေါင်းလုဒ်လုပ်တာနဲ့ အသုံးဝင်တဲ့ desktop environment တစ်ခုရှိဖို့ကြားမှာ ကွာဟချက်တစ်ခု ရှိနေပါသေးတယ်။ Jan က သူ့ကိုယ်သူ ChatGPT အစားထိုးတစ်ခုအဖြစ် ဖော်ပြထားပြီး setup အများစုကို application ထဲမှာပဲ သိမ်းထားတဲ့ ရင်းနှီးပြီးသား chat-style interface ပါတဲ့ open-source desktop app တစ်ခုကို ပေးဆောင်ပါတယ်။ llama.cpp မှတစ်ဆင့် ဒေါင်းလုဒ်လုပ်ထားတဲ့ ပုံစံတွေကို ဒေသတွင်းမှာ run လုပ်နိုင်သလို hosted AI service တွေကိုလည်း ချိတ်ဆက်နိုင်တာကြောင့် တူညီတဲ့ interface ကနေ ဒေသတွင်းနဲ့ cloud-based ပုံစံတွေကို အသုံးပြုနိုင်ပါတယ်။
ဤလက်တွေ့အသုံးချမှုသည် ကျွန်ုပ်တို့၏ အကောင်းဆုံး ဒေသတွင်း LLM Tools ဦးဆောင်သူစာရင်း နှင့် ချိတ်ဆက်ထားသော ပထမဆုံးလမ်းညွှန်ချက်လည်းဖြစ်ပြီး ၊ စာရင်းရှိ ပလက်ဖောင်းများမှတစ်ဆင့် လုပ်ဆောင်နေစဉ် ကျွန်ုပ်တို့၏ကိုယ်ပိုင် စမ်းသပ်ဟာ့ဒ်ဝဲမှ ထပ်ခါတလဲလဲလုပ်ဆောင်နိုင်သော စွမ်းဆောင်ရည်ရလဒ်များကို ထည့်သွင်းနေပါသည်။
အခြေခံ local chat အပြင် Jan တွင် built-in model Hub၊ web search နှင့် page fetching၊ image input၊ MCP integrations နှင့် OpenAI နှင့် တွဲဖက်အသုံးပြုနိုင်သော local API တို့ ပါဝင်သည်။
ဒီလက်တွေ့ကျကျ ကြည့်လိုက်ရအောင်၊ Intel Xeon w5-2465X၊ 128GB RAM နဲ့ 32GB VRAM ပါဝင်တဲ့ NVIDIA RTX 5000 Ada Generation GPU ပါဝင်တဲ့ Windows 11 Pro for Workstations ပါတဲ့ HP Z4 Rack G5 workstation မှာ Jan ကို install လုပ်ခဲ့ပါတယ်၊ setup လုပ်ငန်းစဉ် ဘယ်လိုအလုပ်လုပ်လဲ၊ Jan က local model တွေကို ဘယ်လိုစီမံခန့်ခွဲလဲ၊ GPU acceleration က အလိုအလျောက်အလုပ်လုပ်လား၊ အရာအားလုံးလည်ပတ်နေချိန်မှာ သူ့ရဲ့ အဓိက feature တွေ ဘယ်လိုလုပ်ဆောင်လဲဆိုတာကို ကြည့်ဖို့ပါ။
Jan သည် ကျွန်ုပ်တို့၏ ပထမဆုံးထုတ်ဝေမှုနှင့် ထုတ်ဝေမှုကြားတွင် ပြောင်းလဲခဲ့ပြီး၊ ဤသုံးသပ်ချက် အသက်ဝင်ချိန်မတိုင်မီ v0.8.5 နှင့် v0.8.6 ရောက်ရှိလာခဲ့သည်။ အသစ်ထွက်ရှိလာသော ဗားရှင်းများတွင် llama.cpp ကို Jan ထဲသို့ တိုက်ရိုက်ပေါင်းစပ်ခြင်း၊ GPU offload ကို မည်သို့ configure လုပ်သည်ကို ပြောင်းလဲခြင်း၊ parallel-sequence defaults များကို ချိန်ညှိခြင်းနှင့် conversation prompt caching ထည့်သွင်းခြင်း အပါအဝင် ယခင်တည်ဆောက်မှုမှ နယ်ပယ်များစွာကို ဖြေရှင်းပေးပါသည်။ ထိုပြောင်းလဲမှုများသည် local inference ကို သက်ရောက်မှုရှိသောကြောင့်၊ ကျွန်ုပ်တို့သည် v0.8.6 သို့ အပ်ဒိတ်လုပ်ပြီး ထုတ်ဝေခြင်းမပြုမီ ကျွန်ုပ်တို့၏ စွမ်းဆောင်ရည်စမ်းသပ်မှုအားလုံးကို ပြန်လည်လုပ်ဆောင်ခဲ့ပါသည်။
စမ်းသပ်ခြင်းစနစ်
| component | configuration |
|---|---|
| ကွန်ပျူတာစက်လည်ပတ်ရေးစနစ်ပရိုဂရမ် | Workstations အတွက် Windows 11 Pro |
| စီပီယူ | Intel Xeon w5-2465X၊ 16 cores |
| မှတ်ဉာဏ် | 128GB |
| GPU ကို | NVIDIA RTX 5000 Ada မျိုးဆက် |
| VRAM အ | 32GB |
| NVIDIA ဒရိုက်ဗာ | 597.06 |
| CUDA လိုက်ဖက်ညီမှု | ၁၃.၂ (nvidia-smi) |
| ဇန်နဝါရီ | v0.8.6 |
| call.cpp | ၀.၅.၀၊ တည်ဆောက်ပုံ b၁၁၁၄၆ |
Jan သည် CPU၊ စနစ်မှတ်ဉာဏ်နှင့် RTX 5000 Ada အပါအဝင် ၎င်း၏ Hardware settings စာမျက်နှာမှတစ်ဆင့် စနစ်ဟာ့ဒ်ဝဲကို မှန်ကန်စွာ သိရှိခဲ့သည်။ NVIDIA drivers များ ထည့်သွင်းထားပြီးဖြစ်သော ဤစနစ်တွင် Jan သည် မော်ဒယ်တစ်ခုကို မတင်မီ application အတွင်း CUDA setup ထပ်မံမလိုအပ်ဘဲ GPU အရှိန်မြှင့်တင်မှုကို ဖွင့်ပေးခဲ့သည်။
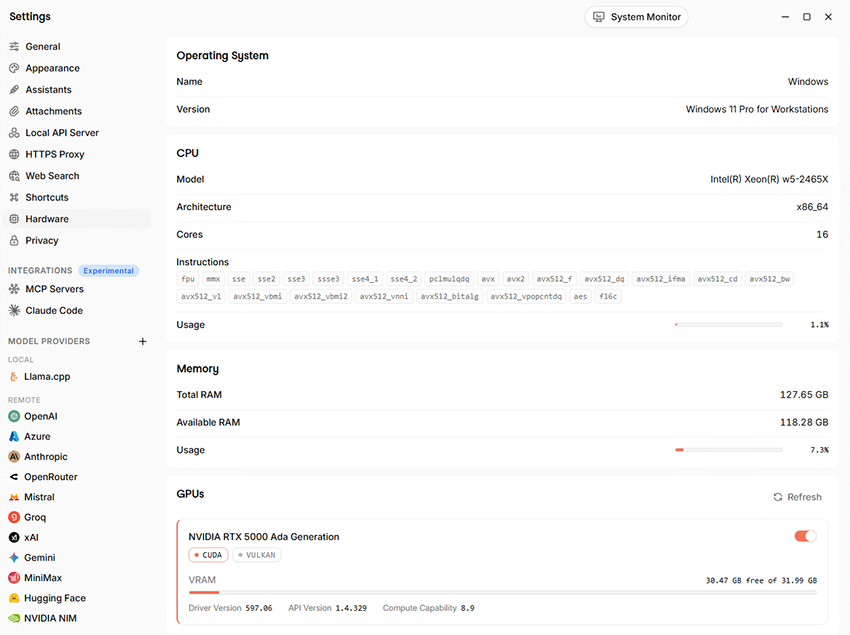
Jan v0.8.6 တွင် Xeon w5-2465X၊ 127.65GB RAM နှင့် 31.99GB VRAM ပါရှိသော NVIDIA RTX 5000 Ada Generation တို့ကို တွေ့ရှိခဲ့သည်။
Jan ကို ထည့်သွင်းခြင်းနှင့် စတင်အသုံးပြုခြင်း
Windows ထည့်သွင်းမှုတွင် စံသတ်မှတ်ထားသော .exe installer ကိုအသုံးပြုပြီး ပထမဆုံးစတင်မှုသည် Jan ၏ အဓိကချတ်မျက်နှာပြင်သို့ တိုက်ရိုက်သွားပါသည်။ Jan သည် ဒေသတွင်းမော်ဒယ်ကိုအသုံးပြုရန် အကောင့်မလိုအပ်ပါ။ ပထမဆုံးအကြိမ်စတင်ချိန်တွင် ၎င်းက အမည်မဖော်လိုသောအသုံးပြုမှုဒေတာကို မျှဝေလိုခြင်းရှိမရှိ မေးမြန်းပြီးနောက် ၎င်း၏အကြံပြုထားသော ဒေသတွင်းမော်ဒယ် Jan V3.5 ကို ဒေါင်းလုဒ်လုပ်ရန် ကမ်းလှမ်းခဲ့သည်။
Jan V3.5 ရဲ့ ကနဦးဒေါင်းလုဒ်ကို 2.8GB မှာ ဖော်ပြထားပါတယ်။ ဒေါင်းလုဒ်ကို နှိပ်လိုက်တာနဲ့ အက်ပ်ထဲမှာ လုပ်ငန်းစဉ်ကို စတင်ပြီး Jan က ပြီးစီးသွားတဲ့အခါ အောင်မြင်မှုအကြောင်းကြားစာ ပြသပေးပါတယ်။ ထည့်သွင်းပြီးတာနဲ့ မော်ဒယ်ကို ချတ်ဝင်းဒိုးရဲ့ အပေါ်ဆုံးမှာရှိတဲ့ ရွေးချယ်ကိရိယာကနေ ရရှိနိုင်ပါပြီ။
Jan က ပထမဆုံးအကြိမ် မိတ်ဆက်ချိန်မှာပဲ အကြံပြုထားတဲ့ Jan V3.5 ဒေသတွင်း မော်ဒယ်ကို 2.8GB ဒေါင်းလုဒ်အနေနဲ့ ပေးလိုက်ပါတယ်။
မော်ဒယ်များကို ကြည့်ရှုခြင်းနှင့် ဒေါင်းလုဒ်လုပ်ခြင်း
Jan's Hub သည် မော်ဒယ်ရှာဖွေတွေ့ရှိမှုနှင့် ထည့်သွင်းမှုကို အပလီကေးရှင်းအတွင်း၌ သိမ်းဆည်းထားပြီး Hugging Face မှ မော်ဒယ်များသို့ တိုက်ရိုက်ဝင်ရောက်ခွင့်နှင့် ဒေါင်းလုဒ်မစတင်မီ ရရှိနိုင်သော အသုံးဝင်သည့်အချက်အလက်များဖြင့် သိမ်းဆည်းထားသည်။ entry တစ်ခုချင်းစီတွင် ဒေါင်းလုဒ်အရွယ်အစား၊ ပမာဏ၊ စွမ်းရည် tag များနှင့် ရရှိနိုင်သော memory နှင့် GPU အတွက် သင့်လျော်သော မော်ဒယ်များကို ကျဉ်းမြောင်းစေရန် ကူညီပေးသည့် hardware-fit indicator တစ်ခု ပါဝင်သည်။
ကျွန်ုပ်တို့၏ RTX 5000 Ada စနစ်တွင် မော်ဒယ်အတော်များများကို အစိမ်းရောင် Fits အညွှန်းဖြင့် အမှတ်အသားပြုထားသည်။ Hub တွင် Jan V3.5 4B အတွက် 2.5GB Q4_K_M ရွေးချယ်မှုကို ပြသထားပြီး Jan V2 VL High ကို 4.7GB တွင် ပြသထားပြီး Multimodal နှင့် Tools ပံ့ပိုးမှု ပါဝင်သည်။ အခြားဗားရှင်းများကို တူညီသော မော်ဒယ်ကတ်မှ ရရှိနိုင်ပါသည်။
Jan သည် llama.cpp မှတစ်ဆင့် ဒေသတွင်းတွင် လည်ပတ်နေသော မော်ဒယ်များနှင့်အတူ OpenAI၊ Anthropic၊ Gemini၊ Groq နှင့် Mistral ကဲ့သို့သော ဝန်ဆောင်မှုပေးသူများထံမှ hosted မော်ဒယ်များကိုလည်း အသုံးပြုနိုင်သည်။ ၎င်းသည် အသုံးပြုသူများအား ဒေါင်းလုဒ်လုပ်ထားသောနှင့် cloud-based မော်ဒယ်များအတွက် interface တစ်ခုကို ပေးစွမ်းပြီး Hub သည် GGUF ဖိုင်များကို ရှာဖွေခြင်းနှင့် ၎င်းတို့ကို ထည့်သွင်းခြင်းမပြုမီ မှတ်ဉာဏ်လိုအပ်ချက်များကို စစ်ဆေးခြင်းတွင်ပါဝင်သော manual အလုပ်အများစုကို ဖယ်ရှားပေးသည်။
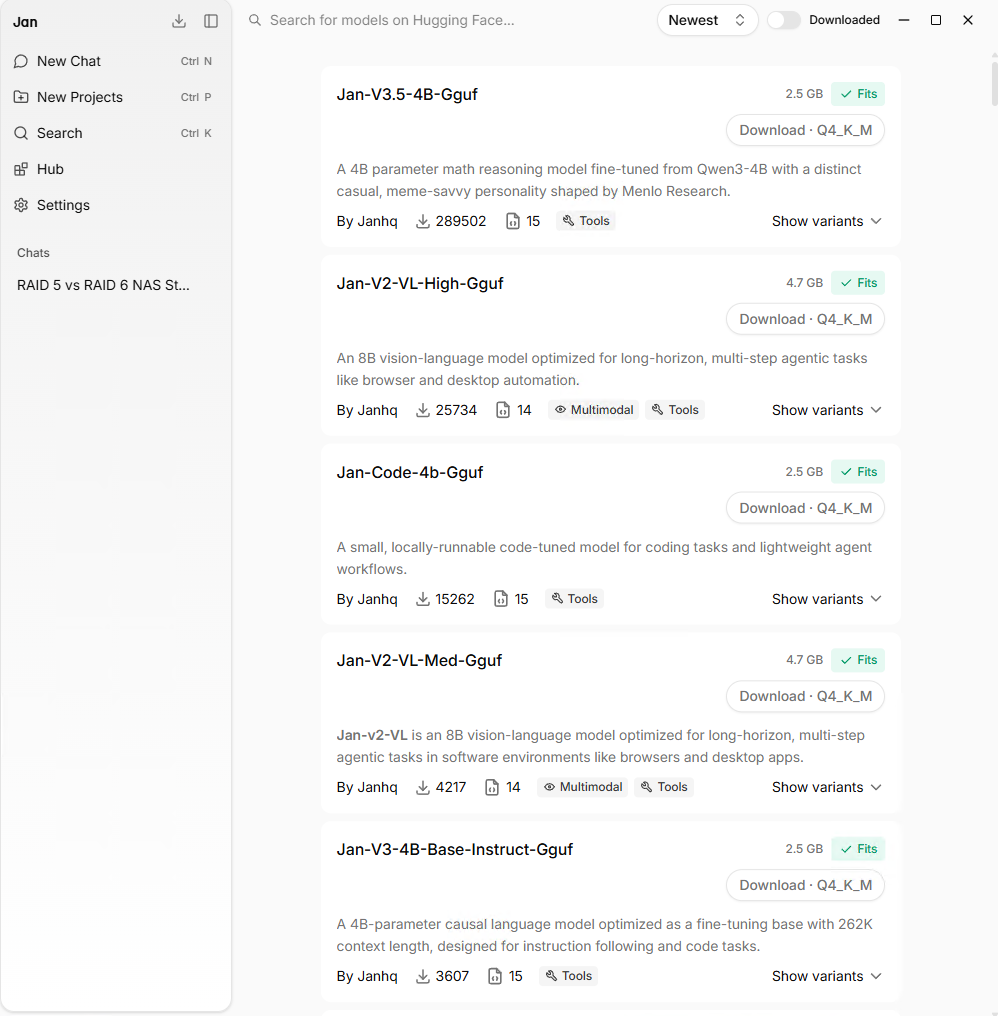
Hub သည် install မလုပ်မီ download size၊ quantization၊ model features များနှင့် hardware-fit status ကိုပြသသည်။
RTX 5000 Ada ရဲ့ 32GB frame buffer ထဲမှာ အလွယ်တကူ တပ်ဆင်နိုင်ပေမယ့် image support ကိုပါ ထည့်သွင်းပေးထားတဲ့အတွက် Jan V2 VL High ကို ကျွန်တော်တို့ရဲ့ ဒုတိယမော်ဒယ်အဖြစ် ဒေါင်းလုဒ်လုပ်ခဲ့တာပါ။
မော်ဒယ်ဆက်တင်များနှင့် GPU အသုံးပြုမှု
v0.8.5 နှင့် v0.8.6 အပ်ဒိတ်စက်ဝန်းအတွင်း မိတ်ဆက်ပေးခဲ့သော အကြီးမားဆုံးပြောင်းလဲမှုတစ်ခုမှာ llama.cpp ကို အပလီကေးရှင်းတွင် စုစည်းပေးထားခြင်းဖြစ်ပြီး၊ ယခင် build များက သီးခြားစီ စီမံခန့်ခွဲပေးခြင်းဖြစ်သည်။ ကျွန်ုပ်တို့၏ ထည့်သွင်းမှုတွင် llama.cpp 0.5.0၊ build b11146 ကို ပြသခဲ့ပြီး၊ Parallel Sequences ကို 0 ဟုသတ်မှတ်ထားသောကြောင့် llama.cpp သည် ၎င်း၏ default behavior ကို အသုံးပြုနိုင်ခဲ့ပြီး၊ Remember Conversations Between Sessions ကို conversation တစ်ခုစီ၏ prompt cache ကို disk ပေါ်တွင် သိမ်းဆည်းထားရန် ဖွင့်ထားသည်။
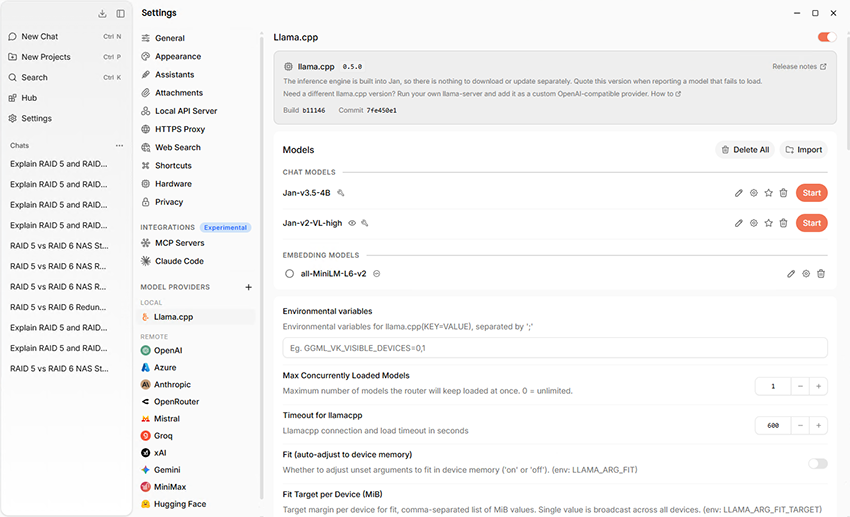
Jan v0.8.6 တွင် llama.cpp 0.5.0 ကို အပလီကေးရှင်းတွင် တိုက်ရိုက်ပါဝင်ပြီး၊ build b11146 ကို local model provider setting တွင် ပြသထားသည်။
Jan V3.5 4B ကို ထည့်သွင်းပြီးသည်နှင့်၊ active model ဘေးရှိ gear icon သည် ၎င်း၏ sampling နှင့် runtime setting များသို့ ဝင်ရောက်ခွင့်ပေးသည်။ ကျွန်ုပ်တို့၏ installation တွင် Jan သည် အပူချိန် 0.8၊ Top P 0.95၊ Top K 40၊ Min P 0.05 နှင့် Repeat Penalty 1 ကို ပြသခဲ့သည်။
မကြာသေးမီက runtime ပြောင်းလဲမှုများသည် default GPU-offload အပြုအမူကို ပြောင်းလဲစေသော်လည်း၊ ကျွန်ုပ်တို့၏ အဆင့်မြှင့်တင်ထားသော Jan V3.5 4B နှင့် Jan V2 VL High profile များသည် v0.8.6 တွင် GPU layer ၁၀၀ ကို ပြသနေဆဲဖြစ်သောကြောင့် ပြန်လည်လည်ပတ်ရန်အတွက် သိမ်းဆည်းထားသော တန်ဖိုးများကို မပြောင်းလဲဘဲထားခဲ့သည်။ အပိုဆောင်းထိန်းချုပ်မှုများတွင် 8,192-token context size၊ Mixture of Experts weights အတွက် CPU settings၊ KV-cache offload နှင့် 2,048 batch size တို့ ပါဝင်သည်။ ဤရွေးချယ်မှုများသည် command line များ သို့မဟုတ် သီးခြား configuration files များကို မတည်းဖြတ်ဘဲ Jan တွင် memory use နှင့် inference အပြုအမူကို တိုက်ရိုက်ချိန်ညှိနိုင်စေပါသည်။
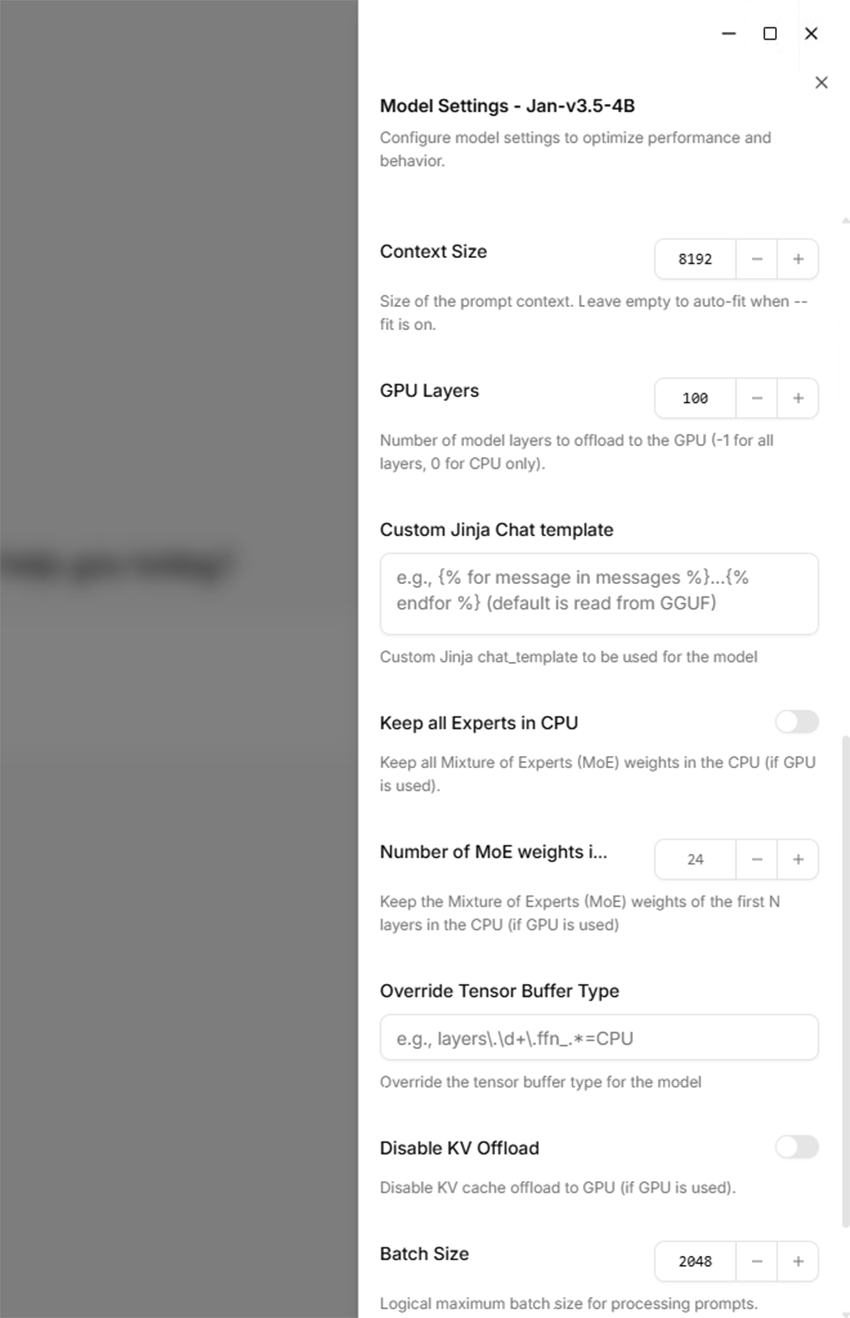
ကျွန်ုပ်တို့၏ အဆင့်မြှင့်တင်ထားသော Jan V3.5 4B ပရိုဖိုင်သည် v0.8.6 တွင် 8,192-token context size၊ 100 GPU layers နှင့် 2,048 batch size ကို ထိန်းသိမ်းထားသည်။
ဒေသခံမျိုးဆက်စွမ်းဆောင်ရည်
RTX 5000 Ada မှာ မော်ဒယ်နှစ်ခုစလုံးကို မောင်းနှင်နေချိန်မှာ၊ အပ်ဒိတ်လုပ်ထားတဲ့ runtime အောက်မှာ decode speed ကို တိုင်းတာဖို့ ကျွန်တော်တို့ရဲ့ text-generation စမ်းသပ်မှုကို Jan v0.8.6 မှာ ထပ်ခါတလဲလဲ လုပ်ဆောင်ခဲ့ပါတယ်။ Web Search ကို ပိတ်လိုက်ပြီး context size ကို 8,192 tokens မှာ ထားခဲ့ပြီး GPU layers တွေကို upgrade လုပ်ထားတဲ့ model profiles တွေအတိုင်း 100 value မှာ ထားခဲ့ပြီး batch size ကို 2,048 မှာ ထားခဲ့ပါတယ်။
ကျွန်ုပ်တို့သည် လုပ်ဆောင်မှုတိုင်းအတွက် စာသားသက်သက်သာပါဝင်သော prompt တစ်ခုတည်းကို အသုံးပြုခဲ့သည်- “RAID 5 နှင့် RAID 6 တို့ကို ၎င်းတို့၏ ပထမဆုံး NAS တည်ဆောက်သူတစ်ဦးအား ရှင်းပြပါ။ တစ်ခုချင်းစီ၏ အဓိက အားသာချက်များနှင့် အားနည်းချက်များကို စကားလုံး ၄၀၀ ခန့်ဖြင့် ထည့်သွင်းပါ။” မော်ဒယ်တစ်ခုစီကို load လုပ်ပြီးနောက် ပထမဆုံးတုံ့ပြန်မှုကို warm-up အဖြစ် စွန့်ပစ်ခဲ့ပြီး thread အသစ်သုံးခုတွင် တိုင်းတာထားသော လုပ်ဆောင်မှုသုံးခု ပြုလုပ်ခဲ့သည်။
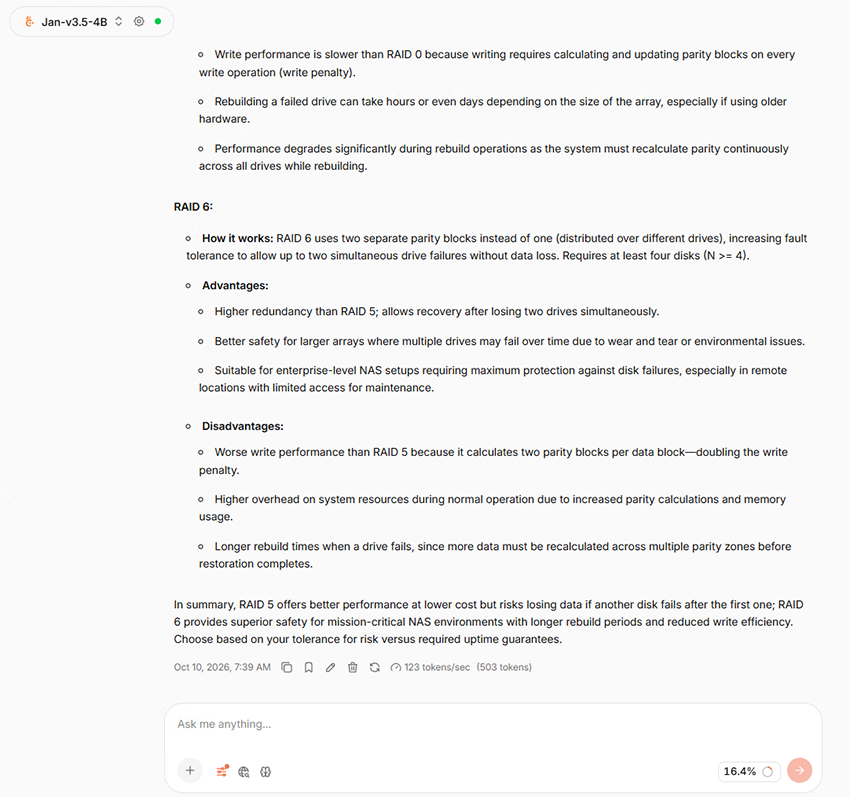
Jan V3.5 4B သည် ဤတိုင်းတာထားသော လုပ်ဆောင်မှုတွင် Jan-report လုပ်ထားသော output တိုကင် ၅၀၃ ခုဖြင့် တိုကင်/စက္ကန့် ၁၂၃ ရောက်ရှိခဲ့ပြီး သုံးကြိမ်စမ်းသပ်မှုမှ အလယ်အလတ်ကိန်းဂဏန်းများနှင့် ကိုက်ညီပါသည်။
ဇန်နဝါရီ V3.5 4B Q4_K_XL သည် တိုင်းတာထားသော လုပ်ဆောင်မှုသုံးခုတွင် ပျမ်းမျှ decode rate 123 tokens/sec ကို မှတ်တမ်းတင်ထားပြီး ဇန်နဝါရီတွင် အစီရင်ခံထားသော output tokens ပျမ်းမျှ 503 ခုနှင့် ပျမ်းမျှ peak GPU memory အသုံးပြုမှု 4,839 MiB ရှိသည်။ ဇန်နဝါရီ V2 VL High Q4_K_M သည် ပျမ်းမျှ 82 tokens/sec သို့ ရောက်ရှိခဲ့ပြီး ဇန်နဝါရီတွင် အစီရင်ခံထားသော output tokens ပျမ်းမျှ 1,728 ခုနှင့် ပျမ်းမျှ peak GPU memory အသုံးပြုမှု 8,197 MiB ရှိသည်။
llama.cpp အချိန်ကိုက်လိုင်းများသည် Jan ၏ မျက်နှာပြင်ပေါ်ရှိ ဒီကုဒ်နံပါတ်များကိုလည်း အနီးကပ်ခြေရာခံခဲ့ပြီး Jan V3.5 4B အတွက် ပျမ်းမျှ အကဲဖြတ်နှုန်းမှာ 122.55 tokens/sec နှင့် Jan V2 VL High အတွက် 82.30 tokens/sec ဖြစ်သည်။ v0.8.6 တွင် conversation prompt caching ကို ဖွင့်ထားပြီး ထပ်ခါတလဲလဲ run မှုများတွင် prompt token တစ်ခုတည်းကိုသာ အကဲဖြတ်နေကြောင်း ပြသသောကြောင့် prefill median ကို ကျွန်ုပ်တို့ မတင်ပြခဲ့ပါ။ ထို cached တန်ဖိုးများသည် full-prompt processing performance ကို အသုံးဝင်သော နှိုင်းယှဉ်မှုတစ်ခု မပေးနိုင်ပါ။
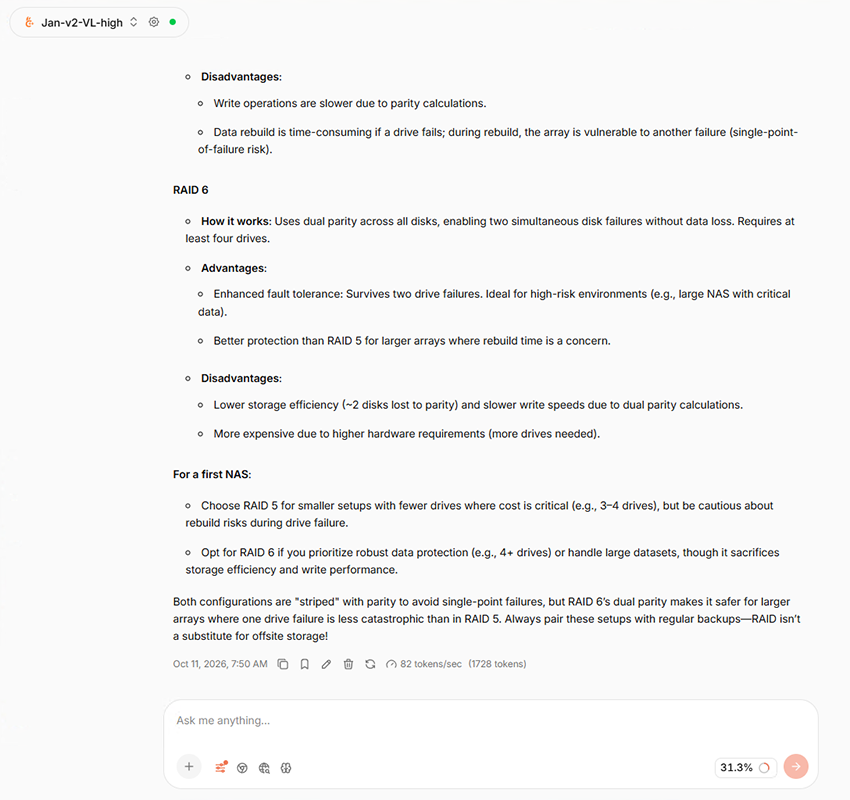
Jan V2 VL High သည် ဤတိုင်းတာထားသော လုပ်ဆောင်မှုတွင် Jan-report လုပ်ထားသော output တိုကင် ၁,၇၂၈ ခုဖြင့် တိုကင်/စက္ကန့် ၈၂ ခုသို့ ရောက်ရှိခဲ့ပြီး သုံးကြိမ်စမ်းသပ်မှုမှ အလယ်အလတ်ကိန်းဂဏန်းများနှင့် ကိုက်ညီပါသည်။
| ပုံစံ | အရေအတွက် | အထွက်တိုကင်များ | ကုဒ်ဖြုတ်မြန်နှုန်း | GPU မှတ်ဉာဏ် |
|---|---|---|---|---|
| ဇန်နဝါရီ V3.5 4B | Q4_K_XL | 503 | ၈.၇၁၂ tok/s | ၆.၁ MiB |
| ဇန်နဝါရီ V2 VL မြင့်မားသော | Q4_K_M | 1,728 | ၈.၇၁၂ tok/s | ၆.၁ MiB |
မှတ်ချက်- Output-token အရေအတွက်၊ decode rate များနှင့် GPU memory ကိန်းဂဏန်းများသည် စွန့်ပစ်ထားသော warm-up run တစ်ကြိမ်ပြီးနောက် တိုင်းတာထားသော run သုံးခု၏ median များဖြစ်သည်။ GPU memory သည် တိုင်းတာထားသော run တစ်ခုစီတွင် တွေ့ရှိရသည့် အမြင့်ဆုံး memory အသုံးပြုမှု၏ median တစ်ခုဖြစ်သည်။ Jan V2 VL High ၏ အစီရင်ခံထားသော output count တွင် မြင်သာသောအဖြေမှာ စကားလုံး ၄၀၀ ခန့်ရှိပြီး Jan သည် token စုစုပေါင်းပိုမိုကြီးမားသော အစီရင်ခံထားသောကြောင့် ကျိုးကြောင်းဆင်ခြင်သည့် token များ ပါဝင်ပုံရသည်။ ထို့ကြောင့် ၎င်း၏ output-token အရေအတွက်ကို Jan V3.5 4B နှင့် တိုက်ရိုက်နှိုင်းယှဉ်ခြင်းမပြုသင့်ပါ။
ဒေသတွင်းချတ်အတွက် Jan ကိုအသုံးပြုခြင်း
မော်ဒယ်တစ်ခုကို ထည့်သွင်းပြီးသည်နှင့် Jan ၏ အဓိက interface သည် လမ်းညွှန်ရလွယ်ကူပါသည်။ မကြာသေးမီက စကားပြောဆိုမှုများသည် ဘယ်ဘက် sidebar တွင် ပေါ်လာပြီး လက်ရှိမော်ဒယ်ကို အပေါ်ဆုံးတွင် မြင်နေရပြီး attachment များနှင့် tool များသည် prompt field အောက်တွင် တည့်တည့်တည်ရှိနေပါသည်။
ထည့်သွင်းထားသော မော်ဒယ်များအကြား ပြောင်းလဲခြင်းသည် ကလစ်အနည်းငယ်သာ နှိပ်ရုံသာ လိုအပ်ပါသည်။ Jan သည် တိုကင်အရေအတွက်နှင့် ထုတ်လုပ်မှုနှုန်းအပါအဝင် တုံ့ပြန်မှု၏အဆုံးတွင် အချက်အလက်များကိုလည်း ပြသပါသည်။ အသေးစိတ်အဆင့်သည် အသုံးပြုထားသော မော်ဒယ်ပေါ်တွင် မူတည်သော်လည်း ကျိုးကြောင်းဆင်ခြင်ခြင်း မော်ဒယ်များသည် ထုတ်လုပ်နေစဉ် ၎င်းတို့၏ စဉ်းစားတွေးခေါ်မှုလုပ်ဆောင်ချက်ကို ပြသနိုင်ပါသည်။
ကျွန်ုပ်တို့ရဲ့ ပထမဆုံး ဒေသတွင်းစမ်းသပ်မှုမှာ Jan ကို NAS တည်ဆောက်သူတစ်ယောက်အတွက် RAID 5 နဲ့ RAID 6 ကွာခြားချက်တွေကို ရှင်းပြဖို့ တောင်းဆိုခဲ့ပါတယ်။ ဒေါင်းလုဒ်လုပ်ထားတဲ့ မော်ဒယ်နှစ်ခုစလုံးက တောင်းဆိုမှုကို ပြီးမြောက်အောင် လုပ်ဆောင်ပေးနိုင်ခဲ့ပြီး Jan V2 VL High က ပိုရှည်တဲ့အဖြေကို ထုတ်ပေးပြီး GPU မှတ်ဉာဏ် 8,197 MiB ကို အသုံးပြုခဲ့ပါတယ်။ 4B မော်ဒယ်ကတော့ 4,839 MiB သာ အသုံးပြုခဲ့ပါတယ်။
Web ကိုရှာရန်
Jan မှာ ဝက်ဘ်ရှာဖွေမှုနဲ့ ချတ်အင်တာဖေ့စ်မှာ တိုက်ရိုက်စာမျက်နှာရယူခြင်း ပါဝင်တာကြောင့် ပံ့ပိုးပေးထားတဲ့ မော်ဒယ်တွေက အဲဒီကိရိယာတွေကို ဖွင့်ထားတဲ့အခါ လက်ရှိအွန်လိုင်းအချက်အလက်တွေကို စကားဝိုင်းထဲ ယူဆောင်လာနိုင်ပါတယ်။ Jan v0.8.6 ကို အပ်ဒိတ်လုပ်ပြီးနောက် ဒီအင်္ဂါရပ်ကို ဖွင့်ပြီး Jan V2 VL High ကို ကျွန်ုပ်တို့ရဲ့ ဒေသတွင်းစမ်းသပ်မှုအတွင်း အသုံးပြုခဲ့တဲ့ RAID 5 နဲ့ RAID 6 မေးခွန်းကို မေးမြန်းခြင်းအားဖြင့် ကျွန်ုပ်တို့ရဲ့ ယခင် Web Search စမ်းသပ်မှုကို ထပ်မံလုပ်ဆောင်ခဲ့ပါတယ်။
Jan သည် လက်ရှိအချက်အလက်များက အထောက်အကူဖြစ်စေနိုင်သည်ဟု ထပ်မံဆုံးဖြတ်ခဲ့ပြီး prompt သည် အွန်လိုင်းတွင် ရှာဖွေရန် မတောင်းဆိုသော်လည်း Web Search ကို ခေါ်ယူရန် ကြိုးစားခဲ့သည်။ ကျိုးကြောင်းဆင်ခြင်ခြင်းမြင်ကွင်းက ရှာဖွေမှုမေးမြန်းချက်တစ်ခု မတင်သွင်းမီ လက်ရှိ NAS အကြံပြုချက်များကို အတည်ပြုရန် ဆုံးဖြတ်သည့် မော်ဒယ်ကို ပြသခဲ့သည်။ ဤလုပ်ဆောင်မှုတွင်၊ configure လုပ်ထားသော Exa ဝန်ဆောင်မှုသည် ၎င်း၏ အခမဲ့ MCP နှုန်းကန့်သတ်ချက်သို့ ရောက်ရှိသွားသောကြောင့် ရှာဖွေမှုကိုယ်တိုင်က ပြီးမြောက်အောင် မလုပ်ဆောင်နိုင်ခဲ့ပါ၊ သို့သော် ပြင်ပအချက်အလက်များ အသုံးဝင်နိုင်သည်ဟု ဆုံးဖြတ်သည့်အခါ Jan V2 VL High သည် Web Search ကို အလိုအလျောက် ခေါ်ယူနေဆဲဖြစ်ကြောင်း စမ်းသပ်မှုက အတည်ပြုခဲ့သည်။
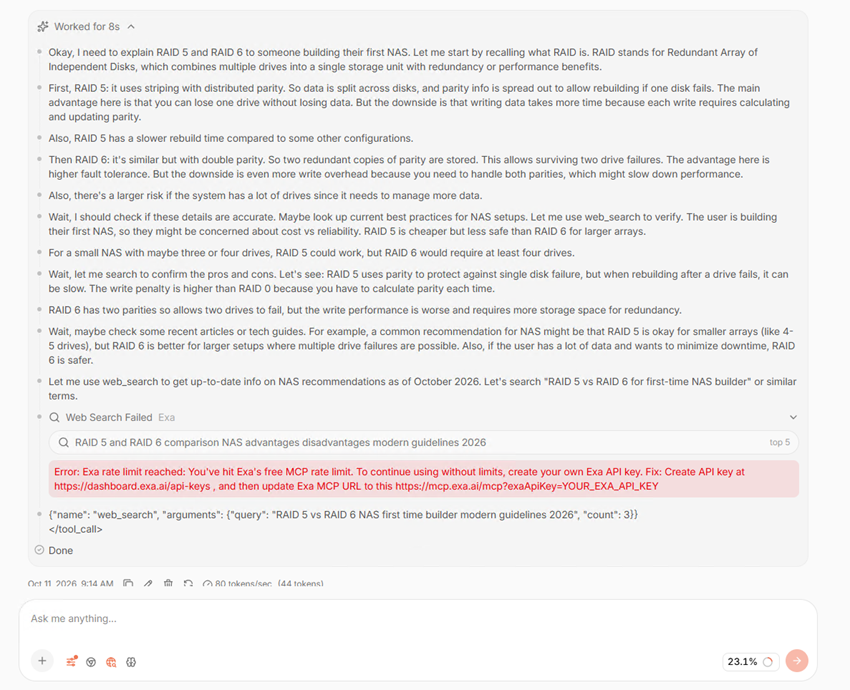
Jan v0.8.6 တွင် Web Search ကိုဖွင့်ထားချိန်တွင် Jan V2 VL High သည် RAID query အတွင်း အွန်လိုင်းရှာဖွေမှုကို အလိုအလျောက်ကြိုးစားခဲ့သော်လည်း Exa ၏ အခမဲ့ MCP နှုန်းကန့်သတ်ချက်က တောင်းဆိုမှုကို ရပ်တန့်စေခဲ့သည်။
Jan သည် MCP ကိုလည်း ပံ့ပိုးပေးသောကြောင့် browser interaction နှင့် အခြား integration များကဲ့သို့သော option များအပါအဝင် တွဲဖက်အသုံးပြုနိုင်သော external tools များနှင့် service များကို application နှင့် ချိတ်ဆက်နိုင်စေပါသည်။ ဤ session အတွင်း MCP ကို ကျွန်ုပ်တို့ မစမ်းသပ်ခဲ့ပါ၊ သို့သော် ၎င်းပါဝင်မှုသည် user များအား ဒေသတွင်းတွင် လည်ပတ်နေသော model များ standard chat interface ထက်ကျော်လွန်၍ ဝင်ရောက်ကြည့်ရှုနိုင်ပြီး လုပ်ဆောင်နိုင်သည့် အခြားနည်းလမ်းတစ်ခုကို တိုးချဲ့နိုင်စေပါသည်။
ဘက်စုံသုံး ထည့်သွင်းမှု
Jan v0.8.6 ကို အပ်ဒိတ်လုပ်ပြီးနောက် image input ကို ပြန်လည်စမ်းသပ်ရန်အတွက်၊ ကျွန်ုပ်တို့သည် Jan V2 VL High တွင် nvidia-smi screenshot အသစ်တစ်ခုကို ပူးတွဲပြီး ပုံတွင်ပြထားသည့် GPU မော်ဒယ်၊ NVIDIA driver ဗားရှင်း၊ စုစုပေါင်း VRAM၊ GPU အသုံးပြုမှု၊ GPU အပူချိန်နှင့် ပါဝါအသုံးပြုမှုတို့ကို ဖော်ထုတ်ရန် တောင်းဆိုခဲ့သည်။ မော်ဒယ်သည် တန်ဖိုးခြောက်ခုလုံးကို မှန်ကန်စွာ ဖော်ထုတ်ခဲ့သည်- NVIDIA RTX 5000 Ada Generation၊ driver 597.06၊ 32,760 MiB of VRAM၊ 1% GPU အသုံးပြုမှု၊ 35C အပူချိန်နှင့် 4W / 250W ပါဝါအသုံးပြုမှု။
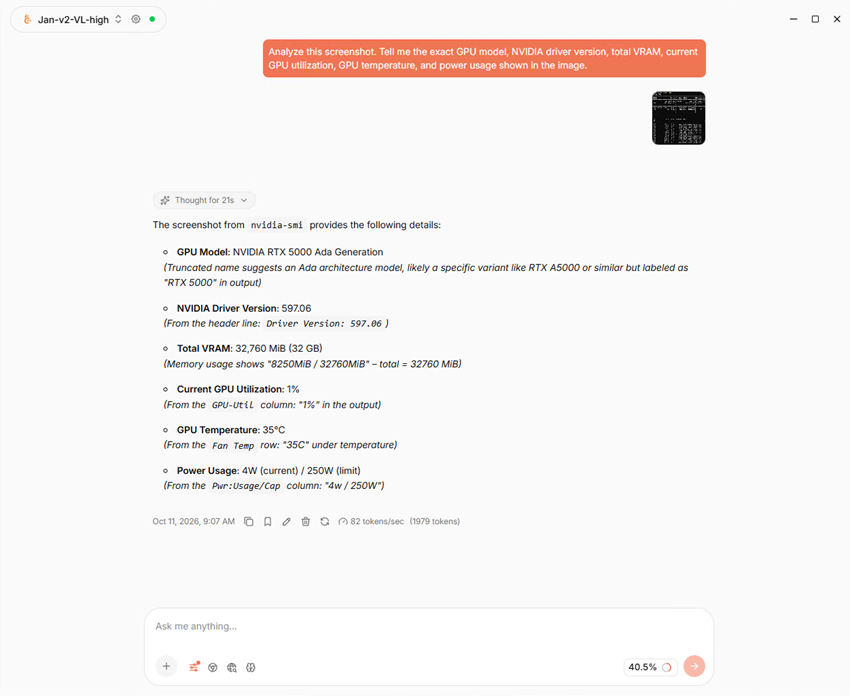
Jan V2 VL High သည် Jan v0.8.6 ရှိ nvidia-smi screenshot အသစ်မှ တောင်းဆိုထားသော hardware value ခြောက်ခုလုံးကို မှန်ကန်စွာ ဖော်ထုတ်နိုင်ခဲ့သည်။
အဲဒါက ကျွန်တော်တို့ရဲ့ အစောပိုင်း Jan build မှာ ကနဦး multimodal စမ်းသပ်မှုထက် ပိုကောင်းပါတယ်။ terminal layout မှတစ်ဆင့် တုံ့ပြန်မှုအများစုကို လုပ်ဆောင်ခဲ့ပါတယ်။ မော်ဒယ်က ဖြေဆိုခြင်းမပြုမီ ၂၁ စက္ကန့် ကျိုးကြောင်းဆင်ခြင်ခဲ့ပြီး Jan က output token ၁,၉၇၉ ခုကို တင်ပြခဲ့ပေမယ့် မြင်သာတဲ့ တုံ့ပြန်မှုက တိုတောင်းပြီး တောင်းဆိုမှုကို တိုက်ရိုက်ဖြေကြားခဲ့ပါတယ်။
ဒေသတွင်း API ဆာဗာ
Jan တွင် Settings menu မှ ဝင်ရောက်ကြည့်ရှုနိုင်သော local OpenAI နှင့် တွဲဖက်အသုံးပြုနိုင်သော API server တစ်ခုလည်း ပါဝင်သည်။ ကျွန်ုပ်တို့သည် Jan V3.5 4B ကို default local API model အဖြစ် ရွေးချယ်ခဲ့ပြီး interface မှ တိုက်ရိုက် server ကို စတင်ခဲ့သည်။
Jan က ဆာဗာကို လည်ပတ်နေတဲ့ နေရာကို အစီရင်ခံတင်ပြခဲ့ပါတယ်-
http://127.0.0.1:1337/v1
built-in server log က အောင်မြင်စွာ လွှတ်တင်နိုင်ခဲ့ကြောင်း အတည်ပြုခဲ့ပြီး Jan ကလည်း အပြန်အလှန်တုံ့ပြန်နိုင်သော API စာရွက်စာတမ်းများကို ဝင်ရောက်ကြည့်ရှုခွင့်ပေးခဲ့သည်။
ကျွန်ုပ်တို့သည် PowerShell ကို အသုံးပြု၍ local API သည် မျှော်လင့်ထားသည့်အတိုင်း အလုပ်လုပ်ကြောင်း သေချာစေခဲ့ပြီး /v1/models သို့ query တစ်ခုဖြင့် စတင်ခဲ့ပြီး Jan V2 VL High အပါအဝင် ထည့်သွင်းထားသော မော်ဒယ်များကို ပြန်ပေးခဲ့သည်။ ထိုမှစ၍ ကျွန်ုပ်တို့သည် Jan-v3.5-4B-Q4_K_XL သို့ chat-completions request တစ်ခု ပေးပို့ပြီး RAID 6 ၏ တစ်ကြောင်းတည်းသော ရှင်းလင်းချက်ကို မေးမြန်းခဲ့ပြီး Jan သည် PowerShell တွင် တိုက်ရိုက် response ပြန်ပေးခဲ့သည်။
“RAID 6 သည် disk array configuration တစ်ခုဖြစ်ပြီး၊ data block တစ်ခုလျှင် သီးခြား parity block နှစ်ခုကို အသုံးပြုခြင်းဖြင့် data redundancy ကို ပံ့ပိုးပေးပြီး array သည် disk နှစ်ခုအထိ data ဆုံးရှုံးမှုမရှိဘဲ ရှင်သန်နိုင်စေပါသည်။”
တုံ့ပြန်မှုတွင် အချက်အလက်အမှားတစ်ခုပါဝင်သည်- RAID 6 သည် data block တစ်ခုလျှင် parity block နှစ်ခုကို အသုံးမပြုဘဲ stripe တစ်ခုလျှင် parity block နှစ်ခုကို အသုံးပြုသည်။
တောင်းဆိုချက်နှစ်ခုလုံး အလုပ်လုပ်နေချိန်တွင် OpenAI နှင့် တွဲဖက်အသုံးပြုနိုင်သော endpoint ကို ပံ့ပိုးပေးသည့် software သည် desktop chat interface မှတစ်ဆင့် prompt အားလုံးကို မပို့ဘဲ Jan ၏ download လုပ်ထားသော model များနှင့် တိုက်ရိုက်ဆက်သွယ်နိုင်ကြောင်း ကျွန်ုပ်တို့ အတည်ပြုခဲ့ပါသည်။
ဘာမှားသှား
ကျွန်ုပ်တို့ရဲ့ ကနဦးစမ်းသပ်မှုကနေ အဓိကပြဿနာက multimodal စမ်းသပ်မှုကနေ လာတာပါ။ Jan V2 VL High က nvidia-smi screenshot ကို နားလည်ပေမယ့် ရိုးရှင်းတဲ့ extraction request တစ်ခုကို လုပ်ဆောင်ဖို့ အချိန်အရမ်းကြာခဲ့ပါတယ်။ အထက်မှာဖော်ပြထားတဲ့ v0.8.6 ပြန်လည်စမ်းသပ်မှုက တန်ဖိုးခြောက်ခုလုံးကို တိကျတဲ့တုံ့ပြန်မှုနဲ့ ပြန်ပေးခဲ့ပေမယ့် ကျိုးကြောင်းဆင်ခြင်ခြင်း ၂၁ စက္ကန့်နဲ့ အစီရင်ခံထားတဲ့ output token ၁,၉၇၉ ခုက မော်ဒယ်ဟာ အဖြေမပေးခင်မှာ အလုပ်တွေ အများကြီးလုပ်နေဆဲဖြစ်ကြောင်း ပြသနေပါတယ်။
v0.8.6 ရှိ Web Search ပြန်လည်စမ်းသပ်မှုသည် ဇန်နဝါရီလပြင်ပတွင် ကန့်သတ်ချက်တစ်ခုသို့ ရောက်ရှိခဲ့သည်- configure လုပ်ထားသော Exa ဝန်ဆောင်မှုသည် ၎င်း၏ အခမဲ့ MCP နှုန်းကန့်သတ်ချက်သို့ ရောက်ရှိနေပြီဖြစ်သောကြောင့် RAID မေးခွန်းအတွင်း မော်ဒယ်ကြိုးစားခဲ့သော အလိုအလျောက်ရှာဖွေမှုကို မပြီးမြောက်နိုင်ခဲ့ပါ။ Web Search ကို အားကိုးသူတိုင်းသည် ပုံမှန်အသုံးပြုရန်အတွက် လုံလောက်သော headroom ဖြင့် search provider ကို configure လုပ်ရန် မျှော်လင့်သင့်သည်။
ထိုအချက်များမှလွဲ၍ v0.8.6 စမ်းသပ်မှုသည် အဆင်ပြေချောမွေ့စွာ ပြီးဆုံးခဲ့သည်။ ထပ်ခါတလဲလဲ local generation ခြောက်ကြိမ်စလုံး crash များ၊ model-load failure များ သို့မဟုတ် GPU detection ပြဿနာများမရှိဘဲ ပြီးမြောက်ခဲ့သည်။
ကောက်ချက်
Windows မှာ local LLM တွေကို run တာနဲ့ပတ်သက်ပြီး စိတ်ဝင်စားသူတိုင်းအတွက် Jan v0.8.6 က setup အလုပ်အများစုကို ဖယ်ရှားပေးထားပြီး မော်ဒယ်တွေ ဘယ်လို run လဲဆိုတာကို ချိန်ညှိဖို့ နေရာအများကြီး ချန်ထားပေးပါတယ်။ ကျွန်တော်တို့ရဲ့ test system မှာ RTX 5000 Ada ကို အလိုအလျောက် သိရှိနိုင်ပါတယ်။ download လုပ်ထားတဲ့ မော်ဒယ်နှစ်ခုစလုံးက GPU acceleration ကို အသုံးပြုထားပြီး Hub က download မလုပ်ခင် မော်ဒယ်အရွယ်အစားနဲ့ hardware-fit အချက်အလက်တွေကို ပြသပေးပါတယ်။ ထိန်းချုပ်မှု ပိုလိုအပ်တဲ့အခါ context size၊ GPU layer နဲ့ memory option တွေလိုမျိုး setting တွေကို ပေးစွမ်းနေချိန်မှာ စတင်အသုံးပြုသူတစ်ယောက်အတွက် လုံလောက်တဲ့ လမ်းညွှန်ချက်တွေ ပေးပါတယ်။
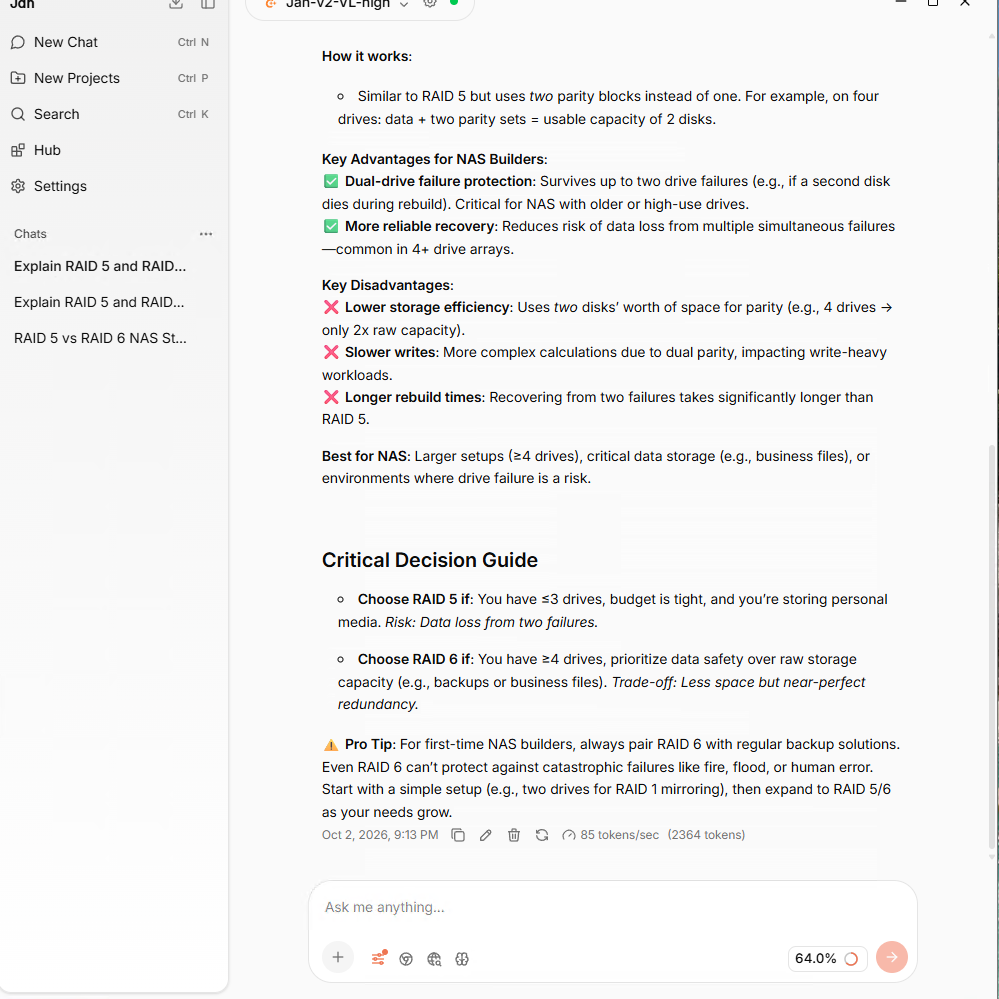
Jan V2 VL High သည် တုံ့ပြန်မှုအောက်တွင် ထုတ်လုပ်မှုအချက်အလက်များကို ပြသနေစဉ် ဒေသတွင်း RAID နှိုင်းယှဉ်မှုကို ပြီးမြောက်ခဲ့သည်။
Jan သည် ဒေသတွင်းမော်ဒယ်များကို လုပ်ဆောင်ခြင်းနှင့် ချတ်ဝင်းဒိုးတစ်ခု ပံ့ပိုးပေးခြင်းထက် ကျော်လွန်၍ တူညီသော interface တွင် အင်္ဂါရပ်များစွာကို ထည့်သွင်းပေးခဲ့သည်။ ကျွန်ုပ်တို့သည် စကားပြောဆိုမှုမှ Web Search ကို တိုက်ရိုက်စမ်းသပ်ခဲ့ပြီး၊ Jan V2 VL High ဖြင့် image input ကို စမ်းသပ်ခဲ့ပြီး၊ ဒေသတွင်း llama.cpp မော်ဒယ်များနှင့်အတူ remote AI provider များ ရရှိနိုင်ကြောင်း မြင်တွေ့ခဲ့ပြီး PowerShell မှ OpenAI နှင့် တွဲဖက်အသုံးပြုနိုင်သော API သို့ request များ ပေးပို့ခဲ့သည်။
ကျွန်ုပ်တို့၏ RTX 5000 Ada စနစ်တွင်၊ ကျွန်ုပ်တို့၏ အပ်ဒိတ်လုပ်ထားသော စာသားထုတ်လုပ်မှု စမ်းသပ်မှုတွင် Jan V3.5 4B သည် ပျမ်းမျှ 123 tokens/sec သို့ ရောက်ရှိခဲ့ပြီး Jan V2 VL High သည် 82 tokens/sec သို့ ရောက်ရှိခဲ့သည်။ Jan V2 VL High သည် v0.8.6 အပ်ဒိတ်ပြီးနောက် ကျွန်ုပ်တို့၏ ထပ်ခါတလဲလဲ multimodal စမ်းသပ်မှုတွင်လည်း ပိုမိုတိကျသော တုံ့ပြန်မှုကို ထုတ်ပေးခဲ့ပြီး nvidia-smi screenshot မှ တောင်းဆိုထားသော တန်ဖိုးခြောက်ခုလုံးကို မှန်ကန်စွာ ဖော်ထုတ်နိုင်ခဲ့သည်။
Jan သည် session တစ်လျှောက်လုံး ယုံကြည်စိတ်ချစွာ လုပ်ဆောင်နိုင်ခဲ့ပြီး GPU တွင် local မော်ဒယ်များကို အသစ်ထည့်သွင်းခြင်းမှ run ခြင်းသို့သွားရန် installer တစ်ကြိမ်၊ မော်ဒယ်ဒေါင်းလုဒ်တစ်ကြိမ်နှင့် click အနည်းငယ်သာ လိုအပ်ပါသည်။
ကျွန်ုပ်တို့၏ အကောင်းဆုံး ဒေသတွင်း LLM Tools ဦးဆောင်သူစာရင်းတွင် နောက်ထပ်ထည့်သွင်းမှုများကို လုပ်ဆောင်သကဲ့သို့ပင် စမ်းသပ်မှုနည်းလမ်းကို အသုံးပြုသွားမည်ဖြစ်ပြီး စာဖတ်သူများအား အင်္ဂါရပ်များနှင့် နေ့စဉ်အသုံးပြုမှု ကွာခြားချက်များအပြင် တူညီသော ဟာ့ဒ်ဝဲမှ စွမ်းဆောင်ရည်ရလဒ်များကို ပေးစွမ်းမည်ဖြစ်သည်။

ဦးဆောင်သူစာရင်း- Jan သည် ကျွန်ုပ်တို့၏ အကောင်းဆုံးဒေသခံ LLM Tools ဦးဆောင်သူစာရင်းတွင် အကောင်းဆုံးဒေသခံ-ပထမဆုံး LLM Desktop အက်ပ်ကို ရရှိခဲ့သည် ။


 အမေဇုံ