

NVIDIA RTX PRO 4500 Blackwell Server Edition သည် လုပ်ငန်းအများစုပိုင်ဆိုင်ပြီးသား ဆာဗာများအတွက် NVIDIA တည်ဆောက်ထားသော ကတ်ဖြစ်သည်။ ၎င်းသည် single-slot၊ passively cooled၊ 32GB GDDR7 ပါရှိသော 165W ဘုတ်တစ်ခုဖြစ်ပြီး Blackwell ၏ အင်္ဂါရပ်အစုံအလင်- FP4 ပါရှိသော ပဉ္စမမျိုးဆက် Tensor Cores၊ စတုတ္ထမျိုးဆက် RT cores၊ encoder သုံးခုနှင့် decoder သုံးခုနှင့် Multi-Instance GPU ပံ့ပိုးမှုတို့ကို ပေါင်းစပ်ထားပြီး ၎င်းကို သီးခြား 16GB partition နှစ်ခုအဖြစ် ပိုင်းခြားနိုင်သည်။ ၎င်းသည် NVIDIA ၏ RTX PRO server လိုင်း၏ ဝင်ပေါက်အဖြစ် L4 ကို အစားထိုးထားပြီး ပါဝါ သို့မဟုတ် အအေးပေးစနစ် စိုးရိမ်စရာမလိုဘဲ 2U PowerEdge၊ ProLiant သို့မဟုတ် ThinkSystem တို့နှင့် ကိုက်ညီသည်။

NVIDIA ရဲ့ ကတ်အတွက် ကမ်းလှမ်းချက်က အရွယ်အစားမှန်ကန်ပါတယ်- လုပ်ငန်းအများစုဟာ AI စက်ရုံတွေ မတည်ဆောက်ကြပါဘူး။ သူတို့ဟာ လေအေးပေးစက်နဲ့ brownfield data center တွေကို လည်ပတ်ပြီး rack power ကို အကန့်အသတ်မရှိ လည်ပတ်ကြပါတယ်။ server class အသစ် မလိုအပ်တဲ့ ပထမဆုံး အရှိန်မြှင့် computing ခြေလှမ်းတစ်ခု လိုအပ်ပါတယ်။ ဒါမှမဟုတ် RTX PRO 4500 ဟာ ဘာတွေကို ဖြန့်ကျက်နိုင်တယ်ဆိုတာကို ဆုံးဖြတ်ပေးတဲ့ workloads နဲ့ power ကန့်သတ်ချက်တွေနဲ့ ပိုပြီး ကိုက်ညီတဲ့ edge မှာ အလုပ်လုပ်နေကြပါတယ်။
RTX PRO 6000 Blackwell သည် ထိုဈေးကွက်၏ ထိပ်တန်းကို 96GB နှင့် 600W အထိ လွှမ်းခြုံထားသည်။ 4500 သည် တူညီသော ဗိသုကာလက်ရာကို ဆက်လက်ထိန်းသိမ်းထားပြီး ကျန်အရာအားလုံးကို ထက်ဝက်ခန့် လျှော့ချထားသောကြောင့် မော်ဒယ်ငယ်များ၊ အလုပ်ငယ်များစွာ သို့မဟုတ် တစ်ဒေါ်လာလျှင် ဝပ်အတိုင်းအတာ ဘတ်ဂျက်ရှိသော ဖောက်သည်များသည် ၎င်းတို့အသုံးမပြုမည့် နေရာအတွက် ပေးဆောင်စရာမလိုဘဲ Blackwell ကို ရရှိကြသည်။
ဒီ GPU အမျိုးအစားအတွက် workloads တွေကို ကောင်းကောင်းနားလည်ထားပါတယ်- အသေးစားဘာသာစကားမော်ဒယ်တွက်ချက်မှု၊ vision AI နှင့် video analytics၊ vector search နှင့် embedding generation၊ transcoding နှင့် vGPU 20 အောက်ရှိ virtual workstations တို့ဖြစ်ပါတယ်။ အသေးစားနှင့် အလတ်စားမော်ဒယ်တွက်ချက်မှုအတွက် L4 ထက် 5x ကျော်နှင့် Nemotron မော်ဒယ်များတွင် 10x အထိ ပိုမိုကောင်းမွန်တယ်လို့ ဆိုထားပြီး ၎င်း၏ launch partner များမှာ edge video အတွက် NTT DATA၊ sequencing အတွက် Pacific Biosciences နှင့် AI-RAN base stations အတွက် Nokia တို့ဖြစ်သည်။ AWS သည် G6 အစားထိုးအဖြစ် ၎င်း၏ G7 instance အသစ်များကို ၎င်းပေါ်တွင် တည်ဆောက်ခဲ့သည်။
ကျွန်ုပ်တို့ရဲ့ RTX PRO 4500 edge review မှာ HPE ProLiant DL145 Gen11 ထဲက L4 နဲ့ ကတ်ကို စမ်းသပ်ပြီးပါပြီ။ L4 ရဲ့ throughput ထက် 2.7x ပိုကောင်းပါတယ်။ ဒီ review က နှစ်နှစ်ကြာ default mainstream inference card ဖြစ်ခဲ့တဲ့ 350W, dual-slot L40S နဲ့ ဘယ်လောက်နီးစပ်လဲဆိုတာနဲ့ အထက်က RTX PRO 6000 က memory နဲ့ power ဘာတွေထပ်ထည့်ပေးလဲဆိုတာကို အဖြေပေးပါတယ်။
သိရှိနိုင်ရန်အတွက်၊ ကျွန်ုပ်တို့သည် 4500 ကို Dell PowerEdge R770 တွင် L40S နှင့် L4 တို့နှင့် ယှဉ်၍ ထည့်ပြီး၊ ကျွန်ုပ်တို့၏ Dell Pro Max Tower T2 မှ RTX PRO 6000 Blackwell data ကို ၎င်း၏ 600W default နှင့် R770 တွင် GPU slot ခွင့်ပြုသည့် 450W cap နှစ်ခုလုံးတွင် ထည့်ပြီး၊ context length နှစ်ခုဖြင့် မော်ဒယ်လေးခုတွင် vLLM online serving ကို လုပ်ဆောင်ခဲ့သည်။
အကျဉ်းချုပ် preview အနေနဲ့၊ ပုံမှန် chat နဲ့ agent context length တွေမှာ 4500 ဟာ FP8 နဲ့ BF16 မော်ဒယ်တွေမှာ L40S နဲ့ ယှဉ်ရင် power ရဲ့ ထက်ဝက်အောက်ပဲ ရှိတယ်။ 8K input မှာ 32GB frame buffer က သူ့ရဲ့ ကန့်သတ်ချက်တွေကို ပြသတယ်။ ပြီးတော့ NVIDIA ရဲ့ Blackwell pitch ကို ဦးဆောင်တဲ့ precision ဖြစ်တဲ့ NVFP4 ဟာ ဒီ vLLM build ရဲ့ ကျန်တဲ့ lineup တွေနဲ့ ကိုက်ညီစွာ လုပ်ဆောင်ပါတယ်။
Key ကို Takeaways
- တစ်နေရာတည်းတွင် 165W ဖြင့် L40S throughput: 512-token input နှင့် output တွင်၊ 4500 သည် ကျွန်ုပ်တို့ run သော FP8 နှင့် BF16 မော်ဒယ်တိုင်းတွင် L40S နှင့် ကိုက်ညီသည် သို့မဟုတ် ကျော်လွန်သည်၊ Ministral 3 14B FP8 တွင် 1,107 vs. 995 tokens/s နှင့် Ministral 3 3B တွင် 2,006 vs. 1,988၊ L40S ၏ ပါဝါ၏ ၄၇ ရာခိုင်နှုန်းနှင့် ၎င်း၏ slot ထက်ဝက်အတွက် အဆင့်သတ်မှတ်ထားသော ကတ်မှဖြစ်သည်။
- L4 ထက် ၃ ဆခန့် အစားထိုးနိုင်ပါတယ်- အတိုချုပ်အခြေအနေတွင် L4 ၏ output throughput ထက် ၂.၈ ဆ မှ ၃.၆ ဆ အထိ၊ L4 ၏ board power ထက် ၂.၃ ဆ အထိ။
- 32GB ကန့်သတ်ချက်ရှိသည်- 8K input မှာ 4500 ဟာ L40S ထက် ၁၇ ရာခိုင်နှုန်းကနေ ၃၃ ရာခိုင်နှုန်းအထိ နောက်ကျကျန်ခဲ့ပြီး L40S ကတော့ ၁၆ ရာခိုင်နှုန်းအထိ ဆက်လက်မြင့်တက်နေတဲ့အချိန်မှာ curves တွေက concurrency 8 မှာ ပြားချပ်သွားခဲ့ပါတယ်။ ပြားချပ်သွားခြင်းကတော့ KV cache ကုန်ဆုံးသွားပြီး 32GB က အဲဒီကန့်သတ်ချက်ကို သတ်မှတ်ပေးတာပါ။
- NVFP4 သည် ကတ်တိုင်းတွင် ဆော့ဖ်ဝဲဇာတ်လမ်းတစ်ပုဒ်ဖြစ်သည်။ Qwen3.8-27B NVFP4 မှာ 4500 ဟာ concurrency 32 မှာ tokens/s 320 ထုတ်လုပ်ခဲ့ပြီး၊ FP4 hardware လုံးဝမရှိတဲ့ L40S 480 နဲ့ RTX PRO 6000 621 တို့ကို ထုတ်လုပ်ခဲ့ပါတယ်။ ဒီ vLLM build မှာရှိတဲ့ NVFP4 path ဟာ memory bandwidth နဲ့ ညီမျှမှု မရှိပါဘူး၊ MAMF sweep မှာတော့ 4500 ရဲ့ FP4 hardware ဟာ FP8 မှာ 280.1 TFLOPS ရှိပြီး 568.6 TFLOPS ရှိတယ်လို့ ပြသထားပါတယ်။
- ပိုကြီးတဲ့ကတ်က သင့်အတွက် ဘာတွေဝယ်ပေးလဲ- Dell R770 GPU slot က ခွင့်ပြုထားတဲ့ အမြင့်ဆုံးပါဝါ 450W အထိသာ ကန့်သတ်ထားတဲ့ RTX PRO 6000 ဟာ 4500 ထက် 2 ဆလောက် ပိုမြန်ပြီး 8K မှာ 2.5x ကနေ 3.2x အထိ မြန်ပါတယ်။ ၎င်းရဲ့ 600W အပြည့်အားဟာ 4500 ထက် 1 ရာခိုင်နှုန်းကနေ 2 ရာခိုင်နှုန်းအထိ ပိုမြန်ပြီး 4 ရာခိုင်နှုန်းကနေ 9 ရာခိုင်နှုန်းအထိ ပိုမြန်တာကြောင့် 6000 က 4500 ထက် ပါဝါအများစု ပိုများပါတယ်။
NVIDIA RTX PRO 4500 Blackwell Server Edition သတ်မှတ်ချက်များ
ကတ်နှစ်ခုမှာ RTX PRO 4500 Blackwell အမည်ရှိပြီး ဆင်တူပေမယ့် ထုတ်ကုန်ကတော့ အတူတူမဟုတ်ပါဘူး။ GTC 2025 မှာ ကြေညာခဲ့တဲ့ Workstation Edition ဟာ 200W၊ dual-slot၊ actively cooled ကတ်တစ်ခုဖြစ်ပြီး DisplayPort output လေးခုနဲ့ memory bandwidth 896GB/s ပါဝင်ပါတယ်။ ကျွန်တော်တို့ ဒီမှာ သုံးသပ်နေတဲ့ Server Edition ကတော့ GTC 2026 မှာ 165W၊ single-slot၊ passive၊ headless board အနေနဲ့ 800GB/s နှုန်းနဲ့ ရောက်ရှိလာခဲ့ပြီး display output တွေနဲ့ clock headroom တွေကို data center feature set တွေဖြစ်တဲ့ MIG၊ confidential computing၊ တတိယ NVENC နဲ့ NVDEC နဲ့ vGPU 20 support တွေနဲ့ လဲလှယ်ထားပါတယ်။ အောက်မှာ တူညီတဲ့ 10,496-core GPU နဲ့ ECC ပါတဲ့ 32GB GDDR7 ပါရှိပါတယ်။
NVIDIA ရဲ့ အချက်အလက်တွေအရ TSMC 4nm custom silicon ၃၇၈ mm² ပေါ်မှာ စတုတ္ထမျိုးဆက် RT cores ၈၂ ခုနဲ့ SM ၈၂ ခုနဲ့ Tensor Cores ၃၂၈ ခု ပါဝင်တဲ့ die တွေကို ထရန်စစ္စတာ ၄၅.၆ ဘီလီယံနဲ့ ဖွဲ့စည်းထားပါတယ်။ အဲဒါတွေက RTX 5080 နဲ့ အတူတူပဲ die မိသားစုဖြစ်တဲ့ GB203 နံပါတ်တွေဖြစ်ပြီး ပေါ့ပေါ့ပါးပါး ဖြတ်တောက်ထားပါတယ်။ အောက်က Tensor ကိန်းဂဏန်းတွေက NVIDIA ရဲ့ sparsity ရှိတဲ့ peaks တွေဖြစ်ပြီး သိပ်သည်းဆက တစ်ဝက်ဖြစ်ပြီး NVIDIA ရဲ့ peakTOPS binary က ဒီကတ်မှာ တိုင်းတာထားတဲ့ 805 TFLOPS FP8 နဲ့ 403 TFLOPS FP16 မှာ အတည်ပြုထားပါတယ်။
| specification | RTX PRO 4500 Blackwell SE | L4 | L40S | RTX PRO 6000 Blackwell SE |
|---|---|---|---|---|
| ပလက်ဖောင်းခြုံငုံသုံးသပ်ချက် | ||||
| ဗိသုကာအတတ်ပညာ | NVIDIA Blackwell | NVIDIA Ada Lovelace | NVIDIA Ada Lovelace | NVIDIA Blackwell |
| CUDA core | 10,496 | 7,424 | 18,176 | 24,064 |
| RT ကို core | ၁၄၄ (စတုတ္ထမျိုးဆက်) | ၃၂၈ (တတိယမျိုးဆက်) | ၃၂၈ (တတိယမျိုးဆက်) | ၁၄၄ (စတုတ္ထမျိုးဆက်) |
| GPU မှတ်ဉာဏ် | ECC ပါရှိသော 32GB GDDR7 | 24GB GDDR6 | ECC ပါရှိသော 48GB GDDR6 | ECC ပါရှိသော 96GB GDDR7 |
| မှတ်ဉာဏ် Interface | 256-bit မှာ | 192-bit မှာ | 384-bit မှာ | 512-bit မှာ |
| မှတ်ဉာဏ် Bandwidth | 800GB / s နဲ့ | 300GB / s နဲ့ | 864GB / s နဲ့ | 1,597GB / s နဲ့ |
| စွမ်းဆောင်ရည် (NVIDIA အမြင့်ဆုံးကိန်းဂဏန်းများ၊ sparsity ပါသော Tensor နှုန်းထားများ) | ||||
| FP32 | 51 TFLOPS | 30.3 TFLOPS | 91.6 TFLOPS | 120 TFLOPS |
| FP16 / BF16 တန်ဆာ | 406 TFLOPS | 242 TFLOPS | 733 TFLOPS | ၁၁.၁၅ PFLOPS |
| FP8 တန်ဆာ | 811 TFLOPS | 485 TFLOPS | 1,466 TFLOPS | ၁၁.၁၅ PFLOPS |
| FP4 တန်ဆာ | ၁၁.၁၅ PFLOPS | အားမထောက်ပံ့ | အားမထောက်ပံ့ | ၁၁.၁၅ PFLOPS |
| RT အဓိက စွမ်းဆောင်ရည် | 154 TFLOPS | စာရင်းမပါ | 209 TFLOPS | 355 TFLOPS |
| ပါဝါနှင့် ပုံစံအချက် | ||||
| အများဆုံးဘုတ်ပါဝါ | 165W | 72W | 350W | 600W အထိ (ပြင်ဆင်နိုင်သည်) |
| form ကို Factor | တစ်ပေါက်တည်း၊ FHFL 4.4 "x ကို 10.5" |
တစ်ပေါက်တည်း၊ HHHL | နှစ်ထပ်အထိုင်၊ FHFL 4.4 "x ကို 10.5" |
နှစ်ထပ်အပေါက်၊ FHFL (လေ) တစ်ပေါက်တည်း၊ FHXL (အရည်) |
| အပူ | မလှုပ်မရှားနေသော | မလှုပ်မရှားနေသော | မလှုပ်မရှားနေသော | တက်ကြွသော (လေ) သို့မဟုတ် အရည် |
| Power က Connector | PCIe CEM5 ၁၆-ပင် ၁ ခု | အပေါက်ပါ ပါဝါရှိသည် | 1x 16 pin | PCIe CEM5 ၁၆-ပင် ၁ ခု |
| Interconnection | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 4.0 x16 | PCIe 5.0 x16 |
| အလေးချိန် | 1,055g | စာရင်းမပါ | စာရင်းမပါ | စာရင်းမပါ |
| အင်္ဂါရပ်များ | ||||
| Multi-Instance GPU | 16GB x 2 အထိ | အဘယ်သူမျှမ | အဘယ်သူမျှမ | 24GB x 4 အထိ |
| NVENC / NVDEC | 3x / 3x | 2x / 4x | 3x / 3x | 4x / 4x |
| လျှို့ဝှက်တွက်ချက်မှု | ထောက်ပံ့ထား | အဘယ်သူမျှမ | အဘယ်သူမျှမ | ထောက်ပံ့ထား |
| vGPU ပံ့ပိုးမှု | ဟုတ်ကဲ့ (vGPU 20) | Yes | Yes | Yes |
ဒီဇိုင်းနှင့်တည်ဆောက်ပါ
4500 Server Edition သည် အမြင့် ၄.၄ လက်မနှင့် အရှည် ၁၀.၅ လက်မရှိသော full-height၊ full-length board ဖြစ်ပြီး slot တစ်ခုသာ ဖြည့်ထားသည်။ ၎င်းသည် half-height၊ half-length card တစ်ခုဖြစ်ခဲ့သည့် L4 နှင့် နှိုင်းယှဉ်ပါက အရေးကြီးသော ပြောင်းလဲမှုတစ်ခုဖြစ်သည်။ L4 သည် ၎င်းနှိုင်းယှဉ်ခဲ့သည့်အတိုင်းပင်ဖြစ်သော်လည်း memory၊ 16-pin power input နှင့် chassis airflow တစ်ခုတည်းဖြင့် 165W လျှော့ချနိုင်သော heatsink အတွက် နေရာလွတ်ပေးရန် form factor ကို FHFL သို့ ပြောင်းရွှေ့ခဲ့သည်။

အဲဒီပုံစံက L4 ကနေ တကယ့်ကွဲထွက်နေတဲ့ တစ်ခုတည်းသောပုံစံဖြစ်ပြီး HHHL slot တိုင်းနဲ့ ကိုက်ညီပြီး slot ကနေ 72W ကို ဆွဲယူတာကြောင့် 1U server တွေနဲ့ small edge box တွေထဲကို ထည့်ထားပါတယ်။ 4500 က အမြင့်အပြည့်၊ အရှည်အပြည့်ဖြစ်ပြီး 16-pin cable လိုအပ်ပြီး ကျွန်တော်တို့အလုပ်လုပ်တဲ့ 1U mainstream server တွေဖြစ်တဲ့ Dell ရဲ့ လက်ရှိ 1U PowerEdge လိုင်းက အဲဒီ connector မပါတဲ့ HHHL ဒါမှမဟုတ် FHHL ကတ်တွေမှာ အများဆုံးဖြစ်ပါတယ်။
လက်တွေ့တွင်၊ ၎င်းသည် 2U ကတ် သို့မဟုတ် FHFL slot များပတ်လည်တွင်တည်ဆောက်ထားသော whitebox 1U chassis အနည်းငယ်အတွက်တစ်ခုဖြစ်သောကြောင့် 1U သို့မဟုတ် edge box များအတွက် L4 များကိုဝယ်ယူသောဆိုင်သည် drop-in အစားထိုးမှုကိုမရရှိပါ။
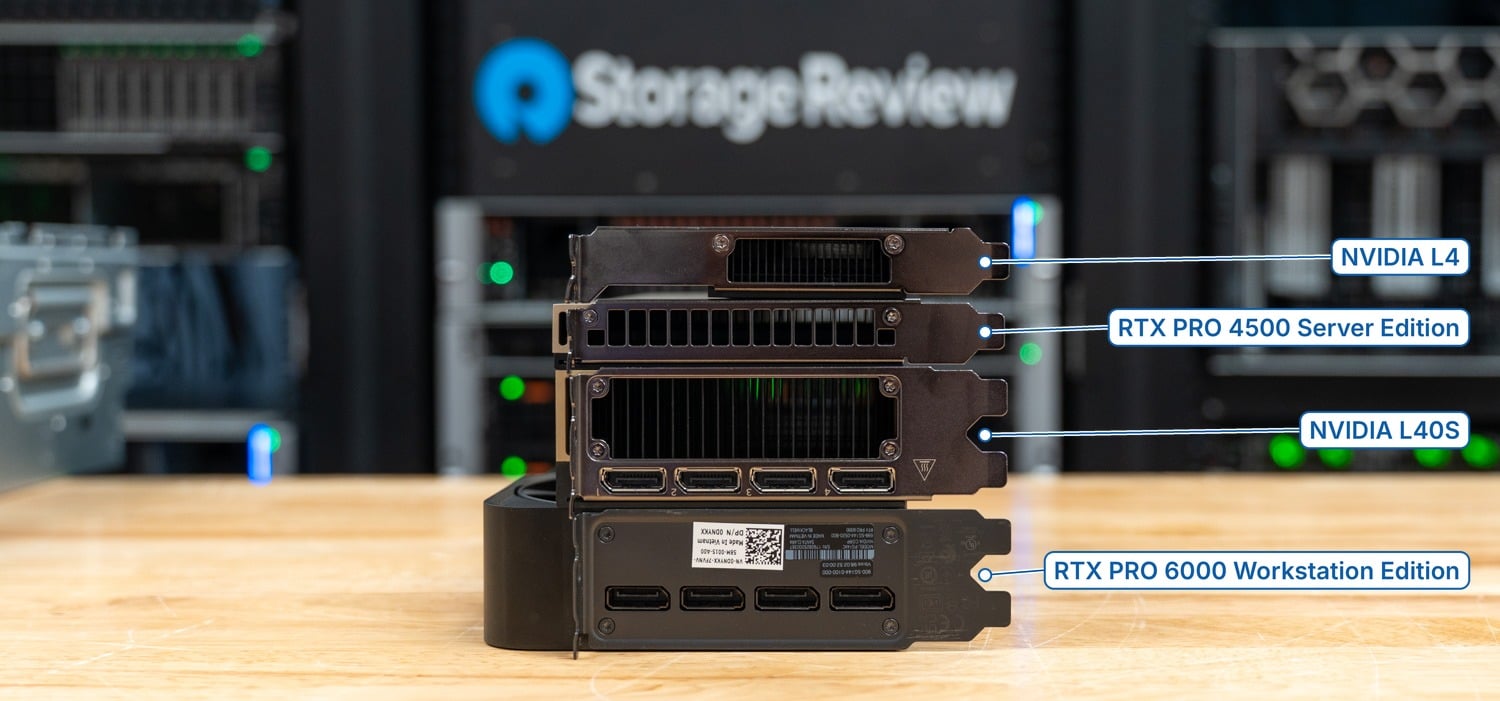
အပေါ်က L4 နဲ့ အောက်က L40S တွေနဲ့ အနားသတ်ပေါ်မှာ စီတန်းထားတဲ့ 4500 မှာ L40S မှာ နှစ်ခုလိုအပ်တဲ့နေရာမှာ slot တစ်ခုလိုအပ်ပါတယ်၊ ဒါကြောင့် double-wide card လေးခုယူတဲ့ 2U server က ဒီ card ရှစ်ခုကို ယူနိုင်ပါတယ်၊ ပြီးတော့ AWS ရဲ့ G7 instance တွေက host တစ်ခုမှာ ရှစ်ခုအထိ run နိုင်ပါတယ်။
ပါဝါကို PCIe CEM5 16-pin connector တစ်ခုတည်းမှတစ်ဆင့် ပေးပို့ပြီး RTX PRO 6000 တွင် အသုံးပြုသည့် connector အတိုင်းဖြစ်ပြီး auxiliary 8-pin option မရှိပါ။ အအေးပေးစနစ်သည် လုံးဝ passive ဖြစ်သောကြောင့် ကတ်သည် server ၏ ပန်ကာများပေါ်တွင် မှီခိုပြီး လေကို မဖြတ်သန်းနိုင်သော chassis တွင် throttle လုပ်မည်ဖြစ်ပြီး ၎င်းသည် ထိုအတန်းအစားအတွက် ပုံမှန်ဖြစ်ပြီး အခြား GPU အားလုံးတွင် လိုအပ်ချက်တူညီပါသည်။
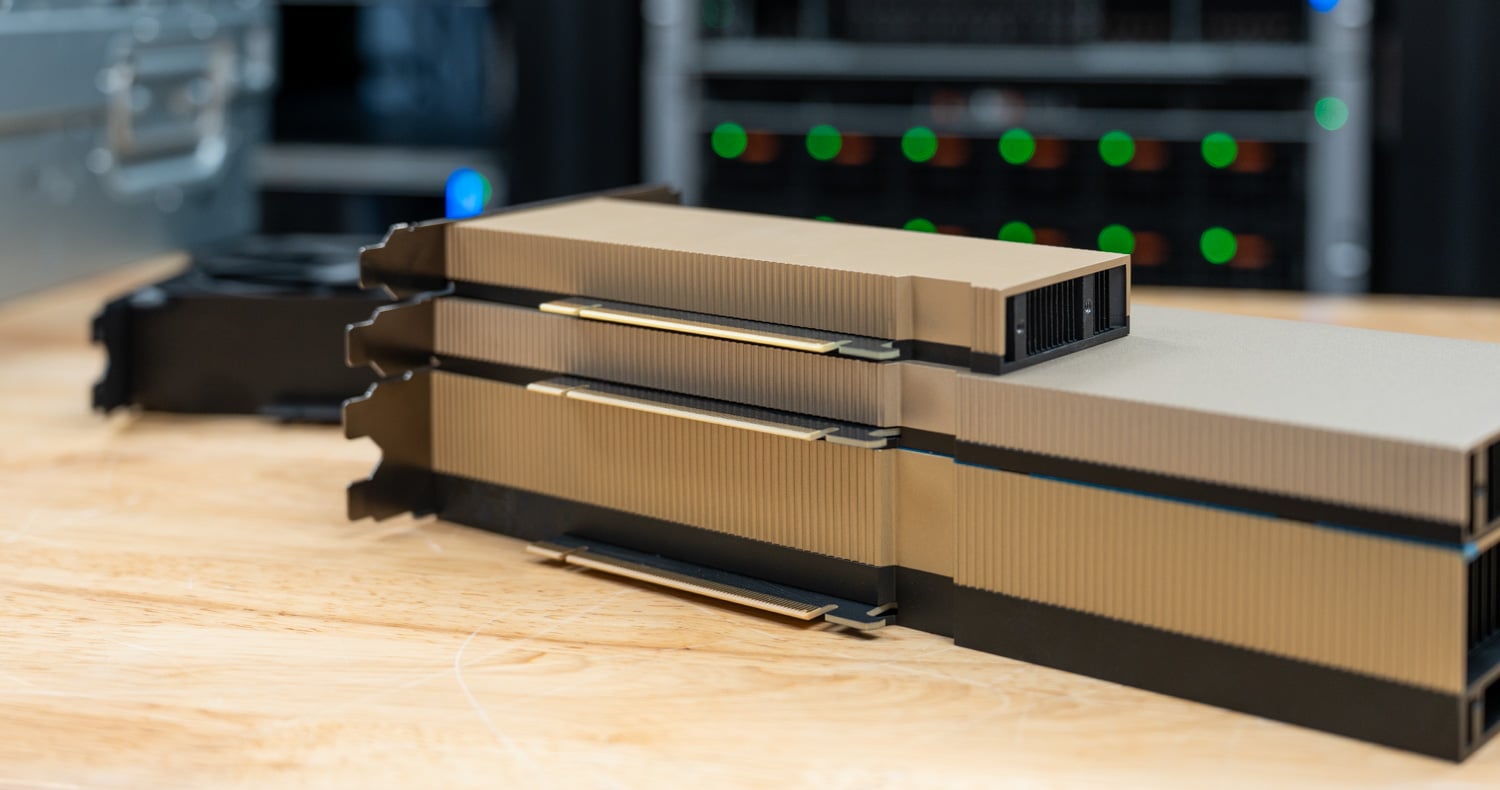
ဒီကတ်မှာ display output မပါတဲ့အတွက် vGPU virtual workstation တွေပဲဖြစ်ဖြစ်၊ rendering ပဲဖြစ်ဖြစ် ဂရပ်ဖစ်အလုပ်တွေက network ကနေ ထွက်သွားပြီး bracket ကနေ vent ထွက်ပါတယ်။ ကိုးခုမြောက်မျိုးဆက် NVENC သုံးလုံးနဲ့ ဆဋ္ဌမမျိုးဆက် NVDEC အင်ဂျင်သုံးလုံးက L4 ရဲ့ generation မှာ 4:2:2 H.264 နဲ့ HEVC encode နဲ့ decode တွေကို ထည့်သွင်းထားပြီး NVIDIA က L4 နဲ့ ယှဉ်ရင် NVDEC အင်ဂျင်တစ်ခုစီမှာ H.264 decode throughput ရဲ့ နှစ်ဆကို ကိုးကားထားပါတယ်။ အောက်က bracket မှာ ရိုက်ထားတဲ့ ပုံက ပိုင်းခြားထားတာကို မြင်သာစေပါတယ်- L4 နဲ့ 4500 မှာ vent တွေပဲ ပါပြီး တခြားဘာမှ မပါပါဘူး၊ L40S နဲ့ RTX PRO 6000 Workstation Edition မှာ DisplayPort output လေးခုစီ ပါရှိပါတယ်။
RTX PRO 4500 Blackwell Server Edition ဘယ်မှာ သင့်တော်လဲ။
NVIDIA ရဲ့ ဘောင်ခတ်ချက်ကတော့ ကတ်ရဲ့ “အဓိကတန်ဖိုးက AI၊ compute၊ graphics နဲ့ video acceleration တို့ကို 165 W, passive, single-slot ဒီဇိုင်းမှာ ပေါင်းစပ်ထားတာဖြစ်ပြီး” “rack density၊ power နဲ့ cooling တွေက အဓိက deployment ကန့်သတ်ချက်တွေဖြစ်တဲ့” server တွေအတွက် တည်ဆောက်ထားတာ ဖြစ်ပါတယ်။ ဒါဟာ NVIDIA က RTX PRO server portfolio ရဲ့ mainstream data center နဲ့ edge segment လို့ ခေါ်တဲ့ နေရာမှာ ရှိပြီး RTX PRO 6000 Blackwell Server Edition အောက်နဲ့ ဘာမှမပိုပါဘူး။ Blackwell server line ရဲ့ entry point ပါ။
L4 နဲ့ယှဉ်ရင် NVIDIA က Nemotron Nano မော်ဒယ်တွေနဲ့ သေးငယ်တဲ့ မော်ဒယ်ဆိုင်ရာ ကောက်ချက်ချမှုမှာ 10x အထိ၊ Cosmos Reason 2 နဲ့ ဗီဒီယို summarization မှာ 4x အထိ၊ 4K မှာ SPECviewperf 15 မှာ 1.9x နဲ့ streaming density 1.8x အထိ ရှိတယ်လို့ ကိုးကားထားပါတယ်။ CPU တွေနဲ့ယှဉ်ရင် Milvus မှာ cuVS CAGRA နဲ့ vector database အလုပ်လုပ်တာမှာ 50x အထိနဲ့ vision AI မှာ 100x အထိ ရှိတယ်လို့ ကိုးကားထားပါတယ်။ နှစ်ခုစလုံးကို dual-socket EPYC 9654 စနစ်တွေနဲ့ ယှဉ်ရင် ရှစ်ကတ်ပါ 4500 server တွေမှာ တိုင်းတာထားပါတယ်။
Dell ရဲ့ server team က 4500 ကို mainstream rack တွေမှာ မြင်တယ်လို့ ပြောပြပါတယ်။ ဘာလို့လဲဆိုတော့ 32GB 4500 သုံးခုက 96GB 6000 တစ်လုံးနဲ့ ဈေးတူတူလောက်ပဲ ရှိလို့ပါ။ အဲဒီအချိန်မှာ ပိုကြီးတဲ့ card က အနိုင်ရလေ့ရှိပါတယ်။ ဒါက GPU ဒါမှမဟုတ် L4 မရှိတဲ့ server အတွက် card တစ်ခုပါ။ 6000 တစ်ခု ဒါမှမဟုတ် တစ်ခုထက်ပိုတဲ့ server အတွက် အကောင်းဆုံး ကိုက်ညီမှု မရှိပါဘူး။
စမ်းသပ်ခြင်း Setup ကို
Dell PowerEdge R770 မှာ Intel Xeon 6787P processors နှစ်ခု (တစ်ခုစီမှာ 86 cores) နဲ့ 2TB DDR5-6400 DIMM ၃၂ ခုနဲ့ configure လုပ်ထားတဲ့ 4500၊ L40S နဲ့ L4 တွေကို install လုပ်ထားပြီး NVIDIA driver 595.71.05 ကို run ထားပါတယ်။ စမ်းသပ်မှုတွေမှာ CUDA 13.4.1 မှာ vLLM 0.27.1 ပါရှိတဲ့ NGC vLLM 26.08-py3 container ကို အသုံးပြုထားတာကြောင့် software stack က card တိုင်းမှာ အတူတူပါပဲ။ card တစ်ခုချင်းစီကို default power limit မှာ သီးခြားစမ်းသပ်ခဲ့ပြီး R770 က card တစ်ခုချင်းစီရဲ့ full rating ကို ပေးစွမ်းပါတယ်- Dell က L4 ကို 72W၊ 4500 ကို 165W နဲ့ L40S ကို 350W မှာ အဲဒီ chassis မှာ ဖော်ပြထားပါတယ်။
RTX PRO 6000 Blackwell က ကျွန်ုပ်တို့ရဲ့ Dell Pro Max Tower T2 မှာရှိတဲ့ workstation card ဖြစ်ပြီး container နဲ့ driver တစ်ခုတည်းမှာ ပါဝင်ပါတယ်။ NVIDIA က workstation နဲ့ server edition တွေကို 600W မှာ အဆင့်သတ်မှတ်ပြီး ကျွန်ုပ်တို့ရဲ့ စမ်းသပ်မှုမှာ တူညီတဲ့ profile ကို ပြသထားတာကြောင့် server card အတွက် ကိုယ်စားပြုပါတယ်။ စကားမစပ်၊ ဒီကတ်တွေ ဘယ်လို scale လုပ်လို့ရလဲဆိုတာကို လေ့လာချင်ရင် XE7740 မှာရှိတဲ့ RTX PRO 6000 Server card တွေရဲ့ review ကို ရေးထားပါတယ်။
ကျွန်တော်တို့ 6000 ကို နှစ်ကြိမ်သုံးခဲ့ပါတယ်။ တစ်ကြိမ်က သူ့ရဲ့ 600W default မှာ၊ နောက်တစ်ကြိမ်က nvidia-smi မှတစ်ဆင့် အတည်ပြုထားသော 450W cap ဖြင့် သုံးခဲ့ပါတယ်၊ ဘာလို့လဲဆိုတော့ R770 က GPU slot မှာ 6000 ကို 450W အများဆုံး ပေးစွမ်းနိုင်လို့ပါပဲ၊ ပုံမှန် 2U server အတွက် 4500 နဲ့ 6000 ကြား ရွေးချယ်တဲ့ ဝယ်သူတစ်ယောက် နှိုင်းယှဉ်သင့်တဲ့ ကိန်းဂဏန်းပါ။ host platform က 6000 အတွက် ကွဲပြားပေမယ့် ဒီလို GPU-bound serving load တွေမှာ CPU နဲ့ PCIe topology က power cap ထက် ရလဒ်ကို အများကြီး လျော့နည်းစွာ ရွှေ့ပေးပါတယ်။
ကျွန်ုပ်တို့သည် vLLM ၏ အွန်လိုင်းဝန်ဆောင်မှုစံနှုန်းကို concurrency အဆင့် ၁၊ ၂၊ ၄၊ ၈၊ ၁၆ နှင့် ၃၂ ဖြင့် request ပုံစံနှစ်ခုဖြင့် အသုံးပြုခဲ့သည်- input token ၅၁၂ ခုနှင့် output token ၅၁၂ ခု၊ ၎င်းသည် chat နှင့် အတို agent turn များနှင့် နီးစပ်ပြီး output ၁၀၂၄ ခုပါသည့် input token ၈,၁၉၂ ခု၊ ၎င်းသည် prefill လွှမ်းမိုးပြီး KV cache ဖြည့်သည့် RAG နှင့် document work နှင့် နီးစပ်သည်။ ဖြစ်နိုင်သည့်နေရာတွင် အုပ်စုတွင် အသေးငယ်ဆုံးကတ်နှင့် ကိုက်ညီစေရန် မော်ဒယ်များကို ရွေးချယ်ခဲ့သောကြောင့် L4 ၏ 24GB သည် အခြေခံအုတ်မြစ်ကို သတ်မှတ်ခဲ့သည်- BF16 ရှိ Ministral 3 3B Reasoning နှင့် Ministral 3 8B Reasoning၊ FP8 ရှိ Ministral 3 14B Instruct နှင့် NVFP4 ရှိ Qwen3.8-27B၊ ၎င်းသည် 32GB ကတ်များနှင့် အထက်ကတ်များနှင့် ကိုက်ညီသော်လည်း L4 နှင့် မကိုက်ညီပါ။
ကျွန်ုပ်တို့သည် တစ်ပြိုင်နက်တည်းအဆင့်တိုင်းတွင် output token throughput ကို အစီရင်ခံပြီး အခြေအနေကိုပြောင်းလဲစေသည့် prefill tokens များအပါအဝင် စုစုပေါင်း throughput ကို ကိုးကားပါသည်။
ဒီမှာမပါတာက- 48GB နဲ့အထက် ကတ်တွေမှာပဲ ကိုင်နိုင်တဲ့ ပိုကြီးတဲ့ မော်ဒယ်တွေ၊ MIG partitioning၊ vGPU၊ video transcode၊ metered power၊ two-card 4500 configuration နဲ့ ဒီအတန်းအစားအထက်က datacenter ကတ်တွေပါ။
အများဆုံးရရှိနိုင်သော Matmul FLOPS (MAMF)
MAMF သည် ကတ်တစ်ခု၏ တိကျမှုတစ်ခုစီတွင် ရောက်ရှိသော အကောင်းဆုံး matmul throughput ကို အစီရင်ခံသည့် ရေရှည်သိပ်သည်းသော GEMM စမ်းသပ်မှုတစ်ခုဖြစ်ပြီး serving stack သည် ရုပ်ပုံမှ ထွက်သွားသည်နှင့် FP4 hardware အလုပ်လုပ်မလုပ် စစ်ဆေးရန် အလွယ်ကူဆုံးနည်းလမ်းဖြစ်သည်။ 4500 သည် BF16 တွင် 135.9 TFLOPS၊ FP8 တွင် 280.1 နှင့် NVFP4 တွင် 568.6 သို့ ရောက်ရှိခဲ့ပြီး၊ တိကျမှုတွင် အဆင့်တစ်ခုစီသည် throughput နှစ်ဆနီးပါး ကျဆင်းသွားခဲ့သည်။ NVIDIA ၏ 202၊ 406 နှင့် 811 TFLOPS များ၏ သိပ်သည်းသော အမြင့်ဆုံးများနှင့် နှိုင်းယှဉ်ပါက၊ ၎င်းသည် တိကျမှုတိုင်းတွင် အမြင့်ဆုံး၏ 67% မှ 70% အထိဖြစ်ပြီး ၎င်းသည် ကတ် 133၊ 275 နှင့် 534 အတွက် NVIDIA ၏ကိုယ်ပိုင် cuBLAS ကိန်းဂဏန်းများနှင့် ကိုက်ညီပါသည်။
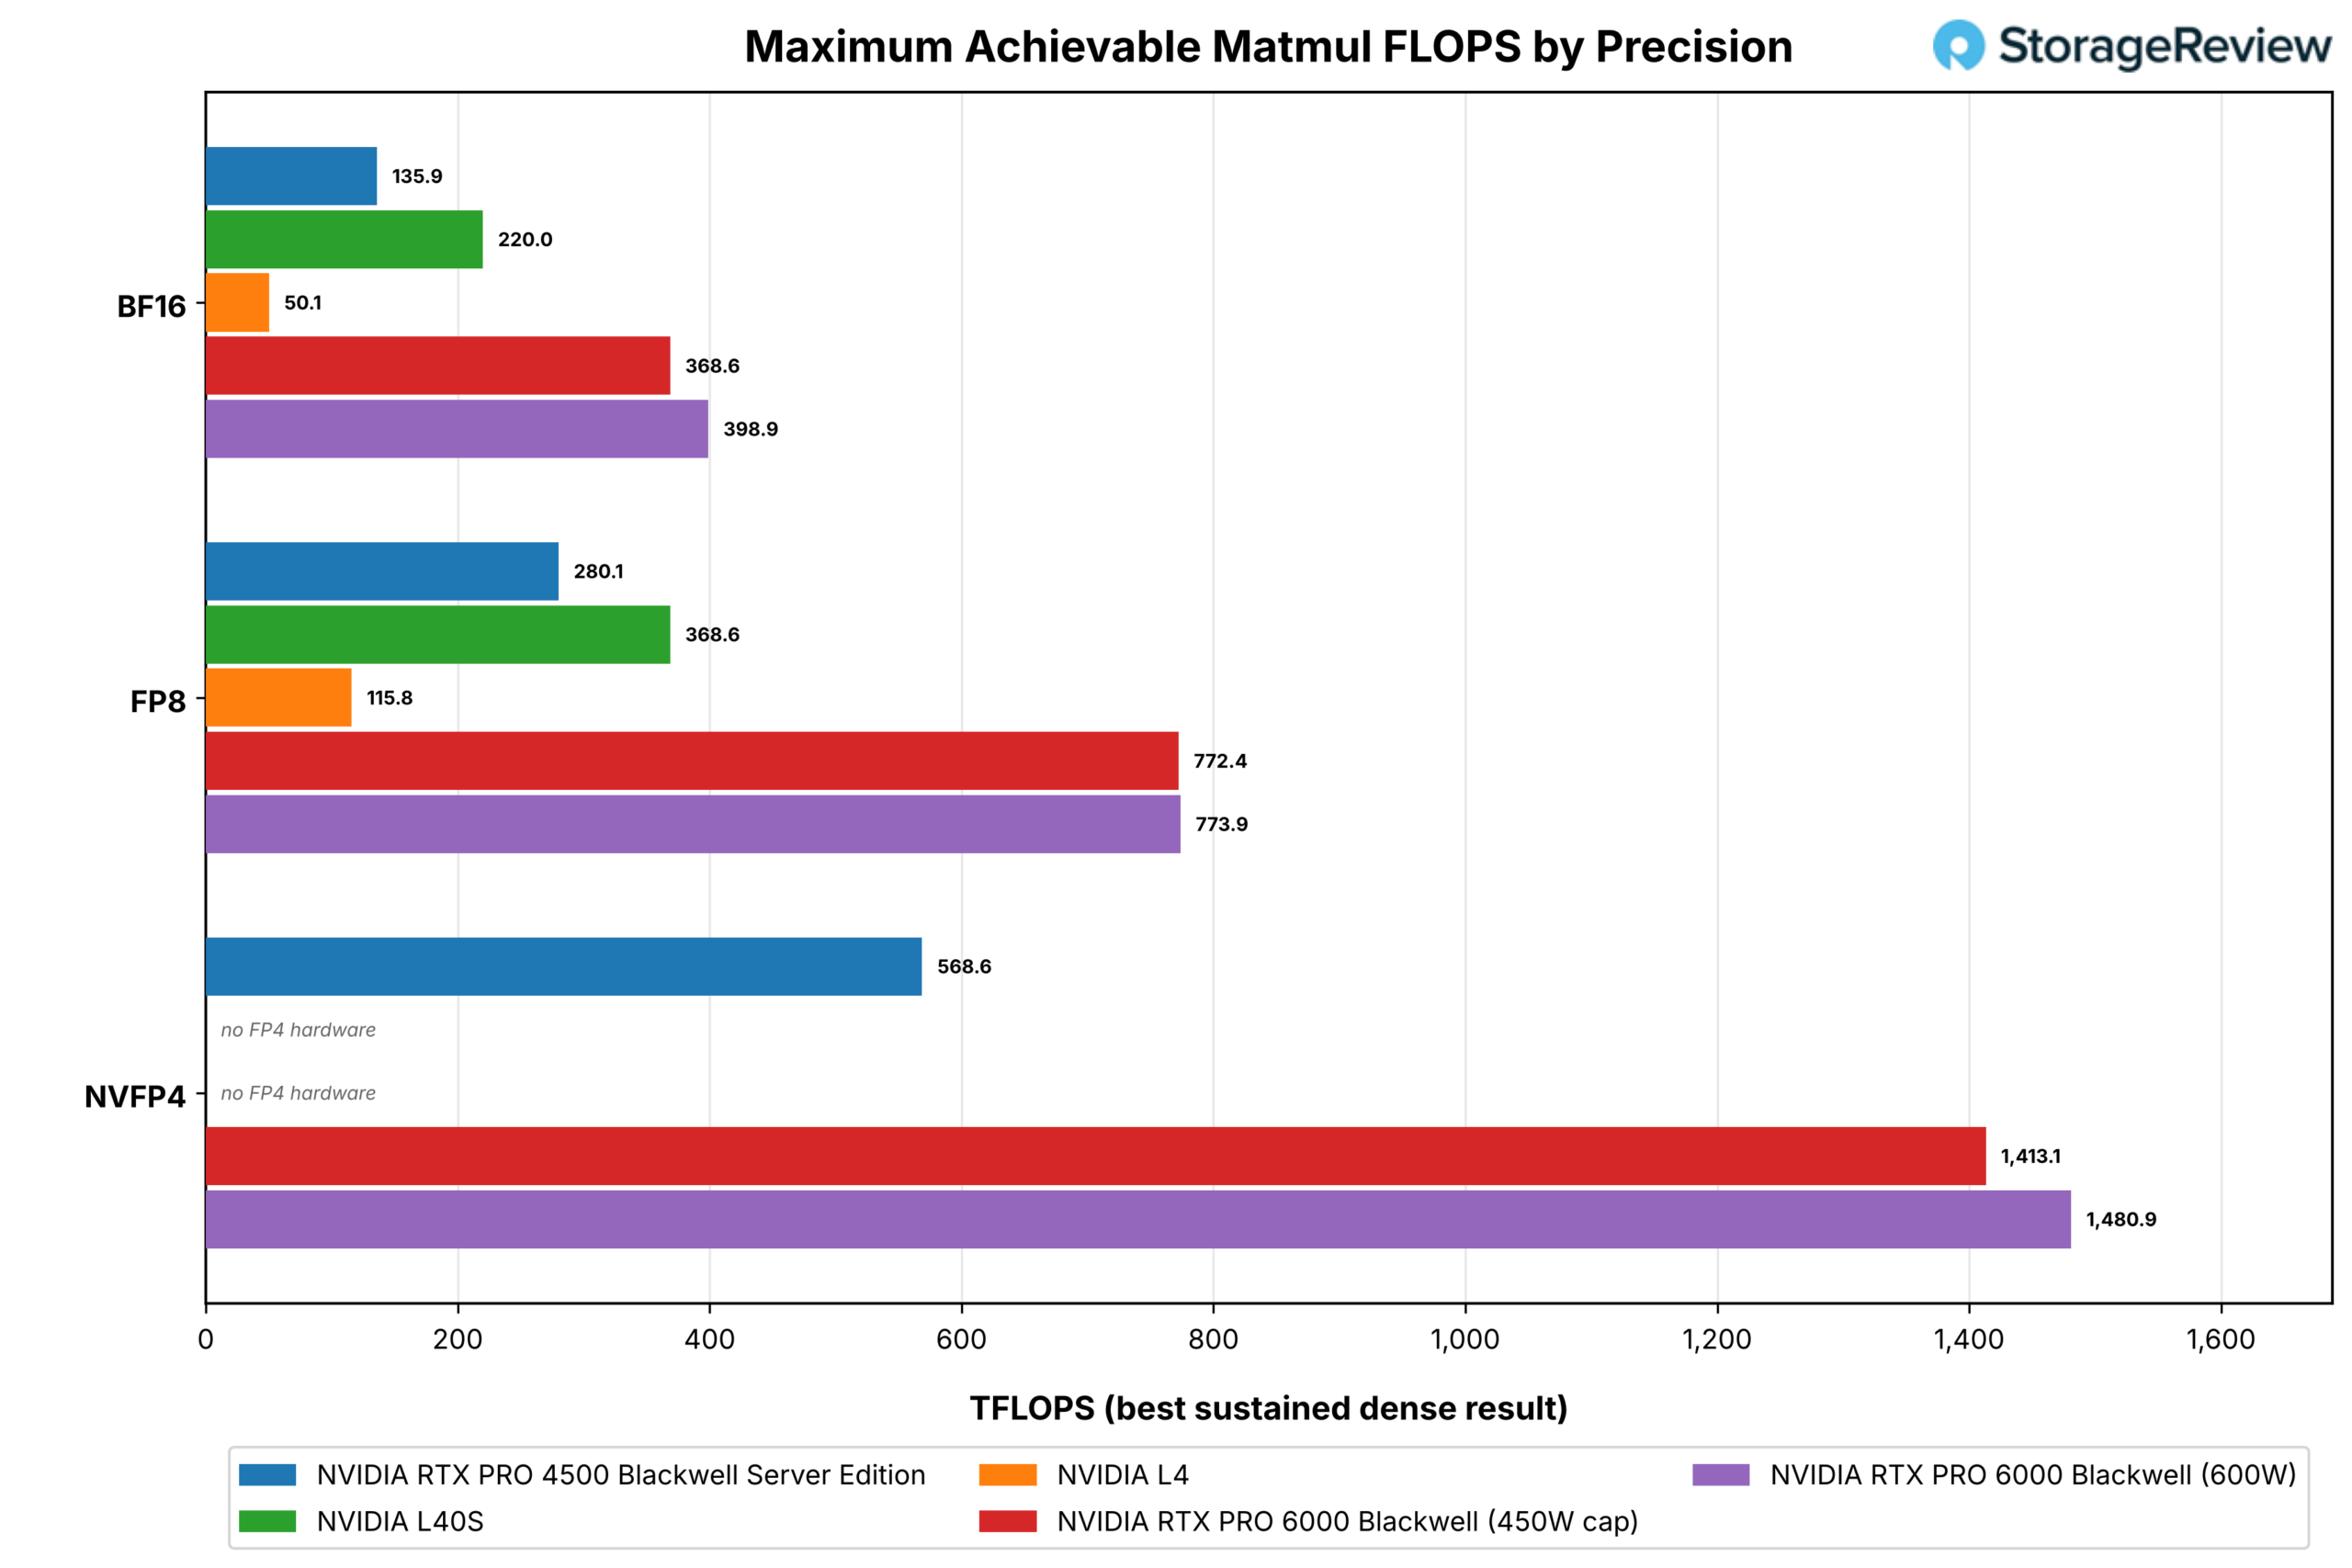
RTX PRO 6000 ကလည်း အလားတူ အတိုင်းအတာနဲ့ တိုင်းတာခဲ့ပြီး 600W မှာ 398.9၊ 773.9 နဲ့ 1,480.9 TFLOPS အထိ ရောက်ရှိခဲ့ပြီး၊ တိကျမှု သုံးခုစလုံးမှာ 4500 ရဲ့ 2.6x မှ 2.9x အထိ ရောက်ရှိခဲ့ပြီး၊ die အရွယ်အစားနဲ့ ပါဝါဘတ်ဂျက်က ခန့်မှန်းထားတာနဲ့ ကိုက်ညီပါတယ်။ 450W ကန့်သတ်ချက်မှာ 368.6၊ 772.4 နဲ့ 1,413.1 အထိ ရောက်ရှိခဲ့ပါတယ်- FP8 မရွေ့လျားဘူး၊ BF16 က 8 ရာခိုင်နှုန်း ဆုံးရှုံးပြီး NVFP4 က 5 ရာခိုင်နှုန်း ဆုံးရှုံးတယ်၊ ဒါကြောင့် 6000 ရဲ့ FP8 tensor path ဟာ ဒီစမ်းသပ်မှုမှာ 450W အောက်မှာ ရှိနေပြီး ကျန်တဲ့ တိကျမှု နှစ်ခုက အမြင့်ဆုံးအဆင့်မှာပဲ ရှိနေပါတယ်။ L40S က BF16 နဲ့ FP8 မှာ 220.0 နဲ့ 368.6 TFLOPS အထိ ရောက်ရှိခဲ့ပြီး L4 က 50.1 နဲ့ 115.8 အထိ ရောက်ရှိခဲ့ပါတယ်။ Ada ကတ်နှစ်ခုလုံးမှာ FP4 Tensor hardware မပါဝင်ပါဘူး။
အသုံးဝင်သော နှိုင်းယှဉ်ချက်မှာ 4500 ၏ NVFP4 ရလဒ်ကို အခြားသူများ၏ FP8 နှင့် နှိုင်းယှဉ်ခြင်းဖြစ်သည်- 568.6 TFLOPS သည် L40S ၏ FP8 အမြင့်ဆုံးပမာဏထက် 1.5 ဆ ပိုများပြီး 165W ကတ်မှ ကန့်သတ်ထားသော 6000 ၏ 74% ဖြစ်သည်။ ၎င်းသည် FP4 ၏ အားသာချက်ဖြစ်ပြီး GEMM အဆင့်တွင် ရှိနေသည်။ နောက်ဆက်တွဲ vLLM serving ရလဒ်များက ၎င်းသည် ဤတည်ဆောက်မှုတွင် serving stack သို့ မရောက်ရှိသေးကြောင်း ပြသနေပြီး MAMF ရလဒ်က NVFP4 kernels များ လိုက်မီလာသည်နှင့်အမျှ serving နံပါတ်များ ဆက်လက်တိုးလာမည်ဟု အကြံပြုထားသည်။
vLLM အွန်လိုင်းဝန်ဆောင်မှု- အကျဉ်းချုပ် (၅၁၂/၅၁၂)
အကျဉ်းချုပ်ပြောရရင် 4500 က သူ့ရဲ့အထောက်အထားကို ဖော်ပြထားပါတယ်- FP8 နဲ့ BF16 မော်ဒယ်သုံးခုမှာ concurrency 32 မှာ သူ့ရဲ့ output throughput က Ministral 3 14B မှာ 1,107 tokens/s နဲ့ L40S အတွက် 995၊ Ministral 3 8B မှာ 1,017 tokens/s နဲ့ Ministral 3 3B မှာ 2,006 tokens/s နဲ့ 1,988 tokens/s ရှိပါတယ်။ အဲဒီထဲက အားလုံးဟာ 165W ရှိတဲ့ Blackwell ကတ်တစ်ခုဖြစ်ပြီး 350W မှာရှိတဲ့ Ada ကတ်နဲ့ ကိုက်ညီတာ ဒါမှမဟုတ် အနိုင်ယူတာဖြစ်ပြီး curves တွေက concurrency 1 ကနေ 32 အထိ တစ်ခုနဲ့တစ်ခု အပြိုင်ဖြစ်နေလို့ ဒါက peak-only ရလဒ်မဟုတ်ပါဘူး။ L4 က တူညီတဲ့ မော်ဒယ်တွေမှာ 364, 279 နဲ့ 704 မှာ ကျရောက်ခဲ့ပြီး 4500 ကို ယခင်မော်ဒယ်ထက် 2.8x မှ 3.6x အထိ မြင့်တက်စေပါတယ်။

RTX PRO 6000 က Blackwell ဘတ်ဂျက်ရဲ့ ကျန်တဲ့အပိုင်းက ဘာတွေပေးစွမ်းနိုင်လဲဆိုတာကို ပြသနေပါတယ်။ 450W မှာ ကန့်သတ်ထားရင် မော်ဒယ်သုံးခုဖြစ်တဲ့ 4500 မှာ 1.95x မှ 2.03x အထိ tokens/s ၂,၁၆၁၊ ၂၀၄၂ နဲ့ ၄,၀၆၉ အထိ ရောက်ရှိခဲ့ပြီး 600W အပြည့်မှာ 2,283၊ ၂,၁၃၉ နဲ့ ၄,၁၅၅ အထိ ရောက်ရှိခဲ့ပြီး ၂.၀၆x မှ 2.1x အထိ ရောက်ရှိခဲ့ပါတယ်။ 6000 curves နှစ်ခုဟာ မော်ဒယ်တိုင်းမှာ concurrency 16 မှတစ်ဆင့် တစ်ခုနဲ့တစ်ခု အပြိုင်တည်ရှိပြီး 32 မှာ ၂ ရာခိုင်နှုန်းကနေ ၅ ရာခိုင်နှုန်းအထိသာ ကွာဟတာကြောင့် အတိုချုပ်ပြောရရင် နောက်ဆုံး 150W က အနည်းငယ်သာ ပေါင်းထည့်နိုင်ပါတယ်။ 4500 နဲ့ ယှဉ်ရင် memory ၃ ဆ ပိုများတဲ့ card ရဲ့ throughput နဲ့ R770 မှာ slot power ၂.၇ ဆ ပိုများပါတယ်။

တောင်းဆိုမှုတစ်ခုလျှင် prefill တိုကင် ၅၁၂ ခုကိုပါ ထည့်သွင်းရေတွက်သည့် စုစုပေါင်း throughput သည် အစီအစဉ်အတိုင်းဖြစ်သည်- 14B မော်ဒယ်ရှိ 4500 အတွက် 2,215 tokens/s နှင့် L40S အတွက် 1,990 နှင့် L4 အတွက် 727၊ 4,323 ကန့်သတ်ထားသော 6000 နှင့် 600W တွင် 4,566။ L4 နှင့် ကွာဟချက်သည် 8B မော်ဒယ်တွင် 3.6x တွင် အကျယ်ဆုံးဖြစ်ပြီး 3B မော်ဒယ်တွင် 2.8x တွင် အကျဉ်းဆုံးဖြစ်ပြီး L40S နှင့် ကွာဟချက်သည် 4500 ၏ အားသာချက်တွင် 12 ရာခိုင်နှုန်းထက် မပိုပါ။

vLLM အွန်လိုင်းဝန်ဆောင်မှု- ရှည်လျားသောအခြေအနေ (8K/1K)
အဝင်တိုကင် ၈,၁၉၂ ခုမှာ ပုံကပြောင်းလဲသွားပြီး အကြောင်းရင်းကို မျဉ်းကွေးတွေရဲ့ပုံသဏ္ဍာန်မှာ မြင်နိုင်ပါတယ်။ Ministral 3 14B FP8 မှာ 4500 က L40S ကို concurrency 8 မှတစ်ဆင့် ခြေရာခံပြီးနောက် 180 tokens/s ခန့်တွင် flatten ဖြစ်နေပြီး L40S က concurrency 16 မှာ 230 အထိ ဆက်လက်တည်ရှိနေပြီး အဲဒီမှာ ရှိနေပါတယ်။ 8B မော်ဒယ်ကလည်း အလားတူပါပဲ- 4500 အတွက် 32 မှာ 185 tokens/s နှင့် L40S အတွက် 277၊ 4500 က 8 မှာ plateau ဖြစ်နေပြီး L40S က 16 မှာ plateau ဖြစ်နေပါတယ်။ 3B မော်ဒယ်မှာ ကတ်နှစ်ခုစလုံးက 16 မှာ plateau ဖြစ်နေပြီး 475 နဲ့ 384 မှာ plateau ဖြစ်နေပါတယ်။

အကြောင်းရင်းကတော့ KV cache capacity ပါပဲ- concurrent 8K request တိုင်းဟာ card ပေါ်မှာ context resident လိုအပ်ပြီး weight တွေ load လုပ်ပြီးတာနဲ့ 32GB frame buffer က 48GB ထက် နည်းတဲ့ပမာဏကို သိမ်းဆည်းထားနိုင်ပါတယ်။ vLLM မှာ KV space ကုန်သွားရင် အသုံးဝင်တဲ့ concurrency ထည့်တာ ရပ်သွားပြီး throughput line က ပြားသွားပါတယ်။ ဒီ model တွေမှာ concurrency 32 မှာ 4500 က L40S ကို ၁၇ ရာခိုင်နှုန်းကနေ ၃၃ ရာခိုင်နှုန်းအထိ ပေးစွမ်းနိုင်ပါတယ်။ short-context ရလဒ်တွေအရ compute ဘက်ခြမ်းက bottleneck မဟုတ်ပါဘူး။ 24GB နဲ့ 300GB/s ရှိတဲ့ L4 က model တိုင်းမှာ concurrency 4 ကနေ token/s ၃၄ ကနေ ၁၃၀ အထိ ပြားနေပါတယ်။

6000 ရဲ့ 96GB ဟာ ဒီစမ်းသပ်မှုမှာ ဘယ်တော့မှ မတိုတောင်းပါဘူး၊ ပြီးတော့ မော်ဒယ်တိုင်းမှာ 32 အထိ မြင့်တက်နေပါတယ်။ 450W ကန့်သတ်ချက်မှာ 552၊ 589 နဲ့ 973 tokens/s အထိ ရောက်ရှိခဲ့ပြီး 4500 မှာ 2.5x မှ 3.2x အထိ ရောက်ရှိခဲ့ပြီး 600W မှာ 608၊ 639 နဲ့ 1,033 ဒါမှမဟုတ် 2.7x မှ 3.5x အထိ ရောက်ရှိခဲ့ပါတယ်။ ပါဝါကန့်သတ်ချက် ပေါ်လာတဲ့နေရာကတော့ ဒီနေရာပါပဲ- long-context prefill က 6000 compute-bound ကို ပိုရှည်စေတာကြောင့် ကတ်က တစ်ပြိုင်နက်တည်း ၁၆ နဲ့ ၃၂ မှာ ၄ ရာခိုင်နှုန်းကနေ ၉ ရာခိုင်နှုန်းအထိ ပေးစွမ်းနိုင်ပြီး တိုတောင်းတဲ့ ကန့်သတ်ချက်မှာ ၂ ရာခိုင်နှုန်းကနေ ၅ ရာခိုင်နှုန်းအထိ ပေးစွမ်းပါတယ်။ ဘယ်လိုပဲဖြစ်ဖြစ် 4500 နဲ့ အချိုးက 2x ကနေ 3x လောက်အထိ ကျယ်လာပြီး မန်မိုရီက ပါဝါထက် အကြောင်းရင်းပိုပါတယ်။

သင့်ရဲ့ workload က document Q&A၊ ရှည်လျားတဲ့ context တွေမှာ RAG လုပ်တာ၊ ဒါမှမဟုတ် tool output ကြီးကြီးမားမား သယ်ဆောင်တဲ့ agent တွေဆိုရင် memory က အဓိက spec ဖြစ်ပြီး 4500 ရဲ့ 32GB က concurrency constraint တစ်ခုပါ။ chat၊ classification ဒါမှမဟုတ် agent turn တိုတိုတွေဆိုရင်တော့ မဟုတ်ပါဘူး။ 8K/1K မှာ total throughput ကို prefill က အဓိကထားပြီး ordering အတိုင်း ပြန်လုပ်ပါတယ်- 14B model မှာ 4500 အတွက် tokens/s 1,713 ရှိပြီး L40S အတွက် 2,070 နဲ့ L4 အတွက် 381၊ 6000 ကို 4,971 မှာ ကန့်သတ်ထားပြီး 600W မှာ 5,474 ပါ။
NVFP4: ဆော့ဖ်ဝဲလ်က အမြင့်ဆုံးအဆင့်ကို သတ်မှတ်ပေးသည့်နေရာ
NVFP4 ရှိ Qwen3.8-27B သည် FP4 Tensor hardware Blackwell leads များကို အသုံးပြုထားသော အုပ်စုတွင် တစ်ခုတည်းသော မော်ဒယ်ဖြစ်ပြီး ရလဒ်အနေဖြင့် သုံးသပ်ချက်တွင် အပြားဆုံး curves အစုံဖြစ်သည်။ short-context test တွင် concurrency 32 တွင် 4500 သည် output tokens/s 320 ထုတ်လုပ်ခဲ့ပြီး L40S၊ 480 နှင့် RTX PRO 6000 သည် 600W တွင် 621၊ capped နှင့် 616 ကို ရရှိခဲ့သည်။ concurrency 1 တွင် 27B မော်ဒယ်တွင် ကတ်တိုင်းသည် 17 မှ 22 tokens/s အကြား ရောက်ရှိခဲ့ပြီး GDDR7 1.6TB/s ပါသည့် 6000 အပါအဝင်ဖြစ်ပြီး 14B FP8 မော်ဒယ်တွင် single-stream တစ်ခုတည်းဖြင့် တူညီသောကတ်သည် 99 tokens/s ထုတ်ပေးပါသည်။

L40S မှာ FP4 Tensor hardware မပါဝင်တာကြောင့် vLLM ဟာ အလေးချိန်နဲ့ ကွန်ပျူတာကို ပိုမိုတိကျစွာ လျှော့ချခြင်း၊ memory-bandwidth-bound path ဖြင့် လုပ်ဆောင်ပြီး 4500 ထက် 1.5x သာလွန်ပါတယ်။ 4500 နဲ့ FP4 hardware တူညီပြီး bandwidth ၂ ဆ ရှိတဲ့ 6000 ဟာ ကတ်နှစ်ခုကို နေရာတိုင်းမှာ ခွဲခြားထားတဲ့ 4500 ထက် ၂ ဆ တူညီပြီး 4500W နဲ့ 600W တွေရဲ့ လည်ပတ်မှုဟာ တစ်ပြိုင်နက်တည်း လုပ်ဆောင်တိုင်းမှာ ၁ ရာခိုင်နှုန်းအတွင်း တူညီတဲ့အတွက် kernel ဟာလည်း power-bound မဟုတ်ပါဘူး။
memory bandwidth နှင့်အတူ မရွေ့လျားသော single-stream throughput နှင့် အောက်ဖော်ပြပါ GPU မည်သို့ပင်ရှိစေကာမူ concurrency-32 ceiling 480 မှ 621 အထိရှိသော series လေးခုလုံး၏ pattern သည် ဤ vLLM build ရှိ NVFP4 kernel path ကို card တိုင်းတွင် ကန့်သတ်ချက်အဖြစ် ညွှန်ပြနေသည်။

8K/1K မှာဆိုရင် 4500 ဟာ concurrency 32 မှာ 153 tokens/s အထိ ရောက်ရှိခဲ့ပြီး L40S အတွက် 190 နဲ့ 6000 capped နဲ့ uncapped အတွက် 402 နဲ့ 425 တို့နဲ့ နှိုင်းယှဉ်နိုင်ပါတယ်။ ဒါတွေက FP8 နဲ့ BF16 မော်ဒယ်တွေမှာ ပြသခဲ့တဲ့ KV-cache-limited ပုံစံတွေပါပဲ၊ 6000 ရဲ့ 96GB ကပဲ ဆက်လက်မြင့်တက်နေစေတာဖြစ်ပြီး တခြားမော်ဒယ်တွေကတော့ ပြားချပ်နေပါတယ်။
NVIDIA မှာ ဒီကတ်မှာ Llama 3.1 8B မှာ 2K/256 မှာ FP4/s ရှိပြီး Nemotron 3 Nano 30B A3B မှာ TensorRT-LLM အောက်မှာ 905 tokens/s ရှိတာကြောင့် hardware ဟာ NVIDIA ရဲ့ stack အောက်မှာ စွမ်းဆောင်ရည် မြင့်မားပါတယ်။ ဒီနေ့ data တွေအရ ဒီကတ်မှာ NVFP4 ဟာ ကျွန်တော်တို့ စမ်းသပ်ထားတဲ့ GPU တိုင်း မျှဝေထားတဲ့ vLLM software story တစ်ခုဖြစ်ပြီး FP4 throughput ကို အားကိုးနေတဲ့ ဝယ်သူတွေဟာ မှီခိုမှုမပြုလုပ်ခင် သူတို့ရဲ့ serving stack ကို စမ်းသပ်သင့်ပါတယ်။
သတ်မှတ်ထားသော ဝပ်အလိုက် စီးဆင်းမှုပမာဏ
ဒီအချီမှာ ပါဝါကို တိုင်းတာခြင်း မပြုလုပ်ခဲ့တာမို့ ဒီတစ်ခါ ရရှိနိုင်တဲ့ စွမ်းဆောင်ရည် တွက်ချက်မှုဟာ ကတ်တစ်ခုချင်းစီရဲ့ စမ်းသပ်ထားတဲ့ ပါဝါကန့်သတ်ချက်နဲ့ နှိုင်းယှဉ်ထားပါတယ်။ Ministral 3 14B FP8 မှာ concurrency 32 မှာ 4500 ဟာ rated watt တစ်ခုကို 6.7 output tokens/s ထုတ်ပေးပြီး L40S အတွက် 2.8၊ L4 အတွက် 5.1၊ RTX PRO 6000 အတွက် 450W cap မှာ 4.8 နဲ့ 6000 အတွက် 3.8 အသီးသီး အသီးသီး ရရှိပါတယ်။ 3B မော်ဒယ်မှာတော့ အချိုးက 4500 အတွက် 12.2၊ L40S အတွက် 5.7၊ L4 အတွက် 9.8၊ capped 6000 အတွက် 9.0 နဲ့ 6000 အတွက် 6.9 ဖြစ်ပါတယ်။
အတိုချုပ်ပြောရရင် 4500 က ဒီအုပ်စုထဲမှာ အထိရောက်ဆုံးကတ်ဖြစ်ပြီး ကန့်သတ်ထားတဲ့ 6000 ကတော့ အနီးစပ်ဆုံးပဲ။ 6000 ကို 450W အထိ လျှော့ချလိုက်ရင် throughput ရဲ့ ၂ ရာခိုင်နှုန်းကနေ ၅ ရာခိုင်နှုန်းအထိ ကုန်ကျပြီး ပါဝါဘတ်ဂျက်ရဲ့ ၂၅ ရာခိုင်နှုန်းကို ပြန်ရတာကြောင့် သူ့ရဲ့ ထိရောက်မှုကိန်းဂဏန်းက လေးပုံတစ်ပုံလောက် ခုန်တက်သွားပါတယ်။ 72W က အလွန်သေးငယ်တဲ့ ပိုင်းခြားကိန်းတစ်ခုဖြစ်တာကြောင့် L4 က ဒီစံနှုန်းမှာ ယှဉ်ပြိုင်နိုင်စွမ်းရှိနေဆဲပါ။ ဒါပေမယ့် တူညီတဲ့ throughput ကိုရောက်ဖို့ slot တွေနဲ့ server သုံးဆလောက် လိုအပ်ပါတယ်။ ဒါက 4500 ကို အဆုံးသတ်ဖို့ တည်ဆောက်ခဲ့တဲ့ ကုန်သွယ်မှုပါပဲ။
8K/1K မှာ အစီအစဉ်ပြောင်းလဲသွားပါတယ်- 14B မော်ဒယ်မှာ 4500 ဟာ rated watt တစ်ခုကို 1.2 tokens/s နှုန်းနဲ့ ရောက်ရှိပြီး၊ capped 6000 ကတော့ 1.2 မှာ ရောက်ရှိပြီး၊ 600W 6000 ကတော့ 1.0 မှာ ရောက်ရှိပြီး၊ L40S ကတော့ 0.7 မှာ ရောက်ရှိပါတယ်။ 4500 ဟာ KV cache ကုန်သွားတာနဲ့၊ သူ့ရဲ့ throughput ဟာ ရပ်တန့်သွားပြီး၊ power rating ကတော့ မရပ်တန့်ပါဘူး၊ ဒါကြောင့် ရေရှည်အခြေအနေမှာ 450W 6000 ဟာ စွမ်းဆောင်ရည်မှာ တူညီပြီး slot တစ်ခုစီရဲ့ အလုပ်ရဲ့ 2.9 ဆ ကို ပေးစွမ်းနိုင်ပါတယ်။
ကောက်ချက်
RTX PRO 4500 Blackwell Server Edition သည် NVIDIA ပြောထားသည့်အတိုင်း လုပ်ဆောင်ပေးသည်- Blackwell ကို slot တစ်ခု၊ ပါဝါဘတ်ဂျက်တစ်ခုနှင့် ယခင်က L4 တွင် ထိပ်ဆုံးမှရပ်တည်ခဲ့သော chassis အတန်းအစားတစ်ခုတွင် ထည့်သွင်းထားသည်။ mainstream server အများစုလည်ပတ်မည့် မော်ဒယ်များ၊ အသေးစားနှင့် အလတ်စားညွှန်ကြားချက်များနှင့် chat-length context တွင် reasoning model များတွင်၊ ၎င်းသည် L40S ၏ ပါဝါထက် ထက်ဝက်အောက်သာရှိသော single-slot ကတ်မှ L40S throughput ကို ပေးစွမ်းပြီး L4 စီမံခန့်ခွဲနိုင်သည်ထက် သုံးဆပိုမိုမြင့်မားသည်။
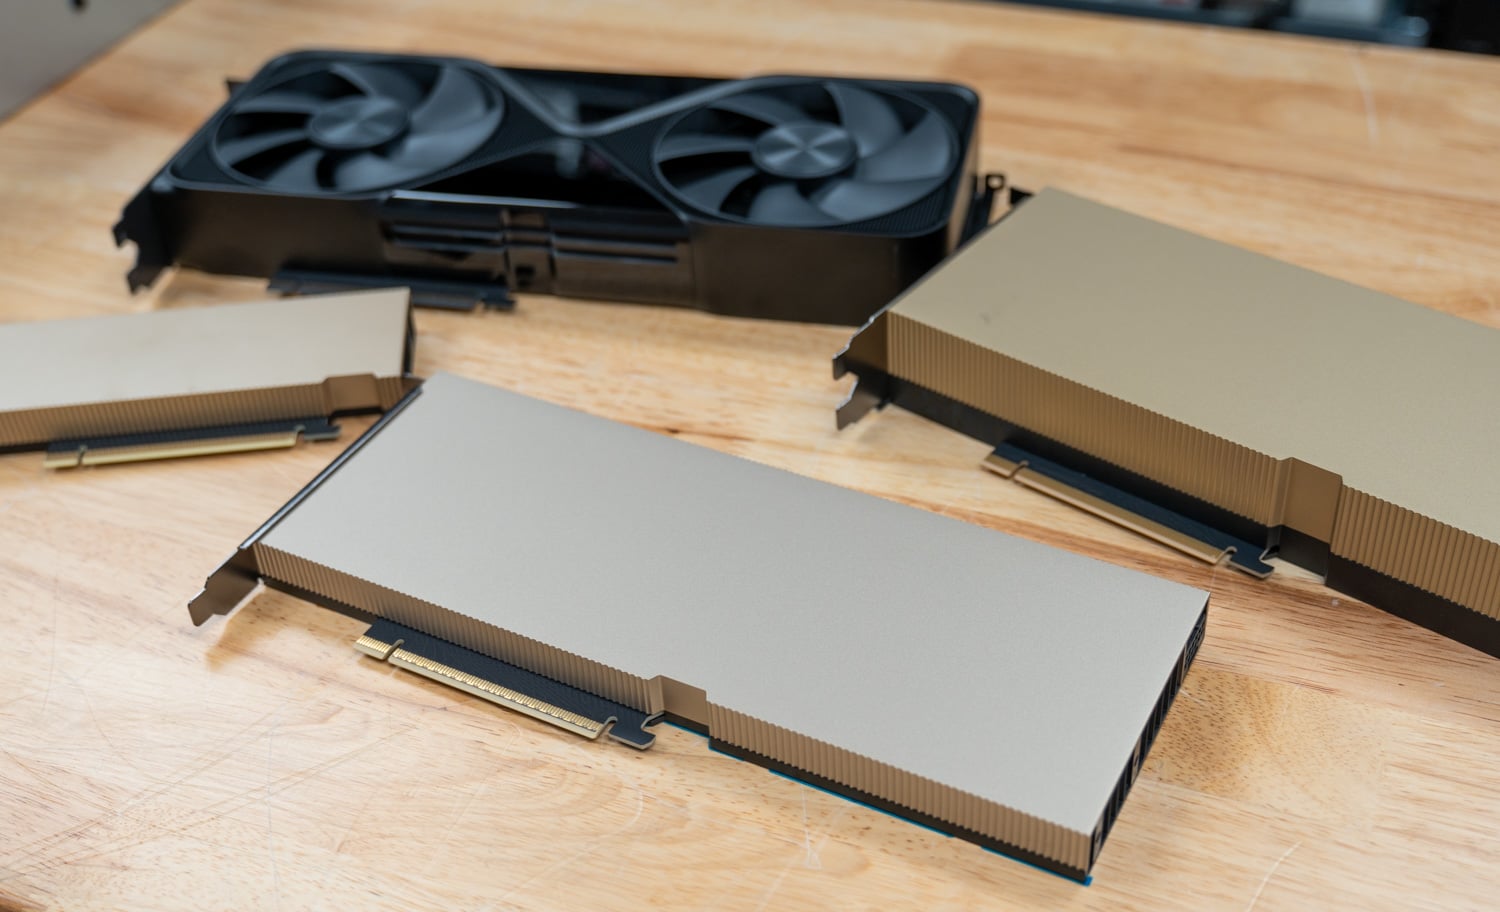
ကန့်သတ်ချက်တွေတော့ ရှိပါတယ်။ မန်မိုရီကနေစပြီး- ဒီကတ်ရဲ့ မော်ဒယ်တွေအတွက် 32GB က လုံလောက်တဲ့ အလေးချိန်ပမာဏပါပဲ၊ ဒါပေမယ့် L40S ရဲ့ 48GB နဲ့ အထူးသဖြင့် 6000 ရဲ့ 96GB တွေက စွမ်းဆောင်ရည်တူညီတဲ့ နေရာမှာ တစ်ပြိုင်နက်တည်း စွမ်းဆောင်ရည်ကို ကန့်သတ်ထားပြီး၊ 6000 က တူညီတဲ့ server က ခွင့်ပြုထားတဲ့ ပါဝါနဲ့တောင် တူညီတဲ့ request shape မှာ 4500 ထက် ၃ ဆလောက် စွမ်းဆောင်ရည် ပိုကောင်းပါတယ်။
Blackwell precision ခေါင်းစဉ်ဖြစ်တဲ့ NVFP4 ဟာ ဒီ vLLM build မှာ FP4 hardware မပါတဲ့ card တွေနဲ့ ကိုက်ညီစွာ လုပ်ဆောင်ပါတယ်၊ MAMF sweep မှာ FP4 hardware က GEMM level မှာ card ရဲ့ FP8 rate ထက် ၂ ဆ ပိုပေးစွမ်းနိုင်တယ်လို့ ပြသထားတာကြောင့် FP4 ရဲ့ အားသာချက်က ကိုယ်ပိုင် stack မှာ အတည်ပြုရမယ့် အားသာချက်တစ်ခုပါပဲ၊ ဒါပေမယ့် software ကနေတစ်ဆင့် အားသာချက်တွေ ပိုများလာတာ ထင်ရှားပါတယ်။
2U server တွေ ဒါမှမဟုတ် FHFL card သုံးတဲ့ 1U chassis ရှိတဲ့သူတိုင်း၊ inference, vision AI, transcoding ဒါမှမဟုတ် virtual workstation capacity တွေကို power ဒါမှမဟုတ် cooling မထိဘဲ ထည့်သွင်းဖို့ လိုအပ်သူတိုင်းဟာ RTX PRO 4500 က အလွန်သင့်တော်တယ်လို့ တွေ့ရှိပါလိမ့်မယ်။ ထို့အပြင်၊ L4 တွေကို ဆက်လက်အသုံးပြုနေပြီး 24GB ကျော်လွန်နေတဲ့သူတိုင်းဟာ 4500 ကို စိတ်အားထက်သန်သင့်ပါတယ်။ workload တွေက long-context ဒါမှမဟုတ် card တစ်ခုလျှင် 48GB ဒါမှမဟုတ် ထို့ထက်ပိုလိုအပ်လောက်အောင် multi-tenant ရှိတဲ့ အဖွဲ့အစည်းတွေအတွက် RTX PRO 6000 က ပိုကောင်းတဲ့ ရွေးချယ်မှုပါ။
NVIDIA ဟာ ဒီကတ်တွေအတွက် ရေကူးလမ်းကြောင်းနှစ်ခုကို သတ်မှတ်ပေးရာမှာ ကောင်းမွန်စွာလုပ်ဆောင်နိုင်ခဲ့ပြီး 4500 ဟာ L4 နဲ့ 6000 ကြားက AI ကွာဟချက်ကို ဖြည့်ဆည်းပေးရုံသာမက 165W သာ ဆွဲယူပါတယ်။
ဦးဆောင်သူစာရင်း- RTX PRO 4500 Blackwell Server Edition သည် ကျွန်ုပ်တို့၏ အကောင်းဆုံး Enterprise GPU များ ဦးဆောင်သူစာရင်းတွင် အကောင်းဆုံး Single-Slot GPU ကို ရရှိထားပြီး ဤသုံးသပ်ချက်မှ L40S နှင့် RTX PRO 6000 အချက်အလက်များလည်း ပါဝင်သည်။



 အမေဇုံ