

Open WebUI သည် chat၊ မော်ဒယ်စီမံခန့်ခွဲမှု၊ ဖိုင်များ၊ ဝဘ်ရှာဖွေမှု၊ tool calling၊ image support၊ knowledge features များနှင့် API access တို့ကို local AI interface တစ်ခုတည်းတွင် ပေါင်းစပ်ထားသည်။ ဤ hands-on review အတွက်၊ ကျွန်ုပ်တို့သည် Windows desktop version ကို အာရုံစိုက်ခဲ့ပြီး ကျွန်ုပ်တို့၏ ဇန်နဝါရီ v0.8.6 စမ်းသပ်မှု မှ hardware နှင့် model files များကို အသုံးပြုခဲ့သော ကြောင့် အလားတူအခြေအနေများတွင် application နှစ်ခုကို နှိုင်းယှဉ်နိုင်မည်ဖြစ်သည်။
ဒါက ကျွန်ုပ်တို့ရဲ့ အကောင်းဆုံး ဒေသတွင်း LLM Tools ဦးဆောင်သူ စာရင်းမှာ ဒုတိယမြောက်ဝင်ရောက်မှုဖြစ်ပြီး စာရင်းထဲက ပလက်ဖောင်းတွေကနေတစ်ဆင့် လုပ်ဆောင်သလိုမျိုး စမ်းသပ်မှုဟာ့ဒ်ဝဲကနေ ထပ်ခါတလဲလဲ လုပ်ဆောင်နိုင်တဲ့ စွမ်းဆောင်ရည်ရလဒ်တွေကို ထည့်သွင်းထားပါတယ်။
Open WebUI သည် open-source၊ self-hosted AI platform တစ်ခုဖြစ်ပြီး၊ လူများရင်းနှီးပြီးသား commercial AI chat service များနှင့် အလွန်ဆင်တူပြီး အလုပ်လုပ်သည့် browser-based interface ကို local နှင့် remote AI model များအတွက် ပေးအပ်ရန် ဒီဇိုင်းထုတ်ထားသည်။ ၎င်းသည် မတူညီသော inference backend များနှင့် OpenAI နှင့် တွဲဖက်အသုံးပြုနိုင်သော ဝန်ဆောင်မှုများနှင့် ချိတ်ဆက်နိုင်သော်လည်း၊ ကျွန်ုပ်တို့စမ်းသပ်ထားသော desktop application သည် ၎င်း၏ bundle llama.cpp environment မှတစ်ဆင့် GGUF model များကို local တွင် run နိုင်သည်။ ၎င်းသည် အထူးသဖြင့် tools၊ model presets၊ web search၊ files နှင့် API access များကို enable လုပ်လိုက်သည်နှင့် basic local chat application ထက် များစွာကျယ်ပြန့်သော scope ကို ပေးစွမ်းသည်။
စမ်းသပ်မှုအတွက်၊ ကျွန်ုပ်တို့သည် HP Z4 Rack G5 workstation၊ NVIDIA RTX 5000 Ada Generation GPU နှင့် ကျွန်ုပ်တို့၏ Jan v0.8.6 review တွင်အသုံးပြုခဲ့သော Jan GGUF မော်ဒယ်နှစ်ခုသို့ ပြန်သွားခဲ့ပါသည်။ ကျွန်ုပ်တို့သည် 8,192-token context၊ 2,048 batch size၊ 100 GPU layers နှင့် တိုင်းတာထားသော text run များအတွက် matching sampling values များကို ထိန်းသိမ်းထားစဉ်တွင် Open WebUI ၏ model presets၊ multimodal input၊ DDGS web search၊ URL fetching နှင့် local API တို့နှင့် အချိန်ဖြုန်းခဲ့ပါသည်။
Open WebUI ကို ကောင်းမွန်စွာလည်ပတ်စေရန် ကျွန်ုပ်တို့မျှော်လင့်ထားသည်ထက် အတော်လေးကြာခဲ့ပြီး ထိုအချိန်အများစုကို ပုံမှန်မော်ဒယ်စမ်းသပ်မှုသို့ မရောက်မီ local llama.cpp နှင့် CUDA setup ထဲသို့ ဝင်ရောက်ခဲ့သည်။ နောက်ဆုံးတွင် အရာအားလုံးအလုပ်လုပ်ခဲ့သော်လည်း လမ်းတစ်လျှောက်တွင် default runtime download ပျက်သွားခြင်း၊ CUDA ဖိုင်များပျောက်ဆုံးခြင်း၊ context allocations အလွန်များပြားခြင်းနှင့် built-in tool system တွင် ပြဿနာအနည်းငယ်နှင့် ကြုံတွေ့ခဲ့ရသည်။
စမ်းသပ်ခြင်းစနစ်
မော်ဒယ်ရလဒ်များကို အပလီကေးရှင်းများတွင် နှိုင်းယှဉ်ရလွယ်ကူစေရန်အတွက် ကျွန်ုပ်တို့၏ ဇန်နဝါရီစမ်းသပ်မှုမှ စနစ်ဖွဲ့စည်းမှုကို မပြောင်းလဲဘဲထားရှိခဲ့ပြီး ဤ Open WebUI လည်ပတ်မှုအတွက် အသုံးပြုသည့် desktop၊ server၊ Python နှင့် llama.cpp ဗားရှင်းများကိုလည်း မှတ်တမ်းတင်ထားပါသည်။
| component | configuration |
| ကွန်ပျူတာစက်လည်ပတ်ရေးစနစ်ပရိုဂရမ် | Workstations အတွက် Windows 11 Pro |
| စီပီယူ | Intel Xeon w5-2465X၊ 16 cores |
| မှတ်ဉာဏ် | 128GB |
| GPU ကို | NVIDIA RTX 5000 Ada မျိုးဆက် |
| VRAM အ | ၃၂,၇၆၀ မီဂါဘိုက် (၃၁.၉၉ ဂစ်ဂါဘိုက်) |
| NVIDIA ဒရိုက်ဗာ | 597.06 |
| CUDA လိုက်ဖက်ညီမှု | ၁၃.၂ ကို nvidia-smi မှ အစီရင်ခံခဲ့သည် |
| WebUI Desktop / Server ကိုဖွင့်ပါ | v0.0.20 / v0.12.2 |
| Python / llama.cpp | ၃.၁၂.၁၃ / b၁၁၆၁၂၊ CUDA ၁၂.၄ |
Open WebUI Desktop ကို ထည့်သွင်းခြင်း
Windows desktop installer သည် llama.cpp ကို ဒေသတွင်းတွင် ထည့်သွင်းနိုင်ပြီး Open Terminal ကို enable လုပ်နိုင်ပြီး installation location ကို Advanced အောက်တွင် ပြောင်းလဲနိုင်သည့် environment setup screen ဖြင့် စတင်သည်။ Open Terminal ကို disable ထားပြီး llama.cpp ကို enable လုပ်ကာ Windows user profile အောက်တွင် default folder ကို ထားကာ ဒေသတွင်း setup ကို ဆက်လက်လုပ်ဆောင်သည်။
package တွေနဲ့ bundle Python environment ကို install လုပ်ပြီးတာနဲ့ Open WebUI က connection တစ်ခုကို ရွေးချယ်ဖို့ ကျွန်တော်တို့ကို တောင်းဆိုပြီး local browser-style interface ကို ဖွင့်ပါတယ်။ အသစ် install လုပ်လိုက်တဲ့အခါ Open WebUI ကို available connection အဖြစ် ပြသပြီး main chat window မဖွင့်ခင် ပထမဆုံး local administrator ကို သတ်မှတ်ပေးတဲ့ Create Admin Account screen ကို ပြသပါတယ်။
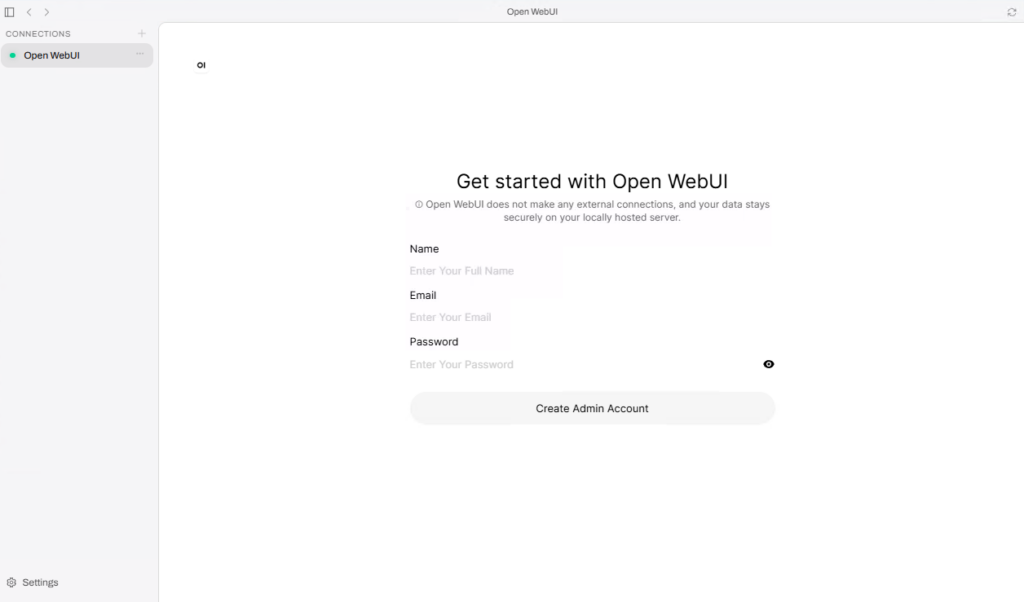
ဒေသတွင်း Open WebUI အသစ်ထည့်သွင်းမှုတစ်ခုသည် အဓိကချတ်အင်တာဖေ့စ်ကို မဖွင့်မီ ပထမဆုံး administrator အကောင့်ကို တောင်းဆိုပါသည်။
အစပိုင်းမှာ ရှုပ်ထွေးနိုင်တဲ့ အသေးစိတ်အချက်အလက်တစ်ခုကတော့ Open WebUI Desktop နဲ့ local Open WebUI server တို့ဟာ သီးခြား version နံပါတ်တွေကို အသုံးပြုကြတာပါပဲ။ ကျွန်တော်တို့ရဲ့ နောက်ဆုံး setup မှာ Desktop v0.0.20 ကို Open WebUI server v0.12.2 နဲ့ အသုံးပြုထားပြီး server ဟာ Windows user ရဲ့ roaming profile အောက်မှာ bundle Python 3.12.13 environment ကနေ run နေပါတယ်။
မော်ဒယ်များထည့်သွင်းခြင်းနှင့် llama.cpp ကို ပြင်ဆင်ခြင်း
desktop application က model files တွေကို inference runtime ကနေ ခွဲထုတ်လိုက်တာကြောင့် Models page က local GGUFs တွေကို စီမံခန့်ခွဲပေးပြီး Inference Runtime က llama.cpp ကို ထိန်းချုပ်ပေးပါတယ်။ V2 multimodal projection file နဲ့အတူ ကျွန်တော်တို့ရဲ့ အစောပိုင်းစမ်းသပ်မှုအတွက် အသုံးပြုခဲ့တဲ့ Jan V3.5 4B Q4_K_XL နဲ့ Jan V2 VL High Q4_K_M files တွေကို copy ကူးခဲ့ပြီး runtime active ဖြစ်ပြီးနောက် models နှစ်ခုစလုံးက selector မှာ ပေါ်လာပါတယ်။
llama.cpp ကို install လုပ်ဖို့ကြိုးစားတာနဲ့ ပထမဆုံး runtime ပြဿနာပေါ်လာပါတယ်။ CUDA 12.4 ကိုရွေးထားပြီး Version field ကို နောက်ဆုံးထားခဲ့တာ ချက်ချင်း installation မအောင်မြင်ခဲ့ပါဘူး။ desktop log ကိုကြည့်လိုက်တော့ Open WebUI က llama.cpp v0.6.0 ရဲ့ နောက်ဆုံးထွက်ဗားရှင်းကို ဖြေရှင်းပြီးဖြစ်ပြီး အဲဒီ release မှာမရှိတဲ့ Windows CUDA archive ကို download လုပ်ဖို့ကြိုးစားနေတာကိုတွေ့လိုက်ရပါတယ်။ ဒါကြောင့် build b11612 ကို pin လုပ်ပြီး ထပ်ကြိုးစားကြည့်ပါတယ်။
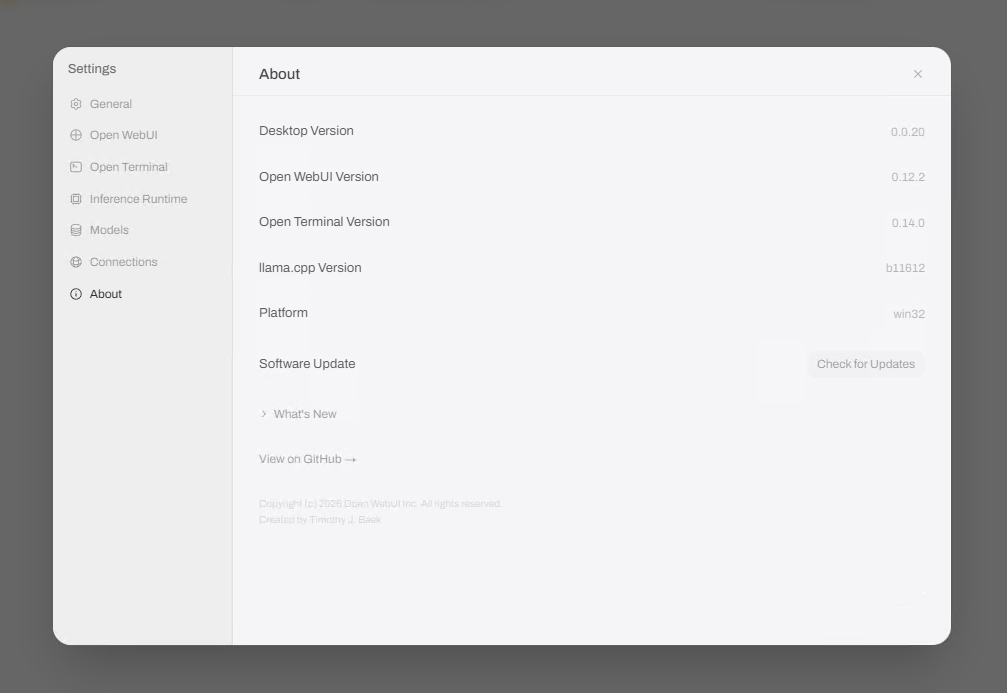
About စာမျက်နှာတွင် စမ်းသပ်စဉ် အသုံးပြုခဲ့သော Desktop၊ Open WebUI၊ Open Terminal နှင့် llama.cpp ဗားရှင်းများကို သီးခြားဖော်ပြထားသည်။
အဲဒါက ပထမပြဿနာကို ကျော်လွှားနိုင်ခဲ့ပေမယ့် llama.cpp က llama.cpp ကို မစတင်နိုင်သေးဘဲ သီးခြား CUDA runtime DLL package ကို main archive နဲ့အတူ download မလုပ်ရသေးလို့ပါ။ ကျွန်တော်တို့ဟာ official CUDA 12.4 package ကနေ cudart64_12.dll, cublas64_12.dll, နဲ့ cublasLt64_12.dll တွေကို b11612 directory ထဲ ကိုယ်တိုင်ထည့်သွင်းပြီးနောက် llama-server ဟာ port 18881 မှာ ပုံမှန်စတင်ပြီး model တွေက chat interface မှာ ပေါ်လာပါတယ်။
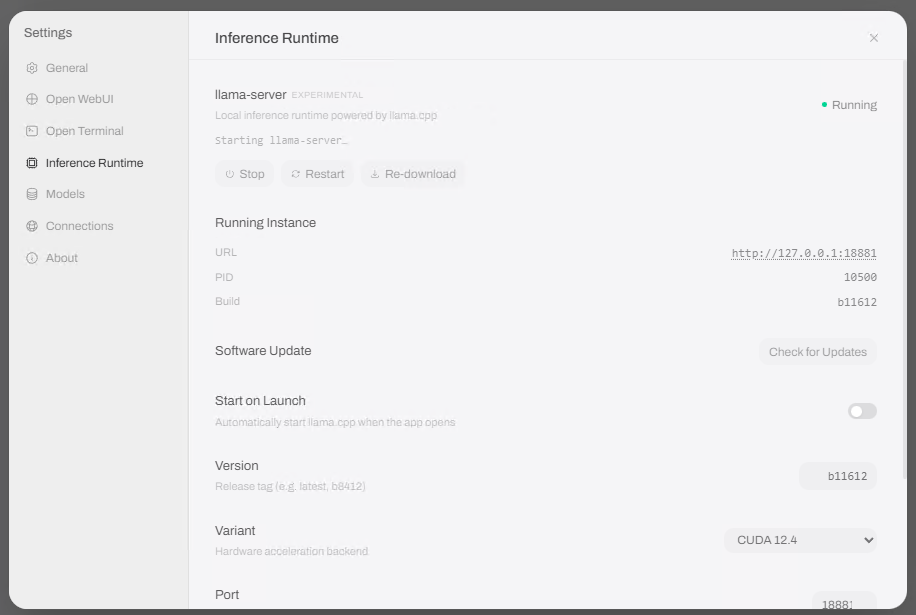
build b11612 ကို pin လုပ်ပြီး လိုအပ်တဲ့ CUDA runtime DLL တွေကို ထည့်ပြီးတဲ့နောက်၊ llama.cpp ဟာ port 18881 မှာ ဒေသတွင်းမှာ run ပါတယ်။
မော်ဒယ်ဆက်တင်များနှင့် GPU အသုံးပြုမှု
Open WebUI သည် ၎င်း၏ မော်ဒယ်ဆက်တင်များကို desktop application နှင့် main web interface နှစ်ခုလုံးတွင် ဖြန့်ဝေထားသောကြောင့် အရာများကို ပြောင်းလဲသည့်အခါတွင် သင်ယူမှုအနည်းငယ်ရှိပါသည်။ desktop ဘက်ခြမ်းတွင် GGUF ဖိုင်များနှင့် llama.cpp runtime ကို လွှမ်းခြုံထားပြီး main interface တွင် per-chat parameters၊ Workspace model presets၊ စွမ်းရည်များ၊ built-in tools၊ web-search options နှင့် server administration တို့ကို ထည့်သွင်းထားသည်။
ကျွန်ုပ်တို့တိုင်းတာထားသော text run များအတွက် llama.cpp သည် 8,192-token context၊ 2,048 batch size နှင့် 100 GPU layer များကို အသုံးပြုခဲ့ပြီး –no-cache-prompt မှတစ်ဆင့် prompt caching ကို disable လုပ်ထားသောကြောင့် benchmark prompt တစ်ခုတည်းကို ထပ်ခါတလဲလဲအသုံးပြုခြင်းသည်ပင် prefill တိုင်းတာမှုကို ဖြစ်ပေါ်စေမည်ဖြစ်သည်။ runtime log ကလည်း Open WebUI သည် configure လုပ်ထားသော GPU value ကို model process တစ်ခုချင်းစီသို့ –n-gpu-layers 100 အဖြစ် ပေးပို့ခဲ့ကြောင်း အတည်ပြုခဲ့သည်။
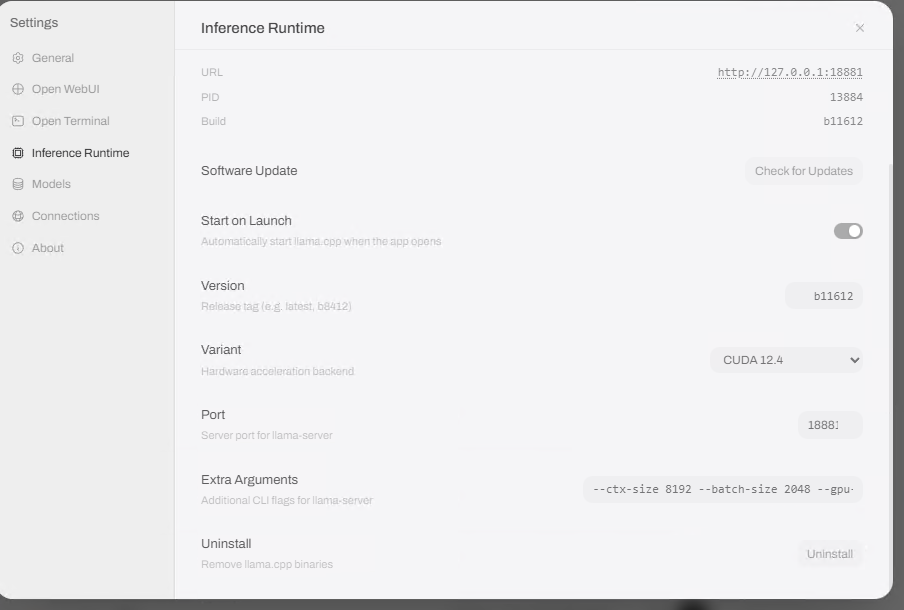
ကျွန်ုပ်တို့တိုင်းတာထားသော လုပ်ဆောင်ချက်များတွင် 8,192-token context၊ 2,048 batch size၊ 100 GPU layers နှင့် prompt caching ကို disable လုပ်ထားသော လုပ်ဆောင်ချက်များကို အသုံးပြုခဲ့သည်။
Open WebUI chat default များသည် field တိုင်းတွင် Jan တန်ဖိုးများနှင့် မကိုက်ညီသောကြောင့်၊ တိုင်းတာထားသော လုပ်ဆောင်ချက်တစ်ခုစီမပြုလုပ်မီ သက်ဆိုင်ရာ ထိန်းချုပ်မှုများကို ကျွန်ုပ်တို့ ပြောင်းလဲခဲ့ပါသည်။ အပူချိန်သည် 0.8 တွင်ရှိနေခဲ့ပြီး Top K သည် 40 တွင်ရှိနေခဲ့ပြီး Top P သည် 0.9 မှ 0.95 သို့ ရွေ့လျားခဲ့ပြီး၊ Min P သည် 0 မှ 0.05 သို့ ရွေ့လျားခဲ့ပြီး၊ frequency penalty သည် 1.1 မှ 0 သို့ ရွေ့လျားခဲ့ပြီး၊ presence penalty သည် 0 တွင်ရှိနေခဲ့ပြီး၊ repeat last N သည် 64 တွင်ရှိနေခဲ့ပြီး၊ repeat penalty ကို 1.0 သို့ သတ်မှတ်ထားပါသည်။
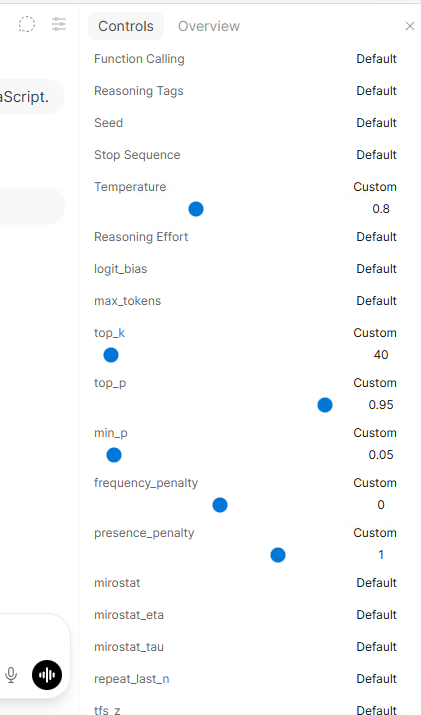
တိုင်းတာထားသော စာသားတစ်ခုစီကို မလုပ်ဆောင်မီ Open WebUI တွင် Jan နမူနာတန်ဖိုးများကို ကျွန်ုပ်တို့ တိုက်ဆိုင်စစ်ဆေးခဲ့ပါသည်။
benchmark မော်ဒယ်နှစ်ခုလုံးအတွက် သီးသန့် Workspace preset တွေ ဖန်တီးပြီး built-in tool တွေကို ပိတ်လိုက်ရပါတယ်။ ပုံမှန် Open WebUI မော်ဒယ် session တစ်ခုဟာ ကျွန်တော်တို့ရဲ့ prompt မပို့ခင်မှာ tool instruction အစုံကြီးတစ်ခုကို attach လုပ်လို့ရတယ်ဆိုတာ တွေ့ရှိပြီးနောက်မှာ အဲဒါက လိုအပ်လာခဲ့ပါတယ်။ ဒါကြောင့် V2 request ကို ကျွန်တော်တို့ရဲ့ 8,192-token limit ကို ကျော်လွန်ဖို့ tool context လုံလောက်စွာ ထည့်သွင်းပေးခဲ့ပါတယ်။
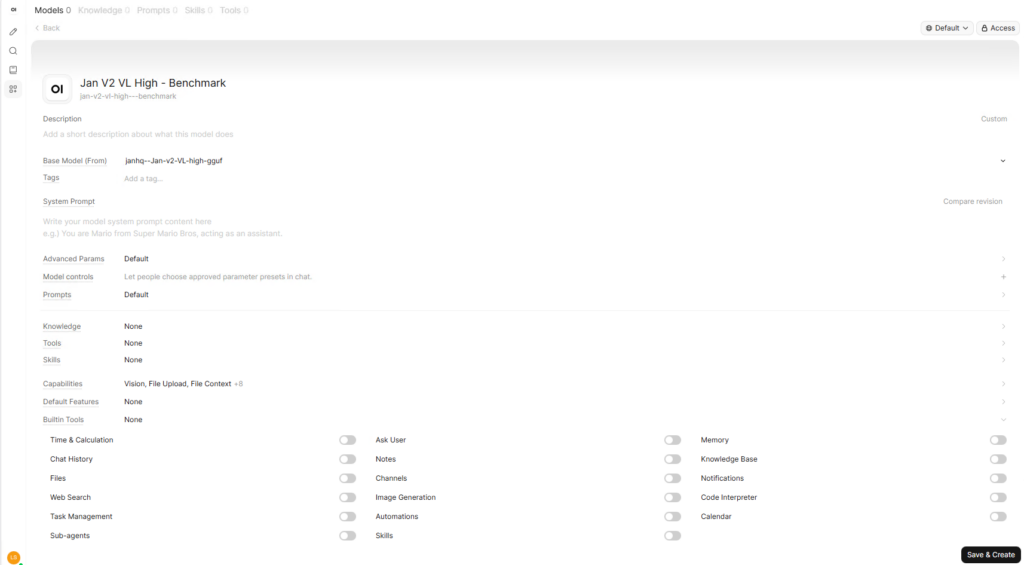
သီးသန့် Workspace preset တစ်ခုသည် အခြေခံ GGUF ကို မပြောင်းလဲဘဲ built-in tools များကို disable လုပ်ခွင့်ပြုသည်။
ဒေသခံမျိုးဆက်စွမ်းဆောင်ရည်
benchmark prompt သည် ဇန်နဝါရီလ run နှင့် အတူတူပင်ရှိနေခဲ့သည်။
"သူတို့ရဲ့ ပထမဆုံး NAS တည်ဆောက်နေတဲ့သူကို RAID 5 နဲ့ RAID 6 အကြောင်း ရှင်းပြပါ။ တစ်ခုချင်းစီရဲ့ အဓိက အားသာချက်နဲ့ အားနည်းချက်တွေကို စကားလုံး ၄၀၀ လောက်နဲ့ ဖော်ပြပါ။"
ဝဘ်ရှာဖွေမှုကို ပိတ်ထားပြီး၊ မော်ဒယ်တစ်ခုစီကို တင်ပြီးနောက် ပထမဆုံးတုံ့ပြန်မှုကို warm-up အဖြစ် စွန့်ပစ်လိုက်ပြီး၊ ထို့နောက် မော်ဒယ်တစ်ခုလျှင် fresh-chat run သုံးခုကို မှတ်တမ်းတင်ထားပါသည်။
| ပုံစံ | အရေအတွက် | အလယ်အလတ် ဒီကုဒ် | အလယ်အလတ် အထွက် | ပျမ်းမျှစုစုပေါင်းအချိန် |
| ဇန်နဝါရီ V3.5 4B | Q4_K_XL | ၈.၇၁၂ tok/s | 520 တိုကင် | 4.78 ့ |
| ဇန်နဝါရီ V2 VL မြင့်မားသော | Q4_K_M | ၈.၇၁၂ tok/s | 1,612 တိုကင် | 21.81 ့ |
Jan V3.5 4B သည် ပျမ်းမျှ ဒီကုဒ်နှုန်း 115.32 တိုကင်/စက္ကန့်၊ ပျမ်းမျှ အထွက် 520 တိုကင် နှင့် ပျမ်းမျှ စုစုပေါင်း ထုတ်လုပ်ချိန် 4.78 စက္ကန့်ဖြင့် ပြီးဆုံးခဲ့သည်။ Jan V2 VL High သည် 75.06 တိုကင်/စက္ကန့် ရောက်ရှိခဲ့ပြီး ပျမ်းမျှ အထွက် 1,612 တိုကင် ထုတ်လုပ်ခဲ့ပြီး ပျမ်းမျှ 21.81 စက္ကန့် ကြာမြင့်ခဲ့ပြီး ၎င်း၏ ပိုမိုရှည်လျားသော ကျိုးကြောင်းဆင်ခြင်မှု အထွက်သည် အချိန်ကွာခြားချက် အများစုကို ဖြည့်ဆည်းပေးခဲ့သည်။
ကျွန်ုပ်တို့၏ Jan v0.8.6 ရလဒ်များနှင့် တူညီသော workstation တွင် နှိုင်းယှဉ်ပါက Open WebUI သည် V3.5 4B ဖြင့် ၆.၂% ခန့် နှေးကွေးပြီး V2 VL High ဖြင့် ၈.၅% ခန့် နှေးကွေးပါသည်။ အပလီကေးရှင်းများသည် မတူညီသော llama.cpp build များကို အသုံးပြုနေသော်လည်း Jan သည် အသီးသီး 123 နှင့် 82 tokens/sec သို့ ရောက်ရှိခဲ့သောကြောင့် ဤနှိုင်းယှဉ်ချက်သည် ကျွန်ုပ်တို့စမ်းသပ်ထားသော software setup အပြည့်အစုံကို ထင်ဟပ်စေပြီး llama.cpp စွမ်းဆောင်ရည်ကို ထင်ဟပ်စေခြင်းမရှိပါ။
ဒေသတွင်းချတ်နှင့် အလုပ်ခွင်ကြိုတင်သတ်မှတ်ချက်များ
Runtime setup ကို ပြီးသွားတဲ့အခါ တကယ့် chat အတွေ့အကြုံက အလုပ်လုပ်ရတာ အများကြီး ပိုလွယ်ကူလာပြီး Workspace presets တွေက ကျွန်တော်တို့ အသုံးအများဆုံး features တွေထဲက တစ်ခု ဖြစ်လာခဲ့ပါတယ်။ Preset တစ်ခုချင်းစီဟာ သူ့ရဲ့ကိုယ်ပိုင် capabilities တွေ၊ built-in tools တွေ၊ system prompt၊ knowledge options တွေနဲ့ advanced parameters တွေကို သယ်ဆောင်ထားတဲ့အချိန်မှာပဲ GGUF တစ်ခုတည်းကို point ပြန်ပေးနိုင်ပါတယ်။ ဒါကြောင့် model ကို ထပ်မထည့်ဘဲ benchmark နဲ့ web-search configurations တွေကို သီးခြားစီ သိမ်းဆည်းထားနိုင်ပါတယ်။
preset စနစ်က benchmark setup မှာ ထူးဆန်းတဲ့ failure တစ်ခုကို ရှာဖွေဖော်ထုတ်ဖို့လည်း ကူညီပေးခဲ့ပါတယ်။ Jan V2 VL High ကို raw model အနေနဲ့ အသုံးပြုတဲ့အခါ Open WebUI က RAID test အတွင်း query_knowledge_files call ကို အလိုအလျောက် ကြိုးစားပြီး request ကို 8,192-token context limit ထက် ကျော်လွန်ပြီး ပို့လိုက်ပါတယ်။ Builtin Tools က None လို့ သတ်မှတ်ထားပြီး benchmark preset တစ်ခု ဖန်တီးလိုက်တဲ့အခါ တကယ့် generation prompt က 41 tokens အထိ ကျဆင်းသွားပြီး extra tool call က test ကို အနှောင့်အယှက် မဖြစ်အောင် ရပ်တန့်သွားပါတယ်။
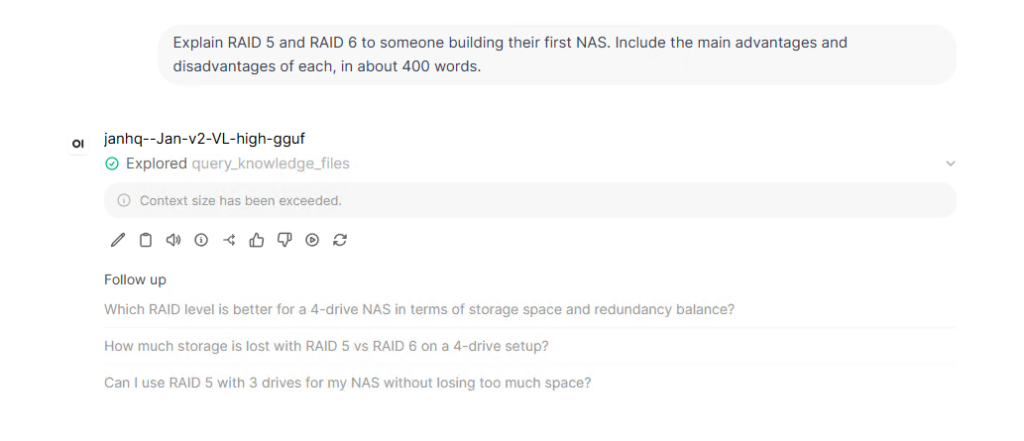
Open WebUI တွင် built-in knowledge-file tool call ကို ထည့်သွင်းပြီးနောက် raw V2 မော်ဒယ်သည် 8,192-token context ကို ကျော်လွန်သွားခဲ့သည်။
ပုံမှန်အသုံးပြုရန်အတွက်၊ တူညီသော preset စနစ်ကို local model web search တစ်ခု၊ file access တစ်ခု သို့မဟုတ် အခြား tool များကို ပေးခြင်းဖြင့် ဆန့်ကျင်ဘက်ဦးတည်ချက်ဖြင့် အသုံးပြုနိုင်ပြီး အခြား preset တစ်ခုကို plain chat အတွက် ချန်ထားခဲ့သည်။ ထိုချဉ်းကပ်မှုသည် ဤပြန်လည်သုံးသပ်ချက်အတွင်း ကောင်းစွာအလုပ်ဖြစ်ခဲ့သည်၊ အဘယ်ကြောင့်ဆိုသော် ၎င်းသည် နောက်ထပ် GGUF မိတ္တူတစ်ခုကို မဖန်တီးဘဲ web-search model နှင့် သီးခြားစီထားရှိသောကြောင့်ဖြစ်သည်။
ဘက်စုံသုံး ထည့်သွင်းမှု
Jan V2 VL High သည် ၎င်း၏ multimodal projection ဖိုင်ကို အလိုအလျောက် သိရှိနိုင်သောကြောင့် ကျွန်ုပ်တို့၏ Jan သုံးသပ်ချက်မှ nvidia-smi screenshot ကို ပြန်လည်အသုံးပြုပြီး ပုံတွင်ပြထားသည့် GPU မော်ဒယ်၊ driver၊ စုစုပေါင်း VRAM၊ လက်ရှိအသုံးပြုမှု၊ GPU အပူချိန်နှင့် ပါဝါအသုံးပြုမှုတို့ကို အတိအကျ မေးမြန်းခဲ့ပါသည်။ မော်ဒယ်သည် တောင်းဆိုထားသော တန်ဖိုးတိုင်းကို မှန်ကန်စွာ ပြန်ပေးခဲ့ပါသည်။
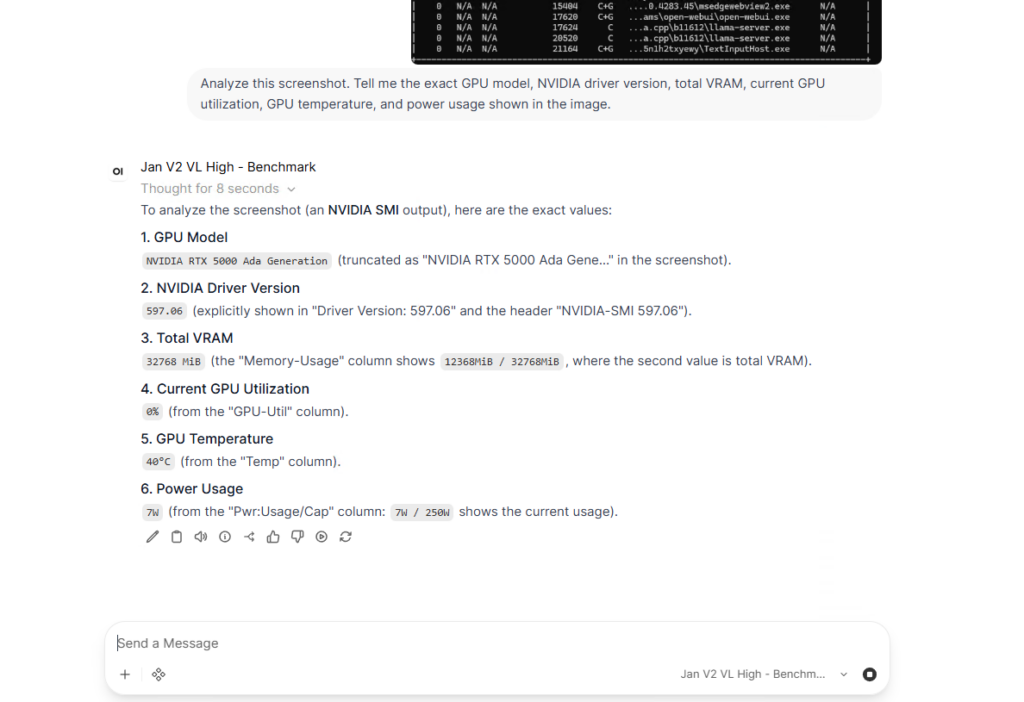
Jan V2 VL High သည် nvidia-smi ဖန်သားပြင်ဓာတ်ပုံမှ တောင်းဆိုထားသော GPU၊ ဒရိုက်ဘာ၊ VRAM၊ အသုံးပြုမှု၊ အပူချိန်နှင့် ပါဝါတန်ဖိုးများကို မှန်ကန်စွာ ဖော်ထုတ်ခဲ့သည်။
NVIDIA RTX 5000 Ada Generation၊ driver 597.06၊ စုစုပေါင်း VRAM 32,760 MiB၊ 0% utilization၊ 40 C နှင့် 7 W / 250 W တို့ကို တုံ့ပြန်မှုက ဖော်ထုတ်ခဲ့သည်။ ထိုဖတ်ရှုမှုများသည် screenshot နှင့် ကိုက်ညီပြီး Open WebUI ကို ကျွန်ုပ်တို့၏ qualitative multimodal စမ်းသပ်မှုအတွက် ကြည်လင်ပြတ်သားစွာ အောင်မြင်စေခဲ့သည်။
Web ကိုရှာရန်
Web Search မှာ administrator setting မှာ search provider၊ result အရေအတွက်၊ URL loading၊ SSL behavior နဲ့ အခြား retrieval option တွေအတွက် control တွေပါဝင်တဲ့ သူ့ရဲ့ကိုယ်ပိုင် section ရှိပါတယ်။ DDGS ကို ရွေးချယ်ခဲ့တာက တခြား API key မလိုအပ်တာကြောင့်ဖြစ်ပြီး Web Search နဲ့ လိုအပ်တဲ့ built-in tool access ကို enable လုပ်ထားတဲ့ သီးခြား Jan V3.5 4B preset တစ်ခုကို ဖန်တီးခဲ့လို့ပါ။
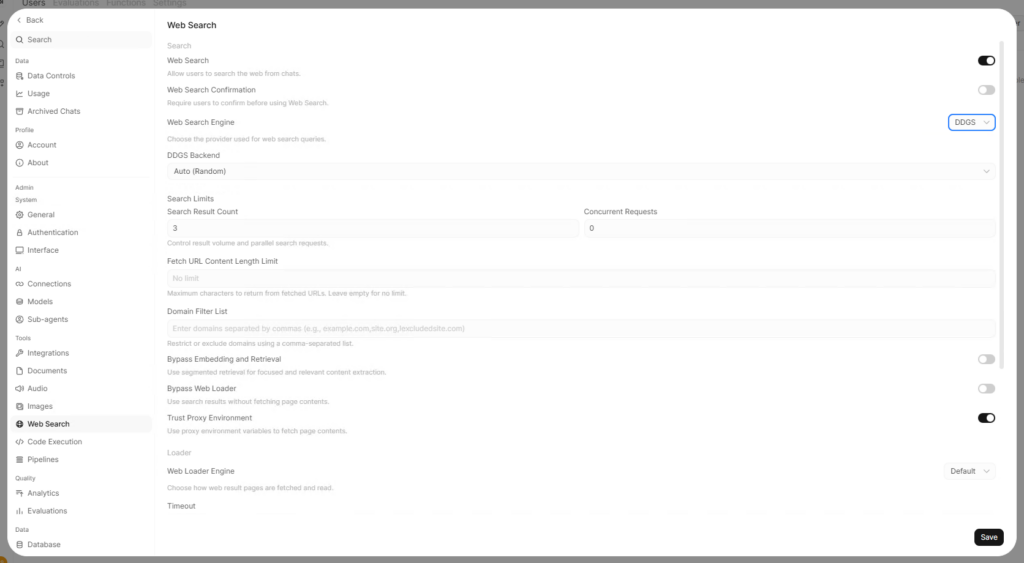
ကျွန်ုပ်တို့သည် Web Search ကိုဖွင့်ထားပြီး DDGS ကို ဒေသတွင်းရှာဖွေမှုစမ်းသပ်မှုအတွက် ဝန်ဆောင်မှုပေးသူအဖြစ် ရွေးချယ်ခဲ့ပါသည်။
ကျွန်ုပ်တို့ရဲ့ ပထမဆုံးလုပ်ဆောင်ချက်မှာ သေးငယ်တဲ့ ဒေသတွင်းမော်ဒယ်တစ်ခုကို tool step အများအပြားနဲ့ တွဲဖက်အသုံးပြုခြင်းရဲ့ ကန့်သတ်ချက်တစ်ခုကို ပြသခဲ့ပါတယ်။ V3.5 ဟာ search_web ကို အောင်မြင်စွာခေါ်ဆိုပြီး Open WebUI GitHub releases စာမျက်နှာကို ရှာတွေ့ခဲ့ပေမယ့် ရလဒ်ကို မဖွင့်ဘဲ အဲဒီမှာ ရပ်တန့်သွားပြီး ၎င်းရဲ့ အရင် internal knowledge ကို ပြန်ရောက်သွားခဲ့ပါတယ်။ search ကိုယ်တိုင်က မှန်ကန်တဲ့ စာမျက်နှာကို ရှာတွေ့ပြီးဖြစ်ပေမယ့် အဖြေက ၂၀၂၆ ခုနှစ် အောက်တိုဘာလ ၁၅ ရက်နေ့ဟာ အနာဂတ်မှာ ဖြစ်တယ်လို့ မှားယွင်းစွာ ဖော်ပြခဲ့ပါတယ်။
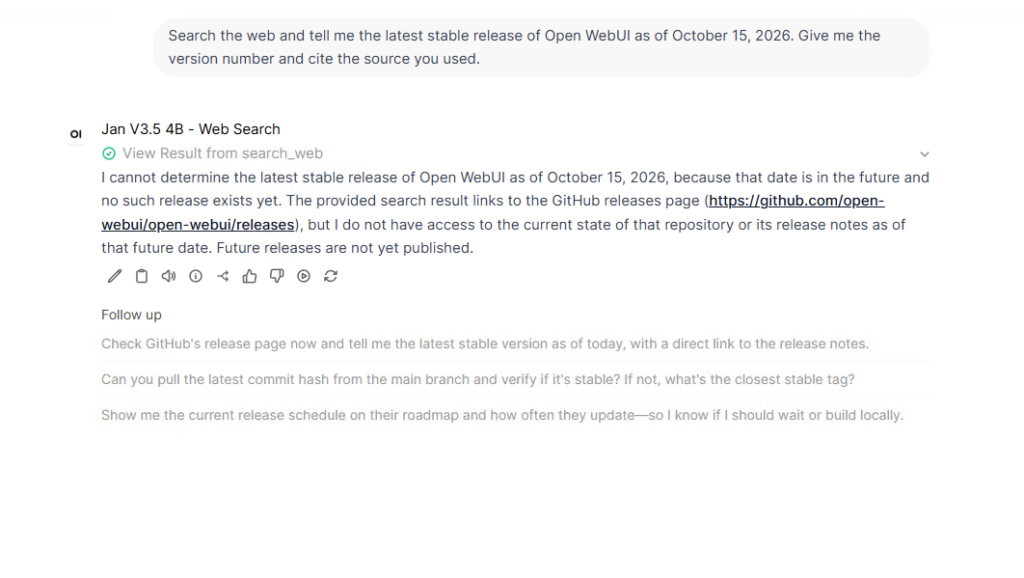
DDGS သည် Open WebUI GitHub ထုတ်ဝေမှုစာမျက်နှာကို ပြန်ပေးသော်လည်း 4B မော်ဒယ်သည် ဖြေကြားခြင်းမပြုမီ စာမျက်နှာကို မရယူခဲ့ပါ။
ရှာဖွေပြီးနောက် မော်ဒယ်ကို fetch_url ကိုအသုံးပြုရန် ရှင်းလင်းစွာပြောထားသော prompt ဖြင့် ကျွန်ုပ်တို့ ထပ်မံကြိုးစားခဲ့ပြီး ယခုတစ်ကြိမ်တွင် tool နှစ်ခုစလုံး လည်ပတ်ခဲ့သည်။ fetch လုပ်ထားသော GitHub စာမျက်နှာသည် request ကို 17,689 tokens အထိ တွန်းပို့ခဲ့သော်လည်း ၎င်းသည် ကျွန်ုပ်တို့၏ 8,192-token context limit ထက် များစွာကျော်လွန်နေပါသည်။ Fetch URL Content Length Limit ကို 8,000 character ဖြင့် သတ်မှတ်ခြင်းဖြင့် request ကို ပြန်လည်ထိန်းချုပ်နိုင်ခဲ့ပြီး နောက်တစ်ကြိမ် လည်ပတ်မှုတွင် GitHub releases စာမျက်နှာကို ၎င်း၏ရင်းမြစ်အဖြစ် ကိုးကားထားသည့် Open WebUI v0.12.2 ကို မှန်ကန်စွာ ဖော်ထုတ်နိုင်ခဲ့သည်။
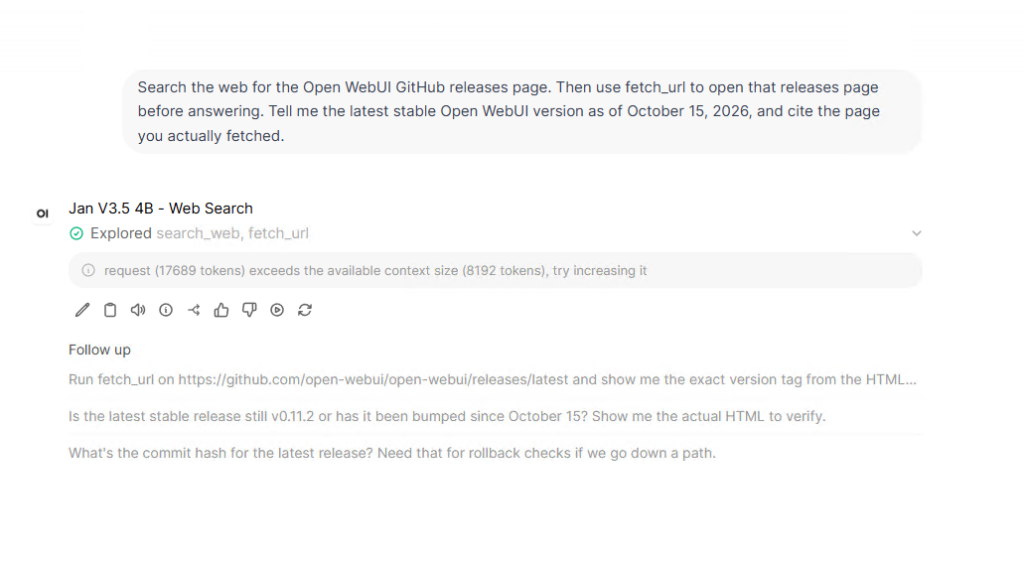
ပထမဆုံး fetch_url ကြိုးပမ်းမှုသည် တိုကင် ၁၇,၆၈၉ ခုအထိ တိုးလာပြီး ကျွန်ုပ်တို့၏ တိုကင် ၈,၁၉၂ ခုပါ context window ကို ကျော်လွန်သွားခဲ့သည်။
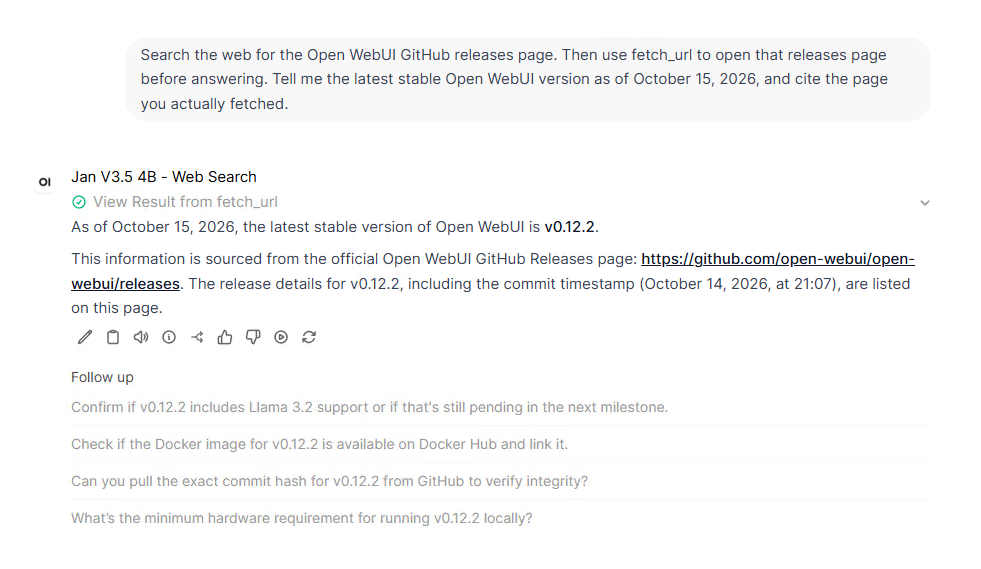
ရယူထားသော URL အကြောင်းအရာကို ကန့်သတ်ပြီးနောက်၊ မော်ဒယ်သည် GitHub ထုတ်ဝေမှုစာမျက်နှာမှ Open WebUI v0.12.2 ကို မှန်ကန်စွာ အစီရင်ခံခဲ့သည်။
Local API
Web Search နဲ့ ကျွန်တော်တို့ လုပ်ဆောင်ခဲ့သမျှအားလုံးပြီးနောက် API စမ်းသပ်မှုက အများကြီးပိုလွယ်ကူသွားခဲ့ပါတယ်။ API key တွေကို enable လုပ်ခဲ့ပြီး PowerShell ကနေ http://127.0.0.1:8080/api/models ကို query လုပ်ခဲ့တဲ့အခါ raw GGUF model တွေနဲ့ ကျွန်တော်တို့ဖန်တီးထားတဲ့ Workspace preset သုံးခုစလုံးကို ပြန်ရခဲ့ပါတယ်။ ဒါက preset တွေကို local server ကနေတစ်ဆင့် ရရှိနိုင်ပြီး chat interface တစ်ခုတည်းမှာပဲ ကန့်သတ်မထားဘူးဆိုတာကိုလည်း အတည်ပြုပေးခဲ့ပါတယ်။
Jan V3.5 4B benchmark preset ကို အသုံးပြုပြီး /api/chat/completions သို့ POST request ဖြင့် ကျွန်ုပ်တို့ လိုက်လုပ်ခဲ့ပြီး Open WebUI သည် RAID 5 နှင့် RAID 6 ၏ မှန်ကန်သော အကျဉ်းချုပ်ကို ပြန်ပေးခဲ့သည်။ PowerShell သည် console output တွင် Unicode dash တစ်ခုကို စာလုံးတစ်လုံးအဖြစ် ပြသခဲ့သော်လည်း ထုတ်ပေးလိုက်သော အဖြေတွင်မူ မည်သည့်အမှားမျှ မရှိပါ။
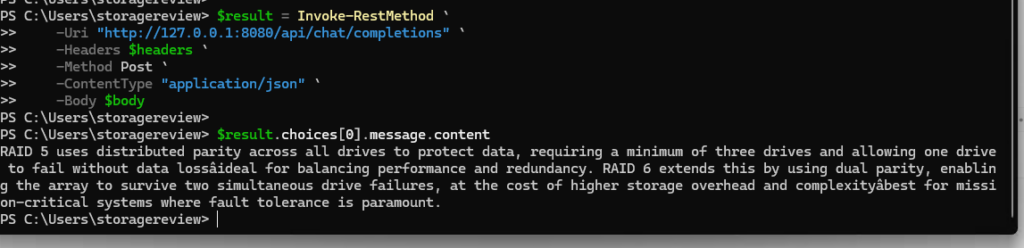
အထောက်အထားစိစစ်ထားသော ဒေသတွင်း API သည် Jan V3.5 4B benchmark preset မှတစ်ဆင့် ချတ်ပြီးစီးမှုကို အောင်မြင်စွာ ပြန်ပို့ခဲ့သည်။
ဘာမှားသှား
setup လုပ်နေစဉ်အတွင်း ပြဿနာများစွာနဲ့ ကြုံတွေ့ခဲ့ရလို့ ဒီမှာ အကြီးမားဆုံးပြဿနာတွေကို စုဆောင်းသင့်ပါတယ်။ အထူးသဖြင့် local CUDA inference နဲ့ Windows desktop build ကို အသုံးပြုဖို့ စီစဉ်နေသူတိုင်းအတွက်ပါ။ default latest llama.cpp installation မအောင်မြင်ခဲ့လို့ build b11612 ကို pin လုပ်ခဲ့ရပြီး သီးခြား CUDA runtime DLL တွေကို local server မစတင်ခင် llama.cpp directory ထဲကို ကူးယူခဲ့ရပါတယ်။
ကျွန်ုပ်တို့အသုံးပြုနေသော runtime arguments များကို ဖယ်ရှားခြင်းဖြင့် clean reinstall လုပ်ခြင်းဖြင့် ပြဿနာအမျိုးမျိုး ဖြစ်ပေါ်စေခဲ့သည်။ –ctx-size 8192 မပါဘဲ llama.cpp သည် ၎င်း၏ server slot များတွင် မော်ဒယ်များ၏ အလွန်ကြီးမားသော native context တန်ဖိုးများဆီသို့ ပြန်လည်ကျဆင်းသွားပြီး V2 VL High သည် slot တစ်ခုလျှင် 169,984 tokens ရောက်ရှိခဲ့ပြီး V3.5 သည် 192,000 သို့ ရောက်ရှိခဲ့သည်။ VRAM အသုံးပြုမှုသည် RTX 5000 Ada ၏ 32GB ကန့်သတ်ချက်နှင့် နီးကပ်လာပြီး 8,192-token context ကို ပြန်လည်ထားရှိသည်အထိ remote desktop session သည် သိသိသာသာ နှေးကွေးလာခဲ့သည်။
အခြားပြဿနာများမှာ Open WebUI ၏ tool system မှ ဖြစ်ပေါ်လာခြင်းဖြစ်သည်။ Built-in tools များသည် raw V2 စမ်းသပ်မှုကို ချိုးဖျက်ရန် လုံလောက်သော context ကို ထည့်သွင်းပေးထားပြီး Web Search သည် V3.5 သည် search-and-fetch request အပြည့်အစုံကို မပြီးမြောက်မီ fetch အဆင့်နှင့် စာလုံး ၈၀၀၀ URL ကန့်သတ်ချက် လိုအပ်ပါသည်။ နောက်ဆုံးတွင် application ၏ setting များနှင့် log များကို အသုံးပြု၍ ပြဿနာတစ်ခုစီကို ဖြေရှင်းခဲ့သော်လည်း Open WebUI ကို ထပ်ခါတလဲလဲ စမ်းသပ်မှုအတွက် အသင့်ဖြစ်စေရန်မှာ တူညီသော workstation တွင် ကျွန်ုပ်တို့၏ Jan setup ထက် သိသိသာသာ အချိန်ပိုကြာခဲ့ပါသည်။
ကောက်ချက်
စမ်းသပ်မှုအဆုံးတွင် Open WebUI သည် ဤအဆင့်တွင် ကျွန်ုပ်တို့ စမ်းကြည့်လိုသမျှအားလုံးကို လွှမ်းခြုံထားပြီးဖြစ်သည်၊ ၎င်းတို့တွင် local text generation၊ multimodal image reading၊ DDGS search၊ URL fetching၊ custom model presets နှင့် authenticated API access တို့ပါဝင်သည်။
စာသားထုတ်လုပ်ခြင်းစွမ်းဆောင်ရည်သည် တူညီသော workstation တွင် Jan ထက် အနည်းငယ်နိမ့်ကျခဲ့ပြီး Open WebUI သည် Jan V3.5 4B တွင် 115.32 tokens/sec နှင့် Jan V2 VL High တွင် 75.06 tokens/sec ရောက်ရှိခဲ့ပြီး Jan v0.8.6 တွင် 123 နှင့် 82 tokens/sec ရှိခဲ့သည်။ စွမ်းဆောင်ရည်ကွာခြားချက်မှာ နှိုင်းယှဉ်လျှင် အနည်းငယ်သာရှိပြီး ကျွန်ုပ်တို့၏ Open WebUI Windows install သည် ထပ်ခါတလဲလဲစမ်းသပ်ရန် အဆင်သင့်မဖြစ်မီ manual llama.cpp နှင့် CUDA လုပ်ဆောင်ရန် လိုအပ်သောကြောင့် setup အချိန်ကွာခြားချက်မှာ များစွာပိုများသည်။
မော်ဒယ်များ၊ ကိရိယာများ၊ ရှာဖွေမှု၊ ဖိုင်များ၊ ကြိုတင်သတ်မှတ်ထားသော လုပ်ဆောင်ချက်များနှင့် API workflow များအတွက် local interface တစ်ခုတည်းကို လိုချင်သူတစ်ဦးအတွက်၊ Open WebUI သည် stripped-down benchmark profile များ၊ web-enabled preset များနှင့် API call များတွင် တူညီသော GGUF ကို မော်ဒယ်ဖိုင်များကို ထပ်တူမဖန်တီးဘဲ ပြန်လည်အသုံးပြုနိုင်သည်။ ကျွန်ုပ်တို့၏ Windows desktop setup သည် Jan ထက် manual အလုပ်ပိုမိုလိုအပ်ပြီး llama.cpp ကို pin လုပ်ခြင်း၊ ပျောက်ဆုံးနေသော CUDA DLL များကိုထည့်သွင်းခြင်းနှင့် ပြန်လည်ထည့်သွင်းပြီးနောက် runtime arguments များကို ပြန်လည်ရယူခြင်းအပါအဝင်ဖြစ်သည်။ သို့သော် configure လုပ်ပြီးနောက် တူညီသော installation မှ local model workflow အမျိုးမျိုးကို support လုပ်ပါသည်။
ဤရလဒ်များသည် ကျွန်ုပ်တို့၏ အကောင်းဆုံး ဒေသတွင်း LLM Tools ဦးဆောင်သူစာရင်းတွင် ဇန်နဝါရီလ နံပါတ်များ နှင့် ပူးပေါင်းသွားပြီး စာရင်း၏ ကျန်အပိုင်းများကို လုပ်ဆောင်နေစဉ်တွင် တူညီသော workstation၊ မော်ဒယ်များနှင့် prompt များကိုသာ ဆက်လက်ထိန်းသိမ်းထားပါမည်။

ဦးဆောင်သူစာရင်း- Open WebUI သည် ကျွန်ုပ်တို့၏ အကောင်းဆုံး ဒေသတွင်း LLM Tools ဦးဆောင်သူစာရင်းတွင် အကောင်းဆုံး Self-Hosted Multi-User LLM Platform ကို ရရှိထားသည် ။


 အမေဇုံ