

Dell Pro Precision 9 T2 ဟာ လွန်ခဲ့တဲ့တစ်နှစ်က ကျွန်တော်တို့ သုံးသပ်ခဲ့တဲ့ single-GPU tower ရဲ့ Xeon ဗားရှင်းဖြစ်ပြီး Dell ရဲ့ workstation တွေကို Precision brand အောက်ကို ပြန်လည်ပြောင်းရွှေ့လိုက်တဲ့အတွက် နာမည်အသစ်နဲ့ platform အသစ်တစ်ခု၊ Intel ရဲ့ Xeon 6 က Core Ultra 9 285K ကို 32-liter chassis ထဲမှာ အစားထိုးအသုံးပြုထားပါတယ်။ ကျွန်တော်တို့ရဲ့ unit မှာ 24-core Xeon 658X၊ 128GB DDR5-6400 RDIMM ECC၊ 300W RTX PRO 6000 Blackwell Max-Q နဲ့ အရှေ့ဘက် FlexBay မှာ 2TB E3.S Gen5 drive နှစ်ခု ပါဝင်ပါတယ်။ Dell.com မှာလည်း အလားတူ configure လုပ်ထားပြီး ဈေးနှုန်းက ဒေါ်လာ ၂၈၃၀၀ လောက် ရှိပါတယ်။
ကျွန်တော်တို့က matrix အနေနဲ့ စမ်းသပ်ခဲ့ပါတယ်- Pro Precision 9 T2 က ကျွန်တော်တို့ရဲ့ full suite ကို Max-Q ကတ်နဲ့ ကျွန်တော်တို့ရဲ့ Pro Max Tower T2 ကနေ ဆွဲထုတ်လာတဲ့ 600W RTX PRO 6000 Blackwell နဲ့ ပါလာပြီး ထပ်ခါတလဲလဲ ပါလာပါတယ်၊ Core-based T2 ကလည်း ကတ်နှစ်ခုလုံးကို ပါပါတယ်၊ ဒါကြောင့် အောက်က ရလဒ်အားလုံးမှာ ကော်လံလေးခုရှိပြီး တစ်စုံစီမှာ variable တစ်ခုကို ခွဲခြားထားပါတယ်- CPU platform ဒါမှမဟုတ် GPU ရဲ့ power limit။ ဒီ suite က ပြီးခဲ့တဲ့အပတ်က RTX Spark notebooks တွေမှာ ပါခဲ့တဲ့ suite နဲ့ အတူတူပါပဲ ၊ ဒီမှာ မိတ်ဆက်ထားတဲ့ ထပ်တိုးမှုအနည်းငယ်လည်း ပါဝင်ပါတယ်။
Xeon သည် throughput ကိုဝယ်ယူပြီး latency ကိုပြန်လည်ပေးသည်။ Pro Precision 9 T2 သည် Cinebench 2026 multi-core တွင် 12,322 ရမှတ်ရရှိခဲ့ပြီး Core T2 တွင် 8,856 ရမှတ်ရရှိခဲ့ကာ LLVM ကို 140.2 စက္ကန့်အတွင်းတည်ဆောက်ခဲ့ပြီး 182.5 စက္ကန့်အတွင်း build လုပ်ခဲ့ကာ STREAM Triad တွင် 122,233MB/s ဖတ်ရှုမှုရရှိခဲ့ကာ 33,003 စက္ကန့်အတွင်း read လုပ်ခဲ့ပြီး ၎င်း၏ single-core Cinebench ရမှတ် 454.1 သည် 285K ၏ 564.4 နှင့် Speedometer ရမှတ် 36.8 ထက် 46.3 သာလွန်သည်။ 600W ကတ်သည် LLM decode တွင် 7 မှ 20 ရာခိုင်နှုန်းခန့်နှင့် tower တစ်ခုခုတွင် prompt processing နှင့် diffusion တွင် 20 မှ 39 ရာခိုင်နှုန်းခန့်တိုးလာပြီး Xeon tower တွင် CPU သည် all-core အလုပ်တွင် 4 မှ 5 ရာခိုင်နှုန်းအထိ ကုန်ကျသည်။
Key ကို Takeaways
- Xeon 6 သည် single-socket tower ရှိ throughput platform တစ်ခုဖြစ်သည်။ Cinebench 2026 multi-core တွင် 12,322 ရရှိခဲ့ပြီး တူညီသော chassis တွင် Core Ultra 9 285K ထက် 39 ရာခိုင်နှုန်း သာလွန်ကာ 7-Zip တွင် 289.6 GIPS ရရှိခဲ့ပြီး 174.8 ရာခိုင်နှုန်း မြင့်မားကာ DGEMM တွင် 768 တွင် 1,638 GFLOPS ရရှိခဲ့ပြီး DDR5-6400 ၏ channel လေးခုမှ memory bandwidth 3.7x မြင့်မားခဲ့သည်။
- 285K မှာ thread တစ်ခုလျှင် မြန်နှုန်းကို ပိုင်ဆိုင်ထားဆဲပါ။ Xeon သည် Cinebench single-core တွင် ၂၀ ရာခိုင်နှုန်း၊ Speedometer တွင် ၂၁ ရာခိုင်နှုန်း နှင့် single-threaded Python တွင် ၂၀ မှ ၃၁ ရာခိုင်နှုန်းအထိ နောက်ကျကျန်နေပြီး core-to-core latency မှာ ၃၈.၁ ns ရှိပြီး core-to-core latency မှာ ၅၆.၂ ns ရှိသည်။
- GPU သည် AI ရလဒ်များကို ဆုံးဖြတ်ပေးပြီး 600W ကတ်သည် အောက်ပါအချက်များတွင် ၎င်း၏ပါဝါကို ရရှိသည်- MLPerf Llama 3.1 8B သည် Max-Q ဖြင့် တစ်စက္ကန့်လျှင် 230.9 တိုကင်များနှင့် 600W ကတ်ဖြင့် တစ်စက္ကန့်လျှင် 252.8 တိုကင်များ ထုတ်လုပ်ပေးပြီး၊ ပထမဆုံးတိုကင်သို့ ရောက်ရှိရန် အချိန်သည် 0.082 မှ 0.059 စက္ကန့်အထိ ကျဆင်းသွားပြီး Qwen-Image 20B သည် 1024×1024 ရုပ်ပုံကို စက္ကန့် 19.7 အတွင်း ထုတ်ပေးပြီး 26.1 စက္ကန့်အတွင်း ထုတ်ပေးပါသည်။
- 600W ကတ်သည် Xeon ၏ CPU လုပ်ဆောင်ချက်ကို ၄ ရာခိုင်နှုန်းမှ ၅ ရာခိုင်နှုန်းအထိ လျှော့ချပေးပါသည်။ Cinebench multi-core သည် 12,322 မှ 11,705 သို့ ကျဆင်းသွားပြီး မိနစ် ၃၀ ကြာ sustained loop သည် 12,328 မှ 11,764 သို့ ကျဆင်းသွားကာ steady-state clocks များသည် 4,274 မှ 4,178MHz သို့ ကျဆင်းသွားခဲ့သည်။ ထို swap သည် Core T2 တွင် ဘာမှ မပြောင်းလဲပါ။
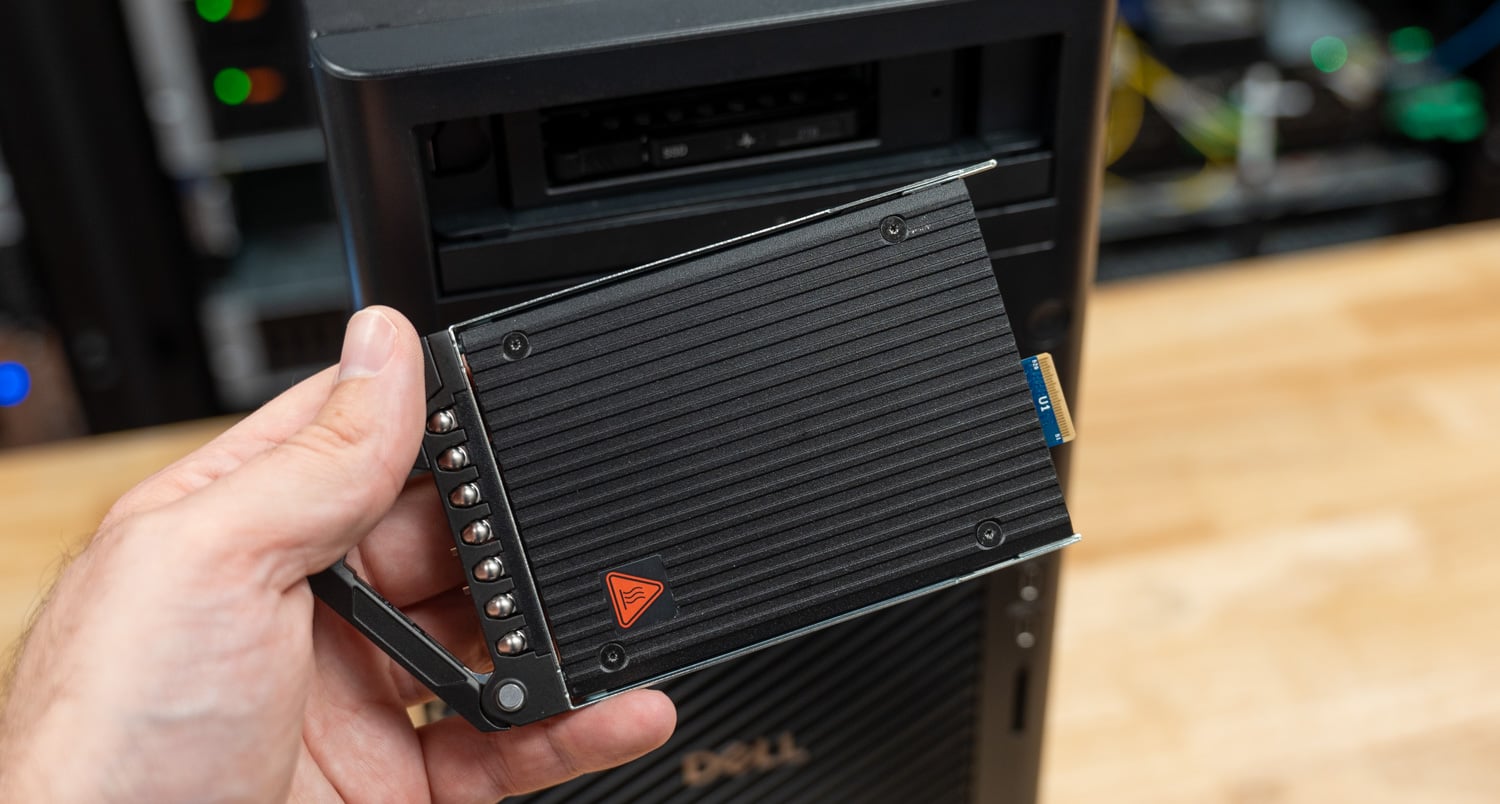
- FlexBay မှာ E3.S တွေကို Graid က VROC နဲ့ strip လုပ်ထားတာတွေ့ရပါတယ်။ ရှေ့ bay မှာ E3.S Gen5 drive နှစ်ခုပါဝင်ပြီး ကျွန်ုပ်တို့ရဲ့ lab မှာရှိတဲ့ tower workstation အတွက် ပထမဆုံးဖြစ်ပါတယ်။ Dell ရဲ့ RAID0 boot option က Graid Technology ရဲ့ VROC နဲ့ 4,097GB volume ထဲကို တည်ဆောက်ပေးပါတယ်။ stripe က 9,332MB/s အစဉ်လိုက်ဖတ်ပြီး 4K random read တွေမှာ 840.1K IOPS အထိ အမြင့်ဆုံးရောက်ပါတယ်။ Core T2 မှာ single Gen5 M.2 ကနေ 1.78M IOPS အထိပဲ ရှိပါတယ်။
Pro Max မှ Pro Precision အထိ
Dell ဟာ ၂၀၂၅ ခုနှစ်အစောပိုင်းမှာ Precision ဆိုတဲ့နာမည်ကို ရပ်ဆိုင်းခဲ့ပြီး အဲဒီတုန်းက workstation အားလုံးက Dell Pro Max ဖြစ်လာခဲ့ပြီး အခုတော့ ပြန်လည်အသုံးပြုလာပါပြီ။ အောက်တိုဘာလ ၇ ရက်နေ့မှာ Dell ဟာ သူ့ရဲ့ GB10 နဲ့ GB300 deskside တွေကို Dell Pro Max ကနေ Dell Pro Precision လို့ အမည်ပြောင်းလဲခဲ့ပြီး Dell.com မှာ Pro Precision 9 T2 ကို T4 နဲ့ T6 tower အသစ်တွေနဲ့အတူ အမှတ်တံဆိပ်တစ်ခုတည်းအောက်မှာ စာရင်းပြုစုထားပါတယ်။ Pro Max ဟာ Core-based စက်တွေအတွက်ပဲ ကျန်ရှိတော့တာကြောင့် ပြီးခဲ့တဲ့နှစ်က ကျွန်တော်တို့ သုံးသပ်ခဲ့တဲ့ Core Ultra tower ကို Dell Pro Max Tower T2 အဖြစ် ရောင်းချနေဆဲဖြစ်ပြီး ဒီမှာ သုံးသပ်ထားတဲ့ Xeon tower ကတော့ Dell Pro Precision 9 T2၊ မော်ဒယ် PW9T2260 ဖြစ်ပါတယ်။
T4 နှင့် T6 တို့သည် အမည်ပြောင်းလိုက်သည်နှင့် Xeon 6 သို့ အလားတူပြောင်းရွှေ့ခဲ့ပြီး Dell သည် တိုးချဲ့မှုဖြင့် tower သုံးခုကို နေရာယူထားသည်။ Pro Precision 9 T4 (PW9T4260) သည် 86-core Xeon 698X အထိ တူညီသော processor စာရင်းကို လုပ်ဆောင်ပြီး memory channel ရှစ်ခုလုံးတွင် DDR5-6400 4TB အထိအတွက် DIMM slot ၁၆ ခု ထပ်ထည့်ကာ 1500W ထောက်ပံ့မှုတွင် 600W RTX PRO 6000 တစ်ခုတည်း သို့မဟုတ် Max-Q ကတ်နှစ်ခုကို ရွေးချယ်နိုင်ပြီး 2400W chassis ကိုလည်း ရွေးချယ်နိုင်သည်။
Pro Precision 9 T6 (PW9T6260) ကတော့ ထိပ်တန်းဖြစ်ပြီး slot ခြောက်ခု၊ 2400W ထောက်ပံ့မှုနဲ့ 600W RTX PRO 6000 ကတ်နှစ်ခု၊ Max-Q ကတ်သုံးခု ဒါမှမဟုတ် RTX PRO 5000 ငါးခုအထိ ထည့်သွင်းနိုင်တဲ့ နေရာပါဝင်ပါတယ်။ T2 ကတော့ မိသားစုအတွက် single-GPU၊ four-channel entry ပါ။
နာမည်ပေးတိကျမှုက အရေးကြီးပါတယ်။ ဘာလို့လဲဆိုတော့ tower နှစ်ခုဟာ အပြင်ပိုင်းကနေ အတူတူပဲဖြစ်ပြီး 387 x 187.7 x 438mm မှာ 32-liter chassis တူညီပြီး၊ bezel နဲ့ front FlexBay တူညီတဲ့အပြင် Dell ရဲ့ configurator မှာ RTX PRO 6000 Blackwell option တွေလည်း အတူတူပဲဖြစ်တာကြောင့် နာမည်ပေးတိကျမှုက အရေးကြီးပါတယ်။ Pro Max Tower T2 က 24-core Core Ultra 9 285K ကို unbuffered DDR5 DIMM slot လေးခုနဲ့ တွဲဖက်အသုံးပြုထားပေမယ့် Pro Precision 9 T2 ကတော့ workstation အတွက် Intel ရဲ့ Xeon 6၊ ဇွန်လတုန်းက ကျွန်တော်တို့ သုံးသပ်ခဲ့တဲ့ Granite Rapids-WS platform ကို အသုံးပြုထားပြီး registered ECC memory၊ PCIe lanes ပိုများပြီး top configuration မှာ 250W processor ပါဝင်ပါတယ်။

Dell က Pro Precision 9 T2 မှာ Xeon 6 processors ခြောက်ခု ပါရှိပါတယ်။ 12-core Xeon 634 မှ 150W မှာ 24-core 658X အထိ ရှိပါတယ်။ 634 ကနေ 658X ကို ရွေးချယ်ဝယ်ယူမယ်ဆိုရင် ဒေါ်လာ ၁၅၆၀ ကျသင့်ပါတယ်။ 658X မှာ 3.0GHz base နဲ့ 4.9GHz turbo မှာ 24 cores နဲ့ 48 threads ပါဝင်ပြီး 285K ရဲ့ 36MB ထက် သုံးဆပိုများပါတယ်။ AVX-512 နဲ့ AMX ကိုလည်း support လုပ်ပါတယ်။ 285K မှာ ဘယ် 285K မှာမှ support မလုပ်ပါဘူး။ ဒီ chip မှာ DDR5-6400 channel ရှစ်ခုနဲ့ Gen5 lanes ၁၂၈ ခု ပါဝင်ပြီး T2 မှာ DIMM slots လေးခုနဲ့ expansion slots ငါးခု ပါဝင်ပြီး T4 နဲ့ T6 ကတော့ ကျန်တာတွေကို support လုပ်ပါတယ်။
| ပလက်ဖောင်း | Dell Pro Precision 9 T2 (စမ်းသပ်ပြီး) | Dell Pro Max Tower T2 (စမ်းသပ်ပြီး) |
|---|---|---|
| processor ကို | Intel Xeon 658X၊ 24 cores / 48 threads၊ 3.0 မှ 4.9GHz၊ 144MB L3၊ 250W | Intel Core Ultra 9 285K၊ 24 cores / 24 threads (8P + 16E)၊ 5.7GHz အထိ၊ 36MB L3၊ 125W |
| ညွှန်ကြားချက်အစုံများ | AVX-၅၁၂၊ AMX | AVX2 (AVX-512)၊ Intel AI Boost NPU |
| မှတ်ဉာဏ် | 4 x 32GB DDR5-6400 RDIMM ECC (ချန်နယ်လေးခု; အများဆုံး 1TB) | ၄ x 32GB DDR5-4400 ECC UDIMM |
| ချဲ့ထွင်မှု | Gen5 x16၊ Gen5 x4၊ Gen4 x16၊ Gen4 x8 နှစ်ခု (x4 လျှပ်စစ်တစ်ခု) | Gen5 x16၊ Gen4 x4 တစ်ခုနှင့် Gen3 x4 နှစ်ခု |
| စမ်းသပ်ထားသည့်အတိုင်း Boot သိုလှောင်မှု | အရှေ့ဘက် FlexBay မှာ 2 x 2TB E3.S Gen5 NVMe၊ RAID0 (VROC by Graid Technology)၊ 4,097GB | 2TB SK hynix PCB01 M.2 Gen5 (တစ်ချောင်းတည်းသော ဒရိုက်) |
| အတွင်းပိုင်း M.2 | M.2 2280 Gen5 ၃ ခု | Gen5 ၁ ခု နှင့် Gen4 M.2 ၂ ခု |
| power supply | 750W စံ; 500W သို့မဟုတ် 1500W ရွေးချယ်နိုင်သည် (စမ်းသပ်ပြီး 1500W) | ၃၆၀ ဝပ်၊ ၅၀၀ ဝပ် သို့မဟုတ် ၁၅၀၀ ဝပ် (၈၀ ပလပ်စတစ် ပလက်တီနမ်) |
| စမ်းသပ်ထားတဲ့ ဂရပ်ဖစ်တွေ | RTX PRO 6000 Blackwell Max-Q (300W) ပို့ဆောင်ပြီး။ 600W ကတ်ကိုလည်း စမ်းသပ်ပြီးပါပြီ။ | RTX PRO 6000 Blackwell (600W) ကို ပို့ဆောင်ပြီးပါပြီ။ Max-Q ကတ်ကိုလည်း စမ်းသပ်ပြီးပါပြီ။ |
| ကိုယ်ထည် | ၃၈၇ x ၁၈၇.၇ x ၄၃၈ မီလီမီတာ၊ ၈.၁၇ မှ ၂၃ ကီလိုဂရမ်အထိ | ၃၈၇ x ၁၈၇.၇ x ၄၃၈ မီလီမီတာ၊ ၈.၁၇ မှ ၂၃ ကီလိုဂရမ်အထိ |
Core T2 ကတော့ M.2 drive တစ်ခုတည်းကနေ boot လုပ်ထားပြီး ကျွန်တော်တို့ရဲ့ Pro Precision 9 T2 မှာတော့ Dell ရဲ့ FlexBay NVMe boot configuration ပါဝင်ပါတယ်- hot-pluggable E3.S Gen5 drive နှစ်ခုကို ရှေ့ bezel နောက်မှာ RAID0 boot option ကနေ 4,097GB volume တစ်ခုအဖြစ် stripe လုပ်ထားပါတယ်။ E3.S က ကျွန်တော်တို့ tower vendor တွေကို တောင်းဆိုနေတဲ့ enterprise form factor ပါ၊ ဘာလို့လဲဆိုတော့ capacity ceiling ကို M.2 ထက် အများကြီးကျော်လွန်ပြီး drive တွေကို chassis ကို မဖွင့်ဘဲ ရှေ့ကိုထွက်လာလို့ပါ။ RAID layer က Graid Technology ရဲ့ VROC ဖြစ်ပြီး Intel VROC code က Graid က ပြီးခဲ့တဲ့နှစ်က လွှဲပြောင်းယူခဲ့ပြီး Computex မှာ ပြန်လည်မိတ်ဆက်ခဲ့ပြီး ဒါက ကျွန်တော်တို့ရဲ့ lab မှာ ပါဝင်တဲ့ ပထမဆုံး workstation ပါ။

600W ကတ်အတွက် နေရာအနည်းငယ်ပိုလိုအပ်ပြီး Max-Q မှာတော့ မလိုအပ်ပါဘူး။ ကျွန်တော်တို့ရဲ့ ယူနစ်မှာ Intel E810-XXV dual-port 25GbE adapter ကို GPU ဘေးက slot မှာ ထည့်ပေးထားပြီး 600W RTX PRO 6000 ကို တပ်ဆင်ဖို့အတွက် ဖြုတ်လိုက်ရပါတယ်။ ကတ်ရဲ့ cooler က slot ရဲ့ ပါဝါအပြင် ဘေးနားက နေရာကိုပါ ယူထားပါတယ်။ full-power ကတ်နဲ့ high-speed NIC ကို လိုချင်တဲ့ ဝယ်ယူသူတွေဟာ မှာယူမှုမပြုလုပ်ခင် slot layout ကို စီစဉ်သင့်ပြီး 1500W supply ကသာ သင့်တော်တဲ့ တွဲဖက်အသုံးပြုနိုင်တဲ့ တစ်ခုတည်းသော နည်းလမ်းဖြစ်ပါတယ်။ ကျွန်တော်တို့ရဲ့ ယူနစ်မှာ 750W standard supply ကနေ $40 upgrade လုပ်ထားတဲ့ 1500W option ပါရှိပါတယ်။
တည်ဆောက်ခြင်းနှင့်ဒီဇိုင်းဆွဲခြင်း
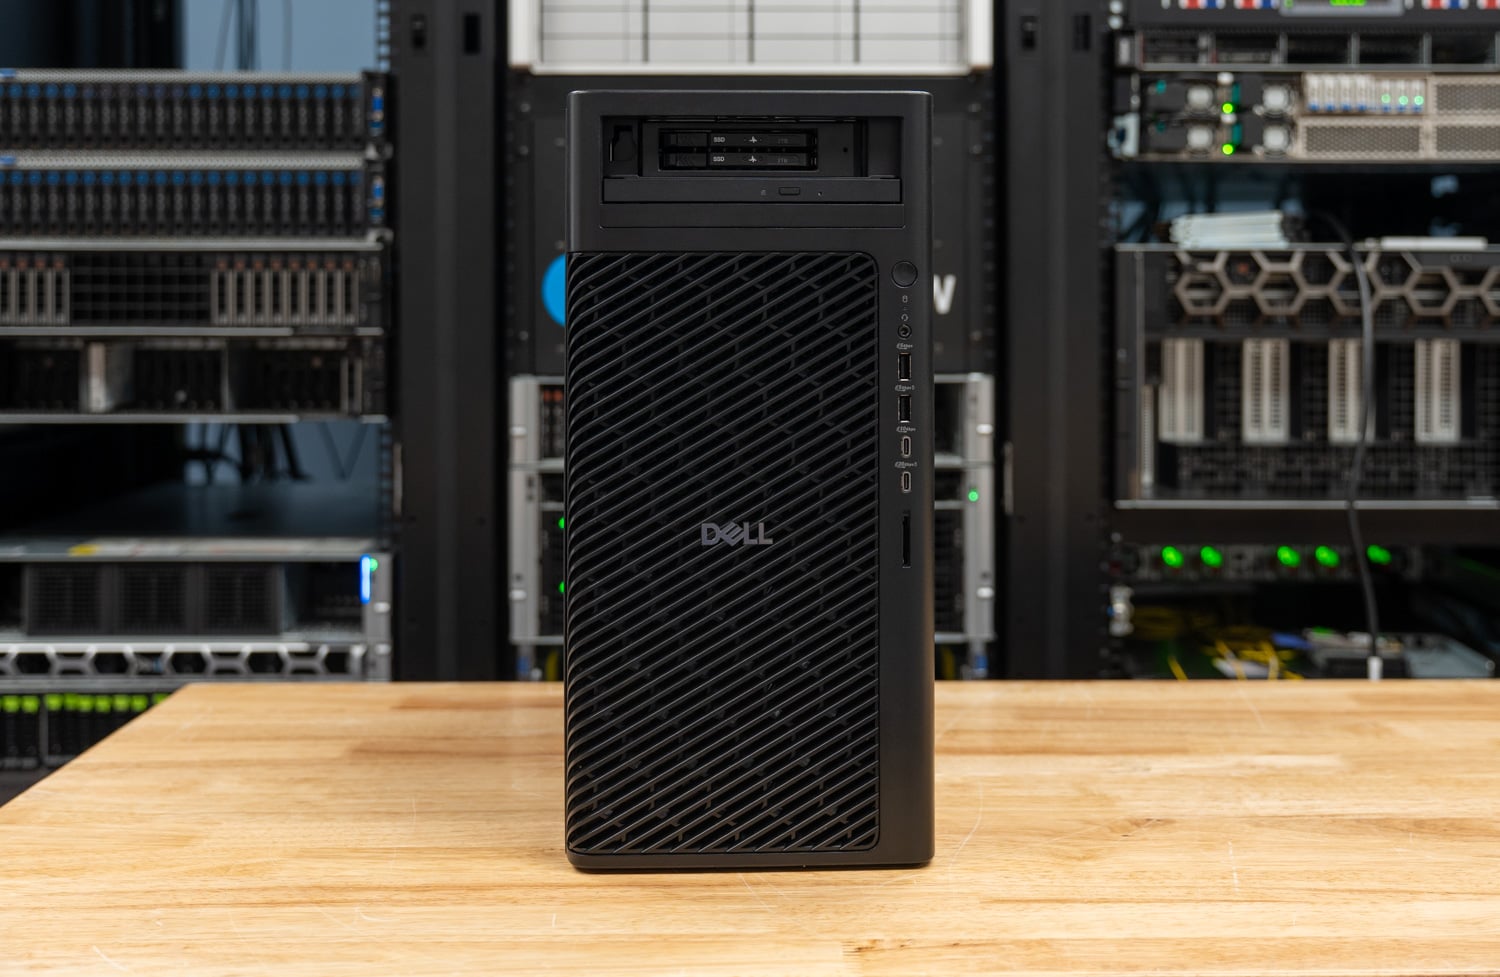
Pro Precision 9 T2 မှာ Pro Max ဗားရှင်းလိုပဲ tool-less tower ကိုအသုံးပြုထားပြီး intake အတွက် full-height mesh front grille၊ side panel အတွက် side latch နဲ့ captive thumbscrew တို့ပါဝင်ပြီး FlexBay နဲ့ အောက်ဘက် bezel နောက်ကွယ်မှာ optional slim optical drive ပါဝင်ပါတယ်။ Dell က chassis ကို ဗလာ ၁၁.၆ ကီလိုဂရမ်နဲ့ ၂၁.၈ ကီလိုဂရမ်အထိ အလေးချိန်ရှိတယ်လို့ စာရင်းပြုစုထားပြီး 1500W supply၊ 658X ရဲ့ cooler နဲ့ two-slot GPU တို့ပါဝင်တဲ့ ကျွန်တော်တို့ရဲ့ မော်ဒယ်ကတော့ အဲဒီအမျိုးအစားထဲမှာ ထိပ်ဆုံးမှာ ရှိပါတယ်။

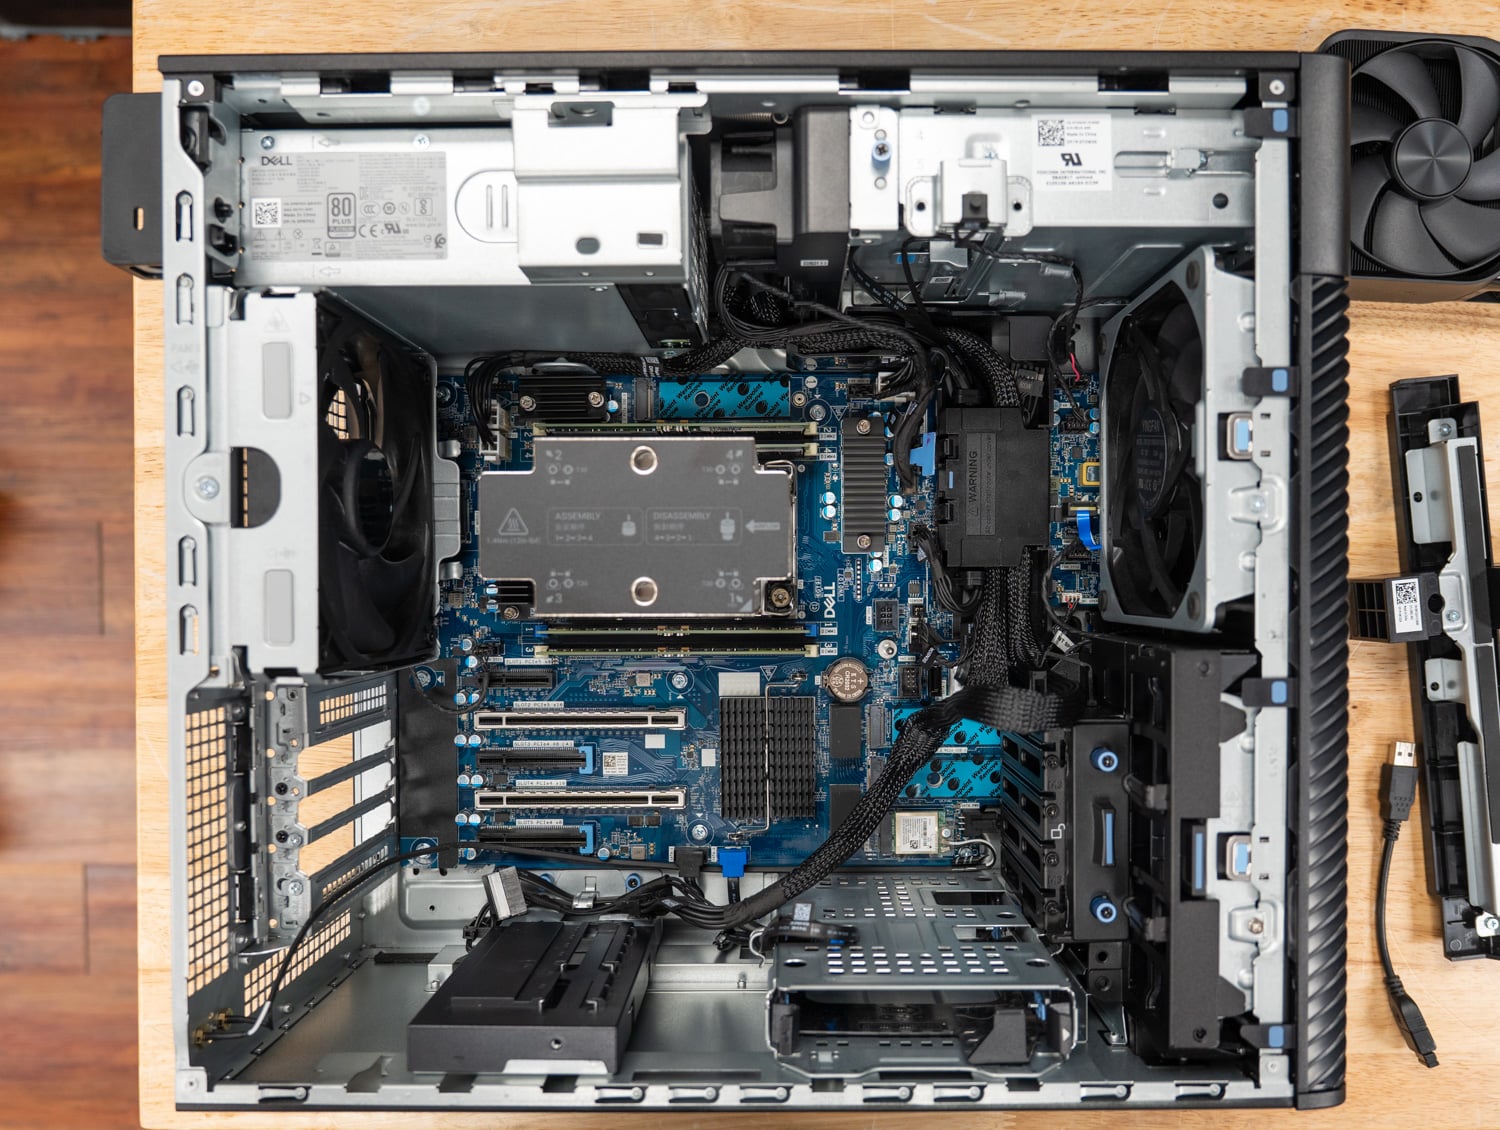
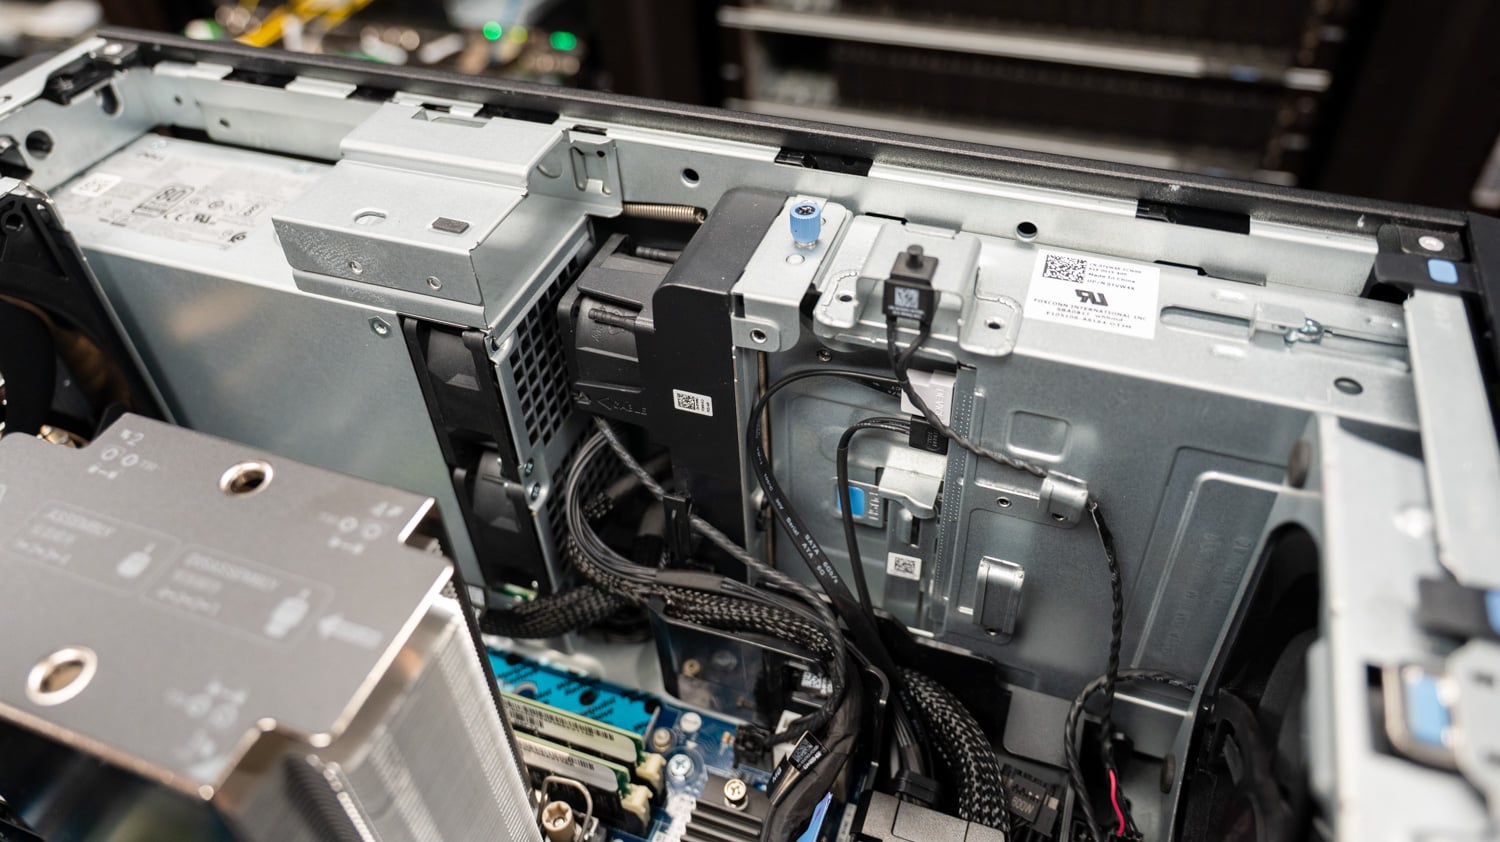
ကိုယ်ထည်အတွင်းပိုင်းကို လေစီးဆင်းမှုပတ်လည်တွင် တည်ဆောက်ထားပြီး Dell သည် လေကို လိုအပ်သည့်နေရာသို့ တိကျစွာ ညွှန်ကြားပေးပါသည်။ DIMM များကို အေးမြစေပြီး CPU မှ ပူသောလေကို ကိုယ်ထည်မှ တိုက်ရိုက်ထုတ်လွှတ်သည့် ကြီးမားသော အအေးခံအဖုံးတွင် အဖုံးအတွင်း၌ ပန်ကာတစ်ခု ပေါင်းစပ်ထားသည်။ အဖုံးဖွင့်ထားခြင်းဖြင့် အဖုံးသည် ကိုယ်ထည်၏ဖွဲ့စည်းပုံအပြင်အဆင်တွင် မည်သို့အလုပ်လုပ်သည်ကို သင်တွေ့မြင်နိုင်ပြီး ၎င်း၏အောက်ဘက်အနားကို GPU အထောက်အပံ့ကွင်းပေါ်တွင် တင်ထားပြီး ဘေးအဖုံးနှင့် အံကိုက်ကိုက်ညီစေပါသည်။
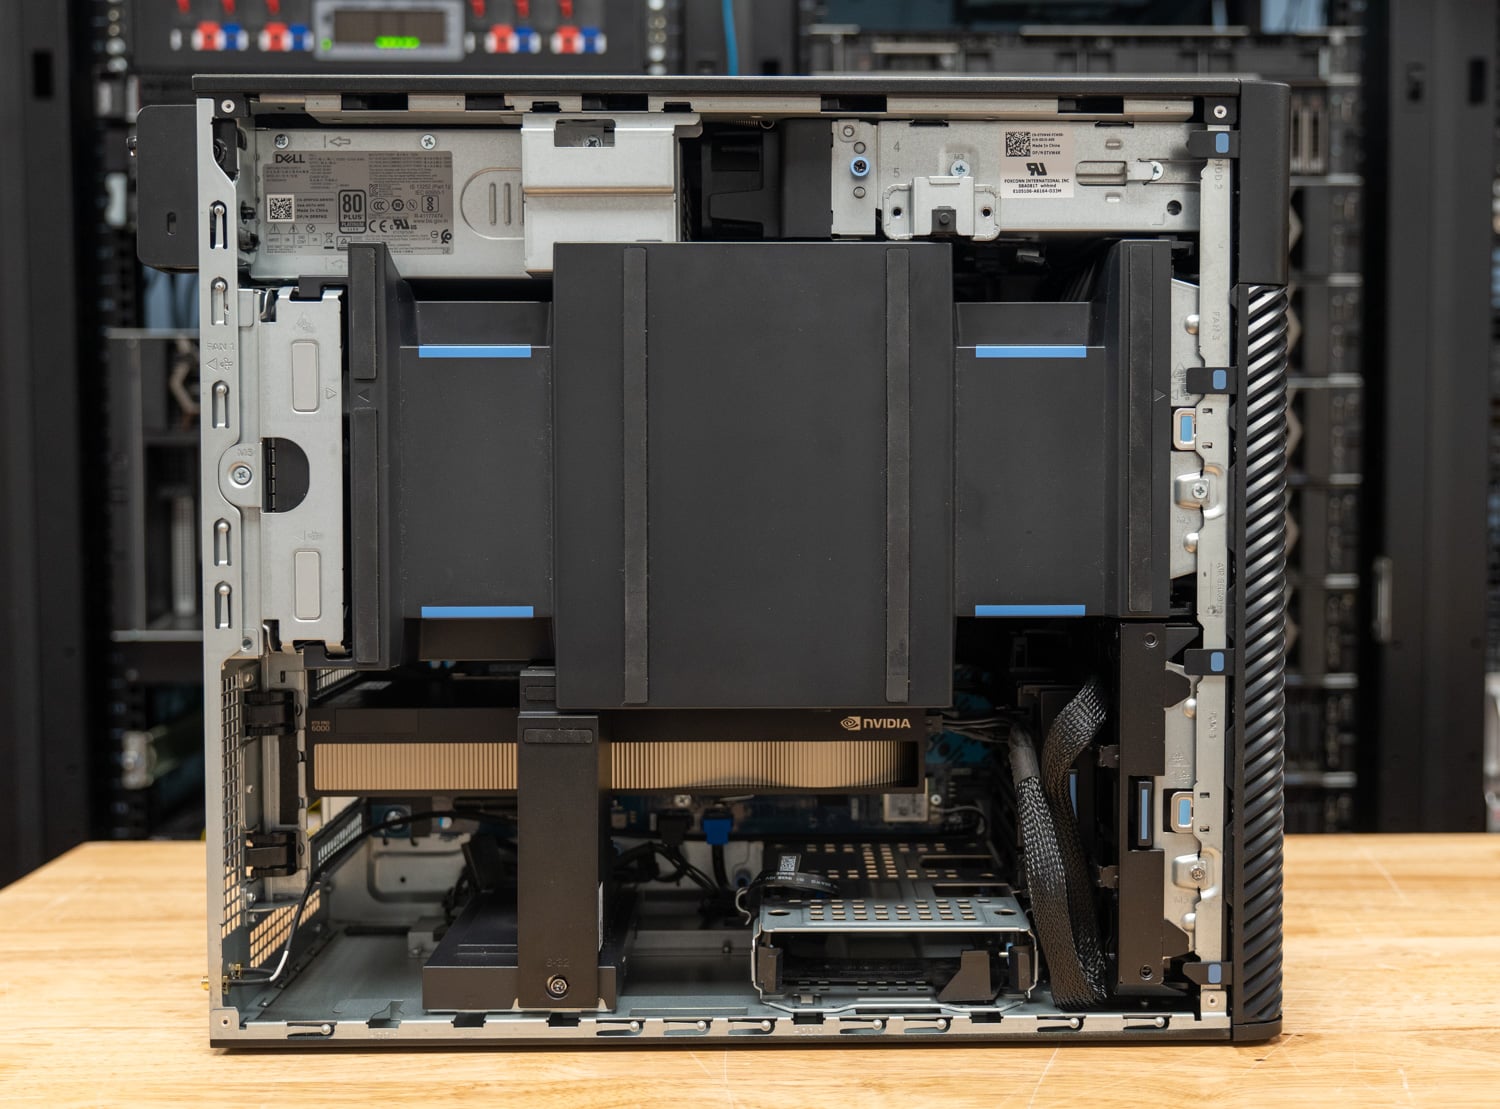
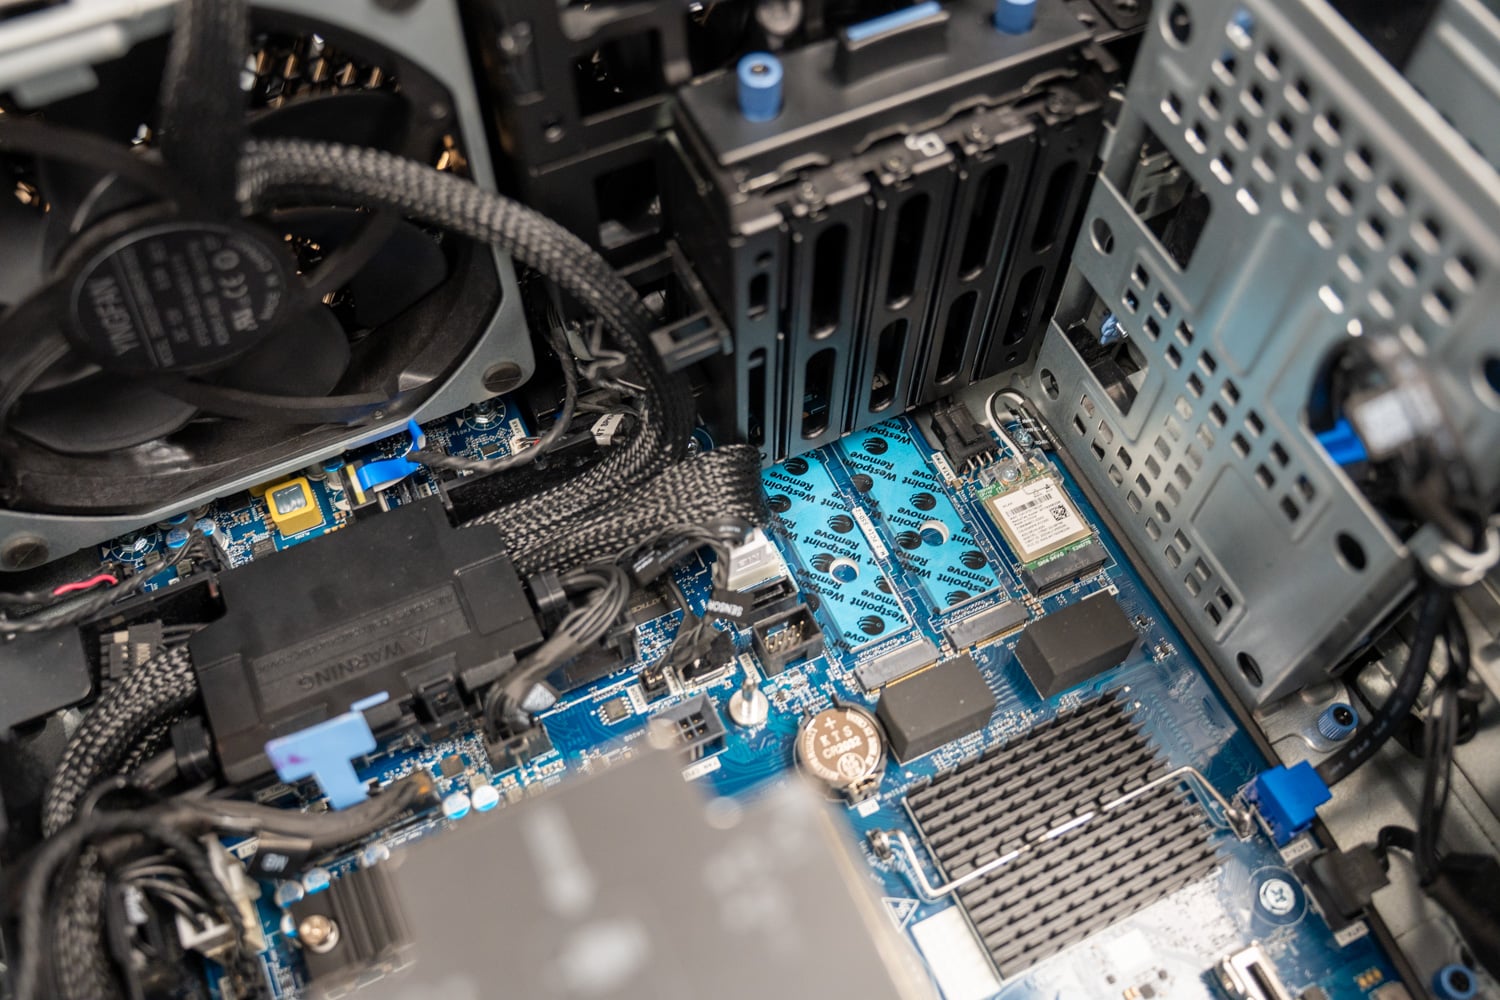
အတွင်းပိုင်းတွင်၊ အပြင်အဆင်သည် Pro Max tower ၏ ပုံစံအတိုင်းဖြစ်သည်- processor နှင့် DIMM slot လေးခုသည် expansion area အထက်တွင်ရှိပြီး Gen5 x16 slot ရှိ GPU ကို ၎င်း၏အစွန်ဆုံးတွင် retention bracket ဖြင့် ထောက်ပံ့ပေးထားပြီး power supply ကို tool-less removal အတွက် handle တစ်ခုဖြင့် နောက်ဘက်တွင် mount လုပ်ထားသည်။ slot ငါးခုစလုံးသည် full height ဖြစ်သည်- slot 2 သည် GPU အတွက် Gen5 x16၊ slot 1 သည် Gen5 x4 ဖြစ်ပြီး ကျန်သုံးခုမှာ Gen4 ဖြစ်ပြီး x16 တစ်ခုနှင့် open-ended x8 နှစ်ခုသည် NIC၊ storage card သို့မဟုတ် ဒုတိယ GPU အတွက်ဖြစ်သည်။ internal M.2 2280 Gen5 slot သုံးခုနှင့် 3.5-inch SATA bay နှစ်ခုသည် ရှေ့ E3.S bay နောက်တွင်ရှိသည်။
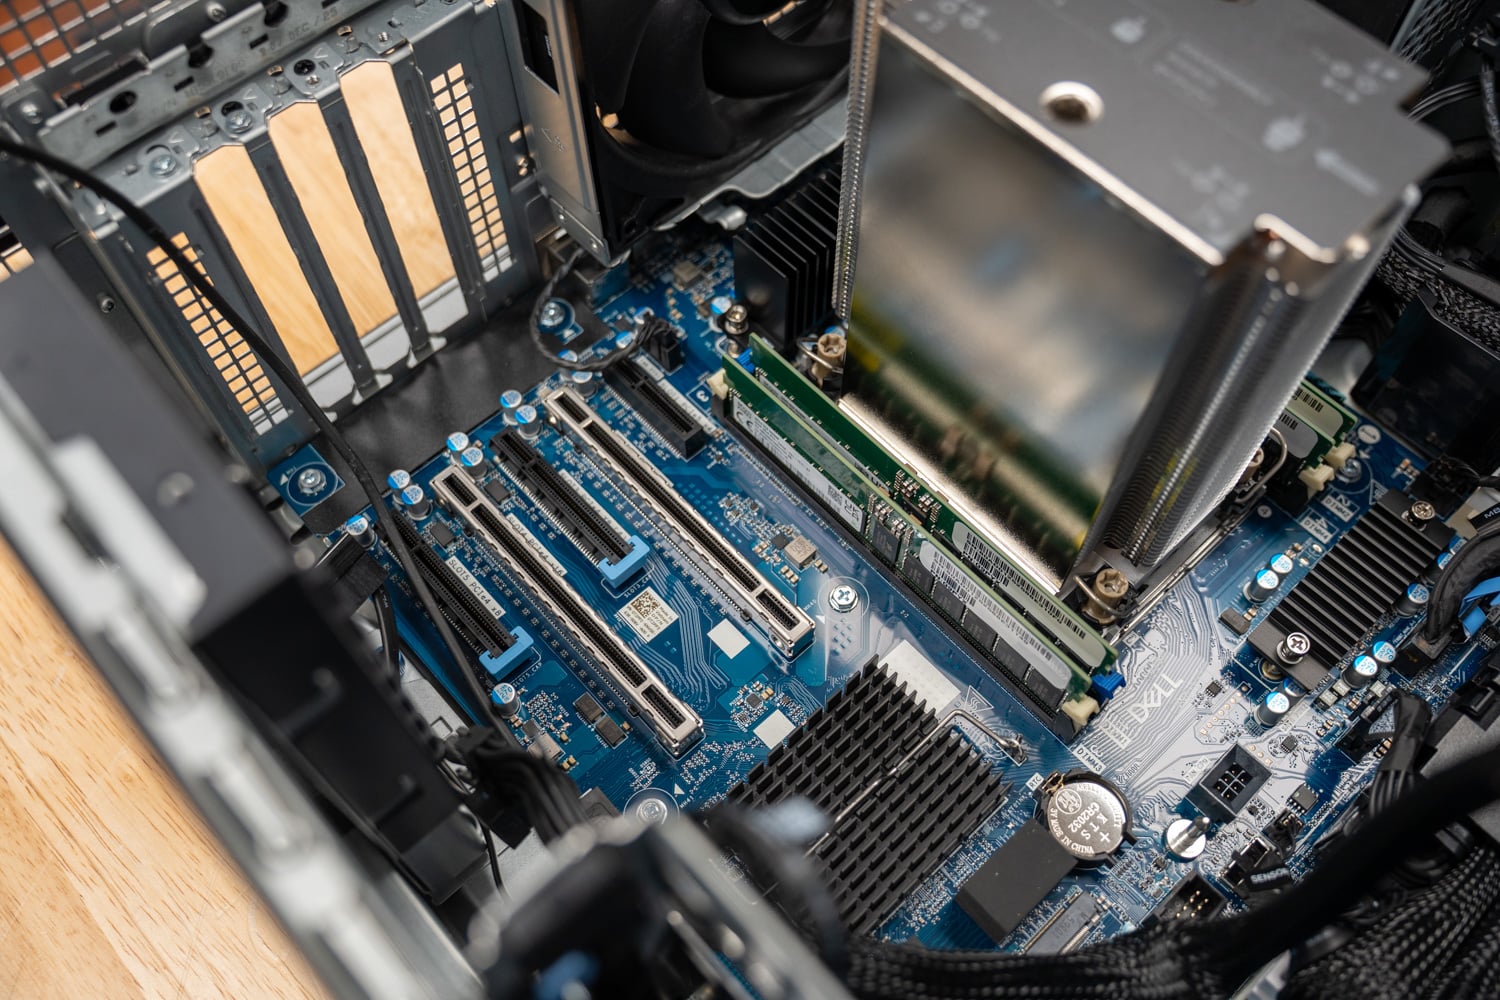
ရှေ့ I/O မှာ headset jack၊ PowerShare ပါတဲ့ 20Gbps USB-C port၊ 10Gbps USB-C port၊ USB-A port နှစ်ခုနဲ့ optional SD slot တစ်ခု ပါဝင်ပါတယ်။ နောက်ဘက်မှာတော့ audio line-out၊ 20Gbps နဲ့ 10Gbps USB-C port တွေ၊ SmartPower ပါတဲ့ USB 2.0 port နှစ်ခု၊ USB-A 5Gbps port နှစ်ခု၊ 1GbE၊ 5GbE NIC ဒါမှမဟုတ် USB-A port နှစ်ခုထပ်ထည့်တဲ့ optional module slot တစ်ခုနဲ့ optional legacy serial port တစ်ခု ပါဝင်ပါတယ်။ ကျွန်တော်တို့ရဲ့ unit မှာ internal M.2 2230 slot မှာ MediaTek MT7925 Wi-Fi 7 card နဲ့ 600W GPU အတွက် ထွက်လာတဲ့ Intel E810-XXV 25GbE card တို့ကို ထည့်သွင်းထားပါတယ်။

Dell Pro Precision 9 T2 သတ်မှတ်ချက်များ
| specification | Dell Pro Precision 9 T2 (PW9T2260) |
|---|---|
| ပလက်ဖောင်းခြုံငုံသုံးသပ်ချက် | |
| ပရိုဆက်ဆာ ရွေးချယ်စရာများ | Intel Xeon 634 (12C, 150W), 636 (12C, 170W), 638 (16C, 180W), 654 (18C, 200W), 656 (20C, 210W), 658X (24C / 48T, 144MB L3, 250W) Xeon 658X ကို စမ်းသပ်ပြီးပါပြီ |
| မှတ်ဉာဏ် | DDR5 RDIMM ECC၊ 5600 သို့မဟုတ် 6400 MT/s၊ slot လေးခု၊ 1TB (4 x 256GB) အထိ စမ်းသပ်ပြီး 128GB (4 x 32GB) DDR5-6400 |
| ဂရပ်ဖစ်ရွေးချယ်စရာများ | NVIDIA RTX A400, A1000, RTX PRO 2000 / 4000 / 4500 / 5000 / 6000 Blackwell (600W) / 6000 Blackwell Max-Q (300W), A800 Active; AMD Radeon Pro W7400; ရွေးချယ်ထားသော ကတ်များတွင် dual နှင့် triple configuration များ စမ်းသပ်ပြီးဖြစ်သည့်အတိုင်း RTX PRO 6000 Blackwell Max-Q Workstation Edition၊ 96GB GDDR7 |
| သိုလှောင်ခြင်း | ရှေ့ FlexBay: E3.S / NVMe drives နှစ်ခုအထိ ပါဝင်ပြီး optional slim ODD သို့မဟုတ် 3.5-inch SATA bay တစ်ခု အတွင်းပိုင်း: M.2 2280 Gen5 NVMe ၃ ခု၊ ၃.၅ လက်မ SATA ၂ ခု RAID: Graid နည်းပညာဖြင့် VROC ပါဝင်သော Intel VMD (RAID0 boot၊ internal RAID0) စမ်းသပ်ပြီးသည့်အတိုင်း RAID0 (4,097GB) ရှိ 2 x 2TB E3.S Gen5 NVMe |
| ချဲ့ထွင်မှု | အပေါက် ၁: Gen5 x၄; အပေါက် ၂: Gen5 x၁၆; အပေါက် ၃: Gen4 x၈ (x၄ လျှပ်စစ်၊ အဆုံးမရှိ); အပေါက် ၄: Gen4 x၁၆; အပေါက် ၅: Gen4 x၈ (အဆုံးမရှိ); Wi-Fi အတွက် M.2 2230 |
| I / O | |
| ရှေ့ပေါက်များ | PowerShare ပါရှိသော USB-C 20Gbps ၁ ခု၊ USB-C 10Gbps ၁ ခု၊ PowerShare ပါရှိသော USB-A 5Gbps ၁ ခု၊ USB-A 5Gbps ၁ ခု၊ နားကြပ်ပေါက်၊ ရွေးချယ်နိုင်သော SD slot |
| နောက်ဘက်ဆိပ်ကမ်းများ | USB-C 20Gbps ၁ ခု၊ USB-C 10Gbps ၁ ခု၊ USB 2.0 (SmartPower) ၂ ခု၊ USB-A 5Gbps ၂ ခု၊ အသံလိုင်းထွက် ၁ ခု၊ RJ45 1GbE ၁ ခု၊ ရွေးချယ်နိုင်သော 5GbE သို့မဟုတ် dual USB-A မော်ဂျူး၊ ရွေးချယ်နိုင်သော serial |
| စမ်းသပ်ထားတဲ့အတိုင်း ကွန်ရက်ချိတ်ဆက်မှု | Intel E810-XXV DA2 dual-port 25GbE SFP28 (600W GPU အတွက် ဖယ်ရှားထားသည်); MediaTek MT7925 Wi-Fi 7၊ Bluetooth 5.4 |
| တန်ခိုးနှင့်ရုပ် | |
| power supply | 750W စံ; 500W သို့မဟုတ် 1500W ရွေးချယ်နိုင်သည်; စမ်းသပ်ပြီး 1500W |
| ရှုထောင့် | ၂၇၀ x ၃၀၀ x ၃၄၀ မီလီမီတာ (၁၀.၆ x ၁၁.၈ x ၁၃.၄ လက်မ) |
| အလေးချိန် | အနည်းဆုံး ၁၁.၆ ကီလိုဂရမ် (၂၅.၅၇ ပေါင်) မှ အများဆုံး ၂၁.၈ ကီလိုဂရမ် (၄၈.၀၆ ပေါင်) အထိ |
| operating system | Windows 11 Pro for Workstations (စမ်းသပ်ပြီး) သို့မဟုတ် Ubuntu Linux 24.04 LTS |
| စီမံခန့်ခွဲမှုနှင့် လုံခြုံရေး | Intel vPro၊ TPM 2.0၊ ကိုယ်ထည်ထိုးဖောက်ဝင်ရောက်မှုခလုတ်၊ သော့ခတ်နိုင်သော bezel ရွေးချယ်မှုများ၊ Kensington slot |
| စျေးနှုန်း | Dell.com အခြေခံဖွဲ့စည်းပုံ $3,978 (Xeon 634, 16GB, RTX A400, 256GB, 750W)၊ စမ်းသပ်ပြီး $28,300 ခန့် (Xeon 658X, 128GB DDR5-6400, RTX PRO 6000 Max-Q, RAID0 တွင် 2 x 2TB Gen5 FlexBay drives, 1500W, 25GbE, Wi-Fi 7)၊ ၂၀၂၆ ခုနှစ် အောက်တိုဘာလ ၁၉ ရက်နေ့အထိ Dell.com ၏ ဈေးနှုန်း |
အဲဒီဈေးနှုန်းမှာ သတိပေးချက်နှစ်ခုပါဝင်ပါတယ်။ Dell.com ရဲ့ configurator မှာ FlexBay drives တွေကို 2TB M.2 2280 Gen5 modules အနေနဲ့ တစ်ခုချင်းစီကို ဒေါ်လာ ၁၇၀၀ နဲ့ စာရင်းသွင်းထားပြီး ကျွန်တော်တို့ရဲ့ unit ထဲက drives တွေကတော့ E3.S ဖြစ်ပြီး Dell ရဲ့ E3.S option က အွန်လိုင်းမှာ ဘယ်တော့ပေါ်လာမလဲဆိုတာ မေးကြည့်ခဲ့ပါတယ်။ Dell က ဝဘ်ဈေးနှုန်းနဲ့ ဝယ်ယူတဲ့ business workstations အနည်းငယ်သာရှိတယ်လို့ ပွင့်ပွင့်လင်းလင်းပြောပါတယ်။ ဒါကြောင့် ဒေါ်လာ ၂၈၃၀၀ ကို volume နဲ့ contract ဈေးနှုန်းတွေ လျှော့ချဖို့ အမြင့်ဆုံးအဆင့်လို့ သတ်မှတ်ပါတယ်။ memory နဲ့ GPU က ဒေါ်လာ ၁၉၀၉၀ ကုန်ကျပြီး 300W ဒါမှမဟုတ် 600W card ကို ရွေးချယ်ပါစေ GPU option ရဲ့ ဈေးနှုန်းက အတူတူပါပဲ။
Dell က ဒီ review unit ကို စမ်းသပ်ပြီးသားအနေနဲ့ ဒေါ်လာ ၃၁,၇၀၀ နဲ့ ရောင်းချနေပြီး E810-XXV 25GbE adapter, Wi-Fi 7, optical drive နဲ့ ProSupport သုံးနှစ်စာ ပါဝင်တဲ့ ဈေးနှုန်းကိုပါ ထည့်သွင်းထားပါတယ်။
စမ်းသပ်ခြင်း Setup နှင့်နည်းစနစ်
ဤသုံးသပ်ချက်တွင် ရလဒ်တိုင်းသည် ကျွန်ုပ်တို့၏ scripted Windows client benchmark suite ဖြစ်သော sr-client 1.2 မှ လာခြင်းဖြစ်ပြီး၊ ၎င်း၏ full run profile တွင် Dell ၏ drivers များနှင့် NVIDIA driver 596.71 ပါရှိသော Dell ၏ factory Windows image ကို configuration လေးခုလုံးတွင် အသုံးပြုထားသည်။ suite သည် နေရာတိုင်းတွင် setting တူညီစွာ သက်ရောက်သည်- Windows power mode ကို Best performance တွင် ထားရှိခြင်း၊ sleep နှင့် display-off timers အားလုံးကို disable လုပ်ခြင်း၊ Windows Firewall နှင့် UAC prompts များကို ပိတ်ခြင်း၊ VBS နှင့် Memory Integrity ကို shipped အဖြစ် ထားခဲ့ခြင်း။ ရလဒ်တိုင်းသည် ထပ်ခါတလဲလဲ pass များ၏ median ဖြစ်ပြီး suite သည် ၎င်းကိုလက်ခံခြင်းမပြုမီ spread ၂ ရာခိုင်နှုန်းကျော်သော စမ်းသပ်မှုကို ပြန်လည်လုပ်ဆောင်သည်။
အောက်ဖော်ပြပါ configuration လေးခုမှာ tower နှစ်ခုနှင့် GPU နှစ်ခုဖြစ်သည်။ Pro Precision 9 T2 သည် ၎င်း၏ Max-Q ကတ်ဖြင့် full suite ကို run ခဲ့ပြီး ကျွန်ုပ်တို့၏ Pro Max Tower T2 မှ 600W RTX PRO 6000 Blackwell ဖြင့် ထပ်မံ run ခဲ့ပြီး Pro Max Tower T2 သည် ကတ်နှစ်ခုလုံးကို အလှည့်ကျ run ခဲ့သောကြောင့် tower အတွင်းရှိ GPU columns များသည် ကတ်တွင်သာ ကွဲပြားပြီး GPU အတွင်းရှိ tower columns များသည် platform တွင်သာ ကွဲပြားသည်။ Core T2 ၏ drive သည် ၎င်းနှင့်အတူ ပါလာသော single 2TB Gen5 M.2 ဖြစ်ပြီး Xeon T2 များသည် ၎င်း၏ two-drive E3.S stripe ဖြစ်သောကြောင့် storage နှင့် model-loading row များသည် configured အဖြစ် နှိုင်းယှဉ်ပါသည်။
| configuration | စီပီယူ | မှတ်ဉာဏ် | GPU ကို | boot drive | OS နှင့် ပါဝါမုဒ် |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T2 (PW9T2260)၊ Max-Q | Intel Xeon 658X, 24C / 48T, 250W | 128GB DDR5-6400 RDIMM ECC (4 x 32GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition၊ 300W၊ 96GB | ၂ x 2TB E3.S Gen5 NVMe၊ VROC RAID0 (4,097GB boot volume) | Windows 11 Pro for Workstations 25H2၊ အကောင်းဆုံးစွမ်းဆောင်ရည် |
| Dell Pro Precision 9 T2 (PW9T2260)၊ 600W | Intel Xeon 658X, 24C / 48T, 250W | 128GB DDR5-6400 RDIMM ECC (4 x 32GB) | NVIDIA RTX PRO 6000 Blackwell Workstation Edition၊ 600W၊ 96GB | ၂ x 2TB E3.S Gen5 NVMe၊ VROC RAID0 (4,097GB boot volume) | Windows 11 Pro for Workstations 25H2၊ အကောင်းဆုံးစွမ်းဆောင်ရည် |
| Dell Pro Max Tower T2 (FCT2250)၊ Max-Q | Intel Core Ultra 9 285K, 24C / 24T, 125W | 128GB DDR5-4400 ECC (4 x 32GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition၊ 300W၊ 96GB | SK hynix PCB01 2TB၊ Gen5 x4 | Windows 11 Pro 26H2၊ အကောင်းဆုံးစွမ်းဆောင်ရည် |
| Dell Pro Max Tower T2 (FCT2250)၊ 600W | Intel Core Ultra 9 285K, 24C / 24T, 125W | 128GB DDR5-4400 ECC (4 x 32GB) | NVIDIA RTX PRO 6000 Blackwell Workstation Edition၊ 600W၊ 96GB | SK hynix PCB01 2TB၊ Gen5 x4 | Windows 11 Pro 26H2၊ အကောင်းဆုံးစွမ်းဆောင်ရည် |
LLM serving ဖြင့် စတင်ပြီး စမ်းသပ်မှုများစွာကို ဤနေရာတွင် စတင်ပါသည်။ ၎င်းသည် llama-server ကို မော်ဒယ်လေးခုဖြင့် လုပ်ဆောင်ပြီး တောင်းဆိုမှုတစ်ခုမှ GPU မှတ်ဉာဏ်တွင် ကိုက်ညီသော အများဆုံး request အထိ concurrency ကို စုစည်းကာ စုစုပေါင်းနှင့် per-user throughput၊ ပထမဆုံး token သို့ ရောက်ရှိချိန်နှင့် output token တစ်ခုလျှင် အချိန်ကို အစီရင်ခံပါသည်။ image generation test သည် FLUX.2 klein 4B၊ Z-Image Turbo 6B နှင့် Qwen-Image 20B တို့ဖြင့် Q4_0၊ Q8_0 နှင့် BF16 အလေးချိန်များတွင် 1024×1024 image များကို ပုံဖော်ပေးပြီး quantized output များကို PSNR နှင့် SSIM ဖြင့် BF16 နှင့် နှိုင်းယှဉ်ကာ အမှတ်ပေးသောကြောင့် speed နှင့် fidelity တို့သည် ယှဉ်တွဲတည်ရှိနေပါသည်။ coding agent test သည် ယခုအခါ Crush တွင် လုပ်ဆောင်ပြီး agent-beside-user test သည် browser benchmark ကို full pass သုံးကြိမ်အထိ ထိန်းထားသည့် ပြန်လည်ပြင်ဆင်ထားသော နည်းလမ်းကို အသုံးပြုသည်။
ဇယားများတွင် အညွှန်းသုံးခု ထပ်ခါတလဲလဲပေါ်လာပြီး N/A ဖြင့်စတင်သောကြောင့် စမ်းသပ်မှုသည် ဟာ့ဒ်ဝဲနှင့် မသက်ဆိုင်ပါ- SMT မရှိသော 285K ရှိ SMT single-core နှင့် core ၂၄ ခုသည် အတန်းတစ်ခုတည်းဖြစ်သော Xeon ရှိ OpenBLAS top-core-class row များ။ တစ်စိတ်တစ်ပိုင်းအမှတ်အသားများသည် suite မှ မှတ်စုတစ်ခုဖြင့် လက်ခံထားသော ရလဒ်ဖြစ်ပြီး အများအားဖြင့် လုပ်ဆောင်မှုသုံးခုအနက် တစ်ခုသည် ၎င်း၏စမ်းသပ်မှုများ မအောင်မြင်သည့် coding agent tier ဖြစ်သည်။ desktop နှစ်ခုလုံးသည် suite ၏ sensor path သို့ CPU သို့မဟုတ် GPU အပူချိန်များကို မဖော်ပြသောကြောင့် ဤသုံးသပ်ချက်အစီရင်ခံစာများသည် thermal table အစား စမ်းသပ်မှုတစ်ခုလျှင် CPU clock များကို ဆိုလိုသည်။
ဒေသတွင်း AI စွမ်းဆောင်ရည်
configuration တိုင်းမှာ GDDR7 96GB ပါဝင်တာကြောင့် မော်ဒယ်စွမ်းရည်က ပေးထားပြီး ကျွန်တော်တို့ရဲ့ local AI suite ရဲ့ အဆင့်တိုင်းဟာ လေးဆင့်စလုံးမှာ အလုပ်လုပ်ပါတယ်။ ဒါကြောင့် ရလဒ်တွေက GPU power limit အလိုက် ကွဲပြားသွားပါတယ်။ စမ်းသပ်မှုတစ်ခုကို memory bandwidth နဲ့ ကန့်သတ်ထားတဲ့နေရာမှာ Max-Q နဲ့ 600W ကတ်တွေက အတူတကွ နီးကပ်စွာ အလုပ်လုပ်ပြီး compute နဲ့ ကန့်သတ်ထားတဲ့နေရာမှာ 600W ကတ်က ဦးဆောင်နေပါတယ်။ CPU platform က အရေးမကြီးသလောက်ပါပဲ။ ဘယ်နေရာမှာပဲဖြစ်ဖြစ် ဦးတည်ချက်က မှတ်သားထားသင့်ပါတယ်။
MLPerf ကလိုင်းယင့် v2.0
MLPerf Client သည် Llama 3.1 8B နှင့် Phi-4-mini တို့ကို prompt အမျိုးအစားငါးခုမှတစ်ဆင့် လုပ်ဆောင်ပြီး အမျိုးအစားများတစ်လျှောက် geometric mean အဖြစ် ပထမ token နှင့် ၎င်းနောက် token rate သို့ အချိန်ကို အစီရင်ခံပြီး llama.cpp ကို configuration တိုင်းတွင် engine အဖြစ် CUDA တွင် အသုံးပြုသည်။ agentic scenarios များသည် Llama 3.1 8B ကို data analyst agent နှင့် software engineering agent အဖြစ် turns များစွာတွင် tools များကို ခေါ်ယူသည်။

| MLPerf ကလိုင်းယင့် v2.0 | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| လာမာ ၃.၁ ၈ဘီ၊ ပထမဆုံးတိုကင်သို့ရောက်ရှိချိန်၊ ဂျီဩမေတြီ (s၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | 0.082 | 0.059 | 0.082 | 0.060 |
| လာမာ ၃.၁ ၈ဘီ၊ တိုကင်နှုန်း၊ ဂျီဩမေတြီပျမ်းမျှ (tok/s) | 230.9 | 252.8 | 230.0 | 246.7 |
| Phi-4-mini၊ ပထမဆုံးတိုကင်အတွက်အချိန်၊ geomean (s၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | 0.045 | 0.034 | 0.044 | 0.034 |
| Phi-4-mini၊ တိုကင်နှုန်း၊ ဂျီအိုမီယန် (tok/s) | 345.9 | 379.0 | 351.0 | 374.3 |
| ဒေတာ ခွဲခြမ်းစိတ်ဖြာသူ အေးဂျင့်၊ အဆုံးမှအဆုံး (များသော၊ နိမ့်လေ ပိုကောင်းလေ) | 17.5 | 15.7 | 16.2 | 14.4 |
| ဒေတာ ခွဲခြမ်းစိတ်ဖြာသူ အေးဂျင့်၊ တိုကင်နှုန်း (tok/s) | 202.9 | 223.9 | 202.3 | 218.4 |
| SWE အေးဂျင့်၊ အဆုံးမှအဆုံး (များလေ၊ နိမ့်လေ ပိုကောင်းလေ) | 16.2 | 14.9 | 14.6 | 13.5 |
| SWE အေးဂျင့်၊ တိုကင်နှုန်း (tok/s) | 197.5 | 214.6 | 195.5 | 210.2 |
Max-Q ကတ်သည် Llama 3.1 8B ကို Xeon tower တွင် တစ်စက္ကန့်လျှင် 230.9 tokens နှင့် Core tower တွင် 230.0 ဖြင့် ထုတ်ပေးခဲ့ပြီး Phi-4-mini သည် 345.9 နှင့် 351.0 ဖြင့် ထုတ်ပေးခဲ့ပြီး၊ ၎င်းသည် တူညီသော GPU မှ တူညီသောအလုပ်ကို လုပ်ဆောင်ပေးပါသည်။ 600W ကတ်သည် Xeon tower တွင် တစ်စက္ကန့်လျှင် 252.8 နှင့် 379.0 tokens အထိ မြှင့်တင်ပေးခဲ့ပြီး ၉ ရာခိုင်နှုန်းခန့် တိုးလာကာ Llama တွင် ပထမဆုံး token အတွက် အချိန်ကို 0.082 မှ 0.059 စက္ကန့်အထိ လျှော့ချပေးခဲ့ပြီး ၂၈ ရာခိုင်နှုန်း လျော့ကျစေခဲ့သည်။ Prompt processing သည် compute-bound ဖြစ်ပြီး decode သည် bandwidth-bound ဖြစ်ပြီး ကတ်နှစ်ခုသည် memory တူညီစွာ မျှဝေအသုံးပြုသောကြောင့် power limit သည် ပထမ token တွင် နောက်ပိုင်း token များထက် ပိုမိုပေါ်လာပါသည်။
agentic scenarios တွေက CPU platform ပေါ်လာတဲ့နေရာတွေပါ။ data analyst agent က Core T2 မှာ Max-Q card နဲ့ ၁၆.၂ စက္ကန့်နဲ့ Xeon T2 မှာ ၁၇.၅ စက္ကန့်နဲ့ SWE agent က ၁၄.၆ စက္ကန့်နဲ့ ၁၆.၂ စက္ကန့်အတွင်း ပြီးမြောက်ခဲ့ပြီး Xeon ရဲ့ tool-call phases တွေက ၁.၅ စက္ကန့်လောက် ပိုကြာခဲ့ပါတယ်။ token rates တွေက ၁ ရာခိုင်နှုန်းအတွင်း တူညီတာကြောင့် model calls တွေကြားမှာ CPU မှာ run နေတဲ့ tools တွေက ကွာခြားချက်ဖြစ်ပြီး 285K ရဲ့ ပိုမြန်တဲ့ core တွေက ပိုမြန်မြန်ပြီးမြောက်ပါတယ်။
မော်ဒယ် Loading
ဤစမ်းသပ်မှုသည် Ollama ရှိ ဒေသတွင်းမော်ဒယ်တစ်ခုကို drive မှ ၎င်း၏ပထမဆုံးထုတ်လုပ်ထားသော token အထိ၊ cold (ဖိုင် cache ကို flush လုပ်ထားသည်) နှင့် warm (ဖိုင်သည် memory တွင်ရှိပြီးသား) အထိ တိုင်းတာပြီး cold load အတွင်း drive ကို မည်မျှမြန်မြန်ဖတ်ခဲ့သည်၊ weight များသည် GPU memory ထဲသို့ရောက်ရှိသောအခါ၊ load အတွင်း read rate ကို drive ၏ 1MB sequential ceiling နှင့် နှိုင်းယှဉ်သည့် load efficiency ကိန်းဂဏန်းတစ်ခုကို အစီရင်ခံပါသည်။ 96GB VRAM ဖြင့်၊ အလွှာသုံးလွှာစလုံးသည် 12.8GB တွင် gpt-oss:20b၊ 21.1GB တွင် Qwen3.6-35B-A3B နှင့် 60.9GB တွင် gpt-oss:120b တို့ကို လုပ်ဆောင်သည်။

| မော်ဒယ်တင်နေသည် (မှတ်ဉာဏ်မြေပုံရေးဆွဲခြင်းဖွင့်ထားသည်) | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| gpt-oss:20b၊ ပထမဆုံးတိုကင်ကို အအေးခံပါ (s၊ နိမ့်လေ ပိုကောင်းလေ) | 9.68 | 9.02 | 7.41 | 7.23 |
| gpt-oss:20b၊ ပထမဆုံးတိုကင်သို့ နွေးနွေးလေးတင်ပါ (s၊ နိမ့်လေ ပိုကောင်းလေ) | 7.52 | 7.18 | 6.60 | 6.61 |
| gpt-oss:20b၊ GPU မှတ်ဉာဏ်သို့ ရောက်ရှိသည်၊ အေးသည် (s၊ နိမ့်လေ ပိုကောင်းလေ) | 4.44 | 4.33 | 3.00 | 2.95 |
| Qwen3.6-35B-A3B၊ ပထမဆုံးတိုကင်သို့ အအေးခံပါ (s၊ နိမ့်လေ ပိုကောင်းလေ) | 13.31 | 12.32 | 11.62 | 11.01 |
| Qwen3.6-35B-A3B၊ ပထမဆုံးတိုကင်သို့ နွေးထားသောဝန် (s၊ နိမ့်လေ ပိုကောင်းလေ) | 11.63 | 10.75 | 10.35 | 9.99 |
| gpt-oss:120b၊ ပထမဆုံးတိုကင်ကို အအေးခံပါ (s၊ နိမ့်လေ ပိုကောင်းလေ) | 32.06 | 32.44 | 28.54 | 28.11 |
| gpt-oss:120b၊ ပထမဆုံးတိုကင်သို့ နွေးနွေးလေးတင်ပါ (s၊ နိမ့်လေ ပိုကောင်းလေ) | 27.18 | 26.49 | 25.58 | 25.73 |
| gpt-oss:120b၊ အအေးခံထားစဉ် ဖတ်ရှုမှုပမာဏ (MB/s) | 9,875 | 9,106 | 11,633 | 11,248 |
| gpt-oss:120b၊ GPU မှတ်ဉာဏ်သို့ ရောက်ရှိသည်၊ အေးသည် (s၊ နိမ့်လေ ပိုကောင်းလေ) | 11.33 | 11.57 | 7.74 | 7.63 |
| gpt-oss:20b မှ ပြောင်းလဲပြီးနောက် gpt-oss:120b ဝန်တင်ခြင်း (s၊ နိမ့်လေ ပိုကောင်းလေ) | 14.30 | 13.97 | 11.89 | 11.93 |
| Drive ceiling၊ DiskSpd 1MB အစဉ်လိုက်ဖတ်ရှုမှု (MB/s) | 11,306 | 11,296 | 11,563 | 11,646 |
Core T2 က မော်ဒယ်တိုင်းကို ပိုမြန်အောင် load လုပ်နိုင်ပြီး drive က အကြောင်းရင်းပါ။ gpt-oss:120b ဟာ Core T2 မှာ ၂၈.၅၄ စက္ကန့်အတွင်း ပထမဆုံး token ကို ရောက်ရှိခဲ့ပြီး Xeon T2 မှာ ၃၂.၀၆ စက္ကန့်သာ ရှိခဲ့ပါတယ်။ 61GB weights ဟာ GPU memory ထဲကို ၇.၇၄ စက္ကန့်အတွင်း ရောက်ရှိခဲ့ပြီး ၁၁.၃၃ စက္ကန့်သာ ရှိခဲ့ပါတယ်။ single PCB01 က 11,633MB/s load ကို ထောက်ပံ့ပေးခဲ့ပြီး၊ သူ့ရဲ့ 11,563MB/s DiskSpd ceiling မှာ ထောက်ပံ့ပေးခဲ့ပြီး၊ E3.S stripe ကတော့ သူ့ရဲ့ကိုယ်ပိုင် 11,306MB/s ceiling မှာ ထောက်ပံ့ပေးခဲ့ပါတယ်။ RAID volume က single drive လောက်နီးပါး ကြီးမားတဲ့ blocks တွေကို ဖတ်ရှုပေမယ့် Ollama ရဲ့ memory-mapped loading path မှာ အဲဒီနှုန်းကို မထိန်းထားနိုင်ပါဘူး။
နွေးသော load များသည် ဖိုင်သည် system memory တွင်ရှိပြီးသားဖြစ်ပြီး VRAM နှင့် llama.cpp ၏ setup ထဲသို့ လွှဲပြောင်းခြင်းသာ ကျန်ရှိသောကြောင့် ကွာဟချက်ကို တစ်စက္ကန့် သို့မဟုတ် နှစ်စက္ကန့်အထိ ကျဉ်းမြောင်းစေသည်- Xeon T2 တွင် ၂၇.၁၈ စက္ကန့်နှင့် gpt-oss:120b အတွက် ၂၅.၅၈ စက္ကန့်နှင့် gpt-oss:20b အတွက် ၆.၆၀ စက္ကန့်နှင့် ၇.၅၂ စက္ကန့်။ GPU ၏ power limit သည် loading တွင် မျှော်လင့်ထားသည့်အတိုင်း တသမတ်တည်း ကွာခြားမှုမရှိပါ။
Coding အေးဂျင့်
Crush သည် terminal coding agent တစ်ခုဖြစ်ပြီး Ollama မှ ဝန်ဆောင်မှုပေးသော local model တစ်ခုကို pinned repository ရှိ fixed coding task တစ်ခုမှတစ်ဆင့် မောင်းနှင်ပေးပြီး repository ၏ စမ်းသပ်မှု ၁၁ ခု အောင်မြင်စေရန် round သုံးကြိမ်အထိ လုပ်ဆောင်ပေးပါသည်။ ကျွန်ုပ်တို့သည် run သုံးခု၏ အလယ်အလတ် wall time၊ အောင်မြင်သည့်အကြိမ်အရေအတွက်နှင့် generation rate ကို အစီရင်ခံပါသည်။ Wall time သည် model မှ tool call များနှင့် token မည်မျှသုံးစွဲရန် ဆုံးဖြတ်သည်ပေါ်တွင် မူတည်ပြီး run တစ်ခုနှင့်တစ်ခု မတူညီသောကြောင့် generation rate သည် ပိုမိုသန့်ရှင်းသော hardware နှိုင်းယှဉ်မှုဖြစ်သည်။ agent-beside-user test သည် agent နှင့် Speedometer ကို အတူတကွ လုပ်ဆောင်ပြီး တစ်ခုချင်းစီသည် တစ်စုံတစ်ခုကို မည်မျှနှေးကွေးစေသည်ကို အစီရင်ခံပါသည်။

| Crush coding agent | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| Tier S၊ gpt-oss:20b၊ 64K အခြေအနေ | ||||
| နံရံအချိန်၊ အလယ်အလတ် (s၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | 55.1 | 99.8 | 57.2 | 43.2 |
| အောင်မြင်မှုများ (၃ ခုအနက်) | 3 | 2 | 3 | 2 |
| ထုတ်လုပ်မှုနှုန်း (tok/s) | 214.1 | 237.9 | 218.0 | 237.7 |
| အဆင့် M၊ Qwen3.6-35B-A3B၊ 64K အခြေအနေ | ||||
| နံရံအချိန်၊ အလယ်အလတ် (s၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | 35.2 | 27.0 | 86.7 | 32.1 |
| အောင်မြင်မှုများ (၃ ခုအနက်) | 3 | 3 | 3 | 3 |
| ထုတ်လုပ်မှုနှုန်း (tok/s) | 234.5 | 242.9 | 223.3 | 245.8 |
| အဆင့် L၊ Qwen3.6-35B-A3B၊ 128K အခြေအနေ | ||||
| နံရံအချိန်၊ အလယ်အလတ် (s၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | 38.1 | 30.6 | 74.1 | 58.8 |
| အောင်မြင်မှုများ (၃ ခုအနက်) | 3 | 3 | 3 | 3 |
| ထုတ်လုပ်မှုနှုန်း (tok/s) | 222.9 | 237.0 | 231.1 | 252.8 |
| Tier W၊ gpt-oss:120b၊ 128K အခြေအနေ | ||||
| နံရံအချိန်၊ အလယ်အလတ် (s၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | 49.1 | 37.9 | 56.6 | 30.8 |
| အောင်မြင်မှုများ (၃ ခုအနက်) | 3 | 3 | 3 | 3 |
| ထုတ်လုပ်မှုနှုန်း (tok/s) | 160.9 | 177.1 | 158.5 | 174.4 |
| အသုံးပြုသူဘေးရှိ အေးဂျင့် (gpt-oss:20b နှင့် Speedometer အတူတကွ) | ||||
| အေးဂျင့်ဘေးရှိ မြန်နှုန်းပြကိရိယာ (ရမှတ်) | 36.6 | 36.7 | 43.2 | 45.2 |
| မြန်နှုန်းပြကိရိယာ နှေးကွေးခြင်း (x၊ နိမ့်လေ ပိုကောင်းလေ) | 1.005 | 1.011 | 1.053 | 1.044 |
| Speedometer (tok/s) အပြင် Agent ထုတ်လုပ်မှုနှုန်း | 218.2 | 231.6 | 212.4 | 229.2 |
| အေးဂျင့် နှေးကွေးခြင်း (x၊ နိမ့်လေ ပိုကောင်းလေ) | 1.006 | 1.009 | 1.023 | 0.998 |
configuration တိုင်းဟာ tier W task ရဲ့ run သုံးခုလုံးကို gpt-oss:120b နဲ့ ပြီးမြောက်အောင် လုပ်ဆောင်ခဲ့ပြီး suite ထဲမှာ အကြီးဆုံး model ဖြစ်ပြီး Xeon tower မှာ တစ်စက္ကန့်ကို 160.9 မှ 177.1 tokens နဲ့ Core tower မှာ 158.5 မှ 174.4 အထိ ထုတ်လုပ်ပေးခဲ့ပါတယ်။ 600W card ရဲ့ တန်ဖိုးက တစ်ခုစီရဲ့ ၁၀ ရာခိုင်နှုန်းလောက် ရှိပါတယ်။ Qwen3.6 task တွေကလည်း တစ်စက္ကန့်ကို 223 မှ 253 tokens နဲ့ သုံးခုမှာ သုံးခုကို ကျော်ဖြတ်နိုင်ခဲ့ပါတယ်။ gpt-oss:20b က ချော်လဲသွားတဲ့ model ပါ။ tier S task က configuration လေးခုထဲက နှစ်ခုမှာ run သုံးခုထဲက တစ်ခုကို ဆုံးရှုံးခဲ့ပြီး သူ့ရဲ့ 128K-context tier M task (ပြမထားပါ) က အနည်းဆုံး run တစ်ခုတော့ ဆုံးရှုံးခဲ့ပါတယ်။ hardware ကတော့ မပြောင်းလဲတဲ့ model behavior ပါ။
agent နဲ့ browser benchmark ကို တစ်ပြိုင်နက်တည်း run တာက discrete GPU နဲ့ 24 cores အပိုပါတဲ့ tower မှာ ဘာမှ မကုန်ကျပါဘူး။ Xeon T2 မှာ agent run နေချိန်မှာ Speedometer က 1.005x နဲ့ Core T2 မှာ 1.053x နှေးသွားပြီး agent ရဲ့ generation rate က case တိုင်းမှာ 2 ရာခိုင်နှုန်း ဒါမှမဟုတ် ဒီထက်နည်းပါတယ်။ agent အပြင် Xeon T2 ရဲ့ Speedometer score 36.6 ဟာ Core T2 ရဲ့ 43.2 ထက် နည်းပါတယ်။ အကြောင်းရင်းတစ်ခုတည်းကြောင့်ပဲ နိမ့်ကျတာပါ။ 285K ရဲ့ per-core speed ကြောင့်ပါ။
Retrieval-augmented မျိုးဆက်
ကျွန်ုပ်တို့၏ RAG စမ်းသပ်မှုသည် SQuAD v1.1 စာပိုဒ် ၂၀,၉၆၃ ပိုဒ်ကို nomic-embed-text ဖြင့် ထည့်သွင်းထားပြီး မေးခွန်း ၂,၀၀၀ စီအတွက် ထိပ်တန်းစာပိုဒ်ငါးပိုဒ်ကို ရယူကာ ၎င်းတို့အနက် ၄၀၀ ကို Phi-4-mini ဖြင့် ဖြေဆိုကာ ရည်ညွှန်းအဖြေများနှင့် ကိုက်ညီမှုနှင့် F1 ကို အမှတ်ပေးပါသည်။ မော်ဒယ်များသည် သေးငယ်သောကြောင့် စမ်းသပ်မှုသည် GPU အဆင့်များအကြား CPU-side vector ရှာဖွေမှုအပါအဝင် pipeline တစ်ခုလုံးကို တိုင်းတာသည်။

| အဝတ်စုတ် | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| နံရံကို စုပ်ယူချိန်၊ ၂၀,၉၆၃ ပိုဒ် (စက္ကန့်၊ နည်းလေ ပိုကောင်းလေ) | 128.5 | 125.5 | 108.1 | 103.0 |
| ထည့်သွင်းမှုနှုန်း (tok/s) | 29,875 | 30,592 | 35,165 | 37,508 |
| ပြန်လည်ရယူရန် မေးမြန်းချိန်၊ p50 (ms၊ ပိုနည်းလေ ပိုကောင်းလေ) | 30.6 | 27.2 | 23.4 | 18.7 |
| အဖြေ၊ Phi-4-mini ပထမဆုံးတိုကင်သို့ရောက်ရှိရန်အချိန်၊ p50 (s၊ နိမ့်လေကောင်းလေ) | 0.099 | 0.087 | 0.089 | 0.083 |
| အဖြေ၊ လျင်မြန်စွာ လုပ်ဆောင်ခြင်း (tok/s) | 20,318 | 26,549 | 21,356 | 26,619 |
| အဖြေ၊ ထုတ်လုပ်မှုနှုန်း (tok/s) | 296.4 | 337.8 | 324.3 | 344.1 |
| မေးခွန်းမှ အဖြေသို့၊ စာမျက်နှာ ၅၀ (s၊ နိမ့်လေ ပိုကောင်းလေ) | 0.152 | 0.133 | 0.130 | 0.120 |
| ပြန်လည်သိမ်းဆည်းခြင်း @၅ (%) | 82.7 | 82.7 | 82.7 | 82.7 |
| အဖြေ F1 (%) | 74.65 | 74.65 | 74.65 | 74.65 |
Core T2 သည် ဤ pipeline မှတစ်ဆင့် ပိုမိုမြန်ဆန်သည်။ ၎င်းသည် corpus ကို 108.1 စက္ကန့်အတွင်း ingest လုပ်ခဲ့ပြီး Xeon T2 တွင် တူညီသော Max-Q card ဖြင့် 128.5 စက္ကန့်၊ 23.4 ms တွင် retrieval လုပ်ခဲ့ပြီး အလယ်အလတ်တွင် 30.6 စက္ကန့်နှင့် မေးခွန်းတစ်ခုကို 0.130 စက္ကန့်ဖြင့် ဖြေဆိုခဲ့ပြီး 0.152 စက္ကန့်ဖြင့် ဖြေဆိုခဲ့သည်။ Embedding နှင့် retrieval နှစ်ခုစလုံးတွင် CPU-bound stages များရှိပြီး ၎င်းတို့သည် 285K ကို အကျိုးပြုသည်။ 600W card သည် platform နှစ်ခုလုံးတွင် prompt processing ကို 25 မှ 30 ရာခိုင်နှုန်းအထိ မြှင့်တင်ပေးခဲ့ပြီး Xeon T2 တွင် တစ်စက္ကန့်လျှင် 20,318 မှ 26,549 tokens အထိ မြှင့်တင်ပေးခဲ့ပြီး အပူချိန် 0 တွင် တူညီသော model များနှင့် အတူတူပင်ဖြစ်သင့်သကဲ့သို့ configuration လေးခုလုံးတွင် တိကျမှုမှာ အတူတူပင်ဖြစ်သည်။
LLM ဝန်ဆောင်မှု
serving test မှာ Ministral 3 3B နဲ့ 8B (4,096-token prompts, 1,024-token outputs)၊ Qwen3.8 27B နဲ့ gpt-oss 120B (8,192-token prompts) တို့နဲ့ llama-server ကို run ပြီး weight တွေပြီးရင် GPU memory မှာ slot တွေ fit နိုင်သလောက် ခွဲဝေပေးပြီးတော့ request တစ်ခုကနေ အဲဒီ limit အထိ concurrency ကို slot လုပ်ပါတယ်။ total throughput (prompt နဲ့ output tokens တွေ ပေါင်းစပ်)၊ output throughput၊ first token ကို ရောက်တဲ့အချိန်နဲ့ output token တစ်ခုအတွက် အချိန်ကို median မှာ ကျွန်တော်တို့ တင်ပြပါတယ်။ 96GB card မှာ gpt-oss 120B က KV cache 22.5GiB ရှိတဲ့ slot ၆၄ ခုနဲ့ ကိုက်ညီပြီး Qwen3.8 27B က ရှစ်ခုနဲ့ ကိုက်ညီပြီး Ministral model နှစ်ခုက သူတို့ရဲ့ context အရ လေးခုနဲ့ ကိုက်ညီပါတယ်။

| llama-server၊ gpt-oss 120B၊ 8,192-token prompts၊ 1,024-token outputs | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| ၁ တစ်ပြိုင်နက်တည်း- အထွက်ပမာဏ (tok/s) | 160.6 | 182.7 | 158.4 | 179.0 |
| ၆၄ ပြိုင်တူ- ပထမဆုံးတိုကင်သို့ရောက်ရှိရန်အချိန်၊ အလယ်အလတ် (ms၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | 1,241 | 918 | 1,238 | 923 |
| ၆၄ ပြိုင်တူ- အထွက်တိုကင်တစ်ခုလျှင် အချိန်၊ အလယ်အလတ် (ms၊ ပိုနည်းလေ ပိုကောင်းလေ) | 5.03 | 4.58 | 5.11 | 4.70 |
| တစ်ပြိုင်နက်တည်း ၆၄ ခု: စုစုပေါင်း throughput (tok/s) | 2,088 | 2,460 | 2,154 | 2,534 |
| တစ်ပြိုင်နက်တည်း ၆၄ ခု: အသုံးပြုသူတစ်ဦးလျှင် အထွက် (tok/s) | 29.0 | 34.2 | 29.9 | 35.2 |
| ၆၄ ပြိုင်တူ- ပထမဆုံးတိုကင်သို့ရောက်ရှိရန်အချိန်၊ အလယ်အလတ် (ms၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | 2,847 | 2,152 | 2,856 | 2,121 |
| တစ်ပြိုင်နက်တည်း ၆၄ ခု: စုစုပေါင်း throughput (tok/s) | 3,296 | 3,805 | 3,531 | 4,220 |
| တစ်ပြိုင်နက်တည်း ၆၄ ခု: အသုံးပြုသူတစ်ဦးလျှင် အထွက် (tok/s) | 5.7 | 6.6 | 6.1 | 7.3 |
| ၆၄ ပြိုင်တူ- ပထမဆုံးတိုကင်သို့ရောက်ရှိရန်အချိန်၊ အလယ်အလတ် (ms၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | 4,315 | 3,491 | 4,607 | 3,622 |
| ၆၄ ပြိုင်တူ- အထွက်တိုကင်တစ်ခုလျှင် အချိန်၊ အလယ်အလတ် (ms၊ ပိုနည်းလေ ပိုကောင်းလေ) | 163.0 | 141.3 | 152.7 | 126.3 |
အသုံးပြုသူတစ်ဦးတည်းသည် Max-Q ကတ်တွင် တစ်စက္ကန့်လျှင် တိုကင် ၁၆၀.၆ ခုနှင့် 600W ကတ်တွင် ၁၈၂.၇ ခုဖြင့် gpt-oss 120B ရရှိပြီး ပထမဆုံးတိုကင်သည် တိုကင် ၈၁၉၂ ခုပါ prompt ပြီးနောက် ၁၂၄၁ နှင့် ၉၁၈ ms တွင် ရောက်ရှိသည်။ ကတ်ကို တစ်ပြိုင်နက်တည်း တောင်းဆိုမှု ၆၄ ခုဖြင့် တင်ခြင်းဖြင့် စုစုပေါင်း throughput သည် Max-Q တွင် တစ်စက္ကန့်လျှင် တိုကင် ၃၂၉၆ ခုနှင့် 600W ကတ်တွင် ၃၈၀၅ ခုအထိ မြင့်တက်ခဲ့ပြီး အသုံးပြုသူတစ်ဦးလျှင် တစ်စက္ကန့်လျှင် တိုကင် ၅.၇ နှင့် ၆.၆ ခုနှင့် ပထမဆုံးတိုကင်များသည် ၄.၃ နှင့် ၃.၅ စက္ကန့် ကုန်ကျသည်။ မျဉ်းကွေးသည် တစ်ပြိုင်နက်တည်း တောင်းဆိုမှု ၄ ခုမှ ၃၂ ခုအကြား ပြားချပ်သွားပြီး ၆၄ ခုတွင် ထပ်မံခုန်တက်သွားပြီး ထိုနေရာတွင် batch သည် ရှည်လျားသော prompt များကို နောက်ဆုံးတွင် လျှော့ချပေးပါသည်။

| llama-server၊ ကိုက်ညီသော အမြင့်ဆုံး တစ်ပြိုင်နက်တည်း လုပ်ဆောင်မှုတွင် output throughput (tok/s) | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| ဓမ္မ 3 3B ကျိုးကြောင်းဆင်ခြင်ခြင်း၊ 4 ပြိုင်တူ | 562.5 | 600.4 | 576.8 | 625.3 |
| ဓမ္မ 3 8B ကျိုးကြောင်းဆင်ခြင်ခြင်း၊ 4 ပြိုင်တူ | 375.8 | 445.1 | 377.9 | 446.3 |
| Qwen3.8 27B၊ တစ်ပြိုင်နက်တည်း ၈ ခု | 153.1 | 189.6 | 152.2 | 187.3 |
| gpt-oss 120B၊ တစ်ပြိုင်နက်တည်း ၆၄ ခု | 366.3 | 422.8 | 392.3 | 468.9 |
| တစ်ခုတည်းသော တောင်းဆိုမှု အထွက်နှုန်း (tok/s) | ||||
| ဝန်ကြီးဌာန ၃ ၈ခ ကျိုးကြောင်းဆင်ခြင်ခြင်း | 232.1 | 241.8 | 232.1 | 246.0 |
| ဝန်ကြီးဌာန ၃ ၈ခ ကျိုးကြောင်းဆင်ခြင်ခြင်း | 165.0 | 183.3 | 164.1 | 180.4 |
| Qwen3.8 27B | 54.0 | 63.7 | 54.1 | 63.0 |
| gpt-oss 120B | 160.6 | 182.7 | 158.4 | 179.0 |
dense Qwen3.8 27B သည် Max-Q တွင် တစ်စက္ကန့်လျှင် 54.0 tokens ဖြင့် single user အတွက် အနှေးဆုံးမော်ဒယ်ဖြစ်ပြီး token တိုင်းသည် parameter 27 billion အားလုံးကို ထိကိုင်သောကြောင့်ဖြစ်သည်။ mixture-of-experts gpt-oss 120B သည် disk တွင် လေးဆပိုကြီးသော်လည်း 3.0x ပိုမြန်သည်။ 600W ကတ်၏ အားသာချက်မှာ dense မော်ဒယ်တွင် အကျယ်ပြန့်ဆုံးဖြစ်ပြီး တစ်ပြိုင်နက်တည်း request ရှစ်ခုတွင် 24 ရာခိုင်နှုန်းနှင့် Ministral 3B တွင် 7 ရာခိုင်နှုန်းခန့်ဖြင့် ကျဉ်းမြောင်းသည်။ tower နှစ်ခုသည် 64-request gpt-oss ကိစ္စမှလွဲ၍ နေရာတိုင်းတွင် 3 ရာခိုင်နှုန်းခန့်အတွင်းရှိသည်။ Core T2 သည် ကတ်တစ်ခုခုဖြင့် 7 မှ 11 ရာခိုင်နှုန်းဖြင့် ဦးဆောင်နေသောကြောင့် server ၏ CPU-side work သည် ထို batch size တွင် ပိုမြန်သော core များကို အကျိုးပြုသည်။
ရုပ်ပုံမျိုးဆက်
ရုပ်ပုံထုတ်လုပ်မှုစမ်းသပ်မှုသည် အလေးချိန်တိကျမှုသုံးမျိုးဖြင့် ပျံ့နှံ့မှုမော်ဒယ်သုံးခုဖြင့် 1024×1024 ရုပ်ပုံများကို ထုတ်ဖော်ပြသပြီး ပုံတစ်ပုံလျှင် အချိန်၊ ဆူညံသံလျှော့ချမှုနှုန်းနှင့် အလေးချိန်များယူထားသော GPU မှတ်ဉာဏ်တို့ကို အစီရင်ခံပါသည်။ ၎င်းသည် BF16 တွင် တူညီသော seed ကိုလည်း ထုတ်ဖော်ပြသပြီး Q4_0 နှင့် Q8_0 output များကို PSNR နှင့် SSIM တို့ဖြင့် နှိုင်းယှဉ်ရမှတ်ပေးကာ ပုံတွင် quantization ကုန်ကျစရိတ်အပေါ် ဂဏန်းတစ်ခုပေးသည်။

| ရုပ်ပုံထုတ်လုပ်ခြင်း၊ ၁၀၂၄×၁၀၂၄ | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| FLUX.၂ အသေးစား ၄B၊ အဆင့် ၄ ဆင့် | ||||
| Q8_0: ပုံတစ်ပုံလျှင် စက္ကန့် (ပိုနှေးလေ ပိုကောင်းလေ) | 1.66 | 1.37 | 1.59 | 1.30 |
| Q8_0: တစ်မိနစ်လျှင် ပုံများ | 36.2 | 43.7 | 37.6 | 46.0 |
| BF16: ပုံတစ်ပုံလျှင် စက္ကန့် (နည်းနည်းပိုနှေးလေ ပိုကောင်းလေ) | 1.60 | 1.34 | 1.55 | 1.27 |
| Z-Image Turbo 6B၊ အဆင့် ၈ ဆင့် | ||||
| Q8_0: ပုံတစ်ပုံလျှင် စက္ကန့် (ပိုနှေးလေ ပိုကောင်းလေ) | 3.82 | 2.89 | 3.78 | 2.82 |
| Q8_0: တစ်မိနစ်လျှင် ပုံများ | 15.7 | 20.7 | 15.9 | 21.3 |
| BF16: ပုံတစ်ပုံလျှင် စက္ကန့် (နည်းနည်းပိုနှေးလေ ပိုကောင်းလေ) | 3.61 | 2.76 | 3.56 | 2.68 |
| Qwen-Image 20B၊ ခြေလှမ်း ၂၀ | ||||
| Q4_0: ပုံတစ်ပုံလျှင် စက္ကန့် (ပိုနှေးလေ ပိုကောင်းလေ) | 25.60 | 19.11 | 25.57 | 18.97 |
| Q8_0: ပုံတစ်ပုံလျှင် စက္ကန့် (ပိုနှေးလေ ပိုကောင်းလေ) | 26.08 | 19.66 | 26.02 | 19.42 |
| BF16: ပုံတစ်ပုံလျှင် စက္ကန့် (နည်းနည်းပိုနှေးလေ ပိုကောင်းလေ) | 26.17 | 20.45 | 26.05 | 20.28 |
| Q8_0: တစ်မိနစ်လျှင် ပုံများ | 2.30 | 3.05 | 2.31 | 3.09 |
| BF16: အလေးချိန်များအတွက် GPU မှတ်ဉာဏ် (GiB) | 45.3 | 45.3 | 45.3 | 45.3 |
Diffusion ဟာ compute-bound ဖြစ်ပြီး 600W ကတ်က ပြသနေပါတယ်- Q8_0 မှာရှိတဲ့ Qwen-Image 20B ဟာ Max-Q မှာ ပုံတစ်ပုံကို ၂၆.၁ စက္ကန့်နဲ့ Xeon tower မှာ 600W ကတ်မှာ ၁၉.၇ စက္ကန့်ကြာပြီး တစ်မိနစ်ကို ရုပ်ပုံ ၃၃ ရာခိုင်နှုန်း တိုးလာကာ Z-Image Turbo က ၃၂ ရာခိုင်နှုန်းနဲ့ FLUX.2 kilometer က ၂၁ ရာခိုင်နှုန်း တိုးလာပါတယ်။ CPU platform က ဒီနေရာမှာ အရေးမကြီးပါဘူး၊ server start ကလွဲလို့ row တိုင်းမှာ tower နှစ်ခုက ၁ ရာခိုင်နှုန်းအတွင်း ရှိနေတာကြောင့် Xeon T2 ရဲ့ RAID volume က weight တွေကို load လုပ်ဖို့ စက္ကန့်အနည်းငယ် ပိုကြာပါတယ်။
| BF16 (တူညီသော မျိုးစေ့) နှင့် နှိုင်းယှဉ်၍ ပမာဏသတ်မှတ်ခြင်း၏ တိကျမှု | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| PSNR (dB၊ မြင့်လေ ပိုကောင်းလေ) / SSIM (မြင့်လေ ပိုကောင်းလေ) | ||||
| FLUX.၂ အသေးစား ၄B၊ Q၈_၀ | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 |
| FLUX.၂ အသေးစား ၄B၊ Q၈_၀ | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 |
| Z-Image Turbo 6B၊ Q4_0 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 |
| Z-Image Turbo 6B၊ Q8_0 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 |
| Qwen-Image 20B, Q4_0 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 |
| Qwen-Image 20B, Q8_0 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 |
fidelity row များသည် configuration လေးခုလုံးတွင် အတူတူပင်ဖြစ်သည်၊ အဘယ်ကြောင့်ဆိုသော် output သည် hardware ပေါ်တွင် မူတည်ခြင်းမဟုတ်ဘဲ weight ပေါ်တွင် မူတည်သောကြောင့်ဖြစ်သည်။ Q8_0 သည် BF16 image ကို 0.938 မှ 0.987 နှင့် 28 မှ 36 dB PSNR တွင် ပြန်လည်ထုတ်ပေးပြီး Q4_0 သည် 0.75 မှ 0.79 SSIM နှင့် 18 မှ 22 dB အထိ ကျဆင်းသွားသည်၊ ၎င်းသည် ကွဲပြားသောပုံတစ်ခုဖြစ်သည်။ 96GB ကတ်တွင် ဤမော်ဒယ်များကို Q8_0 အောက်၌ run ရန် memory အကြောင်းပြချက်မရှိပါ။ Qwen-Image ၏ BF16 weight များသည် 45.3GiB တွင် fit ဖြစ်ပြီး BF16 သည် Q8_0 လမ်းကြောင်းသည် dequantizing လုပ်ရန် အချိန်ကုန်သောကြောင့် မော်ဒယ်သုံးခုလုံးတွင် Q8_0 ကဲ့သို့ မြန်ဆန်စွာ သို့မဟုတ် အနည်းငယ်ပိုမြန်စွာ render လုပ်သည်။
CPU စွမ်းဆောင်ရည်
ပရိုဆက်ဆာနှစ်ခုသည် ကျွန်ုပ်တို့၏ CPU suite ကို သန့်ရှင်းသောမျဉ်းကြောင်းတစ်လျှောက် ပိုင်းခြားထားသည်။ စမ်းသပ်မှုတစ်ခုတွင် core အားလုံးကိုအသုံးပြုသည့်အခါ Xeon 658X သည် အများစုတွင် ၂၇ မှ ၁၅၀ ရာခိုင်နှုန်းအထိ အနိုင်ရရှိပြီး vector များ ပိုမိုကျယ်ပြန့်ပြီး memory traffic များလေ၊ ၎င်း၏ margin ကြီးမားလေဖြစ်သည်။ စမ်းသပ်မှုတစ်ခုသည် thread တစ်ခု သို့မဟုတ် အနည်းငယ်ပေါ်တွင် လုပ်ဆောင်သည့်အခါ Core Ultra 9 285K သည် 5.7GHz P-core ၏ အစွမ်းသတ္တိဖြင့် cache နှင့် memory latency မြင့်မားသော 4.9GHz Xeon core နှင့် နှိုင်းယှဉ်ပါက ၁၃ မှ ၃၁ ရာခိုင်နှုန်းအထိ အနိုင်ရရှိသည်။ Xeon ၏ all-core ရလဒ်များအပေါ် 600W GPU ၏ အကျိုးသက်ရောက်မှုကို ဇယားတစ်ခုစီဖြင့် ဖော်ပြထားကာ clock အပိုင်းတွင် အကျဉ်းချုပ်ဖော်ပြထားသည်။
Cinebench 2026 နှင့် စဉ်ဆက်မပြတ် ဝန်အား
Cinebench 2026 သည် CPU ပေါ်တွင် Maxon ၏ Redshift engine ဖြင့် မြင်ကွင်းတစ်ခုကို ဖန်တီးပြီး single-core၊ SMT single-core (physical core တစ်ခုတွင် thread နှစ်ခု) နှင့် multi-core throughput တို့ကို ရရှိစေသည်။ ကျွန်ုပ်တို့သည် multi-core run ကို မိနစ် ၃၀ ခန့် ထပ်ခါတလဲလဲလုပ်ဆောင်သည့် sustained loop တစ်ခုဖြင့် ၎င်းကို လိုက်နာပြီး steady state ကို ပထမအကြိမ်နှင့် နှိုင်းယှဉ်ပါသည်။

| Cinebench ၂၀၂၆ (အမှတ်များ၊ မြင့်လေ ပိုကောင်းလေ) | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| single-core | 454.1 | 455.6 | 564.4 | 564.5 |
| SMT single core | 599.1 | 601.0 | မရှိပါ (SMT မရှိပါ) | မရှိပါ (SMT မရှိပါ) |
| Multi Core | 12,322 | 11,705 | 8,856 | 8,838 |
| စဉ်ဆက်မပြတ် ကွင်းဆက်၊ ပထမအကြိမ် | 12,201 | 11,731 | 8,717 | 8,788 |
| စဉ်ဆက်မပြတ်လည်ပတ်မှု၊ တည်ငြိမ်သောအခြေအနေ | 12,328 | 11,764 | 8,825 | 8,844 |
| တည်ငြိမ်သောအခြေအနေ / ပထမအကြိမ်အောင်မြင်ခြင်း | 1.010 | 1.003 | 1.012 | 1.006 |
| စဉ်ဆက်မပြတ် လည်ပတ်မှု၊ တည်ငြိမ်သော အခြေအနေ CPU နာရီ (MHz) | 4,274 | 4,178 | 4,669 | 4,690 |
Max-Q ကတ်ထည့်သွင်းထားချိန်မှာ 658X ဟာ multi-core ရမှတ် 12,322 ရရှိခဲ့ပြီး 285K ရဲ့ 8,856 ထက် 39 ရာခိုင်နှုန်းပိုများကာ မိနစ် 30 loop အတွင်းမှာ 12,328 ရရှိခဲ့ပြီး ပထမအကြိမ်ထက် 1 ရာခိုင်နှုန်းပိုများပါတယ်။ core တစ်ခုမှာတော့ အစီအစဉ်ပြောင်းပြန်ဖြစ်သွားပါတယ်- 285K ဟာ Xeon ရဲ့ 454.1 ထက် 564.4 ရရှိခဲ့ပြီး Xeon core တစ်ခုမှာ thread နှစ်ခုရရှိဖို့ 599.1 ရရှိတာကြောင့် 285K ရဲ့ single-thread ကိန်းဂဏန်းကို ကျော်ဖြတ်နိုင်ခဲ့ပါတယ်။
600W ကတ်ကို လဲလှယ်လိုက်တာကြောင့် Xeon ရဲ့ multi-core ရမှတ်က ၁၁,၇၀၅ အထိ မြင့်တက်လာပြီး steady state က ၁၁,၇၆၄ အထိ ကျဆင်းသွားပြီး ၅ ရာခိုင်နှုန်း ကျဆင်းသွားပါတယ်။ steady-state clock က ၄,၂၇၄ ကနေ ၄,၁၇၈MHz အထိ ကျဆင်းသွားပါတယ်။ Core T2 မှာ ၈,၈၅၆ နဲ့ ၈,၈၃၈ မှာ ပြောင်းလဲမှု မရှိပါဘူး။ ဒီ suite က tower နှစ်ခုလုံးရဲ့ CPU ဒါမှမဟုတ် GPU အပူချိန်တွေကို မဖမ်းယူနိုင်တာကြောင့် 250W processor က 600W ကတ်ရဲ့ အပူကြောင့် ဆုံးရှုံးတာလား၊ shared power budget ကြောင့် ဆုံးရှုံးတာလားဆိုတာ မပြောနိုင်ပါဘူး။ chassis မှာ ပိုကြီးတဲ့ ကတ်နဲ့ all-core စမ်းသပ်မှုတိုင်းမှာ ၄ ရာခိုင်နှုန်းကနေ ၅ ရာခိုင်နှုန်းအထိ ဆုံးရှုံးတယ်လို့ပဲ ပြောရမှာပါ။
7-Zip
7-Zip ရဲ့ built-in benchmark က LZMA compression နဲ့ decompression throughput ကို တစ်စက္ကန့်ကို giga-instructions နဲ့ thread တိုင်းမှာ တစ်ကြိမ်၊ single core တစ်ခုမှာ pin လုပ်ပြီးရင် report လုပ်ပါတယ်။ LZMA က integer throughput၊ branch prediction နဲ့ cache နဲ့ memory latency တွေကို အခြေခံထားတာကြောင့် vector width ထက် core count နဲ့ fast memory path ကို ပိုပြီး reward လုပ်ပါတယ်။

| 7-Zip (GIPS၊ မြင့်လေ ပိုကောင်းလေ) | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| ချည်နှောင်ချက်အားလုံး | ||||
| စုစုပေါင်း | 289.6 | 288.9 | 174.8 | 175.7 |
| သိပ် | 276.4 | 273.5 | 151.5 | 151.9 |
| ဒီဇင်ဘာ | 303.0 | 304.4 | 198.1 | 199.4 |
| ချည်တစ်ချောင်း | ||||
| စုစုပေါင်း | 8.74 | 8.05 | 10.82 | 10.83 |
| သိပ် | 8.66 | 7.80 | 9.31 | 9.31 |
| ဒီဇင်ဘာ | 8.83 | 8.30 | 12.33 | 12.34 |
thread ၄၈ ခုတွင် Xeon သည် 289.6 GIPS ဖြင့် အဆင့်သတ်မှတ်ခဲ့ပြီး 285K သည် 24 ခုတွင် 174.8 ရှိပြီး 66 ရာခိုင်နှုန်း ဦးဆောင်ကာ compression သည် 82 ရာခိုင်နှုန်းနှင့် decompression သည် 53 ရာခိုင်နှုန်းဖြင့် ဦးဆောင်ခဲ့သည်။ thread တစ်ခုတွင် 285K သည် 10.82 GIPS ဖြင့် 8.74 ရှိပြီး Xeon tower ရှိ 600W ကတ်ဖြင့် ကွာဟချက်သည် 8.05 အထိ ကျယ်ပြန့်လာပြီး configuration တွင် လည်ပတ်သော clock နိမ့်များနှင့်အညီ ဖြစ်သည်။
Blender၊ HandBrake နှင့် LLVM
Blender 4.5 သည် Monster၊ Junkshop နှင့် Classroom မြင်ကွင်းများကို CPU တွင် Cycles ဖြင့် ဖန်တီးပေးသည်။ HandBrake သည် x265 (HEVC၊ medium preset၊ quality 22) နှင့် SVT-AV1 (preset 8၊ quality 30) ဖြင့် 4K60 clip in software ၏ စက္ကန့် ၆၀ ကို encode လုပ်သည်။ LLVM စမ်းသပ်မှုသည် suite တွင် အရှည်ကြာဆုံး all-core workload ဖြစ်သည့် Clang နှင့် Ninja ဖြင့် LLVM 21.1.4 tree အပြည့်အစုံကို compile လုပ်သည်။

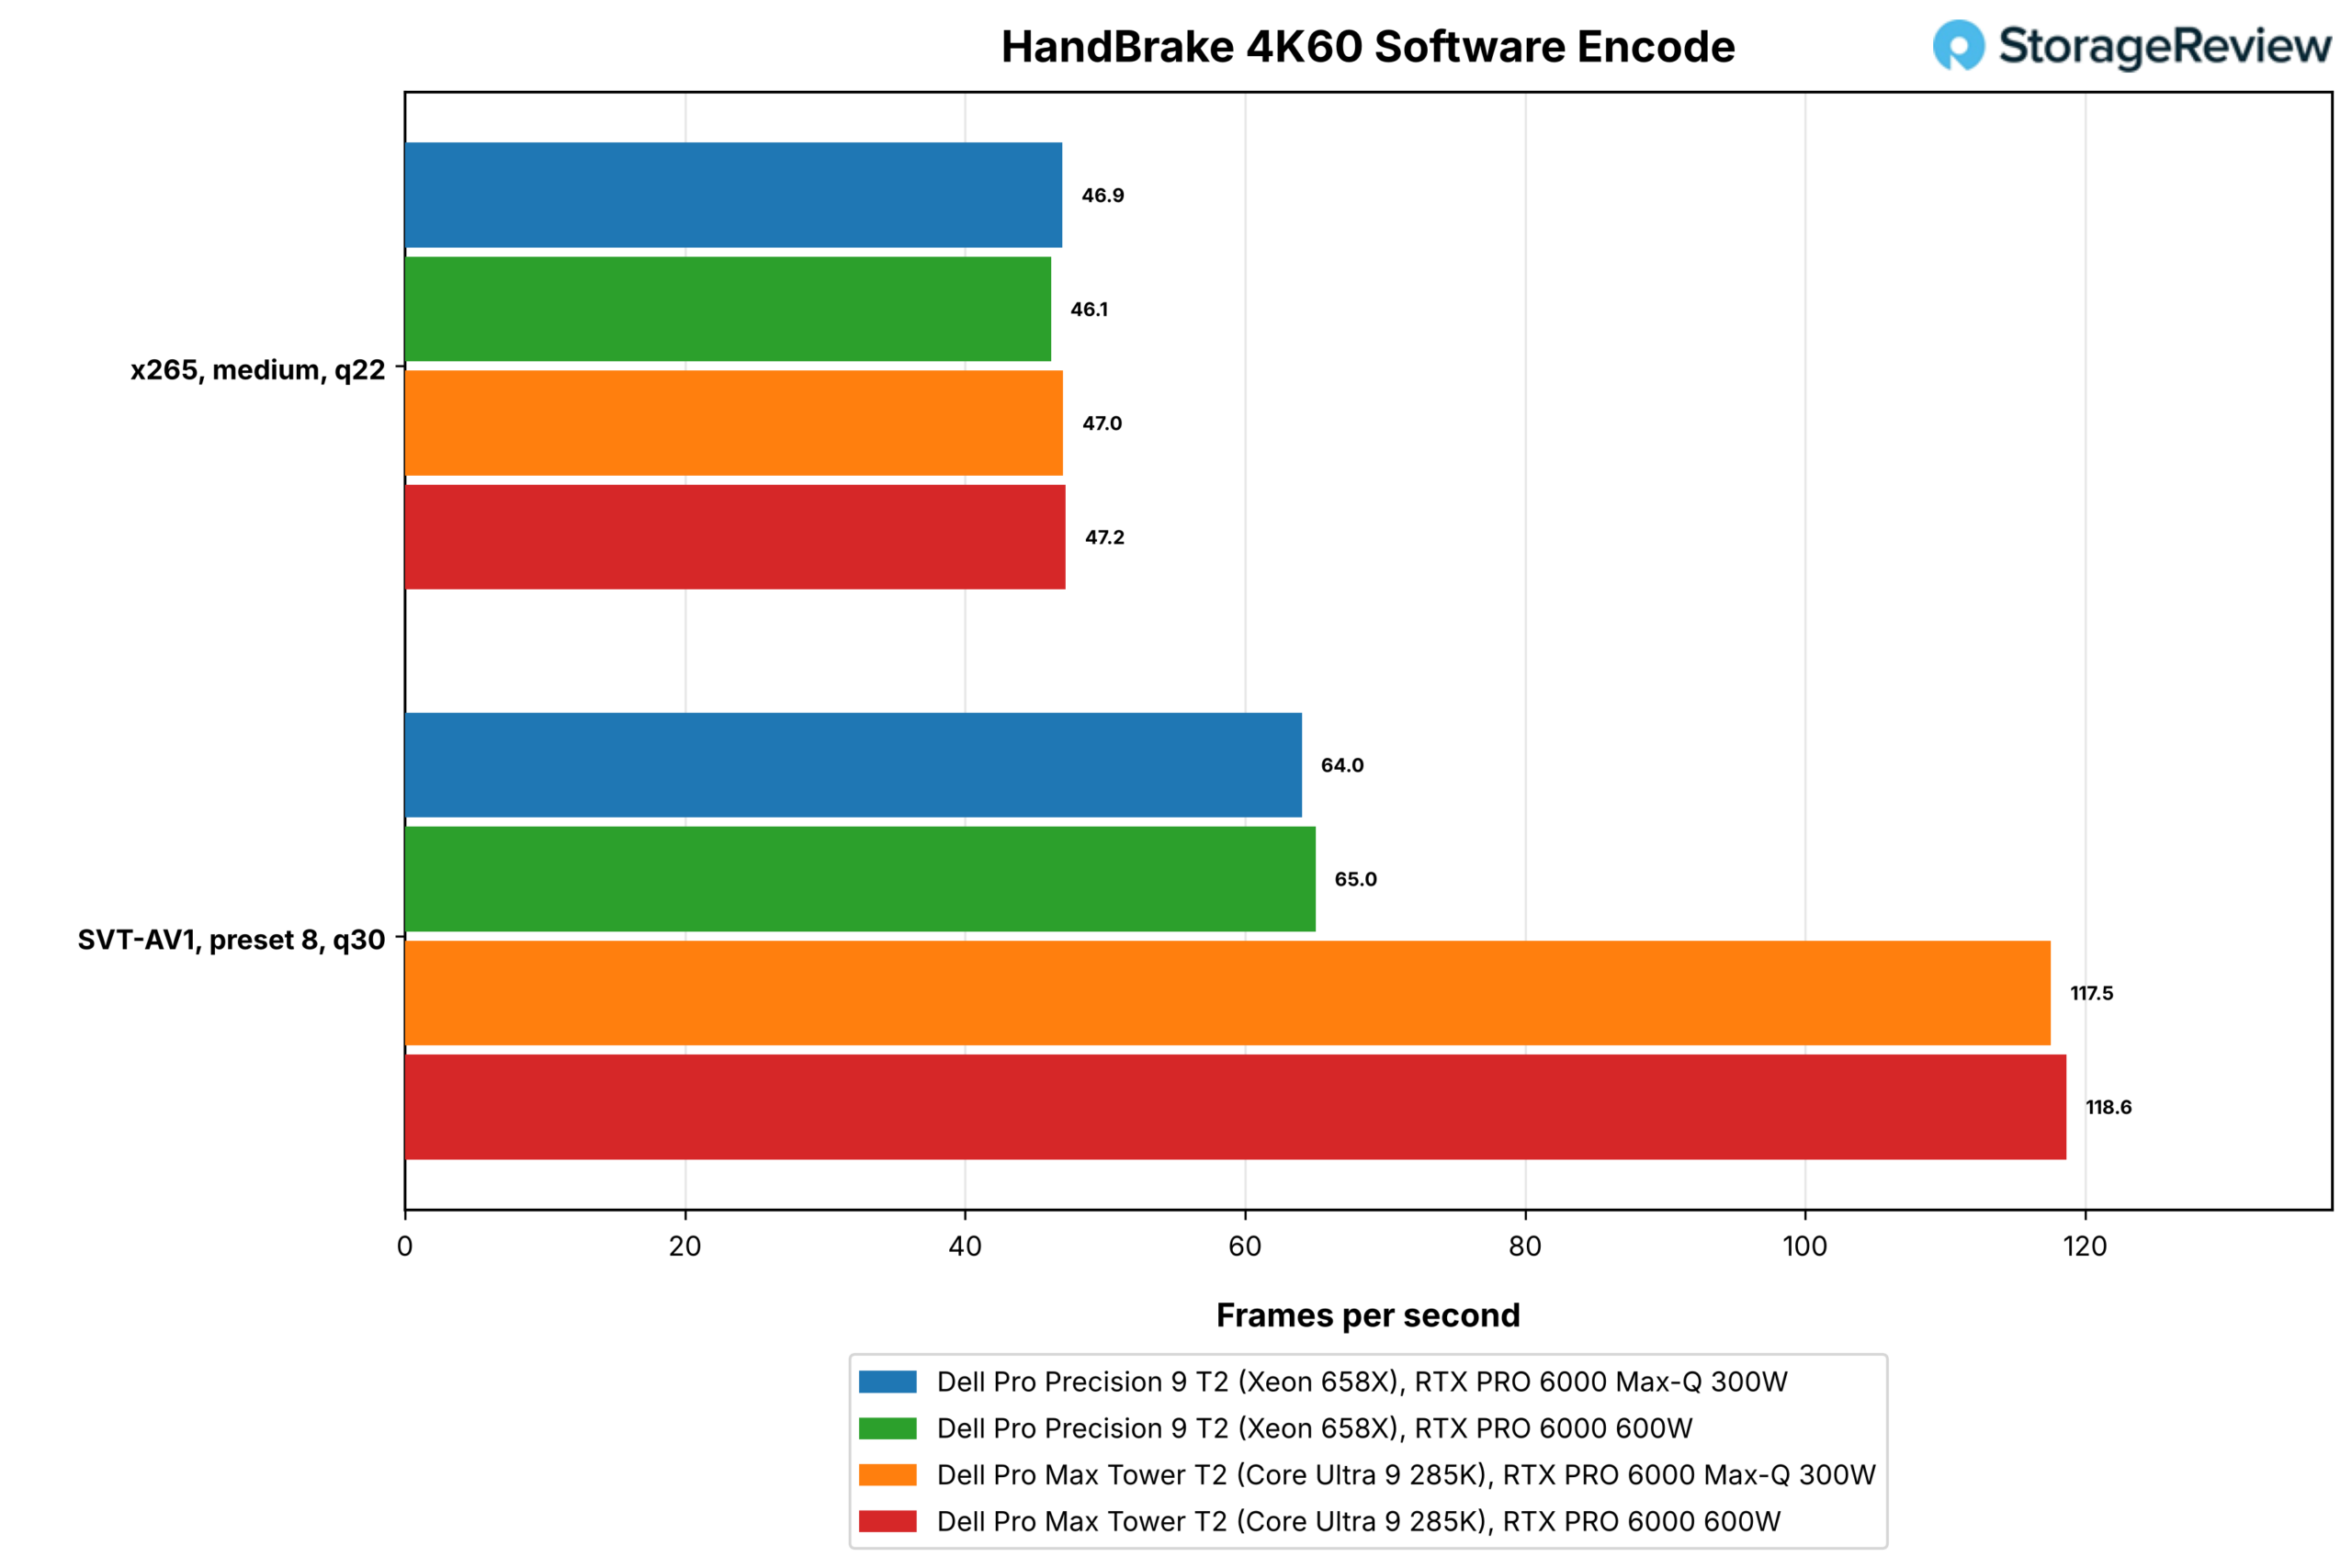
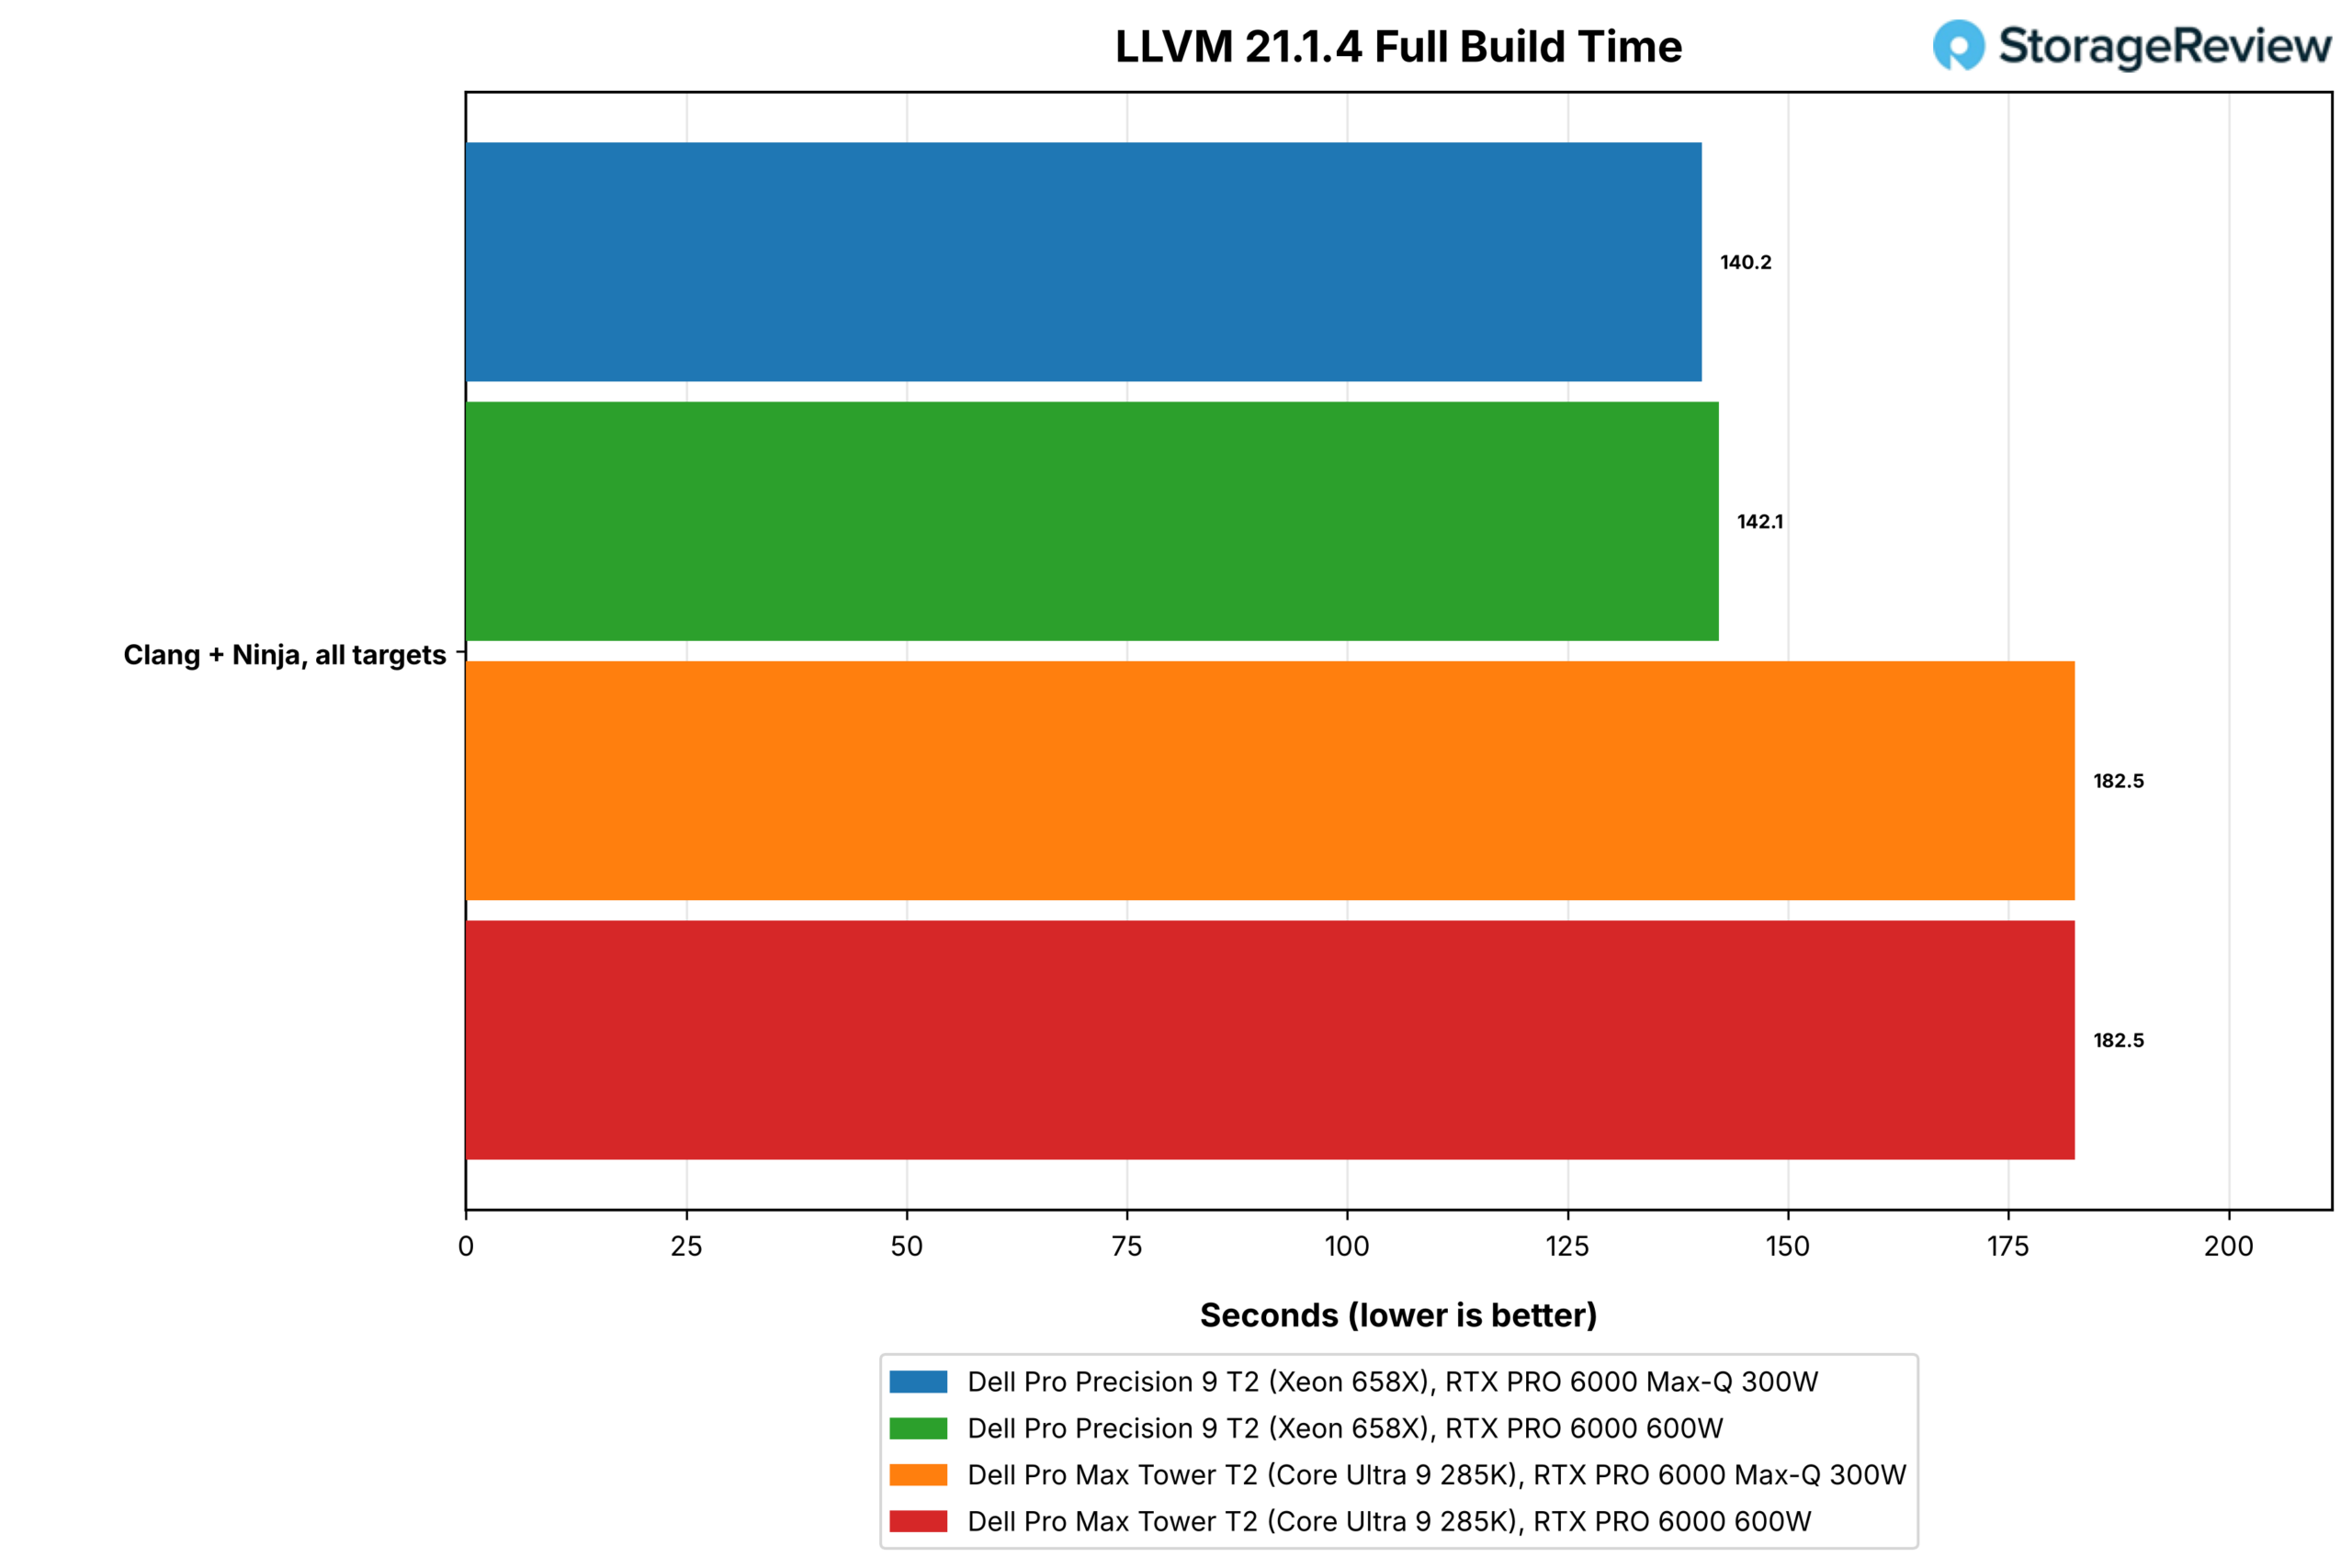
| စမ်းသပ် | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| Blender 4.5 Monster (နမူနာ/မိနစ်၊ များလေ ပိုကောင်းလေ) | 366.2 | 339.0 | 259.6 | 257.7 |
| Blender 4.5 Junkshop (နမူနာ/မိနစ်) | 238.1 | 228.0 | 166.2 | 166.8 |
| Blender ၄.၅ စာသင်ခန်း (နမူနာ/မိနစ်) | 187.2 | 169.2 | 132.5 | 132.3 |
| HandBrake x265၊ အလတ်စား၊ q22 (fps၊ မြင့်လေ ပိုကောင်းလေ) | 46.9 | 46.1 | 47.0 | 47.2 |
| HandBrake SVT-AV1၊ ကြိုတင်သတ်မှတ်မှု ၈၊ q30 (fps) | 64.0 | 65.0 | 117.5 | 118.6 |
| LLVM 21.1.4 တည်ဆောက်မှု (များသည်၊ နိမ့်လေ ပိုကောင်းလေ) | 140.2 | 142.1 | 182.5 | 182.5 |
Xeon သည် Monster ကို တစ်မိနစ်လျှင် နမူနာ ၃၆၆.၂ ခုဖြင့် render လုပ်နိုင်ပြီး 285K တွင် ၂၅၉.၆ ခုရှိပြီး မြင်ကွင်းသုံးခုလုံးတွင် ၄၁ ရာခိုင်နှုန်း ဦးဆောင်ကာ အမှတ်နှစ်မှတ်အတွင်း ရပ်တည်နေကာ LLVM ကို ၁၄၀.၂ စက္ကန့်အတွင်း တည်ဆောက်နိုင်ပြီး ၁၈၂.၅ ခုရှိပြီး အချိန် ၂၃ ရာခိုင်နှုန်း လျော့နည်းသည်။ 600W ကတ်ကို တပ်ဆင်ပြီးနောက် Xeon ၏ Blender ရမှတ်များသည် ၇ ရာခိုင်နှုန်းမှ ၁၀ ရာခိုင်နှုန်းအထိ ကျဆင်းသွားပြီး CPU suite တွင် ကတ်၏ အမြင့်ဆုံးဈေးနှုန်းဖြစ်သည်။
HandBrake ကို encoder လိုင်းများတစ်လျှောက် ပိုင်းခြားထားသည်- medium preset တွင် x265 သည် Xeon တွင် 46.9 fps နှင့် 285K တွင် 47.0 ဖြင့် လည်ပတ်ခဲ့ပြီး တူညီနေချိန်တွင် preset 8 ရှိ SVT-AV1 သည် Xeon တွင် 64.0 fps ရှိပြီး 285K တွင် 117.5 ဖြင့် လည်ပတ်ခဲ့သည်။
အဲဒီကွာဟချက်မှာ ကျွန်တော်တို့ နေ့လယ်ခင်းတစ်ခု အချိန်ကုန်ခဲ့ပြီး အဲဒါက per-thread ရလဒ်ပါ။ ဒီ preset မှာ encoder က Level of Parallelism 6 မှာ ထိပ်ဆုံးရောက်ပြီး Xeon မှာ logical processor ကိုးခုလောက်ရဲ့ အလုပ်တွေကို အလုပ်ရှုပ်နေစေပါတယ်။ AVX-512 အစား AVX2 kernel တွေကို အတင်းအကျပ်လုပ်ခိုင်းတာက ဘာမှမပြောင်းလဲပါဘူး (63.9 fps နဲ့ယှဉ်ရင် 63.8)၊ physical core တစ်ခုစီမှာ thread တစ်ခုစီ pin လုပ်တာက ၂ ရာခိုင်နှုန်း နှေးပါတယ် (62.6 fps)၊ ဒါကြောင့် vector path ဒါမှမဟုတ် SMT scheduling နှစ်ခုစလုံးရဲ့ အကြောင်းရင်း မဟုတ်ပါဘူး။ ကျန်ရှိနေတာက Xeon core နဲ့ mesh between cores တွေဖြစ်ပြီး pipelined encoder က stages တွေကြားမှာ handoff တွေစောင့်နေတဲ့ frame တိုင်းမှာ ခံစားရပါတယ်။
Stockfish၊ primesieve၊ Python နှင့် Browser
Stockfish ရဲ့ built-in bench က စစ်တုရင်ရှာဖွေမှုအမြန်နှုန်းကို တစ်စက္ကန့်ကို node သန်းပေါင်းများစွာနဲ့ အစီရင်ခံပါတယ်။ primesieve က thread အားလုံးမှာ 10^12 အောက် primes တွေကို ရေတွက်ပြီး thread တစ်ခုမှာတော့ 10^11 အောက် primes တွေကို ရေတွက်ပါတယ်။ PyPerformance က CPython benchmarks သုံးခု (go, nbody, နဲ့ regex_compile) ကို မြန်နှုန်းမြင့် core တစ်ခုနဲ့ ချိတ်ဆက်ထားပြီး Speedometer 3.1 က Microsoft Edge မှာ web application responsive ကို တိုင်းတာပေးပါတယ်။
| စမ်းသပ် | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| Stockfish bench၊ ချည်မျှင်အားလုံး (Mnps၊ မြင့်လေ ပိုကောင်းလေ) | 40.87 | 39.17 | 30.10 | 30.63 |
| Stockfish bench၊ ချည်တစ်ချောင်း (Mnps၊ မြင့်လေ ပိုကောင်းလေ) | 1.65 | 1.60 | 1.99 | 1.99 |
| primesieve 1e12၊ ချည်အားလုံး (s၊ နိမ့်လေ ပိုကောင်းလေ) | 7.69 | 7.51 | 6.77 | 6.84 |
| primesieve 1e11၊ ချည်တစ်ခု (s၊ နိမ့်လေ ပိုကောင်းလေ) | 10.09 | 10.76 | 8.72 | 8.72 |
| PyPerformance go (ms၊ နိမ့်လေ ပိုကောင်းလေ) | 91.4 | 91.0 | 64.8 | 64.9 |
| PyPerformance nbody (ms၊ ပိုနည်းလေ ပိုကောင်းလေ) | 68.3 | 68.8 | 54.3 | 53.8 |
| PyPerformance regex_compile (ms၊ ပိုနည်းလေ ပိုကောင်းလေ) | 88.6 | 90.5 | 61.1 | 61.2 |
| Speedometer ၃.၁၊ Edge (ရမှတ်မြင့်လေ ပိုကောင်းလေ) | 36.8 | 37.3 | 46.3 | 46.5 |
thread ၄၈ ခုပေါ်ရှိ Stockfish သည် Xeon တွင် 40.87 Mnps ရောက်ရှိခဲ့ပြီး 285K တွင် 30.10 ရှိပြီး thread တစ်ခုတွင် 285K သည် 1.99 ရှိပြီး 1.65 ဖြင့် ဦးဆောင်ခဲ့သည်။ primesieve သည် all-thread စမ်းသပ်မှုတစ်ခုဖြစ်ပြီး 285K သည် 6.77 စက္ကန့်ဖြင့် 7.69 ဖြင့် အနိုင်ရရှိခဲ့သည်၊ အဘယ်ကြောင့်ဆိုသော် ၎င်း၏ sieve သည် cache တွင် အံဝင်ခွင်ကျဖြစ်ပြီး core များကဲ့သို့ပင် clock နှင့် scale လုပ်သောကြောင့်ဖြစ်သည်။ single-threaded row အားလုံးသည် 285K သို့ 13 မှ 31 ရာခိုင်နှုန်းဖြင့် ရောက်ရှိသွားသည်- PyPerformance သည် 91.4 တွင် 64.8 ms ရှိပြီး regex_compile သည် 88.6 တွင် 61.1 ရှိပြီး Speedometer သည် 36.8 တွင် 46.3 ရှိသည်။
အဲဒီ browser နံပါတ်က ဝယ်သူ စားပွဲမှာ ခံစားရတဲ့ နံပါတ်ပါ။ Speedometer ရမှတ် ၃၆.၈ ဆိုတာက အတော်လေး မြန်နေသေးပေမယ့် တူညီတဲ့ chassis မှာ Core tower ထက် ငါးပုံတစ်ပုံ နိမ့်နေပါတယ်။ Xeon ကို ရွေးချယ်သူတိုင်း စက်ရဲ့ interactive ဘက်ခြမ်းက Core Ultra desktop ထက် တစ်ဆင့် နှေးမယ်လို့ မျှော်လင့်သင့်ပါတယ်။
GROMACS၊ OpenBLAS နှင့် မှတ်ဉာဏ်
GROMACS သည် benchMEM molecular dynamics case ကို rank-and-thread layout လေးခုရှိ cores ၁၆ ခုတွင် လုပ်ဆောင်ပြီး အကောင်းဆုံး layout အတွက် တစ်နေ့လျှင် simulated အချိန်၏ nanoseconds ကို အစီရင်ခံပါသည်။ ကျွန်ုပ်တို့၏ OpenBLAS စမ်းသပ်မှုသည် HPL-style double-precision LU solve ကို ပြဿနာအရွယ်အစားသုံးခုနှင့် DGEMM matrix multiply ကို cores အားလုံးတွင် လုပ်ဆောင်ပြီး 285K တွင် ၎င်း၏ P-cores ရှစ်ခုတွင်သာ လုပ်ဆောင်သည်။ Xeon ၏ cores ၂၄ ခုသည် class တစ်ခုဖြစ်သောကြောင့် ထို row များသည် သက်ရောက်မှုမရှိပါ။ STREAM သည် ကြာရှည်ခံ memory bandwidth ကို တိုင်းတာပြီး latency row များသည် memory သို့ ဝင်ရောက်ခွင့်တစ်ခုတည်းနှင့် cores များအကြားကို တိုင်းတာသည်။

| စမ်းသပ်ခြင်း (မြင့်လေ ပိုကောင်းလေ) | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| GROMACS benchMEM၊ အကောင်းဆုံး အပြင်အဆင် (ns/day) | 47.39 | 47.91 | 37.30 | 37.07 |
| OpenBLAS LU N=10000၊ cores အားလုံး (GFLOPS) | 570.3 | 517.3 | 519.7 | 523.1 |
| OpenBLAS LU N=20000၊ cores အားလုံး (GFLOPS) | 1,208.6 | 1,100.6 | 633.2 | 631.8 |
| OpenBLAS LU N=40000၊ cores အားလုံး (GFLOPS) | 1,659.2 | 1,613.7 | 667.9 | 669.5 |
| OpenBLAS LU N=20000၊ P-core များသာ (GFLOPS) | မရှိပါ (အဓိကအတန်းအစားတစ်ခု) | မရှိပါ (အဓိကအတန်းအစားတစ်ခု) | 515.2 | 517.7 |
| OpenBLAS DGEMM M=8000၊ core အားလုံး (GFLOPS) | 1,637.8 | 1,750.9 | 768.2 | 767.6 |
| OpenBLAS DGEMM M=8000၊ P-core များသာ (GFLOPS) | မရှိပါ (အဓိကအတန်းအစားတစ်ခု) | မရှိပါ (အဓိကအတန်းအစားတစ်ခု) | 565.3 | 566.5 |
ဒီနေရာမှာ AVX-512၊ L3 144MB နဲ့ DDR5-6400 ပေါင်းစပ်ထားတဲ့ channel လေးခုပါ။ DGEMM ဟာ Xeon မှာ 1,638 GFLOPS ရရှိခဲ့ပြီး 285K မှာ 768 နဲ့ ယှဉ်ရင် 11.9GB ကို memory ကနေတစ်ဆင့် stream လုပ်တဲ့ N=40000 LU solve ဟာ 668 GFLOPS နဲ့ ယှဉ်ရင် 1,659 နဲ့ run ခဲ့ပြီး Core tower ထက် 2.5x ပိုများပါတယ်။ 285K ရဲ့ ရလဒ်ဟာ bandwidth-bound ဖြစ်နေတာကြောင့် N=20000 ကနေ N=40000 ကို အနည်းငယ်သာ ရွေ့သွားပြီး Xeon ကတော့ scaling ဆက်လုပ်နေပါတယ်။ 16 cores တွေပေါ်က GROMACS ဟာ Xeon ကို 27 ရာခိုင်နှုန်းနဲ့ 47.39 ns/day မှာ အသာရခဲ့ပါတယ်။

| စမ်းသပ် | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| တိုက်ရိုက်ကူးယူခြင်း (MB/s၊ မြင့်လေ ပိုကောင်းလေ) | 106,698 | 106,512 | 39,477 | 39,426 |
| STREAM စကေး (MB/s) | 105,368 | 105,180 | 39,788 | 39,801 |
| ထုတ်လွှင့်မှု ထပ်ထည့်ခြင်း (MB/s) | 119,520 | 119,332 | 36,324 | 36,306 |
| STREAM Triad (MB/s) | 122,233 | 122,135 | 33,003 | 33,014 |
| မှတ်ဉာဏ် နှောင့်နှေးမှု၊ 1GiB buffer၊ 4KiB စာမျက်နှာများ (ns၊ နိမ့်လေ ပိုကောင်းလေ) | 148.3 | 147.8 | 135.2 | 135.4 |
| Core-to-core latency၊ အတွဲအားလုံး၏ ပျမ်းမျှ (ns၊ ပိုနည်းလေ ပိုကောင်းလေ) | 56.2 | 56.0 | 38.1 | 38.2 |
| Core မှ Core အထိ နှောင့်နှေးမှု၊ အနည်းဆုံး အတွဲ (ns) | 4.6 | 4.6 | 18.6 | 18.6 |
| Core မှ Core အထိ နှောင့်နှေးမှု၊ အများဆုံးအတွဲ (ns) | 65.7 | 66.8 | 44.7 | 44.5 |
STREAM Triad သည် Xeon T2 တွင် 122,233MB/s နှင့် Core T2 တွင် 33,003 ရှိပြီး၊ bandwidth ၏ 3.7 ဆ ရှိပြီး၊ DDR5-6400 RDIMM လေးခုမှ ၎င်း၏ DIMM များနှင့် မလိုက်နိုင်သော platform ပေါ်ရှိ DDR5-4400 UDIMM လေးခုမှ bandwidth ထက် 3.7 ဆ ရှိသည်။ ကုန်ကျစရိတ်မှာ latency ဖြစ်သည်- Xeon တွင် memory သို့ 148.3 ns နှင့် 285K တွင် 135.2 ns နှင့် ပျမ်းမျှအားဖြင့် core များအကြား 56.2 ns နှင့် 38.1 တွင် ရှိသည်။ Xeon ၏ အနိမ့်ဆုံး 4.6 ns သည် core တစ်ခုပေါ်ရှိ SMT မောင်နှမအတွဲဖြစ်ပြီး၊ ၎င်း၏ အများဆုံး 65.7 ns သည် mesh တစ်လျှောက် ခရီးတစ်ခုဖြစ်သည်။
ဂိမ်း
SuperTuxKart 1.5 သည် vsync ကိုပိတ်ထားပြီး အမြင့်ဆုံး preset တွင် 1080p fullscreen တွင် ၎င်း၏ built-in benchmark ကို လုပ်ဆောင်ပြီး ပျမ်းမျှနှင့် တည်ငြိမ်သော frame rate ကို ကျွန်ုပ်တို့ တင်ပြပါသည်။ ဤ resolution တွင် GPU တွင် နေရာလွတ်များစွာရှိသောကြောင့် ရလဒ်သည် CPU အတိုင်းလိုက်လာပြီး စမ်းသပ်မှုသည် အလားတူကန့်သတ်ချက်ရှိသော professional viewport အများအပြားအတွက်ဖြစ်သည်။ ကျွန်ုပ်တို့၏ encode စမ်းသပ်မှု၏ NVENC pass သည် ဤစနစ်များတွင် မပြီးမြောက်ခဲ့ဘဲ ချန်လှပ်ထားခဲ့သည်။

| SuperTuxKart 1.5၊ 1080p Ultra၊ vsync ပိတ်ထားပါ (fps၊ မြင့်လေ ပိုကောင်းလေ) | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| ပျမ်းမျှ | 304.6 | 323.2 | 359.1 | 383.5 |
| ပုံမှန် | 304 | 322 | 354 | 376 |
| တည်ငြိမ် | 161 | 174 | 122 | 135 |
Core T2 ဟာ Max-Q ကတ်နဲ့ ပျမ်းမျှ 359.1 fps ရှိပြီး Xeon T2 မှာ 304.6 ရှိပြီး single-thread gap လည်း ရှိနေပြန်ပါတယ်။ Xeon tower ကတော့ frame rate 122 ထက် 161 fps ပိုများပြီး dips လည်း နည်းပါတယ်။ 600W ကတ်က tower နှစ်ခုလုံးရဲ့ ပျမ်းမျှထက် ၆ ရာခိုင်နှုန်းလောက် ပိုပါတယ်။
နာရီများ ဝန်ပိနေချိန်
Tower နှစ်ခုစလုံးက suite ရဲ့ sensor path မှတစ်ဆင့် CPU ဒါမှမဟုတ် GPU အပူချိန်တွေကို မဖော်ပြတဲ့အတွက် ကျွန်တော်တို့ ပုံမှန်ထုတ်ဝေလေ့ရှိတဲ့ thermal table ကို စမ်းသပ်မှုတစ်ခုချင်းစီအတွင်း ပျမ်းမျှ CPU clock နဲ့ အစားထိုးထားပြီး၊ အဲဒါက 600W card ရဲ့ Xeon အပေါ် အကျိုးသက်ရောက်မှုကို ရှင်းပြတဲ့ နံပါတ်ပါ။ Max-Q ကို ထည့်သွင်းထားတဲ့အခါ 658X ဟာ မိနစ် ၃၀ ကြာ sustained loop မှာ 4,269MHz နဲ့ all-core စမ်းသပ်မှုတိုတိုမှာ 4,040 မှ 4,480MHz ကို ထိန်းထားနိုင်ခဲ့ပါတယ်။ 600W card ကို chassis မှာ ထည့်သွင်းထားတဲ့အခါ အဲဒီစမ်းသပ်မှုအများစုဟာ 300MHz အထိ နိမ့်ကျပြီး အားလုံးက ရမှတ်နိမ့်ကျခဲ့ပါတယ်။
| စမ်းသပ်နေစဉ်အတွင်း ပျမ်းမျှ CPU နာရီ (MHz) | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| Cinebench ၂ | 4,477 | 4,470 | 4,789 | 4,786 |
| စဉ်ဆက်မပြတ် ကွင်းဆက် | 4,269 | 4,182 | 4,663 | 4,682 |
| 7-Zip | 4,414 | 4,307 | 4,854 | 4,837 |
| ငါး | 4,291 | 3,995 | 4,749 | 4,741 |
| Blender | 4,258 | 4,253 | 4,582 | 4,552 |
| HandBrake | 4,188 | 4,180 | 4,601 | 4,622 |
| LLVM တည်ဆောက်မှု | 4,202 | 4,258 | 4,582 | 4,585 |
| ဂရိုမက်စ် | 4,288 | 4,290 | 4,664 | 4,694 |
| OpenBLAS | 4,039 | 3,979 | 4,766 | 4,761 |
| ရေနွေးငွေ့ | 4,321 | 4,326 | 4,687 | 4,676 |
| primesive sieve | 4,441 | 4,268 | 4,814 | 4,810 |
| MLPerf ကလိုင်းယင့် | 4,191 | 4,138 | 3,814 | 3,686 |
| ကုဒ်ရေးအေးဂျင့် | 4,134 | 4,100 | 4,239 | 4,213 |
| LLM ဝန်ဆောင်မှု | 4,261 | 4,169 | 4,229 | 4,209 |
| ပုံရိပ်မျိုးဆက် | 4,044 | 4,008 | 3,702 | 3,837 |
| အဝတ်စုတ် | 4,178 | 4,197 | 4,172 | 4,108 |
| Super Tux Kart | 4,239 | 4,211 | 4,637 | 4,649 |
Stockfish ဟာ 4,291 မှ 3,995MHz သို့ ကျဆင်းသွားပြီး primesieve ဟာ 4,441 မှ 4,268 သို့ ကျဆင်းသွားကာ 7-Zip ဟာ 4,414 မှ 4,307 သို့ ကျဆင်းသွားကာ sustained loop ဟာ 4,269 မှ 4,182 သို့ ကျဆင်းသွားခဲ့ပါတယ်။ 285K ကတော့ ကတ်အမျိုးအစားမခွဲခြားဘဲ all-core စမ်းသပ်မှုတိုင်းမှာ ၎င်းရဲ့အမြန်နှုန်းရဲ့ 20MHz အတွင်း လည်ပတ်နိုင်ခဲ့ပါတယ်။
ပျမ်းမျှနာရီက ရှင်းပြချက်တစ်ခုလုံး မဟုတ်ပါဘူး။ Cinebench နဲ့ Blender တို့က သူတို့ရဲ့ Max-Q ကိန်းဂဏန်းတွေရဲ့ 10MHz အတွင်းမှာပဲ ပျမ်းမျှရခဲ့ပြီး ၅ ရာခိုင်နှုန်းကနေ ၁၀ ရာခိုင်နှုန်းအထိ ဆုံးရှုံးခဲ့ပါတယ်။ ဒါက စမ်းသပ်မှုတစ်ခုရဲ့ ပျမ်းမျှချောမွေ့မှုက တိုတောင်းတဲ့ ရွေ့လျားမှုတွေကို ညွှန်ပြနေပါတယ်။ 658X က 250W အထိ ဆွဲယူပြီး 600W ကတ်က နောက်ထပ် 600W ဆွဲယူပါတယ်။ နှစ်ခုစလုံးက ရှေ့ intake တစ်ခုရဲ့ နောက်ကွယ်က တူညီတဲ့ 32-liter volume ထဲကို ထုတ်လွှတ်ပါတယ်။ limiter က processor ရဲ့ thermal headroom လား၊ platform power cap လားဆိုတာကတော့ external power နဲ့ temperature logging နဲ့ နောက်ထပ်ဖြတ်သန်းရမယ့် မေးခွန်းပါ။ လောလောဆယ်မှာတော့ all-core CPU အလုပ်လုပ်နေတဲ့ ဝယ်သူတွေအနေနဲ့ Max-Q configuration က CPU ဘက်မှာ ပိုမြန်တယ်ဆိုတာ သိထားသင့်ပါတယ်။
သိုလှောင်ရေးစွမ်းဆောင်မှု
ကျွန်ုပ်တို့ရဲ့ သိုလှောင်မှုစမ်းသပ်မှုမှာ fio ရဲ့ boot drive ကို 5GB နဲ့ 25GB footprints တွေနဲ့ ထောင့်လေးထောင့်မှာ တိုင်းတာပြီး file system ကနေတစ်ဆင့် raw device နဲ့ ထပ်မံတိုင်းတာကာ 25GB ရလဒ်တွေကို ဒီမှာ တင်ပြပါတယ်။ Core T2 မှာ boot drive က Gen5 x4 မှာရှိတဲ့ 2TB SK hynix PCB01 တစ်ခုတည်းဖြစ်ပြီး Pro Precision 9 T2 မှာ FlexBay မှာရှိတဲ့ E3.S Gen5 drive နှစ်ခုဖြစ်ပြီး Graid Technology ကနေ VROC မှတစ်ဆင့် 4,097GB RAID0 volume အဖြစ် strip လုပ်ထားပါတယ်။ BitLocker က configuration လေးခုစလုံးမှာ off ဖြစ်နေတာကြောင့် file system row တွေက encryption မဟုတ်ဘဲ NTFS နဲ့ RAID layer ကို တိုင်းတာပါတယ်။


| fio၊ 25GB ပမာဏ၊ QD32 | Pro Precision 9 T2၊ Max-Q 300W | Pro Precision 9 T2၊ 600W | Pro Max Tower T2၊ Max-Q 300W | Pro Max Tower T2၊ 600W |
|---|---|---|---|---|
| အဆင့်ဆင့်ဖတ်ရှုမှု 128K၊ ဖိုင်စနစ် (MB/s) | 9,332 | 9,255 | 11,377 | 11,406 |
| အဆင့်ဆင့်ဖတ်ရှုမှု 128K၊ raw device (MB/s) | 10,782 | 10,675 | 11,186 | 11,444 |
| အဆက်မပြတ်ရေးသားမှု 128K (MB/s) | 6,507 | 6,496 | 7,401 | 7,371 |
| 1MB ကြိုတင်ဖြည့်သွင်းဖတ်ရှုမှု၊ QD32 (MB/s) | 4,617 | 4,679 | 6,440 | 6,346 |
| ကျပန်းဖတ်ရှုမှု 4K၊ ဖိုင်စနစ်၊ အမြင့်ဆုံး (IOPS) | 840,075 | 853,615 | 1,778,576 | 1,756,968 |
| ကျပန်းဖတ်ရှုမှု 4K၊ raw device၊ အမြင့်ဆုံး (IOPS) | 1,107,862 | 1,120,737 | 2,297,681 | 2,294,800 |
| ကျပန်းရေးသားမှု 4K၊ အမြင့်ဆုံး (IOPS) | 557,512 | 550,505 | 957,461 | 921,774 |
| Raw / file system ကျပန်းဖတ်ရှုခြင်း | 1.32x | 1.31x | 1.29x | 1.31x |
| ကျပန်းဖတ်ရှုမှု 4K၊ အလုပ် ၄ ခု၊ p99 နှောင့်နှေးမှု (အမေရိကန်၊ နည်းလေ ပိုကောင်းလေ) | 506 | 485 | 183 | 185 |
| ကျပန်းဖတ်ရှုမှု 4K၊ အလုပ် ၄ ခု၊ p99.99 နှောင့်နှေးမှု (အမေရိကန်၊ နည်းလေ ပိုကောင်းလေ) | 15,270 | 23,462 | 676 | 676 |
| ကျပန်းရေးသားမှု 4K၊ အလုပ် ၄ ခု၊ p99 နှောင့်နှေးမှု (အမေရိကန်၊ နည်းလေ ပိုကောင်းလေ) | 610 | 594 | 228 | 228 |
| မောင်းနှင်မှုအပူချိန်၊ အမြင့်ဆုံး (C) | N/A (RAID နောက်ကွယ်မှ) | N/A (RAID နောက်ကွယ်မှ) | 50 | 57 |
stripe က single drive ထက် မမြန်ပါဘူး၊ block သေးသေးလေးတွေမှာတော့ အတော်လေး နောက်ကျနေပါတယ်။ E3.S drive နှစ်ခုက NTFS မှတစ်ဆင့် 9,332MB/s နှုန်းနဲ့ အစဉ်လိုက် ဖတ်ရှုပြီး raw volume မှ 10,782 နှုန်း၊ PCB01 အတွက် 11,377 နဲ့ 11,186 နှုန်းနဲ့ ဖတ်ရှုပြီး 7,401 နှုန်းနဲ့ ဖတ်ရှုပြီး 6,507MB/s နှုန်းနဲ့ ဖတ်ရှုပါတယ်။ 4K random read တွေမှာ file system မှတစ်ဆင့် volume က 840.1K IOPS မှာ အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး raw drive အတွက် 1.11M နှုန်း၊ single drive အတွက် 1.78M နဲ့ 2.30M နှုန်းနဲ့ ဖတ်ရှုပြီး 557.5K IOPS မှာ random write လုပ်ပြီး 957.5K နှုန်းနဲ့ ဖတ်ရှုပါတယ်။ raw-to-file-system ratio က နှစ်ခုလုံးမှာ 1.3x လောက်ရှိတာကြောင့် NTFS က တစ်ခုချင်းစီမှာ အတူတူပါပဲ။ ကွာခြားချက်က path နှစ်ခုလုံးအောက်မှာ VROC layer ရှိနေတာပါပဲ။
Tail latency ကတော့ အောက်ပါအတိုင်း ဖြစ်ပါတယ်- အလုပ် ၁၆ ခုမှာ အနှေးဆုံး random read ၀.၀၁ ရာခိုင်နှုန်းဟာ volume မှာ ၁၅.၃ ms ကြာမြင့်ပြီး single drive မှာ ၀.၆၈ ms ကြာမြင့်ပြီး 4-job p99 read latency က ၅၀၆ us ရှိပြီး ၁၈၃ ကြိမ် ကြာမြင့်ပါတယ်။ NVMe device နှစ်ခုမှာ အသုံးပြုတဲ့ software RAID က I/O တိုင်းအတွက် CPU hop တစ်ခု ပေါင်းထည့်ပေးပြီး fio CPU readings တွေက sequential passes တွေမှာ ၈၀ ရာခိုင်နှုန်းနဲ့ Core T2 မှာ ၄၀ ရာခိုင်နှုန်း ကြာမြင့်တယ်လို့ ပြသပါတယ်။ volume က drive တွေရဲ့ SMART data ကိုလည်း ဖုံးကွယ်ထားတာကြောင့် suite က သူတို့ရဲ့ အပူချိန်ကို မှတ်တမ်းတင်နိုင်ခြင်း မရှိပါဘူး။
ဒါတွေအားလုံးက FlexBay ကို မှားယွင်းတဲ့ရွေးချယ်မှုဖြစ်စေတာမဟုတ်ပါဘူး။ M.2 မရောက်ရှိနိုင်တဲ့ စွမ်းရည်တွေအထိ ချိန်ညှိနိုင်တဲ့ form factor ရှိတဲ့ T2 front-serviceable, hot-pluggable drives တွေကို ပေးစွမ်းပြီး drives နှစ်ခုကနေ 4TB boot volume က အဆင်ပြေပါတယ်။ ဆိုလိုတာက small-block random I/O၊ local database ဒါမှမဟုတ် heavyly cached model directory ရှိတဲ့ workload ရှိတဲ့ ဝယ်သူတစ်ယောက်ဟာ stripe မပါဘဲ single E3.S drive ဒါမှမဟုတ် Core T2 ရဲ့ရလဒ်တွေက Gen5 drive တစ်ခု ဒီ chassis မှာ ဘာလုပ်လဲဆိုတာပြသတဲ့ internal M.2 slot တွေကို ကြည့်သင့်ပါတယ်။
ကောက်ချက်
Dell Pro Precision 9 T2 သည် workstation processor ပါရှိသော Pro Max Tower T2 ဖြစ်ပြီး review data အရ ဝယ်ယူသူများ မျှော်လင့်သင့်သည့်အတိုင်း အတိအကျဖြစ်သည်ဟု ဆိုသည်။ 32-liter chassis တွင်ပင် Xeon 658X သည် Cinebench multi-core throughput ၃၉ ရာခိုင်နှုန်း၊ memory bandwidth ၃.၇ ဆ၊ DGEMM rate ထက် နှစ်ဆ၊ AVX-512၊ AMX၊ registered ECC memory နှင့် 1TB အထိ path ရှိသော 24-core၊ 48-thread processor တို့ ပါဝင်သည်။ primesieve မှ Python အထိ single-threaded work များတွင် ၁၃ ရာခိုင်နှုန်းမှ ၃၁ ရာခိုင်နှုန်းအထိ ပြန်လည်ရရှိနိုင်ပြီး viewport သို့မဟုတ် terminal တွင် ၎င်းတို့၏ တစ်နေ့တာကို ကုန်ဆုံးသော ဝယ်ယူသူများသည် ၎င်းကို သတိပြုမိကြလိမ့်မည်။
GPU ဆုံးဖြတ်ချက်က ဝယ်ယူသူတွေ နားလည်အောင် ကူညီပေးဖို့ ဒီသုံးသပ်ချက်ကို ဖန်တီးထားတာပါ။ Max-Q နဲ့ 600W RTX PRO 6000 ကတ်တွေက မန်မိုရီ 96GB ကို မျှဝေပြီး တစ်ခုနဲ့တစ်ခု ၇ ရာခိုင်နှုန်းကနေ ၂၀ ရာခိုင်နှုန်းအတွင်း decode လုပ်နိုင်ပါတယ်။ 600W ကတ်က ပထမဆုံး token ကို ပေးပို့ဖို့ အချိန် ၃ ပုံ ၁ ပုံ ဒါမှမဟုတ် ပိုများတဲ့အချိန် မြန်ဆန်စွာ လုပ်ဆောင်တဲ့အခါနဲ့ ရုပ်ပုံတွေ ၂၀ ရာခိုင်နှုန်းကနေ ၃၄ ရာခိုင်နှုန်းအထိ ပိုမြန်လာတဲ့အခါမှာ သူ့ရဲ့ပါဝါကို ရရှိပါတယ်။
Xeon tower မှာ 600W card က all-core work မှာ processor ကို ၄ ရာခိုင်နှုန်းကနေ ၅ ရာခိုင်နှုန်းအထိ ကုန်ကျစေပြီး ဘေးနားက slot လိုအပ်ပါတယ်။ ကျွန်တော်တို့ရဲ့ unit မှာ 25GbE adapter ကို ဖြုတ်လိုက်ရုံပါပဲ။ local model တွေအပြင် CPU render တွေနဲ့ simulation တွေကိုပါ run တဲ့ tower အတွက် Dell က ပို့ပေးတဲ့ Max-Q card က မျှတတဲ့ ရွေးချယ်မှုပါ။ team ကို model တွေ run ပေးတဲ့ ဒါမှမဟုတ် တစ်နေကုန် image တွေကို render လုပ်တဲ့ tower အတွက် 600W card က slot နဲ့ 1500W supply နဲ့ တန်ပါတယ်။
FlexBay မှာရှိတဲ့ E3.S ဟာ ကျွန်တော်တို့ နှစ်ပေါင်းများစွာ tower တစ်ခုမှာ လိုချင်တဲ့ form factor ပါ။ Graid Technology ရဲ့ VROC ဟာ RAID stack အတွက် ယုံကြည်စိတ်ချရတဲ့ pairing တစ်ခုပါ။ Core T2 မှာရှိတဲ့ single M.2 drive ထက် small random I/O မှာ ပိုနှေးပြီး 4K reads and writes မှာ ထက်ဝက်လောက် ပိုနှေးပါတယ်။ RAID'd boot volume မလိုအပ်တဲ့ ဝယ်သူတစ်ယောက်အနေနဲ့ E3.S drive တစ်ခု ဒါမှမဟုတ် internal M.2 slot တွေကို စဉ်းစားနိုင်ပါတယ်။
အခြားတစ်ဖက်တွင်၊ E3.S SSD များသည် ယခုအခါ 60TB ကျော်သွားသည်နှင့်အမျှ၊ ဒေတာအသုံးပြုမှု အလွန်အမင်းရှိသော အသုံးပြုသူများသည် ယခင်က ပြင်ပအကာအရံများ သို့မဟုတ် မျှဝေသိုလှောင်မှုပမာဏတစ်ခု တပ်ဆင်ခြင်းဟု အဓိပ္ပာယ်ရသော လုံးဝအသစ်သော ကမ္ဘာတစ်ခုသို့ ဝင်ရောက်ခွင့် ရရှိမည်ဖြစ်ပြီး၊ flash ဈေးနှုန်းကို လက်တွေ့ကန့်သတ်ချက်အဖြစ် သတ်မှတ်ထားသည်။
Dell.com မှာ configure လုပ်ထားတဲ့အတိုင်း ဒေါ်လာ ၂၈,၃၀၀ လောက်နဲ့၊ စီးပွားရေးလုပ်ငန်းသုံး ဝယ်သူအများစု မမြင်ရတဲ့ volume pricing မတိုင်ခင်မှာ Pro Precision 9 T2 ဟာ ဒီနေ့ခေတ်မှာ configure လုပ်ထားတဲ့ Pro Max Tower T2 ထက် ဒေါ်လာ ၄,၅၀၀ လောက် ပိုများတယ်လို့ စာရင်းပြုစုထားပါတယ်- 285K, 128GB DDR5-4400 ECC, RTX PRO 6000, 2TB Gen5 drive နဲ့ 1500W supply တို့ဟာ ဒေါ်လာ ၂၃,၈၀၀ လောက် ကျသင့်ပြီး tower နှစ်ခုရဲ့ GPU နဲ့ memory option တွေက ဒေါ်လာ ၉၀၀ အတွင်းမှာ ရှိပါတယ်။ ဒုတိယ FlexBay drive က အဲဒီကွာဟချက်နဲ့ ဒေါ်လာ ၁၇၀၀ ကွာဟပြီး ကျန်တာက Xeon platform ပါ။
၎င်းဝယ်ယူရမည့်အရာမှာ desktop ကဲ့သို့ footprint တွင် all-core load အောက်တွင် server ငယ်တစ်ခုကဲ့သို့ လုပ်ဆောင်သည့် single-socket tower တစ်ခုဖြစ်ပြီး Precision အမည် ပြန်လည်ရောက်ရှိလာခြင်းလည်း ဖြစ်သည်။
ဦးဆောင်သူစာရင်း- Dell Pro Precision 9 T2 သည် ကျွန်ုပ်တို့၏ အကောင်းဆုံး Desktop Workstations ဦးဆောင်သူစာရင်းတွင် အကောင်းဆုံး ಒಟ್ಟಾರೆ Desktop Workstation ဆုကို ရရှိထားပြီး ၎င်း၏ RTX PRO 6000 ရလဒ်များသည် ကျွန်ုပ်တို့၏ အကောင်းဆုံး Enterprise GPUs ဘုတ် တွင်လည်း ပါဝင်ပါသည် ။



 အမေဇုံ