

ဓာတ်ခွဲခန်းမှာ၊ flagship GeForce RTX 5090 ကနေ RTX 5070 အထိ NVIDIA ရဲ့ Blackwell 50-Series ကတ်အသစ်တွေအားလုံးနီးပါးကို သေချာစွာ ပြန်လည်သုံးသပ်ဖို့ အခွင့်အရေးရခဲ့ပါတယ်။ အခုတော့ NVIDIA က ဒီစီးရီးရဲ့ နောက်ဆုံးပေါ်နဲ့ ပိုပြီးတတ်နိုင်တဲ့ အဖွဲ့ဝင်တွေဖြစ်တဲ့ GeForce RTX 5060 နဲ့ GeForce RTX 5060 Ti ကို မိတ်ဆက်လိုက်ပါပြီ။
ကျွန်တော်တို့ GeForce RTX 5060 Ti ကို review အတွက် ရရှိခဲ့ပါတယ်၊ အထူးသဖြင့် PNY card ဗားရှင်းပါ။ ဒီမော်ဒယ်မှာ next-gen GDDR7 video memory 16GB ပါဝင်ပါတယ်။ RTX 5060 Ti ရဲ့ 8GB ဗားရှင်းကိုလည်း ဘတ်ဂျက်ကို သတိထားတဲ့ gamer တွေအတွက် မိတ်ဆက်ပွဲမှာ ရရှိနိုင်ပါတယ်။ ဒီ graphics card တွေက မျိုးဆက်ဟောင်း GPU တွေသုံးတဲ့ gamer တွေ၊ အထူးသဖြင့် GeForce RTX 3060 ဒါမှမဟုတ် ඊට පෙනුන්ကနေ upgrade လုပ်တဲ့ gamer တွေအတွက် ရည်ရွယ်ပြီး 1440p gaming အတွက် frame rate တွေကို နှစ်ဆနီးပါး မြှင့်တင်ပေးဖို့ ရည်ရွယ်ပါတယ်။
NVIDIA GeForce RTX 5060 Ti ဗိသုကာ
အသစ်ထွက်ရှိလာတဲ့ PCIe standard Gen5 x16 interface ကို အသုံးပြုထားတဲ့ PNY GeForce RTX 5060 Ti မှာ CUDA cores 4,608 ပါဝင်ပြီး base clock 2.41 GHz နဲ့ boost clock 2.57 GHz အထိ ရှိပါတယ်။ ဒါကြောင့် FP32 compute performance 29.15 TFLOPS ရရှိပြီး GeForce RTX 3060 ရဲ့ 16.2 TFLOPS ထက် နှစ်ဆနီးပါး ပိုများပါတယ်။ 4th-gen ray tracing cores တွေက RT performance 72 TFLOPS အထိ ပေးစွမ်းနိုင်ပြီး real-time reflections၊ global illumination နဲ့ path tracing support တွေကို မြှင့်တင်ပေးပါတယ်။ တစ်ချိန်တည်းမှာပဲ 5th-gen Tensor cores တွေက AI TOPS 759 ကို ပံ့ပိုးပေးတာကြောင့် AI-powered upscaling၊ frame generation နဲ့ complex computational workloads တွေကို သိသိသာသာ တိုးတက်ကောင်းမွန်စေပါတယ်။
GeForce RTX 4060 Ti နဲ့ နှိုင်းယှဉ်ရင် NVIDIA က PNY RTX 5060 Ti ဟာ DLSS 4 နဲ့ Multi Frame Generation ပါဝင်တဲ့ 3D rendering မှာ 2.1× အထိ တိုးတက်ကောင်းမွန်လာတယ်လို့ ဆိုထားပြီး ရိုးရာ rasterization စွမ်းဆောင်ရည်မှာလည်း 20% တိုးတက်လာပါတယ်။ RTX 3060 Ti ကနေ အဆင့်မြှင့်တင်သူတွေအတွက် ဒီခုန်ပျံကျော်လွှားမှုဟာ ပိုပြီး ထင်ရှားလာပြီး DLSS 4 ကိုအသုံးပြုတဲ့အခါ စွမ်းဆောင်ရည် 5× ကျော် တိုးတက်လာပါတယ်။
အထင်ရှားဆုံး hardware အဆင့်မြှင့်တင်မှုတစ်ခုကတော့ GDDR7 memory ကို ရွှေ့ပြောင်းလိုက်တာပါပဲ။ PNY GeForce RTX 5060 Ti မှာ 16GB VRAM ကို ဆက်လက်ထိန်းသိမ်းထားပေမယ့် GDDR6X ကနေ 128-bit bus မှာ next-gen GDDR7 ကို ကူးပြောင်းပေးပြီး memory bandwidth 448 GB/s ကို ပေးစွမ်းနိုင်ပါတယ်။ ဒါက texture streaming ကို ပိုမိုမြန်ဆန်စေခြင်း၊ ချောမွေ့တဲ့ 4K gameplay နဲ့ creative workloads တွေမှာ dataset ကြီးတွေကို ကိုင်တွယ်နိုင်မှု တိုးတက်ကောင်းမွန်လာစေပါတယ်။
DLSS 4 နှင့် AI စွမ်းအားပေးထားသော အင်္ဂါရပ်များ
DLSS 4 ပံ့ပိုးမှုဟာ RTX 50 စီးရီးရဲ့ အကြီးမားဆုံး ဆွဲဆောင်မှုတွေထဲက တစ်ခုပါ။ Multi Frame Generation ကို မိတ်ဆက်ပေးထားပြီး၊ AI စွမ်းအင်သုံး နည်းပညာအသစ်တစ်ခုဖြစ်ပြီး rendered frame တစ်ခုလျှင် frame များစွာကို ဖန်တီးပေးပြီး ပံ့ပိုးပေးထားတဲ့ ဂိမ်းတွေမှာ FPS ကို သိသိသာသာ မြှင့်တင်ပေးပါတယ်။ DLSS 4 က Ray Reconstruction နဲ့ Super Resolution ကို မြှင့်တင်ပေးပြီး အထူးသဖြင့် fast motion ဒါမှမဟုတ် high-action sequence တွေမှာ ရုပ်ပုံကြည်လင်ပြတ်သားမှုနဲ့ တည်ငြိမ်မှုကို တိုးတက်စေပါတယ်။
စိတ်လှုပ်ရှားဖွယ်အကောင်းဆုံး ဖွံ့ဖြိုးတိုးတက်မှုများထဲမှတစ်ခုမှာ NVIDIA ၏ latency လျှော့ချရေးနည်းပညာ Reflex+ နှင့် DLSS 4 ပေါင်းစပ်ခြင်းဖြစ်သည်။ တွဲဖက်လိုက်သောအခါ DLSS 4 သည် frame rate များကို မြှင့်တင်ပေးပြီး system latency ကို လျှော့ချပေးသောကြောင့် ဂိမ်းကစားခြင်းကို ပိုမိုတုံ့ပြန်မှုရှိစေပြီး ယှဉ်ပြိုင်မှုပြင်းထန်သော ကစားသမားများအတွက် အဓိကအားသာချက်တစ်ခုဖြစ်သည်။ ထို့အပြင်၊ 5th-gen Tensor cores များသည် AI processing ကို အားဖြည့်ပေးပြီး ရှုပ်ထွေးသော ဆူညံသံလျှော့ချသည့်အလုပ်များနှင့် inference workloads များကို ထိရောက်စွာကိုင်တွယ်ပေးသည်။
စတင်မိတ်ဆက်ချိန်မှစ၍ DLSS 4 သည် Avowed နှင့် Kingdom Come Deliverance II ကဲ့သို့သော ဂိမ်းအသစ်များနှင့် အလွန်ရေပန်းစားသော Red Dead Redemption II နှင့် Microsoft Flight Simulator ကဲ့သို့သော ဂိမ်းဟောင်းများ အပါအဝင် ဂိမ်းနှင့် ခေါင်းစဉ်ပေါင်း ၁၀၀ ကျော်တွင် ပါဝင်ခဲ့သည်။ RT cores အသစ်များနှင့် AI-assisted denoising နည်းပညာများကြောင့် ray tracing နှင့် path tracing တို့ကို အသုံးပြုသည့် ဂိမ်းများသည် စွမ်းဆောင်ရည်ကို မထိခိုက်စေဘဲ visual fidelity ကို သိသိသာသာ မြှင့်တင်ပေးနိုင်ဖွယ်ရှိသည်။
ဂိမ်းကစားခြင်းအပြင်၊ ဤ AI တိုးတက်မှုများသည် ဖန်တီးမှုဆိုင်ရာနှင့် ထုတ်လုပ်မှုဆိုင်ရာ အလုပ်ဝန်ထုပ်ဝန်ပိုးများထဲသို့လည်း ပျံ့နှံ့သွားပါသည်။ Topaz Video AI၊ DaVinci Resolve နှင့် Adobe Premiere Pro ကဲ့သို့သော အက်ပ်များသည် ယခုအခါ DLSS နှင့် ဆက်စပ်သော နည်းပညာကို အသုံးပြု၍ Timeline scrubbing ကို ပိုမိုချောမွေ့စေခြင်း၊ ဗီဒီယို upscaling ကို ပိုမိုမြန်ဆန်စေခြင်းနှင့် real-time effects rendering တို့ကို ပိုမိုမြန်ဆန်စေပါသည်။ 759 AI TOPS ဖြင့် PNY RTX GeForce 5060 Ti သည် တစ်ချိန်က high-end GPU များအတွက်သာ သီးသန့်ထားရှိခဲ့သော အရှိန်မြှင့်တင်မှုအဆင့်ကို mainstream user များအတွက် ယူဆောင်လာပါသည်။
NVIDIA GeForce RTX 5060 Ti သတ်မှတ်ချက်များနှင့် နှိုင်းယှဉ်ချက်
အောက်တွင် NVIDIA GeForce RTX 5060 Ti နှင့် ၎င်း၏ ယခင်ကတ်များဖြစ်သည့် GeForce RTX 4060 Ti၊ GeForce RTX 3060 Ti နှင့် GeForce RTX 2060 တို့၏ သတ်မှတ်ချက်များကို နှိုင်းယှဉ်ဖော်ပြထားပါသည်။ ဤနှိုင်းယှဉ်ချက်သည် အသုံးပြုသူများစွာ ပိုင်ဆိုင်နိုင်သည့် ယခင်မျိုးဆက်ကတ်များနှင့် GeForce RTX 5060 Ti ၏ စွမ်းဆောင်ရည်ကို မည်သို့နှိုင်းယှဉ်ထားသည်ကို မီးမောင်းထိုးပြပါသည်။
| GPU နှိုင်းယှဉ်ချက် | Nvidia GeForce RTX 5060 တီ | Nvidia GeForce RTX 4060 တီ | Nvidia GeForce RTX 3060 တီ | Nvidia GeForce RTX 2060 |
| GPU ကိုအမည် | GB206 | AD106-350-A1 | GA104 | TU106 |
| ဗိသုကာအတတ်ပညာ | ဘလက်ဝဲလ် ၂.၀ | အာဒါ လော့ဗ်လေ့စ် | အမ်ပီယာ | Turing |
| လုပ်ငန်းစဉ်အရွယ်အစား | 5 nm | 5 nm | 8 nm | 12 nm |
| transistors | 21,900 သန်း | 22,900 သန်း | 17,400 သန်း | 10,800 သန်း |
| သိပ်သည်းဆ | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း |
| Size ကို Die | 181 mm² | 188 mm² | 392 mm² | 445 mm² |
| slot အကျယ် | Dual- slot | Dual- slot | Dual- slot | Dual- slot |
| ရှုထောင့် | 245 မီလီမီတာ 120 မီလီမီတာ 40 မီလီမီတာ×× | 240 111 မီလီမီတာမီလီမီတာမီလီမီတာ x x 40 | X ကို 242 112 | 229 113 မီလီမီတာမီလီမီတာမီလီမီတာ x x 35 |
| TDP | 180 ဒဗလျူ | 160 ဒဗလျူ | 200 ဒဗလျူ | 184 ဒဗလျူ |
| ဗီဒီယို ချိတ်ဆက်မှုများ | 1x HDMI 2.1b ဖြစ်သည် 3x DisplayPort 2.1b |
1x HDMI ၁.၄ 3x DisplayPort 1.4a |
1x HDMI ၁.၄ 3x DisplayPort 1.4a |
HDMI 2.1b ၁ ခု၊ DisplayPort 2.1b ၃ ခု |
| Power က Connectors | 1x 16 pin | 1x 16 pin | 1x 12 pin | 1x 16 pin |
| ဘတ်စ်ကား Interface | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 4.0 x16 | PCIe 5.0 x16 |
| base နာရီ | 2407 MHz | 2310 MHz | 1410 MHz | 1470 MHz |
| နာရီ Boost | 2572 MHz | 2535 MHz | 1665 MHz | 1650 MHz |
| မှတ်ဉာဏ်နာရီ | 1750 MHz ၁၈ Gbps ထိရောက်မှု |
2250 MHz ၁၈ Gbps ထိရောက်မှု |
1750 MHz ၁၈ Gbps ထိရောက်မှု |
1750 MHz ၁၈ Gbps ထိရောက်မှု |
| memory အရွယ်အစား | 8 သို့မဟုတ် 16 GB အထိ | 16 သို့မဟုတ် 8 GB အထိ | 8 GB ကို | 12 GB ကို |
| memory အမျိုးအစား | GDDR7 | GDDR6 | GDDR6 | GDDR6 |
| မှတ်ဉာဏ်ဘတ်စ်ကား | 128 bit နဲ့ | 128 bit နဲ့ | 256 bit နဲ့ | 192 bit နဲ့ |
| မှတ်ဉာဏ် Bandwidth | 448.0 GB ကို / s နဲ့ | 288.0 GB ကို / s နဲ့ | 448.0 GB ကို / s နဲ့ | 336.0 GB ကို / s နဲ့ |
| CUDA core | 4608 | 4352 | 4864 | 2176 |
| TMU များ | 144 | 136 | 152 | 136 |
| ROPs | 48 | 48 | 80 | 48 |
| SM အရေအတွက် | 36 | 34 | 38 | 34 |
| Tensor core | 144 | 136 | 152 | 272 |
| RT ကို core | 36 | 34 | 38 | 34 |
| L1 ကက်ရှ် | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) |
| L2 ကက်ရှ် | 36 ကို MB | 32 ကို MB | 4 ကို MB | 64 ကို MB |
| ပစ်ဇယ်နှုန်း | ၄၆၂.၁ GPixel/s | ၄၆၂.၁ GPixel/s | ၄၆၂.၁ GPixel/s | ၄၆၂.၁ GPixel/s |
| အသွင်အပြင်နှုန်း | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s |
| FP၁၆ (တစ်ဝက်) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | 22.06 TFLOPS (1: 1) | 16.20 TFLOPS (1: 1) | 14.36 TFLOPS (2: 1) |
| FP32 (float) | 29.15 TFLOPS | 22.06 TFLOPS | 16.20 TFLOPS | 7.181 TFLOPS |
| FP64 (နှစ်ထပ်) | ၈၇၉.၃ ဂျီအက်ဖ်လော့ပ်စ် (၁:၆၄) | ၇၉၄ GFLOPS (1: 64) | ၇၉၄ GFLOPS (1: 64) | ၇၉၄ GFLOPS (1: 32) |
| စတင်ရောင်းချသည့် ဈေးနှုန်း (USD) | $ 379 / $ 429 | $ 499 / $ 399 | $399 | N / A |
တည်ဆောက်ခြင်းနှင့် ဒီဇိုင်းရေးဆွဲခြင်း – PNY GeForce NVIDIA RTX 5060 Ti
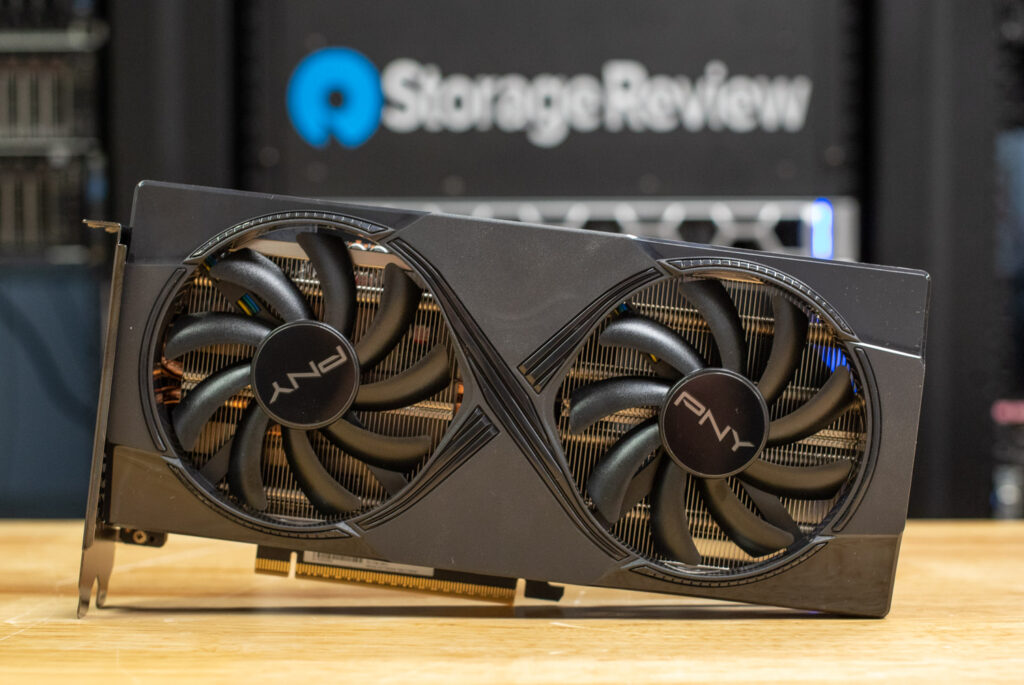
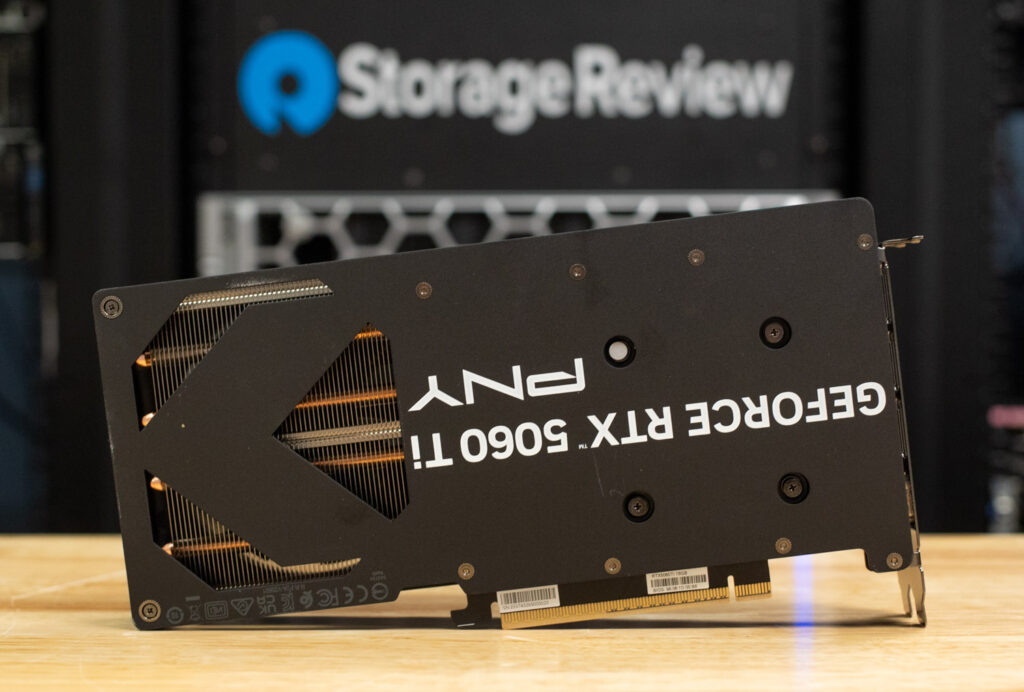
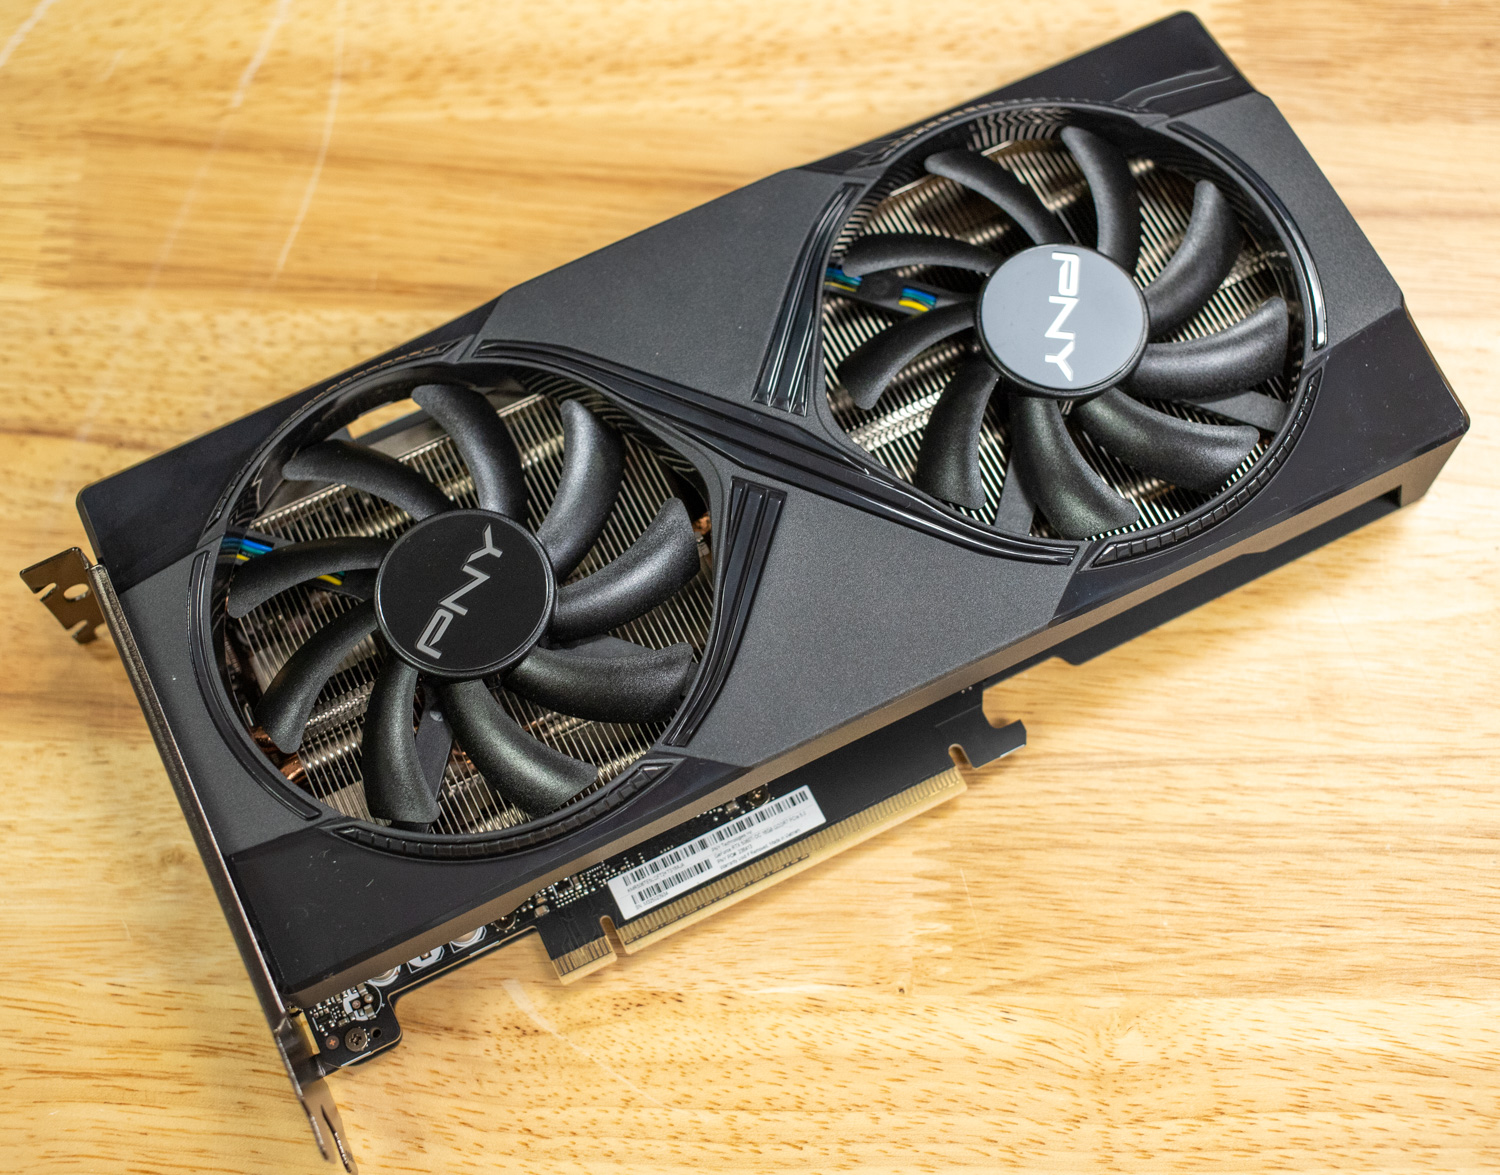
PNY GeForce RTX 5060 Ti မှာ dual-slot ဒီဇိုင်းပါဝင်ပြီး GeForce RTX 5070 Founders Edition ရဲ့ ရုပ်ပိုင်းဆိုင်ရာ အတိုင်းအတာနဲ့ အကြမ်းဖျင်း တူညီပါတယ် ။ အအေးပေးစက်က ကတ်တစ်ခုလုံးရဲ့ အရှည်ကို ဖုံးအုပ်ထားပေမယ့် တကယ့် PCB က အဲဒီနေရာရဲ့ တစ်ဝက်ပဲ နေရာယူထားပြီး ကျန်တာတွေကို 180W TDP ကို စီမံခန့်ခွဲဖို့ ကြီးမားတဲ့ heatsink နဲ့ dual-fan cooling system တွေနဲ့ ထားထားပါတယ်။
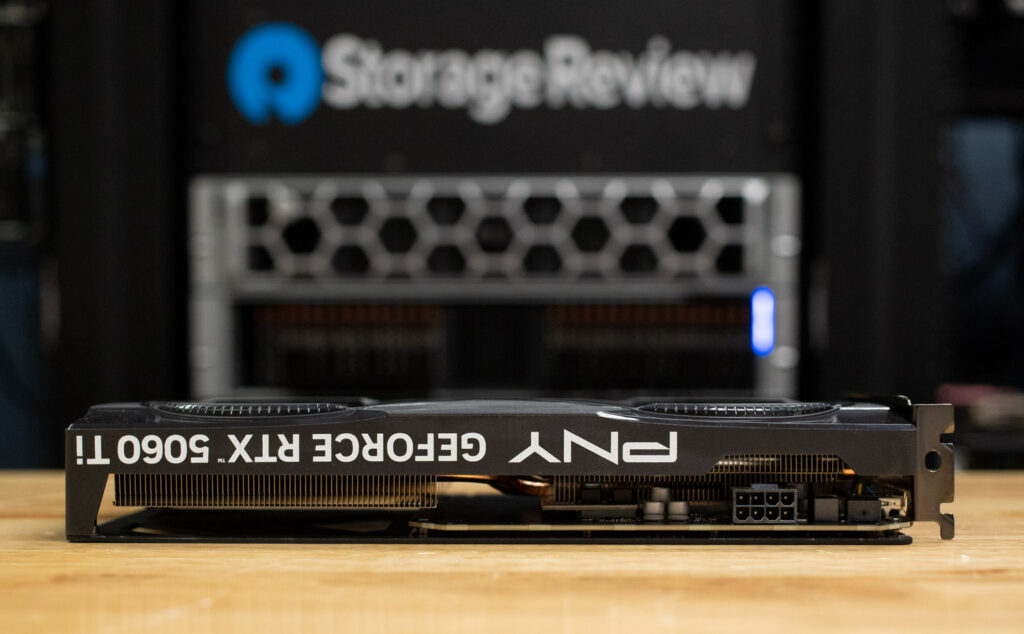
ဒီ PCB တိုတိုလေးက သေးငယ်တဲ့ ရေအေးပေးစနစ်တည်ဆောက်မှုပုံစံတွေအတွက် အထူးဆွဲဆောင်မှုရှိစေပြီး modder တွေအတွက် ရှေ့ဘက်မှာတပ်ဆင်ထားတဲ့ ရေဒီယေတာတွေ၊ ရေလှောင်ကန်နေရာချထားမှု ဒါမှမဟုတ် custom loop tubing တွေအတွက် နေရာပိုရစေပါတယ်။ စံ air-cooled setup တွေမှာတောင် ဒီဇိုင်းက ပိုကျဉ်းတဲ့ mid-tower cases တွေအတွက် ပြောင်းလွယ်ပြင်လွယ်ရှိပါတယ်။ PNY ရဲ့ cooler ဟာ load အောက်မှာ တိတ်ဆိတ်စွာလည်ပတ်ပြီး မလိုအပ်ဘဲ ထူထဲမှုမဖြစ်စေဘဲ တောင့်တင်းမှုကို ပေါင်းထည့်ပေးတဲ့ လေဝင်လေထွက်ကောင်းတဲ့ full-length metal backplate ပါရှိပါတယ်။ တောက်ပြောင်တဲ့ဒီဇိုင်းမဟုတ်ပေမယ့် အလုပ်ကို ထိရောက်စွာလုပ်ဆောင်ပေးပါတယ်။
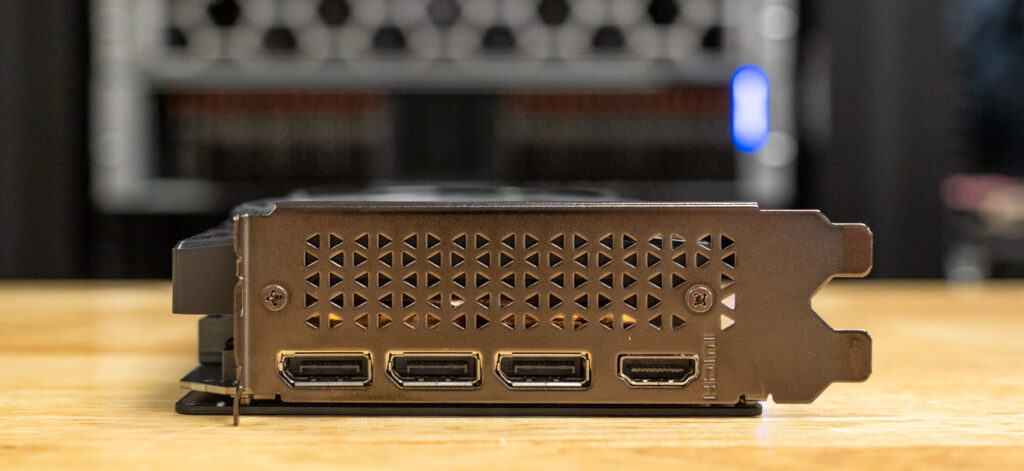
ကတ်သည် 8-pin PCIe connector တစ်ခုတည်းမှတစ်ဆင့် ပါဝါကို ဆွဲယူသောကြောင့် အဆင့်မြှင့်တင်သူများအတွက် အရာအားလုံးကို ရိုးရှင်းစေသည်။ ဤစံ connector ရွေးချယ်မှုသည် ကတ်၏ ထိရောက်သော ပါဝါဒီဇိုင်းကို ထင်ဟပ်စေပြီး အဟောင်းများ သို့မဟုတ် wattage နည်းသော PSU များအသုံးပြုသူများအတွက် အထူးဆွဲဆောင်မှုရှိစေသည်။ ၎င်းသည် အလယ်အလတ်တန်းစားကတ်များမှ လာသူများအတွက် စိတ်ဖိစီးမှုကင်းသော အဆင့်မြှင့်တင်မှုတစ်ခုဖြစ်ပြီး အထူးသဖြင့် compact သို့မဟုတ် prebuilt system များတွင် power supply အစားထိုးခြင်းသည် အကန့်အသတ်ဖြစ်စေနိုင်သည်။ ကတ်တွင် တာရှည်ခံမှုအတွက် သတ္တု dual-slot PCIe backplate ပါဝင်ပြီး 1x HDMI 2.1b နှင့် 3x DisplayPort 2.1b output များပါရှိပြီး ခေတ်မီမော်နီတာအမျိုးမျိုးကို ပံ့ပိုးပေးသည်။
StorageReview AMD Threadripper စမ်းသပ်ပလက်ဖောင်း
ကျွန်ုပ်တို့၏ RTX 5060 Ti စမ်းသပ်မှုအတွက် အသုံးပြုခဲ့သော စမ်းသပ်ပလက်ဖောင်းတွင် အောက်ပါတို့ ပါဝင်သည်-
-
- motherboard: ASUS Pro WS TRX50-SAGE WIFI
- CPU ကို: AMD Ryzen Threadripper 7980X 64-Core
- ရမ်: 64GB DDR5 4800MT/s
- သိုလှောင်မှု: 2TB Samsung 980 Pro
- OS ကို: Workstations အတွက် Windows 11 Pro
- ကားမောင်းသူ: NVIDIA 571.86 GameReady ဒရိုက်ဘာ
AMD Ryzen Threadripper 7980X သည် ကျွန်ုပ်တို့၏ စမ်းသပ်မှုစနစ်၏ အဓိကနေရာတွင် ရှိနေပြီး cores ၆၄ ခုနှင့် ကျယ်ပြန့်သော multi-threading စွမ်းရည်များ ပါဝင်သည်။ ၎င်းသည် CPU ကန့်သတ်ချက်များသည် GPU-focused benchmarks များကို အနှောင့်အယှက်မဖြစ်စေဘဲ အထူးသဖြင့် AI processing၊ ray tracing နှင့် high-resolution rendering တို့တွင် workloads များကို GPU သို့ အများအပြား လျှော့ချပေးပါသည်။
ကျွန်ုပ်တို့သည် 7980X ကို ASUS Pro WS TRX50-SAGE WIFI motherboard နှင့် တွဲဖက်အသုံးပြုခြင်းဖြင့် PCIe bandwidth အများအပြားကို ပေးစွမ်းနိုင်ပြီး GPU သည် အတားအဆီးများမရှိဘဲ ၎င်း၏ အပြည့်အဝ အလားအလာကို ရရှိနိုင်ကြောင်း သေချာစေပါသည်။ ကျွန်ုပ်တို့၏စနစ်တွင် 4800MT/s ဖြင့် 128GB DDR5 မှတ်ဉာဏ်လည်း ပါဝင်ပြီး dataset ကြီးများကို ကိုင်တွယ်ရာတွင် ချောမွေ့စွာလည်ပတ်နိုင်ရန် လုံလောက်သော နေရာလွတ်ကို ပေးစွမ်းသည်။ Samsung 980 Pro သည် အနည်းငယ်ဟောင်းသော Gen4 SSD ဖြစ်သော်လည်း မြန်ဆန်သော read/write speed များကို ပေးစွမ်းနိုင်ပြီး load time များကို အနည်းဆုံးဖြစ်စေပြီး AI model inference သို့မဟုတ် texture streaming ကဲ့သို့သော data များသော အလုပ်များကို storage စွမ်းဆောင်ရည်ကြောင့် အနှောင့်အယှက်မဖြစ်စေပါ။
ကျွန်ုပ်တို့ရဲ့ ယခင် benchmarking မှာ NVIDIA ရဲ့ lower-end xx60-series ကတ်အများစုကို အာရုံစိုက်ခဲ့တာမဟုတ်ပေမယ့် PNY GeForce RTX 5060 Ti ရောက်ရှိလာခြင်းနဲ့အတူ ပြောင်းလဲလာပါပြီ။ ဒီ GPU အသစ်ရဲ့ အနေအထားကို ရှင်းရှင်းလင်းလင်း သိရှိနိုင်ဖို့အတွက် GeForce RTX 5070 နဲ့ GeForce RTX 4070 အပါအဝင် ကျွန်ုပ်တို့ စမ်းသပ်ပြီးသား အဆင့်မြင့်ကတ်တွေနဲ့ နှိုင်းယှဉ်ကြည့်ပါတယ်။ ဒါက ပြီးခဲ့တဲ့ မျိုးဆက်တစ်လျှောက်မှာ ခိုင်မာတဲ့ စွမ်းဆောင်ရည်နဲ့ ထိရောက်မှု အခြေအနေနဲ့ အဆင့်အတန်းမြင့်မားမှုကို ပေးစွမ်းပါတယ်။
- NVIDIA RTX5070 (12GB GDDR7)
- NVIDIA RTX 4070 (12GB GDDR6X)
Benchmarking စမ်းသပ်မှုများ
ကျွန်ုပ်တို့၏ စမ်းသပ်မှုများစွာတွင် ပထမဆုံးမှာ Procyon AI Text Generation Benchmark ဖြစ်သည် ။ ဤ benchmark သည် ကျစ်လစ်ပြီး တသမတ်တည်းရှိသော အကဲဖြတ်နည်းလမ်းကို ပေးဆောင်ခြင်းဖြင့် AI LLM စွမ်းဆောင်ရည်စမ်းသပ်မှုကို ရိုးရှင်းစေသည်။ ၎င်းသည် မော်ဒယ်အရွယ်အစားကြီးများနှင့် variable factor များ၏ ရှုပ်ထွေးမှုကို လျှော့ချနေစဉ် LLM မော်ဒယ်များစွာတွင် ထပ်ခါတလဲလဲ စမ်းသပ်နိုင်စေပါသည်။ AI hardware ဦးဆောင်သူများနှင့်အတူ တီထွင်ထားသော ဤ benchmark သည် ပိုမိုယုံကြည်စိတ်ချရပြီး ထိရောက်သော စွမ်းဆောင်ရည်အကဲဖြတ်မှုများအတွက် ဒေသတွင်း AI accelerator များကို အသုံးပြုမှုကို အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ပေးသည်။ အောက်တွင် တိုင်းတာထားသော ရလဒ်များကို TensorRT ကို အသုံးပြု၍ စမ်းသပ်ခဲ့သည်။
Procyon AI Text Generation စမ်းသပ်မှုမှာ PNY GeForce RTX 5060 Ti ဟာ အုပ်စုထဲမှာ အရိုးရှင်းဆုံး specified ကတ်ဖြစ်ပေမယ့် CUDA cores 4,608 နဲ့ 128-bit memory bus ပါဝင်ပါတယ်။ RTX 5070 ရဲ့ 6,144 cores နဲ့ 192-bit bus နဲ့ RTX 4070 ရဲ့ 5,888 cores တို့ဟာ 192-bit width တူညီတာနဲ့ နှိုင်းယှဉ်ရင် သူ့ရဲ့ကိုယ်ပိုင် စွမ်းဆောင်ရည်ကို ပြသထားပါတယ်။ 5060 Ti ဟာ Phi နဲ့ Mistral ရမှတ် 2,870 နဲ့ 2,807 ရရှိခဲ့ပြီး output token rates 120.7 tokens/s နဲ့ 91.0 tokens/s အသီးသီး ရရှိခဲ့ပါတယ်။ 5070 ရဲ့ 150.4 tokens/s နဲ့ 120.5 tokens/s နဲ့ 4070 ရဲ့ 141.6 tokens/s နဲ့ 99.6 tokens/s တို့ထက် သိသိသာသာ နောက်ကျနေပါတယ်။ ဒီလမ်းကြောင်းဟာ Llama3 နဲ့ Llama2 မှာ ဆက်လက်တည်ရှိနေပြီး 5060 Ti ဟာ throughput နဲ့ duration မှာ နိမ့်ကျနေပါတယ်- Llama3 မှာ 74.7 tokens/s နဲ့ 39.4s ရှိပြီး Llama2 မှာ 41.3 tokens/s နဲ့ 71.3s ရှိပါတယ်။ ပိုလေးတဲ့ မော်ဒယ်တွေအောက်မှာ ကွာဟချက်က ကျယ်ပြန့်လာပေမယ့် 5060 Ti ဟာ ၎င်းရဲ့အတန်းအစားအတွက် ကောင်းကောင်းရပ်တည်နေပါတယ်။ အဆင့်မြင့်ဈေးနှုန်းတွေကို မထည့်သွင်းဘဲ အခြေခံဒေသတွင်း AI အရှိန်မြှင့်တင်မှုကို ရှာဖွေနေတဲ့ အသုံးပြုသူတွေအတွက် ဆွဲဆောင်မှုရှိတဲ့ တန်ဖိုးကို ပေးစွမ်းပါတယ်။
| UL Procyon: AI စာသားထုတ်လုပ်ခြင်း | PNY Nvidia GeForce RTX 5060 Ti | Nvidia GeForce RTX 5070 | Nvidia GeForce RTX 4070 |
| Phi ၏ စုစုပေါင်းရမှတ် | 2,870 | 3,453 | 3,191 |
| ပထမဆုံးတိုကင်သို့ Phi ထုတ်ပေးချိန် | 0.375 ့ | 0.323 ့ | 0.356 ့ |
| တစ်စက္ကန့်လျှင် Phi အထွက်တိုကင်များ | 120.733 တိုကင်/s | 150.435 တိုကင်/s | 141.575 တိုကင်/s |
| Phi ၏ စုစုပေါင်းကြာချိန် | 25.216 ့ | 20.302 ့ | 21.743 ့ |
| Mistral ၏ စုစုပေါင်းရမှတ် | 2,807 | 3,562 | 2,987 |
| Mistral ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.526 ့ | 0.433 ့ | 0.508 ့ |
| တစ်စက္ကန့်လျှင် Mistral Output Tokens များ | 91.057 တိုကင်/s | 120.507 တိုကင်/s | 99.590 တိုကင်/s |
| Mistral ၏ စုစုပေါင်းကြာချိန် | 33.377 ့ | 25.496 ့ | 30.651 ့ |
| Llama3 အလုံးစုံရမှတ် | 2,599 | 3,125 | 2,810 |
| Llama3 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.449 ့ | 0.379 ့ | 0.423 ့ |
| တစ်စက္ကန့်လျှင် Llama3 အထွက်တိုကင်များ | 74.709 တိုကင်/s | 100.388 တိုကင်/s | 82.130 တိုကင်/s |
| Llama3 ၏ စုစုပေါင်းကြာချိန် | 39.489 ့ | 29.720 ့ | 36.147 ့ |
| Llama2 အလုံးစုံရမှတ် | 2,576 | 3,125 | 2,658 |
| Llama2 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.844 ့ | 0.785 ့ | 0.947 ့ |
| တစ်စက္ကန့်လျှင် Llama2 အထွက်တိုကင်များ | 41.386 တိုကင်/s | ၅၆.၆၄၇ တိုကင်/စက္ကန့် | 49.487 တိုကင်/s |
| Llama2 ၏ စုစုပေါင်းကြာချိန် | 71.302 ့ | 53.234 ့ | 61.300 ့ |
UL ပရိုဆိုင်ယွန်- AI ရုပ်ပုံမျိုးဆက်
Procyon AI Image Generation Benchmark သည် ပါဝါနည်း NPU များမှ အဆင့်မြင့် GPU များအထိ မတူညီသော ဟာ့ဒ်ဝဲများတွင် AI inference စွမ်းဆောင်ရည်ကို စဉ်ဆက်မပြတ်နှင့် တိကျစွာ တိုင်းတာပေးသည်။ ၎င်းတွင် စမ်းသပ်မှုသုံးခု ပါဝင်သည်- အဆင့်မြင့် GPU များအတွက် Stable Diffusion XL (FP16)၊ အလယ်အလတ် ပါဝါအားကောင်း GPU များအတွက် Stable Diffusion 1.5 (FP16) နှင့် ပါဝါနည်း စက်ပစ္စည်းများအတွက် Stable Diffusion 1.5 (INT8)။ benchmark သည် စနစ်တစ်ခုစီအတွက် အကောင်းဆုံး inference engine ကိုအသုံးပြုပြီး တရားမျှတပြီး နှိုင်းယှဉ်နိုင်သော ရလဒ်များကို သေချာစေသည်။
Procyon AI Image Generation benchmark မှာ PNY GeForce RTX 5060 Ti ဟာ သူ့ရဲ့အတန်းအစားအတွက် လေးစားဖွယ်ရလဒ်တွေကို ထပ်မံပြသခဲ့ပါတယ်။ Stable Diffusion 1.5 FP16 စမ်းသပ်မှုက 2,110 မှတ်ရခဲ့ပြီး GeForce RTX 5070 ရဲ့ 2,937 နဲ့ 4070 ရဲ့ 2,400 တို့ထက် သိသိသာသာ နောက်ကျနေပါတယ်။ သူ့ရဲ့ ပျမ်းမျှပုံရိပ်ထုတ်လုပ်မှုအချိန် 2.97 စက္ကန့်ဟာ 5070 ရဲ့ 2.13 စက္ကန့်နဲ့ 4070 ရဲ့ 2.60 စက္ကန့်တို့ထက် နောက်ကျနေပါတယ်။ တူညီတဲ့မော်ဒယ်ရဲ့ INT8 မျိုးကွဲကလည်း အလားတူပဲဖြစ်ပြီး 27,705 မှတ်ရခဲ့ပြီး 36,320 (5070) နဲ့ 31,048 (4070) တို့နဲ့ နှိုင်းယှဉ်ရင် ရရှိခဲ့ပါတယ်။ ဒီနိမ့်ကျတဲ့ တိကျမှုစမ်းသပ်မှုမှာ ပုံတစ်ပုံကို 1.13 စက္ကန့်သာ ရရှိခဲ့ပြီး သူ့ရဲ့ပြိုင်ဘက်တွေထက် နှေးကွေးပါတယ်။ Stable Diffusion XL (FP16) မှာ၊ ကွာဟချက်က နည်းနည်းပိုကျယ်လာပြီး 5060 Ti အတွက် 1,837 အသီးသီး၊ 5070 နဲ့ 4070 အတွက် 2,473 နဲ့ 1,940 အသီးသီးရှိပြီး ပုံတစ်ပုံကို 20.4 စက္ကန့် ပုံရိပ်ထုတ်လုပ်နှုန်းရှိပါတယ်။
| UL Procyon: AI Image Generation (အလုံးစုံရမှတ်- မြင့်လေ ပိုကောင်းလေ) | PNY NVIDIA GeForce RTX 5060 Ti | Nvidia GeForce RTX 5070 | Nvidia GeForce RTX 4070 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — အလုံးစုံရမှတ် | 2,110 | 2,937 | 2,400 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — ಒಟ್ಟಾರೆအချိန် | 47.590 ့ | 34.038 ့ | 41.661 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) — အလုံးစုံရမှတ် | 27,705 | 36,320 | 31,048 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) — ಒಟ್ಟಾರೆအချိန် | 9.024 ့ | 6.883 ့ | 8.052 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT8) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — အလုံးစုံရမှတ် | 1,837 | 2,473 | 1,940 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — ಒಟ್ಟಾರೆအချိန် | 326.550 ့ | 242.606 | 309.269 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
လပ်စ်မာ့ခ်
Luxmark သည် open-source ray tracing renderer ဖြစ်သော LuxRender ကို အသုံးပြု၍ အသေးစိတ်ကျသော 3D မြင်ကွင်းများကို ကိုင်တွယ်ရာတွင် စနစ်၏စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည့် GPU benchmark တစ်ခုဖြစ်သည်။ ဤ benchmark သည် server များနှင့် workstation များ၏ graphical rendering စွမ်းရည်ကို အကဲဖြတ်ရန်အတွက် အထူးသဖြင့် visual effect များနှင့် architectural visualization application များအတွက် တိကျသော အလင်း simulation သည် အရေးကြီးပါသည်။
LuxMark benchmark မှာ PNY GeForce RTX 5060 Ti ဟာ သူ့ရဲ့ ရိုးရှင်းတဲ့ specs တွေကြောင့် လေးစားဖွယ်ကောင်းတဲ့ ရမှတ်တွေ ရရှိခဲ့ပြီး “Food” ကဏ္ဍမှာ 6,590 နဲ့ “Hall” စမ်းသပ်မှုမှာ 15,348 ရရှိခဲ့ပါတယ်။ core count မြင့်မားပြီး memory bus ပိုများတာကြောင့် အကျိုးကျေးဇူးရရှိတဲ့ GeForce RTX 5070 နဲ့ 4070 တို့ထက် နောက်ကျနေပါတယ်။
| Luxmark (မြင့်လေ ပိုကောင်းလေ) | PNY NVIDIA GeForce RTX 5060 Ti | Nvidia GeForce RTX 5070 | Nvidia GeForce RTX 4070 |
| အစားအသောက်ရမှတ် | 6,590 | 9,061 | 7,535 |
| ခန်းမရမှတ် | 15,348 | 22,062 | 20,003 |
Geekbench 6
Geekbench 6 သည် အလုံးစုံစနစ်စွမ်းဆောင်ရည်ကို တိုင်းတာသည့် cross-platform benchmark တစ်ခုဖြစ်သည်။ Geekbench Browser သည် မည်သည့်စနစ်နှင့်မဆို နှိုင်းယှဉ်နိုင်စေပါသည်။
Geekbench 6 ရဲ့ GPU OpenCL စမ်းသပ်မှုမှာ PNY GeForce RTX 5060 Ti ဟာ 150,743 မှတ် ရရှိခဲ့ပြီး အသီးသီး 188,892 နဲ့ 174,725 ရရှိခဲ့တဲ့ RTX 5070 နဲ့ 4070 တို့ထက် နောက်ကျကျန်နေခဲ့ပါတယ်။ ဒီထဲမှာ ဦးဆောင်မနေပေမယ့် 5060 Ti ကတော့ သူ့ရဲ့ကိုယ်ပိုင်စွမ်းဆောင်ရည်ကို ဆက်လက်ထိန်းသိမ်းထားနိုင်ပြီး application အမျိုးမျိုးမှာ GPU အရှိန်မြှင့်ထားတဲ့ နေ့စဉ်လုပ်ငန်းဆောင်တာတွေအတွက် ခိုင်မာတဲ့ compute စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ပါတယ်။
| Geekbench (မြင့်လေ ပိုကောင်းလေ) | PNY NVIDIA GeForce RTX 5060 Ti | Nvidia GeForce RTX 5070 | Nvidia GeForce RTX 4070 |
| GPU OpenCL ရမှတ် | 150,743 | 188,892 | 174,725 |
V Ray
V -Ray Benchmark သည် အဆင့်မြင့် V-Ray 6 အင်ဂျင်များကို အသုံးပြု၍ CPU များ၊ NVIDIA GPU များ သို့မဟုတ် နှစ်မျိုးလုံး၏ rendering စွမ်းဆောင်ရည်ကို တိုင်းတာသည်။ ၎င်းသည် အသုံးပြုသူများ ၎င်းတို့၏စနစ်များ၏ rendering စွမ်းရည်များကို အကဲဖြတ်ရန်နှင့် နှိုင်းယှဉ်နိုင်ရန် မြန်ဆန်သော စမ်းသပ်မှုများနှင့် ရိုးရှင်းသော အမှတ်ပေးစနစ်ကို အသုံးပြုသည်။ ၎င်းသည် ထိရောက်သော စွမ်းဆောင်ရည်ဆိုင်ရာ ထိုးထွင်းသိမြင်မှုများကို ရှာဖွေနေသော ပရော်ဖက်ရှင်နယ်များအတွက် မရှိမဖြစ်ကိရိယာတစ်ခုဖြစ်သည်။
V-Ray 6 အင်ဂျင်ကို အသုံးပြု၍ GPU rendering စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည့် V-Ray Benchmark တွင် RTX 5060 Ti သည် 4,457 ရမှတ်ရရှိခဲ့ပြီး 4070 ၏ 4,469 ထက်နည်းပြီး 5070 ၏ 6,553 ထက် သိသိသာသာ နောက်ကျကျန်ခဲ့သည်။ အဆင့်နိမ့်သော အနေအထားရှိသော်လည်း 5060 Ti သည် ဤအလုပ်ပမာဏတွင် 4070 နှင့်အတူ လိုက်မီနေဆဲဖြစ်ပြီး ဘတ်ဂျက်ကျပ်တည်းသော ဖန်တီးမှုပညာရှင်များအတွက် သင့်တင့်လျောက်ပတ်သော rendering စွမ်းရည်များကို ပေးဆောင်သည်။
| V-Ray (မြင့်လေ ပိုကောင်းလေ) | PNY NVIDIA GeForce RTX 5060 Ti | Nvidia GeForce RTX 5070 | Nvidia GeForce RTX 4070 |
| vpath များ | 4,457 | 6,553 | 4,469 |
မာကု 3
3DMark Port Royal၊ Speedway နှင့် Steel Nomad တို့သည် မတူညီသော အခြေအနေများတွင် စွမ်းဆောင်ရည်ကို စမ်းသပ်သည့် GPU benchmark များဖြစ်သည်။ Port Royal သည် ray tracing ကို အာရုံစိုက်ပြီး Speed Way သည် racing simulations များတွင် စွမ်းဆောင်ရည်ကို အကဲဖြတ်ပြီး Steel Nomad သည် မြင့်မားသော intensity၊ လက်တွေ့ကျသော ဂရပ်ဖစ်များဖြင့် GPU များကို စိန်ခေါ်သည်။ ၎င်းတို့သည် rendering၊ lighting နှင့် dynamic scenes များတွင် GPU စွမ်းရည်များကို အကဲဖြတ်သည်။
3DMark benchmarks တွေမှာ PNY GeForce RTX 5060 Ti ဟာ စမ်းသပ်မှုအားလုံးမှာ ယှဉ်ပြိုင်နိုင်စွမ်းရှိတဲ့ စွမ်းဆောင်ရည်ကို ပြသခဲ့ပါတယ်။ Port Royal မှာ 10,432 မှတ်ရခဲ့ပြီး 5070 (14,026) ထက် နောက်ကျကျန်ခဲ့ပြီး 4070 (11,074) ထက် သာလွန်ခဲ့ပါတယ်။ Speed Way စမ်းသပ်မှုမှာ 5060 Ti က 4,184 မှတ်ရခဲ့ပြီး 5070 က 5,869 မှတ်နဲ့ ဦးဆောင်ခဲ့ပြီး 4070 က 4,477 မှတ်ရခဲ့ပါတယ်။ Steel Nomad အတွက် 5060 Ti က 3,611 မှတ်ရခဲ့ပြီး 5070 (5,019) က ထပ်မံသာလွန်ခဲ့ပေမယ့် 4070 (3,748) ထက် အနည်းငယ်သာလွန်ခဲ့ပါတယ်။ 5060 Ti ဟာ ဒီမြင့်မားတဲ့ GPU စမ်းသပ်မှုတွေမှာ သူ့ရဲ့အားသာချက်ကို ထိန်းသိမ်းထားနိုင်တာကြောင့် ထိပ်တန်းစွမ်းဆောင်ရည်ကို မလိုအပ်ပေမယ့် တန်ဖိုးကြီးကြီးမားမားကို လိုချင်တဲ့ gamers တွေနဲ့ creator တွေအတွက် ခိုင်မာတဲ့ရွေးချယ်မှုတစ်ခု ဖြစ်စေပါတယ်။
| 3DMark စမ်းသပ်မှု (မြင့်လေ ပိုကောင်းလေ) | PNY NVIDIA GeForce RTX 5060 Ti | Nvidia GeForce RTX 5070 | Nvidia GeForce RTX 4070 |
| ဆိပ်ကမ်းတော်ဝင် | 10,432 | 14,026 | 11,074 |
| မြန်နှုန်းမြင့်လမ်း | 4,184 | 5,869 | 4,477 |
| သံမဏိ Nomad | 3,611 | 5,019 | 3,748 |
NVIDIA GeForce RTX 5070 Founders ၏ ပါဝါထိရောက်မှုရလဒ်များ
ကျွန်ုပ်တို့သည် ပါဝါသုံးစွဲမှုကို တိုင်းတာရန် Procyon AI Image စမ်းသပ်မှုကို benchmark အဖြစ် အသုံးပြုနေပါသည်။ NVIDIA GPU များမှ ပါဝါထုတ်ယူမှုကို တိုင်းတာရန် ကျွန်ုပ်တို့၏ test bench ရှိ Quarch Mains Analyzer ကို အသုံးပြုပါသည် ။ Stable Diffusion XL FP16 စမ်းသပ်မှုကို လုပ်ဆောင်ခြင်းဖြင့် ဒုတိယမြောက်မှ နောက်ဆုံးပုံရိပ်၏ အချိန်အပိုင်းအခြားကို ကျွန်ုပ်တို့ ကြည့်ရှုပါသည်။ ထိုအချိန်အပိုင်းအခြား၏ အစမှ အဆုံးအထိ အချိန်၊ အမြင့်ဆုံးပါဝါသုံးစွဲမှု၊ ပျမ်းမျှအမြင့်ဆုံးပါဝါသုံးစွဲမှုနှင့် စမ်းသပ်မှုပြီးဆုံးပြီးနောက် အားလပ်ချိန်တို့ကို တိုင်းတာပါသည်။
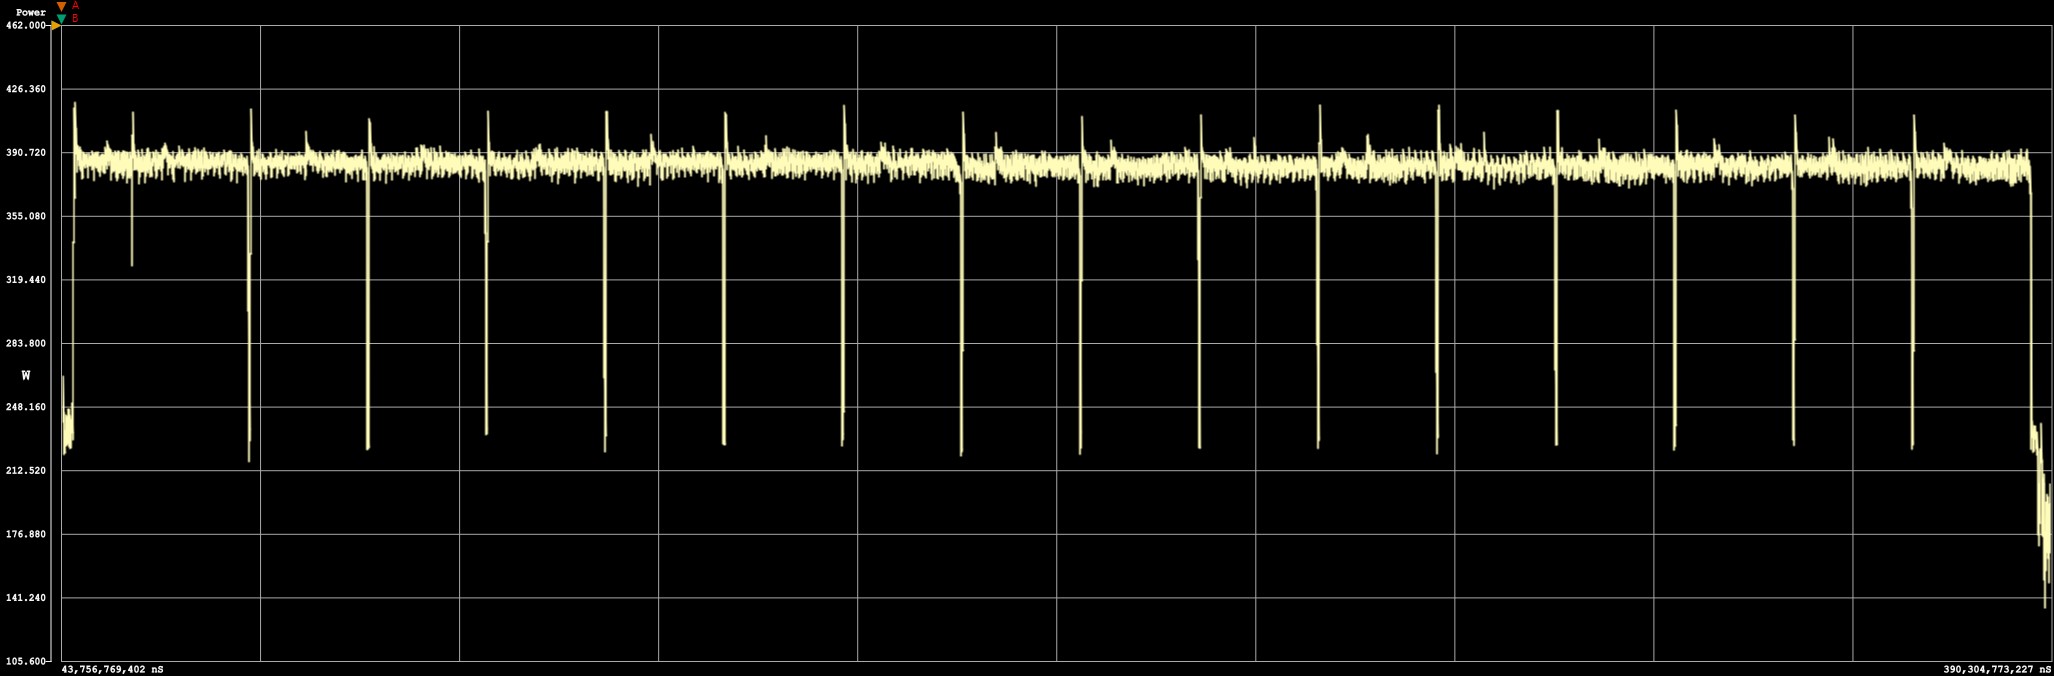
ကျွန်ုပ်တို့ရဲ့ စမ်းသပ်မှုအရ စဉ်ဆက်မပြတ် အလုပ်များနေချိန်မှာ ပျမ်းမျှ 385W သုံးစွဲမှုကို ပြသခဲ့ပြီး အမြင့်ဆုံး 419W နဲ့ idle draw 151W အထိ ရောက်ရှိခဲ့ပါတယ်။ PNY NVIDIA GeForce RTX 5060 Ti မှာ 180W ပါဝါအဆင့်သတ်မှတ်ချက် ပါရှိပါတယ်။ ဒီကတ်ဟာ ကျွန်ုပ်တို့ရဲ့ 20.2 စက္ကန့် စမ်းသပ်မှု cycle ကို ပြီးမြောက်အောင် လုပ်ဆောင်ခဲ့ပြီး ဒီစမ်းသပ်မှုကာလအတွင်း စုစုပေါင်း စွမ်းအင် 2.13 Wh အသုံးပြုခဲ့ပါတယ်။
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL FP16 ရုပ်ပုံပါဝါကို အသုံးပြုထားသည် (နည်းလေ ပိုကောင်းလေ) | PNY NVIDIA GeForce RTX 5060 တီ | Nvidia GeForce RTX 5070 | ASUS Prime NVIDIA GeForce RTX 5070 Ti | Nvidia GeForce RTX 5080 | Nvidia GeForce RTX 5090 |
| ပါဝါသုံးစွဲမှု | 2.13 Wh | 2.46Wh | 1.66Wh | 1.39Wh | 1.16Wh |
| စမ်းသပ်ကာလ | 20.2 ့ | 19.2 ့ | 11.1 ့ | 8.7 ့ | 5.1 ့ |
ကောက်ချက်
GeForce RTX 5060 Ti စီးရီးသည် ဈေးကွက်သို့ သင့်တင့်သော ဒေါ်လာ ၃၇၉ မှ ၄၂၉ အထိ ဝင်ရောက်လာပြီး flagship မော်ဒယ်များ၏ နောက်မျိုးဆက်ဈေးနှုန်းမပါဘဲ NVIDIA ၏ Blackwell 2.0 ဗိသုကာသို့ ဝင်ရောက်နိုင်စေပါသည်။ မှတ်ဉာဏ်ပိုမိုရှာဖွေနေသော အသုံးပြုသူများအတွက် 16GB GDDR7 ပါသည့် PNY RTX 5060 Ti ကဲ့သို့သော ရွေးချယ်မှုများသည် ယခင် midrange GPU များတွင် တွေ့ရလေ့ရှိသော အဓိကကန့်သတ်ချက်ကို ဖြေရှင်းပေးပြီး multitasking၊ AI-enhanced tools များနှင့် လေးလံသော ဂိမ်းပိုင်ဆိုင်မှုများအတွက် နေရာပိုမိုရရှိစေပါသည်။ ယခင်က သုံးသပ်ထားသော GeForce RTX 5090 သို့မဟုတ် GeForce RTX 5080 ကဲ့သို့ AI workhorse မဟုတ်သော်လည်း DLSS 4 နှင့် တိုးတက်ကောင်းမွန်သော ray tracing ကဲ့သို့သော နောက်မျိုးဆက်အင်္ဂါရပ်များကို ပံ့ပိုးပေးနေဆဲဖြစ်ပြီး ပရီမီယံအဆင့်စွမ်းရည်များကို ပိုမို mainstream ပရိသတ်ထံ ယူဆောင်လာပါသည်။
ဂိမ်းကစားခြင်းစွမ်းဆောင်ရည်နှင့်ပတ်သက်လျှင် GeForce RTX 5060 Ti သည် အထင်ကြီးလောက်သော တိုးတက်မှုများကို ပေးစွမ်းပြီး ပံ့ပိုးပေးထားသော workloads များတွင် GeForce RTX 3060 Ti ထက် ၅ ဆအထိ မြှင့်တင်ပေးပါသည်။ ၎င်းသည် 1440p ဂိမ်းကစားခြင်းအတွက် ကောင်းမွန်သောစွမ်းဆောင်ရည်တစ်ခုဖြစ်ပြီး မြင့်မားသော setting များနှင့် ချောမွေ့သော frame rate များဖြင့် ခေတ်မီဂိမ်းများကို ကိုင်တွယ်နိုင်သည်။ ၎င်းသည် GeForce RTX 3060 Ti သို့မဟုတ် GeForce RTX 2060 Super ကဲ့သို့သော ကတ်အဟောင်းများမှ လာသောအသုံးပြုသူများအတွက် အထူးသဖြင့် ၎င်းတို့၏စနစ်တစ်ခုလုံးကို ပြုပြင်မွမ်းမံခြင်းမရှိဘဲ နောက်ဆုံးပေါ် Blackwell အင်္ဂါရပ်များကို အခွင့်ကောင်းယူလိုသူများအတွက် အကောင်းဆုံးအဆင့်မြှင့်တင်မှုတစ်ခုဖြစ်စေသည်။
၎င်း၏ ကျစ်လစ်သော dual-slot ဒီဇိုင်း၊ ထိရောက်သော ပါဝါသုံးစွဲမှုနှင့် လက်လှမ်းမီသော ဈေးနှုန်းတို့ဖြင့် GeForce RTX 5060 Ti စီးရီးသည် လက်တွေ့ကျပြီး ရှေ့ကိုမျှော်ကြည့်သော အဆင့်မြှင့်တင်မှုတစ်ခုအဖြစ် ထင်ရှားသည်။ ၎င်းသည် အဆင့်မြင့်ကတ်များတွင် ပုံမှန်တွဲဖက်အသုံးပြုလေ့ရှိသော ပရီမီယံမပါဘဲ နောက်မျိုးဆက် NVIDIA Blackwell အင်္ဂါရပ်များကို ပိုမိုကျယ်ပြန့်သော ပရိသတ်ထံ ယူဆောင်လာပါသည်။
Amazon မှာ RTX 5060 Ti (တွဲဖက်လင့်ခ်)


 အမေဇုံ