

NVIDIA GeForce RTX 5070 Founders Edition သည် high-end 5080 ပြီးနောက် 50-series စီးရီးအသစ်နှင့် ပူးပေါင်းလာပြီး NVIDIA ၏ Blackwell ဗိသုကာကို အလယ်အလတ်တန်းစား package တွင် ပြသထားသည်။ ၎င်း၏ ပါဝါထိရောက်မှု၊ AI မြင်းကောင်ရေအားနှင့် ray-tracing တိုးတက်မှုများအကြောင်း များစွာ ထင်ကြေးပေးနေကြသော်လည်း လက်တွေ့ကမ္ဘာစမ်းသပ်မှုတွင် ကျွန်ုပ်တို့ကိုယ်တိုင် သိရှိရမည်ဖြစ်သည်။ AI text generation မှ အဆင့်မြင့် 3D rendering အထိ benchmark အမျိုးမျိုးကို ဖြတ်သန်းပြီးနောက် NVIDIA ၏ next-gen roster တွင် မည်သည့်နေရာတွင် ရပ်တည်သည်ကို ကျွန်ုပ်တို့ အတိအကျ ပြောပြနိုင်ပါသည်။
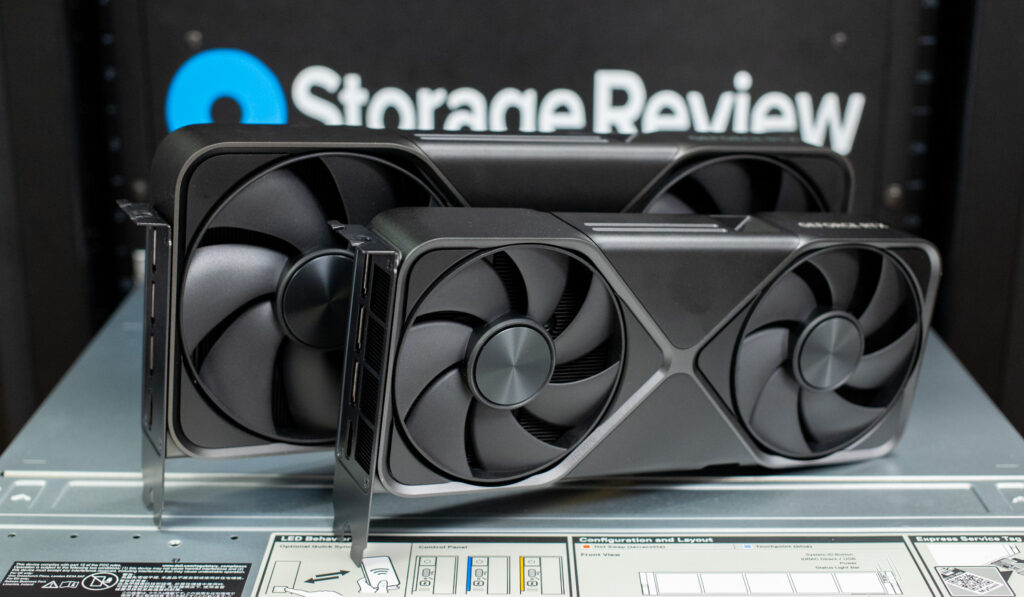
ဂိမ်းကစားသူများနှင့် hardware ဝါသနာရှင်များသည် RTX 5070 သည် အလယ်အလတ်တန်းစားကတ်များ အမြဲကတိပေးထားသည့် ခိုင်မာသော ဈေးနှုန်းနှင့် စွမ်းဆောင်ရည်အချိုးကို နောက်ဆုံးတွင် ပေးစွမ်းနိုင်မည်လားဆိုသည်ကို စိတ်အားထက်သန်နေကြသည်။ လွန်ခဲ့သောနှစ်အနည်းငယ်အတွင်း RTX မျိုးဆက်များစွာသည် ထောက်ပံ့မှုကန့်သတ်ချက်များ၊ ဈေးနှုန်းများ မြင့်တက်ခြင်းနှင့် မျိုးဆက်တစ်ခုပြီးတစ်ခု ခုန်ပျံကျော်လွှားမှုနည်းပါးခြင်းတို့ကြောင့် စားသုံးသူများသည် ပိုမိုအဓိပ္ပာယ်ရှိသော တိုးတက်မှုများကို စိတ်အားထက်သန်နေကြသည်။
စာရွက်ပေါ်မှာတော့ RTX 5070 ဟာ RTX 4070 ထက် ကောင်းမွန်တဲ့ ခုန်ပျံကျော်လွှားမှုကို ကတိပြုထားပြီး DLSS 4 ရဲ့ Multi Frame Generation၊ မြင့်မားတဲ့ memory bandwidth နဲ့ extra raw compute power တွေကို ကြော်ငြာထားပါတယ်။ အားလုံးက ဂိမ်းကစားရတာ ပိုချောမွေ့ပြီး မြန်ဆန်တဲ့ ထုတ်လုပ်မှုအတွက် အထောက်အကူပြုပါတယ်။ ဒါကြောင့် သူ့ရဲ့ features, specifications နဲ့ အသေးစိတ်အချက်အလက်တွေကို ကြည့်ကြရအောင်။ ပြီးရင် ဒီတိုးတက်မှုတွေက အရင်မျိုးဆက်နဲ့ ဘယ်လို နှိုင်းယှဉ်ထားလဲဆိုတာကို လေ့လာကြည့်ရအောင်။ ကြော်ငြာတွေနဲ့ တကယ့်စွမ်းဆောင်ရည်တိုးတက်မှုတွေကို ခွဲခြားပြထားပါတယ်။
NVIDIA GeForce RTX 5070 Founders Edition ဗိသုကာ
PCIe Gen5 interface ကို အသုံးပြုထားတဲ့ RTX 5070 မှာ CUDA cores ၆,၁၄၄ ပါဝင်ပြီး 2.16 GHz base clock မှာ လည်ပတ်ပြီး 2.51 GHz အထိ မြှင့်တင်ပေးပါတယ်။ ဒါကြောင့် FP32 compute performance ရဲ့ 31 TFLOPS ရရှိပြီး 4070 ရဲ့ 29 TFLOPS ထက် သိသာထင်ရှားတဲ့ တိုးတက်မှုတစ်ခု ဖြစ်ပါတယ်။ စတုတ္ထမျိုးဆက် ray tracing cores တွေက RT power ရဲ့ 94 TFLOPS ကို ပေးစွမ်းပြီး real-time reflections၊ global illumination နဲ့ path tracing support တွေကို ပိုကောင်းအောင် ပေးစွမ်းပါတယ်။ ပဉ္စမမျိုးဆက် Tensor cores တွေက 988 AI TOPS ကို တွန်းအားပေးပြီး AI-enhanced upscaling၊ frame generation နဲ့ computational workloads တွေကို သိသိသာသာ တိုးတက်ကောင်းမွန်စေပါတယ်။
RTX 4070 FE နဲ့ နှိုင်းယှဉ်ရင် NVIDIA က 5070 FE ဟာ Multi Frame Generation ပါတဲ့ DLSS 4 ကိုအသုံးပြုတဲ့အခါ 3D rendering မှာ 1.9x အထိ တိုးတက်လာပြီး rasterization စွမ်းဆောင်ရည် 20% ပိုများတယ်လို့ ဖော်ပြပါတယ်။ RTX 3070 ကို ဆက်လက်အသုံးပြုနေသူတွေအတွက် ဒီကွာခြားချက်က ပိုပြီးသိသာထင်ရှားပါတယ်- DLSS 4 မှာ 3x ထက်ပိုတဲ့ စွမ်းဆောင်ရည်နဲ့ ရိုးရာ raster စွမ်းဆောင်ရည် 65% ပိုကောင်းပါတယ်။
သိသာထင်ရှားတဲ့ ဟာ့ဒ်ဝဲတိုးတက်မှုတွေထဲက တစ်ခုကတော့ GDDR7 မန်မိုရီကို ကူးပြောင်းလိုက်တာပါပဲ။ RTX 5070 မှာ 12GB VRAM ကို ဆက်လက်ထိန်းသိမ်းထားပေမယ့် 192-bit bus မှာ GDDR6X ကနေ GDDR7 ကို အဆင့်မြှင့်တင်ထားပြီး မန်မိုရီ bandwidth ကို 675 GB/s အထိ တိုးမြှင့်ပေးထားပြီး 4070 ရဲ့ 504 GB/s ထက် 33% ပိုများပါတယ်။ ဒါက texture loading ကို ပိုမြန်စေခြင်း၊ 4K စွမ်းဆောင်ရည် ပိုကောင်းလာခြင်းနဲ့ ဖန်တီးမှုဆိုင်ရာ အပလီကေးရှင်းတွေမှာ dataset ကြီးတွေကို ကိုင်တွယ်နိုင်မှု တိုးတက်ကောင်းမွန်လာခြင်းတို့ကို ဆိုလိုပါတယ်။
DLSS 4 နှင့် AI စွမ်းအားပေးထားသော အင်္ဂါရပ်များ
DLSS 4 ပံ့ပိုးမှုဟာ RTX 50 စီးရီးရဲ့ အကြီးမားဆုံး ဆွဲဆောင်မှုတွေထဲက တစ်ခုပါ။ Multi Frame Generation ကို မိတ်ဆက်ပေးထားပြီး၊ ဒါက AI စွမ်းအင်သုံး နည်းပညာအသစ်တစ်ခုဖြစ်ပြီး rendered frame တစ်ခုစီမှာ frame များစွာကို ဖန်တီးပေးပြီး ပံ့ပိုးပေးထားတဲ့ ဂိမ်းတွေမှာ FPS ကို သိသိသာသာ မြှင့်တင်ပေးပါတယ်။ DLSS 4 က Ray Reconstruction နဲ့ Super Resolution ကို မြှင့်တင်ပေးပြီး ရုပ်ပုံကြည်လင်ပြတ်သားမှုနဲ့ တည်ငြိမ်မှုကို တိုးတက်စေပါတယ်။
စတင်မိတ်ဆက်ချိန်တွင် Avowed နှင့် Kingdom Come Deliverance II ကဲ့သို့သော ဂိမ်းအသစ်များနှင့် အလွန်ရေပန်းစားသော Red Dead Redemption II နှင့် Microsoft Flight Simulator ကဲ့သို့သော ဂိမ်းဟောင်းများ အပါအဝင် ဂိမ်းပေါင်း ၇၅ ခုကျော်သည် DLSS 4 ကို ပံ့ပိုးပေးပြီးဖြစ်သည်။ RT cores အသစ်များနှင့် AI-assisted denoising နည်းပညာများကြောင့် ray tracing နှင့် path tracing ကို အသုံးပြုသော ဂိမ်းများသည် သိသိသာသာ တိုးတက်မှုကို တွေ့မြင်ရဖွယ်ရှိသည်။
ယှဉ်ပြိုင်မှုပြင်းထန်သော ဂိမ်းကစားသူများအတွက် NVIDIA Reflex 2 သည် Frame Warp ကို ယူဆောင်လာပါသည်။ ၎င်းသည် မောက်စ်ထည့်သွင်းမှုအပေါ် အခြေခံ၍ frame timing ကို တက်ကြွစွာ ချိန်ညှိခြင်းဖြင့် စနစ်၏ နှောင့်နှေးမှုကို လျှော့ချပေးသည့် နည်းလမ်းအသစ်တစ်ခုဖြစ်သည်။ ၎င်းသည် Overwatch၊ Call of Duty multiplayer၊ Marvel's Rivals နှင့် အခြား esports ဂိမ်းများကဲ့သို့ မြန်ဆန်သော shooter ဂိမ်းများကို အကျိုးပြုနိုင်သည်။
အကြောင်းအရာဖန်တီးမှုနှင့် ပရော်ဖက်ရှင်နယ်အလုပ်ဝန်များအတွက် မြှင့်တင်မှုများ
ဂိမ်းကစားခြင်းအပြင် RTX 5070 သည် ဖန်တီးသူများအတွက် အလွန်ကောင်းမွန်ပါသည်။ အဓိက အဆင့်မြှင့်တင်မှုတစ်ခုမှာ hardware-accelerated 4:2:2 video encoding ဖြစ်ပြီး RTX 4070 ထက် professional-grade ဗီဒီယိုများကို ၆ ဆ ပိုမိုမြန်ဆန်စွာ export လုပ်နိုင်ပါသည်။ NVIDIA Studio drivers များသည် ဗီဒီယိုတည်းဖြတ်ခြင်း၊ 3D rendering နှင့် live streaming တို့တွင် အကောင်းဆုံးစွမ်းဆောင်ရည်ကို ပေးစွမ်းပြီး AI-powered tools များကို ဖန်တီးမှုဆိုင်ရာ application ၁၃၀ ကျော်တွင် ပေါင်းစပ်ထားသည်။
AI-based workflows အတွက်၊ FP4 acceleration နှင့် နောက်ဆုံးပေါ် Blackwell tensor cores များကြောင့် 5070 သည် RTX 4070 ထက် GenAI စွမ်းဆောင်ရည် သုံးဆပိုမိုပေးစွမ်းနိုင်သည်။ 50-Series ၏ အထက်ပိုင်းမော်ဒယ်များကဲ့သို့ ပါဝါတူညီမည်မဟုတ်သော်လည်း၊ ၎င်းသည် စက်သင်ယူမှု၊ AI-driven image processing နှင့် computational photography အတွက် အစွမ်းထက်သောရွေးချယ်မှုတစ်ခုဖြစ်စေပြီး အသုံးပြုသူများကို မော်ဒယ်များကို ပိုမိုမြန်ဆန်စွာလေ့ကျင့်ပေးရန်၊ AI ဖြင့် ရုပ်ပုံများကို မြှင့်တင်ရန်နှင့် ဖန်တီးမှုအလိုအလျောက်လုပ်ဆောင်မှု၏ ကန့်သတ်ချက်များကို တွန်းအားပေးရန် ကူညီပေးသည်။
NVIDIA GeForce RTX 5070 Founders Edition စွမ်းဆောင်ရည်နှင့် အအေးပေးစနစ်
4070 ရဲ့ 200W ကနေ 250W TGP တိုးလာပေမယ့်လည်း၊ RTX 5070 ဟာ သိသာထင်ရှားတဲ့ စွမ်းဆောင်ရည် မြှင့်တင်ပေးမှုကြောင့် အံ့သြစရာကောင်းလောက်အောင် ထိရောက်မှု ရှိနေဆဲပါ။ NVIDIA ဟာ ပါဝါဆွဲအားနဲ့ တွက်ချက်မှု အထွက်ကို ကောင်းကောင်း ဟန်ချက်ညီအောင် ပြုလုပ်ထားတာကြောင့် အသုံးပြုသူတွေဟာ စွမ်းအင်သုံးစွဲမှု မမျှတဘဲ စွမ်းဆောင်ရည် သိသိသာသာ မြှင့်တင်မှုကို ရရှိစေပါတယ်။ TGP မြင့်မားတာက မျက်ခုံးပင့်စရာ ဖြစ်နိုင်ပေမယ့်၊ စွမ်းဆောင်ရည်နဲ့ အအေးပေးစနစ် တိုးတက်မှုတွေက စွမ်းအင် အလွန်အကျွံ မဖြုန်းတီးဘဲ ရေရှည် စွမ်းအင် လိုအပ်သူတွေအတွက် စမတ်ကျတဲ့ အပေးအယူတစ်ခု ဖြစ်စေပါတယ်။
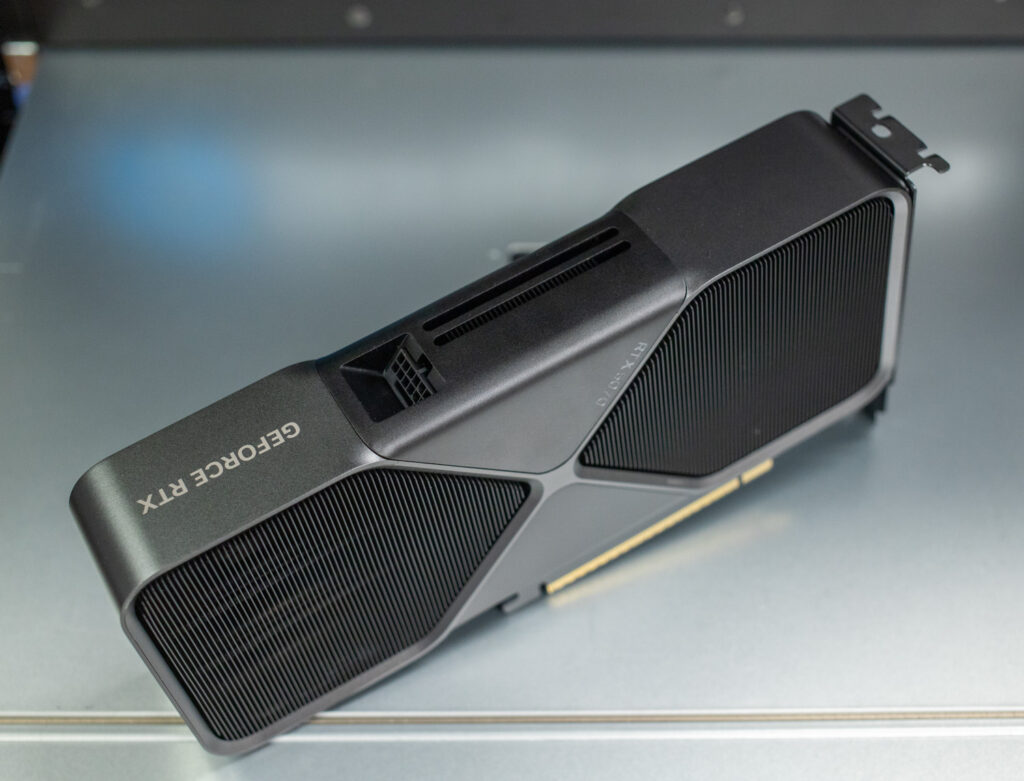
ထို့အပြင် NVIDIA RTX 5070 Founders Edition တွင် လေစီးဆင်းမှုနှင့် အပူပျံ့နှံ့မှုကို ထိရောက်စွာ စီမံခန့်ခွဲပေးသည့် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသော dual-fan setup ပါရှိသည်။ ပိုကြီးသော heatsinks နှင့် တိုးတက်ကောင်းမွန်သော vapor chamber တို့ကြောင့် NVIDIA သည် အပူချိန်တည်ငြိမ်မှုကို ဦးစားပေးကြောင်း ထင်ရှားသည်။ ဆိုလိုသည်မှာ အသုံးပြုသူများသည် 5070 ကို အပူချိန်ထိန်းညှိမှုကြောင့် စွမ်းဆောင်ရည်ကျဆင်းမှုကို စိတ်ပူစရာမလိုဘဲ AI လေ့ကျင့်မှုတိုးချဲ့ခြင်း၊ resolution မြင့်မားသော rendering သို့မဟုတ် အခြားပြင်းထန်သော workloads များမှတစ်ဆင့် တွန်းအားပေးနိုင်သည်။
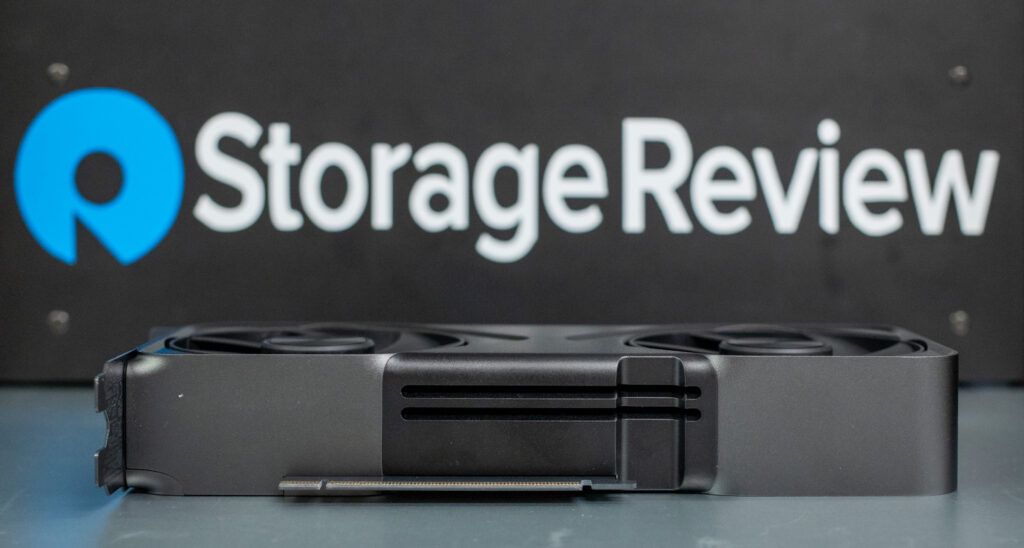
အပူလွန်ကဲမှုစိုးရိမ်စရာမလိုဘဲ ယုံကြည်စိတ်ချရသောစွမ်းဆောင်ရည်ကို လိုချင်သူများအတွက် 5070 ၏ဒီဇိုင်းသည် ရိုးရှင်းသော brute-force power bump ထက် ကောင်းမွန်စွာအင်ဂျင်နီယာပြုလုပ်ထားသော အဆင့်မြှင့်တင်မှုတစ်ခုကဲ့သို့ ခံစားရသည်။
မျက်နှာပြင်နှင့် ချိတ်ဆက်မှု
မျှော်လင့်ထားတဲ့အတိုင်း RTX 5070 ကို refresh rate မြင့်မားတဲ့ ဂိမ်းကစားခြင်းနဲ့ ပရော်ဖက်ရှင်နယ် display setup တွေအတွက် တည်ဆောက်ထားပါတယ်။ DisplayPort 2.1b port သုံးခုနဲ့ HDMI 2.1b port တစ်ခုကနေတစ်ဆင့် 480Hz မှာ 4K နဲ့ 120Hz မှာ 8K ကို ထောက်ပံ့ပေးပါတယ်။ ဒါကြောင့် ဗီဒီယိုထုတ်လုပ်ရေး၊ 3D rendering နဲ့ HDR content ဖန်တီးမှုတွေမှာရှိတဲ့ refresh rate မြင့်မားတဲ့ esports monitor တွေ၊ high-end 4K gaming display တွေနဲ့ ပရော်ဖက်ရှင်နယ် 8K monitor တွေအတွက် အကောင်းဆုံးရွေးချယ်မှုတစ်ခု ဖြစ်စေပါတယ်။
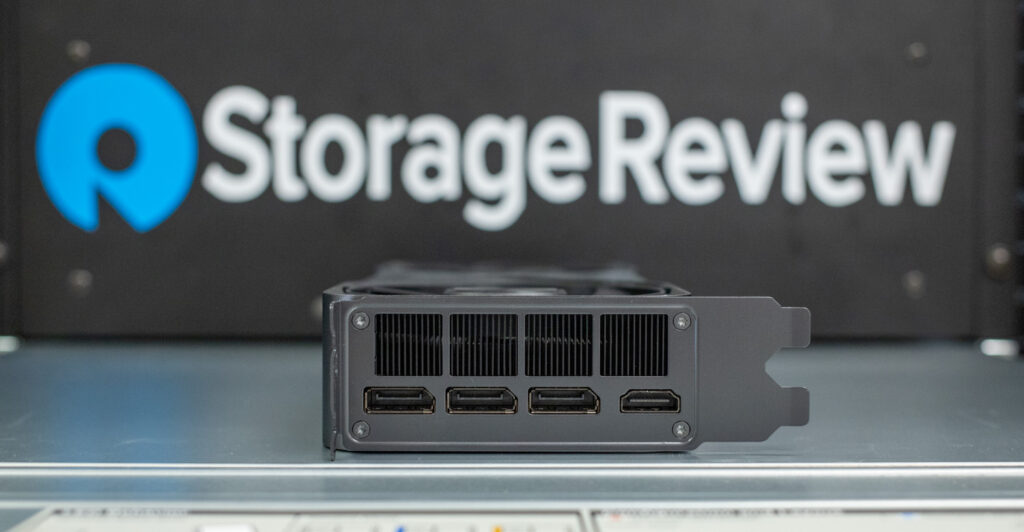
ဒါပေမယ့် HDMI Forum က CES 2025 မှာ HDMI 2.2 ကို ကြေညာခဲ့တာကို သတိပြုသင့်ပါတယ်၊ အဲဒါက bandwidth ကို 96Gbps အထိ သိသိသာသာ မြှင့်တင်ပေးပြီး 10K resolution နဲ့ refresh rate တွေကို 240Hz အထိ ခွင့်ပြုပေးပါတယ်။ အဲဒီစွမ်းဆောင်ရည်အဆင့်အတွက် အနာဂတ်မှာ ခံနိုင်ရည်ရှိဖို့ ရှာဖွေနေတယ်ဆိုရင် နောက်မျိုးဆက် RTX ကတ်တွေက အပြည့်အဝ အသုံးချနိုင်ဖို့ စောင့်ရပါလိမ့်မယ်။
အခု စွမ်းဆောင်ရည်ရလဒ်တွေကို ဆန်းစစ်ပြီး RTX 5070 က ဘာတွေပေးစွမ်းနိုင်လဲဆိုတာ ကြည့်ကြရအောင်။ RTX 4070 ပိုင်ရှင်တွေ ဒါမှမဟုတ် 30 ဒါမှမဟုတ် 20-Series GPU ကို ဆက်လက်ကိုင်ဆောင်ထားသူတွေအတွက် အဓိကမေးခွန်းကတော့ AI-driven graphics၊ ray tracing နဲ့ memory speed တွေမှာ တိုးတက်မှုတွေရှိလာတာက အဆင့်မြှင့်တင်ရကျိုးနပ်စေသလားဆိုတာပါပဲ။
NVIDIA GeForce RTX 5070 Founders Edition သတ်မှတ်ချက်များ
| GPU နှိုင်းယှဉ်ချက် | NVIDIA RTX4070 | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 |
| GPU ကိုအမည် | AD104 | GB205 | GB203 | GB203 |
| ဗိသုကာအတတ်ပညာ | Ada Lovelace | ဘလက်ဝဲလ် ၂.၀ | ဘလက်ဝဲလ် ၂.၀ | ဘလက်ဝဲလ် ၂.၀ |
| လုပ်ငန်းစဉ်အရွယ်အစား | 5 nm | 5 nm | 5 nm | 5 nm |
| transistors | ၄၄၈ သန်း | 31,000 သန်း | 45,600 သန်း | 45,600 သန်း |
| သိပ်သည်းဆ | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း |
| Size ကို Die | 294 mm² | 263 mm² | 378 mm² | 378 mm² |
| slot အကျယ် | Dual- slot | Dual- slot | 2.5 ပေါက် | Dual- slot |
| ရှုထောင့် | 240 110 မီလီမီတာမီလီမီတာမီလီမီတာ x x 40 | 242 မီလီမီတာ 112 မီလီမီတာ x | 304 126 50 မီလီမီတာ | 304 137 မီလီမီတာမီလီမီတာမီလီမီတာ x x 48 |
| TDP | 200 ဒဗလျူ | 250 ဒဗလျူ | 300 ဒဗလျူ | 360 ဒဗလျူ |
| ဗီဒီယို ချိတ်ဆက်မှုများ | HDMI 2.1 ၁ ပေါက်၊ DisplayPort 1.4a ၃ ပေါက် | HDMI 2.1b ၁ ခု၊ DisplayPort 2.1a ၃ ခု | HDMI 2.1b ၁ ခု၊ DisplayPort 2.1b ၃ ခု | HDMI 2.1b ၁ ခု၊ DisplayPort 2.1b ၃ ခု |
| Power က Connectors | 1x 16 pin | 1x 16 pin | 1x 16 pin | 1x 16 pin |
| ဘတ်စ်ကား Interface | PCIe 4.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 |
| base နာရီ | 1920 MHz | 2165 MHz | 2300 MHz | 2295 MHz |
| နာရီ Boost | 2475 MHz | 2510 MHz | OC မုဒ်: 2482MHz ပုံသေမုဒ်: 2452MHz (Boost Clock) |
2617 MHz |
| မှတ်ဉာဏ်နာရီ | 1313 MHz (21 Gbps ထိရောက်မှု) | 2209 MHz (28 Gbps ထိရောက်မှု) | ၁၇၅၀ MHz (၂၈ Gbps ထိရောက်မှု) |
2366 MHz (30 Gbps ထိရောက်မှု) |
| memory အရွယ်အစား | 12 GB ကို | 12 GB ကို | 16 GB ကို | 16 GB ကို |
| memory အမျိုးအစား | GDDR6X | GDDR7 | GDDR7 | GDDR7 |
| မှတ်ဉာဏ်ဘတ်စ်ကား | 192 bit နဲ့ | 192 bit နဲ့ | 256 bit နဲ့ | 256 bit နဲ့ |
| မှတ်ဉာဏ် Bandwidth | 504.2 GB ကို / s နဲ့ | 672.2 GB ကို / s နဲ့ | 896.0 GB ကို / s နဲ့ | 960.0 GB ကို / s နဲ့ |
| CUDA core | 5888 | 6,144 | 8960 | 10,752 |
| TMU များ | 184 | 192 | 280 | 336 |
| ROPs | 64 | 64 | 128 | 128 |
| SM အရေအတွက် | 46 | 48 | 70 | 84 |
| Tensor core | 184 | 192 | 280 | 336 |
| RT ကို core | 46 | 48 | 70 | 84 |
| L1 ကက်ရှ် | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) |
| L2 ကက်ရှ် | 36 ကို MB | 40 ကို MB | 64 ကို MB | 64 ကို MB |
| ပစ်ဇယ်နှုန်း | ၄၆၂.၁ GPixel/s | ၄၆၂.၁ GPixel/s | 313.9 GPixels/s | ၄၆၂.၁ GPixel/s |
| အသွင်အပြင်နှုန်း | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s |
| FP၁၆ (တစ်ဝက်) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) |
| FP32 (float) | 29.15 TFLOPS | 30.84 TFLOPS | 43.94 TFLOPS | 56.28 TFLOPS |
| FP64 (နှစ်ထပ်) | ၈၇၉.၃ ဂျီအက်ဖ်လော့ပ်စ် (၁:၆၄) | ၈၇၉.၃ ဂျီအက်ဖ်လော့ပ်စ် (၁:၆၄) | ၈၇၉.၃ ဂျီအက်ဖ်လော့ပ်စ် (၁:၆၄) | ၈၇၉.၃ ဂျီအက်ဖ်လော့ပ်စ် (၁:၆၄) |
| စတင်ရောင်းချသည့် ဈေးနှုန်း (USD) | $599 | $549 | $749 | $999 |
StorageReview AMD Threadripper စမ်းသပ်ပလက်ဖောင်း
ကျွန်ုပ်တို့၏ RTX 5070 FE စမ်းသပ်မှုအတွက် အသုံးပြုမည့် စမ်းသပ်ပလက်ဖောင်းမှာ အောက်ပါအတိုင်းဖြစ်သည်။
- motherboard: ASUS Pro WS TRX50-SAGE WIFI
- CPU ကို: AMD Ryzen Threadripper 7980X 64-Core
- ရမ်: 128GB DDR5 4800MT/s
- သိုလှောင်မှု: 2TB Samsung 980 Pro
- OS ကို: Workstations အတွက် Windows 11 Pro
- ကားမောင်းသူ: NVIDIA 571.86 GameReady ဒရိုက်ဘာ
AMD Ryzen Threadripper 7980X သည် ကျွန်ုပ်တို့၏ စမ်းသပ်မှုစနစ်၏ အဓိကနေရာတွင် ရှိနေပြီး cores ၆၄ ခုနှင့် ကျယ်ပြန့်သော multi-threading စွမ်းရည်များ ပါဝင်သည်။ ၎င်းသည် CPU ကန့်သတ်ချက်များသည် GPU-focused benchmarks များကို အနှောင့်အယှက်မဖြစ်စေဘဲ အထူးသဖြင့် AI processing၊ ray tracing နှင့် high-resolution rendering တို့တွင် workloads များကို GPU သို့ အများအပြား လျှော့ချပေးပါသည်။
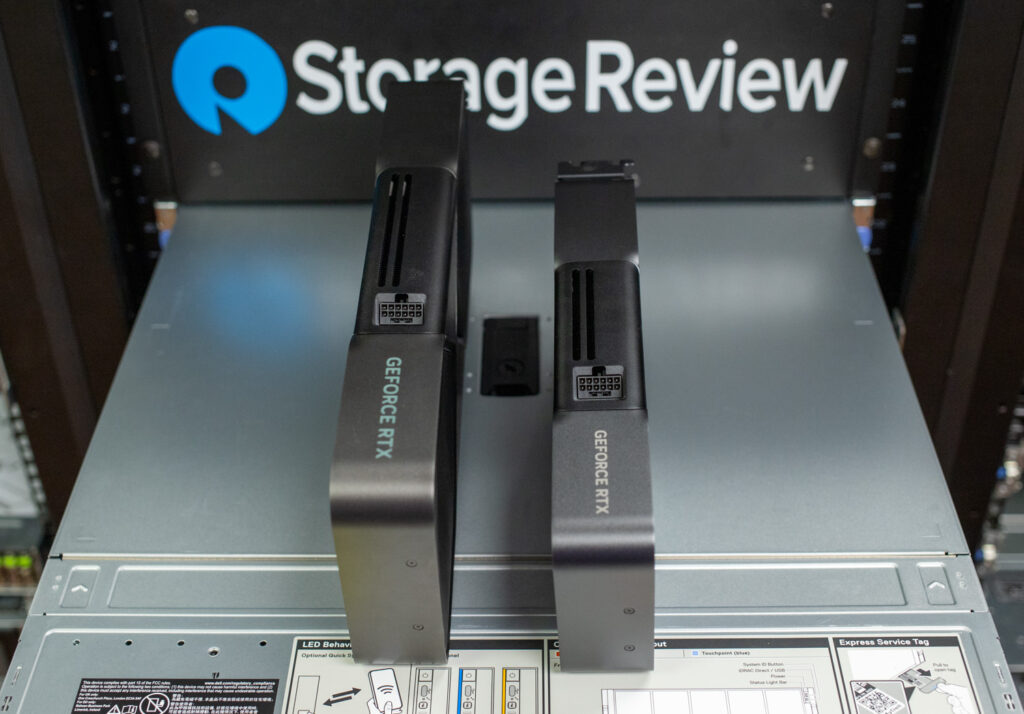
ကျွန်ုပ်တို့သည် 7980X ကို ASUS Pro WS TRX50-SAGE WIFI motherboard နှင့် တွဲဖက်အသုံးပြုခြင်းဖြင့် PCIe bandwidth အများအပြားကို ပေးစွမ်းနိုင်ပြီး GPU သည် အတားအဆီးများမရှိဘဲ ၎င်း၏ အပြည့်အဝ အလားအလာကို ရရှိနိုင်ကြောင်း သေချာစေပါသည်။ ကျွန်ုပ်တို့၏စနစ်တွင် 4800MT/s ဖြင့် 128GB DDR5 မှတ်ဉာဏ်လည်း ပါဝင်ပြီး dataset ကြီးများကို ကိုင်တွယ်ရာတွင် ချောမွေ့စွာလည်ပတ်နိုင်ရန် လုံလောက်သော နေရာလွတ်ကို ပေးစွမ်းသည်။ Samsung 980 Pro သည် အနည်းငယ်ဟောင်းသော Gen4 SSD ဖြစ်သော်လည်း မြန်ဆန်သော read/write speed များကို ပေးစွမ်းနိုင်ပြီး load time များကို အနည်းဆုံးဖြစ်စေပြီး AI model inference သို့မဟုတ် texture streaming ကဲ့သို့သော data များသော အလုပ်များကို storage စွမ်းဆောင်ရည်ကြောင့် အနှောင့်အယှက်မဖြစ်စေပါ။
ဒီ setup က GeForce RTX 5070 ရဲ့ လက်တွေ့စွမ်းဆောင်ရည်ကို ခွဲခြားသိရှိပြီး တိကျစွာ တိုင်းတာနိုင်စေသင့်တာမို့ စလိုက်ကြရအောင်။
RTX 5070 FE ကို အောက်ပါ GPU များနှင့် နှိုင်းယှဉ်ပါမည်။
- NVIDIA RTX5080 (16GB GDDR7)
- ASUS Prime NVIDIA RTX 5070 Ti (16GB GDDR7)
- NVIDIA RTX 4070 (12GB GDDR6X)
UL Procyon: AI စာသားထုတ်လုပ်ခြင်း
ကျွန်ုပ်တို့ရဲ့ စမ်းသပ်မှုတွေထဲမှာ ပထမဆုံးအနေနဲ့ Procyon AI Text Generation Benchmark ပါ ။ ဒီ benchmark ဟာ ကျစ်လျစ်ပြီး တသမတ်တည်းရှိတဲ့ အကဲဖြတ်နည်းလမ်းကို ပေးဆောင်ခြင်းဖြင့် AI LLM စွမ်းဆောင်ရည်စမ်းသပ်မှုကို ရိုးရှင်းစေပြီး မော်ဒယ်အရွယ်အစားကြီးတွေနဲ့ variable factor တွေရဲ့ ရှုပ်ထွေးမှုကို လျှော့ချပေးနေချိန်မှာ LLM မော်ဒယ်အများအပြားမှာ ထပ်ခါတလဲလဲ စမ်းသပ်နိုင်ပါတယ်။ AI hardware ဦးဆောင်သူတွေနဲ့အတူ တီထွင်ထားတဲ့ ဒီ benchmark ဟာ ပိုမိုယုံကြည်စိတ်ချရပြီး ထိရောက်တဲ့ စွမ်းဆောင်ရည်အကဲဖြတ်မှုများအတွက် ဒေသတွင်း AI accelerator တွေကို အသုံးပြုမှုကို အကောင်းဆုံးဖြစ်အောင် လုပ်ဆောင်ပေးပါတယ်။ အောက်မှာ တိုင်းတာထားတဲ့ ရလဒ်တွေကို TensorRT ကို အသုံးပြုပြီး စမ်းသပ်ထားပါတယ်။
ဤနေရာတွင် RTX 5070 Founders Edition သည် ယခင်မျိုးဆက် 4070 ထက် စမ်းသပ်မှုတိုင်းတွင် ပိုမိုကောင်းမွန်လာပါသည်။ Overall Scores၊ Output Time to First Token သို့မဟုတ် Tokens Per Second ဖြစ်စေ၊ 5070 FE သည် စွမ်းဆောင်ရည် မြင့်တက်လာသည်ကို ပြသထားပြီး ယေဘုယျအားဖြင့် 10–15% ဝန်းကျင်တွင် ရှိသည်။ ထိုတိုးတက်မှုသည် AI outputs များ ပိုမိုမြန်ဆန်လာခြင်း၊ စောင့်ဆိုင်းချိန် ပိုမိုတိုတောင်းလာခြင်းနှင့် မော်ဒယ် ကောက်ချက်ချမှု ပိုမိုချောမွေ့လာခြင်းတို့ကို ဖြစ်ပေါ်စေပါသည်။ ဥပမာအားဖြင့် Phi benchmark တွင် 4070 ၏ ရမှတ် 3,191 သည် 5070 FE တွင် 3,453 သို့ မြင့်တက်လာပြီး Tokens Per Second သည် 141.575 မှ 150.435 သို့ မြင့်တက်လာပါသည်။ အံ့မခန်းမဟုတ်သော်လည်း ထိုကွာခြားချက်သည် synthetic workloads များနှင့် လက်တွေ့အသုံးပြုမှုတွင် သိသာထင်ရှားသော တိုးတက်မှုကို မြင်တွေ့ရန် လုံလောက်ပါသည်။
ပိုမိုအစွမ်းထက်သော 5070 Ti နှင့်နှိုင်းယှဉ်ပါက 5070 FE သည် သီးခြားစမ်းသပ်မှုပေါ် မူတည်၍ ၁၅-၂၅% ခန့် လျော့နည်းနေမည်ဟု မျှော်လင့်ရသည်။ ဥပမာအားဖြင့်၊ တူညီသော Phi benchmark တွင် Ti ဗားရှင်းသည် Overall Score တွင် ၄,၁၇၉ ရရှိခဲ့ပြီး FE ၏ ၃,၄၅၃ မှ သိသိသာသာ ခုန်တက်သွားခဲ့သည်။ ဤစွမ်းဆောင်ရည်ကွာဟချက်သည် Mistral နှင့် Llama စီးရီးစမ်းသပ်မှုများတွင် တသမတ်တည်းရှိနေပြီး Ti သည် AI throughput ပိုမိုလိုအပ်သော အသုံးပြုသူများအတွက် ပိုမိုသိသာထင်ရှားသော အနားသတ်ကို ပေးစွမ်းကြောင်း ပြသနေသည်။ တစ်ချိန်တည်းမှာပင်၊ flagship 5080 သည် leaderboard ၏ထိပ်ဆုံးတွင်ရှိပြီး 5070 Ti ထက် နောက်ထပ် ၅-၁၀% ပိုမိုသာလွန်သည်။ ၎င်း၏အားသာချက်မှာ token generation speed နှင့် first token သို့ရောက်ရှိရန်အချိန်တွင် အထင်ရှားဆုံးဖြစ်ပြီး၊ စက္ကန့်၏အစိတ်အပိုင်းတစ်ခုကို လျှော့ချခြင်းသည် မြင့်မားသော workloads များတွင် ပေါင်းထည့်နိုင်သည်။
5070 FE သည် AI inference tasks များအတွက် လွယ်ကူသော ရွေးချယ်မှုတစ်ခု မဟုတ်သော်လည်း၊ ပိုမိုမြန်ဆန်သော generation time များကို လိုချင်သော power user များ သို့မဟုတ် ကျယ်ပြန့်သော dataset များကို ကိုင်တွယ်လိုသူများအတွက် 5070 Ti သို့မဟုတ် 5080 သည် ဤစွမ်းဆောင်ရည်နယ်ပယ်တွင် ၎င်းတို့၏ လိုအပ်ချက်များကို ပိုမိုကောင်းမွန်စွာ ဖြည့်ဆည်းပေးနိုင်ကြောင်း တွေ့ရှိနိုင်ပါသည်။
| UL Procyon: AI စာသားထုတ်လုပ်ခြင်း | NVIDIA RTX4070 | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 |
| Phi ၏ စုစုပေါင်းရမှတ် | 3,191 | 3,453 | 4,179 | 4,400 |
| ပထမဆုံးတိုကင်သို့ Phi ထုတ်ပေးချိန် | 0.356 ့ | 0.323 ့ | 0.290 ့ | 0.277 ့ |
| တစ်စက္ကန့်လျှင် Phi အထွက်တိုကင်များ | 141.575 တိုကင်/s | 150.435 တိုကင်/s | 192.487 တိုကင်/s | 209.459 တိုကင်/s |
| Phi ၏ စုစုပေါင်းကြာချိန် | 21.743 ့ | 20.302 ့ | 15.771 ့ | 14.908 ့ |
| Mistral ၏ စုစုပေါင်းရမှတ် | 2,987 | 3,562 | 4,412 | 4,635 |
| Mistral ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.508 ့ | 0.433 ့ | 0.374 ့ | 0.347 ့ |
| တစ်စက္ကန့်လျှင် Mistral Output Tokens များ | 99.590 တိုကင်/s | 120.507 တိုကင်/s | 160.167 တိုကင်/s | 163.598 တိုကင်/s |
| Mistral ၏ စုစုပေါင်းကြာချိန် | 30.651 ့ | 25.496 ့ | 19.480 ့ | 18.933 ့ |
| Llama3 အလုံးစုံရမှတ် | 2,810 | 3,125 | 4,187 | 4,424 |
| Llama3 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.423 ့ | 0.379 ့ | 0.306 ့ | 0.283 ့ |
| တစ်စက္ကန့်လျှင် Llama3 အထွက်တိုကင်များ | 82.130 တိုကင်/s | 100.388 တိုကင်/s | 131.853 တိုကင်/s | 136.177 တိုကင်/s |
| Llama3 ၏ စုစုပေါင်းကြာချိန် | 36.147 ့ | 29.720 ့ | 22.786 ့ | 21.985 ့ |
| Llama2 အလုံးစုံရမှတ် | 2,658 | 3,125 | 4,284 | 4,790 |
| Llama2 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.947 ့ | 0.785 ့ | 0.560 ့ | 0.493 ့ |
| တစ်စက္ကန့်လျှင် Llama2 အထွက်တိုကင်များ | 49.487 တိုကင်/s | ၅၆.၆၄၇ တိုကင်/စက္ကန့် | 75.905 တိုကင်/s | 83.653 တိုကင်/s |
| Llama2 ၏ စုစုပေါင်းကြာချိန် | 61.300 ့ | 53.234 ့ | 39.545 ့ | 35.703 ့ |
UL ပရိုဆိုင်ယွန်- AI ရုပ်ပုံမျိုးဆက်
Procyon AI Image Generation Benchmark သည် ပါဝါနည်း NPU များမှ အဆင့်မြင့် GPU များအထိ မတူညီသော ဟာ့ဒ်ဝဲများတွင် AI inference စွမ်းဆောင်ရည်ကို စဉ်ဆက်မပြတ်နှင့် တိကျစွာ တိုင်းတာပေးသည်။ ၎င်းတွင် စမ်းသပ်မှုသုံးခု ပါဝင်သည်- အဆင့်မြင့် GPU များအတွက် Stable Diffusion XL (FP16)၊ အလယ်အလတ် ပါဝါအားကောင်း GPU များအတွက် Stable Diffusion 1.5 (FP16) နှင့် ပါဝါနည်း စက်ပစ္စည်းများအတွက် Stable Diffusion 1.5 (INT8)။ benchmark သည် စနစ်တစ်ခုစီအတွက် အကောင်းဆုံး inference engine ကိုအသုံးပြုပြီး တရားမျှတပြီး နှိုင်းယှဉ်နိုင်သော ရလဒ်များကို သေချာစေသည်။
RTX 5070 FE ဟာ image-generation စမ်းသပ်မှုတိုင်းမှာ 4070 ထက် တိုးတက်ကောင်းမွန်လာပါတယ်။ အထူးသဖြင့် Stable Diffusion 1.5 (FP16) မှာ 4070 မှာ overall score 2,400 ကနေ 5070 FE မှာ 2,937 အထိ ခုန်တက်သွားပါတယ်။ ဒီကွာဟချက်က image ထုတ်လုပ်မှု ပိုမြန်စေပြီး FP16 နဲ့ INT8 benchmark တွေမှာ inference time ပိုတိုစေတာကြောင့် 5070 FE ဟာ AI-driven graphics workloads တွေကို အာရုံစိုက်တဲ့ အသုံးပြုသူတွေအတွက် ပြိုင်ဘက်ကောင်းတစ်ယောက် ဖြစ်လာပါတယ်။ 5070 Ti နဲ့ 5080 တွေနဲ့ နှိုင်းယှဉ်ရင် 5070 FE ဟာ စမ်းသပ်မှုအများစုမှာ ၂၀-၂၅% လောက် နောက်ကျနေပြီး AI image-generation လိုအပ်ချက်တွေ အလွန်အမင်း တောင်းဆိုနေတဲ့ အသုံးပြုသူတွေအတွက် Ti ရဲ့ ဈေးနှုန်းက ပိုမြင့်တယ်လို့ ဆိုနိုင်ပါတယ်။ တစ်ချိန်တည်းမှာပဲ 5080 က Ti ထက် ၁၅-၂၀% ပိုသာလွန်ပြီး အဆင့်မြင့်သွားပါတယ်။
တကယ့်လက်တွေ့ဘဝရှုထောင့်ကနေကြည့်ရင် RTX 5070 FE ဟာ 4070 ထက် သိသိသာသာ အားသာချက်ရှိပြီး ကောက်ချက်ချချိန်တွေကို သိသိသာသာ ပိုမြန်စေပြီး အကြောင်းအရာဖန်တီးမှု လုပ်ငန်းစဉ်တွေကို ပိုမိုချောမွေ့စေပါတယ်။ ဒါပေမယ့် ရှုပ်ထွေးတဲ့ ဒါမှမဟုတ် ကြီးမားတဲ့ ရုပ်ပုံထုတ်လုပ်မှု အလုပ်တွေကို ပုံမှန်ကိုင်တွယ်နေရတယ်ဆိုရင် 5070 Ti မှာ ပေးစွမ်းနိုင်တဲ့ 20–25% စွမ်းဆောင်ရည် မြှင့်တင်မှု ဒါမှမဟုတ် 5080 မှာ 15–20% ခုန်တက်မှု အပိုဆောင်းရရှိမှုဟာ ရင်းနှီးမြှုပ်နှံမှုနဲ့ ထိုက်တန်ပါတယ်။
| UL Procyon: AI Image Generation (အလုံးစုံရမှတ်- မြင့်လေ ပိုကောင်းလေ) | NVIDIA RTX4070 | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — အလုံးစုံရမှတ် | 2,400 | 2,937 | 3,755 | 4,650 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — ಒಟ್ಟಾರೆအချိန် | 41.661 ့ | 34.038 ့ | 26.625 ့ | 21.503 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) — အလုံးစုံရမှတ် | 31,048 | 36,320 | 46,744 | 55,683 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) — ಒಟ್ಟಾರೆအချိန် | 8.052 ့ | 6.883 ့ | 5.348 ့ | 4.490 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT8) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — အလုံးစုံရမှတ် | 1,940 | 2,473 | 3,352 | 4,257 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — ಒಟ್ಟಾರೆအချိန် | 309.269 | 242.606 | 178.946 ့ | 140.928 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
လပ်စ်မာ့ခ်
Luxmark သည် open-source ray tracing renderer ဖြစ်သော LuxRender ကို အသုံးပြု၍ အသေးစိတ်ကျသော 3D မြင်ကွင်းများကို ကိုင်တွယ်ရာတွင် စနစ်၏စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည့် GPU benchmark တစ်ခုဖြစ်သည်။ ဤ benchmark သည် server များနှင့် workstation များ၏ graphical rendering စွမ်းရည်ကို အကဲဖြတ်ရန်အတွက် အထူးသဖြင့် visual effect များနှင့် architectural visualization application များအတွက် တိကျသော အလင်း simulation သည် အရေးကြီးပါသည်။
အဆင့်မြင့် ray-tracing စွမ်းဆောင်ရည်ကို တိုင်းတာတဲ့ Luxmark မှာ RTX 5070 FE ဟာ Food scene စမ်းသပ်မှုမှာ 4070 ထက် 20% ခန့် မြှင့်တင်ပေးနိုင်ပါတယ် (7,535 vs. 9,061) နဲ့ Hall scene စမ်းသပ်မှုမှာ 10% ခန့် (20,003 vs. 22,062)။ 5070 Ti နဲ့ နှိုင်းယှဉ်ရင် Food (9,061 vs. 12,073) မှာ 33% ခန့်နဲ့ Hall (22,062 vs. 28,635) မှာ 30% ခန့် နောက်ကျနေပါတယ်။ ဒီကွာခြားချက်က ကြီးမားတဲ့ 3D render တွေ ဒါမှမဟုတ် VFX ပရောဂျက်တွေကို လုပ်ဆောင်နေတဲ့ အသုံးပြုသူတွေအတွက် Ti ရဲ့ ဈေးနှုန်းမြင့်မားမှုကို သက်သေပြနိုင်ပါတယ်။ 5080 သည် ထိုအမြတ်အစွန်းများကို ပိုမိုတိုးချဲ့ပြီး 5070 FE ထက် Food (9,061 vs.13,637) တွင် ၅၀% ကျော်နှင့် Hall (22,062 vs. 30,815) တွင် ၄၀% ခန့် စွမ်းဆောင်ရည်မြင့်မားသည်။
| Luxmark (မြင့်လေ ပိုကောင်းလေ) | NVIDIA RTX4070 | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 |
| အစားအသောက်ရမှတ် | 7,535 | 9,061 | 12,073 | 13,637 |
| ခန်းမရမှတ် | 20,003 | 22,062 | 28,635 | 30,815 |
ဗိသုကာဆိုင်ရာ visualization သို့မဟုတ် visual effects ထုတ်လုပ်မှုကဲ့သို့သော ဆက်စပ် workflow များတွင် 5070 FE သည် 4070 မှ အလုံးစုံ ခိုင်မာသော ခုန်တက်မှုကို ကိုယ်စားပြုနေဆဲဖြစ်သည်။
Geekbench 6
Geekbench 6 သည် အလုံးစုံစနစ်စွမ်းဆောင်ရည်ကို တိုင်းတာသည့် cross-platform benchmark တစ်ခုဖြစ်သည်။ Geekbench Browser သည် မည်သည့်စနစ်နှင့်မဆို နှိုင်းယှဉ်နိုင်စေပါသည်။
အောက်ဖော်ပြပါ ရလဒ်ဇယားတွင် RTX 5070 FE သည် 188,892 မှတ် ရရှိထားပြီး 4070 ၏ 174,725 မှတ်မှ ကောင်းမွန်သော တိုးတက်မှုတစ်ခုဖြစ်သည်။ Geekbench 6 ၏ GPU OpenCL ရမှတ် 8% တိုးလာခြင်း (174,725 မှ 188,892 အထိ) သည် ပထမတစ်ချက်ကြည့်လျှင် များပြားလှသည်ဟု မထင်ရပါ။ သို့သော် ၎င်းသည် မြင့်မားသော resolution ဗီဒီယိုတည်းဖြတ်ခြင်း၊ ရှုပ်ထွေးသော 3D rendering သို့မဟုတ် machine-learning inference ကဲ့သို့သော resource-intensive အလုပ်များကို ကိုင်တွယ်ဖြေရှင်းသူများအတွက် အသင့်အတင့် မြှင့်တင်ပေးနိုင်ပါသည်။ ၎င်းသည် ရိုးရှင်းသော workflow များကို သိသိသာသာ သက်ရောက်မှုမရှိသော်လည်း သင့် GPU ကို ၎င်း၏ ကန့်သတ်ချက်များအထိ မကြာခဏ တွန်းအားပေးပါက အပို headroom ကို ပိုမိုသိသာထင်ရှားစေနိုင်သည်။
| Geekbench (မြင့်လေ ပိုကောင်းလေ) | NVIDIA RTX4070 | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 |
| GPU OpenCL ရမှတ် | 174,725 | 188,892 | 246,875 | 265,397 |
50-Series ရဲ့ အဆင့်မြင့်မော်ဒယ်တွေနဲ့ နှိုင်းယှဉ်ရင် ဒီကွာဟချက်က ပိုကျယ်လာမယ်လို့ မျှော်လင့်ရပါတယ်။ 5070 Ti က ၂၄၆,၈၇၅ မှတ် ရရှိထားပြီး ၃၀% လောက် ပါဝါပိုများပါတယ်။ ဦးဆောင်သူစာရင်းရဲ့ ထိပ်ဆုံးမှာ 5080 က ၂၆၅,၃၉၇ မှတ်အထိ ရောက်ရှိသွားတာကြောင့် workstation ကျွမ်းကျင်သူတွေနဲ့ စိတ်အားထက်သန်သူတွေကို ဆွဲဆောင်နိုင်ပါတယ်။ ဒါပေမယ့် 5070 FE က ပိုဈေးကြီးတဲ့ နယ်ပယ်ကို စွန့်စားစရာမလိုဘဲ ပိုလေးတဲ့ GPU အခြေခံ အလုပ်တွေမှာ သိသိသာသာ အဆင့်မြှင့်တင်မှုကို လိုချင်တဲ့ အသုံးပြုသူတွေအတွက် ကောင်းမွန်တဲ့ နေရာတစ်ခုပါ။
V Ray
V -Ray Benchmark သည် အဆင့်မြင့် V-Ray 6 အင်ဂျင်များကို အသုံးပြု၍ CPU များ၊ NVIDIA GPU များ သို့မဟုတ် နှစ်မျိုးလုံး၏ rendering စွမ်းဆောင်ရည်ကို တိုင်းတာသည်။ ၎င်းသည် အသုံးပြုသူများ ၎င်းတို့၏စနစ်များ၏ rendering စွမ်းရည်များကို အကဲဖြတ်ရန်နှင့် နှိုင်းယှဉ်နိုင်ရန် မြန်ဆန်သော စမ်းသပ်မှုများနှင့် ရိုးရှင်းသော အမှတ်ပေးစနစ်ကို အသုံးပြုသည်။ ၎င်းသည် ထိရောက်သော စွမ်းဆောင်ရည်ဆိုင်ရာ ထိုးထွင်းသိမြင်မှုများကို ရှာဖွေနေသော ပရော်ဖက်ရှင်နယ်များအတွက် မရှိမဖြစ်ကိရိယာတစ်ခုဖြစ်သည်။
ဤနေရာတွင် RTX 5070 FE သည် 6,553 ရမှတ်ရရှိပြီး RTX 4070 မှ 4,469 ရမှတ်ထက် 47% သိသိသာသာ ခုန်တက်သွားခြင်းဖြစ်သည်။ ဤတိုးတက်မှုသည် ray-traced မြင်ကွင်းများ၊ ဗိသုကာအမြင်များ သို့မဟုတ် high-end CGI ကဲ့သို့သော rendering-intensive workloads များတွင် ပိုမိုချောမွေ့သော အတွေ့အကြုံကို ရရှိစေမည်ဖြစ်သည်။ 4070 မှ 5070 သို့ အဆင့်မြှင့်တင်သော ပရော်ဖက်ရှင်နယ်များ သို့မဟုတ် စိတ်အားထက်သန်သူများအတွက်၊ ၎င်းတို့၏ system setup ၏ ကျန်အပိုင်းပေါ် မူတည်၍ render အချိန်များသည် သိသိသာသာ ကျဆင်းသွားနိုင်သည်။
| V-Ray (မြင့်လေ ပိုကောင်းလေ) | NVIDIA RTX4070 | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 |
| vpath များ | 4,469 | 6,553 | 8,018 | 9,311 |
RTX 5070 ကို အဆင့်မြင့်မော်ဒယ်များနှင့် နှိုင်းယှဉ်ကြည့်လျှင် 5070 Ti သည် vpath ရမှတ် 8,018 ရရှိပြီး 5070 FE ထက် ၂၂% ခန့် ပိုမိုကောင်းမွန်ပါသည်။ 5080 သည် 5070 FE ထက် ၄၂% ပိုမိုစွမ်းဆောင်ရည်ရှိသော 9,311 အထိ ရောက်ရှိခဲ့သည်။ Ti နှင့် 5080 တို့သည် လေးလံသော rendering workloads များအတွက် ပိုမိုသင့်လျော်သော်လည်း 5070 FE သည် ယခင်မျိုးဆက်ထက် သိသိသာသာ မြင့်မားသော တိုးတက်မှုတစ်ခုကို ကိုယ်စားပြုပြီး အလယ်အလတ်တန်းစား ရွေးချယ်မှုတစ်ခု ဖြစ်စေပါသည်။
မာကု 3
3DMark Port Royal၊ Speed Way နှင့် Steel Nomad တို့သည် မတူညီသော အခြေအနေများတွင် GPU စွမ်းဆောင်ရည်ကို စမ်းသပ်သည့် benchmark များဖြစ်သည်။ Port Royal သည် ray tracing ကို အာရုံစိုက်ပြီး Speed Way သည် racing simulations များတွင် စွမ်းဆောင်ရည်ကို အကဲဖြတ်ပြီး Steel Nomad သည် မြင့်မားသော intensity၊ လက်တွေ့ကျသော ဂရပ်ဖစ်များဖြင့် GPU များကို စိန်ခေါ်သည်။ ၎င်းတို့သည် rendering၊ lighting နှင့် dynamic scenes များတွင် GPU စွမ်းရည်များကို အကဲဖြတ်သည်။
| 3DMark စမ်းသပ်မှု (မြင့်လေ ပိုကောင်းလေ) | Nvidia GeForce RTX 4070 | NVIDIA RTX5070 | ASUS PRIME NVIDIA RTX 5070 Ti |
| ဆိပ်ကမ်းတော်ဝင် | 11,074 | 14,026 | 19,290 |
| မြန်နှုန်းမြင့်လမ်း | 4,477 | 5,869 | 7,709 |
| သံမဏိ Nomad | 3,748 | 5,019 | 6,458 |
NVIDIA RTX 5070 သည် 3DMark benchmark များတွင် RTX 4070 ထက် 31% အထိ မြင့်မားသော စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ပြီး ၎င်း၏ဈေးနှုန်းအတွက် သိသာထင်ရှားသော တန်ဖိုးမြှင့်တင်မှုကို ပေးဆောင်ပါသည်။ ASUS PRIME RTX 5070 Ti သည် RTX 4070 ထက် ပျမ်းမျှ 41% မြင့်မားသော စွမ်းဆောင်ရည်ကို ပိုမိုမြှင့်တင်ပေးပါသည်။
NVIDIA GeForce RTX 5070 Founders ၏ ပါဝါထိရောက်မှုရလဒ်များ
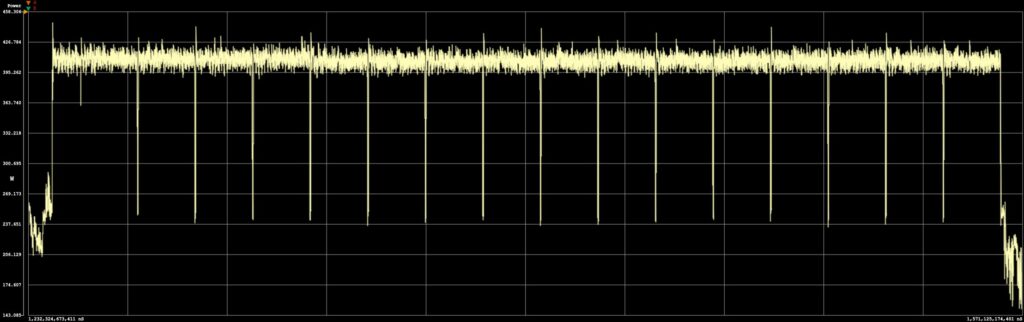
ကျွန်ုပ်တို့သည် 50-series NVIDIA GPU အသစ်အားလုံး၏ ပါဝါသုံးစွဲမှုကို တိုင်းတာရန် Procyon AI Image စမ်းသပ်မှုကို benchmark အဖြစ် အသုံးပြုနေပါသည်။ Stable Diffusion XL FP16 စမ်းသပ်မှုကို လုပ်ဆောင်ခြင်းဖြင့်၊ ကျွန်ုပ်တို့သည် ထုတ်လုပ်နေသော ဒုတိယမြောက် image မှ နောက်ဆုံးအပိုင်းအခြားကို ကြည့်ရှုပါသည်။ ကျွန်ုပ်တို့သည် ထိုအပိုင်းအခြား၏ အစမှအဆုံးအထိ အချိန်၊ အမြင့်ဆုံးပါဝါသုံးစွဲမှု၊ ပျမ်းမျှအမြင့်ဆုံးဆွဲအားနှင့် စမ်းသပ်မှုပြီးဆုံးပြီးနောက် idle ပါဝါတို့ကို တိုင်းတာပါသည်။ ကျွန်ုပ်တို့၏ စမ်းသပ်မှုတွင် စဉ်ဆက်မပြတ် workloads များအောက်တွင် ပျမ်းမျှ 409W သုံးစွဲမှုကို ပြသခဲ့ပြီး အမြင့်ဆုံး 429W နှင့် idle ဆွဲအား 184W တွင် ရရှိခဲ့သည်။ NVIDIA GeForce RTX 5070 တွင် 250W ပါဝါအဆင့်သတ်မှတ်ချက်ရှိသောကြောင့် သုံးစွဲမှုမှာ 225W ဝန်းကျင်ရှိပြီး အမြင့်ဆုံး 245W ရှိသည်။ ကတ်သည် ကျွန်ုပ်တို့၏ 19.2-စက္ကန့် စမ်းသပ်မှုစက်ဝန်းကို စုစုပေါင်းစွမ်းအင်သုံးစွဲမှု 2.46Wh ဖြင့် ပြီးမြောက်ခဲ့သည်။ ၎င်းသည် 5070Ti ထက် သိသာထင်ရှားသော တိုးတက်မှုတစ်ခုဖြစ်ပြီး GeForce RTX 5090 မှ ကျွန်ုပ်တို့တိုင်းတာခဲ့သည်ထက် နှစ်ဆကျော်ပိုများသည်။
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL FP16 ရုပ်ပုံပါဝါကို အသုံးပြုထားသည် (နည်းလေ ပိုကောင်းလေ) | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 | NVIDIA RTX5090 |
| ပါဝါသုံးစွဲမှု | 2.46Wh | 1.66Wh | 1.39Wh | 1.16Wh |
| စမ်းသပ်ကာလ | 19.2 ့ | 11.1 ့ | 8.7 ့ | 5.1 ့ |
ကောက်ချက်
NVIDIA RTX 5070 FE ဟာ အရေးကြီးတဲ့ ဈေးနှုန်းတစ်ခုကို ဒေါ်လာ ၅၄၉ နဲ့ ရောက်ရှိခဲ့ပြီး high-end ဈေးနှုန်းတွေကို မထိခိုက်စေဘဲ စွမ်းဆောင်ရည်နဲ့ next-gen features တွေကို ရောနှောပေးထားပါတယ်။ 30- ဒါမှမဟုတ် 20-series GPU တွေကို အသုံးပြုသူတွေအတွက် ဒီကတ်ဟာ frame rate မြင့်မားခြင်း၊ memory bandwidth တိုးတက်ကောင်းမွန်လာခြင်းနဲ့ DLSS 4 ရဲ့ Multi Frame Generation လိုမျိုး AI-powered features တွေက ပိုမိုချောမွေ့ပြီး တုံ့ပြန်မှုကောင်းတဲ့ အတွေ့အကြုံကို ပေးစွမ်းနိုင်ပါတယ်။ 40-series GPU ကို အသုံးပြုနေတယ်ဆိုရင် 5070 ဟာ အထူးသဖြင့် rendering နဲ့ AI workloads တွေမှာ အဓိပ္ပာယ်ရှိတဲ့ တိုးတက်မှုတွေကို ပေးစွမ်းနေဆဲပါ။
ကျွန်ုပ်တို့ရဲ့ စမ်းသပ်မှုမှာ RTX 5070 ဟာ AI-driven application တွေမှာ 4070 ထက် ၁၀-၁၅% သာလွန်ပြီး rendering နဲ့ compute-heavy tasks တွေမှာ ပိုပြီး မြင့်မားတဲ့ ခုန်ပျံမှုတွေ ပါဝင်ပါတယ်။ ဥပမာအားဖြင့် V-Ray ဟာ စွမ်းဆောင်ရည် ၄၀% ကျော် မြင့်တက်လာပြီး ရှုပ်ထွေးတဲ့ ray-traced scene တွေအတွက် rendering အချိန်တွေကို သိသိသာသာ လျှော့ချပေးပါတယ်။ ဒီတိုးတက်မှုတွေက NVIDIA ရဲ့ Blackwell တိုးတက်မှုတွေကို မီးမောင်းထိုးပြနေပြီး tensor နဲ့ RT cores တွေကို မြှင့်တင်ထားသလို GDDR7 memory ကို ပြောင်းလဲအသုံးပြုထားတာကြောင့် resolution မြင့်မားတဲ့ texture တွေနဲ့ creative workload တွေကို ပိုမိုကောင်းမွန်စွာ ကိုင်တွယ်နိုင်ပါတယ်။ 12GB VRAM ကတော့ အနည်းငယ် လိုအပ်ချက်ရှိနေပေမယ့် ဂိမ်းကစားခြင်းနဲ့ AI tasks အများစုအတွက် အထူးသဖြင့် local model ငယ်လေးတွေအတွက် လုံလောက်ပါတယ်။
အဆုံးစွန်အားဖြင့် RTX 5070 FE သည် နောက်မျိုးဆက်အင်္ဂါရပ်များကို သင့်တင့်သောဈေးနှုန်းဖြင့် ရရှိစေနိုင်သည့် ဟန်ချက်ညီသော ရွေးချယ်မှုတစ်ခုကဲ့သို့ ခံစားရသည်။ NVIDIA သည် 5070 Ti နှင့် 5080 ဖြင့် ပါဝါပိုမိုလိုအပ်သူများအတွက် နေရာချန်ထားခဲ့သော်လည်း အသုံးပြုသူအများစုအတွက် 5070 သည် ကုန်ကျစရိတ်နှင့် စွမ်းဆောင်ရည်ကြားတွင် ထူးကဲသောဟန်ချက်ညီမှုကို ပေးစွမ်းနိုင်သည်။ သို့သော် အမှန်တကယ်စမ်းသပ်မှုမှာ ရရှိနိုင်မှုဖြစ်သည်။ NVIDIA သည် ကုန်ပစ္စည်းအဆင့်များကို တည်ငြိမ်အောင်ထားရှိပါက ၎င်းသည် ယခင်မျိုးဆက်များ၏ ထောက်ပံ့မှုခေါင်းခဲမှုများမရှိဘဲ စွမ်းဆောင်ရည်နှင့် အသုံးပြုနိုင်စွမ်း နှစ်မျိုးလုံးကို ပေးစွမ်းနိုင်သော အလယ်အလတ်တန်းစားကတ်တစ်ခု ဖြစ်လာနိုင်သည်။


 အမေဇုံ