

We hebben inmiddels een paar GB300 DGX-stations bekeken en onlangs hadden we er zelfs twee tegelijk in ons lab: de ASUS ExpertCenter Pro ET900N G3 en de HP ZGX Fury AI Station . Omdat beide towers naast elkaar stonden, wilden we ze aansluiten om te zien wat een tweede GB300 zou kunnen toevoegen aan de prestaties van één machine voor meer gecoördineerde AI-workloads op de werkplek.
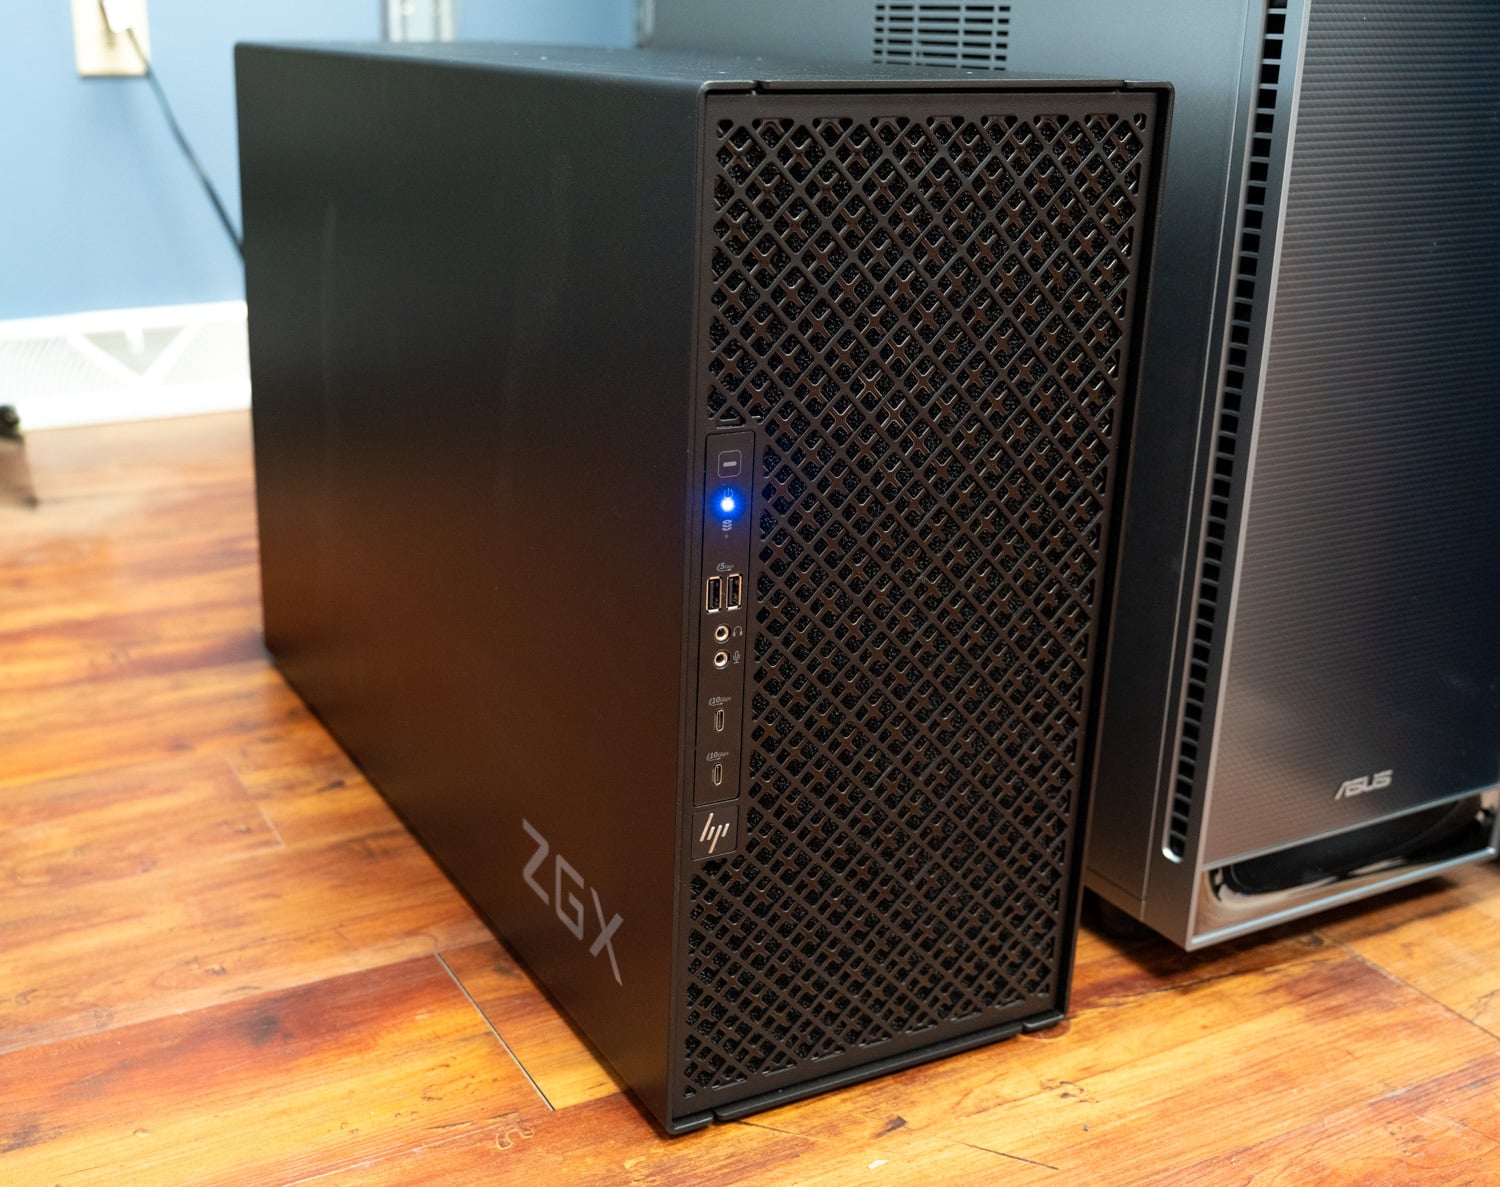
Het stapsgewijs uitbreiden van een desktopopstelling is geen nieuw idee; NVIDIA heeft dit expliciet gepromoot met het GB10-platform. Een van de dingen die de DGX Spark zo bijzonder maakte, was de mogelijkheid om met één systeem te beginnen en er meer aan te sluiten naarmate de werklast toenam. De GB300 begint met aanzienlijk meer prestaties, maar het draaien van grotere modellen of het bedienen van meer gebruikers kan zelfs een van de snelste desktopcomputers die we hebben getest, zwaar belasten. Dat is wat we bedoelden in onze oorspronkelijke MSI-review : als uw werklast één van deze Stations rechtvaardigt, is het gemakkelijk te begrijpen hoe deze uiteindelijk meerdere zou kunnen rechtvaardigen.
Voor veel kopers zullen de kosten bepalend zijn voor het moment waarop een uitbreiding haalbaar wordt. Inzicht in hoe goed twee stations nu samenwerken, geeft iemand die met één station begint een duidelijker beeld van wat hij of zij later zou kunnen winnen door uit te breiden.
Key Takeaways
- Twee kabels, 98% van de lijnsnelheid: Twee 400G DAC's tussen de ConnectX-8-poorten op de ASUS ET900N G3 en HP ZGX Fury leverden NCCL 98 GB/s op voor broadcast, reduce en send/receive, terwijl de twee apparaten samen een maximale doorvoer van 100 GB/s konden bereiken. GPUDirect RDMA haalde 392 Gb/s op elke rail en een RDMA-schrijfbewerking van 8 bytes duurde gemiddeld 1.46 µs. De configuratie werd uitgevoerd volgens de NVIDIA-handleiding.
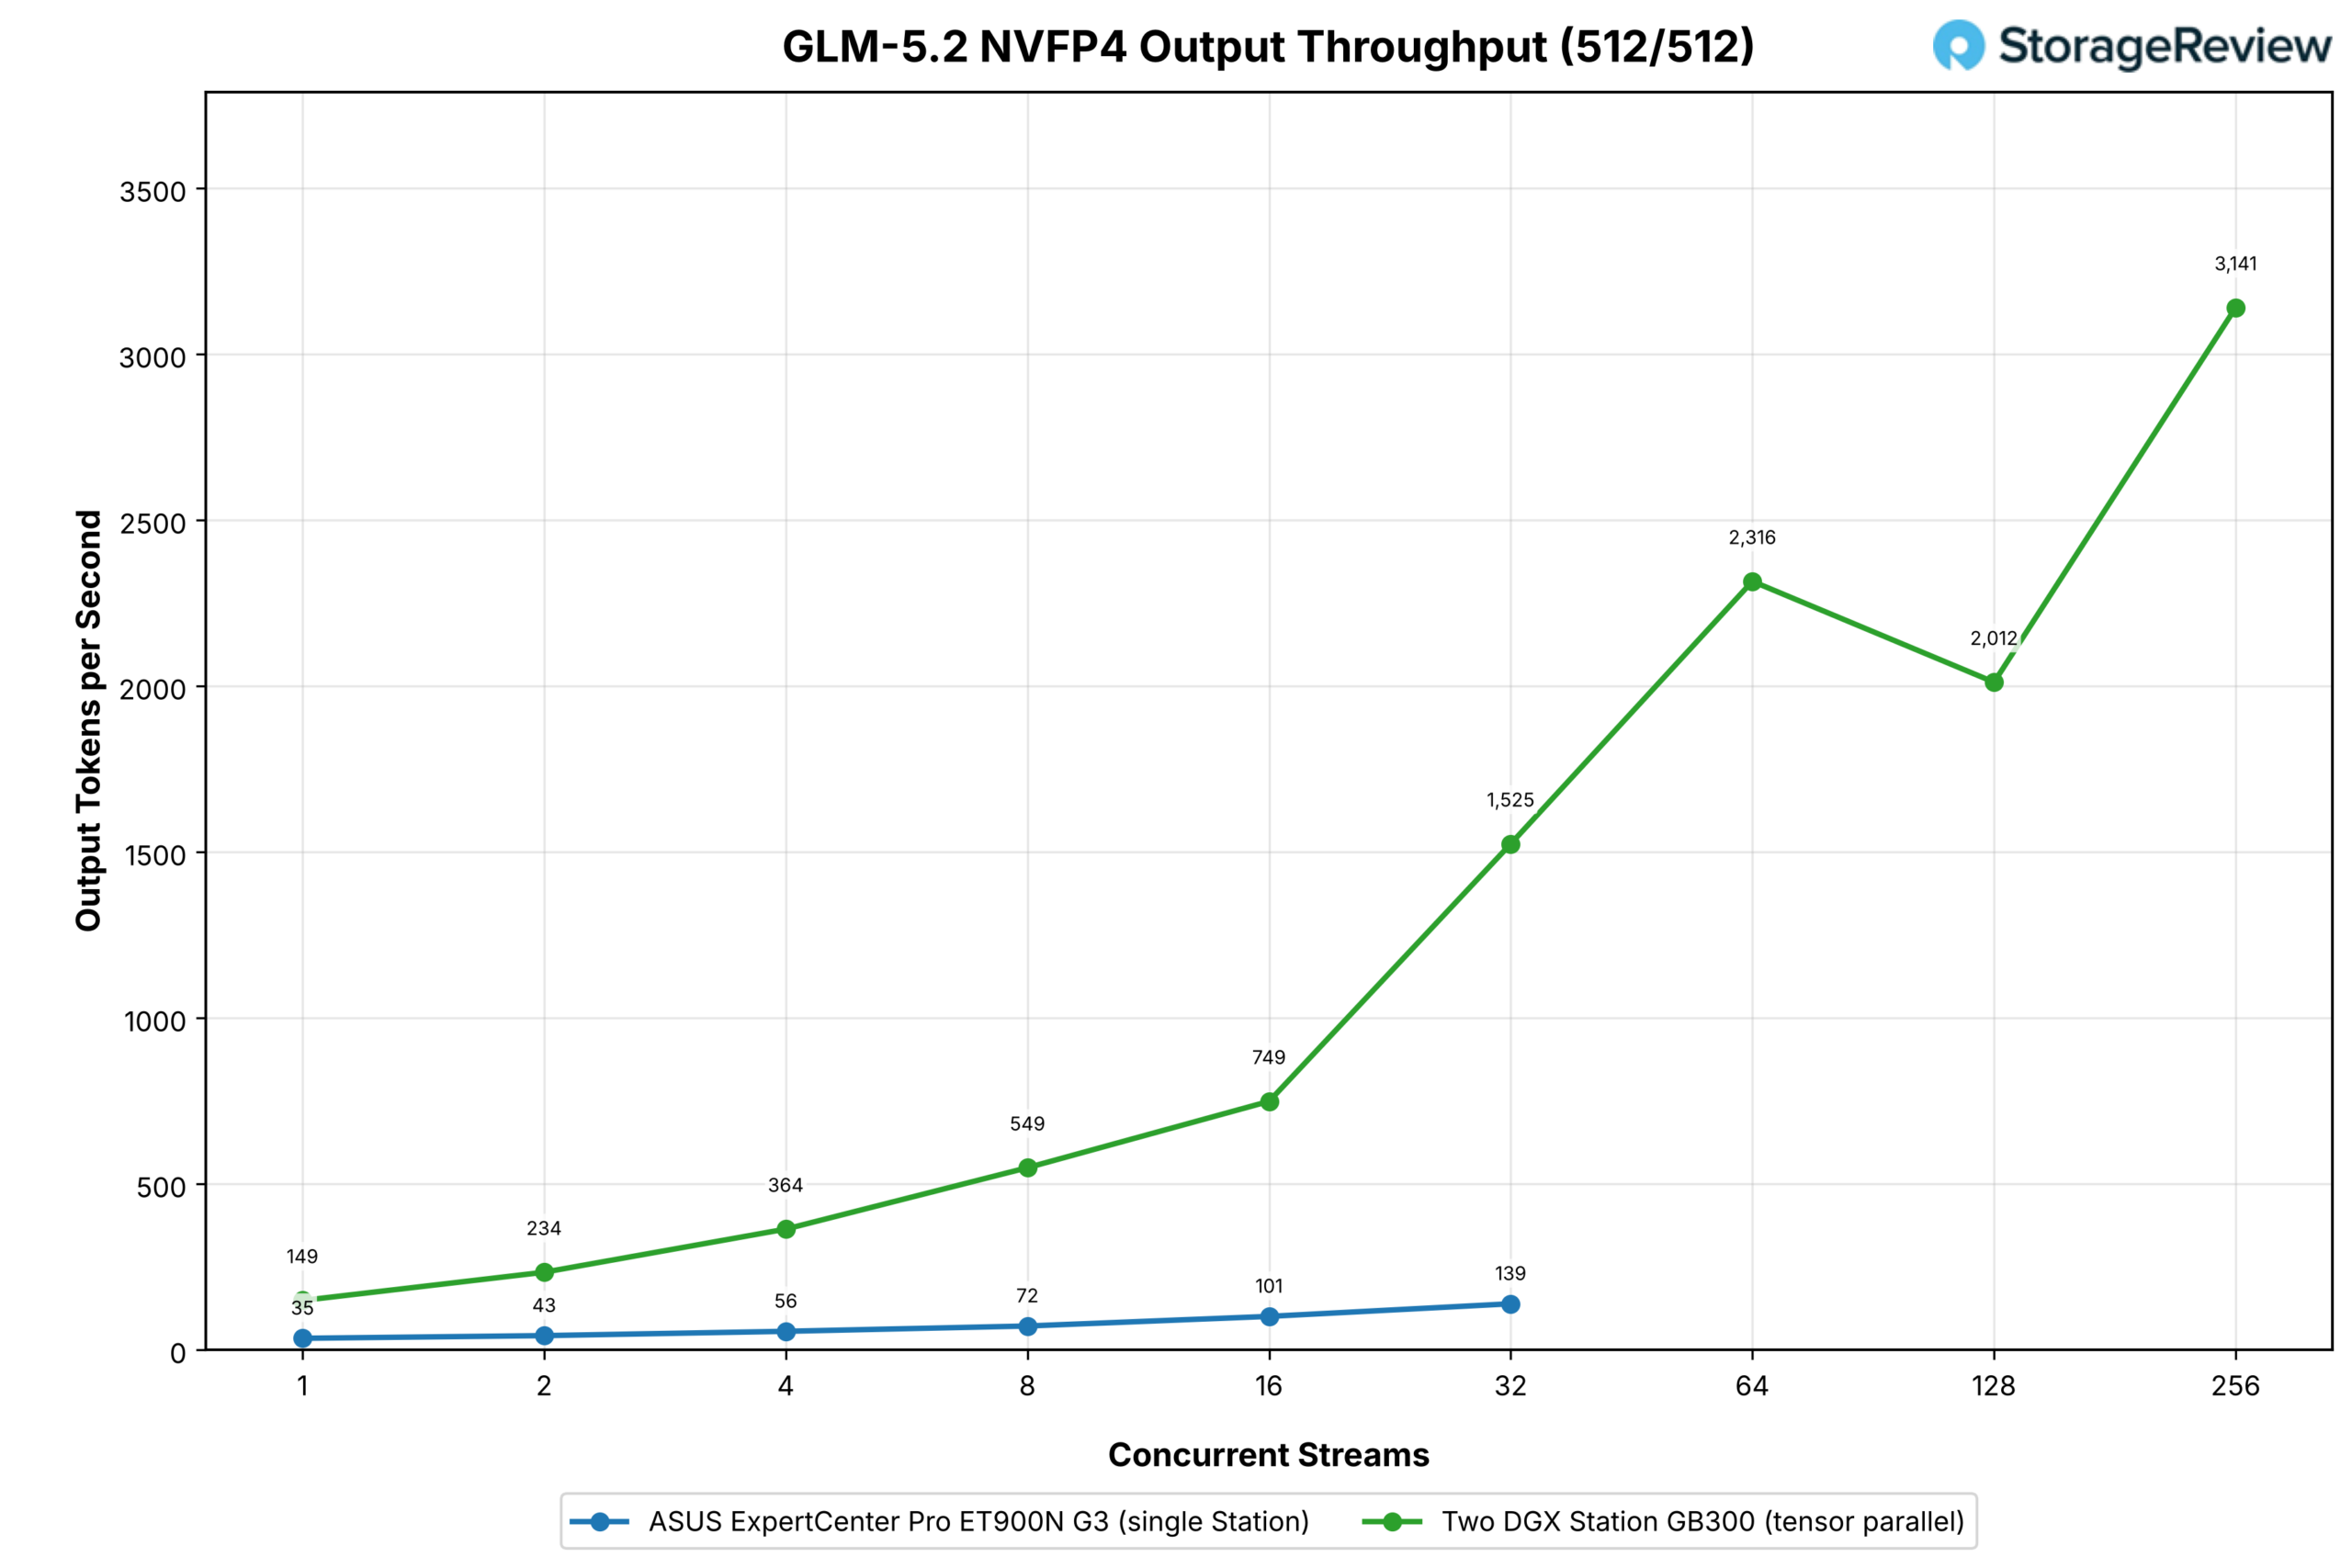
- GLM-5.2 behaalt een 11x hogere score bij gelijke gelijktijdigheid: Het NVFP4-checkpoint van 433 GB slaat ongeveer 215 GB aan expertgewichten op in het Grace-geheugen van één werkstation, dat 139 uitvoertokens per seconde verwerkte bij 32 streams; verdeeld over twee B300's in tensorparallelmodus bereikte het 1,525 tokens bij 32 streams en 3,141 tokens bij 256 streams.
- GLM-5.3 gaat van 188 naar 5,018 tokens per seconde: De grootste winst in de set, 27x, kwam van het andere model dat meer dan 252 GB HBM3e aankan. Het paar bleef bij dezelfde werklast 256 streams verwerken en haalde bijna 600 outputtokens per seconde bij prompts van 8,192 tokens, ongeveer vijf keer zoveel als de enkele toren.
- MiniMax-M3 lange prompts stoppen bij acht streams op één station: De enkele toren leverde nog maar 103 uitvoertokens per seconde bij acht streams toen de KV-cache leeg was; het paar leverde er 736 op hetzelfde moment, 7.1x, en ging door tot 1,801 bij 256 streams.
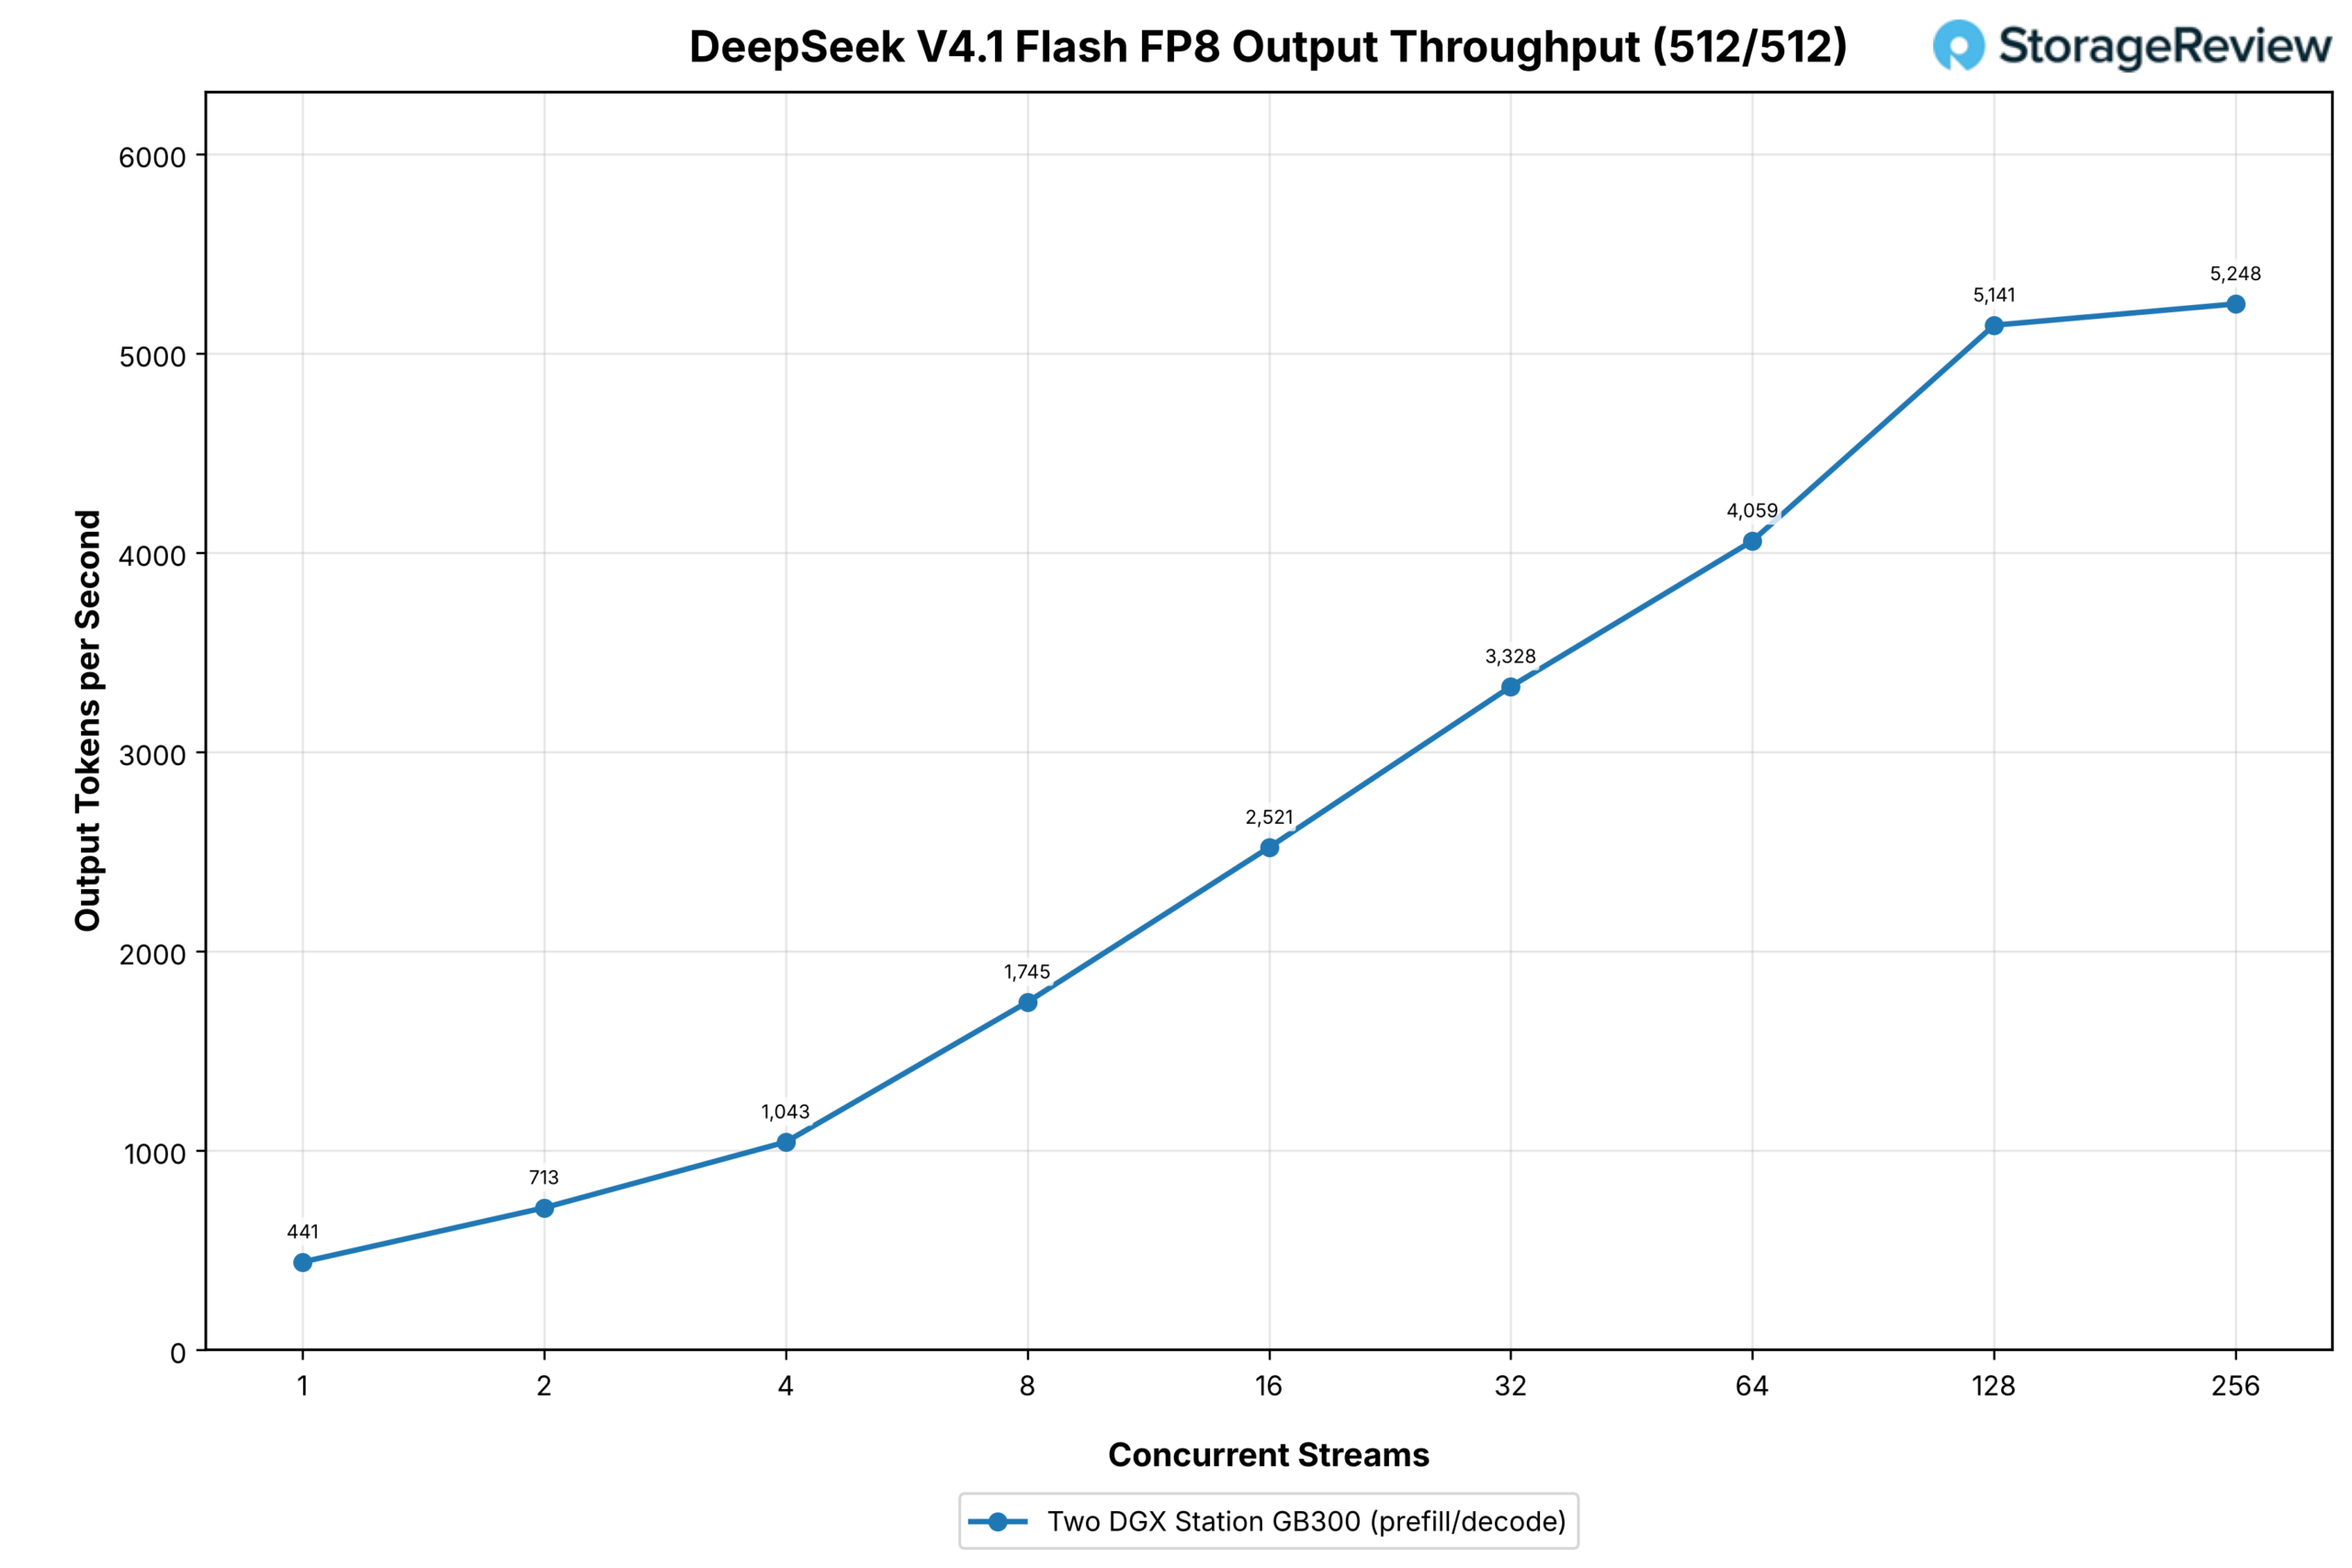
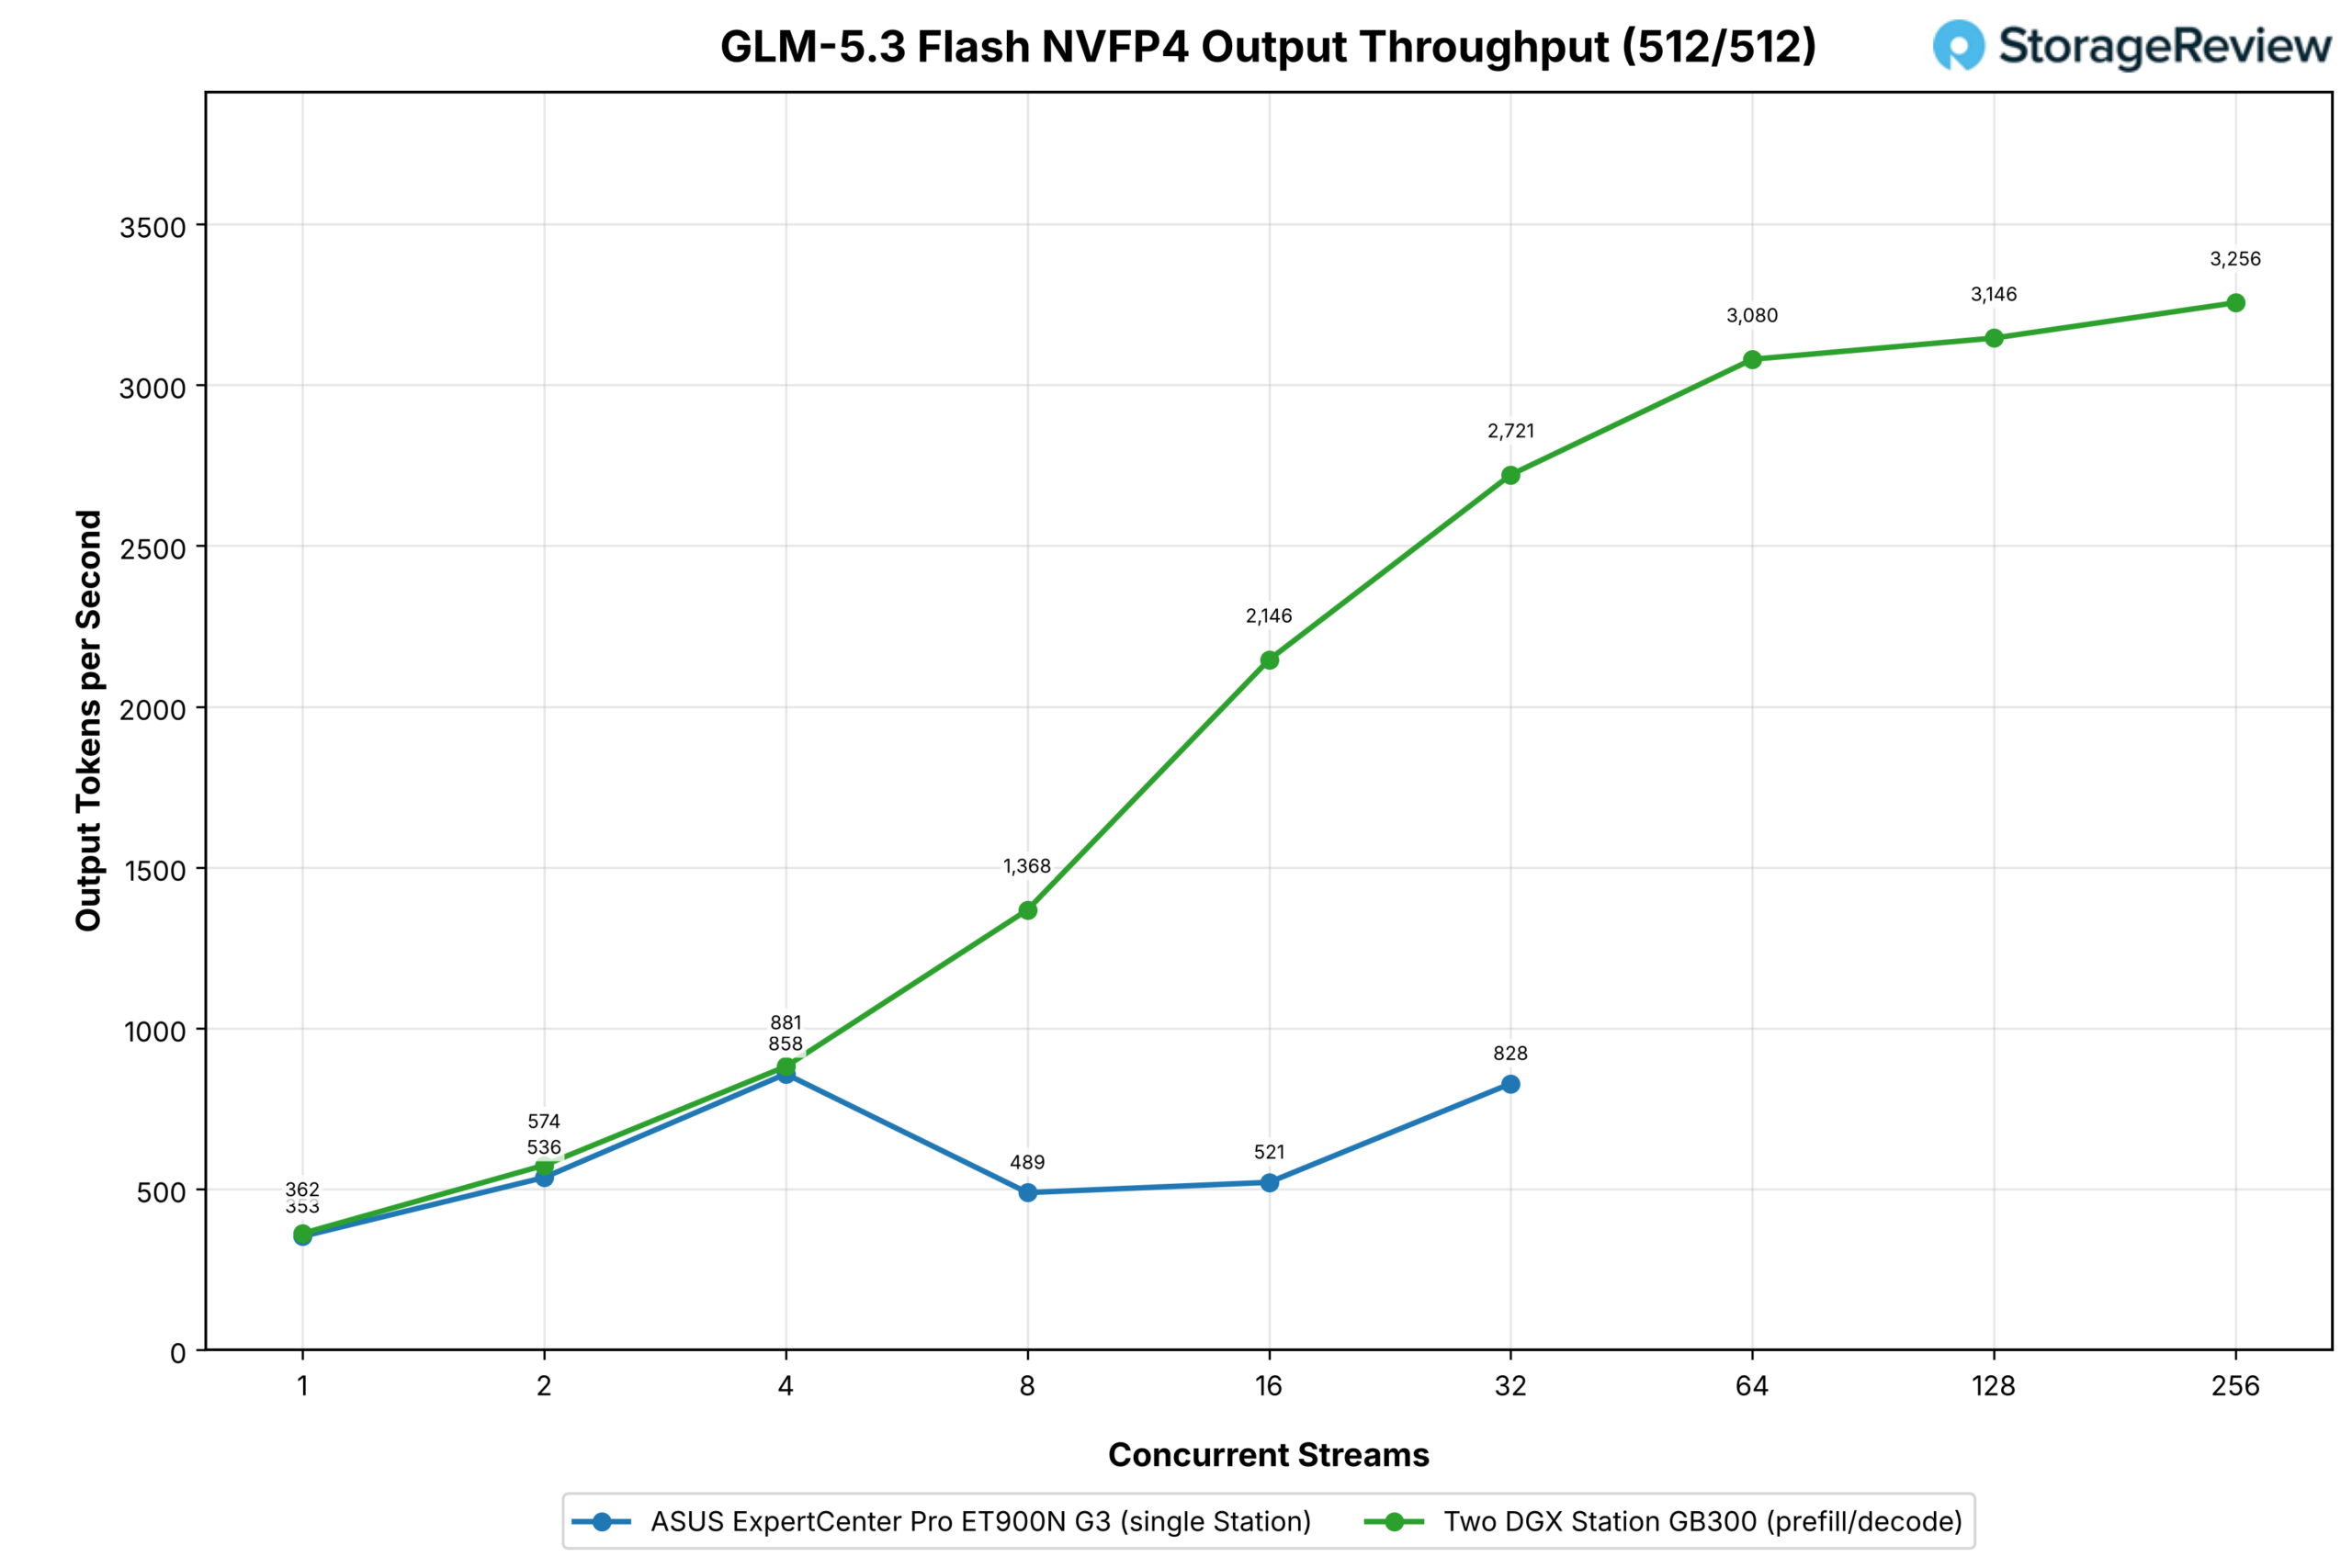
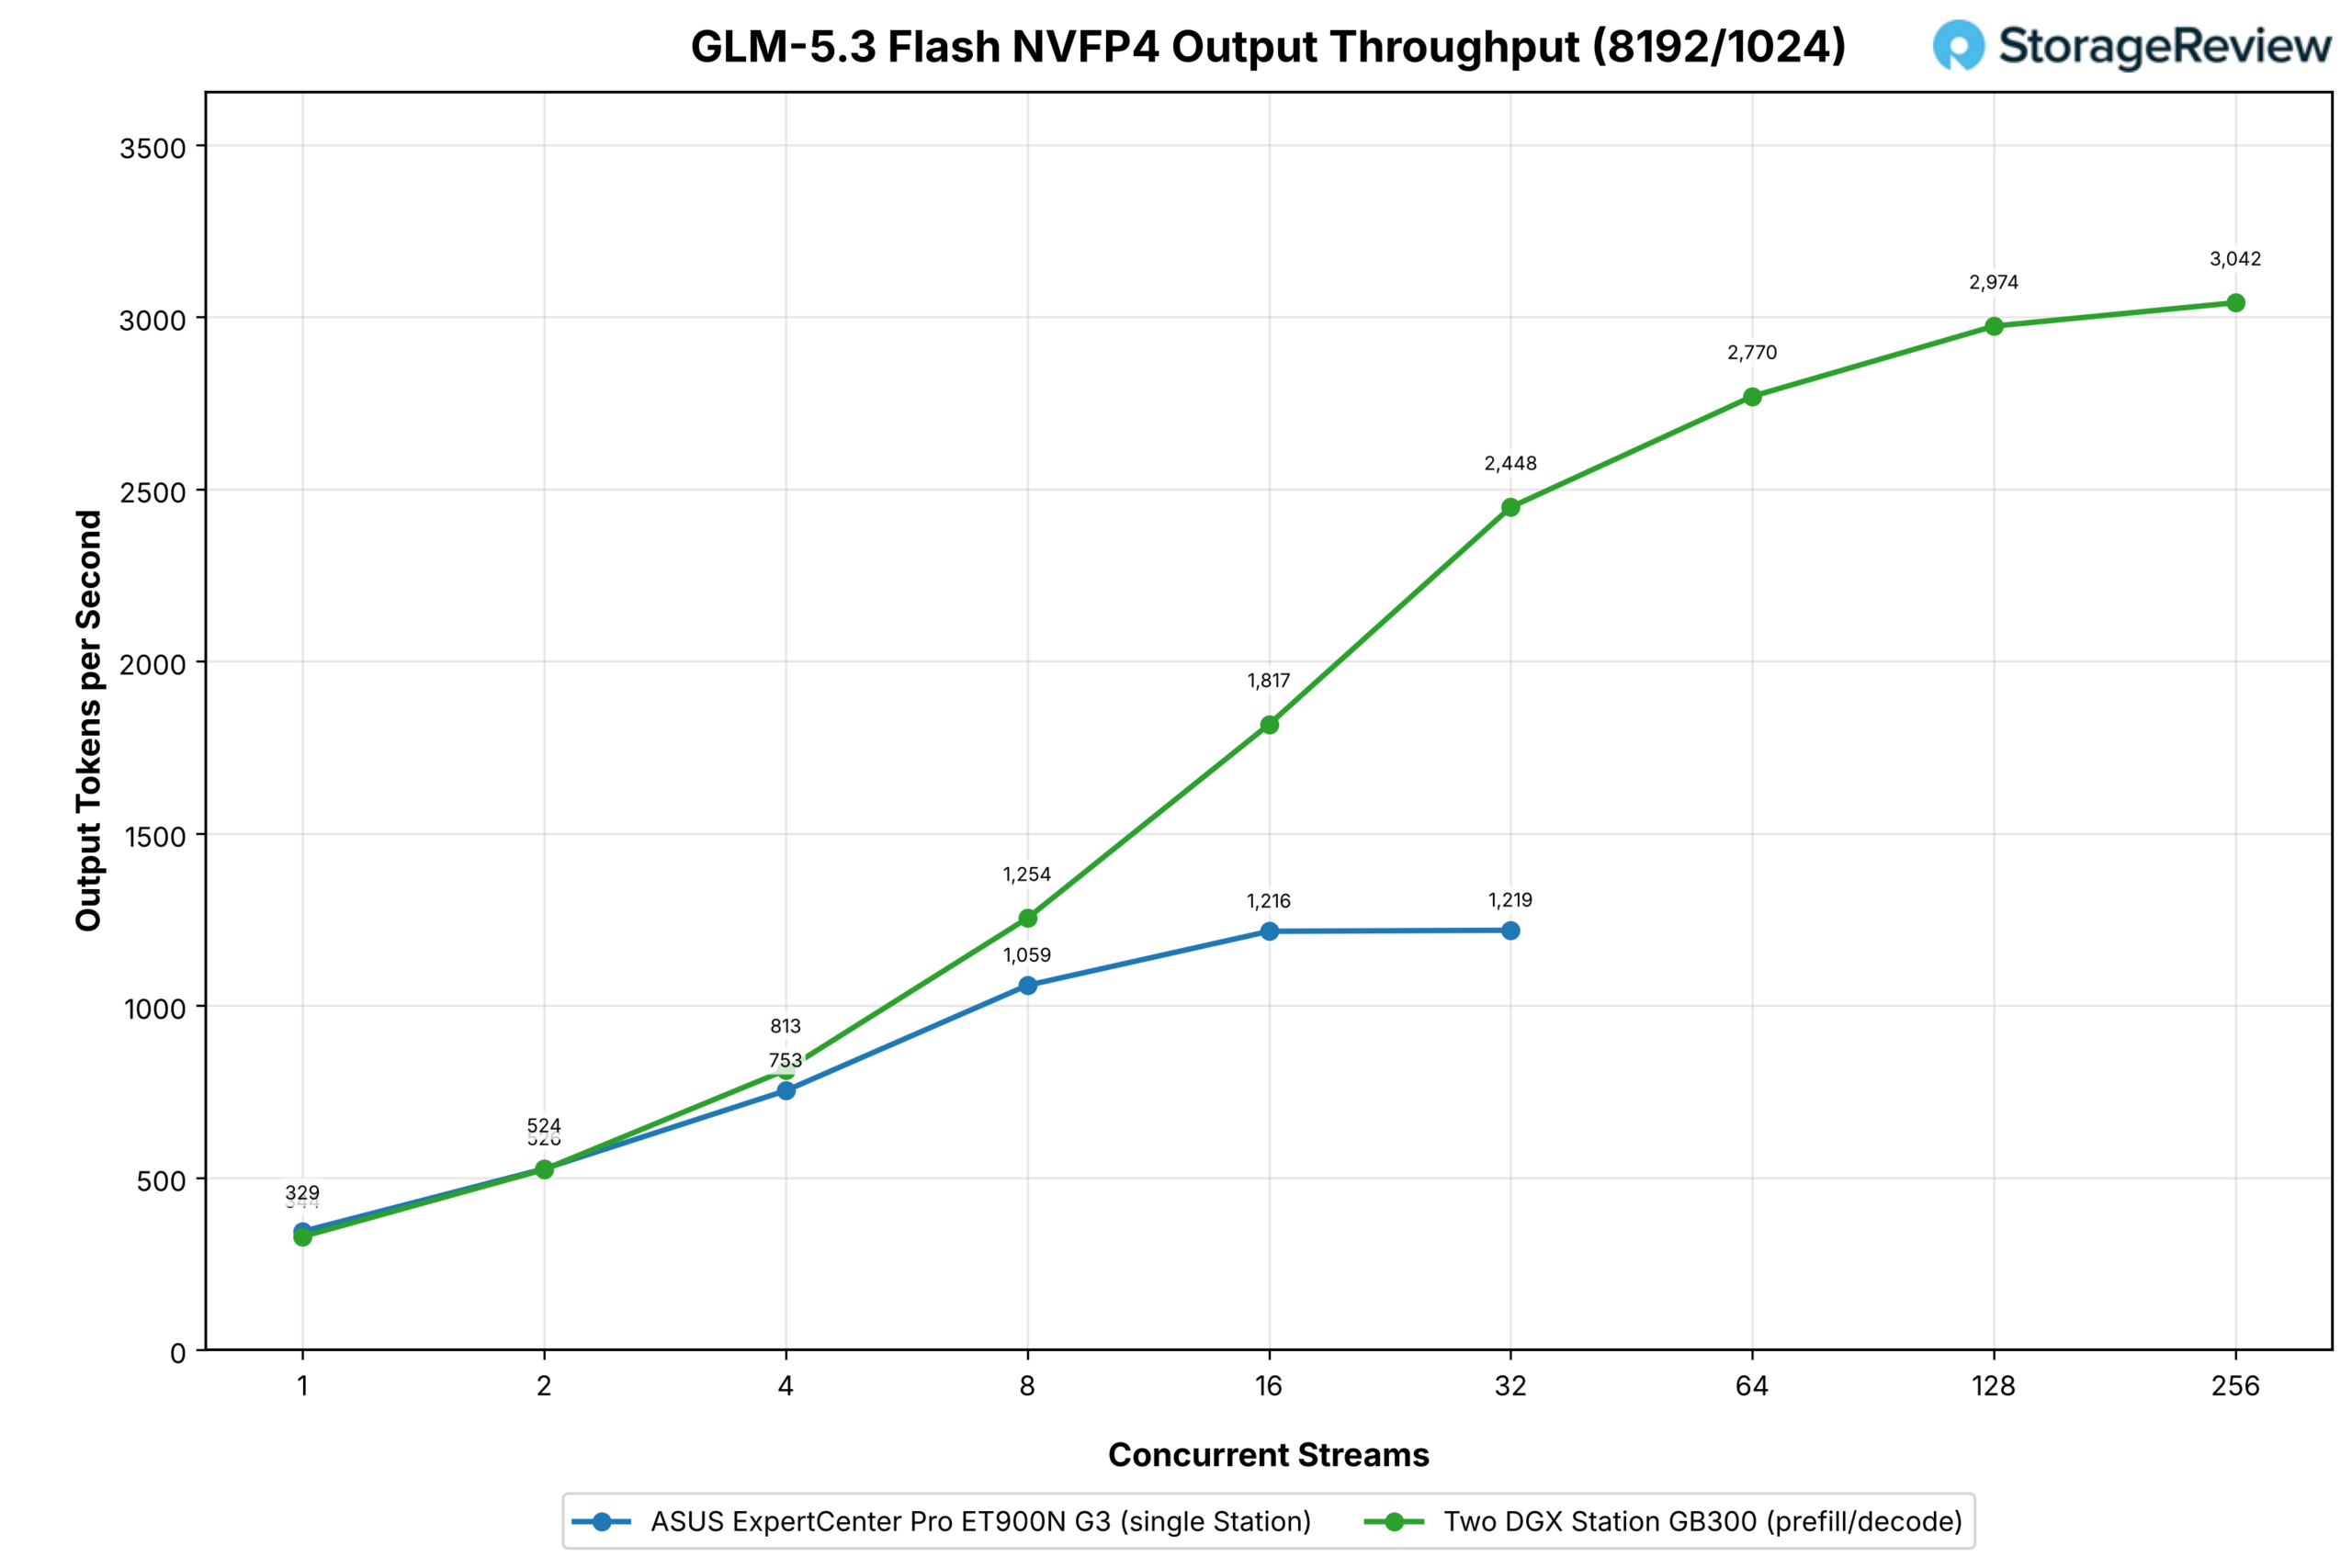
- Modellen die passen, krijgen een tweede kopie en een splitsing voor voorinvullen/decoderen: Met één station in de prefill-modus en het andere in de decode-modus, verdrievoudigde de GLM-5.3 Flash de doorvoer bij korte prompts met 32 streams (van 828 naar 2,721) en verdubbelde de doorvoer bij lange prompts (van 1,219 naar 2,448). De DeepSeek V4.1 Flash behaalde de hoogste uitvoerdoorvoer van alle geteste modellen, namelijk 5,248 tokens per seconde bij 256 streams.
Netwerken op het DGX-station
Voordat we dieper ingaan op het cluster, herhalen we eerst de netwerkmogelijkheden die we in onze MSI-review hebben besproken. De ConnectX-8 SuperNIC doet meer dan alleen de netwerkverbinding verzorgen. De geïntegreerde PCIe-switch verzorgt ook een deel van de interne I/O van het station en maakt verbinding met de Grace en de twee PCIe Gen 6 x4-opslagslots.
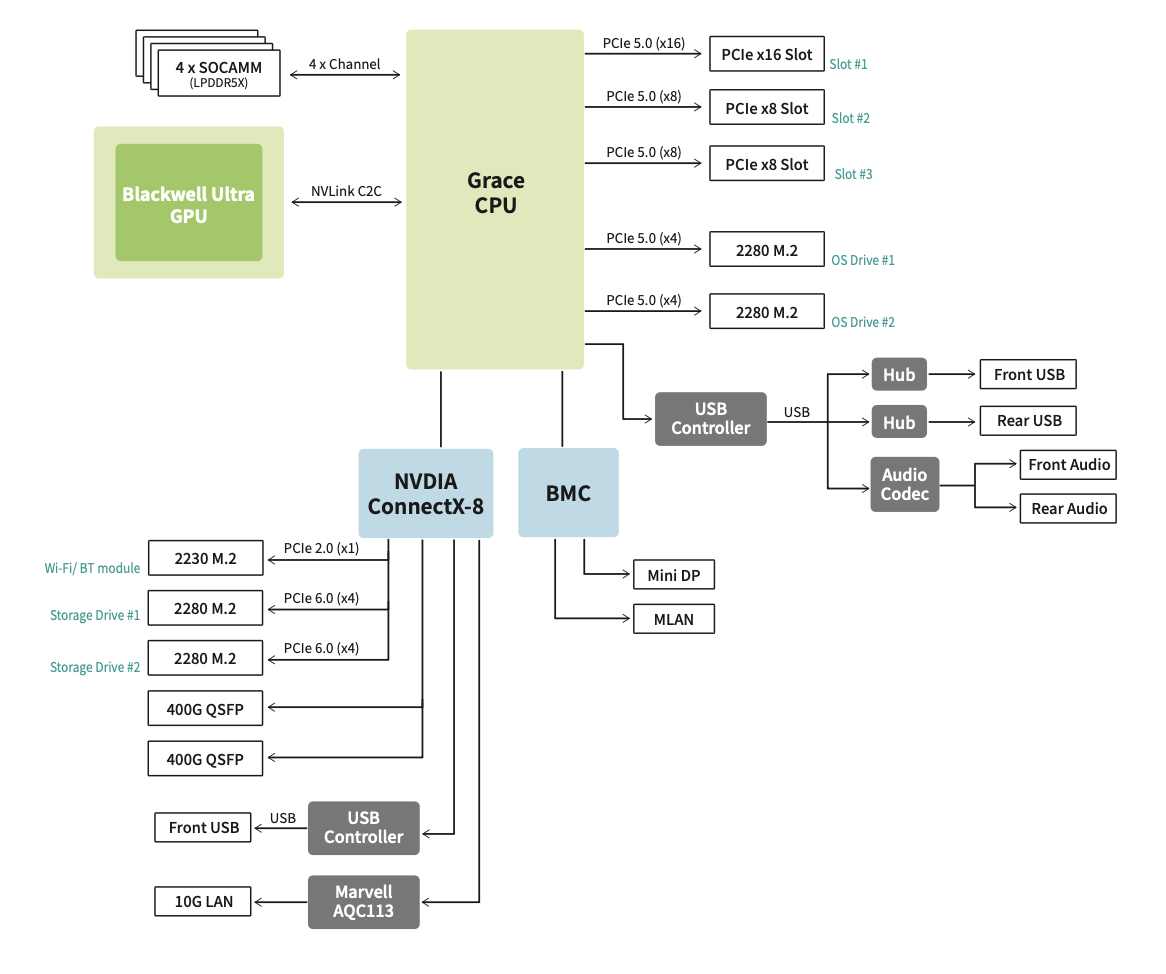
Voor de daadwerkelijke netwerkverbinding biedt het systeem twee QSFP112-poorten met een capaciteit van elk 400 Gb/s, wat een totale bandbreedte van 800 Gb/s oplevert om stations met elkaar te verbinden of aan te sluiten op een groter netwerk.
Vergeleken met de implementatie van de DGX Spark, die we in onze oorspronkelijke DGX Spark-review hebben besproken , was de 400 Gb/s-klasse ConnectX-7 van de Spark krachtiger dan de PCIe-connectiviteit van de GB10 volledig kon benutten. De controller bevond zich achter twee aparte PCIe 5.0 x4-links, waardoor de bruikbare totale netwerkdoorvoer beperkt bleef tot ongeveer 200 Gb/s. De twee fysieke poorten verschenen ook als vier logische Ethernet-interfaces in Linux. Om de volledige bandbreedte te benutten, moesten deze interfaces worden gekoppeld aan de aangesloten cage, moesten beide logische interfaces daarachter worden geconfigureerd en moest ervoor worden gezorgd dat RDMA-verkeer beide PCIe-paden kon gebruiken.
Het Station biedt ons een eenvoudigere configuratie, met twee 400Gb/s-poorten die elk als een onafhankelijke netwerkrail kunnen fungeren.
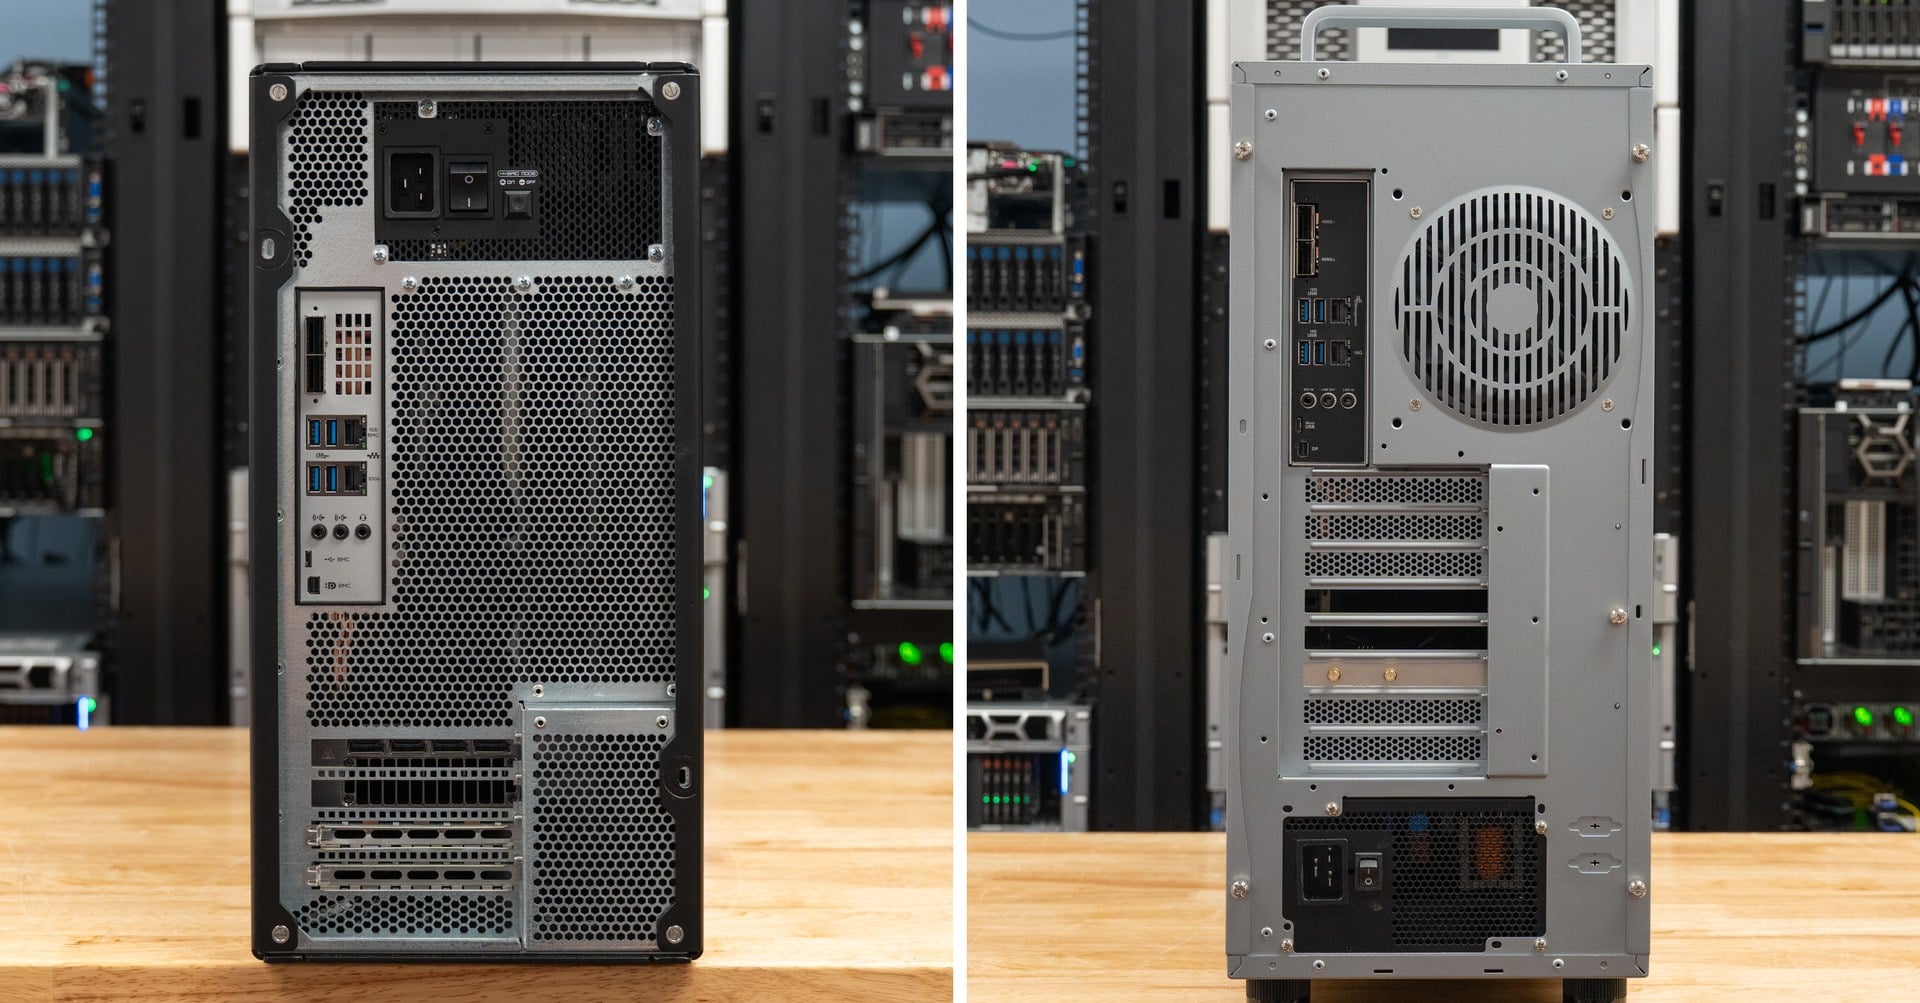
Het verviervoudigen van de bruikbare bandbreedte van de Spark via een paar QSFP-modules verhoogt ook de koelingsbelasting, en tijdens onze tests konden alle exemplaren dit aan. De ConnectX-8 zelf is vloeistofgekoeld, en sommige fabrikanten breiden die koeling uit naar de QSFP-modules, zoals MSI, terwijl andere systemen gebruikmaken van koelplaten en aparte ventilatoren boven de modules, zoals we zagen in onze ASUS-review. Die koeling is vooral nuttig voor optische modules, die meer warmte genereren dan passieve DAC's. Beide benaderingen hebben goed gewerkt tijdens onze tests en we zijn geen problemen met de koeling van de netwerkverbinding tegengekomen.
Twee stations met elkaar verbinden
Het samenvoegen van twee DGX-stations was eenvoudig: we verbonden de ASUS en de HP rechtstreeks met twee 400G DAC-kabels (Direct Attach Copper) tussen hun respectievelijke QSFP112-poorten, waardoor we twee onafhankelijke 400Gb/s-verbindingen kregen.
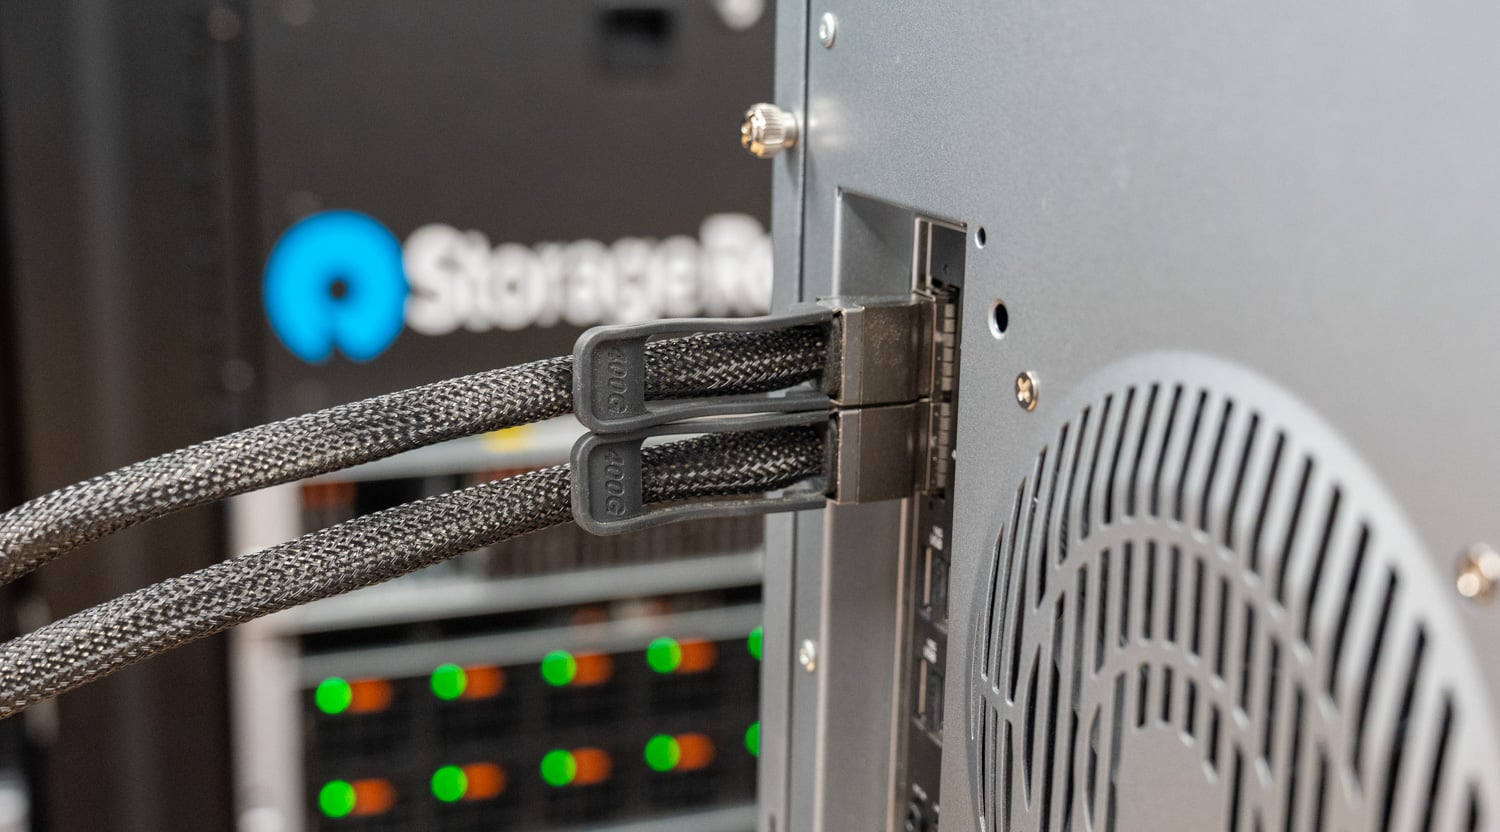
Wat de software betreft, biedt NVIDIA een stapsgewijze handleiding voor het clusteren van de systemen. De instructies waren zo duidelijk dat we simpelweg de link naar Claude Code hebben gegeven en de rest aan het programma hebben overgelaten. Het configureerde het netwerk tussen de twee stations, voerde NCCL-bandbreedtetests uit en gaf ons een rapport met de resultaten.
De handleiding is een genummerd playbook dat wordt uitgevoerd vanaf een derde machine die beide stations via SSH benadert. De poorten zijn bekabeld als bijpassende rails, QSFP0 naar QSFP0 en QSFP1 naar QSFP1, en elke rail wordt zijn eigen point-to-point RoCEv2-link: de scripts zetten de twee ConnectX-8-interfaces op met een MTU van 9,000 bytes, geven elke rail een eigen privé-/24-subnet en passen de RoCE- en GPUDirect-runtime-instellingen toe.
Een validatieronde bevestigt vervolgens dat beide verbindingen getraind zijn op 400G, dat jumbo-pings beide rails passeren en dat de twee RDMA-apparaten, mlx5_0 en mlx5_1, actief worden gerapporteerd. Een ib_write_bw-run op elke rail bewijst dat het fabric RDMA-verkeer verwerkt en niet alleen pings. Daarna wordt NCCL naar beide rails gestuurd met NCCL_IB_HCA=mlx5_0,mlx5_1, en wordt de taak gestart zoals elke andere tweeknoops-run. De onderstaande resultaten zijn het resultaat van deze reeks.
De eerste tabel is afkomstig van nccl-tests, de collectives die een gedistribueerde inferentie- of trainingstaak uitvoert, verdeeld over de twee B300's met beide rails in gebruik. Met één GPU per station komt elke collective neer op de twee GPU's die gegevens uitwisselen via de twee 400G-links, waardoor de kolom 'busbandbreedte' direct overeenkomt met de 100 GB/s (800 Gb/s) die de twee kabels leveren. 'Peak' is het beste resultaat voor alle berichtgroottes; de kolom van 16 GiB vertegenwoordigt het grootste geteste bericht, waarbij de bandbreedte stabiel is.
| Werking | Piekgrootte | Maximale busbandbreedte | Busbandbreedte van 16 GiB |
|---|---|---|---|
| Alles-verminderen | 1 GB | 92.242 GB / s | 91.346 GB / s |
| Allen verzamelen | 16 GB | 87.893 GB / s | 87.893 GB / s |
| Verspreiding verminderen | 2 GB | 93.930 GB / s | 92.905 GB / s |
| Uitzending | 16 GB | 97.975 GB / s | 97.975 GB / s |
| Verminderen | 16 GB | 97.978 GB / s | 97.978 GB / s |
| Allen voor allen | 8 GB | 80.522 GB / s | 80.512 GB / s |
| Verzenden/ontvangen, unidirectioneel | 16 GB | 97.953 GB / s | 97.953 GB / s |
| Verzenden/ontvangen, bidirectioneel | 16 GB | 83.748 GB/s per richting | 167.496 GB/s totaal |
Bij broadcast, reduce en eenrichtingsverzending/ontvangst werden snelheden van 98 GB/s bereikt, 98% van de maximale capaciteit van de twee kabels. De resultaten bij gelijktijdige dataoverdracht in beide richtingen lagen lager: 92 GB/s voor all-reduce en 80 GB/s voor all-to-all. Het resultaat van de bidirectionele verzending/ontvangst dient als referentiepunt: met beide GPU's die tegelijkertijd verzenden, kwam elke richting uit op 84 GB/s, wat neerkomt op een totaal van 167 GB/s over de verbinding.
De tweede tabel gaat onder NCCL door naar het onbewerkte RDMA-pad, waarbij ib_write_bw één rail tegelijk gebruikt. De GPUDirect-rijen schrijven 1 MiB-overdrachten van het HBM van de ene B300 naar het HBM van de andere, waarbij de NIC rechtstreeks GPU-geheugen leest en schrijft; beide rails halen 392 Gb/s, 98% van de lijnsnelheid. De rijen met hostgeheugen zijn de basistest van de handleiding, een enkel wachtrijpaar dat gegevens ophaalt uit Grace-geheugen, dat volgens NVIDIA's handleiding snelheden van 220 tot 230 Gb/s haalt op een 400G-rail; wij zagen 228 Gb/s. De latency-rij betreft een schrijfbewerking van 8 bytes: gemiddeld 1.46 µs.
| Test | bandbreedte | Linkgebruik |
|---|---|---|
| GPUDirect RDMA, GPU-geheugen, ib_write_bw, 1 MiB-overdrachten | ||
| Spoor 0 | 392.15 Gb / s | 98.04% |
| Spoor 1 | 392.15 Gb / s | 98.04% |
| Host-memory RDMA, beide rails | ||
| RDMA-schrijven, eenrichtingsverkeer | 228.15 Gb / s | |
| RDMA-leesbewerking, eenrichtingsverkeer | 228.23 Gb / s | |
| RDMA verzenden, eenrichtingsverkeer | 228.16 Gb / s | |
| RDMA-schrijven, bidirectioneel | 447.10 Gb/s totaal | |
| RDMA-schrijflatentie, 8 bytes | Gemiddeld 1.46 µs; 1.63 en 1.66 µs 99e percentiel per spoor | |
Hoe we het cluster hebben getest
De tijd die we met het paar hadden was beperkt, dus concentreerden we ons op inferentie, de meest populaire AI-taak van dit moment. We zijn van plan dit werk uit te breiden naar grotere clusters. Voor dit artikel hebben we ons gericht op grotere modellen en een enkele Station vergeleken met twee Stations met behulp van tensorparallellisme (TP) en prefill/decode (PD)-disaggregatie.
Tensorparallellisme verdeelt de gewichtstensors en berekeningen binnen het model over meerdere GPU's. In onze configuratie met twee stations, of TP2, bevat elke B300 een deel van het model en verwerken beide GPU's elk verzoek. Dit geeft ons meer high-bandwidth memory (HBM) om de gewichten in op te slaan, samen met meer rekenkracht om ze uit te voeren. Het vereist ook dat de GPU's tussentijdse resultaten uitwisselen en synchroniseren via NCCL gedurende de inferentie, waardoor communicatiekosten onderdeel worden van de kosten voor het uitvoeren van het model.
Gedisaggregeerde inferentie wijst de prefill- en decode-fasen van een verzoek toe aan afzonderlijke workers. Prefill verwerkt de invoerprompt en bouwt de key/value (KV)-cache op, de aandachtstoestand die het model hergebruikt tijdens de generatie. Decode gebruikt die toestand vervolgens om één voor één uitvoertokens te genereren. De twee fasen hebben verschillende verwerkingsvereisten: prefill is rekenintensief, terwijl decode veel geheugenbandbreedte vereist. In grotere omgevingen maakt deze gedisaggregeerde inferentie het voor de operator mogelijk om deze workers onafhankelijk van elkaar op te schalen, afhankelijk van de vraag, zoals ons artikel over KV-cache-offloading heeft aangetoond.
In een configuratie met één node, waarbij beide fasen een worker delen, kan vLLM het voorbereidende werk voor binnenkomende prompts afwisselen met het decodeerwerk van reeds lopende verzoeken. Deze promptverwerking kan de tijd tussen het genereren van uitvoertokens verlengen. In onze PD-configuratie behandelt één station het voorbereidende werk en draagt de KV-cache van het verzoek over aan het andere station, dat de decodering uitvoert. Elke worker heeft toegang tot zijn eigen kopie van het model, inclusief alle gegevens die in het Grace-geheugen zijn opgeslagen. De decodeerworker hoeft niet langer nieuwe promptverwerking in te plannen naast de tokengeneratie, waardoor de inferentiedoorvoer wordt versneld.
Voor onze tests bepaalden de geheugenvereisten van het model welke aanpak we gebruikten. Voor de grootste checkpoints, waarbij één Station een aanzienlijke hoeveelheid modelgewichten naar Grace-geheugen moest overzetten, leverde TP de beste prestaties. Door de gewichten over twee GPU's te verdelen, kon een groter deel van het model in HBM blijven en werd de prestatievermindering bij het overzetten verminderd. Voor modellen die redelijk goed op één Station pasten, volledig in HBM of met beperkte overdracht naar Grace, gebruikten we PD-disaggregatie. Dit omvatte DeepSeek V4.1 Flash, waarbij de Engram-opzoektabellen in Grace DRAM werden geplaatst.
Om de vergelijkbaarheid met onze eerdere dekking te behouden, hebben we onze oude methodologie met vaste invoersequentielengtes (ISL) en uitvoersequentielengtes (OSL) behouden. De gelijke workload gebruikt 512 invoertokens en 512 uitvoertokens, terwijl de workload met veel voorvulling 8,192 invoertokens en 1,024 uitvoertokens gebruikt. We variëren het aantal gelijktijdige verzoeken, terwijl we de sequentielengtes vast houden.
De basislijn voor één station in elke grafiek is de ASUS ET900N G3 uit onze review, waarbij 32 streams zijn verwerkt; de metingen met twee stations gaan tot 256. Elk punt vertegenwoordigt één enkele meting, dus een dip bij een bepaald niveau van gelijktijdigheid wordt gerapporteerd als verzameld.
Inferentieconfiguratie
| Model | Clustermodus | Software | Speculatieve decodering | Grace-herdenking |
|---|---|---|---|---|
| DeepSeek V4.1 Flash (FP8) | Vooraf invullen/decoderen van de gegevens, volledige kopie per station | vllm/vllm-openai:deepseekv41-flash-0909 | Ontwerper van het model zelf, vaste waarde 5 tokens | Twee FP8 Engram-tabellen (188.84 GiB) vastgezet in het Grace-geheugen, plus 131.97 GB aan expertgewichten die zijn uitgelezen, op elk station. |
| GLM-5.3 NVFP4 | Tensorparallel (TP2) | NVIDIA vLLM 26.08 NGC-container (vLLM 0.27.1) | MTP, vast 5-token concept | Geen op het cluster; 215 GB aan expertbelastingen overgezet naar één station. |
| GLM-5.3 Flash NVFP4 | Vooraf invullen/decoderen van disaggregatie, ASUS vooraf invullen, HP decoderen | vLLM 0.28.1 RC1 | MTP, vast 5-token concept | Geen |
| GLM-5.2 NVFP4 | Tensorparallel (TP2) | NVIDIA vLLM 26.08 NGC-container (vLLM 0.27.1) | MTP, vast 3-token concept | Geen op het cluster; ongeveer 215 GB aan expertbelastingen zijn overgezet naar één station. |
| MiniMax-M3 NVFP4 | Tensorparallel (TP2) | NVIDIA vLLM 26.08 NGC-container (vLLM 0.27.1) | EAGLE3, vaste 3-token draft | Geen enkele op het cluster; een deel van de experts is overgeplaatst naar één enkel station. |
Inferentieprestaties
DeepSeek V4.1-flitser
DeepSeek V4.1 Flash draaide in een gedecentraliseerde configuratie, waarbij één station de prefill verzorgde en het andere de decode. Elk station bevatte een volledige kopie van het model: de twee FP8 Engram-tabellen, in totaal 188.84 GiB, opgeslagen in het Grace-geheugen en nog eens 131.97 GB aan expert-gewichten die naar Grace waren overgezet. Daarmee is dit de enige configuratie in de set waarbij Grace-geheugen op beide machines wordt gebruikt. Het is ook het enige model zonder een single-Station-configuratie, omdat de ASUS-review de eerdere V4 Flash-checkpoint gebruikte en de twee niet direct vergelijkbaar zijn.
Op het cluster met twee stations behaalde het native FP8-model een uitvoersnelheid van 441 tokens per seconde bij één stream, 3,328 bij 32 streams, 5,141 bij 128 streams en 5,248 bij 256 streams. Dit was de hoogste uitvoersnelheid van alle modellen in deze test, waarbij de curve alleen aan het einde van de test afvlakte. Ter vergelijking: het enkele ASUS-station leverde in onze test een uitvoersnelheid van 1,766 tokens per seconde bij 32 streams voor V4 Flash.
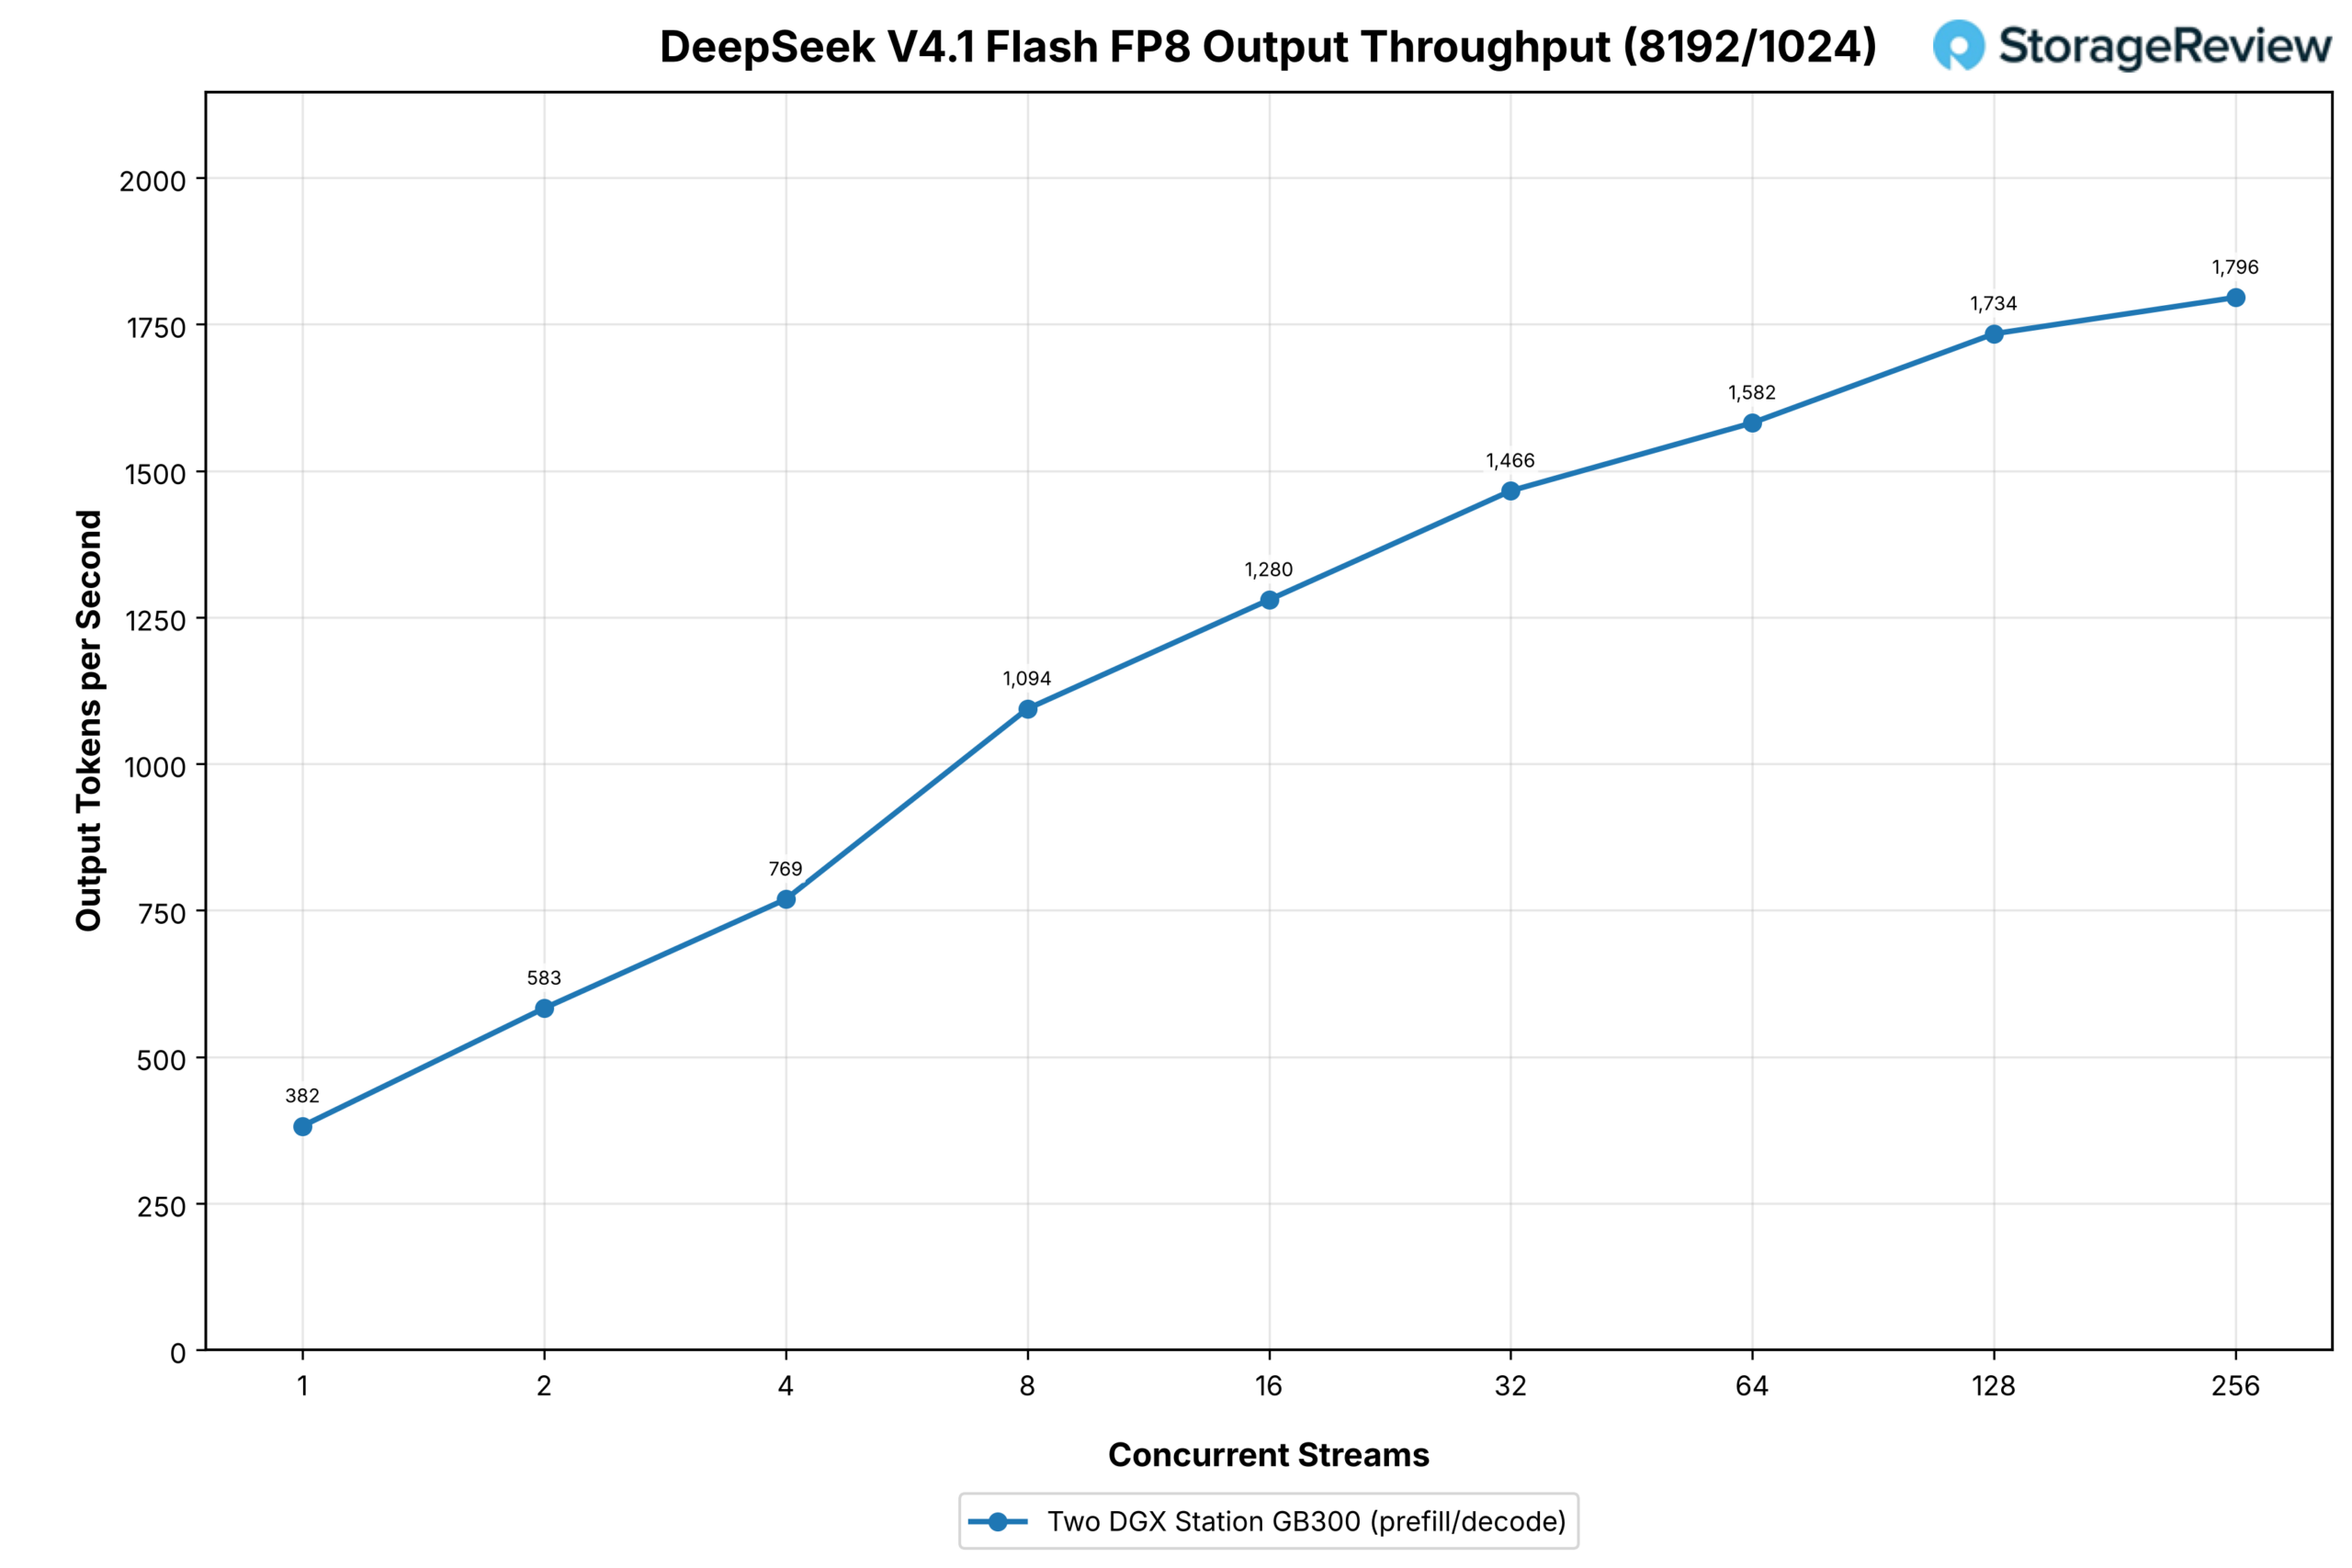
Bij het profiel met veel voorvulling draaide het cluster van 382 uitvoertokens per seconde bij één stream naar 1,466 bij 32 streams en 1,796 bij 256 streams. Omdat elk verzoek 8,192 invoertokens bevat, bereikte de totale doorvoer 16,163 tokens per seconde aan het begin van de sweep. Met de Engram-tabellen en 131.97 GB aan expertgewichten in het Grace-geheugen op elk station, bleven de curves gedurende de hele sweep constant.
GLM-5.3
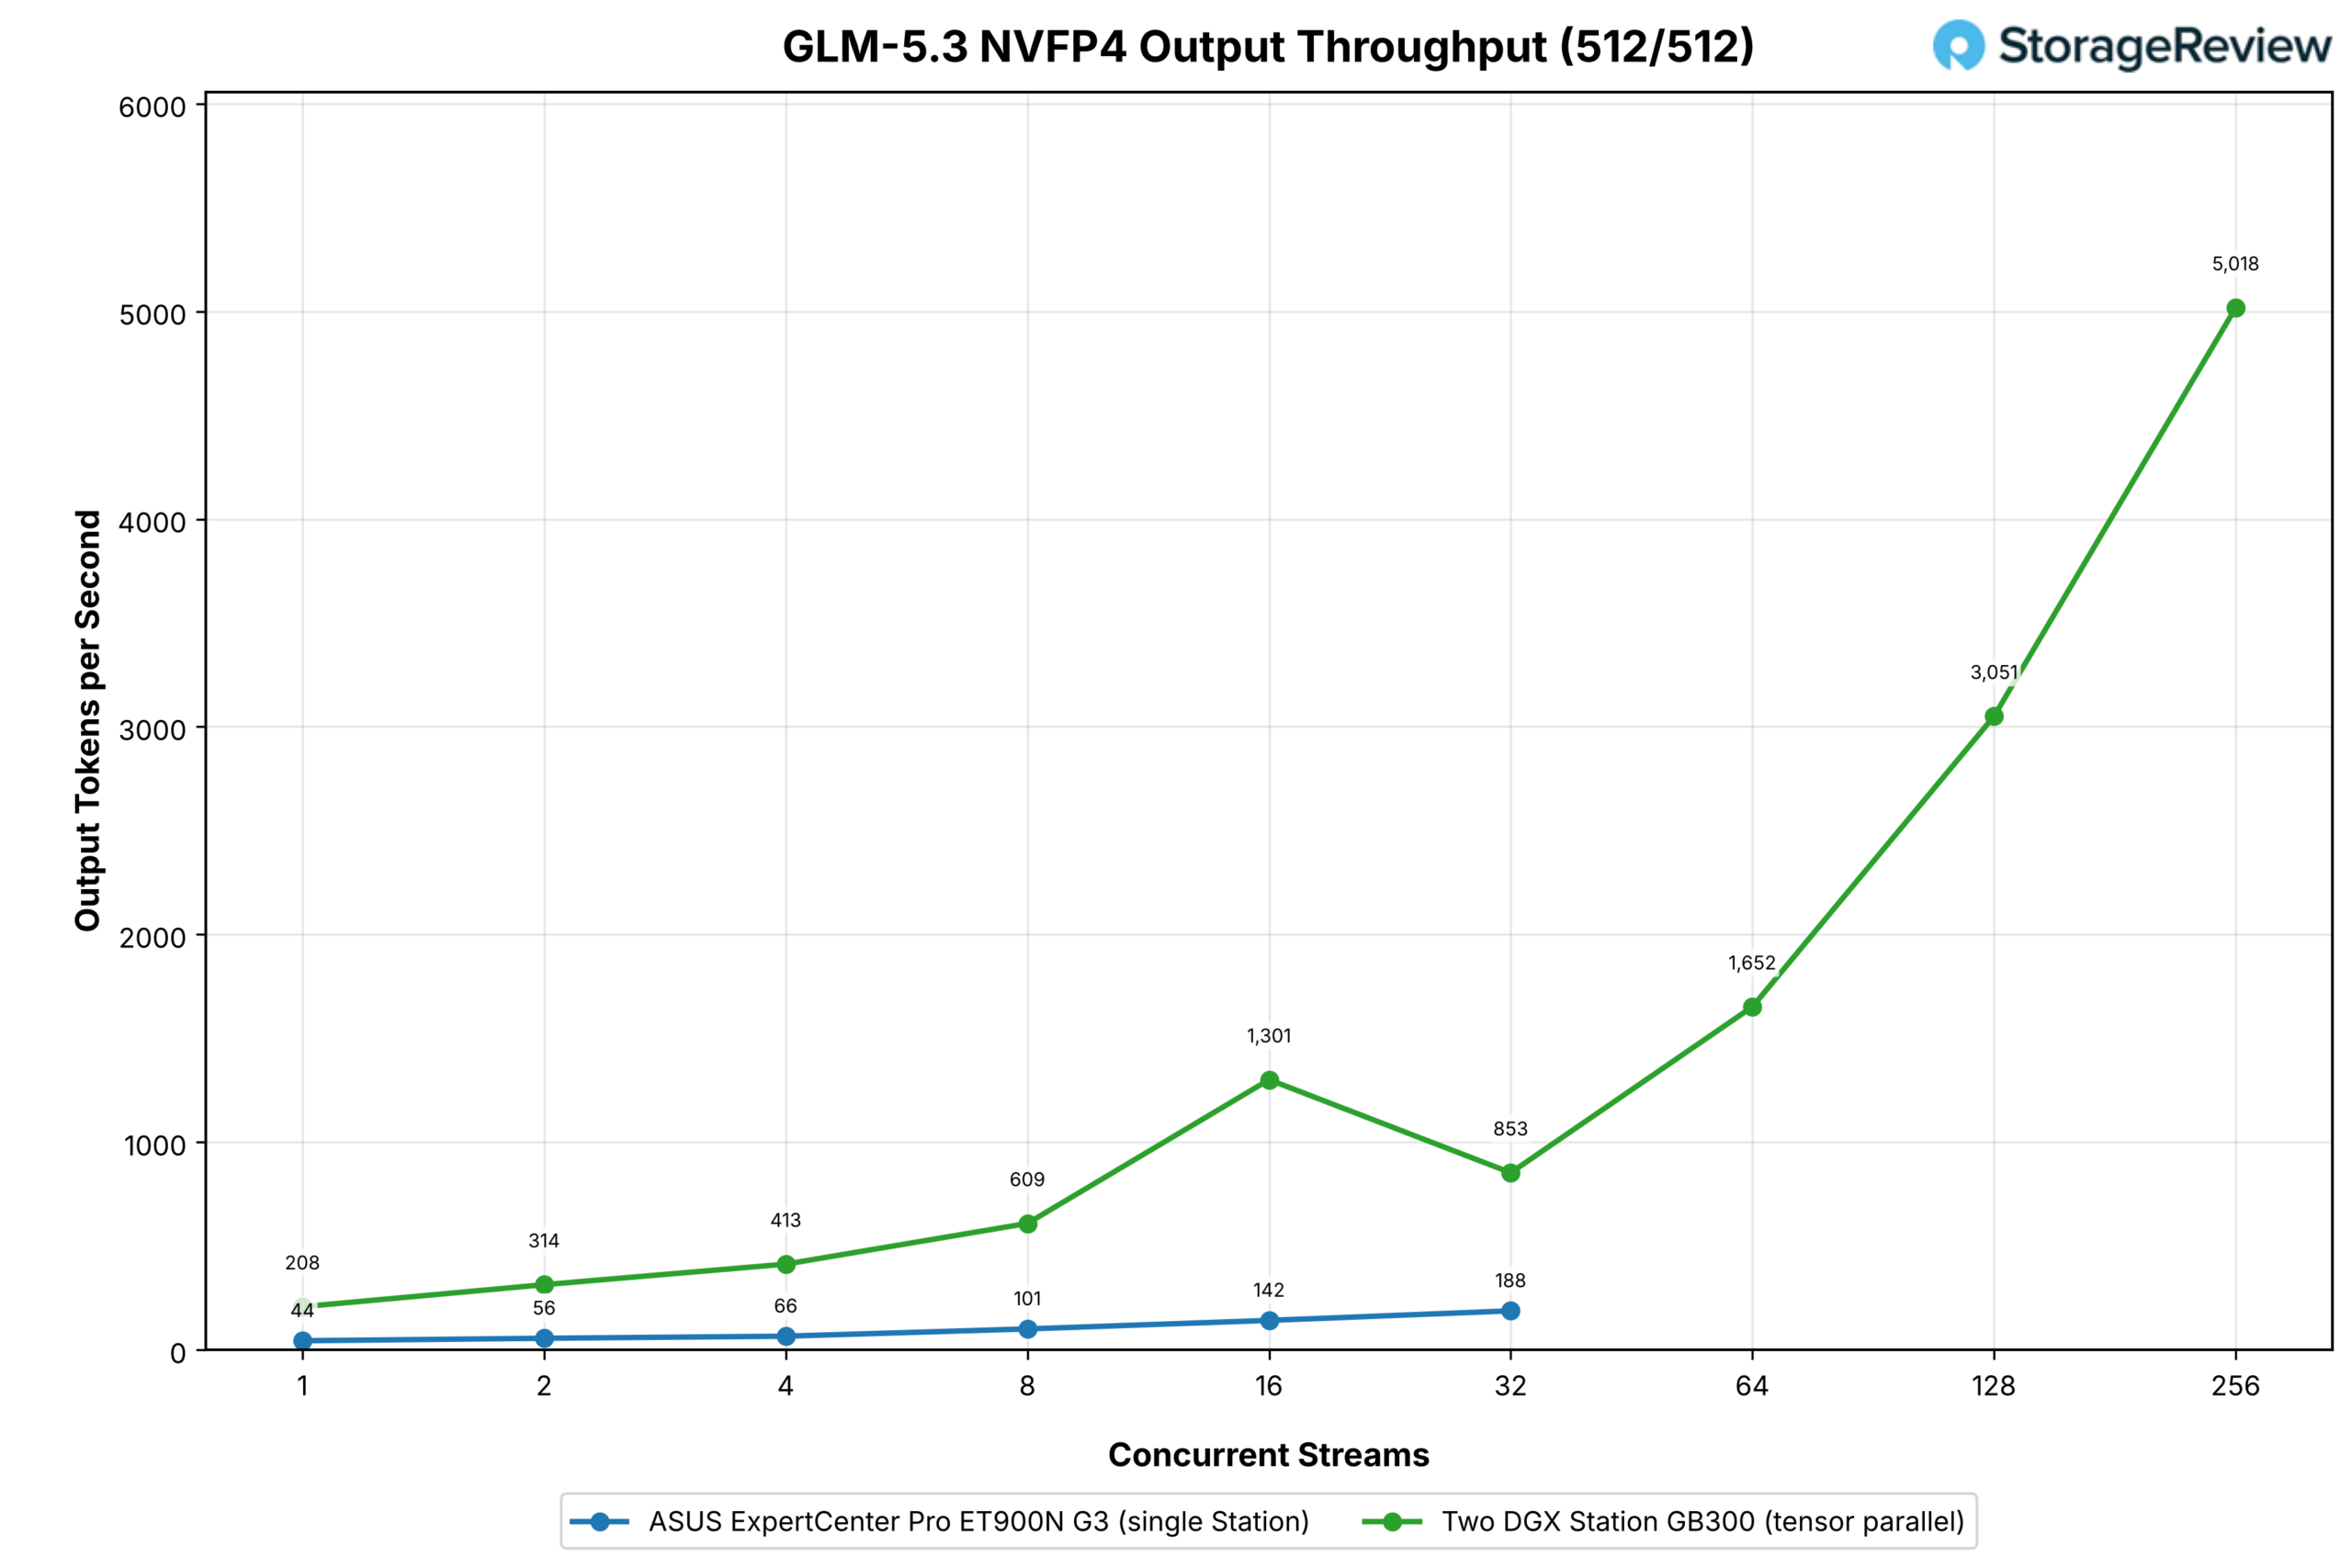
GLM-5.3 draaide in TP2 zonder Grace-offload. Op één station wordt 215 GB aan expertgewichten naar het Grace-geheugen overgeplaatst, en het clusterresultaat volgt GLM-5.2 gedurende het grootste deel van de sweep voordat het ongelijkmatig wordt. Eén station ging van 44 uitvoertokens per seconde bij één stream naar 188 bij 32 streams met dezelfde werklast.
Het cluster met twee stations draaide van 208 bij één stream naar 1,301 bij 16, tussen 4.7 en 9.2 keer zo snel als een enkele toren, daalde naar 853 bij 32, en begon vervolgens weer te stijgen naar 1,652 bij 64, 3,051 bij 128 en 5,018 bij 256. Het punt bij 32 streams is gebaseerd op de verzamelde data; beslissingen over batchverwerking en kernelselectie veranderen naarmate de gelijktijdigheid toeneemt, en een tensor-parallelle implementatie voegt een collective toe aan elke laag die voltooid moet zijn voordat de volgende stap kan worden uitgevoerd, dus de curve is geen rechte lijn, maar het plafond bij 256 streams is 27 keer zo snel als wat één station bereikte bij 32.
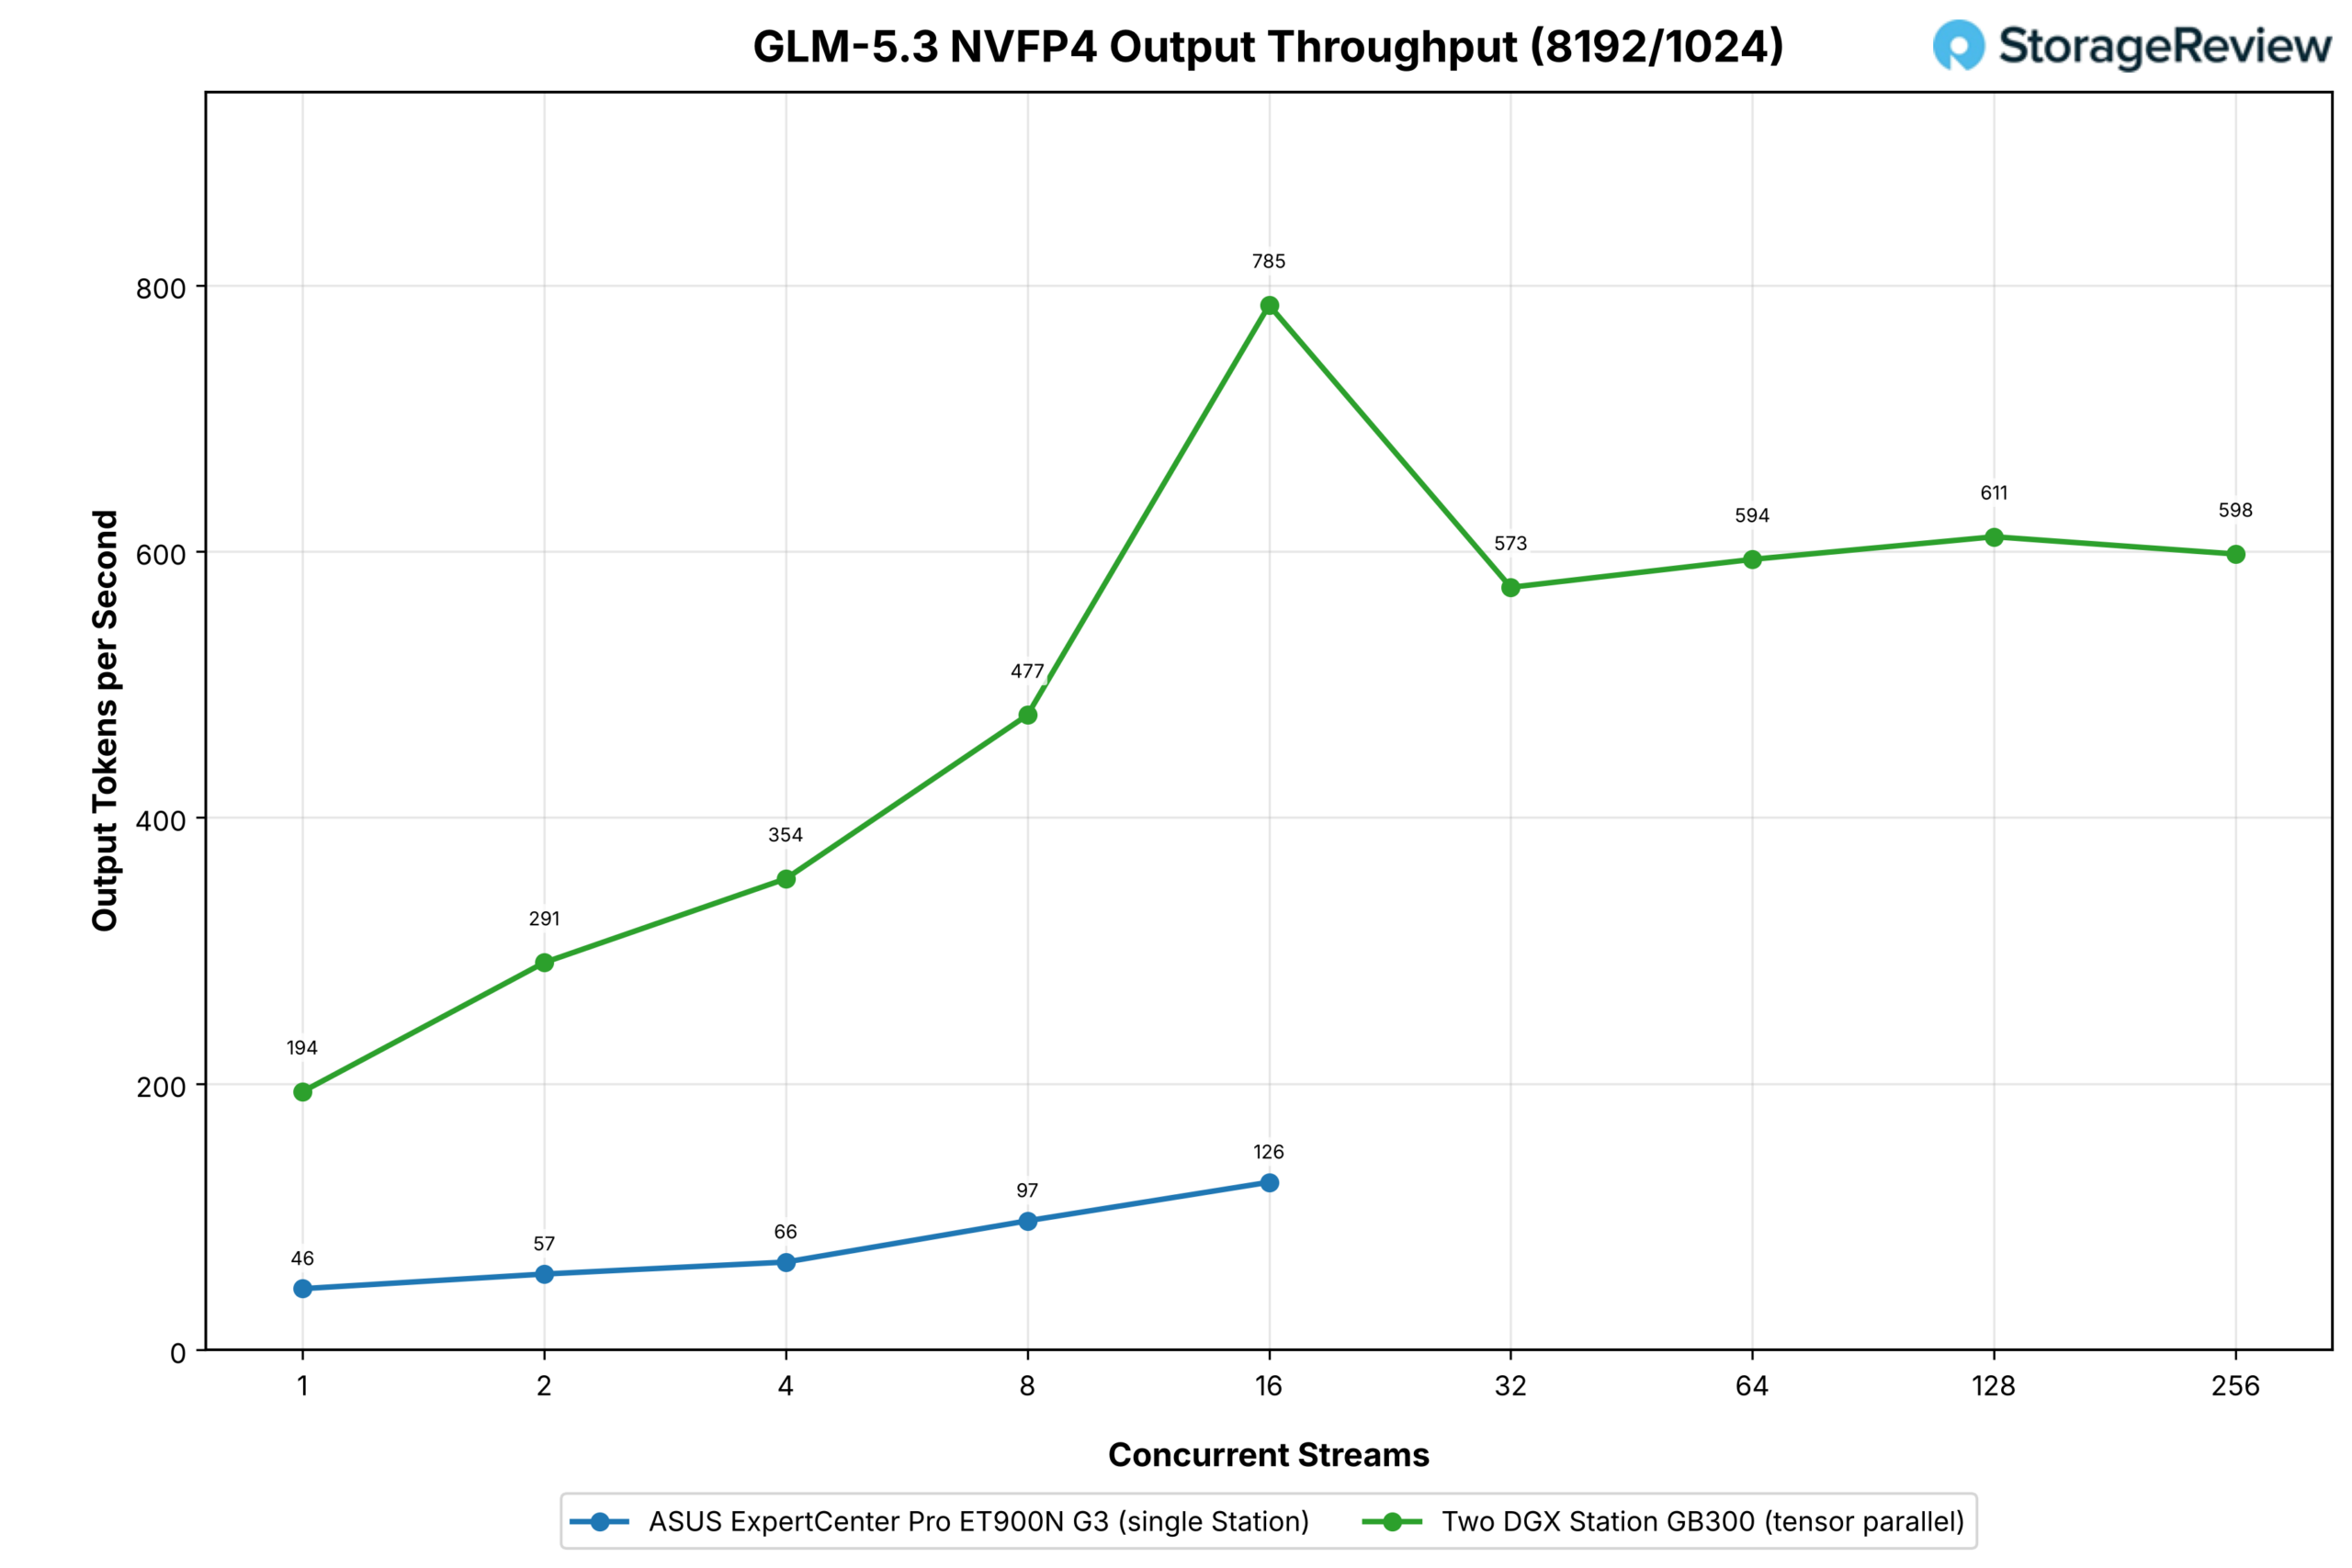
Op het profiel met veel prefill stopte het enkele Station bij 16 streams, zoals bedoeld: een offloaded model vlakt al snel af en er valt weinig te leren door de gelijktijdigheid verder op te voeren. Het steeg van 46 output tokens per seconde bij één stream naar 126 bij 16. Het cluster steeg van 194 naar 785 in hetzelfde bereik, een piek van 6.2x, en stabiliseerde zich vervolgens tussen 573 en 611 bij 32 tot en met 256 streams, een langzame piek van bijna 600 output tokens per seconde, wat nog steeds ongeveer vijf keer de beste prestatie van het enkele Station is.
GLM-5.3 Flash
De GLM-5.3 Flash is klein genoeg om op elk station een volledige kopie te bevatten, waardoor de verwerking gedistribueerd verliep: de ASUS verzorgde de prefill en de HP de decode. De Flash heeft een klein aantal actieve parameters, waardoor de verwerking op één station al snel verloopt: 353 uitvoertokens per seconde bij één stream en 828 bij 32 streams met dezelfde werklast, met een onregelmatige middenweg (858 bij vier streams, 489 bij acht) die we als verzameld rapporteren.
Bij het opgesplitste paar liep de gelijke werkbelasting op van 362 uitvoertokens per seconde bij één stream tot 2,721 bij 32 streams (3.3 keer zoveel als bij één toren) en verder tot 3,256 bij 256 streams.
Bij één en twee streams komt het paar vrijwel exact overeen met één station, wat te verwachten is wanneer het decodeerstation hetzelfde werk alleen doet; de winst treedt op wanneer er voldoende verzoeken in de lucht zijn om het voorvulstation bezig te houden en het decodeerstation te laten profiteren van het feit dat het nooit hoeft te pauzeren om voor te vullen.
Bij het profiel met veel prefill-taken steeg het aantal uitvoertokens per seconde van 344 bij één stream naar 1,216 bij 16 streams en bleef stabiel op 1,219 bij 32 streams, waarna het aantal tokens vanaf 16 streams constant bleef. Het prefill/decode-paar bleef stijgen, van 329 bij één stream naar 2,448 bij 32 streams, het dubbele van het aantal tokens bij het enkele station waar het was gestabiliseerd, en verder naar 3,042 bij 256 streams. Deze splitsing is ontworpen voor lange prompts, omdat het prefill-station de prompts van 8,192 tokens absorbeert, terwijl de KV-cache en de rekenkracht van het decode-station actief blijven.
GLM-5.2
GLM-5.2 draaide in TP2 zonder Grace-offload op het cluster, en dit model levert de sterkste argumenten voor een tweede Station. Het NVFP4-checkpoint is ongeveer 433 GB groot, dus op één GB300 bevindt zich ongeveer 215 GB aan expertgewichten in het Grace-geheugen, en elke decodeerstap die hiermee te maken heeft, gaat via NVLink-C2C naar LPDDR5X met een snelheid van 396 GB/s. Verdeeld over twee Stations bevat elke B300 ongeveer de helft van het model in HBM3e.
Bij een gelijke werkbelasting leverde de enkele ET900N G3 35 uitvoertokens per seconde op één stream en 139 op 32 streams. Het cluster met twee stations begon met 149 tokens per seconde op één stream, 4.3 keer zoveel als de enkele toren, bereikte 1,525 op 32 streams, 11 keer zoveel, en bleef stijgen tot 2,316 op 64 streams en 3,141 op 256 streams, met een daling tot 2,012 op 128 streams. Een model waarbij één station een gesprekssnelheid biedt voor een handvol gebruikers, kan met twee stations een hele afdeling bedienen.
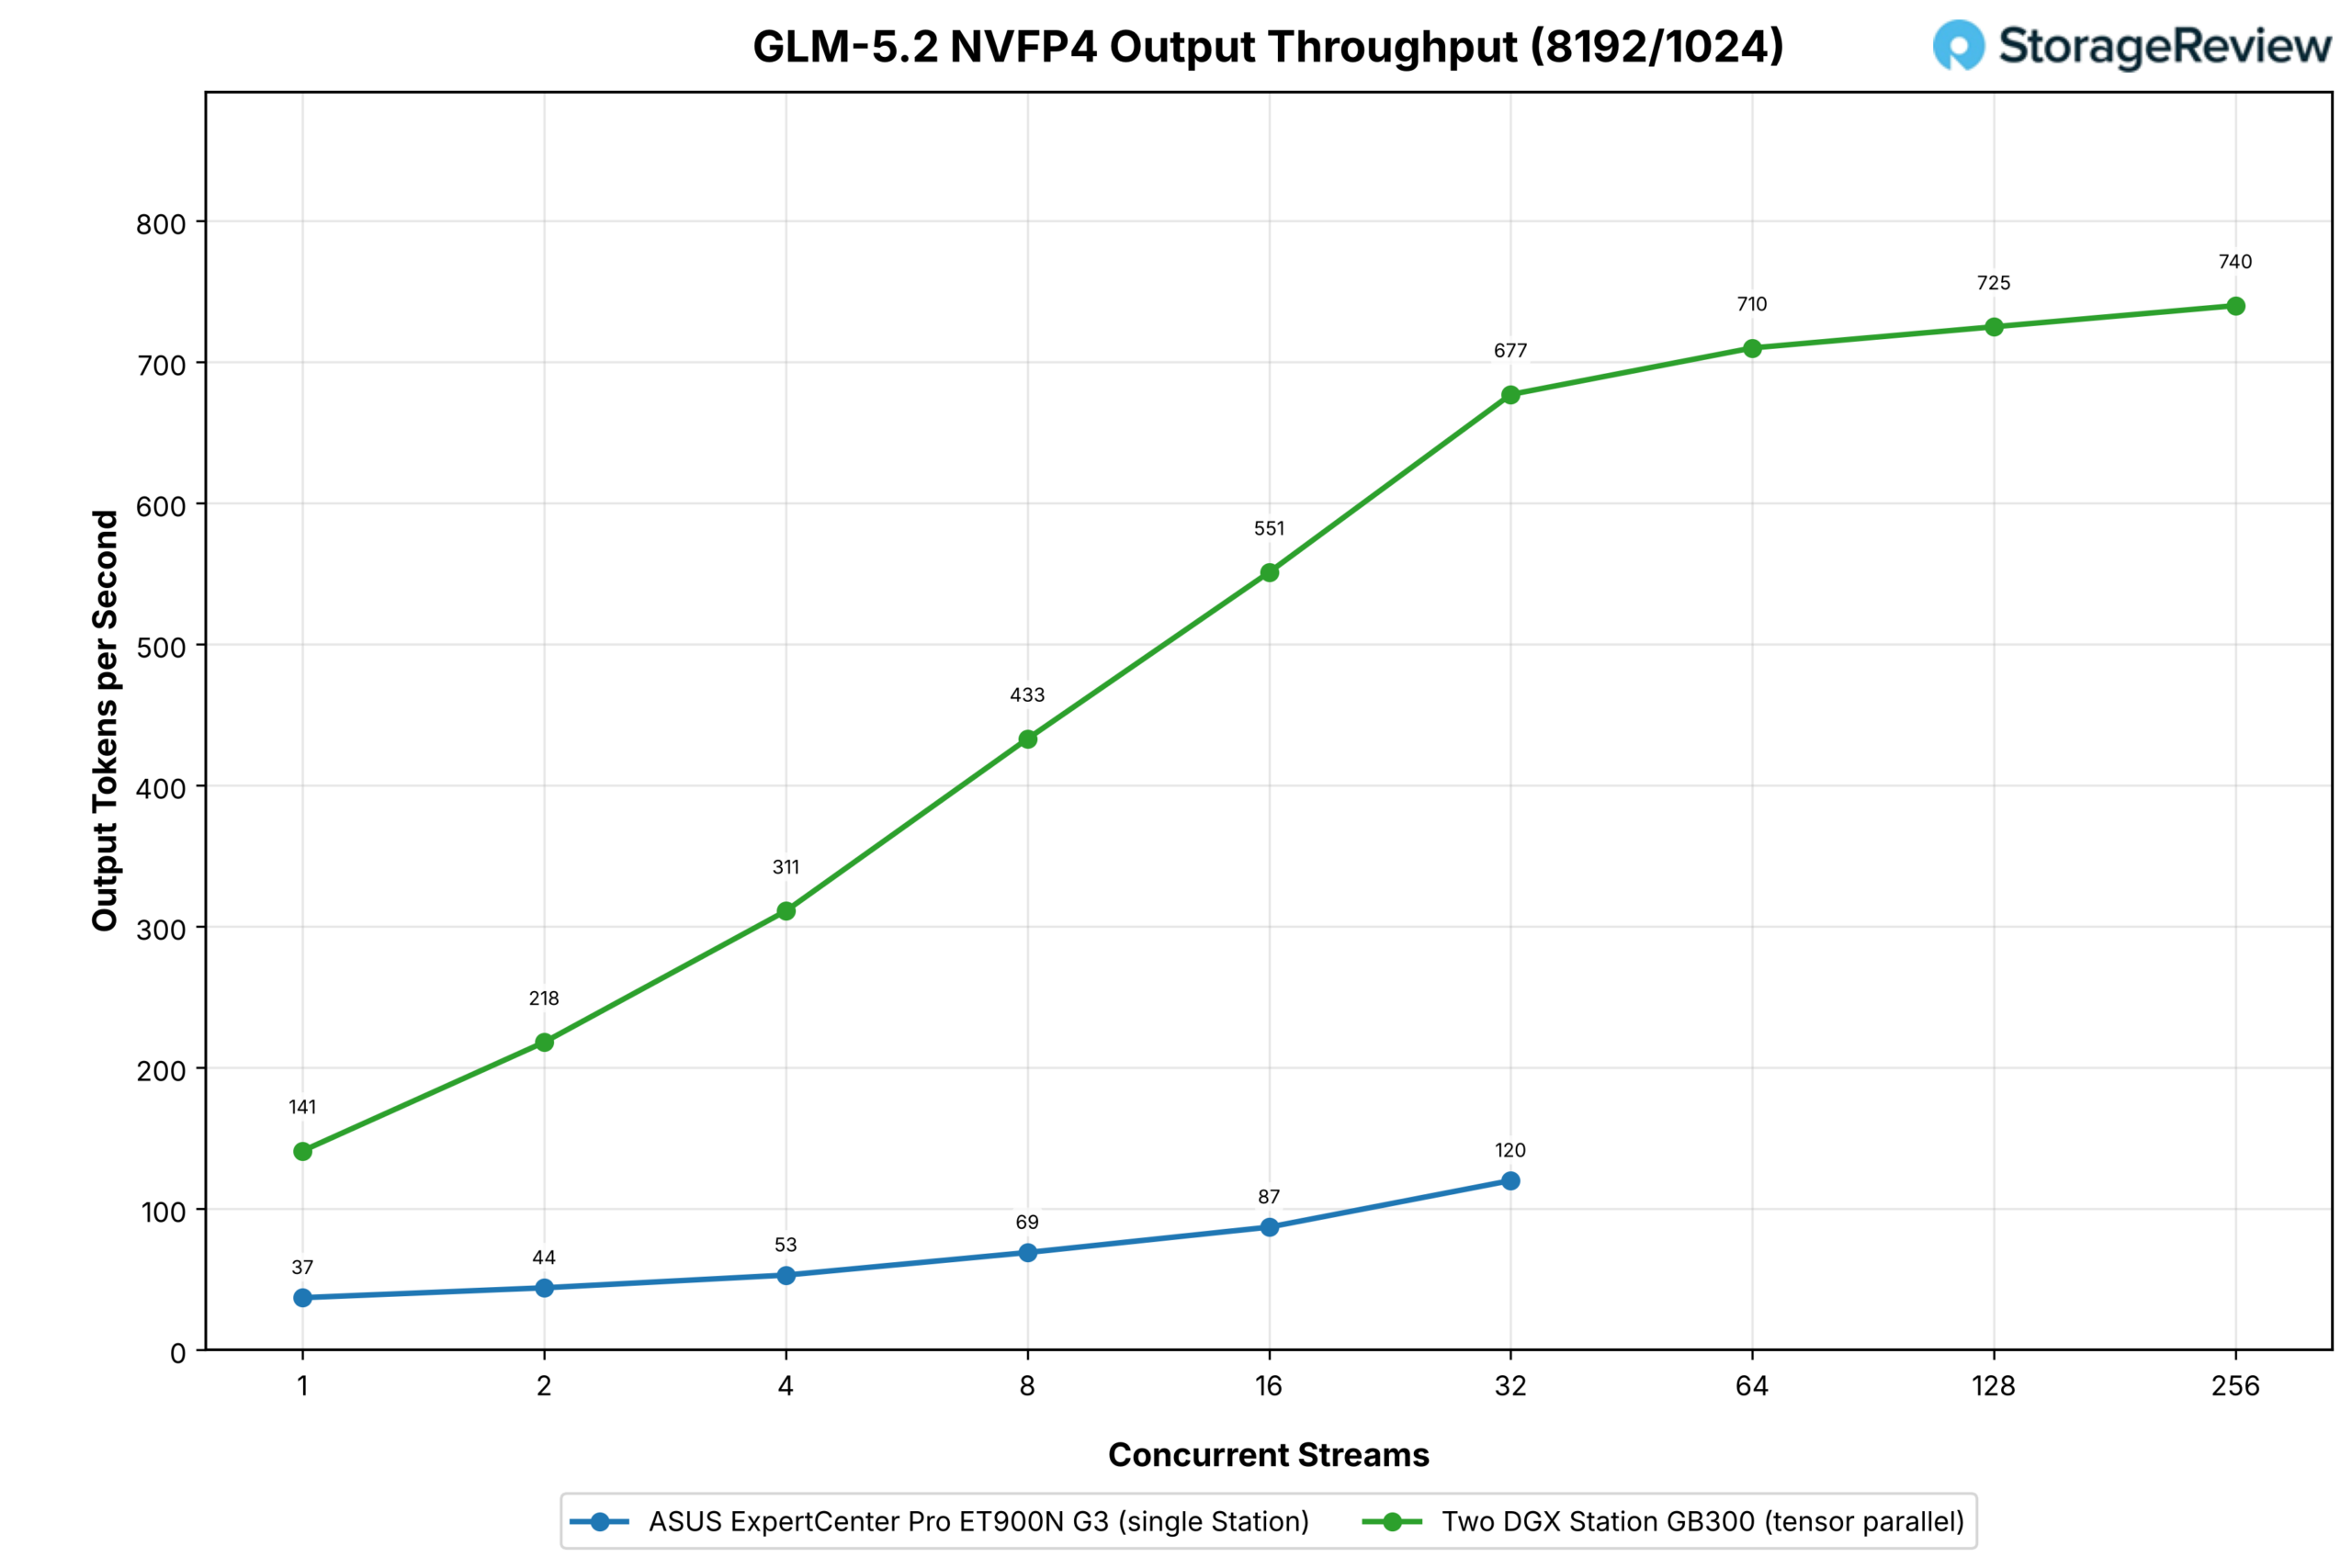
Het profiel met veel voorvulling vertelt hetzelfde verhaal op een lagere hoogte, waarbij één station van 37 uitvoertokens per seconde bij één stream naar 120 bij 32 streams gaat, en de cluster van 141 naar 677 over hetzelfde bereik, 3.8 keer zo snel aan de onderkant van de sweep en 5.6 keer zo snel aan de bovenkant, om vervolgens af te vlakken bij 710, 725 en 740 tot en met 256 streams.
Lange prompts leggen meer werk in de prefill, waar beide configuraties rekenintensief zijn. Daardoor is de offload-penalty die het tweede Station wegneemt een kleiner deel van het totaal dan bij korte prompts. De winst is bij beide profielen ruim meer dan 2x, omdat het tweede Station een 433GB-model uit LPDDR5X haalt en alles in HBM plaatst, en dat is hier belangrijker dan de rekenkracht van de tweede B300.
MiniMax-M3
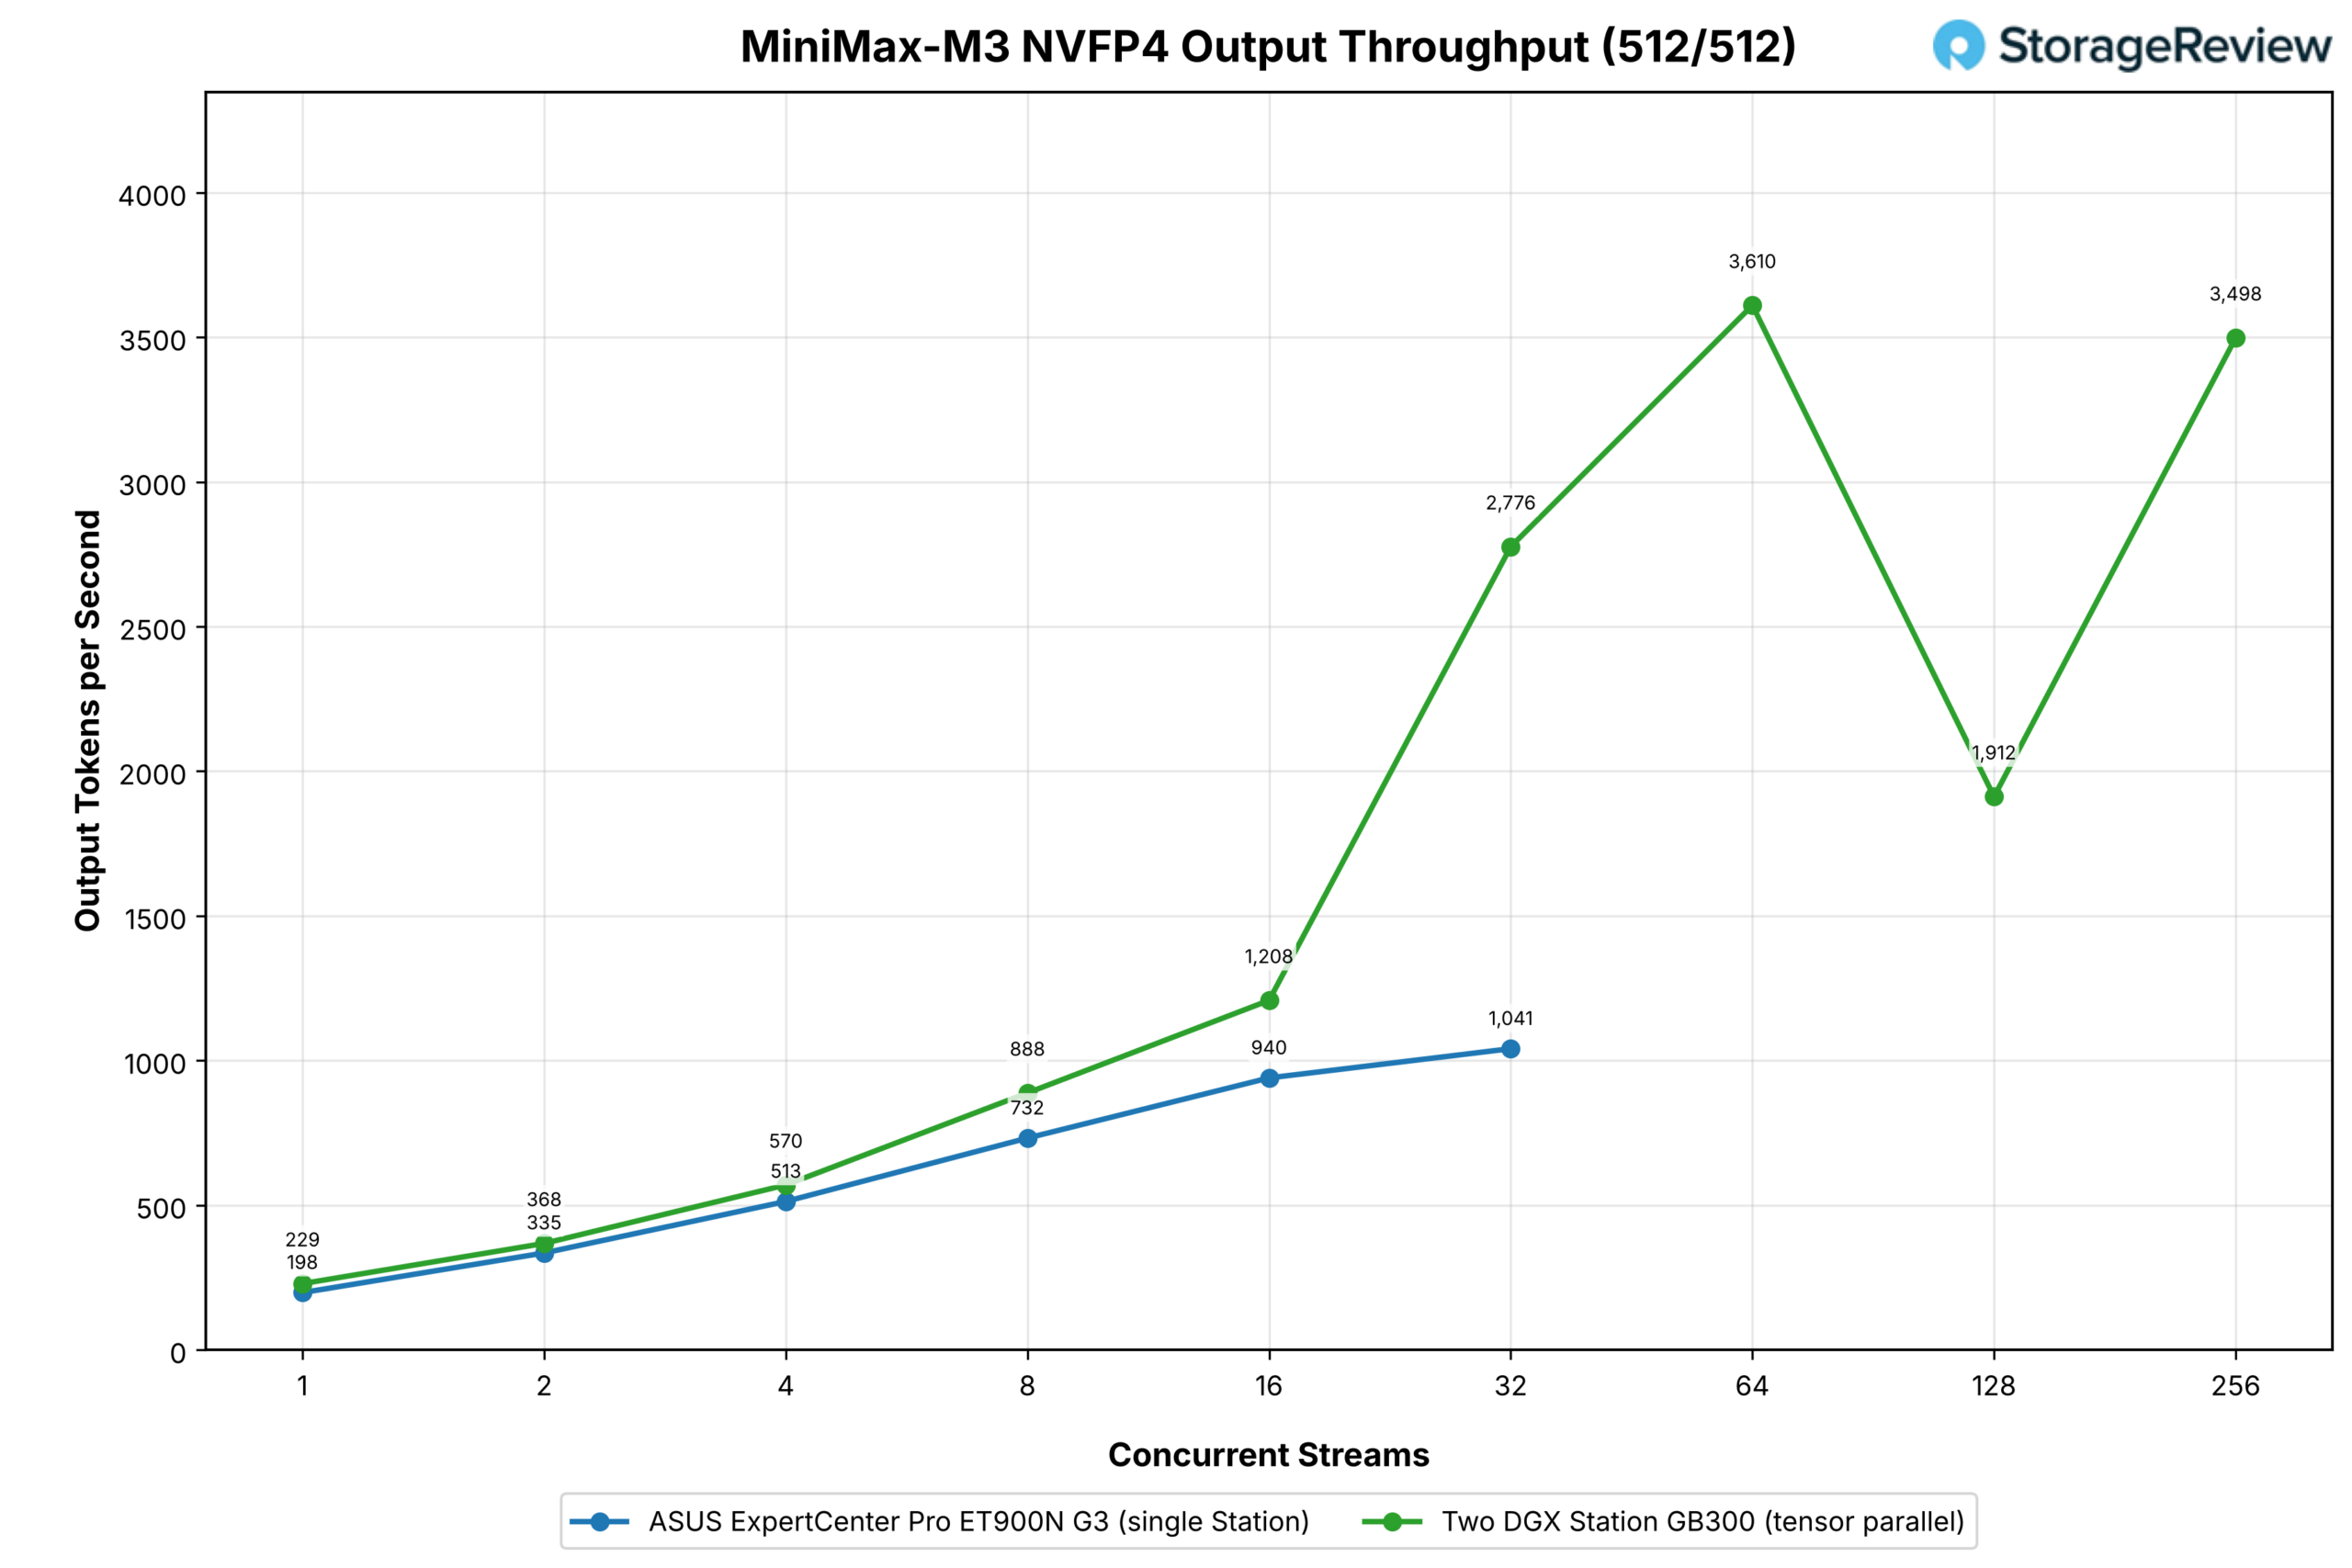
MiniMax-M3 draaide in TP2 zonder Grace-offload. Op één station bevindt het zich precies op de grens van HBM, met een deel van zijn expertise in Grace-geheugen, en in de ASUS-review behaalde het 1,041 uitvoertokens per seconde bij 32 streams met dezelfde werklast als EAGLE3.
Het cluster volgt het enkele station nauwlettend via 16 streams (1,208 tegen 940) en loopt vervolgens weg: 2,776 bij 32, 2.7x de enkele toren, 3,610 bij 64, een daling naar 1,912 bij 128, en 3,498 bij 256. Twee stations dragen hier minder bij dan bij GLM-5.2, omdat één station het grootste deel van dit model al in HBM bewaart. De bijdrage van de tweede GPU ligt daarom dichter bij de pure rekenkracht, met daarbovenop de extra capaciteit van de KV-cache.
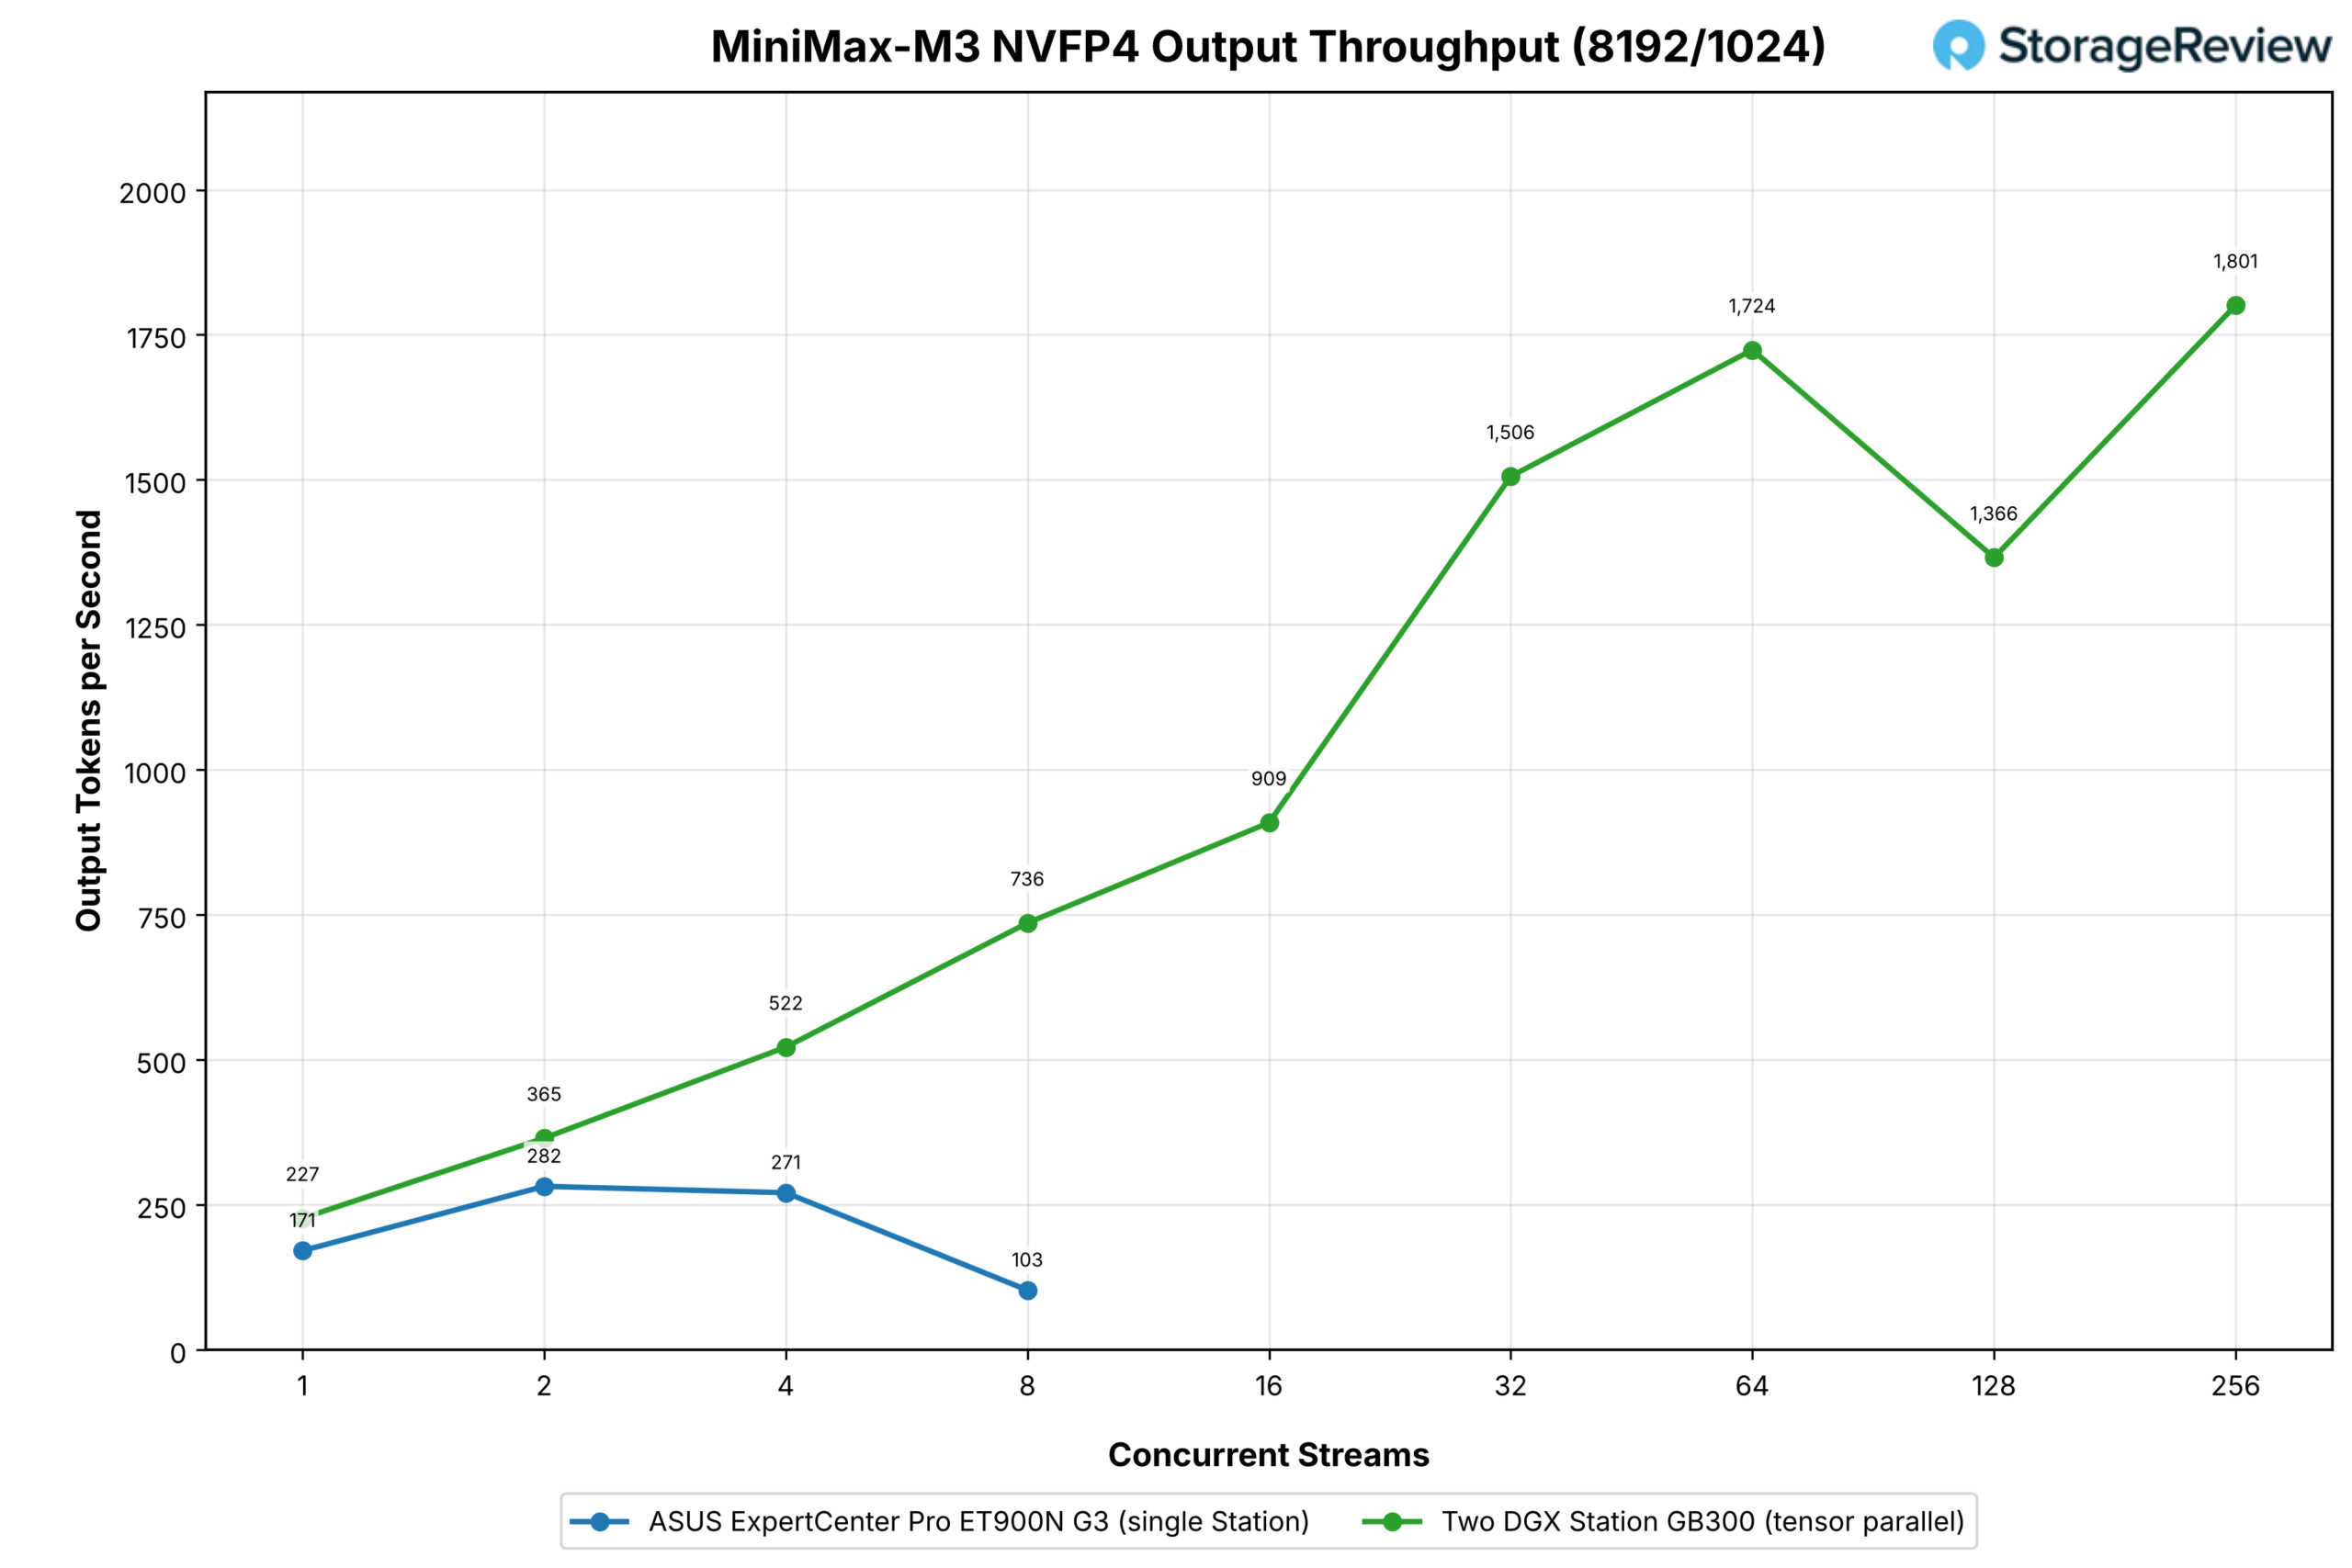
Het profiel met veel vooraf ingevulde tokens zorgde ervoor dat MiniMax-M3 op één station geen ruimte meer had: prompts van 8,192 tokens verbruikten de resterende KV-cache snel, waardoor de enkele toren een piek bereikte van 282 uitvoertokens per seconde bij twee streams, 271 bij vier streams en daalde naar 103 bij acht streams, waar de meting werd beëindigd omdat er niets meer te meten viel.
Met het model verdeeld over twee stations werden dezelfde waarden van 365, 522 en 736 gemeten. Dit betekende een winst van 30% bij twee streams, waar beide configuraties nog cachegeheugen over hadden, en een winst van 7.1x bij acht streams, waar één stream geen cachegeheugen meer had. De cluster behaalde vervolgens waarden van 909 bij 16, 1,506 bij 32, 1,724 bij 64, 1,366 bij 128 en 1,801 bij 256, een bereik dat het enkele station met dit profiel helemaal niet kan bereiken.
Conclusie
Twee GB300 DGX-stations die via hun eigen ConnectX-8-poorten met elkaar zijn verbonden, doen precies wat de documentatie van NVIDIA voorschrijft; de installatie verliep probleemloos en dit zijn de eerste doorvoergegevens die we voor deze configuratie met twee systemen hebben gezien.
Het tweede station bewijst zijn waarde op de modellen die de 252 GB HBM3e-geheugenlimiet overschrijden: GLM-5.2 gaat van 139 uitvoertokens per seconde bij 32 streams op één station naar 1,525 op twee, en verder naar 3,141 bij 256 streams, omdat de splitsing een model van 433 GB uit het LPDDR5X-geheugen haalt; GLM-5.3 bereikt 5,018 bij 256 streams, terwijl het maximum op één station 188 is; MiniMax-M3 gaat bij lange prompts van een toren die vertraagt bij acht streams naar een paar dat nog steeds stijgt bij 256.
Bij de twee modellen die in één station passen, de GLM-5.3 Flash en de DeepSeek V4.1 Flash, is de beste manier om de tweede box te gebruiken, elk station een volledige kopie te geven, het voorvullen en decoderen te scheiden en de decodeerworker zonder pauze te laten genereren; op de GLM-5.3 Flash verdubbelde dit de doorvoer bij lange prompts tot 32 streams en verdrievoudigde de doorvoer bij korte prompts, terwijl de DeepSeek V4.1 Flash de hoogste uitvoerdoorvoer in de set behaalde met 5,248 tokens per seconde.
Onze mening over het product is niet veranderd sinds de review van de MSI XpertStation WS300 : dit is een interessante machine voor een specifieke markt, en als je er een nodig hebt, heb je er misschien nog wel een nodig.
De beste manier om ze te gebruiken is als een flexibele infrastructuur: een pool waarop een team werk plant en die ze opnieuw indeelt naarmate projecten veranderen. NVIDIA heeft de onderdelen in huis om dat mogelijk te maken. Het bedrijf kocht Run:ai voor de planning, Brev voor ontwikkelomgevingen en Lepton voor een marktplaats voor rekenkracht. Elk van deze drie, in combinatie met een rack met Stations, zou het product aantrekkelijker maken, mits je er toegang toe hebt.
De configuratie met twee apparaten schaalde goed; de beste winst die we maten was GLM-5.3, van 188 uitvoertokens per seconde op één station naar 5,018 over het paar (een winst van 27x), en bij gelijke gelijktijdigheid leverde GLM-5.2 een winst van 11x op bij 32 streams, beide op modellen die een enkel station alleen kan verwerken door gewichten naar het Grace-geheugen te schrijven. Dat is een resultaat van GB300 over 2x 400G, en het maakt ons nieuwsgierig hoe een Vera Rubin Station eruit zal zien wanneer NVIDIA er een op de markt brengt, met de volgende generatie HBM en NVLink-C2C.
De toepassing hiervan is onveranderd gebleven: twee werkstations op een bureau, zonder rack of datacenter erachter, voldoen nu aan de eisen die voorheen een GPU-server en de bijbehorende faciliteiten rechtvaardigden. Zo heeft een team dat geen plek in het datacenter kan krijgen, of daar niet op wil wachten, een alternatieve route naar geavanceerde inferentie direct naast zich. NVIDIA heeft de lat hoog gelegd voor deze categorie, ongeacht de prijs. De GB300-klasse staat hoog genoteerd in onze ranglijst van beste desktops voor lokale AI , waar deze clusterdata de keuze nu ondersteunen.



 Amazon