

Advancing AI 2026 było jak dotąd największym wydarzeniem AMD z okazji premiery, na tyle dużym, że podzieliliśmy naszą relację na dwie części. W pierwszym artykule omówiliśmy Instinct MI455X i 72-GPU Helios rack; w tym siostrzanym artykule omówiliśmy to, co nie mogło się z nimi zmieścić: serwerowe procesory EPYC 6. generacji o nazwie kodowej Venice oraz procesor hosta Verano. Procesor zasługuje na osobny nagłówek. Venice oferuje do 256 rdzeni i 512 wątków na gniazdo, przepustowość pamięci 1.6 TB/s, pierwsze złącze PCIe Gen 6 w procesorze serwerowym i 18-krotnie większą przepustowość niż procesory EPYC pierwszej generacji z 2017 roku.
Venice to nie tylko chip. To portfolio, o czym AMD powtarzało na każdej sesji: jeden profil procesora nie pasuje do wszystkich. Ta sama generacja Zen 6 składa się z części o większej gęstości, części klasy enterprise, części HPC ze stosem pamięci podręcznej oraz niskonapięciowego hosta LPDDR. Zanim jednak przejdziemy do prędkości i częstotliwości transmisji, przyjrzyjmy się ofercie.
Skład Venice i Verano
AMD dzieli nowoczesne centra danych na trzy klasy serwerów, a portfolio jest zaprojektowane tak, aby obsłużyć wszystkie z nich. Serwery CPU ogólnego przeznaczenia obsługują bramy sieciowe, pamięci podręczne, warstwy aplikacji, bazy danych i pamięć masową, od których zależy cała reszta. Serwery GPU potrzebują procesora hosta, który zasila akceleratory – w tym zadaniu liczy się prędkość pojedynczego wątku i przepustowość wejścia/wyjścia, a nie rdzenie. Trzecią klasę stanowią gęste serwery CPU przeznaczone do obsługi kodu orkiestracji i wykonywania narzędzi, który powstał wokół usług AI; ten kod jest obciążony gałęziami, podatny na przestoje i wymaga przede wszystkim wątków.
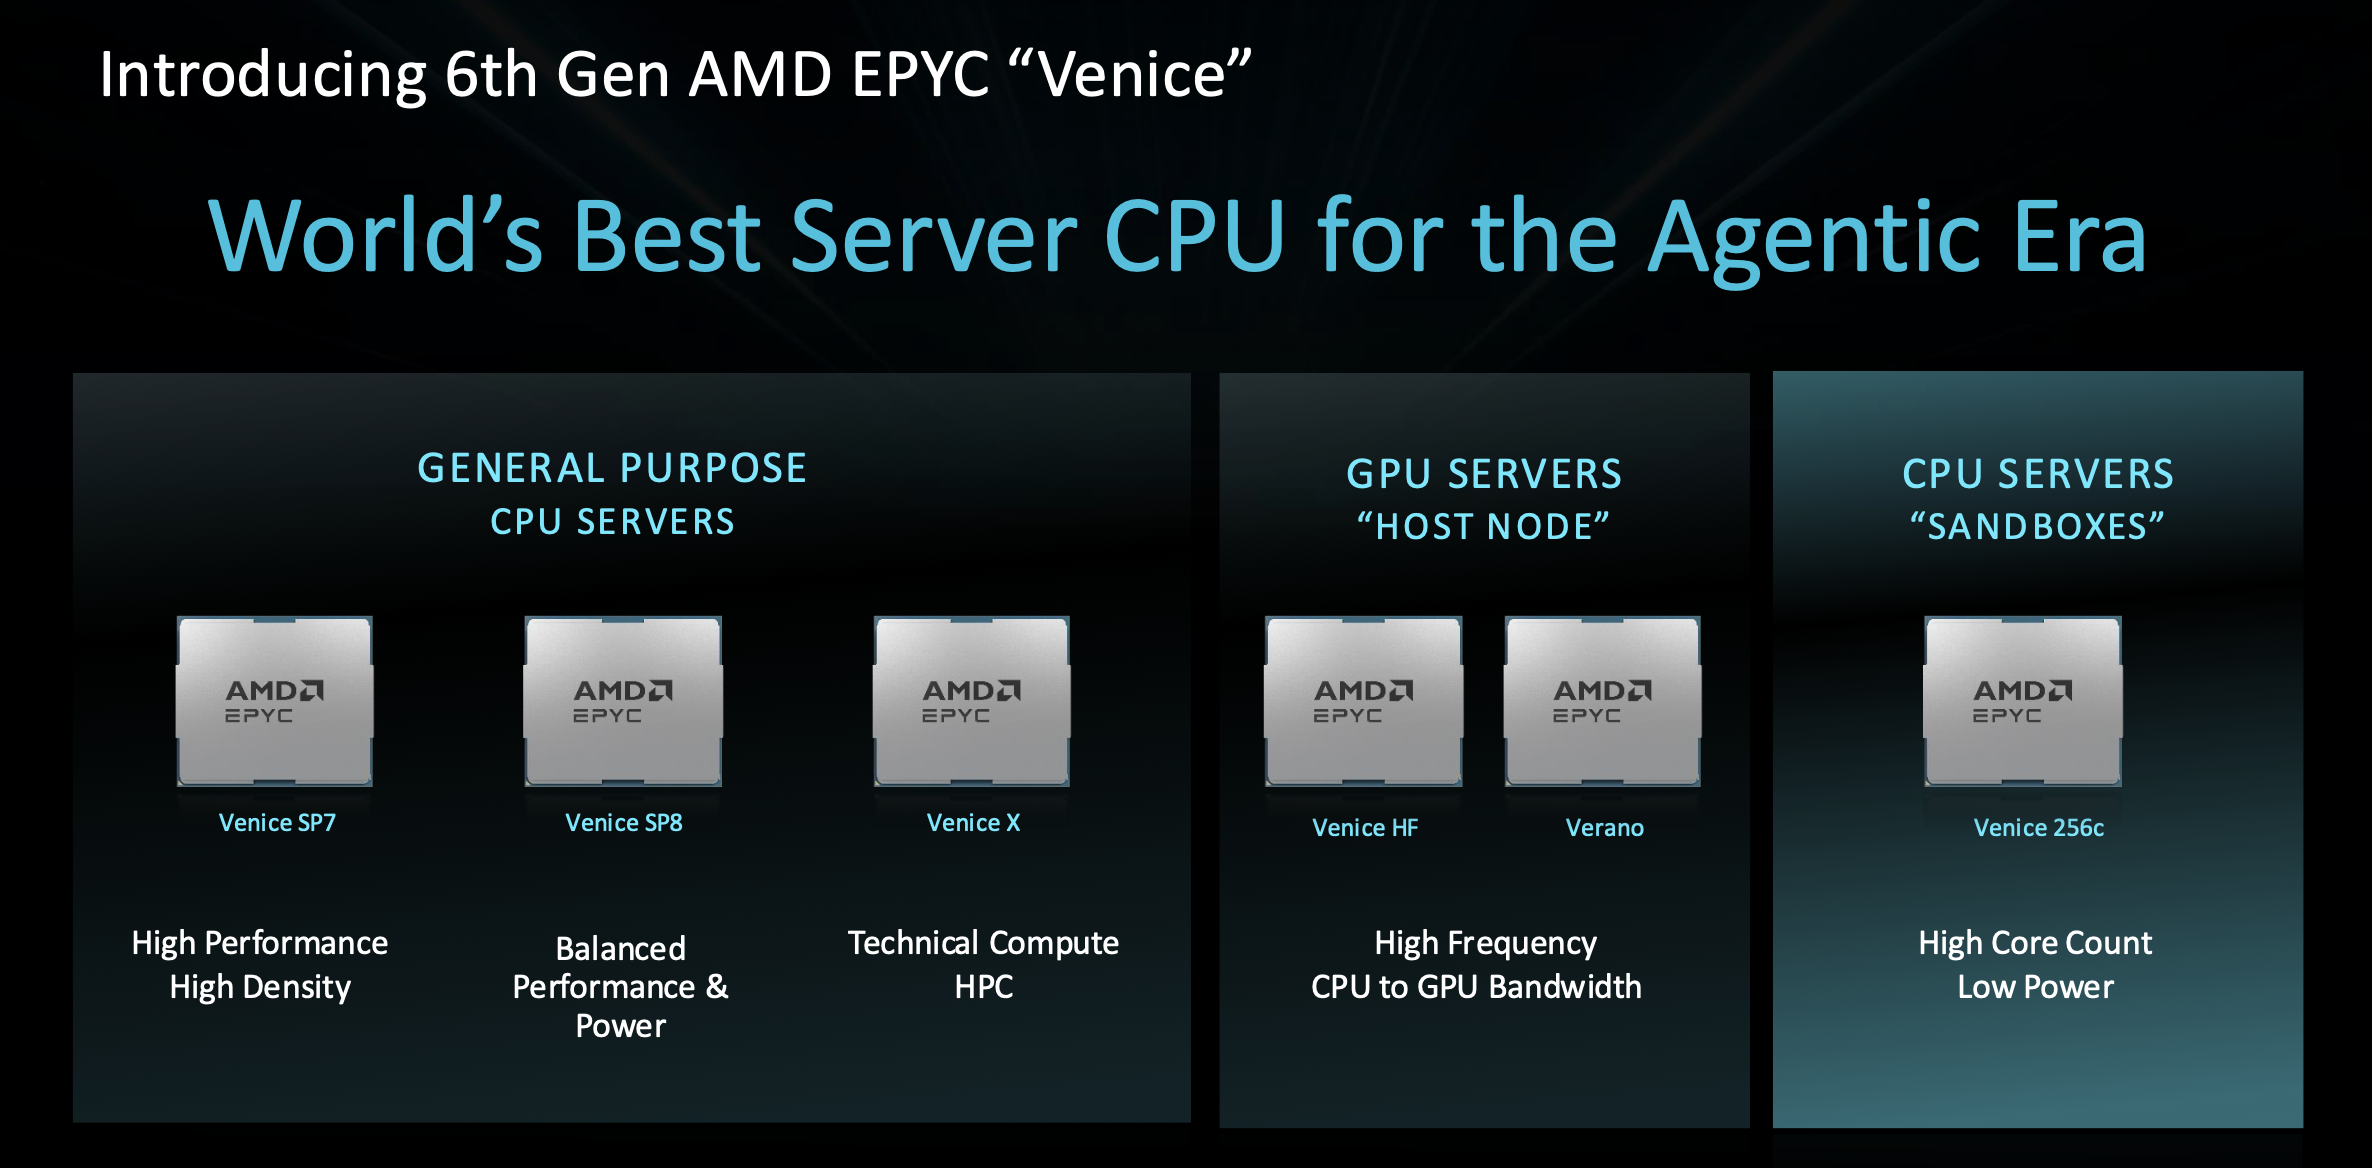
Linia składa się z czterech produktów, a platformy pojawiają się falami: Venice SP7 w czwartym kwartale 2026 r., Venice SP8 w pierwszej połowie 2027 r., a Venice-X i Verano w drugiej połowie. AMD dzieli ten sam krzem na sześć sposobów, a drobniejsze cięcie mapuje bezpośrednio na trzy warstwy. Ogólnego przeznaczenia otrzymuje Venice SP7, SP8 i Venice-X. Pojemnik hosta łączy wysokoczęstotliwościowy kosz Venice z Verano i jego pamięcią LPDDR. Gęste obliczenia otrzymują to, co deck oznacza Venice 256c: dużą liczbę rdzeni przy niskim poborze mocy, zbudowany tak, aby upchać tyle wątków do stojaka, ile pozwala budżet mocy. Verano również świeci: AMD twierdzi, że wybrani klienci wdrożą go jako procesor ogólnego przeznaczenia wszędzie tam, gdzie wydajność na wat systemu jest wiążącym ograniczeniem.
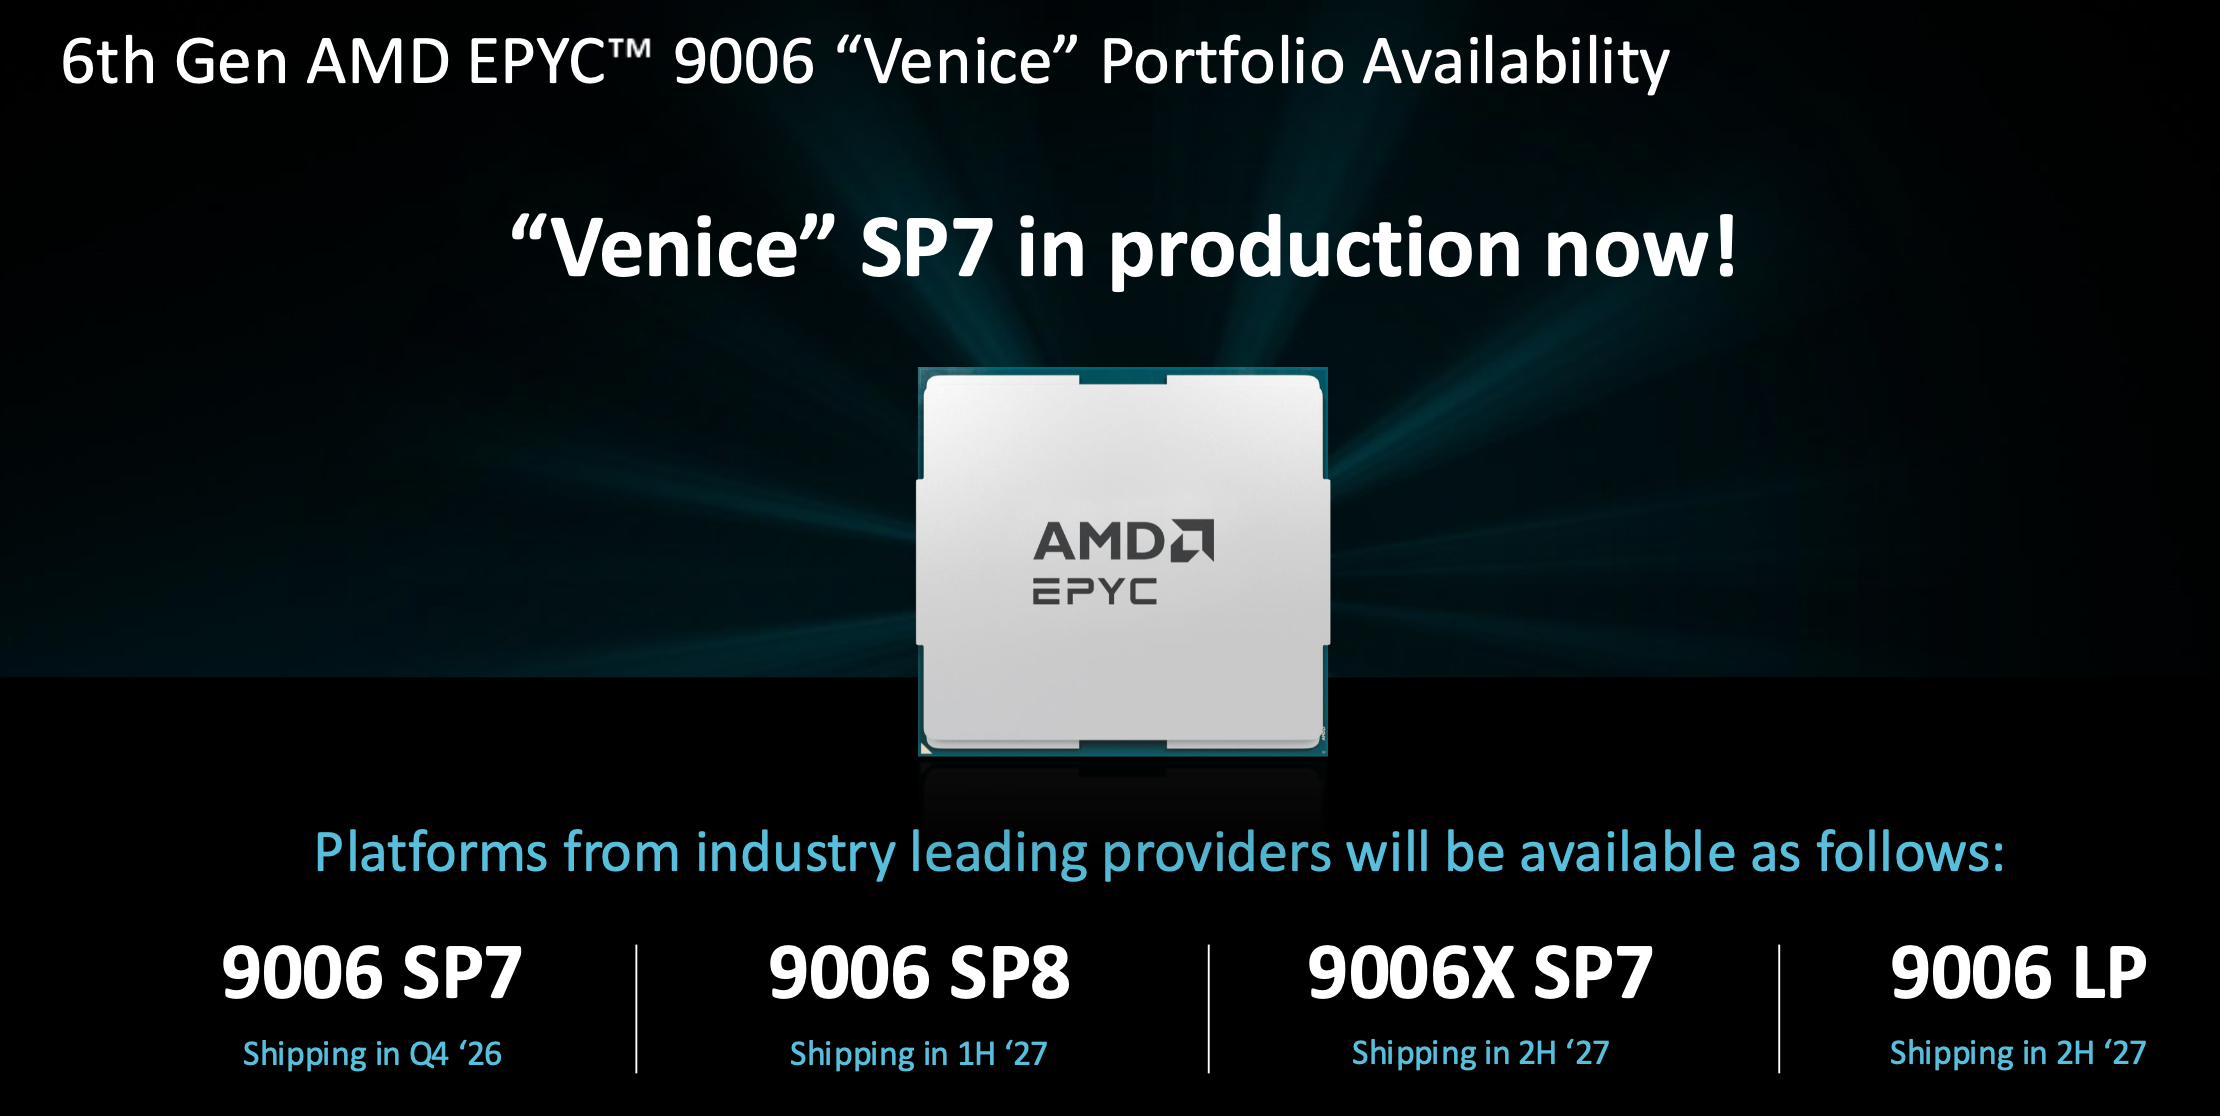
Dzięki przypisom możemy rzucić okiem na jednostki SKU. 256-rdzeniowy procesor EPYC 9996 jest liderem stosu, 9956 ma te same rdzenie o mocy 400 W, a 96-rdzeniowy 9686F to procesor hosta o wysokiej częstotliwości. Helios ma własną wersję tego procesora hosta, EPYC 9G76, w każdej obudowie komputera.
Poziom bez kompromisów
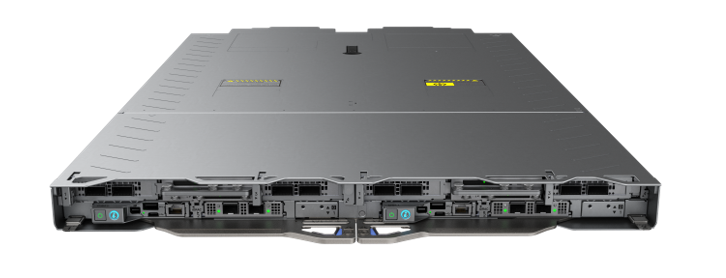
Zanim przejdziemy do tabel specyfikacji, kilka słów o tym, gdzie trafi duże gniazdo. Venice SP7 jest zarezerwowany dla najwyższej, bezkompromisowej klasy wydajności AMD: wdrożeń w centrach danych, systemach hiperskalerskich i systemach obliczeniowych HPC, gdzie przepustowość na szafę jest decydującym czynnikiem, bez szczędzenia kosztów. Dostawcy serwerów już teraz dostosowują się do niego. Dell rozdzielił swój długoletni schemat nazewnictwa PowerEdge, aby zrobić miejsce, a ta klasa mocy obliczeniowej znajduje się teraz w nowej serii 9000, na czele z PowerEdge R9825 i Rack Scale M9825 – flagowymi modelami z dwoma układami Venice w obudowie 3U.
Specyfikacje nagłówka
Cała rodzina buduje na jednej platformie, a niemal każdy jej zakątek jest nowy od czasów Turynu.
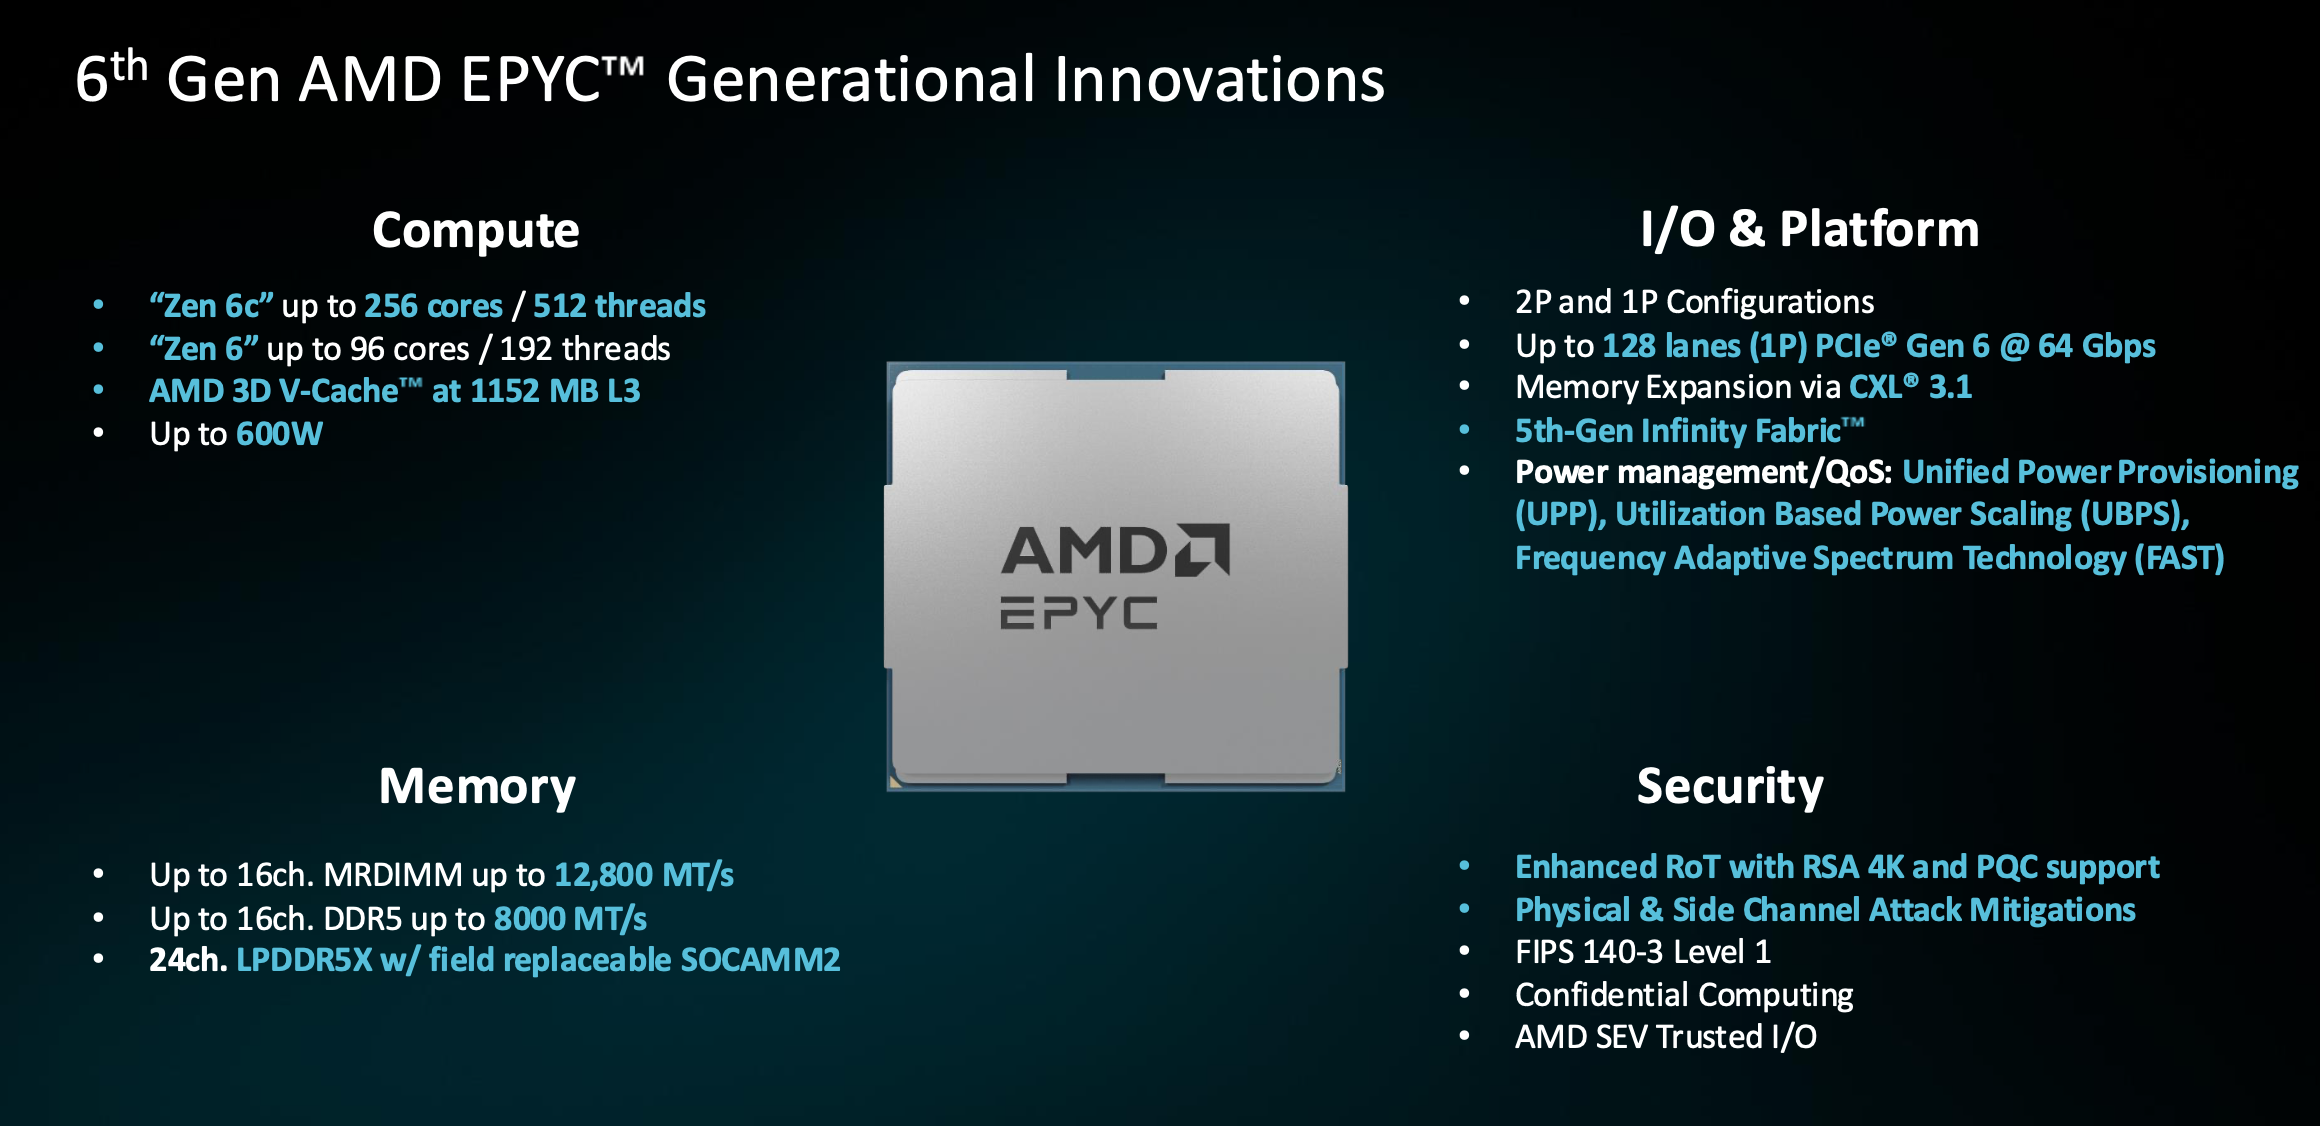
Zacznijmy od rdzeni. Zen 6 jest dostępny w dwóch wersjach: kompaktowy Zen 6c oferuje 256 rdzeni i 512 wątków w gnieździe o mocy do 600 W, podczas gdy standardowy rdzeń zatrzymuje się na 96, ale taktowany jest do 5 GHz. AMD deklaruje ponad 20% wyższą wydajność na rdzeń niż konkurencyjne układy przy tej samej liczbie rdzeni, a gęstość nie zmniejsza pamięci podręcznej: nawet 256-rdzeniowy rdzeń przechowuje około 4 MB pamięci L3 na rdzeń, co w przypadku flagowca stanowi pełny gigabajt. AVX-512 obsługuje tokenizery i modele o 3–8 miliardach parametrów, które coraz częściej działają na samym procesorze.
Zasilanie tych rdzeni wymaga znacznie większego systemu pamięci: 16 kanałów DDR5 o przepustowości 8,000 MT/s lub MRDIMM o przepustowości 12 800, co daje 1.6 TB/s na gniazdo, podczas gdy Turin osiągnął 614 GB/s z 12 kanałów. I/O wykonuje ten sam skok. Venice to pierwszy procesor serwerowy z PCIe Gen 6, 128 liniami o przepustowości 64 GT/s, co stanowi dwukrotnie większą przepustowość na linię niż w przypadku innych procesorów podłączanych obecnie do akceleratorów i stanowi podstawę twierdzenia o relacji host-węzeł, które omówimy później. CXL 3.1 wykorzystuje te linie do rozbudowy pamięci, a wybrane dwugniazdowe platformy hostów AI wymieniają międzygniazdową szerokość xGMI, aby I/O osiągnęło 160 użytecznych linii. Dwa mniej wymagające rozwiązania przenoszą dane bez wykorzystywania rdzeni: SDXI odciąża pamięć podręczną i 30–50 rdzeni zajmujących się szyfrowaniem, a Smart Data Cache Injection umieszcza pakiety sieciowe bezpośrednio w pamięci podręcznej zamiast kierować je przez pamięć DRAM.
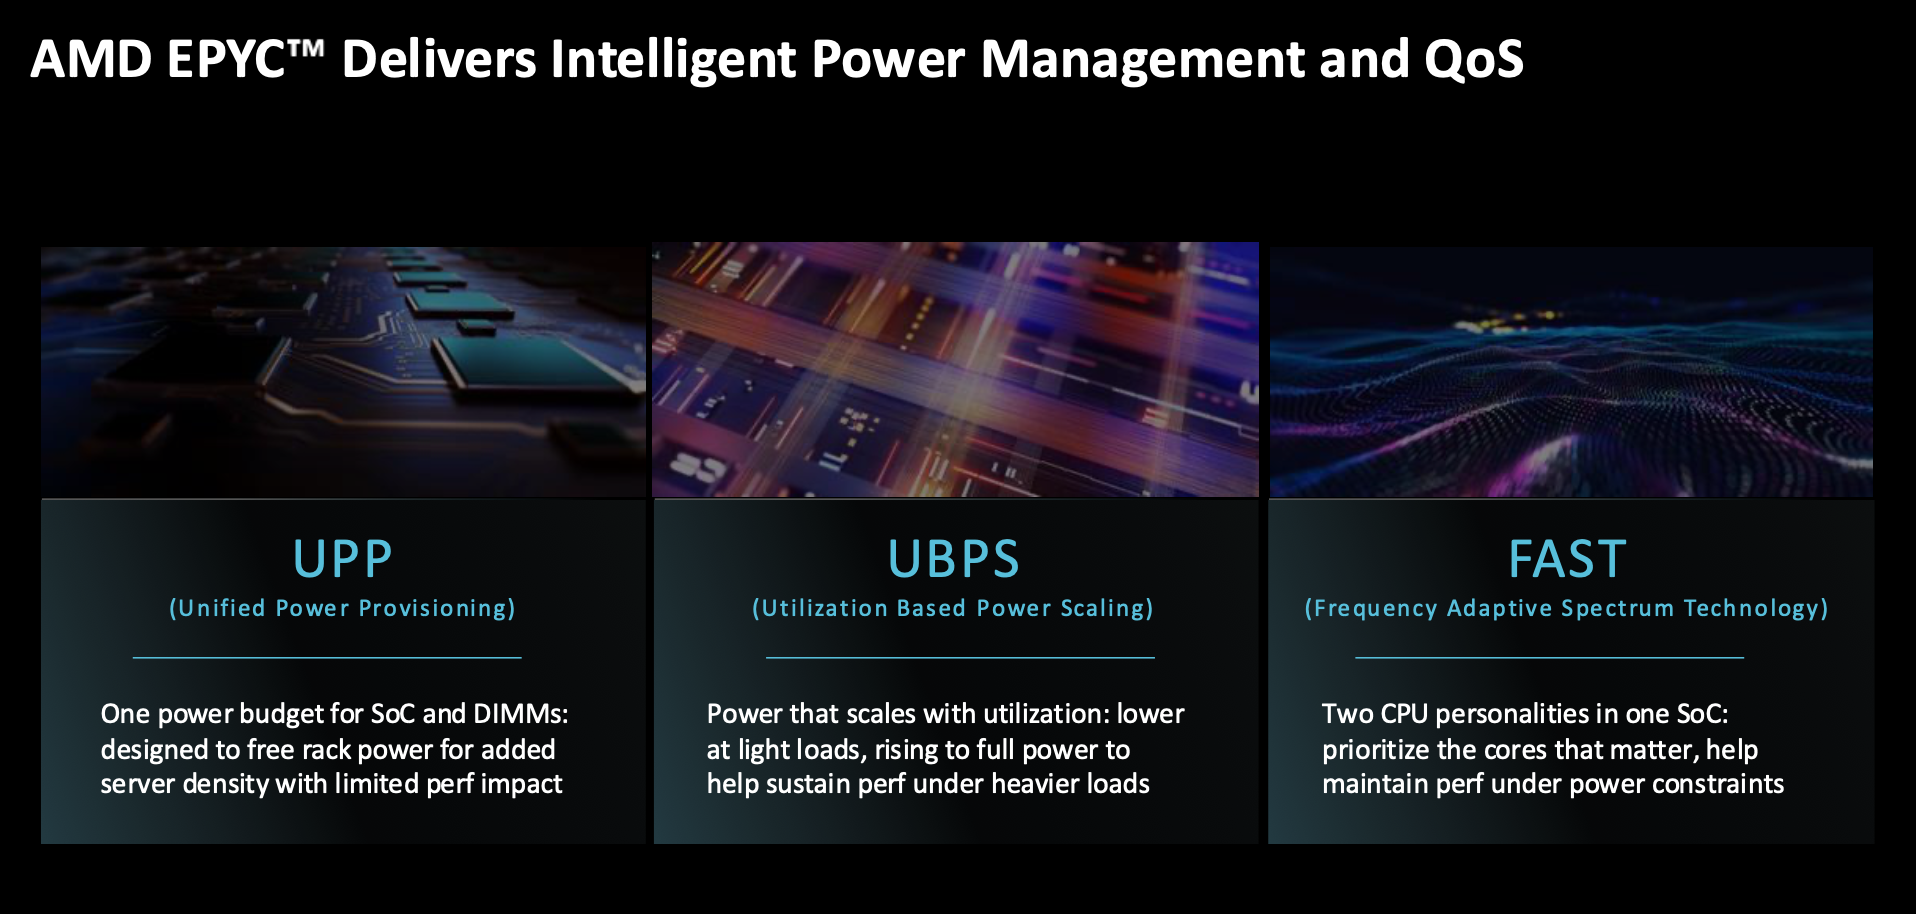
Zarządzanie energią zyskuje trzy nowe pokrętła, które mają znaczenie, ponieważ każde późniejsze porównanie szaf rackowych przez AMD odbywa się w ramach budżetu mocy. UPP łączy budżety SoC i DIMM w jeden, więc obciążenie pamięciowe przenosi waty do modułów DIMM, a obciążenie obliczeniowe je zmniejsza, co albo podnosi wydajność w ramach ustalonego budżetu, albo uwalnia zasilanie szaf rack dla większej liczby węzłów. UBPS ogranicza moc przy niskim obciążeniu, rezygnując ze zwykłego wzrostu wydajności przy niskim obciążeniu na rzecz płaskiej, przewidywalnej linii obciążenia; operatorzy, którzy preferują ten wzrost, mogą go wyłączyć. FAST dzieli jeden SoC na dwie osobowości, utrzymując rdzenie priorytetowe z wysoką częstotliwością, podczas gdy rdzenie w tle działają wolniej, dzięki czemu zadania krytyczne pod względem opóźnień, współdzielące gniazdo z zadaniami wsadowymi, nie ucierpią na tym.
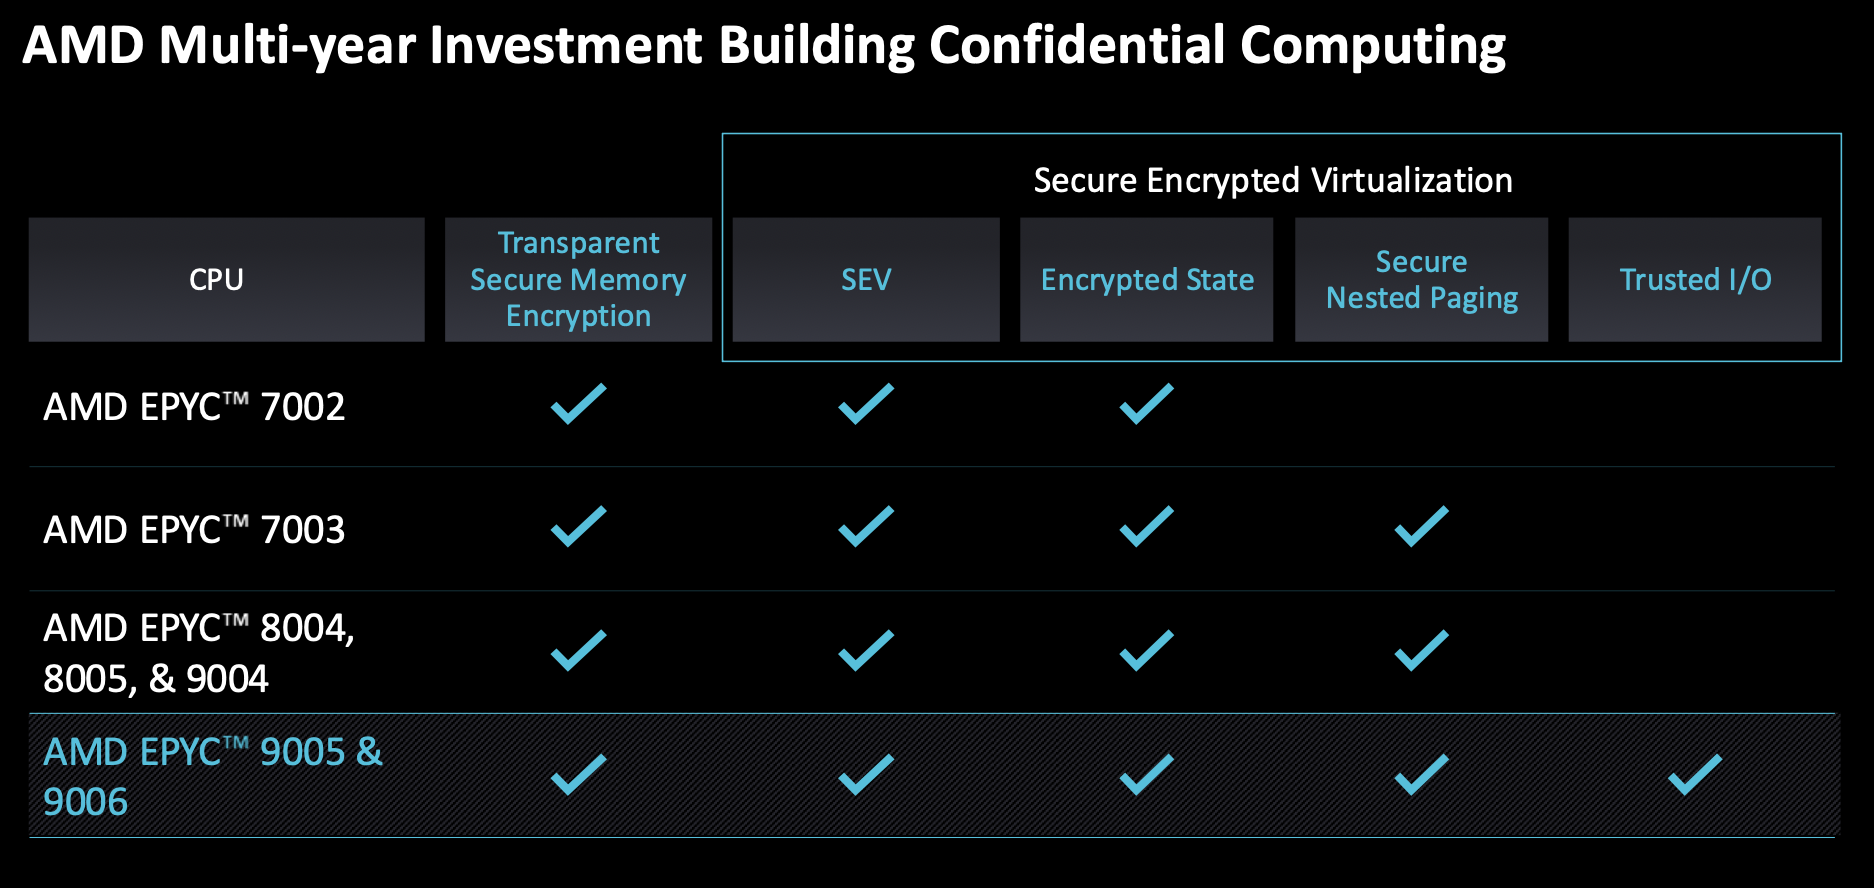
Ze względów bezpieczeństwa, Venice rozszerza linię poufnych obliczeń, począwszy od SEV na procesorach EPYC 7002, poprzez szyfrowanie stanu, bezpieczne stronicowanie zagnieżdżone, aż po technologię Trusted I/O, wprowadzoną w procesorach Turin. Nowością w tej generacji są: ulepszony rdzeń zaufania z algorytmami RSA-4K i postkwantowymi, zabezpieczenia przed atakami fizycznymi i kanałami bocznymi, certyfikat FIPS 140-3 poziomu 1 oraz Device Provenance, potwierdzona historia produkcji, którą Venice będzie jednym z pierwszych produktów AMD.
Wewnątrz portfolio
Poszczególne cztery części różnią się od siebie bardziej, niż sugeruje wspólna nazwa.
| Specyfikacja | 9006 SP7 | 9006 SP8 | 9006X SP7 | 9006 LP „Verano” |
|---|---|---|---|---|
| Rdzenie | Do 256 (512 wątków) | 8 do 128 | Do 96 | Do 72 |
| Szczytowa częstotliwość | 5.0 GHz z 96 rdzeniami (HF) | Oferowane opcje HF | ~ 5.15GHz | Do 5.0 GHz |
| Pamięć | 16 kanałów, do 1.6 TB/s | 8 kanałów z 2 modułami DIMM na kanał | 16-kanałowy moduł MRDIMM o przepustowości 12 800 MT/s | 24-kanałowy LPDDR5X, SOCAMM2 |
| L3 cache | Do 1024MB | Zależne od liczby rdzeni | 1152 MB (pamięć podręczna 3D V) | Zależne od liczby rdzeni |
| I / O | PCIe Gen 6, 96 linii | 128 linii PCIe, 1P i 2P | PCIe 6. generacji | Ulepszone xGMI na poziomie 112 GT/s |
| Celem | Gęstość hiperskalowa, host AI | Enterprise, Edge, przyjazny dla NEBS | HPC, wstępne przetwarzanie AI | Host AI w skali rack |
EPYC 9006 SP7
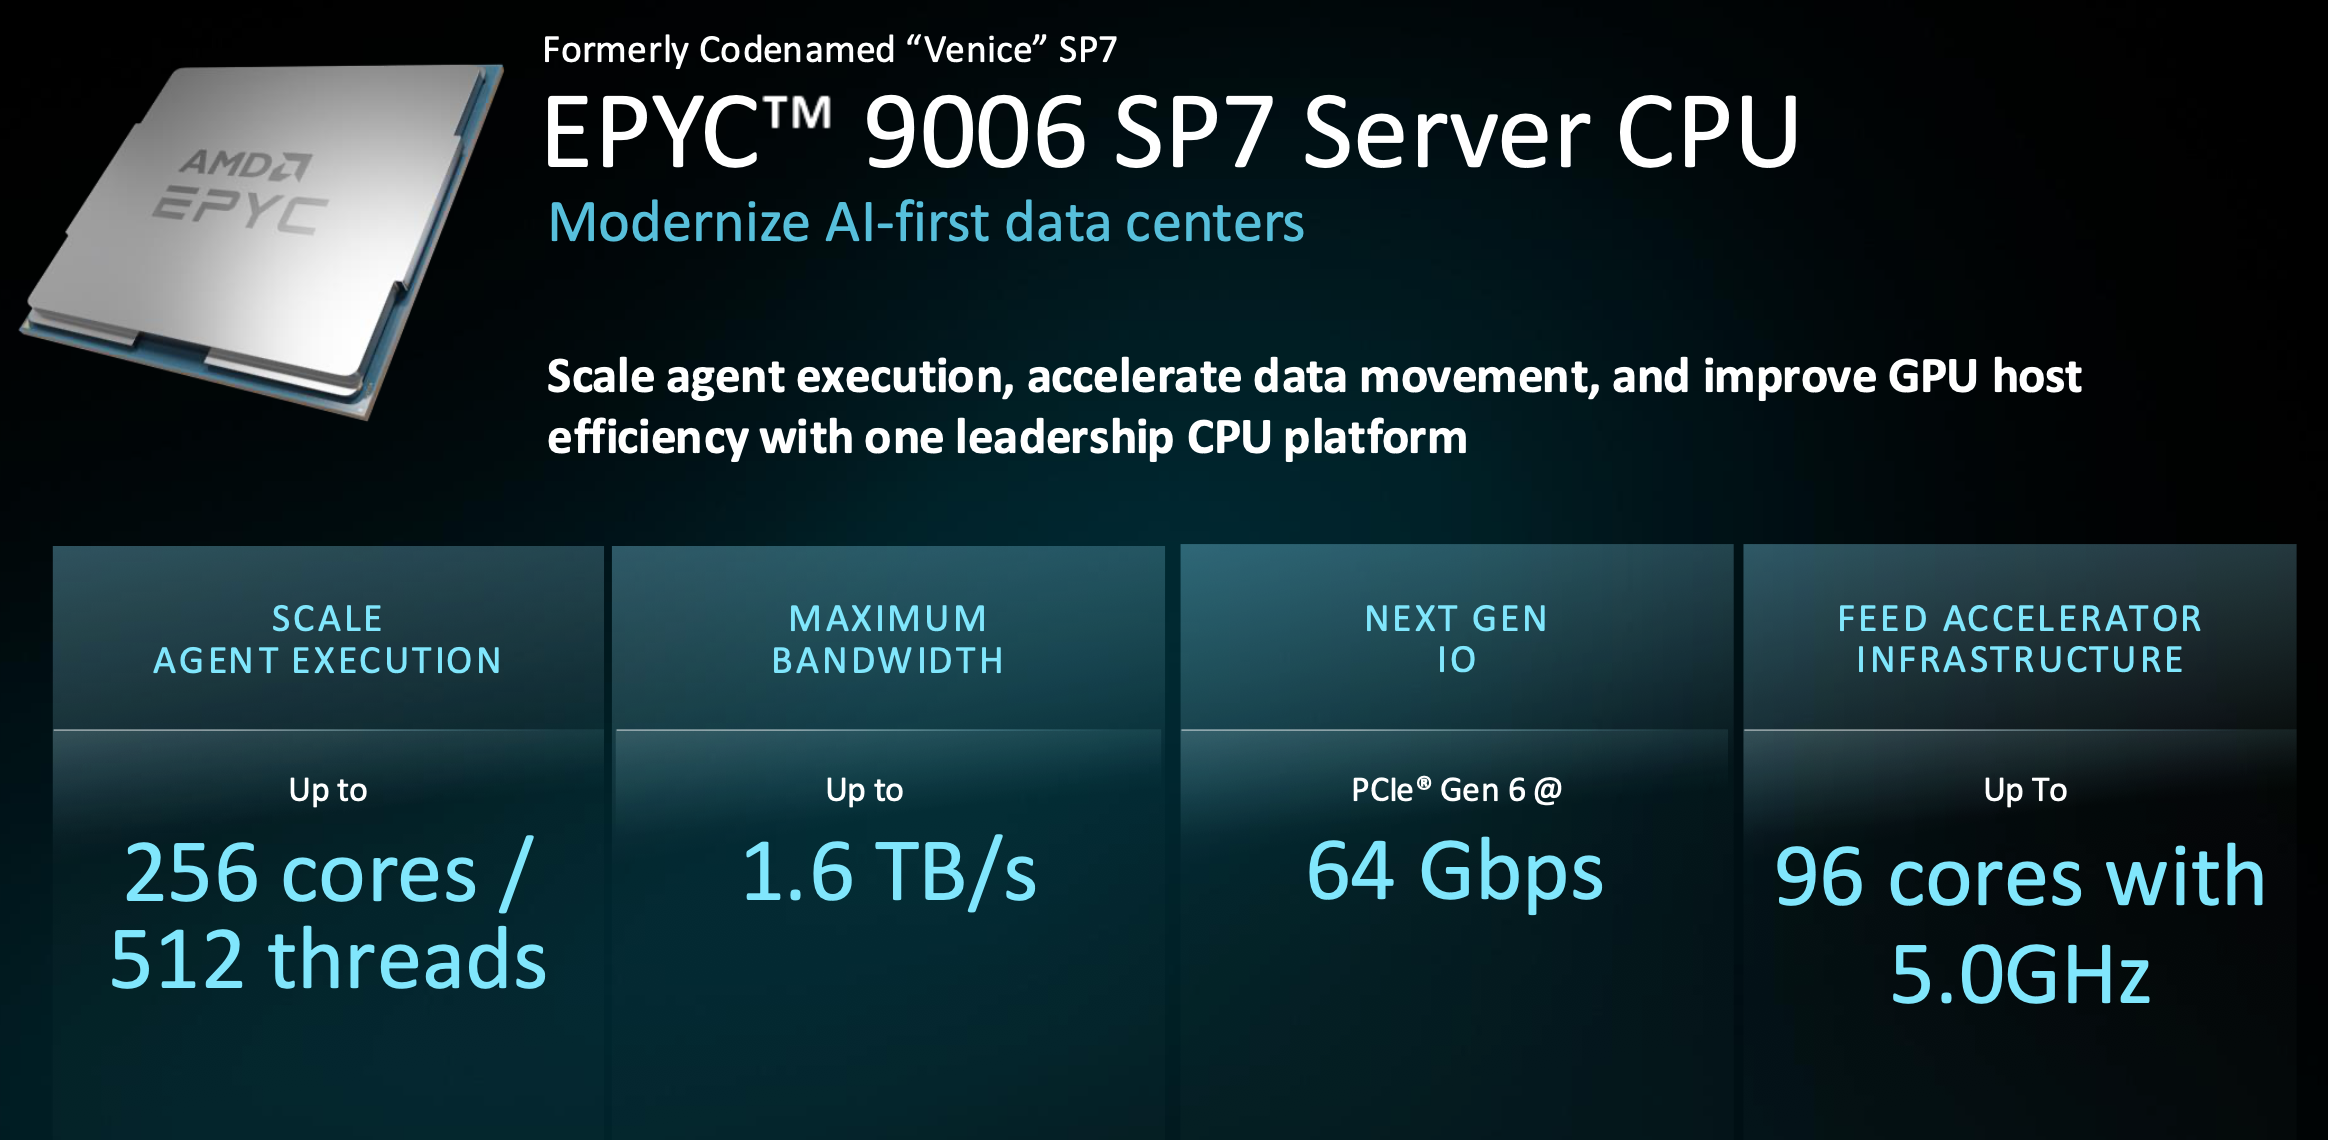
SP7 to flagowe gniazdo, obecnie w produkcji; platformy partnerskie pójdą w jego ślady w czwartym kwartale. Jego moduły o wysokiej częstotliwości zastępują podzespoły Turin HF, które AMD określa jako jedne z najszybciej rozwijających się jednostek SKU, a ich największym wdrożeniem jest Helios, w którym procesor hosta w każdej półce obliczeniowej łączy się z spójną domeną pamięci rack przez Infinity Fabric, a za nim znajduje się 1 TB pamięci DDR5. Ponieważ gniazdo jest standardowe, pasuje do niego każdy model SP7, nawet flagowy z 256 rdzeniami, o czym pisaliśmy w pokrewnym artykule.
EPYC 9006 SP8
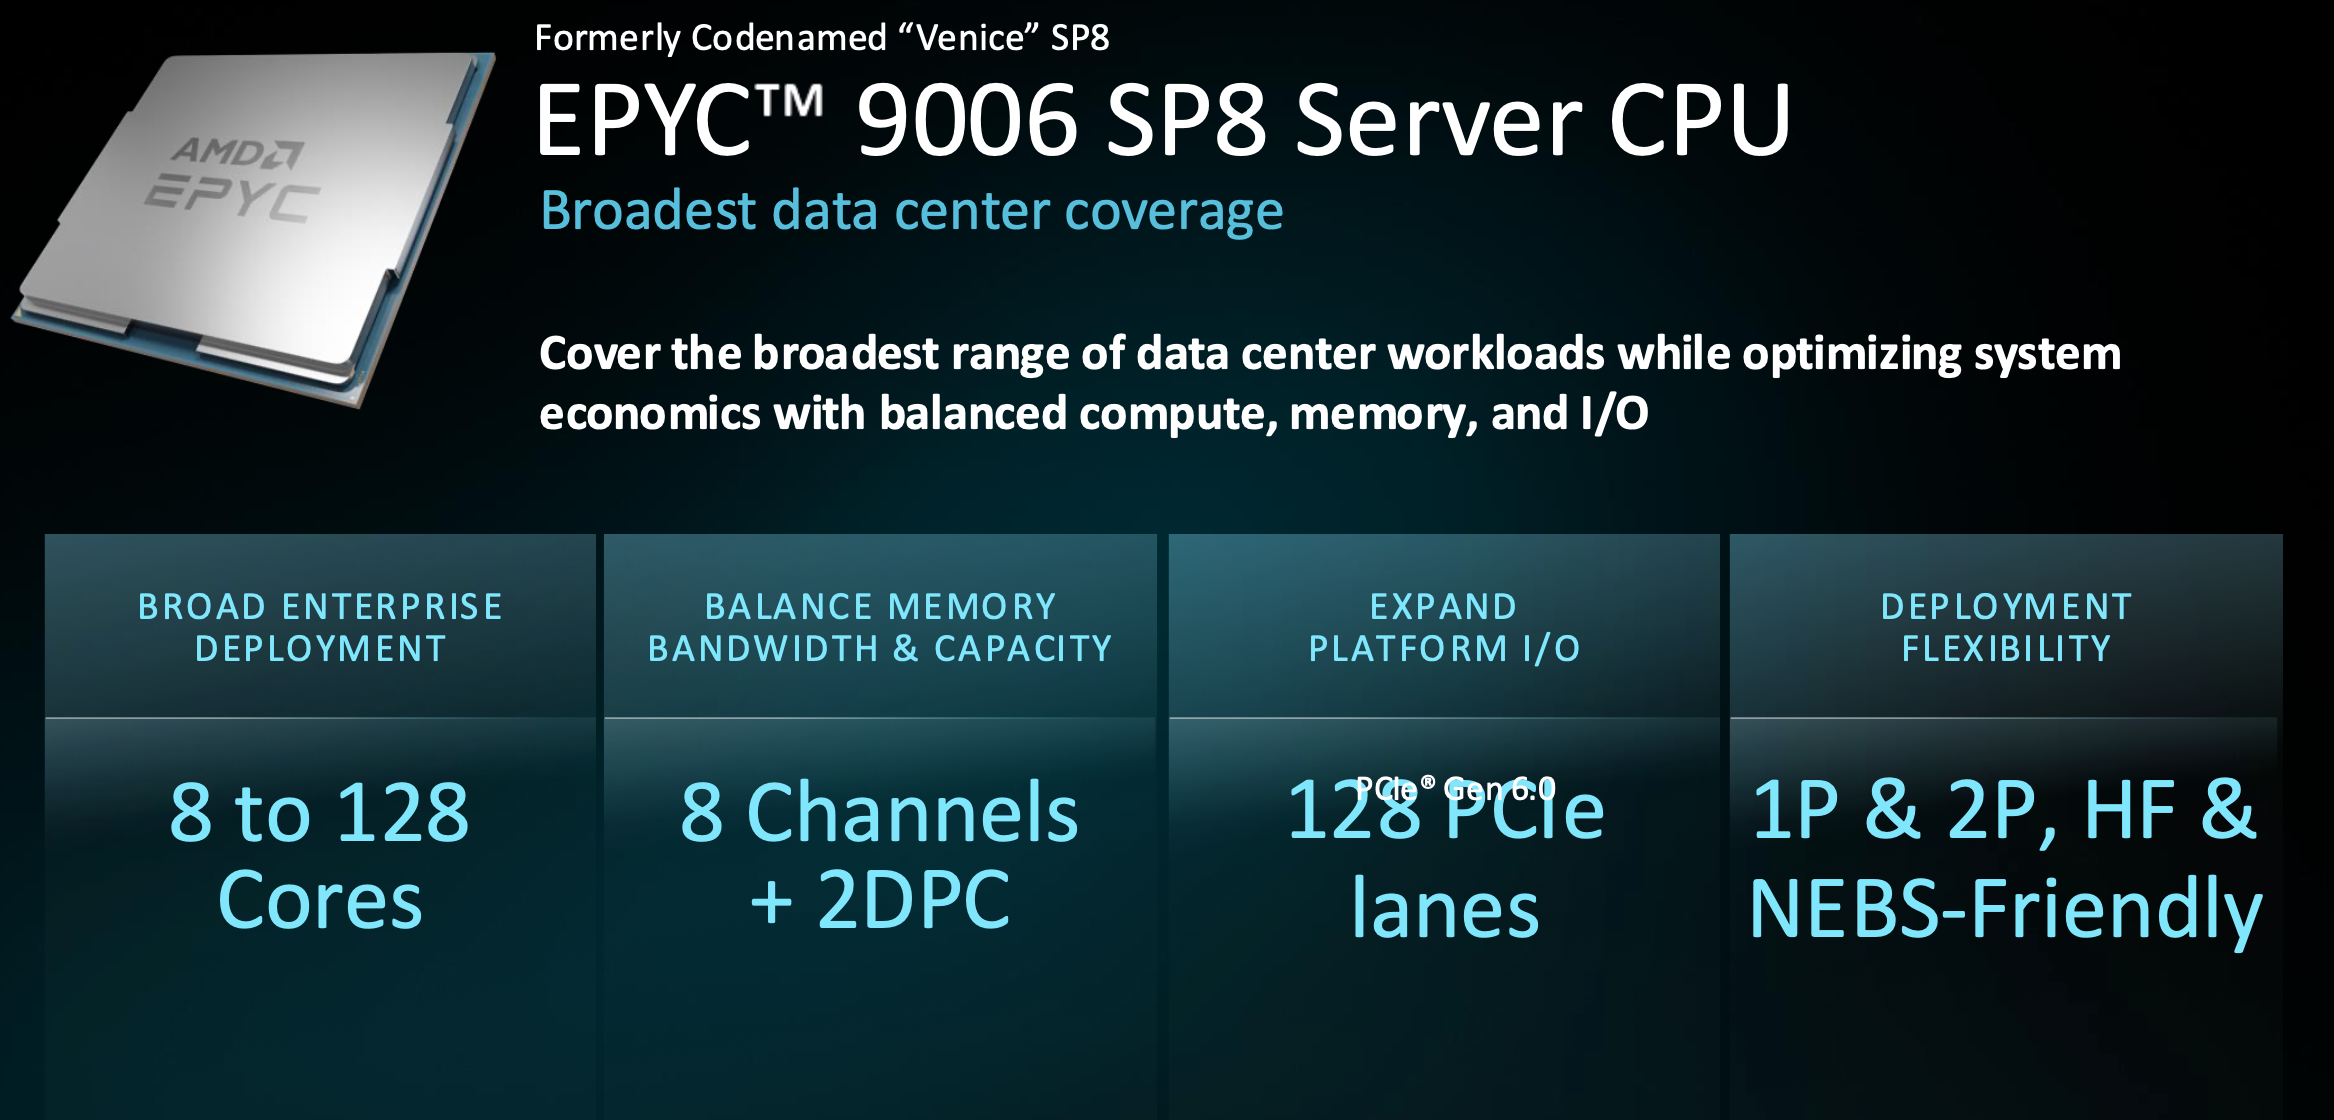
SP8 rezygnuje z ogromnego gniazda, aby obniżyć koszty systemu. Oferuje od 8 do 128 rdzeni, obsługuje 8 kanałów pamięci z 2 modułami DIMM na kanał, obsługuje 128 linii PCIe i jest dostępny w wersjach 1P i 2P z opcjami o wysokiej częstotliwości i zgodności z NEBS dla wdrożeń telekomunikacyjnych i brzegowych. AMD stawia na wydajność o odpowiedniej skali dla przedsiębiorstw, gdzie miarą sukcesu jest wydajność w przeliczeniu na dolara za system, a nie na szafę.
EPYC 9006X „Wenecja-X”
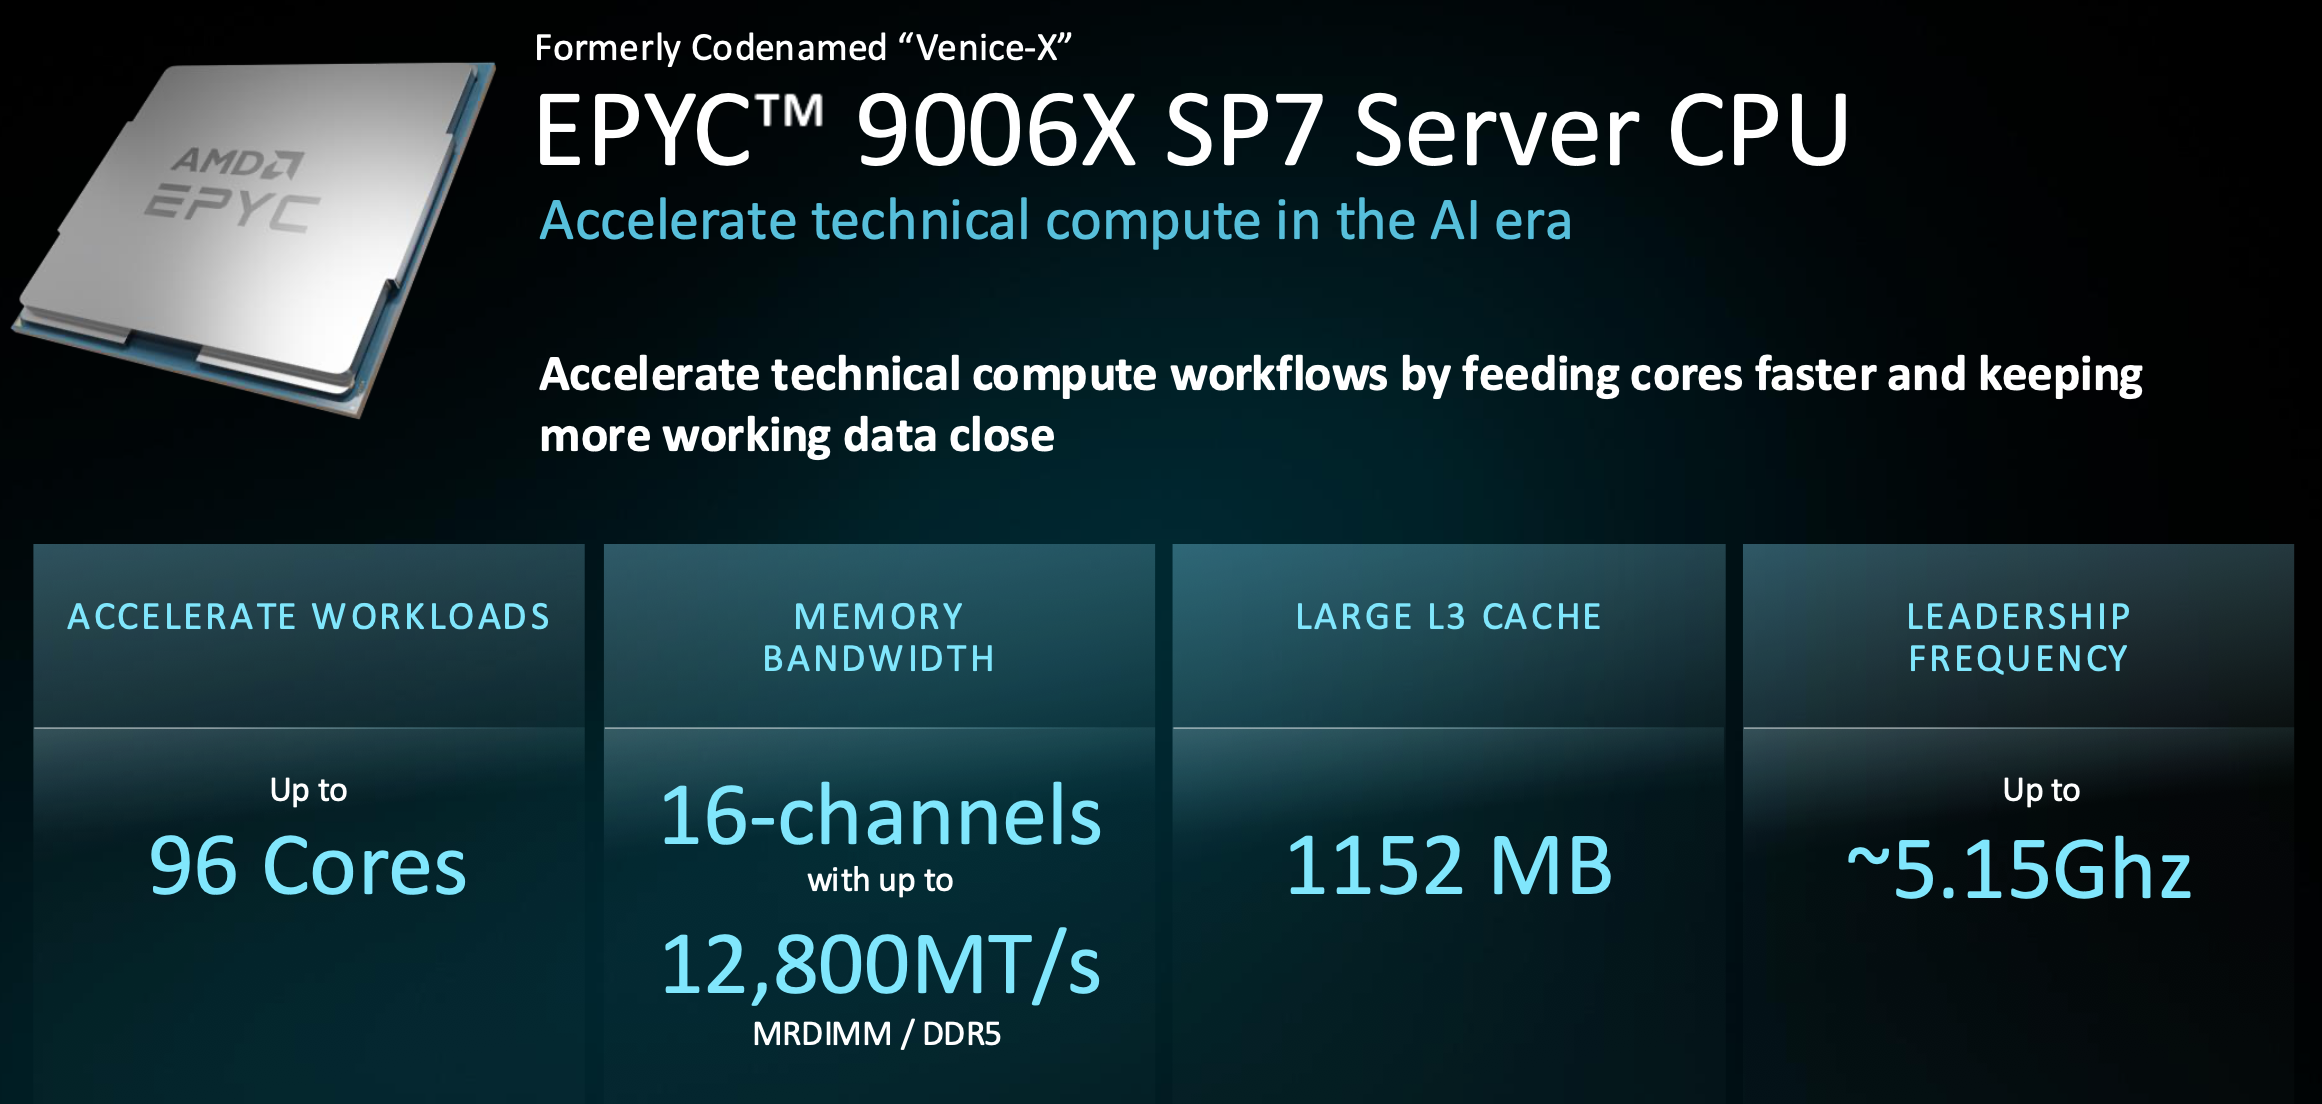
Venice-X łączy 3D V-Cache z 96-rdzeniową konfiguracją o wysokiej częstotliwości i zwiększa pamięć podręczną L3 do 1152 MB, czyli około 3 razy więcej pamięci podręcznej na rdzeń niż standardowe moduły SP7. Taktowanie sięga około 5.15 GHz, a pełny 16-kanałowy system pamięci o przepustowości 12 800 MT/s jest przenoszony. Cele obejmują symulację i modelowanie, analitykę na dużą skalę, bazy danych w pamięci oraz wstępne przetwarzanie AI, które zasila potoki szkoleniowe – obciążenia, w których zestaw roboczy przechowywany w pamięci podręcznej ma większe znaczenie niż dodatkowe rdzenie.
EPYC 9006 LP „Verano”
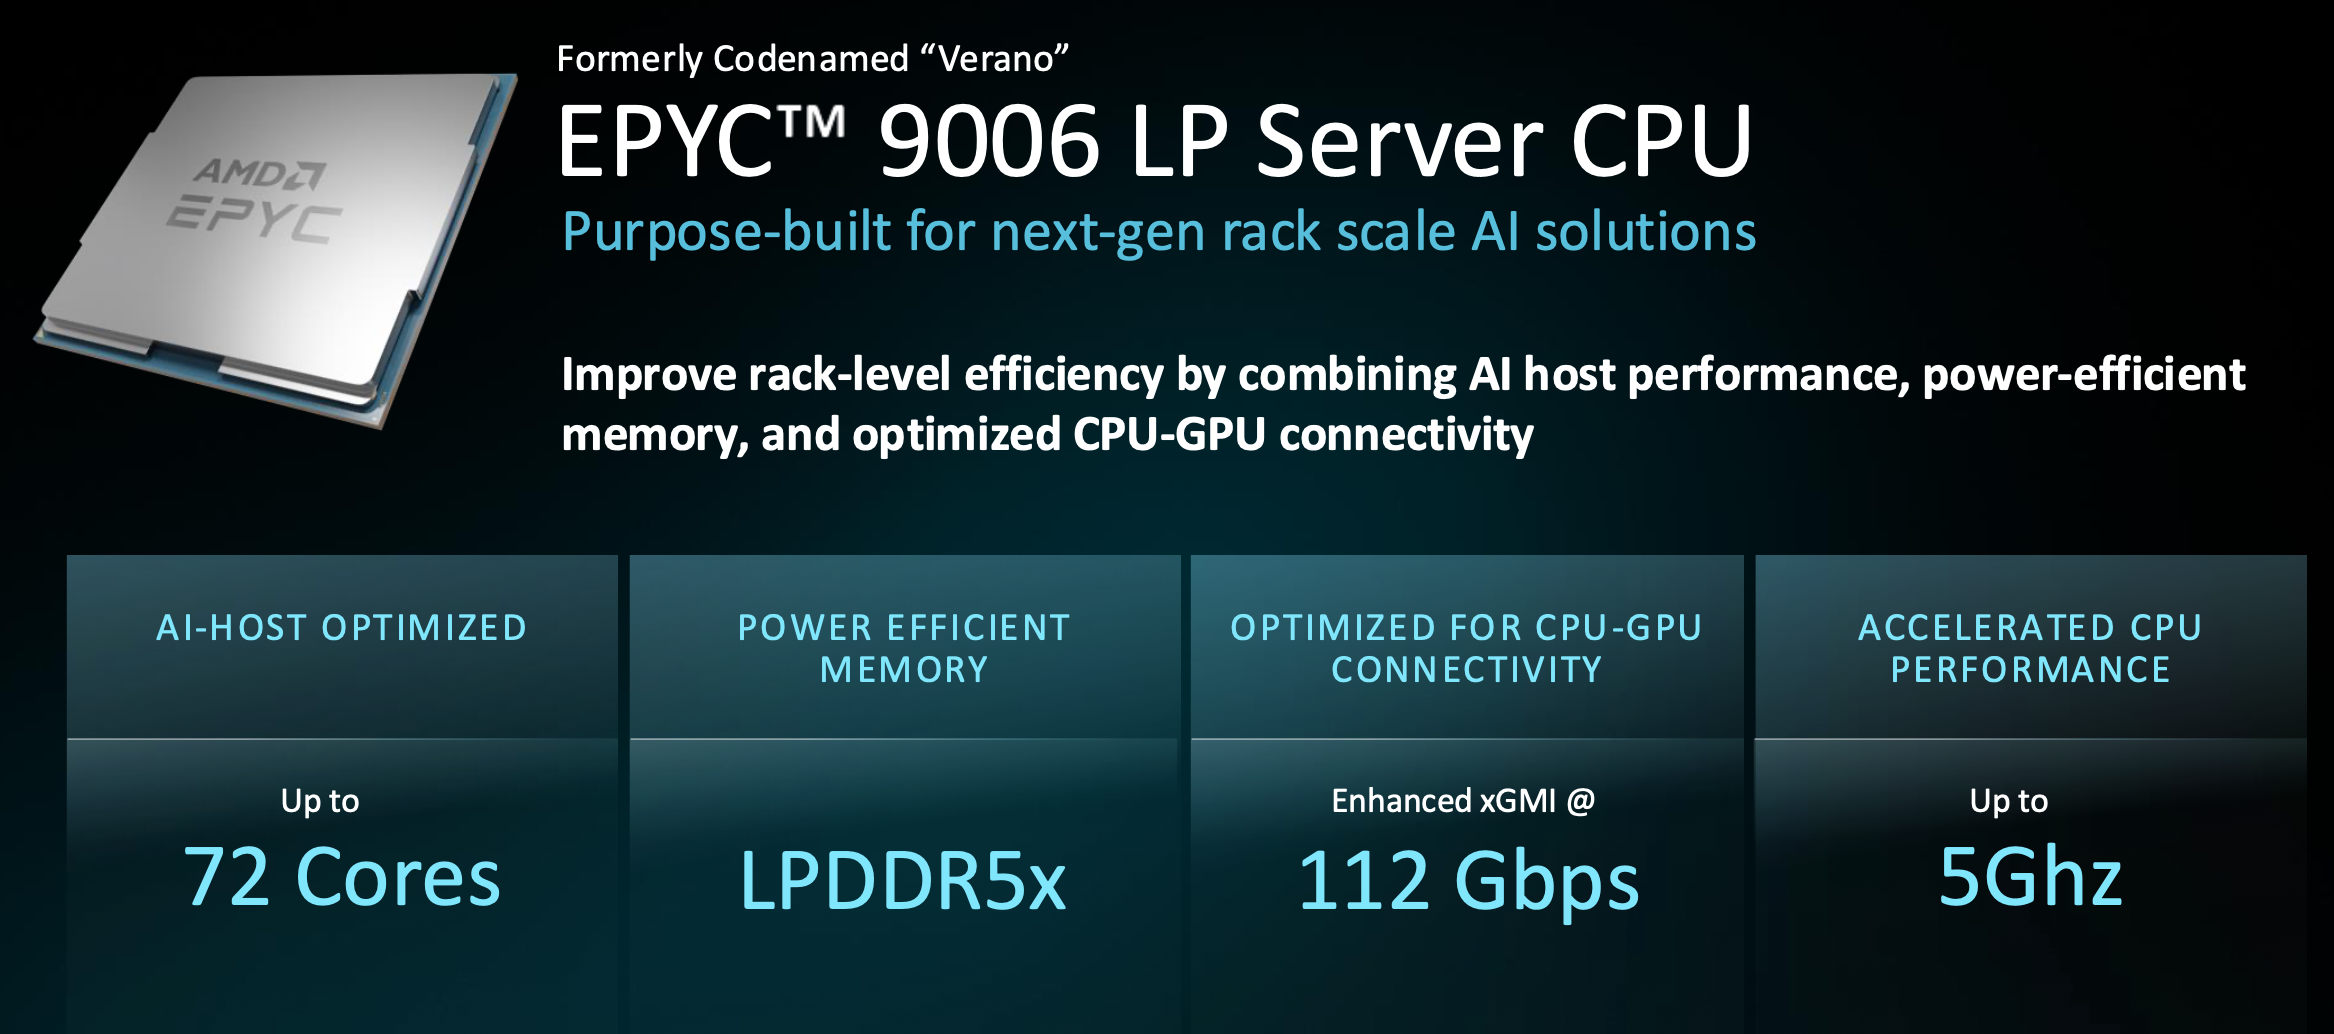
Verano to najbardziej skoncentrowany element w rodzinie: to węzeł hosta AI z maksymalnie 72 rdzeniami 5 GHz, 24 kanałami LPDDR5X i ulepszonym łączem xGMI 112 GT/s dla ruchu CPU-GPU. LPDDR opiera się na modułach SOCAMM2, które można wymienić w terenie, co ma znaczenie w przypadku floty, gdzie awaria lutowanej pamięci w przeciwnym razie zniszczyłaby całą płytę. Jest to również bezpośrednia odpowiedź AMD na Verę firmy NVIDIA, do której jeszcze wrócimy, ponieważ AMD z pewnością już to zrobiło.
Jak wypada Wenecja
AMD udowodniło swoją rację w dwóch podejściach, najpierw prowadząc Turynem, który pokazał, że już ma przewagę, a następnie Wenecją, która pokazała, jak daleko się oddala.
Turyn prowadzi dzisiaj
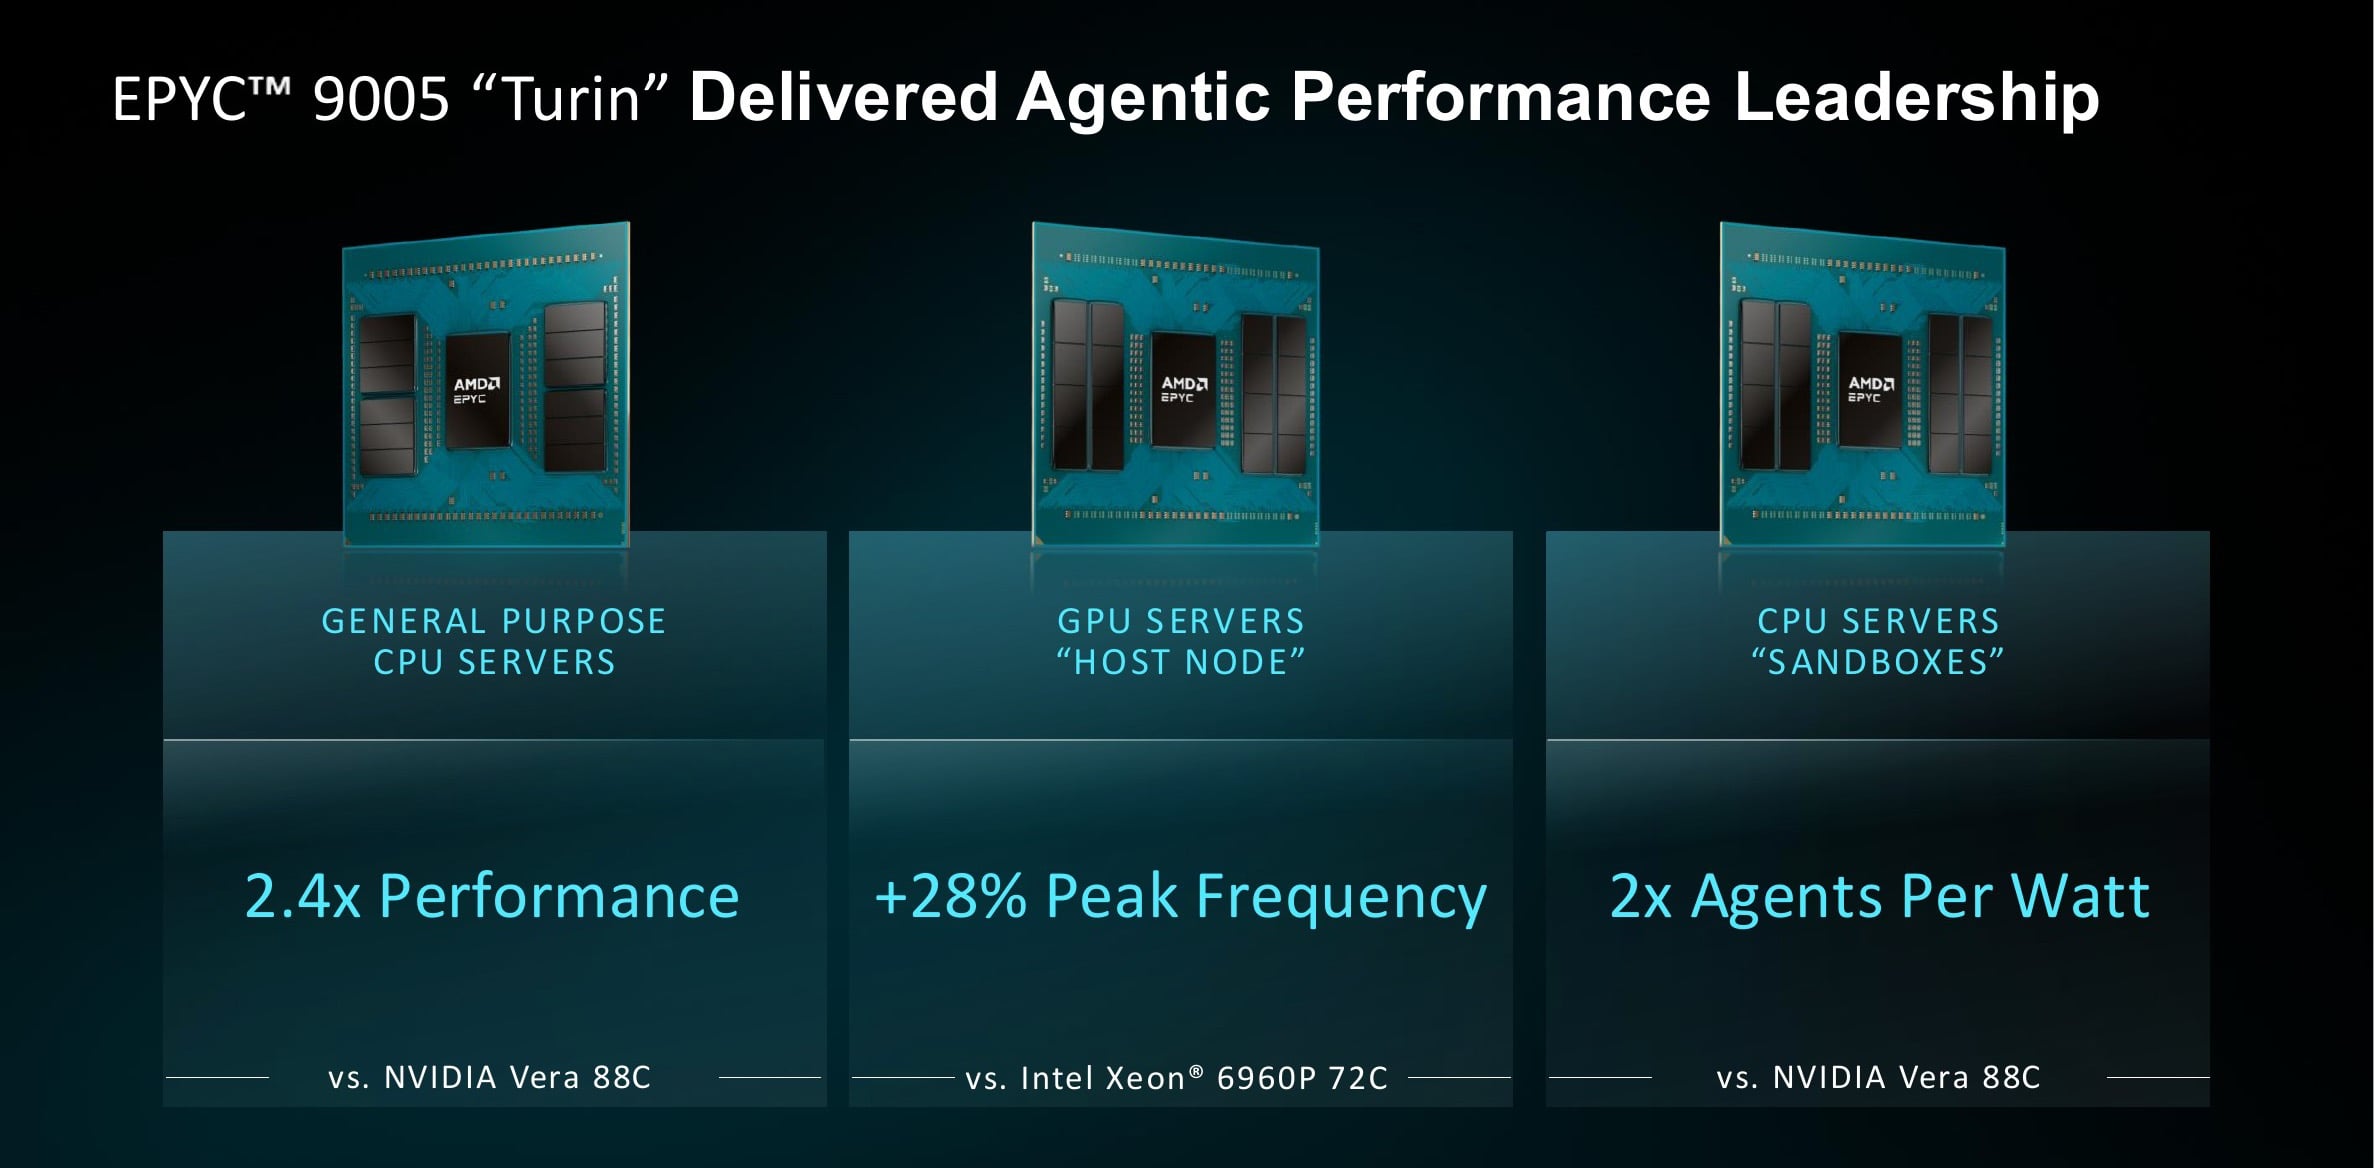
AMD skupiło większość swoich porównań na procesorze Vera firmy NVIDIA, procesorze Arm w platformie Vera Rubin, i rozpoczęło od generacji, którą już oferuje. Według modelowania AMD na poziomie szafy rack, szafa Turin zapewnia 2.4-krotnie większą przepustowość ogólnego przeznaczenia niż Vera i dwukrotnie więcej agentów na wat. Model ustala budżet mocy obu szaf na poziomie 100 kW, porównuje 2-procesorowy procesor EPYC 9965 z 384 rdzeniami z 2-procesorową płytą Vera z 176 rdzeniami i uśrednia wyniki dla sześciu obciążeń: szacowanego SPECrate 2017, serwera Java, NGINX, Redis, Memcached i pochodnej TPC-C.
Tutaj i w dalszej części artykułu obowiązują dwa zastrzeżenia. Vera nie została jeszcze wprowadzona na rynek, więc każda wartość Vera to szacunki AMD dotyczące 88-rdzeniowego, 450-watowego modułu, który NVIDIA opisała w swoich materiałach publicznych. Ponieważ nie istnieje standardowy benchmark dla obciążeń agentowych, AMD uwzględnia wątki sprzętowe jako przybliżenie dla agentów w swoich obliczeniach agentów na wat.
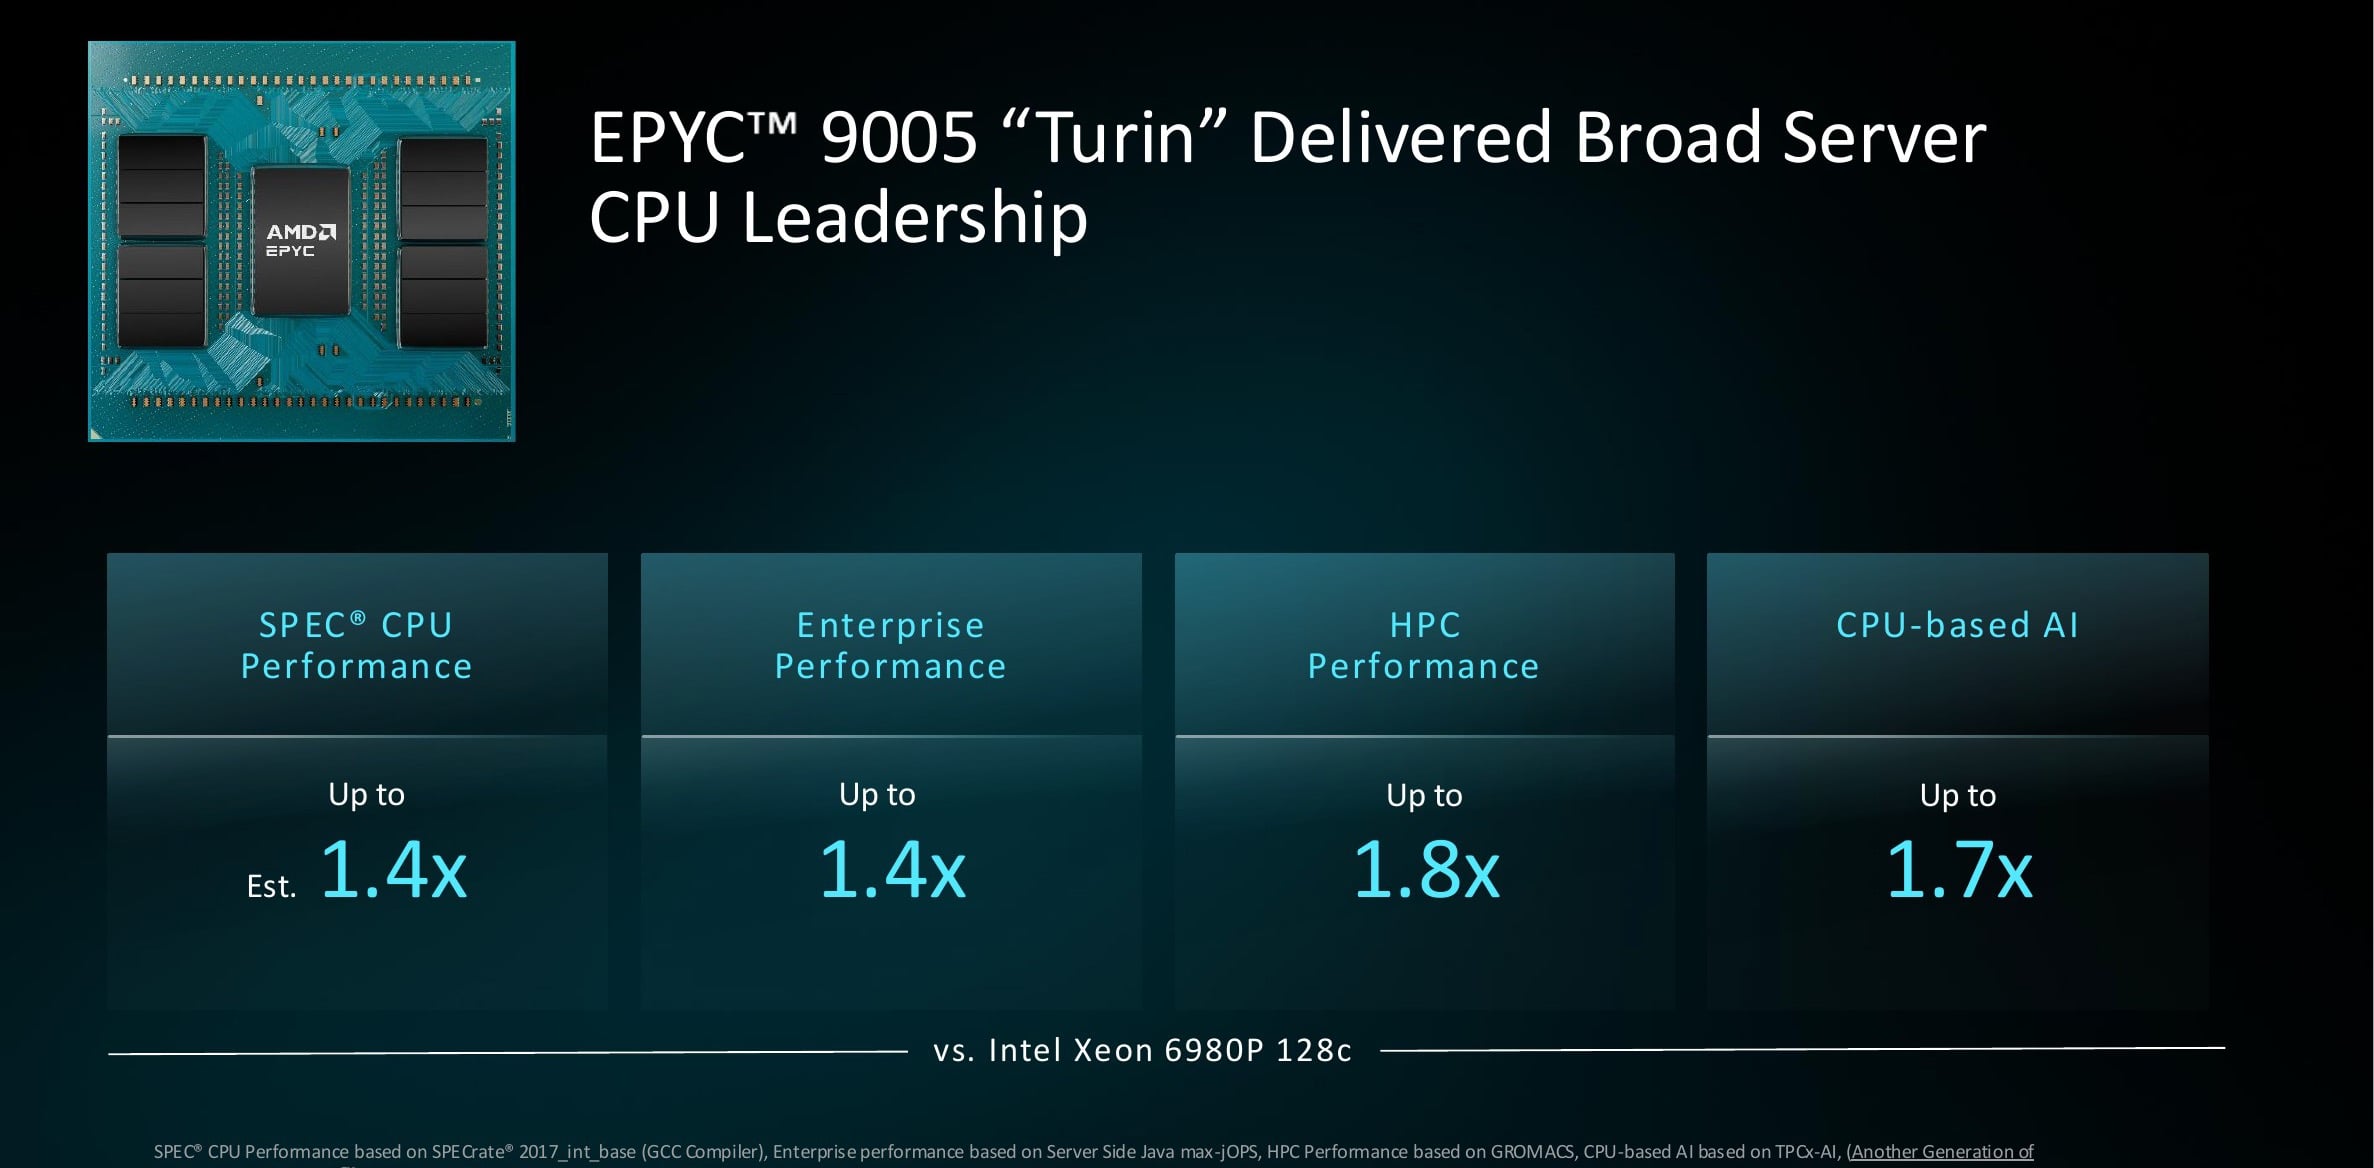
Porównanie z Intelem opiera się na solidniejszych podstawach, ponieważ obie strony dostarczają podzespoły, które AMD mogłoby bezpośrednio testować. Procesory Turina osiągają taktowanie 5.0 GHz, podczas gdy porównywalny Xeon osiąga 3.9 GHz, co daje 28% przewagę częstotliwościową, która ma znaczenie w przypadku procesorów graficznych z pojedynczym wątkiem. W porównaniu z 128-rdzeniowym Xeonem 6980P, AMD ocenia Turina na 1.4x w przypadku procesora SPEC, 1.4x w przypadku Enterprise Java, 1.8x w przypadku HPC i 1.7x w przypadku AI opartego na procesorach.
Wenecja poszerza każdą lukę
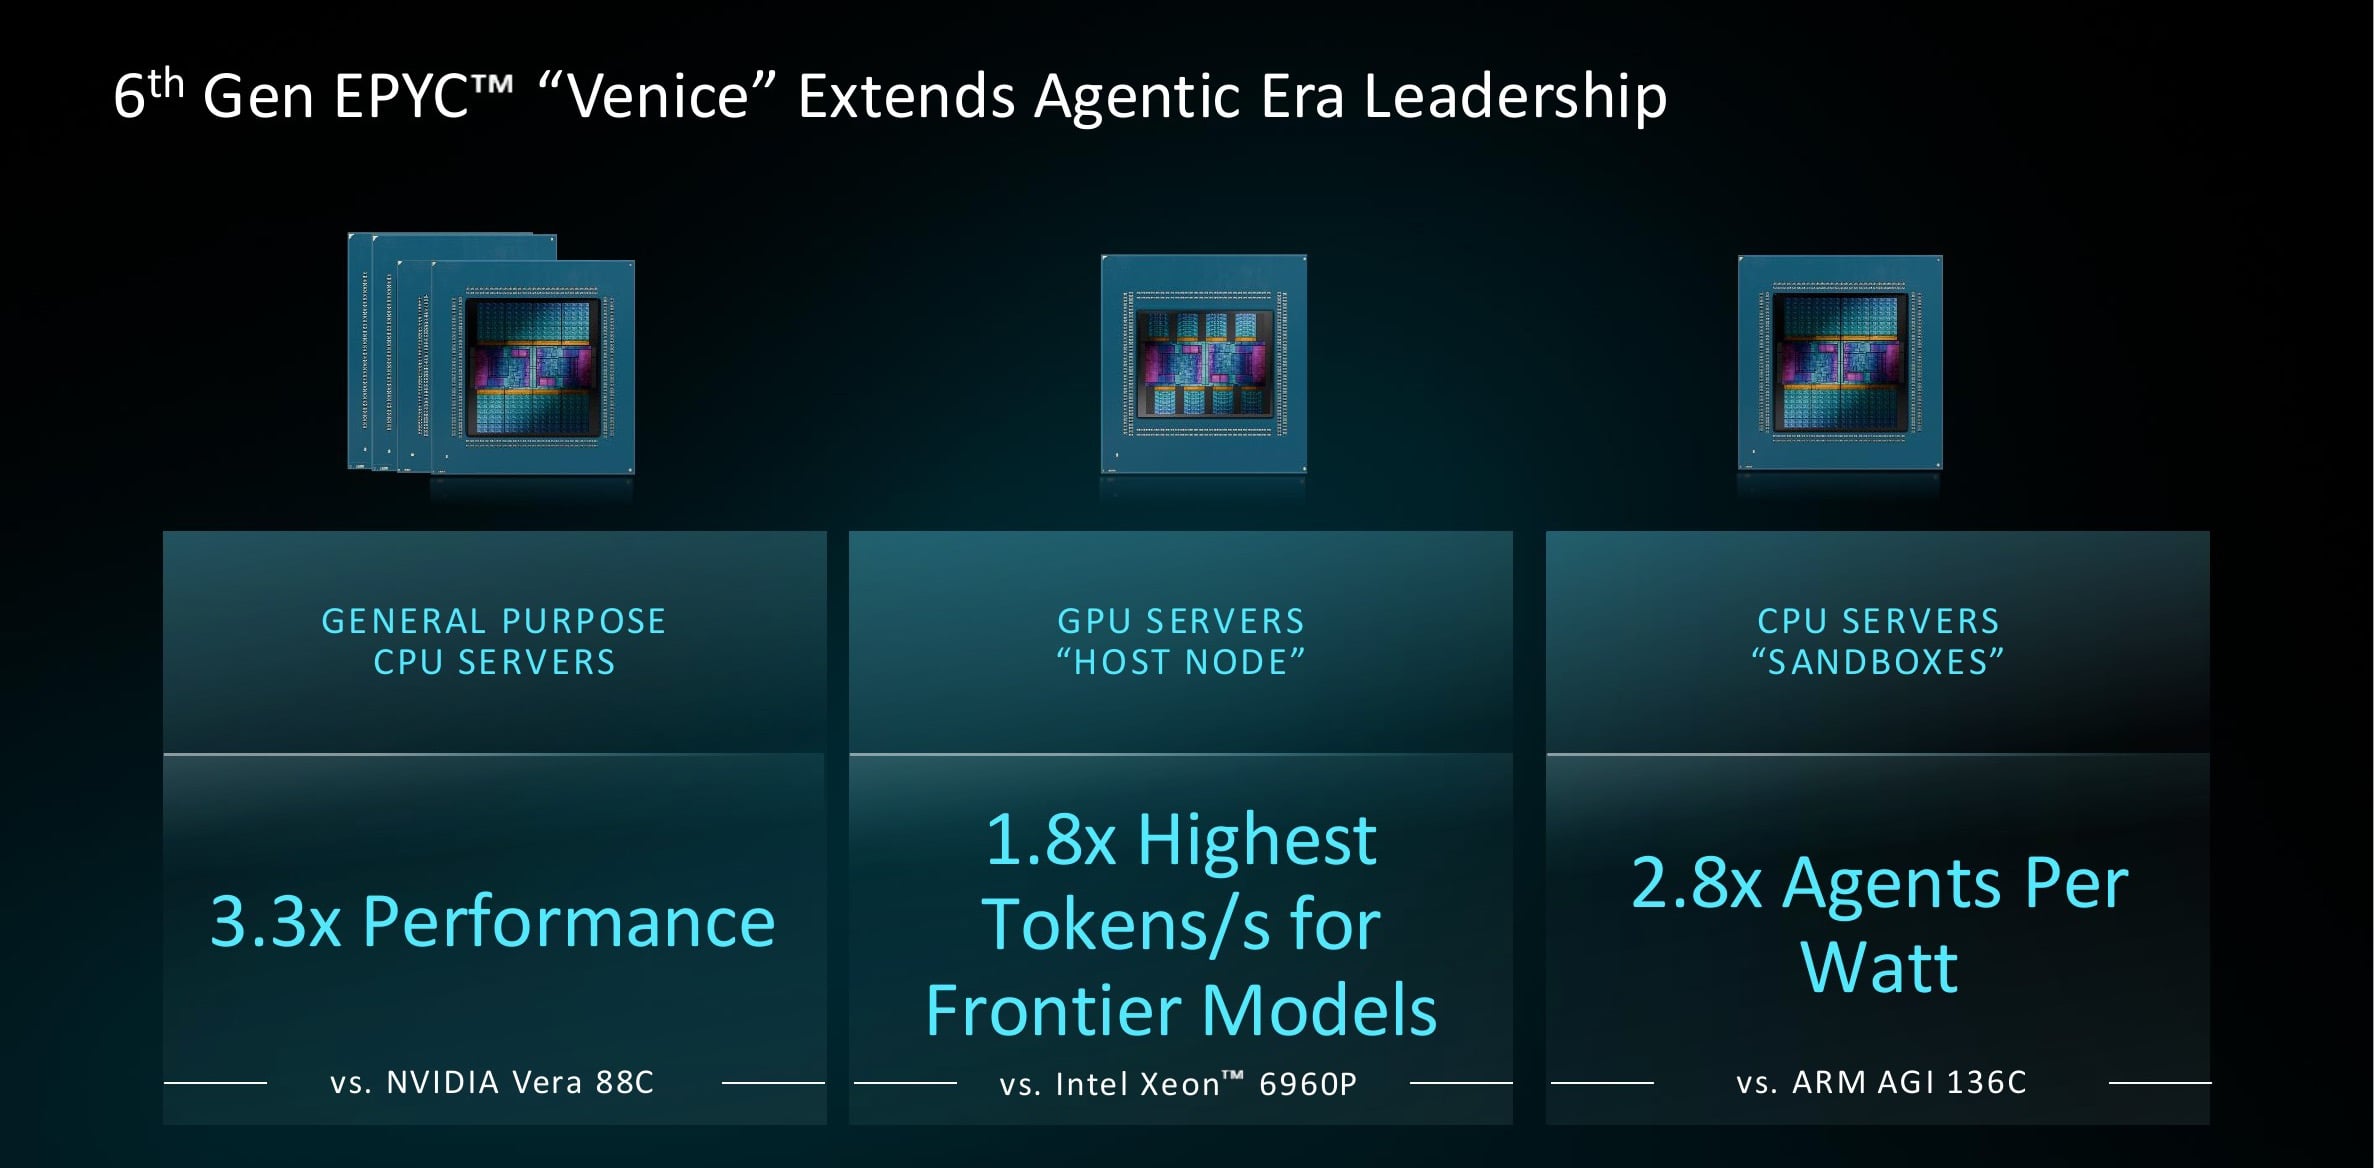
Venice zwiększa przewagę w każdym z tych przypadków. W tym samym modelu rack o mocy 100 kW, teraz z 512 rdzeniami Venice w porównaniu z 176 rdzeniami Vera, AMD deklaruje 3.3-krotnie wyższą wydajność niż Vera w zastosowaniach ogólnych. Venice osiąga 2.8-krotnie większą liczbę agentów na wat niż 136-rdzeniowy Arm AGI i 1.8-krotnie większą liczbę tokenów na sekundę w modelach Frontier, gdy Venice obsługuje GPU. Ta wartość 1.8-krotnie odzwierciedla węższy scenariusz niż sugeruje nagłówek, do którego wrócimy w sekcji dotyczącej węzła hosta poniżej.
Twarzą w twarz z Verą
W teście SPECrate 2026 AMD szacuje, że procesor 2P Venice 9996 ma taktowanie 2070, podczas gdy Vera 925, co daje 2.2-krotną przewagę w przepustowości i przekłada się na około 1.2-krotną przewagę 96-rdzeniowego układu o wysokiej częstotliwości nad Verą na rdzeń. Oba wyniki zostały skompilowane przy użyciu pakietu GCC 15.2, tego samego zestawu narzędzi, którego NVIDIA użyła do opublikowania wyników Vera.
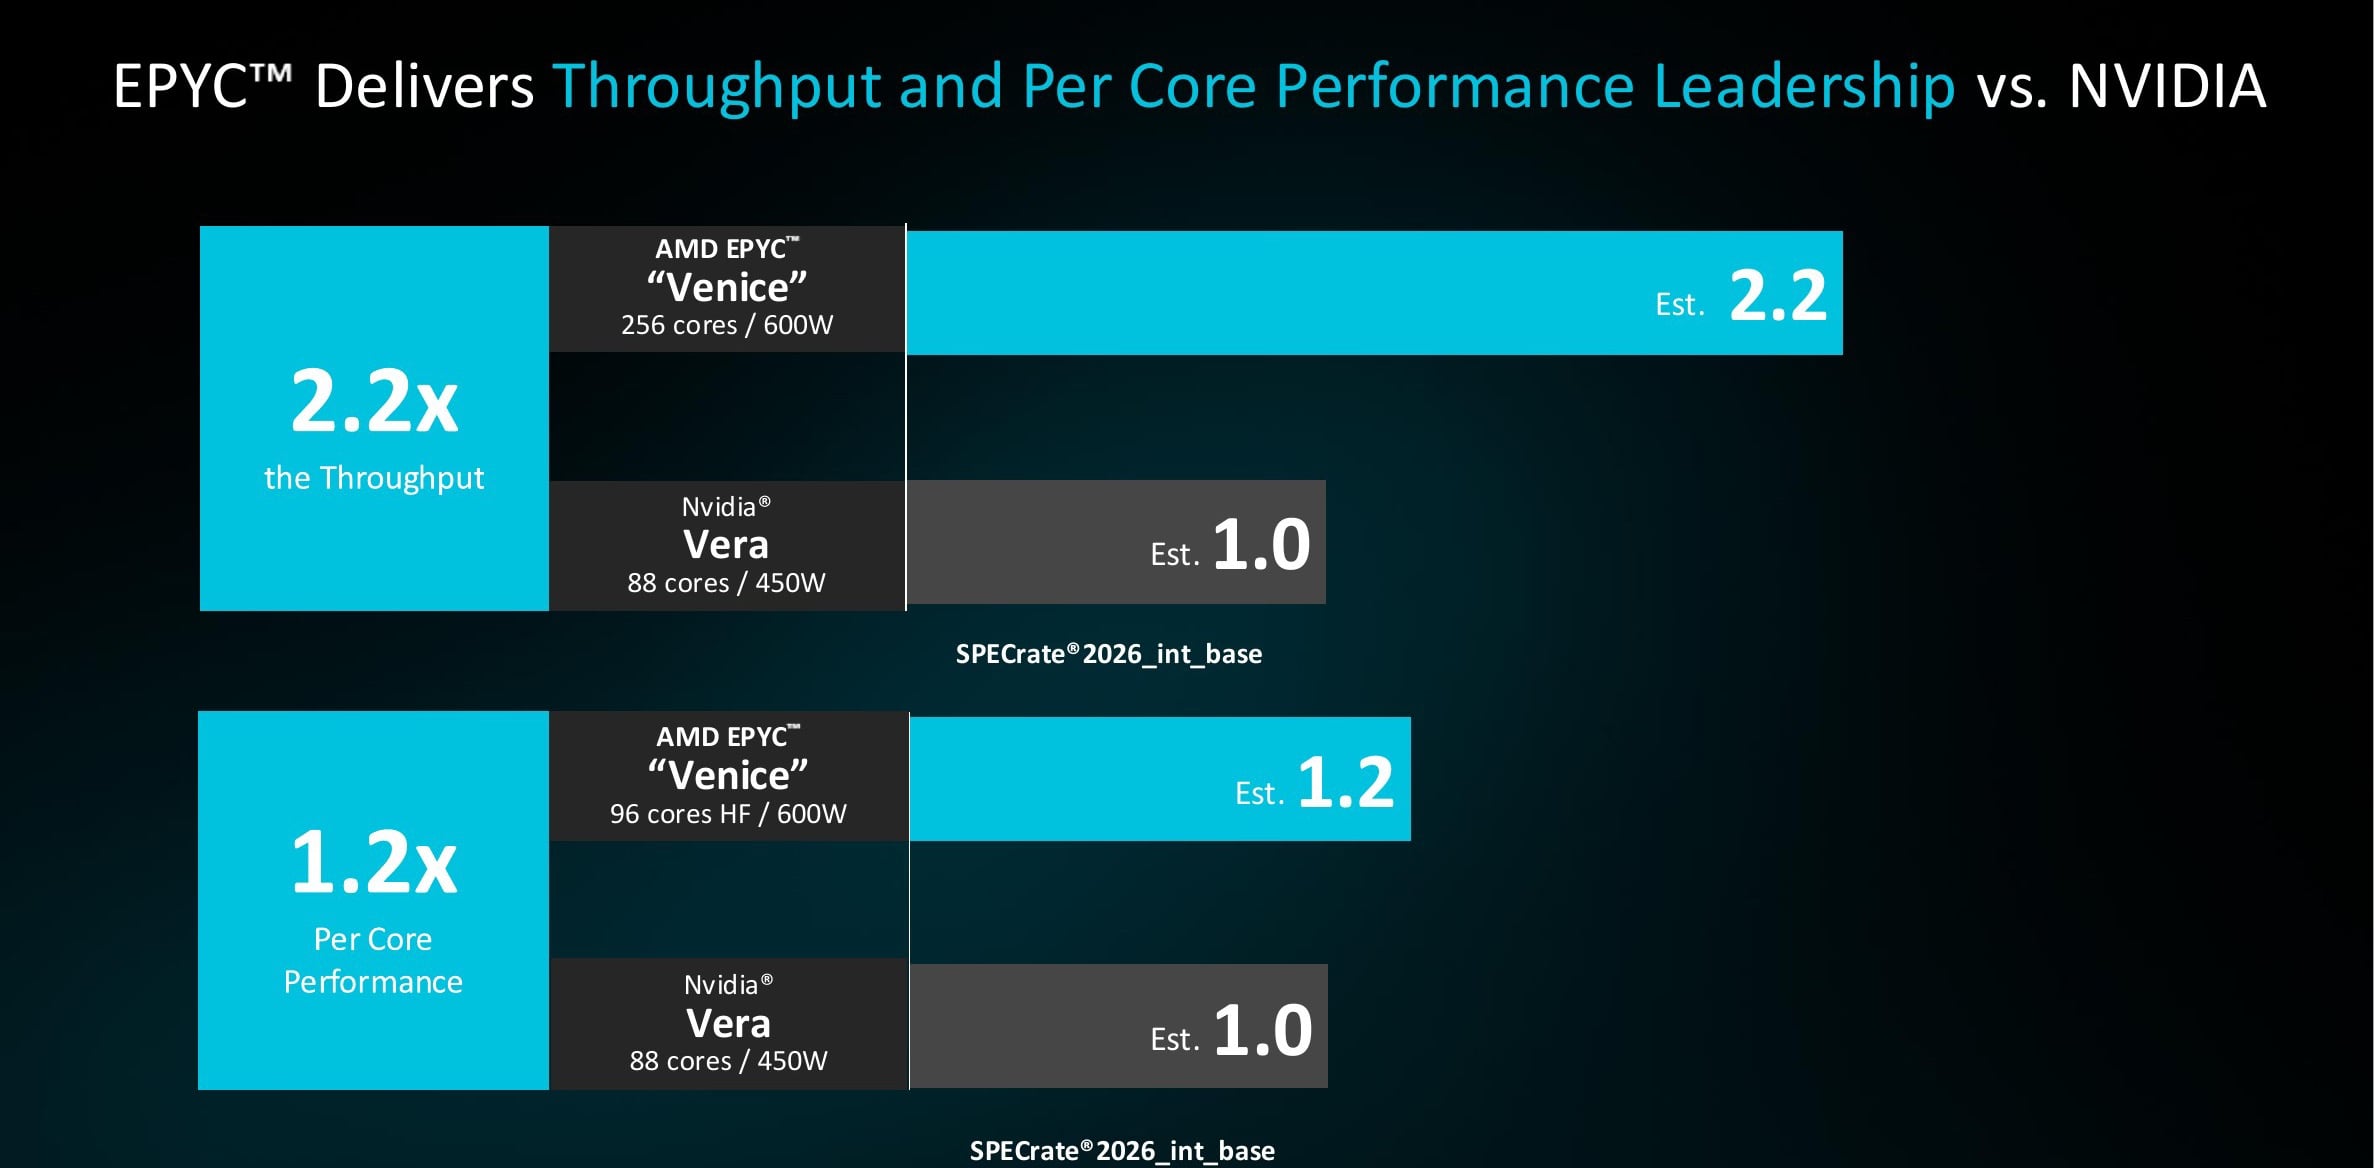
Deklarowana przewaga na rdzeń faktycznie wzrosła w tygodniu premiery. Ravi Kuppuswamy, szef działu inżynierii procesorów w AMD, powiedział prasie, że AMD pierwotnie deklarowało 10% przewagę na rdzeń. Po tym, jak NVIDIA opublikowała własne wyniki Vera na początku tygodnia, jej zespół ponownie przeprowadził porównanie, używając tego samego kompilatora i ustawień, i zmierzył 20% przewagę, a dostrajanie wciąż nie zostało ukończone. 2.2-krotna różnica w przepustowości, jak powiedział, od początku pokrywała się z wewnętrznymi prognozami AMD. W osobnym przypisie przeliczono porównanie przepustowości na rdzeń w teście SPECrate 2017, używając własnego kompilatora AOCC AMD, i otrzymano 1.7-krotność, co czyni 20% bardziej konserwatywnym z tych dwóch obliczeń.
Intel i Arm
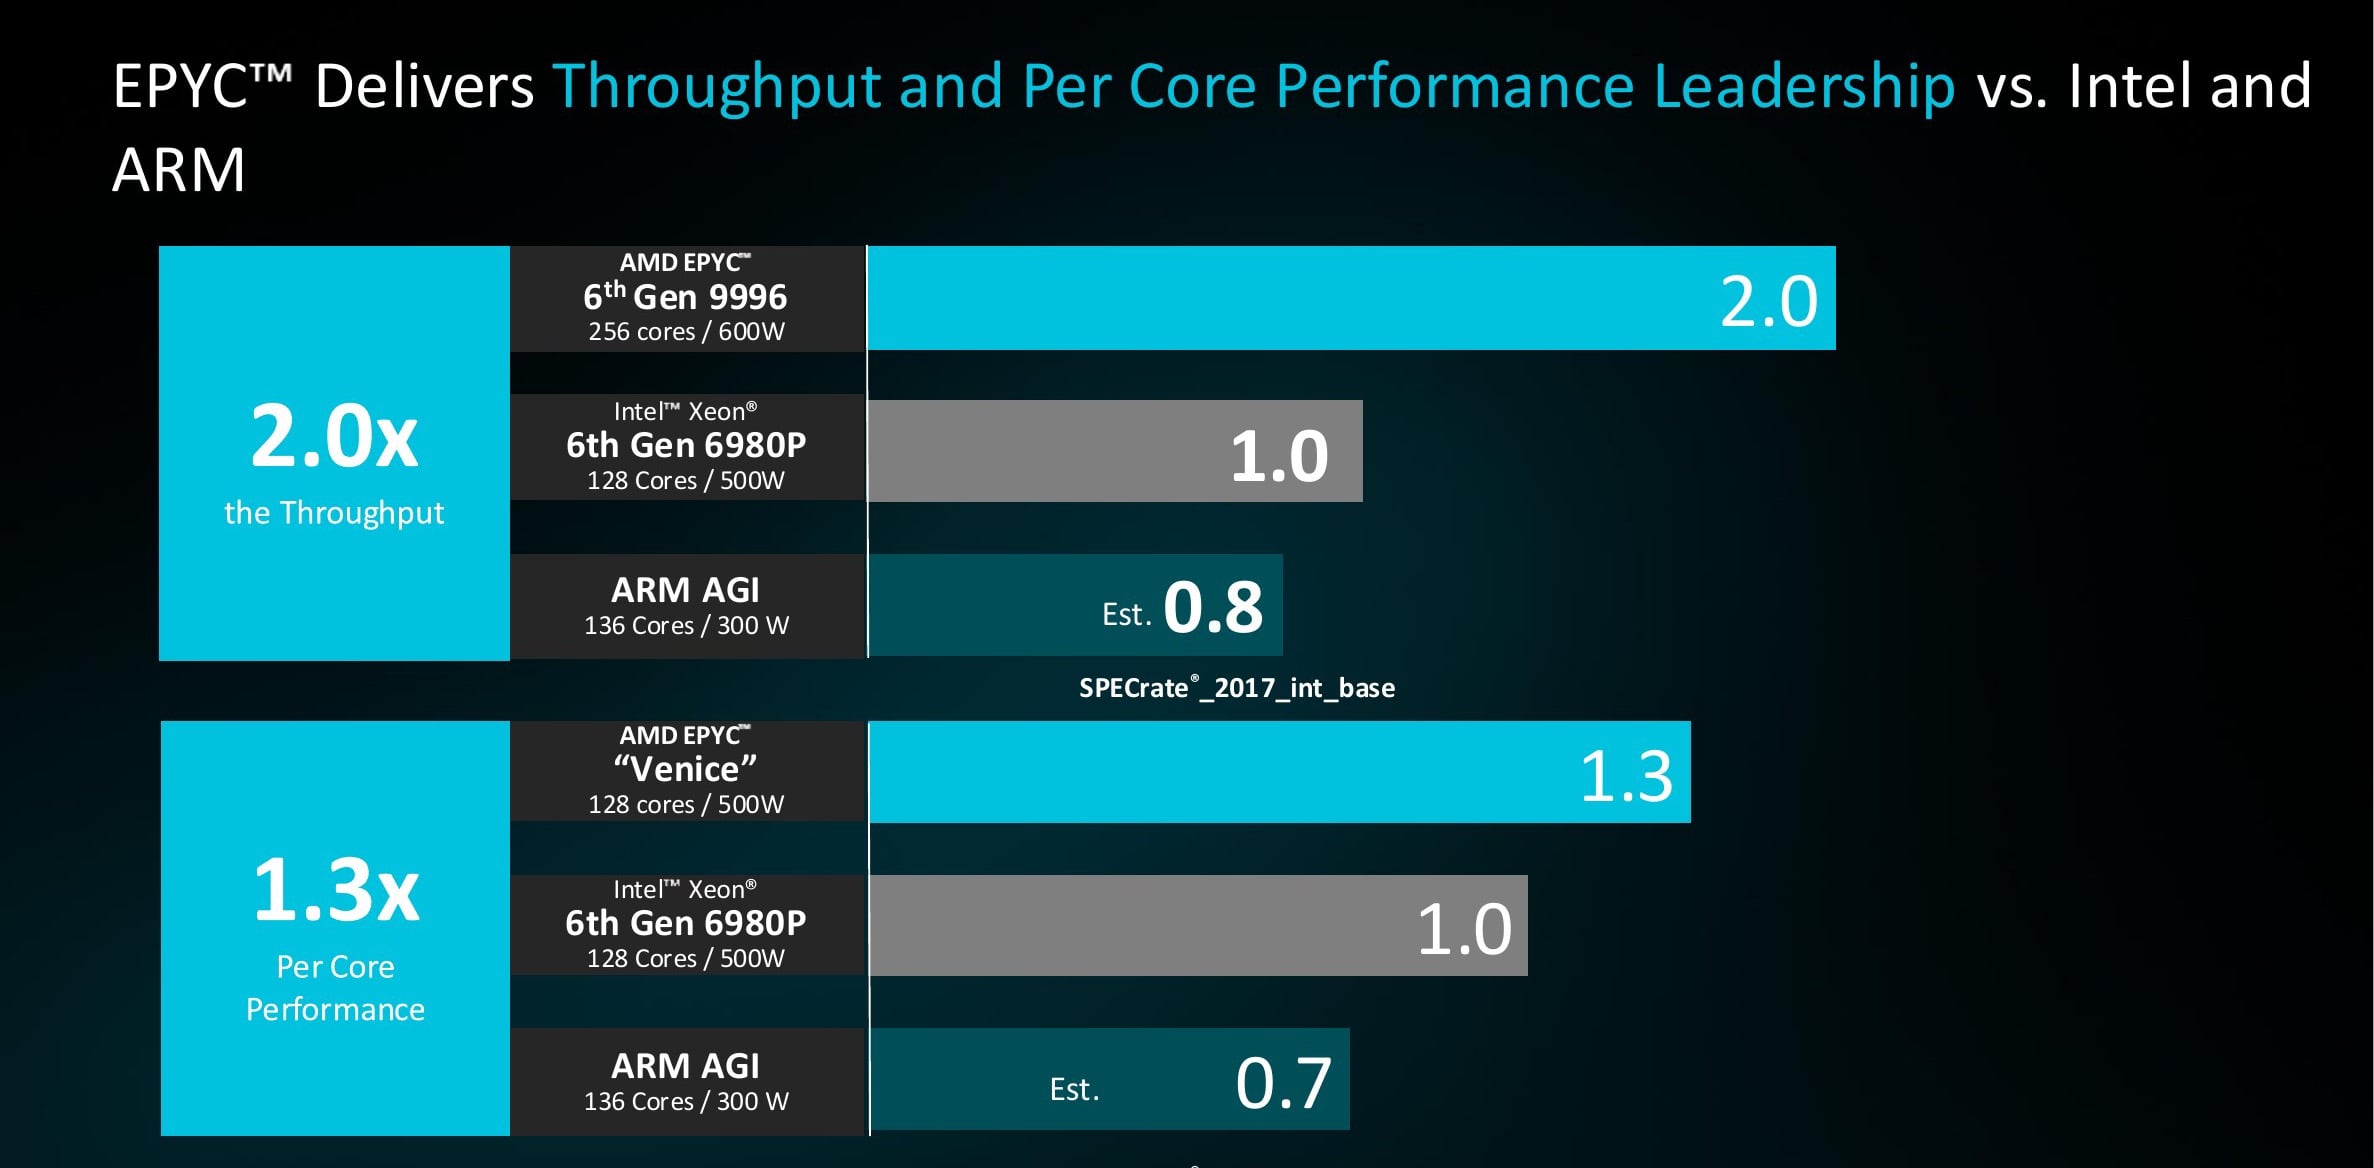
AMD zaprezentowało również szerszy ranking SPECrate 2017. Venice 9996 prowadzi z wynikiem 4900 (256 rdzeni, 600 W, 14 904 USD przy 1Ku), a następnie Turin 9965 z wynikiem 3240, Intel Xeon 6980P z wynikiem 2510 (128 rdzeni, 500 W, 1.3 955 USD), Arm AGI z wynikiem 1944 (136 rdzeni, 300 W) i Vera z wynikiem 1459. Wyniki 9996, AGI i Vera to szacunki AMD; wyniki Turin i Intela to wyniki opublikowane. W porównaniu z Intelem oznacza to mniej więcej dwukrotność przepustowości przy porównywalnej cenie katalogowej, czyli dwukrotność wydajności w przeliczeniu na dolara. W przeliczeniu na rdzeń, konfiguracja Venice ze 128 rdzeniami i 500 W mocy osiąga wynik 13-krotnie lepszy od 6980P, podczas gdy Arm AGI osiąga wynik 0.7-krotnie lepszy. W przeciwieństwie do powyższego porównania Vera, wynik każdego dostawcy został wygenerowany przy użyciu jego własnego, najlepszego zestawu narzędzi: AOCC dla AMD, OneAPI dla Intela i GCC 13 dla Arm.
Rozwiązania chmurowe i HPC
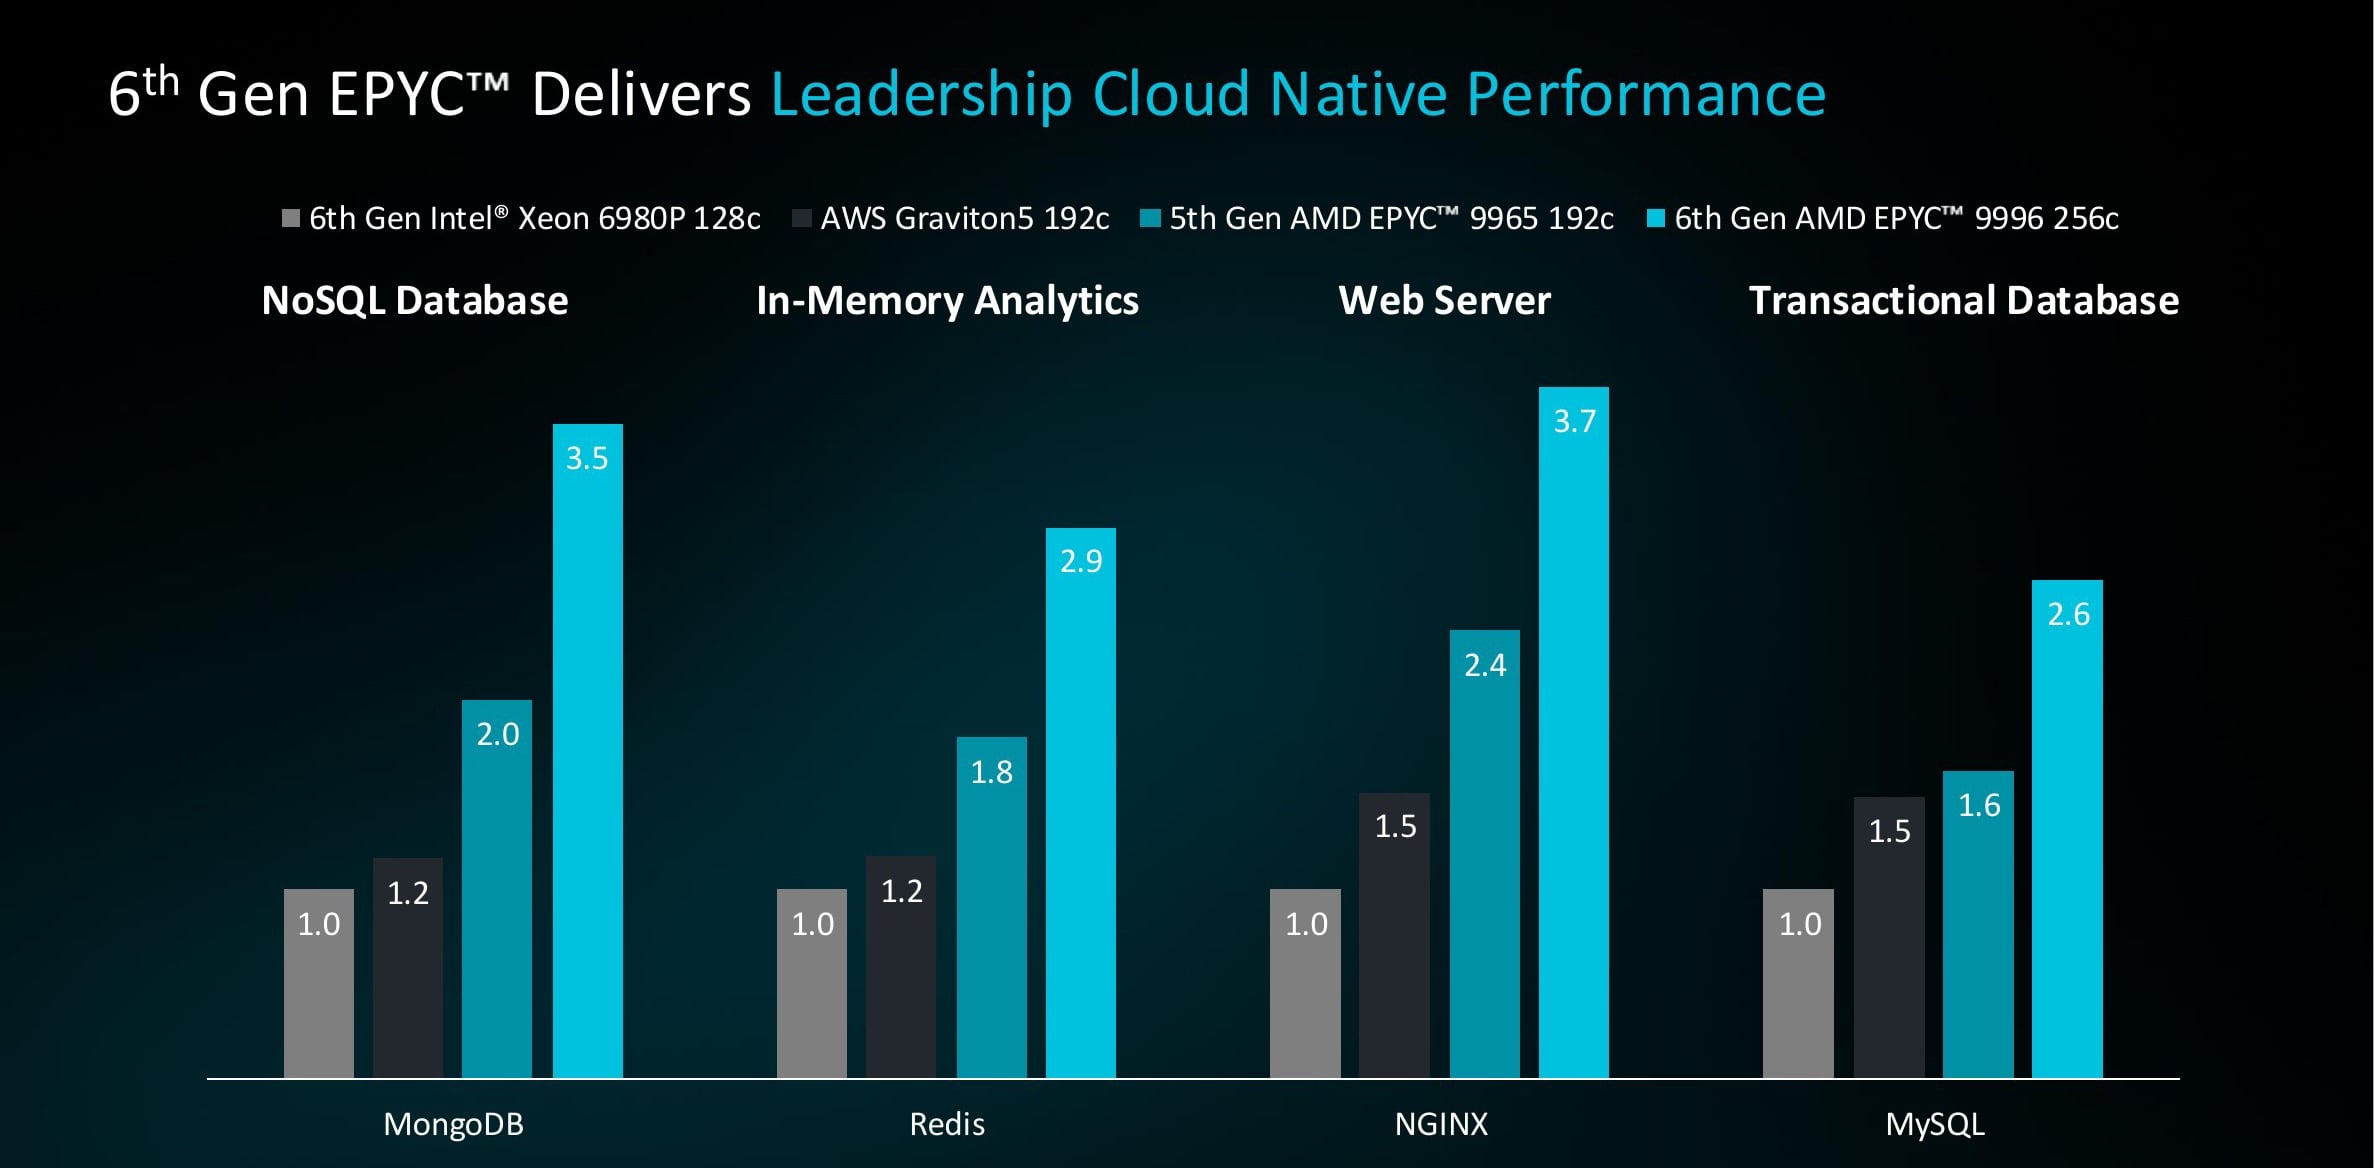
AMD podzieliło również porównanie według obciążenia, przy czym każdy wynik został zindeksowany do Intel 6980P z wartością 1.0. W przypadku rozwiązań chmurowych, 256-rdzeniowy procesor Venice 9996 uzyskał 3.5x w MongoDB, 2.9x w Redis, 3.7x w NGINX i 2.6x w MySQL. Turin uzyskał wynik między 1.6x a 2.4x w tych samych testach, a Graviton5 między 1.2x a 1.5x.
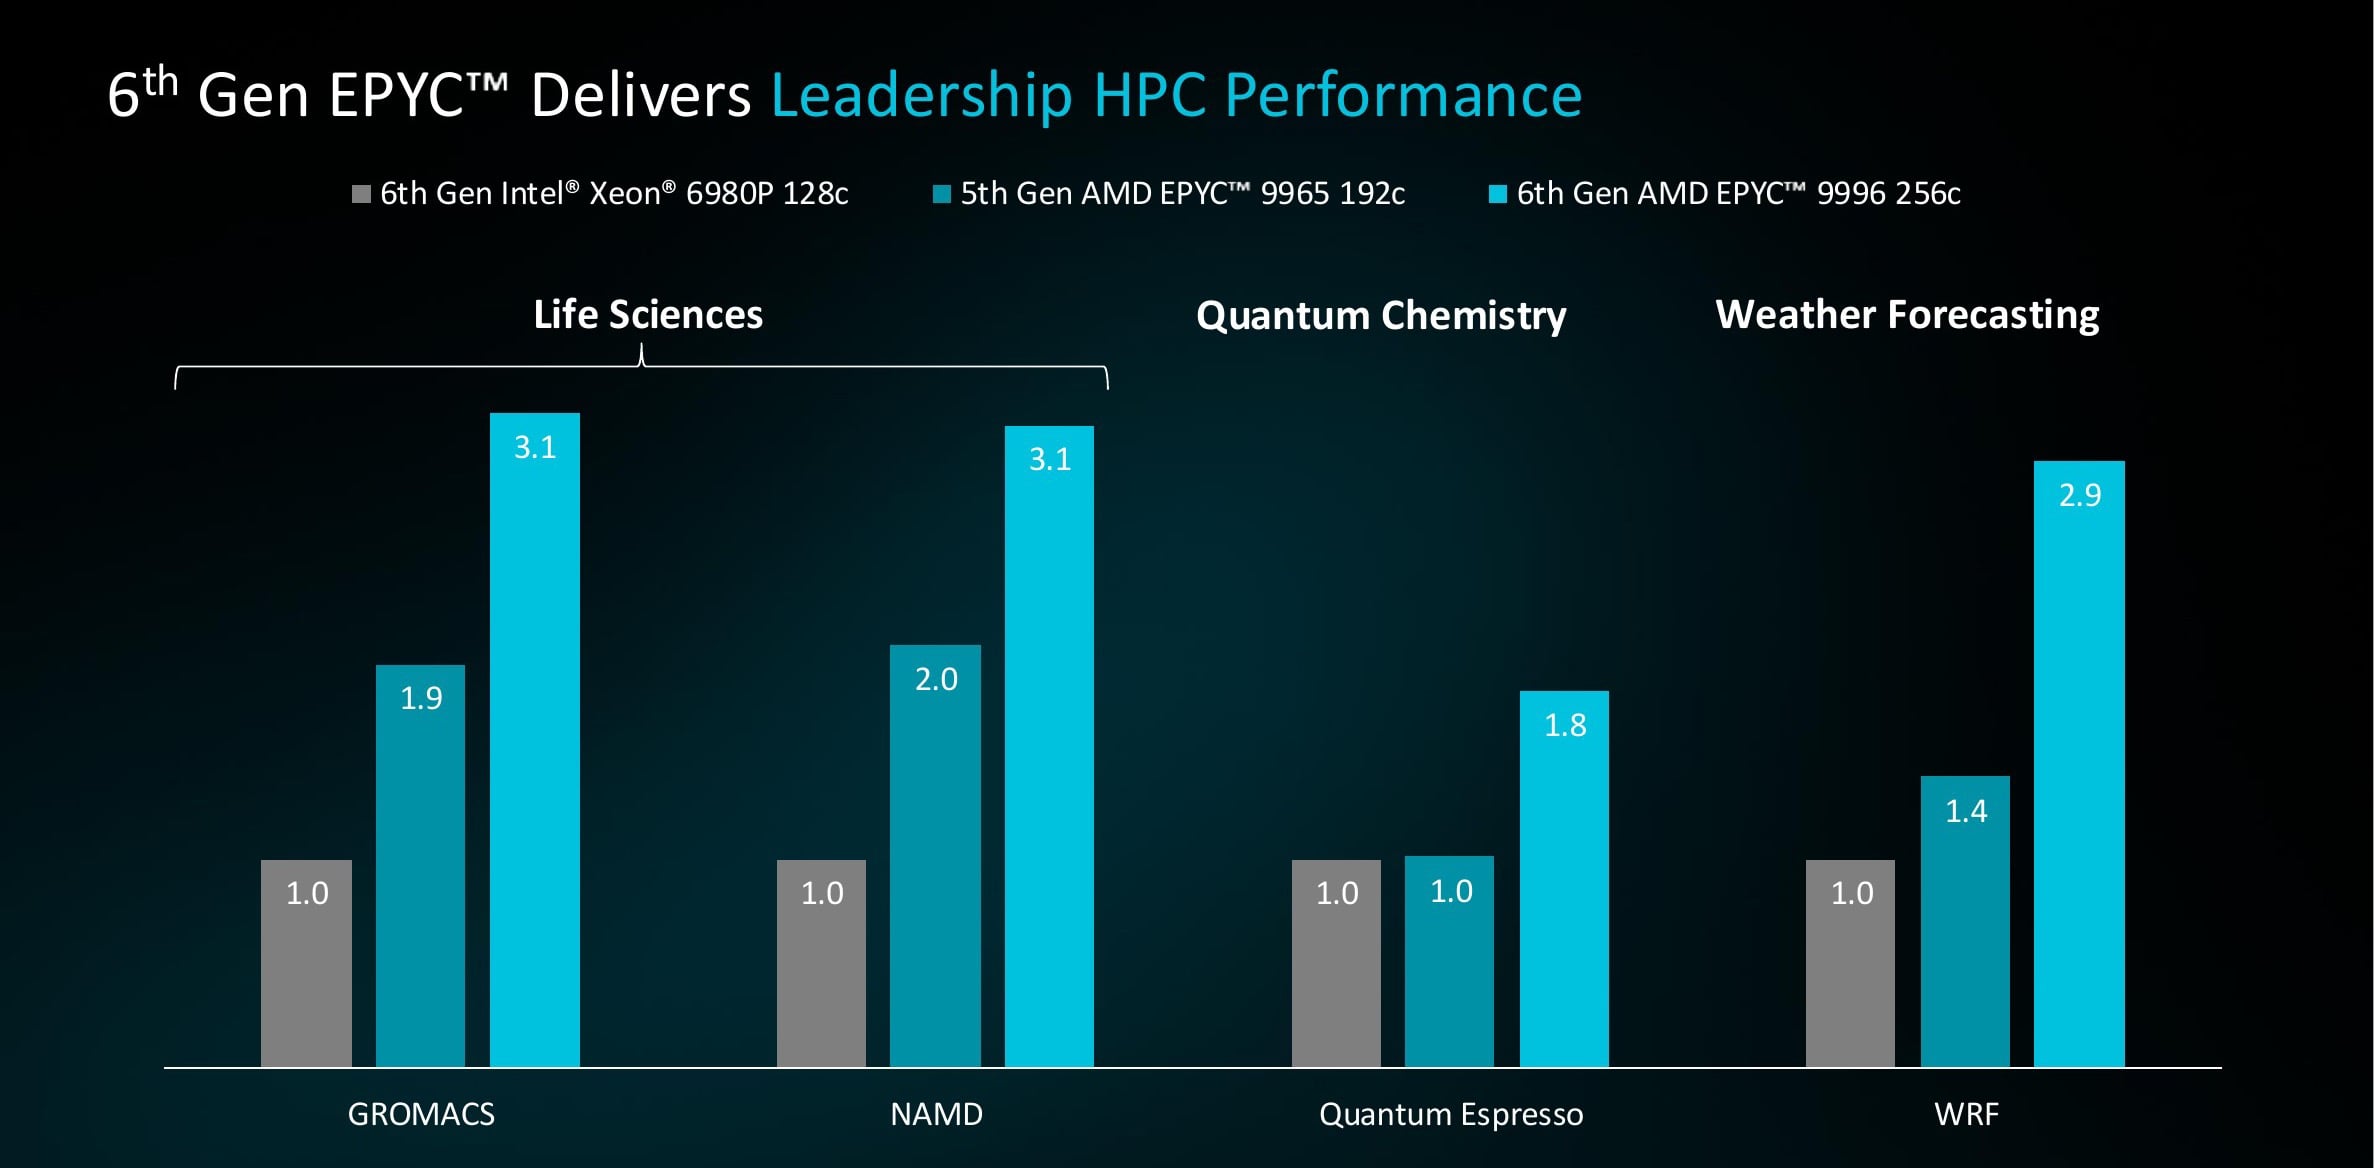
W HPC, Venice osiąga 3.1x w GROMACS i NAMD, 2.9x w WRF i 1.8x w Quantum Espresso. Konfiguracja pamięci znacząco zmienia te wyniki. Ze standardowymi modułami RDIMM 8,000 MT/s, Venice osiąga 2.81x w porównaniu z bazą Xeon w GROMACS; moduły MRDIMM 12 800 MT/s podnoszą ten wynik do 3.13x, a ta sama modernizacja zwiększa WRF z 2.25x do 2.90x. AMD podsumowuje swoją przewagę w HPC na poziomie od 1.8x do 3.5x, w zależności od obciążenia i pamięci. Baza Intela obejmowała moduły MRDIMM 8,800 MT/s, więc różnica nie wynika z połączenia ulepszonej pamięci AMD z wolniejszą konfiguracją Intela.
Węzeł hosta i roszczenie 1.8×
Wracamy do stwierdzenia o 1.8-krotności tokenów na sekundę. Łatwo wymienić stojące za tym ulepszenia sprzętowe: część hosta 5 GHz ma teraz 96 rdzeni zamiast 64, przepustowość pamięci hosta wzrasta z 614 GB/s do 1.6 TB/s, a PCIe Gen 6 podwaja przepustowość łącza CPU-GPU.
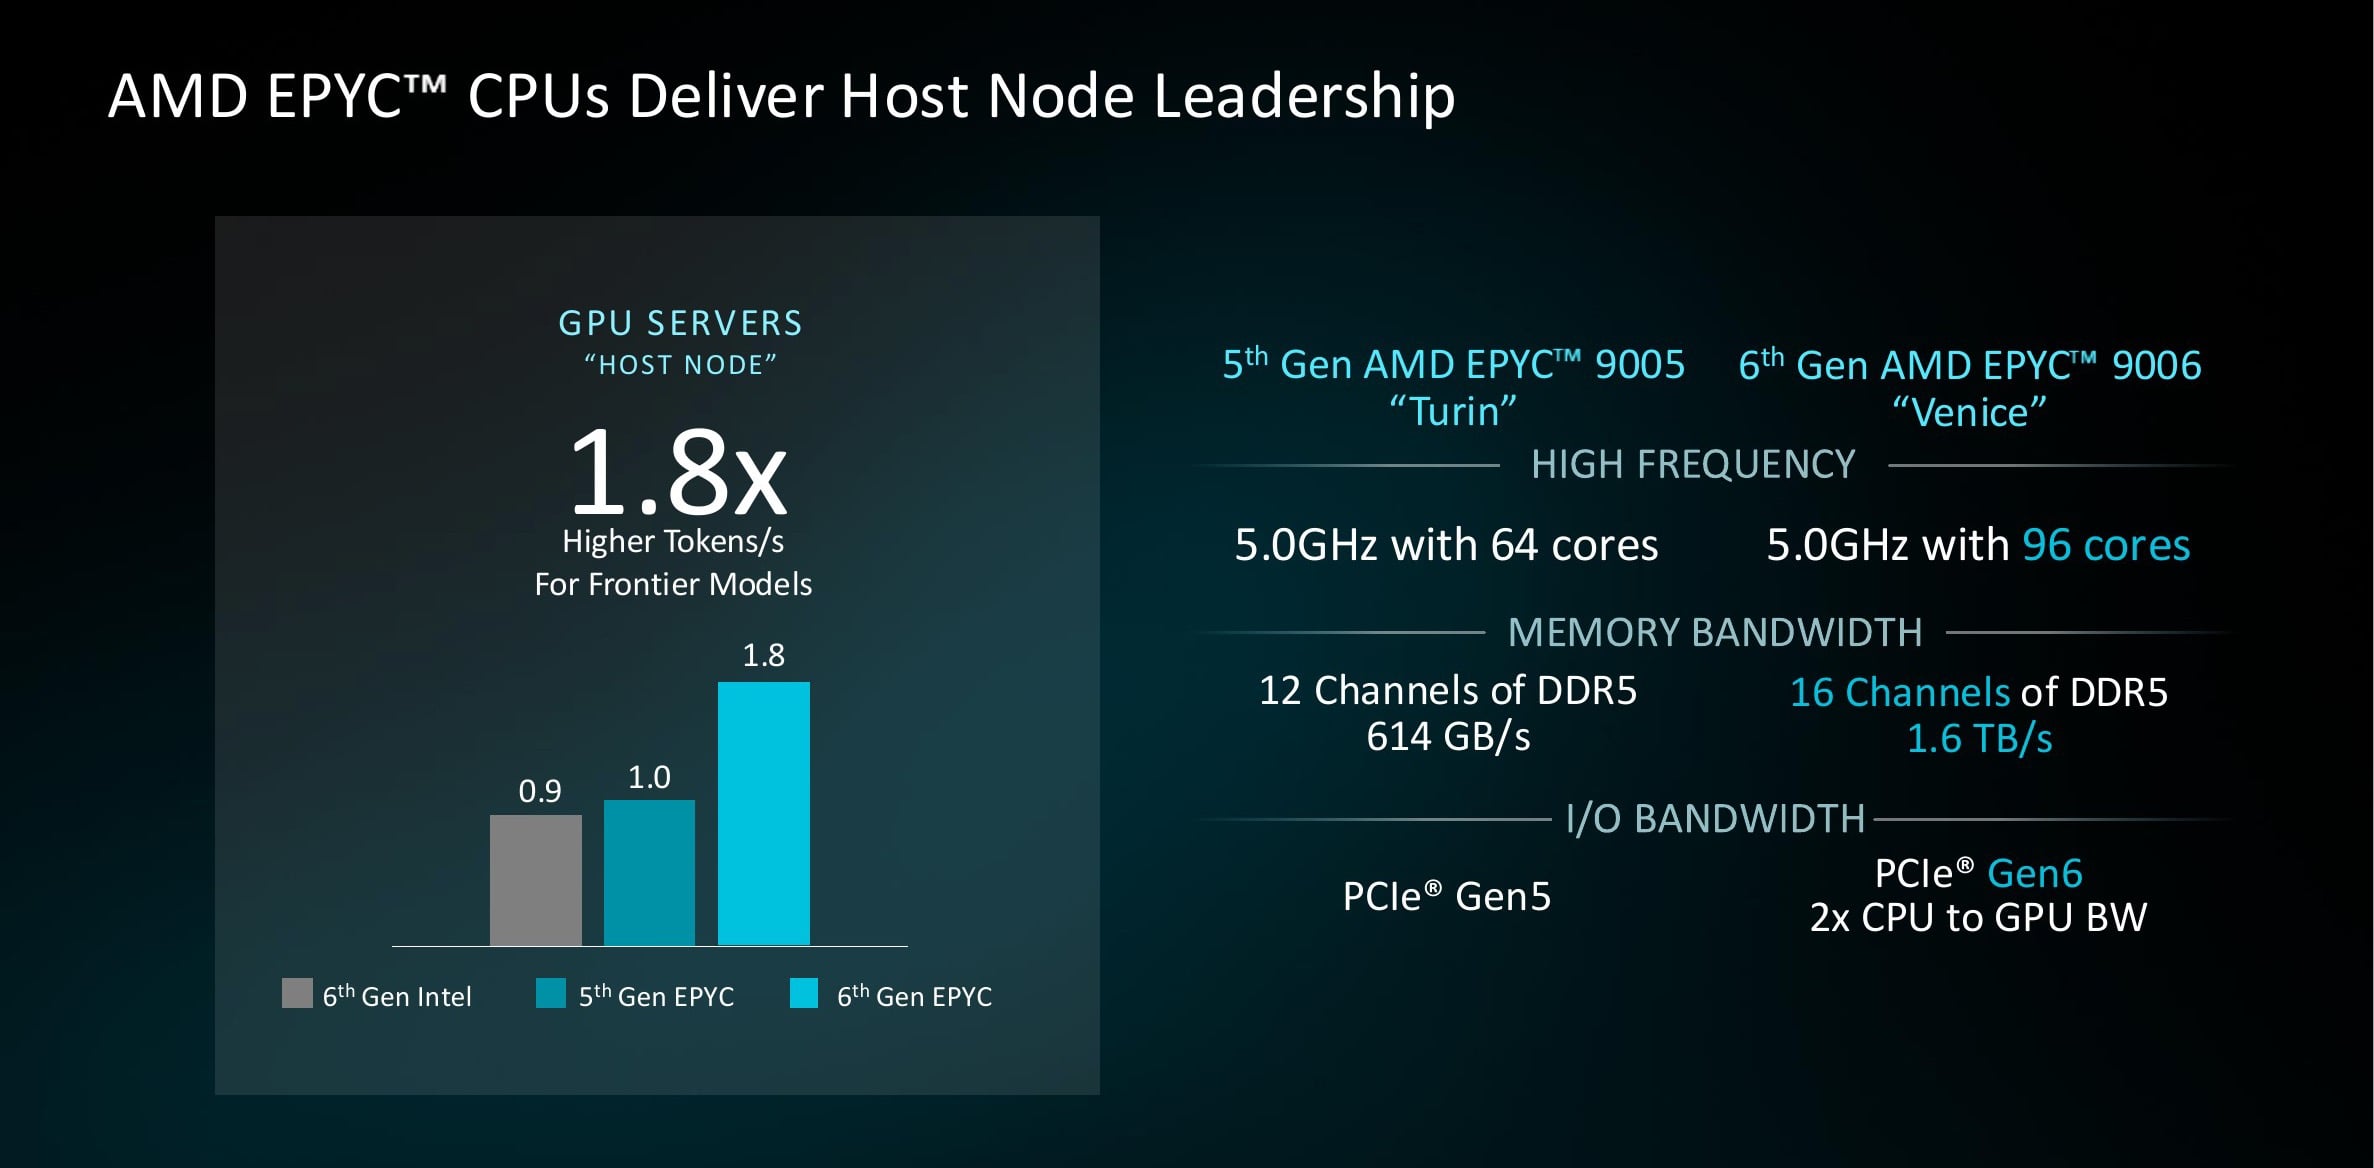
Pierwszą rzeczą do sprawdzenia jest linia bazowa. AMD zindeksowało ten wykres do Turina na poziomie 1.0, a nie do Intela, i umieściło Xeona 6. generacji na poziomie 0.9, dlatego to samo stwierdzenie zbliża się do 2x po przeliczeniu na Xeona 6960P. Przewidywany zysk pochodzi niemal wyłącznie z przepustowości wejścia/wyjścia. AMD przeprowadziło test odciążenia procesora, który przesyłał strumieniowo wagi BF16 Qwen3-30B z pamięci hosta do GPU i wykazał, że ścieżka odbiorcza PCIe Gen 5 x16 działała na poziomie 89% do 95% swojego teoretycznego pułapu, podczas gdy odczyty z pamięci DRAM hosta utrzymywały się poniżej 10% swojego teoretycznego pułapu. Prędkość dekodowania była ograniczona przez transfer, więc podwojenie łącza z PCIe Gen 6 daje poprawę od 1.8X do 1.9X w tym teście. Venice jest obecnie jedynym serwerowym procesorem oferującym PCIe Gen 6 akceleratorom, więc przewaga jest realna i, jak na razie, ekskluzywna. Jego zakres jest jednak wąski: 1.8X opisuje jeden wzorzec odciążenia z ograniczeniem przepustowości i nie należy go interpretować jako obietnicy, że procesory graficzne obsługują każdy model 1.8 razy szybciej na hostach Venice. W dzisiejszych dostawach sprzętu, host Turin pokonuje Xeona 6960P o średnią geometryczną 13% w czasie do pierwszego tokena w obciążeniach vLLM i NIM na tym samym systemie 8X B200, z poprawą w najlepszym przypadku na poziomie 36%.
Gęstość regału
Ostatnim stwierdzeniem jest gęstość: 49 152 rdzenie Wenecji na stojaku, w porównaniu z 36 864 dla Turynu i 22 528 dla Very, przy czym każda część zawiera dwa razy więcej wątków niż rdzeni. Ze wszystkich stwierdzeń w talii, to zmienia się najbardziej po zastosowaniu przypisów końcowych.
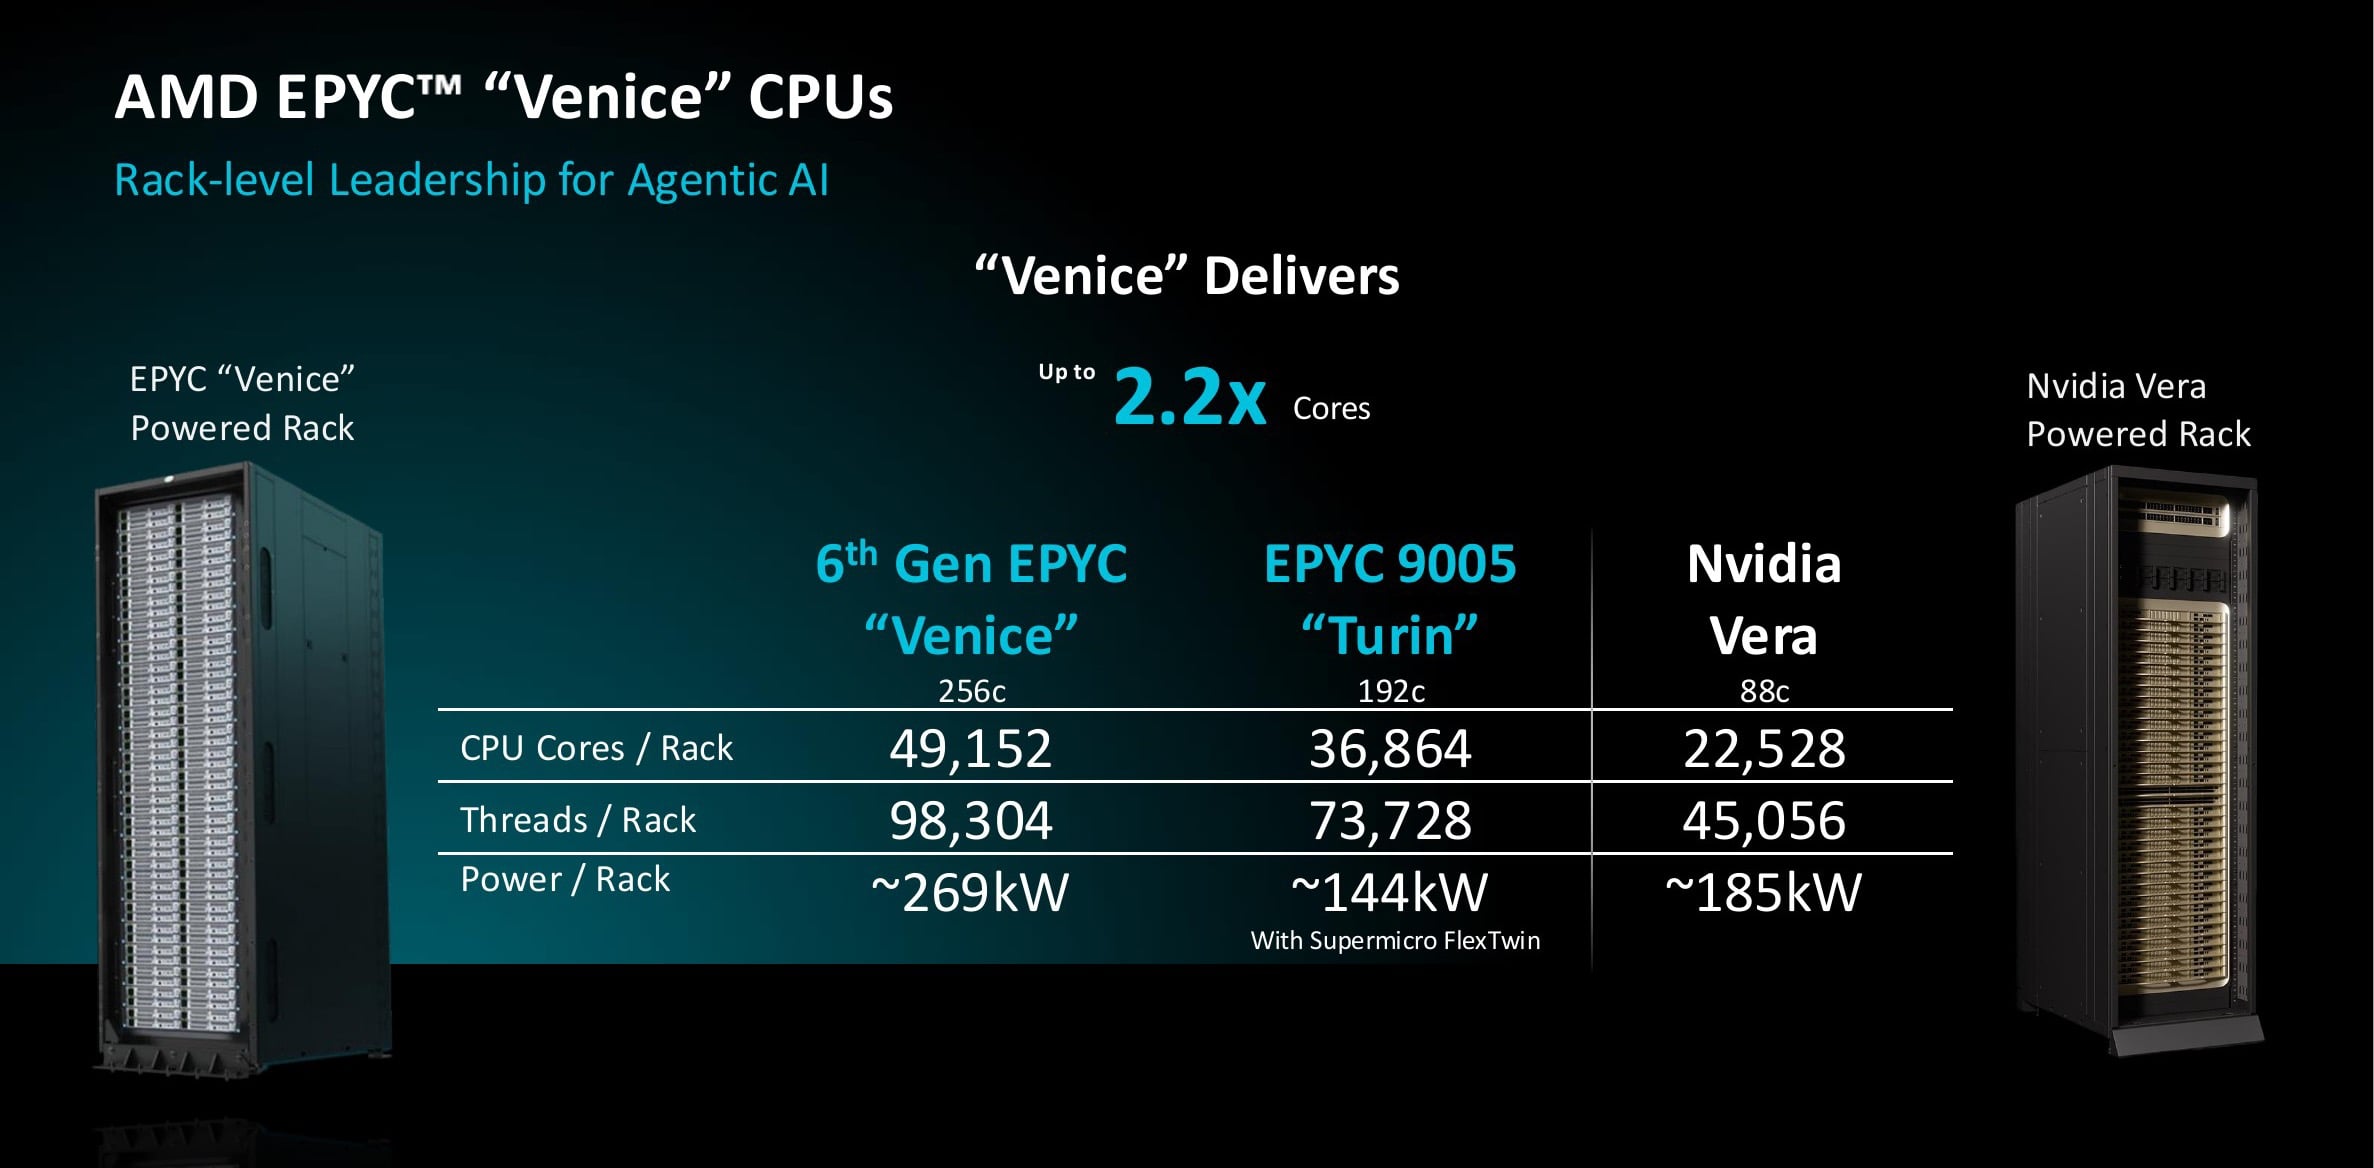
Nagłówek to 2.2X rdzeni Very, ale szafa Venice osiąga ten poziom pobierając 269 kW, w porównaniu do 185 kW Very, więc obie szafy nie są porównywane przy dopasowanej mocy. Przypisy końcowe AMD dostarczają znormalizowane wersje. Przy obu szafach utrzymanych w kopercie 100 kW, 9996 dostarcza 2.08X rdzeni Very, 1.86X Turin i 1.24X Intel 6980P. Zastępując 400-watowy EPYC 9956 flagowym modelem, AMD szacuje 1.91X rdzeni Very przy 26% mniejszym poborze mocy, co daje 2.57X rdzeni na wat szafy. W zależności od tego, który budżet mocy jest stały, prowadzenie plasuje się między 1.9X a 2.2X, i, jak w przypadku każdej liczby Vera w tym artykule, szafa NVIDIA jest modelowana na podstawie opublikowanych specyfikacji, a nie zmierzonych urządzeń. Zaleta gęstości jest znośna po normalizacji; jest po prostu mniejsza niż 2.2X.
Wielki łobuz
Pomijając indywidualne twierdzenia: w segmencie procesorów serwerowych AMD nie ma obecnie bezpośredniego rywala. Najlepszy procesor Intela ustępuje Turinowi, generacji, którą AMD już zastępuje. Konkurenci z Arm plasują się poniżej Turina na każdym wykresie publikowanym przez AMD. Vera nie została jeszcze wprowadzona na rynek, a szacunki AMD wskazują, że jej przepustowość jest mniejsza niż połowa przepustowości Turina 9965, który jest na rynku od półtora roku, a Venice ponownie podwaja przepustowość Turina. Ta pozycja zapewniła AMD 46% przychodów z procesorów serwerowych, według Mercury Research. Dane rynkowe wskazują na to samo. Popyt na procesory EPYC najwyższej klasy obecnie przewyższa podaż, co w rezultacie wydłuża czas realizacji zamówień.
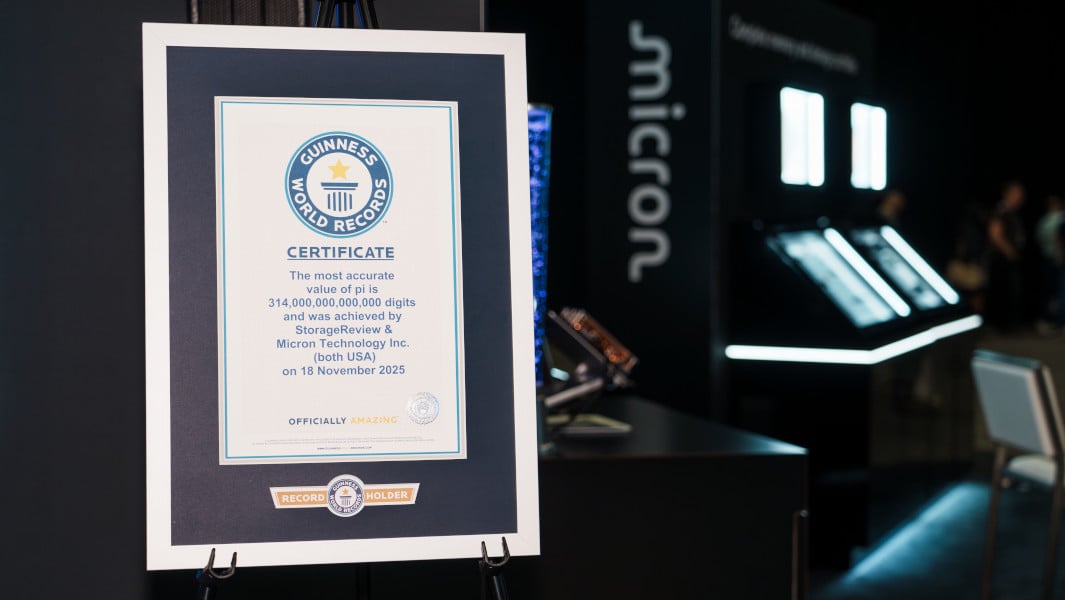
Możemy tutaj dodać własny punkt danych. Nasz rekord świata Pi, wynoszący 314 bilionów cyfr, został ustanowiony na serwerze Dell PowerEdge R7725 z dwoma 192-rdzeniowymi procesorami EPYC 9965 i 1.5 TB pamięci DDR5 – tej samej 384-rdzeniowej konfiguracji 2P, na której AMD modeluje swoje szafy Turin. Obliczenia utrzymywały każdy rdzeń obciążony przez 110 dni i zakończyły się bez sekundy przestoju; pojedynczy błąd pamięci lub awaria w dowolnym momencie uniemożliwiłyby przeprowadzenie próby. Średni pobór mocy wynosił około 1,600 W, a cały przebieg zużył 4,305 kWh, czyli 13.7 kWh na bilion cyfr, w porównaniu z szacowanymi 33 600 kWh w ciągu około 225 dni dla poprzedniego rekordu 300 bilionów cyfr.
Wniosek
Venice to najsilniejsza premiera procesora serwerowego, jaką AMD kiedykolwiek zorganizowało, a jej prawdziwym celem jest szerokość. Jedna generacja Zen 6 obejmuje od procesora o gęstości 256 rdzeni, przez gniazdo klasy enterprise i układ HPC z pamięcią podręczną 1152 MB, aż po węzeł hosta LPDDR, dzięki czemu klient może zbudować każdy poziom centrum danych na tej samej architekturze i bazie oprogramowania. Liczby, na których opiera się premiera, są aktualne po przeczytaniu przypisów końcowych: mniej więcej dwukrotna przepustowość Intela przy porównywalnej cenie katalogowej, 20% przewaga na rdzeń nad Verą przy dopasowanym kompilatorze oraz gęstość procesora w szafie rack od 1.9x do 2.2x w porównaniu z procesorem hosta NVIDIA, w zależności od zakresu mocy.
Komercyjna część historii nie wymaga prognozowania. SP7 jest już w produkcji, a platformy partnerskie mają pojawić się w czwartym kwartale; SP8 pojawi się w pierwszej połowie 2027 roku, a za nim Venice-X i Verano. Firma, która je sprzedaje, generuje już 46% przychodów z procesorów serwerowych, a popyt na ich obecne podzespoły znacznie przewyższa podaż, więc kupujący czekają w kolejce, zamiast się wycofywać. Venice może spaść o rok, ale porównania w tym artykule i tak będą brzmiały jak lider, ponieważ Turin już teraz przewyższa wszystkie inne procesory w zestawieniu, zarówno te z dostarczoną, jak i niedostarczoną wersją. AMD jest tak daleko z przodu, że jego najbliższym konkurentem, na razie, jest jego własna, najnowsza generacja.


 Amazon