

Wersja AMD ROCm 10.1, wydana 5 października, kładzie nacisk na ścieżkę między pamięcią masową a GPU. Pliki punktów kontrolnych, pamięci podręczne klucz-wartość i wagi modeli rutynowo przekraczają teraz pamięć akceleratora, a kiedy to się dzieje, czas poświęcony na przesyłanie danych zaczyna decydować o czasie iteracji bardziej niż obliczenia matematyczne. Wersja ta rozbudowuje AMD Infinity Storage, stos pamięci masowej bezpośrednio dostępny w wersji ROCm 7.14, poprzez połączenie dostępu do pamięci masowej ze środowiskiem wykonawczym HIP i dodanie pamięci hosta obsługującej architekturę NUMA, dzięki czemu dane docierają do GPU bez konieczności przechodzenia przez pamięć CPU.
Bezpośrednie potoki pamięci GPU i pamięć obsługująca NUMA
Biblioteka hipFILE w pamięci masowej AMD Infinity Storage zyskuje asynchroniczny backend szybkiej ścieżki. Żądania odczytu i zapisu są realizowane bezpośrednio w strumieniu HIP, pomijając etap przygotowania pamięci hosta, wymagany przez tradycyjną ścieżkę. AMD twierdzi, że rezultatem jest mniejsze opóźnienie dla silników punktów kontrolnych i odciążenie pamięci podręcznej KV, przy jednoczesnym zachowaniu stałej przepustowości. W informacjach o wydaniu opisano wywołania: hipFileReadAsync() i hipFileWriteAsync() obsługują teraz szybką ścieżkę.
Interfejs API wsadowego wejścia/wyjścia (I/O) przesyła wiele żądań plików jednocześnie i rozdziela je na wewnętrzną pulę wątków roboczych, co utrzymuje kolejki pamięci masowej pełne, gdy zadanie szkoleniowe pobiera duży zbiór danych. Telemetria rośnie wraz z tym: hipFileGetStatsL1, L2 i L3 zwracają stopniowo bardziej szczegółowe statystyki wejścia/wyjścia, a liczniki te przesyłają dane do profilerów ROCm, dzięki czemu operator może określić, czy potok jest ograniczony przez moc obliczeniową, pamięć lub dostarczanie danych.
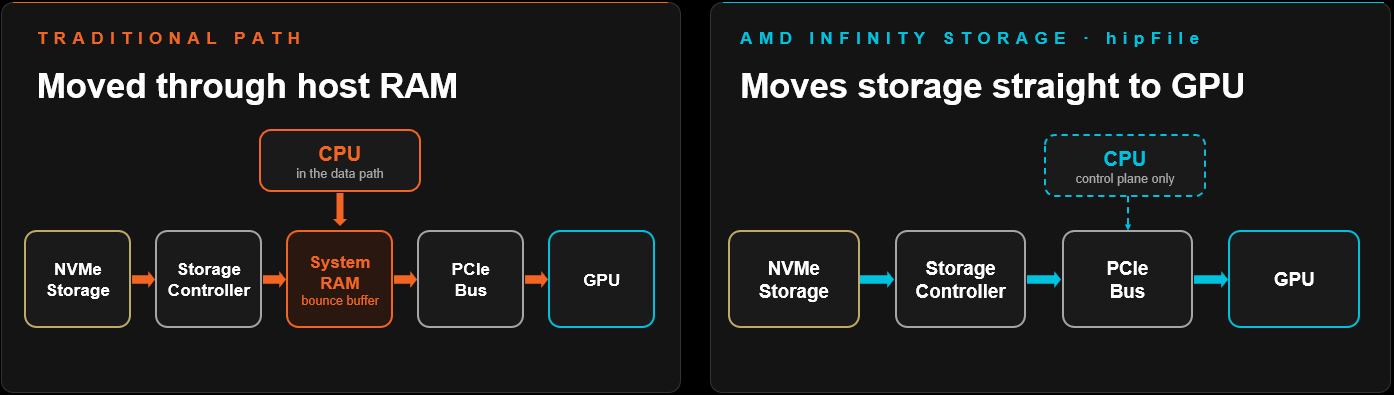
W hostach dwugniazdowych bufor przydzielony do niewłaściwego gniazda generuje karę międzygniazdową przy każdym transferze. ROCm 10.1 rozszerza interfejsy API zarządzania pamięcią wirtualną HIP o hipMemLocationTypeHostNuma i hipMemLocationTypeHostNumaCurrent, dzięki czemu pamięć hosta może być umieszczana na konkretnym węźle NUMA w pełnym cyklu tworzenia, rezerwowania, mapowania i usuwania. Biblioteki takie jak RCCL mogą na tym budować lokalne bufory komunikacyjne NUMA typu zero-copy i utrzymywać ruch między hostem a urządzeniem poza połączeniem między gniazdami.
Interfejs wiersza poleceń ROCm w wersji 1.0.0 i przepływy pracy agentów AI
Interfejs wiersza poleceń ROCm CLI osiąga wersję 1.0.0 jako pojedynczy plik binarny dla systemów Linux, Windows i WSL2, który instaluje, konfiguruje i uruchamia lokalne obciążenia AI na procesorach graficznych AMD. Wykrywa on koła flash-attn i amd-aiter wymagane przez vLLM, obsługuje zaktualizowany układ pakietów ROCm 10 i dodaje flagę dla instalacji w pełni nieinteraktywnych w środowiskach skryptowych lub CI. Pełnoekranowy pulpit TUI wyświetla na żywo dane telemetryczne GPU obok obsługi modelu oraz lokalne okno czatu, umożliwiające sprawdzenie odpowiedzi punktu końcowego.
AMD Skills, pakiet integracji dla agentów kodowania, takich jak Claude Code i Codex, zawiera dwa kolejne. quark-install instaluje AMD Quark z pasującą kompilacją PyTorch, a quark-torch-llm-ptq uruchamia kwantyzację po szkoleniu w PyTorch i Hugging Face LLM ze schematami, takimi jak FP8 i INT4.
Modernizacja profilowania i telemetrii
Pakiet ROCprofiler-SDK dodaje funkcję replay jądra w wersji beta. Sprzęt GPU udostępnia ograniczoną liczbę liczników wydajności na żądanie, więc zebranie pełnego zestawu liczników oznaczało kiedyś ponowne uruchomienie całej aplikacji raz dla każdej grupy liczników. Funkcja replay jądra ponownie uruchamia każde żądanie w miejscu, resetując pamięć GPU między przebiegami i gromadząc cały zestaw w jednym uruchomieniu. Pakiet SDK umożliwia również rozpoczęcie i zakończenie profilowania w dowolnym momencie dla PyTorch Kineto i Triton Proton, a także zawiera funkcję agenta próbkowania na komputerze PC, która przeprowadza asystenta kodowania przez proces próbkowania na komputerze PC w celu znalezienia przestojów obliczeniowych.
Raport ROCm Compute Profiler z linii dachu jest teraz interaktywną stroną HTML, dzięki czemu inżynier może wyizolować pojedyncze jądro i przełączać oś intensywności arytmetycznej między poziomami pamięci podręcznej. Raporty próbkowania PC dla każdego jądra, aż do liczby próbek i zatrzymań dla poszczególnych instrukcji, a nowy przewodnik obejmuje profilowanie vLLM. ROCm Systems Profiler dodaje śledzenie Linuksa dla APU Gorgon Point 1, 2 i 3 (gfx1150, gfx1152 i gfx1153), a ROCm Optiq wizualizuje teraz profile rocprofv3 obok śladów Systems Profiler i analizy Compute Profiler.
AMD SMI (amd-smi) zastępuje ROCm SMI, które zostało usunięte ze standardowej kompilacji w tej wersji. Obejmuje ono procesory graficzne, procesory i układy APU AMD w systemach Linux i Windows, zarówno fizyczne, jak i zwirtualizowane, z interfejsem wiersza poleceń (CLI), biblioteką C (amd_smi_lib) oraz powiązaniami z językami Python, Go i Rust. Świadomość kontenerów obejmuje containerd, CRI-O, Podman, LXC i LXD, w tym kontenery Kubernetes, dzięki czemu administrator klastra może dopasować procesy i wykorzystanie GPU do kontenera, na którym są uruchamiane.
Aktualizacje kompilatora rdzeniowego, biblioteki i obsługa środowiska wykonawczego
Łańcuch narzędzi przechodzi z LLVM 23 do LLVM 24, a makro clang_major raportuje teraz wersję 24, co każdy, kto przypina wersje kompilatora lub linkuje z libLLVM, będzie chciał sprawdzić przed aktualizacją. Kompilacje przyrostowe są szybsze dzięki buforowaniu partycji tworzonych przez optymalizację czasu łączenia kodu urządzenia, więc niezmienione partycje są ponownie wykorzystywane podczas kolejnej kompilacji.
Composable Kernel przyspiesza obsługę uwagi na kartach graficznych Radeon i dodaje do swojego modułu dyspozytorskiego więcej skwantyzowanych typów mnożenia macierzy. MIGraphX zamienia swój kompilator back-end z rocMLIR na rocMLIRTriton, co według AMD poprawia wydajność wnioskowania i często skraca czas kompilacji modelu, jednocześnie utrzymując kompilator w zgodzie z nadrzędnym Tritonem. rocSPARSE wykonuje rozwiązania trójkątne bezpośrednio na macierzach zapisanych w formacie ELLPACK (ELL), bez konieczności wcześniejszej konwersji.
HipThreads, nowość w bibliotekach wątkowych ROCm Core SDK, wprowadza standardowe koncepcje wątków C++ do procesorów graficznych AMD w systemach Linux i Windows. Celem jest przyspieszenie istniejącego kodu wielowątkowego procesora na procesorze graficznym bez konieczności całkowitego przepisywania jąder HIP i prymitywów synchronizacji.
Podsystem Windows dla Linuksa 2 wchodzi w fazę tech preview, w której standardowe pakiety Linuksa są instalowane w systemie gościa, a parawirtualizacja GPU przekazuje zadania sterownikowi hosta systemu Windows. Wersja preview obejmuje pakiety .deb i Python Wheels, ale nie pakiety RPM, a narzędzia profilowania, debugowania i zależne od KFD nie działają jeszcze w WSL2. Jeśli chodzi o wirtualizację, funkcja KVM SR-IOV jest teraz obsługiwana w Ubuntu 26.04 LTS zarówno jako system hosta, jak i gościa, w połączeniu z wersją 9.3.0.K sterownika wirtualizacji AMD GIM.
Na liście obsługiwanego sprzętu znajdują się karty Radeon AI PRO R9600, Instinct MI355X, MI350X i MI350P, serie MI300 i MI200, pozostałe karty z rodziny Radeon AI PRO R9700 oraz procesory Ryzen AI.


 Amazon