

Firma CoreWeave wdrożyła wieloskrzydłowy klaster NVIDIA Vera Rubin NVL72 w chmurze CoreWeave Cloud, łącząc setki procesorów GPU Rubin w jedno skalowalne środowisko przeznaczone do obsługi zadań związanych z agentową sztuczną inteligencją. Każdy stelaż zbudowany przez firmę Dell mieści 72 procesory GPU Rubin, 36 procesorów CPU Vera, interfejs NVLink 6 jako strukturę skalowania, procesory DPU BlueField-4 oraz dwa układy ConnectX-9 SuperNIC na procesor GPU, a stelaże łączą się przez sieć Ethernet NVIDIA Spectrum-X w dwuwarstwowej, nieblokującej strukturze, która według firmy CoreWeave skaluje się do około 128 000 procesorów GPU. CoreWeave jest pierwszym dostawcą usług w chmurze, który zweryfikował i uruchomił pojedynczy procesor Vera Rubin NVL72, a także pierwszym, który opublikował wyniki pomiarów wydajności z jednego z nich; pierwsze recenzowane wyniki platformy pojawiły się w raporcie MLPerf Inference v6.1 w zeszłym tygodniu, gdzie własne zgłoszenie firmy CoreWeave działało na procesorze GB300 NVL72. Oprócz mocy obliczeniowej, CoreWeave AI Object Storage oferuje przyspieszenie zapisu międzyregionalnego i nową warstwę archiwum.
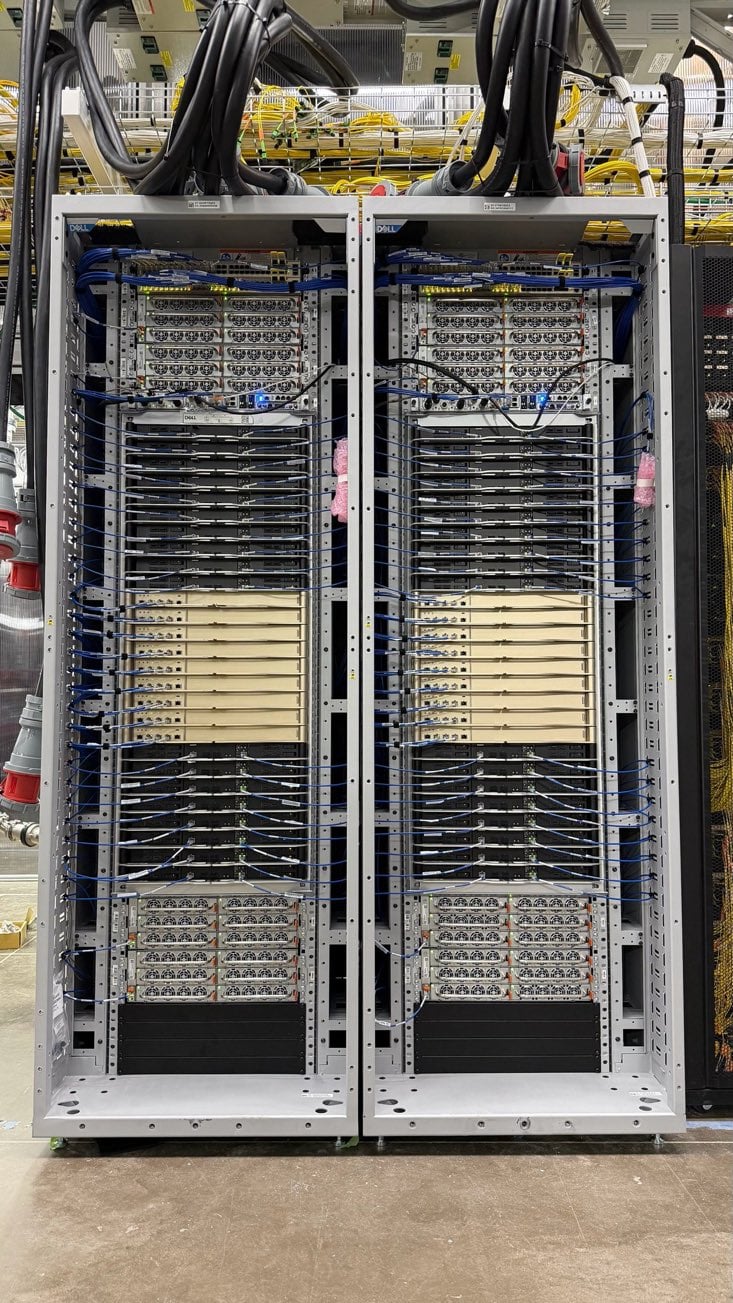
Architektura wielostanowiskowa NVIDIA Vera Rubin NVL72
Konstrukcja wieloskrzynkowa koncentruje się na ścieżkach wykonywania agentów, gdzie pętle wnioskowania szeregowego i wywołania zewnętrznych narzędzi powodują złożone opóźnienia w dostępie do danych w całej rozproszonej infrastrukturze. Dwie karty ConnectX-9 SuperNIC na każdym procesorze graficznym Rubin zapewniają łączność sieciową z prędkością do 1.6 Tb/s na procesor graficzny w ścieżkach wieloszynowych i wielopłaszczyznowych, a CoreWeave opisuje tę strukturę jako modułową, więc dodatkowe szafy NVL72 dołączają się do tej samej nieblokującej topologii w miarę wzrostu pojemności. Szafy działają w oparciu o chłodzenie cieczą o temperaturze 45°C.
CoreWeave łączy ze sobą szafy rack za pomocą oprogramowania Mission Control. Kontroler cyklu życia szaf rack (Rack LifeCycle Controller) odpowiada za dostarczanie i cykl życia każdej szafy rack, wykrywanie sprzętu poprzez flashowanie oprogramowania sprzętowego, walidację, zasilanie i pętle termiczne; warstwa zarządzania szafą rack o nazwie Racky kontroluje zasilanie i infrastrukturę; a programowalny kontroler chłodzenia o nazwie Valvey zapewnia programowalną widoczność i kontrolę nad pętlami chłodzenia cieczą i czujnikami środowiskowymi.
Szafy trafiają do produkcji dopiero po etapowym przejściu walidacji. Na poziomie węzła oznacza to godziny powtarzanej diagnostyki GPU, kontroli transferu CPU-GPU, walidacji połączeń i kontroli termicznej pod obciążeniem oraz realistycznych przebiegów treningowych. Na poziomie szafy, zsynchronizowane zadania na wszystkich 72 GPU weryfikują wydajność NVLink GPU-GPU, a każdy system, który osiąga wynik poniżej oczekiwanego zakresu, trafia do działu rozwiązywania problemów. W szafach CoreWeave obsługuje rozproszone obciążenia, celowo wyłącza ścieżki NVLink, aby wymusić ruch w sieci zaplecza, i monitoruje infrastrukturę fizyczną pod kątem niestabilnych łączy, rosnącej liczby błędów, przegrzewającego się sprzętu i nierównomiernego ruchu, z wzorcami obciążenia naśladującymi aplikacje agentowe: nagłe skoki zapotrzebowania, zmieniająca się współbieżność i nagłe wzrosty komunikacji. Opis CoreWeave dotyczący wdrożenia wieloszafowego omawia każdy etap i stanowi interesującą lekturę.
Aktualizacje pamięci obiektów AI: Zapisy międzyregionalne i warstwa archiwizacji
Usługa pamięci masowej bazuje na rozwiązaniu CoreWeave AI Object Storage i jego lokalnym akceleratorze transportu obiektów (LOTA), buforującym serwerze proxy, który działa na każdym węźle GPU i CPU w usłudze CoreWeave Kubernetes Service i przechowuje obiekty na lokalnej dla węzła pamięci NVMe. CoreWeave raportuje odczyty z pamięci podręcznej z prędkością do 7 GB/s na GPU, a opóźnienie odczytu p99 jest ponad 8 razy niższe niż w przypadku odczytu z zasobnika. Firma podaje również dane jednego z wiodących dostawców modeli, który uruchomił LOTA na ponad 15 000 GPU i 20 PB pamięci podręcznej ze współczynnikiem trafień na poziomie 99.7%. LOTA nie wiąże się z żadnymi dodatkowymi opłatami.
Przyspieszenie zapisu między regionami pozwala aplikacji zapisywać dane do kontenera w regionie zdalnym z lokalnym opóźnieniem, bez konieczności wprowadzania zmian w API lub SDK. Aplikacja wysyła standardowy sygnał zapisu S3 do punktu końcowego LOTA; dane obiektu trafiają trwale do regionu lokalnego, a metadane są zatwierdzane w punkcie zdalnym; obiekt jest natychmiast odczytywalny, również przez zadanie, które go zapisało; a dane migrują do regionu zdalnego w tle. Aplikacje widzą pojedynczą przestrzeń nazw kontenera w regionach z jednolitymi zasadami IAM, regułami cyklu życia i kontrolą dostępu, co eliminuje rozwidlenia i potoki replikacji dla poszczególnych regionów, które zazwyczaj są wymagane przez dystrybucję punktów kontrolnych między lokalizacjami.
„Nasze zbiory danych obejmują wiele regionów i nie możemy sobie pozwolić na to, aby harmonogram szkolenia był dyktowany opóźnieniami w pobieraniu danych między regionami” – powiedziała Cécile Robert-Michon, dyrektor ds. infrastruktury wewnętrznej w Cohere. „CoreWeave AI Object Storage zapewnia nam ujednolicony zasięg zbioru danych w różnych regionach, a odczyty są buforowane lokalnie, więc nic nie czeka w sieci”.
Poziom Archiwum to czwarta klasa pamięci masowej, obok poziomów Gorącego, Ciepłego i Zimnego, przeznaczona dla danych zapisywanych raz i rzadko odczytywanych, takich jak starsze punkty kontrolne treningowe i surowe zestawy danych. Wiąże się z niższymi cenami za pojemność bazową i eliminuje opłaty za pobieranie, buforowanie, pobieranie na żądanie, wczesne usuwanie, warstwowanie i transfer danych wychodzących. Sugerowany przez CoreWeave wzorzec zachowuje najnowsze punkty kontrolne w szybszych warstwach, umożliwiając natychmiastowe ponowne uruchomienie, i automatycznie przenosi je do Archiwum po 60 dniach bez odczytu. Zarówno zapisy międzyregionalne, jak i poziom Archiwum są już dostępne; szczegóły konfiguracji można znaleźć we wpisie CoreWeave dotyczącym pamięci masowej .


 Amazon