

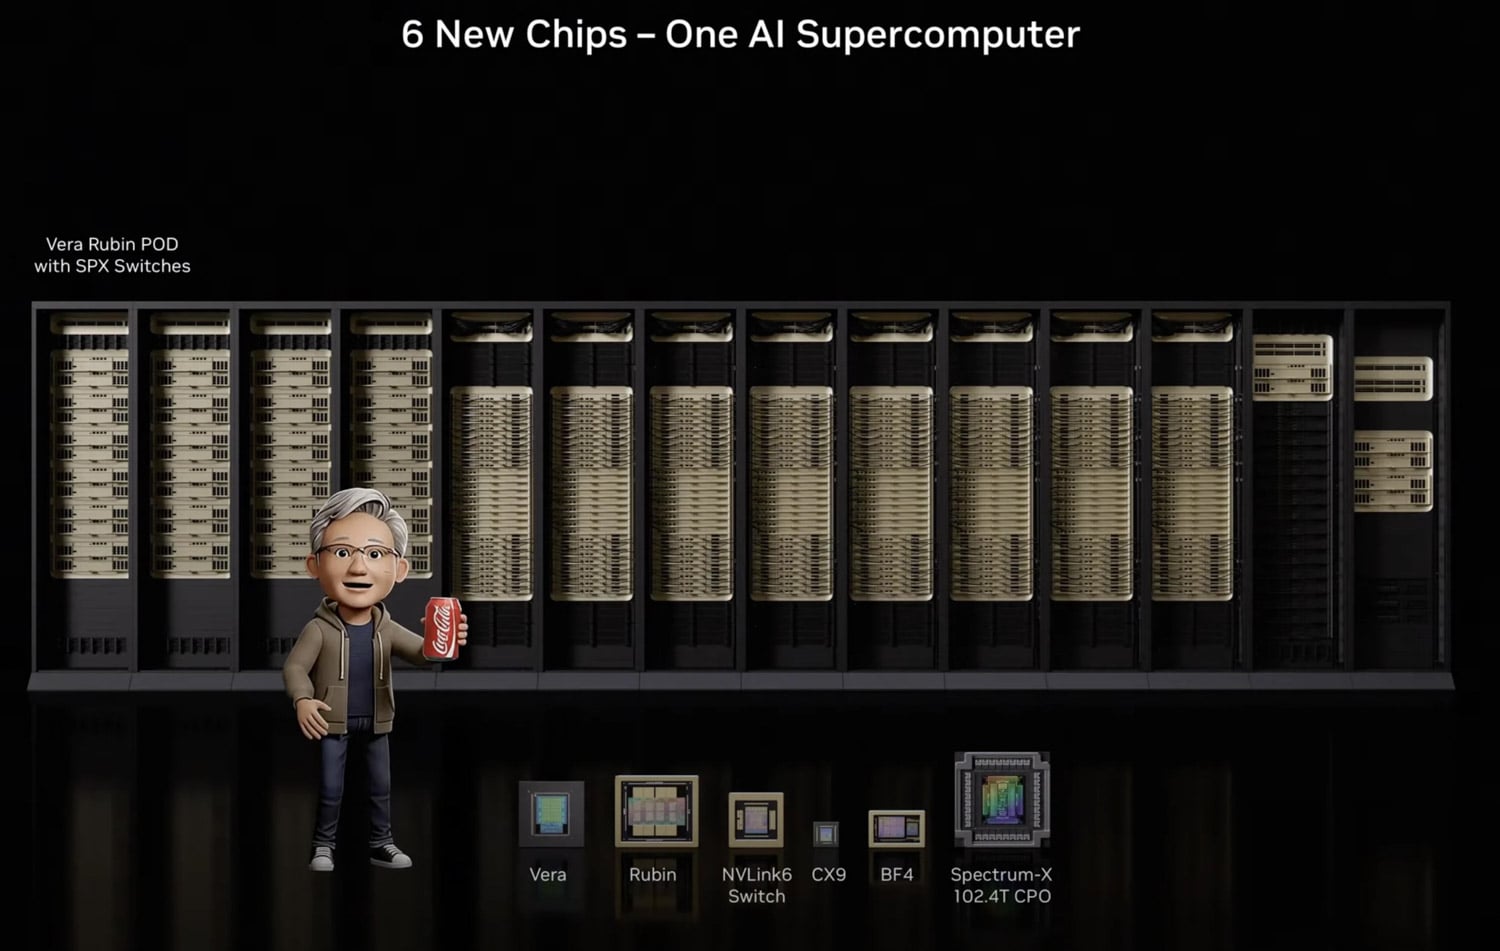
Na targach CES 2026 firma NVIDIA zaprezentowała platformę Rubin, której podstawą jest system Vera Rubin NVL72 w obudowie rack. Jest to architektura rack trzeciej generacji firmy NVIDIA, łącząca sześć wspólnie zaprojektowanych układów w jeden, zunifikowany system. Platforma będzie dostępna u partnerów w drugiej połowie 2026 roku, a wszystkie sześć układów jest już gotowych do produkcji i obecnie przechodzi walidację z rzeczywistymi obciążeniami.
Vera Rubin NVL72: sześć chipów, jeden zunifikowany system
W Vera Rubin NVL72 zastosowano to, co NVIDIA nazywa „ekstremalnym współprojektowaniem”, w którym sześć odrębnych chipów jest wspólnie opracowywanych, aby działać jako zunifikowany system.
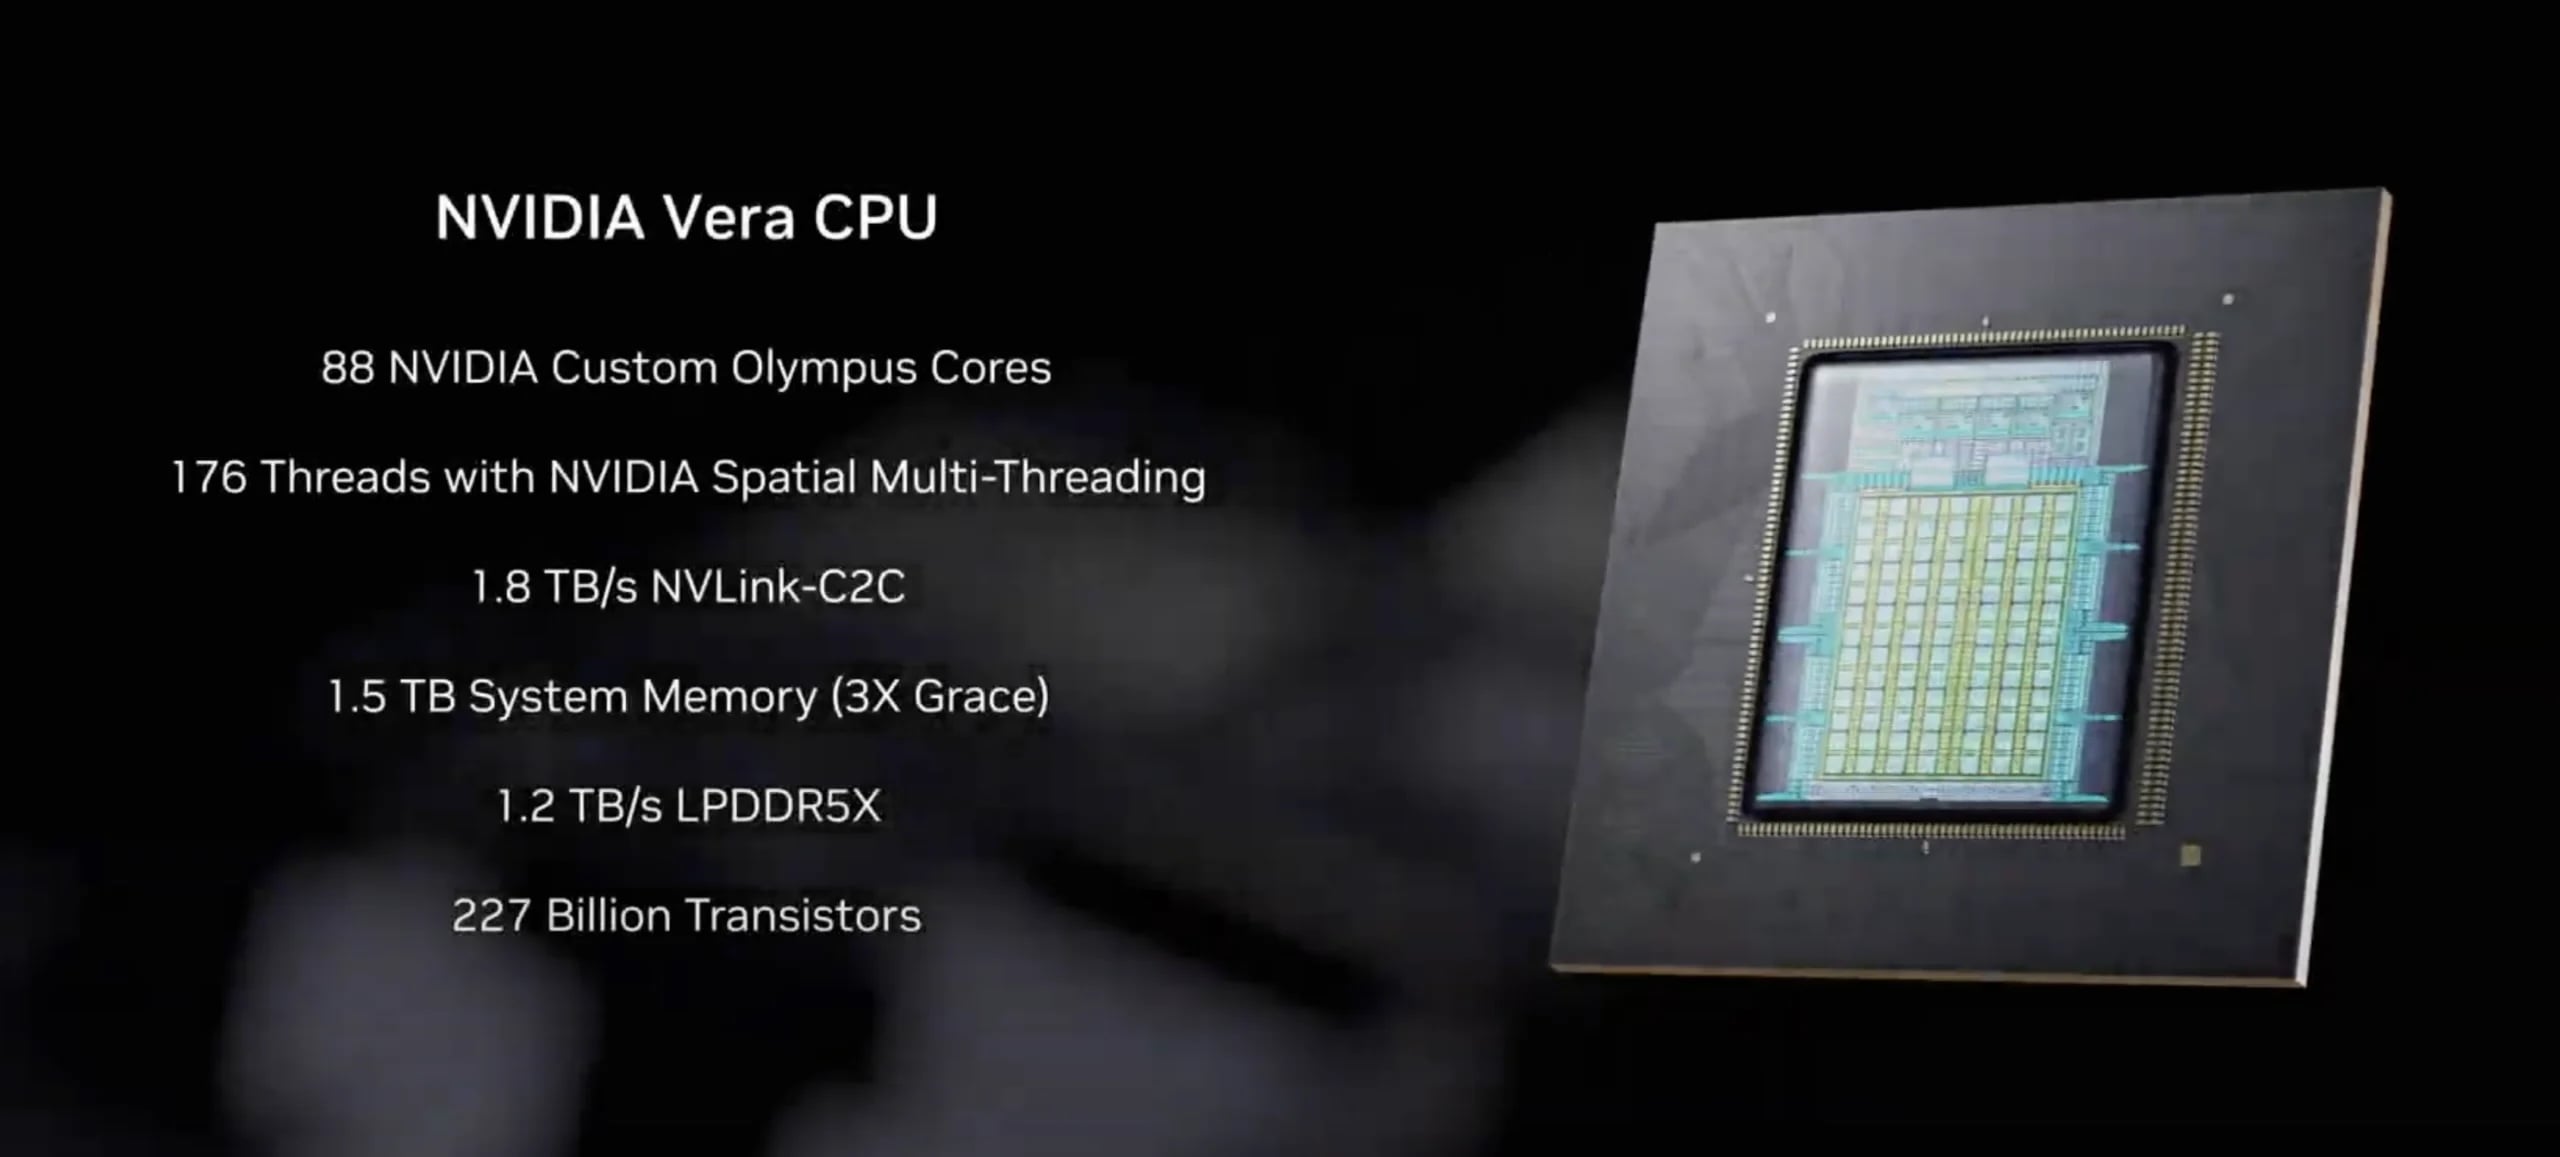
Procesor Vera: ARM Silicon zaprojektowany dla fabryk AI
Pierwszym zaprezentowanym układem był procesor NVIDIA Vera, który kontynuuje inwestycje w dedykowane układy ARM do zadań związanych z AI. Zbudowany na 88 dedykowanych rdzeniach Olympus ARM z pełną kompatybilnością z Armv9.2, układ Vera został zaprojektowany specjalnie z myślą o wymaganiach nowoczesnych fabryk AI w zakresie przesyłania danych i przetwarzania agentowego. Oferuje łączność NVLink-C2C, zapewniając przepustowość 1.8 TB/s dla procesorów graficznych Rubin, podwajając przepustowość C2C w porównaniu z poprzednimi generacjami i działając siedem razy szybciej niż PCIe Gen 6. Procesor Vera podwaja wydajność przetwarzania danych, kompresji i kompilacji kodu w porównaniu z procesorem Grace poprzedniej generacji.
Porównanie generacji: Blackwell Ultra kontra Vera Rubin NVL72
| Specyfikacja | GB300 NVL72 (Blackwell Ultra) | VR NVL72 (Vera Rubin) |
|---|---|---|
| Liczba GPU | 72 procesory graficzne Blackwell Ultra | 72 procesory graficzne Rubin |
| Liczba procesorów | 36 procesorów Grace | 36 procesorów Vera |
| Rdzenie procesora | 72 rdzenie ARM na procesor | 88 rdzeni ARM firmy Olympus na procesor |
| Wydajność wnioskowania FP4 | 1.44 eksaflopsów | 3.6 eksaflopsów |
| NVFP4 na GPU (wnioskowanie) | 20 PFLOPS | 50 PFLOPS |
| NVFP4 na GPU (szkolenie) | 10 PFLOPS | 35 PFLOPS |
| Typ pamięci GPU | HBM3e | HBM4 |
| Przepustowość pamięci GPU | ~8 TB/s | ~22 TB/s |
| Generacja NVLink | NVLink 5 | NVLink 6 |
| Przepustowość NVLink (na GPU) | 1.8 TB / s | 3.6 TB / s |
| Przepustowość łącza NVLink w skali szafy | 130 TB / s | 260 TB / s |
| Skalowalna karta sieciowa | ConnectX-8 (800 Gb/s) | ConnectX-9 (1.6 TB/s) |
| Połączenie CPU-GPU | NVLink-C2C (900 GB/s) | NVLink-C2C (1.8 TB/s) |
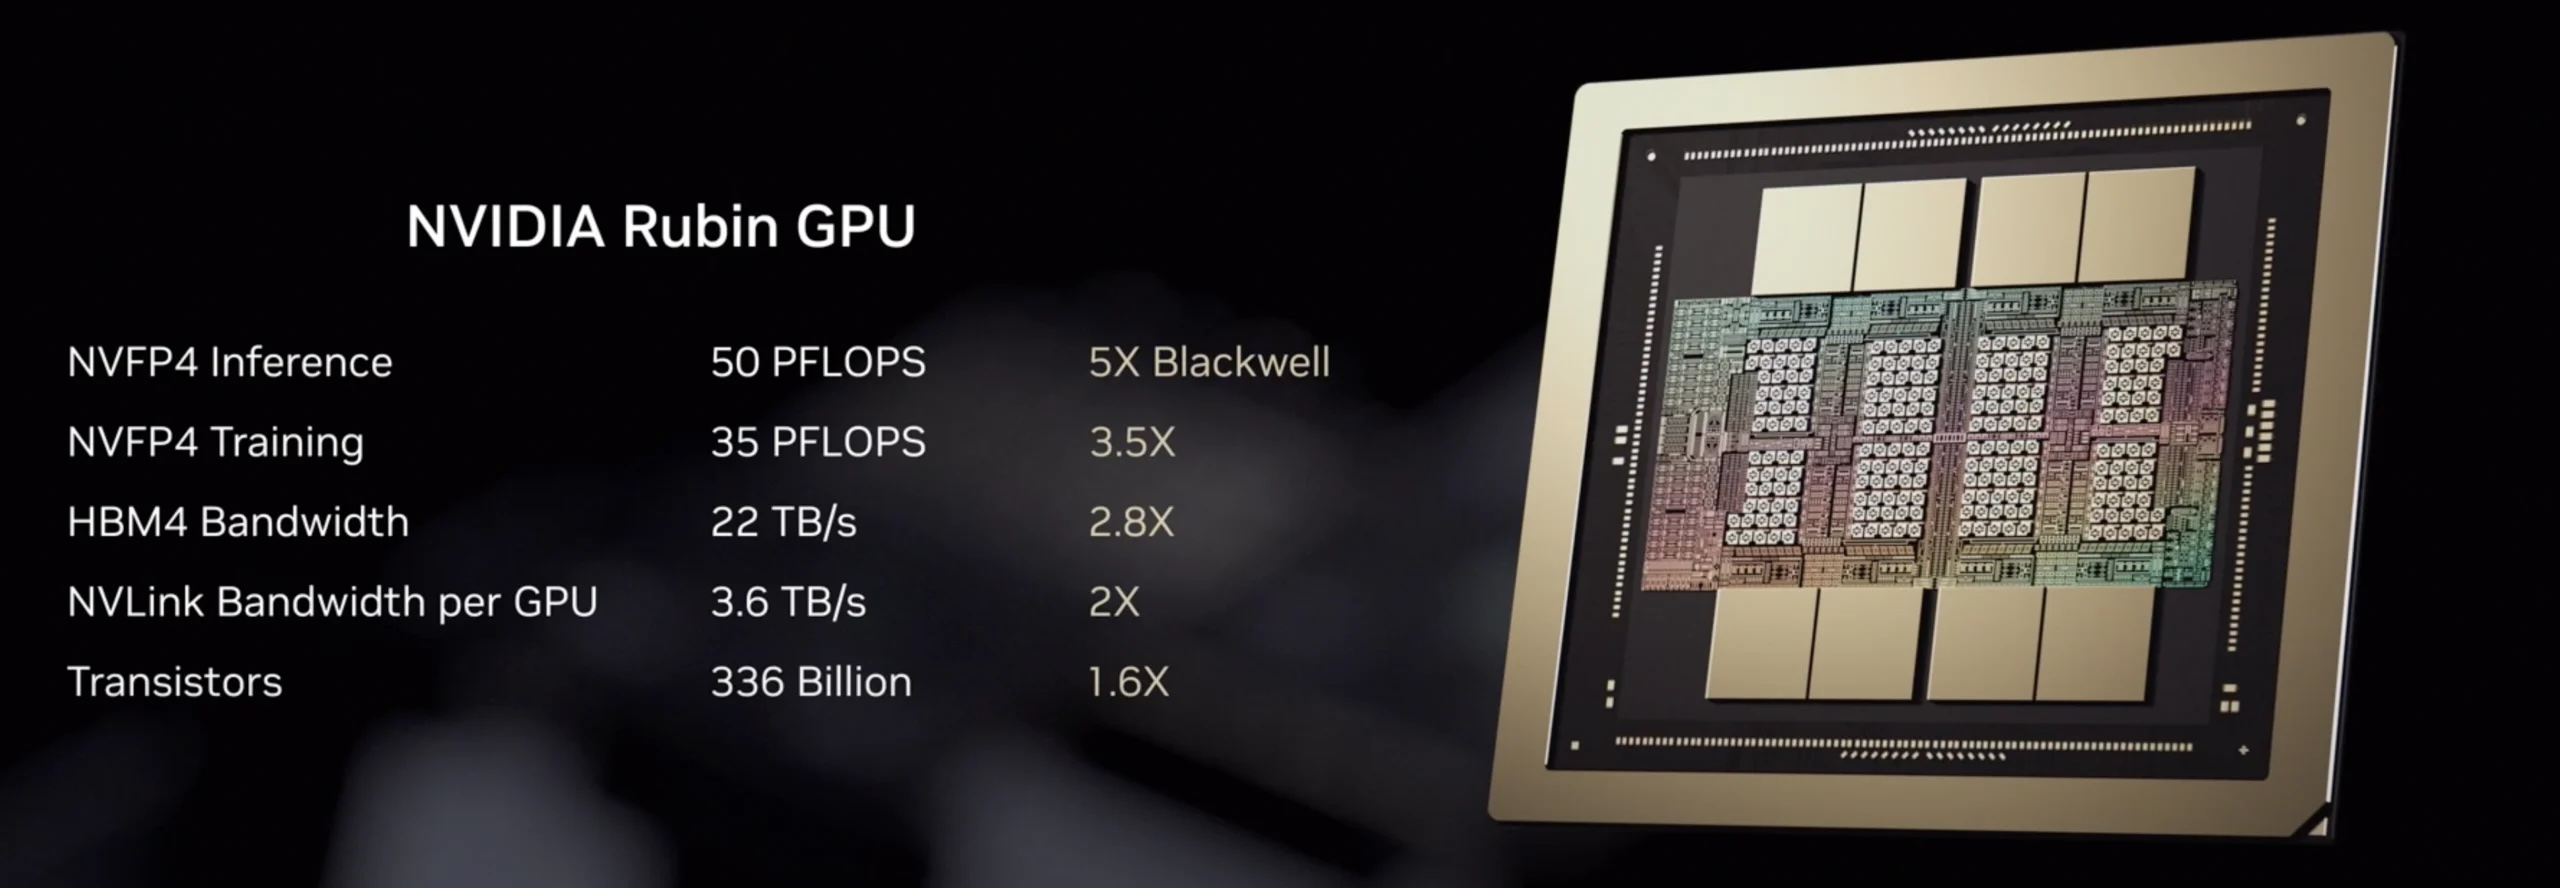
Rubin GPU: silniki Transformer, NVFP4 i HBM4
Następnie zaprezentowano gwiazdę pokazu – procesor graficzny NVIDIA Rubin, wyposażony w silnik Transformer Engine trzeciej generacji ze sprzętowo akcelerowaną kompresją adaptacyjną. Dynamicznie dostosowuje on precyzję w warstwach transformatora, osiągając wyższą przepustowość tam, gdzie można zmniejszyć precyzję, jednocześnie zachowując dokładność tam, gdzie jest ona istotna. Ta implementacja NVFP4 zapewnia 50 petaflopów mocy obliczeniowej do wnioskowania (5x Blackwell) i 35 petaflopów do trenowania (3.5x Blackwell). Procesor graficzny Rubin jest pierwszym procesorem z integracją pamięci HBM4 o przepustowości do 22 TB/s, co stanowi znaczący krok naprzód, rozwiązując problem przepustowości pamięci w dużych modelach MoE.
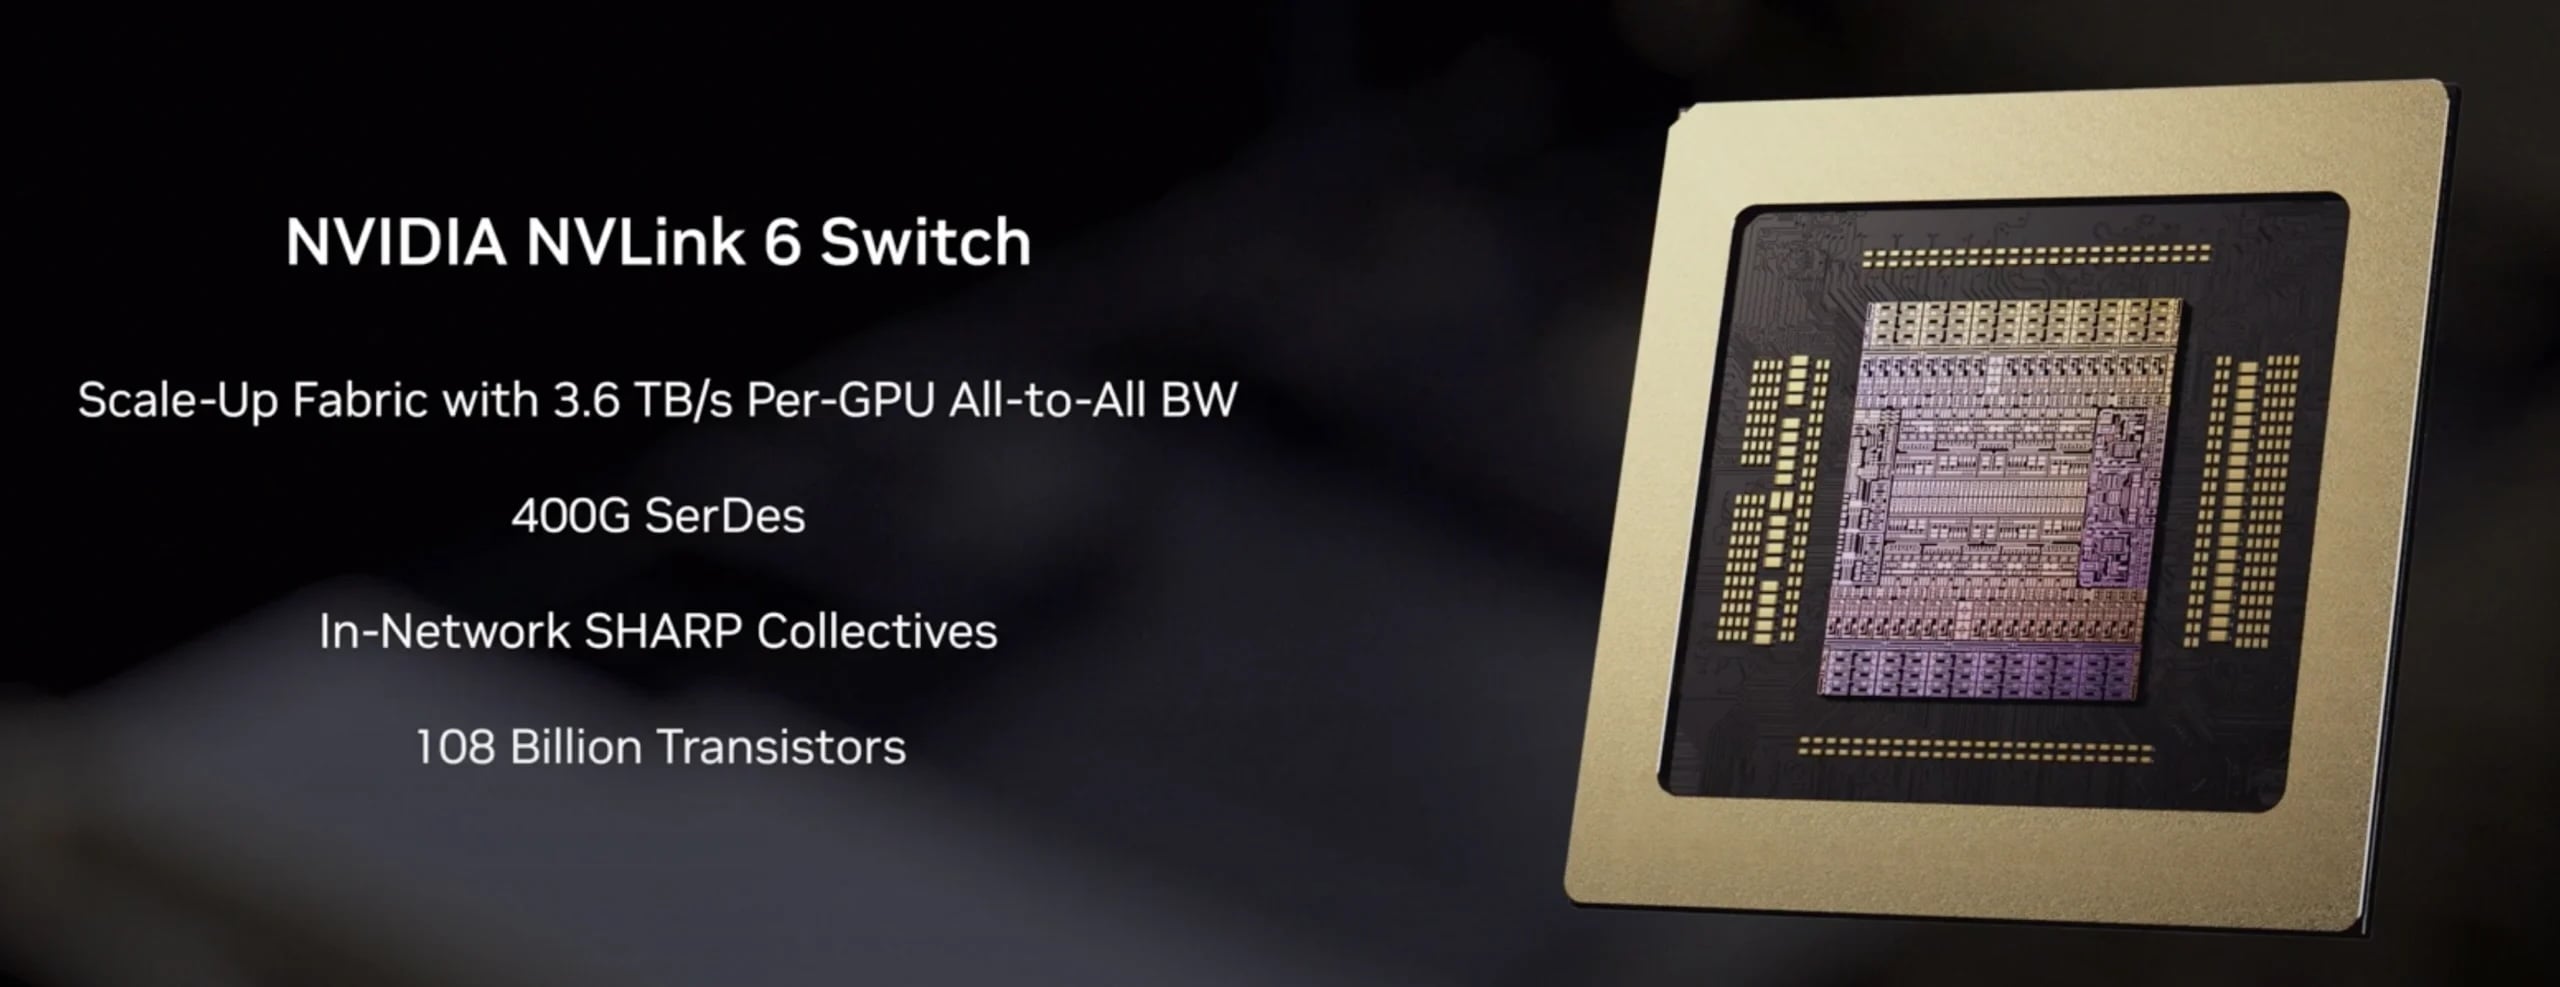
NVLink 6: komunikacja typu „wszystko w jednym” w skali szafy
Przełącznik NVIDIA NVLink 6 podwaja przepustowość na kartę graficzną do 3.6 TB/s, a cała szafa zapewnia skalowalną sieć o przepustowości 260 TB/s – ponad dwukrotnie większą niż przekrojowa przepustowość globalnego internetu. Ta skalowalna struktura umożliwia każdemu procesorowi graficznemu jednoczesną komunikację z każdym innym procesorem graficznym (wymagane dla paralelizmu ekspertów MoE), gdzie wszyscy eksperci muszą udostępniać wyniki w klastrze. Wbudowane obliczenia w sieci przyspieszają operacje zbiorcze i zmniejszają przeciążenie, odciążając zadania, które w przeciwnym razie pochłaniałyby cykle procesora graficznego.
ConnectX-9 SuperNIC: Nowa definicja sieci skalowalnych w poziomie
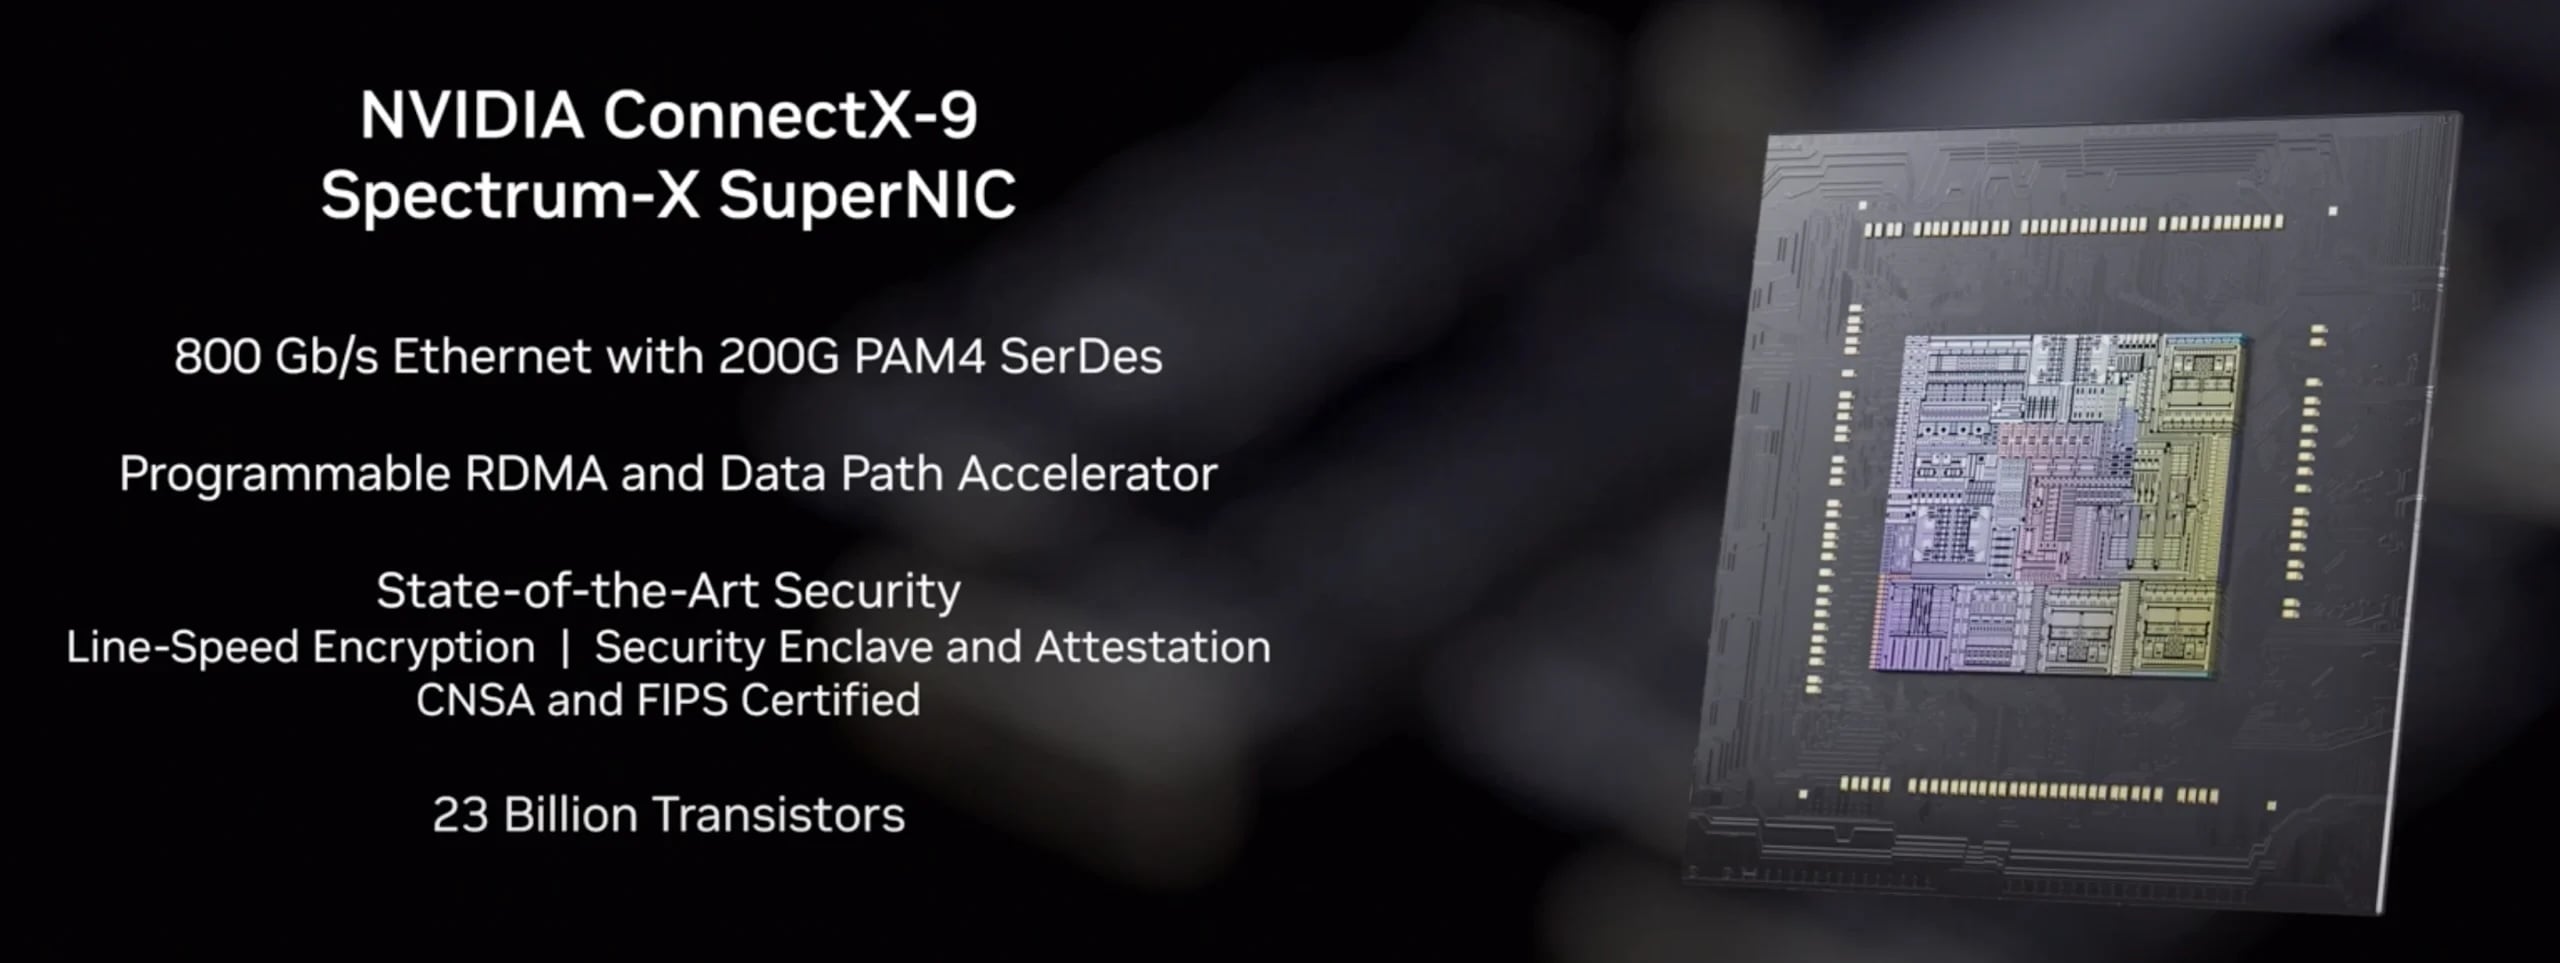
Karta NVIDIA ConnectX-9 SuperNIC obsługuje skalowalną sieć, zapewniając przepustowość RDMA 1.6 TB/s na procesor graficzny, co umożliwia komunikację poza szafą. ConnectX-9 został zaprojektowany we współpracy z procesorem Vera, aby zmaksymalizować wydajność ścieżki danych i wprowadza w pełni programowalną, programowalną i akcelerowaną ścieżkę danych, która umożliwia laboratoriom AI wdrażanie niestandardowych algorytmów przesyłania danych zoptymalizowanych pod kątem ich konkretnych architektur modeli.
BlueField-4 DPU i bezpieczna architektura ASTRA
BlueField-4 to jednostka przetwarzania danych czwartej generacji firmy NVIDIA, która stanowi fundamentalne przeobrażenie w zakresie pamięci masowej i sieci dla obciążeń AI. Nowy DPU posiada 64-rdzeniowy procesor klasy NVIDIA, w porównaniu z 16 rdzeniami ARM Cortex-A78 w BlueField-3, zapewniając 6-krotnie większą wydajność obliczeniową. Zawiera on zintegrowany moduł ConnectX-9 SuperNIC w porównaniu z ConnectX-7 w BlueField-3, podwajając przepustowość sieci do 800 Gb/s. Dostęp GPU do pamięci masowej jest 2-krotnie szybszy niż w poprzedniej generacji. Oprócz ulepszeń specyfikacji, znaczenie BlueField-4 polega na tym, co umożliwia: nowy poziom infrastruktury pamięci masowej natywnej dla AI, którą NVIDIA pozycjonuje jako niezbędną dla agentowej AI na dużą skalę.
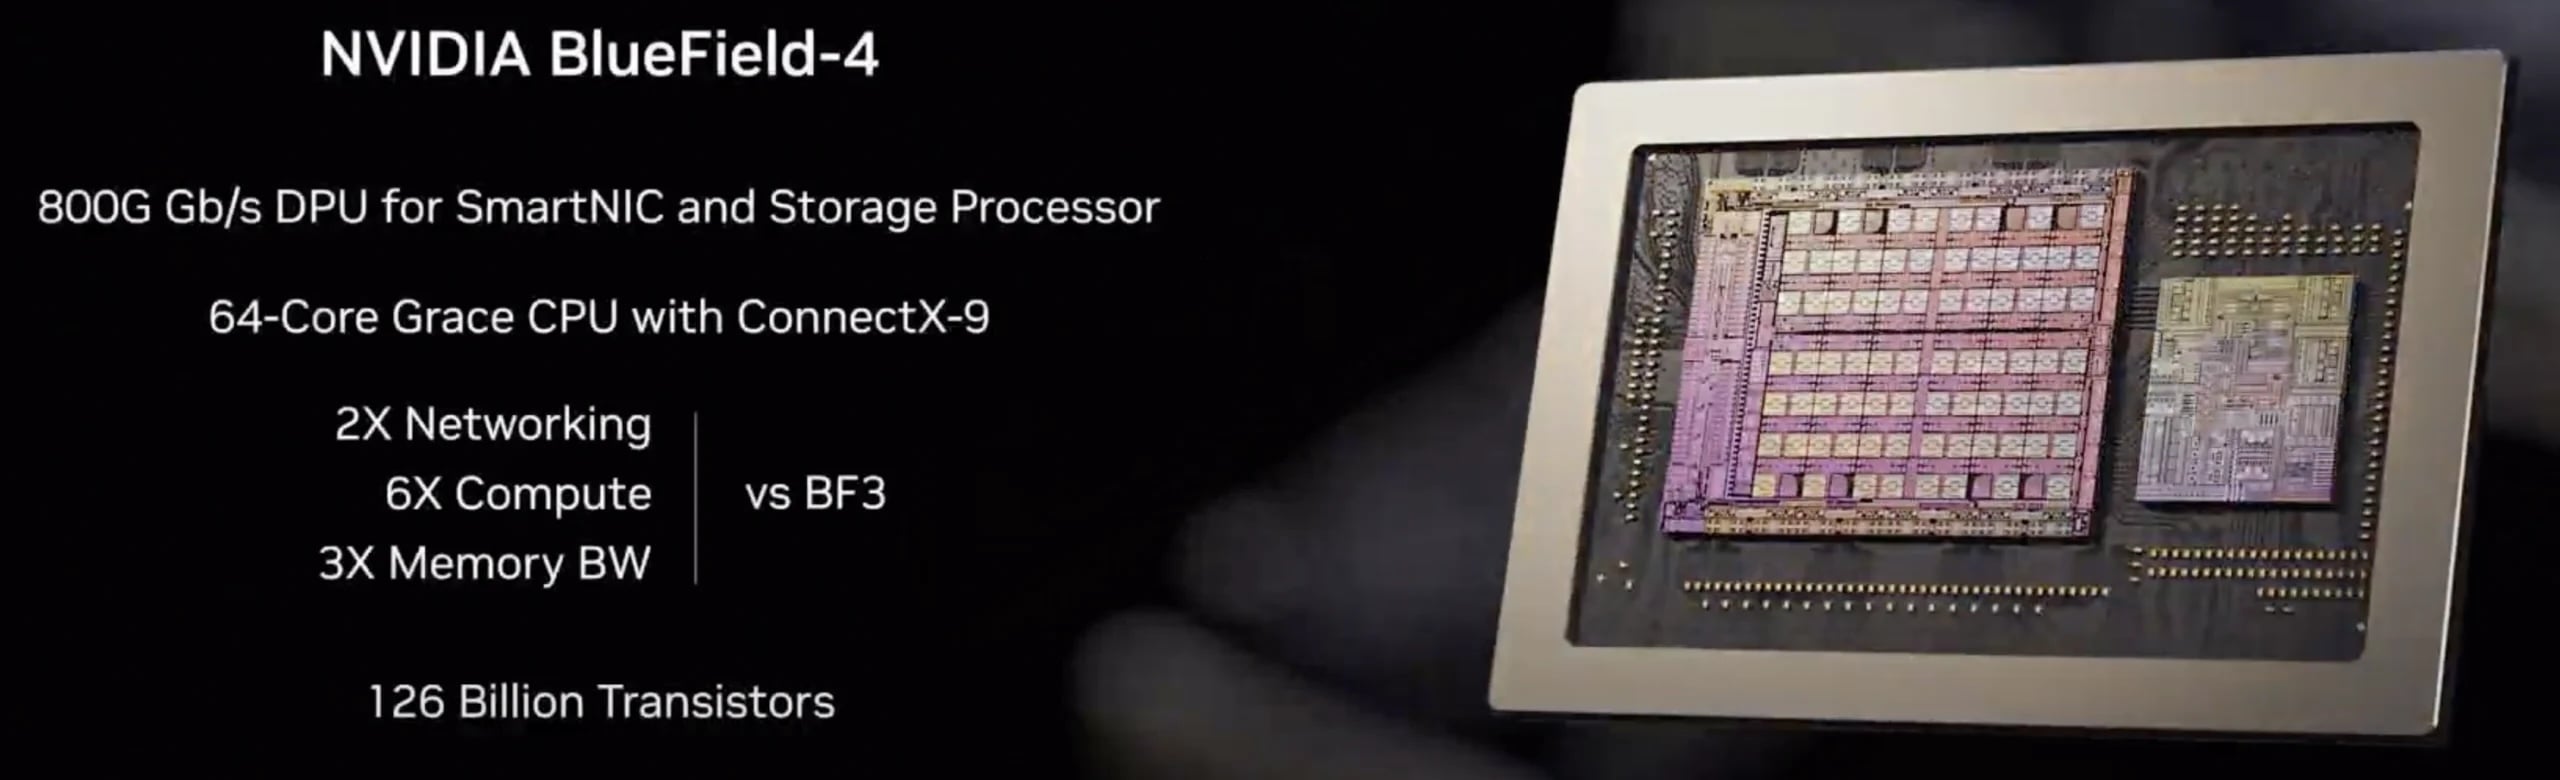
BlueField-4 odciąża sieć, pamięć masową i przetwarzanie zabezpieczeń, dzięki czemu procesory graficzne Rubin i procesory Vera mogą skupić się na wykonywaniu modelu. Jest w pełni zintegrowany z projektem zatwierdzonym przez NVIDIA Enterprise AI Factory, ze wsparciem ekosystemów Red Hat, Palo Alto Networks, Fortinet i innych.
BlueField-4 wprowadza również architekturę ASTRA (Advanced Secure Trusted Resource Architecture). Ta architektura zaufania na poziomie systemu zapewnia pojedynczy punkt kontroli do bezpiecznego udostępniania, izolowania i obsługi środowisk AI na dużą skalę bez obniżania wydajności.
Poufne obliczenia w całej szafie
Vera Rubin NVL72 to pierwsza platforma w obudowie rack, która oferuje poufne przetwarzanie NVIDIA w całym systemie. Poufne przetwarzanie trzeciej generacji zapewnia bezpieczeństwo danych w procesorach CPU, GPU i całej domenie NVLink, a każda magistrala jest szyfrowana w trakcie transmisji. Rozwiązanie to rozwiązuje rosnący problem przedsiębiorstw i laboratoriów AI korzystających z zastrzeżonych modeli w ramach współdzielonej infrastruktury: możliwość zagwarantowania, że modele, dane treningowe i obciążenia wnioskowania pozostaną chronione nawet po wdrożeniu w systemach innych firm.
Przełącznik Ethernet NVIDIA Spectrum-6 napędza skalowalne sieci Nvidii. Został on zbudowany w oparciu o technologię 200G SerDes z optyką w pakiecie (CPO), osiągając przepustowość przełączania 102 TB/s i obsługując ruch wschód-zachód w szafach VR NVL72. Przejście na CPO jest znaczące. Dzięki integracji optyki bezpośrednio z krzemem przełącznika, NVIDIA zapewnia 10-krotnie większą niezawodność, 5-krotnie dłuższy czas sprawności i 5-krotnie lepszą efektywność energetyczną w porównaniu z tradycyjnymi, podłączanymi optykami.

Poprawa kosztów i efektywności modeli MoE
NVIDIA twierdzi, że VR NVL72 oferuje jedną siódmą kosztów tokena w przypadku wnioskowania w modelu Mixture-of-Experts przy tym samym opóźnieniu co Blackwell. Do wytrenowania tego samego modelu MoE w tym samym czasie potrzeba tylko jednej czwartej liczby procesorów GPU. Platforma osiąga 8-krotnie większą moc obliczeniową wnioskowania na wat.
Te ulepszenia odpowiadają wymaganiom modeli MoE, które aktywują tylko podzbiór swoich ekspertów dla danego tokena. Modele takie jak Kimi K2 Thinking zatrudniają 384 ekspertów, ale aktywują tylko ośmiu naraz, co wymaga ogromnej komunikacji między wszystkimi kartami graficznymi. VR NVL72 oferuje skalowalną sieć o przepustowości 260 TB/s, która obsługuje ten wzorzec komunikacji.
Stojak bez kabli zaprojektowany do masowej skali
VR NVL72 charakteryzuje się modułową, bezprzewodową, bezwentylatorową i bezprzewodową konstrukcją tacki, która wykorzystuje wyłącznie płytki PCB i złącza, zamiast wewnętrznego okablowania. Tacki komputerowe łączą się ze sobą za pomocą złączy typu blind-mate po wsunięciu do szafy, eliminując konieczność ręcznego prowadzenia kabli. Jedynymi połączeniami zewnętrznymi są dwa węże wlotowe i wylotowe cieczy, które łączą się z blokami chłodzenia cieczą.

Poprzednie systemy, takie jak GB300 NVL72, wymagały około 100 minut na złożenie pojedynczej tacy obliczeniowej. Każde połączenie kablowe stanowiło potencjalny punkt awarii, co nabiera znaczenia w przypadku setek tysięcy procesorów graficznych. Ułożenie kabli ograniczało ścieżki chłodzenia i zajmowało miejsce, a wentylatory zwiększały złożoność mechaniczną i hałas.
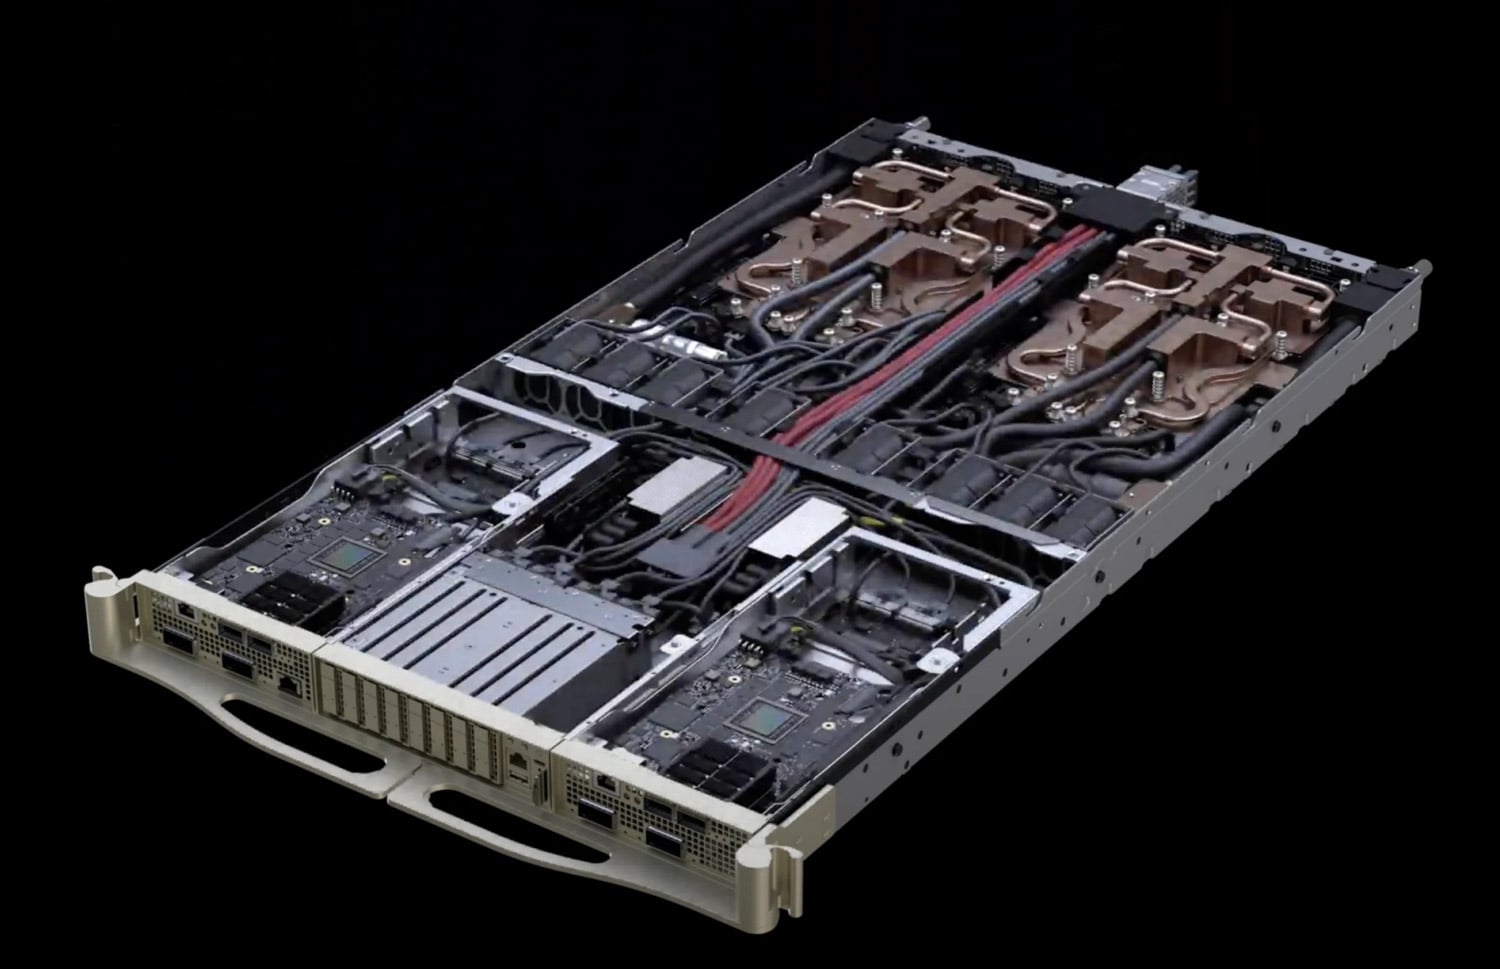
Nowa konstrukcja skraca czas montażu i serwisowania 18-krotnie. Platforma jest również wyposażona w mechanizm RAS (Niezawodność, Dostępność, Serwisowalność) drugiej generacji, obejmujący GPU, CPU i NVLink, który zapewnia kontrolę stanu w czasie rzeczywistym, odporność na błędy i proaktywną konserwację. Półki przełączników NVLink umożliwiają teraz konserwację bez przestojów, co pozwala na utrzymanie sprawności szaf rackowych podczas demontażu lub częściowego zapełnienia półek przełączników. W skali setek tysięcy GPU, te usprawnienia serwisowania przekładają się bezpośrednio na dostępność klastra i jego dobrą przepustowość.
Ta architektura umożliwia przyszłe konfiguracje o wyższej gęstości. Jest to również kluczowe dla umożliwienia realizacji zapowiadanych wcześniej projektów szaf Vera Rubin CPX, które prezentowaliśmy na konferencji AI Infra Summit , a które dodatkowo dodają procesory graficzne do przetwarzania kontekstu do tej samej platformy obliczeniowej w i tak już gęstej konstrukcji.
Platforma pamięci masowej kontekstu wnioskowania
NVIDIA ogłosiła platformę pamięci masowej kontekstu wnioskowania (Inference Context Memory Storage Platform) na targach CES 2026 – nową klasę infrastruktury pamięci masowej natywnej dla sztucznej inteligencji, stworzonej specjalnie dla pamięci podręcznej KV. Platforma oparta jest na sieciach Ethernet BlueField-4 i Spectrum-X. Zapewnia ona do 5 razy większą przepustowość tokenów na sekundę niż tradycyjna pamięć sieciowa używana do kontekstu wnioskowania, do 5 razy lepszą wydajność w przeliczeniu na dolara całkowitego kosztu posiadania (TCO), do 5 razy lepszą energooszczędność oraz 20-krotną poprawę czasu do pierwszego tokena. Sprzętowo przyspieszane rozmieszczenie pamięci podręcznej KV w BlueField-4 eliminuje obciążenie metadanych i redukuje transfer danych, a Spectrum-X Ethernet zapewnia infrastrukturę o wysokiej przepustowości i niskich opóźnieniach dla dostępu opartego na RDMA.
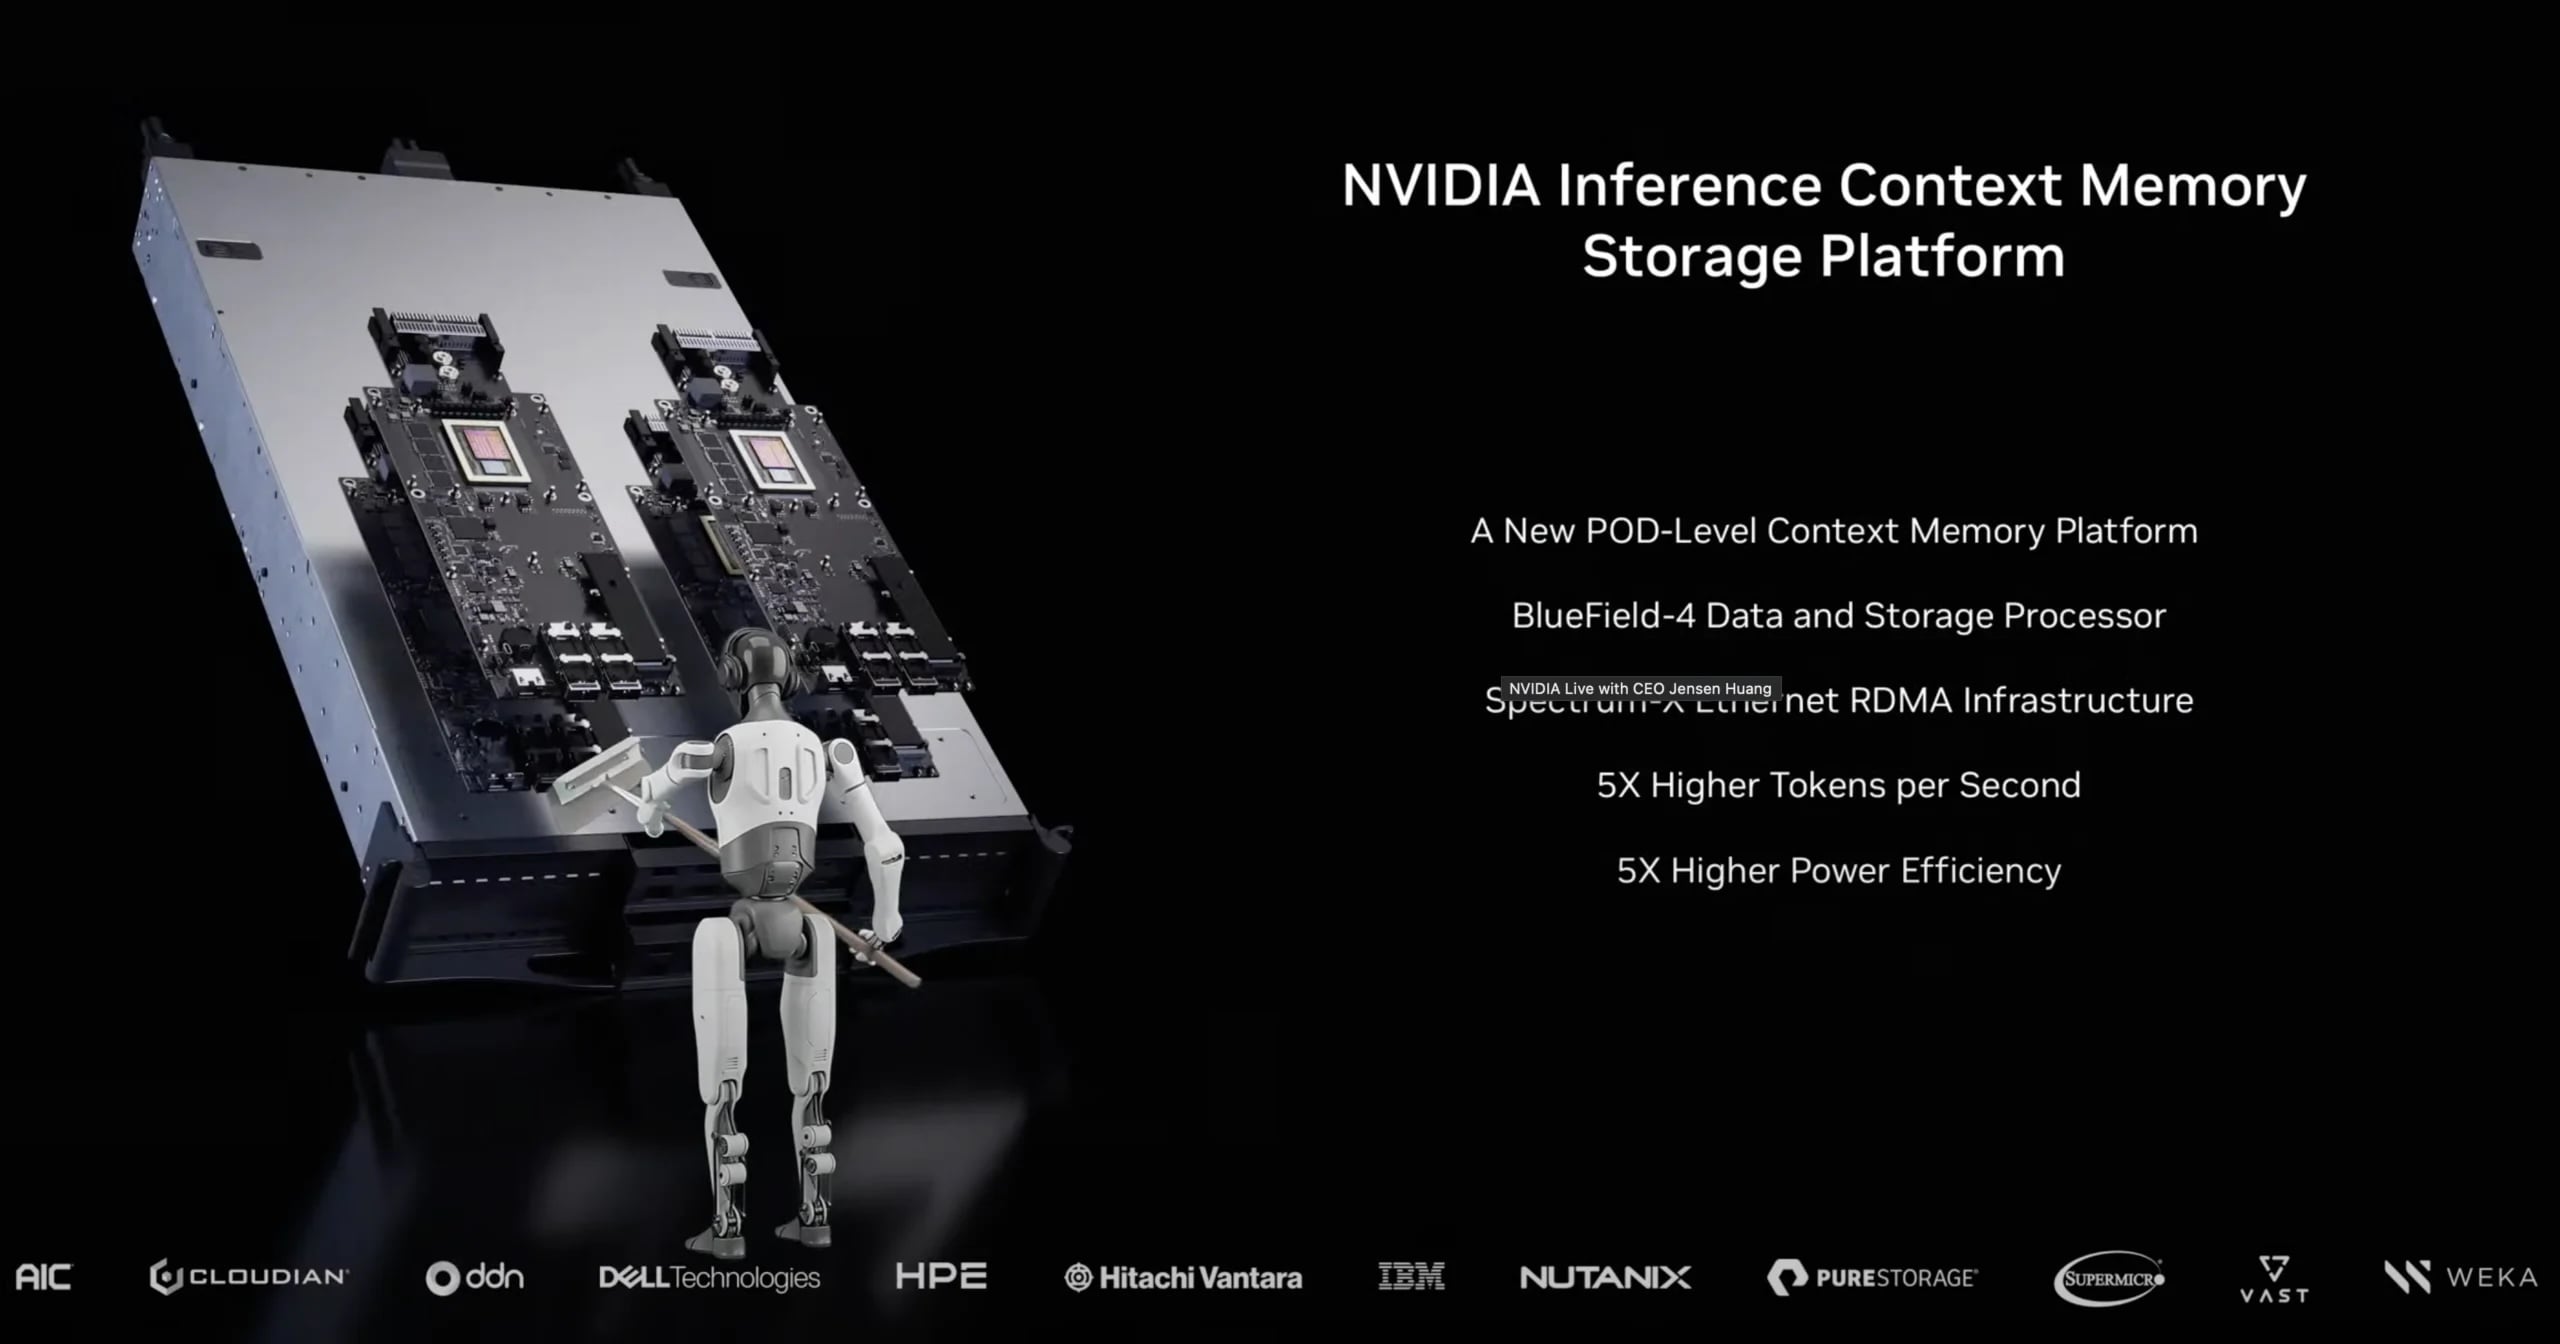
Platforma ta rozwiązuje rosnący problem wąskiego gardła w wnioskowaniu LLM: zarządzanie pamięcią podręczną KV. Modele transformatorowe wykorzystują mechanizm uwagi, w którym każdy wygenerowany token musi obsługiwać wszystkie poprzednie tokeny. Bez buforowania wymaga to ponownego obliczenia wektorów kluczy i wartości dla każdego tokena, co skutkuje złożonością O(n²). Buforowanie KV przechowuje te wstępnie obliczone macierze w pamięci do ponownego użycia, redukując złożoność do O(n). Problem polega na tym, że rozmiar pamięci podręcznej KV rośnie liniowo wraz z długością sekwencji i rozmiarem partii. Pojedyncza konwersacja długiego kontekstu może zużywać gigabajty pamięci. W środowiskach wielodostępnych, obsługujących tysiące równoczesnych żądań w oknach kontekstowych obejmujących miliony tokenów, zasoby GPU HBM ulegają wyczerpaniu. Operatorzy muszą albo zmniejszyć rozmiary partii, skrócić okna kontekstowe, albo zakupić więcej GPU.
Tradycyjna pamięć sieciowa nie została zaprojektowana z myślą o wzorcach dostępu do pamięci podręcznej KV, które wymagają losowego dostępu o niskim opóźnieniu do potencjalnie terabajtów danych przejściowych rozproszonych w wielu równoczesnych sesjach. Platforma pamięci masowej kontekstu wnioskowania (Inference Context Memory Storage Platform) zapewnia dedykowaną warstwę pamięci masowej zoptymalizowaną pod kątem tego obciążenia, umiejscowioną pomiędzy pamięcią główną procesora graficznego (GPU) a konwencjonalną pamięcią masową. Pozwala to fabrykom AI skalować pojemność kontekstu niezależnie od mocy obliczeniowej GPU. Wcześniej omówiliśmy, jak działa odciążanie pamięci podręcznej KV z wykorzystaniem akceleratora pamięci podręcznej KV firmy Pliops w rozwiązaniu NVIDIA Dynamo. NVIDIA skaluje to rozwiązanie za pomocą platformy pamięci masowej kontekstu wnioskowania (NVIDIA Inference Context Memory Storage Platform) i łączy je ze swoim projektem open source Dynamo. Zapewnia to strukturę oprogramowania, która łączy rozdzielone fazy wstępnego wypełniania/dekodowania, inteligentne trasowanie oraz odciążanie pamięci masowej w warstwach na tej nowej platformie.
Partnerzy w dziedzinie pamięci masowych, w tym VAST Data, NetApp, DDN, Dell Technologies, HPE, Hitachi Vantara, IBM, Nutanix, Pure Storage i WEKA, budują platformy z technologią BlueField-4. Będą one dostępne w drugiej połowie 2026 roku.
Alpamayo: oparta na rozumowaniu fizyczna sztuczna inteligencja dla pojazdów autonomicznych
Firma NVIDIA ogłosiła wprowadzenie rodziny Alpamayo, obejmującej otwarte modele sztucznej inteligencji, narzędzia symulacyjne i zestawy danych, zaprojektowane w celu przyspieszenia bezpiecznego rozwoju autonomicznych pojazdów (AV) opartych na rozumowaniu. Rodzina Alpamayo wprowadza oparte na łańcuchu myśli modele wizji, języka i działania, które pozwalają na łączenie ludzkiego myślenia z procesami decyzyjnymi w pojazdach autonomicznych. System bezpieczeństwa NVIDIA Halo stanowi podstawę tych systemów.
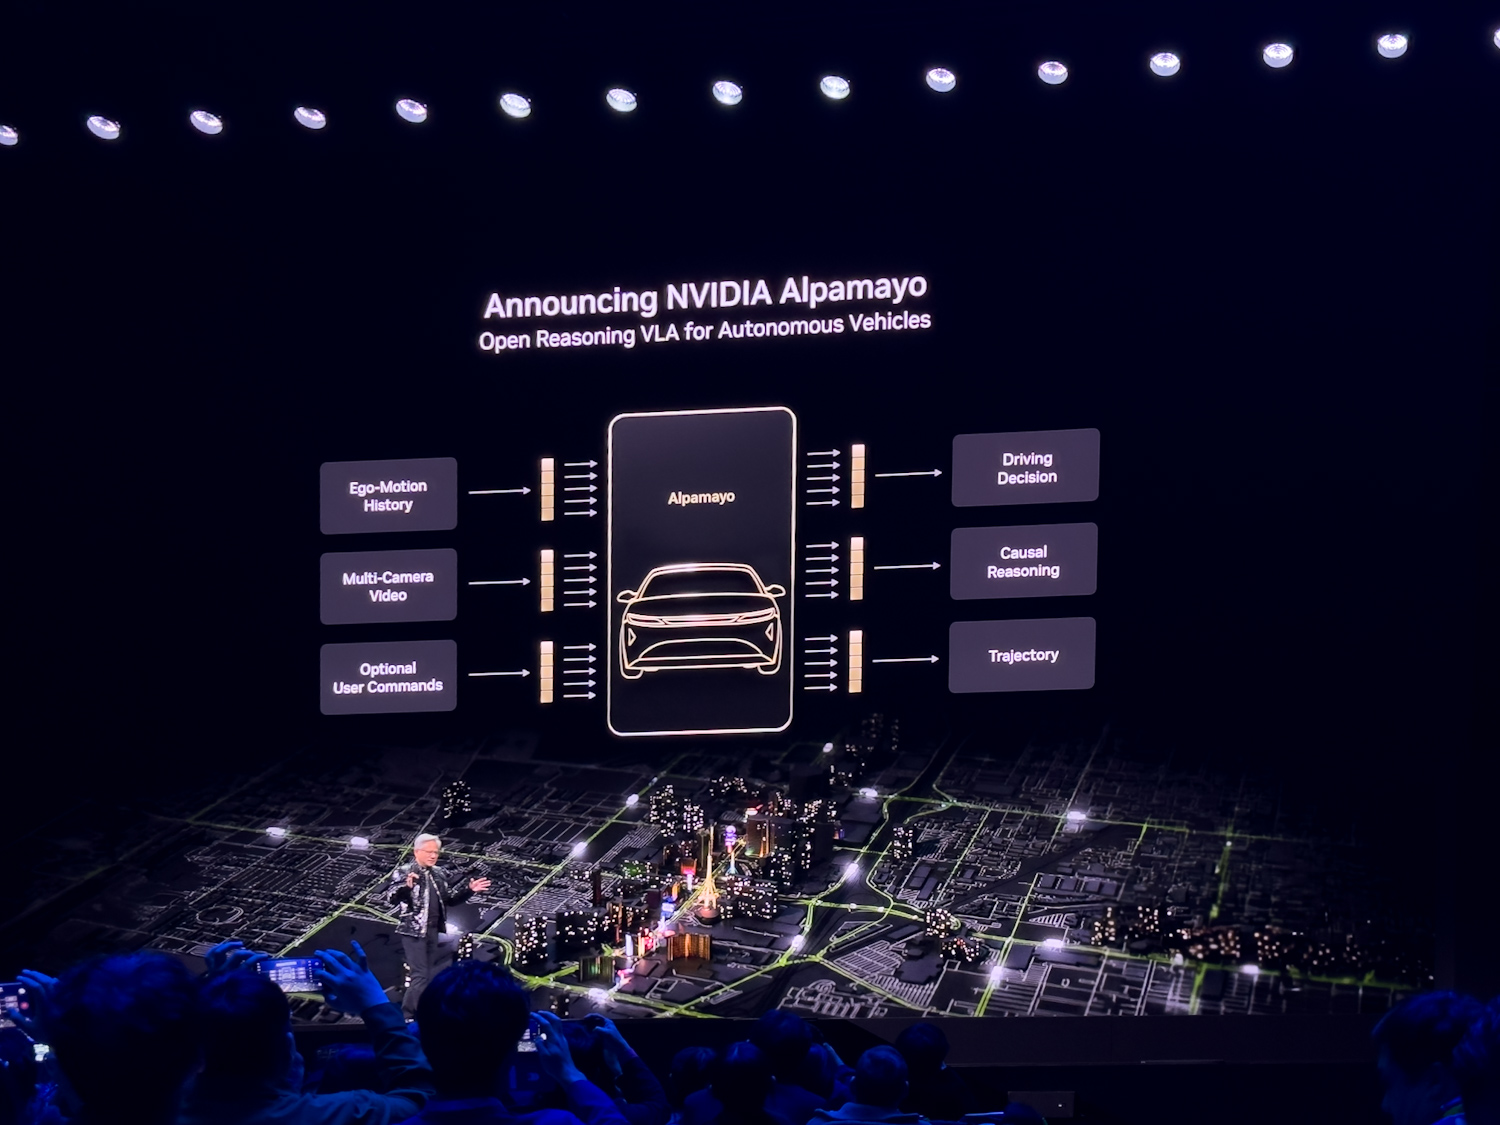
Tradycyjne architektury AV oddzielają percepcję od planowania, co może ograniczać skalowalność w przypadku nowych lub nietypowych sytuacji. „Długi ogon” rzadkich, złożonych scenariuszy pozostaje jednym z najtrudniejszych wyzwań dla systemów autonomicznych, z którymi muszą się bezpiecznie zmierzyć. Alpamayo rozwiązuje ten problem, umożliwiając modelom rozumowanie przyczynowo-skutkowe, analizując nowe scenariusze krok po kroku, aby poprawić możliwości prowadzenia pojazdu i jego wyjaśnialność.
Zamiast działać bezpośrednio w pojazdach, modele Alpamayo pełnią funkcję modeli nauczycielskich na dużą skalę, które programiści mogą dostrajać i przekształcać w szkielety kompletnych stosów systemów autonomicznych. Programiści mogą adaptować Alpamayo do mniejszych modeli wykonawczych na potrzeby rozwoju pojazdów lub wykorzystywać je jako podstawę dla narzędzi programistycznych, takich jak ewaluatory oparte na rozumowaniu i systemy automatycznego etykietowania.
Modele Alpamayo, symulacje i otwarte zbiory danych
Alpamayo 1 to pierwszy w branży model VLA do wnioskowania opartego na łańcuchu myślowym, zaprojektowany dla środowiska badawczego zajmującego się systemami AV, dostępny na platformie Hugging Face. Dzięki architekturze o 10 miliardach parametrów, Alpamayo 1 wykorzystuje dane wejściowe wideo do generowania trajektorii wraz ze śladami wnioskowania, pokazując logikę stojącą za każdą decyzją. Alpamayo 1 oferuje wagi modeli i skrypty wnioskowania typu open source. Przyszłe modele z tej rodziny będą charakteryzować się większą liczbą parametrów, bardziej szczegółowymi możliwościami wnioskowania, większą elastycznością wejścia i wyjścia oraz opcjami do zastosowań komercyjnych.
AlpaSim to w pełni open source'owe, kompleksowe środowisko symulacyjne do tworzenia wysokiej jakości systemów autonomicznych, dostępne na GitHubie. Zapewnia realistyczne modelowanie czujników, konfigurowalną dynamikę ruchu oraz skalowalne środowiska testowe w pętli zamkniętej, umożliwiając szybką walidację i udoskonalanie zasad.
Otwarte zbiory danych Physical AI zawierają ponad 1,700 godzin danych z jazdy zebranych w najszerszym zakresie geograficznym i warunkach, obejmujących rzadkie i złożone przypadki brzegowe ze świata rzeczywistego, niezbędne do rozwoju architektur wnioskowania. Zbiory te są dostępne na platformie Hugging Face.
Programiści mogą dostosowywać wydania modeli Alpamayo w oparciu o zastrzeżone dane flotowe, integrować je z architekturą NVIDIA DRIVE Hyperion zbudowaną z wykorzystaniem akcelerowanych obliczeń NVIDIA DRIVE AGX Thor i weryfikować wydajność w symulacji przed wdrożeniem komercyjnym.
NVIDIA DRIVE, redundantne stosy AV i Mercedes-Benz CLA
NVIDIA pracuje nad samochodami autonomicznymi od ośmiu lat, zatrudniając zespół liczący kilka tysięcy osób. Firma zbudowała pełen stos: układy scalone (podwójne Oriny, podwójne Thory nowej generacji), infrastrukturę (Omniverse i Cosmos), modele (Alpamayo) oraz warstwę aplikacyjną. Mercedes-Benz nawiązał współpracę z firmą NVIDIA pięć lat temu, aby wdrożyć ten stos.
Pierwszy w pełni autonomiczny pojazd firmy NVIDIA, Mercedes-Benz CLA, zostanie wprowadzony na rynek w pierwszym kwartale 2026 roku w Stanach Zjednoczonych, w drugim kwartale w Europie oraz w trzecim/czwartym kwartale w Azji. Euro NCAP przyznało CLA najwyższą ocenę bezpieczeństwa czynnego spośród wszystkich samochodów zgłoszonych w 2025 roku. Każda linia kodu i każdy układ scalony w systemie posiadają certyfikat bezpieczeństwa.

System uruchamia równolegle dwa kompletne stosy AV. Stos Alpamayo wykorzystuje wnioskowanie łańcuchowe i obsługuje złożone scenariusze jazdy. Drugi, klasyczny stos AV, znajdujący się poniżej, jest w pełni identyfikowalny, a jego zbudowanie zajęło od sześciu do siedmiu lat. Ewaluator polityki i bezpieczeństwa decyduje, którego stosu użyć na podstawie poziomu pewności. Jeśli Alpamayo napotka scenariusz, w którym nie jest pewny, system powraca do klasycznego stosu. Ta różnorodność i redundancja w oprogramowaniu odzwierciedla sposób, w jaki systemy krytyczne dla bezpieczeństwa radzą sobie z redundancją sprzętową.
NVIDIA będzie kontynuować aktualizację systemu, wprowadzając nowe wersje Alpamayo. Partnerzy z branży mobilności, w tym JLR, Lucid, Uber i Berkeley DeepDrive, wykorzystują Alpamayo do rozwoju autonomii poziomu 4 opartej na rozumowaniu.
Nowe fizyczne modele sztucznej inteligencji i ogłoszenia dotyczące robotyki
Oprócz zapowiedzi dotyczących infrastruktury i systemów, NVIDIA wykorzystała targi CES 2026 do rozwoju swojej strategii w zakresie fizycznej sztucznej inteligencji (Physical AI), publikując nowe otwarte modele, frameworki i platformy brzegowe, które mają przyspieszyć rozwój robotyki. Firma zaprezentowała aktualizacje swoich modeli świata Cosmos i modeli wnioskowania GR00T do uczenia robotów, a także nowe narzędzia open source (w tym Isaac Lab-Arena) do ewaluacji robotów na dużą skalę. OSMO to platforma do koordynacji brzeg-chmura, zaprojektowana w celu uproszczenia procesów szkoleniowych w heterogenicznych środowiskach obliczeniowych.

Firma NVIDIA podkreśliła szerokie zastosowanie swojego stosu robotycznego w branży, współpracując z takimi partnerami jak Boston Dynamics, Caterpillar, LG Electronics i NEURA Robotics, prezentując autonomiczne maszyny nowej generacji zbudowane w oparciu o technologie NVIDIA. Firma ogłosiła również zacieśnienie współpracy z Hugging Face w celu integracji modeli NVIDIA Isaac i GR00T z platformą open source LeRobot, co jeszcze bardziej poszerzy dostęp dla globalnej społeczności deweloperów robotyki.
W obszarze brzegowym, NVIDIA potwierdziła dostępność modułu Jetson T4000 opartego na procesorach Blackwell, który zapewnia znaczący wzrost mocy obliczeniowej AI i efektywności energetycznej w maszynach autonomicznych i robotyce przemysłowej. Wszystkie te zapowiedzi wzmacniają dążenie firmy NVIDIA do rozszerzenia swojej platformy AI full-stack poza centrum danych, obejmując symulacje, modele, obliczenia brzegowe oraz wdrożenia w rzeczywistych warunkach w robotyce i systemach autonomicznych.


 Amazon