

MLCommons opublikowało MLPerf Inference w wersji 6.1, a runda ta ustanowiła rekord uczestnictwa – zgłosiło się 30 organizacji i zebrano 486 wyników dla centrów danych i urządzeń brzegowych. Do pakietu dołączyły dwa nowe testy: kompleksowy potok RAG dla centrów danych oraz benchmark Edge Agentic Inference dla urządzeń jednoużytkownikowych. Wyniki zawierają pierwsze recenzowane wyniki dla układów NVIDIA Vera Rubin NVL72, AMD Instinct MI350P, Intel Arc Pro B70 i AMD Ryzen AI Max+ 395. MLCommons twierdzi, że najlepszy wynik DeepSeek-R1 na akcelerator w scenariuszu serwerowym jest 5.7 razy lepszy niż w wersji 5.1 rok temu, a najlepszy wynik VLM poprawił się 2.99 razy w ciągu sześciu miesięcy od wydania wersji 6.0.
Dwa nowe testy: kompleksowy RAG i wnioskowanie agentowe na krawędzi
Test RAG End-to-End mierzy kompletny proces odpowiedzi na pytania, kilka modeli i wektorową bazę danych, które współpracują ze sobą. Implementacja referencyjna uruchamia cztery modele jednocześnie: gpt-oss-120B obsługuje dekompozycję zapytań, sprawdzanie wystarczalności i generowanie odpowiedzi; gpt-oss-20B ocenia pobrane dokumenty; e5-base-v2 generuje osadzenia; a ColBERTv2 rerankuje fragmenty. Korpus składa się ze 107 484 fragmentów, podzielonych na fragmenty z 2,515 plików HTML; pytania to 824 zadania wieloskokowe z zestawu danych FRAMES firmy Google; a każde zadanie może przejść przez maksymalnie 5 rund pobierania, zanim proces uzna, że ma wystarczająco dużo dowodów. Wychodzą dwie metryki: liczba dokumentów na sekundę w przypadku budowania wektorowej bazy danych FAISS HNSW oraz liczba zadań na sekundę w przypadku odpowiadania na pytania w oparciu o tę bazę. Sędzia konkursu Llama 3.1-8B ocenia ostateczne odpowiedzi, biorąc pod uwagę cel 97% dokładności. Ocena nie jest ograniczona czasowo.
Test porównawczy Edge Agentic Inference koncentruje się na wzorcu kodowania-asystenta, który przeniósł się na stacje robocze i stacjonarne systemy AI. Model to Qwen3.6-27B z wyłączonym myśleniem, uruchamiany jako Q4_K_M GGUF w llama.cpp w referencji, z oknem kontekstowym o rozmiarze 32 KB obsługiwanym na turę. Obciążenie wydajnościowe to zarejestrowana powtórka 20 trajektorii kodowania agenta, pochodzących z zweryfikowanego testu SWE-bench, obejmujących łącznie 1,007 tur, realizowanych w jednym strumieniu z jednym żądaniem w trakcie realizacji, w sposób, w jaki programista uruchamia agenta na laptopie. Podaną metryką jest średnie opóźnienie na turę, wraz z rozkładami czasu do pierwszego tokena i czasu na token wyjściowy, a dokładność jest oddzielnie bramkowana przez BFCL v4 na poziomie 97% wyniku referencji. MLCommons zaadaptował framework z nadchodzącego testu porównawczego centrów danych MLPerf Agentic.
„Dodaliśmy test RAG typu end-to-end, ponieważ jest oczywiste, że proces zapytań i odpowiedzi wyewoluował poza proste podejście LLM trenowane na korpusie; interesariusze muszą zrozumieć rzeczywistą wydajność wieloetapowych, wielokomponentowych potoków, które są obecnie budowane” – powiedział Miro Hodak, współprzewodniczący grupy roboczej MLPerf Inference. „Podobnie dodaliśmy test Edge Agentic Inference, ponieważ złożone systemy wnioskowania o właściwościach agentowych są coraz częściej hostowane na urządzeniach edge computing, co stwarza nowe wyzwania wydajnościowe, z którymi borykają się dziś nasi klienci”.
Runda ta rozszerza również obsługę dekodowania spekulatywnego, wcześniej ograniczoną do DeepSeek-R1, na test porównawczy GPT-OSS w scenariuszu interaktywnym i definiuje nowy scenariusz interaktywny dla testu VLM z odpowiedziami docelowymi na poziomie około 1.5 sekundy.
Nowy krzem od komputerów stacjonarnych do szaf rack
Karta Vera Rubin NVL72 firmy NVIDIA debiutuje w MLPerf w kategorii Preview, zgłoszonej przez firmy NVIDIA i Nebius na platformie VR200 NVL72. NVIDIA deklaruje do 2.5 raza wyższą przepustowość tokenów niż GB300 NVL72 w DeepSeek-R1 w scenariuszach offline, serwerowych i interaktywnych z wykorzystaniem TensorRT-LLM oraz do 3.7 raza w modelu wizyjno-językowym Qwen3 z wykorzystaniem vLLM i NVIDIA Dynamo. Są to porównania firmy NVIDIA z poprzednią generacją, a oznaczenie Preview oznacza, że platforma ma być dostępna komercyjnie w kolejnej rundzie.
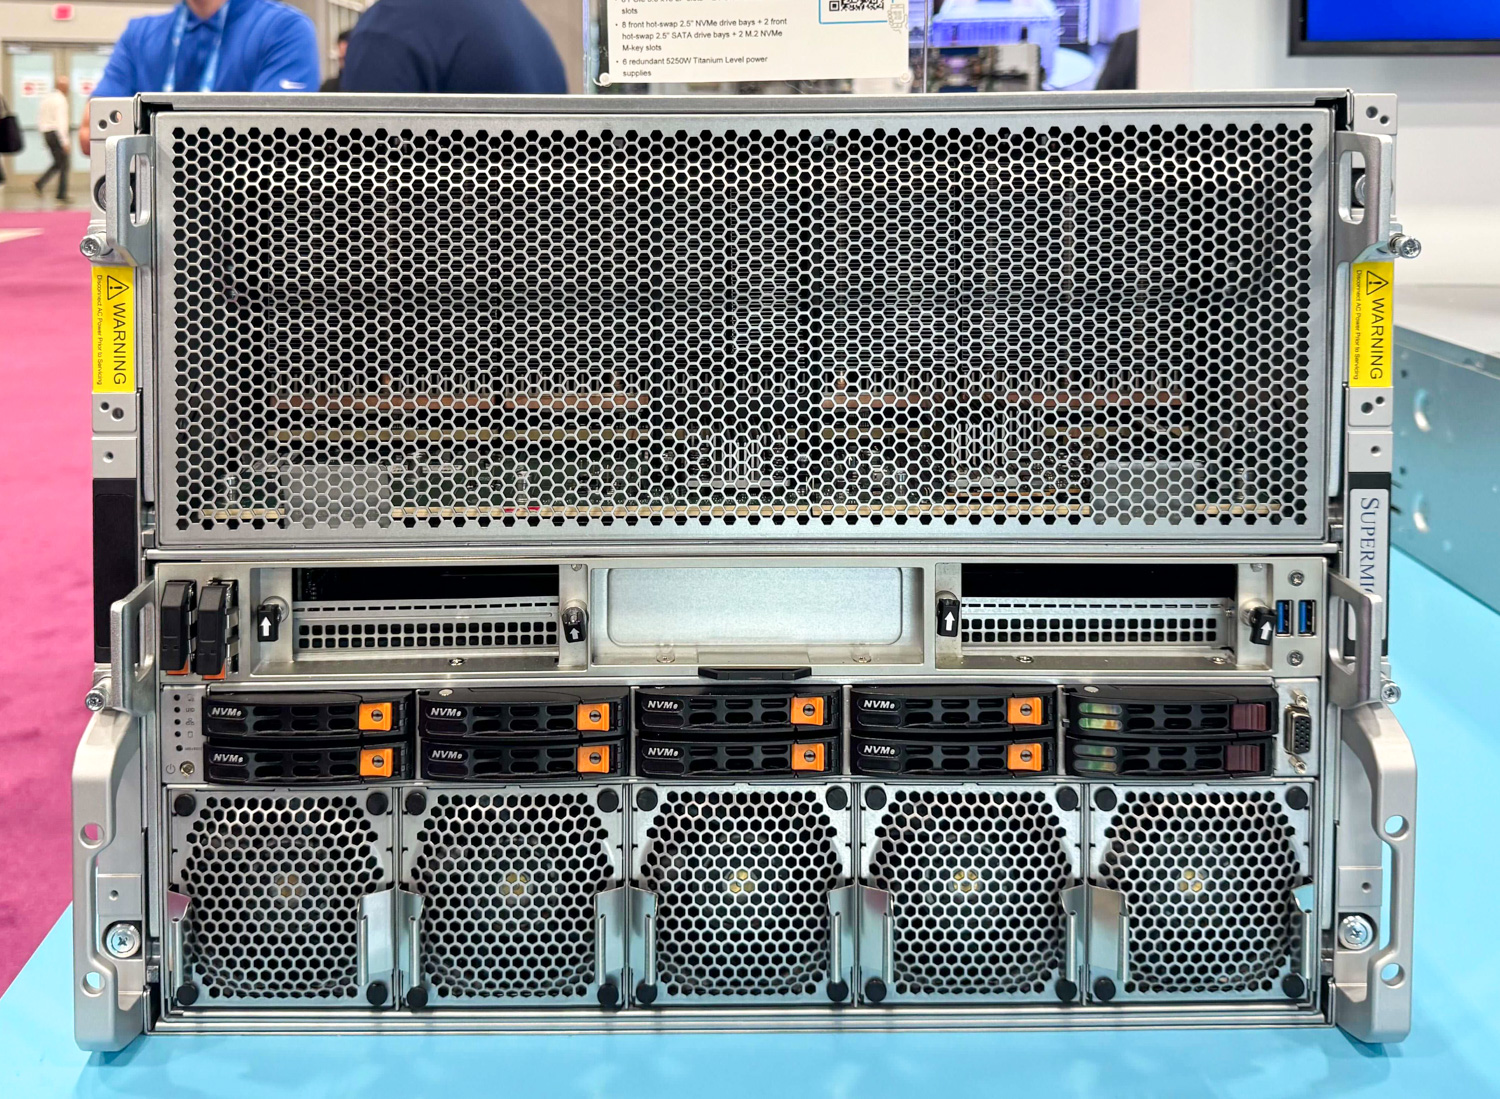
AMD rozszerzyło zgłoszenie MLPerf Inference 6.1 o sześć rodzin modeli obejmujących zadania językowe, wnioskowanie, konwersję tekstu na wideo i rekomendacje, wdrażając Instinct MI355X, MI350X oraz nową kartę PCIe MI350P. Poniżej opisano klaster Crusoe z 512 GPU zbudowany na MI355X, wraz z analizą rundy przez AMD.
Intel Arc Pro B70 pojawia się w węźle z czterema procesorami graficznymi i 128 GB łącznej pamięci VRAM, którą Intel wykorzystał w testach Llama 3.1-8B, Llama 2-70B, gpt-oss-120B, Whisper i nowym teście E2E-RAG; Intel informuje, że gpt-oss-120B poprawił się o 36% w serwerze i o 27% w trybie offline w porównaniu z wersją 6.0 na tym samym sprzęcie. Jeśli chodzi o procesor, Intel twierdzi, że przepustowość serwera Xeon 6980P Llama 3.1-8B wzrosła 2.4-krotnie w porównaniu z wersją 6.0 na tym samym układzie scalonym, co jest wzrostem wyłącznie programowym.
Ryzen AI Max+ 395 pojawił się w teście Atlas Inference, który po raz pierwszy uruchomił nowe obciążenie Edge Agentic zarówno na komputerze stacjonarnym NVIDIA DGX Spark, jak i AMD Strix Halo, z tym samym silnikiem i recepturą kwantyzacji. Atlas raportuje 20.1 tokena na sekundę na DGX Spark, kończąc wszystkie 1,007 tur w mniej niż 64 minuty, oraz 19.63 tokena na sekundę na Strix Halo. To mniejsza różnica niż ta, którą zmierzyliśmy między tymi dwiema platformami w standardowych czasach działania w naszych recenzjach Ryzen AI Halo i DGX Spark , i właśnie taki wynik ma przynieść nowy benchmark.
Większy, bardziej zróżnicowany i bardziej rozproszony
Zgłoszenia wielowęzłowe osiągnęły w tej rundzie rekord, w porównaniu z zerem w wersji 4.0, a trzy wyróżniają się. Crusoe, kolejny nowy zgłaszający, uruchomił największy system w historii wnioskowania MLPerf z AMD: 512 procesorów graficznych Instinct MI355X w 64 węzłach na standardowej strukturze Ethernet RoCE, zgłoszonych dla gpt-oss-120b i DeepSeek-R1. AMD raportuje 5.75 miliona tokenów na sekundę w scenariuszu offline i 5.39 miliona w serwerze na gpt-oss-120b z tego klastra oraz 2.90 miliona offline i 2.41 miliona serwerów na DeepSeek-R1, co AMD nazywa najwyższą łączną przepustowością tokenów w historii MLPerf, ze skalowaniem przepustowości niemal liniowo od 1 do 64 węzłów. Uruchomienie gpt-oss-120b służyło modelowi jako 512 niezależnych replik pojedynczych GPU w natywnym MXFP4; DeepSeek-R1 wykorzystywał SGLang z jedną repliką z ośmioma GPU na węzeł. AMD oddzielnie podaje zgłoszenie GPT-OSS-120B z 72 GPU, 95% wydajnością skalowania i milionem tokenów na sekundę, co jest tym samym osiągnięciem, które osiągnął MI355X w wersji 6.0.
Firma Cisco przedstawiła pierwszy heterogeniczny system benchmarku obejmujący wiele dostawców, łącząc osiem procesorów graficznych NVIDIA H200 i osiem procesorów graficznych AMD Instinct MI350X w jedną pulę inferencyjną na platformie Cisco Silicon One G200 – to samo podejście oparte na akceleratorach mieszanych, które firma sprzedaje za pośrednictwem swojej Secure AI Factory . Geograficznie rozproszony system został opracowany przez MangoBoost we współpracy z firmą Dell: cztery lokalizacje na dwóch kontynentach, hostowane przez MangoBoost, Dell, TensorWave i Microsoft Azure, obejmujące obszar Pacyfiku i działające jako jeden punkt końcowy z wydajnością skalowania, którą MangoBoost deklaruje na poziomie 97%. MangoBoost twierdzi również, że uzyskał pierwsze wyniki pre-fill/dekodowania rozdzielone na GPU AMD Instinct.
W innych wynikach CoreWeave podaje łączną liczbę 1.16 miliona tokenów na sekundę na GB300 NVL72, przy czym przepustowość offline na procesor graficzny wzrosła o 17% w porównaniu z wersją 6.0, HPE podaje 8,500 tokenów na sekundę na procesor graficzny na DeepSeek-R1 na dwóch serwerach Compute XD690 z Blackwell Ultra, a Google skupiło swoje zgłoszenie na DeepSeek-R1, powołując się na przejście branży na modele z dużą mieszanką ekspertów. gpt-oss-120b otrzymało 112 zgłoszeń, najwięcej ze wszystkich obciążeń MLPerf.
Dwa formaty CDNA 4 firmy AMD: OAM i dwugniazdowy PCIe
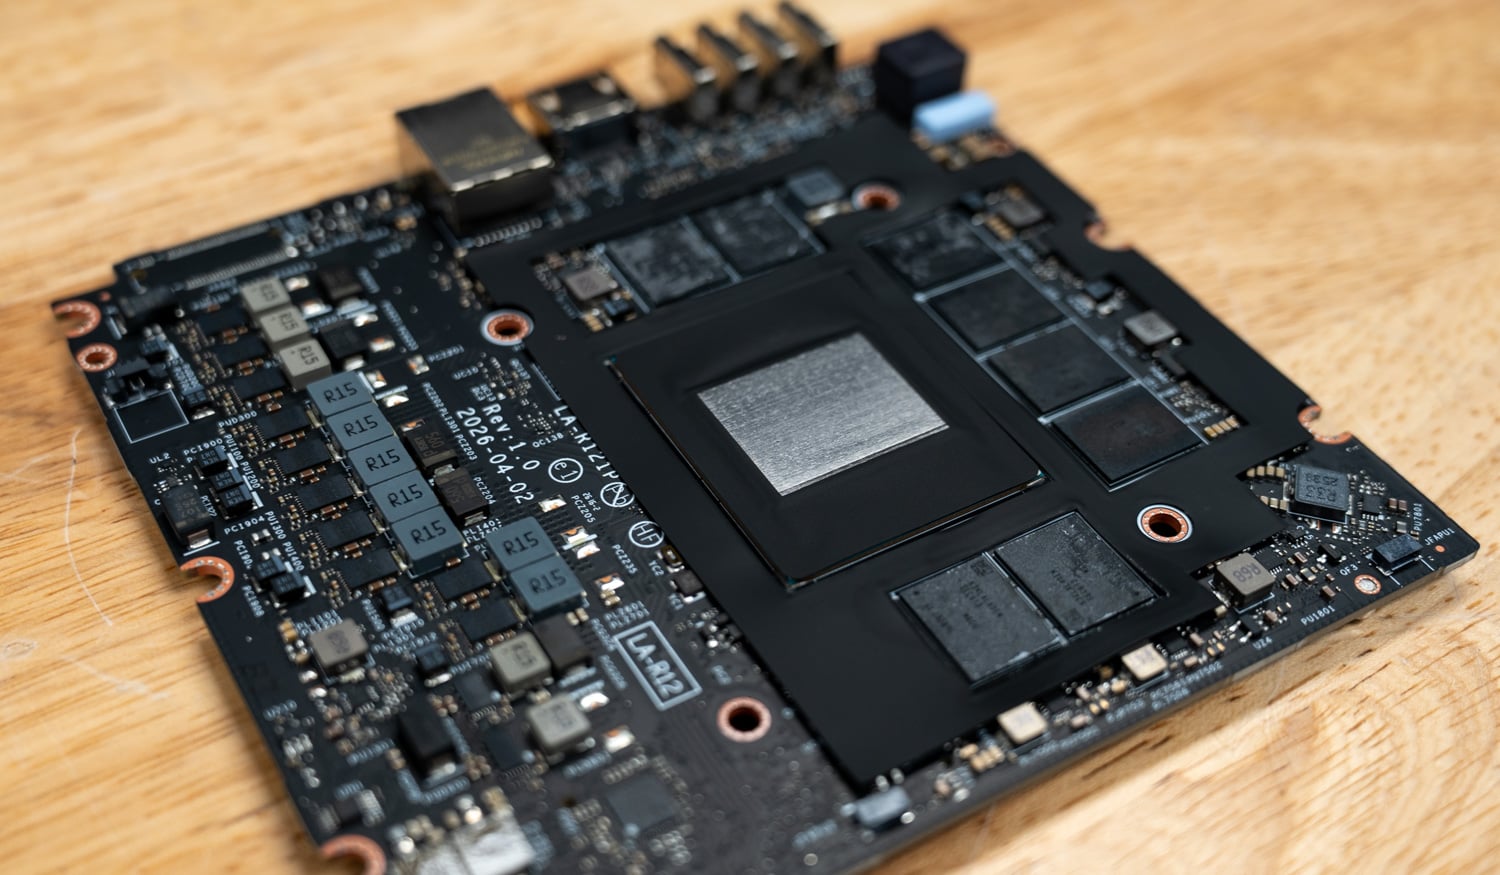
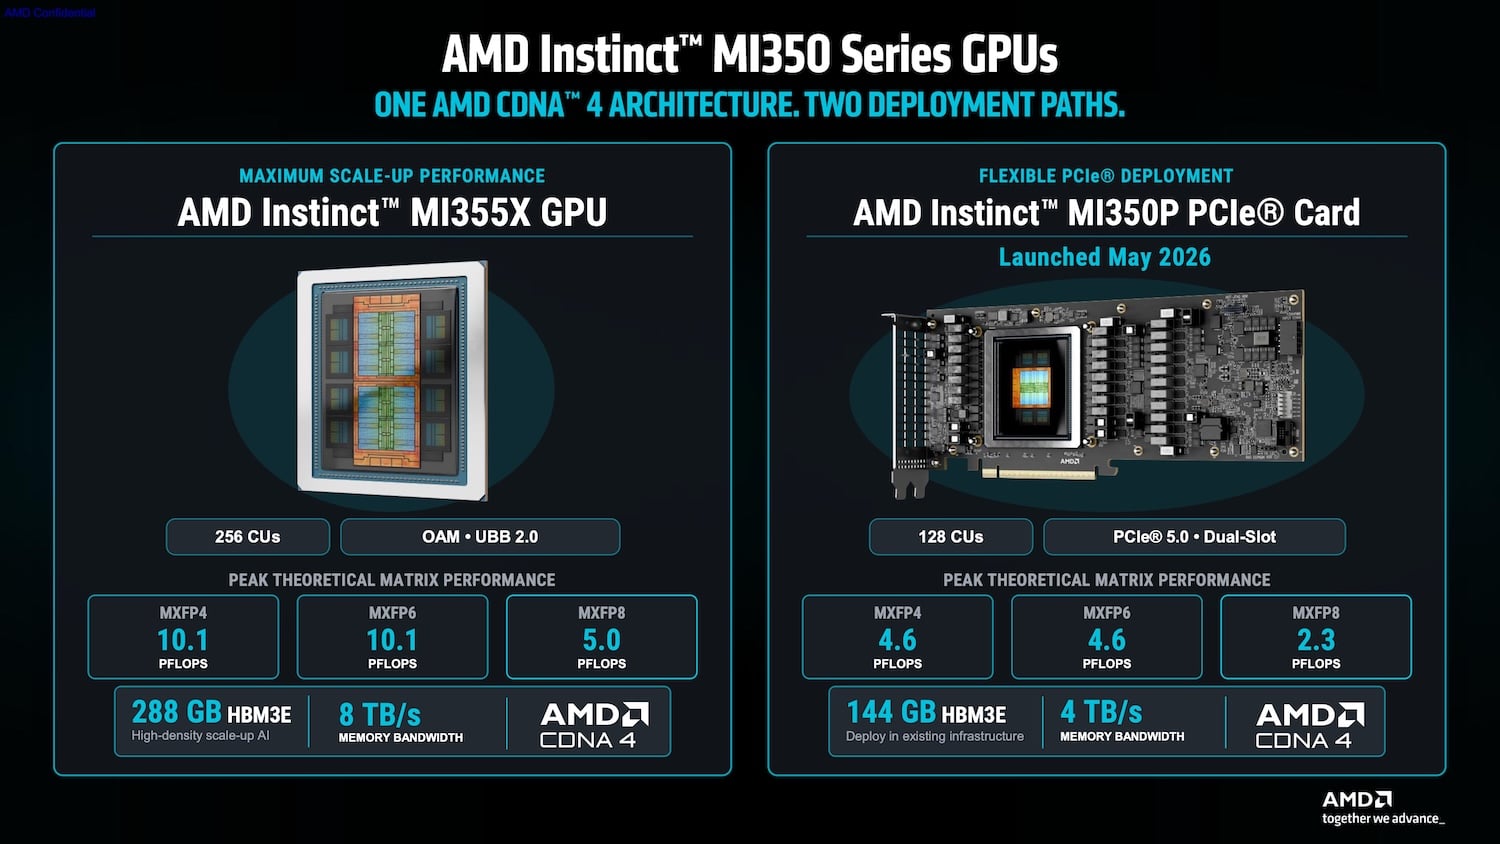
Architektura CDNA 4 firmy AMD jest dostępna w dwóch formatach fizycznych, aby sprostać specyficznym ograniczeniom w zakresie zasilania i chłodzenia centrów danych. Flagowy model Instinct MI355X jest przeznaczony dla węzłów obliczeniowych o wysokiej gęstości, wykorzystując format OAM na platformie OCP Universal Baseboard (UBB 2.0), oferując 256 jednostek obliczeniowych, 288 GB pamięci HBM3E i łączną przepustowość pamięci 8 TB/s. Zapewnia do 10.1 PFLOPS teoretycznej mocy obliczeniowej macierzy MXFP4 i MXFP6. Nowo wprowadzony model Instinct MI350P wykorzystuje tę samą architekturę CDNA 4 w dwuslotowej karcie rozszerzeń PCIe 5.0 do standardowych obudów korporacyjnych, mieszcząc 128 jednostek obliczeniowych, 144 GB pamięci HBM3E, przepustowość 4 TB/s i zapewniając do 4.6 PFLOPS teoretycznej mocy obliczeniowej macierzy MXFP4 i MXFP6.
Rozwój pokoleniowy sterowany oprogramowaniem na identycznym krzemie
Optymalizacja oprogramowania w AMD ROCm v7 przyniosła mierzalny wzrost przepustowości na identycznym sprzęcie MI355X podczas jednego cyklu MLPerf. Testy na węźle MI355X z ośmioma GPU wykazały wzrost przepustowości GPT-OSS-120B o 28% w scenariuszu offline i 38% w scenariuszu serwerowym, podczas gdy wydajność WAN-2.2 SingleStream poprawiła się o 70%. W skali klastra, 72 akceleratory MI355X w MLPerf 6.1 osiągnęły wyższą łączną przepustowość GPT-OSS-120B niż konfiguracja z 94 GPU zgłoszona w rundzie 6.0. W porównaniach konkurencyjnych opublikowanych przez AMD, MI355X z ośmioma GPU prowadził w zgłoszonych wynikach, w porównaniu z NVIDIA B200 i B300 w GPT-OSS-120B, podczas gdy klaster z 72 GPU prowadził w zgłoszonym przez NVIDIA GB200.
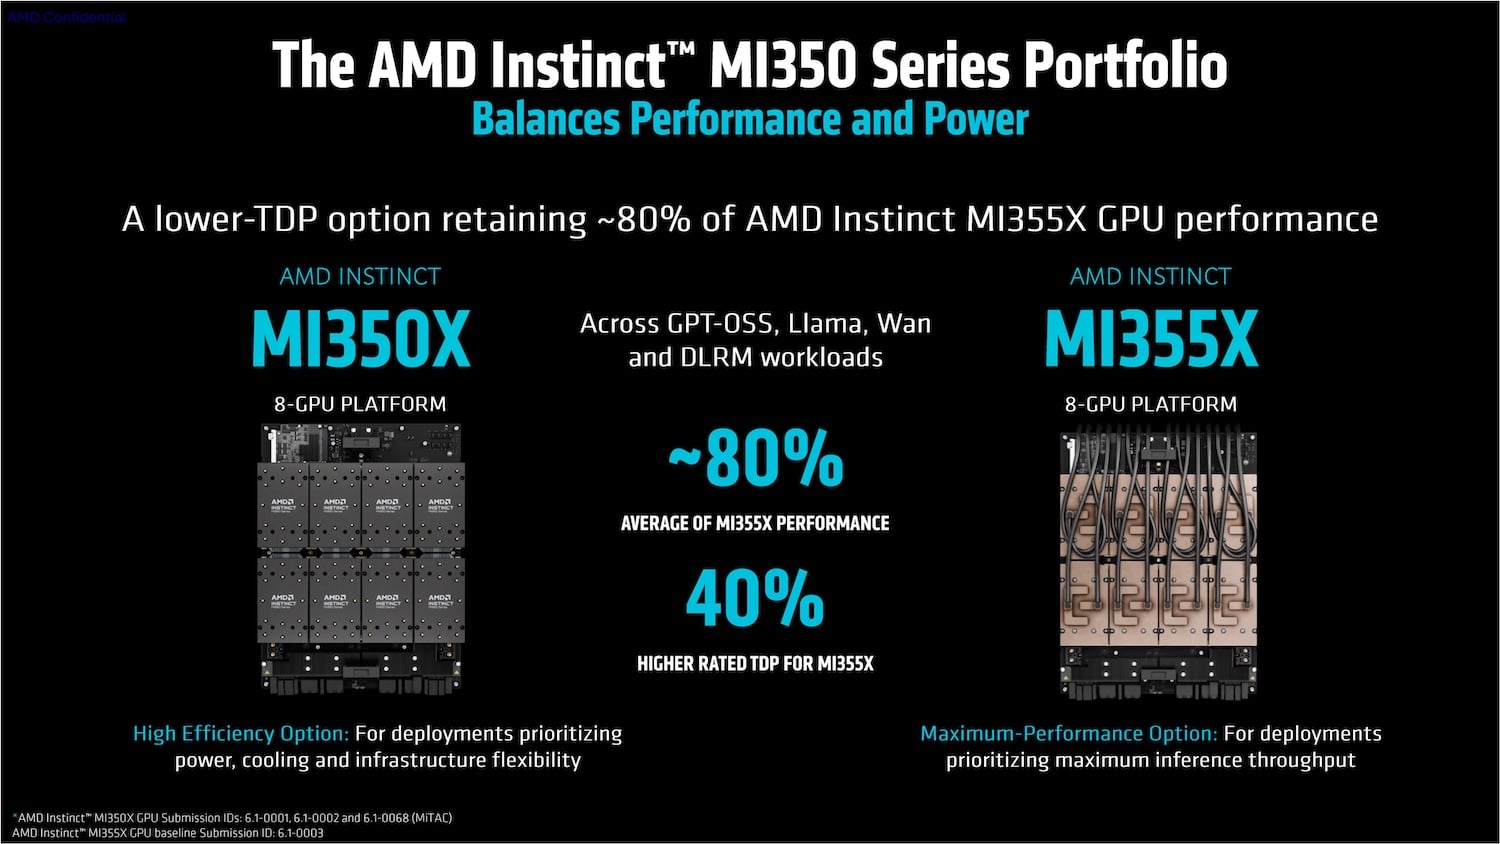
W swojej pierwszej rundzie MLPerf, dwuslotowy system MI350P zgłosił się do pięciu zamkniętych obciążeń, uzyskując czołowe wyniki w porównaniu z wybranymi zgłoszeniami kart NVIDIA RTX PRO 6000 Server Edition i H200 NVL. W przypadku wdrożeń wrażliwych na budżety energii i chłodzenia, system MI350X z ośmioma procesorami GPU utrzymał około 80% wydajności testowej platformy MI355X w obciążeniach GPT-OSS, Llama, WAN i DLRM, podczas gdy MI355X charakteryzuje się o 40% wyższym nominalnym TDP. Zlecone przez Signal65 badanie wykazało, że te wartości przepustowości przełożyły się na niższy koszt operacyjny na dokument i wyższą wydajność tokenów na dolara w ramach ustalonych limitów opóźnień.
Wyniki partnerów AMD i klaster Korea–USA
AMD twierdzi, że porównywalne wyniki testów MI355X od siedmiu partnerów: Dell Technologies, Oracle, Hewlett Packard Enterprise, Supermicro, MangoBoost, Crusoe i MiTAC, mieściły się średnio w granicach 4% wyników systemów referencyjnych, a niektóre przebiegi były im równe lub nieznacznie je przewyższały.
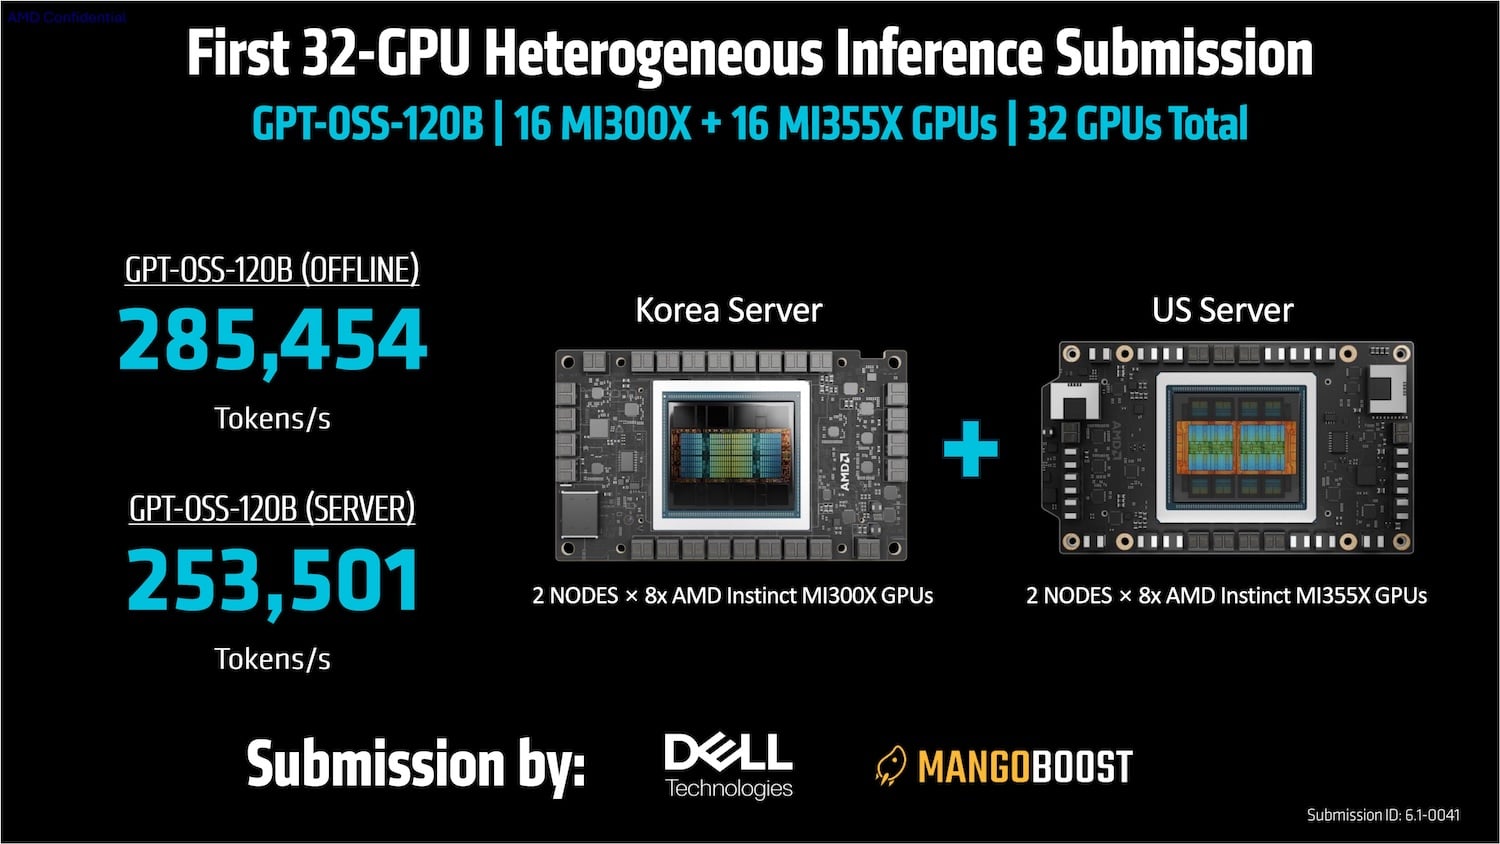
Wspomniany powyżej wpis MangoBoost i Dell to pierwsza heterogeniczna konfiguracja serwerowa z 32 GPU, łącząca 16 procesorów graficznych Instinct MI300X poprzedniej generacji w Korei z 16 procesorami graficznymi Instinct MI355X w Stanach Zjednoczonych w zunifikowany punkt końcowy GPT-OSS-120B. Konfiguracja z podzielonym klastrem dostarczyła 285 454 tokenów offline na sekundę i 253 501 tokenów serwerowych na sekundę. Zgłoszenia działały na platformie ROCm 7; AMD wskazuje na wersję ROCm 10 , z narzędziami profilującymi vLLM, SGLang i ROCm.AI, jako drogę naprzód przed serią MI400 opartą na architekturze HBM4 i następną generacją MI500.
Uprząż zastępująca wnioskowanie MLPerf w centrum danych
Szesnastu z 30 zgłaszających skorzystało w tej rundzie z pakietu MLPerf zorientowanego na API, w porównaniu z jednym otwartym pakietem w wersji 6.0. Pakiet uruchamia prawdziwą konfigurację klient/serwer w oparciu o standardowe API na hostowanym punkcie końcowym, co jest sposobem wdrażania wnioskowania w centrum danych. Pakiet zawiera już nowy test Edge Agentic, VLM-Interactive, gpt-oss, DeepSeek-R1, Llama 3.1-8B oraz konwersję tekstu na wideo. Stanowi on fundament pakietu MLPerf Endpoints, który uruchomi możliwość ciągłego przesyłania zgłoszeń na żądanie w październiku 2026 roku i zastąpi MLPerf Inference jako benchmark dla centrów danych w 2027 roku, ze znormalizowanymi wynikami i rozszerzonymi obciążeniami agentowymi planowanymi dla pakietu Endpoints v1.0.
„W przyszłości MLPerf Endpoints zastąpi Inference w naszej rodzinie benchmarków dla centrów danych, a szybkie wdrożenie naszego rozwiązania zorientowanego na API przyczyni się do płynnego przejścia na ten model” – powiedział David Kanter, szef MLPerf. Sześcioro nowych autorów zgłoszeń w tej rundzie to Atlas Inference, Crusoe, Orrick Industries, ScitiX, VibeHPC oraz Naeem Khoshnevis z Instytutu Kempnera na Uniwersytecie Harvarda, który przesłał pojedynczy wynik H200 Llama 3.1-8B.
Runda wnioskowania opiera się na wynikach MLPerf Storage v3.0 opublikowanych dwa tygodnie temu, a pełne tabele centrów danych i krawędzi, wraz z suplementami dla przesyłających, są dostępne na stronach z wynikami MLCommons.


 Amazon