

Google dodał dwa systemy do swojej oferty TPU ósmej generacji: TPU 8tx, poufny system obliczeniowy oparty na krzemie TPU 8t, oraz TPU 8i Max, który łączy dwa układy TPU 8i w jednym pakiecie do wnioskowania długokontekstowego. Dołączają one do układu treningowego TPU 8t i układu wnioskowania TPU 8i, które Google zaprezentował na konferencji Cloud Next w kwietniu. Google twierdzi, że po raz pierwszy w ciągu jednego roku zaprezentował cztery systemy TPU.
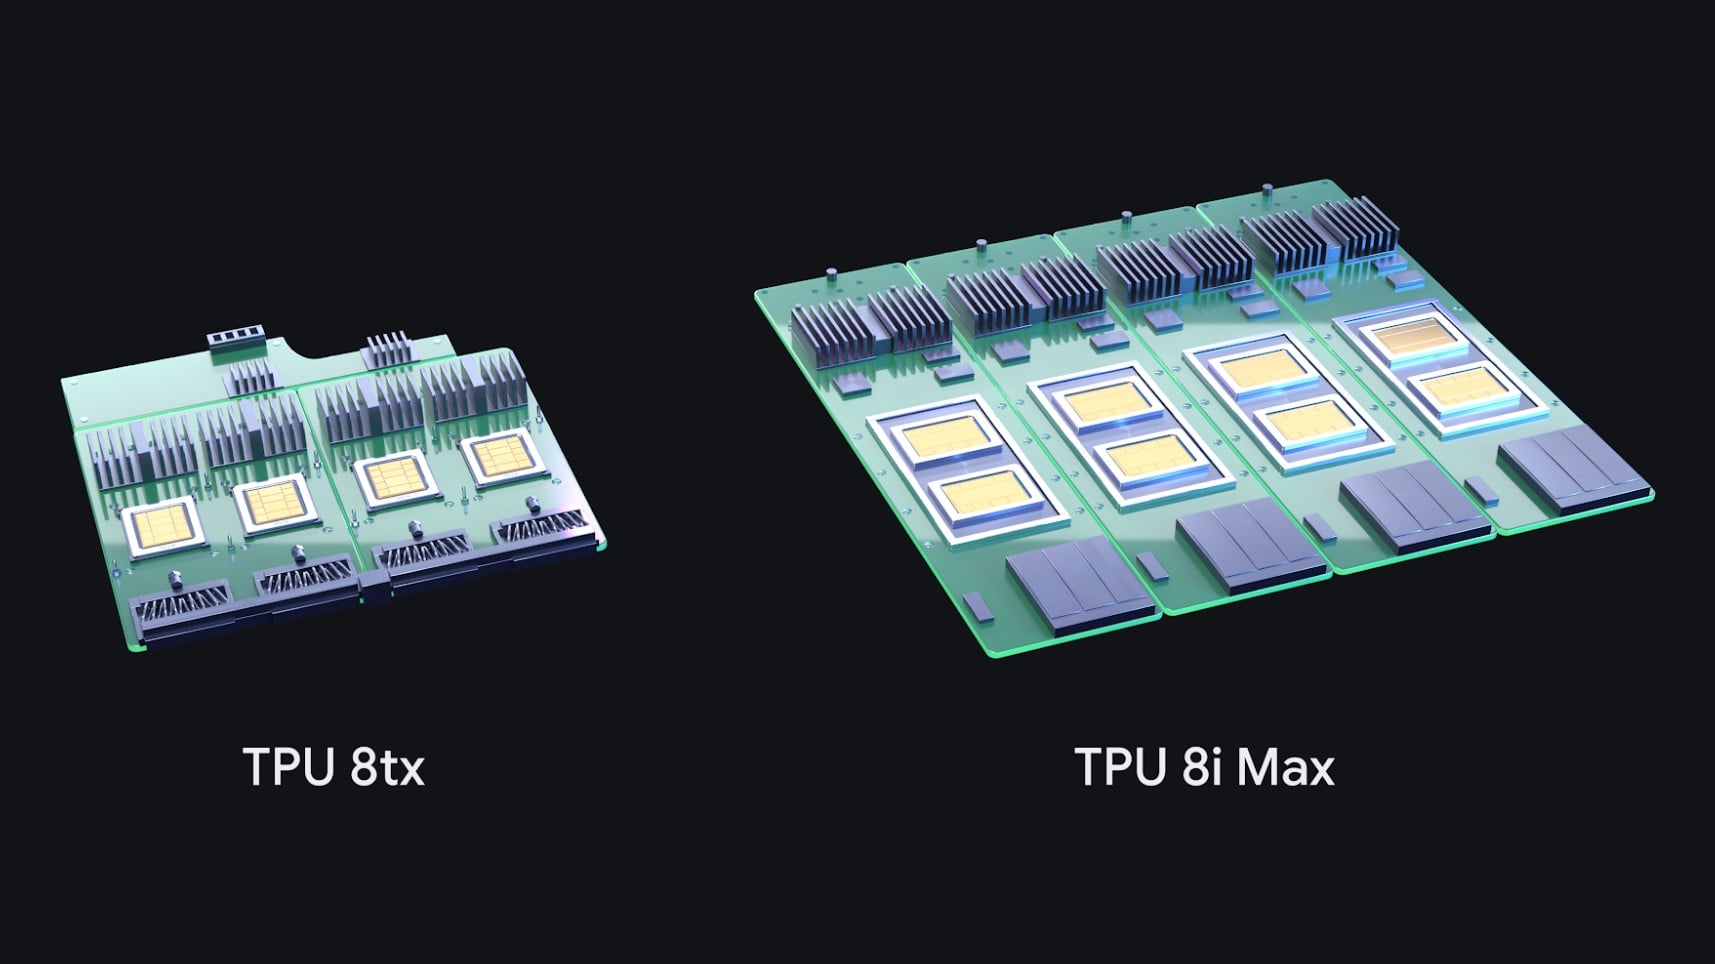
Google opisuje te dwa dodatki jako nowe systemy zbudowane wokół istniejących układów scalonych, zmieniające obudowę, szybką pamięć, sieć i zabezpieczenia wokół krzemu, aby dopasować je do obciążenia, i przypisuje to modułowemu podejściu dostarczanie wyspecjalizowanych konfiguracji w ciągu kilku miesięcy. Według Google, TPU mają obecnie prawie 100 klientów, w tym laboratoria pionierskie, firmy handlowe, sprzedawców detalicznych i uniwersytety, a niektórzy klienci mogą teraz wdrażać TPU bezpośrednio w swoich centrach danych.
TPU 8tx: Poufne obliczenia na krzemie TPU 8t
TPU 8tx wykorzystuje ten sam krzem co TPU 8t, łączy go z procesorami hosta AMD EPYC piątej generacji i wbudowuje poufne przetwarzanie w sprzęt, dzięki czemu dane i wagi modeli pozostają chronione i izolowane podczas użytkowania. Google wymienia szyfrowanie łącza PCIe, atestację kryptograficzną i bezpieczne enklawy pamięci wśród swoich funkcji bezpieczeństwa, a system jest skierowany do regulowanych przedsiębiorstw i rządów, które korzystają z pionierskich lub zastrzeżonych modeli i agentów, a także poufnych danych.

TPU 8tx wykorzystuje również sieć Boardfly o niskim opóźnieniu, stworzoną przez Google dla TPU 8i, która według Google zapewnia do 2 razy niższe opóźnienie niż TPU 8t przy niemal zerowym spadku wydajności. Google pozycjonuje ją do bezpiecznego wnioskowania i szkolenia na małą skalę, dzięki czemu zespół może precyzyjnie dostroić dane prywatne, przekształcić duży model w mniejszy i szkolić agentów poprzez uczenie ze wzmocnieniem bez konieczności przenoszenia poufnych danych między oddzielnymi klastrami.
TPU 8i Max: dwa układy wnioskowania w pakiecie
TPU 8i Max koncentruje się na przepustowości pamięci dla obciążeń takich jak dziesiątki agentów pracujących na całej bazie kodu lub godziny nagrań wideo. Google połączył dwa układy TPU 8i w jednym pakiecie, podwajając moc obliczeniową, pamięć SRAM w układzie i przepustowość HBM w porównaniu z TPU 8i. Google podawał 384 MB pamięci SRAM dla TPU 8i w momencie premiery, więc podwojona wartość daje 768 MB na pakiet 8i Max, a Google nie ujawnił pojemności HBM pakietu. Ponieważ 8i Max mieści dwa razy więcej krzemu w istniejącej obudowie szafy, Google twierdzi, że zapewnia więcej mocy obliczeniowej na metr kwadratowy i na wat.

Google mapuje teraz cztery systemy ósmej generacji na etapy pracy agenta: TPU 8t do szkolenia w zakresie skalowania, TPU 8i do wnioskowania z niskim opóźnieniem, TPU 8tx do obliczeń poufnych oraz TPU 8i Max do obsługi ogromnych okien kontekstowych i najwyższej gęstości obliczeniowej na szafę. Google nie poinformował, kiedy TPU 8tx i TPU 8i Max trafią do klientów Google Cloud ani nie opublikował cen żadnego z systemów.

Synchronizacja TPU, ścieżki chmurowe i dynamiczne segmentowanie GKE
Google udostępniło również na zasadzie open source TPU Sync, bibliotekę C++, która traktuje pamięć HBM układu scalonego, pamięć DRAM hosta, współdzieloną pamięć masową i sieć centrum danych jako pojedynczą hierarchię pamięci. Układa ona pamięci podręczne KV poza układem scalonym, przesyła strumieniowo kontekst z węzłów prefill do węzłów dekodujących oraz synchronizuje wagi uczenia wzmacniającego między trenującymi a próbnikami. Google twierdzi, że TPU Sync zmniejsza opóźnienie transferu KV o ponad 90% i skraca czas do pierwszego tokena średnio o 90% w otwartych modelach mieszanych ekspertów o parametrach od 235 do 480 B.
Cloud Pathways, środowisko uruchomieniowe Google DeepMind, na którym opiera się Gemini, jest teraz ogólnie dostępne w Google Kubernetes Engine. Wykorzystuje pojedynczy kontroler do orkiestracji systemów TPU w wielu segmentach w celu wstępnego trenowania, uczenia przez wzmacnianie i wnioskowania wielohostowego, a także utrzymuje długotrwałe zadania w działaniu pomimo awarii sprzętu dzięki ułamkowej wymianie segmentów i elastycznemu reshardingowi.
Dynamiczne cięcie GKE, również ogólnie dostępne, wykorzystuje optyczne przełączanie obwodów do łączenia kostek TPU w większe topologie lub dzielenia ich na mniejsze, odizolowane obciążenia bez konieczności ponownego tworzenia pul węzłów. Google twierdzi, że skraca to czas uruchamiania zadań nawet pięciokrotnie i przyspiesza odzyskiwanie po awarii nawet 4.5-krotnie. Pakiet agentów TPU w wersji zapoznawczej integruje się z narzędziami programistycznymi, takimi jak Claude Code, Cursor i Google Antigravity, aby wdrażać obciążenia, diagnozować wąskie gardła i automatycznie dostrajać jądra. Nowy, open source'owy silnik XLA Serving Engine obsługuje modele wytrenowane w Pythonie z poziomu środowiska wykonawczego C++ w procesorach TPU, GPU i CPU.



 Amazon