

Firma HPE wprowadziła na rynek rozszerzoną generację superkomputerów HPE Cray, zaprojektowanych z myślą o zagęszczeniu wydajności, efektywności i potrzebach operacyjnych sztucznej inteligencji na dużą skalę. Oferta koncentruje się na architekturze serwerów typu blade wielu dostawców i wielu obciążeń, zunifikowanym oprogramowaniu do zarządzania systemami oraz wysokowydajnej strukturze połączeń, tworząc spójną platformę przeznaczoną dla instytucji badawczych, agencji rządowych i dużych przedsiębiorstw, która przyspiesza odkrycia, symulacje i produkcję sztucznej inteligencji.
Łączenie architektur AI i HPC
Najnowsza platforma Cray firmy HPE łączy technologie HPC i AI w ujednoliconą architekturę, która zapewnia deterministyczną wydajność na dużą skalę, z kontrolą operacyjną oczekiwaną przez korporacyjne IT. Ogłaszając platformę, Trish Damkroger, starszy wiceprezes i dyrektor generalny ds. rozwiązań infrastruktury HPC i AI w HPE, podkreśliła, że łączenie architektur AI i HPC jest niezbędne do zwiększenia gęstości wydajności i osiągnięcia nowych poziomów postępu naukowego i technologicznego. Podsumowując, stanowisko HPE jest jasne: AI i superkomputery zbiegają się, a HPE zamierza przewodzić, oferując zintegrowane systemy, które wspierają zarówno badania naukowe, jak i realne rezultaty.
To rozszerzenie stanowi kontynuację wprowadzonego w zeszłym miesiącu systemu HPE Cray Supercomputing GX5000, stworzonego specjalnie z myślą o zintegrowanej erze AI+HPC, a obecnie uzupełnionego o system pamięci masowej HPE Cray Supercomputing Storage Systems K3000. System K3000 wyróżnia się jako pierwszy fabrycznie produkowany system pamięci masowej z wbudowanym oprogramowaniem open source DAOS (Distributed Asynchronous Object Storage), zaprojektowanym w celu utrzymania wydajności w przypadku obciążeń AI i symulacji wymagających dużej ilości operacji wejścia/wyjścia.
Szybka adopcja w wiodących ośrodkach badawczych
Wczesne wdrożenie platformy obejmuje wybór Centrum Obliczeń Wysokiej Wydajności Uniwersytetu w Stuttgarcie (HLRS) oraz Centrum Superkomputerów Leibniza (LRZ) Bawarskiej Akademii Nauk i Humanistyki. Ich systemy nowej generacji, Herder z HLRS i Blue Lion z LRZ, będą wykorzystywać superkomputer HPE Cray GX5000. Wdrożenia te podkreślają dynamikę rozwoju europejskich ośrodków HPC pierwszego poziomu, które chcą rozszerzyć możliwości odkryć opartych na sztucznej inteligencji, zapewniając jednocześnie rygor HPC klasy produkcyjnej.
Nowe, chłodzone bezpośrednio cieczą serwery obliczeniowe typu blade od wielu dostawców
HPE wprowadza trzy nowe moduły obliczeniowe typu blade, które można łączyć w szafie HPE Cray GX5000, aby dostosować je do profili obciążeń, budżetów i ograniczeń infrastruktury. Wszystkie moduły typu blade wykorzystują bezpośrednie chłodzenie cieczą, oferują dwa wbudowane dyski SSD NVMe do akceleracji lokalnej w węzłach oraz integrują cztery lub osiem punktów końcowych HPE Slingshot 400 Gb/s, zapewniając łączność o wysokiej przepustowości i niskich opóźnieniach. Obsługiwane procesory obejmują wiodące procesory graficzne (GPU) – NVIDIA Rubin i AMD Instinct MI430X – oraz procesory AMD EPYC „Venice”, co umożliwia precyzyjne dopasowanie mocy obliczeniowej do charakterystyki obciążenia.
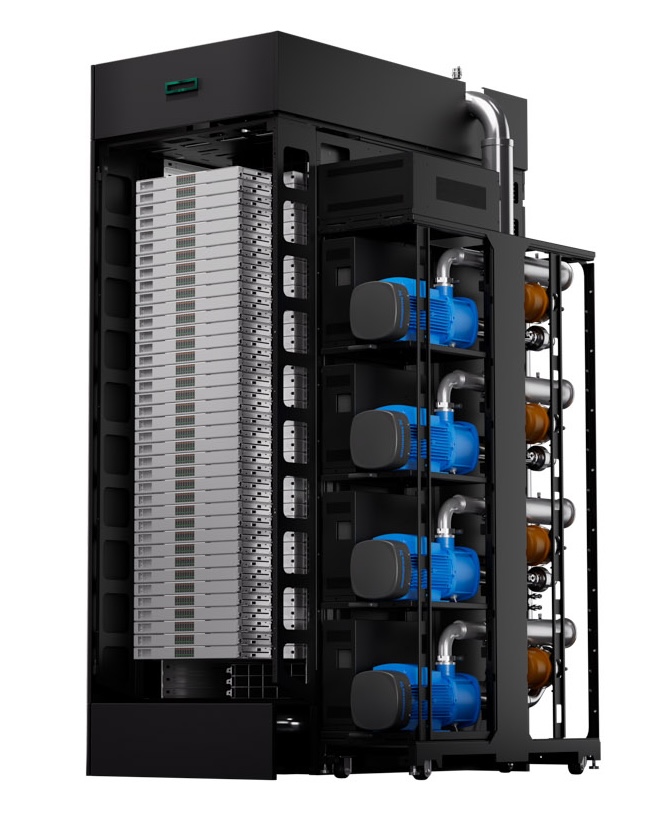
- HPE Cray Supercomputing GX440n Accelerated Blade: Zaprojektowany jako uniwersalny silnik AI-HPC, ten moduł łączy cztery procesory NVIDIA Vera z ośmioma procesorami graficznymi NVIDIA Rubin. Dzięki maksymalnie 24 modułom w szafie, konfiguracje można skalować do 192 procesorów graficznych w szafie – co jest przydatne w przypadku szkoleń AI na dużą skalę, wnioskowania wielowęzłowego i przyspieszonych przepływów pracy symulacyjnych.
- HPE Cray Supercomputing GX350a Accelerated Blade: Zoptymalizowany pod kątem obliczeń o mieszanej precyzji, GX350a łączy pojedynczy procesor AMD EPYC SP7 600 W „Venice” (do 256 rdzeni) z czterema procesorami graficznymi AMD Instinct MI430X z serii MI400. To połączenie koncentruje się na szkoleniu AI i akceleracji HPC, z wysoką wydajnością FP16/BF16, zachowując jednocześnie możliwości symulacji z podwójną precyzją – do 28 modułów na szafę daje 112 procesorów graficznych AMD MI430X.
- HPE Cray Supercomputing GX250 Compute Blade: Zaprojektowany do obsługi dużych obciążeń o podwójnej precyzji i wyłącznie z wykorzystaniem procesora (np. CFD, symulacji pogody i tradycyjnych), serwer GX250 integruje osiem procesorów AMD EPYC „Venice” na moduł, każdy z maksymalnie 256 rdzeniami. Dzięki obsłudze do 40 modułów w szafie, serwer ten jest idealny dla obiektów konsolidujących duże zadania MPI z przewidywalnym zachowaniem skalowalności.
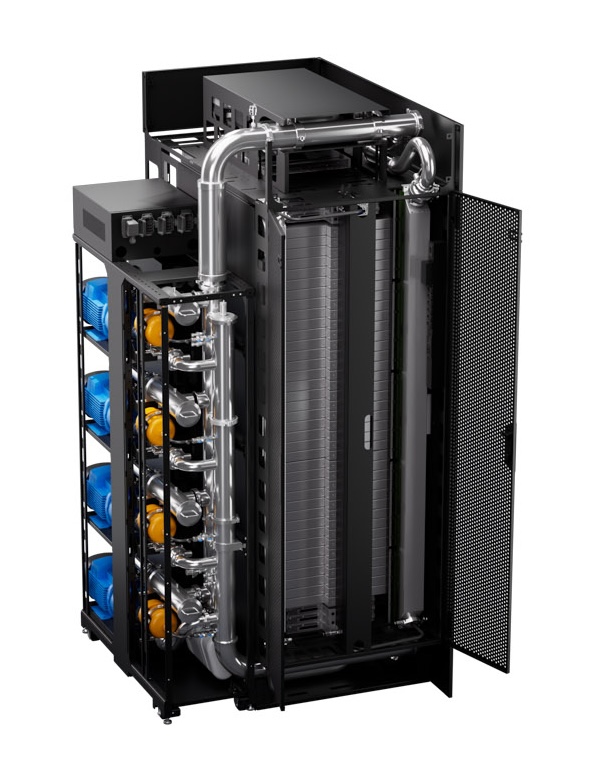
Elastyczne łączenie tych modułów na poziomie szafy umożliwia projektowanie dostosowanych systemów, od wysp szkoleniowych AI z dużą liczbą procesorów GPU po pule symulacyjne obsługiwane przez procesory CPU, bez marnowania zasobów zasilania, chłodzenia lub połączeń.
Zunifikowane zarządzanie systemami wielodostępnymi
Oprogramowanie HPE Supercomputing Management zapewnia obsługę wielu dzierżaw i bezpieczeństwo klasy korporacyjnej w środowiskach fizycznych, wirtualnych i kontenerowych. Celem jest maksymalizacja wykorzystania zasobów, przy jednoczesnym zapewnieniu operatorom silnej kontroli nad izolacją użytkowników, projektów i obciążeń. Zarządzanie energią to funkcje najwyższej klasy. Oprogramowanie oferuje telemetrię w czasie rzeczywistym i historyczną, szacowanie kosztów oraz narzędzia do planowania z uwzględnieniem zużycia energii, umożliwiając organizacjom optymalizację efektywności energetycznej i prognozowanie wydatków.
Zakres operacyjny obejmuje cały cykl życia systemu, w tym dostarczanie zasobów, monitorowanie, nadzór nad zasilaniem/chłodzeniem oraz elastyczne skalowanie, z ulepszonymi mechanizmami kontroli bezpieczeństwa i ulepszonym raportowaniem. Dla zespołów ds. operacji technicznych efektem końcowym jest pojedyncza płaszczyzna sterowania zaprojektowana dla mieszanych środowisk AI i HPC o wysokim obciążeniu.
HPE Slingshot 400 dla systemów opartych na GX5000
HPE Slingshot 400, dostępny teraz dla klastrów HPE Cray Supercomputing GX5000, rozwija infrastrukturę połączeń dzięki architekturze przełączników typu blade z bezpośrednim chłodzeniem cieczą, opracowanej z myślą o wdrożeniach o wysokiej gęstości i stałej przepustowości w złożonych obciążeniach AI+HPC. Każdy przełącznik typu blade oferuje 64 porty o przepustowości 400 Gb/s, a konfiguracje na poziomie obudowy obsługują:
- 8 przełączniki z 512 portami
- 16 przełączniki z 1,024 portami
- 32 przełączniki z 2,048 portami
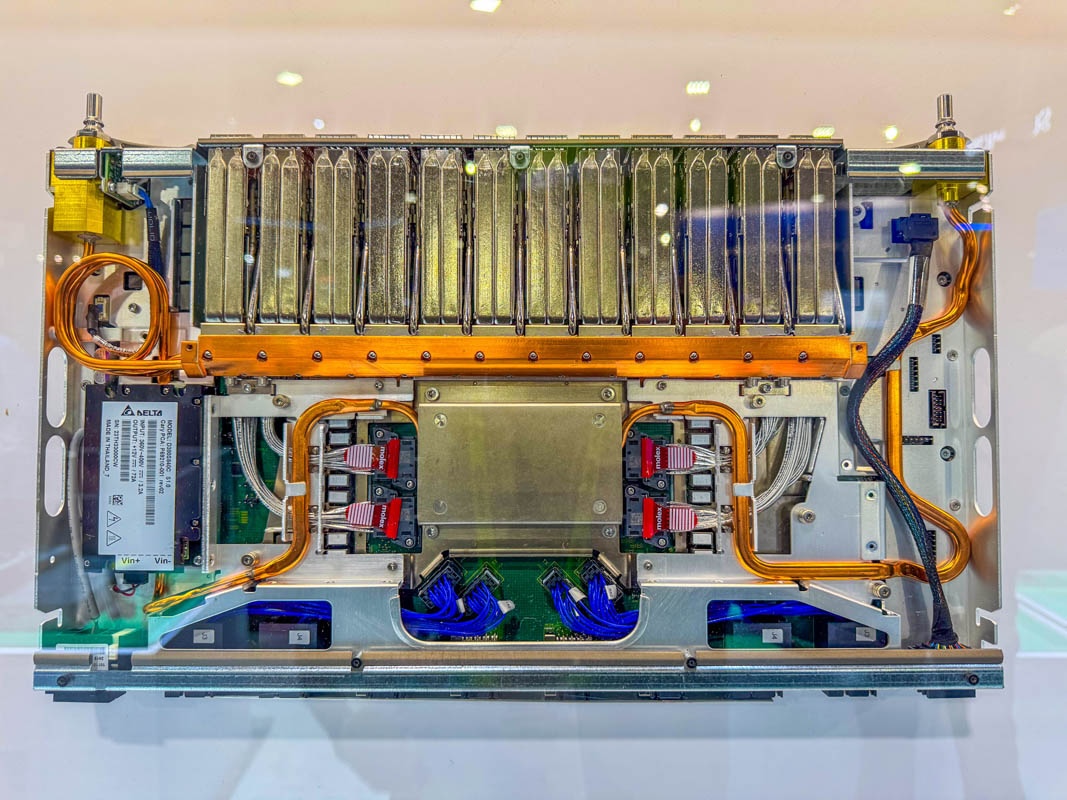
Zaprezentowany po raz pierwszy w zeszłym roku, Slingshot 400 został zaprojektowany z myślą o wykorzystaniu topologii o wyższej wydajności serwera GX5000, co pozwala na redukcję opóźnień, zwiększenie stałej przepustowości i poprawę niezawodności, przy jednoczesnym zachowaniu kontroli nad kosztami. W środowiskach wielodostępnych i mieszanych przepływach pracy, połączenie to zapewnia przewidywalną wydajność w dużej skali.
Pamięć masowa oparta na DAOS przyspieszająca sztuczną inteligencję ograniczoną do wejścia/wyjścia
Systemy pamięci masowej HPE Cray Supercomputing Storage Systems K3000 wykorzystują serwery HPE ProLiant Compute DL360 Gen12 z wbudowanym systemem DAOS, aby priorytetyzować dostęp do obiektów o niskim opóźnieniu, wysoki paralelizm i liniowe skalowanie – atrybuty kluczowe dla potoków AI obciążonych wejściem/wyjściem oraz punktów kontrolnych symulacji. Platforma równoważy moc obliczeniową na węzeł pamięci masowej z pamięcią i gęstością NVMe, aby zapewnić zasilanie procesorów graficznych i procesorów w oparciu o wzorce współbieżnego dostępu.
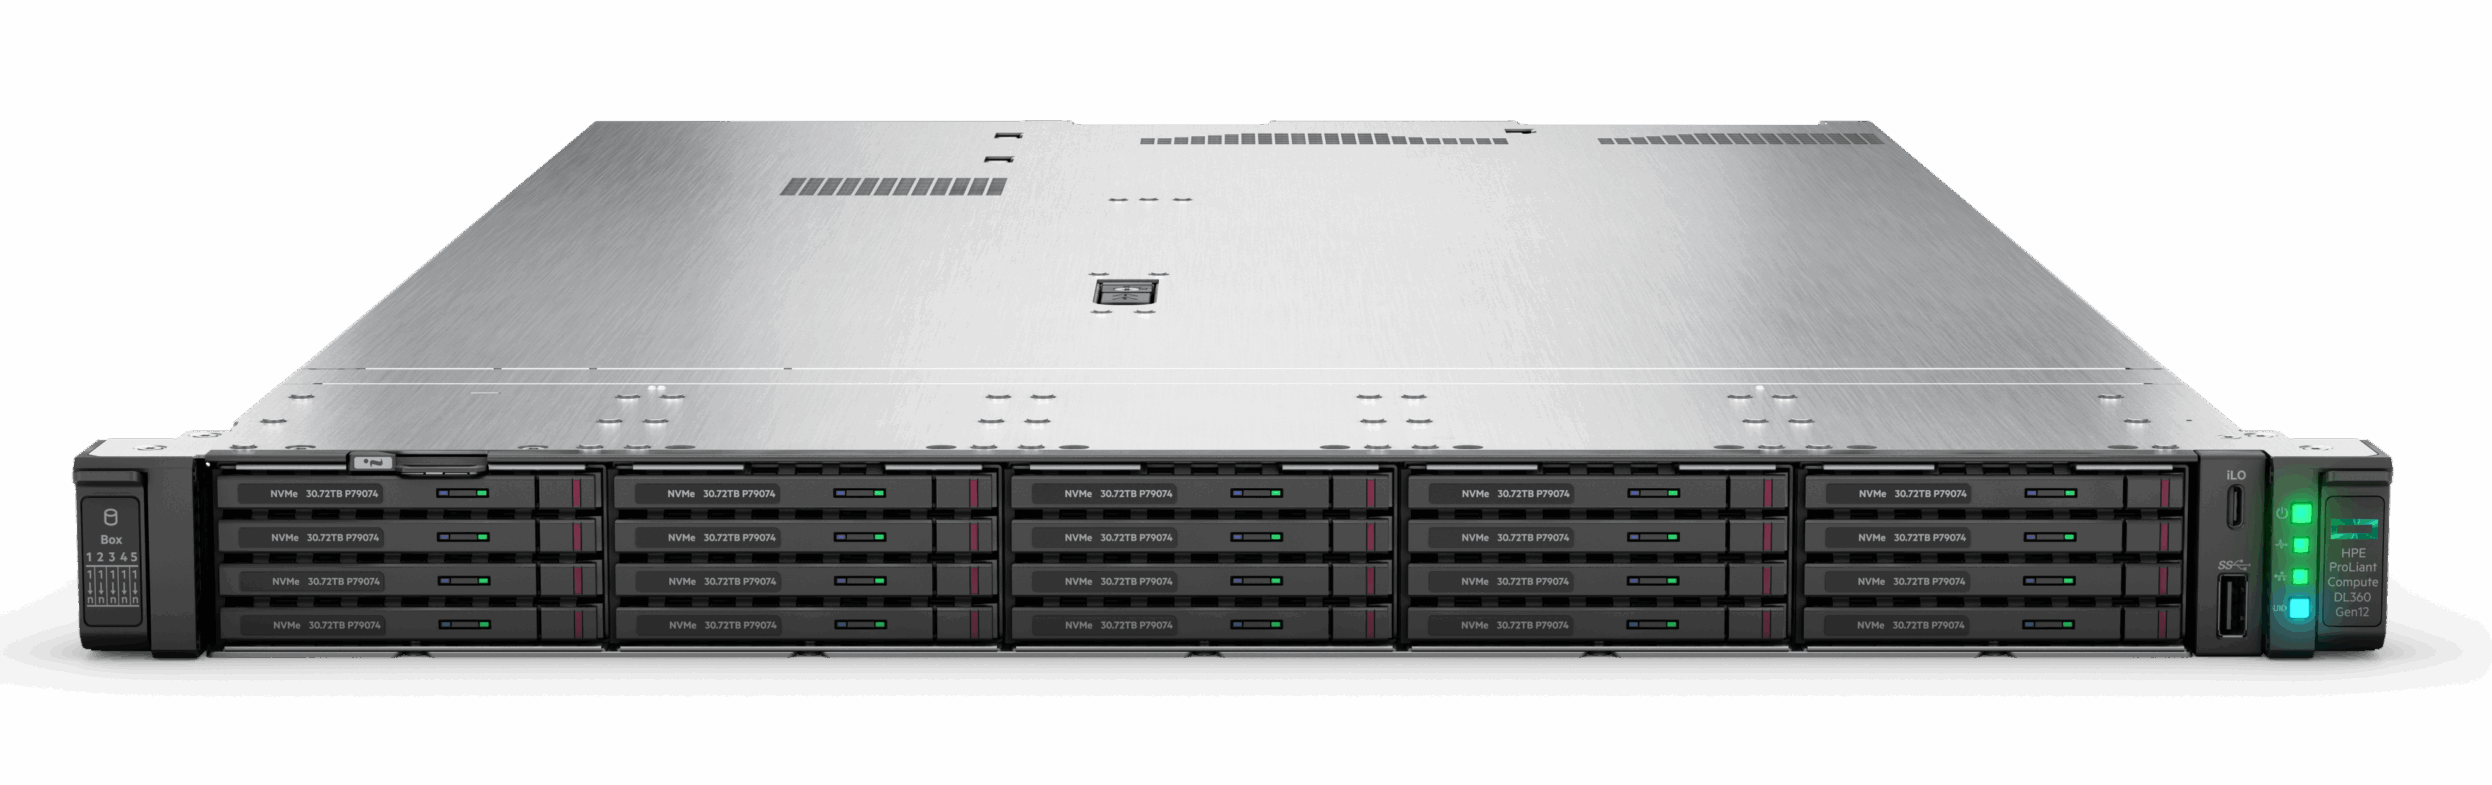
Konfigurowalne opcje umożliwiają dostrojenie wydajności lub pojemności:
- Zoptymalizowane pod kątem wydajności serwery pamięci masowej DAOS z 8, 12 lub 16 dyskami NVMe
- Serwery pamięci masowej DAOS zoptymalizowane pod kątem pojemności z 20 dyskami NVMe
- Rozmiary dysków NVMe: 3.84 TB, 7.68 TB lub 15.36 TB
- Opcje pamięci DRAM: 512 GB, 1,024 GB lub 2,048 GB, dostosowane do liczby dysków i profili obciążeń
Wybór połączeń międzysystemowych odzwierciedla heterogeniczne sieci centrów danych i potrzeby przepływu pracy:
- HPE Slingshot 200
- HPE Slingshot 400
- InfiniBand NDR
- 400 Gigabit Ethernet
Wprowadzając DAOS do fabrycznie zintegrowanego i obsługiwanego przez dostawcę systemu, HPE zamierza skrócić czas wdrażania, zmniejszyć złożoność integracji i zwiększyć stałą wydajność w przypadku sztucznej inteligencji (AI) i obliczeń o dużej wydajności (HPC) przetwarzających duże ilości danych.
Dostępność:
- Systemy pamięci masowej HPE Cray Supercomputing K3000 z serwerami HPE ProLiant Compute: początek 2026 r.
- HPE Cray Supercomputing GX440n Accelerated Blade, GX250 Compute Blade i GX350a Accelerated Blade: początek 2027 r.
- Oprogramowanie do zarządzania superkomputerami HPE: początek 2027 r.
- HPE Slingshot 400 dla systemów opartych na GX5000: początek 2027 r.
Portfolio rozwiązań Cray nowej generacji firmy HPE ma na celu zniesienie tradycyjnych silosów AI/HPC, zapewniając wyższą gęstość wydajności na szafę i usprawniając operacje w instytucjach skalujących symulację oraz szkolenie/wnioskowanie AI na wspólnej, wysoce wydajnej platformie.


 Amazon