

Lightbits Labs, firma, która wynalazła technologię NVMe przez TCP, wkracza w obszar oprogramowania inferencyjnego, oferując Inferra, silnik orkiestracji pamięci podręcznej KV, który zadebiutuje publicznie jutro, 15 września, na konferencji AI Infra Summit w Santa Clara. Oprogramowanie wirtualizuje pamięć GPU w warstwach pamięci DRAM i NVMe oraz przekształca pamięć podręczną KV w trwałą warstwę danych. Dzięki temu stany uwagi dla obciążeń długokontekstowych i wielosesyjnych nie muszą mieścić się w HBM ani być przeliczane po ich wystąpieniu. Lightbits twierdzi, że oferuje do 16 razy więcej równoczesnych sesji inferencyjnych na istniejących procesorach GPU, ponad 100-krotną poprawę opóźnień dzięki wstępnemu pobieraniu stanów uwagi zamiast ich przeliczania oraz okna kontekstowe obsługujące do 10 milionów tokenów. Silnik został już uruchomiony w programach beta dla klientów, w tym w OVH.
Wstępne pobieranie zamiast ponownego obliczania
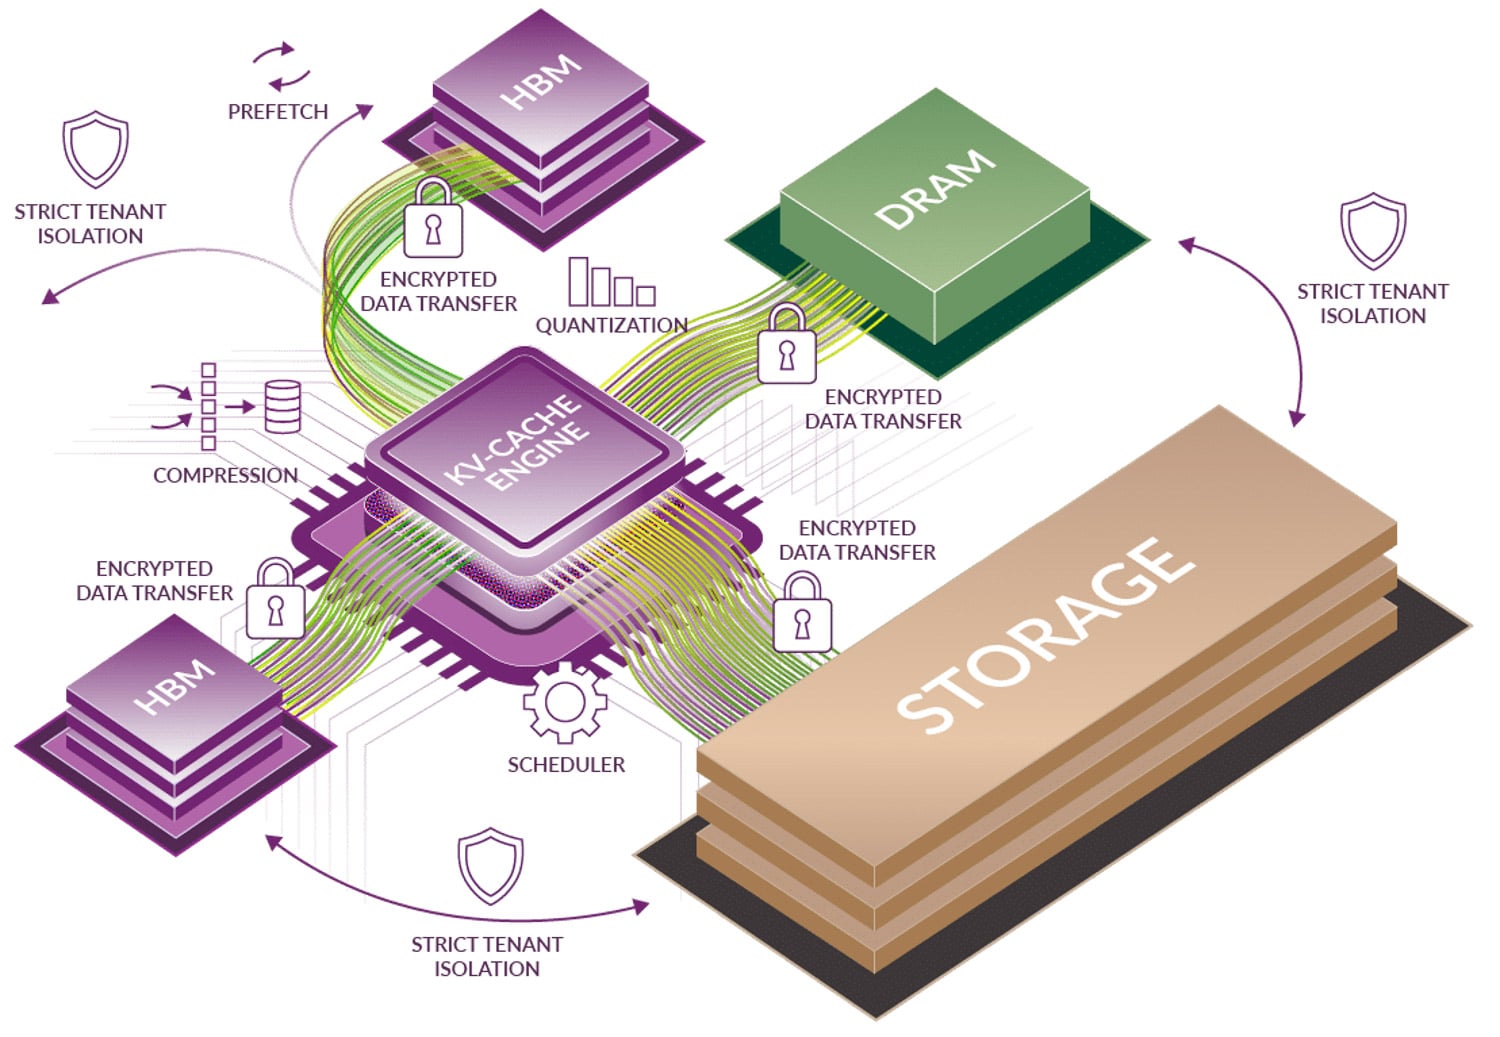
Wąskim gardłem, na które natknęliśmy się w naszym fragmencie dotyczącym odciążenia pamięci podręcznej KV do flashowania , jest to, które omówiliśmy w naszym fragmencie dotyczącym odciążenia pamięci podręcznej KV do flashowania: wraz ze wzrostem długości kontekstu i mnożeniem się sesji, pamięć podręczna KV przekracza możliwości GPU, a stos obsługujący albo ją usuwa i ponownie oblicza prefill później, albo ogranicza liczbę sesji, które GPU może obsłużyć. Obie ścieżki zużywają cykle GPU na pracę, która już została wykonana. Inferra utrzymuje aktywność pamięci podręcznej na wszystkich poziomach pamięci i pamięci masowej, a predykcyjny prefetcher ściąga stany uwagi z powrotem do GPU, zanim model ich potrzebuje. Lightbits twierdzi, że takie podejście skraca zarówno czas do pierwszego tokena (TTFT), jak i czas na token wyjściowy (TPOT), a podana wartość 100x to poprawa opóźnienia w porównaniu z ponownym obliczeniem tych stanów od podstaw.
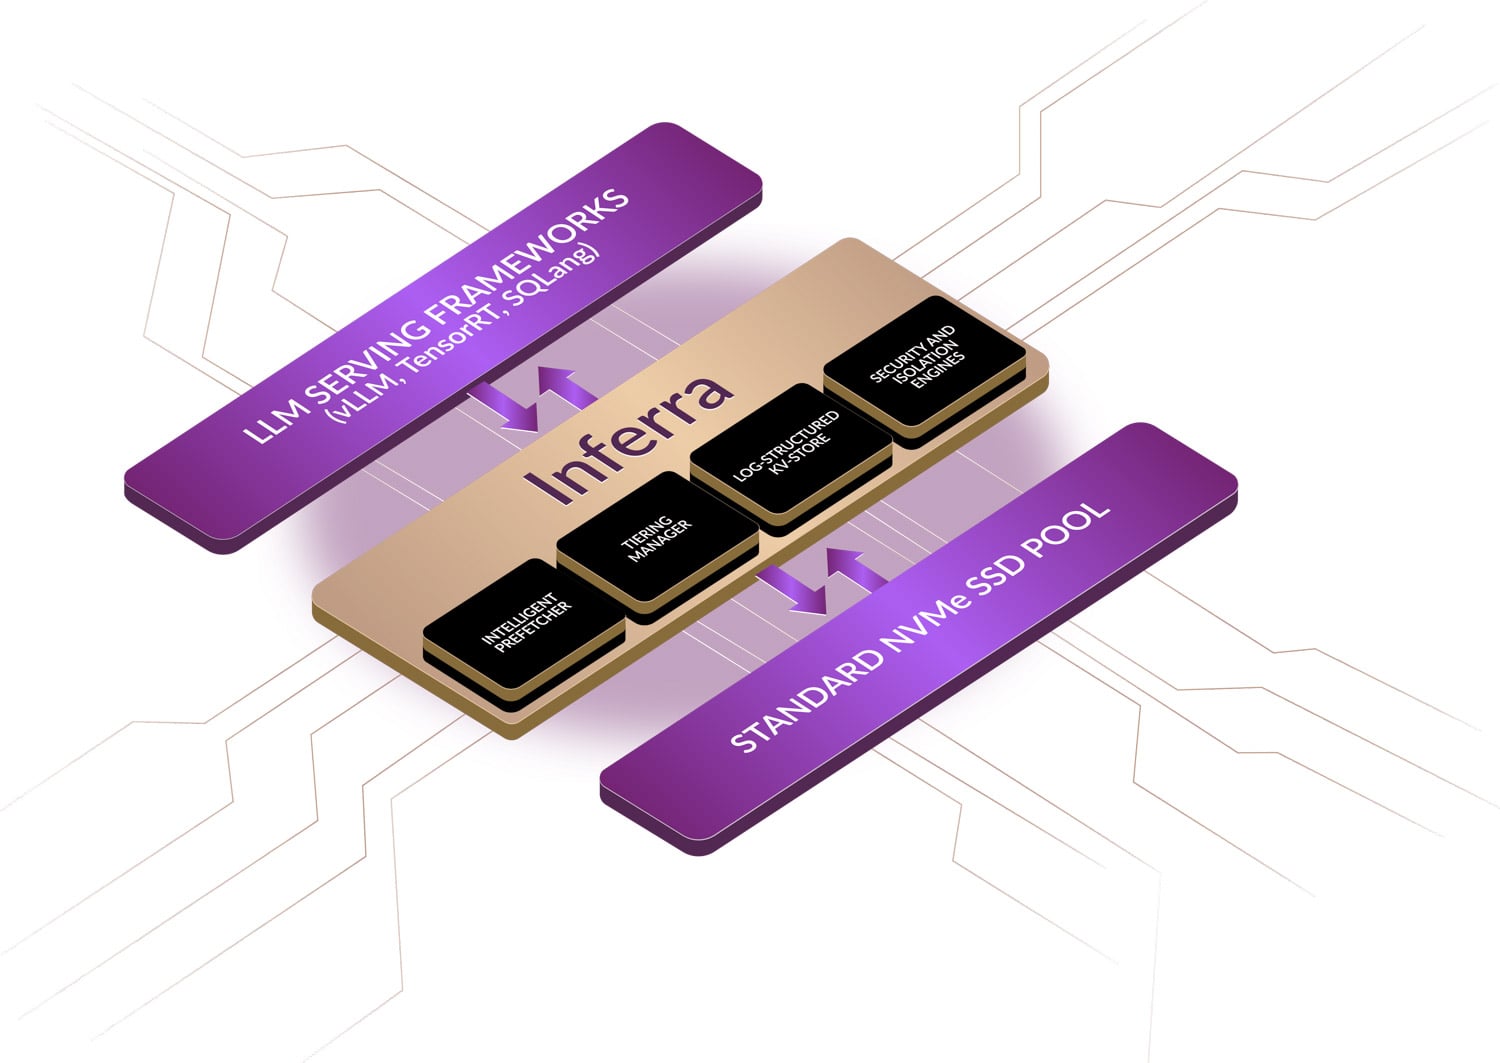
Schemat blokowy Lightbits przedstawia cztery części: inteligentny prefetcher, menedżer warstw, magazyn KV oparty na logach oraz silniki bezpieczeństwa i izolacji, znajdujące się pomiędzy strukturą serwującą powyżej a standardową pulą dysków SSD NVMe poniżej. Firma wymienia vLLM, TensorRT i SGLang jako obsługiwane struktury serwujące i twierdzi, że silnik jest niezależny od GPU i dysków SSD. Magazyn oparty na logach to to, co sprawia, że warstwa flash jest praktyczna dla pamięci podręcznej, która zmienia się stale, ponieważ dodaje aktualizacje sekwencyjnie i utrzymuje małe losowe zapisy z dysków, a my przyjrzeliśmy się, jak dysk 3 DWPD sprawdza się w tej roli w naszej recenzji Solidigm D7-PS1030 . Po stronie wielu najemców Lightbits opisuje bezpieczną izolację najemców i inteligentne zarządzanie pamięcią podręczną w ramach współdzielonej infrastruktury wnioskowania, z szyfrowanym transferem między warstwami, co pozwala neocloudowi przekazać jedną pulę KV wielu klientom ze spójnymi umowami SLA.
Avigdor Willenz, współzałożyciel i prezes Lightbits Labs, określił premierę jako odejście od pamięci masowej przeznaczonej do trenowania procesów. Wnioskowanie „to zupełnie inny paradygmat” – powiedział – a „modernizacja starszych systemów treningowych i pamięci masowej w celu rozwiązania wąskiego gardła związanego z pamięcią podręczną KV po prostu nie działa. Została stworzona dla innej ery. Zaprojektowaliśmy Inferrę od podstaw specjalnie po to, aby rozwiązać problem wydajności GPU, i już sprawdziła się w testach beta dla klientów”.
OVH, Solidigm i pokazy na stoisku nr 219
OVH jest klientem testowym. „Dzięki inteligentnemu warstwowaniu pamięci podręcznej KV firmy Inferra udało nam się wykazać znaczny wzrost wykorzystania GPU, torując drogę do zapewnienia naszym klientom bardziej skalowalnej i ekonomicznej podstawy dla ich agentów AI i obciążeń RAG” – powiedział Yaniv Fdida, dyrektor ds. produktów i technologii w OVH. Solidigm uruchomił silnik w swoim laboratorium AI Central Lab na dyskach D7-PS1010 , a Avi Shetty, wiceprezes ds. ekosystemu, rozwiązań i wspierania rynku, powiedział, że wyniki „pokazały, jak pamięć masowa podłączona do sieci (NAS) z inteligentną wirtualizacją warstwy oprogramowania może przełamać barierę pamięci dla szerokokontekstowej, agentowej AI”. Połączenie puli NVMe podłączonej do sieci (NAS) z warstwą oprogramowania to domena Lightbits; jego blokowa pamięć masowa LightOS jest oparta na NVMe/TCP od 2019 roku.
Ramesh Chettuvetty, starszy wiceprezes ds. produktów i biznesu AI w Lightbits, nazwał Inferrę „pierwszym na świecie silnikiem akceleracji pamięci podręcznej KV, który eliminuje bezczynne procesory graficzne (GPU) i obsługuje okna kontekstowe o wydajności do 10 milionów tokenów na sprzęcie klasy masowej” i dodał, że „zapewnia natychmiastowy zwrot z inwestycji i generuje dodatnie oszczędności netto od pierwszego dnia”. Są to zapewnienia dostawców, które pojawiły się przed jakimikolwiek niezależnymi testami, a wydanie nie zawiera cen, opakowań ani daty ogólnej dostępności; silnik jest obecnie w fazie beta dla klientów. Lightbits przeprowadza demonstracje na żywo wyników gęstości sesji i opóźnień na stoisku 219 podczas szczytu i opublikował narzędzie Pod Efficiency Analyzer dla zespołów, które chcą zamodelować oszczędności GPU na własnym klastrze przed jego rezerwacją.


 Amazon