

Firma Microsoft zaprezentowała dziś na szczycie OCP Global Summit platformę Azure Maia 300 – trzecią generację własnego akceleratora inferencyjnego i pierwszą zbudowaną w oparciu o technologię wielochipletową. Każdy akcelerator łączy układ obliczeniowy TSMC N2P z ośmioma stosami HBM4, co daje 288 GB pamięci o przepustowości 18 TB/s i TDP na poziomie 950 W. Szafa Maia 300 mieści 96 takich stosów w obudowie o mocy 167 kW. Microsoft deklaruje o 40% więcej tokenów na megawat niż wiodące systemy oparte na GPU i do 7 razy większą przepustowość tokenów w szafie niż Maia 200. Wdrożenia produkcyjne rozpoczną się w 2027 roku w ramach tego, co Microsoft określa mianem wdrożeń Maia o mocy wielu gigawatów.
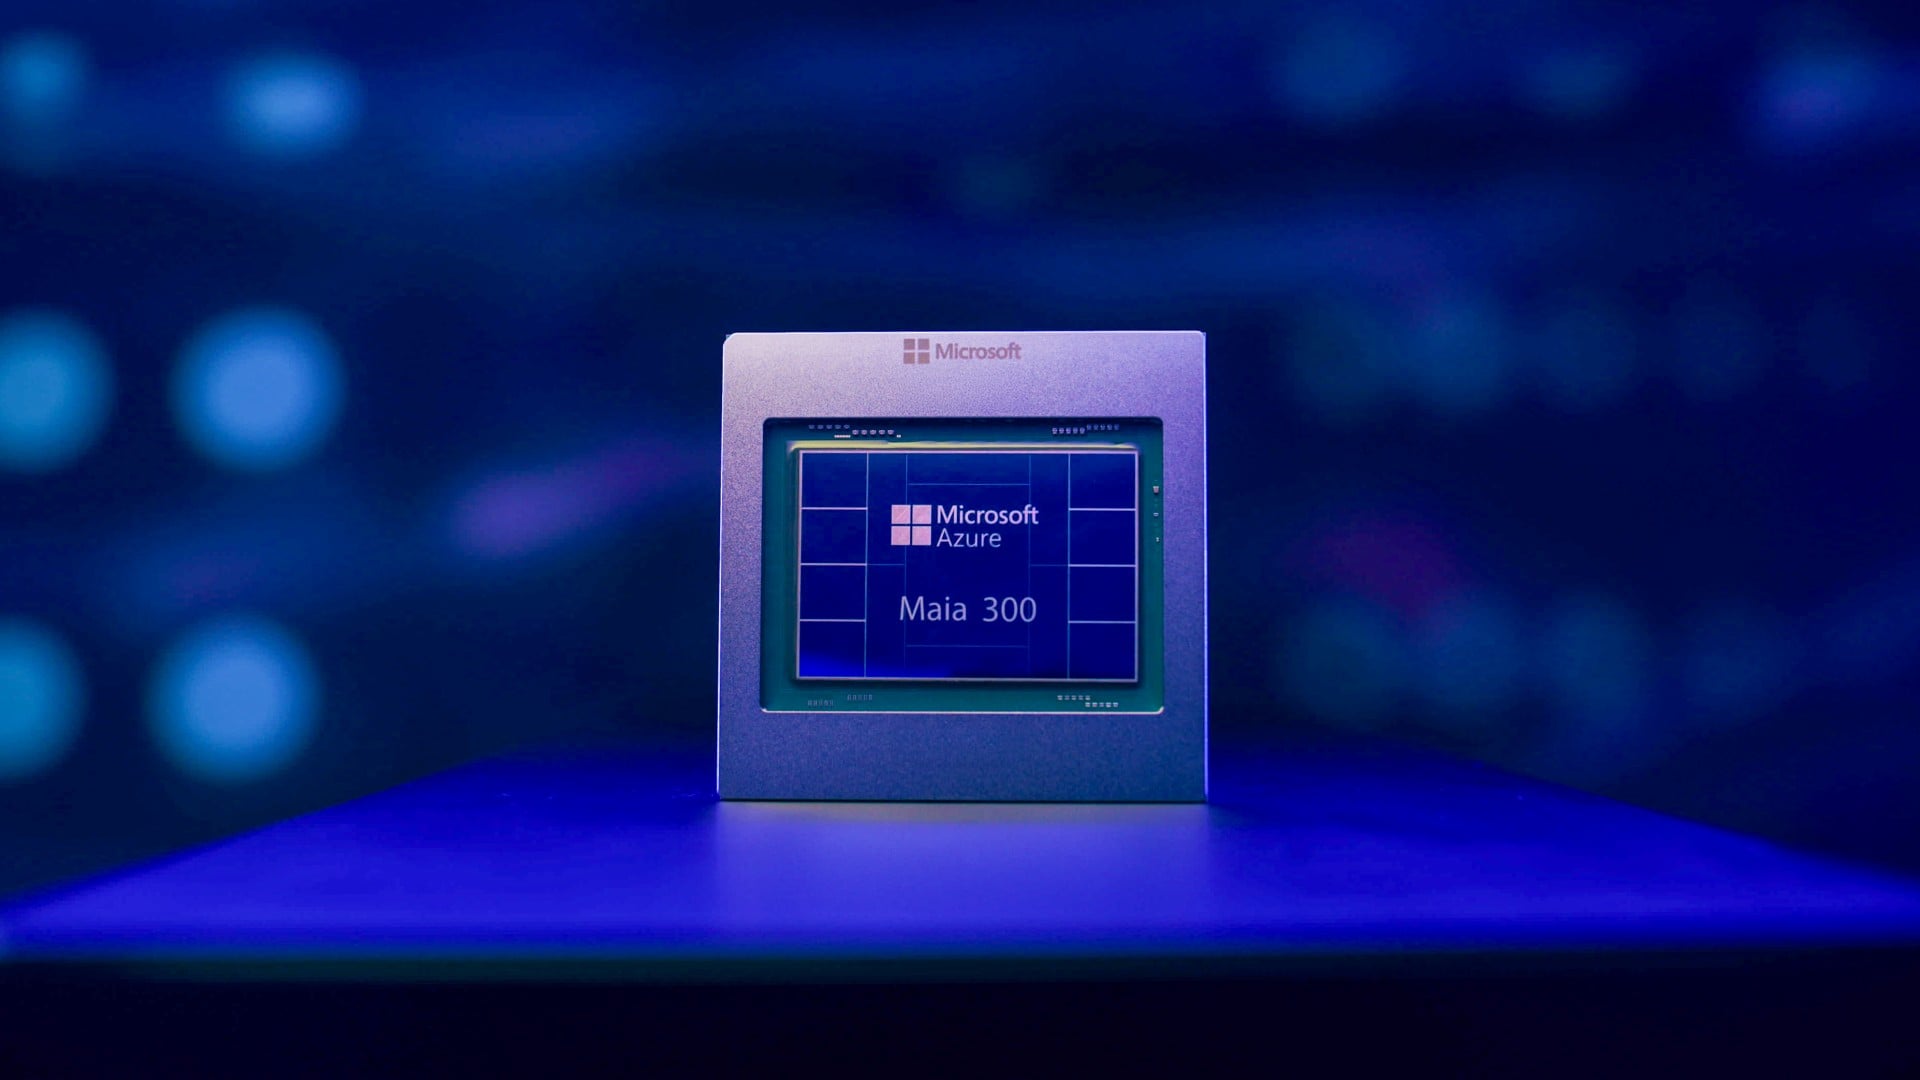
Maia 300 Silicon: układ obliczeniowy N2P, osiem stosów HBM4, 32 porty 400G
Maia 200 to monolityczny układ N3P z sześcioma stosami HBM3E. Maia 300 dzieli konstrukcję na główny układ obliczeniowy na N2P, dwa układy wejścia/wyjścia i cztery układy pamięci. Osiem stosów HBM4 zwiększa pojemność z 216 GB do 288 GB, a przepustowość z 7.1 TB/s do 18 TB/s. Maksymalny ruch obliczeniowy jest mniejszy: 13.8 POPS w FP4 i 6.9 POPS w FP8, w porównaniu z 10.1 i 5.1, co oznacza 37% wzrost mocy obliczeniowej w FP4 przy 2.5-krotnym wzroście przepustowości pamięci. Microsoft podsumowuje, że układ zapewnia 2.5-krotny wzrost przepustowości, 33% większą pojemność i około 2-krotny wzrost przepustowości HBM na wat w porównaniu z Maia 200.
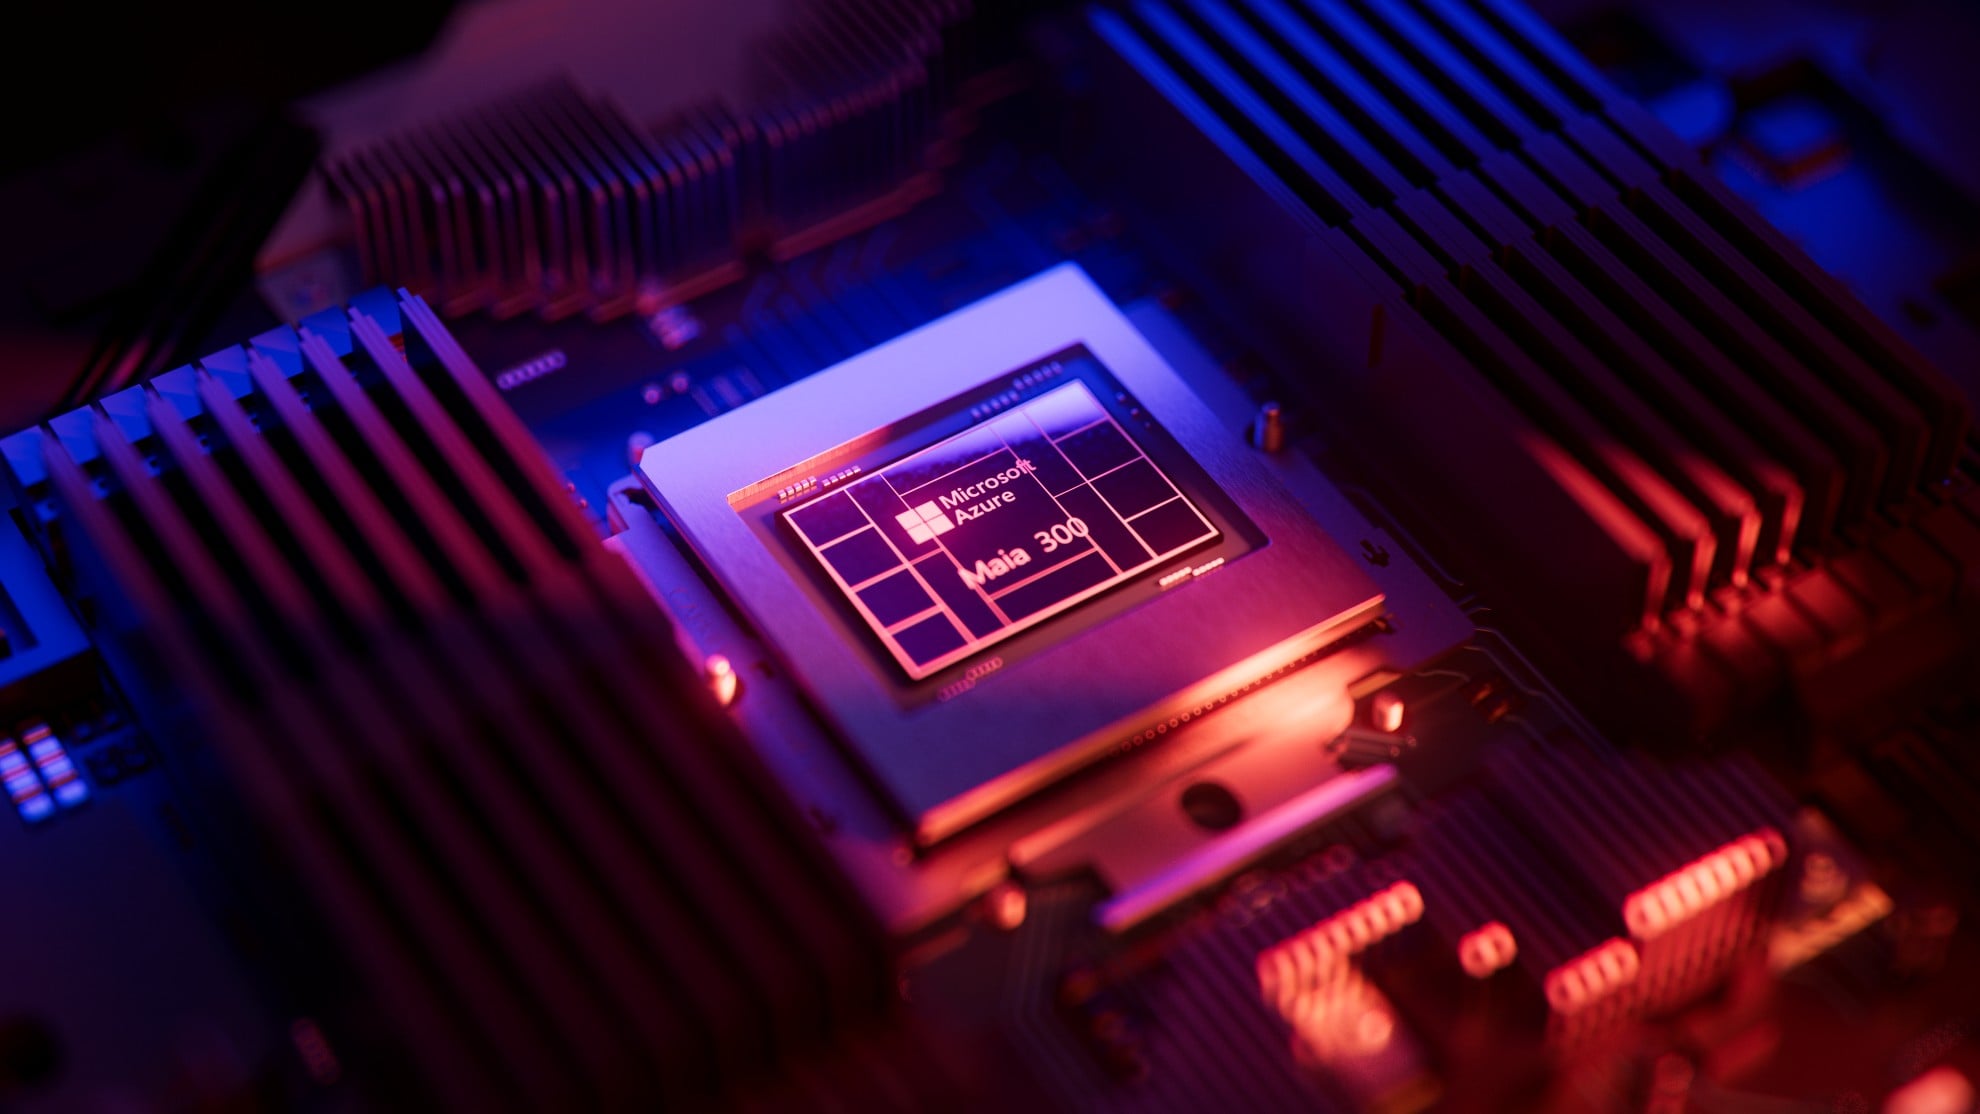
Strona obliczeniowa jest zorganizowana jako cztery klastry po 12 kafelków, z których każdy zawiera jednostkę tensorową, procesor wektorowy, reshaper, silnik DMA i lokalną pamięć SRAM, a nad nimi współdzieloną pamięć SRAM klastra i sieć na układzie scalonym. Microsoft nazywa to podejście architekturą przepływu danych definiowaną programowo: oprogramowanie umieszcza dane w tych lokalnych pamięciach, silnikach DMA i sieci. Układ SoC udostępnia hostowi interfejs PCIe Gen6 x16 oraz 32 porty Ethernetu 400 Gb/s poprzez wbudowany kontroler sieciowy AI, który stanowi infrastrukturę skalowania.
W procesorze Maia 300 organizacja pamięci przechodzi z jednolitego dostępu do układu NUMA w chipletach, co pozwala na umieszczanie danych w pobliżu procesora, który ich używa. Precyzja spada jeszcze bardziej dzięki ulepszonemu MXFP4 i sprzętowej konwersji typów danych, co ma na celu zmniejszenie liczby bajtów przesyłanych na token, zarówno w przypadku obliczeń, jak i pamięci podręcznej KV. Jądra mogą również wykorzystywać wbudowaną pamięć SRAM jako programowo zarządzany dysk podręczny, aby odciążyć HBM. Microsoft przypisuje wzrost mocy na wat tym zmianom, ponieważ TDP wzrasta z 750 W do 950 W, a firma deklaruje ponad 2.5-krotny wzrost wydajności na wat.
96 akceleratorów na stojak, 12 288 w Superpodzie
Szafa Maia 300 podwaja liczbę akceleratorów do 96 i zwiększa moc szafy z 64 kW do 167 kW, co daje około 1.74 kW na slot akceleratora, uwzględniając funkcje sieciowe, chłodzenie i konwersję mocy. W szafie oznacza to 27.6 TB pamięci HBM, 1,728 TB/s łącznej przepustowości HBM i 1,324 POPS FP4 według danych Microsoftu, w porównaniu z 10.4 TB, 341 TB/s i 485 POPS dla szafy Maia 200. Dwukierunkowa przepustowość skalowania na akcelerator wzrasta z 2.8 TB/s do 3.2 TB/s, a dwupoziomowa sieć Ethernet z niestandardowym transportem AI firmy Microsoft osiąga teraz superpod 12 288 akceleratorów, dwa razy więcej niż około 6,000 w poprzedniej generacji.
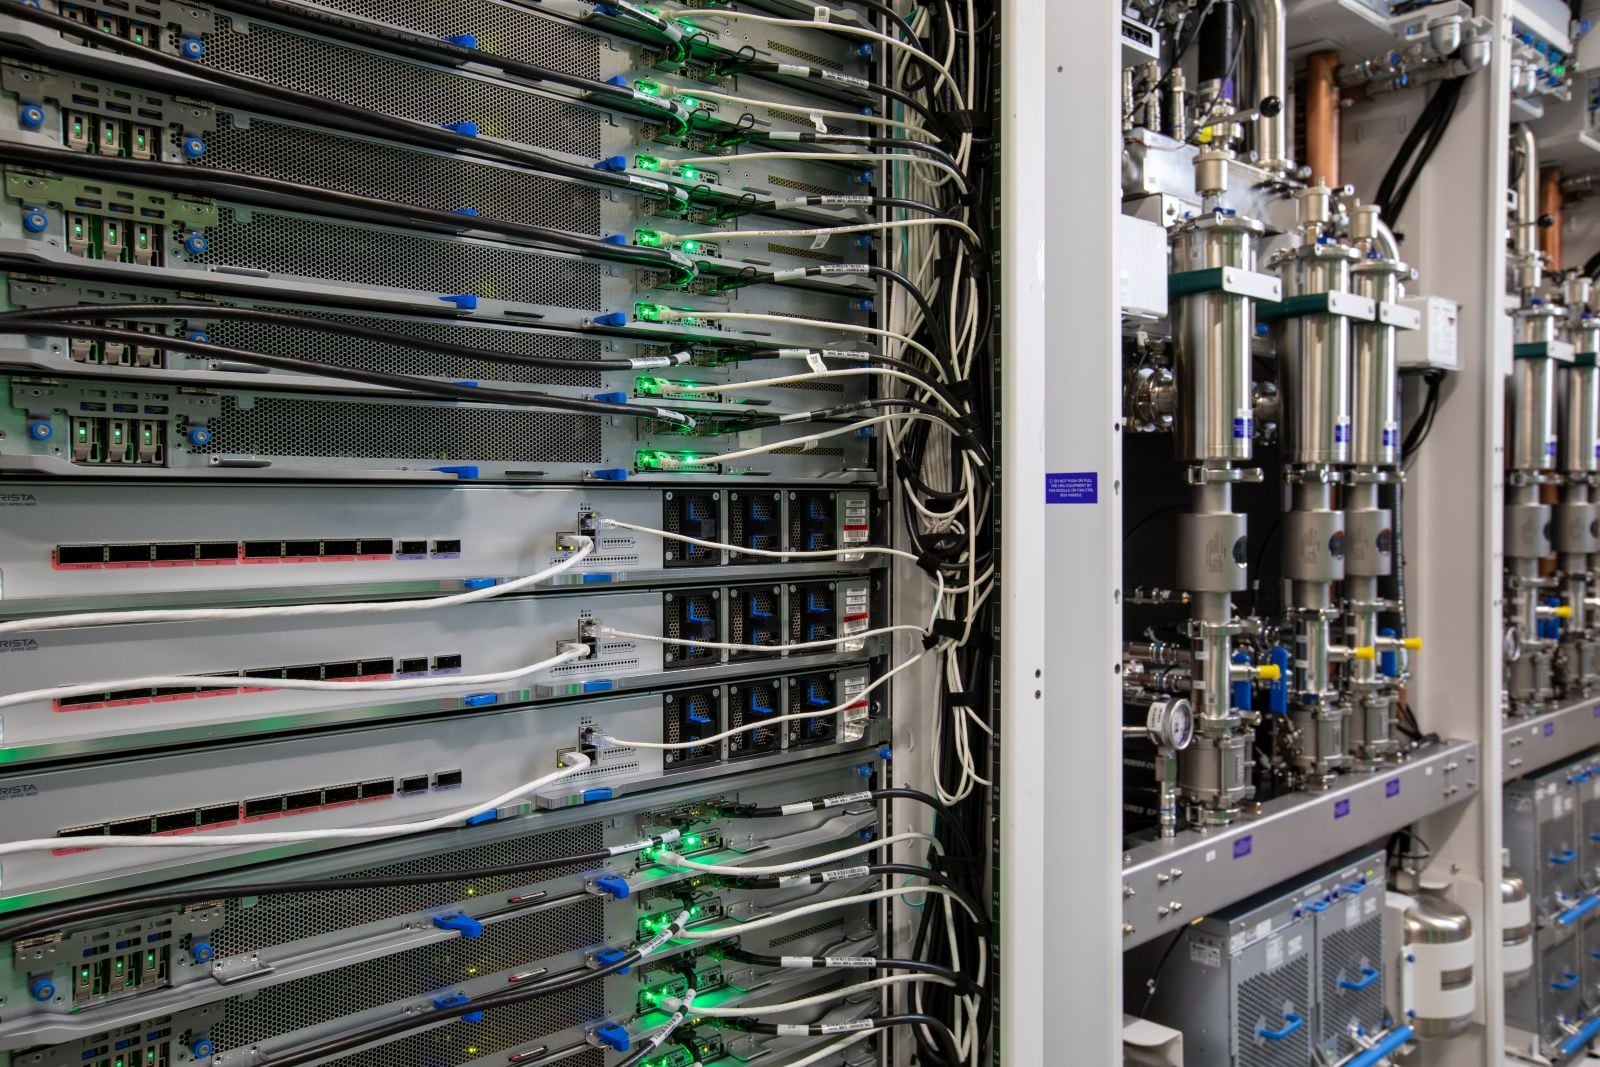
Diagram szafy Microsoftu przedstawia zadania podzielone na szafy w strukturze skalowania z ruchem równoległym między nimi, co jest wzorcem ruchu generowanym przez duże modele mieszane ekspertów w czasie obsługi. Firma twierdzi, że ten sam model komunikacji obejmuje każdy akcelerator w superpodzie, więc zadanie obejmujące 16 akceleratorów i zadanie obejmujące cztery szafy korzystają z tej samej semantyki.
Specyfikacja Maia 300
| Specyfikacja | Maja 300 | Maja 200 |
|---|---|---|
| Akcelerator | ||
| Przetwarzanie | Wielochipletowa matryca obliczeniowa N2P | Monolityczny N3P |
| Szczyt FP4 | 13.8 POPS | 10.1 POPS |
| Szczyt FP8 | 6.9 POPS | 5.1 POPS |
| TDP SoC | 950W | 750W |
| HBM | 8 x HBM4, 288 GB, 18 TB/s | 6 x HBM3E, 216 GB, 7.1 TB/s |
| Interfejs hosta | PCIe Gen6x16 | Nie podano |
| Skalowanie przepustowości (dwukierunkowe) | 3.2 TB/s | 2.8 TB/s |
| Sieć zaplecza | Dwupoziomowa skalowalność Ethernetu z transportem AI, 32 x 400 Gb/s | Skalowanie dwupoziomowej sieci Ethernet z transportem AI |
| Domena Rack i Scale-Up | ||
| Akceleratory na szafę | 96 | 48 |
| Moc stojaka | 167kW | 64kW |
| Pojemność stojaka HBM | 27.6TB | 10.4TB |
| Szerokość pasma HBM w szafie | 1,728 TB/s | 341 TB/s |
| Szczyt FP4 stojaka | 1,324 POPS | 485 POPS |
| Domena skalowania | Około 12,288 akceleratorów | Około 6,000 akceleratorów |
Gdzie pasuje Maia 300 i na czym opierają się te roszczenia
Maia 200 jest obecnie produkowana przez Microsoft Copilot i zespół modelu MAI, a do końca roku zajmą się nią GitHub Copilot i Microsoft Foundry. Microsoft twierdzi, że wdraża ją w Stanach Zjednoczonych, Europie i Australii, wykorzystując do 1.7 razy więcej tokenów na wat niż jego infrastruktura GPU w przypadku wbudowanych funkcji sztucznej inteligencji w aplikacjach Teams, Copilot i Cowork.
„Będziemy skalować naszą rodzinę Azure Maia do wdrożeń o mocy wielu gigawatów począwszy od 2027 roku, dzięki czemu Maia stanie się głównym systemem wnioskowania dla produktów i usług Microsoft” – napisał Scott Guthrie, wiceprezes wykonawczy ds. chmury i sztucznej inteligencji, ogłaszając Maia 300. NVIDIA i AMD pozostają w flocie szkoleniowej Microsoftu, a firma nie oferuje Maia jako typu instancji, którą klienci Azure mogą wynająć. Główne deklaracje dotyczące wydajności, o 40% więcej tokenów na megawat niż w przypadku wiodących systemów opartych na GPU, nie wymieniają nazwy GPU, modelu ani konfiguracji serwera. Ponieważ Maia działa tylko w Microsoft, nikt spoza firmy nie może jej przetestować.
Opublikowane specyfikacje potwierdzają ten projekt: przepustowość pamięci na akcelerator wzrosła 2.5-krotnie, a moc obliczeniowa FP4 wzrosła o 37%, a szafa oferuje 5.1-krotnie większą przepustowość HBM niż szafa Maia 200 przy 2.6-krotnie większej mocy. Jest to układ zaprojektowany do dekodowania fazy wnioskowania długoterminowego i agentowego, gdzie wąskim gardłem jest zasilanie jednostek arytmetycznych, i wskazuje, jak hiperskaler skaluje część wnioskowania, gdy kontroluje obciążenie od początku do końca. Omawialiśmy premierę Maia 200 w styczniu, a Microsoft zapowiada, że więcej szczegółów zostanie przedstawionych na konferencji Ignite w listopadzie.




 Amazon