

NVIDIA ogłosiła Minervę na targach GTC Berlin, platformę AIOps, która pobiera dane telemetryczne z procesorów graficznych, sieci, pamięci masowej, harmonogramów i obciążeń AI na nich działających, a następnie stosuje uczenie maszynowe, aby znaleźć komponent o obniżonej wydajności, zanim spowolni on zadanie szkoleniowe. Dell Technologies, Lenovo i Supermicro będą oferować ją w swoich portfolio rozwiązań AI Factory Operations, IREN już z niej korzysta, a IBM, Jio, Lambda, Quake AI, Tesla, Aolani i Bitdeer AI planują ją wdrożyć. NVIDIA nie opublikowała cen ani daty powszechnej dostępności.
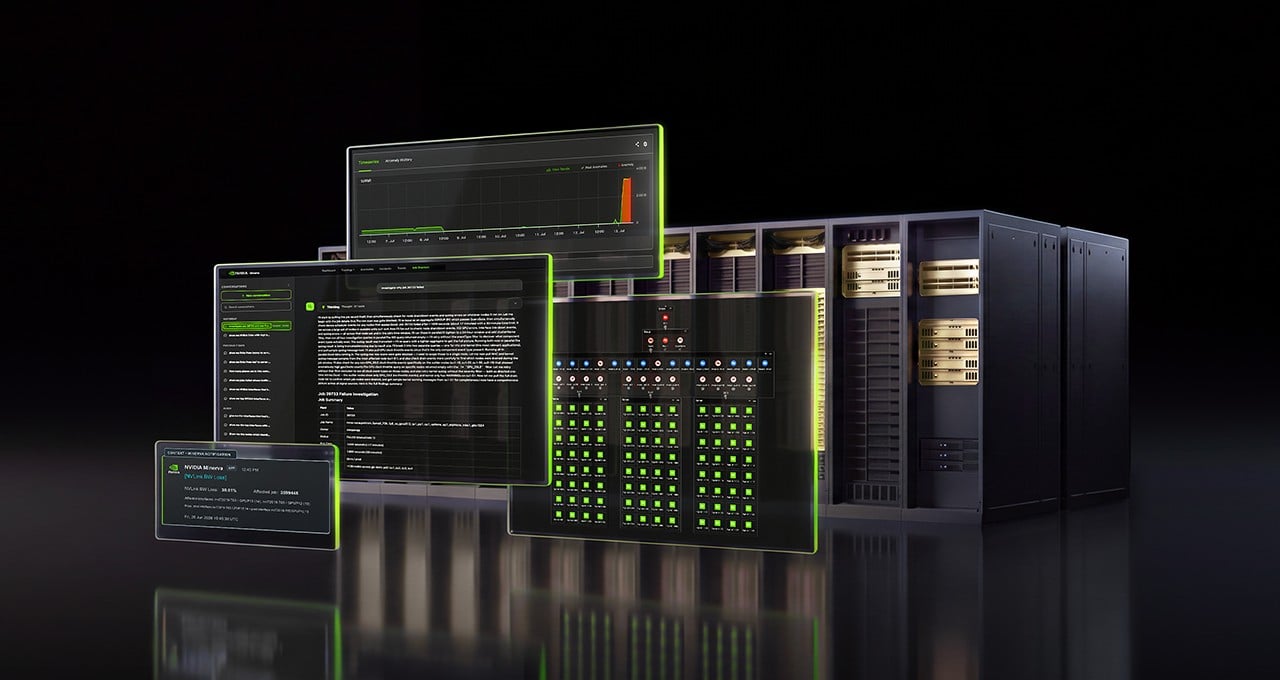
Problem, z którym mierzy się Minerva, jest znany każdemu operatorowi dużego klastra: tysiące procesorów graficznych (GPU) w sieci o wysokiej przepustowości zachowują się jak jedna maszyna, więc pojedynczy element, który nie spełnia specyfikacji, wydłuża cały proces. Przykładami NVIDII są procesor graficzny nagrzewający się bardziej niż sąsiednie układy i dysk NVMe tracący wydajność pod obciążeniem – sygnał danych, który obecnie znajduje się w narzędziu sieciowym, narzędziu obliczeniowym i panelu zespołu ML, z których każdy ma oddzielny widok tego samego klastra.
Co ogląda Minerva
Minerva buduje dynamiczny graf wiedzy, który mapuje procesory graficzne (GPU), karty SuperNIC, przełączniki, kable i zadania na nie zaplanowane, a następnie analizuje to, co NVIDIA określa jako miliardy punktów danych na godzinę, za pomocą nadzorowanego i nienadzorowanego uczenia maszynowego. Modele uczą się normalnego zachowania fabryki, sygnalizują anomalie, których wcześniej nie zaobserwowały, przewidują pojawiające się awarie i korelują powiązane zdarzenia za pomocą topologii, dzięki czemu powolne zadanie szkoleniowe można powiązać z odpowiedzialnym za nie komponentem w fabrykach NVIDIA, liczących setki tysięcy procesorów graficznych.
Dane wyjściowe są zorganizowane w formie incydentów, z powiązanymi zdarzeniami pogrupowanymi w jeden element i dołączoną prawdopodobną przyczyną źródłową, co, jak twierdzi NVIDIA, zastępuje lawinę alertów jednym elementem, który można podjąć. Wbudowany asystent odpowiada na pytania w języku naturalnym na podstawie danych telemetrycznych na żywo i zaleca rozwiązanie problemu, a platforma łączy się z zewnętrznymi narzędziami agentowymi. Operatorzy decydują, czy dana osoba zastosuje środek zaradczy, czy też Minerva przekaże go automatyzacji za pośrednictwem interfejsów API infrastruktury i systemów zewnętrznych.
NVIDIA opisuje korzyści jako wydajność fabryki AI, którą mierzy w godzinach pracy GPU, dobrej wydajności, czasie sprawności klastra i produkcji tokenów. Deklarowane rezultaty to dłuższe odstępy między przerwami, szybsze naprawy i mniej alertów do triażu, a zespół operacyjny przechodzi z konserwacji reaktywnej na proaktywną. Są to deklaracje dostawców bez załączonych danych liczbowych; NVIDIA nie opublikowała danych dotyczących średniego czasu naprawy ani czasu sprawności dla Minervy.
Gdzie znajduje się w stosie
NVIDIA sprzedaje już oprogramowanie operacyjne do swoich projektów referencyjnych. Rozwiązanie Mission Control , wprowadzone w marcu 2025 roku, obsługuje aprowizację klastrów za pośrednictwem Base Command Manager, zarządzanie obciążeniami za pomocą Run:ai, telemetrię i autonomiczne odzyskiwanie zadań w systemach DGX SuperPOD. W tym samym tygodniu co Minerva, NVIDIA udostępniła w wersji deweloperskiej trzy komponenty systemu operacyjnego DSX OS typu open source do zarządzania cyklem życia fabryki opartego na sztucznej inteligencji: Config Manager do konfiguracji sieci, Rack Management Service do zarządzania zasilaniem, inwentarzem, oprogramowaniem układowym i przełącznikami na poziomie szafy rack oraz Cluster Readiness Engine do walidacji klastrów GPU z rozproszonymi obciążeniami.
Skala problemu, z którym mierzy się Minerva, została ujawniona w artykule Prometheus firmy Meta w zeszłym tygodniu. Meta obsługuje każdą domenę NVL72 jako segment 64-GPU, a pozostałe osiem GPU jest przechowywanych jako zapasowe w szafie, przechowuje około 2% szaf w rezerwie i poddaje kwarantannie każdy naprawiony system do czasu zatwierdzenia. Roczna praca nad ustaleniem przyczyn awarii z inżynierami NVIDIA na miejscu pozwoliła zmniejszyć liczbę przerw o 99% i wydłużyć średni czas między przerwami do ponad 54 000 godzin pracy GPU, z docelowym wynikiem 100 000.
To hiperskaler, który obsługuje specjalnie zaprojektowany potok telemetryczny i wspólny zespół triażowy z firmą NVIDIA. Minerva wygląda jak gotowa wersja tej dyscypliny, coś bliższego gotowej usłudze dla przedsiębiorstwa lub neocloud, które potrzebuje wglądu na poziomie hiperskalera w stan GPU, infrastruktury i pamięci masowej, a także związanego z tym procesu rezerwowego i ponownego uruchamiania, dostarczanego przez tych samych producentów OEM, którzy sprzedają ją w szafach rack.
NVIDIA nie ujawniła, jak Minerva odnosi się do Mission Control lub DSX OS, czy będzie dostarczana jako oprogramowanie, urządzenie, czy usługa hostowana, ani jak będzie wyglądać opakowanie OEM od Dell, Lenovo i Supermicro. Strona dokumentacji produktu kieruje klientów do zespołu ds. obsługi klienta NVIDIA, gdzie znajdą instrukcję obsługi. Numerem referencyjnym klienta jest IREN, który według NVIDIA wykorzystuje Minervę do optymalizacji swoich fabryk sztucznej inteligencji.
„NVIDIA Minerva zapewnia naszemu zespołowi operacyjnemu jeden widok na sieć, procesory graficzne i zadania na nich wykonywane” — powiedział Denis Skrinnikoff, dyrektor ds. technologii w IREN, który uważa, że dzięki temu rozwiązaniu zespół mógł poświęcić więcej czasu na proaktywną konserwację.
Jeśli chodzi o pamięć masową, interesujące jest stwierdzenie, że zachowanie dysku pod obciążeniem jest sygnałem wejściowym, obok danych telemetrycznych GPU i macierzy, ponieważ zwalniające urządzenie NVMe rzadko jest widoczne w wykorzystaniu GPU, dopóki nie nastąpi punkt kontrolny lub etap ładowania danych. Głębokość danych telemetrycznych pamięci masowej oraz to, które platformy OEM i macierzowe je zasilają, będą interesujące do zbadania, gdy zobaczymy, jak to rozwiązanie wchodzi na rynek.



 Amazon