

NVIDIA, Rebellions i SK Telecom ogłosiły plan budowy suwerennej infrastruktury wnioskowania AI w Korei Południowej, opartej na procesorze neuronowym nowej generacji R200 firmy Rebellions, połączonym wewnątrz szafy z technologią NVIDIA NVLink Fusion i opartym na architekturze szaf NVIDIA MGX. SK Telecom wdroży systemy w swoim centrum danych AI, obok swoich modeli i usług. Firmy spodziewają się, że systemy R200 będą gotowe do wdrożenia w 2028 roku.
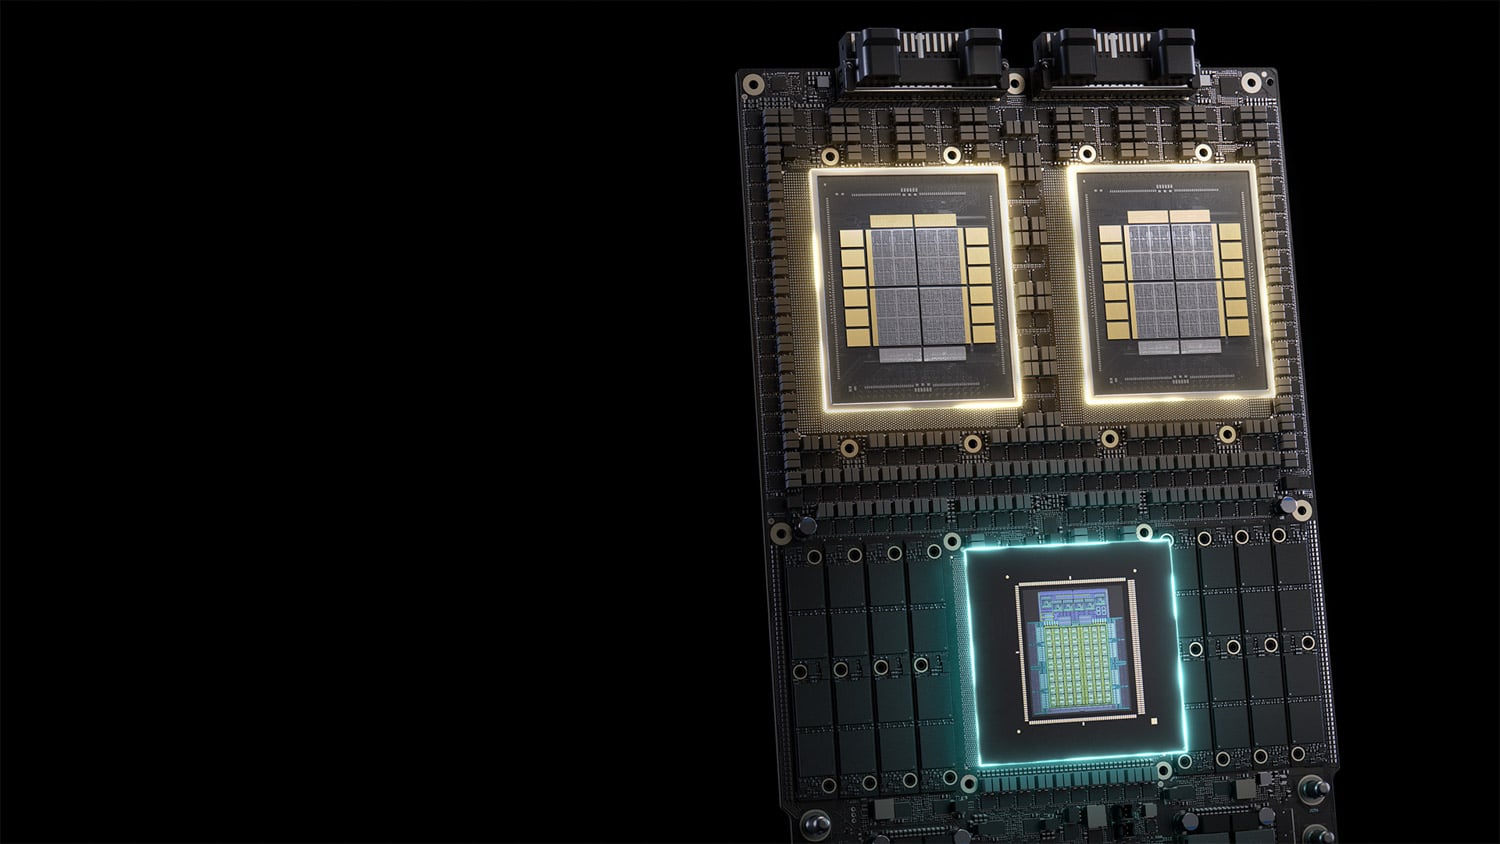
NVLink Fusion łączy jednostki NPU R200
Firma Rebellions projektuje platformę R200 z myślą o wnioskowaniu o niskich opóźnieniach i energooszczędności w modelach granicznych, w tym wielobilionowych modelach opartych na analizie danych eksperckich. NVLink Fusion to program firmy NVIDIA, który ma na celu wprowadzenie niestandardowego układu scalonego do infrastruktury skalowalnej: producent układów scalonych integruje technologię NVLink ze swoim procesorem i uzyskuje dostęp do przełączania NVLink firmy NVIDIA, jej sieci o wysokiej przepustowości i niskich opóźnieniach oraz otaczającego ekosystemu infrastruktury. Firma Rebellions planuje wykorzystać tę technologię do połączenia procesorów NPU R200 w szafie rack za pośrednictwem sieci skalowalnej NVLink oraz do włączenia tych procesorów do platformy NVIDIA jako elementu systemu skalowalnego.
Firmy nie ujawniły specyfikacji R200, przepustowości NVLink na jednostkę NPU ani żadnych wyników wydajności dla planowanej konfiguracji. Rebellions wymienia Rebel100 jako swój obecny układ scalony, a ogłoszenie R200 nie wspomina o pamięci, węzłach procesowych ani mocy, więc krok między tymi dwiema generacjami pozostaje nieznany.
Architektura MGX Rack wspiera rozwój systemu
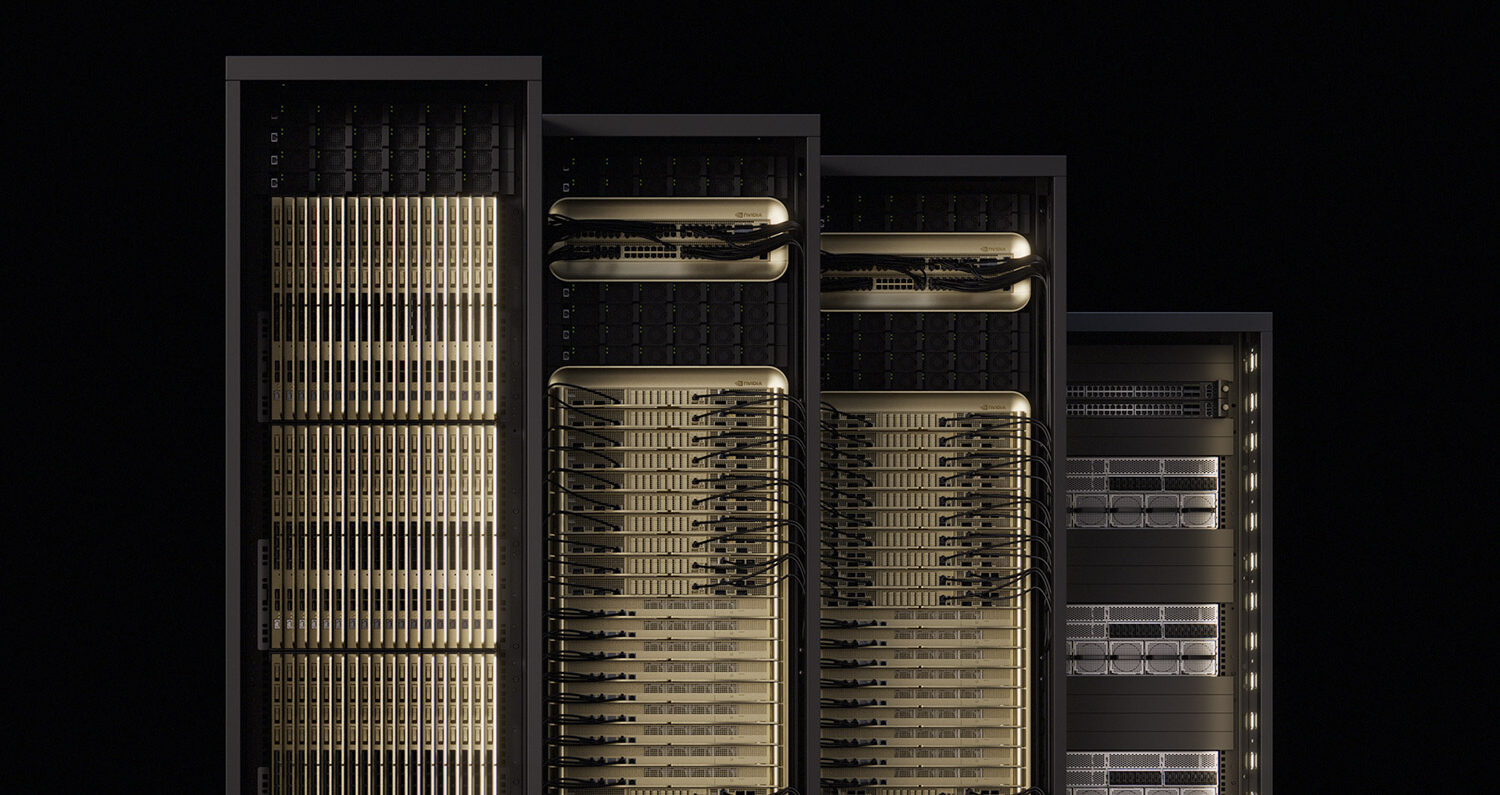
Architektura stelaża MGX firmy NVIDIA i projekty referencyjne dają firmie Rebellions punkt wyjścia dla systemu, a także dostęp do producentów oryginalnych projektów i dostawców komponentów, którzy już tworzą sprzęt MGX. MGX definiuje wspólne elementy stelaża, w tym wymiary, zasilanie i chłodzenie, dzięki czemu systemy GPU i NPU mogą zajmować tę samą konstrukcję centrum danych. SK Telecom planuje wdrożyć systemy R200 w swoim centrum danych AI w standardowym stelażu MGX, co pozwoli firmie zaplanować zasilanie i chłodzenie przed ostatecznym montażem procesora.
Procesory graficzne do wstępnego wypełniania, układy NPU do dekodowania
Najciekawszym szczegółem technicznym jest podział wnioskowania, który planują opracować trzy firmy. Wnioskowanie składa się z dwóch faz o różnych wymaganiach sprzętowych: wstępnego wypełniania, które przetwarza monit i jest zazwyczaj ograniczone obliczeniowo, oraz dekodowania, które generuje tokeny pojedynczo i jest zazwyczaj ograniczone przepustowością pamięci i opóźnieniem. Proponowana konfiguracja uruchamia wstępne wypełnianie na procesorach graficznych NVIDIA, a dekodowanie na układach NPU Rebellions, połączonych przez sieć NVLink.
Deklarowanymi celami są wyższa przepustowość wnioskowania i lepsza efektywność energetyczna. Korzyści z przekazywania dekodowania do NPU pozostają zamierzeniem projektowym do momentu powstania systemów, ale logika ta wydaje się sensowna na papierze. Rozdzielone wstępne wypełnianie i dekodowanie jest już powszechną praktyką w pulach GPU, w tym w środowisku serwerowym Dynamo firmy NVIDIA; rozdzielenie dwóch faz na różne architektury procesorów za pośrednictwem NVLink to nowy element.
Współzałożyciel i dyrektor generalny Rebellions, Sunghyun Park, powiedział, że współpraca łączy krzem AI i projekt systemu firmy z możliwościami połączeń i skalowania w szafach firmy NVIDIA oraz modelami i operacjami centrów danych firmy SK Telecom. Celem jest uzyskanie wnioskowania o niskich opóźnieniach i energooszczędności dla modeli granicznych na dużą skalę.
SK Telecom łączy modele i usługi
SK Telecom dostarcza modele i klientów. Planuje uruchomić na infrastrukturze swoje autorskie modele bazowe, w tym AX K2, wraz z usługami skierowanymi do odbiorców publicznych, opracowanymi w ramach rządowego projektu AI for All (sztuczna inteligencja dla wszystkich). Operacje, modele i usługi centrów danych SK Telecom uzupełniają to, co firmy określają mianem suwerennej strategii AI opartej na pełnym stosie, a prace te opierają się na szerszym partnerstwie SK i NVIDIA, o którym wspomniano podczas lipcowego szczytu Korea AI Summit.
Koreańskie Ministerstwo Nauki i ICT wspiera współpracę między firmą NVIDIA a koreańskimi firmami NPU, począwszy od Rebellions i SK Telecom, i zapowiada szerszą współpracę obejmującą dostawy fizycznej sztucznej inteligencji i procesorów graficznych. Celem jest świadczenie usług sztucznej inteligencji dostosowanych do koreańskiego języka, branż i priorytetów w sektorze publicznym i prywatnym.
Dostępność:
Oczekuje się, że systemy Rebellions R200 będą gotowe do wdrożenia w 2028 roku. Nie podano harmonogramu pobierania próbek, programu wczesnego dostępu, daty ogólnej dostępności ani cen.


 Amazon